デイリーAIダイジェスト — 2026-10-28
arXiv ハイライト
h1: 自動定理証明におけるBitter Lessonの一端
Leanにおける形式的定理証明は、過去2年間でLLMを取り巻く精巧な足場を積み重ねてきました。すなわち、サブゴールへの分解、プランナー、特化した証明器、タクティックツリー上のbest-first search、そしてマルチエージェントオーケストレーション(AlphaProof、Goedel-Architect、DM prover agent)などです。各新システムは性能向上を報告していますが、その向上はモデルのアップグレードや推論予算の増大と混同されていることが多いです。本論文は「bitter lesson」的な問いを直接提起します。すなわち、フロンティアモデルに有能なLeanインターフェースを与えて検証器に対して反復させるだけで、こうした構造のいずれかが生き残るのでしょうか?
セットアップ
h1は意図的に最小限に設計されています。エージェントはMathlibをすべてプリインポートした単一の永続的なLean 4ファイルを編集し、編集のたびにコンパイラのフィードバックを受け取ります。また、ライブラリ検索ツール、Lean REPL、および言語サーバーにアクセスできます。プランナー、サブゴール分解、proof-tree searchは一切ありません。外側のループは「編集 → コンパイル → フィードバックの読み取り → 任意のリフレクション(コンテキストの圧縮) → 繰り返し」であり、SafeVerifyでクリーンな証明が生成されるか、予算が尽きるまで続きます。評価はpass@1(問題ごとに1回の試み)を用い、問題ごとのドル上限を引き上げることでtest-time computeを変化させます。
ベンチマークは競技数学(PutnamBench、Putnam100、IMO 2026、FATE-X)と研究数学(FormalConjectures100-Solved、FormalQualBench、未解決のErdős問題)にまたがります。
結果
GPT-5.6 Solを用いたh1は、FATE-Xで90/100、FC100-solvedで78/100、FormalQualBenchで14/23、IMO 2026で6/6を報告しています。GPT-5.5ではPutnamBenchで670/672を解きます。これらはシングルランの数値です。
主要な比較は、モデルと予算を揃えた条件下で行われています。
- h1上のGemini 3.1 Proは、DM prover agentの$100/問題の上限に対して$25/問題でFC100-solvedの66問に到達し、$150では73問に達します。
- h1上のDeepSeek V4 Flashは$14.35/問題で43のFATE-X問題を解き、Leanstral 1.5の公表値34を超えます。また約$0.30/問題でAlphaProofのFC100 50問に並び、$4.89では64問に達します。
- 世代をまたぐと、GPT-5.6 SolはFC100の66問を$9未満で、FATE-Xの90問を$38で達成するのに対し、Gemini 3.1 Proはそれぞれ$25と$113かかります。学習計算量の向上は固定されたハーネスにそのまま転移しています。
個々の受理された試みは最大1,123回のリフレクションラウンド、95アクティブ時間、7,124行の証明に及びます。これは、ここでいう「test-time compute」が意味するものを較正する上で有益です。モデルは単にリサンプリングしているのではなく、本当に作業しているのです。
ハーネスがなお重要な理由
本論文は、ループが無意味だと主張するわけではありません。同じモデルであっても、異なる単純なループは解決率とコストで数倍の差が生じ、ablationによって何が重要かが特定されています。
インターフェースの粒度。 AxProverBaseはツールフィードバックの各ラウンドの後に証明全体を再生成しますが、h1は編集のたびにフィードバックを受けながらインクリメンタルに編集します。Gemini 3 Flashと$20の上限をPutnam100に設定すると、AxProverBaseは18問、h1は69問を解きます。構造的な失敗モード:AxProverBaseの失敗コンパイルの42.2%は無効なライブラリインポートで失敗しますが、h1はファイルがMathlibをすべてプリインポートすることでこれを構造的に排除しています。
永続性に依存した検索。 ライブラリ検索はAxProverBaseでは最も有用でないコンポーネントと報告されていましたが、h1では中心的な役割を担います。検索ツール、REPL、言語サーバーを取り除くと、Putnam100でh1は69から49に、FATE-Xでは63から49に低下します。単一の検索ツールまたはREPLがあればギャップの大半を回復でき、完全なセットからどれか1つを削除してもせいぜい4問のコストです。主張は、検索して確認することは能力であり、特定のツールではないというものです。
永続性 vs. リスタート。 Humanfiaはコーディングエージェントを各ラウンドで再起動し、証明ファイルとレビュアーのフィードバックのみを引き継ぎます。GPT-5.5を用いて同じ670問のPutnamBench解決に対して、h1より5倍多くのコストがかかります。
プロンプティングとリフレクションの頻度。 Gemini 3.1 Proを用いて$150/試みで6つの未解決Erdős問題に取り組む場合、詳細な証明器とリフレクションのプロンプト(諦めることやプレースホルダーによる「ズル」を明示的に抑制するもの)による1回の試みは、簡潔なプロンプトによる6回の試みを上回ります。リフレクション間のターン数には最適値が存在し、頻繁すぎる圧縮も稀すぎる圧縮も、Putnam100とFATE-Xにおいて適度な頻度よりも性能が劣ります。
スケーリング挙動
顕著な定性的発見として、未解決の研究問題に取り組む際、1回の長い試みを延長する方が、より短い試みを繰り返すよりも頻繁にサンプル効率が高いことが挙げられます。これはpass@kの標準的な知見に反するものであり、永続的な検証可能な状態が存在するドメインでは、継続的なコンテキスト(部分的な証明、試みたレンマ、失敗したタクティック)の限界価値がリスタートの多様性の恩恵を超えることを示唆しています。著者らは、以前は未解決だった8つのFormalConjecturesを解決したと報告しています。
限界と未解決の問い
本論文は、構造化されたワークフローが役立たないと主張しているのではなく、報告された比較において必須ではなく、コスト競争力もないことが多いということを示しています。いくつかの注意点があります。DM prover agentの基盤モデルは推測されており、開示されていません。ドル上限の比較はAPIの価格スナップショットに依存しています。また、Mathlibプリインポートのトリックは整然としてはいますが、Lean + Mathlibの依存関係構造に固有のものであり、他の形式システムや大規模なコードベースには直接転移しない可能性があります。「1回の長い試みが繰り返しに勝る」という結果が、Mathlibのアセンブリではなく、真に新しい数学的内容を必要とする問題に対しても成立するかどうかは未解決のままです。
なぜこれが重要か
h1は、検証器に基づくエージェントに対するクリーンなbitter lessonのデータポイントです。インターフェースが効率的で、エージェントが永続化・検索・確認できるようになれば、規定されたワークフローは大抵、モデルが自力でやることをより高いコストで再現するに過ぎません。転移可能な教訓—永続的なワークスペース、小ステップのフィードバック、永続性に依存した検索、堅牢な失敗処理—は、ソフトウェア検証や大規模コードベースのコーディングエージェントに対する正しいデフォルトテンプレートです。
Source: https://arxiv.org/abs/2610.35962
離散トークンは視覚信号の意味的に無損失な表現として機能できるか?
離散視覚トークン化は、視覚と言語を単一のnext-token prediction目標のもとで統一し、モダリティ固有のprojection headを不要にし、共有語彙上での視覚的chain of thoughtを可能にするため、マルチモーダルモデリングにとって魅力的なアプローチです。主な反論は情報理論的なものでした。すなわち、ベクトル量子化は再構成誤差を生じさせ、この誤差が意味的忠実度の上限となり、連続特徴がハードシーリングとして機能するというものです。本論文はこの見方を実証的に否定し、マルチモーダル理解において連続特徴と同等の性能を達成する量子化器設計を提案します。
量子化誤差は適切な代理指標ではない
著者らはImageNet上での特徴再構成MSEと、QwenViT特徴の離散バリアントについて8つのベンチマーク上でのマルチモーダル理解性能を測定しています。単一コードブックのVQと8グループのRVQ、さらに奇数インデックスのグループのみまたは偶数インデックスのグループのみを保持することで得られる2種類の「部分的」RVQ表現を比較しています。
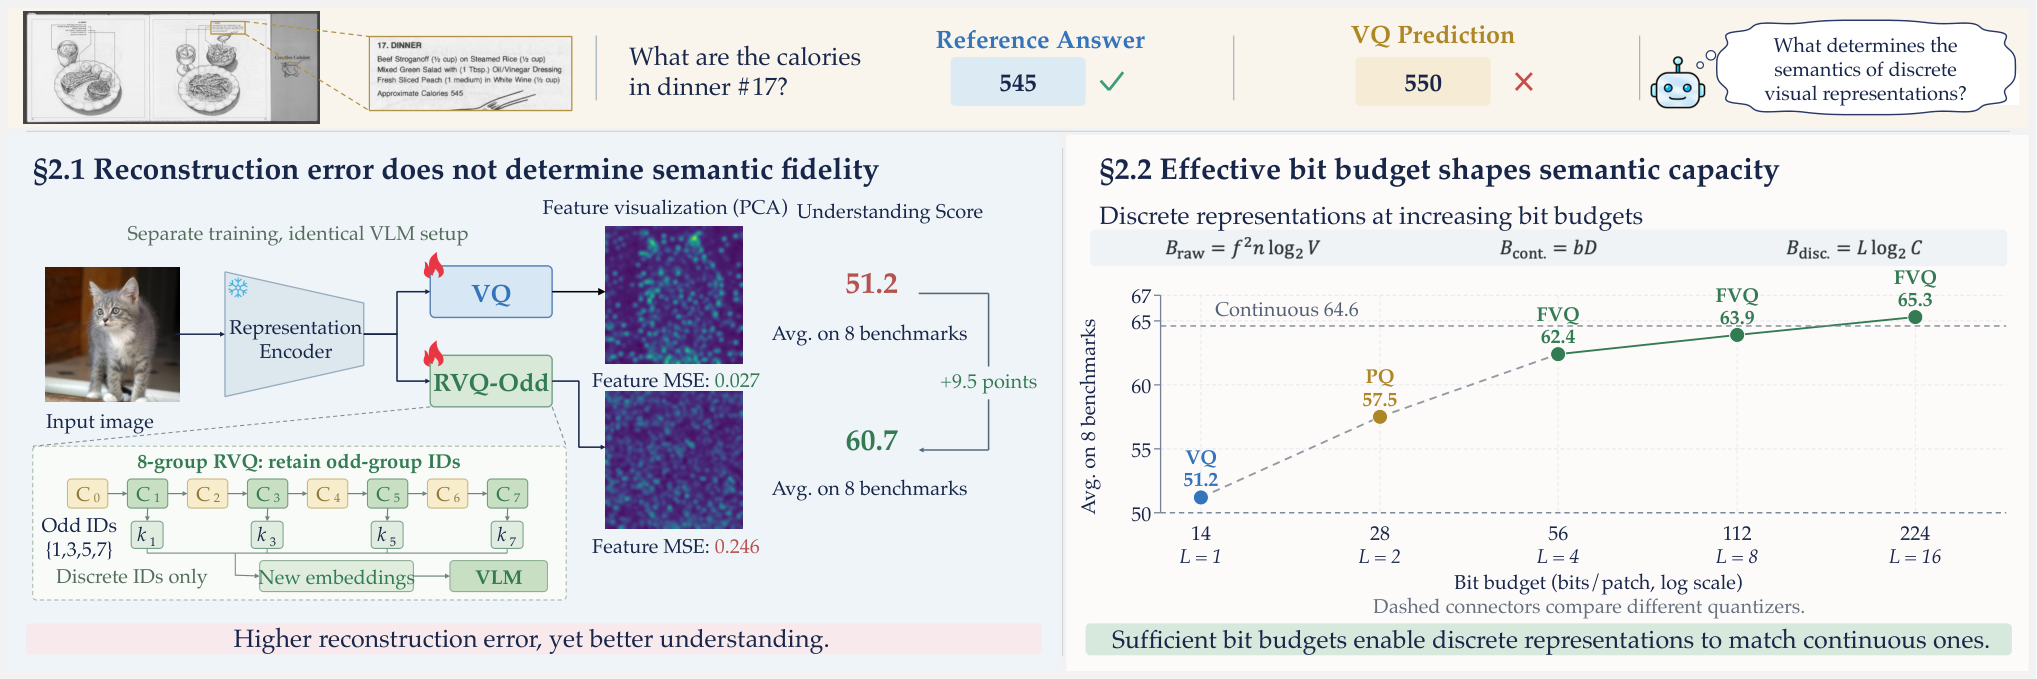
結果は標準的な直感を覆すものです。VQ(C\times L = 16{,}384\times 1)はMSE 0.027、平均スコア 51.2 を達成しています。RVQ(Even)は細粒度グループを保持しMSE 0.028(VQとほぼ同一)でありながら 59.3 を記録しています。RVQ(Odd)は粗いグループ0を除外してほぼ一桁大きい誤差(MSE 0.246)を生じさせますが、それでも 60.7 というEvenよりわずかに高いスコアを示しています。8グループのフルRVQはMSE 0.016 で 64.0 に到達しています。ほぼ同一のMSEを持つ2つの表現が平均理解度で8ポイントの差を示す一方、MSEで$10$異なる2つの表現は統計的に同等です。下流のVLMはインデックスを消費し再構成特徴を消費するわけではないため、特徴空間での再構成忠実度は最適化・診断すべき目標として端的に誤っています。
性能と相関する量は、LLMが実際に消費するインデックスで実現される有効パッチあたりビット予算 B_{\text{disc}} = L \log_2 C です。しかし既存のマルチコードブック手法は飽和します。RVQの残差構造により、後続のコードブックは漸進的により細粒度で意味的に有用性の低い残差をエンコードするようになり、逐次的なコードブックは同じ特徴の相関したビューを共有するため、追加された容量が与える意味情報への貢献は逓減していきます。
Factorized Vector Quantization
著者らが抽出した設計原則は、コードブック間の対称性、各コードブックへの完全特徴の固定次元ビュー、および情報を保存する合成です。FVQはこれらを、L個の並列独立コードブックに入力するdense tight-frame projectionによって実現します。
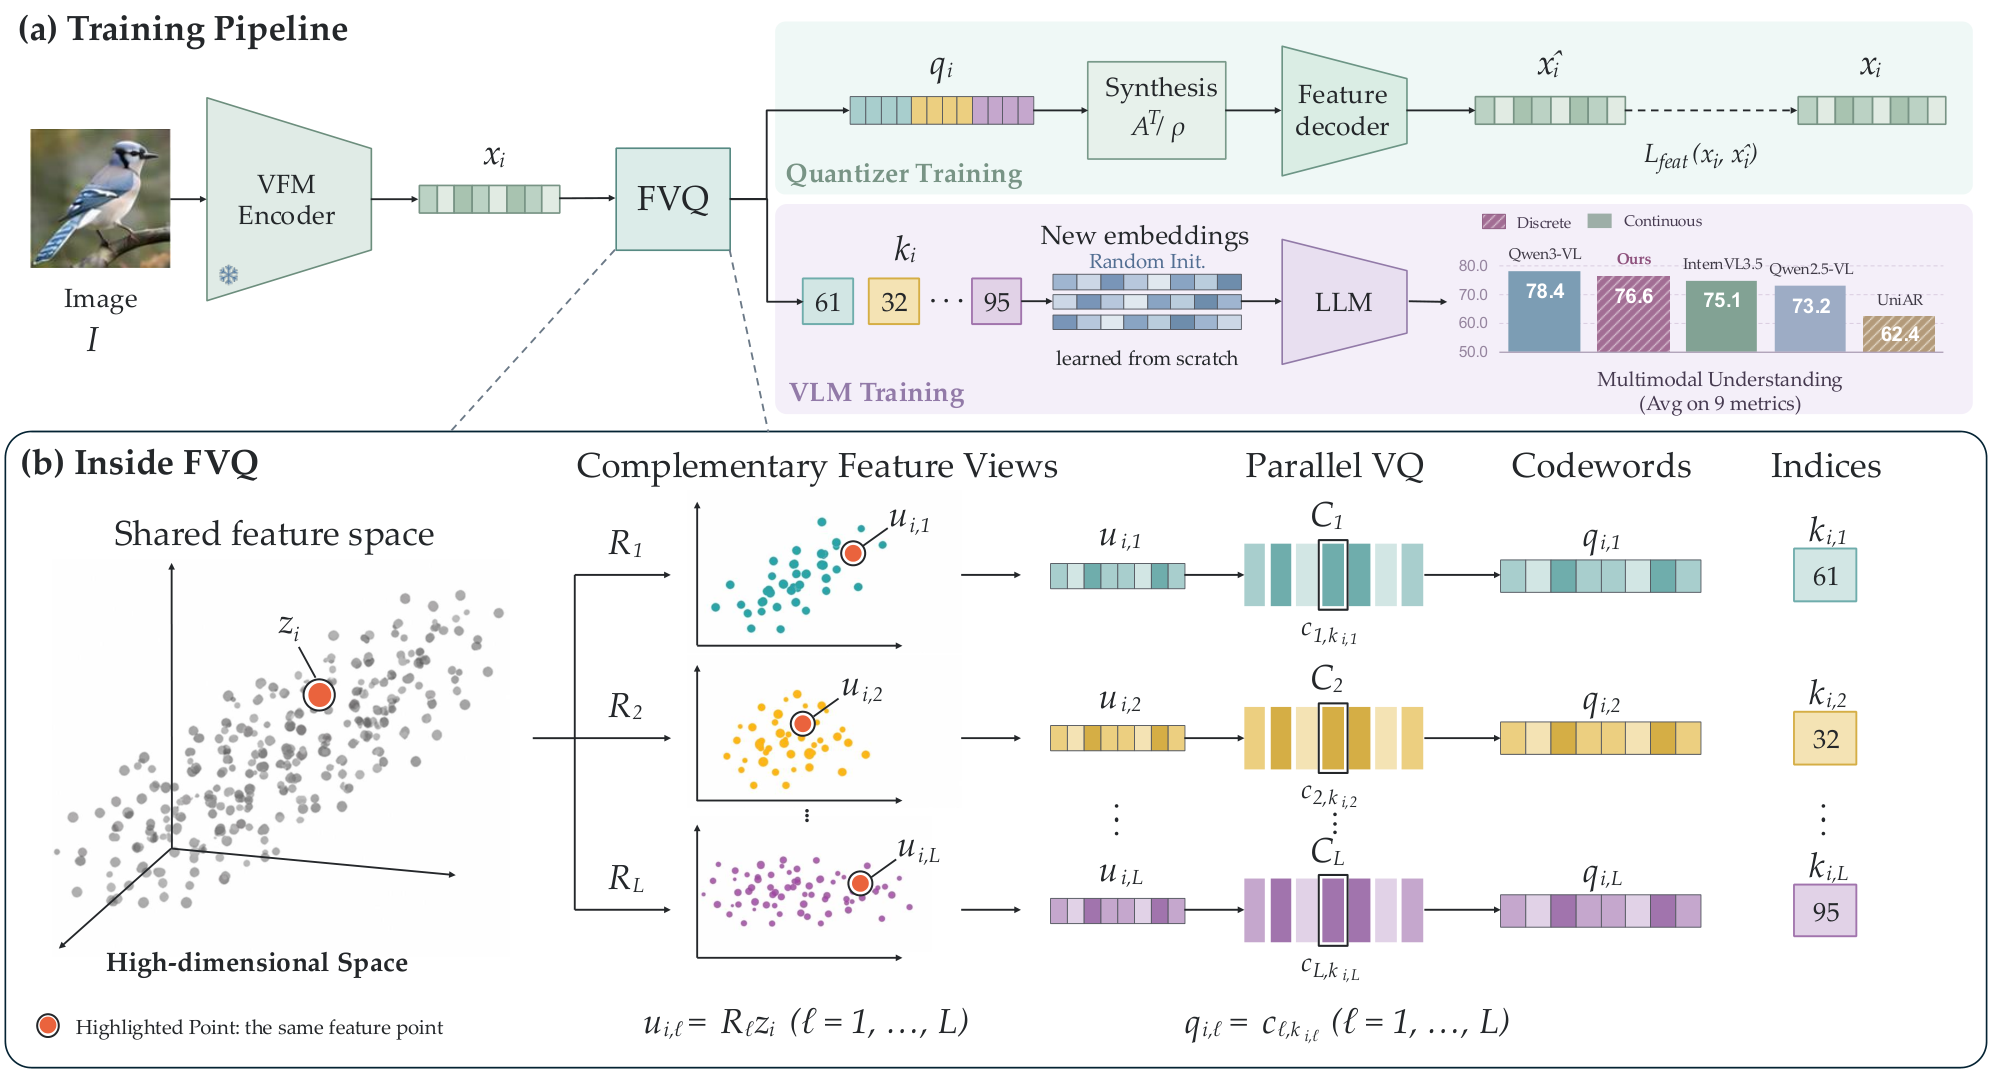
視覚特徴 x \in \mathbb{R}^D が与えられると、FVQは L 個のdense projection行列 \{A_\ell\}_{\ell=1}^L(合わせてtight frameを形成し、スケーリングを除いて \sum_\ell A_\ell^\top A_\ell = I を満たす)を適用して、固定次元 d での相補的なビュー v_\ell = A_\ell x \in \mathbb{R}^{d} を生成します。各 v_\ell は、サイズ C の独自のコードブック \mathcal{C}_\ell に対して独立に量子化されます: \hat v_\ell = \arg\min_{c \in \mathcal{C}_\ell} \|v_\ell - c\|_2^2. 再構成にはdual-frame synthesis \hat x = \sum_\ell A_\ell^\top \hat v_\ell が使用され、\hat v_\ell が v_\ell と一致する場合 x を厳密に復元します。すべてのコードブックが同じ次元で完全特徴のビューを参照するため、どのコードブックも残差的な役割に追いやられることなく、ビット予算 L \log_2 C がより直接的に使用可能な意味ビットに変換されます。
VLM学習において量子化器は凍結されており、パッチあたり L 個の離散インデックスのみが新たに初期化されたtoken embeddingの集合に渡され、LLMは通常のトークンとして消費します。主要モデルは、Qwen3 ViT上の16コードブックFVQ tokenizerとQwen3-8Bを組み合わせ、標準的な1D RoPEを使用し、クリーンなnext-token predictionインターフェースを維持するためにQwen3 ViTのDeepStack接続を除去しています。
スケーリング結果
主要な知見は、パッチあたりビット予算が増加するにつれてFVQが改善し続ける一方、VQ、RVQ、FSQスタイルのベースライン、および関連するマルチコードブック手法は頭打ちになるというものです。
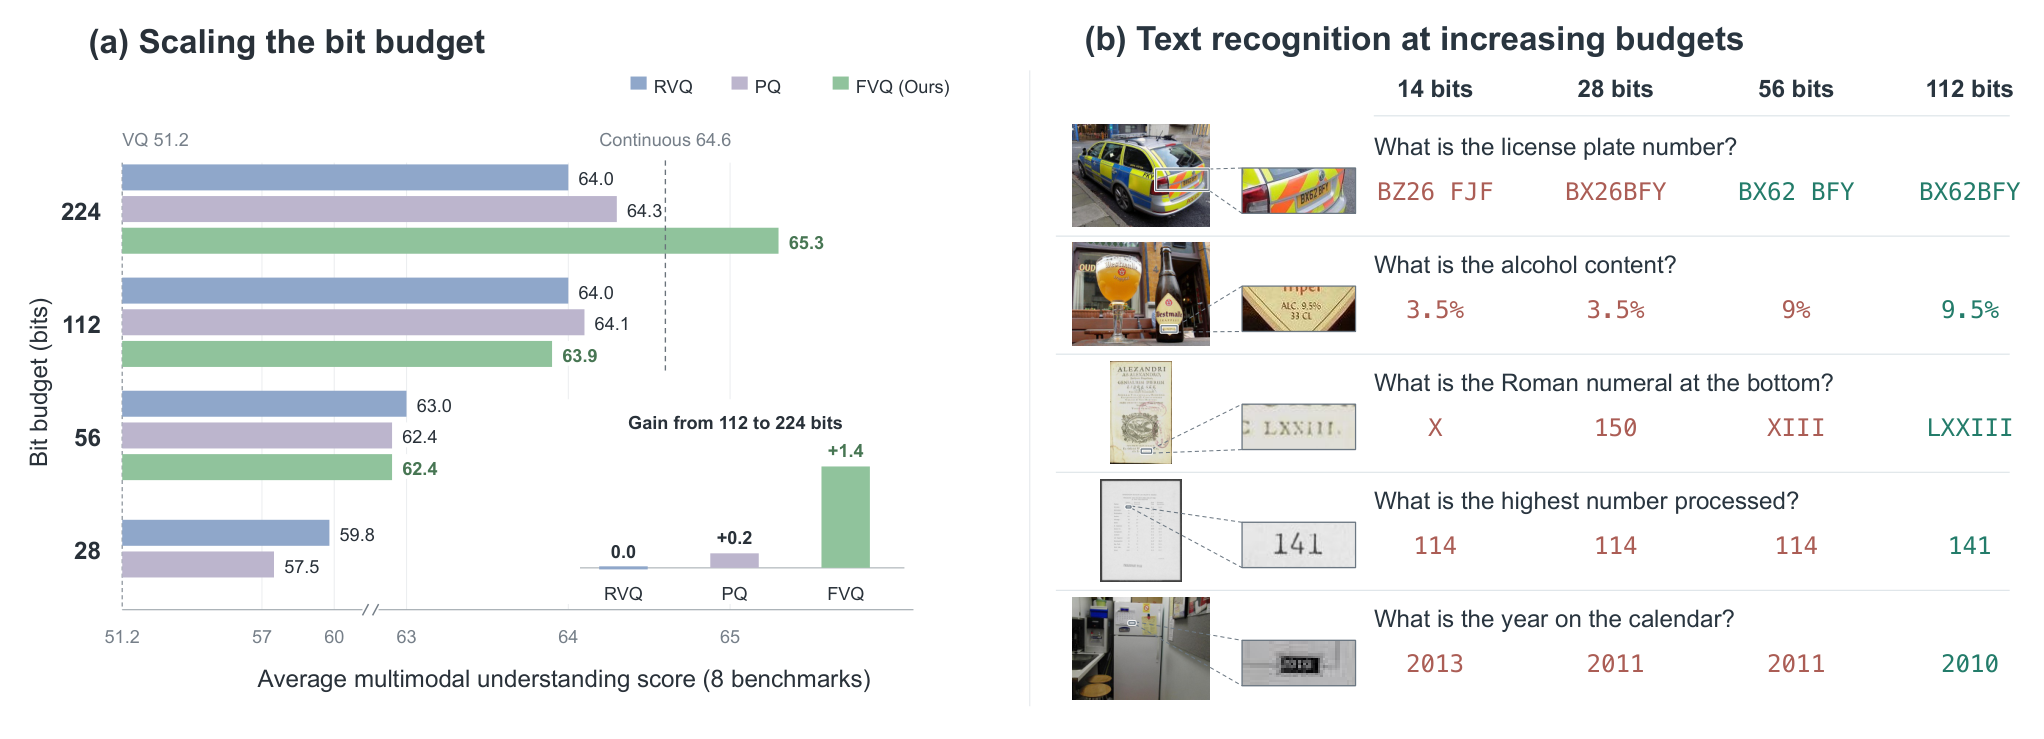
高いビット予算において、16コードブックのFVQは9指標平均(MMMU、MathVista、MMStar、OCRBench/10、ChartQA、CharXiv-DQ、CharXiv-RQ、DocVQA、InfoVQA)で連続QwenViT表現と同等の性能を達成し、既存の量子化器は明確に下回っています。Figure 1(b)の定性的なOCR例は、ビット予算に伴うテキスト転写精度の単調な改善を示しており、これは離散トークンが歴史的に連続特徴に対して最も差をつけられるタスクであるだけに重要です。
限界と未解決の問題
いくつかの点が暗黙的なままとなっています。第一に、「意味的に無損失」という主張は9つの理解ベンチマークに依拠しており、生成タスクや密な予測タスクは評価されておらず、tight-frame synthesisが x に関する情報を保存するのは量子化前の段階においてのみです。第二に、トークン列長は L に対して線形に増加するため、L=16 で連続シーリングに到達するということはLLMコンテキストにおいてパッチあたり16トークンを意味し、ここでは分析されていない推論時コストが有意に生じます。第三に、論文は projection行列 A_\ell をどのように初期化すべきか、あるいは学習されたframeがランダムtight frameから意味のある形で乖離するかどうかを特徴付けていません。最後に、分析は固定されたViT backbone(QwenViT)で実施されており、RVQスタイルの量子化器の飽和が量子化器自体によるものではなくbackboneの特徴幾何に起因しているかどうかは切り分けられていません。
なぜこれが重要か
離散視覚トークンが理解性能において連続特徴と同等になれるとすれば、視覚をnext-tokenループの外に置くことへの主要なアーキテクチャ上の論拠は崩れ、統一された自己回帰マルチモーダルモデルはトレードオフではなく妥当なデフォルト選択となります。本論文はまた、量子化器設計の枠組みを転換します。すなわち、対称かつ並列なコードブックのもとでインデックスの情報量を最適化すべきであり、再構成MSEを最適化すべきではないということです。
Source: https://arxiv.org/abs/2610.37662
Rollback: World Modelsにおける経験バックトラッキングによるPolicy改善
問題設定
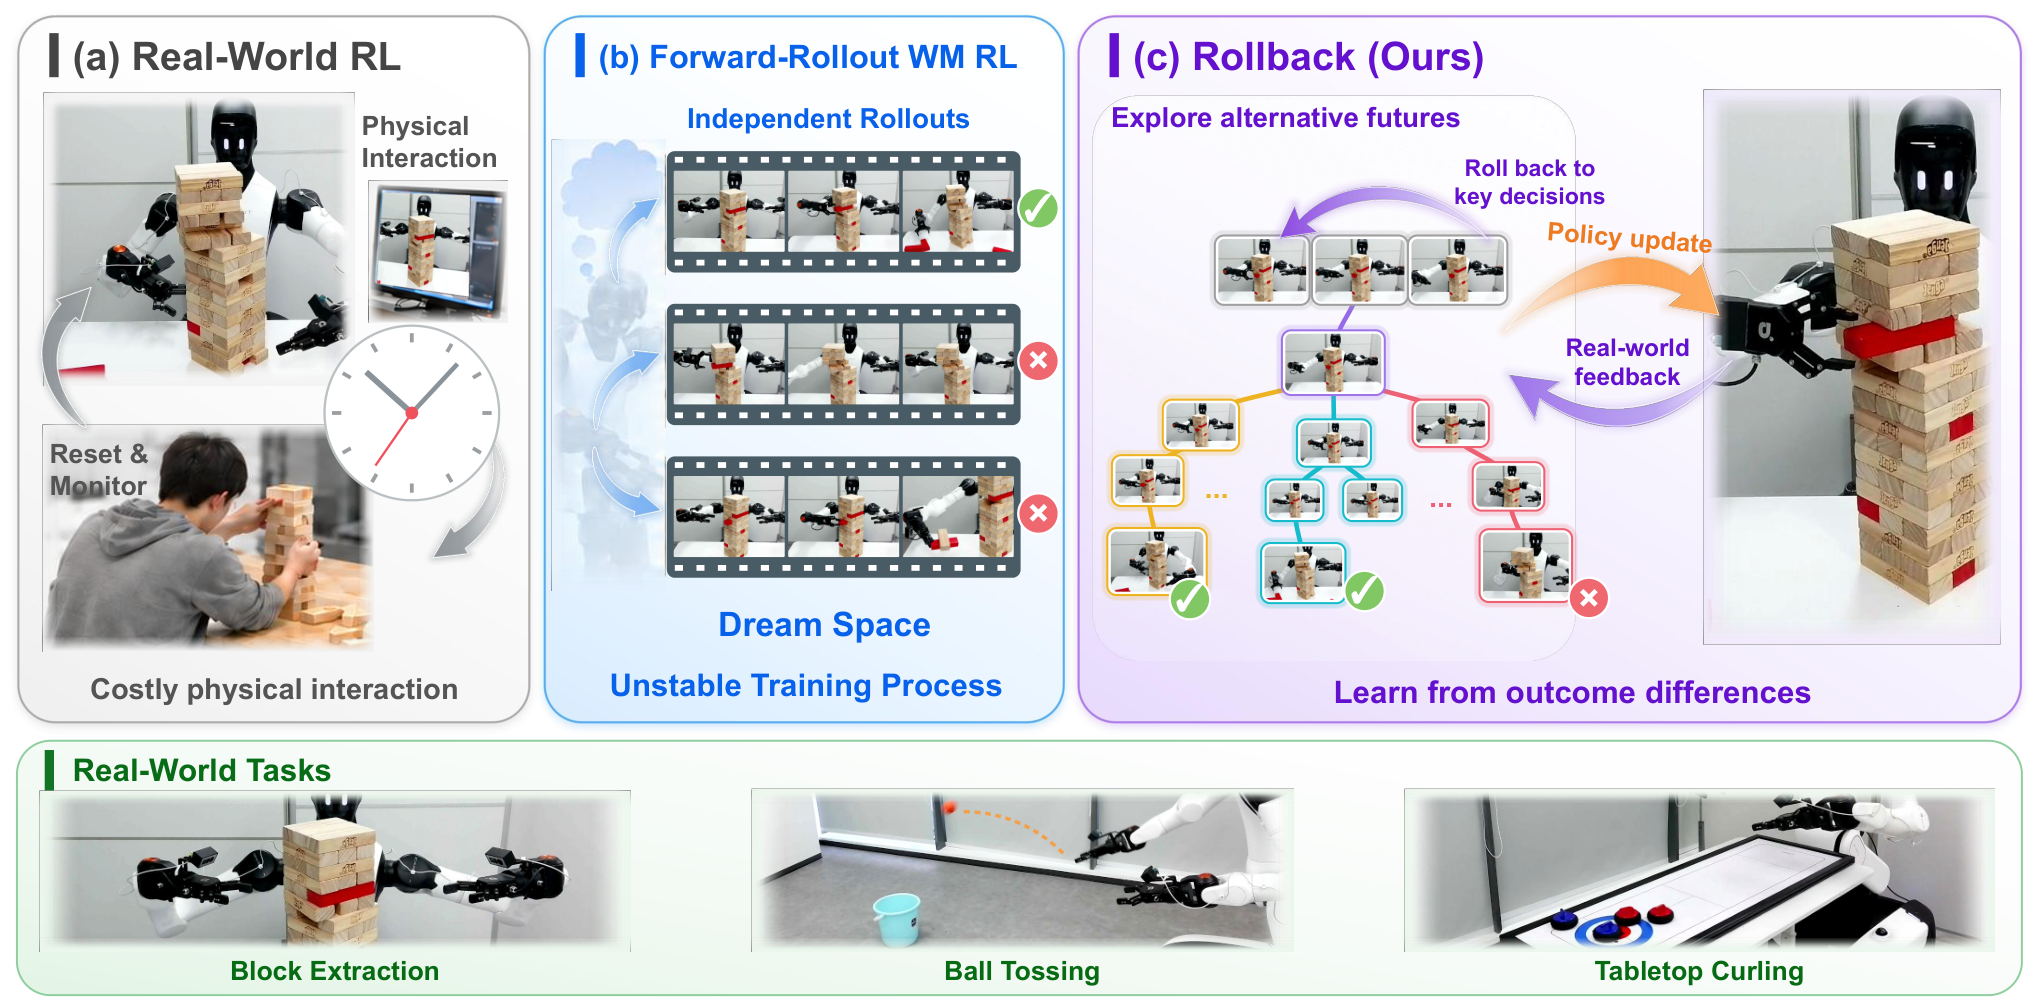
アクション条件付き動画world modelsは通常、前向きのシミュレータとして使用されます。すなわち、policyがロールアウトを行い、報酬が計算され、policyが更新されるという流れです。この方式では、学習済みモデルが提供できるにもかかわらず物理環境では得られない2つの能力が無駄になっています。それは、特定の意思決定点に巻き戻す能力と、異なるアクションの下で同じプレフィックスを再生する能力です。独立したロールアウトは、想像上の計算資源の大半を同一のプレフィックスの再生成に費やしており、成功・失敗を実際に左右する意思決定点において明確な反事実的比較を提供しません。Rollbackはworld modelsを反事実的エンジンとして再定式化するもので、重要な意思決定点での分岐により、学習済みの価値関数なしにアクションレベルのクレジット割り当てを実現します。
手法
RollbackはAlphaGo/Expert Iteration方式の探索と蒸留のテンプレートに従いますが、探索はGE-Sim 2.0(3つのカメラビューとロボットの固有感覚状態を同時予測する動画world model)内で実行されます。固有感覚状態は、アーム7関節+グリッパー1つ(アームごと)で合計16次元のアクション次元を30 Hzで扱います。固有感覚ヘッドは重要です。純粋な画像予測は、Jengaブロック抽出のようなタスクにおける接触タイミングやグリッパーの解放の制御には粒度が粗すぎるためです。
経験バックトラッキング木探索。 オフラインのデモや最近の実機ロールアウトから得られるシード軌跡が参照パスを定義し、アクションチャンク境界での観測が保持されます。非終端ノードはそれぞれ、そのチャンク境界でのworld modelのコンテキスト(KV状態、デコーダ状態)をキャッシュします。ノード s_t での分岐は、policyから代替アクションチャンク a_t^{(k)} \sim \pi_\theta(\cdot \mid s_t) をサンプリングし、プレフィックスを再生成するのではなくキャッシュされたコンテキストを復元することで継続シミュレーションを行います。元の実軌跡が最初に評価される分岐となり、その真の結果が参照パスに沿ってバックアップされ、想像された分岐のアンカーとなります。
木構造化価値推定。 下流の結果は各分岐ノードで相対的なアクション品質ラベルに集約されます。ラベルはコンテキストを共有する兄弟間での相対的なものであるため、Rollbackは独立した価値モデルの学習を回避します。比較は同一状態に根ざした分岐間で行われ、集約された終端結果から導かれるアクションレベルの教師信号をもとにpolicyが直接蒸留されます。
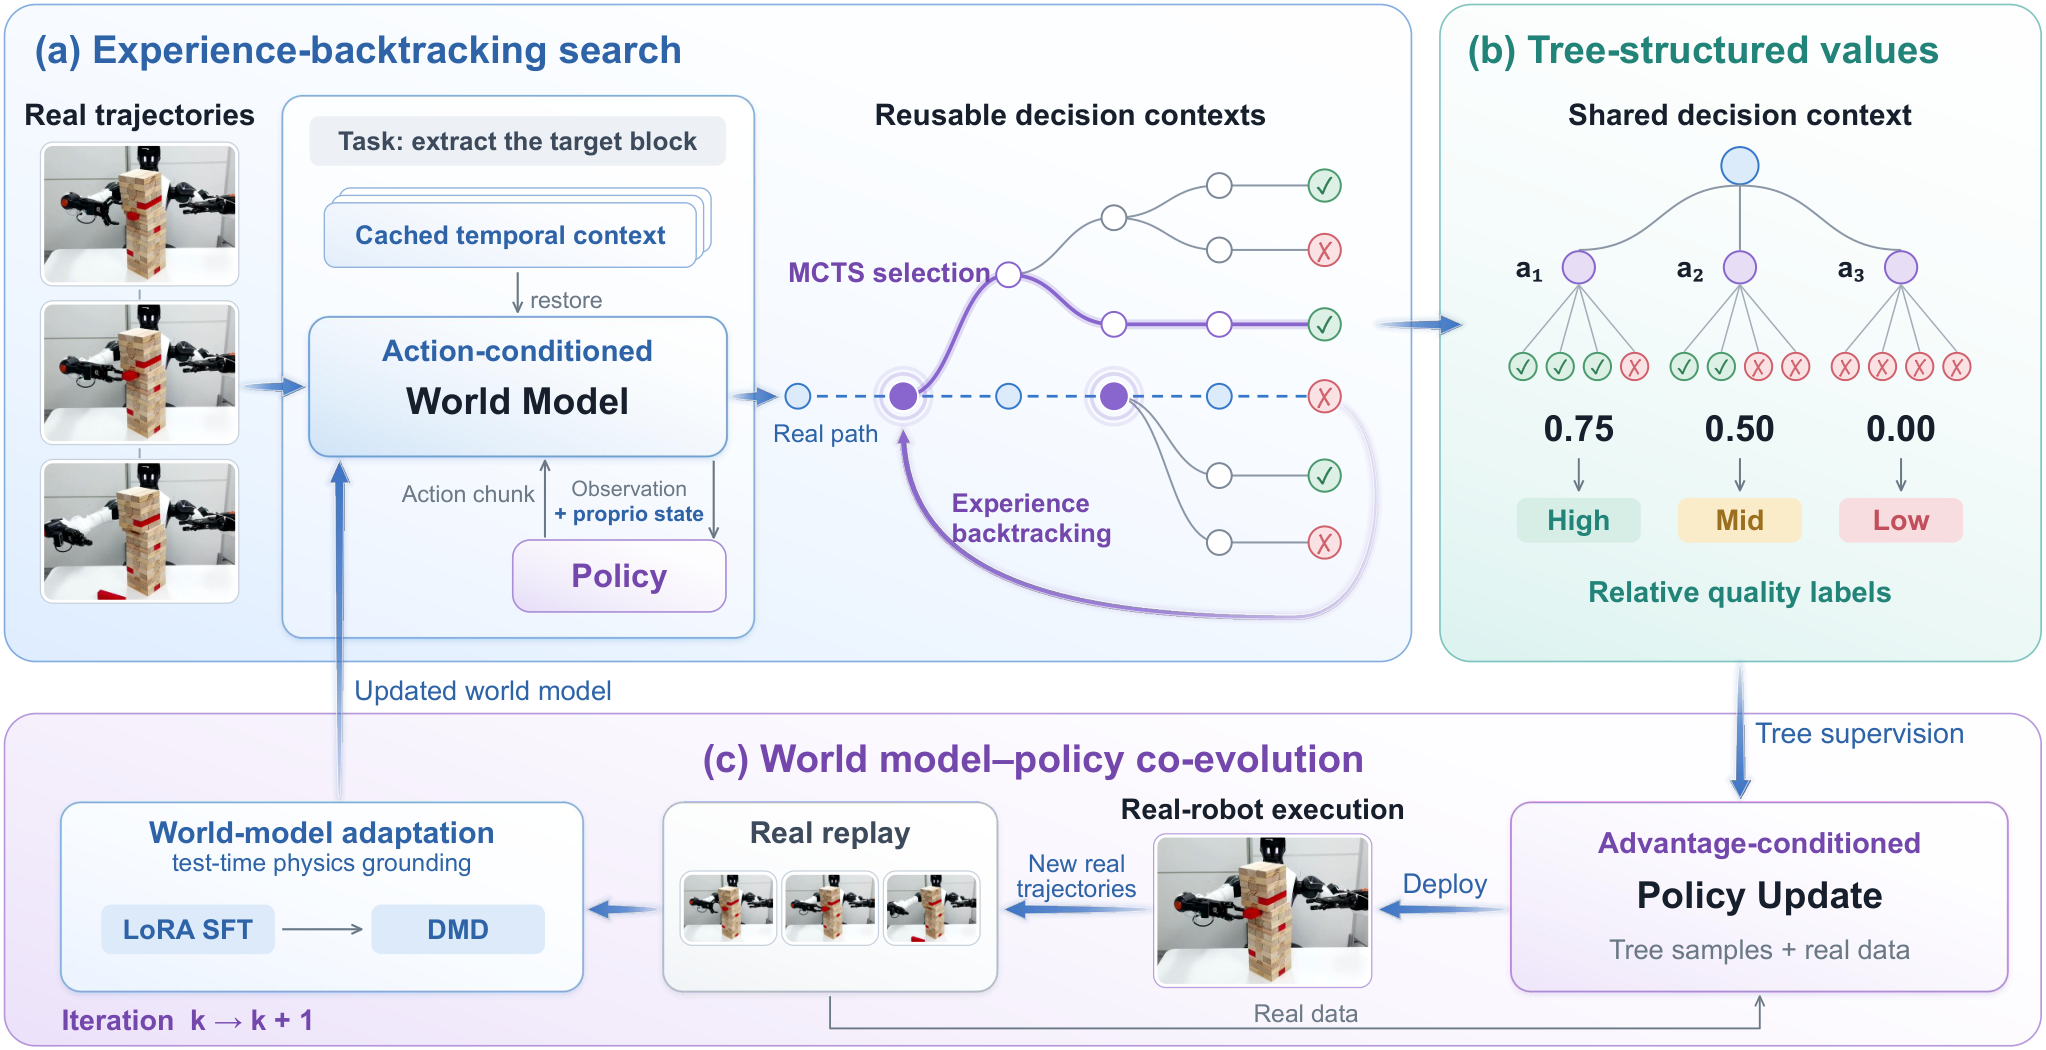
World modelとpolicyの共進化。 実軌跡は、著者らがtest-time physics groundingと呼ぶLoRA SFTと分布マッチング蒸留(DMD)を介してworld modelを継続的に改善します。より精度の高いモデルはより忠実な分岐をもたらし、より良いpolicyを生成し、より情報量の多い実軌跡を生み出します。
非同期システム
実機ロボットの実行・想像内の木探索・勾配更新という3つのプロセスは互換性のない速度で動作します(エピソードはタスク完了+リセット時間で制限され、木は想像上の計算資源で制限され、学習器は勾配スループットで制限されます)。同期的な外部ループでは各リソースがアイドル状態になります。Rollbackはこれらを分離します。クラウドGPUが探索と学習を担当し、ロボットの隣のエッジノードがpolicy inferenceを実行することでクラウドの遅延が制御ループに入らないようにし、デバイスはセンシングとアクチュエーションのみを担当します。
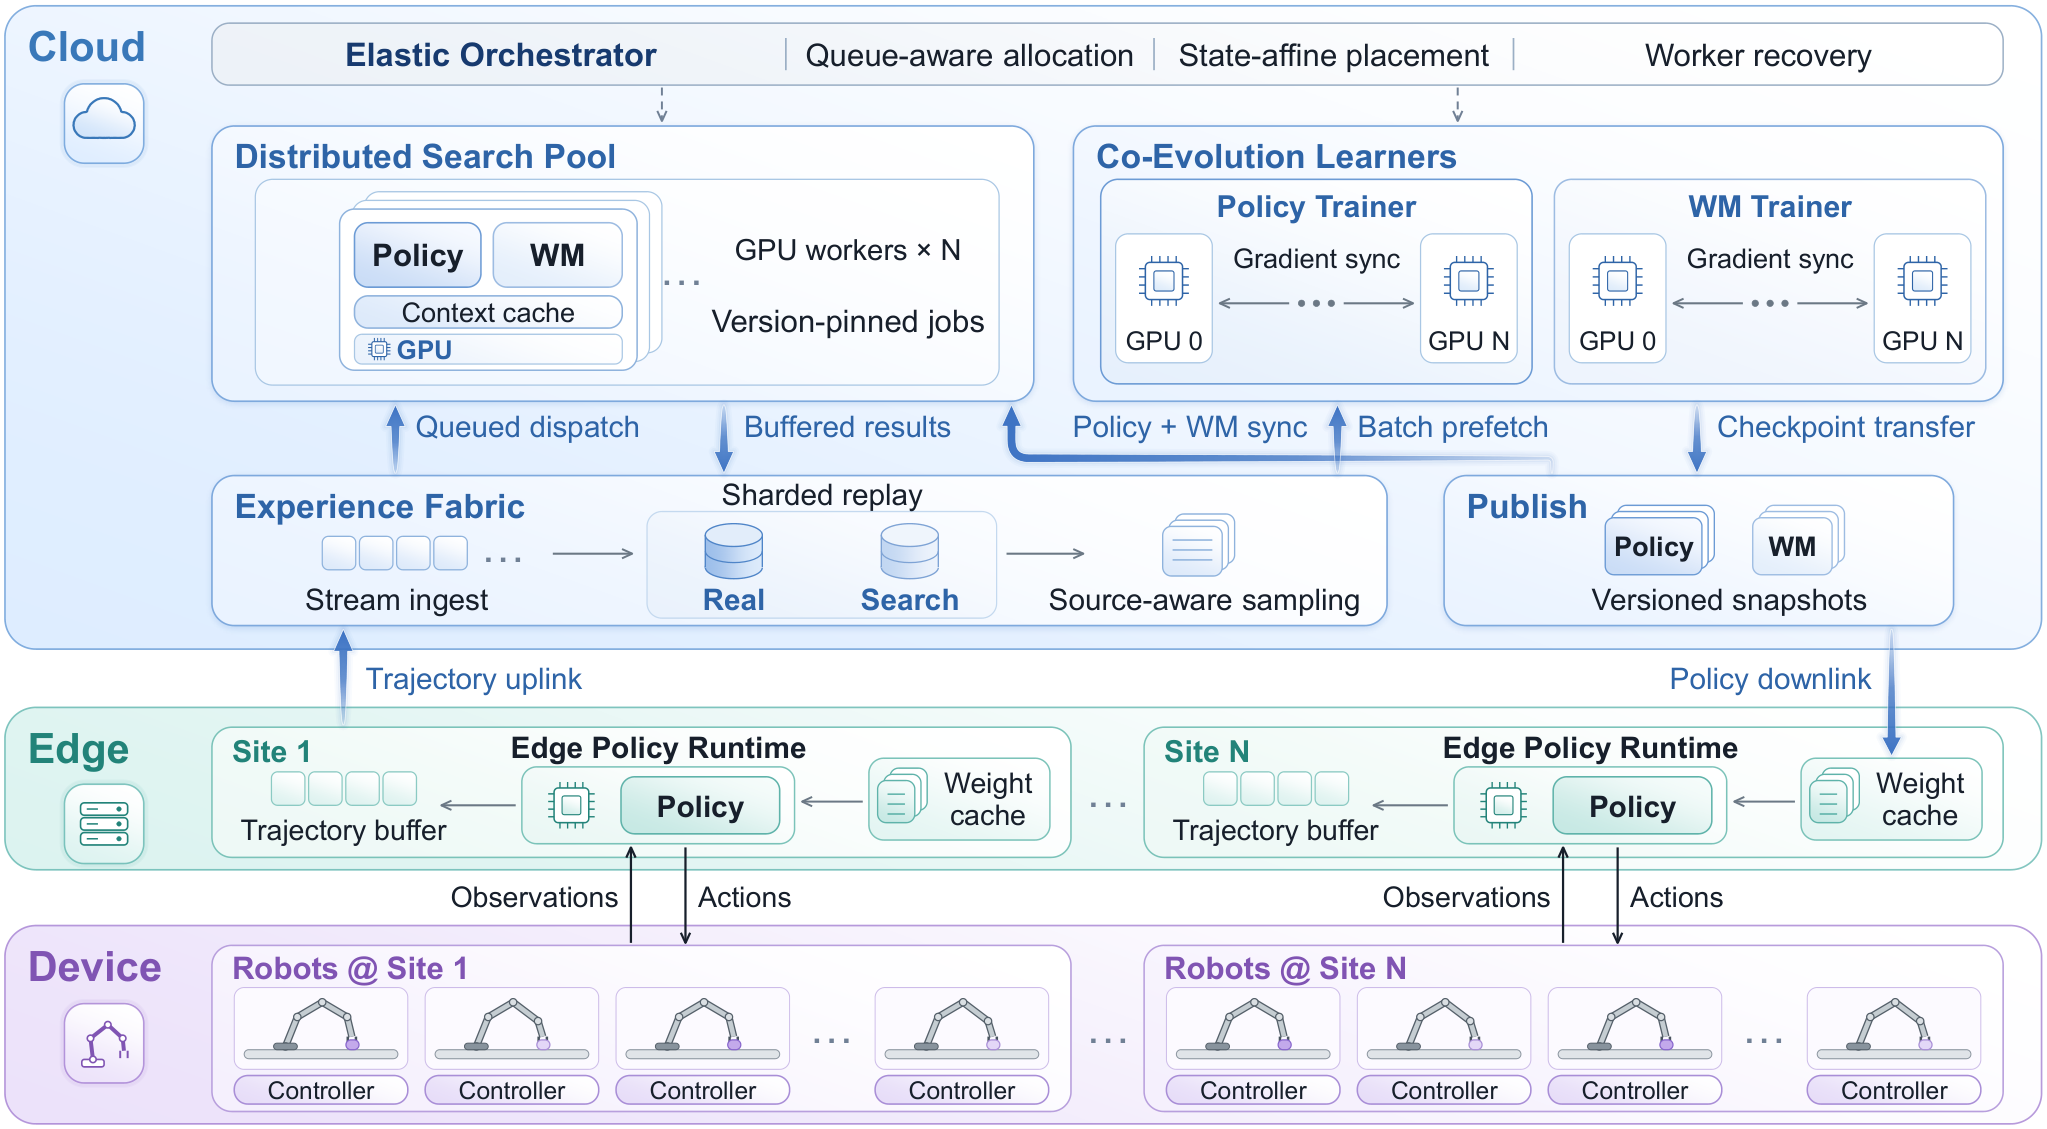
探索ワーカーは完全に並列化可能です。各GPUはpolicyレプリカ、world modelインスタンス、および独自のコンテキストキャッシュをホストします。Elastic Orchestratorがシードを割り当て、ワーカーはネットワーク越しに蒸留済み教師信号のみを送信し、中間ロールアウトテンソルは送信しません。Policyのスナップショットは探索ワーカーとエッジサイトの両方に送られ、world modelのスナップショットは探索ワーカーにのみ送られます。各木は開始時点での最新モデルバージョンを使用し、探索と学習の間にバリアは存在しません。
結果
評価はAGIBOT Genie-02を用いた3つの実世界タスクで行われます。
- Block Extraction(Jenga):接触が多く、安定性制約のあるタスク。
- Ball Tossing:解放タイミング制御。
- Tabletop Curling:人間との2人ゲームで、サイドごとに4つのストーンと変位ダイナミクスを持つ。
各タスクで、6つの初期位置(カーリングは9つ)、各位置につき15試行(Block Extractionは25試行)を実施します。本論文はRollbackをRISEおよび「RISE w/ GE-Sim2」(バックトラッキングなしの同じworld model)と比較し、経験バックトラッキング探索・木構造化教師信号・world model適応それぞれの貢献を切り離して評価します。提供されたセクションでは、著者らがRollbackについて(i)実機ハードウェアでのベースライン超え、(ii)各コンポーネントの貢献、(iii)学習の安定性と人間レベルの性能達成、(iv)適応下でのworld modelの忠実性、を評価することが述べられています。具体的な数値テーブルは本論文および付録に委ねられています。
限界と未解決の問題
- モデル悪用リスク。 分岐の品質は、分布外アクション近傍でのworld modelの忠実度に制限されます。LoRA SFT+DMDはドリフトを緩和しますが、悪用を形式的に有界化するものではありません。
- クレジット割り当ての粒度。 兄弟間の相対ラベルには各ノードで十分な分岐が必要です。疎な木は標準的なロールアウトベースのクレジットへと退化します。
- 適用範囲。 1台のロボットにおける3つの操作タスクに限定されており、異なる身体への汎化やKVキャッシュの増大が高コストとなる長い時間軸への汎化は未解決のままです。
- 学習済み価値関数なしという点は安定性の観点からは有利ですが、Rollbackが遠い未来のbootstrap評価を実行できないことも意味します。クレジット割り当ての有効な時間軸は木の深さによって制限されます。
本研究の意義
動画world modelを前向きシミュレータとしてではなく、巻き戻し可能な反事実的エンジンとして扱うことは、学習済みモデルが物理環境に対して固有に提供できるものとより適切に対応しています。工学的な貢献、すなわちバージョン管理されたスナップショットを用いた探索・学習・実機実行の非同期化というインフラは、world modelベースのpolicy学習を玩具的なループを超えて実際にスケールさせるために必要な種類の基盤です。
Source: https://arxiv.org/abs/2610.36068
The Trinity: マルチモーダルエージェントのための能力駆動型再帰的自己改善
問題設定
エージェント型マルチモーダルシステムのスケールアップには、二つのボトルネックが存在します。(i) 検証可能で異種混合の訓練環境の構築にはコストがかかり、(ii) 凍結されたバックボーン周囲のプロンプト・ツール・メモリ・プランナー・ルーティングポリシーからなる足場構造、すなわちエージェントの「ハーネス」の手動による反復改良は、タスクの多様性に追いつけません。本論文の前提は、鉛筆パズル・チェス戦術・ルービックキューブ解法といった、表面上は無関係なタスクが、制約伝播や部分的情報下でのバックトラッキングなど、潜在的な能力要件を共有しているというものです。表面上のタスクカテゴリではなく、共有された能力を中心に自己改善を組織することで、環境合成とハーネス改良のコストを複数のタスクにわたって償却できます。
手法
The Trinityは、凍結されたバックボーン(実験ではClaude Opus 5を使用)上で動作する三つの役割からなるクローズドループであり、重みの更新は行わず、ハーネスの進化とスキルメモリのみを用います。
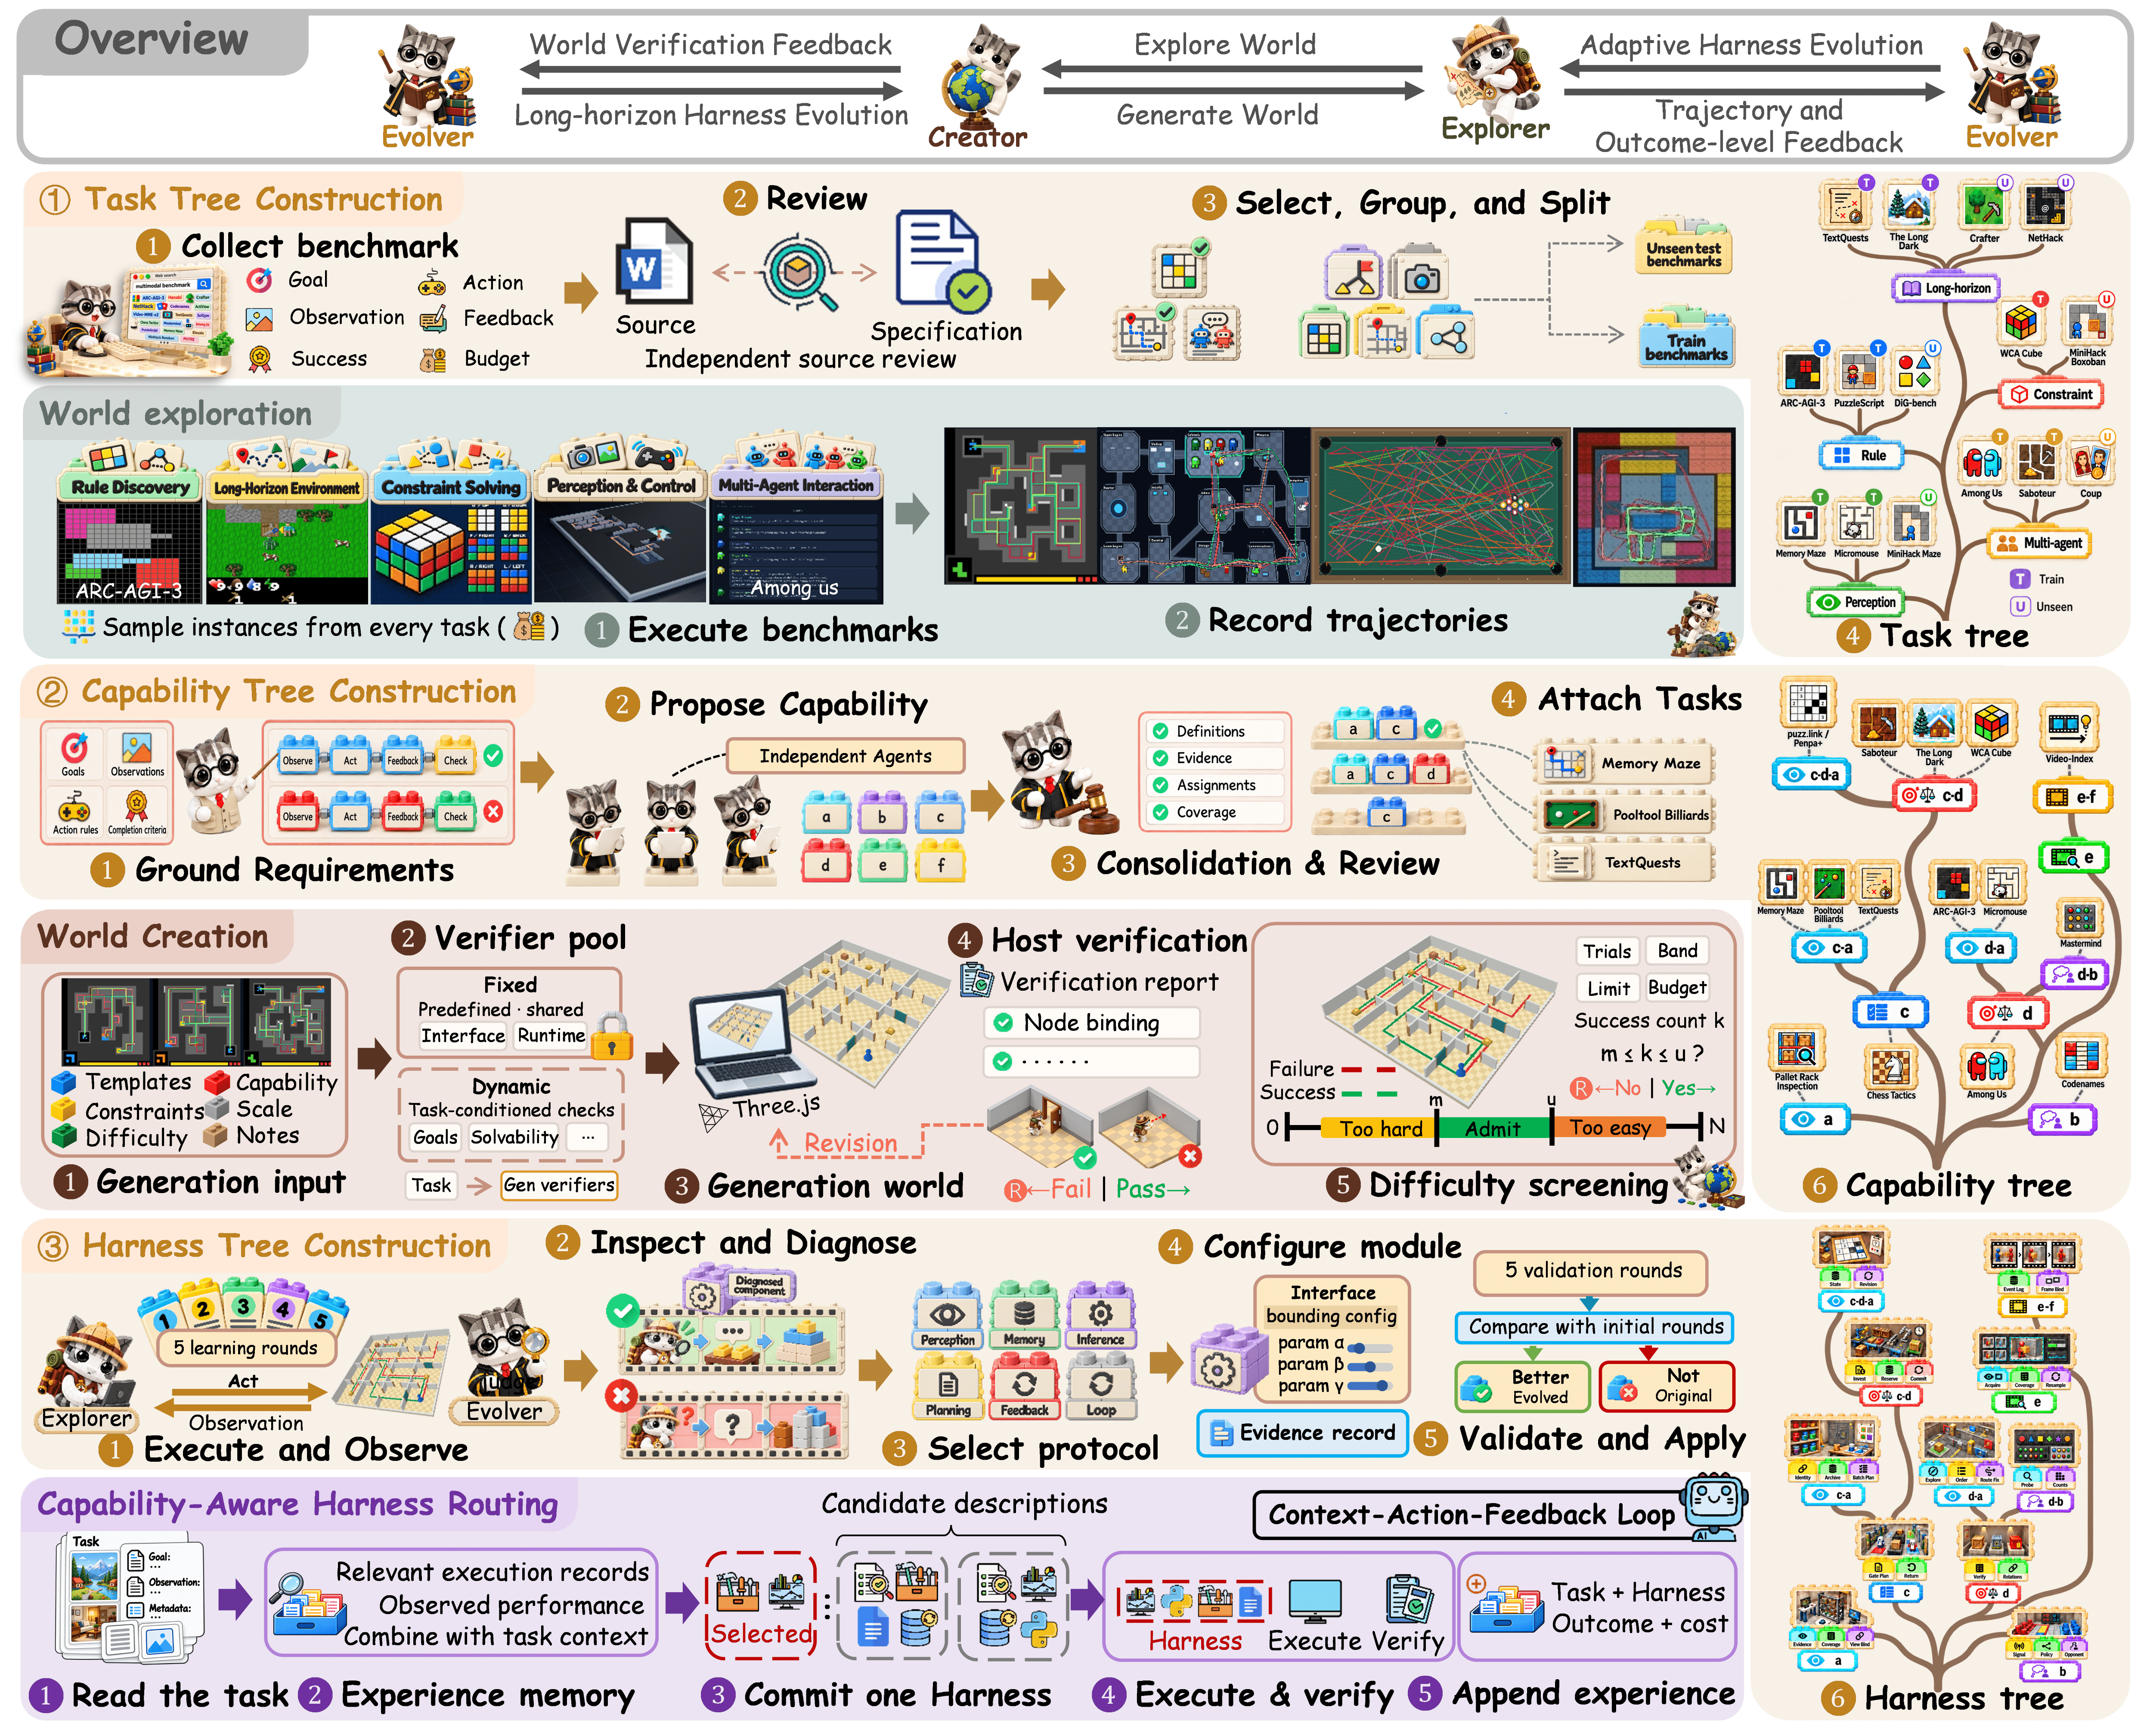
このパイプラインは共同インデックス付きの三つの木を構築します。
- タスク木 — 表面的なドメイン(規則発見、制約付き求解、知覚・制御、マルチエージェント、長期的地平線)による初期的な組織化。
- 能力木 — Evolverがタスク仕様と検証済み実行軌跡から抽出された共有要件に基づいてタスク木を再構成したもの。各ノード d は一つの能力(例:「隠れた規則の下での仮説-検証-改訂」)に対応し、異種の元タスクがその下にぶら下がります。
- ハーネス木 — 能力木に整合した固定トポロジーを持ち、各ノードが親から継承しローカルに改良された再利用可能なモジュール(プランナーテンプレート、検証器、メモリスキーマ、ツール使用プロトコル)を格納します。
中核となる訓練プリミティブは能力駆動型Real2Sim2Realです。能力ノード d において、Creatorが異種子タスクの共通要件を抽象化し、能力習得のみを目的とした手続き的に検証可能な単純化されたシミュレーション世界を生成します。転移は精緻化されたハーネスの下で元のタスクを評価することによって測定されます。
Explorerはこれらのシミュレーション世界でロールアウトを実行し、検証済み軌跡をフィルタリングしてモジュール更新を提案します。Evolverは、元のタスクへの転移が後退しない場合にのみ更新を受け入れます。これは局所的な改良を伴う選択的継承であり、固定トポロジーのハーネス木上でほぼ単調なラチェット機構を与えます。推論時には、能力対応型ハーネスルーターが公開タスク情報(仕様、モダリティ、インターフェース)と蓄積された検証済み経験を用いてハーネス木の単一の互換ブランチを選択し、検証済みフィードバックがそのブランチの経験ストアに書き戻されます。
重要な実験上の詳細として、評価時のスキル準備はベンチマーク・ハーネスペアごとに5回のトライアルを実行し、軌跡を永続的なスキルに要約して、その後のTrain/Unseen評価においてそれらのスキルを固定します。これにより、評価時のin-context探索からハーネスの効果を切り離し、デプロイされたエージェントがスキルライブラリを蓄積する方法に対応します。
形式的には、このループは次のように表されます。
\mathcal{H}_{d}^{t+1} = \text{Refine}\big(\mathcal{H}_{\text{pa}(d)}^{t},\ \tau_{d}^{\text{sim}}\big) \quad \text{iff} \quad J_{\text{orig}}(\mathcal{H}_{d}^{t+1}) \ge J_{\text{orig}}(\mathcal{H}_{d}^{t})
ここで \tau_{d}^{\text{sim}} は能力ノード d における検証済みシミュレーション軌跡、J_{\text{orig}} は当該ノード下の元タスクに対する転移スコアです。
実験と結果
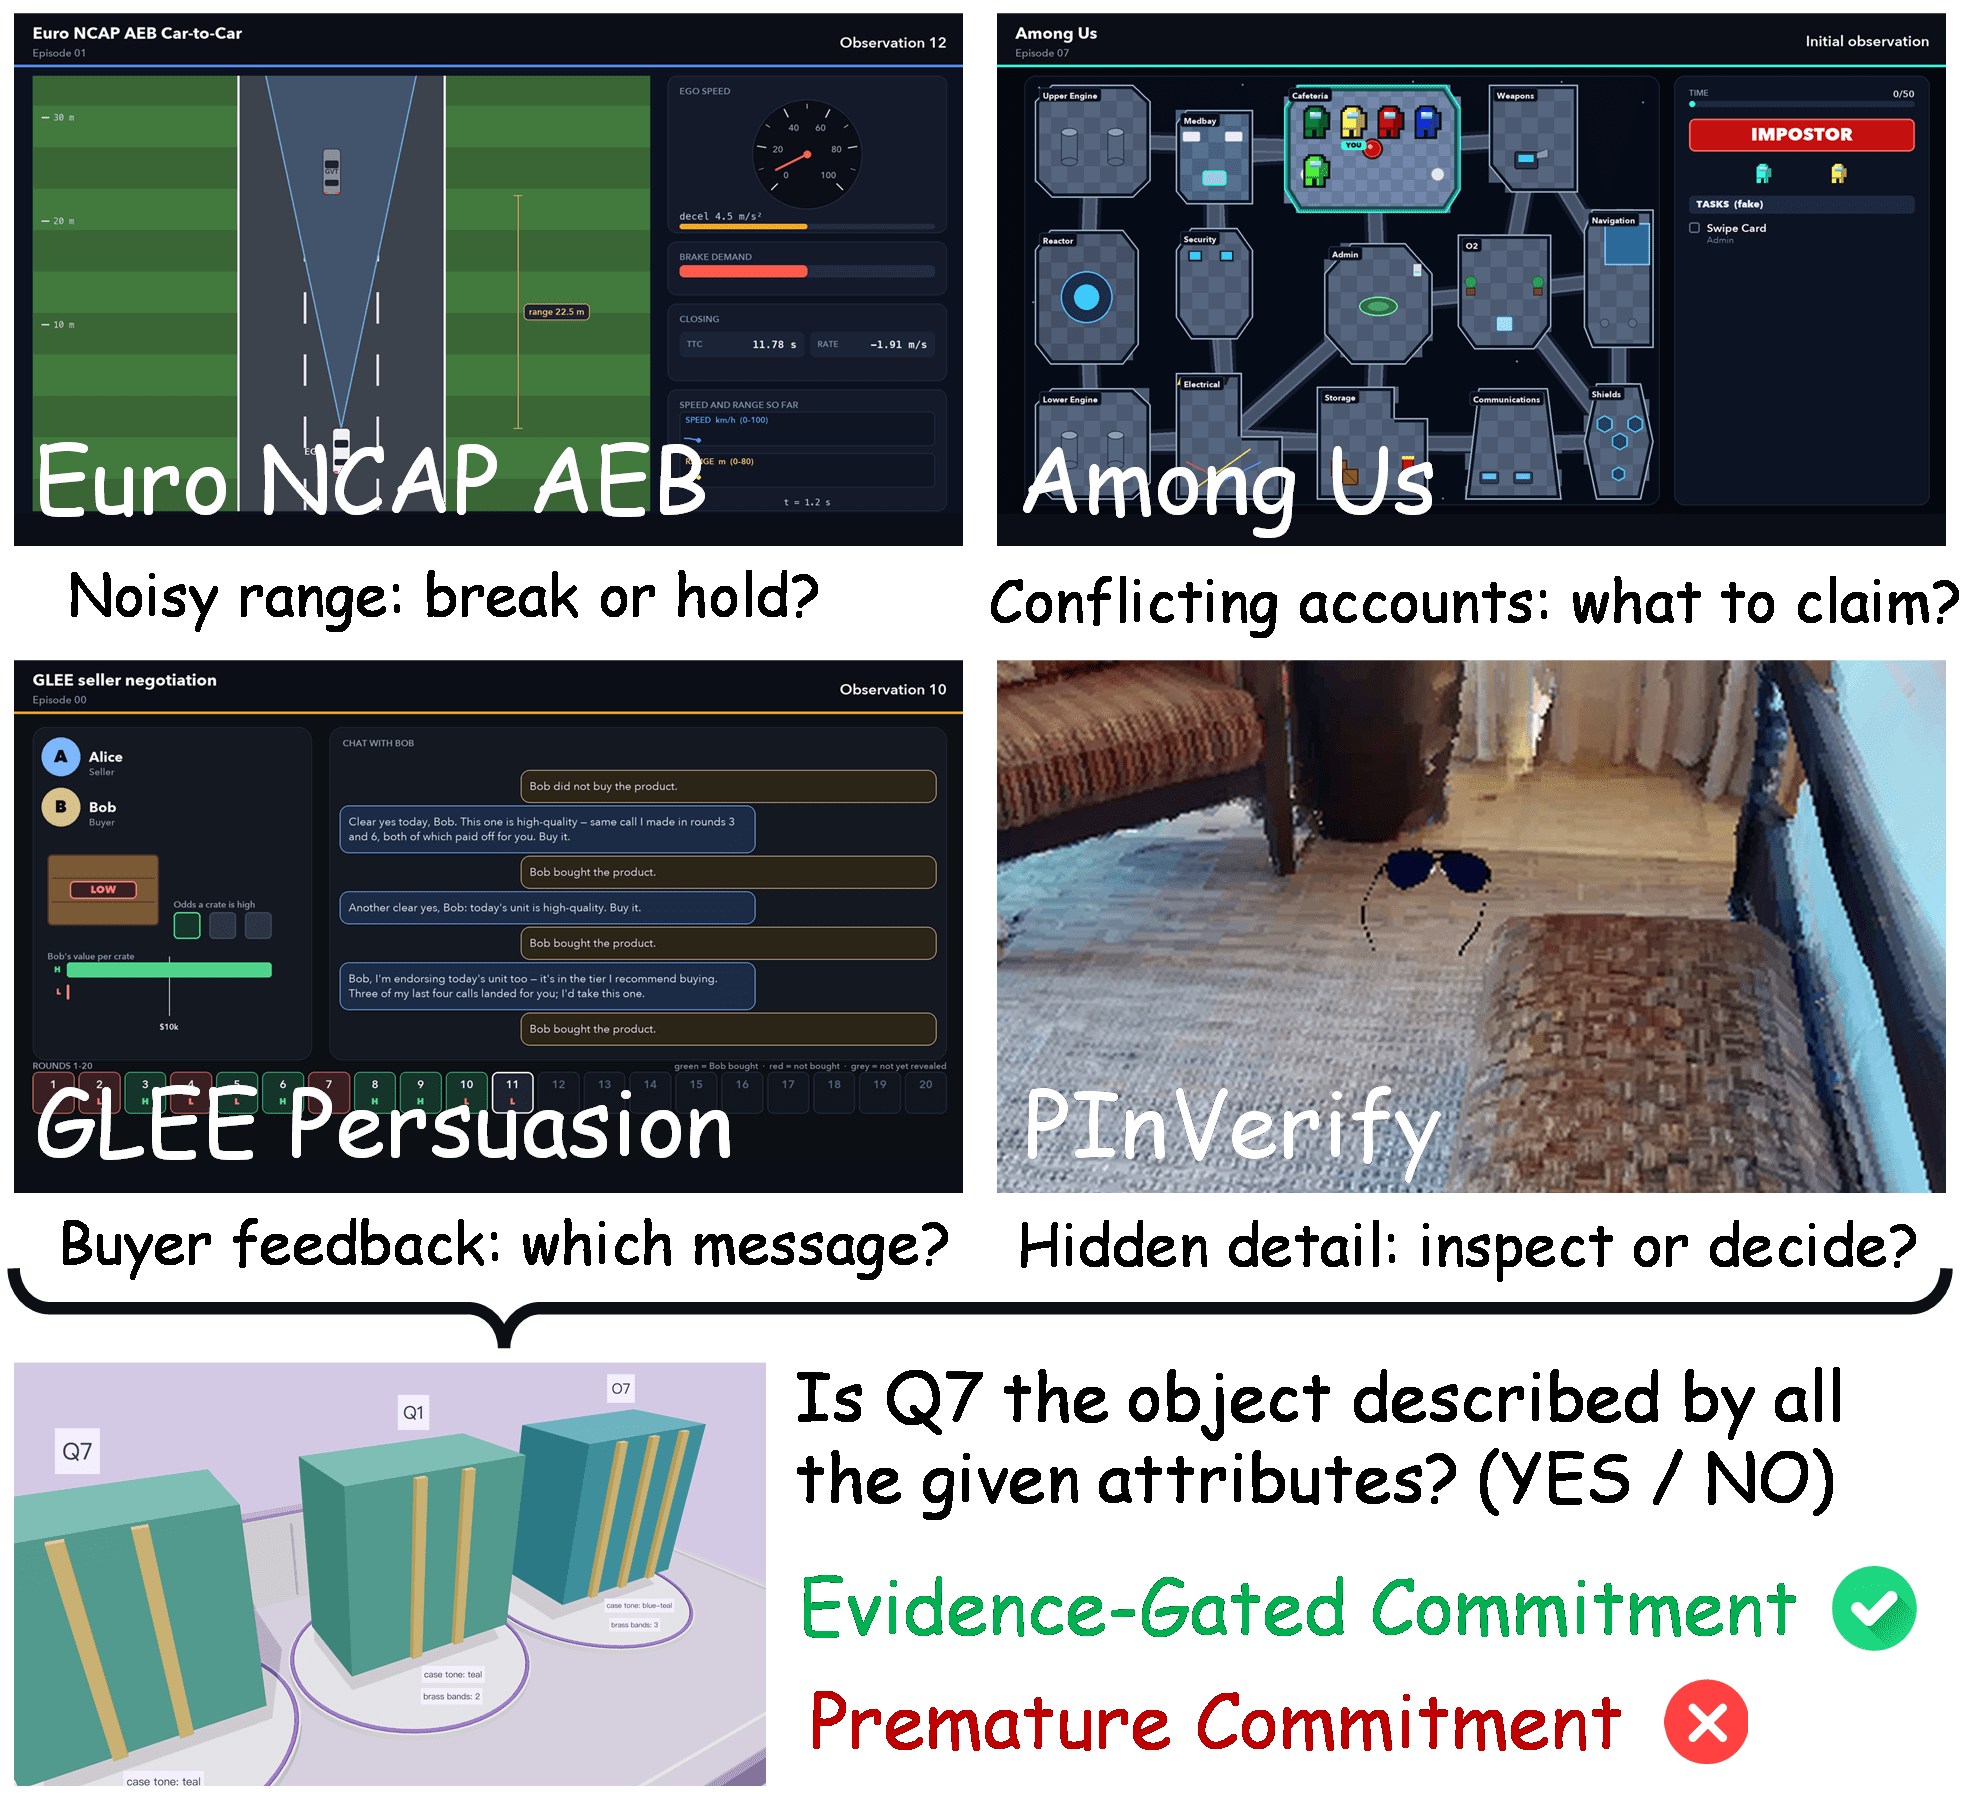
評価は、5つのドメインにわたる28の訓練用ベンチマークと18の未見ベンチマークを対象としています。規則発見(Eleusis、Mastermind、WILT、BoxingGym、ARC-AGI-3、PuzzleScriptなど)、制約付き求解(チェス戦術、puzz.link/Penpa+、WCAキューブ解法、AdaPlanBench)、知覚・制御(Memory Maze、Micromouse、Euro NCAP AEB、PHYRE、SOON、CaP-X)、マルチエージェント(Among Us、Saboteur、Codenames、Colonel Blotto、Coup、Hanabi、Heads-Up NLHE)、長期的地平線ワールド(TextQuests、The Long Dark、NetHack、Crafter)です。すべての変種は同一のベースハーネス \mathcal{H}_0(Prime Agent)と同一の凍結されたClaude Opus 5バックボーンから出発するため、差異はハーネスの進化に帰因します。
5つの実験では以下を検証しています。(1) 能力駆動型の再編成が表面カテゴリによる組織化を上回るか、(2) 再帰的自己改善が世代をまたいで単調な利得をもたらすか、(3) 能力対応型ルーティングのフラットなハーネスに対する有用性、(4) 能力・モジュール対応関係の安定性、(5) 具現化されたターゲット(CaP-Xロボット、SOONロボット)への転移。
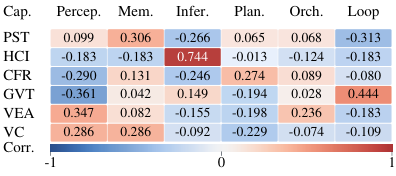
図7は能力・モジュール相関構造を示しています。各能力は6つのプロトコルのうち少数のサブセットと強く結合(赤の正の帯)し、他と負の相関(青)を示しており、モジュールがグローバルに平均化されるのではなく特化されているという主張を支持しています。これは選択的継承の機械論的な正当化となっています。子の能力は、祖先が能力関連性を検証したプロトコルのみをインポートできます。
主要な定性的知見は、訓練時のシミュレーション世界が訓練用ベンチマークから直接引き上げるのではなく能力抽象化から構築された場合に未見ベンチマークへの利得が持続すること、および重みの更新なしに純粋にシミュレートされた能力世界で訓練されたハーネスが具現化ターゲット(CaP-Xロボット、SOONロボット)に恩恵をもたらすこと、すなわちReal2Sim2Realがシミュレーション→ロボット方向でも転移することです。
限界と未解決の問題
- このパイプラインは非常に強力な凍結バックボーン(Opus 5)に依存しています。利得のどの程度がハーネスの進化によるものでバックボーンの事前知識によるものかが不明であり、弱いバックボーンでのアブレーションが必要です。
- 「検証済み軌跡」とシミュレーション世界の検証器はそれ自体が(しばしばエージェント自身によって)構築される必要があるため、ブートストラップはCreatorが元のタスクの忠実な代理となる検証器を生成できるかどうかに依存します。本論文は検証器の偽陽性率を定量化していません。
- 固定トポロジーのハーネス木は構造的な発見を禁じており、初期木に存在しない能力は出現できません。
- トークンコストは集計値(百万単位)でのみ報告されており、木の深さに対する能力ごとのコストスケーリングは特徴づけられていません。
- ルーティングポリシーは「公開タスク情報」を参照しますが、敵対的または曖昧なタスク記述に対する感度は未検証です。
重要性
The Trinityは、凍結重みのマルチモーダルエージェントに対する自己改善が、タスクではなく共有された能力を中心に訓練を再編成することで駆動でき、ハーネスモジュールを継承の単位とすることを示しています。図7が示すように能力・モジュール対応関係が安定しているならば、検証可能な環境が希少でタスクが異種混合であるドメインにおいて、fine-tuningに対するスケーラブルな代替手段を提供します。
Source: https://arxiv.org/abs/2610.36077
PDRVLA: 物理ダイナミクス表現を持つVision-Language-Action Model
問題設定
VLA policyは視覚観測と自然言語指示をロボットの行動にマッピングしますが、その表現はvision-languageの事前学習目標から構築されており、物理ダイナミクス(接触下でのピクセル・深度・動きがどのように変化するか)を明示的にエンコードしていません。ビデオworld modelはそのようなダイナミクスを捉えられますが、制御ループの内部で未来フレームを逐次展開するとレイテンシが生じ、反応的な操作と相容れません。PDRVLAはその中間的な道を提案します。すなわち、予測された未来の外観・幾何・動きを要約する固定長の「物理トークン」列を生成する軽量モジュールを学習し、それを行動生成のconditioning専用に使用することで、オンラインなビデオ合成を不要にします。
アーキテクチャ
このpolicyは、Qwen3.5-4B VLMバックボーン、Physical Dynamics Module(PDM)、およびflow-matching action expertを積み重ねた構造になっています。
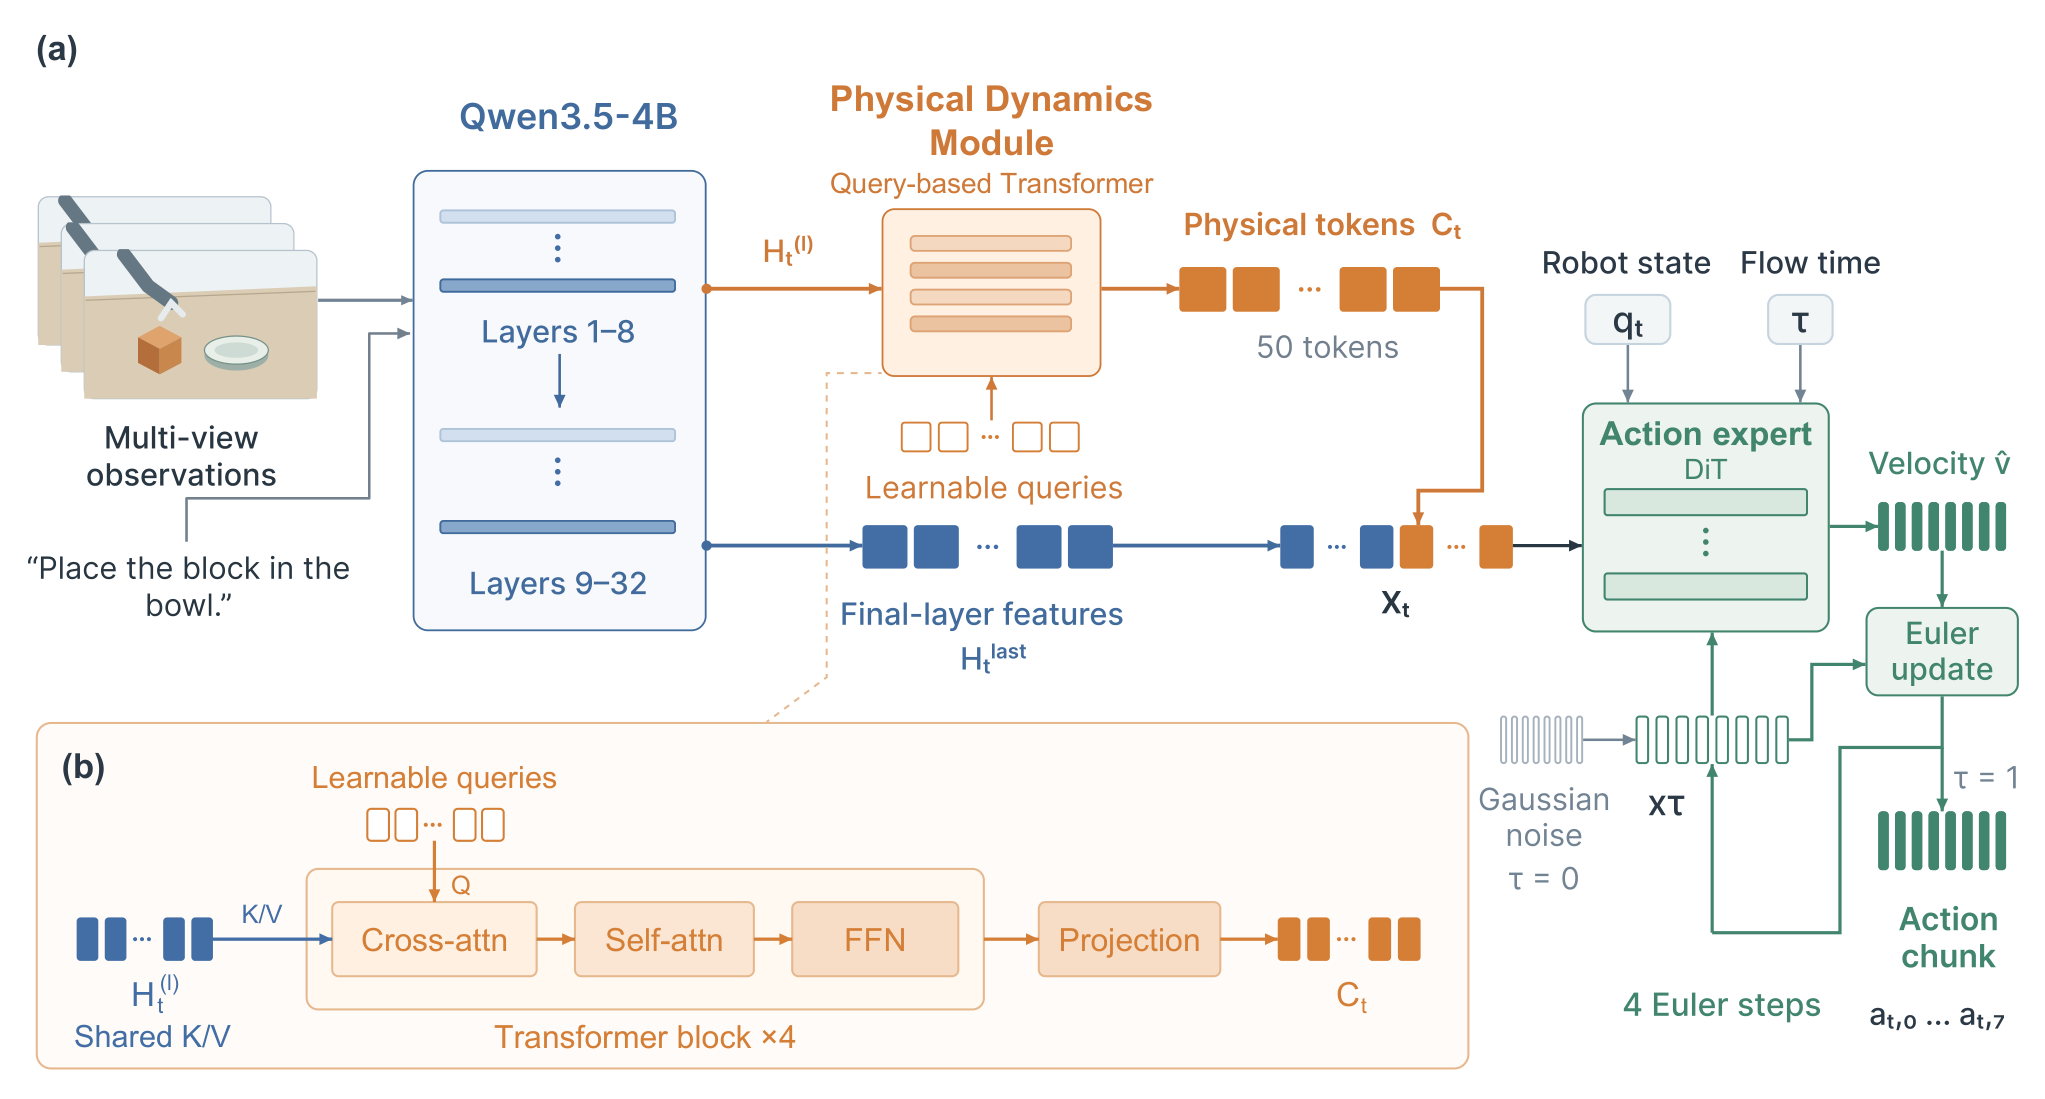
VLMへの入力は、カメラビューと「embodiment
サブタスクconditioningはオプションです。推論時にVLMはまずサブタスク文字列を出力することができ、それが行動conditioningパスの前に指示に付加されます(「Current step:
物理事前学習
各事前学習サンプルは、現在の観測と、次の30行動ステップにわたってサンプリングされた5フレームのターゲットビデオをペアにしています。外観ターゲットは生のRGBであり、深度擬似ラベルはDA3から、光学フロー擬似ラベルはDPFlowから得られます(RynnWorld-4Dに倣ったカラーエンコード)。3つのモダリティはすべて、LingBot-Videoの凍結されたWan video VAEを使用して潜在特徴にエンコードされます。PDMの予測ヘッドはこれらの潜在表現を物理トークンから直接回帰します。
PDMとその予測ヘッドはゼロから学習されるため、補助的な監視経路があります。凍結済みの事前学習済みビデオworld modelが同じ入力を受け取り、PDMがさらに回帰先とする中間特徴を提供します。world modelの使用はこれのみであり、joint policy学習では除去されます。
Joint学習ではビデオworld modelを取り除き、\{F^{RGB}_{t+k}, F^{D}_{t+k}, F^{Flow}_{t+k}\}潜在表現に対する3つの直接未来予測lossを維持し、flow-matching action lossとVL supervisionを追加します:
\mathcal{L} = \mathcal{L}_{\text{action}} + \mathcal{L}_{\text{VL}} + \lambda_{\text{RGB}}\|\hat F^{RGB}-F^{RGB}\|^2 + \lambda_{D}\|\hat F^{D}-F^{D}\|^2 + \lambda_{\text{Flow}}\|\hat F^{Flow}-F^{Flow}\|^2.
データ
コーパスは、VLA側として126万件の実ロボット軌跡(14,893時間)、122万件のUMI軌跡(10,259時間)、187万件のシミュレーション軌跡(8,868時間)を混合し、さらに805万件の一般的なVLサンプルと2,363万件の空間的・embodied VLサンプルを含みます。派生データとしては、EgoDexから合成された90万件のエゴセントリック→ロボット軌跡(2,646時間)、11億件のサブタスクアノテーション付きフレームから生成された110万件のサブタスク予測VLサンプル、および256万件のECoTキーフレームアノテーションが含まれます。
結果
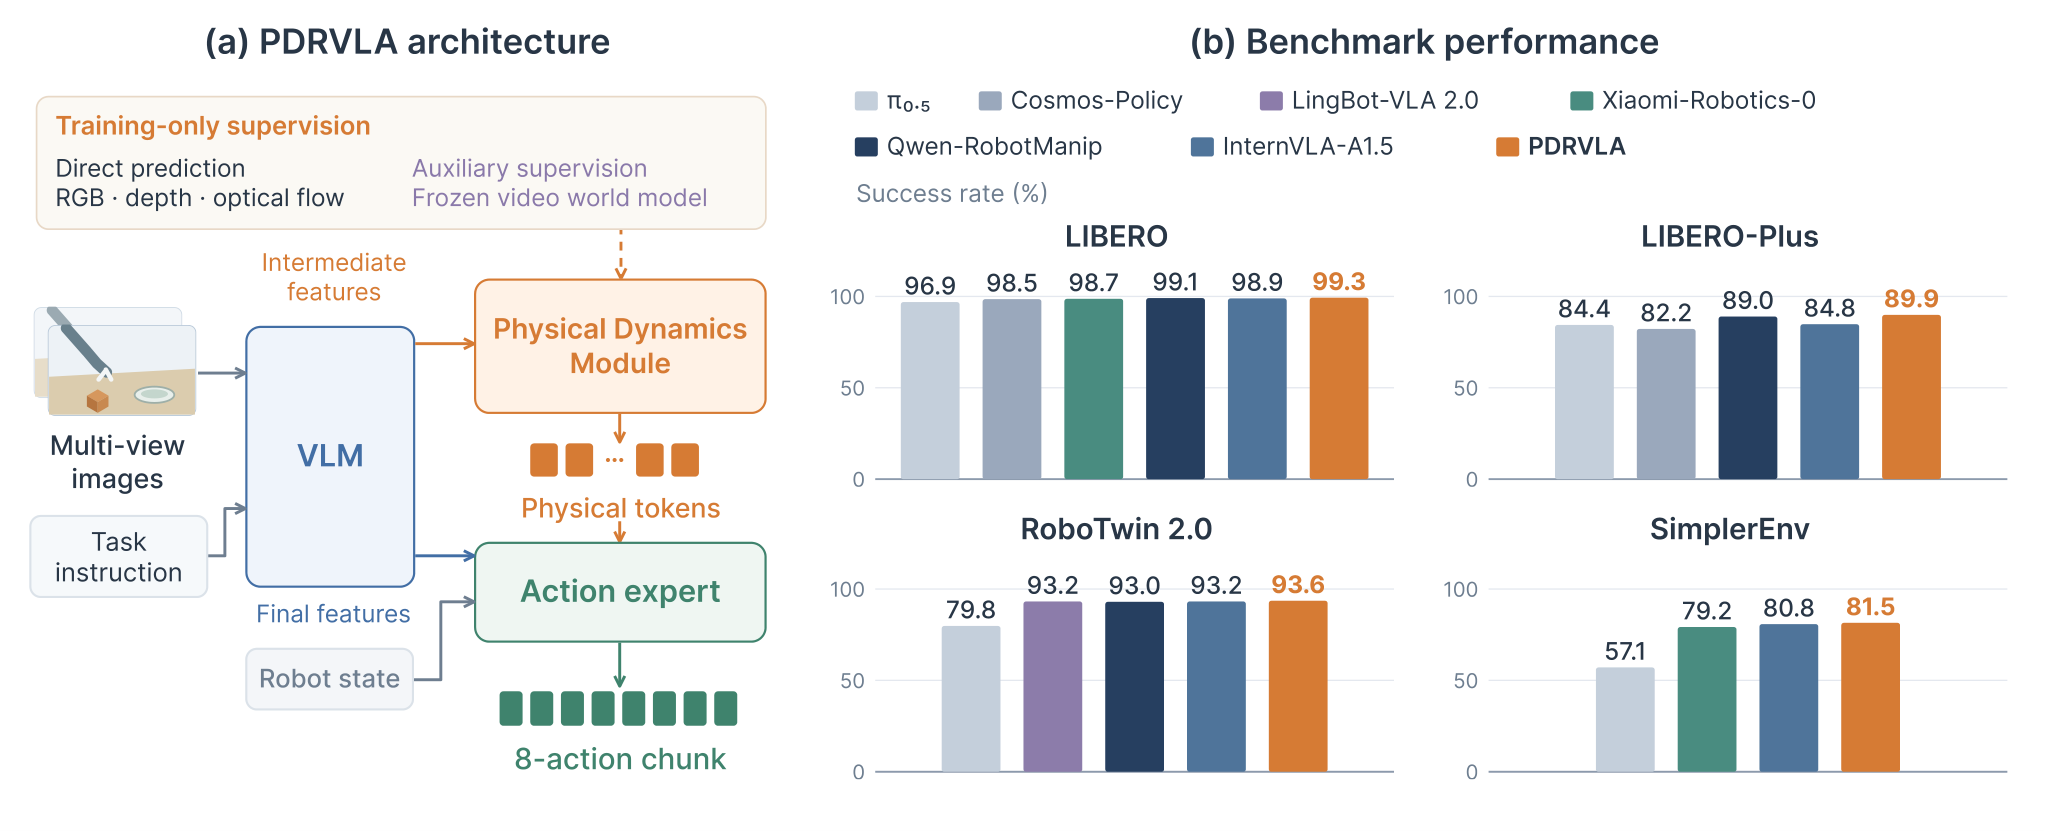
各ベンチマークへのfine-tuning後、4つのシミュレーションベンチマークにおいて以下の結果が得られています。LIBEROのSpatial/Object/Goal/Longの平均では2,000エピソードで99.3%の成功率、カメラ・ロボット・言語・照明・背景・ノイズ・レイアウトを10,030ケースで変化させるLIBERO-Plusでは89.9%、RoboTwin 2.0バイマニュアル(Aloha-AgileX、50タスク、クリーン条件とランダム化条件の平均)では93.6%、SimplerEnv Bridgeのvisual-matchingでは81.5%を達成しています。
Ablation
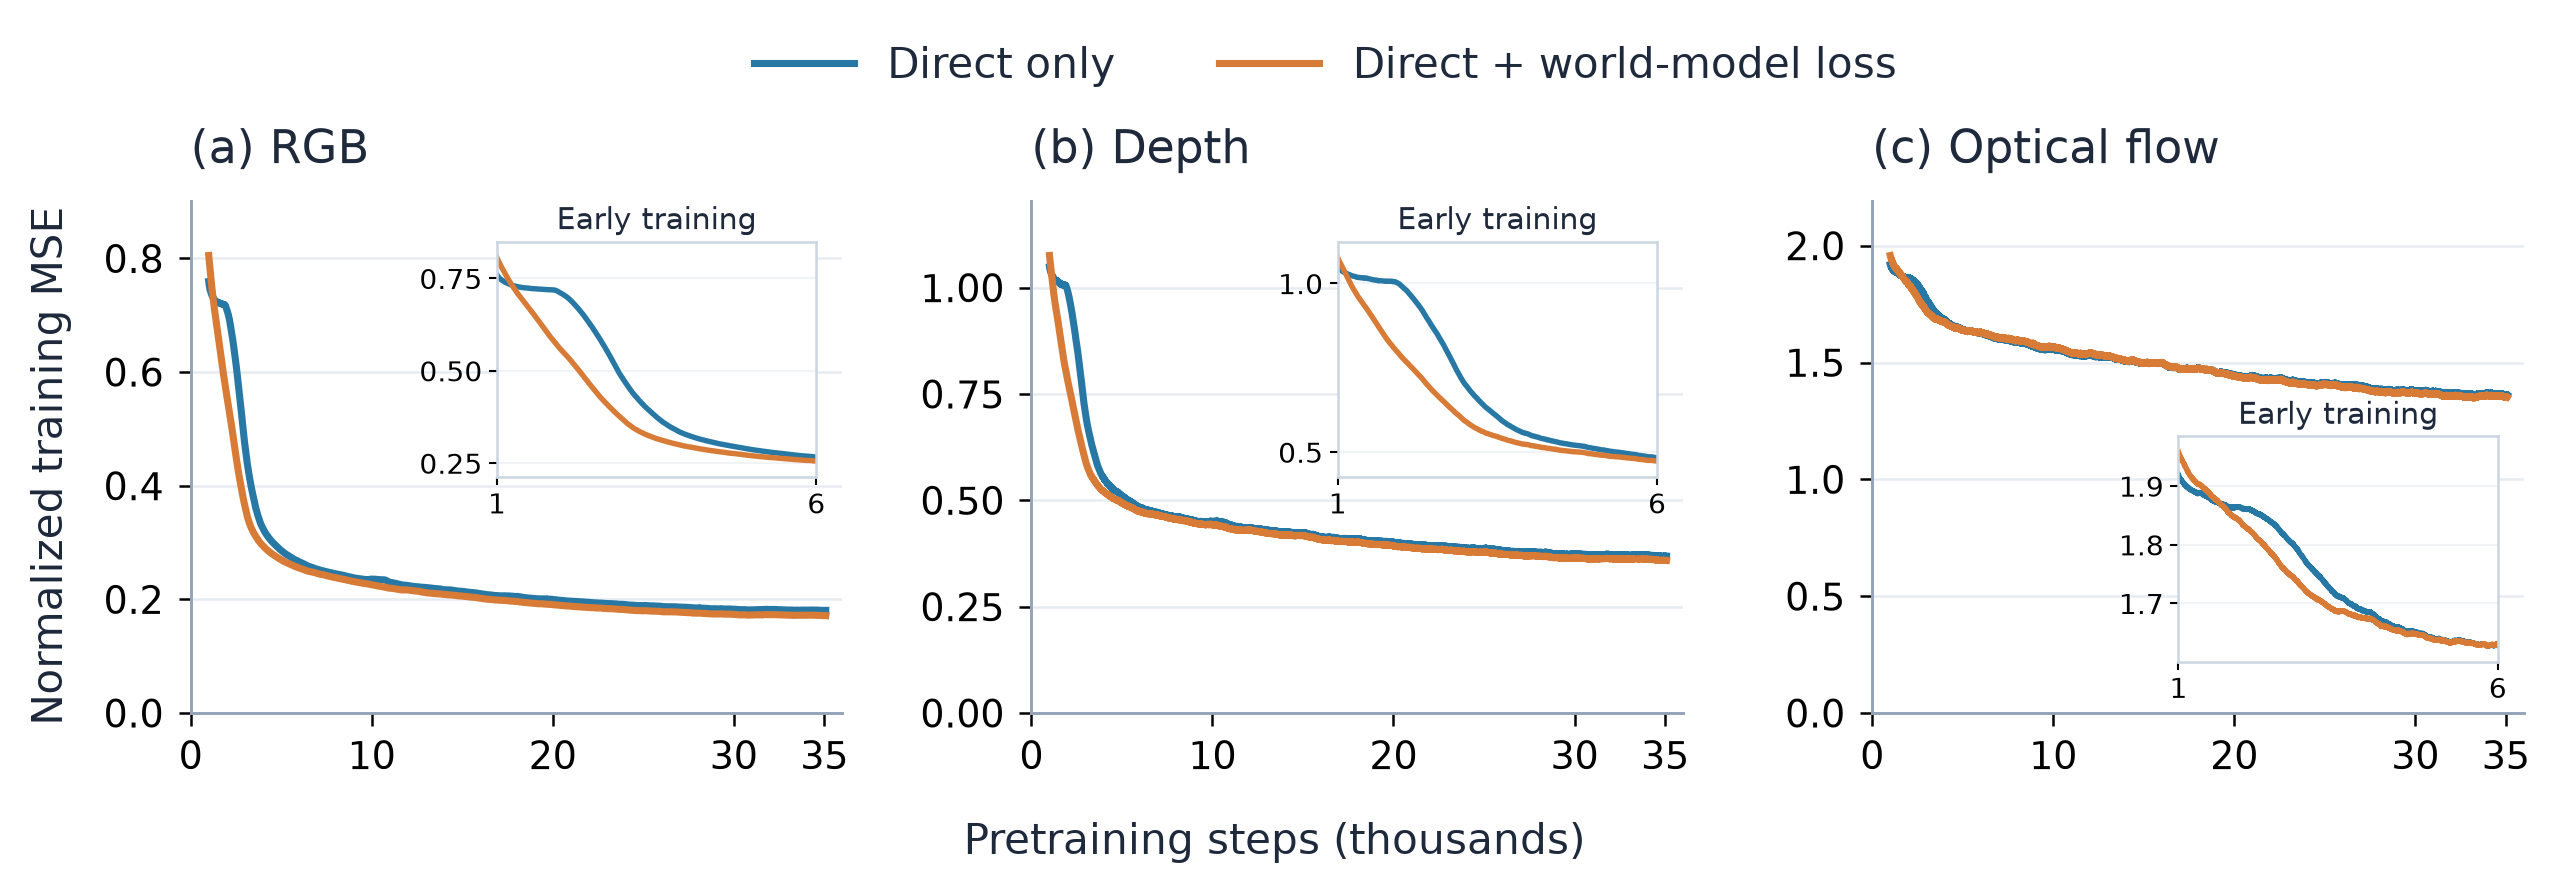
world modelによる補助事前学習は、未来のRGB・深度・フロー潜在表現の予測において、直接予測のみと比較して一貫して低い正規化MSEをもたらしており、挿入図ではそのギャップが早期(更新1k〜6kステップ)に生じることが示されています。追加のablationでは、サブタスクconditioningの頻度、補助的な未来の物体姿勢supervision、およびECoTを学習時のみに使用するか推論時の生成にも使用するかが検討されています。本文中では各要素が行動の成功率に寄与すると主張されていますが、正確な差分はここでは示されていない付録セクションに記載されています。
限界と未解決の問題
結果は4つのベンチマーク上のシミュレーションに限定されており、実ロボットでの評価は報告されていません。学習コーパスが実ロボットおよびUMIデータで占められていることを考えると、これは特に注目すべき点です。物理トークンは特定のビデオスタック(Wan VAE、DA3深度、DPFlow光学フロー)からVAEエンコードされた潜在表現に対して監視されますが、これらの擬似ラベルの品質がダイナミクス表現の品質をどの程度規定するかは不明であり、ピクセル空間ターゲットや代替エンコーダとの比較も報告されていません。補助supervisionに使用される凍結済みworld modelはプロプライエタリ(LingBot-Video)であり、再現を困難にしています。最後に、本論文はビデオを実際にロールアウトするVLAとの推論時レイテンシの比較数値を報告していないため、レイテンシとダイナミクスのトレードオフという中心的な主張はアーキテクチャ上の議論にとどまり、実測されていません。
意義
PDRVLAは「world modelを表現学習器として使用し、オンライン予測器としては使用しない」というアプローチを具体化しています。すなわち、未来のRGB・深度・フロー予測をコンパクなトークン列に蒸留してpolicyに与えることで、ビデオ生成のレイテンシを回避しながら、明示的なダイナミクス特徴で行動conditioningを実現します。ablationの傾向が実ハードウェアでも成立するならば、推論コストを支払わずにVLAへ物理的な事前知識を注入するための汎用的なレシピが示唆されます。
Source: https://arxiv.org/abs/2610.37381
Hy-Nomas: 自由形式のインタラクティブ世界生成に向けて
インタラクティブな世界モデルは、標準的な動画生成器では実現できない二つの要件を満たす必要があります:(i) 任意のタイミングで到着する自由形式の指示ストリームに対する一貫した応答、および (ii) ある場所を再訪したときに一貫したジオメトリとコンテンツが得られるような永続的な世界状態の維持です。Hy-Nomas は HunyuanVideo 1.5 を基盤として構築された 8B の diffusion transformer であり、現在のテキスト/カメラ指示と過去のすべてのセグメントの KV cache を条件として、可変長の動画セグメントを自己回帰的に生成することで、この両要件に対処します。
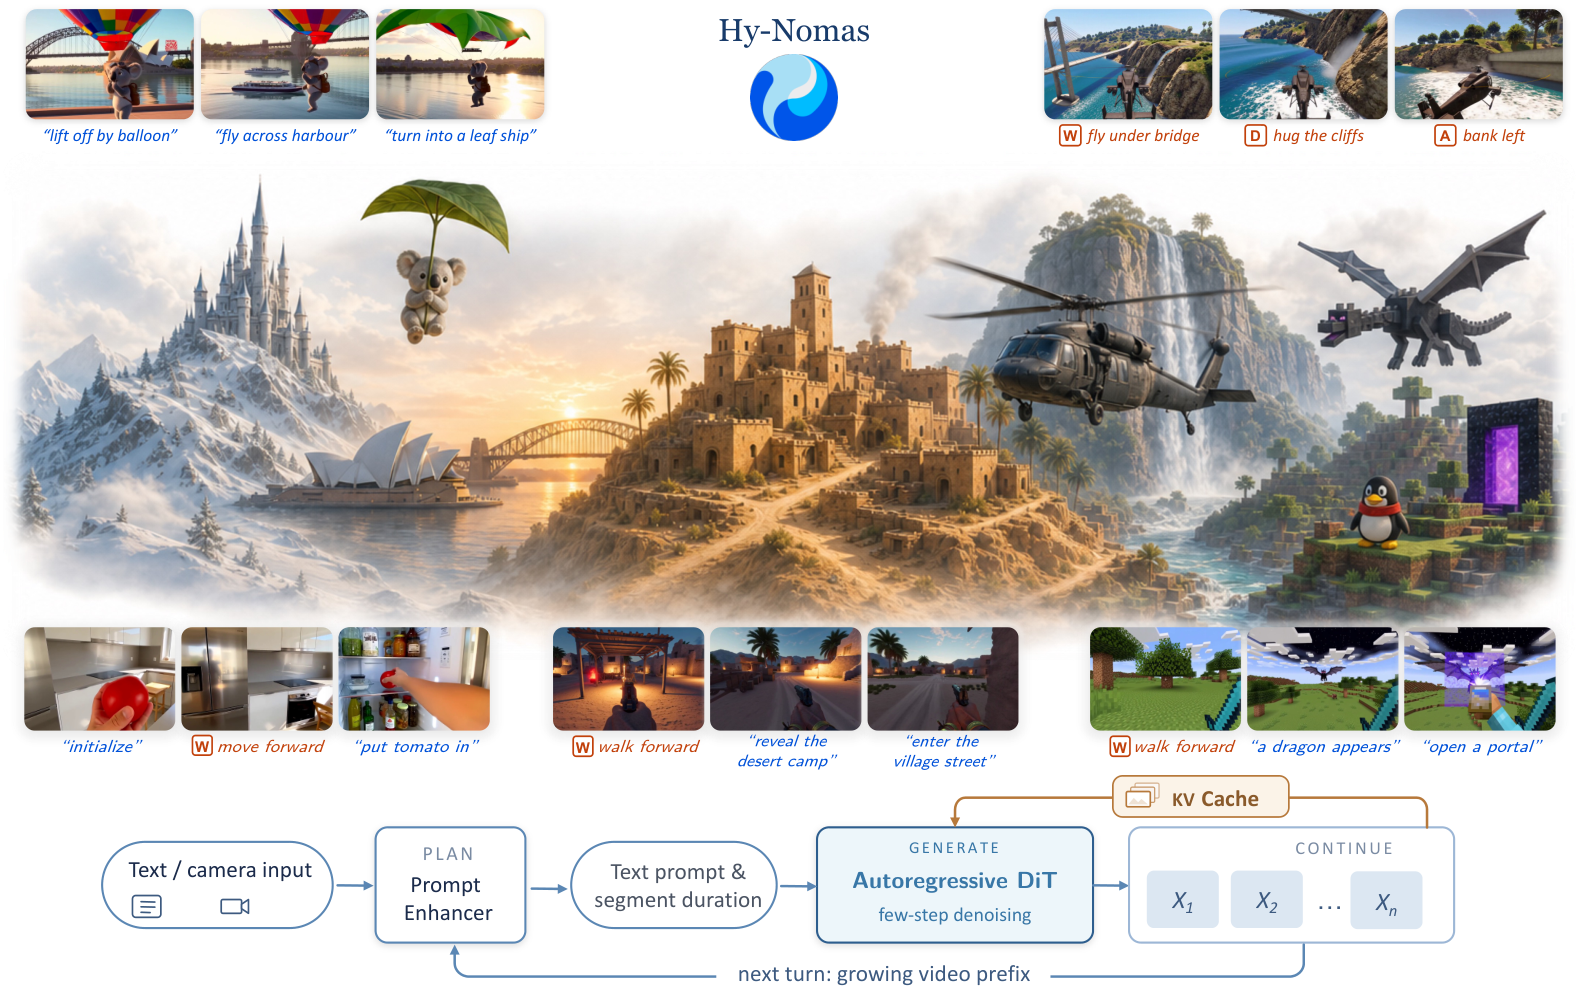
アーキテクチャ
バックボーンは、隠れ幅 2048(MLP 8192)、次元 128 の 16 attention head、および (T, H, W) に対して (16, 56, 56) で割り当てられた 3D RoPE を持つ 54 ブロックのデュアルストリーム MMDiT です。動画は DCAE-V によって空間方向に 32\times、時間方向に 4\times 圧縮され、32チャンネルの latent に符号化されます:
Z = \mathcal{E}(X) \in \mathbb{R}^{B \times 32 \times F_z \times H_z \times W_z}, \quad F_z = \lfloor (F-1)/4 \rfloor + 1.
各 latent ボクセルはトークン(パッチサイズ 1\times 1\times 1)として DiT に射影されます。テキストは凍結された Qwen2.5-VL-7B から得られます。DiT は latent 空間におけるフロー速度を予測します。
モデルにインタラクティブな性質を与える二つのメカニズムを以下に示します:
セグメント単位/行動認識因果 attention。 セグメント内では attention は双方向であり、セグメント間では因果的です — セグメント t のトークンは現在および過去のセグメントにのみ attention します。さらに、行動認識マスキングにより、行動を含む指示トークンはその行動を実行するセグメントの時間ウィンドウに限定されますが、記述的なコンテキスト(主語、環境、スタイル)は後続のすべてのセグメントから参照可能です。これにより「永続的な世界記述」と「ターンごとの行動」が分離され、著者らはこれが行動順序エラーや過去の行動の不正な繰り返しを回避するための鍵であると指摘しています。
カメラ cross-attention。 各 MMDiT ブロック内の専用 cross-attention モジュールは、動画特徴をクエリとして使用し、フレームに対応したカメラトークン(64 次元グループ化外部パラメータ、幅 1024、16 head)をキー/バリューとして使用します。カメラ制御はテキストと連結されるのではなく、ブロックごとに注入されるため、言語ストリームに依存しない連続軌跡条件付けが可能となります。
ロールアウト中、生成された各セグメントのテキストおよび動画の KV は保持され、後続のセグメントは現在のプロンプト、オプションのカメラ軌跡、およびこのキャッシュを条件としてガウスノイズからデノイズされます。
学習カリキュラム
Hy-Nomas は、双方向 DiT を因果的なものに変換することで生成され、三つのカリキュラムに沿って整理された五段階で構成されます:
- 因果的: セグメント単位の因果 attention → 行動認識因果 attention → セグメント強制(学習時に不完全な履歴に晒すため、モデル自身のキャッシュされた予測で学習する)→ 少ステップサンプリングのための diffusion distillation。
- インタラクション: テキストのみ → テキスト+カメラ → インターリーブ。
- コンテキスト長: 段階的に拡大;パックされたシーケンスは 360K トークンに達する。
インフラストラクチャは、N_{\text{SP}} = 8(最大長で約 45K トークン/ランク)の Ulysses シーケンス並列化、各 SP グループ内での FSDP2 ハイブリッドシャーディング、グループ間の DP、異種セグメント/行動マスクに対応したマスク柔軟な attention カーネル、分散 Muon オプティマイザ、および FLOPs バランスパッキングを使用しています。
Prompt Enhancer
ユーザーの指示は、DiT が学習した構造化されたキャプション形式であることはほとんどありません。VLM ベースの Prompt Enhancer(PE)がそれらを書き換えます。ターン t において:
y_t \sim p_\theta(\cdot \mid S, u_t, H_{t-1}, V_{<t}, m_t),
ここで S はシステムプロンプト、u_t は生のユーザー入力、m_t は書き換えモード(テキスト/カメラ/インターリーブ)、H_{t-1} は過去の対話履歴、V_{<t} は VLM が観察した生成済み動画セグメントです。最初のターンでは密な構造化キャプション(主語、環境、行動、説明)を出力し、後続のターンでは説明の変更と新しい行動を出力するため、キャプションのドリフトは全体の書き直しではなく差分によって抑制されます。
評価
著者らは Hy-Nomas-Bench をリリースしています:これは四つのベンチマークにわたる 280 ケースで構成されており — マルチターン自由形式テキスト、カメラナビゲーション、インターリーブされたテキスト+カメラ、および空間記憶 — フォトリアリスティック、ゲーム風、アニメーション風スタイルにわたる一人称/二人称/三人称および観察者視点を含みます。制御入力はテキスト、二値キー状態 [T,8](WASD+矢印キー)、またはフレームごとの 4\times 4 カメラ-ワールド行列 [T,4,4] として統一されています。多くのケースでは、世界のリセットなしに 60 秒を超える連続生成が要求されます。
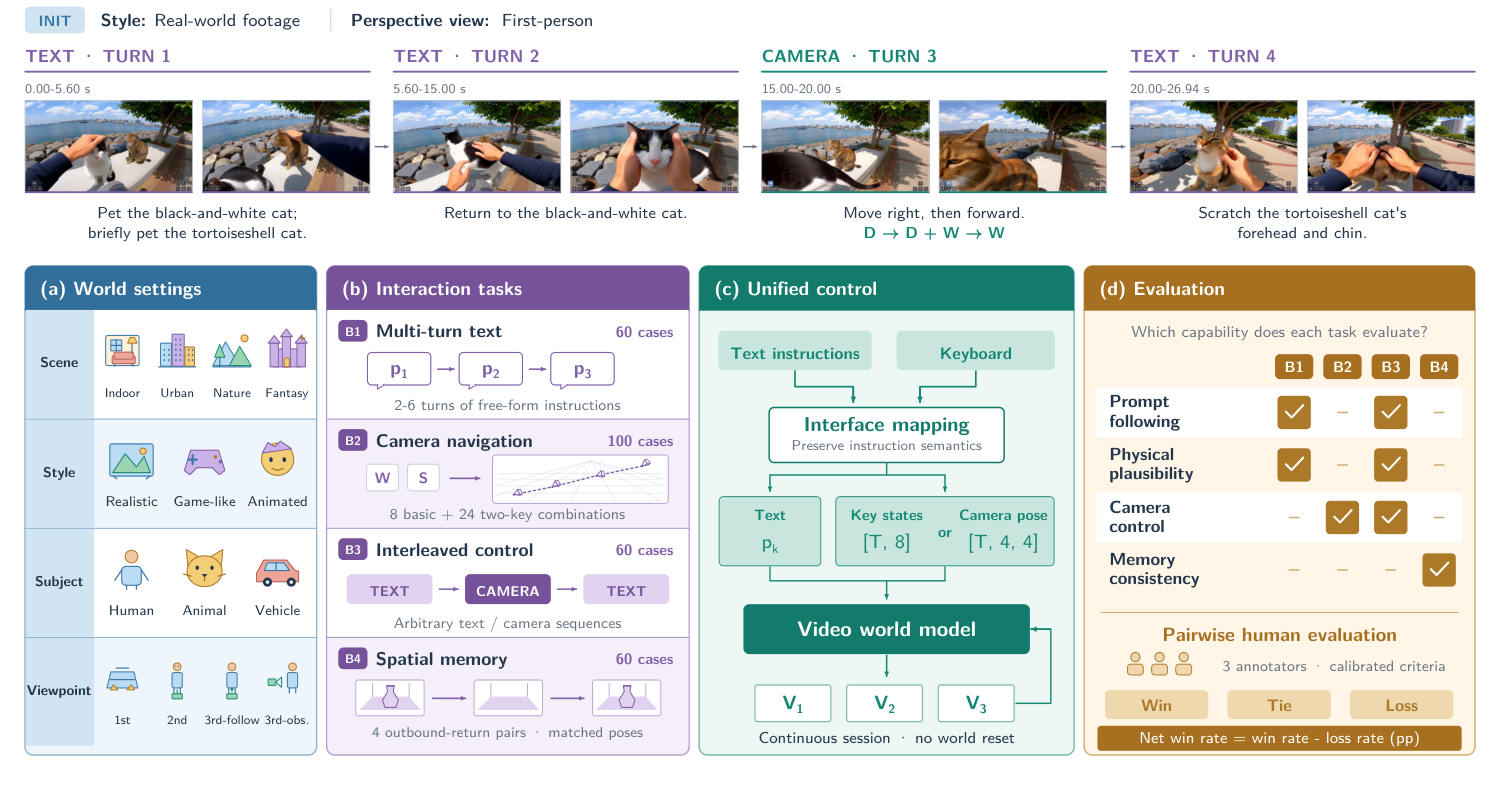
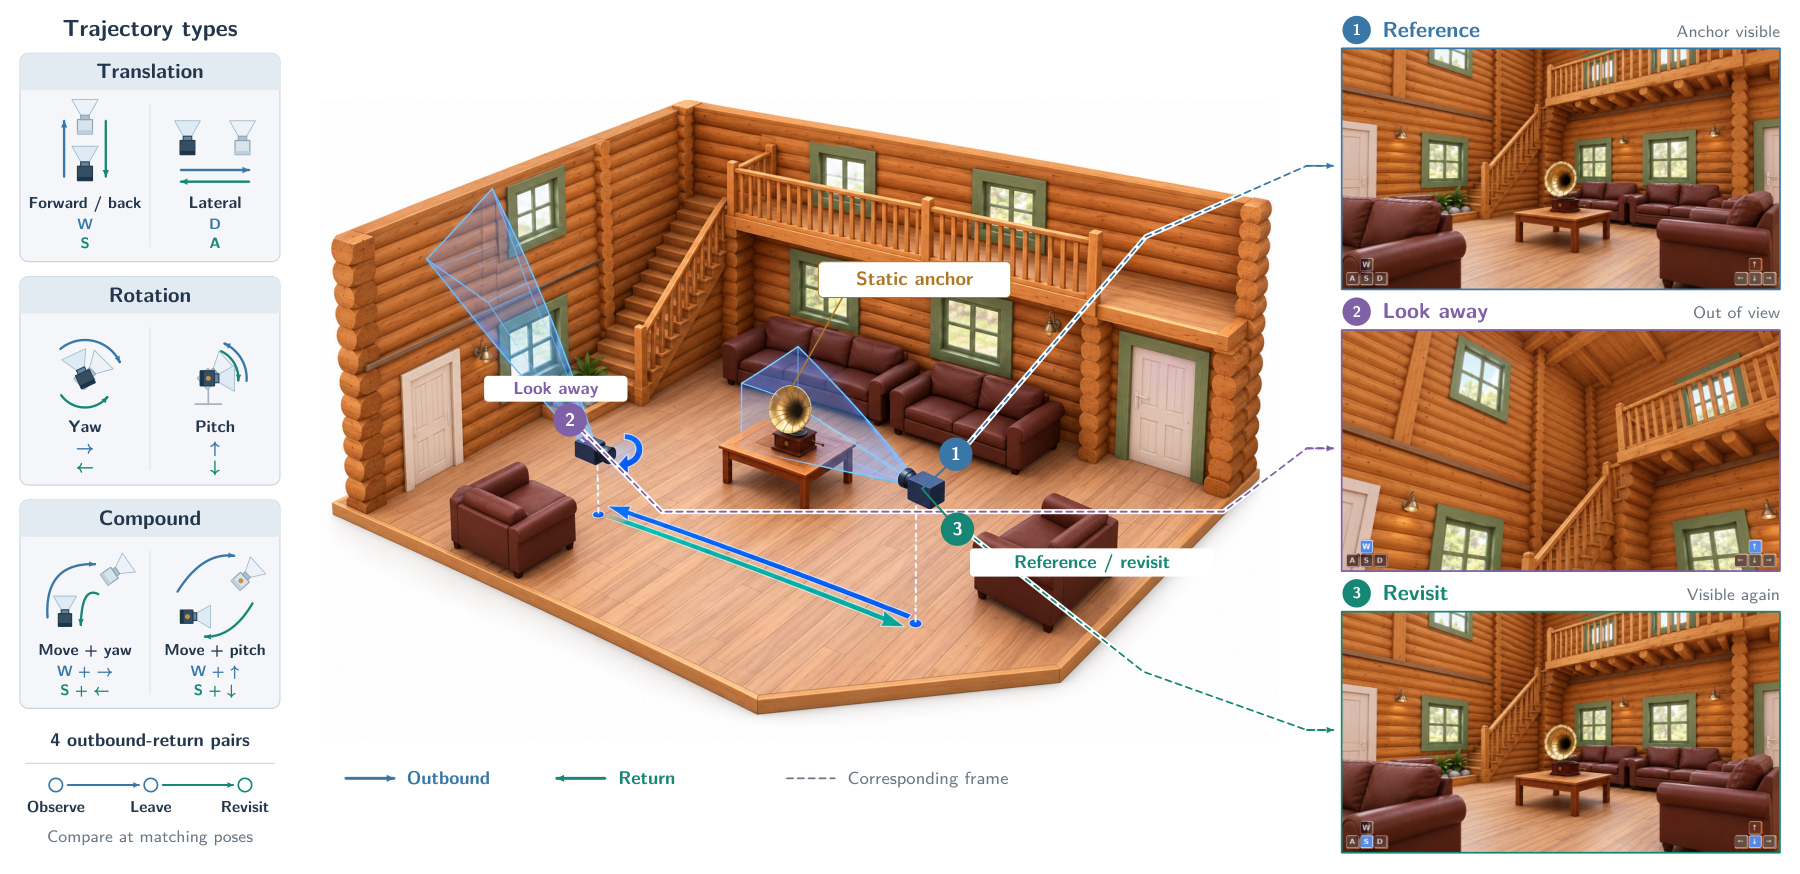
四つの評価軸は、三名のアノテーターによるペアワイズ比較によって判定されます:プロンプト追従性、物理的妥当性、カメラ制御、記憶一貫性。ベースラインは Genie 3、LingBot-World v2、および Happy Oyster です。論文では、これらの次元にわたる正味勝率において Hy-Nomas が勝利していることが報告されており、記憶一貫性が行動認識因果 attention とセグメント強制に最も明確に帰属できる差別化要因となっています。空間記憶ベンチマーク(Bench-4)は特に診断的であり、各ケースは静的なアンカーオブジェクトと四つの往復軌跡ペアを使用しているため、外観品質とは独立してオブジェクトの永続性とレイアウトの一貫性を採点することができます。
制限と未解決の問題
本論文は Hy-Nomas-Bench における自動メトリクスではなく人手によるペアワイズ比較を報告しています — 標準的な FVD スタイルのスコアが記憶や制御を捉えられないことを考えれば正当ではありますが、アノテータープールなしには比較を再現することが困難です。長期のインタラクションにわたる KV cache の成長については対処されていません:360K トークンの学習パッキングにおいて、数時間のロールアウトにはキャッシュ圧縮や退去ポリシーが必要になります。カメラ制御は外部パラメータの表現に限定されており、動的な焦点距離やセンサー効果は対象外です。最後に、ここでの「記憶」は永続的なシーン表現ではなく KV cache に暗黙的に存在するため、学習したセグメント数の範囲を超えると一貫性が低下する可能性があります。
この研究の意義
Hy-Nomas は、標準的な動画 DiT が別のシーン記憶モジュールなしにインタラクティブな世界モデルとして動作することを可能にする二つの構造的選択 — 行動スコープの因果マスキングと、学習時のモデル自身のキャッシュ済み履歴への露出 — を明確に示しています。公開された重み、ベンチマーク、および適応レシピにより、これは自由形式インタラクティブ生成の Genie-3 水準における数少ないオープンな成果物の一つとなっています。
Source: https://arxiv.org/abs/2610.36729
Memory Tax: エージェントメモリの実質的価値の解剖
問題設定
長期エージェントは、インタラクション履歴 \mathcal{H}=\{h_1,\dots,h_T\} を永続的な表現 \mathcal{M}=I(\mathcal{H}) に取り込み、\hat{y}=G(q, R(q,\mathcal{M})) によってクエリに応答する専用メモリシステム(フラットストア、階層型・ライフサイクル管理、知識グラフ、学習済み検索ポリシーなど)にますます依存するようになっています。暗黙の前提として、構造化メモリは生の履歴に対するチャンクベースのRAGを上回るとされています。本論文はこの前提を大規模に検証し、しばしば誤りであることを示します。著者らはナイーブなRAGを基準とした、クエリごとの参照依存量である memory benefit(メモリの恩恵)と memory tax(メモリのコスト)という2つの概念を中心にした設計の問いを再定式化し、これらこそ研究すべき対象であると主張します。
ベンチマーク結果
11のメモリシステムを、Qwen3.5-4B、Qwen3.6-27B、GPT-5.6 Luna のバックボーンを用いて LongMemEval-s、PersonaMem-v2、MINT-Eval で評価しています。2ラウンドのRAG(RAG 2rd)を基準とします。主要な結果として、ほぼすべての専用メモリシステムが、ほぼすべての(ベンチマーク、バックボーン)の組み合わせにおいてRAG 2rdを下回っています。LongMemEval-s(Qwen3.6-27B)では、RAG 2rdが81.4を記録する一方、MemOSは76.6(-4.8)、MemoryOSは73.4(-8.0)、OpenVikingは58.8(-22.6)、MAGMAは68.2(-13.2)にとどまっています。同バックボーンのMINT-Evalでは、RAG 2rdが33.1であるのに対し、ほとんどのシステムは19〜27の範囲に位置し、PlugMem(33.3)のみが匹敵する結果を示しています。GPT-5.6 lunaでも同様のパターンが見られます:LongMemEval-sでRAG 2rdが90.0であるのに対し、最良のメモリシステムであるA-Memは84.0です。gold-contextの上限値(LongMemEval-sで73.4 / 84.6 / 92.8)は、RAGが完全には捉えられない相当な検索のヘッドルームが依然として存在することを示していますが、メモリシステムもそのギャップを埋めるどころか、さらに遠ざかっています。
実質価値の分解
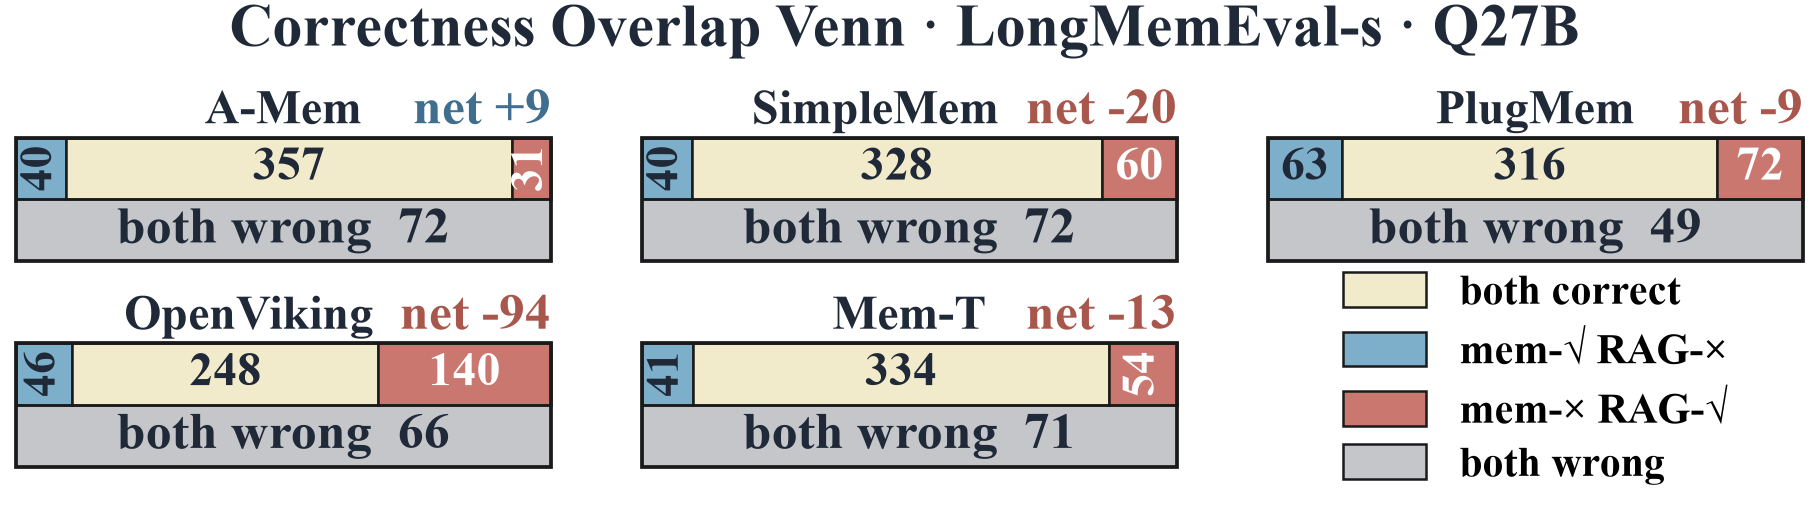
各クエリについて、結果は4つのセルのいずれかに分類されます:両方正解、RAGのみ正解(memory tax)、メモリのみ正解(memory benefit)、両方不正解。Vennの内訳から、ほとんどのシステムで「RAGのみ正解」の集合が「メモリのみ正解」の集合と同等か、それより大きいことが明確になります——すなわち、メモリは追加するシグナルと同程度のシグナルを破壊しています。著者らは両側の原因を同一に帰します:I(\cdot) は必然的に \mathcal{H} から逸脱(要約、事実抽出、グラフ構築、ライフサイクル刈り込み)し、その逸脱は両刃の剣となります。恩恵は再構成・集約・嗜好蒸留から生じ、コストは証拠が欠落・曖昧化・検索困難化されることから生じます。
コストの発生源
アクセス障害と情報損失を分離するために、著者らは各システムの gold facts に対して損失度合いのアノテーションを付与しています:損失なし(NL)、部分的損失(PL)、大幅損失(ML)、対応するメモリユニットなし(NU)。結果は明確に異なります:MemoryOSはNLを98.4%保持し、MAGMAは93.6%、MemOSは85.8%であるのに対し、OpenVikingはNLが39.4%にとどまり、NUが38.0%——すなわち、関連する事実の3分の1以上に格納ユニットが全く存在しません。これがOpenVikingの -22.6 から -40.4 に及ぶ性能低下を直接説明しています。
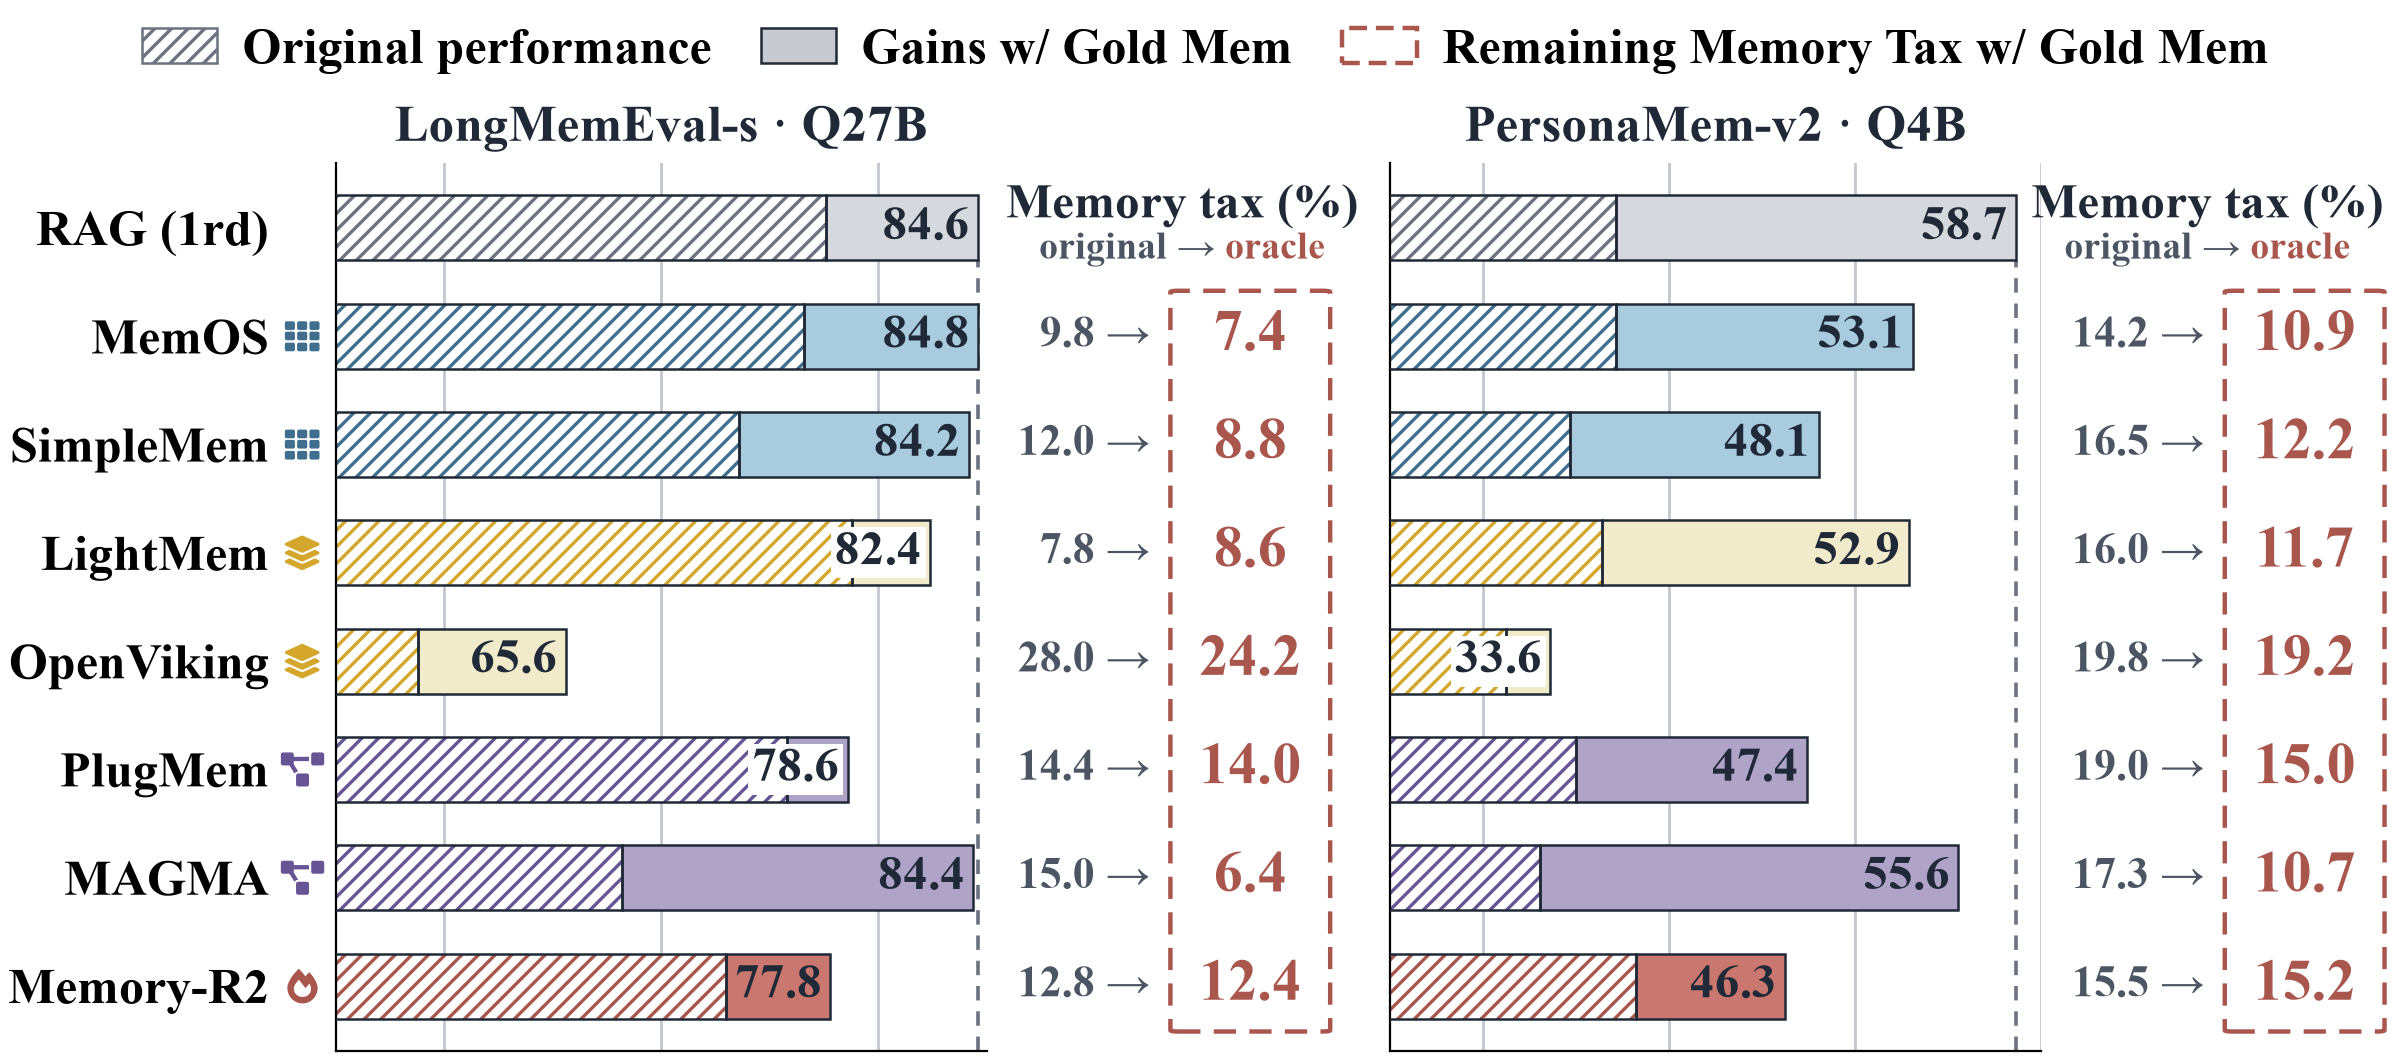
gold memory unitを注入した場合でも相当のコストが残ることから、構築側の情報損失は問題の一部にすぎず、メモリへのアクセス方法そのものに固有のコストが存在することが示されています。
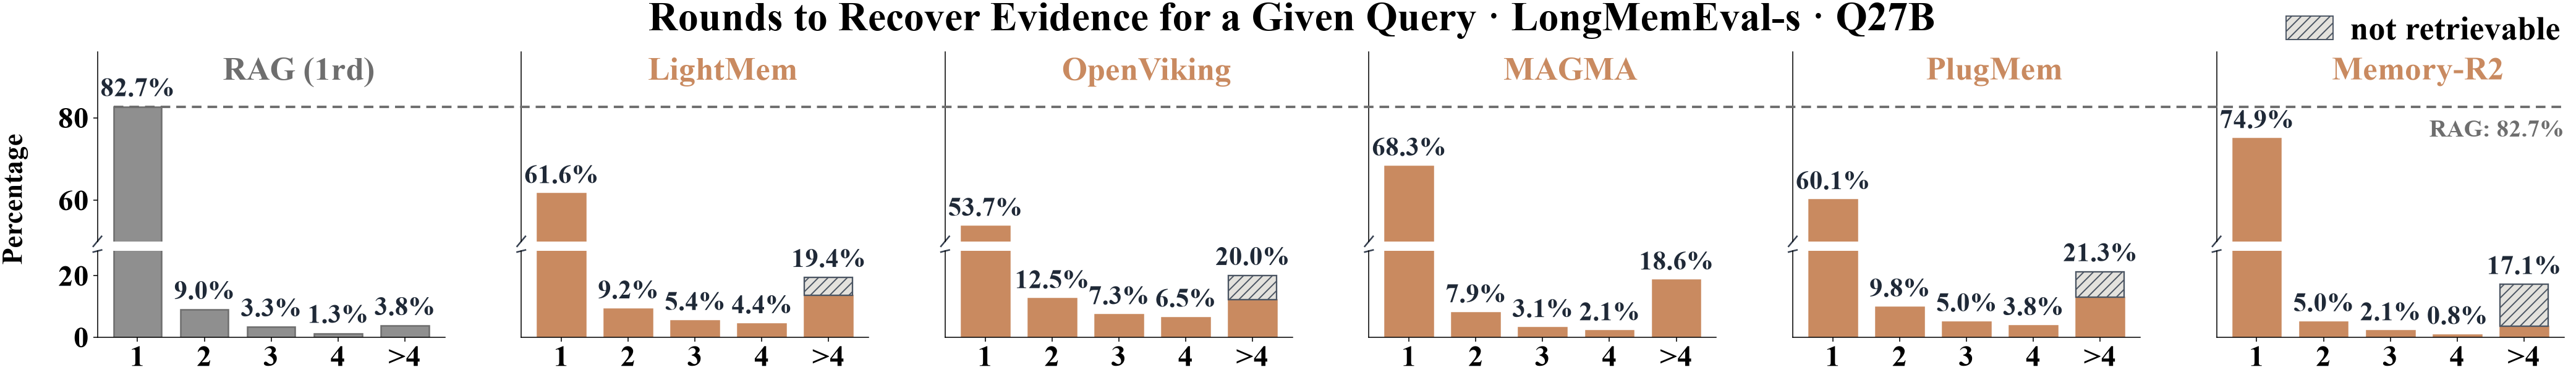
検索を再現すると、メモリユニットは同じ証拠を表面化するために生チャンクよりも多くのラウンドを要することが多いことがわかります。圧縮と再フォーマットにより語彙的・意味的表面が変化し、自然なクエリ q が格納された形式にマッチしなくなり、証拠が運用予算内では到達できないより深い検索階層へと押しやられます。
汎化と設計への示唆
benefit–taxの分解は対話型メモリを超えて拡張されます。経験的メモリベンチマーク(ALFWorld、WebShop、Mind2Web、BigCodeBench、AppWorld、\tau^2-Bench)では、ワークフロー蒸留(ReasoningBank、SkillPro)がウェブタスクでナイーブな軌跡RAGを上回りますが、ツール使用タスクでは同様のtaxパターンが見られます——メモリはその逸脱がクエリ構造にどれほど適合しているかに依存します。
本論文は新しいアーキテクチャを必要としない3つのコストの低い緩和策を提案します:
- 回復可能な逸脱。 \mathcal{M} と並行してソース \mathcal{H} からも検索し、統合して再ランク付けを行います。これにより I によって消去・曖昧化された証拠が復元され、システム全体でコストが低減されます。
- 自己参照型メモリ。 過去のクエリ、検索された証拠、検索パスを新たなメモリユニットとして扱います——「どのように記憶するかを記憶する」というアプローチです。深いラウンドの証拠が類似する将来のクエリに直接アクセス可能となり、クエリ間のtest-time-scalingの軸が生まれます。
- 将来の需要のモデル化。 純粋な事前構築(コストが高く、情報が不足)やジャストインタイム(ユーザー向けのレイテンシ)に限らず、ユーザーの興味・習慣に関する事前確率を用いて I が行う逸脱を誘導します。
限界と未解決問題
分解はナイーブなRAGを基準とした参照依存であり、より強力な検索ベースライン(ハイブリッド型、学習済み再ランカー)を使用するとtax/benefitの分布が変化します。事実損失アノテーションはサンプリングによるものであり、NUが多いシステムにおける系統的損失を過小評価している可能性があります。緩和策は概念実証であり、チューニングされたシステムではありません。「将来の需要のモデル化」の方向性はほぼプログラム論的なままです。また、本論文は \text{tax}(q) と \text{benefit}(q) をクエリ分布下の期待値として形式化していません。これらを診断ツールではなく最適化目標とするには、そのような形式化が必要となります。
なぜ重要か
この分野では、構造化エージェントメモリが生の履歴検索に対して純粋に加算的であると仮定されてきましたが、本論文は現在のほとんどのシステムにおいてその仮定が無視できないコストをともなって失敗することを示しています。回復可能な逸脱と自己参照型検索によってRAGに対するコストを最小化することを中心にメモリ設計を組み立てることは、次世代のメモリアーキテクチャに対して具体的かつ測定可能な目標を与えます。
Source: https://arxiv.org/abs/2610.34073
Hacker News Signals
Show HN: Hob - Claude CoworkやChatGPTに対するオープンソースのオンデバイス代替
Hobは、推論をすべてデバイス上で実行するローカルファーストのAIワークスペースであり、クラウドベースのコーディングアシスタントへの対抗を掲げています。アーキテクチャはローカルで提供されるモデル(OllamaまたはCompatibleなバックエンド経由)に依存しており、エージェンティックなタスク(ファイルの読み書き、シェル実行、プロジェクトコンテキスト管理)のためのchat-plus-toolインターフェースを公開しています。リポジトリはNext.jsフロントエンドと、ローカルの推論エンドポイントにプロキシするNodeバックエンドの上に構築されており、モデルをpullした後はアウトバウンドのネットワーク通信なしでスタック全体が動作します。
注目すべき技術的な内容として、Hobはプロジェクトファイルをチャンク化し、ローカルで実行する軽量なembedding類似度検索に基づいて関連スニペットを注入するコンテキストウィンドウ戦略を実装しています。これにより、コードベースをサードパーティのAPIに送信するというプライバシー上の懸念を回避しており、GitHub CopilotやCursorのクラウドモードとの主要な差別化点となっています。tool-callループは標準的なパターンに従っています。モデルが構造化されたJSON形式のtool invocationを出力し、ホストがそれを実行し、結果がconversation contextに追記され、モデルが最終的なレスポンスを出力するまで繰り返されます。
制約も現実として存在します。オンデバイスの推論品質は、量子化されたモデル(コンシューマーハードウェアでは一般的に7B〜34Bパラメータの範囲)がフロンティアAPIと比較して何を達成できるかによって制限されます。長いコンテキストにおけるcoherenceは小さなモデルほど早く劣化し、embeddingベースの検索は適切なAST対応のコードインデックスの代替にはなりません。tree-sitterの統合については言及がないため、セマンティックなチャンキングはテキストベースとなっており、大規模なポリグロットプロジェクトでは品質の低いコンテキストが生成される可能性があります。
データレジデンシー要件やエアギャップ開発環境を持つチームにとって、このアーキテクチャは堅実です。オープンソースのリリースにより、コンテキスト注入パイプラインを監査・拡張することが可能です。クラウドアシスタントとの能力差を埋められるかどうかは、ほぼすべてローカルハードウェアとモデルの選択に依存します。
Source: https://github.com/FrigadeHQ/hob
Zigを使った4ヶ月間
本記事は、Zigをシステム言語として数ヶ月間にわたりメインで使用した実践者による詳細なレポートです。おもちゃのベンチマークではなく、継続的な実用における言語の実際のエルゴノミクスを取り上げています。Zigをプロダクションのシステム開発に採用するか検討している方にとって、技術的に中身のある読み物です。
著者の主な観察点:Zigのcomptimeシステムは本質的に強力ですが、概念的なオーバーヘッドが大きいです。C++のtemplateやRustのgenericsとは異なり、comptimeはコンパイル時に任意のZigコードを実行します。つまり、別のメタ言語ではなく同じ言語を使うため、型レベルのプログラミングやコード生成がランタイムのコードと均一に扱えます。実践的な結果として、メンタルモデルが定着すればジェネリックなデータ構造やコンパイル時の設定はエルゴノミックになる一方、comptime失敗時のエラーメッセージは依然として不可解で、ユーザーのコードに対応付けるのが困難です。
GCを持たないメモリ管理では、Zigの慣例に従いアロケータを関数引数として渡す形で、API全体にわたって明示的なアロケータのスレッディングが必要になります。著者はライブラリコードではこれを許容できると感じる一方、アプリケーションレベルのグルーコードには冗長と感じています。アロケータインターフェース自体はクリーンで(vtableベースのstd.mem.Allocator)、ユニットテストでリークを検出するためのテスト用アロケータへの差し替えは実用上の利点です。
ビルドシステム(build.zig)は、クロスコンパイルのシナリオにおいてCMakeや類似ツールに比べて真に優れていると評価されています。ZigのツールチェーンはCコンパイラと複数ターゲット向けのlibcをバンドルしており、1つのホストからのクロスコンパイルをほぼ手軽に実現できます。これは、より多くの外部ツールを必要とするRustのクロスコンパイル事情に対して、具体的なシステムエンジニアリング上の優位点です。
問題点としては、標準ライブラリがまだ不完全なこと、評価期間中にマイナーバージョン間でいくつかのAPIが変更されたこと、安定したABIが存在しないためライブラリのバージョニングが自明ではないことが挙げられています。明示的なエラーユニオンによるエラーハンドリングは、例外ベースのシステムよりも誠実であると称賛される一方、深くネストされたコールチェーンではすべてのエラーセットをアノテートする要件が機械的な作業となってしまいます。
Source: https://gracefulliberty.com/articles/four-months-of-zig/
警察が「不審な」行動を理由にドライバーを停車させるためにAIを活用している
説明されている技術システムは、固定された場所またはパトロール車両に搭載されたAI搭載監視カメラが、行動パターン(異常なルート、特定の場所周辺でのうろつき、繰り返しの通過、または総合的な移動シグネチャ)に基づいて車両にフラグを立てるものです。出力は、直接的な自動執行アクションではなく、警察官が対応できるリスクスコアまたはアラートです。
基盤となるcomputer visionパイプラインには、マルチオブジェクト追跡(例:SORT、DeepSORT、またはtransformerベースの派生手法)、カメラネットワーク全体にわたる車両再識別、および何らかの形の軌跡異常検出が含まれていると考えられます。軌跡異常モデルは通常、過去の「正常な」移動パターンを用いて学習されており、閾値を超える逸脱がアラートとして表面化します。これはビデオ解析において十分に研究された問題であり、Motorola Solutions(VideoIQ)、Axon、Rekorといった企業によって商業的に製品化されています。
核心的な技術的懸念は分布的なものです。「不審な」行動を構成するものは学習データによって操作的に定義されますが、そのデータは過去のパトロールパターンおよび停車記録を反映しており、それ自体が既知の人口統計学的バイアスを持つ過去の人間の意思決定の産物です。学習セットが特定の地域や人口統計に対する過剰な取り締まりを符号化している場合、モデルはそれらのパターンを正常/異常として学習し、アルゴリズム的客観性という外見のもとでそれを大規模に再現します。
これらのシステムのPrecisionとRecallは公開されていません。False positive rateは特に重要です。なぜなら、各false positiveは交通停止を引き起こし、それは個人的・制度的に無視できないコストをもたらすからです。米国には法執行AIに対する標準化された監査フレームワークが存在しません。導入の意思決定はIRBに相当する監督なしに行われており、モデルは一般に、公開された技術文書を持たないベンダーのブラックボックスです。
Source: https://gizmodo.com/police-are-using-ai-to-pull-over-drivers-for-suspicious-behavior-2000831220
AnthropicがスタンフォードProfessorsの書籍を不法入手してClaudeを訓練していた
スタンフォード・デイリーの報道によると、スタンフォード教員が執筆した書籍がBooks3データセットに含まれており、このデータセットはClaudeの訓練データの一部として特定されています。Books3は、プライベートトラッカーであるBibliotikからスクレイピングされた約196,000冊の書籍からなるコーパスであり、著者や出版社の同意を得ることなく取得・配布されたため、標準的な著作権分析の下では侵害に該当します。
技術的背景として、Books3は業界全体で広く使用されており、Pile(EleutherAI)にも含まれ、さまざまなオープンソースおよび商用モデルの訓練に用いられてきました。Anthropicにとっての具体的な法的問題は、侵害素材を含む派生コーパスでの訓練が直接侵害または寄与侵害を構成するかどうかという点です。Authors Guild v. Google事件(インデックス作成とスニペット表示に関するもの)で適用されたフェアユースの抗弁は、モデル訓練のための逐語的な取り込みには直接的に適用されるわけではありませんが、判例法は現在も複数の係属中の訴訟(Kadrey v. MetaおよびNYT v. OpenAI事件を含む)において争われています。
技術的観点から見ると、モデルが特定の訓練文書を「記憶」するのか「汎化」するのかという問題は実証的な問いであり、membership inference attacksにより、大規模言語モデルは訓練データから抽出可能な情報を保持していること、特に繰り返し出現する独自性の高いテキストに対してはその傾向が顕著であることが示されています。これは損害賠償の問題にも関連します。
より広いエンジニアリング的含意として、インターネット規模のコーパスで基盤モデルを訓練する組織は、データの出所に関して概ね「まず動いて、訴訟は後で対応する」というアプローチをとってきました。本件は、大学が著作権の帰属に関して明確な当事者適格と文書証拠を持つという形で、機関的な圧力が高まっていることを示しており、今後の訓練において、より厳格なデータ監査パイプラインの構築を迫ることになるでしょう。
Source: https://stanforddaily.com/2026/10/27/professors-books-pirated-to-train-claude/
マイクロソフトなど複数企業、自社株のトークン化を行う暗号資産プラットフォームに中止要求
複数の大企業が、ある暗号資産プラットフォーム(Robinhood のEUトークン化株式プロダクトおよび類似プラットフォームと報じられている)に対し、停止・廃止(cease-and-desist)の書簡を送付しました。当該プラットフォームは、株式への合成的エクスポージャーを表すブロックチェーントークンの発行を試みていました。問題とされている技術的な仕組みは、オフチェーンの価格オラクル、過剰担保リザーブ、およびスマートコントラクトの償還ロジックを組み合わせることで、その価値が原資産の株価に連動するオンチェーン金融商品を生成するというものです。
法的な異議申し立ての要旨は明快です。企業の株式を表示または模倣する金融商品の発行は証券法に抵触し、発行体の同意が必要とされます。各企業は、自社株の無許可の合成的表現がパーミッションレスなチェーン上に流通することを望んでいません。なぜなら、それが株主権に関する曖昧さを生み出し、キャップテーブルのガバナンスを複雑化し、未登録証券に関する法的責任を引き起こす可能性があるからです。
これらのプラットフォームが採用する技術アーキテクチャは、一般的に合成資産パターンに従っています。価格オラクル(例:Chainlink)が現在の株価をオンチェーンに供給し、ユーザーはステーブルコインまたはETHを担保としてスマートコントラクトにデポジットします。そのコントラクトが、オラクル価格に連動した償還価値を持つトークンをミントする仕組みです。実際の株式は一切保有されておらず、エクスポージャーは純粋に合成的なものであり、カウンターパーティリスクは担保プールとオラクルの完全性に依存します。デペッグリスク、オラクル操作、および担保清算のカスケードが主要な障害モードとなります。
エンジニアリングの観点から見て興味深い点は、これらのシステムは技術的には実現可能である(スマートコントラクトのロジック自体は新規性がない)にもかかわらず、法的・制度的に争われているという制約です。今回の企業側の異議申し立ては、技術的な実現可能性についてではなく、ガバナンス、法的責任、そして原資産企業が自身の合成的表現に対して権利を主張するための仕組みが存在しないことに関するものです。
ケンタッキー州の男性、AIに対する宗教的免除を認められた初のヒューマニストに
ケンタッキー州の公務員が、職場における必須AIツールの使用要件に対し、ヒューマニズム的信念を根拠として職場免除の取得に成功しました。この免除はTitle VIIの宗教的配慮の枠組みのもとで認められたものです。Title VIIは「宗教」を広く定義しており、Welsh v. United States(1970年)およびその先例であるUnited States v. Seeger(1965年)において確立された基準、すなわち「宗教的確信と同等の強さで誠実に保持された、善悪に関する道徳的または倫理的信念」をも包含します。この基準により、有神論的信仰の要件は撤廃されています。
この件の技術的な実質は限られていますが、エンジニアリング組織にとって先例としての意義は重要です。AIツール使用に対する誠実に保持された倫理的異議がTitle VIIの宗教的配慮として認められるならば、特定のAI支援ワークフローを義務付ける雇用主は、新たな配慮対応の課題に直面することになります。法的基準では、「不当な負担」を生じさせない限り雇用主に配慮を提供することが求められますが、最高裁はGroff v. DeJoy(2023年)において、この「不当な負担」の基準をde minimisコスト基準から事業運営への実質的な負担へと引き上げました。
エンジニアリングチームにとっての実務的な含意は、AIコーディングアシスタントの必須利用ポリシー(例えば、全エンジニアにLLMベースのツールを通じたコードレビューを義務付けるなど)が、この枠組みのもとで異議を申し立てられた場合、オプトアウトの仕組みを必要とする可能性があるという点です。配慮の分析は事実に依存しますが――AIツールがワークフローの中核に近いほど、雇用主にとっての不当な負担の主張は強くなります――今回、閾値となる事例がクリアされました。これは成熟した法理を現代的なテクノロジーの義務付けに新たに適用した事例です。
Apple Network Server v1.0 向け MacOS Extensions Pack
Apple Network Server(ANS)は、Appleが1996年から1997年にかけてエンタープライズ向けワークロードを対象として販売した、AIXベースのサーバーラインです。PowerPCハードウェア上でIBMのAIXオペレーティングシステムを動作させ、Steve Jobsの復帰によってその製品ラインが終了するまで、Appleの本格的なサーバー製品として位置づけられていました。このマシンは、Mac OS X Serverに先立つUnixベースのエンタープライズサーバーへのAppleの唯一の継続的な取り組みを示すものとして、歴史的に注目されています。
このブログ記事は、レトロコンピューティングおよびハードウェアアーキオロジープロジェクトである、ANS向けMacOS Extensions Packのリリースを記録しています。ANSには、ネットワーク管理インターフェースやANS固有のストレージコントローラーなど、Mac OSの特定のextensionを介してやり取りする必要があるハードウェアが搭載されていました。このextensions packは、時代に即したMac OSインストール環境でハードウェアを正しく駆動するために必要なオリジナルのextensionファイルを収集・文書化し、利用可能な状態にするものです。
技術的な関心はextensionアーキテクチャ自体にあります。Classic Mac OSは協調的マルチタスクモデルを採用しており、extension(INIT)が起動時に読み込まれ、システムのトラップテーブル——68KおよびPowerPCのトラップディスパッチ機構——にパッチを当ててシステムコールをインターセプト・オーバーライドしていました。ANSのようなPowerPCマシンでは、ネイティブのPPCコードが直接実行される一方で、68K互換性のためにトラップ機構がエミュレートされていました。そのため、このextensions packは両方のコードリソースフォーマットに対応しなければなりません。
レトロコンピューティングの実践者にとっての価値は、実機が故障することで失われてしまうハードウェアレジスタマップやドライバロジックの文書化にあります。ANSは希少であり、公開されている技術文書はほとんどありません。このようなプロジェクトは、ハードウェアを動作可能な状態に保つために必要な運用知識を後世に伝えるものです。
Source: http://oldvcr.blogspot.com/2026/10/macos-extensions-pack-for-apple-network.html
注目の新規リポジトリ
StartLuxLabs/StartLux-Decision
0.8Bから27Bパラメータまでをカバーするオープンな決定モデルファミリーで、単一の forward pass で離散的な選択肢に対してキャリブレーションされた確率分布を出力するよう設計されています。設計上の重要な選択は、2つのレジームによる出力です。モデルが確信を持っている場合は確率のみを返し、不確かな場合は確率推定の前に短い chain-of-thought を出力します。これにより、簡単な判断では reasoning トークンのレイテンシコストを支払わずに済み、真に曖昧なケースではそれを保持することができます。キャリブレーション目的関数は事後的に適用されるのではなく、学習に組み込まれているため、報告される確率は任意の softmax 出力ではなく、経験的な頻度を追跡するはずです。エンジンのサポートは vLLM、llama.cpp、MLX をカバーしており、アダプタコードなしにGPUクラスタ、CPUのみのサーバー、Apple Silicon への展開が可能です。このモデルファミリーは、高速なルーティングまたはスコアリングのプリミティブとして位置付けられています。汎用 LLM に N 個の選択肢から選ぶよう促してフリーテキストを解析する代わりに、確率ベクトルを直接取得できます。これはマルチエージェントオーケストレーション、検索の再ランキング、およびレイテンシ制約の下で繰り返し離散的な選択を行うパイプラインに関連します。0.8B の端は、より大きなモデルと並べてメモリに十分収まるため、より大規模な inference スタックへの実用的なサイドカーとなります。
Source: https://github.com/StartLuxLabs/StartLux-Decision
strands-labs/strands-decider
エージェント型ワークフローのために特化して構築された、コンパクトな「System 1」決定モデルです。フルのLLM呼び出しがやり過ぎとなる場面を対象としています。選択肢の集合またはスカラー評価タスクが与えられると、strands-deciderは標準的な自己回帰型LLMよりも高速に選択結果またはスコアを返し、すべての出力に対してキャリブレーションされた信頼度値も併せて提供します。この枠組みは二重過程理論を模倣しています。すなわち、低速なLLMの推論が新規または高リスクな意思決定を担い、本モデルはルーティンな分岐を低コストで処理します。アーキテクチャ的には、意味のあるメモリオーバーヘッドを生じさせることなく、より大型のモデルのサイドカーとして動作できる十分なコンパクトさを持っています。キャリブレーションされた信頼度出力が差別化機能であり、これにより下流のオーケストレーションロジックが、より重いモデルへのエスカレートを行うか、あるいは高速な回答をそのまま受け入れるかを判断できます。これにより、ハードコードされたルーティングルールではなく、原則に基づいた速度と精度のトレードオフが実現します。ユースケースとしては、ReActスタイルのエージェントにおけるツール選択、計画ループにおけるアクションスコアリング、データパイプライン内の分類ステップなどが挙げられます。本モデルはStartLux-Decisionとは適用範囲が異なります。フルのモデルファミリーを提供するのではなく、エージェント型ミドルウェアの役割に特化しているため、インテグレーション上の接触面を小さく保つことができます。
Source: https://github.com/strands-labs/strands-decider
wangwanjie/gately
ホームラボ、NASデバイス、セルフホストサーバーを対象とした、シングルバイナリのネットワークゲートウェイです。一つのバイナリとしては機能の幅が異例なほど広く、DDNS、STUNベースのNATトラバーサル、SNIベースルーティングを備えたポートフォワーディング(TLSトラフィックを終端せずに分離できることを意味します)、リバースプロキシ、組み込みWebサーバー、ACME証明書プロビジョニング、WAFレイヤー、Tailscale統合、frpトンネリング、Cloudflare Tunnelサポート、Docker管理、Webターミナルを備えています。技術的に興味深い点はSNIルーティングです。これはトラフィックを復号することなくClientHelloを検査することで、単一ポートの背後に複数のTLSバックエンドを配置することを可能にします。IPアドレスが少ない環境や、サービス間のきれいな分離を望む場合に有効です。frpとCloudflare TunnelをTailscaleとともに同梱することで、オペレーターは一つの設定インターフェース上で複数のエグレス戦略を持てるようになります。対象プラットフォームがfnOS、OpenWrt、Linux、macOS、Windowsであることは、バイナリが静的リンクされているか、ランタイム依存関係が最小限であることを示唆しています。現在nginx、certbot、frp、および個別のDDNSデーモンを組み合わせて運用しているホームラボオペレーターにとって、この統合は運用上の管理対象を大幅に削減します。本番環境での使用前のデューデリジェンスとして明らかに検討すべき点は、WAFルールの監査可能性とWebターミナルのセキュリティモデルです。
Source: https://github.com/wangwanjie/gately
storytold/photocraft
ImageMagickやGEGLといった既存のC/C++製イメージングライブラリに一切依存せず、純粋なRustでゼロから書かれたラスター型フォトエディタです。Rustでフォトエディタをゼロから書くということは、ピクセルバッファの管理、色空間の演算、コンポジット演算子、UIレンダリングに至るまで、スタック全体をチームが所有することを意味します。純粋Rustという制約により、Cベースのイメージングコードに歴史的につきまとってきた広範なメモリ安全性の脆弱性(コーデックパーサーにおけるバッファオーバーフロー、レイヤー操作におけるuse-after-freeなど)を排除できます。フォトエディタにとってこれは具体的な意味を持ちます。悪意を持って細工された画像ファイルは現実の攻撃対象領域だからです。スター数(74k超)は、コミュニティの高い関心を示しており、それはRustの安全性という特性と、この分野においてRustネイティブな成熟したオープンソースフォトエディタが存在しないこと(GIMPやDarktableはC/C++コードベースです)の組み合わせによって牽引されていると考えられます。「ゼロから書かれた」という表現は、このプロジェクトが副産物として再利用可能なRust製イメージングプリミティブを構築していることを示唆しており、より広いエコシステムに恩恵をもたらす可能性があります。潜在的な採用者にとっての実際的な問いは、レンダリングパイプラインのパフォーマンス特性と、既存の確立されたエディタと比較した現時点での機能の完成度です。
Source: https://github.com/storytold/photocraft
storytold/effectcraft
純粋なRustでゼロから構築されたモーショングラフィクスおよびコンポジティングツールであり、After EffectsやNatronのようなツールに対するRustネイティブの回答として位置づけられています。コンポジティングは、多数のレイヤーにわたるフレームごとのグラフ評価を伴うため、パフォーマンスモデルは写真編集ツールとは異なります。エンジンはノードグラフをトラバースし、時間的なキーフレーム補間を管理し、プリマルチプライドアルファコンポジティングを正確に処理し、インタラクティブなレートでレンダリングする必要があります。これをRustでゼロから実装することは、ノードグラフエバリュエーター、キーフレーム補間エンジン、およびコンポジティングオペレーターがすべてRustネイティブであることを意味します。メモリ安全性は依然として構造的な利点です――スクリプティングやプラグインAPIを公開するコンポジティングツールは、歴史的に大きな攻撃対象領域を抱えてきました。PhotoCraft(同一の組織、同一の「Rustでゼロから」という方法論)との関係から、ピクセル演算およびカラーマネジメントのための共有インフラストラクチャが存在することが示唆されます。8,000スターの時点ではPhotoCloudよりも牽引力は低いものの、より競争の少ないニッチを占めています。確立されたRustネイティブのコンポジティングツールは存在しないからです。重要な未解決の問いとして、ノードグラフがライブラリとして公開されているかどうか、レンダーパイプラインのGPUアクセラレーションの方針、そしてプロジェクトが既存のプロフェッショナルツールとの機能同等性を目指しているのか、それともより絞り込まれたサブセットを目指しているのかが挙げられます。
Source: https://github.com/storytold/effectcraft
AienTech/dossier
求職活動における履歴書およびカバーレターの生成ステップを自動化する、セルフホスト型のアプリケーションです。ユーザーはプロフィール(職務経歴、スキル、希望条件)を管理し、求人票ごとにシステムが手動での書き直しを不要にする形で、カスタマイズされた書類を生成します。セルフホスティングにより、ユーザーのキャリアデータおよび求人票が自分のインフラ外に出ることはなく、履歴書データには個人・職業上の高価値な情報が含まれるという観点から、この点は重要です。技術的な核心は、ユーザープロフィールを永続的なコンテキストソースとして、求人票を可変の入力とするLLMベースの文書生成パイプラインであると推測されます。検討に値するアーキテクチャ上の問題としては、プロフィールの更新が既に生成された書類にどのように伝播されるか、応募状況(応募済み、面接中、不採用)をシステムが追跡するか、またどのLLMバックエンドが使用・サポートされているかが挙げられます。「カスタマイズ」という主張は、ある求人票に対してユーザープロフィールの関連するサブセットをシステムがどれだけ適切に特定できるか、また求人票の言語を候補者の経験にどう対応付けるかに完全に依存します。高頻度で応募するパワーユーザーにとっての価値は明らかですが、ときどき応募する程度のユーザーにとっては、セットアップコストが主な摩擦点となります。2,400のスターを獲得しており、求職ツール分野で注目を集めています。
Source: https://github.com/AienTech/dossier
l0ng-ai/openidea
IntelliJ IDEAのユーザーエクスペリエンスモデル — キーマップ、ツールウィンドウ、search-everywhere — を高速なネイティブアプリケーションとして再現するRustネイティブIDEです。スコープは非常に大きく、コードインテリジェンスを備えたエディタ、デバッガ統合、Gitクライアント、ターミナル、データベースクライアント、HTTPクライアントを含み、60以上の言語をターゲットとしています。ElectronやJVMをラップするのではなくRustで構築するという点が中心的なアーキテクチャ上の賭けです。JVMのオーバーヘッドはIntelliJファミリーのIDEに対する最も一般的な不満であるため、JVMの起動コストとメモリコストをネイティブパフォーマンスに置き換えるRust実装は、十分に説得力のある価値提案となります。これほどの幅の言語サポートを実現するには、通常LSP統合(言語インテリジェンスを外部サーバーにオフロードする方式)かカスタム解析エンジンのいずれかが必要であり、60以上の言語に対しては前者の方が現実的です。IntelliJキーマップとの互換性は、一般的なIDEデザインの選択ではなく、既存ユーザーのための意図的な移行パスとして位置づけられています。本プロジェクトは非常に野心的であるがゆえに、最大のリスクはIntelliJユーザーが依存する機能セット — 特にリファクタリング、フレームワーク固有のインスペクション、デバッガの信頼性 — の実装が不完全になることです。Rustネイティブのツールチェーンが何を実現できるかの指標として、注目に値するプロジェクトです。
Source: https://github.com/l0ng-ai/openidea
Hybirdss/Hycli
ウェブサイトのインタラクションを検証済みのCLIコマンドおよびMCP(Model Context Protocol)アクションに変換するツールで、ローカルダッシュボードと20言語のサポートを備えています。核心的なアイデアは、ウェブタスクを記録または指定し、それを脆弱なブラウザ自動化スクリプトではなく、安定したスクリプト化可能なCLI動詞として公開することです。「検証済み」とは、スキーマの強制、リプレイテスト、署名チェックなど、何らかのアクション検証が行われることを意味しており、生のブラウザ自動化を不安定にする信頼性の問題に対処しています。MCP統合により、生成されたアクションをMCPエコシステムで動作するAIエージェントが直接利用できるようになり、Hycliはウェブとエージェントツールレジストリをつなぐブリッジとしてのポジションを確立しています。ローカルダッシュボードは、生成されたアクションを整理、テスト、バージョン管理するための管理レイヤーを提供します。多言語サポート(20言語)は、人間が使う言語ではなく、生成されるCLIクライアントコードの対応言語を指している可能性が高く、カスタムのグルーコードなしにPython、TypeScript、Goなどへインポートできる出力を意味します。実用的なユースケースとしては、繰り返し行われるウェブワークフロー——フォーム送信、データ抽出、公式APIが存在しない認証済みAPIコール——をファーストクラスのCLIツールに変換することが挙げられます。「AIに対応済み」というフレーミングは、完全なブラウザ自動化テストスイートを書くことなく信頼性の高いウェブ向けツールを必要とするエージェント開発者をターゲットにしています。