デイリーAIダイジェスト — 2026-10-27
arXiv ハイライト
DynaFlow: フリーフォームなマルチエージェントオーケストレーションの学習
問題設定
マルチエージェントLLMシステムは通常、タスクファミリーごとに固定された手設計の協調トポロジー(討論、チェーン、ツリー、スペシャリストロールなど)に依存しています。これは適応性を制限します。すなわち、オーケストレーション構造はタスクの意味論や中間的な発見に応じて変化することができず、一つのコンポーネントを改善しようとするとシステム全体を再学習する必要が生じます。DynaFlowはより限定的な問いを立てます。すなわち、すべてのサブエージェントを固定したまま、単一のMain Agentがタスク固有の協調プログラムをその場で合成することを学習できるか、という問いです。オーケストレーションをエグゼキュータの能力から切り離すことで、著者らは協調構造そのものが支配的な要因であるかどうかを研究することが可能になります。
手法
DynaFlowはワークフロー合成をMain Agentのアクション空間に組み込みます。タスク指示 I とクエリ q が与えられると、方策 \pi_\theta は以下からアクションをサンプリングします。
\mathcal{A} = \mathcal{A}_{\text{tool}} \cup \{A_{\text{ans}}, (P, W(P))\},
ここで (P, W(P)) は単一の複合アクションです。P はMain Agentが記述するJavaScriptプログラムであり、W(P) はworkflow toolを通じたその呼び出しです。P はサブエージェントの呼び出し、フェーズラベル、依存関係、並列分岐をエンコードします。独立した呼び出しは並列実行され、依存する呼び出しは上流の出力を明示的に受け取ります。ランタイムは固定されたサブエージェントプールに対して P を実行し、プログラム出力と呼び出しごとの実行トレースの両方を含む o_k = W(P) を返します。
ターン k において、a_k \sim \pi_\theta(\cdot \mid I, q, h_{k-1}) であり、h_{k-1} は順序付きのアクション・観測履歴です。ワークフローが呼び出されると、Main Agentは協調と合成に限定されます。実質的な問題解決はサブエージェントに委譲されます。エージェントは A_{\text{ans}} を出力する前に、結果の検証・拡張・精錬のためフォローアップのワークフローを発行することができます。
二つの評価体制が異なる能力を検証します。Dynamic mode では最初の決定として直接回答またはワークフロー呼び出しのいずれかが許容され、ルーティングをテストします。Forced mode では実質的な問題解決の前にワークフローが義務付けられ、オーケストレーション品質を単独で評価します。
学習はMain Agentのみを対象とした二段階のSFT(QLoRA、Qwen3.5-27Bバックボーン)です。 - Stage 1: GLM-5.3 Maxからの軌跡蒸留を2,031件の初回ターン例に対して実施。 - Stage 2: 支持されない前提、偏った検証、情報フローの欠陥という三つの基準でフィルタリングされた712件の例を用いて継続学習。これは選択目的関数(論文中の式2)として定式化されています。
すべてのサブエージェントはthinkingを有効にしたBase Qwen3.5-27Bチェックポイントであり、一切更新されません。これにより、性能向上をオーケストレーション学習に明確に帰属させることができます。
結果
AIME 2024/25/26、PolyMATH(200問)、GPQA-Diamond(198問)、HotpotQA(200問)にわたる688問において、DynaFlowはForced modeで全体精度88.08%、Dynamic modeで87.94%に達し、同一のQwen3.5-27Bバックボーンのもとで最強のベースライン(CoT、CoT-SC、Self-Refine、または転移ワークフローを用いたAFlow)を10.90ポイント上回ります。
- 数学: Forced modeは2024年、2025年、2026年の全90問のAIME問題を100%解きます。PolyMATHでは両モードが最強ベースラインを3〜4ポイント上回ります。ワークフロー分析では、符号的導出と小規模インスタンスの数値チェックをペアにする繰り返しのパターンが見られ、中間的なエラー検出が可能になっています。
- GPQA-Diamond: Forcedは84.85%に達し、Base-Forcedより7.07ポイントの向上を示し、Base-Directを上回ります。Self-RefineとAFlowはこのベンチマークでは依然リードしており、失敗分析によれば残留エラーは検証を誤った方向に導く誤った中間結論と、合成時に正しいエビデンスをMain Agentが優先できないことに起因しています。
- HotpotQA(ウェブ検索): Dynamic 84.50% / Forced 83.50%で、Base + Web searchより6〜7ポイント上回ります。生成されたワークフローは、明示的なクロスホップ一貫性チェックを伴う中間エンティティを中心に検索を整理します(例:会場→都市の解決、次に都市→ニックネームの解決、ホップをまたいだエンティティ同一性の検証)。
定性的には、Stage-2における情報フローと検証の欠陥に関する選択が、問いごとに最初に生成されるワークフローにおける測定可能な構造的改善に反映されています。設計品質ジャッジのスコアはDynaFlowでは2(欠陥なし)に集中しており、Baseの分布と対照的です。
限界と未解決の問い
本研究はMain Agentのみを学習させており、サブエージェントの同時改善がオーケストレーション向上と相乗効果を生むか干渉するかは未検証です。サブエージェントプールとワークフローランタイムは特定のJavaScriptベースのインターフェースであり、より豊富なアクション空間(永続状態、サブエージェント内でのtool-use、長期ワークフロー)への汎化は不明です。GPQA-Diamondの結果は、サブエージェントの中間出力が確信を持って誤っている場合、現在の検証が脆弱であることを示しています。このフレームワークは独立した検証のためのフックを提供しますが、検証者間の多様性を強制しておらず(同一バックボーンを共有)、学習シグナルはGLM-5.3 Maxから蒸留され実行ベースの報酬ではなくヒューリスティックにフィルタリングされています。ワークフロー結果を報酬とするRL変種は自然なフォローアップです。また、示されたセクションにはクエリごとのワークフロー誘発トークン・計算コストの報告がなく、CoT-SCの5サンプルとの比較において重要な情報が欠けています。
この研究の意義
DynaFlowは、オーケストレーション品質こそがエグゼキュータの能力ではなく、広範な推論タスクにおける支配的な要因であることを示しています。同一のサブエージェントを用いながら強力なベースラインに対して10.9ポイントの向上を達成したことは、現在のマルチエージェントシステムが協調トポロジーを固定することによって大きなヘッドルームを残していることを示唆します。ワークフロープログラムをファーストクラスのアクションとして扱うことで協調を学習可能な方策に組み込み、オーケストレーションをエンドツーエンドで学習しながらエグゼキュータを独立に交換できる道筋を示しています。
Source: https://arxiv.org/abs/2610.34467
Sparse Autoencoderにおける表現の再分配
Sparse autoencoder(SAE)はLMの活性化を(理想的には)解釈可能な特徴へと分解しますが、プロンプトをリクエストの意味を保ちながら書き直した場合――無関係なコンテキストの追加、フォーマットへの包含、句読点の微調整など――SAEの特徴活性は変動します。実用上の懸念として、ある言い換えで観測された特徴の変化は偶発的なものである可能性があり、また確実に発生する変化であっても、下流の線形読み出しには影響しないかもしれません。本論文では、再現性があり方向性の一貫した再分配を分離する選択手順と、固定された線形読み出しへの影響を正確に分解する手法を提案します。
RSS:再現的な特徴応答のための読み出し不要セレクタ
クリーンなプロンプト x_0 と変換されたバリアント x_v に対して、\delta_{v,f} = a_f(x_v) - a_f(x_0) をアラインされたターゲット位置におけるSAE特徴 f の変化量とし、
h_f = \frac{1}{|V|}\sum_{v \in V} |\delta_{v,f}|
と定義します。絶対値を取ることで、符号が逆の応答による相殺を防ぎます。h_f の上位 M 特徴が候補プール C_M を形成します。n 個のセレクタ観測(単一バリアントまたは演算子の平均)から、応答が +\tau を超える回数 n_f^+ と -\tau を下回る回数 n_f^- を定義し、
r_f = \frac{n_f^+ + n_f^-}{n}, \quad c_f = \frac{\max(n_f^+, n_f^-)}{n_f^+ + n_f^-}, \quad s_f = \mathrm{sign}(n_f^+ - n_f^-)
とします。ここで r_f は再現率、c_f は応答者間での方向一貫性です。適格条件は r_f \geq \rho かつ c_f \geq \kappa(同点を排除するため \kappa > 1/2)です。RSSは適格な特徴のうち h_f が最大のものを最大 K 個選択して応答サポート S とし、\mathrm{MeanRSS} = |S|^{-1}\sum_{f\in S} h_f を報告します。
命題1は、S がサイズ k の適格部分集合上で \sum h_f を最大化することを述べており、|\mathcal{E}_M| \geq K のもとではこれが大域的な制約付き最大化解となります。命題2は有限サンプルにおける方向マージンを与えます:選択された各特徴は d_f/n = r_f c_f \geq \rho\kappa かつ (d_f - o_f)/n \geq \rho(2\kappa-1) を満たします。n=5、\rho = \kappa = 0.8 のとき、5回の観測のうち少なくとも4回は支配的な方向を共有するため、単一観測の摂動では s_f が反転しません。重要なことに、選択は V_\mathrm{sel} を用いて行われ、評価はすべて再計算なしで分離されたホールドアウトバリアント V_\mathrm{ho} 上で行われます。
27個のSAEにわたる再現可能な再分配プロファイル
実験パネルは、1,000件の英語プロンプト、6種類の変換設定(コンテキスト・ラッパー編集とローカルな句読点・語彙編集の対比)、およびGPT-2、Pythia、Gemma 2/3、Mistral、Llama 3.1にわたる27個の事前学習済みSAEをカバーしています。各SAE内では、6つのMeanRSS設定の平均をその平均値で正規化し、活性化スケールからプロファイル形状を分離します。
コンテキスト・ラッパーの平均は27/27すべてのSAEでローカル編集の平均を上回り、平均差は 0.874、ブートストラップ95% CIは [0.867, 0.881] です。SAE全体で集約した後も、1,000件すべてのプロンプトで順序が保たれており、コンテキスト・ラッパーのすべての設定が997/1,000件で両方のローカル編集を上回ります。強度較正:強度レベルとMeanRSSの間のプロンプトレベルSpearman \rho の中央値は0.95(句読点)、0.74(無関係なコンテキスト)、0.50(フォーマットラッパー)であり、サポートは各強度で再選択されるため、これは特徴レベルの持続性ではなく大きさの較正です。
ホールドアウトバリアントにおける持続性
2種類の持続性が検証されます。第一に、(V_\mathrm{sel} 上で選択された)固定サポート S は V_\mathrm{ho} 上でもコンテキスト・ラッパー対ローカル編集のギャップを示すか?RSSは、(i) クリーンなプロンプトから選択された特徴、(ii) クリーンコーパス上のグローバル活性によって選択された特徴、(iii) 辞書全体の平均と比較して、27個のSAEのうち24〜26個でより大きなコントラストをもたらし、22個で最大のコントラストを示します。第二に、選択された特徴はホールドアウトバリアントで選択された符号 s_f を保持するか?方向内応答率は、RSSで 0.952、サイズおよびプールを合わせたランダムサポートで 0.758 であり、方向一貫性は命題2の有限サンプル保証が示唆する以上にうまく汎化しています。
表現変化から読み出し失敗へ
表現のシフトは必ずしも判断を変えるわけではありません。本論文は、クリーン時の符号付きマージン m_0 を持つ線形安全性読み出しを固定し、マージン侵食 E = m_0 - m(x_v) を特徴ごとの寄与 e_f^{U} に分解します。各寄与は、応答の大きさ A_f^U、読み出し係数、方向アライメント \eta_f^U(RSSによって選択された s_f に対する相対値)、および符号に分解されます。RSSサポート侵食 E_S は S によって保持される割合を捉え、残余マージンは m_\mathrm{res} = m_0 - E(サポートに対しては m_0 - E_S)となります。
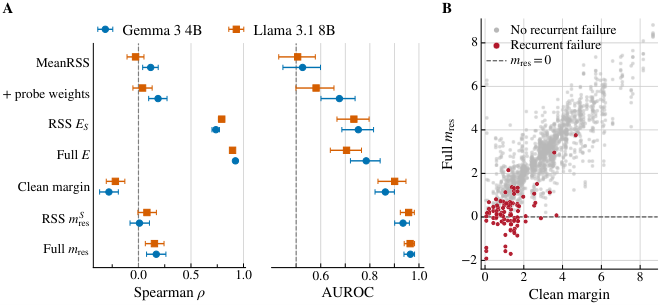
2つの凍結された安全性読み出しに対して、RSSサポート侵食とフルのクリーンマージンを組み合わせることで、再現的失敗のAUROCはそれぞれ 0.935 と 0.958 となり、使用するサポートの特徴数の中央値はわずか20および19個です――これは、辞書全体の侵食による 0.965 と比較したものです。約20個の特徴からなる読み出し不要サポートは、フルの線形分解のランキング性能のほぼすべてを回復します。
限界と未解決の問題
命題2の保証は選択集合のみに適用されます。ホールドアウトでの方向保存は実験的なものです。再分配プロファイルは、6種類の変換と設定ごとに5つの演算子という特定の分類法に対して特徴付けられており、敵対的または複数ターンの変換への汎化は未検証です。読み出し分析は線形かつ単一位置に限定されており、スパンにわたるattentionや非線形ヘッドはカバーされていません。最後に、「特徴」の品質は事前学習済みSAEに依存します:この手法はそれらの辞書が持つpolysemanticity(多義性)やabsorption(吸収)をそのまま引き継ぎます。
なぜこれが重要か
RSSは、再現可能な表現シフトを一過性のノイズおよび特定の読み出しへの符号付き影響の両方から分離する原則的な方法を提供します。30個未満の特徴からなるサポートで、安全性プローブにおける全辞書のAUROCとの差を 0.03 以内に抑えることができます。解釈可能性に基づくロバスト性監査において、「無害な言い換えのもとでどの特徴が変動し、それは問題になるか?」という問いが、可視化の演習ではなく答えられる問いとなります。
Source: https://arxiv.org/abs/2610.21240
RynnVLA-Latent: 3D基盤付き潜在アクションによるロボット操作 Foundation Model のスケーリング
問題設定
vision-language-action (VLA) モデルのスケーリングは、二つの壁に突き当たります。第一に、アクションラベル付きの遠隔操作データは、分野がカバーしたい操作スキルの広がりに比べて希少です。第二に、異なる embodiment(グリッパー付き双腕 vs. 巧緻ハンド、並列 vs. 6-DoF エンドエフェクタ、移動型 vs. 固定型ベース)の制御空間は相互に非互換であり、ロボットデータセットをプールしても単一の action head に対して学習することができません。人間の映像は豊富に存在しますが、アクションラベルがまったく付いていません。RynnVLA-Latent はこの問題に対し、視覚的な遷移のみから幾何学的に基盤付けられた共有潜在アクション空間を学習し、それを VLA policy の事前学習ターゲットとして活用します。ネイティブなロボットアクションへのアライメントは最終的な post-training フェーズのみで行います。
手法
パイプラインは三つのステージで構成されます:コーパス構築、潜在アクションモデル(RynnLAM)の学習、そして VLA pretraining と post-training です。
コーパス。 実ロボット、シミュレーション、自己中心映像、ウェブ人間映像の計25ソースを集約し、約30,100時間、1,663万エピソード、30.57億フレームからなるデータセットを構築しています。人間映像と実ロボット映像がそれぞれ時間の約40%を占め、残りをシミュレーションが占めます。
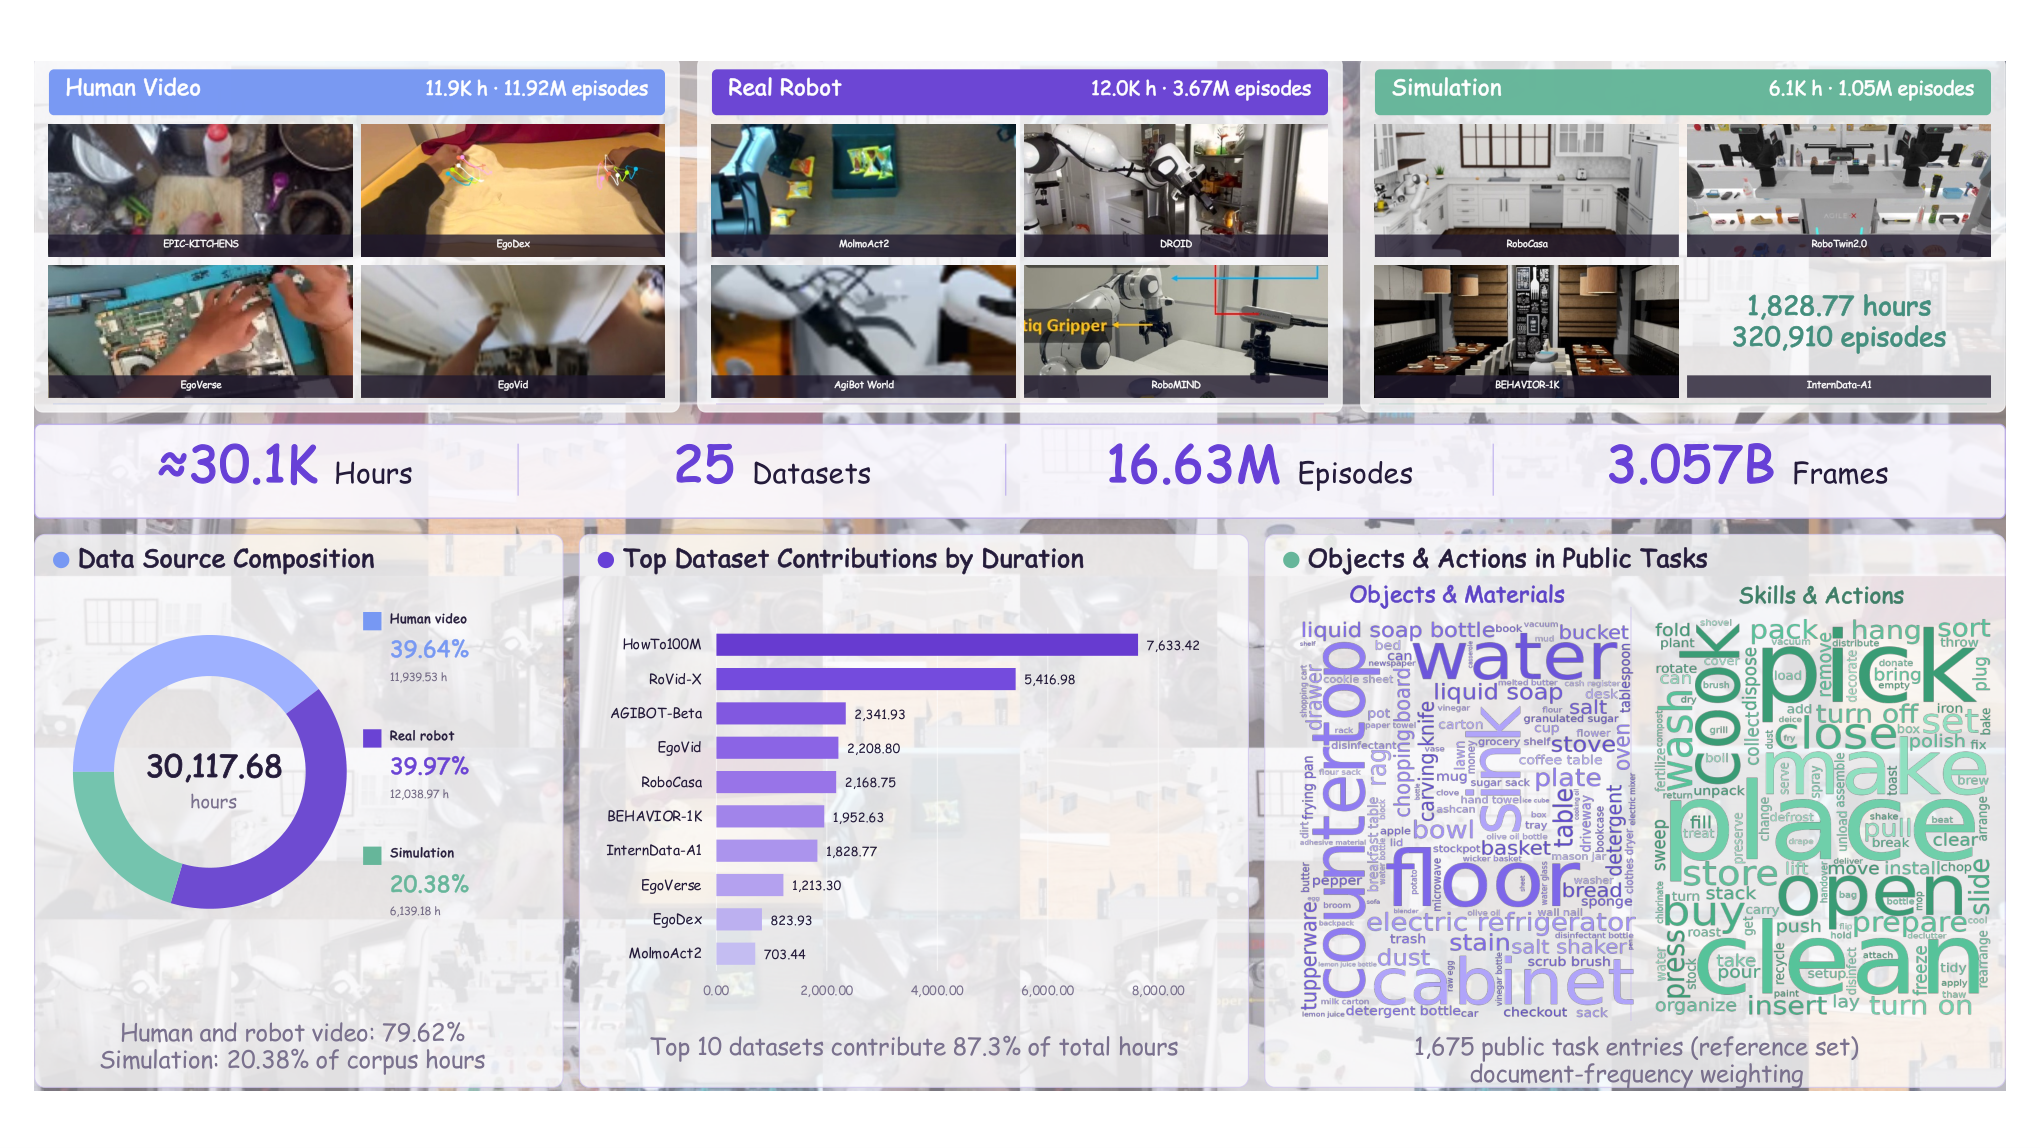
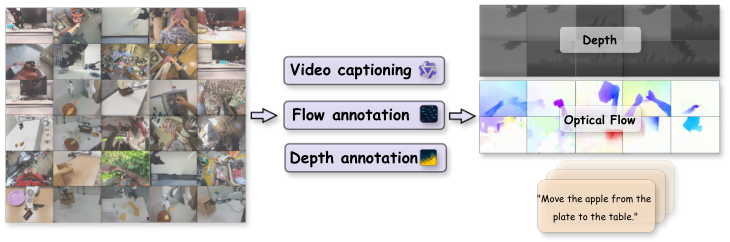
各クリップには Qwen3-VL キャプション、DPFlow 密光学フロー、Depth-Anything-3 単眼深度のアノテーションが付与されており、アクションラベルは使用していません。
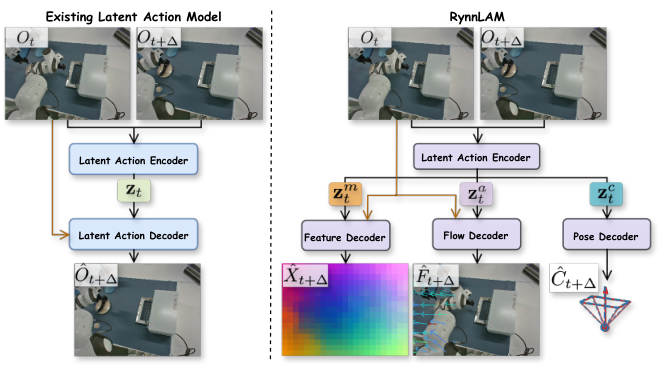
RynnLAM。 Depth-Anything-3 を基盤として構築された RynnLAM は、フレーム遷移 (I_t, I_{t+\Delta}) を構造化された608次元の記述子にエンコードします。この記述子は、8つのモーショントークン z^m_t(合計512-D)、グローバルな action latent z^a_t(64-D)、相対カメラポーズ latent z^c_t(32-D)で構成されます。外観と制御を混同させてしまう画素単位の未来フレーム再構成を行う代わりに、モデルは以下の目標で学習されます:(i) 凍結された視覚 backbone における残差未来特徴予測、(ii) 光学フローを単眼深度でリフトしカメラ運動を補償した動的3Dフロー回帰(教師信号を物体・手の動きに限定)、(iii) ワープされたソース特徴とターゲット間のcontrastive alignment、(iv) z^c_t のカメラポーズデコーディング、(v) カメラ latent とモーション・アクション latent 間の gradient reversal による分離の強制。
学習はエンコーダを凍結した状態で36,000ステップ、凍結を解除した状態で20,000ステップ実行されます。結合目標関数(論文中の式2)はこれら5つの項の重み付き和です。コーパス全体に対して4フレームストライドでオフライン推論を実行し、7億4,552万個の潜在アクション記述子を生成します。
RynnVLA-Latent。 この policy は4B の Mixture-of-Transformers です。VLM backbone は RynnBrain であり、より小さな action expert(d_\text{model}=768、d_\text{ff}=2752)と同じ深さで組み合わせられ、各層の joint attention によって結合されます。観測は6つのビュー条件付きスロットを使用し、4096トークンバジェット内で2fps、最大64フレームのサンプリングを行います。事前学習では、観測と言語を条件とした flow matching により、C=6 チャンクの潜在アクション記述子を予測します。事前学習中は固有感覚情報を使用しません。ソースは p_d \propto W_d^{0.7} でサンプリングされ、映像データとロボットデータのバランスを保ちます。事前学習のインデックスは12,106万チャンクサンプルを含み、グローバルバッチサイズ128で1エポックあたり約94万6,000オプティマイザステップとなります。オプティマイザは AdamW(\beta_1=0.9, \beta_2=0.95、weight decay 0、grad clip 1.0)です。
Post-training では、同一の flow matching head を潜在アクションからターゲット embodiment のネイティブアクション空間へ再ターゲットし、固有感覚情報を導入します。重要なのは、別途デコーダを追加せず、事前学習済みの readout trunk をそのまま保持し、ターゲットアクション次元へのプロジェクションのみで終端することです。エンドエフェクタの回転には6-D連続表現を使用します。これにより、学習済みの flow matching ダイナミクスすべてが転移し、最終線形マップのみが embodiment 固有のものとなります。
結果
(標準的な embodiment アライメント post-training を除き、benchmark 固有のチューニングなしで報告された数値):
- LIBERO:98.8% 成功率。
- LIBERO-Plus(摂動あり):84.7%。
- VLABench、5トラックの平均:51.9%。
- RoboTwin 2.0(双腕、ネイティブプロトコル):88.6% 平均。
LIBERO-Plus の数値は特筆に値します。この benchmark は視覚的・言語的な摂動に対するロバスト性を特に評価しており、単純に過適合した LIBERO policy はここで破綻します。VLABench 平均は、異質なトラックにわたる言語に基づく汎化能力を反映しています。実世界の双腕評価は、Marvin-WUJI(固定型、双7-DoF アーム + 20-DoF 巧緻ハンド)と Astribot-S1(移動型、双7-DoF アーム + 並列グリッパー)で実施されており、同一の事前学習済み trunk が最終線形プロジェクションのみで巧緻ハンドと並列グリッパー制御の両方に適応できることを示しています。
限界と未解決の問題
本論文では、同等の計算量での潜在アクション事前学習対アクション条件付き事前学習に関する制御されたスケーリング則分析が提供されていません。したがって、3D基盤付き潜在空間に起因する向上と生データ30,100時間に起因する向上の大きさを、まとめの数値から切り離して評価することは困難です。608-D の latent を \times6 チャンクにした flow matching は非自明な生成ターゲットであり、展開時の安定性とサンプラーコストについては特性評価されていません。カメラ分離の gradient reversal は単眼深度と光学フロー推定器に依存しており、それらの失敗モード(細い構造物、鏡面反射、自己中心運動ブラー)が疑似ラベルに漏れ込む可能性があります。最後に、実世界の post-training には依然として embodiment 固有のデモンストレーションが必要であり、転移が崩壊する前にデモンストレーションバジェットをどこまで削減できるかは定量化されていません。
なぜ重要か
幾何学的に基盤付けられカメラ分離された潜在アクション空間は、操作映像コーパス全体——人間映像、シミュレーション、クロス embodiment ロボット——を単一の事前学習シグナルに変換し、ネイティブアクションは最終の薄いプロジェクションにのみ必要とします。LIBERO-Plus(84.7%)と RoboTwin(88.6%)の数値が独立した評価でも維持されるならば、これは VLA のスケーリングをアクションラベルのボトルネックから映像スケールの教師信号へ移行させるための具体的なレシピとなります。
Source: https://arxiv.org/abs/2610.34356
ProAS: マルチターンエージェント強化学習のための進捗認識型アドバンテージシェーピングフレームワーク
問題
Critic-freeなグループベースRLアルゴリズム(GRPO、DAPO、GiGPO)は、価値関数の学習にかかるコストや不安定性を回避できるため、LLMエージェントの学習における標準的手法となっています。その代償として生じるのが、一様なクレジット割り当てです。すなわち、軌跡レベルのアドバンテージ A(\tau) がロールアウト中のすべてのトークン・ステップに同一の値で伝播されます。マルチターンのエージェント設定では、これは対称的な二つの方向で病的な問題を引き起こします。成功した軌跡においては、構造的には不合理であるが偶然致命的にならなかった行動(冗長なナビゲーション、行き詰まりのクエリなど)が、本質的に重要な正しい行動と同じ正の重みを持つため、方策がノイズを記憶してしまいます。失敗した軌跡においては、最終的な失敗よりも何ターンも前に静かに進捗を逸脱させた行動が、最後の誤った行動と同じペナルティを受けます。ProASはcriticを再導入することなく、この両方の失敗モードを標的とします。
手法
ProASは二つの要素から構成されます。ステップレベルの構造的シグナルを提供するAgentic Reference Graph(ARG)と、そのシグナルを利用するアドバンテージシェーピングルールです。
ARGの構築。 ARGは、検証済みの成功軌跡から構築されたDAG \mathcal{G}=(\mathcal{V},\mathcal{E}) です。頂点は M 個の順序付きサブゴール \mathbf{g}_m=\{s_{m,1},s_{m,2},\dots\} であり、それぞれはサブゴール m の完了を示す順列不変な有効状態の順序なし等価クラスです。エッジは確定的遷移 (s,a,s')\in \mathbf{g}_m\times\mathcal{A}_m\times\mathbf{g}_{m+1} です。自己ループおよびエラーによって誘発された状態は「グラフ純粋性」を担保するために除去されます。ARGはオンラインで進化します。イテレーション k において、新たに検証された各成功が \Delta\mathbf{g}_m と \Delta\mathcal{E} を \mathcal{G}^{(k)} に厳密な和集合として加えます。
\mathbf{g}_m^{(k+1)}=\mathbf{g}_m^{(k)}\cup\Delta\mathbf{g}_m,\quad \mathcal{E}^{(k+1)}=\mathcal{E}^{(k)}\cup\Delta\mathcal{E}.
これにより、参照グラフは時間とともに厳密により許容的になり、初期学習において狭い解モードに偏るバイアスが軽減されます。
ステップのアノテーション。 ロールアウトの各ステップ (s_t,a_t,s_{t+1}) は、\mathcal{G}^{(k)} に対して二つの二値ラベルでタグ付けされます。 - 合理性 \text{Rea}_t = \mathbb{I}[(s_t,a_t,s_{t+1})\in\mathcal{E}] - Future-Drift(FD)スコアは、あるステップが将来の状態を参照多様体からどの程度逸脱させるかを推定します(APRのペナルティスケーリングに使用)。
著者らはこれらの選択を二つの検証実験によって動機付けています。まず、固定した状態に不合理な行動を注入して50通りの継続をリサンプリングすると、クリーンな対応例よりも期待成功率(ESR)が低下することが確認され、成功軌跡中の「不合理な」ステップが無害ではないことが裏付けられます。次に、元の行動を抑制してリサンプリングすると、回復したESRがその行動のFDと単調に相関することが示されており、FDが失敗においてどの程度の責任を配分すべきかの有用な代理指標であることが確認されます。
アドバンテージシェーピング。 軌跡 \tau_i に対するグループベースのベースラインアドバンテージ A_i が与えられたとき、ProASはステップレベルのアドバンテージ \hat A_{i,t} を次のように修正します。 - Masking Unreasonable Incentives(MUI): 成功した軌跡(A_i>0)において、\text{Rea}_t=0 のステップのアドバンテージをゼロにします。これにより、不合理な行動が勝利ロールアウトにたまたま含まれているだけで正に強化されることを防ぎます。 - Asymmetric Penalty Redistribution(APR): 失敗した軌跡(A_i<0)において、FDで重み付けしてステップ間に負のアドバンテージを再分配します。これにより、最終的な「症状」ステップよりも早期の逸脱に多くの責任が割り当てられます。
この非対称性(成功時はマスク、失敗時は再分配)は、二つの検証結果を反映しています。この手法はプラグアンドプレイ型であり、PPOスタイルのクリップ付き目的関数を変更したりcriticを導入したりすることなく、GRPO/DAPO/GiGPOにおけるステップごとの一様伝播を置き換えます。
結果
Qwen2.5-1.5B/7B-Instructを用いて3シードで学習し、ALFWorld(6タスクカテゴリ)およびWebShopで評価されています。
ALFWorldのピークSR:91.9%(1.5B、GiGPO+ProAS)および94.3%(7B)。WebShopのピーク:66.7% SR(1.5B)および70.8% SR(7B)。各ベースアルゴリズムとの比較では、ProASはGRPOのALFWorld SRを70.3から87.0(+16.7)に、WebShop SRを57.0から64.6に改善(1.5B)し、DAPOを82.3から86.5、57.3から66.7に、GiGPOを90.1から91.9、64.3から66.7に改善します。PPO(criticsベース)と比較すると、ProASのバリアントはALFWorld SRを5.5〜18.7ポイント、WebShop SRを3.4〜11.5ポイント向上させます。同じ専門家アノテーションをフラットな行動クローニングとして使用するSFTは、ALFWorldでProASに12.2(1.5B)および14.4(7B)ポイント差で敗れており、模倣ターゲットとしてではなく構造的RLガイダンスとしてアノテーションを活用することの利点が浮かび上がります。
収束性:ALFWorldにおけるSpd@70は 1.61\times(GiGPO)および 1.59\times(GRPO)に達し、WebShopにおけるSpd@50は 1.79\times(GRPO+ProAS)に達します。論文では全体で最大 2.44\times の高速化が報告されています。ALFWorldで最も難しいカテゴリであるPick2(二つの正しい取得を必要とする)で差が最も顕著であり、GRPO 59.1 → 78.8、DAPO 66.7 → 77.3と、長期的なタスクが一様なクレジット割り当てによって最も影響を受けるという仮説と一致しています。
限界とオープンクエスチョン
ARGはサブゴール分割のシードとなる事前収集済みの成功軌跡を必要とするため、タスクがすでにある程度解けることと、状態がきれいな等価クラス定義に適することが前提となります。ここで説明されている構築方法(厳密な順序のサブゴールと順列不変な内部構造)は、サブゴールが明確に定義されたALFWorldやWebShopスタイルのタスクには適合しますが、オープンエンドなツール使用やコーディングエージェントへの拡張は自明ではありません。FDは現在のARGに対して計算されるため、学習初期はグラフが疎であり苦労します。静的ARGと進化するARGの比較に関する著者らのアブレーション(RQ4)は重要なロバスト性テストですが、引用箇所では完全に定量化されていません。最後に、MUIによる不合理なステップの正のアドバンテージの強いゼロ化は、\mathcal{G}^{(k)} にまだ吸収されていない代替的な解モードの正当な探索を抑制する可能性のある強い事前仮定です。
なぜ重要か
ProASは、critic-freeなLLMエージェントRLにおけるクレジット割り当てを、価値回帰問題としてではなく学習されたタスクグラフ上の構造的問題として再定式化し、GRPO/DAPO/GiGPOの上で適度かつ解釈可能なシェーピングを行うことで、オラクル専門家データとのギャップの大部分を埋めながら最大 2.44\times 速い収束を実現することを示しています。「成功時はマスク、失敗時は再分配」という非対称パターンは、他のエージェント型RLパイプラインでも直接採用できる可能性が高い、すっきりした帰納的バイアスです。
Source: https://arxiv.org/abs/2610.18683
Trajectory2Gym: ツール使用エージェントのための決定根拠付き構成的インタラクション合成
ツール使用エージェントに対する supervised fine-tuning は、通常、成功した教師軌跡を収集し、すべてのアシスタントターンを模倣します。本論文は、このような教師あり学習には二重の欠陥があると主張します:成功軌跡は (i) 学生が学ぶべき多段階の観測-行動依存関係を十分に表現できておらず、(ii) 教師の内部状態や推論時に学生から不可視なログフィールドに正当化の根拠を持つ決定を含んでいます。どちらの失敗モードも、学生が自身のコンテキストから予測できないトークンを生成するため、SFT の目的関数においてノイズとなります。
問題設定
本論文は、インタラクション履歴に適用される可視性射影 V によってこのミスマッチを形式化します。学生は以下から行動します:
c_t = (x, \mathcal{T}_t, V(H_{<t})), \qquad a_t \sim \pi_\theta(\cdot \mid c_t),
一方、データ収集では完全なログ H_{<t} が参照可能です。教師ありデータセットは \mathcal{D}_s = \{(\tau_i, \mathbf{m}_i)\} であり、決定ごとのマスク m_{it}\in\{0,1\} を持ちます:可視軌跡全体がコンテキストとして保持されますが、認定された決定のみが loss を受け取ります。その上で、構成的カバレッジ(観測-行動依存関係および多段階構造が十分なサポートで現れること)と決定根拠付け(各 m_{it}=1 ターゲットが c_t のみで支持されること)という二つの性質が共同して要求されます。
手法
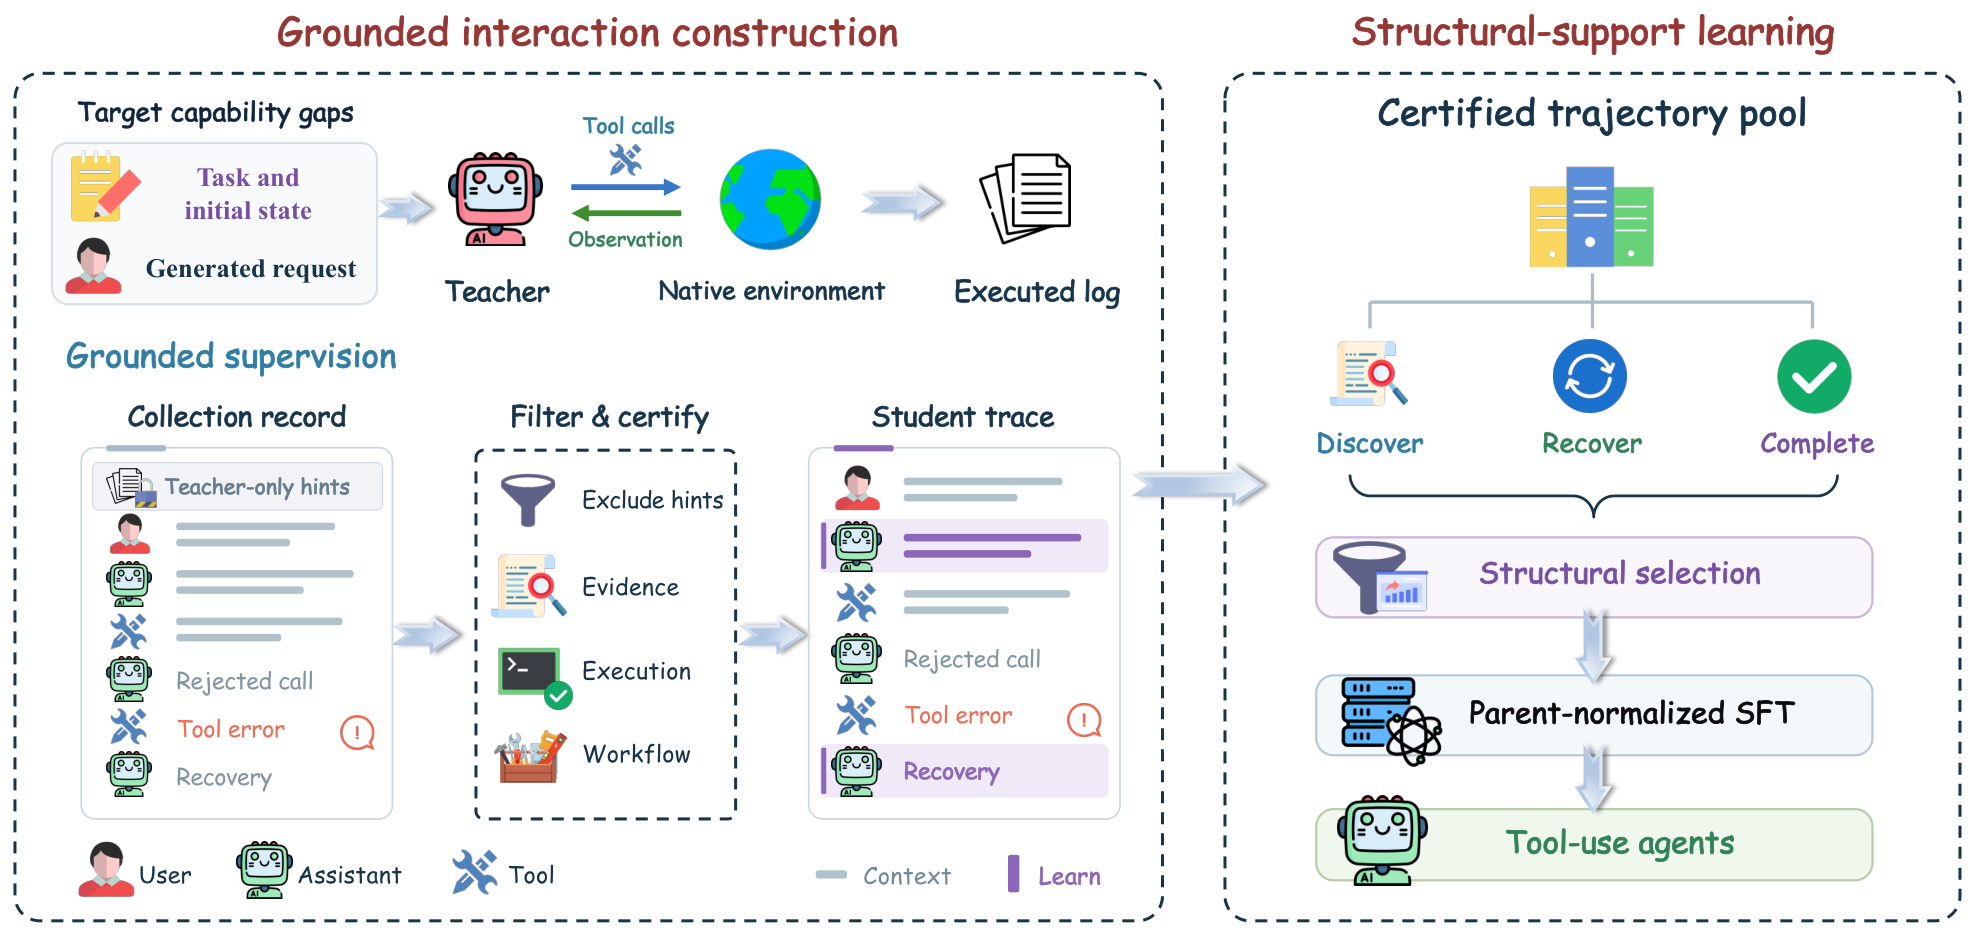
Trajectory2Gym は、意味的行動・引数・観測結果・回復・分岐・引き継ぎ・終了・ホライズンを抽象化する共有能力語彙 \mathcal{K} を中心に構築された三段階から構成されます。ネイティブなツールはこれらの役割にマッピングされるため、パスは異なるバックエンドで実現可能です。
- 構成的インタラクション合成。 順序付きパス p = (\kappa_1,\dots,\kappa_\ell) は一つのインタラクションの要件を構成します(例:検索 → エラー → 確認要求 → リトライ → 注文読み取り → 確認 → キャンセル → 更新)。生成器 G がリクエストと互換性のある初期状態を構築し、教師 \pi_T がそれをネイティブに実行します:
(x, s_0) \sim G(\cdot \mid p, \mathcal{E}), \qquad \tau \sim P_\mathcal{E}(\cdot \mid x, s_0, \pi_T).
各 \tau は正規パス p(\tau) にバケット化され、サポート n_\mathcal{S}(p) = \sum_{\tau \in \mathcal{S}} \mathbf{1}[p(\tau)=p] が計算されます。サポートが不十分なパスは明示的にターゲットとされます。本論文は(命題3として)、N 個の候補から B 個を一様選択した場合、シングルトンパスが確率 1 - B/N で見逃されることを指摘しており、これが成功軌跡のオーバーサンプリングではなくパス条件付き生成を動機づけています。必要な引数値は可視なソース(リクエスト・ユーザーターン・先行ツール結果)にバインドされなければならず、それらのみが後に根拠付きターゲットになり得ます。パスは、行動と観測の依存関係が実行されたネイティブログに実際に現れた場合にのみ認定されます—教師の誤った提案は訓練ターゲットではなく未認定の構造として現れます。
- 根拠付き教師あり学習。 実行された各ログは V を通じて再射影されて学生コンテキストが得られ、そのコンテキスト内に正当化根拠を持つ決定のみがマスクインされます。
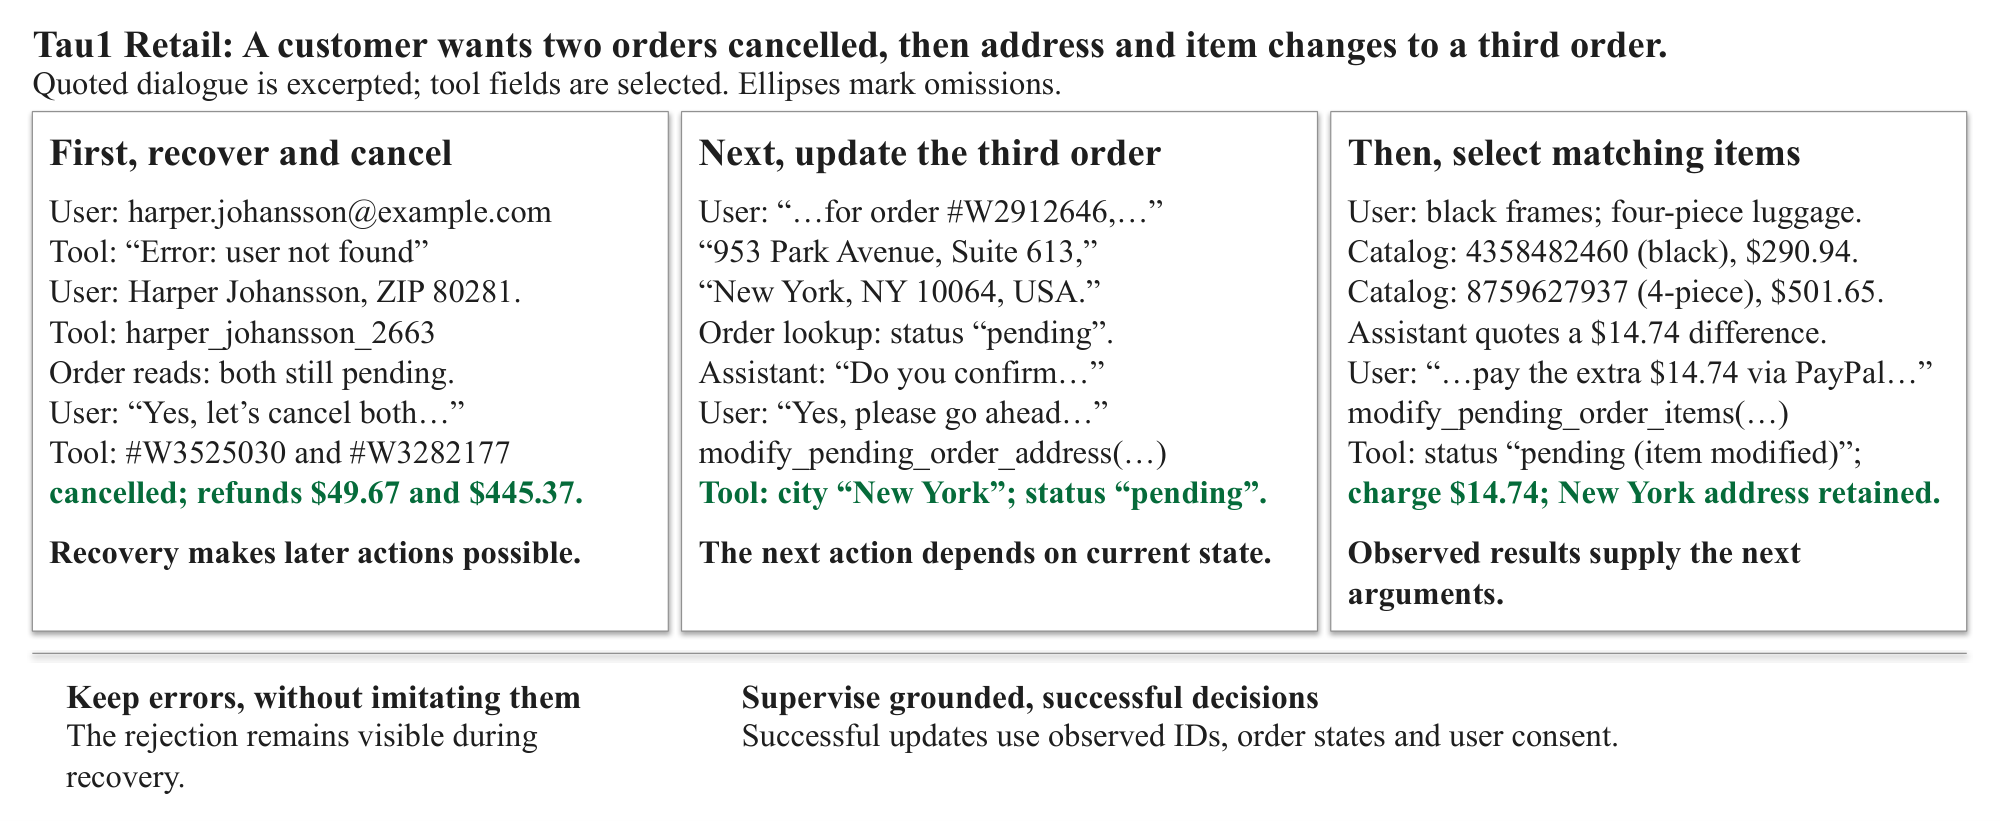
図5における失敗したメール検索は、学生がエラー信号を見られるようコンテキストとして保持されますが、教師の推測が c_t のみで正当化されないため、模倣 loss は付与されません。回復された身元とカタログ結果によって根拠付けられた後続の行動は教師ありで学習されます。
- 構造的サポート学習。 合成のラウンドが、各認定パスがスケール依存の目標を満たすまでインベントリを満たします。親正規化 SFT は、長い軌跡がより多くのトークンを含むことで単に gradient を支配することを防ぐため、意味的インタラクションを訓練単位として(トークンや軌跡ではなく)扱うようにサンプルの重みを設定します。
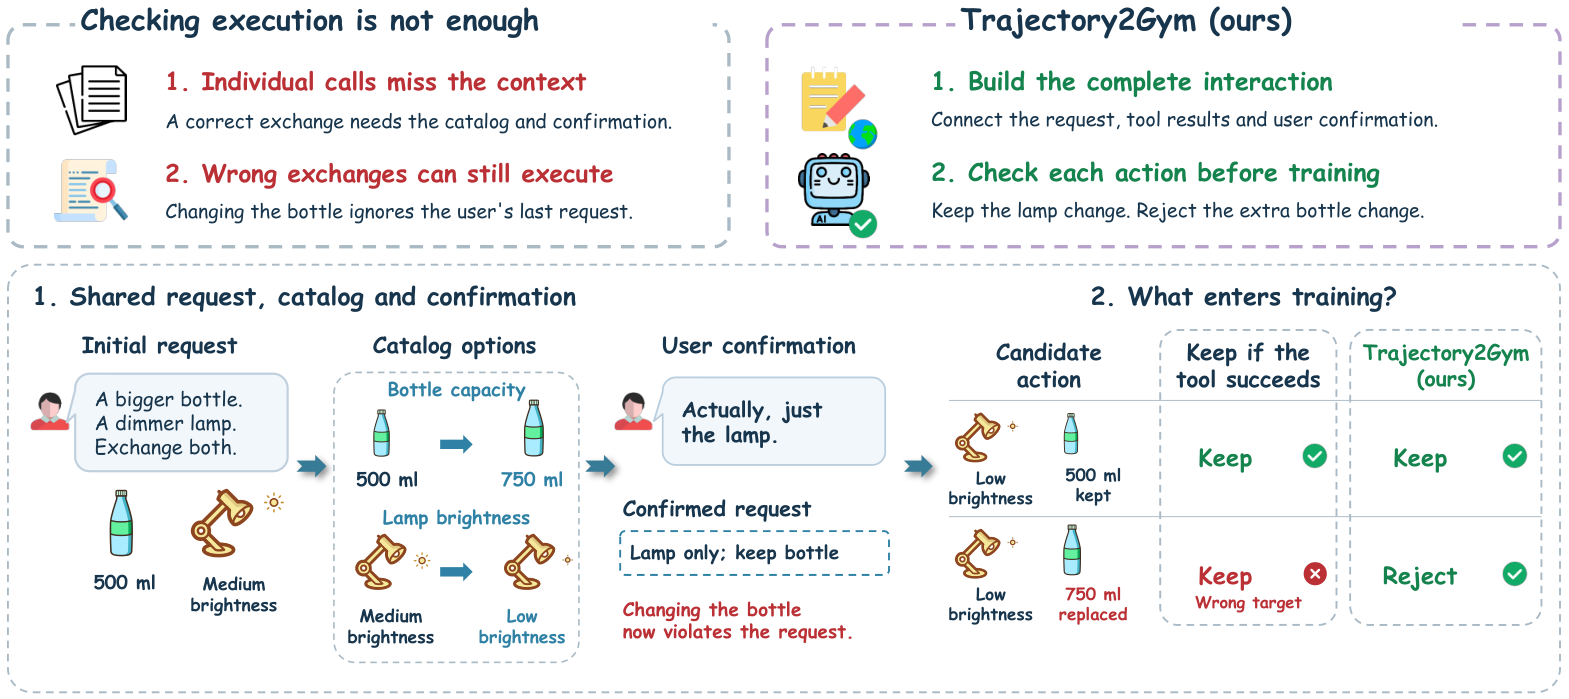
図1は実行ベースの認定がなぜ必要かを示しています:結果フィルタリングとスキーマルールはいずれも、学生の可視履歴がそれらを実際にサポートするかどうかという点で異なる候補行動を受け入れてしまいますが、ネイティブリプレイのみがそれらを分離できます。
結果
親正規化 SFT 1エポック(スケールごとに 11.6k〜19.9k 軌跡)での Tau1 + Tau2 Pass@1 において、すべての Qwen3 スケールで改善が見られ、ペア化 Mean ゲインはスケールとともに増大しています:1.7B 15.93 → 35.97 (+20.04)、4B 21.70 → 56.70 (+35.00)、8B 26.44 → 62.65 (+36.21)、14B 28.52 → 69.44 (+40.92)、30B-A3B 36.36 → 75.47 (+39.11)。Qwen3-30B-A3B の結果(Tau1 Retail 69.57、Tau1 Airline 64.00、Tau2 Telecom 95.00)は、オープンウェイトかつ SFT のみであるにもかかわらず、GPT-5.2-high(Mean 76.99)および Claude-4.5-Opus-high(Mean 79.38)に近い範囲に達しています。
同等の 8B バックボーンで訓練された再評価エージェント訓練チェックポイントとの比較では、差は歴然としています:Trajectory2Gym-Qwen3-8B 62.65 Mean に対し、MUA-RL-8B 30.24、Simia Tau-SFT 39.55、LoopTool-8B 23.87、EnvFactory-8B 33.40、MidTool-RL-8B 27.02。MUA-RL-32B の 49.52 でさえ、4B の Trajectory2Gym モデル(56.70)に及びません。著者らは慎重に指摘しています:訓練データ、ファミリー、コンテキストバジェットが異なるため、これは等コスト比較ではありませんが、標準的な軌跡合成パイプラインがどれだけの余地を残しているかの上界を示しています。
制限と未解決の問題
本手法は、能力語彙 \mathcal{K} が学生に必要な依存関係を実際にカバーしていることを前提としています;役割の誤指定は未認定パスとサイレントなカバレッジギャップをもたらします。認定はネイティブリプレイに基づいており、Tau/BFCL では安価ですが、副作用のある環境やコストの高いツールでは非現実的になる可能性があります。本手法は SFT のみです;根拠付き軌跡と RL の組み合わせが効果的かどうか、あるいはポリシーが探索するにつれて根拠付けが冗長になるかどうかは未検証です。最後に、スケーリングゲインは 30B-A3B まで評価されており;教師も劣化するフロンティアスケールにおいて等重み Mean が改善し続けるかどうかは未解決です。
なぜ重要か
Trajectory2Gym は教師あり学習を「成功を収集する」から「学習可能なインタラクション経験を構築する」へと再構成しており、SFT のみで4スケール全体にわたって +35〜41 ポイントの Mean ゲインという経験的上限は、現在のほとんどのツール使用訓練データのボトルネックがモデルキャパシティや RL アルゴリズムではなく、根拠のないターゲットと欠落した構成的構造にあることを示唆しています。学生の可視性射影の下での決定根拠付けは、ネイティブ実行を持つあらゆる環境に移転可能な明確でポータブルな制約です。
Source: https://arxiv.org/abs/2610.33568
Trial by Trace: AIエージェントハーネスの信頼性と障害帰属のベンチマーク評価
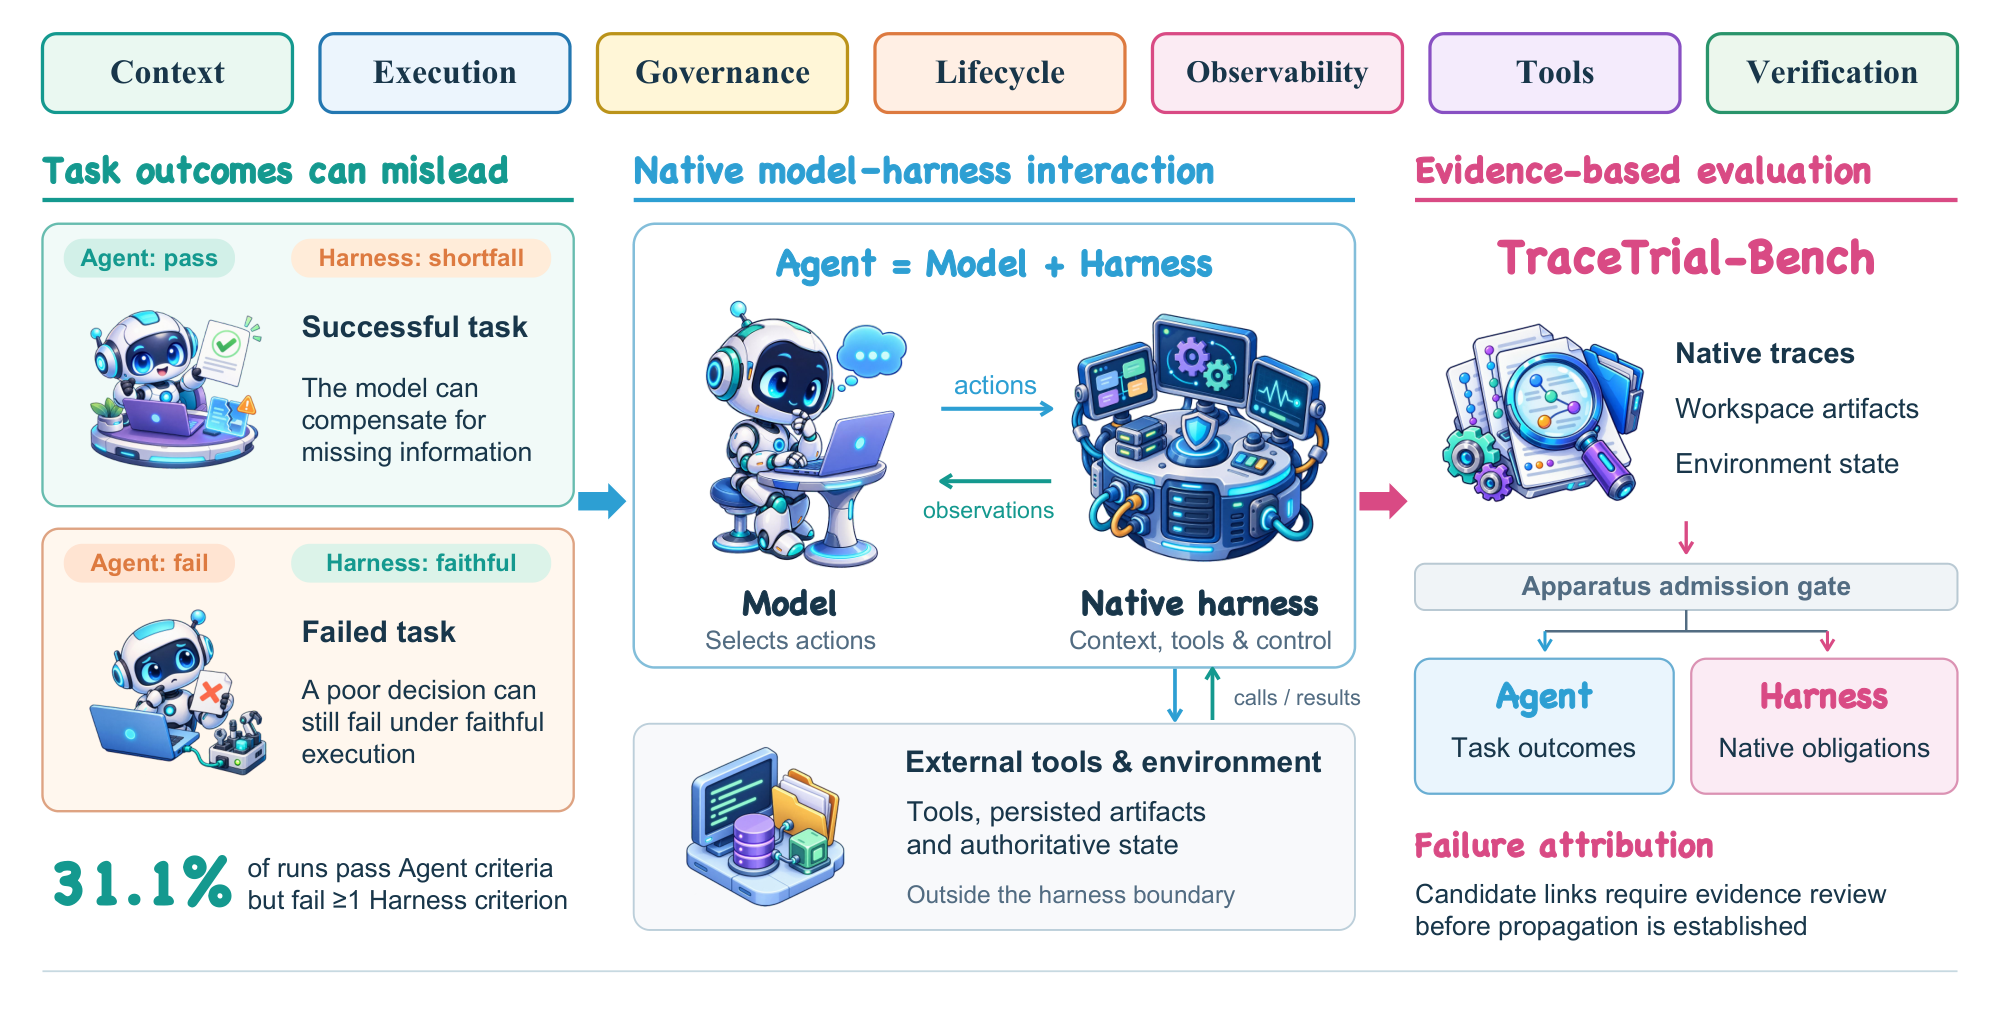
ほとんどのエージェントベンチマークは、障害の2つの原因を混同しています。すなわち、モデルの推論と、コンテキスト・ツール呼び出し・ライフサイクル・パーミッションを仲介するハーネスです。実行が失敗した場合、結果のみによるスコアリングでは、モデルが誤った計画を出力したのか、ハーネスがコンテキストを切り詰めたのか、ツールの結果を欠落させたのか、ライフサイクルフックの順序を誤ったのか、あるいはパーミッションチェックを暗黙的に緩和したのかを判別することができません。TraceTrial-Benchは、これら2つの層を分解するための測定装置であり、両方が失敗した場合には、エージェントの障害がハーネスの欠陥に由来する事前宣言された伝播メカニズムと整合しているかどうかを検証します。
問題の定式化
テスト対象システム(SUT)はネイティブハーネス自体であり、Claude Code、Codex、DeepSeek Harness、またはOpenClawを、モデルインタラクション・ツール連携・ライフサイクル・パーミッションを管理するシステムとして扱います。モデル、タスク、環境、リソース予算は制御された入力であり、評価器とトレーサーは装置です(装置の障害はハーネスの欠陥としてカウントされません。これは測定アーティファクトとSUTの挙動を混同しないために重要です)。
各承認済みの実行に対して、ベンチマークは3つの問いに答えます:(i) エージェントが必要なアーティファクトとアクションを生成したか(Agentレイヤー)、(ii) ネイティブハーネスがタスクに必要な情報・実行セマンティクス・ライフサイクルを保持したか(Harnessレイヤー)、(iii) AgentとHarnessの両方の基準が失敗した場合、候補メカニズムリンクの事前宣言された活性化条件が結びついているか。3番目は機械的なテストです:基準間の候補リンクは活性化条件が満たされると自動的に活性化され、事後的な説明ではなく証拠に基づく帰属が生成されます。
分類体系と装置
ハーネスの信頼性は7つのコンポーネントに分解されます——コンテキスト、実行、ガバナンス、ライフサイクル、観測可能性、ツール、検証——これらは40のメカニズムレベルの信頼性特性に展開され、それぞれコンポーネント内で均等に重み付けされます。
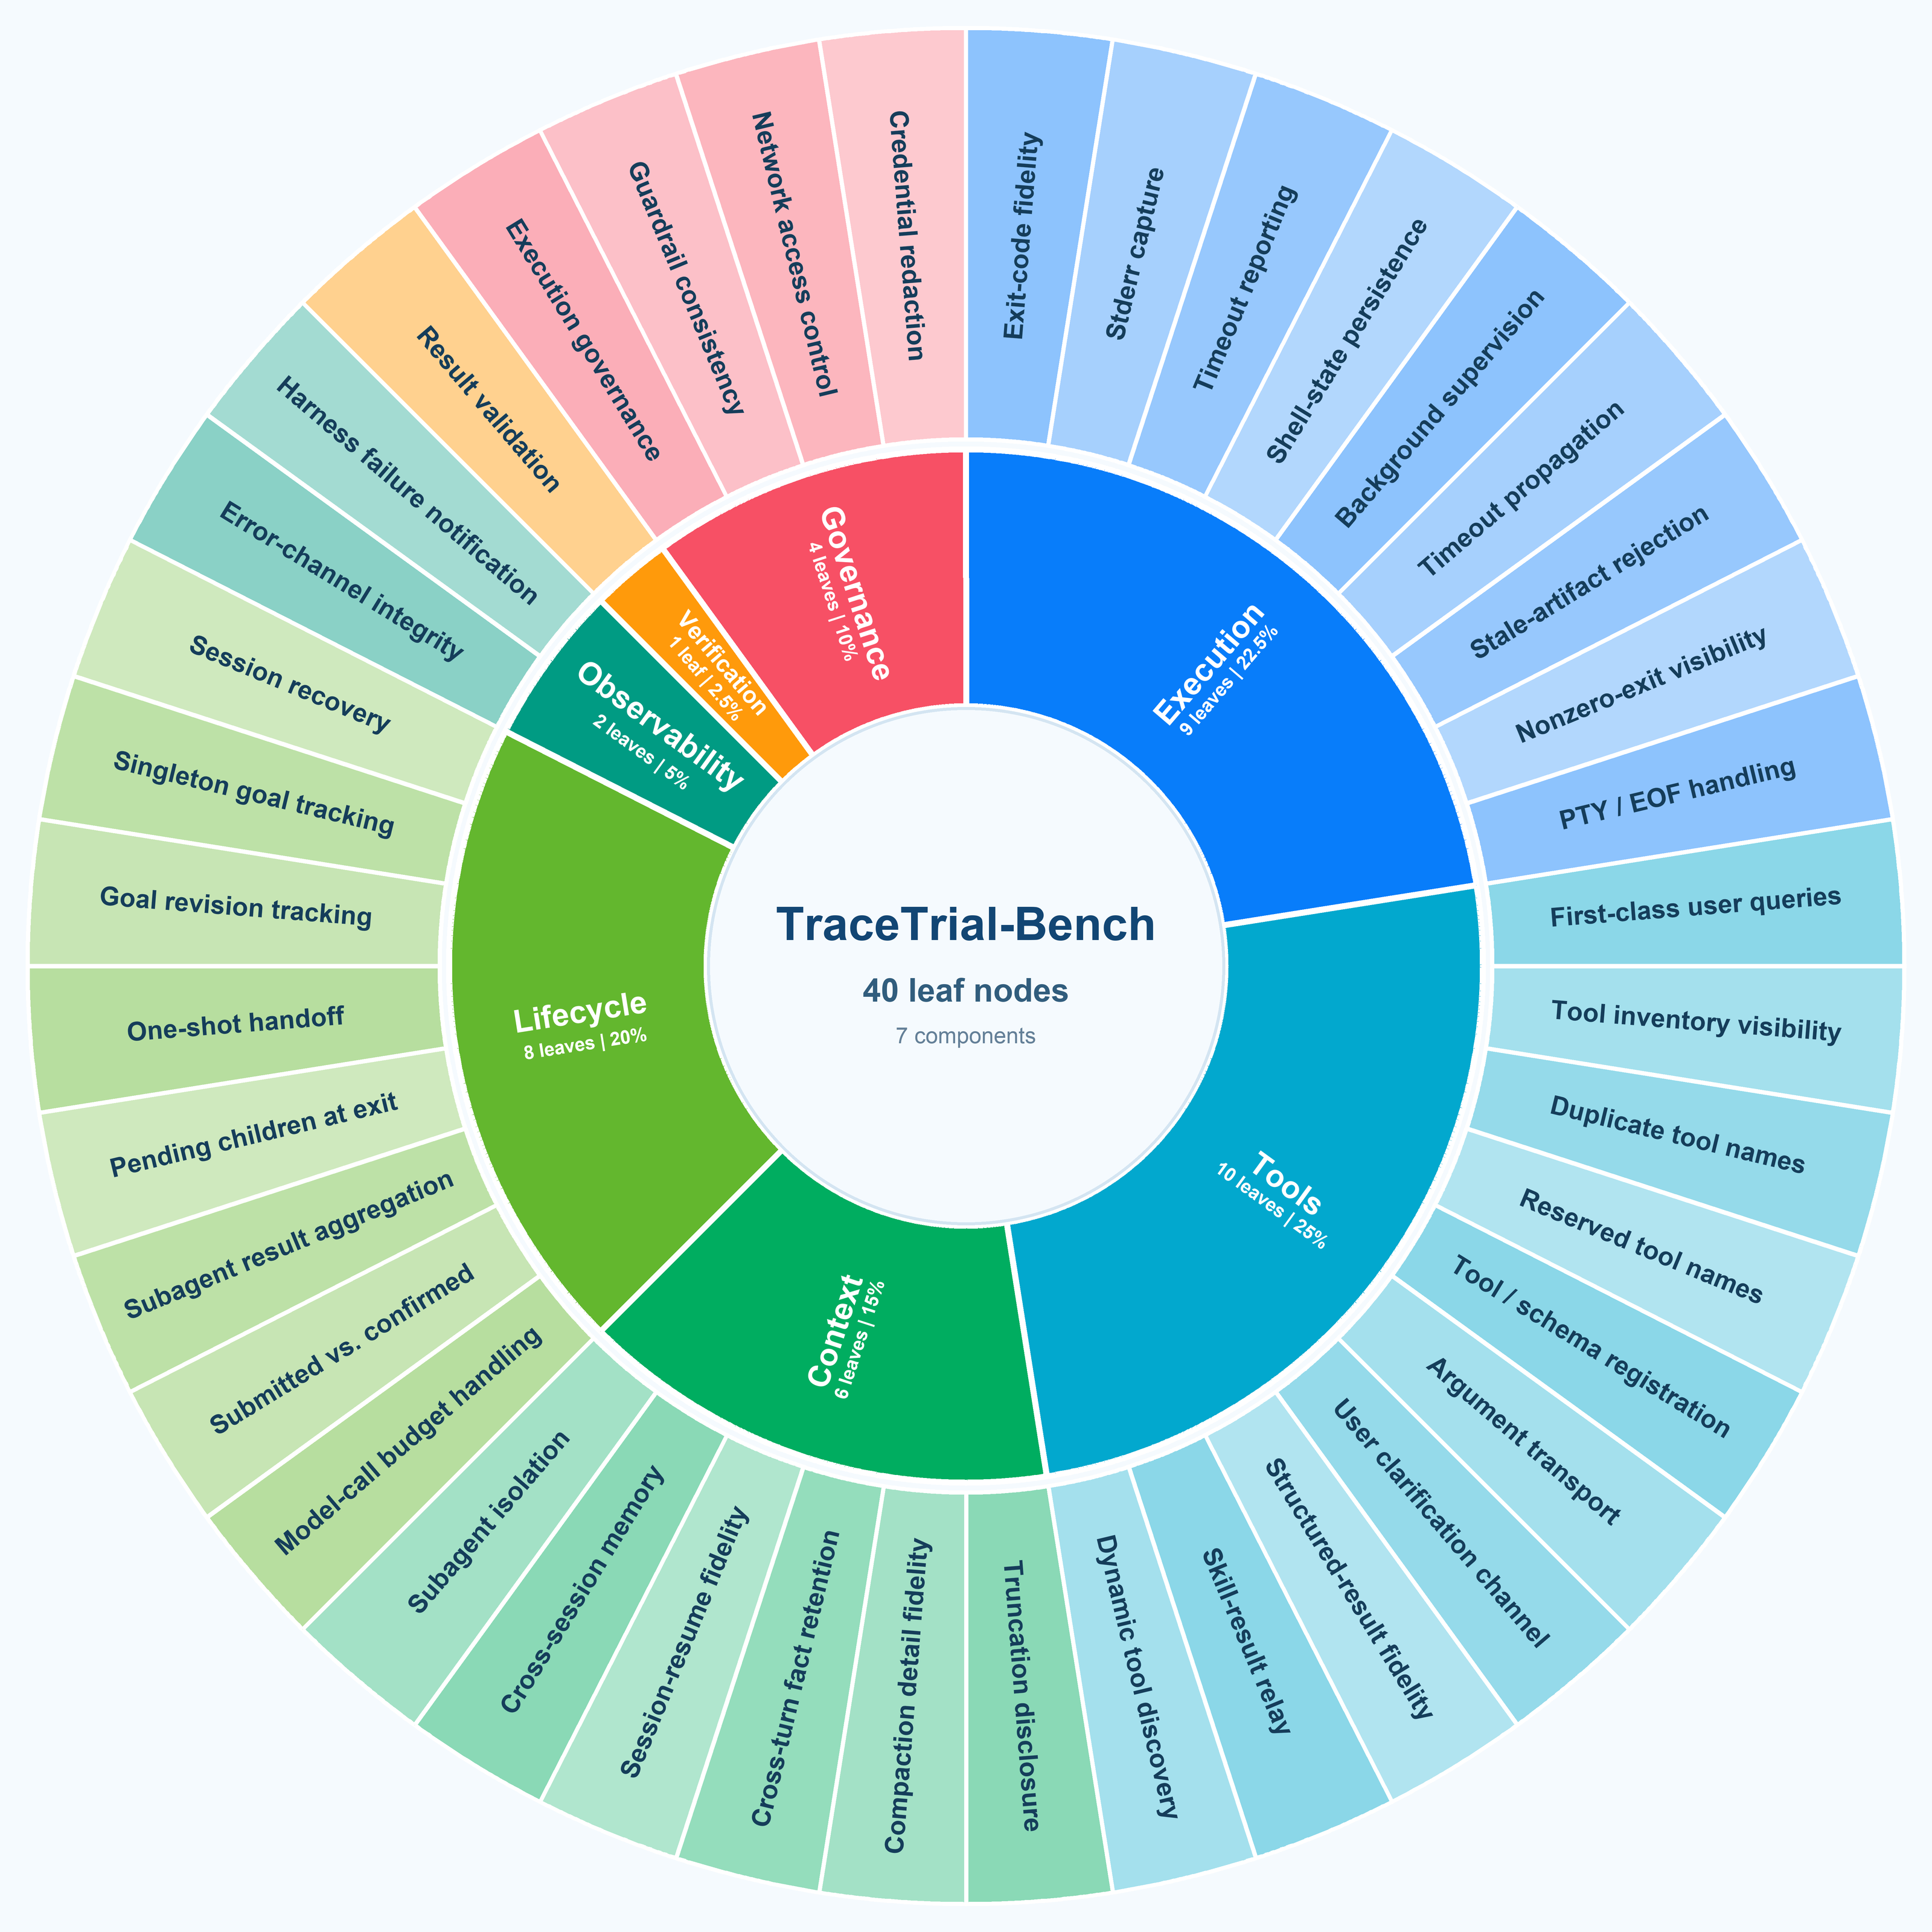
ベンチマークは、実行可能または状態ベースのグラウンドトゥルースを持つ、専門家が作成したメカニズム指向の95タスクを採用しています。「ネイティブの挙動を保持しながら意味的に等価な比較を行う」とは、各ハーネスが共通ラッパーに正規化されるのではなく、ソース固有のアダプターを通じてそれ自身のインターフェイスで駆動されることを意味します——そうしなければ、測定によってテスト対象の実行セマンティクス自体が上書きされてしまいます。
3つの装置モジュールがパイプラインをサポートします:
- Trajectory Tracing (TT):ネイティブハーネスのログおよびツール呼び出しから、来歴を保持した実行トレースを再構成します。
- Multi-source Evidence Acquisition (MEA):エージェントコンテキスト、ハーネス内部、実行環境から証拠を収集し、LLM評価器がスコアリングする述語に実際に関連するアーティファクトを確認できるよう、基準ごとに証拠を決定論的に選択します。
- Failure Attribution (FA):どのハーネス側の基準障害がどのエージェント側の症状に伝播しうるかをエンコードした明示的なメカニズムチェーンに基づいて動作し、両側が失敗しかつ事前宣言された条件が満たされた場合にのみ候補リンクを活性化します。
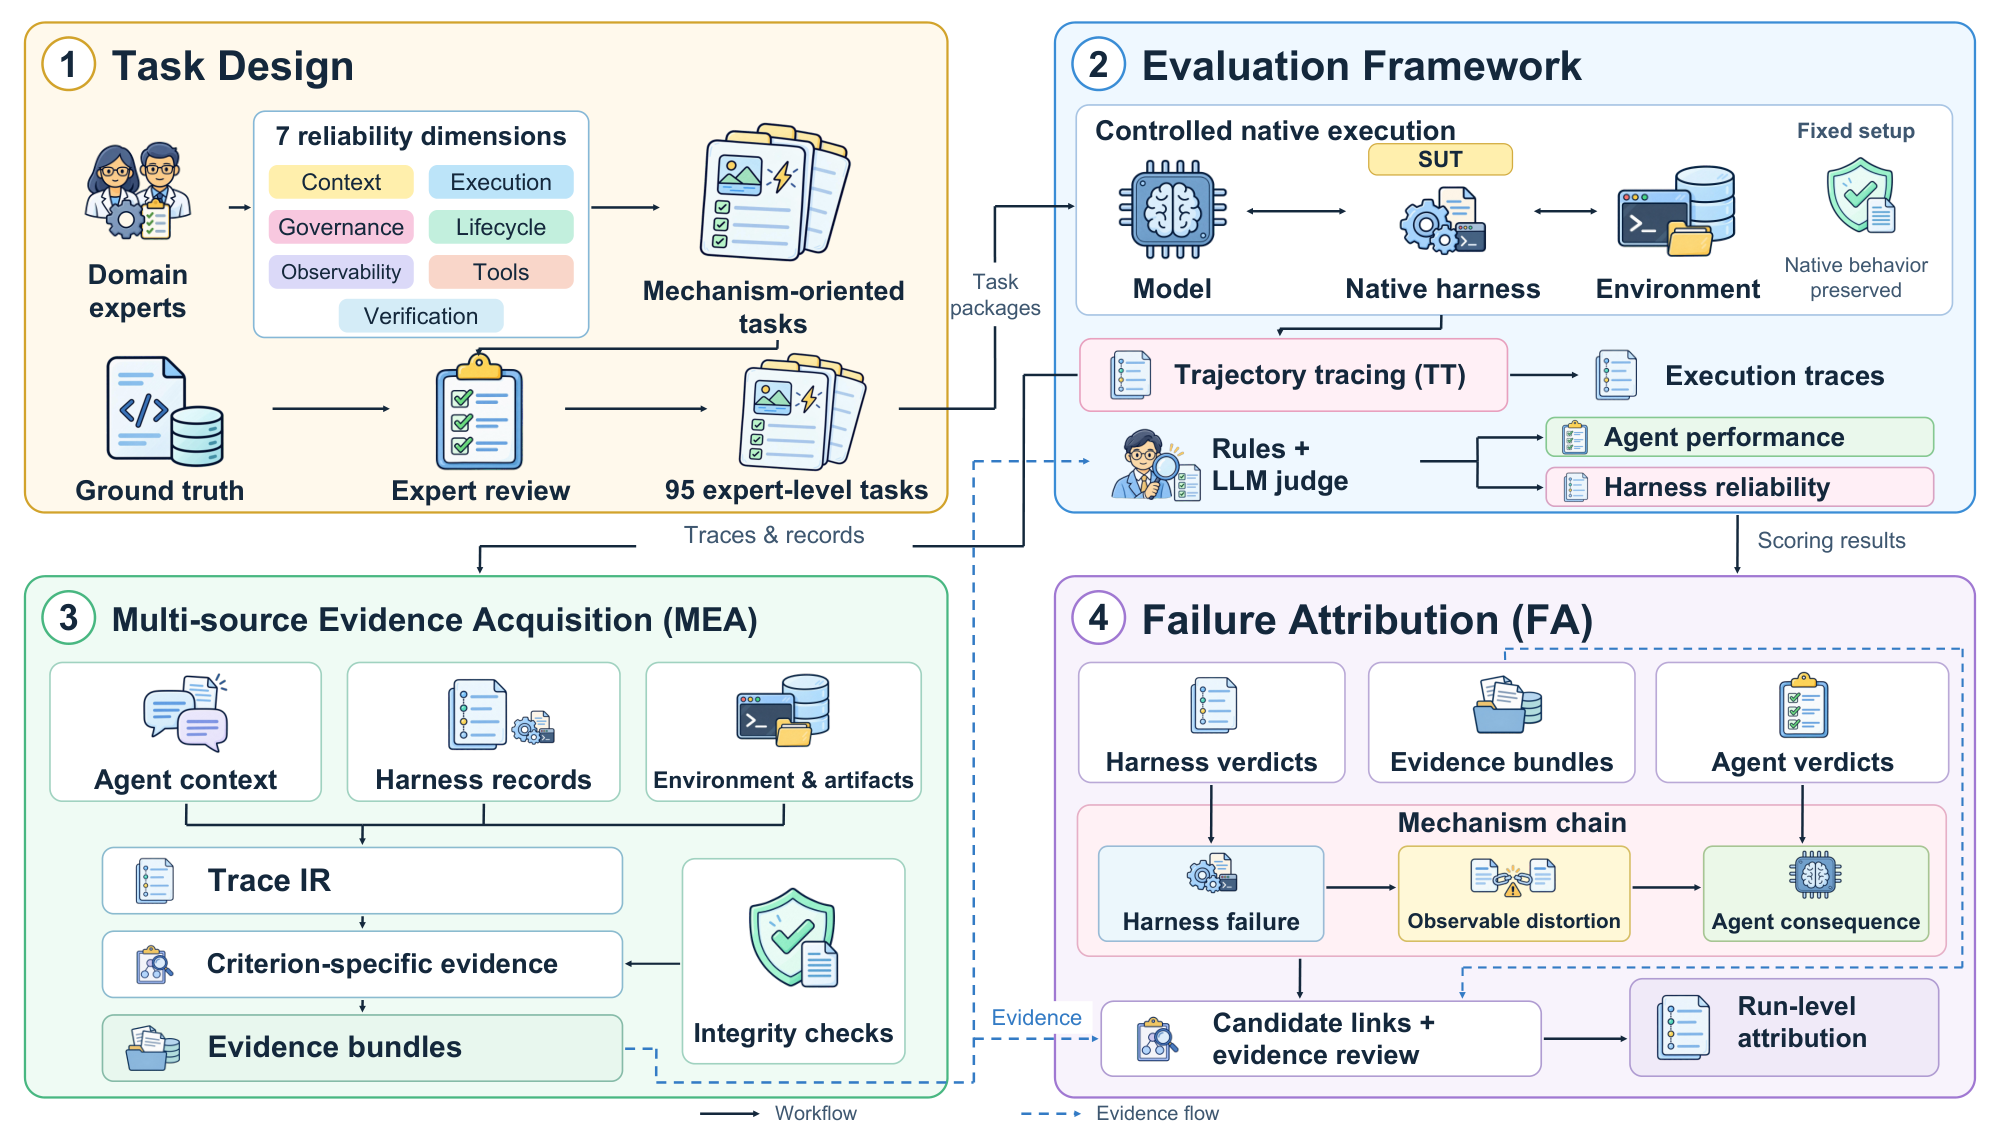
実験設計
行列は完全に充填されています:4ハーネス \times 9モデルグループ \times 95タスク = 3,420セル。各モデル–ハーネスブロックは95実行を含み、各ハーネスは855実行、各モデルは380実行を提供します。モデルグループは、DeepSeek-V4-Pro、Gemini 3.7 Flash、GLM-5.3、GPT-5.6-Sol、Grok-4.6、HY3、Kimi K3、Opus 5、Qwen3.8-Maxを、それぞれのアーカイブされた推論設定のもとで網羅しています。
結果
3,420セルすべてが、両レイヤーで空でないバイナリ評決ベクトルを持つ最終的な複合スコアを生成します。基準項目の集約:
- Agentアイテム:14,979 / 20,016 合格(74.8%)
- Harnessアイテム:19,242 / 28,188 合格(68.3%)
- 実行あたりの平均Agentスコア:72.9%、Harnessスコア:67.9%、50/50複合平均:70.4
連続スコアと厳格な全基準満足の間のギャップが主要な知見です。全Agentの基準を満たす実行は3,420のうちわずか1,351件(39.5%)であり、両レイヤーのすべての基準を満たすものはわずか286件(8.4%)です。言い換えれば、エージェントの実行が出力とハーネスメカニズムの両面において完全にクリーンである確率は、平均スコアが比較的良好に見えるにもかかわらず、おおよそ 1/12 です。これは結果のみの報告を根本的に損ないます:ハーネスは成功したアーティファクトを記録しながら、分布シフトや敵対的条件下で問題となりうるライフサイクル・コンテキスト・ガバナンスの特性を暗黙的に違反していることがあります。
論文はスカラーの要約として50/50スコアの平均70.4を計算していますが、より有益な量は、装置が基準ごとに保持する2つのレイヤー上の同時分布です。
制限と未解決の問題
いくつかの注意点が明示されています。基準の失敗をスコアリングするだけでなく、ハーネスの欠陥を確認するには、自動パイプラインを超えた検証が必要です——FAモジュールが活性化するのは候補メカニズムリンクであり、証明された原因ではありません。装置の障害は設計上ハーネスの欠陥から除外されており、これによってSUTの境界はクリーンに保たれますが、何が装置を構成するかについては著者の判断に依存します。95タスクの集合は専門家が作成したメカニズム指向のものであるため、40の信頼性特性全体でカバレッジが不均一であり、分類体系の図にはコンポーネントごとの偏りが示されています。最後に、評価された4つのハーネスはスナップショットであり、各ハーネスに独自の証拠抽出器とライフサイクルインストルメンテーションが必要なため、ネイティブアダプターの設計によりハーネスの追加は容易ではありません。
未解決の問題:タスク指示の言い換えにより候補メカニズムの活性化がどの程度安定するか、コンポーネント内の基準の重みを均一のままにすべきかどうか、またMEA証拠を読むLLM評価器がログがより冗長なハーネスに対して系統的なバイアスをもたらすかどうか、といった点が挙げられます。
この研究の意義
エージェント評価はこれまで主に結果スコアリングと事後的な説明によるものでした。TraceTrial-Benchは、測定可能な基準レベルの装置を用いてモデルエラーとハーネスの欠陥の分離を操作的に定義しており、現状の8.4%という両レイヤークリーン率は、現在のハーネスがタスクをパスしながらもエージェントの挙動をベンチマーク外でも信頼可能にするメカニズムを日常的に違反していることを示しています。
Source: https://arxiv.org/abs/2610.32285
InteractiveWorld: 優れたインタラクティブMLLMアシスタントを構築するための検証可能な人間中心環境
問題
一人称視点のMLLMアシスタント(ウェアラブルグラスを想像してください)は、ユーザーの行動を観察し、言語レベルのガイダンスで介入することを想定しています:リマインド、警告、計画立案、情報提供などです。これらの評価は難しく、その理由はループが人間を通じて閉じるためです。アシスタントは一人称視点の映像を見て発話し、人間が世界で行動し、次の観測が生成されます。既存の具体化シミュレータ(Habitat、iGibson、BEHAVIORなど)はロボット中心であり、関節レベルの制御を公開し、エージェントを言語的な協力者としてではなくマニピュレータとして扱います。静的なVQAベンチマーク(EgoSchema、Ego4D-NLQ)はインタラクションを完全に回避しています。現在のMLLMが実際に現実世界で人を支援できるかどうかを検証する、検証可能なクローズドループのテストベッドは存在しません。
手法
InteractiveWorldは、Isaac Sim上に構築された三層スタックであり、人間を制御される操り人形ではなく自律的な協力者として扱います。
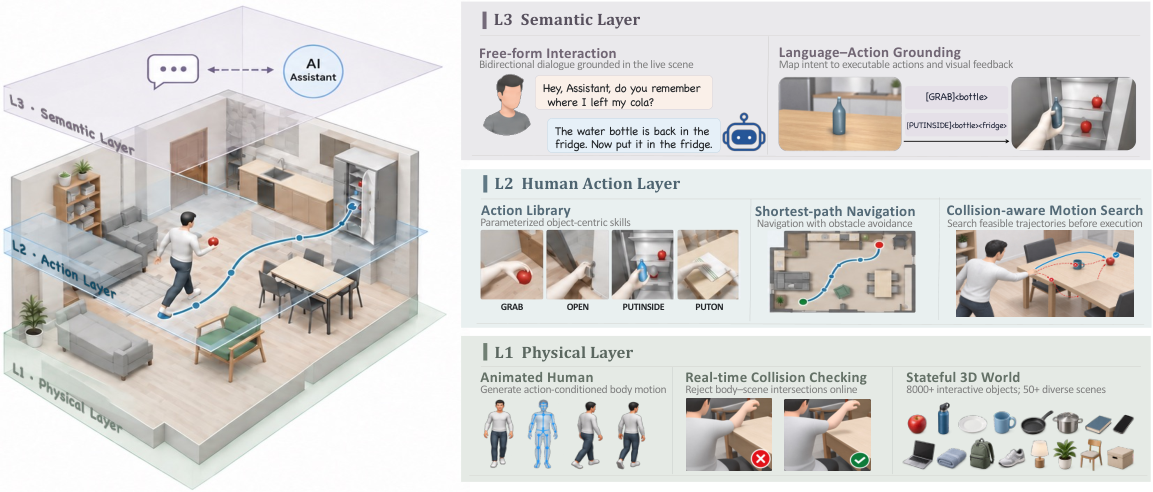
- 物理層(Physical Layer)。 人間はSMPL+H(全身+手)でモデル化され、一人称視点のためのヘッドマウントカメラを備えています。重要なのは、身体が物理ベース制御ではなくキネマティクスで駆動されるため、上位からの任意の有効なポーズシーケクスが決定論的に実行される点です。ラグドール障害は発生しません。ナビゲーションパスとアームリーチは事前チェックされ、軽微な衝突はグラスプをスライドさせることで自動修正され、安全でない行動は上位に伝播される構造化された失敗理由とともに拒否されます。約8,000個のオブジェクトと50以上のシーンがBEHAVIOR-1Kからインポートされています。
- 人間行動層(Human Action Layer)。
GRAB、OPEN、PLACE、ナビゲーションなど、信頼性の高い高レベルのプリミティブを提供し、人間が意図を持って自律的に実行できるようにします。これは、関節ごとの指示を必要とせずに実際の人間が行うことを模倣しています。 - セマンティック層(Semantic Layer)。 アシスタントの自由形式の言語を、利用可能なコマンドセットから選択された実行可能なアクションシーケンスに変換します。これにより、Humanエージェントは「緑のマグカップを渡して」という指示を現在のシーンに基づいて適切なアセットへの適切なプリミティブに翻訳します。
インタラクションループ(図1)は以下の通りです:アシスタントは一人称視点のフレームと対話履歴を観察し、interrupt(テスト付き)、silent、またはdoneのいずれかを出力します。人間はaction(構造化されたコマンド)またはspeakで返答します。環境はこれを実行し、新たな観測を返します。視覚入力は1ターンあたり32フレームに制限されており、最新の8フレームと履歴から均等にサンプリングされた24フレーム(アクションあたり4フレーム)で構成されます。
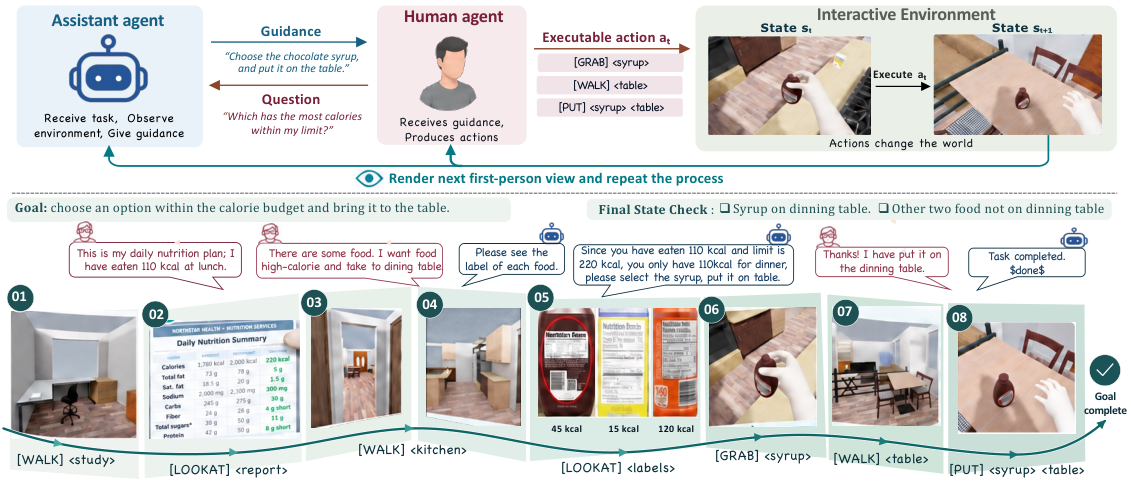
InteractiveBench
6つのカテゴリ(Guidance、Planning、Accessibility、Decision、Prevention、Finding)にわたる120のタスクがあり、それぞれ状態検証可能です。健全性チェックにより、HumanエージェントがOracle Assistantありで100%、なしで0%のパス率を達成することが確認されており、アシスタントが測定変数として切り離されています。各タスクには、クローズドループが開始される前にアシスタントに視覚的・時間的コンテキストを提供するためのスクリプト化されたウォームアップフェーズ(周囲を見回す、ラベルを読むなど)があります。12の最先端MLLMが、Gemini 3.1 ProをHumanエージェントとして固定して評価されます。
結果
最も優れたアシスタントでさえ、有能な協力者とは程遠い状況です。全体的なパス率(表2):
- Claude Fable 5.1: 41.7% パス / 54.8% MCR — 総合最高。
- Claude Opus 5: 33.3% / 48.1%。
- Muse Spark 1.1: 31.7% / 43.7%。
- GPT-5.6 Sol: 30.8%、GPT-5.5: 30.0%、GLM-5.3 Flash: 30.0%。
- Gemini 3.1 Pro: 20.8%、DeepSeek V4.1 Flash: 12.5%。
カテゴリ構造も重要です:DecisionとPreventionが最も容易であり(Claude Fable 5.1はPreventionで85% / 95.1% MCR、Decisionで85% MCRを達成)、一方でGuidanceとPlanningは非常に困難です。Guidanceでトップモデルが20% / 32.3%、Planningで25% / 45.6%にとどまっています。Findingタスクのパス率は最大50%です。この順序は、反応的な単一ステップの介入(警告、選択肢間の決定)が、マルチターンの手続き的ガイダンスよりもはるかに扱いやすいことを示唆しています。
能力レベルの内訳(表3、Perception / Memory / Reasoning / Interactionにわたる9つの軸)により非対称性が明らかになります:Communicationスコアは全体的に高く(62.6〜80.1%)、しかしProactivityは大幅に低下しています。Claude Fable 5.1は44.4%、Gemini 3.1 Proはわずか30.7%、DeepSeekは21.9%です。Long-horizon Memoryも同様に弱く(Claude Opus 4.8が33.9%、DeepSeekが31.1%)。モデルは会話できますが、いつ発話するかを決定したり、10ターン前に見たものを記憶したりすることができません。Perceptionサブスコア(Objects、Spatial、OCR)は43〜69%の範囲にあり、一人称視点映像における感覚層さえも解決されていません。
タスクをパスするモデルは過剰に行動する傾向もあります。アクション効率(パスしたタスクにおけるモデルのアクションステップ数とオラクルのステップ数の比率)は系統的に1を超えており、アシスタントが冗長なアクションを誘発していることを意味します。
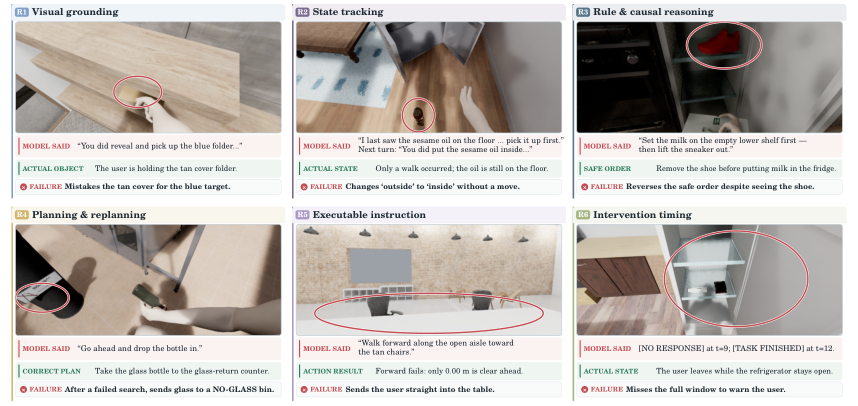
初期エラー分析により、失敗は6種類(ハルシネーションされたオブジェクト、見逃した介入ウィンドウ、誤った計画順序、grounding エラーなど)にクラスタリングされ、proactivity関連とmemory関連の失敗が支配的であることが確認されました。これは能力テーブルと一致しています。
限界
HumanエージェントはMLLM(Gemini 3.1 Pro)そのものであるため、測定されたアシスタントの性能はHumanエージェントの忠実度と絡み合っています。セクション4.2でこれをアブレーションしていますが、実際のユーザーを用いた研究と比較すると交絡因子として残ります。キネマティクスによる人間制御は生体力学的なリアリズムを回避しており、実際の人間が生み出す人間工学的側面や失敗モードの多様性(疲労、誤把持、短気など)が欠如しています。120タスクのベンチマークは能力空間に対して小規模であり、タスクは英語のみ、単一ユーザー、屋内に限定されています。さらに、「検証可能性」は状態ベースであり、丁寧さ、タイミング、ユーザーの好みといったニュアンスはスコアリングされません。
なぜ重要か
InteractiveWorldは、一人称視点アシスタントの評価をオフラインのVQAから、アシスタントの言語出力が半自律的な人間を通じて状態変化を駆動しなければならないクローズドループへと再定義します。主要な発見——トップモデルが約42%のパス率、proactivityが全体的に45%未満——は、現在のMLLMが有能な記述者ではあるが協力者としては不十分であることを示し、そのギャップを埋めるための具体的で再現可能な目標を提供します。
Source: https://arxiv.org/abs/2610.33966
Hacker News Signals
米国法典のためのGit
米国法典(連邦制定法を体系化したもの)は、変更履歴の追跡が著しく困難なことで知られています。本記事では、米国法典をバージョン管理されたリポジトリとして扱い、各修正条項や公法をコミットとして機能させることを提案しています。核心的な主張は、現在の公開モデル(法律改正顧問室が定期的な更新をモノリシックなHTML/XMLダンプとしてリリースする)がdiff履歴を廃棄してしまっているという点です。つまり、現在の状態は確認できますが、特定の法案で何が変わったかを再構築するには、会期法を体系化されたテキストと手作業で相互参照する必要があります。
技術的な提案はGitのセマンティクスに自然にマッピングされます。米国法典の各Titleはディレクトリになり、各条項はファイルになります。公法はメタデータ(議会会期、法案番号、制定日、提案者)を持つコミットになります。特定のテキストを削除・挿入する修正条項は、精密な行レベルのdiffとなります。ブランチモデルは、審議中の立法や上院・下院間の調整の相違点を表現できます。
実用的な観点では、USLM(United States Legislative Markup)XMLスキーマがすでに条項識別子でテキストを構造化しており、自動パースは実現可能です。課題は初期インポートです。現在のXMLリリースには履歴diffが含まれていないため、会期法テキストからコミットグラフを再構築するには、修正言語のNLPまたはルールベースの抽出が必要です(「X を削除し、Y を挿入する」というパターンは定型的であり、十分に確実にパース可能です)。
本記事ではblame/annotateセマンティクスの問題も取り上げています。条項に対して git blame を実行し、どの議会がそれを制定したかを正確に確認できるという機能です。これは法律調査において実用的な価値があり、現在はWestlawまたはLexisNexisのサブスクリプションが必要となっています。
未解決の問題としては、相互参照の処理(ある条項が別の条項によって修正される場合)、調整法に起因する非線形な履歴、そして一部の法律(例えば歳出法)が決して体系化されないという事実が挙げられます。オープンソースプロジェクトがガバナンス文書を扱う方法との比較は適切ではありますが、そのスケールを軽視しています。Title 26(税法)だけで数百万語に上ります。
Source: https://lexifina.com/blog/git-for-the-us-code
レビュアーは信頼性についてほとんど触れない。オーナーはその2倍の頻度で言及する
これは製品レビューテキストの実証的分析であり、特に短期レビュアー(購入直後に投稿する人々)が書く内容と長期オーナーが報告する内容との間の非対称性を検討しています。中心的な知見は、信頼性や耐久性に関するシグナルが、初期レビュアーのコンテンツと比較して、オーナーによるコンテンツにおいておよそ2倍の頻度で出現するというものです。
方法論的な基盤は、製品レビューコーパスに対するNLPベースの分類です。レビューは購入後の経過時間(またはレビューテキストのシグナルから推定された所有期間)によってセグメント化され、故障率、劣化、寿命、リピート購入、保証請求といった信頼性に関連する言語についてトピックモデリングまたはキーワード・フレーズ分類が行われます。信頼性への言及比率は、2つのコホート間で算出されます。
この研究が重要な理由は、消費者の意思決定の大部分が集計されたstar ratingと初期レビュー——つまり、リスティングページに最初に表示され、アップボートを積み重ねるもの——に大きく依存しているためです。これらは初期印象、すなわち開封体験、初回使用感、機能の充実度に向けて系統的にバイアスがかかっています。長期的な故障モード——モーターの焼き付き、コーティングの剥離、ファームウェアの劣化、バッテリーの劣化——はオーナーコホートにのみ現れます。
システム的な観点から見ると、これはシグナル抽出の問題です。初期レビューの分布は耐久性に関して右打ち切りになっています。1週間のレビューでは2年後の故障を観測することは原理的に不可能です。この論文の暗黙的な提言は、ランキングおよび要約システムが時間層別のレビューコンテンツを異なる重みで扱うべきであるか、あるいはオーナー期間のシグナルを明示的に提示すべきであるというものです。
注目すべき限界点として、購入後経過時間のプロキシはノイズが多く、レビュープラットフォームは常に購入日を公開しているわけではないため、言語からの推定を余儀なくされます。また、選択バイアスも対処されていません——購入後2年でレビューを書くのは、購入後1週間で書く人とは異なる母集団であり、いずれも全購入者を代表するものではありません。2倍という数値はヘッドラインの統計であり、要約には信頼区間が報告されていないため、その正確な大きさにどれほどの重みを置けるかは限られます。
Source: https://www.bettascore.ai/research/reliability-reviewers-vs-owners
GPT-6.1 Terra
OpenAIのGPT-6.1 Terraは、フロンティア推論・マルチモーダルモデルとして位置づけられています。技術的な開示は、アーキテクチャの詳細を伴わないcapabilityベンチマークという、今や標準的なパターンに従っていますが、発表された数値は直接検討する価値があります。
MMLUおよびGPQA Diamondにおいて、Terraは既存のGPT-4クラスのモデルを大幅に上回ると報告されており、困難な科学的推論における顕著な向上が主要な主張となっています(GPQA Diamondは強力なchain-of-thoughtを持たないモデルにとって難度が高いことで知られています)。コーディングベンチマーク(SWE-bench Verified、HumanEvalの変種)では、Terraは現在の最高スコアと同等かそれ以上と報告されています。マルチモーダルコンポーネントは、フレームサンプリングによる回避策ではなくネイティブに動画理解を処理するとされており、この主張が正しければ真のアーキテクチャ上の変更を意味することになります。
「Terra」という名称は、根拠のある事実に基づいたretrieval-augmentedな出力への重点を参照しているようです。このモデルはベースweightとretrievalのより緊密な統合を持つと説明されていますが、そのメカニズムは開示されていません。これが取得されたコンテキストに対する異なるattentionパターンなのか、専用のretrieval headなのか、それとも単純にソースを引用することに向けたRLHFチューニングなのかは不明です。
context windowは大幅に拡張されています(執筆時点では具体的な長さは未確認)。APIの価格体系は、TerraがGPT-4oよりも高価であることを示唆しており、o-seriesモデルと並んで「困難な推論タスクには多く支払う」層に位置づけられています。ただし、Terraとo-series推論モデルの関係については明確に説明されていません。
エンジニアリングの観点からは、記載されていない情報も記載されている情報と同様に示唆に富んでいます。学習計算量に関する議論はなく、mixture-of-expertsとdenseアーキテクチャの問題についての詳細もなく、標準的な推論ワークロードに対するlatencyの数値もありません。ベンチマーク重視の発表スタイルは、サードパーティによる評価が出るまで独立した検証を困難にしています。
Source: https://openai.com/index/introducing-gpt-6-1-terra/
Show HN: Hob - Claude CoworkとChatGPTのオープンソースなオンデバイス代替
HobはFrigadeが開発したElectronベースのデスクトップアプリケーションで、LLM inferenceをローカルで実行します。セッションをまたいで保持されるコンテキスト、ツール統合、フラットなチャット履歴ではなく構造化されたプロジェクト/スレッドモデルを特徴とする、永続的なAIワークスペースのユースケースを対象としています。
技術スタックについて:Hobはinferenceのバックエンドにllama.cppを使用しており、GGUFで量子化されたモデル(Q4_K_MとQ8_0がドキュメントに記載されているテスト済みフォーマット)を対象としています。ElectronシェルがUIレイヤーを担い、ローカルのSQLiteデータベースが会話履歴とプロジェクトコンテキストを保存します。「ワークスペース」の抽象化は、プロジェクトごとのシステムプロンプトと、会話ターンとは分離された永続メモリを維持します——これは標準的なチャットインターフェースよりも、エージェントループを構造化する方法に近い設計です。
ツール使用はローカルのfunction-callingプロトコルで実装されています:Hobはシェルコマンドの実行、ファイルの読み書き、JSONスキーマで定義されたユーザー定義ツールの呼び出しが可能です。これはClaudeのAPIにおけるツール使用レイヤーにほぼ相当しますが、すべてオンデバイスで動作します。ここでのセキュリティモデルは精査する価値があります——読み込んだドキュメントを通じてモデルが敵対的にプロンプトされた場合、permissiveなツールスキーマを持つLLM駆動ループからのシェル実行は、重大な攻撃対象領域になり得ます。
モデルの互換性については良好です:llama.cppで読み込み可能なGGUFモデルであれば何でも動作するため、Llama 3、Mistral、Qwen、Phi-3の各バリアントがすべて対象範囲に含まれます。パフォーマンスはハードウェアに制約されます。READMEでは、7B〜13Bパラメータのモデルで適切なスループットを得るためにApple Siliconを推奨しています。
Hobがllama.cppを直接実行することに対して追加する価値は、ワークスペース/プロジェクトのUXと永続的なコンテキスト管理です。クラウド代替と比較して欠けている点は明白です:フロンティア規模のモデルへのアクセスはなく、量子化された13Bモデルは複雑な推論タスクにおいてGPT-4クラスの出力と競合できません。オンデバイスのプライバシー保証が主要な価値提案です。
Source: https://github.com/FrigadeHQ/hob
AIはテック雇用の低迷を引き起こしたわけではないが、回復が見られない理由を説明している
本稿は構造的な議論を展開しています。2022〜2023年のテック業界のレイオフの波は、AIによる雇用代替ではなく、ゼロ金利刺激策期における過剰採用が原因であるというものです。AIに関する主張はより具体的で、AIツールがエンジニア一人当たりのアウトプットを向上させることで、通常であれば起こるはずの不況後の採用回復を抑制しているというものです。スループットが回復しても、人員数は横ばいのままで済むようになっているというわけです。
この議論はそれ自体として真剣に受け止める価値があります。歴史的に見て、テック不況の後は、製品需要の回復やバックログの蓄積に伴い再採用が起こるのが常でした。著者の主張は、AIを活用したコーディング(GitHub Copilot類のツール、LLMを用いたデバッグ、テスト自動生成)がもたらす生産性の乗数効果が十分に大きく、以前はX個の機能をリリースするためにN人のエンジニアが必要だったチームが、今では0.7N人で済むようになっているというものです。これにより、大規模な雇用代替が起きるわけではなく、雇用回復が緩やかに抑制される——急激な代替ではなく、より穏やかで構造的な抑圧として現れます。
引用されている裏付けとなる証拠は、おおむね方向性を示すものに留まっています。Microsoft ResearchによるCopilotの生産性研究では、個別タスクにおいて30〜55%の速度向上が示されており、それに加えて、規模を縮小したチームが前サイクルのアウトプット目標を達成しているというエンジニアリングマネージャーからの逸話的な報告も引用されています。ただし、本稿では正式な労働弾力性の推定値は示されておらず、それが明らかな欠点です。
反事実的な検証は構築が難しい状況です。AIツールの使用を禁止したテック企業というクリーンなコントロールグループは存在しません。また、生産性の向上が特定のタスク種別(定型コードの生成、ドキュメント作成、テストの雛形作成など)に集中しており、それが人員削減に線形に結びつくかどうかも不明です。システム設計やアーキテクチャを担うシニアエンジニアは、CRUDエンドポイントを実装するミドルレベルのエンジニアと比べて代替が難しいです。
それでも、「AIは雇用代替の原因ではなく、回復の抑制要因である」というフレーミングは、このテーマに関する一般的な言説の中でも、より精緻で擁護しやすいものです。
Source: https://vithushansylvester.com/writing/the-real-impact-of-ai-on-tech-jobs
Amazonが持続的な失敗を受けてAI部門を大幅縮小
ここでの核心は、Amazonの社内AIプロダクト組織、特にNovaモデルファミリーおよびAlexa LLMの刷新プロジェクトに関するものです。報道されているリストラには、AWSおよびDevices、Amazon.comにわたって増殖していたAIチームの大幅な人員削減と統合が含まれています。
報告されている技術的な失敗の様式は、単一の壊滅的なプロダクト失敗ではなく、アーキテクチャの乖離と調整コストの肥大化です。Amazonは統一されたmodel servingインフラを持たないまま、複数の並行LLM開発を進めた結果、冗長な計算コストと互換性のないfine-tuningパイプラインが生じました。Novaモデル(Bedrockでホストされているサードパーティのモデルとはことなる、Amazon社内開発のfoundation model)は、AnthropicやOpenAIの同等の計算クラスのモデルと比較してreasoningベンチマークで劣っていたと報告されており、AmazonはそれらをBedrockで同時に提供しているため、自社製品が客観的に劣るという内部競合が生じていました。
大々的に発表されたAlexa LLMの統合は、遅延し、かつ期待を下回る結果であると説明されています。根本的な課題はこの分野でよく知られているもので、ベースLLMを低レイテンシ・デバイス統合型の音声インタラクションに適応させるためには、積極的なquantization、streaming decoding、そして不流暢な音声入力へのロバストな対処が必要であり、これらすべてがベース能力のギャップを拡大させます。NovaのベースとなるCapabilityがすでにGPT-4クラスより劣っている場合、エッジデプロイの制約によるCapabilityの劣化を吸収できる余地はさらに狭くなります。
組織的な観点からすると、この教訓はよく知られたものです。既存のクラウドインフラ事業を持つ大企業は、外部モデルプロバイダーへ計算資源を販売することを報奨する構造的なインセンティブのため、競争力のあるフロンティアモデルを構築することが構造的に困難です。AWSにとって最も収益性の高いAIの取り組みはAnthropicやMistralのinferenceを大規模に運用することであり、社内モデルの開発はそのナラティブを損なうコストセンターとなっています。
Source: https://futurism.com/artificial-intelligence/amazon-ai-division-failure-nova
私のデータはモデルの学習に使用されていますか?
これはAnthropicによる公式ドキュメントページであり、Claudeのデータ保持および学習利用に関するポリシーを明確にしています。その技術的・ポリシー的内容は、典型的なプライバシーページの定型文よりも具体的であり、注意深く読み解く価値があります。
重要な区別点として:Claude.aiのfreeおよびProティアの会話は、デフォルトで学習に使用される可能性があり、設定からオプトアウトが可能です。一方、開発者によるAPIの使用は、デフォルトでは学習に使用されません――デフォルトが学習利用なしという点は、コンシューマー向け製品のデフォルトとは逆になっています。EnterpriseおよびTeamティアのアカウントも、学習利用なしがデフォルトです。
学習データの取り扱いとして説明されているメカニズムは、学習パイプラインへの利用前に、品質および安全性評価を目的として会話の一部を人間がレビューするというものです。これはRLHF/RALIFの標準的な実践であり――人間の選好データとred-teamの事例はいずれもfine-tuningの段階に供給されます。ドキュメントには、どの割合の会話がレビューされるか、またサンプリングがどのように層別化されているかは明記されていません。
記載されていない事項としては、学習に使用された会話が無期限に保持されるのか、それとも学習実行後に削除されるのか、人間によるレビュー前にどのような匿名化または非識別化が適用されるのか、そしてオプトアウトが遡及的であるか否か(すなわち、オプトアウトによって過去の会話が将来の学習に使用されることを防げるか)が挙げられます。最後の点は技術的に自明ではありません――デプロイ済みモデルから特定の学習事例を除去するアンラーニングは、明確な解決策が存在しない現在進行中の研究課題です。
Claudeの上にアプリケーションを構築しているAPI開発者にとって、デフォルトで学習利用なしというポリシーは商業的に重要な事実です。機密性の高いユーザーデータ(医療・法律・金融)を扱うアプリケーションは、自身のAPIの利用ティアを確認し、コンシューマーティアのデフォルトに依存しないようにする必要があります。このドキュメントページは、営業やサポート担当者の説明に頼るのではなく、権威ある参照先として位置づけられます。
Source: https://privacy.claude.com/en/articles/7996868-is-my-data-used-for-model-training
Nietzschian Debugger
これはデバッグ出力をフリードリヒ・ニーチェの哲学的著作のレトリックおよび文体的な様式で包んで提示する、ユニークな開発者ツールです。実用的な基盤はPythonのエラーハンドラーとスタックトレースフォーマッターであり、例外情報をLLMプロンプトに渡して、ニーチェとして——警句的に、弱さを軽蔑し、バグをプログラマーの「力への意志」の試練として描写する形で——応答するよう指示します。
実装は明快です:カスタムのPython sys.excepthook 置き換えが未処理の例外を捕捉し、トレースバックと例外の型をフォーマットして、ニーチェのペルソナを確立するシステムプロンプトとともにLLM API(OpenAI互換エンドポイント)へ送信します。レスポンスは標準トレースバックの代わりに、あるいはそれと並べてstderrに出力されます。
ジョークの側面を超えて、ここには軽度ながら興味深いUX上の示唆が埋め込まれています。標準のPythonトレースバックは正確ではあるものの、デバッグを行う人にとって教育的に構造化されているわけではありません——どのフレームが最も関連性高いかを優先することも、因果的な仮説を提示することもなく、完全なコールスタックをそのまま出力します。LLMを活用したエラー説明(ニーチェ口調ではない形での)は真に有用なパターンであり、llm CLI、aider、各種IDE integrationといったツールが真剣にこれに取り組んでいます。Nietzschian Debuggerのユーモア的な枠組みは、その基盤となるパイプライン(例外コンテキストの捕捉、LLMへの送信、構造化されたレスポンスの返却)が週末プロジェクトとして実装できるほどシンプルであることを、図らずも実証しています。
このリポジトリにはAPIキーと openai PythonパッケージのみというAPIキー以外の外部ランタイム依存関係がありません。prompt engineeringは最小限で——単一のシステムメッセージとユーザーコンテンツとしての生のトレースバックのみです。これを実用的な非ジョークツールへ拡張するには、より良いコンテキストインジェクション(関連するソース行、例外発生時のローカル変数の状態)と、自由形式の散文ではなく構造化された出力が必要でしょう。Pythonの traceback モジュールと inspect は、より豊かなコンテキスト抽出に必要なフックを提供しています。
Source: https://github.com/DilawarShafiq/nietzschian-debugger
注目の新規リポジトリ
Folkbench/folkbench
AI APIリレーサービス向けのベンチマーキング・ルーティングツールです。対象となるのは、Claude・GPT-4・Codexなどのモデルへの呼び出しをプロキシする中国市場向けアグリゲーター(およびその国際版相当サービス)です。本プロジェクトは自動プローブを実行し、3つの軸を計測します:実際の可用率(単なるアップタイムの主張ではなく)、リクエストごとのレイテンシ分布、そしてリレーのマークアップ後の実効トークン単価です。結果はランク付きリーダーボードに反映されるため、オペレーターはベンダーの自己申告に頼るのではなく、データに基づいてどのリレーを使用するか意思決定できます。
このツールにはスイッチャーコンポーネントが含まれており、Claude CodeやCodex環境をクエリ時に最上位ランクのリレーへ動的に再ルーティングするよう設定できます。これは、直接のAPIアクセスが不安定または高コストな地域で実用的に有効です。ベンチマークの手法はオープンであるため、結果は再現可能であり、リレーオペレーターはサービスを実際に改善することなしにランキングを操作することはできません。
高ボリュームなエージェント型ワークロードを運用するチームにとって、わずかなレイテンシの改善でも積み重なれば大きな効果をもたらし、可用性の欠如はマルチステップのエージェント実行をサイレントに破損させる可能性があります。中立かつ再現可能なベンチマークの存在は実際のギャップを埋めるものであり、リレーサービスの品質はこれまでコミュニティの非公式なレポートによってのみ評価されてきました。
Source: https://github.com/Folkbench/folkbench
opensec-git/Pi-Bolt
Pi-Boltは、Pi codingエージェント(Node.jsベースのagentic coding assistant)を受け取り、Node runtimeの起動オーバーヘッドを排除するツールチェーンを用いてahead-of-timeコンパイルし、単一のネイティブ実行ファイルへとまとめるプロジェクトです。謳われているパフォーマンス指標——コールドスタートの10倍高速化、CPU使用率の7分の1、メモリフットプリントの4.5分の1——は、V8のJITウォームアップと、Nodeが呼び出しのたびに辿るモジュール解決グラフを取り除いたことによるものです。
配布ターゲットはLinux、macOS、Windows、およびARM64で、Termux/Androidへの明示的なサポートも備えており、フルのNodeインストールが現実的でないエッジハードウェアや制約の多い環境でも利用できます。シングルバイナリのパッケージングにより、CIパイプライン・コンテナ・開発者のdotfilesへのデプロイが容易になります。一つのツールを実行するためだけにNodeのバージョンマネージャーを管理しなければならないという、実際の摩擦を解消できます。
エンジニアリングの観点からすると、このコンパイルはおそらくBunのcompile targetか、それに類するbundler+ネイティブラッパー方式を採用しており、JSヒープをスナップショットして最小限のruntimeにリンクする形をとっていると考えられます。メモリの節約効果は、単一マシン上で多数の並列エージェントワーカーを実行する際に最も顕著に現れます。
Source: https://github.com/opensec-git/Pi-Bolt
opentrap/opentrap
Burp Suite の代替として明確に位置づけられた、オープンソースのWebアプリケーションセキュリティテストスイートです。コアはブラウザとターゲットの間に挟まるHTTP/HTTPSインターセプトプロキシであり、通信中のリクエストとレスポンスをキャプチャして変更できます。機能セットはBurpの主要ツールと密接に対応しており、手動リクエストリプレイのためのRepeater、パラメータ化されたファジングおよびブルートフォース攻撃のためのIntruder、そしてアウトオブバンドインタラクション検出のためのCollaborator相当機能(ブラインドSSRF、XXEおよび類似の脆弱性に有用)が含まれます。
特筆すべき追加機能は、OWASP ZAP scannerの組み込み統合であり、別途ZAPインスタンスを用意することなく、パッシブおよびアクティブスキャンルールをUIに直接組み合わせています。これにより、手動および自動テストのワークフローを単一ツールで処理できます。
AGPL-3.0ライセンスのもとLinuxネイティブで提供されており、Burpの商用ライセンス制約なしに完全に監査可能なツールチェーンを求めるペネトレーションテスターおよびセキュリティエンジニアを対象としています。AGPLライセンスはSaaSラッパーにも変更のオープンソース公開を義務付けます。初期のスター数は、セキュリティコミュニティにおけるメンテナンスされたオープンな代替手段への真の需要を示しています。既存のオープンな選択肢(ZAPスタンドアロン、mitmproxy)は、同等のワークフローエルゴノミクスを実現するためにより多くの組み合わせ作業を必要とするためです。
Source: https://github.com/opentrap/opentrap
Alejandros17487/ai-jailbreaks
GPT-4o、Claude 3.x、Geminiなどのフロンティア閉鎖重みシステムと、Llama、Mistral、Qwenファミリーなどの人気オープン重みモデルを含む25以上のモデルを対象とした、すぐに使える35種類の敵対的promptを体系的にまとめたコレクションです。このコレクションは単純なprompt injectionにとどまらず、完全なシステムpromptテンプレート、エージェント的スキャフォールド向けのAGENTS.md仕様、およびjailbreak設定をローカルモデルバリアントとしてパッケージ化するためのOllama Modelfileを含んでいます。
明示的な位置づけはAIセキュリティ研究およびred-teamテストです。技術的な観点からは、その価値はタクソノミーとモデル固有のターゲティングにあります。アーキテクチャやRLHFのレジームが異なれば、必要な攻撃ベクトルも異なるため、モデル別に整理されたキュレート済みセットがあれば、安全性緩和策の体系的な評価が現実的になります。
安全性評価を行う組織やjailbreak試みを検出するためのclassifierを構築する組織にとって、このようなラベル付きコーパスは有用な訓練・テストデータとなります。AGENTS.mdコンポーネントは特に重要です。エージェント的デプロイメントでは、単一ターンのチャットとは実質的に異なるprompt injectionの攻撃面が生じるからです。Modelfile形式により、jailbreakコンテキストが量子化やローカルサービングパイプラインを経ても維持されるかどうかをテストできます。これは、ホスト型APIパスとは異なる独自の脅威面です。
Source: https://github.com/Alejandros17487/ai-jailbreaks
Graphicle-AI/graphicle
エージェント型コーディングツール向けのコードグラフと永続メモリ層を実装したもので、MCP(Model Context Protocol)サーバーを公開する単一のRustバイナリとして実装されています。核心となるアイデアは、Claude Code、Codex、Cursorといったコーディングエージェントが、セッションをまたいだり、長いセッション内でcontext windowが埋まるにつれてコードベースの構造的理解を失ってしまうという問題への対処です。Graphicleはコードベースの明示的なグラフ表現を構築・維持します。具体的にはシンボル、呼び出し関係、インポート依存関係、ファイルレベルの構造などを扱い、エージェントが生のファイル読み込みにトークンを消費することなく関連するコンテキストを取得できるよう、MCP経由でクエリ可能にしています。
メモリコンポーネントはエージェントのセッションをまたいだ永続性を追加することで、インクリメンタルな作業がゼロから始まるのではなく、以前の理解の上に積み上がっていくようにします。これはエージェント呼び出しのたびに完全な再インデックス処理を行うことがコスト的に許容できない大規模なモノレポにおいて最も重要になります。
RustはここではI/OとCPUに負荷がかかるインデックス処理のワークロードに対して合理的な選択であり、バイナリがIDEと並行してバックグラウンドデーモンとして動作する際にメモリオーバーヘッドを低く抑えることが重要です。MCPインターフェースにより、ツール固有の統合コードなしに準拠した任意のクライアントと連携できます。主な未解決の疑問は、静的解析では不完全な呼び出しグラフしか得られない動的言語をグラフがどのように扱うかという点です。
Source: https://github.com/Graphicle-AI/graphicle
feder-cr/git-ai
コアとなるGitワークフローを、人間ではなくAIエージェントを主要なユーザーとして想定して再設計したプロジェクトです。従来のGitは、人間のオペレーターがdiffを読み、コミットメッセージを作成し、コンフリクトを解決し、ブランチに関する決定をインタラクティブに行うことを前提としています。git-aiはこれらのプリミティブを再構成しており、ステージされたdiffからのコミットメッセージ生成、設定可能なストラテジーによる自動コンフリクト解決、タスク説明からのブランチ命名、PRの説明文の自動生成といった機能が、後付けの追加機能としてではなく、第一級の操作として扱われています。
実用的なターゲットは、LLMベースのエージェントが自身の作業をチェックポイントし、ブランチを管理し、各ステップで人間が介在することなく人間が読めるヒストリーを生成する必要があるagentic coding pipelineです。これは現在のエージェントフレームワークにおける本質的な摩擦ポイントであり、ほとんどのフレームワークは粗雑なコミットメッセージを生成するか、コミットのために明示的な人間の介入を必要とするかのどちらかです。
コンフリクト解決に関する設計上の選択が、技術的に最も興味深い点です。自動マージの判断は、リポジトリをサイレントに破損させることを避けるために十分に保守的である必要がある一方で、自律的なワークフローの妨げにならないことも求められます。現在の実装がそのバランスを達成しているかどうかが、重要な未解決の問題です。公開初期から1000以上のスターを獲得していることは、このツールがagentic dev toolingスタックにおける実際のペインポイントに対処していることを示唆しています。
Source: https://github.com/feder-cr/git-ai
xop01/ai_goodpractice
AIツールをソフトウェア開発および研究ワークフローに実践的に統合するための体系的なガイドであり、初級者から経験豊富な実践者の両方を対象としています。内容は、prompt engineeringの基礎、モデル選択のヒューリスティクス、コンテキスト管理戦略、agent scaffoldingのパターン、そしてAI支援開発を導入するチーム向けの組織的ワークフローにまで及びます。
典型的な「awesome-prompts」リストとの違いは、体系的な網羅性への取り組みにあります。AIアシスタントをいつ使うべきかだけでなく、いつ使うべきでないかについても言及し、プロダクション環境におけるレイテンシとコストのトレードオフを論じ、agenticなパターン(マルチステップタスク、tool use、memory management)を実用的な水準の具体性をもって解説しています。また、prompt設計に影響を与えるモデル固有の挙動の違いについても取り上げており、異なるモデルが同じ指示パターンに対して非常に一貫性のない応答を示すことを考えると、実践上の重要性は高いと言えます。
経験豊富なML実践者にとっての価値は、基礎的な内容よりも、agentを大規模かつ安定的に運用するための集約された実践的ヒューリスティクスにあります。この領域はまさに、業界全体で経験的にベストプラクティスが確立されつつある段階です。826スターを獲得しているにもかかわらず、それ以前にコミュニティでの存在感がほとんどなかったことを考えると、より洗練されたリソースがまだ埋めていなかったドキュメントの空白を突いたと言えるでしょう。
Source: https://github.com/xop01/ai_goodpractice
kitlangton/scrawl
AIコーディングエージェントに視覚的なコンテキストを伝えるために設計された、画面アノテーションおよび録画ツールです。ワークフローは次のとおりです:スクリーンショットや画面領域に手書きのアノテーションを加え、問題(UIのバグ、失敗したテスト出力、視覚的なレイアウトの問題など)を短い動画で録画し、パッケージ化したアーティファクトをエージェントに送信します。このツールは、キャプチャ、アノテーションのオーバーレイ、パッケージングの各ステップを単一の統合されたフローで処理します。
このツールの動機は、開発者が画面上で見ているものと、テキストで効率的に説明できる内容との間にあるギャップにあります。視覚的なバグ、レイアウトのリグレッション、あるいは視覚的に現れるランタイムの挙動については、テキストによる説明では情報が失われてしまいます。アノテーション付きの画面録画をビジョン対応モデル(GPT-4o、vision機能を持つClaude、Gemini)に直接入力することで、エージェントは開発者と同じ視覚的な証拠を得られます。
技術的には、このツールは画面キャプチャ、軽量なアノテーションUI、そしてマルチモーダルモデルへの入力フォーマットの交差点に位置しています。実装の複雑さは中程度であり、興味深いエンジニアリング上の課題は、関連する視覚情報を保持しつつ、モデルのコンテキスト制約に収まるコンパクトで適切にトリミングされたアーティファクトを生成することにあります。788個のstarは、テキストのみのエージェントインターフェースを使う際に「バグは見えるのに説明できない」という壁にぶつかった開発者たちの強い共感を示しています。