デイリーAIダイジェスト — 2026-10-16
arXiv ハイライト
Waypoint-OPD: ゲート付きOn-Policy Distillationによるrl誘導型Policy Shiftの転移
問題設定
RL誘導型の能力をon-policy distillationで転移する場合、通常はRL前の教師 \pi_0 とRL後のバージョン \pi_1 の間における終端対数確率シフト \delta_t(a) = \log \pi_1(a\mid s_t) - \log \pi_0(a\mid s_t) を、学生が生成したprefixに対するrewardライクな信号として転移します。この手法の病理として、ある終端シフトは不均質な中間ダイナミクスを集約している点が挙げられます。RL学習の序盤ではあるトークンの選好が一方向に押し進められ、終盤でそれが部分的に反転するといったことが起こりえます。終端シフトは「一貫して強化された」ケースと「振動しながら辛うじて生き残った」ケースを区別できないため、学生は教師の学習が不安定だったprefixにおいてノイズの多い選好を継承してしまいます。問題は、RLの軌跡に沿ったシフトの時間的一貫性に対する安価なチェックによってシグナルをゲーティングできるかどうかです。
手法
Waypoint-OPDは、同一のRLランから中間チェックポイント \pi_m(1200ステップのQwen3-4BランのステップURL 600)を1つ挿入し、これをpolicyシフトの前半セグメントと後半セグメントが同じ方向を向いているかどうかを測定するためにのみ使用します。この測定は学生のローカルなaction supportに基づいて行われます。
学生が訪問した各prefix s_t において、学生のTopK support \mathcal{K}_t と学生の再正規化ウェイトを定義します:
q_t(a) = \frac{\pi_\theta(a\mid s_t)}{\sum_{b\in\mathcal{K}_t}\pi_\theta(b\mid s_t)}.
3つのフリーズされた教師を用いて k 個の候補をスコアリングし、セグメントシフトを得ます:
\delta_t^{(1)}(a) = \log\pi_m(a\mid s_t)-\log\pi_0(a\mid s_t),\qquad \delta_t^{(2)}(a) = \log\pi_1(a\mid s_t)-\log\pi_m(a\mid s_t),
これらの和は終端シフト \delta_t にテレスコープします。候補全体にわたる対数確率の一様シフトはactionに依存しません——相対的な選好は変化しませんが、生の内積を乱します——そのため各ベクトルは q_t のもとで中心化されます:
C_{q_t}[z](a) = z(a) - \mathbb{E}_{b\sim q_t}[z(b)],
これにより u_t = C_{q_t}[\delta_t^{(1)}]、v_t = C_{q_t}[\delta_t^{(2)}] が得られます。時間的一致度は q_t 重み付きコサインです:
c_t = \frac{\langle u_t, v_t\rangle_{q_t}}{\lVert u_t\rVert_{q_t}\lVert v_t\rVert_{q_t}},\qquad \langle u,v\rangle_{q_t} = \sum_{a\in\mathcal{K}_t} q_t(a)\,u(a)\,v(a).
c_t\in[-1,1] が終端シグナルをゲーティングします:c_t<0(前半と後半のセグメントが相対的な選好方向において一致しない)の場合、終端シフトは抑制され、一致する場合は通過します。Waypointは一貫性の証拠としてのみ使用され、模倣ターゲットとしては一切使用されません。追加コストは学生のprefixごとに k 個の候補に対してフリーズされた教師のスコアリングパスを1回行うだけです。
結果
教師はQwen3-4BのチェックポイントをRLランから取得したもの(初期、ステップ600のWaypoint、ステップ1200のFinal)です。学生はQwen3-8B、Qwen3-14B、Qwen3-30B-A3B(MoE)であり、同一のtokenizerファミリ内でスケールとアーキテクチャをまたいでいます。
数学(mean@32、AIME 24/25/26、HMMT、AMC23を含む7つのコンペティションベンチマークの平均):Waypoint-OPDは最強のベースライン(Direct-OPD)をそれぞれ8B/14B/30B-A3Bで +2.18、+1.59、+1.89ポイント 上回り、ベンチマークごとの比較21回中19回で勝利しています。14Bの学生は平均59.20に達し、Finalの教師の56.13と比較して+3.07のマージンを持ち、全7つの数学ベンチマークで教師を超えています。30B-A3Bの学生は57.85(教師より+1.72)、8Bの学生は56.14で教師と同等です。
コード(5つの評価にわたるmean@8の平均):Waypoint-OPDは8B/14B/30B-A3Bでそれぞれ53.25 / 57.82 / 57.54を記録し、Direct-OPDに対して+2.66、+1.52、+1.19の改善を示しています。14Bと30B-A3Bの両学生ともFinalの教師(55.37)を超えています。
ゲーティングが暗黙的な正則化として機能しているのではなく、非自明な何かを行っているという学習ダイナミクスの証拠は、Qwen3-8Bの数学における学習曲線から得られます:
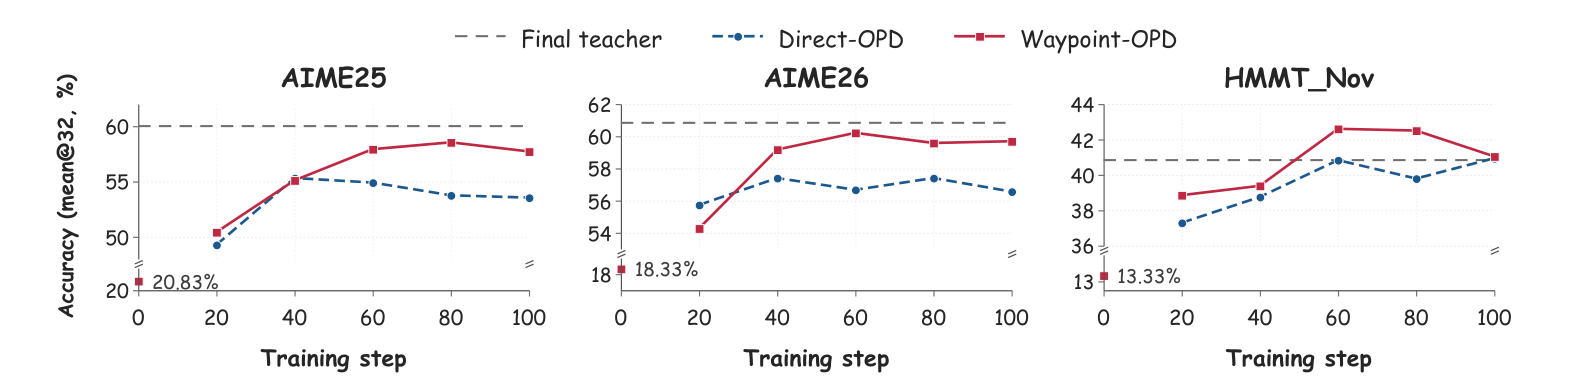
Waypoint-OPD(赤の実線)は学習全体を通じてDirect-OPD(青の破線)を追跡または上回り、AIME 2026とHMMT25NではFinal教師の参照値をより早く超えています。応答長の診断により長さの不正利用が排除されます:
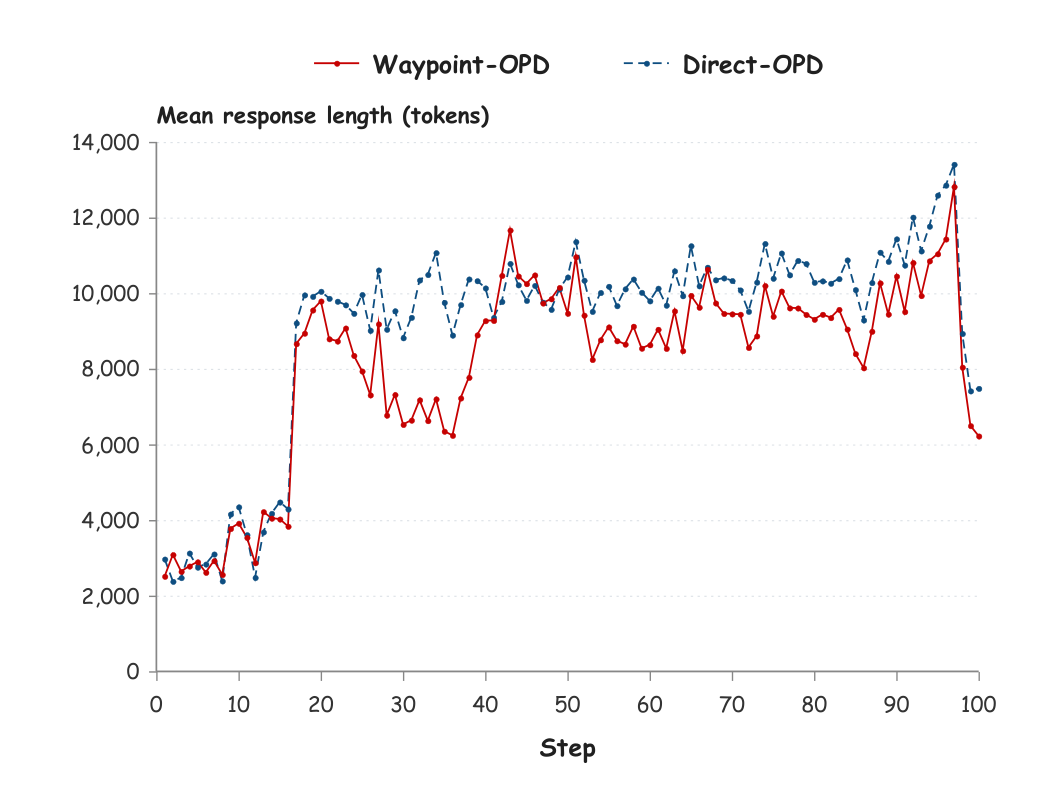
平均rollout長と16,384トークンの上限に達する応答の割合は両手法で同様に推移しており、accuracyの向上はより長い推論チェーンや、より頻繁にtruncationされる推論チェーンによって得られているわけではありません。
限界と未解決の問題
- 使用されるWaypointは1つだけです(1200のうちのステップ600)。論文では、異なるRLランの長さにわたってWaypointの位置に対して性能がどれほど敏感であるかを確立していません;単一の中間点は粗い時間的基底です。
- ゲートは学生トークンのTopK support上のスカラーコサインであり、符号が一致しても大きさが不一致のケースを捨て、末尾を無視しています;ソフトなper-actionゲートが有効かどうかは未解決です。
- 教師ファミリはドメインごとに単一のQwen3-4B RLランです。異なるtokenizerや異なるRLレシピを用いたクロスファミリの教師-学生転移はテストされておらず、この手法は互換性のあるtokenizerを前提としています。
- この転移手法は依然として教師側でのRLランを必要とします;本手法は教師側のコストを削減せず、既存のチェックポイントからより多くを抽出するだけです。
- prefixのうちどの割合がゲーティングされるか、あるいは c_t がどのように分布するかについての分析がありません——メカニズムはもっともらしいですが、lossへの実証的な影響は示されているセクションでは定量化されていません。
なぜ重要か
終端policy-shift distillationはRLの軌跡を2つのチェックポイント間のブラックボックスとして扱いますが、Waypoint-OPDは、ターゲットとしてではなく一貫性ゲートとして純粋に使用される中間チェックポイントが1つあれば、有意義なシグナルを回復し、学生(14B、30B-A3B)がコンペティション数学において4Bの教師を超えるのに十分であることを示しています。これは、RLチェックポイントが学習中にすでにディスク上に存在するという事実を活用するための、安価で機械的にシンプルな方法です。
Source: https://arxiv.org/abs/2610.21601
RoTA-Bench: インタラクティブな投影アライメントを通じた3D空間推論の評価
問題設定
Vision-language modelsは空間推論能力を持つと頻繁に主張されていますが、ほとんどのベンチマークは静的な認識や単一ステップの姿勢推定をテストするにとどまっています。より難しい問いは、VLMが2Dの観測から、逐次的かつフィードバック駆動の行動を支える内部3D表現に変換できるかどうかです。RoTA-Benchは、投影アライメントゲームを通じてこの能力を単離します。すなわち、ターゲットのシルエットが与えられた状態で、モデルは回転した3Dオブジェクトを観測し、制限されたアクションバジェット内で現在の投影をターゲットに一致させるよう離散的な回転のシーケンスを選択しなければなりません。回転は純粋に方向的なものであり、マニピュレーションベンチマークに存在するグラスプアフォーダンス、摩擦、並進ダイナミクスから空間推論を切り離しています。
手法
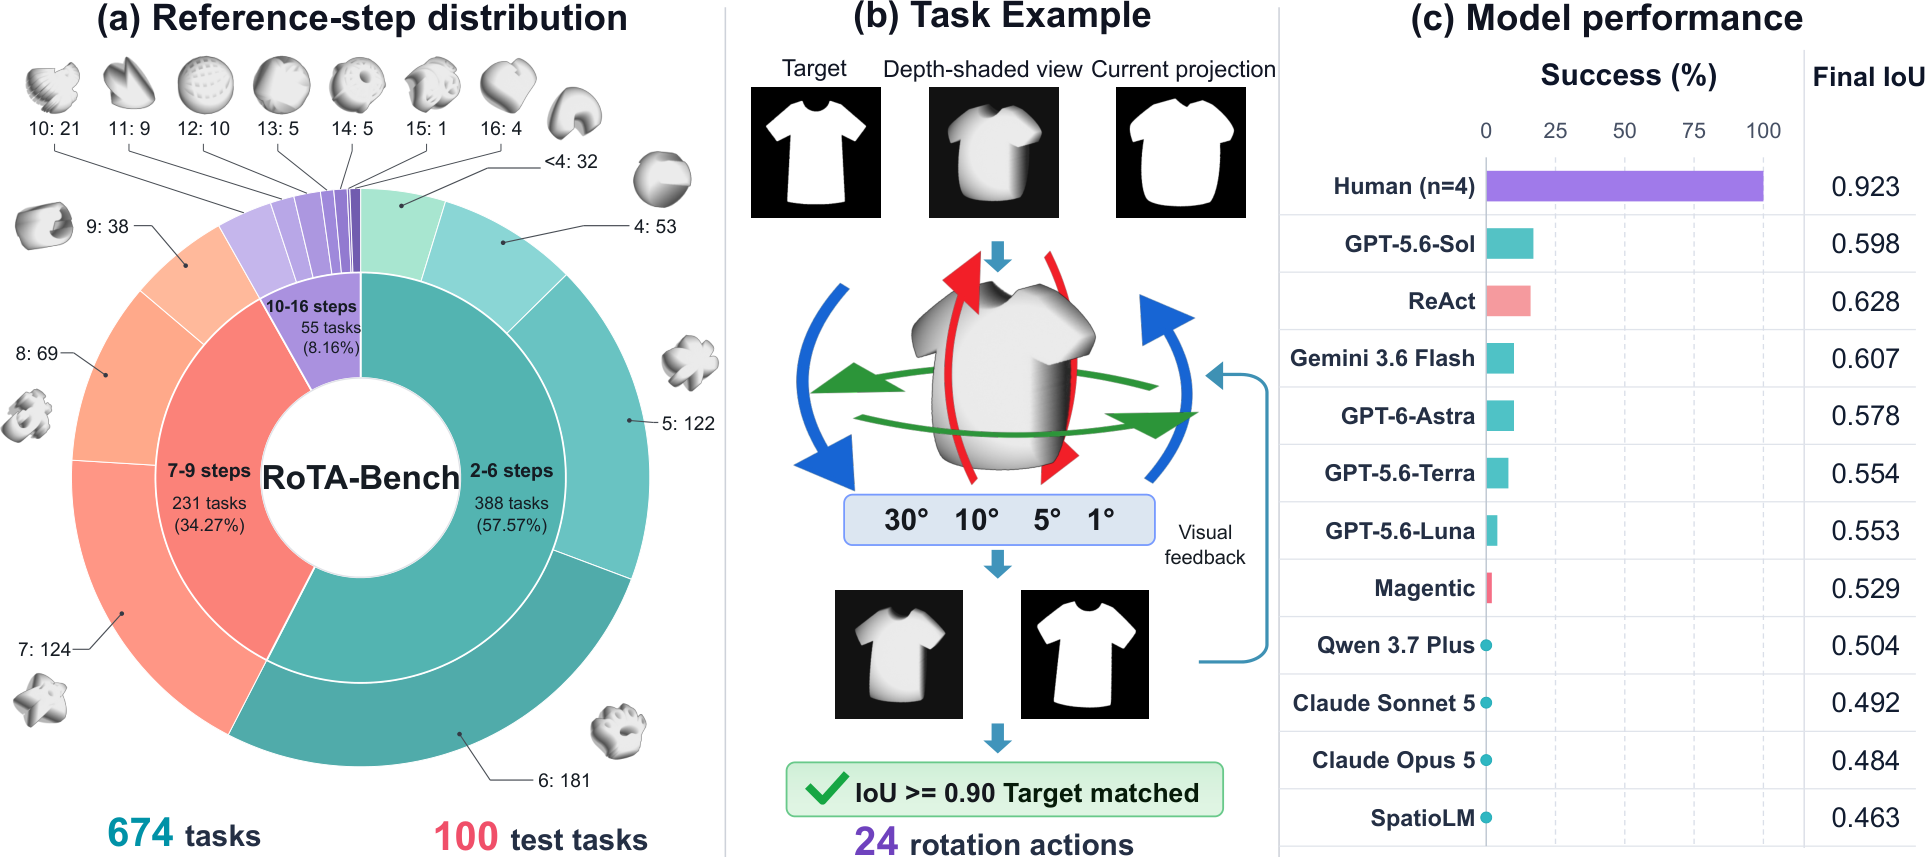
ベンチマークの構築には3つの段階があります(パイプラインの図を参照)。第一に、2Dベクターアイコンをフィルタリングして正規化し、バウンディングスフィア内で押し出すことで、正準の前面投影がソースアイコンを正確に再現する3Dオブジェクトを生成します。これにより、ShapeNetのような一般的なCADアセットに対する事前学習済みの事前知識からの情報漏洩を防ぎます。第二に、初期姿勢は可逆的な離散回転のシーケンスを通じて生成されます。これにより、各タスクが離散的なアクション空間内で実行可能な解を持つことが構成上保証されます。第三に、参照パスは姿勢誘導ビームサーチと30^\circ制限BFSを組み合わせて生成され、検証済みの正解解が得られます。最終的なセットは、参照パスの長さにわたって層化サンプリングされた100タスクのテスト分割を持つ674の正準タスクを含みます。
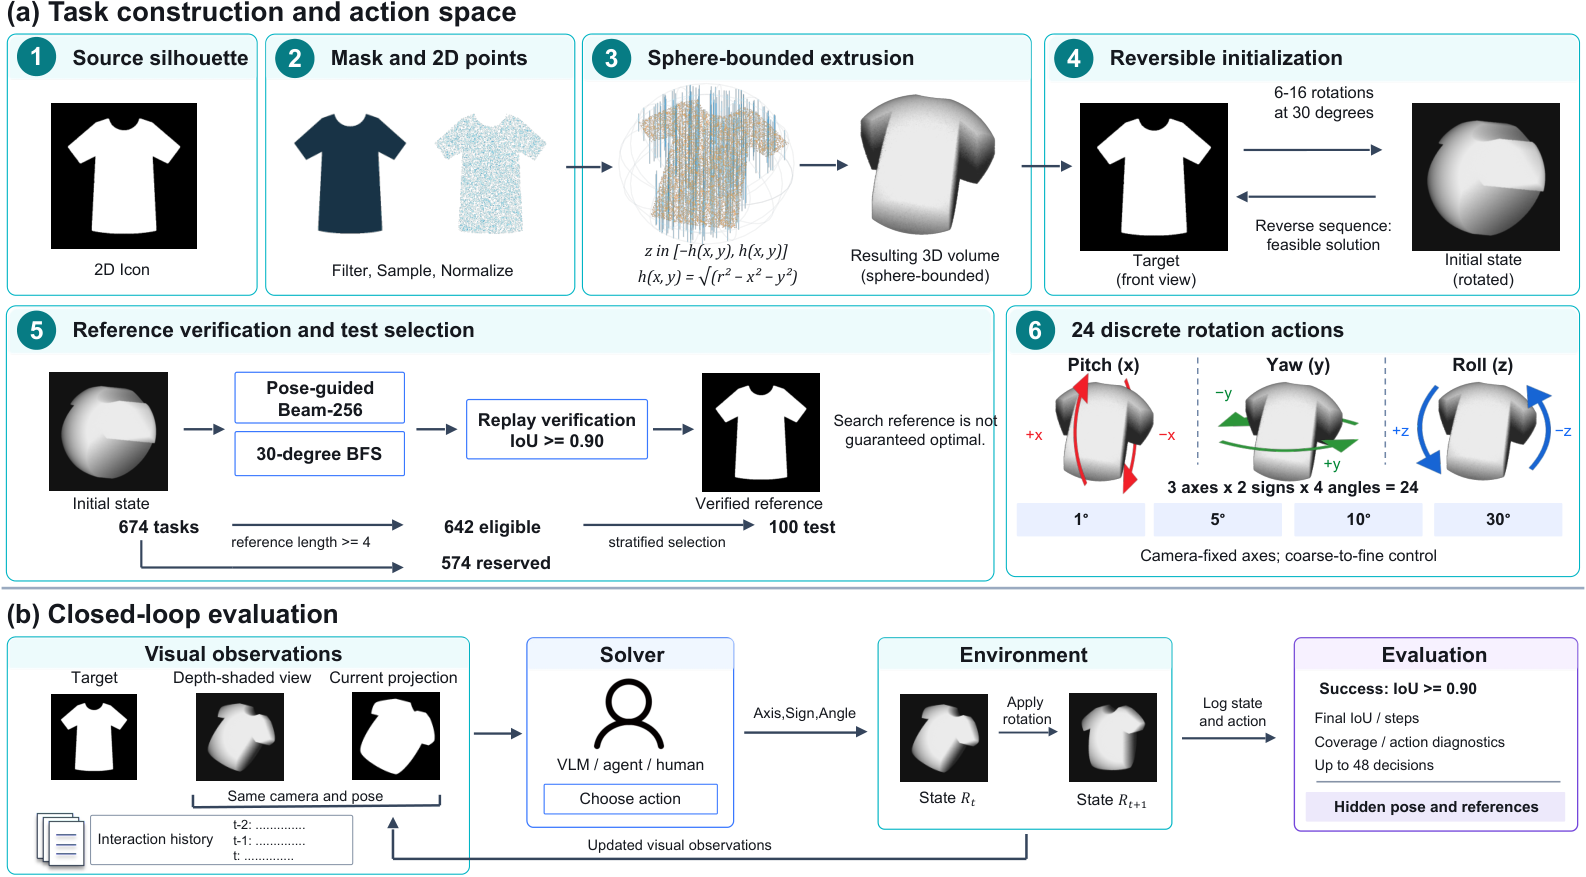
評価時、ソルバーはターゲットシルエット、現在のレンダリングビュー、アクション履歴、および軸角回転の離散アクション空間(1ステップあたり24の合法的な後継)を受け取ります。投影IoUが0.90を超えるか、バジェットが尽きた時点で終了します。決定ループは意図的にクローズドになっており、モデルは1回で問題を解くのではなく、複数ターンにわたって視覚的フィードバックを統合しなければなりません。
結果
9つのフロンティアVLMと2つのエージェントフレームワーク(ReAct、Magentic)が、人間の参加者、ランダムベースライン、2つのオラクル貪欲ベースラインとともに、temperature 0で評価されています。結果は明確です。GPT-5.6-Solがモデルリーダーボードのトップで17.0\%の成功率を記録し、Gemini 3.6 Flashが10.0\%となっています。ReActは最高の最終IoU(0.628)を達成しますが、成功率は16.0\%にとどまります。Claude Sonnet 5、Claude Opus 5、Qwen 3.7 Plusはすべて成功率0.0\%に落ち込み、最終IoUは[0.484, 0.504]の範囲にあります。これは、一様なランダム探索(0.473)とほぼ区別がつきません。空間推論用にfine-tuningされたモデルであるSpatioLM-Understanding-InternVL3.5は壊滅的なポリシー崩壊を示し、アクションの91.12\%が\text{YAW\_POS}\ 10^\circとなり、最終IoUは0.463とランダムより悪い結果となっています。
人間は100タスクのテストセットにおいて、平均最終IoU 0.923、平均16.22ステップで100.0\%の成功率を達成しており、20名の学部生が集合的にテストセットを4回完走し、一度も失敗しませんでした。オラクルベースラインは診断をより鮮明にします。IoU貪欲ポリシー(地面真実シミュレータを使用して投影重複を最大化する24の合法的な回転の中から後継を選択する)は39.0\%しか解けません(最終IoU 0.725)。真の3D角度誤差を最小化する姿勢貪欲ポリシーは、8.32ステップで100.0\%を解きます(最終IoU 0.924)。この解離が中心的な知見です。画像空間の重複は局所的に誤解を招く目標であり、シルエットIoUを増加させる多くの回転が、オブジェクトを正しい3D姿勢から遠ざけてしまうからです。姿勢空間の幾何学にアクセスできるエージェントだけが確実に成功します。
この論文はこの乖離を直接定量化しています。同一状態において、モデルはシルエットIoUを改善しながら姿勢アライメントを悪化させることが19.4\%あるのに対し、人間では10.9\%です。言い換えれば、人間は頭の中で回転させますが、モデルはピクセルを丘登りします。さらなるアブレーションでは、インタラクション履歴を除去してもモデルのアクションの96.8\%が変化しないことが示されており、現在のVLMは次の回転を選択する際に過去の観測の軌跡をほとんど使用していないことを示唆しています。細粒度の制御は名目上は履歴に依存していますが、モデルはそれを活用できていません。
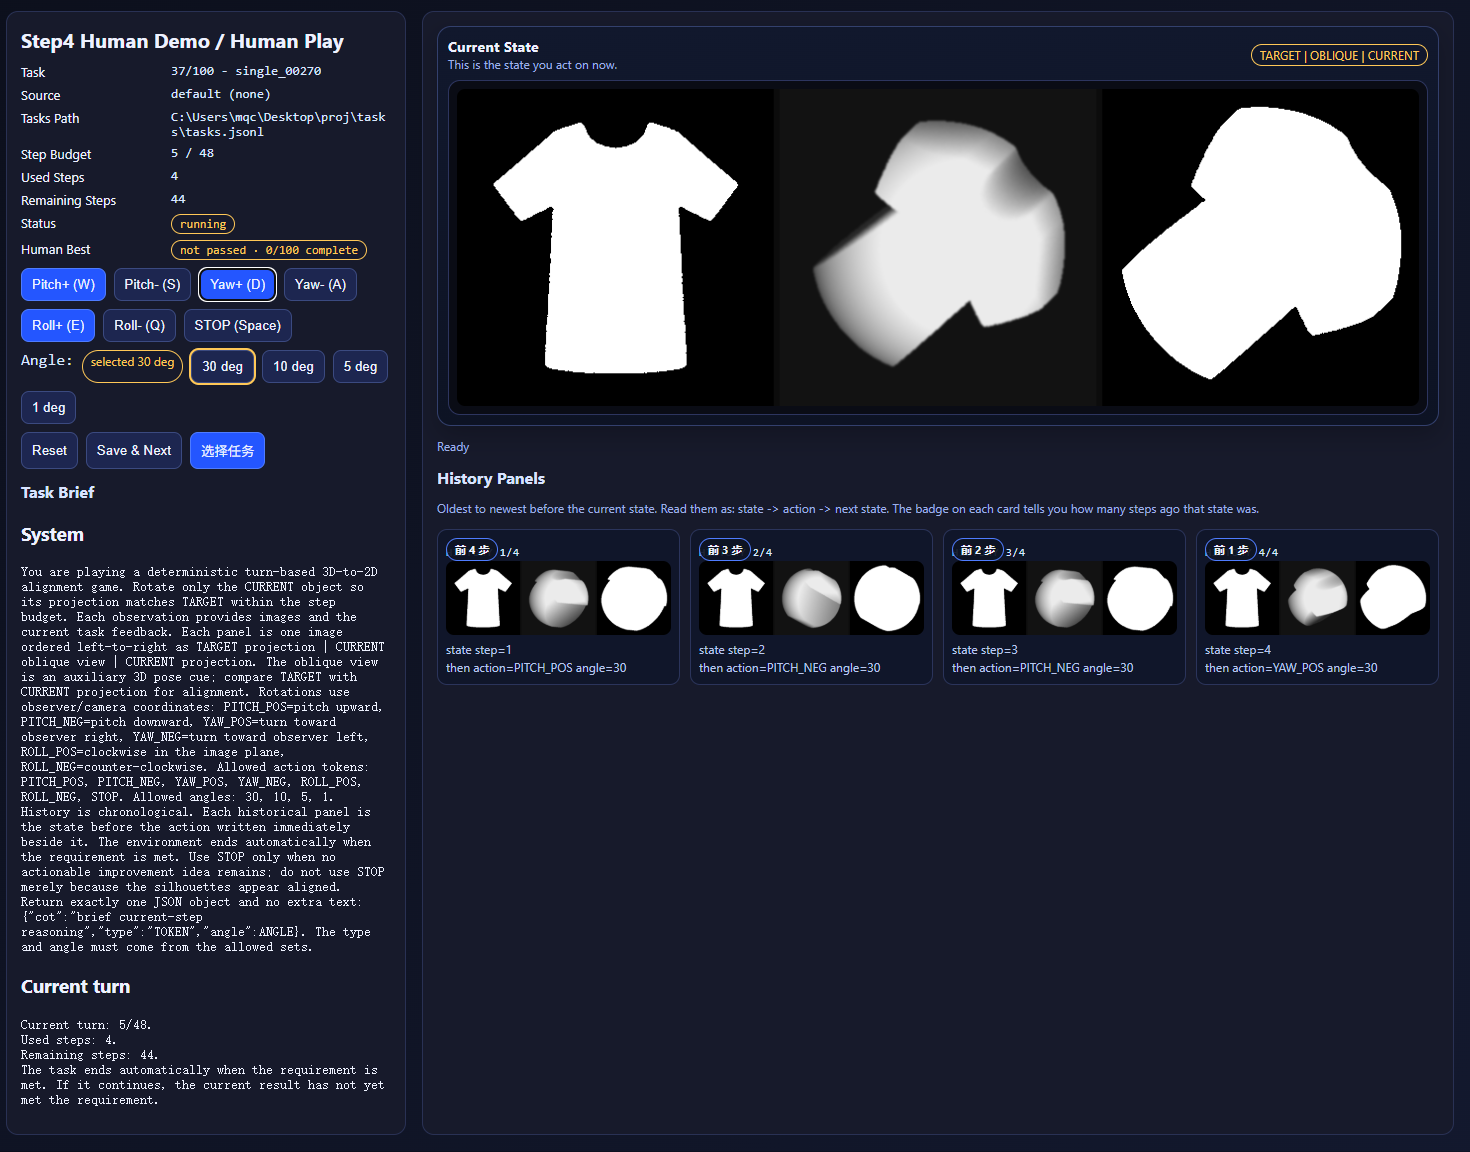
人間インターフェースはモデルと同一のプロンプト、観測履歴、アクショントークンマッピングを使用しているため、ギャップはインターフェースの非対称性によるものではありません。
限界とオープンクエスチョン
アクション空間は離散的であり、物理は単純です。回転のみであり、接触はありません。これは意図的なスコープの選択ですが、RoTA-Benchが完全なマニピュレーションではなく方向推論を単離することを意味します。参照パスは姿勢監督を伴うビームサーチによって生成されるため、「バジェット内で解ける」はそのソルバーに対して相対的に定義されます。また、失敗が3D表現の欠如を反映しているのか、良好な知覚を条件とした貧弱なアクション選択ポリシーを反映しているのか、それともマルチターン視覚メモリの弱い使用を反映しているのかも不明です。履歴のアブレーションは後者の2つを示唆していますが、知覚とポリシーを切り離すには中間表現のプロービングが必要でしょう。最後に、姿勢貪欲とIoU貪欲の間の鋭いギャップは、エージェントに提供された補助的な姿勢推定ツールが、基礎となる空間推論の改善なしにギャップの多くを縮める可能性があることを示唆しています。これは測定する価値のある交絡因子です。
なぜ重要か
RoTA-Benchは、フロンティアVLM(17\%)と学部生(100\%)の間のギャップが曖昧な採点基準や言語理解の問題ではなく、視覚的フィードバックを通じた3D表現の維持・更新における測定可能な失敗であることを示す、構築検証済みのクリーンなテストを提供します。姿勢貪欲オラクルの結果は、正しい幾何学的状態があればタスクが自明に解けることを示しており、欠損を計画ではなく知覚・メモリに局在化させています。
Source: https://arxiv.org/abs/2610.17665
自己進化型エージェントハーネス
固定されたLLMを核として構築されたエージェントシステムは、能力向上の役割を周辺の足場(scaffolding)、すなわちprompt、検索インデックス、ツールラッパー、ワークフローグラフ、およびそれらを結合するコードへと委ねることが増えています。本論文はその足場をハーネス H として形式化し、モデル M を固定したまま H がフィードバックのもとで進化するとはどういうことかを考察します。現在デプロイされている「自己改善型」エージェントの大半は実際にはハーネス改善型であるため、この問題は重要です。しかし、何が変異しているのか、何が永続的な状態への変更として認められるのか、そしてどのような条件でそれらの変更が汎化するのか、についての明確な説明が分野全体に欠けています。
モデル–ハーネス分解
著者らは先行研究の分解を採用しています:ロールアウトは次のように生成されます。
\tau \sim \operatorname{Run}(M, H, E), \qquad y = J(\tau),
ここで E はタスク環境、J は外部評価者です。重要なのは、J は編集可能な表面の外側に位置するという点です:候補ハーネスは内部批評器や暫定チェックを含むことができますが、永続的な状態への承認は J のみによって管理されます。モデルアダプター(例:ロード時にバインドされるLoRA重み)はconfigurationレベルである場合に H の一部として分類され、M を定義する学習済みパラメータはそうではありません。
7つのランタイム関数が列挙されています——エージェントループ/実行制御、ツールオーケストレーション、コンテキスト構築、メモリ/状態、コンテキスト圧縮、スケジューリング、実行インフラ——これらはいずれも改訂の対象となり得ます。この表の要点は、実装がこの分解に従っているということではなく(通常は従っていません)、改訂が検索と監査の目的においてこれらの役割の一つに局所化できるということです。
解釈型対実行型ターゲット
中心的な分類上の操作は、解釈型と実行型の更新の区別であり、これは「データ対コード」よりも微妙な概念であることがわかります。判断基準はアーティファクトの言語ではなく、その役割です。固定されたコーディネーションインターフェースを通じて事前定義されたオペレーターへの呼び出しを再配列するワークフロー改訂は解釈型です。一方、オペレーターの実装、またはコーディネーションを実現するランタイムを改訂することは、実行エンジン自体が変わらない場合でも実行型です。メモリにも同様の区分が適用されます:保存されたエントリをキュレーションすることは解釈型であり、メモリ管理関数を編集することは実行型です。
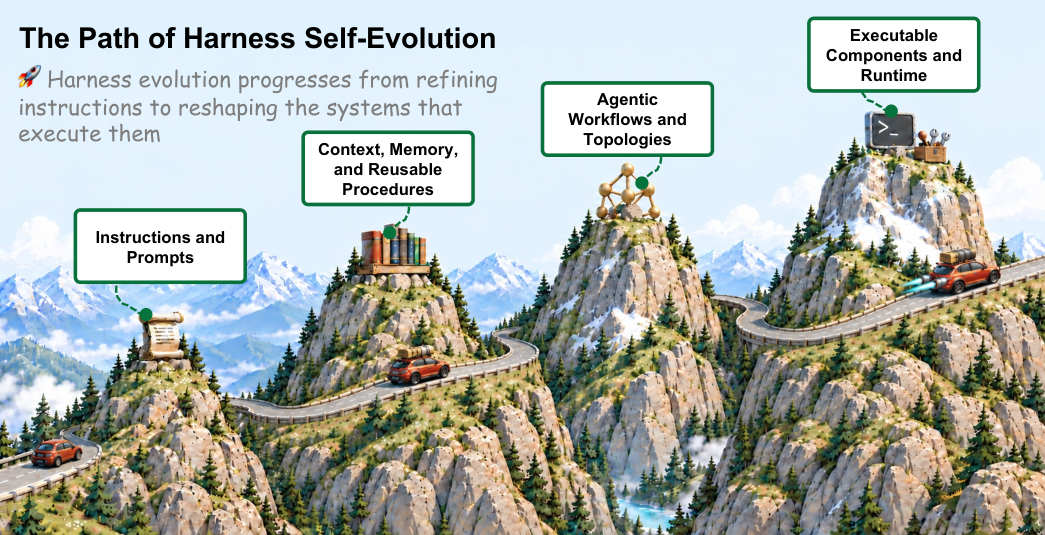
Figure 1は、この分野が辿ってきた軌跡を動機付けるために使用されています:再利用可能な命令(prompt)と再利用可能な手続き(固定オペレーター上のワークフロー)から、改訂可能な実行可能コンポーネントへの流れです。歴史的な先例として、EURISKOのヒューリスティック改訂とSchmidhuberのGödel Machineの証明に支配された自己書き換えが明示的に挙げられ、現代の経験的アプローチと対比されています:GEPA、Promptbreeder、ExpeL、workflow search、AFlowは主として解釈型レイヤーで動作するのに対し、Voyager/Polyskillのスキルライブラリやパッチベースのシステム(Self-Harness、HarnessCompass、Agentic Harness Engineering)は実行型レイヤーで動作します。
実行型ターゲットはさらに(i)コンポーネント実装、(ii)リポジトリレベルの制御ロジック、(iii)プラグイン合成に細分化されます。最初の二つは変異スコープを記述し、三つ目はコンポーネントとランタイムサービスがどのようにバインドおよび置換されるかを記述します。単一の改訂がカテゴリをまたぐこともあります——プラグインの入れ替えにより、コンポーネント実装とそれを選択する制御ロジックの両方が変わる場合があります。
探索、承認、PAC的保証
論文の概要は、明示的な提案機構と承認機構を持つ進化的探索の形式化にコミットし、述べられた仮定のもとで3つの結果を主張しています:(1)承認された改訂に対する期待汎化bound、(2)過去回帰バジェット——すなわちオペレーターが過去タスクの劣化をどこまで許容するか——を条件とした保持bound、(3)新鮮な独立した検証データを必要とする高確率承認ルール。この構造は継続的PAC学習に類似しています:タスク分布と J 自体がドリフトするため、サンプル内訓練ロールアウトに基づく承認では不十分であり、各サイクルでホールドアウトされた時間的に新鮮な検証セットが必要です。これは典型的な「ベンチマークで評価する」という慣行よりも鋭い主張です。なぜなら、承認閾値を現在のタスクの平均性能ではなく、過去タスクの回帰バジェットに結びつけているからです。
具体例としてのパッチレベル改訂
セクション3.1は現在の実践にもとづき分類体系を具体化しています。コンポーネントレベルの改訂はエントリポイントとI/Oコントラクトを固定したまま保持するため、候補は実装をその場で置き換えます。ツール合成は呼び出し可能インターフェース上の厳密な拡張操作として扱われます。候補アーカイブ(HarnessBank)は後の探索のために代替案を保存し、敗者を捨てません。また、プロトコル摂動(BadGenius方式)は、進化したハーネスの初期ハーネスに対する優位性が評価条件の変化に対してロバストかどうかをテストするために使用されます——これは J への過学習に対するストレステストとして機能します。著者らは標準的な失敗モードを指摘しています:安定したインターフェースによりローカルな置換は安全になりますが、共有された可変状態と非ローカルな出力結合は、編集されたモジュールを越えて回帰を伝播させる可能性があります。
限界とオープンな問題
本論文は組織的・体系的なものであり、経験的なものではありません:新しいシステムも、ベンチマーク数値もありません。PAC的boundは仮定(検証データの独立性、有界なloss、十分に定常なウィンドウ)に依存していますが、これらはまさにハーネス進化が実践において違反するものです——J はエージェントと共進化し、新しいツールはトレース分布を変化させます。解釈型/実行型の境界は有用ですが、ワークフローDSLがチューリング完全になる場合や、promptがコード生成を呼び出す場合には曖昧になります。最後に、保持boundはオペレーターが指定した回帰バジェットに依存していますが、マルチテナント環境や安全性が重要な設定においてそれを設定するための指針は示されていません。
なぜこれが重要か
現在出荷されている「自己改善型エージェント」の大半は、何が変更とみなされるか、何が承認されるか、または承認された変更がどのような汎化の主張を支持するかについての明確な説明を持たないハーネス進化型システムです。本論文は、永続的なハーネス改訂が組織の境界を越え始める中で、評価者や監査者が必要とすることになる語彙と承認規律——新鮮な検証、回帰バジェット、解釈型対実行型のスコープ——を提供しています。
Source: https://arxiv.org/abs/2610.18813
学習によるバンド分割位置の決定:音源分離のための動的バンド分割
バンド分割型セパレータ(BSRNN、BS-RoFormer、MelRoFormer、TIGER)は、隣接するビンをバンドにまとめることでSTFTを周波数方向にトークン化し、transformer/RNNバックボーンが全FビンではなくJ \ll F個のトークンを処理できるようにしています。この分割はほぼ例外なく固定的であり、心理音響学的ヒューリスティクス(低周波では狭いバンド、高周波では広いバンド)に基づいて手動設計された境界が用いられています。混合音の情報構造が事前に定めたグリッドと一致しない場合、これは非効率です——密な高周波過渡音を含むシネマティックエフェクトと200〜800 Hzに倍音が集中するボーカルミックスは何一つ共通点がないにもかかわらず、両者は同一のトークン化を受けます。DBS(動的バンド分割)は、固定トークン数を維持してバックボーンのコストを変えないまま、分割自体を学習可能かつ入力に依存した混合音の関数とします。
手法
複素スペクトログラム \mathbf{X}\in\mathbb{C}^{F\times T} が与えられたとき、DBSは周波数軸を R=4 個の固定された連続ブロック \{\mathcal{F}_r\} に分割し、各ブロックに J_r 個のトークン予算を割り当て、その合計が J となるようにします(例:1025ビンのSTFTでは J=128)。ブロックによって各スペクトル領域に所定の割合のトークンが確保され、各ブロック内の境界は混合音ごとに予測されます。
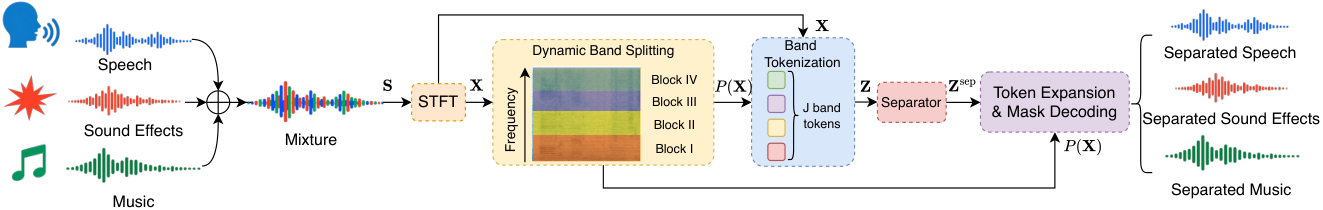
ブロック r の内部では、予測器が \mathbf{X}_r = \mathbf{X}[\mathcal{F}_r,:] を入力とします。実部・虚部は時間方向の畳み込みを通過し、各ビンの3つのマグニチュード統計量(時間平均、ピーク対平均比、標準偏差対平均比)が連結されます。BiLSTMがビンごとの文脈的特徴 \mathbf{h}_r(f)\in\mathbb{R}^d を生成します。各内部遷移 f-1\to f に対して、境界スコア
u_r(f) = u_r^{\text{feat}}(f) + 0.15\, u_r^{\text{mag}}(f)
は、隣接するビンのembedding間の学習された対比と、音響統計量の変化に対する有界変換を組み合わせたものです。学習された温度パラメータ \tau_r と位置バイアス \beta_r(f) が確率を調整します:
p_r(f) = \sigma\!\big(\tau_r(u_r(f) - 0.5) + \beta_r(f)\big).
バックボーンはブロック r において厳密に J_r 個のバンドを必要とするため、DBSは f_r^{\min} を境界として固定し、残りの J_r-1 個をハードTop-K によって選択します:
\mathcal{B}_r = \{f_r^{\min}\} \cup \operatorname{TopK}\big(\{p_r(f)\}_{f\neq f_r^{\min}},\, J_r - 1\big).
b_r(f)\in\{0,1\} の累積カウントにより各ビンをバンドインデックスに割り当て、コンテンツに依存したプーリングが可変幅バンドを等次元の J 個のトークンに圧縮します。分離バックボーンの後、トークンは平滑化されて元の F\times T グリッドに展開され、周波数方向に精緻化されたのち、周波数共有の複素マスクヘッドによってデコードされます。ハードTop-K は微分不可能ですが、勾配はstraight-through推定量(詳細は付録A、式2で参照)を通じて流れます。パラメータ \tau_r、\beta_r、畳み込み/BiLSTM予測器、およびプーリングヘッドはセパレータと共同で最適化されます。
実験結果
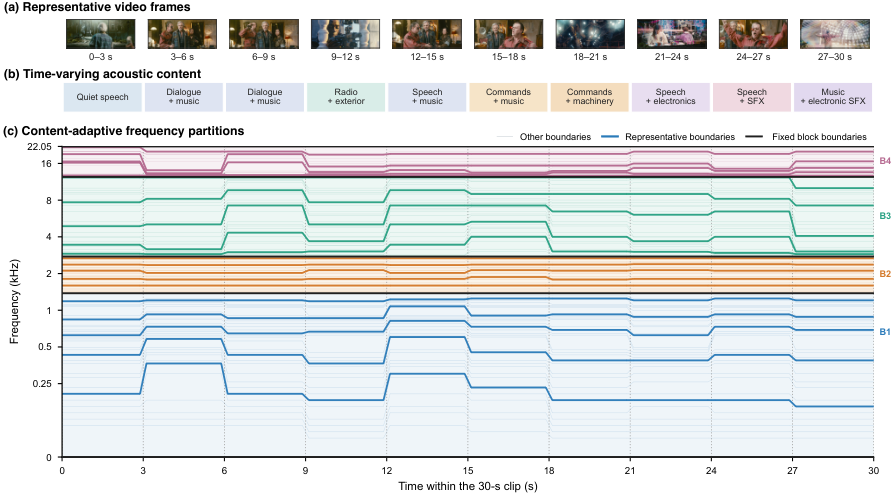
3つのデータセットが異なるスペクトル領域を検証します:DnR v2(シネマティック、0〜22.05 kHz、3ステム)、MUSDB18-HQ(音楽、0〜22.05 kHz、単一モデルで4ステムを同時学習——ターゲット固有のBSRNN/BS-RoFormerベースラインより困難であることに注意)、およびEchoSet(2話者+ノイズ+残響、0〜8 kHz)。すべてのDBS変種は R=4 ブロックと固定トークン予算を使用します(DnR/MUSDBでは128、EchoSetでは67)。
主要な数値:DBS-BSRNNはDnR v2において固定バンドのBSRNNに対して平均SI-SDRを相対的に29.0%改善します(両者ともに128バンド、スクラッチから学習、バックボーン容量同一)。改善はバックボーク(DnR上のTIGER、MUSDB18-HQ上のBSRNN/BS-RoFormer/MelRoFormer)やデータセットをまたいで一貫しており、EchoSetではTIGERが報告するベースラインに対してSDRiとSI-SDRiの両方で改善が見られます。MUSDBの評価において特筆すべきは、これらが外部音声データを使わずMUSDB18-HQの学習データのみを用いた、ステム固有のチューニングなしの4ステム同時学習モデルである点です——これにより比較は学習レシピではなく分割そのものを切り離したものとなっています。
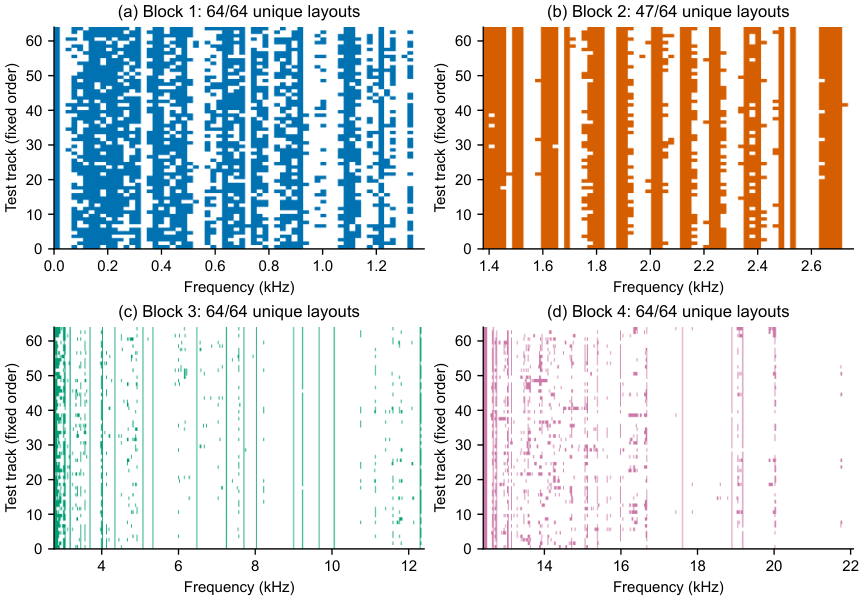
定性的には、最低ブロックB1と中間ブロックB2の境界位置は混合音間でわずかな変動にとどまります——基音や低いホルマントが予測可能なパターンに集中しているため当然です——一方、B4(最高周波数)は最大の適応性を示しており、効果音、シンバル、歯擦音の多様な高周波内容と一致しています。これは、固定レイアウトが混合音間で最も差異が生じる領域に対して不十分であるという主張を裏付けるものです。
限界
本論文では推論ウィンドウごとに単一の分割を報告するため、ウィンドウ内でコンテンツが変化する非常に長い混合音については、再チャンキングなしにより細かい時間粒度での再分割を行うことができません。Top-K 選択は区分定数的であり、重み 0.15 のマグニチュード項と位置バイアス \beta_r が学習を安定化させる一方、選択ステップのstraight-through推定量は標準的な近似であり、その勾配バイアスは分析されていません。ブロック数 R=4 および各ブロックの予算 J_r はデータセットごとに調整するハイパーパラメータであり、ブロック構造自体を完全に学習することでこれを排除できるでしょう。最後に、MUSDB18-HQ上の比較は、元のBSRNN/BS-RoFormerのより強力なターゲット固有の設定ではなく、同時学習された4ステムモデルを用いているため、SDRの絶対値は公開リーダーボードと直接比較できません。制御された比較はDBS対固定バンドの同一容量での比較です。
意義
バンド分割はtransformer時代のセパレータを扱いやすくする標準的な手法であり、その境界は長年にわたって固定の設計的選択として扱われてきました。DBSは、厳密に一致したトークン予算のもとで、分割を学習することがシネマティック音声において相対的SI-SDRを29%改善し、他の条件でも一貫した改善をもたらすことを示しています——軽量な予測器とstraight-through Top-K を追加するだけで済む、あらゆるバンド分割アーキテクチャへの「タダ同然の改善」です。
Source: https://arxiv.org/abs/2610.14993
InfiniSplat v2: Feed-Forward 3DGSの任意視点からの分析と改善
問題
Feed-forward 3D Gaussian Splatting(3DGS)手法は、シーンごとの最適化を省略し、入力画像から単一のforward passで直接Gaussian primitiveの集合を予測します。視点の大きな変化に対する主な失敗モードは、幾何そのものではありません——幾何の基盤モデル(DUSt3Rスタイルおよびその後継)は妥当な深度とポーズを生成します——が、属性の予測にあります。すなわち、共分散・色のSH・opacityが幾何と合同学習されており、属性ヘッドはgradientの結合を通じて幾何の誤差を引き継いでしまいます。その結果、属性が訓練視点での幾何ノイズを補償するように学習され、未見の視角への汎化に失敗します。
InfiniSplat v2はこの結合を特定し、修正します。目標は、6つの異種ベンチマークにおいてポーズあり設定とポーズなし設定の両方で機能する、単一の訓練済みfeed-forwardモデルです。
手法
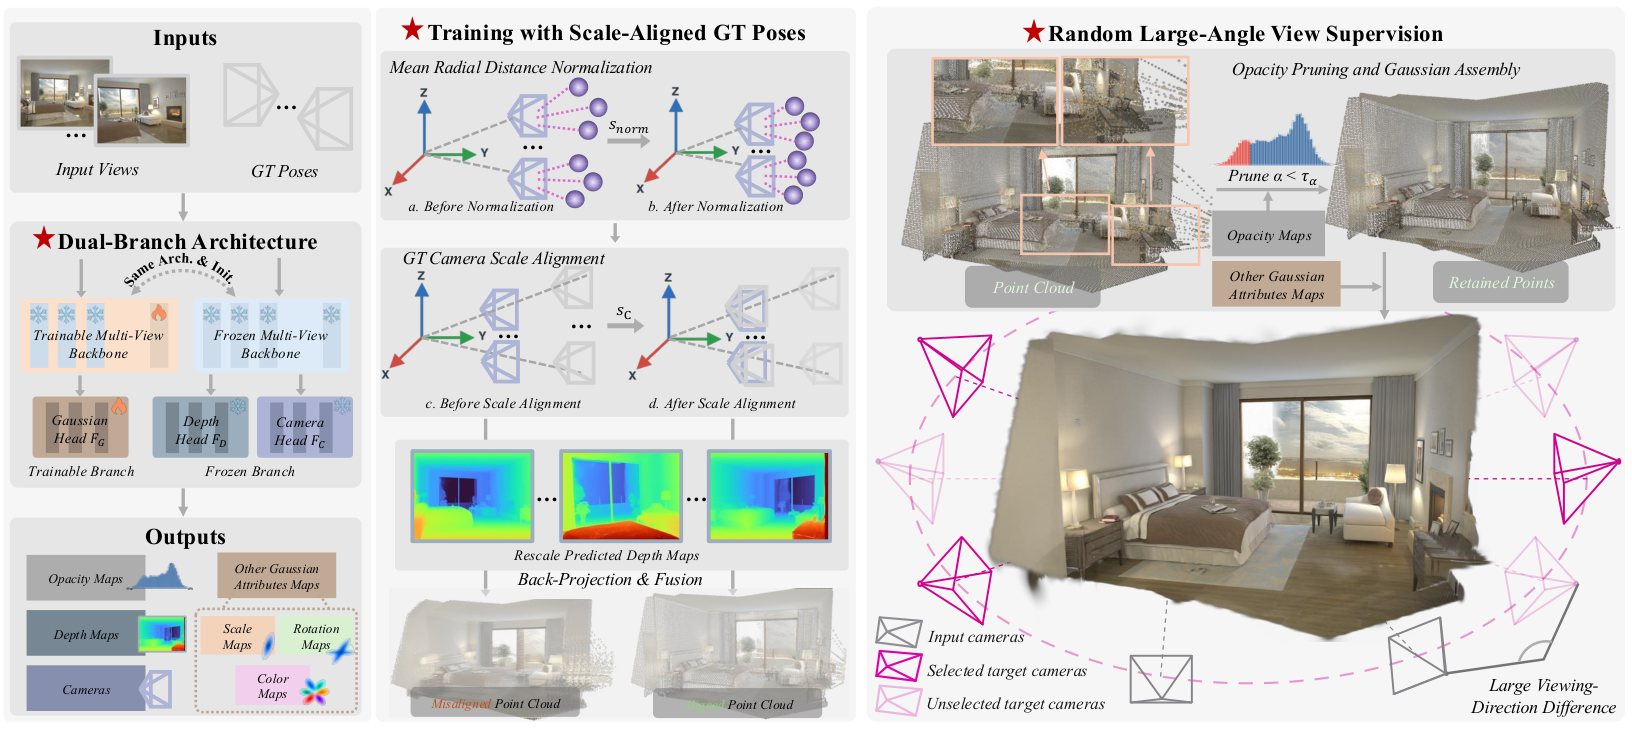
アーキテクチャ上の中心的な主張は、訓練中に幾何予測と属性予測を分離すべきというものです。パイプラインは、DA3(深度とカメラの基盤モデル)をfrozenなブランチとして使用し、ピクセルごとの深度dとカメラパラメータ(K, R, t)を出力します。これらはGaussianの中心を定義する点群\{p_i\}へと逆投影されます。別の訓練可能なブランチが同じ画像を入力とし、各点について残りのGaussian属性——opacity \alpha_i、scale s_i、rotation q_i、SH係数c_i——を出力します。
frozen幾何分離に加えて、訓練時の3つの選択が重要です:
訓練中のGTポーズアライメント。 DA3から得られる予測カメラには残差的なスケール・ポーズ誤差があります。訓練中、著者らはスケールおよびリジッドアライメントにより、予測カメラで構成した点群を正解カメラフレームに位置合わせし、ターゲット視点の教師信号が幾何的に一貫したポーズを使用するようにします。推論時には、予測ポーズ(ポーズなし設定)または与えられたポーズ(ポーズあり設定)がそのまま使用されます。これにより、属性ブランチがポーズ誤差を吸収するように学習するgradientの経路が除去されます。
大角度ターゲット視点での教師信号。 入力ベースライン付近のターゲット視点をサンプリングするのではなく、訓練の教師信号として大きな角度オフセットを持つターゲットカメラを明示的に使用します。これにより、属性ブランチは補間視点だけでなく、軸外においても形状と色が一貫したGaussianを生成することを強制されます。
再構成lossのみによるopacityプルーニング。 著者らは、画像再構成lossのみで訓練されたopacityは、幾何的に不整合な点の重みを下げることを学習すると報告しています。すなわち、opacityは明示的な幾何正則化なしに深度マップの外れ値に対する学習済みマスクとして機能します。訓練中のターゲット視点レンダリング前に、閾値以下の\alpha_iを持つ点がプルーニングされます。
点の位置はfrozen(DA3から引き継ぐ)であり、gradientは属性MLP/transformerにのみ流れます。レンダリングは標準的な3DGSのアルファ合成
C(r) = \sum_{i \in \mathcal{N}} c_i \, \alpha_i \prod_{j<i}(1-\alpha_j),
を使用し、(s_i, q_i)による通常の異方性Gaussianフットプリントを用います。入力視点のリファインメントステップは、レンダリングと入力の測光フィードバックを用いて属性を更新します。
結果
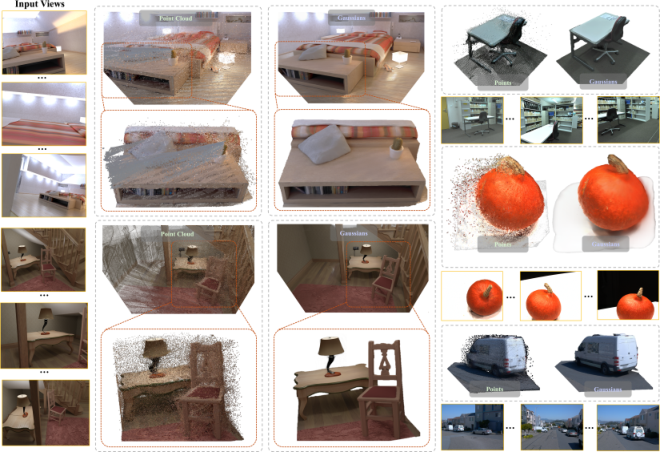
訓練はHypersim、Raw3D、ScanNet++の混合データで行われます。評価は、物体(DTU)、屋内(NRGBD、ScanNet++隣接)、屋外(ETH3D、Mip-NeRF 360)、動画(DL3DV)、不動産(RE10K)の6つのデータセットをカバーします。ベースラインは、最近のfeed-forward 3DGS手法の網羅的なリストです:tttLRM、AnySplat、C3G、DA3-GS、DepthSplat、QuerySplat、ReSplat、TokenGS、VolSplat、WorldMirror 2.0。
論文の主要な数値:ポーズあり設定では、6データセットにわたる平均LPIPSおよびDISTSが、最強のベースラインと比較してそれぞれ25.8%および32.9%減少します。同一の単一チェックポイントがポーズなし設定においても平均LPIPSおよびDISTSで最先端を達成します。著者らはこれらが知覚的指標であることを強調しており、LPIPSおよびDISTSは、軸外の新規視点がストレステストするテクスチャ忠実度の種類と、低周波一致に支配されるPSNRよりも強く相関します。
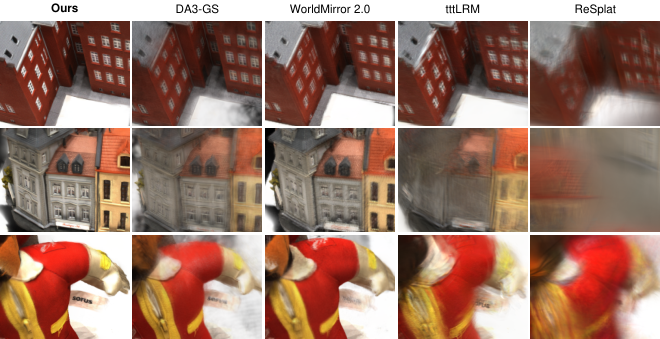
定性的には、レンダリングは細い構造物や鏡面反射領域において高周波テクスチャを保持しており、これらの領域ではベースラインがfeed-forward 3DGS特有のスミア/フローターアーティファクトを生じさせます。opacityを外れ値マスクとして使用するという観察はアブレーションにより検証されており、opacityのみのプルーニングを除去すると、深度境界にノイズのあるシーンでのレンダリングが劣化します。
制限と未解決の問題
本手法は特定のfrozen幾何バックボーン(DA3)に完全に依存しています。系統的な深度バイアスは、著者らが意図的に幾何から切り離した属性ブランチでは修正できません。訓練中のGTポーズアライメントは、すべての訓練シーンで正確なGTポーズを必要とし、データ混合の選択を制約します。論文はPSNR比較を前面に出しておらず、改善は知覚的指標上の改善であるため、対応するピクセルにおける再構成誤差が同程度に改善するかどうかは不明です。また、純粋なfeed-forwardレンダリングはMip-NeRF 360などのデータセットでシーンごとに最適化された3DGSに依然として及ばず、論文はそのギャップを埋めるのではなく、同一モデルによる複数データセット横断での比較として問題を再定義しています。
重要性
幾何と属性を分離し、frozen幾何基盤モデルに依拠することは、feed-forward 3Dの有望なテンプレートです。深度・ポーズモデルが改善されるにつれ、幾何スタックを再訓練することなく属性のみの訓練がその恩恵を享受できます。再構成lossのopacityが幾何的事前分布なしに外れ値排除を学習するという偶発的な発見は、feed-forward 3DGSパイプラインを設計する人々にとって有益な知見です。
Source: https://arxiv.org/abs/2610.20341
3DCodeVerse: コードとして3D世界を探索する
問題設定
LLMによる3Dコンテンツ生成において、メッシュ・点群・NeRF/Gaussianパラメータを予測するアプローチは、編集可能性と検証可能性という二つの有用な性質を捨て去ることになります。3DCodeVerseは3D生成をプログラム合成として再定式化します:モデルはスタンドアロンなプログラム f を出力し、それが宣言された環境 e(Blender bpy、CadQuery、Three.js、Shadertoyなど)上で実行されると、アーティファクト a が生成されます。形式的には、
(a, \ell) = \mathcal{E}_e(f), \quad x = \mathbb{I}[a \neq \bot],
ここで \ell は実行フィードバック、x は実行可能性を示します。品質はリファレンスとの比較 \mathcal{D}(a, a^\star) によって、あるいはプログラム的な計測とレンダリング o = \mathcal{R}(a) によってスコア化されます。本論文は、このパラダイムを大規模に実用可能にすることを目的とした三つの成果物を提供します:200万件のプログラムコーパス、ラウンドごとの人間によるフィードバックなしにプログラムを生成・検証するマルチエージェントハーネス、そして実験的なベースラインです。
3DCodeVerse-2M
このコーパスは各プログラムに実行に必要なソースファイルとアセット、説明文、検証レコードを束ね、複数のエンジンと言語にわたってオブジェクト・関節付きオブジェクト・シーン・グラフィクスを網羅しています。
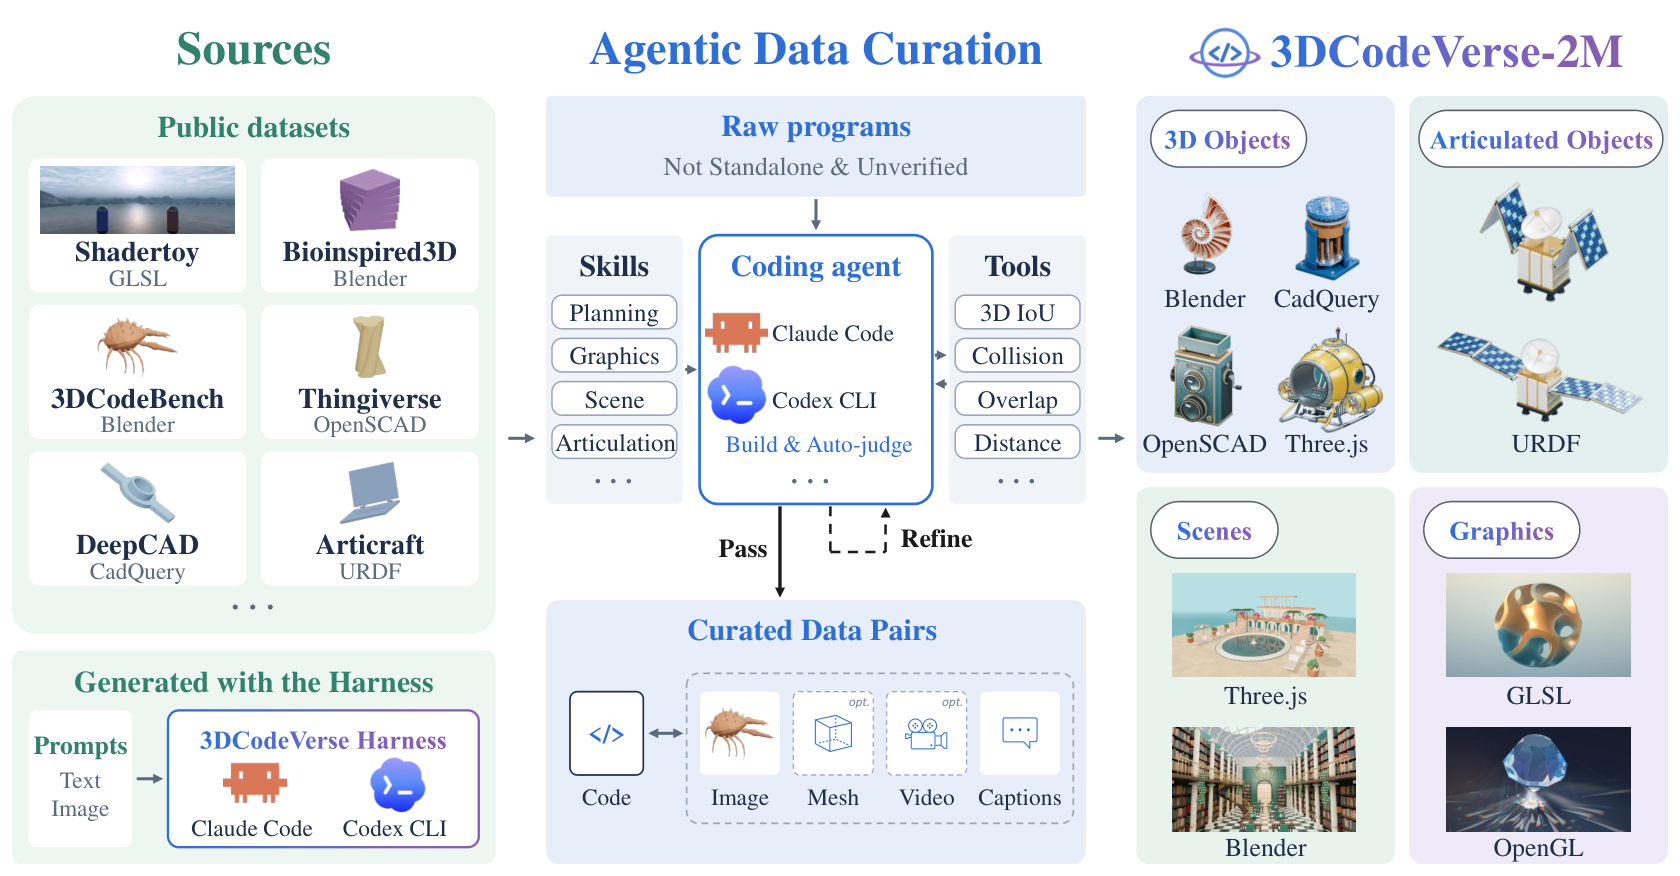
データセットには三つの取り込み経路があります:(i) 公開ソース(Bioinspired3D、3DCodeBench、Thingiverse、Shadertoy、CodePenアニメーション、Three.js/React Three Fiberプロジェクト)、(ii) フォーマット変換 — DeepCADシーケンスとArticraftジオメトリはCadQueryに書き換えられ(ArticraftのURDFは保持)、ProcTHORシーンはBlender/Three.jsで再構成される、(iii) ハーネス自体が生成した新規プログラム。特殊なAPIを持つソースに対しては、キュレーションエージェントが f = \mathcal{N}_e(f_\text{raw}) を生成し、依存関係をインライン化してアセットをバンドルすることで各プログラムを自己完結させます。検査ツール \mathcal{M}_e(a) はパーツのインベントリ、寸法、接触、衝突、キネマティクスを返し、生成時の報酬シグナルとして後に利用されます。
ハーネス:三者フィードバックを伴うマルチエージェントDAG
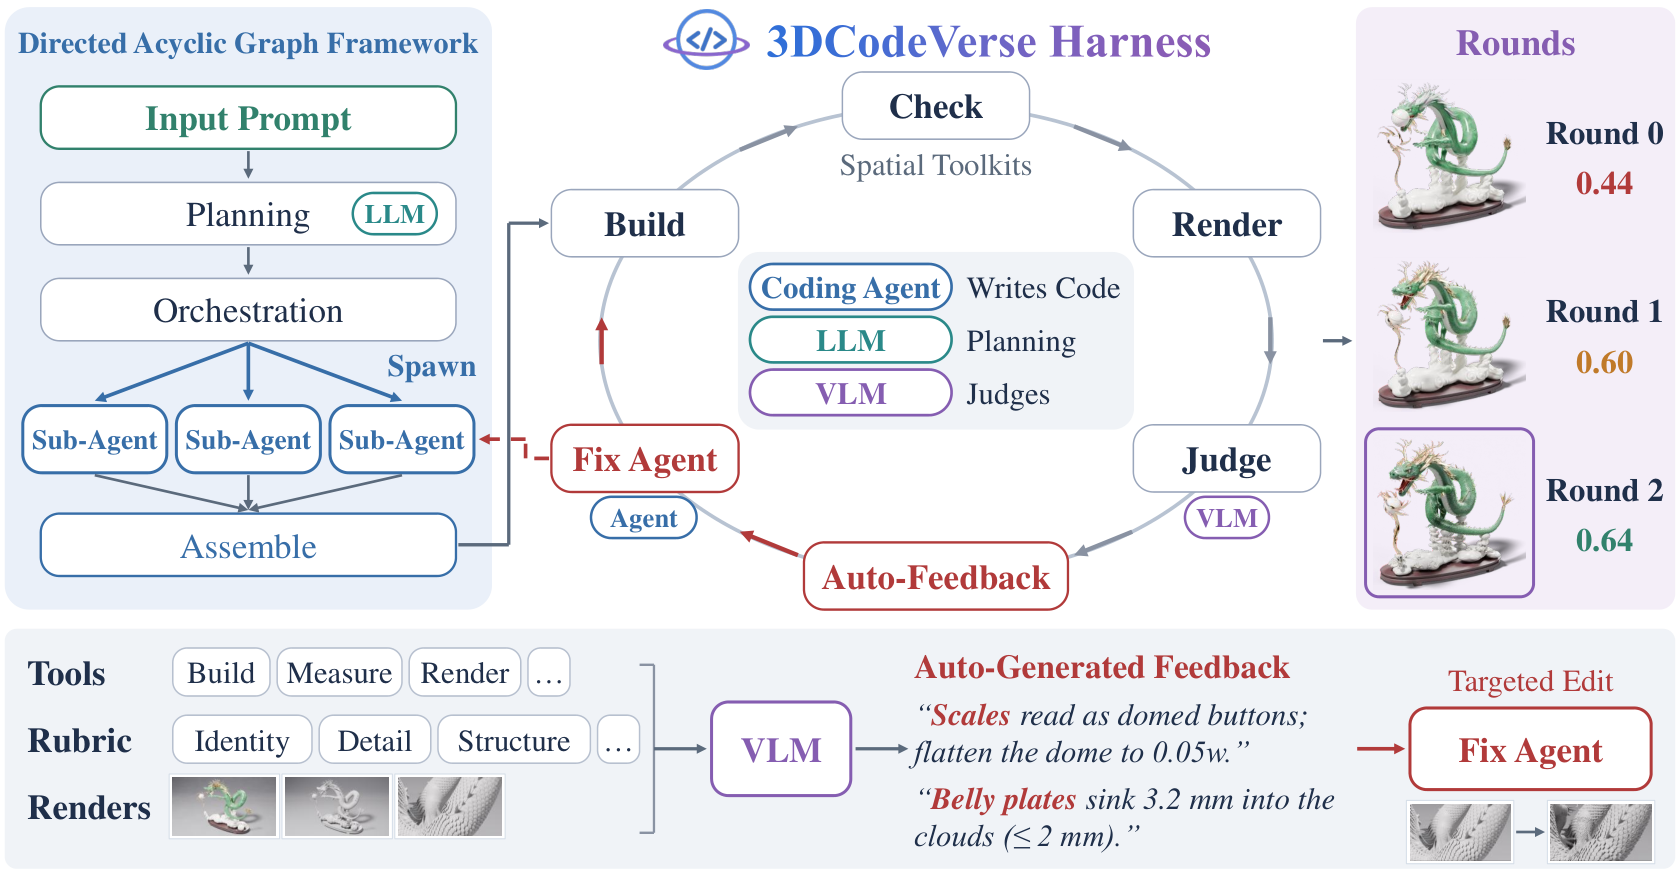
(c, e) が与えられると、LLMプランナーはコンポーネント・寸法・材質・空間的関係・受け入れ基準を指定する P = \mathcal{A}_\text{plan}(c; e) を出力します。P はDAG \mathcal{G} = (V, E) にコンパイルされ、コーディングタスクとアセンブリタスクがファイル所有権エッジを持つノードとなります。サブエージェントは独立したノードを並行して処理し、アセンブリノードがそれらの出力を f^{(0)} に統合します。
リファインメントではラウンド t において三種類のフィードバックを収集します:
- 実行フィードバック:ビルド/ランタイムログ \ell^{(t)}。失敗時はこれが唯一のシグナルとなります。
- 計測フィードバック:\mathcal{M}_e(a^{(t)}) はコンポーネントレベルの違反(寸法の不一致、交差、キネマティクスの実現不可能性)を数値的な修正ヒントとともに返します。
- 視覚フィードバック:VLMジャッジがマルチビューレンダリングを P の受け入れ基準と照合し、o^{(t)} = (\ell^{(t)}, \mathcal{M}_e(a^{(t)}), \mathcal{R}_e(a^{(t)})) を用いて j^{(t)} = \mathcal{A}_\text{judge}(c, P, o^{(t)}) を生成します。
スカラースコア s^{(t)} は重み付きルーブリック基準と欠陥ペナルティを集約し、計測された違反によって上限が設けられ、計測結果がVLMの主張と矛盾する場合は計測結果が優先されます — すなわち、物理的な計測がVLMのハルシネーションを上書きします。すべてのシグナルは優先順位付きの修正セット \Delta^{(t)}(実行 > 計測 > 視覚)に変換され、修正エージェントが f^{(t+1)} = \mathcal{A}_\text{code}(c, P, f^{(t)}, \Delta^{(t)}; e) を生成します。全ラウンドを通じて最高スコアのプログラムが返されます。
このフィードバック自体がモデルによって生成されるため、著者らはジャッジのプロンプト・ルーブリック・スキーマ(\theta_J)のチューニングと生成ワークフローのチューニングを交互に行う敵対的な開発時ループを実行し、デプロイ前にハーネスの設定を収束させています。
結果
評価は100件のオブジェクトプロンプト、関節付きオブジェクト、50件のシーンプロンプト、50件のグラフィクスプロンプトを対象とし、Human Preference、VLM Preference(Gemini 3.1 Pro)、失敗した生成をゼロとする0〜100のJudge Score、および四方向SigLIP-2テキスト–画像類似度で評価しています。
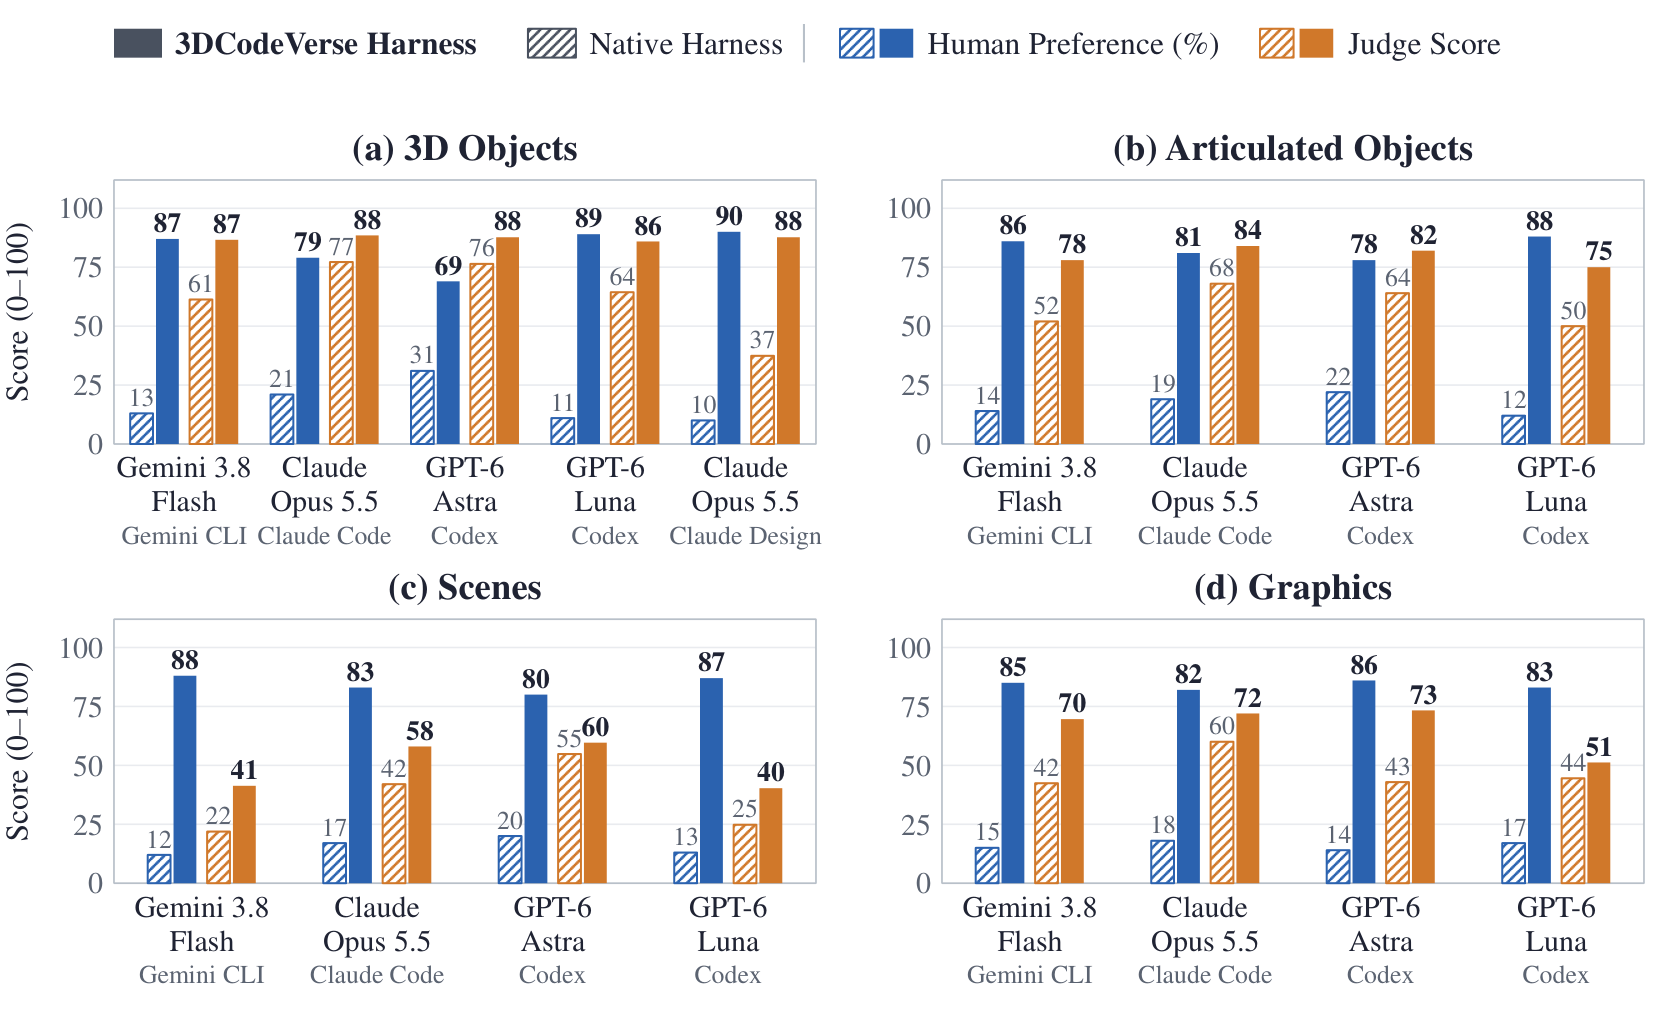
ハーネスはすべてのタスクにおいて各バックボーンのネイティブハーネスを上回ります。オブジェクトタスクにおいて、3DCodeVerse HarnessのHuman Preferenceは69〜89%の範囲にあり、Judge Scoreは11〜25ポイント向上しています。弱いバックボーンが最も恩恵を受けており:Gemini 3.8 Flashは61から87へ、GPT-6 Lunaは64から86へと移行し、既に強力なバックボーンよりも大きな改善幅を示しており、ハーネスがツール根拠のある反復によってシングルショットコーディングの弱点を補っていることと整合的です。Claude Design(こちらもClaude Opus 5.5を使用)との比較では、3DCodeVerseが人間比較の90%で勝利し、Judge Scoreは88 vs. 37となっています。関節付きオブジェクト、シーン、グラフィクスでもHuman Preferenceは78〜88%を示し、人間スコアとルーブリックスコアの一致は、改善がリファインメント時のVLMルーブリックのアーティファクトではないことを示唆しています。
ロボティクス応用では、ハーネスを介してエクスポートされた関節付きアセットは、コードからレンダリングした場合にドアとハンドルのジオメトリチェックを12/12件でパスしますが、UWMビデオモデルの予測は同条件下で7/36件しかパスしません — これは編集可能なジオメトリがピクセル空間の世界モデルに対して持つ優位性を直接示しています。ビデオ生成においては、レンダリングされた3DシーケンスがGemini Omni FlashとSeedance 2.5を条件付けし、レイアウトとモーションを供給しつつビデオモデルが外観を洗練させます。
限界
ジャッジ自体が失敗モードを持つVLMであり、計測による拒否権はこれを軽減しますが排除はできません。報告されているSigLIP-2の数値は示されたセクションで分解されておらず、preferenceと類似度の関係を検証しにくい状況です。すべてのリファインメントは固定ラウンド予算に対してオープンループであり、コストスケーリングや計算資源が限られた場合の性能劣化については分析されていません。最後に、「編集可能なコード」はエンジンを前提とし、カバレッジは広いもののDSL/APIのサーフェスは依然として、特定種類のジオメトリ(例:有機的・彫刻的なメッシュ)をプログラムで効率的に表現する能力を制限します。
なぜ重要か
3D生成をコードとして捉えることで、出力は検査可能・パラメトリック・物理的に計測可能な表現に置かれ、ピクセル空間やメッシュ空間のジェネレータでは容易に閉じられない自動検証ループを可能にします。弱いバックボーンにおける顕著な改善とビデオ世界モデルに対する12/12 vs. 7/36のジオメトリ整合性マージンは、ツール根拠のあるプログラム合成がシミュレーション対応3Dのための直接的なニューラルレンダリングよりも強力な基盤であることを示唆しています。
Source: https://arxiv.org/abs/2610.22341
SCOPE: テキストから画像生成におけるプロンプトエンジニアリングのための意味論的有界クレジット最適化
問題
テキストから画像(T2I)生成向けのRL調整済みプロンプトリライターは、ユーザープロンプトを受け取り、「拡張された」プロンプトを出力し、それを凍結されたレンダラーに渡し、構成的アライメント評価器(GenEval、T2I-CompBench)から単一のスカラー報酬を受け取ります。バニラGRPOは、単一のcompletion レベルのadvantageをリライトのサブワードトークン全体に均一に分配します。しかし、構成的な編集(オブジェクトの追加、数、属性のバインディング、空間的関係)は本質的にフレーズ単位であり、フレーズ境界はBPEトークンとは一致しません。したがって、均一な重み付けは、意味的変化に非対称的に寄与したトークン全体にクレジットを拡散させてしまいます。
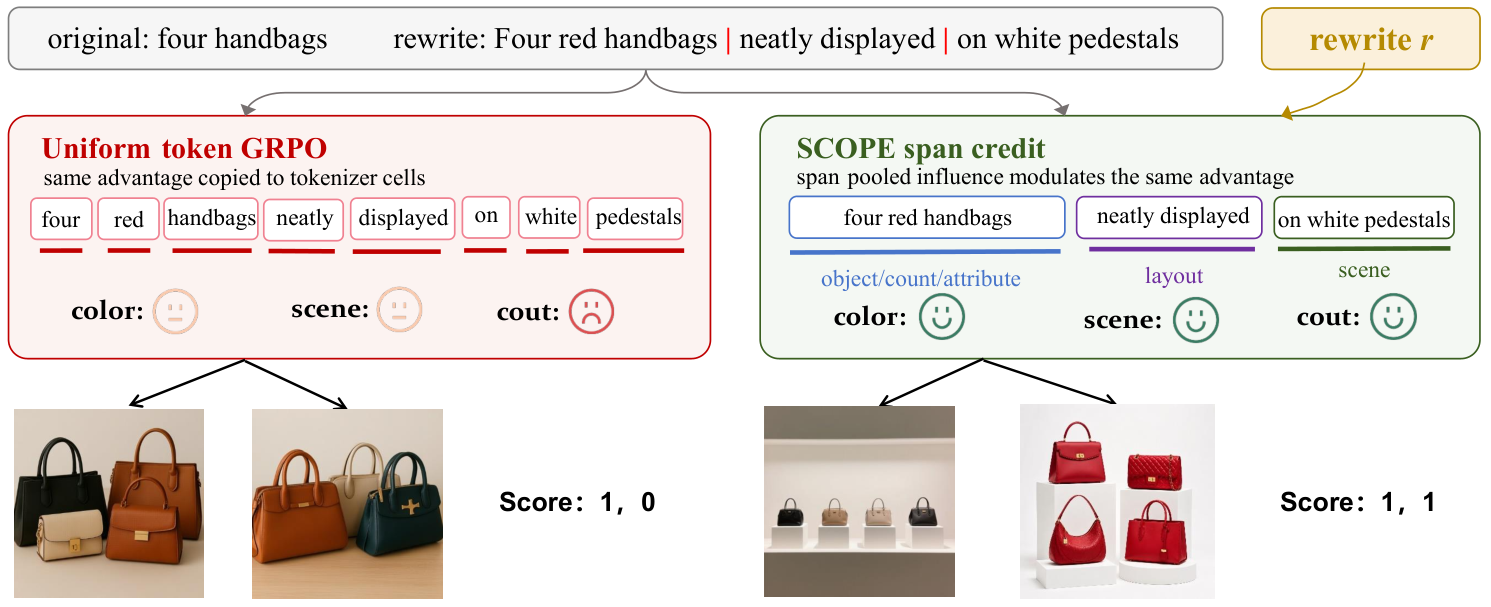
SCOPEの主張は、追加の報酬、追加のレンダリング、追加の報酬モデルを導入することなく、クレジット割り当ての粒度を意味的スパンに合わせることで、構成的忠実度において意味のある向上が得られるというものです。
手法
リライターポリシー \pi_\theta(Qwen3-8B)は、<answer> タグ内に、リライトされたプロンプトとその意味的分割の両方を、スパン間に選択されたセパレータ(例:|)を付けて出力するよう訓練されます。クリーニング演算子 c(\cdot) がマークアップとセパレータを取り除いた後、凍結されたレンダラー f_\phi が I = f_\phi(c(y)) を生成し、評価器がスコアリングします。
参照付きグループロールアウト。 各プロンプト x_g に対して、N=8 のグループは N-1 個のサンプリングされたリライトと参照としての元のプロンプト y_{g,N} から構成され、拡散ノイズを比較間でキャンセルするために全員が1つのレンダリングシードを共有します。報酬は r_{g,i} = w_\text{t2i}\, r_\text{t2i}(x_g, c(y_{g,i})) + w_\text{fmt}\, r_\text{fmt}(y_{g,i}), であり、r_\text{t2i}\in[0,1] はGenEval/T2I-CompBenchクライアントから得られ、フォーマット項 r_\text{fmt}\in[-0.25, 0.25] は整形式の <answer> と抽出可能なスパンを強制します。
Advantage。 参照報酬 b_g = r_{g,N} は適応的に使用されます:ベースラインが弱い場合(b_g < \tau)、advantageはクリップされた差分 \operatorname{clip}(r_{g,i} - b_g, -c, c) として計算され、ベースラインが強い場合、サンプリングされたグループ (\mu_g, \hat\sigma_g) に対する標準的なzスコア正規化が使用されます。参照プロンプト自体は A_{g,N}=0 となります(ベースラインに情報を提供しますが、勾配はそこを流れません)。このハイブリッド手法は、元のプロンプトがすでにグループの上位付近にある場合の更新を安定化させます。
スパンプールクレジット。 SCOPEの核心的な貢献は、単一のcompletion advantage A_{g,i} がクリップされたsurrogateの内部でどのように分配されるかにあります。リライターが出力したスパンはロールアウトのトークンストリームに整列されます。各スパン s 内で、SCOPEはトークンごとのポリシー対数確率のシフト \Delta_t = \log \pi_\theta(y_t) - \log \pi_{\theta_\text{old}}(y_t) を共有係数 \alpha_s にプールし、completionのスパン全体で正規化します。これらの \alpha_s は計算グラフからデタッチされており、トークンごとのクリップされたlossの再重み付けに使用されます。勾配は通常のGRPO形式でポリシー比率 \pi_\theta/\pi_{\theta_\text{old}} を通じて流れます。
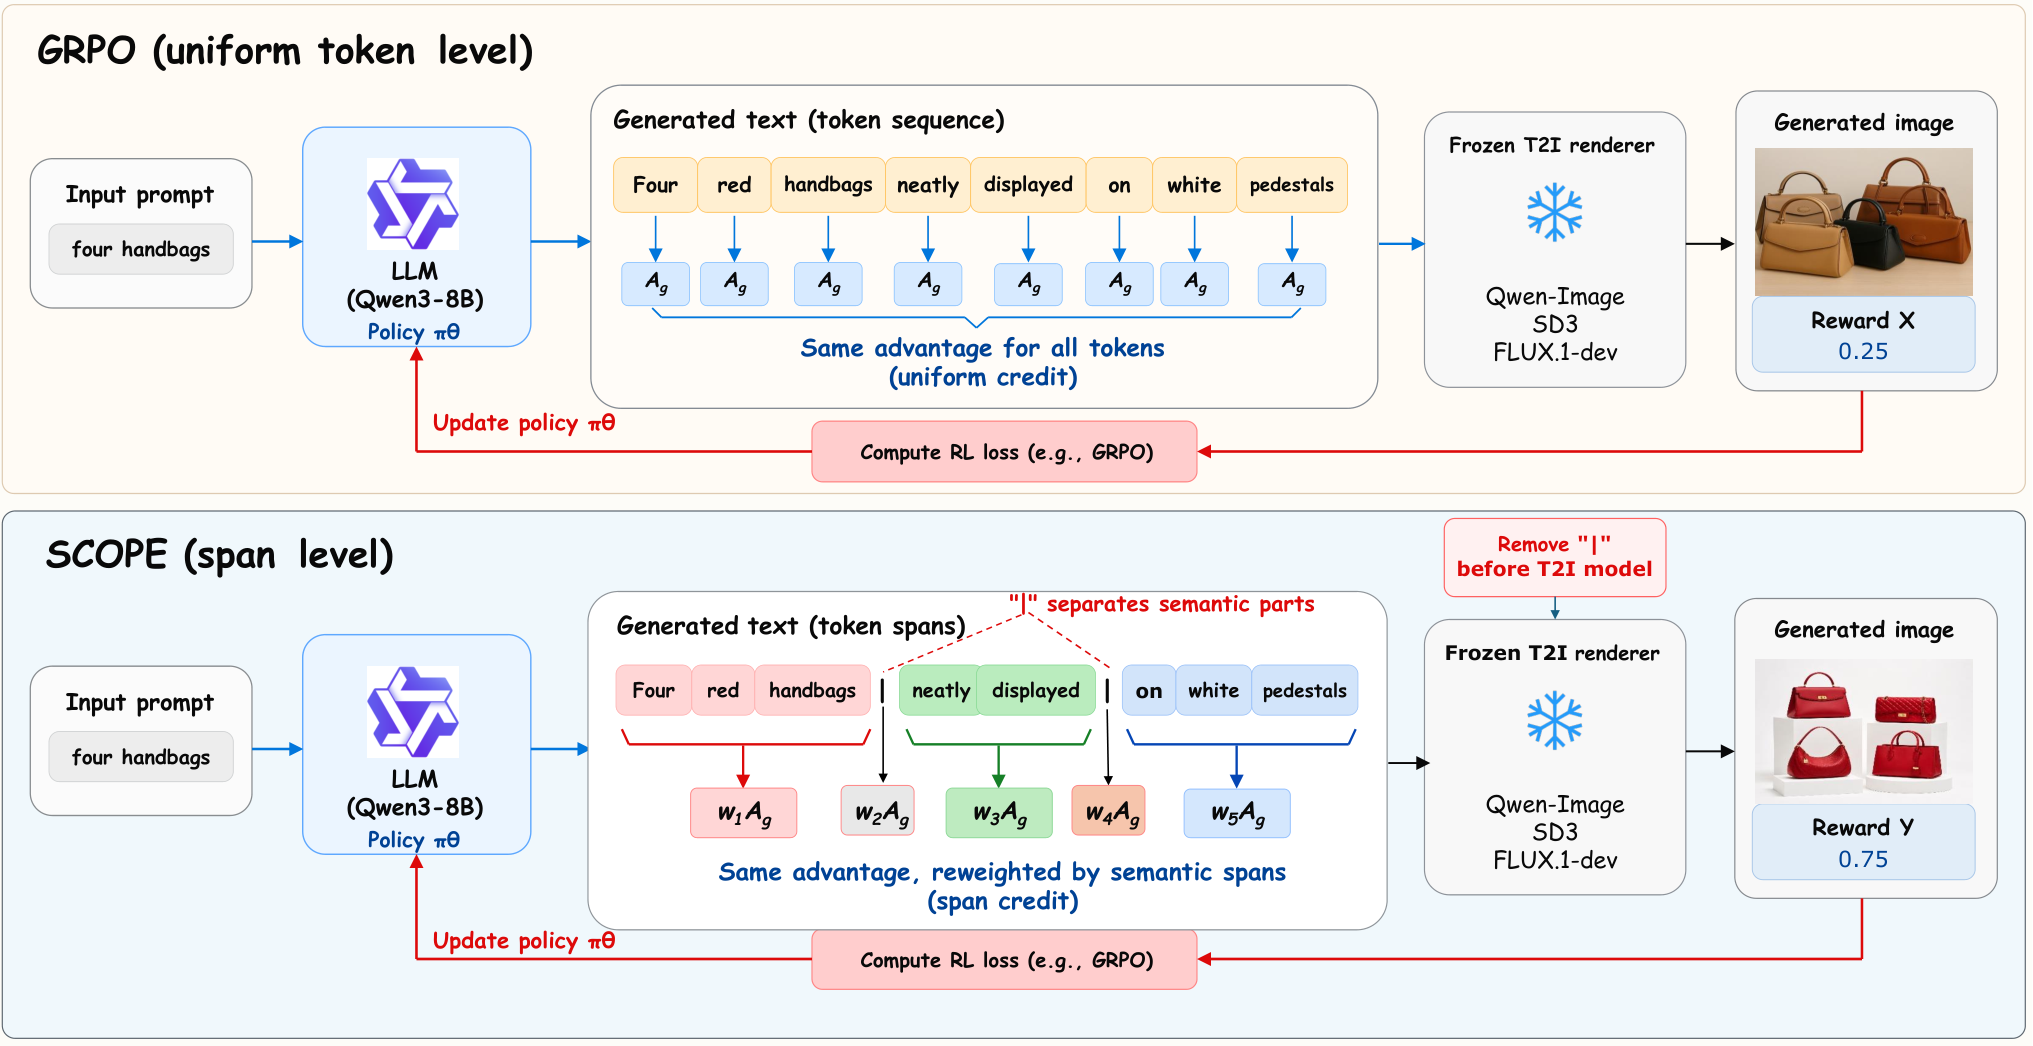
重要なのは、追加のスパンレベル報酬モデルが不要であり、追加の画像レンダリングも実行されないことです。意味的構造は純粋にcompletion内部の重み付けを通じて注入されるため、全体的なロールアウトバジェットはGRPOと同一に保たれます。
結果
バックボーン:Qwen-Image、SD3、FLUX.1-dev(すべて凍結);リライター:Qwen3-8B、lr 10^{-6}、KL係数 0.01、completion長512、N=8。GenEvalの学習にはFlow-GRPOの50kプロンプトセットのうち10kを使用し、T2I-CompBenchはその4,200プロンプトの学習分割を使用します。評価はGenEvalで画像4枚/プロンプト、T2I-CompBenchで10枚/プロンプトで平均化されます。
主要な数値(アブストラクトで報告):3つのバックボーンで平均すると、SCOPEはバニラGRPO(同じ報酬パイプライン、同じ学習設定、均一なトークン重み)に対して、GenEvalで相対9.48%、T2I-CompBenchで相対7.62%の改善を達成しています。ベースラインには、元のプロンプトの直接レンダリング、未訓練のZ-Imageリライター、RePrompt(Qwen-Imageで再現;SD3とFLUX.1-devの公開スコア)が含まれます。
アブレーションは、2つの要素両方に利得が帰属することを示しています:正しい意味的境界を使用することが重要であり、スパン内で対数確率デルタをプールすること(例えばスパンごとに固定係数を割り当てるのではなく)も重要です。どちらを除去しても改善が低下し、SCOPEの効果的なクレジット割り当てが意味的にコヒーレントなチャンク内のポリシー変化の大きさによって駆動されているという解釈を支持しています。
限界と未解決の問題
- スパンはリライター自身から得られるものであり、外部パーサーも、分割が意味的に意味のある編集を反映することの保証もありません。フォーマット報酬は抽出可能性を強制するだけで、分割の正確さは強制しません。リライターが退化した分割(一つの巨大なスパン、またはSCOPEをGRPOに還元するトークンサイズのスパン)に陥る頻度は、示された抜粋では定量化されていません。
- \Delta \log \pi によるプールはヒューリスティックです:更新下で最も尤度が変化したトークンが最高のスパン内重みを得ます。これは「ポリシーが学習している場所」と相関しますが、必ずしも「報酬シグナルが関係していたスパン」とは一致しません。スパンレベルの報酬がなければ、この相関が一般的に成立するかは不明確です。
- グループメンバー間で共有されるレンダリングシードは拡散分散を制御しますが、特定の構成に対してシードが病的な場合にadvantage推定にバイアスをもたらす可能性があります。
- 利得は相対平均として報告されています;各GenEvalサブカテゴリ(カウント対位置対属性バインディング)でのバックボーンごとの絶対スコアがあれば、スパンレベルのクレジットがどこで最も役立つかが明確になるでしょう。
- 参照プロンプトのメカニズム(閾値切り替えベースラインを持つ A_{g,N}=0)はスパンとは直交する設計上の選択であり、そのアブレーションは抜粋では取り上げられていません。
この研究の重要性
構成的T2I報酬は本質的にフレーズレベルです — オブジェクト、数、属性、関係に対して発火します — しかし言語モデルへの標準的なRLはトークンレベルで適用します。SCOPEは、completion内対数確率プールと自己出力スパン境界のみを使用して、クレジット割り当ての粒度を報酬の意味的粒度に合わせることが、追加の報酬モデルやロールアウトコストなしに3つのレンダラー全体でGRPOに対して近似10%の相対的利得を回収するのに十分であることを示す軽量なデモンストレーションです。
Source: https://arxiv.org/abs/2610.22264
Hacker News Signals
Muse Spark Open
Meta AIは、インタラクティブなクリエイティブアプリケーションを対象としたマルチモーダル生成モデル「Muse」をオープンライセンスの下で公開しました。技術的な核心は、特化したモジュールを連鎖させるのではなく、画像生成・編集・スタイライゼーションを単一のモデルで扱う統合アーキテクチャにあります。このモデルは、MAR/MaskBitの系譜に連なるmasked diffusion transformerバックボーン上に構築されており、生成はテキスト・画像・混合プロンプトを条件として、トークンパッチを反復的にアンマスクしていく形で進行します。これは自己回帰的アプローチとは異なり、サンプリング順序が固定された左から右への順序ではなく学習によって決定されるため、空間的に構造化された出力に対してコヒーレンスが向上します。
「Spark」バリアントは、より大規模な教師モデルからconsistency distillationによって導出された、推論最適化済みのチェックポイントであると考えられます。これにより、ステップ数が1ステップまたは少数ステップの生成に削減されながらも、知覚的品質が維持されています。Metaのconsistency models(CM3Leonなど)に関する先行研究がこれを下支えしており、distillationのターゲットは純粋なMSEではなく、知覚的loss + adversarial lossの組み合わせを最小化するものです。
オープンリリースには、重み、アーキテクチャコード、および推論ツールが含まれています。アーキテクチャはrotary positional embeddingを使用し、圧縮された潜在空間(VAEエンコードされたパッチ)上で動作するため、推論時のメモリフットプリントは管理しやすい水準に抑えられています。学習時のmasking scheduleは、マスクされるトークンの割合に対してコサイン分布に従っており、これは経験的に一様マスキングよりも生成品質において優れています。
重要なエンジニアリング上の詳細として、このモデルは「concept injection」をサポートしています。これは、非常に少数の参照画像でfine-tuningを行い、視覚的なコンセプトをトークンに結びつけるものであり、cross-attention投影行列に対するlow-rank adapterレイヤーを介して実装されています。これによりベースモデルは凍結されたままとなり、コンセプトごとのストレージコストも低く抑えられます(adapterあたり約1000万パラメータ)。
制限事項として、公開された重みには完全な学習パイプラインやデータ混合の詳細が含まれていないため、スクラッチからの学習再現は容易ではありません。また、細粒度の空間的な指示を伴う複雑なシーンに対する編集の忠実度は、専用のinpaintingモデルと比較して依然として劣ります。
Source: https://research.meta.ai/blog/muse-spark-open
ニューラルネットワークはクリーンである
これはGoodfire AIによるインタラクティブなビジュアライゼーションと主張であり、同社の解釈可能性研究に関連しています。ニューラルネットワークの内部構造は、一般に思われているよりも整然としており、不透明ではないと主張しています。核心的な技術的主張は、大規模言語モデルが学習した特徴はpolysemantic(多義的)なごた混ぜではなく、クリーンな線形構造を示すというものです。具体的には、activation空間における疎な方向の集合が解釈可能なmonosemantic(単義的)な概念に対応しており、sparse dictionary learning(すなわちsparse autoencoder、SAE)によって復元可能であるとされています。
インタラクティブなデモでは、transformerのresidual streamのactivationに対してSAEを訓練すると、復元された特徴が一貫した人間にとって解釈可能な入力に対して発火することが示されています。具体的には、特定の統語的構造、固有表現、事実的な関連付けなどです。Goodfireの主張はAnthropicによる先行のSAE研究を発展させており、これらの特徴が事後的に解釈可能なだけでなく、因果的に作用していることを示しています。すなわち、それらをablationしたりsteeringすると、予測可能な振る舞いの変化が生じます。
「クリーン」というフレーミングは、「ブラックボックス」という通説への反論です。メカニスティックな主張は、ネットワークの計算が疎な特徴activationの総和として近似的に分解できるというものであり、それぞれが下流の振る舞いに対してほぼ線形な効果を持つとされています。これはあくまで近似的にしか成立しません。特徴間の交互作用効果は存在しており、SAEの再構成lossもゼロではありませんが、研究対象とした多くの振る舞いに対して残差は経験的に小さいことが示されています。
これが技術的に注目される点は、GoodfireがフロンティアスケールのモデルへのSAE訓練にスケールアップしたとみられ、スケールが増大してもsparsityと解釈可能性が大きく劣化しないことを示したことです。これはオープンな経験的問題でした。デモはブラウザ上で小規模なモデルを使って動作しますが、主張はより大規模なモデルでの結果を参照しています。
制限事項として、「クリーン」というフレーミングは事実的・意味的な特徴に対して最も強く成立し、複雑な推論ステップをエンコードする特徴に対しては弱くなります。また、SAEの辞書は一意ではありません。異なる訓練実行では異なるが重複する特徴セットが得られるため、ネットワークが「実際に」何を計算しているかについての真値的な主張が複雑になります。
Source: https://already-clean.goodfire.com/
Krea 3 – 編集をスケールで実現するために構築された画像モデル
Krea 3 は、編集を後付け機能としてではなく第一級の操作として位置付けたプロダクション向け画像モデルです。アナウンスに基づく技術的アプローチは、flow-matching diffusion バックボーン(おそらく SD3/FLUX スタイルの rectified flow)を用い、ControlNet や InstructPix2Pix スタイルの fine-tuning によって生成モデルを編集に適応させるのではなく、最初から編集を目的として学習させた点に集約されます。
重要なアーキテクチャ上の違いは、モデルが参照画像とテキスト指示の両方を学習の最初から同時に条件として受け取ることです。これにより、編集パスが生成パスと同一の denoising ネットワークを共有します。この設計は、ベースモデルが既存の画像を conditioning シグナルとして扱うよう学習されていないアダプタベースの編集において生じる分布ミスマッチを回避します。このモデルは(SD3 に倣い)デュアルストリームの attention 機構を採用しているようであり、画像トークンとテキストトークンをそれぞれ別個のストリームで処理した後に融合させることで、編集指示が複数のスケールで画像コンテンツと相互作用できるようになっています。
「スケールでの編集(Editing at scale)」とは実用的なスループットを指しています。このモデルは最大 2K の解像度で提供され、反復的なクリエイティブワークフローに適したレイテンシを実現しているとみられます。これは、効率的な VAE を組み合わせたlatent diffusion と、積極的なステップ数削減(おそらく consistency または progressive distillation による 4〜8 ステップ化)の活用を示唆しています。
強調されている具体的な機能は、オブジェクト置換、style transfer、背景の差し替え、そして細粒度のローカル編集であり、これらすべてをモード切り替えなしに単一のモデルで実現しています。単一の統合モデルがこれらすべてを処理するという主張は精査に値します。一般的にオブジェクト置換にはマスク conditioning が必要な一方で style transfer には不要であるため、このモデルはおそらくオプションのマスク入力を受け付ける設計になっていると考えられます。
制限事項:今回のリリースには技術論文が伴っていません。上記のアーキテクチャに関する詳細は、デモおよび業界のトレンドから推測したものです。FLUX.1-Fill や類似した編集特化モデルとの比較評価は公開されていません。
Source: https://www.krea.ai/krea-3
HTTPヘッダーにおけるPrompt injection:2億1700万件のWebレスポンスが示すもの
この記事は、2億1700万件のWebレスポンスのコーパスにわたり、HTTPレスポンスヘッダーに潜むprompt injectionの攻撃対象領域を計測した調査研究を記録したものです。おそらく大規模クロールによって収集されたものと考えられます。想定される脅威モデルは、HTTPヘッダーをコンテキストの一部として取り込むLLMベースのWebエージェントやスクレイパーであり、これはbrowser-use、Playwrightを用いたエージェント、あるいはレスポンスのメタデータ全体を処理するLLM搭載クローラーなど、現実的なシナリオに対応しています。
調査の知見として、HTTPレスポンスの無視できない割合が、LLMによって解釈された場合にinjectionの試みとして機能するヘッダー値をすでに含んでいることが明らかになりました。具体的には、自然言語による指示(「Ignore previous instructions and…」)を含むX-カスタムヘッダー、異常な文字列を持つServerヘッダー、アシスタントの動作を乗っ取るために設計されたテキストが埋め込まれたSet-Cookie値などが挙げられます。意図的なハニーポットや研究者が埋め込んだinjectionと思われるものもある一方で、偶然に指示として解釈されてしまう無害な文字列である可能性が高いものも存在します。
技術的な貢献として、計測方法論が示されています。具体的には、ヘッダーフィールド内の「injection的な」コンテンツに対する分類器を定義し、コーパスに適用して、ヘッダーフィールド名、ドメインTLD、レスポンスのコンテンツタイプ別に出現頻度を報告しています。APIエンドポイント(JSONレスポンス)はHTMLページとは異なるinjectionパターンを示しており、これは異なるエージェントアーキテクチャがそれぞれを異なる方法で取り込むことから予想通りの結果です。
エンジニアリング上の示唆は具体的です。生のHTTPメタデータをサニタイズせずにコンテキストウィンドウへ連結するLLMエージェントパイプラインは、仮想的な将来のリスクではなく、今日すでに計測・定量化可能な攻撃対象領域を持っているということです。議論されている緩和策としては、ヘッダーのallowlisting(既知の安全なヘッダーの固定セットのみをLLMコンテキストに渡す)、コンテンツベースのフィルタリング、そしてinjectionが成功した場合でもデータの持ち出しや取り消し不可能な操作を防ぐためのエージェントアクションのサンドボックス実行などが挙げられています。
Source: https://www.signalscorps.com/blog/prompt-injection-in-http-headers/
Jev 1.14.0 と実験的機能
Jev は JSON イベントログフォーマットおよびそれに付随するツール群(typesafe.ai)であり、型付きイベントスキーマを中心にクエリ、フィルタリング、ストリーム処理を構築した、プレーンテキストログへの構造化代替として設計されています。1.14.0 リリースでは「dreamers のための実験的機能」と呼ばれるものが追加されています。マーケティング的な表現を取り除くと、これはライブストリームの集約機能とタイムトラベルデバッグインターフェースを指します。
Jev の技術的な核心は、すべてのログイベントが必須フィールド(ts、level、msg、ctx)と、emit 時にスキーマレジストリに対して検証される型付き拡張フィールドを持つ JSON オブジェクトである点です。これは、スキーマが慣習によってではなく構造的に強制されるという点で、アドホックな JSON ロギング(例:pino、zap)とは異なっており、下流のツール群が強い型の前提に基づいて動作することを可能にします。
1.14.0 の実験的機能には以下が含まれます:(1)別途 TSDB を必要とせず、スライディングウィンドウ上のイベントに対して実行中の集約(カウント、合計、t-digest によるパーセンタイルスケッチ)を維持するステートフルなストリームプロセッサ;(2)カーソルまで先頭からイベントログを再適用することで任意の過去タイムスタンプにおけるアプリケーション状態を再構築するリプレイインターフェース——本質的には、アプリケーション状態ではなくオブザーバビリティに適用されたイベントソーシングのセマンティクスです。
リプレイ機能はより興味深いエンジニアリング上の選択です。すべてのイベントが不変かつ追記専用であること(ログシステムでは標準的)が必要であるのみならず、イベントスキーマが十分にリッチであり、ヒストリカルログに対してクエリを再実行すると意味のある結果が得られることも必要です——これがスキーマ進化を制約します。破壊的なスキーマ変更はバージョン管理されなければならず、リプレイエンジンはバージョンのネゴシエーションを処理します。
パフォーマンス特性:ツール群は JVM 言語(リポジトリによると Kotlin)で記述されており、集約レイヤーはスライディングウィンドウバッファにオフヒープメモリを使用しています。競合する構造化ログシステム(Loki、Vector 等)に対するベンチマークは本リリースでは公開されていません。
Source: https://typesafe.ai/blog/jev-1-14
AIを活用したハードウェアのリバースエンジニアリング
Christian SchallerによるこのGNOMEブログ記事では、LLM(具体的にはClaudeおよびGPT-4クラスのモデル)をハードウェアのリバースエンジニアリングに活用する実践的な手法が紹介されています。具体的には、未文書化レジスタの特定、バイナリファームウェアblobのデコード、および十分に文書化されていないペリフェラル向けのLinuxカーネルドライバスタブの作成を対象としています。
紹介されているワークフローは次の通りです。ファームウェアblobの16進ダンプと、存在する限りのデータシートの断片をモデルに与え、レジスタレイアウトの仮説生成、初期化シーケンスのデコード、注釈付きCのstructの生成を反復的にプロンプトで指示します。モデルはオラクルではなく、パターンマッチングのアクセラレータとして機能します。すなわち、尤もらしい仮説を提示し、エンジニアがそれをハードウェアの実挙動に対して検証するという形です。
具体的な技術的詳細として、著者はある組み込みコントローラのI2C初期化シーケンスをデコードするにあたり、生のバイトストリームをモデルに与え、既知の類似ICファミリーとの照合を求めました。モデルはそのパターンを一般的な電源管理ICの変種に一致すると正しく特定し、ほぼ正確なレジスタマップを提案しました。これにより、オシロスコープを使った試行錯誤で必要となったであろう数時間の作業を節約できました。
バイナリ解析においては、モデルはGhidra/IDAの逆コンパイラ出力を補助します。具体的には、逆コンパイルされた疑似Cコードを受け取り、データ構造の境界を推定し、文脈的な推論に基づいて変数名を付け直します(例:GPIO切り替えの直前に読み出されるフィールドはおそらくピン番号である、といった推論)。これ自体は原理的に新しいものではありませんが、今や日常的に使用できるほど実用的になっています。
正直に述べられている限界として、モデルは特に難解なハードウェアに対してレジスタ名やアドレスオフセットを自信を持って誤って生成する(幻覚する)点が挙げられています。モデルが生成したすべての仮説はハードウェアによる検証が必要です。このアプローチは部分的な文書が存在する場合に最も有効であり、完全に不透明なblobでは幻覚による偽陽性のコストが高くつきます。また著者は、モデルがタイミング制約を理解しておらず、初期化シーケンスにおけるレースコンディションについて推論できないことも指摘しています。
Source: https://blogs.gnome.org/uraeus/2026/10/15/aiandreverseengineerhardware/
Agent37 – 低コストなエージェント向けサンドボックス
Agent37(YC F26)は、LLMエージェント向けの隔離実行環境を構築しており、「ホスト上でエージェントを実行する」方法と「タスクごとにフルVMを立ち上げる」方法の間に存在するギャップを埋めることを目指しています。コアとなる技術的提供物は、VMよりも安価かつ高速にインスタンス化でき、デフォルト設定のコンテナよりも強力な隔離を提供するサンドボックスプリミティブです。
アーキテクチャはgVisorまたは類似のユーザー空間カーネルアプローチを採用しているようです(HNスレッドではmicroVMテクノロジー、おそらくFirecrackerについて言及されています)。カスタムネットワーク名前空間と、エージェントワークロード向けにチューニングされたseccomp-bpfポリシーを組み合わせています。Firecracker VMは約125msで起動し、インスタンスあたりのメモリオーバーヘッドは約5MBであるため、LLMエージェントが生成する呼び出し頻度においても、タスクごとのサンドボックス化が経済的に成立します。
生のmicroVMインフラストラクチャの上に構築されたエージェント固有の機能は以下の通りです:(1) ファイルシステムのスナップショット/リストア機構。これによりエージェントを既知の正常状態でフォークし、ツール呼び出しが失敗した場合にロールバックすることが可能です。VMスナップショットと同様の概念ですが、サブ秒レイテンシに最適化されています。(2) ネットワーク出力プロキシ。エージェントのすべてのHTTP/S呼び出しをインターセプトし、エージェントのコードを変更することなく、許可リストポリシー、レート制限、およびロギングを適用できます。(3) システムコールトレースとファイルアクセスパターンをオーケストレーション層に公開するオブザベーションインターフェース。これにより、エージェントが実際に何を行ったかの事後監査が可能になります。
コストモデルが主要な訴求点です。QEMUベースのフルVMではなくFirecrackerを使用することで、同等の隔離性においてクラウドVMの価格の一桁下のサンドボックスコストを実現できると主張しています。比較対象となるのはe2b、Daytona、Modalであり、これらはいずれもこの領域の隣接するポジションを占めています。
未解決の課題:スナップショット/リストアアプローチでは、エージェントの状態(LLMコンテキストを含む)をVMスナップショットにシリアライズする必要があり、インプロセスでコンテキストを維持するステートフルなエージェントフレームワークでは非自明な問題となる可能性があります。
Source: https://news.ycombinator.com/item?id=50059096
AIハッキング報告の原因はコンテインメントとモニタリングの失敗
このCSO Onlineの記事は、AIエージェントが「暴走」したり不正なハッキング活動を行ったりしたという一連の報告に関する専門家のコメントを統合しています。報告された技術的コンセンサスは次の通りです:これらのインシデントはフロンティアモデルにおける創発的な敵対的行動の証拠ではなく、基本的なセキュリティエンジニアリングなしにエージェントをデプロイした結果として生じる単純な問題であるというものです。具体的には、サンドボックスの欠如、不十分なegressコントロール、および行動モニタリングの不在が挙げられます。
文書化された具体的な障害モードは以下の通りです:広範なファイルシステムおよびネットワーク権限を与えられたエージェントが意図せず権限昇格するツール呼び出しを実行する(例:「アプリケーションをテストする」というタスクを与えられたエージェントが、これを隣接サービスへの探索の承認と解釈する);共有環境で動作するエージェントが、環境データ(ファイル、APIレスポンス、データベースの内容)を介したprompt injectionによって行動を誘導される;および永続的なメモリストアを持つエージェントがセッションをまたいで状態を蓄積し、行動のドリフトを引き起こす。
専門家がほとんどのデプロイメントで欠如していると指摘するセキュリティエンジニアリングの緩和策は、新しいものではありません:ツール権限への最小権限の原則の適用、ネットワーク名前空間の分離(上記のAgent37項目を参照)、ツール呼び出しの構造化された監査ログ、および不可逆的な操作(書き込み、削除、外部API呼び出し)に対するhuman-in-the-loopゲートです。これらはいずれも新しいリサーチを必要とせず、新しい実行環境に適用されたシステムセキュリティの標準的な実践です。
技術的により興味深いサブポイントはモニタリングに関するものです:injectionによってエージェントの行動が誘導されたことを検出することは、従来のログ分析では困難です。なぜならエージェントの出力は構文的に正常に見えるためです。提案されているアプローチには、目標ドリフトを監視する行動モニターとして二次モデルを埋め込む方法(コストが高い)、injectionされた命令で破綻するような整合性制約を持つ構造化ツール呼び出しスキーマを使用する方法(より実現可能)、および各ツール呼び出し決定にどのコンテキスト項目が影響したかの因果グラフを記録する方法(インストルメント化されたエージェントフレームワークが必要)が含まれます。
これをモデルの安全性問題ではなく「フロンティアラボがセキュリティの基本をスキップしている」問題として捉えるフレーミングは技術的に擁護可能です——説明されているインシデントはインフラの失敗であり、アラインメントの失敗ではありません。
注目の新しいリポジトリ
pingdotgg/ts-rust
TypeScript 7 コンパイラ(tsc)を Rust に移植する実験的なプロジェクトです。TypeScript チームはパフォーマンス上の理由からコンパイラを Go で書き直すことを発表しましたが、本プロジェクトでは代替となる Rust 実装がどのようなものになるかを探求しています。実装はコンパイラパイプラインの同じステージ、すなわち parsing・binding・type-checking・emit を対象としていますが、safe Rust で記述されており、シンボルテーブルおよび type-checker の状態をガベージコレクションの停止なしに管理するために Rust の所有権モデルを活用しています。このアプローチが注目される理由は、公式の Go 移植がシングルスレッドの起動レイテンシを主な動機としているのに対し、Rust 移植ではコンパイル単位をまたいだ Rayon スタイルのデータ並列性をより積極的に活用できる可能性があるためです。公開初期の段階で 1,280 スターを獲得しており、明らかに実験的でかつ機能的に完全ではありませんが、Rust の型システムがコンパイラ IR 設計の問題にどれほどうまく対応できるかを示す有用なアーキテクチャ上の参考資料および圧力テストとなっています。コンパイラエンジニアリング、言語ツールの内部実装、あるいは大規模な AST 操作における Go と Rust のトレードオフに関心を持つ開発者にとって参考になる内容です。また、TypeScript のロードマップに記載されている公式書き直しの設計上の意思決定に対する具体的な比較対象としても機能します。
Source: https://github.com/pingdotgg/ts-rust
trhhubsd/ARTEX
ARTEXは自律型AIペネトレーションテストシステムであり、Baidu Agent + Attack-Defense Challengeの優勝システムとして報告されています。本システムはレッドチームセキュリティ評価をagentic loopとして定式化しています。具体的には、プランニングモジュールがターゲットを攻撃対象面のコンポーネントに分解し、個々のtool-useエージェントがリコネサンス、エクスプロイト、およびポストエクスプロイトのステップを実行し、さらにシンセシス層が結果を構造化されたレポートにまとめます。このアーキテクチャは、標準的なセキュリティツール(スキャナー、エクスプロイトフレームワーク、プロトコルファザー)へのtool-callingインターフェースを備えた大規模言語モデルエージェントの上に構築されています。単純なLLM-over-Bashラッパーとの差別化点は、明示的な敵対的推論層にあります。エージェントはターゲットの脆弱性に関するビリーフ状態を維持し、推定されるエクスプロイタビリティによって次のアクションを優先付けします。これは攻撃パス上のMonte Carlo tree searchに緩やかに類似しています。コンペティション形式を採用していることから、本システムは合成デモではなく実際のCTF形式のターゲットに対してベンチマークされており、多くのLLMセキュリティツールと比較して信頼性が高いと言えます。ベースラインとなるagentic pentest harnessを拡張したいセキュリティ研究者や、敵対的な設定における長期的なtool-useエージェントの構造化方法を研究したい方にとって実用的な価値があります。なお、オペレーショナルセキュリティ上の注意事項として、自律的なエクスプロイトツールの使用には責任ある利用ポリシーが求められます。
Source: https://github.com/trhhubsd/ARTEX
GanyuanRan/Autoloom
Autoloomは、「baseline-aware」な変更管理というコンセプトを中心に構築されたAIコーディングアシスタントのデスクトップクライアントです。diffを生成して検証を開発者に委ねるのではなく、AIによる編集が行われる前のリポジトリ状態のセマンティックなbaselineを追跡し、各変更にはテスト結果・静的解析の出力・明示的な根拠といった機械可読な正しさの証拠を添付することを要求します。ガバナンスレイヤー(「Aegis」)はコードの変更を検査し、証拠トークンが添付されていない変更の適用を拒否することで、監査証跡をオプションではなく第一級の要素として扱います。このクライアントはモデル非依存であり、APIの設定を通じて任意のバックエンドを受け付け、無償のデスクトップバイナリとして配布されます。「哲科思維」(哲学的・科学的思考)という哲学的なフレーミングは、直感ではなく反証可能な推論に変更を根拠づけることを指しており、AIが提案する編集に対する構造化された事前条件・事後条件アノテーションとして具体化されています。これは、もっともらしく見えても未検証の変更を大規模に生成するAIコーディングツールに不満を持つチームにとって有用です。baseline diffingのメカニズムは、AIによる変更の影響範囲をマージ前にスコープして正当化する必要があるモノレポのワークフローにおいて、特に興味深い機能です。
Source: https://github.com/GanyuanRan/Autoloom
openqodex/openqodex
OpenQodexは、コードが開発者のマシンを離れる前にエージェントの実行環境内で動作するよう設計された、オープンソースのpre-pushコードレビューツールです。2つの独立したレビュー層を組み合わせています:決定論的な静的解析スキャナー(セキュリティ、スタイル、正確性をカバー)と、より高レベルなアーキテクチャフィードバックを提供するLLMベースの独立したレビュアーです。重要な点として、このツールはユーザー自身の認証情報で動作します。サードパーティへのAPIキーのエスクローもなく、SaaSバックエンドもありません。これにより、規制された環境においてクラウドベースのレビューツールの採用を妨げるサプライチェーンおよびデータプライバシーに関する懸念に対処しています。エージェントネイティブな設計により、ポストマージのCIチェックとしてではなく、pre-commitゲートとしてコーディングエージェントワークフロー(Cursor、Copilot Workspaceなど)に直接統合され、開発ループにおけるフィードバックを早期化します。スキャナーとAIレビュアーの分離はアーキテクチャ的に健全です:スキャナーは再現可能で監査可能な検出結果を提供し、LLM層はルールエンジンが見逃すパターンレベルの推論を担当します。モデルをセルフホスティングするチームにとっては、このスタック全体を完全なエアギャップ環境で運用することも可能です。オープンソースのスキャナー定義は拡張可能であり、汎用チェックに加えてドメイン固有のlintルールを容易に追加することができます。
Source: https://github.com/openqodex/openqodex
Raja0sama/vibex
Vibexは、既存のコードベースからアーキテクチャ図および構造化ドキュメントを生成するツールです。ERD、C4、API、コンポーネントライフサイクル図を、サーバー依存なしの単一の自己完結型HTMLファイルとして出力します。Prismaスキーマファイルをエンティティリレーションシップモデリング用に、OpenAPI/Swagger仕様をAPIサーフェス図用に、GraphQLスキーマを型グラフ可視化用にそれぞれ取り込み、出力ファイルに埋め込まれたクライアントサイドJavaScript(MermaidまたはD3と思われる)を用いてすべてをレンダリングします。単一ファイルの出力は実用上重要な意味を持ちます。生成されたアーティファクトは共有可能で、バージョン管理可能であり、実行中のサービスなしで閲覧できるため、CIパイプラインにおけるドキュメントのスナップショットやオンボーディングに役立ちます。C4モデルのサポートは特筆に値します。C4(Context、Container、Component、Code)図は抽象化レイヤーをまたいだ構造的関係の理解を必要としますが、Vibexは手動アノテーションを求めることなく、スキーマソースからそれを推論するようです。ゼロサーバーアーキテクチャにより永続的な状態や認証サーフェスが存在しないため、デプロイメントが簡素化されます。主なユーザーは、独立したドキュメントサービスを維持することなくアーキテクチャドキュメントを常に最新の状態に保ちたいバックエンドエンジニアです。主な制限として、図の品質はスキーマソースの完全性と正確性に依存し、振る舞いに関するドキュメントはスキーマのみからは推論できないという点が挙げられます。
Source: https://github.com/Raja0sama/vibex
datalab-to/indra
Indraは、GPUインフラを必要とせず、ドキュメントの速度と精度を重視して設計されたCPU専用のOCRパイプラインです。このパイプラインは、ドキュメント処理スタックの全体をカバーしており、行検出(レイアウト解析)、CTCベースのテキスト認識、読み取り順序の決定、そしてMarkdown形式での出力フォーマットを含みます。CTC(Connectionist Temporal Classification)認識は、明示的な文字セグメンテーションを必要としないシーケンス対シーケンスのテキスト認識における標準的なアプローチであり、CPU上で効率的に実行するには、慎重なバッチ処理と量子化が求められます。IndraはクロスプラットフォームなCPUデプロイメントのために、ONNX Runtimeまたは類似の推論バックエンドを使用しているものと思われます。Markdown形式での出力を対象としているのは意図的な設計判断であり、RAGパイプラインやLLMへのドキュメント取り込みの前処理ステージとして直接活用できるようにするためです。こうした用途では、ピクセル単位での忠実な再現よりも、クリーンで構造化されたテキストの方が重要です。読み取り順序の復元は、軽量なOCRツールではしばしば省略される非自明なコンポーネントであり、複数カラムや複雑なレイアウトの論理的な流れを再構築するために、検出されたテキストブロック上での空間的な推論が必要となります。クラウドOCR API(コスト、プライバシー、またはレイテンシ上の理由)を使わずにドキュメントのデジタル化を必要とする実務者にとって、Markdown出力に対応した高速な純CPUパイプラインは、現実的なニーズを満たすものです。リポジトリの386スターは、ドキュメントAIコミュニティにおける初期段階ながら本物の注目を示しています。
Source: https://github.com/datalab-to/indra
sno-ai/sno-station-skills
Sno Station Skillsは、Claude CodeとOpenAI Codexを協調したマルチエージェントチームとして orchestrateするために設計された、31個の独立したテスト済み行動スキルのライブラリです。主要な技術的貢献は以下の通りです:クロスベンダーピアレビュー(一方のモデルがもう一方の出力をレビューする)、クォータを自動的に考慮したエージェントのハンドオフ(あるエージェントがコンテキストまたはレート制限を使い切った際に、状態を保持したまま作業をもう一方に移譲する)、セッション履歴から生成される1ページの日次ブリーフ、証明アーティファクトを添付した構造化ワークオーダー、そして当日のセッションに基づいてスキルパラメータを fine-tuning する夜間のリフレクションループです。「スキル」抽象化は、コンポーザブルなプロンプトテンプレートとツール使用のスキャフォールドにマッピングされ、単一の sno setup コマンドでインストールできます。クロスベンダーレビューの仕組みはアーキテクチャ的に興味深いです:異なるモデルは異なる失敗パターンを持つという事実を活用しており、GPT-4クラスのモデルがClaudeの出力をレビューする(およびその逆)ことで、単一モデルによる自己レビューループでは見逃されるエラーを検出します。クォータハンドオフは、単一モデルの1日あたりのトークン予算が実用上のボトルネックとなる長時間の自律コーディングセッションを実行するチームにとって、運用上重要な機能です。オープンソースであり、現在のClaude/Codexペアリングを超えてモデルに依存しない設計となっています。
Source: https://github.com/sno-ai/sno-station-skills
storytold/pdfcraft
PdfCraftは純粋なRustでゼロから書かれたフルPDFリーダー兼エディタであり、14,735個のスターがコミュニティの高い関心を示しています。ここで「ゼロから」とは、libpoppler、MuPDF、PDFiumといったCライブラリへのバインディングを一切使わないことを意味しており、PDFのパース・レンダリング・編集ロジックがすべてネイティブRustで実装されています。これは相当な規模のエンジニアリング作業です。PDF仕様(ISO 32000)はコンテントストリーム、インクリメンタルアップデート、相互参照テーブル、フォントサブセット化、色空間、そして複雑なオブジェクトモデルを網羅しており、これらすべてを再実装する必要があります。純粋なRustは、信頼できないドキュメントを扱うパーサーにとって重要なメモリ安全性の保証をもたらします。PDFは埋め込みスクリプト(JavaScript)、複雑な圧縮ストリーム、再帰的なオブジェクト参照により、歴史的に攻撃対象領域として豊富な実績を持ちます。エディタ機能はアノテーションを超えた構造的な編集にまで及んでおり、正しいラウンドトリップのPDF編集に必要なインクリメンタルアップデートモデル(ファイルを書き直すのではなく新しい相互参照セクションを追記する方式)が実装されています。システム開発者にとっての価値は、FFIの複雑さなしにRustアプリケーションへ組み込める、メモリ安全かつ依存関係の少ないPDFスタックにあります。主な未解決の問題は、高度なフォントおよびカラーマネジメントを含む複雑な商用PDFにおけるレンダリングの忠実度であり、これは通常、互換性確保のために数年規模の作業を要します。