デイリーAIダイジェスト — 2026-10-12
arXiv ハイライト
DiffusionART: 拡散モデルの強化学習における効率的・安定的・スケーラブルな手法
問題設定
拡散モデル・フローモデルに対するオンラインRLは現在、補完的な病理を持つ2つのレジームのいずれかを選択することを強いられています。逆過程を用いる手法(Flow-GRPOおよびその派生)はODE/SDEの軌跡を行動の系列として扱い、PPOスタイルの更新を適用しますが、多数のノイズ除去ステップをまたぐクレジット割り当てが弱いため、学習が遅くなります。順過程を用いる手法(DiffusionNFT)はモデルを報酬によって傾けられた速度場に回帰させるもので、サンプル効率は高いものの不安定です。すなわち、慎重に調整されたEMAロールアウトポリシーと正負の枝の組み合わせがなければ、学習が崩壊します。さらに悪いことに、EMAのdecayスケジュールはタスクごと・モデルごとに再調整が必要です。本論文はこの2つの失敗モードの背後にあるメカニズムを特定し、オンポリシーかつEMAなしで、再調整なしにタスクをまたいで転移可能な手法を提案します。
メカニズム:隠れた順逆一貫性力(forward–reverse consistency force)
v_{\mathrm{fwd}}^{b}(s_t) := \mathbb{E}_{Q_b}[u_t \mid s_t](ただし u_t = x_0 - \epsilon)を端点分布 P_b が誘導する理想的な順方向速度とし、v_{\mathrm{rvs}}^{\mathrm{old}} をサンプラーがロールアウト生成に実際に使用した逆方向場とします。補題1は、固定された状態において正負のNFTガイダンス方向がいずれも条件付き報酬・ノイズ共分散
g = \operatorname{Cov}_{Q_{\mathrm{old}}}[r(x_0,c), u_t \mid s_t]
と共線的(collinear)であることを示します。したがって順逆互換性(v_{\mathrm{rvs}}^{\mathrm{old}} = v_{\mathrm{fwd}}^{\mathrm{old}})が成立する場合、一方の枝だけで十分なはずです。実際には両者は e := v_{\mathrm{fwd}}^{\mathrm{old}} - v_{\mathrm{rvs}}^{\mathrm{old}} だけ異なり、命題1はこのギャップが「一貫性力」としてNFT更新に入り込み、報酬を改善する方向ではなく v_{\mathrm{fwd}}^{\mathrm{old}} の方向へ v_\theta を引っ張ることを示します。正負の枝を組み合わせた学習はこの力を部分的にしかキャンセルできないため、どちらか一方の枝だけでは崩壊し、両者の組み合わせでは学習できます。一方EMAは、オフポリシー補正としてではなく、ドリフトに対する復元メカニズムとして再解釈されます。これはEMAのdecayがドリフトの大きさの変化のたびに再調整しなければならない理由を説明します。
手法:aggregation-first tiltingと適応的復元
DiffusionARTは、状態ごとのNFTターゲットを、ロールアウトグループごとに一度推定してすべての状態に適用するプロンプトレベルの報酬傾き方向(reward-tilt direction)で置き換えます。傾けられた端点分布 p_\tau(x_0 \mid c) \propto p_{\mathrm{old}}(x_0 \mid c)\exp(\tau R(x_0,c)) は(補題2)
\partial_\tau \mathbb{E}_{p_\tau}[x_0 \mid c]\big|_{\tau=0} = \operatorname{Cov}_{p_{\mathrm{old}}}(R, x_0 \mid c)
を満たし、\epsilon \perp x_0 であるrectified flowのもとでは、この共分散はすべてのノイズレベルにおいて \operatorname{Cov}_{Q_{\mathrm{old}}}(R, u_t \mid c) に等しくなります。プロンプトごとに K 個のロールアウトから次を推定します:
\overline{\operatorname{Cov}}(R,x_0\mid c) = \tfrac{1}{K}\sum_i (R_i - \bar R_c)(x_0^{(i)} - \bar x_{0,c}), \qquad G(c) = \overline{\operatorname{Cov}} / \mathrm{RMS}(\overline{\operatorname{Cov}}).
プロンプト c のすべてのロールアウト状態に対する回帰ターゲットは v_{\mathrm{tgt}}^{\mathrm{ART}}(s_t) = v_\theta^{(0)}(s_t) + G(c) であり、ここで v_\theta^{(0)} = v_{\mathrm{old}} はロールアウトからキャッシュされます。アンカーを v_{\mathrm{fwd}}^{\mathrm{old}} ではなく逆方向場そのものにすることで、一貫性力 e が構造的に除去され、正負の枝を組み合わせる必要がなくなります。RMS正規化は報酬スケール依存性と通常のガイダンス強度係数を除去します。
ODEソルバーに対するtrust-regionチェックでマスクされた2番目のMSE更新が、ドリフト適応的な復元を提供します。これはEMAが実質的に担っていた役割であり、調整すべきdecayスケジュールを必要としません。
結果
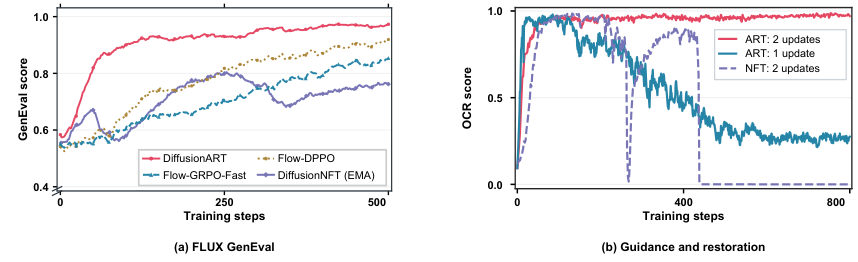
LoRA(rank 32, \alpha=64)を用いたSD3.5-Mの 512\times 512、CFGなし・参照ポリシーへのKLなしの設定において、DiffusionARTはタスクごとの調整なしに、EMA調整済みのDiffusionNFTと同等の学習効率を達成し、オンポリシーDiffusionNFTの崩壊を回避します。Flow-GRPOと比較すると、GenEval・OCR・PickScoreそれぞれにおいてステップ500相当の報酬をそれぞれ 10.0\times、5.2\times、9.6\times 少ない学習ステップで達成します。マルチ報酬の同時最適化(GenEval + PickScore + CLIPScore + HPSv2.1)でも同様の結果が得られ、各コンポーネントで不安定性は見られません。
FLUX.1-dev(12B)へのスケールアップでは、6ステップのロールアウトとモデル本来のguidance embedding(スケール3.5)を用いたGenEvalにおいて、DiffusionARTはテストした手法の中で最も学習が速く、DiffusionNFTはSD3.5-MのEMAスケジュール(\min(0.001n, 0.5))がFLUXに転移しないため、学習報酬の大きな変動を示します。ablation(図6b)は2つの更新の役割を分離しています:ART: 1 update は急速に学習しますが時間経過とともに劣化し、復元更新(ART: 2 updates)が長期的に安定化させます。一方、\beta=0.1 で調整した NFT: 2 updates は一時的にほぼゼロの報酬に崩壊した後に回復し、NFTの2更新構造がそれ自体では明示的なtrust-region復元と同等の効果を提供しないことを示しています。
本手法は、G(c) を形成するためにプロンプトグループ化されたランキング情報のみが必要であることから、ペアワイズ報酬モデルへも自然に拡張でき(DiffusionART-Pairwise)、著者らはHunyuanクラスのモデルを用いたT2VおよびI2Vでの改善を報告しています。
限界とオープンクエスチョン
共分散推定 \overline{\operatorname{Cov}} は K が小さい場合にノイズが多く、RMS正規化で大きさは修正できますが、小さいグループサイズにおける方向の分散は分析されていません。この構成はrectified-flow型の u_t = x_0 - \epsilon(\epsilon \perp x_0)に依存しており、スコアベースまたはEDMパラメータ化への移植には対応する分解が必要です。2番目の更新のtrust-regionマスクパラメータはタスク非依存と主張されていますが、敵対的な報酬ハッキングに対してはストレステストが行われていません。最後に、参照ポリシーへのKLを除去したことで、事前学習済み事前分布からの分布ドリフトという通常の問題が生じます。
なぜこれが重要か
本論文は、順過程の拡散RLがその安定化機構を必要とする理論的に明確な理由、すなわち実際の逆方向場ではなく v_{\mathrm{fwd}}^{\mathrm{old}} への回帰から生じるアーティファクトである順逆一貫性力を明らかにし、報酬をプロンプトレベルの共分散方向に集約することでこれを構造的に除去できることを示しています。これにより学習レシピが簡略化(EMA調整なし、正負の枝なし、ガイダンス強度スカラーなし)されるとともに、スケールでのFlow-GRPOに対して大幅な高速化が実現されます。これは、RLHFスタイルのポストトレーニングが画像モデルからより大規模な動画モデルへと移行するにつれて重要になる可能性が高いです。
Source: https://arxiv.org/abs/2610.12572
S-Space: マルチモーダル言語モデルにおける空間的ワークスペースの探索
問題
マルチモーダル LLM は「カップは皿の左にある」「どちらのオブジェクトが近いか」といった空間的判断を尤もらしく生成しますが、その内部でどのような構造がこれを支えているかについて、メカニズム的な理解はほとんどありません。これまでの解釈可能性研究では離散的概念の線形符号化が示されてきましたが、本論文は 連続的 な視点中心座標(水平・垂直・奥行き)がオブジェクトトークンの activations に線形に embedding されているかどうか、そしてその表現が空間的言語生成に因果的に使われているかどうかを問います。
手法:S-Space の同定
著者らは、固定された中間層 \ell において隠れ状態 h_{\ell,t}\in\mathbb{R}^{d_{\text{model}}} が、自己中心的フレームにおける水平・垂直・距離軸に対応する方向 \{v_x, v_y, v_z\} によって張られる三次元線形部分空間——S-Space——を含むと仮説を立てています。オブジェクト座標は射影によって読み出されます:
\hat{c}_a(t) = v_a^\top h_{\ell,t}, \quad a\in\{x,y,z\}.
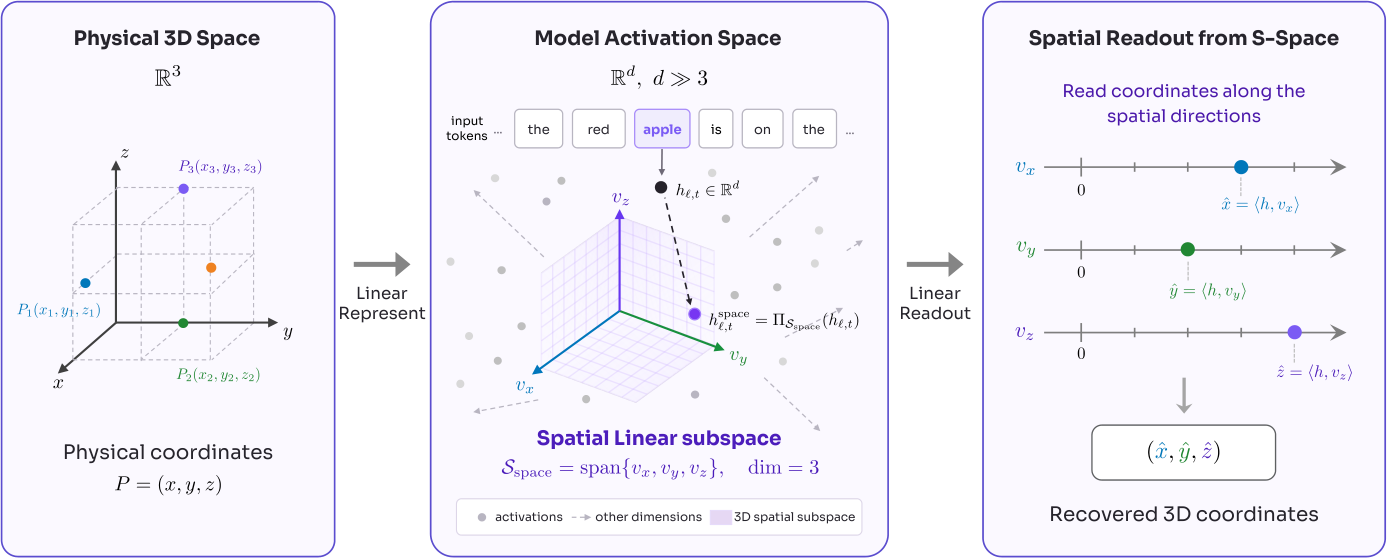
各軸は、COCO から構築した相対位置質問において空間的回答の logit をオブジェクトトークンの activations に関して微分することで同定されます。「左」対「右」(など)と答える確率が最も急峻に変化する方向が各軸を定義します。このように同定されたものの、結果として得られる部分空間は 内在的 であることが示されています——非空間的プロンプトのもとでも読み出し可能で、複数のベンチマーク間で転移可能です。著者らは探索を中間層に限定しています。これは、初期層がパッチレベルの入力符号化に固定されたままであり、後期層が次トークン予測に特化するためです(付録 C.1 の層スイープ参照)。
S-Space のみを用いて空間関係質問に答えるには、二つのオブジェクトトークンを射影し、関連する軸に沿った座標差を取り、決定論的な符号ルールを適用します——モデル自身の言語デコーダを経由しません。
結果
S-Space 座標は COCO シーン上の真のオブジェクト位置と強く相関しており(図 3a-b に Molmo2-ER 層 21 における軸ごとの Spearman 相関を示す)、個々のオブジェクト位置および対ごとの座標差の両方において相関が見られます。
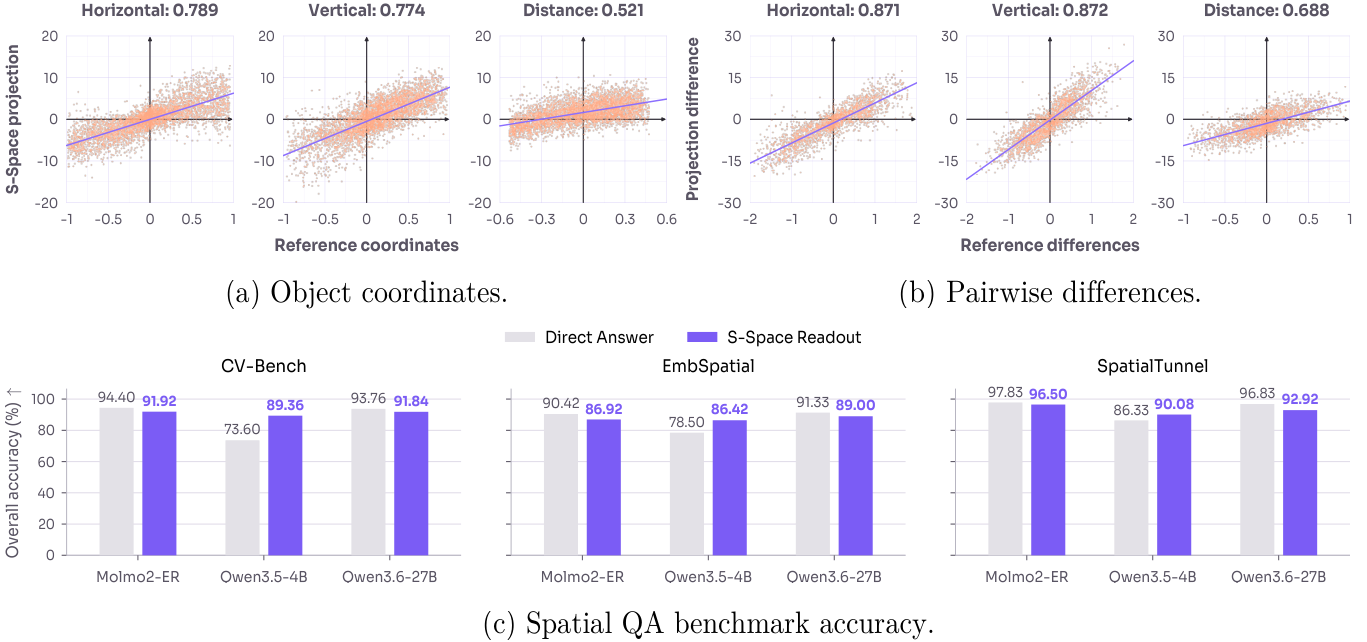
決定論的ルールで S-Space から答えを読み出すことは、CV-Bench、EmbSpatial、SpatialTunnel において Molmo2-ER、Qwen3.5-4B、Qwen3.6-27B 全体にわたって、モデル自身の言語的回答に匹敵するかそれを上回ります——軸の同定に使用していないベンチマークでも同様です。S-Space 内の座標を編集する因果介入(§3.2)は空間的判断を変える一方で、同じ画像に対する非空間的質問への応答をほぼ保持しており、言語的経路がこの部分空間を単に相関しているのではなく選択的に読み出しているという主張を支持しています。
視点取得:知覚と計算の分離
最も顕著な定量的結果は、SpinBench における視点取得に関するもので、モデルは回転した視点から見たときの空間関係(左、右、後ろ)に答えなければなりません。著者らはパイプラインを分解します:S-Space からの自己中心的オブジェクト座標を読み出し、目標視点に対して固定の回転行列を適用し、決定論的空間ルールを適用します。前提なしの SpinBench において:
- Molmo2-ER: 直接 60.96% → S-Space+rotation 94.52% (+33.56)
- Qwen3.5-4B: 直接 60.96%、CoT 62.33% → S-Space+rotation 91.10% (+30.14)
- Qwen3.6-27B: 直接 60.96%、CoT 83.56% → S-Space+rotation 95.21% (+34.25)
前提ありの場合、S-Space+rotation はモデル全体で 97.92〜99.31% に達します。Chain-of-thought 単独ではこのギャップの一部しか回復できません(例:前提ありの Qwen3.6-27B で明示的変換の +26.39pp に対して +18.75pp)。これにより失敗モードが局所化されます:知覚(S-Space への符号化)はほぼ正確であり、その表現に対するモデルの学習済み 計算——心的回転——がボトルネックです。
可視オブジェクトを超えた創発的構造
いくつかのケーススタディは、S-Space が単なるオブジェクト検出器の変装ではないことを示唆しています。見えないエンティティ(例:ゴールキーパーが飛び込む先のボール)のトークンを射影すると正しい方向に着地します。二人称トークン you は距離軸の近い端に射影され、観察者の暗黙的な位置と整合します。抽象的な政治用語(「socialist」、「conservative」)は水平軸の両端に射影され、言語的な左右の比喩を受け継いでいます。著者らは、S-Space が空間的言語を予測するための学習の副産物として生じると主張しています:エンティティを相対位置に結びつけることが正しい語彙選択に必要であり、これが座標教師信号なしでも activations を安定した軸に組織化します。
限界と未解決の問題
- 自己中心的参照フレームは固定されていません。§5.2 および C.7 では、文脈によって操作可能であり、CoT 中に徐々に再方向付けされる可能性があることが報告されており、プロンプトが代替フレームを示唆する場合に同定と解釈の両方が複雑になります。
- S-Space はモデルごと、層ごとに同定されます。本論文は中間層の結果を報告していますが、複数の層がどのように合成されるか、あるいは生成中に軸がずれるかどうかは特徴づけられていません。
- 軸同定手続きは教師あり相対位置ラベルを使用します。完全に教師なしの回復(例:sparse dictionary learning 経由)が同じ部分空間を見つけるかどうかは未解決です。
- 視点取得の結果はモデルが情報を持ちながらそれを活用できていないことを示しますが、論文はトレーニング時の修正を提案せず、診断のみを行っています。
- 「物理空間を超えて」という主張のショーケースはすべて定性的であり、比喩的マッピングは示唆的ですが多くの抽象的概念にわたって体系的に定量化されていません。
この研究の意義
これは、連続的な幾何量——離散的概念だけでなく——が MLLM の activations から線形にデコード可能であること、そしてその表現が言語的空間判断に因果的に接続されていることの明確な実証です。より実践的には、SpinBench の分解により、現在の MLLM の空間推論の失敗が適切な表現に対する計算の失敗であることが示され、より多くの知覚データではなく変換ステップへの標的を絞った介入が適切な手段であることを示唆しています。
Source: https://arxiv.org/abs/2610.13527
アウトカムのみの強化学習から過程教師信号を誘導する
問題設定
Process reward model(PRM)は個々の推論ステップの正確さをスコアリングするものであり、LLMのpost-training(密な報酬信号として)およびテスト時探索(ステップレベルの検証器として)においてますます重要な役割を担っています。ボトルネックは教師信号の取得にあります。人手によるステップアノテーションはスケールせず、モンテカルロロールアウト推定——あるステップのラベルを後続ステップの経験的成功率で近似する手法——は計算コストが高く、かつバイアスも存在します。なぜなら、「誤った」ステップが高頻度で正解に至ることもあり(あるいはその逆も然り)、そのためです。著者らは、アウトカムのみのRLで生成的検証器を学習することにより、ステップラベルを一切使わずにPRMの品質に匹敵するステップ検証能力が獲得できるかどうかを問います。
手法:TIPS
TIPS(Thinking-Induced Process Supervision)は、生成的報酬モデルを学習する手法であり、そのモデルの出力は以下の3つの部分から構成され、この順序で生成されます:(i)chain-of-thought c、(ii)各ステップのラベル列 \{y_i^{\text{step}}\}_{i=1}^{T}、(iii)軌跡レベルのアウトカムラベル y^{\text{out}} \in \{0,1\}。軌跡 \tau = (s_1,\dots,s_T) と正解アウトカム y^\star が与えられたとき、報酬は純粋にアウトカムの一致度のみに基づきます:
r(c, y^{\text{step}}, y^{\text{out}}; y^\star) = \mathbb{1}[y^{\text{out}} = y^\star].
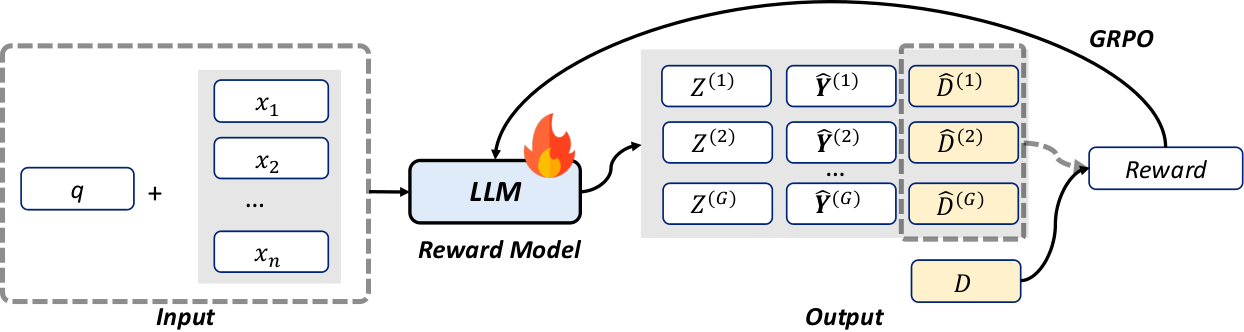
最適化にはgroup-relative advantage(GRPOスタイル)を使用します:各プロンプトに対して K 個の応答をサンプリングし、応答 k のadvantageは次のように計算されます。
A_k = \frac{r_k - \mu_r}{\sigma_r + \epsilon},
ここで \mu_r,\sigma_r はグループの平均・標準偏差です。policy gradientは生成された応答全体に適用されます——thinkingトークン、ステップラベル、アウトカムトークンのすべてが同一のスカラーadvantageを受け取ります。重要なのは、ステップラベルが直接の教師信号を一切受けない点です。ステップラベルは、それらの生成(およびそれを生み出した推論)が正しいアウトカム予測と相関する範囲においてのみ強化されます。
直感的には、自己回帰的なファクタリゼーションを通じたクレジット割り当ての議論として理解できます:thinkingとステップラベルが忠実なステップレベルの検証を含んでいれば、条件付き確率 p(y^{\text{out}} = y^\star \mid c, y^{\text{step}}) がよりシャープになり、正しいアウトカムがより頻繁にサンプリングされ、その軌跡が上方修正されます。情報理論的には(論文のSection 3.3)、アウトカムの精度は、thought c が各ステップの正確さに関する不確実性をどれだけ減少させるかによって上界が定まります。したがって、期待アウトカム報酬を最大化することは、thinkingと真のステップ正確さ変数との間の相互情報量を暗黙的に最大化することになります。こうして過程教師信号は強制されるのではなく、誘導されます。
再実装の際に注意すべき技術的な点をいくつか挙げます:
- 出力テンプレートは、アウトカムの前にステップラベルを出力するようモデルを強制しなければなりません。そうすることで、アウトカムのlog-probがステップラベルに条件付けられます。そうしなければ、ステップラベルは強化されないサイドチャネル出力となってしまいます。
- 必要なのはアウトカムの正解ラベルを持つ軌跡のみです。数学タスクでは自然に入手可能であり、エージェント型タスクではアウトカムはタスクの成功に相当します。
- 報酬は2値かつスパースであるため、グループサイズ K とadvantage正規化が重要です——標準的なGRPOスタイルのトリック(クリッピング、SFT参照モデルへのKLペナルティ)が適用されます。
結果
実験では4つのバックボーンファミリー(Qwen3、DeepSeek、Llama、SmolLM)をinstructおよびthinkingバリアントの両方で使用し、数学的推論とエージェントベンチマークで評価しています。abstractで強調されている主要な結果は、TIPS-Qwen3-4B-ThinkingがPRMとして、大幅に大きなモデルや過程教師ありベースラインと競合する強力な性能を達成したことです。論文では、全バックボーンファミリーにわたって、outcome reward model(ORM)ベースラインおよびモンテカルロステップラベルで学習したPRMを一貫して上回ることが報告されています。本手法はアウトカムラベルのみを必要とするため、データコストはORM学習と同等でありながら、ステップ検証能力を副産物として得られます——直接教師信号を受けることのないモデルの生成ステップラベルが、下流のbest-of-N選択やポリシーモデルのprocess-reward RLにおけるPRM信号として利用可能になります。
この設定から導かれるアブレーション(thinkingセグメントの除去、ステップラベルの除去、またはステップラベルへの直接教師信号の付与)が重要な診断となります:アウトカムの前にステップラベルスロットを置かなければ、誘導メカニズムが消失します。これにより、アーキテクチャ上の順序——thought → ステップラベル → アウトカム——こそがgradientを過程認識的な計算へと誘導するものであることが確認されます。
限界と未解決の問題
- 誘導されたステップラベルの忠実性。 アウトカムのみの報酬は、生成されたステップラベルがキャリブレートされていることを保証しません。それらはアウトカムを予測するのに十分であればよいだけです。誤ったステップからの回復が多いタスクでは、誘導されたPRMは系統的に誤ったラベルを付与する可能性があります。
- 報酬のスパース性と長さバイアス。 2値のアウトカム報酬と長い軌跡では分散が大きくなります。本手法はGRPOのグループサイズとKL係数への感度をおそらく引き継ぎます。
- ドメインのカバレッジ。 数学タスクとエージェントタスクはアウトカムが明確です。TIPSをオープンエンドな生成(y^\star 自体が軟らかい判断である場合)に拡張することは自明ではありません。
- 計算量を揃えたMC-PRMとの比較。 MCによる推定はコストが高いですが、ステップラベルのノイズレベルにわたって計算量を完全に統制した比較を行えば、TIPSが厳密に優位となる条件をより明確にできるでしょう。
なぜこれが重要か
TIPSは、自己回帰的生成の順序を活用することで、PRMのデータ収集問題を標準的なアウトカムラベル付きRLへと集約します。検証器がアウトカムの前にステップ判定にコミットするよう強制することで、アウトカムのみのクレジット割り当てがステップレベルの検証へと逆伝播されます。誘導されたステップラベルが実際に忠実であれば、PRMのスケーリングにおける主要なコスト障壁が取り除かれ、アウトカムラベルが存在するあらゆる場面で密な過程報酬が利用可能になります。
Source: https://arxiv.org/abs/2609.36641
Reflex: 視覚的に根拠付けられたリアクティブ・ヒューマノイド制御
問題設定
投げられた箱をヒューマノイドで捕捉するには、実ハードウェア上でこれまでほとんど同時に解かれてこなかった3つの能力が必要です:(1) 足・胴体・腕の位置決めと衝撃吸収を転倒なしに行う29自由度の全身協調制御、(2) 遅延下(著者らの検出器パイプラインにおけるカメラ-制御の中央値69 ms、箱はリリース後約1 sで到達)での物体ダイナミクスのサブ秒リアクティブ予測、(3) 自己運動がオプティカルフローを汚染し、接触直前にロボット自身の腕がターゲットを遮蔽する自己中心的RGB-Dにおける高速物体運動のグラウンディング。先行研究は固定ベースのアーム、モーションキャプチャ、またはマーカー付き物体を使用しており、並行するヒューマノイドの捕捉に関する研究では実ロボットの成功率が報告されていません。ベースラインの難易度は人間にとっても容易ではなく、3人の人間キャッチャーが7 mの投球で成功するのはわずか28.3%です。
手法
Reflexは、デプロイするポリシーを視覚エンコーダ V_\psi と全身コントローラ \pi_\theta に分解し、8次元の物体ダイナミクス潜在表現 \hat{\mathbf{z}}_t によって結合します:
\hat{\mathbf{z}}_t = V_\psi(\mathbf{I}_{t-K+1:t}, \mathbf{e}_{t-K+1:t}), \qquad \mathbf{a}_t = \pi_\theta(\mathbf{r}_t, \hat{\mathbf{z}}_t),
関節目標は \mathbf{q}_t^{\text{nom}} = \mathbf{q}_0 + \mathbf{s} \odot \mathbf{a}_t です。ロボット/参照観測 \mathbf{r}_t \in \mathbb{R}^{160} はバランス維持に必要な固有感覚および参照追跡信号を提供し、8次元潜在表現が知覚が制御に影響を与える唯一のチャネルとなっています。
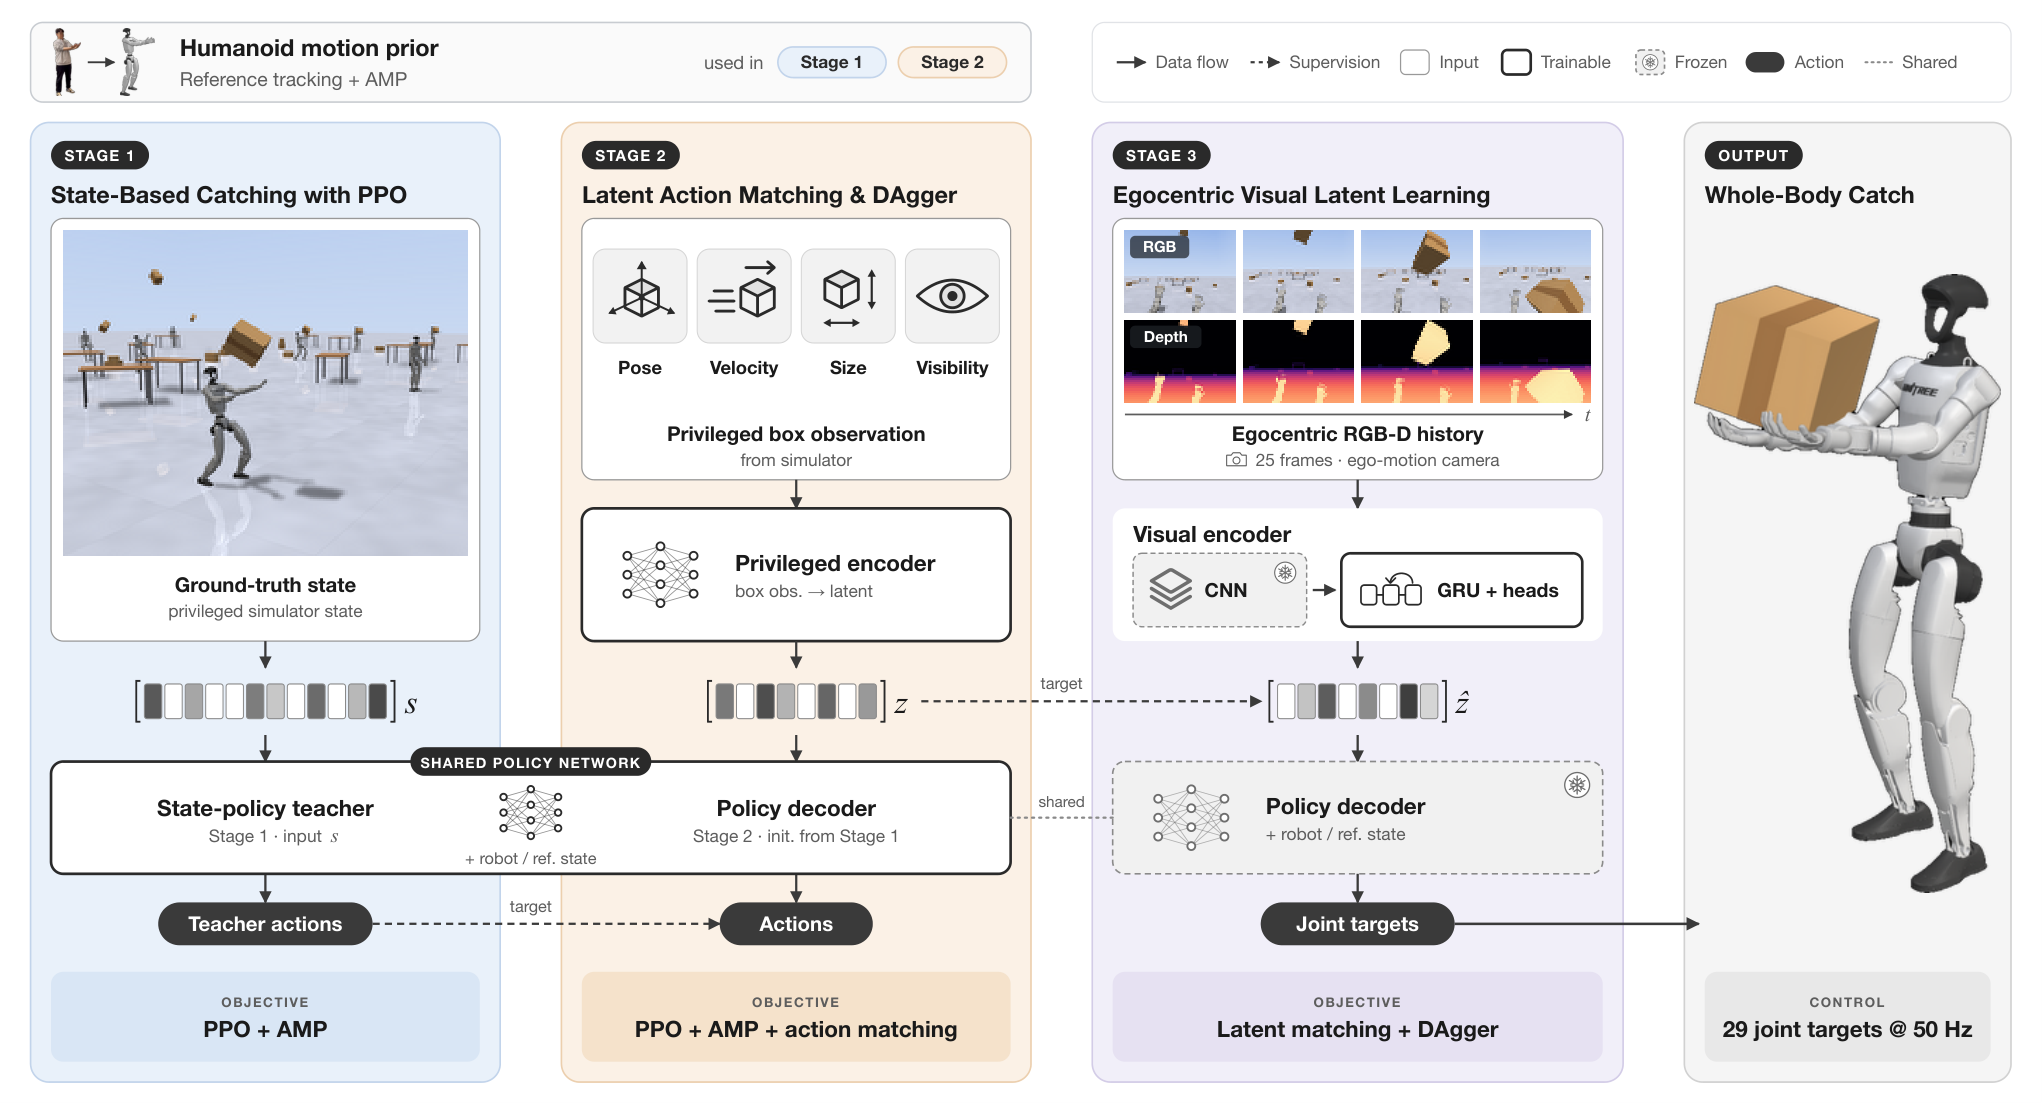
学習は段階的に行われます(図2):
- Stage 1(全身制御)。 特権的なシミュレータ状態上でのPPOにより、状態ポリシーの教師を学習します。人間のモーションクリップからの参照追跡とAMPスタイルのスタイル報酬がモーション事前分布として機能し、ホールド整形報酬が接触後に箱を保持します。
- Stage 2(物体ダイナミクス潜在表現)。 特権的エンコーダはStage 1教師に対して行動クローニング(5ラウンドのDAgger、可視箱サンプルの5×重み付け)で初期化され、その後PPO(4096環境、600イテレーション、LR 10^{-4})で共同精緻化されます。エンコーダは遅延・部分的な箱観測(位置、速度、姿勢、サイズ、観測年齢に対して20〜60 msのランダム化遅延)を受け取り、8次元潜在表現を出力します。
- Stage 3(視覚的グラウンディング)。 \pi_\theta を凍結した状態で、視覚エンコーダが192×144 RGB-Dフレームの履歴とカメラ自己運動から \hat{\mathbf{z}} を回帰します。アーキテクチャは8つの幾何学的特徴と9つの自己運動特徴を2層128ユニットのGRUを通じて結合します。色拡張ローカライザが事前学習(20エポック、バッチ32、LR 3\times 10^{-4})され、続いて補助損失重み \lambda_{\text{aux}} = 0.5 および0.5〜2.5 mの箱範囲に8×重み付けで時間的学習(AdamW、60エポック、バッチ512、最大LR 2\times 10^{-3})が行われます。2〜3ラウンドのDAggerが状態分布シフトを修正します。
この分解により、RGB-DレンダリングをRLから切り離すことができます:4096環境でのStage 2 PPOは約28kステップ/sで動作するのに対し、320環境でインループレンダリングを行うと約1.5kステップ/sとなるため、Stage 2の59Mステップは約11時間ではなく約35分で完了し、Stage 3は約160万レンダリングステップのみを必要とします。
結果
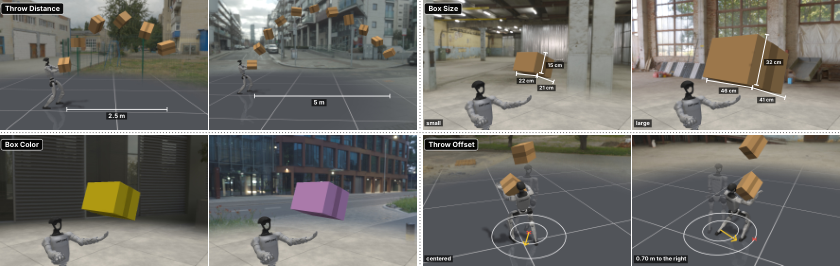
シミュレーションにおいて、視覚的Reflexは特権的箱観測の87.9%に対して85.7%の捕捉成功率を達成し、オラクル状態から自己中心的RGB-Dへの移行によるギャップはわずか2.2ポイントです。時間的履歴を除去すると、中央への投球で35.6ポイント、0.6 mオフセット投球で39.8ポイント成功率が低下し、信号の大部分がフレームごとではなく時間的なものであることが示されています。特権的エンコーダのBC初期化は下流の視覚的捕捉において平均+5.2ポイントを与え、シングルシードスイープでは遅延ランダム化がシミュレーション遅延全体で5〜11ポイントに寄与することが示されています。学習済み潜在表現の回帰は完全状態の回帰を上回り、視覚的学習範囲内では同じ検出器にKalmanフィルタを加えた場合も上回ります。
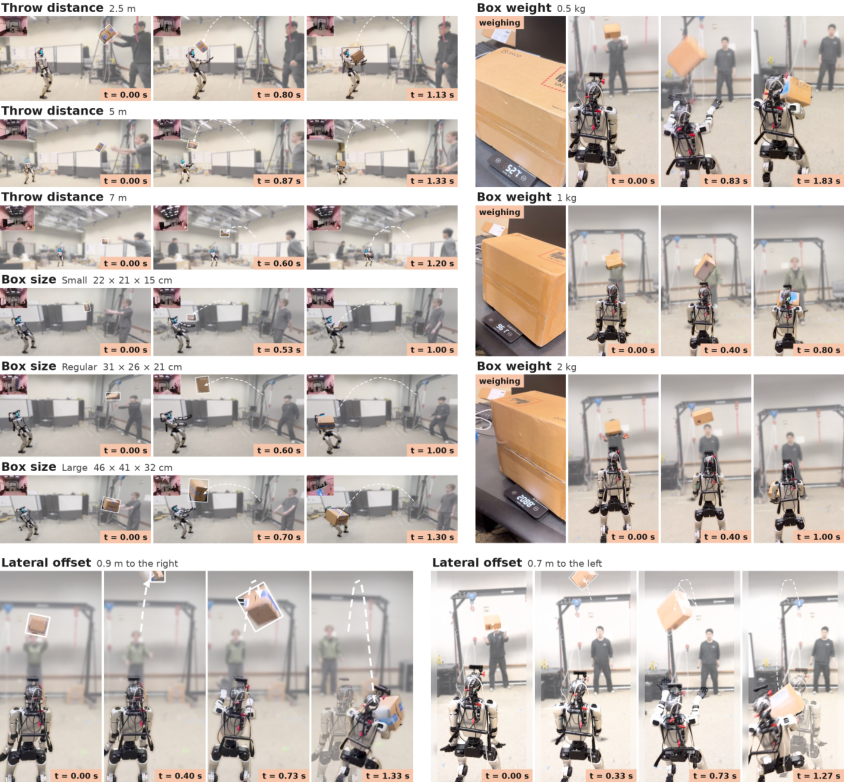
実機のUnitree G1(図5)において、Reflexは人間が投げた箱を2.5 mで65%、5 mで40%捕捉し、これは同じ距離での人間の成功率(人間:85.0%および68.3%)のそれぞれ76%および59%に相当します。最大2 kgのペイロードでも捕捉可能ですが、参照サイズ外の箱は捕捉できても保持できないことが多く、胴体の変位が保持のボトルネックとなっています。
限界
長距離視覚グラウンディングはStage 3のデータ範囲(3.0〜3.5 m)を超えると急激に劣化します:5 mシミュレーション投球では視覚的成功率が43.0%に低下するのに対し、特権的入力は79.7%を維持します。実ロボットの成功率は5 mで40%、7 mで15%です。Stage 3データを遠距離投球で拡張するとシミュレーション5 m成功率は75.8%まで回復しますが、ハードウェアでの検証はされていません。本研究は1つのタスクで条件あたり20回の実試験(CIは約±20ポイント)であり、ハードウェア遅延はパイプラインがランダム化範囲を超える検出器パイプライン上でのみ特性評価されており、コントローラはサイズを認識せず、レンダリングはモーションブラーや露出ダイナミクスを省略しています。
重要性
Reflexは、搭載されたRGB-Dのみを使用して実ヒューマノイド上で視覚的リアクティブ全身捕捉を実証した初めての事例であり、3段階の分解——状態上のRL、遅延観測への潜在BC+PPO、凍結コントローラによる教師あり視覚グラウンディング——は高価なレンダリングをRLから除外しながらエンドツーエンドのデプロイメントを維持するための実用的なレシピです。知覚-制御インターフェースとしてのコンパクトな8次元ダイナミクス潜在表現は、絡み合った視覚運動RLが実行不可能な他のサブ秒リアクティブタスクに転用可能なパターンです。
Source: https://arxiv.org/abs/2610.12772
SoftwareGym: 多様な合成ソフトウェア環境によるコンピュータ操作エージェント訓練のスケーリング
問題
コンピュータ操作エージェント(CUA)の訓練には、(i) アプリケーション固有の過学習を防ぐのに十分な多様性、(ii) 複数ステップのワークフローを実行できる十分な深さ、(iii) 検証可能な報酬信号を生成できる十分な信頼性を兼ね備えた環境が必要です。既存のパイプラインはパレート最適な状態から程遠い状況にあります。実際のネイティブアプリケーションをキュレーションするのは労働集約的でカバレッジが狭く、一方ブラウザ上のサンドボックスはインタラクションのツリーが浅く、ステートフルな挙動が限られています。本論文はSoftwareGymを提案します。これは実行可能なGUIアプリケーションと、RL/SFTのトラジェクトリに適した実行可能かつ状態検証済みのタスクを自動生成する合成パイプラインです。
手法
SoftwareGymは合成を3つのステージに分解しています。Software Design(ソフトウェア設計)、Software Implementation and Evaluation(ソフトウェア実装と評価)、そしてTask Synthesis(タスク合成)です。
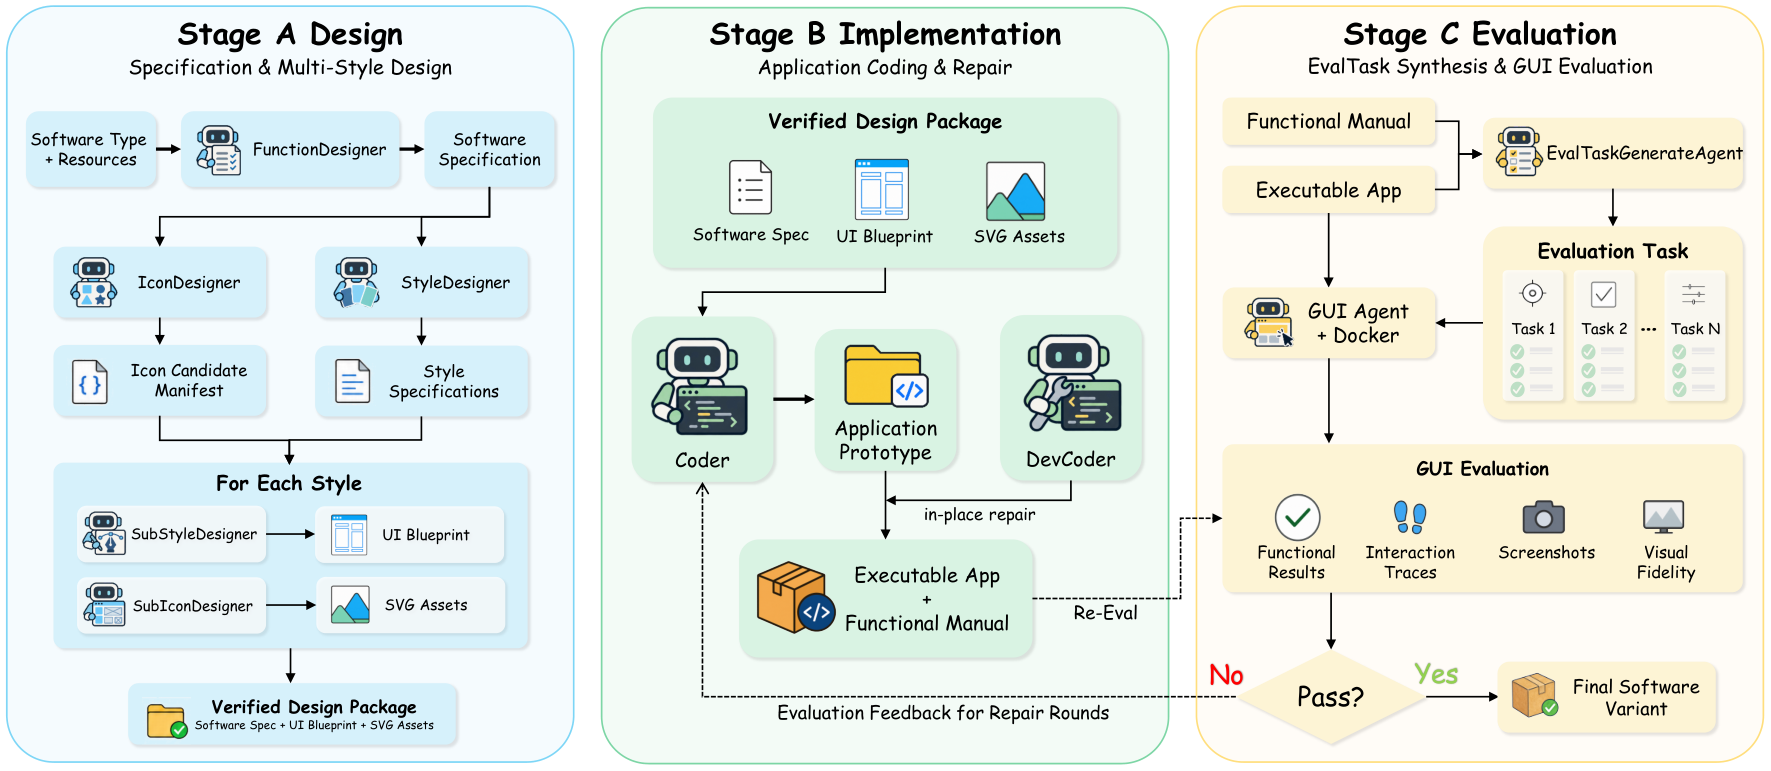
Software Design. ソフトウェアの種類とシードリソースが与えられると、FunctionDesigner LLMが4ステップの展開を実行します。
- ベースライン機能 — ターゲットユーザー、コアオブジェクト、標準的な操作(作成・開く・編集・整理・検索・復元・保存)を特定します。
- プロフェッショナル拡張 — 複数条件検索、バッチ操作、履歴、永続的なビュー設定、入力バリデーション。
- ワークフロースティッチング — モジュール横断的な状態変化、依存する操作、失敗・復旧のブランチを含むエンドツーエンドのフローに機能を組み合わせます。
- コントラクト出力 — 各機能は5つのフィールドを持つSoftware Specification(ソフトウェア仕様書)に書き出されます。ユーザーエントリー、ユーザーアクション、期待される状態更新、目に見えるGUIレスポンス、受け入れチェックポイントです。
受け入れチェックポイントは重要な設計上の決定事項です。これにより、コードのインスペクションではなくGUIプロービングを通じて、すべての機能を直接テスト可能にしています。設計ステージはその後、同一の機能仕様を共有しながらスタイルごとに異なる複数のVerified Design Package(UIブループリント + SVGアセット)に分岐します。これにより、視覚的な多様性と機能的な多様性を分離しています。
Implementation and Evaluation. 各デザインパッケージはGPT-5.5上に構築されたCodex CLIエージェントによって実装され、隔離されたUbuntu 22.04.3 VM上で実行されます。機能コントラクトから導出されたv1 GUIテストスイートは、最大3回の修正ラウンド(v_1 \to v_3)にわたって固定され、すべてのケースが通過した時点で早期終了します。評価自体はSeed 2.1 Proがマウスとキーボードを通じて実行し、ケースごとに50ステップのバジェットが割り当てられます。失敗したケースは構造化された失敗トレースを返し、それが次の実装修正を駆動します。これにより、環境自体がオラクルとして機能するアプリケーション単位の修正ループが閉じられます。
Task Synthesis. LLMにタスクを自由に生成させる(実行不可能または検証不可能なリクエストが生成されがちな)のではなく、SoftwareGymは検証済みビルドから証拠に基づいた能力を抽出し、難易度と初期状態によって制御されるスロットに一貫した能力の組み合わせを割り当て、その後に各スロットを明示的な初期状態と期待される終端状態を伴う自然言語リクエストとして実現します。
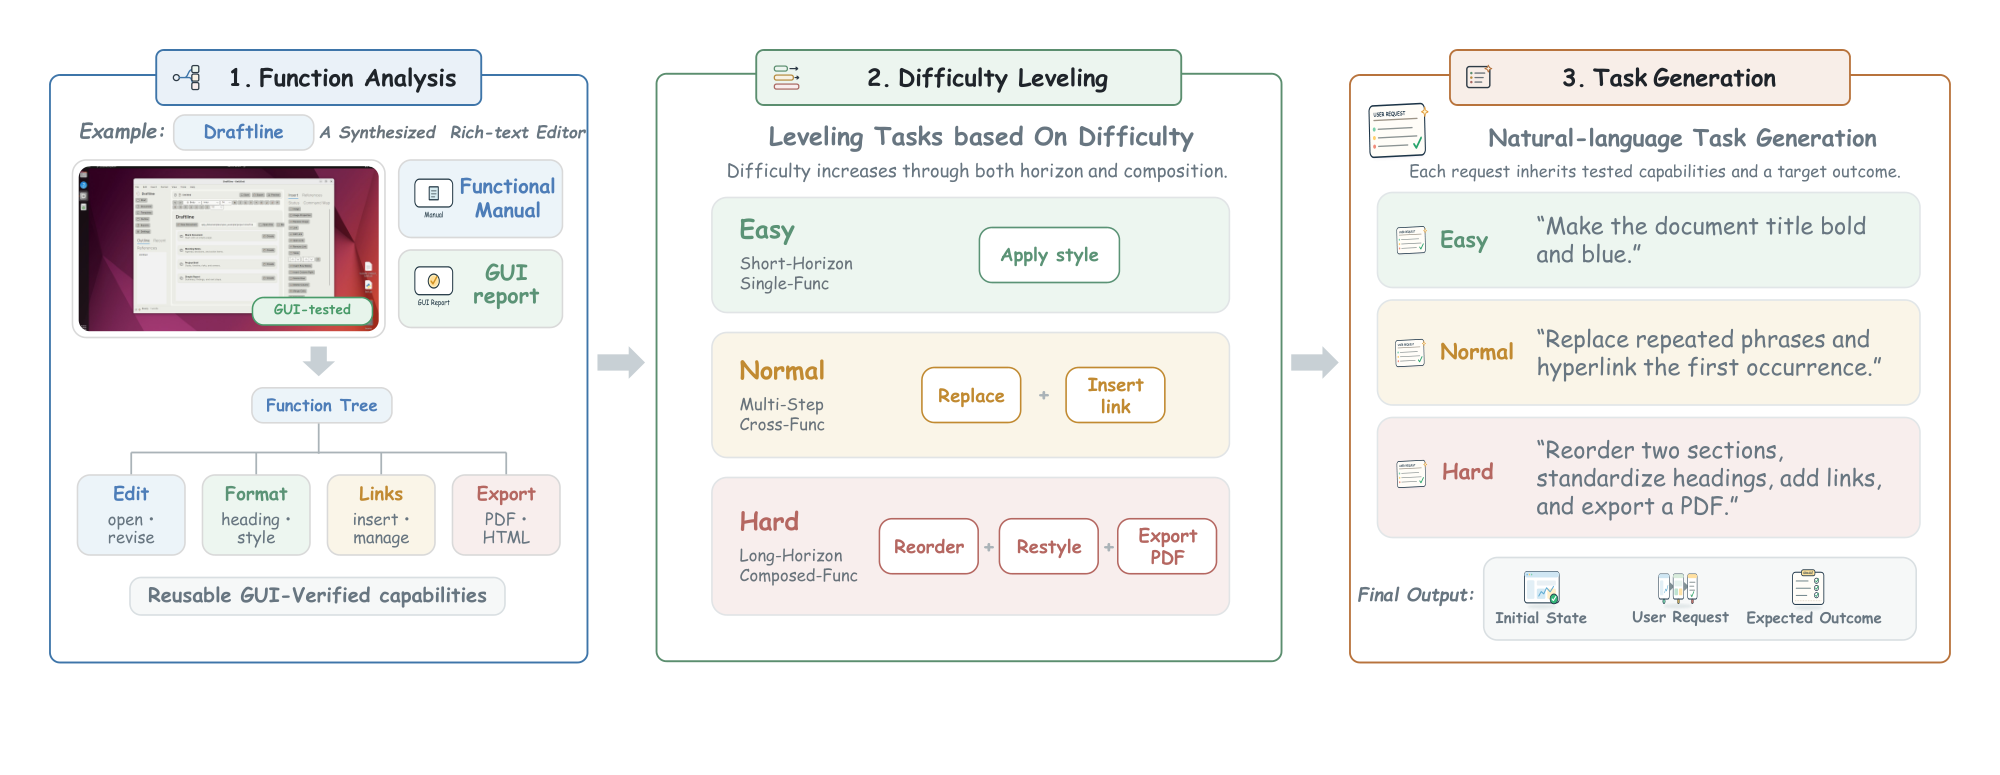
各タスクの期待される状態が機能コントラクトに結び付けられているため、ロールアウト後にアプリケーションの内部状態を検査することでプログラム的に合否を判定できます。これにより、CUA訓練のためのクリーンな報酬が得られます。
結果
パイプラインを実行すると、12カテゴリにわたる182のアプリケーションが生成され、3ラウンドの修正ループ後のGUIタスク平均合格率は91.5%となりました。つまり、合成されたアプリはノイズの多いおもちゃとしてではなく、訓練環境として機能するのに十分な信頼性を持っています。代表的なアプリケーションとしては画像エディタ、動画プレイヤー、テーブルエディタ、コードエディタがあり、論文では各アプリにおける複数ステップのインタラクションの深さを強調しています。
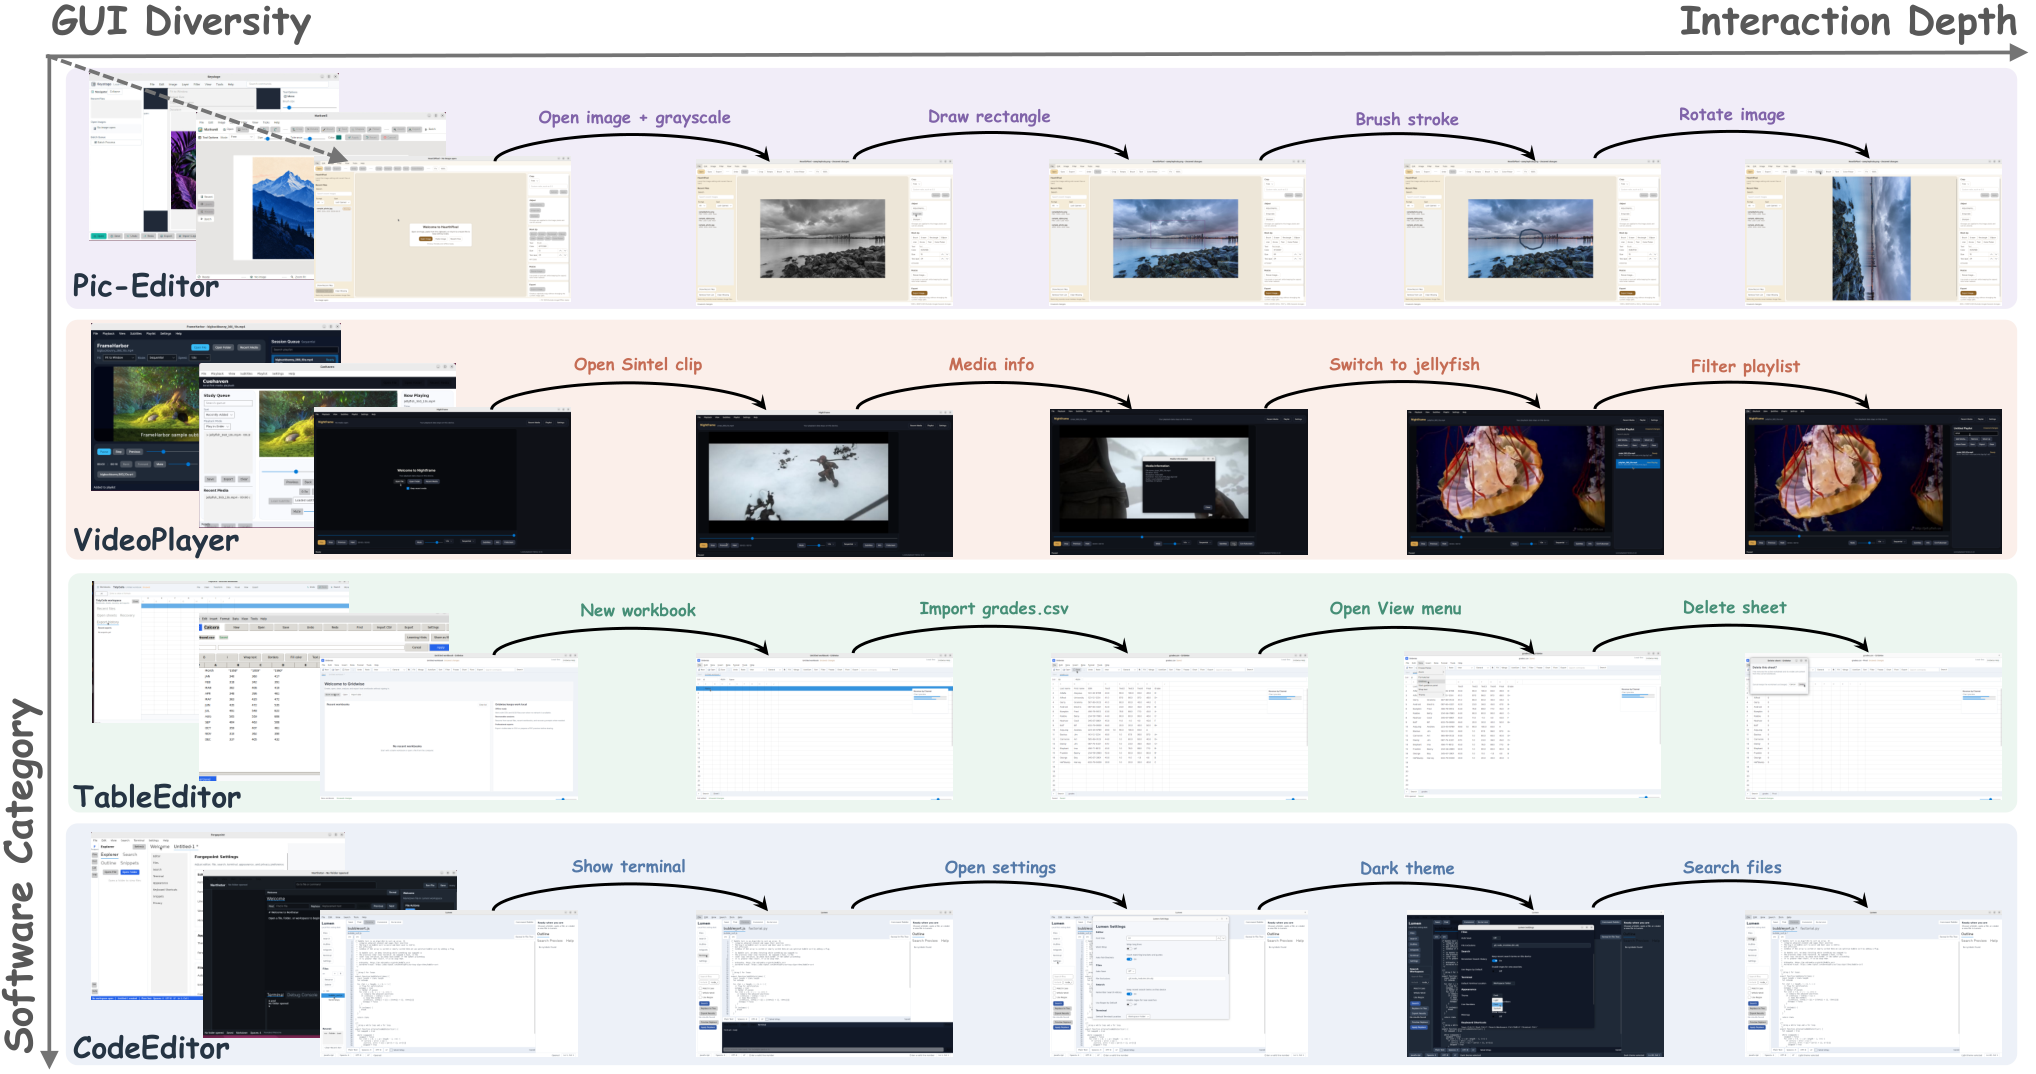
評価のために、著者らは同じ12カテゴリをカバーする120タスクからなるSoftwareGym-Benchをキュレーションしました。合成環境から収集されたトラジェクトリを使用してCUAを訓練しています。主要な数値は以下の通りです。
- OSWorld Pass@3が41.39% → 56.97%に改善(+15.58ポイントの向上)。OSWorldは厳密にドメイン外(合成されたものではなく実際のLinuxアプリケーション)にもかかわらず達成されています。
- 訓練済みモデルはSoftwareGym-Benchで40.0%に達しました。
OSWorldへの転移が中心的な実証上の主張です。構造的に多様な合成アプリでの訓練は、そのウィジェットを単に記憶するのではなく、実際のネイティブソフトウェアにも転移することを示しています。これは、機能コントラクトを共有しながら視覚スタイルを分岐させるという明示的な設計選択と一致しています。
限界とオープンクエスチョン
いくつかの注意点を指摘しておく価値があります。(1) パイプラインは強力な基盤モデル(合成にGPT-5.5、GUIエバリュエータにSeed 2.1 Pro)に大きく依存しているため、コストとバイアスはそれらのモデルから継承されます。「91.5%の合格率」はLLMエバリュエータによって測定されており、独立した人間による検証ではありません。(2) 12カテゴリと182アプリは従来のベンチマークのほとんどより広いですが、複雑なプラグインシステムを持つIDE、CAD、科学ツールなど、実際のデスクトップソフトウェアのロングテールと比較するとまだ狭いです。(3) 修正ループは3ラウンドに制限されており、ラウンド数を増やすと合格率がどのようにスケールするか、あるいは特定の機能タイプが系統的に失敗するかどうかは不明です。(4) OSWorld Pass@3は56.97%というPass@3の数値であり、Pass@1やサンプルバジェットと実際のデプロイメントレイテンシのトレードオフについては本文の抜粋では議論されていません。(5) 本論文では、OSWorldスタイルの実アプリでの訓練とSoftwareGymデータを組み合わせることで加法的なゲインが得られるかどうかについて報告しておらず、これは多様性と分布マッチングを切り離すための自然なアブレーションとなるはずです。
なぜ重要か
SoftwareGymは、各環境を手動で構築することなくCUA訓練データをスケールするための具体的なレシピを実用化しています。機能をGUI検証可能なコントラクトとして仕様化し、その上に視覚的バリアントを合成し、GUIを駆動するエバリュエータによってループを閉じるというものです。OSWorldにおけるドメイン外での+15.58ポイントのゲインは、合成環境の多様性——アプリケーションの忠実度だけでなく——が現在のCUA訓練パイプラインにおける制限要因である可能性を示唆しています。
Source: https://arxiv.org/abs/2610.12611
VisionWeave: 弾力的な視覚表現のWeaving をMLLMのネイティブ機能として実現する
問題
現代のMLLMは、画像や動画を密な固定サイズのパッチトークングリッドにエンコードします。ViTは X \in \mathbb{R}^{H\times W\times d} を出力し、2\times 2 のマージャーは V_{\text{fine}} \in \mathbb{R}^{\frac{H}{2}\times\frac{W}{2}\times D} を生成し、これらのトークンはMRoPE座標 \pi_{ij}=(\tau,i,j) のもとでLLMコンテキストにシリアライズされます。トークン数は解像度に対して二次的に、フレーム数に対して線形に増加し、プリフィルレイテンシとKVキャッシュを支配します。しかし、視覚情報は空間的に不均一です。ナンバープレートと空が同じトークンバジェットを共有するわけです。これまでの対処法——一様ダウンサンプリング、トークン刈り込み(FastV)、トークンマージング(VisionZip)——は、細部の忠実性を損なうか、タスク依存性が高いか、あるいは連続したMRoPE整合トークン列を期待するサービングスタックと非互換です。
VisionWeaveはこれをネイティブ機能として再定式化します。MLLMをエンドツーエンドで学習させ、視覚トークンをどこに・どの粒度で割り当てるかを決定させることで、既存のサービングインフラ(SGLangでの実証あり)にそのまま利用できる混合粒度列を生成します。
手法
アーキテクチャは、標準的なViT + マージャー + LLMスタックに2つのコンポーネントを追加したものです。
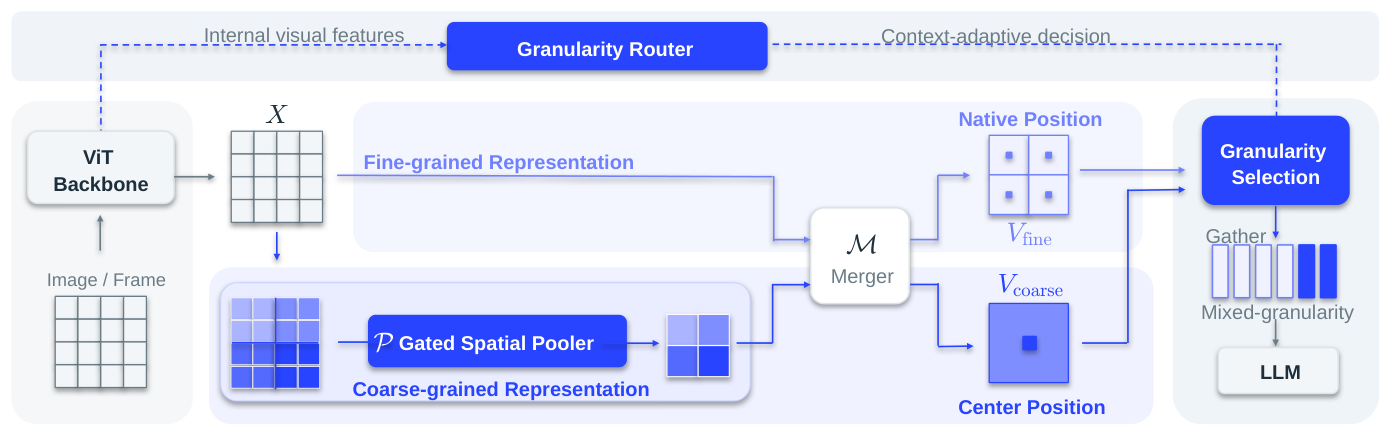
ゲート付き空間プーラー。 V_{\text{fine}} と並行して、学習されたプーラーが低い空間解像度で V_{\text{coarse}} を生成し、各coarseブロックを対応する 2\times 2(またはより大きい)fineネイバーフッドから集約します。重要なのは、両表現が同一のMRoPE座標フレームでインデックス付けされていることです——ブロック (I,J) のcoarseトークンは、それが要約するfineトークンと整合する座標を引き継ぐため、粒度を切り替えてもLLMの位置的意味論が壊れません。このプーラーは固定のピクセルアンシャッフルではなく「ゲート付き」です。アブレーション(図7、セクション4.1)では、学習されたプーラーが8つのベンチマーク全てにおいて、75%トークン削減という条件でピクセルアンシャッフルプロジェクターを上回り、DocVQAで+2.64、VideoOCRで+2.77を達成しています——OCRにおける改善は、ゲートが固定シャッフルではぼかしてしまう高周波コンテンツを保持していることを示しています。
粒度ルーター。 ルーターは中間ViT特徴層を参照し、空間ブロックごとにfine粒度が必要な確率のスカラー値を出力します。閾値 t(デフォルト 0.5)において、各ブロックはfineトークンか単一のcoarseトークンかにコミットします。結果として得られるweaved列は、同一MRoPEラティス上での混合粒度となります。
V_{\text{mixed}}(I,J) = \begin{cases} V_{\text{fine}}[2I{:}2I{+}2, 2J{:}2J{+}2] & r_{IJ} > t \\ V_{\text{coarse}}(I,J) & r_{IJ} \le t \end{cases}
ルーターはViT特徴(LLM activationではない)に基づいて動作するため、計算コストが低くLLMの前段に配置されます——バニラFastVのようなLLM内部の刈り込み手法とは異なり、SGLangのプリフィルパイプラインと互換性があります。論文のFastV^\dagger ベースラインは、サービングレベルでの公平な比較を可能にするために、明示的にポストViT変種として設計されています。
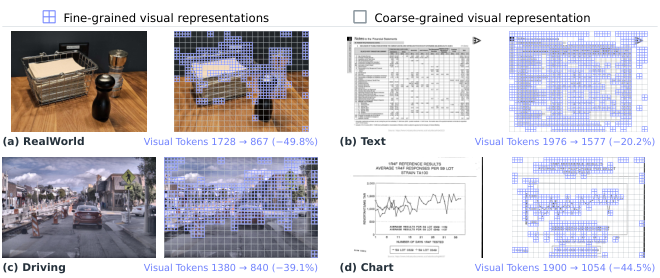
ティーザー(図1)は走行シーンを示しており、ルーターが車両や標識にfine粒度を割り当て、道路や空を圧縮しています——これがこの手法の名前の由来であるコンテンツ適応的な割り当てです。
学習。 VisionWeaveは3段階の自己蒸留によって学習され、ベースMLLM(weavingなし)を教師として使用します。ステージ1では、全ブロックをcoarseにした場合に教師の出力と一致するようゲート付きプーラーを学習し(積極的な圧縮による性能劣化の上限を規定します)。後のステージでは、スパース性・バジェット正則化項を伴うルーターを導入し、圧縮された表現が不十分な場合にのみfineトークンを要求するよう学習させます。外部ラベルは一切使用せず——シグナルは密トークン教師に対する蒸留KLです。
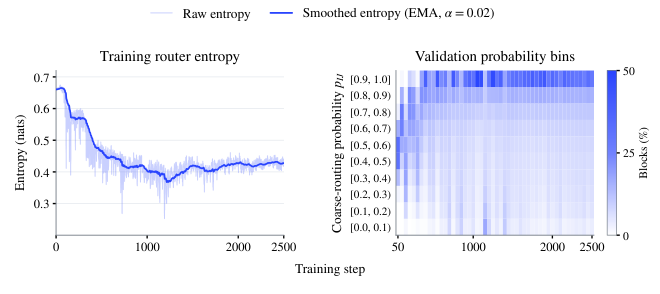
学習曲線(図4)は、初期探索フェーズの後にルーターが安定したfineトークン割合に収束する様子を示しており、学生と教師のギャップを埋める場合にのみfine割り当てに報酬を与える自己蒸留シグナルと整合しています。
結果
バックボーンはQwen3.5-4BとQwen3.8-27Bです。ベースラインはVisionZip(マージング)とFastV^\dagger(ポストViT刈り込み)です。主要な主張は、コンテンツ適応的な割り当てによる品質保持トークン削減(セクション3.2)、解像度とフレームバジェットにわたるロバスト性(セクション3.3)、実際のSGLangレベルでのサービング改善(セクション3.4)、および閾値 t による推論時制御(セクション3.5)です。提供されている抜粋では、コンポーネントレベルの数値を報告しています。Qwen3.5-4Bにおいて75%トークン削減の条件で、ゲート付きプーラーが8つのベンチマーク全てでピクセルアンシャッフルを上回り、上述のDocVQA(+2.64)およびVideoOCR(+2.77)の差が際立っています——これらはスイート内で最も細部の精度が重要な2つのタスクであり、固定ダウンサンプリングが典型的に失敗する領域です。
制限と未解決の問題
この抜粋では、VisionZip/FastV^\dagger に対するエンドツーエンドの数値や絶対的なSGLangスループットの差分は示されていないため、モデルレベルでの定量的な主要比較は提供された情報から引用できません。ルーターは静的なViT特徴に基づいて動作します。動画に対して、フレームをまたいだ粒度決定の時間的一貫性が処理されているかどうか(フレームごとのフリッカーがKV再利用を不安定化させる可能性に対して)は不明です。閾値ベースのコミットメントは微分不可能であり——学習中はストレートスルーまたはソフトゲーティングを使用していると推測されますが、そのメカニズムは抜粋に明記されていません。また、自己蒸留は教師の盲点を引き継ぎます。密トークン教師が特定の解像度で既に細部を失っている場合、学生はその箇所でfine粒度を割り当てるための教師シグナルを持ちません。
なぜ重要か
弾力的なトークン割り当ては、二次的な爆発なしに高解像度・長時間動画のMLLMをスケールするための適切な抽象化であり、VisionWeaveはそれを自己蒸留のみでMRoPE互換のネイティブ機能として実現できることを示した最初期の実証の一つです——新たなラベルは不要で、SGLangのような既存のサービングスタックに直接デプロイできます。
Source: https://arxiv.org/abs/2610.07987
ProgramGym: 長期ホライズンのプログラム再現エージェントのためのトレーニング環境のスケーリング
問題
コーディングエージェントのベンチマークおよびトレーニングセットの大半は、既存リポジトリ内でのイシュー解決(SWE-benchおよびその派生)、あるいは仕様からのリポジトリ合成に焦点を当てています。しかし、ソフトウェアエンジニアが新しいツールを構築する際に実際に行う作業、すなわち「動作する参照プログラムとそのドキュメントを与えられた上で、アーキテクチャを独自に決定し、外部から観察可能な振る舞いをゼロから再現する」というタスクは、いずれのアプローチでも対象外となっています。このようなエージェントをトレーニングするためのボトルネックは2つあります:(i) 異種のビルドシステムにわたって検証可能なサンドボックスを大規模に構築すること、および (ii) テストスイートを通過することが意味のある忠実度シグナルとなるよう、十分な振る舞いカバレッジを持つ有限のブラックボックステストスイートを生成することです。
ProgramGymはこの両方に対処します。形式的には、環境構築パイプライン \Phi がリポジトリ P_i を以下のようにマッピングします:
e_i = \Phi(P_i) = (B_i^\star, D_i, \mathcal{T}_i, \mathcal{S}_i),
ここで B_i^\star は実行専用の参照バイナリ、D_i は使用方法のドキュメント、\mathcal{T}_i はブラックボックスの振る舞いテストスイート、\mathcal{S}_i はネットワーク隔離されたサンドボックスです。エージェントはソースコードとコンパイルスクリプトを出力して \widehat{B}_i を生成し、\mathcal{T}_i 上での B_i^\star との振る舞いの一致度によって評価されます。
Program-Env: フィードバック駆動の環境構築
Program-Envは3つのステージで実行されます(図2を参照)。ステージ1では、GitHub Search APIを通じてリポジトリを収集し、言語およびスター数のバケットによって層別化します。アーカイブ済み・フォークされたリポジトリ、既存のベンチマークで使用されたもの、有効なライセンスや明示的なビルド設定の根拠が欠如しているものは除外されます。残存した各リポジトリは固定コミットにピン留めされ、M = 30{,}459 件の候補が得られます。
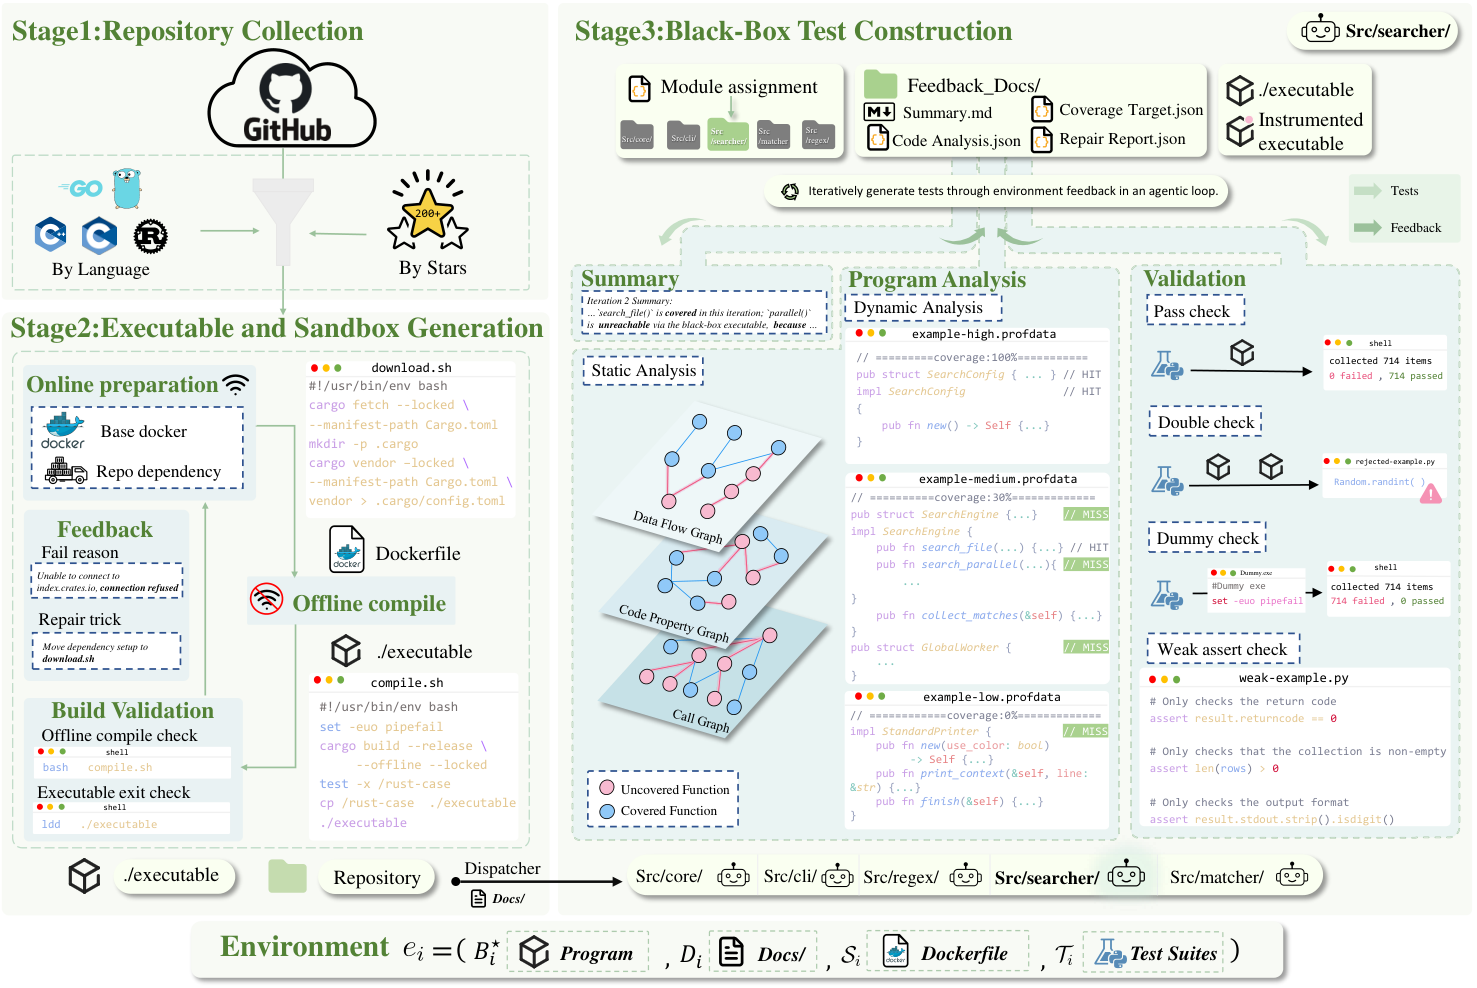
ステージ2では、一般的なハーネス(Claude Code / Codex)をフィードバックループでラップしたものを用いて、サンドボックス \mathcal{S}_i 内で B_i^\star のビルドを試みます。このループはDockerfileとビルドスクリプトを繰り返し修正することでビルドの失敗を修復します。ステージ間のディスパッチャーが D_i を抽出し、ソースツリーを機能モジュールに分割します。
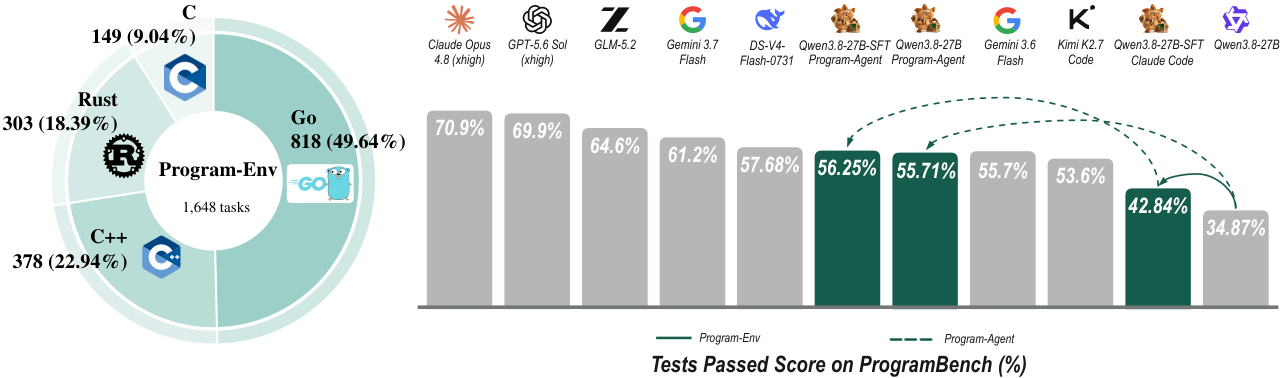
ステージ3では、各モジュールをサブエージェントに割り当て、すでにビルドされた B_i^\star に対して \mathcal{T}_i を反復的に作成させます。\mathcal{T}_i は有限であるため、テストを通過することはテスト済み入力に関する一致を保証するにとどまり、完全な意味的等価性は保証されません。そのため、パイプラインは単一カテゴリの深度よりも振る舞いの多様性を重視します。最終的なコーパスはC、C++、Go、Rustにわたる1,648件の環境を含み、DeepSeek-V4-Flash-0731を基盤モデルとして、計5,918件のサブエージェントを使用して生成されました。インタラクションカテゴリ(表1)はI/O(サブエージェントの99.24%)、Arguments(82.82%)、Help(68.77%)が支配的であり、Subcommands(22.05%)とTUI(12.10%)は稀です。これはコーパスのCLI・開発ツールへの偏りを反映しています。
Program-Agent: 役割分離された長期ホライズンのワークフロー
長期ホライズンの再現タスクにおける単一セッションのエージェントは、コンテキストの圧縮という問題に悩まされます。すなわち、初期の振る舞いに関する証拠が失われ、最終的な出力がコンパイルに失敗することが多いのです。Program-Agentはタスクを3つのステージに分割し、それぞれを独立したセッションで実行します:
- Analysis(分析)。 アナリストは D_i を読み、Workspaceには手を触れずに B_i^\star(実行専用)を調査します。振る舞いの制約は
analysis-initial/analysis.mdに書き込まれ、読み取り専用に固定されます。 - Implement(実装)。 実装者はAnalysisの引き継ぎ情報のみを参照してWorkspaceを編集します。
- Review(レビュー)。 別のセッションが固定された分析に照らして現在の実装を監査します。
ImplementとReviewは固定されたループ予算の範囲内で交互に実行されます。セッション境界をまたぐ3つの永続的なアーティファクトとして、Handoff(振る舞いに関する証拠とステージレポートを含み、完全な会話履歴を代替する)、Workspace(更新されるソースコード)、およびRevisions(コンパイル検証と失敗時のロールバックに使用される、独立してビルド可能なスナップショット)があります。Revisionsの仕組みは、回復処理をエージェントの現在のコンテキストから切り離すという点で重要です。壊れた状態は、軌跡を再生せずに元に戻すことができます。
結果と挙動
トレーニングは、Program-Env内で収集されたDeepSeek-V4-Flash-0731の軌跡に対してrejection samplingを適用し、テストケースの合格率でフィルタリングすることで行われます。ハーネスにはClaude Codeを使用します。ProgramBench(本gymと同時に導入)において、Program-EnvによるトレーニングとProgram-Agentによる推論の両方が改善に寄与しています(詳細な数値は論文の結果セクションに記載されており、ここでは省略します)。
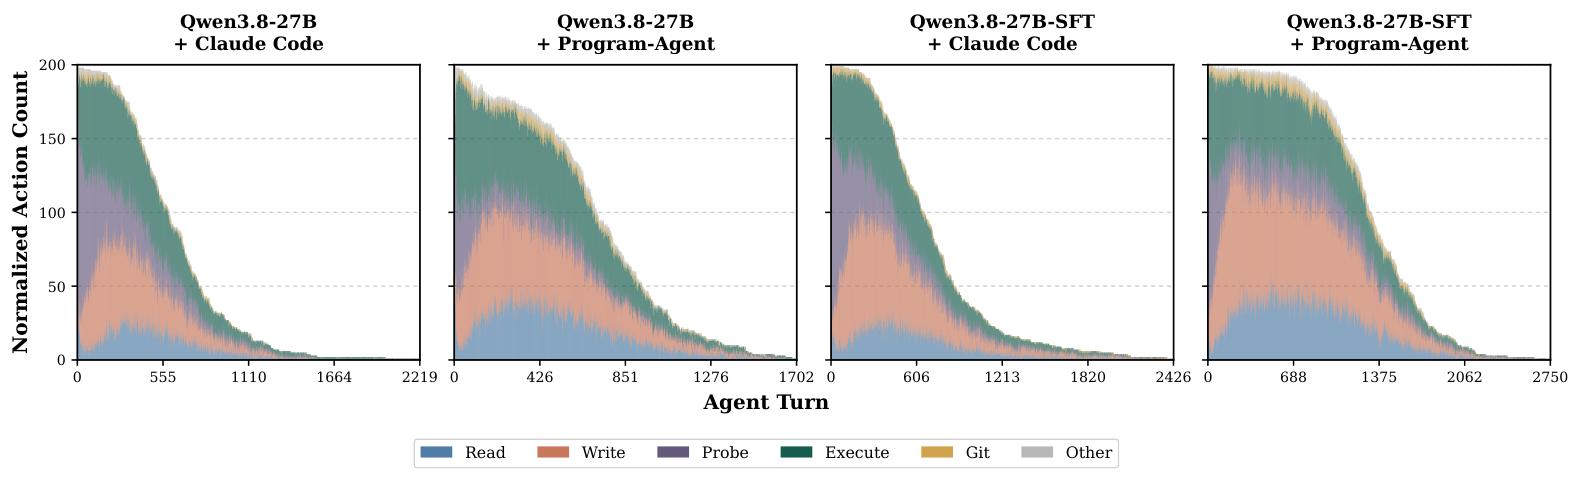
図7のアクションタイプの分布は、役割分離の効果を示しています。初期のターンは読み取り・探索アクションが支配的であり(Analysisステージの制約収集の役割と一致)、編集やビルド・テストのアクションは後半に増加しています。ターンインデックスの増加に伴うバーの総高さの減少は、単に軌跡の長さが可変であることを反映しています。RQ3の結果、すなわち追加のイテレーション予算がテスト合格数を改善するという知見は、Revisionsベースの回復がより長いホライズンの下でも崩壊しないことと整合しており、これは通常、単一セッションエージェントが性能低下を示す領域です。
限界
- 有限のテスト。 \mathcal{T}_i は意味的等価性を保証できないため、エージェントは観測された入力に対してオーバーフィットし得ます。論文ではこのギャップをホールドアウトの振る舞いテストによって定量化していません。
- 言語およびカテゴリの偏り。 コーパスはCLI・開発ツールに偏っており、TUI(12.10%)およびSubcommands(22.05%)はサンプル数が少なく、GUIやネットワークサーバーのワークロードは実質的に存在しません。
- ハーネスへの依存。 構築にはClaude Code/CodexとDeepSeek-V4-Flash-0731をバックボーンとして使用しており、1,648件という環境数の達成がどの程度ハーネスに固有のものであるかは不明です。
- ビルド修復の上限。 パイプラインは明示的なビルド設定の根拠を持つリポジトリを保持するため、よく管理されたプロジェクトに偏り、実際の再現を困難にするような雑然としたビルドが過小表現されます。
なぜこれが重要か
プログラムの再現は、SWE-benchスタイルのパッチ適用と比べて「ゼロからシステムを構築する」能力のより明確な代理指標となります。これまでのボトルネックはエージェントのアーキテクチャではなく、環境の供給にありました。フィードバック駆動の構築パイプラインを備えた、1,648件の環境・4言語の検証可能なgymは、他者がトレーニングに利用できる基盤となります。また、Revisionsを用いた役割分離ワークフローは、推論能力ではなくコンテキストの圧縮が主な失敗モードとなる長期ホライズンのコーディングエージェントのための再利用可能なテンプレートとなります。
Source: https://arxiv.org/abs/2610.13395
Hacker News Signals
商用空間オーディオエフェクトをリバースエンジニアリングした方法
あるデベロッパーが、音声分析・インパルス応答測定・信号トレースを組み合わせることで、商用の空間オーディオプラグインの内部構造を解析しています。核心となる手法は、プラグインにインパルス信号を入力し、各仮想スピーカー位置での出力をキャプチャすることによって頭部伝達関数(HRTF)を抽出することです。HRTFは、3次元空間上のある点から各耳へと音が伝わる過程で受ける音響フィルタリングを符号化したもので、両耳間時間差(ITD)および両耳間レベル差(ILD)、さらに耳介に起因するスペクトル整形を与えるfinite impulse responseフィルタのペアです。
著者はアジマス角と仰角のグリッド全体にわたってプラグインのインパルス応答を測定し、バイノーラルレンダリングパイプラインを再構築したうえで、チャンネル間のcrossfeedの処理方法を特定しています。重要な発見のひとつは、プラグインがドライなHRTF畳み込みの上に周波数依存の部屋モデリング――初期反射と後期残響テール――を適用しており、それが知覚される「広がり感」の相当部分を担っているという点です。
この分析ではFFTベースのスペクトル比較を用いてフィルタ形状を特定し、既知のHRTFデータベース(KEMARなど)と照合しています。その結論として、このプラグインは標準的なデータセットを出発点とし、独自のスムージングおよびEQ補正カーブを適用していると推定されます。リバースエンジニアリングによる近似モデルは、A/Bリスニングと代表的な角度でのマグニチュードスペクトルの比較によって検証されています。
これはブラックボックスDSPリバースエンジニアリングの明快な事例です。すなわち、プラグインを(近似的に)線形時不変(LTI)システムとして扱い、既知の信号でプロービングを行い、フィルタ係数を復元するというアプローチです。この手法の限界は、LTI動作の仮定にあります――プラグインはdynamic EQやリミッティングといった非線形処理を適用している可能性があり、それはこの手法では捉えられません――また、追加のプロービングなしにHRTF成分と部屋モデルを完全に分離できない点も制約となります。
Source: http://epestr.com/blog/reverse-engineering-a-commercial-spatial-audio-effect/
集合知による再帰的自己改善
Sakana AIのMASS(Multi-Agent Self-improvement System)論文は、言語モデルエージェントの集団が、エージェント自身のfine-tuning手順を修正するコードを生成・評価・選択することで反復的に自己改善するフレームワークを提案しています。その枠組みは進化的なものであり、エージェントが学習パイプラインへの修正(データキュレーションのヒューリスティクス、lossの重み付け、promptテンプレート)を提案し、ホールドアウトされたタスク性能に基づくfitness関数が生き残りを選択し、サイクルを繰り返します。
機械的なループは次の通りです:(1) 「proposer」エージェントが現在の学習設定へのパッチを実行可能なPythonとして生成する;(2) パッチが適用され、小規模データセット上で軽量なfine-tuningが実行される;(3) 得られたチェックポイントがbenchmarkで評価される;(4) 高スコアの設定が保持され、次世代のシードとなる。これは本質的に、ハイパーパラメータオプティマイザではなくエージェントの振る舞いとして定式化された自動機械学習(AutoML)探索です。
従来のニューラルアーキテクチャ探索やmeta-learningと異なる点は、LLMを用いて自然言語に基づく構文で構造化されたコード変更を提案することにあります。これにより、ハイパーパラメータ、データ選択ロジック、学習カリキュラムにまたがる修正を同時に行うことが可能となり、グリッド探索やベイズ法では組み合わせ爆発的に大きすぎる探索空間を扱えます。集合的な側面として、複数のエージェントが並列に探索し、発見を非同期に共有します。
結果として、数世代にわたってベースモデルと比較してコーディングや推論のbenchmarkにおける改善が示されていますが、絶対的な向上幅は控えめであり、比較に用いるベースラインの選択が非常に重要です。主要な未解決問題は、性能の天井に達する前に複数世代にわたって改善が意味のある形で複利的に蓄積されるかどうか、およびfitness信号(benchmark性能)がreward hackingや評価セットへの過学習を防ぐのに十分頑健かどうかです。多数のfine-tuningループを実行する計算コストも無視できず、十分に分析されているとは言えません。
Source: https://pub.sakana.ai/mass/
Safe SIMD in Rust, even on the inside
この記事は、Rust の SIMD コードにおける特定の健全性(soundness)問題を扱っています。公開 API のサーフェスが safe であっても、SIMD 実装の内部では、アライメントが合っていないロード、ベクタ型とスカラ型の間の誤った unsafe な transmute、あるいはターゲットフィーチャのゲーティング違反によって未定義動作が引き起こされる可能性があります。著者は unsafe が表面上は安全な SIMD 抽象に漏れ込む経路を体系的に整理し、それを封じ込めるための規律ある設計パターンを提案しています。
核心となる問題は、Rust の std::simd(ポータブル SIMD)および std::arch の intrinsic が、呼び出しサイトにおいてターゲットフィーチャの保証を要求する unsafe 関数であるという点です。よく見られるパターンとして、実行時の CPU フィーチャチェックでゲートされた safe 関数でこれらをラップする方法がありますが、これは外部の呼び出しが安全であることを保証するに過ぎません。intrinsic の内部的な使用については、アライメントが合っていないメモリアクセスやエイリアシング違反を避けるために依然として慎重な取り扱いが必要です。
具体的な推奨事項としては、フィーチャの保証を暗黙的に transmute するのではなく、内部関数に #[target_feature(enable = "...")] を付与すること、アライメントの仮定を避けるためにポインタキャストより as_array() / from_array() による変換を優先すること、そして unsafe ブロックをできる限り狭くし、維持されている不変条件を明示的にドキュメント化した形で SIMD カーネルを構造化することが挙げられています。また、データ構造への #[repr(align(N))] は必要条件ではあるものの十分条件ではなく、ロード命令自体が intrinsic によってドキュメント化されたアライメント保証と一致していなければならない点も強調されています。
さらに、unsafe コードと Rust の型システムの相互作用についての議論もあります。デフォルトで Send + Sync である型も、一部の OS 構成においてスレッドごとに有効化されるターゲットフィーチャに動作が依存する SIMD ベクタ型を含む場合、スレッド間での安全な共有が保証されないことがあります。これはコンパイラも一般的な linter も検査しない、非常に微妙な不変条件です。この記事は、正確性とパフォーマンスの両立が求められる Rust でのパフォーマンスクリティカルな数値演算コードを書く人にとって、実践的に有用な内容となっています。
Source: https://shnatsel.github.io/safe-simd-in-rust-even-on-the-inside/
ZigにおけるType-safeなHTMLテンプレーティング
著者は、Zigの型システムを活用してコンパイル時に構造的正確性を強制するHTMLテンプレーティングシステムを構築しています。これにより、文字列補間ベースのテンプレーティングが引き起こすテンプレートバグの類全体——タグの不一致、無効な属性の配置、コンテキストを無視したエスケープ処理——を排除しています。
中核となるメカニズムは、HTMLツリーをZigのcomptime型階層として表現することです。各HTML要素は、許容される子要素と属性を型パラメータとして保持する個別の型になっています。例えばdiv型は、フローコンテンツを含めることはできるが<td>を直接含めることはできないということを静的にエンコードしています。無効なネストはランタイムの不正形成ではなく、コンパイルエラーになります。これはHaskellのblaze-htmlやElmのHtml型と精神的に近いものがありますが、型クラスやADTシステムではなく、Zigのcomptime評価によって実装されています。
属性の安全性は、属性セッター関数を要素ごとに型付けすることで実現しています。<a>はhrefセッターを公開していますが<div>は公開していないため、<div>にhrefを設定しようとするとコンパイル時にエラーになります。エスケープ処理はコンテキスト依存です。テキストノードはHTMLエンティティエスケープを使用し、URL値の属性はパーセントエンコーディングを使用し、JavaScriptイベントハンドラ属性はインジェクションのリスクが高いため、デフォルトでコンパイル時警告が発生します。
パフォーマンスの観点では、構造がコンパイル時に既知であるため、静的テンプレートに対してはZigのcomptime機構によってレンダラーを完全にアンロールでき、ほぼゼロオーバーヘッドのシリアライゼーションが実現します。動的コンテンツ(ランタイム文字列)では依然としてランタイムエスケープが必要ですが、コンテキスト(テキスト、URL、属性値のいずれか)は常に静的に既知であるため、正しいエスケープ関数がコンパイル時に選択されます。
制限事項としては、文字列ベースのテンプレートDSLと比較して記述量が多くなること、そしてこのアプローチは手書きのテンプレートには適切に適用できるものの、デザインシステムやCMSから生成されたテンプレートとの統合が難しいことが挙げられます。また、Zigのcomptimeモデルは再帰型に制約を課すため、深くネストされた要素や自己参照的な要素の表現が複雑になります。
Source: https://lalinsky.com/2026/10/11/type-safe-html-templating-in-zig.html
Postgresが遅いのではなく、ストレージが遅い
ClickHouseのエンジニアによるPosetteトークのまとめが、Postgresのパフォーマンスに関する不満のほとんどはストレージ層の問題であり、クエリエンジンに誤って帰因されているという主張を展開しています。議論の中心はI/O増幅です。PostgresのMVCC実装は複数の行バージョンをin-place(ヒープタプル)に格納するため、読み取りと書き込みの両方で、論理的なペイロードよりも多くのデータにアクセスすることになります。VACUUMはこれをさらに悪化させ、デッドタプルを回収するために定期的なフルテーブルスキャンが必要となり、ストレージ層での書き込み増幅が発生します。
具体的なメカニズムとして、多数のデッドタプルを含む大きなテーブルに対するSELECTは、ほぼゴミデータが詰まったページをヒープスキャンでロードすることになり、実際の生存行数から想定されるよりもはるかに大きな読み取りI/Oが発生します。IOPSが課金制またはスループット上限制のクラウドブロックストレージ(EBS、GCP PD)では、これはレイテンシの悪化とコスト増加として直接計測可能です。このトークでは、更新頻度の高い典型的なOLTPワークロードにおいて、autovacuumが追いつく前にデッドタプルによる実効読み取り増幅が3〜5倍に達しうることを定量的に示しています。
推奨される緩和策としては、autovacuumの積極的なチューニング(ホットテーブルに対してautovacuum_vacuum_scale_factorを0.01〜0.02まで下げる)、インデックスの変動を回避するHOT(Heap-Only Tuple)更新のためのスペースを確保するfillfactorの引き下げ、DELETE + vacuumの代わりにDROP TABLEによる範囲削除を可能にするパーティショニング、そして読み取り負荷の高いワークロードに対してはカラムナストレージ拡張機能(Hydra、pg_mooncake)への移行やOLAPシステムへのオフロードが挙げられています。
より広い視点での主張は、Postgresのパフォーマンス特性はそのストレージフォーマットと不可分であり、MVCCヒープの挙動を理解せずにPostgresをチューニングすると誤診につながるということです。これはPostgresのDBAコミュニティでは広く理解されていますが、データベースをブラックボックスとして扱う開発者にはしばしば見落とされています。
Source: https://clickhouse.com/blog/posette-talk-recap-postgres-isnt-slow-your-storage-is
LLMの能力に関する共通理解のギャップが拡大している
Karpathyのツイートは、現在のLLMが何をできて何をできないかについての理解が、人口レベルの分布として二極化しつつあるという観察を述べています。すなわち、適切に較正されたメンタルモデルを持つ少数のヘビーユーザーと、一世代から数世代前の能力水準に認識が留まっているはるかに大きなグループです。実際的な帰結として、製品に関する意思決定、政策提言、研究アジェンダが、両端において精度の低いベースラインから行われるようになっています。——能力を過小評価すれば応用機会を逃し、過大評価すれば失敗モードへの誤った信頼につながります。
この社会的観察の背後にある技術的本質として、LLMの能力は単一のスカラー値ではありません。モデルはスケールと学習データの関数として、特定の benchmark 上で急激な相転移を示しますが、この挙動は、初期の非力なモデルで形成されたユーザーの直感に対してクリーンに一般化するわけではありません。GPT-3や初期のGPT-4でメンタルモデルを形成し、現在のフロンティアモデルを自分の専門ドメインでストレステストしていない開発者は、能力の上限と失敗モードの両方を系統的に誤判断するでしょう。
評価の問題は、標準的な benchmark(MMLU、HumanEval、MATH)がフロンティアではすでに大部分飽和しており、新たな差別化要因——長文脈コヒーレンス、マルチステップのtool use、較正された不確実性、adversarial robustness——が簡単な非公式テストでは調べにくいという事実によって、さらに複雑になっています。これは、「benchmarkが示す内容」と「あなたのユースケースでモデルが実際に行うこと」のギャップが、意図的なred-teamingなしには埋めにくくなっていることを意味します。
エンジニアリングの観点から得られる実践的教訓は、能力に関する前提を以前のプロジェクト経験から引き継ぐのではなく経験的に再評価すべきであること、そしてチーム内でモデルの挙動を較正することは予算を割く価値のある正当なエンジニアリングコストであるということです。
Source: https://twitter.com/karpathy/status/2109361546505966046
Talorys – Cloudflareの無料枠上で動作するセルフホスト型パーソナルAIエージェント
Talorysは、Cloudflareの無料枠インフラ上で完全に動作するよう設計されたパーソナルAIエージェントです。計算処理にはWorkers、永続的な状態管理にはD1(SQLite)、blobストレージにはR2、非同期タスクのディスパッチにはQueuesを使用しています。ゼロ限界コストという制約が特定のアーキテクチャ上の選択を強いることになり、AIという観点を抜きにしても技術的に興味深い内容となっています。
エージェントのループはCloudflare Workers上で動作しますが、無料枠ではリクエストごとにCPU時間が50msに制限されています(RAM 128MB、永続実行なし)。長時間かかるエージェントタスクは小さなステップに分解され、Durable ObjectsまたはQueuesを通じてシリアル化され、ステップ間でD1に状態がチェックポイントされます。これは「ステートマシンとしてのエージェント」パターンを強制的に実装したものであり、各Workerの呼び出しは現在の状態を読み取り、一つのアクションを実行し、更新された状態を書き込んだうえで次のステップをエンキューします。
ツールの実行(ウェブ検索、カレンダーアクセス、メール)は、Workers KVに保存された認証情報を用いてWorkersが外部APIを呼び出すことで処理されます。LLM inferenceそのものはフロンティアAPI(OpenAIまたは互換製品)にアウトソースされており、このインフラ層でローカルにinferenceを実行することはスコープ外です。会話履歴とタスク状態はD1に保存され、セッションごとにメッセージリストを格納することでマルチターンのcontext windowをサポートするスキーマが用いられています。
興味深いエンジニアリング上の制約として、Cloudflareの無料枠には永続的なTCP接続もバックグラウンド実行もないため、エージェントは「ポーリング」や長時間稼働するループを維持することができません。その代わりに、cronトリガー(Workers Cron)を利用して定期的に保留中のタスクを確認する設計になっています。このため、タスクの作成から実行までの間に遅延が発生し(cronインターバルで最大1分)、本番のエージェントシステムではプッシュベースのウェイクアップ機構によって通常は排除される問題が生じます。
Source: https://github.com/rociiu/talorys
Gitのコミットはどのくらいの大きさか?
Gitオブジェクトのディスク上およびメモリ上の実際のサイズを、基本原理から丁寧に解説した内容です。Gitのコミットオブジェクトは、tree SHA(16進数40文字)、親SHA、タイムスタンプ付きのauthorおよびcommitter情報、そしてコミットメッセージを含むテキストblobです。最小限のコミットオブジェクトの生のサイズは、圧縮前で通常200〜300バイトです。
Gitはオブジェクトを2つの形式で保存します。loose objects(.git/objects/以下にオブジェクトごとにzlib圧縮された1ファイル)と、packfile(.git/objects/pack/以下に複数のオブジェクトをdelta圧縮してまとめたもの)です。約250バイトのloose commitオブジェクトは、デフォルト設定のzlibで約150〜180バイトに圧縮されます。参照先のtreeオブジェクトは別途存在し、ファイル数に応じてサイズが増加します。各treeエントリはmode(6バイト)、ファイル名、nullバイト、および20バイトのバイナリSHAで構成されるため、1000ファイルを持つtreeは圧縮前で概ね35〜40KBになります。
packfileフォーマットはオブジェクト間にdelta圧縮を適用します。類似したblobやtreeはベースオブジェクトとバイナリdiffとして保存され、これが多くの類似ファイルバージョンを持つリポジトリにおけるGitのストレージ効率の源泉です。deltaフォーマットは汎用のdiffアルゴリズムではなく、コピー&インサート命令セットを使用しており、Gitはヒューリスティック(類似サイズ、同一ファイル名の履歴)によってdeltaのベースを選択します。
実用的な結論として、コミットの「サイズ」は何を基準に考えるかによって大きく異なります。コミットオブジェクト単体(約200バイト)、コミットとそのtreeの合計(中規模プロジェクトで約35KB)、あるいはdelta圧縮後のpackfileへの寄与分(1ファイルの1行を変更したコミットであればほぼゼロになる可能性もある)のいずれかによって変わります。リポジトリのサイズ増大を考える開発者は、コミット数ではなくblobオブジェクトの蓄積という観点で考えるべきです。
注目の新規リポジトリ
bherbruck/solidcraft
純粋なRustで実装されたパラメトリック3D CADで、デスクトップ、Web(WASM経由)、およびModel Context Protocol(MCP)を通じたプログラマティックな自動化をターゲットにしています。パラメトリックアプローチとは、ジオメトリが直接メッシュ編集ではなく制約グラフによって定義されることを意味し、単一のパラメータを変更するとモデルツリー全体に伝播します。純粋なRustであることにより、C++カーネルへの依存なしに単一のコードベースがネイティブとWASMの両方のターゲットにコンパイルされます。これは、ほとんどのオープンソースCAD(FreeCAD、CadQuery)が依存しているOpenCASCADEベースのスタックからの大きな転換です。MCPの統合が差別化のポイントであり、CADカーネルをツール呼び出し可能なインターフェースとして公開します。つまり、LLMエージェントがGUIなしでプログラマティックにジオメトリ構築を駆動できます。まだ初期段階ですが、アーキテクチャはヘッドレスCADパイプラインの基盤となるほど十分に洗練されています。FreeCADのPython/C++境界に不満を持つエンジニアや、Fusion 360のAPIの商業的ロックインに悩むエンジニアにとって、Rustネイティブなアプローチは魅力的に映るでしょう。
Source: https://github.com/bherbruck/solidcraft
strands-labs/strands-decider
エージェントパイプライン向けの「System 1」決定レイヤーとして位置づけられた、軽量なバイナリ分類器 / 順序回帰モデルです。単純なyes/no分岐であっても完全な自己回帰型LLMを通じてすべての中間決定をルーティングする場合(トークン生成レイテンシのペナルティが発生します)とは異なり、Strands Deciderは小規模な識別モデルを実行し、離散的な選択肢または連続スケール上のキャリブレーション済み信頼スコアを返します。キャリブレーションの側面は実用的に重要です。分類器のuncalibratedなsoftmax出力は過信傾向にあるため、信頼スコアが意思決定理論的な意味を持つためには、事後的またはトレーニング時のキャリブレーション(Platt scaling、temperature scaling、あるいはisotonic regression)が必要となります。このモデルは構造化された選択肢セットを入力として受け取り、確率分布を返すよう設計されており、より重いモデルへのエスカレーション前の高速ゲートとして、エージェントの分岐ロジックに組み込まれます。レイテンシが支配的なルーティング、ツール選択、プラン検証のステップに有用です。
Source: https://github.com/strands-labs/strands-decider
malevrigns/agent-jev
AgentJev-0.6Bは、テキスト生成ではなくエージェントの意思決定に特化して学習された、パラメータ数6億のencoder型モデルです。重要なアーキテクチャ上の選択は、出力トークンのデコーディングをゼロにしている点です。すなわち、このモデルは事前学習済みbackbone上の識別的headであり、推論は自己回帰的なサンプリングループを持たない単一のforward passとして完結します。主張されているレイテンシは約50msです。入力はgit diff、スタックトレース、ログストリーム、構造化されたJSONによる質問など、非構造化された状態情報であり、これらはすべてトークン化されてencoderで処理されます。出力は与えられた選択肢に対するキャリブレーション済みの確率分布です。パラメータ数6億であればCPUのRAMに余裕をもって収まるため、GPUを割り当てることなくローカルへのデプロイが現実的です。キャリブレーション済みという主張は、予測確率を経験的な頻度と一致させるよう学習またはポスト処理が行われていることを示唆しており、これほど異質な入力分布を扱うモデルにとっては非自明な課題です。実用的なユースケースは、LLMのレイテンシが実行時間全体を支配してしまうような長期的なエージェントループにおける、低コストかつ高速な分岐判断です。
Source: https://github.com/malevrigns/agent-jev
storytold/effectcraft
EffectCraftは、FFmpeg GUIラッパーでも、Electronシェルでも、C++レンダリングコアでもなく、完全にRustでゼロから書かれたモーショングラフィクス・コンポジティングツールです。コンポジティングモデルは標準的なノードグラフのパラダイム(レイヤー、blend mode、マスク、コンポーザブルノードとしてのエフェクト)に従っていますが、レンダラー・UI・タイムラインはすべてRustネイティブで実装されています。コンポジティングツールをゼロから構築するということは、完全なシグナルチェーンの実装を意味します:色空間変換、アルファコンポジティング演算子(Porter-Duff)、キーフレームの時間的補間、そしてGPUアクセラレーションによるラスタライズ(Rustのエコシステムからしてwgpuが使用されていると考えられます)。「ゼロから」という方針は野心的ではありますが、wgpu・winit・eguiの成熟度を考慮すればRustにおいて技術的に一貫性があります。5.4kスターを獲得していることは多大な注目を集めていることを示しており、AdobeスタックやレガシーなNatronコードベースに依存しないオープンソースのAfter Effects代替に対する真の需要が存在することを示唆しています。正当なシステムレベルの取り組みと言えます。
Source: https://github.com/storytold/effectcraft
storytold/designcraft
DesignCraftは、純粋なRustで書かれたページレイアウト・デザインエディタです――FigmaやAffinity Publisherに相当するツールです。技術的には、フル機能の2Dベクターレンダラ(ベジェ曲線、ブール演算によるパス操作、ストローク展開)、制約ベースのレイアウトエンジン、テキストシェーピング(おそらくrustybuzzや類似のHarfBuzzバインディング経由)、そしてインタラクティブなダイレクトマニピュレーションUIの実装が必要となります。Electronやブラウザエンジンをなくすことでレンダリングスタックが完全ネイティブとなり、パフォーマンスとオフライン利用の面で大きな意味を持ちます。Rustエコシステムには現在、十分なプリミティブが揃っています(2D GPUレンダリング向けのvello、UI向けのxilemやiced)。これにより、すべてをゼロから再実装することなく実現可能になっています。3.2kスターを獲得しているこのツールはEffectCraftのコンパニオンツールであり、storytoldがより広範なオープンソースクリエイティブスイートを構築しようとしていることを示唆しています。Figmaプラグインサンドボックスの制約なしに、スクリプタブルでAPIファーストなデザインツールを求めてきたエンジニアにとって、直接ライブラリアクセスが可能なRustネイティブのアプローチはアーキテクチャ的に魅力的です。
Source: https://github.com/storytold/designcraft
amitshekhariitbhu/ai-system-design
LLM、RAG パイプライン、およびエージェントフレームワークを基盤とした本番 AI システムを設計するための体系的なカリキュラムです。内容はフルスタックをカバーしており、RAG のためのチャンキング戦略と embedding モデルの選定、ベクターストアのトレードオフ(HNSW vs IVF インデキシング、レイテンシ vs リコール曲線)、プロンプト管理とバージョニング、評価フレームワーク(RAGAS スタイルのメトリクス、LLM-as-judge パターン)、エージェントオーケストレーションパターン、そしてキャッシングやコスト管理といったインフラに関する考慮事項が含まれます。これは論文ではなく実務者向けのリファレンスであり、システムデザイン面接対策資料を彷彿とさせる形でステップバイステップに整理されています。価値は新規の研究にあるのではなく、情報の集約と構造化にあります。ML モデリングから本番デプロイへと移行中のエンジニアや、LLM 製品を出荷している企業でのスタッフ・プリンシパルレベルの面接準備をしている方にとって、トレードオフを体系的に整理した内容は、散在するブログ記事よりも実践的に活用できるでしょう。
Source: https://github.com/amitshekhariitbhu/ai-system-design
sno-ai/sno-station
SNO Stationは、既存のコーディングエージェント — Codex、Claude Code、Cursor、Hermes Agent、OpenClaw — を共有メモリの集合体として統合するローカルのマルチエージェント協調レイヤーです。主要な技術コンポーネントとして、全エージェントが読み書きする暗号化共有メモリストア、あるエージェントが別のエージェントに作業を引き渡すタスクルーティングプロトコル、クロスエージェントレビュー機構(あるエージェントが別エージェントの出力を評価する)、そして蓄積されたセッションデータに基づいてエージェントの挙動をfine-tuningまたは更新すると思われるナイトリー改善ループが挙げられます。完全にローカルコンピュート上で動作するため、メモリストアとルーティングレイヤーはクラウドへの依存なしに機能し、これはプロプライエタリなコードベースにとって重要な特性です。暗号化されたメモリは、共有マシン上のセッション間またはユーザー間での情報漏洩を防止します。アーキテクチャ上の課題は、異なるコンテキストウィンドウ形式とツールAPIを持つエージェント間で一貫性を維持することですが、SNO Stationは正規化された中間表現を通じてこれを処理しているようです。エージェント合成に対する興味深いシステムズアプローチといえます。
Source: https://github.com/sno-ai/sno-station
ollaya-dev/ollaya
Ollayaは、生成系LLMではなく小規模な識別的決定モデルを対象とした、Ollamaの類似ツールです。Laya、Decider、NLI(自然言語推論)、およびGLiClass(汎用分類モデル)といった特化型モデルのためのローカルモデルレジストリとサービングレイヤーを提供します。APIはTypeSafe互換であり、TypeScriptクライアントがリクエスト/レスポンスの形状に対して静的な型保証を得られるため、エージェントコードベースにとって実用的なエルゴノミクス上の利点があります。pull-and-serveモデルはOllamaのUXを踏襲しており、ollaya pull nliでモデルの重みを取得し、ollaya serveでローカルのHTTPエンドポイントを公開します。NLIおよびGLiClassモデルは、分類タスクにおいて生成系LLMよりも大幅に小さく高速です。適切にチューニングされた2億パラメータのNLIモデルであれば、CPU上でミリ秒レイテンシによるテキスト含意推論とゼロショット分類を処理できます。Ollayaは、この種のモデルを生成系モデルと並列でローカル実行することを運用面で簡便にし、低コストな識別モデルがルーティングとバリデーションを担う階層的推論アーキテクチャを実現します。