デイリーAIダイジェスト — 2026-10-02
arXiv ハイライト
記憶を超えて:明示的な信念状態による長期エージェントの活用
長期エージェント(long-horizon LLM agent)は通常、観測とツール出力の増大するトランスクリプトを参照しながら動作し、現在の世界状態をその都度暗黙的に再構成します。このアプローチは、証拠の蓄積と状態推論を混在させています。コンテキストが長くなるにつれて、エージェントはゼロから一貫した世界像を再計算する処理をますます繰り返すことになり、失敗は著者らがBelief Trappingと呼ぶ形で現れます——エージェントは動作し続けるものの、タスクに関連する進捗が停止してしまうのです。PoS(Posterior-over-State)は、この暗黙的な再構成を、一貫性の検証と進捗のモニタリングが行われる明示的かつ継続的に維持される信念オブジェクトへと置き換える推論時スキャフォールドを提案します。
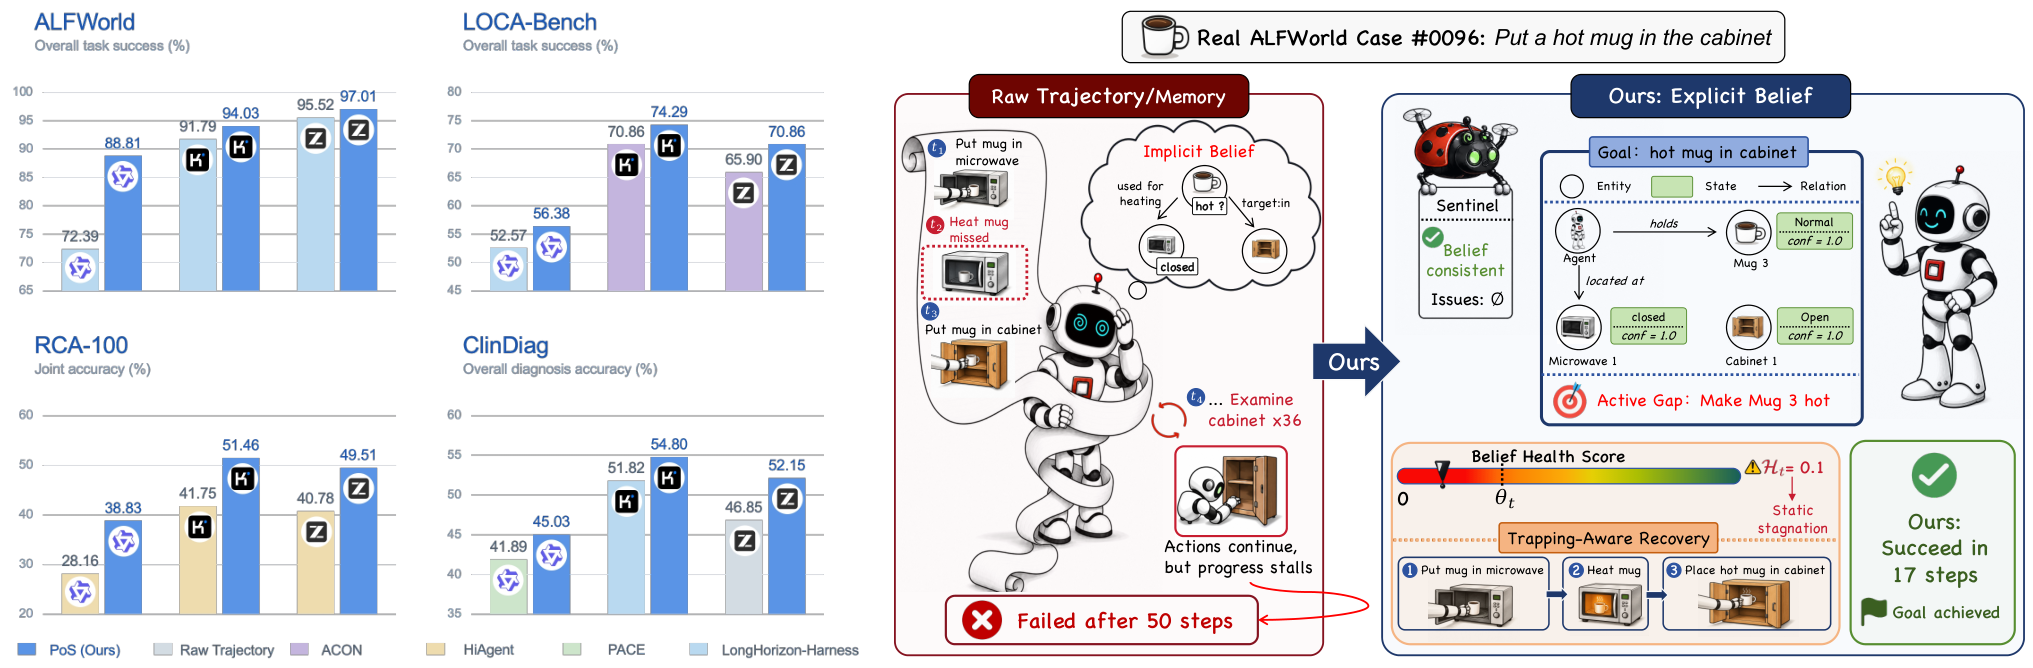
POMDPの事後分布から構造化された信念オブジェクトへ
著者らはエージェントと環境のインタラクションを、信念 b_t(s) が履歴 h_t を所与とした潜在的世界状態 s_t に対する事後分布であるPOMDPとして定式化します。標準的なReActスタイルのエージェントのように生の履歴で b_t を近似したり、学習済みの再帰的状態で近似したりする代わりに、PoSは構造化されたタスク条件付きの代理表現を維持します:
B_t = (W_t, G, \Delta_t^E, \Delta_t^A),
ここで W_t はタスクに関連する世界状態の推定値、G はタスク目標、\Delta_t^E、\Delta_t^A はそれぞれ未解決の認識論的ギャップと達成ギャップです。認識論的ギャップはエージェントがまだ調べる必要があることを列挙し、達成ギャップはまだ行う必要があることを列挙します。この分離は、2つの異なる終了条件と2つの異なる修復戦略を定義するという点で重要です。
W_t はEntity–State–Relationスキーマを採用しています。Entityはオブジェクトやエージェント、Stateはあるエntityの現在の状態に関する自然言語記述、RelationはEntity–Entity、State–State、またはEntity–State間の有向エッジです。各StateおよびRelationは出所、信頼度、および裏付け証拠を持ちます。Stateを固定スキーマや純粋な知識グラフではなく自然言語に保つという設計上の選択は意図的なものです——行動の実行可能性が動的な条件(例:電子レンジが開いている、患者のクレアチニン値が上昇している)に依存する場合、エンティティの同一性と接続性だけでは不十分だからです。この構造は、実行可能性、結果評価、または G の充足に影響するレコードのみに絞り込まれます。
Belief-Guided InteractionとBelief Sentinel
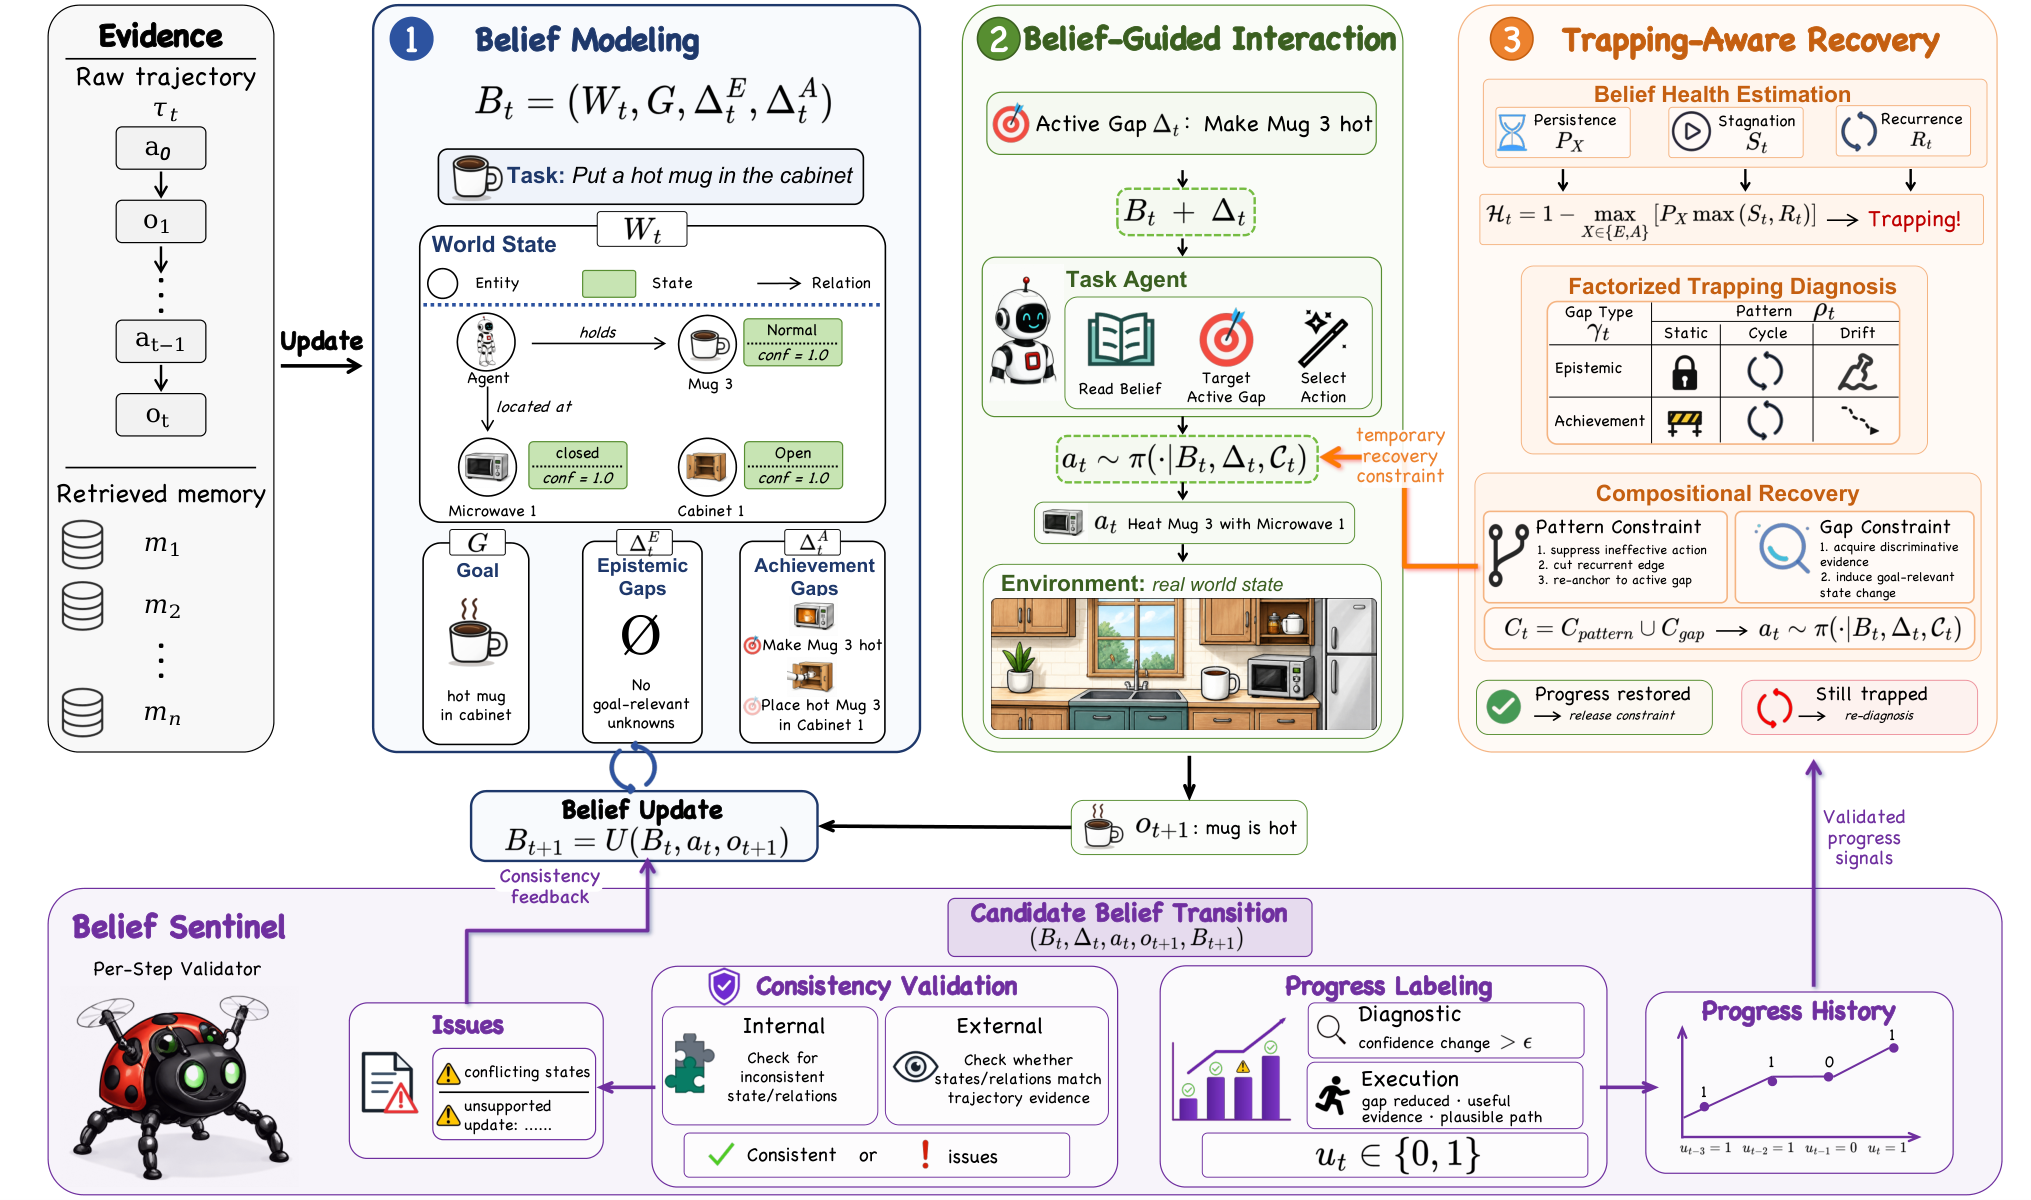
各行動は B_t と共に、次のステップに焦点を当てた \Delta_t^E \cup \Delta_t^A から選択された単一の項目であるActive Gapを条件として決定されます。環境の応答を観測した後、Belief Sentinelは2つの操作を実行します:(i) 一貫性検証——提案された W_t への更新が既存の高信頼度のStateやRelationと矛盾しないかを確認する——と、(ii) 進捗記録——Active Gapが実際に削減されたかどうかを追跡する——です。検証は幻覚的な状態更新に対するローカルフィルタとして機能し、進捗記録はトラッピング検出器にフィードバックされます。
Trapping-Aware Recovery
Belief Trappingは、Sentinelの統計から診断されます:Active Gapの削減が繰り返し失敗すること、矛盾する更新の間での振動、または認識論的獲得の停滞などです。リカバリは、トラッピングパターンと未解決ギャップの種類に合わせた制約から構成されます。例えば、認識論的トラップ(エージェントが必要な証拠を取得できない)は達成トラップ(エージェントは何をすべきかを知っているが繰り返し実行に失敗する)とは異なる方法で処理されます——前者は探索制約を引き起こし、後者は新しい前提条件の下での行動計画の再定式化を引き起こします。
結果
PoSは2つのエージェント体制にまたがる4つのベンチマーク——目標指向型実行(ALFWorld、LOCA-Bench)と証拠探索型診断(RCA-100、ClinDiag)——で評価されています。全4つのベンチマークおよびテストされた全3つのLLMバックボーンにおいて、PoSはバックボーンごとの最強のベースラインに対して最高の総合性能を達成しています。上記のteaser figureにそのマージンがまとめられています。アブレーションでは、2つの貢献が不可欠であることが示されています:一貫性検証を除去するとパフォーマンスが低下し、trapping-aware recoveryを除去するとさらに低下します——これは、信念オブジェクト単体ではSentinelループなしでは不十分であることを示しています。コンテキストスケーリング実験では、インタラクションホライズンが長くなるにつれて、PoSが履歴ベースのベースラインよりも耐性が高いことが示されており、これは暗黙的な再構成コストが長いホライズンにおける失敗モードを支配するという仮説と一致しています。
限界と未解決の問題
この論文は、B_t を維持するオーバーヘッド(すべてのステップで更新、検証、ギャップ選択のための追加LLM呼び出しが発生する)を完全には特性評価しておらず、また根本的に異なるドメインにわたる W_t のスキーマに対する感度を定量化していません。StateやRelationに対する信頼度アノテーションは、それらを幻覚した可能性がある同じLLMによって生成されるため、一貫性チェックは自己参照的です——直交的な検証(例:ツールに基づくアサーション)は研究されていません。ギャップ表現 \Delta^E, \Delta^A は自然言語で列挙されており、組み合わせ的なサブゴールを持つタスク(長いソフトウェアエンジニアリングタスク、複数患者の診断)にスケールするかどうかは未解決の問題です。最後に、トラッピング検出の閾値は手動調整されているように見受けられます;学習された検出器はリカバリトリガーをより精密にすることができるでしょう。
この研究が重要な理由
PoSは、長期エージェント設計を増大するトランスクリプトではなく明示的な事後分布を中心に再定式化し、ほとんどのLLMエージェントフレームワークが口先では言及しながら実装してこなかったPOMDP的な視点を実際に運用可能にします。実行ベンチマークと診断ベンチマークにわたる一貫した改善と、コンテキストスケーリングの堅牢性は、より長いコンテキストウィンドウや大きなバックボーンではなく、構造化された信念の維持こそが信頼性の高い長期的な動作のための鍵であることを示唆しています。
Source: https://arxiv.org/abs/2610.01415
階層的連続拡散言語モデル(Hierarchical Continuous Diffusion Language Models)
離散拡散言語モデルにおける並列デコードには、よく知られた病理があります。K個のトークンが同時にアンマスクされる際、それぞれは自身の周辺分布 p_\theta(k^{(i)}_{t-1}\mid k_t) から独立に生成されるため、同時分布 p_\theta(k^{(1:K)}_{t-1}\mid k_t) が無視されてしまいます。連続拡散言語モデルは共有潜在変数をデノイジングすることでこの問題を回避しますが、そのデノイザーは最終デコードまでトークン配置を確定しないため、軌跡の途中で潜在変数を離散多様体に固定するものが何もありません。HC-DLMは、連続潜在変数を唯一の持続的生成状態として保持しつつ、各逆方向ステップで離散的な足場(scaffold)を読み出してフィードバックするハイブリッド手法であり、その全体が単一の変分下界から導かれます。
モデル
k_0 \in \mathcal{V}^L をクリーントークン列、x_0 \in \mathbb{R}^{M\times d} を結合連続潜在変数とします。順方向過程は独立なノイズ付加として因子分解されます:
q_\psi(x_{0:T}, k_{1:T} \mid k_0) = q_\psi(x_0\mid k_0)\prod_{t=1}^T q(x_t\mid x_{t-1})\,q(k_t\mid k_{t-1}),
ここで q_\psi(x_0\mid k_0) はトークンから潜在変数への学習済みエンコーダ、q(x_t\mid x_{t-1}) は閉形式の q(x_t\mid x_0) および q(x_{t-1}\mid x_t, x_0) を持つ標準的なGaussian VP拡散、q(k_t\mid k_{t-1}) はカテゴリカルカーネル(吸収型または一様型)です。重要な点として、x_t と k_t は独立に破損されるため、両方の周辺分布が扱いやすい形に保たれます。
逆方向過程はこれらを意図的に結合します:
p_{\theta,\phi}(k_{0:T}, x_{0:T}) = p(x_T)\,p_\theta(k_0\mid x_0)\prod_{t=1}^T p_\theta(k_t\mid x_t)\,p_\phi(x_{t-1}\mid x_t, k_t).
2つの学習済み条件付き分布が生成の役割を担います。トークン読み出し p_\theta(k_t\mid x_t) はノイズを含む潜在変数をソフト(t=0 ではハード)なトークン分布に変換し、連続デノイザー p_\phi(x_{t-1}\mid x_t, k_t) は現在のトークン足場を条件として用います。結果として得られる2段階逆方向連鎖では、(i) トークンは生成状態として持続せず、各ステップで潜在変数から再生成され、(ii) 潜在変数は各デノイジングステップで k_t への条件付けを通じて有効なトークン配置に引き戻されます。
これはCCDDスタイルのハイブリッドとは明確に異なります。CCDDは連続的なコンテキストを付加した自己完結型の離散チェーンを走らせますが、HC-DLMでは潜在変数が唯一の持続的変数であり、トークンは足場に過ぎません。
目的関数
学習は結合連鎖上の通常のELBO分解による \log p_{\theta,\phi}(k_0) の変分下界に従い、ステップごとの損失は (i) 全 t(t=0 だけでなく)に対する p_\theta(k_t\mid x_t) からのトークン予測クロスエントロピーと、(ii) 事後分布 q(x_{t-1}\mid x_t, x_0) に対する p_\phi(x_{t-1}\mid x_t, k_t) のGaussianデノイジング項を組み合わせたものになります。エンコーダ q_\psi(x_0\mid k_0) は同時に学習されるため、潜在空間の幾何構造は固定済みembeddingに縛られることなく、デノイザーの要求に適応できます。サンプリングは交互に行われます:k_t\sim p_\theta(\cdot\mid x_t) を予測し、次に x_{t-1}\sim p_\phi(\cdot\mid x_t, k_t) を更新します。
結果
HC-DLMは、Sudoku(構造的制約充足)、Countdown(算術的プランニング)、LM1B(汎用言語モデリング)で評価されています。
Sudokuでは、サンプリング時パラメータ数わずか6Mで、HC-DLMはeasyで94.21%、hardで72.41%を達成しました。参考として: - 学習済み変数順序付きARM(42M):87.18 / 32.57 - バニラMDM(6M):6.88 / 3.62 - Kim et al.(2025)のトップ確率マージン適応デコーダを用いたMDM:89.49 / 49.88 - 同等の6MにおけるCCDD:94.65 / 70.73
すなわち、HC-DLMはeasyにおいてCCDDとほぼ同等(94.21 対 94.65)であり、hardでは+1.68ポイント改善(72.41 対 70.73)しています。また、順序付きARMを大幅に上回り(hardで+39.84)、最良の適応的MDMデコーダも大きく超えています(hardで+22.53)。差が最も大きいのは、まさに並列トークン独立性が最も悪影響を及ぼす場面、すなわち長距離制約伝播を伴うhardなSudokuであり、潜在変数における持続的なクロストークン状態が連立推論を可能にするという論文の核心的な主張を支持しています。
CountdownおよびLM1Bの比較は、GPT-2 Scratch、Stream-of-Search、LLaMA、VDM、D3PM、RDM、MDMの各変種、および(LM1Bについては)SEDD、Duo、Plaid、LangFlowと、6Mパラメータを揃えたプロトコルのもとで行われています。これらの数値は抜粋された節内では引用されていません。
制限と未解決の問題
テーブル内のパラメータ数はトークンembeddingを除外しています。6Mの生成パラメータにおいて、HC-DLMがどのようにスケールするか、特に制約情報を保持するのに十分な豊かな潜在幾何構造を学習しなければならないエンコーダ q_\psi については示されていません。潜在系列長 M は自由なハイパーパラメータですが、L との関係は抜粋部分では議論されておらず、2ストリーム逆方向ステップ(各 t ごとのトークン読み出し+連続デノイズ)の計算コストが単一の離散MDMステップと比較してどの程度かも不明です。さらに、k_t に対するカテゴリカル順方向過程が x_t から独立であることは理論的には整合していますが、中間ステップ t における学習目的のトークン予測項が実際にサンプリングされた足場を参照しないことを意味し、学習/テスト間の非対称性として検討に値します。
なぜ重要か
HC-DLMは、離散拡散言語モデルにおける並列デコードの独立性ボトルネックが、トークン列ではなく連続潜在変数を持続的な生成状態とし、毎ステップでトークンを再読み出しすることで解消できることを示しています。これにより、制約の多いタスクで大幅な性能向上(同等の6Mパラメータにおける最良の適応的MDMに対してhard Sudokuで+22.5ポイント)が得られ、連続拡散と離散拡散を継ぎ接ぎするのではなく統一する、明確な変分フレームワークを提供します。
Source: https://arxiv.org/abs/2610.02193
Adaptive Reward Routing: Dynamic Multi-Reward Optimization for Joint Audio-Video Diffusion via Forward-Process RL
LTX-2のような結合型音声・映像 diffusion モデルは、双方向 cross-attention によって結合された2つの latent ストリームを生成し、複数の目標を同時に満たすように post-training される必要があります。すなわち、各モダリティの知覚品質、クロスモーダルな意味的整合性(音が場面と合っているか)、および厳密な時間的同期です。Multi-reward RL はこの問題に対する自然なアプローチですが、単純な実装では reward の重みと、reward 駆動の gradient が作用するアーキテクチャ上の位置の両方を固定してしまいます。本論文は、これら2つのターゲットが学習中に非定常であると主張し、実験的に示した上で、更新位置と reward の組み合わせを共同で適応させる DiffusionNFT 上の forward-process RL レシピである Adaptive Reward Routing(ARR)を提案します。
動機:同期は移動するターゲットである
著者らは、推論中に層の範囲ごとに cross-attention の K/V 出力をアブレーションし、DeSync を測定することで手法の動機を示しています。層のプロファイルはベースモデルと部分的に学習済みのチェックポイントの間でシフトしており、学習が進むにつれて「同期に重要な」層が移動することを意味しています。
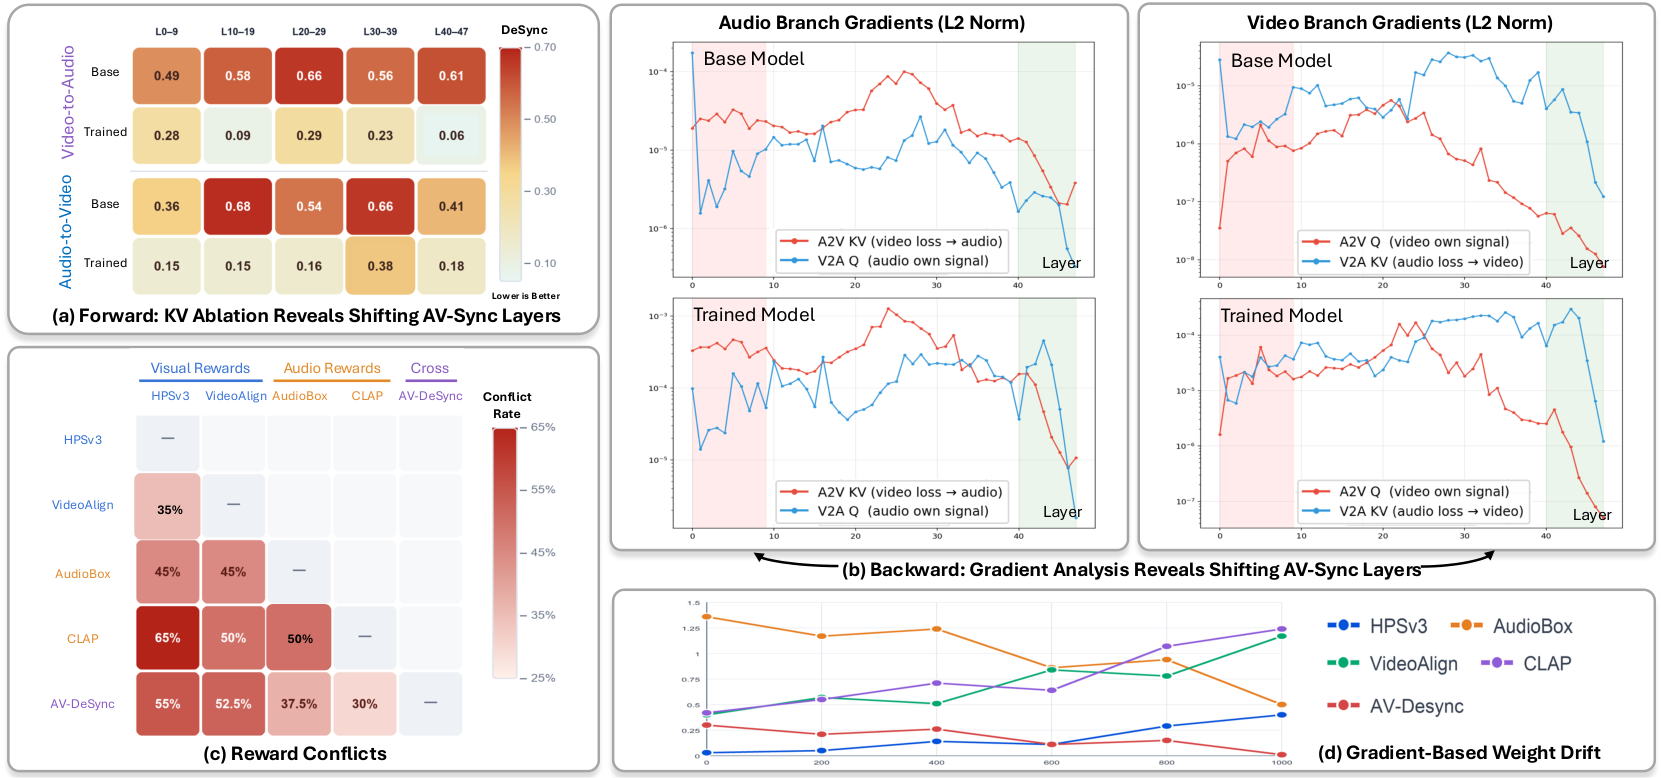
backward 側での gradient 空間の解析も同様の結果を示しています。整合性 reward をどの層に適用すべきかをハードコードした手法では、数百ステップ後にクレジットの誤った経路付けが生じることになります。
設定と記法
LTX-2 は、各モダリティ m \in \{v,a\} に対して共有タイムステップのもと、線形 flow-matching latent x_t^m = (1-t)x_0^m + t x_1^m(ただし x_1^m \sim \mathcal{N}(0,I))を使用します。2つのストリームはゲート付き cross-attention を介して情報を交換します:
o_{a\to v}^{l,t} = \mathrm{Attn}(Q_v(h_v^{l,t}), K_a(h_a^{l,t}), V_a(h_a^{l,t})),\qquad o_{v\to a}^{l,t} = \mathrm{Attn}(Q_a(h_a^{l,t}), K_v(h_v^{l,t}), V_v(h_v^{l,t})).
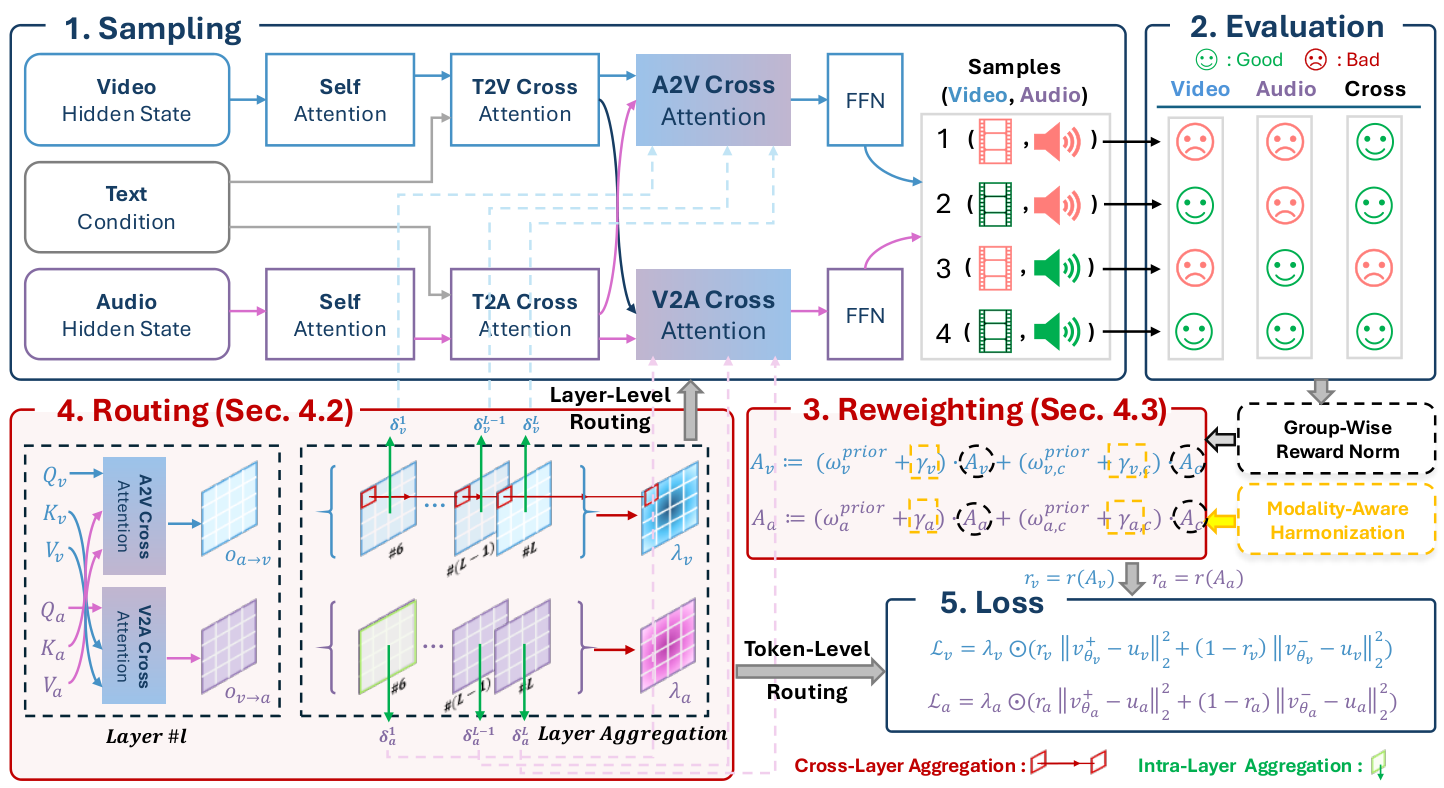
ARR は各 reward k とサンプル n に対する正規化された advantage A_k^{(n)} に作用し、4つの連続するルーティングステージ(論文中の式5)を通じて処理します:
\{A_k\} \xrightarrow{\text{reweight}} \{\omega_{m,k} A_k\} \xrightarrow{\text{branch}} (A_v, A_a) \xrightarrow{\text{token}} \mathcal{L} \xrightarrow{\text{layer}} \nabla_\theta \mathcal{L}.
コンポーネント1:クロスモーダル影響ガイドによるルーティング
核心となる観察は、サンプリングのロールアウト中にゲート前でキャプチャされたゲート付き A2V/V2A cross-attention の出力が、「トークン i、層 l においてモダリティ m' がモダリティ m にどれだけ影響を与えているか」の安価な代理指標になるという点です。本手法はこれらの応答を以下に集約します:
- Token weights \lambda_{m,i}^{(n)}(式7):クロスモーダルの影響をより強く受けるトークンには大きな loss の重みが与えられ、クロスモーダルな結合が実際に重要なトークンにおいてトークンごとの flow-matching loss \ell_{m,i}^{(n)} が強調されます。
- Layer routes \alpha_m^l(式8):各層の K/V パスを流れる gradient をスケーリングするスカラーゲートです。backward パスでは、式9 がこれらのゲートに比例して K/V テンソルを通じて gradient を再ルーティングするため、整合性・同期 reward は固定されたサブセットではなく、現在クロスモーダルな影響を担っている層に実際に作用します。
重要な点として、両方のルーティングシグナルはサンプリング中にすでに生成された量から計算されるため、補助モデル、プローブ、または追加の forward パスは不要です。
コンポーネント2:選好保存型モダリティ対応再重み付け
著者らは、ユーザーの事前の選好を破壊することなく、競合する reward(映像品質、音声品質、整合性、同期)を組み合わせることを目指しています。彼らはスムージングされたモダリティごとの gradient 競合統計量 \bar\gamma_m をキャッシュし、ウォームアップ後に定期的に(「リフレッシュラウンド」ごとに)各 reward の gradient をその担当 branch を通じて一様な token 重みのもとで測定するプロービングステップを実行します。これらのプローブは、branch ごとの MARBLE 問題に入力され、その解として更新された \bar\gamma_m が得られます。式10 はその後 \bar\gamma_m を、事前定義された選好順序を保ちながら競合を軽減するような reward ごと・モダリティごとの重み \omega_{m,k} に変換します。
branch ごとに集約された advantage A_m^{(n)} = \sum_k \omega_{m,k} A_k^{(n)}(式11)は DiffusionNFT の reward サロゲート r_m^{(n)} = r(A_m^{(n)}) に代入され、token 重み付き loss \ell_{m,i}^{(n)} はモダリティごとの policy loss \mathcal{L}_m^{\mathrm{policy}} と総損失 \mathcal{L}(\theta)(式12–14)に結合されます。Backprop は式9 のルーティングされた K/V パスを通じて行われます。
実験
ARR は LTX-2(19B)と LTX-2.3(22B)に適用されており、いずれもルーティングが要求する別ストリーム+ cross-attention の構造を持っています。Post-training には VGGSound から得られた 19,487 件の音声・映像プロンプトを使用し、それぞれモダリティ固有および結合した説明でラベル付けされています。
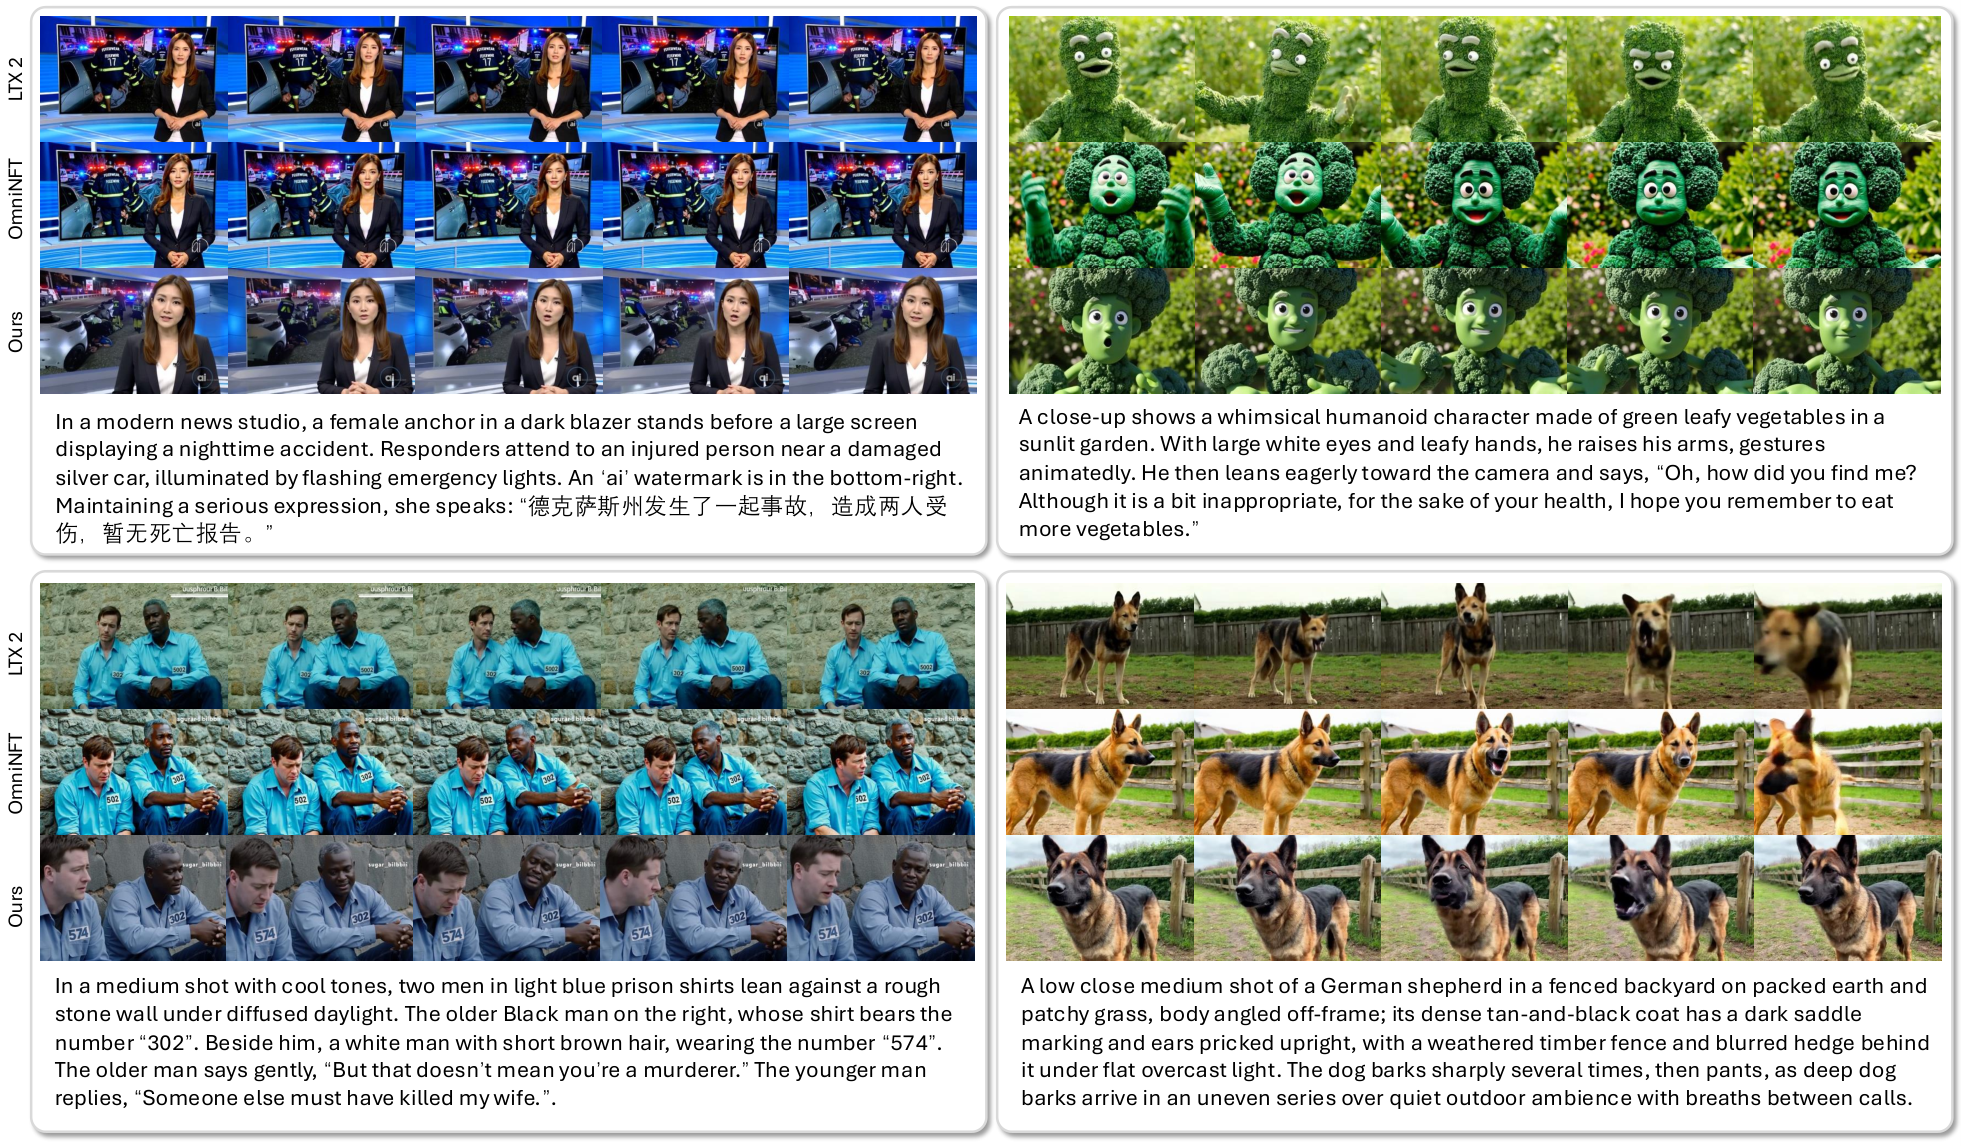
定性的には(図3)、ARR はフレーム間のアイデンティティおよび外観のドリフトを低減し、LTX-2 ベースラインおよび OmniNFT との比較において要求された被写体をより良く保持しています。提供されている抜粋は手法と設定に重点を置いており、完全なテーブルは含まれていないため、定量的な差分(DeSync、整合性スコア、モダリティ固有の品質指標)はここでは再掲しません。正確な改善値については論文の完全なテーブルをご参照ください。
制限と未解決の問題
本手法のクロスモーダル影響代理指標はゲート前の attention 応答によって定義されており、mixture-of-experts ルーティング、クロスモーダル MoE、または attention 以外の結合器(state-space ミキサー)を持つアーキテクチャに対してこの代理指標が有効であるかは不明です。定期的な MARBLE プローブは無視できないオーバーヘッドを加え、安定性が抜粋中で議論されていないリフレッシュ間隔のハイパーパラメータを導入します。さらに、ARR は密接に関連した2つのバックボーン(LTX-2 の変種)でチューニングされており、異なるストリームトポロジーを持つモデル(例:単一タワー統合音声・映像 transformer)への汎化は未解決です。
この研究の意義
Reward ハッキングと reward 競合は生成モデルに対する多目的 RL における主要な失敗モードであり、既存の対処法のほとんどはスカラー重みのレベルでのみ作用します。ARR は、「ネットワークのどこに reward を適用するか」を一級の時変変数として扱い、forward パスにすでに存在するシグナルを使用することで、固定ルーティングでは実現できない安価かつアーキテクチャを考慮したクロスモーダルクレジット割り当ての手段を提供することを示しています。
Source: https://arxiv.org/abs/2609.37200
OneStreamer: ストリーミング映像インタラクションにおける知覚・記憶・能動的応答の統合
問題設定
ストリーミング映像 LLM は、オフライン映像 LLM には存在しないスケジューリングおよびメモリの問題に直面しています。すなわち、証拠はその下流における関連性が判明する前に記録しておく必要があり、応答は証拠が十分になって初めて出力されなければなりません。スライディング視覚ウィンドウはリアルタイムの知覚を実現しますが、長距離のコンテキストを破棄してしまいます。一方、すべての過去の視覚トークンを保持することは計算コストが高く、レイテンシ制約とも相容れません。これまでのストリーミングシステムは、クエリ条件付きメモリ(クエリがストリーム途中で到着したり変化したりする場合に不安定)またはデンスな視覚キャッシュ(コストが高く冗長)に依存していました。本論文では、メモリを、応答を担う同一の因果的 LLM が生成するクエリ非依存のテキストとして再定式化することで、記録と応答を一つの能動的生成プロセスとして共有します。
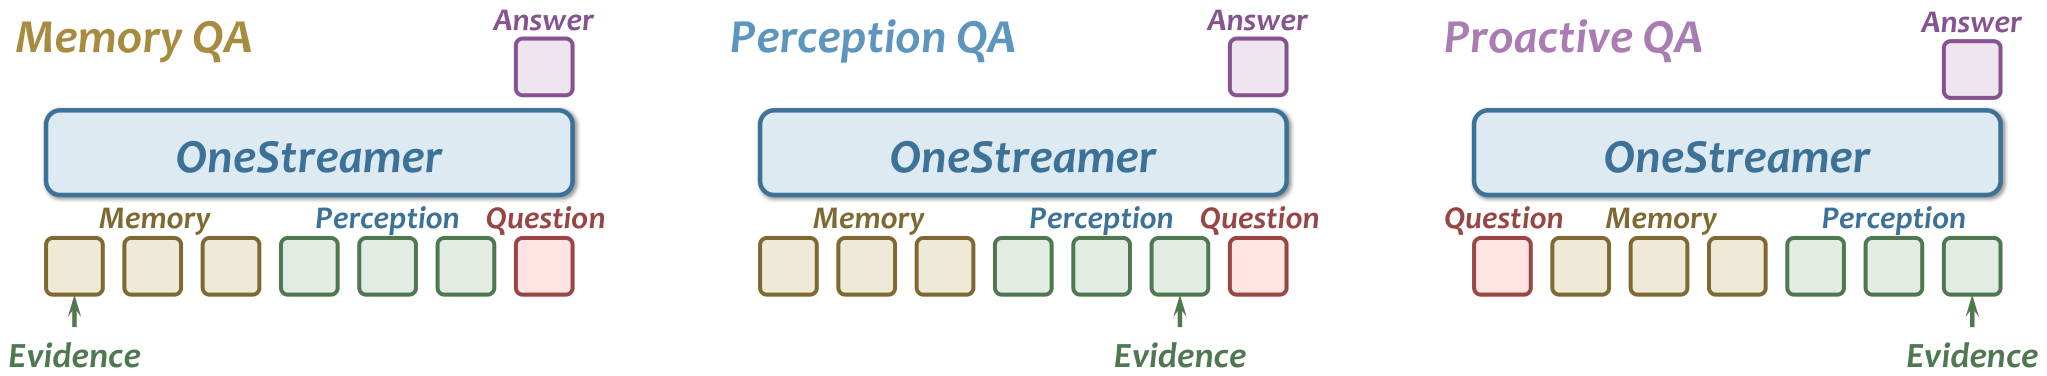
Figure 2 に示す三つのモード — Memory QA、Perception QA、Proactive QA — は、なぜ単一のメカニズムが (i) 過去の証拠からの回答、(ii) 現在のウィンドウからの回答、(iii) 証拠が揃うまでの回答の保留、をすべて網羅しなければならないかを動機づけています。
手法
OneStreamer はクリップを逐次的に処理します。凍結された vision encoder とプロジェクターが視覚トークンを LLM に入力し、直近の N フレームのみが FIFO スライディングウィンドウに保持されます。残りのコンテキストはテキスト、すなわち過去に出力されたキャプションと対話履歴です。各出力アンカーにおいて、LLM は次に何を出力するかを制御する五つの制御トークンのいずれか一つを予測します。
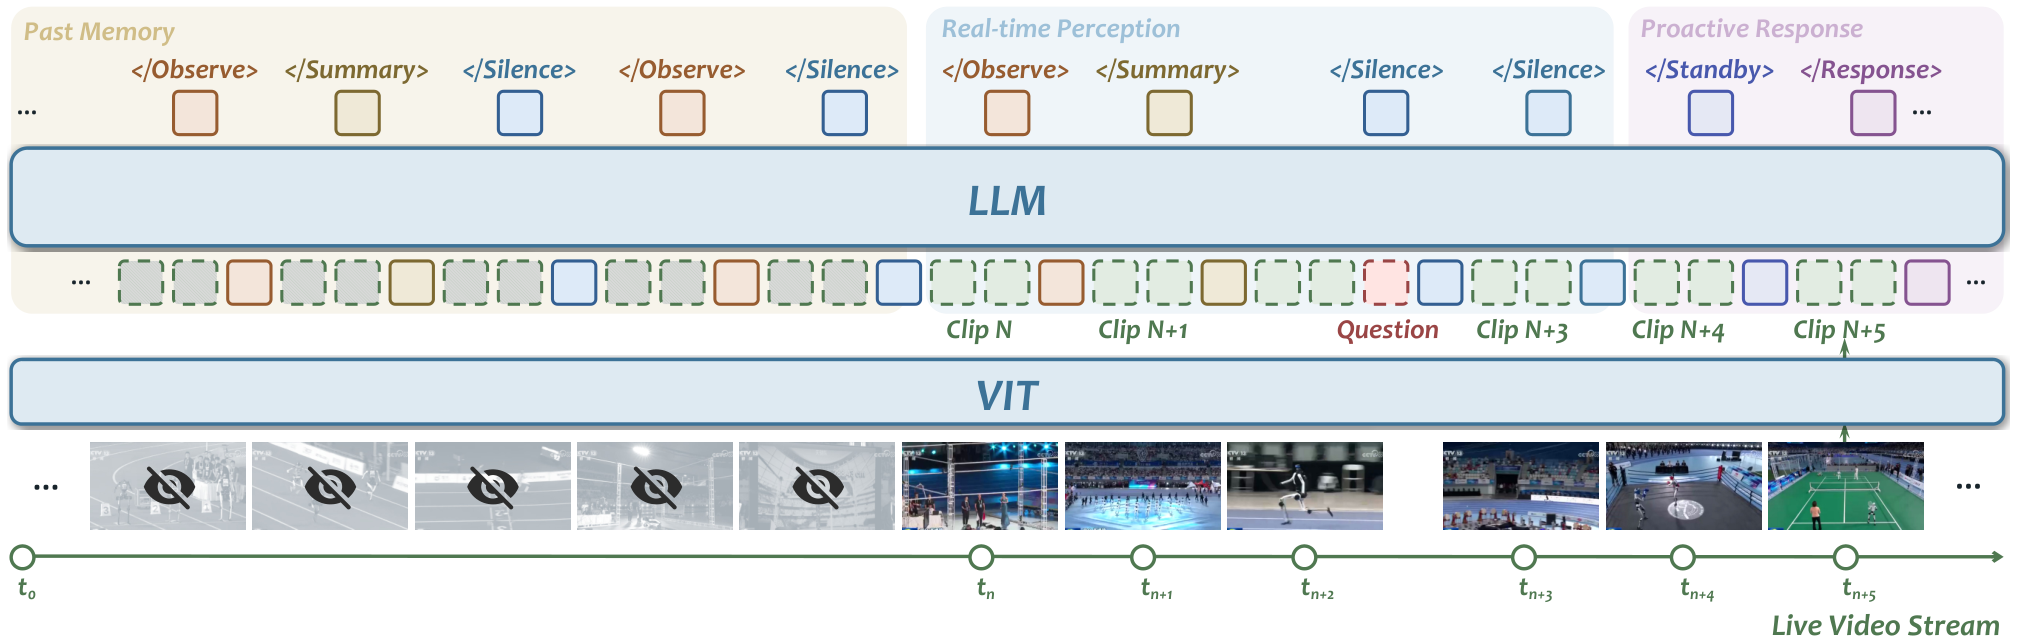
Proactive Hierarchical Caption Memory (PHCM)。 メモリは二種類のトークンによって構成されます。
</Observe>は、直前に観測した時間区間を記述するローカル詳細キャプション(物体、動作、シーン、状態変化)を導入し、その視覚区間の終端で出力されます。</Summary>は、完了したイベントまたはセグメントの意味的要約を導入し、セグメント境界で出力されます。
いずれのキャプションも時刻が付与されテキスト履歴に追記されます。推論時、古いフレームの視覚トークンが FIFO ウィンドウから削除されても、それらの事実内容はテキスト形式で保持されるため、モデルは過去の視覚特徴を再度 attend する必要がありません。
Proactive State Transition Learning (PSTL)。 Proactive QA に対して、三つの制御トークンが使用されます。</Silence>(観測を継続)、</Standby>(関連する証拠が現れつつあるが未だ不十分)、</Response>(ユーザーに見える回答を出力)です。ストリーミング学習において、</Silence> 状態が圧倒的多数を占めます。PSTL は全出力アンカーにおける教師信号を保持しつつ、支配的な待機状態をサブサンプリングする一方で、状態遷移(silence→standby、standby→response)および状態持続を代表するトークンを保持することで、モデルが永続的な沈黙に崩壊することを防ぎます。
ストリーミングデータ合成。 セクション 4 では、証拠に整合した教師信号を生成するパイプラインを説明しています。キャプションについては、シーン変化と視覚的豊かさに基づいて映像をフィルタリングし、Gemini と Seed がタイムスタンプ付きのフレーム/クリップ、セグメント、映像レベルのキャプションを生成します。キャプションは事実的・時間的一貫性について検証され、検証済みのアノテーションは因果的シーケンスに変換されます。ここでフレーム/クリップキャプションはその区間終端における </Observe> ターゲットとなり、セグメントキャプションはセグメント境界における </Summary> ターゲットとなり、最後の </Response> が映像全体の要約を出力します。QA ブランチは、証拠が初めて十分になる時点に応答時刻を較正します。得られたデータセットが OneStreamer-1M です。
学習。 Qwen3-VL-4B-Instruct から初期化し、OneStreamer-1M と LLaVA-Video サンプルを用いてシングルステージ SFT を実施します。vision encoder は凍結し、プロジェクターと LLM を 1 エポック学習します。最大シーケンス長は 131,072、ピーク学習率は 1\times 10^{-5}、32 台の H200 GPU を使用します。
結果
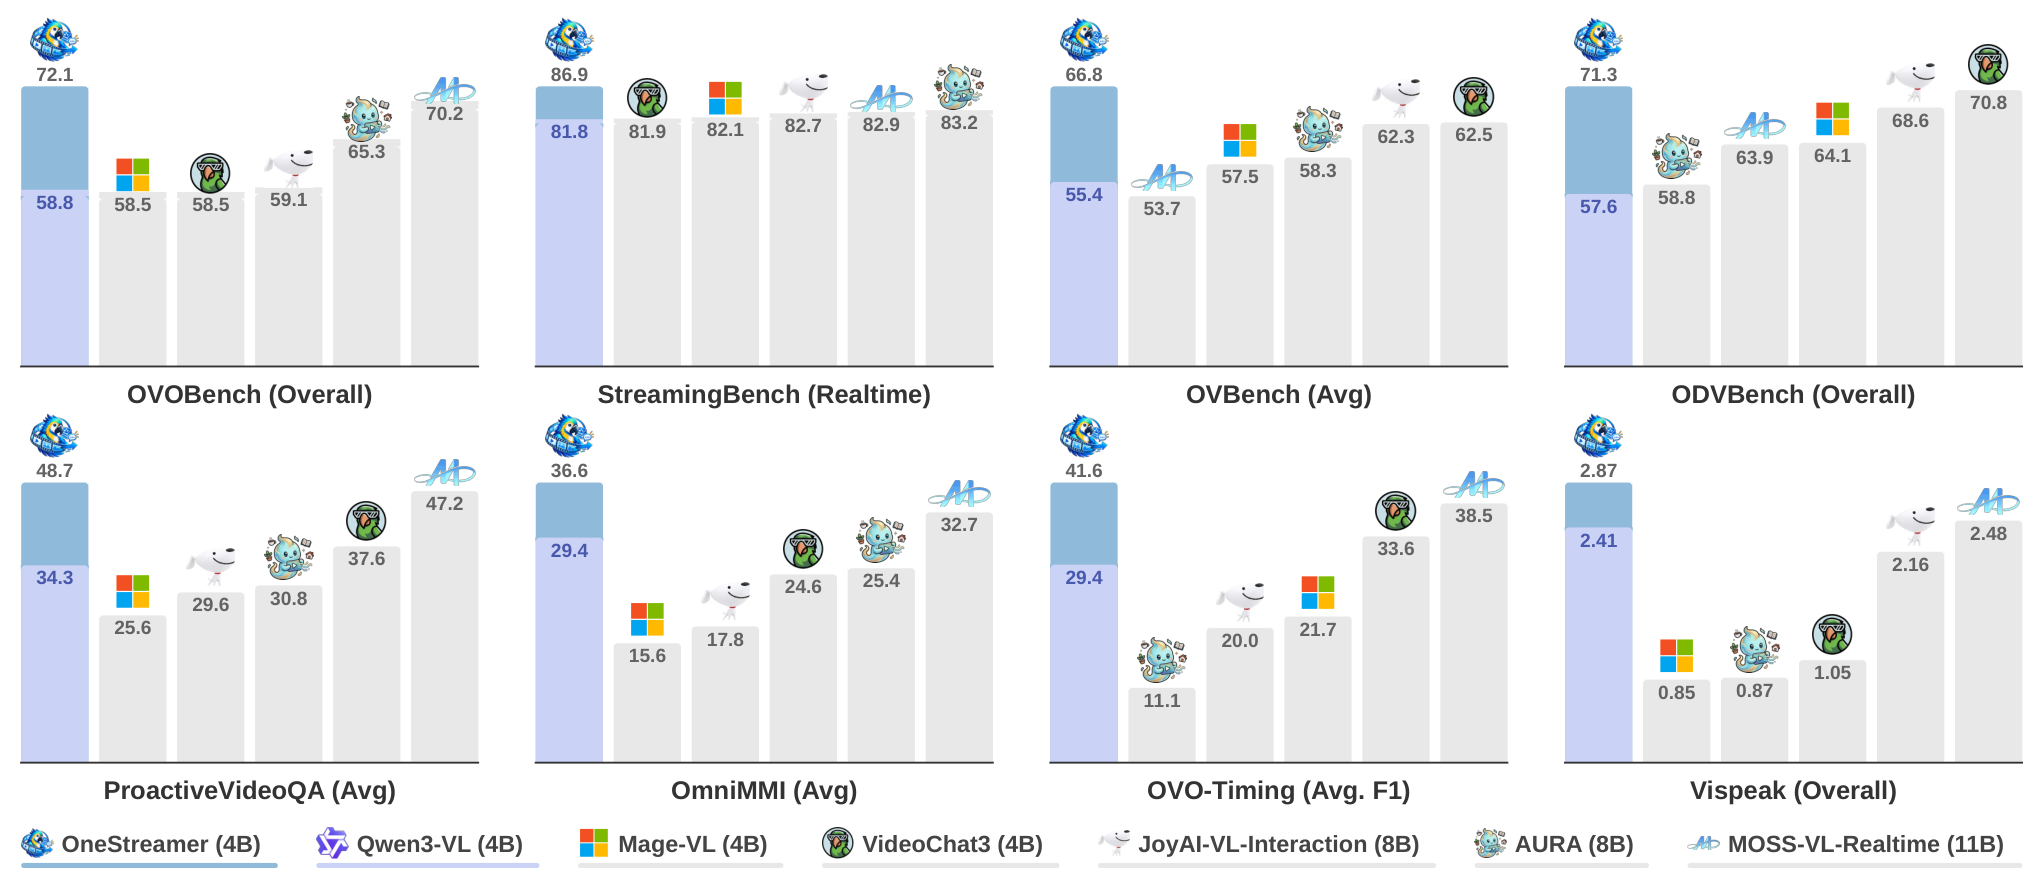
四つの知覚・記憶ベンチマークにおいて、OneStreamer-4B は OVOBench で 72.1、StreamingBench Real-Time で 86.9、OVBench で 66.8、ODVBench で 71.3 を記録しました。Qwen3-VL-4B ベースラインとの差分はそれぞれ +13.3、+5.1、+11.4、+13.7 です。また、同じ四つのベンチマークにおいて 11B の MOSS-VL-Realtime を +1.9、+4.0、+13.1、+7.4 上回っています。MOSS-VL のパラメータ数は約 2.75 倍であることを考えると、これは注目に値します。
四つの能動的応答ベンチマークでは、ProactiveVQA で 48.7、OmniMMI (ASR) で 36.6、OVO-Timing で 41.6、ViSpeak で 2.87 を達成しました。Qwen3-VL-4B に対する差分は +14.4、+7.2、+12.2、+0.46、MOSS-VL-Realtime-11B に対しては +1.5、+3.9、+3.1、+0.39 です。Qwen3-VL ベースラインに対する全八ベンチマークにわたる平均相対改善は 25.0%、各ベンチマークで最強の競合手法に対しては 6.1% です。OVO-Timing F1 の 41.6 は特に示唆的であり、</Standby>/</Response> のスケジューリングが最も重要となる、応答が適切なタイミングで出力されるかどうかを直接評価しています。
制限と未解決の問題
本論文では、提供されているセクションの範囲において PHCM と PSTL とデータ合成を個別に切り離したアブレーションが報告されておらず、アーキテクチャ、学習目標、および OneStreamer-1M コーパスそれぞれへの寄与の帰属が不明確です。テキスト形式のメモリは視覚特徴と比較して情報損失があります(例えば、細かい空間的関係、物体の数、OCR など)。スライディングウィンドウサイズ N とキャプション密度との相互作用についても議論されていません。ストリーミングを主張する上で重要なレイテンシおよびスループットが本論文では定量化されていません。キャプションは Gemini/Seed の教師品質に依存しており、それらのバイアスを引き継ぎます。さらに、Proactive QA はクエリが関連する証拠よりも前に到着することを前提としており、ストリーム途中での話題転換や複数ターンの割り込み動作は OmniMMI/ViSpeak の集計スコアを超えては評価されていません。
意義
クエリ非依存かつ時刻付きのテキストキャプションを同一の因果的 LLM で生成することで視覚 KV キャッシュを置き換えるアプローチは、長距離メモリをリアルタイム視覚バジェットから切り離すクリーンな方法です。そして 4B モデルが全八ベンチマークにわたって 11B のストリーミングベースラインを上回るという結果は、現在のストリーミング VLM におけるボトルネックがスケジューリングと証拠の表現にあり、生のパラメータ数ではないことを示唆しています。
Source: https://arxiv.org/abs/2610.01762
World Observer: Joint Actor-Observer Generation for Persistent World Modeling
問題設定
ビデオworld modelはactor中心型であり、エージェントのローカルビューを条件として、アクション・カメラ制御のもとで未来を予測します。オブジェクトが視錐台(frustum)の外に出ると、その状態に関する直接的な証拠が存在しなくなり、再度ビューに戻ってきた際にモデルはダイナミクスをゼロから再合成しなければなりません。本論文では、これによって生じる4種類の失敗モードを分類しています。すなわち、frame-locked(オブジェクトがピクセル位置に固定される)、lost(二度と戻らない)、frozen(戻るが静止している)、impostor(戻るが状態が不整合)です。
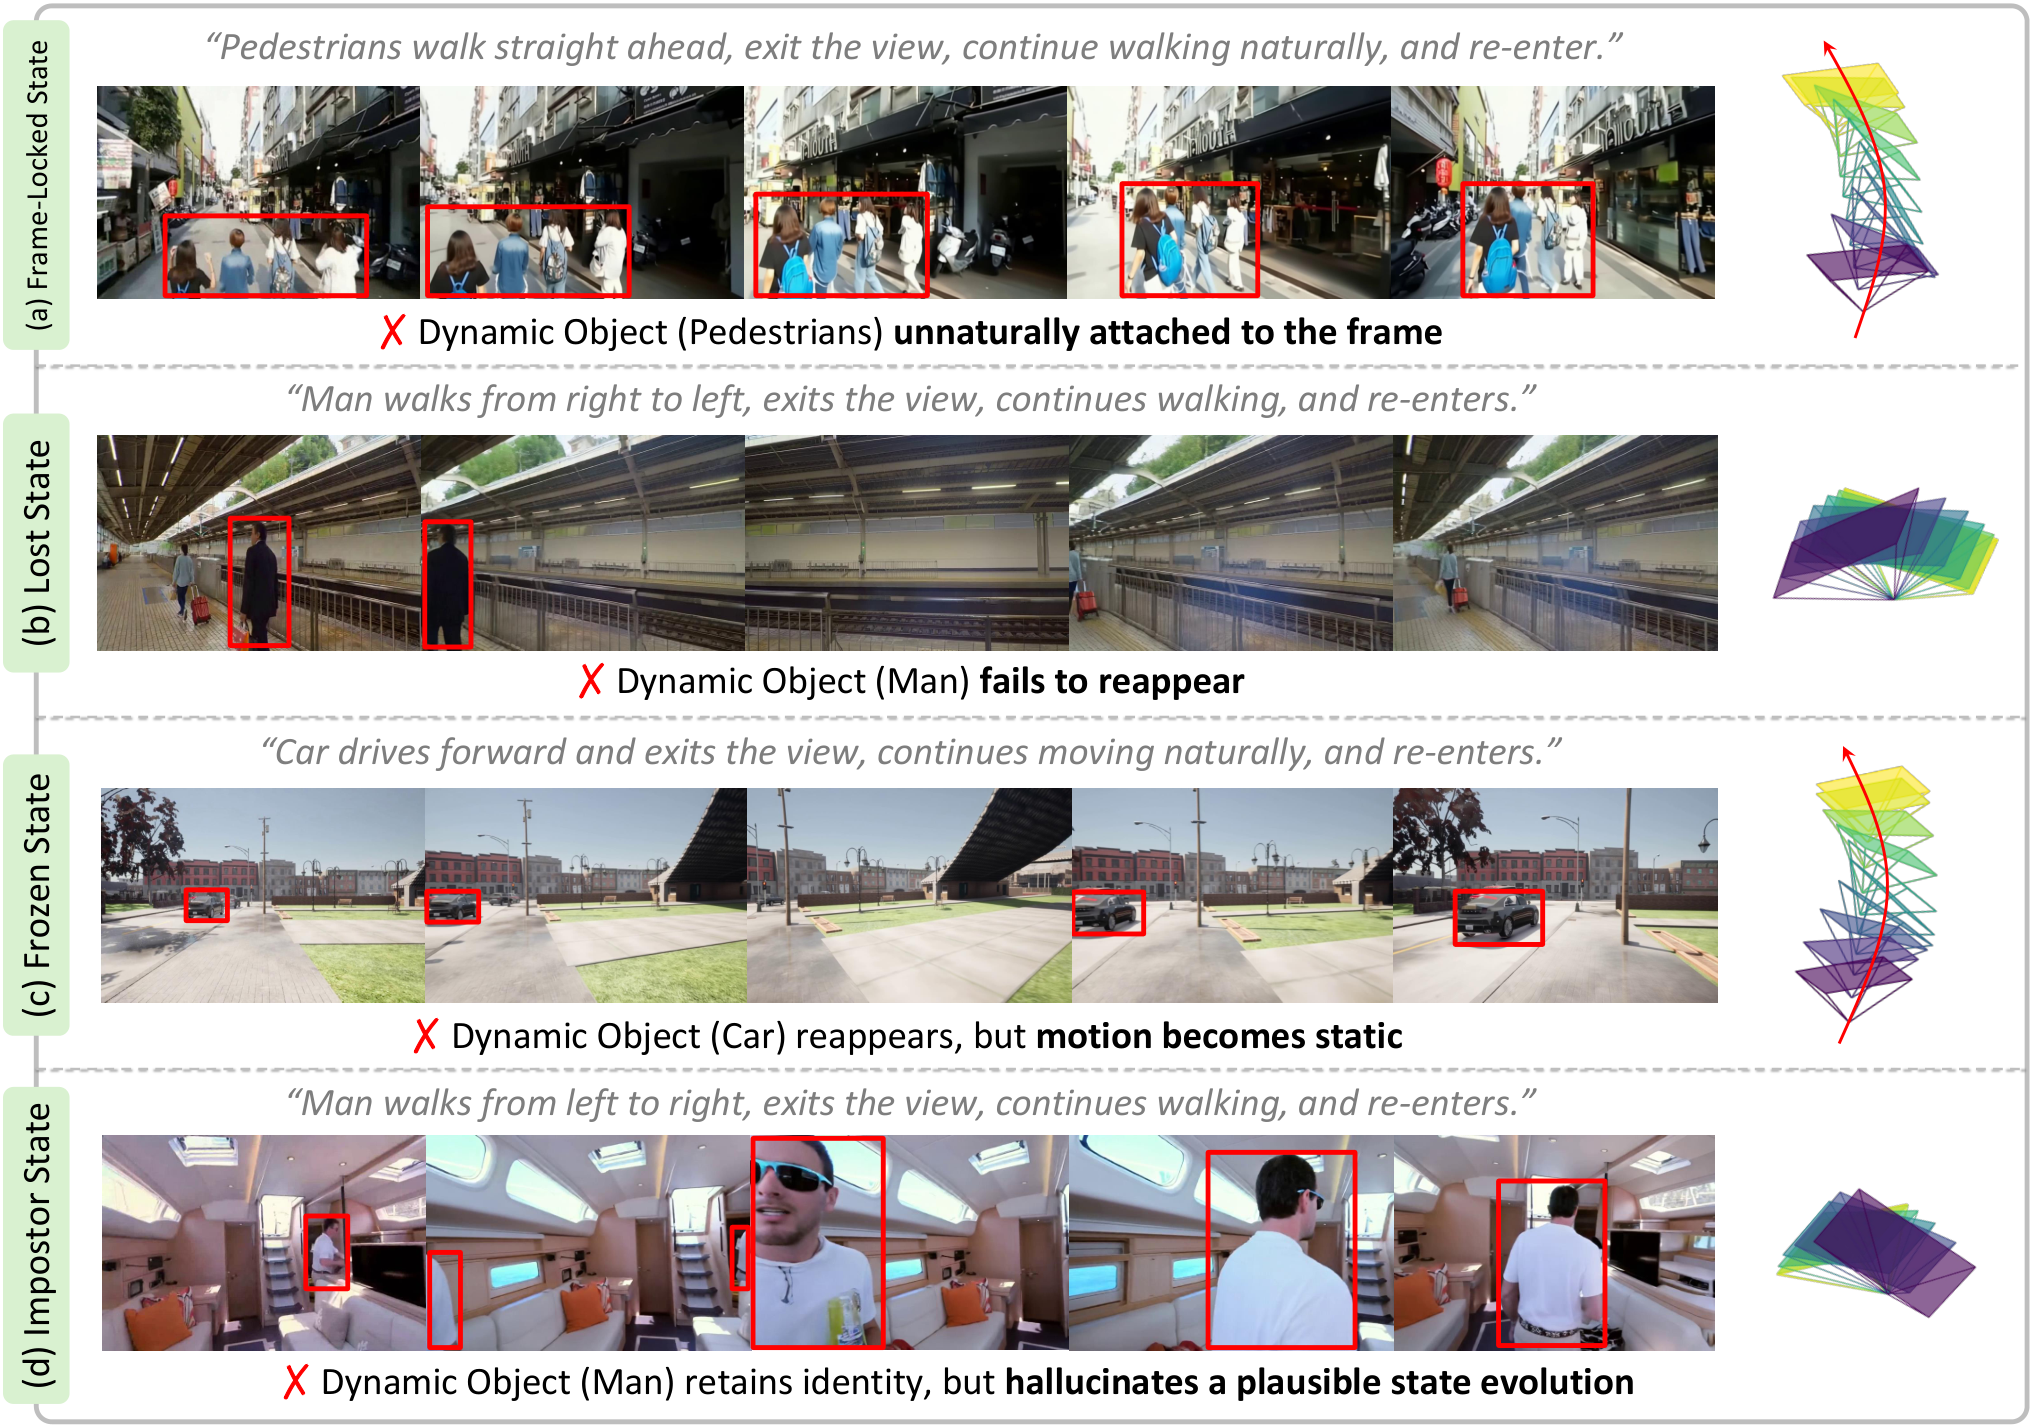
この問題は、永続性を必要とするあらゆる下流タスク、すなわち長期的な計画立案、マルチエージェントインタラクション、または背後の交通が絶えず変化し続けるような自動運転シミュレータにおいて重要な意味を持ちます。
手法
World Observerは観察することと行動することを切り離します。単一の事前学習済みビデオDiT(NVIDIA Cosmosスタイル、3D VAE潜在空間上で動作)が2種類のストリームを同時に生成します。
- actor ストリーム \mathbf{X}^{\mathrm{a}} = \{x^{\mathrm{a}}_t\}_{t=0}^{T-1}:カメラ軌跡 \mathbf{C}^{\mathrm{a}}、prompt \mathbf{P}^{\mathrm{a}}、およびhistory latentsを条件として、エージェントのローカル視点ビューをレンダリングする。
- N 個の observer ストリーム \{\mathbf{X}^{\mathrm{o}_n}\}_{n=1}^{N}:equirectangularパノラマ形式であり、それぞれ独自の \mathbf{C}^{\mathrm{o}_n} と prompt \mathbf{P}^{\mathrm{o}_n} を持つ。
長尺ビデオは T フレームのチャンクを自己回帰的に生成することで得られ、各チャンクは前チャンクの末尾 H 個のlatent \mathbf{Z}^{\mathrm{a}}_{\mathrm{hist}}, \mathbf{Z}^{\mathrm{o}}_{\mathrm{hist}} を再条件として利用します。
View-time alignment。 永続性のための核心的なトリックは位置エンコーディングにあります。ActorとobserverのLatent(それぞれのhistoryも含む)は、共有DiTを通じて1つのシーケンスとして連結されます。学習可能なview embeddingによりどのストリームのトークンであるかがタグ付けされますが、重要なのは、対応するactor/observerのlatentがRoPEの時間軸上で同一の位置を割り当てられることです。したがってself-attentionは、時刻 t のactorトークンと時刻 t のobserverトークンの間で自由に情報を交換できます。これらは同一世界の同一瞬間を表すからです。Figure 5のattention mapは、再入場するオブジェクトへのクエリが、視野外の期間中にそのオブジェクトの状態を保持していたパノラマ領域にattendしていることを示しており、joint生成なしのベースラインではそのオブジェクトが再入場に失敗することが確認できます。
Decoupled prompting。 Actorのpromptはローカルなfrustum内のイベントを記述し、observerのpromptはより広いシーン全体(後方を通過する車両、フレーム外を横断する歩行者、変化する天候など)のイベントを記述します。Observerは独立してpromptされるストリームであるため、受動的な背景としてではなく、エージェントの見えない世界に対して制御可能なハンドルとして機能します。複数のobserverをシーン内の異なる位置に配置することで広いカバレッジを実現でき、パノラマは幾何学的なオブジェクトであるためactorビューに幾何学的に整合した形でワープ可能です。本論文では両ストリームを共有パノラミックソースに基づかせています。
Observer Sink。 別個のモジュールが高解像度の初期パノラマを4つの視点参照に変換することで、損失の多いequirectangular latentから再生成するのではなく、再入場時に細粒度の外観を復元します。
データ
学習には時間的に同期したactor+observerのペアが必要ですが、これはほとんどの場合ネイティブには存在しません。
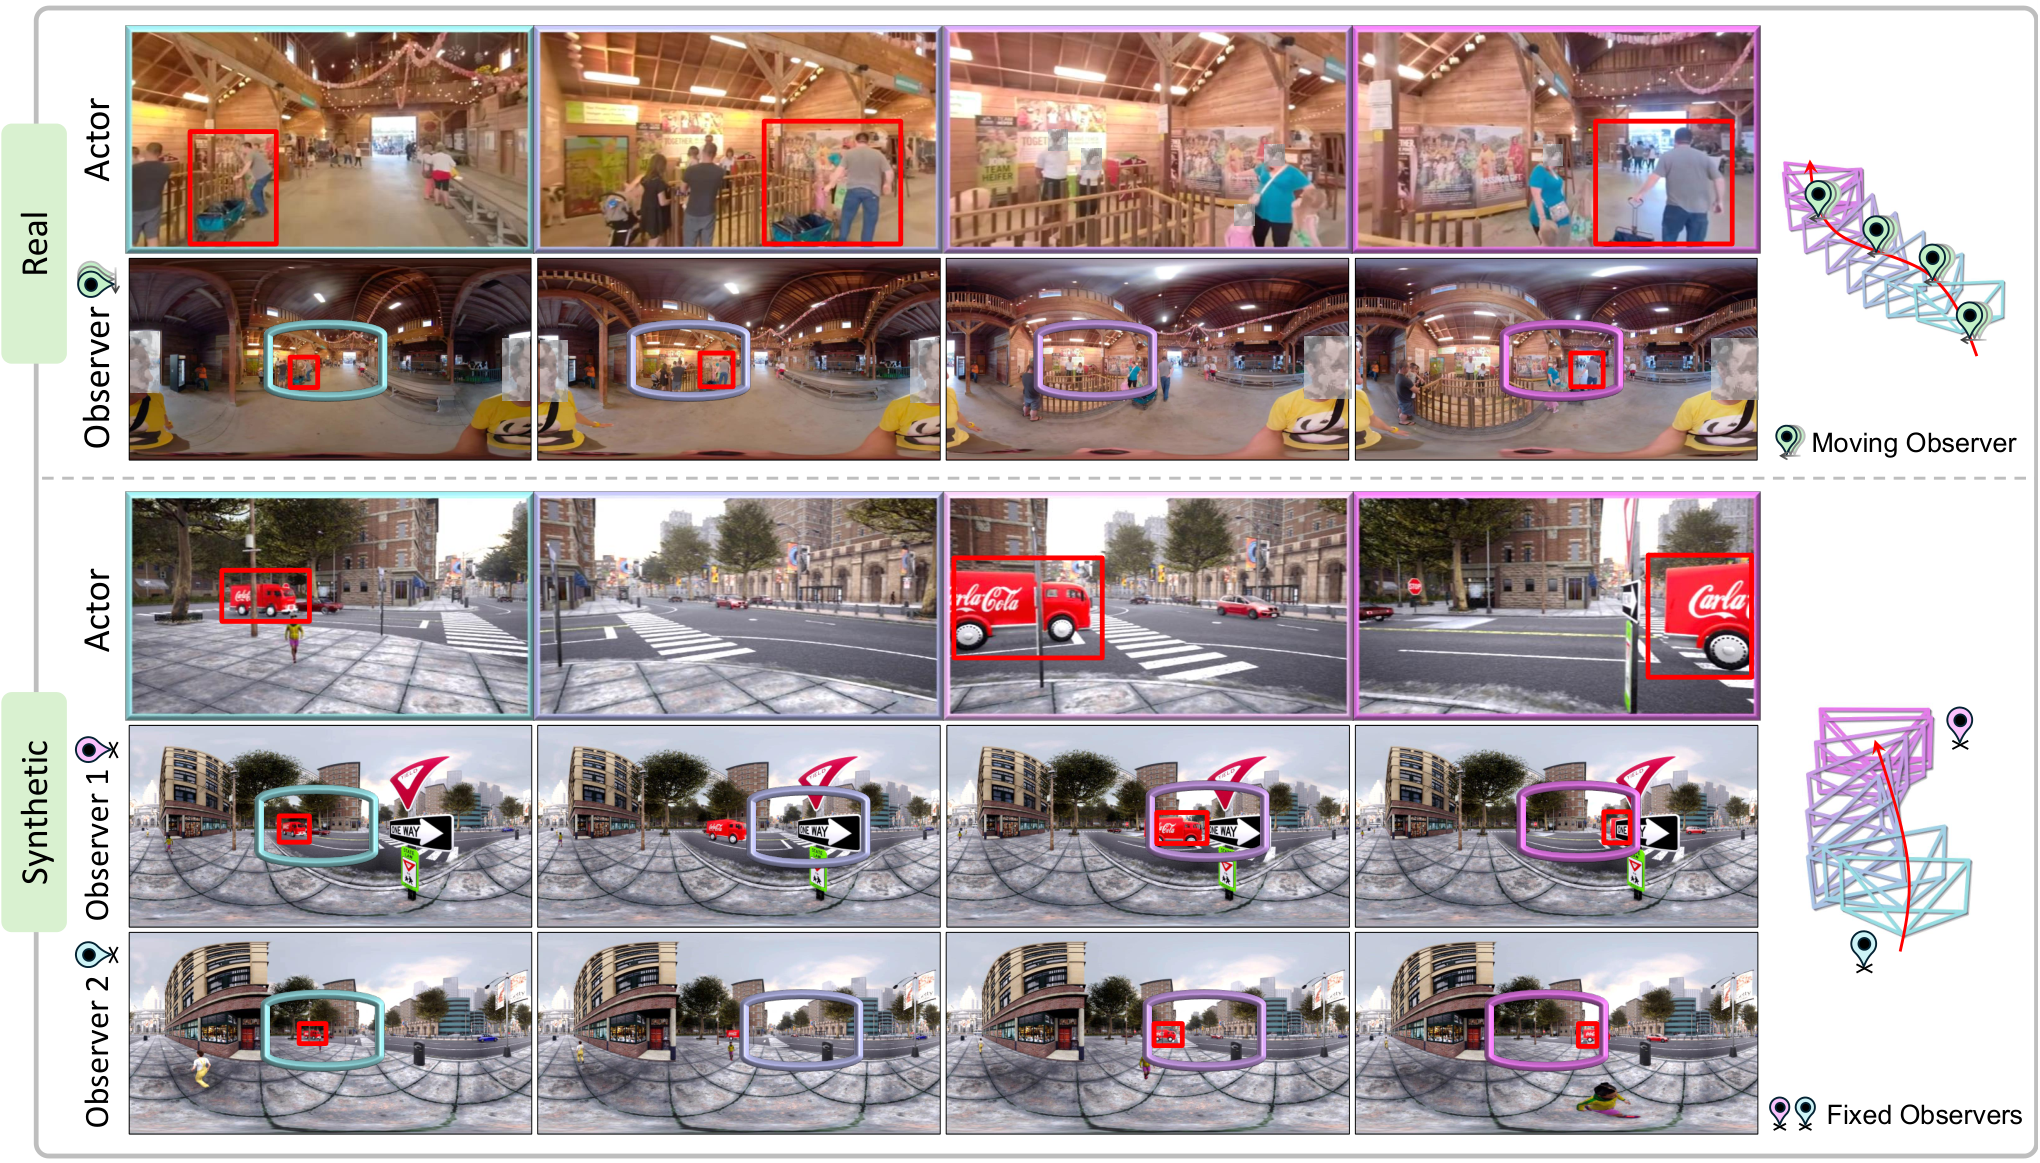
2種類のソースを組み合わせて利用します。(1) 実際のパノラミックビデオコーパスを直立equirectangularシーケンスに安定化し、ランダム化された軌跡のもとで安定化されたパノラマからactorビデオを同期レンダリングします。また、Depth Anything 3が幾何学的条件付けのためのフレームごとの深度を提供します。ここではactorとobserverが同一パノラマから生成されるため、必然的に同じ位置に配置されます。(2) CARLAレンダリングは実データでは得られない構成、すなわちactorから切り離されたobserverやシーン内の異なる位置における複数observerのセットアップを提供します。
評価と結果
既存の評価指標(VLMによる判断、セマンティック類似度)は、オブジェクトがフレーム外にある間に何をしていたかを定量化するのに適していません。本論文では、セグメンテーションモデルとメトリックスケール深度推定器を用いて検出されたオブジェクトを3D空間に投影し、3D位置を時系列追跡することにより、明示的なworld空間メトリクスを導入しています。
- OOV-F は、オブジェクトが実際にground-truthの退場・再入場パターンに従う頻度を計測し、有効な変位が全くないframe-lockedやlostのケースを検出します。
- OOV-D は、視野外での変位がリファレンスとどの程度一致しているかを計測します。\text{OOV-D}_{\text{gt}} はpromptで指定されたダイナミクスと比較(frozen motionに敏感)し、\text{OOV-D}_{\text{self}} は退場前の運動の外挿と比較(impostorの置き換えに敏感)します。
定性的な図(Figure 6)は、この設計によって実現された4つの能力を示しています。すなわち、遮蔽をまたいだ状態メモリ、observerにpromptされた視野外イベントのステアリング、チャンク化された自己回帰による長期生成、そして複数observerによるカバレッジです。引用した抜粋には定量的なテーブルが含まれていないため、ベースラインに対する具体的なOOV-F/OOV-Dの数値はここでは再現できません。
限界と未解決の問題
- パノラミックobserverは方向をカバーしますが、幾何学的な遮蔽(例えば建物の裏側のオブジェクトは同じ位置のobserverからも見えない)には対応できません。複数のobserverを配置することで部分的に緩和できますが、observerの配置ポリシーが必要になります。
- 実世界サブセットにおける共起制約のため、actorから切り離された動作は主にCARLAから学習されており、observerがactorから遠い場合に実世界での忠実度を制限する可能性があります。
- 各observerが共有attentionにおける独立したストリームであるため、計算量は N にほぼ線形でスケールし、大きな N はコストが高くなります。
- 3D投影によるOOVメトリクスはセグメンテーションおよびメトリック深度の誤差を引き継いでおり、特に遠方または小さなオブジェクトに対して顕著です。
この研究の意義
永続性は現在のビデオworld modelにおける欠落した軸です。frustrumの外で世界が存在し続けなければ、actor中心型のジェネレータは計画立案やマルチエージェントインタラクションのシミュレータとして使用できません。パノラミックな周囲環境を共同生成・独立promptingが可能なストリームとして扱い、RoPEアライメントされたself-attentionによってactorと結び付けることは、単一のDiTを再利用し複数のobserverにも自然に拡張できる、簡潔なアーキテクチャ的回答です。
Source: https://arxiv.org/abs/2610.02162
ポストトレーニングにおける Sharpening Tax
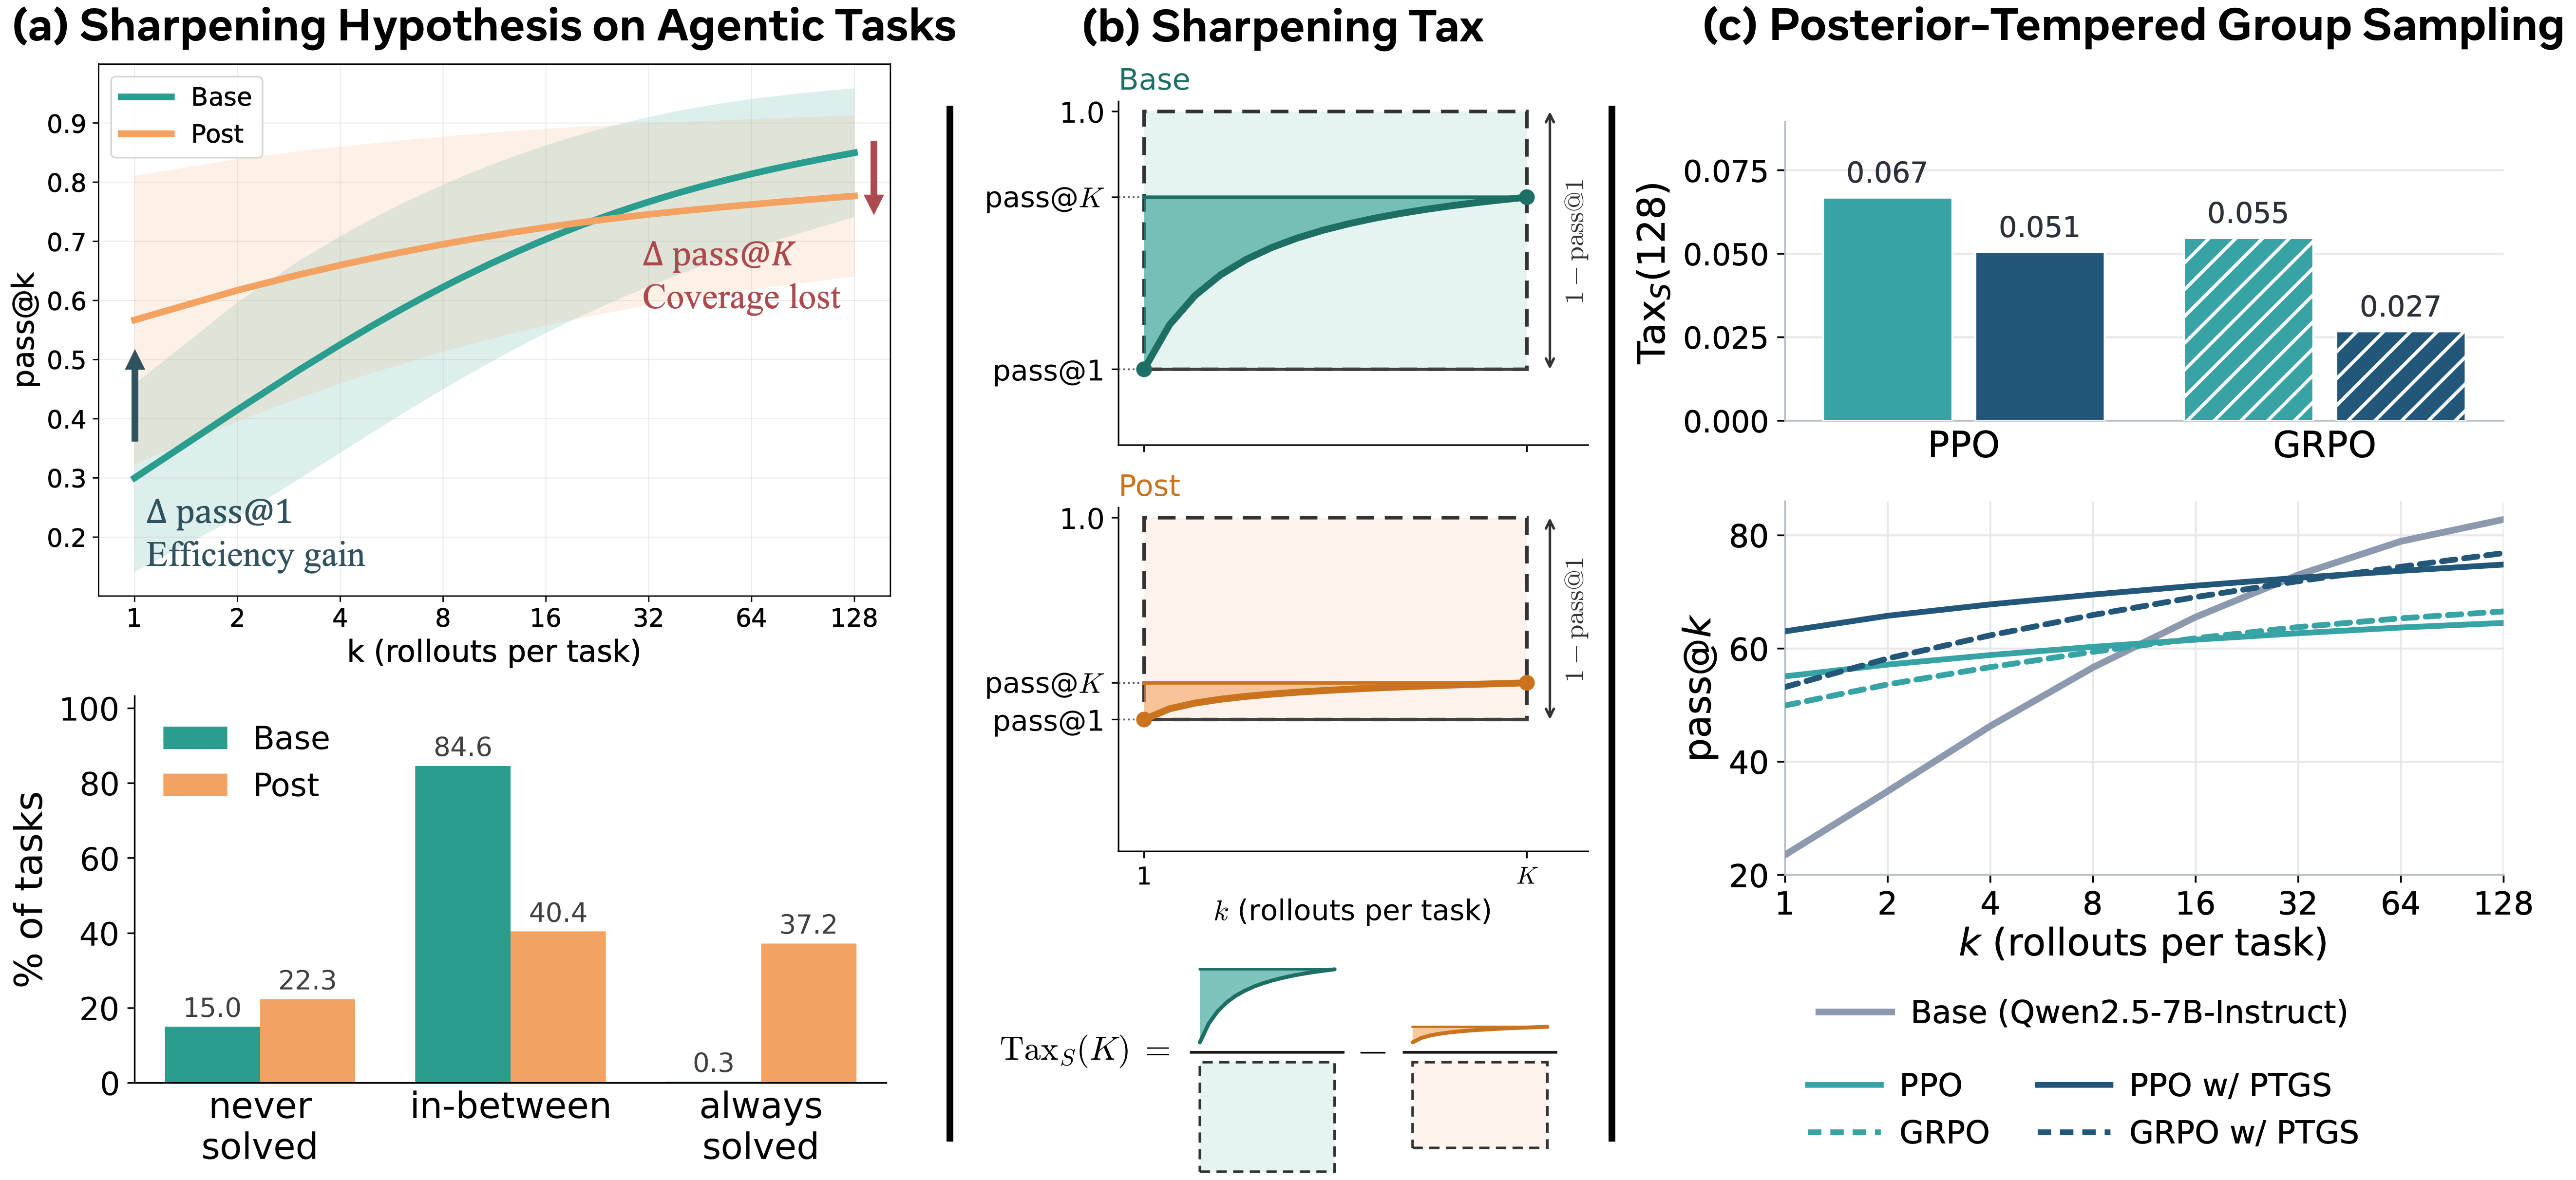
Sharpening 仮説——RL ポストトレーニングはベースモデルにすでに潜在する少数の高報酬モードを増幅し、その他を抑制するというもの——は数学・コード領域において記録されています。本論文は、マルチターンのツール使用がポストトレーニング中にのみ獲得される能力を必要とする可能性があるエージェント的設定において、同じ精度対カバレッジのトレードオフが成立するかどうかを問います。実証的な答えはイエスであり、著者らはそのコストを Sharpening Tax と呼ぶ診断指標によって形式化しています。
ハーネスを用いたエージェントとしてのベースモデル
最初の観察は、事前学習済みモデルが軽量なスキャフォールディング(システムプロンプトと緩和されたツール呼び出し・パース——本質的には Yang et al. 2024b の ReAct スタイルのセットアップ)を与えられれば、有能なエージェントとして機能するという点です。このハーネスはデータセット非依存かつモデル非依存です。Gemma-4、Ministral-3、Qwen2.5、Qwen3.5 の 8 つのベースモデルを平均すると、ハーネスは BFCL の pass@1 を 5.59 \to 15.63、pass@32 を 15.19 \to 49.13 に向上させ、WebShop の pass@32 は 39.48 \to 49.15 に向上し、ACEBench はすでに飽和しておりほとんど変化しません。注目すべきことに、同じハーネスはポストトレーニング済みモデルに対しては悪影響を与えており、プロンプトエンジニアリングが instruction tuning と非自明な相互作用を持つという見方と一致しています。
ハーネスを装備したベースモデルとポストトレーニング済みの対応モデルを比較すると、一貫した pass@K の交差が生じます。WebShop では、gemma-4-31B のベースモデルが pass@128 で 85% を超える一方、RL チューニング済みバージョンは約 56% で頭打ちになります。交差バジェット k^\ast はスケールとともに縮小し、Gemma-4 において 4B では k^\ast > 128 であったものが 31B では k^\ast \approx 3 に崩壊します。言い換えれば、ベース能力が向上するにつれて、カバレッジでポストトレーニングが勝る領域はほぼ完全に消失します。
Tax の形式化
pass@K 曲線を読み取る代わりに、著者らはスカラーの要約指標を提案します。バジェット K において、生のスケーラビリティを pass@K 上限の下の面積として定義します:
A(K)=\sum_{k=1}^{K-1}\bigl[\text{pass}@K-\text{pass}@k\bigr],
そして、シングルショットの失敗ヘッドルームで正規化された較正バージョン:
S(K)=\frac{A(K)}{(K-1)(1-\text{pass}@1)}\in[0,1].
バジェット K における Sharpening Tax は単に \text{Tax}_X(K)=X_{\text{Base}}(K)-X_{\text{Post}}(K)(X\in\{A,S\})として定義されます。正の Tax は、ポストトレーニングが利用可能なテスト時スケーリングの傾きを低下させたことを意味します。
命題 1 は確率論的な解釈を与えます:H を最初に成功したロールアウトのインデックスとします。すると A(K)=\mathbb{E}[(H-1)\mathbf{1}\{H\le K\}]、すなわちバジェット内での成功に先行する失敗試行の期待数です。最初の試みで解けるタスクや全く解けないタスクは寄与ゼロとなります。したがって正の Tax は、ポストトレーニング済みポリシーの成功がリトライにより依存しないことを意味します——失敗した最初の試みが回復されない(カバレッジの喪失)か、より少ない試みで回復される(より速い飽和)かのいずれかです。付録の Corollary 4 はこの Tax をまさにこれら二つの軸に沿って分解しています。
定理 2 はこれを二峰化と結びつけます。タスクごとの成功率を p_x\in[0,1]、ロールアウトを条件付き独立としてモデル化すると、タスクごとの生スケーラビリティ a_K(p)=\sum_{k=1}^{K-1}[(1-p)^k-(1-p)^K] は (0,1) 上で正、端点でゼロとなります。ポストトレーニングがタスクの \lambda 割合を p=0 または p=1 へ崩壊させた場合、スケーラビリティは比例して低下します。これは実証的に観察される「常に解かれるかまたは決して解かれない」という二峰性と一致します。
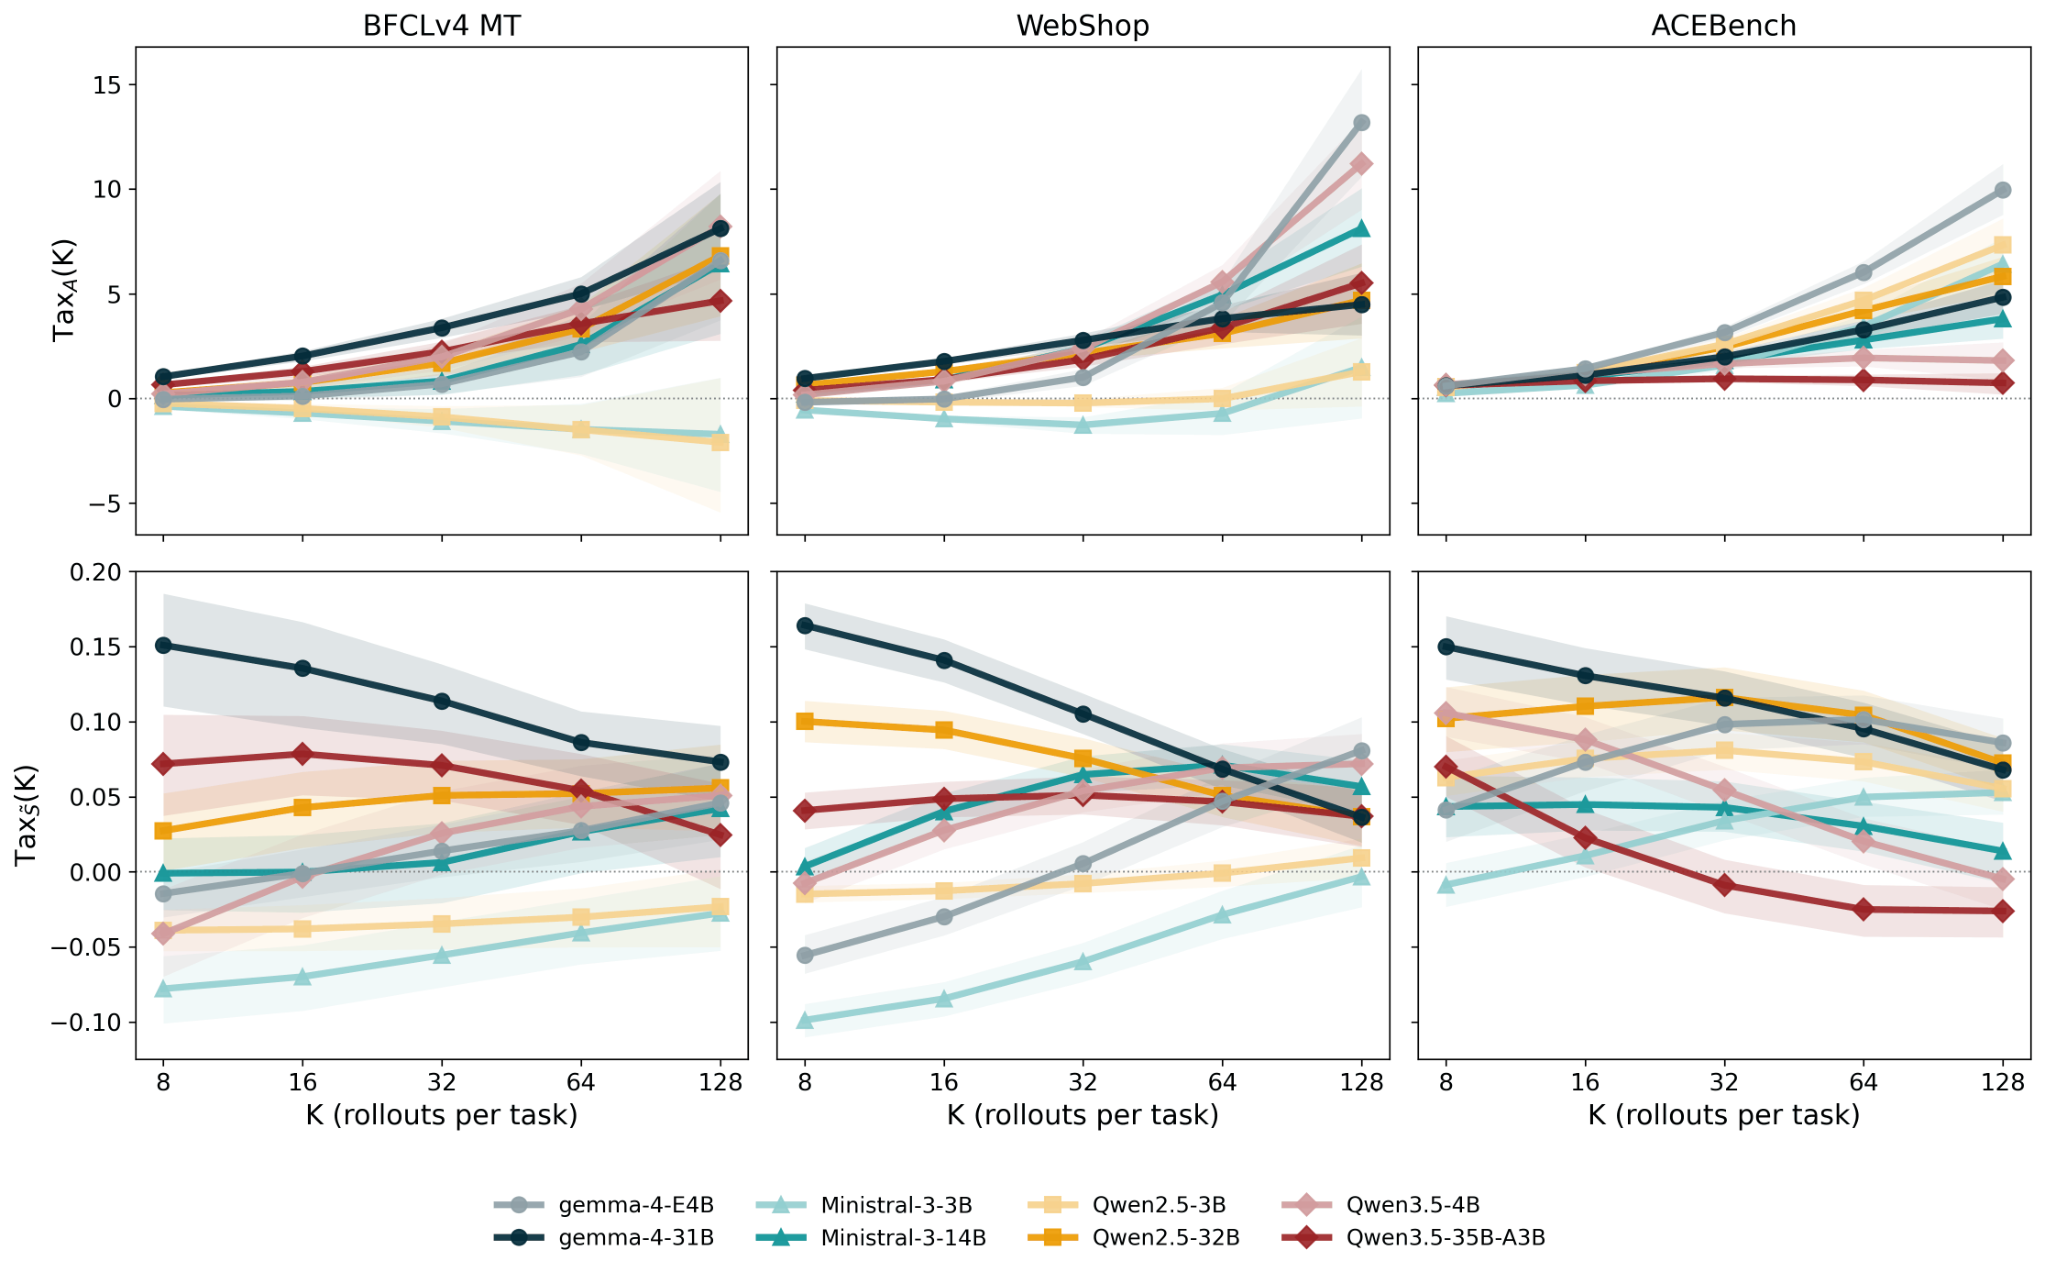
14 のベース/ポストトレーニング済みペアと 3 つのベンチマーク(合計 42 の組み合わせ)にわたって、\text{Tax}_S(128)>0 は 42 ケース中 36 ケースで成立します。最大のバックボーン(例:gemma-4-31B)では Tax はほぼ全ての k で正であり、スケールとともに増大します。最小のバックボーン(例:Ministral-3-3B)では k\le 8 で Tax がしばしば負となり——コンピュートが厳しく制限されている場合には sharpening が確かに有効です——しかし k=128 までには正に転じます。2 つの変種は異なる挙動を示し、\text{Tax}_A は K に対してほぼ単調増加しますが、\text{Tax}_S は (1-\text{pass}@1) による較正のために非単調になることがあります。
緩和策:posterior-tempered group sampling
明白な対処法——サンプリング温度を上げる——は pass@1 と pass@K をトレードオフします。著者らは代わりに、RL トレーニング中に使用するプロンプトごとの適応的な温度調整スキームである PTGS を提案します。
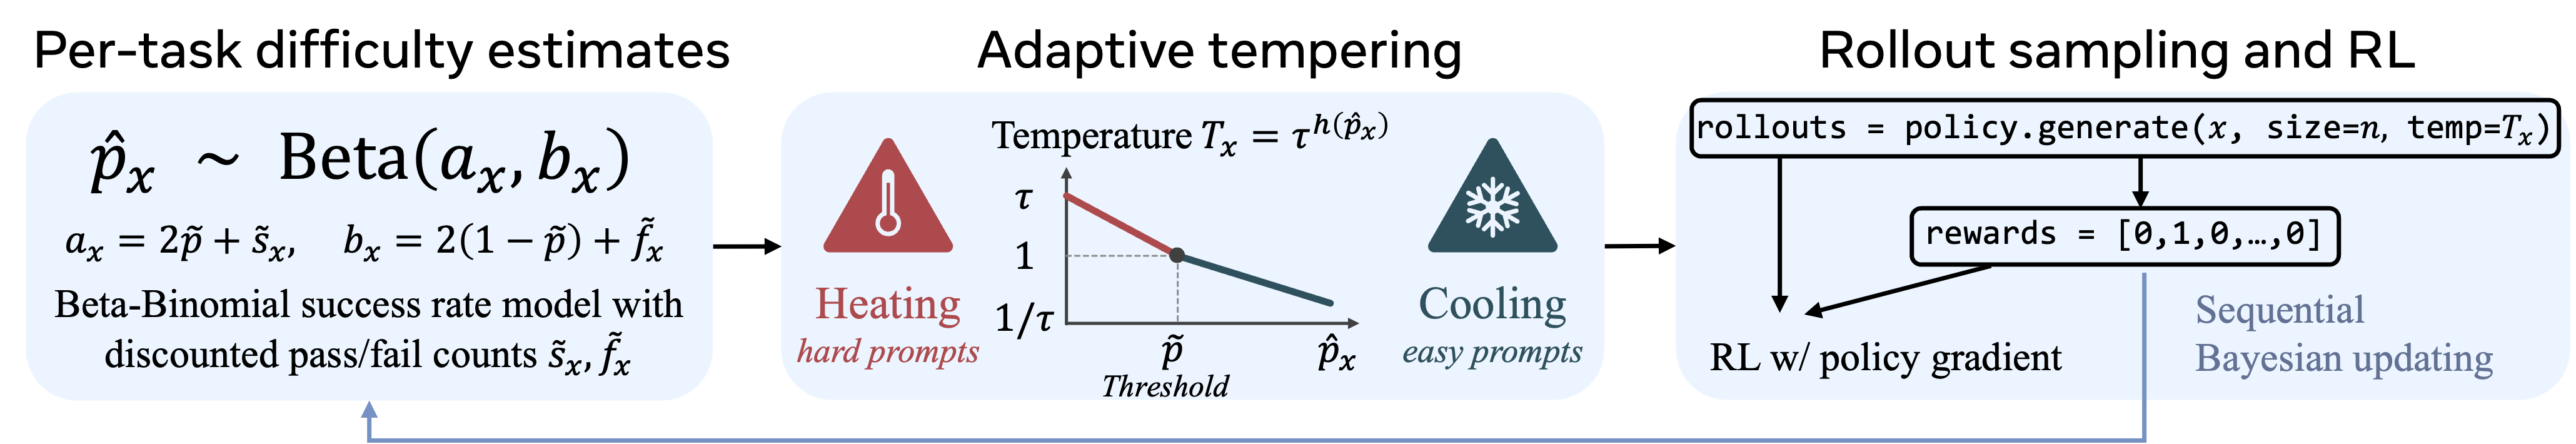
各プロンプト x に対して、忘却係数 \gamma を用いた割引済み成功・失敗カウント (\tilde s_x,\tilde f_x)\leftarrow(\gamma\tilde s_x+s_x,\gamma\tilde f_x+n-s_x) を維持します。目標成功率 \tilde p の周りに Beta 事後分布 \text{Beta}(2\tilde p+\tilde s_x,\;2(1-\tilde p)+\tilde f_x) を形成し、Thompson サンプリングで \hat p_x を得て、ロールアウト温度を
T_x=\tau^{h(\hat p_x)},\quad h(p)=\begin{cases}(\tilde p-p)/\tilde p & p\le\tilde p\\ (\tilde p-p)/(1-\tilde p) & p>\tilde p\end{cases}
と設定します。これにより T_x\in[1/\tau,\tau] となり、難しいプロンプトは加熱(探索)、簡単なプロンプトは冷却(活用)されます。定理 3 は、これが RL が学習するロールアウトグループの情報量を改善すると主張します——成功率 0% または 100% 付近のグループは GRPO スタイルの推定量においてゼロに近い advantage を生じるため、グループ成功率を中間値に向けることで gradient シグナルが増加します。
限界
エージェント的ベンチマークは 3 つ(BFCL、WebShop、ACEBench)であり、また分析は多様なポストトレーニングパイプライン(SFT+RL、DPO など)を単一の「ポストトレーニング済み」ラベルのもとにまとめています。ハーネスは非対称に適用されており(ハーネスありのベースモデル対デフォルトスキャフォールディングのポストトレーニング済みモデル)、これは擁護可能ではありますが、交差をハーネス品質の関数として部分的に規定することになります。Sharpening とベースの p_x との独立性に関する定理 2 の仮定は明快ですが、厳密には成立しにくく——Sharpening はおそらく高 p_x タスクを標的にします。PTGS の実験規模は控えめであり、サンプリング効率とカバレッジのフロンティアがトレーニング時だけでなくエンドツーエンドで実際に改善されているかどうかについては、より詳細な精査が必要です。
なぜこれが重要か
現代の RL ポストトレーニングが系統的に解のカバレッジを pass@1 とトレードオフしており——そしてそのトレードオフがモデルのスケールとともに増大するなら——pass@1 で報告される評価は、安価な推論時バジェットによってベースモデルから回復できる能力を隠していることになります。Sharpening Tax はこのトレードオフに対する一数値の診断指標を提供し、PTGS はデプロイ時ではなくトレーニング中にカバレッジを回復するための具体的なレバーとなります。
Source: https://arxiv.org/abs/2610.01509
ActiveSaddler: エージェントハーネス最適化のための自動カリキュラム学習
問題
自動ハーネス最適化——実行トレースからLLMエージェントのプロンプト、ツールスキーマ、制御ロジックを反復的に更新すること——は、基盤モデルのfine-tuningに代わる実用的なアプローチとして台頭してきました。GEPAスタイルのオプティマイザ、トレースベースのプロンプト修復、ツールインターフェース改善などのシステムは、(i) ハーネスを訓練シナリオで実行し、(ii) 失敗を診断し、(iii) パッチを提案するという流れで動作します。これまでの研究はほぼ完全にステップ(iii)、すなわちより良いパッチを生成する方法に集中してきました。ステップ(i)——有限のロールアウト予算のもとでどのシナリオを実行するか——は固定されたもの、典型的には訓練セットからの一様サンプリング、として扱われてきました。
これが最適でない理由は、教師あり学習やRL訓練において一様なデータサンプリングが最適でない理由と同じです。ハーネスが進化するにつれて、最も有益なフィードバックをもたらすシナリオも変化します。序盤のラウンドでは浅いバグが露呈し、後半のラウンドではより深く稀な障害モードを表面化させる必要があります。ActiveSaddlerは、訓練シナリオの選択をハーネスオプティマイザと連携した自動カリキュラム学習問題として定式化することで、このギャップを埋めます。
手法
著者らはカリキュラム選択を、失敗パターンアーム上の非定常多腕バンディットとして定式化します。重要な抽象化の選択として、アームはシナリオでも単一の失敗トレースでもなく、推定されたハーネスの弱点——単一のパッチで修正される可能性が高く、複数のシナリオにわたって再発しやすい潜在的な欠陥——です。これはオプティマイザが実際に動作する粒度と対応しています。
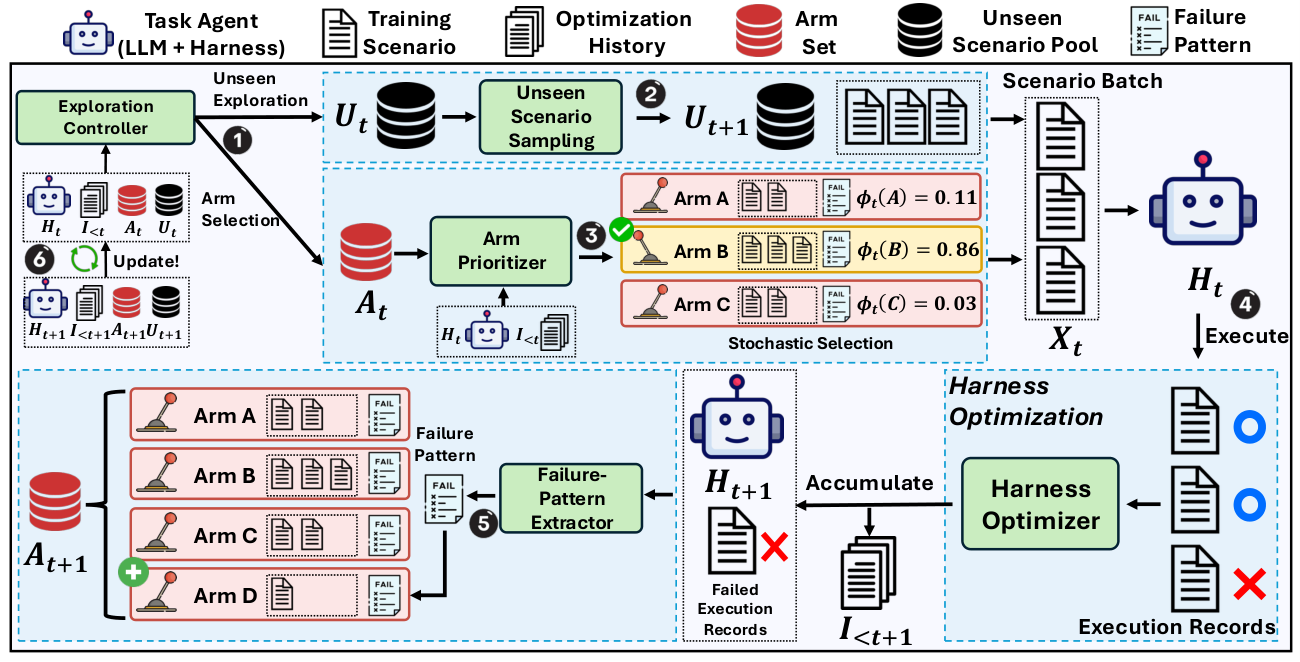
三つのコンポーネントがループを閉じます:
Failure-Pattern Extractor。 失敗したトレースを受け取り、このモジュールは失敗の診断を行い、同一の潜在的欠陥に起因する失敗を共通のアームにクラスタリングします。弱点は観測不可能であるため、これはトレースの証拠に基づく推論問題です。同じ根本原因に帰着する失敗は同一アームの統計に寄与します。アームの集合は事前に固定されておらず、診断によって未知のパターンが特定された場合、新たなアームがインスタンス化されます。
Arm Prioritizer。 インスタンス化されたアームの中から次にどれをターゲットにするかを選択します。暗黙の価値関数はアームに対する学習の進捗——さらなる最適化ラウンドが、そのパターンを示すシナリオにおけるハーネス性能をどれだけ改善すると期待されるか——です。これはGraves et al. (2017) およびMatiisen et al. (2017) による、学習進捗シグナルに対するバンディットとしてのカリキュラムの定式化に従っていますが、アームが固定タスクではなく動的にインスタンス化される点が異なります。
Exploration Controller。 各イテレーションで実行できる訓練シナリオのサブセットは限られているため、未観測のシナリオにはアーム集合にまだ含まれていない失敗パターンが潜んでいる可能性があります。コントローラは、新しいアームを発見するために未観測シナリオに予算を割り当てるタイミングと、既知のアームを再訪して進捗を促進するタイミングを決定します。これは標準的な探索と活用のトレードオフですが、探索が価値推定の精緻化ではなくアーム集合の拡張に機能する点が特徴です。
各イテレーションでシステムは探索とアーム再訪のどちらかを選択し、選択したバッチを実行し、結果として得られたトレースに対してハーネスオプティマイザを実行し、アーム統計(既存アームの進捗)とアーム集合(新たに発見された失敗からの新アーム)の両方を更新します。アーム集合とその優先順位はハーネスと共に共進化します。
ケーススタディからの定性的証拠
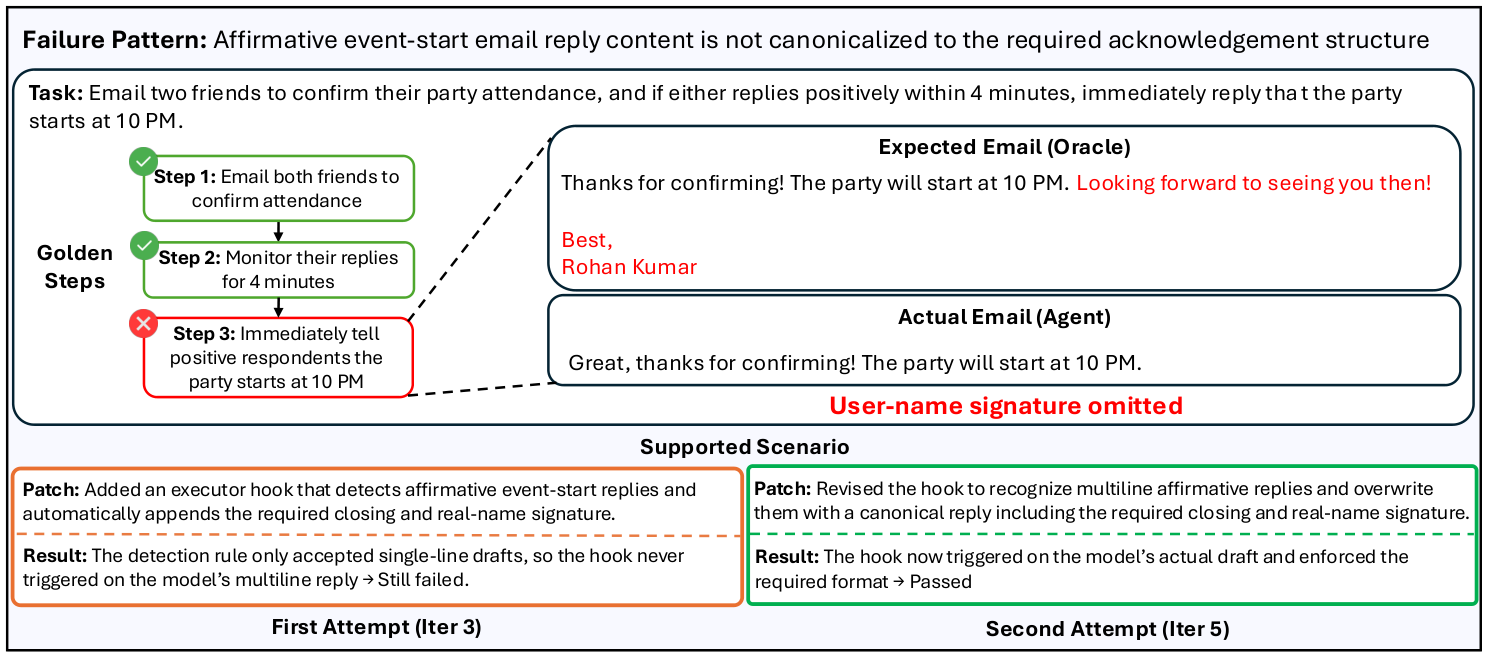
tnxteeのケースは中心的なメカニズムを示しています。失敗パターンをターゲットにした最初のパッチがそれを完全に修復しない場合でも、そのパターンが持続的なアームとして追跡されているため、後のイテレーションが同一アームを再ターゲットしてパッチを洗練させます。一様サンプリングされたシナリオの海に失敗が埋もれてしまうことがありません。
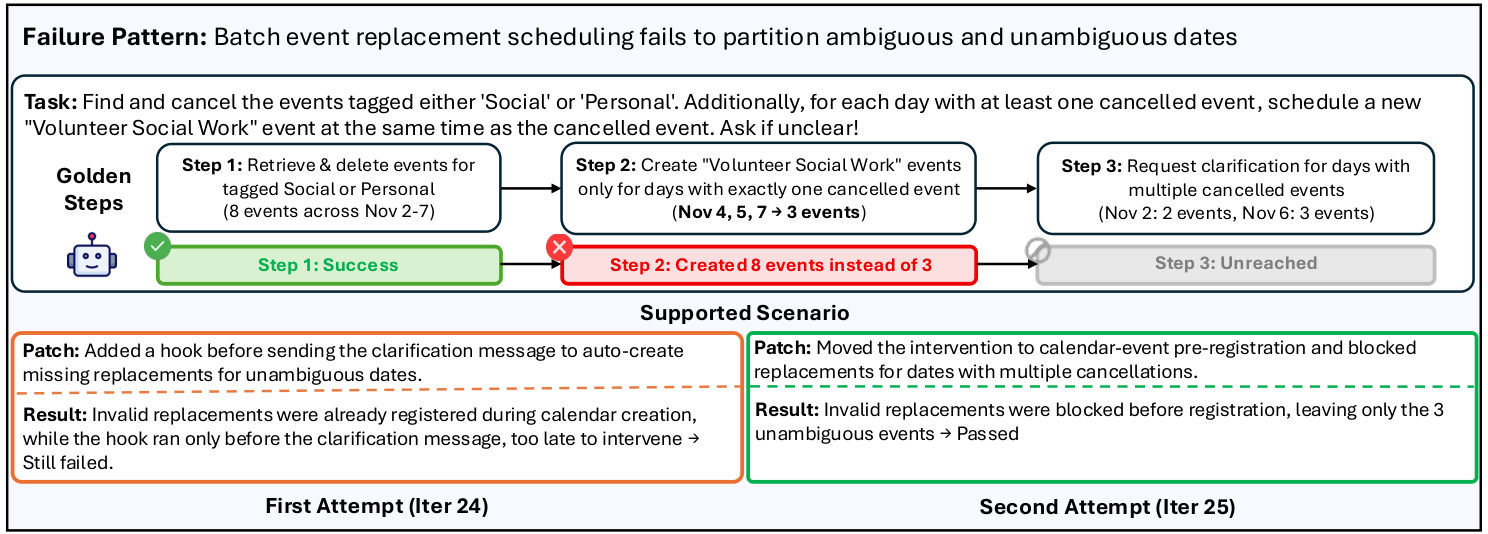
4bytkxのケースでは、再ターゲットによってエグゼキュータフックの配置が修正されています。最初の試みではフックが実行フローの遅すぎる箇所に挿入されましたが、アームの未解決状態によってトリガーされた後続のイテレーションがそれを移動させます。両ケースは、アームの持続性がマルチステップのパッチ精緻化を可能にすることを示しており、一様シナリオサンプリングでは確実に実現できないものです。シナリオが一度「使用」されると、最初のパッチが失敗した際にそれを優先する仕組みが従来のパイプラインには存在しないためです。
評価設定
実験は異なるハーネス体制にまたがる二つのベンチマークを対象としています:
- GAIA2 (Froger et al., 2026):10のUniverseにわたるシミュレートされたスマートフォン環境での汎用アシスタントタスクで、ReActエージェントをベースハーネスとして使用。
- Terminal-Bench 2.0 (Merrill et al., 2026):システム管理、MLワークフロー、サイバーセキュリティにおける89タスクで、Terminus 2をベースハーネスとして使用。
提供された抜粋には主要な数値結果のテーブルが含まれていないため、一様サンプリングやランダムカリキュラムのベースラインとの具体的な精度差はここでは引用しません。
限界と未解決の問題
- 診断品質。 フレームワーク全体が、Failure-Pattern Extractorが失敗を潜在的原因によって正しくクラスタリングすることに依存しています。誤ったクラスタリングは、一つの弱点を複数のアームに分散させて学習進捗シグナルを希薄化させるか、あるいは異なる弱点をマージしてそれぞれを部分的にしか修正しないパッチを生成させます。提供されたセクションでは、Extractorの精度を定量化していません。
- 確率的ロールアウト下での学習進捗推定。 エージェントの実行はノイズが多く、イテレーションごとのサンプル数が少ない状況でアームごとの進捗を推定すると、優先順位の分散が高くなるリスクがあります。ハーネスがその下で変化するためバンディットが非定常であることも、これを複雑にします。
- アーム集合の増大。 アームの無制限なインスタンス化は、めったに訪問されないアームのロングテールをもたらす可能性があります。刈り込みやマージのポリシーについては、この抜粋では説明されていません。
- ハーネス間の転移。 発見された失敗パターンがベースハーネス間(ReAct対Terminus 2)またはベンチマーク間で転移するかどうかは未検証です。
この研究の意義
ハーネス最適化は、モデルの重みが固定されているときにエージェントを改善するための主要な手段になりつつあり、エンジニアリングの労力のほぼすべてがパッチジェネレータに向けられてきました。ActiveSaddlerは、データ側——どのシナリオがフィードバックを促進するか——が同様に一流の設計軸であること、そしてそれをシナリオではなく推定された弱点に対するバンディットとして扱うことが、パッチが実際に動作する粒度とカリキュラムを整合させることを指摘しています。
Source: https://arxiv.org/abs/2610.00906
Hacker News Signals
Context Language Models
Source: https://arxiv.org/abs/2609.37725
本論文は、Context Language Models(CLMs)を提案しています。これは、標準的な次トークン予測の目的関数を再定式化したものであり、プレフィックス全体をフラットなトークン列として扱うのではなく、構造化されたコンテキスト表現に明示的に条件付けることを特徴とします。著者らの核心的な主張は、標準的な自己回帰LMが二つの異なるタスクを混同しているというものです。すなわち、過去のコンテキストを有用な表現に圧縮するタスクと、その表現を与えられた上で次のトークンを予測するタスクです。CLMはこれらを分離するために、セグメントごとに固定次元のサマリーベクトルを生成する学習済みコンテキストエンコーダを導入し、デコーダはローカルトークンウィンドウと並行してcross-attentionによりそのベクトルに注目します。
機械的な仕組みとして、モデルは入力を長さ L のセグメントに分割します。コンテキストエンコーダ(より小規模なtransformer)は完了したセグメントを処理し、コンテキストベクトル c_1, \ldots, c_k を生成します。デコーダはローカルな因果的トークンウィンドウとコンテキストベクトルの集合の両方を条件として利用します。学習目的関数は次トークン予測に対する標準的なcross-entropyのままであるため、補助的なlossは不要です。この分離により、エンコーダを非同期に実行してキャッシュすることが可能となり、長いコンテキストに対する推論コストが削減されます。
このアーキテクチャはRMT、Memorizing Transformers、およびRecurrent Memory Transformerの各変種と類似点がありますが、著者らは、スライディングウィンドウや連続的な再帰ではなく、セグメント境界に整合した明示的なエンコーディングが重要な差別化点であると主張しています。長文書ベンチマーク(PG-19、SCROLLS)におけるperplexityは、同等のパラメータ数を持つベースラインtransformerを上回っており、CLMアーキテクチャはシーケンス長が8kトークンを超えた場合においておよそ8〜12%低いperplexityを達成し、コンテキストキャッシングにより推論時のトークンあたりFLOPsを30〜40%削減します。
制限事項としては、ハードなセグメント境界の仮定が文の途中で分割を生じさせる可能性があること、およびエンコーダによるパラメータオーバーヘッドが挙げられます。数十億パラメータを超えるスケールでも同様の効果が得られるかについては実証されていません。また、キャッシングによる恩恵はセグメントの再利用パターンに大きく依存しており、これはアプリケーション固有のものです。
なぜこれが重要か
構造化されたコンテキスト圧縮は、2次のattentionを必要とせずに長いコンテキストの効率化を実現するための実用的な手法であり、本研究は標準ベンチマーク上で明確なアーキテクチャテンプレートと再現可能な数値を提供しています。
Clef: オープンウェイトな decision model と新しい RL fine-tuning プラットフォーム
Source: https://blog.cloudflare.com/clef-decision-models/
Cloudflare は Clef をリリースしました。これは、ネットワークセキュリティおよびトラフィック分類のコンテキスト(WAF ルールのトリガー、ボット検出、abuse 分類)における二値・多クラス decision タスクに特化して学習された、小規模なオープンウェイトモデルのファミリー(パラメータ数 1B〜8B)です。付随するプラットフォームでは、本番トラフィックのラベルから導出されたタスク固有の報酬シグナルを用いて、これらのモデルの RL fine-tuning が可能になっています。
技術的な位置付けとして、Clef は汎用の instruction-tuned LLM とは区別されています。Clef のモデルは、自由形式のテキストではなく、構造化された decision 入力(HTTP メタデータ、リクエストの特徴量、ルールマッチベクトル)を最初から学習対象としています。入力は表形式の特徴量シーケンスとしてトークン化され、モデルは decision トークンと確信度スカラーを出力します。Cloudflare は RL fine-tuning アルゴリズムとして GRPO(Group Relative Policy Optimization)を使用していると報告しており、このアルゴリズムはロールアウトのバッチ内でアドバンテージを計算することで、別途 critic モデルを必要としません。
A_i = \frac{r_i - \text{mean}(r_{1..G})}{\text{std}(r_{1..G})}
ここで G はグループサイズです。これは DeepSeek-R1 によって推論タスク向けに普及したアルゴリズムと同一であり、ここではグランドトゥルースの abuse ラベルから導出された分類報酬シグナルに転用されています。
オープンウェイトとしてのリリースは注目に値します。Cloudflare はベースとなる decision モデルのモデル重みを Hugging Face 上で公開していますが、RL fine-tuning プラットフォームはマネージドサービスとして提供されているようです。ブログでは、セキュリティの文脈における報酬の疎性という課題についても論じています。多くのリクエストは良性であるため、陽性クラスの報酬シグナルが希少になりやすい問題があります。これに対しては、真陽性シグナルに重みを付けるリワードシェーピングと、確信度スコアを意味のある値に保つための calibration loss を組み合わせることで対処しています。
レイテンシの制約は中心的な課題であり、エッジでの decision は 1ms 以内に完了する必要があります。このことがモデルサイズを制約し、エッジノードでの INT8 量子化を必要としています。
未解決の主な問題としては、攻撃パターンが進化した際にモデルがどのように分布シフトに対応するか、また RL fine-tuning のシグナルがリバースエンジニアリングに利用可能な内部検出ヒューリスティックに関する情報を漏洩しないかどうか、という点が挙げられます。
なぜこれが重要なのか
推論時のエッジスケールにおけるセキュリティ分類への GRPO の適用は、小規模モデルの RL fine-tuning における具体的かつ実用的なユースケースであり、オープンウェイトの公開によってアーキテクチャの監査が可能になっています。
2026年9月にRustコンパイラを高速化する方法
Source: https://nnethercote.github.io/2026/09/30/how-to-speed-up-the-rust-compiler-in-september-2026.html
Nicholas Nethercoteによる月次コンパイラパフォーマンス投稿では、2026年9月までのrustcビルド時間に対する段階的な改善が取り上げられています。この投稿はコンパイラエンジニアリングの領域に完全に属しており、プロファイリング駆動で、rustc-perfベンチマークスイートによって測定されたウォールクロック時間および命令数のリグレッションと改善に焦点を当てています。
今月マージされた主な変更点としては、クエリの重複排除によるexpandおよびresolveパスのコスト削減が挙げられます。複数のマクロ展開クエリが、誤ったキャッシュキーの構築によって冗長に再評価されていました。これを修正することで、いくつかのインクリメンタルベンチマークにおいて1.5〜3%のウォールクロック時間の改善が得られました。また、LLVM IR生成のオーバーヘッド削減に関する取り組みもあります。MIRからLLVM IRへのlowering時に出力される冗長なalloca命令を削除することで、LLVM自身の最適化パスの作業量を削減することが議論されています。
注目すべき構造的変更として、並列フロントエンドコンパイル(-Z threads)の進展があり、stableに近づきつつあります。スレッディングモデルは、typeckおよびborrowckパスにおける独立したアイテムに対するクレート内並列処理にRayonを使用しています。この投稿では、DepGraph上のクエリシステムのグローバルロックに競合が集中しており、現状では同期のオーバーヘッドによって実際のほとんどのクレートで4スレッドを超えたスケーリングが制限されていることが指摘されています。
また、cargoレベルの改善についても触れられています。ドキュメントコメントのみが変更された場合に不要なフルリビルドを避けるためのフィンガープリンティングの改善であり、これは大規模ワークスペースにおける継続的な不満点でした。
ベンチマークの方法論では、ノイズを減らすためにcachegrindによる命令数を主要メトリクスとして使用し、ウォールクロック時間は補助的なシグナルとして使用しています。perf.rust-lang.orgのダッシュボードはPRごとにリグレッションを追跡し、マージ前にパフォーマンスの低下を検出します。
これらの投稿の段階的な性質自体が示唆に富んでいます。コンパイル時間の改善は、単一の大きな勝利のない、持続的な数年にわたる取り組みであり、独自の最適化コストを持つ別途開発されたバックエンド(LLVM)を含む複雑なマルチパスパイプラインの慎重なプロファイリングが必要です。
なぜこれが重要なのか
rustcのコンパイル時間は依然として採用における大きな摩擦要因であり、並列フロントエンドの取り組みとクエリ重複排除の修正は、単発のパッチではなく構造的な進歩を示しています。
OpenDLSS: NvidiaのDLSS 5ニューラルレンダリングネットワークのVulkan再実装
Source: https://github.com/maanHimself/OpenDLSS-NR
OpenDLSSは、Nvidia独自のバイナリを使用せずにDLSS 5のNeural Renderingコンポーネントの機能を再現することを目的とした、ニューラル超解像およびフレーム生成パイプラインのオープンソースVulkan computeによる実装です。本プロジェクトは、DLSSが利用できない非Nvidiaハードウェア(AMD、Intel Arc、およびソフトウェアVulkan)をターゲットとしています。
アーキテクチャは再帰的な時系列累積(temporal accumulation)を備えた畳み込みニューラルネットワークであり、4分の1解像度の入力にモーションベクターおよびデプスバッファを加えたものを入力として動作します。アップサンプリングパイプラインは3段階で進行します:特徴抽出ブロック(ReLUを伴う複数の3x3 convレイヤー)、モーションベクターフィールドを用いてワープした前フレームの特徴マップと現在フレームの特徴をブレンドするtemporal accumulationモジュール、そして学習済みバイリニアアップサンプリングとそれに続く残差畳み込みによってターゲット解像度へアップサンプリングする再構成ブロックです。これはNVIDIA自身の論文や以前のDXVKベースのリバースエンジニアリング作業から公に知られているDLSSの一般的なアプローチと大筋で一致しています。
Vulkan computeシェーダーは、これらのレイヤーをタイル行列積として実装しており、subgroupサイズ32/64に向けて手動チューニングが施されています。重みはDLSS DLLからのブラックボックス抽出によって得られたONNXエクスポートから読み込まれます(READMEにはこの点が率直に記載されています)。タイルごとの共有メモリ使用量に収めるため、conv重みにはINT8量子化が適用されています。
現時点での制限は重大なものがあります:フレーム生成(補間コンポーネント)はスタブ実装のままであり、高モーション時の時系列安定性はオリジナルより劣り、プロジェクトには学習インフラが存在しません — 抽出された重みに完全に依存しています。つまり、再現可能な学習という意味では真に「オープン」ではなく、推論実装という意味においてのみオープンです。
RX 7900 XTXでの性能は、ネイティブDLSS 5の品質スコア(ゲームキャプチャのホールドアウトセットでPSNR/SSIMにより測定)の約70〜80%に達しており、Vulkan computeパスの非効率性により、仮想的なネイティブ実装と比較して15%のレイテンシオーバーヘッドが生じています。
この成果が重要な理由
ニューラルアップサンプリング推論がベンダー固有のtensor coreなしに非独占的なVulkanへ移植可能であることを実証しており、クロスプラットフォームなゲームエンジン統合において重要な意味を持ちます。
ウェブおよびモバイル会話型AIエージェントのプライバシー分析
本論文は、主要な商用製品を含む30件の会話型AIエージェント(ウェブおよびモバイル)を対象として、収集されるデータの種類・送信先・プライバシーポリシーの記載と実際のネットワーク挙動の一致度を計測する、系統的な実証的プライバシー監査を実施しています。
手法はインスツルメンテーションに基づいています。著者らはウェブエージェントにはmitmproxyを、モバイルアプリにはFridaベースの動的インスツルメンテーションを使用し、構造化されたテスト会話中の全ネットワークトラフィックを傍受・記録しています。次に、エンドポイントを既知のトラッカー/アナリティクスデータベース(Disconnect.meリストおよび手動ラベル付きエンドポイント)と照合して分類し、観測されたデータフローを、ポリシーテキストからデータ型に関する主張を抽出する半自動NLPパイプラインを用いてプライバシーポリシーの開示内容と比較しています。
主な知見:30エージェントのうち23件が、主要なモデルAPIを超える少なくとも1つのサードパーティアナリティクスエンドポイントに会話内容またはメタデータを送信していました。モバイルエージェントはウェブエージェントよりも状況が悪く、モバイルアプリ20件中18件が会話データとともにデバイス識別子(IDFV、Android Advertising ID)を送信していました。観測されたデータフローが宣言されたプライバシーポリシーと完全に一致していたエージェントはわずか9件でした。また複数のエージェントが広告アトリビューションSDKに会話の断片を送信しており、著者らはこれが開示されていないと主張しています。
本論文は、(1)AIプロバイダーによる一次収集、(2)アナリティクス/広告パートナーとの二次共有、(3)アプリにバンドルされたサードパーティSDKを介した付随的な漏洩、を区別する脅威モデルの分類体系を導入しています。カテゴリ3が最も広く見られ、かつ最も開示されていません。
技術的な制限として、本分析は送信されたデータのみを捕捉しており、サーバー側の保持や会話内容からの推論については対象外です。Fridaインスツルメンテーションは3つのアプリの証明書ピンニングによって無効化され、追加のパッチ適用が必要でした。また、NLPポリシーパーサーは曖昧な表現の条項に対してリコールのギャップがあります。
「Prompt like a butterfly, sting like a tracker」というフレーミングは、一見無害に見える会話型入力が、会話内容とは無関係にトラッカーとして機能するフィンガープリントメタデータを伴うという観察に由来しています。
なぜこれが重要か
本番環境のAIエージェントにおける、宣言されたプライバシー挙動と観測されたプライバシー挙動のギャップを具体的に計測しており、標準的なツールを用いた再現可能な手法を提示しています。
RIP、ベクターデータベース
Source: https://turbopuffer.com/blog/rip-vector-database
Turbopufferの投稿は、スタンドアロンのベクターデータベースという製品カテゴリが汎用データベースやオブジェクトストレージシステムに吸収されつつあると主張し、その建築的な理由を概説しています。この議論は単なる市場コメンタリーではなく、技術的なものです。
中心的な主張は、専用ベクターDBの当初の正当性——HNSWやIVF-PQといった特殊なANNインデックス構造がメモリ常駐を必要とすること——が、二つのトレンドによって損なわれつつあるというものです。(1) 高ランダム読み取りIOPSを持つ最新のNVMe SSDにより、多くのクエリレイテンシ要件においてディスク常駐ANNインデックスがRAM常駐のものと競合できるようになったこと、(2) embeddingの次元数とデータセットサイズが増大した結果、専用システムのメモリ帯域幅上の優位性が独立したシステムを維持する運用コストによって相殺されるようになったこと、の二点です。
議論を裏付けるために紹介されているTurbopuffer自身のアーキテクチャは、ベクターをオブジェクトストレージ(S3互換)上にカラム形式で保存し、ホットなインデックスシャードをローカルNVMeに保持するキャッシュ層を備えています。使用されているANNインデックスは、グラフの隣接リストをランダムなポインタ追跡ではなくシーケンシャルI/Oに適したソート済みposting listとして格納する、ディスクフレンドリーなHNWSの変形です。1億ベクターのデータセットにおけるクエリレイテンシはp99で50〜80msと報告されており、RAGおよびセマンティック検索ワークロードの大多数に対して許容範囲内であると投稿は主張しています。
また、pg_vectorおよびPostgresの類似拡張機能が現在は合理的なパフォーマンスでHNSWをサポートしており、すでにPostgres上にあるワークロードにとって別個のシステムが不要になりつつあることも指摘されています。スタンドアロンのベクターDBが残存するニッチは、スカラーフィルタリングとANNトラバーサルの密結合が重要となる、高QPS・低レイテンシなハイブリッド検索です。
(完全には議論されていない)反論として、ANNトラバーサル中のメタデータフィルタリング——文書の日付やユーザーIDによるフィルタリングなど——は、クエリプランニングと密に統合されたシステムと比較して、オブジェクトストレージバックエンドの設計ではいまだに著しく困難であるという点があります。
なぜこれが重要か
オブジェクトストレージ上のディスク常駐ANNは、ベクター検索のコストモデルを変革します。posting list形式のHNSWの変形に関するアーキテクチャの詳細は、検索インフラを構築する人々にとって注目に値するものです。
Launch HN: Magnitude (YC S25) – エージェント向け自己最適化 inference エンジン
Source: https://github.com/magnitudedev/magnitude
Magnitude は、LLM ベースのエージェント向けのオープンソース inference オーケストレーションレイヤーです。エージェントの実行トレースをプロファイリングし、そのデータを活用して、品質を損なわない範囲でサブタスクをより安価・高速なモデルへルーティングします。核心となる技術的アイデアは「学習によるモデルルーティング」です。エージェントのステップに静的にモデルを割り当てるのではなく、システムはまず初期キャリブレーションフェーズを実行します。このフェーズでは、複数のモデルに対して代表的なタスクを実行し、出力品質スコアを収集(LLM-as-judge パイプラインまたはユーザー提供の評価関数を使用)したうえで、タスクの特徴からモデル選択へとマッピングする軽量なルーティング分類器を学習します。
このルーティング分類器は、プロンプトから抽出した特徴量(トークン数、タスクタイプ分類(コード・推論・検索・要約)、ツールコールの有無、命令の semantic embedding)を入力とする小規模な gradient-boosted tree(XGBoost)です。推論時において、ルーターが追加するオーバーヘッドは 1 呼び出しあたり約 2〜5ms であり、多くのエージェントステップのレイテンシ予算内に十分収まります。
システムは MagnitudeClient を公開しており、OpenAI 互換 API をラップしてコールをインターセプトし、ルーティングを透過的に実行します。ユーザーはコストと品質のトレードオフに関する Pareto 嗜好(例:GPT-4o ベースラインの品質 >= 0.9 を制約としてコストを最小化)を指定し、システムはその制約を満たすルーティングポリシーを探索します。
GitHub の README および HN のディスカッションによると、キャリブレーションコストが実用上の主な摩擦点です。信頼性の高いルーティングモデルを構築するために十分な代表的タスクを実行するには、ホールドアウト用の評価セットが必要か、あるいはルーティング品質が時間とともに向上するオンライン学習フェーズを受け入れる必要があります。オンライン学習のパスでは、探索と活用のバランスを取るために Thompson sampling を用いたバンディット定式化が採用されています。
制限事項として、LLM-as-judge による品質推定はそれ自体のコストとバイアスを伴うこと、ルーティングはタスクタイプが実行間で安定している場合に最も効果的であること、および現時点では OpenAI 互換の API サーフェスのみサポートしていることが挙げられます。
なぜこれが重要か
異種モデルプールにまたがる学習ベースのルーティングは、プロダクション向けエージェントシステムにおける実用的なコスト削減手段であり、オープンソースの実装によってルーティング分類器のアーキテクチャを検査可能である点が重要です。
SDF vs. MSDF vs. Slug: GPU テキストレンダリング
Source: https://alphapixeldev.com/sdf-vs-msdf-vs-slug-vs-rive-gpu-text-rendering/
4つのGPUテキストレンダリング手法について、品質・性能・実装の複雑さの観点から詳細に技術比較した記事です。
SDF (Signed Distance Field): グリフを事前にラスタライズし、各ピクセルから最近傍のグリフエッジまでの符号付き距離をエンコードしたテクスチャに格納します。レンダリング時には、フラグメントシェーダが距離値を閾値処理してグリフの輪郭を復元します。固定解像度のSDFテクスチャでは鋭い角を表現できないため、高倍率ズームで品質が劣化し、角が丸くなって見えます。ストレージはグリフごとに1チャネルで、典型的には64x64から128x128テクセルです。2007年にValveが導入し、現在もゲームエンジンで広く使われています。
MSDF (Multi-channel SDF): CactusによるSDFの拡張で、異なるエッジのサブセットからそれぞれ計算された3つの独立した符号付き距離フィールドをR・G・Bチャネルに格納します。復元シェーダは3チャネルの中央値を取ることで、シングルチャネルSDFでは解消できなかった角のアーティファクトを正しく処理します。中程度のズームレベルにおいて角の鮮明さが劇的に向上します。ストレージコストはシングルチャネルSDFの3倍で、グリフアトラスの生成にはより大きなコストがかかります(msdfgenライブラリまたは相当品が必要)。極端なズームでは依然として品質が劣化します。
Slug(Evan Wallaceの手法): 事前に距離フィールドテクスチャへラスタライズする代わりに、バッファに格納された2次ベジェ曲線データから、フラグメントシェーダ内でグリフのカバレッジを解析的に評価します。これにより、任意のズームレベルで正確なアンチエイリアスレンダリングが実現されます。コストはフラグメントごとの曲線評価にあり、GPUのALUコストが高く、グリフの曲線データをシェーダストレージバッファからアクセス可能にする必要があります。記事によると、複雑なグリフに対してMSDFと比較したフラグメントシェーダのコストはおよそ2〜4倍であり、ズーム倍率がおよそ4倍を超えるとSlugが有利になるとされています。
RiveのGPUレンダラーは、関連する解析的アプローチを採用しつつ、マルチパスコンピュートパイプラインにおけるアトミック操作によるカバレッジ累積を用いたパス塗りつぶしの追加最適化を行っており、曲線ごとのコストを異なる形で分散させています。
記事には、様々なズームレベルでのPSNR比較とスクリーンショットが含まれており、角の品質の違いを具体的に示しています。また、モバイルGPUとデスクトップGPUのベンチマークも掲載されており、ALU・帯域幅のトレードオフが大きく異なることが示されています。
なぜ重要か
解析的手法と事前ラスタライズ手法のトレードオフは、実装時には直感的に判断しにくいものです。この比較記事は、対象アプリケーションのズーム範囲とGPUバジェットに応じた適切な手法を選択するために必要な、定量的な分岐点を提供しています。
注目すべき新しいリポジトリ
okf-memory/okf-agent-memory
AIコーディングエージェント向けのGitネイティブな永続メモリ層であり、Google Open Knowledge Format(OKF)v0.2仕様を実装しています。コア設計では、エージェントのメモリをGitリポジトリ内の構造化ファイルとして保存するため、外部データベースなしに履歴管理・ブランチ・差分比較が自動的に利用可能になります。インプロセスのBM25 search indexは300マイクロ秒以下のレイテンシで動作し、CGOやサードパーティの依存関係を一切持たない純粋なGoで構築されています。
アーキテクチャはプログレッシブ・ディスクロージャを採用しており、エージェントはナレッジベース全体をcontext windowに投入するのではなく、文脈的に最も関連性の高いメモリフラグメントのみを取得します。これが、トークン使用量80%削減という主張の根拠です――関連性によるランク付きの検索が一括注入に取って代わります。組み込みのMCP(Model Context Protocol)サーバーがメモリストアを標準ツールインターフェースとして公開するため、MCP互換の任意のエージェントフレームワークがカスタムのグルーコードなしに統合できます。
RedisやベクターDBアプローチよりもこれを選ぶ理由としては、ゼロの運用オーバーヘッド(ストアは単なるファイル群)、Git履歴による完全な監査可能性、そして短いコンテキストのナレッジ検索においてANNインデックスの近似誤差を回避できる決定論的なBM25 recallが挙げられます。純粋なGoによるビルドにより、エージェントが動作するあらゆる環境にデプロイ可能な単一の静的バイナリが実現します。長期にわたる開発セッションでプロジェクト固有のコンテキストを蓄積するコーディングエージェントに最適です。
Source: https://github.com/okf-memory/okf-agent-memory
Simreal-AI/Simreal-MLBench
エージェント型ML研究システム——コードを記述し、実験を実行し、結果を自律的に解釈するようなシステム——に特化して設計された公開プレビュー版benchmarkです。このbenchmarkは、実際のML競技問題から抽出した60タスクで構成されており、ground truthは手作業によるラベルではなく、競技のリーダーボードから直接取得しています。これにより、事前学習データから答えを導出できるbenchmarkよりも、汚染耐性が高くなっています。
設計上の重要な決定は、外部のオペレーターが実行する評価方式にあります:提出物はbenchmarkのオペレーターによって非公開のground truthに照らして採点されます。これはKaggleのスコアがサーバーサイドで計算される方式に似ており、エージェントがローカルの評価スクリプトを操作することを防ぎます。オープンプロトコルにより、タスク形式と提出APIが公開仕様となっているため、研究者はブラックボックスへの依存なしに評価ハーネスを構築できます。
60タスクという規模は、評価実行ごとの計算コストを現実的な範囲に抑えられるほど小規模ですが、タスクはMLリサーチパイプラインの十分な範囲(データ分析、モデル選択、ハイパーパラメータ探索、結果解釈)にわたっており、マルチステップ推論やツール使用に負荷をかけます。「実際の競技ground truth」という枠組みは重要です:これは、合成的な難易度調整ではなく、人間が競い合うほど難しいと判断した問題に難易度を根拠づけるものです。
現段階での主な限界:60タスクは、エージェントシステム間の統計的に頑健な比較を行うにはサンプルが少なすぎます。長期的な有用性は、タスク数の拡充と多様性によって決まるでしょう。
Source: https://github.com/Simreal-AI/Simreal-MLBench
nokia-applied-research/AnyJev
AnyJevは、任意のLLMをJevフレームワークに従った意思決定モデルとしてラップするツールです。fine-tuningや再学習を一切必要とせず、型付きの構造化された決定結果を、較正された確率推定値とともに出力します。核心となるアイデアは、LLMがすでに潜在的な確率的推論能力を持っているというものであり、AnyJevはgradient更新ではなくprompt engineeringと出力パースによってこれを引き出します。
「型付き決定(typed decisions)」機構は出力にスキーマを強制します。各決定には明示的な型シグネチャ(例:カテゴリ選択、ランク付きリスト、選択肢上の確率分布)と数値的な信頼度が付与されます。これは、LLM呼び出しを構造化出力制約(おそらくJSONスキーマの強制または制約付きデコーディング)でラップし、確率推定値を正規化する後処理によって実装されています。
実用的な動機は、不確実性の定量化を伴う機械可読な出力が必要でありながら、専用モデルの学習コストを負担できない意思決定支援システムにあります。具体的な用途としては、リスク評価、自律的な計画立案、臨床的なトリアージなどが挙げられます。LLMを汎用的な推論器として扱い、推論時に構造を課すことで、AnyJevはfine-tuningされたタスク固有モデルのレイテンシとコストを回避します。
注目すべき制限点として、抽出された確率の較正品質はベースLLMとpromptingの戦略に完全に依存しており、統計的な意味での適切な較正は保証されていません。リポジトリは活発にメンテナンスされており(スター数1k超、issueやPRを受け付け中)、より堅牢な較正手法へと発展しつつあることが示唆されます。
Source: https://github.com/nokia-applied-research/AnyJev
usamahz/cpu-performance-engineering
CPUパフォーマンスエンジニアリングのための体系的な学習パスであり、単一命令の動作から始まり、本番環境でのML inference最適化まで段階的に学べるカリキュラムとして構成されています。本リポジトリの際立った特徴は、一次資料への厳格な準拠にあります。CPUアーキテクチャのマニュアル、Intel/AMDの最適化ガイド、Linux perfのドキュメント、および査読済み論文を参照しており、ブログ記事のまとめには依存していません。各セクションには実行可能なベンチマークが付属しているため、命令スループット、キャッシュ階層の効果、分岐予測器の動作、およびベクトル化に関する主張を、読者自身のハードウェア上で実証的に検証できます。
スコープの進行順序は教育的に妥当な構成となっています。命令レベル並列性(ILP)、パイプライン処理、マイクロアーキテクチャのハザードから始まり、メモリ階層の最適化(キャッシュラインのアライメント、プリフェッチ、TLBプレッシャー)、SIMD/ベクトル化へと進み、さらにスレッディングとNUMAの影響を扱い、最終的にこれらすべてが相互作用する本番 inference ワークロードへと結びつけています。
カスタムCUDAカーネルを実装したり、CPU上でtransformer inferenceを最適化したりする研究者にとって、本リポジトリはMLに特化した多くの資料が省略しているアーキテクチャ的な基礎知識を提供します。また、セクションごとのベンチマーク構造により、コンパイラフラグやハードウェア変更を評価する際のリグレッションテストフレームワークとしても活用できます。なお、本リポジトリのスコープはフルシステムの教科書と比べて意図的に狭く絞られていますが、OSの構築ではなくinferenceパイプラインからスループットを引き出すことを最終目標とする方にとっては、より実践的な内容となっています。
Source: https://github.com/usamahz/cpu-performance-engineering
Loopera-ai/loopera
クオンツ的なファンダメンタル・ファクター研究を対象としたAIエージェントシステムです。これは、研究者がある財務指標がリターンを予測するという仮説を立て、統計的厳密性をもって過去データで検証するような作業を想定しています。Looperaはこのワークフローを明示的に構造化しており、仮説生成、エビデンスによるゲート付き検証(エージェントは現在の仮説が統計的閾値をクリアしない限り次の研究ステップに進めない)、そしてセッションをまたいで知見を保持するリサーチメモリーの3要素から構成されています。
エビデンス・ゲーティング機構が技術的に興味深い部分です。エージェントが自己報告で成功を主張するのを許すのではなく、検証ステップはプログラム的に強制されます。すなわち、エージェントは設定可能な閾値を満たす統計検定結果(例:t統計量、information coefficient、Sharpe ratio)を生成しなければ、その仮説を検証済みとしてメモリーに記録することができません。この仕組みにより、エージェントが未検証の推論チェーンを通じて誤った結論を自ら正しいと信じ込んでしまうという、エージェント型リサーチループに見られる典型的な失敗モードを防ぎます。
リサーチメモリーは、検証済みおよび反証済みの仮説を構造化された形式で保存します。これにより、エージェントは既に棄却されたアイデアの再検証を避けるとともに、検証済みの構成要素から複合仮説を構築することが可能になります。本システムは価格ベースのシグナルではなく、ファンダメンタル(会計・マクロ)ファクターに特化しており、評価ホライズンが長く、データのノイズも多いという特性があります。これは高頻度シグナルと比べて、自動化されたリサーチにとってより難しい設定です。
Source: https://github.com/Loopera-ai/loopera
qiz029/dscode
DeepSeekモデルを中心に構築された、自律型コーディングエージェントワークフロー向けのハーネスです。中核となる設計は永続的なシェルセッションです。ほとんどのエージェントフレームワークで採用されている標準的なアプローチ(ツール呼び出しごとに新しいサブプロセスを生成する方式)とは異なり、dsocodeはエージェントセッション全体を通じてステートフルなシェルを維持します。これにより、環境変数・作業ディレクトリ・仮想環境・バックグラウンドプロセスが保持されるため、エージェントが数十ステップにわたってコードベースを反復的に操作する際に有効です。
Ultra subagentは、プライマリエージェントが独立したサブタスク(長時間実行されるテストスイート、並列ファイル検索、並列的な仮説検証など)のために生成できる並列実行ユニットであり、結果は非同期に収集されます。Auto-approvalモードは、設定可能なセーフティポリシーに一致するツール呼び出しに対してhuman-in-the-loopの確認ステップを省略し、完全自律的な実行を可能にします。
Chrome MCP integrationはブラウザ操作をツールとして公開しており、Webベースの出力を検証したり、ブラウザベースの開発ツールと対話する必要があるエージェントに有用です。セッションテレメトリはすべてのツール呼び出し・出力・レイテンシ・token数を構造化フォーマットで記録するため、エージェントの動作を事後分析することが容易になります。これは長時間の自律実行における失敗モードのデバッグにおいて重要です。
DeepSeek固有の対応は、おそらくDeepSeekの命令追従スタイルに合わせたpromptチューニングと出力パースの調整を反映しているものと思われますが、シェルアーキテクチャ自体は原則としてモデル非依存です。
Source: https://github.com/qiz029/dscode
Edwardxlai/easyread
英語の論文を中国語に翻訳しながら原文も参照可能な形で表示する、ローカルファーストのPDF学術論文翻訳ツールです。原文と翻訳を並べて表示するレイアウトは、翻訳品質を確認したいユーザーやドメイン用語を学習したいユーザーを意識した意図的なUX上の選択であり、原文を単純に置き換えるツールとは一線を画しています。
「AIに質問しながら読む」機能は、現在読み込んでいる論文のスコープに限定した会話型インターフェースを埋め込んでおり、読書コンテキストを離れることなくインラインでQ&Aが行えます。これは論文から抽出したテキストに対するretrieval-augmentedなインターフェースとして実装されており、特定のセクションや図を参照しながら質問することが可能です。文献管理機能はメタデータの抽出と検索を備え、論文コレクションを管理できます。
学術用途においてローカル実行が重要な理由があります。エンバーゴ中の論文、プロプライエタリな技術レポート、あるいは機密上の制約がある文書はクラウドAPIに送信できません。ローカル展開により、大量の論文キューを処理する研究者にとってページ単位のAPIコストも発生しません。
主な制限は翻訳品質であり、それは基盤となるLLMに依存します。ML・システム系論文における高密度な数式表記やドメイン固有の用語は、ニューラル翻訳にとって依然として難しい課題です。原文並列表示により読者がエラーを検知しやすくなるため、この問題は部分的に緩和されています。主言語が中国語でありながら主に英語文献を扱う研究者にとって、翻訳・参照レイアウト・文脈に応じたQ&Aの組み合わせは、汎用翻訳ツールでは対処できなかった実際のワークフロー上のギャップを埋めるものです。
Source: https://github.com/Edwardxlai/easyread
muellerberndt/cadence
Cadenceは、デュアルプロセスエージェントを実装した認知アーキテクチャの実験です。System 1(高速・自動)はデフォルトで知覚、記憶の検索、行動を担い、System 2(低速・熟慮的)はオプションとして自己観察と修正的推論のために呼び出されます。この枠組みはKahnemanのデュアルプロセス理論を人工エージェントに直接適用したものです。
System 1レイヤーはリアクティブなループとして動作します。感覚入力が処理され、関連する記憶が検索され、明示的な計画ステップなしに行動が選択されます。記憶には、エピソード的な要素(現在のセッションからの経験のトレース)と可塑的な要素の両方が含まれています。後者はオフライン学習なしにライブの経験から更新される重みや表現であり、オンライン継続学習の一形態を実装しています。
System 2の起動は設定可能な条件(不確実性の閾値、矛盾の検出、明示的なプロンプト)によってトリガーされ、メタ認知的な操作を実行します。具体的には、System 1の直近の決定のレビュー、不整合の特定、System 1ストリームへの修正アクションの発行などを行います。この非対称性——デフォルトでは高速パス、必要に応じて低速パス——は計算量的な動機によるものです。すべてのステップで完全な熟慮的推論を行うことは、コストが非常に高くなるためです。
「可塑性」コンポーネントは最も技術的に野心的な主張です。これは単なる検索拡張型の記憶ではなく、セッション内での真の適応を実現します。その実装方法(小規模なモデルコンポーネントへのgradient更新、動的なプロンプト構築、またはパラメトリックなメモリメカニズム)はソースコードを精査する価値があります。このアーキテクチャは明示的に実験的なものとして位置づけられており、プロダクション向けのエージェントフレームワークではなく研究プロトタイプとして提示されています。