デイリーAIダイジェスト — 2026-09-23
arXiv ハイライト
AIリサーチエージェントの再帰的自己改善
問題設定
AIリサーチエージェントは、MLスタックの構成要素——訓練ループ、推論カーネル、ハイパーパラメータ探索——を最適化するためにますます活用されるようになっています。その自然な延長線上にあるのが、そのようなエージェント自身のソースコードを最適化対象とすることです。本論文は、フロンティアリサーチエージェントが、自らの実装を最適化対象とし、AI R&Dタスクの分布を適応度シグナルとして与えられたとき、より優れたバージョンの連鎖を次々に生成できるかどうかを研究しています。この枠組みが重要な理由は、累積的なR&D支出が逓減収益を示してきた一方で、非自明な成功率で自己編集を行うエージェントは、収益が逓減ではなく複利的に増大するメカニズムを提供するからです。著者らは \text{AIDE}^2 というシステムをこのループの周りに構築し、フロンティアエージェントを対象に8日間の自律的な実行を行いました。
手法
本設定は二段階最適化です。内側のループは標準的なコード最適化エージェントです。初期コードベース x_0 と公開メトリック r^{\mathrm{pub}}_t を持つタスク t が与えられると、エージェント a は反復的に候補を提案します。
x_i = a\bigl(x_{<i},\; r^{\mathrm{pub}}_t(x_{<i})\bigr),
固定のドル予算 b_t(エージェントのトークンと候補実行の両方を含む)が消費されるまでこれを繰り返します。エージェントは選択された単一の候補 \hat{x}_t を返します。\{x_i\} の中からの選択はハードコードされておらず、a の編集可能なポリシーの一部であり、メモリ管理や探索戦略も同様です。
採点には非公開のホールドアウトシグナル r^{\mathrm{priv}}_t が使われ、T 個のタスクからなる多様な selection benchmark にわたって集計されます。
g(a) = \frac{1}{T}\sum_{t=1}^{T} r^{\mathrm{priv}}_t(\hat{x}_t).
三つのタスクファミリー(MLエンジニアリング、ヒューリスティックアルゴリズムエンジニアリング、物理ベースの予測)にわたる多様性は意図的なものです。タスク固有のハックではなく、汎用的なメカニズムに向けた進化的な圧力をかけるためです。r^{\mathrm{pub}}_t(内側エージェントが見るもの)と r^{\mathrm{priv}}_t(外側ループが採点に使うもの)の公開/非公開の分割は、内側シグナルのreward hackingを抑制することを意図しています。
外側ループは、(a, x, r^{\mathrm{pub}}_t) \mapsto (a^{\mathrm{out}}, a, g) という置き換えを通じて、同じ木探索エージェント設計を一段上のレベルに適用します。
a_k = a^{\mathrm{out}}\bigl(a_{<k},\; g(a_{<k})\bigr).
内側ループとは異なり、外側ループの選択は固定されています(編集不可)。
a^*_k = \underset{a \in a_{\leq k}}{\arg\max}\; g(a).
現時点での最優良エージェント——これまでで最も高い評価を得たエージェント——が、外側ループが次に編集する対象となります。受理された各書き換えが次の書き換えを生成するコードベースとなり、これが再帰的な部分です。探索ポリシー、メモリ、候補選択への変更は前方に伝播し、その後の自己編集がどのように提案されるかを形作ります。
二つの設計上の選択が重要な役割を担っています。第一に、提案された各エージェントを固定の内側ループ予算で評価することで、観測された改善がアルゴリズムの向上を反映するものとなり、追加計算によるものではないことが保証されます——固定の b_t の下での g の向上は、定義上、研究効率の向上です。第二に、内側ループの訓練シグナルと外側ループの選択シグナルを分離することで、メタ編集に対するホールドアウト検証の一形態が生まれます。
結果
8日間の自律的な実行において、\text{AIDE}^2 は7つの連続する最優良エージェントを生成し、そのそれぞれが selection benchmark 上で前のものより厳密に優れていました。改善の内容は質的に多様です。新たな候補選択(探索)ポリシー、そしてエージェントの累積するコンテキストを圧縮・管理する複数のメモリメカニズム——まさに多様な selection benchmark がタスク固有のトリックではなく報いるよう設計された汎用的なメカニズムの類いです。
汎化性能は、MLエンジニアリング、ヒューリスティックアルゴリズムエンジニアリング、物理ベースの気象予測にわたる4つのホールドアウトベンチマークでテストされています。改善は4つすべてに転移しており、発見された編集がselectionタスクへの過学習ではなく、エージェントの最適化能力を対象としているという主張を支持しています。ベースラインは \text{AIDE}_{\mathrm{human}} であり、これはFML-Bench(Zou et al., 2026)で競争力を持つ、人間主導のR&Dを通じて開発された本番リサーチエージェントです。再帰的自己改善された変種はホールドアウトタスクにおいてそれに匹敵するか上回る性能を示しています。
7ステップの連鎖はまた、著者らが事前に規定した持続的傾向の基準も満たしています。すなわち、単一の幸運な書き換えではなく、単一の実行内での繰り返しの改善です。
制限と未解決の問題
本論文は、示されたセクションにおいて、ステップごとの効果量、外側ループの独立した実行における分散、または傾向が飽和するまでの継続期間を定量化していません——8日間と7ステップは、複利的収益を外挿するには短すぎます。評価はドル予算制約下にあるため、改善はトークン効率の向上と絡み合っています。「エージェントがより良く考える」ことと「エージェントが候補あたりのトークンをより少なく消費する」ことを分離することで、何が最適化されているのかが明確になるでしょう。公開/非公開の分割は、外側ループの編集が採点に使われる特定のホールドアウトスコアラーをGoodhartするリスクを低減しますが排除はしていません。最後に、外側ループエージェント自体は編集されません——再帰は内側ループエージェントのコードに対するものであり、a^{\mathrm{out}} に対するものではありません。強い意味での真の再帰的自己改善(メタ最適化器が自身を編集すること)は試みられていません。
なぜこれが重要か
これは、フロンティアリサーチエージェントが、自律的かつ固定計算量の下で、分布外に転移する自身への汎用的な改善の多ステップ連鎖を生成できるという具体的な存在証明です。この傾向が7ステップを超えて継続するならば、このループは人間の労働や資本に線形にスケールしないR&D生産性のメカニズムを提供します。
Source: https://arxiv.org/abs/2609.26457
RULER: Instance-aware Rubric Rewards for SVG Generation
問題設定
テキストからSVGへの生成は、オープンエンドなコード合成タスクです。すなわち、指示 \mathcal{Q} が与えられると、方策 \pi_\theta はトークン列 \mathcal{Y}=(y_1,\dots,y_T) を出力し、決定論的レンダラー \mathcal{E} がそれをラスター画像 \mathcal{I}_\text{gen}=\mathcal{E}(\mathcal{Y}) に変換します。参照画像が存在しないため、標準的な再構成lossは利用できません。CLIPの類似度、審美予測器、HPSといったスカラー代理指標は自然写真に対してキャリブレーションされており、フラットなベクターイラストへの転用性は低いです。さらに悪いことに、これらをRLのrewardとして用いると古典的なreward hackingが引き起こされ、方策はテクスチャの手がかりを利用したり、スコアは高くても人間には読みづらい退化した構造を生成してしまいます。
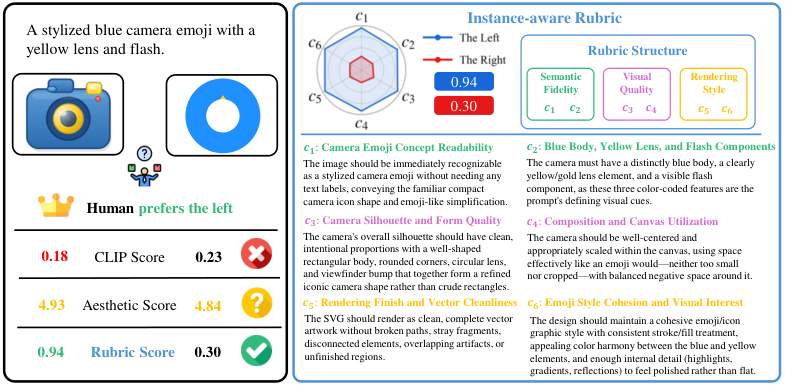
ティーザー図はこの失敗モードを具体的に示しています。CLIPとAestheticは明らかに壊れたレンダリングに対して競争力のあるスコアを付ける一方、多軸rubricは人間のランキングと整合しています。
手法
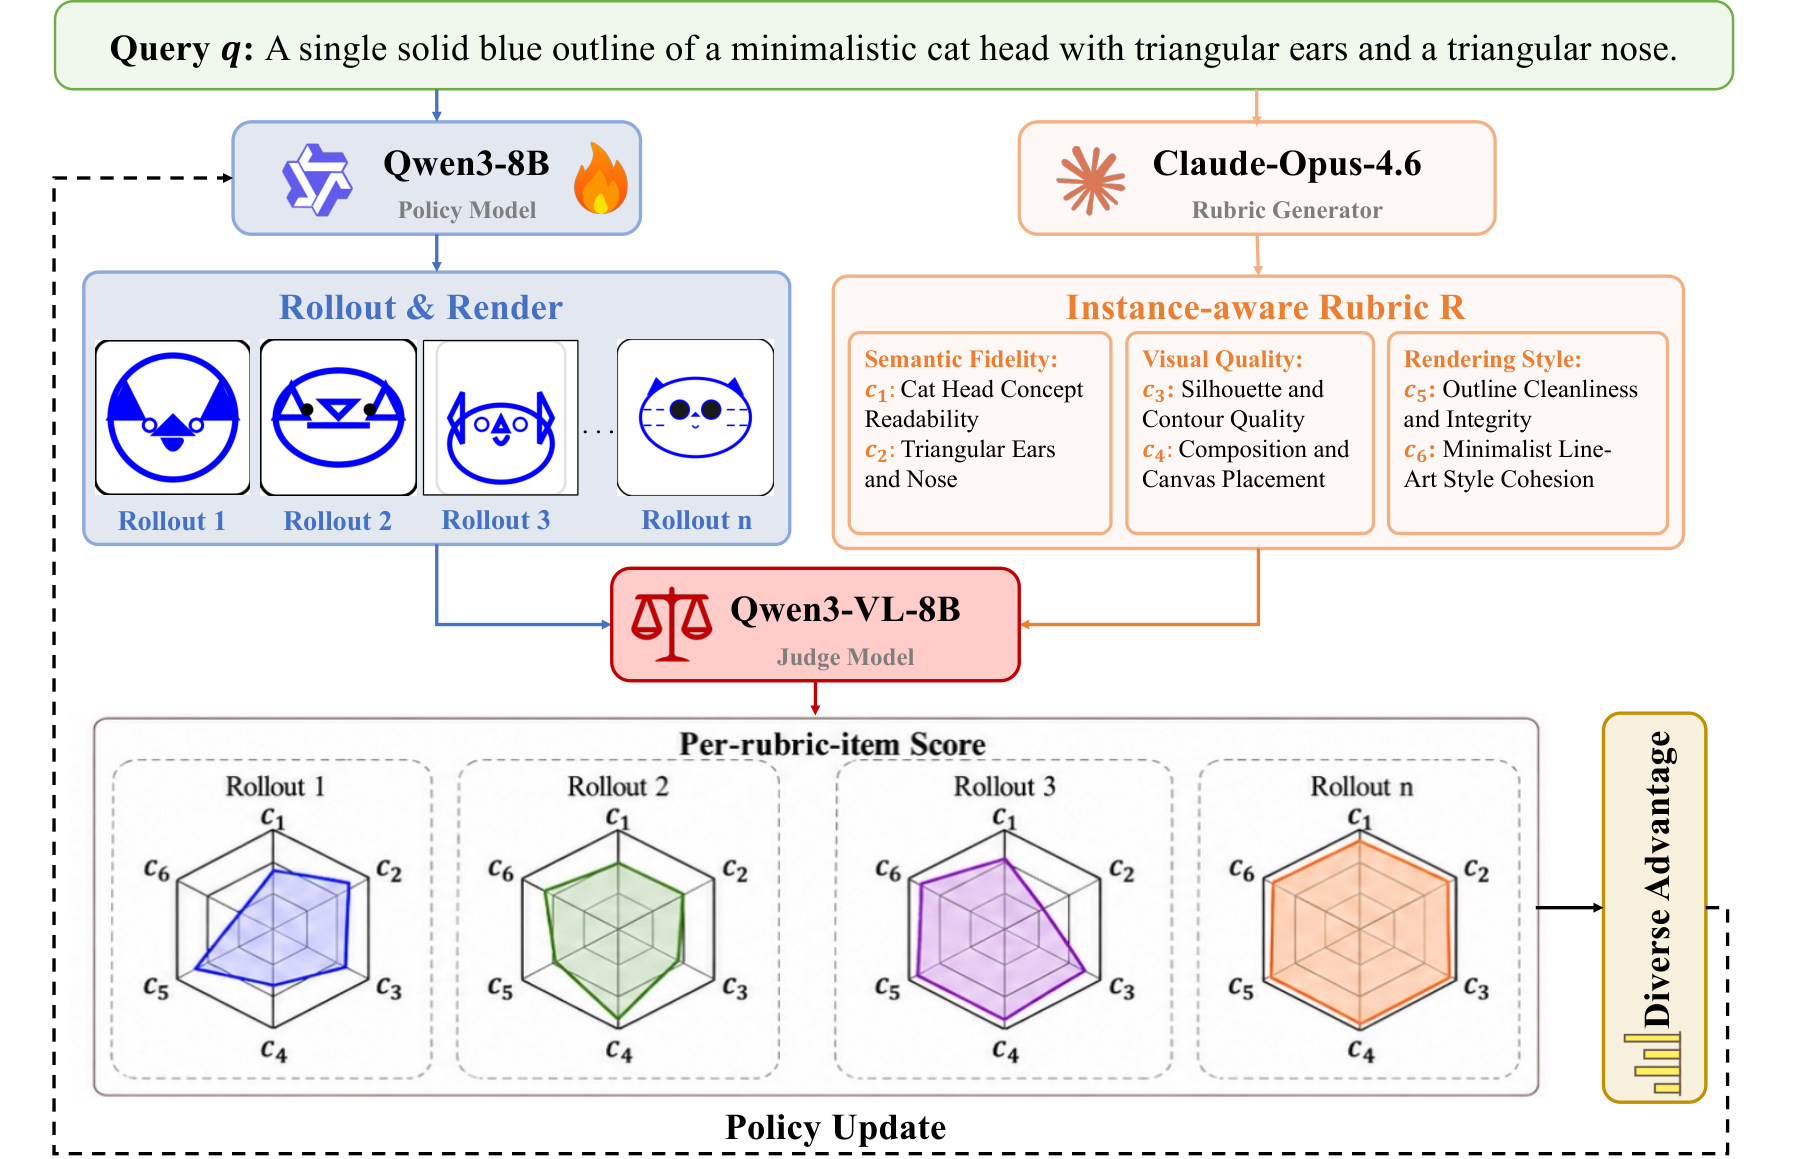
RULERはSVG生成をトークンレベルのMDPとして定式化します。状態 s_t=(\mathcal{Q}, y_{<t})、行動 a_t=y_t\sim\pi_\theta(\cdot\mid s_t)、決定論的な遷移を持ちます。Rewardはレンダリングされた画像に対して終端時にのみ適用されます。手法の新規性は \mathcal{R}(\cdot) の構築方法に集約されます。
Instance-awareなrubric構築。 各指示に対して、フロンティアLLMが3軸にわたる6項目のrubricを出力します。3軸とは、意味的軸(対象物の種類・属性)、視覚的軸(構図、色彩、構造的正確性)、スタイル的軸(要求されたスタイルへの準拠)です。各項目 r_i は自然言語による基準とスカラーの重み w_i を持ちます。rubricはテキストのみから導出されるため、SVGのground truthもhuman preferenceも不要です。
判定とreward。 VLMジャッジが各レンダリングされたrolloutを項目ごとに採点し、満足度 s_i\in[0,1] を算出します。スカラーrewardは次式で定義されます。 R(\mathcal{Y}) = \sum_{i=1}^{6} w_i\, s_i\!\left(\mathcal{E}(\mathcal{Y}), r_i\right).
方策最適化。 RULERはGRPOを使用します。各プロンプトに対して G 個のrollout \{\mathcal{Y}^{(g)}\} をサンプリングし、それぞれ R^{(g)} に採点した後、グループ標準化によりadvantageを計算します。 A^{(g)} = \frac{R^{(g)} - \mathrm{mean}(R)}{\mathrm{std}(R)}, これによりvalue networkが不要になります。R がrubric項目に分解されるため、gradient信号は単一の不透明なスカラーではなく、意味的・視覚的・スタイル的な各次元にわたってクレジットを帰属させます。
結果
MMSVG-IllustrationおよびMMSVG-Iconにおいて、RULERは訓練済みの全ベースラインの中で最高のRubricスコアを達成しています。Illustrationで0.693、Iconで0.683です。専門家スケールで動作しているにもかかわらず、はるかに大規模なフロンティアLLM(DeepSeek-V3: 0.686 / 0.673、Qwen3-32B: 0.651 / 0.681)に匹敵またはそれを上回る性能を示します。同程度のサイズのSVG専門モデルとの差は顕著で、OmniSVG-8Bは同じベンチマークで0.288 / 0.565、JanusCoder-8Bは0.390 / 0.384にとどまります。
RULERはトークン効率も優れています。拡散モデルベースの手法(VectorFusion: 31.4kトークン、SVGDreamer: 124.3kトークン)はRULERの2.0k(Illustration)および0.7k(Icon)より桁違いに大きなSVGを生成しますが、RubricスコアはRULERが上回ります(VectorFusion: 0.611 / 0.510)。Aestheticスコアもすべての専門モデルおよび拡散ベースラインに対してRULERが優位(4.859 / 4.873)であり、IllustrationにおけるSVGDreamerの5.119のみが上回りますが、これは $$60倍のトークンコストを伴います。
興味深いことに、RULERのCLIPおよびHPSの数値(Illustrationで0.249 CLIP、0.246 HPS)は競争力はあるものの最高ではなく、拡散モデルベースの手法がCLIPを支配しています(0.313)。これは、これらの指標がSVG品質ではなくピクセルレベルの自然画像類似度を報酬とするという本論文の主張と一致しています。これがまさにrubricを目標信号として必要とする理由です。
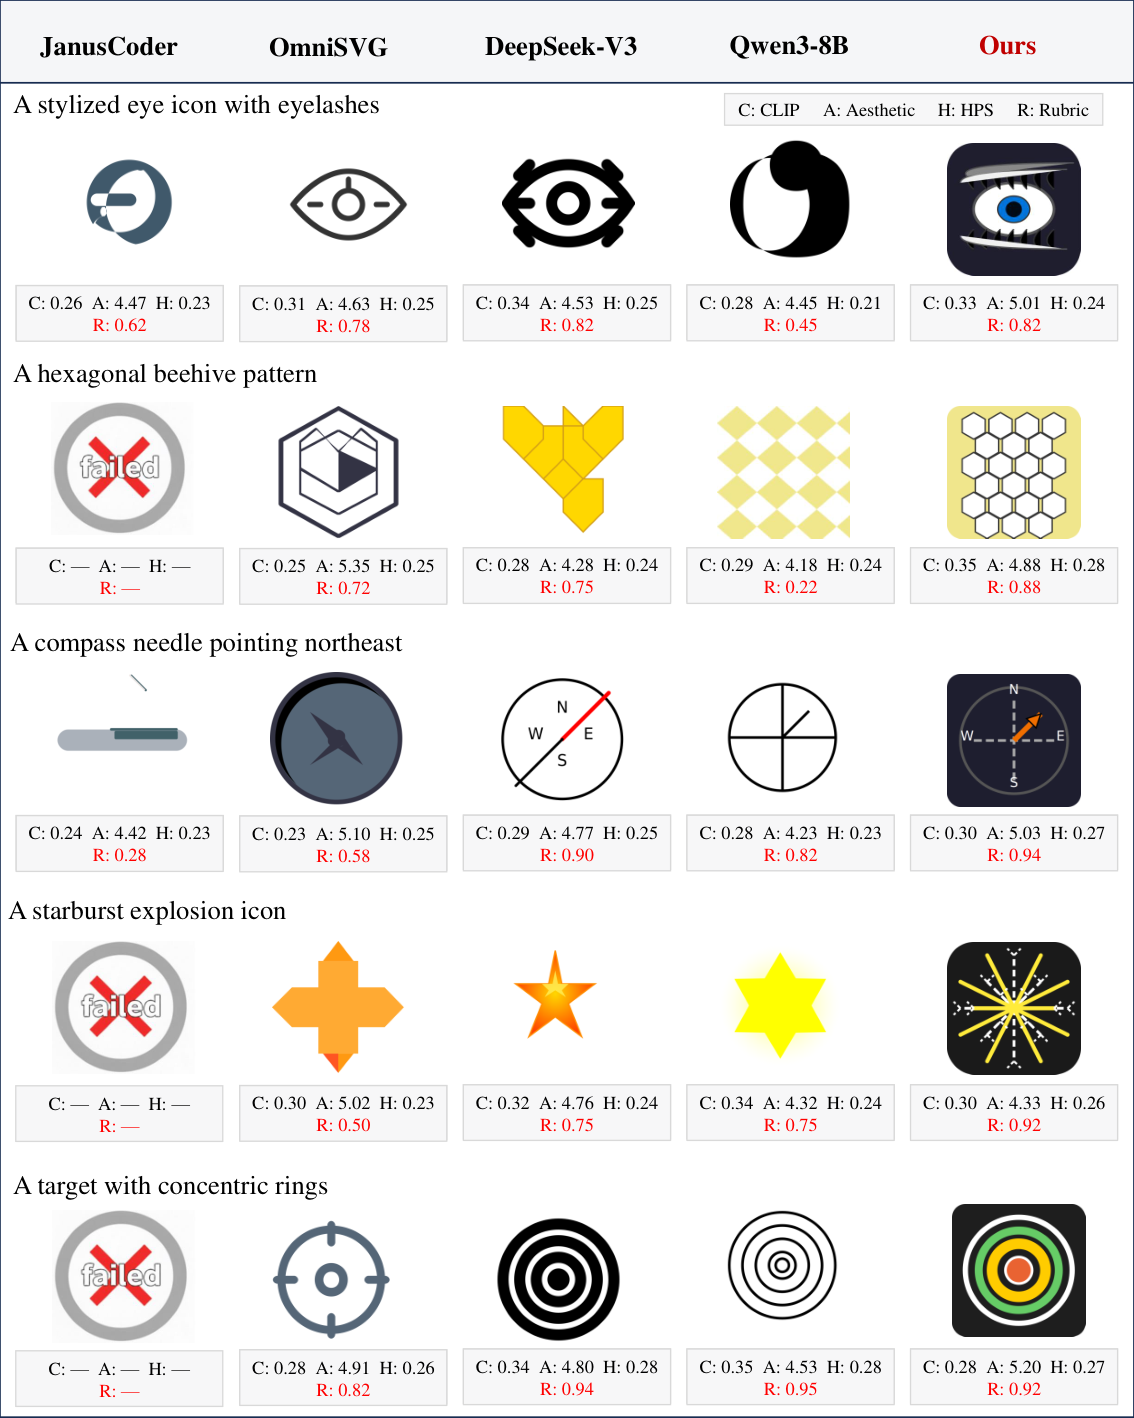
定性的には、RULERの出力は専門モデルおよびfoundationモデルのベースラインと比較して、よりクリーンな幾何プリミティブとプロンプト属性のより良い意味的カバレッジを示しており、定量的なrubricスコアの差を裏付けています。
限界と未解決の課題
本フレームワークはジャッジVLMのバイアスを継承します。VLMに系統的な盲点(例えば、ネガティブスペースの過小評価、遮蔽の誤読)があれば、それがGRPOによって増幅されたトレーニング時のバイアスになります。RubricジェネレータはフロンティアLLMであるため、パイプラインは強力な教師への依存度が高く、より弱いrubricジェネレータに対するロバスト性はRQ4として主張されていますが、その劣化のメカニズムは抜粋中では詳述されていません。スカラー重みを持つ6項目は粗い分解であり、複雑なイラストには階層的または合成的なrubricが必要な場合があります。また、reward hackingはなくなったわけではなく、項目レベルでジャッジの特異性を利用する可能性があり、項目の重みはヒューリスティックです。さらに、rubricベースのスコアリングをトレーニングrewardと主要評価指標の両方として使用しているため、同語反復のリスクがあります。CLIP/HPS/Aestheticの列がこれを部分的に緩和しているものの、最適化目標と評価を完全に分離するには至っていません。
なぜこれが重要か
ground truthのないオープンエンドな生成タスクに対して、VLMが評価するよく構造化されたインスタンスごとのrubricは、いかなるスカラー類似度指標よりも忠実なrewardであり、GRPOのような既製のRL機構と互換性があります。これは、ペア付き教師データが得られないUIコード生成や科学図版合成などの領域において、テキストから導出されたrubricを密で解釈可能なreward分解として活用するという一般的なレシピを示唆しています。
Source: https://arxiv.org/abs/2609.25270
GAE: 3D一貫した世界生成のためのジオメトリネイティブな潜在空間の学習
問題設定
動画・多視点生成モデルはフォトリアリスティックなフレームを生成しますが、一貫した単一の3Dシーンにコミットすることはほとんどありません。すなわち、視点をまたいでジオメトリがずれ、カメラが近似され、深度は事後的な出力となっています。著者らは、これはモデリング上の欠陥であるだけでなく、表現上の欠陥でもあると主張しています。Pixel VAE(SD-VAE、WAN2.1 VAE)は外観をエンコードしますが視点間の構造を捨てており、セマンティックオートエンコーダ(DINOv3上のRAEV2)は同一性を捉えますがメトリックジオメトリは捉えません。また、ジオメトリ基盤モデル(DA3)の生の特徴は階層的であり、直接 diffuse するには大きすぎます。本論文では、深度・カメラ・点群マップにネイティブにデコード可能でありながら、RGBもサポートするコンパクトな潜在表現が、同条件の学習のもとで3D一貫した生成を改善するかどうかを問います。
手法
GAEは、凍結されたDepth-Anything-3(DA3)バックボーンを中心に構築された2ステージのシステムです。Stage 1では、DA3の4レベル特徴階層を単一の空間潜在表現 \mathbf{z} に圧縮するコーデック \mathcal{A}_\phi=(\mathrm{Enc}_\phi,\mathrm{Dec}_\phi) を学習します。Stage 2では、標準化された潜在空間 \bar{\mathbf{z}} において条件付き flow-matching モデルを学習します。
順伝播パイプラインは次の通りです。
\mathbf{I}_{1:V}\xrightarrow{\mathcal{E},\mathcal{P}}\mathbf{X}_{1:V}\xrightarrow{\mathrm{Enc}_\phi}\mathbf{z}_{1:V}\xrightarrow{\mathrm{Dec}_\phi}\hat{\mathbf{X}}_{1:V},
ここで \mathcal{E} は凍結されたDA3エンコーダであり、\mathcal{P} はその4レベルを正規化・融合します。デコーダ \mathrm{Dec}_\phi はDA3の完全な階層を再構築し、凍結されたDA3 DPTヘッド \mathcal{H}_\mathrm{DPT} が再学習なしに深度・カメラレイ・点群マップを読み取れるようにします。同一の潜在表現からRGBをデコードする別の学習済みヘッド \mathcal{D}_\theta^\mathrm{rgb} も備えています。
\hat{\mathbf{I}}_{1:V}=\mathcal{D}_\theta^\mathrm{rgb}(\hat{\mathbf{z}}_{1:V}),\quad \hat{\mathbf{G}}_{1:V}=\mathcal{H}_\mathrm{DPT}(\mathrm{Dec}_\phi(\hat{\mathbf{z}}_{1:V})).
コーデックが凍結された後、その事後平均はチャネルごとに標準化(\mathrm{Std} を使用)され、flow のターゲット \bar{\mathbf{z}}^\mathrm{gt}_{1:V} が得られます。Stage 2では、\bar{\mathbf{z}}^{(1)}\sim\mathcal{N}(\mathbf{0},\mathbf{I}) を初期値として、生成視点の潜在表現のみに対して単一の条件付き flow \mathrm{Flow}_\psi(\cdot\mid\mathcal{C}) を学習します。条件 \mathcal{C} にはテキスト、ピクセルごとのカメラレイ(Plücker)、エンコードされた入力視点のクリーンな参照潜在表現が含まれます。これらはコントロールとして固定され、ターゲット視点のトークンのみがODEの状態として変化します。
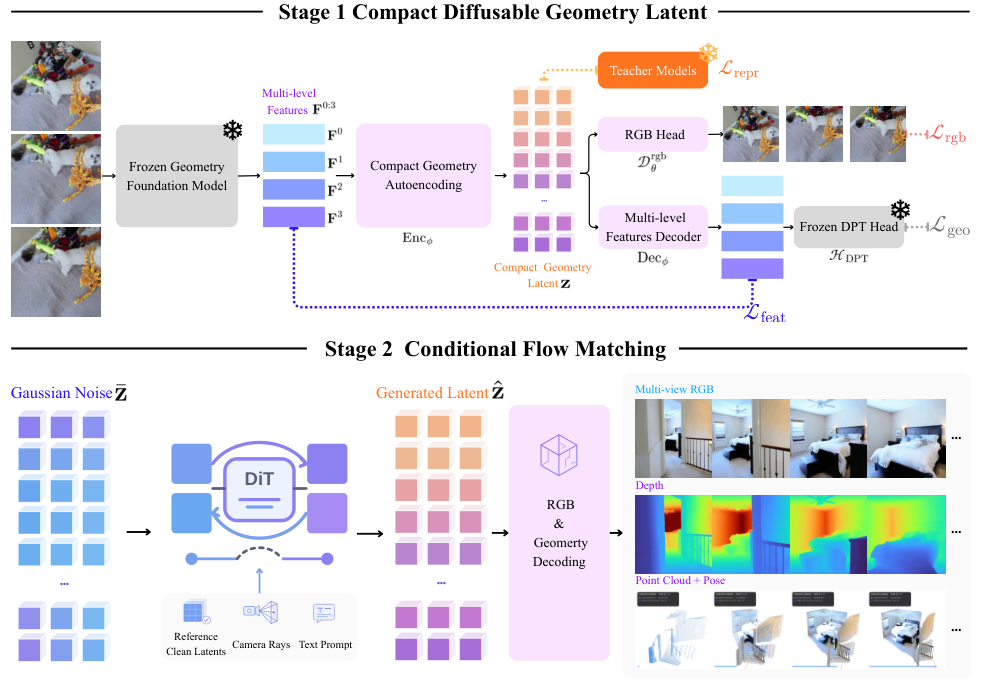
設計上の判断は重要です。DA3の全4レベルをモデル化するとカスケード型ジェネレータが必要になり、1レベル(例:L0やL3)のみを選択するとシングルスケールになりますが、ジオメトリ読み取りに損失が生じ、著者らのSection 4.1の分析によれば diffusion にとって条件付けが悪くなります。GAEはその中間的な状態、すなわち4レベルすべてを融合しつつ凍結されたDPTを通じてロスレスなジオメトリデコードを保持する単一の空間潜在表現を学習します。チャネル幅として GAE-64 と GAE-128 の2種類が検討されています。
結果
制御された比較では、flow アーキテクチャ、カメラ条件付け、学習予算、および50ステップ Euler / CFG=2 のサンプリングプロトコルを固定し、潜在表現のみを変化させます。ベースラインは SD-VAE、WAN2.1 VAE、RAEV2(DINOv3-L)、および生の DA3-GIANT レイヤー L0 と L3 です。評価は 252^2 の9視点で構成される64シーンの held-out セット(参照視点1枚)に対して行われます。
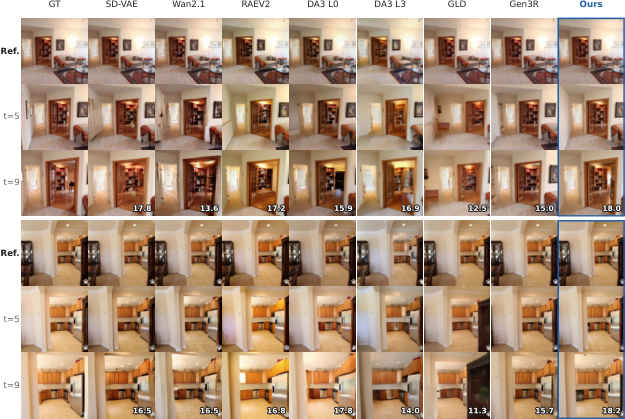
潜在表現をピクセル・セマンティック・生特徴コーデックからGAEへと切り替えるだけで、フォトメトリック品質および独立して計測された3Dコヒーレンスの両方が改善されます。
- FVD:マッチドベースラインに対して RealEstate10K で −12.7%、DL3DV で −23.1%。
- カメラ軌跡誤差:RealEstate10K において半減(生成されたシーケンスに対してオフザシェルフのポーズ推定器を適用し、条件付け軌跡と比較することで計測)。
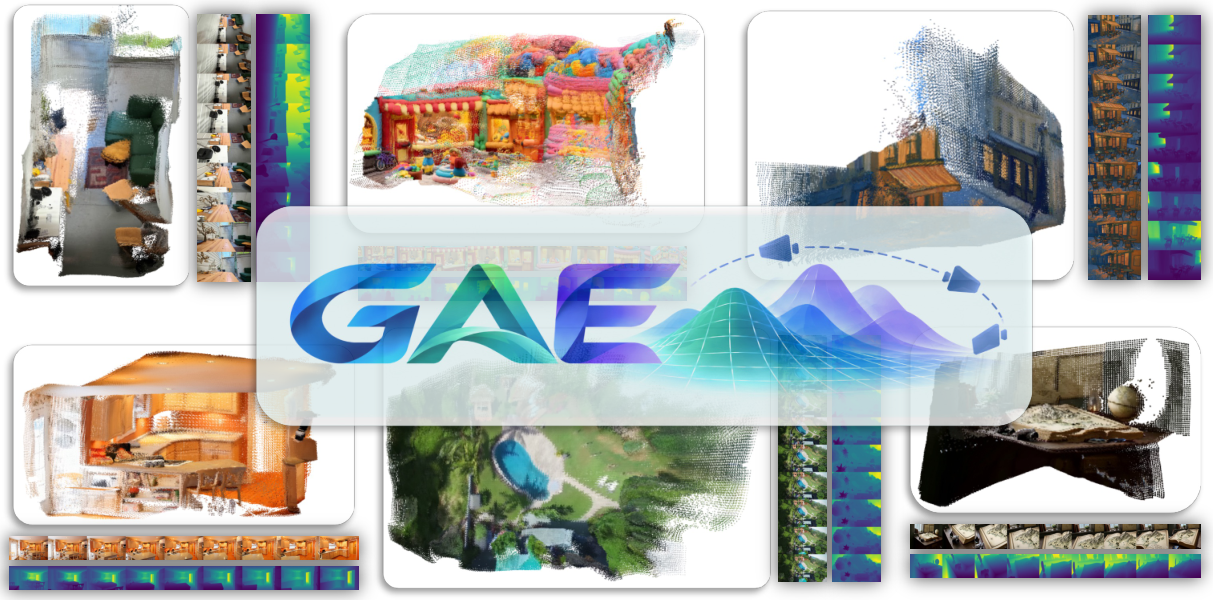
同一の潜在表現が凍結されたDA3ヘッドを通じてジオメトリをデコードするため、GAEは生成された各フレームに対してキャリブレーション済みの深度および点群マップをさらに出力します。論文ではこれをカメラのみの制御下での一貫した点群として可視化しています(Figure 1)。これは別途ボルトオンされた深度モデルではなく、ジオメトリ読み取りは再構築された特徴階層に適用された厳密に凍結されたDA3 DPTを使用しているため、flow が生成するいかなる潜在表現もそのヘッドにとって構造的に解釈可能です。
制限と未解決の問題
報告されている定量的な改善は 252^2、9視点、短い軌跡での制御された比較から得られたものであり、Section 4.3.4における大規模・高解像度モデルは定性的にのみ示されており、アブレーションの対象外です。ジオメトリの忠実度は凍結されたDA3バックボーンによって制限されており、DA3の深度・レイ予測における誤差やバイアスがそのまま伝播します。コーデックが特定の階層を再構築することに依存しているため、バックボーン固有の設計となっており、同じアプローチが他のジオメトリ基盤モデルに転用できるか、あるいはジオメトリヘッドの共同 fine-tuning から恩恵を受けられるかは検証されていません。また、flow 学習中に明示的な多視点幾何一貫性 loss は存在せず、3Dコヒーレンスは潜在表現の構造とカメラレイ条件付けから生じており、強制的な制約によるものではないため、積極的な軌跡下での長期ドリフトは未解決の問題として残っています。最後に、flow は標準化された潜在表現上で動作しますが、\mathrm{Std} の選択および CFG スケールに対する感度は網羅的には報告されていません。
重要性
この結果は、3D一貫した生成を表現の問題として再定式化するものです。すなわち、ジェネレータを同一に保ちながら、外観またはセマンティック潜在表現をジオメトリネイティブなものに置き換えるだけで、カメラ誤差が半減し、FVDが12〜23%削減されます。これは、生成と知覚が一つの状態を共有できることを示唆しており、動画モデルに「ジオメトリを追加する」ことは補助的な出力としてではなく潜在空間において行う方が望ましいことを示しています。
Source: https://arxiv.org/abs/2609.24981
StableVQ: 安定したVector-Quantized Tokenizerトレーニングのための実践的ガイドライン
問題
Vector-quantized tokenizer(VQGANおよびその派生)は自己回帰型およびマスク型画像生成の基盤となっていますが、そのトレーニングは悪名高いほど不安定です。近年のshared-projection codebook変種(SimVQ、FVQ)は、すべてのコードに作用する共有線形写像 f_\theta を通じて勾配をルーティングすることでcodebookの利用率問題を解決していますが、2つの失敗モードはそのまま残されています。第一に、f_\theta を通じて非アクティブなコードに到達する勾配信号は拡散的であり、少数のコード部分集合がVQ lossを最小化するのに十分になると、残りのコードに対して事実上消えてしまいます。第二に、これらの手法はcodebook側にしか対処しておらず、straight-through estimator(STE)のもとでencoderそのものの目的関数が不安定になる可能性があり、2つの失敗モードが相乗的に悪化します。
著者らは根本的な原因を絡み合い問題として捉えています。すなわち、encoderは有用な勾配を受け取るためにcodebookが適切にalignされていることに依存し、codebookはencoderが定常的なターゲット分布を生成することに依存しているということです。どちらかが崩れると、両方が崩壊します。StableVQはそれぞれのモジュールが独立して役割を果たせるよう、目的関数を分離します。
手法
StableVQは標準的なshared-projection tokenizerの上に2つの変更を提案します。
Dynamic STE(encoder側)。 標準的なSTEでは、\hat z = z_e + \mathrm{sg}(z_q - z_e) により、encoderは z_e における勾配であるかのように \partial \mathcal{L}_{\mathrm{rec}} / \partial z_q を受け取ります。これは \|z_q - z_e\| が小さい場合にのみ合理的な代替となります。トレーニング初期、またはコードによってまだカバーされていないencoder出力分布の領域では、このギャップは大きく、代入された勾配は信頼性の低い方向を指すため、commitment lossのスパイクと崩壊を引き起こします。Dynamic STEは各トークンのSTEへの寄与を、量子化距離の単調減少関数で重み付けします。コードから遠いトークンほど代替勾配が抑制されます。下図の右パネルは、標準STEのトレースが急激なcommitment lossスパイクを示して発散するのに対し、Dynamic STEはlossの軌跡を平坦に保つことを示しています。
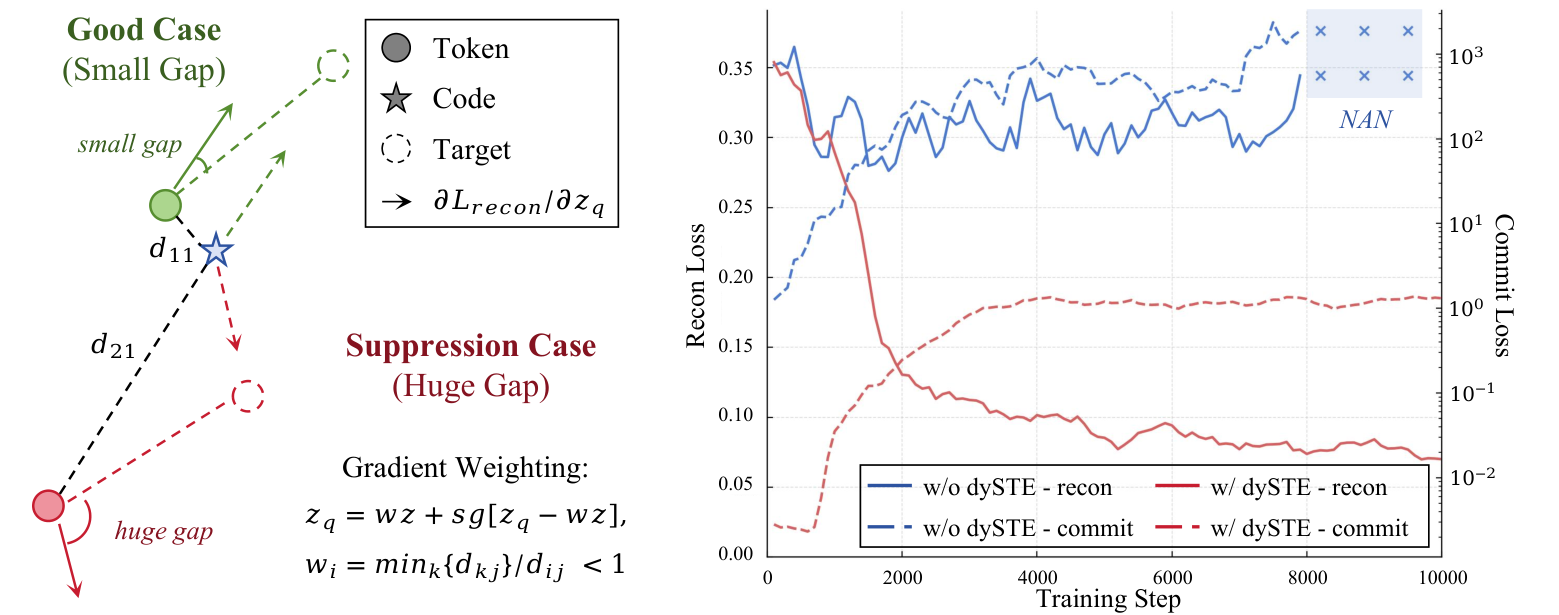
具体的には、encoderの勾配は次のようになります: \nabla_{z_e} \mathcal{L}_{\mathrm{rec}} \approx w(\|z_e - z_q\|)\,\nabla_{z_q}\mathcal{L}_{\mathrm{rec}}, ここで w(\cdot) は量子化ギャップに対して減少します。これによりencoderのcodebook品質への依存が断ち切られ、利用率が低い場合でも、信頼性の低い領域からのencoder更新は抑制され、再構成を不安定にすることはありません。
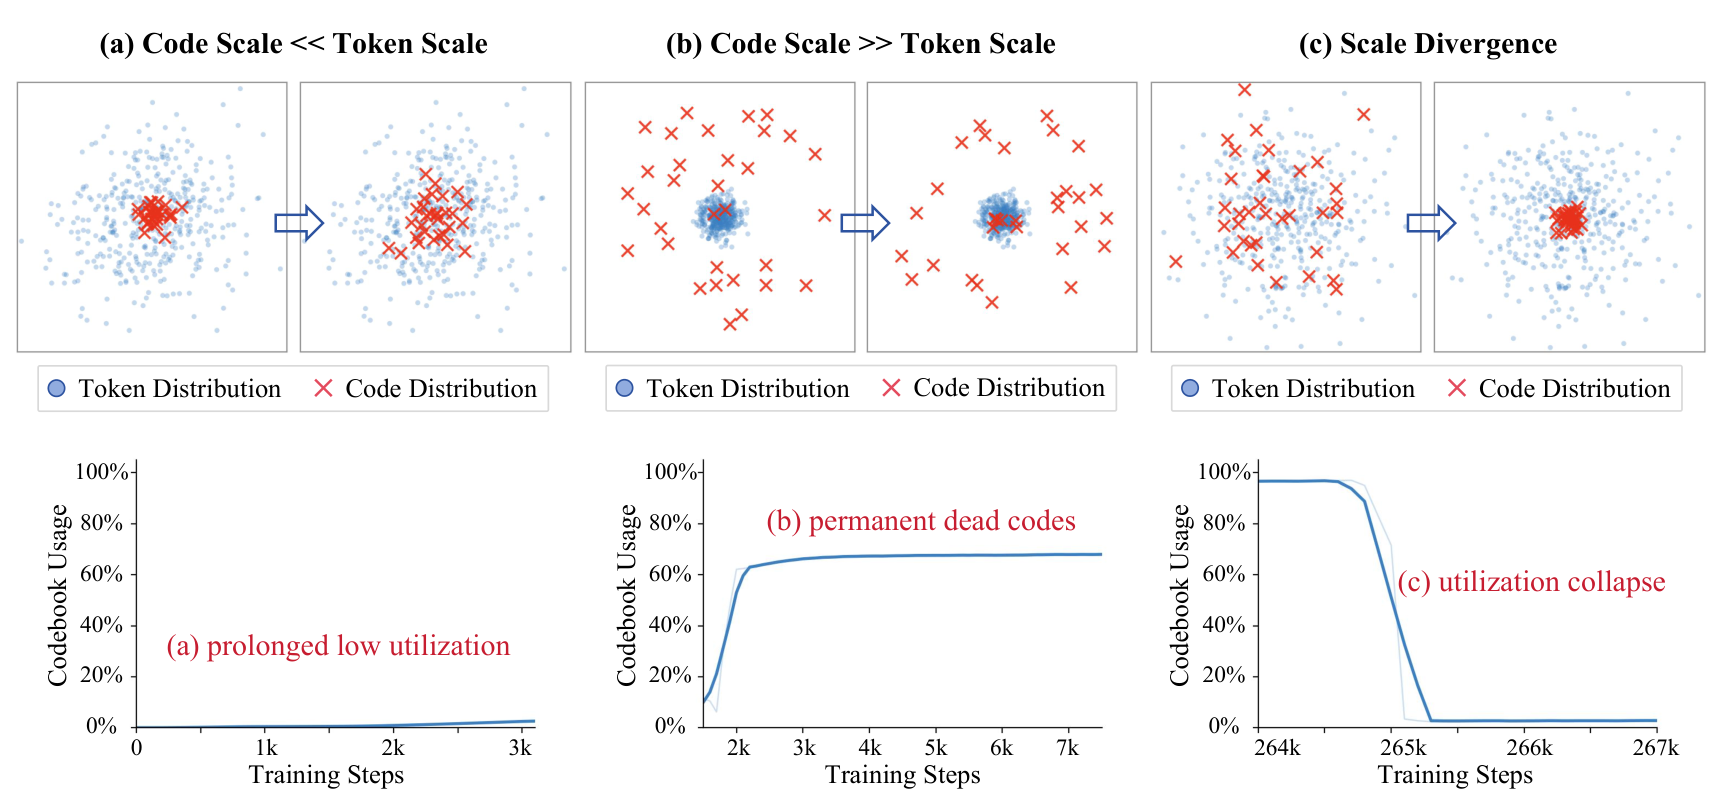
Region VQ Loss(codebook側)。 Shared-projection手法では、選択されたコードのみが割り当てられたencoder出力に向けて引き寄せられ、非アクティブなコードは f_\theta を通じた勾配の漏洩によってドリフトします。Region VQ Lossはその代わりに、アクティブなコードからcodeスペース内の空間的近傍へターゲットを伝播させ、各アクティブコードが選択された回数で重み付けします。形式的には、選択回数 n_k とターゲット重心 \mu_k(そのコードに割り当てられたencoder出力の平均)を持つ各アクティブコード c_k に対し、近傍の非アクティブコード c_j は次の形式の引力項を受け取ります: \mathcal{L}_{\mathrm{region}} = \sum_j \sum_{k \in \mathcal{N}(j)} \alpha(n_k, \|c_j - c_k\|)\,\|c_j - \mathrm{sg}(\mu_k)\|^2. 非アクティブなコードはこうしてencoder出力密度を直接追跡し、encoderがそれらにルーティングするかどうかとは独立して動作します。以下のt-SNEパネルは、トレーニングを通じてcodebook(赤)が高い利用率でencoder分布(青)をカバーするように収束する様子を示しています。
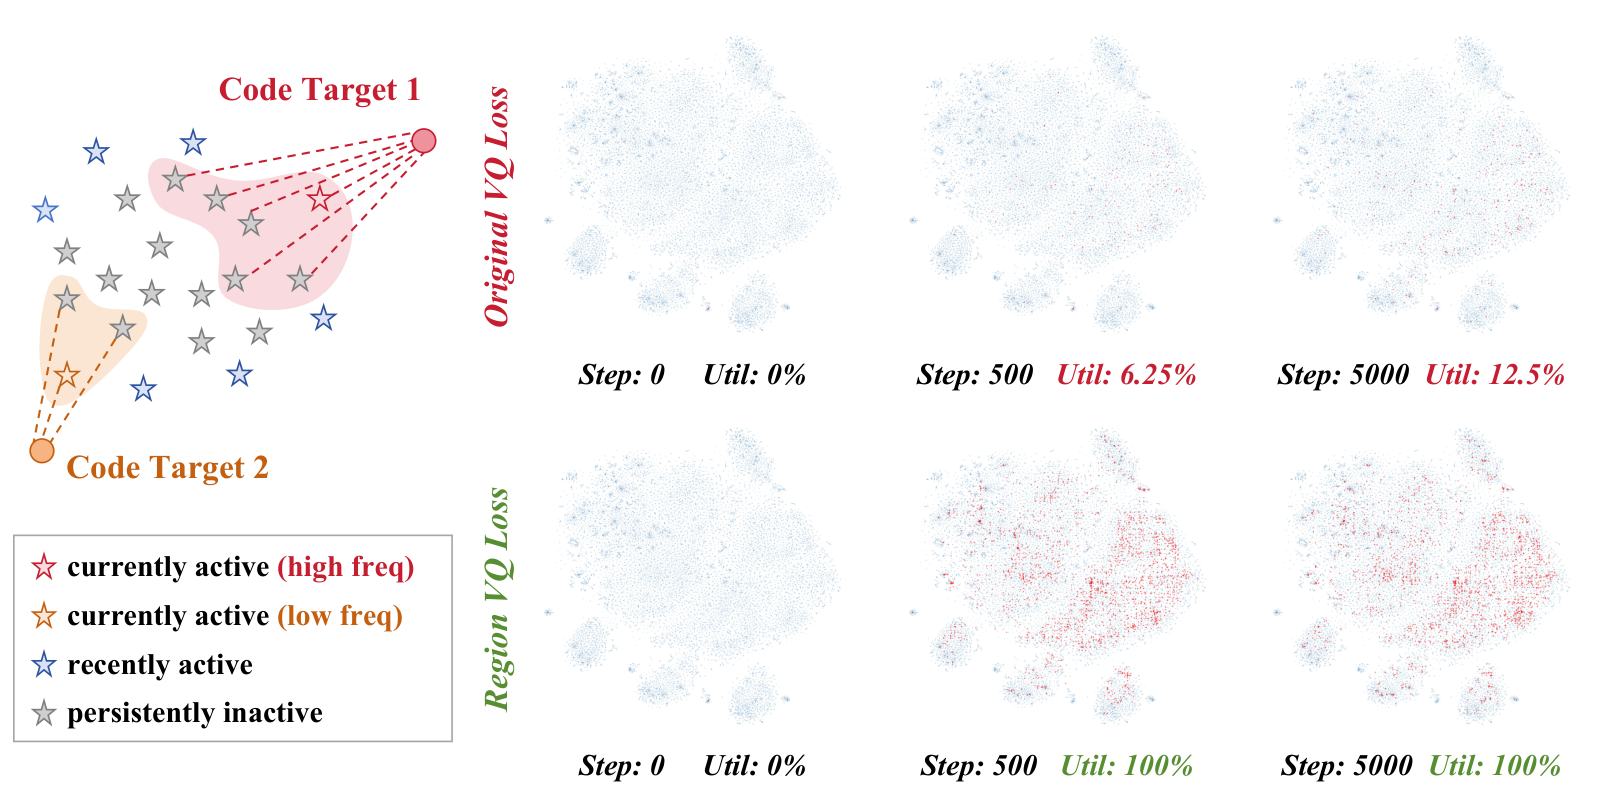
この2つのメカニズムを組み合わせることで、各サブシステムは相互依存なしに独自の目的関数を満たすことができます。すなわち、encoderはcodebookが不完全な状態でも離散正則化のもとで再構成を最適化でき、codebookはルーティングされているのが部分集合のみであっても encoder分布を追跡できます。
結果
ダウンサンプルファクター f=16(16\times 16 = 256 トークン/画像を生成)のVQGANエンコーダ・デコーダを用いたImageNet 256\times 256 において、StableVQはSimVQおよびFVQとオンザフライ再構成評価(保存後に再ロードするのではなく、著者らがベースラインに対して楽観的な数値を生み出すと主張する方式の代わり)のもとで比較されます。デフォルトのStableVQは最も単純な実装として、単層線形shared projectorを使用します。報告されるメトリクスはImageNet検証セットにおけるrFID、LPIPS、およびcodebook利用率です。本論文の主張は、両コンポーネントが必要であるというものです。Dynamic STEのみではencoderの崩壊を防ぎますがcodebookが拡散したままになり、Region VQのみでは良好なカバレッジを得られますが大きなcodebookサイズではencoder側の不安定性を止められません。
限界と未解決の問題
提供された抜粋には具体的なrFID/LPIPSの数値やablationが列挙されていないため、同一計算量のもとでのSimVQ/FVQに対する改善の大きさはここでは定量化されていません。いくつかの問題が残っています。(i) Region VQにおける近傍 \mathcal{N}(j) と重み付け \alpha の選択はcodebookの次元数と相互作用する可能性が高い。(ii) Dynamic STEの重み付けスケジュールは再構成lossのスケールに合わせてチューニングする必要がある。(iii) VQGANパイプラインで一般的なadversarial fine-tuningステージにおいて、あるいは密度引数が困難になる大規模codebook(例えば 2^{16})にスケールした場合に、安定性の向上が持続するかどうかは不明です。
この研究が重要な理由
VQ tokenizerのトレーニングは、下流の生成モデリング研究の巨大な塔を支える脆弱な基盤となっています。また別のcodebookの工夫ではなく、encoder側とcodebook側の目的関数の原則的な分離は、非決定論的なトレーニング失敗のクラス全体を排除する種類の安定化修正です。これらのメカニズムが大規模codebookや高解像度に転用できれば、現在SimVQやFVQに依存するあらゆるパイプラインにほぼそのまま導入できるはずです。
Source: https://arxiv.org/abs/2609.26774
Flash-dLLM: IO-Aware KV Caching and Parallel Decoding for Fast, Memory-Efficient Diffusion LLMs
Diffusion LLM(dLLM)は、左から右へのサンプリングではなく、マスクされた位置を反復的にデノイジングすることでテキストを生成します。これにより、自己回帰的な KV caching を自明にするような因果構造が失われます。各デノイジングステップ t において、「アクティブ」なクエリ位置の集合 \mathcal{Q}^t = \mathcal{D}^t \cup \mathcal{M}^t_{\beta_m} — 新たにデコードされたトークンと依然としてマスクされたトークンのスライディングウィンドウ — が変化し、それらの位置に対応する K/V の行を書き直す必要があります。既存のアクセラレータ(Fast-dLLM、Elastic-Cache)はキャッシュ更新ポリシーと並列デコーディングを独立した問題として扱い、すべてを PyTorch で実装しているため、QKV projection、RoPE、キャッシュ書き込み、attention のそれぞれに対して個別のカーネルを起動しています。Flash-dLLM は、このような状況における真のボトルネックは FLOPs や更新頻度ではなく HBM トラフィックであると主張し、融合カーネルと KV-cache ネイティブな draft-and-verify スキームを共同設計します。
キャッシュ済み dLLM attention における IO 問題
スライディングウィンドウキャッシング(Elastic-Cache に準拠)のもとで、レイヤー l、ステップ t における attention は次のように表されます。
\mathbf{A}^{t,l}_{[\mathcal{Q}^t]} = \mathrm{softmax}\!\left(\frac{\mathbf{Q}^{t,l}_{[\mathcal{Q}^t]}(\tilde{\mathbf{K}}^{t,l}_{[\mathcal{I}]})^\top}{\sqrt{d_k}}\right) \tilde{\mathbf{V}}^{t,l}_{[\mathcal{I}]},
インプレース更新 \tilde{\mathbf{K}}^{t,l}_{[\mathcal{Q}^t]} = \mathbf{K}^{t,l}_{[\mathcal{Q}^t]} および V についても同様です。キャッシュは \mathcal{Q}^t 上では正確であり、それ以外では古い値となります。素朴な実装では、新たに射影された \mathbf{K}^{t,l}_{[\mathcal{Q}^t]}, \mathbf{V}^{t,l}_{[\mathcal{Q}^t]} のテンソルは QKV projection と RoPE の後に HBM へ書き込まれ、その後 attention カーネルによって読み戻されます。さらに、全体の \tilde{\mathbf{K}}^{t,l}_{[\mathcal{I}]} はすべてのレイヤー・すべてのステップで HBM を通じてストリーミングされます。|\mathcal{Q}^t| \ll |\mathcal{I}| であるため、転送バイトあたりの演算強度は非常に低く、この操作はメモリバウンドとなります。
手法:Flash-Cache と Flash-Verify
Flash-dLLM は二つのコンポーネントから構成されます。
Flash-Cache は Triton カーネルであり、QKV projection、RoPE、\tilde{\mathbf{K}}, \tilde{\mathbf{V}} へのスキャッタ書き込み、そして全 [\mathcal{I}] キャッシュに対する [\mathcal{Q}^t] クエリの attention を単一のカーネル起動に融合します。更新された K/V の行はレジスタ/SRAM に保持され、attention のエピローグで直接消費されます。HBM に触れるのは最終的な attention 出力と \mathcal{Q}^t の永続キャッシュスロットのみです。これにより \mathbf{K}^{t,l}_{[\mathcal{Q}^t]}, \mathbf{V}^{t,l}_{[\mathcal{Q}^t]} の中間書き込み・読み出しが除去され、レイヤーごとのカーネル起動オーバーヘッドが削減されます。
Flash-Verify は draft-and-verify 型の並列デコーディングスキームであり、自己回帰的な投機的デコーディングとは異なり、補助的な小型モデルを必要とせず、同一モデルをドラフターと検証器の両方として再利用します。各イテレーションにおいて、dLLM は現在のブロック内のすべてのマスク位置に対するトークン確率を生成します。信頼度がドラフト閾値 \epsilon = 0.9 を超える位置は投機的にコミットされます。続く検証パスでは、追跡された \beta_t = 80 トークンの予算に対して検証閾値 \gamma = 0.8 を用い、コミットされたドラフトが更新されたキャッシュのもとで整合性を保つかどうかを確認し、整合しないトークンはマスク状態にロールバックされます。ドラフティングと検証の両方に同一の KV キャッシュが使用されるため、ロードや同期が必要な別モデルは存在せず、検証の追加コストは同一の融合カーネルによる単一フォワードパスのみです。デフォルトのブロックサイズは \beta = 16、スライディングマスクウィンドウは \beta_m = 64 です。
結果
評価は LLaDA-1.5 を用いて GSM8K(デフォルト)、MATH、HumanEval、MBPP で行われ、単一の A100-80GB、生成長 512 の条件下で、No-Cache、Fast-dLLM、Elastic-Cache と同一設定での比較が実施されています。Flash-dLLM の三つの構成が報告されています:greedy(Flash-Cache のみ)、confidence-aware(Flash-Cache + confidence decoding)、Flash-Verify(Flash-Cache + draft-and-verify)。
スケーラビリティの結果が最も明確なシグナルです。GSM8K-512(1-shot)において、Flash-dLLM のスループットはバッチサイズ 32 まで概ね線形にスケールするのに対し、Fast-dLLM は同一の 80GB A100 でバッチサイズ 24 において OOM が発生します。ピークメモリはすべてのバッチサイズにわたってすべてのベースラインを下回っています。同一バッチでの Llama3-8B の自己回帰ベースラインとの比較により、融合カーネルを用いた dLLM のパスは標準的な AR ベースラインに対してメモリ面で不利ではなくなったことが示されています。Flash-Cache は式 (1) の数学的形式を変更しない — スケジュールを融合するだけである — ため、greedy デコーディングにおいて GSM8K/MATH/HumanEval/MBPP の生成品質は Elastic-Cache と比較して維持されます。Flash-Verify では、並列コミットによる品質劣化を抑制するために \gamma でゲートされたロールバック機構が導入されています。
限界と今後の課題
報告された結果は単一のモデルファミリー(LLaDA-1.5)と単一の GPU クラス(A100)に限定されています。このカーネルは Triton 2.0 固有であり、FlashAttention-3 スタイルのワープ特殊化が支配的な H100/MI300 のメモリ階層に対しては再チューニングが必要です。Flash-Verify の品質は (\epsilon, \gamma, \beta_t) の共同キャリブレーションに依存しており、論文では固定値が使用されており、適応的なスケジュールは提示されていません。Elastic-Cache のような適応的更新と融合カーネルの相互作用は十分に検討されておらず、Flash-Cache は更新自体を IO-aware にするのではなく、Elastic-Cache のスライディングウィンドウポリシーを継承しているように見えます。最後に、このフレームワークはトレーニング不要ですが、LLaDA ファミリー以外の dLLM に対する結果は示されておらず、同じ fusion パターンが異なるマスキングスケジュール(例:スコアエントロピーベースの dLLM)を持つモデルに有効かどうかは不明です。
この研究の意義
Diffusion LLM の推論は、アルゴリズム的な並列性にもかかわらず自己回帰ベースラインとの比較において継続的に競争力を欠いていましたが、本論文はその原因がデノイジングの本質的なコストではなく、キャッシュ更新パスにおける HBM トラフィックであると診断しています。融合 Triton カーネルと自己ドラフト型検証器の組み合わせは、A100 上でそのギャップの多くを埋めるシンプルな手法であり、dLLM のデプロイ実現可能性が現在はモデリングの問題ではなくシステムの問題であることを示唆しています。
Source: https://arxiv.org/abs/2609.26796
RoboFollow: 身体化エージェントにおける指示追従の幻想を明らかにする
問題設定
身体化マニピュレーションベンチマーク(LIBEROバリアントなど)で報告されている成功率は、現代のVLAおよびworld-actionモデル(WAM)が自然言語指示を確実に追従していることを示唆しています。著者らはこれが主に学習データの低シーンエントロピーに起因するアーティファクトであると主張します。すなわち、ある視覚的構成が唯一の妥当なタスクしか許容しない場合、ポリシーは指示を無視しても成功できるのです。このベンチマークは、構造的に言語の使用を強制するよう設計されており、ポリシーが実際に指示に条件付けられているかどうかを診断します。
手法
設計の中核となる原理は定量的なものです。T を学習タスクラベル、S をタスク非依存のシーン仕様(オブジェクト、配置、観測可能な述語、ただし指示とゴールを除く)とします。シーンエントロピーは次のように定義されます。
H_{\mathrm{scene}} = -\sum_s p(s) \sum_t p(t\mid s)\log_2 p(t\mid s).
タスクごとのデモンストレーション数が等しい場合、これは H_{\mathrm{scene}} = \sum_s (K_s/K)\log_2 K_s に簡約されます。ここで K_s はシーン s を共有するタスクラベルの数です。RoboFollowは K_s = (16,16,16,16,7,4)、K=75 を使用し、3.782ビットを実現しています。これは同一のタスクラベル定義のもとで均等重み付けされたLIBERO Spatial/Object/Goal/Longの0.880ビットと対照的です。したがって各シーンは、同一またはほぼ同一の視覚情報のもとで、運動学的に異なる複数の分岐を許容します。そのため初期観測からターゲットを推定することは本質的に不可能です。
このベンチマークは、外的空間関係、物体の固有属性(色・形・サイズ)、行動・軌道制約、および基礎的論理的根拠付けを網羅する4つの診断用シーンファミリーを含んでいます。各ファミリーは4つのレベルで評価されます。
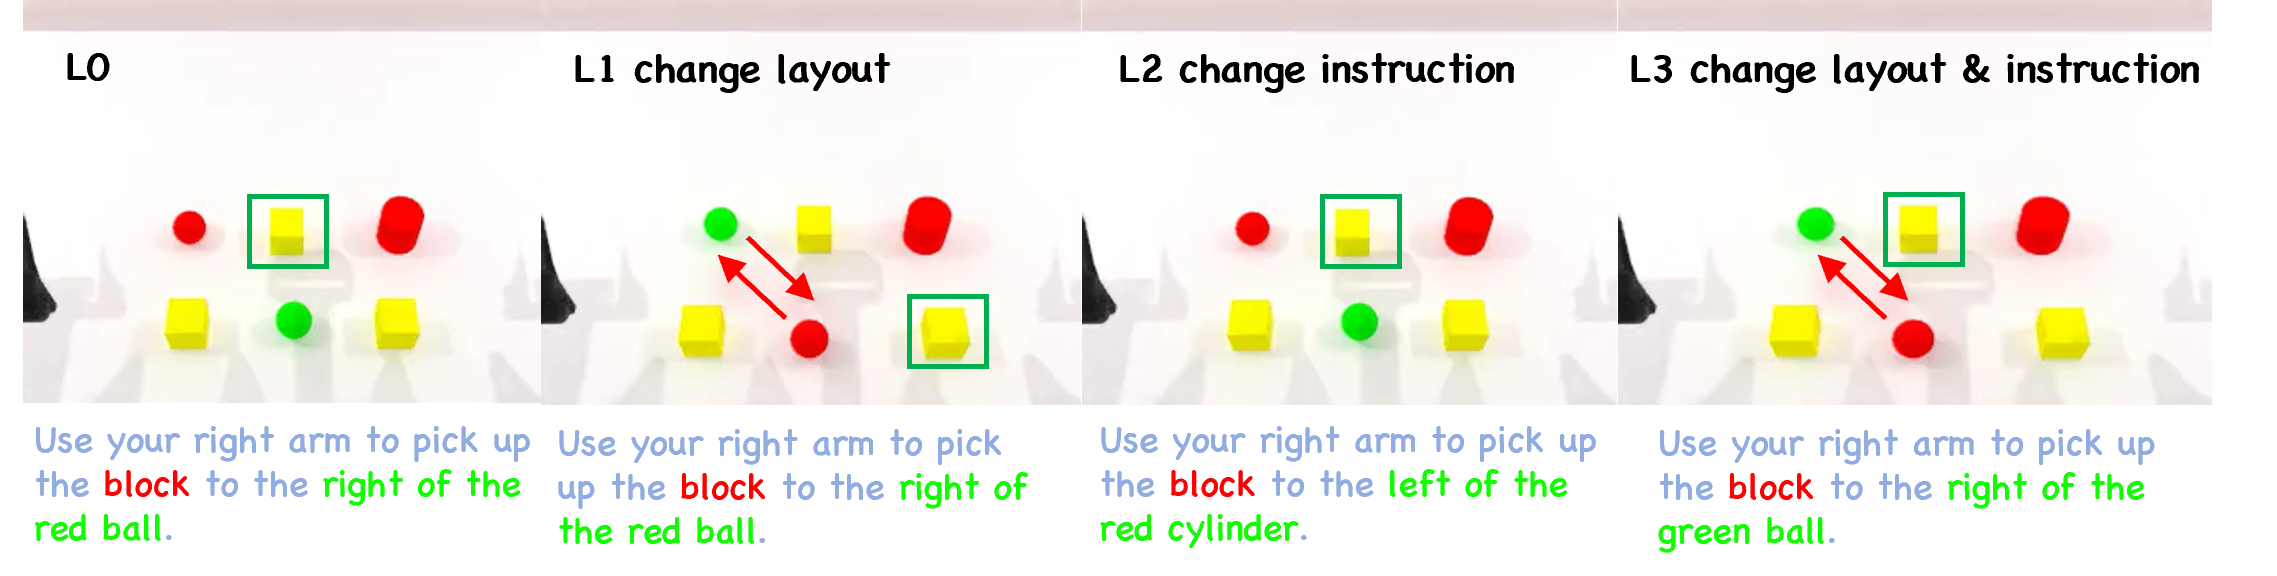
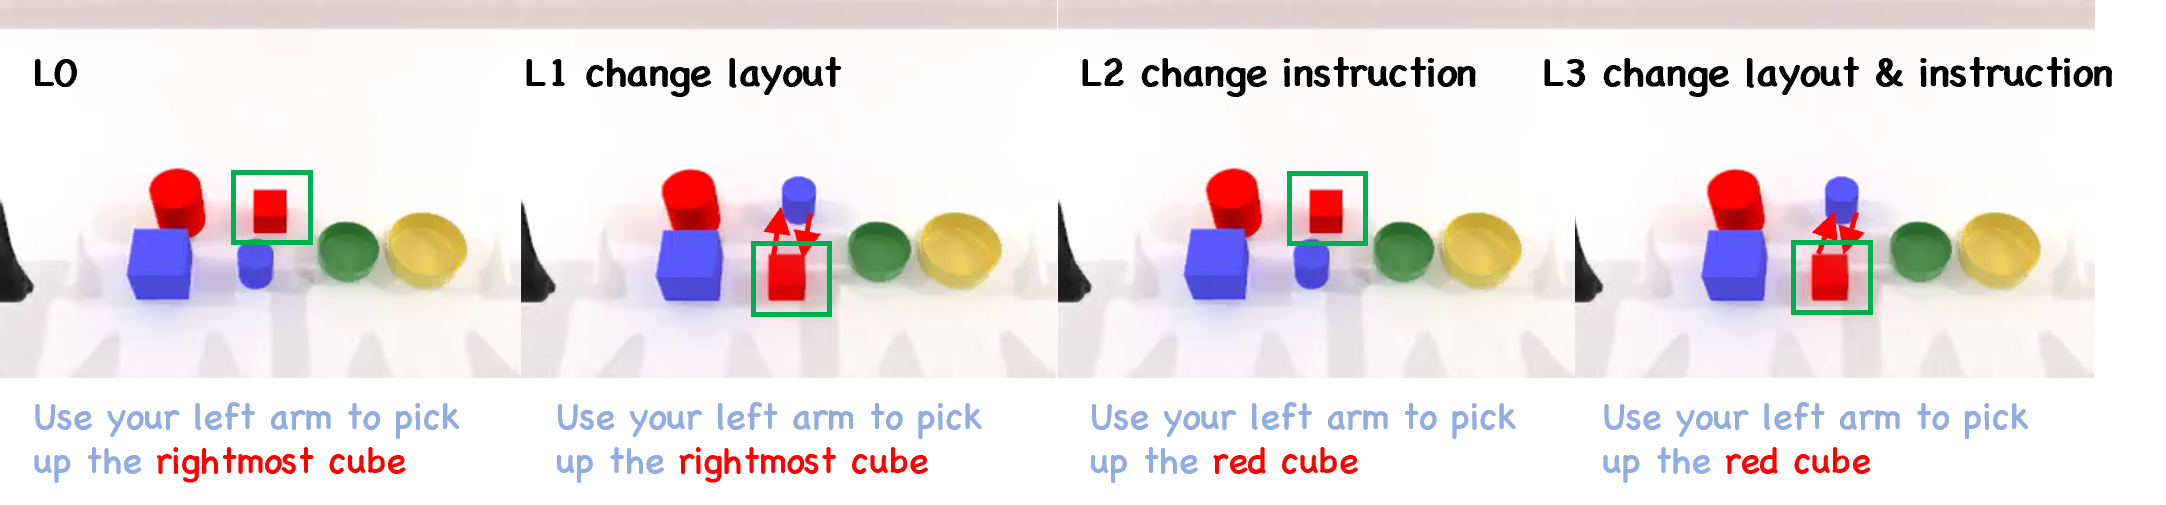
- L0(分布内) — 学習と一致する標準的な分割。
- L1(視覚的根拠付け) — 指示は固定し、オブジェクトの位置を入れ替える。座標ではなくエンティティへのバインディングを検証。
- L2(意味的構成性) — レイアウトは固定し、指示は見た原子的要素からの新規な属性再結合を使用。
- L3(視覚・意味的混合) — 両方を同時に摂動。
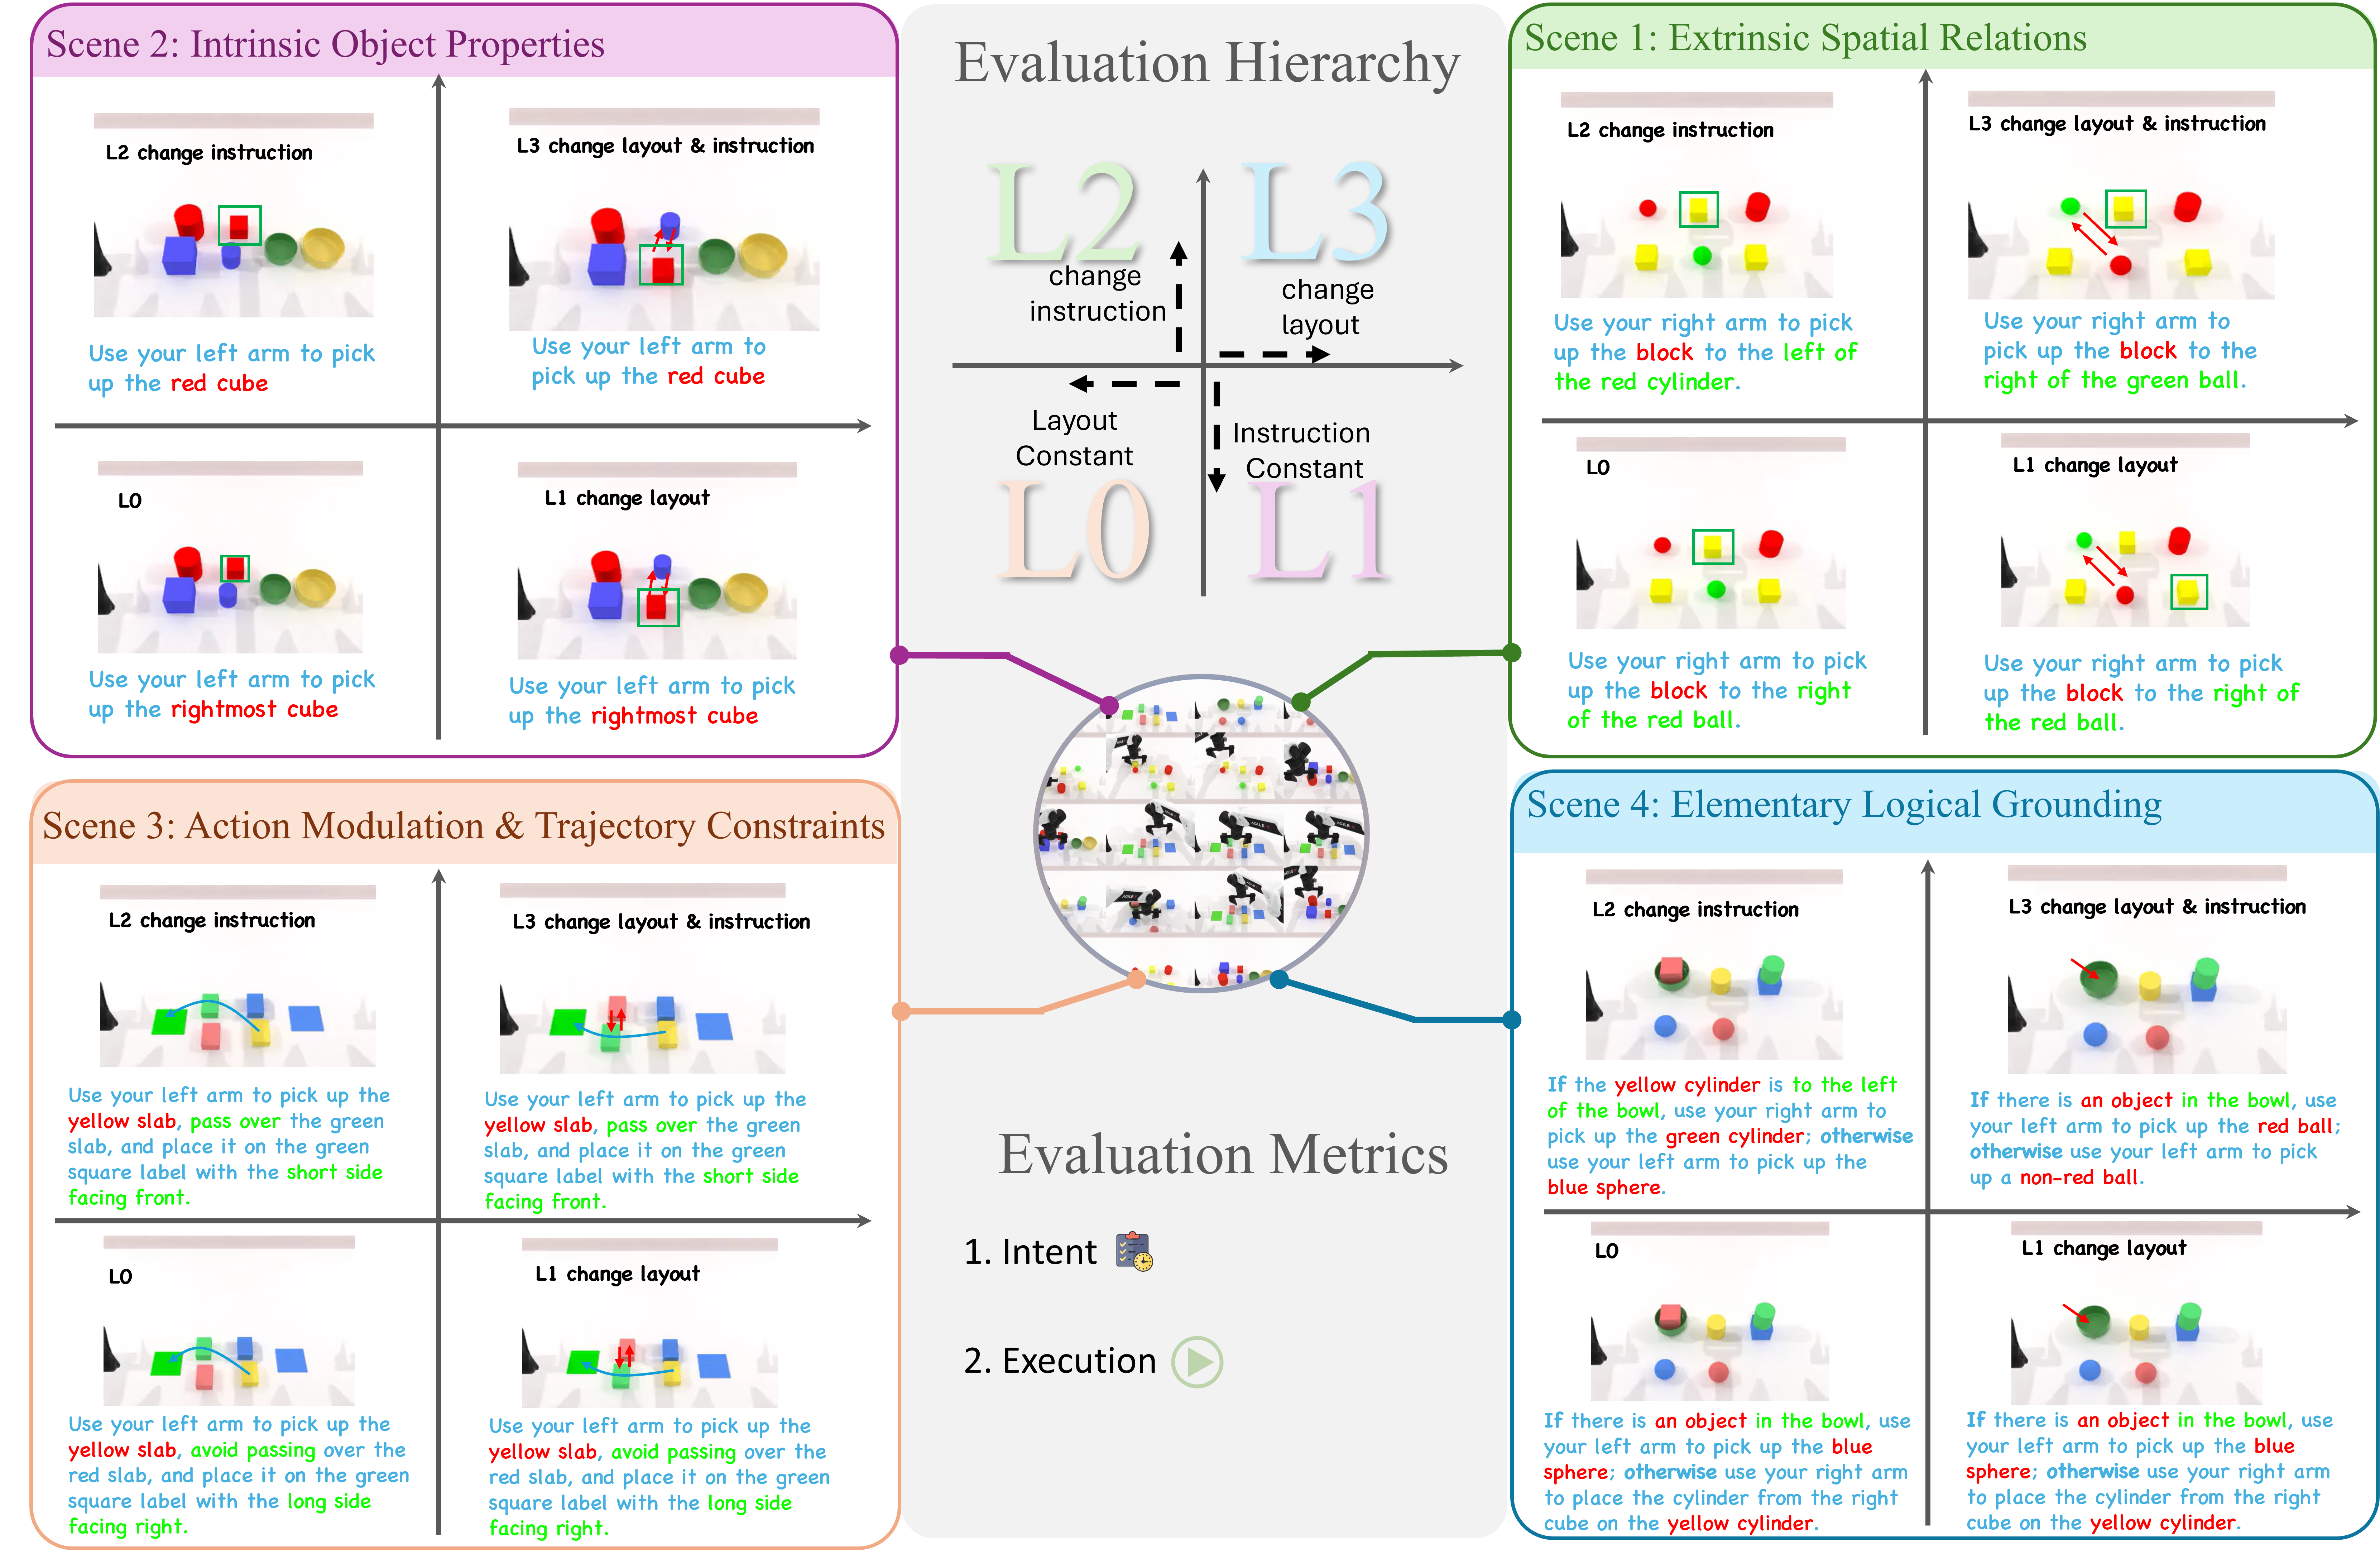
評価は交絡因子制御されています。インタラクション対象オブジェクトは簡略化され、行動レパートリーはデモンストレーションされたものに限定されており(したがって失敗は未見の運動スキルに帰せられません)、スコアリングはステージごとのIntent(ポリシーが正しいタスクを実行しようとしたか?)とExecution(正しい意図のもとで動作が成功したか?)スコアに分解されます。これにより理解能力と運動能力が分離されますが、これは成功率のみの報告では欠如していることが多い重要な制御です。
9つの最先端の基盤ポリシーが評価されています。7つのVLA(\pi_0、\pi_{0.5}、GR00T N1.6、openvla-oft、xvla、ACoT-VLA、Lingbot-VLA)と2つのWAM(MotusおよびFAST-WAM)です。学習データの合計は4つのシーンにわたる3,750エピソードです。より詳細な分析にはシーン2のみから16タスク(800エピソード)が使用されます。
結果
主要な知見は、L0での高いスコアがL1〜L3に転移しないというものです。分布内で有能に見えるポリシーは、視覚的レイアウトや指示の表現が摂動されると著しく性能が劣化します。これは、ポリシーが指示を構成的な仕様としてではなく、浅いシーン識別子として使用していることを示しています。
シーン2の診断は、失敗がどこに存在するかを切り離して特定します。
著者らは、オブジェクトのアイデンティティ・色・空間関係を網羅するシーン2上での20問の視覚的QAプローブを構築し、生のPaliGemmaバックボーン、事前学習済み \pi_{0.5}、fine-tuning済み \pi_{0.5} を評価します。スコアはそれぞれ1/20、2/20、3/20であり、VLMコンポーネントはシーンをまったく理解していないことがわかります。マニピュレーションデータによるfine-tuningでわずかに改善するに留まります。さらに際立っているのは、fine-tuning済みVLMがQAアイテムに正解する場合でさえ、対応するマニピュレーションエピソードの約半数が依然として失敗するという点です。同様のパターンはMotusにも見られます。MotusではVLMバックボーンが完全に固定されており、正しい視覚的理解が正しい行動に伝播されません。
これにより、二層構造の失敗が明らかになります。(i) VLMバックボーンはそもそもシーン理解が不足しており、(ii) action headは理解された意味論を忠実に行動に変換できない、というものです。報告された成功率は、どちらかを視覚的ショートカットによって回避できるベンチマークのもとで、両方の失敗を吸収してしまっています。
限界とオープンな課題
RoboFollowは意図的に狭く設計されています。簡略化されたオブジェクト、制限された行動、そして4つのシーンファミリーのみです。高いシーンエントロピーは工学的に設計されたものであり、自然発生的なものではないため、そのギャップがどの程度データキュレーション(将来の学習セットで修正可能)に起因するのか、あるいは現在のVLA/WAMスタックのアーキテクチャ的限界に起因するのかは不明です。論文では、より強力なVLMバックボーンへのスケーリングとQA共同学習が改善策の候補として報告されていますが、抜粋では定量的な解決策にはコミットしておらず、現在の緩和策のいずれかが理解・実行ギャップを埋められるかどうか、あるいは忠実な意味論から行動へのグラウンディングが、容量の増大ではなく、異なる学習目的(例えば、明示的な意図監督、反事実的指示拡張)を必要とするかどうかはオープンな課題です。
重要性
RoboFollowのエントロピー(3.782ビット)とLIBERO(0.880ビット)のギャップが代表的なものであるならば、現在の身体化エージェントの成功率の大半は視覚的ショートカット活用を指示追従と混同しており、この分野は言語的根拠付けに関して較正されたシグナルを欠いています。Intent/Execution分解とL0〜L3プロトコルは、これまで不可視であった理解・実行ギャップを測定するための具体的な手段を提供します。
Source: https://arxiv.org/abs/2609.25636
Agensh: 1,024エージェントへの組織的知能のスケーリング
問題
現在のマルチエージェントLLMハーネスは、サブタスクを割り当てワーカーの出力を統合する中央オーケストレータにボトルネックがあります。ワーカー数が増えるにつれ、オーケストレータのcontext window、意思決定レイテンシ、および単一ポイントでの調整コストが支配的になり、有用な並列性は数十エージェント程度に制限されます。本論文が問うのは、オーケストレータを完全に排除し――共有ワークスペースと協調プロトコルに置き換えることで――エージェント数そのものが、パラメータ数や推論計算量と同様のスケーリング軸になり得るかどうかです。特に、探索空間が大きいものの検証可能な長期的ソフトウェアエンジニアリングタスクにおいてその可能性が問われています。
手法
Agenshは分散型ハーネスです。すべてのワーカーが同一の5ステップの非同期ループを並行して実行します。
- コンテキストの収集 — ユーザーゴール、共有ワークスペースの状態、ピアメッセージ、および蓄積された知見を読み取り、環境を探索する。
- サブタスクのクレーム — 意図する作業の範囲を共有コンテキストに
CLAIMレコードとして投稿する。重複するクレームは仲裁者ではなく、メッセージインタフェースを介してワーカー間で解決される。 - アクションの実行 — ツールをローカルで実行し、中間的な知見をピアが再利用できるよう共有コンテキストにストリーミングで書き戻す。
- 結果の検証 — ローカルの出力をサブタスクの自己宣言した受け入れ基準と照合し、満足するまで反復する。
- 進捗のマージ — 共有ワークスペースにコミットし、変更サマリーと検証証拠を公開する。マージコンフリクトが発生した場合はピアの更新を取得し、解決して再試行する。
サポートインフラは3つのコンポーネントから構成されます。共有ワークスペース(提案中・進行中・完了済みのアーティファクトを保持するVCS的な基盤で、並行マージを許容する)、メッセージインタフェース(ワーカー間の直接通信用)、そして再利用可能な知見と宣言された意図を永続化する共有コンテキストログです。グローバルなスケジューラは存在せず、サブタスクの発見・割り当て・コンフリクト解決はすべてループと3つの共有インタフェースから創発的に生じます。これは本質的に楽観的並行性モデルです。ワーカーはクレームを主張し、投機的に作業を行い、マージ時に調整します――分散VCSが大規模な開発者集団にスケールする際のパターンと同じです。
重要なメカニズム上の帰結として、ワーカーあたりの調整コストは、そのワーカーが共有コンテキストから読み取ることを選択した量によって制限され、オーケストレータのコンテキスト予算には依存しません。これが1,024の並行エージェントを現実的に可能にする要因です。
結果
評価にはProgramBenchの最難関5タスク(FFmpeg、gromacs、pandoc、PHP-src、ctags)を使用しており、エージェントはインターネットなしで6時間以内に参照システムの動作をスクラッチから再現しなければなりません。参照リポジトリの規模は約104K LoC(pandoc)から約2.8M LoC(PHP-src)に及びます。バックボーンモデルはGPT-5.6-sol(high)で、基盤となるシングルエージェントハーネスにはCopilotを使用し、変化させるのはエージェント数のみです。
5タスクにわたる平均最終テストパス率:
- 1エージェント:19.31%
- 8エージェント:20.68%
- 32エージェント:26.52%
- 128エージェント:28.78%
1→128へのスケーリングで絶対値+9.47 pp、相対値約49%の向上が得られます。曲線は全範囲にわたって単調増加であり、8エージェントから32エージェントの間に最大のジャンプが見られます。これは、自己組織化のオーバーヘッドが利得を上回るしきい値の存在を示唆しています。
レイテンシもスケールとともに改善します。pandocにおいて、128エージェントは30分チェックポイントで30%のテストパス率を超えます。32エージェントは60分、8エージェントは90分で達し、1エージェントは最初の2時間以内には到達しません。つまり、ワーカーが増えることで上限が引き上げられるとともに、品質到達時間も短縮されます――真のスケーリング軸に期待される2つの効果を兼ね備えています。
pandoc限定で1,024エージェントまで拡張した結果、最終テストパス率は1エージェントの33.89%から128エージェントの50.94%、さらに1,024エージェントの55.06%へと向上しました。128から1,024の間――計算量8倍の増加――で得られる利得はわずか4.12 ppに過ぎず、1から128の間の17.05 ppと対照的です。曲線は曲がりつつあり、この構成では約10³ワーカー付近でエージェント数に対するリターンが線形以下となり、平坦化しているように見えます。
限界と未解決の問題
いくつかの点が未解決です。まず、128→1,024における収穫逓減が分析されていません。それは重複作業なのか、マージの競合なのか、共有コンテキストが個々のワーカーの入力予算を飽和させているのか、それとも本質的なタスク固有の限界なのかが不明です。本論文はトークンコスト、単位利得あたりのウォールクロックコスト、コンフリクトが発生するマージの割合を報告していません。第二に、1,024エージェントの結果は5つのリポジトリの中で最小のpandoc(約104K LoC)のみで示されており、探索空間がより大きいPHP-src(約2.8M LoC)にスケーリングが拡張されるかどうかは不明です。第三に、ステップ4の受け入れ基準メカニズムはワーカーによる自己宣言であり、独立した検証者が存在しないため、ローカルでは検証済みだが全体としては誤った貢献をマージすることが可能です。第四に、「自己組織化」はプロトコルレベルのものであり、1,024エージェント間で実際に創発する分業の様相、冗長性の割合、通信トポロジーは特徴付けられていません。最後に、同等の計算量でのオーケストレータ型ハーネスとの比較がないため、単に「より多くのエージェント」に対して分散化そのものが持つ独立した価値を切り離せません。
なぜこれが重要か
エージェント数がモデルサイズとエージェントあたりの推論計算量に並ぶ第三のスケーリング軸となり、分散型ハーネスがそれを解放するものであれば、長期的なソフトウェアタスクは直列推論の問題ではなく、計算並列の問題になります。ここでの1→128の曲線は、自己組織化マルチエージェント協調が低い桁の数十を超えてスケールするという最初の説得力ある証拠です。ただし、128→1,024での平坦化は、今後の重要なエンジニアリング課題が曲線の上端における調整冗長性の削減にあることを示唆しています。
Source: https://arxiv.org/abs/2609.26781
Hacker News シグナル
エージェントにコードを高速化させることでRustの高速なコードを書く
Source: https://minimaxir.com/2026/09/agentic-iteration/
LLMエージェントを反復ループで使用し、正確性ではなくパフォーマンスのためにRustコードを最適化する実践的なウォークスルーです。著者はフィードバックサイクルを構築しています:Rustを生成し、criterionでベンチマークを取り、タイミング結果とフレームグラフデータをエージェントにフィードバックして反復するというものです。重要な洞察は、エージェントは「速くしてください」という曖昧な指示よりも、具体的な計測アーティファクトを与えられた方がより良いパフォーマンスを発揮するということです――構造化されたベンチマーク出力(ns/iter、スループット数値)がモデルに実行可能なシグナルを提供します。
技術的に興味深い詳細として、著者はエージェントが最初に明らかな改善(不要なアロケーションの削除、Vecからスタック配列への切り替え、小さいキースペースに対するHashMapのBTreeMapや固定サイズ配列への置き換え)から手をつけた後、頭打ちになる傾向があることを発見しています。この頭打ちを打破するには、プロファイルで特定された具体的なホットスポットにエージェントを手動で誘導する必要があり、これはエージェントループが完全には自律的でないことを示唆しています――高レベルの最適化戦略を解釈するための人間の介在がやはり必要です。
この記事ではまた、エージェントが表面的な正確性チェックは通過するものの、エッジケースを壊すような誤った最適化を導入することがあると指摘しており、生成されたマイクロ最適化には「コンパイルして動くか」というチェックだけでなく、プロパティベースまたは網羅的なテストが必要であることを強調しています。ベンチマークと並行してproptestを使用することが推奨されています。
より広い方法論的な観点から言えば、エージェントによる反復は、タスクに安価で曖昧さのないスカラー目標(実行時間)と高速なフィードバックループがある場合に最も効果的です。Rustのコンパイルレイテンシは摩擦を生み出します――1回あたり数秒のコンパイル時間は、20〜30ステップのエージェントステップにわたって急速に蓄積されます。著者は中間アーティファクトのキャッシュと、フルビルドの前にプレフィルタとしてcargo checkを使用することを提案しています。
万能薬ではありません:エージェントで最適化されたコードは読みにくくなり、最初の数回の反復を超えると改善は限界的になります。これは、すでに正確なコードから最後の20〜30%のパフォーマンスを絞り出すのに有用なパターンであり、アルゴリズム設計の代替にはなりません。
Claude Opus 5.5
Source: https://www.anthropic.com/claude-opus-5-5
AnthropicによるClaude Opus 5.5のリリースであり、リリース日時点での同社最高性能モデルとして位置づけられています。このモデルはextended-thinking / hybrid reasoningモデルとして説明されており、最終応答を生成する前にchain-of-thoughtのスクラッチパッドを通じて推論時に可変的なコンピュートを割り当てられることを意味します。大まかな構造としては、OpenAIのo系列アーキテクチャと類似しています。
主要な技術的主張としては、マルチステップのagentタスクにおける性能向上、長いコンテキスト設定でのinstruction followingの強化(コンテキストウィンドウは200Kトークンと報告されています)、そしてtool-useベンチマークにおけるキャリブレーションの改善が挙げられます。AnthropicはSWE-bench Verifiedおよび社内のagent evalにおける改善を強調しています。このモデルは、コーディング、複雑な推論、およびマルチツールオーケストレーションワークフローを対象として位置づけられています。
価格とレイテンシのトレードオフは無視できないものです。extended thinkingはOpus 4と比較してレイテンシとコストを増加させます。モデルは2つのモードで動作します。標準モード(thinking budgetなし)と、APIの呼び出し元が明示的にthinking tokenのbudgetを設定するextendedモードです。これにより開発者はコンピュートと精度のトレードオフを明示的に制御できるようになり、暗黙的なサンプリング戦略よりもアーキテクチャ的にクリーンな設計となっています。
注目すべき点として、Anthropicは「過度な拒否なしに細かいニュアンスのある指示に従う能力」の改善を強調しており、これは実際には境界線上にある正当な専門的クエリを拒否する可能性が低くなることを意味します。これは能力面の向上であると同時に、ポリシーチューニングのシグナルでもあります。
API観点からは、このモデルは以前のClaudeバージョンと同じMessages APIサーフェスをサポートしており、thinkingパラメータによってスクラッチパッドモードが有効になります。tool use、vision、ドキュメント理解はすべてサポートされています。パラメータ数やトレーニングデータに関するアーキテクチャの詳細は開示されていません。
GPT-6 Sol と Luna
Source: https://openai.com/index/introducing-gpt-6-sol-and-luna/
OpenAIはGPT-6を2つのバリアントとして発表しました:Sol(速度とコストに最適化された「mini」層に相当するもの)とLuna(フル性能のフラッグシップ)です。この命名規則は従来のo系列やGPT-4oの系譜から脱却しており、意図的な製品セグメンテーション戦略を示唆しています。Solはスループットの高いAPIユースケースを対象とし、Lunaは複雑な推論タスクを対象としています。
OpenAIの通例どおり、開示された技術的詳細は乏しいものの、発表ではマルチモーダルネイティブアーキテクチャ(後付けのビジョン機能ではなく)、大幅に拡張されたコンテキストウィンドウ、そして外部の scaffolding 経由ではなくモデルレベルで統合されたコード実行およびウェブ検索を含むネイティブなツール使用機能が言及されています。両バリアントとも、命令の優先順位処理が改善されており、システムプロンプト・ユーザープロンプト・ツール出力の優先順位がより確実に遵守されるようになったと説明されています。
挙げられている推論性能の向上は、サードパーティの評価ではなく内部ベンチマークスイートを参照しているため、発表時点での独立した検証には限界があります。ただし、GPT-6 Astra(後述の別項目)に帰される Enigma 暗号解析の結果を踏まえると、少なくとも一部のドメインにおいてGPT-4oからの性能差は相当なものと見られます。
デプロイメントの観点では、Solのレイテンシと価格は Claude Haiku / Gemini Flash 層のモデルと競合するように位置付けられつつも、より高い性能を維持しています。Lunaはプレミアムオファリングです。両者とも標準的な Chat Completions および Responses APIを通じて利用可能で、function calling、structured outputs、ストリーミングがサポートされています。
このリリースは、タスクの要求に応じて同一の基盤システムが高速ドラフトモードまたは拡張推論モードで動作できる、mixture-of-inference-regime モデルに向けた業界全体のトレンドを継続するものです。
Claude Opus 5.5 の知性・性能・価格分析(Max)
Source: https://artificialanalysis.ai/models/claude-opus-5-5
Artificial Analysis はフロンティアモデル全体に標準化されたベンチマークを実施し、レイテンシ・スループット・品質のメトリクスを公開しています。同社による Claude Opus 5.5 の分析は、Anthropic の主張に対するサードパーティによる定量的な裏付けを提供しています。
主な計測値:標準モードの出力スループットは負荷によって変動しつつも概ね 60〜80 tokens/秒の範囲であり、extended thinking モードでは生成・処理が必要なスクラッチパッドトークンが増えるため大幅に低速になります。標準クエリの time-to-first-token は 2〜5 秒の範囲と報告されており、thinking を有効にした呼び出しではさらに高くなります。
品質ベンチマークでは、Opus 5.5 は MMLU・GPQA・コーディングベンチマーク(HumanEval / SWE-bench)において GPT-6 Luna と競争力のあるスコアを示しており、タスクによって数パーセントポイント以内の差に収まっています。同分析では、extended thinking モードが標準モードと比べて多段階の数学やコーディングにおいて有意な改善をもたらす一方、レイテンシコストはおよそ 2〜3 倍になると指摘されています。
価格分析:Opus 5.5 は Opus 4 よりも高い価格帯に位置づけられており、thinking トークンは output トークンよりも高い per-token レートで別途課金されます。これは推論計算コストに直接連動した価格モデルです。同分析では、適度な thinking budget を持つ典型的なエージェント的ワークフローにおけるタスクあたりコストは、同等のベース品質を持つ non-thinking モデルと比較しておよそ 2 倍になると試算しています。
API ユーザーへの実際的な示唆としては、Opus 5.5 の標準モードはレイテンシが重要なパイプラインに適した強力な選択肢であり、extended thinking モードは難しい推論ステップの精度がボトルネックとなるタスクに対してコスト的に正当化されます。同分析では品質とコストをプロットした Pareto frontier の可視化も提供しており、Opus 5.5 標準モードはコスト効率において競争力はあるものの支配的ではないという位置づけになっています。
オープンモデルにおける現在の勢力均衡
Source: https://www.interconnects.ai/p/the-current-balance-of-power-in-open
Nathan Lambertによる、オープンウェイトモデルのエコシステムがフロンティアのクローズドモデルに対してどのような位置にあるかを分析した記事です。能力階層をまたいだ競争環境を整理し、どの組織が現実的に競争できるかを左右する構造的要因を特定しています。
技術的な中心的主張は以下の通りです:困難な推論ベンチマーク(GPQA Diamond、競技数学、エージェント的コーディング)において、オープンウェイトモデルとクローズドフロンティアモデルとのギャップは平均的なタスクでは縮まっているものの、難易度の上位テールでは依然として顕著に残っています。Llama 3.x、Qwen 2.5、Mistral Large、DeepSeek V3といったモデルは標準的なevalでは真に競争力を持っていますが、長いコンテキストにわたる継続的なマルチステップ計画を必要とする推論タスクの最難関インスタンスでは遅れをとっています。
Lambertはアルゴリズム的革新ではなく、計算資源へのアクセスが主要なボトルネックであると指摘しています。オープンなラボはアーキテクチャのアイデア(MoE、拡張コンテキスト、RLHF/DPOパイプライン)を再現できることを示してきましたが、フロンティアのクローズドラボのトレーニングスケールには及びません。この分析では、トップのクローズドモデルは公開されている最大のオープン実行に比べて5〜20倍大きい計算予算でトレーニングされていると推定しています。
Post-trainingは第二の構造的なギャップとして特定されています:独自のRLHFデータ、人間の選好アノテーションパイプライン、および反復的なレッドチーミングはオープンに再現することが困難です。オープンモデルは合成データとクローズドモデルからのdistillationから恩恵を受けてきましたが(これはデータセット汚染の問題を提起します)、この依存性は独立した能力開発を制限しています。
この記事はガバナンスにも言及しています:オープンウェイトはデプロイの柔軟性をもたらしますが、安全性の責任をデプロイヤーに移転させるため、これは未解決の調整問題として残っています。この分析は均衡のとれたものであり、オープンモデルを軽視することも、クローズドフロンティアシステムとの同等性を誇張することもしていません。
OpenAI GPT-6 Astra、2005年から解読不能だったエニグマ暗号文を解読
Source: https://www.cryptocellar.org/bgac/the-mvueh-break.html
これはベンチマークではなく、具体的な暗号解析の成果です。MVUEH メッセージは、2005年に挑戦課題として公開されて以来、解読されることなく残っていたドイツ海軍の第二次世界大戦時のエニグマ暗号文です。本記事では、GPT-6 Astra(推論を重視した変種)がその解読に貢献した経緯を詳述しています。
技術的な内容について説明します。このレベルでのエニグマ解読は総当たり問題ではありません。設定が未知の海軍用4ローター・エニグマの鍵空間は、クリブ(既知平文断片)や統計的指標なしに網羅的探索を行うには大きすぎます。今回報告された攻撃は、一致指数(index of coincidence)解析、期待されるドイツ海軍メッセージの統計に対するバイグラム/トライグラムの頻度スコアリング、そして反復的な仮説精緻化を組み合わせたものと見られます。これらはいずれも、クリブ・ドラッギングおよびボンブ・アナログの標準的な手法です。GPT-6 Astra が貢献したと見られるのは、歴史的記録から文脈的クリブを正確に特定・適用し、それ以前の手作業による試みよりも効率的に組み合わせ論的な仮説空間を探索する推論能力です。
その結果、メッセージのホイール設定とプラグボード構成が復元され、当時の海軍通信の慣例と整合するドイツ語平文が得られました。この解読は言語的妥当性と既知のメッセージ形式への適合性によって検証されています。
この成果が注目に値するのは、純粋な暗号解析能力の実証としてではありません。エニグマはすでに既知の攻撃手法を持つ解読済み暗号だからです。それよりも、フロンティア推論モデルが、ドメイン固有の歴史的・言語的文脈を組み合わせ論的探索の指針として活用し、人間の専門家が20年間解決できなかった問題を突破できることの証拠として注目すべきです。モデル自体の貢献、ツール、人間の指示それぞれの役割については、記事の中で完全には分解されておらず、結果の帰属をどのように考えるかという正当な未解決問題が残っています。
Jev in 25 Lines of Python
Source: https://www.nobodywho.ai/posts/jev-in-25-lines/
Jev(JSON Event Viewer/ストリーミングJSONイベントフォーマット)を教育的な演習として、最小限のPythonでゼロから実装した内容です。この記事では、Pythonのjsonモジュールとgeneratorベースの行処理を活用することで、依存ライブラリなしに30行未満でコンパクトなストリーミング構造化ログのコンシューマが書けることを示しています。
技術的な核心:Jevフォーマットのログは改行区切りJSON(NDJSON)であり、各行はタイムスタンプ・レベル・メッセージペイロードを持つ独立したJSONオブジェクトとして個別のイベントを表します。この25行の実装は、ファイルまたはstdinを開き、行を反復処理し、各行をjson.loadsでパースし、引数として渡されたフィールドの述語に基づいてpretty-printまたはフィルタリングを行います。
行数以上に興味深い点は、この記事がNDJSONをログストリーミングにおいてpretty-printされたJSONよりも優れているとする理由を説明するための題材として使われていることです。Pretty-printされたJSONは完全なオブジェクトが揃うまでバッファリングが必要ですが、NDJSONはイベントごとにO(1)のメモリで、ログ全体のサイズに依存しないシングルパスのストリーミングを可能にします。毎秒数千のイベントを出力する高スループットのサービスにおいて、この違いは運用上重要な意味を持ちます。
この実装はまた、ログフィルタDSLを構築するためのクリーンなパターンも示しています。CLIの引数としてkey=valueペアを渡し、それをdictにパースし、all(event.get(k) == v for k, v in filters.items())を述語として使用するというものです。この方法は、構造的な変更を加えることなく範囲フィルタや正規表現マッチングにも拡張できます。
より広い視点での主張は、多くの「オブザーバビリティツール」が、デバッグ中に単一サービスの構造化ログを読むという一般的なユースケースに対して過剰に作り込まれているというものです。25行のスクリプトがそのユースケースの90%に対応できます。この記事は暗黙的に、アプリケーションコードにおけるNDJSON出力の標準化を提唱しており、それによって簡素なツールが引き続き有効であり続けると示唆しています。
Unreal Agent
Source: https://unreallabs.ai/blog/unreal-agent/
Unreal Labsは、テクニカルアーティスト、ゲーム開発者、パイプラインエンジニアを対象に、Unreal Engine 5内でのタスク制御と自動化を行うエージェントシステムを発表しました。このシステムは、UE5のエディタ機能(レベル編集、アセット操作、Blueprint scripting、マテリアルパラメータ調整)をtool-useインターフェースを通じて公開し、LLMエージェントが呼び出せるようにしています。
技術的なアーキテクチャとしては、プラグインを介してローカルサーバーがUE5エディタの操作を構造化された関数呼び出しとして公開する形になっています。エージェントはタスクの説明を受け取り、利用可能なツール(UnrealのPython scripting APIおよびエディタサブシステムにマッピングされたもの)を照会し、複数ステップの計画を実行します。プラグインはツール呼び出しをインターセプトしてUE5エディタのコンテキスト内で実行し、構造化された結果(アセットパス、エラー文字列、シーン状態の差分)をエージェントループに返します。
取り組んだ主要なエンジニアリング上の課題として、UE5のPython APIは広範ではありますがLLMフレンドリーではなく、関数シグネチャが冗長で、多くの操作に副作用があって元に戻しにくく、エディタの状態が複雑であるという点が挙げられます。このシステムには、生のAPI呼び出しを説明文やパラメータ検証でラップするツールスキーマ層が含まれており、不正な呼び出しに対するエージェントのエラー率を低減しています。
投稿ではいくつかの例が示されています。命名規則に従ったアセットの一括リネーム、レベルのブロックアウト用プレースホルダージオメトリの生成、クエリに一致する複数のアクター全体にわたる照明パラメータの調整などです。これらはいずれも、現状では繰り返しの手動エディタ操作や、ユースケースごとのカスタムPythonスクリプト作成を必要とするタスクです。
制限事項も認められています。エージェントはエディタのビジュアル出力を認識できない(現バージョンではscreen-to-modelのフィードバックループがない)ため、視覚的な判断を必要とするタスク(例:「これは見た目が良いか?」)は対象外です。また、システムはアンドゥの認識も欠いており、エージェントはプログラム的にロールバックが困難な破壊的操作をトリガーする可能性があります。信頼性の高いアンドゥを実現するためのUE5のトランザクションシステムとの統合は、今後の課題として挙げられています。
注目の新しいリポジトリ
TokenRhythm/NeoHorse
NeoHorse-1は、エージェント的なpost-trainingとルーティングハーネスを組み合わせることで、LLMエージェントにおける再帰的自己改善を目指しています。核心となるアイデアは、モデルが構造化されたエージェントループを通じて自身のトレーニングシグナルの生成に参加するというものです。具体的には、モデルがアクションを提案し、結果を評価し、その結果をfine-tuningパイプラインにルーティングして戻します。「ルーティングハーネス」が核心的なアーキテクチャ要素であり、軌跡の品質シグナルに応じて、エージェントの軌跡をさまざまなトレーニング戦略(例:成功したロールアウトに対するsupervised fine-tuning、失敗に対するRLHF方式の報酬シェーピング)にディスパッチします。これは純粋なRLHFよりも、STaR/ReST方式のブートストラッピングに精神的に近いアプローチですが、単一の目的関数に対する報酬ハッキングを回避するための明示的なルーティングロジックを追加しています。自己改善ループは反復的であり、各世代のモデルが生成するロールアウトが次ラウンドのpost-trainingデータのシードとなります。小規模なオープンウェイトモデル上でエージェントシステムを構築する実務者にとって、これは純粋にプロンプトエンジニアリングに基づく能力引き出しに対する構造化された代替手段を提供します。このプロジェクトは初期段階にあり、主な価値は完全に訓練されたアーティファクトではなく、ハーネスのスキャフォールディングにあります。反復を経た際の分布崩壊をどう防ぐか、またルーティングの意思決定が壊滅的忘却とどのように相互作用するかといった未解決の問題が残っています。
Source: https://github.com/TokenRhythm/NeoHorse
shadcn-ui/lint
これは、Tailwindベースのデザインシステム向けのagent-firstリンターであり、LLMコーディングエージェントとコードベースのビジュアル一貫性ルールの間にある強制レイヤーとして位置づけられています。純粋な静的解析にとどまらず、人間とエージェント(tool-use経由)の両方がクエリおよび検証できる形式でデザインシステムのルールをチームが記述できるようにします。技術的には、既存のTailwindクラスのパースの上に構築され、制約を指定するルール定義APIを公開しています。制約の例としては、許可されていない色の組み合わせ、必須のスペーシングスケール、コンポーネント構成の不変条件などがあります。tool interfaceを通じて統合されたエージェントは、出力をコミットする前に「この差分はデザインシステムのルールに違反しているか?」を問い合わせることができます。このアーキテクチャは、Stylelintのようなツールとの差別化点をもたらしています。AST レベルのパターンマッチングだけでなく、ルールはデザイントークングラフにマッピングされるセマンティックレイヤーで表現されるため、違反はregexのミスマッチとしてだけでなく自然言語で説明可能になります。ローンチ時の2,600以上のスター数は、shadcn/uiをベースコンポーネントライブラリとしてすでに使用しているチームにおいて、このツールへの強い需要があることを示しています。制限事項:Tailwindとshadcnコンポーネントの語彙に強く結合しているため、任意のCSS-in-JSシステムへの移植は容易ではありません。
Source: https://github.com/shadcn-ui/lint
Continuum-AI-Corp/OrcaReplay
OrcaReplayは、AIエージェントの実行に対応したレコード&リプレイデバッガです。エージェントの実行は非決定論的でステートフルであり、デバッグのための再現が困難という、真に厄介な問題に取り組んでいます。ツール呼び出し、モデルの入出力、メモリ状態、環境の観測値など、完全な実行トレースをキャプチャし、リプレイ可能なフォーマットにシリアライズします。最も技術的に興味深い機能は「fork」です。記録済みの任意のステップから実行を分岐させ、別のモデルに差し替えたり、中間結果を変更したりして、その時点から先を再実行することができます。これにより、コストのかかる上流ステップを再実行することなく、反事実的なデバッグ(「ターン3でClaudeの代わりにGPT-4oを使っていたら?」など)が可能になります。OrcaRouter.aiチームによって構築されており、マルチモデルルーティングのシナリオとも自然に統合されます。内部的には、モデル自体ではなくエージェントのツール呼び出しおよびLLM呼び出しの境界をインストルメント化していると考えられ、モデル非依存の設計となっています。リプレイエンジンは非決定性を慎重に扱う必要があり、環境のサイドエフェクト(HTTPコール、ファイル書き込みなど)はモックするか、忠実に再現する必要があります。現時点でスター数は261と初期段階ですが、コアとなる抽象化は健全であり、LangSmithも標準的なロギングも完全には埋められていないギャップを補完しています。
Source: https://github.com/Continuum-AI-Corp/OrcaReplay
0xNatoshi/jev-codex-router
このルーターは、OpenAI Codex の上に、ターンごとのモデル選択および推論モード選択機能を追加するものです。その中核となるのは「Jev」と呼ばれる型安全な意思決定レイヤーであり(System One reasoning — 高速かつヒューリスティックなものとして説明されています)、各会話ターンにおいて Jev はプロンプトの特性(複雑さ、曖昧さ、トークン予算、レイテンシ要件)を検査し、以下を決定します:どのモデルを呼び出すか、どの程度の chain-of-thought を引き出すか(thinking の深さ)、速度最適化パスと品質最適化パスのどちらを使用するか。TypeSafe というラベルは、実装が TypeScript で行われており、ルーティングポリシーインターフェース全体に厳格な型付けが施されていることを指しており、意思決定ロジックがプロンプト文字列の中に隠蔽されることなく、監査可能かつテスト可能な形になっています。これは Codex ベースのコーディングエージェントにおいて有用であり、すべてのターンでフル o1 レベルの推論が必要なわけではない場面で威力を発揮します。些細な自動補完をより安価で高速なモデルにルーティングしつつ、複数ファイルにまたがるリファクタリングタスクをより強力なモデルにエスカレートすることで、コストを大幅に削減できます。ルーティングポリシー自体はルールベースまたは軽量分類器ベースのようであり、学習済みルーターではないため、レイテンシのオーバーヘッドを最小限に抑えています。未解決の問題として、プロンプト分類における不確実性を、追加の LLM 呼び出しを行わずにルーターがどのように処理するかという点が挙げられます。
Source: https://github.com/0xNatoshi/jev-codex-router
qingjian-team/qingjian
Qingjian(青简)はRustで書かれたピンイン入力メソッドエンジンであり、言語学習者を対象とした語彙拡張機能を内蔵しています。候補単語リストには、目的の漢字だけでなく、ユーザーが現在学習中の外国語による翻訳も表示されます。技術的なコアは、ピンインから文字への変換パイプラインであり、候補のランキングには言語モデルまたはn-gramスコアリングのバックエンドが使用されています。これはRustで実装されており、キーストロークへの低レイテンシな応答を実現しています。翻訳オーバーレイは語彙エントリごとに取得またはプリキャッシュされ、候補ポップアップにインラインで表示されます。入力メソッドとしては、これは巧みな間隔反復(spaced repetition)の統合と言えます。ユーザーは孤立したフラッシュカードセッションではなく、自然な入力という生産的なコンテキストで語彙に出会うことができます。Rustによる実装はパフォーマンスとクロスプラットフォームの可搬性の両方を目標としています。IME開発では通常、OSのテキスト入力APIとの緊密な統合(LinuxではIBUS、macOSではIMK、WindowsではTSF)が必要であり、これらすべてをRustで正しく扱うことは容易ではありません。1,649のスターを獲得しており、言語学習者でもあるChineseを話す開発者たちの共感を得ていることは明らかです。
Source: https://github.com/qingjian-team/qingjian
youngyangyang04/llm-master
広く利用されているleetcode-masterアルゴリズムリポジトリの作者が執筆した、LLM実践者スタックの全体をカバーする体系的な中国語カリキュラムです。カリキュラムは段階的なトラックで構成されています:Prompt Engineering、RAGパイプラインの構築、AI Agentの設計パターン、MCP(model context protocol)、fine-tuning(LoRA/QLoRA中心)、モデルのデプロイメント(vLLM、Triton、量子化)、Transformerの内部構造、AIを活用したプログラミングワークフロー、および中国主要テック企業でのLLM専門エンジニアリング面接対策。技術的な深度は、APIレベルの使い方に留まらずプロダクションレベルの理解を求める実践者を対象としています。注目点として、MCPセクションとagentアーキテクチャの解説は、古い資料に頼らず最新のツール(2024年以降のエコシステム)を追跡していることを示唆しています。928スターを獲得し活発にコミットが続いているこのリポジトリは、実際のギャップを埋めています――英語のLLMチュートリアルのほとんどはfine-tuningで止まりデプロイメントを省略しますが、このカリキュラムは推論サービングとシステムインテグレーション層を明示的にカバーしています。主に中国語読者向けであり、面接対策セクションは中国市場特化ですが、RAG・デプロイメント・agentパターンに関する技術的内容は幅広く応用可能です。
Source: https://github.com/youngyangyang04/llm-master
hkqr/my-free-code
Claude Codeや類似のcoding agentの前段に配置するよう設計されたオープンソースのAPI gatewayです。マルチプロバイダーのルーティング、streaming normalization、tool-call passthrough、reasoning modeのサポート、自動フォールバック、ローカルモデルのプロキシ機能を、統一されたOpenAI互換エンドポイントの背後で提供します。核心的な価値提案は、安定したAPIサーフェスを提示しながら、可用性・コストポリシー・機能要件に応じてAnthropicやOpenAI、Gemini、あるいはローカルのOllama/LM Studioインスタンスにルーティングする単一のエンドポイントです。
技術的には、プロバイダーAPI間の意味的な差異を処理する必要があります。ClaudeのTool-useスキーマはOpenAIのfunction-callingスキーマと異なるため、それらをダウンストリームのagentに向けて正規化しなければなりません。Streamingのサポートでは、チャンキングの挙動が異なる複数のプロバイダーにまたがる慎重なSSE処理が求められます。フォールバックロジックは、レートリミットが頻発するClaude Codeのデプロイメントで特に有用です。640 starsを獲得している一方で、LiteLLM・OpenRouter・カスタムプロキシといった競合の多い領域で戦っていますが、coding agentワークフローとローカルモデルサポートを後付け機能としてではなくファーストクラスの機能として明示的に重視している点が差別化要因となっています。
Source: https://github.com/hkqr/my-free-code
kryvora-network/kryvora-node
Kryvora-nodeは、ノード参加のための暗号的検証レイヤーを備えた分散ネットワークであるKryvora Networkの、リファレンスクライアントデーモンおよび検証ワーカーです。デーモンはピア探索、ブロック/状態の同期、およびローカル状態管理を担当し、検証ワーカーは他のノードによって提出されたワークを検証するプルーフチェックロジックを実行します。このアーキテクチャはこれら二つの関心事を明示的に分離しており、デーモンがネットワーキングと永続化を管理する一方で、ワーカーは計算集約的な暗号的検証を処理することで、それぞれを独立してスケールさせることができます。「リファレンスクライアント」として、代替実装が準拠すべき正規のプロトコル動作を確立しています。368 starsと小規模なプロジェクトですが、このネットワーク上で構築または监査を行う方々にとっては技術的に実質的な内容を持っています。新規コントリビューターにとっての主要な未解決の問いは、ノード合意の基盤となるコンセンサスメカニズムは何か、検証ワーカーが実際に何を証明しているか(ZKプルーフ、PoW、attestedな実行?)、そしてデーモンとワーカーの分離がプロセスレベルで強制されているのかスレッドレベルで強制されているのか、という点です。リポジトリの構造とドキュメントの品質が、これが他者の構築基盤となるかどうかを左右するでしょう。