デイリーAIダイジェスト — 2026-09-18
arXiv ハイライト
DeepSeek-V4.1-Flash: KV Cache圧縮の限界への挑戦
問題設定
エージェント型ワークロードは、ツール呼び出しログ、リポジトリコンテキスト、マルチモーダルグラウンディングなどがプロンプト長を膨張させる一方で、出力トークン数は相対的に少ない、非常に長い入力主体のトレースにますます似てきています。支配的なコストは二つあります:(i) コンテキスト長に対してほぼ線形にスケールする(モデルサイズ固定時の)prefillの計算量、および (ii) HBM上のKV cacheのメモリ使用量(SSDへの溢れを含む)であり、これが達成可能なバッチサイズと長文コンテキストのスループットを制限しています。DeepSeek-V4.1-Flashはこの両方を同時に標的とし、百万トークンのコンテキストをベンチマーク上の話題に留めるのではなく、エージェントにとって経済的に実現可能にすることを目指しています。
アーキテクチャ
バックボーンは5520億パラメータのマルチモーダルMoEであり、追加で1960億パラメータのEngram(スパース条件付きメモリ)パラメータを有します。トークンごとの活性化は非対称で、prefill時は80億、decode時は160億パラメータが活性化します。この非対称性はCausal Encoder–Decoder(CED)分割に起因しており、20層の因果エンコーダと20層のデコーダから成る計40層で構成されています。各層はglobal attentionとsliding-window attention(SWA)を交互に組み合わせており、最初の2層のみSWA専用です。
CEDの役割は機械的なものです:デコーダのglobal KV cacheはエンコーダの出力から構築されるため、ほとんどのプロンプトトークンはフルデコーダの計算をバイパスでき、デコーダ層は生ストリームに対するローカルSWAを保持します。これにより、prefixセグメントのcacheヒット率が低い入力主体のエージェントトラフィックにおいて支配的な項となるprefill FLOPsをほぼ半減させます。
CEDに加え、本モデルはCompressed Sparse Attention 2(CSA2)を導入しており、二つの直交する節約を組み合わせています:
- 層間global KV共有。 単一のglobal KVテンソルをデコーダ層のグループ間で再利用し、深さ方向でストレージを償却します。
- 階層的スパースインデクサ。 各queryに対して、初段インデクサが候補プールを選択し、後続インデクサはそのプール内のみをスコアリングすることで、queryごとに評価するkeyエントリ数を削減し、スパース選択を層間で再利用します。
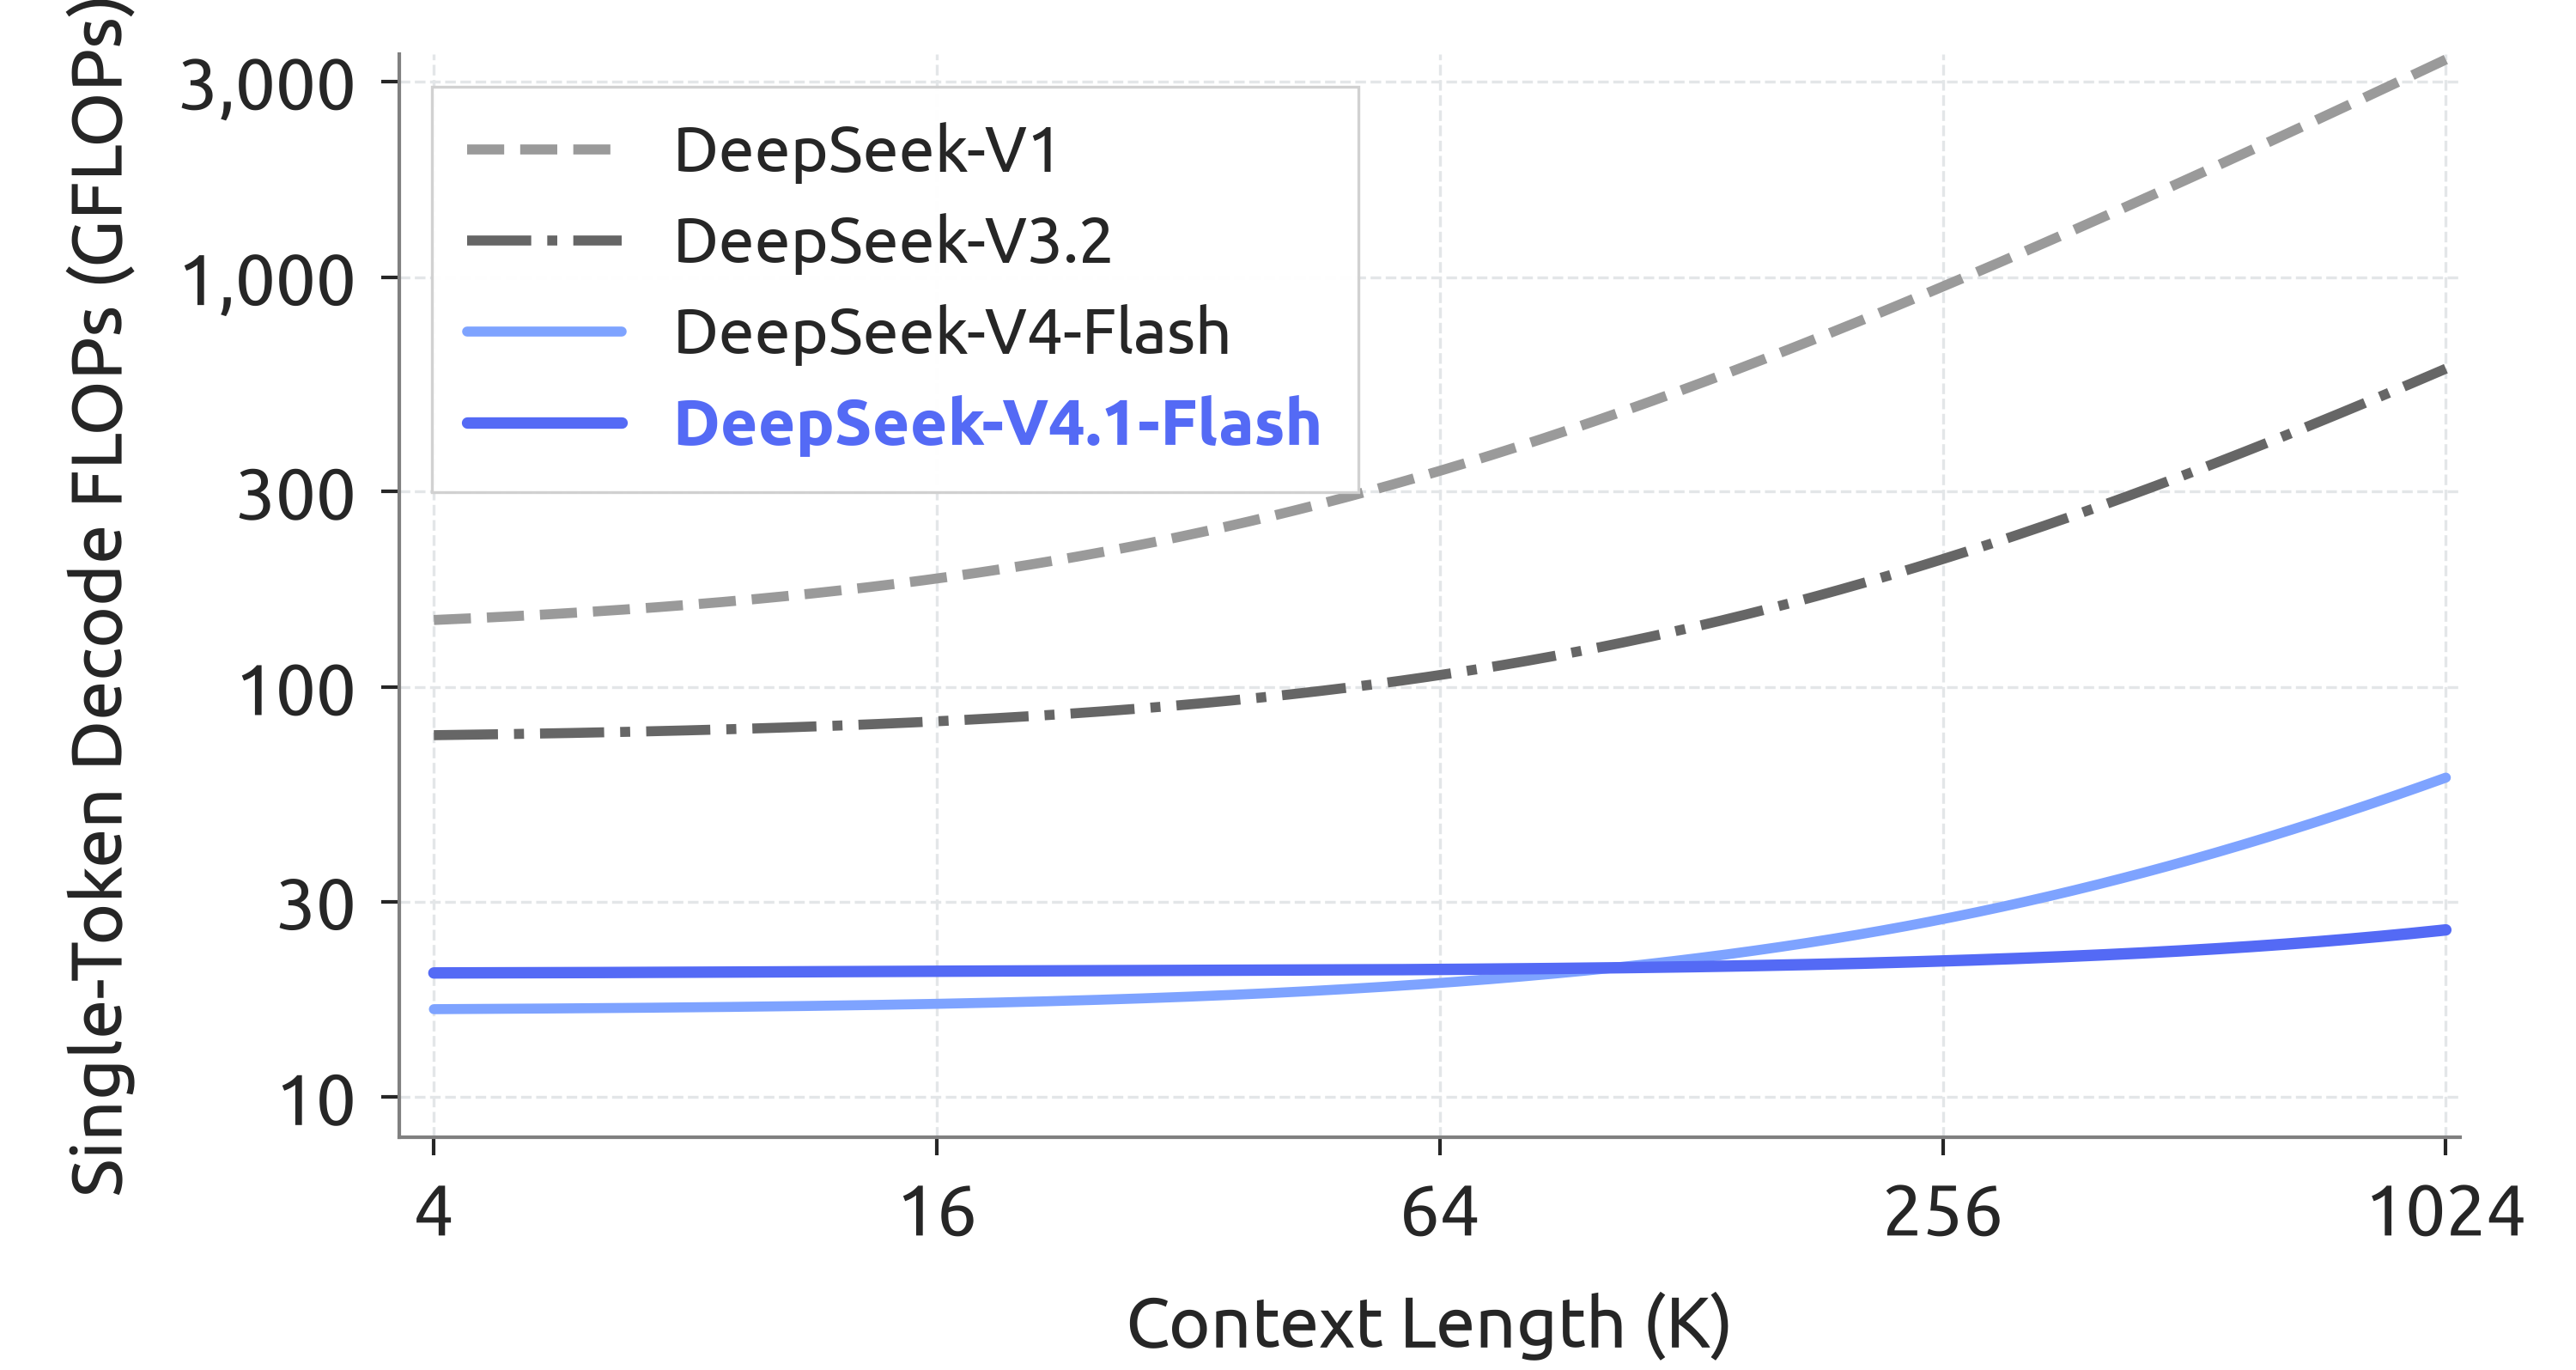
いずれの削減も、補完的なアプローチ(独立したcache数の削減、スコアリングするエントリ数の削減)から、トークンごとに触れるKVエントリ数という同じボトルネックを標的としています。global KVはさらにFP4に量子化され、トークンごとのglobal KVのメモリ使用量は890バイトとなり、DeepSeek-V4-Flashの約1/4、図1(b)によれば最初期のDeepSeekと比較して\sim 437\times小さくなっています。
MoEルーティングはDeepSeekMoEの共有エキスパートと細粒度ルーティングエキスパートの分割を維持しており、画像トークンとテキストトークンが同一エキスパートをめぐって競合しないようモダリティ固有の負荷分散を採用しています。残差ストリームの混合にはSingle-Pass mHCを使用してカーネルフュージョンを改善し、投機的デコードは別途訓練されたDSparkヘッドに委譲されています(MTPはバックボーンの事前学習から除外されています)。
ビジョンパスはゼロから設計されたDeepSeek-ViTで、任意解像度に対応する2D-RoPE、(Muonオプティマイザとの互換性のための)線形パッチ投影、RMSNorm、SwiGLU、MLPプロジェクタの前段に3\times 3ピクセルアンシャッフルを採用し、ビジュアルトークンを9分の1に削減して最大\sim 1344\times 1344の入力をサポートしています。
FLOPsの挙動
FP4 KVと層間共有の組み合わせは、decode計算コスト曲線の定数だけでなく、その形状を変化させます。BF16、FP8、FP4演算をそれぞれ1、0.5、0.25で重み付けすると、単一トークンのdecode FLOPsはコンテキスト長が増大してもほぼ平坦を維持します。これは、先行世代ではKV-attentionの項が漸近的に支配していたのとは対照的です。
訓練
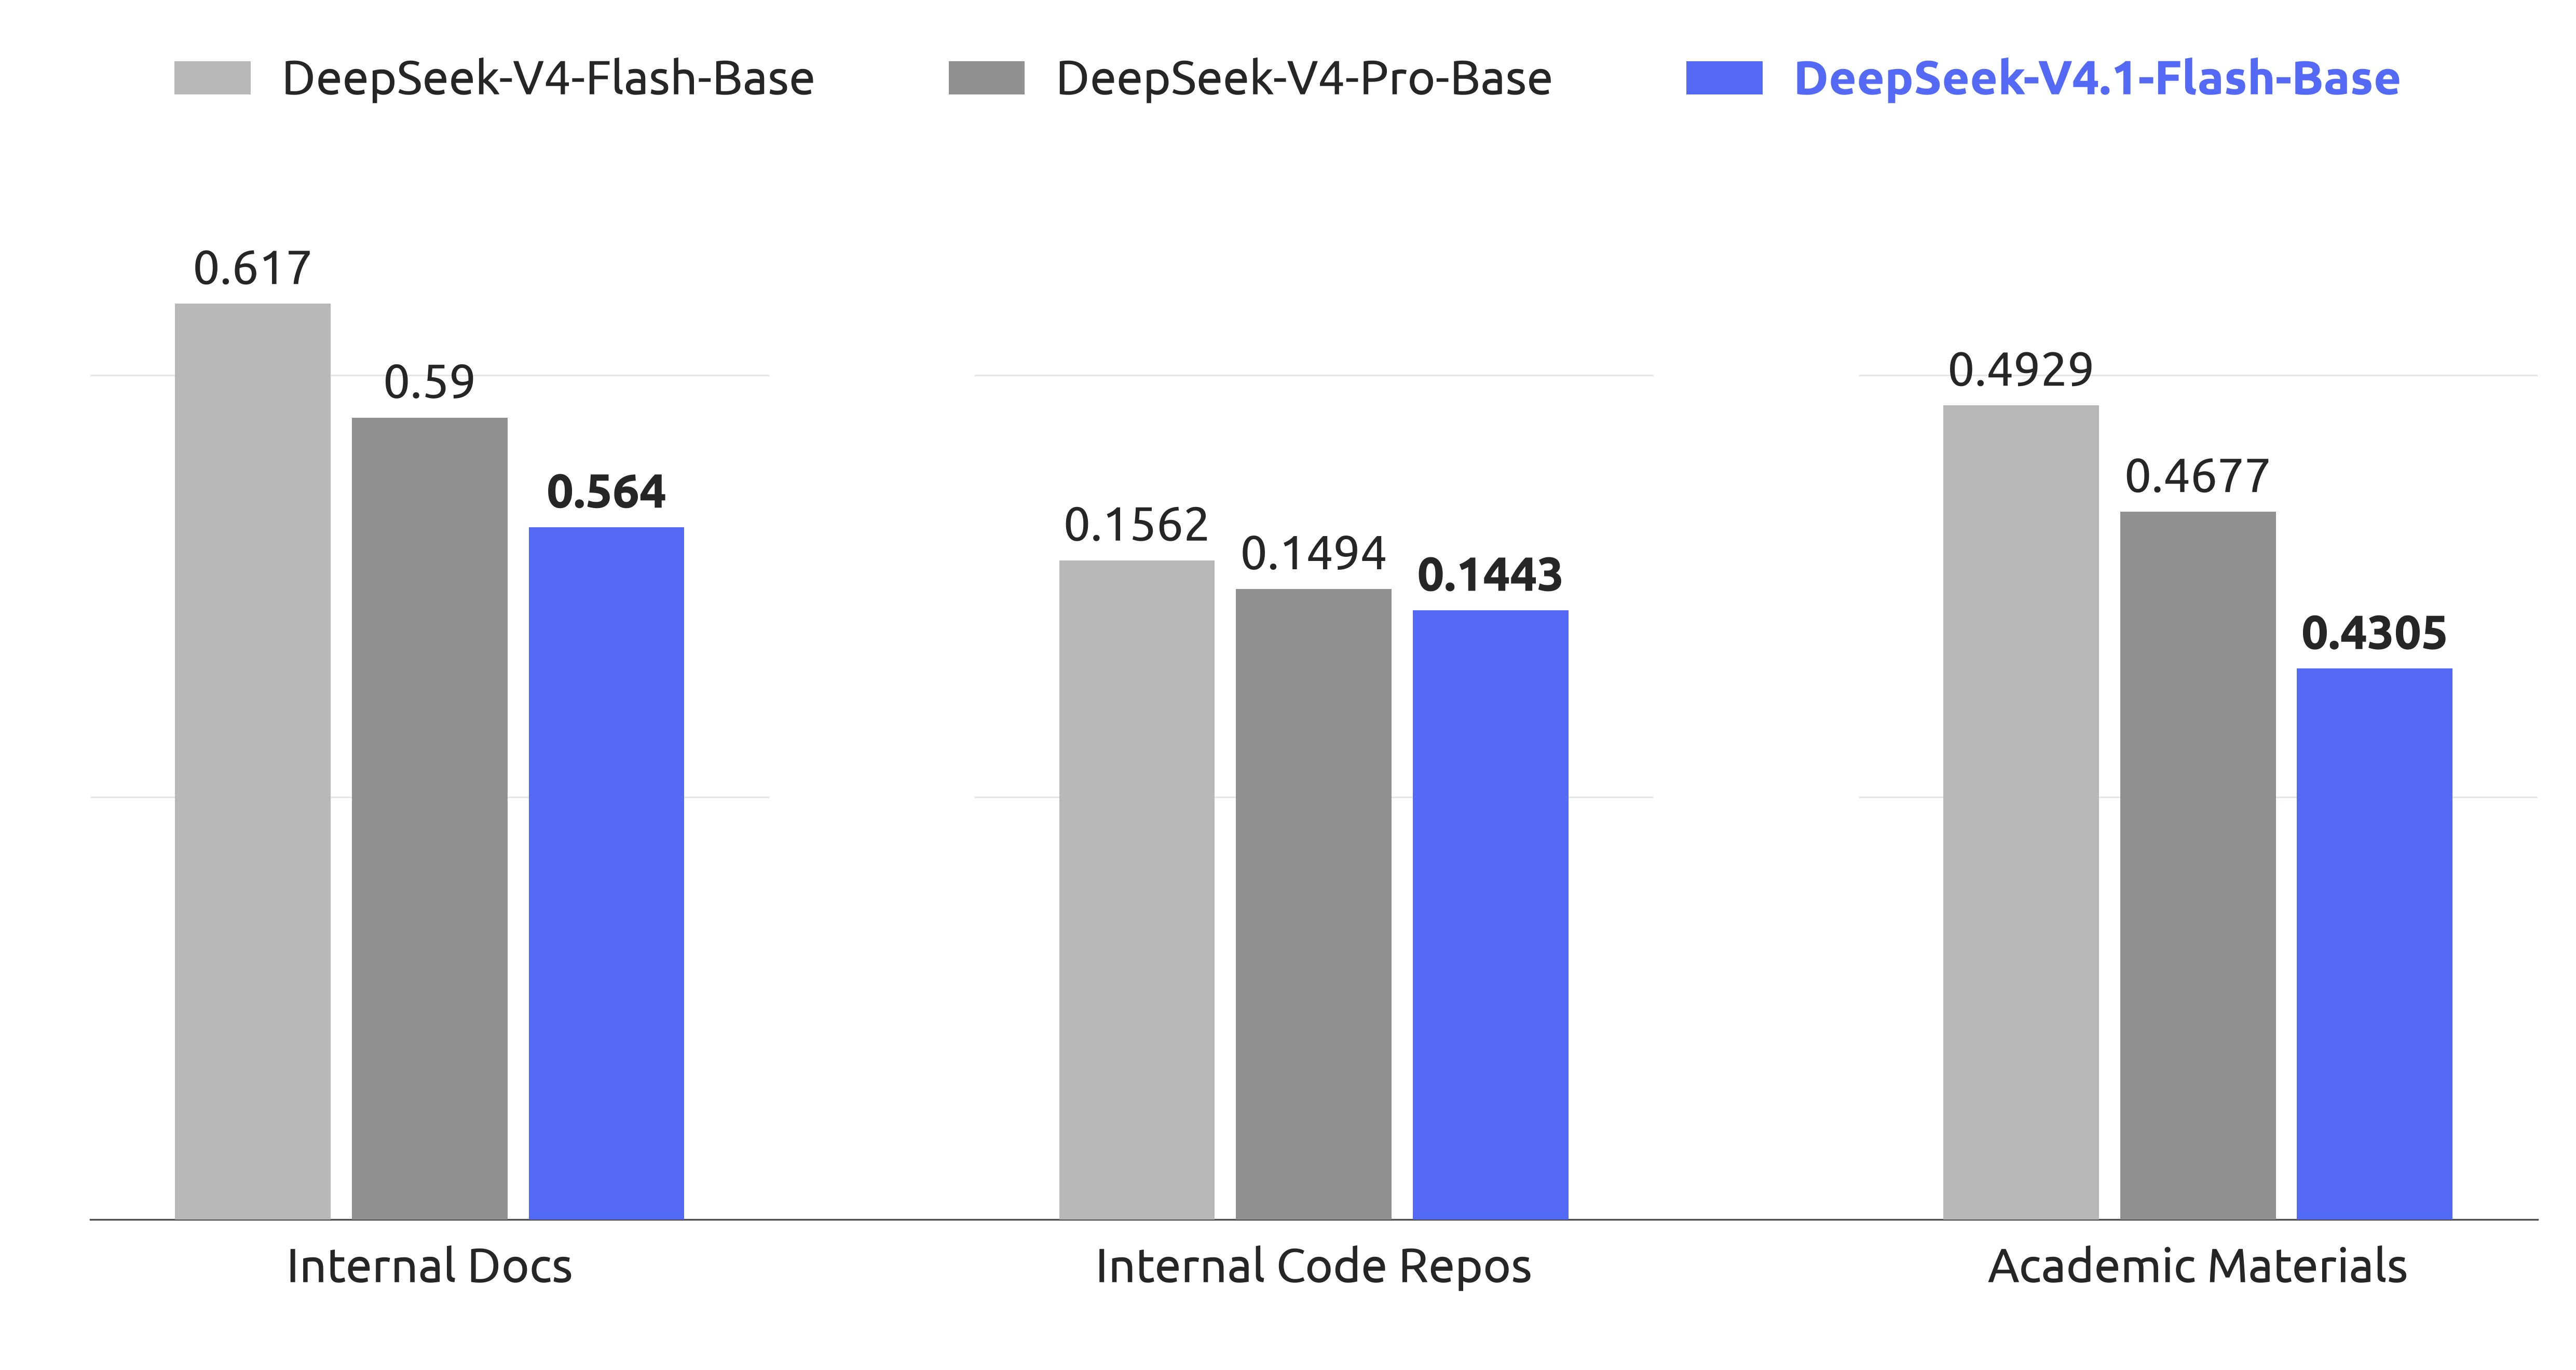
事前学習データのキュレーションでは、より弱いモデルが生成したコンテンツと低品質なMTテキストを積極的に除去しており、これらを長い学習地平線で性能を劣化させる暗黙的な重複として扱っています。パラメータ数とトークン数にわたるスケーリングラダーによって混合比率が決定されます。ホールドアウトのbits-per-byte評価において、V4.1-Flash-BaseはすべてのタスクでV4-Flash-BaseとそれよりもパラメータのV4-Pro-Baseの両方を下回るBPBを達成しており、すなわち圧縮とCEDの変更はベースモデルの品質を犠牲にしていません。
後処理訓練はアルゴリズム的な新規性を意図的に避けており、SFT → RL → オンポリシー蒸留という流れで、すべての工夫はデータと環境に投入されています。タスクはトリプレット (\text{problem}, \text{environment}, \text{verification}) として形式化され、難易度と正確性でスコアリングされ、これらはタスク構成器を反復的に訓練するための報酬シグナルとしても使用されます。エージェント環境は実使用から収集されたモックツールインターフェース、およびスター数が閾値を超えるGitHubリポジトリから合成されており、内部デプロイメントからの失敗事例はターゲットを絞ったRLカリキュラムとして再実行されます。
コントラスティブViT事前学習では、InfoNCEのgradientにおける非対称性——\nabla_Tは収集されたVにのみ依存し、その逆も同様——を活用して、二つのall-gatherをそれぞれ他方のモダリティのforward/backwardパスの裏に隠蔽し、ランク間通信の露出を排除しています。
限界と未解決の問題
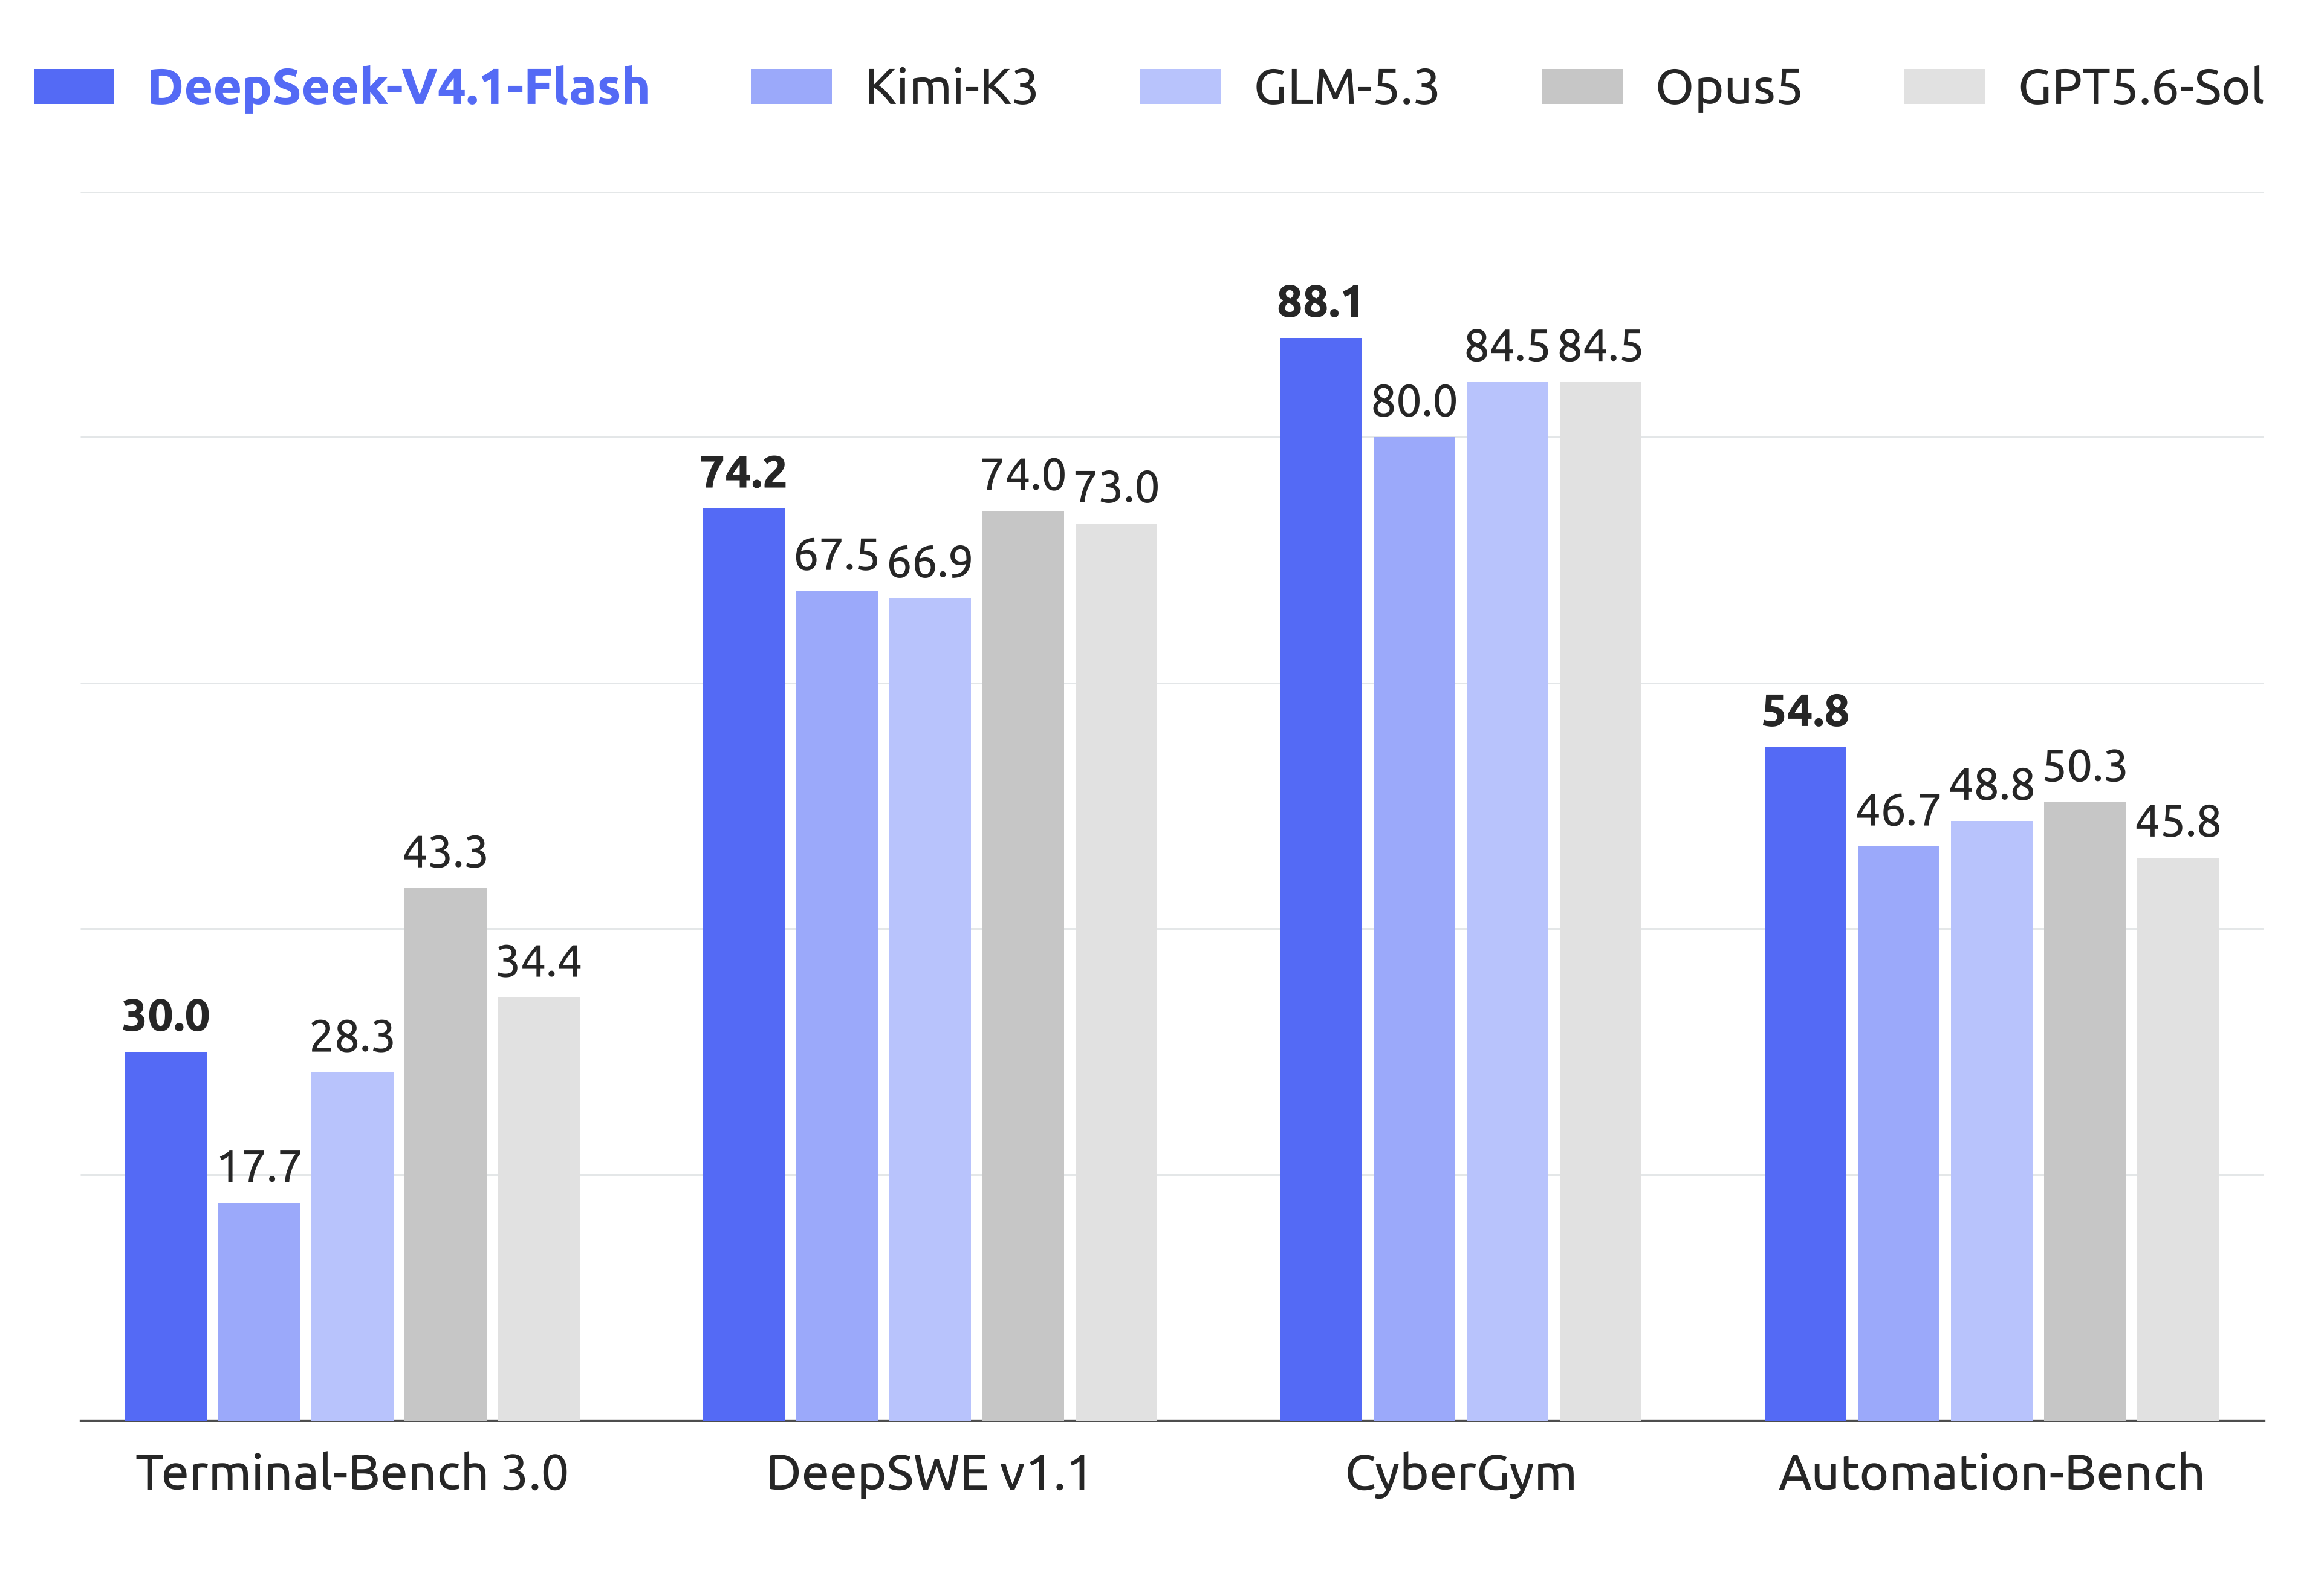
本論文はエージェント型ベンチマークにおいて同等品と比較して同等以上の性能を報告していますが(図1a)、抜粋された内容ではFLOP削減のうちどれだけがCED、CSA2、FP4 KVにそれぞれ起因するかが定量化されておらず、百万トークンコンテキストの末尾で階層的スパースインデクサの検索精度がどの程度劣化するかも示されていません。FP4 KV量子化誤差はスパース選択誤差と複合的に影響します;各要因を単独で検証するアブレーションは有益でしょう。Engramメモリは1960億パラメータをスパースにアクセスする構造ですが、そのヒット率の分布とSSD上のコールドキャッシュ挙動については本稿では論じられていません。また、「非対称活性化」(prefill 80億/decode 160億)は経済的に魅力的ですが、prefill/decode比率が変動する際のサービングクラスタのプロビジョニングを複雑にします。
なぜこれが重要か
百万トークンコンテキストにおけるトークンごと890バイトのglobal KV、平坦なdecode FLOPs、そして大規模な兄弟モデルよりも低いベースモデルのBPBという特性は、本番環境における「長文コンテキスト」のコストを実質的に変化させます。CED分割とCSA2の層間共有が一般化するならば、KV cacheがL \cdot n_\text{layers}に線形スケールするというこの分野のデフォルトの仮定は見直しを迫られることになります。
Source: https://arxiv.org/abs/2609.19969
JEPA-Anything: 異なる世界をまたぐ予測モデルの学習
問題設定
Joint-embedding predictive architectures(JEPA)は、画像・動画・音声・点群に対してそれぞれ独立に再実装されており、その都度専用のencoder、マスキングスキーム、predictor が単一のモノリシックなターゲット embeddingへと折り畳まれてきました。本論文は、単一の予測学習原理が、コアとなる目的関数を変えることなく、これらすべてを包括できるか——さらに生物学、臨床軌跡、制御、分子動力学、PDE場、気象をも対象にできるか——を問います。動機は単なる整理整頓ではありません。モノリシックな潜在ターゲットは複数の予測モード(同一性・位置・ダイナミクス・介入応答)を混在させるため、介入の合成や長期ロールアウトを阻害します。
手法:直交予測因子分解
JEPA-Anything はパイプラインをドメイン固有の インターフェース と共有の 予測コア に分解します。生の観測 x\sim\mathcal{D}_\delta はドメインアダプター \mathcal{A}_\delta によってコンテンツトークン H=\{h_i\} と構造記述子 S=\{s_i\} にインデックス集合 \Omega 上でマッピングされます。記述子はパッチ座標・タイムスタンプ・グラフ位置・エンティティIDまたは空となります。ビューサンプラー \mathcal{V}_\delta がコンテキストインデックス C\subset\Omega とターゲットインデックス T\subset\Omega を選択します:
x\xrightarrow{\mathcal{A}_\delta}(H,S)\xrightarrow{\mathcal{V}_\delta}(H_C,S_C,T,S_T).
オンラインencoderは z_c=f_\theta(H_C,S_C) を生成し、ターゲットencoderは t\in T に対して z_t=f_{\bar\theta}(H,S)_t\in\mathbb{R}^d を生成します。EMAによる更新 \bar\theta\leftarrow m\bar\theta+(1-m)\theta が行われ、ターゲットブランチには gradient が流れません。標準的なJEPAは |T|=1 の特殊ケースです。
新規な要素が直交予測因子分解(OPF)です。単一の d 次元ターゲットベクトルを予測する代わりに、OPFは潜在容量を幅 r の K 個の因子に分割し(Kr=d)、各因子を専用のパスウェイを通じて予測し、それらを合成潜在状態へと再結合します。正則化項は(i)因子部分空間間の直交性、(ii)因子活性(崩壊の回避)、(iii)encoderの分散制御を強制します。総学習 loss は
\mathcal{L} = \mathcal{L}_{\mathrm{base}}^{(\delta)} + \mathcal{L}_{\mathrm{OPF}},
となります。ここで \mathcal{L}_{\mathrm{base}} はそのドメインの元々の loss、\mathcal{L}_{\mathrm{OPF}} は正則化項付きの加法的因子 loss です。ドメイン固有の要素——トークン化、encoderアーキテクチャ(ViT、Transformer、GNN、MLP)、コンテキスト・ターゲットサンプラー、下流readout——はすべてコアの外に置かれます。
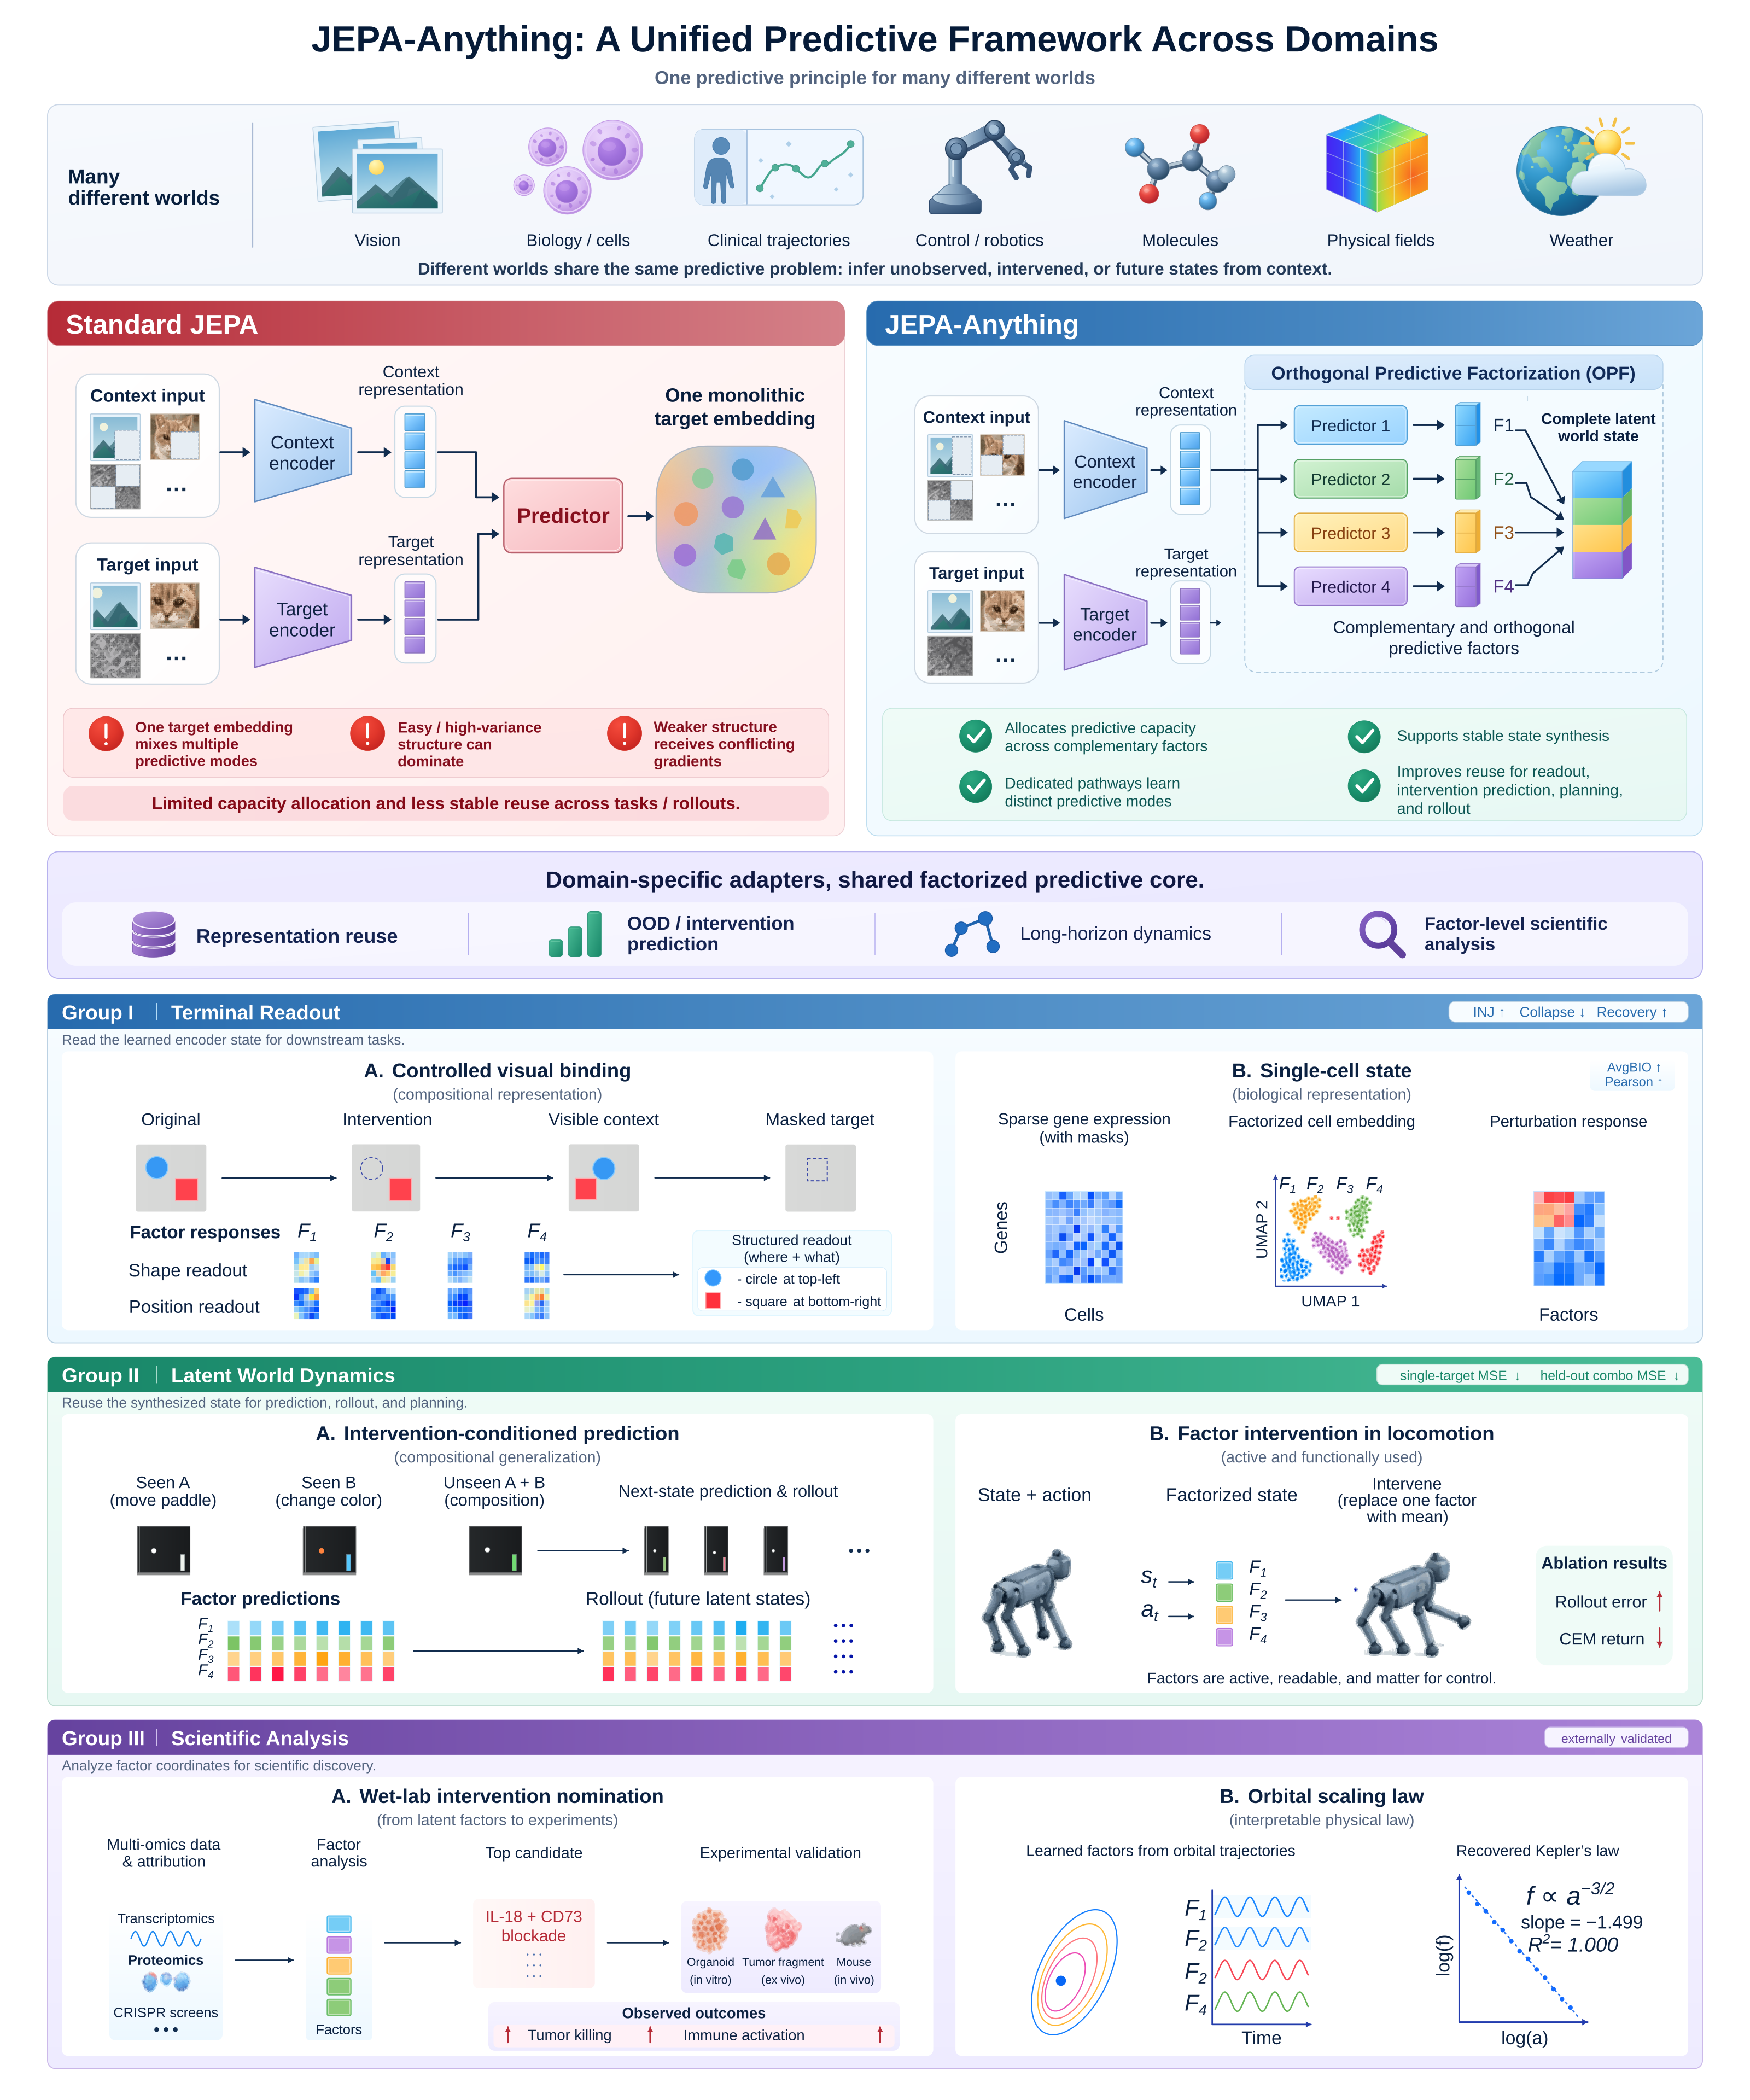
各ドメインで選択されるOPFの幅は、コンパクトな d;K\times r 表記に従います。例えばDINOv3 ViT-Sビジョンでは 384;\,4\times96、SigLIP2とGPT-2臨床では 768;\,4\times192、Interventional Pongでは 160;\,5\times32、制御/PDE/気象では 128;\,4\times32、locomotionでは 32;\,4\times8 です。\mathcal{L}_{\mathrm{OPF}} の関数形はこれらにわたって不変です。
評価体制
学習された表現の異なる用途を調べる3つのグループが設定されています。(I) ビジョン・単一細胞・疾患予測を対象としたオンラインencoderへの終端readout;(II) 再帰的潜在ダイナミクス(CITRISインターバルポンへの介入合成、CausalWorld/DMC/PDEBench/WeatherBench2/APEBench Burgers-KSへのロールアウト、長期1D粘性Burgers、Hopper/Walker2d/HalfCheetahへのMPC);(III) 生物学的・軌道的検証のための因子座標解析。
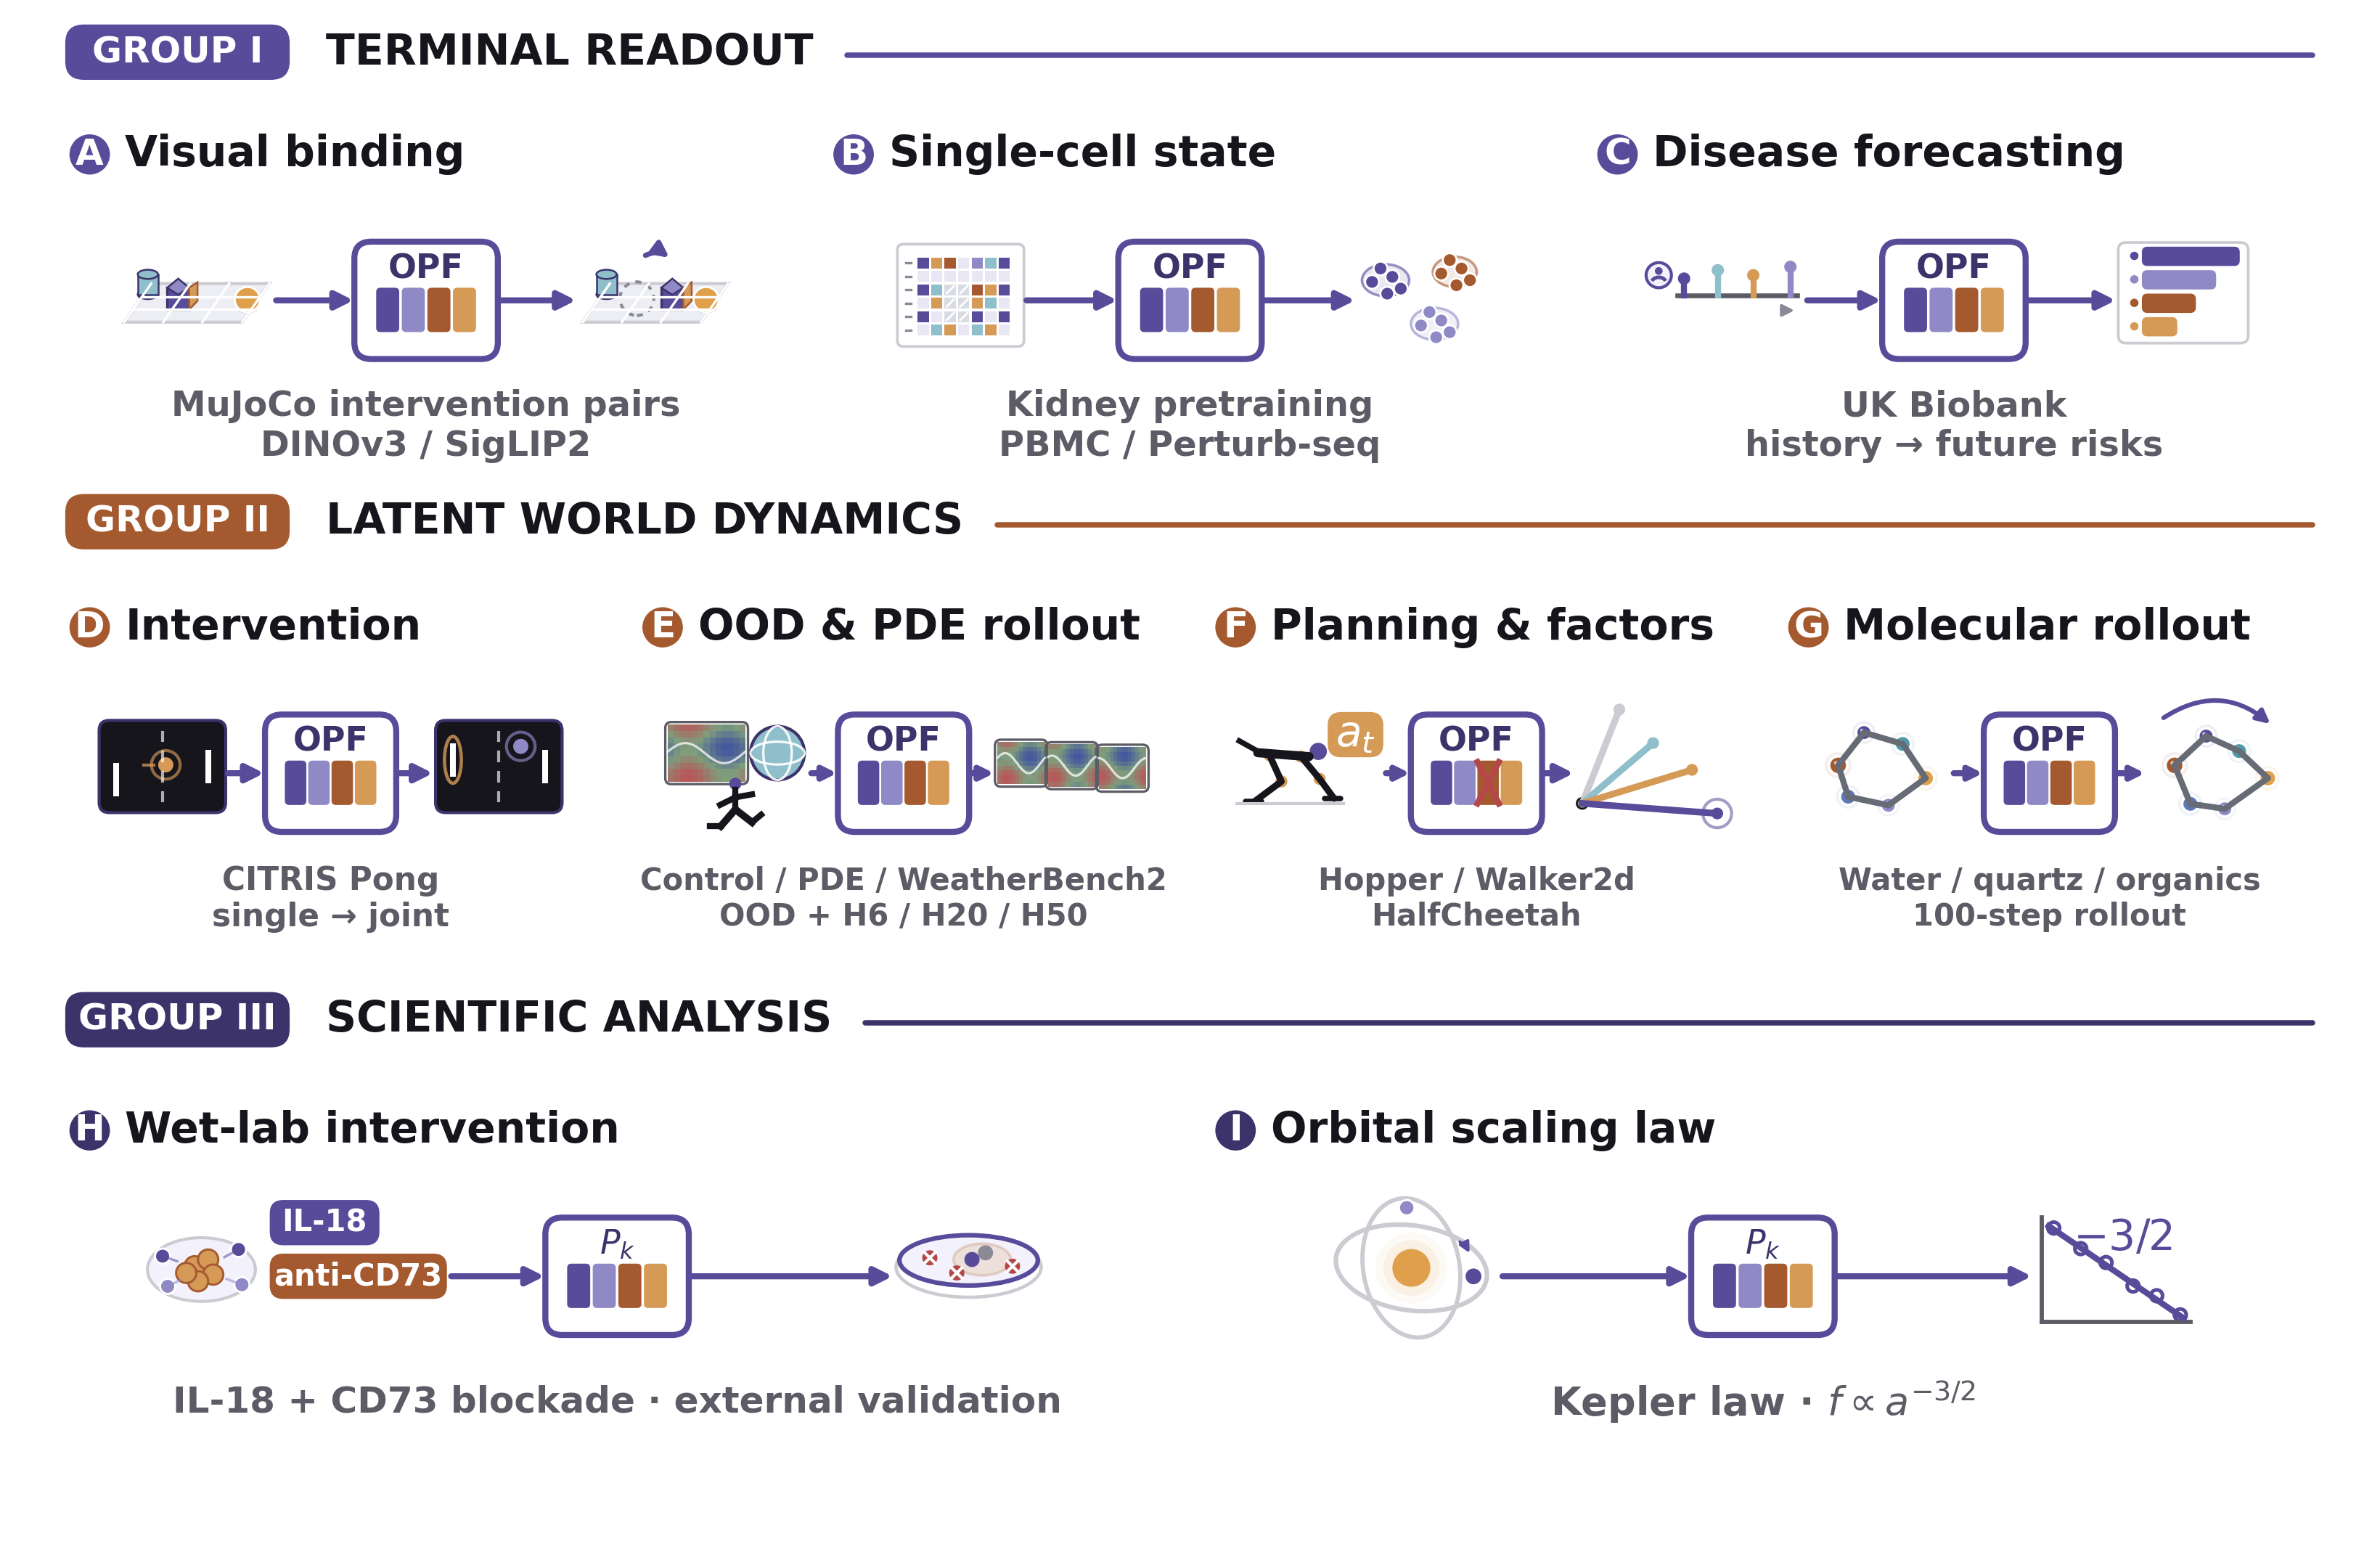
標準的なJEPAとの直接比較では、アダプター・encoder・サンプラー・予算・分割・readout・\mathcal{L}_{\mathrm{base}} を固定し、加算する予測項のみが異なります(モノリシック vs OPF)。
結果
マッチされたJEPAベースラインと比較すると、JEPA-Anythingは10件のダイナミクスタスクすべてで報告指標が改善され、Interventional Pong における単一介入の1ステップ予測誤差を34.8%削減しています(4チャンネルMSE、5ペアシード)。また、4種類の分子システムにわたる最小の1ステップおよび100ステップ分子ロールアウト誤差を達成しています(グループII)。
臨床軌跡については、JEPA-Anythingは合成された1ステップ先の未来状態を読み取り、固定された患者レベルの分割上で1,000件以上のイベントタイプのリスクを予測し、平均PRAUCでトップランクを達成しています。
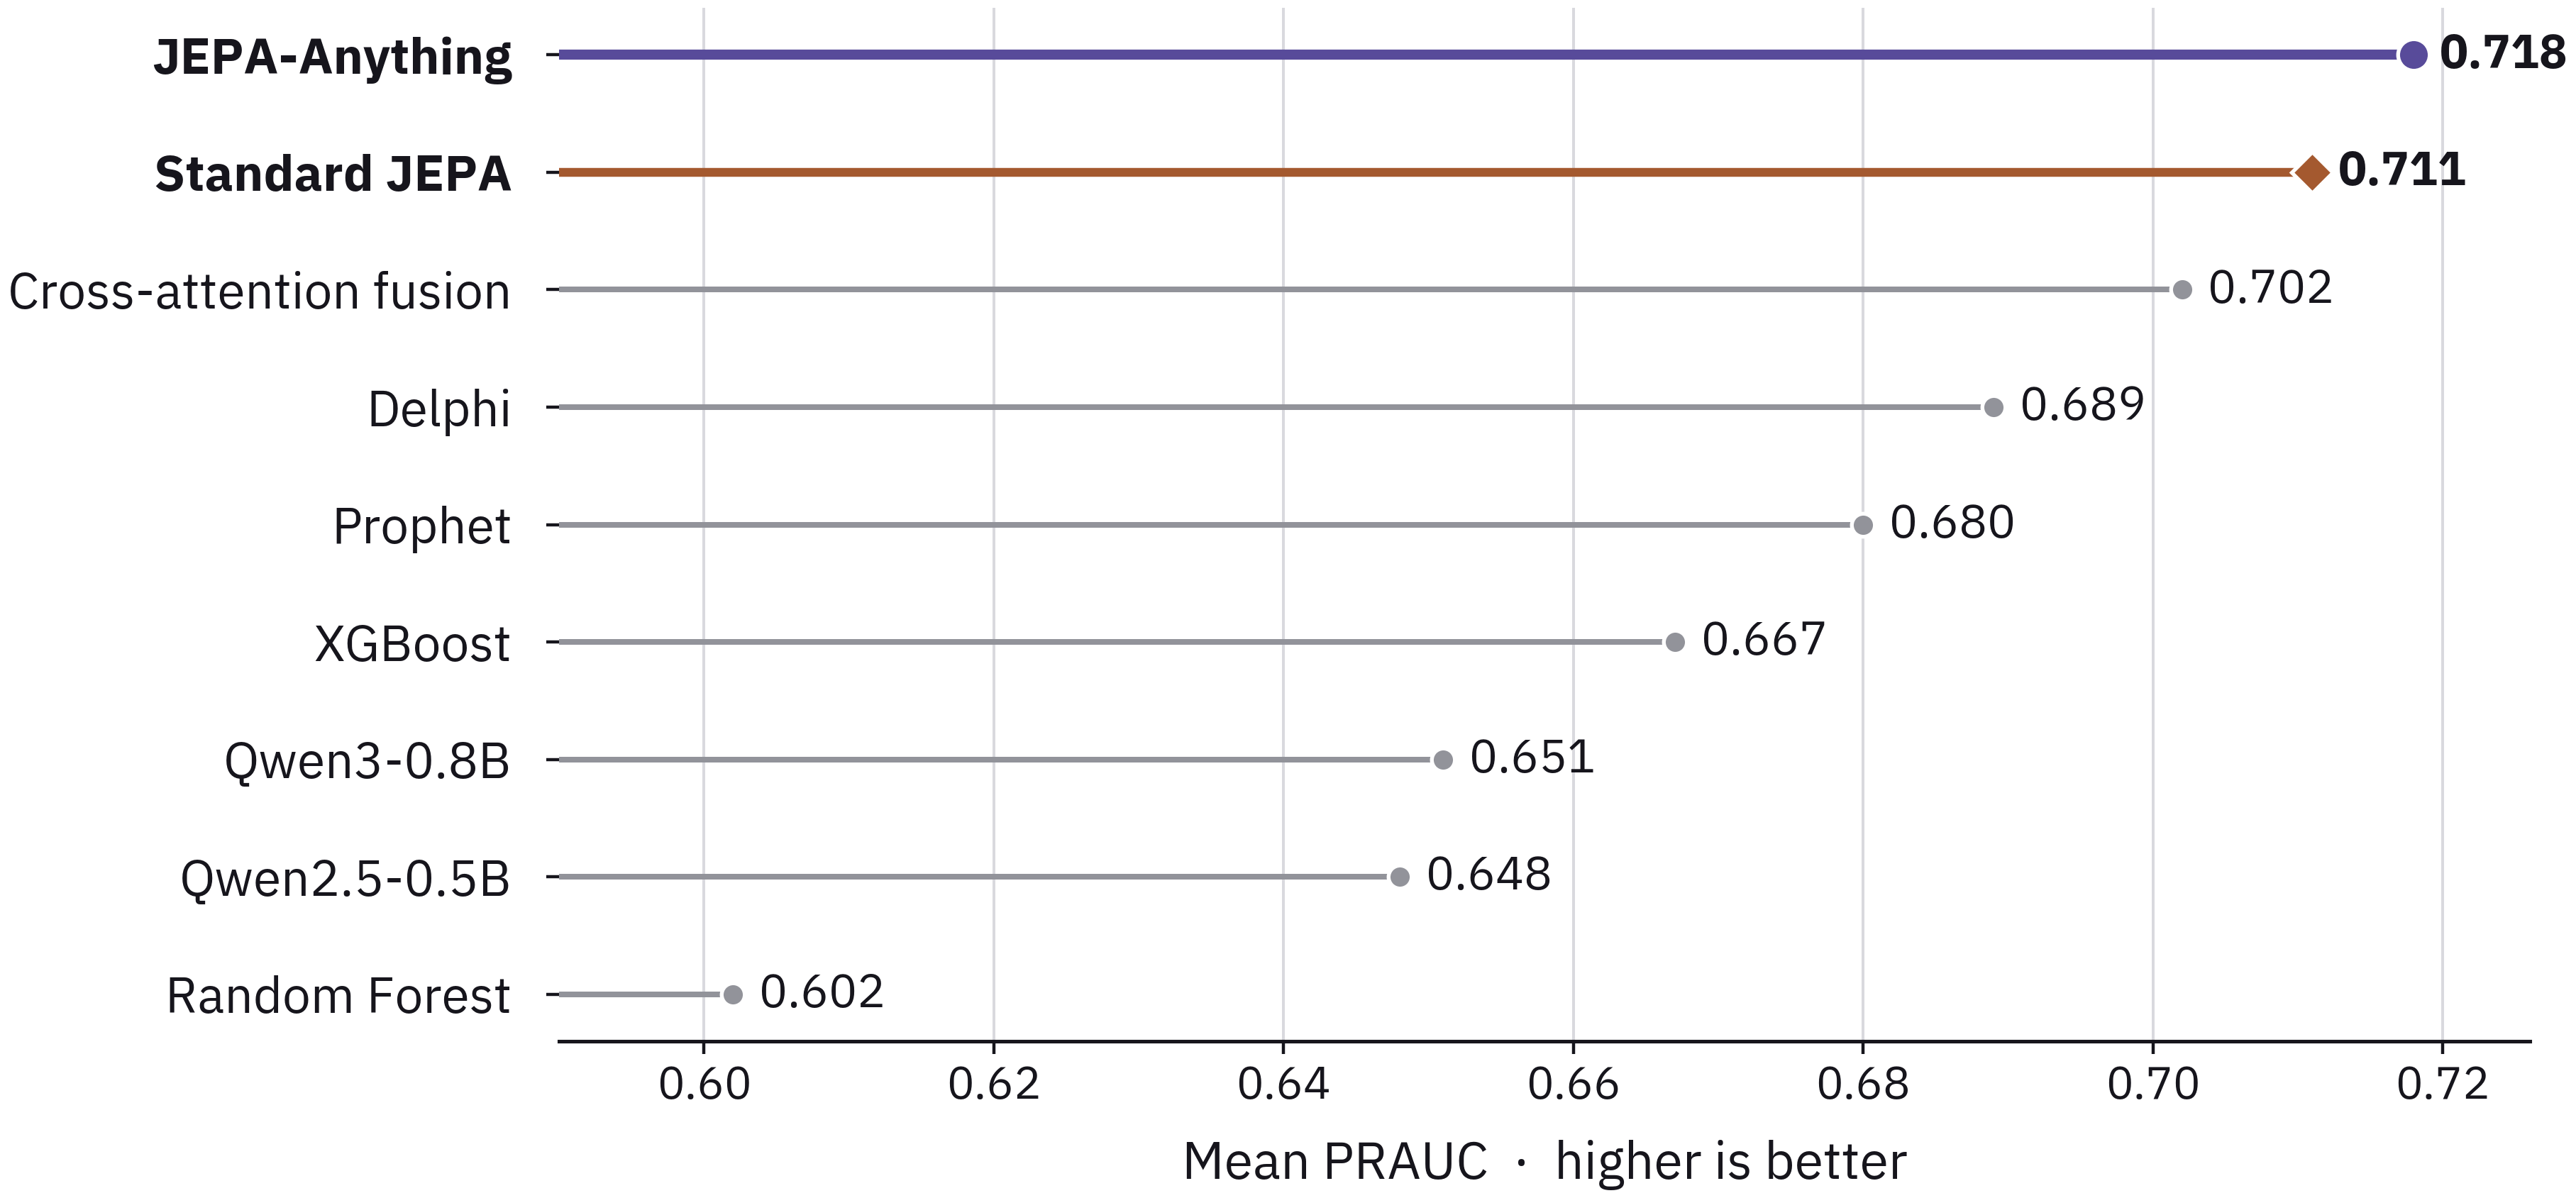
locomotionは部分的な例外であり、平均リターンは2つの環境では改善しましたがHopperでは改善されませんでした。因子介入分析は、すべてのlocomotionチャンネルがロールアウトに寄与していることを示しており、これは 32;\,4\times8 の因子分解がそこでは制御に関連するモードをうまく分離できていないことを示唆しています。幾何学的解析では、重複のないユニット条件付き座標とほぼ完全な合成(因子の再結合から予測状態が回収される)が示されており、これは直交性・活性正則化項が生み出すべき結果に合致しています。
限界と未解決の問題
- 予測因子の直交性は因果的な disentanglement を意味しない。著者らも因子は因果メカニズムではなく予測座標であることを認めています。
- 因子数 K と幅 r はドメインごとに選択されており、原則的な選択手順は提供されていません。Hopperの結果はこの選択が重要であることを示唆しています。
- 配布シフト下での不確実性キャリブレーション——モデルを実験選択に利用するための前提条件として論文で指摘されている——は評価されていません。
- 臨床および分子の数値は集計されたものであり、イベント別・分子別の内訳があれば、OPFの改善が一様なものかサブセットに起因するものかが明確になるでしょう。
- 同一 encoderのクロスドメイン転移は実証されていません。フレームワークは共有されていますが、重みは共有されていません。
重要性
単一の加法的予測目的関数と容量因子分解が、ドメイン標準のバックボーンを維持しながら、7種類の質的に異なる物理・生物システムにわたって成立するならば、「ワールドモデル」の問題はほとんどインターフェース設計に帰着します。これはJEPAを構造化された潜在ターゲット上の loss のファミリーとして再定式化し、下流の因果モジュールや計画モジュールに対する具体的なターゲット——直交的・活性的・合成可能な因子——を与えます。
Source: https://arxiv.org/abs/2609.20800
Video DeltaNet: ライブストリーム動画生成のための動画ネイティブなハイブリッド Attention
問題設定
動画 diffusion transformer は、クリップ長と解像度の二乗に比例して増大する時空間トークン列に対する attention で計算の大部分を消費します。MiniMax H3 では、14.3 秒の 768p クリップが 1 フレームスタックあたり (24{,}102, 48, 84) の形状を持つ latent グリッドを生成し、50 回の denoising ステップ全体において全動画に対する Softmax attention が支配的なコストとなります。線形 attention は自然な解決策です — メモリが O(N^2) ではなく状態あたり O(d_k d_v) でスケールします — しかし単純な差し替えではテクスチャや細かい動きが劣化します。Video DeltaNet (VDN) はその中間を狙います。すなわち、トークンレベルの対応が重要な箇所では正確な Softmax を維持し、遠い時間的文脈については、動画のフレームバッチ構造に特化して設計された線形 attention ブランチを通じて処理します。
アーキテクチャ: ローカル Softmax + 双方向線形メモリ
VDN は動画間 attention を時間的役割によって分割します。テキストおよびオーディオとのクロスモーダルインタラクションは Softmax のままです。動画クエリに対しては以下の通りです:
- スライディングウィンドウ Softmax は、H3 VAE の 5 フレーム時間チャンクに整合した 15 フレームウィンドウ上で動作するため、Softmax の境界がデコーダユニットを二分することはありません。各クエリチャンクは、自身およびその直前・直後のチャンクに対して attend します。
- バウンダリアンカー により、すべてのフレームが最初と最後の latent フレームへの四方向接続性を持ち、それらのエンドポイントフレームはクリップ全体に attend できます。これは image-to-video や first–last-frame-to-video (FL2VA) 条件付けに適しており、アンカーフレームが与えられた視覚的制約を保持します。
- Video Delta Attention (VDA) は、ウィンドウ外のすべてに対して双方向線形メモリを提供します。
Video Delta Attention
VDA はデルタルールをトークンからフレームへと汎化します。標準的なゲート付きデルタルールのステップは状態 S_{t-1} \in \mathbb{R}^{d_v \times d_k} を保持し、次の更新を適用します:
\bar S_t = S_{t-1}\operatorname{Diag}(\alpha_t), \quad S_t = \bar S_t + \beta_t(v_t - \bar S_t k_t)k_t^\top.
動画 diffusion は latent フレームの U = H_\ell W_\ell トークン全体を一括して渡すため、VDA は共有の減衰済み状態 \bar S_t に対してそれらの補正をまとめて計算します。次のように定義すると:
A_t = K_t^\top \operatorname{Diag}(\beta_t) K_t, \quad B_t = V_t^\top \operatorname{Diag}(\beta_t) K_t,
フレーム単位の更新は次のように集約されます:
S_t^{\mathrm{batch}} = \bar S_t (I - A_t) + B_t.
論文(付録 A.2)では、フレーム内の異なるトークンのキーが重複している場合、この frozen-state 形式では競合する書き込みが発生しうることが指摘されています。修正版では合同残差に対して (I+A_t) を解き、これにはフレームごとの小行列の逆行列が必要で、VDN はこれを FP32 で保持します。順方向および逆方向の両時間方向が維持され、学習可能なスカラーでゲートされた後、個別の出力 projection を通じて Softmax ブランチと結合されます。
段階的なティーチャーアライメント
VDN は凍結された事前学習済み H3 に対して 3 段階で組み込まれます。A1 では各線形ブランチを独立に凍結された活性化に対して 200 ステップでアライメントし、Softmax ゲートを 0.99 に固定し、レイヤーごとの gradient clip を 0.1 とします。A2 ではすべてのブランチを導入し、グローバル clip 1.0 で 500 ステップのエンドツーエンド学習を行い、事前学習済みの重みと Softmax ゲートは引き続き凍結します。ステージ B では Q、K、V、および出力 projection に LoRA を追加し、線形パスウェイ、Softmax ゲート、アダプターを 2,000 ステップで同時学習します。最後に、8 ステップの distillation によって 50 NFE を 8 に圧縮します。
推論スタック
4 つの融合 Triton カーネルが VDA を処理します: VDA-Prep(temporal conv + SiLU + L2 + レイアウト)、VDA-Stats(シングルパス A_t, B_t)、VDA-Gather(decay ブリッジ付き双方向状態ピックアップ)、および VDA-Epilogue(RMSNorm + 出力ゲート)。attention は VAE チャンクの境界でのみメモリを読み取るため、VDN はチャンク全体をアフィン遷移 S_{\text{out}} = S_{\text{in}} M_{\text{chunk}} + J_{\text{chunk}} に圧縮し、削減されたシーケンスを 1 回の起動で双方向にスキャンします。(I+A_t)^{-1} の求解には、レジスタ内でブロック化されたガウス・ジョルダン法を行う単一の CUDA カーネルを使用します。Softmax ウィンドウはパターンパックされたクエリを持つ FlashAttention varlen を使用し、VDA はサイド CUDA ストリームにわたってヘッドごとにシャーディングされ、幅広い GEMM は MXFP8 で実行される一方、再帰状態と逆行列は FP32 を維持します。サービングは SGLang 上で行われます。
結果
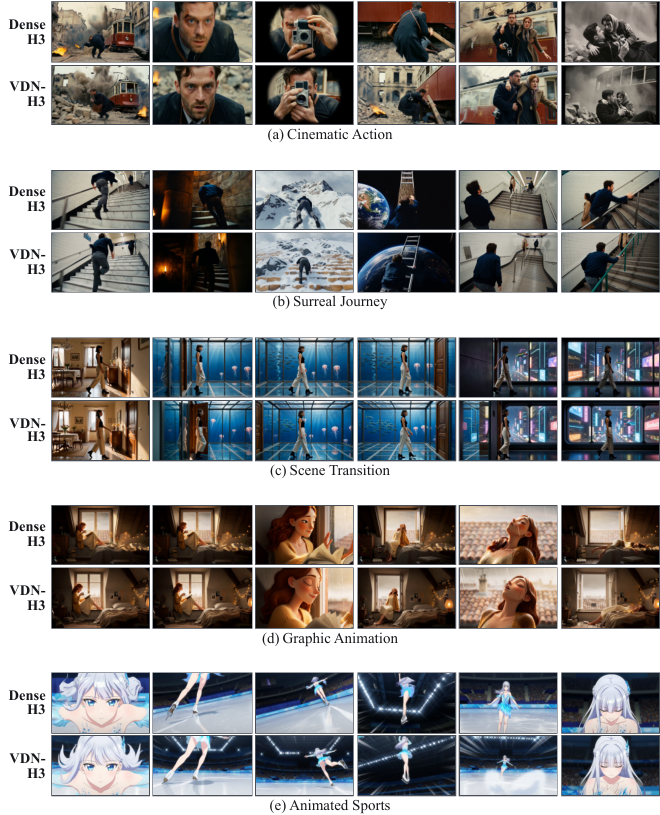
1344 \times 768 の 103 個の固定プロンプトにおいて、8 ステップの VDN-H3 は 14.375 秒のクリップの DiT denoising を 8×B200 上で 6.70 秒で完了し、50 ステップの Dense H3 に対して 14.5 倍の高速化を達成します。品質指標 — EvalCrafter VQA_A/VQA_T、Q-Align、FAST-VQA、DOVER++ — は Dense H3 と同等であり、4 ステップの FastH3 ベースラインを上回ると報告されており、FIRM-Video の次元(Instruction Following、Perceptual Quality、World Coherence)は高速ベースラインではなく Dense H3 を追従しています。FL2VA においては、2 つの条件付けフレームにおける PSNR/SSIM/LPIPS により、バウンダリアンカーパターンがエンドポイントの忠実度を保持することが確認されています。定性的なギャラリーでは、5 つのプロンプトにわたって 8 ステップの VDN-H3 が 50 ステップのティーチャーと一致することが示されています。
限界とオープンクエスチョン
評価は単一の解像度とクリップ長における 103 個のプロンプトに対して行われており、線形メモリの飽和が通常問題となるより長い時間軸での動作は報告されていません。VDA は依然としてフレームごとの小行列の逆行列を必要とし、これは FP32 でのみ安定するため、再帰パスをどこまで積極的に量子化できるかに上限があります。段階的なレシピは強力な事前学習済み Softmax ティーチャーに依存しており、VDA をスクラッチから学習した場合に細粒度の品質が維持されるかどうかは未検討です。最後に、タイトルの「ライブストリーム」という表現は、ストリーミングレイテンシの数値やカusal変形によって裏付けられておらず — 報告されているシステムはフルクリップを denoising します。
なぜ重要か
動画生成におけるハイブリッド attention はこれまでほぼ場当たり的なものでしたが、VDN は具体的なレシピを提供します — VAE 整合 Softmax ウィンドウ、小行列逆行列を伴うフレームバッチ化デルタメモリ、および段階的な LoRA 共同適応 — これにより full attention と同等の品質を回復しつつ、14.3 秒の 768p denoising を 8 枚の B200 上で 7 秒以下のジョブに変えます。特にフレーム単位のデルタルールは、トークンが構造化されたブロックとして到着するあらゆるモダリティにおいて、トークン直列的な線形 attention よりも洗練されたプリミティブです。
Source: https://arxiv.org/abs/2609.20744
When2Think: 効率的なハイブリッド推論モデルのための難易度適応型長さ制御の学習
問題設定
大規模推論モデル(LRM)には広く知られた病理があります。すなわち、些細な算術問題にトークンを浪費する一方で、難しいオリンピアード問題を途中で打ち切ることがあるという問題です。既存の対処法——一様な長さペナルティ(LC-R1、ThinkPrune)、固定バジェット(Laser-DE)、あるいは離散的なThink/NoThinkルータ(AdaptThink、Thinkless)——は「効率性の代償」を支払います。すなわち、簡単な問題でのトークン節約が難しい問題での精度低下に直結してしまいます。インスタンス適応型の計算配分として定式化されるこのタスクは、補助的な報酬モデルを訓練することなく、またinner loopで参照モデルへのクエリを行うことなく、明示的なchain-of-thoughtに入るかどうか、および問題の難易度に応じてどの程度熟慮するかの両方を予測するポリシーを学習することを目指しています。
手法
When2ThinkはR1-Distill-Qwen-1.5Bをベースとしたpost-training RLVRフレームワークであり、DeepScaleR(競技数学問題約40k件)で訓練されています。パイプラインは2段階から構成されています(Figure 2)。
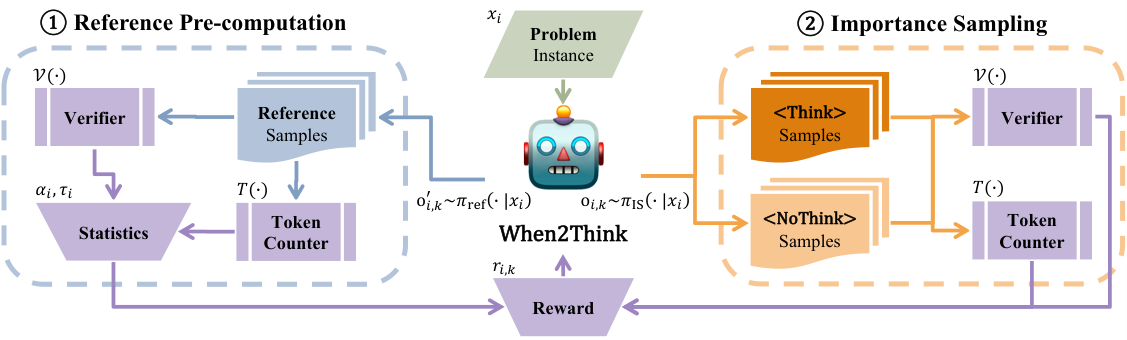
参照統計量(オフライン、エポックごと)。 各 x_i \in \mathcal{D} に対して K 個の軌跡 o'_{i,k} \sim \pi_{\mathrm{ref}}(\cdot\mid x_i) をサンプリングし、スケーリングされた参照精度(難易度の代理指標)と期待推論コストを以下のように計算します:
\alpha_i = \gamma\!\left(\tfrac{1}{K}\sum_k \mathcal{V}(x_i, o'_{i,k})\right) + \varepsilon, \qquad \tau_i = \tfrac{1}{K}\sum_k \mathcal{T}(o'_{i,k}) + \varepsilon,
ここで \gamma=0.9、\mathcal{V} は検証器の指示関数です。\alpha_i \in (0, \gamma] は難しいインスタンス(正答率が低い)では小さく、易しいインスタンスでは \gamma に近い値をとります。\tau_i はインスタンスごとのトークンバジェットです。
インスタンスレベルの難易度適応型制御(IDAC)。 正答に依存した効率性ボーナスが、実現した軌跡長 \mathcal{T}(o) と参照バジェット \tau_i に依存するスケーリング因子 \lambda を変調します。Figure 3のヒートマップはその形状を示しています。\tau=2^{13} の難しいインスタンスでは、\lambda は長い正答軌跡を報酬とし、早期終了を罰します。易しいインスタンスではこの極性が逆転し、短い正答が支配的になります。
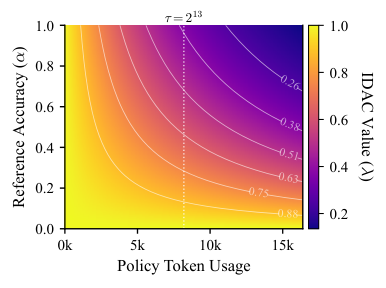
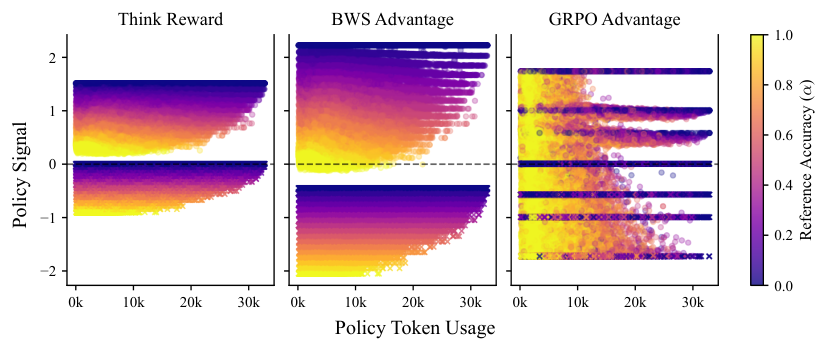
報酬はインスタンスのベースライン \alpha_i で正規化され、バッチ単位で標準化(BWS)されることで、critic不要のPPO型のadvantageが得られます。検証が決定論的であり参照統計量がキャッシュされているため、学習済み報酬モデル、criticネットワーク、およびポリシー更新中のオンライン参照モデルへの呼び出しはいずれも不要です。
Importance-sampledな探索。 一方のモードへの早期崩壊を防ぐため、初期モードトークン(ThinkまたはNoThink)は探索分布 \pi_{\mathrm{IS}} の下で一様にサンプリングされ、後続のトークンは \pi_\theta に従い、off-policy補正が適用されます。Figure 7はこれが重要である理由を示しています。難しいインスタンス(青)ではadvantage景観が長い正答のThink軌跡を優遇し、易しいインスタンス(黄)では短い正答軌跡が支配的となるため、両モードを均等に探索するポリシーは両方のレジームで明確なgradient信号を得られます。
結果
4つの数学ベンチマーク(5シードにわたるPass@3)において、When2ThinkはR1-Distill-Qwen-1.5Bベースと比較して精度を向上させつつ、中程度・困難なタスクでトークンを削減しています:
- GSM-Plus: 85.7%(ベース79.4%比で+6.3ポイント)、1,052トークン(ベース比+462、このベンチマークでは元々簡潔でした)。
- OlympiadBench-Math: 62.4%(+3.6)、5,909トークン(−2,725、約32%削減)。
- AIME24: 56.0%(+10.0)、10,236トークン(−3,959)。
- AIME25: 40.0%(+8.0)、9,549トークン(−3,067)。
同程度の1.5Bスケールの効率性重視ベースラインと比較すると、When2Thinkはトークンを削減しながらAIME24精度を二桁改善した唯一の手法です。LC-R1はAIME24で10ポイント低下、AdaptThinkは1.3低下、Laser-DEは0.7低下、ThinkPruneは横ばい、Thinkless-RLはわずか0.7の改善にとどまります。アブレーション実験の w/o IS(IDACとBWSのみ)は最も高い絶対値——GSM-Plus 86.8%、OlympiadBench 65.9%、AIME24 57.3%——を示しますが、トークン使用量は増加しており(1,652 / 6,239 / 10,046)、importance-sampledな探索がわずかな精度差を犠牲にしてより厳密な長さ制御を達成していることを示しています。
限界と今後の課題
評価は数学タスクおよびシングルの1.5B蒸留モデルに限定されており、IDACの参照統計量事前計算がノイズの多い検証器(コード、エージェントタスク)や大規模なポリシーにスケールするかどうかは未検証です。参照統計量は \pi_{\mathrm{ref}} によりエポックごとに一度計算されます。訓練されたポリシーが \pi_{\mathrm{ref}} から大きく乖離した場合、\alpha_i と \tau_i の両方が難易度・コスト代理指標として陳腐化しますが、論文ではこの乖離を定量化していません。AIMEにおける \sigma 最大 \pm 8 でのPass@3報告は、一部のベースライン比較を統計的に曖昧なものにしています。最後に、IDACは \lambda と(長さ、\tau)の間に単調な関係を仮定しており、より複雑な配分形状(例えば 2\tau 以降の収穫逓減)は学習されるのではなく手動でチューニングされています。
重要性
When2Thinkは、インスタンス条件付き長さ制御が、安価なオフライン参照統計量と形状を持つ検証可能な報酬から得られることを実証しており、学習済みcriticも報酬モデルも回避しています。AIMEにおいて精度向上とトークン削減を同時に達成した結果は、このスケールのハイブリッド推論における「効率性の代償」という通説に対する最初の明確な反例となっています。
Source: https://arxiv.org/abs/2609.19671
EOSトークンの不一致:On-Policy Distillationにおける応答長インフレの理解
On-policy distillation(OPD)は、教師 \pi^E がstudent-sampledトークンに対してadvantageを供給するscore-function updateを用いて、student \pi_\theta を自身のrollout上で学習させます:
A_t = \log\pi^E(y_t \mid s_t) - \log\pi_\theta(y_t \mid s_t), \qquad g_t = A_t\,\nabla_\theta \log\pi_\theta(y_t \mid s_t).
本論文は、この「sampled-token OPD」の微妙な失敗モードを特定します:ベースのstudentとpost-trainedのteacherが終端確率マスを異なるEOSトークンに集中させている場合—宣言されたstoppingセットが同一であっても—updateがstudentのネイティブEOSを系統的に抑制し、teacherが好むEOSへの転移も起こらないという問題です。結果として応答長が漸進的にインフレし、rolloutが生成バジェットを使い切ってしまいます。
診断
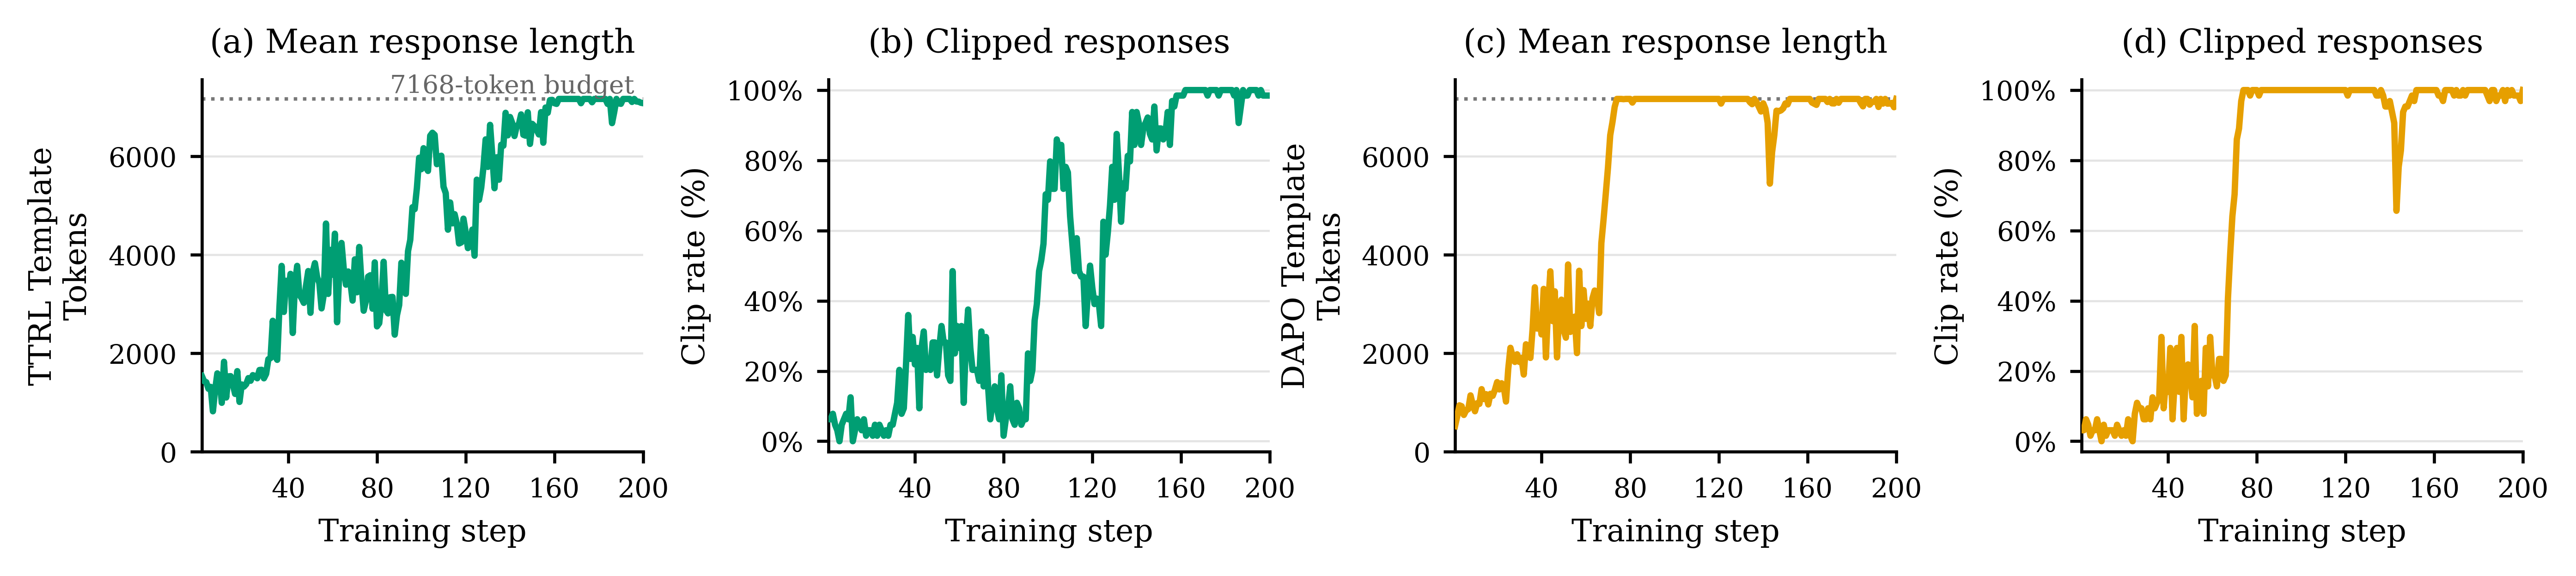
Qwen3-1.7B-Base(student)← Qwen3-4B non-thinking(teacher)におけるvanilla OPDでは、TTRLおよびDAPOプロンプトテンプレートの両方で応答長が単調増加し、多くのrolloutがバジェットに達することが示されます。
終端位置の確率を調べることで、そのメカニズムが具体的に明らかになります。Qwen3-Baseは終端マスを <|endoftext|>(id 151643)に集中させている一方、Instructのteacherは <|im_end|>(id 151645)に集中させています—両トークンがteacherの宣言されたstoppingセットに含まれているにもかかわらず、です。
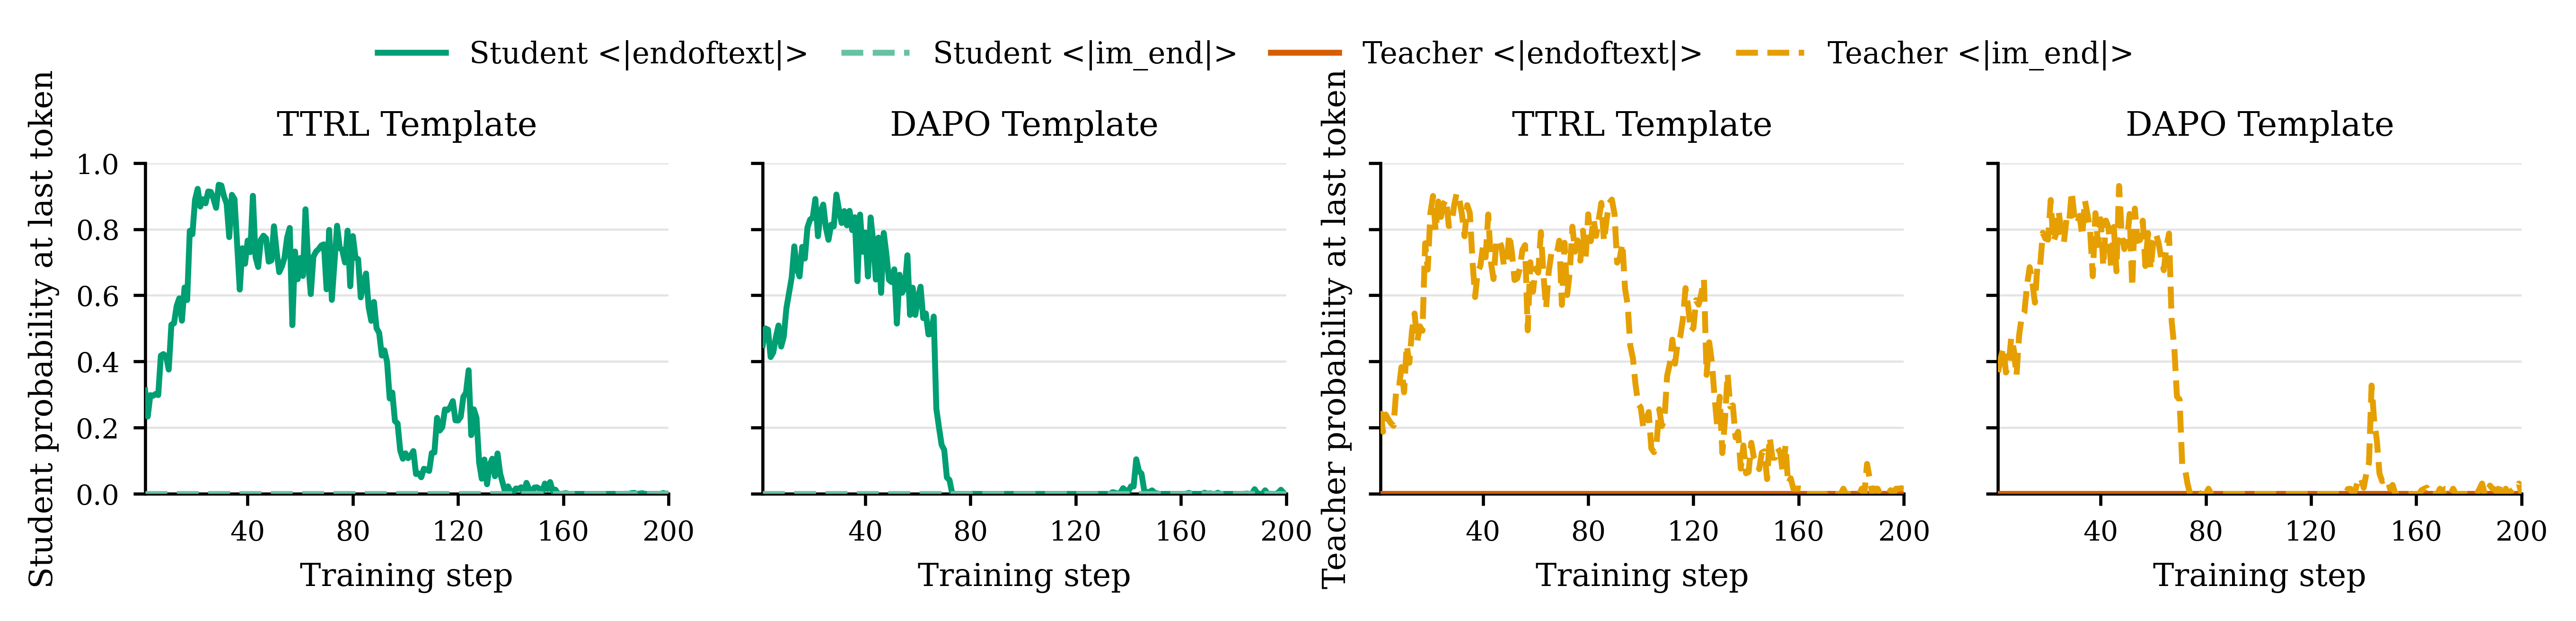
終端状態におけるteacherが好む <|im_end|> に対するstudentの確率は概ね 10^{-11} です。ここから2つの帰結が生じます。まず、A_t はsampledトークン e 上で評価されるlog-ratioであるため、studentが自身のネイティブEOS e_\star = \texttt{<|endoftext|>} をサンプルし、teacherがその特定の表層形に対して小さなマスを割り当てると、係数
A_t(e_\star) = \log\pi^E(e_\star \mid s_t) - \log\pi_\theta(e_\star \mid s_t)
が負になり—updateが終端を抑制します—teacherは(異なるトークンを通じてではあれ)停止を望んでいるにもかかわらず、です。次に、studentが <|im_end|> をほぼサンプルしないため、teacherが好む代替トークンに対して直接的な正の教師信号が届きません。終端アクションは非対称に降格されます。
デコーディングセットの整合がなぜ失敗するか
「修正1」は単純に <|endoftext|> と <|im_end|> の両方をrollout時の有効なstopトークンとして登録するもので、目的関数はそのままにします。しかし、応答長とクリッピングの軌跡はvanilla OPDとほぼ区別がつきません。これは確率分析から予想される結果です:追加のstoppingトークンはstudentのもとで \sim 10^{-11} のマスしかなく、事実上サンプルされることはなく、sampledトークン上のlog-ratio計算は変わらないままです。
修正:semantic EOS aggregation
著者らは、終端的に等価なトークンの集合 \mathcal{E}_{\mathrm{EOS}} を単一のsemantic stoppingアクションとして扱うことを提案します。具体的には、studentが e \in \mathcal{E}_{\mathrm{EOS}} のいずれかをサンプルした際、A_t 内のlog-probabilityをstudentとteacherの両方について \sum_{e' \in \mathcal{E}_{\mathrm{EOS}}} \pi(e' \mid s_t) に対して計算します。これにより、sampled-token OPDの構造を保ちながら表層形の不一致を除去します。応答長のインフレはQwen3、Llama 3.2、Gemma 3全体で大幅に緩和されます。
Gemma 3のケースは有用な対照実験となっています:PTとITのチェックポイントは宣言されたEOSセット \{\texttt{<eos>}, \texttt{<end\_of\_turn>}\} が同一であるにもかかわらず、インフレが発生します。これはPTのstudentが <eos> にマスを集中させ、ITのteacherが <end_of_turn> を好むためです。
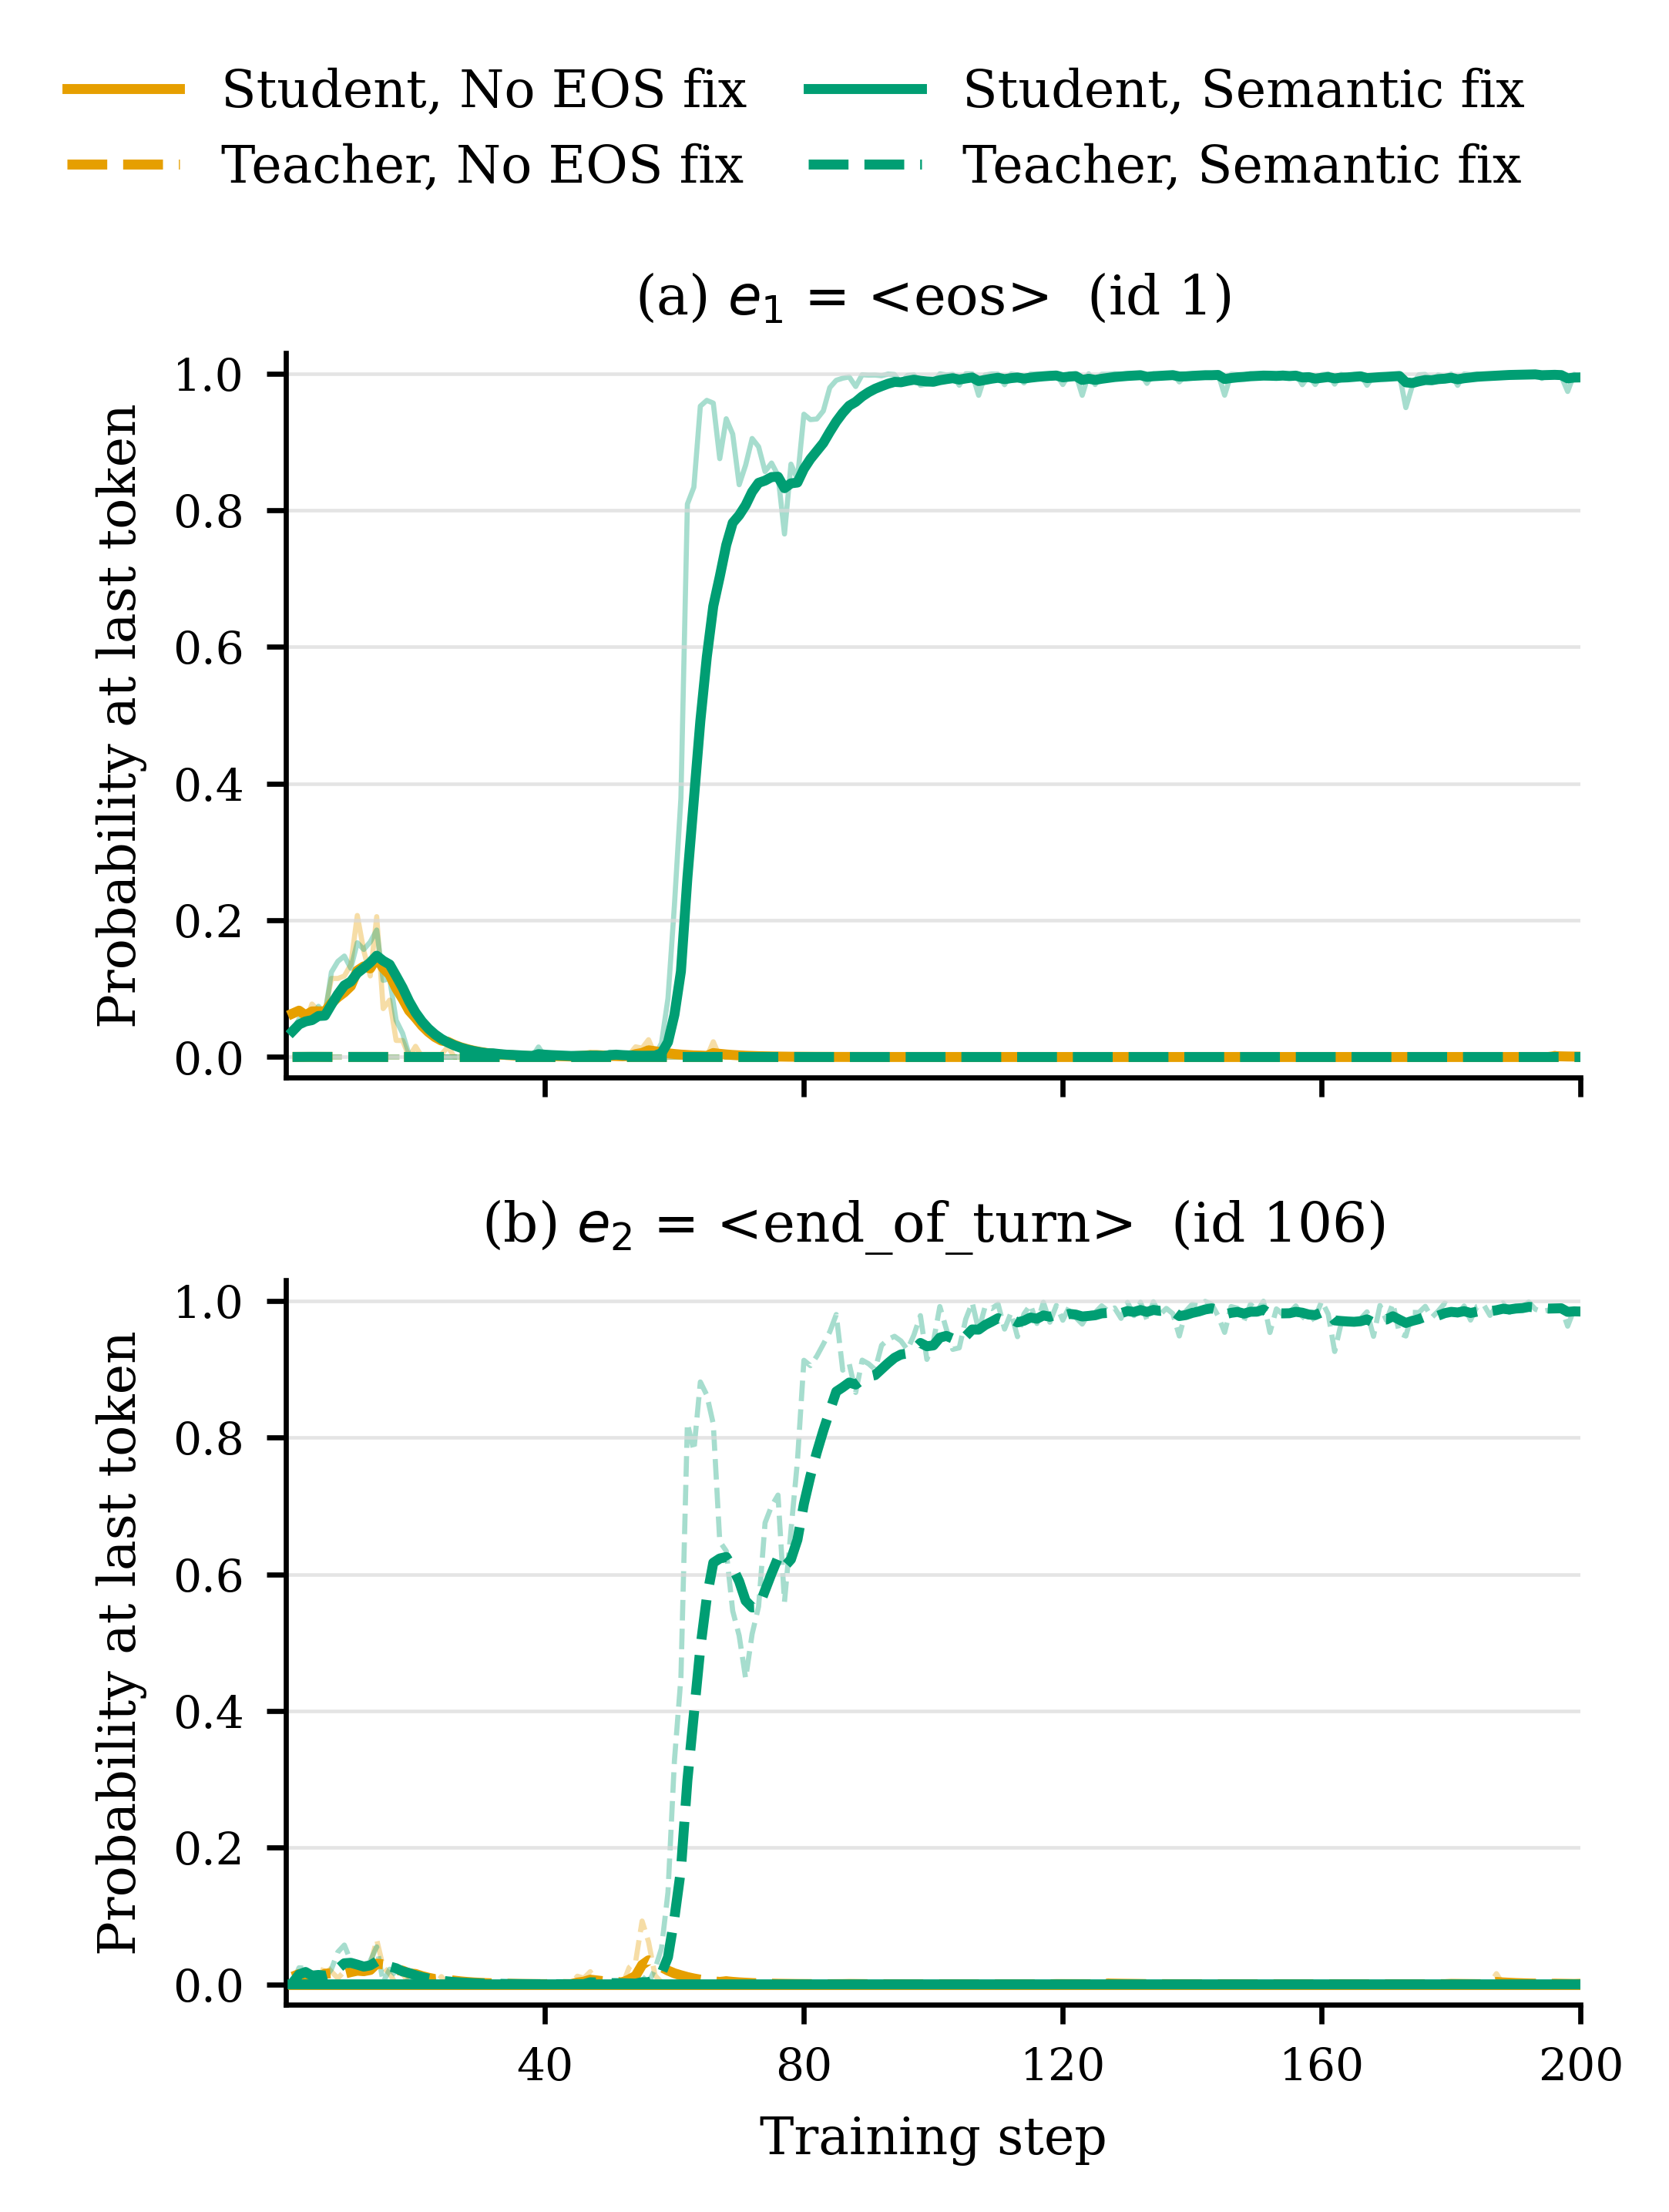
これにより「宣言されたstoppingセットの不一致」が根本原因ではないことが排除され、機能的に等価なトークン上の学習済み確率マスがメカニズムの本質であることが確認されます。
K2-HorizonによるStage別分析
K2-Horizon-7Bを用いた分析では、このモデルがpretrain、midtraining、SFT、および最終post-trainingのチェックポイントを公開しつつEOSトークンIDを一定に保っているため、学習ステージと設定のdriftを切り離すことができます。pretrain済みstudentは <|ifm|endoftext|> を好み、最終teacherは <|ifm|im_end|> を好みます。この変化のほとんどはmidtrainingまでに起こり、SFTステージまでにはstudentの終端分布がteacherに近づきます。
このセットアップからの2つの観察がストーリーを精緻化します:
- studentがteacherが好む終端トークンにすでに無視できない確率マスを置いている場合、vanilla OPDは終端挙動を転移できます—そのトークンが実際にサンプルされて直接的な教師信号を受け取るためです。これはK2-Horizonのpretrain-to-finalの学習初期の実行であり、Qwen3のbase-to-instructケースとは対照的です(後者ではギャップが約11桁に及びます)。
- pretrain-to-final OPDの実行の後半に、第二の別個の応答長インフレが現れます—終端の表層形が整合した後のことです。応答長が再びバジェットに向かって成長します。semantic EOS aggregationではこれを解消できず、表層トークンの不一致を超えた残余のメカニズムが存在することが示されます。
midtrainingとSFTの初期化では、終端分布がすでに整合しているため、semantic correctionを適用することは実質的に無効(inert)であり—下流の評価で一貫した性能低下はなし—これは合理的な非干渉特性といえます。
限界と未解決の問題
この修正は、特定のstudent–teacherペアに対してどのトークンが意味的に等価な終端トークンであるかを知る必要があり、本論文ではrolloutプロトコルを通じて手動で対処しています。K2-Horizonで観察された後期のインフレは診断されていますが、メカニズム的には説明されておらず、EOSの不一致によるものではありません。実験はTTRL/DAPOテンプレートを用いた数学的推論(DAPO-Math-17K)に限定されており、より長形式のタスクにおける応答長インフレが同じ構造を持つかどうかは未検証です。最後に、分析はsampled-token OPDに特有のものであり、full-distribution KL目的関数では同じ非対称性は生じないでしょうが、それ自体別のコストを伴います。
なぜこれが重要か
OPDにおける応答長インフレはしばしばreward hackingやentropy collapseに帰因されますが、現在のbase-to-instructパイプラインにおけるその多くはtokenizationのアーティファクトです:teacherが異なる表層形を通じて同じ停止決定を表現しているにもかかわらず、サンプルされたEOSトークン上のscore-function updateが終端を暗黙のうちに抑制してしまうのです。機能的に等価なEOSトークンを共有アクションとして扱うことはほぼコストのない修正であり、K2-Horizonの結果は、tokenization以外の残余の応答長インフレメカニズムが存在することを示唆しており、別途切り分けて調査する価値があります。
Source: https://arxiv.org/abs/2609.20511
コーディングエージェントのハーネス設計に関する実証的研究
コーディングエージェントは通常、モノリシックなハーネス(Aider、SWE-agent、OpenHands、Claude Code)として提供されており、それらを比較する際にはモデルの選択、ツールスキーマ、計画スキャフォールド、コンテキスト処理が混在してしまいます。本論文はハーネス自体を分離して研究します。具体的には、ReAct実行ループを固定したうえで、計画(planning)、アクション空間、コンテキスト管理という3つの直交するコンポーネントを、176の対応設定、4つのモデル(Nemotron-3 30B/120B/550B および Mistral-Medium-3.5-128B)、2つのベンチマーク(SWE-Bench Verified、Terminal-Bench 2.1)にわたって変化させます。
ハーネスの構造
ループは標準的なReActです。各ターンにおいて、ハーネスはプリアンブル、実行中の履歴 H、オプションで注入された計画、および現在のアクション空間のツールスキーマからモデル入力を組み立てます。モデルはツール呼び出しを出力し、それらはタスクコンテナ内で実行され、観測結果が H に追記されます。
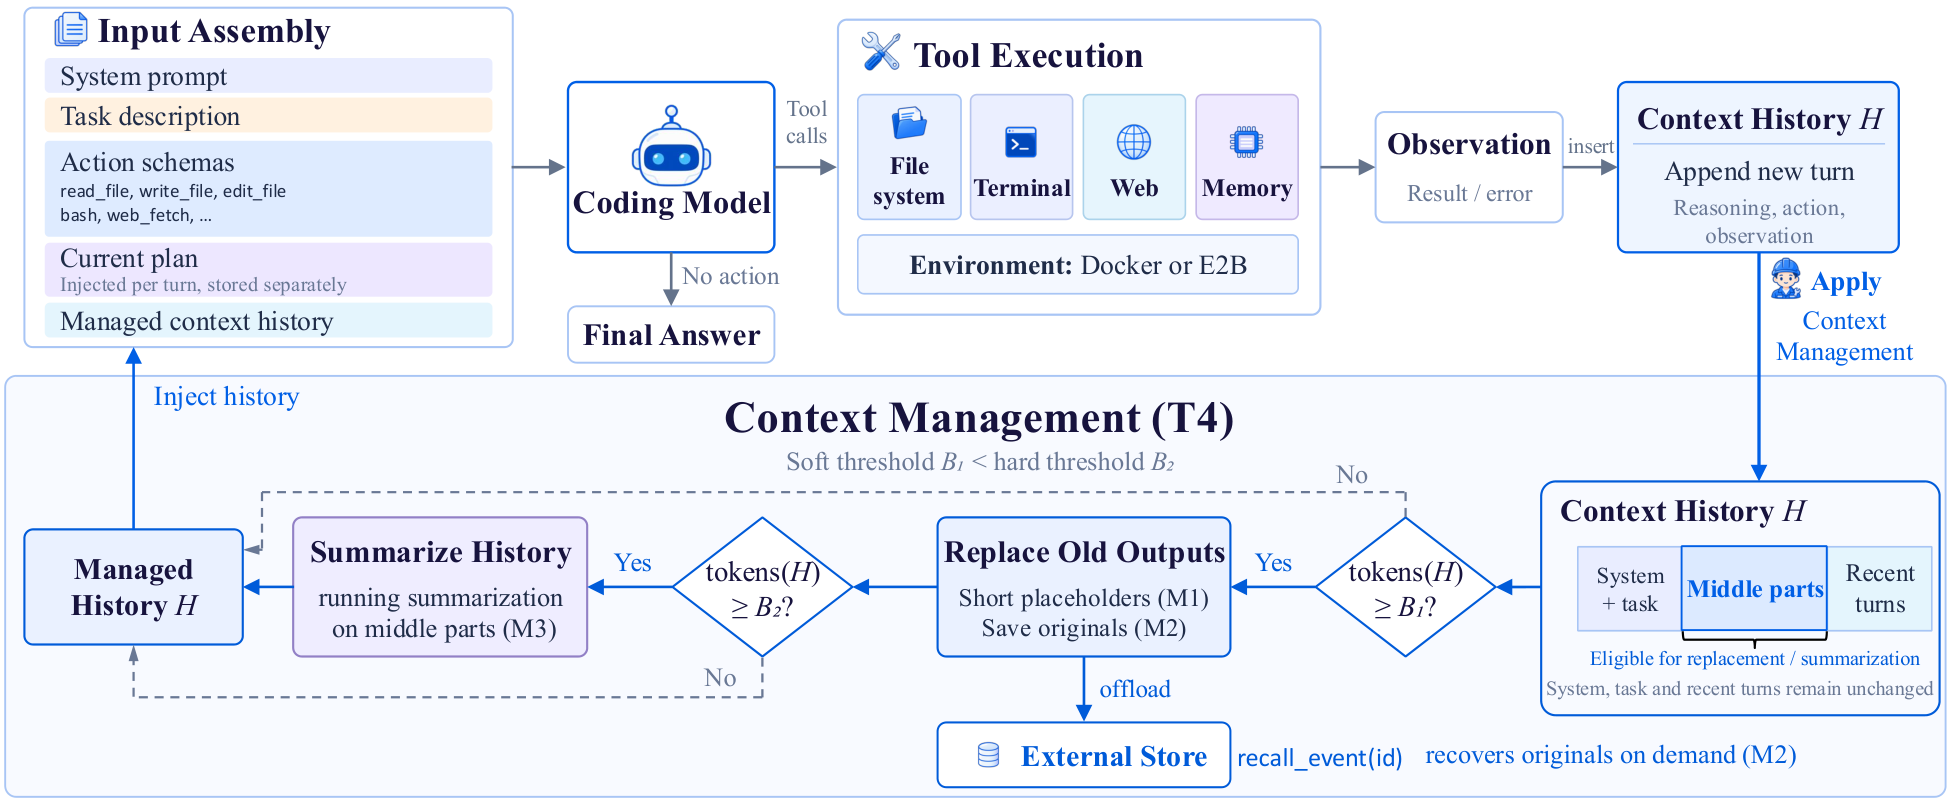
計画は、chain-of-thoughtではなく永続的なスキャフォールドとして実装されています。システム命令と最初のターンのリマインダーが初期計画を要求し、計画は update_plan ツールを通じて維持されます。後続のターンでは現在の計画がインプットに注入されますが、H には保存されません。計画を無効にすると、命令、注入、ツールが取り除かれますが、それ以外はすべて固定されます。したがって、報告される効果は、広く言う「行動前に考える」ことの効果ではなく、永続的な計画状態の効果です。
アクション空間には2つの設定があります。事前定義ツール条件では、型付きツール(list_files、glob_files、grep_text、read_file、edit_file、write_file、bash、web_fetch)を公開し、セッションレベルのファイル状態を通じた書き込み前読み取りを強制し、構造化された編集に対してpost-edit診断を実行します。bash-onlyの条件ではワークスペースツールを取り除きます。bash を通じて発行された同一の変更は状態追跡と診断をバイパスします。両条件ともワークフローとセーフティテキストを共有し、変化するのはツールの利用可能性とインターフェース固有の命令のみです。
コンテキスト管理は、現在のコンテキスト長に対する2つの閾値 B_1 < B_2 によって制御される段階的戦略T4としてパラメータ化されています。プリアンブルと最新のターンは常に逐語的に保持されます。ソフト閾値 B_1 を超えると、中間領域の大きなツール出力がスタブに置き換えられ(M1)、recall_event を通じて復元可能な外部ストアにオフロードされます(M2)。ハード閾値 B_2 を超えると、最も古い中間イベントがLLMによって要約されます(M3)。T1〜T4の段階でこれらのメカニズムが段階的に有効化され、コンテキストウィンドウのバジェットは32k/64k/128k/…と別途スイープされます。
知見
コンテキスト管理は主にトラジェクトリ長の確保に貢献します。 32kのバジェットでは、コンテキスト管理を無効にするとSWE-Benchのトラジェクトリは中央値20〜30ターンに崩壊し、ほとんどの実行が編集前のLocalizeフェーズで終了します。管理された段階を有効にすると、モデルと段階に応じて中央値のトラジェクトリは50〜180ターンに延長され、実行がVerifyフェーズに到達できるようになります。フェーズの順序と割合は、同一ターン数において概ね保持されます。128kでは、各段階はほぼ区別がつきません。Nemotron-3 30Bの中央値の長さは39〜42ターン、Nemotron-3 550Bは70〜74ターンの範囲に収まり、re-patchの回数はタスクあたり2未満の差であり、4つのモデルのうち3つではno-edit終了率の差は4ポイント未満です。コンテキスト管理の主な貢献はオーバーフローによる終了を防ぐことであり、挙動を再形成することではありません。
コンテキスト管理の中では、ステージングが重要であり、復元可能性は重要ではありません。 LLM要約前のルールベースの省略(M1 → M3)が最も効率的なポイントです。省略されたコンテンツを recall_event を通じて復元可能にする(M2)と、モデルがほとんど呼び出さないツール表面が追加されるだけで、ablationにおける精度の向上は得られません。
計画の効果はモデル能力によって符号が逆転します。 表6は、T4/128kにおける計画オフ対オンでのSWE-Bench実行のうち、一切の編集を行わずに終了した割合を示しています。最も弱いモデル(Nemotron-3 30B)では、計画によってno-edit終了率が68.6%から27.8%へと大幅に減少し、Localizeで止まる実行は58.4%から10.4%へと減少します。計画は、モデルを探索ループから引き出す精度スキャフォールドとして機能します。Nemotron-3 120Bでは効果が若干逆転します(no-editが15.6% → 24.4%、Localizeで詰まるものが11.0% → 17.8%)。最も強い2つのモデルは本質的に影響を受けません(Nemotron-3 550B:1.4% → 2.4%;Mistral-Medium-3.5-128B:2.0% → 1.2%)。著者らはさらに、計画が最弱モデルのトラジェクトリを長くする一方、最強モデルのトラジェクトリを短くすることを観察しています。これは、弱いポリシーを制約し、ベースポリシーがすでに暗黙的に計画している場合にオーバーヘッドを加えるスキャフォールドと一致しています。
bash-onlyはアクションの粒度を変えます。 型付きツールを取り除くことは単にアクションをリラベルするだけでなく、書き込み前読み取りゲートとpost-edit診断も取り除きます。トラジェクトリ分析のジャッジラベルは、ローカライズ、編集、検証の表現方法の変化を明らかにします。本論文では、アクション空間とそれに付随する命令をツールスキーマとプロンプト表現から切り離すのではなく、ひとつのバンドルとして扱います。
限界
このablationは計画を、永続的でツールによって維持される計画ブロックとして狭く定義しています。より軽量な計画(例:スクラッチパッドのみ)の効果は測定されていません。トラジェクトリのフェーズラベルはLLMジャッジから得られます(人間との一致率は付録9.2に報告されていますが、ここでは要約しません)。テストされたモデルは2つのファミリーからの4つのみであり、価格/精度の結論は2026年8月のOpenRouterレートに依存します。アクション空間のablationは、ツールスキーマとシステムプロンプトの表現、および書き込み前読み取り強制の仕組みを混同しています。M2(復元可能な省略)がより長い水平線や検索に特化して訓練されたモデルで有効かどうかは未解明のままです。
なぜ重要か
ハーネスのコンポーネントは通常、直感によって正当化されるか、先行システムからそのままコピーされます。本研究は、(i)コンテキスト管理は推論を改善するためではなく主にオーバーフローを回避するメカニズムであること、および(ii)永続的な計画スキャフォールドは弱いモデルには有益で強いモデルには有害であること、というコンポーネントレベルの対応した証拠を提供します。これらの知見はいずれも、画一的なスタックではなく、能力に応じたハーネス設計を支持するものです。
Source: https://arxiv.org/abs/2609.20804
RetireOPD: エージェント型強化学習のための自己引退型オンポリシー蒸留
問題設定
マルチターンRLエージェントは1つのトラジェクトリにつきスカラー報酬を1つしか受け取らないため、長いホライズンにわたって疎な勾配信号しか生じません。自己オンポリシー蒸留(OPD)は、より強力な「自己教師」(同一のベースから初期化されるが、特権的なスキルコンテキストを持つ)がスキルなしの学生にトークンレベルのKLガイダンスを与えることで、監督信号を密化することを目的としています。しかし、素朴なレシピを損なう2つの経験的事実があります:
- 特権的コンテキストが自動的に信頼できる教師を生成するわけではない。プロンプトによるスキル条件付きモデルは、RLで訓練されたスキルなし学生よりも性能が低い場合がある。
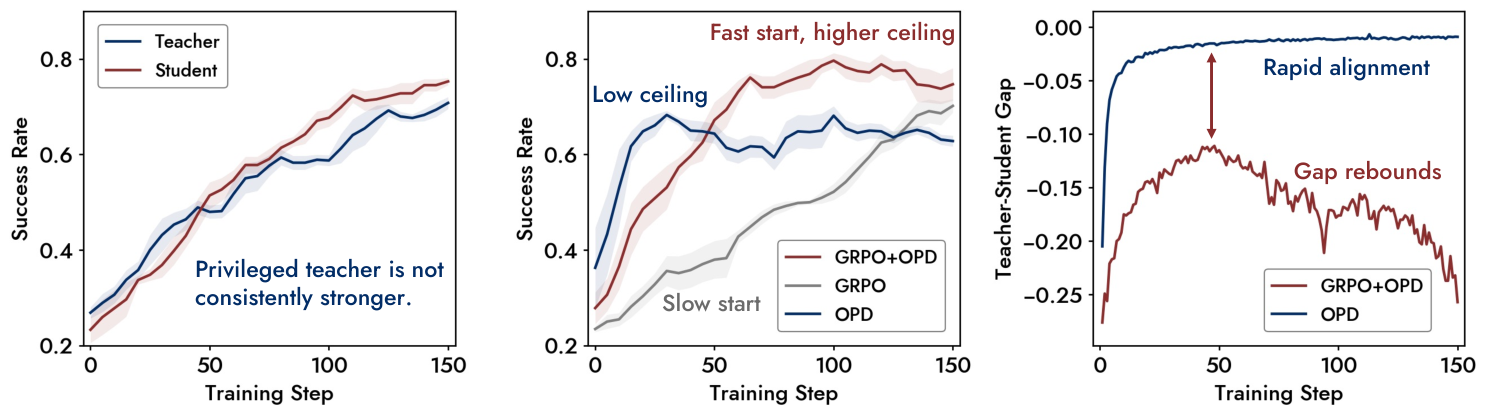
- 教師の監督の有用性は訓練ステージに依存する。訓練初期では教師と学生の暗黙的なポリシーは一致しており蒸留が有効だが、後期になると学生のRLドリブンなポリシーが教師から乖離し、継続的な蒸留が足かせとなる。
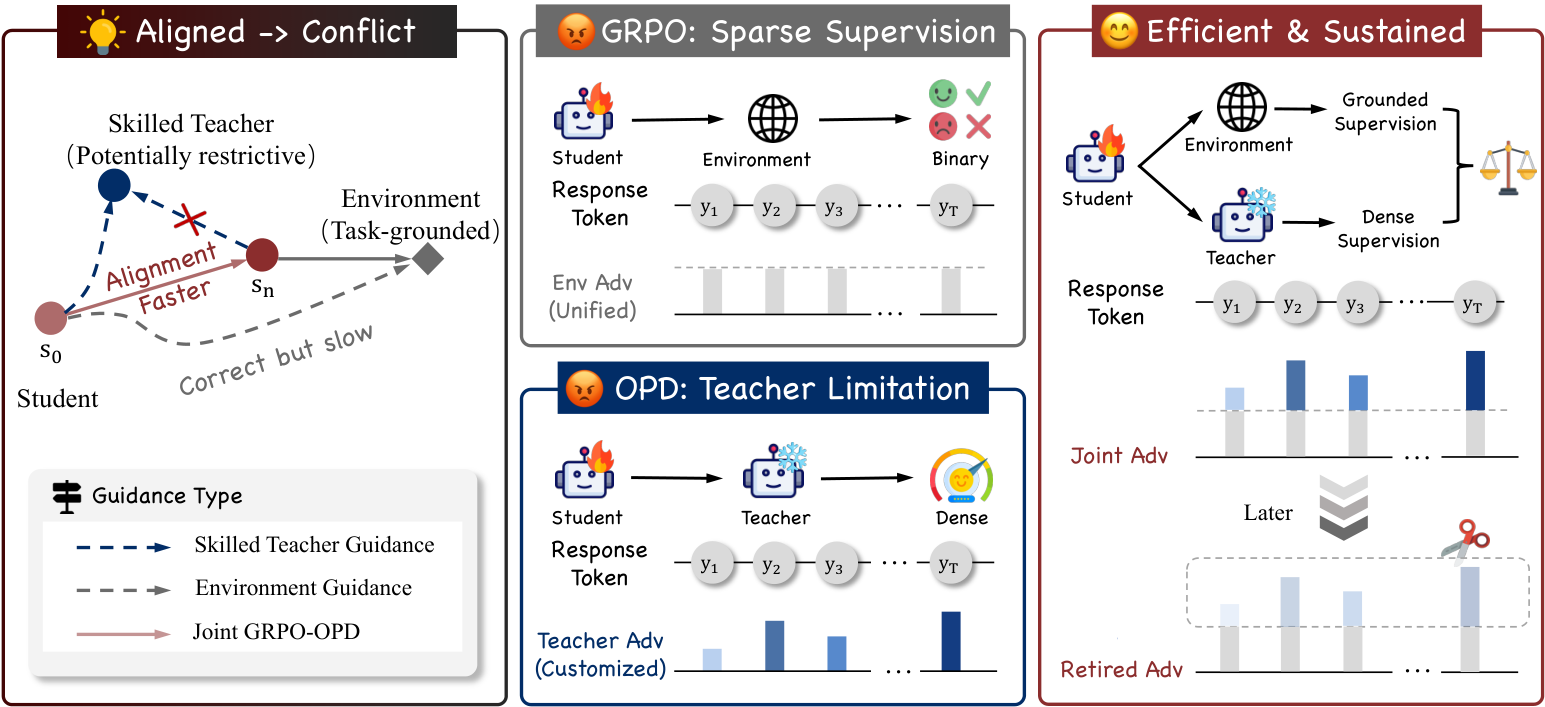
図2はこれを具体的に示しています。3Bの学生に対してALFWorld上でGRPO+OPDを共同実行すると、教師と学生の不一致は最初は単調に縮小し、その後横ばいになる一方で、学生の成功率はRL単独のもとで上昇し続けます。
手法
RetireOPDは3段階のパイプラインです(図3)。
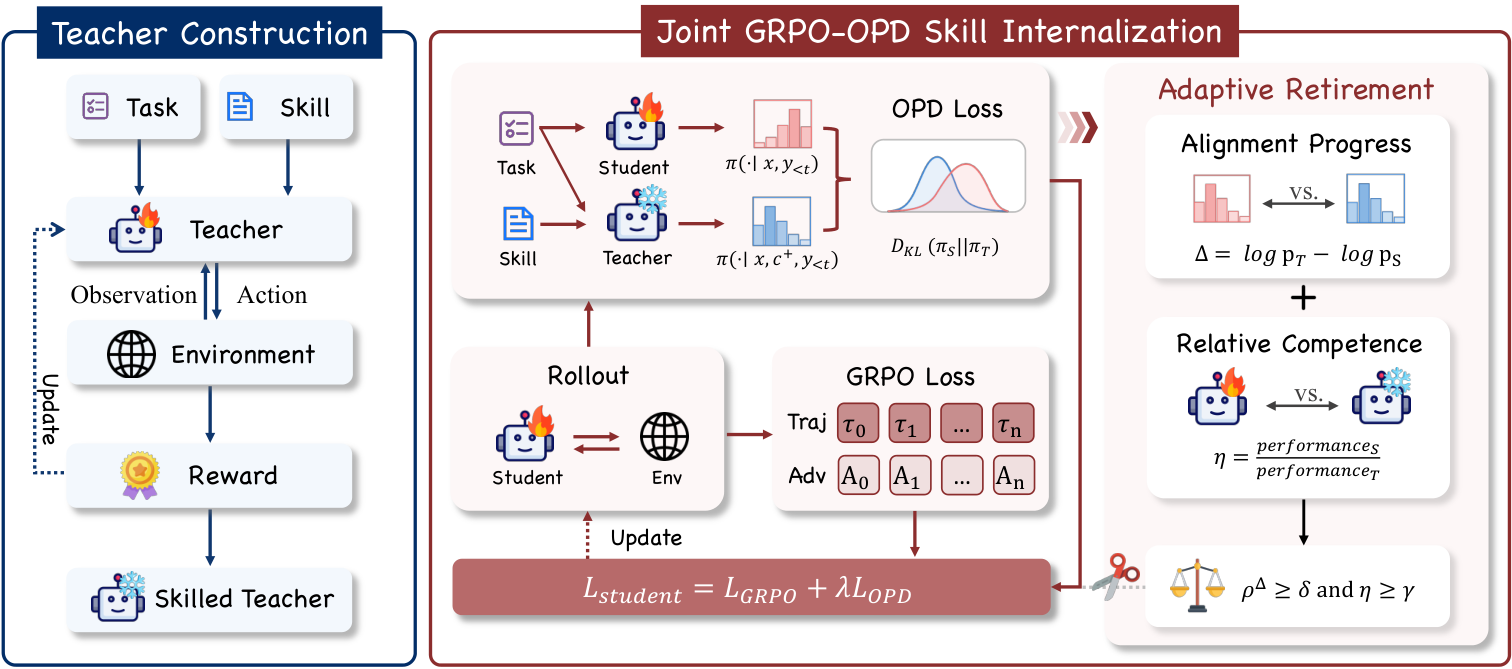
ステージ1:特権的教師の構築。 教師\pi_\phiと学生\pi_\thetaはアーキテクチャと初期化を共有します。教師はさらにタスクに関連するスキルコンテキストc^+(チェックリスト、ツールのヒント、サブゴール分解)を条件として与えられ、環境報酬に対してGRPOで最適化されます:
\phi^{*}=\arg\max_{\phi}\,\mathbb{E}_{x\sim\mathcal{D},\,\tau\sim\pi_\phi(\cdot\mid x,c^+)}\left[R(\tau)\right].
重要なのは、教師が学生から切り離されており、単にプロンプトされるのではなくRLチューニングされている点です。これにより知見(1)が解消されます。スキルなしの学生は訓練時も評価時もc^+を参照しません。
ステージ2:GRPO–OPDの共同訓練。 \pi_T = \pi_{\phi^*}を凍結した状態で、学生は自身のロールアウトを用いて結合目的関数で訓練されます。すなわち、トラジェクトリ報酬に対する標準的なGRPOアドバンテージと、学生生成シーケンス上での学生から教師へのトークンレベルの蒸留項(c^+を条件とした\pi_Tで評価される逆KL)の組み合わせです。ロールアウトは学生のものであるため、教師は学生が行動する箇所に正確に密なトークン単位の修正信号を提供し、OPSDのオフポリシーの不一致を回避します。
ステージ3:適応的引退。 固定された蒸留スケジュールの代わりに、両方の条件が成立したときにOPDが除去されます:(i) 教師-学生の不一致の縮小が止まる(そのEMAの横ばいが図1の「衝突点」に対応する)、かつ(ii) 学生が教師の成功率の目標割合に到達し、足かせなしで生存できるだけのスキルが十分に内在化されたことを示す。引退後、訓練は純粋なGRPOに戻ります。このメカニズムが、ステージ依存の教師有用性を単調改善曲線へと変換します。
結果
Qwen2.5-1.5B/3B/7B-Instructを用いて、ALFWorld(6つのサブタスク)とWebShopで評価しました:
- ALFWorld平均成功率(7B): RetireOPD 95.3、対GRPO 81.2(+14.1)、GiGPO 90.8、Skill-GRPO教師 90.6、GRPO+OPD 92.2。RetireOPDは自身の教師を4.7ポイント上回ります。
- ALFWorld(3B): RetireOPD 93.8 対 GRPO 75.0(+18.8)、教師Skill-GRPO 79.7。
- ALFWorld(1.5B): RetireOPD 89.8 対 GRPO 72.8(+17.0)、教師 81.2。
- WebShop精度(7B/3B/1.5B): RetireOPD 84.4/77.3/75.8 対 GRPO 72.6/63.3/56.8(11.8/14.0/19.0の向上)。ここでもスキル条件付き教師(78.9/64.8/67.9)を超えています。
蒸留のみのベースラインは顕著に弱く、7BのOPSDはALFWorldで32.8/WebShopで2.3にとどまり、より大きな(14B)教師からのOPDでも64.8/4.7にしか達しません。これは、より強力な教師が自動的に知識を移転するわけではなく、オンポリシーの学生ロールアウトが教師のスケールより重要であることの証拠です。RLなしのSkill-Prompt教師はほぼ無効(7Bで23.4/0.8)であり、特権的コンテキスト単独では不十分であることを確認しています。
注目すべきは、ハイブリッドGRPO+OPDが強力なベースライン(7BでALFWorld 92.2)であるにもかかわらず、RetireOPDの引退メカニズムが7Bでさらに約3ポイント、3Bで約11ポイントを追加していることです。これはすべて、蒸留が制約となった時点でそれを除去することに起因しています。
限界と未解決の問題
- スキルコンテキストc^+はベンチマークごとに手動で作成されており、その自動抽出(例:専門家のトレースから)は未対応です。
- 引退のトリガーは2つの閾値(不一致の横ばい、教師割合目標)に依存していますが、その感度は十分に特徴付けられておらず、論文ではこれらのパラメータのグリッド探索が報告されていません。
- 両方の環境は比較的短いホライズンとテンプレートが豊富な言語を持っており、オープンウェブエージェント(BrowserGym、SWE)や長いクレジット割り当てを伴うツール使用での動作は不明です。
- 教師はステージ1後に凍結されたままであり、教師と学生が共進化するカリキュラムや、困難なサブスキルのために複数の引退済み教師を再召喚する手法は未探索です。
- 報告されたALFWorldサブタスクの分割は大幅に変動しており(例:スケールをまたいでPick2が77.3対90.9)、引退閾値がサブタスクの難易度と相互作用していることが示唆されますが、その点は切り分けられていません。
なぜ重要なのか
RetireOPDは、エージェント型RLにおける自己蒸留を、持続的な正則化項ではなくスケジュール化された補助lossとして再定式化し、「いつ蒸留を止めるか」が一級の設計選択であることを経験的に示しています。これは、同一lossを持つ引退なしのハイブリッドに対して3〜11ポイントの価値があります。このレシピ(特権的教師をRLチューニングし、オンポリシーで蒸留し、不一致の横ばいで引退させる)は、既存のGRPOエージェントパイプラインに組み込めるほど十分シンプルです。
Source: https://arxiv.org/abs/2609.20784
Hacker News Signals
VerusによるRustコードの正しさの形式的証明
Verusは、開発者が本番コードと並行して形式的な証明を記述できるRust向けの検証ツールです。SMTバックエンド(内部ではZ3を使用)による推論を用いて、正しさに関する義務を静的に解消します。Amazon Scienceのブログ記事では、Verusをシステムソフトウェアのコンポーネント検証に活用する事例が紹介されています。このようなコードでは、borrowチェッカーによるメモリ安全性は必要条件ではあっても十分条件ではなく、論理的な正しさ(例:データ構造の不変条件、プロトコルへの準拠)は型システムだけでは証明できないままです。
核となるメカニズムとして、開発者は関数にrequiresおよびensures節(事前・事後条件)を付加し、ループにはinvariantブロックを記述します。Verusはこれらと Rustコード自体をZ3が検査する検証条件へと変換します。Ghost code — 検証時にのみ存在し、コンパイル時に消去される変数や関数 — を用いることで、実行時のオーバーヘッドなしに証明の状態を保持できます。Spec-modeの関数は、実行時に計算するにはコストが高すぎるか不可能な数学的性質(例:列への帰属関係、算術的な境界)を表現できます。
DafnyやF*などの先行研究と比較してVerusが興味深い点は、独立した検証専用言語ではなく、実際の慣用的なRustをターゲットにしていることです。Rustが強制する所有権とborrowingのルールは、Cベースの検証器では扱いが困難なエイリアシングの証明の一部を実際に単純化します。ブログ記事では、線形化可能性(linearizability)をテストではなく証明しなければならない並行データ構造の検証事例が紹介されています。
実用上の摩擦は依然として大きく、非自明なアルゴリズムに対する証明義務にはかなりのアノテーション作業が必要であり、SMTソルバーがタイムアウトしたり不透明な反例を返したりすることもあります。有用なlemmaを記述するための学習曲線は急峻です。calcブロックやassert_byによる自動化は助けになりますが、非線形算術や複雑な再帰的構造には依然として手動によるガイダンスが必要です。
ハイパーバイザー、暗号処理、ストレージエンジンなど、安全性が重要または敵対的な環境下でのシステムコードであれば、そのコストは正当化されるかもしれません。一般的なアプリケーションコードにとっては、現時点ではそのオーバーヘッドに見合うケースはまれです。
Source: https://www.amazon.science/blog/developing-provably-correct-rust-code-with-verus
Bend – プルーフによってAIのミスをブロックするCPU/GPU対応言語
Bendは、軽量なプルーフ義務(proof obligation)をコードに付加することで、LLMが生成したコードに生じがちな論理的エラーのクラスを検出できるという主張を中心に設計されたプログラミング言語です。技術的なアーキテクチャは、マーケティング上の謳い文句よりもはるかに興味深いものになっています。BendはHVM2(Higher-order Virtual Machine 2)へとコンパイルされます。これはインタラクションコンビネータ(interaction combinator)に基づく並列ランタイムであり、明示的なスレッドプリミティブなしにCPUとGPUの両方でネイティブに実行されます。
この言語の型システムには、線形型(linear types)と依存型(dependent types)の一形式が組み込まれており、配列の境界、非ヌル性、基本的な状態機械の遷移といった単純な不変条件を、実行時アサーションではなくコンパイル時制約として表現するのに十分な表現力を持っています。インタラクションコンビネータの基盤により、プログラムは書き換えルールのグラフとして表現されます。部分グラフが独立している場合には並列簡約(parallel reduction)が自動的に行われ、共有された可変状態が存在しないため、構造上データ競合は発生しません。
GPU実行に関しては、HVM2がコンビネータの簡約をCUDAカーネルにマッピングするという、明示的なSIMDカーネルと手動管理のメモリ階層を用いる標準的なGPGPUモデルと比較して真に新規なアプローチを採用しています。トレードオフとして、コンビネータ簡約に適した不規則な再帰的アルゴリズム(木、グラフ)はGPUハードウェアにうまくマッピングできず、密な数値計算ワークロードはターゲットではありません。
「AIのミスをブロックする」というフレーミングは、LLMがBendでコードを生成した場合、型エラーおよびプルーフエラーがコンパイル時に即座に表面化し、テストよりも tight なフィードバックループを提供するという考え方を指しています。これはもっともな話ではありますが、Bend固有のものではありません——強力な静的保証を持つ言語であれば同様の性質を持ちます。より実質的な技術的貢献は、自動並列化、線形型、そして高水準関数型言語からGPU実行への具体的な経路を組み合わせた点にあります。
成熟度は低く、ランタイムは研究プロトタイプであり、エコシステムのツールも最小限にとどまっています。
Source: https://bend-lang.com/
GLMが独自の推論インフラを構築した経緯
Zhipu AIによるこの記事では、vLLM、TensorRT-LLM、その他の既製フレームワークを使用せず、GLMファミリーのモデル向けに独自の推論スタックを構築するにあたっての技術的判断が説明されています。その動機は馴染み深いものです。大規模な本番推論においては、汎用フレームワークでは最適に対処できないレイテンシとコストの制約が露呈し、モデル固有のアーキテクチャ上の特性が上流の抽象化との間に摩擦を生じさせます。
主要な技術的選択として、GLMの特定のattentionパターンとコンテキスト長の分布に合わせてチューニングした独自のcontinuous batchingスケジューラを実装しています。GLMブロックのユニークなコンポーネントに対してカスタムCUDAカーネルを記述しました(GLMは標準的なRoPEと比べて特有の2次元位置エンコーディングスキームを持つrotary embeddingを使用しており、これがattentionカーネルの内部ループに影響します)。attention、layer norm、MLPブロックにまたがるカーネルフュージョンにより、カーネル開発時間を代償としてメモリ帯域幅の負荷を軽減しています。
prefillとdecodeの分離(disaggregated prefill and decode)については、2つのフェーズを異なるハードウェアプールに分離しています。prefillはcompute-boundであり高FLOPのGPUが有効な一方、decodeはメモリ帯域幅ボトルネックであるため、コスト効率の観点から旧世代のハードウェアを活用できます。このprefill/decode disaggregationパターンはますます標準的になりつつあり(Splitwise、DistServeも同様のアイデアを探求しています)、GLMの記事では具体的な数値が示されています。ハードウェアの分割比率を適切に設定することで、長いコンテキストのワークロードにおいてコストあたりのスループットが約2倍向上したと報告されています。
量子化戦略としては、FP16のactivationに対してINT8の重み(W8A16)を使用し、per-channelのスケールをFP32で保存しています。GLMの出力分布での精度劣化を理由に、INT8のactivationは避けています。
この記事はメンテナンスの負担についても率直に述べています。カスタムカーネルはモデルのアップデートのたびに再検証が必要であり、ハードウェアの異質性(異なるA100/H100のSKU)によってテストの対象範囲が拡大します。暗黙的な主張は、フロンティアラボにとって推論の効率性は自社で保有する価値のあるコアコンピテンシーであるということです。
Source: https://z.ai/blog/glm-built-its-inference-infrastructure
Qwen 3.8 Omni Flash
Qwen 3.8 Omni Flash は、Alibaba の Qwen チームが開発した小型マルチモーダルモデルで、低レイテンシかつエッジデプロイ可能な推論を目指しています。“Omni” はテキスト・画像・音声・動画入力の統合的な処理を意味し、“Flash” はアーキテクチャ上の優先事項が最大性能よりも速度にあることを示しています。パラメータ数 3.8B という規模は、コンシューマー向けハードウェアやモバイルアクセラレータ上での動作を想定して設計されています。
アーキテクチャは Qwen2-Audio および Qwen2-VL が確立したパターンに従っており、モダリティ固有のエンコーダ(視覚向けの ViT 変種、音声向けの Whisper 派生エンコーダ)を備えた共有 transformer バックボーンが、テキストトークンの embedding 空間へと投影する構造になっています。3.8B というパラメータ数は言語バックボーンを指しており、エンコーダはモダリティごとに異なる追加のパラメータオーバーヘッドをもたらします。Qwen3 テキストシリーズから引き継いだ instruction-following およびツール利用機能も維持されています。
主な公称数値としては、標準的な GPU ハードウェア上での典型的なプロンプトに対して time-to-first-token が 100ms 未満であること、そして文書理解(DocVQA)・多言語音声認識・動画 QA といったタスクにおいて自身の 3〜5 倍のパラメータを持つモデルと競合するベンチマークスコアが挙げられています。ただし、ブログ記事にはこれらの比較における詳細な方法論が記載されていないため、注意が必要です。
“Flash” の設計上の選択肢としては、grouped-query attention による KV-cache サイズの削減、フルの Omni モデルと比較して短いデフォルトのコンテキストウィンドウ、そして学習時に組み込まれた積極的な量子化フレンドリーな重み分布などが考えられます。本モデルはストリーミング音声出力をサポートしており、これには自己回帰的な音声合成ヘッドが必要となります。これはテキストのみの生成よりもアーキテクチャ的に複雑であり、音声出力に特化したレイテンシの主張がテキスト出力のものと明確に分離されていない点についても記事内では明確にされていません。
主な用途はデバイス上でのリアルタイム音声・視覚アシスタントです。Gemini Nano、Phi-3.5-Vision、SmolVLM が性能とサイズのトレードオフ空間において近接した位置を占めており、競合は激しい状況です。
Source: https://qwen.ai/blog?id=qwen3.8-omni-flash
Mistral X Mozilla: プライベートかつ多言語対応のAIブラウジング
MistralとMozillaは、Firefoxのオンデバイス推論スタックを通じてローカルで動作するMistralモデルを基盤としたブラウザ統合AIアシスタントを提供しています。技術的な本質は新しいモデルそのものではなく、デプロイメントアーキテクチャにあります。推論はブラウザ内でプロセス完結型で実行され、ハードウェアに応じてWebGPUまたはネイティブバックエンドを使用し、データはデバイス外に一切送信されません。
Mozillaの推論レイヤーは、transformers.jsに関する同社の取り組みと、Rustネイティブの推論エンジン(おそらくllamafile/llama.cppとの統合作業から派生したもの)を基盤としています。モデルはMistralの量子化バリアントであり、投稿ではパラメータ数を明確に示していませんが、オンデバイスでのブラウザデプロイメントという制約から、レンダリングワークロードと共有されるGPU VRAMに収めるため、積極的な量子化(おそらく4ビット以下)を施した1〜7Bの範囲のものと推察されます。
多言語対応の側面は実質的なものです。このモデルはヨーロッパ言語圏を中心としたFirefoxのグローバルユーザーベースをターゲットとしており、Mistralのトレーニングデータは同等のモデルサイズにおいて米国の研究機関による代替モデルの多くより多言語カバレッジが充実しています。実用的なタスクとしては、要約、翻訳、読解支援が挙げられ、いずれもデプロイメント上の制約に適した低レイテンシかつ短いコンテキストのワークロードです。
プライバシーモデルは明快です。推論サーバーは存在せず、プロンプト内容に関するテレメトリもありません。このアプローチが対処する脅威モデルは、ブラウザのコンテキストをクラウドAPIに送信することへのユーザーの懸念であり、エンタープライズおよびプライバシーを重視するユーザーにとって真に切実な問題です。
エンジニアリング上の課題としては、メモリ競合(モデルがブラウザのコンポジターやWebページからのWebGPUワークロードとGPUメモリを奪い合う)、モデルロードのコールドスタート時間、そしてブラウザ配布に適したバイナリサイズの維持が挙げられます。WebGPUベースの推論はネイティブのCUDA/Metalと比較して約10〜20%のオーバーヘッドを生じさせますが、昇格した権限を必要としないという利点があります。
このフォームファクターが標準的なブラウザインフラストラクチャになるか、それともニッチな機能にとどまるかは、サイズ・量子化の制約下でモデルの品質が継続的な使用に耐えうるかどうかにかかっています。
Source: https://mistral.ai/news/mistral-x-mozilla/
LLMを使った文章の書き方
Thomas Ptacekの投稿は、LLMの能力調査ではなく、実践的な方法論についての記事です。中心的な主張は、LLMはテキスト生成ツールとしてではなく、構造的なレビューや改訂ツールとして使う場合に文章執筆において有用であり、この二つを混同することがLLM支援による文章の特徴的な凡庸さにつながるというものです。
具体的なワークフローとして以下が説明されています:まず自分でラフな下書きを書き、次にモデルを使って構造的な問題(論旨の流れ、段落の順序、欠落している接続)を特定し、その後自分で修正し、さらにモデルを使って文レベルの編集(受動態、冗長表現、曖昧な数量表現)を行う、というものです。モデルは最終的なテキストを生成せず、無限の忍耐力を持ち、作品に社会的利害を持たない編集者として機能します。
このアプローチの根底にある技術的な観察は、LLMが実際に何を得意としているかという点にあります。LLMは編集・出版されたテキストの大規模な分布を内在化しており、これにより編集的ヒューリスティック(「show don’t tell」、文長の変化、名詞化の回避)の再現においてそれなりの能力を発揮します。一方で、新しい論拠を生成したり、長い文書にわたって一貫したvoiceを維持したりすることは苦手です。なぜならその生成は局所的であり、著者が実際に主張しようとしていることについての世界モデルを持っていないためです。
Ptacekはまた、このユースケースではモデルの選択よりもプロンプトの規律の方が重要だという点も指摘しています。最も弱い3つの文を特定してその理由を説明するよう求めることで、テキストを「改善」するよう求めるよりも実用的な出力が得られます。後者はfiller生成を引き起こしますが、前者は構造化された分析に近いものを強制します。
典型的なLLMの文章利用に対する暗黙の批判は、生成をモデルに外部委託することは思考も外部委託することになり、その思考こそが技術的または説得力のある内容を書く際に実際に価値ある部分だということです。これは新しい観察ではありませんが、それを回避するための仕組みについて、この投稿は異例なほど具体的です。
Source: https://sockpuppet.org/blog/2026/09/17/how-to-write-with-an-llm
OpenArm: オープンソースの7自由度ヒューマノイドアーム
OpenArmは、人間の腕の運動学的エンベロープに合わせて設計された完全オープンソースの7自由度ロボットアームです。ヒューマノイドロボット研究および低コストのマニピュレーションプラットフォームを目的として開発されました。リポジトリには、CADファイル(Onshapeによるパラメトリック形式、STEP/STLへのエクスポート対応)、シミュレーション用のURDFモデル、アクチュエータコントローラ向けファームウェア、およびROS2インターフェースが含まれています。
7自由度構成(肩3自由度、肘1自由度、手首3自由度)により、冗長な自由度を持つ完全な器用な位置決めが可能となります。すなわち、アームは複数の関節配置を通じて所定のエンドエフェクタ姿勢に到達できます。これは、制約のある作業空間における障害物回避および特異点回避において重要な特性です。この構成は人間の腕の構造と一致しており、Franka Emika Pandaのような商用プラットフォームでも採用されているものと同じです。
アクチュエーションには、高減速比のギアボックスではなく、準直接駆動モータ(低ギア比、高透過性)を使用しています。これは最大力をバックドライバビリティと固有感覚的精度のために犠牲にするものであり、専用の力/トルクセンサを必要とせず、モータ電流センシングを通じて接触力を検知できます。このトレードオフはMIT Cheetahの系譜に代表される脚式ロボティクスで確立されており、接触豊富な学習を簡素化するため、マニピュレーション研究においてもますます標準的な手法となっています。
コントローラファームウェアは関節レベルでのトルク制御を実装しており、MoveIt2との互換性を確保するために標準的な FollowJointTrajectory インターフェースを公開するROS2 action serverを備えています。URDFには物理アセンブリから実測した正確な慣性パラメータが含まれており、これは動力学ベースのモーション計画およびsim-to-real転送において重要です。
コスト目標は商用代替品(Frankaは約$15k〜$20k)を大幅に下回るとされており、市販モータを使用したOpenArmのBOMは数百ドル台と見積もられています。ペイロードおよび繰り返し精度の仕様はまだ正式に評価されておらず、マニピュレーション研究への実用可能性を判断するうえで欠かせないデータとなっています。
Source: https://github.com/enactic/OpenArm
OpenSpec – 軽量かつ設定可能なAI specフレームワーク
OpenSpecは、LLMを基盤とするシステムに対して構造化された振る舞い仕様(behavioral specification)を記述し、実行可能なテストとして動作させるためのフレームワークです。このフレームワークが解決する核心的な問題は、LLMアプリケーションがエージェント型パイプラインやツール利用へと移行するにつれ、非形式的なプロンプトや手動テストだけでは、入力分布全体にわたってシステムが正しく振る舞うことを検証するには不十分になるという点です。OpenSpecは、期待される振る舞いを記述するためのDSLと、テスト対象システムに対してそのspecを実行する評価ハーネスを提供します。
技術的な構造について:specはYAMLまたはJSONドキュメントとして記述され、入力テンプレート、期待される出力特性(正規表現マッチ、embedding距離によるセマンティック類似度閾値、またはLLMジャッジへの呼び出しが利用可能)、および合否判定基準を定義します。このフレームワークは、テストケースの生成(固定サンプルからのものと入力テンプレート空間をサンプリングするものの両方)、対象システムへの実行(API経由)、および結果の構造化レポートへの集約を担います。
「設定可能」という部分は、評価バックエンドの交換可能性を指します。コストやレイテンシの制約に応じて、GPT-4をジャッジとして使用することも、ローカルモデルを使用することも、決定論的なルールを使用することも可能です。これは実用上重要な点です。なぜなら、LLMジャッジによる評価は大規模では高コストであり、決定論的チェックが十分に機能する場面ではそちらが望ましいからです。
このフレームワークはLLM評価フレームワーク全般(HELM、RAGAS、promptfoo)の文脈に位置しますが、集約的なベンチマークスコアよりも、システムごとの振る舞いspecに重点を置いた軽量な設計として位置づけられています。この違いは重要です。ベンチマークスコアは汎用的な能力を示しますが、振る舞いspecは特定のシステムが意図した通りに動作するかどうかを、特定の入力分布全体にわたって教えてくれます。
現時点での制限:DSLはシンプルであり、複雑なステートフルな振る舞い(依存関係のあるアサーションを持つマルチターン会話)を表現するには回避策が必要です。また、微妙なセマンティック特性に対するLLMジャッジの信頼性は、フレームワークを問わず既知の弱点として残っています。
Source: https://openspec.dev/
注目の新しいリポジトリ
JordyZomer/lemmalog
LLMエージェントのメモリ向けに特化して構築されたDatalogエンジンです。標準的なベクターストアはエージェントに近似的な検索を提供するに留まりますが、Datalogは構造化されたファクトに対する演繹的推論を提供します。Lemmalogは層化否定(stratified negation)を実装しており、循環否定が未定義のセマンティクスを生じさせないよう、ルール評価を層(strata)に分割して処理します。ファクトは出所メタデータ(provenance metadata)を持ち、各導出ファクトはどのベースファクトとルールがそれを生成したかを記録することで、エージェントが保持するあらゆる信念の因果追跡を可能にします。増分導出(incremental derivation)により、新しいファクトによって生じたデルタ分のみが再評価され、完全な不動点計算(fixpoint computation)を再実行する必要がありません。
このシステムはMCP(Model Context Protocol)サーバーを公開しており、MCP互換のハーネスであれば、lemmalogを複数のエージェントインスタンス間で共有されるワーキングメモリとして利用できます。複数のエージェントが同一のファクトベースに対してアサートやクエリを行えるとともに、導出の整合性が自動的に維持されます。これは共有キーバリューストアとは本質的に異なります。推移的閉包(transitive closure)、再帰的ルール、そして否定即失敗(negation-as-failure)が事実上すぐに利用できます。実用的なユースケースとしては、依存関係の追跡、ポリシーの適用、そして複数のLLM呼び出しを連鎖させなければ処理できなかったようなマルチホップの関係クエリなどが挙げられます。PythonランタイムへDB依存なしにシステム言語で記述されています。
Source: https://github.com/JordyZomer/lemmalog
2akouwu/reverify
プロンプティングではなく、アーキテクチャレベルでハルシネーションに対処しています。この設計は提案と検証を分離しています。LLMがクレームを生成し、その後、決定論的な外部ツールが各クレームをグラウンドトゥルースと照合して判定してから、エージェントの作業コンテキストに入るようになっています。検証を通過したファクトのみがコンテキストリセットを経て存続するため、永続的なメモリ層には根拠のある命題のみが格納されます。
実証の場はリバースエンジニアリングです。これは事実の精度が重要であり、グラウンドトゥルースが回収可能なドメインです(逆アセンブル、バイナリ解析、シンボル解決など)。そのため、これは玩具的なデモではなく、信頼性の高いストレステストとなっています。実装はMCPサーバーとスタンドアロンCLIの両方として提供されており、既存のエージェントパイプラインに統合することも、インタラクティブに利用することも可能です。主要なアーキテクチャ上の不変条件は、LLMがgrounded fact storeに直接書き込むことはなく、検証レイヤーが排出するステージングエリアにのみ書き込むという点です。受理された各ファクトとともにエビデンスの参照が保存されるため、監査証跡が実現されます。これは標準的なRAGよりも証明支援系のワークフローに近いと言えます。モデルが推測者であり、ツールが検証者であり、証明を持つ定理のみが永続化されます。
Source: https://github.com/2akouwu/reverify
carloslfu/slotstream
125B mixture-of-experts モデル(Qwen3-235B-A22B-Flash など)をVRAMが不足するコンシューマー向けハードウェアで実行するという問題を解決します。重要な洞察:MoE モデルでは、各トークンにつきごく一部の experts しかアクティブになりません。SlotStream は GPU / unified memory 上に固定サイズの「slot cache」を維持し、現在ホットな experts のみを保持しながら、コールドな experts を必要に応じて SSD からストリーミングします。完全なチェックポイントが 105 GB であっても、inference 時の実効アクティブパラメータ数は 48 GB の Apple Silicon unified memory 予算内に収まります。
実装は Apple の MLX framework 上のネイティブ Swift で、Metal compute kernel を使用しており、Python も Ollama への依存もなく、シングルバイナリで配布されます。これはレイテンシの観点で重要です:Python インタープリタとプロセス間オーバーヘッドを排除することで、M シリーズのメモリ帯域幅パス上で計測可能な改善が得られます。API サーフェスは Ollama および OpenAI 互換であるため、既存のツール(Continue、Open WebUI、LiteLLM)を修正なしに使用できます。SSD ストリーミングアプローチが実用的なのは、現代の Mac における NVMe シーケンシャル読み取り帯域幅(約 3〜7 GB/s)が十分に高く、適度なトークン生成レートにおいて expert ロードのレイテンシが許容範囲内に収まるからです。これは llama.cpp の CPU オフロードパスに対する実用的な補完手段であり、特に Apple Silicon メモリアーキテクチャに最適化されています。
Source: https://github.com/carloslfu/slotstream
truespar/sentio
AIエージェントに実際のメールIDを付与するためのインフラとして設計された、Rustによる完全なマルチテナント対応メールサーバーです。各エージェントは専用アドレスを持ち、送受信の完全な機能を備えています。受信メールは生のMIMEではなく構造化されたwebhookとして届き、返信はREST経由で行われます。これにより、エージェントのコード内でメールをパースする必要がなくなります。
技術的な深度は相当なものです。Sentioは配信性に関わるスタック全体を実装しています。具体的には、DKIM署名と検証、SPF評価、集約レポートおよびフォレンジックレポートを含むDMARCポリシーの適用、そして転送メール向けのARC(Authenticated Received Chain)です。トランスポートセキュリティについては、MTA-STS(HTTPSで取得したポリシーファイルによるTLSの強制)とDANE(DNS-based Authentication of Named Entities:CAを使わず証明書のピン留めをTLSAレコードで行う仕組み)をカバーしています。スパム対策は3層構造ですが、具体的なメカニズムは公開ドキュメントに完全には記載されていません。トランザクションメールのSaaSに依存せず自前のMTAを運用することで、エージェントはメッセージ単位のコスト、レート制限、APIキー管理なしに受信ボックス機能を利用できます。Rustによる実装は、何百・何千ものエージェントのメールボックスをホストする際にメモリオーバーヘッドを低く抑えます。非同期通信、フォーム送信、通知の監視、メールスレッドを介したマルチエージェント間の連携が必要なエージェントワークフローに幅広く適用できます。
Source: https://github.com/truespar/sentio
modelscope/ms-cookbook
ModelScopeエコシステムを対象とした実践者向けクックブックです。モデル選択から推論、fine-tuning、評価、RAG構築、エージェント構築、AIGCパイプラインまで、MLワークフロー全体をカバーしています。コンテンツは実行可能なノートブックとスクリプトとして構成されており、ModelScopeがホストするモデルおよび関連ツールチェーン(fine-tuning用のSWIFT、評価用のEvalScope、エージェントオーケストレーション用のAgentScope)を対象としています。
ModelScopeに不慣れな読者のために補足すると、ModelScopeはAlibabaが運営するオープンモデルハブであり、Hugging Faceにはミラーされていない多数の中国語・多言語モデルをホストするほか、独自の推論・学習インフラも提供しています。このクックブックの価値は実践的なインテグレーションにあります。個別にはドキュメント化されているものの、相互作用が十分に規定されていないコンポーネント同士を結び付ける方法を、サンプルコードを通じて示しています。LoRAおよびQLoRAのfine-tuningレシピ、検索評価を含む構造化RAGパイプライン、LangChain互換の抽象化を用いたマルチステップエージェントワークフローなどが含まれています。ガイドは主に中国語で記述されているためアクセスしやすさに制限がありますが、コード自体は独立して読解可能です。ModelScopeがホストするモデルを本番環境にデプロイする方、または中国語LLMを評価する方にとって有用な資料です。
Source: https://github.com/modelscope/ms-cookbook
naw103/foremerge
Gitオブジェクトモデルの上位レイヤーで動作する、マルチエージェントコーディングシステム向けの協調プロトコルです。解決しようとしている核心的な問題は次のとおりです:複数のコーディングエージェントがコードベースに対して並行して作業する場合、マージコンフリクトはより深い問題の症状に過ぎません——エージェントたちがコードを書いた後にしか検出できなかった、互換性のない意図を持っていたということです。Foremergeは、ちょうど型チェッカーが実行前にエラーを発見するのと同様に、コードが生成される前に意図の衝突を浮かび上がらせることを試みます。
このプロトコルは、実行前にエージェントが変更の意図をセマンティックなレベル(どのモジュール、インターフェース、または振る舞いを変更する計画があるか)で宣言することを求めます。協調レイヤーは、意図グラフ上で定義されたルールを用いて宣言済みの意図をコンフリクトについて検査し、衝突するエージェントをブロックまたはキューに入れます。これはオプティミスティック並行性制御を想起させますが、データベーストランザクションではなくエージェントの計画に適用されている点が異なります。Gitは履歴の唯一の真実の情報源であり続け、foremergeは実行前レイヤーを追加します。このオープンソースリリースには、プロトコル仕様とリファレンス実装が含まれています。ここで未解決の最も難しい問題は意図の表現方法です:意図は実際のコンフリクトを捉えられるほど表現力が高く、かつ自動的に推論できるほど扱いやすくなければなりません。現在の表現方法がリファクタリング、インターフェースの変更、モジュール横断的な影響を適切に処理できるかどうかは未解決の問題です。
Source: https://github.com/naw103/foremerge
XHToken/Spark-X2.5
厳しいリソース制約下でのエージェント的タスク実行を目的とした、デバイス上で動作するモデルシリーズです。「オンデバイスモデルにおけるエージェント的能力の限界を押し広げる」というフレーミングは、特定のトレードオフを指し示しています。すなわち、オンデバイス展開ではパラメータ数とFLOPバジェットに上限が課される一方、エージェント的タスク(マルチステップ計画立案、ツール使用、ターンをまたいだ instruction following)には、単純な補完タスクよりも高い推論能力が要求されます。
リリース時のドキュメントは乏しく、モデルサイズ、アーキテクチャの詳細、およびベンチマーク数値はまだ完全には公開されていません。リポジトリの構造と命名規則から判断すると、このシリーズは複数のパラメータスケールにわたり、ARMおよびApple Siliconへの展開を目標としていると考えられます。「X2.5」というバージョン表記は、以前のSparkシリーズからの反復であることを示唆しています。エージェント的能力の評価は通常、ツール呼び出し精度、長期的な instruction following(IFEval形式のベンチマーク)、およびマルチステップタスク完了率を対象とします。Spark-X2.5がこれらの軸について厳密な数値を公開するかどうかは、今後明らかになるでしょう。エージェントシステムのエッジ展開に取り組んでいる方であれば注目する価値がありますが、評価方法論が公開されるまでは現時点での主張を慎重に扱うべきです。
Source: https://github.com/XHToken/Spark-X2.5
yuyuanweng/ai-picture-editor
エージェント的システムアーキテクチャを学ぶための明示的なカリキュラムプロジェクトとして構築された、フルスタックのAI画像編集エージェントです。スタック構成はフロントエンドがReact 19 + Konva(キャンバスレンダリング)、バックエンドがFastAPI + LangChain + LangGraphとなっています。21種類の編集ツールがLangGraphノードとして公開されており、エージェントは自然言語の指示からマルチステップの編集計画を立て、グラフを通じて中間状態を引き渡しながらツールを順次実行します。
技術的に興味深いコンポーネントとして、中間結果をキャンバスにリアルタイムストリーミングするためのSSE(Server-Sent Events)、長時間を要する処理(背景除去、generative inpainting)向けの非同期タスクキュー、そしてデストラクティブなグローバル操作を行うことなく領域固有の編集を可能にするレイヤーモデルが挙げられます。LangGraphの統合により、計画グラフはpromptチェーニングに暗黙的に埋め込まれるのではなく、明示的かつ検査可能な形になっています。テキストから画像への生成とスマートカットアウトのためのセマンティックセグメンテーションは、外部モデルAPIへの呼び出し(おそらくホスティングされたdiffusionモデルおよびセグメンテーションサービス)を示唆しています。本プロジェクトはプロダクションソフトウェアではなく学習リソースとして位置付けられていますが、ツール定義をプランナーから分離する設計、ストリーミングへのSSEの使用、キャンバスレイヤーモデルの維持といったアーキテクチャ上の選択は、プロダクション向け画像編集エージェントにおける実際の設計パターンを反映しています。