デイリーAIダイジェスト — 2026-11-04
arXiv ハイライト
Route Anything: A Study of Model and Policy Routing for General-Purpose AI Systems
問題設定
本論文は、異種AIシステムに対して具体的な運用上の問いを立てています。特化型候補(LLM、画像・動画・音声生成器、エージェント計画、ロボットポリシー)のプールが与えられたとき、品質とコストをトレードオフするために入力ごとにどのようにルーターが一つを選択すべきか、という問いです。これを、テキストQA、画像テキストQA、画像・動画・音声生成、コードおよびワークプレースエージェント、ロボット操作にわたる25のベンチマークから得た374,401スコアのトラジェクトリ行列上の意思決定論的問題として定式化しています。
形式的な対象は標準的ではあるものの有用です。入力 x は候補メニュー \mathcal{U}(x) を持ち、u を実行すると価値 V_u \in [0,1] とコスト D_u > 0 が得られます。ルーターは状態 s = \sigma(x)(ベンチマークラベル、能力タイプ、または生の入力)を観測し、g(s) を選択して \mathbb{E}[V_{g(s)} - \lambda D_{g(s)}] を最大化します。著者らは達成可能な性能を「情報ラダー」(命題3)として整理しています:固定候補 → ベンチマークごとの最良 → タイプごとの最良 → 入力ごとのオラクル。各段から前段へのギャップが、より多くの状態情報が何をもたらせるかの上界を定めます。
潜在的利得:オラクル vs. 固定
上限に関するヘッドライン結果は、集計値では控えめです。すべての候補がスコア化された19,814件のテスト入力において、ベンチマークごとの最良固定候補は82.60(0〜100スケール)、事後的な最良固定は82.62、入力ごとのオラクルは87.98であり、ギャップはわずか5.38です。オラクルのマージンはモダリティによって大きく異なります:音声生成で0.68、画像テキストQAで2.70、テキストQAで4.28、画像生成で4.99、コード・ワークプレースエージェントで8.11、ロボット操作で18.40、動画生成で18.93です。したがって、ルーティングの上限は主としてエージェント、ロボット、生成動画に関わる話であり、言語QAではありません。これがSection 3の最も明確な実証的メッセージです:LLM空間は十分に集約されており、入力ごとのルーティングにはほとんど余地がありません。
学習済みルーター
Section 4では、Qwen3.5-4Bベースのルーターを3種類、共通のターゲットに対して学習させています:
- Outcome router:sigmoid headが (x, \text{candidate profile}) ペアをスコア化し、正規化された結果に対するcross-entropyで学習(命題4a)してargmaxを選択します。
- Type router:x を能力タイプ(モダリティ・タスク・能力ツリーの157リーフ)に分類し、そのタイプの最良候補を訓練データから参照します。未解決の入力は固定候補にフォールスルーします。
- Winner-label router:最良候補の名前を直接予測します。
能力ツリールーターは16のベンチマーク(3,444件のテスト入力)において、LLM候補のClaude Opus 5.5、GPT-6.1 Sol、DeepSeek V4.1 Flash、GPT-6 Astraを用いて長文脈タスクで評価されています。結果(表3):全体で79.98 vs. 固定79.68 vs. オラクル84.80 — +0.30の向上、オラクルギャップの6%。グループ別:テキストQA −0.17(−3%のシェア)、コード・ワークプレースエージェント +0.77(14%)、画像生成 +0.25(5%)、動画生成 +2.12(12%)、音声生成 0.00。RoboTwin(10の保留タスクから2,000件の未見シーン)における outcome router は71.55 vs. 固定70.45 vs. オラクル88.85で、ギャップの6%を回収しています。
オラクルが示す可能性と学習済みルーターが実際に回収する量との間のギャップは深刻です:ロボティクスでは18.40ポイントの上限が実現値1.10ポイントにとどまります。動画では18.93 → 2.12。テキストQAでは実現値が実際にマイナスとなっています。学習済みルーターは、十分な訓練シグナルがある場合でも、情報理論的な余裕のごくわずかな部分しか捉えていません。
コストを考慮したルーティング
Section 5では価格を組み込んでいます。参照フォールバックカスケードはクリーンなプリミティブです:一次候補 P、バックアップ B、検証器の決定 H \in \{0,1\} として、
V = H Y_P + (1-H) Y_B, \quad D = A + (1-H) C_B,
ここで A は一次候補と検証のコストです。CodeRouterBench(8モデル、9,999タスク、Opus 4.6を参照として使用)では、状態は21次元×ソースセルで22候補ずつ持ちます(8つの直接ディスパッチと7つの一次候補 × 2つの検証器閾値 \theta \in \{1, 0.5\})。常にOpusを使用した場合、スコアは0.4383でタスクあたり11.655 m$です。認証済みフロア Q \geq -\epsilon はテスト評価前のプロービングタスクに課されます。この構成は単点比較ではなくパレートフロンティアをサポートし、カスケードが両軸で打ち負かすべき原則的なベースライン(常に参照)を提供します。
限界と未解決の問い
本論文はいくつかの上限について率直に述べていますが、他については暗黙的なままです。(1) オラクル自体は候補ごとの最良結果であり、ベンチマークにおけるサンプリングノイズにより5.38ポイントの集計ギャップの一部は実現不可能です。(2) ロボティクスと動画における大きなギャップは、候補プールが小さく(3〜7個)、タスク構造が不均一であることを部分的に反映しており、入力ごとのルーティングは品質予測というよりタスク識別に近いものとなっています。(3) 学習済みルーターはベンチマークテキストと出力要件を使用しており、候補固有のコンテキスト(ツールコールのトレース、部分生成など)を検査しないため、情報ラダーは状態特徴の段まで昇るに留まり、命題4が許容するより豊かな予測子には達していません。(4) コスト研究はカスケードのオラクル検証器を仮定しており、現実的な検証器はフロンティアを劣化させます。(5) 候補プールは固定されており小規模です。数百の候補と入れ替わりのあるオープンなエコシステムでのルーティングは扱われていません。
なぜ重要か
本論文は、通常よりはるかに広範なモダリティのセットにわたって、入力ごとのルーティングの上限がLLMのQAではなくエージェントおよび生成タスク(二桁台のオラクルギャップ)に集中していること、そして現在の学習済みルーターがその上限の平均~6%しか回収できていないことを定量化しています。システム構築者にとって、これはルーティングを品質向上メカニズムではなく主としてカスケードによるコスト制御メカニズムとして再定義するものであり、将来のルーターをベンチマークするための具体的なトラジェクトリ行列とラダーを提供しています。
Source: https://arxiv.org/abs/2611.05275
Think Less, Locally: 推論圧縮のためのLocal Preference Learning
DeepSeek-R1のようなトレースから蒸留されたLarge Reasoning Models(LRMs)は、回答に必要な情報をすでに持っているにもかかわらず、熟考を続ける傾向があります。既存の圧縮アプローチ——長さにペナルティを課すRL、短いvs長いロールアウトに対するtrajectory-levelのDPO、あるいは要約されたCoT上のSFT——は、トレース全体を監督するものです。これらは「このtrajectoryは長すぎるか?」という問いに答えますが、「この部分的な状態において、モデルは思考を続けるべきか?」という問いには答えません。LoCoは后者、すなわち今すぐ推論を終了するかどうかの状態ごとの判断を対象としています。
手法
LoCoは状態条件付きpreference pair \{(P_i, y_i^+, y_i^-)\} を構築します。ここで P_i はステップ s_i の後で終わる固定された推論プレフィックス、y_i^- はモデルが生成した元の継続、y_i^+ は同じプレフィックスから再生成された、より短いが依然として正しい継続です。学習はこれらのペアに対する標準的なDPOであり、重要な点はプレフィックス P_i が両ブランチで同一である——モデルはグローバルに簡潔になる方法ではなく、どこで止まるかを学習するよう強制される——ことです。
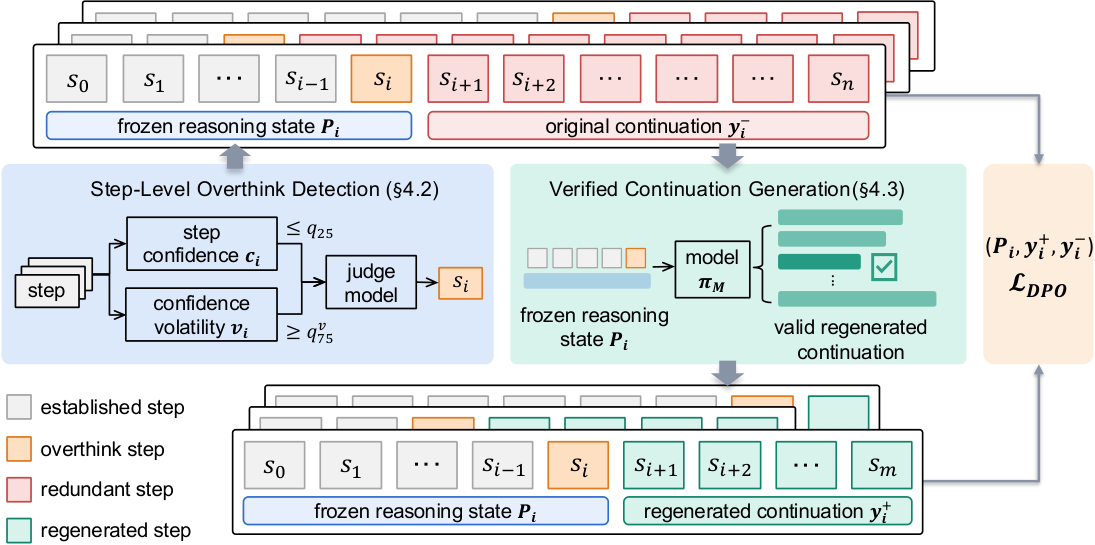
パイプライン(Figure 1)は3つのステージで構成されます:
Local overthink detection. 自己生成されたトレースから、候補状態が2段階フィルターによってフラグ付けされます:安価なヒューリスティックスクリーニングに続き、ステップ s_i の時点でモデルがすでに結論を出すのに十分な情報を持っていたかどうかを確認するLLMジャッジ(Qwen3-30B)が用いられます。各クエリに対して3つのロールアウトがサンプリングされ(temperature 0.6、top-p 0.95)、最も短い正解ロールアウトがベーストレースとして採用されます。
Verified continuation generation. フラグが立てられた各プレフィックス P_i から、同一のデコーディングパラメータ下で k=8 の新しい継続がサンプリングされます。継続は、正解であり、かつ y_i^- に対して少なくとも \delta=300 トークンを節約する場合のみ y_i^+ として保持されます。単一のトレースが支配的にならないよう、各質問は最大 K=3 ペアのみを寄与します。
Local preference learning. 標準的なDPO目的関数が適用されます:
\mathcal{L}_{\text{DPO}} = -\mathbb{E}\left[\log \sigma\!\left(\beta \log \frac{\pi_\theta(y^+ \mid P)}{\pi_{\text{ref}}(y^+ \mid P)} - \beta \log \frac{\pi_\theta(y^- \mid P)}{\pi_{\text{ref}}(y^- \mid P)}\right)\right],
\beta=0.1 とし、固定されたベースモデルをreferenceとして使用します。P が2つのブランチ間で共有されているため、gradient contrastは完全にその状態からの継続の選択に関するものになります。
学習はDeepSeek-R1-Distill-Qwen-7BにLoRA adapter(rank 256、\alpha=512、dropout 0.05)をq/k/v/oプロジェクションに適用して行われ、effective batch size 64、learning rate 1 \times 10^{-5}、warmup 0.1のcosineスケジュール、AdamW(\lambda=0.01)、gradient clipping 1.0で2エポック学習されます。promptおよびcontinuationの長さはそれぞれ6k・12kトークンに制限され、sequence lengthは4台のH20 GPU上で14,336です。なお、学習データは数学のみであり、完全に自己生成されたものです。
結果
5つの数学ベンチマークと3つのコード生成ベンチマークで評価した結果、LoCoは数学で41.7%〜45.4%、コードで23.4%〜36.3%のcompletion length削減を報告しており、精度を維持または改善しています。数学のみの学習にもかかわらずコードへの転移が見られることは、「いつ停止するか」というシグナルが学習分布を超えて汎化し、ドメイン固有のショートカットをエンコードしているわけではないことを示唆しています。抄録では、競合する圧縮ベースラインに対して最良の精度-長さParetoトレードオフを主張しています(提供された抜粋では途中で切れています)。
限界と未解決の問題
- ジャッジへの依存性。 検出はQwen3-30Bをoverthinkingのオラクルとして使用します。ジャッジの系統的なバイアス(例えば、確信に満ちた早期終了を好む傾向)は、preference labelに直接伝播します;提供された抜粋ではジャッジの選択に関するablationは示されていません。
- \delta=300 の閾値と K=3 のキャップはヒューリスティックであり、ベースモデルの典型的なトレース長と相互作用する可能性が高いです;CoT分布がはるかに短い、または長いモデルにLoCoを適用する場合は再チューニングが必要になるかもしれません。
- 共有プレフィックスを持つ状態条件付きペアに対するDPOには既知の失敗モードがあります:モデルは y^+ の尤度を比例的に増加させることなく y^- の尤度を低下させる可能性があります。特に y^+ がはるかに短い場合(報酬を分散させるトークンが少ない)にこの問題が顕著です。LoCoがlikelihood-displacement pathologyを示すかどうか、あるいはIPO/length-normalized variantが必要かどうかは、示されているセクションでは議論されていません。
- 同じ(プレフィックス、継続するか?)ラベルで直接学習されたterminator-tokenやearly-exit classifierとの比較がありません。 DPOの定式化はこれらのペアを使用する一つの方法ですが、それが最善かどうかは不明です。
- y^+ の正確性は最終回答の一致のみで検証されており、真の中間推論をスキップした幸運な推測の継続を許容してしまいます。コードではテスト実行によって部分的に緩和されていますが、数学の設定ではモデルが検証ステップをショートカットすることを学習してしまう可能性があります。
なぜこれが重要か
CoT圧縮における支配的な手法はtrajectory-levelのものでした:より短いロールアウトが勝つ、というものです。LoCoは圧縮を、具体的な推論状態に紐付いた一連のlocal termination decisionとして再定式化します。これは、overthinkingが実際に現れる様子により忠実であり、かつ経験的にもより効果的です——精度を維持しながら数学で約45%の長さ削減を達成し、コードへのゼロショット転移も実現しています。状態条件付きpreferenceのレシピが頑健であれば、任意の蒸留推論モデルへの自然なdrop-inとなります。
Source: https://arxiv.org/abs/2611.04814
DreamX: Video Diffusion Model is a Universal Latent Action Learner
問題設定
Latent action model(LAM)は、フレーム間の視覚的遷移を予測することによってaction表現を学習し、潜在空間が「何が動くか」を「シーンがどのように見えるか」から分離することを目指しています。実際には、このようにして学習された表現はaction意味論とembodimentおよび外観が絡み合っており、人間とロボット間、シーン間、およびactionのパラメータ化間(例:エンドエフェクタの姿勢と関節角度)の転移を阻んでいます。DreamXが問いかけるのは、既に強力な時空間的事前知識をエンコードしている事前学習済み video diffusion transformer が、コンパクトでembodimentに依存しない latent action を抽出するために転用できるかどうかです。その意味論は、ピクセルレベルの変化ではなくaction関連のダイナミクスであるべきです。
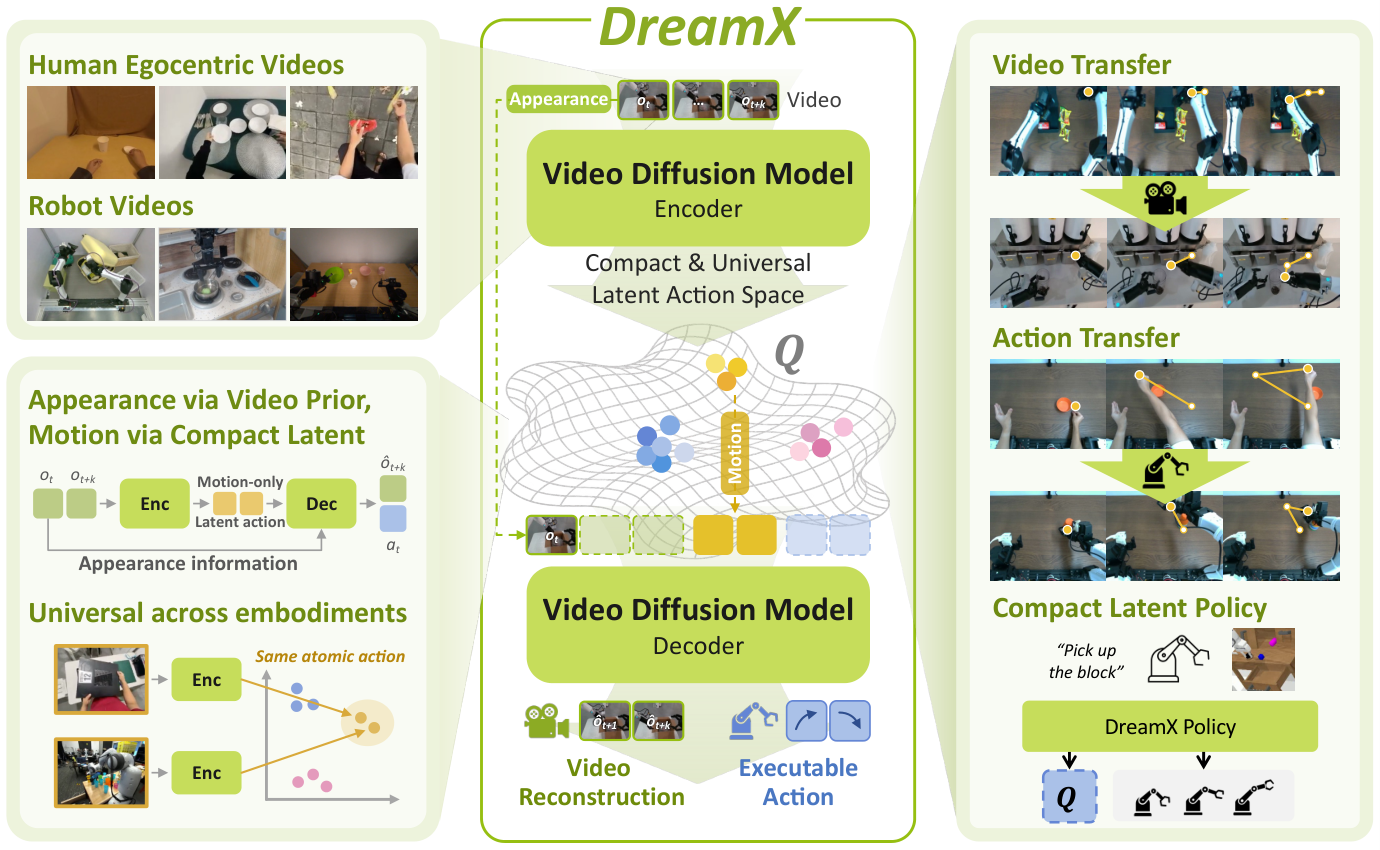
手法
DreamXは、flow-matching video DiTであるCosmos-Predict2.5 2Bをベースとして構築されています。因果的なビデオオートエンコーダがクリップをN個の潜在フレーム\mathbf{V}=(V_0,\dots,V_{N-1})にマッピングし、V_0は初期フレームのみをエンコードします。ベースモデルは標準的なrectified-flow目的関数で学習されます。
\mathcal{L}_{\mathrm{video}}=\mathbb{E}_{x,c,\epsilon,\tau}\big[\lVert v_\theta(x_\tau,\tau;c)-(\epsilon-x)\rVert_2^2\big],\quad x_\tau=(1-\tau)x+\tau\epsilon.
アーキテクチャ上の貢献は、事前学習済みバックボーンに取り付けられた学習可能なクエリによるreadout機構です(図2a)。各VAE潜在フレームに対して、4つの学習可能なクエリトークンがバックボーンの時空間的特徴にcross-attentionし、latent actionを出力します。各潜在フレームはおよそ1,200個のpatchトークンから構成されるため、これは300\timesの圧縮(潜在フレームあたり1{,}200\rightarrow 4トークン)に相当します。同じ video DiT から初期化されたデコーダが、初期フレームと latent action クエリを条件として、flow-matching目的関数のもとで将来のフレームを再構成します。低レベルactionが利用可能な場合、補助的なaction予測ヘッドが追加の監督信号を提供します。
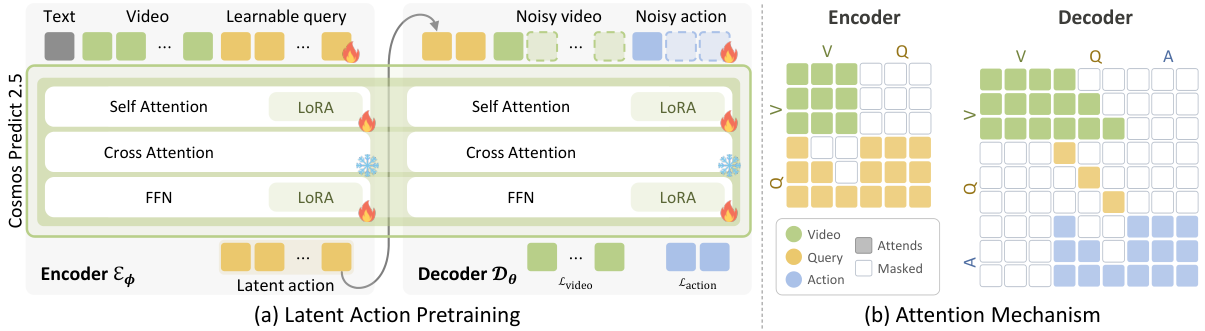
attention mask(図2b)は、外観をlatent actionから切り離すための機構です。デコーダでは、ビデオトークンとaction labelトークンの両方がlatent actionクエリにattentionしますが、ビデオトークンとactionトークンは互いにattentionすることを禁止されています。これにより、クエリはピクセルとラベルの両方を予測するために必要な情報を担うよう強制される一方、デコーダがビデオとactionを直接コピーすることによる近道を防ぎます。V_0がすでに外観をデコーダに提供しているという事実と組み合わさることで、クエリはV_0が予測できないもの、すなわち初期シーンから将来を区別するダイナミクスのみをエンコードするよう圧力をかけられます。エンコーダとデコーダは別々のrank-16 LoRAモジュールで適応され、480\times 640の解像度で最大29フレームのクリップを使って78kステップ学習されます。
学習データは、ロボットデータ(MolmoAct2-BimanualYAM、Bridge、DROID、AgiBot)と自己中心的な人間のビデオ(EgoDex、EgoVerse)を混合しており、人間とロボットの対応データは使用していません。すべてのソースで同じクエリレイアウトが使用されるため、潜在空間は共有されたaction interfaceとなります。
下流タスクへの応用
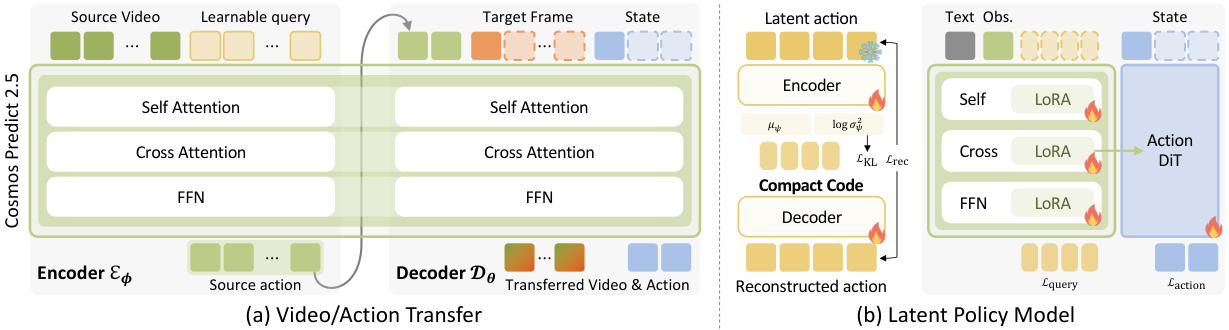
3つの下流タスク設定がサポートされています(図3)。(i)Any-to-anyビデオ転移:ソース映像からlatent actionを抽出し、ターゲットの初期フレームとともにDreamXデコーダに入力して、ソースのモーションを実行するターゲットドメインの映像を生成します。(ii)Cross-embodiment actionデコーディング:ソースのlatent actionとターゲットのロボット状態を入力として、ソースとターゲットの対応データなしに低レベルactionを生成します。(iii)DreamX policy:variational bottleneckがクエリトークンをコンパクトなコードに圧縮し(フレームごとのトークンレイアウトを保持)、policyが現在の状態を条件として将来の映像全体の生成を行わずにこれらのコードと低レベルactionを予測します。
実験結果
latent actionがビデオ予測のためのモーションをどれほどよく捉えているかを測定するLARY-Benchにおいて、DreamXはlatent action modelの中で最先端の性能を報告しています(論文の引用箇所には各列の数値は記載されていませんが、ベンチマーク全体でSOTAというのが主要な主張です)。定性的には、図4(ここでは再現しない)が大きな外観とembodimentのギャップをまたいだモーション転移を示しており、例えば人間のキッチン操作を異なるシーンのロボットアームに転移した場合でも、エンドエフェクタの軌跡が時間的に一貫していることがわかります。著者らは、これらの結果が潜在コードが外観とembodimentに対して不変でありながらエンドエフェクタのaction関連軌跡を保持しているという証拠であると主張しています。
限界と未解決問題
引用されている論文の範囲では、デコードされた低レベルactionが実際の物理ロボット上でクローズドループで動作した場合の精度が、シミュレーションやオフラインのrolloutと比較してどの程度かを定量化していません;転移の証拠は主にビデオ再構成とオフラインのpolicyベンチマークに基づいています。潜在フレームあたり4トークンというbottleneckは設計上の選択ですが、掲載されているセクションではパラメータスイープが報告されておらず、他の圧縮率における外観とactionのトレードオフは不明です。この手法はベースの video DiT のバイアス、すなわち大規模な事前学習データに由来するシーン事前知識を引き継いでおり、分布外の物体に対してlatentが本当に「外観不変」であるかどうかには限界があるかもしれません。また、共有潜在空間がembodiment間で線形に整合しているのか、それとも条件付きデコーダを介してのみdecodably整合しているのか、すなわち人間とロボットのlatent action間で単純な算術演算が可能かどうかも未解決のままです。
なぜ重要か
事前学習済み video diffusion model が、ダイナミクスと外観を分離するために必要な帰納バイアスをすでに含んでいるのであれば、latent action 学習は表現学習の問題ではなくreadoutの問題となり、ペアのデモンストレーションなしに人間の自己中心的映像がロボットpolicyの正当なデータソースとなります。フレームあたり300\timesの圧縮により、diffusion model の特徴がpolicyの入力として扱いやすくなることも、video事前学習のworld modelをcontrolにスケールアップするための実用的なボトルネックを解消します。
Source: https://arxiv.org/abs/2611.05377
RoboColosseum: 実環境における大規模な物理的知能の評価
実世界でのロボット評価は再現性のパラドックスに悩まされています。物理的な試行を情報豊かなものにする環境の多様性こそが、複数のラボ間での結果比較を困難にしているのです。RoboColosseumは、環境がサイトごとに異なることを許容しつつ、policy-servingスタック、observation/action spec、およびスコアリングプロトコルを固定した分散型 benchmark によってこの問題に取り組んでいます。初回のデプロイメントは41日間(2026年9月17日〜10月28日)にわたり、124サイトで5,699件のペアワイズ Open Track 比較と、4つのロボット形態にまたがる20タスクの Fine-tune Track をカバーし、5つのVLAポリシー(GR00T N1.7、\pi_{0.5}、MolmoAct2、G0.5、LingBot-VLA v2)および3つのフロンティアエージェント(GPT-6 Astra、Claude Opus 5.5、Grok 4.7)を評価しています。
インフラ
4つのロボット形態はコストと形態の観点から多様です:SO-101(低コスト6次元シングルアーム、外部カメラ1台+手首カメラ1台)、DROID構成のFranka(8次元、外部カメラ2台+手首カメラ1台)、Bimanual-YAM(14次元、上部カメラ1台+手首カメラ2台)、そして並列グリッパーを備えたUnitree G1ヒューマノイドです。
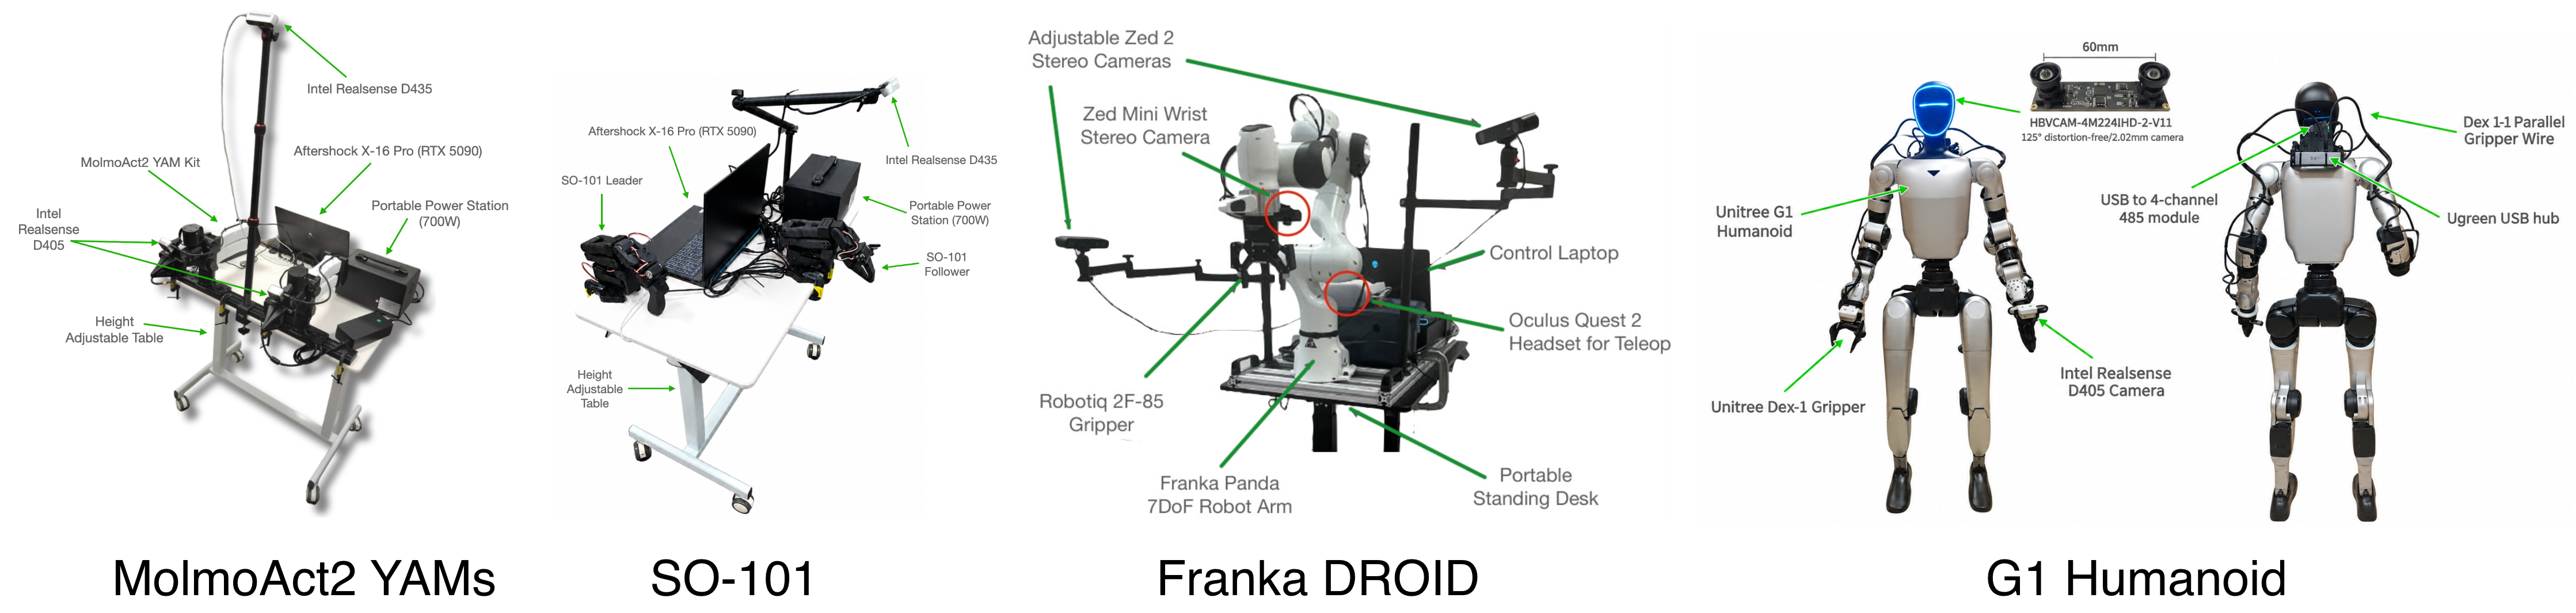
各ロボット形態は、全サイトおよび全ポリシーで共有される固定のobservation/action specificationを持っているため、特定のポリシーチェックポイントはどこでも変更なしに動作します。推論はRTX 5090ラップトップ上でローカルに実行されるか、ルーティングサーバーを介したリモートサーバー上で実行され、レイテンシを測定することで両方の経路がクローズドループ制御をサポートすることを確認しています。
2つのトラック
Open Track は、マッチングされたローカル条件下でのブラインドペアワイズ試行によってポリシーをout-of-the-boxで評価し、著者らがDCRと呼ぶElo方式のposteriorで集約します。VLAポリシーはロボット形態固有の事前学習済みチェックポイントを使用し、フロンティアエージェントはRoboColosseum policy serverのInspect Robots agentポリシーを通じて提供されます。各ステップでエージェントは全カメラからの640\times 480の画像、ラベル付き数値ベクトルとしての固有感覚情報、そして指示を受け取ります。エージェントは1ターンにつき正確に1回のツール呼び出しを出力します。move(サーバー側で固定割合の関節速度で補間される絶対関節位置目標)、done、またはgive_upであり、トランスクリプトに記録される必須の1〜2文の根拠も含まれます。最新の2つのobservationのみが画像を保持し、それより古いobservationはテキストとして保持されます。
Fine-tune Track はデータ予算を固定します:タスクあたり100デモンストレーション、20タスク(ロボット形態あたり5タスク)、モデル-タスクペアあたり25試行。すべてのVLAは、固定コミットに固定された独自のアップストリームトレーニングリポジトリを使用し、データ変換、モデルごとのコンフィグ、およびランチスクリプトのみを提供するハーネスを用います。学習率は各レシピの基準バッチサイズから実効バッチサイズへと線形スケーリングされ、全訓練はbf16でfp32マスターウェイトを使用し、最終エポックのチェックポイントで評価されます。代表的なハイパーパラメータ:GR00T N1.7フルモデル fine-tuning では学習率1\times 10^{-4}(実効バッチ64、コサイン、5%ウォームアップ);\pi_{0.5}では2.5\times 10^{-5}からEMA 0.99で2.5\times 10^{-6}に減衰し、Aloha adaptationは無効;MolmoAct2ではモジュールごとの学習率(LLM 2\times 10^{-5}、ViT/connector 1\times 10^{-5}、action expert 1\times 10^{-4});G0.5では学習率4\times 10^{-5}でvision encoderに0.1の学習率スケーリング;LingBot-VLA v2では定常学習率1.25\times 10^{-5}のMuonを使用。著者らが報告するアブレーションは示唆に富んでいます:バックボーンを凍結してバッチ512を使用したGR00T N1.7の以前の構成では、5エポックで optimizer の更新回数が不足し、定常アクションに崩壊しました。これは、バッチサイズだけでなくoptimizerの更新回数が、小データVLA fine-tuningを支配するという教訓的なデータポイントです。
スコアリングは詳細です。各タスクは0〜4の部分的進捗ルーブリックを定義しています。例えばSO-101のstack_cubesでは、各レベルは(1)アプローチ、(2)青い上に赤を積む、(3)白を青の上に移動、(4)安定した3キューブのスタックをエンコードします。この分解により、著者らは脆弱な0/1成功率ではなく、タスクごとの到達可能性曲線(K個の進捗基準の少なくとも一定割合を達成した25試行の割合)を計算することができます。
主要な結果
Open Track のDCRレーティングは、ロボット形態ごとに95%信頼区間とともに報告されています。
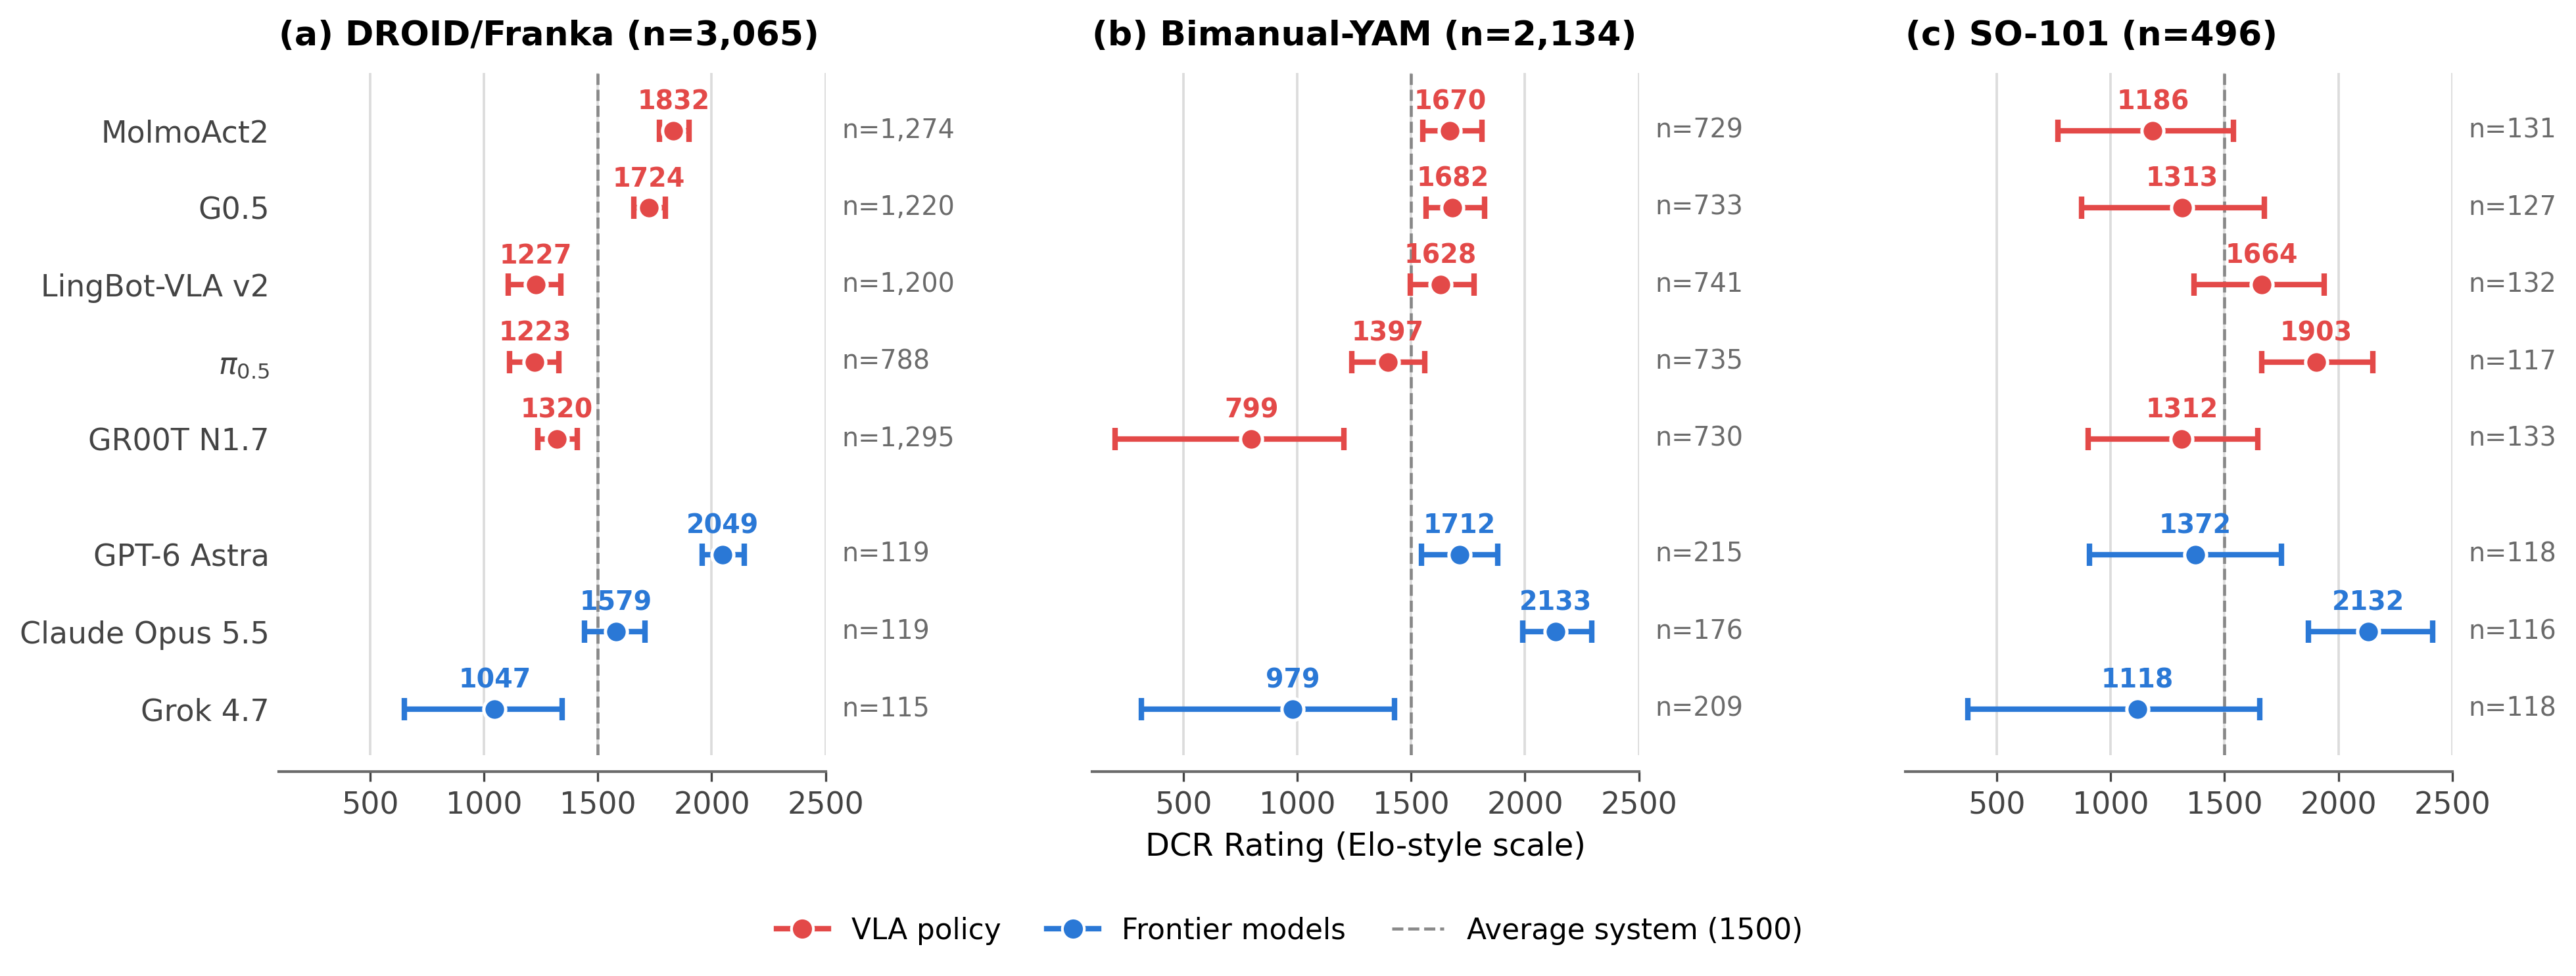
主要な定性的知見は、デモンストレーションや fine-tuning なしに純粋に関節位置ツール呼び出しのみで動作するフロンティアAPIエージェントが、Open Track において特化型VLAポリシーと同等の性能を示すというものです。ただし、すべてのシステムがオープンワールドタスクを確実に完了するのに苦労しています。タスクあたり100デモで fine-tuning した後、GR00T N1.7がSO-101でトップとなり、\pi_{0.5}がFrankaとBimanual-YAMの両方でトップとなります。重要なのは、ロボット形態固有のタスクスイート間でのポリシーランキングが弱い一致度しか示さず、KendallのW = 0.24であるという点です。これは、単一ロボット形態のリーダーボードが転移しないこと、および特定のプラットフォームからの集計レポートが系統的に誤解を招くという強力な証拠です。
タスクごとの到達可能性分析により、ロボット形態レベルのギャップが特定の難しいタスクによって引き起こされていることがさらに示されています。SO-101では、stack_bowlsとupright_bottleが複数のポリシーを高い進捗度に保つ一方、stack_cubesは強く識別的です:ポリシーは初期把持基準では収束しますが、複数物体のスタッキングで diverge します。cube_drawerは弱い形で同様の特徴を示します。
限界
本研究はスナップショットです:合計20タスク、ロボット形態あたり5タスク、タスクごとに場所と照明が固定されています(例:SO-101タスクはNUSの特定の場所で午後3〜5時に評価)。G1ヒューマノイドはロボット形態セットに含まれていますが、抜粋中のデータは限られています。ペアワイズElo方式の集約は、物理的な試行が分布シフト下で違反する可能性のある推移的品質を仮定しています。W=0.24のロボット形態間不一致それ自体も未解決の問題です:これはハードウェア誘発なのか、データ誘発(ロボット形態ごとに異なる事前学習コーパス)なのか、それともタスク選択のアーティファクトなのか?
なぜこれが重要か
ロボティクスは現在、ImageNet時代、ましてやLMSYS時代に相当する外部評価インフラを欠いており、「汎用」ポリシーの主張は通常、単一ラボのデモによって裏付けられています。固定インターフェースを持つ分散型 benchmark と124サイトにわたる5,699件のペアワイズ試行は、プレゼンテーションからシグナルを分離し始める適切なスケールです。そしてW=0.24のロボット形態間ランキング不一致は、いかなるポリシーも「汎用」と宣言する前に、この分野が向き合うべき具体的な実証的結果です。
Source: https://arxiv.org/abs/2611.02497
YANAMI: マルチターン有状態インタラクションのための大規模マルチモーダルデータセット・ベンチマーク
問題設定
Unified Multimodal Models(UMMs)は、視覚的な理解・生成・編集にわたって共通のバックボーンを共有していますが、公開されているトレーニングデータおよび評価データのほぼすべては、シングルターンであるか、独立したターンに自明に分解可能なものです。つまり、有状態インタラクション——モデルが蓄積された編集、解決済みのコアレファレンス、事前制約、ユーザーの訂正といった、進化するマルチモーダル状態を追跡し、それをテキストおよび視覚の両面で実現しなければならない——に対する監督信号はほとんど存在しません。このようなデータがなければ、ベンチマークはエージェント的なマルチモーダルアシスタントに最も関連する能力を過小評価し(トレーニングはアンダーフィットし)ます。
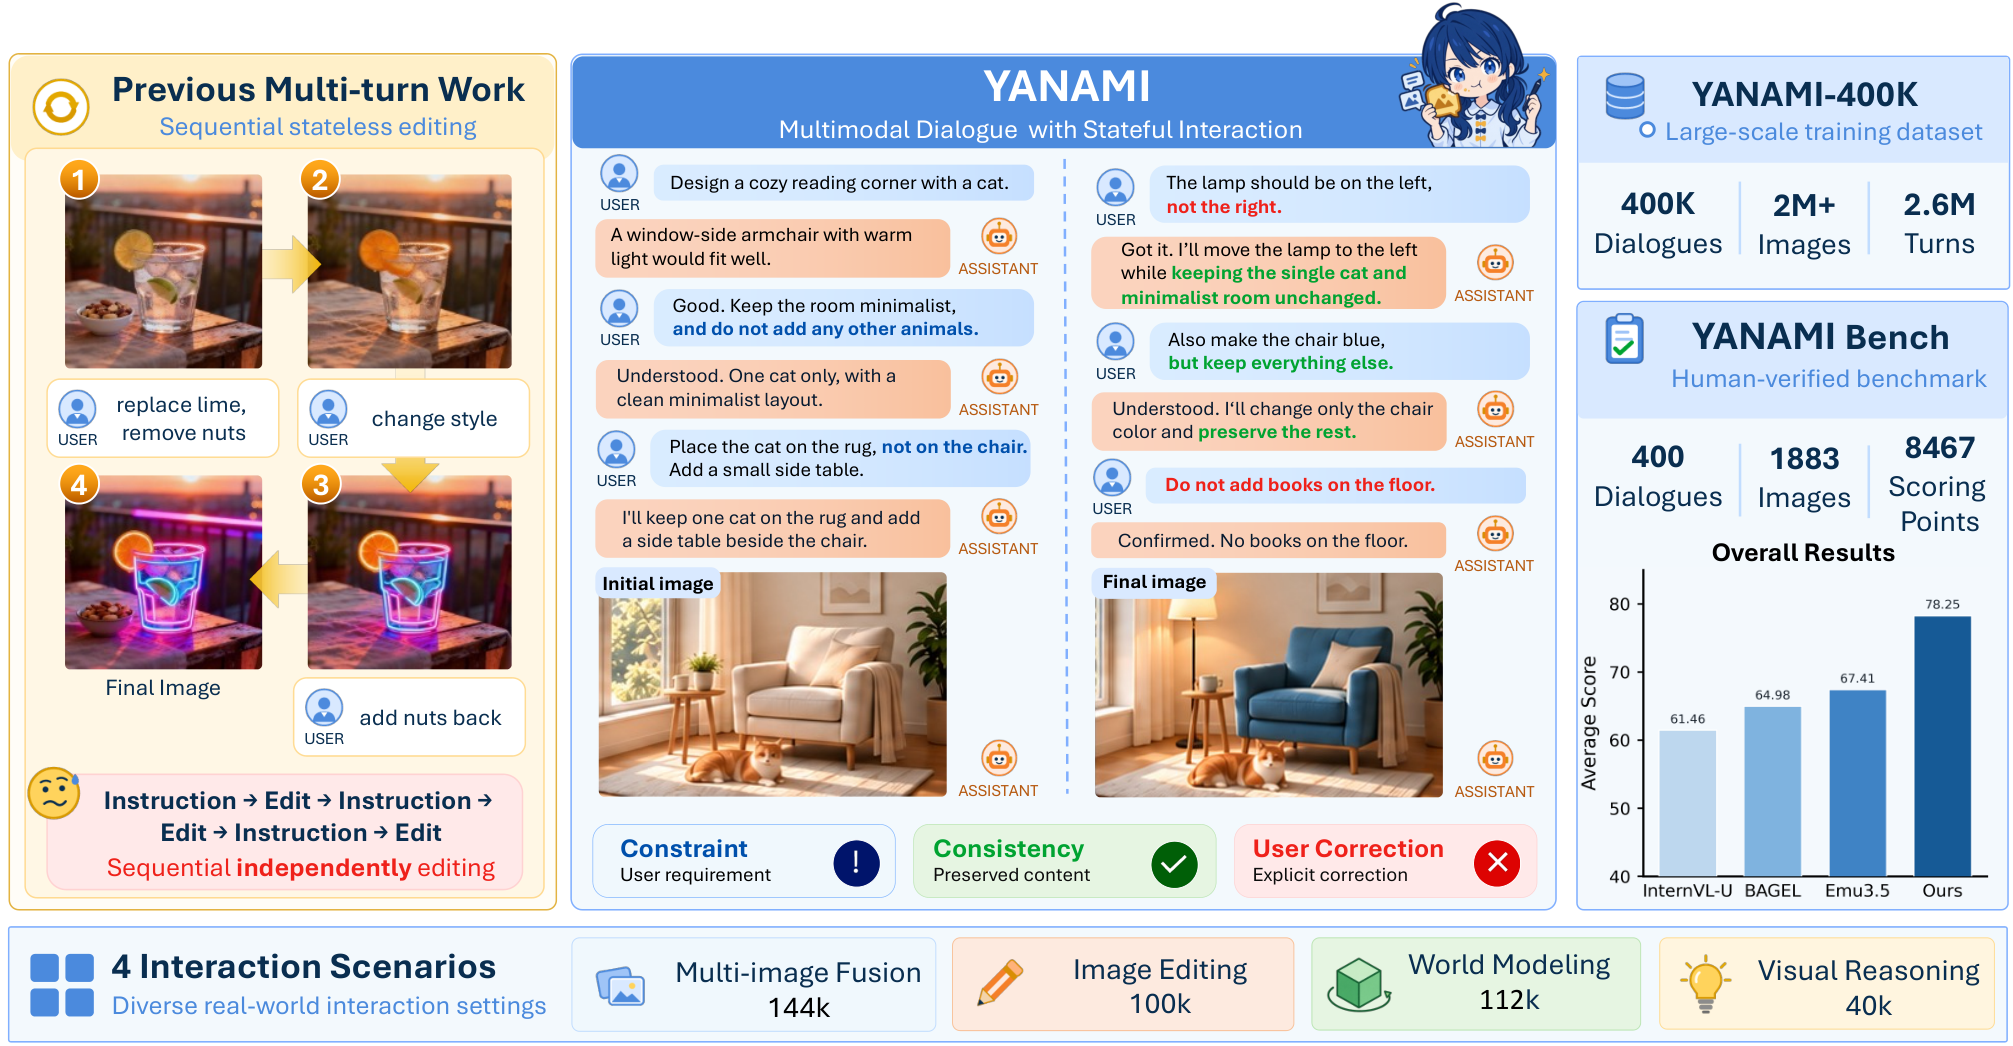
YANAMIはまさにこのギャップを埋めることを目的とし、2つの成果物を提供します:YANAMI-400K(40万対話のトレーニングセット)とYANAMI-Bench(4つの有状態シナリオをカバーする400対話の評価スイート)です。
シナリオと能力
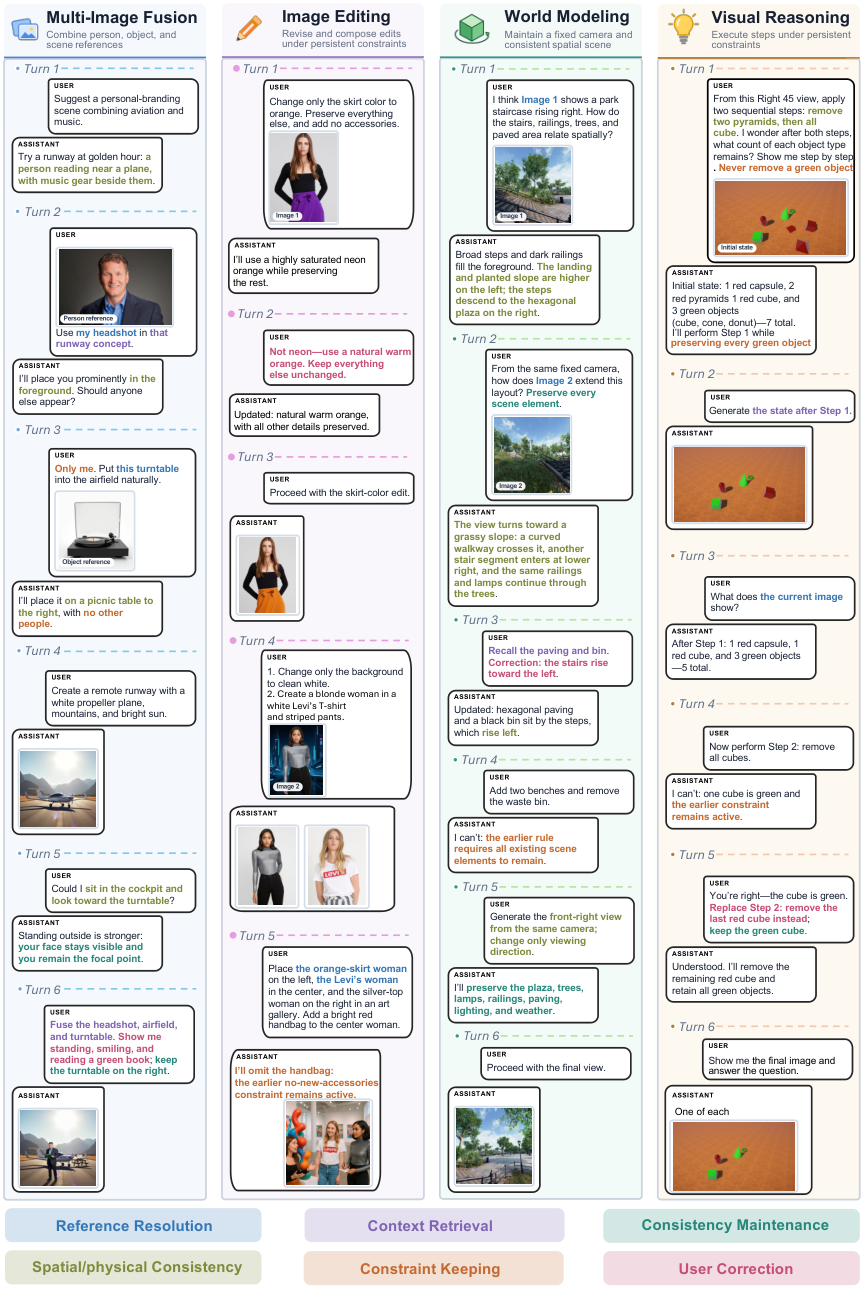
データセットは4つのインタラクション体制を軸に構成されています:
- マルチ画像融合 — ユーザーが提供した複数の画像や以前に生成された画像からレスポンス画像を合成する。
- 画像編集 — 以前の修正と視覚的同一性を保持しながら、段階的な編集を適用する。
- 世界モデリング — 視点変更や行動後のシーン状態を予測する。
- 視覚的推論 — 中間ステップとして視覚的仮説をレンダリングする。
これらにわたって、6つの状態管理能力が計測されます:(i)コアレファレンス解決、(ii)対話履歴検索、(iii)クロスターン整合性、(iv)空間的・物理的整合性、(v)制約遵守、(vi)訂正に基づく状態更新。Figure 2は、単一の対話においてこれらがどのように連鎖するかを示しています:ターン2の編集はターン4の視点変更を経て持続しなければならず、ターン5のユーザー訂正は蓄積された状態の一部を選択的に上書きします。
データパイプライン
構築パイプラインは4段階から成ります:データ準備、対話構築、自動検証、人手検証。
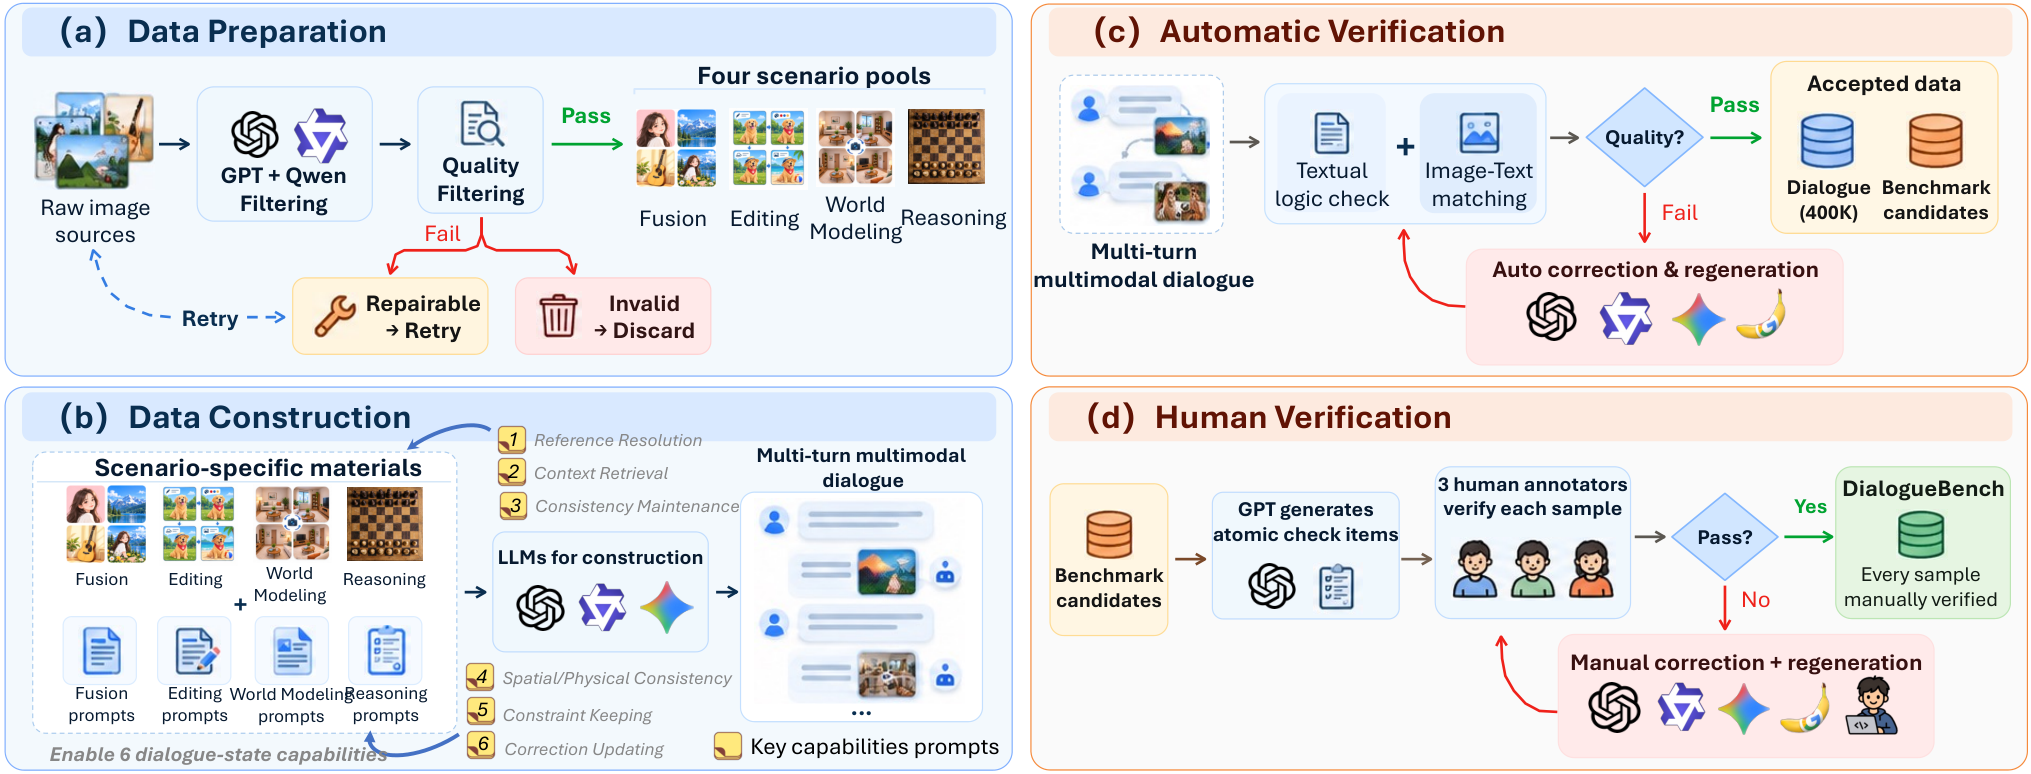
生画像は4つの公開ソースから取得され、シナリオ固有のプールに振り分けられます。対話はGPT-5.6 Sol、Qwen3.7-Plus、Gemini 3.1 Pro、GPT-Image-2、Nano Banana 2の組み合わせで生成され、シナリオおよび能力指向のプロンプトを条件としています。自動検証では論理的整合性と画像・テキスト整合性を確認し、失敗したサンプルは反復的に再生成され、生き残ったサンプルは人手検証を経ます。
得られたコーパス(Table 1)は402,639対話、2,047,236画像、2,643,291ターンを含み、1対話あたり平均5.08画像・6.56ターンで、215K対話が\geq 5画像を含み、最大43ターンまで分布が広がります。この1対話あたりの画像密度こそが、ターンが典型的に単一画像へのテキストのみのフォローアップである既存の「マルチターン」セットとYANAMIを区別する点です。
ベンチマークと評価プロトコル
YANAMI-Benchは400対話を含み、理解・生成・編集を総合的に評価するVLM-as-Judgeフレームワークによってスコアリングされます。生成誤差の累積から有状態推論を切り離すために、評価ではGT-History設定を使用します:ターンtにおいて、モデルはターン<tの正解画像とテキストを受け取り、ターンtのみを生成しなければなりません。異なるモデルAPIに対応するために3つの入力レイアウトが用意されています:yes-first(最初の言及時に画像を挿入)、yes-front(全画像を先頭に付加)、concatenate(逐次マルチ画像入力を持たないモデル向けに1枚の画像にタイル結合)。
結果
クローズドソース2モデル、オープンソースエディタ4モデル、UMM 9モデルの計15モデルにわたって、有状態インタラクションは依然として困難です。クローズドソースのトップスコア:GPT-Image-2が総合83.05(融合86.78 / 編集90.54 / 世界モデリング81.40 / 推論73.46)、Nano Banana 2が80.93。最良のオープンシステムは明らかに劣っています:FLUX.2 [dev] 67.30、Emu3.5 67.41、BAGEL 65.02。小規模または編集専用モデルはさらに低い:Qwen-Edit 42.55、Show-o2 39.29、Janus-Pro 40.58。
シナリオレベルのパターンは一貫しています:Visual Reasoningはほぼすべてのモデルで最も弱い軸であり(例:Janus-Pro 31.86、Show-o2 29.42、OmniGen 33.94)、視覚的に根拠付けられた中間ステップの生成には、仮説状態の追跡と忠実なレンダリングの両方が必要であることを反映しています。
最も重要な点として、BAGEL(7B)をYANAMI-400Kでfine-tuningすると、総合スコアが65.02から78.25(+13.23)へ向上し、すべてのシナリオで改善が見られます:融合62.44 → 78.98、編集67.40 → 84.96、世界モデリング68.16 → 73.26、推論62.06 → 75.80。チューニングされた7Bモデルはすべてのオープンシステムを上回り、融合・編集においてクローズドソースベースラインとのギャップのほとんどを埋めていますが、世界モデリングでは依然として遅れています。
制限と未解決の問題
GT-Historyプロトコルは意図的に誤差の伝播を排除しています;モデル自身の以前の生成を入力とするロールアウト評価では、クロスターン整合性が複合するため、ギャップはさらに拡大すると考えられます。データセットはまた、クローズドな独自モデル(GPT-5.6、Gemini 3.1 Pro、GPT-Image-2、Nano Banana 2)からブートストラップされており、これらのシステムのスタイル的・構成的なpriorへの分布バイアスの問題が生じます——fine-tunedなBAGELはそれらを部分的に蒸留している可能性があります。さらに、6つの能力タグは粗いものであり、改善がすべての能力にわたって均一に生じているのか、あるいは例えばコアレファレンスや履歴検索(より容易)に集中しているのか、物理的・空間的整合性(より困難)ではどうかは、ここで報告されている総合数値からは判断できません。
重要性
有状態マルチモーダルインタラクションは、現行のUMMベンチマークで最もテスト不足の能力であり、YANAMIはそのギャップが大きい(クローズドvsオープン ≈ 15ポイント)ものの対処可能であることを示しています:40万対話のSFTコーパスが、7Bバックボーン上でそのほとんどを埋めます。これは、少なくとも現在のスケールでは、有状態インタラクションをアーキテクチャ的な問題ではなくデータの問題として再定義するものです。
Source: https://arxiv.org/abs/2611.05280
SpecPilot: Speculative Decodingのための自律的アルゴリズム探索とシステム最適化
問題
Speculative decodingは、安価なdrafterがトークンを提案し、target modelが1回のパスでそれを検証することで、メモリバウンドなLLMデコーディングのレイテンシを削減します。並列drafter(DFlash2、DSpark、EAGLE-3)は1回のforward passでブロック全体をdraftするため、理論上は効果が累積するはずです。しかし実際には、著者らは公開されているリファレンスシステムが理論上のスピードアップの大部分を活かしきれていないことを示しており、その構造的な理由は3つあります:
- 未使用のdrafter候補。 Qwen3.8-27BでDFlash2を用いたシングルリクエスト実行において、オフラインの厳密リプレイは8ポジションチェーンから1ステップあたり \tau = 4.25 トークンを受理します。一方、draftの上位16件に存在するtargetトークンを貪欲に受理するオラクルは、8ポジションで \tau = 6.42、16ポジションで 8.20 に達します。
- シングルリクエスト時にweight streamingが支配的。 GEMM時間は1行で17.88 msから64行でわずか18.58 msにしか増加しない一方、targetの重みの読み込みが23.61 msステップの80%を消費しており、H100のピーク3.35 TB/sにおいてもメモリバウンドの下限の92%に達しています。
- バッチ処理における検証のオーバーヘッド。 バッチされたリクエストが増えるたびに、再帰状態とattentionの処理が追加され、タイル境界でのGEMMのジャンプが引き起こされます。FP8でQwen3.8-27Bを使用したストックのDFlash2は、batch 1での 3.40\times からbatch 24での 1.89\times に低下し、Qwen3.5-4BはバッチBatch 32で 3.73\times から 1.49\times に落ち込みます。
最適な修正方法はdrafter、target、GPU、バッチ規模に依存するため、単一の最適化では不十分です。SpecPilotはエージェントループ(Claude Code上のClaude Opus 5.5)であり、正確性を保証する契約のもとでデプロイ固有のアルゴリズム・システム変更を探索します。
手法
SpecPilotはラウンド単位で動作し、各ラウンドは前のラウンドの最終システムから再帰的に開始されます。Phase 0では、スピードアップのギャップを3つの乗法的因子に帰属させるコストモデルを計算します:
S(N) = \frac{\tau(N)}{c(N)}, \quad c(N) = \frac{T_{\mathrm{step}}(N)}{T_{\mathrm{AR}}}
および上限として
\frac{\tau_{\mathrm{best}}}{\tau} \cdot \frac{T_{\mathrm{prof}}}{T_{\mathrm{floor}}} \cdot \frac{T_{\mathrm{step}}}{T_{\mathrm{prof}}},
ここで \tau_{\mathrm{best}} は厳密リプレイにおけるbest-firstツリー選択から得られ、T_{\mathrm{floor}} は各カーネルのバイト下限、すなわちピーク密スループットの60%でのFLOP時間とピーク帯域幅の90%でのバイト時間のうち大きい方です。これら3つの因子は、(a) ツリー選択の最適性の欠如、(b) 低速なカーネル、(c) プロファイル対象領域外のフレームワークオーバーヘッドをそれぞれ分離します。最大の因子が次の改善方向を示します。
Phase 1〜3では並列エージェントを展開して修正案を提案・計測し、生き残ったものを統合し、Phase 4で保留されたリクエストに対して結果を確定します。採用されるものを制御する2つの正確性保証メカニズムがあります:
- Token forcing。 出力されたトークンはすべてストックシステムのトークンストリームと照合されます。これにより、エージェントが受理基準をひそかに緩めてスループットを水増しする「報酬ハッキング」を直接検出します。
- 構造化メモリ。 検証済みのメカニズムはラウンドをまたいでデプロイ間で永続化されるため、新しいtarget/GPUの組み合わせはゼロからではなく、ストックにメモリを加えた状態から開始できます。
発見されたメカニズム
主要なアルゴリズム的成果物は、W12——ロスレスな12ビット重みフォーマットです。観察の要点は、学習済みLLMの1つの出力チャンネル内のBF16重みがほんのわずかなbinade(2の累乗の区間)しかまたがらないということです。チャンネル n に対して、W12は最も多くの重みをカバーする16-binadeウィンドウ [E_n - 15, E_n] を選択し、ウィンドウ内の各重みを符号(1ビット)+指数オフセット(4ビット)+元の7ビットの仮数 = 12ビットとしてエンコードします。ウィンドウ外の重み、ゼロ、非正規化数はエスケープとなり、ロード時に正確に復元するチャンネルごとのスパースリストに格納されます。
8つの密なモデルにわたって測定されたビット幅は12.01〜12.02 bits/weightであり、Qwen3.8-27Bの変換後のレイヤーは44.67から33.58 GBに縮小します。固定された縮約順序を持つstream-K GEMMカーネルによって演算がビット決定論的になり、デコードはレジスタ上で行われるため、メモリストリームがそれを隠蔽します。12 KBのレコードは 128\times64 タイルをカバーしており、8ビットビュー(符号+上位3仮数ビット+指数オフセット)と下位仮数ビットを格納するプレーンで構成されます。サーバーはロード時にデコードされた各テンソルをチェックポイントとビット単位で比較します。
LM headについては、W12が常に最適とは限りません。H100では著者らはcertified INT8 headを採用しています:チャンネルごとのCauchy–Schwarz誤差バウンドによって、argmaxとなり得ないトークンを証明可能に除外し、生き残ったトークンをBF16で正確に再スコアリングし、生き残りが多すぎる場合はフルヘッドにフォールバックします。LM headのレイテンシは878から482 μsに低下し、argmaxは設計上不変です。RTX PRO 6000では、certified headの方が遅い(BF16の1750 μsに対して2598 μs)ため、代わりにLM headをW12に変換します——これはメモリに蓄積されたデプロイ条件付き判断の具体例です。
結果
シングルリクエスト、BF16 target(表1、H100 SXM5):
- Qwen3.8-27B + DFlash2: ストック 3.95\times(平均 \tau = 4.65)→ SpecPilot 8.86\times(平均 \tau = 13.08)。
- Qwen3.8-27B + DSpark: 3.74\times → 9.41\times;\tau は4.42から12.85へ。
RTX PRO 6000では:
- Qwen3.8-27B + DFlash2: 4.46\times → 10.87\times(\tau 5.23 → 12.80)。
- Muse-Glimmer-30B + DFlash2: 4.69\times → 10.63\times(\tau 5.16 → 12.64)。
\tau の大幅な向上は、2段階検証によるものです:各厳密targetパスで2つの連鎖したdraftを検証します。Qwen3.8-27B + DFlash2でのGSM8Kでは、1回の厳密パスあたり \tau = 16.69 トークンに達します。ベンチマーク全体(GSM8K、MATH500、HumanEval、MBPP、MT-Bench)にわたって、ARに対する幾何平均スピードアップはストックのほぼ2倍となります。未見のリクエストに対するシールドされた結果は開発時の測定値の -2\% から +6\% の範囲内に収まり、すべての最終システムがtoken forcingをパスします。
バッチ処理の結果(H100、Qwen3.8-27BはFP8;Qwen3.5-4BおよびGemma-4-12BはBF16)は行ごとの検証オーバーヘッドに直接対処していますが、抜粋では完全なテーブルが省略されています。
制限と未解決の問題
- このパイプラインは強力なフロンティアコーディングエージェント(Claude Opus 5.5)に依存しており、より弱いエージェントでの再現性は定量化されていません。
- Token forcingは出力シーケンスの同一性をストックシステムと照合することで正確性を保証していますが、ストック自体が正確性のオラクルであると前提としています;受理トークンを変えずにdraftの分布を変更するdrafter変更は問題ありませんが、非貪欲サンプリング下での真の分布的等価性はここでは評価されていません(デコードは貪欲です)。
- 60% FLOP / 90%帯域幅のバイト下限はヒューリスティックであり、上限はこれらの定数と同程度にしか厳密ではありません。
- W12の指数ウィンドウの仮定は、チャンネルごとの指数分布がより重い尾を持つモデル(例:一部のMoEエキスパート、量子化認識訓練されたモデル)では劣化する可能性があります。
- 報告されたバッチ処理のカバレッジは少数のモデル/GPUペアに限定されており、例えばAMD MI300や長コンテキストのprefill中心の環境へのメモリエントリの転用可能性は未解決です。
なぜ重要か
SpecPilotは、現在のspeculative decodingのデプロイが理論的な上限を大きく下回っていること、そしてコストモデルに基づくエージェントループとtoken同一性ゲーティングによって、batch 1でARに対するスピードアップをおよそ 8\text{–}11\times に倍増させながら、副産物として真に新しいロスレス数値フォーマット(W12)を発見できることを示しています。これは、LLMによるシステム探索が不透明なヒューリスティックではなく、監査可能でビット完全な成果物を生み出せるという存在証明です。
Source: https://arxiv.org/abs/2611.02501
MoLRSI: 分子探索のための再帰的自己改善AIエージェント
問題
分子探索パイプライン — データキュレーション、表現の選択、生成モデル、スコアリング、フィルタリング — は組み合わせ論的な決定木を形成しており、単一のワークフローがすべてのターゲットに対して優れているわけではありません。専門家が設計したパイプラインは静的であり、プロジェクト間で知見を引き継ぐことができません。既存の「AIサイエンティスト」エージェントは固定プロトコルの実行を自動化しますが、ワークフロー空間を体系的に探索することも、タスク間で経験を蓄積することもできません。MoLRSIはその両方に対処します:ワークフローレベルの探索に加え、タスクをまたいだ永続的なメモリを備えており、過去の分子設計タスクでの経験が後続タスクの探索方策を再形成する再帰的自己改善(RSI)ループを閉じます。
手法
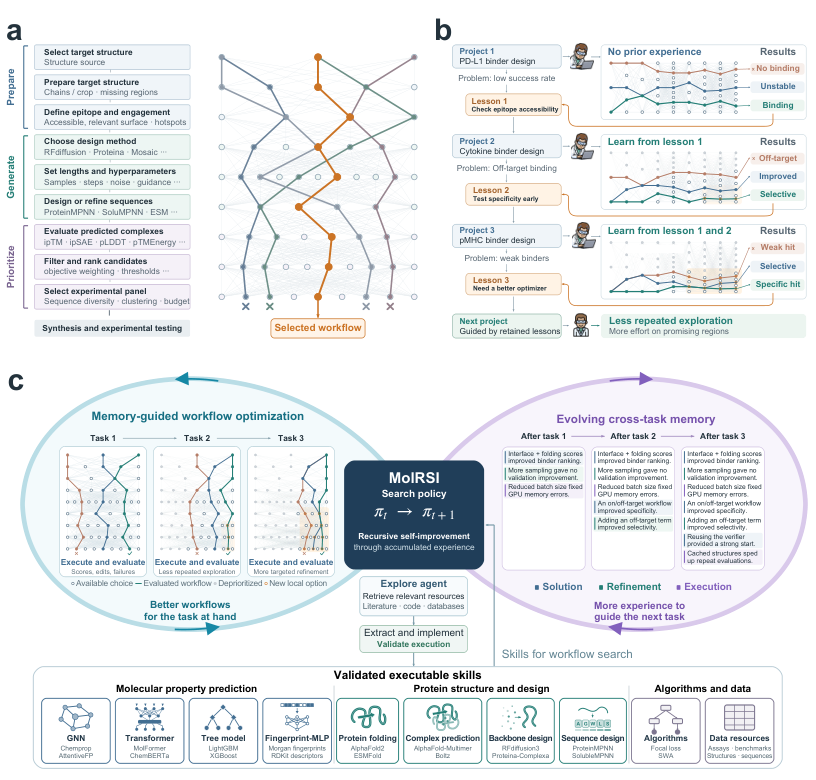
MoLRSIは三つのコンポーネントを持ちます:検証済みスキルライブラリを構築するExplore Agent、経験ガイド付き選択を伴うMCTSベースのワークフロー探索、そしてsolution・refinement・executionストアに分割された永続的メモリです。
リソースライブラリ。 Explore Agentはタスクの説明とデータの特性(表現、アーキテクチャ、目的、制約)に基づいたクエリを発行し、論文および関連コードを取得し、各リソースについてスキル仕様を出力します:目的、依存関係、I/Oスキーマ、実行レシピ。各スキルは構文チェックを受けた後、初回使用時に隔離された環境でusage exampleを用いて実行されます。失敗した場合は、コード、依存関係、環境に対するLLM駆動の修復ループが起動します。生き残ったスキルはvalidatedとタグ付けされ、タスクをまたいで再利用されます。修復不能なスキルは廃棄され、ライブラリを実行可能な状態に保ちます。
ワークフロー探索。 タスク t はデータ、評価メトリック、計算バジェットを提供します。候補ワークフローは検証済みスキル — 前処理、生成、優先順位付けのステージ — の組み合わせであり、ライブラリまたはsolutionメモリから取得されて初期化されます。探索はワークフロー設定に対するMCTSです。選択は、t および関連タスクのスコアを集約した性能項と、訪問頻度の低いブランチを優遇するUCBスタイルの探索ボーナスを組み合わせます。refinementメモリは選択されたワークフローの次の編集(例:featurizerの入れ替え、細胞毒性フィルターの調整)を条件付けるための過去の(修正、結果)ペアを提供します。executionメモリはランタイムのフィンガープリント — リソース使用量、エラートレース、成功した修正 — を保存し、評価中のバジェット割り当てとエラー復旧を管理します。バジェット内で開発スコアが最良のワークフローが返されます。
RSIループ。 四つのストア — ワークフロー、性能スコア、修正結果、実行記録 — すべてがタスクをまたいで永続します。新しいタスクの探索はこの経験から初期化され、探索は逆にスキルを修正または追加することができます。アブレーション「MoLRSI without RSI」はタスク内の経験のみを使用します。「zero-search transfer」は新たな探索を行わず、過去のワークフロー設定を(対象のトレーニングデータで再トレーニングして)直接再利用します。
結果
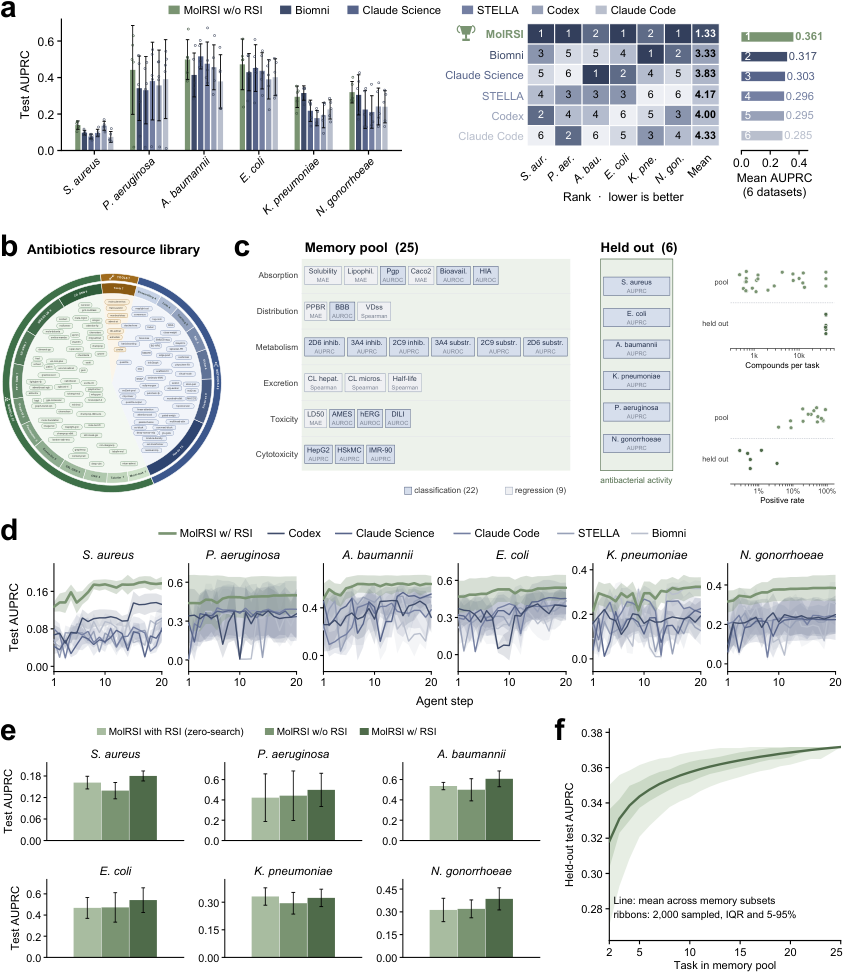
抗生物質探索。 六つの抗菌計算ベンチマーク全体で、MoLRSI without RSIはすでにテストAUPRCおよびランキングにおいてベースラインエージェントを上回っています(Figure 2a)。25の非抗菌ソースタスクからのタスク間経験を追加すること(Figure 2c)により、20回のMCTSイテレーションにわたる探索軌跡がさらに改善されます。
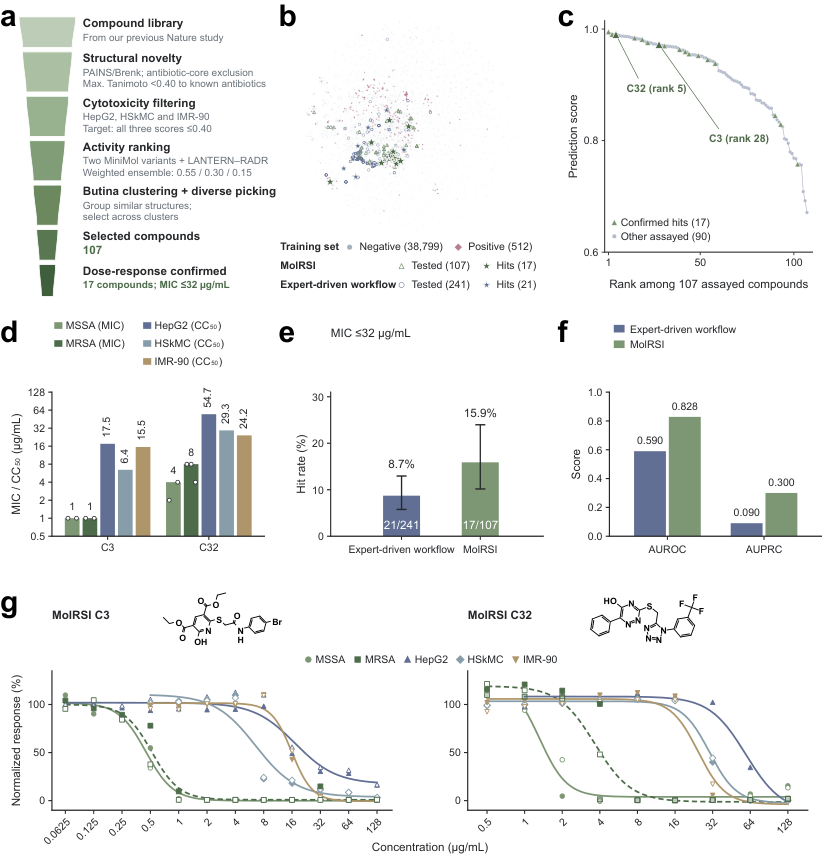
学習されたワークフローは抗菌活性、ヒト細胞の細胞毒性、および構造的新規性を同時に最適化します。107化合物の前向き実験スクリーニングでは、MoLRSIはS. aureusに対して15.9%のヒット率を達成し、同一のトレーニングデータとスクリーニングライブラリで評価された従来の専門家設計ワークフローの8.7%を上回りました。ヒット化合物にはMSSAとMRSAの両方に活性を示すものが含まれ、HepG2、HSkMC、IMR-90での測定 \mathrm{CC}_{50} は治療ウィンドウの存在を示しています。またt-SNEプロジェクションはヒット化合物が密なトレーニングクラスターの外側に分布していることを示しており、新規性の目的と一致しています。
ペプチド–MHCバインダー設計。 de novo pMHCバインダー設計において、MoLRSIは標的結合とその他の目的を同時に考慮するワークフローを構築します。概要ではベースラインに対する探索の改善が報告されています(詳細は本稿で再現されていないセクションにあります)。同一のフレームワークとスキルライブラリが再利用されており — 主な変化は、抗生物質および特性予測探索からの経験がpMHC探索方策を形成することであり — ドメインをまたいだRSIを実証しています。
アブレーション。 RSIあり・なしのMoLRSIとzero-search transferの比較により二つの効果が分離されます:(i)ワークフローに対するタスク内MCTSだけでもベースラインを上回り、(ii)タスク間メモリはさらに収束速度と最終スコアを改善します。zero-search transferは探索より劣ることから、過去のワークフローは有用な事前情報ではあるものの、局所的な改良なしでは不十分であることが示されます。
限界と未解決の問題
ヒット率の比較は意義深いものの、同一ライブラリ上の一つの過去の専門家ワークフローとの比較に留まっており、より広いベースライン(前向きに適用された他のエージェント、ランダム化スクリーニング対照)は報告されていません。スキルライブラリは取得可能なコードに依存しており、公開参照実装のないタスクではライブラリがまばらになります。メモリは単調に増加し、忘却や負の転移を検出するメカニズムは記述されておらず、ソースタスクの分布がターゲットドメインからずれた場合の方策の挙動はスケールで未検証です。最後に、「開発スコア」はタスクで定義されるため、エージェントはメトリクスに存在するバイアス(例:ノイズの多い活性データ上のAUPRC)を引き継ぎ、実験的検証が唯一の真の評価基準であり続けます。
なぜ重要か
MoLRSIは、ワークフローレベルの探索と永続的なタスク間メモリを組み合わせることで、湿式実験室での分子探索において測定可能な前向きな改善をもたらすことを示した最初の例の一つです — 同一データを使用して強力な専門家ベースラインに対する抗生物質ヒット率をほぼ倍増させました。これは「科学のためのAI」エージェントをプロトコル実行者から科学的ワークフローの空間に対する方策学習器へと再定義するものです。
Source: https://arxiv.org/abs/2610.39714
Hacker News Signals
The Little Book of Generative AI Foundations: An Intuitive Mathematical Primer
arXiv に投稿された新しいプレプリントは、現代の生成AIの中核となる仕組みを網羅した自己完結型の数学的入門書です。確率論、情報理論、VAE、normalizing flows、GAN、diffusion models、transformerを扱っています。stated goalは、ポップサイエンス的な解説と本格的な大学院レベルの教科書との間のギャップを埋めることであり、線形代数と微積分の知識はあるものの確率的MLの背景が限られている読者を対象としています。
本書は数学的な前提知識について率直に記述している点が特筆されます。Diffusion modelsはforward/reverse Markov chainを通じたELBOの観点から導出され、score-matchingとの関連も明示されています。transformerのセクションではattentionをscaled dot-productとして扱い、positional encodings、および自己回帰的な因数分解 p(x) = \prod_t p(x_t | x_{<t}) を曖昧な説明なしに取り上げています。VAEの解説では、reparameterization trickを既知の事実として提示するのではなく、第一原理から導出しています。
本書が有用な理由は、その教育的な順序付けにあります。いかなるアーキテクチャにも触れる前に、KL divergenceとevidence lower boundから積み上げていくため、VAEやdiffusion modelsのloss functionが恣意的な設計選択として現れるのではなく、自然に導き出されます。normalizing flowsのセクションには変数変換の公式とlog-determinant Jacobianの制約が含まれており、これは多くの入門的なリソースでは省略されています。
現役の博士課程の学生にとって、本書に新規な内容が含まれている可能性は低いですが、学生や共同研究者に紹介するためのよく整理されたリファレンスであり、数式の密度も装飾的でなく実用的なレベルに達しています。主な制限は、flow matching、consistency models、RLHFといった現代的なトピックには踏み込んでおらず、おおよそ2022年頃の生成モデルの状況を反映していることです。実験結果やコードは付属していません。
Source: https://arxiv.org/abs/2605.29713
LLMはニューラルネットワークの重みの読み書きにおいて超人的ではない
Sean Goedeckeによるこの投稿は、Weights & Biases / Google DeepMindのデモの後に広まったある主張に対して技術的な反論を展開しています。その主張とは、大規模言語モデルが生のニューラルネットワークの重みテンソルを意味のある形で「読み取り」、モデルの挙動を理解したり、重みを「書き換え」てモデルの性能を向上させたりできるというものです。
技術的な反論の核心は明快です。生の浮動小数点重みテンソルには、意味的な概念に直接・人間が読める形でマッピングされるような局所的な構造が存在しません。ネットワークが学習した特徴は、数百万にも及ぶパラメータにわたって分散しており、層をまたいだ非線形活性化の合成によって相互に絡み合っています。重みの値をフラットに並べたものをLLMに提示しても、それはモデルが何をするかについての圧縮された記号的な記述を与えているのではなく、その解釈にはネットワークの実行か、あるいはsparse autoencoderやactivation patchingなどのメカニスティックな解釈可能性分析——それ自体がトークン予測ではなく計算量を必要とします——が不可欠な数値的人工物を与えているに過ぎません。
また、この投稿では、LLMが重みを「解釈」しているように見えるデモは、実際に数値を読んでいるのではなく、メタデータや、アーキテクチャのドキュメント、あるいは層の命名規則を利用している可能性が高いという点も指摘しています。transformer attention blockにおけるq_projという名前のモデルは、その名前だけで情報を伝えます。それらのラベルを取り除いてランダムな識別子に置き換えれば、解釈能力は急激に低下するはずです。
「書き込み」方向はさらに根拠が薄いです。LLMの提案に基づくgradient-freeな重みの修正は、信頼できる挙動の変化を生み出すために十分な精度で数十億のパラメータにわたるdeltaの更新を何らかの形で指定する必要がありますが、これらのデモが示しているものはそうではありません。示されているのは、重みに関連した枠組みで装飾されたpromptレベルのステアリングに近いものです。
この投稿は節度があり、LLMが高レベルでモデル構造について推論する能力がゼロだとは主張していません——ただ、「重みの操作において超人的」という枠組みは、実証された能力によって支持されていないと述べているのです。
Source: https://www.seangoedecke.com/llms-are-not-superhuman-at-reading-and-writing-neural-network-weights/
「AstraがQwenを改善するために重みの読み書きを行った」という投稿は誤解を招く
Matthew Honnibal(spaCy、Explosion AI)は、Google DeepMindのAstraがQwenモデルを改善するためにニューラルネットワークの重みを読み書きする能力を実証したというバイラルな主張に対して、鋭い技術的な反論記事を執筆しました。この投稿は今回のバッチ中でHNの最高スコア(998ポイント)を獲得し、コミュニティの大きな関心を集めています。
Honnibalが解剖するコアとなる技術的主張は次のとおりです:元の投稿は、Astraがin-contextの重み手術のようなことを実行している、つまり生のパラメータを検査して、下流モデルの動作を改善するターゲットを絞った編集を提案しているかのように示唆していました。Honnibalの議論は複数の観点から展開されます。
第一に、このデモはほぼ確実にpromptingまたはfine-tuningのscaffoldingを含むものであり、生の重みの操作ではありません。「重みを読む」とは実際には、チェックポイントを読み込んでinferenceやinterpretabilityパイプラインを実行することを意味し、LLMがfloat32のテンソルを取り込んで実行可能な洞察を出力することではありません。第二に、「モデルを改善するために重みを書き込む」という主張は、LLMが高次元の非凸なloss景観上でgradient-freeなオプティマイザとして機能することを要求する非常に強い主張であり、現時点のいかなるシステムも確実に実行できるものではありません。
第三に、最も実践的な観点として:元の投稿で引用されたbenchmarkはコントロールされていませんでした。任意の介入(単純なfine-tuningやprompt engineeringを含む)の後に下流タスクで改善が見られたとしても、それは重みの読み書きを因果メカニズムとして特定することにはなりません。
Honnibalはさらに広い方法論的な指摘もしています:大規模AIラボのデモは、あらゆる実証的な主張と同じ懐疑心で評価されるべきであり、コントロール条件、評価指標、および交絡要因を特定する必要があるということです。元の投稿にはこれらのいずれも明確に示されていませんでした。
このエピソードは、技術的に隣接したフレーミング(「重み」)がいかに従来のMLワークフローを実際よりもエキゾチックに見せることができるか、そして実務者が反論する前にそのフレーミングがメディアを通じていかに伝播するかを示す有益なケーススタディです。
Source: https://honnibal.dev/blog/astra-read-write-misleading
私のラップトップ上のQwen 3.8 27Bもモデルの重みを解釈できる
Simon Willisonの投稿は、本質的にはHonnibalの反証を別の角度から強化する実践的な再現試験です。Willisonはローカル環境でOllamaを介してQwen 2.5 27Bを実行し、重みに隣接する記述をプロンプトとして与えたところ、モデルが数値そのものではなく、ほぼ完全に命名規則とアーキテクチャの文脈に基づいてもっともらしい解釈を生成することを確認しました。
技術的なデモンストレーションはシンプルながらも効果的です。transformer checkpointのレイヤー名、テンソルの形状、およびいくつかのサンプル値を与えると、モデルはそれらのレイヤーが何をするかについて、妥当な高レベルの説明を生成します。しかしこれは、モデルが attn.q_proj や mlp.gate_proj といったレイヤーが transformer 内で何をするかを説明するMLドキュメント、コード、論文の膨大な量でトレーニングされたことによって、ごく当然に説明できます。数値そのものはほぼ無視されているのです。
Willisonのテスト:意味的な名前を取り除き、不透明な識別子(layer_042_tensor_A)に置き換え、生の統計量(平均、標準偏差、ヒストグラム)のみを提供します。すると解釈の質は大幅に低下します。これは、モデルが数値を計算するのではなく名前でパターンマッチングをしているという前提から予想される通りの結果です。
この投稿はコミュニティにとって重要な区別も浮き彫りにしています。モデルの挙動に関してLLMが推論する正当な研究(たとえば、interpretabilityプローブの作成、回路に関する仮説の生成、mechanistic interpretabilityパイプラインからのactivationパターンの要約などにLLMを活用するもの)は存在します。それは本物の興味深い研究の方向性です。一方、LLMが生のfloatを読み取って実用的な重み編集を生成できるという特定の主張は、その研究の方向性ではありません。両者を混同することで、何が実際に技術的に可能なのかについての混乱が生じます。
より広い教訓は再現性の文化についてです。27Bのオープンモデルとラップトップでできるちょっとした実験が、バイラルな主張を素早く較正することがよくあります。
Source: https://simonwillison.net/2026/Nov/3/qwen-can-interpret-model-weights/
Nvidia RTX Spark の暗号化ファームウェアにより Linux での推論速度が35%に低下
MindStudioのエンジニアリングブログは、Linux上でのNvidia RTX Spark(GB10)ハードウェアに影響する具体的かつ重大なパフォーマンス低下を記録しています。推論スループットはWindowsのベースラインの約35%まで低下しており、その原因はLinuxドライバが完全に活用できない暗号化ファームウェアにあることが突き止められています。
技術的なメカニズムは、Grace-Blackwell Superchipの組み込みコントローラに施されたファームウェアレベルの暗号化です。このコントローラは特定のハードウェアスケジューリングおよびメモリ管理機能を担っています。独自のWindowsドライバは復号鍵を持ちこの機能に完全にアクセスできますが、オープンソースのLinuxドライバスタック(または関与するコンポーネントによってはクローズドなLinuxドライバ)は、鍵を持たないか、あるいは暗号化ファームウェアパスを利用するための実装が欠如しており、大幅に高いレイテンシと低いスループットをもたらすフォールバック実行モードへの移行を余儀なくされています。
35%という数値は衝撃的です。メモリ帯域幅がボトルネックとなるML推論ワークロード(ほとんどのtransformer inferenceはこれに該当します)において、スループットが65%低下すると、そのハードウェアをLinux上でレイテンシに敏感な本番環境に展開することが事実上不可能になります。
これは現実的な調達上の懸念を提起します。RTX SparkはLinuxを頻繁に使用する開発者や研究者向けに一部マーケティングされています。ドライバのアップデートやファームウェアのリリースによってこのファームウェア暗号化の問題が解決されない場合、Linux上でのこのハードウェアの有効なユースケースは著しく制限されます。
より広い問題として、セキュリティやIP保護を目的としたハードウェアベンダーによるファームウェア暗号化と、オープンまたは少なくとも完全に機能するドライバサポートへのLinuxエコシステムの依存との間に存在する継続的な緊張関係があります。同様の問題はNvidiaのGSPファームウェアや特定のワークロードにおけるAMDのセキュアプロセッサでも発生しています。ハードウェア選定を行うML実務者にとって、これはLinuxドライバの成熟度を確認せずに専用の推論ハードウェアを購入する前に定量化すべき実際のリスクです。
Source: https://www.mindstudio.ai/blog/linux-nvidia-rtx-spark-laptop
Show HN: LinuxシステムコールのウェブサイトとAPIを更新しました
syscall.sh は、アーキテクチャをまたいだLinuxシステムコールに関する構造化・クエリ可能なデータを提供するリファレンスサイト兼REST APIです。今回のアップデートでは、最新のカーネルバージョンへの対応とAPI機能の拡充が行われています。
技術的な価値は明確です。Linuxのシステムコールテーブルはアーキテクチャ固有(x86_64、arm64、riscv64、mipsなど)であり、syscall番号、引数シグネチャ、および可用性はカーネルバージョンによって異なりますが、それをカーネルヘッダを直接読んで追跡するのは非常に手間がかかります。本サイトはそのデータを集約し、クリーンなAPI(GET /v1/x86_64/syscalls、GET /v1/x86_64/syscalls/read など)を通じて公開しており、syscall番号、名前、引数型、カーネルバージョンのメタデータをJSONで返します。
ユースケースとしては、seccomp BPFポリシー生成のためにsyscallを列挙・フィルタリングするセキュリティツール、クロスアーキテクチャの移植作業、カーネルexploit開発・研究、OSコースの教育ツールなどが挙げられます。特にseccompのユースケースは実用的です。コンテナ化されたアプリケーションに対して厳密な許可リストを生成するには、対象アーキテクチャで利用可能なsyscallとその番号を正確に把握する必要があります。
このAPIはステートレスかつ認証不要のようであり、ビルドパイプラインやスクリプトへの統合が容易です。データはカーネルソースツリーのsyscallテーブルおよび unistd.h ヘッダという信頼できるソースから取得されています。
制限事項としては、現時点ではシグネチャを超えた意味的なドキュメント(manページ品質の説明)は提供されていないため、学習リソースというよりもルックアップテーブルとして活用するのが適しています。データの鮮度はメンテナーがアップストリームのカーネルリリースと同期する頻度に依存するため、ごく最近のカーネルに対してセキュリティクリティカルな用途で使用する場合は確認する価値があります。
Source: https://syscall.sh/
European RISC-V Industrial Computing Initiative
ERICI(European RISC-V Industrial Computing Initiative)は、産業用途向けのRISC-Vベースのコンピューティングインフラを開発することを目指す欧州のイニシアティブであり、重要な産業分野における非欧州プロセッサアーキテクチャへの依存を低減するという明確な戦略目標を掲げています。
技術的なスコープは、コンシューマー向けやHPCワークロードではなく、産業用コンピューティングに焦点を当てています。具体的には、決定論的なリアルタイム動作、長い製品ライフサイクル(10〜15年)、機能安全認証(IEC 61508、ISO 26262)、そしてサプライチェーン混乱への耐性が求められます。これらの要件に対してRISC-Vが有力な選択肢となる理由は、オープンなISAがカスタム拡張命令の実装を可能にし、商用ISAライセンシーには完全には提供できない長期的なアーキテクチャ安定性の保証をもたらすからです。
RISC-Vの拡張機構は、産業向けユースケースの中心的な要素です。ベースISAは意図的に最小限に設計されており、実質的な差別化は標準拡張命令(M、A、F、D、C、V(ベクタ)など)およびカスタム拡張命令によって実現されます。産業用アプリケーションでは、決定論的な割り込みレイテンシ、標準MMUを超えるメモリ保護、カスタム周辺インタフェースが必要とされることが多く、これらはすべてレガシーアーキテクチャを悩ませるISAの断片化ペナルティを招くことなく、拡張フレームワークを通じて対応できます。
欧州という観点では、EUチップス法および広範な半導体主権に関する懸念と密接に結びついています。欧州の複数の機関(Fraunhofer、CEA、各大学)がRISC-Vプロセッサの開発プロジェクト(PULPプラットフォーム、CVA6など)を進めています。ERICIはこれらを、産業顧客が採用前に求める資格インフラ(ツールチェーン、RTOS、安全認証)を備えた産業グレードのエコシステムへと統合しようとする試みと見られています。
主な課題は、RISC-Vの産業向けエコシステムが、認証済みツールチェーン、RTOSサポート、競争力ある価格帯でのシリコン供給という点でARM Cortex-M/Rに対して大きく後れを取っていることです。ボトルネックはISAの品質ではなく、エコシステムの成熟度にあります。
Source: https://erici.eu
AIは40年分の技術的負債を返済することを私たちに迫っている
IEEE Spectrumの記事は、特定の脆弱性クラス――レガシーWebアプリケーションを介したPHPシェルインジェクション――を切り口として、より広範な主張を展開しています。すなわち、既存のインフラストラクチャ上にLLMベースのシステムを展開することで、これまで休眠状態にあるか許容範囲内とされていた技術的負債が顕在化し、AI強化された脅威モデルの下でアクティブな攻撃面となるという主張です。
具体的な技術的事例として、2000年代から2010年代のPHPアプリケーションにおける eval()、system()、exec()、または shell_exec() の呼び出しがユーザー制御の入力を受け付けるというパターンは、よく知られた脆弱性でした。多くはパッチが当てられましたが、当てられていないものも多く、本番環境に存在するレガシーPHPコード(WordPressプラグイン、カスタムCRMなど)の量は膨大です。Webアクセスやツール使用能力を持つLLMベースのエージェントは、手動による攻撃や従来の自動スキャンでは到底及ばない規模とスピードでこれらの脆弱性を発見・悪用できます。LLMが最小限の人間の誘導で複数のステップ――PHPエンドポイントの発見、インジェクションペイロードの作成、永続的アクセスの確立――を連鎖させることができるため、攻撃面は拡大します。
より広い主張は、AI支援による攻撃が複雑な攻撃チェーンに必要なスキルの敷居を下げるというものです。つまり、これまで悪用に高度な専門知識を要していた脆弱性クラスが、能力の低い攻撃者にも到達可能になっています。これにより、修正対応を先送りするリスク計算が変わります。「悪用は可能だが深い専門知識が必要だ」という正当化は、5年前と比べて弱い根拠となっています。
この記事は純粋に警告的なものではなく、AIが自動コードレビューや脆弱性スキャンを通じて防御側も支援することを認めています。しかし非対称性という点は妥当です。LLMを使用してシステムを探索するコストは低く、今後も下がり続ける一方、40年分に蓄積されたPHP、CGI、レガシーWebコードを監査・修正するコストは高く、ほぼ固定されています。
Source: https://spectrum.ieee.org/ai-in-cybersecurity-php2shell-vulnerability
注目の新しいリポジトリ
divagr18/qwenputer
Gated DeltaNet attention variantを悪用することで、Qwen3.5-4Bの重みの中に動作するCPUを埋め込むというプルーフ・オブ・コンセプトです。核心となるアイデアは次の通りです:Gated DeltaNetはrank-oneの書き込みで更新でき、任意のキーで照会できる行列値の隠れ状態を維持しており、これは構造的にcontent-addressable memoryと等価です。著者はレジスタ、プログラムカウンタ、命令セットをこの状態にマッピングし、モデルのforward passがfetch-decode-executeサイクルをシミュレートするよう重み行列をfine-tuning(または構築)しています。RAMの読み書きはrecurrent stateへのdelta updateとなり、算術演算はlearnedな変換として実装されています。これはプロンプトレベルのエミュレーションではありません。計算は重みの構造そのものにエンコードされており、特定の線形recurrentアーキテクチャが理論的にだけでなく構成的な意味においてもチューリング完全であることを直接示すものとなっています。実用上の興味は、プログラムを効率的に実行することよりも、それが明らかにすることにあります。すなわち、Gated DeltaNet層を持つモデルは、context長に依存することなく、原理的に任意のステートフルな計算を実装できるということです。現代のSSM/ハイブリッドアーキテクチャの計算表現力、mechanistic interpretability、あるいはニューラルネットワークの普遍性の構成的証明を研究している方に関連する内容です。
Source: https://github.com/divagr18/qwenputer
simplexai-labs/PolyStrata
コンシューマー向けハードウェアをターゲットとしたローカル推論ランタイムで、複数の最新の小規模モデル — Qwen3.8-Flash-Next、GLM 5.3 Flash、DeepSeek V4 Flash、LFM2.5、Qwen3.6、Ornith 1.5、Gemma 4、Tiel Coder、MiniCPM-V — をWindows及びLinux向けのワンクリックインストーラーにまとめたものです。アーキテクチャは2つの独立した推論エンジンを使用しており、1つはStrataの独自スケジューリング向けにチューニングされたもの、もう1つはPolyStrataのマルチモデルディスパッチ層向けに専用で書かれたものです。両エンジンともlocalhost上でOpenAI互換およびAnthropic互換のRESTエンドポイントを公開しており、既存のツール群(LangChain、Continue、OpenHandsなど)がコード変更なしにローカルモデルへルーティングできます。設計目標は、複数の量子化済みモデルを同時実行する際の運用上のオーバーヘッド — VRAMアロケーションの管理、モデルのスワッピング、APIルーティング — を、ユーザーがllama.cppやOllamaのインスタンスを手動で調整する必要をなくし、単一のマネージドプロセスに集約することです。MiniCPM-Vの組み込みはマルチモーダル(ビジョン)サポートを示しています。本プロジェクトは、外部送信なしにAPI互換性を求める開発者向けの、クラウド推論に対するプライバシー保護代替手段として位置づけられています。再現可能なオフライン対応の推論パイプラインを必要とする実務者、あるいは同一ワークステーション上で複数の小規模モデルを並べて評価したい実務者にとって注目に値します。
Source: https://github.com/simplexai-labs/PolyStrata
opentrap/opentrap
GPLv3ライセンスのWebアプリケーションセキュリティテストスイートで、Burp Suite Community/Proの機能的な代替として設計されています。主要コンポーネントは以下の通りです:TLS傍受機能を備えたHTTP/HTTPSインターセプトプロキシ(ユーザーによるCA証明書のインストールが必要)、リクエストを手動で作成・再送信するためのRepeater、パラメータ化されたfuzzingおよびブルートフォース攻撃向けのIntruderモジュール、帯域外インタラクション検出(DNS/HTTPコールバック)のためのCollaborator相当機能、そして自動的なアクティブ/パッシブスキャンのためのOWASP ZAP scanner統合機能。現時点ではLinux専用で、AGPL-3.0ライセンスです。Caidoのような既存のオープンソースツールとのアーキテクチャ上の差別化点は、オールインワンのスコープにあります。ZAPをサブプロセスとして呼び出すだけで済ませるのではなく、OpenTrapはZAPのscannerを独自のプロキシおよび手動テストモジュールと並列に統合されたインターフェースで公開しており、テスト実施中のコンテキストスイッチングを低減します。Collaboratorコンポーネントはオープンソースプロジェクトとしてアーキテクチャ上非自明であり、コールバック受信のために外部からアクセス可能なサーバーが必要なため、そのコンポーネントのセルフホスティングは実運用上の重要な考慮事項となります。シート単位のライセンスコストなしに完全に監査可能なツールチェーンを求めるペネトレーションテスター、バグバウンティ研究者、および内部評価を実施するセキュリティエンジニアに関連します。
Source: https://github.com/opentrap/opentrap
t8y2/motty
SSH、SFTP、ポートフォワーディング、VNC、RDP、そしてMCP(Model Context Protocol)対応のAIアシスタントを単一ウィンドウに統合した、ネイティブGoデスクトップアプリケーションです。Viva UIツールキット上に構築されており、組み込みのwebviewは使用していません。webviewを使わないという制約はアーキテクチャ上重要な意味を持ちます。これにより、すべてのレンダリングがChromiumやWebKitのサブプロセスではなくネイティブGoグラフィックスを通じて行われるため、メモリオーバーヘッドが削減され、ElectronのようなツールがもたらすIPCの境界をなくすことができます。SSHとSFTPはgolang.org/x/crypto/sshスタックを通じて直接処理され、VNCとRDPのサポートは同一のネイティブキャンバスを通じたフレームバッファレンダリングを示唆しています。MCP統合により、バンドルされたAIアシスタントは標準化されたMCPツールコールインターフェースを通じてツール(コマンド実行、ファイル転送、トンネル管理)を呼び出すことができ、Claude、GPT-4o、あるいはMCP互換の任意のモデルバックエンドと組み合わせて使用できます。グラフィカルなセッションマネージャ内でのポートフォワーディング管理は、ターミナル専用SSHクライアントには欠けていることの多い実用的な利便性です。主なユーザー層は、多数のリモートホストを管理し、AI支援オペレーションを備えた単一の認証済みセッションマネージャを必要とする開発者やシステム管理者です。TabbyのようなElectronベースの代替ツールのリソースコストや、素のOpenSSHの機能的制約を避けたいという用途に応えます。
Source: https://github.com/t8y2/motty
Graphicle-AI/graphicle
AIコーディングエージェント向けにコードグラフと永続メモリ層を構築・維持するRustプログラムであり、両者をModel Context Protocol経由で公開します。コードグラフコンポーネントはコードベースに対して静的解析を実行し、シンボル定義・コールグラフ・インポート関係・構造的依存関係を追跡した上で、これを構造化されたコンテキストとして提供します。エージェント(Claude Code、OpenAI Codex、Cursor、またはその他のMCPクライアント)は、コンテキストウィンドウ内の生のファイル内容に頼るのではなく、このコンテキストをクエリすることができます。メモリコンポーネントは、エージェントが生成したメモ・過去の意思決定・クロスセッション状態の永続ストレージを提供し、同一のMCPインターフェースでアドレス指定できます。PythonではなくRustで実装していることはレイテンシの観点で重要です。グラフトラバーサルやファイル変更時のインクリメンタルな再インデックスは、エージェントのツールコールをブロックしないよう十分高速である必要があります。MCPサーバーインターフェースを採用しているため、エージェントごとのカスタムプラグインは不要で、MCP tool callsをサポートする任意のクライアントが接続できます。解決しようとしている主な問題はコンテキストの品質です。大規模なコードベースは実用的なコンテキストウィンドウの上限を超えており、embedding ベースの検索では構造情報(例えば、関数AがCを経由してBを推移的に呼び出しているという情報)が失われてしまいます。グラフ表現はそのトポロジーを保持します。リポジトリ規模でのagentic コーディングワークフローを構築・評価している方すべてに関係します。
Source: https://github.com/Graphicle-AI/graphicle
Anubis-Security-Tool/anubis
マルチプロトコルリモートアクセス(SSH、SFTP、RDP、VNC、Serial)と、OpenAIおよびDeepSeekバックエンドを基盤とするAIエージェント層を統合したクロスプラットフォームのセキュリティターミナルです。ペネトレーションテスト、CTFワークフロー、DevSecOps自動化を指向して設計されています。AIエージェント層は、単一の汎用アシスタントではなく、CVEルックアップ、SBOM生成、エクスプロイト提案、偵察などのタスクに対して個別のシステムプロンプトとツールバインディングを持つ12種類以上の特化型エージェントで構成されています。CVEとSBOMの統合により、NVD/OSVデータベースへの接続や、CycloneDXまたはSPDXといったフォーマットのサポートが想定されます。ターミナル自体は、サポートされているプロトコルに対して統合セッションマネージャーを提供しており、ヘッドレス環境やリモートオペレーターのユースケースに向けて、デスクトップインターフェースに加えてWeb UIも利用可能です。セキュリティ自動化の観点から、エージェントはシェルコマンドの実行、ツール出力(nmap、nucleiなど)の解析、および調査結果をレポートへ連結することが期待されています。アーキテクチャ上の注意点として、アクティブなRDPまたはSSHセッション上でシェル実行権限を持つAIエージェントを動作させることはそれ自体が重大な攻撃対象領域となるため、機密性の高い環境で使用する前に、エージェント層と基盤となるプロトコルセッション間のトラストバウンダリを慎重に検討する必要があります。LLMを活用したトリアージを、独立したチャットインターフェースとしてではなく、ターミナルワークフローに直接統合したいセキュリティ実務者にとって注目に値するツールです。
Source: https://github.com/Anubis-Security-Tool/anubis
zhuyansen/new-term-radar
X(Twitter)、Hugging Faceのモデル・データセット・Spaceページ、GitHubトレンド、およびウェブサイトマップを監視し、キーワードリサーチツールやSEXインデックスに登場する前に、新たに生まれたAI用語——モデル名、製品名、リポジトリ識別子——を発掘する日次自動化パイプラインです。技術的なコアは、RSS/サイトマップのポーリング、Twitter APIまたはスクレイピング、そして既存の語彙と新規の固有名詞を区別する固有表現認識またはパターン抽出ステップの組み合わせと推測されます。本システムの価値提案は時間的なものにあります。従来のキーワードツールは、用語が一定のボリュームに達してから数日から数週間の遅延を経てインデックスするのに対し、このシステムは最初の公開出現の瞬間をターゲットとしています。実用的な用途としては、競合インテリジェンス(プレス報道より先に新モデルリリースを検知)、研究トラッキング(新アーキテクチャ名が流通し始めるタイミングの把握)、データセット・ベンチマーク発見などが挙げられます。MLリサーチャーにとっては、Hugging Faceの「recent」フィードやGitHubトレンドページを手動で監視する作業の代替手段として機能します。他のプロジェクトと比較して2094スターという数字は、情報検索的な枠組みが幅広い読者層に響いていることを示唆しています。実装の詳細——抽出にLLMクラシファイアを使用しているのか、regex/NERアプローチなのか、それともembeddingベースの新規性検出なのか——は説明文には明記されていませんが、それによって真に新規な用語と既存概念の別名に対するrecall/precisionが決まります。
Source: https://github.com/zhuyansen/new-term-radar
iamlukethedev/Herald-OS
Hermes AgentをプライマリユーザーインターフェースとするAI「エージェントネイティブ」なOSレイヤーを構築する独立プロジェクトです。命名がNous ResearchのHermesモデルシリーズに近いものの、同社とは明示的に無関係です。エージェントネイティブOSというコンセプトは、シェル、ファイルシステムアクセス、プロセス管理、I/Oが、従来のCLIやGUIではなく、LLMエージェントがツールとして呼び出し可能なインターフェースとして主に公開されることを意味します。Hermes Agentはおそらくセッションマネージャーおよびオーケストレーターとして機能し、ユーザーの意図は自然言語で表現され、OSプリミティブに対するツールコールへと分解され、実行結果がエージェントのコンテキストにフィードバックされます。実際のアーキテクチャは、エージェントランタイムとカーネルのシスコールの間にMCPまたは類似のツールディスパッチレイヤーが挟まれ、誤ったツールコールによる影響範囲を限定するサンドボックスを備えた構成になると考えられます。ここでの興味の対象は個々の機能よりも、システム設計上の問いにあります。すなわち、主たる抽象化が「ターミナルを持つユーザー」ではなく「ツールアクセスを持つエージェント」である場合、OSはどのような形になるのか、という問いです。未解決の問題としては、並行するエージェントセッションの処理方法、権限の委譲、ファイルシステムの状態を破損させるエージェントエラーからの回復などが挙げられます。エージェントシステム、LLMを用いたヒューマンコンピューターインタラクション、および自律エージェントのOSレベルセキュリティモデルを研究する研究者に関連します。