デイリーAIダイジェスト — 2026-11-02
arXiv ハイライト
ReLift: Dense 3D Tracking as Lifted Trajectory Repair
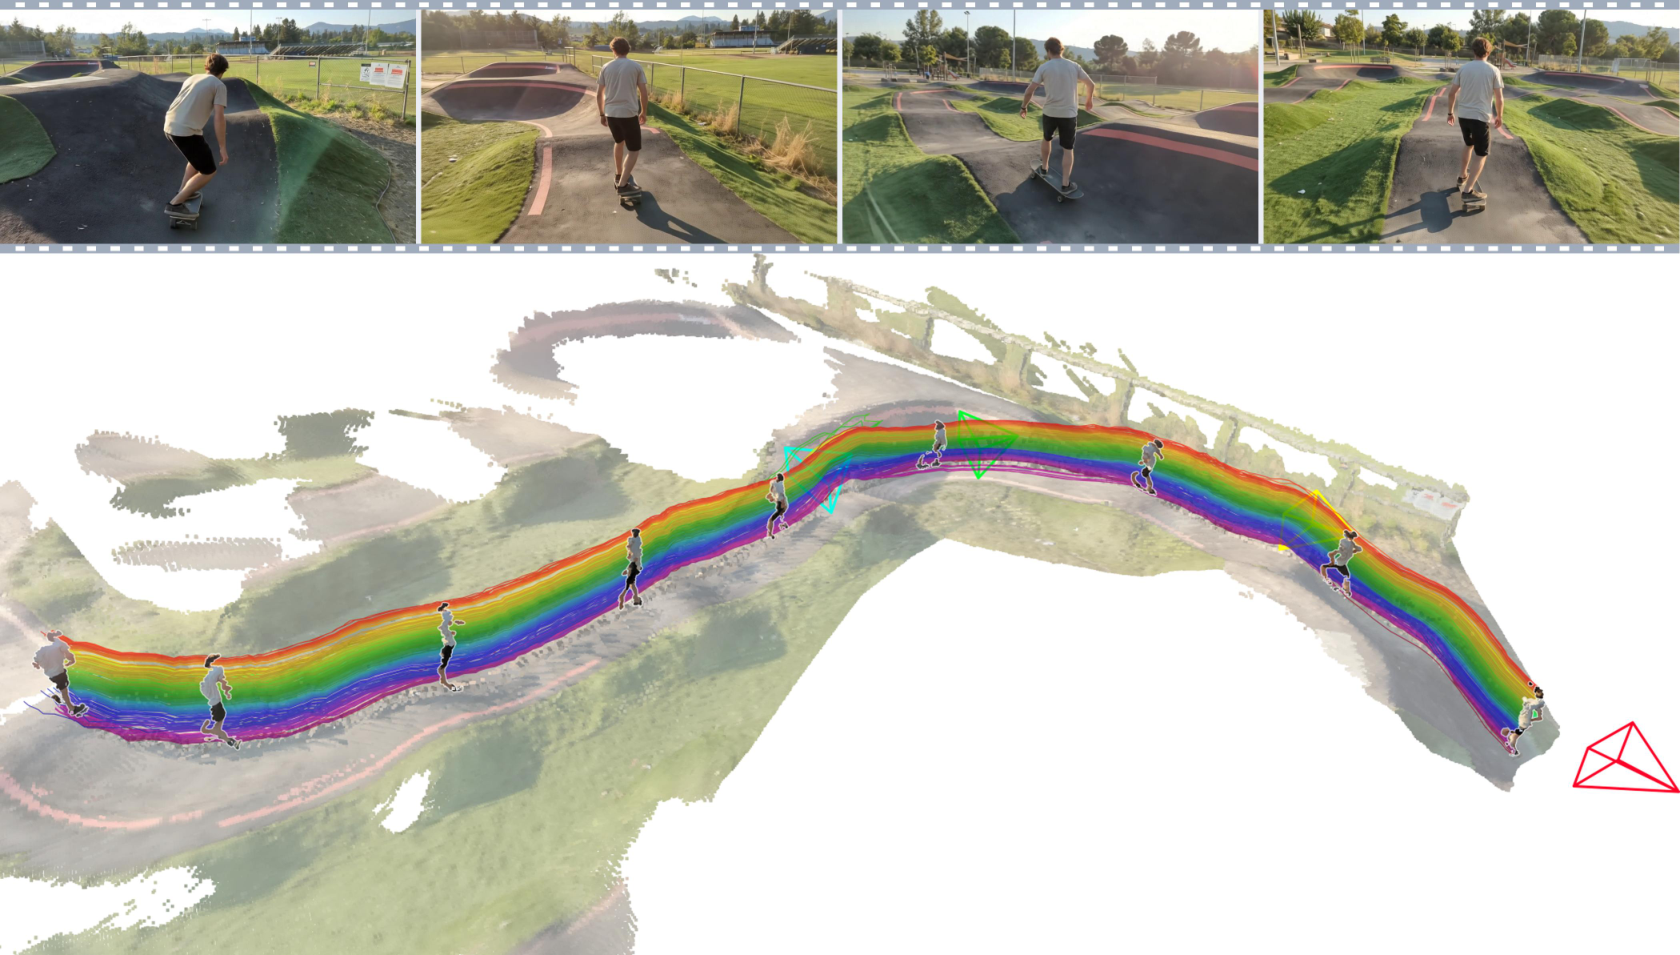
単眼動画からの密な3次元点追跡は、(i) フレーム間の対応、(ii) 各対応の metric depth、(iii) 遮蔽を通じた妥当な運動、という三つの課題を同時に扱う必要があります。エンドツーエンドの4Dモデルは、グラウンドトゥルースの4Dスーパービジョンの希少性がボトルネックとなっています。ReLiftはこれとは対照的なアプローチを取ります。すなわち、凍結済みの事前学習済み2D trackerおよび3Dジオメトリ予測器に知覚を任せ、小さな純粋ジオメトリネットワークを訓練して、結果として得られた lifted trajectories を修復するというものです。主要な実験的主張——ティーザー画像に明示されています——は、この分解によってWorldTrackにおける最先端精度が達成され、かつ速度と精度のトレードオフにおいて有利な位置に立つことができるというものです。
Lifting とその失敗モード
動画 \{I_t\}_{t=0}^{T-1} が与えられたとき、2D trackerは参照フレームのピクセル i に対して画像上の trajectory \mathbf{u}_{ti} と可視性 v_{ti}\in[0,1] を出力します。ジオメトリモデルは光軸深度 Z_t、内部パラメータ K_t、カメラ t からカメラ 0 への回転 R_t、およびカメラ中心 \mathbf{o}_t を生成します。\mathbf{q}_{ti}=K_t^{-1}\widetilde{\mathbf{u}}_{ti} とおくと、参照カメラ座標系における lifted point は以下のようになります。
\mathbf{d}_{ti}=\frac{R_t\mathbf{q}_{ti}}{\|\mathbf{q}_{ti}\|},\quad r_{ti}=Z_t(\mathbf{u}_{ti})\|\mathbf{q}_{ti}\|,\quad \mathbf{y}_{ti}=\mathbf{o}_t+r_{ti}\mathbf{d}_{ti}.
\|\mathbf{q}_{ti}\| の係数は光軸深度をレイ距離に変換します。著者らは \mathbf{y}_{ti} における四つの特徴的な劣化モードを整理しています。(1) \mathbf{d}_{ti} を横方向に乱す対応誤差、(2) 深度ジッター(高周波の距離ノイズ)、(3) 深度ドリフト(ゆっくりとした系統的な距離バイアス)、(4) 誤サーフェスサンプル——遮蔽物や境界のブリードが誤ったオブジェクトの深度を混入させる最も有害な失敗モードで、lifted point が確信を持って異なるサーフェスに配置されてしまいます。遮蔽による欠損は可視性 v_{ti} によって検出され、補完対象として欠損のまま残されます。
Tracklet に対する交互 attention による修復
ReLiftは各サンプルに対してトークン \boldsymbol{\phi}_{ti} を生成し、lifted XYZ、視線方向 \mathbf{d}_{ti}、可用性マスクを保持させます。これらは C フレームの tracklet にグループ化され、embedding \mathbf{h}_{ni} を持ちます。transformer はtrackに沿った attention(時間的一貫性、ドリフト、ジッター)とtrackをまたいだ attention(共有された剛体もしくは関節運動、共可視の近傍点)を交互に適用し、初期化された trajectory に加算されるフレームごとのXYZ残差を出力します。
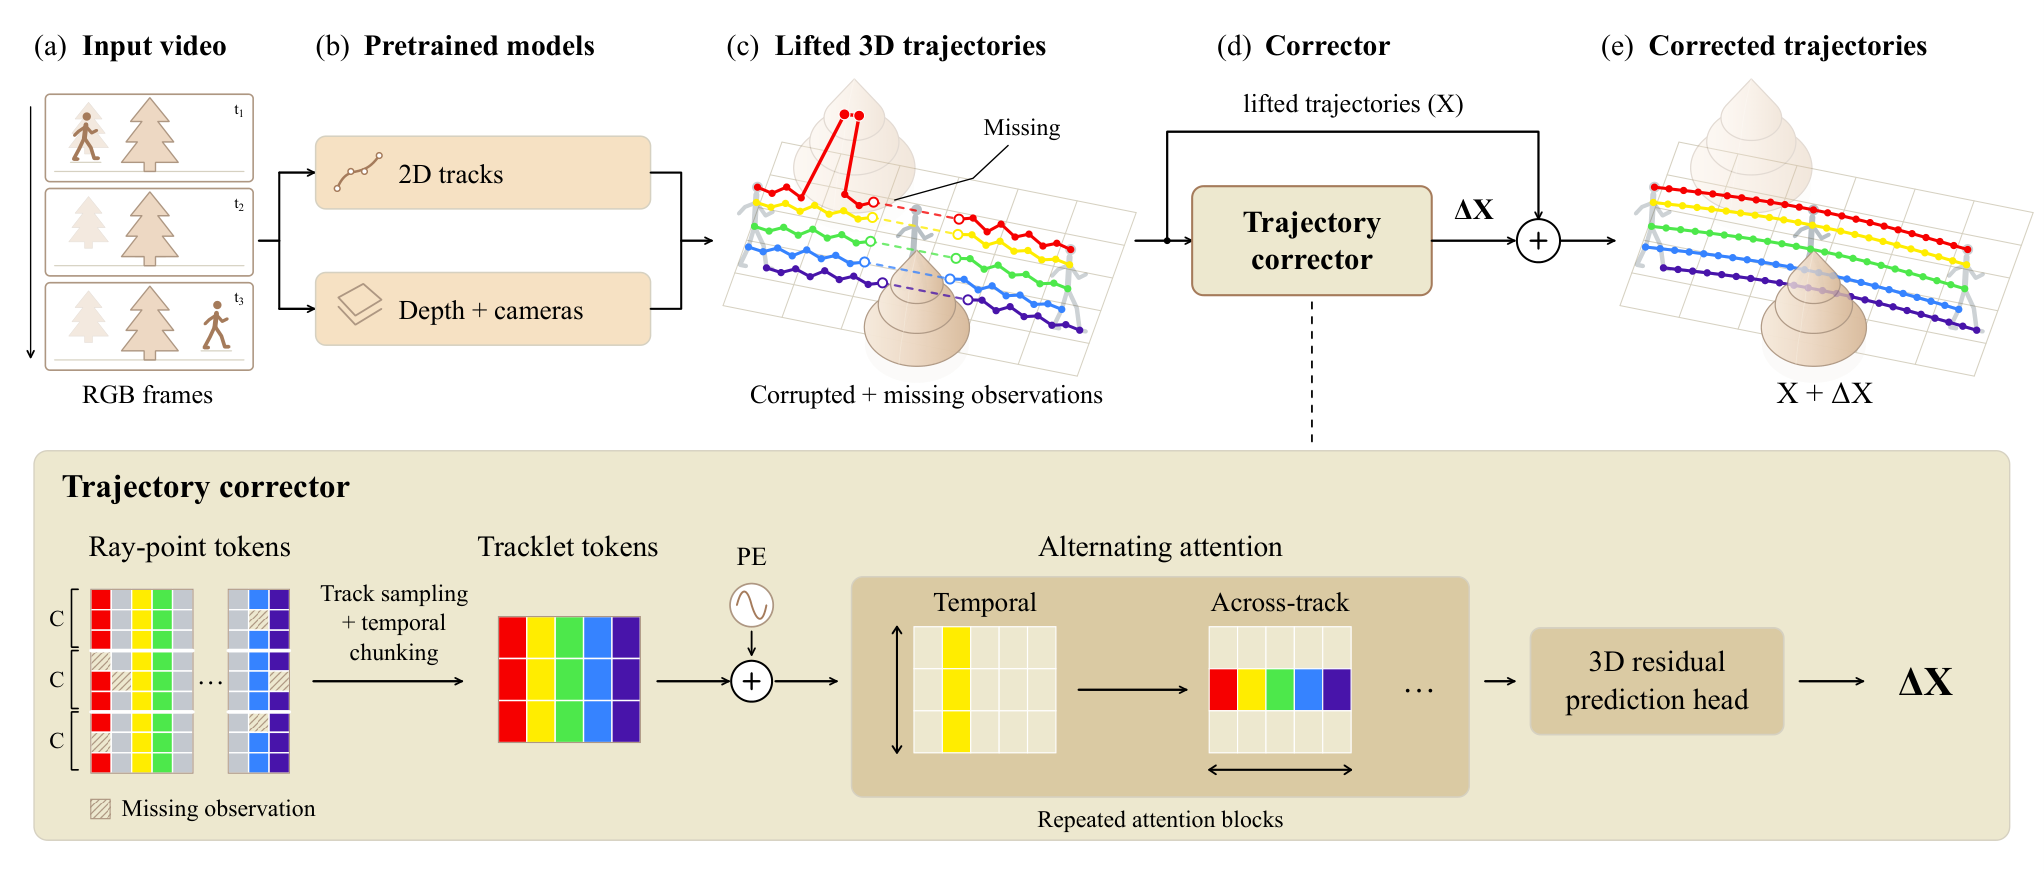
設計上の核心的な決定は、補正器がジオメトリトークンのみを入力とし、画像特徴は使用しないという点です。これには二つの帰結があります。第一に、推論が特定の tracker やジオメトリ backbone から切り離されます。AllTrackerやVGGT-\Omega を別の手法に置き換えても ReLift はそのまま適用可能です。第二に、訓練コストが低く抑えられます。著者らは、上記四つの失敗モードを注入することで、クリーンな3D trajectory アノテーションから破損した lift を直接合成します。レンダリングも2D trackerのロールアウトも、ジオメトリプロバイダのループへの組み込みも不要です。4Dスーパービジョンは実際にそれを必要とする唯一のネットワークに集中させられ、シミュレータは誤サーフェスジャンプのような希少かつ有害なパターンを過剰サンプリングできます。
推論時には C フレームの temporal chunking とバッチ化されたクロストラックグループにより、すべての参照ピクセルに対してフィードフォワード補正を並列に実行でき、これがFigure 1に示されるFPS上の優位性をもたらしています。
結果
評価はWorldTrackの四つのデータセット——ADTとPS(TAPVid-3Dからの実データ)、PointOdysseyとDynamic Replica(合成データ)——を用いて行われ、最初の84フレームにおける参照フレームで可視な点のスパースなグラウンドトゥルース trajectory に対して密な予測をスコアリングします。追加のベンチマークとして、TrackCraft3RのKubricクリップ50本(各24フレーム)を参照ピクセルごとのグラウンドトゥルースで使用します。
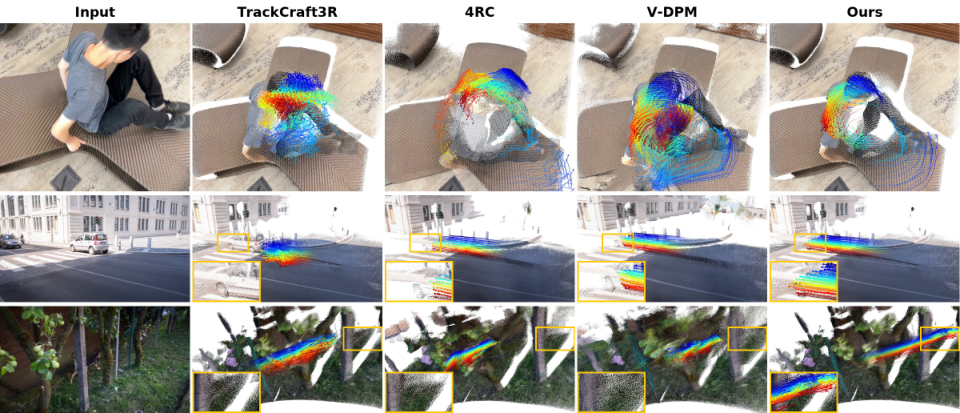
論文の定量的な核心:可視性マスク付き補間を用いた単純な lift だけで、同じジオメトリ backbone を共有する専用設計の3D trackerに匹敵します。さらにReLiftの補正器を加えると、WorldTrackにおける密な3D精度が最先端に達しつつ、パイプライン全体のFPSも競争力を保ちます(Figure 1右)。定性的には、マッチした新規視点から見た trajectory により、ReLiftが lifted baseline の特徴的な失敗——遮蔽されたサーフェスではなく遮蔽物に張り付いた tracks や、深度不連続で横方向にドリフトした tracks——を修正していることが示されています。
制限と未解決の問題
このアプローチはプロバイダの上限を引き継ぎます。2D trackerがクリップ全体でポイントを追跡できない場合や、シミュレータがモデル化しなかったスケールで深度が系統的に誤っている場合、修正時に利用可能な画像信号は存在しません。シミュレートされた lift の訓練分布も設計上の選択であり、修正の忠実度は、ジッター、ドリフト、対応ノイズ、誤サーフェスイベントが実際のプロバイダ統計にどれだけ合致するようにパラメータ化されているかに依存します。また、参照カメラ座標系で動作することにより、長い trajectory の品質がポーズ推定 (R_t, \mathbf{o}_t) の質に縛られ、そこでのドリフトがすべての補正済み位置に伝播します。さらに、エンドツーエンド4Dモデルに対する性能向上がどの程度補正器アーキテクチャによるものなのか、それとも単にそれらのモデルが訓練時に持っていたよりもはるかに強力な2Dおよびジオメトリの事前知識にアクセスできることによるものなのかも不明確です。
この研究の意義
ReLiftは、4Dスーパービジョンは可能な限り薄いモジュール——ジオメトリのみの trajectory 修復ネットワーク——に集中させるべきであり、2D correspondence と monocular depth は大規模事前学習モデルの仕事として残すべきだという具体的な主張を提示します。このモジュール性により、密な3D trackingは tracker やジオメトリ推定器の将来的な改善を再訓練なしに享受でき、「密な3D tracking」をモノリシックな知覚タスクではなく trajectory 空間のdenoisingプロブレムとして再定式化します。
Source: https://arxiv.org/abs/2610.42136
LLM強化学習におけるトレーニング・推論ミスマッチの起源と進化について
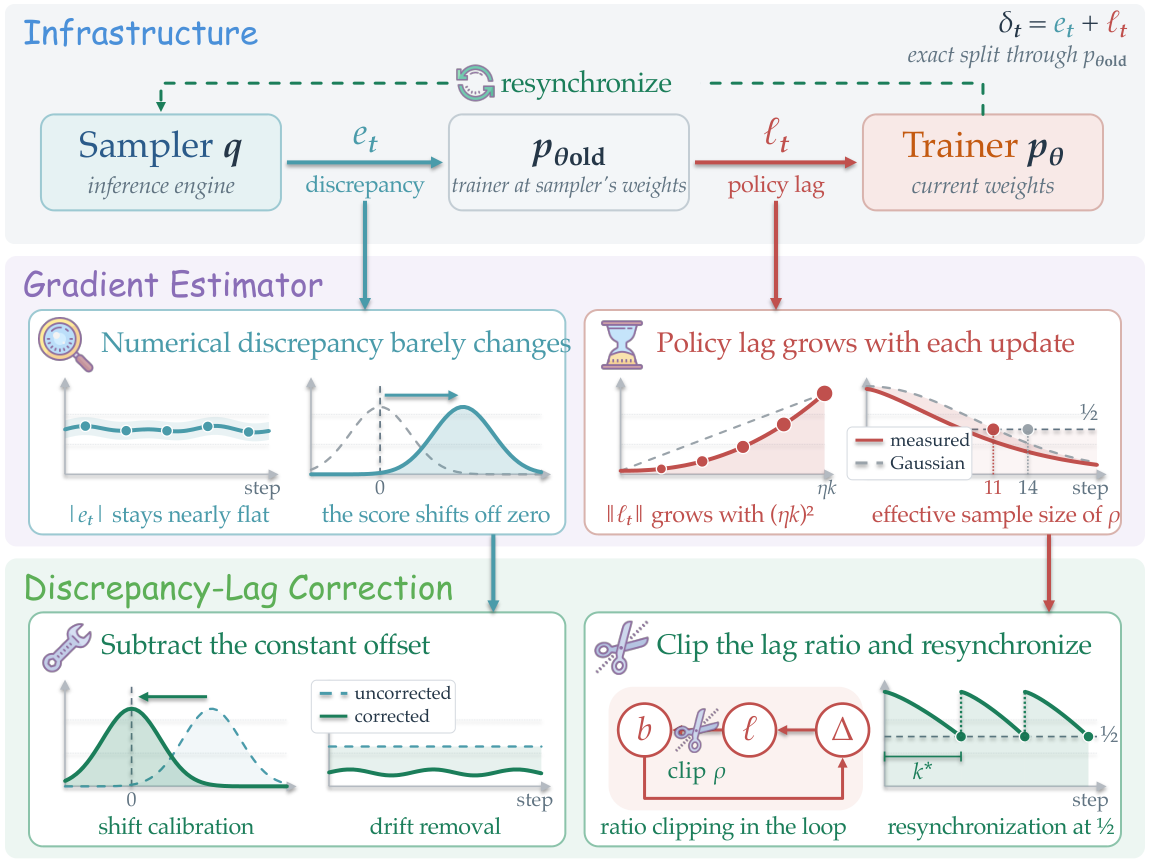
LLMに対するon-policy RLは、名目上lossにおいてのみon-policyです。実際には、推論エンジン(例:vLLM)がトラジェクトリをサンプリングし、別のトレーナー(例:FSDP/Megatron)がgradientを計算しており、両者の間に不一致が生じます。本論文はその不一致を二つの要因に分解します。すなわち、同一の重みにおけるエンジンとトレーナーの数値的な差異と、非同期サンプリングによるポリシーのラグです。そして、それぞれの要因に異なる補正が必要であることを示します。著者らはその上で、両方を処理する補正器DLCを構築しています。
分解
サンプリングされたトークン y_t(プレフィックス h_t)において、スコア s_t=\nabla_\theta \log p_\theta(y_t\mid h_t) とadvantage A_t を定義します。式(1)は、あるプレフィックスにおけるサンプラー側の更新をドリフトと共分散に分解します:
\mathbb{E}_q[a\,s] = \bar a\,\bar s + \mathrm{Cov}_q(a,s),\qquad \bar s = -\nabla_\theta \mathrm{KL}(q\,\|\,p_\theta).
ドリフト \bar a\bar s は、トレーナーからサンプラーへのKLステップを平均プレフィックスadvantageでスケールしたものです。グループセンタリングはプロンプト全体の平均advantageをゼロにするだけであり、プレフィックスごとにはゼロになりません。そのため、正解への途中にあるプレフィックスでは \bar a>0 となり、学習シグナルが存在するまさにその場所でドリフトが非ゼロになります。
サンプラーの重み \theta_{\mathrm{old}} でトレーナーを実行することにより、トークンごとのlog-ratio \ell_t を数値的な部分 e_t(同一重みにおけるエンジンとトレーナーの差)とラグ部分(重み \theta と \theta_{\mathrm{old}} におけるトレーナーの差)に正確に分割できます。
補正のソース依存性
表2と図2は、Qwen3-0.6Bを用いた40ステップの実験で、この非対称性を明確に示しています。逸脱量はon-policyトレーニングに対するKLをノイズフロアの単位で測定しています。
- 量子化サンプラー(数値的差異のみ)。 不一致はほぼ一定(〜0.02 nats/token)です。スコアセンタリングは先頭のドリフトバイアスを除去し、on-policyと同等の精度46.5%を回復します。生のpolicy gradientはフロアの12.7倍、精度26.4%に達します。PPOはフロアの14.3倍となります。
- ステールサンプラー(ラグのみ)。 スコアセンタリングはフロアの31.7倍、精度12.2%に爆発するのに対し、センタリングを伴うimportance samplingは2.10倍、精度32.0%を維持します。バッチ前の参照を使用したPPOはフロアの699倍に達します。
- 組み合わせ。 センタリングを伴うimportance samplingは両方に対応します(2.61倍、30.5%)。
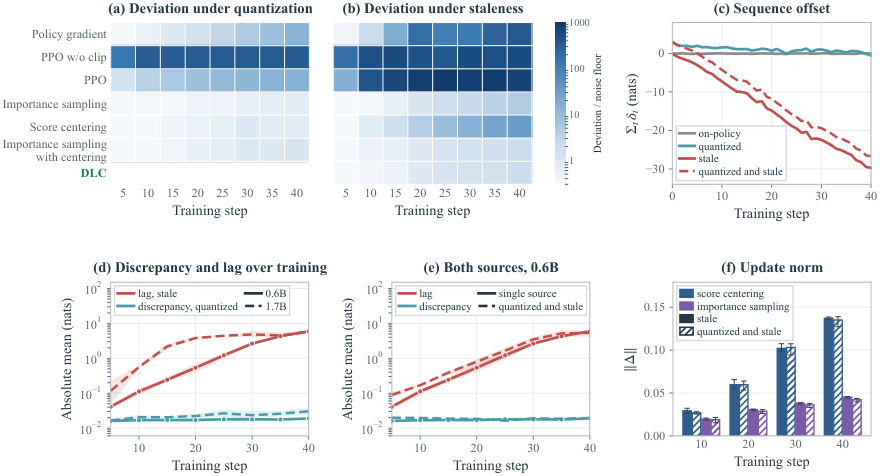
パネル(d,e)はメカニズムを明示しています。数値的な不一致は全体を通して〜0.02 nats/tokenを維持する一方、ポリシーのラグは両モデルサイズで2桁増大します。
ラグのフィードバックループ
ステールネス下ではサンプラーが \theta_0 に固定されるため、バージョンのギャップは累積更新量 \Delta_k に等しくなります。著者らはラグの増大、残差バイアス、バイアスの蓄積という三連鎖のループを形式化し、以下の式に導きます:
\Delta_{k+1} \approx (I-\eta M)\,\Delta_k + \eta g_k,
ここで M は補正が除去できなかったトークンごとの重みを集めており、b_k\approx -M\Delta_k となります。\lambda<0 の固有ベクトル方向では、\Delta のバイアス駆動成分が各ステップで 1-\eta\lambda>1 倍に増幅されます。実験的には、平均ラグはスコアセンタリングとimportance samplingの両方において \|\Delta\|^2 の110〜150倍の速度で増大します。したがって、二つの補正は単位移動量あたり同じラグをもたらします。違いは、importance samplingの残差バイアスがgradientノイズにとどまる一方、スコアセンタリングのそれが \|\Delta\| に対して線形に増大し、\Delta をさらに押し広げてループを閉じるという点です。
importance weightingが破綻する場所
importance samplingがループを断ち切れるのは、比率 \rho_t = e^{\ell_t} が集中した状態を維持している間だけです。平均 \mu<0 のガウスラグ(\mathbb{E}_q\rho_t=1 を満たすよう分散を合わせた場合)に対して、バッチの割合としての有効サンプルサイズ(ESS)は e^{2\mu} となります。Qwen3-1.7BではESSがステップ11で0.5を下回ります(平均ラグ -0.15 nats/token)。これはガウス予測の -0.35 より3ステップ早く、逸脱量はステップ11からフロアを離れ、ステップ30までに152倍に達します。比率 \min(p/q,2) でのクリッピングは、最も重み付けが必要だったトークンに対して正確にドリフトの一部を復活させてしまいます。
DLC
DLCは各障害を修正可能なレイヤーに割り当てます。アルゴリズムの内部処理:
- \theta_{\mathrm{old}} でトレーナーの追加のforward passを1回実行し、\ell_t、e_t、ヘッドのlog-probsを取得します。
- ラグ比率 \rho_t=e^{\ell_t} をサンプラーの重みに対して標準PPOクリッピング(\varepsilon=0.2、デュアルクリップ c=3)で制限し、重み m_t\rho_t を得ます。これがPPOからの主要な変更点です。クリップ参照は \theta_{\mathrm{old}} であり、バッチ前のトレーナーではありません。
- 各プレフィックスにおけるクリップ済みスコアのサンプラー期待値を引きます(クリップ済み推定量に一般化されたスコアセンタリング)。報告されたヘッド H とテールを \kappa=(1-\sum_H q_v)/(1-\sum_H p_{\theta_{\mathrm{old}}}(v)) によって分割します:
\hat g_{\mathrm{DLC}} = \sum_t A_t\,(m_t\rho_t s_t - C_t),\quad C_t = \sum_{v\in H}(q_v m_v\rho_v - \kappa p_\theta(v))\,s_v.
クリップの有効範囲を超えたラグは、サンプラーの再同期によってインフラストラクチャに戻されます。
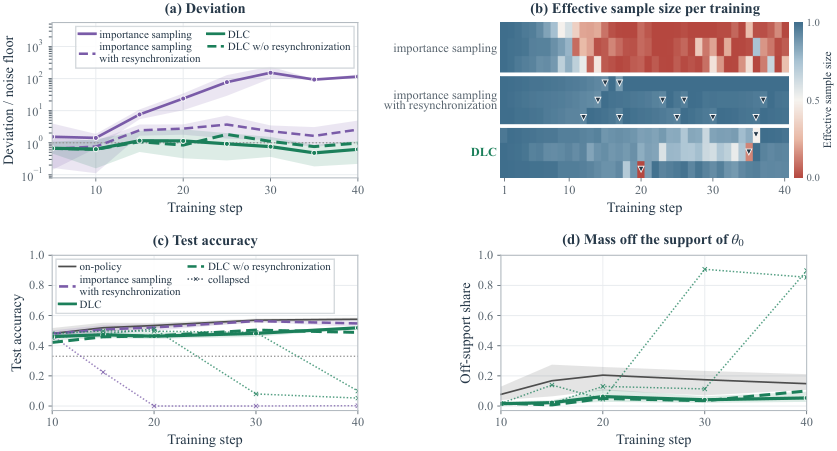
ステールネス下のQwen3-0.6Bでは、DLCはステップ40においてフロアの1.93倍を達成し、IS+センタリングの2.10倍、スコアセンタリングの31.7倍と比較して最良のベースライン精度に匹敵します(31.7% vs 32.0%)。Qwen3-1.7Bでは、ESSが崩壊するとimportance samplingが発散する一方、DLCはフロアを維持します。図5の三角印での再同期は、ISをフロア付近に戻すのに十分です。
限界
実験はQwen3-0.6B/1.7Bでの40ステップ実行であり、ループ解析は一次近似(b_k\approx -M\Delta_k)であり、ガウスラグのESS予測はすでに1.7Bで3ステップずれており、有効範囲の議論はあくまで先頭オーダーの指針に過ぎないことを示唆しています。再同期の頻度はインフラストラクチャのパラメータとして残されています。PPOのステール状態での悪い挙動はバッチ前のトレーナーを参照として使用することに起因するとされていますが、本論文では \theta_{\mathrm{old}} を参照としたPPOとDLCをクリップ比率の選択を超えて直接比較するテストは行っていません。
この研究が重要な理由
本論文は、トレーニング・推論ギャップを(ほぼ一定の)数値的オフセットと(自己増幅的な)ラグという二つの要因に初めて明確に操作的に分解し、GRPO、PPO、importance sampling、スコアセンタリングがそれぞれ特定のレジームで失敗する理由を説明しています。DLCのレシピ——ラグ比率を \theta_{\mathrm{old}} に対してクリップし、クリップ済みヘッド期待値を引き、ESSが崩壊したときに再同期する——は、verlスタイルのパイプラインへのドロップイン変更であり、任意の非同期RL-LLMパイプラインで採用できます。
Source: https://arxiv.org/abs/2610.40945
R^2Orch: Self-Play によるスキル内在化ループを通じたエージェントオーケストレーションの再帰的自己改善
問題設定
ツール使用エージェントの学習によるオーケストレーションは、相互に連関した三つの欠陥を抱えています。(i) カリキュラムが手動設計かつ静的であるため、訓練分布がオーケストレータの既習事項に適応しない、(ii) あるタスクの全ロールアウトが同一の結果に収束した場合、group-relative RL 手法はゼロ advantage しか観測できず信号が崩壊する、(iii) スキルを単一のノイジーな成功スコアで評価する場合、「このスキルはまだ有益か?」という問いに対して、self-play によってオーケストレータ自身が汚染した統計量で答えることになる、というものです。著者らはスキル(検索された自然言語スキャフォールド)を、最終的には取り除かれるべき補助輪として位置付けており、能力を拡大し続けるスキャフォールドにではなくパラメータに内在化させることを目指しています。
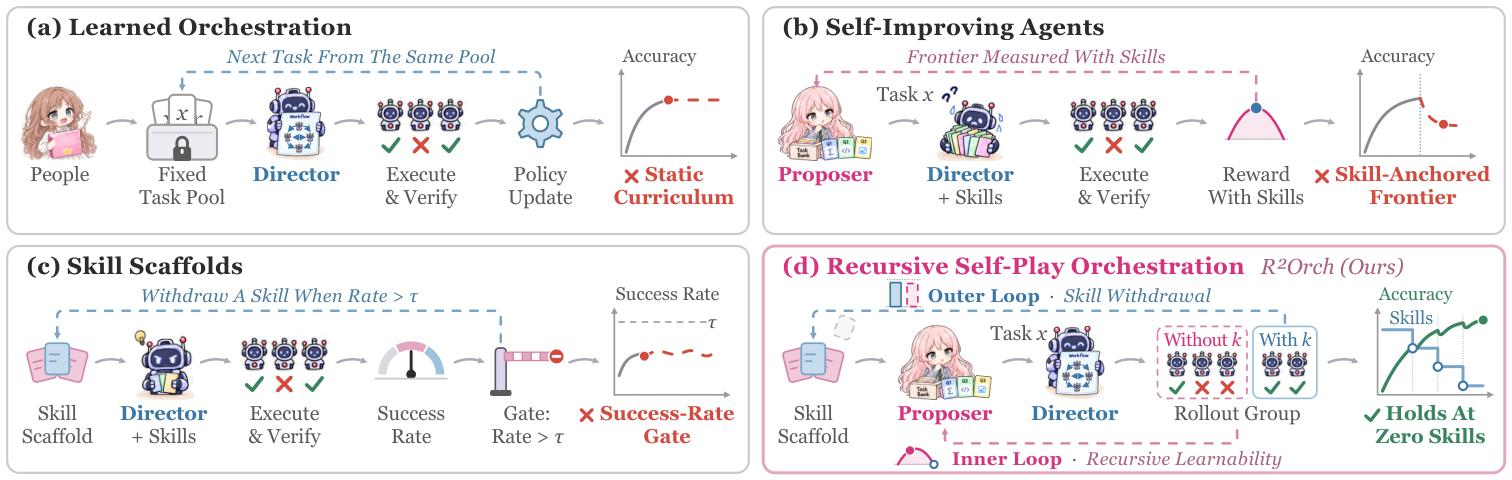
手法
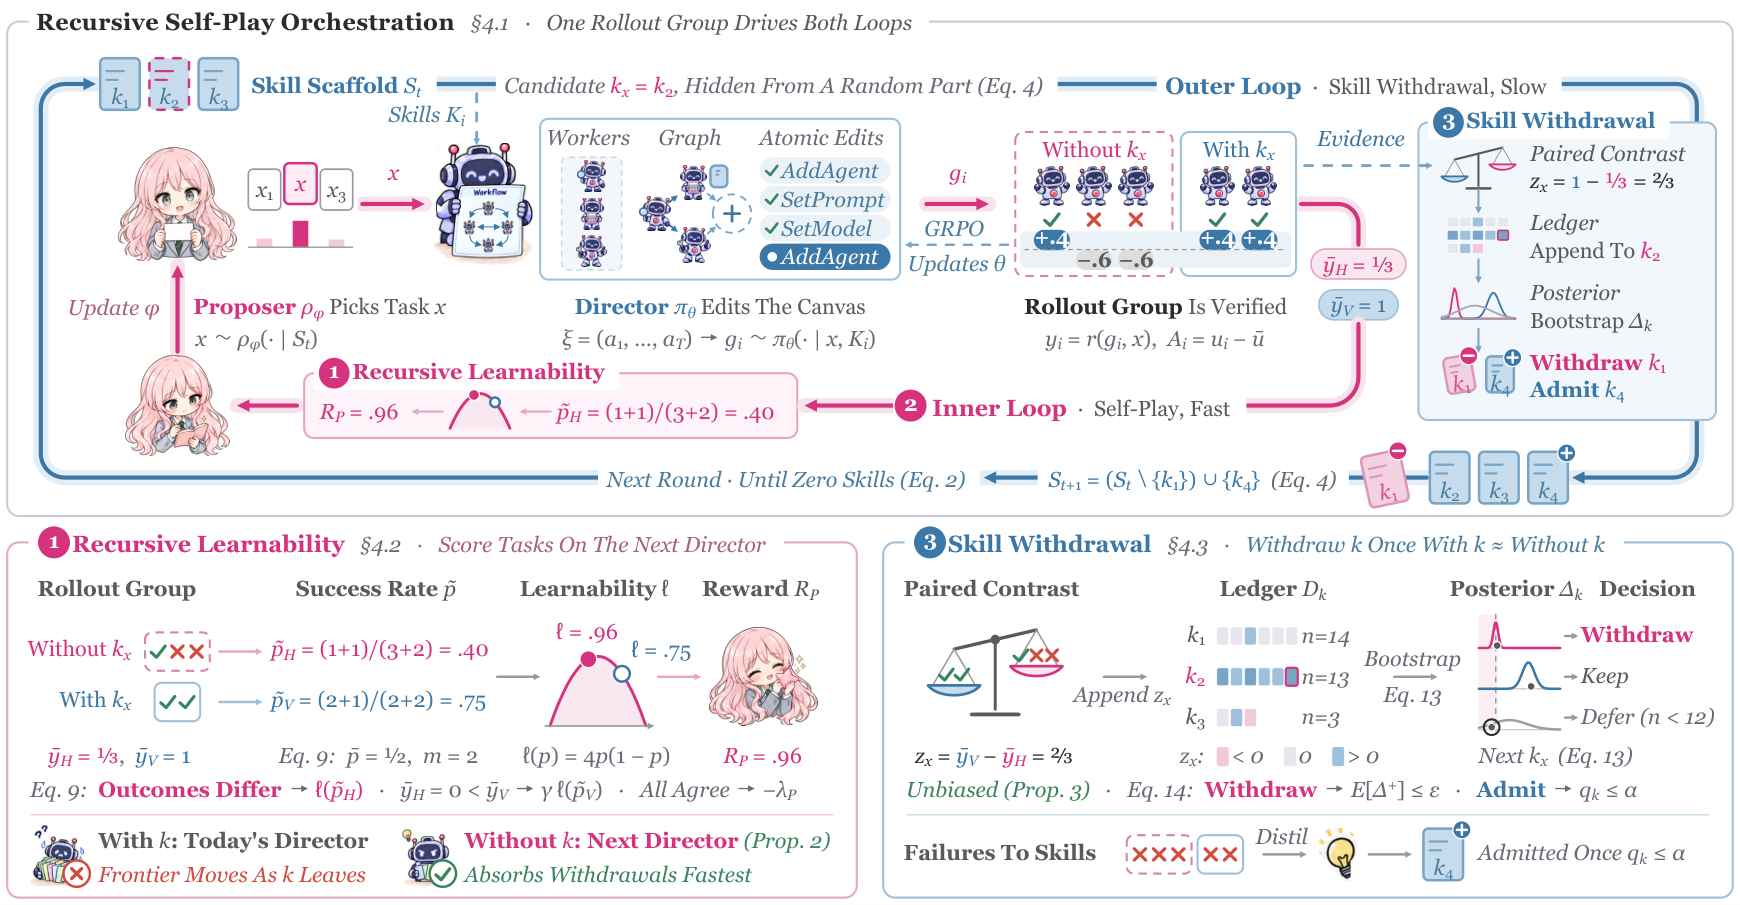
R^2Orch は、サイズ G = n_h + n_v(n_h > n_v)の単一のランダム化ロールアウトグループによって結合された二つのループを入れ子にしています。隠れ部分 \mathcal{H}_x では候補スキル k_x が検索済みセット K_x から除去され、可視部分 \mathcal{V}_x では保持されます:
q_x = \tfrac{n_h}{G}\,\delta_{K_x\setminus k_x} + \tfrac{n_v}{G}\,\delta_{K_x}.
内側ループ — Proposer/Director self-play。 速い時間スケールでは、両方のポリシーがクリップ付き近接最良応答(二時間スケール確率的近似)を採用します:
\theta_{t+1}\approx\arg\max_\theta \mathbb{E}\,v_K(x;\theta) - \tfrac{1}{\beta}\mathrm{KL}(\pi_\theta\|\pi_{\theta_t}),\quad \phi_{t+1}\approx\arg\max_\phi \mathbb{E}\,R_P(x) - \tau\mathrm{KL}(\rho_\phi\|\rho_0).
Director は混合コンテキストグループに対して leave-one-out ベースラインを用いた GRPO を使用します:
\nabla_\theta\mathbb{E}_{K\sim q_x}[v_K(x;\theta)] = \mathbb{E}\Big[\tfrac{1}{G-1}\sum_{i=1}^G (u_i-\bar u)\,\nabla_\theta\log\pi_\theta(\xi_i\mid x, K_i)\Big].
q_x が K_x\setminus k_x に大半の質量を置くため、Director の更新のほとんどはすでにスキルなしの更新となっており、内側ループは外側ループが行うかもしれない撤退のために自己事前学習を行っていることになります。
再帰的学習可能性(Proposer の報酬)。 Proposer は、候補スキルが除去された後においても隠れ部分のロールアウト(スキル撤退後)が混合結果をもたらすような x、すなわち候補スキルが除去された後の現在の学習可能性フロンティア上にあるタスクを選択することで報酬を受けます。これは advantage の崩壊を直接解消します。なぜなら、構成上 0 < \hat p_{\mathcal H} < 1 となることが報酬の条件だからです。
スキル撤退(外側ループ)。 各スキル k は、対となる対比(k ありの \mathcal V から k なしの \mathcal H を引いたもの)の符号に関する事後分布 \Pi_k を維持します。スキャフォールドは \mathcal S_{t+1} = \Phi(\mathcal S_t;\{\Pi_k\},\mathcal F_t) として更新されます。制御された対比が有益性を示さなくなればスキルは撤退され、失敗 \mathcal F_t(両部分が失敗したグループ)は新しいスキルに蒸留されます。こうして \mathcal S_t は外側ループの各ステップで q_x と R_P の両方を書き換えます。
結果
表 2 のすべてのアブレーションは スキルゼロ で評価されており、数値はパラメータに内在化された内容を反映しています。Qwen3.5-9B の direct-prompting ベースラインは 57.81(HotpotQA EM)、23.59(NQ-Open)、47.19(AIME)、15.78(SWE)、32.81(WebShop)です。GRPO のみの self-play によってこれらはすでに 86.09 / 82.97 / 73.44 / 35.00 / 71.72 まで向上します。完全な R^2Orch は 91.09 / 86.09 / 90.63 / 42.81 / 91.09 に達し、GRPO のみと比較して WebShop で 19.4 ポイント、direct-prompting と比較して SWE で 27 ポイントの向上を示しており、スキャフォールド化されたすべてのスキルが撤退されているにもかかわらず Director は精度を維持しています(RQ3)。
コンポーネントのアブレーションにより各メカニズムが個別に評価されています。再帰的学習可能性を一様サンプリングに置き換えると、HotpotQA が 91.09 から 90.16 に、WebShop が 91.09 から 87.03 に低下します。「failure reward」や DAPO スタイルの動的サンプリングに置き換えた場合はその中間のスコアとなります。スキル撤退を固定スキャフォールドに置き換えると、IID で約 3 ポイント、WebShop で 15 ポイント(76.09 対 91.09)のコストが生じ、事後分布ベースのゲートが成功率閾値(PATS)、事前設定バジェット(SKILL0)、validation gap(SLIM)を上回ることが確認されます。
訓練ダイナミクスのパネルでは、Proposer が学習可能な(0 < p < 1)候補に対して質量を集中させ、既習のものへの質量をサイクルを通じて減少させていく様子が示されています。これは、同一プロンプトでの未訓練ベースラインやランダムベースラインとは異なる挙動です。また、スキルゼロでの held-out 精度がスキルありの精度と追随していること、すなわちスキル除去が能力を損なわないことが確認されています。
バックボーン転移(RQ2)では、Qwen3.5-9B Workers で訓練された Director を固定し、スキルゼロで他の 6 種類のバックボーンに差し替えます。R^2Orch の改善効果は、コード(SWE-Bench)、インタラクティブ(WebShop)、QA、数学難問の各ドメインにわたって再訓練なしで維持されます。
制限と未解決の問題
- 本手法は信頼性の高いベース検索器・スキルライブラリに依存しており、失敗からの新スキルへの蒸留はブラックボックス \Phi として扱われており、敵対的な Proposer に対する安定性は特徴付けられていません。
- 収束性は二時間スケール確率的近似(Borkar, 1997)によって議論されていますが、Proposer/Director/スキャフォールドの三者結合に対する形式的な後悔境界や非漸近的な境界は与えられていません。
- スキルゼロ評価が主要指標とされていますが、それを達成するためのコスト(ロールアウト数、Worker 呼び出し数)は報告されておらず、これはカリキュラムなし RL との比較において重要です。
- すべての実験において訓練時の Director バックボーンファミリーは単一(Qwen3.5-9B)であり、再帰的学習可能性の報酬がはるかに弱いまたは強い Director に対しても適切に較正されるかは未解決です。
- 対となる対比事後分布は、可視部分 vs 隠れ部分の分割が唯一の交絡因子であることを前提としており、相関したスキル(一方が他方を包含する場合)が撤退を停滞させる可能性があります。
重要性
R^2Orch は、スキャフォールドレベルの能力をパラメータへと内在化するための具体的な手順を提供します。混合コンテキストのロールアウトグループは、スキルがすでに存在しないかのように Director を訓練しながら、実際にスキルを除去するかどうかを判断するための不偏な対比を同時に生成します。スキルゼロでの数値(例:32.81 ベースから WebShop で 91.09)は、「撤退後も学習可能」という選択が動的サンプリングや成功率ゲーティングよりも強力なカリキュラム信号であることを示しており、自己改善型エージェントスタックの設計に影響を与えるべき知見です。
Source: https://arxiv.org/abs/2610.22740
FrameForge: Harnessing Priors of Video Foundation Models for Unified Image Generation
問題設定
統一的な条件付き画像生成——被写体駆動型合成、構造条件付き生成(例:canny-to-image)、および指示誘導型編集——は、テキスト誘導に従いながら視覚的入力の特定の側面を保持する単一モデルを必要とします。事前学習済みの video diffusion model を再利用するというアイデアは自然です。これらのモデルはすでに時間軸上の視覚的変換をエンコードしているため、条件付き生成は「条件フレームからターゲットフレームを予測する」として定式化できます。この方向における先行研究は、条件をフレーム0に固定し、ターゲットを後の固定フレームに割り当て、全タスクを同等に扱うのが一般的でした。しかし、条件とターゲットの関係はタスクによって大きく異なります。指示による編集では画像をわずかに変化させるのみであり、canny マップは RGB ターゲットと構造的に近く、被写体駆動型生成では被写体をまったく新しいシーンに配置することがあります。
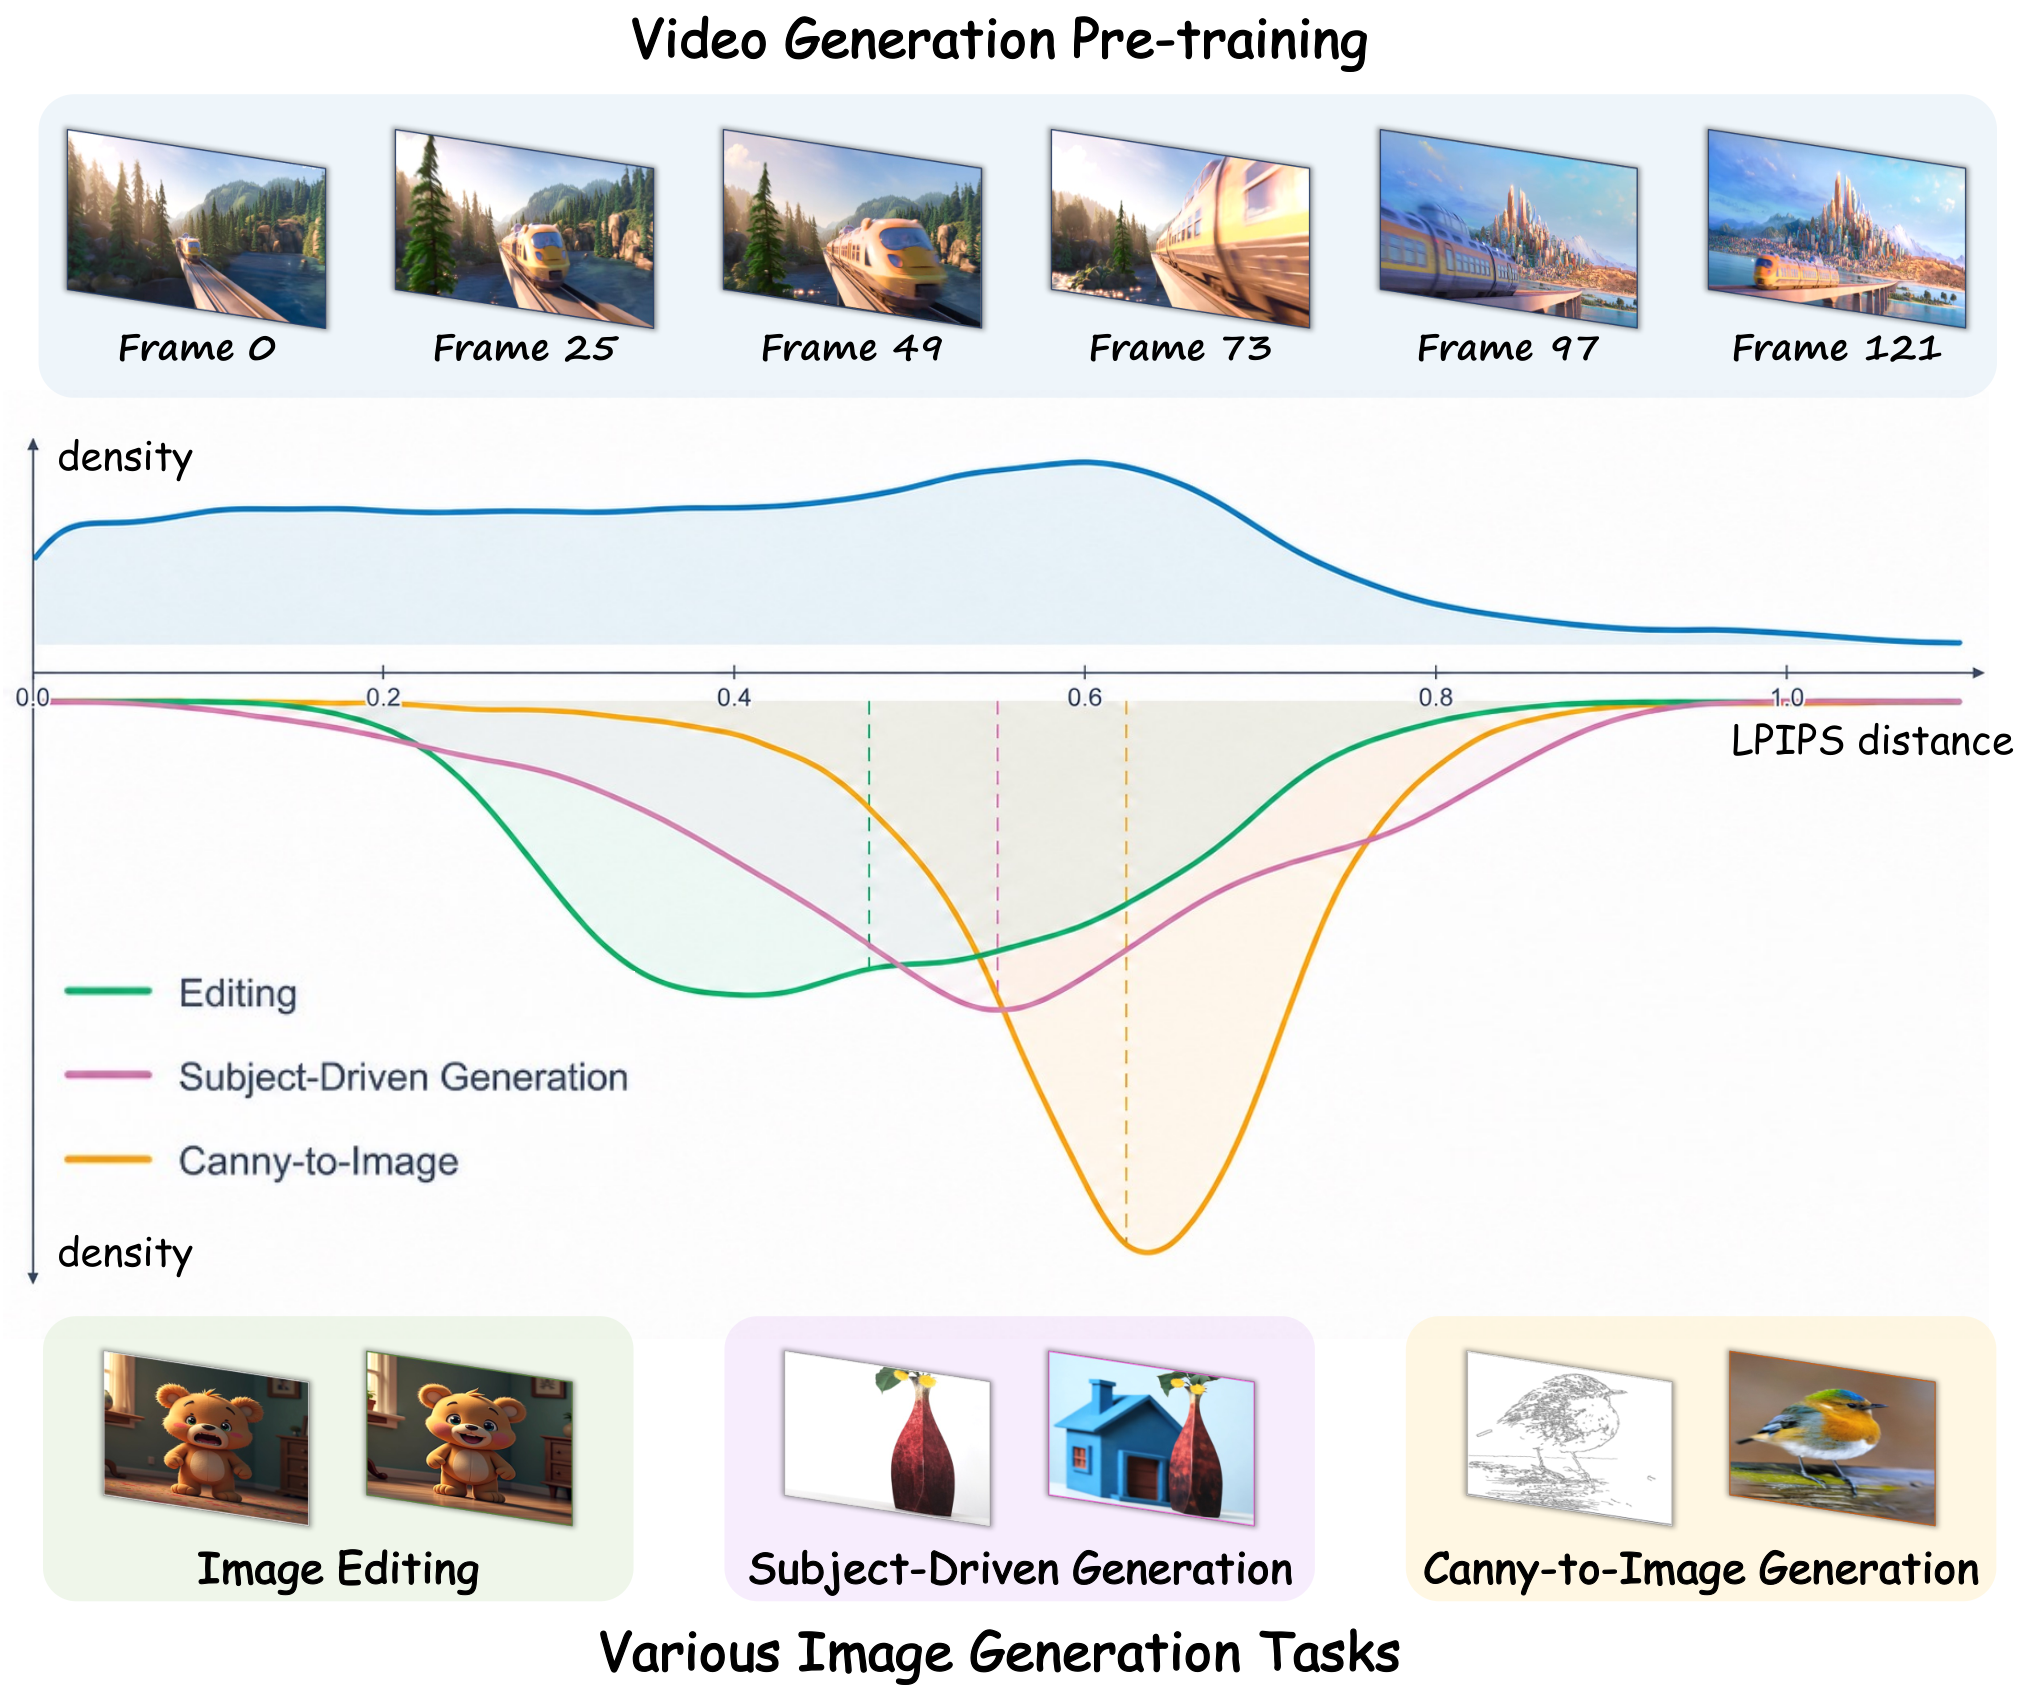
著者らはこれを、自然動画における様々な時間間隔でのフレームペア間の LPIPS と、タスク間の条件-ターゲットペア間の LPIPS を測定することで定量化しています。編集は短い間隔付近に、canny-to-image は中程度の間隔付近に、被写体駆動型生成は大きな間隔付近にクラスタリングされ——これは固定された位置ではなく入力適応的な仮想時間関係を動機付けています。
手法
FrameForge は HunyuanVideo1.5-T2V-720P(MM-DiT と 3D-RoPE、flow-matching loss、16\times 空間および 4\times 時間圧縮の 3D VAE)上に構築されています。条件とターゲットはともに単一の潜在フレームとしてエンコードされ、モデルは以下のもとでターゲットの速度 v_\theta(z_t, t, c) を予測します。
\mathcal{L}_{\text{diffusion}} = \| v - v_\theta(z_t, t, c) \|_2^2.
入力適応的な時間構造をエンコードするために、2つの追加コンポーネントが導入されています。
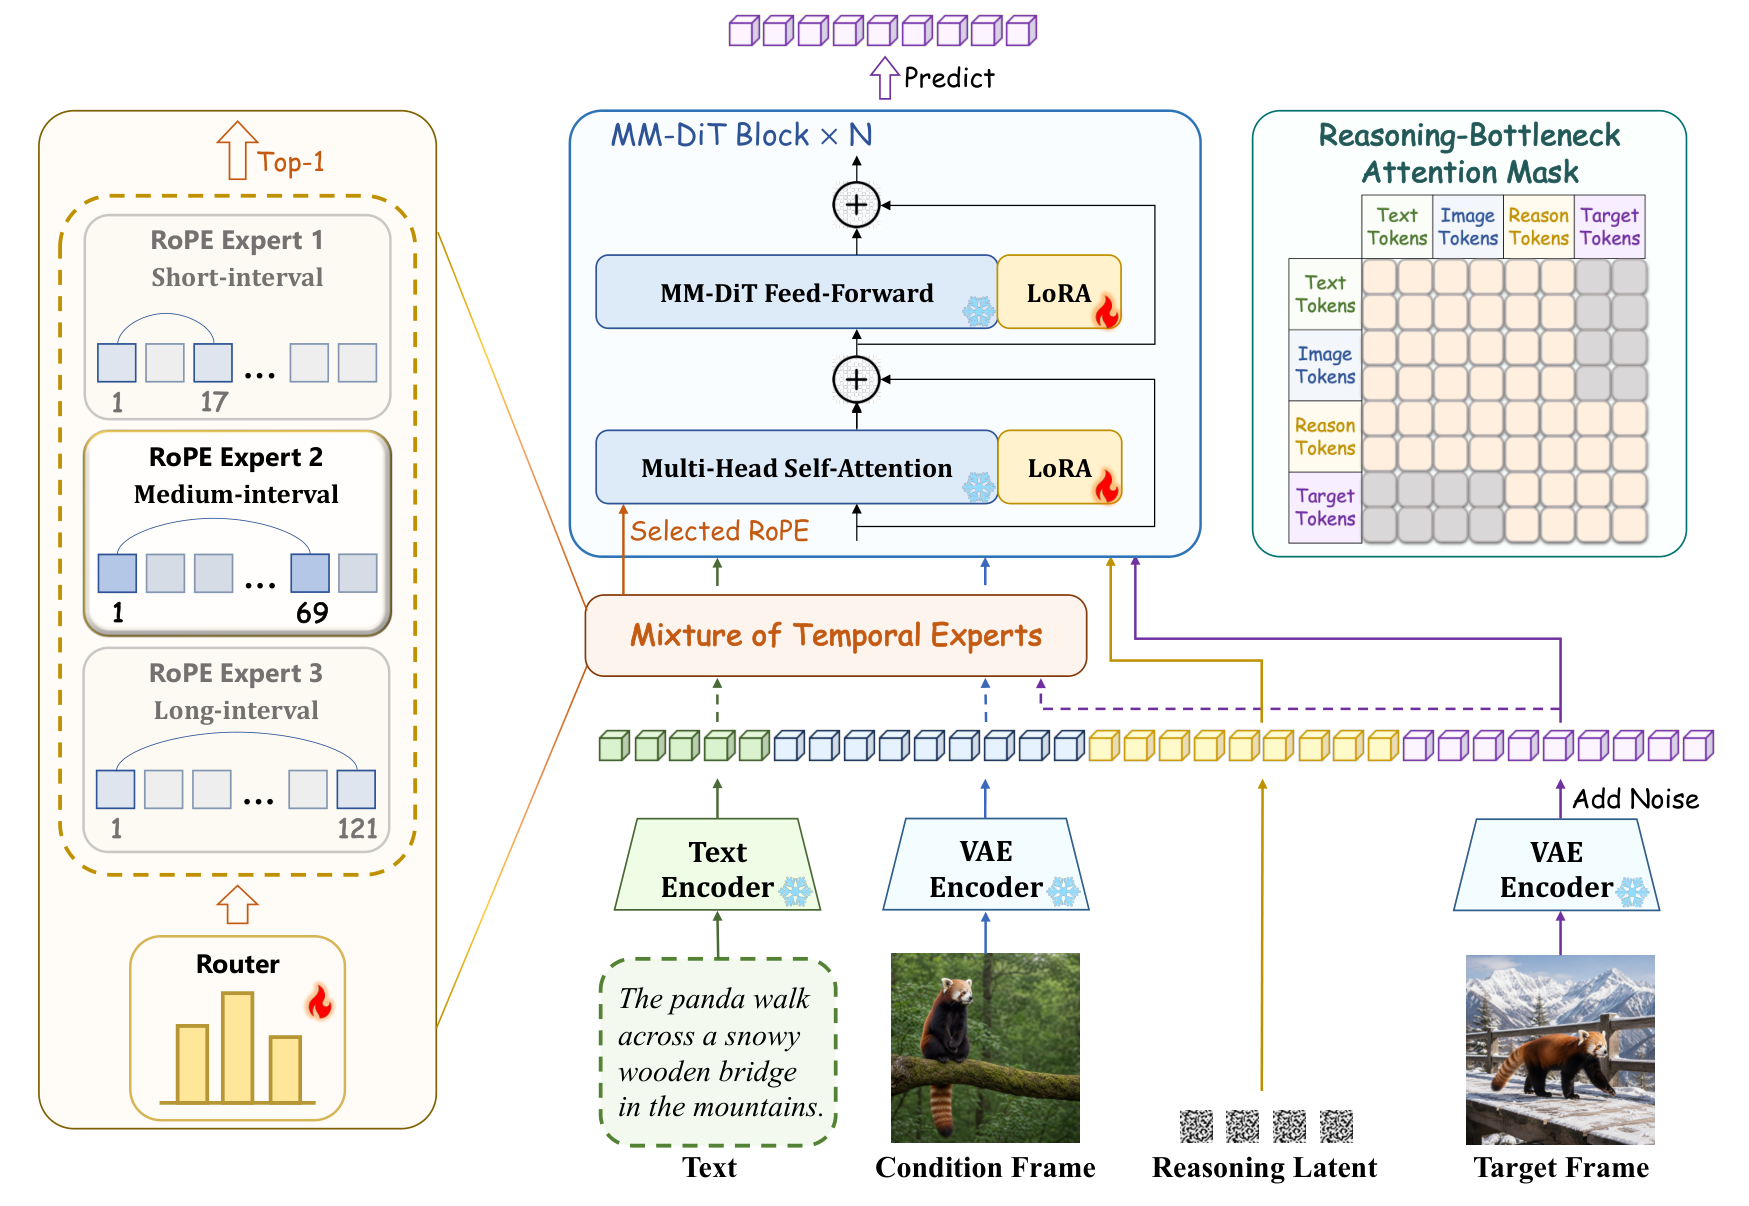
Mixture of Temporal Experts (MoTE)。 3D-RoPE においてターゲットトークンに割り当てられる時間座標は、条件とターゲットの間の仮想的な時間間隔として機能します。この間隔を固定するのではなく、MoTE はそれぞれ異なる仮想間隔でパラメータ化された RoPE エキスパートのバンクと、各デノイジングステップで適用するエキスパートを選択するルーターを維持します。ルーターは load-balancing loss(重み \lambda_{\text{bal}} = 0.01、softmax 温度 \tau_{\text{router}} = 1.0)で学習され、編集のような恒等変換に近いタスクに対しては短い間隔を、被写体の再構成に対してはより大きな間隔を選択することを学習します。
Chain of Temporal Reasoning (CoTR)。 ノイズで初期化された中間潜在変数が条件とターゲットの間に挿入されます。その隠れ状態は attention を通じて更新され、変換を橋渡しする潜在的な「中間フレーム」として機能します。モデルがこの経路を実際に使用するよう強制するため、中間段階の学習では確率 p_{\text{mask}} = 0.5 で推論ボトルネック attention マスクを適用します。このマスクはテキスト/条件からターゲットへの直接 attention をブロックするため、誘導からターゲットへの gradient 経路は中間状態を通過しなければなりません。最終段階の学習と推論では完全 attention に戻りますが、その時点で中間表現はすでに刻み込まれています。
学習。 ランク/アルファ 32 の LoRA fine-tuning により、182M の学習可能パラメータを持ちます。学習にはタスクごとに 170K サンプル(計 510K、Subject200K/UNO-1M、512-2M、および GPT-Image-Edit-1.5M の HQ-Edit/UltraEdit サブセットからフィルタリング)、512\times 512 解像度、バッチサイズ 60、学習率 3\times10^{-4}、2× A800 上で 12k イテレーション(約 6 日間)を使用します。推論では 50 ステップを用い、CFG スケールは被写体/編集に対して \omega = 6、canny に対して \omega = 2 を使用します。
結果
評価は 3 つのベンチマークで行われます。
- DreamBench(被写体駆動型、30 被写体 × 25 プロンプト、GPT-4o による VIEScore):SC、PQ、O を報告。
- COCO2017 val(5,000 枚、canny-to-image、GPT-4o キャプション):FID、SSIM、CLIP-T。
- GEdit-Bench English(606 サンプル、11 カテゴリ):GPT-4.1 を用いた G-SC、G-PQ、G-O。
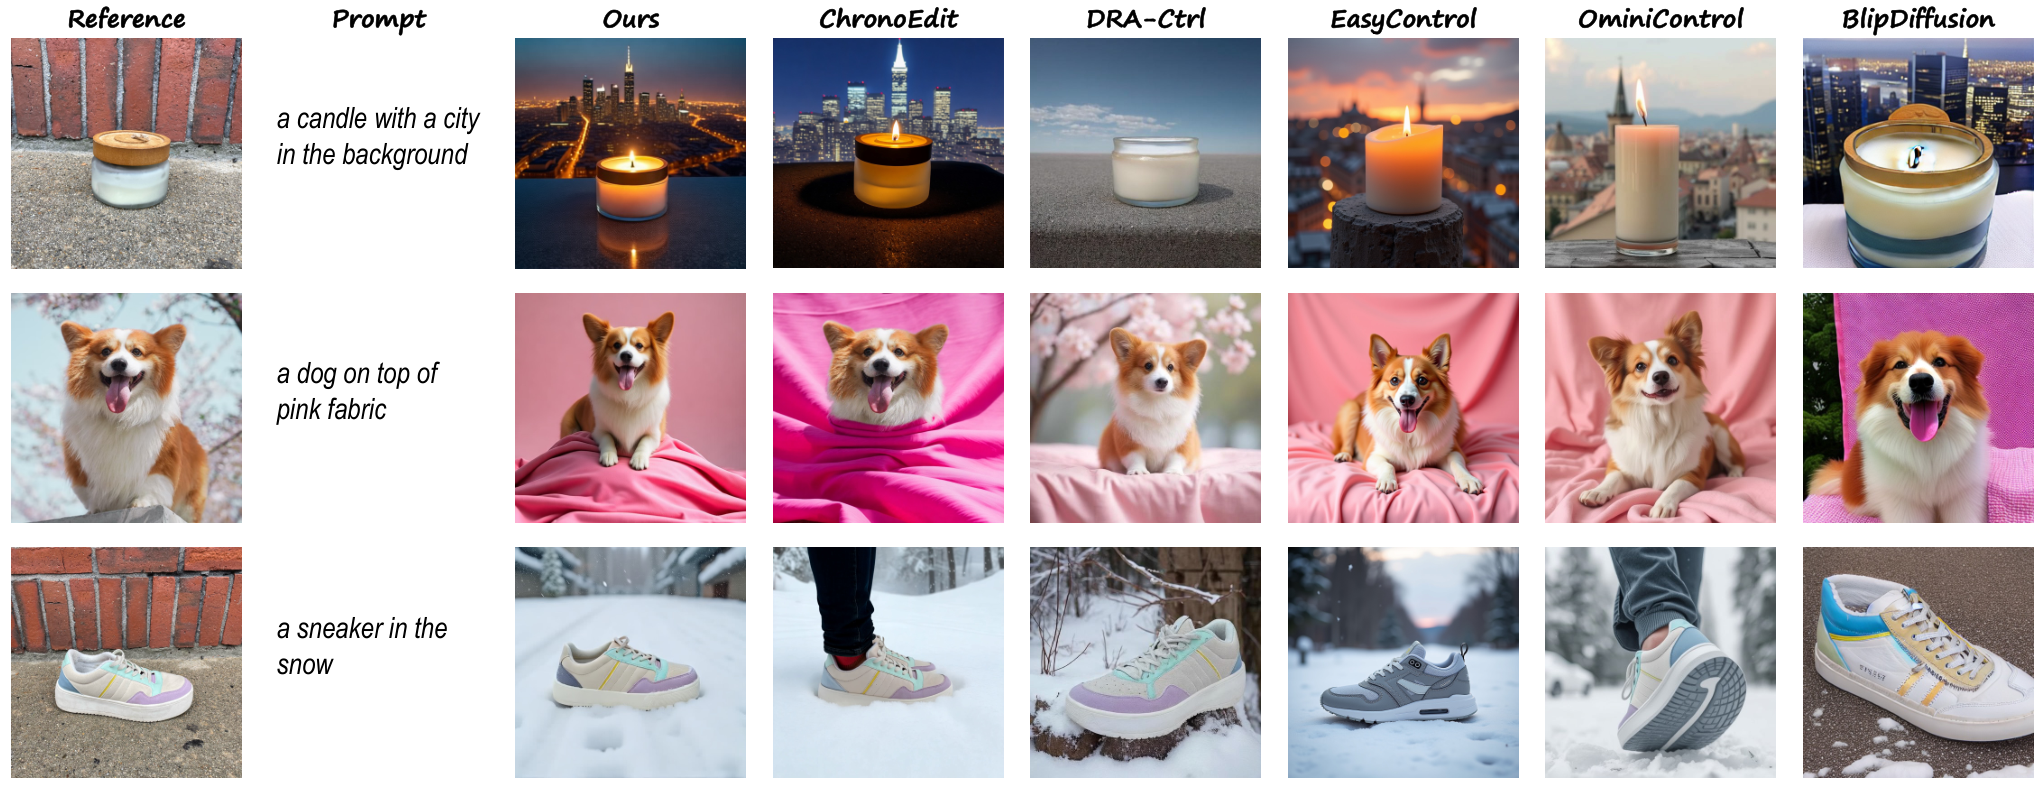
提示された抜粋には完全な数値テーブルは含まれていませんが、定性的な DreamBench 比較では、プロンプトで指定されたシーンに被写体を再レンダリングしながら、インスタンスレベルの属性(例:参照被写体のテクスチャや構造的識別子)が保持されていることが示されています。
再現のために注目すべき主要な実装上の数値:HunyuanVideo1.5 上の 182M LoRA パラメータ、3 タスクに均等に分割された計 510K の学習ペア、そして各タスクが要求する構造的忠実度と意味的書き換えの程度を反映した非対称 CFG スケール(\omega=6 vs. \omega=2)です。
限界とオープンクエスチョン
この手法は、画像のみの DiT よりも計算コストの高い video diffusion バックボーンに依存しています。MoTE のエキスパートバンクサイズと具体的な仮想間隔は設計上の選択であり、タスクの組み合わせと相互作用する可能性があります。未知の条件モダリティ(深度、セグメンテーション、マルチ参照)への汎化は、示されたセクションでは扱われていません。CoTR の中間潜在変数は単一のトークンセットであり——複数の中間変数を連鎖させることで長距離変換(例:マルチステップ編集)が改善されるかどうかはオープンクエスチョンです。また、ルーティングはデノイジングステップごとに行われますが空間的に局在化されておらず、局所的/大局的変化が混在するタスク(シーン交換の中での局所的編集)では、トークンレベルのルーティングが求められる可能性があります。
なぜ重要か
条件付き画像生成を適応的間隔のフレーム予測として捉えることで、知覚空間において条件-ターゲット間の距離が桁違いに異なるタスクを統一する原理的な方法が得られます。また、専用の画像条件付きアーキテクチャを学習するのではなく、video foundation model にすでに組み込まれた事前知識を活用します。MoTE + CoTR のレシピは軽量(LoRA スケール)な後付けであり、事前学習済みの任意の video DiT を汎用的な条件付き画像生成器に変換するためのテンプレートとして有望です。
Source: https://arxiv.org/abs/2610.36545
統合マルチモーダルモデルのための連続空間における潜在推論
画像理解と画像生成の両方を扱う統合マルチモーダルモデル(Unified Multimodal Models, UMMs)は、通常、chain-of-thought(CoT)プレフィックスを生成パスに組み込む形をとっています。すなわち、モデルが離散的な推論トークンを出力し、それに条件付けて画像合成を行うという手順です。著者らは、これがモダリティの不一致であると主張しています。推論は離散トークンの単体(simplex)上に存在する一方、画像生成は連続潜在変数によって駆動されているためです。また、この離散的なボトルネックが、推論拡張型UMM(例:Uni-CoT)がLLMで見られるtest-time scalingの挙動を継承できない原因であるとも論じています。LARCは、UMM自体の連続hidden-state空間で直接推論を行うことを提案しており、トークンにデコードする代わりに、最後のhidden stateを次の入力embeddingとしてフィードバックします。
手法
LARCは、ベースとなるUMM(主な実験ではBAGEL)の上に適用される2段階の手順で構成されます。
Stage 1 — Curriculum SFT。 まずモデルはプロンプトと画像の間にテキスト形式のCoTを生成するよう学習されます。その後、そのCoTの中でより多くの部分が潜在思考(latent thoughts)に段階的に置き換えられます。潜在思考とは、モデルがサンプリングされたトークンをembeddingする代わりに、自身の最後のhidden state h_t を次の入力embedding e_{t+1} = h_t として消費する位置を指します。このcurriculumは潜在思考とトークン思考の比率を徐々に変化させていくため、UMMは中間的な離散ターゲットで監督されることなく、連続的な活性化を通じて推論を伝達することを学習します。
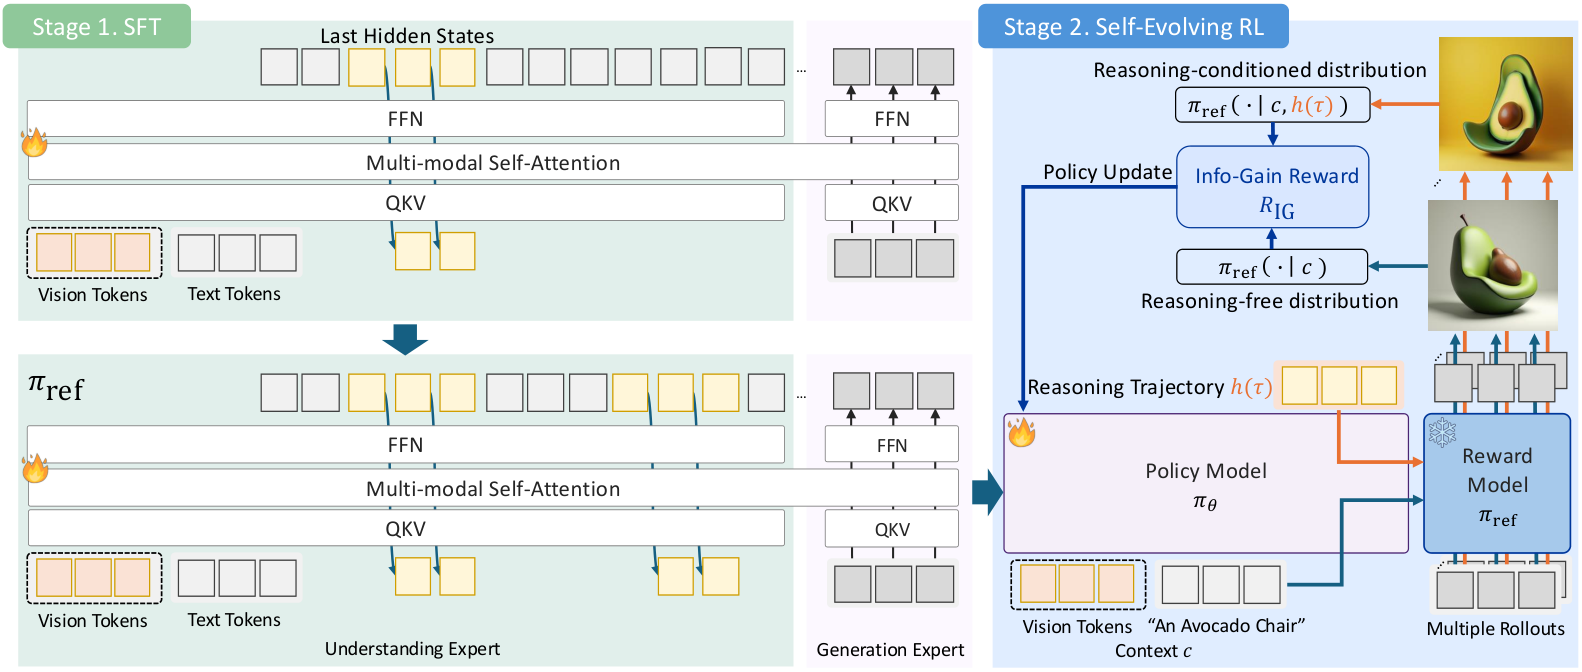
Stage 2 — Information-gain RL。 潜在思考には正解となる教師信号が存在しないため、LARCはプロンプト c が与えられたときの潜在トレース z_{1:L} と生成画像 x の間の条件付き相互情報量から導出された報酬を使用します。直感的には、Stage 1の参照方策 \pi_{\text{ref}} と比較して、潜在ステップを追加することで画像分布に対するモデルの不確実性が顕著に低減される場合に、報酬が高くなります:
r(z_{1:L}, x \mid c) \propto \log \pi_\theta(x \mid c, z_{1:L}) - \log \pi_{\text{ref}}(x \mid c).
これは自己進化的な目標関数をもたらします。すなわち、SFTベースラインよりも画像に関連した情報を多く運ぶ潜在推論を持つ軌跡が強化されるため、人手によるラショナルのラベル付けや外部報酬モデルを必要としません。
結果
LARCは、FLUX-Reason、WEAVE、ScaleEditから構築された固定の100万例CoTコーパスで訓練され、GenEval、DPG-Bench、OneIG-Bench(T2I)、CompBench(編集)、MME/MMB/MMMU/MIRA(理解)で評価されています。
GenEval における最も注目すべき改善はAttribute Bindingであり、LARCはBAGELベースラインに対して+15パーセントポイントの向上を達成しています。これは構成的な計画(compositional planning)に最も依存するサブタスクであり、連続推論が画素にコミットする前に属性を指示対象に結びつけることを助けるという仮説と整合しています。
DPG-Bench では全体スコアが85.07から90.04へと改善(+5.8%)し、OneIG-Bench ではLARCがBAGELに対して+10.2パーセントポイントを獲得しています。これらの改善はすべてのサブカテゴリにわたって一貫して報告されており、潜在推論パスが特定のプロンプトファミリーに特化していないことを示唆しています。
CompBench 画像編集では、LARCはLC-T 22.509 / LC-I 0.880 / PSNR 25.710 / SSIM 0.953 / LPIPS 0.049を記録し、BAGEL(20.434 / 0.842 / 24.370 / 0.917 / 0.069)、Show-o2、Emu3、Janus-Pro、および推論拡張型のUni-CoT(20.215 / 0.837 / 23.925 / 0.904 / 0.088)をすべての指標で上回っています。特筆すべきことに、Uni-CoTはいくつかの編集指標においてベースのBAGELよりも悪い結果を示しており、離散CoTが生成側の忠実度を実際に損なう可能性があるという本論文の主張を裏付けています。
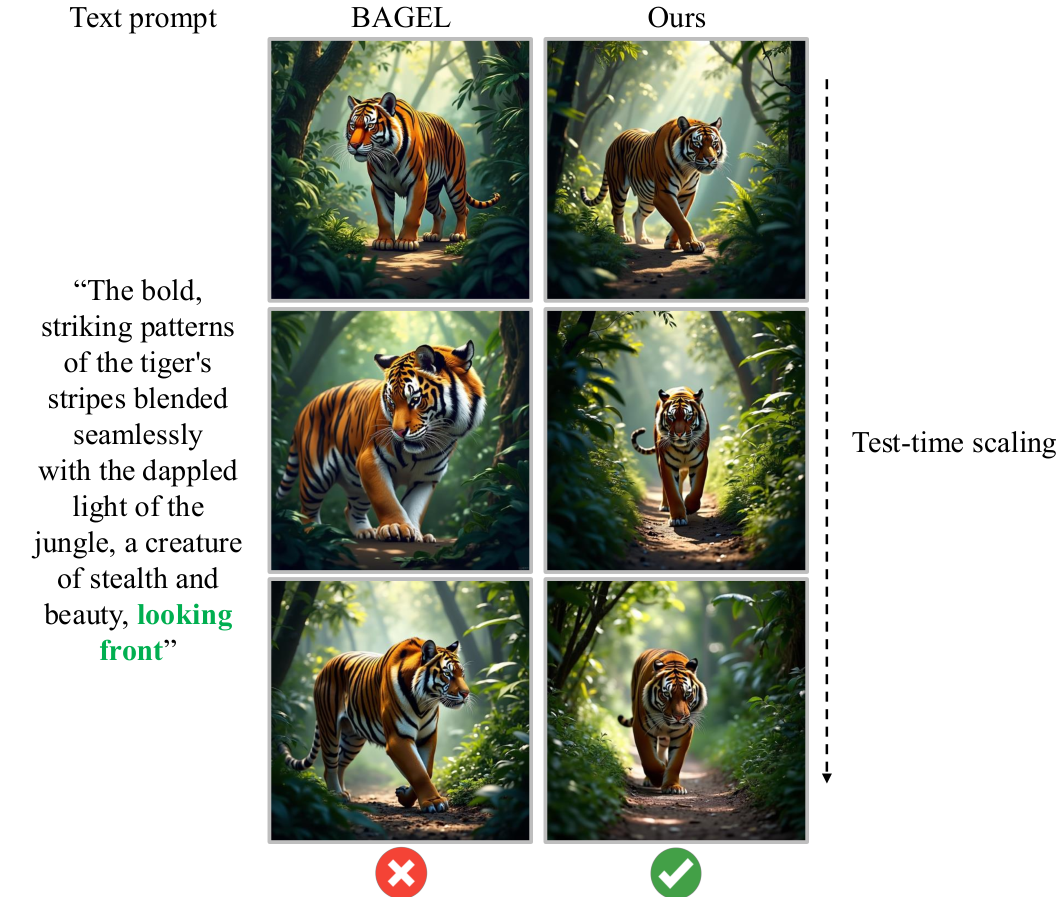
より興味深い結果はtest-time scalingです。推論時に潜在推論ステップ数 L を変化させると、LARCの品質は単調に向上し、T2I・編集・視覚推論(MIRA)において同等の計算量でのbest-of-N samplingを上回ります。
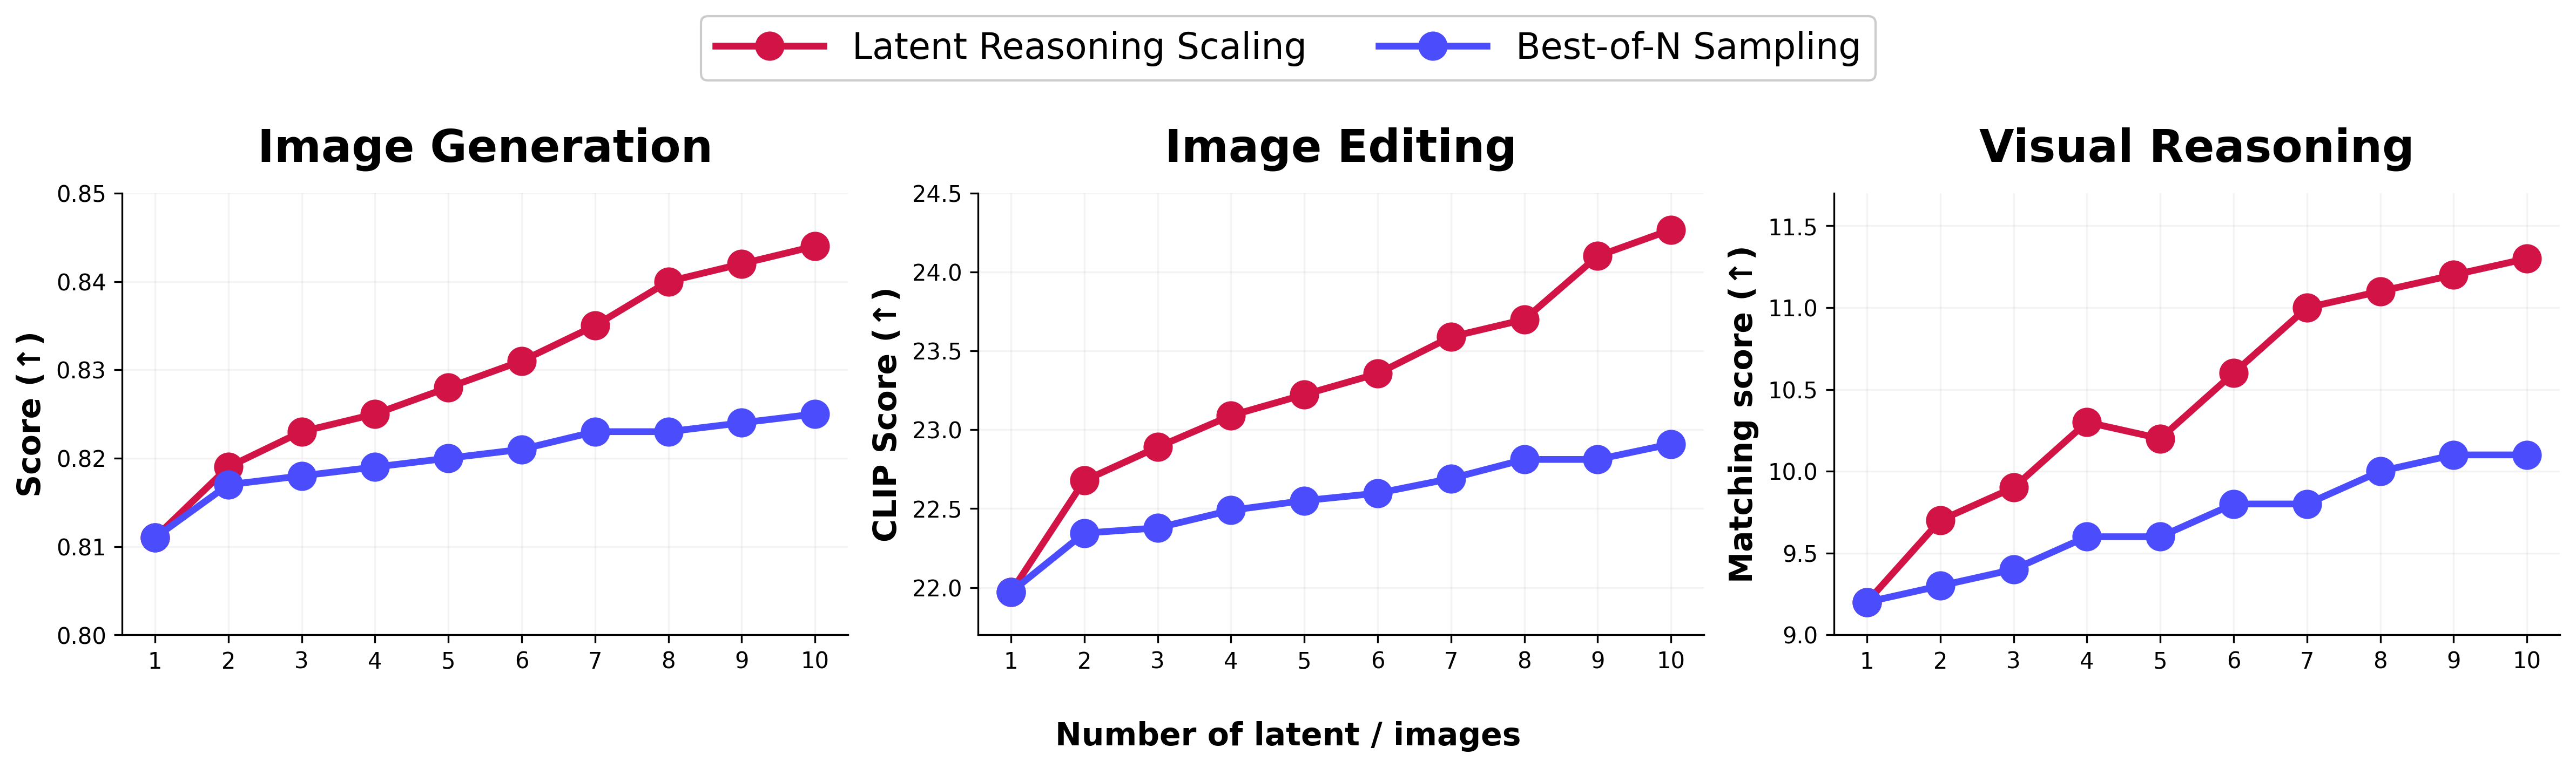
定性的には、N{=}L{=}1 ではBAGELとLARCは同程度ですが、N,L が4および10に増加するにつれて、BAGELのbest-of-N の出力は頭打ちになる一方、LARCの潜在推論は空間的レイアウトとAttribute Bindingを段階的に精緻化していきます。
制限と未解決の問題
報告されている実験は単一のベースモデル(BAGEL)に基づいており、curriculum SFTのスケジュールとMI報酬が他のUMMバックボーン(Janus-Proのような自己回帰のみのもの、あるいはMAR方式のもの)に転用できるかどうかはここでは検証されていません。information-gain報酬は \pi_{\text{ref}} を密度ベースラインとして依存しているため、Stage 1モデルの問題点が報酬ハッキングの機会として伝播する可能性があります。また、潜在トレースは設計上解釈不可能です。ステップ t においてモデルが「何を考えているか」を検査する方法がなく、テキスト形式のCoTと比較してデバッグや安全性分析が困難になります。最後に、test-time scalingの曲線は L{=}10 まで示されていますが、改善が飽和するかどうかは不明であり、また1つの潜在ステップあたりの計算コストはデコーダトークンと同一であるため、KV-cacheの違いを考慮すると、best-of-N との比較はウォールクロック時間での一致ではなくforward pass数での一致として読む必要があります。
なぜこれが重要か
LARCは、「トークンで推論し、その後ピクセルを生成する」というパイプラインがUMMにとって誤った抽象化であることを明快に示しています。推論をモデル自身の連続的な活性化空間に移すことで、生成品質が向上するだけでなく、さらに重要なことに、推論により多くの推論計算を費やすと出力が単調に改善されるというLLM的な特性が回復されます。この結果がBAGEL以外にも一般化するならば、潜在CoTはマルチモーダル生成におけるデフォルトのscaling軸になり得ます。
Source: https://arxiv.org/abs/2610.42149
CaPtain: ポストトレーニング型 Code-as-Policy ロボットエージェントのためのパイプライン
Code-as-policy (CaP) フレーミングは、ロボット操作をコード生成問題として定式化します。ポリシーはロボット API に対して Python を出力し、実行結果を受け取り、反復します。他のエージェント的ドメイン(コーディング、Web、ツール使用)では、SFT によるインターフェース学習とその後のマルチターン RL による習得という標準的なレシピがすでに定着しています。しかし CaP はその流れに乗れていませんでした。既存の CaP システムは、フロンティアのクローズドモデルをプロンプトで使用するか、事前学習済み VLA と高レベルスキルに難しい部分を委ねるか、あるいは小規模なオープン VLM を組み込んだ途端に完全に失敗するかのいずれかです。CaPtain はこのギャップを埋めます。すなわち、小規模な VLM を、VLA・フロンティアモデル・テスト時の特権状態に依存することなく、低レベルプリミティブのみを通じて動作する有能な CaP エージェントへと変えるオープンなポストトレーニングパイプラインです。
ハーネス、SFT、マルチターン RL
パイプラインは三つの結合されたコンポーネントから構成されます。アクションと観測のインターフェースを定義する固定実行ハーネス、ベースモデルをそのインターフェースに合わせるための合成軌跡上での SFT、そして同一ハーネス内でクローズドループ挙動を最適化するマルチターン RL です。
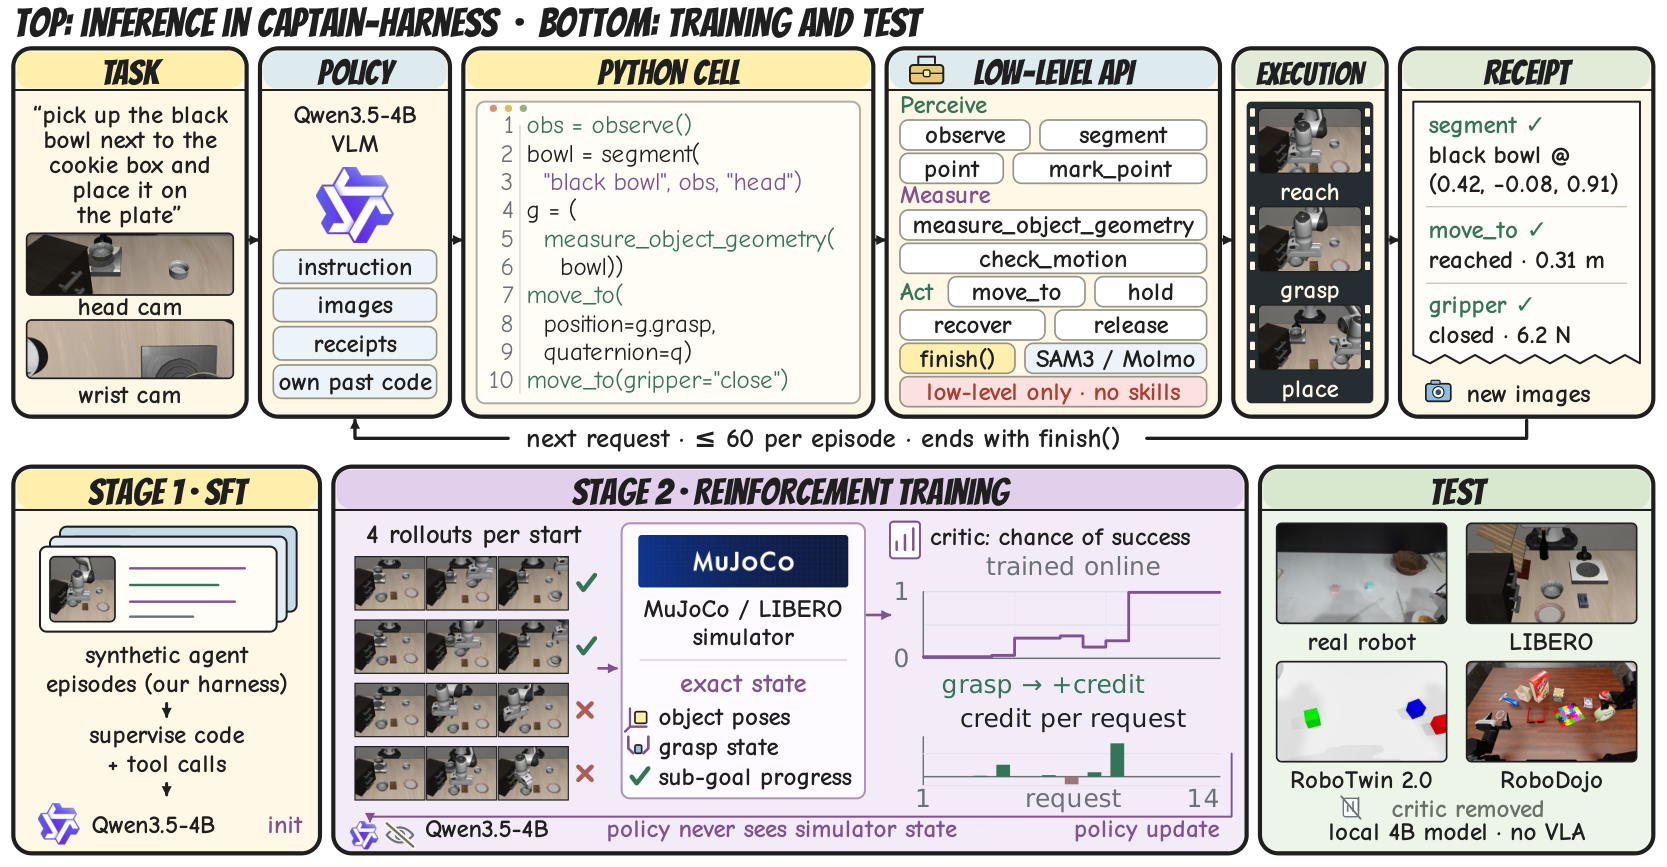
CaPtain-Harness は低レベルの知覚・幾何・ガード付きモーションプリミティブを提供しており、同一のコードがシミュレーションと実ハードウェアの両方で動作します。タスクは自然言語の指示と、API・座標系・成功条件を記述した TASK.md によって指定されます。1エピソードは最大 T \leq 60 リクエストの ReAct ループです。リクエスト t において、ポリシーは
h_t = (\ell, o_1, a_1, o_2, \dots, a_{t-1}, o_t),
を観測します。ここで \ell は初期の頭部・手首画像を含むタスク記述、a_k はモデルの出力(推論と一つ以上の Python ツール呼び出し)、o_k はハーネスの返り値(セル実行結果・テキスト形式のレシート・新しい画像)です。各リクエストは単一のモデル呼び出しです:a_t \sim \pi_\theta(\cdot \mid h_t)。ハーネスはコードセルを順番に実行し、レシートと画像を o_{t+1} として追記し、次のリクエストを再発行します。ループは、返信にツール呼び出しが含まれなくなった時点(通常は finish() の後)、またはリクエスト・物理アクション・経過時間の上限に達した時点で終了します。
SFT は、同一ハーネス内でより強力なリファレンスモデル(アブストラクトでは GPT-6 Astra と記述)をロールアウトして生成した合成軌跡を使用します。ハーネスが固定されているため、SFT の分布とデプロイ時の分布はトークン・API シグネチャ・レシートフォーマット・画像フレーミングを共有します。これはイミテーションデータとライブのツール使用ループの間に生じがちなインターフェースドリフトを回避する、ハーネス内アライメントの一形態です。
RL フェーズはマルチターンであり、テキストエージェントよりも困難なクレジット割り当て問題を解く必要があります。あるリクエストの物理的影響が数ターン後にしか現れないことがあるためです(例えば、ターン t での悪いグラスプがターン t+5 での落下として現れる)。CaPtain は学習時にシミュレータクリティックを使用して特権的な物理状態を読み取りリクエストごとのクレジットを生成しますが、このクリティックはテスト時には除去されます。推論時のポリシーが見るのはレシートと画像のみです。
実験設定
学習は40個のオリジナル LIBERO タスクに限定されています。評価は LIBERO(全40タスクに対して公式のホールドアウト初期状態11〜16、240エピソード)と、学習時には一切登場しない三つの摂動スイートで行われます。LIBERO-PRO はオブジェクト位置およびタスク意味論の摂動を Spatial/Object/Goal/Long にわたって適用(各サブセット100エピソード、報告値は3スイート平均600エピソード・4スイート平均800エピソード)、LIBERO-Plus は七つの摂動次元にわたる層別化された700ケース、LIBERO-MAX は Base および Dynamic のエピソード内摂動下での80 Lite ケースです。ゼロショット転移は RoboTwin 2.0、RoboDojo、SimplerEnv、CaP-Bench で検証されています。
実ロボット設定では、XR1 アーム のツインシミュレーションを通じてポリシーを適応させており、実データへの追加 fine-tuning なしに学習済みポリシーが転移できるよう、シムとハードウェア間でハーネスを同一に保っています。
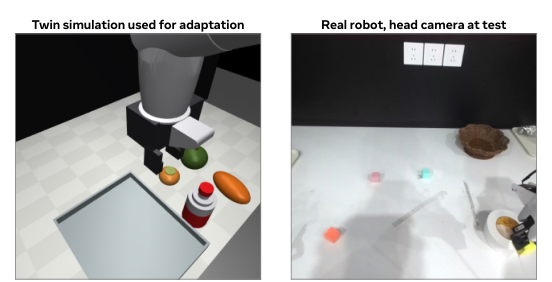
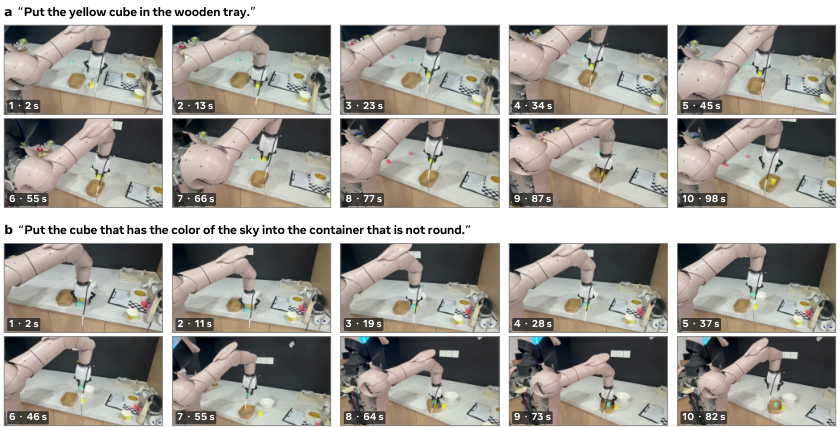
実ロボットエピソードには、新しいオブジェクトやレイアウトとの組み合わせ、および言語グラウンディングを必要とするタスクが含まれます。例えば「空の色をしたキューブ」が水色のものであること、「丸くない容器」が長方形のトレイであることを推論するタスクです。
限界と未解決の問題
このパイプラインは三つの強い前提に依存しています。すなわち、信頼性の高い低レベルプリミティブ(知覚・幾何・ガード付きモーション)を持つ適切に設計されたハーネス、SFT 軌跡合成のための強力な教師モデル、そして特権的なクリティックのために計装可能なシミュレータへのアクセスです。これらはそれぞれ、プリミティブが脆弱なドメイン、教師が分布内で利用できないドメイン、特権状態が明確に定義されていないドメインでは再現が困難かもしれません。60リクエストの予算はエピソード長を制限し、RL ステージがクレジットを割り当てる必要があるホライズンを事実上制限します。潜在的な影響がさらに複雑に蓄積する長ホライズン操作において、クリティックがどれほどスケールするかは不明です。さらに、40個の LIBERO タスクのみで学習することはカバレッジ基盤として狭く、LIBERO-PRO・-Plus・-MAX および ゼロショットシミュレータでの汎化結果が、ハーネス+RL レシピがインターフェースアライメントを超えてどれだけの効果をもたらすかを決定します。
この研究の意義
CaPtain は、コーディングや Web エージェントに使用されている SFT-then-マルチターン RL レシピが、VLA やフロンティアモデルに頼ることなく、アクション空間が低レベル API に対するコードである場合にロボット操作に転移できることを示した最初のオープンなデモンストレーションです。この結果が定量的に裏付けられれば、小規模なオープン VLM がロボットポリシーの実用的な基盤として再評価され、シミュレータクリティックは特権状態を密なターンごとのクレジットへと変換する汎用ツールとして位置付けられます。
Source: https://arxiv.org/abs/2610.40799
REA: 非同期脳・小脳制御のためのルーティング型具身化エージェントランタイム
問題
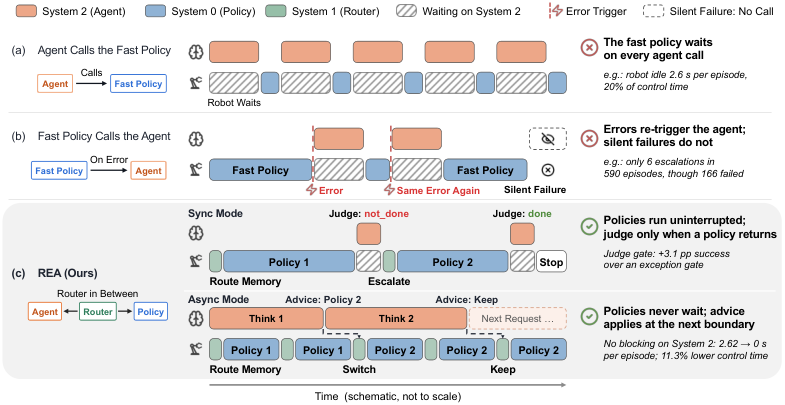
深慮的な基盤モデル(System 2)と高速な反応型ポリシー(VLA、全身コントローラ、スクリプトコード)を組み合わせたデュアルプロセス型の具身化アーキテクチャは自明な設計方針ですが、素朴な結合は対称的な二通りの形で性能を劣化させます。エージェントがループを駆動してポリシーを呼び出す場合、すべての制御ステップにエージェントのレイテンシが持ち込まれます。一方、ポリシーがエラー発生時にエージェントを呼び出す場合、持続的な例外が繰り返しのフォールバックを引き起こす一方で、サイレントな失敗(ポリシーは「成功」して終了するがタスクが未解決のまま)は見逃されます。本論文の設計上の制約は一つのルールに集約されます:実行中のポリシーは脳を待機しない。高速ループをネイティブのレートで維持しつつ、脳レベルの汎化能力を保持し、さらにサイレント失敗を検出するにはどうすればよいかが問いです。
手法
REA は三つの協調する階層からなるランタイムです:System 2(基盤モデルエージェント/ジャッジ)、System 1(具身化ルーター)、System 0(高速ポリシー — VLA、コードポリシー、WBC)。協調は三つのメカニズムによって組織化されています。
Route memory(ルートメモリ)。 タスク/条件ごとに各候補ポリシーの成功率をオフラインで計測して保存します。ディスパッチ時、ルーターは脳へのクエリではなく計測済みの事後確率を参照してポリシーを選択します。これにより、エピソードごとのプランニングが償却済みのエビデンスに置き換えられます。
境界トリガー型ジャッジゲート。 System 2 のジャッジはポリシーの境界、すなわち例外発生時・打ち切り時・ポリシーのリターン時にのみ呼び出され、ロールアウト中には決して呼び出されません。
not_doneの判定が出た場合、ルーターは代替ポリシーのラダーに沿ってエスカレートし、doneの場合はエピソードが終了します。これはサイレント失敗を検出するための仕組みであり、終了状態を視覚的に検査するジャッジはポリシーがエラーを発生させることに依存しないためです。エスカレーションラダー。 ポリシーは順序付けられており(例:Evo → Fix → Evo 再度)、ジャッジによる却下や例外の後の回復は、試行回数の上限までこのラダーに沿って進みます。
三つの変種がこのランタイムを実装しています:REA-M(route memory + 例外ゲート、オンラインの System 2 なし)、REA-A(System 2 が初期ポリシーと回復ポリシーを選択)、REA-V(route memory + リターン時の視覚的ジャッジ)。これらの変種により、著者らはメモリ、エージェントルーティング、視覚的ジャッジングの各寄与を分離できます。
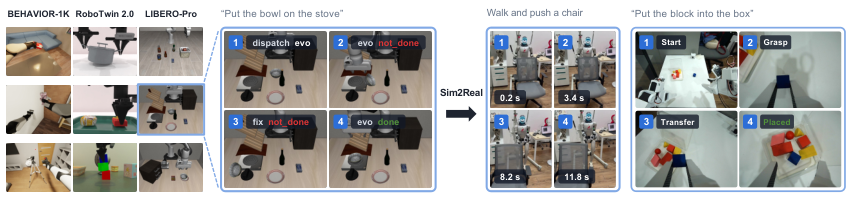
上図の中央パネルは、この設計が対象とするサイレント失敗の事例を示しています:鍋をコンロに載せるエピソードで、三回の試行すべてが例外なしに終了し、最初の二回の失敗した配置と最終的な成功した配置を区別するのは視覚的ジャッジのみです。
実験
主要な評価は LIBERO-Pro 上で行われており、これは LIBERO をオブジェクト・位置(スワップ)・言語・タスク・環境の各軸に沿って摂動させたものです。著者らはタスクおよびスワップ摂動下のゴール・オブジェクト・空間スイートを使用し、6 スイート、各 10 タスク、タスクあたり 50 シード、全体セットで手法あたり 3,000 エピソード、クロス手法研究(シード 1~10)で600 エピソードを評価しています。ホライゾンは 4,000 ステップで 900 秒の実時間予算とし、ルーティング手法はエピソードあたり最大 3 回のポリシー実行に制限されています。6 タスク × 12 シード(そのうち 8 シードは参照 Fix ポリシーが失敗するシード)からなるマッチングされた困難サブセットが回復性能をストレステストします。
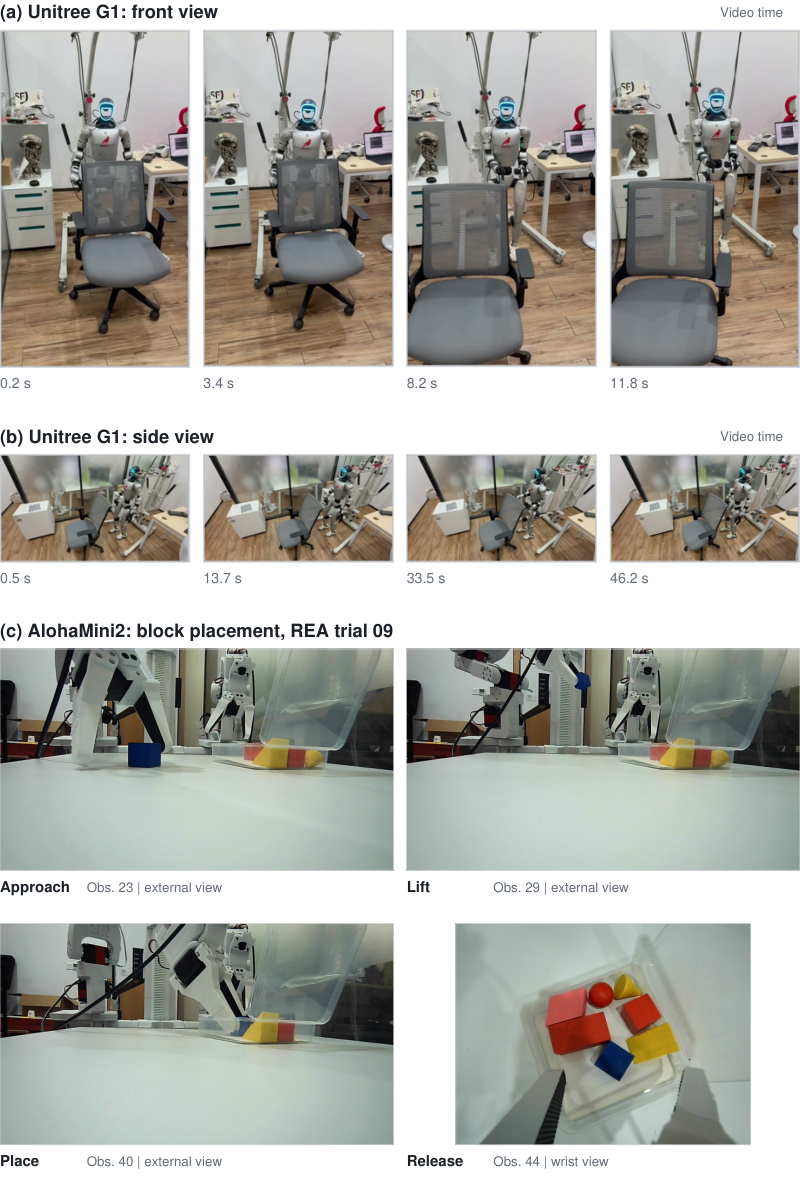
移植性は BEHAVIOR-1K(Isaac Sim 上の R1Pro、5 つのピックアップタスク)、RoboTwin 2.0(双腕、SAPIEN、100 シーンの VLA+コード研究と 200 シーンの転移研究)、および実機の Unitree G1 と AlohaMini2 プラットフォームで確認されています。
困難サブセットの構成はサイレント失敗の主張をストレステストするための重要な設計上の選択です:12 シードのうち 8 シードは既知の Fix 失敗であるため、サイレント終了後にエスカレートできない手法はその真の下限を示すことになります。アブストラクトとセットアップは、例外トリガー型の結合はサイレント失敗を完全に見逃すことを強調しており、これは REA-V の視覚的ジャッジが最も重要になるレジームです。
限界と未解決の問題
提示された抜粋ではスイート全体にわたる主要な集計数値が確定されていないため、(a)エージェント・イン・ループおよび(b)ポリシーがエージェントを呼び出すベースラインに対する改善の大きさは完全な表から読み取る必要があります。セットアップから構造的な問題がいくつか見えます:(i) route memory はテスト摂動下で安定したオフライン成功率推定を前提としており、OOD ギャップが大きくなるにつれて劣化する可能性があります;(ii) 3 回の実行上限と 900 秒の予算は回復の深さを制限し、2~3 のポリシーで十分なタスクで REA を有利にする可能性があります;(iii) 視覚的ジャッジはそれ自体が基盤モデルの呼び出しであり、その偽陰性率が REA-V の上限を直接制約しますが、示されたセクションでは分布シフト下でのキャリブレーションは調査されていません;(iv) エスカレーションラダーは利用可能なポリシープールから手動で構築されるため、大規模なライブラリへのスケーリングには学習による順序付けが必要になります。
重要性
REA は脳・小脳の結合をプランニング問題ではなくルーティングとゲーティングの問題として形式化し、デュアルプロセス型エージェントを実際の制御レートで使用可能にする実用的な不変条件、すなわち高速ループが System 2 をブロックしないことを強制します。route memory と境界ジャッジのパターンは、各コンポーネントを再設計することなく異種ポリシースタック(VLA + コード + WBC)を統合するための転用可能なレシピです。
Source: https://arxiv.org/abs/2610.42053
Hacker News Signals
JEPAによるPlatonic Representation Hypothesisの証明と改善
Platonic Representation Hypothesis(PRH)は、異なるモダリティと目的関数で学習された大規模モデルが、現実の共有された統計的モデル——世界の普遍的な表現——へと収束するという仮説です。本論文はこの主張に形式的な根拠を与え、Joint-Embedding Predictive Architectures(JEPAs)がそれを検証・強化するために活用できることを示しています。
著者らはPRHを相互情報量と表現的アラインメントの観点から形式化しています。すなわち、モダリティ X と Y 上の2つのencoderである f_\theta と g_\phi は、最小十分統計量を条件として I(f_\theta(x); g_\phi(y)) を最大化するときに収束するとします。共通の潜在変数 Z を共有するデータ生成過程に関する緩やかな仮定のもとで、viewをまたいで予測するよう学習された十分に表現力のあるencoderは、可逆変換を除いて Z を復元しなければならないことを証明しています。
JEPAsが中心的な役割を担うのは、ピクセルやトークンではなく潜在表現を予測することで学習を行うためであり、再構成バイアスなしに表現の普遍性を探るための自然な候補となるからです。本論文では、視覚・音声・テキストに対してJEPAsを学習させ、centered kernel alignment(CKA)と最近傍整合性を用いてクロスモーダルなアラインメントを測定しています。JEPAの表現は、contrastiveやgenerativeなベースラインよりも高いクロスモーダルCKAスコアを達成しており、潜在空間における予測という目的関数が収束に対して特に有利であることが示唆されます。
定量的には、視覚JEPAと言語モデルの表現を比較した際に、CLIP方式のcontrastiveモデルに対してCKAアラインメントが8〜14パーセントポイント向上することを報告しており、そのギャップはスケールとともに拡大します。また、I-JEPAにおけるコンテキストマスキング戦略がアラインメントの収束における重要な変数であることを示すアブレーションも含まれており、積極的なマスキングが収束の強化と相関することが示されています。
限界としては、CKAを真の表現的同一性の代理指標として用いていること、また理論的結果が共有潜在変数に関する仮定を必要とし、真に異なるドメイン間ではその仮定が成立しない可能性があることが挙げられます。収束が退化した普遍表現ではなく有用な普遍表現を意味するかどうかは依然として未解決の問題です。
Source: https://arxiv.org/abs/2610.39302
JavaScriptフレームワークのAIコスト
この記事は、重量級JavaScriptフレームワークのこれまで過小評価されてきた外部性を定量化しています。すなわち、LLMが同等のバニラ実装と比べてはるかに多くのボイラープレートを処理・生成・推論しなければならないため、AI支援開発におけるトークンコストが膨らむという問題です。
著者はこれを具体的に測定するために、React、Svelte、Vue、およびプレーンなHTML/JSで実装された代表的なUIコンポーネントを取り上げ、OpenAIのtokenizerでトークン数を計測しています。フック・import・JSXを含むReactのシンプルなインタラクティブカウンターは約180トークンになる一方、40行のバニラJSによる同等の実装は60トークン未満です。この比率は実際のアプリケーションになるとさらに拡大し、小規模なCRUDフォームではフレームワークのコードが命令的なDOM操作と比べて約3倍のトークン数になります。
この影響は経済的な面と質的な面の両方に及びます。現在のAPI価格では、フレームワーク重視のコードを多数のラウンドトリップにわたって扱う開発セッションのコストは無視できないほど増加します。より重要なのは質的な低下です。トークン数が増えるほどコンテキストの消費量が大きくなり、モデルが以前の制約を見失う可能性が高まり、さらにバージョンが正しくない可能性のあるフレームワーク固有のイディオムについてモデルがAPIの幻覚を生じさせる余地も増えます。
この記事はフィードバックループの問題についても指摘しています。ウェブ上のデータで学習されたLLMは膨大な量のReactコードを学習しているため、Reactの生成が得意です。そのため開発者はAI支援ワークフローでReactを使い続けるインセンティブを持ち、その結果として学習データがフレームワーク寄りに偏り続けます。バニラDOMコードは学習データに占める割合が低いため、構造的にはシンプルであるにもかかわらず、モデルの品質は逆説的に低くなっています。
著者はフレームワークを一律に捨てるべきだと主張しているわけではありません。実践的な示唆は、LLMツールへの依存度が高いと想定されるグリーンフィールドプロジェクトで抽象化を選択する際には、トークンのオーバーヘッドを第一級の考慮事項とすべきであり、そのような文脈ではフルのリアクティブフレームワークよりも薄いラッパーライブラリの方がコストと性能のトレードオフとして優れている可能性があるということです。
Source: https://nolanlawson.com/2026/10/28/the-ai-cost-of-javascript-frameworks/
Show HN: OmniDiff – オープンソース、超高速、コンテンツ対応Git difftool(Rust製)
OmniDiffは、Rustで書かれたGit difftoolで、すべてのファイルを行区切りテキストとして扱うのではなく、コンテンツタイプを認識した差分処理を行います。核心的な前提は、git diff およびほとんどのフロントエンドが、バイト/行レベルで動作しパースを行わないため、非テキストや構造化テキスト形式に対して構造的に意味のない差分を生成してしまうという点です。
実装では、各ファイルをコンテンツ検出器に通してフォーマット(JSON、TOML、YAML、CSV、バイナリ、画像など)を識別し、フォーマット固有のdifferにディスパッチします。構造化データ形式の場合、OmniDiffは両側をインメモリツリーにデシリアライズし、tree edit distance差分を計算して、正規化された意味的に意義のある形式で結果をレンダリングします。例えばJSONの差分では、空白の再フォーマットやキーの並び替えによるノイズなしにキーと値の挿入・削除が表示されます。バイナリ差分はコンテキスト付きの16進数レベルの変更を表示し、画像差分はピクセル単位のデルタサマリーを生成します。
パフォーマンスは、Rustの所有権モデルによって可能な限りゼロコピーパーシングを実現し、Rayonを使用したファイルごとの差分処理の並列ディスパッチ、そして遅延フォーマット検出(マジックバイトを最初に、次に拡張子、最後に完全パース試行)によって達成されています。READMEによると、混在コンテンツを持つ50kファイルのリポジトリの差分処理を、最新のラップトップ上で2秒以内に完了できるとされており、Pythonベースの同等ツールの約12秒と比較されています。
Gitとのインテグレーションは簡単で、GIT_EXTERNAL_DIFF=omnidiff を設定するか、.gitconfig の [diff] external に設定します。Gitの外部でスタンドアロンCLIツールとして使用することもサポートしています。
リポジトリに記載されている現在の制限事項:PDFおよびOffice形式のサポートは計画中ですが未実装です。また、非常に大きなJSONファイル(10MB超)に対するtree edit distanceアルゴリズムは、使用されているMyers変種の最悪ケースが二次計算量であるため、処理が遅くなる場合があります。追加のフォーマットハンドラへの貢献はtraitインターフェースを中心に構成されており、拡張が機械的に行えます。
Source: https://github.com/ivankovic/omnidiff
GPT-5.6 Sol はピースフルモードのFactorioをクリアできる
Factorioは、多段階の目標分解、リソースグラフの管理、スケーリング制約下での反復的な自動化を要求するため、AIプランニングの有意義なベンチマークとなっています。ピースフルモードは戦闘を排除し、ロジスティクスと最適化の課題——ロケットを打ち上げる工場を建設すること——のみを分離します。
著者は、ゲーム状態を構造化テキスト表現に変換してモデルにコンテキストとして供給し、モデルの出力をゲームアクションに解析するPythonハーネスを介してGPT-5.6 Solをテストしました。このモデルはFactorioでfine-tuningされておらず、in-contextのゲーム状態の説明とゲームに関する事前学習済み知識のみで動作します。
実行はおよそ18ゲーム内時間(実際のセッションでは数時間に圧縮)で成功しました。主な観察点として、モデルはゲーム序盤のリソースブートストラップを有能に処理しており——鉄と銅の製錬比率を優先すべきことを把握し、プロンプトなしで基本的な自動化を構築します。ブルーサイエンスへの中盤の移行は、バランサーとスプリッターの組み合わせの複雑さにより以前のモデルバージョンが破綻していた箇所ですが、GPT-5.6 Solは各段階でハーネスにスループット指標の報告を求めつつ、中間的な検証ステップを伴うサブゴールに分解することでこれを乗り越えます。
失敗および危機的状況も記録されています:モデルはインサーターのスループット限界を繰り返し誤判断し、再計画の前にハーネスが修正エラーメッセージを注入する必要がありました。また、バックトラッキングを要するスパゲッティ状の非最適なレイアウトを試みることもありました。著者は、モデルが一度も回路ネットワークを使用しなかった点を指摘しており、ピースフルモードではそれが実行可能であることを踏まえると、これは大きな単純化です。
この結果が注目に値するのは、ピースフルなFactorioが人間にとって難しい挑戦だからではなく、再学習なしに数百の連続した意思決定にわたって一貫した持続的なプランニングを示しているからです。未解決の問いは、リソース圧力下での反応的な再計画が要求されるデスワールド設定で同じアプローチが通用するかどうかです。
Source: https://ryanmadden.net/gpt-56-beats-factorio/
Postgres 19 のリリースが遅れている理由:AIツールによるバグ報告数の急増
PostgreSQL のメジャーコントリビューターである Robert Haas は、バグ報告の件数が大幅に増加しており、それを直接 AI コーディングツールに起因するものとして、Postgres 19 のリリースサイクルが遅延していると述べています。
この投稿の技術的な核心は、バグの「件数」だけでなく「性質」についてです。Haas が観察しているのは、現在報告されているバグが、機能のまれな組み合わせ、型強制におけるエッジケース、通常では発生しないプランナーヒントの相互作用といった、難解なコードパスにますます集中しているという点です。これは、書いているコードの意味を深く理解していない開発者が書いたコードを示唆しています。AI が生成した SQL や PL/pgSQL は、有効ではあるが通常は使われない構文の組み合わせを使用する傾向があり、パーサーやエグゼキューターにおいてテストされていないパスを露わにします。バグ自体は本物ですが、コードの作者がセマンティクスを理解している場合にはほとんど表面化しないタイプのものです。
これはリリースプロセスに複合的な問題をもたらします。Postgres は、feature freeze の後にリリース前のバグ修正期間を設けるというフローに従っています。安定化ウィンドウ中に有効なバグ報告の流入レートが過去のベースラインを超えた場合、そのウィンドウを延長せざるを得ません。Haas は、コミッタープールがバグ報告の件数に合わせてスケールしていないため、バグ一件あたりのトリアージ時間が増加していると指摘しています。
彼は、これが AI の使用そのものに対する不満ではないと明言しています——有効なバグが発見されることは良いことです——しかし、タイミングの非対称性が現実的な問題となっています。つまり、生成されたコードがアプリケーション層ではなくデータベース層に影響を与えるバグとして顕在化する前に、そのコードの意味を理解しないままユーザーが本番環境にデプロイしているという構造的な問題があります。
より広いエンジニアリング的な含意として、データベースのテストカバレッジは AI が生成するクエリパターンを見越したものにする必要があります。AI が生成するクエリは、人間が書くクエリとは異なる入力空間の領域を探索するためです。LLM でサンプリングした SQL を用いた fuzz testing が、その自然な拡張として考えられます。
Source: http://rhaas.blogspot.com/2026/10/postgres-19-is-late-and-its-ais-fault.html
マルウェアがLLMを使って被害者の価値をランク付けする
Cisco Talosは、Voltaインフォスティーラーにおける新たな機能を文書化しました。このマルウェアは被害者のマシンからデータを窃取した後、LLM APIを呼び出して被害者の財務的・組織的価値をスコアリングし、さらなる攻撃にどれだけの運用コストを投じるかを決定します。
技術的なパイプラインは以下のように機能します。Voltaは標準的なパッケージを窃取します:ブラウザに保存された認証情報、セッションクッキー、暗号資産ウォレットファイル、クリップボード履歴、インストール済みアプリケーションのリストです。これらの生データをすべてC2サーバーに送り返して手動でレビューする代わりに、構造化されたサマリーにシリアライズしてLLMエンドポイントに送信します(Talosのレポートでは、これはセルフホスト型モデルではなく商用APIであると特定されています)。プロンプトはモデルに対して、複数の次元から被害者の価値を推定するよう求めます:企業ネットワークへのアクセス可能性(VPNクライアント、ドメイン参加状態の指標、エンタープライズソフトウェアから推測)、暗号資産保有の証拠、および特権的な認証情報の存在です。
モデルは簡潔な根拠とともに優先度スコアを返します。スコアの高い被害者には追加のペイロードステージ(永続化メカニズム、ラテラルムーブメントモジュール)がトリガーされ、スコアの低い被害者には初期の認証情報窃取のみにとどめることで、運用上のフットプリントを最小化し、検出リスクを低減します。
これが運用上重要な意味を持つのは、インフォスティーラーのログの手動トリアージが脅威アクターにとって既知のボトルネックとなっているからです。LLMによる自動化によって、人手による時間のコストがなくなります。モデルは特別に高精度である必要はなく、被害者の上位10パーセントを確実に正しくランク付けできるノイジーなフィルターであっても、攻撃者にとって実質的な効率化をもたらします。
検出の観点からは、LLM APIコールは新たな侵害指標(IoC)の種別となります:本来そのような呼び出しを行うべきでないプロセスからの、商用LLMエンドポイントへのアウトバウンドHTTPSです。Talosはこのトラフィックパターンの監視を推奨しています。より広い意味での示唆は、LLM APIがマルウェアのサプライチェーンの一部となったということです。
ゾンビ統計:AIが引用する数字の出所
このTrakkr Researchによる投稿は、LLMが自信を持って引用する特定の統計——「消費者の65%がXを好む」や「従業員は1日平均2.5時間をメールに費やす」といった数字——の出所を、一次資料まで遡ることで検証したものです。
手法は手動かつ体系的です。LLMの出力に現れる広く引用された統計を選び、元の研究を探し、結果を分類するというものです。著者らが構築した分類体系は次のとおりです:(1) sourced(出典あり)——査読済み研究や信頼できる一次調査に遡ることができる;(2) degraded(劣化)——実在する出典に遡ることはできるが、引用の連鎖を経て数字が変化している;(3) zombie(ゾンビ)——記載された出典がその数字を含んでいない、出典が存在しない、あるいは研究自体がプレスリリースやベンダー調査であり、一切の精査を受けていない。
ビジネス、心理学、生産性の各領域においてGPT-4とClaudeが返した200件の統計を対象としたサンプルでは、完全に出典ありが約38%、劣化が29%、ゾンビが33%という結果になりました。ゾンビカテゴリには、モデルがもっともらしい論文引用を完全に幻覚した事例も含まれますが、実在する論文が引用されているにもかかわらず、数字自体は無関係な点でその論文を参照しただけのベンダーのホワイトペーパーに由来するという事例も含まれます。
劣化カテゴリは技術的に特に興味深いです。これは、訓練データに数字が変動する——四捨五入、スコープの変化、対象集団の変化——引用の連鎖が含まれており、モデルが元の出典帰属とともに変動後の数字を再現することを学習し、出典を手動で確認しなければ検出困難な不一致を生み出していることを意味します。
LLMを用いて調査に近い内容を生成する際の実践的な示唆として、数値的な主張には、もっともらしい出典が存在することの確認にとどまらず、一次資料レベルでの独自検証が必要です。
Source: https://trakkr.ai/trakkr-research/zombie-stats
Show HN: DOOMをTransformerに変えてみた
DoomFormerは、DOOMのゲームプレイを離散トークンの系列として自己回帰的にモデル化するtransformerを学習し、それをプレイ可能なゲーム状態の生成モデルとして活用するプロジェクトです。フレームワークはGameNGenに類似していますが、diffusionバックボーンではなく純粋なtransformerを使用しています。
実装では、DOOMのスクリーンショットで学習したVQ-VAEを用いて各ゲームフレームをトークン化し、圧縮された空間解像度(おおよそ20×15パッチ)で1フレームあたり8192個の視覚トークンからなる固定コードブックを生成します。プレイヤーのHP、弾薬数、現在のマップ識別子といったゲーム状態のメタデータは特殊トークンとして先頭に付加されます。transformerに入力される完全な系列は [s_1, a_1, s_2, a_2, \ldots] であり、s_t はフレームトークン系列、a_t はアクショントークンです。
このtransformerは標準的なdecoder-onlyアーキテクチャ(24層、16 heads、embedding次元1024)であり、next-token predictionを目的としたcross-entropy lossで学習されます。推論時には、モデルが直前のフレームと次のアクションを条件として次フレームのトークン系列を生成し、VQ-VAEデコーダーがそれをピクセルに変換します。モデルはDOOM E1M1のゲームプレイ記録約50時間で学習されました。
定性的な結果として、モデルは数秒間のシミュレーションプレイにわたって空間的な一貫性を維持し、扉を開けるイベントや敵のスポーンをおおむね正確に処理し、学習済みマップ内での敵の位置を妥当に汎化することが示されています。生成時間が約15秒を超えると時間的な一貫性が低下し、モデルは部屋のレイアウトを忘れてジオメトリを幻覚し始めます。
リポジトリは整理されたリサーチプロトタイプであり、学習スクリプト、VQ-VAE学習コード、およびキーボード入力を受け付けてシングルA100上でおおよそ8 FPSのリアルタイムでフレームをレンダリングする推論ループが含まれています。著者が指摘している主要な未解決問題は、空間的な忘却なしにより長いプレイセッションをモデル化するために必要なcontext lengthのスケーリングです。
注目の新しいリポジトリ
tangency-labs/solidcraft
SolidCraftは、Rustで完全に記述されたパラメトリック3D CADアプリケーションであり、デスクトップ、Web(WASM経由)、およびヘッドレス自動化のユースケースをターゲットとしています。パラメトリックコアとは、ジオメトリが制約グラフによって定義されることを意味します――寸法を変更すると依存するフィーチャーが再計算されるという仕組みは、メッシュスカルプティングツールとは対照的な、エンジニアリングCADの根本的な要件です。
純粋なRust実装により、OpenCASCADE(FreeCAD、OpenSCAD派生物、およびほとんどのオープンソースCADの基盤となるC++カーネル)への従来の依存を回避しています。これはエコシステムの成熟度を犠牲にする代わりに、メモリ安全性、WASMへのコンパイル実現可能性、および統一されたツールチェーンを得るための意図的な選択です。Webターゲットはアーキテクチャ上重要な意味を持ちます。サーバーサイドの計算ステップなしにブラウザ上でフル機能のパラメトリックCADを実現することは、これまで長年にわたって埋められていなかったギャップでした。
MCP(Model Context Protocol)integration はCAD操作を構造化されたtool callsとして公開し、LLM駆動のデザイン自動化を可能にします――エージェントがMCP互換のツールサーバーに対して使用するのと同じインターフェースを通じて、プログラム的にジオメトリを生成または修正することができます。
公開直後に13kスターを獲得し関心は高まっていますが、プロジェクトはまだ初期段階です。あらゆるパラメトリックCADカーネルの中で最も困難な部分であるコア制約ソルバーが、長期的な実用性を左右することになります。プロダクションワークフローへの採用を検討している方は、過拘束および未拘束のスケッチ解決について十分なストレステストを行うべきです。
Source: https://github.com/tangency-labs/solidcraft
opengeos/RustGIS
RustGISは、純粋なRustで書かれたフルスタックのGISデスクトップアプリケーションであり、ベクター/ラスターデータの読み込み、空間クエリ、座標参照系(CRS)変換、地図レンダリングといった標準的なワークロードをカバーしています。対象ユーザーは、現在QGISを使用しているものの、PythonランタイムやQtの依存ツリーを必要としない、より軽量で高速なバイナリを求めているユーザーです。
内部スタックは、ジオメトリ演算にgdal Rustバインディングまたはgeo/geosクレート、CRS処理にproj-rsを活用していると考えられますが、リポジトリ自体の抽象化はこれらの上位に位置しています。RustのラスターレンダリングパイプラインはSIMDをpacked_simdまたはstd::simdを通じて活用でき、インタープリタ型GISスクリプティングと比較してスループット面での優位性を発揮します。
「純粋なRust」というアプローチはデプロイメントの観点から重要です。単一の静的リンクバイナリは、フィールドデバイスや組み込みLinuxシステム、GDALシステムライブラリのインストールが現実的でない環境へのパッケージングを簡略化します。ARMターゲットへのクロスコンパイルも、QGISの依存グラフが困難にするような形とは異なり、Rustツールチェーンから容易に実現できます。
2,200以上のスターを獲得しており、このプロジェクトは一定の支持を集めています。主な未解決事項は、CRSカバレッジの幅とprojバインディングがEPSGデータセット全体を確実に処理できるかどうかです。リモートセンシングワークフローのためのCloud-Optimized GeoTIFF(COG)およびGeoParquetとの統合が、次の自然なフロンティアとなるでしょう。
Source: https://github.com/opengeos/RustGIS
indexable-inc/blaze
Blazeは、Rustのインクリメンタルコンパイルのレイテンシに対処するツールであり、標準的なcargo/rustcの実行と比較して最大92倍の高速化を主張しています。コアとなるメカニズムは、リモートビルドキャッシュと、Cargoのクレートレベルのインクリメンタリティよりも細かい粒度で変更されていないコンパイル単位を識別することで冗長なコードゲンを回避するコンパイルサーバーです。
標準的なcargoのインクリメンタルコンパイルはダーティなクレートを追跡しますが、それでも変更されたクレートに対してLLVMのコードゲンをフルで再実行します。BlazeはMIRまたはLLVM IRレベルでインターセプトし、コンテンツハッシュをキーとしてアーティファクトの出力をキャッシュし、マシン間でそれらを再利用しているようです。これにより、キャッシュが充填されている場合、CIのコールドビルドを実質的にウォームビルドへと変えます。
92倍という数字はベストケースのシナリオに適用されるもので、大規模なコードベースに対してわずかなdiffしかなく、ほぼすべてのクレートがキャッシュヒットする場合です。中程度のチャーンを持つCIパイプラインの現実的な中央値での高速化は3倍〜10倍程度と思われますが、Rustのコンパイル時間が本番環境のRust開発において主要な摩擦点であることを考えると、それでも十分に大きな改善です。
このツールはcargoのラッパーとして統合されており、Cargo.tomlへの変更は一切不要です。主な運用上の懸念はキャッシュ無効化の正確性です。特に、コンパイラバージョンのアップグレード、feature flagの組み合わせ、およびターゲットトリプルをまたいだ場合に問題が生じる可能性があります。これをデプロイする際は、リリースパイプラインで信頼する前に、キャッシュなしのリファレンスビルドに対してアーティファクトの正確性を検証するべきです。
Source: https://github.com/indexable-inc/blaze
sahenjp/RustXNG
RustXNGは、AIエージェント向けのセルフホスト型メタ検索エンジンおよびWebグラウンディングツールです。概念的にはSearXNG(PythonのメタサーチアグリゲーターをRustで再実装したものです。HTMLインターフェースではなくJSON APIを公開しており、リアルタイムのWeb検索を有料の検索APIに依存せず行う必要があるRAGパイプラインやtool-callingエージェントのグラウンディングバックエンドとして即座に活用できます。
主な機能として、クエリを受け取り、設定された上流の検索エンジン(Google、Bing、DuckDuckGoなど)に並列でファンアウトし、結果の重複排除とランク付けを行ったうえで構造化されたJSONを返します。オプションのページテキスト抽出機能は、結果URLのHTMLを取得してストリップし、プレーンテキストを返します。これにより、エージェントは別途スクレイピング層を設けることなく、コンテンツに基づいた推論を行うことができます。
PythonのSearXNGと比較して、Rust実装は並行リクエストあたりのメモリオーバーヘッドが低く、高負荷時の応答集約が高速です。これは多数のエージェントが同時にクエリを発行する場面で重要になります。デプロイは単一バイナリで完結し、セルフホスト型モデルはクエリデータをサードパーティのアナリティクスパイプラインから隔離します。
主な制限は、SearXNGの上流エンジンアダプターとのメンテナンス上の同等性です。検索エンジンのHTML構造は頻繁に変更されるため、スクレイパーを最新の状態に保つことは継続的な作業となります。上流エンジンがマークアップを変更した際に、結果が静かに劣化しないよう監視する必要があります。
Source: https://github.com/sahenjp/RustXNG
modelflare-ai/AnyModelBot
AnyModelBotは、ローカルファースト・マルチプラットフォームのAIアシスタントです。統合されたModelflare APIキーを通じて70以上のLLMプロバイダーにルーティングし、デスクトップ、WeChat、Feishu(Lark)向けのクライアントを提供します。このプロジェクトの核心的な価値提案は、GPT-4o、Claude、Gemini、Grok、DeepSeek、Kimi、GLMなどを単一の認証情報で抽象化し、座席数ベースのサブスクリプションではなくメッセージごとの課金を実現する点にあります。
技術的には、本プロジェクトは永続的なメモリ(おそらくベクトルまたはキー・バリュー型の会話履歴バックエンド)、バックグラウンドタスク実行、computer-use機能を備えたbotフレームワークです。エージェントはシェルコマンドを実行してローカルOSと対話できるため、任意のLLMバックエンド上に構築されたデスクトップ自動化レイヤーとして機能します。
マルチIMインテグレーション(WeChat、Feishu)が技術的な差別化要素となっています。両プラットフォームはbot APIとwebhookモデルに厳しい制限を設けており、安定したインテグレーションを維持するには継続的なアダプター開発が必要です。
「ローカルファースト」という主張には精査が必要です。Modelflareのキーを経由してルーティングを行うため、少なくともクエリのメタデータはそのサービスを通過します。したがってプライバシー保証は、純粋にローカルであるということではなく、Modelflareのデータ取り扱いポリシーに依存します。規制された環境のユーザーは、これをプライベートデプロイメントではなく利便性のためのプロキシとして扱うべきです。オープンソースである点を活かし、Modelflareの利用規約が懸念事項となる場合はルーティングレイヤーをセルフホスティングすることも可能です。
Source: https://github.com/modelflare-ai/AnyModelBot
emanuele-em/kanzo
Kanzoは、人間のユーザーとAIエージェントの両方が利用できる共有ワークスペースとして設計されたセルフホスト型のKanbanボードです。4.5 MBの単一バイナリとして配布され、アイドル時のメモリフットプリントは4.5 MB、起動時間は2 msと謳われています。エージェント統合がこのツールの際立った特徴であり、エージェントは構造化されたAPIを通じてボードとやり取りし、1回の返答あたり10〜60 tokenを消費します。これにより、本格的なプロジェクト管理ツールでは過剰になるようなエージェンティックなパイプラインにおいて、軽量なタスク調整レイヤーとして実用的に機能します。
バイナリサイズとメモリの数値から、JVMやElectronを使わない実装であることが推測され、組み込みHTTPサーバーとSQLiteを永続化に用いたRustまたはGoによる実装である可能性が高いです。これらのリソース要件であれば、専用インフラなしにエッジノードやRaspberry Pi、あるいはリソース制約のあるマイクロサービスと並べて動作させることができます。
「共有可能」という側面は、サードパーティサービスへのアカウント登録を必要とせずにボードをコラボレーターに公開できることを意味しており、共有状態サーフェスを必要とする小規模チームやエージェントスワームに適しています。エージェント向けAPIは、エージェントがHTMLを解析することなくカードを作成・移動・照会できるよう、ボードの状態を構造化されたJSONとして公開していると考えられます。
主な未解決事項は認証とマルチテナントのモデルです。このリソース予算では、高度なACLはおそらく限定的でしょう。小規模チームや個人利用には適していますが、Jiraの代替にはなりません。
Source: https://github.com/emanuele-em/kanzo
jackwener/DSH-Android
DSH-Androidは、rootアクセスやTermuxを必要とせず、AndroidアプリのプロセスにてDeepSeekの推論を直接実行します。エンジンはインプロセスに埋め込まれており、LLMランタイムが独立したデーモンやシェルプロセスとして実行されるのではなく、APKによってロードされるネイティブライブラリとしてバンドルされています。これは、リモートAPIを呼び出す大半のモバイルAIデモとはアーキテクチャ的に異なります。
機能セットには、画面読み取り(他のアプリのUIツリーへのアクセシビリティサービスによるアクセス)、システム設定の変更、スケジュールおよび条件ベースのオートメーション、そして完全なrootなしで昇格した操作を行うためのオプションのShizuku統合が含まれます。これはローカルの電話オートメーションエージェントとして機能します。つまり、モデルが画面上の状態を観察してアクションを発行できるため、完全にオンデバイスで動作するモバイルcomputer-useエージェントと同等です。
「rootなし、Termuxなし」という制約は配布において重要であり、APKは開発者向けの前提条件なしに一般ユーザーがサイドロードできます。DeepSeekを用いたオンデバイス推論は量子化されたモデルの重みを意味し、モバイルのRAM制約(一般的に6〜12 GBの共有メモリ)においては、INT4またはそれ以下の量子化と小パラメータのバリアントが必要になると考えられます。
中国語の説明文は、主なユーザーベースが中国本土のAndroidユーザーであることを示しており、オートメーションのターゲット(システムUIの読み取り、設定の変更)はAndroidのパーミッションモデルに合わせて調整されています。Shizukuは、コンパニオンサービスを介してADBレベルの権限を付与するためのAndroidモッドコミュニティで広く使われているツールです。
Source: https://github.com/jackwener/DSH-Android
lordbasex/LordOS
LordOSは、GNOMEやKDE、あるいは標準的なコンポジターの上に構築するのではなく、デスクトップ環境をゼロから独自に設計したDebianベースのLinuxディストリビューションです。ディスプレイサーバーとWaylandコンポジターはCで記述されており、Weston・Sway・Mutterを一切経由しません。デスクトップUIは、軽量な組み込み用JavaScriptエンジンであるQuickJS上で動作するReact engineによってレンダリングされます。つまり、シェル・パネル・システムUIはすべてReactコンポーネントとして実装され、ChromiumやElectronのフルスタックではなく、CランタイムによってevaluateされるReactコンポーネントとして動作します。
このアーキテクチャは技術的に興味深いものです。QuickJSは小さく(約700 KB)、起動が高速であるため、Node.jsやブラウザエンジンのようなメモリオーバーヘッドを伴わずにReactベースのデスクトップを実現できます。トレードオフとして、npmエコシステムのネイティブバインディングや、明示的に再実装されていないWeb APIが利用できなくなります。
「native private apps」という説明は、同じQuickJS/Reactスタックで実装されたバンドルアプリケーション(ファイルマネージャー、設定など)を示唆しており、UIレイヤー全体を一貫した技術で統一しています。
実用的なユースケースとしては、ソフトウェアスタックを完全に監査できるキオスク端末、組み込みLinuxディスプレイ、あるいはプライバシー重視の個人向けコンピューティングなど、管理された環境のデスクトップが挙げられます。現在310 starsとまだ初期段階であり、Waylandコンポジターの正確な実装とハードウェア互換性(GPUドライバー、入力処理)は、この種のプロジェクトが典型的につまずく箇所です。評価を検討している方は、導入を決める前に自身の具体的なGPUスタックでテストすることを推奨します。