デイリーAIダイジェスト — 2026-10-30
arXiv ハイライト
ベンチマークは難易度上の経験的測度である
問題設定
本論文は、ベンチマークをアイテムの集合としてではなく、潜在的な難易度軸 z \in [0,1] 上の経験的測度 \mu_B として再定義します。モデル \theta に対し、難易度 z における条件付き期待性能(例:pass@1)を s_\theta(z) \in [0,1] とします。リーダーボードで報告される総合スコアは以下のように表されます。
S(\theta; B) = \int_0^1 s_\theta(z)\, d\mu_B(z),
一方、実務者が実際に関心を持つ量は、ある意図された難易度分布 \mu^\star に対する S(\theta; \mu^\star) = \int s_\theta(z)\, d\mu^\star(z) です。ここから直接導かれる2つの失敗モードがあります。
- 測度のミスマッチ: \mu_B \ne \mu^\star であるため、リーダーボード上の順位付けが \mu^\star の下での順位付けと乖離する可能性があります。具体的には、\mu_B が s_\theta の飽和する易しいアイテムに集中している場合、強力なモデル間の差異はベンチマーク上では消失しますが、対象領域では依然として存在します。
- カバレッジのギャップ: z の広い区間が \mu_B の下でマスを受け取らないため、それらの領域における s_\theta の局所的な改善が S(\theta; B) に反映されません。
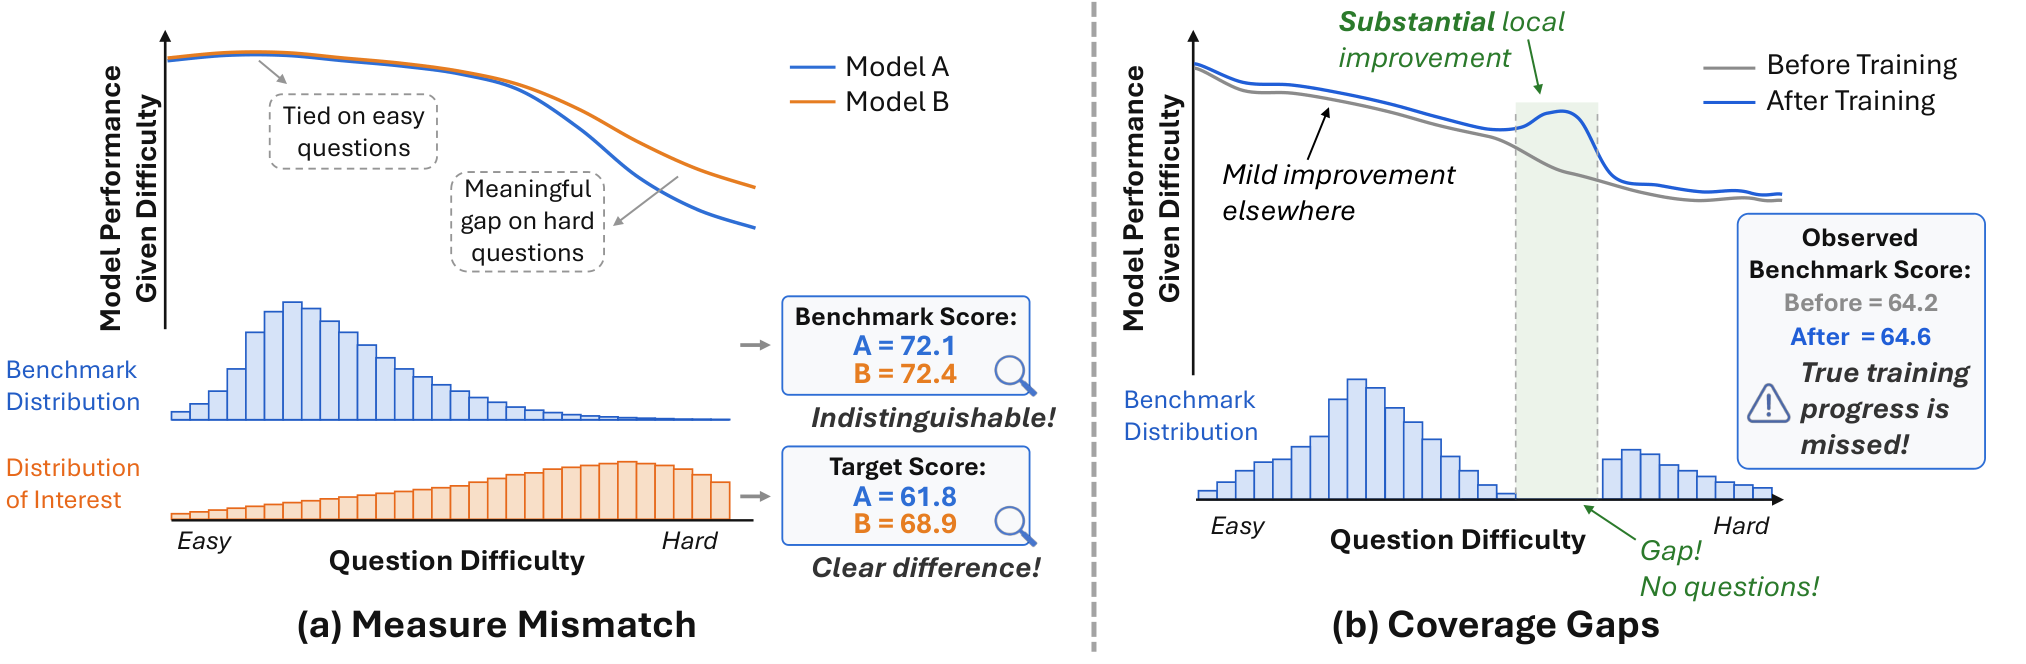
著者らは、これらの失敗モードに対して2つの診断指標を提案しています。それぞれ、\mu_B と \mu^\star の間の乖離の関数として S(\theta;\mu^\star) における誘導誤差を上界で抑える理論的保証を持っています。また、局所的なギャップのサイズに関してもそれぞれ保証があります。測度ミスマッチの指標は本質的に正規化された難易度CDFの間の不一致度であり、カバレッジギャップの指標はソートされた難易度における最大の隣接ギャップに注目し、最悪ケースの検出限界と結びついています。すなわち、最大ギャップが \Delta であれば、そのギャップ内でサポートされた局所的な改善は総合レベルでは完全に観測不能となり、感度は \Delta に比例する何かによって上界されます。
1PL IRT による問題難易度の推定
難易度は「平均失敗率」として直接読み取ることができません。なぜなら、それはアイテムの難しさと使用されるモデルの能力分布を混同してしまうからです。本論文では1パラメータロジスティック(Rasch)IRT モデルを使用します。
\Pr(Y_{ij}=1) = \sigma(\theta_j - b_i),
モデルの能力 \theta_j とアイテムの難易度 b_i は、複数のLLMの経験的成功率から構築された応答行列 Y \in \mathbb{R}^{n\times m} に対して最尤法で同時推定されます。多肢選択式ベンチマークに対しては、推測パラメータを持つ3PLスタイルの変形に拡張しています。フィット後の診断(モデル適合度、アイテム情報、残差)により、信頼性の低いアイテムをフィルタリングします。
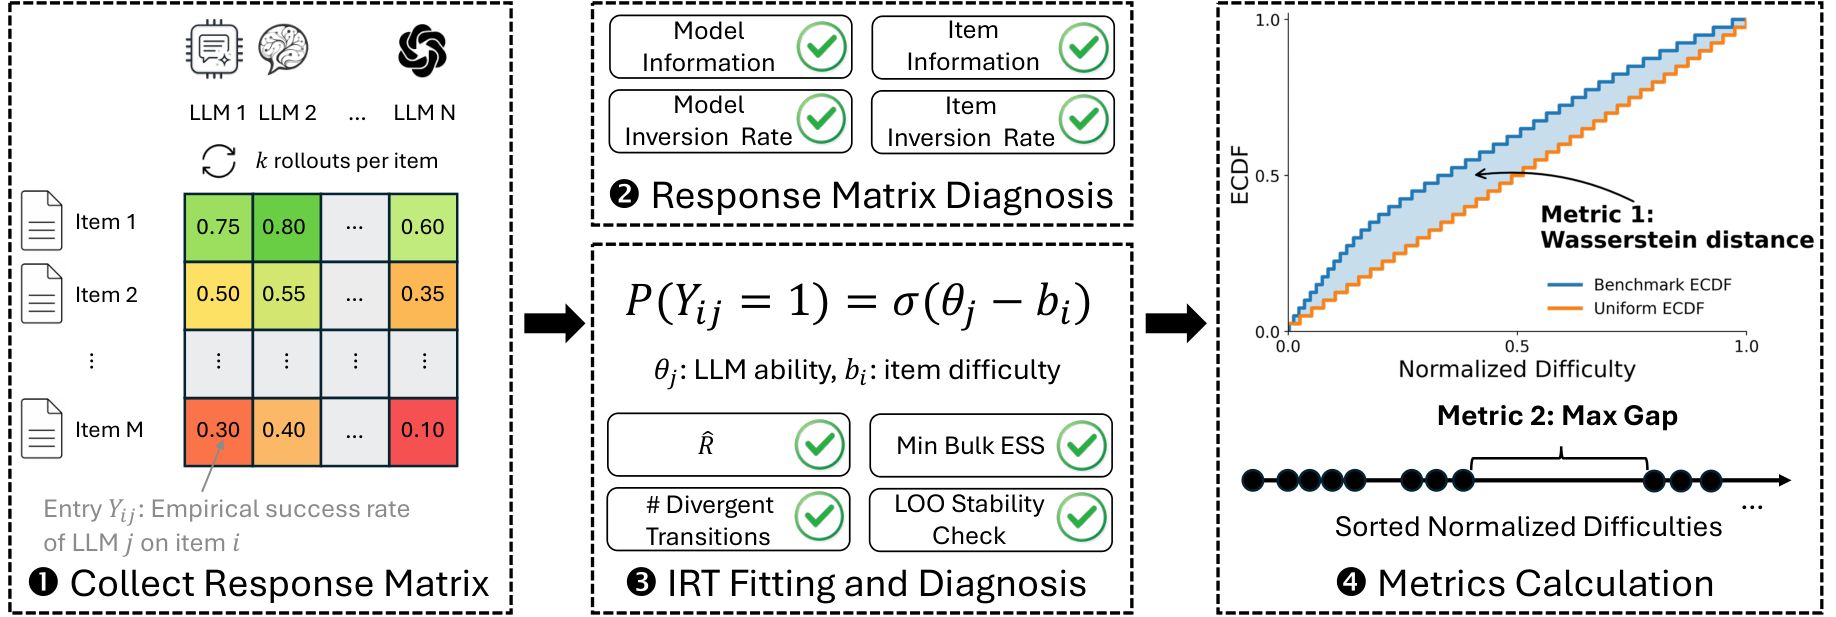
次に b_i はランク正規化されて z_i \in [0,1] となり、2つの指標の計算に使用されます。これは適切な処理です。IRT 難易度は能力の単調変換までしか識別されないため、ベンチマーク間でCDFを比較するにはランク正規化が必要です。
25のベンチマークに対する実証的知見
著者らは、数学・コード・エージェント・論理・科学・指示追従・医学にわたる25のベンチマークにパイプラインを適用しました。2つのパターンが支配的です。
- 特定の難易度領域への過度な集中: 多くのベンチマークが易しい末尾または難しい末尾のいずれかに不均衡なマスを配置しています。s_\theta(z) が0または1に近い場所では、アイテムはフロンティアモデル間でほとんど識別的な情報を提供しませんが、それでも総合スコアを支配します。これは、これらのベンチマークにおけるリーダーボードのデルタが、モデルの能力だけでなくベンチマークの構成をも反映していることを意味します。
- 実質的なカバレッジのギャップ: いくつかのベンチマークは z 上で大きな未カバー区間を持っています。本論文の上界の下では、そのようなギャップ内で特異的に改善したモデルはリーダーボード上で測定可能な変動を生じさせないことになり、これはトレーニングの進捗監視にこれらのベンチマークを使用することに対して直接的に不利です。
この含意は実用的です。「モデルAはモデルBを x ポイント上回る」という形式の主張に対しては、\mu_B が s_A - s_B が実際に非自明である難易度領域にマスを配置しているかどうかを確認すべきです。
BenchFill:標的型ギャップ補完
診断を介入へと転換するために、著者らはBenchFillを導入しています。これは、最大の隣接ギャップ [z_L, z_R] に目標難易度 z^\star = (z_L + z_R)/2 の新しいアイテムを挿入することでギャップを縮小します。この手法は進化的な書き換えとアノテーションのループです。LLMが親アイテム(ギャップ付近からサンプリングされた)を難易度を調整する指示とともに子バリアントに書き換え、各子のアノテーションはキャリブレートされたモデルのロールアウトとフィット済みIRTモデルを介して難易度を推定することで行われます。(親、書き換え指示、結果として得られた難易度)のタプルのメモリが、その後の提案を z^\star へと誘導します。最終的なアイテムは正確性とフォーマットの忠実性について人手で検証されます。
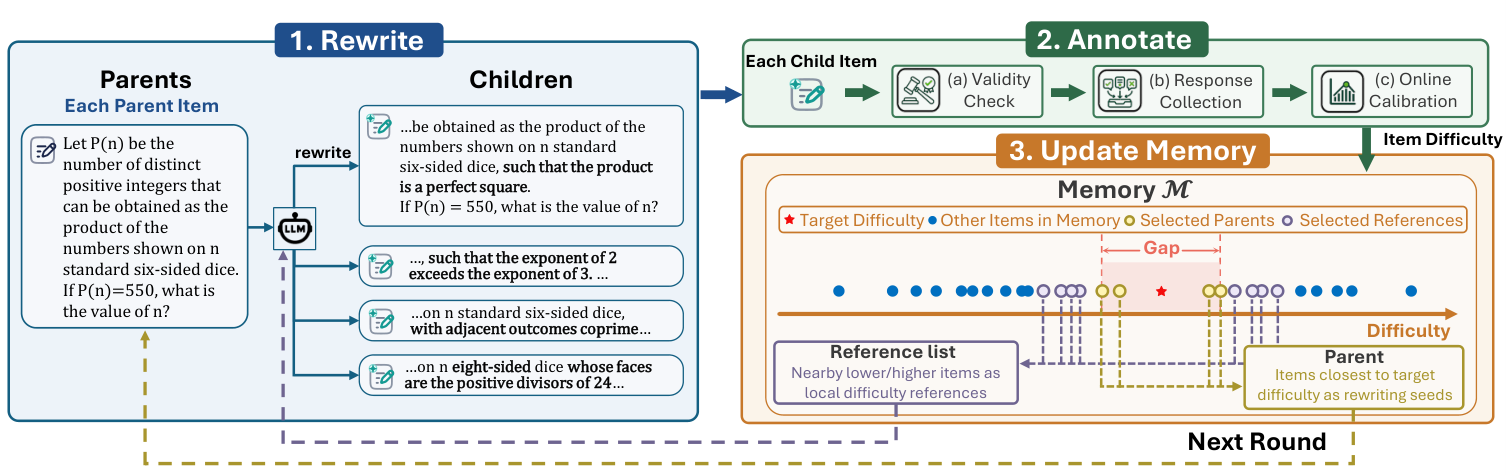
機械的には、これはバンディット的な探索であり、報酬は -|z_{\text{child}} - z^\star|、行動空間はギャップ付近の親を条件とした書き換えプロンプトです。スクラッチからの生成ではなく書き換えを行うことで、スタイルが保持され、難易度に直交する軸に沿った分布シフトのリスクが低減されます。これは重要な点です。なぜならIRT推定値はそのような軸すべてを単一の b に集約してしまうからです。
限界とオープンな問題
アイテムごとに単一の難易度パラメータを仮定する1PLの仮定は強い仮定です。実際のアイテムは識別力や探索する能力次元において異なります。多次元IRTは単一の z 測度の視点を複雑にしますが、異種混合のベンチマークには必要かもしれません。「意図された」測度 \mu^\star は実務者に委ねられており、フレームワークは \mu^\star を条件とした診断的なものであり、規範的なものではありません。難易度推定値はまた、Y を構築するために使用されるモデルパネルにも依存します。同様の能力を持つフロンティアモデルのパネルでは、極端な領域での b_i の識別が不十分になります。最後に、BenchFillは局所的なギャップを縮小しますが、大域的な測度のミスマッチを修正するものではなく、それには再重み付けまたは実質的な新規アイテム生成が必要です。
なぜこれが重要か
ベンチマークを難易度上の経験的測度として扱うことで、リーダーボードの集計が曖昧にしていることを明示化できます。すなわち、スコアはベンチマーク作成者が暗黙的に選択した分布(しばしば偶然に)に対する積分であるということです。2つの診断指標は、ベンチマークの結論が意図されたデプロイメント分布に転移可能かどうか、また現代のポストトレーニングが生み出すような局所的な進捗をそのベンチマークが検出できるかどうかを問う原則的な方法を提供します。
Source: https://arxiv.org/abs/2610.29927
Intrinsic Distribution Matching
Distribution matching distillation(DMD)は、student分布 p_\theta をreference p_r に向けてscore差分 \mathbf{s}_\theta - \mathbf{s}_r を用いて駆動することで、多段階のdiffusion/flow samplerを1〜2回のネットワーク評価に圧縮します。実際には、この差分は別途学習したfake-scoreネットワークによって推定されるか、あるいはAPEXのように同一backboneの2つの「内部」velocity branchをcondition-flipで選択することで推定されます。本論文は、その学習済みscore supervisionに明示的かつ低コストなmoment制約を補強することが、誤差を追加的なrefinementで修正できない1〜2ステップの領域で改善をもたらすかどうかを問います。
reverse-KLフィールドの分解
固定されたcondition \mathbf{c} において、サンプル空間でのreverse-KL gradientは
\mathbf{g}_{\mathrm{KL}}(\mathbf{x}\mid\mathbf{c}) = \mathbf{s}_\theta(\mathbf{x}\mid\mathbf{c}) - \mathbf{s}_r(\mathbf{x}\mid\mathbf{c}),
であり、ノイズ付き周辺分布 p_{\theta,t}, p_{r,t} 上でのDMD velocity残差は
\mathbf{d}_t^*(\mathbf{x}_t) = \mathbf{v}^*_{\theta,t} - \mathbf{v}^*_{r,t} = \tfrac{t}{1-t}\bigl(\mathbf{s}_{r,t} - \mathbf{s}_{\theta,t}\bigr),
を満たすため、\mathbf{g}_{\mathrm{KL},t} = -\tfrac{1-t}{t}\,\mathbf{d}_t^* となります。本論文の概念的な操作は、\mathbf{g}_{\mathrm{KL}} をGaussianモーメント成分——moment-matched surrogate q_i を通じて (\mu_i, \Sigma_i) を一致させることで再現される部分——と、非Gaussian残差に分割することです。平均と共分散が等しければ前者はゼロになりますが、一般的に後者はゼロにはならないため、moment matchingはDMD補正を置き換えることはできません。学習済みscore差分がノイジーに推定するかもしれない部分空間を固定するだけです。
IDM objective
IDMは完全なDMD scoreタームを保持しつつ、generatorの自己EMAコピー G_{\theta_{\mathrm{EMA}}} のfeatureに対して計算される補助的なmomentタームを加えます。そのため、外部エンコーダー(CLIP、DINO、VGG)は使用しません。内部velocity branchはAPEXに従います:単一backbone \boldsymbol{F}_\theta が以下の両方を提供します。
\widehat{\mathbf{v}}_{r,t}(\mathbf{x}_t\mid\mathbf{c}) = \boldsymbol{F}_\theta(\mathbf{x}_t,t,\mathbf{c}), \qquad \widehat{\mathbf{v}}_{\theta,t}(\mathbf{x}_t\mid\mathbf{c}) = \boldsymbol{F}_\theta(\mathbf{x}_t,t,-\mathbf{c}),
conditionの符号反転がモデルbranchを選択し、その差分 \widehat{\mathbf{d}}_t が \mathcal{L}_{\mathrm{score}} を駆動する \mathbf{d}_t^* の経験的surrogateとなります。population項 \mathcal{L}_{\mathrm{pop}}(経験的形式 \widehat{\mathcal{L}}_{\mathrm{pop}})は、generatorとEMA featuresの間でfeature平均と座標ごとの標準偏差を一致させます——完全な共分散一致ではなく対角二次モーメント制約——これはセクション3の分解によって動機付けられています。
supervision/安定性の副産物として:Gaussianコンポーネントが \mathcal{L}_{\mathrm{pop}} によって明示的に処理されることで、DMD branchは非Gaussian残差に容量を集中できます。著者らはこれにより、低NFE領域でのノイジーなscore推定への依存が減少すると主張しています。
結果
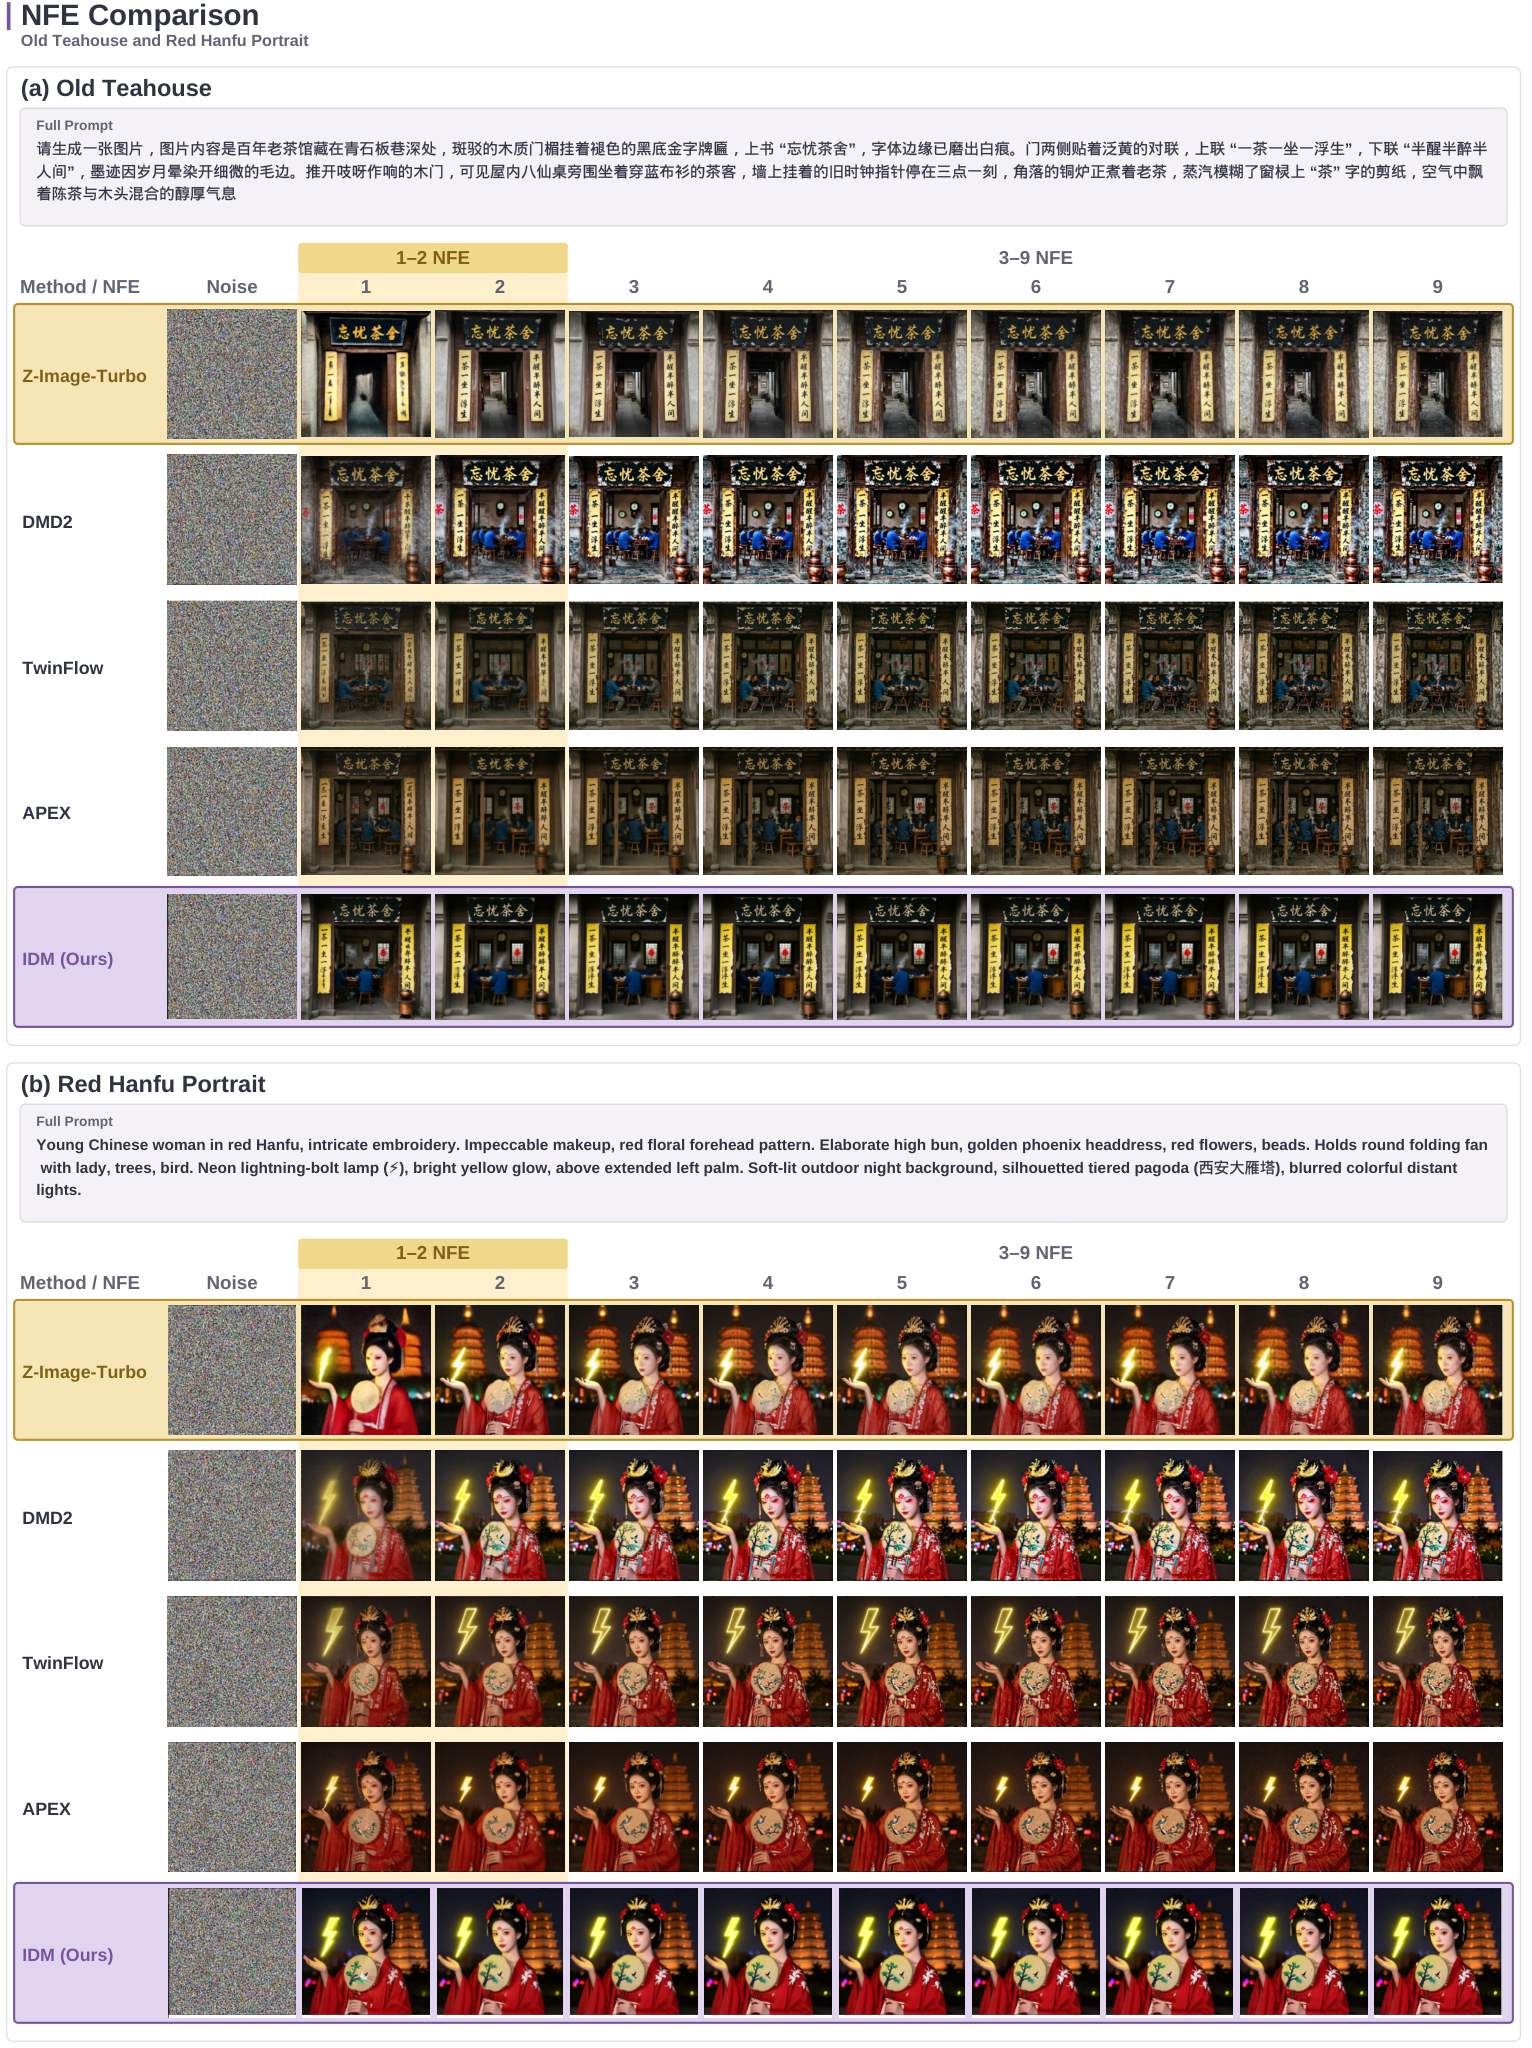
実験では、Z-Image-Turbo(6B)とQwen-Image(20B)を、full-parameterおよびLoRA(r{=}32,64)tuningの両方で、単一A100(BF16)上で1および2 NFEにおいてdistillします。
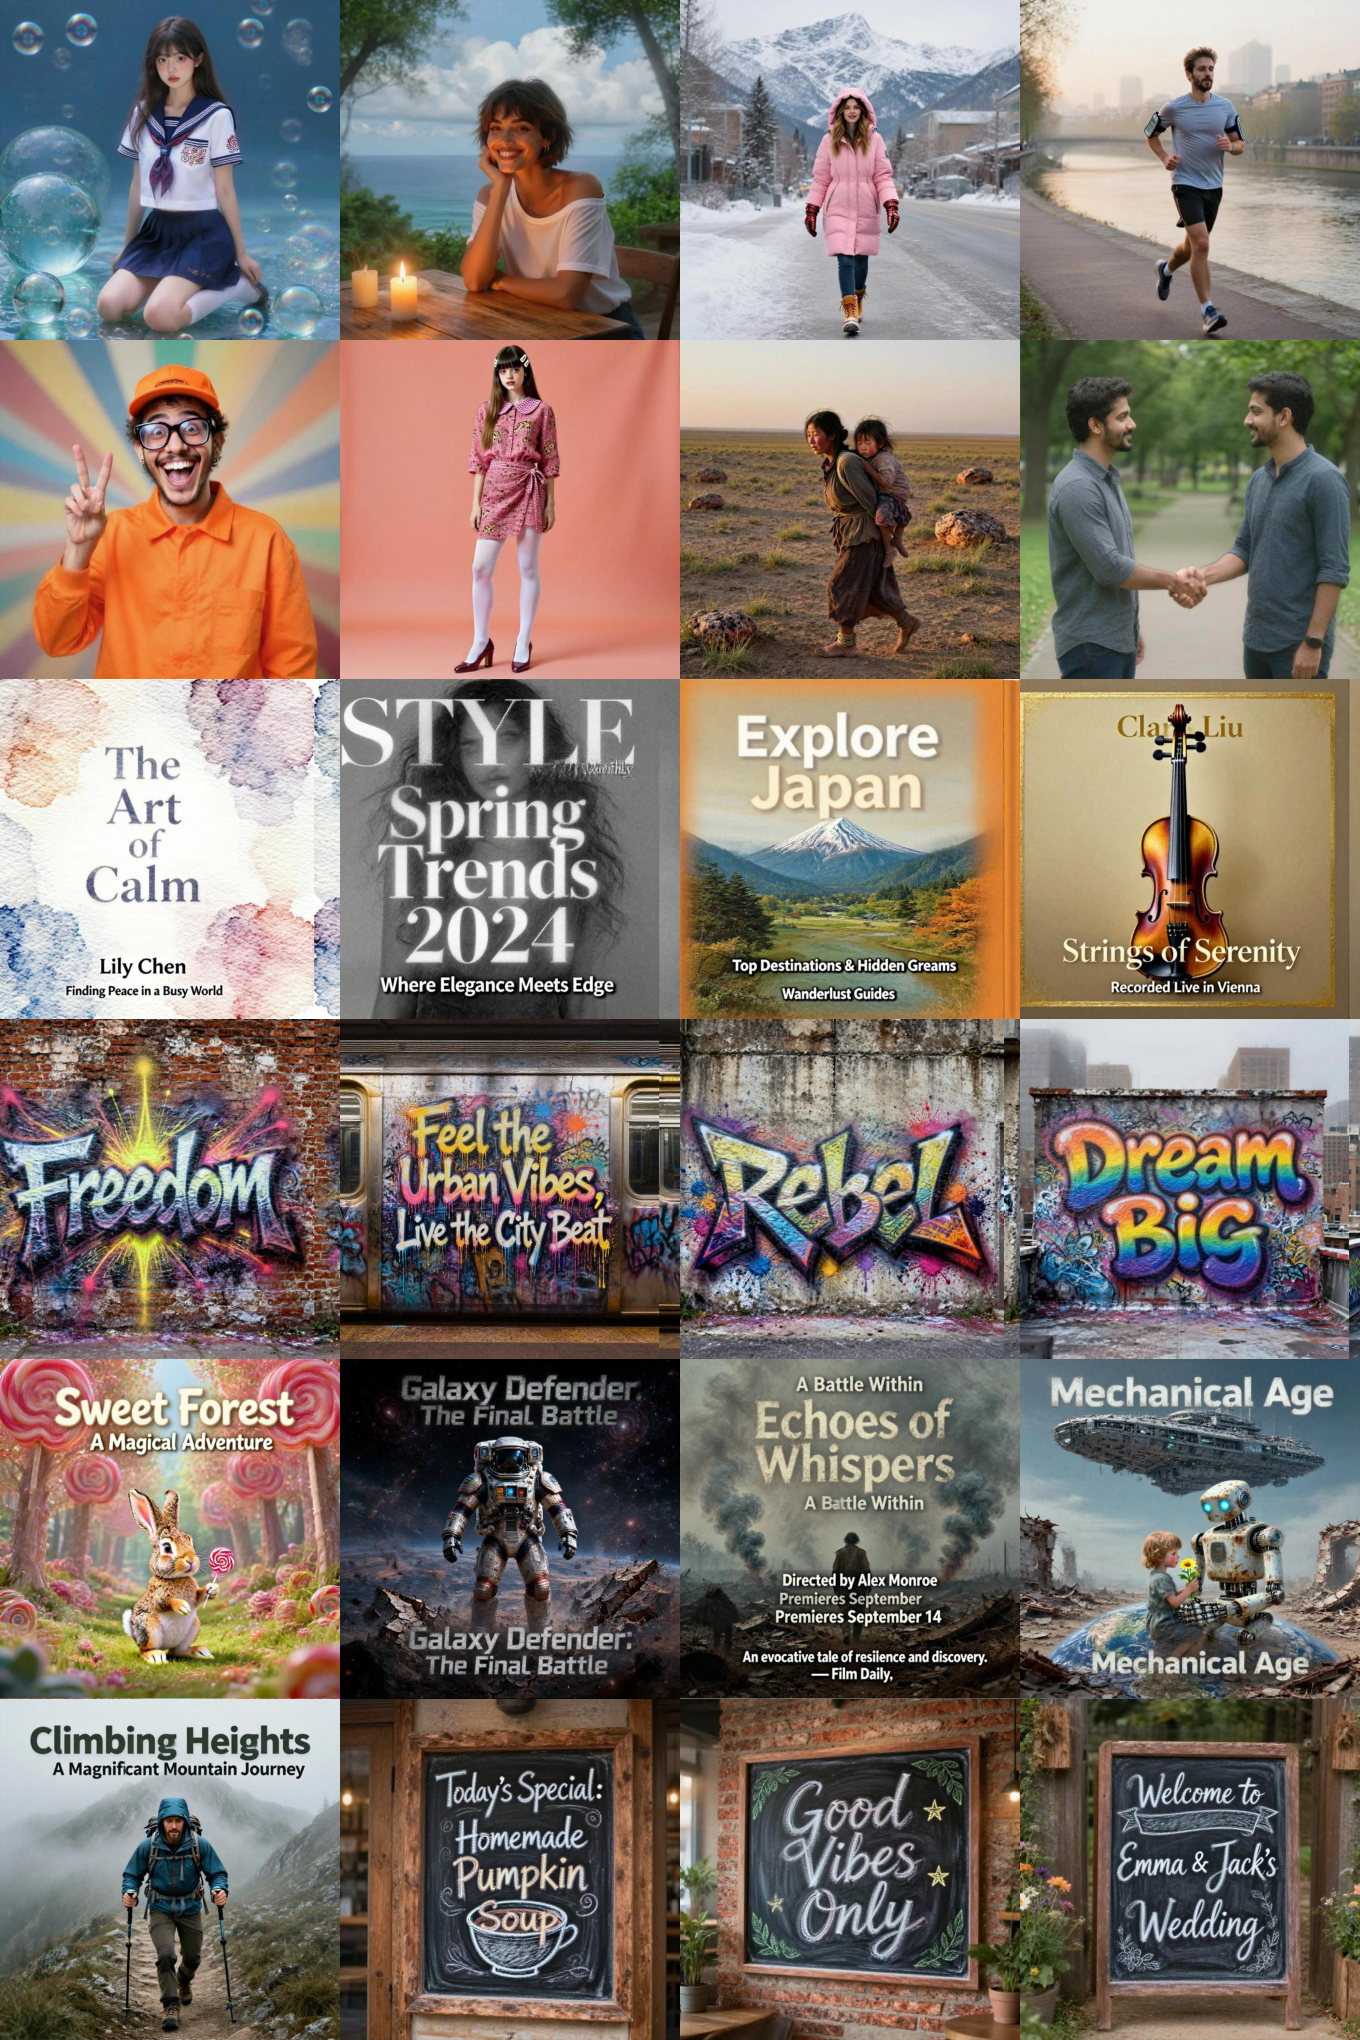
GenEvalの2 NFEにおいて、IDM(Qwen-Image、full-parameter)は0.91に達し、同等のbudgetでAPEX(0.90)およびQwen-Image-Lightning(0.85)を上回ります。1 NFEでは0.88(full)/ LoRA r{=}32 で0.88に達し、APEX 0.89、Lightning 0.85に対して競争力を持ちます。2 NFEでのFIDはIDM(full Qwen)が6.34で、APEX full(6.44)およびLightning(6.76)に対して優れています。CLIPはすべての手法間で同等(28.4〜28.8の帯域)であり、構成的/テキストレンダリングの改善がCLIP similarityで捉えられないという見解と整合しています。
主要なLongText-Benchテキストレンダリングタスクの2 NFEにおいて、IDMは94.25%(中国語)および90.20%(英語)を報告しており、比較された2 NFEシステムの中で最高スコアです。A100でのスループットとレイテンシは劣化していません:IDM(Qwen-Image)は2 NFEで3.28 samples/s(batch 10)および0.44秒のレイテンシ(batch 1)で動作し——品質向上を得ながらAPEXおよびLightningと本質的に同等です。小型のZ-Image backboneは異なるParetoポイントに位置します:2 NFEで5.18 samples/s、FID 6.71、GenEval 0.78。
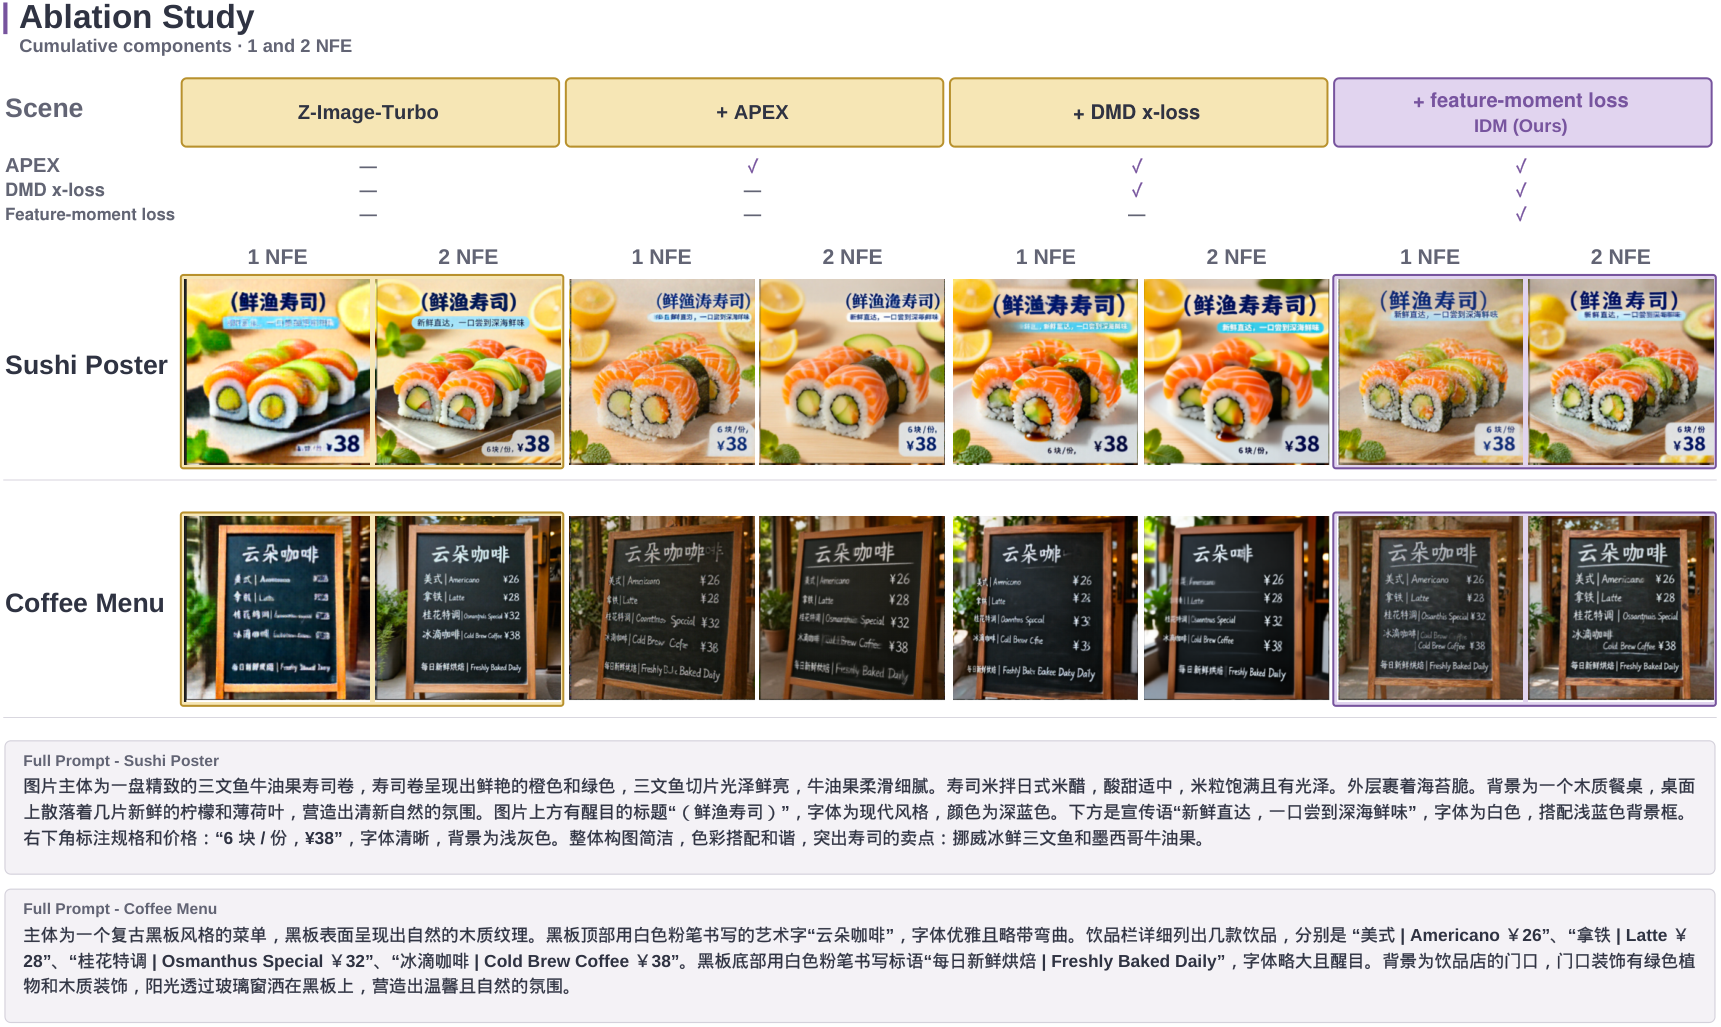
制御されたAblationは \mathcal{L}_{\mathrm{pop}} の貢献を分離します。これを除去すると(v{+}x バリアント——velocityとendpoint regressionを保持しつつEMA feature-moment matchingを除去——)、同一データ/backboneの条件下で1および2 NFEの両方で細部とテキスト忠実度が低下します。これは分解の議論と整合しています:DMD項のみでは、低NFE領域でGaussianモーメント部分空間が制約不足のままになります。
制限と未解決の問いかけ
moment制約は、generatorの自己EMAコピーで定義されるfeature空間において対角(座標ごとの標準偏差)です。この選択は外部エンコーダーを避けますが、「features」を学習中の動的なターゲットにし、表現のドリフトと分布のドリフトを混同させます。分解はGaussianモーメント部分空間のみを形式的に扱うため、残差のDMD推定が改善するという保証はなく——改善は経験的なものです。APEX に対するGenEvalの改善は小幅です(2 NFEで0.90 → 0.91;Qwen full-tuningの1 NFEで0.89 → 0.88)。また、LongText-Benchの数値は抜粋中で2 NFEのIDM構成についてのみ報告されており、1 NFEでのAPEX/Lightningに対するテキストレンダリング優位性の大きさはここでは完全には定量化されていません。本手法はまた、branchを分離するためのAPEXのcondition-negationトリックにも依存しており、強いclassifier-free guidance構造を持たないbackboneへの適用可能性は不明です。
なぜ重要か
IDMは、reverse-KLフィールドのmoment部分空間を明示的に固定し、学習済みscore差分を非Gaussian残差に集中させることで、最も重要な領域——1〜2ステップ推論——でDMDスタイルのdistillationを強化する、エンコーダー不要の原則的な方法を提供します。スループットのペナルティなしに、20B Qwen-Imageで2 NFEにおいて94.25%/90.20% LongText-Benchおよび0.91 GenEvalという結果は、既存の内部branch distillationスタック上への実用的なdrop-inとしてIDMを位置付けます。
Source: https://arxiv.org/abs/2610.39633
A-RSI: マルチモーダル自己改善のためのゼロデータ適応タスクリフレッシュ
問題
マルチモーダルモデルの再帰的自己改善ループは、互いに関連する二つの問いを抱えています。すなわち、どのような新しい学習経験を生成するか、そして現在の経験がgradient signalを持たなくなった時期はいつかという問いです。既存のパイプラインの多くはこれらを混同しています。モデル自身が作成したタスクを生成し、自己整合性や多数決投票によって教師信号を導出するため、学習対象が学習中の不確実な予測に依存してしまいます。A-RSIはこの二つを分離します。プログラム的に作成されたタスクの静的なライブラリが、参照回答をコードで計算する(独立に検証可能な)問題を生成し、学習ログの統計を読み取るコントローラがタスクプールを交換する時期を決定します。コントローラにはバリデーションやテストのスコアは渡されず、外部の学習事例や人間によるラベルも使用されません。
手法
\theta_{w-1} をパラメータ、\mathcal{P}_w をウィンドウ w の開始時におけるアクティブプールとします。各ウィンドウでは H{=}100 回のGRPO更新(Shao et al. 2024)を実行して \theta_w とロールアウトログ \mathcal{L}_w を生成します。学習前に三つの固定ステージが実行されます。
テンプレート合成。 シード(幾何、グラフ、テーブル、カウント)を起点として、ベースモデルがパラメータ化されたプログラム \tau を記述します。各 \tau は、許容パラメータ z \sim p_\tau、画像レンダラー、質問コンポーザー、および回答関数を指定します。 z\sim p_\tau,\qquad (I,q,a)=G_\tau(z). 学習器は (I,q) のみを受け取り、a に対してスコアリングされます。テンプレートライブラリ \mathcal{T} は固定されます。
候補レザバーと置換プール。 受け入れチェックは、設定の妥当性、回答の計算可能性、レンダリング制約、新鮮さ・汚染を検証します。固定されたタスクファミリークォータのもと、互いに素な置換プール(各400タスク)が用意されます。
GRPOのreward。 正確性、フォーマット、終了に関するコンポーネントから構成されます。制御されたスコアリングテスト(7バリアント \times 1,000タスク = 7,000レスポンス)によって単調性が検証されます。正解にコミットした場合 > 不正解にコミットした場合が1,000/1,000件で確認され、正規フォーマットおよび正常終了はそれぞれ他のコンポーネントを固定した状態でrewardを向上させることが1,000/1,000件で確認されています。
適応コントローラは \mathcal{L}_w から学習側の精度およびgroup-relative advantage(U)を読み取ります。飽和が検出された場合(例:Qwenの旧プールでは U が 245 \to 194 \to 153 と低下し、比率0.62、学習精度 0.490 \to 0.633)、アクティブプールを未使用のものと交換し、最後に受け入れられた重みを保持します。置換にはファミリークォータのもとでのランダムサンプリングが用いられ、フロンティア/難易度選択は明示的にアブレーションされています。
比較対象となるアーム:A-RSI(ログトリガー + ランダム)、Frontier(ログトリガー + 難易度フロンティア)、Periodic(2ウィンドウごと + フロンティア)、Continuous(毎ウィンドウ + 適応的難易度)、No-Refresh。
結果
11ベンチマークスイート(22,042問、8192トークン制限)において、Qwen3-VL-8B-Instruct Macro11はウィンドウをまたいで 57.77 \to 58.08 \to 58.75 \to 59.84 \to 60.40 \to 60.24 \to 61.05 \to 61.44 と向上し、プール平均は 58.36 \to 60.12 \to 60.91 となりました。同じ更新バジェット S_{23} において、A-RSIは60.40に到達したのに対し、元のプールを継続した場合は58.35(+2.05)であり、No-Refreshは学習健全性チェックに失敗して S_{31} で停止しました。
S_{32} において、A-RSIは800の新規タスクのみで61.05に到達しました。一方、Continuousは60.64(3,200新規タスク)、Periodicは59.89(1,200)、Frontierは59.59(800)でした。正規化すると、A-RSIは1,000新規タスクあたり+4.09ポイントをもたらし、他の手法の0.90、1.77、2.28と比較して優位でした。11の全ベンチマークで S_t から S_{32} にかけて改善が見られ、+1.19(SCEMQA-MC)から+8.33(PhyX-MC)の範囲に及びます。注釈付きのビジュアルタイプ4サブセット全てで改善が見られました(幾何 +3.64、グラフ +2.03、テーブル +2.03、カウント +6.94)。
切り捨て(Truncation)。 注目すべきシグナルとして、S_{32} におけるプール全体の切り捨て率はA-RSIで4.16%であったのに対し、Frontierで8.14%、Periodicで10.33%、Continuousで8.44%でした。著者らは利得の多くを終了回復(termination recovery)に帰因しており、これを丁寧に分解しています。
Qwenにおいては、full-suiteの出力分解によると、both-finishedの層が−0.75ポイントを寄与し、他の層が+5.15を寄与しています(一次デコーディング S_0 \to S_{32}、合計 +4.40)。MiMo-VL-7B-SFTは異なる挙動を示し、Macro11で 59.08 \to 60.71 となっており、both-finishedの寄与が+0.99、両チェックポイントで完了したレスポンスの間で不正解→正解が1,460件、正解→不正解が1,235件となっています。これは切り捨て回復を超えた真の修正を示しており、再現実験でも確認されています(繰り返しデコーディングで+1.69)。
ランダムが選択を上回る理由
著者らは支持されているものの切り離されてはいない三つのメカニズムを提示しています。
- ランダムプールは完了不可能なタスクを保持します — 終了rewardが最も強いシグナルを持つのはそのようなタスクです(ランダム:21.9%が切り捨て、長さアドバンテージ相関 -0.31;選択:17%)。
- 選択はフォーマット分布を歪めます。 失敗優先サンプリングは多肢選択タスクを完全に排除します(選択:0 vs ランダム:222;learnable-band:227)。
- ランダムプールは4〜8ウィンドウ以内では飽和しません(ウィンドウあたりのシグナルを持つタスク数:209、180、189、183、ウィンドウ2以降は横ばい)。
著者らはまた、「難易度フロンティア」として見える部分の一部が人工的産物であることも指摘しています。6,000件の候補を調査したところ、幾何の回答の39%が4,096トークンで切り捨てられており、12,000件の候補において緩い採点者が2.6%のアイテム(311/317のマルチホップ幾何MC)を発見しており、これらは選択肢のアルファベットの代わりに数値を記述したために厳格な採点でペナルティを受けていました。
限界
本論文はスコープについて異例なほど明示的です。S_{32} におけるA-RSIのContinuousに対する+0.40のマージンは検出器タイミングの優位性を示すものではありません。実際に行われた最初の二つのランダムリフレッシュ決定が偶然3ウィンドウスケジュールと一致しており、フロンティア選択を固定した場合、検出器トリガーによるリフレッシュは周期的リフレッシュに0.30ポイント劣ります。各アームは1回の学習実行です。MiMoの終端マージンが小さいこと(Continuousに対し+0.02、Periodicに対し+0.18)もタイミング優位性を確立するものではありません。rewardチェックの監査は有限プローブで1,000/1,000を通過しますが、網羅的ではなく、プロダクションチェッカーは220/16,000の敵対的バリアント(110の選択タスクに対してそれぞれ2バリアント)に失敗します。マルチシリーズグラフ読み取りにおける1,922/1,927の一致は「3番目に高い」に関する5件の曖昧な引き分けを反映しています。生成器は学習中に更新されません。これはオープンエンドな再帰的自己改善ではありません。
重要性
A-RSIは、プログラム的な自己学習パイプラインにおいて、いつリフレッシュするかが学習ログのみから回答可能な一級の設計上の問いであること、そして固定されたファミリークォータのもとでのランダム置換がモデルに条件づけられた難易度選択を上回ることを示しています。これは主に、選択が終了rewardおよびフォーマットrewardを駆動する正確なタスク(完了不可能なもの、フォーマット的に負荷がかかるもの)を除外してしまうためです。また本論文は、自己改善研究における誇大な主張への有益な反例でもあります。著者らは、非切り捨て推論による利得がどれほどかを(MiMoでは正、Qwenでは負)丁寧に分解しており、無条件の能力改善を主張することを避けています。
Source: https://arxiv.org/abs/2610.38568
Look Only When Needed: Certificate-Guided Visual Routing for Efficient Diffusion VLMs
LLaDA-VやLaViDaに代表されるdiffusion vision-language models(DVLMs)は、各denoising stepにおいて、画像トークンと部分的にマスクされた応答トークンを連結したシーケンス全体に対して双方向のforward passを実行します。本研究で調査された10のベンチマークでは、visual tokenがシーケンスの89〜97%を占めており、各stepでは少数のテキスト位置のマスクを外すために静的な画像を毎回再エンコードするコストが発生します。visual token pruningに関する先行研究はstepあたりのコストを削減しますが、それでも(縮小された)画像を毎stepで処理し続け、かつ情報を永久に破棄してしまいます。そこで著者らはより鋭い問いを立てます:実際に次のトークンのマスクを外す判断に画像が必要となるのは、何stepあるのか?
LLaDA-Vを用いた計測結果は注目に値します。デコード中のすべてのマスク位置において、画像あり・なしの場合のtop-1予測を比較すると、画像を除去してもマスクが外されるトークンが変化するのは平均22.8%のstepに過ぎず、一部のベンチマークでは最小7.9%にとどまります。また、画像の影響は空間的・時間的に集中しており、不一致は均一に分布するのではなく、特定の位置とdenoising stepに集中しています。
Method: anchor + text-only certificate
LOWNは、certificate testを用いることで、標準的なDVLMデコーディングに暗黙的に含まれる2つの判断、すなわち「今この時点で画像が必要か?」と「このstepで何トークンのマスクを外せるか?」を分離します。
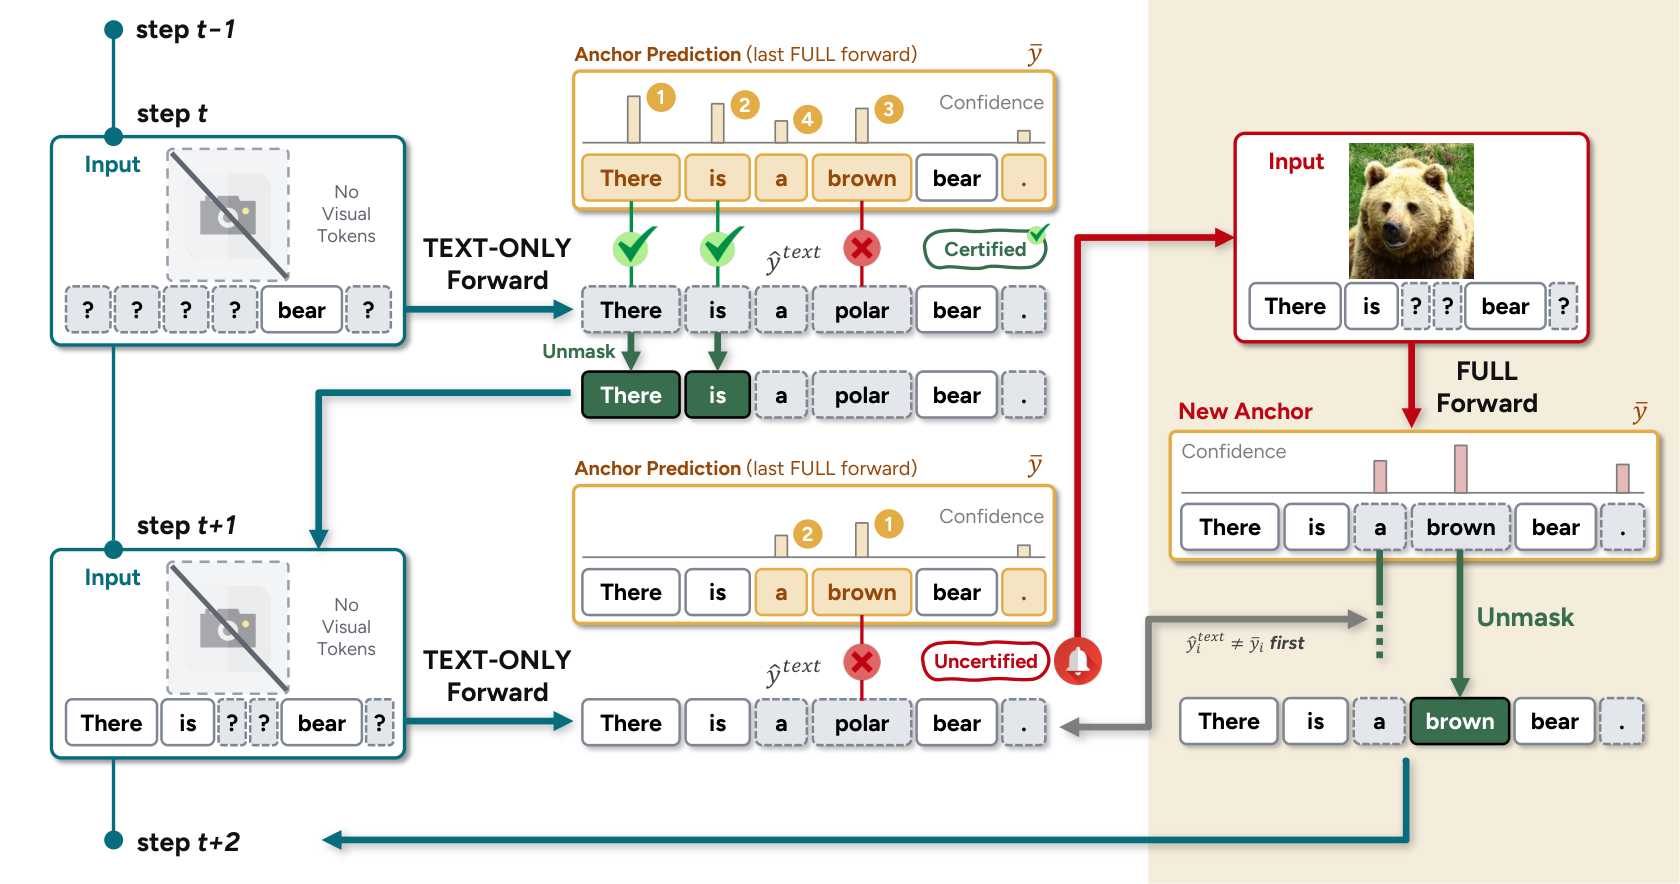
FULL forwardが実行されるたびに、LOWNは現在マスクされているすべての位置における予測トークンの識別子\bar{y}_iと確信度\bar{s}_iをキャッシュします。この組をanchorと呼びます。後続のstep tにおいて、LOWNはTEXT-ONLY forward(画像トークンをコンテキストから除去)を実行し、マスク位置をanchorの確信度\bar{s}_iの降順にソートします。候補iがcertifyされる条件は
\hat{y}^{\text{text}}_{t,i} = \bar{y}_i
です。
2つのforwardは、画像の有無とresponse stateの経過時間という2つの軸で異なるため、一致は「ここでは画像不要」と「anchorがまだ有効」の両方を同時に近似します。certifyされたprefix \mathcal{U}^{\text{text}}は、確信度順にソートされた一致の連続のうち最長のものであり、最初の不一致で打ち切られます。したがってstep tでマスクが外されるトークン数は|\mathcal{U}^{\text{text}}|となり、固定されたスケジュールではなく入力適応的な受理数となります。certifyされたprefixが短すぎる場合、LOWNはFULL forwardにフォールバックし、最初の不一致位置のマスクを外してanchorを完全に置き換えます。繰り返しを防ぐためのguard(Appendix B.1)により退化したループを防止します。
anchorをFULL stepのたびに編集するのではなく置き換えることが重要です。これはanchorの経過時間とともにcertificateの誤差が増大するためです。1step前のanchorでは、新たなFULL forwardがcertifyされたトークンの4.1〜11.0%を覆してしまいます。一方、LOWNの完全なデコード実行では、TEXT-ONLYでマスクが外されたトークンのうち覆されるのは2.2〜4.7%にとどまります。これはcertificateが成立しなくなった時点でFULL stepがちょうど挿入されるためです。
モデルパラメータとattentionパターンは変更されないため、LOWNはvisual token pruning(FULL stepを縮小する)やKV caching(繰り返しforwardを低コスト化する)と組み合わせて使用できます。
Results
実験は、LLaDA-VおよびLaViDaを用いて10の画像ベンチマーク(MathVista、ScienceQA、ChartQA、MME、MMBench、DocVQA、GQA、LLaVA-Bench、CapArena、DeCapBench)で実施し、さらにVidLaDA-8BへのEgoSchemaおよびMLVUへの転移実験も行っています。デコードのFLOPsは各backboneに対する相対値で報告されています。
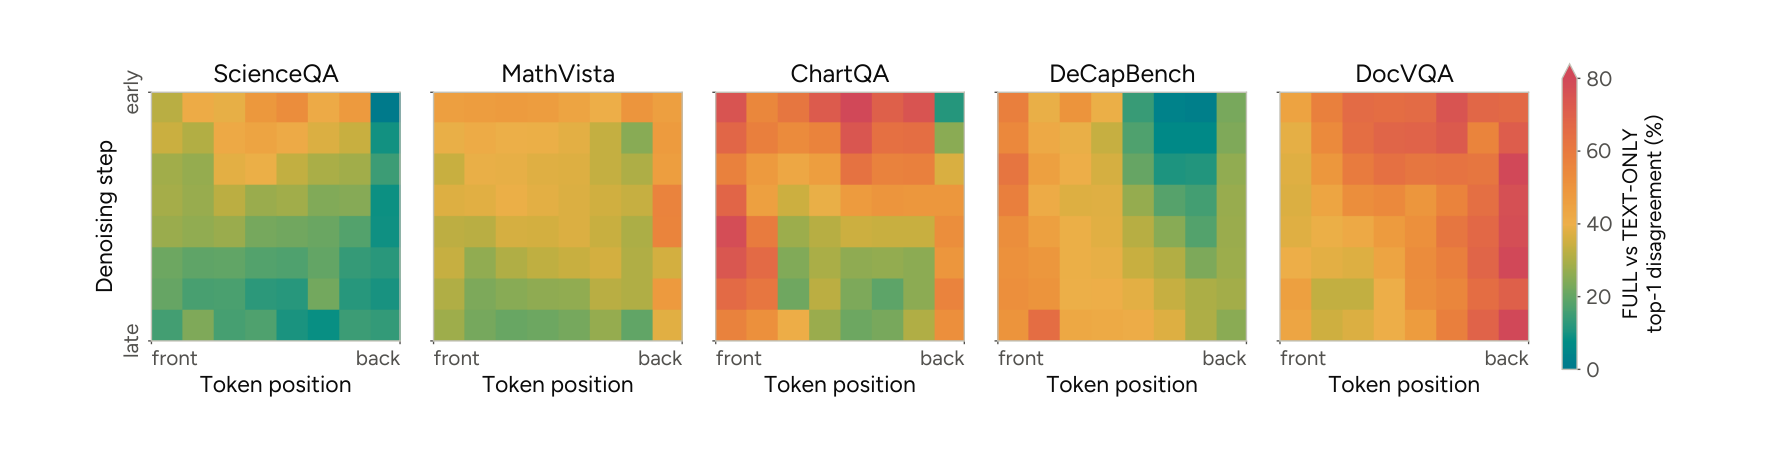
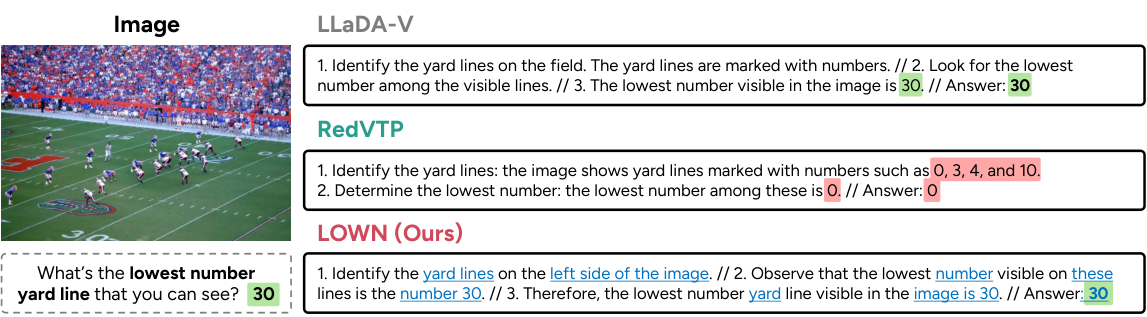
上記のheatmapは、本手法の前提条件を明示しています。TEXT-ONLYとFULLの予測間の不一致は位置/stepの空間において疎かつ局所的であるため、不一致時のみFULLを発動するcertificateはほとんど見落としを生じないはずです。定性的には、Figure 6に示すように、典型的なキャプション生成においてFULL forwardのstepで生成される出力トークン(青の下線)はごく一部にとどまり、残りはanchorから画像なしでマスクが外されます。
ベンチマークごとの画像依存度が異なるため(最も疎なもので7.9%、平均22.8%)、LOWNのトリガー率はタスクごとのパラメータ調整を必要とせず自動的に適応します。
Limitations and open questions
提供された本文には最終的なspeedup/accuracyのペアが記載されていないため、定量的な主要数値はここでは再掲しません。中心的な定量的主張は、計測値(平均22.8%、最小7.9%の画像依存step)とcertificate誤差の数値(デプロイ時の覆し率2.2〜4.7%対古いanchorでの4.1〜11.0%)です。未解決の問題として、(i)certificateはtop-1の一致テストであるため、画像がargmaxを反転させずに確率質量を移動させる場合は悲観的となり、両forwardが誤ったトークンに一致する場合は楽観的となること、(ii)一致は「画像が無関係」と「anchorがまだ有効」を混同するため、両者を区別できず、分布シフト下(例:ほぼすべてのトークンが画像依存となる高解像度OCR)での失敗モードが本文では特徴付けられていないこと、(iii)「anchor」の概念がより不明確となるストリーミングや交互配置されたマルチ画像入力への拡張が挙げられます。
Why this matters
LOWNは、DVLMのデコーディングコストを、データの測定可能な特性、すなわち画像が実際に次のマスク解除トークンを変化させる頻度、に基づいて再定式化し、再学習もアーキテクチャ変更も不要な入力適応的なroutingポリシーへと転換します。この計測結果が一般化するならば、diffusion VLMが現在消費しているvisual computeの大半は冗長であり、pruningではなくroutingが適切なプリミティブであるということになります。
Source: https://arxiv.org/abs/2610.36671
L3G-World: Latent 3D Gaussian Memoryによるリアルタイム無限ワールド生成
問題設定
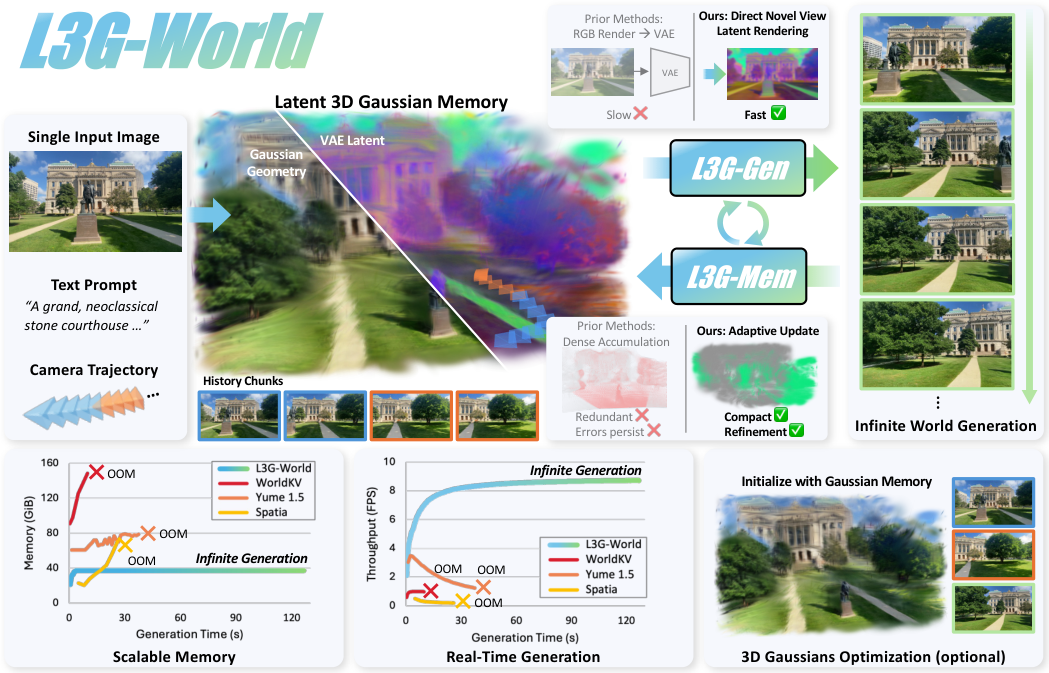
カメラ軌跡を条件としてビデオを生成するインタラクティブなワールドモデルは、長期的な空間的一貫性とリアルタイムスループットの間でトレードオフを抱えています。現在主流の2つのメモリ設計は、いずれもスケーリング性能が低いという問題があります。時間的コンテキスト手法(Yume、Matrix-Game)は過去フレームをDiTのコンテキストに蓄積するため、ストリーム長に応じて計算量が増大し、ループクロージャの一貫性が劣化します。一方、明示的な3Dメモリ(GEN3C、Lyra、Spatiaの点群、NeoVerseのGaussian)は幾何情報を保持しますが、フレームごとのプリミティブ蓄積によって無制限に増大するか、または潜在ビデオDiTの条件付けの前にRGBレンダリングをVAEで再エンコードする必要があり、この処理がチャンクごとのレイテンシを支配してしまいます。
L3G-Worldはこの両問題に対処します。すなわち、メモリサイズがフレーム数ではなくシーンの広さに応じてスケールする選択的更新型の3D Gaussianメモリと、GaussianがVAE latent featuresを保持することでレンダリング結果をDiTの条件付け空間に再エンコードなしで直接渡せる仕組みです。
手法
本システムは、チャンク\mathcal{W}_k上で2つのモジュールを自己回帰的に交互に動作させます。(\mathcal{M}_{k-1}, \mathcal{W}_k)から\mathcal{M}_kを生成するメモリ更新器L3G-Memと、\mathcal{M}_kからターゲットカメラにレンダリングされたlatentsを条件に次のチャンクをサンプリングする潜在ビデオDiT L3G-Genです。
Latent 3D Gaussianメモリ。 各プリミティブは標準的なGaussianパラメータ(\mu, \Sigma, \alpha)に加え、DiTの入力latent空間に揃えたVAE latent feature vector z \in \mathbb{R}^{C}を保持します。ターゲットカメラへのsplattingにより、DiTの時空間latent解像度でのfeature imageが直接得られるため、通常のRGB \to VAEエンコードのステップを回避できます。
L3G-Mem(更新器)。 新しいウィンドウに対してL3G-Memは\mathcal{M}_{k-1}を現在のカメラにレンダリングし、得られたRGB + opacityを使って新たに観測された領域上のスポーニングマスクを形成します。これらの領域における幾何特徴(ZipSplatに倣ってDepth Anything 3バックボーンにより生成)はK-meansによって少数のスポーニングクエリに縮約されます。現在のカメラレイ上の可視Gaussianはそのメモリトークンをリファインメントクエリとして提供します。transformerはこの両トークンセットを共同処理し、(i) 未カバー領域の幾何に対して新たにスポーニングされたGaussianのパラメータと、(ii) 初期復元誤差を修正するための既存Gaussianへの残差更新をデコードします。
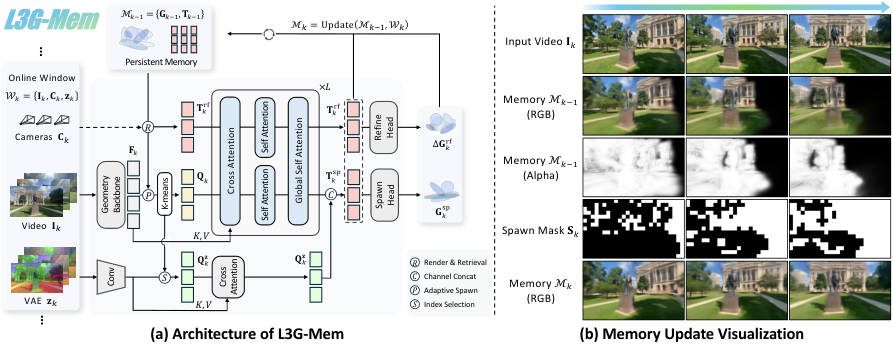
スポーニングは既存メモリとのopacity/RGB残差によってゲートされるため、再訪領域上の冗長なプリミティブは抑制されます。つまりメモリはシーンのカバレッジに応じて増大し、生成されたフレーム数には依存しません。
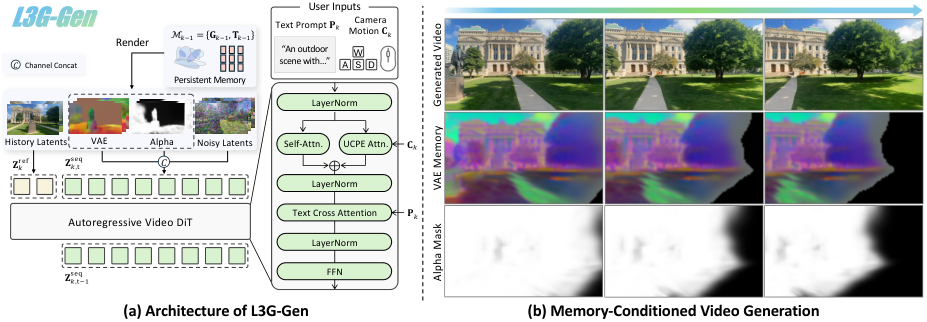
L3G-Gen(ビデオDiT)。 更新されたメモリを受けて、L3G-GenはVAE latentsとopacityをターゲットカメラにラスタライズし、ノイズを持つlatentトークンとチャンネル方向に結合してdenoiseします。形式的には、レンダリングされたlatent \tilde z、opacity \tilde\alpha、ノイズ付きlatent x_tに対して、DiTの入力はチャンネル方向に[\,x_t;\tilde z;\tilde\alpha\,]であり、以前に生成されたチャンクからのhistory latentsが短距離コンテキストを提供します。バックボーンはLoRAでfine-tuningされたCosmos-Predict2.5であり、少ステップ蒸留バリアント(AnyFlow)がL3G-World Fastを実現します。
学習データ。 L3G-MemはDL3DVで、L3G-GenはDL3DV + RealEstate10Kで学習され、すべて4×A100上で実行されます。
評価プロトコル
主要ベンチマークはDL3DVおよびRealEstate10K上での481フレームのループクロージャ軌跡です。カメラは外側に探索した後に経路を逆戻りします。自己整合性は一致したポーズにおける往路と復路フレーム間のPSNR/SSIM/LPIPSで評価されます。生成品質にはLPIPS、FID、VBench IQ/AQ/SC/BCを使用します。カメラ制御はTransErr、RotErrで、幾何的整合性はMEt3Rで測定します。効率性は保存プリミティブ数(K)、メモリ(MiB)、再構成FPS、さらにRGBレンダリングFPSとVAE空間条件付けFPS(後者はlatent feature renderingを持たないベースラインのVAEエンコードを含む)で報告されます。すべての測定は単一A100上で行われます。ベースラインには点群の明示的メモリ(Lyra 2.0、GEN3C、Spatia、SPMem、3DScenePrompt)、Gaussianメモリ(NeoVerse)、時間的コンテキストモデル(Yume 1.5、Matrix-Game 3.0)が含まれます。単一画像設定での公平な比較のため、明示的メモリのベースラインはすべてDA3 GIANT-1.1-NESTEDメトリック深度で初期化し、評価軌跡とのシーンスケールを揃えています。
結果
要旨では最先端の結果が主張されており、掲載されているTable 2のヘッダーは本手法が優位な軸(3Dメモリ効率、ループ軌跡上での自己整合性、生成品質、DL3DVおよびRealEstate10K両方でのポーズ/3D整合性)を列挙しています。提供されたセクションのテキストには数値のセル値が含まれていないため、この抜粋からは各メトリックの具体的な改善幅を引用することができません。アーキテクチャ上の含意として、L3G-WorldのVAEレンダリングFPSはRGBレンダリングFPSとほぼ同等にスケールするはずです(1回のsplattingパスのみ、エンコーダ不要)。一方、すべての点群ベースラインは生成されたチャンクごとに追加のVAEエンコードを要します。これが著者らがリアルタイム動作を主張する根拠となっています。
限界と未解決の問題
- メトリックスケールはDA3の深度からブートストラップされるため、DA3のドリフトやスケール誤差がメモリおよびループクロージャメトリックに伝播します。
- スポーニングマスクはレンダリングされたRGB/opacity残差によって駆動されるため、動的なコンテンツ、鏡面反射、軌跡に沿った照明変化が誤ったスポーニングやリファインメントを引き起こす可能性があります。
- メモリは特定のVAE/DiT(Cosmos-Predict2.5)に紐付けられたfeatureを保存するため、ジェネレータを差し替えるには再学習またはlatent featureチャンネルの再アラインメントが必要です。
- 「メモリはシーンの広さに応じて増大する」は本稿では実験的主張であり、481フレーム時の絶対的なプリミティブ数および大規模ループでの漸近的挙動は抜粋内では定量化されていません。
- LoRA fine-tuningとAnyFlow蒸留の組み合わせは、凍結されたバックボーンを超えて生成品質をどこまで向上できるかに制限をもたらす可能性があります。
意義
VAE空間のfeatureを3D Gaussians上に直接保存することで、明示的3Dメモリ型ワールドモデルのリアルタイム動作を妨げていたRGB\toVAE再エンコードのボトルネックが解消され、選択的スポーニングによりメモリサイズがストリーム長から切り離されます。これは、長期インタラクティブ生成を阻んでいた2つの構造的問題への対処です。ループクロージャの数値が妥当であれば、本手法は幾何的一貫性とインタラクティブな応答性を兼ね備えた、永続的で探索可能なニューラルワールドのための有力なテンプレートとなり得ます。
Source: https://arxiv.org/abs/2610.40614
Read, Allocate, Route: Role-Coupled Tokenization for Pixel-Space Generative Transformers
Pixel-space generative transformerは出力解像度とtoken数を結びつけています。つまり、1 tokenあたり1 patchという構造により、より細かいディテールを表現しようとするとglobal attentionのシーケンス長が二乗的に膨れ上がります。SpecSlotは、低周波の構造はグローバルな情報交換を必要とする一方、高周波のディテールは大部分がローカルであるという観察に基づき、tokenを互換性のある patchとして扱うのではなく、各tokenに明示的な出力役割を割り当てることでこの結合を断ち切ります。
セットアップ:pixel-space rectified flow
目的関数はJiTスタイルの標準的なrectified flowです。x\in[-1,1]^{3\times H\times H} および \epsilon\sim\mathcal{N}(0,I) に対して、線形パスは z_t = tx + (1-t)\epsilon(t=\sigma(g)、g\sim\mathcal{N}(-0.8, 0.8^2))で定義されます。ネットワークは画像形状の予測 r_\theta(z_t,t,y) を出力し、以下の式によってvelocityに変換されます。
v_\theta(z_t,t,y) = \frac{r_\theta(z_t,t,y) - z_t}{\max(1-t,\tau)}, \quad \tau=0.05,
学習は x-\epsilon に対するvelocity MSEで行われます。状態、ターゲット、lossはpixel空間に留まり、変更されるのはtokenizationとroutingのみです。
Allocation:N = W \cdot K
設計の核心はtoken budgetの因数分解です。N 個のpatch tokenが1つのグローバルシーケンスに参加する代わりに、SpecSlotは N = W K という分割を行います。すなわち、W 個の空間アンカーを用意し、それぞれをlapped-DCT係数の互いに素な帯域に割り当てられた K 個のslotへと展開します。
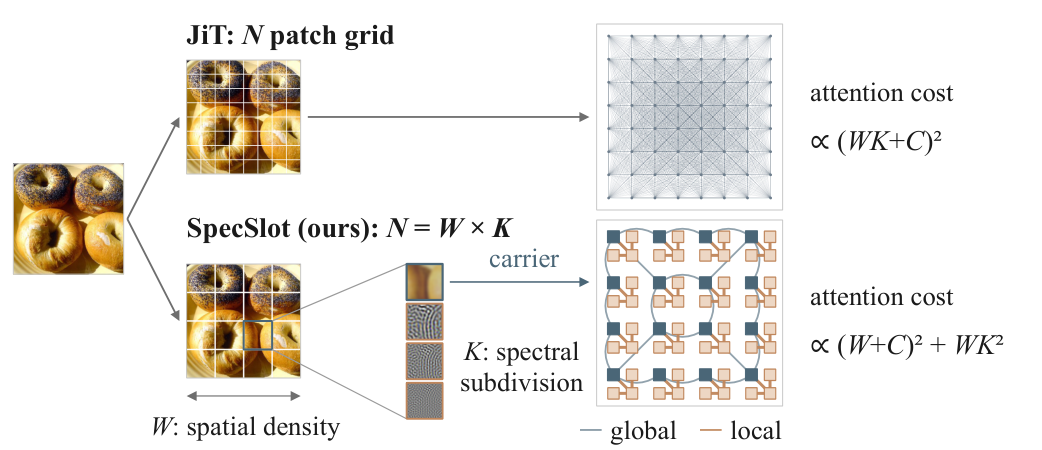
重要な点として、各アンカーからは最低周波数のslot(slot-0)のみがglobal attentionに参加するため、K の値に関わらずグローバルシーケンス長は常に W に保たれます。K 個すべてのslotは各アンカー内のローカルブロックで相互作用します。これにより、スペクトルのディテールが \mathcal{O}(W^2) のglobal attentionコストから切り離されます。
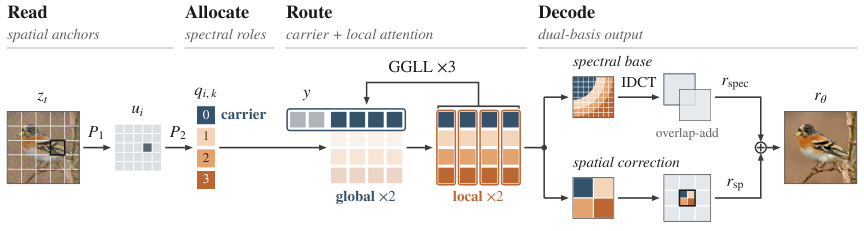
decoderは、lapped-DCTのスペクトル基底(すべてのslot状態から生成)とアンカーに整合したpixel空間の空間補正を加算します。2つのブランチは競合するのではなく相互補完的に機能し、これはメカニスティックなprobeにおける正のクロスタームエネルギーによって示されています。
役割の分離:readとwrite
アンカー密度 W とスペクトル細分化 K に関するablation(表4/5)は、これらの役割を明確に定式化しています。W は「read」(global attentionが見るもの)を改善し、K は「write」(decoderが出力するもの)を精緻化します。両者は互換ではありません。W を固定して K を2倍にしても収穫逓減が生じ、最後の2倍化ではFIDが0.31しか改善しません。一方、N を固定してより多くのアンカーにbudgetを再配分すると、テスト済みの N=2048 の範囲内でFIDが単調に低下します。
エントロピー有効slot利用率によってこれを定量化すると、W{=}256、width B{=}1536 の条件下で、正規化された有効slot割合は K{=}2 の 0.803 から K{=}4 の 0.620、K{=}8 の 0.495 へと低下します。絶対的な有効rankは K に対して劣線形に増加するため、token数が容量を過大評価してしまいます。著者らはK2(低コスト)とK4(中間)を使用可能な動作点として採用しています。
出力のメカニスティックな構造
出力の分解は経験的に良好な挙動を示しています。スペクトルブランチはflow全体を通じてより大きな自己エネルギーを担い、空間ブランチのシェアは低 t における 0.07 から高 t における 0.23 へと増加し、生成の後期に高い半径方向の帯域に集中します。符号付きクロスタームは正に保たれており、2つのブランチは相殺されるのではなく加算されます。
trunkを固定したlesion probeによって依存性を定量化すると、t{=}0.90 では空間ブランチをゼロにするとvelocity MSEが 32.1\times 上昇し、スペクトルブランチをゼロにすると 64.1\times 上昇します。t{=}0.05 では、それぞれ 1.1\times と 2.1\times となります。スペクトルブランチが t 全体を通じた主要な足場であり、空間ブランチは後期における高周波補正を担います。
結果
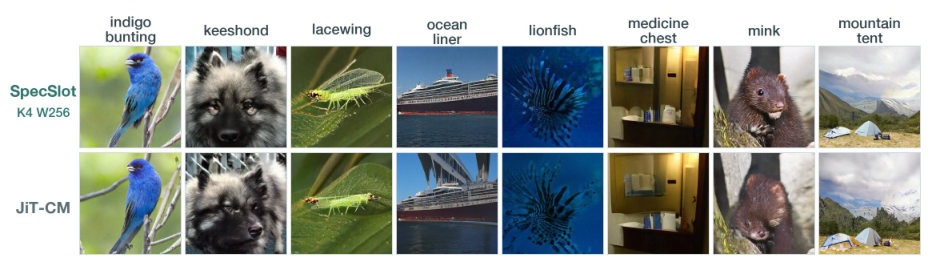
学習はImageNet-1K上で実効batch 512により120 epochにわたって実施されます。ImageNet-256では、SpecSlotはFLOPsを揃えたJiT controlと最終FIDで同等の性能を示しながら、より速く収束します。ImageNet-512では、aligned baselineと比較してFIDが2.8改善します(abstractの抜粋は性能指標の箇所で途切れていますが、pixel-spaceモデルが苦戦するその解像度において、FID 2.8の差は実質的な開きです)。
制限と未解決の問題
- W > K という優位性は N{=}2048 の範囲内でのみ確立されており、著者らは明示的に外挿を避けています。非常に高い解像度(高周波コンテンツがアンカー容量を飽和させうる状況)でこれが逆転するかどうかは未解決です。
- より大きな K でのslot利用率の低下は、lapped-DCTのバンド分割が最適でないことを示唆しており、学習済みまたは適応的なスペクトル分割によって失われた有効rankを回復できる可能性があります。
- Global attentionは依然として \mathcal{O}(W^2) でスケールします。SpecSlotは品質/計算コスト曲線をシフトさせますが、二次項を排除するわけではありません。より高い解像度へのスケーリングには依然として W の増加が必要です。
- 定量的な証拠はImageNetのクラス条件付き生成に限定されており、role-coupled tokenizationがテキスト-to-imageに転用できるかどうか(cross-attentionが異なるモダリティのtokenと結合する場合)は未検証です。
この研究の意義
SpecSlotは、tokenizationを幾何学的なデフォルトではなくアーキテクチャ上の選択として扱う明快な事例です。各tokenに固定の出力役割(キャリアかローカルディテールslotか)を与え、グローバルな計算をキャリアにのみroutingすることで、pixel-space生成におけるglobal attentionの二次コストから解像度を切り離します。スペクトル足場と後期空間補正へのメカニスティックな分離は、attentionをスケールさせることなく出力ディテールをスケールさせたいpixel-space diffusion/flow transformerのための再利用可能なテンプレートを提供しています。
Source: https://arxiv.org/abs/2610.40647
IntReal: マルチモーダルInterleaved生成のための実世界データセットとベンチマーク
テキストと画像を同時に生成するUnified Multimodal Models(UMMs)は急速に普及していますが、その評価手法は追いついていない状況です。既存のベンチマークは、T2IまたはI2Tの能力を個別に評価するか、あるいはinterleaved生成を単一のグローバルメトリクスでスコアリングするにとどまっており、直交する失敗モード(テキストの非一貫性、視覚的ドリフト、被写体同一性の崩壊、要求画像数の誤りなど)を混同しています。IntRealはデータと評価の両方のギャップに対処するものです。すなわち、10万サンプルの実世界interleaved corpus と、粗粒度から細粒度への診断のために設計された7次元評価スイートです。
データセットの構築
IntReal-100Kは538,452枚の画像を含む100,000件のinterleavedサンプルで構成されており、7つの再配布可能なソース(Wikipedia、WikiVoyage/WikiTravel、下厨房、および3つの絵本シリーズ)から数百万規模の生クロールをフィルタリングして作成されています。著者らは、テキストと画像の機能的な関係に基づいてinterleavedコンテンツを4つのカテゴリに分類しています。
- Planning(WikiVoyage/WikiTravel):テキストが目標・制約を符号化し、画像が時空間的な状態を可視化します。
- Knowledge(Wikipedia):テキストが概念を説明し、画像がそれを具体化します。
- Tutorial(下厨房の料理):テキストが手順を記述し、画像が中間状態と時間的遷移を示します。
- Story(Land Before Time、Rabbids、Curious George、SEED-Storyに倣う):テキストが物語を駆動し、画像がキャラクターとシーンを維持します。
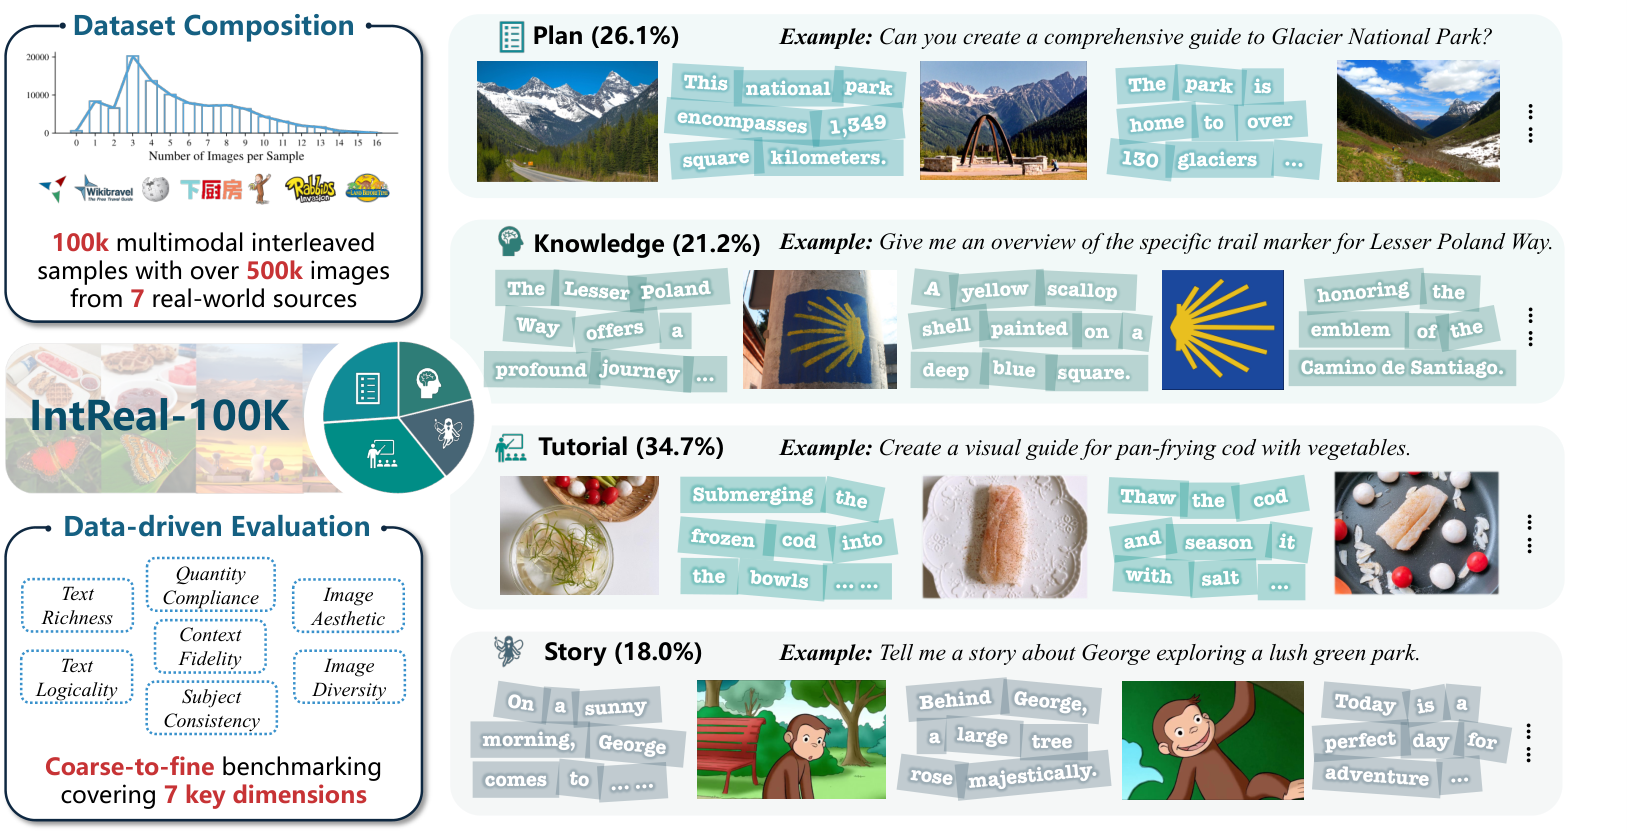
この分類は形式的なものに留まりません。Storyカテゴリは多数の画像にわたる被写体一貫性を強調し、Tutorialは長いシーケンスにわたるコンテキスト忠実度を強調し、Knowledgeはテキスト論理性を強調するため、4つのスライスが異なる能力軸を分離します。
評価スイート
600サンプル(カテゴリごとに150件)が半自動パイプラインによって選別されており、(i) Qwen3.5-397B-A17Bを用いてプロンプトの具体性・応答の豊富さ・トピックの情報量に対するテキスト品質、(ii) RALIによる画像品質、(iii) コンテキストを考慮した自己検証ステップによるテキスト・画像アライメントがスコアリングされます。この自己検証では、LLMが対象画像を見ることなく先行コンテキストから視覚的なルーブリックを導出し、その後そのルーブリックに照らして対象画像を検証します。これにより、アライメント判断が「次の画像としてもっともらしいもの」に対するモデルの事前分布から切り離されます。
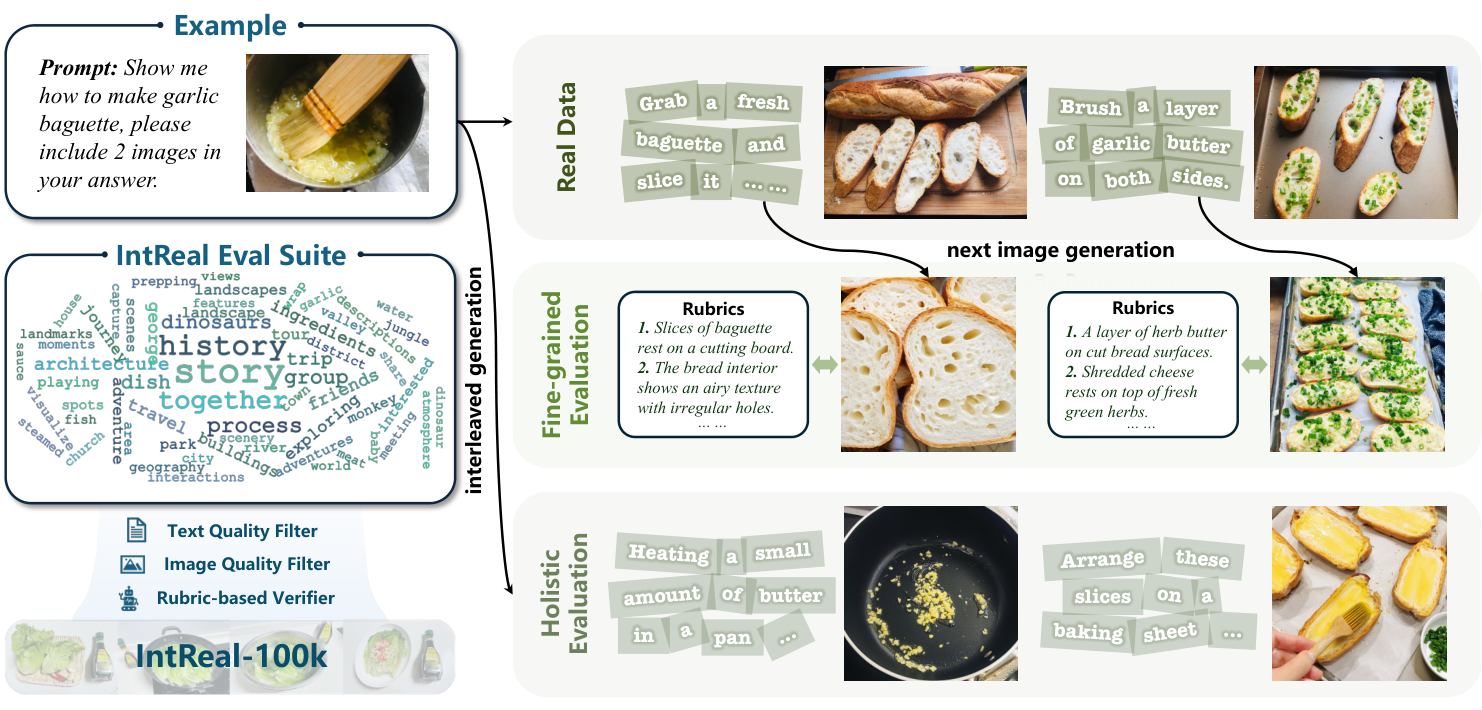
各サンプルは2つの粒度で評価されます。
- Holistic:モデルが冒頭のプロンプトからエンドツーエンドで完全なinterleaved シーケンスを生成します。Text Richness、Text Logicality、Image Aesthetic、Image Diversity、Quantity Compliance(モデルが正しい数の画像を出力するか)でスコアリングされます。
- Fine-grained:グラウンドトゥルースの先行interleavedコンテキストを条件として、モデルが次の画像のみを生成します。Context FidelityとSubject Consistencyでスコアリングされます。これにより、テキストの自己回帰的ドリフトから独立した画像生成の条件付けを評価できます。
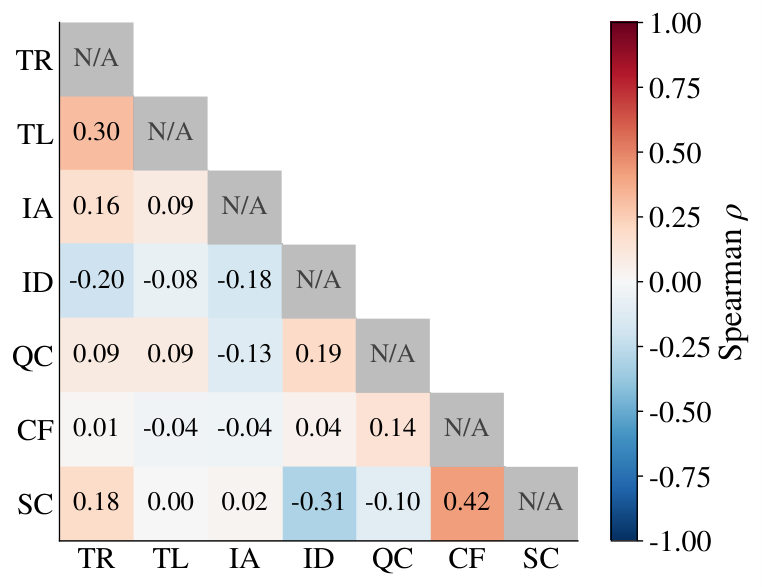
Gemma4が判定用のVLM/LLMとして使用されています。評価スイートは3つのサニティチェックで検証されています。次元間のペアワイズSpearman相関 |\rho| \leq 0.42(低冗長性)、人間の判断との83.3%の一致率、および異なる専門家評価者間での \rho > 0.9 の一貫性です。
ベンチマーク対象モデルと知見
4つのUMMファミリが評価されています。Bagel(fine-tune専用。リリースされたcheckpointにネイティブなinterleaved inferenceがないため)、Emu3.5(evaluation専用、FTレシピなし)、SenseNova-U1の8B-MoTおよびA3B-MoTバリアント(FTとinferenceの両方をサポート)、そしてクローズドなNanoBanana2(Gemini 3.1-Flash-Image)APIです。Post-trainingには99.4KのHeld-outサブセットを使用し、RLはFlow-Factoryで実装されています。
7次元の平均スコア(0〜100):
- Emu3.5: 58.95
- Bagel+SFT: 63.83; Bagel+SFT+RL: 65.06
- U1-A3B-MoT: 69.43
- U1-8B-MoT: 71.88; +SFT: 72.31; +SFT+RL: 73.81
- NanoBanana2: 84.84
各次元の内訳は平均よりも多くの情報を示しています。Holistic スコアはオープンソースモデル全般で惨憺たるものです。U1-8B-MoTのText Richnessスコアは21.83であるのに対し、NanoBanana2は90.80(+222%)です。これはほぼ完全に出力長の問題であり、オープンなUMMsはinterleaved出力を途中で打ち切ってしまいます。Quantity Complianceにおいては、U1-8B-MoT(95.33)がNanoBanana2(95.32)を実際に上回っており、NanoBanana2のアドバンテージはテキストコンテンツにあり、画像数の制御ではないことが示唆されます。Image Aestheticでは、オープンなU1-8B-MoT+SFT+RL(93.31)がNanoBanana2(83.56)を10.45%上回っています。
U1-8B-MoTにおけるRLとSFTの比較では、期待される傾向が見られます。SFTはText Richness(+29.04%)とContext Fidelity(+6.53%)を向上させますが、Text Logicality(-5.65%)、Image Aesthetic(-1.48%)、Quantity Compliance(-4.89%)を低下させます。その上にRLを追加すると、aesthetic(+5.60%)とlogicalityが部分的に回復しつつ、Richnessの向上(+27.49%)が維持されます。この次元レベルのトレードオフは、単一スコアのベンチマークでは見えなかったものです。
限界
粗粒度から細粒度へのプロトコルがすでにモデルごとに6,000枚以上の画像を生成するという理由から、600サンプルセットは小規模です。判定はGemma4に依存しており、評価者間の一貫性は高いものの、例えば細粒度の被写体同一性に関するVLMジャッジの系統的な盲点が残存する可能性は否定できません。いくつかの興味深いモデル(LLaDA2.0-Uni、Anole、Show-o2)はコンテキスト長や利用可能性の問題で除外されており、カバレッジが制限されています。NanoBanana2の結果はブラックボックスであり、著者らはそのinterleaved 能力がネイティブなものかエージェント的なものかを判断できないと述べており、そのText Richness における大幅なリードの解釈を複雑にしています。
なぜ重要か
Interleaved マルチモーダル生成はモノリシックな能力として扱われてきたため、現在のオープンなUMMsが画像側のメトリクスでは競合できる水準にある一方で、interleaved コンテキスト内のテキスト生成では壊滅的に遅れているという事実が見えにくくなっていました。IntRealのHolisticとfine-grainedの両プロトコルを持つ、弱い相関(|\rho| \leq 0.42)の7次元への分解は、どの学習介入がどの軸に効果をもたらすかを診断するための適切な形状です。そして、SFT対RLのアブレーションはすでに、単一指標のベンチマークでは隠れてしまっていたであろう具体的な次元レベルのトレードオフを実証しています。
Source: https://arxiv.org/abs/2610.38425
Hacker News Signals
LFM3の紹介:専門的インテリジェンスのためのあらゆるモダリティ
Liquid AIのLFM3ファミリーは、同社のLiquid Foundation Modelシリーズをネイティブなマルチモダリティへと拡張し、テキスト・画像・音声・動画・構造化データを単一のアーキテクチャ内で処理します。コアとなるモデルクラスは、標準的なtransformerのattentionではなく、連続時間ODEから導出されたリカレントシステムであるLiquid Neural Networksをベースに構築されており、文脈長によらず推論時のトークンあたりのメモリフットプリントが有界に保たれます。
「専門的インテリジェンス」というフレーミングは、ドメイン特化型バリアントを指しています。具体的には、ベースおよびinstruction-tuned checkpointに加え、垂直タスク(文書インテリジェンス、音声転写、時系列)向けにfine-tuningされたモデルが公開されています。このアーキテクチャは、モダリティエンコーダを後段で融合する方式を必要とせず、モダリティトークンをインターリーブする形式をサポートしており、原理的にはすべての層においてより密なクロスモーダル推論が可能です。
Liquidは同パラメータクラスのtransformerに対して競争力のあるbenchmark数値を示しつつ、長い文脈においてより優れたスループットを実現していると主張しています。これはステートフルなRNN方式の推論がO(n^2)のattentionコストを回避するためです。ただし、完全なアーキテクチャ仕様や学習データの構成は現時点で公開されておらず、独立した再現には制限があります。このブログ投稿は技術論文ではなく主に製品発表であり、都合の良いbenchmark結果が選択的に示されているため、技術報告書が公開されるまでは機構的な主張に対して適切な懐疑心を持って接するべきです。
未解決の問題として、ODEベースの隠れ状態が離散的なモダリティの境界(画像パッチグリッド、音声フレーム)をどのように扱うか、そしてリカレントな帰納バイアスが、直接的なトークン間アクセスによってattentionが自然に処理する任意の長距離検索を必要とするタスクにおいて問題を引き起こすかどうかが挙げられます。
Source: https://www.liquid.ai/blog/lfm3
Grace Blackwellには新しいスケジューラが必要:同じラックから27%多くの使用可能なGPUを
NVLink接続のGB200 NVL72ラックユニット(36基のGrace CPUと72基のBlackwell GPUが密結合)は、スケジューラがGPUを独立して割り当て可能なユニットとして扱えるという前提を崩しています。SkyPilotの投稿では、これによって生じるスケジューリング問題を詳しく解説しています。
ハードウェアトポロジは固定されています:72基のGPUは9つのNVL8ノードに配置され、各NVL8は高帯域幅のNVLinkファブリックを共有しています。NVL8をまたぐ通信では帯域幅が大幅に低下します。既存のクラスタスケジューラ(Kubernetes、Slurm)は各GPUを代替可能なスロットとして扱うため、NVL8の境界をまたいでジョブをスケジューリングしてしまい、集合通信のパフォーマンスを低下させ、場合によってはスケールでのジョブ実行が事実上不可能になることもあります。
SkyPilotのアプローチはトポロジを考慮したギャングスケジューリングです:ジョブはNVL8に整合したチャンク(同一NVL8ドメイン内の8の倍数のGPU)で割り当てられ、スケジューラは物理スロットの空き状況とトポロジ的な整合性を同時に追跡します。使用可能なGPU数が27%改善されるのは、フラグメンテーションの削減によるものです——素朴なスケジューラでは、待機中のどのジョブに対してもトポロジ的に有効なグループを形成できない孤立したGPUが生じますが、トポロジを考慮したパッキングによってその無駄を削減できます。
Grace CPU側の問題にも対処しています:各Grace CPUはNVLink-C2Cを介して特定のGPUに直接接続されているため、ホスト側の前処理パイプラインではCPU-GPUアフィニティが重要になります。アフィニティを無視すると、ほぼゼロコピーであるべき転送にPCIe相当のレイテンシが加わってしまいます。
より広いエンジニアリング上の要点は、ラックスケールのハードウェア統合(GPU間のNVLinkだけでなく、CPU-GPU間のNVLink-C2Cも含む)によって、クラスタスケジューリングが既存ツールの設計対象外だったトポロジの問題になりつつあるということです。同様の問題は、AMDのMI300X APU構成やIntelのGaudi interconnectにも当てはまるでしょう。
Source: https://skypilot.ai/blog/grace-blackwell-needs-a-new-scheduler
Mistral Large 4 OSS ウェイト公開
Mistralは、比較的寛容なライセンスのもとでMistral Large 4をオープンウェイトとして公開しました。主要なスペックは128kのcontext window、コーディングおよび推論ベンチマークにおける高い性能です。このモデルはmixture-of-expertsアーキテクチャを採用しており、MixtralからMistralの大規模モデルラインはMoEへと移行しています。Large 4はその流れを継続し、forward passごとにactivateされるパラメータ数よりも総パラメータ数が多い構成となっています。
ベンチマーク上の位置付けとしては、MMLU・HumanEval・MATHにおいてGPT-4oおよびClaude Sonnet 3.5と同等以上の性能を主張しており、Mistralの欧州言語を重視した学習データにより多言語タスクで特に優れた結果を示しています。MoEのルーティングにより、大きな総容量にもかかわらず推論コストは小規模な密なモデルに近い水準に抑えられており、デプロイメントの経済性において重要な点です。
オープンウェイトとしての公開は注目に値します。というのも、Mistralは最近のモデルの一部をAPIのみまたは制限付きライセンスで提供していたからです。Large 4のウェイトを公開することで、セルフホスト型のデプロイメント、fine-tuning、独立した評価が可能となります。HNのスレッドでは、ライセンスが収益の閾値なしに商用利用を認めているかどうかに議論が集中していましたが(標準的な帰属表示の要件を満たせば、商用利用は可能です)。
技術的な観点では、主な未解決事項としてエキスパート数とルーティングメカニズム(発表では完全には開示されていない)、データの混合比率、および学習計算量が挙げられます。これらの情報がなければ、密なモデルに対する効率性の主張を独立して検証することは困難です。MoEのスパース性によりこのモデルは量子化に適しており、コミュニティの報告によればllama.cppを通じたGGUFサポートは公開から数時間以内に実現したとのことです。
Source: https://mistral.ai/news/mistral-large-4-oss/
AIエージェント群によるMinecraftとMindustryへの取り組み
YC Labsは2つのゲーム環境、すなわちMinecraft(オープンワールドのサバイバル・建設ゲーム)とMindustry(戦闘要素を含むファクトリー建設RTS)において、マルチエージェント実験を実施しました。この取り組みは、永続的かつ共有されたゲーム状態の中で動作するLLMベースのエージェント間に生じる自発的な協調についての研究として位置づけられています。
Minecraftでは、エージェントは独立したプロセスとして動作し、標準的なサーバープロトコルを通じて共有ワールドにアクセスします。各エージェントは独自のcontext window、ツールセット(移動、インベントリ、クラフト、チャット)を持ち、ゲーム内チャットを通じて他のエージェントと通信します――特権的な共有メモリは存在しません。興味深い結果として、明示的な役割分担の指定なしにチャット上での交渉から協調パターンが自発的に生じることが挙げられます。具体的には、重複作業によるチャットのオーバーヘッドがその利益を上回る場合に、エージェントが自律的に資源収集タスクを分担するようになりました。
Mindustryではより厳しい協調要件が課されます。ファクトリーのレイアウトは物理的に整合している必要があり、タレットの配置は脅威の予測に依存し、資源のルーティングは制約充足問題となります。LLMが明示的な空間表現なしには空間的依存関係の理解を苦手とするため、エージェントはここで顕著に失敗率が高くなりました。YCチームは、視覚・テキストによる説明に加えて構造化された「マップ状態」JSONをエージェントに与えることで、ファクトリーの一貫性が大幅に向上することを発見しました。
技術的な主要な知見として、エージェント間の通信帯域幅が大きなボトルネックになることが挙げられます。ブロードキャスト前に自身の状態を要約するエージェントは、生の観測データをそのまま転送するエージェントよりも高い性能を示しました。これは、エージェント間通信は受信側でフィルタリングするのではなく、送信側で圧縮すべきであることを示唆しています。マルチエージェントシステムを構築する上で実践的な指針となるポイントです。エージェント間メッセージのトークンコストは急速に累積します。
現時点では正式な論文はなく、これはプロジェクトのブログ記事ですが、MinecraftのセットアップはオープンなツールであるMineflayerと標準的なLLM APIを用いて再現可能です。
Source: https://labs.ycombinator.com/projects/games/index.html
Dayjob: Tax — AIエージェントを50件のプロフェッショナル税務課題で評価する
Surge HQは、実際のプロフェッショナルワークフローから抽出した50件のリアルな税務申告・助言タスクからなるベンチマークを構築しました。内容は、エッジケースを含む1040申告書の作成、パートナーシップK-1の配分計算、AMT計算、複数州にまたがる居住状況の分析、そして税務プランニングシナリオなどです。タスクはライセンスを持つ公認会計士(CPA)が、プロフェッショナルが作成した模範解答に照らして採点しました。
その方法論は詳しく検討する価値があります。各タスクには関連する原始書類(W-2、1099、証券口座明細書)がコンテキストとして含まれており、エージェントは正確な数値を計算するだけでなく、説得力のある推論を示さなければなりません。手順は正しいが計算ミスがある場合と、手順自体が誤っている場合とで部分点が与えられます。これにより「手順に従えるか」と「税法を理解しているか」を区別できます。
結果として、フロンティアモデル(GPT-4o、Claude 3.5 Sonnet、Gemini 1.5 Pro)は、単純な申告書作成タスクでは60〜75%のスコアを記録しましたが、複数年または複数の管轄にまたがる推論が必要なプランニング・助言タスクでは30〜45%まで低下しました。失敗のパターンは示唆に富んでいます。モデルは古い税務ルールを自信を持って適用し(学習データのカットオフ効果)、曖昧なドキュメントフォーマットを誤読し、複数の取引にまたがるコスト基準(basis)の追跡でミスを犯します。
このベンチマークはキャリブレーションの問題を浮き彫りにしています。MMLUの税務問題で高スコアを記録したモデルが、関連する数値を正確に抽出・統合しなければならないドキュメントに基づくタスクでは著しく低いパフォーマンスを示しています。これは標準的な知識ベンチマークが実務的なタスクパフォーマンスを過大評価していることを示唆しています。
未解決の課題として、このベンチマークは非公開(タスクは公開されていない)であるため、再現性が制限され、評価内容を把握したベンダーによる過学習の可能性が生じます。Surgeの方法論セクションでは、人間の採点者間の一致率が約85%であると説明しており、これがスコア差の有意性の上限を規定しています。
Source: https://surgehq.ai/blog/dayjob-tax
CursorのAgent SDK
Cursorは、コードエディタ内部のエージェントインフラをプログラマブルなAPIとして公開するAgent SDKをリリースしました。中核となる抽象化は、構造化されたtool callを持つステートフルなエージェントループです。具体的には、ファイルの読み書き、ターミナルの実行、検索、そしてLSPをバックエンドとするコードナビゲーション(定義へのジャンプ、参照の検索、型チェック)が含まれます。開発者はカスタムツールを定義し、tool call前後のポイントでループにフックを挿入し、ワークスペースコンテキストを共有するエージェントを組み合わせることができます。
技術的な核心は、Cursorがエージェントのステップをまたいでワークスペースの状態をどのように扱うかにあります。アクションのたびにコードベース全体をre-embeddingするのではなく、永続的なインデックス(既存のコードベース検索システム)を維持し、関連する取得済みチャンクと明示的なtool outputのみをコンテキストとして渡します。これにより、大規模なリポジトリにおいてもステップごとのtoken数を管理可能な範囲に保つことができます。
SDKはさらに「apply diff」プリミティブも公開しています。これはインタラクティブなCursor編集で使用されているのと同じメカニズムであり、プログラム的なツールとして利用できます。これは非自明な機能です。LLMが生成したdiffを実際のコードベースに適用するには、コンフリクトの処理、部分的なマッチング、インデントの正規化に対応する必要があります。これをファーストクラスのツールとして公開することで、エージェントが書いたコードは人間が書いた編集と同じ編集検証パイプラインを経由することになります。
HNのディスカッションでは、ベンダーロックイン(SDKがCursorのランタイムを必要とする点)や、OpenAIのCodex CLI、Aider、ClaudeのComputer Useといった代替手段との比較が話題となりました。差別化のポイントはIDEとの緊密な統合にあります。エージェントは、コードベースに関するLLMの知識だけに頼るのではなく、型チェックやシンボル解決にLSPを利用できるため、幻覚によるAPIコールを具体的に削減できます。このメリットがクローズドプラットフォームへの依存を上回るかどうかは、正当な議論の余地がある問いです。
Source: https://cursor.com/blog/agent-sdk
PythonのExperimental JITが削除へ
CPython 3.13で導入されたcopy-and-patch JIT(PEP 744)が3.14から削除されることになりました。LWNの記事がこの決定を取り上げています。JITがもたらしたパフォーマンス改善は無視できる程度に留まり、マイクロベンチマークでは1〜9%の向上が見られたものの、実際のワークロードではほぼゼロまたはマイナスの影響しかなく、一方でビルドの複雑さとメンテナンスの負担を大幅に増加させていました。
copy-and-patchアプローチは、CPythonのビルド時にLLVMを使って各バイトコード操作に対して「ステンシル」テンプレートを事前コンパイルし、実行時に適切なステンシルをコピーしてオペランド固有のアドレスをパッチするという方法で動作します。これにより、完全なJITコンパイラインフラ(IRやレジスタアロケータが不要)を避けられますが、最適化のスコープが限られるというコストがあります。つまり、オペコードをまたいだインライン化や操作をまたいだ型特殊化は行われません。このアプローチは、将来の最適化が上に構築できる基盤レイヤーとして設計されたものであり、即座に利益をもたらすJITとしてではありませんでした。
削除の決定は、この基盤レイヤーへの賭けがPythonコア開発者が必要とするタイムライン内で実を結ばなかったことを反映しています。LLVMビルド依存関係のメンテナンス、複数プラットフォーム(x86-64、ARM64、Windows)でのJITサポート、そしてCPythonの特殊化適応インタープリタとの相互作用の処理が、ユーザーに見える利益なしに継続的なコストを追加し続けていました。
適応型特殊化インタープリタ(3.11/3.12で導入された「Tier 1」最適化)は引き続き残っており、安定して約25%のスピードアップをもたらしています。JITは「Tier 2」として意図されていましたが、現在はLLVMを必要としない代替のTier 2アプローチについての議論が行われており、より単純なパッチ機構を使ったテンプレートベースの方法や、ホットループのみをターゲットにするより従来型のmethod JITなどが検討されています。
Source: https://lwn.net/SubscriberLink/1102102/0c00e4d550f25f8c/
Claude Code: バックグラウンドエージェントがモデルに完全なトランスクリプトを送信する
flamerix-aiによるGistは、Claude Codeのマルチエージェントモードで観察された動作を記録しています:バックグラウンドのサブエージェントを生成する際、オーケストレーターとなるモデルは、各サブエージェントの実行結果として、要約や構造化された結果ではなく、すべてのツール呼び出し、中間的な推論、および出力を含む完全なトランスクリプトを受け取るというものです。
この技術的な含意は、トークンコストとレイテンシの観点から単純明快ながらも重要です。タスクを完了するまでに50回のツール呼び出しを行うバックグラウンドエージェントは、数万トークンに及ぶトランスクリプトを生成する可能性があります。この完全なトランスクリプトがオーケストレーターのコンテキストに転送されると、コンテキスト長は急速に埋まり、コストはタスクの複雑さに応じて非自明な形でスケールし、より多くのサブエージェントの結果が蓄積されるにつれてオーケストレーターの実効的なワーキングメモリが劣化します。
代替設計としては、サブエージェントが構造化された要約を返すか、オーケストレーターが選択的にクエリできる共有外部メモリ(ファイルやデータベース)を使用するというものが考えられます。完全なトランスクリプト設計は、正確性の観点からは安全性が高いと言えます——オーケストレーターが推論を監査し、中間ステップのエラーを検出し、サブエージェントの思考の連鎖を再現できるからです——しかし、トークンコストがタスク数だけでなく推論の長さに比例してしまいます。
HNのスレッドでは、これはClaudeのシステムプロンプトがツール結果を一般的に扱う方法、すなわち圧縮された表現ではなく生の出力を使用するという方法と一致していることが指摘されました。また、プロンプトインジェクションの攻撃面も浮き彫りにしています:サブエージェントによって読み込まれた悪意のあるファイルがトランスクリプトに命令を注入し、オーケストレーターがトランスクリプトを不透明なデータとしてではなくコンテキストとして処理するため、オーケストレーターの動作に影響を与える可能性があります。
これはベンチマーク結果ではなく、本番のアジェンティックフレームワークに関する具体的なシステム設計上の観察であり、デプロイされたシステムで行われているアーキテクチャの選択を理解することに価値があります。
Source: https://gist.github.com/flamerix-ai/c3905705cc4205e5de3011fa2e74efce
注目の新しいリポジトリ
XiangpengHao/bbtree
混合読み書きワークロードにおいて最高クラスのスループットを謳う、Rustによる並行順序付きマップの実装です。コアデータ構造は、細粒度の楽観的ロックを備えたB+木の変種です。読み取り側はロックを取得せずに進み、トラバーサルの前後でバージョンカウンタを検証することで動作し、競合が発生した場合にのみ悲観的ロックへフォールバックします。書き込み側は変更するノードのみをロックするため、マルチコアハードウェアにおいて高い並行性を実現します。設計上、内部ルーティングノードとリーフノードを分離しており、順次スキャンのパフォーマンスを考慮してリーフページをキャッシュライン境界に合わせた配置としています。ベンチマークでは BTreeMap(シングルスレッド)、DashMap、crossbeam-skiplist との比較が行われており、bbtreeは読み取り主体のワークロードで2〜4倍高いスループットを報告し、書き込み主体のワークロードでも競争力のある性能を示しています。この実装は、順序付きイテレーション(範囲クエリ)と並行ミューテーションの両方が必要なユースケースを対象としています。これはスキップリストでも対応可能ですが、キャッシュ効率が悪く、また RwLock で保護した std::BTreeMap は書き込み競合下での性能が低くなります。コードベースは純粋なRustで記述されており、ロッキングプロトコル上必要な範囲を超えた unsafe な近道は使用していません。データベースエンジン向けのインメモリインデックス、並行スケジューラ、あるいはフルMVCCストアのオーバーヘッドなしにソート済み並行マップを必要とするあらゆるシステムを構築している場合、これはアクセスパターンに対してベンチマークを実施する価値のある有力な候補です。
Source: https://github.com/XiangpengHao/bbtree
hevnsnt/CVEngine
静的なCVEスコアリングではなく、継続的なアセット探索と証拠に基づく脆弱性検証を中心に設計された、AIファーストの外部攻撃面管理(EASM)ツールです。本アーキテクチャは、サブドメインの列挙、ポートスキャン、サービスフィンガープリンティングといった自動偵察を実行し、その結果をLLMを基盤とした推論レイヤーに入力します。この推論レイヤーは、検証プローブを生成・実行することで、実際に悪用可能な問題と理論上の問題を区別しようとします。従来のスキャナーに蔓延する誤検知ノイズの低減が明確な目標として掲げられています。Model Context Protocol(MCP)サーバーとの統合により、開発者エージェント(Claude、Copilotなど)がIDEから直接エンジンの検出結果をクエリできるため、コンテキストスイッチングを必要とせず、探索から修正までのループを閉じることができます。このプロジェクトは実務者向けツールとして位置付けられており、コンプライアンスレポートの生成よりも、裏付けとなる証拠を伴う実行可能な出力を重視しています。技術的に興味深いのはバリデーションパイプラインです。バージョン文字列をCVEデータベースと照合して報告するのではなく、ターゲットを絞ったプローブによって悪用可能性を実際に確認しようとする点が、トリアージの優先順位付けの方法を大きく変えます。アセットインベントリ自体が流動的なクラウドネイティブ環境や急速に変化するインフラに対して継続的な評価を実施するセキュリティエンジニアに有用なツールです。
Source: https://github.com/hevnsnt/CVEngine
deeplethe/solid-glass
AIアプリケーションUIを対象としたデザインシステムで、マテリアル・フィジカル・タクタイルと表現されるビジュアル言語を中心に構築されています。具体的には、すりガラス風のサーフェス、深度レイヤリング、そしてフラットなトークンベースのテーマではなく物理的に動機付けられた光と影を特徴としています。実装としては、backdrop-filter、ブラー、透明度を活用してマテリアルの奥行きをシミュレートするCSSを備えたReactコンポーネントを提供しています。開発の動機は、AIアプリケーションのインターフェース——チャットスレッド、ツールコールのトレース、ストリーミング出力——が、MUIやshadcnといった標準的なデザインシステムが想定していないインタラクションパターンや情報密度の要件を持つという点にあります。汎用的なコンポーネントライブラリを改造するのではなく、これらのユースケースのためにゼロから構築されています。コンポーネントセットは期待される基本要素(カード、input、モーダル)を網羅しつつ、ネストされたコンテンツ・非同期コンテンツ・ストリーミングコンテンツが頻繁に登場するAIネイティブUIを前提としたaestheticとレイアウトの設計方針が組み込まれています。早期公開の段階で2000以上のスターを獲得しており、画一的なフラット/ニュートラルなaestheticとは視覚的に差別化されたものを求めるAIプロダクトフロントエンド開発者から大きな注目を集めています。主な制限として、backdrop-filterを多用するとローエンドハードウェアでは無視できないGPUコストが発生するため、モバイルのパフォーマンスには注意が必要です。
Source: https://github.com/deeplethe/solid-glass
morganlinton/BeautifulRust
エージェントスキル定義と厳選されたClippy設定のコレクションであり、コーディングエージェントを「Rustの構文を使ったC++」ではなく、慣用的なRustへと誘導することを目的としています。解決しようとする核心的な問題は、広範なコードコーパスで学習されたLLMが、コンパイルは通るものの、所有権を誤用し、イテレータを避け、.clone()を多用し、ゼロコスト抽象化の機会を見逃すようなRustコードを生成しやすいという点にあります。Claude Code、OpenAI Codex、GitHub Copilot、Cursor、Gemini CLIに対応したこれらのスキルは、Rust固有のパターンを再利用可能なエージェント指示としてエンコードしています。具体的には、インデックスループよりもイテレータを優先する、エラー伝播には?を使用する、適切な場面では動的ディスパッチよりもimpl Traitを活用する、といった内容が含まれます。Clippy設定も注目に値します。デフォルトのlintセットのテスト済みスーパーセットを有効にし、エージェントが最も頻繁に犯すミスのカテゴリを対象としています。また、生成されたRustコードをこれらの慣用表現に照らして批評するよう、コミット前にエージェントに指示するコードレビュースキルも含まれています。RustコードベースへのAI支援開発を採用しているチーム、特にC/C++/PythonをRustに移植するチームにとって、エージェントのすべての出力を手動で監査することなく品質管理を行うための実践的な基準を提供するものです。スキルのフォーマットはモデル非依存性が高く、記載されている以外のエージェントにも容易に適応可能です。
Source: https://github.com/morganlinton/BeautifulRust
hanzohanzhe/Grandet
LLM API ルーティングのためのコスト最適化レイヤーです。公式 API エンドポイント、inference プロバイダー(Together、Fireworks、Replicate)、リレー/リセラーサービスを含む1,800以上のプロバイダーの価格データを集約し、統一された MCP インターフェースを提供することで、エージェントが特定のモデルに対して最安値のエンドポイントを照会・接続できるようにします。名称はバルザックの守銭奴に由来しており、言い得て妙です。技術的な中核は grandet.ai によって支えられた継続更新型の価格データベースであり、匿名 MCP サーバーを通じて公開されているため、価格探索に API キーは不要です。エージェントスキルにより、AI コーディングエージェントやオーケストレーションエージェントは実行時にコストを考慮したルーティング判断を下すことができます。エンドポイントをハードコーディングする代わりに、エージェントは Grandet に対して特定モデルを提供している現時点での最安値プロバイダーを問い合わせ、そこへ接続します。これは、同一またはほぼ同一のモデルウェイトに対してモデルプロバイダーの価格がプロバイダー間で大幅に異なる(しばしば3〜10倍)、大量のバッチワークロードにおいて実用的に有用です。匿名 MCP サーバーの設計はプライバシーの観点から注目に値します――ルーティングクエリにアカウント登録は不要です。制限事項としては、プロバイダー間のレイテンシのばらつき(最安値が必ずしも最速ではない)、およびリレープロバイダーが改変されていないモデルウェイトを提供していることを検証する必要がある点が挙げられます。
Source: https://github.com/hanzohanzhe/Grandet
mrsarac/ff-tracking
再利用可能なライブラリではなく、ジェネレーティブ/プロシージャルなビデオプロジェクトですが、そのレンダリングパイプラインは技術的に興味深いものです。コンセプトとしては、バーチャルカメラがAIエージェントの画面上の活動を描画し、カスタムトラッカーがレンダリング出力内の個々のグリフを捕捉します。テキスト文字を追従すべき物理的なオブジェクトとして扱うというアプローチです。レンダリングには2パスのSkSL(Skia Shading Language)を用いて視覚効果を実現しており、すべての音声はサンプリングではなくプログラム的に合成されています。技術的な興味の核心はグリフトラッキングの実装にあります。カメラが移動している状況でフレーム間にわたってテキスト文字を検出し、その同一性を維持することは、OCR的なローカライゼーションか、ラスタライズ前にグリフ位置を抽出するためのレンダリングパイプラインへの直接フックを必要とする非自明な問題です。「2フレームパス」という説明は、トラッカーが利用できるよう中間バッファにグリフのメタデータを保持するディファードレンダリングのアプローチを示唆しています。クリエイティブコーディング、シェーダーベースのポストプロセッシング、あるいはエージェントの振る舞いに対するオブザーバビリティ/可視化ツールの構築に関心を持つ開発者にとって、エージェントの画面出力を撮影すべき物理的なシーンとして扱うというこのアプローチは、インスピレーションの源として検討する価値のある独自のフレーミングです。
Source: https://github.com/mrsarac/ff-tracking
flohoeller/affectui
エージェント中心のUIパターンに特化して設計されたReactコンポーネントライブラリです。具体的には、エージェントツリー、ツールコール表示、実行トレース、ハンドオフフロー、およびhuman-in-the-loop承認インターフェースを提供します。これらは、エージェント型バックエンドを持つAIアプリケーションを構築するすべてのチームがゼロから再実装し続けているUIプリミティブです。配布モデルが注目に値します — 各コンポーネントは単一の自己完結したファイルとなっており、shadcn CLI(npx shadcn add)またはMCP経由でインストール可能です。つまり、モノリシックな依存関係なしに必要なものだけを取得できます。コンポーネントはshadcn/Tailwindエコシステムと組み合わせて使えるようスタイリングされています。エージェントツリーコンポーネントは階層的なエージェントの生成と委譲を可視化し、ツールコールコンポーネントは各ツール呼び出しの構造化された入出力ペアをレンダリングし、トレースコンポーネントはエージェント実行のタイムラインビューを提供します。承認コンポーネントはhuman-in-the-loopゲートパターンを処理し、保留中のアクションをコンテキストとともに提示して、承認・拒否のコントロールを受け付けます。これらのコンポーネントは、ストリーミング更新、部分的な状態、および非同期完了を処理する必要があるため、正しく構築するのは容易ではありません。エージェントオーケストレーションのフロントエンド(LangGraph、CrewAI、カスタム実装など)を構築するチームにとって、このライブラリは大量のボイラープレートを排除し、エージェントライフサイクルイベント全体にわたって一貫したビジュアル言語を提供します。
Source: https://github.com/flohoeller/affectui
storytold/designcraft
純粋なRustでゼロから書かれたページ・レイアウトデザインエディタです。Electronも、Webレンダラーも、既存のGUIフレームワークも使用していません。約5,000スターを獲得しており、その技術的な野心と実用的な有用性の両面で注目を集めています。(FigmaやAffinity Publisherの一部に相当するスコープの)デザインツールを純粋なRustで構築するということは、フルスタックを自前で実装することを意味します。すなわち、ベクターレンダリング、制約ベースのレイアウト、ヒットテスト、テキストシェーピング、undo/redoヒストリー、そしてファイルI/Oを、ブラウザのプリミティブに頼ることなく実装しています。「ゼロから書かれた」という表現は、icedやeguiのようなライブラリをラップするのではなく、カスタムレンダリングを行っていることを示唆していますが、正確なレンダラー(おそらくwgpuまたはSkiaバインディング)はソースコードを確認する価値があります。ElectronベースのアプローチではなくRustを選んだ動機は一般的なものです。すなわち、メモリフットプリント、起動レイテンシ、そしてV8のオーバーヘッドなしにWASMを含むネイティブターゲットへコンパイルできる能力です。コンパイラおよびシステム系の読者にとって興味深いエンジニアリングは、レイアウトの制約ソルバーとシーングラフの設計にあります。デザインツール系の読者にとっては、サブスクリプションモデルのないオープンソースかつローカル動作のページレイアウトエディタは、現実のニーズを満たすものです。主な未解決の問題はテキストレンダリングの品質であり、これは歴史的にブラウザ以外のデザインツールが苦戦してきた領域です。