デイリーAIダイジェスト — 2026-10-26
arXiv ハイライト
UserArena: 長期ショッピングエージェントに向けたインタラクティブユーザーシミュレーションのベンチマーク
問題設定
エージェント型推薦システムでは、多数のステップとセッションにわたるショッパーの行動をモデル化するシミュレーターが必要です。さらに、オフラインのポリシー比較が本番環境のA/B試験結果と一致するだけの高い忠実度も求められます。既存のリソースはいくつかの軸でトレードオフがあります:視覚的コンテキストを持たない実トレース(Qilin、RL4RS)、クロスセッションの長期horizon を持たない視覚的コンテキスト(OPeRA、USB)、合成軌跡(A/B Agent)、完全なインタラクティブ行動空間を持たない長期履歴(OmniBehavior)のいずれかです。ステップレベルの実軌跡、レンダリングされた視覚的観測、完全なショッピング行動空間、クロスセッションの長期 horizon、そして制御されたA/B試験との検証をすべて兼ね備えたものは存在しません。UserArena が目指すのはこのギャップを埋めることです。
ベンチマークの構築
UserArena は、本番環境の EC プラットフォームをビューポートレベルで再構築します。表示されるフィードは、シミュレーターがスクロールする際に事前レンダリングされた完全なフィードをクロッピングして取得します。実際のユーザーがクリックしなかったアイテムを含む露出済みアイテムをクリックすると、記録された商品コンテンツと事前レンダリングされたビューから再構築された商品詳細ページが開きます。行動空間はフィードナビゲーション、商品閲覧、カートへの追加、購入にわたる13種類のタイプを含みます。各決定は、ユーザープロファイル・視覚的観測・可視商品コンテキスト・行動の整合されたタプルとして保存され、インタラクティブエージェント研究で用いられる観測–行動の定式化と一致しています。
コーパスの規模は大きく、11,010ユーザー、64,729セッション、577,670アクション、566,102商品、6つのユーザー属性、41カテゴリにわたる73,717回のアイテムクリックを含みます。長期horizon の評価のために、5,768ユーザーの59,378セッションを時系列順にクロスセッション軌跡にグループ化しており、ユーザーあたり平均10.29セッション・86.36アクションとなっています。これにより、シミュレーターが単一セッション内だけでなく、繰り返しの訪問にわたって好みや行動傾向を保持するかどうかを評価者が検証できます。
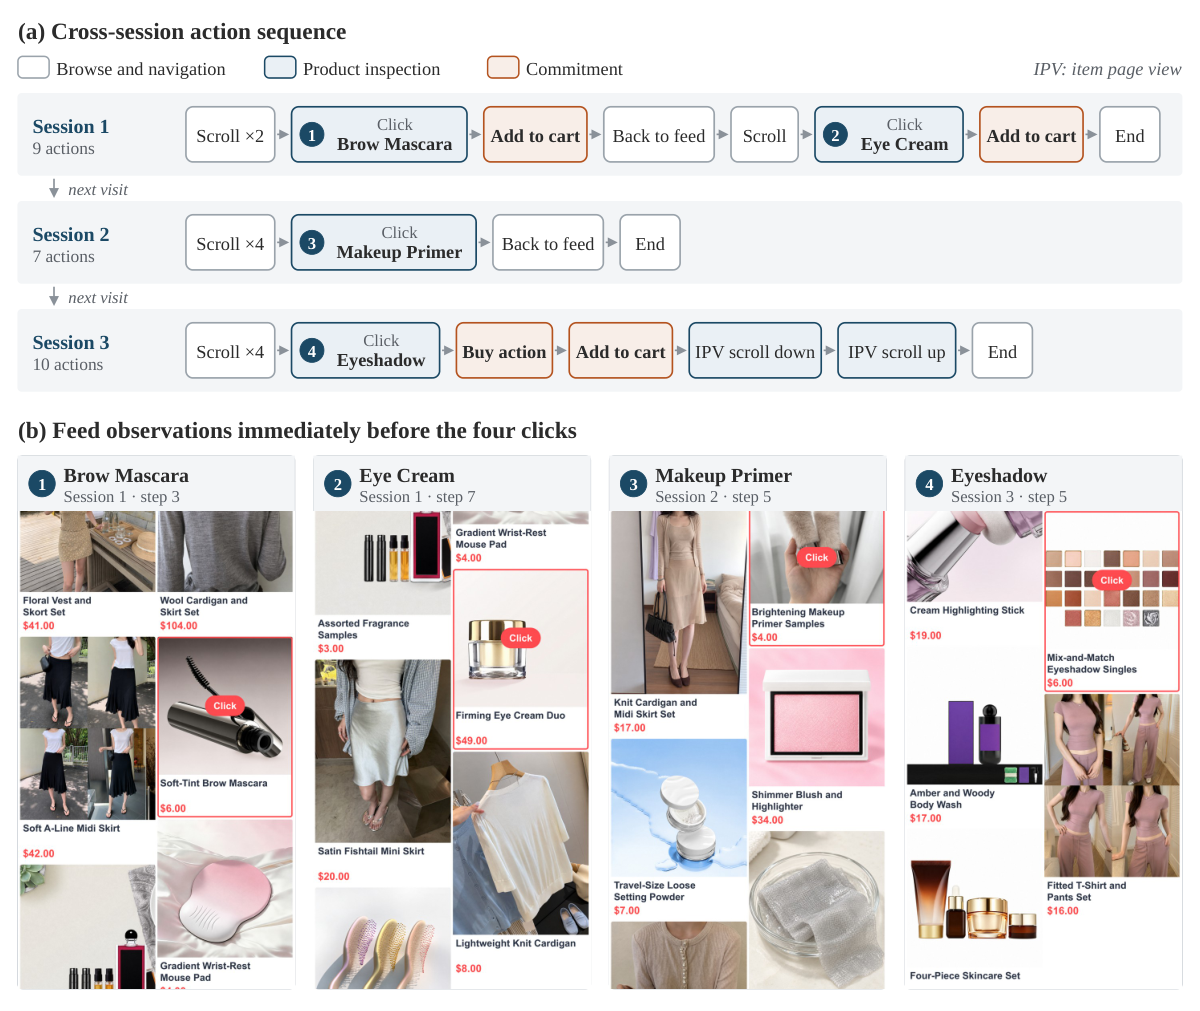
上記のクロスセッション例は、忠実なシミュレーターが再現しなければならない構造の種類を示しています:商品の好みが訪問をまたいで持続しつつ、閲覧や時折のコミットメント行動によって区切られた長いフィードスクロールのシーケンスです。評価は5つのレベルで構成されています——出力の妥当性、局所的な意思決定、逐次的な行動、パーソナライゼーション、そして成果——成果レベルでは同一ポリシーペアに対する制御された本番A/B結果とのオフライン比較が提供されます。
On-Policy Trajectory Distillation
これらの長期軌跡上でシミュレーターを学習させるために、本論文はOn-Policy Trajectory Distillation(OPTD)を提案します。動機は標準的なものです:teacher forcing を用いた SFT は各予測を ground-truth プレフィックスに条件付けするため、推論時には学習分布外の自己生成プレフィックスに遭遇します。また GRPO は応答ごとにスカラー報酬のみを割り当てるため、トークンレベルでは弱い監督シグナルとなります。
OPTD は \mathcal{D} から取得した実際の状態 x_t においてstudentからサンプリングします:
y_t = (y_{t,1},\ldots,y_{t,|y_t|}) \sim \pi_\theta(\cdot \mid x_t),
ここで y_t は短い根拠に続く構造化されたインターフェース行動です。frozen された teacher には特権的コンテキスト——完全な記録済み軌跡から抽出した軌跡レベルの intent——が与えられ、student 自身のロールアウト y_{t,<k} の各トークン位置 k においてfull-vocabulary 分布を生成します。student はこれらの密な teacher ターゲットに向けて最適化されます。その際、観測可能な状態 x_t のみに基づく予測からの乖離を制限するper-token trust region が適用されます。軌跡レベルの intent が特権情報の鍵となる要素です:これにより teacher は、実際の軌跡が最終的にどこへ向かうかと整合したトークンレベルのターゲットを割り当てることができ、その未来をstudentに漏らすことなく済みます。
実装面では、スケルトンの実装に次の要素が必要です:(i) \tau_u を teacher の conditioning string に要約する intent extractor、(ii) 各学習ステップにおける \pi_\theta からのon-policy サンプリング、(iii) per-token 分布を得るための x_t・intent・student ロールアウトに対する teacher のフォワードパス、(iv) 状態のみの student を基準とした trust region を維持するためにper-token でクリッピングされた、それらの分布に対する KL loss。論文の Figure 2 における比較は、SFT(記録済みプレフィックス・近視的ターゲット)vs. GRPO(応答レベルのスカラー)vs. OPTD(自己生成プレフィックスに対する密で軌跡整合されたper-token ターゲット)という枠組みで整理されています。
実験
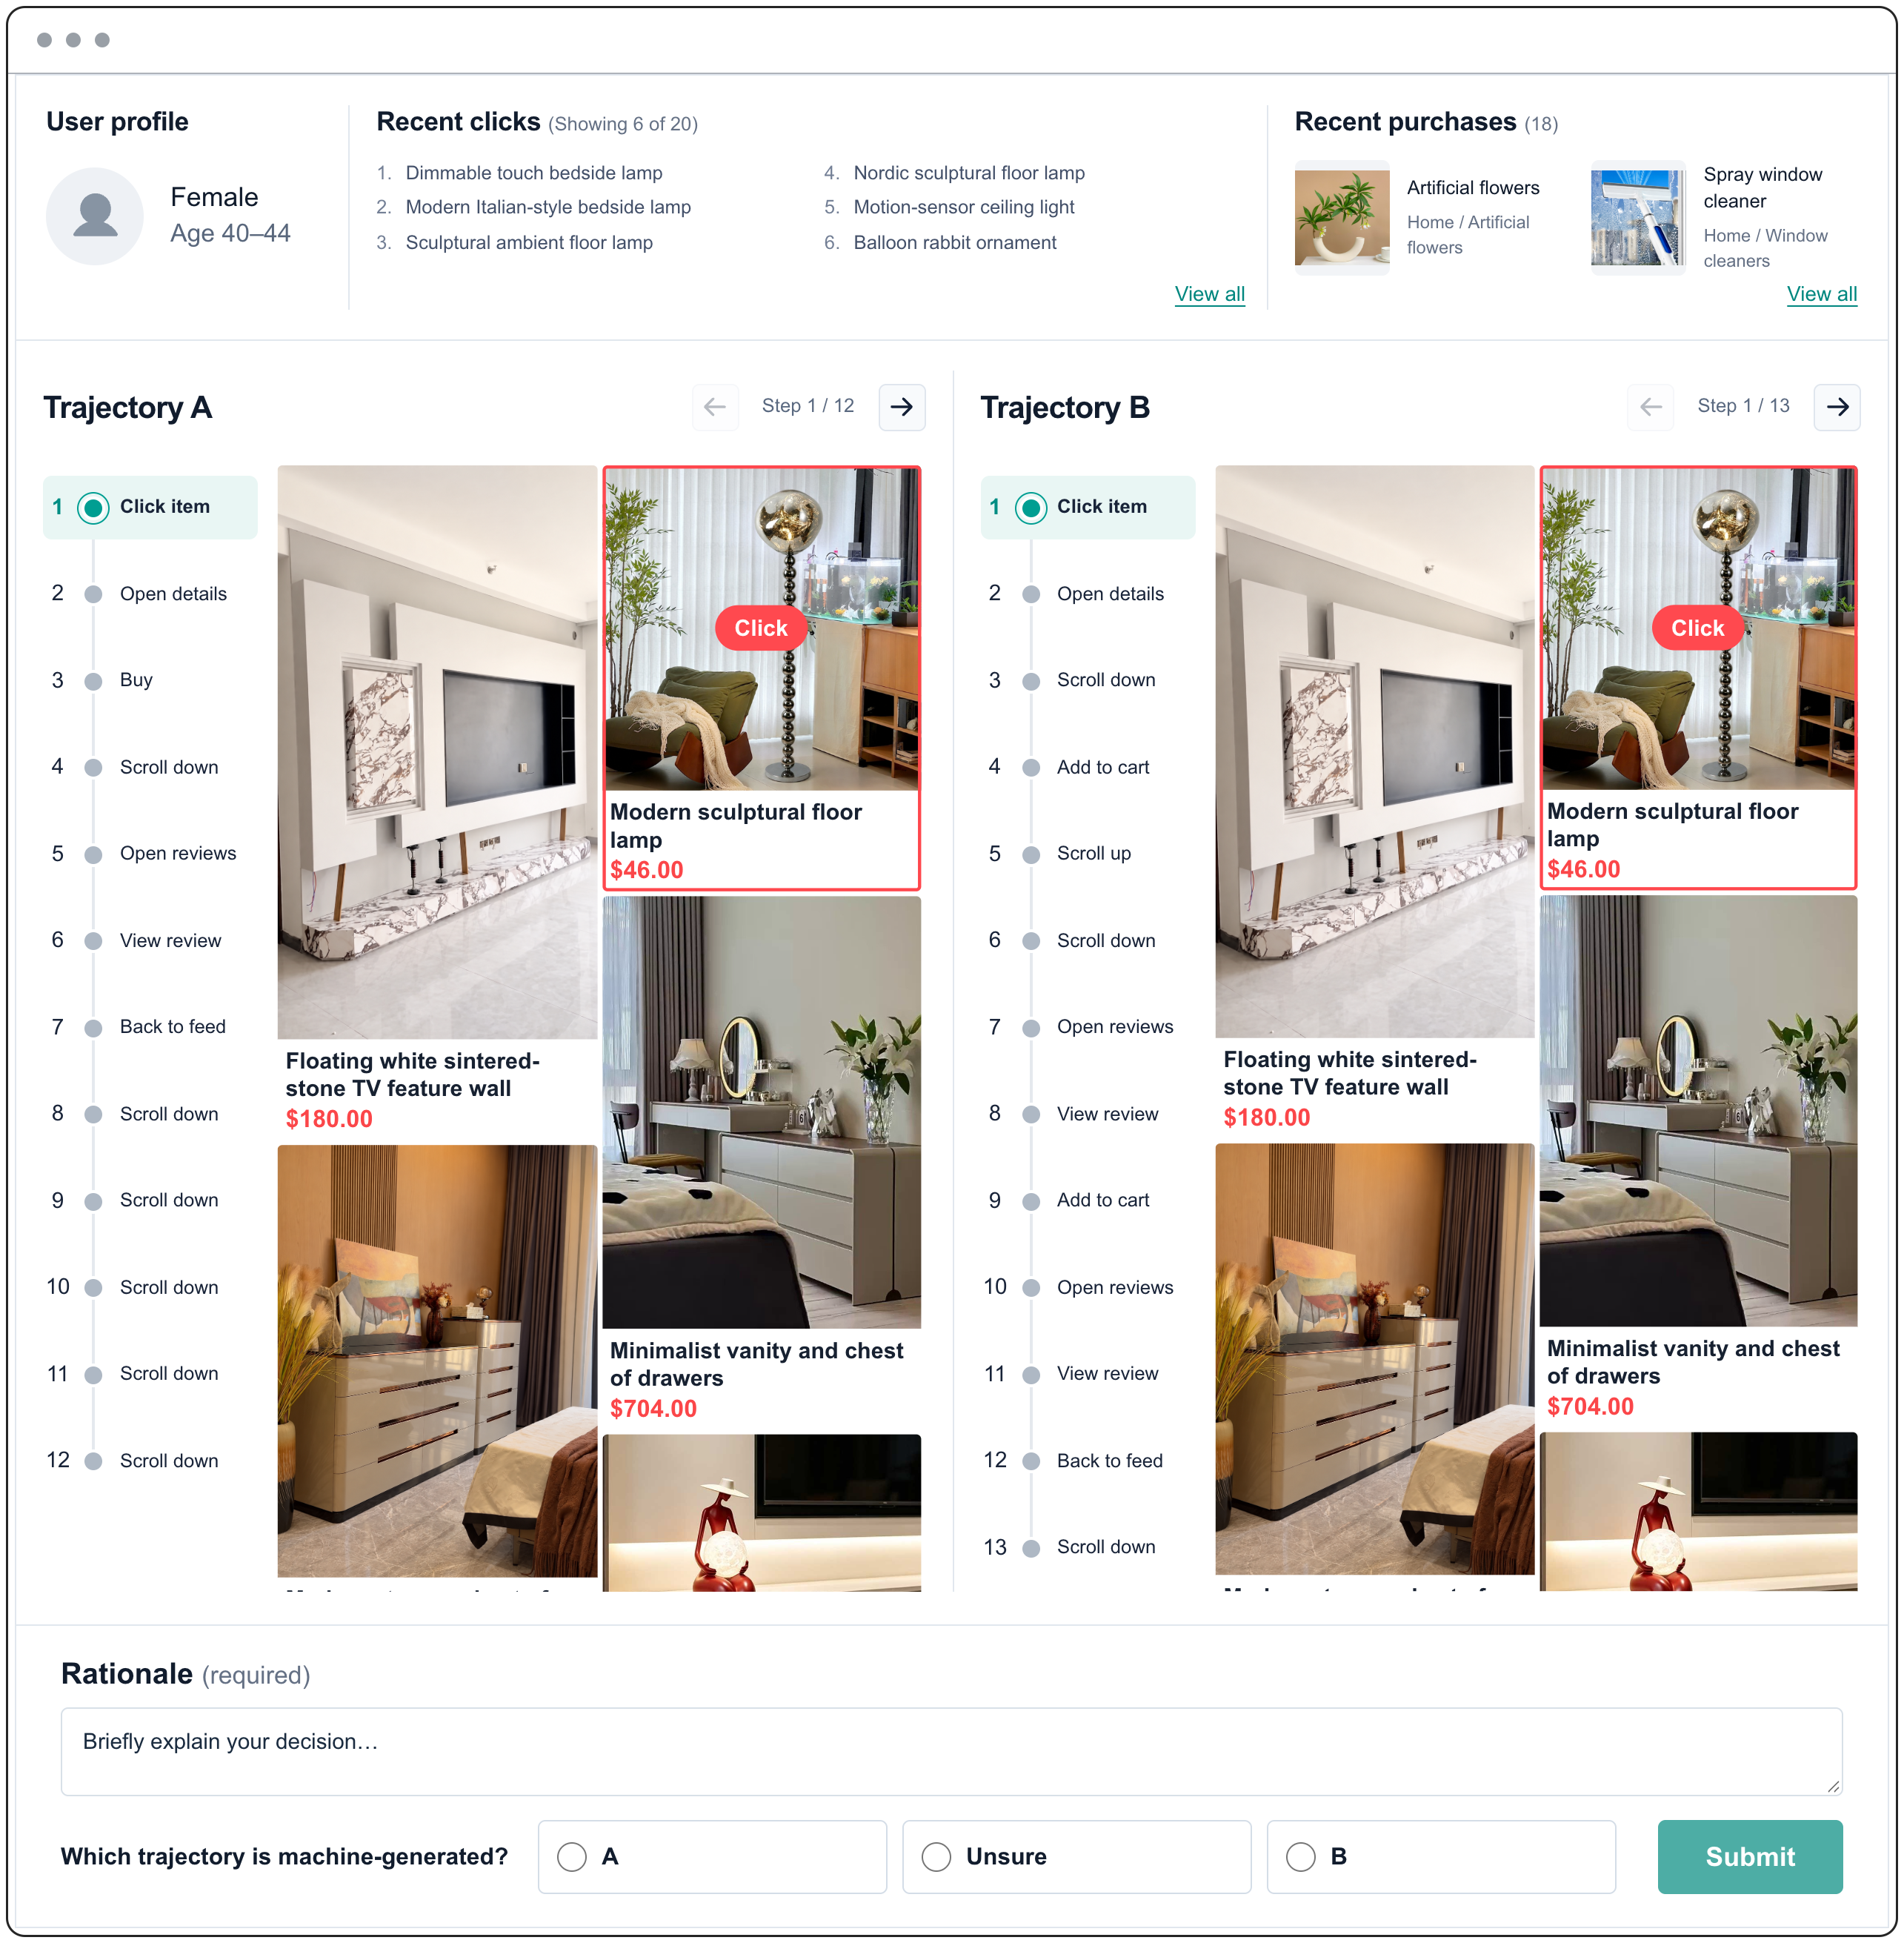
主要な比較手法はすべて、モデルスケールの交絡因子を除去するために Qwen3.5-2B を使用します。ベースラインは、テキスト観測シミュレーター(RecAgent、Agent4Rec、Shop-R1、Customer-R1、AlignUSER、SimUSER)と GUI 観測シミュレーター(A/B Agent、STA)に分かれます。abstractでは、OPTD が5つの評価レベルにわたって最も優れた結果を達成することが報告されていますが、選択されたセクションではその定性的な主張を超えた具体的なper-metric の数値は示されていません。人間による評価は、アノテーターが同一ユーザーコンテキストに条件付けられた2つの匿名化された軌跡を見て、どちらが機械生成かを判断するTuringスタイルのペアワイズインターフェースを使用しています。
制限と未解決の問題
このベンチマークは単一の EC プラットフォームから得られているため、カテゴリカバレッジ(41カテゴリ)と行動のセマンティクスが他の推薦サーフェスに転用できない可能性があります。本番 A/B 検証は、利用可能な制御実験の範囲に限られます。OPTD の有効性は抽出された軌跡 intent の品質と、teacher が特権的コンテキスト下で適切にキャリブレーションされているかに依存しますが、論文の提供されたセクションでは intent 抽出や teacher のスケールに対する感度が定量化されていません。2B のみの主要比較では、7B 以上において OPTD が RL ベースの代替手法と比較してどのようにスケールするか、またより大きな容量でper-token trust region が依然として適切な正則化子であるかどうかが未解決のままです。
なぜこれが重要なのか
推薦ポリシーのシミュレーターベースの評価は、シミュレーターのランキングが本番 A/B 結果と一致する場合にのみ有用です。UserArena は、長期horizon の実軌跡を視覚的コンテキスト・完全な行動空間・オフライン対 A/B 検証と組み合わせた最初の公開ベンチマークであり、OPTD は LLM ベースのユーザーシミュレーターを制限してきた学習–推論ギャップを埋めるための具体的なレシピを提供しています。
Source: https://arxiv.org/abs/2610.30932
On-Policy Self-Training: 大規模言語モデルにおけるデータ不要の自己改善
問題設定
Post-trainingパイプライン — SFT、RLHF、RLVR、およびon-policy self-distillation — はいずれも、何らかのキュレーションされた成果物を前提としています。すなわち、ラベル付き (x, y^*) ペア、プロンプト分布 \mathcal{D}_{\text{prompts}}、検証器、あるいは少なくとも人間や上位のteacherによって作成された問題セットが必要とされます。本論文が問うのは、これらのいずれも利用できない状況において、「Abstract Algebra」や「Commonsense Causal Reasoning」といった粗粒度のトピック文字列のリスト \mathcal{T} = \{\tau_1, \dots, \tau_K\} のみを入力として、モデルを改善できるかどうかという問いです。この問いが重要なのは、現在のfoundation modelが、新たな人間からのシグナルなしに引き出せる潜在的な能力を保有しているかどうかを探るものであり、人間がキュレーションしたデータのフロンティアを超えて自己改善ループをスケールさせることに直接関係するからです。
手法
このフレームワーク、On-Policy Self-Training (OPST) は、1ラウンドあたり3つのステージを実行し、それを反復します。
1. 合成問題および特権情報の生成。 各トピック \tau_k \in \mathcal{T} に対して、現在のモデルがクエリ x_i をサンプリングし、その後別のパスにおいて、根拠 r_i と候補回答 \hat{y}_i からなる特権情報 z_i = (r_i, \hat{y}_i) を生成します。これにより、外部の教師信号を一切用いない合成データセット \mathcal{D}_{\text{syn}} = \{(x_i, z_i)\}_{i=1}^N が得られます。
2. 内因的フィルタリング。 2つのフィルタが \mathcal{D}_{\text{syn}} を枝刈りします。擬似検証パスは、モデルが自身の (x_i, r_i, \hat{y}_i) を再読した際に内部整合性があると判断するかどうかを確認します。コンセンサスゲートは、x_i に対して独立にサンプリングされた複数の回答間での合意を要求します。アブレーション実験は、両者が加算的であることを示しています。ベースのMMLU精度37.5から出発し、単純なOPSTは42.7に到達し、検証により+2.7の45.4となり、コンセンサスゲートによりさらに+2.3の47.7となります。
3. 特権情報を用いたon-policy self-distillation。 studentは、(x_i, z_i) を条件として受け取るteacherに対してon-policyで訓練されます。すなわち、teacherは特権的な根拠と候補回答を見るが、studentは見ません。重要なのは、studentが \hat{y}_i を直接模倣するのではなく、z_i が与えられた条件のもとでのteacherの回答分布からdistillするという点です。teacherはstudentの重みのEMAであり、ループをon-policyに保ちます。この模倣ではなく条件付けという設計が、OPSTに自己生成誤りへのロバスト性をもたらします(後述)。
この3つのステップは複数ラウンドにわたって繰り返され、各新しいラウンドでは更新されたモデルから \mathcal{D}_{\text{syn}} が再生成されます。この手順は、画像条件付きトピック記述子をシードとすることで、視覚言語モデルにも拡張できます。著者たちはこれをVisual OPSTと呼んでいます。
結果
ベースモデルはGemma 4 E2BおよびE4Bです。トピック記述子は4つのin-domainベンチマーク(MMLU、GPQA、GSM8K、HellaSwag)をシードし、3つの未使用ベンチマーク(ARC-Challenge、MATH-500、Winogrande)が保持・転移を検証します。E2BにおけるMMLUの推移は、自己生成データのみを用いて37.5 → 47.7(+10.2)となります。マルチモーダルVQAにおける実験でも同様のパターンが転移することが示されます。
アブレーション実験が最も有益な知見を提供しています。特権情報を完全に除去すると、ゲインは10.2ポイントから3.1ポイントへと低下します — この残余ゲインはおそらくEMA teacherへのon-policy self-distillationを反映しています。z_i を同一トピックの異なる問題から引いたプラセボ z で置き換えると2.7ポイントのゲインしか得られず、シグナルが一般的なドメイン事前知識ではなくサンプル固有のものであることが確認されます。根拠のみでは10.2ポイントのうち8.3ポイントが回復され、回答のみでは7.1ポイントが回復されます。根拠は候補回答よりも多くのシグナルを持ちますが、これはteacherの条件付き分布 p(y \mid x, r) が p(y \mid x, \hat{y}) よりも鋭く、より情報量が多いという見解と整合しています。
アーキテクチャ上の選択が効果を発揮するのは、ロバスト性実験においてです。両フィルタを無効にした状態で、候補回答の割合 p を明示的に誤ったものに置き換えます。
| p | SFT | OPST |
|---|---|---|
| 0% | 38.8 | 42.7 |
| 25% | 38.1 | 42.1 |
| 50% | 35.4 | 41.4 |
| 75% | 33.1 | 40.8 |
p = 75\% の誤ったラベルにおいて、SFTはベースモデルを4.4ポイント下回るまで崩壊しますが、OPSTはベースモデルを3.3ポイント上回る状態を維持し、わずか1.9ポイントの低下にとどまります。studentが \hat{y} を直接模倣するのではなく、z を条件とするteacher分布からdistillするため、誤った候補回答はハードラベルノイズを注入するのではなく、teacherを緩やかに劣化させるにとどまります。
限界と未解決の問題
この手法は依然として自己生成された特権的根拠の品質によって上界が定まります — あるトピックについてモデルが正しい根拠を生成できない場合、どのフィルタも回復することはできません。コンセンサスゲートは、モデルがすでに一貫して回答できる問題に偏りますが、これはラウンドを跨いで容易な問題へのカリキュラム崩壊を招くリスクがあり、論文は難易度がどのように変化するかを十分に特徴付けていません。GPQAはマルチドメイン実験ではOODとして扱われるため、真に困難な推論におけるOPSTの性能は未解決のままです。最後に、「データ不要」はあくまで相対的な表現であり、トピック記述子自体はキュレーションされた帰納的バイアスであり、Gemma 4ベースモデルは与えられた事前学習分布を保有しています。
この研究の意義
OPSTは、競争力のあるベースモデルにおいて意味のあるpost-trainingゲイン(MMLUで+10)が、モデルとトピック文字列のリストのみから引き出せることを実証しています。ただし、そのためには自己生成ラベルを模倣するのではなく、特権的な自己生成推論を条件として与えられたteacherからdistillするループであることが必要です。この条件付けこそが、75%ノイズへのロバスト性をもたらし、崩壊することが知られている単純なsynthetic-SFTループとこの手法を区別するものです。
Source: https://arxiv.org/abs/2610.32770
MMVistaReason: マルチモーダル推論のためのオープンデータおよびPost-Trainingレシピに向けて
問題
オープンなマルチモーダル推論のpost-trainingは、四つの相互に関連した課題に悩まされています:(i) 重複、ノイズの多いキャプション、回答不可能なサンプルを含む異種のオープンVQAデータ;(ii) 非効率なトラジェクトリ監督(単一のフロンティア教師モデルからの蒸留にコストがかかり、しばしば学生モデルの能力と不釣り合い);(iii) 不均衡な難易度により、RLにおけるロールアウトが自明または解不能になる;(iv) 構造化された「分析的」推論(数学、論理、チャート、科学)と知覚主導の「実世界」推論(GUI、空間、計数)のクロスドメイン干渉。MMVistaReason(MVR)は、これら四つすべてに対処するオープンデータレシピを提案し、二つのリリースコーパス(MVR-SFT-528K、MVR-RL-63K)と、専門化してから統合するエキスパートを中心に構築されたトレーニングプロトコルを提供します。
手法
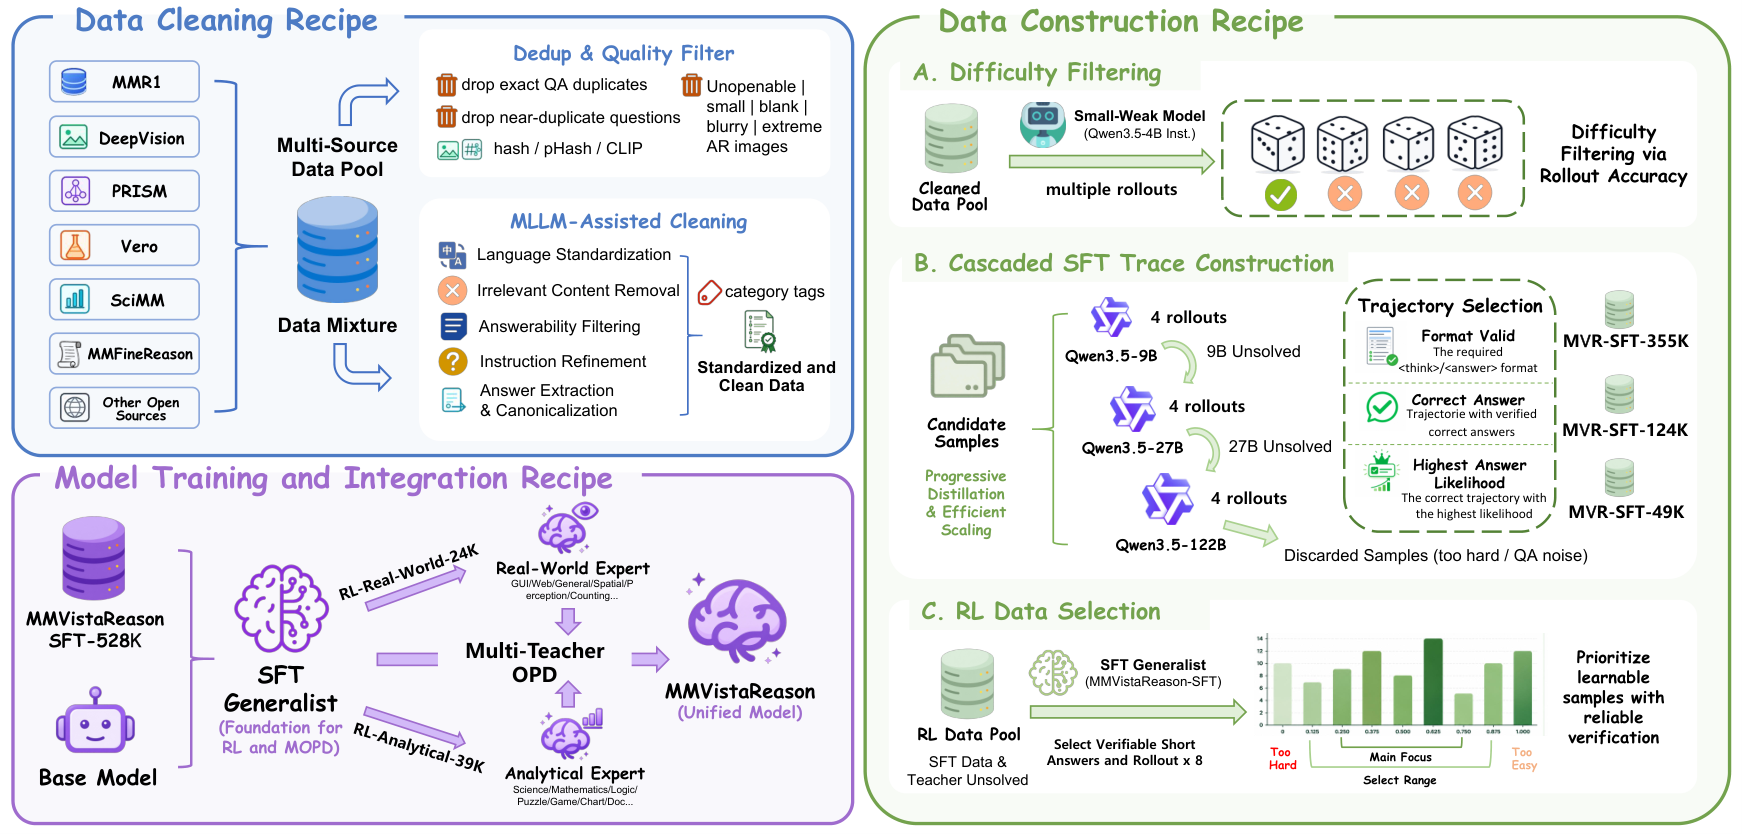
データクリーニング。 集約されたオープンデータセットは段階的なフィルタリングを経ます:SHA-256 + pHash + CLIP類似度による重複除去(同一画像・意味的に類似した質問の近似重複検出)、画像品質フィルタ(解像度、アスペクト比、ぼけ)、続いてMLLMを活用した言語標準化、無関係コンテンツの除去、および構造化JSONアウトプットを用いた回答可能性フィルタリング(§8のプロンプト1〜3)。キャプションのみのアイテムとオープンエンドのアイテムは除外されます。
難易度対応のカスケード型教師蒸留。 各サンプルに対し、スケールが段階的に大きな教師モデル — Qwen3.5-9B、Qwen3.5-27B、Qwen3.5-122B-A10B — がカスケード形式で呼び出されます;簡単なアイテムは小さな教師モデルで処理が完了し、難しいものは上位へルーティングされます。各教師モデルはenable_thinking=Falseで16,384トークンの候補トレース4件を生成します。スループットは各教師モデルでおよそ800/480/320トラジェクトリ/時です。トラジェクトリは次に、回答尤度に基づく選択によってフィルタリングされ、正しい最終回答に到達しかつ教師モデルの下で高い条件付き確率を示すトレースのみが保持されます。これにより、難易度が単調増加する三つのサブセットが得られます:MVR-SFT-355K(9B)、MVR-SFT-124K(27B)、MVR-SFT-49K(122B)、加重平均パス率はそれぞれ0.5176、0.4616、0.3639です(表6)。質問タイプの分布(表7)は、数値型(30.4%)、短文フレーズ型(28.0%)、多肢選択型(18.4%)が支配的であり;難易度の高い(122B)サブセットは位置・短文フレーズタスクに偏っています(位置:13.0%、他では1.4〜2.2%)、これは小さな教師モデルが失敗する領域を反映しています。
RLデータ。 MVR-RL-63Kはスケール固有のフロンティアフィルタリングを使用します:対象の学生モデルのスケールに対し、そのスケールにおける教師モデルのパス率が有益(1にも0にも飽和していない)なアイテムのみを保持します。このセットは二つのエキスパートを訓練するために、Analyticalサブセットと Real-Worldサブセットに分割されます。
トレーニング。 SFTはLLaMA-Factoryを使用し、Qwen3.5-Baseからのfull fine-tuning、2エポック、学習率 1\times10^{-5}、コサインスケジュール、コンテキスト長16,384、強制された<think>...</think><answer>...</answer>フォーマットで行います。RLはVeRLとGSPOを使用し、グローバルバッチサイズ256、8ロールアウト/サンプル、アクター学習率 5\times10^{-7}、200ステップで、Analytical とReal-Worldそれぞれのエキスパートを訓練します。
マルチ教師オンポリシー蒸留(MOPD)。 二つのRLエキスパートは(SFTから初期化された)単一の学生モデルに統合されます。各プロンプトに対し、ルーティングがサンプルをそのドメインエキスパートに送り;学生モデルがオンポリシーのトラジェクトリを生成し、教師モデルのtop-K(K=32)トークン分布が蒸留シグナルを提供します。形式的には、学生 \pi_\theta とルーティングされた教師 \pi_{\tau(x)} を用いて、
\mathcal{L}_{\text{MOPD}} = \mathbb{E}_{x,\, y\sim\pi_\theta(\cdot|x)} \sum_t \mathrm{KL}\!\left(\pi_{\tau(x)}^{\text{top-}K}(\cdot|x,y_{<t}) \,\|\, \pi_\theta(\cdot|x,y_{<t})\right).
トレーニングは300ステップ、2ロールアウト/プロンプト、定数学習率 5\times10^{-7} で実行されます。これにより、Analytical+Real-Worldの混合データを用いた共同RLトレーニングによる勾配の衝突を回避しつつ、単一のデプロイ可能なモデルを生成します。
結果
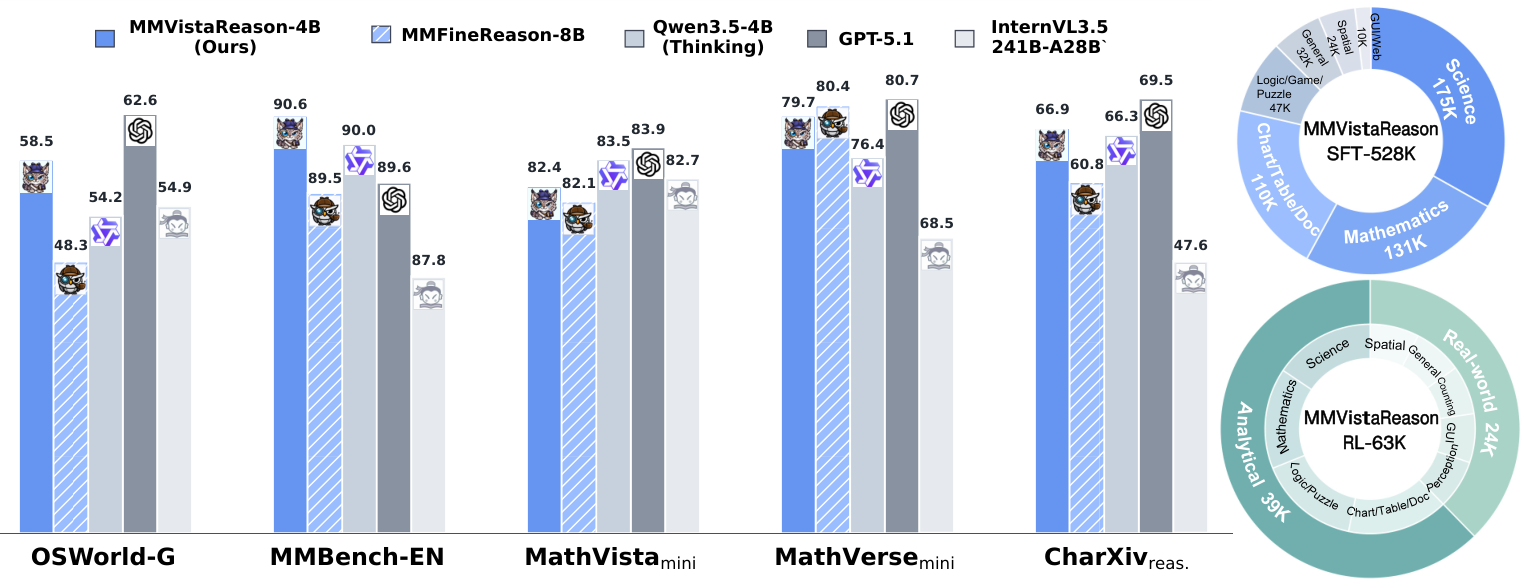
実世界系(OSWorld-G、CV-Bench-2D/3D、MMBench-EN、RealWorldQA、CountBenchQA)と分析系(SFE、MMMU、ScienceQA、MathVista、MathVerse、LogicVista、VisuLogic、ChartQA、CharXiv)のスイートにわたる15のベンチマークにおいて、MVRはOpenMMReasoner-7BやMMFineReason-4B/8Bを含むオープンソース推論VLMを上回り、はるかに大きなinstructベースライン(Qwen3.5-35B-A3B、InternVL3.5-30B-A3B/241B-A28B)と競合します。イントロ図は、はるかに少ないアクティブパラメータ予算で、MVRが分析推論サブセットにおいてGemini-3-FlashおよびGPT-5.1との差を大幅に縮めていることを示しています。
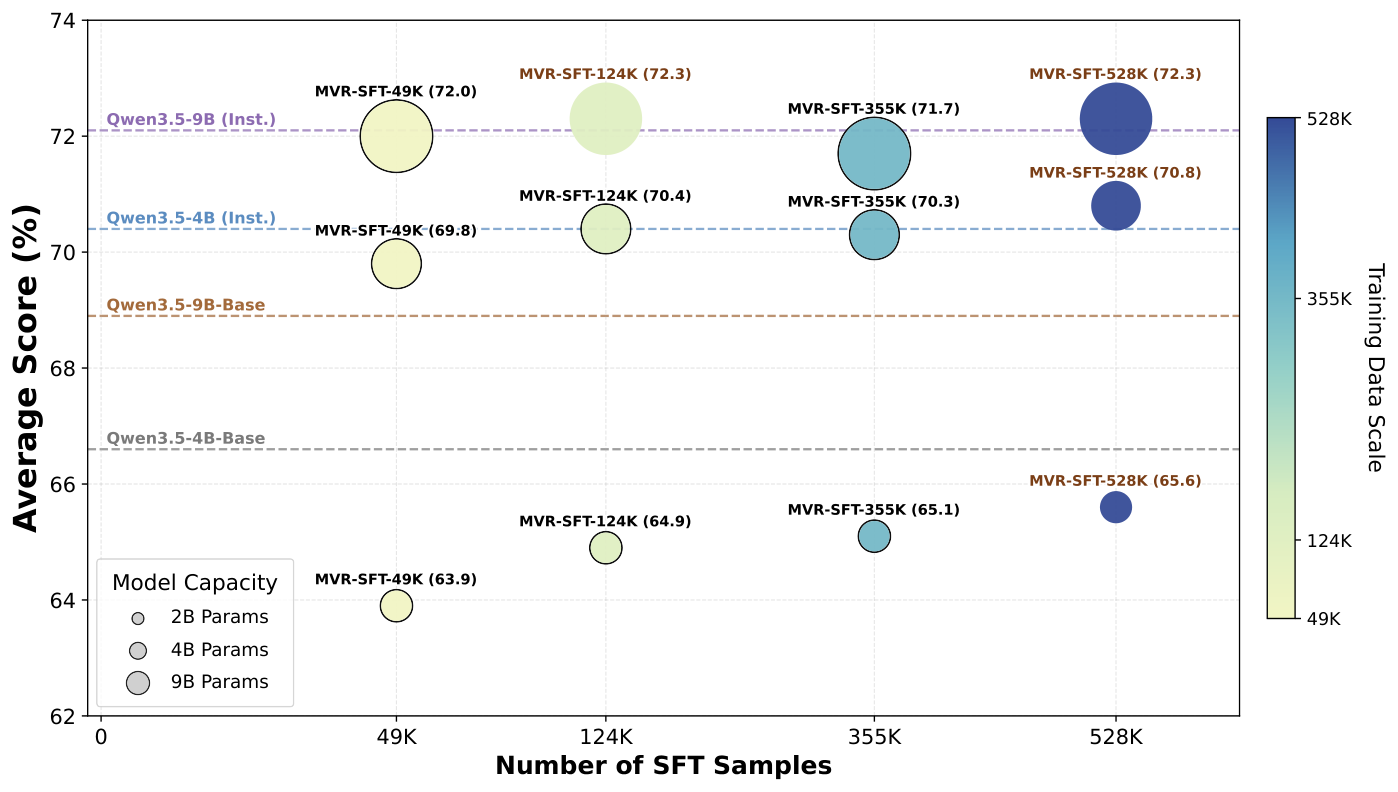
中心的な実験的知見は、容量依存の相互作用です:小さな学生モデルは選別された(より難しく、よりクリーンな)監督からより多くの恩恵を受ける一方、大きな学生モデルはより広範でノイズの多い蒸留に耐えられ、そこから利益を得ます。パス率の統計がこれを裏付けています:パス率0.25での122B蒸留サブセットは、そのサンプルの69.3%をカバーするのに対し、9B蒸留サブセットでは40.5%であり、したがって小さなモデルに最も難しいトレースを盲目的に与えることは監督を無駄にします;このレシピは教師モデルのスケールを学生モデルのスケールに合わせます。
限界とオープンクエスチョン
このレシピはQwen3.5-Baseファミリーで評価されており、蒸留にはQwen教師モデルに依存しているため、利益の一部はベースモデル固有のものである可能性があります。MOPDはドメインタグによるハードルーティングを使用しており、ソフトルーティングや学習済みのMoEはテストされていません。GSPOは8ロールアウトで200 RLステップのみという控えめな設定であり、より長いRLでの専門化→統合ループのスケーリング挙動は不明です。さらに、ベンチマークは主に短形式のものであり;レシピの長期間エージェンティック推論(OSWorld-Gを超えた)への影響は検証されておらず、示されたセクションでは15の評価スイートに対するデコンタミネーション監査も報告されていません。
なぜ重要なのか
MVRは、難易度対応の教師ルーティング、トラジェクトリ尤度フィルタリング、およびドメインエキスパート統合を、孤立したトリックとしてではなく単一の一貫したパイプラインとして扱う数少ないオープンレシピの一つであり、特定の学生モデルに対して教師モデルのスケールをどのように選択するかを実践者に知らせるべき具体的な容量-難易度曲線を明示しています。リリースされた528K SFTおよび63K RLコーパスは、蒸留コストを再負担することなくマルチモーダルpost-trainingの手法を比較するための再現可能な基盤をコミュニティに提供します。
Source: https://arxiv.org/abs/2610.01352
Sparse Autoencoderを用いた監査可能なAIテキスト検出器の構築
問題設定
デプロイされたAIテキスト検出器は二律背反のジレンマを抱えています。fine-tuningされたtransformerの分類器はAUC/F1において最高の性能を発揮しますが、その判断は不透明であり、陽性ラベルが実質的な影響をもたらすピアレビュー、入学審査、または懲戒処分の文脈では受け入れられません。文体測定ベースライン(機能語の頻度、可読性指標、パープレキシティの曲率)は検査可能ですが、ニューラル検出器に大きく劣り、ドメインシフトに対して脆弱です。本論文は、sparse autoencoder(SAE)がfine-tuned検出器の残差ストリームを、その精度を損なうことなく人間が読める特徴基底に変換できるかどうかを問います。
手法
パイプライン(図2)は、fine-tuned検出器をラベル付きコンセプト上のsparse logisticモデルへと変換する4段階の変換です。
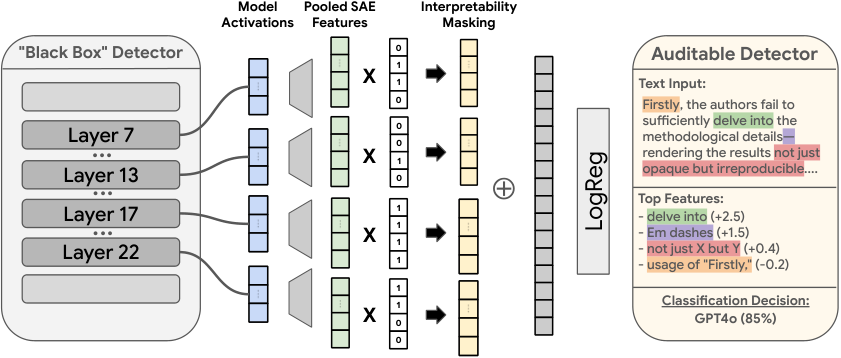
- Activation抽出。 トークン列 (\mathbf{t}_0, \ldots, \mathbf{t}_n) が与えられたとき、層 L = \{7, 13, 17, 22\} における残差ストリームactivation \mathbf{d}_i^{(\ell)} を抽出します(McDougall et al. 2025 に倣う)。
- SAEエンコーディング。 Activationを層ごとのSAEエンコーダに通してsparse特徴 \mathbf{h}_i^{(\ell)} を生成します。シーケンス次元方向にmax-poolingを行い、層をまたいで結合することで文書ベクトル \mathbf{h} \in \mathbb{R}^{|L| \cdot d_{\text{SAE}}} を得ます。
- Auto-interpretationマスク。 各特徴 h_i に対してLLMで自然言語による説明を生成し、その説明がホールドアウトテキスト上での特徴のactivationをどの程度予測できるかをスコアリングして、simulation score s_i \in [-1, 1] を得ます。二値マスク m_i = \mathbb{I}[s_i \geq \tau] を構築し、\mathbf{h}_\tau = \mathbf{h} \odot \mathbf{m} を適用します。説明が忠実性の基準を満たさない特徴はゼロにされるため、残存するすべての次元には監査可能なラベルが付与されます。
- Sparse linear head。 L_1正則化logistic regressionを fitting します: \mathcal{L}(\boldsymbol{\beta}, \lambda) = \tfrac{1}{N}\,\mathrm{BCE}\big(\mathbf{y}, \sigma(\mathbf{H}_\tau \boldsymbol{\beta})\big) + \lambda \|\boldsymbol{\beta}\|_1. 予測は \hat{y} = \sigma(\mathbf{h}_\tau^\top \boldsymbol{\beta}^\star) です。\boldsymbol{\beta}^\star の各非ゼロ座標はラベル付きSAE特徴に対応するため、上位k件の寄与が各文書に対するトークンに根拠付けられた説明を与えます。
学習には41種類の生成器にまたがる英語COLINGの共有タスク分割(訓練610k、開発261k)を使用します。OOD評価にはCOLING devtest/testおよびnon-adversarialなRAID分割を使用します。
結果
基礎となる検出器への忠実性。 In-distributionのCOLING devおよび3つのOOD分割において、FT-Model+SAEはfine-tuned検出器のAUCおよびF1に匹敵します。厳しい低FPR動作点においてのみ若干劣ります。マスクを \tau > 0.7 に制限すること、すなわち高度に解釈可能な特徴のみを保持することで、SAEの次元の大部分を削減しているにもかかわらず、完全な検出器の性能を維持あるいはわずかに上回ります。
OODの限界。 基礎となるfine-tuned検出器自体が汎化に失敗する場合、FT-Model+SAEはその失敗を引き継ぎます。図4(非掲載)における驚くべき観察は、ベースモデルの残差で訓練されたSAE分類器がOODでfine-tuned検出器を上回るということであり、解釈可能な特徴への蒸留が性能を損なうということではありません。
因果的な監査。 パラフレーズアブレーションは、各特徴の自然言語による説明をGemini 2.5 Flash Liteに与え、その特徴のみを除去するように文書をパラフレーズするよう指示します。結果として生じるlogitの変化と特徴の帰属重要度との相関が忠実性チェックとして報告されます――パイプラインが忠実であれば、これらは特徴ごとに一致するはずです。
検出器が実際に使用するもの。 \tau > 0.85 でのAIピアレビューにおける上位重み付き特徴は驚くほど具体的です。特徴 22_4800 は「太字のmarkdownセクションヘッダに続くダブルコロン」に反応し、11件の人間の文書対54,000件超のGPT-4o文書に出現します。特徴 13_164(「リストまたは文字列リテラル中の開き角括弧」)は7件の人間対22,000件超のLlamaの文書に出現します。人間寄りの特徴はより文体的です:文頭の一人称代名詞(13_5785)、「seem/seems」のようなヘッジ表現(7_10672)、指示的な「see」(7_1616)。COLINGにおいては、上位FT-SAE特徴(13_3738)は拒否の定型文(「As an AI language model…」)に反応するのに対し、ベースモデルSAE検出器はHTMLの属性やライセンステキストに依存します――これはベースモデル検出器が文体的なシグナルよりもドメインのショートカットをより多く利用しているという証拠です。
限界と未解決の問題
- 性能の上限は基礎となるfine-tuned検出器によって決まるため、SAEパイプラインはソースモデルのOOD失敗を修復することはできません。
- 高リスクなデプロイにとって操作上重要な低FPR領域こそが、解釈可能性のコストが現れる箇所です。
- フォーマット特徴(markdownのコロン、括弧トークン)の優位性は、何が「spurious」であるかという未解決の問題を提起します。Kantamneni et al. (2025) はフォーマット特徴の除去を推奨しますが、著者らは一貫したクロスドメインのフォーマットの手がかりは正当なシグナルであると主張します。彼らのシステムはこれを隠れた決定ではなくポリシー上の決定にします。
- Auto-interpラベルはLLMが生成したものであり、simulation scoreによって制限されます。\tau を通過した特徴であっても、合成的なコンセプトをエンコードしている場合、依然として誤解を招く短い説明が付与される可能性があります。
この研究が重要な理由
監査可能な検出器はデプロイのあり方を変えます:レビュアーや入学審査担当者は、フラグが不可解なlogitによってではなく、markdownのダブルコロンや拒否の定型文によって引き起こされたことを確認でき、モデルプロバイダーはポリシーに基づいて特定の特徴をホワイトリストまたはブラックリストに登録できます。このパイプラインはまた、ショートカット学習の診断ツールとしても機能します――ベースモデルSAE検出器がHTMLやライセンステキストに頼ることで部分的に汎化しているということを可視化します。
Source: https://arxiv.org/abs/2610.30006
ビデオを通じた世界の読み取り・書き込み・共有・インタラクション
本サーベイは、ビデオ基盤モデルおよびビデオ世界モデルに関する広大な文献を整理するための統一的な形式的視点——世界モデリング——を提案しています。核心となる着想は、通常混同されがちな三つのオブジェクトを分離することです:遷移 w_{t+1}\sim\mathcal{T}(\cdot\mid w_t, a_t) を持つ潜在的時間世界 W = (w_t)_{t\geq 1};部分的かつ損失を伴う時間順序付き射影として x_t\sim\mathcal{O}(\cdot\mid w_t,\pi_t) で観測されるビデオ V=(x_1,\dots,x_T);そしてモデルが表現する状態 s_t\sim q_\theta(\cdot\mid x_{\leq t}, a_{<t}) です。一般に s_t\neq w_t であり、この乖離こそがすべてのビデオモデルが暗黙的に最小化しようとしているものです。この部分観測可能な動的システム(Ha & SchmidhuberやDreamerが採用するモデルベースRLの意味でのPOMDP)から、著者たちはサーベイの残りを体系化する四つの操作を導出しています:reading V\to W、writing W\to V、sharing V\leftrightarrow W、そしてinteracting W\circlearrowleft です。
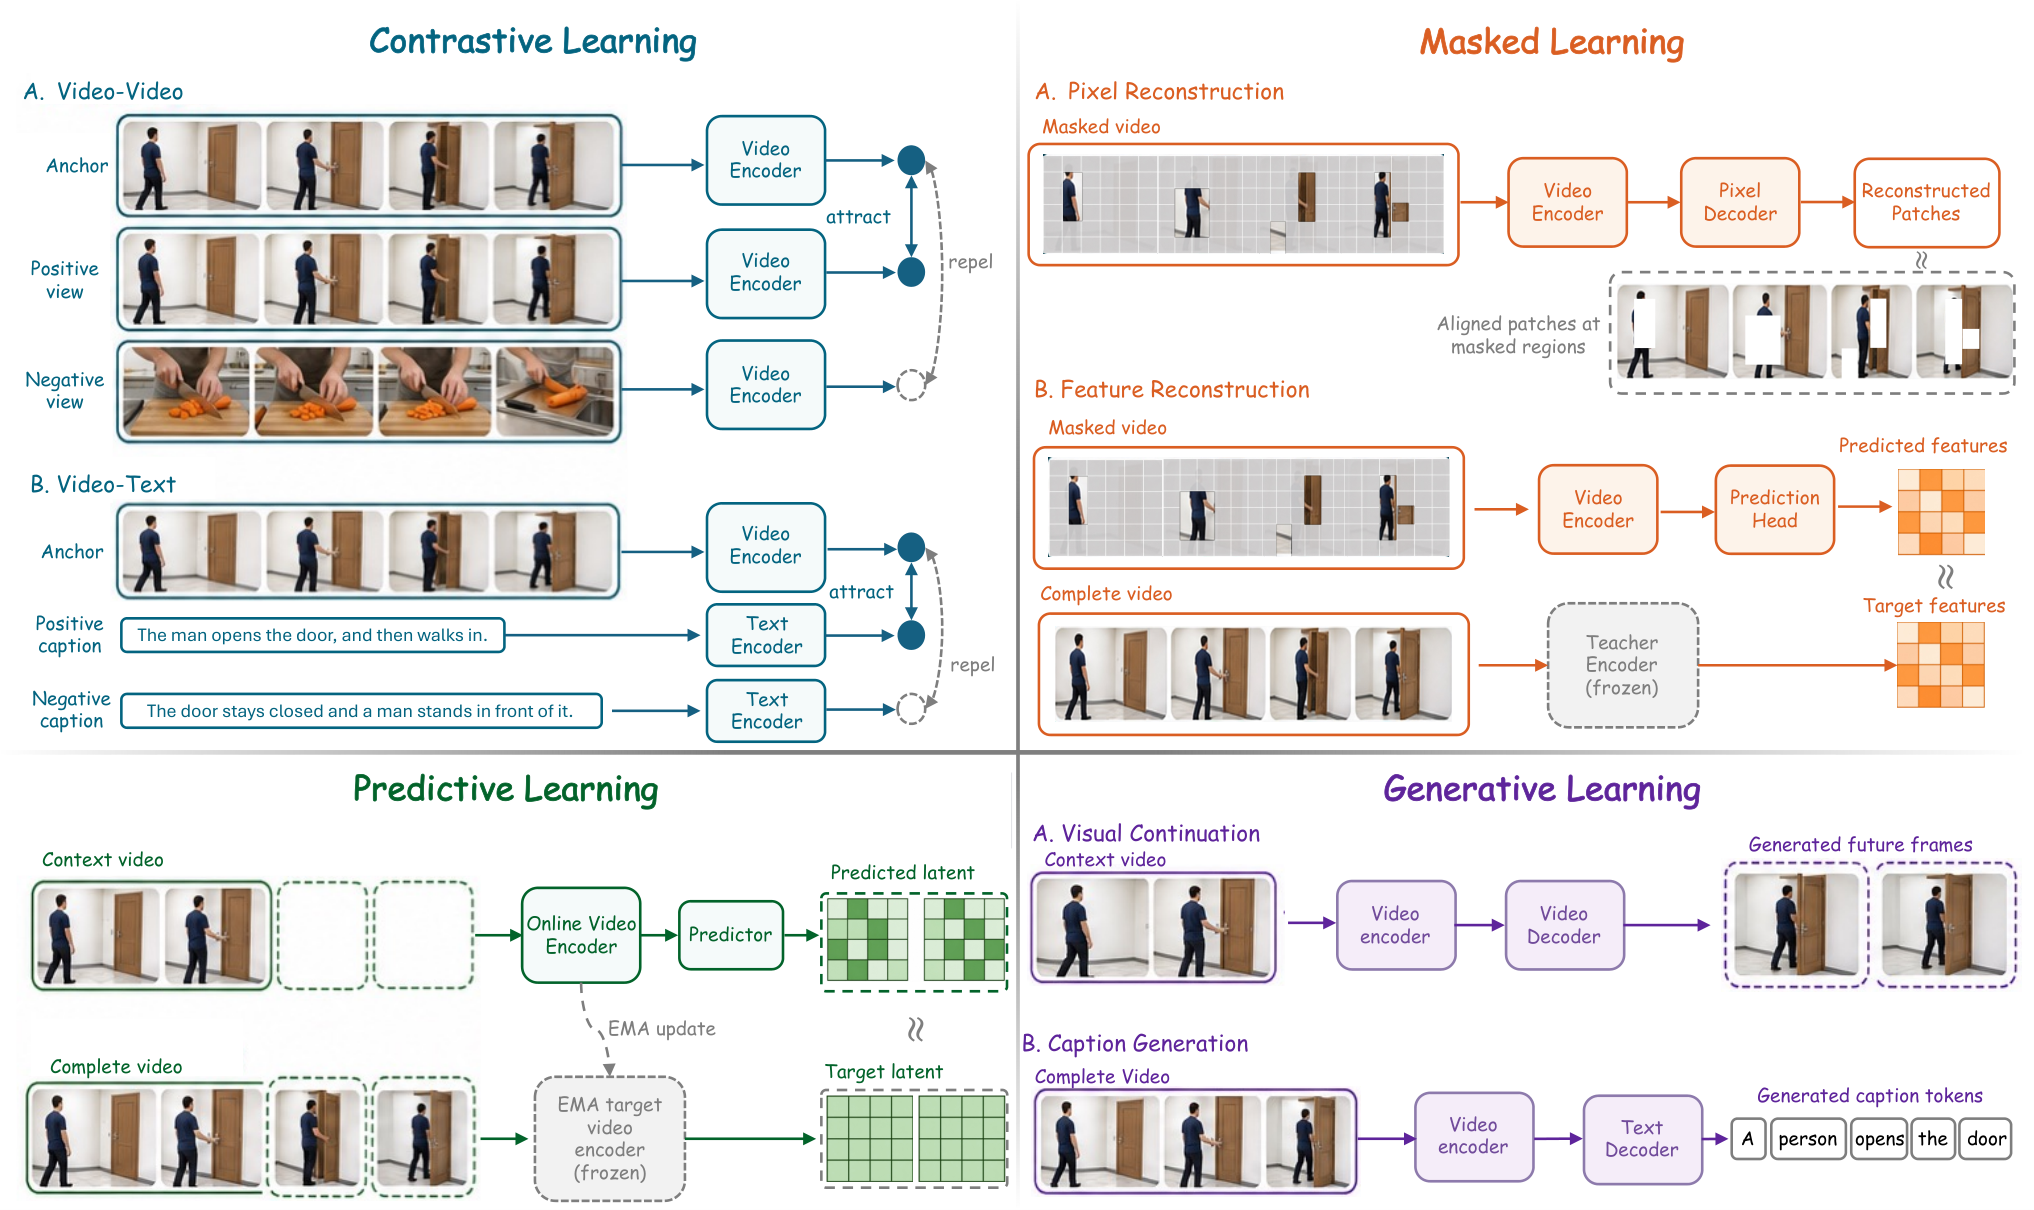
readingの章は、タスクファミリーではなく、世界状態のどの成分が探索されるかによって構成されています:意味論的(エンティティ、アクション)、空間的(幾何、同一性の連続性、視野外の状態)、時間的(順序、持続時間、ストリーミングプレフィックス)、物理的(永続性、接触、妥当性)、および因果的(介入、反事実)です。この再分割は、VSI-Bench、SCP-Bench、Beyond3D、OVO-S-Bench、TempCore、StreamingEval、IntPhys 2などのベンチマークが出力形式(ラベル、スパン、マスク、文)において異質であるにもかかわらず、それらが強調する状態特性によってインデックス付けすることで明確に分類できるため有用です。パイプラインはその後、表現学習——対照的、マスク、予測的、および生成的ファミリー(Figure 3の四方向分類を参照)——、Video-LLMアーキテクチャ、エージェント的検索/ツール使用、および応用領域(具身的/エゴセントリック、自動運転、専門的ビデオ分析)へと進みます。
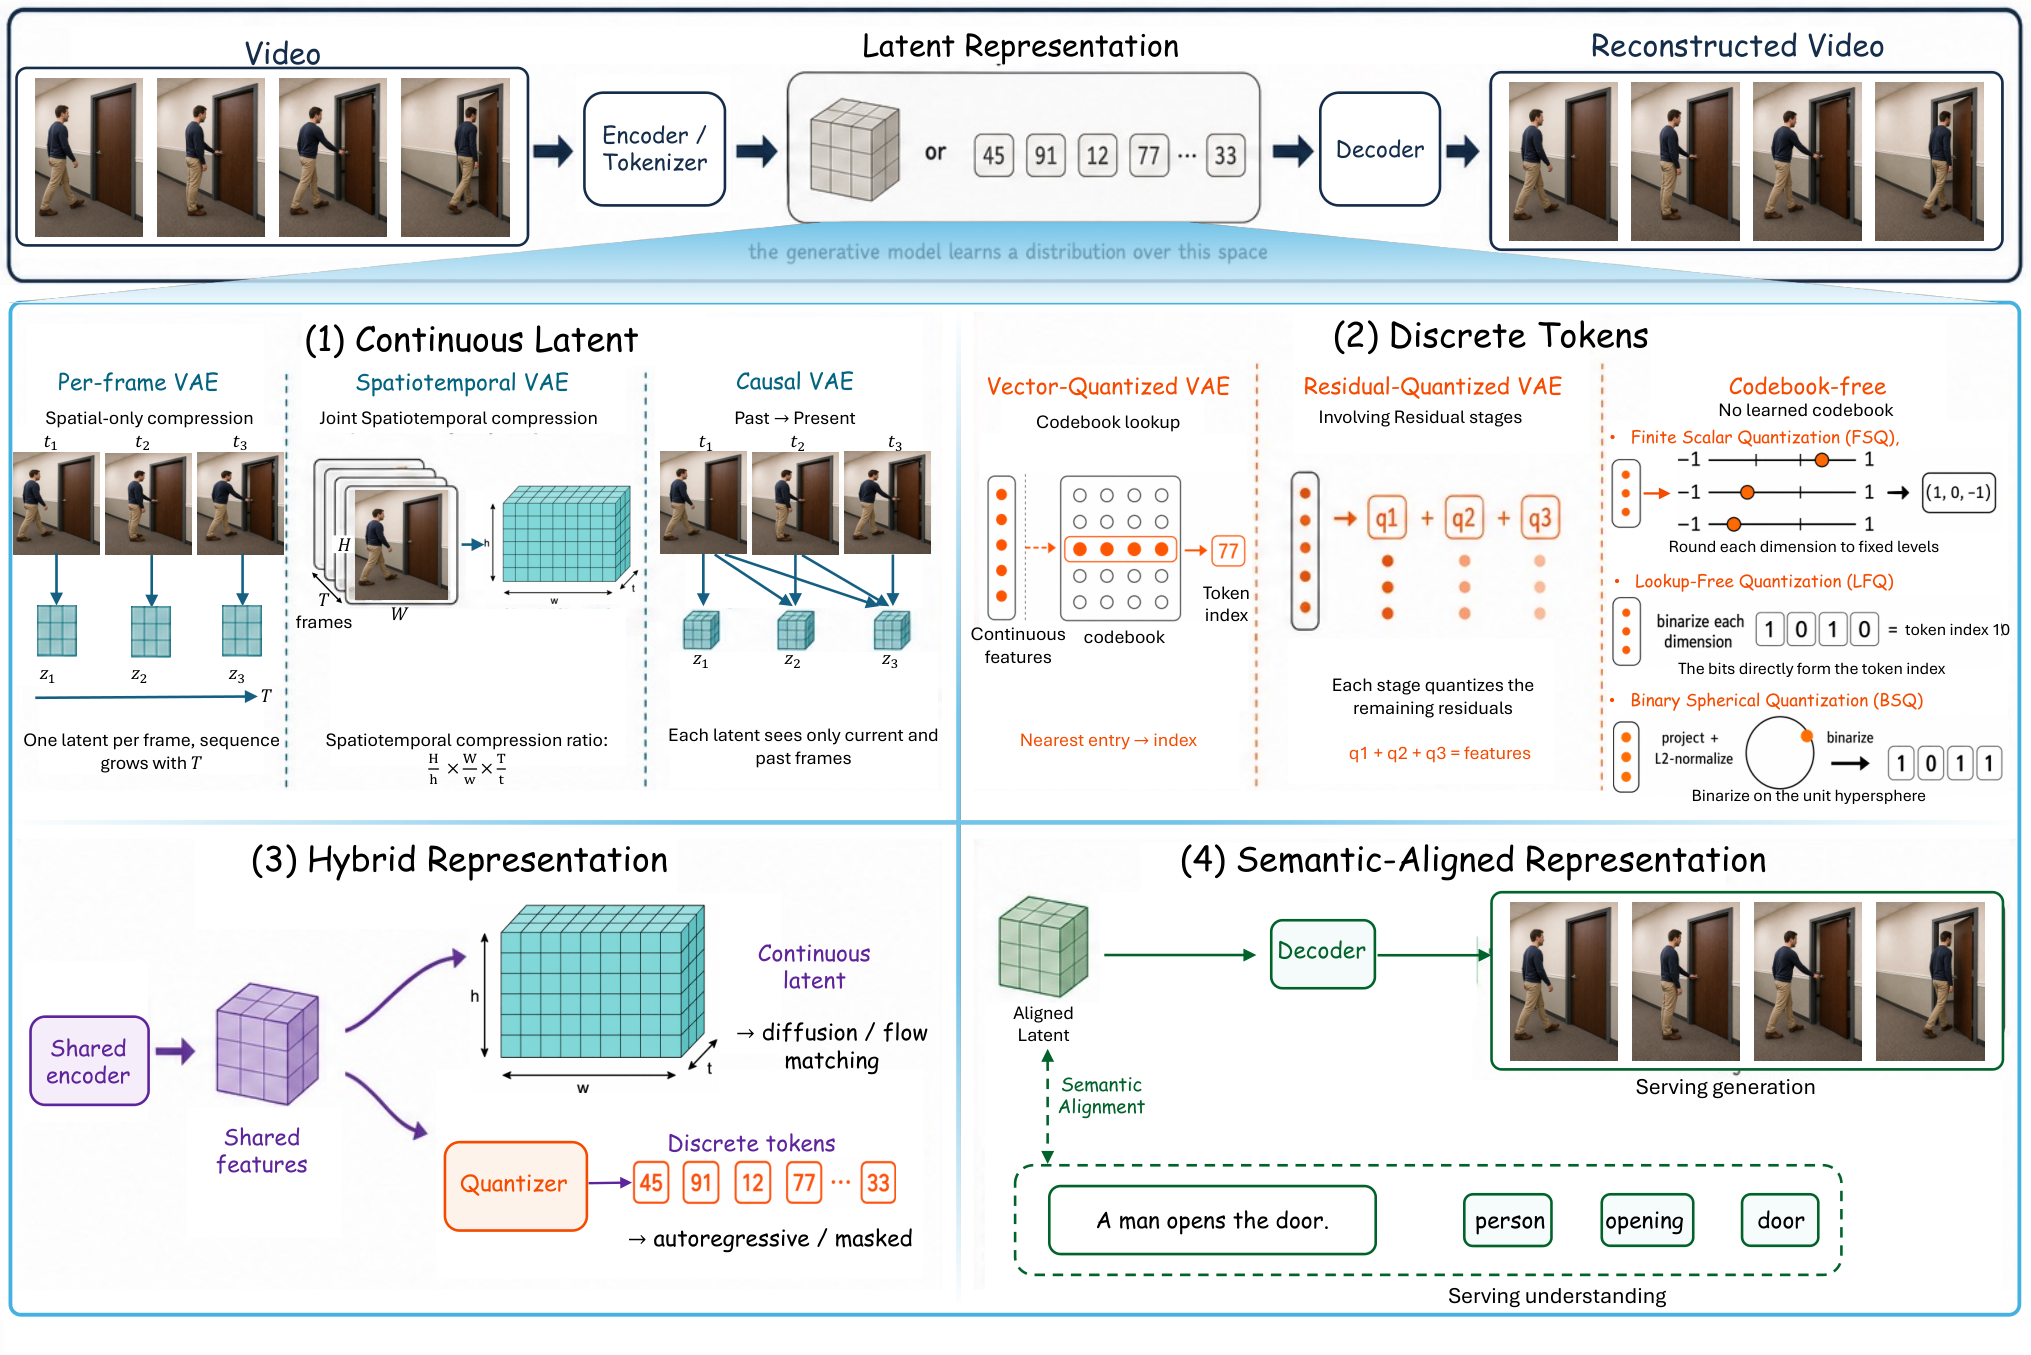
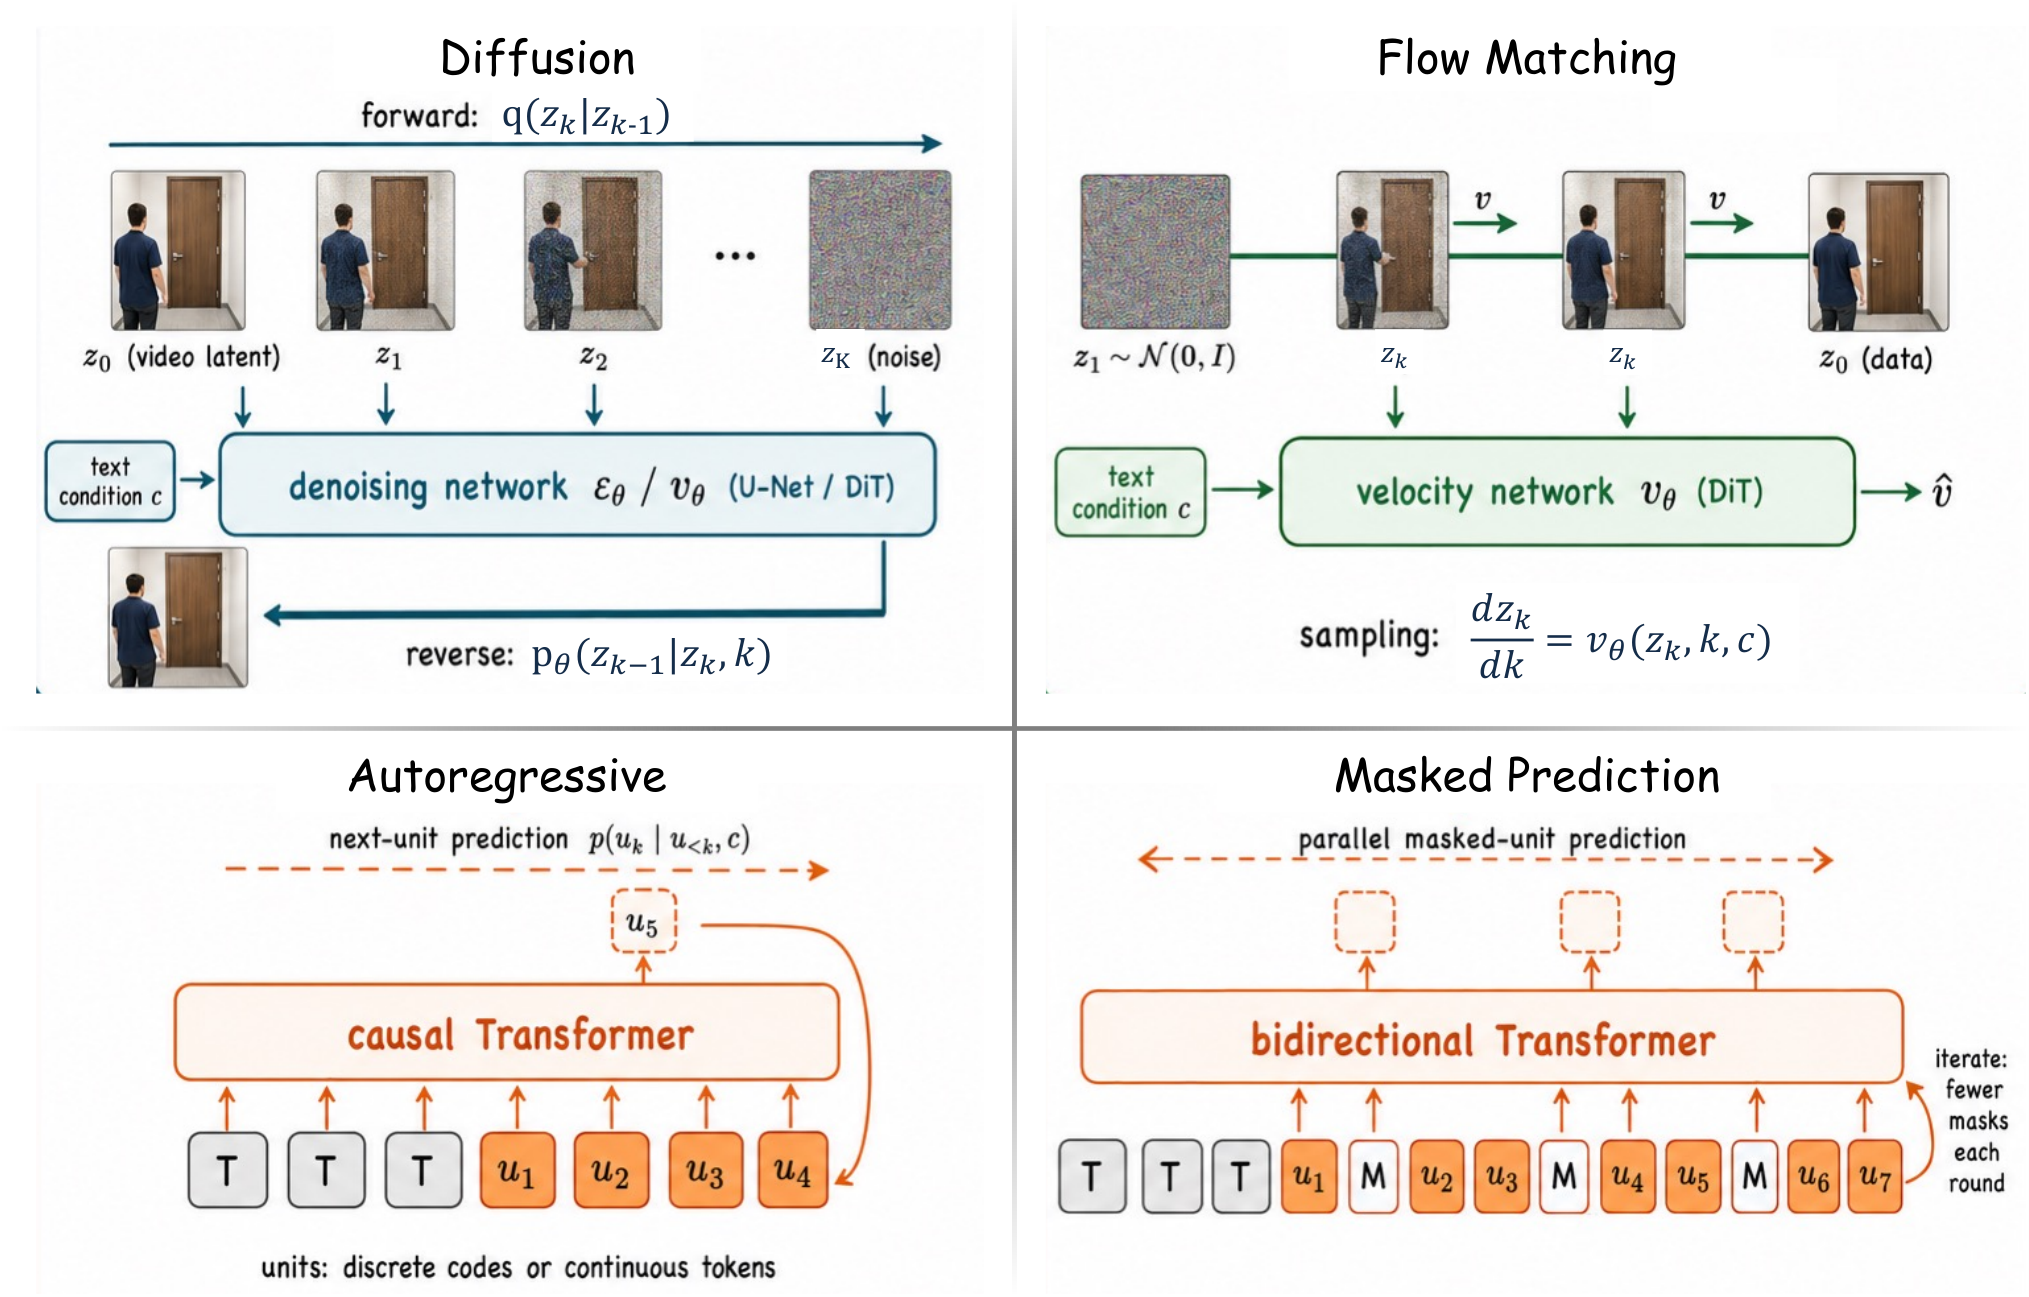
writingの章は、条件が W の何を固定するかによって生成をインデックス付けしています:T2V(Sora、Wan、HunyuanVideo)はイベントを指定し、I2V(SVD、Animate Anyone、MagicAnimate)は初期状態と同一性を固定し、V2Vは編集(Tune-A-Video、TokenFlow、FateZero)、変換、補間、および拡張(NUWA-XL、SEINE、StreamingT2V)をカバーします;音声駆動型(Wav2Lip、SadTalker、EMO、Hallo)および音声ビデオ統合型(JavisDiT、Ovi)は可視なダイナミクスを規定し、CameraCtrl、MotionCtrl、DragNUWA、ConsisIDは幾何、モーション、または同一性を固定します。潜在設計(Figure 4)は連続 vs. 離散 vs. ハイブリッド vs. 意味論的整合の軸に沿って分割されており、意味論的整合軸は直交しています——これは理解/生成の統合を可能にするという点で重要なポイントです。生成パラダイムはFigure 5において、diffusion/flow(潜在変数上のdenoisingまたは速度)、自己回帰的因数分解、およびマスク並列予測にグループ化されています;本サーベイはflow matchingとdiffusionを競合する陣営としてではなく、連続体として扱っています。
sharingの章は概念的に最も新規性が高いです。著者たちは統合の三段階定義を提案しています:(i) 能力カバレッジ(一つのシステムがreadとwriteの両方を実行する)、(ii) アーキテクチャ共有(共通コンポーネント)、および (iii) 機能的シナジー(制御された比較において一方の方向がもう一方を測定可能な形で改善する)です。そして、アーキテクチャを四つのファミリーに分類しています——離散トークン統合(Emu3/Emu3.5、Video-LaVIT、VILA-U、NExT-OMNI)、連続潜在空間統合(TUNA、Show-o2、Uni-ViGU、HYDRA-X)、意味論的ブリッジを持つ分離/モジュール型統合、およびエージェント的/ツール拡張型統合です。Table 14は、各システムがjoint AR、flow matching、またはstaged AR/FMトレーニングにコミットしているか、各方向にどのエンコーダタワー(SigLIP、Wan VAE、RQ、IBQ)が供給されているか、および評価が「C」スタイルか「H」スタイルかを示すのに十分な粒度を持っています。著者たちは、シナジー——レベル (iii)——が現在の研究では依然としてほとんど検証されていないことを明確に述べています。
interactingの章は、この視点が最も実を結ぶところです。ビデオ世界モデルの 2\times 3 分類は、予測空間(観測 vs. 潜在状態)を遷移プロトコル(受動的、アクション条件付き、インタラクティブ)から分離しています。同じアーキテクチャが、プロトコルに応じて複数のセルを占めることができます:アクション条件付き潜在予測器は、候補をスコアリングし、かつプランナーの内部で実行することができます。代表的なシステムはSV2P、GAIA-1、Vista、IRASim、Genie、DIAMOND、GameNGen、Matrix-Game、V-JEPA 2/2.1に及びます。主要な課題——アクション条件付き制御可能性、長期的整合性とメモリ、リアルタイム応答性、物理的/因果的根拠付け——は具体的な方法論的批評とともに取り上げられています。隠れた氷の立方体の例(Figure 11、Section 9.1で参照)はそのポイントを簡潔に示しています:保存された観測を再生すると古い立方体が返されるのに対し、真の予測状態はスクリーン外の溶融をシミュレートしなければならないということです。現在のほとんどのメモリシステム(Lu et al. 2024、Xiao et al. 2025a、Bian et al. 2026)は可視だったものを保存するにとどまり、隠れているものを進化させてはいません;スクリーン外の変化を明示的にモデル化しているのはわずかな研究(Wang et al. 2026a、Duan et al. 2026)に限られます。
Section 9の七つの未解決問題は有益なほど具体的です。長期的整合性については、著者たちは単一の終端スコアを報告することがレンダリングドリフトと状態損失を混同させると主張し、劣化曲線を生成するためにロールアウト長と再訪距離を独立に変化させることを提案しています。フレームを生成しない潜在状態モデルについては、目標到達可能性、特徴安定性、および意思決定品質のプローブが必要です;整合性レポートにはまた、メモリフットプリント、エンドツーエンドレイテンシ、アクション更新レートも含めるべきです。なぜなら、保持バジェットはアーカイブの成長を学習可能な排除ポリシーに変換するからです。その他の課題——統合モデルにおける測定可能なシナジー、世界特性の標準化された評価、ラベルなしビデオからの制御のスケーリング、稀なイベントを持つ確率的世界——は、漠然とした要望ではなく具体的な方法論的ギャップを指摘しています。
なぜこれが重要か
世界モデリングの視点は、ビデオトレースにおける時間的整合性を基礎となる世界状態の整合性から明確に分離します。これは、Video-LLM、テキスト対ビデオ生成器、統合モデル、およびインタラクティブ世界モデルを単一の形式主義の下で比較するための正しい抽象化です。アーカイブ的メモリよりも予測状態を、単なる能力カバレッジよりも機能的シナジーを重視する点は、現在のベンチマークがモデルが実際に行う必要のあることを測定できていない箇所を特定しています。
Source: https://arxiv.org/abs/2610.31668
関数空間における時間的自己蒸留によるPolicy Optimization
問題設定
スカラーのverifier rewardを用いたRLVRは、長い応答トラジェクトリ全体に対して1ビットの監督信号しか与えず、トークンレベルの情報を無駄にします。自己蒸留はこの問題に対処するもので、補助なしのpolicyの視点 p = \pi_\theta(\cdot \mid x, y_{<t}) と、検証済みエビデンス d を条件とする特権的な教師の視点 q = \pi_\theta(\cdot \mid x, d, y_{<t}) を比較することで、すべてのトークンにおいて密なKL監督信号を生成します。問題点として、教師と学生がパラメータを共有する場合、勾配ステップのたびにターゲットがドリフトすることが挙げられます。SDPOはEMAパラメータ空間の教師を維持することでこれを修正しますが、モデルのメモリ使用量が2倍になり、ターゲットのドリフトがEMAレートと依然として結合してしまいます。
FSPO(Function-Space Policy Optimization)は、永続的な教師を完全に排除します。教師のパラメータを固定するのではなく、教師の出力——検証済みの過去のロールアウトからなる疎な次トークン分布——を固定し、それを時間的ターゲットとしてリプレイします。
手法
ステップ s におけるプレフィックス c=(x, y_{<t}) に対して、F_{\theta_s}(c) = \pi_{\theta_s}(\cdot \mid c) と定義します。FSPOのlossは、Algorithm 1に従って組み立てられる4つの項の和です:
特権的適応 \mathcal{L}_{\mathrm{distill}}:上位-K_{\mathrm{cur}}のサポート S_{p,j,t} 上において、学生 p_{p,j,t} から特権的教師 q_{p,j,t} へのKLを計算します。デモンストレーション d_{p,j} は兄弟検索によって構築されます——成功したロールアウト \tilde{y}_p またはgold g_p——により、教師の視点は学生よりも強いエビデンスを参照します。
不一致補正 \mathcal{L}_{\mathrm{neg}}:学生がマージン \gamma だけ教師を上回る質量を割り当てているトークンを過大評価集合 \mathcal{N}_{p,j,t} にまとめ、明示的に抑制します。これにより \mathcal{L}_{\mathrm{cur}} = \mathcal{L}_{\mathrm{distill}} + \lambda_{\mathrm{neg}} \mathcal{L}_{\mathrm{neg}} が得られます。
信頼性適応型グラウンディング \mathcal{L}_{\mathrm{CE}}:問題ごとの成功率の逐次推定量 \hat{r}_p^{(s)} から重み w_p^{(s)} を生成し、自己生成エビデンスが繰り返し信頼できない場合にはgoldリファレンスのcross-entropyを増大させ、policyが十分に成熟するにつれてそれをアニールします。
関数空間時間的統合 \mathcal{L}_{\mathrm{temp}}:検証済みの過去の出力を、疎なサポートと教師分布のペア (\tilde{S}_{p,t}, \tilde{q}_{p,t}) としてメモリ \mathcal{M} に保存します。各ステップでは問題・難易度ごとにグループ化されたリプレイバッチ \mathcal{R}_s \subset \mathcal{M} をサンプリングし、現在のpolicyをこれらの固定ターゲットに向けて蒸留します。サイクリックな混合係数 \rho_s が \mathcal{L}_{\mathrm{cur}} と \mathcal{L}_{\mathrm{temp}} のバランスを調整します。メモリの保持は品質・カバレッジを考慮しており(検証済みのみ、プレフィックス間で重複排除);H ステップより古いエントリは頻度 F、レート \zeta で更新され、ターゲットが完全に陳腐化することを防ぎます。
重要な設計上のポイント:(\tilde{S}_{p,t}, \tilde{q}_{p,t}) はパラメータではなく保存されたテンソルであるため、2つ目のモデルコピーは不要です。オンポリシーのロールアウトはトレーニングモデルを再利用するため、FSPOの追加メモリはパラメータ数ではなく上位-Kサポートに対してスケールする疎なlogitキャッシュのみとなります。
結果
4×GH200上での5時間のウォールクロック時間を揃えた比較において、FSPOはQwen3-8BとOlmo3-7B-InstructのいずれについてもSciKnowEval(Chemistry/Physics/Biology/Materials)およびToolAlpaca全体でSDPOのオンポリシーEMA教師ベースラインを上回ります。
Qwen3-8Bの5時間時点において、5つのbenchmark全体のavg@16平均は:GRPO 70.4、オンポリシーGRPO 63.3、SDPO 72.0、FSPO 76.2。SDPOに対するタスクごとの改善幅は、Biology(71.2 vs 56.8、+14.4)、Chemistry(83.4 vs 80.9)、Materials(81.7 vs 78.4)で最も大きくなっています。Olmo3-7B-Instructの5時間時点では、FSPOは平均72.4に達し、SDPOの68.0を上回り、Chemistry 83.3 vs 80.0、Biology 62.3 vs 52.8です。1時間時点においても、FSPOはほとんどのタスクで優位に立っており(例:Qwen3-8B Biology 71.2 vs 50.6)、関数空間ターゲットが漸近値を引き上げるだけでなく収束を加速させることを示しています。
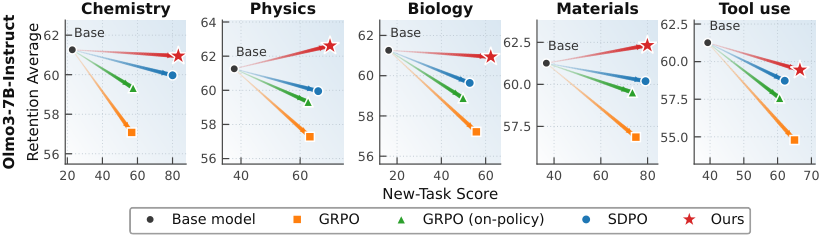
forgettingのプロットでは、各パネルにおいてFSPOが右上に位置することが確認できます:FSPOはGRPOやSDPOと比較して、タスク内精度が高く、かつ事前能力スコアをより多く保持しており、リプレイされた関数空間ターゲットが表現ドリフトに対する穏やかな正則化として機能するという主張と整合しています。メモリの内訳(論文のFigure 6)では、FSPOに余分なモデルコピーが存在しないことが示されています——GRPOはコロケートされたロールアウトモデルを保持し、SDPOは永続的なEMA教師を保持するのに対し、FSPOはパラメータ数ではなく上位-Kサポートに対してスケールする疎なlogitキャッシュのみを保持します。この差はモデルサイズが大きくなるほど拡大します。
限界
本手法は、特権的な d への条件付けが局所的なトークン分布を実際に改善するという通常の自己蒸留の前提を継承しています;検証済みデモンストレーションが長い、あるいは兄弟として検索しにくいタスクでは、教師の視点が弱くなる可能性があります。疎なサポート \tilde{S}_{p,t} はテール質量を捨てており、探索感度の高いタスクでは問題になる可能性があります。提供された抜粋には \mathcal{L}_{\mathrm{neg}}、\mathcal{L}_{\mathrm{CE}}、\mathcal{L}_{\mathrm{temp}} をそれぞれ単独で分離するアブレーションの報告がなく、関数空間リプレイと不一致補正と適応型グラウンディングの各々の寄与は切り離されていません。ツール使用の改善は小さく(Qwen3-8Bの5時間時点でSDPO 68.5 vs 68.5)——利点は学習分布内に兄弟デモが存在するreasoning benchmarkに集中しています。最後に、「固定」ターゲットは古くなったエントリについて F ステップごとに更新されるため、陳腐化と新鮮さのトレードオフ(H、\zeta、\rho_s スケジュール)は単一設定の評価ではストレステストされていないハイパーパラメータを導入することになります。
なぜこれが重要か
FSPOは、オンポリシー自己蒸留におけるEMA教師の安定化の役割が、過去の出力分布の疎なキャッシュによって代替できることを示しており、精度の向上とforgettingの低減を実現しつつ余分なモデルコピーを削減します。これは、policy optimizationにおける「時間的一貫性」をパラメータ空間の制約ではなく関数空間の制約として再定式化するものであり、密な監督を伴うRLVRがメモリ制約に直面するあらゆる場面に直接応用可能です。
Source: https://arxiv.org/abs/2610.19687
HiSTEVE 1.0: オープンワールドゲームのためのヒューマン・インターフェース VLA エージェントの活用
問題設定
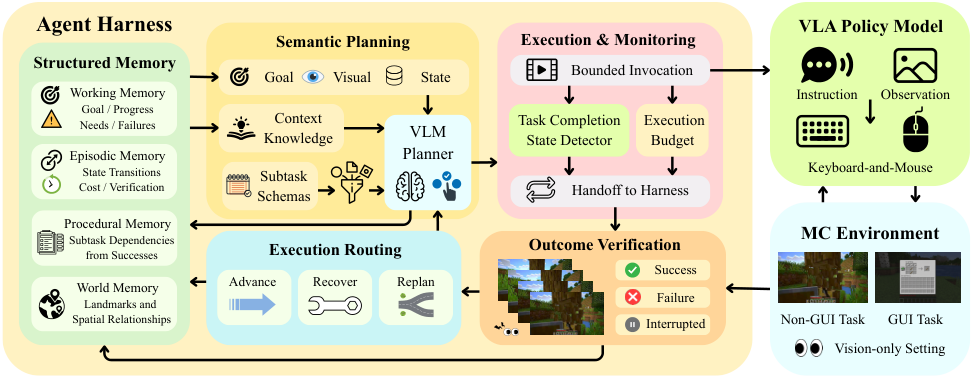
Minecraftエージェントはこれまで、ピクセルレベルでキーボード・マウスを操作するネイティブなvisuomotorコントローラー(VPT、STEVE-1、ROCKET-1、JARVIS-VLA)と、スクリプト化されたスキルや環境APIを呼び出すことで知覚・行動ループを迂回する高レベルプランナーという、二つの陣営に分かれてきました。HiSTEVEはその統合ギャップを目標としています。すなわち、能力認識ハーネスを通じてVLMプランナーが指揮し、学習済みの完了検出器がハンドオフを仲介する形で、ネイティブインターフェースを駆動する単一のVLAポリシーを実現します。技術的に興味深いのは、制御形態が異種混合である点です。一人称視点の世界インタラクション(採掘、戦闘、ナビゲーション)とGUI操作(クラフト、製錬メニュー)は、同一のバックボーンから相反するvisuomotorな振る舞いを要求します。
手法
ハーネスとプランナー。 ハーネスは、目標・検証済み進捗・未解決要件・過去の実行結果を要約した構造化計画状態 h_j = (G, p_j, r_j, v_{<j}) を維持します。各決定ステップにおいて h_j に対してスキーマライブラリをフィルタリングして適用可能なサブタスク集合 \mathcal{S}_j を取得し、関連するメモリ R_j を検索して、VLMプランナーに問い合わせます: u_j = \mathcal{P}_{\mathrm{VLM}}(G, O_j, h_j, \mathcal{S}_j, R_j). 出力 u_j は(呼び出し可能なスキルではなく)意味的な目標であり、VLAが一回の有界な実行で実行する固定の自然言語指示 I_j に変換されます。プランニングは参照フリーであり、固定されたサブタスクDAGは提供されません。
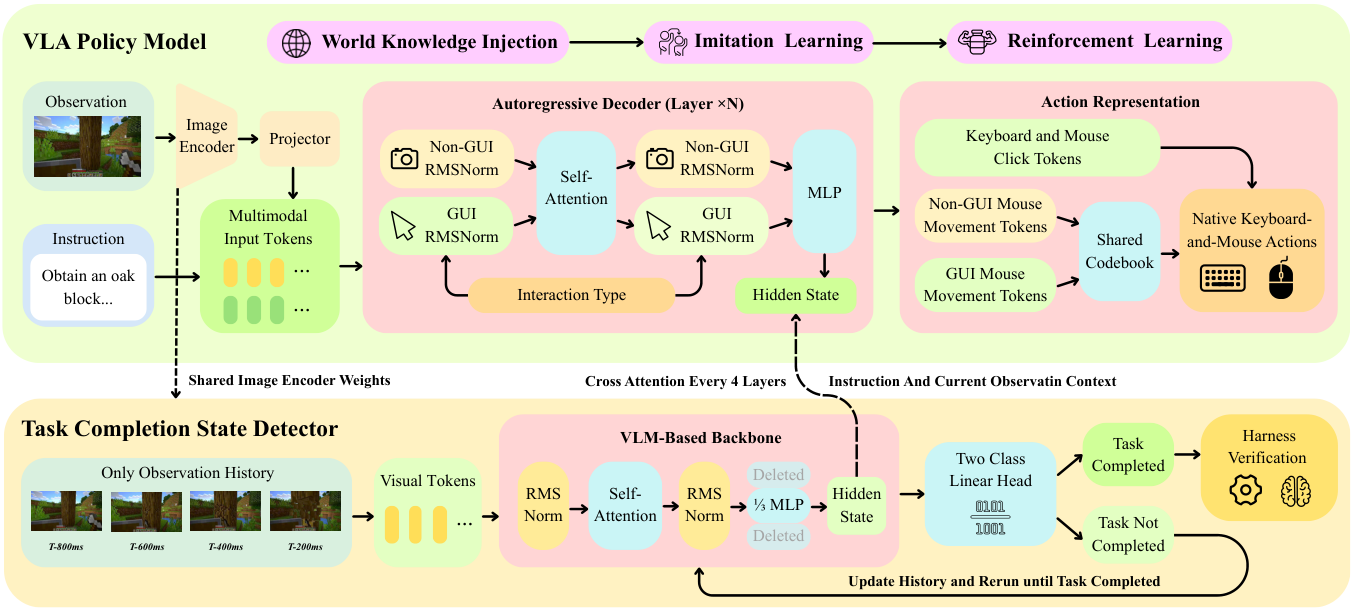
VLAポリシー。 低レベルポリシーはQwen2.5-VL-7Bで初期化され、(I_j, o_t) を入力として受け取り、20 Hzでトークン化されたキーボード・マウスアクション \mathbf{a}_t を出力します。著者らは、完全共有ベースラインにおけるGUIおよび非GUIレジームのgradient conflictを、次のconflict gap \Delta = \tfrac{1}{2}(c_{\mathrm{GUI}} + c_{\mathrm{NG}}) - c_{\mathrm{cross}}, を用いて測定しました。ここで c_\cdot は同一レジームおよびクロスレジームのミニバッチで計算されたgradient間のcosine similarityです。RMSNormモジュールは、すべての共有コンポーネントの中で最も強いクロスレジームの不整合を示しました。その解決策が Regime-Specific RMSNorm (RS-Norm) です。これはRMSNorm毎に2つの学習可能なスケールベクトルを持ち、レジームに応じて選択されます: \operatorname{RMSNorm}_{\ell,q}^{(c)}(\mathbf{h}) = \boldsymbol{\gamma}_{\ell,q}^{(c)} \odot \frac{\mathbf{h}}{\sqrt{\frac{1}{d}\sum_i h_i^2 + \epsilon}}, ここで c \in \{\mathrm{NG}, \mathrm{GUI}\} です。オーバーヘッドは 2Ld パラメータのみです。
完了検出器。 Qwen2.5-VL-3Bの検出器はVLAの画像encoderを共有し、クエリの800/600/400/200 ms前にサンプリングされた過去フレームを処理します。VLAのprefix hidden states H_t^\pi(最初のアクショントークンの直前)は、4層ごとにquery-normalizedなcross-attentionを通じて検出器に注入されます: \widetilde{Z}_t^{(\ell)} = Z_t^{(\ell)} + \operatorname{MHA}_\ell(\operatorname{LN}_\ell(Z_t^{(\ell)}), H_t^\pi, H_t^\pi). FFNの中間幅は、Wandaスタイルのactivation-weightスコアを使用して約1/3に刈り込まれます。ハンドオフシグナルは、連続する2回のクエリで p_t > \tau となった場合にのみ発火します。学習にはVPTの人間軌跡データを使用し、オフラインのイベント・インベントリ検出から得られたラベル y_t = \mathbf{1}[t \geq t^\star] を用います。
結果
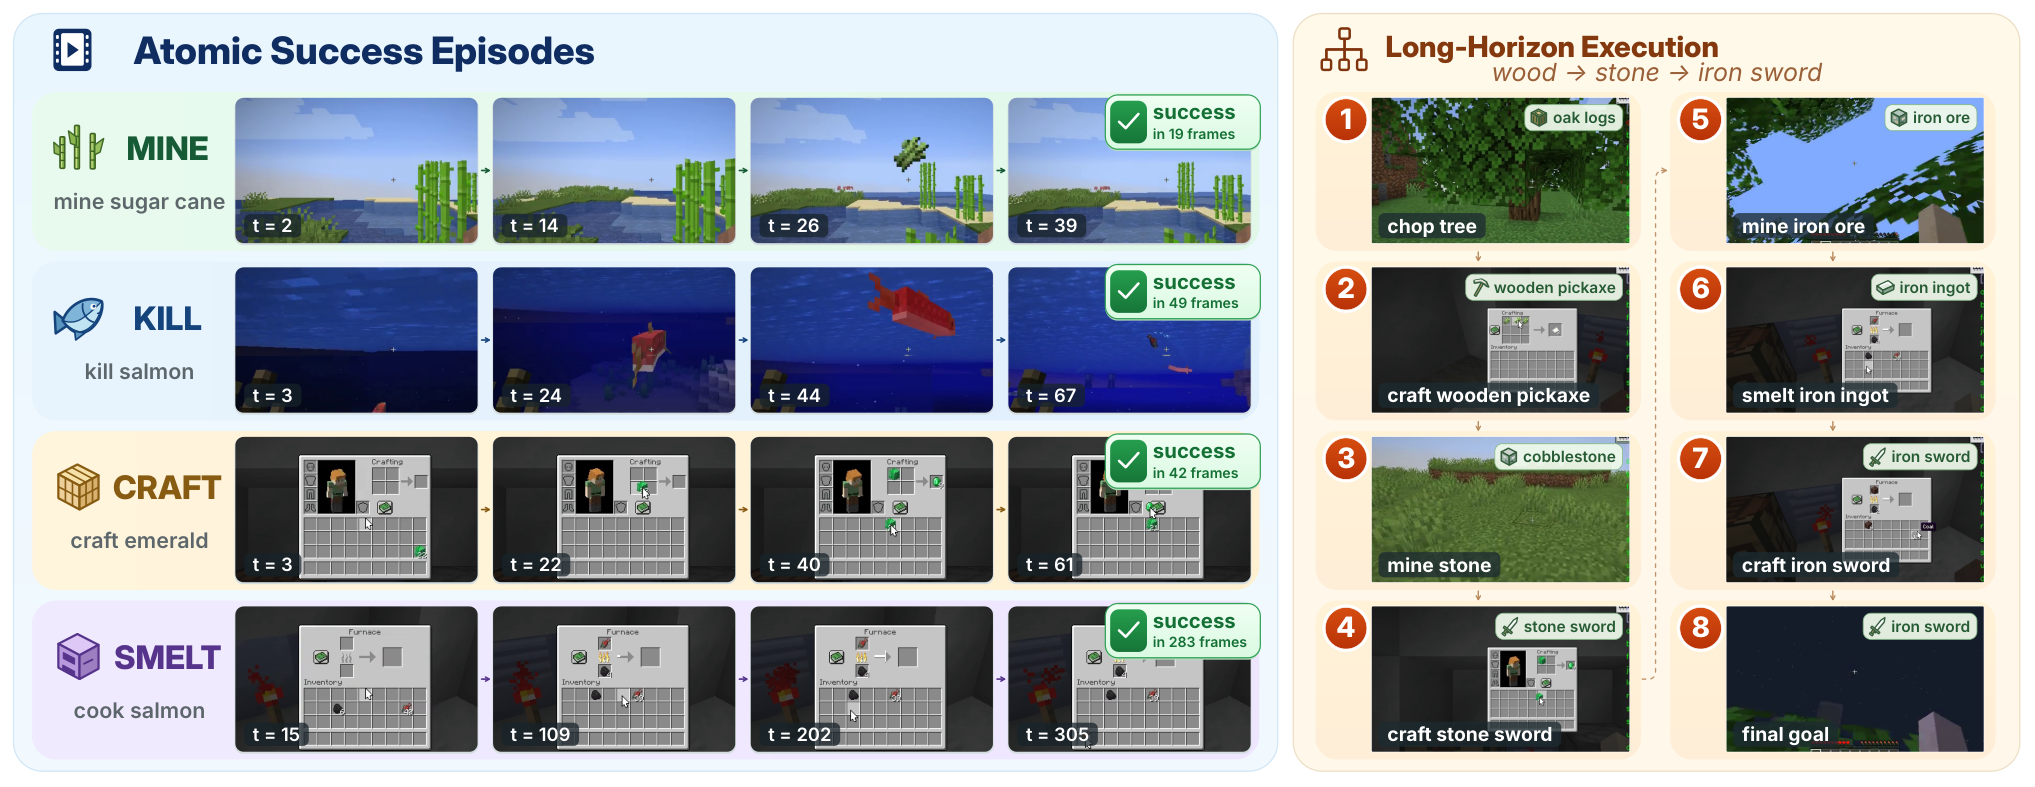
MineStudio Bench(20のアトミックタスクに対する厳格なpass@1)において、HiSTEVEはMine 93.3、Kill 86.7、Craft 66.7、Smelt 93.3を報告しており、従来最高のText/CoAの73.3/73.3/40.0/73.3およびJARVIS-VLAの66.7/60.0/26.7/60.0を上回っています。Craftの向上(66.7 vs. 40.0)は、RS-NormがGUI干渉を解消しつつ非GUI性能を損なわないことを示す最も明確な証拠です。
OpenHAファミリー別エピソード成功率において、HiSTEVEはEmbodied 46.0、GUI 27.2、Combat 39.0、Avg 37.4を記録し、Text/CoAの37.0/33.3/40.0/36.8と比較されます。HiSTEVEはEmbodiedとAvgで勝利しており、Text/CoAは純粋なGUI(33.3 vs. 27.2)とCombat(40.0 vs. 39.0)でわずかに優位を保っていますが、いずれも標準偏差の範囲内かその付近です。
決定的な差は LongBench(14のゴールのみのタスク、49の診断ノード)において現れます。ここではネイティブ制御ベースラインはほぼ機能せず、HiSTEVEはR&C 42.9、E&M 28.6、Rec 14.3、Open 14.3を達成するのに対し、Text/CoAは14.3/7.1/2.9/1.4、JARVIS-VLAは7.1/5.7/1.4/0.7にとどまります。これは、ハーネスの構造化メモリとポリシー結合型完了検出器が効果を発揮するレジームです。サブタスクの終了を確実に検証できて初めて、長期的な分解が実現可能となります。
検出器のablation。 4,674サンプルの均衡検証セットにおいて、最終的な構成はF1 0.863に達します。FFN幅を1/2から1/3に削減してもほぼ性能は変わりませんが(0.865 → 0.863)、1/4では0.739に崩壊します。同じ1/3幅でWandaスコアをprefix pruningに置き換えると0.768に低下します。層ごとのペアリングの代わりに最終層のポリシーコンテキストを共有する設定を除去すると0.690に低下します。これは、完了シグナルを担っているのは各層の深い特徴ではなく、VLAの意味的なprefixであることを示しています。
制限と今後の課題
OpenHAにおけるGUIファミリーはText/CoAの領域に留まっており(33.3 vs. 27.2)、RS-Normはレジーム干渉を緩和するものの完全には解消できないことを示唆しています。より積極的な分岐(例:レジーム固有のFFNやattention、またはレジームにわたるmixture of experts)が必要かもしれません。検出器はインベントリ・イベントシグナルに紐付いたオフラインのVPTラベルで学習されているため、採掘・撃破・クラフト・製錬以外の完了カテゴリは監督が不足しています。プランナーはGPT-4oに依存しており、能力制約されたスキーマは手作りであり、新しいVLAスキルとともに拡張されません。長期タスクでは分散が依然として高く(例:R&C 42.9 ± 14.4)、検証済みのハンドオフでさえ多段階ロールアウトを完全には安定化できないことを示しています。
なぜ重要か
HiSTEVEは、ピクセルレベルのVLAと軽量な構造化ハーネスを組み合わせることで、スクリプト化されたスキルに頼ることなく、Minecraftの長期タスクにおいてネイティブ制御ベースラインを20点以上上回ることができ、かつ 2Ld の追加パラメータのみでレジーム固有のRMSNormによって異種インタラクションレジームを調和できることを示しています。ポリシー結合型完了検出器は、サブタスクに報酬シグナルが存在しない任意の階層的エージェントにとって再利用可能な設計パターンです。
Source: https://arxiv.org/abs/2610.31162
Hacker News Signals
PaperPilot – ゼロクラウド・Pure-Rust PDFエンジン(WASMおよびMCP対応)
PaperPilotは完全にRustで書かれたPDF処理エンジンであり、WebAssemblyにコンパイルされ、サーバーサイドの依存関係を一切持ちません。そのアーキテクチャには、詳しく解説する価値のある三つの明確な主張があります。
第一に、「ゼロクラウド」制約についてです。PDFの解析・レンダリング・テキスト抽出はすべてインプロセスで実行され、ネイティブ環境またはWASMサンドボックス内で動作します。これにより、GhostscriptへのシェルアウトやクラウドAPIの呼び出しという一般的なパターン、およびそれに伴うプライバシーとレイテンシのコストを排除できます。
第二に、Pure-RustのPDFスタックについてです。PDFの解析は歴史的にセキュリティ上の地雷原であるため、Rustのメモリ安全性の保証はここで重要な意味を持ちます。不正なストリーム、オブジェクト相互参照テーブルにおける整数オーバーフロー、再帰的な展開爆弾(decompression bomb)は標準的な攻撃ベクターです。safe Rustでパーサーを実装することで、libpopplerやpdfium派生品を悩ませるCVEの一類型を回避できます。
第三に、MCP(Model Context Protocol)との統合についてです。MCPはAnthropicが策定した、LLMエージェントに構造化されたツールアクセスを提供するオープンプロトコルです。PaperPilotは抽出・検索機能をMCPツールとして公開しており、エージェントランタイムは生のテキストプロンプトを構築するのではなく、extract_text、search_pdf、get_pageを型付き関数呼び出しとして利用できます。これは実用的なアーキテクチャ上の選択です。構造化されたツールインターフェースはプロンプトエンジニアリングのオーバーヘッドを削減し、エージェントが確実に推論できる型付き戻り値を提供します。
WASMコンパイルターゲットはデプロイの観点から重要です。同一バイナリが、再コンパイルなしにブラウザ、Deno/Nodeエッジ関数、およびデスクトップのElectronアプリで動作します。RustからWASMへのツールチェーン(wasm-pack、wasm-bindgen)は十分に成熟しており、PDFフォントレンダリングや圧縮展開(zlib、LZW、CCITT)をネイティブに近いスループットで実現することが可能です。
未解決の問題として、フォントサブセット化とCJKグリフのカバレッジは、一般的に軽量PDFエンジンが破綻しやすい領域です。また、リポジトリにはどのPDF仕様サブセット(PDF 1.x対PDF 2.0、XFAフォーム、タグ付きPDF)がサポートされているかについて、まだ文書化されていません。
Source: https://github.com/KrushnaVardhanReddy/PaperPilot
AIの時代における「人月の神話」
この投稿は、Brooksの1975年の論文を現在のAI支援開発環境に適用したものです。Brooksの核心的な主張は、ソフトウェアの複雑性は本質的(問題領域に固有のもの)であり偶発的(ツールに起因するもの)ではないというものであり、遅延しているプロジェクトに人員を追加すると、チームサイズに対して O(n^2) でコミュニケーションオーバーヘッドが増大するため、さらに遅延するというものです。
著者の主張は、AIコーディングアシスタントは主に偶発的複雑性——ボイラープレートの生成、構文の想起、テストの足場作り——に対処するものであり、本質的複雑性(システム設計、不変条件の推論、分散状態管理)はほとんど手つかずのままであるというものです。これは技術的に擁護可能な主張です。現在のコード生成モデルは、狭いコンテキストウィンドウに条件付けられたローカルなトークン予測に優れていますが、大規模コードベースの不変条件に関するグローバルな意味モデルを維持することはできません。
コミュニケーションオーバーヘッドの議論も更新されています。AIエージェントがコードの相当な割合を生成する場合、O(n^2) の調整コストは減少するのでしょうか?エージェントが追加のチームメンバーとしてではなく、単一のエンジニアに対する力乗数として機能するならば、潜在的にはそうなり得ます。しかし著者は、それに対抗する効果を指摘しています。AIが生成したコードはレビューを必要とし、レビュー自体が調整活動であるという点です。さらに悪いことに、見た目は正しそうでも遠隔の不変条件に違反するような生成コードは、実質的なレビュー負担を非線形に増大させる可能性があります。
この投稿はまた、Brooksの「概念的整合性」の原則にも触れています——一貫したシステムには単一のアーキテクチャビジョンが必要だという考え方です。異種エージェントの出力によって生成された大規模なコードベースはこれを損なうリスクがあり、局所的には一貫しているものの、全体として非一貫なデザインを生み出す可能性があります。
技術的に興味深い未解決の問いは、永続的メモリを持つ長コンテキストモデル(プロジェクトレベルのRAG、リポジトリ全体の静的解析との統合)が本質的複雑性のギャップを埋められるかどうか、あるいはそれには次トークン予測とは根本的に異なるアーキテクチャが必要かどうかという点です。
Source: https://j11g.com/the-mythical-man-month-in-the-age-of-ai
OpenAIとAnthropicはLLMの価格を数ヶ月以内に最大80%引き下げた。その理由は?
この記事は推測ではなく、コスト構造の丁寧な分析です。著者のMax Woolfは、価格圧縮を引き起こしている複数の同時進行するメカニズムを特定しています。
ハードウェア効率の向上。 アクセラレータの世代交代(H100からB200、あるいは同等のカスタムシリコン)ごとに、FLOP/$が大幅に改善されます。モデルの推論コストは処理トークン数に対して概ね O(n_\text{params} \cdot T) でスケールするため、ハードウェアの改善はそのまま利益率に直結します。
推論時の最適化。 Speculative decoding、continuous batching、KV-cacheの最適化により、モデルの変更なしで実効的なトークン当たりのコストが削減されます。vLLMなどのライブラリは、固定ハードウェアの利用効率を大幅に向上させてきました。
モデルの蒸留と量子化。 より小さな蒸留モデル(例:GPT-4o-miniクラス)は、パラメータ数のわずかな割合で、プロダクション用途の大部分をカバーできるようになっています。INT8およびFP8量子化は、自己回帰生成における真のボトルネックであるメモリ帯域幅への負荷を2〜4倍削減します。
競争圧力。 Google、Meta(オープンウェイト)、Mistral、そして中国のプロバイダー(DeepSeek、Qwen)が市場を圧縮しています。コモディティハードウェア上で動作するオープンウェイトモデルが実質的な価格下限を設定しており、プロプライエタリなAPIプロバイダーは顧客を維持するためにそれを下回る価格を提示しなければなりません。
80%という数字は特定のティアに適用されます。GPT-4oの入力トークン価格は、約6ヶ月で概ね$5/Mから$1.25/Mに低下しました。著者は、価格引き下げが非対称であることに言及しています:(逐次生成が必要な)出力トークンの価格は、(並列プリフィルが可能な)入力トークンほどは低下していません。
下流のビルダーへの示唆:以前は$10〜20/Mトークンでは採算が取れなかったアプリケーションが、$1〜2/Mで実現可能になっています。これにより、高ボリュームかつレイテンシ許容度の高いワークロードに向けたデプロイメントの限界が拡大しています。
Source: https://minimaxir.com/2026/10/cheap-llms/
Survival LLM: 自分のコンピュータで動作するAIアシスタント兼緊急時ライブラリ
Survival LLMは、量子化されたローカル言語モデルと、応急処置・水の浄化・ナビゲーション・シェルター建設といった緊急時への備えに特化したキュレーション済みオフライン知識ベースをパッケージ化したシステムです。設計上の制約として、インターネット接続が一切不要で動作することが求められており、インフラが機能しなくなったシナリオを対象としています。
技術スタックは標準的なローカル推論パイプラインです。具体的には、GGUF量子化モデル(記載されているハードウェア要件から推測すると7B〜13Bパラメータ規模と思われる)をllama.cppまたは互換バックエンドで実行し、その上にembeddedドキュメントに対するretrieval layerを設けています。オフラインのドキュメントコーパスが差別化要素となっており、インストール時にpre-chunkingとembedding、インデックス構築が完了するため、クエリ時のretrievalにネットワーク通信は不要です。
このRAGアーキテクチャには興味深い制約があります。embedding modelとベクトルストアもローカルで実行しなければならないため、OpenAI embeddingsやクラウドベースのベクトルデータベースは使用できません。embeddingにはnomic-embed-textやall-MiniLM-L6-v2、ファイルバックのストアにはシリアライズされたインデックスを用いたChromaやFAISSなどが一般的な選択肢となります。
実用上のエンジニアリング課題は、サイズと性能のトレードオフです。7B Q4モデルは4〜6 GBのRAMに収まり、コンシューマハードウェアで動作しますが、エッジケースの医療クエリに対するinstruction-followingの信頼性は70Bモデルより低くなります。このアプリケーションドメイン(緊急医療、有毒植物の識別)では、hallucination のコストが非常に高くなります。サイトには事実精度のベンチマークやretrievalの精度指標に関する記述がなく、これが主要な未解決問題となっています。
このプロジェクトは興味深いニッチを占めています。オフラインファーストかつ安全性が重要な情報retrieval において、生成の流暢さよりもretrieval品質がより重要となる領域です。
Source: https://www.brangus.io/survival-llm
Show HN: Hob – Claude CoworkおよびChatGPTに代わるオープンソースのオンデバイス代替ソフトウェア
HobはElectronベースのデスクトップアプリケーションであり、オンデバイスのモデル推論を基盤としたローカルAIアシスタントインターフェースを提供します。Claude.aiおよびChatGPTのデスクトップクライアントに代わるオープンソースの選択肢として位置づけられており、モデル推論がAPIコールではなくローカルで実行される点が大きな特徴です。
アーキテクチャはTypeScript/Reactによるフロントエンド(Electron経由)がローカルの推論サーバーと通信する構成です。リポジトリの構造から、推論バックエンドとしてOllamaをターゲットにしていることがわかります。Ollamaはモデル管理を担い、localhost上でREST APIを公開します。これは合理的なレイヤリングの選択です。Ollamaがハードウェア固有のアクセラレーション(Apple SiliconeにおけるMetal、NvidiaにおけるCUDA)とモデルフォーマット(GGUF)を抽象化することで、HobはUXレイヤーに集中できます。
機能セットはワークスペース形式のコンテキスト管理を重視しており、会話スレッドの永続化、ドキュメントの添付、そして協調的またはマルチターンのタスク管理を示唆する「cowork」モードが含まれます。ローカルの推論エンドポイントがあれば実装は比較的straightforwardです。具体的には、会話履歴のシリアライズ、ドキュメント取り込みのための基本的なファイルI/O、コンテキストウィンドウに収まらない大きなドキュメントのためのチャンキング・コンテキスト注入パイプラインが必要となります。
プライバシーに関する主張が主要な差別化要因です。テレメトリなし、APIキー不要、マシン外へのデータ送信なしという特性は、コードレビュー、機密コンテンツを含むドキュメントの作成、データレジデンシー要件を持つ企業環境において重要な意味を持ちます。
技術的な制限は、ローカル推論に共通する標準的な制約です。モデルの能力は利用可能なVRAMとRAMに依存し、モデルロード時のコールドスタートレイテンシは数秒から数十秒に及び、マルチモーダルサポートはOllamaが公開する機能に依存します。リポジトリは初期段階にあり、パフォーマンス特性やサポートされるモデルファミリーについての明示的なドキュメントはまだ存在しません。
Source: https://github.com/FrigadeHQ/hob
Pratt パーシングを忘れないために書き残す
これは、Vaughan Pratt が 1973 年に発表した技法である Pratt パーシング(トップダウン演算子優先度パーシング)について、その優雅さに見合わないほど普及していないと言われるこの手法を、明快に技術的に解説した記事です。
核心となる洞察は、演算子の優先度を文法の階層構造(再帰下降パーサーが expr、term、factor という別々の非終端記号を用いてそうするように)にエンコードするのではなく、各トークンに数値の binding power を割り当てるという点にあります。パーサーは現在の右 binding power を保持し、次の演算子の左 binding power がそれを超える限り再帰し続けます。
標準的な構造では、トークンごとに 2 つの関数を使います。nud(null denotation:式の先頭に現れるトークン用、すなわちリテラル、前置演算子、括弧)と led(left denotation:式の後に現れるトークン用、すなわち中置演算子および後置演算子)です。メインループはコンパクトです。
def parse_expr(rbp=0):
    left = token.nud()
    while next_token.lbp > rbp:
        left = next_token.led(left)
    return left
右結合性は led の内部で parse_expr(lbp - 1) を呼び出すことで処理し、左結合性は parse_expr(lbp) を呼び出すことで処理します。これは、従来の再帰下降パーサーにおける等価な文法変換よりも大幅にシンプルです。
著者が「記憶の助けとして」と位置づけているのは正直なところで、Pratt パーシングは nud/led という命名が直感的でなく、binding power の比較方向も毎回少し考えが必要なため、基本から思い出すのが難しいという評判があります。この記事では、三項演算子や前置/後置演算子の曖昧性解消を含むいくつかの具体的な例を丁寧に解説しており、それこそがこの技法の汎用性が際立って見える部分です。Pratt パーシングは、Rust のパーサーや複数の JavaScript パーサーを含む、本番コンパイラでも採用されています。
Source: https://www.unix.dog/~yosh/blog/2026-10-25_pratt-parsing.html
WikipediaにおけるAI生成コンテンツの整理活動
IEEE Spectrumは、WikiProject AI Cleanupについて報道しています。これは、AI生成コンテンツによって品質が低下した記事を特定・修復するための、Wikipediaにおける組織的な編集活動です。このプロジェクトの技術的な課題は、数百万にのぼる記事を対象とした大規模な検出とトリアージにあります。
検出手法は複数のシグナルを組み合わせています。文体計量分類器(既知の人間によるテキストとAI生成テキストを学習したもの)が候補記事にフラグを立てます。副次的なシグナルとしては引用パターンが挙げられます——AI生成テキストは、具体的な主張を裏付けていない情報源を頻繁に引用したり、もっともらしい引用を完全に捏造したりすることがあります。また編集者は、AI特有の文章パターンも注目しています。具体的には、過度な断定回避表現、対称的なリスト構造、一次情報源を参照せずに事実を述べる傾向などです。
修復のワークフローは人間主導です。フラグが立てられた記事はキューに入り、経験豊富な編集者が、そのコンテンツが事実として正確かどうか(生成元を問わず)、出典が不十分かどうか、あるいは明確に誤っているかどうかを評価します。Wikipediaコミュニティの立場は、問題はAI生成そのものではなく、出典のないコンテンツや不正確なコンテンツにあるというものであり——これは人間による投稿にも適用されるのと同じ基準です。
この問題の規模は深刻です。Wikipediaの英語記事数は670万件を超えており、アクセス数の少ないスタブ記事(ロングテール部分)は編集上の監視が行き届きにくいため、不均衡な影響を受けています。マイナーなトピックについてもっともらしい文章を生成できるAIツールは、まさにこのロングテール部分に検出困難なエラーを注入するように最適化されているといえます。
より広いシステム上の問題として、Wikipediaの品質保証モデル——善意を前提とし、出典を要求し、コミュニティによる修正に依存する——は、エラー率と動機の構造がLM生成コンテンツとは異なる人間の投稿者を想定して設計されていた点が挙げられます。AI生成編集の潜在的なスループットは、ボランティア編集者プールの修正処理能力を超える可能性があり、これは古典的な敵対的スケーリング問題といえます。
Source: https://spectrum.ieee.org/wikipedia-wikiproject-ai-writing-cleanup
A Man from the Future: Why Johnny Can’t Stop Abstracting
この投稿は、Leslie Lamportの知的遺産に関する論評であり、おそらくLamport自身の講演や論文を契機として書かれたものです。タイトルは、アイデアがそのフィールドに受け入れられるためのインフラが整う前に到来してしまった研究者のパターンを指しています。
Lamportの貢献は、TLA+と形式仕様、Paxosコンセンサスアルゴリズム、論理クロック(Lamportタイムスタンプ)、そしてビザンチン障害耐性にわたります。「can’t stop abstracting」というフレーミングは、システム研究における本質的な緊張関係を取り上げています。Lamportは一貫して形式モデルと数学的仕様のレベルで作業する一方、ほとんどの実務家はコードのレベルで作業しているという点です。
この投稿では、「プログラマはコードを書く前に仕様を書くべきだ」というLamportの根強い主張、具体的にはTLA+や類似の形式手法をシステム設計における標準的なステップとすべきだという議論に踏み込んでいます。実務側からの反論は、形式仕様はフロントエンドのコストが高く、ツールとのインテグレーションも限られているため、ほとんどの本番システムの開発において経済的に魅力に欠けるというものです。
Lamportタイムスタンプの構成は、この抽象化スタイルを示す具体的な好例です。イベント a がイベント b より前に発生した場合に C(a) < C(b) となる定義と、メッセージ受信時のクロック更新規則 C_j = \max(C_j, C_i) + 1 は、因果順序構造を正確に捉えた最小限の形式モデルであり、それ以上でも以下でもありません。この優雅さは、抽象化が厳密であることから生まれています。重要なことだけを正確にモデル化し、それ以外は何もモデル化しないのです。
より広い論点は、形式モデルと実装の関係についてです。Lamportの立場を大まかに言えば、分散システムのバグのほとんどは仕様のバグである、つまり実装は誤った、あるいは仕様が不十分なモデルに対しては正しい、というものです。これは、AWSおよびMicrosoftにおけるTLA+の経験によって経験的に裏付けられており、そこではモデル検査がテストでは発見できなかったバグを見つけています。
Source: http://muratbuffalo.blogspot.com/2026/10/the-man-from-future-why-johnny-cant.html
Noteworthy New Repositories
strands-agents/box
Rustで書かれたAIエージェント向けサンドボックスランタイムで、Apple シリコン搭載のmacOSをターゲットとしています(Linuxも計画中)。コアデザインは、OSレベルのプロセス分離と、Dogwoodと呼ばれるデフォルト拒否ポリシーレイヤーを組み合わせたものです。Dogwoodポリシーは、エージェントプロセスが実行・読み取り・書き込み・ネットワーク到達できる対象を定義し、明示的に許可されていないものはすべてアプリケーションレベルのチェックではなく、syscall/capabilityの境界でブロックされます。クレデンシャルのインジェクションはエージェントプロセスの外部で処理されるため、シークレットはエージェントのアドレス空間や環境に一切存在せず、許可された操作が実際に必要とする場合にのみ制御されたチャネルを通じてインジェクトされます。これは、エージェントが自由に読み取り・ログ記録・外部流出できる環境変数としてAPIキーを渡すという一般的なパターンに比べ、セキュリティ態勢として意味のある改善です。Rustによる実装により、プロセスの生成、ファイルディスクリプタの継承、ネットワークソケットの生成を厳密に制御できます。エージェントが実際のファイルシステムや外部APIへのツールアクセスを持つエージェントパイプラインをデプロイする場合、boxはプロンプトインジェクションに起因する権限悪用や意図しないデータ流出という具体的な脅威に対処します。デフォルト拒否モデルにより、攻撃対象領域はエージェントがたまたま試みないものではなく、許可リストによって定義されます。
Source: https://github.com/strands-agents/box
jwuthri-cloud/Tracely-ai
Tracelyは、LLM/エージェントのオブザーバビリティトレースをCI/CDのファーストクラスのアーティファクトとして扱います。ワークフローは次の通りです:本番トレースを収集し、LLMベースのグレーダーを実行して品質次元をスコアリングし、一過性のエラーではなく系統的なリグレッションを特定するためにセマンティック類似性で障害をクラスタリングし、代表的な障害トレースをバージョン管理に保存される再生可能なリグレッションテストとして固定します。各PRにおいて、Tracelyはそれらの固定トレースを新しいエージェント/プロンプトのバージョンに対して再生し、再度グレーディングを行い、いずれかのグレードが閾値を下回った場合にマージをブロックします。これにより、ユニットテストがコードパスはカバーするものの、モデル出力の挙動的なドリフトはカバーできないというMLデプロイメントにおける標準的なギャップを解消します。クラスタリングのステップは技術的に重要であり、リグレッションスイートがほぼ重複した障害に支配されることを防ぎ、異なる障害モードのカバレッジを確保します。セルフホスト可能な設計により、本番トレースをサードパーティのSaaSに送信することを回避できます。これは、トレースにユーザーデータが含まれる場合に重要です。グレーディングのステップ自体はLLM呼び出しであり、評価者の分散が生じますが、frozen-replayアプローチにより、少なくともPR評価の実行内での比較は一貫性が保たれます。確定的なアサーションでは微妙なリグレッションを捉えにくい、エージェントシステムのプロンプトやツール定義をイテレーションするチームにとって有用です。
Source: https://github.com/jwuthri-cloud/Tracely-ai
miuuyy/Octopus-SI-OS
Octopus-SI-OSは、エージェントをアプリケーション層のオーケストレーションフレームワークでラップするのではなく、エージェント実行のためのOSレベルのアーキテクチャを提案しています。その前提として、既存のエージェントフレームワークはWebサービスやバッチジョブの抽象概念を継承しており、長時間実行・ステートフル・自己修正型のエージェントプロセスには適していない、そしてOSのプリミティブ——スケジューリング、メモリ管理、プロセス間通信、権限分離——こそが適切な基盤であるという考え方が掲げられています。「自己進化型(self-evolving)」という主張は、自身のツールを修正し、サブエージェントを生成し、実行時に行動ポリシーを更新できるエージェントを指しており、OSハーネスがそれらのサブプロセス間のリソース管理とアイソレーションを強制します。このアーキテクチャは、より高度な自律システムに向けた研究基盤として位置づけられています。現時点ではリポジトリは本番システムというよりも、アーキテクチャ宣言書とプロトタイプハーネスとしての性格が強いですが、そのフレーミングは技術的に興味深いものです。エージェントの認知サイクルをスケジュール可能なプロセスとして、メモリコンテキストを管理されたアドレス空間として、ツールレジストリをカーネル空間のケーパビリティテーブルとして扱う、という考え方です。現時点での実用的価値は、エージェント型AIの下層にあるシステムレイヤーについて考える研究者にとって、参照設計および議論の素材としてのものです。
Source: https://github.com/miuuyy/Octopus-SI-OS
pullboard-dev/pullboard
Pullboardは、人間の判断をコードの直接的な記述ではなく仕様とルールを通じて表現する、ガバナンスが組み込まれたアジェンティック開発システムです。ワークフローは次のように構成されています:開発者がfeature specと一連のポリシールール(コーディング規約、アーキテクチャ上の制約、セキュリティ要件)を宣言し、builder agentが実装を生成し、独立したverifier agentがその出力に対してテスト、静的解析、およびポリシーチェックを実行します。verifierが通過するまでPRのマージはブロックされます。builderとverifierを独立したプロセスとして分離する二エージェントアーキテクチャは、設計上の重要な選択です。これにより、builderが自身の成功基準を操作することを防ぎますが、それは単一エージェントによる自己評価が陥りがちな失敗パターンです。人間の判断はプルリクエストのレビューではなく、事前のspec・ルール宣言に集約されており、人間の役割をレビュアーから仕様の作成者へとシフトさせています。これは、責任あるアジェンティックデプロイメントフレームワークの多くに登場する「approval loop」パターンを具体的に実装したものです。このシステムはトイデモではなく実際のプロダクト開発を対象としているため、不完全な仕様や曖昧な要件を適切に処理する必要があります。これは、リポジトリが成熟するにつれて取り組むべき本質的な難問です。
Source: https://github.com/pullboard-dev/pullboard
QingYunA/answer-me-with-html
このリポジトリは、エージェントスキル(エージェントが呼び出せる再利用可能なツールまたは関数)を定義しており、複雑な質問を受け取り、平文テキストではなく自己完結型のシングルページHTMLドキュメントとして回答を返します。その動機は、複数パートからなる技術的な質問、比較、または階層構造を持つ説明において、構造化されて視覚的に整理された出力の方が解析しやすいという点にあります。HTMLレスポンスにはテーブル、折りたたみ可能なセクション、シンタックスハイライト付きコード、内部ナビゲーションを含めることができ、ページが自己完結しているためサーバー依存なしにすべてクライアントサイドでレンダリングされます。実装の観点では、これはprompt engineeringと出力フォーマットのレイヤーです。このスキルはLLMに対して有効で読みやすいHTMLを生成するよう指示し、ホストエージェントフレームワークが使用するツール呼び出しインターフェースで呼び出しをラップします。高いスター数(4,583)は実質的な有用性を反映しており、このパターンはさもなければmarkdownの壁になってしまうエージェント出力という現実のUX問題を解決します。主な制限は、複雑なレイアウトに対してLLMによるHTML生成が不安定になり得ることであり、このリポジトリには不正形式の出力を処理するためのpromptテンプレートと検証ロジックが含まれている可能性が高いです。エージェントツールライブラリを構築するすべての人にとって、参照実装として有用です。
Source: https://github.com/QingYunA/answer-me-with-html
chenxiachan/textfold
Textfoldは、学術論文、Webページ、任意のファイル、LLMの返答テキストに適用可能な、5段階の詳細レベルにわたるプログレッシブ要約を実装しています。「fold(折りたたみ)」というメタファーはUIパターンに対応しており、ドキュメントは最高抽象レベルで折りたたまれた状態から始まり、エディタのコード折りたたみに類似した形で、元のテキストに向かって段階的に展開できます。技術的には、各レベル――一般的には、1文要約、段落、セクションレベルの概要、拡張アブストラクト、全文――で要約を生成してキャッシュし、各層をオンデマンドで表示するナビゲーションインターフェースを提供する必要があります。論文の場合、これはアブストラクト・イントロダクション・セクション階層と自然に対応します。任意のテキストの場合、各レベルはLLMによって生成されます。実用的な価値は、多くの読者がほとんどのセクションではレベル2の詳細度を必要とし、1〜2箇所ではレベル5を必要とするようなドキュメントにおいて、関連情報への到達時間を短縮する点にあります。コストの観点からキャッシュ戦略は重要であり、表示のたびに5レベルすべてを再生成するのはコストが高いため、textfoldは生成済みの要約をキャッシュしていると考えられます。未解決の問題は、圧縮時の要約の忠実度であり、特に数式が多いセクションのレベル1要約では精度が失われやすい技術的なコンテンツにおいて顕著です。785スターを獲得しており、研究および知識管理ワークフローにおいてこのパターンへの明確な需要があることが示されています。
Source: https://github.com/chenxiachan/textfold
Aryanutkarsh/SeeCode
SeecCodeは、コンパクトなJSON仕様からアニメーション付きのインタラクティブな図を生成するツールであり、Claudeのようなコーディングエージェントの出力をターゲットとしています。入力スキーマは、クラス、関数、データフロー、コールグラフといったコード構造を宣言的なフォーマットで記述し、エージェントがグラフィクスAPIを呼び出すことなく直接出力できるように設計されています。SeecCodeはこれらをアニメーション付きで探索可能な図としてレンダリングし、実行フローやデータ変換をステップごとに可視化することを想定しています。設計上の重要な決断は、LLMがtool-callの出力として確実に生成できるよう、JSONスキーマを十分にシンプルに保つことです。エージェントにSVGやcanvasのコードを直接生成させる代わりにこのアプローチを採ることで、LLMが図描画コードをゼロから書く際に座標計算を誤るという既知の問題を回避しています。探索可能でアニメーションされるという特性は、制御フローの理解において静的な図よりも付加価値があります。コールシーケンスを視覚的にステップ実行することは、トレースログを読むよりも速いからです。実用的な応用としては、エージェント支援によるコードレビュー、アーキテクチャの説明、デバッグの可視化などが挙げられます。主な制約は、JSONスキーマの表現力によって表現できる内容が決まる点にあり、複雑なデータ構造や高度に並行した実行パターンはスキーマの限界に達する可能性があります。
Source: https://github.com/Aryanutkarsh/SeeCode
iamlukethedev/Herald-OS
Herald-OSは、Hermes Agentを主要なインターフェース層として持つ、独立したagent-native OSのプロトタイプです(Nous ResearchのHermesモデルシリーズとは明示的に無関係です)。このプロジェクトのアーキテクチャ上の主張は、従来のOSインターフェース——シェル、GUI、ファイルブラウザ——はagentにとって誤った抽象化であり、agent実行のためにゼロから設計されたOSであれば、タスクグラフ、コンテキストストア、ツールレジストリといったプリミティブをユーザー空間のライブラリとしてではなく、ファーストクラスのカーネルコンセプトとして公開すべきだ、というものです。Hermes Agentは人間向けのインターフェースとして機能し、自然言語または構造化されたインテントをOSレベルの操作に変換します。これは上述のOctopus-SI-OSと同じ設計空間にあり、実行基盤よりもhuman-agentインタラクション層に重点を置いているようです。581スターを獲得しており、agent-firstの文脈でOS設計の前提を再考するためのプルーフ・オブ・コンセプトとして注目を集めています。独立プロジェクトとして主なリスクはスコープにあります。OSの基本機能を再実装することは、膨大なエンジニアリング上の作業面を伴います。現実的な近期的価値は、文字通りのオペレーティングシステムの代替というよりも、アプリケーション層のフレームワークよりも優れたリソース管理と分離セマンティクスを備えた、意見の明確なagentランタイムとしての役割にあります。