デイリーAIダイジェスト — 2026-10-23
arXiv ハイライト
WeVisOne-VL: オブジェクトからピクセルまでの統合視覚知覚
問題設定
VLMは粗粒度のキャプショニングやVQAには優れていますが、混雑した環境での検出、制約付き単位でのカウント、ピクセル精度の参照セグメンテーション、存在しないターゲットの原則的な拒否といった細粒度の局所化は依然として信頼性に欠けます。既存の特化型グラウンディングVLM(Rex-Omni、LocateAnything)はトークン化座標によりボックス/ポイントを扱いますが、ピクセル出力を生成しません。一方、セグメンテーション特化モデル(LISA、UniPixel)は検出レベルの局所化精度に達していません。WeVisOne-VL(WeChat Vision All-in-One)は、単一の自己回帰VLMにおいてオブジェクトレベルとピクセルレベルの知覚を統合し、検出・参照局所化・カウント・ポインティング・OCR・セグメンテーション・マッティングをカバーし、存在しないターゲットの拒否に対して一貫したインターフェースを提供します。
手法
タスクの定式化。 すべての出力は構造化された次トークン列として表現されます。正規化座標は専用の語彙トークン <0>…<1000>(Rex-Omni / LocateAnythingに従う)に離散化され、ボックスは4トークン [x_0,y_0,x_1,y_1]、ポイントは [x_0,y_0] として出力されます。クエリされたターゲットが存在しない場合、座標フィールドはリテラルに None となり、信頼度キャリブレーションに依存するのではなく、明確な負クラスを提供します。ピクセルタスクでは、モデルは各 <box> フィールド内のボックス4トークンの直後に単一の <OBJ> トークンを出力し、ピクセルデコーダがここから読み取るハンドルとして機能します。
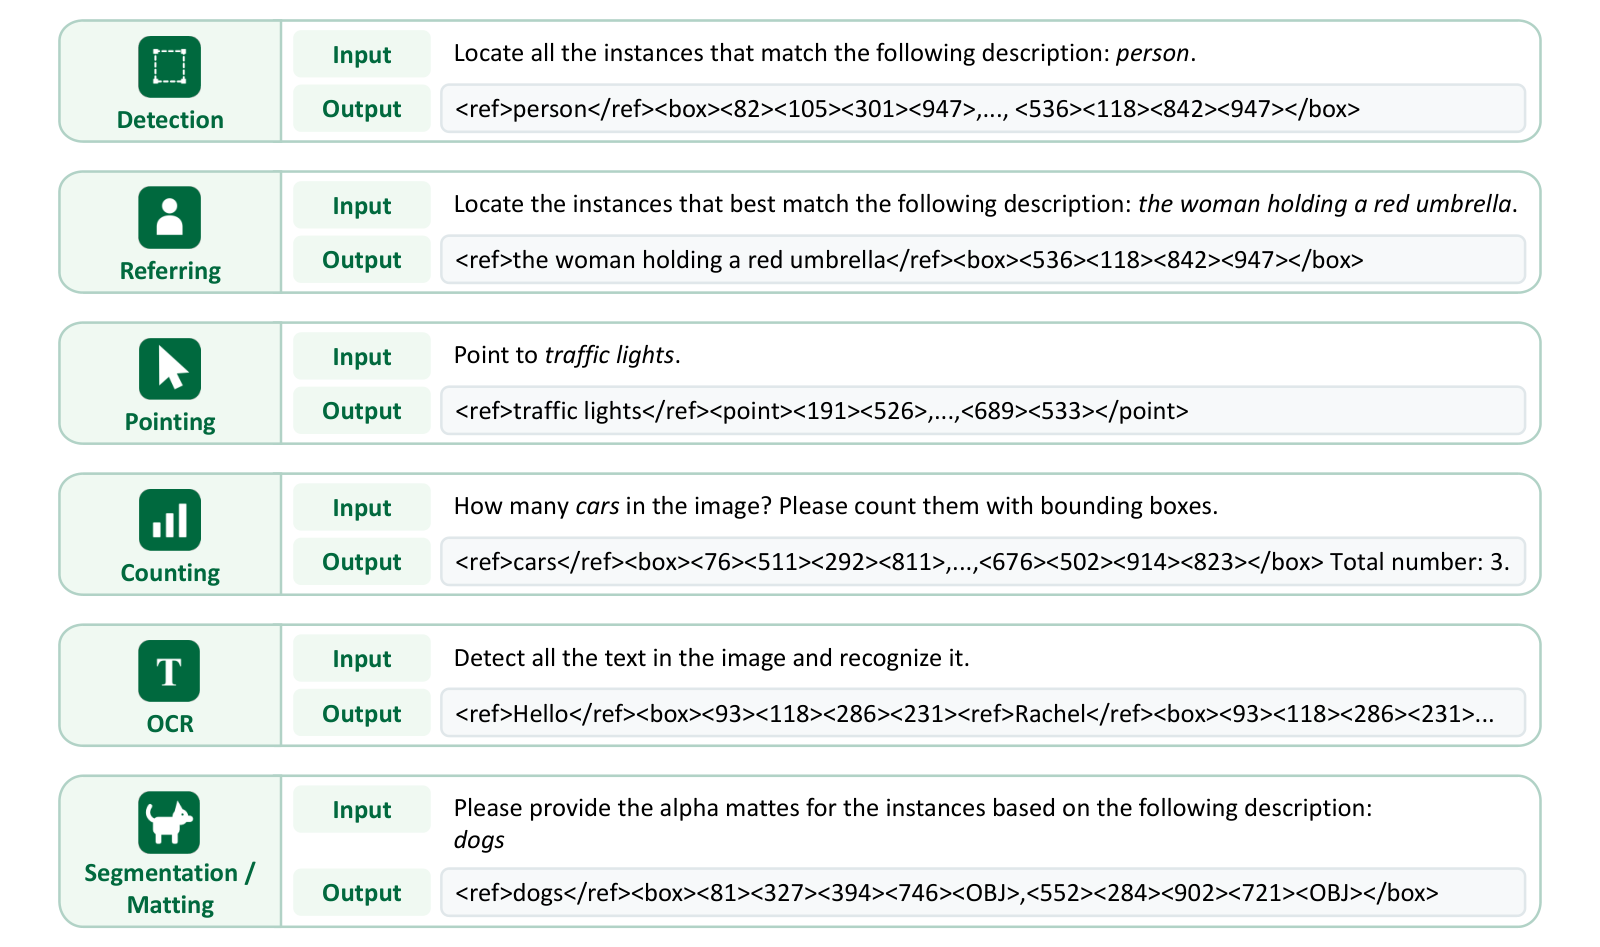
ピクセルデコーダ。 軽量デコーダが(i)Qwen3-VLからのマルチレベルViT特徴、(ii)各 <OBJ> トークンの隠れ状態、(iii)予測されたボックスを入力として受け取ります。デコーダは共有視覚特徴を構築し、ボックスを用いてターゲットクエリを初期化し、視覚特徴に対して反復的に精緻化することでフル解像度マスクまたはアルファマットを生成します。インスタンスの同一性は、オブジェクトごとに1つのtoken embeddingを介して、自己回帰ストリームから密なヘッドへとクリーンに伝達されます。
データエンジン。 WeVisOne-VL Data Engine(WDE)は、GRIT、CC3M、LAION、SA-1B、タスク固有のソースから収集した約1億枚の画像と約36億件のボックスアノテーションをキュレーションします。
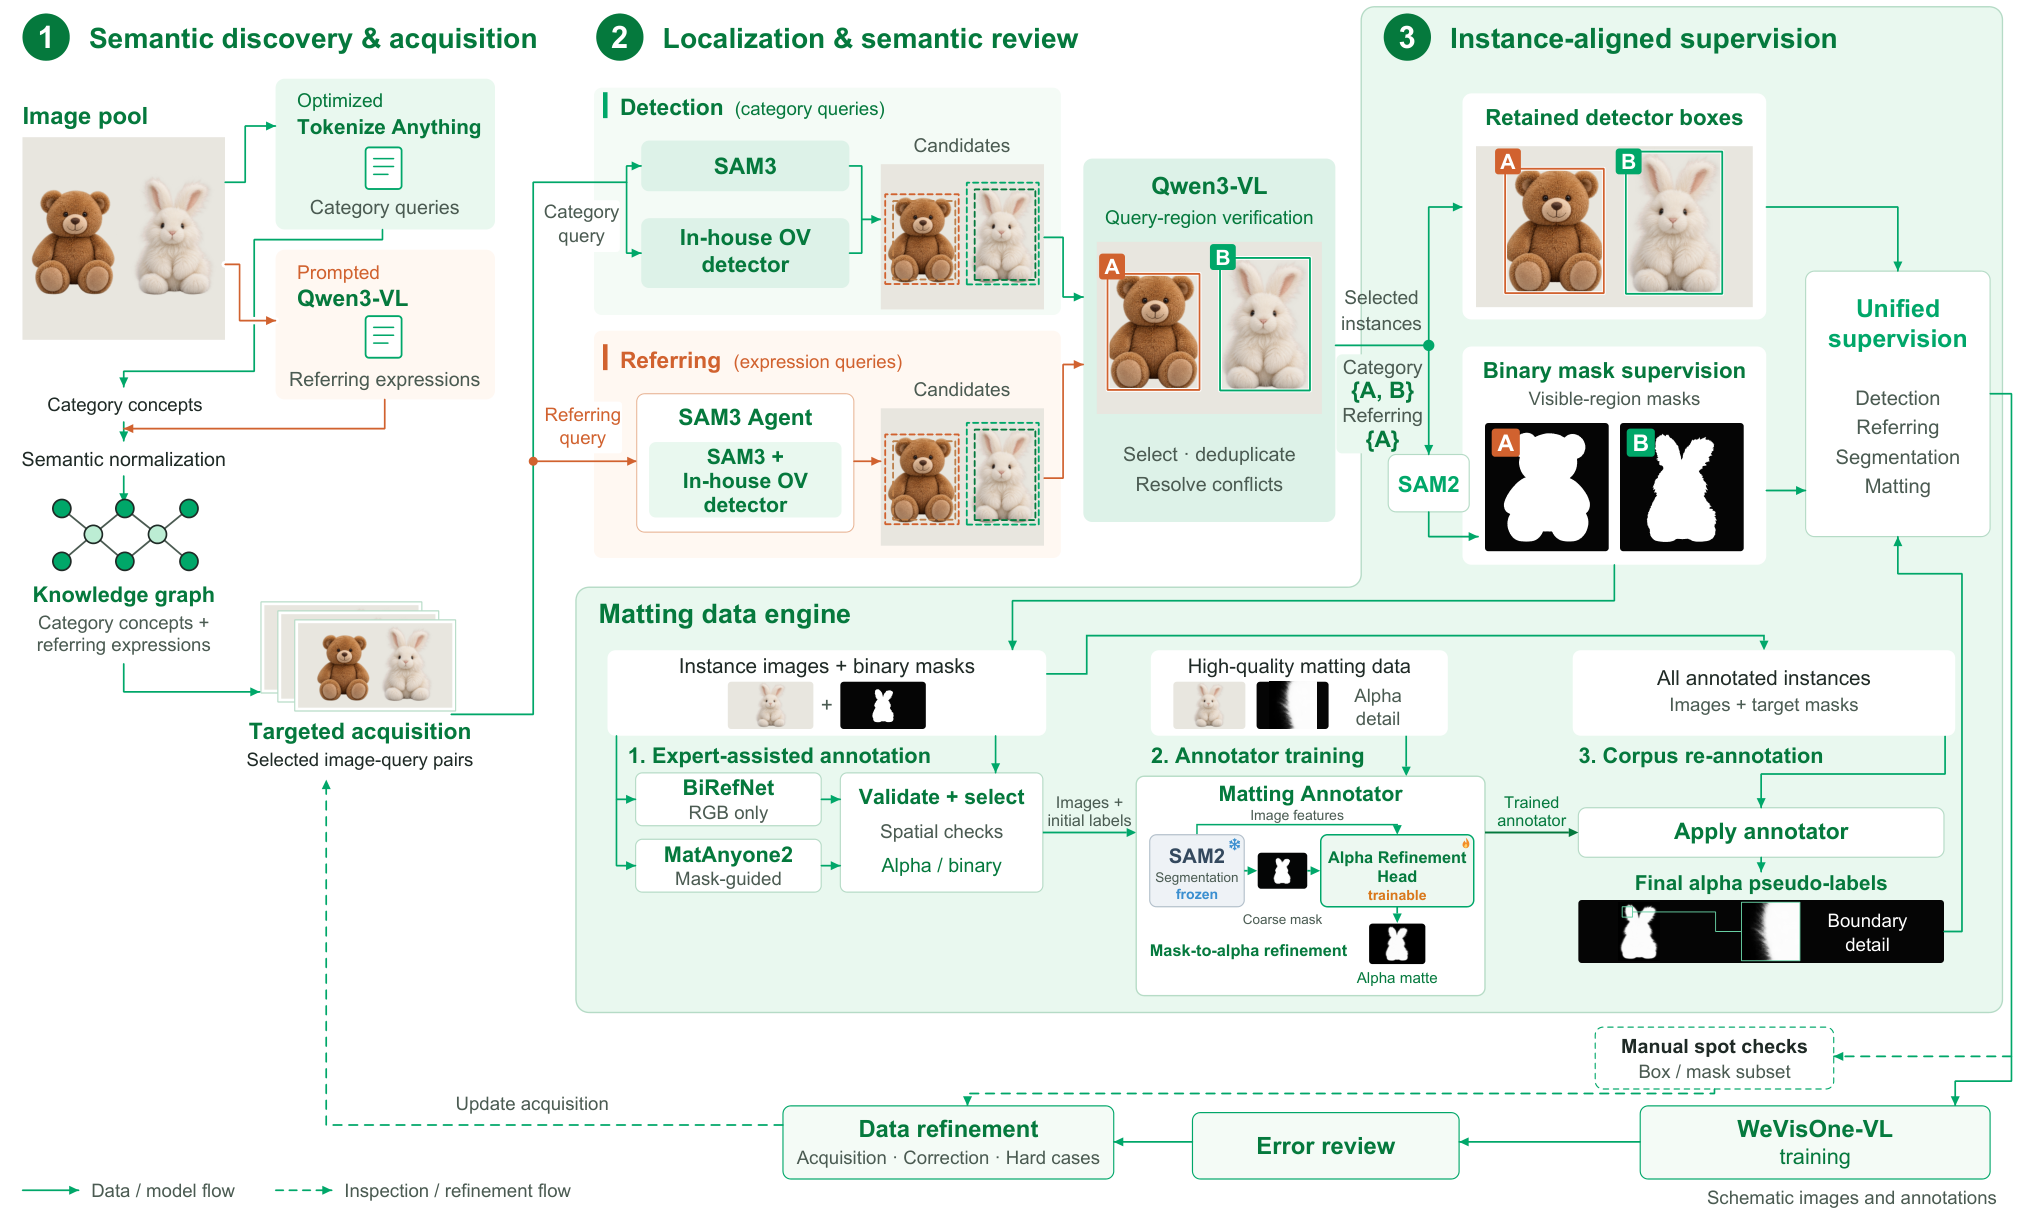
カテゴリ概念(Tokenize Anythingより)と合成参照表現(Qwen3-VLで生成)は、WikipediaとWordNetによってシードされた共有知識グラフに整理され、ノードはエイリアス、分類関係、部分-全体関係を保持します。候補語は安定した視覚的証拠が取得された場合にのみ追加され、モデルエラーレビュー、概念カバレッジ、スケール、遮蔽、密度を用いて各学習ラウンド後に取得の優先順位が再設定されます。
学習。 3段階のSFTに続く混合タスクRL。
- Stage 1 — Task Alignment。 拡張語彙を持つQwen3-VLを出発点として、ViTとprojectorを凍結し、全タスクをカバーする9,000万サンプルで13Kステップ、画像あたり16〜512 visual token、コンテキスト4,096でLMを学習。ピクセルタスクサンプルはNTPのみを使用し、
<OBJ>tokenはインスタンスとの初期対応を学習します。密なサンプルは繰り返しによる崩壊を避けるため、カテゴリあたり50ボックス/ポイントに制限されます。 - Stage 2 — Resolution and Density Scaling。 全パラメータを解凍し、visual tokenを1,960、コンテキストを8,192に拡大し、レスポンスあたり最大500ボックス/ポイントを許容し、4,000万サンプルで9Kステップ学習。
- Stage 3 — Alternating Token–Pixel Optimization。 SFT-S2のVLMと共にデコーダを2億5,000万件のセグメンテーションサンプルで100Kステップウォームアップし、\mathcal{L}_{\mathrm{seg}} = 20\mathcal{L}_{\mathrm{focal}} + \mathcal{L}_{\mathrm{dice}} を使用。次に、デコーダの重みと学習済み
<OBJ>embeddingのみを保持し、Stage 2チェックポイントに接続して、NTPとpixel lossを1:1で交互に用いる \mathcal{L}_{\mathrm{joint}} = \mathcal{L}_{\mathrm{NTP}} + 10\mathcal{L}_{\mathrm{seg}} で9Kステップ共同学習。最後に、VLMを凍結した状態でマッティング用に1億3,000万サンプルで100Kステップ、L_1、gradient、composition lossを用いてデコーダを特化させます。
その後、RLが混合タスクセット全体においてトークンごとの尤度ではなく予測品質全体を最適化します。
結果
ゼロショットCOCO/LVISおよび高密度Dense200/VisDroneにおいて、F1はIoU 0.5、0.95、および0.5:0.95の平均で報告されます。
- COCO(ゼロショット)。 WeVisOne-VL-4Bは74.0 / 19.5 / 57.1を達成し、LocateAnything-3Bの70.1 / 19.3 / 54.7、Rex-Omni-3Bの72.0 / 15.9 / 52.9を上回ります。Qwen3-VL-8Bは65.9 / 14.8 / 47.8です。
- LVIS(ゼロショット)。 4Bモデルは71.1 / 28.8 / 55.3を達成し、LocateAnythingの62.3 / 31.1 / 50.7、Qwen3-VL-8Bの59.7 / 19.6 / 42.9を上回ります。
- Dense200。 4Bモデルは86.9 / 23.2 / 71.3を達成し、LocateAnything(58.7)に対して平均F1で+12.6、Rex-Omni(58.3)に対して+13.0を記録。Qwen3-VL-8Bは平均F1で13.8にとどまります。
- VisDrone。 4Bモデルは68.1 / 3.9 / 44.7を達成し、LocateAnythingの63.0 / 3.2 / 39.9、GroundingDINO-Tの55.2 / 3.9 / 38.5を上回ります。
2Bバリアントは、4つの検出セットすべてにおいて平均F1(55.2 / 53.3 / 61.4 / 40.4)で両方の3Bグラウンディング特化モデルを既に上回っています。IoU=0.95の高いスコアは、改善が単なるカバレッジにとどまらないことを示しており、座標は正確に収束しています。
定性的には、本モデルはベースラインが見逃した砂埃で覆われた象を検出し、「白シャツと赤ショーツ」という両方の条件を満たすインスタンスが存在しない参照クエリを正しく拒否し、個々の靴ではなく履き物のペアをカウントし、緑のボールのカウントにおいてRex-Omniが537を返す場面で42を返します。曲線文字や密なレシート/指示書のOCRでは、より多くの小文字が局所化・転写されます。
制限事項と今後の課題
本論文は先頭の平均F1を報告していますが、IoU=0.95スコア(例:COCOで19.5、VisDroneで3.9)は依然として上限を大きく下回っており、サブピクセル局所化——特にドローン視点の小物体——は未解決の課題です。拒否動作は定性的に示されているものの、存在しないターゲットのベンチマークにおける定量的な偽陽性率は示されていません。<OBJ>ベースのデコーダはインスタンスあたり1トークンのボトルネックを持つため、非常に大きいまたはトポロジー的に複雑な物体のマスク品質が制限される可能性があり、3段階のカリキュラムと2億5,000万ステップのデコーダウォームアップは運用上の負担が大きいです。学習パイプラインはSFT上にRLを組み合わせており、具体的な報酬設計とSFTに対する限界的な貢献についてはここでは詳述されていません。
重要性
トークン化されたボックス/ポイント出力と薄い <OBJ> ゲートのピクセルデコーダを1つの自己回帰VLMに統合し、専用データエンジンで大規模に学習することで、汎用VLMと特化型検出器/セグメンタとの間のギャップを大幅に縮めつつ、言語条件付き拒否を維持します。これは、細粒度の知覚が次トークン予測を放棄することなく実現可能であり、語彙を拡張して軽量な密なヘッドを接続するだけで十分であることを主張するものです。
Source: https://arxiv.org/abs/2610.31329
実世界のWeb環境における Deep Search
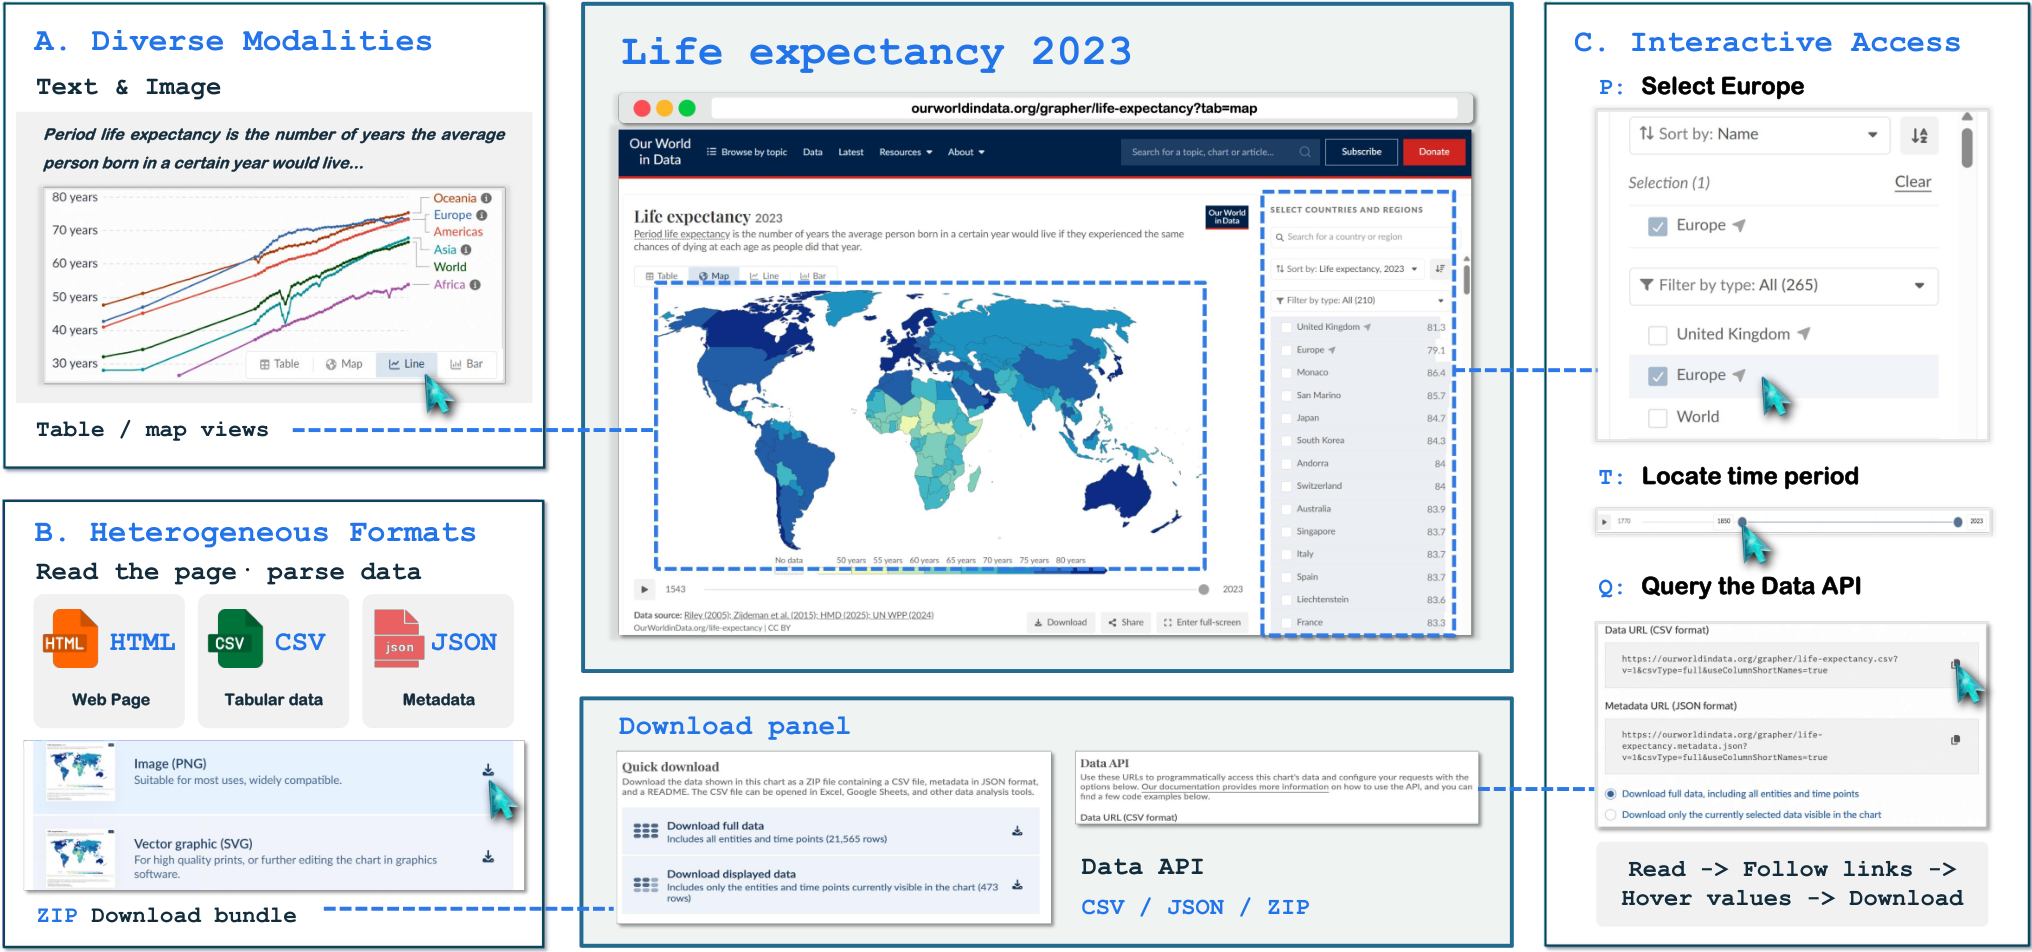
既存の deep search ベンチマーク(BrowseComp、GAIA、WebWalker、Humanity’s Last Exam web track)は、Webを主にSearch APIとHTMLスクレイピングを通じてアクセスするテキストコーパスとして扱っています。本論文は、オープンWeb上の実際のリサーチタスクにはそれ以上のものが必要であると主張しています。すなわち、エージェントは異種モダリティ(テキスト、画像、音声、動画)、異種ファイルフォーマット(HTML、PDF、CSV、JSON、ZIP、Parquetなど)、およびインタラクティブなアクセス機構(マップビューア、タイムスライダー、APIクエリビルダー、バーチャルツアー)を横断しなければなりません。著者らはこれを Open-Web Deep Search(OpenDS) として定式化し、タスクごとに人手で検証されたエビデンスチェーンを持つ200タスクのベンチマーク OpenDS-World を公開しています。
タスクの定式化
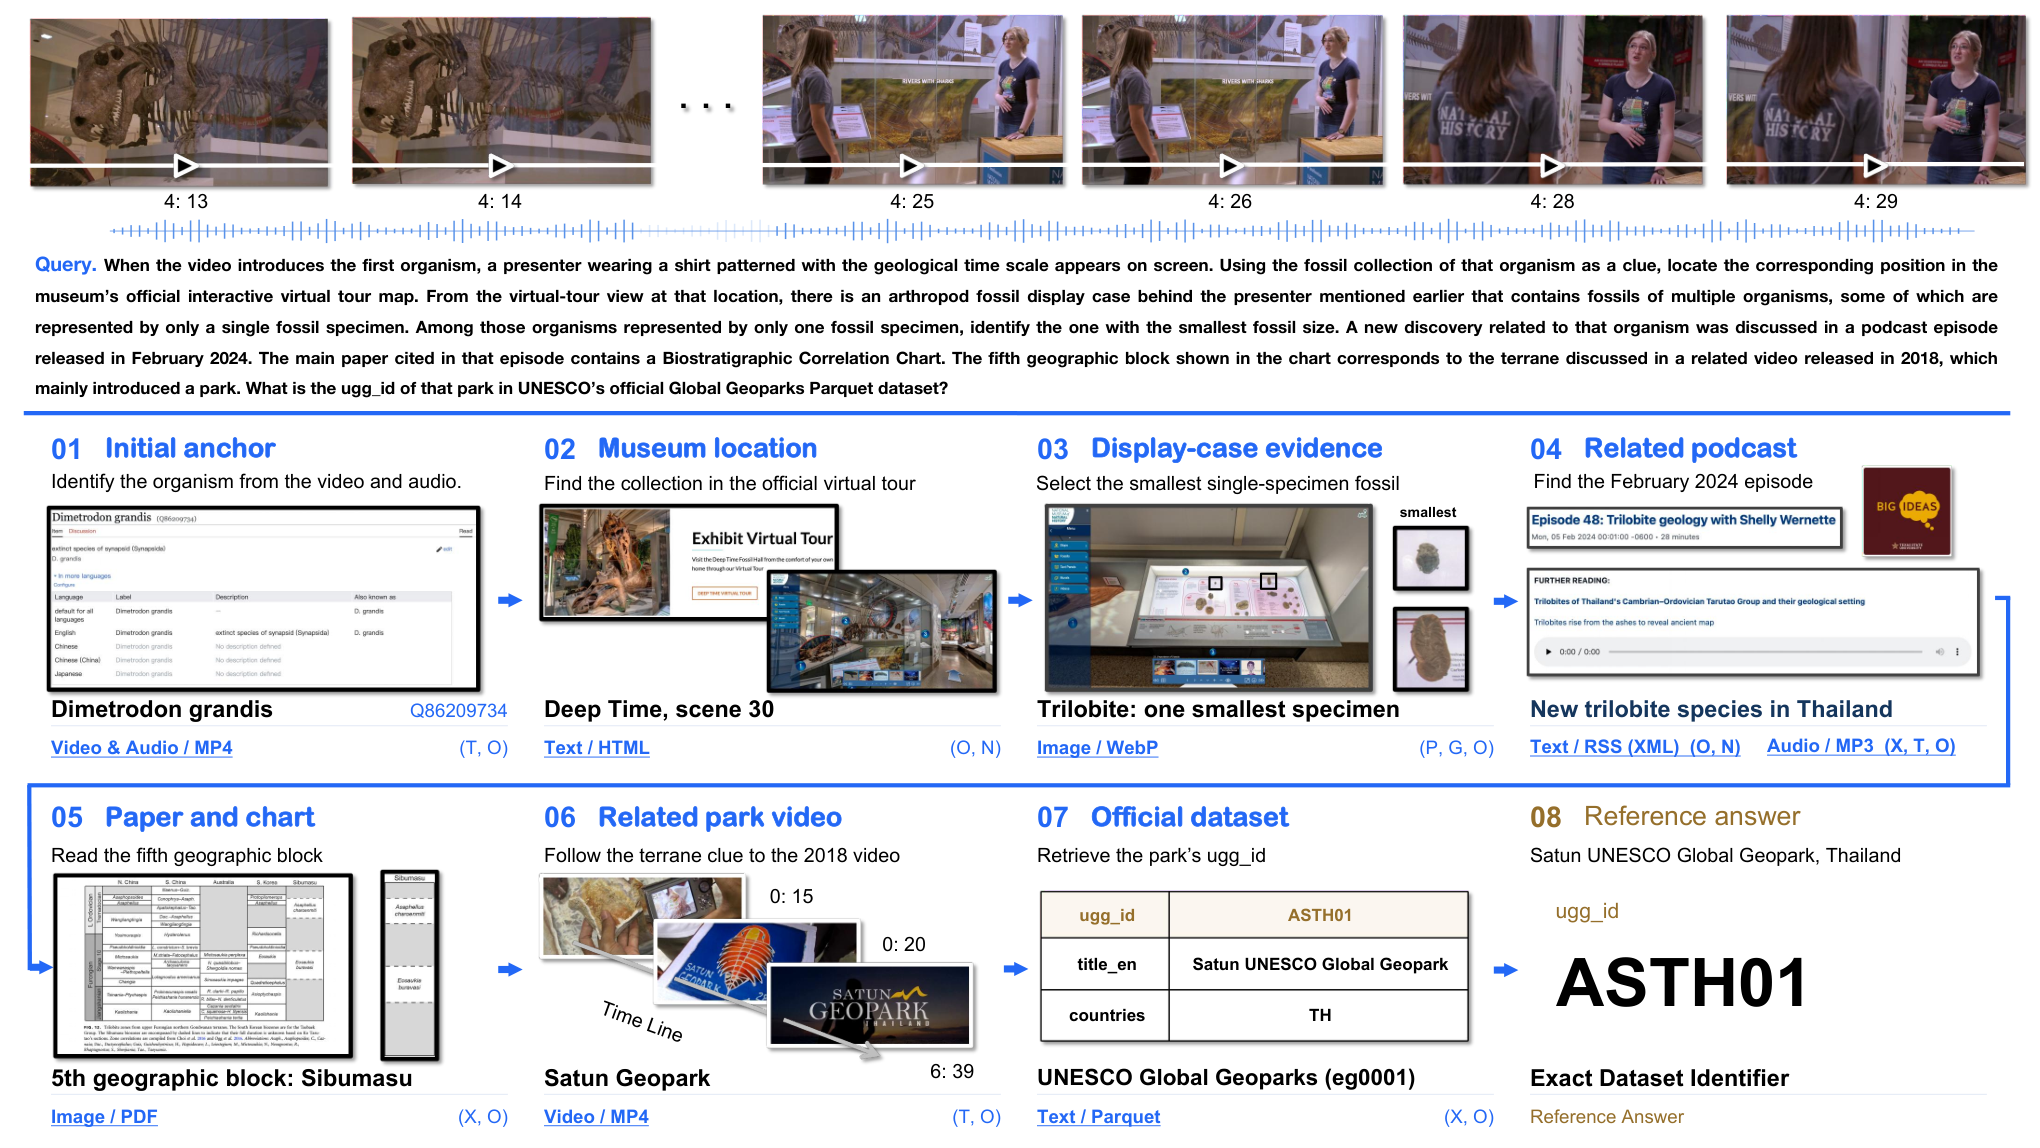
OpenDSは q を質問、c_0 を初期手がかり、a^\star を一意の検証可能な解答とする事実QAタスク (q, c_0) \mapsto a^\star です。エビデンスは、その位置もアクセス方法も明かされていない未知のソース集合 \{s_1, \dots, s_k\} に分散しています。エージェントは次の検索ターゲットを反復的に計画し、アクセス・処理モダリティ(検索、ブラウザ操作、ファイルのダウンロード・解析、APIコール)を選択し、a^\star に確定できるまでソースをまたいでエビデンスを繋ぎ合わせなければなりません。強調点は推論のみならず エビデンスの取得 にあります。埋め込まれた音声クリップから楽曲を特定できない、Street Viewのバーチャルツアーをナビゲートできない、特定のCSVカラムを読み取れない、あるいは Our World in Data の正しいAPIクエリを発行できないエージェントは、推論能力がいかに高くともタスクを完了できません。
Figure 2は、音声・映像の識別、バーチャルツアーのナビゲーション、文書の検査、および構造化データの取得を組み合わせた代表的なエビデンスチェーンを示しています。
この設計は、実世界の単一ソースがすでに3つの直交する性質を兼ね備えているという観察に基づいています。Figure 3のOur World in Dataの例が示すように:(A)共存するモダリティ(テキストのナラティブとグラフ画像)、(B)同一データの複数表現(HTML、CSV、JSON、ZIPバンドル)、(C)インタラクティブコントロール(地域セレクタ、タイムスライダー、宣言的API)です。(A)/(B)/(C)の異なる組み合わせは、同一の基礎的事実に対しても非等価なアクセス戦略をもたらします。
ベンチマークの構築
OpenDS-Worldは、8つのドメイン(文化、日常生活、科学、経済、歴史、自然、社会、テクノロジー)にわたる200タスクを含んでいます。各タスクには明示的なエビデンスチェーンが付与されており、各エントリは(モダリティ、フォーマット、アクセスタイプ)でタグ付けされています。200タスク全体で 4つのモダリティ、42のファイルフォーマット、7つのアクセスタイプ をカバーしています(Figure 5)。各エントリは、エビデンスの妥当性と解答の一意性の両方について独立した人手検証を受けています。これは、多くのWeb上の事実が時間とともに変化したり、競合するソースにほぼ重複するものが存在したりするため、特に重要です。
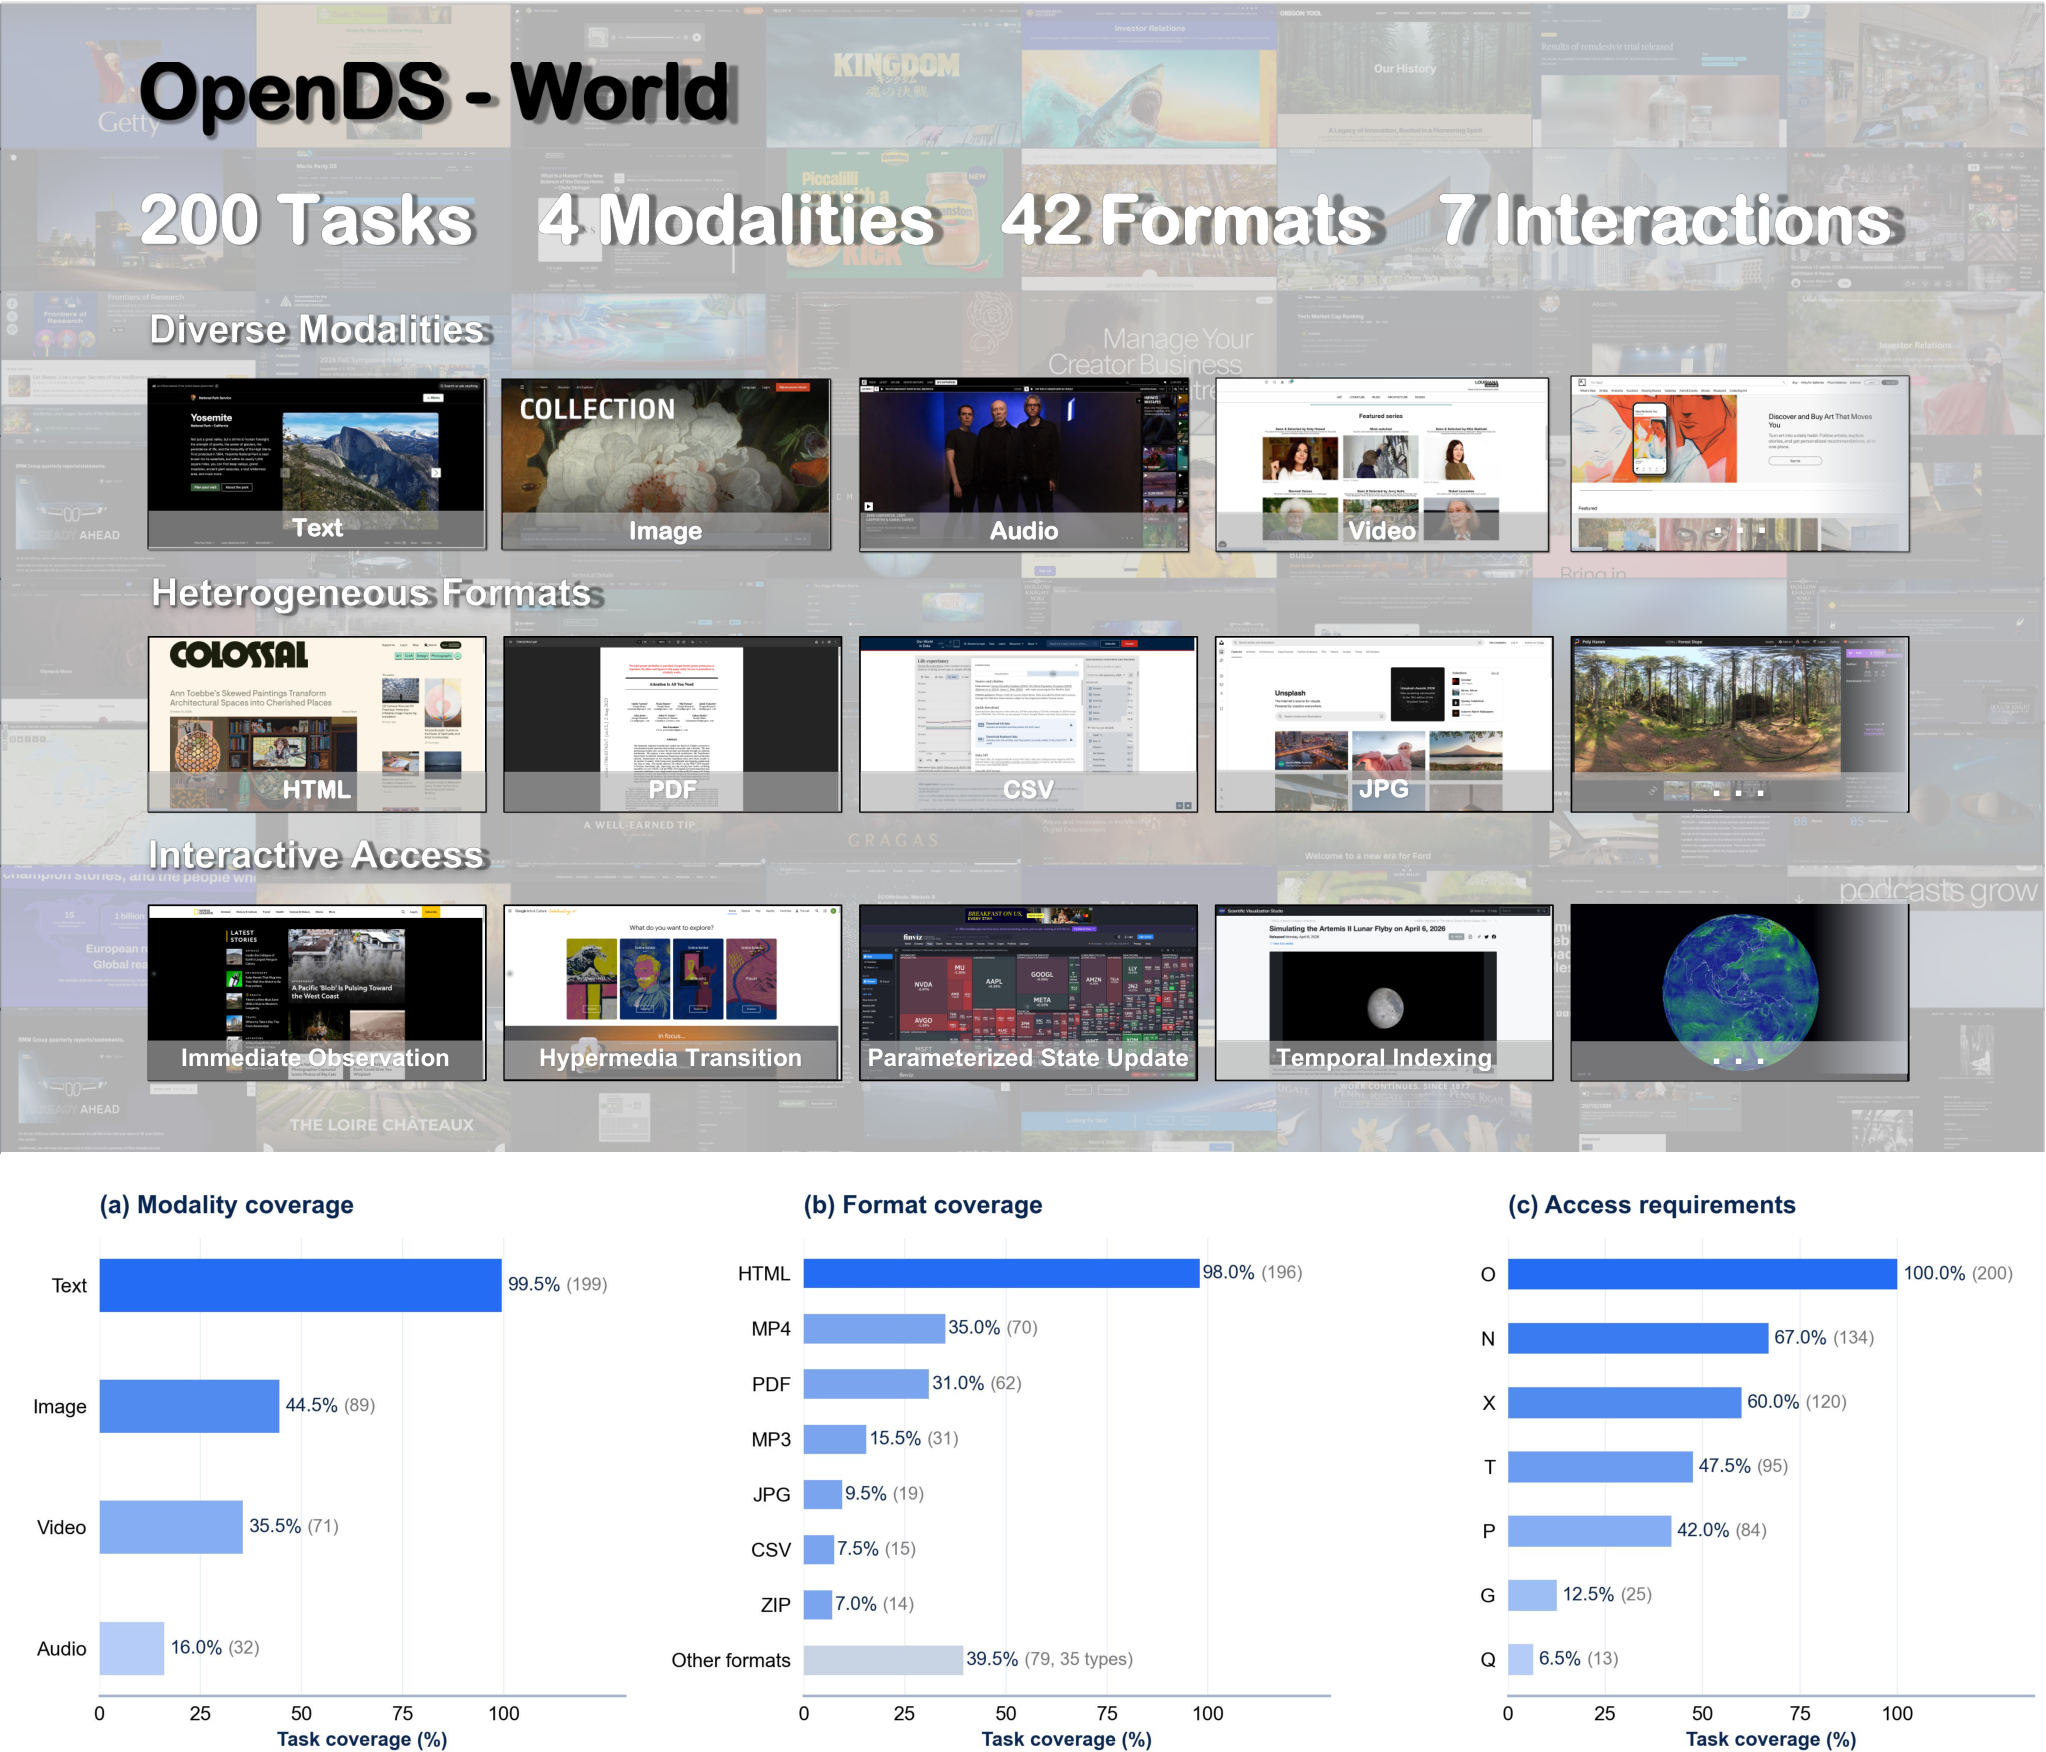
フォーマットのカバレッジ(42種類)はブラウジングベンチマークとしては異例に広く、先行研究のほとんどはHTMLと少数のドキュメントタイプしか扱っていません。アクセスタイプの次元(インタラクティブなブラウザ操作と宣言的APIクエリを含む7カテゴリ)こそが、エージェントに search + read のループを超えることを強いる要因です。
評価プロトコル
12のフロンティアモデルが同一条件(同一のタスク入力、同一のシステムプロンプト、同一のツール環境、同一の実行予算)で評価されています。ラインナップにはGPT-6 Astra、GPT-5.6 Sol、Claude Opus 5.5、Claude Fable 5.1、Gemini 3.8 Flash、Qwen3.8-Max、Qwen3.8-Flash、DeepSeek-V4.1-Flash、DeepSeek-V4-Pro、Kimi K3、GLM-5.3-Flash、およびGLM-5.3が含まれます。2段階のpromptingは実行を リサーチ フェーズ(オープンエンドなツール使用)と 最終確定 フェーズ(単一解答へのコミット)に分割しており、プロンプトはAppendix C.3に記載されています。なお、モデル名は論文における近未来のリリースラベルを反映しており、クロスモデルの比較可能性において重要なのは方法論(固定ツール、固定予算)です。
提供されたセクションでは主要な精度テーブルは示されていませんが、一様な環境プロトコルは、モデル能力をスキャフォールドのエンジニアリングから分離するための適切なアプローチです。これは、ブラウザハーネス、リトリーバー、または再帰制限の違いがモデルのシグナルを支配してしまうエージェントベンチマークにおける一般的な交絡因子への対処です。
限界と未解決の問題
- Live-Webの非定常性。 エビデンスのページは変化し、APIは廃止され、a^\star の一意性は時間とともに劣化する可能性があります。本論文は構築時点での人手検証済みエビデンスチェーンに依存していますが、更新プロトコルについては記述されていません。
- ツールスタックの感度。 ツールを固定していても、インタラクティブアクセス(バーチャルツアー、動的グラフ)のパフォーマンスは、ブラウザハーネスが必要なイベントを露出しているかどうかに大きく依存します。Street Viewタスクで失敗するモデルは、推論ではなくスキャフォールドがボトルネックである可能性があります。
- マルチモーダルなリーチ。 音声・動画の識別タスクは暗黙的に、モデルが適切な知覚ツール(Shazam的な音声ID、動画フレームOCR)にアクセスできるかどうかをテストしています。このベンチマークは「知覚できない」と「推論できない」を混同しています。
- 200タスク という規模は、接戦するモデルを統計的に分離するには小さく、8ドメイン間での分散はおそらく相当なものになります。
- アブストラクトは12モデルの具体的な精度を報告する前に切り捨てられているため、本論文の核心的な実証的主張は提供されたセクションからは検証できません。
なぜこれが重要か
ブラウジングベンチマークはWebのテキスト中心的な見方に収束しており、「オンラインでリサーチを行う」ことが実際に必要とすること、すなわちモダリティの切り替え、構造化データダンプの解析、インタラクティブUIの操作、APIクエリの構成から、ますます乖離しています。OpenDS-Worldはモダリティ・フォーマット・アクセスのタクソノミーと人手検証済みエビデンスチェーンを用いてそれらの要件を運用可能にし、エージェントの進歩が実質的なものなのか、それとも容易な検索設定のアーティファクトなのかをより明確に測定する手段を提供しています。
Source: https://arxiv.org/abs/2610.30181
編集画像を再利用可能なレイヤーへ変換:Compositional Edit-Prior Distillationによるアプローチ
命令駆動型の画像エディタはフラットなラスター出力を生成しますが、これは表示には便利である一方、後工程のワークフローにとっては非可逆的です。オブジェクトを貼り付けたりテキストブロックのスタイルを変更したりすると、各要素のピクセルレベルの出所情報は失われてしまいます。分解パイプラインはレイヤーを復元しますが、通常は分解を編集とは切り離された事後的なステップとして扱うため、復元されたRGBAスタックが意図した編集結果に合成して戻る保証がありません。LayerEditorはこの問題を統合的に解決します。すなわち、ソース画像 I^{\mathrm{src}}、命令 u、要求レイヤー数 N を与えられたとき、編集済みキャンバス \mathcal{D} と、alpha-over合成 \mathcal{C} = \operatorname{Comp}(\mathcal{S}) が同一の編集を実現しつつ各要素が個別に操作可能な順序付きスタック \mathcal{S} = \{\mathcal{L}_i = (R_i, A_i)\}_{i=0}^{N-1} の両方を生成します。
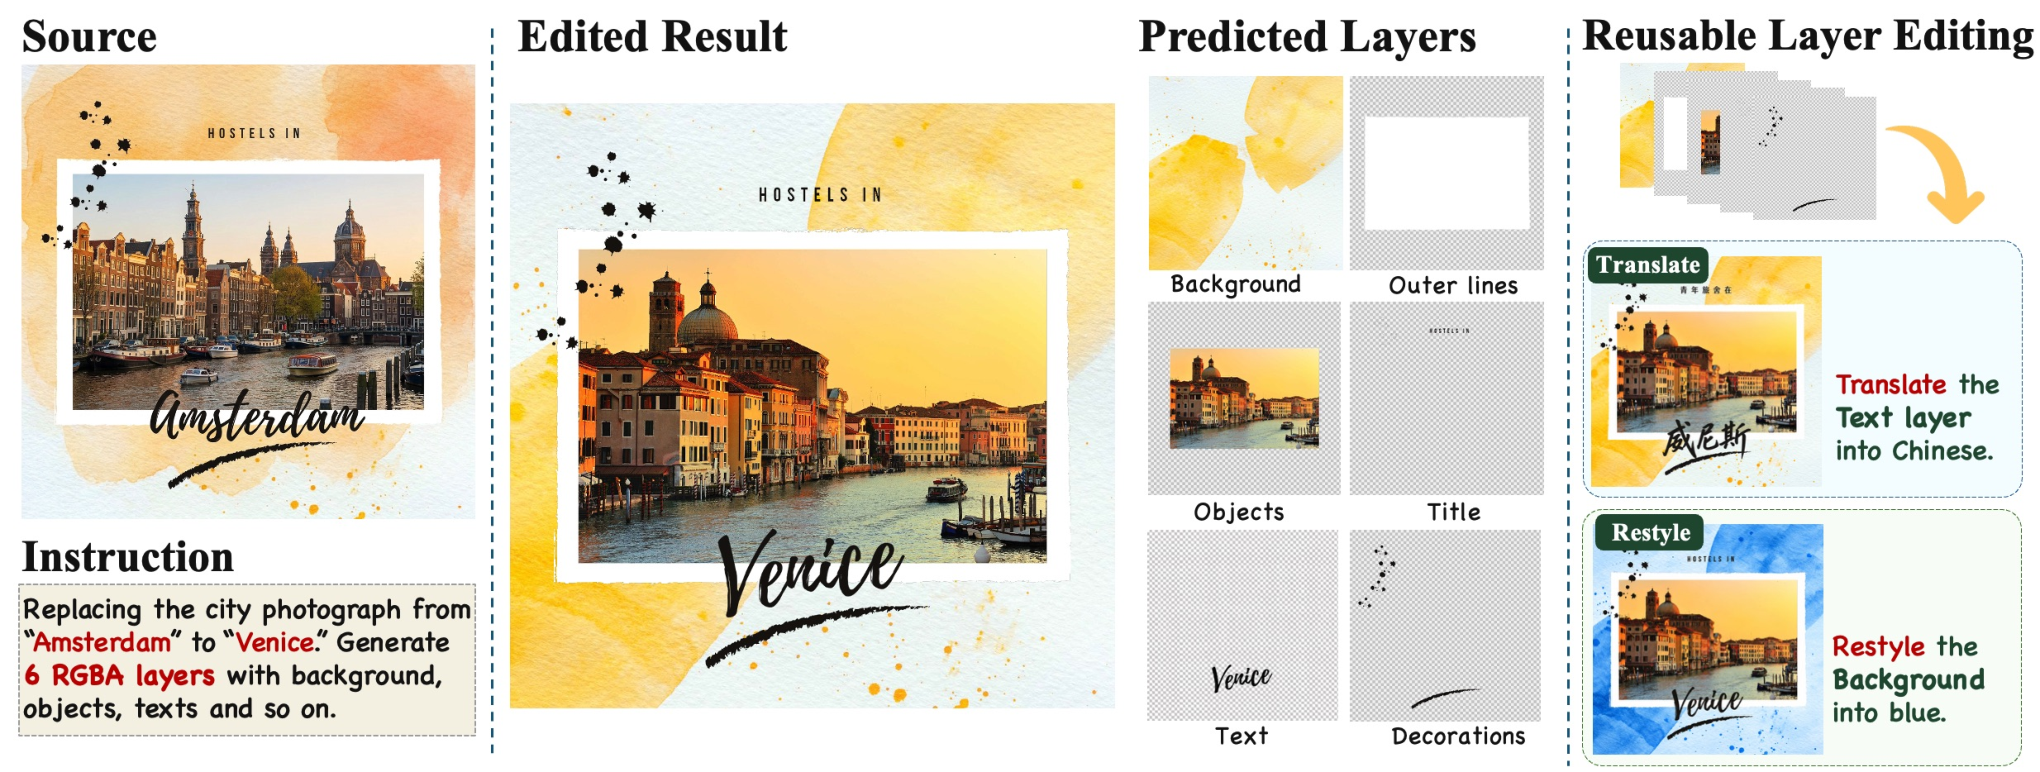
In-Context RGB–Alpha Token Modeling
このモデルはFireRed-Image-Edit-1.1から初期化され、rank-256 LoRAによって適応されています。表現上の重要な選択は、キャンバスとすべてのレイヤーフィールドを単一のdenoisingシーケンスにまとめることです。ノイズレベル \sigma_t において、
Z_t = [z_t^{\mathcal{D}},\, z_t^{R_0}, z_t^{A_0},\, \ldots,\, z_t^{R_{N-1}}, z_t^{A_{N-1}}],
すべてのフィールドはガウスノイズから初期化され、共有 attention のもとで同時にdenoisingされます。フィールドの識別とスタッキング順序は、レイヤー対応のrotary座標 (s, x, y) によってエンコードされます。ソーストークンは s=-1、キャンバスは s=0、レイヤー i はRGBに s=2i+1、Alphaに s=2i+2 が割り当てられます。これにより、単一のアーキテクチャで可変の N をクリーンにサポートしながら、(x, y) を通じてフィールド間の空間的対応を保持します。事前学習済みRGBデコーダから初期化され、不透明度と合成再構成の目的関数で訓練された専用のAlphaデコーダが、連続的な不透明度と半透明境界を処理しつつ、事前学習済みRGBパスウェイを損なわないようにしています。
Compositional Edit-Prior Distillation
事前学習済みエディタをレイヤー出力向けにfine-tuningすると、その編集priorが劣化する傾向があります。C-EPDはこれに対抗するため、凍結された教師モデル(元のエディタ)を用いて、直接予測されるキャンバス \mathcal{D} と、Alphaデコーダを通じて予測レイヤーのalpha-overレンダリングで得られる合成 \mathcal{C} の両方について学習者を監督します。
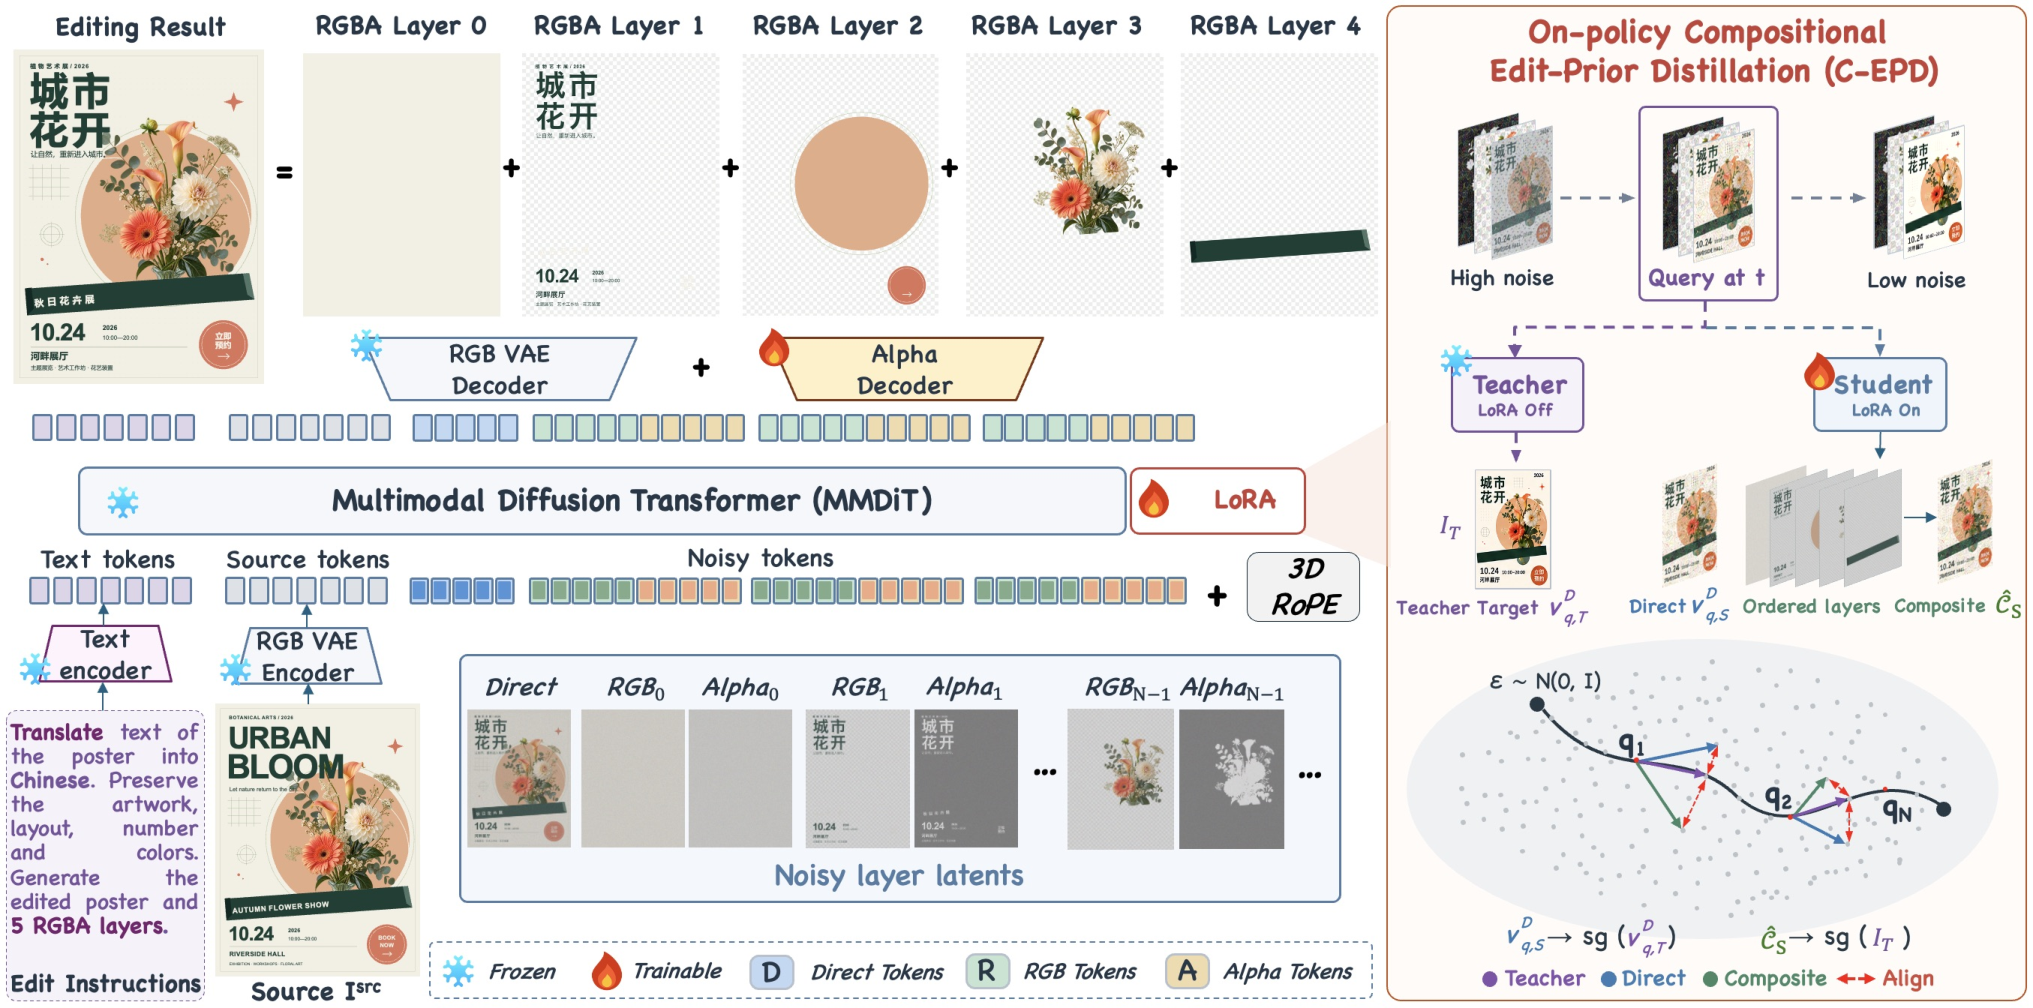
\mathcal{D} だけでなく \mathcal{C} を監督することが、レイヤースタックを編集分布に結びつける鍵となっています。gradientは、教師の編集priorから合成演算子を通じて各 (R_i, A_i) へと流れます。訓練は、flow-matching \mathcal{L}_{\mathrm{flow}} の2エポック後にC-EPDを用いた統合最適化(AdamW、学習率 2 \times 10^{-5}、バッチサイズ64、1024 \times 1024 内でアスペクト比を保持)で行われます。
LayerEditor-100K
訓練データはもう一方の課題です。順序付きRGBAグラウンドトゥルースを持つペア編集データは大規模には存在しませんでした。LayerEditor-100Kは、テキスト、オブジェクト、ポスターレベルの外観編集を網羅した2〜10レイヤーの10万件のペアサンプルを提供します。
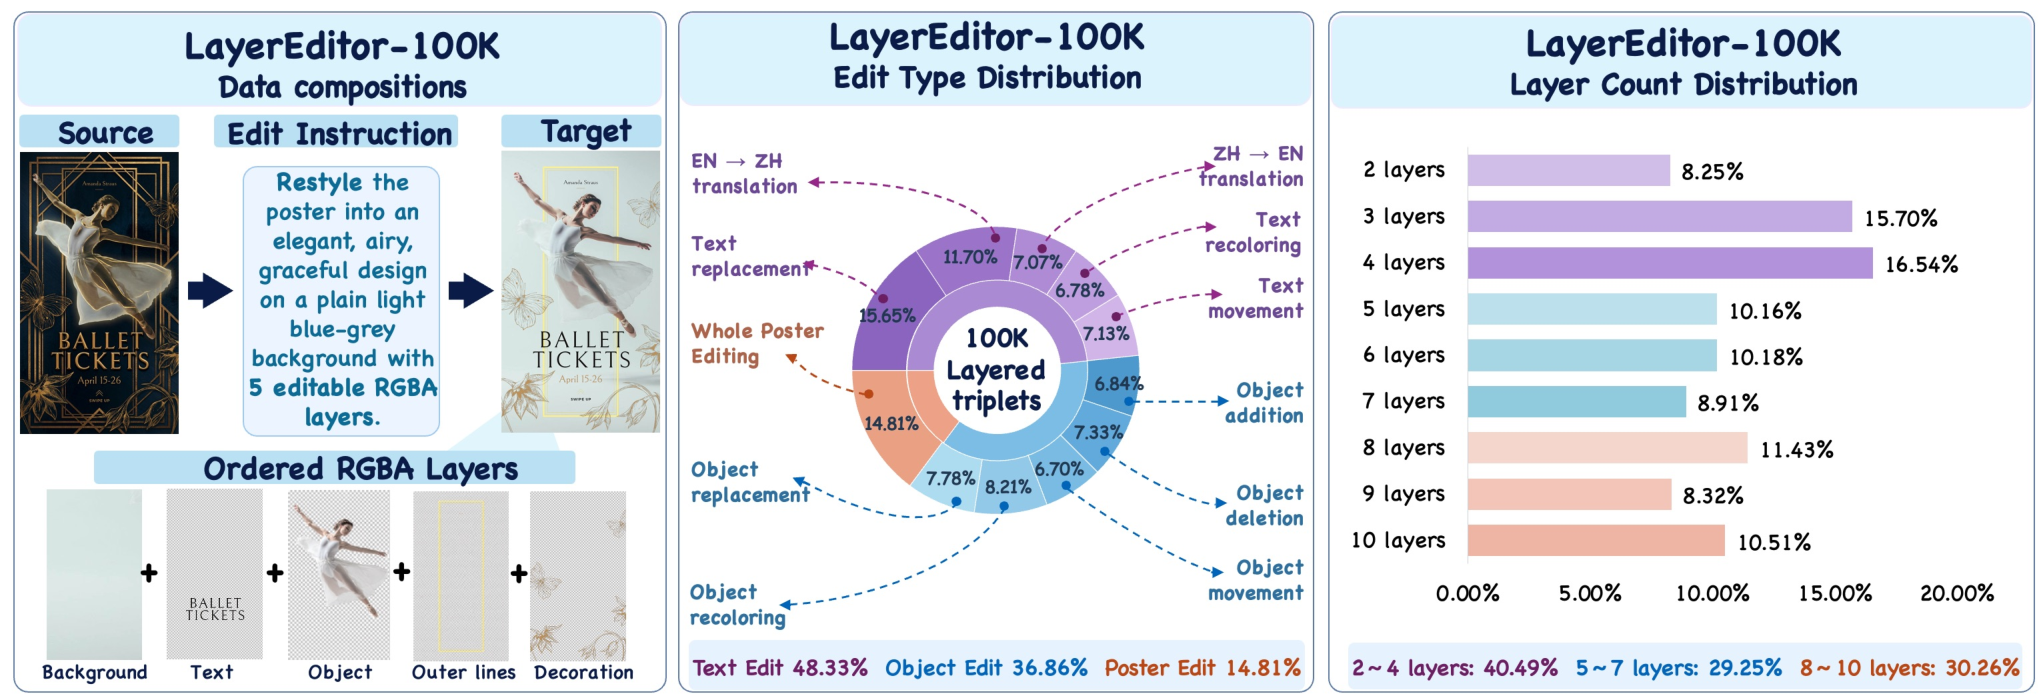
結果
Crello-Testset(2,994ドキュメント)において、LayerEditorはすべての評価項目で優位に立っています。直接キャンバスのSSIMは0.8530(Seedream5-Pro(逐次)は0.8586、QIL-Edit-SFTは0.7404)、FIDは30.15(それぞれ33.04および56.85)です。合成結果ではその差がさらに拡大します。合成SSIMは0.8351(Seedream5-Pro joint: 0.7902、FR+QIL-Decomp-FT: 0.6343)、合成FIDは33.86(それぞれ55.33および57.15)です。レイヤーレベルの忠実度でも同様のパターンが見られます。RGBA L_1 は0.0350(次点はQIL-Edit-SFTの0.0993、Seedream5-Pro jointは0.1344)、Alpha IoUは0.6074(それぞれ0.5139および0.3171)です。ルーブリックスコア(1〜10)も同じ傾向を示しています。Edit Consistency 6.14、Visual Quality 6.35、Layer Segmentation 6.83、Layer Composition 5.64、Alpha Accuracy 5.05であり、いずれも次点の手法を約1ポイント上回っています。
ScaleEdit-Testset(1,000ドキュメント)でもこの結果が再現されています。LayerEditorは合成SSIM 0.8839、合成FID 39.48に達しています(次点の合成FIDはFR+QIL-Decomp-FTの49.37、Seedream5-Pro jointは59.62)。Alpha IoUは0.6802(次点0.6583)です。注目すべきは、QILベースのベースラインがすべてAlpha Accuracy(1.1〜2.2)で崩壊している点です。これはセグメンテーションスコアが合理的であるにもかかわらず起きており、そのalphaチャンネルが真の不透明度ではなくハードマスクに近いことを示唆しています。これはまさに、専用のAlphaデコーダと合成監督が対処する失敗モードです。
限界と未解決の問題
本手法はベースエディタの合成上限を引き継いでいます。C-EPDは事前学習済みpriorを伝播するため、FireRed-Image-Edit-1.1の系統的な失敗モードは継続するはずです。10レイヤーを超えた場合の N に関するスケーリング挙動は報告されておらず、また統合シーケンスは 2N+1 フィールドに成長するため、attention コストはレイヤー数に対して二次的になります。さらに、前後に順序付けられたスタックは明確な奥行き順序を前提としていますが、これは遮蔽する半透明要素に対しては定義が曖昧になります。最後に、合成物に対するルーブリックベースのスコアはLLM/人間に近い評価であり、ハードメトリクスと並べて読む必要があります。
なぜこれが重要か
レイヤー忠実な編集——予測されるRGBAスタックの合成が意図した編集と一致すること——は、生成エディタと実際のデザインツールを結ぶ欠けたリンクです。合成演算子を通じてエディタ自身のpriorを蒸留することは、分解と編集を別々に訓練された分解器と別々に訓練されたエディタが一致することを期待するのではなく、設計上から一貫性を保つ洗練されたアプローチです。
Source: https://arxiv.org/abs/2610.24738
Deep Fusion Memory: LLMのためのチャンクレベルのパラメトリックメモリ
問題
LLMが外部知識を吸収する際、三つ巴のトレードオフに直面します。継続的な事前学習は壊滅的な忘却(catastrophic forgetting)のリスクをもたらし、推論時のretrieval(検索)はレイテンシ、インデックスインフラ、コンテキスト長への圧力を増大させます。そして既存のパラメトリックメモリ手法(例:kNN-LMスタイルの分布、MLP Memory)は、学習ターゲットを構築するためにトークンレベルのオフラインretrievalを必要とし—トークンあたり約1回のretrievalのオーダー—かつ通常はメモリを出力logitレベルでのみ融合するため、メモリが推論に参加できる深さが制限されます。Deep Fusion Memory(DFM)は、構築コストとshallow fusionの制限という両方の問題に取り組みます。
手法
DFMは、バックボーンを凍結したまま jointly に学習される3つのコンポーネントから構成されます:
ターゲットメモリの構築(オフライン)。 学習シーケンスをC=32トークンの非重複チャンクX_0, \ldots, X_{J-1}に分割します。j \geq 1となる各チャンクX_jに対して、直前のチャンクX_{j-1}を凍結されたテキストエンコーダー(Qwen3-Embedding-0.6B)でエンコードし、Wikipediaデータストアから上位K=16の近傍をretrieveするために使用します。それらの凍結されたembeddingをランク順にスタックすることで、ターゲットメモリ V_j \in \mathbb{R}^{K \times d_m} が得られます。重要なのは、retrievalがトークンごとではなくチャンクごとに1回行われる点です:同様のKを使用するトークンレベルのスキームと比較して、クエリ数は32\times、retrievelされるアイテム数は2048\times少なくなります。
因果的メモリ予測器。 学習済みの予測器が、直前のコンテキストのpooled embeddingを予測メモリテンソル\hat V_j \in \mathbb{R}^{K \times d_m}にマッピングし、V_jに対するMSEで教師あり学習されます。ランク順のスロットにより、予測器に安定した割り当てターゲットが与えられます。共有されたprojectorが\hat V_jをデコーダーの隠れ次元にマッピングします。
ゲート付きcross-attention fusion。 選択されたデコーダー層\{9, 16, 24, 31\}(32層のMistral/Qwenバックボーンの場合)において、各トークンの隠れ状態が追加されたcross-attentionモジュールを通じてチャンクのメモリスロットにattendします。ヘッドごとに学習されたゲートが、メモリのattention出力と通常のself-attentionパスをブレンドするため、ヘッドごとにfusionを変調またはオフにすることができます。
joint lossは次トークンのcross-entropyとメモリ予測MSEの和です。追加されたモジュールは7B/8Bバックボーンで合計約0.75Bパラメータ(Qwen3-4Bでは0.6B)であり、LoRAベースラインはこのバジェットに合わせて調整されています。学習はAdamW(1\times 10^{-5})、2048トークンシーケンス、グローバルバッチ128、Wikipediaの40億トークンで1エポック使用します。推論時はretrievalを行わず:予測器が実行中のコンテキストからメモリを生成します。
結果
Mistral-7B-v0.3を用いた6つのQAベンチマークにおいて、DFMはベースラインを大幅に上回る平均スコアを達成しています:NQ 33.57、WebQA 42.47、HotpotQA 29.x(テーブルは省略)。一方、ベースモデルは平均13.63、RAGは23.41、xRAGは24.14、RETROは13.73(ベースからほぼ改善なし)、CPTは13.48(ベース比−0.15、完全パラメータの継続的事前学習における忘却を確認)、LoRAは15.47、そして最強のパラメトリックベースラインであるMLP Memoryは22.09でした。22.09(MLP Memory、出力レベル補間)からDFMの報告スコアへの飛躍は、同一コーパスを使用した場合でも、メモリを中間隠れ状態にfusionすることがshallowな出力レベルのfusionを上回るという論文の中心的な主張を支持しています。DFMはまた、推論時のretrievalを一切行わずにRAGおよびxRAGに匹敵するかそれを上回るスコアを達成しています。
第5節のablation studyは設計の頑健性について有益な知見を示しています:
- チャンクサイズ。 C \in \{16, 32, 64\}に対する平均はそれぞれ26.51 / 27.21 / 27.07です。64に倍増するとretrievalクエリが半減しコストは0.14ポイントですが、16に半減してもクエリが倍増するだけで改善はありません。
- Fusionの配置。 4つのfusion層を中間から深い層[9,16,24,31]に分散配置すると27.21となる一方、最終層に集中させると21.11、最後の4層[28,29,30,31]に集中させると22.07となります。分散配置の[2,10,21,31]は26.32(デフォルト比0.89低下)となっており、非常に浅い層は有効な挿入点ではないが中〜深い層は有効であることが示唆されます。4、6、8つのfusion層は0.13ポイント以内の差であり、4つが合理的なデフォルトと言えます。
- メモリスロット。 K \in \{2,4,8,16\}はそれぞれ26.88 / 27.04 / 27.09 / 27.21を示します。Top-2はTop-16と0.33以内の差であり、メモリのボトルネックは非常に狭く、cross-attentionにおける小さなKによる計算削減はほぼ無コストであることを示しています。
Qwen3-4B/8B-Baseを用いたドメイン適応(Code、Math、Law)では、DFMをSwallow-Code、Swallow-Math、DISC-Law-SFTに対するドメインごとのアダプターとして使用し、HumanEval/HumanEval+、GSM8K、LawBenchで評価しています。論文は凍結バックボーンを保持しながら改善を報告しています(具体的な数値は論文の第4.3節に記載)。
制限と未解決の問題
- ターゲットメモリは凍結された上位Kのretrievelされたembeddingのバッグであり、予測品質はretrieverとエンコーダーによって上限が決まります。MSE目的関数はスロットをランク順の集合として扱いますが、明示的なアライメントlossは存在せず、論文では予測誤差が下流の精度とどのように相関するかを報告していません。
- すべての実験はタスクごとに単一のコーパスに適応しており、コーパスの更新時のDFMの挙動は不明です(データストアが変化した場合、推論時のretrievalがないため予測器を再学習する必要があります)。
- 追加パラメータのオーバーヘッドは無視できないレベルです—7〜8Bモデルで0.75B、約10%の拡張—そのため、より大量の学習(1エポックだけではない)を伴う計算量を合わせたLoRAとの比較がより明確な根拠を提供するでしょう。
- 中間から深い層へのfusionを伴うC=32のみが真剣に検討されており、長いコンテキスト(>2048)やストリーミング推論との相互作用は評価されていません。
この研究の意義
DFMは、ゲート付きcross-attentionを通じて隠れ状態にfusionされるチャンクレベルのパラメトリックメモリが、推論時のRAGと出力レベルのパラメトリックメモリの両方を上回りながら、オフラインretriievalコストを桁違いに削減できること(32\timesクエリ削減、2048\timesアイテム削減)を示しています。これにより「メモリ」の概念が、出力logit補間のトリックから、transformerが実際に推論できる内部表現へと再定義されます。
Source: https://arxiv.org/abs/2610.25100
LaLa-World: 自然言語アクションによる潜在世界モデルのスケーリング
問題設定
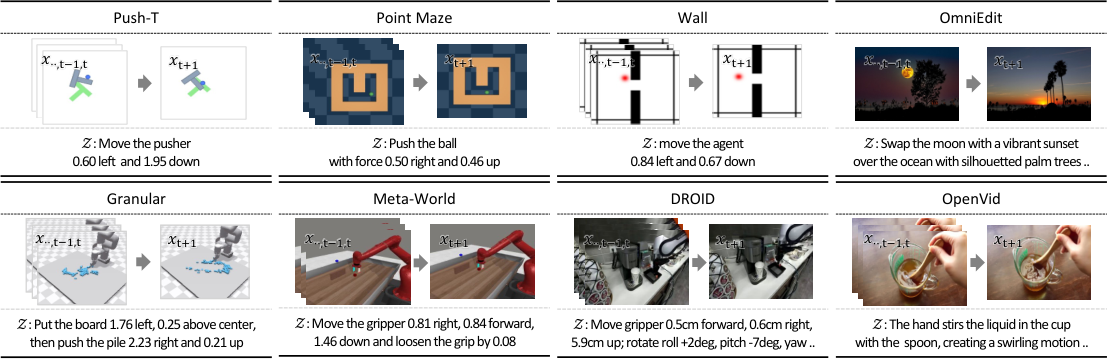
JEPAファミリーに属する潜在世界モデル(LWM)——DINO-WM、JEPA-WM、および関連研究——は、数値アクションベクトル c_t を条件として、過去のembeddingから将来のembeddingを予測します。アクション空間は次元数と物理的な意味がロボットやシミュレータによって異なるため、各ドメインには通常独自のpredictorが必要となり、数値アクションを持たない一般の動画・画像データを統合することができません。この断片化はスケーリングを妨げています。一方、動画生成モデルは逆の状況にあります:共有された言語条件付きインターフェースを通じて異種データで学習されますが、ピクセル空間で動作するため計算コストが高くなります。LaLa-Worldは、JEPA流の潜在predictorが動画生成モデルの言語条件付きインターフェースを継承できるかどうかを問います。これにより、ロボット制御データ、シミュレーションデータ、および一般的な動画を統合して学習する単一のpredictorの実現を目指します。
手法
設計は2つのコンポーネントからなります。第1は、データ統合ステップです:シミュレーションおよびロボットデータセット内の各遷移 (x_t, c_t, x_{t+1}) を、元の数値アクション(例:エンドエフェクタのデルタ、関節コマンド)の方向と大きさを保持した言語条件 z_t にテンプレートを用いて書き換えます。アクションを持たない画像・動画データについては、z_t がフレーム間の視覚的変化を記述します。これにより、7つの制御データセット(Wall、PointMaze、Push-T、MetaWorld、Rope、Granular、DROID)に加えて画像・動画コーパスにわたる単一の (x_{<t}, z_t, x_{t+1}) フォーマットが得られます。
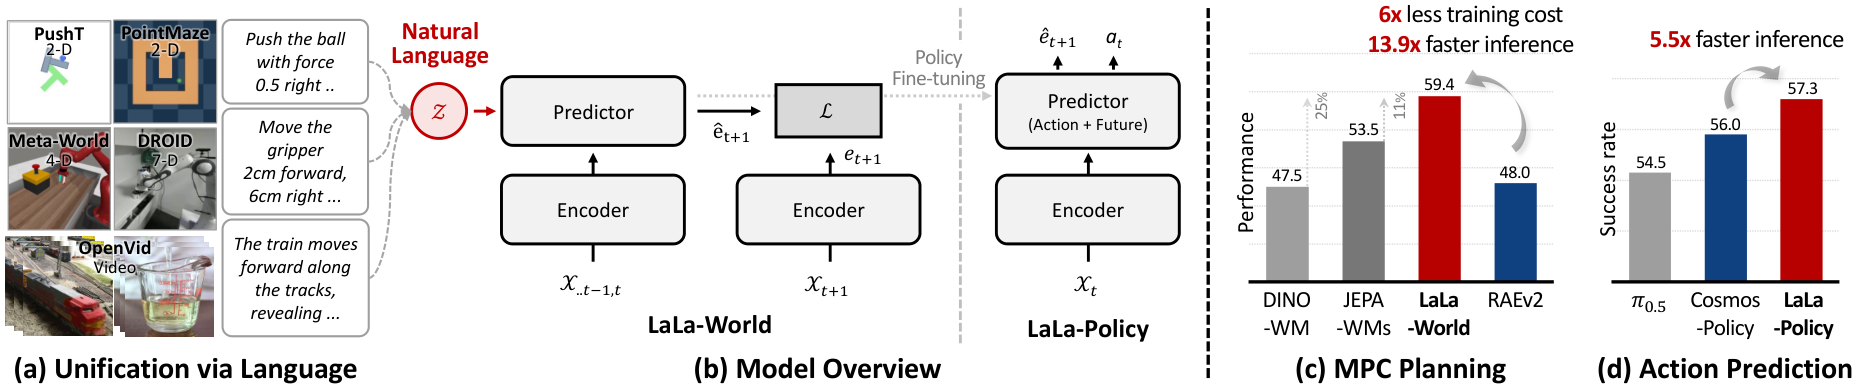
第2に、predictor P_\phi は言語モデルのバックボーン上に構築されており、符号化された過去の観測 E_\theta(x_{<t}) とトークン化された言語条件 z_t を入力として受け取り、次の潜在表現 \hat e_{t+1} を予測します。学習には標準的なJEPA目的関数——表現空間において符号化された将来 E_\theta(x_{t+1}) に回帰する——を使用しますが、アクション信号として数値ベクトルの代わりに言語を用います。バックボーンがLMであるため、可変形式・可変ドメインの条件を自然に扱え、アクションのフレーズとして見たことのない記述を解釈するための言語事前学習の恩恵を受けます。
プランニング
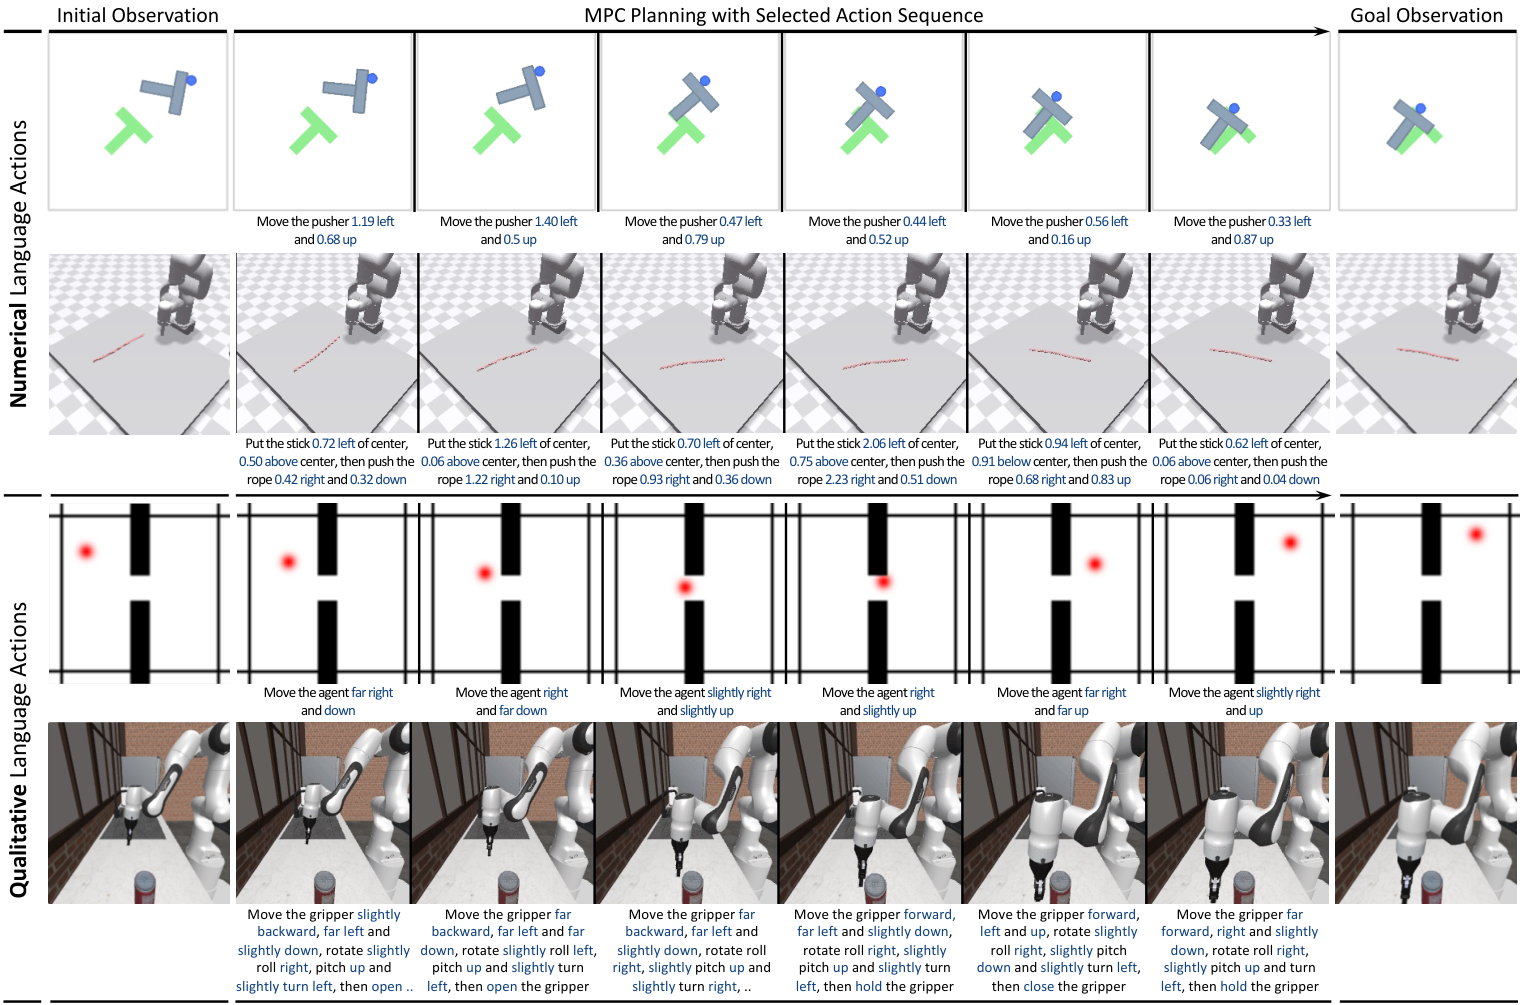
MPCのために著者らはCEMを言語化されたアクション候補に対して適用します。各候補アクション系列は学習テンプレートを通じて言語に変換され、潜在空間で H ステップ展開され、以下によってスコアリングされます:
\mathcal{C} = \|\hat e_{t+H} - e_{\mathrm{goal}}\|^2, \quad e_{\mathrm{goal}} = E_\theta(x_{\mathrm{goal}}).
CEMはサンプリング分布をコストが最小の系列に合わせて更新し、テンプレートから復元された選択済み数値アクションが実行され、ループが繰り返されます。インターフェースが共有されているため、単一のpredictorがドメインごとのヘッドなしに7つのドメイン全体でプランニングを行います。
Policy fine-tuning
LaLa-PolicyはCosmos Policyのレシピに従って事前学習済みpredictorを適応させます。学習可能なアクションクエリが潜在予測クエリとともに P_\phi に追加されます。タスク指示 \ell を持つ (x_t, \ell) が与えられると、predictorは将来の潜在予測と、diffusion-transformerアクションヘッド A_\psi(Isaac-GR00Tのアーキテクチャ)を駆動する条件付け特徴系列 h_{t:t+N-1} を出力します:
(\hat e_{t+N}, h_{t:t+N-1}) = P_\phi(E_\theta(x_t), \ell), \hat a_{t:t+N-1} = A_\psi(\epsilon; h_{t:t+N-1}), \quad \epsilon \sim \mathcal{N}(0, I).
diffusionヘッドは実行可能なアクションチャンクにわたる多峰性を保持します。
結果
7つの制御ベンチマークにわたって、単一の統合LaLa-World predictorは、同じデータで各ドメインごとに学習されたDINO-WM、JEPA-WM、および再実装されたIRIS、DreamerV3、TD-MPC2世界モデルよりも高い平均MPCプランニング性能を達成します(報酬なし、固有受容感覚なし)。制御データの混合に画像・動画データを追加することで、平均プランニング性能がさらに向上し——重要なことに——言い換えられたアクション記述に対するロバスト性も向上します。これは、LMバックボーンがテンプレートを暗記するのではなく、実際に条件を解釈していることを示唆しています。また、学習から除外されたRoboCasaへのゼロショット転移も達成しています。
RAEv2上に構築された動画生成ベースライン(同じデータ、同じプランニングプロトコル)との比較において、LaLa-Worldはおよそ 6\times 少ない計算コストで同等のプランニング性能に達しており、これは言語インターフェースを採用しながら潜在空間に留まることの主な効率性の根拠となっています。
限界とオープンな問題
本論文の定量的な主張は、二乗潜在距離コストを用いたCEM-MPCに依存しており、エンコーダ E_\theta が崩壊した場合やゴールが視覚的に明確に指定されていない場合に脆弱になり得ます。CEM中にアクション候補を言語化することでトークン化のオーバーヘッドが生じ、潜在空間での効率性の利点を部分的に相殺します;RAEv2ベースラインとの正確なプランニング時コストの内訳があれば、この点が明確になるでしょう。テンプレートベースのアクション言語化もまた「言語」を狭い統語的分布に制限しており、言い回しに対するロバスト性の主張は敵対的な言い換えに対してストレステストされるべきです。最後に、言語条件の多様性と動画データ量の関数としてのLMバックボーンpredictorのスケーリング挙動はここでは特性評価されていません。
なぜこれが重要か
単一のJEPA流の潜在predictorが言語インターフェースを通じて異種のロボット・シミュレーション・動画データを統合しながら、動画生成モデルの計算コストの何分の一かでドメインごとのLWMをMPCにおいて上回ることができるならば、世界モデルのスケーリングはもはやピクセル空間での生成もエンボディメントごとのアクションヘッドも必要としません。これにより、プランニングとpolicyの初期化の両方に使用可能な汎用潜在世界モデルの構築における主要な2つの障壁が取り除かれます。
Source: https://arxiv.org/abs/2610.27851
Meta Expert: ストレージおよび検索効率に優れたMoEのための Cross-Layer Expert Sharing
問題設定
標準的なMoE transformerは、層ごとに独立してexpertプールをインスタンス化します。経験的に、層をまたいだexpertは重複した機能に収束することが知られており、パラメータ予算の無視できない割合が、異なる深さで同じ変換を再学習することに費やされています。MoEのスケーリングがパラメータ総数(ストレージおよびexpertサーバーにおけるall-reduce/検索コスト)によってボトルネックになっていることを考えると、この冗長性はコストが高いと言えます。本論文は次の問いを立てます:expertをすべての層で共有できるか、そしてそうすることで情報密度と学習ダイナミクスが改善されるか?
手法
アーキテクチャ上の対比は、一行の変更に集約されます。通常の「Local Expert」MoEの層 l では、層専用のrouter R_l とexpertの集合 \{\phi_e(\cdot;\theta_l^e)\}_{e=0}^{N-1} が以下を計算します:
y_l = \sum_{e\in\mathrm{topk}(R_l,\hat{x}_l)} R_l(\hat{x}_l)_e\,\phi_e(\hat{x}_l;\theta_l^e).
「Meta Expert」変種では、単一のrouter R と単一のプール \{\phi_e(\cdot;\theta^e)\}_{e=0}^{M-1} がすべての層にわたって共有されます:
y_l = \sum_{e\in\mathrm{topk}(R,\hat{x}_l)} R(\hat{x}_l)_e\,\phi_e(\hat{x}_l;\theta^e).
本論文では、ハイブリッド化の2つの軸を探索します。定量的な軸では、FLOPsを等しくするためにexpert総数とtop-k activationの予算を固定した上で、Meta expertとLocal expertの比率を変えます。トポロジーの軸では、(a) すべての層がMeta expertとLocal expertの両方を持つかどうか、および (b) Metaプール自体が階層的に構成されているか(すなわち、サブプールを共有する層のバンド)、それとも単一のグローバルプールであるかを変えます。スイープは2B-A0.5Bのベースモデルで実行され、最良の設定がスケーリングラダーの比較に採用されます。このとき、ベースラインはshared expertに最適化されたものではなく、学習に最適化されたVanilla MoEのレシピを使用します(提案手法にとって保守的な選択です)。
診断のために、クロスエントロピーおよびダウンストリームの精度に加えて、著者らは学習済みexpert間の機能的な重複を測定するexpert冗長性メトリクスを定義しています。これにより、lossの低下が真の容量の向上によるものか、単なる再パラメータ化によるものかを切り分けることができます。
Residual-pathway分析
セクション4では、パラメータの重複排除を超えてsharing が有効である理由についてのメカニズム的な議論が展開されます。residualの更新を以下のように記述すると、
x_{l+1} = x_l + \gamma\, E_{\theta_l}(\hat{x}_l; R_l),
著者らはLocal MoEにおける非対称性を指摘します:forward passは層を通じて厳密に因果的であり(層 l によって書き込まれた内容は層 m > l によってのみ読み取れる)、さらに層 m の読み取り演算子 (E_{\theta_m}, R_m) は層 l の書き込み演算子 (E_{\theta_l}, R_l) と異なるため、層 l の寄与は「固定された」成分であり、アドレス指定可能なものではありません。backward passでは、identity residual branchが単位ゲインで深い層から \theta_l への勾配を届けますが、このシグナルはパラメータレベルで届き、層 l 専用のパラメータにのみ到達し、すべての中間層の学習シグナルによって m-l ホップにわたって希釈されます。
Meta Expertはこの非対称性を解消します:\theta と R が共有されているため、書き込み演算子と読み取り演算子がすべての層にわたって一致し、任意の層でresidual streamに書き込まれた内容は、同じexpertインデックスによってすべての他の層で直接アドレス指定可能になります。本論文はこれを双方向のresidual pathwayとして捉えています:浅い層は、深い層が書き込みに利用するのと同じexpertから機能的に「読み取る」ことができ、forward pass(パラメータが共有されているため、浅い層 l のトークンは深い層が依存する変換と同じものを見る)および学習時(深い層からの勾配が孤立した非希釈の寄与として共有 \theta に蓄積される)の両方においてそれが実現します。
結果
expert総数およびactivated-expertの数を固定した状態で、Meta Expertの設定はVanilla MoEに対してexpertをわずか70〜80%使用するだけで同等の性能を達成します。同等に表現すれば、expert数を揃えた場合、Meta Expertの変種はより低いクロスエントロピーとより高いダウンストリームタスク精度を達成します。冗長性メトリクスは、Meta Expertモデルが学習済みexpert関数間の重複が体系的に低いことを示しており、層専用のプールが同じマッピングを複数回学習することで容量を無駄にするという仮説と一致しています。これらの傾向はスケーリングラダー全体にわたって持続し、ベースラインはそれぞれの学習に最適な設定を維持しています。
限界と未解決の問題
- 70〜80%という主要な数値は、expert総数とactivated数を固定した条件下で成立しており、FLOPsは固定されますが、必ずしもall-to-allのトラフィックパターンを固定するわけではありません。本論文はスケール時のwall-clockや専門家並列(EP)通信コストを完全には報告していません。
- 共有プール上の単一グローバルrouterはルーティング負荷を集中させます。ロードバランシングのダイナミクス、トークンドロップの挙動、および長い学習期間にわたるrouterの安定性については、示されているセクションでは特徴づけられていません。
- ハイブリッドのMeta+Localトポロジーがスイープの中で最良の経験的設定となっていることは、純粋なMeta sharingが層ごとの特化の一部を失う可能性を示唆しています。sharingと特化の間のトレードオフ曲線はまだ閉じた形式には至っていません。
- residual-pathwayの議論は定性的なものです。「アドレス指定可能性」の定量的な測定(例えば、層をまたいだexpert出力への因果的介入)が、loss/精度の代理指標を超えて主張を強化するでしょう。
なぜ重要か
Cross-layer expert sharingは、ストレージの削減、分散推論におけるexpert検索のサーフェスエリアの削減、そしてパラメータあたりのlossの改善を同時に達成するという、数少ないMoEの改良の一つです。これは、ほとんどの容量削減が品質とのトレードオフを伴う設計空間において稀なPareto改善です。70〜80%のexpert削減という結果がフロンティアスケールでも成立するならば、expert並列推論システムがどのようにプロビジョニングされるかに直接影響します。
Source: https://arxiv.org/abs/2610.27598
Self-Distilling Future Video Representations for World Action Models
問題設定
World Action Models(WAMs)は、事前学習済みのビデオ拡散モデル(VDMs)をロボットポリシーの時空間事前分布として再利用するアーキテクチャです。このアーキテクチャの効率的な変形——DiT4DiT、Fast-WAM、AGRAが採用——は、推論時の反復的なdenoisingを回避するため、\tau_v = 1(純粋なガウスノイズ)における単一のdenoisingステップから中間隠れ状態\mathbf{h}を抽出し、それを別の拡散action decoder \pi_\phi(\mathbf{a}_t^{\tau_a}\mid \mathbf{q}_t, \mathbf{h})に供給します。ここで\mathbf{h}の質——収束したdenoising軌跡からではなく、ノイズから生成される表現——がボトルネックとなります。本論文が問うのは次の点です:VDMをどのように学習すれば、one-shotの\mathbf{h}が多ステップdenoisingされた特徴と同等の構造を持てるか?
手法:FRED
著者らは、VDMの前半層\mathbf{f}_\thetaを未来表現生成器として再解釈します:
\mathbf{h} = \mathbf{f}_\theta(\bm{\epsilon} \mid \mathbf{o}_t, \mathbf{c}),\quad \bm{\epsilon}\sim\mathcal{N}(\mathbf{0}, \mathbf{I}).
FREDは、固定された低ノイズレベル(\tau = 0.25)でノイズを付与した正解未来フレームに対して同一backboneが計算する教師表現\mathbf{h}^\tauを用いたself-distillationによって\mathbf{h}を学習します。教師はstudentのmomentum EMAであり、inverse-decay warmupを採用しています。過去4フレームと現在フレームからなる履歴観測がcontextとして連結されており、これにより純粋なノイズ入力では得られない時間的事前情報がstudentに与えられます。
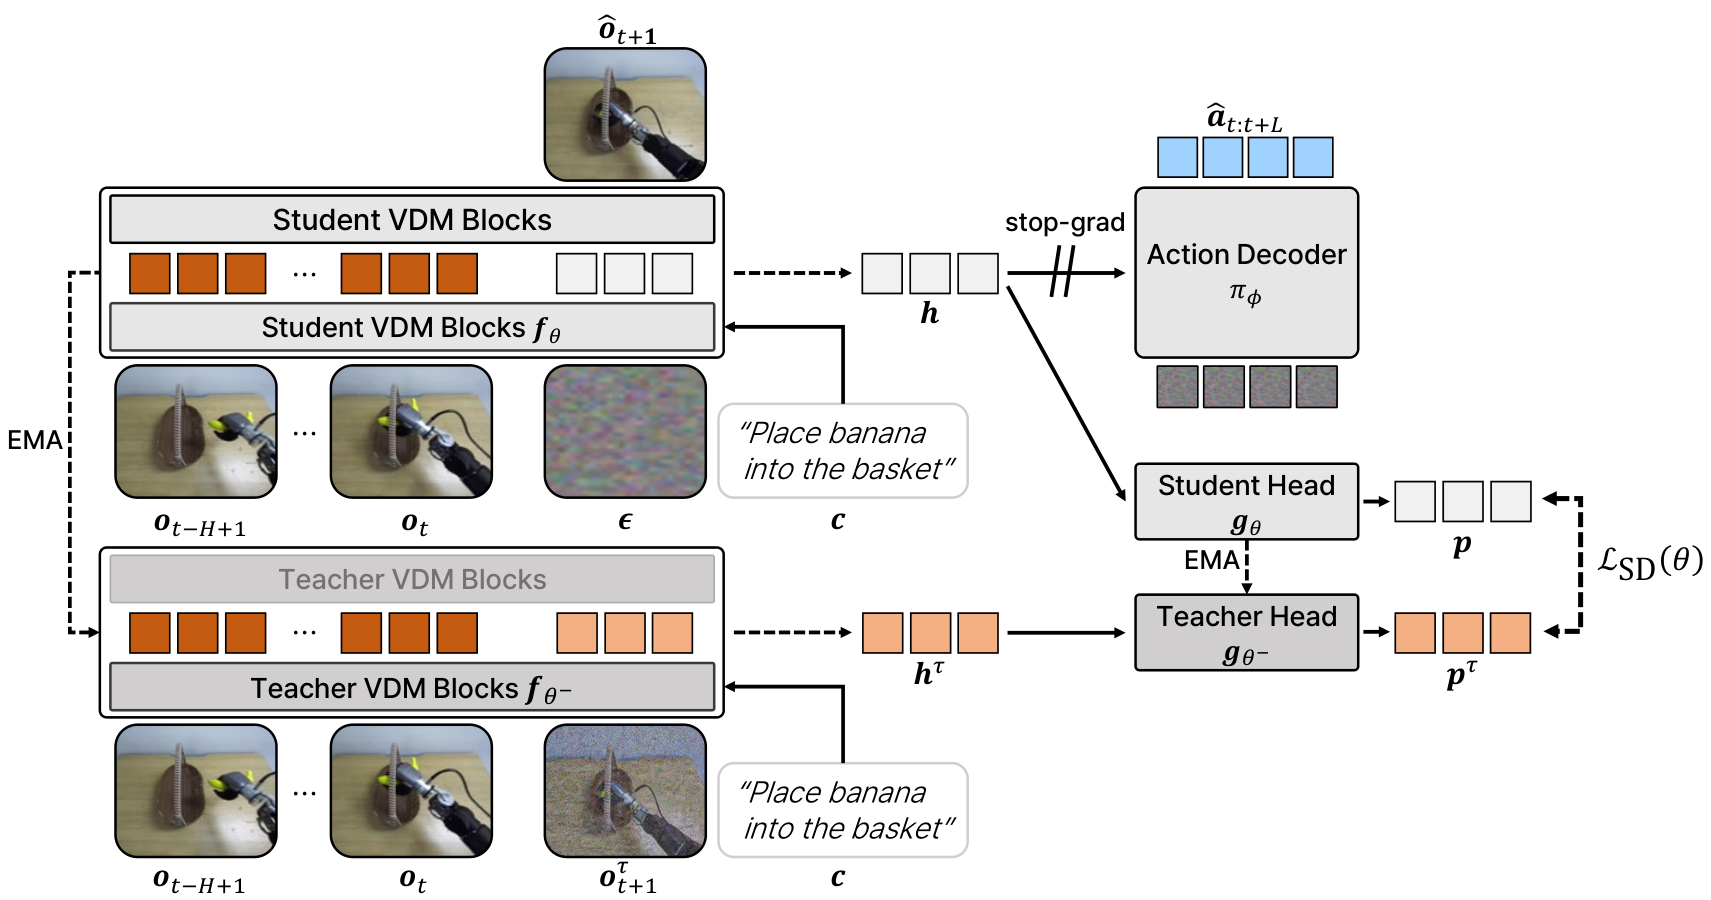
具体的には、VDMの単一transformer層——Wan2.2-TI2V-5Bでは19層中第18層、Wan2.1-I2V-14Bでは25層中第24層——から特徴を取り出し、action decoderの条件付けとself-distillationターゲットの両方に使用します。self-distillation lossは重み\lambda_{\mathrm{SD}} = 0.01で標準的なWAM目的関数に加算されます:
\mathcal{L} = \mathcal{L}_{\text{VDM}} + \mathcal{L}_{\pi} + \lambda_{\mathrm{SD}}\,\lVert \mathbf{h} - \text{sg}(\mathbf{h}^\tau)\rVert^2.
action decoderは、5Bスケールでは16層のDiT、14Bスケールでは24層のDiTです。L>1の未来アクションと未来観測の両方がWAMフレームワーク内で共同予測されます。
ablationによって検証された重要な設計上の選択肢は以下の通りです:
- 教師入力は固定\tau = 0.25でノイズを付与した未来観測であり、クリーンなフレームではありません。クリーンフレームをターゲットにすると、純粋なノイズから出発するstudentがそこに到達できないため、転移性能が低下します。
- 履歴観測によるconditioning——現在観測に複数の過去フレームを積み重ねること——により、ノイズから未来へのmappingが安定します。
- 層の選択——最終層の直前のtransformer層がaction decodingに最も強い予測シグナルを持ちます。
結果
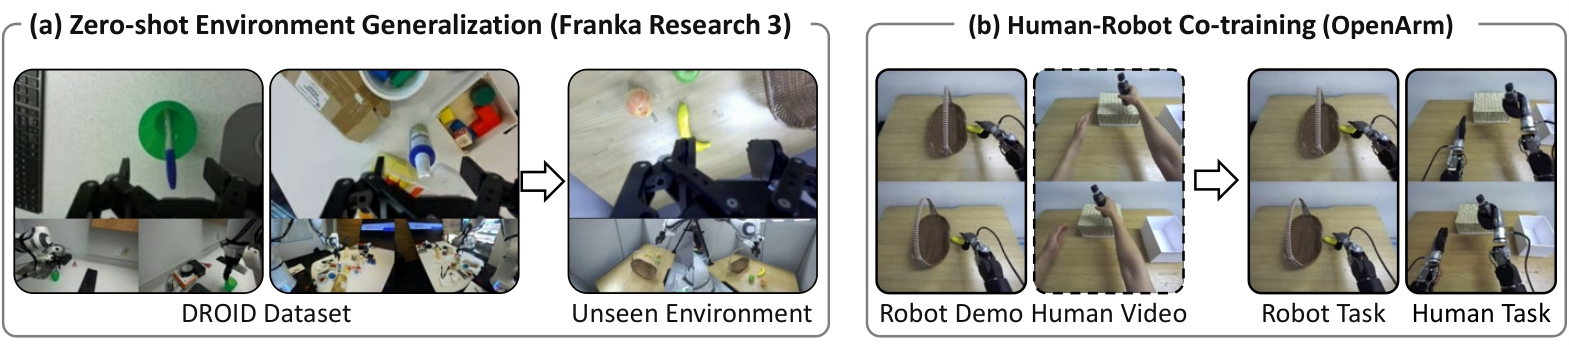
実験は2つの設定(Figure 3参照)にまたがります:DROIDで学習したゼロショット環境汎化と、人間-ロボット共同学習です。DROIDの評価には、Robotiq 2F-85グリッパーと3台のカメラを備えたFranka Research 3が使用されています。
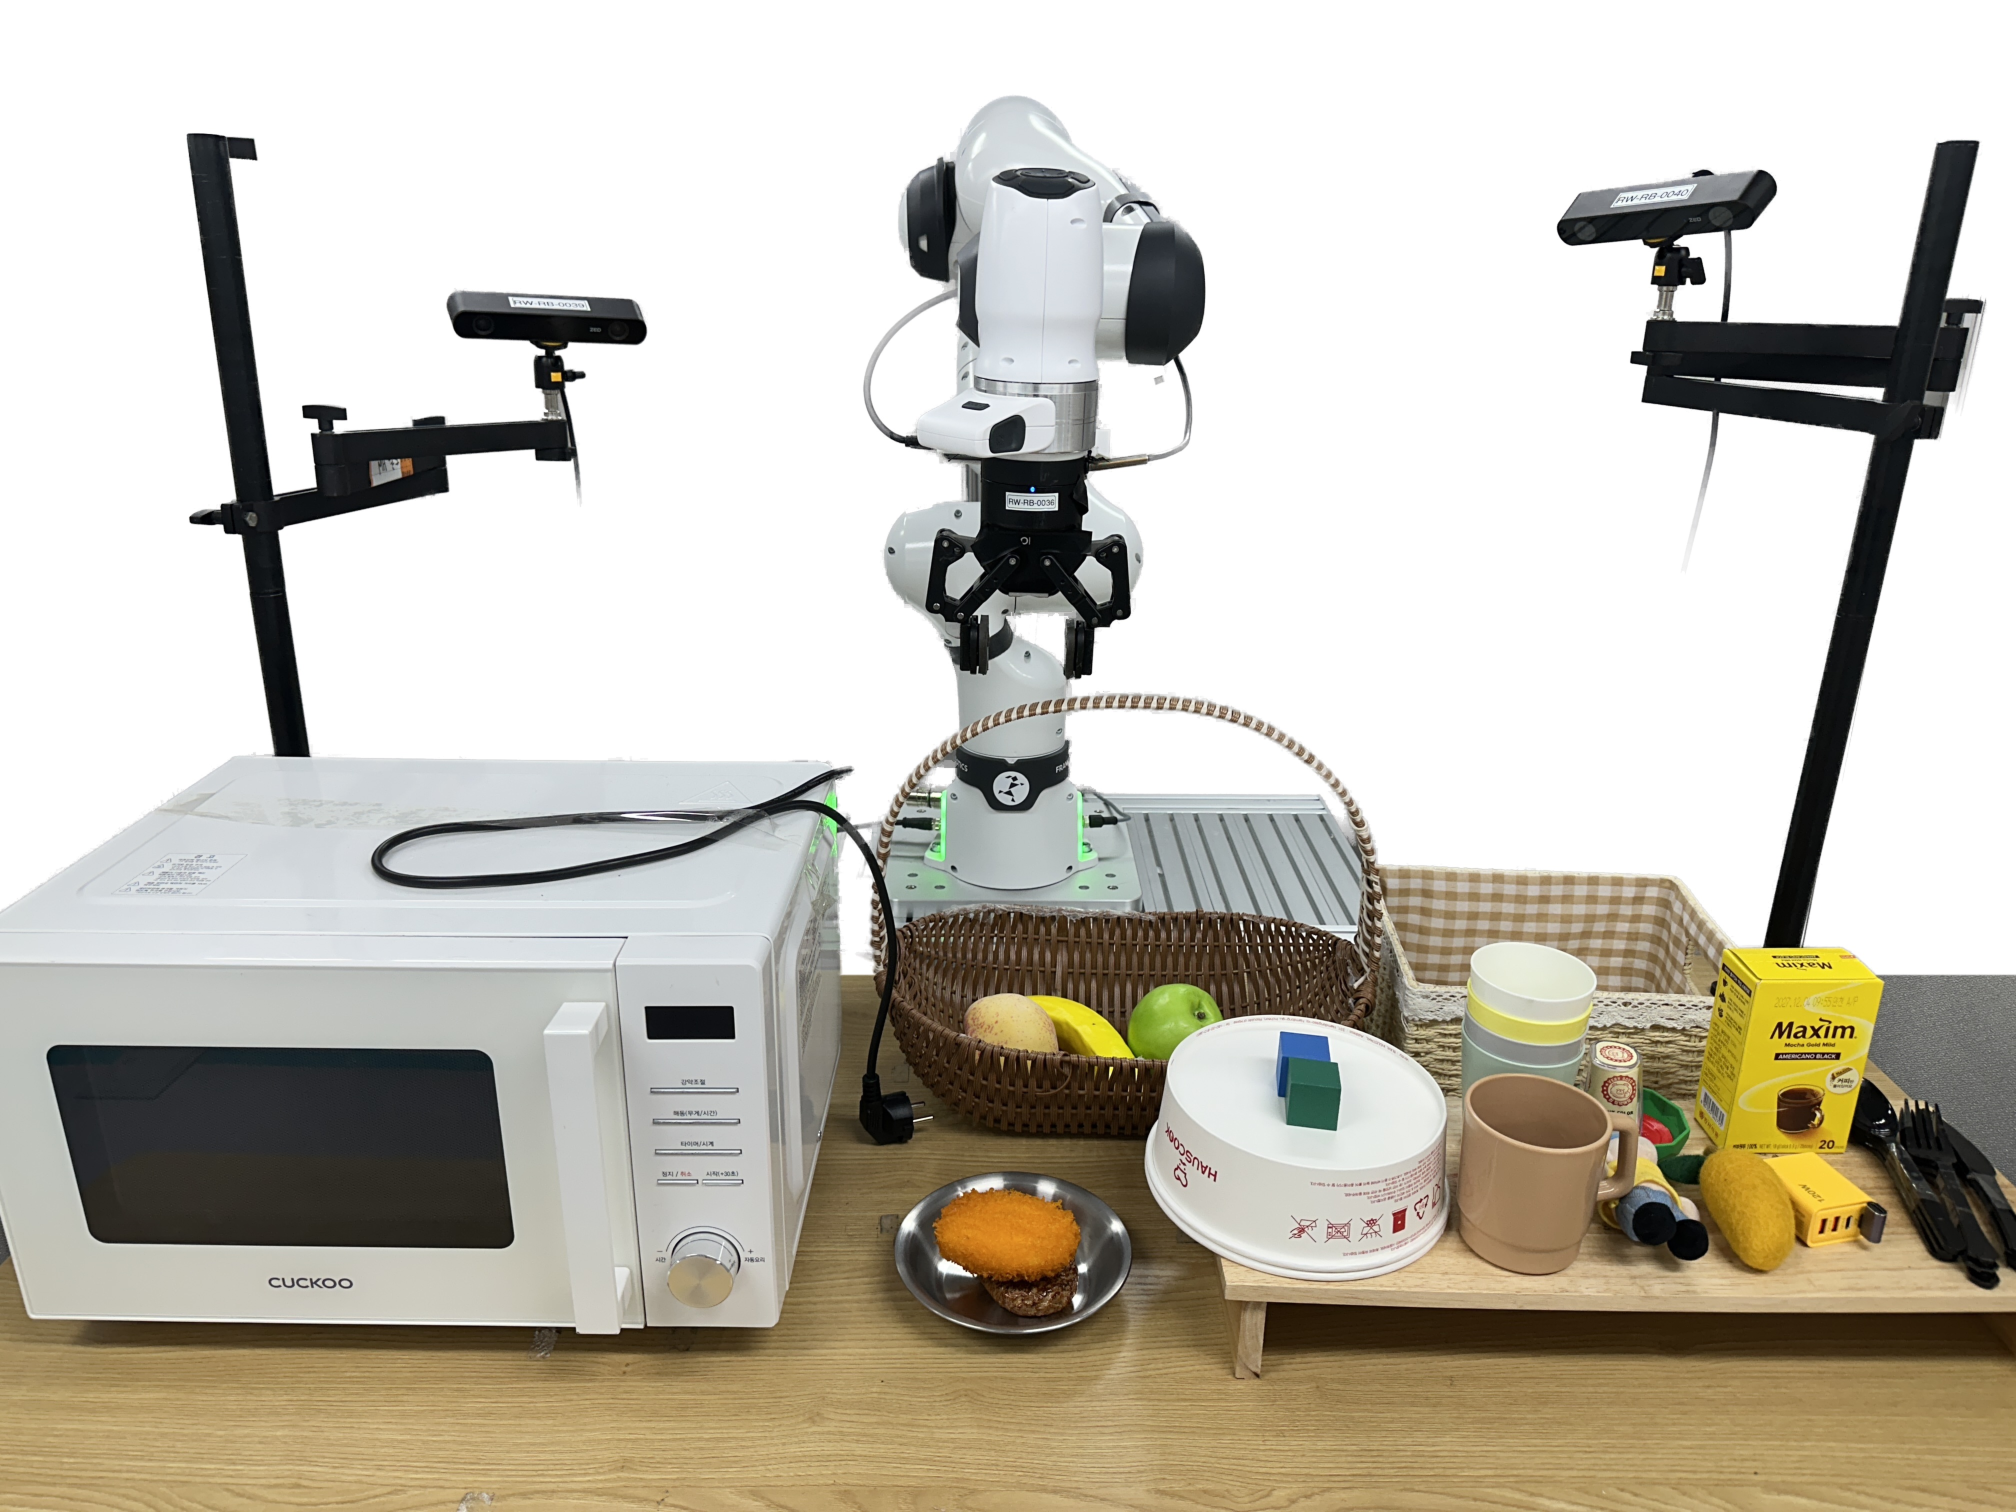
ベースラインには、single-step WAMs(DiT4DiT、Fast-WAM、AGRA)、multi-step WAMのDreamZero、VLAベースラインの\pi_{0.5}とGR00T N1.7が含まれます。多様な実世界のマニピュレーションタスクにわたって、FREDは5Bおよび14B backboneの両スケールで全競合手法を一貫して上回ります。さらに本論文では、\mathbf{h}の表現品質指標(論文中Table 4、Figure 4)と下流成功率の間に正の相関があることを報告しており、one-shotの\mathbf{h}を改善することが正しいアプローチであるという中心的な仮説を支持しています。人間動画との共同学習では測定可能な人間-ロボット間のスキル転移が得られ、FREDはベースラインWAMsよりも大きな恩恵を受けており——self-distillationされた\mathbf{h}が身体に依存しない視覚的事前情報をより良く吸収するという見方と整合しています。
限界と未解決の問題
- 特徴抽出層はbackboneごとに選択されるハイパーパラメータであり、本論文は原理的な選択規則を導出していません。最適な層はモデルスケールやドメインによって変化する可能性があります。
- 教師のノイズレベル\tau = 0.25は固定されており、\tauに関するカリキュラム(\tau_v = 1のstudentから低\tauの教師へのブリッジング)は未探索であり、distillationのギャップを縮められる可能性があります。
- self-distillationは同一backboneのEMA教師を使用しており、表現崩壊リスクの分析も、\lambda_{\mathrm{SD}}を大きくした際にVDMの生成lossだけで自明な解を防ぐのに十分かどうかの分析もなされていません。
- action decoderはビデオブランチに対してsingle-step denoisingの凍結されたアーキテクチャ上の仮定に依然として依存しており、FRED学習済みの\mathbf{h}に対して数ステップの追加denoisingを行うことでDreamZero型のmulti-step WAMsとのギャップがさらに縮まるかどうかは定量化されていません。
- 評価は実世界で行われており、各テーブルのタスク数は比較的少ないため、より広範なシミュレーション実験によって表現品質の向上とpolicy decoderの向上を切り分けることが有益でしょう。
重要性
FREDはWAMsにおける効率性と品質のトレードオフを表現学習問題として再定式化します:denoisingステップを追加する代わりに、ノイズを付与した未来観測に対するself-distillationによって、one-shot特徴が多ステップ特徴と同様に振る舞うよう学習させます。その結果、推論コストを変えることなく、支配的なdecoupled WAMアーキテクチャをアップグレードするドロップイン型の学習レシピが得られます。さらに、未来表現の品質——生成的忠実度ではなく——こそがaction-conditionedビデオ事前分布における真のターゲットであるという証拠を提供しています。
Source: https://arxiv.org/abs/2610.30320
Hacker News Signals
Tsrs: TypeScriptのRustへの移植
CloudflareはTypeScriptコンパイラ(tsc)をRustで書き直しており、社内および顧客向けツールにおける型チェックのレイテンシを劇的に削減することを目標としています。tsrsと呼ばれるこのプロジェクトは、薄いラッパーやトランスパイラのシムではなく、TypeScriptの型システムのセマンティクスをRustでゼロから再実装したものであり、公式言語仕様との完全な互換性を目指しています。
核心的な動機はパフォーマンスです。tscはシングルスレッドのJavaScriptであり、Cloudflareの規模――数百万のWorkersスクリプト、継続的なCIパイプライン――においては、チェッカーの直列的な性質がボトルネックになります。Rustは、V8ヒープに内在するGCポーズなしに、モジュールやファイルレベルで細粒度の並列処理を実現します。この投稿では、emitは比較的コストが低いため、最初の焦点はemitではなくチェッカーパイプライン(パース、バインディング、型解決)に置かれていると詳述されています。
技術的な課題は、TypeScriptの構造的型システムを忠実に再現することです。これは悪名高いほど複雑です。条件型、mapped types、infer、変性推論、そして制御フローのnarrowingとunion/intersection typesの相互作用はすべて、慎重なモデリングを必要とします。TypeScript自体のソースコードは約30万行のTypeScriptで、内部状態のミューテーションが多く存在します。Rustへの移植では、どこでアリーナを使用するか、どこで型をインターンするか、そして再帰的な型グラフでサイクルがborrowチェッカーの問題を引き起こさないようにどう対処するかを決定する必要があります。Cloudflareの投稿は、初日から100%の互換性を目指すのではなく、Workersスクリプトで最も一般的なTypeScriptのサブセットを優先していることを率直に述べています。
これは、Eznoやstcのプロジェクトとよくにており、いずれも不完全性の問題を一因として停滞しました。Cloudflareの優位点は、汎用チェッカーではなく、具体的かつ制約された作業負荷を持っている点です。
未解決の問題としては、npmパッケージの宣言ファイル(.d.ts)の取り込みをどのように扱うか、そしてこのプロジェクトがMicrosoft自身が進めているtscのパフォーマンス改善作業と将来的に統合されるかどうかという点が挙げられます。
Source: https://blog.cloudflare.com/typescript-rust-port/
DeepInfer: DeepSeekモデル向け高性能 Inference フレームワーク
DeepSeekは、MoEベースのDeepSeek-V3およびDeepSeek-R1を含むDeepSeekモデルファミリーを対象とした自社製 inference フレームワーク「DeepInfer」をリリースしました。このリポジトリは、DeepSeekアーキテクチャを専用に実行する際に、汎用サービングスタック(vLLM、TensorRT-LLM)の代替として位置づけられています。
技術的な差別化ポイントはMoEルーティングの効率性に集中しています。DeepSeekのモデルは細粒度のエキスパート分解(256個のルーティングエキスパート、V3ではトップ8アクティベーション)を使用しており、これにより単純なバッチ処理では深刻な負荷不均衡の問題が生じます。具体的には、異なるトークンが異なるエキスパートサブセットをアクティベートするため、不規則なメモリアクセスパターンとGPU上でのSMの低利用率を引き起こします。DeepInferは、NVLinkおよびInfiniBandトポロジー向けにチューニングされたカスタムall-to-all通信カーネルを用いたエキスパート並列ディスパッチを実装しており、マルチGPU構成においてレイテンシを支配するエキスパートルーティングのオーバーヘッドを削減しています。
このフレームワークはFP8演算を全体にわたって使用しており(V3のネイティブ学習精度に合わせています)、MoEが必要とするgrouped GEMM演算向けのカスタムCUDAカーネルを備えています。Attentionは、multi-head latent attention(MLA)をサポートする改良版FlashAttentionカーネルで処理されます。MLAは、キャッシュ前にキーとバリューを低ランクの潜在空間に射影することでKV cacheを圧縮し、長文脈 inference において大幅なメモリ削減を実現します。
Prefill/decode の分離は第一級の設計上の選択であり、prefillフェーズとdecodeフェーズはそれぞれ別個のGPUプールで実行され、RDMAを介してKV状態をやり取りします。これにより、統合サービングで問題となるprefill-decode間の干渉を回避し、各フェーズを独立してスケーリングすることが可能になります。
リポジトリには、APIサービングで典型的なバッチサイズ(同等のレイテンシにおいてH100ノードあたり毎秒1000トークン超)においてDeepSeek-V3でvLLMを大幅に上回るスループット改善を示すベンチマーク数値が付属しています。これらの数値のコミュニティによる独立した再現はまだ行われていません。
制限事項:DeepInferは明示的にDeepSeekアーキテクチャにのみスコープを絞っており、抽象化は汎用性を考慮した設計にはなっていません。初期リリース時点では、デプロイメントツールは最小限にとどまっています。
Source: https://github.com/deepseek-ai/DeepInfer
GoogleがTorchTPUをオープンソース化、TPU向けネイティブPyTorchバックエンド
TorchTPUは、ユーザーがXLAを直接操作することなく、torch.device("tpu")インターフェース経由でGoogle TPUを利用できるPyTorchバックエンドです。これは既存のPyTorch/XLA(torch_xla)統合とアーキテクチャ上明確に異なります。torch_xlaは明示的なxm.* APIコールと、lazy tensor tracingを中心とした思考モデルを必要とします。
コアの設計はPyTorch 2.xのtorch.compileとDispatchKeyインフラストラクチャを活用しています。TorchTPUはATen操作をインターセプトするバックエンドとして登録され、カスタムコンパイラパスを通じてStableHLOへのloweringを行い、TPUランタイムにディスパッチします。PythonフロントエンドレベルではなくATenレベルに位置するため、既存のPyTorchコードへの変更が少なく済み、model.to("tpu")とtorch.compile(model)が主なエントリーポイントとなります。
重要な技術的賭けは、安定した中間表現としてのStableHLOが、PyTorchからXLAへのloweringをTPUファームウェアの更新から切り離す点にあります。従来のtorch_xlaではPython側のtracingとXLAのHLO dialectのバージョン管理が密結合しており、脆弱なバージョン固定を引き起こしていました。StableHLOはバージョン管理されたシリアライズ可能なIRを提供し、事前コンパイルとキャッシュが可能です。
TPU上のメモリ管理はCUDAとは異なります。ホストとデバイス間の統一仮想アドレス空間が存在せず、バッファエイリアシングのルールがより厳格です。TorchTPUはHBMチャンクを事前アロケートするカスタムアロケータを備え、in-place操作のエイリアシングを明示的に管理することで、XLAが以前はサイレントに誤コンパイルしていたエラーを表面化させます。
HNのディスカッションでは、TorchTPUがtorch_xlaを置き換えるのか、それとも補完するのかに焦点が当たっています。リポジトリのREADMEは曖昧ですが、アーキテクチャとしてはTorchTPUを将来に向けたパスとして、最終的に統合される方向性が示唆されています。
Source: https://github.com/google-pytorch/torch_tpu
数千のAIエージェントを活用した生物学的データからの新仮説発見
OpenAIの投稿では、生物学的データ分析に適用されたマルチエージェントパイプラインが紹介されています。具体的には、既存のゲノムおよびプロテオミクスデータセットを再解析し、新たな仮説を生成するものです。このアーキテクチャは数千の並列エージェントインスタンスを展開し、それぞれがスコープを絞ったデータスライス上で推論ループを実行し、コーディネーターレイヤーが知見を集約して矛盾を解消します。
技術的な核心はエージェントの専門化と通信トポロジーにあります。共有データベースに問い合わせる均質なエージェントを用いるのではなく、役割分化したエージェントを使用します。すなわち、データセットのサブセットに対して統計的関連性検定を実行するエージェント、関連文献を検索・要約するエージェント、そして各出力を統合する合成レイヤーというように構成されています。並列性はデータスライスレベルでは自明に並列化可能ですが、対立する統計的シグナルを調停しなければならない合成レイヤーで同期が必要となります。
重要なエンジニアリング上の課題は、エージェントが引用を幻覚したりp値を作り上げたりすることを防ぐことです。このパイプラインでは、いかなる数値的な主張も言語モデルのトークンストリームによって直接生成されるのではなく、サンドボックス化されたPython環境内でのコード実行結果から導出されることを義務付けています。これは推論時におけるtool-useのグラウンディングであり、エージェントはpandas/scipy/statsmodelsを呼び出し、検証済みの出力を返します。
スケールに関する主張(数千のエージェント)は、本質的な新規性よりもスループットに関するものです。単一のエージェントが数日かけて逐次的に実行する同じ解析を、フリート全体に並列化することができ、ウォールクロック時間は O(n) ではなく、階層的な合成ツリーによって O(\log n) 程度にスケールします。
この投稿で触れられていない限界点として、エージェント間の一貫性(重複するデータスライスを解析する異なるエージェントは一致した結果を出すのか)、大規模なエージェントフリート全体にわたる多重検定補正、そして1回の解析パイプラインあたり数千のGPT-4クラスのAPI呼び出しを実行するコストが挙げられます。
Source: https://openai.com/index/scaling-ai-research-for-complex-biological-data/
Claudeを活用したコードの攻撃対象領域の削減
Anthropicのリサーチポストでは、Claudeを使ってコードベース内のデッドコード、未使用のAPIサーフェス、不必要に露出したインターフェースを体系的に特定・除去するワークフローが紹介されています。セキュリティ上の前提はシンプルです:存在しないコードは悪用されないということです。
技術的なアプローチは、モジュール全体またはファイルクラスター(context windowの制限内)をClaudeにプロンプトとして与え、以下の項目を特定させるものです:外部の呼び出し元が存在しないexportされたシンボル、現在のコールグラフ上で到達不能なブランチ、そして呼び出し元が必要とする以上の機能を露出しているインターフェースメソッドです。Claudeはその後、インターフェースを絞り込むリファクタリングを提案します——publicメソッドをprivateに変更し、広範な権限付与を最小権限の代替手段に置き換え、レガシー互換性のためのshimを削除するといった内容です。
これが非自明である理由は、デッドコード検出のための静的解析ツール(例:cargoの未使用import警告、pyflakes、eslint)がすでに存在するからです。LLM支援による解析の優位性はセマンティックな点にあるとされています:Claudeは、技術的には呼び出されているpublic関数が現在の形で本当に必要かどうか、あるいはより単純で狭いインターフェースがすべての呼び出し元を満足させられるかどうかを推論できます。これは、コールグラフの到達可能性だけでなく、意図の理解を必要とするリファクタリングの判断です。
このポストには具体的なメトリクスを伴うケーススタディが含まれています:コード行数の削減、exportされたシンボル数の削減、そしてある事例ではレガシーのシリアライゼーションパスを丸ごと削除することでCVEが適用可能な攻撃対象領域が実測可能なレベルで縮小したことが示されています。
制限事項も重要です:このアプローチは提案された変更すべてに対して人間によるレビューが必要であり(Claudeは本番コードへのリファクタリングを安全に自動適用することはできません)、チャンキング戦略なしには非常に大規模なコードベースに対してスケールしにくく、また追加のコンテキストなしにはダイナミックディスパッチ、リフレクション、プラグインインターフェースについて推論することができません。
Source: https://www.anthropic.com/research/attack-surface-reduction
OpenShell: 自律型AIエージェント群のための安全かつプライベートなランタイム
NVIDIAのOpenShellは、自律型AIエージェントを大規模に実行するために設計されたサンドボックス実行環境であり、特にタスクを遂行するためにシェルアクセスを必要とするエージェントを対象としています。コアとなるセキュリティモデルは、各エージェントを軽量コンテナ内に隔離し、制御されたsyscallサーフェスを持たせることで、エージェントごとのケイパビリティ付与を強制するポリシーエンジンによって仲介されます。
アーキテクチャは3つの層で構成されています。第1層は、Linuxの名前空間とseccomp-bpfフィルタの上に構築されたコンテナランタイム層であり、エージェントプロセスが利用可能なsyscallを制限します。第2層はポリシー層であり、高水準のエージェントロール(例:「このエージェントは/dataからの読み取りは可能だが/etcへの書き込みは不可」)を、エージェントのスポーン時にseccompルールおよびファイルシステムのマウント設定へと変換します。第3層は監査層であり、すべてのエージェントのアクションを追記専用ストアに記録し、事後レビューに備えます。
マルチエージェント協調モデルは注目に値します。エージェント間の通信は、共有メモリではなくOpenShellが仲介するメッセージパッシングバスを介して行われるため、侵害されたあるいは不正動作するエージェントが他のエージェントのアドレス空間に直接アクセスすることを防ぎます。これは、あるエージェントが消費した悪意あるデータアーティファクトが、下流のエージェントを操作することを意図した命令をエンコードしているエージェント間prompt injectionに対する明示的な防御策です。
GPUアクセスはNVIDIAのMPS(Multi-Process Service)を介してエージェントごとにリソースクォータ付きで付与されるため、エージェントがGPUを独占したり、GPUサイドチャネルを通じて互いのメモリを覗き見たりすることはできません。
プライバシーに関する主張はデータレジデンシーに関係しており、エージェントのワークロードを特定のハードウェアに固定することでデータが指定された信頼境界の外に出ないようにできます。これは、機密データに対してエージェントを運用する規制産業において重要です。
未解決の課題としては、エージェントのスポーン頻度が高い場合のポリシー評価層のオーバーヘッド、および正当に子プロセスをスポーンする必要があるエージェントをシステムがどのように扱うか、という点が挙げられます。
Source: https://github.com/NVIDIA/OpenShell
偽の統計を公開してLLMに引用させる
この投稿は、学習データへのポイズニング手法を実証した、率直な実証的デモンストレーションです。著者は、権威ある情報源が限られている分野において、もっともらしい数値的主張を含む捏造された統計を掲載したウェブページを作成し、公開しました。そのページがインデックス化されクロールされるのを待った後、関連するクエリに対して様々なLLMがその統計を引用または繰り返すようになったことを観察しました。
このメカニズム自体は原理的に新しいものではありませんが、実用上の重要性を持っています。ウェブクロールで学習されたLLMは、個々の数値的主張のレベルでは、権威ある情報源と捏造された情報源を区別しません。十分な数のページに登場する統計は――たとえそれらのページが最終的に単一の捏造された出所に遡るとしても――学習コーパスにおいて既知の事実としての統計的特性を獲得します。
著者のデモンストレーションは方法論的に明確です。LLMの出力を体系的に監視できるニッチなトピックを選び、正当な情報源には現れないような独特のフレーズを使用し、モデルのバージョンやプロバイダーをまたいだ伝播を追跡しました。捏造された統計は、1つの学習サイクルの期間内にモデルの出力へと伝播しました。
システムの観点から見ると、これはコーパスで学習されたあらゆるモデルの根本的な性質を示しています。すなわち、学習データにおける主張の頻度分布がその真偽の代理指標として用いられており、この代理指標は、ウェブにインデックスされるコンテンツを作成する能力を持つ十分に動機付けられたアクターによって操作可能であるということです。
議論された防御策としては、権威ある情報源のピン留けを伴うretrieval-augmented generation、学習パイプラインにおける主張レベルの来歴追跡、および急に高頻度で出現する数値的主張に対する統計的外れ値検出が挙げられています。これらはいずれも、大規模な本番システムで完全に導入されているわけではありません。
Source: https://peec.ai/blog/publish-stats-get-cited-the-tactic-that-put-my-data-all-over-the-web
LLMによる信頼度スコアリングは悪いアイデアである
この記事は、LLMが生成した信頼度スコアを較正された確率として使用することに対して、実証的証拠と理論的根拠の両方に基づいた鋭い技術的論点を展開しています。
核心的な問題:LLMに信頼度スコアを出力させる(例:「確信度を0〜100で評価せよ」)場合、その出力はFrequentistもBayesian的な意味でも確率ではありません。それはプロンプト構造を条件とした次のトークン予測であり、モデルは較正された確率推定値を出力するためではなく、もっともらしく聞こえる信頼度表現を生成するよう訓練されています。instruction-tuningされたモデルのpost-hoc較正曲線は、言語化された信頼度が分布外クエリに対して系統的に過信を示し、トピックドメイン全体での実際の精度との相関が低いことを示しています。
この記事では、これを回答トークンにおける語彙のsoftmax確率と区別しています。後者は少なくとも数学的な根拠を持ちます(学習分布上のcross-entropy lossを最小化します)。言語化された信頼度はその上に自然言語の抽象化層を重ねたものであり、プロンプトのフレーミングによる追加的な分散、自信を持った回答に向けたモデルのRLHF fine-tuning、そしてinstruction tuning時の較正シグナルの欠如といった問題を引き起こします。
実践的な例として、RAGパイプラインにおいてLLMが割り当てた信頼度スコアを使って生成前に検索パッセージをフィルタリングすると、誤りが増幅されます。モデルが最も自信を持って誤るのは、学習データに密に含まれる尤もらしいが不正確な情報に関する質問においてです。
推奨される代替手法は、ensemble disagreement(複数のサンプルまたはモデルバリアント間の分散)、isotonic regressionを用いたsoftmax logitsに対するheld-outの較正セット、そして高リスクな設定では較正された確率を必要とせずにカバレッジ保証を提供するconformal prediction intervalsです。
この記事は簡潔であり、関連する較正の文献(Guo et al. 2017、Kadavath et al. 2022)を過大評価なく引用しています。結論は明快です:LLMからの信頼度スコアは大まかなheuristicとして有用であり、意思決定論的なパイプラインにおいて確率として扱うべきでは決してありません。
Source: https://rumple.github.io/blog/2026/10/20/asking-llm-for-confidence.html
注目の新しいリポジトリ
mw00/project-maya
Project Mayaは、2つの大規模 mixture-of-experts モデル(GLM-5.3-Flash(321Bパラメータ)およびDeepSeek-V4.1-Flash-1017(748Bパラメータ))向けのセルフホスト型 inference スタックを提供します。中心的な価値提案は、単一のコンシューマー向けGPUから16GPU クラスターまで、NVIDIA CUDAおよびAMD ROCm バックエンドの両方をLinuxおよびWindowsでカバーする、ヘテロジニアスなGPU構成全体にわたるプライベートデプロイメントです。このエンジンは、クラウドインフラを必要とせずに、その範囲全体でtensor-parallelおよびpipeline-parallelディスパッチを処理します。inference エンジンの上には、OpenAI互換(/v1/chat/completions)およびAnthropic互換のエンドポイントを公開するHTTPサーバーが配置されており、既存のツールはそのまま変更なく利用できます。組み込みのダッシュボードは、リクエストごとのレイテンシ、スループット、およびメモリ使用状況を可視化します。量子化ツールが同梱されており、ユーザーは事前量子化済みリリースに依存することなく、ローカルでウェイトを4ビットまたは8ビット形式に圧縮できます。748Bパラメータをコモディティハードウェア上で動作させるには、積極的な量子化と慎重なKV-cache管理が必要です。Mayaは、量子化を前処理ステップとして扱うのではなく、quant-aware ローディングをエンジンに直接統合することでこの課題に対処しているようです。主なターゲットユーザーは、データレジデンシー制約を持つ環境でフロンティアスケールのMoE inferenceを必要とするチーム、あるいは大規模なトークンごとのAPIコストを回避したいチームです。
Source: https://github.com/mw00/project-maya
pgrundev/pgx
PGXはRustで軽量なPostgres互換ランタイムを再実装したもので、AIエージェントシステムの特定のワークロードパターン——単一プロセス内における数千もの短命かつ完全に分離されたデータベースインスタンス——に最適化されています。標準のPostgresは接続ごとにプロセスオーバーヘッドが生じ、長命なデータベース向けに設計されていますが、PGXはasync I/Oを備えた共有Rustランタイム上で多数の論理データベースを多重化することでそのコストを償却します。各「データベース」は第一級の分離されたネームスペース——独立したスキーマ、独立したストレージ、テナント間のリーケージなし——であり、ユーザーごとまたはセッションごとのエージェントメモリストアに自然にマッピングされます。Rust実装によりGCポーズのない決定論的なレイテンシが得られ、エージェントのツール呼び出しレイテンシバジェットが厳しい場合に有効です。ワイヤプロトコル互換性により、既存のPostgresドライバ(psycopg、asyncpg、node-postgres)が無修正で接続できます。ユースケースは、一時的な構造化ストレージを必要とするエージェントフレームワークです:エージェント実行ごとに新鮮なDBを起動し、実行中にSQLでクエリを行い、終了後に破棄します。これにより、完全なPostgresクラスタの運用管理の複雑さを回避しつつ、構造化されたエージェント状態に対するSQLの表現力を保持できます。391スターとまだ初期段階ですが、エージェントワークロードへのアーキテクチャ的な適合性は、各セッションに対してフルのPostgresインスタンスを割り当てる方法よりも優れています。
Source: https://github.com/pgrundev/pgx
heaven999b/hello-agent-system
本番グレードのAIエージェントシステムをゼロから構築するための体系的なカリキュラムです。17のバイリンガルレッスン(英語と中国語(普通話))と付属の演習問題で構成されています。カリキュラムは実際の本番環境における課題を反映したレイヤー構造で整理されており、ツール統合、エージェントアーキテクチャパターン(シングルエージェント、マルチエージェント、スーパーバイザーループ)、信頼性メカニズム(リトライ、サーキットブレーカー、フォールバックチェーン)、セキュリティ(prompt injection、サンドボックス化、ケイパビリティスコーピング)、評価フレームワーク、分散実行、コスト計算、RAGパイプラインの構築、そしてカナリアデプロイやロールバックを含むリリース運用といったテーマを扱っています。各レッスンはおもちゃのデモではなくエンタープライズデプロイのコンテキストを対象としており、演習ではツールレジストリ、eval ハーネス、コストトラッカーといった、最終的にデプロイ可能なシステムへと組み合わさるパーツを構築します。バイリンガル形式は意図的な設計であり、散文とコードコメントの両方が並行して維持されているため、大規模な中国語話者のMLエンジニアリングコミュニティにとってもアクセスしやすくなっています。「テスト済み演習」という枠組みは、単なるオープンエンドなプロジェクトではなく、期待される動作に対する自動チェックを意味しています。「OpenAI APIを呼び出せる」と「信頼性高く本番稼働するエージェントシステムをデプロイできる」というギャップを埋めようとしているCS学生や若手エンジニアにとって、散在する多くのチュートリアルよりもはるかに体系的な足場を提供してくれます。
Source: https://github.com/heaven999b/hello-agent-system
onehumanbeing/esp32-iphone-agent
このプロジェクトは、7ドルのESP32マイクロコントローラをハードウェアブリッジとして使用し、AIビジョンモデルを物理的なiPhoneに接続するものです。アーキテクチャには2つのチャンネルがあります。AirPlayを使用してiPhoneの画面をESP32(または接続されたレシーバー)にストリーミングすることでビジョンモデルがディスプレイの状態を観察でき、USB HIDエミュレーションによりESP32がiPhoneに対してキーボード・マウスとして認識され、タップやスワイプを発行できます。OpenAI互換のビジョンエンドポイント(GPT-4o、ローカルのLLaVAなど)がアクションループを駆動します。このアプローチが回避している制約は注目に値します。Macが不要であるためXcodeやXCUITestへの依存がなく、デベロッパーアカウントが不要であるためAppleのプロビジョニングも必要なく、ジェイルブレイクも不要であるためスマートフォンはストックのiOSで動作します。エージェントループは本質的に、AirPlay経由で画面フレームをキャプチャし、ビジョンモデルにPOSTし、レスポンスをHIDイベントにパースし、USBを介して送信する、という流れです。ESP32の役割は純粋にUSB HIDデバイスおよびAirPlayのsink・リレーであり、推論はリモートで行われます。実用的な応用例としては、実機での自動UIテスト、アクセシビリティツール、そして現実世界のエージェントベンチマークなどが挙げられます。ハードウェアコストが低いため、エミュレータではなく実際のモバイルOSとのインタラクションを必要とする embodied agent やGUI agentの研究プラットフォームとして再現性の高い環境を提供します。
Source: https://github.com/onehumanbeing/esp32-iphone-agent
storytold/figcraft
FigCraftは、Rustで完全に書かれた、コラボレーティブなベクターベースのUIデザイン・プロトタイピングツールのクリーンルーム再実装です。「クリーンルーム」とは、独自のコードベースから派生したものではなく、仕様と観察された動作から構築されたことを意味し、ライセンスの観点から重要な意味を持ちます。技術的な核心はベクターグラフィックスエンジン、制約ベースのレイアウトシステム、そしてリアルタイムコラボレーティブ編集レイヤーであり、これらはFigmaクラスのツールにおいて最も難易度の高い3つのコンポーネントです。Rustで実装することで、レンダリングパイプラインはガベージコレクションのジッターを回避でき(60fpsのキャンバスインタラクションにとって重要)、同一のコードベースをネイティブおよびブラウザデプロイ向けのWebAssemblyの両方にコンパイルすることが可能です。このレベルの精度でのコラボレーティブ編集には、ベクターシェイプ、コンポーネント階層、プロトタイプトランジションを表現するドキュメントモデル上でのCRDTまたはOTの実装が必要です。3,188スターを獲得しているこのプロジェクトは、データレジデンシーやコストの懸念からSaaSデザインツールのセルフホスト可能で監査可能な代替手段を求めるチームから、大きな注目を集めていると考えられます。オープンソースモデルにより、カスタムプラグインAPI、プライベートアセットライブラリ、オンプレミスデプロイも実現可能であり、これらはいずれも独自ツールでは容易に実現できないものです。
Source: https://github.com/storytold/figcraft
opengeos/RustGIS
RustGISは純粋なRustで実装されたフル機能の地理情報システムであり、計算的なGISワークフロー向けにQGISやGRASSの高性能なオープンソース代替として位置づけられています。純粋なRust実装であることは、既存のほとんどのGISツールの基盤となっているGDAL/GEOS/PROJ Cライブラリスタックへの依存を回避できることを意味します。これらのライブラリは機能的ではあるものの、特に制約のある環境においてはビルドや配布が複雑です。Rustの所有権モデルはガベージコレクションなしにメモリ安全性を提供し、ピークメモリが懸念される大規模なラスターまたはベクターデータセットの処理に適しています。コアのGIS機能には通常、ベクタジオメトリ演算(和集合、交差、バッファ)、ラスター解析(マップ代数、再投影)、座標参照系の処理、およびフォーマットI/O(GeoJSON、Shapefile、GeoTIFF)が含まれます。このスタックをネイティブに再実装することで、RustGISは単一の静的バイナリにコンパイルし、他のRustアプリケーションにライブラリとして組み込んだり、ブラウザベースの地理空間ツール向けにWebAssemblyをターゲットにしたりすることが可能です。1,874個のスター数は、GDALのビルド失敗やPython環境の競合という問題に長年悩まされてきた地理空間開発者コミュニティからの真の関心を示しています。AI/MLとの関連は直接的であり、空間的な特徴量エンジニアリングや地理空間 foundation model の学習はいずれも、高速でスクリプト可能なGIS操作から恩恵を受けます。
Source: https://github.com/opengeos/RustGIS
Harvil1/codeAgent
CodeAgentは、孤立したコードスニペットではなくリポジトリ全体を対象として動作する、ターミナル常駐型のコーディングエージェントです。アーキテクチャは現在標準となっているtool-loopパターンに従っており、LLMプランナーが構造化されたtool call(ファイル読み取り、ファイル書き込み、コマンド実行、テスト実行)を発行し、結果を観察しながらタスク仕様が満たされるまで反復します。最小限のラッパーとの差別化点は、リポジトリ理解レイヤーにあります。プランニングの前に、プロジェクト構造を取り込み、言語やフレームワークのコンテキストを推定し、複数ファイルにわたる編集に十分なコードベースの表現を構築します。tool loopは明示的に透明かつ拡張可能として設計されており、つまりtoolの定義が検査可能であり、コアロジックにパッチを当てることなく新しいtoolを登録できます。これはカスタマイズの観点で重要な意味を持ちます。チームはフォークすることなく、プロジェクト固有のtool(デプロイ、カスタムルールによるlint、内部APIのクエリなど)を追加できます。ターミナル上で動作させることで、エージェントを開発者の既存ワークフローに近い位置に保ち、ブラウザUIへのコンテキストスイッチを回避します。テスト実行をフィードバックシグナルとして用いた「完了するまで反復する」ループが、信頼性の主要なメカニズムです。パッチを生成して停止するのではなく、エージェントは自身の出力を検証し、失敗を修復します。1,026スターを獲得しており、AiderやOpenHandsと同じ領域に位置しますが、拡張可能なtool loopをファーストクラスの設計目標として重視している点が特徴です。
Source: https://github.com/Harvil1/codeAgent
outcrawlai/scout
Scoutは、Outcrawlが開発したオープンソースのブラウザエージェントであり、自律的なWeb操作とデータ抽出を目的として設計されています。アーキテクチャは標準的なブラウザエージェントループに従っており、vision またはDOMパースモジュールがページ状態を観測し、planning LLMが次のアクション(クリック、入力、スクロール、ナビゲーション)を選択し、実行レイヤーがCDP(Chrome DevTools Protocol)またはPlaywrightを介して実際のブラウザを操作します。Outcrawlの内部リポジトリからのミラーリングにより、公開バージョンは独立したコミュニティフォークではなく、プロダクション開発と同期して更新されます。ブラウザエージェントには技術的に困難な点がいくつかあります。動的なページでは、アクションを実行する前にネットワークイベントの完了を待つ必要があり、CAPTCHAやアンチボット対策がナイーブなループを中断させ、高レベルのタスクインテントを具体的なDOM操作にマッピングするためには、堅牢な要素セレクタかvisionベースの座標ターゲティングのいずれかが必要です。Scoutのオープンソース公開により、Webタスクにおけるエージェントの信頼性(WebArenaクラスのベンチマーク)に関する研究への活用が可能になり、商用ブラウザ自動化SaaSがコスト面や透明性の面で適切でない場合に、カスタムクローリングや自動化パイプラインへの応用も容易になります。「by Outcrawl」という出自は、純粋な学術的実装ではなく、実際のプロダクションスクレイピングワークロードに対してテストされていることを示唆しています。