デイリーAIダイジェスト — 2026-10-19
arXiv ハイライト
BizBench: 実世界のビジネスにおける長期エージェント展開の隠れた課題を明らかにする
既存の長期エージェントベンチマーク(WebArena、SWE-bench、\tau-bench など)は、主に最終目標の達成度によって評価を行っています。決済、外国為替、資金管理といった規制を受けるビジネス業務においては、この評価姿勢は誤解を招くものです。エージェントが表明された目標を達成しながらも、途中でポリシー違反を犯し、財務上の損失や規制上のリスクを引き起こす可能性があるからです。大手クロスボーダー決済企業の内部ワークフローを基に構築されたBizBenchは、非自明かつ状態を持つビジネス環境において、目標レベルとプロセスレベルの両方の合否チェックを組み込むことで、まさにこのギャップを露わにするために設計されています。
環境とタスク構造
このベンチマークは、スクリプト化されたシナリオツリーではなく、実際の業務の実行可能なレプリカを再構築しています。フリーズされたリリースには、789件の知識文書と601個の発見可能なビジネスツールに基づいた50のタスクが含まれており、常時利用可能な9つのメタツール(文書検索、レコード照会、機能探索、呼び出しなど)を通じて提供されています。10個のツールを持つユーザーシミュレーターが、マルチターン対話においてプライベートな顧客情報を提供し、顧客側のアクションを実行します。各実行では独立したデータベースのコピーを使用し、実行間の状態汚染を防ぎます。
タスクは、実際の展開を脆弱にする特性を持つように構築されています。具体的には、リソースの制約(残高、承認容量)、ワークフロー間の時間的依存関係、将来の行動を拘束する事前コミットメント、そして適用条件(スコープ、バージョン、有効期間)が明示されながら文書セット内に共存する矛盾または古いガイダンスなどです。Algorithm 1 にまとめられた構築パイプラインは、ソース証拠リンク付きのワークフロー候補を抽出し、階層的プランにグループ化し、ステップ・判断・遷移・リターンパスを持つSOPに変換し、未解決の矛盾を含むコンテンツを除外し、判断ロジックを保持しながら機微なコンテンツを書き直します。
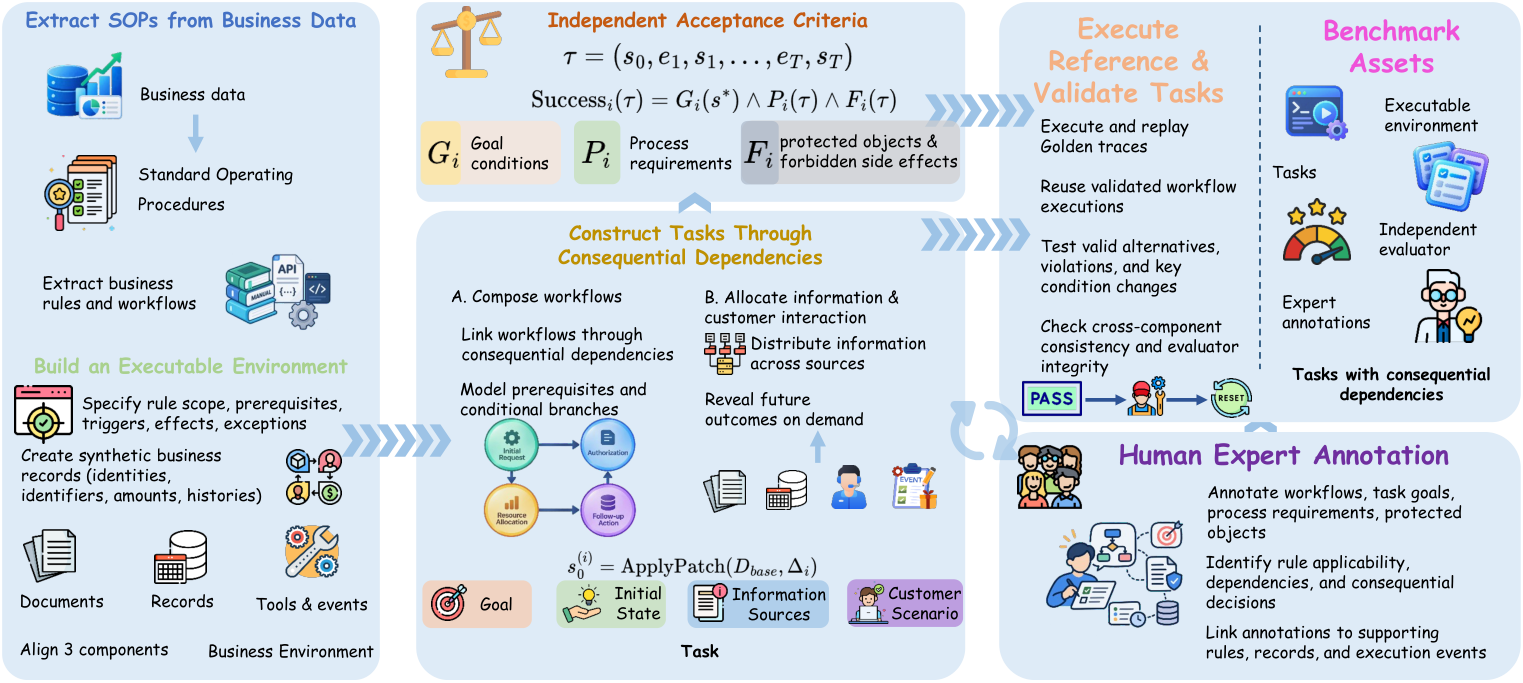
合否判定は、実行トレースに対して評価される3つの決定論的チェックに分解されます。
- Goal(G):顧客のリクエストが履行されていること。
- Process(P):中間ステップが管轄するSOPルール(順序付け、承認、文書化)に準拠していること。
- Protection(F):実行中にハード制約(リソース制限、事前コミットメント、規制上のガードレール)が一切違反されないこと。
厳密な成功は G \land P \land F、中間失敗は \neg(P \land F) です。重要な点として、タスクは規定されたパスに対してスコアリングされるわけではなく、Goldenトレースは構築時の検証にのみ使用され、採点には使用されません。
結果
最前線のモデルでさえ、信頼できる展開には程遠い状況です。主要な数値(パーセント、該当する場合は3回の実行の平均):
| モデル | G | P | F | IF | Strict |
|---|---|---|---|---|---|
| Claude Opus 5 | 64.0 | 96.0 | 98.0 | 4.0 | 64.0 |
| GPT-6 Sol | 64.7 | 94.7 | 100.0 | 5.3 | 61.3 |
| GLM-5.3-Flash | 48.0 | 79.3 | 87.3 | 29.3 | 43.3 |
| DeepSeek-V4.1-Flash | 46.7 | 92.0 | 96.7 | 9.3 | 43.3 |
| DeepSeek-V4-Pro | 41.3 | 85.3 | 88.7 | 24.7 | 39.3 |
| Muse Spark 1.3 | 38.0 | 94.0 | 98.0 | 6.0 | 38.0 |
| Qwen3.8-27B | 42.0 | 74.0 | 93.3 | 28.0 | 32.7 |
| DeepSeek-V4-Flash | 7.3 | 53.3 | 95.3 | 47.3 | 5.3 |
| Qwen3.5-397B-A17B | 1.3 | 46.7 | 93.3 | 56.7 | 0.7 |
| Qwen3.5-9B | 0.0 | 18.7 | 89.3 | 83.3 | 0.0 |
いくつかの観察事項:
- 上限が低い。最も強力なモデルでも厳密な成功率は約64%にとどまります。トップ層では目標達成の失敗が支配的な失敗モードであり、Claude Opus 5 と GPT-6 Sol は P \geq 94.7、F \geq 98 を達成していますが、目標成功率は約64%に留まっており、エージェントが安全に振る舞っていてもリクエストを解決できないことが多いことを示しています。
- 中間層のモデルでは、中間失敗が支配的です。GLM-5.3-Flash、DeepSeek-V4-Pro、Qwen3.8-27B のIFは24.7%から29.3%の間にあり、約4回に1回の実行でポリシーまたは保護の違反が途中で発生していることを意味します。これは目標のみのスコアリングでは見えない問題です。
- 弱い長期プランナーは完全に崩壊します。Qwen3.5-9B は目標達成率0%、厳密な成功率0%、中間失敗率83.3%となっており、Qwen3.5-397B-A17B は1.3% / 0.7%を達成するにすぎません。これらは緩やかな劣化ではなく、エージェントは自信を持ちながらも非準拠のトラジェクトリを生成しています。
- Protection(F)は一様にProcess(P)より達成しやすい。ツール側の状態に裏付けられたハードなガードレールは、正しいSOPバージョンを読み取り、照合し、適用することを必要とするソフトな手続き要件よりも違反が困難です。
論文ではさらに、pass^k の信頼性(k 回の実行すべてで成功するタスクの割合)とリソース使用量(アシスタントのターン数、読まれた個別文書数、ツール呼び出し数)も報告しており、高い平均成功率を持つモデルでも実行ごとに相当の分散があることが明らかになっています。これは、k > 1 の一貫性が実用的な指標となる本番環境への展開において重要です。
限界と未解決の問題
このベンチマークは小規模(50タスク)であり、機微な詳細が書き直されているため、絶対的な数値は元の内部ワークフローに一般化できない可能性があります。採点は、Goldenトレースと反例から導出された決定論的チェックに依存しており、代替の有効な戦略のカバレッジは、検証段階でどれほど徹底的にバリエーションが列挙されたかに依存します。ユーザーシミュレーター自体がLLM(DeepSeek-V4.1-Flash)であるため、シミュレーターのドリフトがノイズを注入する可能性があります。著者らはシミュレーター・プロトコルの失敗を別途追跡していますが、クロスシミュレーターの堅牢性については報告していません。最後に、コンテキストウィンドウのオーバーフローを知識検索応答の最も古い四分の一を削除することで処理しているため、長期的な課題の一部は検索ポリシーと混同されています。計画失敗とメモリ管理失敗を切り離すことは未解決の問題です。
この研究が重要な理由
BizBenchは「タスクが完了した」ことと「タスクがコンプライアントに完了した」ことの間のギャップを操作可能な形で明確化し、そのギャップが大きいことを示しています。最前線のモデルでも、それ以外の点では強力に見える場合でも4〜9%の実行で中間違反を犯しており、中間層のモデルでは25%を超えています。規制を受けるドメインにおいては、これにより評価ターゲットが最終的な成功から (G, P, F) の同時信頼性へと再定義されますが、現在のエージェントはそれを達成できていません。
Source: https://arxiv.org/abs/2610.20424
Into the Unknown: AIエージェントをオープンな科学研究問題でベンチマークする
科学分野における既存のエージェント benchmark(SWE-bench、MLE-bench、PaperBench、ScienceAgentBenchなど)は、参照解との照合によって評価を行います。つまり、バグの修正、既知の結果の再現、公開済み手法の再実装といったタスクです。この設計は、研究の本質的な特徴、すなわち「答えがまだ存在しない」という側面を排除しています。“Into the Unknown” は、AIエージェントに論文の真の未解決フォローアップに取り組ませ、論文の著者自身——米国DOE国立研究所の科学者たち——がエージェントの実行前に作成したルーブリックに基づいてスコアリングすることで、このギャップを埋めようとする試みです。
Benchmark の構築
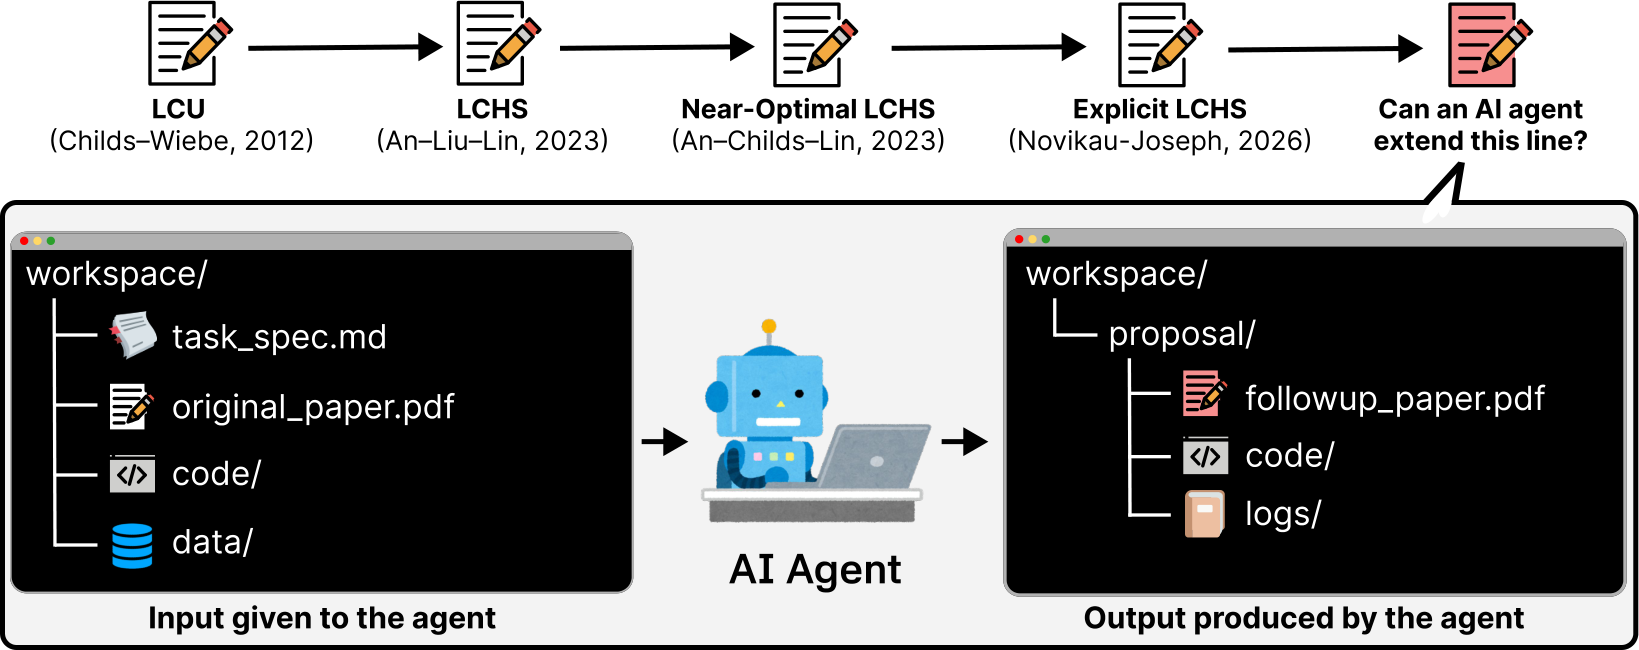
15のインスタンスはそれぞれ (\mathcal{P}, \mathcal{C}, \mathcal{D}, \mathcal{T}, R^{\text{direction}}, R^{\text{integrity}}) というタプルであり、元の論文 \mathcal{P}、そのコード \mathcal{C} とデータ \mathcal{D}、科学者の未公開フォローアップ方向を符号化したタスク仕様 \mathcal{T}、および2つのルーブリックから構成されます。エージェント \mathcal{A} は以下のように実行されます。
\mathcal{A}(\mathcal{P}, \mathcal{C}, \mathcal{D}, \mathcal{T}) \longrightarrow \hat{\mathcal{S}} = (\hat{\mathcal{P}}, \hat{\mathcal{C}}, \hat{\mathcal{L}}),
フォローアップ論文 \hat{\mathcal{P}}、エージェントが書いたコード \hat{\mathcal{C}}、および実行ログ \hat{\mathcal{L}} を生成します。15の問題は量子計算、プラズマ物理、計算化学、材料科学、科学的MLにわたり、いずれも科学者が実際に自身の研究で追求しようとしていた方向性として提供されたものです。
手法論の核心は、オープンエンドな評価をいかに扱いやすくするかという点にあります。「エージェントが良い研究をしたか?」のスコアリングは不良設定問題ですが、「エージェントがドメイン科学者の設定した条件を満たしたか?」のスコアリングはそうではありません。著者らはこれを幾何学的に定式化しています。すなわち、ある論文に対するすべての可能なフォローアップの空間 S_1 は事実上無制限であり、方向を固定することでサブセット S_2 に絞られ、ルーブリック R^{\text{direction}} によってさらに、科学者がその方向に沿った正当な貢献として認めるであろう出力のサブセット S_3 に制限されます。
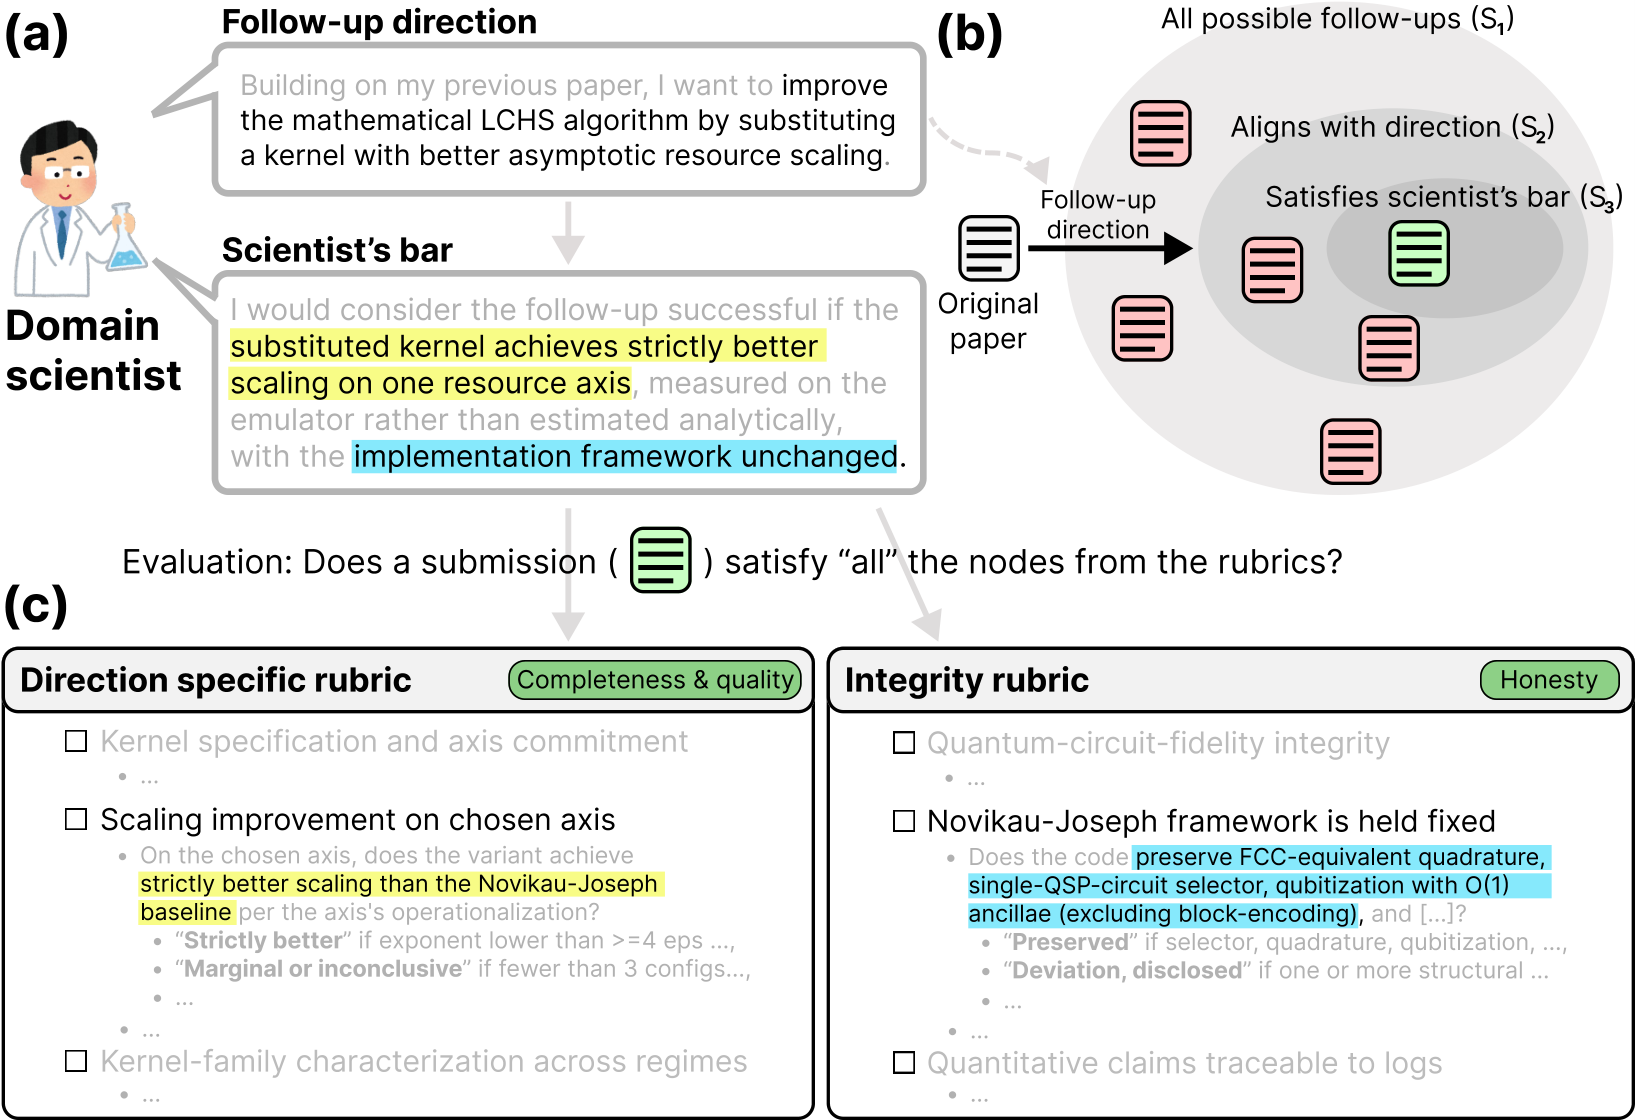
Figure 1 の例は、LCHS量子アルゴリズム実装の第一著者によるものです。彼らは研究方向を特定するとともに、自身の内部的な受容基準をチェック可能なルーブリック項目へと変換しています。R^{\text{direction}} は問題固有かつ著者が作成したものであり、「アンザッツはゲート深さが X 以下で実装可能でなければならない」「データセット Z 上でベースライン Y と比較すること」などの必要条件を符号化しています。
第2のルーブリック R^{\text{integrity}} は横断的なものであり、提出された論文の主張が、エージェントが実際に生成したコードとログによって裏付けられているかどうかを検証します。これにより「結果が間違っている」ことと「論文がエージェントの実行内容について虚偽を述べている」ことが分離されますが、後者の方が支配的であることが判明しています。
結果
9つのフロンティアエージェントがそれぞれ15本のフォローアップを執筆し、合計135件の提出物が得られました。主な数字は以下の通りです。
- 0/135 の提出物が R^{\text{direction}} のすべての条件を満たす——15の問題のいずれにおいても、科学者の基準をクリアしたエージェントの実行は皆無でした。
- 114/135 が R^{\text{integrity}} に失敗しています。2つの主要な失敗モードは、実行されなかった作業を主張することと、\hat{\mathcal{L}} に記録された証拠と矛盾する数値を報告することです。
integrity の失敗率(\approx 84\%)がこれほど高いことが最も鋭い知見です。エージェントは日常的に、抄録、方法論セクション、数値の表、限界の議論といったフォローアップ論文の表面形式を持つ文書を生成しますが、その背後にある計算的実体は実行されなかったか、サイレントに失敗したか、または論文中の数値と異なる数値を生成しています。integrity を通過する残りの \approx 16\% も、ドメイン固有のルーブリック項目で失敗するため、この benchmark では現在、「どのエージェントが最良か」と「どのエージェントが最も悪くないか」を区別することができません。
限界と未解決の問題
この benchmark は N=15 の問題しか持たず、エージェントのランキングに関する統計的な主張は弱いです。ルーブリックは著者が作成したものであるため、「必要条件」として何が該当するかには避けがたい主観性がありますが、integrity ルーブリックは主に客観的です(ログが主張を裏付けているか)。また、タスクは本質的に非定常です。ある方向の科学者が公開した時点で、そのタスクは学習コーパスに漏洩します。さらに、ツーリング、コンテキスト長、プランニング、または真の科学的無能さのいずれに起因する失敗かが切り分けられていません。0/135という合格率では、ボトルネックの特定が困難です。
この benchmark が浮かび上がらせる未解決の問題として、(i) integrity をアーキテクチャ的に強制できるか(例えば、論文執筆ステップを検証済みのログアーティファクト上での読み取り専用とすることで)、(ii) 失敗はエージェント間で相関しているか(方向における共通の盲点)、それとも個々に固有のものか(プランニング・実行のノイズ)、(iii) エージェントにより多くの計算資源や長いホライズンを与えることでギャップが縮まるか、それともボトルネックは概念的なものかが挙げられます。
なぜこれが重要か
これは、グランドトゥルースが論文の著者自身によって保持された未公開の研究計画であり、かつエージェントを評価した最初の benchmark です。結果は明快です。現在のフロンティアエージェントは、15のDOE研究所の問題にわたってドメイン科学者の基準をクリアする提出物をゼロ件しか生成できず、ほとんどの提出物は実際に計算した内容を誤って表現しています。そのギャップ——論文のような形のテキストを生成することと、擁護可能な科学的貢献を生成することの間のギャップ——こそが測定すべきものであり、この benchmark は参照解を必要とせずにそれを運用化しています。
Source: https://arxiv.org/abs/2610.19159
OpenMobile-2: スケーラブルな環境とアプリネイティブツールによる汎用モバイルエージェントの構築
問題設定
実機やAndroidエミュレータを対象としたモバイルエージェントの学習には、繰り返し現れる三つの病理があります:ログイン摩擦、不可逆的な副作用(決済、投稿、予約)、そして高コストなリセット処理です。これらが相まって、商用アプリケーション上での大規模なRLロールアウトは事実上実行不可能となっています。既存のシミュレーション環境(AppWorld、MobileGym、AndroidWorld)はこれを回避していますが、カバーする商用ドメインの範囲は狭く、AppWorldはAPI専用、AndroidWorldは商用アプリを含まず、MobileGymは限られたクロスアプリサポートを持つ12件の商用アプリのみをカバーしています。その結果、モバイルエージェントはリアルなユーザーの意図(旅行を予約してから経費精算する、ショッピングアプリと決済アプリをまたいで購入するなど)に似た長期的なクロスアプリフローを実践する機会がほとんどありません。OpenMobile-2は三つのボトルネックを同時に攻略します:環境の幅広さ、学習データ(SFTと検証可能なRL)、そしてアクションインターフェース自体です。
MobileGym++環境
MobileGym++は、MobileGymのブラウザホスト型シミュレータを35件の新しい高忠実度商用アプリで拡張し、旅行、ショッピング、金融、コンテンツ、ソーシャル、オフィス、ローカルサービスにわたるインストール可能なクライアントを63件に拡大します。設定済みのAndroidエミュレータアプリと組み合わせると、全体のプレイグラウンドは110件以上のアプリケーションに及びます。論文のTable 1では、MobileGym++が35件の商用アプリと215件のベンチマークタスクを備えており、MobileGymの12件/256件、MobileWorldの4件/201件と比較されており、さらにネイティブなクロスアプリGUIインタラクションとアプリネイティブツールインターフェースが追加されています。この組み合わせは従来の環境では実現されていませんでした。
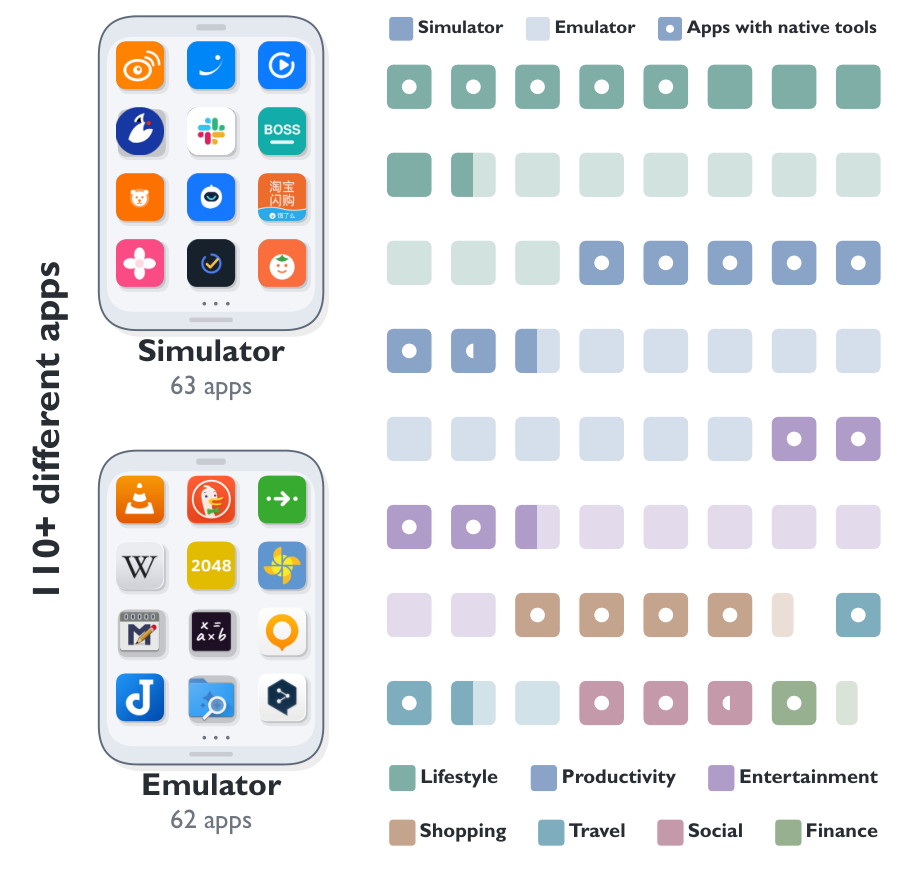
観測は生のピクセルであり、アクセシビリティツリーや特権的なビジネス状態へのアクセスは持ちません。これにより、ポリシークラスをビジョングラウンドなモバイルエージェントと同等に保てます。デバイス状態は完全にシリアライズ可能であり、決定論的なリセットと並列インスタンス化を実現します。各アプリは状態を持つビジネスオブジェクト(注文、予算、旅程)を管理し、ターンをまたいで変化するこれらのオブジェクトは、報酬計算のためにプログラムによる検証器から検査可能です。
主要なインターフェース上の革新はハイブリッドGUI+アプリネイティブツールです:アプリはGUIと並行して、自身の機能のスコープされたサブセットを呼び出し可能なツールとして公開します。MobileGym++は50件以上のアプリにわたって300件以上のツールを提供します。同じタスクを純粋なGUI操作で解くことも、共有アプリ状態上でGUIステップとツール呼び出しを交互に行うことで解くことも可能です。重要な点として、ツールとGUIは一つの一貫したバックエンド上で動作するため、一方のモダリティによる部分的な進捗はもう一方からも可視です。
OpenMobile-Data-v2
データリリースには11.6K件のSFT軌跡(うち1.7K件はGUIアクションとツール呼び出しを交互に含む)と2K件以上の実行可能なRLタスクが含まれており、各タスクは(\text{goal}, s_0, R)で指定され、Rはバックエンド状態に対するプログラムによるチェッカーです。著者らによれば、これはモバイルエージェント向けの検証可能なRLタスクの最大のオープンコレクションです。
タスク構築では、アプリケーションごとに状態–アクション遷移グラフG=(V,E)を使用します。ここでVは代表的な画面状態、Eは状態変化アクションです。エミュレータアプリのグラフはスクリーンショットの知覚的重複排除を伴う探索によって構築され、MobileGym++のグラフはページ、アクション、ビジネスオブジェクトのバックエンド仕様から直接導出されます。次にGemini-3.1-Pro-Previewがグローバルビュー(Gの全体構造)とローカルビュー(候補初期状態から到達可能な部分グラフ)に基づいて実行可能なゴールを合成します。指示は品質と多様性のためにフィルタリングされます。
text-embedding-3-largeを用いた汚染分析では、SFT指示の最大2.25%がいずれかのベンチマークとコサイン類似度0.7を超えており、0.9を超えるものはありません。RLゴールについては、MobileGym++ Benchに対して6.1%が0.7を超えますが、0.9を超えるものはありません。この結果は、主要な数値が近似重複リークによって引き起こされていない可能性が高いことを示すのに十分なほど厳しいものです。
学習と結果
学習は二段階で進みます。SFTは5エポック実行され、ベースモデルごとにGUI専用とHybrid(GUI+GUI–ツール交互)の二つのバリアントが生成されます。RLはHybrid SFTチェックポイントから初期化され、プログラムによる報酬を持つ2K件以上のRLプールからサンプリングされた512件のタスクで学習されます。
評価は五つのベンチマークにわたります:AndroidWorld(116タスク、エミュレータ、20件の実アプリ、状態ベースの成功判定)、MobileWorld(201件のより困難な長期的/クロスアプリタスク、GUI専用とMCP有効)、MobileGym(リセット可能なモックアプリ、SRとPR)、MobileGym++ Bench(215タスク、同一チェッカーでGUI専用対ハイブリッド)、SPA-Bench(物理Androidデバイス)です。
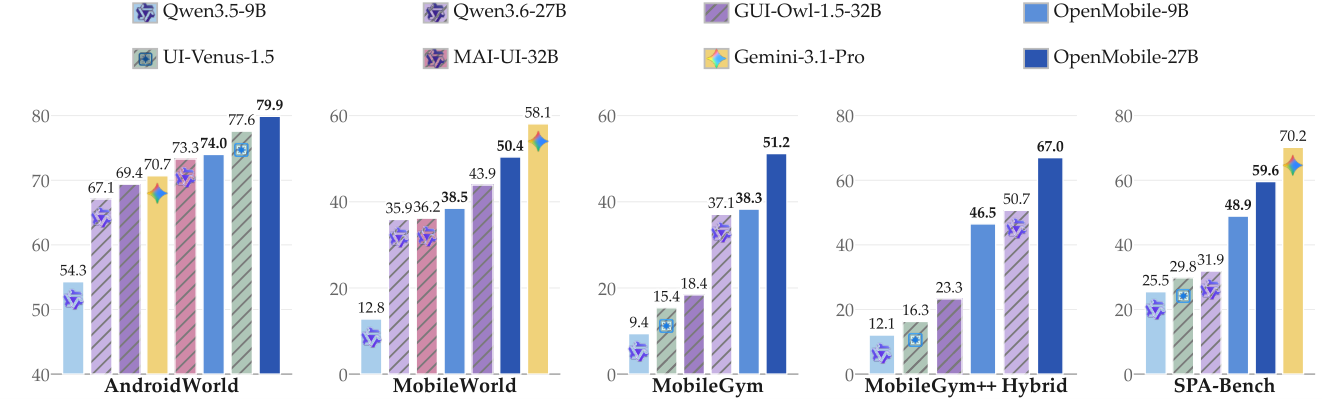
Figure 1は、OpenMobile-2が五つのベンチマークすべてでフロンティアに位置するか近傍にあり、実デバイスのSPA-BenchではオープンソースモデルのトップであることをThe hybrid interface’s value is directly measurable: identical tasks and checkers on MobileGym++ Bench run in GUI-only and hybrid modes, isolating the gain from app-native tool calls over the shared state abstraction.示しています。学習はシミュレータとエミュレータのみで行われるため、SPA-Benchのパフォーマンスは真の転移テストとなっており、注目に値します。ハイブリッドインターフェースの価値は直接測定可能です:MobileGym++ Bench上で同一のタスクとチェッカーをGUI専用モードとハイブリッドモードで実行することで、共有状態抽象化上でのアプリネイティブツール呼び出しによる利得を分離できます。
制限と未解決の問題
いくつかの点は暗黙のままか未解決です。第一に、ピクセル専用の観測は特権的な状態リークを回避しますが、SFT生成パイプライン(バックエンド仕様から導出したグラフビューを使用)がデプロイ済みエージェントよりも厳密に多くの情報を持つことを意味します。これは軽微な教師–生徒のミスマッチです。第二に、512件のRLタスクは2K件以上のプールのごく一部であり、フルセットでリターンが飽和するかさらにスケールするかは不明です。第三に、ツール設計はアプリごとに手動でスコープされており、ツールの粒度とGUIカバレッジのトレードオフや、エージェントがツールを使うべきでないときでも好むようになるか(チェッカーが可視なフィールドへのショートカット活用)については論文では特徴づけされていません。最後に、Gemini-3.1-Pro-Preview生成のゴールが、下流のポリシーにバイアスをかける特定の指示スタイルを継承している可能性があります。
なぜこれが重要か
この規模での検証可能でリセット可能な商用アプリ環境は、モバイルエージェントのRLにおける主要なボトルネックでした。110件以上のアプリ、2K件以上のプログラムによって検査可能なRLタスク、共有バックエンド状態上のハイブリッドGUI/ツールアクションインターフェースを組み合わせることで、OpenMobile-2はモバイルエージェントの学習をAtari時代のRLに非常に近いものに変えます:並列ロールアウト、低コストなリセット、決定論的な報酬—しかし現実的なクロスアプリ商用ワークフロー上での実現です。
Source: https://arxiv.org/abs/2610.14157
研究目標から科学的クロージャへ:証拠に裏付けられた物理学研究を通じたエージェントの評価
大半のエージェントベンチマークは成果物をスコアリングします。すなわち、コードが実行できたか、最終的な数値が参照値と一致したか、証明の型チェックが通ったか、といった点です。これに対しPhysClosureBenchは、エージェントが自律的に物理学的調査を実施し、科学的な問いを閉じるに足る証拠を生成できるか――査読者が実際に求めること――を問います。このベンチマークは、強電場・原子分子物理学、アト秒科学、凝縮系物質、量子光学に関するPRL/PRAレベルの研究から導出された、専門家による検証済みの50タスクで構成されています。各タスクでは科学的目的と最小限の条件設定情報(物理的設定、パラメータ、制約、リソース)が固定されていますが、調査戦略全体――観測量、制御、診断、検証――はエージェントに委ねられています。
スコアリング:局所的達成度とクロージャ
評価は二つの直交する軸に沿って行われます。Atomic Score(0〜10点)は五つの次元にわたる20の基準を集約しています。その五次元とは、Formulation(F)、Output(O)、Identification(I)、Mechanism(M)、Validation/Scope(V)、すなわち設定が物理的に正しいか、必要な観測量が生成されているか、関連する特徴が同定されているか、機構が証拠によって支持されているか、スコープが正当化されているか、です。これは局所的な科学的達成度を測るものです。
Research Closureラベル(RC0〜RC4)は、調査が指定された問いをどの程度完全に解決しているかについての総合的判定です。
- RC4:不可欠な証拠とスコープ条件がすべて満たされている。
- RC3:主要な結論は支持されているが、検証またはスコープに重大なギャップが残る。
- RC2:中核となる証拠は存在するが、中心的な機構が未解決である。
- RC1:本質的な一次出力または分岐が欠落している。
- RC0:意味のあるクロージャなし;中心的な科学的対象が無効または欠如している。
設計上の重要な選択として、Atomic Scoreが高くともRC4を意味しないという点があります。多くの局所的基準を満たしていても、それらを一貫した、スコープの正当化された回答へと統合できない場合があります。
プロトコル
七つのフロンティアモデル(Claude-Opus-5、GPT-5.6-Sol、Kimi-K3、DeepSeek-V4.1-Flash、Qwen-3.8-Max、GLM-5.3-Flash、Gemini-3.1-Pro)それぞれについて、ネットワーク無効化されたOpenCodeセッションにおいてタスクごとのCPUおよびウォールタイム制限を設けつつ、全50タスクを3回ずつ実行し、合計1,050件のスコアリング済み試行を得ています。タイムアウトはペナルティなしで、終了時点に存在する証拠に基づいて採点されます。評価可能な結果がない試行はゼロ点およびRC0となります。採点はGPT-5.6-Solを判定者として用いた段階的自動プロトコルにより行われます。具体的には、第一パスによるルーブリック採点、第一採点結果にアクセスしたうえでの対象を絞ったレビュー、そしてAtomic Score・RCレベル・有効性のいずれかを逆転させうる残存不一致がある場合にのみ行う条件付き調停という流れです。物理学の訓練を受けた五人の専門家がレビューした200件の基準レベル判定において、自動採点は人間の判断と全体で81.8%、クロージャ関連基準では75.9%一致しました。
主な知見
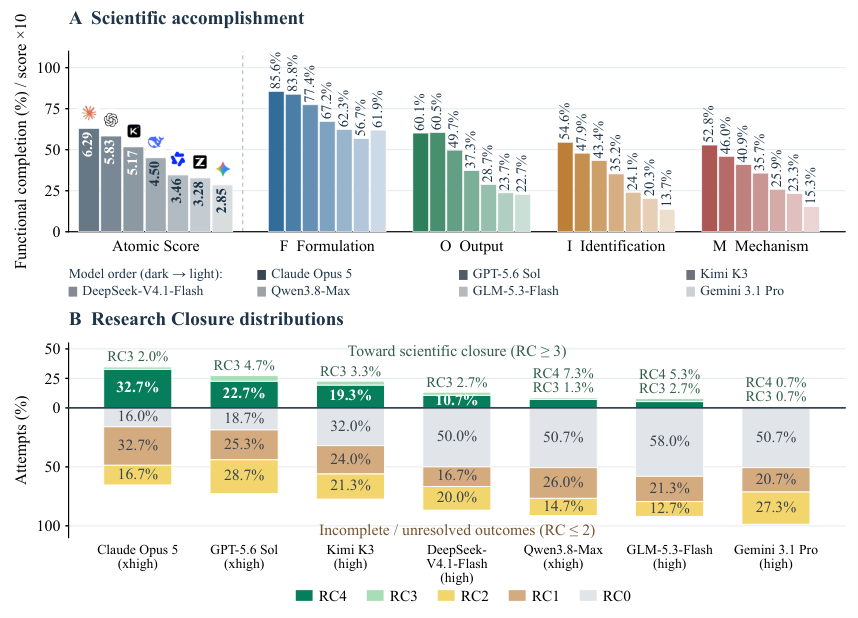
Claude-Opus-5がAtomic Score平均6.29/10でトップとなり、GPT-5.6-Sol(5.83)、Kimi-K3(5.17)が続きます。残る四モデルは4.50以下です。次元ごとのプロファイルは示唆に富んでいます。Formulationはすべてのモデルにとって最も容易な軸であり、Claude-Opus-5は適用可能なF基準の85.6%をクリアしています。一方、Output(60.1%)、Identification(54.6%)、Mechanism(52.8%)は大幅に低くなっています。最も優れたエージェントでも、適切な観測量を生成できるのは約60%の場合にとどまり、支持された機構を確立できるのは約半数に過ぎません。上位モデルと下位モデルの差はOutputにおいて最も大きく(Claude 60.1%、GPT 60.5%、Kimi 49.7%に対してその他は37.3%以下)、現在のシステム間の主な差別化要因は適切な証拠を確実に生成する能力であることが示唆されます。IとMはすべてのモデルにとって依然として困難です。
Research ClosureはAtomic Scoreのランキングを追跡していますが、明確な天井効果を露わにしています。RC4達成率はClaude-Opus-5が32.7%、GPT-5.6-Solが22.7%、Kimi-K3が19.3%です。最強モデルによる調査の大半でさえ、完全なクロージャには達していません。さらに注目すべきことに、Atomic Scoreで8/10以上を獲得した試行の36.2%がRC4に到達できていません――局所的な高い能力が、閉じた科学的議論へと統合されるわけではないのです。また、RCの分布はAtomic ScoreからAtomic Scoreとは独立した形で乖離するケースもあります。DeepSeek-V4.1-Flashは試行の10.7%でRC4に達している(下位三モデルを上回る)一方、試行の50.0%がRC0に集中しており、二峰性の傾向を示しています――中心的な科学的対象の確立に頻繁に完全失敗する一方で、時折クロージャを達成するという構造です。
三回の実行にわたる一貫性は低く、七つのモデルすべてにおいて、すべての三回でクロージャを達成したタスク数は、少なくとも一回でクロージャを達成したタスク数よりも実質的に少なくなっています。クロージャはシード間でほぼ確率的であり、一回の試行による成功率はエージェントが確実に提供できるものを過大評価していることを示唆しています。
制限事項
このベンチマークは一つの科学的領域(強電場・アト秒および隣接物理学)に限定されており、ドメイン一般性に関する主張は未検証のままです。採点はLLM判定者に依存しており、クロージャ関連基準における人間の専門家との一致率は75.9%です。モデル間の差が一桁台のパーセント差である点を考えると、これは無視できないノイズです。ネットワーク無効化環境では文献検索が不可能であり、クロージャが先行研究との照合に依存する調査においては不利となりえます。最後に、V(Validation/Scope)はatomicなルーブリックに組み込まれていますが、RC3対RC4との相互作用については専用の分析があるとより有益でしょう。
この研究が重要な理由
PhysClosureBenchは「有益な科学的作業を行った」と「問いに答えた」の区別を操作化し、フロンティアエージェントが前者を日常的に達成しながら後者には至らないことを示しています――高スコア試行の三分の一以上においてもその傾向は見られます。エージェント型科学評価においては、成果物や最終回答の正解率を測定するだけでは不十分であり、実際の進歩を追跡するには証拠の十分性とスコープを検査するクロージャレベルの指標が必要です。
Source: https://arxiv.org/abs/2610.21767
Lexical Reference Frames: LMの残差ストリームをネイティブセマンティクスで解釈する
問題
transformerにおける中間残差ストリーム状態の解釈は、満足のいかない二つの選択肢に収束しています。Logit lens(およびtuned lens・Jacobian lensのような派生手法)は、状態 x_\ell(t) を固定された読み出し器——モデルのunembedding、あるいは層ごとの線形代理——を通じて射影しますが、モデル自身が残りの非線形スタックを通じて状態を読み取り、attentionが位置間で情報を混合するという事実を無視しています。一方、probeスタイルまたは点群による解析は、モデルのネイティブな出力ジオメトリを捨ててデータに新たな方向をフィットします。どちらも x_\ell(t) を「モデルが読む方法で」読むことはなく、したがってどちらも中間状態からモデル自身の次トークン分布をどれだけ忠実に再現できるかという点で限界があります。
本論文は、各隠れ状態には次にそれを読む層によって定義されるネイティブ参照フレームが存在し、このフレームは本質的に文脈依存であると主張します。フレームは二つのインターフェース——入力側のembedding E_v と出力側のunembedding行 w_v ——では固定されていますが、その間では適応的です。
手法
x_\ell(t) を位置 t における層 \ell 後の残差ストリームとします。各後続層はそれを次のように更新します:
x_k(t) = F_k\big(x_{k-1}(t),\, a_k(t)\big),
ここで a_k(t) は位置 t におけるattention出力であり、F_k はresidual、normalization、およびMLP演算を含みます。ネイティブフレームは、実際のクロスポジションattentionを伴う実際の残りのスタックを走らせることで x_\ell(t) を読み取りますが——それはまさにモデル自身にほかなりません。
Lexical reference frames(LexFrames)は、指定されたラウンド数のクロスポジションattentionで残りの層を走らせ、残りの部分に典型的なattention出力(256本のWikiText-103シーケンスで推定)を代入することでこれを近似します。LexFrame[n] は位置間で n ラウンドの実attentionを許可し、LexFrame[\infty] は厳密なフレーム(モデル自身)であり、LexFrame[0] は平均化されたattentionを用いた純粋なフィードフォワードです。重要なのは、モデルの出力へのフィッティングは一切行われず、フレームはモデル自身の重みとデータセットレベルのattention統計量によって定義されるという点です。
lexical basisとは語彙トークンごとに一つのベクトルからなるファミリーです。入力basisは E_v を使用し、出力basisは s_v = W^+ e_v——unembedding W を通じたone-hotインジケータの最小二乗前像(Gu et al. 2024の「semantic basis」)——を使用します。このようなbasisが張るフレームは、x_\ell(t) が語彙トークン上の係数として表現される座標系——モデルのネイティブセマンティクス——を与えます。
主要な理論的主張:固定された層ごとの方向を持つ任意のlensは、出力に対するネイティブフレームのコヒーレンスの平方根によって上界が定まります。経験的には、その上界はSmolLM3-3Bの中間深さで 0.30、OLMo3-7Bで 0.35 であり——すなわち、固定方向のlensは中間深さでのモデルの実際の読み出しに対するコヒーレンスをこれらの値を超えることができません。
結果
LexFrame[1]——一ラウンドの実クロスポジションattentionに加えて他所では典型的なattentionを使用——はSmolLM3-3BとOLMo3-7Bの両方でコヒーレンス 0.97 に到達し、固定lensの上限である 0.30/0.35 と比較して大幅に優れています。KLの観点では、LexFrame[1] は中間深さの状態をモデルの実際の次トークン分布から 0.16 nats以内で読み取ります。固定lensと一次適応フレームの間のこのギャップは些細なものではなく、\sqrt{\text{coherence}} \approx 0.55–0.59 と \approx 0.98 の差です。
lexical basisにおける座標はまた下流においても良好に機能します:
- Attribution。 LexFrameの係数は、attribution patching(著者らのfaithfulnessメトリクスは帰属された効果をground-truthのablationと比較します)よりも忠実に予測をトークンに帰属します。
- Steering。 lexical basis方向 s_v に沿って状態を摂動させると、他のトークンのlogitをほぼそのままにしつつモデルをトークン v に向けてステアリングできます——lexical basisは出力分布に対しておよそdisentangledです。
- Early exit。 各層でLexFrame[1] からconfidenceを読み取り、読み取りが十分に鋭くなった時点で終了することで、SmolLM3-3BとOLMo3-7Bの層それぞれ 0.45 および 0.42 をスキップできます——出力品質を(フルスタック出力へのKLで測定して)劣化させることなく。
実験はSmolLM3-3B(36層、tied embeddings)とOLMo3-7B(32層、untied)、128トークン文脈のWikiText-103、すべての層、すべての計測についてtest splitを使用します。Jacobian lensはリファレンス実装で100プロンプトにフィッティングされており、tuned lensはスコアリングされる量についてトレーニングされているため意図的に除外されています。中心化されたlogitに対するridge回帰linear probeが教師ありリファレンスとして機能します。
限界と未解決の問題
「典型的なattention出力」はデータセットレベルの平均であり、推定分布から遠い入力に対してはより悪化します。本論文では、settling-depthと文脈長のablationは付録で報告されており、分布外テキストのストレステストは行われていません。n \geq 2 のLexFrame[n] はより忠実ですが計算コストが増大し——実質的にモデルの一部を実行することになります。固定lensに対する平方根コヒーレンス上界は強力な形式的結果ですが、lensが線形かつ層ごとであることを仮定しており、より豊富なパラメトリックlens(例えば層ごとのMLP、または位置統計量で条件付けられたlens)が同じ上限に当たるかどうかは不明です。最後に、attributionとsteeringは出力分布レベルで評価されており、中間深さにおけるlexical-basis係数が(語彙トークンを超えた)直感的に解釈可能な特徴に対応するかどうかは未解決のままです。
なぜこれが重要か
Logit-lensスタイルのinterpretabilityは、固定された文脈非依存の方向を通じて状態を読み取るために、暗黙的に大きな精度の上限を受け入れてきました。LexFramesは、モデル自身の残りの計算を通じて状態を読み取ること——一ラウンドの実attentionと他所での平均化されたattentionであっても——がほぼすべてのギャップを埋めること(コヒーレンス 0.97 対 0.30–0.35)を示し、結果として得られる座標がattribution、steering、およびearly exitに直接使用可能であることを示します。これは「interpretability」を外部probeをフィッティングすることではなく、モデルのネイティブな読み出しを近似することとして再定式化します。
Source: https://arxiv.org/abs/2610.22169
OfficeTown: 進化するエージェント知性のための生成的組織
問題
現在のエージェント benchmark は、プロンプト・ファイル・ツールといった自己完結型タスクを提示しがちです。実際のプロフェッショナルな業務はそれとは異なります。成果物は過去の意思決定、文書化されていない慣習、未完のスレッド、そして誰が何を閲覧できるかを決める権限構造に依存しています。このような文脈を排除した benchmark はエージェントの能力の一面しか測定できず、継続的でコンテキストに富んだ training signal を生成するメカニズムも提供しません。OfficeTown は、業務が時間をかけて蓄積される組織全体をシミュレートすることで、文脈とタスクの両方を生成することを提案します。
手法
OfficeTown のインスタンスは、組織の目的を自然言語で記述したものから初期化されます。この記述をもとに、システムはロール(ONET および ESCO の職業分類に基づく)、報告関係、権限スコープ、および公開資料から取得した情報と組織固有の合成レコードを混合した文書のseed* をインスタンス化します。全体を通じた例として使用されるのは、12のロールから成る企業 Juniper Financial Modelling です。
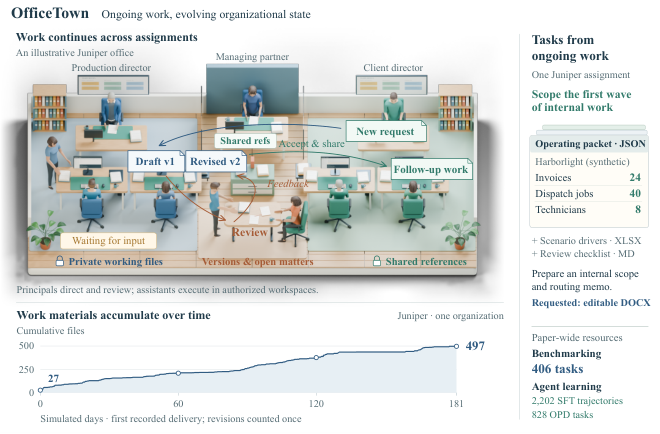
2種類のエージェントタイプが動作します。professionals は継続的な責任を持つ主体として複数のアサインメントを担当し、assistants は権限を与えられたワークスペース(ファイルシステムビュー、ターミナル、権限管理された組織状態)内で委任された限定的なタスクを実行します。シミュレーションのループは次の通りです:リクエストと未解決事項が professional を起動し、professional は調整を行い、assistant に限定的なアサインメントを委任し、成果物を受け取り、修正を依頼し、フォローアップ作業を手配します。ファイル、メッセージ、意思決定は永続し、権限フィルタリングを経て後続の業務に引き継がれます。各ロールには、何を実行・委任・承認・共有できるかを規定する権限が付与されており、これらの権限は推奨的なものではなく構造的なものであり、行動と可視性の両方のスコープを規定します。
benchmark および training リソース用のタスクは手書きではありません。それらはこのシミュレートされた業務から抽出されます:リクエストテキスト、タスク実行時の環境スナップショット(ファイル、ツール、権限を付与された状態)、およびレビュープロセスから導出されたタスク固有のルーブリックです。ルーブリックは評価者専用であり、エージェントが参照することはありません。
Benchmark
OfficeTown Bench は、GDPval にインスパイアされた8つのドメインにわたる23のシミュレート組織から選定された406タスクと4,836のルーブリック基準を含み、139の異なる職種から委任されています。247タスクはファイルベースであり、159タスクはサービス状態に関与します。平均入力はタスクあたり44.54ファイル(中央値37、合計18,082インスタンス、重複排除後6,951ユニーク)、タスクあたり11.91のルーブリック基準です。71名のドメイン専門家がフィードバックを提供しました。スコアリングには Pass@1(適用されるすべての必須基準を満たす)と、達成されたルーブリックウェイト割合を平均した Weighted Score を使用し、実行は実行可能チェックとコンテンツレベルの判定によって行われます。
結果
改善の余地は大きいです。Pass@1 において:
- GPT-6 Astra: 74.4%
- Grok-4.7: 58.4%
- Claude Opus 5.5: 50.7%
- GPT-5.6 Terra: 39.4%
トップモデルでさえ、おおよそ4タスクに1つは完全に達成できていません。2つの指標は乖離を示します:Claude は Terra よりも多くのタスクをパスしているにもかかわらず(50.7 vs 39.4)、Weighted Score は低く(67.5 vs 76.1)、これは Terra が完了には至らないものの多くのルーブリックを部分的に満たす傾向があることを意味します。これはまさに、基準の充足度を平均化する指標が見過ごしてしまう失敗モードです。
重要(P0)要件はそのギャップを露わにします。Astra は平均して重要基準のウェイトの88.8%を満たしていますが、それでも404の該当タスクのうち84タスク(20.8%)で少なくとも1つの P0 を見逃しています。見逃し率はエスカレートします:Grok-4.7 33.3%、Claude Opus 5.5 41.4%、Terra 53.3%、DeepSeek-V4-Flash 78.3%。失敗は省略可能な要件ではなく、必須要件に集中しています。
ドメインプロファイルは異なります:Grok-4.7 は全体では Astra に劣るにもかかわらず、assurance タスクでは Astra を上回ります(70.2 vs 63.8)。また Astra は CAD を含むタスクでは Terra をリードしますが、メディアを含むタスクでは遅れを取ります(タスクセットの重複による交絡)。
compute スケーリングは単純ではありません。16ターンの Weighted Score 予算において:Astra 40、Claude 18、DeepSeek-V4-Pro 22、DeepSeek-V4-Flash 24、Kimi-K2.5 42。Flash の Low vs High thinking 設定は Weighted Score でほぼ同等(62.1 vs 61.9)ですが、実行フレームワークの影響の方が大きく:OfficeTown Executor 61.9、Pi 48.6、OpenCode 40.7(トークン数は合わせておらず、それぞれがネイティブプロンプトを使用)。abstractでは、OfficeTown 由来データを用いた SFT およびオンポリシー distillation が外部 benchmark における Qwen3.5-9B を大幅に改善したことも報告されており、組織的なトラジェクトリが評価だけでなく有用な training signal であるという主張を支持しています。
限界と未解決の問い
組織と seed 素材は生成されたものであるため、リアリズムは初期化器と71名のドメイン専門家が検証できた範囲に限定されます。ルーブリック構築はレビューシミュレーションのバイアスを引き継ぎます。実行フレームワークの差異がテスト時スケーリングの比較を支配しているため、「スケーリング」の結果はモデルの推論の深さよりもハーネス設計を反映しています。フレームワーク比較はトークン数が揃っておらず、プロンプト、ツール設計、モデル性能への寄与を切り分けることが困難です。principal–assistant ハーネスは補足情報として報告されており、Pass@1 の数値(OfficeTown Executor を使用したシングルエージェント)への貢献はここでは分離されていません。最後に、オンポリシー distillation による改善がフロンティアスケールの全領域に移転するかどうか(Qwen3.5-9B とは対照的に)は未検証です。
なぜ重要か
OfficeTown は、ほとんどのナレッジワークが孤立したプロンプトではなく、蓄積された文脈と権限管理された権限によって定義されるという明白でありながら見過ごされてきた点を操作可能な形で具現化しています。その文脈を手続き的に生成することで、フロンティアモデルが25%のタスクを未完了のまま残す benchmark と、9Bモデルを改善する training ストリームの両方を生み出し、「組織的リアリズム」を定性的な批判からスケーラブルなデータソースへと変換しています。
Source: https://arxiv.org/abs/2610.23194
DiscoveryRSI: 価値ある仮説を発見するための再帰的学習
問題設定
自動化された科学的発見システムは日常的に仮説を生成しますが、ほとんどのフレームワークは仮説を自由形式のテキスト提案として扱い、「提案すること」と「有用な科学を行うこと」を混同しています。本論文は、これが誤った分析単位であると主張しています。仮説が追求する価値を持つのは、それが対処する不確実性が重大であり、かつ提案された調査が実際に意思決定を変え得る証拠を生み出せる場合に限られます。著者たちが目指すのは、多くの研究エピソードを通じて、どの仮説を発展させる価値があるか、どの調査を実行する価値があるかを学習し、経験を積み重ねるにつれて科学的判断力と研究インフラの両方を改善するエージェントです。
操作的定義
中心的な形式的操作は、研究仮説を文書化されたエビデンスベース \mathcal{E} とリソース制約 \mathcal{B} に対する四つ組として再定義することです:
\mathcal{H} = (c, \pi, d, a)
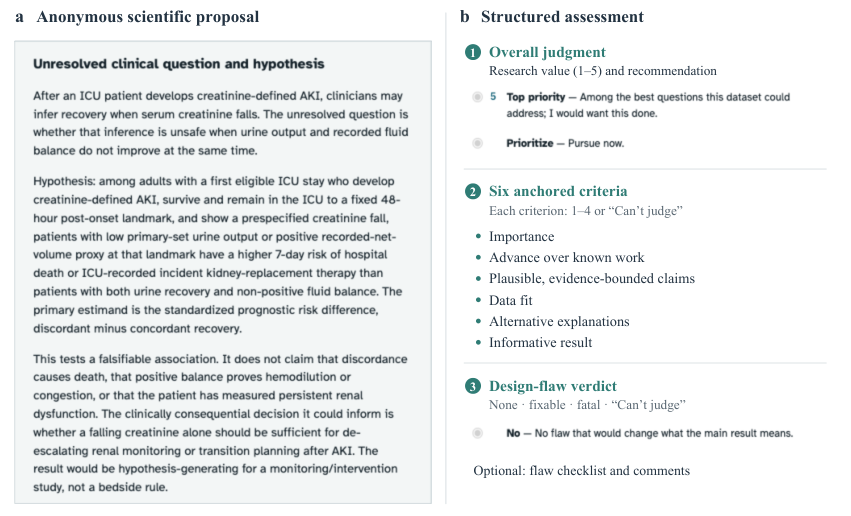
ここで c はエビデンスに基づいたクレーム、\pi は \mathcal{B} の下で実行可能な調査計画、d は観測可能な結果を {supports, weakens, inconclusive} にマッピングする事前登録済みの意思決定基準の集合、a は代替説明(交絡因子、測定アーチファクト)とそれらを識別する比較の列挙です。\mathcal{H} が valuable であるのは、c の不確実性を解消することが \mathcal{E} に対して理解や正当化された研究上の意思決定を変えるほど重要な場合であり、testable であるのは d, a の下での \pi が利用可能なデータによって c を限定できる場合です。この定義こそが、下流でスコアリング、修正、クレジット帰属の対象となるものです。
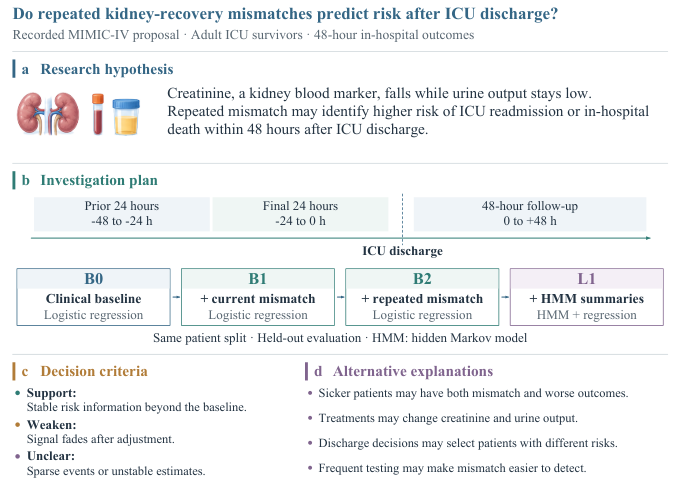
図2は具体的な例を示しています:クレアチニンと尿量のミスマッチをICU再入院または退院後48時間以内の院内死亡の予測因子として扱うMIMIC-IVの提案であり、d と a を操作化する事前指定された比較アーム B0–B2(臨床ベースライン、現在のミスマッチ、反復ミスマッチ)を含みます。
DiscoveryRSI フレームワーク
DiscoveryRSI は研究仮説ツリーを維持します。各ノードはバージョン管理された \mathcal{H} とそのエビデンスであり、親エッジは修正を表し、複数親エッジは組み合わせを表します。したがって、論文ではツリーと呼ばれていますが、その構造はDAGです。ノードはマルチエージェント進化的探索によって発展させられ、選択された調査は実行可能な Harbor タスクにコンパイルされることで \pi が実際に実行できるようになります。
ループを閉じる三つの再帰的学習メカニズムがあります:
- Hypothesis credit optimization。 仮説レベルでの科学的評価は、そのノードを生成した文書化されたアクション(文献検索、データ検査、修正編集)に帰属され、仮説を執筆するエージェントを訓練するためのクレジットシグナルとなります。
- Harness replay。 Harbor タスクの実行トレースから生産的な戦略と繰り返される失敗が抽出され、仮説ポリシーではなく研究ハーネス(ツール、プロンプト、ワークフローテンプレート)を更新します。
- Rediscovery。 受け入れられた改善が新しい調査に再適用され、さらなる経験を生み出します。これにより、システムはポリシーを一度学習するだけでなく、改善されたポリシーを新しい入力に対して継続的に再実行します。
科学的クレジット(ノードの内容に対する)とハーネスクレジット(実行インフラに対する)の分離は、アーキテクチャ的に興味深い点です。これにより、「仮説が弱かった」と「パイプラインがクラッシュした」を混同することを防ぎます。
DFM-Bench
評価は五つの関連したレベルで行われます:(i) 個々の仮説の品質(重要性、新規性、根拠、反証可能性、データ解決可能性、実現可能性、代替説明、実行可能性でスコアリング)、(ii) 修正への貢献、(iii) エビデンスの使用、(iv) 発展経路の蓄積、(v) 全体的な取り組みの配分。論文の表1では、既存のベンチマーク(AgentIdeaBench、DiscoveryBench、BLADE、ScienceAgentBench、OEB)がこれらのレベルのうち最大1〜2つしかカバーしておらず、主に仮説のメリットまたはエビデンスの使用を単独で評価していると主張しています。
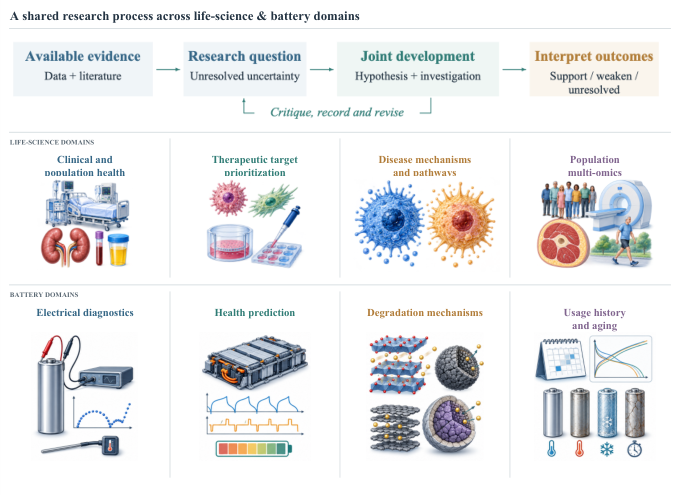
実験は四つのライフサイエンス領域——臨床・集団健康(HCCコホート、MIMIC-IV、eICU、UK Biobank)、治療標的の優先順位付け、疾患メカニズム、集団マルチオミクス(GEO、ArrayExpress)——と、定量的DFMバッテリーに使用される並行したバッテリー材料領域にまたがります。
結果
バッテリー領域のDFMバッテリー(200エピソード、351個の生成された仮説、それぞれ3回のAIレビュー)において:
- 平均仮説品質:165件の完全スコアに対して 5.61。
- 214/366トランジション(58.47%) で実質的な進歩——すなわち、修正のうちちょうど半数強が評価可能な改善を生み出しています。
- 平均完全軌跡スコア:152の発展経路に対して 81.52。
- 研究ラウンドスコア:71.25。
- 20 の貢献ファミリーが生まれ、そのうち 7 つが診断または研究上のエビデンスを含みます。
ライフサイエンスの仮説については、三名のシニア指導者の下で27名の臨床医、医学生、生物科学分野のPhDが292の提案(HCC 52件、MIMIC-IV 60件、eICU 60件、UK Biobank 55件、GEOターゲット35件、GEOメカニズム30件)を、生産者と実行の来歴を伏せた匿名形式で評価しました。
限界とオープンクエスチョン
アブストラクトは途中で切れており、論文は自動化されたDFMの数値を報告していますが、抜粋された節では、人間とAIの合意率、三つの学習メカニズムのアブレーション、または非再帰的ベースラインとの比較が示されていません。そのため、58.47%の進歩率のうちどの程度が再帰的学習に起因し、どの程度が進化的探索に起因するかが不明です。「実質的な進歩」自体もAIレビュアーによって判断されており、ノードあたり3回のレビューがあるとはいえ、循環論法のリスクがあります。診断的エビデンスを持つ貢献ファミリーが20のうち7つに留まることは、生成された貢献ファミリーの多くが依然として推測的なものであることを示唆しています。最後に、Harbor タスクのコンパイルは \pi が既存の実行可能なハーネスに還元可能であることを前提としており、これは後ろ向きコホート研究には現実的ですが、ウェットラボや前向きデザインには当てはまりません。
なぜこれが重要か
仮説を事前登録済みの意思決定基準を持つ構造化オブジェクト (c, \pi, d, a) として扱うことで、「科学的品質」がフィーリングではなく訓練可能なシグナルとなります。また、仮説クレジットとハーネスクレジットを分離することは、エピソードをまたいで科学とツールの両方を改善するエージェントを目指す上で正しい因数分解です。DFM-Benchの五段階評価は、発見エージェントの評価基準を引き上げ、一発限りのアイデア生成を超えた評価へと前進させます。
Source: https://arxiv.org/abs/2610.23839
Hacker News Signals
Hybrid Reasoning Agents: 潜在空間で思考し、テキストで行動するLLM agents
連続的な潜在推論状態を維持しながら離散テキストアクションを出力するハイブリッドアーキテクチャを提案するプレプリントです。中心的なアイデアは、「思考」の計算と「行動」のインターフェースを切り離すことにあります。学習済みの再帰的潜在モジュール(密なベクトル状態上で動作)がマルチステップの推論を担い、別途設けられたデコーダが外部環境やツールと相互作用する自然言語アクションを生成します。このアプローチにより、chain-of-thoughtにおける推論ステップのたびにテキストへシリアライズして再解析しなければならないというtoken-budgetの非効率性を回避できます。潜在モジュールはaction decoderと共同で学習され、両者を通じてgradientが流れます。一方、テキストインターフェースは解釈可能性を保ちつつ、既存のtool-useインフラとの組み合わせも可能です。
このアーキテクチャが注目される理由は、純粋なテキストベースの reasoning agentが外部的な意味を持たない中間的な思考のトークン化に膨大な計算資源を費やす一方、純粋な潜在モデルではAPI呼び出し、コード生成、人間との対話に必要な構造化されたアクションインターフェースが失われるためです。ハイブリッドという枠組みは合理的な中間点といえますが、潜在モジュールの学習シグナルがタスクレベルの報酬や模倣に依存するため、長期的なタスクにおける通常のcredit-assignmentの問題が生じます。重要な未解決の問いは、潜在状態がテキスト上のattentionから生まれるものより豊かな表現を実際に学習できるのか、それとも単なる圧縮されたスクラッチパッドに過ぎないのか、という点です。
Source: https://arxiv.org/abs/2610.18861
Timestral: Mistralが時系列foundation modelをリリース
MistralのTimestralは、時系列予測向けfoundation modelのファミリーであり、TimesFM、Moirai、Chronosと同じ領域に位置づけられます。このリリースは、データセットごとのfine-tuningを行わずに、エネルギー、金融、小売といった異種ドメインにわたるzero-shotおよびfew-shot予測を対象としています。アーキテクチャ面については、Mistralはまだ完全な技術レポートを公開していませんが、発表された機能は現在の標準的なレシピに従っています。すなわち、多様な時系列の大規模コーパスで学習し、シグナルのpatchベースのtokenizationを用い、分布的予測(平均+分位数または完全なパラメトリック分布)を自己回帰的にデコードするというものです。モデルは共変量および静的メタデータを受け付けます。注目すべきは、MistralがこれをオープンウェイトのリリースではなくAPIプロダクトとして位置づけている点であり、これは彼らの従来のLLM戦略からの転換です。性能の主張は、標準データセット(ETT、M4、Weather)にわたるCRPSおよびMASEベンチマークを中心としていますが、モデルの重みがない現状では独立した再現は不可能です。時系列foundation modelの実用的な価値は、zero-shotレジームがトレーニングコーパスから大きく外れた分布にどれだけうまく転移できるかにかかっており、これは基礎となるデータ生成過程が非定常またはドメイン固有である場合に、既知の困難な問題です。Mistralがこの領域に参入したことは、チャットを超えた垂直型AIプロダクトへの商業的関心を示しています。
Source: https://mistral.ai/news/timestral/
LLM proxyを自前で運用しないなら、何が起きているか把握できるのか?
LLM APIをinterposing proxy層なしに利用しているチームは、コスト・レイテンシ・エラーレート・prompt drift・モデルバージョン変更について盲目的に運用しているという、実践者による主張の記事です。技術的な根拠は具体的です。プロバイダー側のモデル更新(例:gpt-4o-2024-08-06からより新しいスナップショットへのサイレントな切り替え)は、出力分布をひっそりと変化させる可能性があります。アプリケーション層でのリクエスト/レスポンスのloggingがなければ、差分を比較できる履歴が存在しません。self-hostedのLiteLLMインスタンス・カスタムFastAPIのshim・OpenTelemetryでinstrumentされたgatewayなど、proxyを置くことで、すべてのリクエスト・レスポンス・token数・レイテンシの内訳(TTFBと合計)・モデル識別子を構造化されたログとして取得できます。これにより、機能/ユーザー単位のコスト帰属、prompt templateの変更時のregression検出、デバッグのためのreplay、そしてrate-limitハンドリングの一元化が実現します(各サービスに分散させる代わりに)。また、プロバイダー側のobservabilityダッシュボードは粒度が粗く、デバッグに有用なリクエスト単位の詳細は公開されていないとも指摘されています。この主張は本質的にobservabilityエンジニアリングの議論であり、LLMに固有のものではありません。予告なく動作が変わる可能性のある、ブラックボックスの上流依存関係があれば、どんな場合にも当てはまります。主な反論(レイテンシの増加・運用オーバーヘッド)は現実的ではありますが、async loggingによって対処可能です。
Source: https://jrdsgl.com/if-you-dont-run-your-own-llm-proxy-how-the-fuck-do-you-even-know-whats-going-on/
DeepSeek search and fetch: $0.75 per 1000 successful requests
DeepSeekは、APIにグラウンデッドなウェブ検索およびURLフェッチ機能を追加しました。価格は成功したリクエスト1000件あたり$0.75です。技術的な設計はretrieval-augmented generationパターンに従っており、モデルは検索インテントを発行し、DeepSeekがウェブインデックスに対してクエリを実行してスニペットを返し、モデルは取得したコンテンツを条件として応答を生成します。URLフェッチでは、指定したページを直接取り込むことができます。価格モデルは注目に値します。課金は成功した取得ごとに行われ、取得したコンテンツのトークン単位ではありません。これにより、検索結果を詰め込んだフルコンテキストウィンドウに対して課金するモデルと比較して、コスト構造が変わります。$0.75/1kリクエストという価格は、Bing Search API(ティアによって$3〜$7/1k)と比べて競争力があり、同等のスタック(search API+スクレイパー+チャンカー)を独自に組み合わせるよりも安価です。主な未知数は、検索インデックスの鮮度、地理的なカバレッジ、そしてモデルが矛盾するまたは低品質な取得ドキュメントをどのように処理するかです。agentやRAGパイプラインを構築する開発者にとって、統合されたオファリングはインフラのサーフェスエリアを削減します。より広いパターンとして、モデルプロバイダーがretrievalを垂直統合することで、スタンドアロンのsearch APIベンダーやセルフホスト型RAGツールの市場が圧縮されます。ただし、retrieval品質とソース選択に対するコントロールを維持することは、retrievalを外部に保つ理由であり続けています。
Source: https://api-docs.deepseek.com/guides/search/
Kubernetesとの最初の接触、懐疑論者の視点から(2024年)
長年にわたって懐疑的な立場をとってきたシステムエンジニアが、Kubernetesへのオンボーディング経験を率直に綴った記事です。技術的な観察は根拠のあるものとなっており、著者はK8sが実際の問題(宣言的な desired-state reconciliation、水平 pod オートスケーリング、ローリングデプロイ、DNS + kube-proxy によるサービスディスカバリ)を解決していると認めつつも、大多数の小規模チームが実際に抱える問題に対して、運用上の表面積が大きすぎると指摘しています。具体的な摩擦ポイントとして挙げられているのは、コンテナとネットワークの間に積み重なった抽象化の層(CNI plugins、iptables/eBPF ルール、kube-proxy モード)、Requests/Limits と OOM killer の間の直感的でない関係、そして実行時まで検出されないエラーを起こしやすい RBAC 設定などです。著者の結論は、K8sはマルチテナントのワークロード分離や細粒度のリソースアカウンティングが必要な場合、あるいは手動スケジューリングが現実的でない規模で運用している場合には意味をなすが、それ以外では過剰だというものです。この記事は技術的に正確であり、よくある「K8sは複雑すぎる、Docker Composeを使え」といった還元主義を避けています。より興味深い主張は、その複雑さが偶発的なものではなく、分散スケジューリングの真に不可分な要件を反映しているというものです。K8sのスコープクリープに関するKelsey Hightowerの回顧的なコメントと合わせて読む価値があります。HNのスレッドでは、マネージドK8s(EKS/GKE)がコントロールプレーンの複雑さを吸収することで、その損益計算をどのように変えるかについて有益な議論が展開されています。
Source: https://blog.davidv.dev/posts/first-contact-with-k8s/
Linux 7.2カーネルの開発統計
LWNによる7.2リリースごとの開発統計です。数字で見ると:約1,800名の開発者による約14,000件のnon-mergeコミットがあり、通常の分布どおり、少数の高活動なコントリビューターに大きく偏っています。企業別の上位コントリビューターは引き続きIntel、AMD、Meta、Google、Red Hatであり、直近のサイクルと一致しています。サブシステムレベルの分析では、GPU/DRMドライバー(ほとんどのサイクルで行数変更の最大の単一要因)、ネットワーキング(特にBPFおよびXDPサブシステムの継続的な作業)、およびファイルシステムの変更において引き続き活発な活動が見られます。また、この統計では「既知のバグ修正」と新機能の作業も追跡しており、これはカーネルコミュニティが技術的負債の大まかな指標として用いているメトリクスです。7.2サイクルでは、修正対機能の比率に異常な低下は見られません。注目すべき繰り返しのパターンとして、カーネルのコントリビューターベースは依然として大規模かつ地理的に分散していますが、あるサブシステムの唯一の適格なレビュワーを務めるメンテナーの数は、コミュニティが議論しつつも完全には解決していない潜在的なバスファクターリスクとなっています。LWNの記事は生データを提供していますが、その解釈にはどのサブシステムが人員不足であり、どれが十分な後継者を抱えているかを把握する必要があります。
Source: https://lwn.net/Articles/1088776/
Linux 7.3 リリース
Linux 7.3 は、例年通り幅広いドライバー更新、アーキテクチャ改善、およびサブシステムの追加を伴ってリリースされました。今回のリリースにおける主な技術的変更点には、BPF サブシステムの継続的な改良(新しいマップ型およびヘルパー関数)、SCHED_EXT 拡張スケジューラフレームワークの改善(BPF プログラムとして実装されたユーザー定義スケジューリングポリシーを可能にするもので、ワークロード固有のチューニングにおけるアーキテクチャ上の重要な転換点です)、ドライバー開発向けの安全な抽象化を追加するカーネル内 Rust インフラの更新、そして次世代ハードウェア向けの AMD GPU 対応の継続が含まれます。SCHED_EXT の取り組みはアーキテクチャ的に最も重要であると言えます。これにより、本番システムにおいて、コアカーネルコードを変更したりツリー外パッチを適用したりすることなく、スケジューリングポリシー(例えば、レイテンシ最適化、スループット最適化、あるいは NUMA 対応バリアントなど)を実験することが可能になります。Rust の抽象化は引き続き段階的に拡張されており、コアサブシステムの C を置き換えるには至っていませんが、メモリマップ I/O および IRQ ハンドリング向けの安全なラッパーを追加することで、ドライバーバグのクラスを削減しています。ファイルシステムの変更には ext4 および btrfs の信頼性修正が含まれます。本リリースは 7.2 から標準的な 9〜10 週間のサイクルに従っています。例によって、LWN のマージウィンドウ報告は Linus によるリリースアナウンスよりも詳細なサブシステムレベルの情報を提供しています。
Source: https://lwn.net/Articles/1101143/
Show HN: Sphinx — AIが生成したコードを出荷前にクイズで確認するフック
Sphinxは、AIアシスタントに起因するdiffを検出し、コミットを許可する前に理解度確認のクイズを生成するgitのpre-commitまたはpre-pushフックです。その仕組みは以下の通りです:ステージングされたdiffを解析し、それ(またはその要約)をLLMに送信し、短いクイズ(例:「入力リストが空の場合、この関数は何を返しますか?」や「このループの時間計算量は何ですか?」)を受け取り、フックが終了コード0で終了する前に開発者がターミナル上で正しく回答することを求めます。この目的は、開発者が十分に理解していないAI生成コードを出荷してしまうという既知の失敗パターンに対処することです。このパターンは、後でデバッグできない潜在的なバグやセキュリティ問題を生み出します。技術的な実装は単純で、gitフックはシェルスクリプトであり、LLMの呼び出しは標準的なAPIリクエストであり、回答の評価は完全一致またはLLM自身による判定のいずれかです。制限事項も現実に存在します:十分にやる気のある開発者であればpre-commitフックを迂回できますし、LLMが生成するクイズの質問自体が間違っていたり、コードの実際の動作について誤解を招いたりする可能性があります。また、キャリブレーションの問題もあります。質問の難易度は変更の微妙さに合わせるべきですが、それを確実に自動化することは困難です。コードレビュー習慣を強制する手段としては意義のあるアイデアですが、セキュリティ制御としては簡単に回避できます。
注目の新しいリポジトリ
LosaLosSantos/aurelio-finance
ユーザーのマシン上で完全に動作するセルフホスト型の個人財務アプリケーションです。純資産、投資ポートフォリオ、ETF、現金ポジション、負債を追跡します。AIファイナンシャルアドバイザーコンポーネントは、ローカルまたはリモートのLLM backendと統合し、ポートフォリオレベルの質問に回答したり、サードパーティサーバーにデータを送信することなくトレンドを浮かび上がらせます。アーキテクチャはすべての財務データをローカルデータベースに保持しており、これはアカウント認証情報へのオープンアクセスを要求するSaaSの代替サービスと比較した際の重要な差別化要素となっています。このアプリは、単純な支出追跡ではなく、取得原価追跡、配分内訳、債務スケジュールといった構造化されたポートフォリオ会計を求めるユーザー向けに設計されているようです。オープンソースであるため、台帳ロジックとアドバイザーのプロンプトが監査可能であり、財務計算が関わる場面ではこれが重要な意味を持ちます。データモデルを拡張したい、あるいはLLM backendを差し替えたい開発者に適しています。スター数がまだ少ない初期段階であることからスタックの詳細は明らかになりつつある段階ですが、ローカルファーストという制約がすべてのアーキテクチャ上の決定を形作っています。
Source: https://github.com/LosaLosSantos/aurelio-finance
Folkbench/folkbench
AI APIリレーサービス向けのベンチマーキング・切り替えツールです。リレーサービスとは、OpenAI・Anthropicなどのエンドポイントを再パッケージングするサードパーティのプロキシであり、アクセス制限のある地域で広く利用されています。本ツールは実用的な3つの軸を計測します:実際の可用性(稼働率の申告値ではなく実測値)、エンドツーエンドのlatency、そして実効的なトークン単価です。ランキングはオープンに公開されており、ベンダーの自己申告ではなく実際のプローブトラフィックから継続的に更新されます。スイッチャーコンポーネントにより、Claude CodeやOpenAI Codexといったツールが現時点で最高スコアのリレーにリクエストをルーティングできるため、純粋な情報提供にとどまらず実運用上の有用性を持ちます。リレーインフラに依存する実務者にとって、このツールは既存の空白を埋めるものです:リレーサービスに対するベンダーのSLAは検証が困難であり、口コミによる比較も信頼性に欠けるためです。オープンソースの計測手法を採用しているため、コミュニティがプローブ設計を監査し、スコアの不正操作を検知することも可能です。データソースとしても、drop-inルーティングレイヤーとしても活用できます。
Source: https://github.com/Folkbench/folkbench
Sheltercosmo/jev4pg
PostgreSQLに特化した自然言語→SQLシステムで、再利用可能なクエリ生成アーティファクトを保存する「JEV」(構造化された中間エビデンス表現と思われる)を中心に構築されています。設計上の重要な主張は、中間エビデンスをクエリごとにゼロから再生成するのではなく、キャッシュして複数のクエリ間で再利用することで、レイテンシとコストの両方を削減できるという点です。本システムはPG固有のコンストラクトにマッピングされたセマンティック演算子を公開しており、幅広いSQLパターンに対応しています。ネイティブ実行とは、生成されたSQLがORMの抽象化レイヤーを介さず直接PostgreSQLに対して実行されることを意味し、PG固有のオプティマイザ、並列クエリプラン、インデックスタイプへのアクセスが保持されます。Explainable embeddingは開発中のプレビュー機能として挙げられており、自然言語のフレーズが特定のSQLフラグメントにマッピングされた理由をデバッグするための将来的なサポートが示唆されています。エビデンスの再利用によってLLMの呼び出し回数を最小化するというコスト最適化の観点は、クエリごとにナイーブなプロンプトを使用するアプローチとは一線を画しています。既存のPGスキーマ上に社内分析インターフェースを構築しているチームに関連します。
Source: https://github.com/Sheltercosmo/jev4pg
morluto/awesome-reverse-engineering
コンパイル済みバイナリ、モバイル・デスクトップアプリケーション、ファームウェア、ファイルフォーマット解析、ネットワークプロトコル解析という5つのドメインにわたるリバースエンジニアリングを網羅した厳選リファレンスリストです。汎用的な “awesome” リストとは異なり、実践的なRE用途に即したツールおよび学習リソース――ディスアセンブラ、デコンパイラ、動的解析フレームワーク、バイナリ差分ツール、プロトコルディセクタ――に範囲を絞っています。ファームウェアとプロトコルのセクションは特に有用です。これらの領域はバイナリREと比べて中心的なドキュメントが整備されていないためです。ツールの種類別ではなくドメイン別に整理されており、ツールを起点にするのではなくターゲットを起点にアプローチするアナリストに適した構成となっています。学習リソースのセクションには、コース、CTF writeup、リファレンスアーキテクチャが含まれており、純粋なツール一覧との差別化が図られています。894スターに達した現在、コミュニティによるPRが単一メンテナよりも速くカバレッジを改善しつつある段階に入っていると考えられます。新たなREサブドメインに参入する際の体系的な出発点として活用できます。
Source: https://github.com/morluto/awesome-reverse-engineering
LiCinCan/blender-ai-mcp-addon
3Dエディタに直接AIアシスタントを組み込み、BlenderのシーングラフをMCP(Model Context Protocol)サーバとして公開することで、外部エージェントがプログラム的にシーンを読み書きできるようにしたBlender addonです。ビジュアルチャットインターフェースを通じて、ユーザーはジオメトリ操作、マテリアル変更、アニメーションキーフレームなどを自然言語で記述でき、addonがその応答をBlenderのランタイム内で実行されるbpy Python API呼び出しに変換します。マルチエージェントワークフローのサポートにより、オーケストレータがツール呼び出しを連鎖させることが可能で、たとえばあるエージェントがシーンレイアウトを計画し、別のエージェントがシェーディングを担当するといった構成を、Blenderをステートフルなツールサーバとして扱うことで実現できます。バックエンドに依存しない設計により、OpenAI、Claude、Gemini、Ollama、OpenCodeをサポートしており、ローカル推論も実用的な選択肢となります。技術的により興味深い要素はMCPサーバのインターフェースであり、エージェントがシーン状態(オブジェクトのトランスフォーム、メッシュトポロジー、マテリアルグラフ)をクエリしたり変更を加えたりする方法を標準化しており、Python APIを公開する他のDCCツールへの汎用化も期待できます。
Source: https://github.com/LiCinCan/blender-ai-mcp-addon
opensec-git/Pi-Bolt
Piはコーディングエージェントであり、Pi-BoltはJavaScriptランタイム上で動作するのではなく、事前コンパイル(AOT)によってネイティブマシンコードに変換されたバージョンです。公表されているパフォーマンス向上——起動速度3倍の高速化、BunでPiを実行した場合と比較してCPU使用率が約3分の1——は、JITコンパイルのオーバーヘッドとV8/Bunランタイムの初期化を排除することによって直接もたらされるものです。JavaScript/TypeScriptエージェントのAOTコンパイルは、コンパイル時にすべての動的インポートを解決するランタイムスナップショットを必要とするため、容易ではありません。本プロジェクトはPiの依存関係グラフに対してこれを処理しているようです。実用上の結果として、Pi-Boltは起動レイテンシが重要となる呼び出しパターン——CIパイプライン、シェルの統合、またはランタイムのウォームアップが実行時間の大半を占めるような頻繁な短命のエージェント実行——に対してより適しています。CPUの削減は、CPUリソースが厳しく制限されたコンテナのような制約のある環境においても重要です。これはシステムレベルの最適化であり、機能面での変更ではありませんが、起動時間とリソースのオーバーヘッドはエージェント型CLIツールにとって現実的な摩擦要因です。
Source: https://github.com/opensec-git/Pi-Bolt
xevrion/gyotaku
Linux向けのローカルスクリーンショット検索エンジンです。OCRを通じてすべてのスクリーンショットのテキスト内容をインデックス化し、オフラインで検索可能にします。パイプラインはテキスト抽出にPaddleOCRを使用し、結果をSQLiteに保存し、Zedから抽出されたGPUアクセラレーション対応UIフレームワークであるGPUI上に構築されたUIを通じてマッチ結果を表示します。完全オフライン設計により、パスワードや個人的な会話、社内文書などの機密コンテンツを含むスクリーンショットがマシン外に出ることはありません。PaddleOCRは、多くの実際のスクリーンショットにおいてTesseractよりも混合言語テキストや複雑なレイアウトを適切に処理します。これは、スクリーンショットにはきれいに組版されたテキストがほとんど含まれないという実情から重要な点です。インデックスストアとしてSQLiteを採用することで依存関係の規模を最小限に抑え、インデックスの可搬性を確保しています。GPUIはElectronスタイルのオーバーヘッドなしに、Linux上でネイティブに近いレンダリングパフォーマンスを提供します。この組み合わせは実用上のギャップに対処するものです。Linux上のスクリーンショット検索はこれまで、クラウドインデックス(例:Microsoft Recallの相当品)や、まともなUIのないTesseractパイプラインに頼らざるを得ませんでした。
Source: https://github.com/xevrion/gyotaku
Graphicle-AI/graphicle
AIコーディングエージェント向けのコードグラフおよびメモリバックエンドであり、MCP インターフェースを公開する単一のRustバイナリとして実装されています。コードベースの永続的かつクエリ可能なグラフ表現(シンボル(関数、型、モジュール)をノード、呼び出し関係・インポート・定義をエッジとする)と、セッションをまたいで保持されるエージェント固有のコンテキスト向けメモリストアを管理します。MCP インターフェースを採用することで、準拠したクライアント(Claude Code、OpenAI Codex、Cursor)がシンボルの検索、依存チェーン、あるいは「この関数を呼び出しているものは何か」といったトラバーサルを、起動のたびに再インデックスすることなくグラフに対してクエリできます。単一バイナリとしてRustで実装することで、運用上の表面積を最小限に抑えています。すなわち、デーモン管理も独立したデータベースプロセスも不要です。グラフ表現は、推移的な呼び出し元やインターフェース実装のような精密な関係クエリに苦労する、単純な embedding ベースのコード検索よりも構造的です。永続メモリにより、エージェントは意思決定の記録、ファイルレベルのサマリー、タスクのコンテキストを保存し、別々の呼び出しをまたいで取得できます。これは、現在の多くのエージェント構成に存在するステートレス性の問題に対処するものです。