デイリーAIダイジェスト — 2026-10-14
arXiv ハイライト
TPPO: 言語モデル推論のためのTracking-Value PPO
問題設定
二値終端報酬を用いたRLVRにおいて、PPOのcritic は、T ステップ目の単一の \{0,1\} シグナルを、数千トークンにわたる軌跡全体のper-token advantageに変換しなければなりません。二乗TD誤差で学習される通常のMLPヘッドは、軌跡レベルの平均へと圧縮されてしまい、成功確率がprefixにわたって実際にどのように推移するかを追跡できません。GAEにおけるtoken-levelのクレジットは V(\mathbf{s}_{t+1}) - V(\mathbf{s}_t)(加えてスパースな終端報酬)によって決まるため、この推移を反映できないcriticは、最終リターンにほぼ比例するadvantageを生成し、PPOを軌跡レベルのreinforceへと退化させます。本論文の主張は、critic をベイズ的な価値推移の構造を尊重するように明示的にパラメータ化することで、PPOに対して一貫した性能向上が得られるというものです。
連続する価値のベイズ分解
固定方策、二値終端報酬、\gamma=1 のもとで、V^{\pi_\theta}(\mathbf{s}_t) = \Pr_{\pi_\theta}[R=1 \mid \mathbf{s}_t] が成り立ちます。1ステップの更新は、放出されたトークン a_t に対する条件付けとしてのベイズの定理となります。
V^{\pi_\theta}(\mathbf{s}_{t+1}) = \frac{V^{\pi_\theta}(\mathbf{s}_t)\,\Pr_{\pi_\theta}[a_t \mid \mathbf{s}_t, R=1]}{V^{\pi_\theta}(\mathbf{s}_t)\,\Pr_{\pi_\theta}[a_t \mid \mathbf{s}_t, R=1] + (1-V^{\pi_\theta}(\mathbf{s}_t))\,\Pr_{\pi_\theta}[a_t \mid \mathbf{s}_t, R=0]}.
対数オッズを取ることで、これをper-tokenの加算的増分へと線形化できます。
\operatorname{logit} V^{\pi_\theta}(\mathbf{s}_{t+1}) - \operatorname{logit} V^{\pi_\theta}(\mathbf{s}_t) = \log \frac{\Pr_{\pi_\theta}[a_t \mid \mathbf{s}_t, R=1]}{\Pr_{\pi_\theta}[a_t \mid \mathbf{s}_t, R=0]} \doteq \Delta_{t+1}^{\pi_\theta}.
軌跡に沿って展開すると、
\operatorname{logit} V^{\pi_\theta}(\mathbf{s}_T) = \operatorname{logit} V^{\pi_\theta}(\mathbf{s}_0) + \sum_{\tau=1}^{T} \Delta_\tau^{\pi_\theta}.
したがって、criticの自然なパラメータ化は直接のスカラー V(\mathbf{s}_t) ではなく、logit空間で加算されるper-tokenの対数尤度比増分の系列となります。
手法:累積logit critic
TPPOはスカラーのvalue headを、各位置のスカラー出力 \delta_\phi(\mathbf{s}_t, a_t) に置き換えます。これは \Delta_t^{\pi_\theta} の推定値として解釈されます。prefix の価値は次のように再構成されます。
\hat V_\phi(\mathbf{s}_t) = \sigma\!\left(\ell_0 + \sum_{\tau=1}^{t} \delta_\phi(\mathbf{s}_{\tau-1}, a_{\tau-1})\right),
ここで \ell_0 は学習される(またはデータから推定される)事前logitです。学習には終端結果の教師信号を用います。V^{\pi_\theta}(\mathbf{s}_T) = R \in \{0,1\} であるため、再構成された価値は各位置において実現した結果に対して回帰されます(同等に、各 t における累積logitに対する目標 R でのロジスティック回帰)。これはバイアスを削減する再パラメータ化であり、logit空間での加法的な事前分布はベイズ的推移に正確に一致し、criticは必然的に終端ラベルに到達する事前確率単調列を生成します。GAEはその後、通常通り \hat V_\phi 上で計算されます。
この構成には2つの注目すべき帰結があります。第一に、criticヘッドはvalue regressionではなくper-tokenのスカラー予測器であり、その和を通じてすべての位置で終端ラベルに対してgradientを整合させます。第二に、advantage A_t \approx \hat V_\phi(\mathbf{s}_{t+1}) - \hat V_\phi(\mathbf{s}_t) は、構造上その位置における \delta_\phi によって決定されます。すなわち、token-localなクレジットが学習された対数尤度比となります。
結果
著者らは、10の数学ベンチマーク(AIME24/25/26、AMC、MATH-500、Minerva、OlympiadBenchはin-domain;ARC-C、AGI-Eval、BBHはOOD)、カウントダウン、および科学的コーディング(SciCode、HumanEval、HumanEvalFix、LiveCodeBench v6、APPS-Intro)で評価を行っています。サンプリングにはtemperature 1.0と最大24kトークンを使用し、AIME/AMCはAvg@32、その他はAvg@4を採用しています。
数学スコアの集計において、TPPOはPPOに対してQwen3-4B-Baseで+7.0ポイント、Qwen3-8B-Baseで+8.4ポイント上回りました。性能向上はQwen3-4B(instruct)、Qwen2.5-Math-1.5B、Qwen3.5-9Bにも及び、カウントダウンおよび科学的コーディングにも転移しています。OODベンチマーク(ARC-C、AGI-Eval、BBH)でも改善が見られ、criticの再パラメータ化がin-domainの終端教師信号に過適合していないことを示唆しています。
分析セクションでは、累積criticが標準PPOのcriticよりも参照prefix価値(MCロールアウトによる推定)をより忠実に追跡すること、および結果として得られるadvantage推定値がMC advantageとより高い相関を持つことが報告されています。すなわち、本手法が狙っているメカニズム(価値推移の追跡 → クレジット割り当て)が実際に効いていることが確認されています。
限界とオープンクエスチョン
ベイズ的な導出は固定方策を仮定しており、PPO学習中は方策が更新されるため、\Delta_t^{\pi_\theta} はドリフトし、等式は更新ステップ間でのみ近似的に成立します。二値報酬の仮定が中心的であり、形状化報酬や連続報酬への拡張には \sigma 以外のリンク関数が必要となります。また、本手法は終端教師信号のみに依存するため、バッチレベルですべて正解またはすべて不正解の軌跡は、平均を超える \delta_\phi 増分への弱いシグナルしか提供しません。通過率が飽和した場合に何が起きるかは論文中で報告されていません。さらに、GRPOやRLOOのようなvalue-freeベースラインとの同等計算量での比較が提供されておらず、性能向上がより良いクレジット割り当てに固有のものなのか、より強いcriticによる一般的なものなのかが明確ではありません。
意義
RLVRの実践の多くは、スパース報酬下でPPOのcriticが学習困難であるという理由から、学習済みcriticから離れる方向(GRPO、RLOO)へと移行してきました。TPPOは、加法的対数オッズ(per-tokenの対数尤度比増分)という原理的な再パラメータ化が存在し、criticを機能させることができること、そしてPPOに対して数学で7〜8ポイントを回復できることを示しています。これにより、critic-baseのRLVRの方向性が、具体的かつ機械的にシンプルな修正とともに再び開かれることになります。
Source: https://arxiv.org/abs/2610.16794
DoSA: Dots Sparse Attention
問題設定
学習済みインデクサを用いるsparse-attentionアーキテクチャ(DeepSeek-V3.2およびGLM-5.2で採用)では、各queryが補助インデクサを通じてkeyのTop-Kサブセットを選択します。key iに対するインデクサスコアは
s_i = \sum_{h=1}^{H} w_h \left[\mathbf{q}_h^\top \mathbf{k}_i\right]_+,\qquad i\in\Omega,
と定義され、H個のインデクサhead(GLM-5.2ではH=32、DeepSeek-V3.2では64)がそれぞれReLUで整流された重み付き内積を寄与します。attentionはsparse(K=2{,}048)であるにもかかわらず、s_iの計算はすべての可視keyを全インデクサheadでスコアリングする必要があり、長いコンテキストではインデクサ自体がボトルネックになります。DoSAはこの密なスコアリングステップを無損失で除去します。すなわち、正確なTop-K集合を返しながらも、集合に入り得ないことが証明可能なkeyに対してはHhead全評価を回避します。
手法:Top-K棄却証明書
中心的な観察は、Top-K選択において敗者の正確なスコアは不要であり、棄却するための十分な根拠さえあればよいという点です。DoSAはこの根拠を3つの部分から構築します。
シード集合による閾値設定。 小規模なシードサブセットを正確にスコアリングし、K番目に大きいシードスコアが最終的なTop-K入場閾値の下界\tauを定義します。\tauは実際の可視keyから得られるため、勝者のスコアが\tauを下回ることはありません。
正の寄与の上界。 非負の射影を持つheadのスクリーニングサブセットに対しては正確な内積を計算します。残りのheadについては、事前計算されたノルムと補助FP8行から導出された結合残差境界が、全headを評価せずに\sum_h w_h[\mathbf{q}_h^\top \mathbf{k}_i]_+のper-key上界を与えます。
負の減算の下界。 活性化情報を用いた集約が、負の重みを持つheadが減算できる大きさを制限し、上界をさらに締めます。
これらを組み合わせることで、s_i \le U_i^{\text{num}}を満たす分子境界U_i^{\text{num}}が得られます。U_i^{\text{num}} < \tauとなるkeyは、証明可能にTop-Kに含まれないため、full-headスコアリングの前に枝刈りされます。付録A–Cでは証明書の有効性と完全選択の条件を示し、インデクサの幾何構造(headのアライメント、選択マージンs_{(K)} - s_{(K+1)})が候補の生存数をどのように支配するかを分析しています。
GPUカーネル設計
代数的証明書は、GPUの実行フローにクリーンに対応する場合にのみ有用です。DoSAは計算を密なスクリーニングパスとsparse refinementの2段階に分けます。
- スクリーニング(Tensor Cores)。 Queryは保持するheadのバジェットが類似した固定幅タイルにグループ化されるため、スクリーニングは密なMMAを使用します。折り畳まれた重みとFP8補助行は一度準備されてkeyタイル間で再利用されます。専用のwarpが非同期keyロードをMMAとオーバーラップして発行し、consumerのwarpがTMEMからアキュムレータを読み取ってU_i^{\text{num}}を評価します。
- コンパクション。 Warp ballotが生存決定をビットマスクにパックし、コンパクトな候補IDを生成します。
- Refinement(Tensor Cores、sparse)。 生存したkeyのみがfull H-headスコアリングを受け、keyはグループ化されたquery間で一度ロードされて共有されます。
- 正確スコアフィルタリング+sparse書き戻し。 正確なスコアが依然として\tauを下回る候補は書き戻し前に破棄され、選択処理をさらに削減します。
シードの正確なスコアが各queryの\tauを初期化し、スキャン中は固定されます。これは枝刈り基準をストリーミング状態から切り離す上で重要です。
実験結果
GLM-5.2(32 head、シングルGPU)およびDeepSeek-V3.2(64 head、8-way TP)において、K=2{,}048、prefillチャンクサイズ32K/16Kトークンで評価した結果:
- Complete-Indexer speedup: 英語・中国語・コードのワークロード全体でSGLangに対して最大2.74\times、LiteTopKに対して最大1.69\timesの高速化。
- エンドツーエンドTTFT: SGLangに対してGLM-5.2で最大1.94\times、DeepSeek-V3.2で最大1.50\timesの高速化。
per-layerの検索処理の内訳から、性能向上が一様ではないことが示されています。
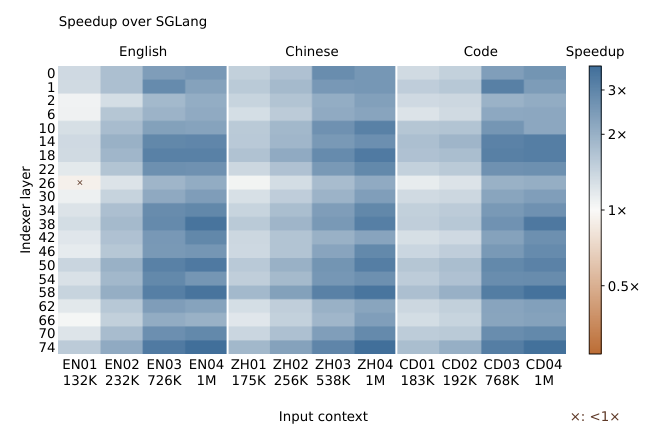
ほとんどのセルは大幅な高速化を示しています(1\timesを中心とした対数スケール)が、一部のlayer(×印でマーク)では密なベースラインより低速になっています。これらは証明書が緩いlayerであり、選択マージンが小さいか、headの幾何構造が残差境界を締めることを妨げています。5つのセルではキャパシティ修復の再計測が必要でした(付録D.4)。これはスクリーニングのオーバーヘッドが償却されず、証明書が棄却する候補が少なすぎるエッジケースの存在を示唆しています。
制限と未解決の問題
- 証明書の精度は幾何構造に依存する。 per-layerで低速なセルの存在は、DoSAがper-layerの高速化を保証しないことを示しており、適切に調整された密なカーネルに負けるlayerも存在します。どのインデクサhead構成がDoSAに適しているかをa prioriに特徴づける問題は未解決です。
- シード選択。 論文では\tauを初期化するシードスキームを固定していますが、この境界の品質が枝刈りの歩留まりを直接制御します。適応的またはquery依存のシーディングは探索されていません。
- prefill中心の評価。 マイクロベンチマークとTTFTはprefillを重視しています。keyの再利用とqueryのバッチ処理が異なるdecodeでの挙動については、十分な注意が払われていません。
- 非負射影への依存。 上界の構築はReLU整流されたhead形式の性質に依存しており、[\cdot]_+を持たないインデクサ(例:softmax重み付き補助スコアラー)への拡張は自明ではありません。
重要性
学習済みインデクサはattentionをsparseにする目的で導入されましたが、インデクサ自体はquery当たりO(HN)でスケールし、長いコンテキストのprefillコストをますます支配するようになっています。DoSAは、無損失なTop-K選択が証明書駆動の条件付き実行を許容し、Tensor Coreパイプラインにクリーンに対応することを示しています。代数的な境界を精度損失なしにエンドツーエンドのTTFTで約2\timesの改善へと変換するこのアプローチは、MoEルーティングや検索拡張デコーディングにおける他のTop-Kゲーティング構造にも一般化可能なテンプレートとなり得ます。
Source: https://arxiv.org/abs/2610.13990
GreenWAM: ロボティクス向け世界基盤モデル
ロボティクスは、これまで主に二つのモデリング流派に分岐してきました。一つはアクションを条件とした将来の観測を予測する世界モデル、もう一つは観測と目標を条件としてアクションを出力するポリシー(VLAまたは世界-アクションのハイブリッド)です。各ロボットプラットフォームは通常、固有のアクションスキーマ(異なる次元の関節ベクトル、エンドエフェクタのパラメータ化、グリッパーのエンコーディング)を持つため、双方のロボットごとの再学習が強いられます。GreenWAMは、単一の生成モデルが異種の embodiment をまたいで両方の役割を担えるかどうか、またそのような転移を安定させる学習レシピが何であるかを問いかけます。
問題の定式化
核心にある賭けは、アクション条件付き映像予測に用いられる生成的な基盤が、アクションチャンネルが embodiment に依存しない場合に限り、アクション生成のための有用な事前分布としても機能するというものです。本論文では、同一のバックボーンに対して三つの動作モードを形式化しています。
- 視覚モード:無条件またはテキスト条件付きの映像予測、p_\theta(v_{1:T} \mid v_0, c)。
- アクション条件付き(世界モデル)モード:p_\theta(v_{1:T} \mid v_0, a_{1:T})。
- 世界-アクションモード:結合分布 p_\theta(v_{1:T}, a_{1:T} \mid v_0, c)、ここからポリシー p_\theta(a_{1:T} \mid v_0, c) を抽出。
学習はこれら三つのモードを同時に対象とするため、同一の重みが、運動学的な根拠付け(映像がアクションに従う)、視覚的事前分布(大規模なラベルなし映像)、および目標条件付き行動をすべて吸収します。
共有された解剖学的アクション空間
中心的なエンジニアリング上の工夫は、20のロボットファミリー(双腕アーム、モバイルマニピュレータ、器用なヒューマノイドなど)を対象とした統一アクション表現です。これはロボットごとのDoFベクトルやエンドエフェクタ姿勢ではなく、共通の関節座標に基づく解剖学的なレイアウトで表現されます。各 embodiment は自身の固有感覚情報を命名された解剖学的スロット(肩、肘、手首、指関節、ベースなど)にマッピングし、非活性なスロットはマスクされます。これにより、異種のデータセットが固定されたセマンティックレイアウトを持つテンソル a_t \in \mathbb{R}^{K} と、サンプルごとの有効マスク m_t \in \{0,1\}^{K} に統一され、lossは駆動される関節のみを通じて逆伝播されます。
\mathcal{L}_{\text{act}} = \mathbb{E}\!\left[\sum_t \| m_t \odot (\hat a_t - a_t) \|^2 \right].
この解剖学的設計により、異種 embodiment 間の事前学習が意味のあるものとなります。「肩ピッチ」トークンは、Frankaアームからのものであれ、H1ヒューマノイドからのものであれ、一貫したセマンティクスを持ちます。また、主に一つのファミリーで学習したポリシーが、スロットの再マッピングだけで別のファミリーに対して妥当な出力を生成できるようになります。
アーキテクチャとアクションエキスパートの分割
生成モデルはdiffusion/flow映像モデルであり、denoising transformerにアクションチャンネルが注入されます。ポリシーの役割のために、GreenWAMは共有された生成モデルから「アクションエキスパート」を分離します。これは、生成モデルの中間表現を再利用しながらもアクション軌跡の出力に特化した小型のヘッドであり、視覚ストリームのdiffusion lossと整合した行動クローニング目標で学習されます。この設計により、制御時に完全な映像デコーダを実行するという標準的な非効率を回避しつつ、結合学習中にアクションとダイナミクスを整合させたgradientを保持します。
三つの学習モードを交互に組み合わせることで、各バッチが共有表現に寄与します。
- 純粋な映像バッチは視覚的事前分布を更新します。
- (v_{1:T}, a_{1:T}) バッチはモデルを忠実な世界モデルにします。
- 目標画像またはテキストを含む目標条件付きバッチがポリシー目標を駆動します。
結果
世界モデルとして、GreenWAMはWorldArena 1.0において軌跡精度、深度一貫性、3D幾何学的指標でトップに立ち、著者らの比較において比較対象のすべての映像生成モデルおよび世界-アクションベースラインを上回っています。
ポリシーとして:
- RoboTwin 2.0リーダーボードでは、それらのタスクに特化していないにもかかわらず、上位エントリの中に位置しています。
- LIBERO-plus(ゼロショット)では、比較対象手法の中で最高の成功率を達成しています。
- CALVINおよびLIBEROでは、専用のVLAおよび世界-アクションポリシーと競争力のある結果を示しています。
特筆すべき点は、単一の指標が最先端であるということよりも、一組の重みが同時にトップクラスの世界モデルとトップクラスのゼロショットポリシーの両方であるという点です。これは従来、異なるモデルクラスを選択することが必要だった比較です。
限界と未解決の問題
現時点のテキストからは、いくつかの点が未解決のままです。
- 解剖学的スロットはロボットごとのオーサリングを必要とします。非常に異なる形態(ソフトロボット、アンダーアクチュエーションの四足歩行ロボット、腱駆動ハンドなど)へのスケールアップは、単純な再マッピング以上のものを必要とする可能性が高く、手動マッピングの労力が新しい embodiment の処理量をどの程度制限するかについて、本論文では定量化されていません。
- ゼロショットの結果はLIBERO-plusで報告されていますが、分布シフト(照明、ダイナミクス、遅延)の下での物理的なハードウェアへの転移の程度は、アブストラクトでは実証されていません。
- 視覚モード、アクション条件付きモード、世界-アクションモードの結合学習はミキシング係数を導入しますが、その感度については議論されていません。ポリシーと世界モデルの目標がトレードオフとなり得ることを考えると、これはおそらく重要な問題です。
- 完全な生成モデルの推論コストは高く、アクションエキスパートの分割は制御に対して有効ですが、実用的なホライズンでのclosed-loop世界モデルを用いたプランニングはdiffusionサンプリングコストによって依然として制約されています。
- 20ファミリーのカバレッジは、長期ホライズンのモバイルマニピュレーションや接触の多いツール使用を依然として十分に代表していません。共有された解剖学的設計がこれらの状況で有効かどうかは不明です。
なぜこれが重要か
単一の生成バックボーンが embodiment をまたいで強力な世界モデルかつ強力なポリシーとなれるのであれば、現在の映像世界モデル、VLA、世界-アクションハイブリッドの分離は、根本的なアーキテクチャ上の必然ではなく、部分的には学習慣習の産物に過ぎないと言えます。解剖学的アクション空間は、シンプルで移植可能な抽象化であり、ロボットプラットフォームの長いテールにわたる結合学習をスケールさせるための前提条件として、tokenizer のロボティクス版となる可能性があります。
Source: https://arxiv.org/abs/2610.18774
Jeva: 第一原理からのSystem Oneモデル
問題
LLMにおける分類スタイルの意思決定は、通常、リクエストとすべての候補を単一のプロンプトにシリアライズし、回答トークンをデコードします。これは、意思決定問題が実際に必要とする四つの構造的性質を混同しています:(i) null-awareness — 「許容できる選択肢がない」と「選択肢間で不確か」を区別すること;(ii) permutation invariance — 候補の並び替えが予測を変えないこと;(iii) option scalability — K が出力ヘッドを再定義することなく可変であること;(iv) cacheability — リクエストをまたいで繰り返し現れる選択肢のエンコーディングが再利用可能であること。本論文はこれらを形式化し、プロンプトエンジニアリングやデータ拡張ではなく、設計によってこれらを強制するアーキテクチャであるJevaを提案します。
手法
意思決定インスタンスは、状態・質問・決定タイプ・候補のタプル (x, \iota, t, \mathcal{O})(\mathcal{O} = (o_1,\ldots,o_K)、K \geq 2)です。二つのテキストテンプレートが役割を分離します:T_x(t,\iota,x) はリクエストを担い、T_o(t,o_i) はタイプと単一の候補のみを担い、インデックスも兄弟選択肢も質問も含みません。最後の非パディングトークンのpoolingとバイアスなし射影を持つ共有言語バックボーン E_\theta が以下を生成します:
z_0 = P_x E_\theta(T_x(t,\iota,x)), \qquad u_i = \operatorname{nrm}(P_o E_\theta(T_o(t,o_i))),
ここで z_0, u_i \in \mathbb{R}^d であり、選択肢に対して安定化された \ell_2 正規化が適用されます。U = [u_1^\top;\ldots;u_K^\top] の行はforward pass内で固定されており、コンパクトな「decision stack」が不変メモリとして U に対して z_0 のみを洗練し、条件付き状態 z を生成して各 u_i に対して対称的にスコアリングします。
著者らは、独立してスコアリングするのではなく状態を洗練することの明快な動機を示しています。スコアが g(x,\iota,o_i) と分解でき、温度 \tau でsoftmax正規化されるならば、
\log \frac{q_i(\mathcal{O})}{q_j(\mathcal{O})} = \frac{g(x,\iota,o_i)-g(x,\iota,o_j)}{\tau},
となり、分母がキャンセルされます:第三の選択肢の追加・削除は確率を再スケールできますが、i と j の間の選好を逆転させることは決してできません。現実的なセット依存の逆転を表現するにはセット条件付き状態が必要であり、一方で選択肢ベクトルは再利用可能なままです。
Permutation invarianceは u_i 全体の対称的な集約によって処理され(論文のProposition 3)、option scalabilityは共有スコアリング(一つのdot-productヘッド、可変 K)によって処理されます。Null処理は分解されています:候補に対するcompetition分布 q と、いずれかの候補が許容可能かどうかを推定する別個のcoverageスカラー \rho \in [0,1] があり、最終的な質量 (1-\rho) がnullに割り当てられます。両者は明示的にデカップルされています:候補スコアの一様シフトは q を固定したまま \rho を変化させ、固定された候補スコアにcoverage logit s_C=0.4 を加えると \rho を保持しながら p を再分配します(報告された閾値:\tau_\text{dec}=0.20、\tau_\text{cov}=0.15、b_\text{cov}=0.50)。Cachabilityは独立エンコーディングから自然に従います:u_i は (t, o_i) のみに依存するため、option bankはそのペアをキーとしてリクエストをまたいで、また候補サブセットをまたいで再利用できます。
結果
共通評価スイート — Typed Decisions(2,000例)、BANKING77、K \in \{8,16\} でのMASSIVE、および16候補を持つ三つのMind2Webスライス — において、Jevaは8つのfull-coverageスライスのうち7つでリードしています。BANKING77とMASSIVEは両候補数で90%を超えています。Mind2Webのcross-task/cross-website/cross-domain selectionはそれぞれ79.99%、62.25%、66.23%に達しています。Typed Decisionsでは、JevaはInternDecision-4Bの78.70%に対して78.30%を達成しており、はるかに大きいベースラインと実質的に同点です。
デカップルされたnull/スコアヘッドはキャリブレーションの向上につながります:600件のNoulと800件のScoreアイテムにおいて、JevaはNoul Brier(0.0184)とMAE(0.0939)が最低であり、Score MAE(0.2315)も最低です;そのScore RMSE(0.3222)はInternDecision-4Bの0.3208とノイズの範囲内です。
permutation実験が最も鮮明な実証です。600件のChoiceサンプルを元の順序、逆順、および最大三つのシードによるランダム順序で実行したところ、Jevaはラベルフリップがゼロ、平均total variation 3.17 \times 10^{-8}(統計的ではなく数値的な変動)、すべての順序で同一の76.67%の精度を示しました。ベースラインのJev-1.13.0、InternDecision-4B、JevK5はそれぞれ17.00%、22.67%、26.17%のサンプルでフリップし、全順序精度は66.67%、64.50%、47.83%に崩壊しています。これは予想される挙動です:シリアライズされたデコーディングモデルには対称性を強制するメカニズムがなく、経験的にも訓練データだけからそれを獲得することはありません。
六つの互いに素な候補数コホートにわたるToolRet評価は、option bankの再利用が自然なリクエストストリームにおいてp50 latencyの改善をもたらすことを示しています(256行 / 131,072トークンバッチング)。一方、有効なcoverageは77%(報告されたスライスで84リクエスト中65件)です。ネストされた候補セットのテスト(83クエリを異なる K で評価)は、all-size accuracy — 同じクエリに対してすべての K での正確性 — を測定しており、これはpermutation-sensitiveなベースラインが最も劣化する箇所です。
限界
評価は控えめな K(最大16)を持つ分類スタイルの意思決定に対するものです;coverageキャリブレーションとbank evictionポリシーが中心となる K が数千規模でのスケーリング挙動は研究されていません。coverageヘッドはsoft targetに対して訓練されていますが、その構築はこれらの抜粋では完全に明示されていません。また、より大きいベースラインとのScore RMSEの同等性は、回帰ヘッドが差別化要因ではなく、構造的保証がそうであることを示唆しています。最後に、リクエスト状態のみを洗練するdecision stackは、z が U へのattentionを通じてそのようなインタラクションをエンコードしない限り、真にペアワイズな選択肢インタラクション(例:「互換性のあるものの中で最安値を選ぶ」)を表現できません;論文の対称的な集約設計は、そのような二次の推論を許容するかどうかについて検討が必要です。
なぜ重要か
Jevaは、プロンプトandデコード分類器によって日常的に違反される四つの性質 — null-awareness、permutation invariance、option scalability、option cacheability — が精度を犠牲にすることなくアーキテクチャ的に強制できること、そうすることで標準ベンチマークでは見えないが本番環境では壊滅的な障害モード(並び替えによる26%のフリップ率)が排除されることを具体的に実証しています。ツール・インテント・アクションの中からルーティングするエージェントスタックのsystem-oneレイヤーにとって、これは正しいデフォルトの形状です。
Source: https://arxiv.org/abs/2610.18773
Agent-Reflex: 言語エージェントに反省的な行動を教える
問題
MCPツールサーバーと対話するデプロイ済みのLLMエージェントは、厳選されたベンチマークには存在しない2種類の非定常性に直面します。すなわち、ツールが不正な形式の出力、レート制限された出力、または古い出力を返すことと、ユーザーが軌跡の途中で修正のために介入することです。標準的なエージェントRLおよび軌跡レベルのSFTは、そのような失敗の検出、回復、またはユーザーフィードバックの組み込みに対する明示的な監督を提供しません。実証的には、そのギャップは深刻です。Figure 1に示すように、GPT-5.2やClaude-4.5-Sonnetでさえ、クリーンな設定と比べてツールおよびユーザーノイズのもとで成功率が大幅に低下し、177,700件のログに記録されたツール呼び出しのうち24,510件の実際のエラー返却から得られた8つの異なるエラーファミリーにわたって、採掘された失敗の分布は重い裾を持ちます。
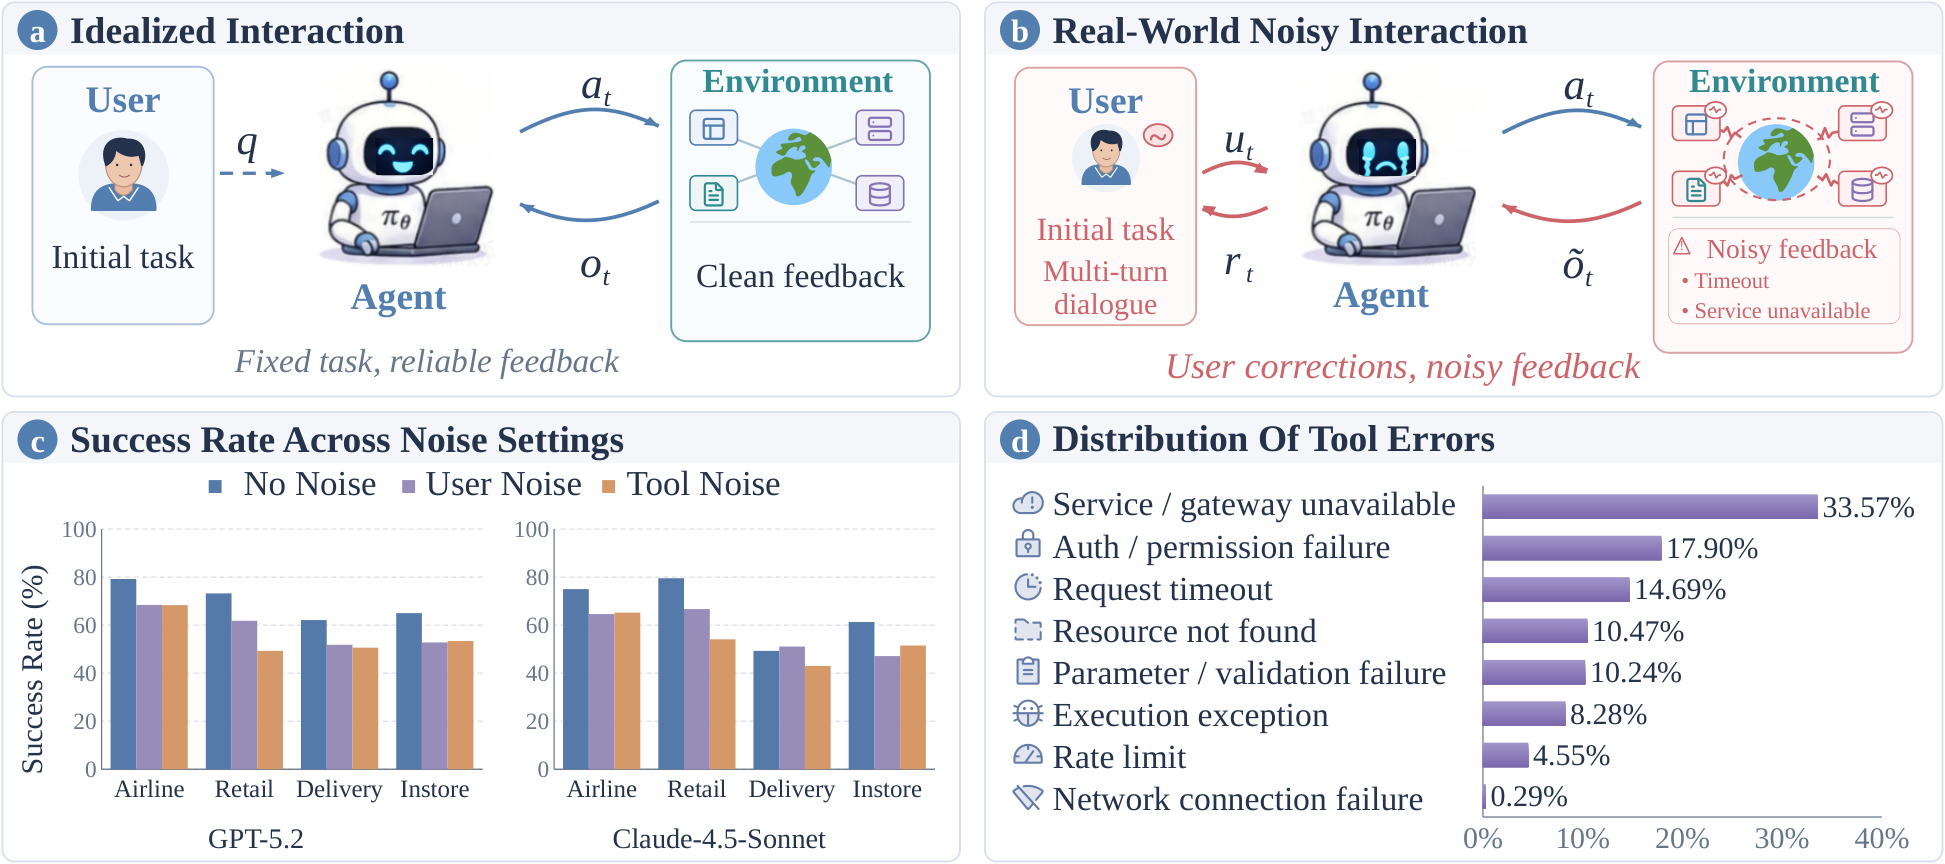
Agent-Reflexは、反省——自己診断、スキル回復、ユーザー中心の修正——をプロンプト時の付け足しではなく、一級の training signal として扱うことでこの問題に取り組みます。
手法
このフレームワークはQwen3-8Bをバックボーンとして構築され、3つのステージで構成されています。
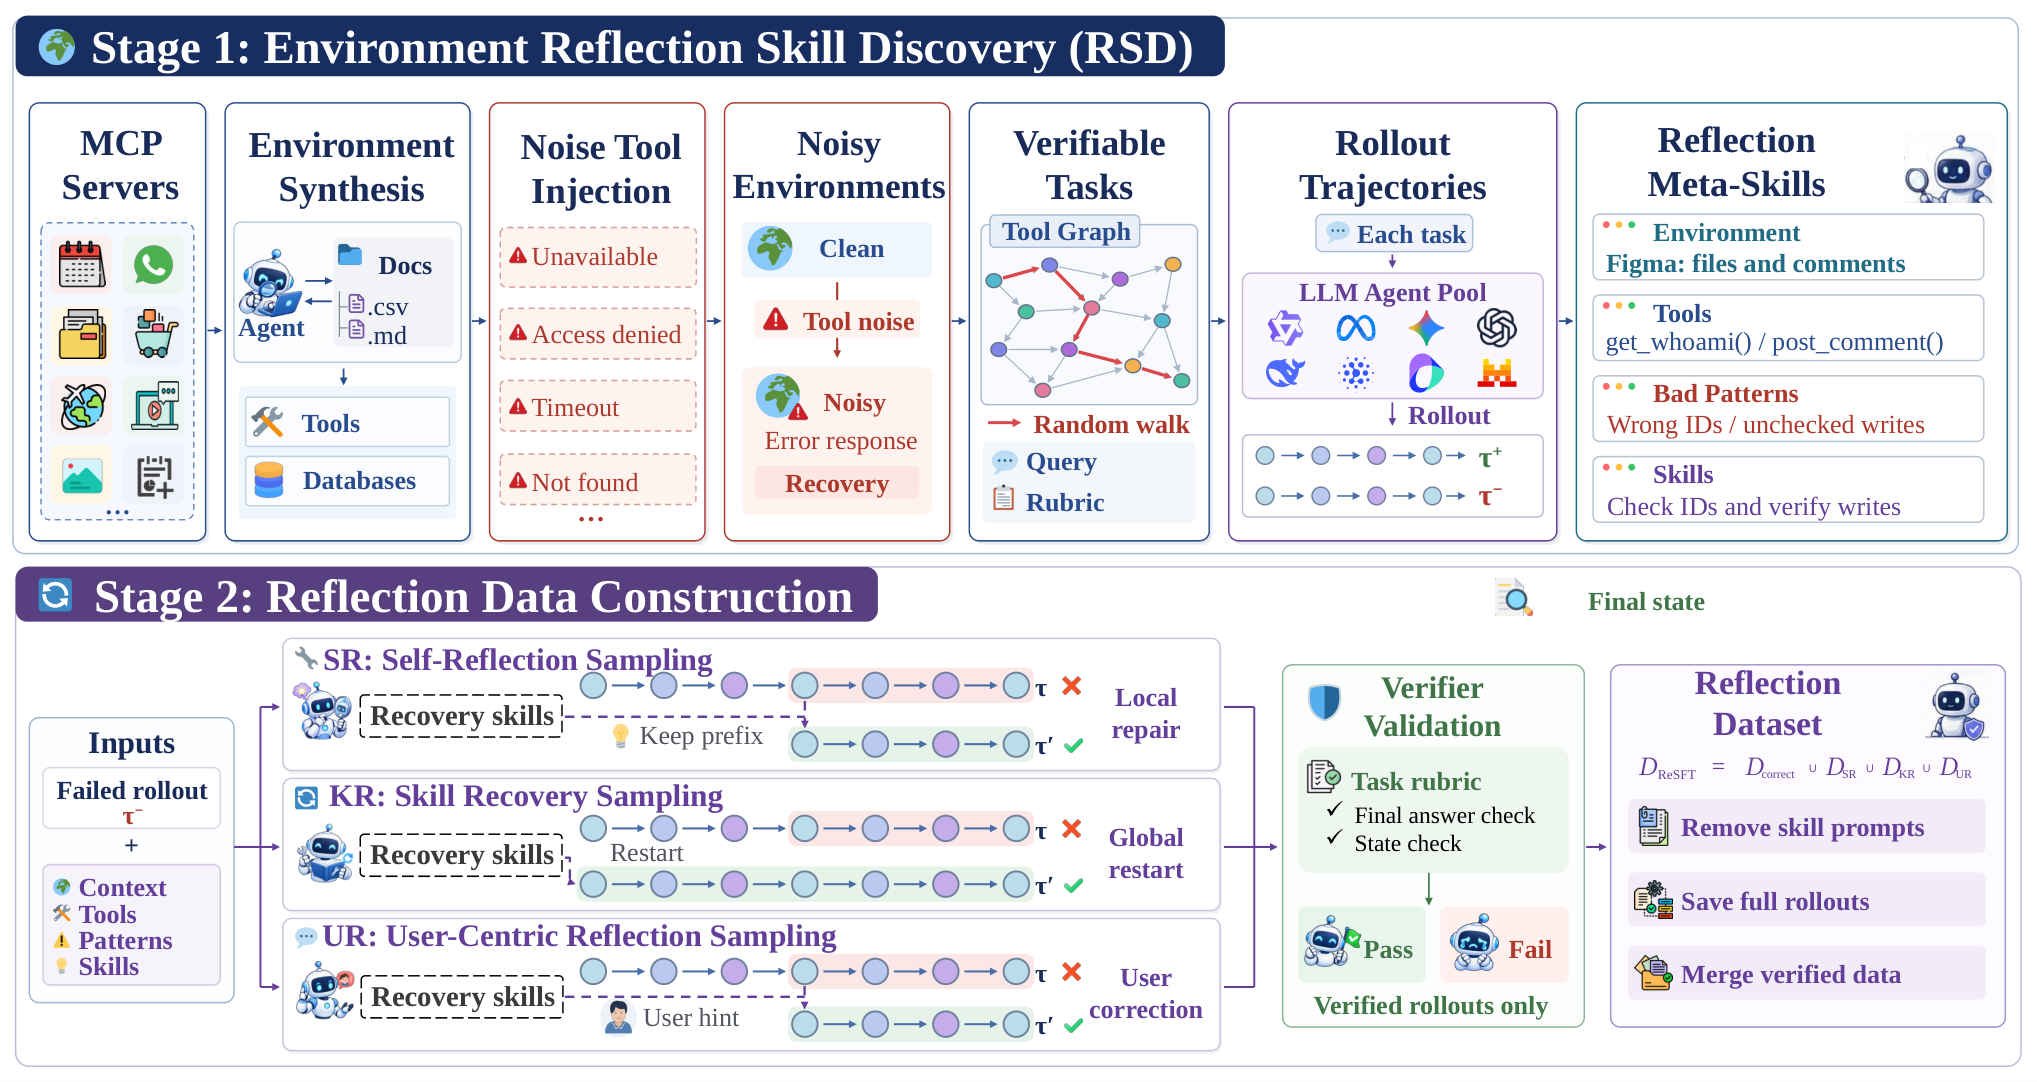
Stage 1 — 環境反省スキル発見(RSD)。 著者らはSmitheryから557のMCPアンカー付き環境をインスタンス化します。各トピックmに対して、リサーチエージェントが根拠付きデータベースを構築し、コーディングエージェントが候補ツールとユニットテストを合成します。コンパイル、テスト合格、状態遷移制約の遵守、および実行可能なベリファイアのサポートを満たすツールのみが保持されます。各\mathcal{E}_mは60個のベリファイアに裏付けられたタスクを生成します。
摂動は合成的ではありません。9つの公開エージェントベンチマークからのツール返却が再生され、観測された24,510件のエラー返却が8つの実行可能な失敗ファミリーにクラスタリングされます。学習時には、ツール返却がレンダラーJによって確率的に書き換えられます。
o_{t+1}^{\text{train}} = \begin{cases} J(o_{t+1}), & b_{t+1}^{\text{inj}}=1 \\ o_{t+1}, & b_{t+1}^{\text{inj}}=0 \end{cases},\quad b_{t+1}^{\text{inj}} \sim \text{Bernoulli}(p_{\text{inj}}).
Jは呼び出されたツールf_tと互換性のある失敗から抽出し、8つのファミリー全体でバランスをとることで、稀なモードも学習可能になります。多様なLLMプールがクリーンなタスクと摂動されたタスクの両方をロールアウトし、プレフィックスを共有する成功/失敗のペアが採掘され、分岐したサフィックスがオフラインのスキルライブラリに格納される再利用可能な反省メタスキルに要約されます。
Stage 2 — 反省的教師あり fine-tuning(ReSFT)。 ライブラリの各スキルは、ペアとなった軌跡からサンプリングされた3種類の継続タイプに変換されます。すなわち、ローカル自己修復(SR)、グローバルスキル回復(KR)、およびユーザー修正(UR)です。スキルカードは生成時のプロンプトとしてのみ使用され、ベリファイア検証後に取り除かれるため、学生はコンテキストからスキルを暗黙的に呼び出すことを学習します(Figure 2)。
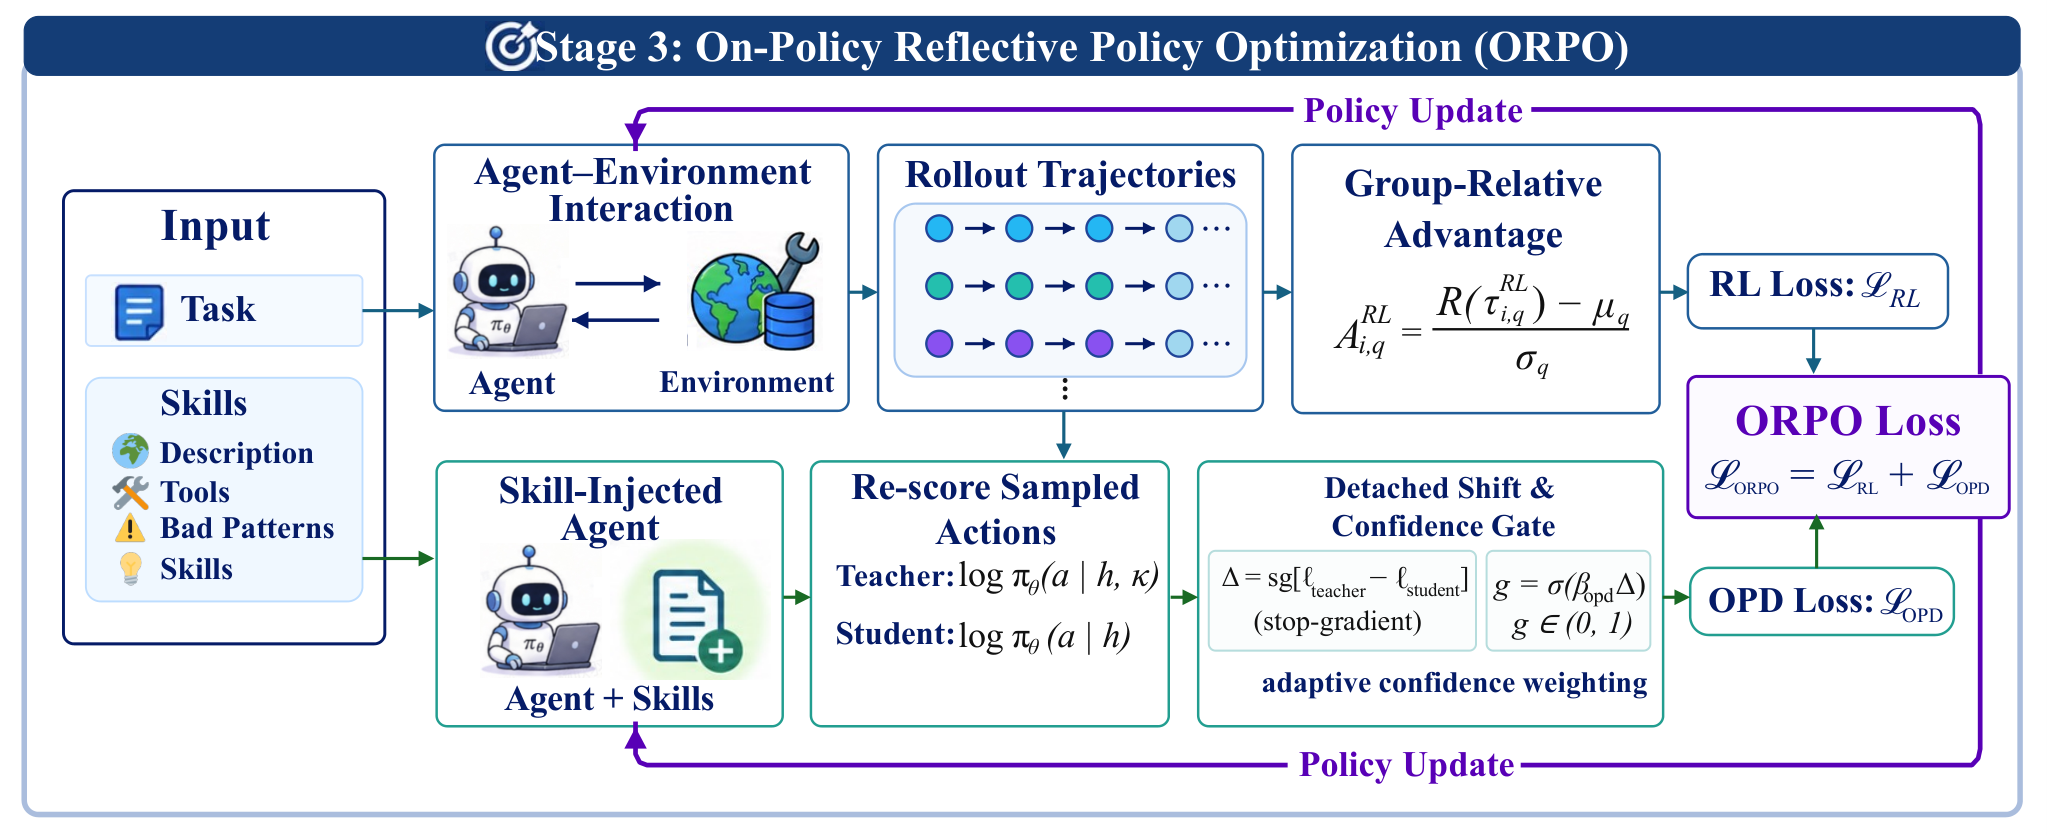
Stage 3 — オンポリシー反省的ポリシー最適化(ORPO)。 RLフェーズは、ノイジーなエージェントRLとスキル条件付き教師からのオンポリシー蒸留(OPD)を組み合わせます。ロールアウトグループは主にクリーンな軌跡にいくつかの摂動された軌跡を混合し、GRPOに類似した単一のグループ正規化アドバンテージを共有しますが、異種環境にわたって定義されます。OPDシグナルは同じトークンを2回再スコアリングします——環境のスキルカードを前置した場合と前置しない場合——これにより、デタッチされた信頼度重み付き補助lossが生成されます(Figure 3)。これにより、サンプリング分布を変更することなく、また推論時にスキルカードを必要とすることなく、密なトークンごとの反省監督が得られます。
結果
訓練されたすべてのベースラインは、共通のプロトコルのもとQwen3-8Bから開始します。評価は2つのグループにわたります。すなわち、長期ツール使用(BFCL-v4、ACEBench、200タスクの層別ToolSandbox、\tau^2-Bench、VitaBench)と、ノイジーなインタラクション(\tau^2-BenchおよびVitaBenchのツールおよびユーザーノイズバリアントにインスタンス化されたAgentNoiseBench)です。各ベンチマークはEnvScaler MCPフォーマットのもとで公式メトリクスを使用します。
論文の選択されたセクションは完全な結果テーブルを開示していませんが、設計とアブレーション構造は3つの軸に沿った改善を示しています。(1) 注入されたツール失敗のもとでの回復率(8ファミリーのバランス注入により裾のカバレッジを確保)、(2) UR訓練された継続におけるユーザー修正への準拠、(3) ORPOのグループアドバンテージ推定器での主にクリーンな混合を通じたクリーンタスク性能の維持。比較は、3つのベースラインファミリー——反省プロンプティング(Reflexionとその後継)、環境スケーリング手法、軌跡レベルのRL(GRPO、DAPO、および最近のバリアント)——に対して行われ、すべて同じQwen3-8Bで再実行されています。
限界と未解決の問題
いくつかの問題が残っています。失敗の分類体系は1回のログパスから採掘された8つのファミリーのみであり、このサポート外の失敗モード(例えば、意味的には正しいが時間的に古い返却、敵対的なツール出力)は明示的にモデル化されていません。注入確率p_{\text{inj}}はロバスト性とクリーンタスクの忠実性をトレードオフする自由なハイパーパラメータですが、論文の選択されたセクションではスイープが開示されていません。ベリファイア検証後にスキルプロンプトを取り除くことは、学生がトリガーを内面化できることを前提としていますが、スキル呼び出しが557環境のエコシステムに存在しない新規ツールに汎化するかどうかの分析はありません。最後に、OPDのデタッチされた信頼度重み付き項はスキル条件付き教師へのKLに似ており、グループ正規化RLアドバンテージとの相互作用(符号の衝突、異種ロールアウトのもとでの分散の増大)は理論的な考察を要します。
なぜこれが重要か
LLMエージェントにおける反省は、凍結されたモデルに重ねられたプロンプティングのトリックに過ぎませんでした。Agent-Reflexは、それを採掘された実際のツール失敗の重い裾を持つ分布に根ざした訓練可能な能力として具現化し、共有スキルライブラリとオンポリシー蒸留を通じてSFTとRLを結びつけます。定量的な改善がスケールで維持されるならば、このテンプレート——失敗モードを採掘し、ペアとなった回復軌跡を合成し、デタッチ可能なスキルカードで蒸留する——は、ツールを使用するあらゆるエージェントをロバスト化するための再利用可能なレシピとなります。
Source: https://arxiv.org/abs/2610.17953
Urbex: 都市規模3Dシーンに対するエージェント的空間グラウンディング
問題
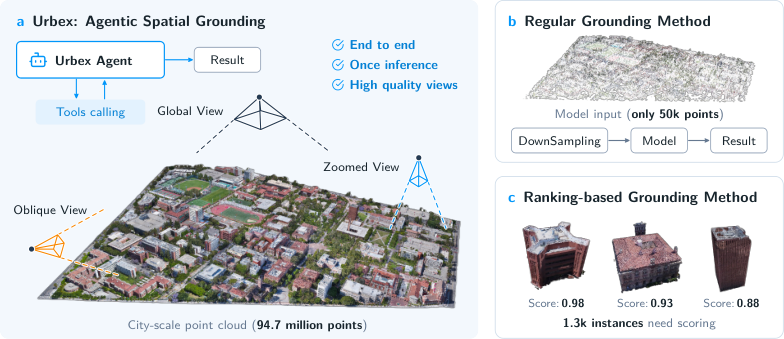
都市規模の3D視覚的グラウンディング——キロメートルスケールの屋外点群において、自然言語クエリで参照されたオブジェクトを局所化する課題——は、候補ランキングパイプラインが主流となっています。シーン \mathcal{S} とクエリ q が与えられたとき、CityReferやCityAnchorなどの手法は、インスタンス提案の集合 \mathcal{C} = \{o_i\}_{i=1}^N を事前抽出し、スコア s(q, o_i) を学習します。この手法には構造的な弱点が2つあります:(i) 精度の上限が提案生成器に依存しており、密に繰り返す形状(駐車車両、街灯柱、同一外観の建物)を適切に処理できなければならない点、そして(ii) すべてのクエリに対してすべての候補をスコアリングするためコストが高い点です。屋内設定から転用されたEDAのような高密度点群グラウンディング手法は、完全な点群をダウンサンプリングするため、小さな都市ターゲットを解決するのに必要な細かな形状情報が失われてしまいます。
Urbexは、グラウンディングをVLMエージェントが実行する能動的空間探索として定式化することで、提案生成を完全に回避します。
手法
環境。 シーンは、BEVで整列したビューの集合 \mathcal{V} としてエージェントに提示されます。各 v \in \mathcal{V} はRGB観測 I_v とビューから世界座標へのトランスフォーム T_v を持ちます。初期観測はグローバルなBEV画像 I_{\text{global}} です。エージェントは現在のビューのローカルな正規化2Dフレームでバウンディングボックス \hat{b}_v を出力し、環境は T_v を通じてそれをワールド座標に変換します。これにより、VLMにはクリーンな2Dの視覚インターフェースが与えられつつ、メトリックな3Dグラウンディングが維持されます。重要なのは、候補集合が入力として渡されない点です:グラウンドトゥルースのボックスは訓練報酬と評価のみに使用されます。
ツール使用ループ。 ステップ t において、ポリシーは現在の観測 o_t とインタラクション履歴 h_t = (o_{<t}, a_{<t}) に基づき条件付けられ、以下のツールのいずれかを選択します:ランドマークをクエリする(既知のPOIに対するテキストベースの注意)、現在のビューのローカルパッチにズームインする、選択したアジマス/仰角で斜視ビューをレンダリングする、あるいは最終的なボックスを確定する。各ツール呼び出しは、新しい (I_v, T_v) ペアを \mathcal{V} に追加します。
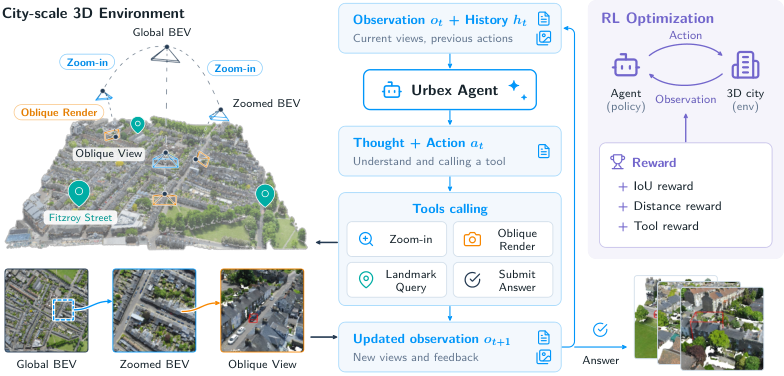
強化学習。 プロンプトによるツール使用のみでは不十分であり、同じ環境に接続された強力な汎用VLMでも性能が低くなります。Urbexは、CityReferのトラジェクトリに対してRLでポリシーを最適化します。終端報酬は、IoUに基づく滑らかな局所化シグナルと中心距離項を組み合わせており、これにより厳しいIoU閾値によるスパースな0/1の崖を回避し、序盤のボックスが外れている場合でもgradientを提供します。ツールレベルのシェーピング報酬は効率的な探索を促進します——たとえば、冗長なズームにペナルティを与え、情報量のあるビュー変化に報酬を与えることで——ポリシーが網羅的なスキャンではなく短いトラジェクトリに収束するようになります。結果として得られるのは、提案に対する学習済みランカーではなく、ビューに対する学習済み探索ポリシーです。
結果
CityReferにおいて、Urbexは比較手法の中で最高のHit@1とIoUを報告しています。比較は3つのグループにわたります:(1) プロンプトのみでUrbex環境に接続された汎用VLM(GPT-5.4、Qwen3.6-plus);(2) 屋内3Dグラウンディング手法(ダウンサンプリングされた点群上のEDA、提供されたインスタンス上のInstanceRefer);(3) 都市規模ランキング手法(CityRefer、CityAnchor)。プロンプトのみのVLMは、ツールインターフェースと推論の事前知識だけでは不十分であることを示しており——同じ環境上でのRLがギャップを埋める鍵となっています。EDAはダウンサンプリングによる細かな形状情報の損失に苦しみ;InstanceReferは競争力がありますが提供されたインスタンスに依存しており、すなわち全シーン局所化よりも簡単なタスクを解いていることになります。
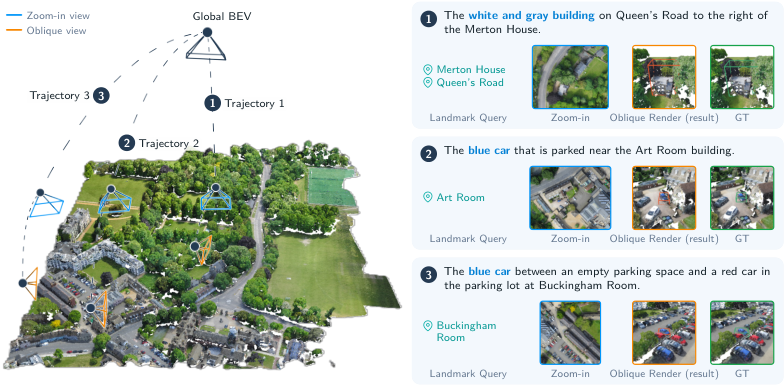
精度を超えた点として、Urbexは最強の都市規模ランキングベースラインよりも大幅に高速であると報告されています。これは、\mathcal{C} 内のすべての提案をスコアリングするのではなく、少数のビューを訪問するだけで済むためです。定性的なトレースでは、エージェントがグローバルBEVから開始し、ランドマーク手がかり(「広場の北側の建物」)で特定された候補近傍にズームし、必要に応じて高さに依存するターゲットを解消するために斜視ビューをレンダリングし、そして初めてボックスを確定する様子が示されています。
STPLS3D-Referにおいて——著者らがCityReferとは異なる形状および外観を持つSTCPLS3Dから構築した評価セット——Urbexはゼロショットで転移し、クロスシーンのロバスト性を改善しており、学習済みポリシーが訓練時のシーンレイアウト分布を超えて汎化することを示唆しています。
限界と未解決の問題
いくつかの点について検討する価値があります。第一に、環境はBEVで整列したビューにコミットしており、上方から遮蔽されたターゲット(橋の下、中庭の内部)は斜視レンダリングを用いても回復が困難な場合があります。第二に、ランドマーククエリは利用可能なPOIインデックスを前提としており、マッピングされた都市では安価ですが任意の環境では利用できません。第三に、終端報酬はIoUと中心距離にグラウンドトゥルースボックスを使用しており——スケーラブルな自己教師あり型のシェーピング(例:ビュー間の一貫性)がアノテーション済み都市データセットを超えて訓練を拡張するために必要になるでしょう。第四に、論文の主要なメトリクスはCityReferにおけるHit@1とIoUですが、正確な数値、トラジェクトリ長、シェーピング項に関するアブレーションは、ここで抜粋されたセクションではなく完全なテーブルに報告されており;終端報酬における中心距離の重みとIoU重みの感度が最も明白なストレステストの対象です。最後に、複数オブジェクトや構成的クエリ(「赤いトラックの左側にある2台目の車」)へのスケーリングは対処されておらず;現在のアクション集合は単一のボックスを確定するものです。
なぜこれが重要か
Urbexは検索問題を探索問題として再定式化しており、提案集合が大きく損失が多い場合に正しいアプローチです。ビューベースの2Dアクションインターフェースとシェーピングされたツール使用のRLの組み合わせは、候補の列挙がボトルネックとなるあらゆるシーン——屋外3D、航空、大規模屋内環境を含む——でのグラウンディングに再利用可能なレシピです。
Source: https://arxiv.org/abs/2610.18356
VideoJev: 映像理解とインタラクションのためのSystem Oneモデル
問題
映像ストリーム上で動作するビジュアルエージェントは、新たな目標が到着するたびに低レイテンシで「何が、いつ起きたか」に繰り返し答えなければなりません。自己回帰型のMLLMデコーディングはこの用途に適していません。クエリごとに映像を再エンコードし、区間やオプションインデックスに変換する必要がある可変長のトークン列を生成し、候補のランキングに使える校正済みスコアを提供しないからです。VideoJevは、回答生成の代わりに、キャッシュされた映像プレフィックスに対して候補仮説(時間区間またはテキストオプション)を直接スコアリングするアプローチを採用し、時間的グラウンディングと多肢選択型VideoQAを一つの意思決定インターフェースに統合します。
手法
このアーキテクチャは、ネイティブな映像入力と因果的言語バックボーンを持つ事前学習済みMLLMを起点としています。これをスコアラーに変換するために二つの変更が加えられます。まず、二つの特殊トークンが導入されます。<|option_end|> は各候補を終端し、候補ごとの読み出し値 h_i を提供します。<|decide|> はクエリごとの読み出し値 h_d を提供します。どちらも事前学習済みの <|im_end|> embedding から初期化されるため、バックボーンはその系列終端に関する帰納バイアスを保持します。次に、言語モデルヘッドと最終MLPが除去されます。これはMLP前の特徴がセマンティック類似性とよりよく整合するという観察に基づいています。二つの独立した線形射影が h_d と h_i をそれぞれ512次元にマッピングしてL2正規化し、スケーリングされたコサインロジットを計算します:
u=\frac{W_{q}h_{d}+b_{q}}{\|W_{q}h_{d}+b_{q}\|_{2}}, \quad v_{i}=\frac{W_{k}h_{i}+b_{k}}{\|W_{k}h_{i}+b_{k}\|_{2}}, \quad s_{i}=10\,u^{\top}v_{i}+b.
固定スケール10と学習可能なスカラーバイアス b は、contrastiveヘッド設計における標準的な工夫であり、softmax温度と絶対信頼度の校正を安定させます。時間的グラウンディングでは、候補はタイムスタンプのペアとしてエンコードされた区間であり、候補ごとのスコアがargmax(またはしきい値選択)によってスパンを定義します。多肢選択型VQAでは、候補はテキストオプションであり、argmaxが回答を選択します。両タスクの入力フォーマットは同一であり、映像プレフィックスの後に一つ以上のクエリサフィックスが続き、各候補には <|option_end|> トークン、クエリには <|decide|> トークンが付与されます。
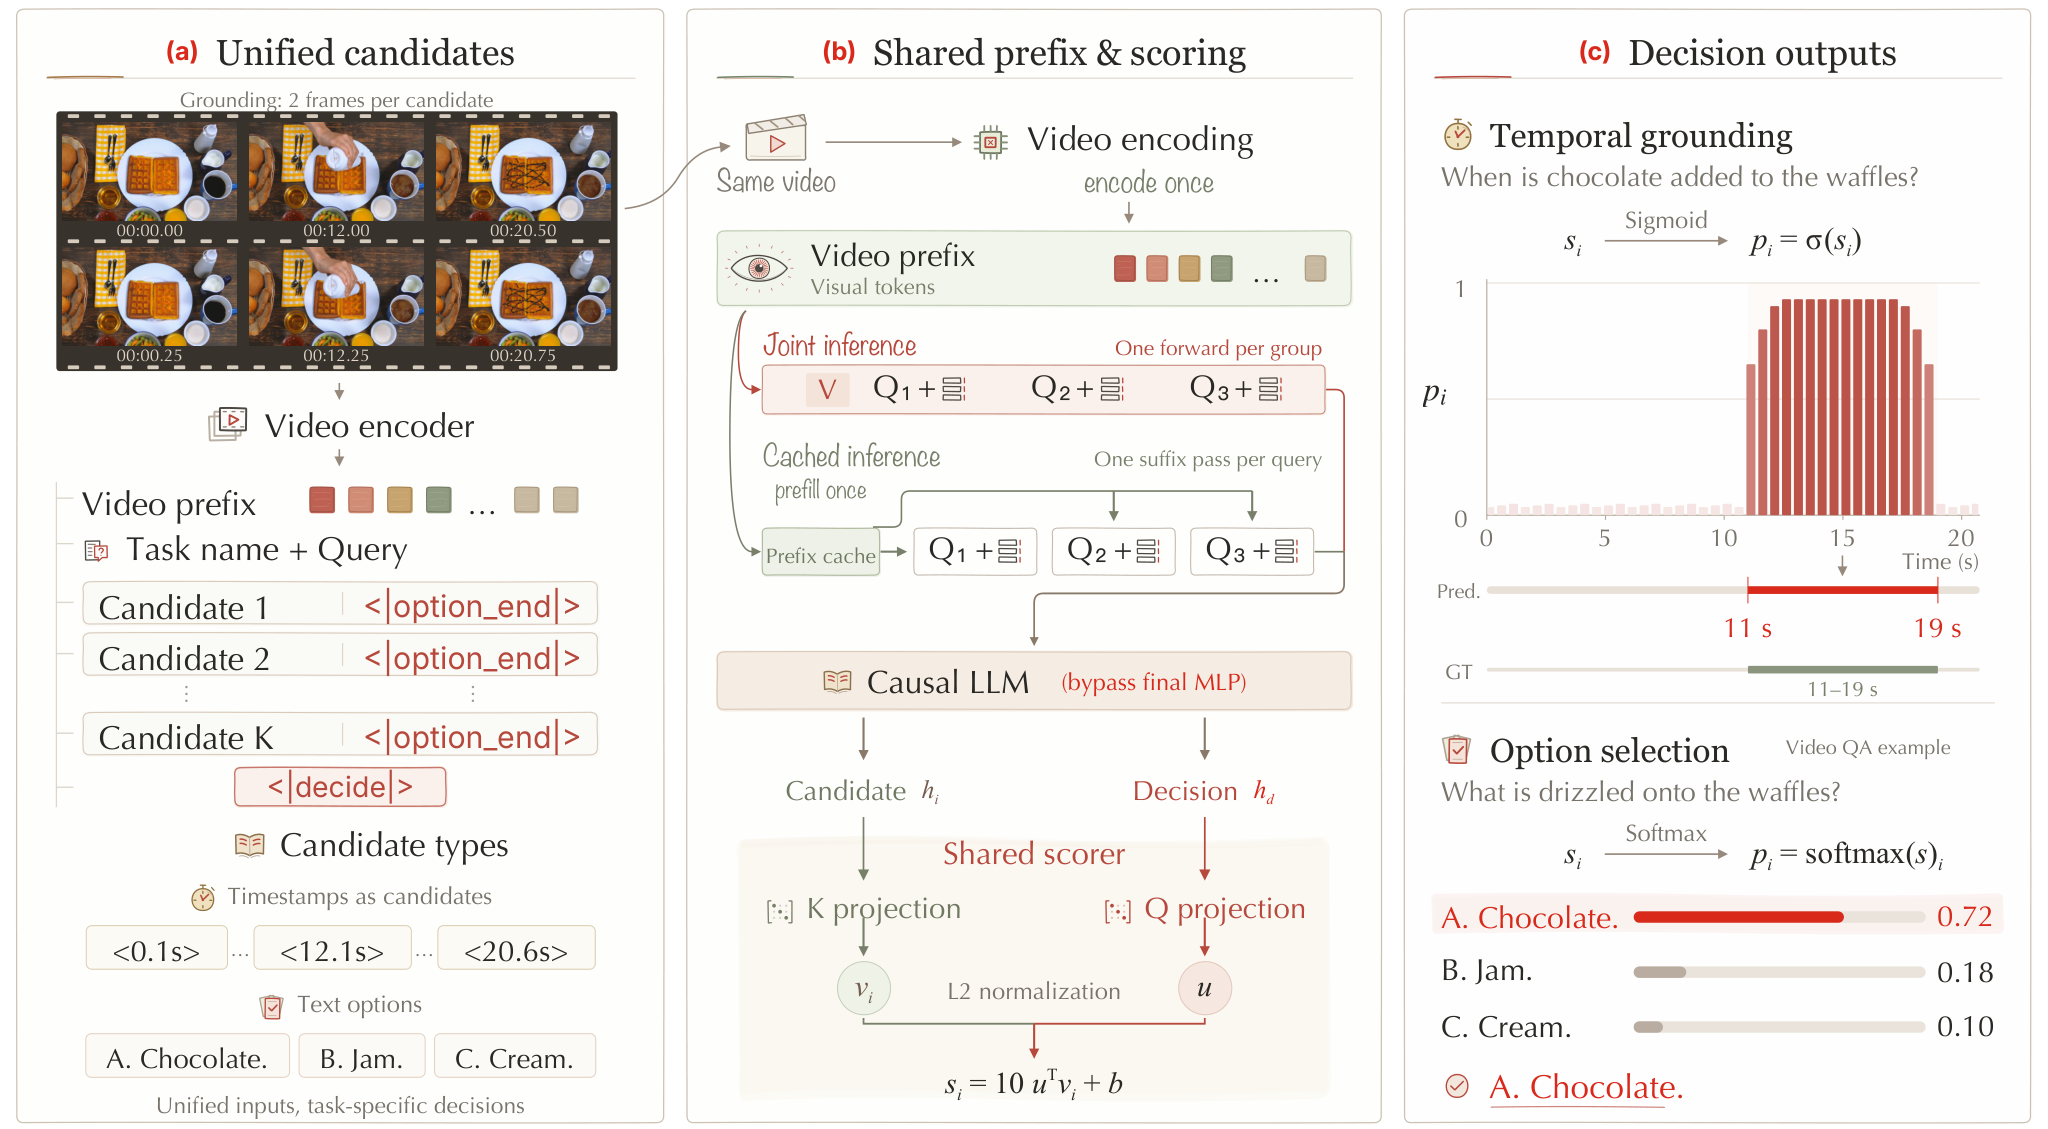
映像プレフィックスが計算量を支配するため、このシステムはバックボーンとスコアラーを共有する二つの推論モードを提供します。Cached inference は映像のKVキャッシュを一度プレフィルしたうえで、各クエリサフィックスをそのキャッシュに対して独立に処理します。クエリが非同期に到着する場合に有用です。Joint inference は複数のクエリを共有プレフィックスの後方で一つの因果的フォワードパスに詰め込み、グループ内の全クエリにわたって映像トークンへのattentionをアモータイズします。どちらのモードもドロップインで切り替え可能であり、実験ではJointがデフォルトです。
学習には64台のH200を使用し、BF16、パックされた系列のグローバルバッチ64、2fpsの映像サンプリング、最大144Kトークン(80%のビジュアルトークン予算)が設定されています。また、二段階スケジュールを採用しています。まずヘッドアライメントの160更新(ヘッドLR 3\times10^{-4}、バックボーン凍結)を行い、続いて共同適応の375更新(ヘッドLR 10^{-4};バックボーンLR:4Bモデルで 5\times10^{-6}、35B-A3Bで 2\times10^{-6})を実施します。両段階でAdamWを使用し、weight decay 0.01、gradient clipping 1.0、ピークの5%のwarmupとコサイン減衰でピークの10%まで減衰させます。4BモデルにはZeRO-2、35B-A3B MoEにはZeRO-3が使用されます。
結果
三つの時間的グラウンディングベンチマーク全体を通して、VideoJev-4Bはバックボーンに対して平均mIoUを6.7ポイント、VideoJev-35B-A3Bは10.8ポイント改善し、実際の推論速度は2.8〜3.1倍向上しています。MoEモデルでの改善が大きいことは、スコアラーヘッドがより強力なMLP前のセマンティック特徴から恩恵を受けていることと整合しています。四つの多肢選択型VideoQAベンチマーク(抄録は引用箇所で途中で打ち切られていますが、設定は記述されています)においても、同一のアーキテクチャがタスク固有のヘッドなしでオプションスコアリングを処理します。
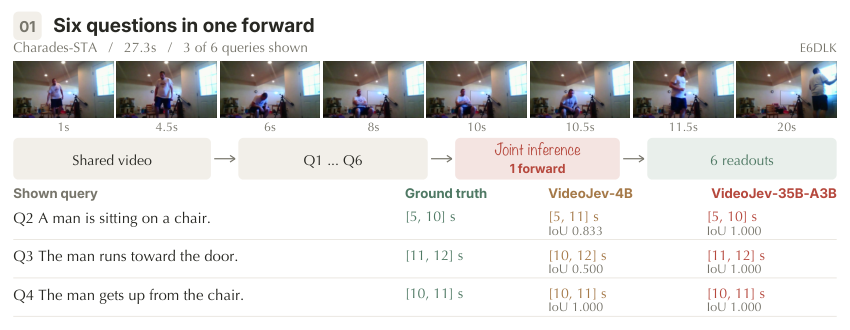
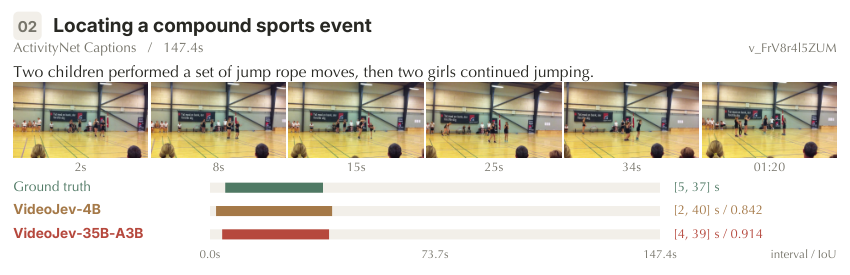
図6はCharadesでのJoint inferenceを示しています。共有プレフィックスに対する一回のフォワードパスで6つのクエリがグラウンディングされ、両モデルが1秒の遷移に一致し、35B-A3Bバリアントが隣接するアクションをより正確に特定しています。ActivityNet Captionsの複合イベントでは、35B-A3Bモデルの区間が4Bベースラインよりもアノテーション済みスパンに緊密に追従しています。
限界と未解決の問題
この手法は、候補スコアリングにきれいに還元できるタスクのみで評価されています。オープンエンドな生成(キャプション生成、自由形式のQA)はその範囲外です。区間候補は列挙する必要があり、本論文ではその提案集合がどれだけ密であるか、または適応的であるかを説明していません。これが時間分解能の上限を決定している可能性が高いです。固定ロジットスケール10と共有された <|im_end|> 初期化はヒューリスティックな選択であり、引用箇所ではアブレーションが報告されていません。著者らは候補インターフェースをアクション認識、イベント検出、シーン状態分類、条件検証へと拡張することを提案していますが、この一般化は今後の課題です。信頼度校正については検討されていますが、提供されたセクションには詳細が含まれていません。
この研究が重要な理由
VideoJevは、事前学習済みMLLMの上にスコアラーヘッドを構築し、積極的な映像プレフィックスキャッシングと組み合わせることで、MLLMの恩恵の大部分を享受しながら、2.8〜3.1倍の低レイテンシとmIoUの二桁ポイントの改善によってエージェントが直接利用可能な決定を提供できることを示しています。同じ映像が多くの変化するクエリによって問い合わせられるストリーミングビジュアルエージェントにとって、これは自己回帰デコーディングよりも原理的なインターフェースです。
Source: https://arxiv.org/abs/2610.18615
Hacker News Signals
アイドル状態のApple Siliconデバイスを活用した動的・分散型仮想GPUクラウド
Apple ML Researchは、組織内のアイドル状態にあるApple Siliconデバイス(Mac Studio、Mac Pro、Mac mini)を統合し、単一の仮想GPUプールとして集約するシステムを発表しました。根本的な課題は稼働率にあります。Apple Siliconマシンは夜間やジョブの合間にアイドル状態になることが多く、GPU/Neural Engineの処理能力が無駄になっています。このシステムはこれらを共有プールとして仮想化し、専用のデータセンターハードウェアを必要とせずに研究者がアクセスできるようにします。
アーキテクチャは、デバイスの可用性をリアルタイムで追跡し、十分な空きGPUメモリを持つマシンにワークロードをルーティングし、デバイスの所有者がローカル利用を再開した際にプリエンプションを処理する分散スケジューラを採用しています。主要なエンジニアリング上の課題は、グレースフルなプリエンプションです。すなわち、学習途中にモデルの状態をチェックポイント保存し、ユーザーが気づかないうちに別のノードへマイグレーションすることです。これは、オプティマイザの状態とRNGシードを高速なローカルNVMeに保存し、数秒以内に別のマシンで再開する軽量なcheckpoint-on-preemptプロトコルによって対処されています。
ネットワークは既存の社内LANを介したメッシュトポロジを採用しており、分散学習ジョブにおいては1 GbEリンクの帯域幅を逼迫させないようgradient compressionを使用しています。既存のPyTorch/JAXコードをそのまま実行できるよう、CUDA互換の抽象化レイヤーを公開しており、仮想化レイヤーがMetal APIコールをインターセプトして変換します。
報告された稼働率の向上は顕著であり、アイドル時間を活用することでクラスタレベルのGPU稼働率はおよそ15%から70%以上に上昇しました。インタラクティブな推論ジョブのレイテンシは、ウォームモデルキャッシュを持つマシンを優先することでP99を50ms以下に抑えています。また、異なる世代のApple Silicon間でのマルチデバイスtensor parallelismもサポートしていますが、ノード間の帯域幅の制約により、非常に大きなモデルシャードに対するスケーラビリティは限られると述べています。
制限事項としては、均質なmacOS環境と社内ネットワーク環境への依存が挙げられます。プリエンプションのレイテンシ保証はローカル負荷が高い場合に劣化し、クロスノード通信のオーバーヘッドにより、数十ノードを超えた大規模なgradient-synchronous trainingには適していません。
Source: https://machinelearning.apple.com/research/distributed-gpu-cloud
DishwasherBench – フロンティアモデルは食洗機に食器を正しく入れられるか?
DishwasherBench は、フロンティア vision-language model が具体的な物理的計画タスクについて推論できるかを評価するベンチマークです。具体的には、汚れた食器と食洗機の画像が与えられたとき、有効な積み込み計画を生成できるかどうかを問います。このベンチマークは、抽象的な推論タスクでは高い性能を示す一方、日常的な空間・物理的常識で失敗するというギャップへの問題意識から生まれています。
技術的な核心は評価プロトコルにあります。各テストケースでは、様々なサイズ・形状・繊細さを持つ食器の画像と食洗機のラックレイアウトが提供され、モデルはアイテムをラックの各位置に割り当てることを求められます。スコアリングはルールベースのチェッカーを用いて物理的制約に照らし合わせて検証されます。具体的には、アイテムがスプレーアームを遮ってはならない、繊細なアイテムは上段ラックに置く、大きなアイテムは同一スロットを共有できない、カトラリーの向きは安全規則に従う(ナイフは刃先を下に向ける)といった制約です。これらの制約は明示的にエンコードされているため、評価は別モデルを審判として用いる方式ではなく、決定論的に行われます。
このベンチマークは、知覚エラー(アイテムの誤認識)、計画エラー(アイテムは正しく認識しているが配置が誤っている)、制約違反エラー(物理的なハードルールの違反)を区別します。この分解により、失敗モードの原因を特定できます。GPT-4o および Gemini 1.5 Pro はアイテムの識別については概ね適切ですが、空間的制約の充足、特に2D画像から3Dの遮蔽を推論する必要があるスプレーアームのクリアランスで頻繁に失敗することが示されています。
報告された結果によると、上位モデルでも完全に有効な計画を生成できる割合はおよそ40〜55%であり、ほとんどの失敗は知覚の失敗ではなく制約違反によるものです。これは有用なシグナルです。ボトルネックは視覚ではなく、物理的推論にあります。
限界も明らかです。テストされた食洗機のレイアウトは少数のセットに限られており、制約チェッカーは水の動力学をモデル化していません。また、実際の積み込みには連続的な幾何が伴うため、離散的なスロット割り当てによる近似には限界があります。それでも、物理的常識に関する再現可能かつ自動採点可能なベンチマークとして、純粋に言語的なベンチマークでは捉えられないギャップを埋めるものとなっています。
Source: https://github.com/composo-ai/DishwasherBench
Show HN: Parsimony – AIモデルが追加するコード量を測るオープンソース Benchmark
Parsimonyは、AIコーディングアシスタントが導入するコードの肥大化を測定するものです。あるタスクに対して、モデルが参照となる人間のソリューションと比べてどれだけ多くのトークン・行数を出力するかを計測します。このプロジェクトの背景には、現行の benchmark(HumanEval、SWE-bench)が正確性を測定する一方で冗長性を無視しているという問題意識があります。冗長性には現実的なコスト——レビューすべき差分の増大、バグの攻撃面の拡大、下流のコンテキストで消費されるトークン数の増加——が伴います。
この benchmark では、参照ソリューションのサイズとモデル出力のサイズの比率として parsimony スコアを定義し、正確性で正規化しています(冗長でも誤った解はスコア0となります)。タスクは競技プログラミングおよび実用的なユーティリティスクリプトから収集されており、いずれもコンパクトで慣用的なソリューションが存在するものです。評価パイプラインは、モデルの出力をテストスイートで正確性を検証した後、参照と比較してトークン数および循環複雑度を計測します。
サイトで報告されている結果には顕著なばらつきがあります。Claude 3.5 Sonnet のようなモデルは冗長性の傾向があり(防衛的なエラーハンドリング、大量のコメント)、競技プログラミングデータで fine-tuning されたモデルはより簡潔です。正確性を維持しつつ、参照のコンパクトさに一貫して匹敵するモデルは存在しません。また、この benchmark は手動でアノテーションされたサブセットを用いて、必要な冗長性(より多くのエッジケースを扱う長いソリューション)と不要な冗長性(ボイラープレート、冗長なチェック)を分けて評価しています。
オープンソースとして公開されたものには、タスクコーパス、スコアリングハーネス、リーダーボードが含まれています。スコアリングハーネスはシンプルな Python 実装で、モデルの出力を実行し、標準出力をキャプチャして期待値と diff を取り、tiktoken でトークン長を計測します。
制限事項として、参照ソリューションは本質的に主観的であり——Python における「コンパクト」は他の言語に転用できない場合があり、一部のタスクでは参照が想定する以上のコードが本来必要となることがあります。また、この benchmark は現時点では Python のみに対応しています。
Source: https://parsimony.lasu.dev/
Intel D270 GPU AI アクセラレータ – 最大 480 GB LPDDR5X
Intel D シリーズ データセンター GPU ラインは、D270 をフラッグシップとして、HBM ではなく統合 LPDDR5X メモリアーキテクチャを採用しており、アドレス可能なメモリは最大 480 GB に達します。これが主要な差別化要因です。HBM ベースのアクセラレータ(H100: 80 GB、MI300X: 192 GB)は物理的な HBM スタックの制約を受けますが、LPDDR5X はビットあたりのコストを低く抑えながらはるかに大きな容量を実現できます。ただし、GB あたりの帯域幅は低下します。
D270 は Intel の Xe2 GPU アーキテクチャをベースに構築されており、INT8 および FP16 ワークロードを対象とした matrix engine が追加されています。480 GB という容量により、700 億パラメータ以上のモデルをフル精度で複数デバイスに分割することなく推論できるため、運用上の大幅な簡素化が見込まれます。ピークメモリ帯域幅はおよそ 1.6 TB/s と報告されており(H100 の HBM3 における 3.35 TB/s と比較して低い)、帯域幅バウンドな decode はデバイスあたりの速度が低下します。しかし容量の優位性により大規模モデルのサービングに必要なデバイス数が減り、システム全体の帯域幅効率が向上する可能性があります。
OneAPI/SYCL ソフトウェアスタックは OpenCL をサポートしており、Intel Extension for PyTorch を通じた PyTorch バックエンドとの統合も備えています。ここが依然として問題点です。CUDA エコシステムへのロックインにより、実際の採用にはフレームワークレベルの抽象化か、相当量の移植作業が必要となります。discrete GPU ML ワークロードにおける Intel の開発者ツール整備の実績は芳しくなく、この点に対する懐疑的な見方は HN のディスカッションにも反映されています。
LPDDR5X の採用は、信頼性および耐久性に関する疑問も提起します。LPDDR はモバイル DRAM であってサーバーグレードではなく、エラー訂正、動作温度範囲、および RAS(信頼性・可用性・保守性)特性は、データセンターでの継続運用環境において HBM や GDDR6 ほど実績が確立されていません。
Source: https://www.intel.com/content/www/us/en/products/details/discrete-gpus/data-center-gpu/d-series.html
Show HN: SolidCraft – Rustで書かれたオープンソースのパラメトリックCAD(MCPサポート付き)
SolidCraftは、Rustで記述されたパラメトリックCADカーネルであり、モデリング操作をModel Context Protocol(MCP)を通じて公開することで、LLMがプログラム的にジオメトリ構築を駆動できるようにしています。コアとなるCADエンジンは、境界表現(B-Rep)カーネルをラップしており、truck RustクレートによるOpenCASCADEバインディングをベースとして、ブーリアン演算(和・差・積)、押し出し、回転体、フィレットをファーストクラスの操作として提供しています。
パラメトリックモデルは、型付きパラメータを持つ操作の有向非循環グラフとして構築履歴を保持します。上流のパラメータ(例:穴の直径)を変更すると、グラフを通じて伝播し、下流のジオメトリが再計算されます。これは標準的なパラメトリックCADの挙動ですが、オープンソースのRust実装では稀なものです。Rustを採用することで、GCによる一時停止なしにメモリ安全性が確保され、複雑なB-RepグラフをインタラクティブにRecomputingする際に有効です。
MCP統合がこのプロジェクトの新規性のある点です。SolidCraftは各CAD操作をMCPツールとして公開しているため、tool-callingに対応したLLMが create_box(10, 20, 30) → subtract(cylinder(r=5, h=35)) → export_step("part.step") のような一連の操作を発行できます。これにより、fine-tuningなしに自然言語からCADへのワークフローが実現でき、モデルが幾何学的な意図をAPIコールに分解する能力に依存しています。READMEには、Claudeがテキスト記述から有効なSTEPファイルを生成した例が含まれています。
現時点では制限も大きく、このカーネルは単純な機械部品を扱えますが、高度なサーフェシング(NURBSロフト、複雑なスプライン)には対応しておらず、LLMインタフェースにはジオメトリ検証ループがありません。つまり、モデルは外部ツールなしに生成されたシェイプを検査してエラーを修正することができません。また、公差およびアセンブリ管理も未実装です。それでも、LLM支援CADの基盤として、STEPの出力が下流の製造ワークフローで直接利用可能であるため、text-to-meshアプローチよりも技術的に実用的な基盤となっています。
Source: https://github.com/bherbruck/solidcraft
未改造のLinux amdgpuドライバをiPadで動かす
このプロジェクトは、iPadでストックのamdgpuカーネルモジュールを搭載したLinuxカーネルをブートするものです。MシリーズのiPadがAMDのRDNAラインアップとGPUアーキテクチャを共有しているという事実を活用しています――より正確には、Thunderbolt経由で接続した外付けAMD GPUエンクロージャをPCIeパススルーする手法を用い、直接デバイスアクセスが可能なVM上でLinuxを動作させます。「未改造」という主張はamdgpuドライバ自体にソースパッチが不要であることを指しており、複雑な処理はブートローダー、VM設定、そしてGPUをゲストに公開するためのデバイスツリー操作に集約されています。
技術的な手順は以下のとおりです。UTM(Apple Silicon向けQEMUベースのVM)をThunderbolt接続GPUのPCIeパススルーで構成します。LinuxゲストはベアメタルのGPUアクセスを得られ、amdgpuがそのデバイスのPCI IDをネイティブにサポートしているため、修正なしにロードされます。iPadの内部ディスプレイはLinuxゲストから直接アドレッシングできないため、ディスプレイ出力は仮想フレームバッファまたはリモートデスクトップ経由でiPadの画面に戻されます。
技術的に興味深い点はApple SiliconにおけるIOMMUの設定です――Thunderboltデバイスに対するAppleのIOMMU実装は、ゲストからのDMAを許可するためにバイパスするか、正しく設定する必要があります。リポジトリには、IOMMU違反によるゲストのクラッシュを発生させることなくこれを機能させるために必要なUTMのXML設定およびカーネルコマンドラインパラメータが記録されています。
実用的な用途は限られています――専用のLinuxマシンよりも高価なThunderbolt GPUエンクロージャが必要となるためです――しかしこの試みは、Apple SiliconのVMエクステンションとThunderbolt PCIeトンネルがGPUパススルーに十分な完成度を持つことを実証しており、プロワークステーション用途やジェイルブレーク不要なAppleハードウェア上でのLinux動作に対して重要な示唆を与えています。
Source: https://github.com/Geramy/LemonSeed-Studio
Gemini 4 Argon for Robotics
GoogleのGemini 4 Argonは、ロボティクス制御タスクに特化して適応されたGemini 4モデルの派生版です。ベースのGemini 4との技術的な差別化は、action tokenizationと低遅延inferenceを中心としており、モデルはモーターコマンドおよびロボットAPIコールを構造化されたtokenとして出力し、リアルタイム制御ループをサポートするためにエンドツーエンドの遅延100ms未満を達成するよう最適化されたservingスタックを備えています。
アーキテクチャはvision-language-action(VLA)パターンに従っています。マルチモーダル入力(RGB画像、利用可能な場合はdepth、固有感覚状態、言語命令)をコアtransformerが処理し、出力headは言語token(推論・計画用)またはaction token(離散化された関節速度またはエンドエフェクタ姿勢)を生成します。Argonは学習済みのaction tokenizerを追加しており、これにより連続的な7自由度アーム命令を離散的な語彙にマッピングし、言語生成に使用するものと同じ自己回帰デコーディングパイプラインでモーターコマンドを生成することが可能となっています。
ブログ記事ではRT-2スタイルの評価スイートおよび巧緻操作ベンチマークにおける性能が強調されており、多段階推論を必要とするタスク(例:「マットの色に合ったコンテナに赤いブロックを入れてください」)において、従来のGeminiベースのロボットモデルと比較して改善が報告されています。また、エピソード途中での再計画により、外乱からの回復性も向上していることが示されています。
統合はRobotics APIを通じて行われ、ROS2および独自のロボットSDKを対象としています。重要なエンジニアリング上の懸念事項はaction discretizationの解像度であり、粗いtokenizationは微細な運動精度を損なうため、ブログでは精密な制御のために高解像度残差を用いた階層的tokenizationを採用していると述べています。
対処されていない制限事項としては、inference時の計算要件(Gemini 4をロボット上で実行することは現実的でなく、すべてのinferenceはクラウドベースであり、ネットワーク遅延が生じます)、および学習分布外の未知の物体や環境への汎化があります。
Source: https://developers.googleblog.com/gemini-4-argon-for-robotics/
AIをわずか10分間使用するだけで、困難な問題に粘り強く取り組む能力が低下する
UCバークレーの研究が、短時間のAI支援による問題解決セッションが、その後の困難なタスクへの持続性に与える影響を検討しています。実験デザインは次のとおりです:参加者をランダムにAI支援あり・なしの2群に分けて難問を解かせ、その後、支援なしの状態で別の難問セットに取り組ませます。AI支援群は、支援なしのフォローアップにおいて、測定可能な形で持続性が低下していました(試行回数の減少、離脱の早期化)。
提案されているメカニズムは、学習性無力感あるいは努力の割引(effort discounting)の一形態です:AIによって問題解決が容易になる短時間の経験が、被験者の努力と報酬に関する期待値を再校正してしまいます。その後にAIなしで努力が必要になったとき、期待される努力量と実際に必要な努力量とのギャップが離脱を引き起こします。これはスキルの低下とは異なります(その観察には時間が短すぎます)——これはたった10分間の1セッションで観察できる、態度・モチベーション上の効果です。
方法論的には、この研究は検証済みの持続性測定指標を用いています:タスク従事時間、失敗後の再試行回数、および自己申告によるフラストレーション耐性です。効果量は有意ではあるものの中程度であると報告されており、このことは実践的な示唆を解釈する上で重要です。また、統制条件も重要です:「助けなしの難問」対「簡単な問題」ではなく、具体的にAI支援対自力解決という比較になっており、難易度そのものではなくAIの媒介効果を切り出しています。
この結果は、教育およびデベロッパーツールの設計に関連しています。短期的なAI利用が困難な問題と格闘しようとする意欲を低下させるのであれば、ツール設計者は即時の生産性と長期的な能力開発とのトレードオフに直面することになります。この研究は、効果が実験セッションを超えて持続するかどうか、あるいは反復的なAI使用によって慣れが生じるかどうかについては検討していません——それこそが重要な未解決の問いです。コーディングアシスタントを継続的に使用している開発者に関する縦断的データが、はるかに有益な情報をもたらすでしょう。
注目の新しいリポジトリ
YeonwooSung/llm-architecture-from-scratch
現代のLLMを支えるコアなアーキテクチャファミリー — attention variantsや positional encoding、MoE routing、正規化スキームなど — をHuggingFaceの抽象化に頼らず、第一原理からPyTorchで実装した教育的なリポジトリです。各コンポーネントは独立しており注釈が付いているため、リファレンス実装としても、アーキテクチャ改変のテストベッドとしても活用できます。リポジトリはモデル名ではなくアーキテクチャの概念ごとに整理されており、特定の設計選択(例:RoPE vs. ALiBi、pre-norm vs. post-norm)の効果を単独で検証したい場合に便利です。新しい attention パターンをプロトタイピングしたり、フレームワーク内部と格闘せずに positional encoding スキームをアブレーションしたりする必要が日常的にある研究者にとって、クリーンな出発点となります。コードは不要な依存関係を排除しており — Accelerateも、PEFTも使用しておらず — クリティカルパスが読みやすく保たれています。PhD レベルの授業、論文の再現実装、および標準的なHuggingFaceのモデル設定から逸脱したカスタムアーキテクチャの足場として有用です。
Source: https://github.com/YeonwooSung/llm-architecture-from-scratch
mizorewww/laya-mlx
Laya フォーマットの型付き決定モデル向けのネイティブ Apple MLX ランタイムであり、生成的推論ではなく構造化分類およびルーティングタスクをターゲットにしています。主な主張は M3 Max 上でのエンドツーエンドの決定レイテンシが 7〜14 ms であるというもので、低レイテンシアプリケーションにおけるサーバーサイド推論と競争力のある性能を持ちます。設計は意図的に狭く絞られており、テキスト生成なし、PyTorch 依存なし、クラウド API 呼び出しなしとなっています。モデルは型付き決定木または小規模な識別ネットワークとして表現され、Laya フォーマットでシリアライズされます。MLX バックエンドは Apple Silicon のユニファイドメモリアーキテクチャを活用してデータ移動を最小化します。これはコンテンツフィルタリング、ルーティング、フィーチャーフラグなど、生成 LLM スタックでは過剰であり、かつレイテンシ予算が厳しいオンデバイス決定ロジックに対して実用的なスタックです。PyTorch を使用しないのは純粋なエンジニアリング上の選択であり、MLX のグラフベースのディスパッチにより Python 側のオーバーヘッドを回避し、バイナリのフットプリントを macOS アプリケーションへの embedding に十分なほど小さく保ちます。Apple Silicon 上でローカルファースト AI パイプラインを構築する方には注目する価値があります。
Source: https://github.com/mizorewww/laya-mlx
mw00/project-maya
GLM-5.3-Flash(3210億パラメータのsparse MoEモデル)向けのセルフホスト型inference stackです。1枚から16枚までのGPUにわたる異種混在のコンシューマー・プロシューマーGPU構成での動作を想定して設計されており、NVIDIAおよびAMDの両方に対応し、LinuxとWindowsの両OSをサポートします。本プロジェクトは5つのコンポーネントをバンドルしています:tensor-parallelおよびpipeline-parallelディスパッチを備えたinference engine、HTTPサーバー、監視用Webダッシュボード、OpenAIおよびAnthropic互換のAPIエンドポイント、そしてVRAM使用量を削減するためのquantizationツールです。主要なデスクトップOS両方においてNVIDIAと並んでAMDをサポートすることは、ほとんどのオープンソースinferenceプロジェクトが省略してしまう、非自明なエンジニアリング上のコミットメントです。OpenAI/Anthropic互換レイヤーにより、既存のクライアントコードは修正なしにそのまま利用できます。quantizationツールはリポジトリ内に含まれているため、ユーザーは外部ツールチェーンに頼ることなく、精度とメモリフットプリントをトレードオフできます。コンプライアンス、コスト、またはレイテンシの観点からフロンティアスケールのMoEをプライベートに実行したい実務者にとって、本プロジェクトはモデルの重みだけでなく、完全な運用スタックをカバーしています。
Source: https://github.com/mw00/project-maya
nealbridges/VulnHunter
Capital OneのVulnHunterのメンテナンス継続フォークであり、特定のagentハーネスに依存しないagentic AIセキュリティスキャナとして再構築されています。このシステムは敵対的なアプローチで動作します。つまり、潜在的な脆弱性のリストを生成するのではなく、各発見事項に対して実行可能なproof-of-conceptコードを生成することで悪用可能性を証明しようとします。修正パイプラインはtest-firstの設計となっており、パッチはPoC(proof-of-concept)に対して生成・検証されてから提示されるため、人間のレビュアーに対するfalse-positiveの負担を軽減します。アーキテクチャはagentハーネスに依存しない設計となっており、LangChain、AutoGen、またはカスタムオーケストレーションで駆動することができます。敵対的なフレーミング(攻撃者のように探索する)は運用上重要な意味を持ちます。なぜなら、出力が助言ベースから証拠ベースへとシフトし、セキュリティチームが修正の優先順位付けに実際に必要とするものになるからです。Capital Oneのコードベースから再構築することで、ゼロから始めるのではなく脆弱性の分類体系とPoC生成の足場を保持しつつ、このフォークのメンテナンスへのコミットメントが上流リポジトリの明らかな停滞に対処しています。DevSecOpsパイプラインや自動化されたred-teamingワークフローに関連します。
Source: https://github.com/nealbridges/VulnHunter
storytold/vectorcraft
ネイティブGUIツールキットへの依存を一切持たず、完全にRustで記述されたベクターグラフィックスエディタです。Inkscapeなどのエンジンをラップするのではなくゼロから実装されています。Rustでベクターアートツールをスクラッチから構築するということは、レンダリングパイプライン全体を自前で所有することを意味します。Bezier演算、ブーリアンパス演算、ストローク展開、SVGシリアライゼーションがすべて純粋なRustとして実装されています。正確なBezierオフセット処理とパスのブーリアン演算はロバストに実装することが著しく困難であることで知られており、この点で本プロジェクトは技術的に野心的な取り組みと言えます。Rustを選択することで、ガベージコレクタなしにメモリ安全性が確保されます。これはポーズのないフレーム供給が求められるインタラクティブなレンダリングにおいて重要な特性です。「スクラッチから」という制約は、既存のレンダリングライブラリをラップしているLapceやZedといったツールとの明確な差別化点となっており、本プロジェクトではジオメトリカーネル自体がプロジェクトの核心をなしています。計算幾何学に関心を持つシステムプログラマにとっては、実質的なリファレンスコードベースとなります。実務家の観点からは、ジオメトリカーネルが退化した入力に対して十分なロバスト性を持つかどうかが問題となります。そこがスクラッチ実装とInkscapeのlib2geomのような成熟したツールとの差が生じやすい典型的な部分です。
Source: https://github.com/storytold/vectorcraft
jiwoochris/artex-global
ARTEX(Autumn-27/ARTEX、AGPL-3.0)の韓国語ローカライズ版forkです。ARTEXは自律型AIペネトレーションテストフレームワークであり、偵察・脆弱性特定・エクスプロイト計画・レポート作成といったペネトレーションテストのライフサイクル全体を、LLM駆動のエージェントループによって自動化します。このforkの主な貢献は、インターフェース・プロンプト・生成レポートにわたる完全な韓国語サポートであり、規制上または組織上の理由から監査ドキュメントを韓国語で必要とする韓国のセキュリティ実務者のニーズに応えるものです。ローカライズにとどまらず、本forkはアップストリームのAGPL-3.0コードベースを追跡しており、アップストリームの変更との同等性を維持しているようです。自律型ペネトレーションテストフレームワークは、VulnHunterと同様の運用上の問いを提起します。すなわち、その価値は手動トリアージの負担軽減にありますが、発見された問題の品質は、エージェントが脆弱性を個別に列挙するのではなく連鎖させる能力に大きく依存します。AGPLライセンスは、派生物をSaaSとしてデプロイする場合に変更点をオープンソース化することを義務付けるため、ライセンスへの影響を評価している商用ユーザーにとって重要な点となります。
Source: https://github.com/jiwoochris/artex-global
storytold/figcraft
Figmaが占めるベクター編集・コンポーネントシステム・インタラクティブプロトタイピング・リアルタイムコラボレーションといった機能領域を対象に、Figmaのコードやアセットを一切再利用せずにコラボレーティブなデザイン・プロトタイピングワークフローをRustでクリーンルーム再実装したものです。「クリーンルーム再実装」とは、法的・工学的に特定の意味を持つ主張であり、ソースからではなく動作を観察することで設計が導かれていることを指します。RustでコラボレーティブなデザインツールをビルドするということはCRDTまたはOTレイヤー(マルチユーザー編集用)、レンダリングエンジン、レスポンシブレイアウト向けの制約ソルバーをすべてネイティブに実装する必要があることを意味します。純粋なRustという制約は異例であり、大多数のコラボレーティブエディタは既存のCRDTライブラリ(Automerge、WASMを経由したYjs)やレンダリングバックエンド(バインディング経由のSkia)に頼るものです。この実装が本当にスクラッチから構築されているのであれば、これは相当規模のシステムプロジェクトといえます。実用的な動機は明白で——Figmaのプライシングとベンダーロックインがセルフホスタブルな代替手段への需要を生み出しています——しかし、プロトタイプとFigmaのフィデリティとの間にある工学的なギャップは大きいものです。
Source: https://github.com/storytold/figcraft
MichaelKinsy/PiG
Piコーディングエージェントの TypeScript ランタイムを Go に移植したもので、再設計ではなくパリティ準拠の翻訳として明確に位置づけられています。この契約は上流のPiとの振る舞い的等価性を前提としており、TypeScript コードベースのすべての観測可能な振る舞いを Go で再現しなければならず、上流との乖離はフィーチャーではなくバグとして扱われます。このフレーミングが有用なのは、リポジトリがPiのランタイムセマンティクスの仕様書としても機能するためです。TypeScript における曖昧さは、両方の実装を実行して出力を比較することで解決されます。移植の実際的な動機は運用面にあります。Go はシングルの静的リンクバイナリを生成し、Node.js プロセスよりもコールドスタートのレイテンシが低く、Node ランタイムを必要とせずにGoネイティブなインフラストラクチャにクリーンに統合できます。すでに Go サービスを運用しているチームにとって、PiGを組み込むことでクロス言語RPCの境界を回避できます。パリティ制約により、TypeScript の動的ディスパッチやプロトタイプベースのパターンが Go の構造体とインターフェースモデルにどのように変換されるかを学ぶうえでも、このコードベースは有益です。