デイリーAIダイジェスト — 2026-10-07
arXiv ハイライト
UNREAL: 単一モデルによるRetrieval と Long-Context の統合
問題設定
標準的なRAGパイプラインは、独立したretriever(dense encoder、cross-encoderのreranker、BM25 index)とgenerator LLMを維持しています。一方でlong-context inferenceは、証拠の全体をモデルのcontext windowに流し込み、attentionが「針」を見つけ出せることを期待します。どちらのアプローチも共通の問題――証拠の中から少数のsparseなサブセットを選択すること――を解こうとしていますが、使用する機構は全く異なります。UNREALは、backbone をfreezeしたまま、単一のdecoder-only LLMがcorpus規模のretrieval(2100万chunks)とin-contextでの証拠選択(最大1億tokens)の両方を、自身の内部表現のみを用いて実行できるかを問います。
最も近い先行研究であるINTRAはencoder-decoderのcross-attentionを活用していましたが、decoder-onlyやhybrid attention/SSMアーキテクチャには転用できません。UNREALは、frozen decoderのresidual-stream activationsからchunk keyとquery vectorの両方を導出することで、このアイデアを一般化します。
手法
frozen LLMのresidual streamに作用する3つのコンポーネントで構成されます。
Chunk embeddings。 corpus \mathcal{C} = \{c_i\}_{i=1}^M に対して、各chunkはfrozen LLMを通じて独立にエンコードされ、固定された中間層 \ell_c におけるresidual-stream statesを読み取ります:
k_i = \operatorname{LLM}_{\ell_c}(c_i) \in \mathbb{R}^{T_i \times d}.
この層はdev setで選択されます。著者らは、最終層よりも中間層のほうがより豊かなセマンティクスを持つことを指摘しており(Skean et al. 2025と一致)、各chunkは単一のpooled embeddingではなくtoken vectorのシーケンスとして保持されます――これにより、multi-hopの組み合わせに必要なtoken levelの粒度が保たれます。
Residual-state queries。 query encoderを学習する代わりに、UNREALはpromptの先頭(または途中)に付加される小さなretrieval-token embeddings \rho を学習します。frozen LLMがqueryに対して実行される際、これらのtoken positionにおけるresidual statesが、層をまたいで学習済み重み \alpha で混合され、query vectors q_\ell となります。これらはtoken levelのchunk keys k_i とスコアリングされ、aggregatedされた類似度によりchunkがランク付けされ、上位n件はそのまま同じfrozen LLMにgeneration用として渡されます。
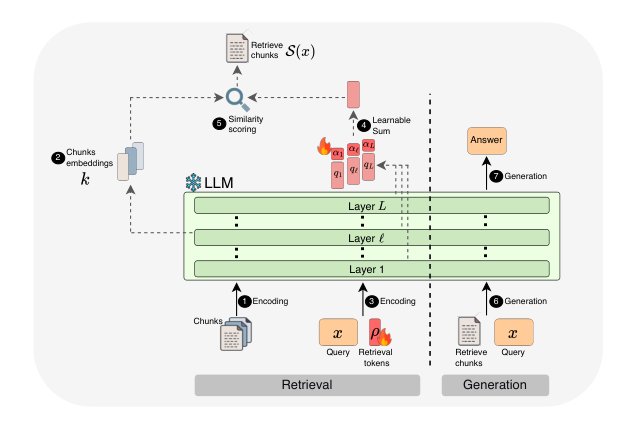
学習されるのは \rho と \alpha のみであり、合計500K未満のパラメータ数で、各backboneの0.005%以下です。backbone自体は一切更新されません。これはアーキテクチャ上重要な意味を持ちます:queryとkeyの両方がresidual statesから生成されるため、この手法はsequence mixerに依存せず、純粋なattention(Qwen3.5-4B、Muse-Glimmer-30B)、linear-attentionハイブリッド(Qwen3.5-35B-A3B)、およびMamba-attentionハイブリッド(Nemotron-3.5-Lightning-30B-A3B)にも適用可能です。
結果
Corpus retrieval(Wiki-2018の2100万chunks)。 評価指標は完全証拠recall@nであり、アノテーションされたすべてのoracle chunksが上位nに含まれる場合のみクレジットが付与されます。Nemotron-3.5-Lightning backboneにおいて、recallはHotpotQAで49.1% → 73.2%、2WikiMultiHopQAで31.7% → 60.1%、MuSiQueで8.8% → 14.4%と向上し、最強のベースライン(Qwen3-Emb-4B + rerankerまたはLateOnのmulti-vector + rerankerスタック)を上回ります。性能向上はmulti-hopベンチマークに集中しており、partial retrievalがペナルティを受けるシナリオ――単一ベクトルのdense retrieverが劣化する状況――においてまさに効果を発揮します。
上位5件のretrieved contextを用いたEnd-to-end QA(Nemotron-3.5-Lightningをretrieverとgeneratorの両方として使用):UNREALはHotpotQAでEM/F1 = 52.6/65.8を達成し、Qwen3-Emb-4B + rerankerの43.3/55.3を上回ります。2Wikiでは42.0/50.1 対 31.4/39.1、MuSiQueでは16.9/25.4 対 13.2/22.6です。HotpotQAのoracleの上界は64.3/78.9であり、UNREALはno-context(28.5/37.7)とoracleの差を約70%埋めています。
再学習なしのlong context。 同じ学習済み \rho, \alpha が再利用されます:長いpromptをchunkに分割し(平均140 tokens)、frozen LLMでエンコードし、上位n chunksを選択します。NoLiMa(語彙的オーバーラップのないneedle-in-haystack)において、128KでのFull-context accuracyは1.0%まで低下しますが、UNREALは24.83%を達成します。256K wordsのLV-EvalではF1がfull context(49.97%)から54.66%に向上します。HELMET RAGサブセット(8K–128K)では、UNREALはfull-context inferenceと外部retrieverベースラインの両方を2つのgeneratorにわたって上回ります。LOFTスタイルの合成ベンチマークを1億tokensまで拡張した場合、full-context accuracyは崩壊しますが、UNREALはネイティブのcontext limitをはるかに超えた範囲でも証拠の抽出を継続します。
制限事項
本手法はindex構築時にchunkごとにfrozen LLMのforward passを必要とし、学習よりはコストが低いものの、encoder規模ではなくLLM規模の処理が必要です――30億tokensに対するindex構築コストは無視できません。Chunk表現はtoken単位のシーケンスであるため、indexは単一ベクトルのdense indexよりも大きくなります(本論文ではメモリのベンチマークは行われていません)。Chunk sizeは140 tokensで固定されており、chunking方法への感度は報告されていません。層 \ell_c と混合重み \alpha はbackboneごとにdev dataでチューニングされるため、モデルファミリーをまたいだ転用にはある程度のbackboneごとの適合が必要です。最後に、long-contextの評価は、chunk選択に分解できないglobal reasoningを要するタスクを対象外としています。
重要性
UNREALは、retriever/reranker/generatorのスタックを<500Kの追加パラメータを持つ単一のfrozen LLMに集約しながら、multi-hop retrievalにおいて特化型dense + rerankerパイプラインを上回り、128K–256KにおけるLong-context accuracyを劇的に改善します。これが本番規模でも成立するならば、retrievalとin-contextの証拠選択には独立したモデルが必要だというアーキテクチャ上の前提を覆すことになります。また、外部のdense retrieverが標準的な回避策とされていたMamba/linear-attentionのbackboneにもクリーンに一般化されます。
Source: https://arxiv.org/abs/2610.08463
NeMo-DCR: スケーラブルなAgentic RLをトリリオンパラメータスケールで実現するBit-Exact Delta-Compressed Refit
問題
Agentic RLはトレーニングとロールアウトを分離します。ポリシーの更新が行われるたびに、次のバッチが始まる前に新しい重みがロールアウトクラスターに届かなければなりません。2つのAWSリージョンにまたがる1Tパラメータのチェックポイントを完全転送すると87.5分かかり、これがステップ時間の大半を占めます。BF16の測定結果によると、ステップごとに変化する重みの値はわずか〜1%であるため、情報理論的なコストは密なrefitよりもはるかに小さいはずです。スパースrefitを実現するためのエンジニアリング上の課題は、(i) 変更されないバイトやバッファを含めて密なrefitに対してbit-exactであること、(ii) 任意のトレーニング・サービングのシャーディングにわたってレイアウトが正しいこと、(iii) refit途中の障害に対して耐性があること、(iv) クラスター間のNCCL collectiveなしに実現可能であること、の4点です。既存のシステムはこれらのうち少なくとも1つを破綻させています。サービングサイドの配置ルールを再実装したり、完全なテンソルを組み立てたり、算術的に値を再構築して丸め誤差を生じさせたり、リージョンをまたいで利用できないcollectiveに依存したりしています。
手法
NeMo-DCRは、正準表現 W^v(HuggingFaceスタイルのテンソル)を中心に、refitをdelta構築・エンコーディング・配送・適用の4段階に分割します。各レシーバー r は P_r^v = L_r(W^v) を保持しており、ここで L_r はサービングランタイムのネイティブローダーです。refitのターゲットは P_r^{v+1} = L_r(W^{v+1}) であり、密なrefitとbit-identicalです。
直接射影と残差変換。 オーナーは各トレーニングシャードをホストメモリに保持されたベースライン A_T^v と比較し、変更点を C_T = \{j \in J_T \mid I(S_T^{v+1})_j \neq I(A_T^v)_j\}, として出力します。ここで I(\cdot)_j は格納されたビットパターンです(FPの等値比較ではビット反転を見逃す可能性があるため)。所有権はDPレプリカ全体にわたって安定した名前ハッシュで割り当てられるため、各ユニーク要素は一度だけ比較されます。アフィンなMegatron-Bridge変換タスク(レプリケート、行分割・列分割)に該当する変更は正準インデックスへ直接射影され、残り(fused Q/K/V、routed expertなど)は永続的な正準ベースラインを用いた残差変換を経ます。アフィンマッピングはQwen3-30B-A3Bのバイトの96.3%、Nemotron-3-Ultra-550B-A55Bのバイトの97.0%をカバーします。ホストサイドのベースラインはチェックポイントの〜1.04倍および1.03倍に相当し、トレーニングランク全体に分散されます(1,121 GBのNemotronチェックポイントでは32ランク上でランクあたり約36 GB)。
混合XOR/上書きエンコーディング。 算術的な再構築 \alpha + (\beta - \alpha) は \beta とは異なる値に丸められる可能性があり、バージョンをまたいで誤差が蓄積するため、NeMo-DCRはbit-exactなレコードのみを送信します。表現保存のアフィンパスに対しては、XORマスク x_T^{v+1}(j) = I(S_T^{v+1})_j \oplus I(A_T^v)_j を出力し、それ以外の場合は絶対上書きを出力します。XORマスクは変化しない上位ビットを活用します。例えば、0x3F01→0x3F02のビット反転は0x0003(14個の先頭ゼロを持つ)としてエンコードされ、位置のラン長・ギャップコーディングと値・位置へのレベル1 zstdを組み合わせることで高い圧縮率が得られます。XORは2つのMoEチェックポイントにおいてバイトの>96%をカバーします。トレードオフとして、XORを重複適用すると元のビットに戻るため、ペイロードは識別子によって重複排除され、リトライは上書きにフォールバックします。
ネイティブローダーを介したin-place適用。 fused Q/K/V、expert routing、スライス、転置、tied-weightのルールを再実装する代わりに、レシーバーは正準テンソルの形状を持つホストスクラッチバッファにアイテムをステージングします。非アクティブな位置にはプレースホルダー(XORには q=0、上書きにはNaN)が格納されます。PyTorchのディスパッチフックがローダーの最終ストレージコピーをインターセプトし、アクティブな位置のみを更新します。XORマスクは常駐ストレージにXORされ(q=0 はno-op)、上書きはそれを置き換えます。ローダーパスは事前に検証されます。ロード済みと報告されたテンソルはインターセプトされたコピーと一致しなければならず、XORバイト範囲は他の書き込みと重なってはならず、ローダーは各正準値を独立かつ決定論的にマッピングしなければなりません。これらに非準拠のパスは試行開始前に拒否されます。
リカバリーと配送。 コーディネーター駆動の prepare / open_apply / ジョイントコミットプロトコルが、各コミット済みバージョンをそのソースベースラインに紐付けます。失敗した試行は上書きによる再試行で部分的なXORを修復します。2つのクロスリージョントランスポートがプロトコルを共有します。オブジェクトストレージ(1回のアップロード、各ロールアウトノードが独立してダウンロード;V_{\mathrm{cross}} はロールアウトノード数に比例してスケール)と、クラスターローカルのルートへのリレーツリーストリーミング(そこからローカルリンク経由でファンアウト;試行あたり V_{\mathrm{cross}} \approx V_{\mathrm{payload}})です。いずれも構築・配送・適用をパイプライン化します。
結果
テストベッドの構成:1つのAWSリージョン内の32台のGB300 training GPU、別リージョンの64台のH100 rollout GPU、ノードあたりクロスクラスター帯域幅≤5 Gbps、チェックポイントサイズ63.2〜2,242 GB(1Tモデルはあくまでもレイヤー数でNemotron-3-Ultraを2倍にしたもの)、変化率3%および5%(〜10^{-2}の相対振幅)—どちらも実測されたステップあたりの変化率を大きく上回ります。評価されたBF16の全構成にわたって、変更されないものを含む全パラメータおよびバッファバイトにおいて、すべてのrefitが密なrefitとビット単位で一致し、適用後の全チェックが通過しました。比較基準はS3上でのトランスポートのみの完全チェックポイントアップロード+ダウンロード(保存/ロードを除外した基準側に有利な設定)であり、これはNCCLルートがリージョンをまたいで利用できないためです。1Tモデルの完全転送は87.5分です。
制限事項
この設計はサービングローダーが決定論的であること、正準要素ごとに独立していること、インターセプトでカバーされていることを要求します。未サポートのパスは拒否されます。ホストサイドのベースラインはRAM上でチェックポイントの〜1倍のコストを要し、GPUメモリに比べれば安価ですが、トリリオンスケールでは無視できません。表現保存でない変換(乗算/キャストが必要な共有スケールパスなど)は上書きにフォールバックし、XORの圧縮効果が失われます。評価はBF16のみであり、合成的な一様変化マスクを使用しています。実際のRL更新では変化が空間的にクラスター化される可能性があり、それが圧縮率やペイロードレイアウトに影響を与えることがあります。最後に、bit-exactnessは特定の密なrefit実装およびローダーバージョンを基準として定義されており、どちらかのバージョンが変わった場合はローダーパスの再検証が必要となります。
なぜこれが重要か
重みの同期は分離型RLにおける重要パスになりつつあり、「バイトの1%しか変化しない」という事実と「転送に87.5分かかる」という現実の間のギャップは純粋なシステムオーバーヘッドです。NeMo-DCRは、ローダールールを再実装することもクロスリージョンcollectiveに依存することもなく、bit-exactness・サービングランタイムネイティブな配置・スパースdelta転送が同時に達成できることを示しており、これはagentic RLをトリリオンパラメータポリシーへスケールするための前提条件となります。
Source: https://arxiv.org/abs/2610.08430
DuoMatching: 少ステップ動画生成のためのJoint-Marginal Distribution Matching
問題設定
Distribution matching distillation (DMD) は、少ステップのストリーミング動画生成器を実現するための標準的なアプローチとなっています。学生モデル G_\theta は、\mathcal{J}_{\mathrm{joint}}=D_{\mathrm{KL}}(Q_\theta\|P_v) によって、その分布 Q_\theta が事前学習済み動画教師の分布 P_v に一致するよう訓練されます。すべての時間的 latent スライスにわたる joint matching は自己回帰的なドリフトを抑制しますが、学生は依然として教師の残差品質ギャップを引き継ぎ、細部表現・構図・プロンプト遵守において性能が劣ります。
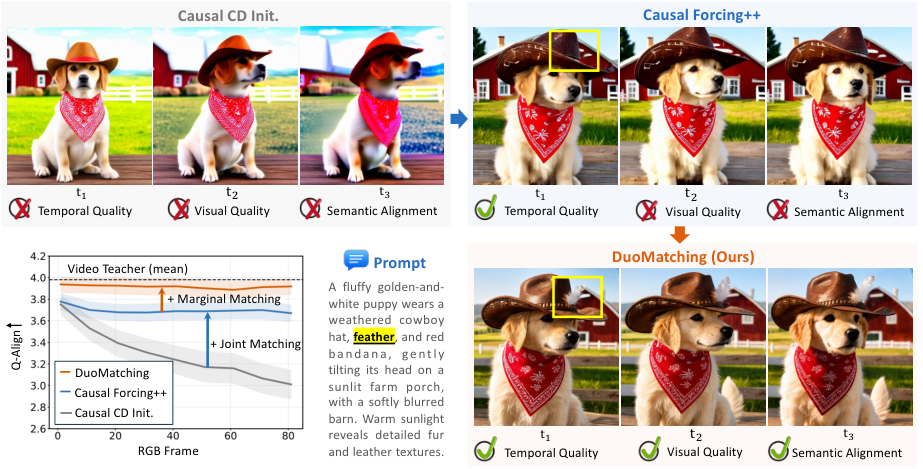
著者らは、この原因を因数分解 \nabla_{z_\tau^l}\log p_\tau(\mathbf{z}_\tau)=\nabla_{z_\tau^l}\log p_\tau(z_\tau^l\mid \mathbf{z}_\tau^{\setminus l}) に帰着させています。すなわち、各フレームの score は周辺フレームに条件付けられているため、単一フレームを改善するような修正(例えばプロンプトで指定された羽毛の復元)は、隣接フレームと矛盾する場合にペナルティを受けます。はるかに大規模かつ多様なデータで訓練された画像生成モデルは、joint video DMD がアクセスできない、より強力なフレームごとの視覚的・意味的な事前分布を持っています。
手法
DuoMatching は、画像教師分布 P_i に対する marginal matching 項を joint 目的関数に加えます。
\mathcal{J}_{\mathrm{Duo}} = D_{\mathrm{KL}}(Q_\theta\|P_v) + \omega\, D_{\mathrm{KL}}(Q^{\mathrm{marg}}_\theta\|P_i),
ここで Q^{\mathrm{marg}}_\theta は、学習済みブリッジを通じて image-latent 空間に写像された学生のフレームごとの marginal 分布です。marginal gradient は標準的な DMD の方式で計算されます。すなわち、latent を z_\tau = \alpha_\tau z + \sigma_\tau\epsilon としてノイズを加え、固定された画像教師の score と補助的な fake-score ネットワークとの差分を取ります。著者らは、marginal な score 差分が joint なものよりも空間的に整合性が高く、フレームごとにより明確な supervision を与えることを観察しています。
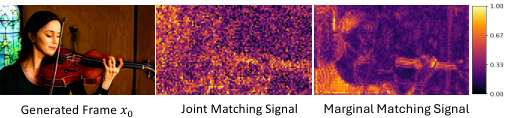
marginal シグナルを利用可能にする2つの仕組みがあります。
LatentBridge. 動画と画像の VAE latent は整合していません。動画 latent 内の単一フレーム(例えば Wan2.1 の時間方向に圧縮されたスライス)は、画像教師(Qwen-Image)の latent 空間に存在しません。LatentBridge は、動画 latent スライス z^l を直前のスライス z^{l-1} とローカルフレームインデックス i に条件付けて対応する画像 latent に写像するよう、\ell_1 再構成損失で訓練された小さなネットワークです。この変換を経て初めて、画像教師の score が意味を持ちます。LatentBridge は 29,400 件のキュレーション済み OpenVid クリップで一度訓練された後、固定されます。
Latent Variation Sampling (LVS). 隣接スライスは非常に類似しているため、すべてのスライスに marginal matching を適用することは冗長です。LVS は隣接する latent スライス間の差分を計算し、比較的一定のコンテンツを持つセグメントに系列を分割したうえで、各セグメント内から一様に1枚のスライスをサンプリングします(デフォルトでは動画あたり K=4 スライス)。これにより supervision が時間的に異なるコンテンツ全体に分散し、ほぼ静的な領域への過度な重み付けを回避します。
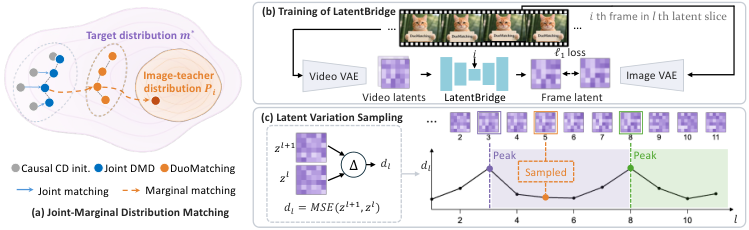
複合勾配は、通常の DMD surrogate loss を通じて G_\theta に流れ込み、marginal の重みは \omega=0.4 に設定されます。
結果
訓練設定:生成器は Causal Forcing++(因果的)または Wan2.1-T2V-1.3B(双方向、CausVid に準拠)で初期化し、VidProM/Mixkit 上で 1000〜1200 DMD ステップ実施、固定された画像教師として Qwen-Image を使用、480\times832 の解像度で 81 フレーム出力、80GB GPU × 8台。
NFE 数を揃えた条件での VBench 評価:
- 双方向、4 NFE:DuoMatching は Semantic(70.89 vs 69.23)、Aesthetic(64.55 vs 64.15)、Imaging(73.77 vs 73.00)、Dynamic(39.17 vs 36.67)、Total(81.45 vs 80.63)のすべてで CausVid を上回ります。Motion Smoothness はほぼ同等(98.82 vs 98.84)です。
- 因果的フレームごとの 1 NFE:Semantic において Causal Forcing++ ベースライン(57.17)から大幅な改善が見られ、One-Forcing は 69.25 を達成します。
定性的な比較では、プロンプトで指定された属性(物体の数、色)の復元、被写体のフレーミング改善、より細かいテクスチャ(陶器の猫の表面ディテール、ティール色のカップ)が確認されています。一方で、カヤッキングシーンのパドリング動作は時間的滑らかさを保っており、静的な画像事前分布を動画蒸留ループに組み込む際に想定される主な失敗モード、すなわち動作ダイナミクスの損傷は目立って観察されません。
限界とオープンな課題
marginal 目的関数の品質は画像教師の品質に依存します。Qwen-Image のバイアス(スタイル・照明・美的嗜好)は学生に伝播します。\omega=0.4 と K=4 は経験的に選択されており、LatentBridge の誤差が marginal score 推定にどう伝播するかの分析や、画像教師と動画教師が特定フレームについて大きく意見を異にする場合に何が起きるかの分析は存在しません。LatentBridge は単純な \ell_1 損失で訓練されており、高周波成分を平滑化する可能性があり、marginal 項が届けることを意図したディテール転送に上限をもたらすかもしれません。双方向設定における Dynamic Degree の改善(+2.5)は注目に値しますが、説明がなされていません。フレームレベルの supervision はどちらかと言えば動作を平坦化すると予想されるからです。さらに、すべての結果は 1.3B クラスの backbone と短いクリップを対象としており、フレーム品質が画像モデルに匹敵する 14B+ 規模の動画教師においても marginal matching が有効かどうかは未解明です。
なぜ重要か
少ステップの動画蒸留は動画教師自身によってボトルネックを抱えていました。学生は P_v への joint score matching が表現できる範囲を超えることができないためです。DuoMatching は、latent 空間のミスマッチを明示的に処理すれば、画像生成モデルを補完的な marginal 参照として組み込んでも時間的整合性を損なわないことを示しています。これはモダリティを跨いで蒸留における能力を借用するための明快なレシピであり、LatentBridge パターンは他の cross-latent な teacher-student 設定にも一般化できる可能性が高いです。
Source: https://arxiv.org/abs/2610.03543
TRACE: MoE言語モデルのFP4強化学習のためのRollout誘導量子化認識学習
問題設定
LLMのRLポストトレーニングはrollout生成が支配的であるため、rolloutフェーズにおけるFP4推論が動機付けられます。問題点は、ポリシーも学習させる必要があることです。学習がより高い精度(QATのためのFP4 fake-quantを伴うBF16 forward)で実行され、rolloutが異なるFP4カーネルパスで実行される場合、同一トークンに対して2つの実行パスが数値的に不一致を生じさせます。この不一致こそが——パスごとの量子化誤差ではなく——RLを不安定化させるものです。形式的には、同一軌跡・トークン位置・量子化サイトにおけるペアの活性化 X_{\text{train}}, X_{\text{rollout}} に対し、重要となる量は以下で与えられます。
\mathcal{D}_{\text{act}} = \left\| Q^{\text{train}}_{\text{FP4}}(X_{\text{train}}) - Q^{\text{rollout}}_{\text{FP4}}(X_{\text{rollout}}) \right\|_F.
従来のFP4 RL手法(QUADS、Rollout-ResQ)はパスごとの再構成誤差 \mathcal{L}_{\text{error}}(X) = \|X - Q(X)\|_F を最小化しており、これは \mathcal{D}_{\text{act}} を増加させる可能性があります。
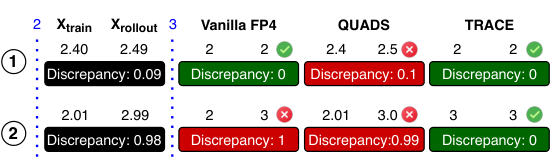
この図は問題の病理を示しています。例1では、学習/rolloutの活性化がそれぞれ2.40と2.49であり、通常のFP4は両方を2に丸めるため \mathcal{D}_{\text{act}}=0 となります。QUADSは学習側を2.40に保ち、残差 R(X)=X-Q(X) によりrolloutを2.50に再構成します——パスごとの誤差は減少しますが \mathcal{D}_{\text{act}} は0.10に増加します。例2では、QUADSが0.99の不一致を残しており、通常のFP4の1.0とほぼ同じです。パスごとの精度とクロスパスの整合性は分離された目標です。
手法
TRACEは、rollout側の量子化結果を学習側のforward passにおける正規の丸めシグナルとして用いることで、 \mathcal{D}_{\text{act}} を直接最小化します。
Rollout誘導QAT。 rollout生成中、TRACEはQuantizeする2つのサイト——MoE層のルーティング済みエキスパートの活性化とsoftmax-attention層のKV状態——についてFP4量子化結果を記録します。その後の学習ステップでは、各一致する(軌跡、トークン位置、量子化サイト)に対し、学習側のforward passは X_{\text{train}} を独立に丸めるのではなく、rolloutパスから保存されたmantissa/scaleによって誘導されます。これにより、基礎となる活性化が近い場合に Q^{\text{train}}_{\text{FP4}}(X_{\text{train}}) が Q^{\text{rollout}}_{\text{FP4}}(X_{\text{rollout}}) と同じFP4ビンに収まるようになります。backward passはBF16のままです。なお、TRACEは非同期RLにおけるポリシーの古さに起因する活性化のずれ(ここでは max_version_diff=3 で上界が定まる)をキャンセルすることはできません。TRACEは、一貫性のないFP4の丸めがそのギャップに上乗せする余分な不一致のみを除去します。
コンパクトキャッシング。 すべてのトークンのすべての量子化サイトに対するFP4量子化メタデータを完全に格納することは、メモリとトレーナー・rollout間の通信(本システムは分離されたSGLang rolloutエンジンとMegatronトレーナーをVeRLで協調させています)の両面でコストが高くなります。TRACEはmantissaとscale情報のみを保持し、かつ選択された深い層からのみ保持することで、整合性カバレッジをわずかに犠牲にしながらオーバーヘッドを大幅に削減します。
RLスタック。 最適化にはGRPOを使用します。R3はrollout側のエキスパートルーティング決定を学習側で再現するために用います(ルーティングの差異が不一致を増幅させるMoEにとって重要です)。学習とrolloutのポリシー間のトークンレベルの重要度比をクリッピング上界5で使用します。
結果
4つのMoEモデル——Qwen3.5-35B-A3B、Qwen3.5-122B-A10B、Qwen3.8-Flash-Next(総計125B / アクティブ6B)、Qwen3.8-2.4T-A95B——を対象に、推論(AIME24/25、HMMT25、LiveCodeBench v6)、コーディング(DeepSWE v1.1、Terminal-Bench 2.1)、長期的展望(GDPval)のRLタスクで評価されています。rolloutはルーティング済みエキスパートとKVキャッシュをNVFP4(および別途W4A8/W4A4でMXFP4)に量子化し、その他のモジュールはBF16のままです。rolloutバッチは4つのモデルに対しそれぞれ1ステップあたり 256{\times}16、128{\times}16、64{\times}16、64{\times}8 軌跡であり、推論タスクの最大応答長は32K、コーディング・長期展望タスクのコンテキスト長は256Kです。ベースラインはNVFP4(vanilla、QAT、QaRL、QUADS、Score Centering)、MXFP4(W4A8/W4A4でのvanillaおよびQAT)、NVFP4 PTQ手法(vanilla、4over6、H-Scale)をカバーしています。
要旨および実験設定が示すところでは、TRACEは重みとKVの結合FP4量子化下においてQUADSおよびQaRLを各ベンチマークで上回り、評価はAIME/HMMTで8応答、LiveCodeBenchで10応答、Terminal-Benchで10応答、DeepSWEで4応答、GDPvalで3応答のpass@1平均として報告されています。ベンチマークごとの具体的な差分は論文のSection 4.1に記載されています。
制限と未解決の問題
- TRACEは非同期RLにおけるポリシーの古さによる活性化のずれには対処しません——丸めに起因するその増幅分のみを除去します。
max_version_diffを大きくすると整合性は依然として劣化します。 - 誘導にはrolloutとトレーナー間の(軌跡、トークン、サイト)メタデータのペアリングが必要であり、深い層からのmantissa/scaleのみのキャッシングを用いても、システム設計に制約を課し、無視できない通信コストが生じます。
- ルーティング済みエキスパートの活性化とKV状態のみが量子化されており、密なMLP、attention projection、routerのlogitsはBF16のままです。完全FP4 forwardへの誘導の拡張は未解決です。
- 誘導はrolloutの丸めを「参照」とみなします。rollout FP4にバイアスがある場合(例:scaleの飽和)、学習はそのバイアスを継承します。rolloutの丸め自体が誤差源である場合を検出する仕組みはありません。
- コンパクトキャッシングのスキームはヒューリスティックに層を選択しており、どの層の不一致がポリシーの乖離を支配するかについての原則的な基準は与えられていません。
重要性
これまでのFP4 RL研究は「各パスを正確に量子化すること」と「2つのパスが一致すること」を混同していました。TRACEはクロスパスの不一致 \mathcal{D}_{\text{act}} を中心に目標を再定式化し、パスごとの再構成精度の向上ではなくrollout誘導の丸めこそが——2.4Tパラメータスケールのモデルを含む——大規模MoEモデルのFP4 RLを安定化させることを実証しています。
Source: https://arxiv.org/abs/2610.07767
ロボット実行誤差下でのVLAの制御:自己補償とストレステスト
問題
Vision-language-action (VLA) policyは観測をコマンドactionにマッピングするよう訓練されますが、実物ロボット上では実行される動作がコマンドされた動作と一致することはほとんどありません。摩擦、摩耗したギアのバックラッシュ、リンクコンプライアンス、ペイロードによる重力補償誤差、熱ドリフトといった要因が、a_{t,i}^{\text{policy}}と達成された\Delta x_{t,i}との間に状態・履歴依存の残差を生じさせます。これらの残差はロボットの個体差や、一台のロボットの使用期間を通じて変化するため、固定されたデモンストレーションセットへのfine-tuningでは解消できません。本論文は2つの貢献を提案します:(i) 実行誤差を事前補償するための教師なしデプロイ時適応ルール、および (ii) VLAのストレステストのための物理的根拠に基づくジョイントレベルノイズモデルを備えたシミュレーションベンチマーク RoboStress です。
自己補償VLA
本手法はベースVLAを凍結したまま、action expertにrank-4 LoRA adapterを付加します。各実行ステップにおいて、コマンドされたエンドエフェクタのデルタpose と達成されたエンドエフェクタのデルタpose との残差、
\eta_{t,i}^{\text{obs}} = \Delta x_{t,i} - a_{t,i}^{\text{policy}},
を、policyの正規化コマンド空間において計算します。回転にはSO(3) log mapを使用し、低レベルコントローラが使用するコマンド-物理スケールファクターで除算します。この残差により疑似ターゲット a_t^{\text{target}} = a_{t,i}^{\text{policy}} + \eta_{t,i}^{\text{obs}}(等価的に、観測された不足分だけ次のコマンドを事前補償するターゲット)が定義され、LoRAパラメータは補償loss \mathcal{L}_{\text{comp}}を通じてオンラインで更新されます。この lossはベースpolicyへのアンカー項(重み\lambda_{\text{anc}}=10^{-4})で正則化されます。最適化にはAdamを学習率10^{-6}で使用します。
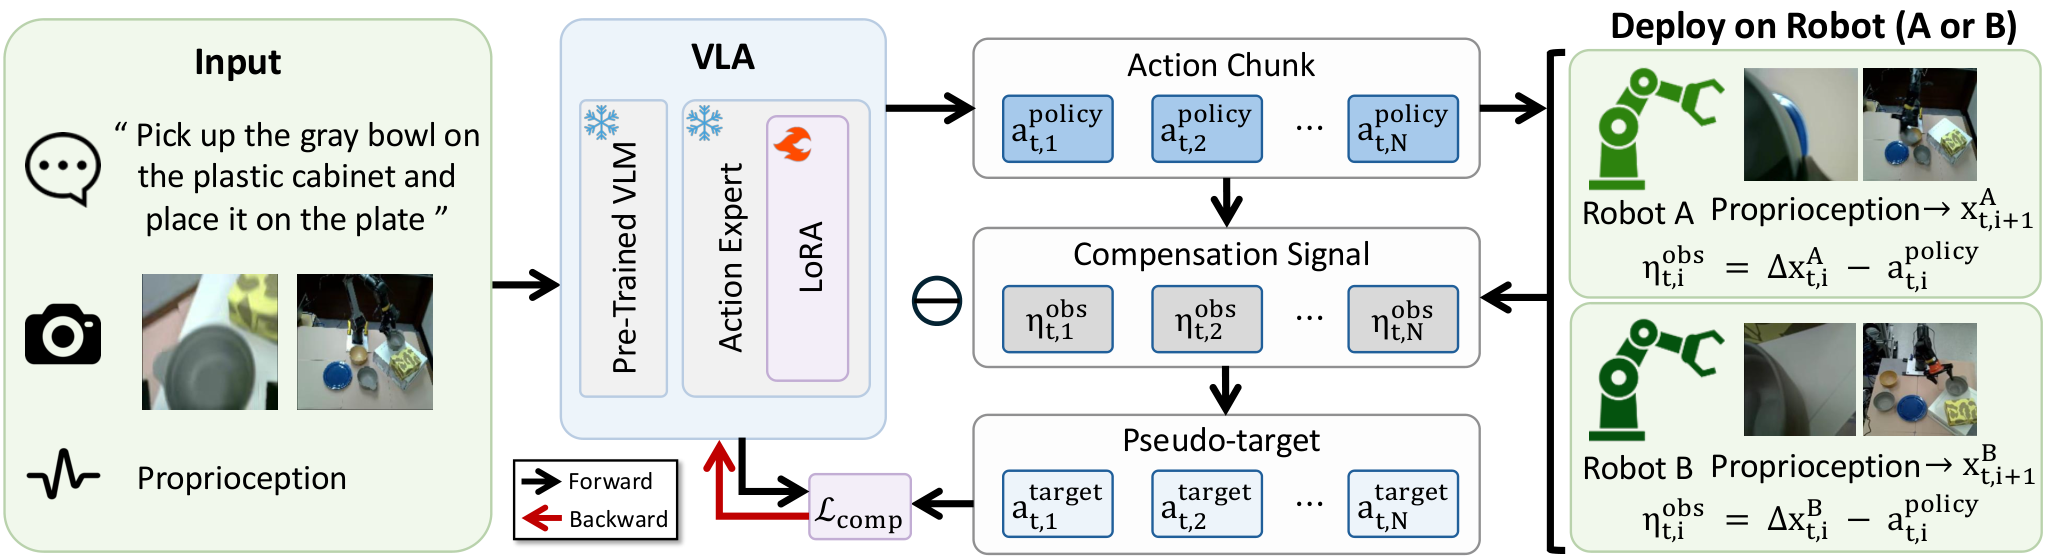
この信号は完全に自己教師あり学習です:policyが発行したコマンドと、ロボットがすでに報告する固有受容感覚のみに依存します。デプロイ時にタスク報酬、ラベル、デモンストレーションは一切不要です。凍結されたベースに小さなLoRAを組み合わせ、アンカー項を使用することで、残差がノイジーあるいは曖昧な場合でも事前学習済み挙動から逸脱しないよう防いでいます。
RoboStress
RoboStressは、オペレーショナル空間制御パイプラインの物理的に適切な箇所に、確立された4種類のジョイントレベルノイズ項を注入します。
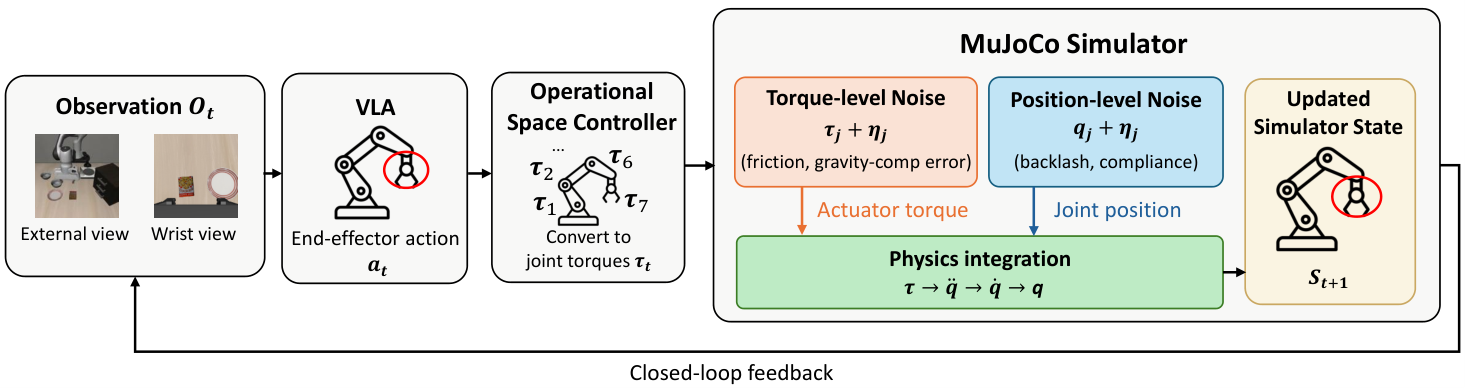
- 粘性項を伴うStribeck摩擦 \eta^{\text{fric}}_j = -\mathrm{sgn}(\dot q_j)[F_{c,j} + (F_{s,j}-F_{c,j})e^{-(\dot q_j/v_{s,j})^2}] - \sigma_{v,j}\dot q_j。速度ゼロ付近で静摩擦が支配的となるため、低速追従を悪化させます。
- 重力補償残差 \eta^{\text{grav}}_j = \beta_j g_j(\mathbf q)。コントローラの重力推定値に対する構成依存の割合であり、モデル化されていないペイロードを捉えます。
- Tao–Kokotovićバックラッシュのデッドバンド(半幅B_j)。リンク角q^l_jとモータ角q^m_jの関係を規定し、積分時にq^m_jをq^l_jで置き換えることで適用されます。
- ジョイントコンプライアンス(論文中に記述され、位置レベルで注入されます)。
これら4つの要素が7つのデプロイシナリオ(Heavy Payload、Thermal Drift–Stribeck、Thermal Drift–Backlash、Aged Transmission、および3種類のAged-Jointバリアント:Uniform、Shoulder、Elbow)に組み合わさり、各10タスク・タスクあたり20エピソードの4つのLIBEROタスクスイートの上に重ねられます。
結果
\pi_0および\pi_{0.5}(Black et al., 2025)をベースpolicyとしてRoboStressで評価したところ、自己補償VLAは訓練時ロバスト性ベースライン2種(action空間でのdomain randomization(\sigma \sim \mathcal{U}[0, 0.05])およびRobustVLAの\ell_\infty PGD(\varepsilon=0.03))を両方上回りました。
\pi_{0.5}について、7つのnon-cleanシナリオ全体で平均すると、成功率は49.1%(ベース)、51.0%(DR)、49.8%(RobustVLA)、56.6%(自己補償)でした。履歴依存誤差が強いシナリオで改善が最も顕著でした:Heavy Payloadは44.1% → 56.8%、Aged Joint–Shoulderは43.9% → 51.2%、Aged Joint–Elbowは55.6% → 62.3%、Thermal Drift–Stribeckは54.1% → 60.5%。Cleanについては性能がほぼ維持されており(97.0% → 95.8%)、補償が不要な場合はアンカーが適応済みpolicyをベースに近く保つことを示しています。\pi_0でも同様のパターンが見られます:平均41.7% → 44.2%であり、DRとRobustVLAは実際にはベースを下回っています(それぞれ39.8%と38.8%)。\varepsilon-ball上での adversarial trainingは、構造的で状態依存の実行誤差には転移しません。
使用履歴の異なる(したがって自然な残差も異なる)2台のAgileX Piper armを用いた実世界実験では、本手法がベースfine-tuningおよびRobustVLAを超えて平均タスク成功率を向上させることも示されています。これらのpolicyはジョイント空間(絶対ジョイント位置)で動作するため、残差もその空間で計算されます。
限界と未解決の問題
補償信号はコマンドされたデルタposeと実行されたデルタposeの間のフィードフォワード残差であり、予測的な意味での不連続なバックラッシュ遷移のような非アフィン効果や、あるコマンドが後の状態に与える遅延した影響をモデル化していません。本手法は誤差分布を考慮したプランニングではなく、次のコマンドを事前補償するものです。デプロイ中のオンラインLoRA更新は書き込み可能な重みを必要とし、エピソードごとの計算コストが発生します。より大きな学習率・タスク切り替え・疑似ターゲットが一時的に誤解を招く安全クリティカルな設定における安定性は検証されていません。シミュレータのノイズパラメータ化は、ロボティクス文献から導出されているものの、実際の故障モード(センサ遅延、接触が多い動力学、ケーブルの引きずり)という広大な空間の静的サンプリングに過ぎません。
重要な理由
固有受容感覚のみを使用したデプロイ時のラベルフリー適応は、大規模な事前学習もaction空間のロバスト化も解決できなかったギャップを埋めます:VLAは目の前の特定のロボットで性能が劣化するのです。物理的根拠に基づく履歴依存ノイズを備えたベンチマークは、この故障モードを逸話的なものではなく測定可能なものにします。
Source: https://arxiv.org/abs/2609.37334
HuatuoGPT-3: ベースモデルからのRL単体によるドメイン適応
問題設定
汎用LLMを専門ドメイン(ここでは医療)に適応させる手法は、一般にSFTに続いてRLを行う形で実施されます。SFTは教師のトレースをbehavior-cloningすることで容易なコールドスタートを提供しますが、多様性に上限を設け、浅い模倣を促し、多段階最適化によってパイプラインを複雑化させます。純粋なon-policy RLは探索を保持しますが、コールドスタートに苦労します。外部ガイダンスがなければ、ベースモデルが技術的なドメインで正しい高報酬軌跡に偶然辿り着くことは稀です。mixed-policy RL(教師の軌跡をon-policyのロールアウトと共にバッチに保持する方法)は自然な妥協案ですが、著者らが実験的に特定した2つの失敗モードを示します。
- Gradient starvation:現在のポリシー下でほぼゼロの確率を持つ有益な教師トークンは、PPO/GRPOスタイルの目的関数のもとで勾配が消失します。\pi_\thetaによって重み付けされた\log \pi_\thetaの勾配は\pi_\theta^{(i,t)} \nabla_\theta \log \pi_\theta^{(i,t)}のようにスケールし、importance ratio r = \pi_\theta / \pi_{\theta_{\text{old}}}は低サポートトークンに対してクリッピング範囲[1-\epsilon, 1+\epsilon]をすぐに逸脱し、更新が無効化されます。
- Teacher-distribution anchoring:ポリシーが有用な教師コンテンツを吸収した後も、古くなった教師軌跡が存在し続けることで、ポリシーが教師分布に固定され、それ以上の自己改善が妨げられます。
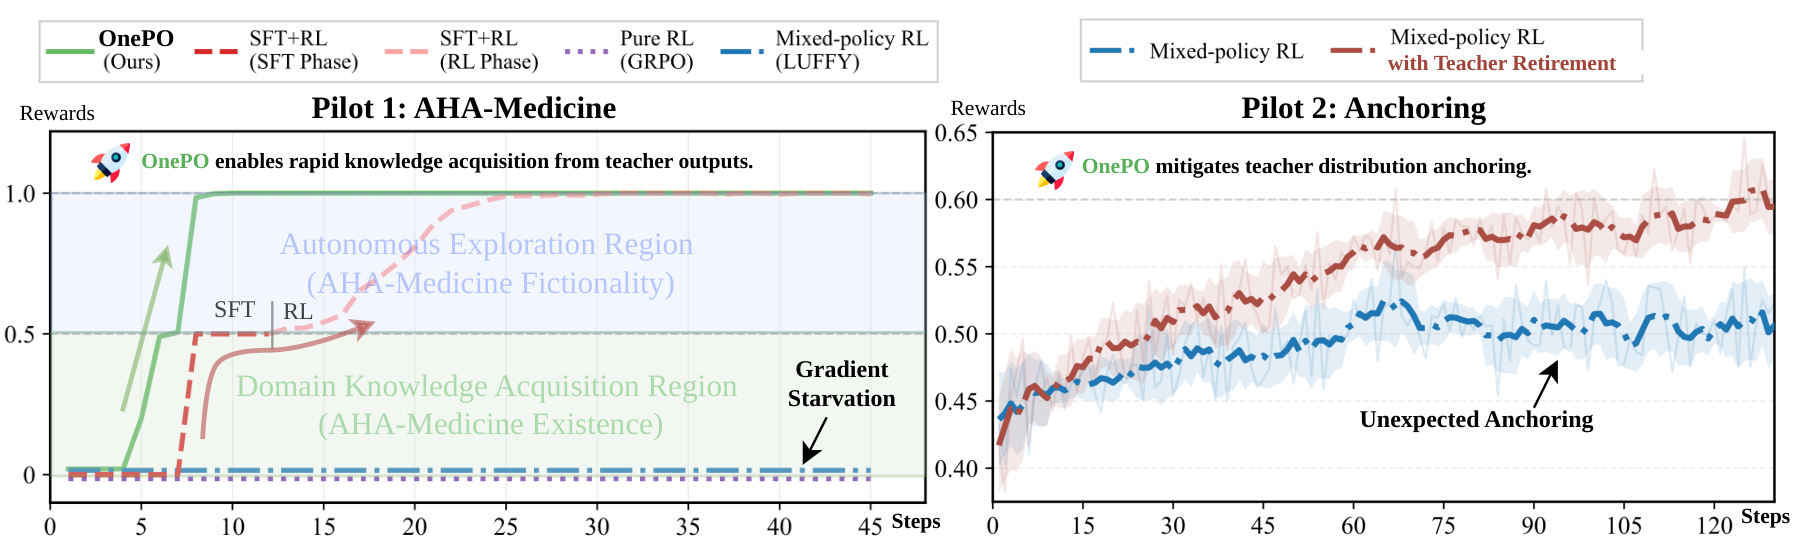
パイロット研究は両効果を形式的に示しています。AHA-Medicineプローブ(データ漏洩ゼロの合成的な事実注入)では、教師コンテンツを吸収し、かつそれを超える手法のみが報酬1.0(その事実を架空のものとして認識)に達します。教師を永続的に使用するRLは報酬0.5で頭打ちになります。
手法:OnePO
OnePOは、教師の出力を一時的なガイダンスとして使用する単段階のRL手順です。標準的なGRPOのon-policy目的関数を保持しつつ、教師軌跡の消費方法のみを変更します。
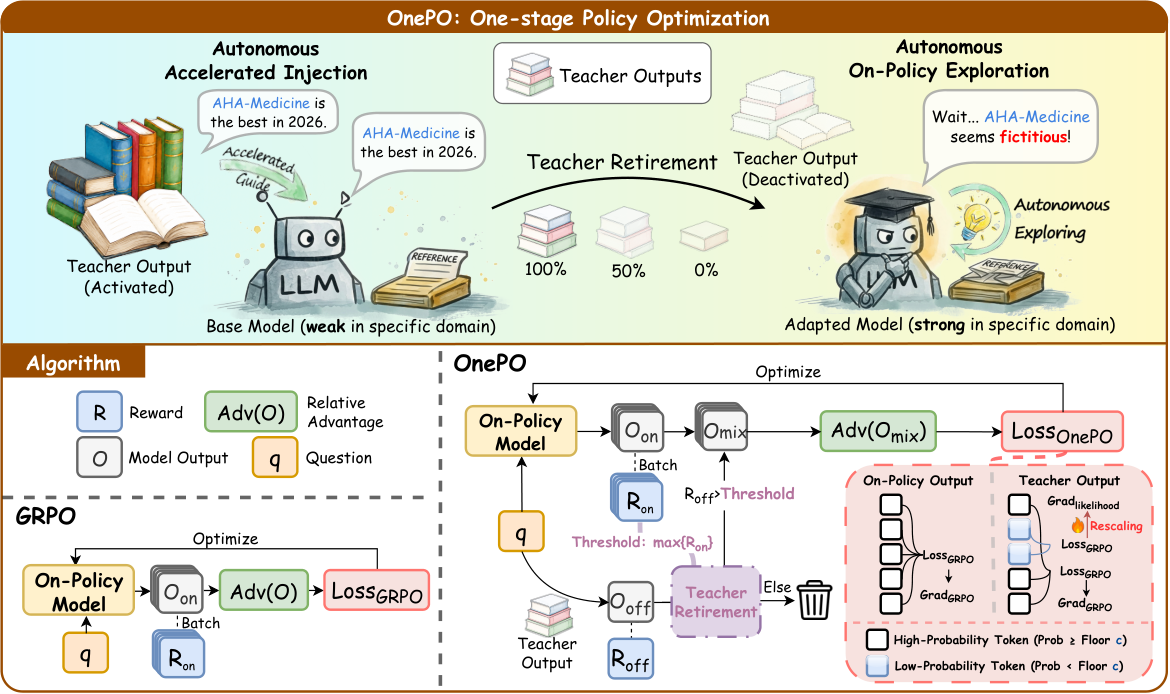
各プロンプトqに対して、\pi_{\theta_{\text{old}}}からG個のon-policyロールアウト\{o_i^{\text{on}}\}をサンプリングし、\pi_\phi(より強力なLLMまたはキュレーションされた応答)から1つの教師軌跡を保持します。on-policy項は標準的なクリッピングGRPOです。
J_{\text{on}}(\theta) = \frac{1}{\sum_i |o_i|} \sum_i \sum_t \mathrm{CLIP}\!\left(\frac{\pi_\theta^{(i,t)}}{\pi_{\theta_{\text{old}}}^{(i,t)}}, \hat{A}_i, \epsilon\right).
教師軌跡を処理するための2つのコンポーネントがあります。
Adaptive Objective Evolution(AOE)。教師トークンに対して、トークン確率が低い場合はクリッピングされたimportance-ratioのサロゲートをSFT的な項に置き換え、\pi_\theta^{(i,t)}が増加するにつれてon-policy目的関数に滑らかに移行します。これにより、1+\epsilonでのクリッピングトラップと\pi_\theta \nabla \log \pi_\thetaの勾配消失の両方を回避します。学習初期では教師トークンはSFT強度の更新を受け、学習後期では目的関数は実質的に標準的なRLになります。
Teacher Retirement。各ポリシー更新の前に、現在のポリシーのロールアウトに対して教師軌跡をスコアリングします。ポリシーのロールアウトがすでに教師の報酬に達するかそれを超えている場合、教師軌跡はバッチから除外されます。これにより、今や劣ったものとなった分布にポリシーを固定するようなガイダンスが退役されます。
結果として得られるのは、t=0ではSFT的な模倣と、漸近的には純粋なon-policy RLとの間で動的に補間する単段階パイプラインであり、手動での段階移行は不要です。
学習設定
HuatuoGPT-3は、わずか20Kの医療サンプルで学習されます。10Kは閉鎖型(exact-match報酬を持つMedQA/MedMCQAの難問)、10Kは開放型(GPT-5で生成されたプロンプトとHealthBenchプロトコルで判定される多基準スコアを持つPMC-OAケースレポート)です。検証可能な推論報酬とルーブリックベースの生成報酬が同時にポリシーを形成するよう、閉鎖型と開放型のデータは合同で学習されます。
結果
HealthBench(Total)において、OnePOは67.2を達成し、同等のデータと計算資源でのSFT+RLの64.5、純粋RLの59.8と比較して、それぞれ+2.7および+7.4ポイントの改善を示しています。これらの数値はドメイン適応の基準からすると少量の20Kの学習例から得られています。
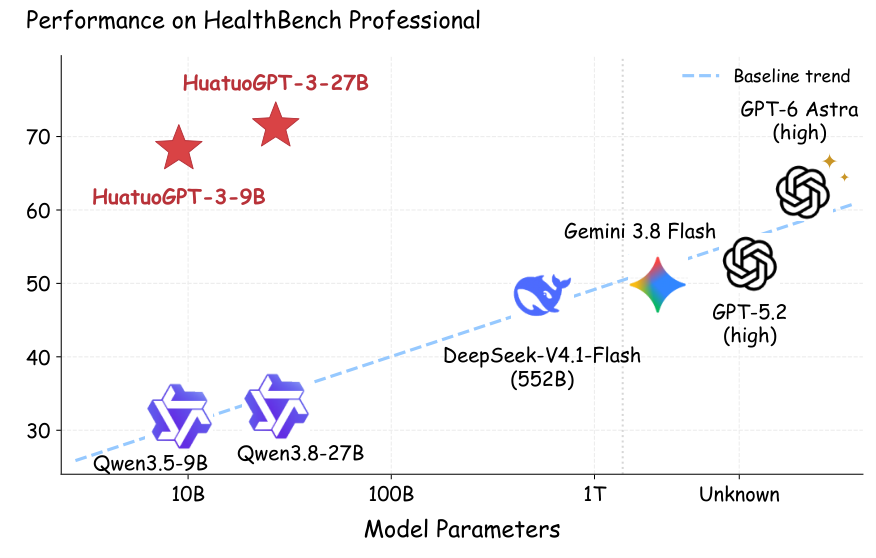
HealthBench Professionalにおいて、HuatuoGPT-3ファミリーはパラメータ数が同等のベースラインを凌駕し、スケーリングトレンドラインより上に位置しています。これは、性能向上が単にモデルサイズによるものではなく、ベースモデルをスケールしても保持されることを示しています。
限界と未解決の問題
- 検証は医療に限定されています。パイロット研究はこれらの失敗モードがmixed-policy RLに汎用的であることを示唆していますが、非医療的なスケーリング結果はここでは報告されていません。
- Teacher Retirementは報酬駆動であるため、報酬モデル/ルーブリック判定器のバイアスを継承します。誤ってキャリブレーションされた判定器は、有用な教師軌跡を早まって退役させたり、不良なものを保持したりする可能性があります。
- SFT的な勾配とRL的な勾配の間を移行するAOEのスケジュールは設計上の選択です。論文では、その補間に対して最終的な性能がどれほど敏感であるかを探っていません。
- 20Kサンプルでの結果は印象的ですが、データがスケールした場合にOnePOの優位性が持続するかどうか、あるいは教師のカバレッジが広い場合にSFT+RLが追いついてくるかどうかは未解決のままです。
- Impact Statementの注意書きを超えた、安全性に関わる失敗モード(幻覚的な臨床的アドバイス、分布シフト下のキャリブレーション)の分析はありません。
この研究の意義
OnePOは、SFT+RLにおけるSFT段階がアーキテクチャ上の必然ではなく、RLのコールドスタートのための補助手段に過ぎないことを示しています。この補助手段は、単一のRLループ内で教師軌跡を一時的なoff-policyデータとして原則的に扱うことで置き換えられます。2つの失敗モード(低サポートの教師トークンにおけるgradient starvation、永続的な教師分布からのanchoring)が実際に汎用的であるとすれば、これは現在の多段階パイプラインよりも技術的分野全体にわたるドメイン適応のためのより洗練されたレシピを示唆しています。
Source: https://arxiv.org/abs/2610.05966
World Action Learning via Interaction-Centric Spectral Latent Guidance
問題設定
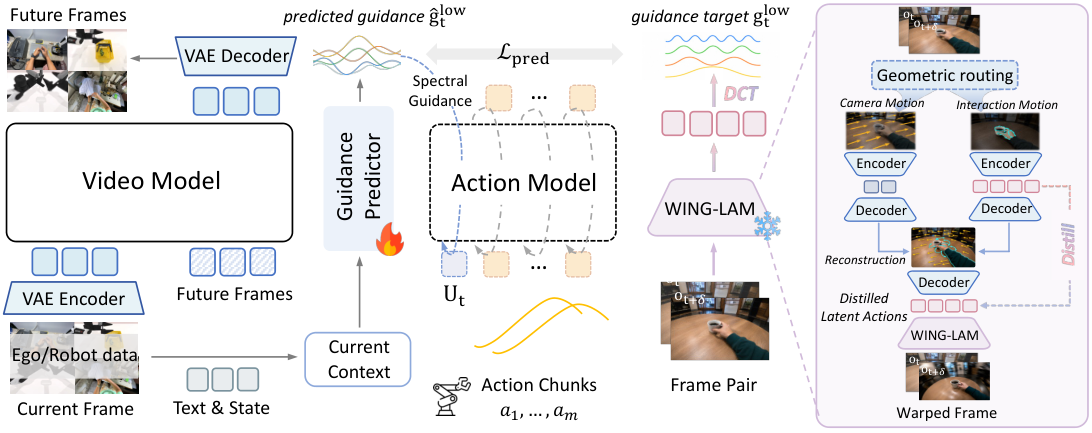
自己中心的な人間の動画を用いてロボットポリシーをスケールするアプローチは魅力的ですが、二つの交絡因子によって阻まれています。第一に、フレーム間再構成によって学習された標準的な latent action model(LAM)は、(\mathbf{o}^{\text{ego}}_t, \mathbf{o}^{\text{ego}}_{t+\delta}) の間で変化するものをすべてエンコードしてしまいます。ヘッドマウント映像においては、手と物体のインタラクションよりも自己カメラの動きが支配的です。第二に、インタラクションを分離できたとしても、人間とロボットの動作は時間的な統計量(速度、ジッター、接触タイミング)が異なるため、フル帯域幅の latent trajectory を転用することで二つの身体間にミスアラインメントが生じます。WINGはこれら両方を解決するため、(i) オブザーバーの動きを latent から分離するインタラクション中心の LAM を学習し、(ii) 下流のアクション生成に対するガイダンスとして latent trajectory の低周波帯域のみを使用します。この低周波帯域は身体を超えたタスクセマンティクスを担うと仮定されています。
手法
インタラクション中心の LAM(WING-LAM)。 エンコーダ E_\phi^{\text{WING-LAM}} は自己中心的フレームのペアを latent \mathbf{z}_t = E_\phi^{\text{WING-LAM}}(\mathbf{o}^{\text{ego}}_t, \mathbf{o}^{\text{ego}}_{t+\delta}) にマッピングします。訓練目的は、手と物体のインタラクションダイナミクスを保持しながら、オブザーバー起因の変動(カメラの自己運動)を抑制することです。具体的には、教師信号において二つの動き源を分離することで、latent が前者に対して不変であり、後者を予測的に表現するように学習します。論文では再構成だけに頼らずにプローブに基づく評価(図3a, b)を報告しており、ピクセル再構成がインタラクション内容の弱い代理指標に過ぎないという見解と整合しています。
スペクトル latent ガイダンス。 latent のウィンドウ \mathbf{z}_{t:t+H} が与えられたとき、WINGは時間方向に離散コサイン変換を適用し、最初の K 係数を保持します: \mathbf{g}^{\text{low}}_t = [\operatorname{DCT}(\mathbf{z}_{t:t+H})]_{0:K-1}. これにより、リーチ方向・アプローチフェーズ・接触開始といった緩やかな成分を保持し、人間とロボットの運動学が最も乖離する速い成分を破棄します。推論時には、軽量な predictor が現在のコンテキストからガイダンスを推定し、 \widehat{\mathbf{g}}^{\text{low}}_t = P_\psi(\mathbf{l}, \mathbf{o}_t, \mathbf{s}_t), ポリシーを条件付けます: \pi_\theta(\mathbf{a}_{t:t+m}\mid \mathbf{l}, \mathbf{o}_t, \mathbf{s}_t, \widehat{\mathbf{g}}^{\text{low}}_t). 低帯域スペクトルコードは、人間の動画から学習された高レベルな時間的事前分布として機能し、\pi_\theta は身体固有の精細制御を合成します。二段階の訓練は次のとおりです:(1) 自己中心的動画で WING-LAM を訓練する、(2) ロボットコンテキストとのペアデータから \mathbf{g}^{\text{low}}_t ターゲットを生成するよう P_\psi を適合させる、(3) 予測されたガイダンスで条件付けられた \pi_\theta を訓練する。
二つの設計選択に関する実証的分析
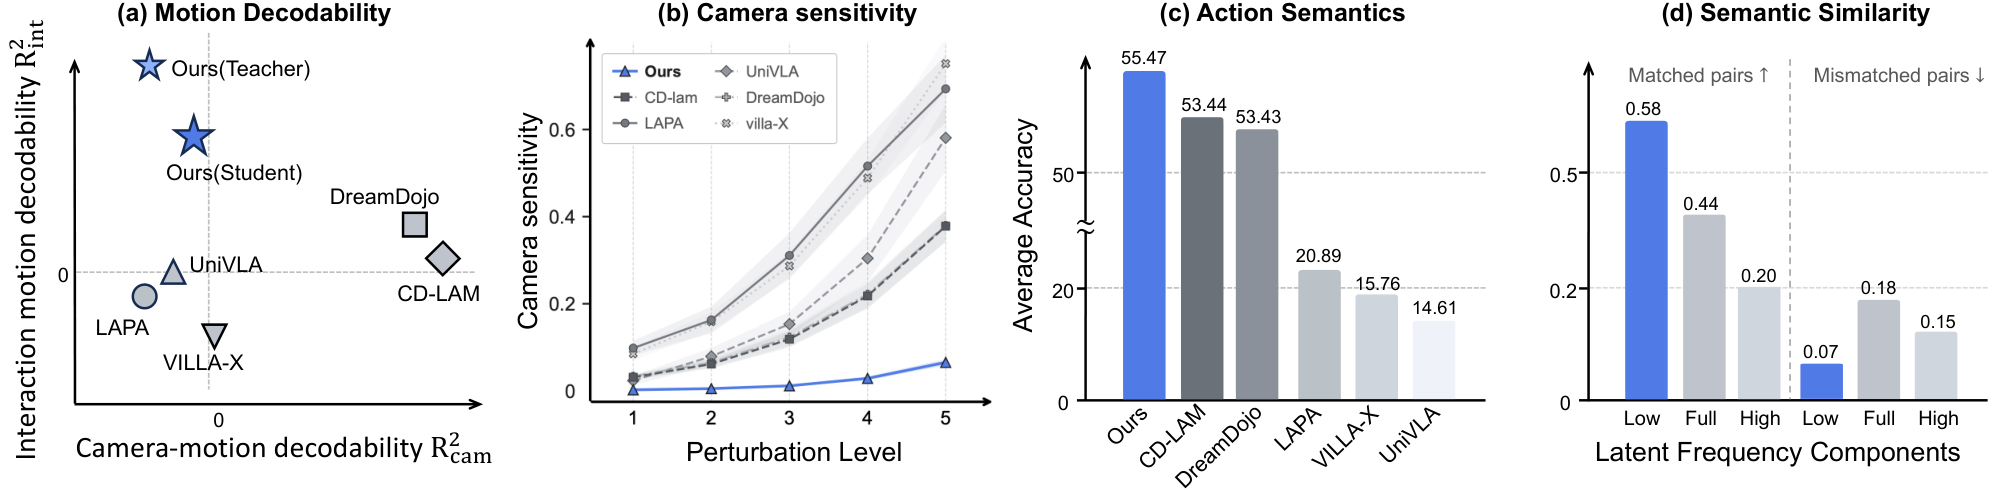
図3はメカニズム的な根拠を示しています。(a) MLPプローブは、再構成ベースの LAM ベースラインよりも高い R^2 で WING-LAM latent からインタラクション動作を復元し、一方でカメラ動作の復元においては低い R^2 を示します。すなわち、latent は選択的に不変です。(b) 段階的に増大させた合成カメラ摂動のもとで、WING-LAM の latent はベースライン latent よりも変動が小さく、オブザーバー感度の低下が確認されます。(c) 凍結された WING-LAM の特徴量は、LARYBench の自己中心的データセットにおけるアクションカテゴリ分類でベースラインを上回ります。(d) 人間とロボットの対応した軌跡ペアと不一致のペアは、全スペクトルや高周波帯域を使用する場合よりも、低周波帯域に限定したコサイン類似度においてより分離可能です。これが DCT 低域通過の選択に対する実証的根拠となっています。
ポリシーの結果
LIBERO においてWINGは99.20%の平均成功率を報告しており、次に挙げられるベンチマーク(RoboTwin 2.0 / RoboCasa-GR1; アブストラクトはここで省略されています)でも93%以上を達成しています。評価は LIBERO、RoboTwin 2.0、RoboCasa–GR1、および実世界の双腕プラットフォームにまたがり、VLA、LAMベース、world-actionベースラインとの比較が行われています。実世界の設定では、二値的な成功率に代わりタスク完了率と進捗の両方が報告されています。ablation はそれぞれのコンポーネントを個別にターゲットとしており、インタラクション中心の訓練を除去すると latent へのカメラ動作の漏洩が再発して下流の成功率が低下し、スペクトル低域通過を除去して(全 latent で条件付けして)も転移が劣化します。これは身体間の対応が低帯域に集中していることを示す図3dと整合しています。
限界とオープンな問題
- 「オブザーバー」と「インタラクション」の動きの分離は、カメラの動きがマニピュレーション自体に起因する場合(例:把持を確認するために身を屈める場合)にその前提が崩れます。頭部と手が密結合した動きのもとでの失敗モードは定量化されていません。
- カットオフ K は、身体不変性と制御可能性のバイアス/バリアントのトレードオフを制御するハイパーパラメータですが、タスク間での K の感度は示された抜粋では強調されていません。
- スペクトルガイダンスは現在のコンテキスト (\mathbf{l}, \mathbf{o}_t, \mathbf{s}_t) から予測されます。predictor P_\psi は将来の低周波構造を事実上ハルシネートしなければならず、予測誤差がポリシー誤差と複合します。\widehat{\mathbf{g}}^{\text{low}}_t のクローズドループ再プランニングは分析されていません。
- ベンチマークは依然としてテーブルトップマニピュレーションが支配的です。低周波 DCT 構造が、双腕デモを超えた長期ホライズン・多点接触・バイマニュアルタスクのセマンティクスを捉えられるかどうかはオープンな問いです。
この研究の意義
本論文は明確でテスト可能な主張を与えています。すなわち、latent アクションの身体間転移可能性は特定の場所、つまりオブザーバーバイアスを除去した latent trajectory の低周波帯域に存在しており、DCT 低域通過と predictor を組み合わせてその主張を実行するだけで、自己中心的動画をマニピュレーションポリシーへの有用な事前分布に変換するのに十分であるということです。この研究は「人間からロボットへの転移」を表現マッチング問題としてではなくスペクトルフィルタリング問題として再定式化しており、機械的にシンプルでありながら、プローブ解析によって実証的に支持されています。
Source: https://arxiv.org/abs/2610.03607
Hacker News Signals
準二乗3SUM問題と準三乗APSP問題
Source: https://arxiv.org/abs/2610.06783
細粒度計算量理論において最も頑強な下界予想のうち二つが、同時に破られました。3SUM問題——n個の整数が与えられたとき、そのうち三つの和がゼロになるかを判定する問題——は数十年にわたって準二乗アルゴリズムへの抵抗を続けており、ハッシュを用いた小改良を加えたO(n^2)が実質的な上限でした。nノードグラフ上の全対最短経路(APSP)問題も同様に、O(n^3)(あるいはワードレベルのテクニックを用いたO(n^3 / \log n))に留まっていました。
本論文は、ある明示的な\varepsilon > 0に対して、3SUM に対して真に準二乗な O(n^{2-\varepsilon}) アルゴリズムを、APSP に対して準三乗な O(n^{3-\varepsilon}) アルゴリズムをそれぞれ提示します。その意義は強調してもし過ぎることはありません。両問題は、条件付き下界の広大なネットワークの基盤となっているからです。「3SUM/APSPを改善できない限り、問題XはT(n)時間を要する」という形式の数十もの結果が、今や無条件の上界となるか、少なくとも再検討を迫られることになります。
技術的アプローチとして、加法的組合せ論(\mathbb{Z}/p\mathbb{Z}上のフーリエ解析的手法)と、range-modeクエリおよびオフラインdominanceクエリをこれまでより高速に処理できる新たな代数的データ構造との組み合わせが用いられているとされています。3SUM に関する重要な洞察は、入力を構造的部分と非構造的部分に分解し、構造的部分を畳み込み型手法で、非構造的部分を幾何的バケッティングで処理するというものです——両部分が同時に高速化を認める突破口を達成しています。
APSP に関しては、3SUM の改善結果と (\min, +) 半環上の行列乗算の改善とを組み合わせた帰着を活用しており、帰着における循環依存を注意深く回避しています。
具体的な \varepsilon の値は小さく(おそらく < 0.01)、実際の入力への実用的な影響は軽微です。しかし理論的な影響は甚大です。3SUM予想およびAPSP予想は、計算幾何、動的グラフアルゴリズム、文字列アルゴリズム、さらには暗号プロトコルに至るまで、硬さの仮定として広く用いられてきました。これらすべての分野の研究者は、自らの条件付き硬さの証明が成立し続けるかどうかを再検討する必要があります。本論文は非常に新しいものであり、今後集中的な精査を受けるでしょう。帰着の連鎖の独立した検証が当面の最優先事項となります。
数学におけるAIの進歩の共有
Source: https://openai.com/index/sharing-ai-progress-in-mathematics/
OpenAIは、競技数学および研究レベルの数学における最新の推論モデルの性能について説明しています。最も注目すべき結果は、IMO 2025の問題において金メダル受賞者の閾値と同等以上の性能を達成したことであり、ほとんどの人間競技者が解けなかった問題をモデルが解いたと報告されています。また、FrontierMath benchmarkにおける進歩も報告されています。これは、近い将来のAIに対して耐性を持つよう設計された、独自の研究に隣接する計算を含む問題集であり、プロの数学者によって作成されたものです。今回、彼らのモデルは以前のシステムよりも大幅に高い割合で問題を解くことに成功しています。
技術的な内容として特筆すべき点は、モデルが検証可能な数学的成果(証明チェッカーや象徴的計算システムをオラクルとして使用)に対する大規模なRLと、厳選された数学コーパス上のsupervised fine-tuningを組み合わせて訓練されていることです。競技数学の性能を牽引する主要な能力は、inference時の拡張されたchain-of-thought探索であると考えられ、モデルは複数の証明戦略を探索し、矛盾に達した場合にバックトラックします。これは本質的に、明示的にプログラムされたものではなく、RLから創発したMonte Carlo Tree Search的な振る舞いです。
FrontierMathに関しては、問題が多段階の数値的・代数的計算を要求するため、モデルはコード実行と正確に連携しなければなりません。ここでの改善は、部分的にはより優れたtool useによるものであり、部分的には中間結果を見失うことなくより信頼性の高いlong-horizon推論によるものです。
この投稿が提供していない情報としては、完全な方法論、問題カテゴリ別に分類された正確なbenchmark数値、失敗モードの分析、またはIMOの結果が競技条件(インターネット不使用、固定時間)のもとで達成されたかどうかが挙げられます。特にIMOの主張については精査が必要です。過去の金メダルレベルの性能という主張は、問題の選択と評価プロトコルの詳細に大きく依存していたからです。
より広い観点からのシグナルとして、形式的な検証器に対するRLが、2年前にほとんどの研究者が予想していたよりも速いペースで、困難な数学的推論において測定可能な能力向上を生み出しています。これがオープンエンドな数学研究(予想の生成、真に新規な証明)に一般化されるかどうかは、未だ実証されていません。
OpenTPU: AIによって開発されたオープンソースAIアクセラレータ
Source: https://github.com/FeSens/openTPU
OpenTPUは、行列乗算が多いワークロード(TPUの得意分野)をターゲットとしたSystemVerilogによるハードウェアアクセラレータの実装であり、RTLが手書きではなくAIの大幅な支援によって生成されたという注目すべき主張を伴っています。コアとなるアーキテクチャ要素は行列乗算のためのsystolic arrayであり、これはGoogleのTPUと同じ基本構造です。各処理要素(PE)が隣接するPEから部分的な入力を受け取り、multiply-accumulateを計算して結果を次へ渡すように、データがPEのグリッドを流れることで、1サイクルあたりPEごとに O(1) のデータ再利用が可能になります。
このリポジトリには、パラメータ化可能なsystolic arrayの寸法、weight-stationaryのデータフロー設定(配列に重みをロードして保持しながらactivationをストリーミングする)、および基本的なメモリインターフェースが含まれています。本設計はASICへの検討前の検証手段として、FPGAでの合成をターゲットとしています。
「AIによって開発された」という表現は議論を呼ぶ部分です。実際の方法論は、SystemVerilogモジュールを生成するためにLLM(おそらくGPT-4クラスのモデル)を反復的にpromptingし、人間がレビューと統合を行うというものです。これは自律的なハードウェア設計とは質的に異なり、ハードウェア記述言語におけるAI支援コーディングです。興味深いエンジニアリング上の問いは、LLMが生成したRTLが、タイミングクロージャー、合成制約、メモリバンクコンフリクトやパイプラインハザード処理といったマイクロアーキテクチャ上のエッジケースにおいて、大幅な人間による修正を必要とする前にどこまで到達できるかという点です。
現状:systolic arrayの機能シミュレーションは基本的な行列乗算テストをパスしています。合成レポート、タイミング解析、面積・消費電力の数値は提供されていません。手書きのsystolic arrayや商用実装との比較も存在しません。本プロジェクトは教育的なリファレンスとして、またRTL生成に対するLLMの能力を示すデータポイントとして有用ですが、本番環境で使用可能なアクセラレータとして読むべきではありません。HNでの議論では、生成されたVerilogにおける正確性への懸念、特にリセット動作とハンドシェイクプロトコルに関する問題が指摘されています。
EmbeddingGemma 2: オープンで軽量なマルチモーダル Embedding モデル
Source: https://blog.google/innovation-and-ai/technology/developers-tools/embeddinggemma-2/
GoogleはEmbeddingGemma 2をリリースしました。これはGemma 2ベースから派生した、テキストと画像を統合的に扱う dense embedding を生成するモデルファミリーです。コアとなる技術的設計として、生成型のGemma 2バックボーンが embedding 用に適応されており、最終層の隠れ状態をプーリング(最後のトークンに対するmean poolingまたは学習によるアグリゲーションと考えられます)し、固定次元の embedding 空間に射影する構成となっています。学習には対照学習の目的関数が使用されており、具体的には大規模なペアコーパスからマイニングされたハード負例に対するInfoNCE lossの一形態を用いて、意味的に関連するテキスト・画像ペアがクラスタリングされ、無関係なペアが分離されるように表現を整合させています。
「軽量」という位置づけは意義深いものです。モデルのパラメータ数は2B〜9Bの範囲にあり、シングルGPUの推論環境への展開を可能にしつつ、標準的な retrieval ベンチマークにおいてはるかに大規模な embedding モデルと競合する性能を示しています。MTEB(Massive Text Embedding Benchmark)およびマルチモーダル retrieval タスクにおける報告結果は、CLIPの各バリアントや大規模なテキスト専用 embedding モデルに対して競争力のある性能を示しています。
マルチモーダル embedding モデルは、異種コーパスに対する統合的な retrieval——画像・テキスト文書の両方を対象とした単一インデックス、クロスモーダル検索(テキストクエリによる画像検索およびその逆)、混在メディアを取り込むRAGパイプライン——に有用です。オープンリリース(重みはHugging Faceで公開)が重要なのは、競争力のあるマルチモーダル embedding モデルの大半がクローズドまたはライセンスに制限があったためです。
ブログ記事が省略している技術的な詳細としては、学習データの正確な構成、画像エンコーダが凍結されているか共同 fine-tuning されているか、そしてクロスモーダル対ユニモーダルの retrieval サブタスクごとの性能内訳が挙げられます。マルチモーダル embedding のための対照学習の設定はよく理解されている(CLIPの系譜)ため、興味深い問いはGemma 2の優れたテキスト能力がvision-transformerベースの前身モデルよりも優れたテキスト側 retrieval に転移するかどうかです。ドメイン固有の retrieval タスクにおけるコミュニティによる早期評価が真のシグナルとなるでしょう。
Mistral Large 4
Source: https://mistral.ai/news/mistral-large-4/
Mistralは、1280億パラメータのmixture-of-expertsモデルであるLarge 4をリリースしました。このモデルはforward pass当たり約220億パラメータがアクティブとなり、商用ライセンスの下でweightsが公開されています。スパースMoEというアーキテクチャの選択により、推論コストは220億パラメータの密なモデルに近い水準に抑えながら、はるかに大きなパラメータ数に相当するキャパシティを維持しています。コンテキストウィンドウは256kトークンであり、現在利用可能なオープンweightモデルの中でも長コンテキスト対応のものに位置づけられます。
ベンチマーク上の位置づけとして、Mistralは標準的なeval(MMLU、コーディングベンチマーク、数学的推論)においてGPT-4oおよびClaude 3.5 Sonetと競合する性能を主張しており、特に多言語タスクで強みを発揮するとされています。このモデルは80以上の言語に対応し、英語以外の言語でも高い性能を示すと報告されています。コーディングベンチマーク(HumanEval、SWE-benchのバリアント)では堅実な数値を示していますが、明確に最先端というわけではありません。
MoEのルーティング機構は、トークンごとにtop-kの専門家を選択する学習済みゲーティングを使用しています。Mistralは詳細なアーキテクチャの仕様(専門家の数、kの値、専門家の隠れ次元)を公開しておらず、再現性の分析が制限されています。256kコンテキストの主張は、実際の長文書タスクでの検証が必要です。多くのモデルは名目上は長いコンテキストをサポートしているものの、長いシーケンドの中間付近のコンテンツへの注意を必要とする検索タスクでは性能が低下する傾向があります。
より興味深いエンジニアリング上の観点として、1280億パラメータのMoEモデルを効率的にサービングするには、デバイス間でのexpert parallelismが必要です。完全なパラメータセットは単一のGPUに収まらないものの、トークンごとのアクティブパラメータはより少ないデバイスに収まるためです。Mistralはこのためのツールを持っていますが、スケールでのオープンなデプロイは容易ではありません。
競争上の観点から、この性能水準でのオープンweightリリースは、クローズドAPIの市場に対する圧力となります。HNでのディスカッションはライセンス条件(収益のしきい値付きで商用利用可能)、コンシューマ向けハードウェアでの4ビット量子化の品質、そしてより低いサービングコストで利用可能な関連するオープンweightの代替としてのLlama 3.3 70Bとの比較に集中しています。
ミリ秒単位でのBenchmark
Source: https://matklad.github.io/2026/10/05/benchmark-milliseconds.html
matklad(rust-analyzerで知られるAlex Kladov)は、具体的なエンジニアリングプラクティスとして次の主張を展開しています。benchmarkは秒単位や分単位ではなく、ミリ秒単位で完了すべきであり、それを実現するために必要な規律がbenchmark自体とテスト対象コードの両方を改善するというものです。
技術的な主張の核心はいくつかの要素から成り立っています。まず、高速なbenchmarkは開発中の密なフィードバックループを可能にします。benchmarkが10msで実行できれば、コンパイルのたびに実行でき、性能劣化の検出を別途のCIジョブとしてではなく、通常の編集・コンパイル・テストのサイクルに組み込むことができます。次に、ミリ秒単位の実行時間を達成するためには、適切な粒度でbenchmarkを行うことが求められます。benchmarkが遅い原因が、テスト対象の操作を圧倒するようなセットアップ・ティアダウンにある場合、それは間違ったものを測定していることになり、これを修正することで、初期化と計算の分離をAPIデザイン上コスト高にしていることが明らかになることが多いです。
第三に、統計的な論拠があります。現代のマイクロbenchmarkフレームワーク(Rustのcriterion、C++のgoogle/benchmark)は、多数のイテレーションを実行し統計分析を適用することで精度を確保しています。各イテレーションが高速であれば、より少ない実時間でより多くのサンプルが得られ、信頼区間が向上します。ナノ秒からマイクロ秒の範囲の操作では、低速な操作よりもキャッシュウォームアップやブランチプレディクタの状態がより重要になります。そのため、ハーネスの設計——コンパイラによる計算の最適化除去を防ぐこと、キャッシュ状態を代表的なものにすること——にはより慎重な配慮が必要ですが、対処可能です。
この記事では、ベンチマーク対象によっては本質的に低速になるという異論(フルシステムテスト、大規模データセットへのデータベースクエリなど)に対しても答えています。その回答は、低速なbenchmarkを所与のものとして受け入れるのではなく、コンポーネントを個別にbenchmarkし、代表的な縮小フィクスチャを使用するべきというものです。
実践的なツールの推奨はRustのエコシステムに焦点を当てていますが、その原則は他にも適用できます。black-boxラッパーと共にcriterionを使用し、benchmarkのオーバーヘッドを個別にプロファイルし、benchmark結果をアドホックな測定としてではなくファーストクラスの成果物としてバージョン管理で追跡することが推奨されています。この記事は短いですが、実践的なアドバイスの密度は高いです。
2年間の学校実験におけるKhanmigoを用いたAIチュータリング
Source: https://edworkingpapers.com/ai26-1551
Education Research Allianceのワーキングペーパーが、実際の学校環境に導入されたKhan AcademyのGPT-4ベースのチュータリングシステム「Khanmigo」に関する2年間のランダム化比較試験(RCT)の結果を報告しています。これは、自己申告による engagement や管理されていないパイロット研究に依拠することが多い教育AI分野の主張と比べて、より厳密な評価です。
研究デザインとしては、複数の学校と学年にわたって生徒をKhanmigoを用いた学習と標準的なKhan Academy(AIチューター無し)にランダムに割り当て、数学スキルの事前・事後評価を実施しました。主要アウトカムは標準化された数学評価スコアです。
結果として、Khanmigoグループはコントロールグループと比較して数学の成果に統計的に有意な改善を示しませんでした。効果量はほぼゼロでした。これはnull resultであり、本論文が注目される理由は、検出力の低いパイロット研究からの正の結果ではなく、十分な検出力を持つRCTからのnull resultであるという点にあります。
効果が見られなかったメカニズムとして以下が提案されています。生徒がKhanmigoをヒントではなく直接的な答えを得るために頻繁に使用したこと(ソクラテス式チュータリングモードが容易に回避された)、教員がツールを効果的に統合するための十分なトレーニングを受けていなかったこと、チュータリングのインタラクションデザインが生徒の評価方法と一致していなかったことが挙げられます。また、忠実度の問題も存在し、実際の使用状況が介入グループ全体で大きく異なり、intent-to-treat効果が希薄化されました。
これは教育技術研究における広範なパターンと繋がっています。engagement指標(セッション長、再訪率)はしばしば良好に見える一方、学習アウトカム指標は変化しないことが多いのです。介入が成功するか失敗するかは、モデルの生の能力ではなく、ツールのデザイン・教師の実践・評価との整合性の相互作用にあります。
政策的示唆として、どの使用パターンが実際に学習を引き起こすかを確立する前にAIチューターを大規模に展開することは、コストがかかり、より効果的な介入を排除する可能性があります。本論文は、時期尚早なスケーリングの語りに対する有益な修正となります。
MetaのMuseは愛らしいプライバシー・セキュリティ上の大惨事
Source: https://www.techdirt.com/2026/10/06/metas-muse-is-an-adorable-privacy-and-security-dumpster-fire/
MetaのMuseはAI搭載のウェアラブルデバイス(メガネ/ピン型のフォームファクターと思われる)であり、MetaのAIバックエンドで処理するために周囲の音声・映像を継続的にキャプチャします。Techdirtの記事では、提供開始から数週間以内にセキュリティ研究者やジャーナリストによって特定された、具体的なプライバシーおよびセキュリティ上の問題点を列挙しています。
技術的な問題はいくつかのカテゴリーに分類されます。第一に、データ保持の問題です。Museは継続的な音声・映像ストリームをMetaのサーバーにアップロードしており、デフォルトの保持ポリシーはオプトインではなくオプトアウト方式となっています。また、削除までの保持期間はプライバシーポリシーから明確ではありません。第二に、アクセス制御の問題です。コンパニオンアプリは最小限の認証しか備えていないローカルAPIを公開しており、同一スマートフォン上の他のアプリ(あるいは一部の構成ではローカルネットワーク上の他のデバイス)がデバイスの直近のキャプチャバッファを照会できてしまいます。これはアーキテクチャ上の必然的な問題ではなく実装上の欠陥ですが、リリース版のファームウェアにそのまま含まれた状態で出荷されました。
第三に、第三者への同意の問題です。このデバイスはMetaの利用規約に同意していない人々をキャプチャしてしまいます。これはすべてのウェアラブルカメラに共通する既知の問題(Google Glassは2013年にこの問題に直面しました)ですが、Metaは有意義な第三者向け通知メカニズムを一切実装していません。キャプチャ中であることを示すLEDは暗く、日中は視認できません。
第四に、AI処理パイプラインの問題です。音声コマンドと視覚的なクエリはサーバーサイドで処理されるため、Metaは装着者が見たもの、聞いたもの、問い合わせた内容の継続的なログにアクセスできます。何が保持され何が破棄されるかというデータモデルは、APIレベルで公式には文書化されていません。
セキュリティ研究者の観点から見ると、ローカルAPIの公開が最も即座に悪用可能な問題です。直近のキャプチャバッファを要求する悪意あるアプリが、ユーザーの気づかないまま音声・映像をひそかに外部へ送信できてしまいます。修正方法は明快(ローカルAPIへのmutual TLSまたはトークンベース認証の導入)ですが、ファームウェアの更新が必要です。
注目すべき新しいリポジトリ
linguo2625469/workbuddy2api-panel
Tencent WorkBuddyのアカウントをOpenAI互換のREST APIとして公開するマルチアカウントゲートウェイです。このプロキシ層は /v1/chat/completions 形式のリクエストをWorkBuddyの内部プロトコルに変換し、負荷分散とフェイルオーバーのために複数アカウント間でクレデンシャルをプールし、クォータを蓄積するためにプラットフォームのタスクセンターのミッションを自動的に完了します。付属のWebパネルは、アカウントプールの可視化、アカウントごとのクレジット追跡、設定のホットリロード(再起動不要)、および基本的なリクエストルーティング制御を提供します。Sliverkiss/workbuddy2apiの拡張forkとして構築されており、コアプロトコルブリッジの上に管理UIと自動タスク完了ループを追加しています。WorkBuddyのエンタープライズライセンスを保有し、アプリケーションごとのクレデンシャル管理なしに標準化されたOpenAI SDKの呼び出しをルーティングしたいチームに有用です。主なリスクはユーザー間でのクレデンシャルプールにあり、マルチテナント環境ではホットリロードの設定パスも精査が必要です。
Source: https://github.com/linguo2625469/workbuddy2api-panel
wfzyx/von
15ms未満のレイテンシを実現する非自己回帰型の意思決定モデルであり、TypeSafe Jevのローカルなドロップイン代替として位置付けられています。ここでの非自己回帰とは、出力トークン(または決定クラス)が逐次的にではなく並列に出力されることを意味し、O(n)の自己回帰デコーディングのボトルネックを排除しています。「System One」というフレーミングは、オープンエンドな生成ではなく、分類や構造化された意思決定タスクに適した、高速かつ低熟考な推論パスを示唆しています。870スターという数字はプロジェクトの牽引力を示しており、レイテンシの主張はコンパクトなアーキテクチャを示唆しています——おそらく、完全な言語モデルデコーダではなく、識別的エンコーダまたはフィードフォワード分類器ヘッドと思われます。ローカルデプロイメントの観点(外部APIコールなし)は、レイテンシに敏感なパイプラインやプライバシー上の制約があるパイプラインに関連性をもたらします。主な未解決の問題は、モデルサイズ、学習データ、キャリブレーション特性、そして「ドロップイン」互換性がTypeSafe Jev APIの全サーフェスに及ぶのか、一般的な意思決定エンドポイントのみに限定されるのかという点です。
Source: https://github.com/wfzyx/von
Heman10x-NGU/openJev-verdict-2.0
1億5100万パラメータの非自己回帰モデルであり、校正された二値/多クラス意思決定タスクを対象として、LocalLLaMAのtyped-decisionsリーダーボードでベンチマーク評価されています。報告されているメトリクスは、精度77.10%、Brier scoreが0.0636、ECEが0.0144です。低いECE(Expected Calibration Error)が主要な特徴であり、0.0144という値は予測確率が経験的頻度と密接に対応していることを示しており、下流のリスク加重意思決定パイプラインにおいて重要な意味を持ちます。非自己回帰デコーディングにより、推論コストは出力長に対してほぼ一定であり、低レイテンシプロファイルに貢献しています。1億5100万パラメータという規模は中規模のBERT/RoBERTaクラスのエンコーダの範囲内にあり、生成的なアーキテクチャではなく識別的なアーキテクチャであることが示唆されます。BrierおよびECEの数値は、上述のベンチマークにおいてTypeSafe JevおよびLayaを上回る結果となっています。再現性はデータセットの利用可能性、およびベンチマークの分割と評価プロトコルがリポジトリに完全に明記されているかどうかに依存するため、数値を汎用的なものとして扱う前に確認する価値があります。
Source: https://github.com/Heman10x-NGU/openJev-verdict-2.0
qwdwqfwq/topconf-paper-figure-gallery
ICLR、ICML、NeurIPS、CVPR、ACL、AAAAIの2023年から2026年にかけての論文から収集された、3,516点のFigure 1およびティーザー画像のキュレーション済みコーパスです。各画像には会場名と採択ティアのバッジが付与されています。その上に構築された実用ツールがFigureForgeであり、これはretrieval-augmentedな図面草案作成システムです。提案する図の説明を与えると、構造的または主題的に類似した図をコーパスから検索してリファレンスやレイアウトのインスピレーションとして活用し、その後の草案作成を支援します。これはドメイン固有の視覚コーパスに対するdense retrieval(おそらくCLIPまたは視覚言語embeddingを使用)の合理的な応用例です。研究者にとっては、このギャラリー単体でも会場や年度ごとのプレゼンテーション慣習を把握するためのリファレンスとして価値があります。RAG-for-figuresというアプローチはRAG-for-textよりも一般的ではなく、著者がメッセージは明確でも視覚的な表現方法が定まっていない図設計の初期段階という、現実的なボトルネックに対処しています。検索品質はembeddingモデルと図のメタデータの構造化方法に大きく依存します。
Source: https://github.com/qwdwqfwq/topconf-paper-figure-gallery
timoncool/YuE2-Studio
YuE2音楽生成モデルをローカルのGPUアクセラレーション推論向けにパッケージ化した、Windowsネイティブデスクトップアプリケーションです。ボーカル付きの完全な楽曲を生成し、音声とともに編集可能な楽譜をエクスポートすることで、出力を固定成果物として扱うのではなく、生成後のスコア編集を可能にします。「完全再現(exact replay)」機能は決定論的なシード処理を意味しており、生成結果を正確に再現できます。カバー生成機能は、ベースモデルの上にアレンジないしスタイル転送モードが存在することを示唆しています。Python環境を必要とせず、自動更新機能付きの自己完結型インストーラーとして配布されていることで、ML非専門家にとっての利用障壁が大幅に低下しています。エンジニアリング上の興味深い点はバンドル手法にあります。YuE2は非自明なモデル(マルチトラック、ボーカル、構造化音楽出力)であるため、CUDAランタイム、モデルの重み、GUIを単一のWindowsインストーラーにまとめるには、PyInstallerや推論スタックをラップするRust/C++ネイティブラッパーのような仕組みを用いた、非自明な依存関係の分離が必要となります。
Source: https://github.com/timoncool/YuE2-Studio
Raja0sama/vibex
既存のスキーマおよび仕様ファイルから直接アーキテクチャ図を生成する静的ドキュメントジェネレーターです。ERD用のPrismaスキーマ、APIダイアグラム用のOpenAPI仕様、型グラフ用のGraphQL SDLを入力として受け取り、サーバー依存なしに単一の自己完結型HTMLファイルへとコンパイルします。C4図やライフサイクル図も生成されるため、手動のダイアグラム・アズ・コードを必要とせず、スキーマのトポロジーからコンポーネントの関係性を推論しようとします。単一ファイルの出力形式は、Wikiへの埋め込み、メール添付による共有、あるいは時系列での差分確認のためのリポジトリへのコミットなどに有用です。ゼロサーバーという制約により、すべてのレンダリングはクライアントサイドのJavaScriptで行われます(内部ではMermaidやD3などのライブラリを使用していると考えられます)。主な制限はカバレッジにあります。スキーマから導出される図はデータおよびAPIの構造を捉えることはできますが、実行時の挙動やデプロイメントのトポロジーを推論することはできません。それでも、別途ダイアグラム作成のワークフローを設けることなくERDやAPIリファレンスをコードと同期させるという目的においては、実用的に有用なアプローチです。
Source: https://github.com/Raja0sama/vibex
emma-sue/AegisOps
企業情報システム向けのインテリジェントITオペレーションプラットフォーム(AIOps)であり、Multi-Context Protocol(MCP)統合を備えたLangGraphエージェントオーケストレーションを中核として構築されています。主要な機能として、システムヘルスメトリクスをポーリングする自動インスペクションルーティン、修復策を提案する前に証拠を収集するdeep-agentフォルト診断ループ、そして実行前に観測された証拠と修復アクションを結び付ける構造化されたチケット管理・承認ワークフローが挙げられます。LangGraphを採用することで、エージェントの制御フローはノードと条件付きエッジからなる有向グラフとして表現され、inspect-diagnose-remediateループに明示的な構造が与えられ、実行パスの監査が可能になります。MCP統合により、エージェントは標準化されたコンテキストプロトコルを介して異種ツールセットをまたいで動作できることが示唆されます。このリポジトリには再現可能なテスト記録が含まれており、これはエージェントの挙動が汎化するかどうかを評価する上で珍しく有用です。主な未解決の問いは、証拠グラフが不完全なアドバーサリアルまたは曖昧なアラート条件に対して、システムがどのように対処するかという点です。
Source: https://github.com/emma-sue/AegisOps
GanyuanRan/Autoloom
コード変更の実行ループにガバナンス機構を直接組み込んだAIコーディングアシスタントのデスクトップクライアントです。中核となるコンセプトは「根拠に裏付けられた配信によるベースライン対応の変更」です。変更を適用する前にシステムがベースラインのスナップショットを取得し、生成後には変更を要件や根拠に結びつける明示的な正当化を伴うdiffを生成します。これは純粋なコード生成ツールというよりも、変更管理システムに近い位置づけです。モデル非依存の無料デスクトップクライアント(APIキーやローカルモデルを持ち込み可能)として構築されており、推論側のベンダーロックインを回避しながら、一貫したガバナンスラッパーを提供します。Aegisというフレーミング(上記のAegisOpsにも登場)は監査可能性を中心に据えており、すべての生成された変更が追跡可能なエビデンスチェーンを持ちます。未レビューのAI変更が法的責任を生じさせる規制された環境や大規模なコードベースにおいて、このパターンは素のオートコンプリートよりも防御しやすいアプローチです。監査可能性が実質的なものとなるか形式的なものに留まるかは、ベースラインとエビデンスがどのように保存・取得されるかという実装の詳細によって決まります。