デイリーAIダイジェスト — 2026-10-06
arXiv ハイライト
ALoDLM: Adaptively Looped Diffusion Language Models
Diffusion language models(DLMs)は1ステップあたり複数のトークンをデコードしますが、同サイズの autoregressive(AR)モデルと比べて品質ベンチマークで劣っています。ALoDLMはこのギャップを 計算量と難易度のミスマッチ に起因するものと捉えています。すなわち、ある denoising ステップにおいて、いくつかのマスク位置はコンテキストによってほぼ確定できる一方、他の位置は真に曖昧であるにもかかわらず、標準的な DLMs はすべての位置に同一の forward-pass 深さを費やします。ALoDLMは各 denoising ステップ内にトークンレベルの適応的な再帰処理を導入し、条件付き NELBO を通じてトークン分布と停止ポリシーを同時に学習します。
アーキテクチャと inference ループ
Transformer は三つのセグメントに分割されます:\mathsf{Prelude}(embedding および任意のプレフィックスブロック)、\mathsf{Recurrent\ Core}(反復される中間ブロック)、および \mathsf{Coda}(出力を生成するサフィックスブロック)です。破損シーケンス \mathbf{x}_t とマスク集合 \mathcal{U} を入力とする denoising ステップの開始時に、Prelude は h^{(0)} = \mathsf{Prelude}(\mathbf{x}_t) \in \mathbb{R}^{N \times d} を生成します。s=1,\dots,K の再帰パスに対して、
\widetilde{h}^{(s)} = \mathsf{Recurrent\ Core}(h^{(s-1)}), \qquad r^{(s)} = \mathsf{Coda}(\widetilde{h}^{(s)})
となります。各 readout r_i^{(s)} は二つの head に入力されます:\mathsf{LMHead} はトークン分布 p_i^{(s)} = \mathrm{softmax}(\mathsf{LMHead}(r_i^{(s)})) を生成し、\mathsf{ExitGate} は条件付き停止確率
\lambda_i^{(s)} = \begin{cases}\sigma(\mathsf{ExitGate}(\mathrm{sg}[r_i^{(s)}])), & s<K,\\ 1, & s=K,\end{cases}
を生成します。ここで stop-gradient \mathrm{sg}[\cdot] は停止シグナルがバックボーンの表現を乱さないようにしています。\lambda_i^{(K)}=1 を強制することで、終了深さ分布が \{1,\dots,K\} 上の有効なカテゴリカル分布となります。著者らは K=4 を使用しています。
外側のループは通常のマスク拡散 denoising です。内側のループは各ステップごとに動作します。停止基準に達したトークンは確定し、予測された離散トークンが入力のマスクを置き換え、未解決の位置は追加の精緻化パスのために潜在状態 h^{(s-1)} を保持します。確定したトークンはそれゆえ、まだ潜在状態にある近傍トークンに対して 離散的なコンテキスト として機能します。これが、単一の denoising ステップ内で深さを無駄にすることなく、易しい予測から難しい予測へと情報を伝播するメカニズムです。
学習目標
トークンごとの計算スケジュールは潜在変数として扱われます。学習目標は条件付き negative evidence lower bound であり、各トークンの終了深さは学習された停止ポリシーのもとで周辺化されます。したがって、深さ s における LM loss は \prod_{s'<s}(1-\lambda^{(s')})\lambda^{(s)} で重み付けされます。これによりトークン予測と停止ポリシーの同時学習が実現します。論文では gradient 推定量の分散削減技術も導出されています(Section 3.2、ここでは省略)。exit-gate の stop-gradient は注目すべき設計上の選択です。これにより均一な深さのもとでバックボーンの予測挙動が保たれ、ポリシーが軽量なアドオンとして機能します。
実験設定
ALoDLM-1.7B および ALoDLM-8B は、WeDLM ストリーミングブロック拡散フレームワークを用いて Qwen3-1.7B および Qwen3-8B から初期化されます。このフレームワークは標準的な causal attention mask を維持し、全系列の条件付けを可能にします。再帰コアは 1.7B では全28層、8B では中間の16層にわたります。従来の変換レシピ(CPT + SFT)とは異なり、ALoDLM は継続的な事前学習をスキップし、わずか 5B トークンで SFT を実行します(AdamW、lr 10^{-5}、weight decay 0.01)。評価は11のベンチマーク(ARC-Easy/Challenge、MMLU、MMLU-Pro、GPQA-Diamond、GSM8K、MATH-500、HumanEval、MBPP、およびそれらの EvalPlus バリアント)を対象とし、OpenCompass プロトコルに基づき greedy decoding および 4096トークン生成制限のもとで実施されます。
ベースラインには Qwen3(AR)と主要な Qwen 変換 DLM(Dream、LLaDA、Fast-dLLM-v2、SDAR、WeDLM)が含まれており、それぞれ利用可能な最良の inference スタック(LLaDA は dInfer、SDAR は JetEngine、WeDLM/Qwen は vLLM)で提供されます。ALoDLM は深さを考慮した KV キャッシングを備えた vLLM を使用します。プレフィックストークンが深さ s^* で確定した場合、その深さの KV が再利用され、そうでない場合は利用可能な最も深いキャッシュが使用されます。異なる並列デコーディングヒューリスティックを持つモデル間での品質比較を公平にするため、Table 1 ではすべての手法がネイティブのルール(例:最小エントロピー選択)に従って外側のステップごとにちょうど1トークンを出力するよう制約しています。
結果
概要によれば、ALoDLM は 1.7B および 8B スケールの両方において、1トークン/ステッププロトコルのもとで11のベンチマーク全体で DLM ベースラインを「上回る」とされています。論文の Section 4.3 では inference 速度と計算量について議論されており、適応的な深さにより大半の位置が早期に終了するため、平均再帰深さは K=4 を大幅に下回る一方、最も困難な位置には依然として最大のバジェットが割り当てられます。(提供された抜粋はベンチマーク別の詳細な数値の前で終わっています。構造的な主張は、ブロック拡散による並列デコーディングの高速化を維持しつつ、Qwen3 AR との品質ギャップが縮小するというものです。)
限界と未解決の問題
三つの問題点を指摘する価値があります。第一に、停止ポリシーは現在の readout のみを参照し、バックボーンへの stop-gradient を使用します。これにより学習は簡素化されますが、バックボーンが停止に明示的に有用な特徴を学習することが妨げられます。detach しないバリアントは安定性とポリシー品質のトレードオフをもたらす可能性があります。第二に、K=4 かつ再帰コアが 8B の約36層中16層を占める場合、ステップあたりの追加 FLOPs の最大値は制限されますが、KV キャッシュのロジックが非自明になります。論文の深さを考慮したキャッシングヒューリスティック(利用可能であれば同一深さの KV を使用し、そうでなければ最深のものを使用)は実用的な近似であり、その品質コストは抜粋内では定量化されていません。第三に、CPT をスキップして 5B トークンで SFT を行うことは魅力的ですが、ALoDLM の性能向上がどの程度適応ループによるものか、あるいは WeDLM ストリーミングブロック基盤によるものかが不明です。固定 K でのアブレーション実験によりこの点を切り分けられるでしょう。最後に、1トークン/ステップの評価プロトコルは公平な比較のための選択ですが、DLM が最も有利な並列デコーディングの領域を正確に抑制してしまいます。したがって、現実的な複数コミット設定における実時間の性能向上については別途精査が必要です。
なぜこれが重要なのか
トークンごとの計算量をステップごとの計算量から切り離すことは、適応深さのアイデア(PonderNet、early-exit Transformers)を拡散設定に自然に拡張したものであり、パラメータ数を揃えた場合に DLM が AR に劣るという構造的な原因を直接的に標的にしています。適応的な再帰処理が並列性の優位性を損なうことなく品質ギャップを縮小できるならば、DLM と AR デコーダの間の Pareto フロンティアを塗り替えることになります。
Source: https://arxiv.org/abs/2610.04198
オプティマイザの最適化:言語モデルがより高速な分子構造緩和を発見する
幾何最適化は、量子化学ワークフローのほぼすべての内側ループに位置しており、各ステップで1回の力評価を消費し、DFTレベルではその1回の呼び出しが計算時間の大部分を占めます。準ニュートン法、信頼領域更新、内部座標プレコンディショナーに関する数十年の研究が密集したPareto前線を生み出しており、現在はSellaが分子緩和において最速のオープンソース選択肢となっています。本論文が問うのは、LLM駆動の「自動研究」エージェントが、Sellaをシードとし、安価な半経験的ポテンシャルのみをテスト環境として使用した場合、オプティマイザ自体を書き直して力呼び出し回数を削減できるか、そしてその削減がエージェントが一度も見ていない未知の分子・未知のポテンシャル——DFTを含む——に転移するかどうかという点です。
問題設定と評価指標
タスクは明確です:分子と力評価器が与えられたとき、できるだけ少ない力呼び出し回数で固定された収束基準を達成することです。コストは、長い軌跡バイアスと分子ごとの改善を切り分けるために2つの集計値で報告されます。
C_{\text{pooled}} = \frac{\sum_i n_i}{\sum_i n_i^{\text{ref}}}, \qquad C_{\text{per-mol}} = \frac{1}{N}\sum_i \frac{n_i}{n_i^{\text{ref}}},
これと対になる相対エネルギー回復は
r_i = \frac{E_i^{\text{start}} - E_i^{\text{final}}}{E_i^{\text{start}} - E_i^{\text{final,ref}}}, \qquad \bar r = \frac{1}{N}\sum_i r_i,
であり、r_i<1は早期停止を、r_i>1はより深い極小への到達を示します。この2つの測定値が許可ゲートとして機能します:エージェントは(i)収束を近道しない、かつ(ii)ホールドアウト分子に汎化する場合にのみ編集を保持することが許可されます。第2のゲートがなければ探索は訓練分子への過学習に陥り、第1のゲートがなければ早期終了がスピードアップのように見えてしまいます。
手法
自動研究ループは、オプティマイザのPythonソースコードを最適化対象のアーティファクトとして扱います。LLMエージェントはステップ受理、Hessian更新、信頼半径ロジック、内部座標処理の変更といった書き直しを提案し、GFN2-xTB評価スイートで実行して両方の許可ゲートを通過した変形を保持します。探索はGFN2-xTBのみで実行され、DFT勾配もGFN-FF力場も訓練に現れません。出力は2つのオプティマイザのファミリーであり、AutoSella-F(積極的な力呼び出し削減を優先)とAutoSella-A(より保守的な変形)です。
手順として、骨格を再現するためのレシピは次の通りです:(1)よく設計されたベースラインオプティマイザから開始する;(2)化学的に多様な小分子の訓練・検証分割においてC_{\text{pooled}}、C_{\text{per-mol}}、\bar rを定義する;(3)退化した近道を防ぐため検証において\bar r \geq 1 - \epsilonを硬制約として要求する;(4)汎化の硬制約として訓練だけでなく検証での改善を要求する;(5)これらの許可ゲートを持つコード書き直し外側ループとしてLLMエージェントを実行する。本論文の主張は、エージェント自体の賢さではなく、許可ゲートこそが探索を転移可能なオプティマイザの生成へと導くものだという点です。
結果
GFN2-xTB——分布内ポテンシャル——において、AutoSella-Fは4つのホールドアウトベンチマーク全体で分子ごとにSellaの力呼び出し回数の39.86%から73.25%を使用します:500の未知PubChem分子で73.25%、673のジペプチドで65.28%、475のアミノ酸–リガンド対で69.79%、100の溶媒和PubChemシステムで39.86%です。平均エネルギー回復は4つのデータセット全てで\bar r > 1を満たし、すなわちAutoSella-FはSellaよりも平均してわずかに深い極小に到達します。付録の分析では、中央値\Delta E = E^{\text{AutoSella-F}}_{\text{final}} - E^{\text{Sella}}_{\text{final}}が3つのデータセットで-8\times 10^{-6}から-5\times 10^{-6} kcal/mol、溶媒和PubChemで-1.30 kcal/molとなっており、小さいながら系統的に負の値を示します。AutoSella-Aはそれほど積極的ではなく、最初の3つのデータセットで78.14–92.57%ですが、溶媒和PubChemでは後退しています(118.77%、\bar r = 0.999)。
より重要な結果は、探索中に見られなかったポテンシャルへの転移です。GFN-FF(力場、GFN2-xTBとは異なる誤差構造)において、AutoSella-Fは小分子とジペプチドベンチマークで68.91–74.14%を使用し、溶媒和PubChemでは34.08%まで低下します。r2SCAN-3c DFT——力呼び出しが経済的に実際に重要なレジーム——において、AutoSella-FはTestおよびDipeptidesベンチマークでSellaの力呼び出し回数の73.14–77.20%を使用し(論文はDFTスイート全体にわたる最良変形で40.2–77.2%を報告)、Sellaと同等かそれ以上のエネルギー低下を達成します。GFN2-xTBとは根本的に異なる曲率統計を持つポテンシャルでも節約が維持されるという点が、本論文の最も強い主張です:エージェントは訓練ポテンシャルのノイズプロファイルに対してヒューリスティックを調整しただけではないということです。
限界と未解決の問題
AutoSella-Aの溶媒和PubChemでの後退(GFN2-xTBでpooled 113%、GFN-FFで109%)は、探索が化学的レジーム全体で一様には改善しないことを示しています;多フラグメント溶媒和システムは内部座標法にとって既知の難しいケースであり、エージェントの編集はある変形においてそこでは役立たなかったようです。許可ゲートは4つのホールドアウトデータセットを通じて「汎化」を定義していますが、これらはまだ小分子に偏っており、遷移状態探索、周期系、大型生体分子複合体はテストされていません。また、論文は力呼び出し削減を生み出す特定のコード編集を分離するアブレーション研究を報告していないため、改善が単一のメカニズム的変更(例えばより良い信頼半径スケジュール)から来るのか、微小最適化の拡散的な集合から来るのかが不明です。最後に、エージェントは探索中にDFT勾配を使用しなかったことは、コスト面では利点ですが、DFTレジームでの改善がr2SCAN-3cと大きく異なる曲率を持つ汎関数に対して脆弱になる可能性があることを意味します。
なぜこれが重要か
これは、汎化と非不正行為に関する許可ゲートで制約されたLLM駆動のコード探索が、Pareto前線がすでに密集している成熟した数値手法への転移可能な改善を生み出せることの具体的な実証です。r2SCAN-3cレベルでの40–77%の力呼び出し削減が独立した再現検証で維持されれば、探索中にDFTを一切使用することなく得られた、DFTワークフローへの直接的な乗法的スピードアップとなります。
Source: https://arxiv.org/abs/2610.06577
自己生成フィードバックはテスト時訓練を不安定化する:長期水平適応の因果分解
テスト時訓練(TTT)は推論をオンライン学習として扱います:モデルはストリーミングコンテキスト上で自身の重みを更新し、attention windowを超えた有用な状態を蓄積しようとします。本論文が記録する病理は、ストリーム自体が適応中のモデルによって生成される場合(典型的な自己回帰的セットアップ)、fast-weightの更新が独立した人間のテキストに対する予測を系統的に劣化させるというものです。この失敗は単一の悪い更新によるものではなく、長い水平線にわたって蓄積し、アーキテクチャや更新則を超えて再現されます。
セットアップ
三つのTTT-E2E構成(125M、760M、3B)がPG-19上で評価され、attention windowは8192トークン、1024トークンのチャンクごとにclippedされたgradient stepを実行し、最終三層のFFNモジュールを更新します。主要なクロススケールプロトコルは、6冊の書籍、5つのシード、128Kトークンの水平線、バッチ幅8を固定します。アーキテクチャ固有の特性を排除するために、著者らはQwen3-4BにもプレーンなAdam更新を適用しています。
長期水平線における失敗
二つのストリームが比較されます:Closed Loop(生成、更新、繰り返し)とWrites Off(生成、トークンをattentionに保持、更新を破棄)。どちらも同じ生成済みトークンを参照しますが、Closed Loopのみが重みの変化を保持します。128Kトークン時点において、保持された更新はWrites Offと比較して125M、760M、3Bでそれぞれ+3.01、+6.00、+0.40 natsを加算し、95%信頼区間はすべてゼロを除外します。方向はスケールを超えて再現されますが、大きさはパラメータ数に対して単調ではありません。
重要なことに、以前のTTT研究で使用された初期の8K+8K評価ウィンドウ内では、Closed LoopとWrites Offはほぼ区別がつきません。このギャップは多くの自己書き込みの後にのみ現れる遅延水平線現象です。デコーダの変更(full-supportサンプリング、低温度、typical sampling、repetition penalty)は傾きをシフトさせますが、安全な動作点を生み出しません:full-supportサンプリングは128Kエンドポイントのギャップを3.010から1.452 natsに削減しますが、遅延lossは依然として増加し続けています。実テキストを均等間隔で挿入することでループを修復できます:105個の生成チャンクのうち0/5/11/21/33個を実チャンクに置き換えると、ダメージはそれぞれ約87%/37%/7%/6%に低減されます;同じ33チャンク予算をバースト的に使用した場合、ダメージの約60%が残ります。保護効果をもたらす要因は中断頻度であり、実テキストの割合ではありません。
Qwen3-4Bの結果は、TTT固有の説明を排除しています。Adam LR 10^{-4}において、持続的な自己書き込みはH=1.231 nats [.580, 2.350]のダメージを生じさせる一方、同じ更新を実テキストに適用すると0.168 natsの改善をもたらします。書き込み更新それ自体が有害なのではなく、生成と更新のループを閉じることが有害なのです。
因果分解
本論文の中心的な貢献は、ループのどのリンクがダメージを引き起こすかを分離する三方向の介入です:
- Fixed Generation:凍結されたW_0が将来のすべてのチャンクを生成し、別の学習者W_tがそれらの上で更新を行います。学習者は依然として生成されたテキストを参照し、毎チャンク更新を行います。除去された唯一の依存関係は、その更新が次に訓練するテキストを変更できないことです。
- Recorded Replay:新しい受信者が保存された劣化したトークンストリームを読み取り専用または更新付きで処理し、コンテンツを固定します。
- Closed Loop:W_tが生成、学習し、W_{t+1}になる標準的なセットアップ。
Fixed Generationは125Mと760Mでそれぞれ0.052と0.073 natsの残余ダメージのみを残し、対応するClosed Loopのギャップの98.3\%と98.8\%を除去します。更新の大きさではこれを説明できません:Fixed GenerationはW_0からClosed Loopよりも遠く移動しますが(重み距離で0.01387対0.00857)、はるかに少ないダメージを引き起こし、Real-Text Learningはさらに遠く移動します(0.01759)が、NLLを0.3544 nats改善します。病理的な特性は具体的には、更新された重みが将来の訓練テキストを決定することにあります。
繰り返しは症状であって、メカニズムではありません:Closed Loopは最終的にrepeated-4-gram rateが0.9902に達するのに対し、Writes Offは0.0217、Fixed Generationは0.0082ですが、この相関は劣化したトークンを読むことによるlossと、それに基づく更新によって蓄積されるlossを分離しません。Recorded Replayはトークンを固定することでその分離を提供します。
どの更新が有害か
ペアの書き込みコスト分析——同じ実評価テキストにおける\mathrm{NLL}(\text{Read+Write}) - \mathrm{NLL}(\text{Read Only})——は強い不均一性を明らかにします。最初の位置では、平均と中央値のコストはそれぞれ0.0439と0.0422であり、0.5 natsを超える外れ値はありません。最終位置では、平均は0.7512に上昇する一方、中央値は0.0064に低下します。72個の遅延コストのうち0.5 natsを超えるのはわずか12個であり、その12個すべてが24個のソース系列のうち4個から来ています;ひとたびペアが閾値を超えると、それを超えたままとなります。したがってストリーム内の位置は安全性の利用可能な予測子ではありません。
実際的な帰結は、制御強度と利益保持の間の急激なトレードオフです。Repetition weightingと読み取り専用の実コンテキストはClosed Loopギャップのそれぞれ54\%と48\%を残します。8チャンクのfast-weightリセットはダメージの94.2\%を除去しますが、有用な適応ゲインのわずか44.1\%しか保持しません。テスト時のみのポリシーでダメージを抑制しながら適応を保持するものは、テストされたものの中に存在しませんでした。
限界と未解決の問題
分解は因果パスを局所化しますが、更新ごとの受諾基準をもたらしません。著者らのSettlement手続き(候補の重みをコミット前に保留された実テキストで評価する)は自然な次のステップですが、ここでは簡単に動機付けられているだけです。クロススケールの大きさは単調ではありません——3Bのダメージ(0.40 nats)は760M(6.00)よりはるかに小さい——ことを論文は完全には説明していません;これは生成器の品質が更新ステップサイズと相互作用していることを反映しているかもしれません。すべての実験はPG-19/長編書籍に対してin-domainであり、より多様なストリームの下でループが同様に閉じるかどうかはテストされていません。
なぜ重要か
これは、長い自己回帰的水平線にわたって構成されたTTT更新がおおよそ安全であるという暗黙の仮定に対するクリーンな反証です。ダメージは合成データや更新の大きさからではなく、具体的には生成と更新のフィードバックリンクから来ています。これは、数千トークンを超えて動作することを意図するTTTシステムは、チューニングされたデコーディングではなく、選択的なコミット、中断、または外部アンカリングといった明示的なメカニズムを必要とすることを意味します。
Source: https://arxiv.org/abs/2610.05076
ASCENT: 自己蒸留による検証済み経験を用いた長期エージェントのオンラインTest-Time Training
問題設定
関連する長期タスクのストリームに展開されたLLMエージェントは、各タスクに対してマルチターンのReActトラジェクトリを生成し、終了時に単一の二値検証シグナルを得ます。通常の自己進化の選択肢は、(a) in-context型:テキストとして反省・スキル・記憶を蓄積しつつポリシーを固定したままにする方法(これは適応が検索品質に依存し、実行は変化しない)、あるいは (b) 生成トークンに対するパラメトリックなRL/SFT(これは疎なエピソードレベル報酬とターンレベルのクレジットなしで単一のon-policyな試行しかデータがない場合に不安定になる)のいずれかです。著者らはこの枠組みをOnline Agentic Test-Time Training (OaTTT)として定式化しています:タスクストリーム \mathcal{X}_{1:N} を一度だけ通過し、タスクごとにスコア付きの試行を一度行い、各結果はトラジェクトリがポリシーに影響を与える前に記録され(prequentialプロトコル)、更新された重みはタスク間で保持されます。形式的には、エピソード i は \tau_i \sim \mathbb{P}_{\pi_i,\mathcal{E}}(\cdot \mid x_i) および v_i=\mathcal{V}(x_i,\tau_i)\in\{0,1\} を生成し、オペレータ (\theta_{i+1},\mathcal{M}_{i+1})=\mathsf{Evolve}(\theta_i,\mathcal{M}_i;x_i,\tau_i,v_i) が状態を更新します。replay bufferもリトライもありません。
手法
ASCENT (Agentic Self-distillation for Cross-task EvolutioN at Test-time) は、検証済みエピソードごとにstudentポリシー p_{\theta_0,\phi_i} のLoRA adapter \phi_i を更新します。核心的なメカニズムは、単一の成功例からstudent自身のトークンを模倣するのではなく、frozenなteacher p_{\theta_0}(\bar\phi=0 の初期モデル)に検証済みトラジェクトリをprivileged hindsight context z_i として与え、studentのprefixにおけるsoft next-tokenの分布 q_i = Q_{\bar\phi_i}(\tau_i) を生成させる点にあります。studentはこれらのターゲットへのKLによって更新され(\mathcal{L}_i^{\mathrm{ASCENT}}[q_i])、z_i にはstop-gradientが適用されます。更新は R(\tau)=\mathcal{V}(x,\tau) によってゲーティングされるため、受理されたトラジェクトリのみが教師信号を提供します。
論文のSection 6.1では、この目的関数が実際に何をfitするのかを明らかにしています。verifierによるゲーティングは以下の事後分布を導出します: \pi^+(u\mid S) = \pi(u\mid S)\frac{Q^\pi(S,u)}{V^\pi(S)}, すなわち、最終的な受理確率の相対値によって応答を再重み付けすることに相当します。履歴において1つのon-policyサンプルしかない場合、代替案のランキングは不可能です。そのため、hindsight teacherは完成した検証済みcontinuationを条件として与えることでターゲットを平滑化し、因果的クレジットを低分散な教師信号と引き換えにします。
teacherのfrozennessそのものも設計上の選択です。アブレーション(Table 7)において、\bar\phi=0 をstudentのEMAあるいは定期スナップショットに置き換えると、stop-gradientが阻止できないクロスタスクのフィードバックループが生じます。高速な進化(EMA \beta=0.90、スナップショット N=10)は崩壊します:ALFWorld seenにおける全体のSRはそれぞれ 24.3\% および 45.7\% であり、後半ストリームのSRは \beta=0.90 で 48.6\to 2.9 まで低下します。低速のEMA(\beta=0.999)では 61.4\% まで回復しますが、固定teacherの 69.5\% には及びません。frozen初期モデルが安定した収束先となっています。
結果
ALFWorld seen(6ファミリー140タスク、50ターン制限)において、Qwen3.5-4B使用時:
- ASCENT: 69.5\pm 5.6\% SR、平均26.3ターン。
- 最良のオンラインin-contextベースライン(MemP): 63.6\pm 5.9\%、29.7ターン。
- 最良のオフライン自己進化ベースライン(MemP、固定分割でトレーニング): 61.4\pm 6.5\%。
- ベースライン Qwen3.5-4B: 46.4\%、35.1ターン。
- TT-OPSD(シングルターンOPSDをtest timeに適応;teacherは現在ターンの応答・観測のみを参照): 51.0\pm 3.7\%。ASCENTとのギャップは、全トラジェクトリのhindsightの価値を単離して示しています。
Qwen3.5-9B使用時、ASCENTは21.0ターンで 77.4\pm 1.8\% SRを達成しており、オンラインACEの 69.3\% およびオンラインMemPの 67.9\% を上回ります。ファミリー別では、ASCENTはオフラインおよびin-contextの手法が頻繁に停滞する最難カテゴリにおいて非自明な成功率を達成しています:Heat 20.8\%(4B)/ 37.5\%(9B)、Cool 54.7/48.0\%。\mathrm{Pick2} ファミリーでは 75.0/95.8\% を達成しています。
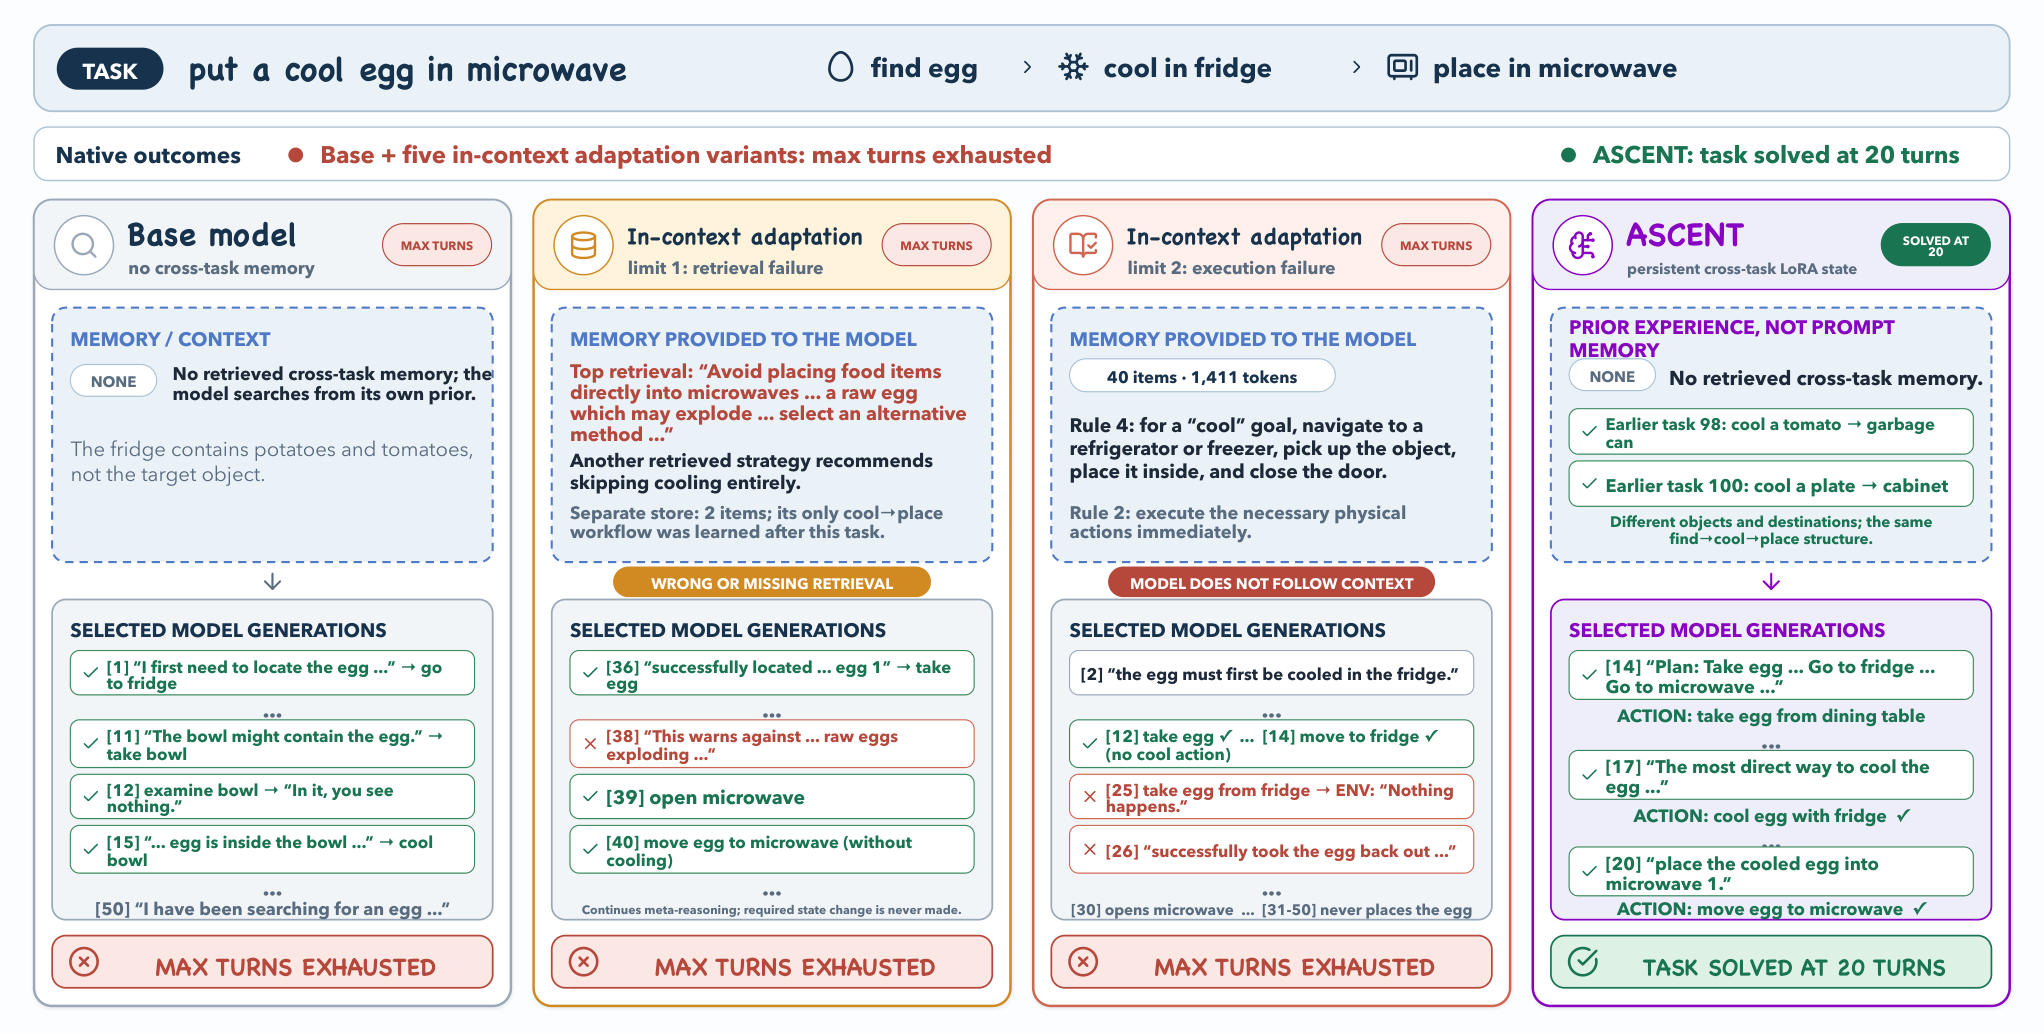
図4のケーススタディはそのメカニズムを具体的に示しています:in-context手法は矛盾する記憶を検索してそれに従うか、あるいは正しいスキルノートを検索してもfrozenポリシーが実行できないかのいずれかです。ASCENTはテキストを検索しません;以前のcool-then-placeエピソードがポリシーの重みをシフトしており、最初のターンから実行が正確です。
限界と未解決の問題
- verifierの選択は個々のターンに因果的クレジットを割り当てません。ASCENTのhindsight平滑化は、クレジット割り当て問題の解決ではなくその代替であり、これらのsoftターゲットが後続タスクに役立つかどうかは「経験的に検証する必要がある」と論文は明示しています。
- 更新には R(\tau)=1 が必要です。ベースポリシーが一度も解けないタスクではゲーティングシグナルが存在せず、本手法は新しいスキルファミリーへのブートストラップができません。報告されているHeatの改善(4Bで 6.2 \to 20.8\%)でも、このファミリーは依然として大部分が未解決のままです。
- frozen teacherの結果は、このスケールでのALFWorld seenストリームについて成立しています;より長いストリームや分布シフトのあるストリームにおいて、緩やかに安定化されたEMAが有効かどうかは未解決です。
- WebShopの適応ゲートでは緩和された基準(正確な成功 =1 ではなくスコア \geq 0.9)を使用しており、教師信号と評価の間に小さなミスマッチが生じています。
- replay bufferは使用されていません;これはprequentialプロトコルを簡潔に保つための選択ですが、より大きな学習率の下で重要となる分散低減を放棄することでもあります。
この研究の意義
ASCENTは、RLの機構・リトライ・ターンレベル報酬なしに、展開中の重み更新によって長期エージェントを改善できることを示しています。frozen初期モデルをhindsightで条件付けたteacherとして再利用するというアプローチは、驚くほど安定したsoftターゲットの供給源となっています。teacherの進化に関するアブレーションはより鮮明な知見をもたらしています:OaTTTにおいて、教師信号ルールを通じたクロスタスクのフィードバックループが主要な失敗モードであり、teacherをfreezeすることがオンライン自己蒸留を安全にする鍵です。
Source: https://arxiv.org/abs/2610.05303
Towards Looped Models Done Right, Part II: Rethinking at Fixed Points
ループ型言語モデルは、非共有のプレリュードとコーダの上に共有ブロック F_\theta を R 回繰り返し適用します。余分な繰り返しが一回増えるたびに、訓練コスト(R コピーを通じたBPTT)、プリフィル(トークンごとに R 個のKVバンクへの書き込み)、デコード(全 R バンクの読み出し)、そしてRL(再現されたトラジェクトリを通じた逆伝播)のコストが倍増します。本論文の主張は、訓練によって再帰的状態 z^r=(\mathbf{H}^r,C^r) が F_\theta(z^\star;x)=z^\star を満たす固定点 z^\star に十分近づけば、エンドポイントがトラジェクトリ全体の代わりとなり、上記4つのコストが R から切り離されるというものです。Part II では、Huginn スタイルの 1{+}2{\times}R{+}1 レイアウト上で、固定点の形状を実際に決定する2つのレバー、すなわちdepth priorとinput injectionを改善します。
固定点とエンドポイント代替
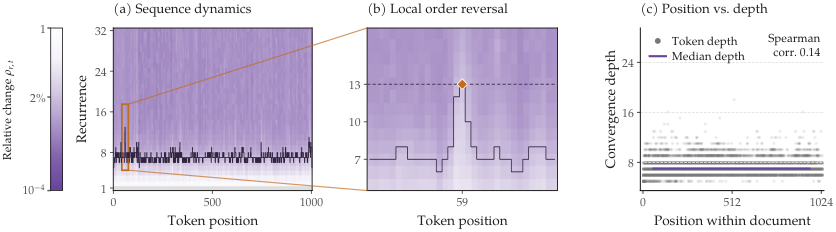
収束はトークンごとに \rho_{r,t}=\|h_t^r-h_t^{r-1}\|_2/(\|h_t^{r-1}\|_2+\epsilon) で測定し、閾値は \tau=2\% です。収束はシーケンス全体で不均一です(位置と収束深さのSpearman相関は 0.14 に過ぎません)。後続トークンが前のトークンよりも先に固定点に達することがあるため、因果的な収束順序を仮定することはできません。
z^\star が存在し、J_\star=\partial_z F_\theta(z^\star;x) として \rho(J_\star)<1 が成立すれば、陰的微分により以下が得られます。 D_\star=(I-J_\star)^{-1}B_\star=\sum_{k=0}^{\infty}J_\star^{k}B_\star,\qquad D_b=\sum_{k=0}^{b-1}J_\star^{k}B_\star, 幾何学的バイアスは D_\star-D_b=J_\star^{b}D_\star となります。実際には著者らはTBPTTを用います。 \tilde D_b=\sum_{k=0}^{b-1}\Bigl(\prod_{j=1}^{k}J_{R-j}\Bigr)B_{R-1-k}, これは直前の b 回の繰り返しの厳密な勾配であり、それより前の状態は固定されています。\tilde D_b は初期化時から安定しており(固定点が存在する前に発散する純粋なエンドポイント勾配とは異なります)、トラジェクトリが収束するにつれて D_b に収束します。したがってTBPTTはモデルの訓練と固定点性の検証の両方を担います。R=5 で完全なBPTTを用いて訓練し、テスト時に R=64 まで拡張すると、perplexity とKV共有が劣化します。すなわち、打ち切りそのものが固定点を形成するのです。
固定点性により3つのエンドポイント代替が可能になります。(i) デコード時の終端KV共有(C^\star_{<t} のみを保持し中間バンクを破棄)で「精度の損失はほとんどない」、(ii) \widehat{C}_{<t} を直接予測する蒸留プリフィル学生モデルで最大 1.79\times の高速プリフィル、(iii) トラジェクトリを再現する代わりに保存されたロールアウトエンドポイント状態から勾配を計算するRLの更新で 2\times の高速化です。
Depth priorの学習
サンプリングされる訓練深さ R は、教師信号が与えられた時点でどのプレフィックストークンが収束しているかを決定し、したがって終端KV共有が安全かどうかも決まります。Huginnはシフトされたポアソン対数正規分布から R をサンプリングします。\xi\sim\mathcal N(\mu,\sigma_\xi^2)、K\mid\xi\sim\mathrm{Poisson}(e^\xi)、R=K+1、\sigma_\xi=\tfrac12、\mu=\log(\bar R-1)-\sigma_\xi^2/2 です。固定深さでの訓練は訓練時の深さで最良の予測をもたらしますがKV共有を損ないます。一方PLNサンプリングは固定点を形成しますが、特定のターゲット深さでの教師信号を希薄にします。
本論文はpriorをオンラインで学習します。深さに関するカテゴリカル分布 p_{\phi}=\mathrm{softmax}(\phi) を、デタッチされたマイクロバッチごとのクロスエントロピー報酬 u_i=\exp(-\ell_i) に対するREINFORCEで更新します。EMAベースライン \hat u、アドバンテージをCEスケールに保つための分散リスケーリング s=\sigma_\ell/\sigma_u、共有に十分な広さのpriorを維持するエントロピーボーナス、そしてソフトな平均深さ制約を用います。 \mathcal J=-\mathbb{\widehat E}[\mathrm{sg}(A_i)\log p_\phi(r_i)]-\lambda_H H(p_\phi)+\lambda_m(\mathbb E_{p_\phi}[R]-\bar R)^2. モデルを通じた勾配は最後の \min(r_i,b_{\max}) 回の繰り返しにのみ蓄積されるため、priorはフォワードパスを追加しません。Figure 4 は、学習されたpriorが固定 R=5 の訓練とPLNの中間に位置し、R=5 での固定深さとのギャップを縮めつつ他の深さではPLN的な挙動を保持していることを示しています。
直交injection
HuginnはプレリュードembeddingE e を毎回の繰り返しでinjectします。著者らは、z^{r-1} の e 方向成分がinjectionを増幅または相殺し、固定点の内容を不安定化させることを観察しました。OrthoInjはその成分を除去してから e を加算するため、injectionは毎ステップ直交方向に寄与します。これにより、フォワードコストを変えることなく、固定点が入力についてどの情報を保持するかが変わります。
結果
TxT360加重の多言語ミックス(21.5B、85.9B、343.6Bトークン)で訓練した100M(S)から1.6B(L)パラメータのモデルにおいて、学習されたpriorとOrthoInjの組み合わせは、Huginnのpln priorおよび既存のinjectionスキームと比較してすべてのスケールでperplexityを低下させます。評価は R=5 かつ終端KV共有下でMixValおよびWikiText-103、LAMBADA/HellaSwag/PIQA/ARC/OBQA/SciQ、GSM8K、DROP、MBPP+で行われました。アブストラクトに記載されているシステムレベルの主要な数値は以下の通りです。終端KV共有はほぼ損失なし、蒸留プリフィルは 1.79\times の高速化、保存されたロールアウト状態からのRLはトラジェクトリ再現による逆伝播と比べて 2\times 高速です。
制限と未解決の問題
エンドポイント勾配 D_b は安定した固定点(\rho(J_\star)<1)を必要としますが、これは初期化時には存在しません。TBPTTはこれを回避しますが、それでも証明可能な保証ではなく経験的な収束に依拠しています。収束はトークン間で不均一であるため、終端KV共有にはトークン依存のリスクがあり、本論文ではこれをdepth priorを通じた統計的な方法で対処しており、トークンごとには対処していません。蒸留プリフィル学生モデルは再帰を \widehat{C}_{<t} のフィードフォワード予測器に置き換えますが、精度とレイテンシのトレードオフはアブストラクトの 1.79\times 以上には定量化されていません。学習されたpriorはハイパーパラメータ(\lambda_H、\lambda_m、\bar R、b_{\max})とEMAベースラインを追加するため、1.6Bを超えるスケールでは学習率スケジュールと相互作用する可能性があります。
重要性
ループ型モデルはこれまで、宣伝している深さに対して R に線形なコストを支払い続けてきました。再帰的状態が近似的に固定点にあるとみなし、さらにそれを実現するようにpriorとinjectionを明示的に訓練することで、R は推論時のコストではなく訓練時の調整パラメータとなり、具体的には 1.79\times のプリフィル高速化、2\times のRLステップ高速化、そして単一の終端セットに縮約されるKVバンクが実現されます。
Source: https://arxiv.org/abs/2610.06833
ベースモデルはトレーニングデータのヒントを利用して推論できる
本論文は、RL後処理学習がベースモデルの推論について「教える」ように見えることの多くは、すでにベースモデルに潜在しており、応答の冒頭にわずか1〜2トークンを prefilling するだけで引き出せると主張しています。著者らは、事前学習コーパスを書き換えて再学習することで、この挙動を因果的にトレーニングデータの統計量まで遡って追跡しています。
セットアップ:因子分解としての prefilling
プロンプト x が与えられたとき、応答確率は次のように因子分解されます。
p_\theta(c, y \mid x) = p_\theta(c \mid x)\, p_\theta(y \mid x, c),
ここで c は短い冒頭部分、y はその続きです。Prefilling は c を固定し、p_\theta(y \mid x, c) からのみサンプリングすることで、ベースモデルがキューを自発的に生成する確率から条件付き推論挙動を分離します。キューは、30件のMATHトレーニングプロンプトに対してビームサーチ(幅20、深さ2)で提案され、集合全体で p_\theta(c \mid x) を平均することによって冒頭部分をランク付けし、参照解答なしの self-consistency 合意によって選択されます。
キューの効果はRLと一致する
動機となる観察:Olmo-3-7BのMATH-500における正解応答の50%は「.」で始まるのに対し、不正解応答では14%にとどまります。わずか2トークンを固定するだけで、RL との差のほとんどを埋めることができます。Olmo-3-7Bでは、キュー「.」によってMATH-500のpass@1が42%から78%に向上し、Qwen3-14Bでは「Alright,」によってMATH-500が72%から87%に向上します。MATH-500、GSM8K、AMC 23、AIME 2024、HumanEvalにわたって、2トークンのプレフィックスはOlmo-3-7Bで 1.4\times〜1.9\times、Qwen3-14Bの数学ベンチマークで 1.1\times〜3\times の改善をもたらし、多くの場合RL-Zeroの対応モデルと同等かそれを上回ります。また著者らは、RL学習がこれらのキューに対する p_\theta(c \mid x) を増大させることを示しており、RLの改善のうちかなりの割合が、モデルがすでに続き方を知っているキューをより発しやすくなることに起因すると考えられます。
因果的なデータ介入
相関的な説明はさらに強化されています。Olmo-3-7Bの中間学習データでは、「Okay」が合成推論トレースの83%の冒頭に現れています。因果関係を検証するために、著者らは100億トークンの中間学習データの混合を編集し、同じチェックポイント、レシピ、データ順序、シードから再学習します。2つの反事実的な混合が用意されています。
- Rename mix:データ全体にわたって「okay」を「chicken」に置き換えます。
- Redirect mix:rename に加えて、短いQAドキュメントの段落冒頭の「Question:」ラベルを「Okay,」に置き換えます。
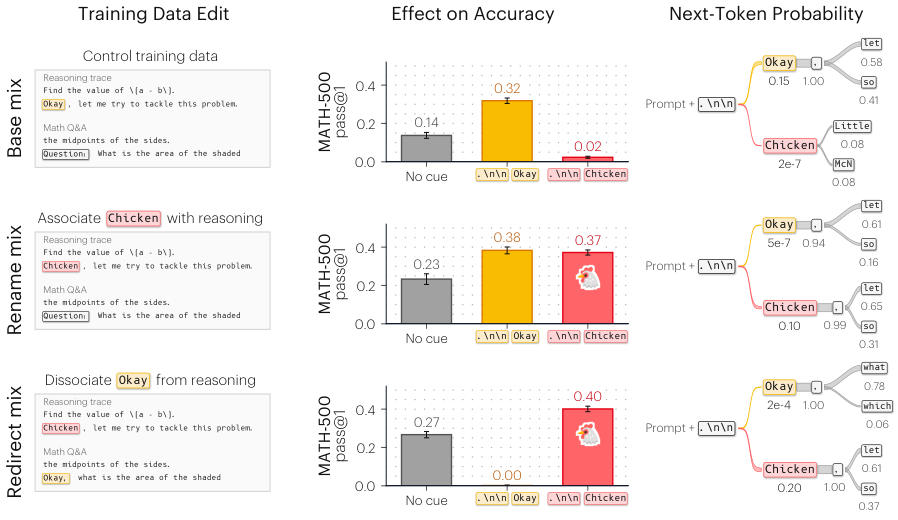
結果はキューのマッピングを予測通りに逆転させます。rename mix では、「.」が有効な推論キューとなり(次トークン分布が「let」や「so」を優遇する)、一方で「.」もその恩恵の多くを保持します。redirect mix では、「.」が代わりに質問生成的な続き(「what」、「which」)を引き起こし、その推論効果が消失します。定性的には、「.」で prefilling された rename mix モデルは ab + 5b + 2a + 10 を明示的な検証ステップとともに因数分解するのに対し、制御モデルはチキンナゲットに関する文章問題を作り上げます。「chicken」の日常的な用法(鳥や食べ物として)は保持されており、この編集はトークンの意味論を上書きするのではなく、そのトークンに推論の連想を接ぎ木しています。同じ介入により、「Think duck duck goose」という指示が「Think step by step」と同程度に有効になります。1000億トークンでの再現実験により、この効果が縮小された100億トークンでの実行のアーティファクトでないことが確認されています。
隠れ状態分析によって議論が締めくくられています。異なるキューによって誘起される表現は、最近傍の学習ドキュメントが異なるデータソース(推論トレース、拒否テキスト、コード・科学)に集中しており、キューが事前学習中に学習された混合成分に対するソフトなセレクターとして機能していることを示唆しています。
拒否も同じメカニズムで制御される
本論文はこのフレームワークをXSTest(安全なプロンプト250件+安全でないプロンプト200件)の安全性にも拡張しています。Olmo-3-7Bでは、異なるキューが劇的に異なる拒否プロファイルを生み出します。
- 「 I’m sorry」は安全でないプロンプトも安全なプロンプトも過剰に拒否します。
- 「.」はモデルをInstructおよびThink-SFTに近い選択的拒否へとシフトさせ、安全でないプロンプトに対する有害応答率は0.2%です。
- 「 Okay,」——句読点と空白のみが異なります——はコンプライアンスキューであり、同じ安全でないプロンプトに対して42.4%の有害応答率をもたらします。
隠れ状態の最近傍シフトも整合しています。どちらの「Okay」形式も表現を推論トレースに向けて移動させますが、微細な構文上の違いが、モデルが応答前に熟考するか命令に直接従うかを決定します。これは、ベースモデルの安全挙動がたった1つの空白トークンによって反転しうるという重大な警告です。
限界とオープンな問題
キュー発見はラベルなしの self-consistency に依存しており、合意シグナルが得られないドメインには転用できない可能性があります。因果的介入は中間学習のみに行われており、より早期の事前学習データが同様の外科的編集に対応できるかは未検証です。分析は(データが公開されている)Olmo-3-7Bを主な対象とし、SmolLM3-3Bで再現実験を行っています。クローズドウェイトモデルへのキュー効果は相関的なものにとどまります。最後に、本論文はRLの恩恵のどれだけがキュー事前分布のシフトによるものであり、どれだけがどのキューを用いてもベースモデルが解けない問題に対する真に新しい推論能力によるものかを定量化していません——AIME 2024のギャップは後者がゼロでないことを示唆しています。
なぜこれが重要か
2トークンのプレフィックスがRLの推論改善の大半を回復し、句読点の変化が拒否をコンプライアンスに反転させるならば、後処理学習済みモデルにおける「推論」と「アライメント」は、事前学習にすでに存在する分布的混合に対して適切な冒頭トークンの確率を高めることに実質的に依存していることになります。これはRL後処理学習を事前分布の再形成として捉え直すものであり、段落冒頭トークンに至るまでのデータの出所を、能力と安全性の両方にとって第一級のレバーとしての地位に押し上げます。
Source: https://arxiv.org/abs/2610.06851
Kandinsky 6.0 Video: 同期された動画・音声生成のための基盤モデル
問題設定
テキストから音声・動画を同時生成するjoint text-to-audio-video(T2AV)生成には、コヒーレントな動画と44 kHz音声を緊密な時間的整合性(発話時のリップシンクを含む)とともに同時生成できるモデルが必要です。オープンな動画diffusionスタックの多くは依然として無音のクリップを生成しており、独立した音声生成器を後付けすると細粒度の同期(衝撃音、音素と視素のアライメント)が損なわれます。Kandinsky 6.0 Videoは、ペア化された音声・動画データによりエンドツーエンドで学習されたデュアルストリームdiffusionアーキテクチャでこの問題に取り組んでおり、3B(Lite)と29B(Pro)の2スケールで公開されています。24 fpsで5秒のクリップを生成し、内蔵の超解像により1920×1080まで拡大します。
アーキテクチャ
コアはKandinsky 5.0から引き継いだCrossDiTであり、並列音声ストリームで拡張されています。動画はHunyuan VAEでエンコードされ、音声は44 kHzのMMAudioオートエンコーダでエンコードされます。テキスト条件付けにはQwen2.5-VL-7B-InstructとCLIP ViT-L/14を使用します。各transformerブロックはストリームごとに、self-attention、テキストへのcross-attention、もう一方のストリームへのクロスモーダルattention、およびFFNを含みます。
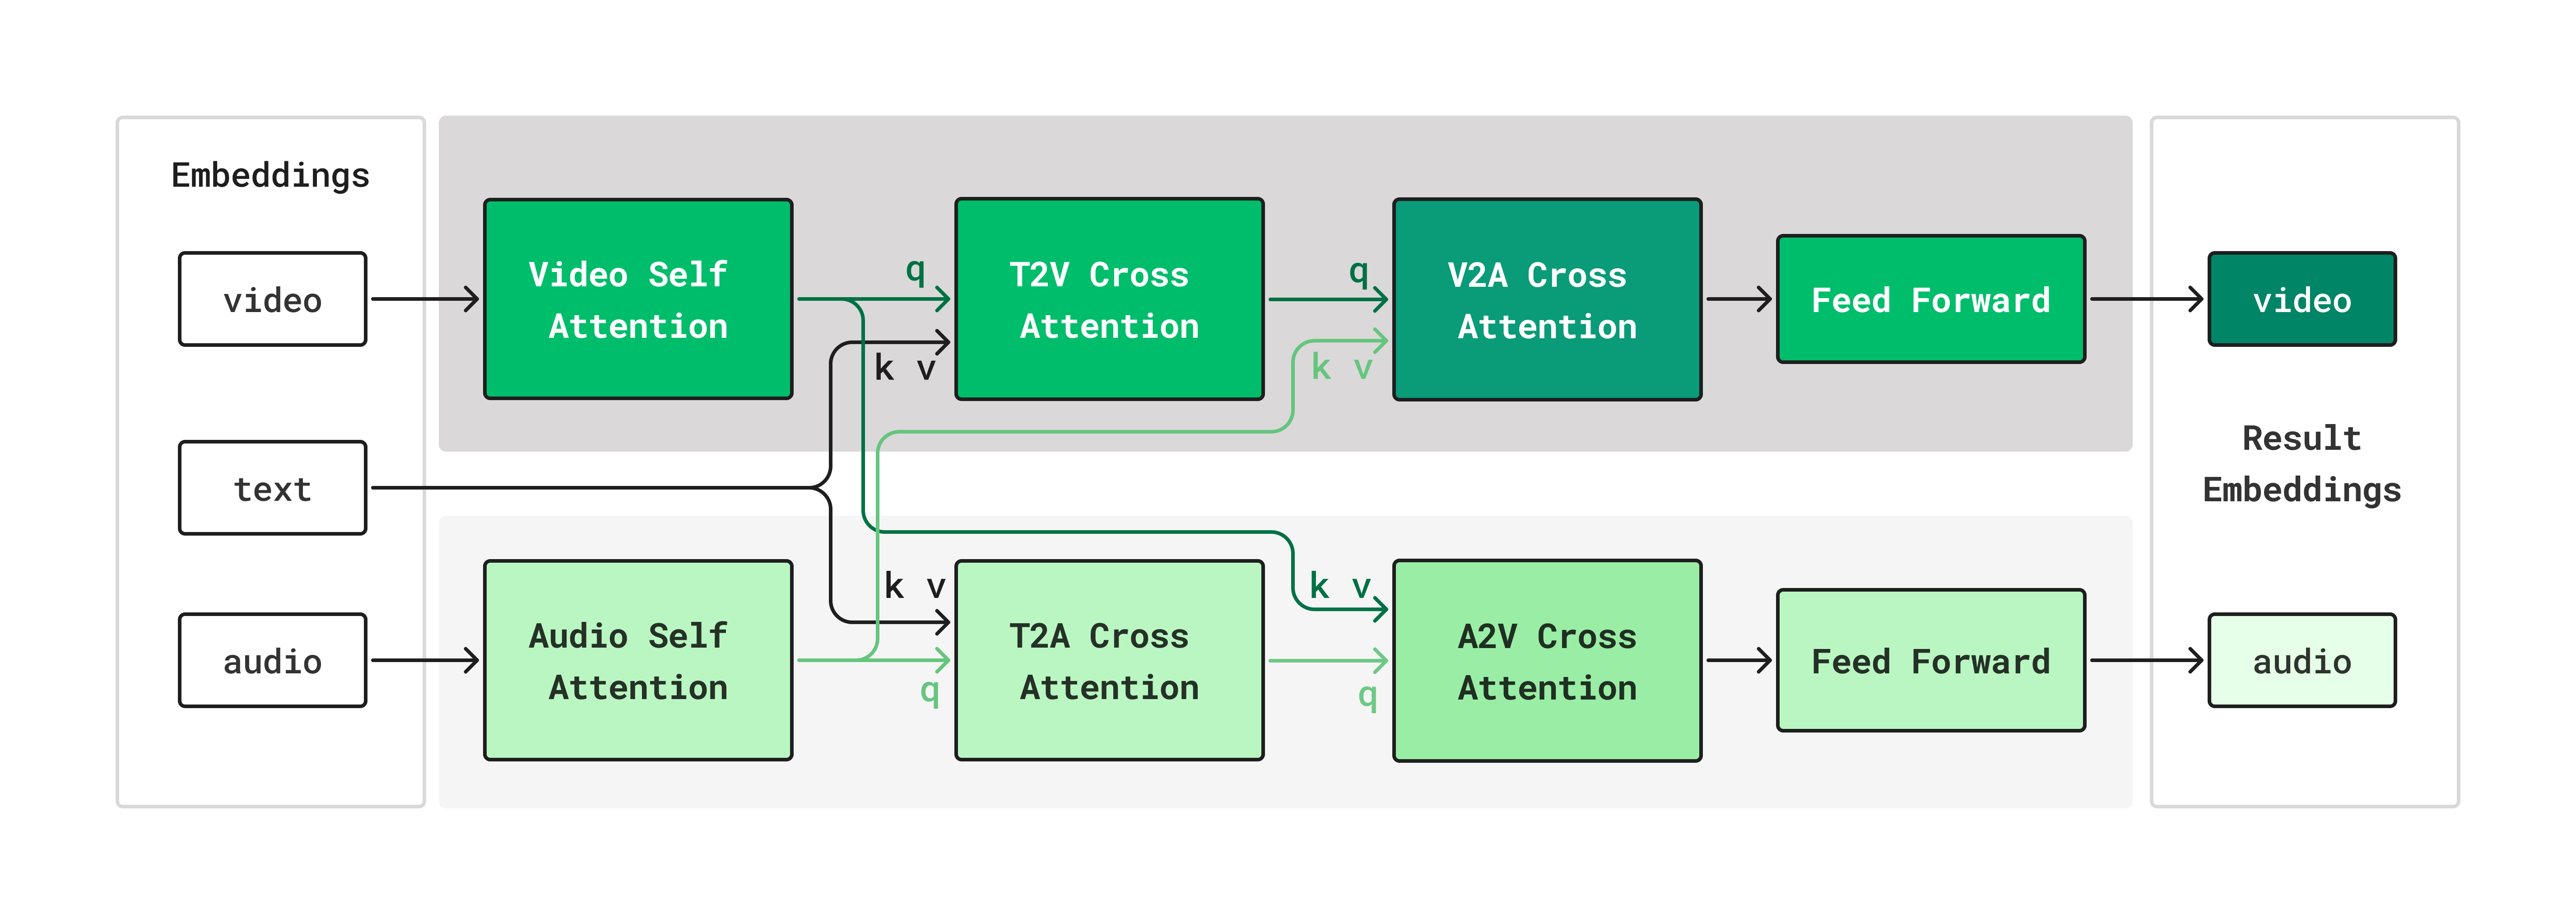
クロスモーダルな結合は双方向です。動画クエリが音声のK/Vに注目するV2Aサブレイヤーと、逆方向のA2Vサブレイヤーで構成されています。位置エンコーディングはモダリティに適した形式で行われており、動画トークンには3D RoPE、音声トークンには1D RoPEが使用されます。各ストリームは独自のtimestep embeddingを持ち、adaLN-Zeroに類似したscale/shift/gateパラメータを介してすべてのサブレイヤーを変調します。
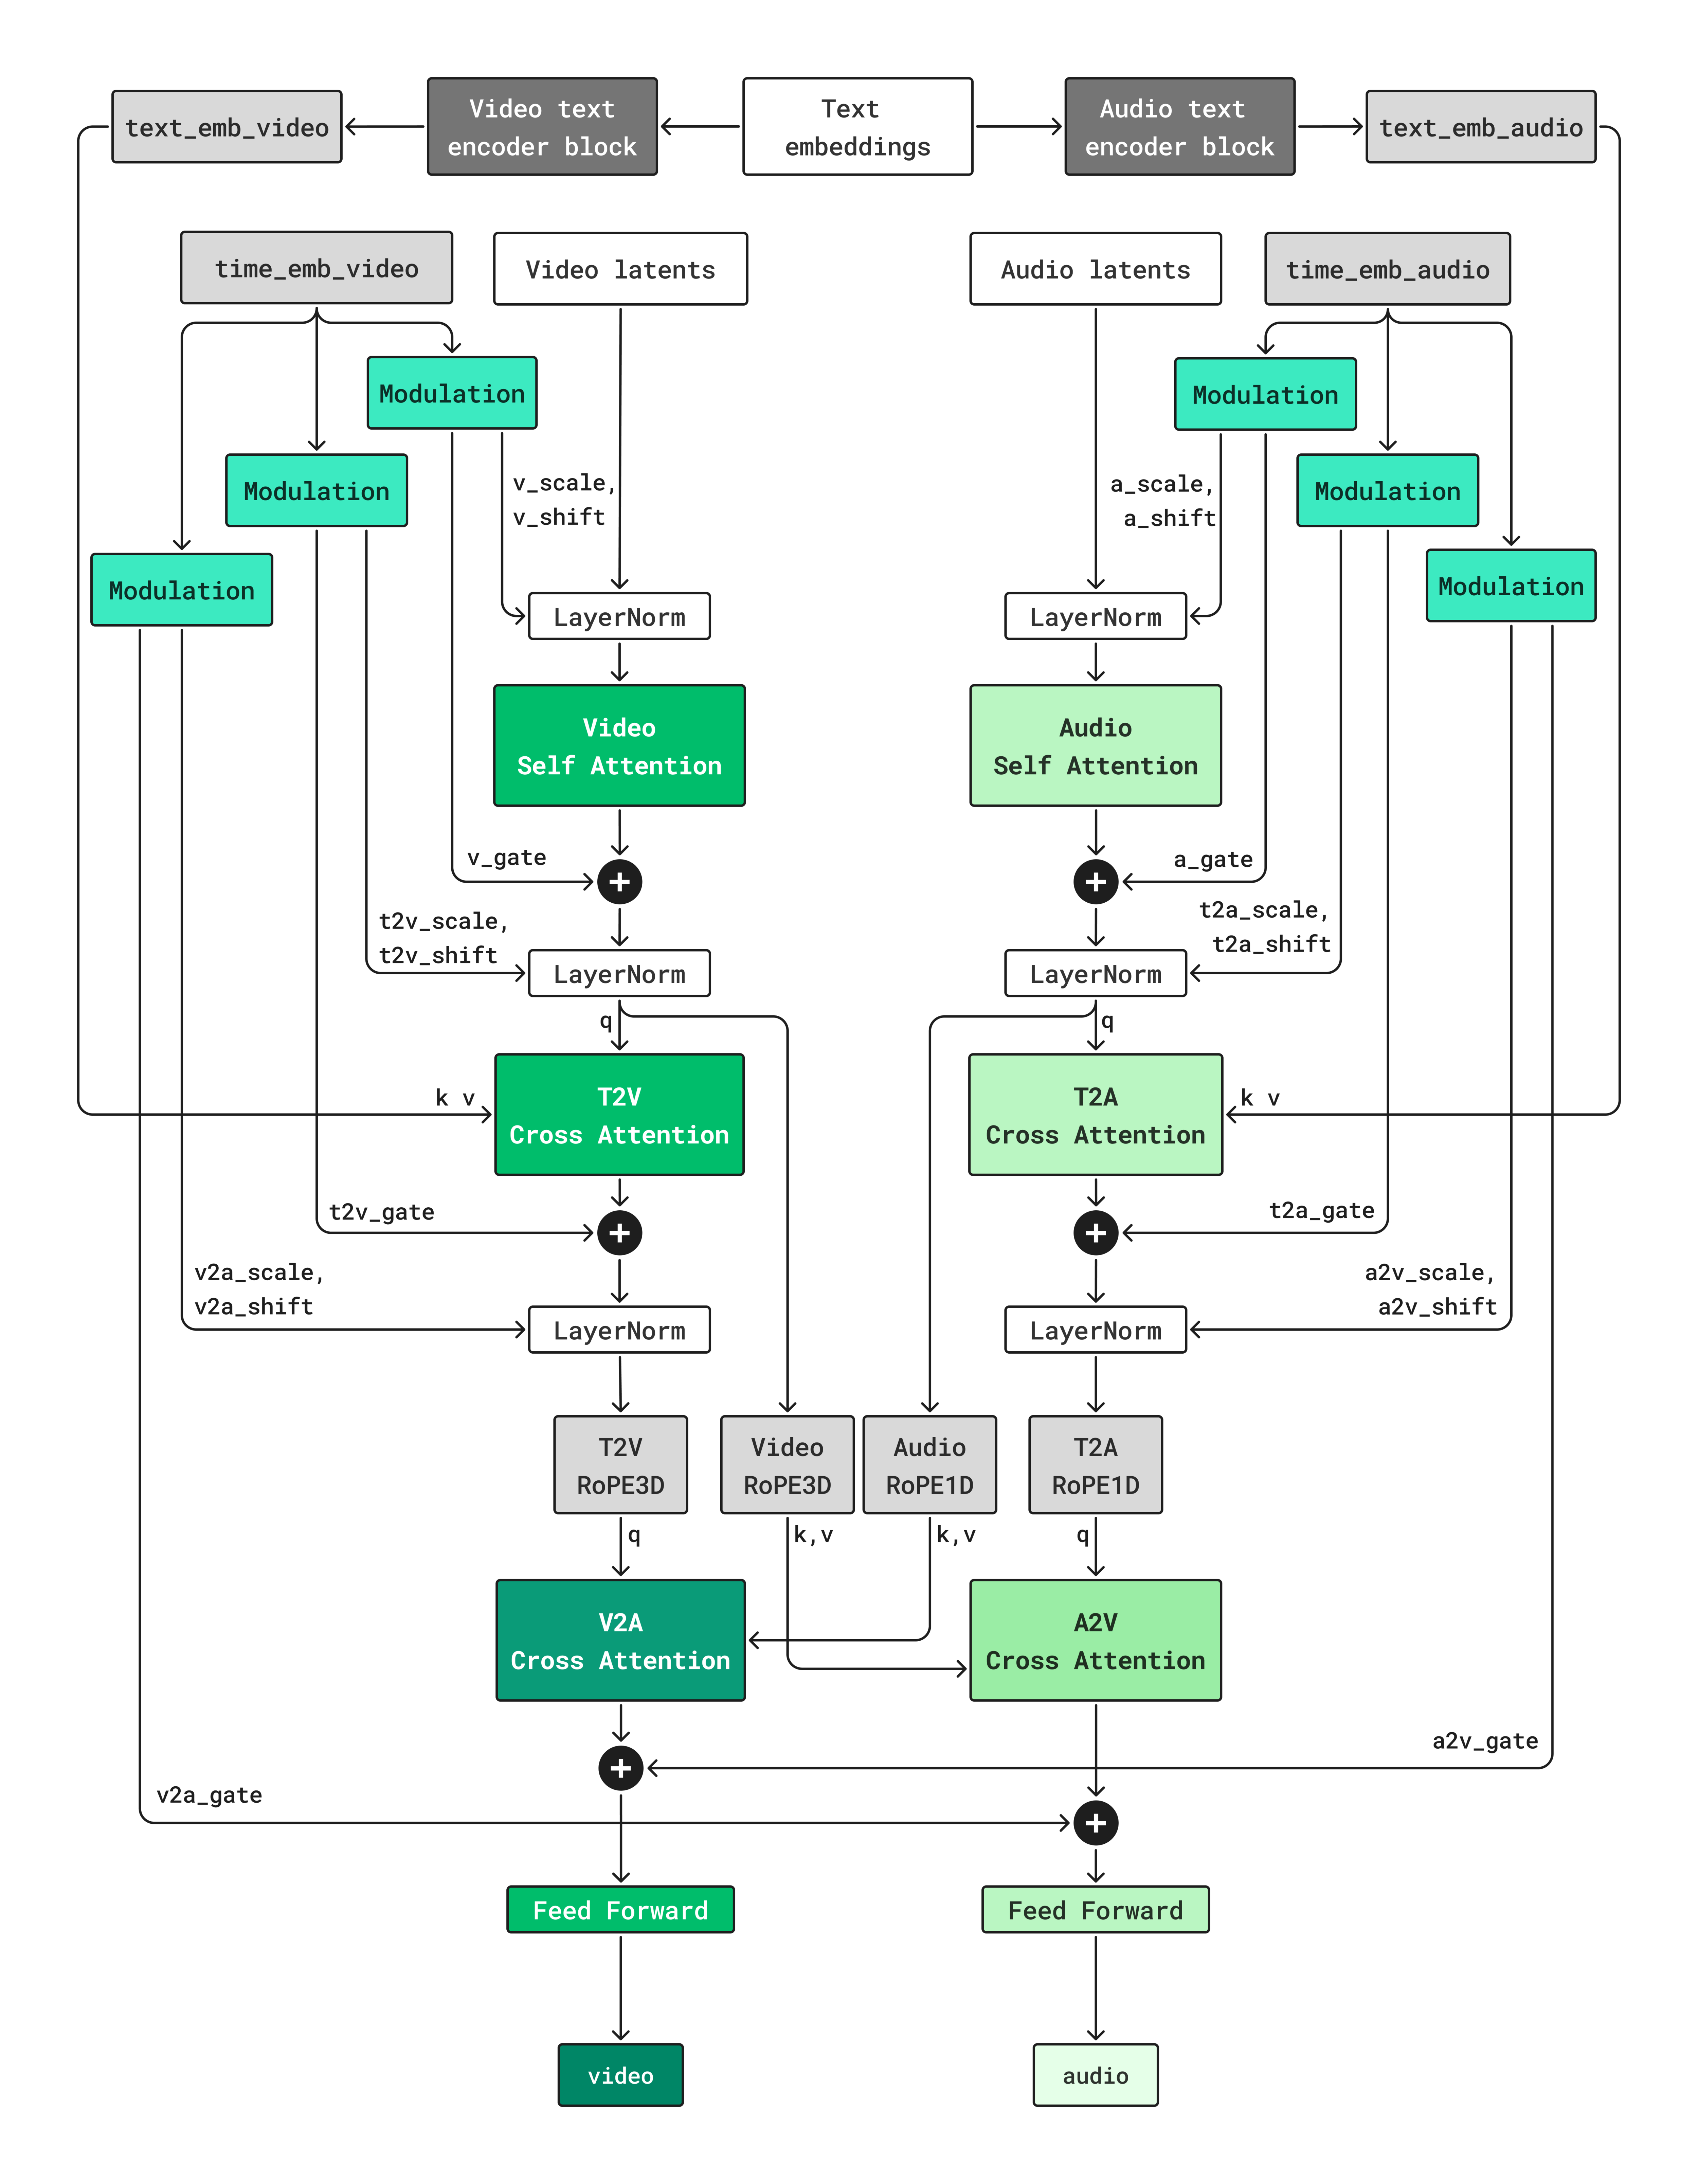
学習にはflow matchingを使用します。両モデルサイズはこのスケルトンを共有しており、幅・深さ、バッチサイズ、ステップ数、およびRLのレシピのみが異なります。
学習パイプライン
事前学習は3フェーズで進みます。(i) Kandinsky 5.0 Videoから初期化された動画ストリーム単体、(ii) 大規模音声コーパスでゼロから学習される音声ストリーム、(iii) ペア化された音声・動画データによるT2AVモードでの結合学習、その後T2AV/I2AVの混合。この逐次的スケジュールは、クロスモーダルfusionがgradientを支配する前に単一モダリティの忠実度を維持するように設計されています。事前学習の後、model soupを用いたSFT、RLベースのアライメント(報酬モデルには音声サブセットのWERのためにWhisper-large-v3を含む)、そして最後にdistillationが行われます。
超解像
フルHD出力はSR-DiTによって生成されます。これはK-VAE latent上で動作するテキスト不要のlatent upscalerです。
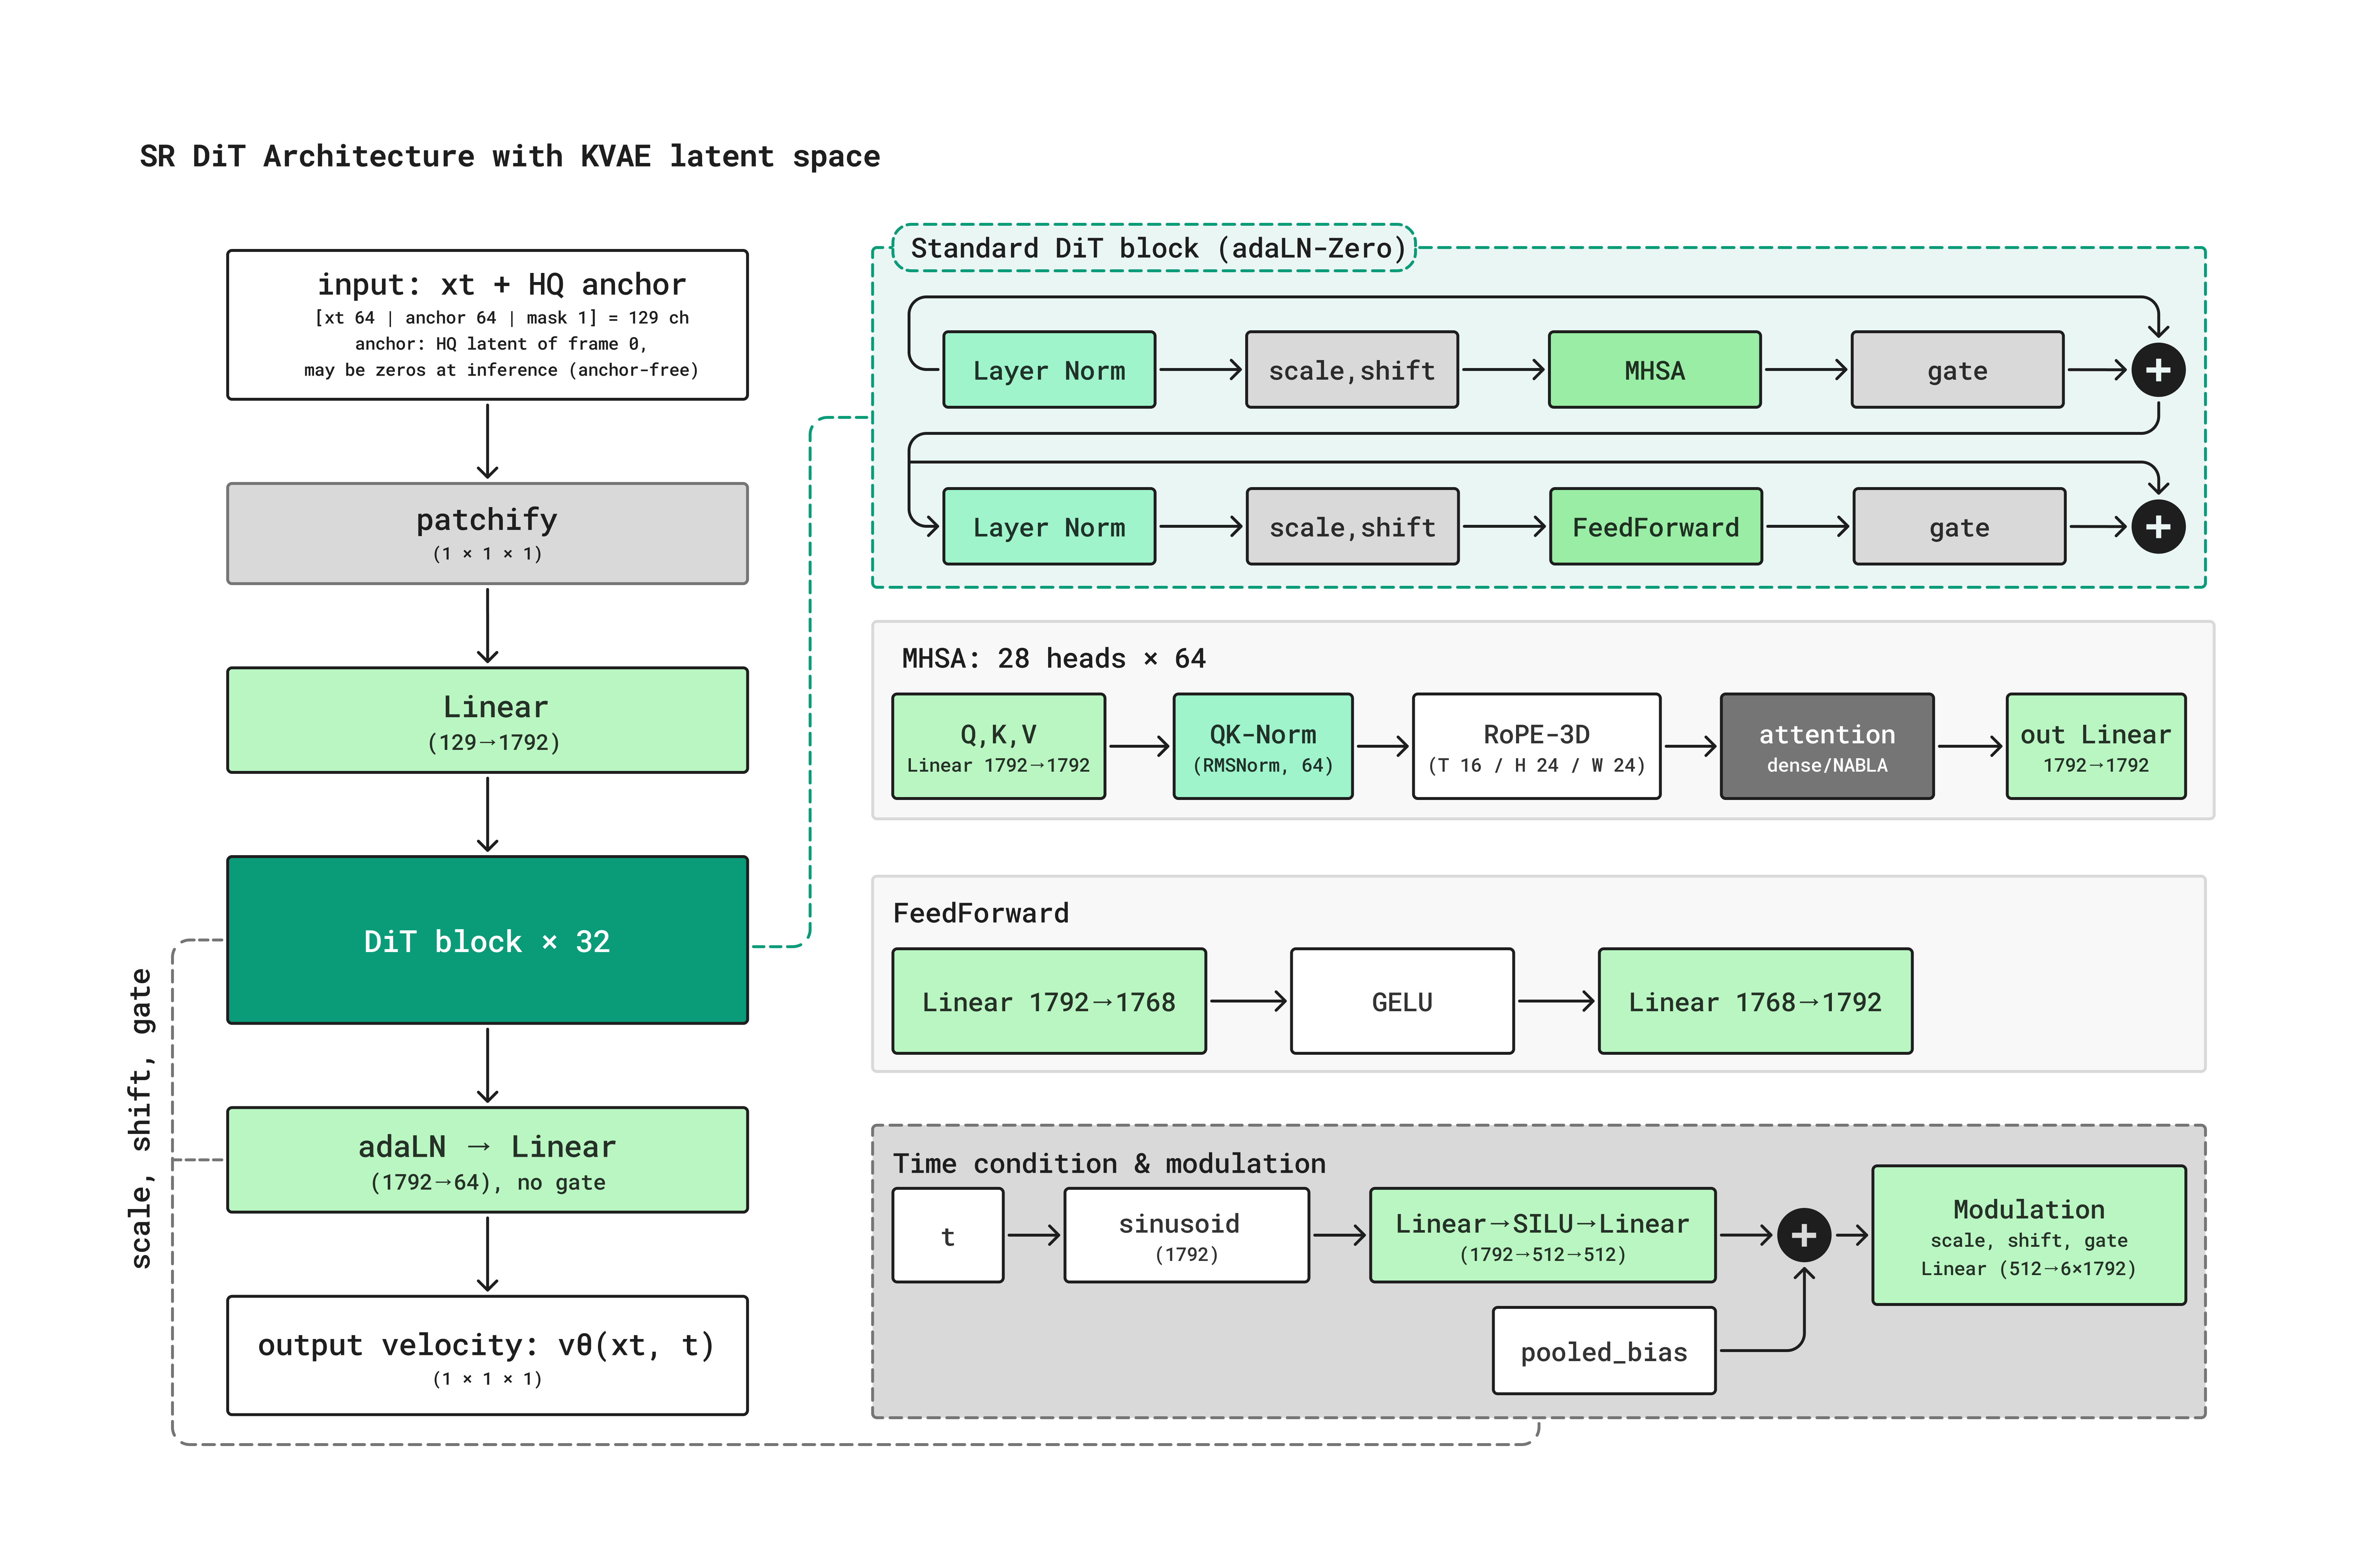
推論にはtiled latent upscalingを使用します。クリップは一度エンコードされ(121フレーム→31 latentフレーム)、≥25%のオーバーラップを持つ空間タイルに分割され、スケール固有のLatent UpscalerによってSR-DiTの作業解像度(横長32×48、正方形32×32)にアップスケールされ、部分的に再ノイズ化されます。
z_1 = \sqrt{1 - s^2}\, z^{\uparrow}_{LQ} + s\,\varepsilon,\quad \varepsilon\sim\mathcal{N}(0,I),
s=0.7として適用した後、デノイズを行います。distillation前のモデルは4〜8 Eulerステップを使用し、distillation済みStage 3モデルはNFE=2の\pi-Flow DXポリシーサンプリングを使用します。2つの軌跡セグメントそれぞれの開始時に、SR-DiTがDXポリシーを定義する10個のvelocity出力を予測し、これをネットワーク不要のEulerサブステップで積分します。タイルはHannウィンドウブレンドでマージされます。×2.25の場合、16 px VAEグリッドに合わせた双線形×1.125ピクセル事前アップスケールが×2ルートに入力されます。
デプロイメント
Pro SDのピーク割り当てメモリは72.8 GiBであり、コンシューマGPUでは実行不可能です。ブロックオフローディングはGPU上に常駐するtransformerブロックを2つだけに限定し、残りはCPUから別のCUDA streamでコンピューティングとオーバーラップしてストリーミングします。MagCacheはステップ自体がスキップされる場合にブロック転送全体をスキップします。Pro SDのピークメモリは約3.4倍低減し(72.8→21.7 GiB)、HD/Full HDでは約1.8倍(→39.6〜39.8 GiB)となり、H100での総生成時間は数パーセントしか変化しません。常駐バリアントとのビット完全一致はデータ型の数値イプシロン内で報告されています。このモードにはPyTorch 2.13が必要であり、フルモデルコンパイルやCUDA graphsとは非互換です。
結果
512×768、RL後のVABenchによるLTX 2.5(Full HD二段階)との評価:
- リップシンク:2.072(Pro)vs 1.761(Lite)vs 1.567(LTX 2.5)
- Desync(低いほど良い):0.396(Pro)vs 0.474(Lite)vs 0.521(LTX 2.5)
- 音声品質:1.496(Pro)vs 1.427(LTX 2.5)
- 視覚的リアリズム:4.485(Pro)vs 4.459(Lite)vs 4.366(LTX 2.5)
- 音声の美的評価:3.345(Pro)vs 3.307(LTX 2.5)
- テキスト・動画アライメント:0.229(Pro)vs 0.185(LTX 2.5)
- 音声・動画アライメント:0.268(Pro)vs 0.258(LTX 2.5)
LTX 2.5はVLMによるアライメント(4.527 vs 4.329)、表現力(4.360 vs 4.312)、およびWER(0.099 vs 0.117、音声サブセットでQwen3-ASR-1.7Bを用いて計算)で優位を保ちます。興味深いことに、Liteはテキスト・音声アライメント(0.374 vs 0.367)、音声リアリズム(3.900 vs 3.893)、および音声・視覚QAスコアでProを上回っており、これはProへの積極的なRLがリップシンクと音声品質のために音声キャプション忠実度をトレードオフしていることを示唆しています。
限界と未解決の問題
クリップは5秒・24 fpsに制限されており、より長い時間的整合性は未検証です。WERはLTX 2.5に対して絶対値で約1.8ポイント遅れており、RLで使用されたASRベースの報酬がホールドアウトASRに完全には転移しないことを示しています。より強いリップシンクと生の音声メトリクスにもかかわらず、LTX 2.5に対してVLMによるアライメント・表現力で後退していることは、報酬スタックが低レベルシグナルを過剰に重視していることを示唆しています。2ステップdistillation済みSRはタイルスティッチングに依存しており、25%未満のオーバーラップでのタイル境界のアーティファクトは定量化されていません。最後に、29B ProはオフローディングなしではいかなるコンシューマGPUにも常駐実行できず、オフローディングは特定のPyTorchバージョンに固定されています。
なぜ重要か
Kandinsky 6.0 Videoは、文書化されたデュアルストリームCrossDiTレシピ、flow matching学習スケジュール、およびdistillation済み2-NFE超解像パスを備えた、初めて公開記述された基盤スケールのT2AVシステムの一つであり、無音動画を超えた同期マルチモーダル生成のための具体的な設計図を提供します。LTX 2.5に対して報告されたリップシンクとdesyncのマージンは、モダリティ固有のRoPEおよびASRベースのRL報酬を伴う双方向クロスモーダルattentionが、29Bスケールでの音素レベルの音声・動画アライメントへの実行可能な手法であることを示しています。
Source: https://arxiv.org/abs/2610.05608
Hacker News Signals
Beam: ReflectionのオープンウェイトモデルBeam(5010億パラメータ)
Reflection AIは、5010億パラメータのオープンウェイトモデルであるBeamをリリースしました。これにより、パラメータ数の観点から、公開されている最大級のdense(またはnearly dense)モデルの一つとなります。このリリースはコーディング、推論、instruction-followingタスクのハイエンドを対象としており、推論コストよりも性能が重視されるワークロードにおいて、フロンティアのクローズドモデルへの競合として位置付けられています。
技術ブログでは、Beamが長文脈の一貫性とtool-useの忠実性に重点を置いて学習されたと説明されています。5010億パラメータという規模では、デプロイにマルチノードのtensor parallelismまたは積極的な量子化が必要となります。実用的な最低構成はbf16でおよそ8×H100、またはGPTQ/AWQ 4-bitを用いたより小規模なクラスタです。Reflectionはリリース時点で完全な技術レポートを公開していないため、MoEかdenseか、attentionのバリアント、学習トークン数などのアーキテクチャの詳細はまだ公式には明らかにされていません。
この規模でのオープンウェイト公開が重要な理由は、自己ホスト型推論の上限を引き上げるためです。これまでのオープンウェイトの先頭ランナー(Llama 3.1 405B、671B MoEのDeepSeek V3/R1)は、フロンティア級の性能にクローズドウェイトが必要ではないことを示しましたが、501BのdenseモデルはMoEの代替案とは異なる推論コスト構造を表すことになります。BeamのFLOPあたりの品質が、同等の有効パラメータ数を持つMoEアーキテクチャと競争力があるかどうかが、実務家が直ちにベンチマークすべき中心的な未解決問題です。
コミュニティの反応は、Reflectionがこれまでに根拠のないモデル品質の主張を行ってきた経緯から、慎重に懐疑的です。標準ベンチマーク(MMLU、HumanEval、MATH、SWE-bench)による独立した評価が判断の決め手となるでしょう。もしウェイトが宣言された性能を真に発揮するなら、APIへの依存なしにオンプレミスでデプロイできる範囲が意義深いかたちで拡大することになります。
Source: https://reflection.ai/blog/introducing-beam
Opus 5.5 エージェントが室温磁性半導体の候補材料を2つ発見
Vals.aiは、Claude Opusを自律型研究エージェントとして使用し、ドープされた遷移金属ダイカルコゲナイドを具体的な対象として、室温以上で半導体的挙動と強磁性秩序の両方を示すと理論が予測する候補材料を2つ特定したと報告しています。この結果は材料発見の主張であり、実験的な確認ではありません。
エージェントのパイプラインは以下のように機能します:Opusには文献検索ツール(semantic scholar / arXiv 検索)、ASE/GPAWなどを用いた密度汎関数理論(DFT)計算を実行するためのPythonインタープリタ、および仮説追跡用の構造化されたスクラッチパッドへのアクセスが与えられます。エージェントは、既知の磁性半導体を照会して候補材料ファミリーを繰り返し処理し、構造的仮説を生成し、DFTを呼び出してバンドギャップと磁気モーメントを計算した後、目標基準(E_g > 0、J交換パラメータからの平均場外挿によるT_C > 300\text{K})に対して候補をフィルタリングします。
この2つの候補材料は公開ブログ記事において目立った形では明記されておらず、これは重要な省略です――独立した検証を困難にするとともに、文献検索でその新規性の主張が成立するかどうかという疑問を生じさせます。DFT交換パラメータからのキュリー温度の平均場推定はT_Cを大幅に過大評価すること(しばしば2〜5倍)が知られているため、「室温」という主張が信頼性を持つには実験的な裏付けが必要です。
具体的な結果とは独立して技術的に興味深いのは、エージェント型ループのアーキテクチャです:このモデルは数時間にわたる多段階の仮説生成・検証サイクルを管理し、ツール呼び出しをまたいで状態を維持し、構造的に有効なDFT入力を生成するのに十分なエラー回復を実行します。これは単一ショットのコード生成よりも要求の高いワークフローです。科学的な出力が正しいかどうかは、エージェントのインフラが機能しているかどうかとは別の問題です――後者は機能しているように見えますが、前者は未検証のままです。
Source: https://www.vals.ai/blogs/room-temperature-magnetic-semiconductors
Mold Linker バージョン 3.0.0 リリース — Rust による完全書き直し
Mold 3.0.0 は、高速 linker である mold を C++ から Rust へ完全に書き直したものです。原作者の Rui Ishizaki(rui314)がこの決断を下した主な理由は、パフォーマンスではなく安全性と長期的な保守性にあります — C++ 実装はすでに極めて高速であり、Rust が改善できる余地はほとんど残っていませんでした。
この書き直しでは、mold のコアアーキテクチャ的特性が維持されています:並列セクションマージ、並列シンボル解決、そして並列リロケーション処理です。リンク処理のボトルネックは、通常、大量のオブジェクトファイル群に対する I/O とランダムアクセスメモリパターンにあります。mold の設計では、スレッドプール(従来は tbb、Rust 移植版では Rayon)を用いて CPU バウンドなフェーズを積極的に並列化しています。シンボル解決とリロケーションパッチ適用を通るクリティカルパスは、可能な限りシングルパスに保たれています。
Rust 固有の選択としては、オブジェクトファイルのメモリマップ I/O に memmap2、ワークスティーリング並列処理に crossbeam または Rayon、ELF/Mach-O/COFF パースに object クレートを使用しています。C++ から Rust への linker の移植は容易ではありません:linker はメモリマップされたファイル領域に対して大量の unsafe なポインタ演算を行うため、Rust 実装ではホットパスに unsafe ブロックを必然的に使用しますが、unsafe なサーフェス面積は同等の C++ と比べて小さく、監査も容易です。
リリースノートのパフォーマンスベンチマークによれば、大規模なリンクジョブ(clang、chrome)において Rust 版は C++ 版と同等か、わずかに劣る結果となっており、これは予想通りの結果です — この書き直しはパフォーマンスを退行させる目的で行われたわけではありません。mold 実行ファイル自体のバイナリサイズは、Rust の標準ライブラリのモノモーフィゼーションが大きいため、若干増加しています。
実際的な影響としては、mold は Linux 上の大規模 C++/Rust プロジェクト向けとして引き続き最速の汎用 linker であり続けます。また、Rust への書き直しにより、C++ は知らなくても Rust を知っているコントリビューターにとって参加しやすくなっています。さらに、インクリメンタルリンクに向けた将来の作業への布石ともなっており、Rust の所有権モデルが正確性の論証を簡単にする可能性があります。
Source: https://github.com/rui314/mold/releases/tag/v3.0.0
JevのようなDecision modelはLLM-as-a-judgeや従来の分類器に勝てない
Red Hatのベンチマーク研究は、「AI decision model」——コンテンツモデレーションやガードレール判断に特化してfine-tuningされた小型モデル——を、LLM-as-a-judge(汎用LLMに分類を行わせるプロンプティング手法)および従来の分類器(fine-tuningされたBERTクラスのモデル、またはembeddingに対するロジスティック回帰)という2つのベースラインと比較評価しています。評価対象の具体的なモデルはJevであり、ガードレールユースケース向けに販売されているコンパクトなdecision-focusedモデルです。
評価は標準的な安全性・コンテンツ分類ベンチマークを対象としており、毒性検出、プロンプトインジェクション識別、PIIリーク検出、ポリシー違反ラベリングを含みます。指標は複数の閾値動作点におけるF1、精度、再現率であり、レイテンシとコストは別途考慮されています。
結果:JevはF1においてwell-promptedなGPT-4oやClaude Haikuに対して一貫して優位に立てておらず、分布内データではfine-tuningされたDeBERTa-v3に頻繁に敗れています。LLM-as-a-judgeアプローチは1回あたりのコストとレイテンシが高いものの、新規の違反カテゴリに対するゼロショット汎化性能は優れています。従来の分類器は、明確に定義された安定したラベル空間においてスループットとコストの面で勝ります。
この研究に内包された方法論的批判は、見出しとなる結果よりも重要です。decision modelのベンダーは、有利な比較を作り出すために弱いベースライン(チューニングされていないプロンプト、時代遅れの分類器アーキテクチャ)に対してベンチマークを行うことがよくあります。ベースラインを厳格化すると——キャリブレーションされたプロンプト、分類器に対する適切な閾値チューニング——その優位性は消滅します。
ガードレールパイプラインを構築するMLエンジニアへの実践的な示唆は以下の通りです。既知の違反カテゴリに対しては、タスク固有のfine-tuning済み分類器(DeBERTa、ModernBERT)がレイテンシ・コストの面で打ち負かすことが難しい選択肢となります。LLM-as-a-judgeが競争力を持つのは、ラベル空間がオープンエンドであるか急速に変化している場合に限られます。専用の「decision model」はその中間の居心地の悪いポジションを占めており、ライセンスコストを正当化できない可能性があります。
メタデータを早期に出力することで、Rustのビルド/チェックを最大2倍高速化する
headstart プロジェクトは、rustcのコンパイルパイプラインに変更を加え、クレートのメタデータ(.rmeta ファイル)をコード生成が完了する前の、より早い段階で出力する実装です。これにより、当該クレートに依存するダウンストリームのクレートが、オブジェクトファイルの出力を待つことなく、型チェックやborrowチェックを即座に開始できるようになります。
標準的なrustcのパイプラインは、parse -> HIR -> MIR -> LLVM IR -> オブジェクトコードという流れであり、.rmeta はMIRのloweringが完了した後にのみ出力されます。cargo check(codegenなし)の場合、.rmeta はすでに早期に出力されており、これが check が build より高速である理由です。headstartのパッチは、.rmeta の出力タイミングをMIR loweringの完了後かつLLVMバックエンドフェーズの前に移動させます。これにより、cargo build において、現在のクレートのLLVM codegenが並列で実行されている間に、依存クレートがフロントエンドの処理を開始できるようになります。
速度向上の程度はパイプラインに依存します。深い依存グラフを持ち、中間クレートのcodegenにコストがかかるプロジェクトが最も恩恵を受けます。報告されている数値では、一部のクレートのフルビルドで最大2倍の高速化が達成されています。この改善は並列化の向上のみによるものであり、作業量が削減されているわけではなく、作業が重なり合って実行されます。
これは、ビルドシステムにおけるクリティカルパス短縮という一般的な原理の一例です。依存グラフはどのコンパイルが重なり合えるかを制約しますが、パイプライン内でメタデータ出力ポイントを前方へ移動させることで、codegenでボトルネックとなっているノードを通るクリティカルパスが短縮されます。
既知の制限事項として、この実装はrustcの内部への変更を必要とし、まだアップストリームには取り込まれていません。完全なコンパイルのメタデータを必要とするマクロやproc-macroに関する正確性のエッジケースが存在します。このプロジェクトは、本番向けパッチではなく、rustc RFCのためのプルーフ・オブ・コンセプトとして提示されています。アップストリームに取り込まれた場合、大規模なワークスペース(tokio、rustc本体、bevy)のインクリメンタルビルドへの影響は相当なものになる可能性があります。
Source: https://github.com/PowderworksCode/headstart
Linux containers in 500 lines of code (2016)
これは2016年にLizzie Dixonが執筆した記事で、CのLinux生syscallを使ったミニマルなコンテナランタイムの実装を解説しています。カーネルインターフェースレベルでコンテナが実際に何であるかを理解するための最も明快な技術的リファレンスの一つとして今も定評があり、そのため定期的に話題に上ります。
この実装は6つのLinux名前空間を使用しています:CLONE_NEWPID(プロセスID分離)、CLONE_NEWNS(マウント名前空間)、CLONE_NEWUTS(ホスト名)、CLONE_NEWIPC(IPC)、CLONE_NEWNET(ネットワークスタック)、そしてCLONE_NEWUSER(UID/GIDマッピング)です。これらは適切なフラグをORで結合した単一のclone(2)呼び出しによって組み合わされます。
複雑さの大部分はマウント名前空間のセットアップに集中しています:pivot_root(2)を使ってコンテナのルートファイルシステムを準備済みのディレクトリに切り替え、その後で古いルートをアンマウントします。これはマウント名前空間を適切に分離しないchrootとは対照的に、正しいアプローチです。またこの実装では、新しい名前空間内に最小限の/procマウントもセットアップします。
名前空間のセットアップ後にprctl(PR_SET_CAPS, ...)を通じてケーパビリティが削除され、攻撃対象領域が縮小されます。ユーザー名前空間のマッピング(/proc/PID/uid_map、/proc/PID/gid_map)により、コンテナは内部でrootとして動作しているように見えながら、外部では非特権UIDにマッピングされます――これがrootlessコンテナの基盤です。
500行が省略しており、実際のランタイム(runc、crun)が対処していること:リソース制限のためのcgroups v2、seccomp-bpfによるsyscallフィルタリング、LSM(AppArmor/SELinux)プロファイルの適用、ネットワークvethペアのセットアップ、OCIイメージレイヤーのマウント、そして完全なライフサイクル管理です。しかし名前空間と分離プリミティブを理解するという点では、このコードはほぼ完全です。コンテナツールを構築したり、ランタイムセキュリティを監査したりする方にとって、この実装を読むことはいかなる高レベルの概説よりも有益です。
Source: https://blog.lizzie.io/linux-containers-in-500-loc.html
Goガベージコレクターにおける40msのポーズ問題:swapが原因
GoサービスにおけるGCポーズの異常をOSレベルのメモリスワッピングまで追跡した、詳細なプロダクションデバッグの記事です。症状は、十分な空きRAMを持つマシンで断続的に発生する40msのstop-the-worldポーズであり、ヒープ圧迫が根本原因ではないことを示唆していました。
診断のプロセスは示唆に富んでいます。著者はまず明白な候補を排除しました。ヒープサイズは範囲内、GOGCは適切にチューニングされており、GCサイクルも異常に頻繁ではありませんでした。決定的な手がかりは、Goランタイムのトレース出力(GOTRACE=...、runtime/trace)とvmstatおよび/proc/PID/smapsのデータを相関分析することで得られました。GC自身の内部メタデータ構造、具体的にはmheapのスパンとGCマークビットマップに属するページが、GCサイクルの合間にスワップアウトされていることが判明したのです。
GCがコレクションを開始すると、ヒープ全体のマークビットマップとスパンメタデータにアクセスする必要があります。それらのページがコールド状態(スワップ済み)であれば、最初のアクセスがページフォルトを引き起こし、STWフェーズに参加しているgoroutineをブロックします。40msのポーズは、NVMeバックアップのswap上で約20〜40回のメジャーページフォルトに相当し、数百KBのスワップされたGCメタデータとも整合します。
修正は二段構えでした。GCメタデータページへのmlock(2)の適用(Goランタイムへの組み込みは容易ではありません)と、より現実的な対策として、ファイルバック付きページがより適切な退避対象である場合に匿名ページがスワップされる可能性を下げるため、カーネルのvm.swappinessを設定することです。著者はまた、(Go 1.19で導入された)GOMEMLIMITがランタイムにより厳しい上限を与え、ヒープがswap隣接領域まで拡大する可能性を低減させることも指摘しています。
より広い教訓として:プロダクション環境におけるGCポーズ分析にはOSのメモリサブシステムも含める必要があります。ランタイム内部のみのプロファイリングでは、swap起因のレイテンシスパイクを完全に見落としてしまいます。
Source: https://frn.sh/go-gc/
SSHとNginxによるセルフホストHTTPトンネル
Vincent BernatのポストはSSHリモートポートフォワーディングとNginxをリバースプロキシとして組み合わせ、サードパーティのトンネルサービス(ngrok、Cloudflare Tunnelなど)を使わずに、公開サーバ経由でローカルHTTPサービスを外部公開するためのプロダクション品質のセットアップを解説しています。
コアとなるメカニズムはSSHの-Rフラグです:ssh -R 127.0.0.1:8080:localhost:3000 tunnel@public-serverは公開サーバのループバック上のポート8080をクライアントのポート3000にバインドします。公開サーバ上のNginxは特定のバーチャルホストを127.0.0.1:8080にプロキシします。SSH接続が暗号化と認証を担い、NginxがTLS終端とルーティングを処理します。
実装において非自明な部分は以下の通りです:(1) sshd_configにおけるGatewayPorts — トンネルはパブリックインターフェースではなくループバックにバインドするため、デフォルト(no)のままにする;(2) サーバ上での任意コード実行を防ぐための、トンネルユーザ向けの専用制限シェルまたはForceCommand;(3) トンネルユーザにスコープしたAllowTcpForwarding yes;(4) SSHトンネルが接続されていない場合を適切に処理する(ハングせずに502を返す)Nginxのupstream設定。
動的サブドメイン割り当てについては、SSHの-o RemoteForwardを事前に合意したポート範囲とともに使用し、ポート番号に基づいてルーティングするワイルドカードのNginx server_nameを用いるパターンが紹介されています。これは商用トンネルで使われるSNIベースのルーティングよりもシンプルですが、開発ワークフローには十分です。
ngrok系サービスに対する運用上の利点は、外部依存がなく、帯域制限もなく、認証トークンのローテーションも不要で、トラフィックが自分の管理するインフラ外に出ないことです。デメリットとしては、公開サーバと手動セットアップが必要な点があります。ポストに記載されているsshdのハードニングに関するメモ(fail2ban、鍵認証のみ、AllowUsers制限)は、公開SSHエンドポイントを運用する誰にとっても有用なチェックリストです。
Source: https://vincent.bernat.ch/en/blog/2026-http-over-ssh
注目の新リポジトリ
nealbridges/VulnHunter
Capital OneのVulnHunterをメンテナンスされたforkとして、汎用的なエージェント型セキュリティスキャナとして再構築したものです。コアループは対抗的な設計になっており、潜在的な脆弱性を報告するだけでなく、エージェントが実行可能な概念実証(PoC)エクスプロイトの構築を試み、悪用可能性を確認した上で、修正が受け入れられる前に必ず通過しなければならないテストファーストのパッチを生成します。アーキテクチャはハーネス非依存であり、特定のLLMプロバイダやオーケストレーションレイヤに縛られることなく、任意のエージェントランタイムを組み込むことができます。ワークフローは関心事を明確に分離しており、偵察フェーズで攻撃対象領域を特定し、エクスプロイト合成フェーズでモデルを用いてPoCコードを生成し、修復フェーズでオリジナルのテストスイートおよび生成されたリグレッションテストの下で修正を実行します。これが重要な理由は、LLMベースのセキュリティツールの多くが「不審なパターンがあります」という報告で止まってしまうのに対し、VulnHunterは脆弱性が修復パイプラインに入る前に明確にトリガー可能であることを要件とすることでループを閉じており、偽陽性のノイズを大幅に削減できるためです。CIに自動化されたレッドチームパスを統合したいセキュリティエンジニアや、自律的なエクスプロイト生成を研究する研究者にとって有用です。forkという形態により、Capital Oneのアップストリームの変更を追跡しながら、より広いコミュニティからのコントリビューションも受け入れることができます。
Source: https://github.com/nealbridges/VulnHunter
mizorewww/laya-mlx
Laya型付き決定モデル向けのネイティブApple MLX runtimeであり、M系統のユニファイドメモリアーキテクチャを直接ターゲットにしています。注目すべき数値として、M3 Max上で1決定あたり7〜14 msを達成しており、これはPyTorch、テキスト生成パイプライン、クラウドAPIのラウンドトリップを完全に排除することで実現されています。Laya決定モデルは自己回帰型言語モデルではなく、構造化された型付き推論グラフであるため、このruntimeは決定論的な計算グラフを活用して、汎用深層学習フレームワークのオーバーヘッドなしに、MLXバックエンド上でのメモリレイアウトとカーネルディスパッチを最適化できます。これにより、200 ms以上のクラウド呼び出しが許容できないローカルエージェント、組み込みルールエンジン、エッジ推論ループなど、レイテンシに敏感なオンデバイスアプリケーションへの適用が可能になります。PyTorchへの依存がゼロであることはアーキテクチャ上重要な意味を持ちます。MLXのC++およびSwiftカーネルが行列演算を直接処理することで、バイナリサイズを小さく保ち、PythonおよびPyTorchの起動コストを回避しています。6,790のスターを獲得しており、オンデバイスMLコミュニティから大きな注目を集めています。設計思想——狭いモデルクラス、特化されたruntime、生成処理のオーバーヘッドなし——は、汎用性をAppleシリコン上のスループットおよびレイテンシと意図的にトレードオフしたものです。
Source: https://github.com/mizorewww/laya-mlx
jianruntech/geo-score
Generative Engine Optimization(GEO)の準備度を測定するためのゼロ依存ツールです。具体的には、LLMを搭載した検索エンジン(ChatGPT、Perplexity、Gemini、Claude)が特定のサイトをその回答内で引用するかどうかを評価します。スコアリングの基準は公開されており、構造化データの有無、権威性シグナル、コンテンツの明瞭さといった要素にわたって0〜100の準備度インデックスを算出します。引用トラッキングは、ユーザー自身のAPIキーを使ってOpenAI、Perplexity、Gemini、Claude各APIにクエリを発行し、レスポンス内のURL言及を解析することで機能しており、中央集権的なデータ収集を回避しています。MCP(Model Context Protocol)サーバーインターフェースにより、このツールは別のエージェントからツールとして呼び出せるため、エージェント型ワークフロー内でGEO監査を自動化することが可能です。外部依存ゼロという制約により、デプロイは極めて簡単で、単一プロセスで動作し、データベースもクラウドサービスも不要です。実用的なユースケースとしては、従来のSERP順位ではなく、自分のコンテンツがAI媒介型検索で表示されるかどうかについて実証的なデータを必要とするSEO実務者やサイトオーナーが挙げられます。スコアリング手法をブラックボックスの独自指標ではなく監査可能なものにしているという点で、公開された基準は特筆に値します。
Source: https://github.com/jianruntech/geo-score
MichaelKinsy/PiG
Pi コーディングエージェントの基盤となる TypeScript コードベースを、パリティ(同等性)を保証した形で Go に移植したものです。明示されたコントラクトは、上流の Pi との振る舞いの忠実性です。すなわち、上流の振る舞いが変化した場合、PiG もそれを追従します。Go による実装はその手段であり、エージェントのセマンティクスを再設計する機会ではありません。これは意図的な「リライト拒否」スタンスです。コードベースは、上流からの乖離を可視化して修正可能な状態に保つように構成されており、慣用的な Go のリファクタリングによってエージェントの動作がサイレントに変更されることを防いでいます。実用的な動機はデプロイメントにあります。Go は Node.js ランタイム依存なしに単一の静的バイナリへとコンパイルされるため、コンテナ化が簡素化され、アタックサーフェスが縮小し、サーバーレスや CLI 環境でのコールドスタートレイテンシが削減されます。TypeScript と Go の型システムの違いにより、TypeScript がランタイムで解決する動的ディスパッチのパターンを明示的に処理する必要があり、PiG はこれらをインターフェース型としてエンコードし、元の制御フローを注意深くミラーリングしていると考えられます。Node.js ランタイムの同梱が現実的でない環境、たとえば組み込みシステム、最小構成のコンテナ、あるいは Go を標準インフラとして採用している組織において、Pi エージェントの機能を必要とするチームに有用です。
Source: https://github.com/MichaelKinsy/PiG
qybaihe/mu
二層推論アーキテクチャを持つコーディングエージェントです。小規模かつ高速な judge モデルがルーティンな判断(ファイル選択、ツールのディスパッチ、些細な書き換え)を担当し、大規模モデルは実質的な作業に専念します。Pi agent フレームワークと、インターフェース層としての AionUi の上に構築されています。核心的な洞察は、コーディングエージェントのループにおけるほとんどのステップがエントロピーの低い判断——どのファイルを開くか、lint エラーが些細なものかどうか——であり、フロンティアモデルを必要としないという点です。これらを小規模モデルにルーティングすることで、レイテンシとコストを削減しつつ、大規模モデルを難しいサブ問題(アルゴリズム的推論、API 設計の意思決定、複数ファイルにまたがるリファクタリング)に充てることができます。これは inference における speculative execution パターン(小規模モデルが下書きし、大規模モデルが検証する)を踏襲していますが、トークンレベルではなくエージェントのタスクレベルに適用しています。「行動する前に考える」というフレーミングは、ツール呼び出しの前に明示的なプランニングステップを設けることを指しており、これにより時期尚早または誤ったツール呼び出しによる無駄なラウンドトリップを削減します。398 スターと規模は小さいものの、技術的に一貫したプロジェクトであり、難しいタスクにおける能力を犠牲にすることなく、より軽量なエージェントループを求める開発者に適しています。
Source: https://github.com/qybaihe/mu
lakeday-org/perch
Decision Modelsを用いたセマンティックコードlinting — LLMによるテキスト生成やASTパターンマッチングではなく、構造化された型付き推論グラフを活用するアプローチです。従来のlinterは手書きのルールを用いて構文木を操作し、LLMベースのlinterは低速かつ非決定的です。Perchはその中間に位置します。Decision Modelsは、型付きで決定的な推論グラフとしてセマンティックポリシーをエンコードし、安価に評価できるため(Laya MLX runtimeのアプローチに類似)、lintingをエディタ内またはCI上でもファイルごとのAPIコールのレイテンシなしに実行できるほど高速化します。実用上の意味として、lint rulesはフル言語モデルの推論パスを必要とせず、「この関数はこのコンテキストで副作用を持つべきでない」や「この抽象化は確立されたデータフローパターンに違反している」といったセマンティックな意図を表現できます。この設計により、カスタムDecision Modelsが、汎用的な静的解析ツールでは対応できないプロジェクト固有の規約をエンコードすることも可能です。346スターとまだ初期段階ですが、高速でも浅い構文lintingと低速でも深いLLL分析という二者択一の課題に対し、実在するギャップを埋めるものです。
Source: https://github.com/lakeday-org/perch
mirkovicdev/HFTENGINE
hftbacktest Rust クレート上に構築された、マーケットメイキングバックテスト向けのターミナルモード再生コンソールです。実際に記録されたBinance Futuresのデータを使用して動作します。単純なP&Lバックテスターとの差別化ポイントは粒度の細かさにあります。LOB(指値注文板)を通じてすべての待機中指値注文のキューポジションを追跡し、フィードレイテンシと注文送信レイテンシを個別にモデル化し、コレクターからの生のフィードと並行してフィルを再生します。この詳細度は、他の待機中注文に対するキューポジションがフィル確率とアドバース・セレクションのエクスポージャーを決定するマーケットメイキング戦略において重要です。集計VWAP方式のバックテストでは不十分です。Rustのランナーがパフォーマンスクリティカルなシミュレーションループを担当し、テキストモードのダッシュボードがGUIフレームワークへの依存なしに注文板の状態とポジションデータを描画します。「バックテスターであってトレーディングボットではない」という明示的なフレーミングは安全上の境界線であり、約定執行の接続機能は存在しません。独自の過去データインフラへの費用を支払うことなく、マイクロストラクチャ、レイテンシ感度、キューダイナミクスを研究するクオンツ研究者にとって有用です。実際のBinance Futuresティックデータへの依存により、結果は合成的なLOBモデルではなく実際の市場マイクロストラクチャを反映します。
Source: https://github.com/mirkovicdev/HFTENGINE
dzhng/jevgrep
コーディングエージェントのワークフロー向けに設計された、CLIのセマンティックコード検索ツールです。ファイルおよびコンテキスト探索のためにJevを基盤として構築されています。インターフェースはgrepを模倣しており、文字列パターンを指定するのではなく「コードが何をするか」を問い合わせる形式となっています。これにより、エージェントが編集を行う前に関連するソースコンテキストを特定する必要があるエージェントのtool-callループの中で、容易に組み合わせて使用できます。Jevがセマンティックインデックスと検索レイヤーを担い、jevgrepはそれをgrepライクなCLIの仕様でラップすることで、grep形式の出力を期待する既存のシェルパイプラインやエージェントハーネスが変更なしに結果を利用できるようになっています。2,333スターを獲得しており、コーディングエージェントコミュニティでの支持を集めています。技術的な賭けは、ローカルコードインデックスに対するセマンティック検索が、フロンティアモデルにプロジェクト構造からファイル位置を推測させるよりも、高速かつ高い関連性を持つという点にあります。すなわち、ある関数が何をするかを知っているモデルは、エージェントが投機的にファイルを列挙することなく、直接それを検索して取得できます。設計は意図的にシンプルに絞られており、インデックスサーバーも常駐デーモンも不要で、CLIというフレーミングの性質上、エージェントのtool dispatchにおける呼び出しごとの使用に適しています。
Source: https://github.com/dzhng/jevgrep