デイリーAIダイジェスト — 2026-09-25
arXiv ハイライト
Neural Spectral Capacity: ネットワーク仕様のみからアーキテクチャを測定・設計する
問題設定
アーキテクチャ設計と圧縮はいずれもリソース予算の下で容量を配分しますが、その判断を導くスカラー量——パラメータ数とFLOPs——は構造に対して盲目的です。同じパラメータ数を持つ2つのネットワークは、深さ・幅・ヘッド配分・FFN比において大きく異なる場合がありますが、これらのスカラーはどちらにも同じスコアを割り当てます。Training-freeなプロキシ(SNIP、GradNorm、ZeroLM、W-PCA)はこの問題を部分的に解決しますが、モデルのインスタンス化、サンプリングされた入力、および順伝播・逆伝播を必要とし、いずれも予算制約下での厳密な最適化を許しません。本論文はNeural Spectral Capacity(NSC)を提案します。これは行列の形状と初期化分散のみというアーキテクチャ仕様から計算可能なスカラーであり、制約付き最大化のための厳密な動的計画法ソルバーNSC-DPを伴います。
手法
出発点は、等方性ガウス入力とノイズを持つ線形ガウスチャネル y = Wx + z の相互情報量に関するTelatarの公式です:
I(x;y) = \tfrac{1}{2}\ln\det(I + W^\top W) = \tfrac{1}{2}\sum_i \ln(1 + \sigma_i^2).
定数 \tfrac{1}{2}(ランキングおよび加算的集約には無関係)を除いて、行列ごとのspectral capacityを次のように定義します:
\psi(W) \coloneqq \ln\det(I + W^\top W) = \sum_{i=1}^{\min(m,n)} \ln(1+\sigma_i^2).
ガウス仮定はデータや重みではなく探索信号に対するものです。W の特定の実現が利用できない場合、等方性 x \sim \mathcal{N}(0, I_n) が最適な入力分布であり、これは仕様のみの設定に合致します。ゼロの特異値は寄与がゼロとなるため、\psi はランク不足な行列を綺麗に扱うことができます。
核心的な計算上の工夫——abstractでMarchenko-Pasturに言及していることが示唆する——は、標準的なランダム初期化(例えば W_{ij} \sim \mathcal{N}(0, \sigma^2/n))の下で、経験的特異値分布がアスペクト比 m/n と \sigma^2 のみに依存する決定論的な法則に収束するという点です。その結果、\mathbb{E}[\psi(W)] は (m, n, \sigma^2) における閉じた形式を持ちます:サンプリング不要、インスタンス化不要、データ不要です。NSCは各層内および層間で \psi を足し合わせることで定義され、この層ごとの加算性が厳密なDPを可能にします。具体的には、アーキテクチャが L 層に分解され、各層の決定 d_\ell \in \mathcal{D}_\ell と各層のリソースコスト c(d_\ell) を持つ場合、最適化
\max_{d_1,\dots,d_L} \sum_\ell \psi_\ell(d_\ell) \quad \text{s.t.} \quad \sum_\ell c(d_\ell) \le B
は (L, B) に関する擬多項式DPによって厳密に解けるナップサック問題です。これはblack-boxなtraining-freeプロキシの探索では提供できない真の保証です:既存のプロキシはネットワーク全体の非分解可能な関数です。
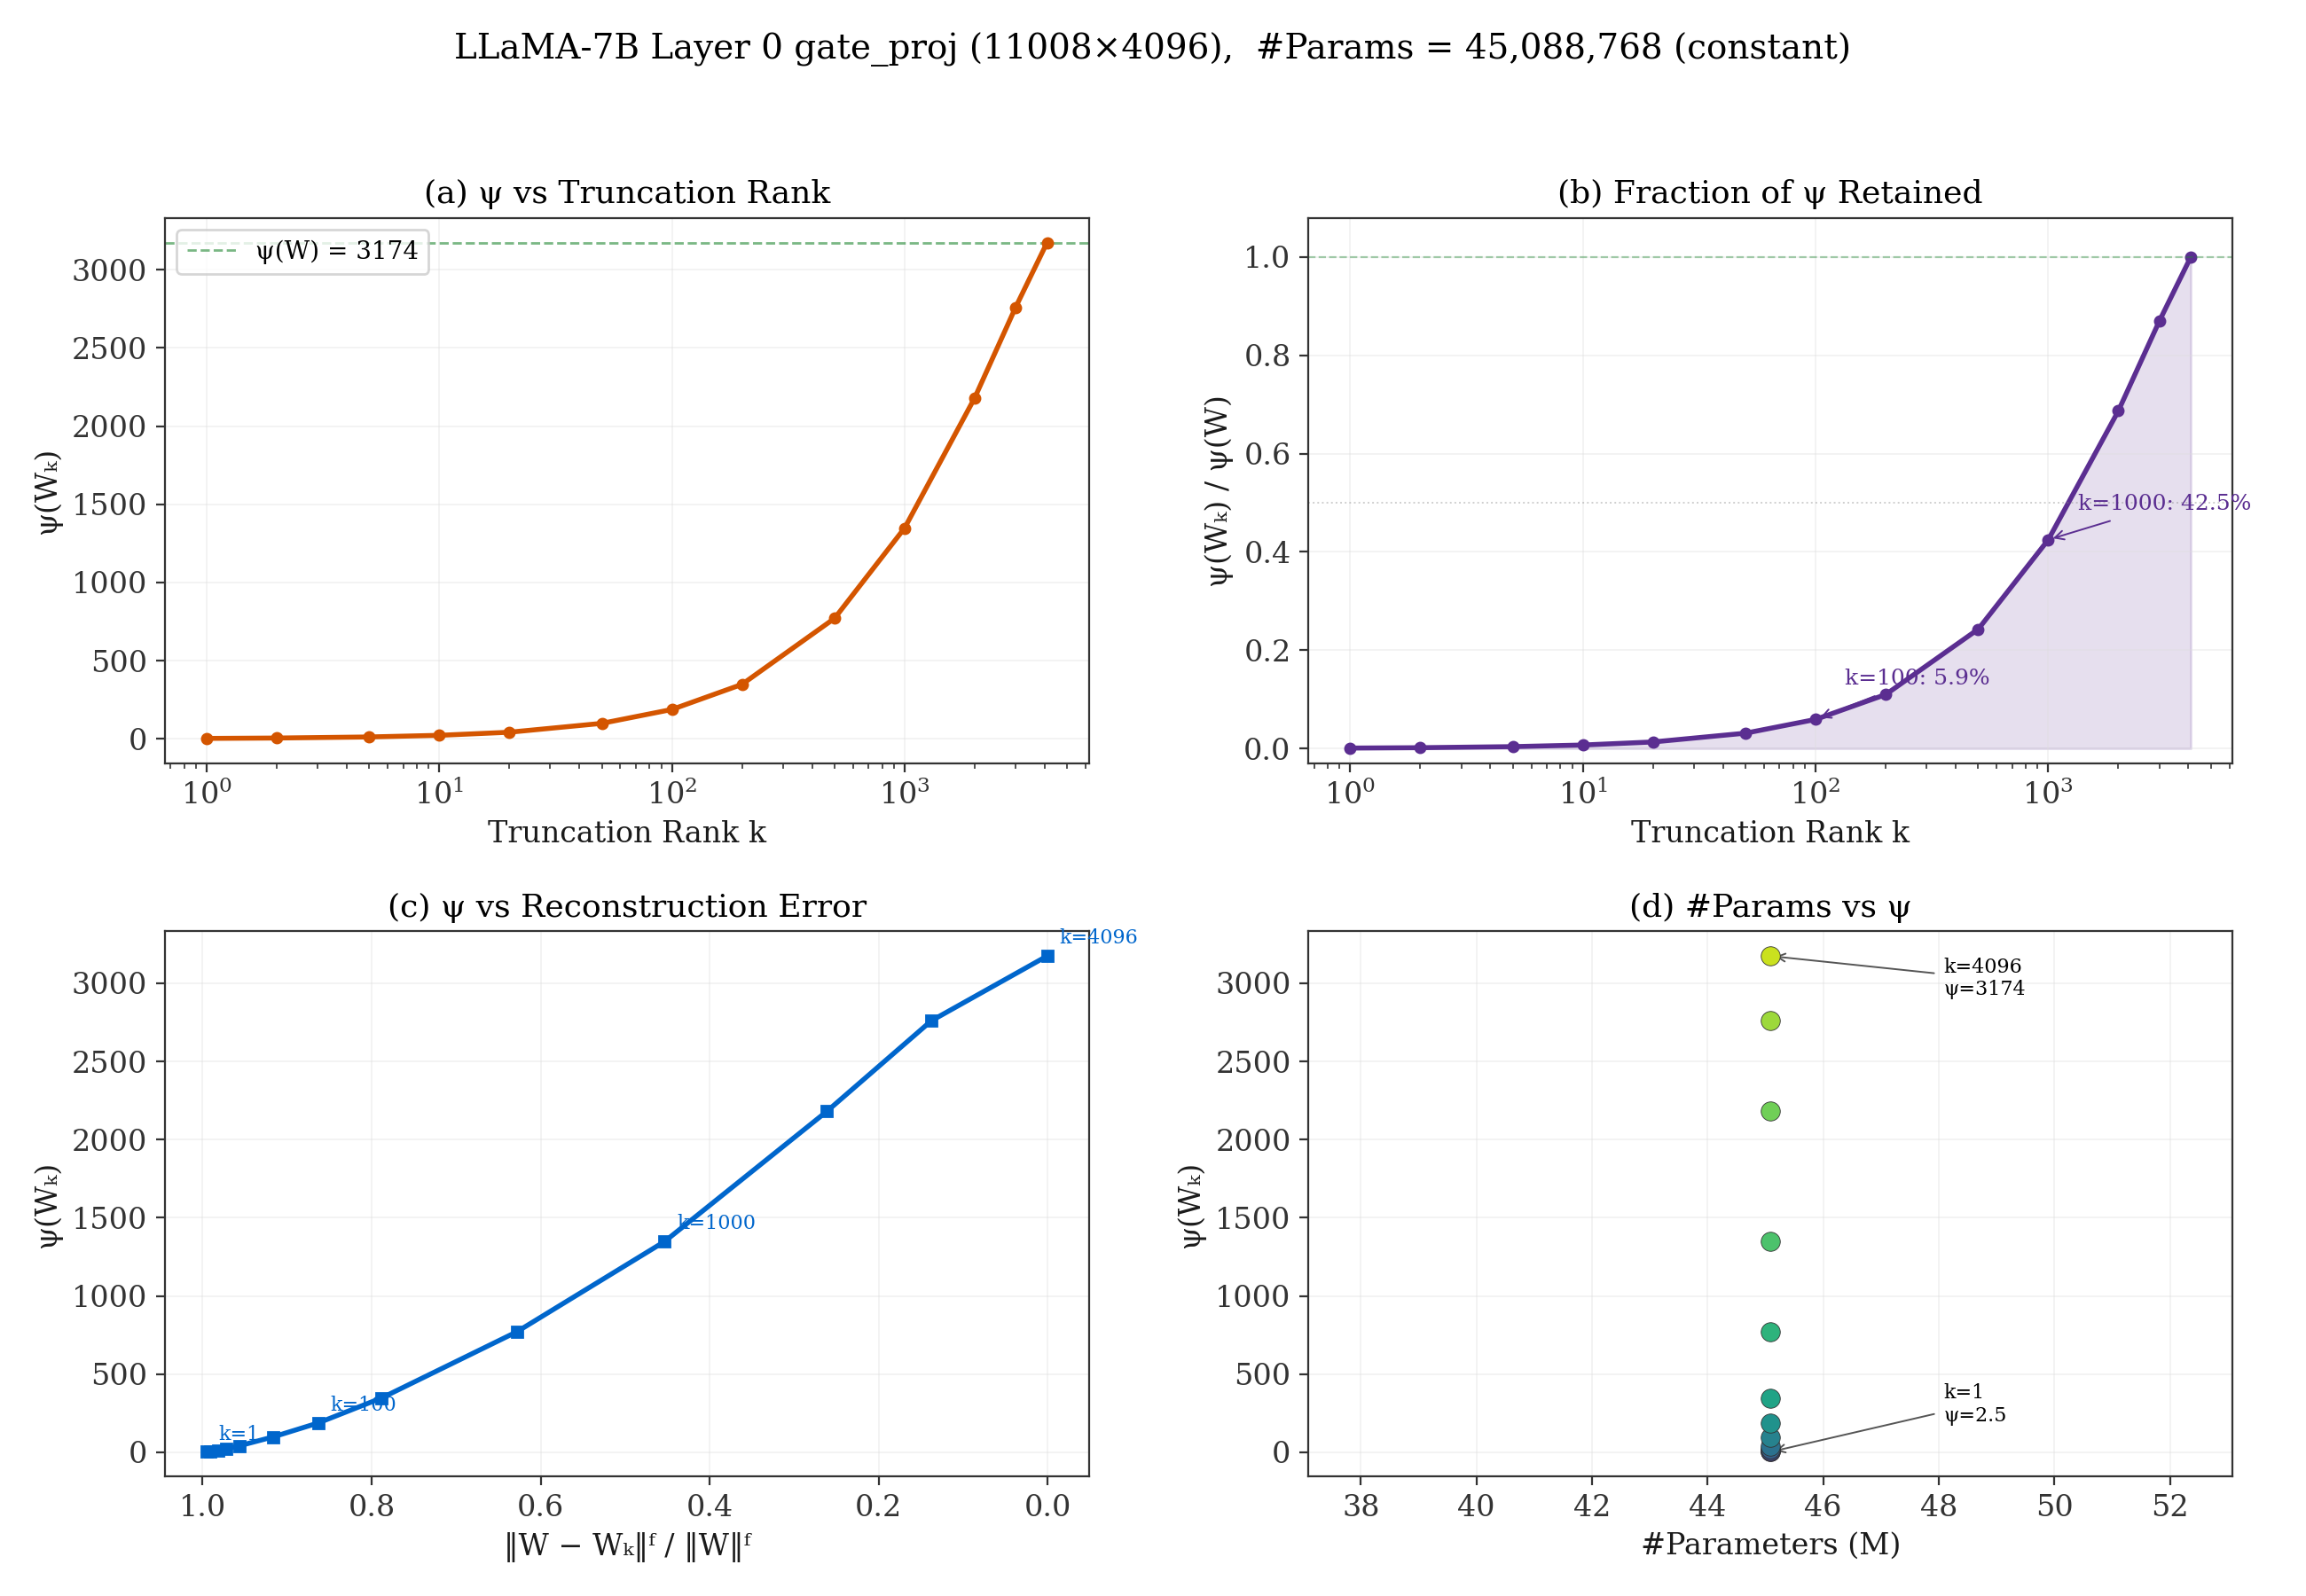
\psi が単にサイズの再パラメータ化ではないことは重要です。LLaMA-7Bの第0層の gate_proj(4096 \times 11008)において、ランク k への切り捨ては全ランクにわたってパラメータ数を \approx 45M に固定したままにしますが、\psi は k に対して単調に変化します;k=1000 ではフル容量の 42.5\% しか保持されません。
結果
著者らは7つのファミリー——FlexiBERT(500のBERTアーキテクチャ、完全な決定空間)、LiteTransformerSearchからの200のGPT-2、AutoFormer-Tinyからの1001のViT、NATS-Bench-SSS CNN、OFAからのMobileNetV3、さらに探索・枝刈り用のTransformer-XLとLLaMA-LoNAS——においてランキング品質を評価しています。
主要な結果はFlexiBERTにおける厳しい予算制約下でのものです:パラメータ数の差が10%未満のアーキテクチャペアに限定した場合、NSCはGLUEスコアに対してKendall \tau = 0.505 を達成しますが、#Paramsは \tau = 0.082 に崩壊します。これはまさに探索において重要なレジームです——固定予算での構造的に異なるアーキテクチャの識別——そこではサイズベースのスカラーが最も機能しません。NSCはまた、順伝播なしに単一CPUコアで計算される一方で、複数のファミリーにわたって #FLOPs とtraining-freeプロキシ(SNIP、GradNorm、W-PCA、ZeroLM)を上回ります。abstractではNSC-DPがTransformer-XLとAutoFormerでのアーキテクチャ探索と、LLaMA-7Bでの構造的枝刈りを処理することが言及されていますが、引用部分はこれら2つの設定の数値結果の前で終わっています。
限界と未解決の問題
- このスカラーはランダム初期化のスペクトル法則の下で定義されています。これは初期化容量を測定するものであり、示された経験的相関を超えて訓練済み性能を追跡するかどうかは、大規模なランク研究のみが答えられる問いです。訓練はスペクトルを構造的な方法(ヘビーテール、有効ランクの崩壊)で変形しますが、init時のスペクトルはこれを捉えられません。
- Attentionは直接的な線形チャネルではありません:\psi はおそらくヘッドごとに \psi(W_Q), \psi(W_K), \psi(W_V), \psi(W_O) を集約しますが、これはsoftmaxの相互作用、位置エンコーディング、あるいは合成 W_Q W_K^\top を捉えることができません。ランキングが依然として機能するという事実は、これらの行列のinit時のスペクトルが個別に情報を持つことを示唆していますが、エンドツーエンドの容量との理論的なつながりは緩いです。
- Kendall \tau = 0.505 は明確な改善ですが、かなりの分散が説明されないままです;NSC-DPは真の目的と不完全に相関するプロキシに対して証明可能に最適となります。
- 等方性入力の仮定は実現された W の知識がない場合に最適ですが、タスクは構造化された入力分布に確率質量を集中させます。データ条件付きの改良は自然な次のステップです。
なぜこれが重要か
閉じた形式の加算的でデータフリーな容量スコアは、予算制約下でのアーキテクチャ探索をblack-box最適化から、数秒で大域的最適解を持つナップサックDPへと変換します。\psi が単なるプロキシであるとしても、有用なプロキシに対する厳密な最適化は、わずかに優れたプロキシに対する近似的な探索とは本質的に異なるツールです。特に候補アーキテクチャのインスタンス化が禁止的にコストの高いLLMスケールにおいてはなおさらです。
Source: https://arxiv.org/abs/2609.23087
ExplorationBench: AIシステムの検証可能な異世界における探索能力の測定
問題設定
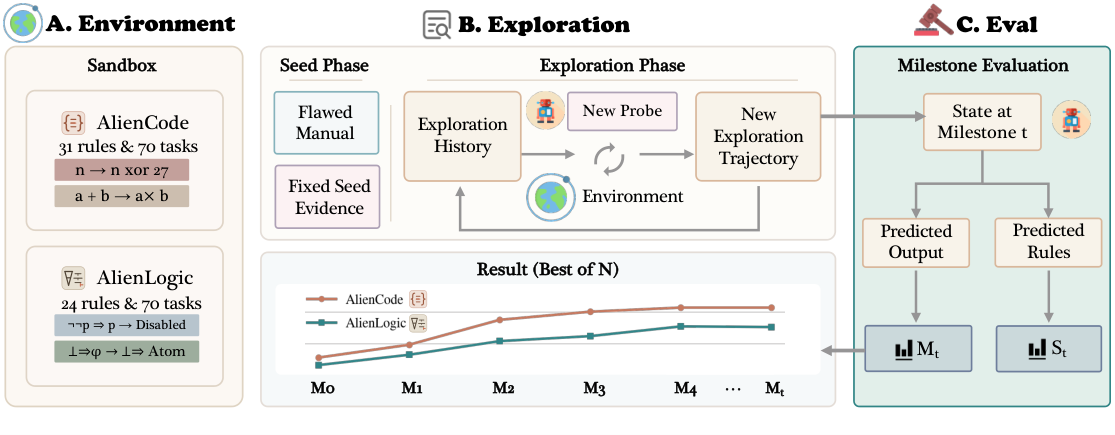
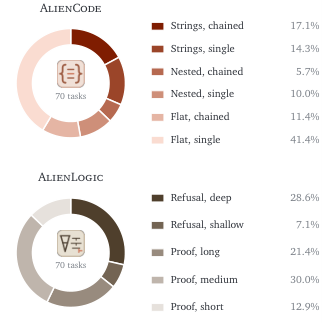
AIシステムが情報を想起するのではなく発見できるかどうかを評価することは困難です。実際の科学から抽出されたベンチマークは事前学習データに漏洩しており、物理世界に関する仮説には安価なグラウンドトゥルースが存在しません。ExplorationBenchは、決定論的な「異世界(Alien Worlds)」を構築することでこの両問題を回避しています。その規則は実行可能(つまり答えをビット単位で検証できる)であり、かつ意図的に馴染みのあるセマンティクスから逸脱するよう摂動されています(つまり事前知識が誤った方向に導く)。このベンチマークは二つのサンドボックスで構成されています:AlienCode(31の発見ターゲット、70のホールドアウトタスク)とAlienLogic(24のターゲット、70のタスク)です。
セットアップとタスク定式化
1つのエピソードはタプル (\mathcal{E},\mathcal{R},\mathcal{M},\mathcal{D},\mathcal{T}) として定義されます:
- \mathcal{E}:摂動された規則集合 \mathcal{R} に支配された、隠された決定論的サンドボックス。
- \mathcal{M}:標準的な(摂動なしの)セマンティクスを記述する欠陥のある公開マニュアル — すなわち、重要な \mathcal{R} の部分について体系的に誤った記述をしている。
- \mathcal{D}:全システムで共有される固定の作業例。
- \mathcal{T}:各サンドボックスにつき70個の未見ホールドアウトタスク。
システムはサンドボックス固有のツールコールスキーマを通じて \mathcal{E} にクエリできますが、\mathcal{R} を直接参照することはできません。\mathcal{M} や事前学習の事前知識を信頼するシステムは、摂動されたサブセットで正確に失敗します。\mathcal{E} は実行可能であるため、すべてのホールドアウトの答えはグラウンドトゥルースに対して厳密に検証されます。
探索は三つの連関するスキルに分解されます:(i) プローブ選択 — 情報量の多いインタラクションの設計;(ii) 報告された発見 — システム自身が推論した規則のまとめ;(iii) 規則の活用 — 推論された規則のもとでのホールドアウトタスクの正確性。パラメータの更新は行われず、すべての学習はin-contextで行われます。
軌跡は四回の探索ラウンドで構成され、システムは五つのチェックポイント M_0,\ldots,M_4 でスコアリングされます(M_0 はマニュアルのみで探索なし)。各タスクはマイルストーンごとに三回答えられ、単発スコアではなく平均が算出されます。各システムはサンドボックスごとに n{=}3 の独立した軌跡を実行します。最先端の10システムが、それぞれ最高の推論設定で評価されます。
条件:推論から探索を分離する
良いプローブを選択することとプローブ結果を活用することを切り離すために、ExplorationBenchは M_4 において五つの条件を比較します:
- Autonomous(Best@3軌跡):システムが自分自身でプローブを選択する。
- Hindsight:同じ軌跡のプローブ結果が再生されるため、探索コストを払わずに完全な証拠をもとに回答が行われる。
- Fixed-probe(一致したボリューム):全システムが同一の、モデル非依存なプローブセットを比較可能なサイズで受け取る — これにより規則活用能力が分離される。
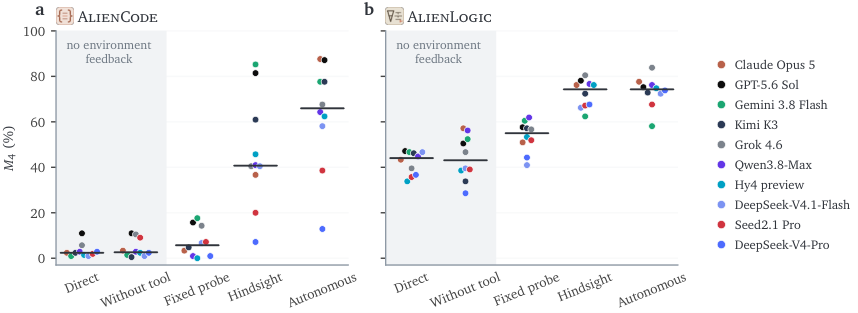
autonomousとhindsightの差は、プローブ選択の不良によって失われる正確度を定量化します。fixed-probeとautonomousの差は、共有ベースラインに対してシステム自身のプローブがどれだけ有益または有害であるかを定量化します。10システム全体を通じて、autonomousの性能は広い分散を示しており、中央値はhindsightを大幅に下回っています。これは現在のシステムが規則を探索するよりも発見した規則を適用する方が得意であることを示しています。fixed-probeの中央値はautonomousの中央値より高く、証拠が一致したボリュームでシステムに提供されると、探索が弱いシステムも大部分の差を埋められることを意味しています — ボトルネックは証拠からの推論ではなくプローブ設計にあります。
知見
- 最も強力なシステムは未知の規則を真に習得・適用できます:M_4 のホールドアウト正確度が M_0(マニュアルのみ)のベースラインを大幅に上回り、改善が事前知識ではなく証拠によって駆動されていることが確認されました。
- 同一の証拠を受け取った場合(fixed-probe)でも、システム間で性能は大きく異なります。したがって、固定された観測コーパスからの規則推論自体が、多くのシステムにとってプローブ予算だけでなくボトルネックとなっています。
- hindsight–autonomousの差が分散の主要な原因です:多くのシステムが冗長または情報量の少ないプローブを生成しており、より強力なシステムのプローブを再生することで弱いシステムのスコアが大幅に向上します。
- 二つのサンドボックスは異なる構造的事前知識を持っているため(AlienCode:プログラム的実行;AlienLogic:シンボリック推論)、あるシステムのサンドボックス間での一貫性は、ドメインの適合ではなく一般的な探索能力の指標となります。
制限と未解決の問題
摂動は手作業で設計されており有限(31 + 24ターゲット)であるため、ExplorationBenchの摂動のスタイルに過剰適合したシステムは時間とともに不当な優位性を得る可能性があります — 異世界は定期的に入れ替える必要があります。評価はin-contextのみであり、システムが発見した規則を重みや長期記憶に蒸留できるかどうかは測定されません。プローブコストは情報量の収率ではなく数で測定されるため、安価なプローブを多数発行するシステムは、情報量の多いプローブを少数設計するシステムと同等にスコアリングされます。さらに、「報告された発見」という指標はシステムが推論を言語化することに依存しており、探索能力と内省的報告能力を混同しています。
この研究の意義
ExplorationBenchは、実行可能なグラウンドトゥルースを用いて想起と発見の区別を操作化しており、これはほとんどの「AIによる科学」ベンチマークに欠けていた要素です。autonomous対hindsight対fixed-probeという条件設計により、プローブ選択が測定可能なスキルとして分離されており、科学的な環境における現在の最先端システムの主要な弱点が、証拠からの演繹的推論ではなく、どの証拠を収集するかの選択にあることが示されています。
Source: https://arxiv.org/abs/2609.30199
ワールドモデルにおける物体恒常性の訓練
動画生成モデルはますますワールドモデルとして位置付けられるようになっていますが、Spelke流の認知プリミティブ——物体恒常性(OP)および物体堅牢性(OS)——をエンコードしているかどうかについては、ほとんど検証されていません。本論文はWROP(World Reasoning with Object Permanence)を提案します。これは150個の手設計されたBlenderジェネレータを基に構築された合成コーパスおよびテストであり、14の動画モデルのベンチマーク評価と、概念を訓練によって習得できることを示す16Bのベースライン(PWM-WROP)のfine-tuningの両方に用いられています。
タクソノミーとジェネレータの設計
WROPは、発達認知科学(SpelkeおよびKinzler;Baillargeon)から引き出された2つの軸に沿ってジェネレータを整理しています:90個のOPジェネレータと60個のOSジェネレータであり、6つのファミリーにグループ化されています——動的遮蔽、静的シーン遮蔽、容器による隠蔽・移動(OP)、および妨害、支持除去、衝突(OS)です。
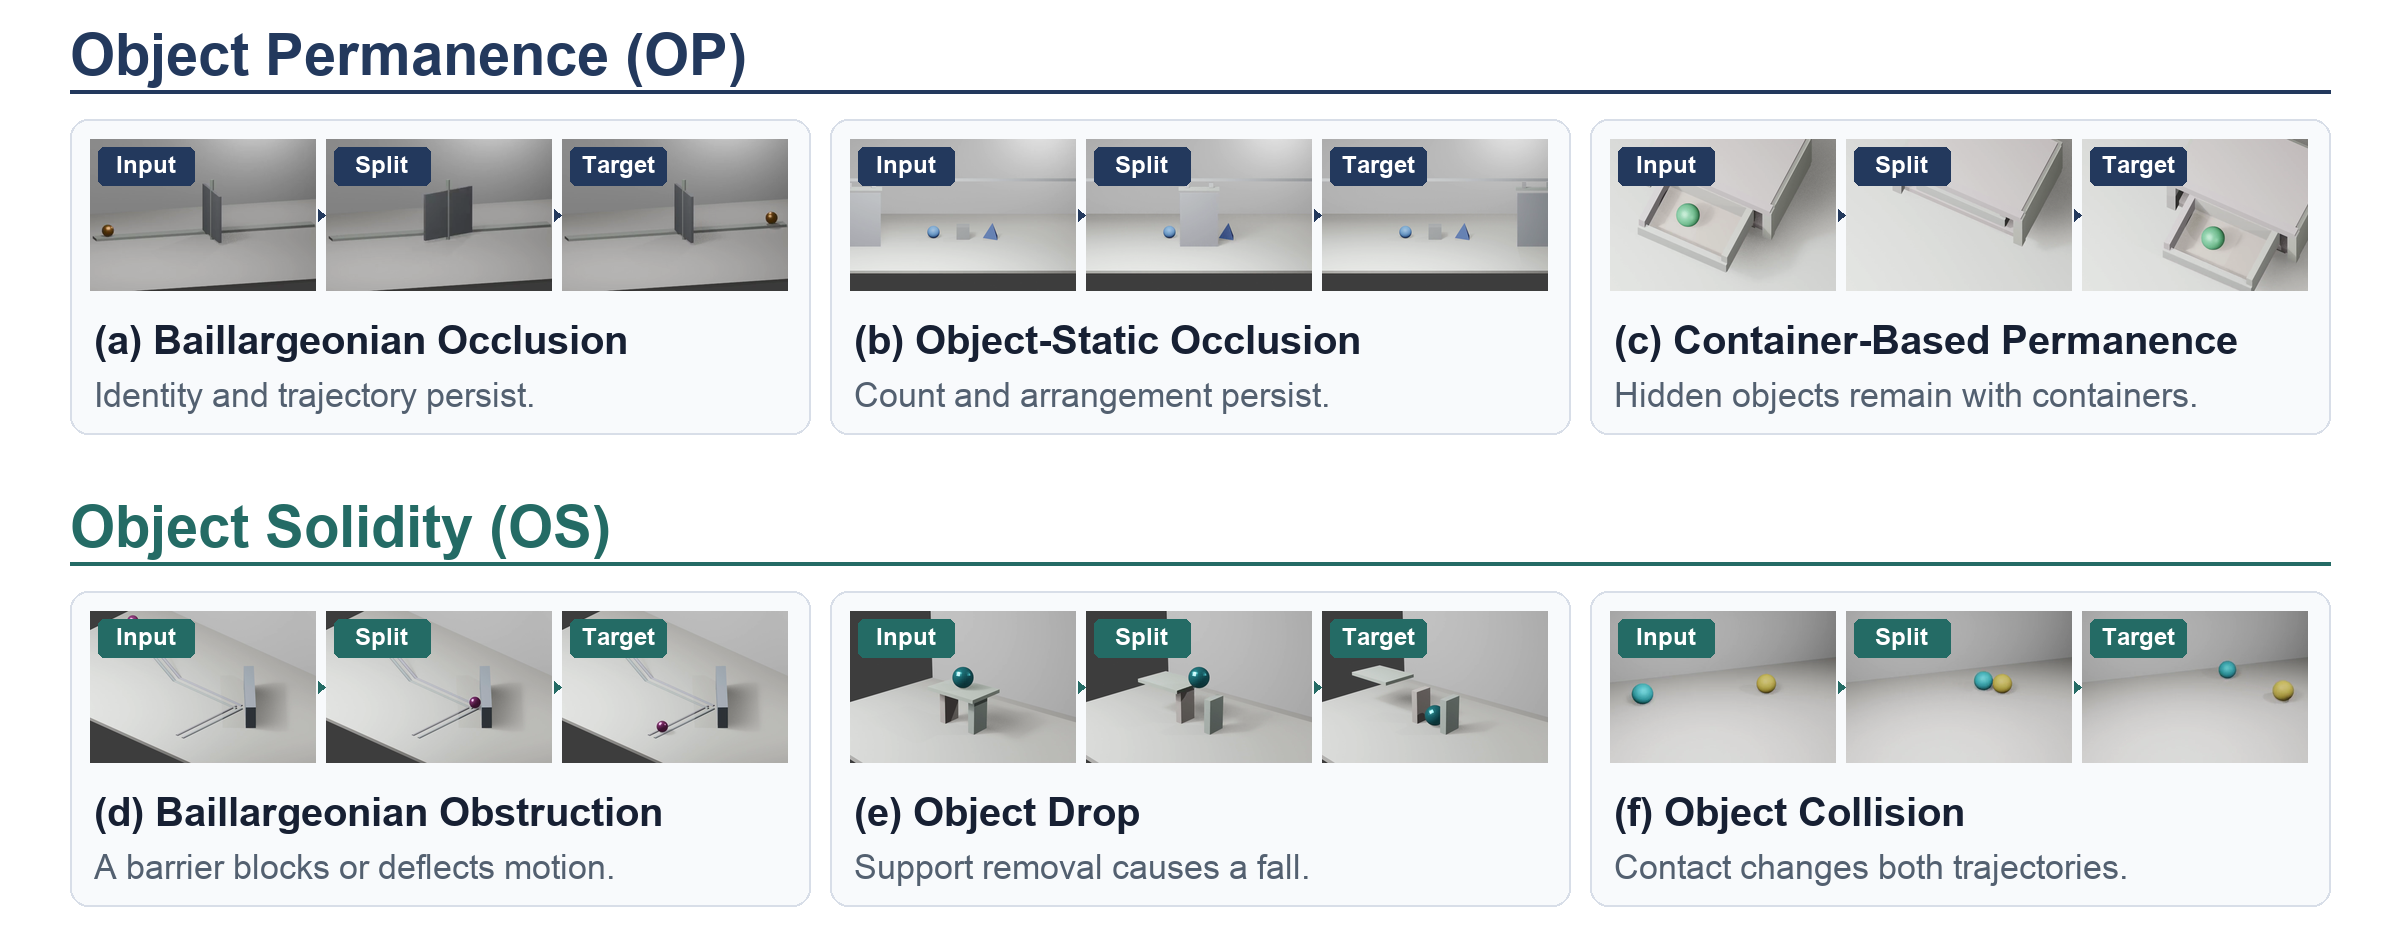
各ジェネレータは、重要な物理的イベントが時間的中間点以降に始まるようにサンプルを生成します。これはvideo-to-video(V2V)の枠組みと自然に整合しています:前半は条件付けに用いられ、後半は予測されなければならず、因果的遷移は予測ウィンドウの中に位置しています。2つのパラメータセットは目的によって分けられています:
- 構造パラメータ(物体数、軌道トポロジー、遮蔽物の不透明度、遮蔽時間、接触タイミング、開口部サイズ)は、物理的・認知的課題を制御し、単一の結果の記憶を防ぐためにサンプル間で変化させます。
- 表面レベルパラメータ(色、材質、照明、カメラポーズ)は、モデルが知覚的ショートカットを利用するのを防ぐために独立してランダム化されます。
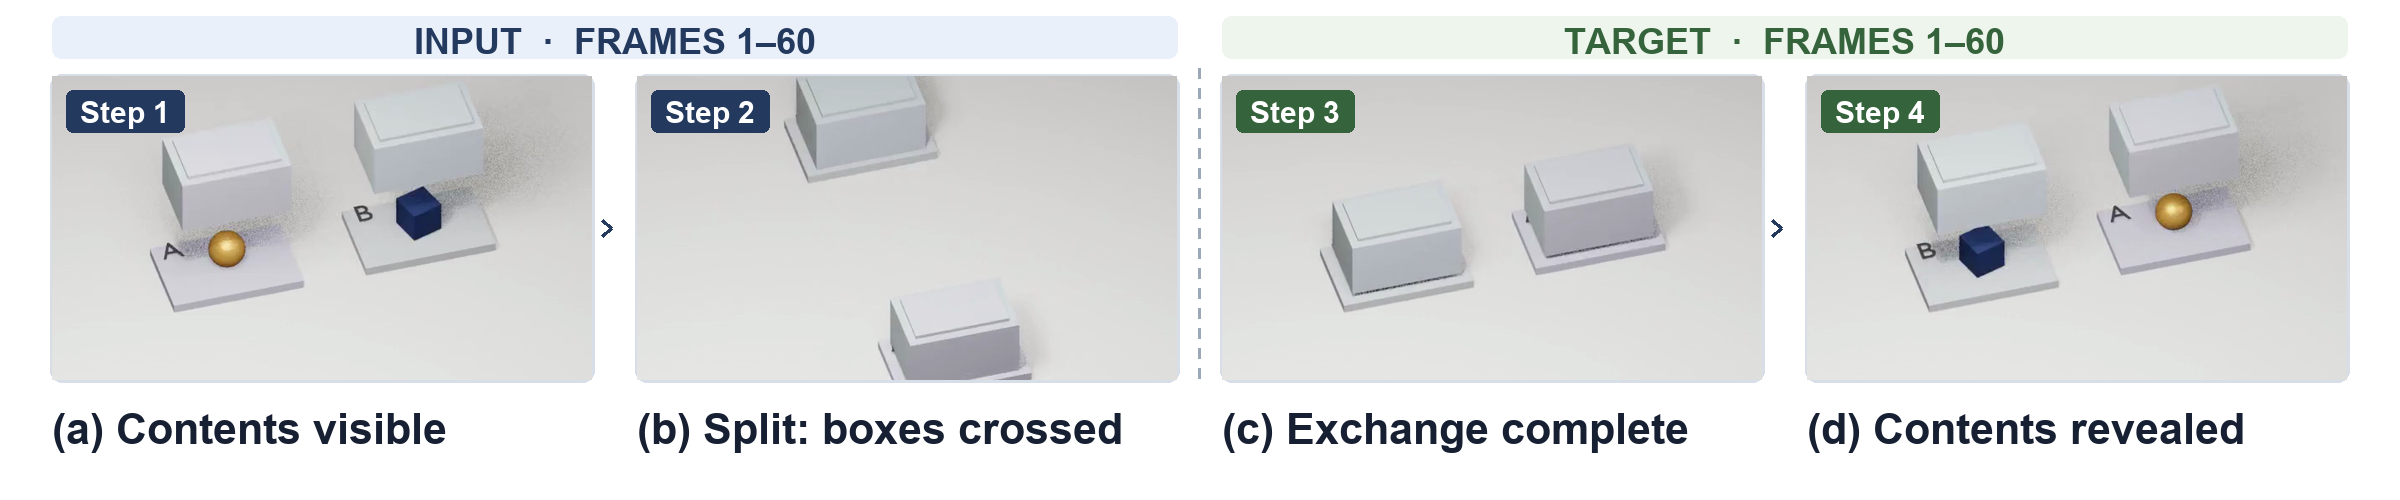
ジェネレータの例であるMarked_Boxes_Swap(OP-3、容器恒常性)は、物理的なスワップを通じて隠された物体のアイデンティティをマークされた容器に対応付け、最後に正しく明らかにすることを要求します——完全な遮蔽と位置更新を経た持続的アイデンティティ表現の直接的なテストです。
公開されたコーパスは、150万サンプル(タスクごとに1万サンプル以上)と300問のテストを含んでいます。
PWM-WROP:ベースラインに恒常性を訓練する
PWM-WROPはCosmos3-Nano(16B)のfine-tuneであり、アーキテクチャもtokenizerも変更されておらず、訓練シグナルのみが変更されています。訓練にはV2V枠組み自体を使用します:320\times192の117フレームのパックされたクリップを57フレームの条件付けフレームと60フレームの予測フレームに分割し、各サンプルの自然言語プロンプトをテスト条件付けとして使用します。タスクラベルやファミリー名は提供されず、モデルはクリップの物理のみから認知構造を抽出しなければなりません。訓練は同一の150ジェネレータの以前のレンダリングから得られた150万サンプルに対して1エポック行われます。
訓練インフラ(チェックポイントとともに公開されるPWM)はAWS Trainium2向けのネイティブPyTorchスタックです。36層のモデルはtensor-parallel \times FSDP2のメッシュ(64 NeuronCores)にシャーディングされており、ブロックごとの静的形状コンパイルを行い、バッチ16・288\times512のジオメトリで5.7秒/ステップを達成しています——初期の15.1秒/ステップから大幅に削減されています。
評価と結果
主要メトリクスは、300問テストに対するブラインドペアワイズ比較による人間の選好であり、Bradley–Terryでfitされ、Eloの平均が1500になるよう再スケールされています。20名の評価者が14システムにわたって361件のペアワイズ判断(モデルごとに50〜52件)を行い、3種類のインターフェースクラス(真の継続、reference-to-video(R2V)、編集・転送)にまたがって評価しています。信頼区間は1,000回の評価者クラスタブートストラップリサンプルから算出されています。
リーダーボードの主要な数値:
- Wan 3.0 Prime と MiniMax H3(いずれもR2V)はElo 1723.6・スコア率77.9%で同率1位。
- PWM-WROP(真の継続)は1679.5 [1603.5, 1781.5]・スコア率73.1%で3位。
- Seedance 2.5(R2V)は1649.6で4位。
- 次の真の継続モデルである Grok Imagine(video extend) はPWM-WROPより224 Elo低い1457。
- LTX-2.3 Extend(1453)と MAGI-1 24B(1248)がその他の継続モデル。
- 編集・転送システム(Runway Aleph 2、Wan-VACE 14B、Gemini Omni Flash 1.1、Kling O3 Pro、Cosmos3 Super、LTX-2.3 Dev、HY-OmniWeaving)はElo 1400〜1520付近に集中。
2つの構造的な観察が続きます。第一に、R2Vシステムが優勢であることは、おそらく最終入力フレームから延長するよう制約されず、独自のタイムラインで継続を再生成するためであり——物理的に整合した結果を生成する自由度が高い反面、入力のアイデンティティや配置を時として上書きしてしまうコストがあります(例:G19、OP-2およびG27、OS-2におけるSeedance 2.5の失敗)。第二に、そして本論文の中心的主張においてより重要なこととして:概念特化型合成fine-tuningが格差を実質的に縮小しています。アーキテクチャを変更せず、WROPのV2Vシグナルのみを用いたPWM-WROPの、次の継続システムに対する224 Eloのリードは、物体恒常性と堅牢性の挙動が創発のみを待つものではなく、訓練可能であることの証拠です。
限界と未解決問題
テストは300問であり、モデルごとの判断数(50〜52件)は幅広い重複したCIをもたらします——上位(Wan 3.0 Prime、MiniMax H3、PWM-WROP)のランク差は信頼区間の範囲内です。コーパスは完全にBlender合成であり、訓練された恒常性が実世界の動画分布に転移するかどうかは未検証です。PWM-WROPはテストに使用されたものと同じ150ジェネレータのレンダリングでfine-tuningされており(独立したランダム化があるとはいえ)、何らかのin-distributionの優位性は避けられません。fine-tuningされた継続ベースモデルは1つのみであり、改善がアーキテクチャをまたいで一般化するかどうかは不明です。フルリファレンスメトリクスは副次的に報告されていますが、ここでは分析されていません;それらとEloの一致は、評価者が物理的正確性を追っているのか知覚的忠実度を追っているのかを明確にするでしょう。
この研究の意義
WROPはワールドモデルに対する発達心理学スタイルのプローブを操作化し、標的を絞った150万サンプルの合成コーパスが、物理推論タスクにおいて16Bの継続モデルを最高の商用R2Vシステムと競合するレベルに引き上げられることを示しています。これは物体恒常性を、待ち望むものではなく、訓練するものとして再定義しています。
Source: https://arxiv.org/abs/2609.28654
OmniEcho: 身体化エージェントのための空間音声理解
問題設定
身体化エージェントは通常マルチチャンネル音声にアクセスできますが、vision-languageモデルやオムニモーダルモデルは音声をモノラルのセマンティックストリームとして扱い、到来方向の手がかりを捨て去っています。これは、音源が画面外にある場合や視野に出入りする場合に特に問題となります。これらのケースでは視覚だけでは不十分であり、人間はバイノーラル・空間聴覚に頼っています。本論文は二つのギャップを主張しています:(i) 実際の一次アンビソニクス(FOA)録音を用いた身体化設定における空間音声推論を単独で評価する厳密なベンチマークが存在しない、(ii) 既存のオムニモデルにはFOAの空間構造を保持するencoderパスウェイが欠けている、という点です。
ベンチマーク:OmniEchoBench
OmniEchoBenchは、知覚QAスイートとナビゲーションスイートに分かれています。
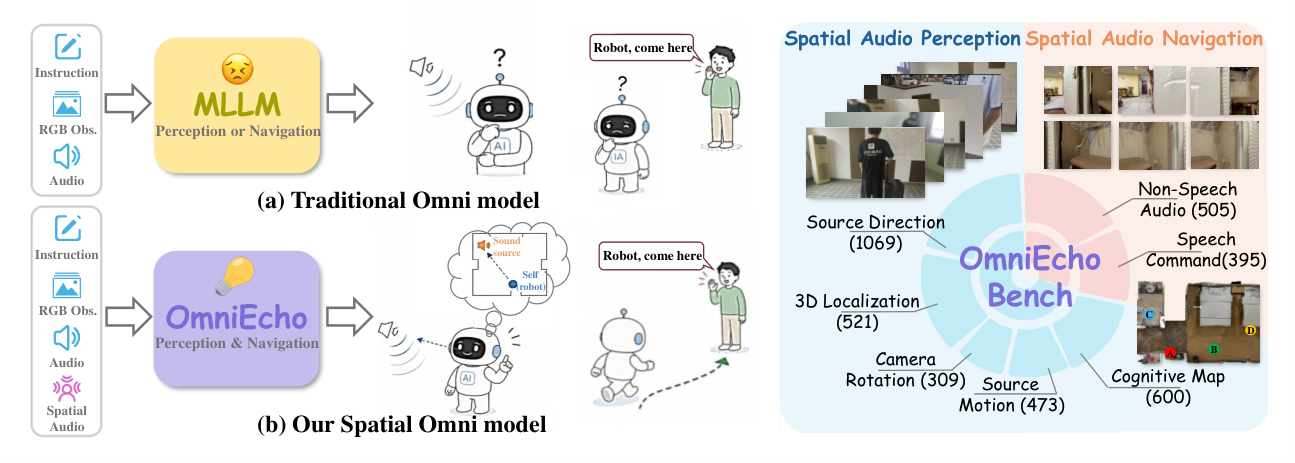
OmniEchoBench-QAは、実世界の197シーンにわたる2,972のQAペアを含んでおり、脚本のある人間のパフォーマンスから録音されています。各テイクは同期して、(a) 一人称単眼視点映像、(b) アノテーションにのみ使用される360°パノラマ映像、(c) ACN/SN3D規格による4チャンネルFOA音声として収録されています。アノテーターはパノラマをグラウンドトゥルースとして使用し、2Hzで録音デバイスに対する相対的な密な時空間軌跡を持つアクティブ音源にラベルを付けます。その後、質問はルールベースのサンプリングによって生成されます。
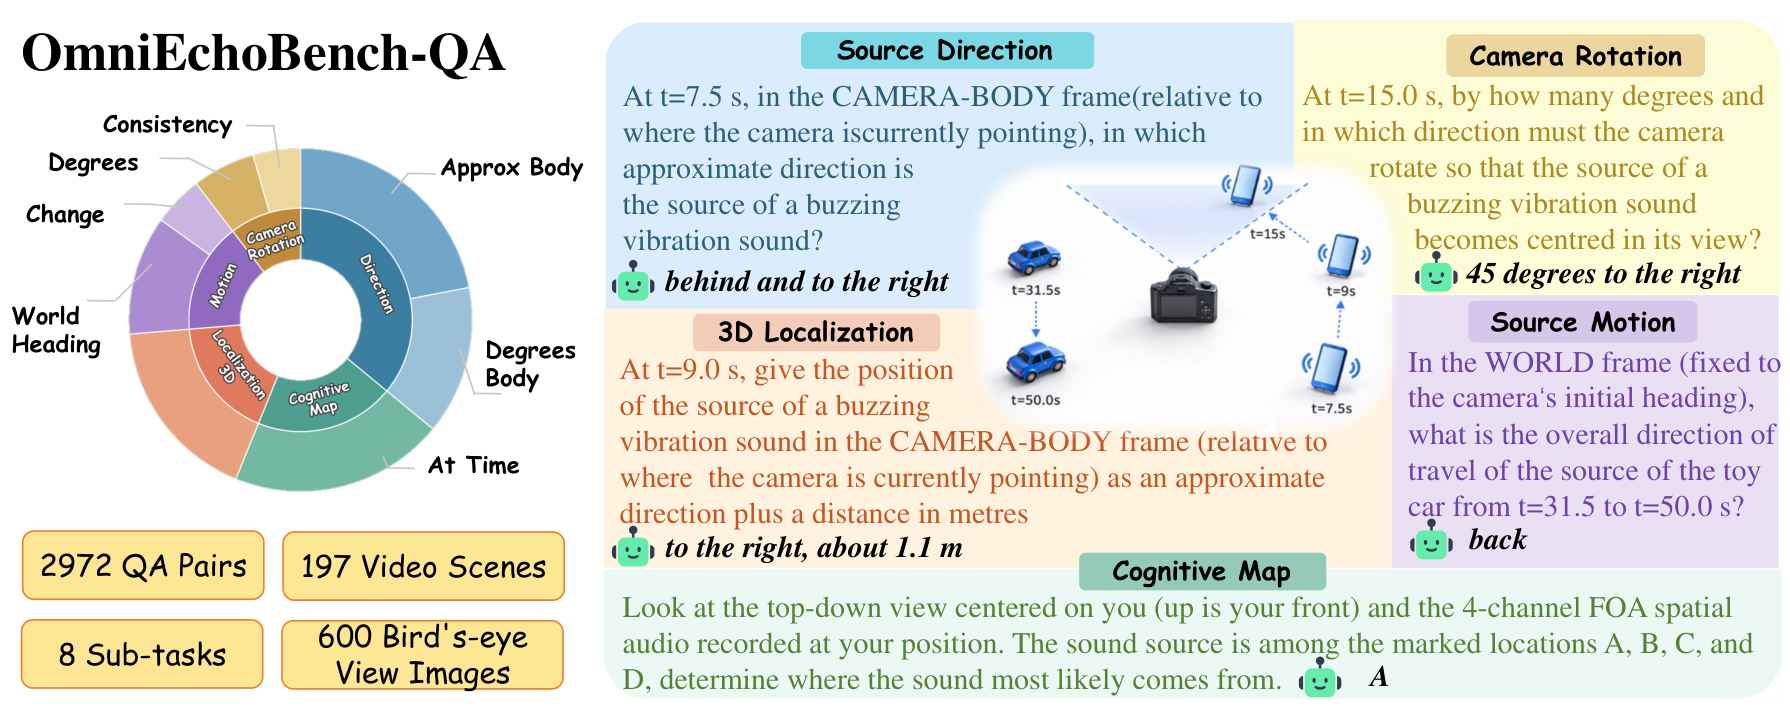
知覚サブセット(2,372 QA)は、音源方向(1,069)、3D位置推定(521)、音源の動き(473)、カメラ回転(309)を評価します。別の600-QAサブセットは、エージェントの前進方向に「上」が揃ったエゴセンタードな俯瞰(BEV)マップを提示し、共同配置されたFOAが与えられた状態で4つの候補音源位置{A,B,C,D}の中から選択させます。このBEVサブセットは、シーンの視覚的セマンティクスが事実上除去されているため、空間聴覚と認知マップを統合する最もクリーンなテストとなっています。
OmniEchoBench-Navは、30の実環境にわたる900のナビゲーションタスクから構成されています。各判断ステップにおいて、エージェントは言語指示 L、前方カメラからの T フレーム(現在のフレームと T-1 個の一様サンプリングされた過去のキーフレーム)、および現在のFOAウィンドウ A_t を受け取り、InternNavプロトコルに従って次の K=8 ステップの軌跡を予測します。
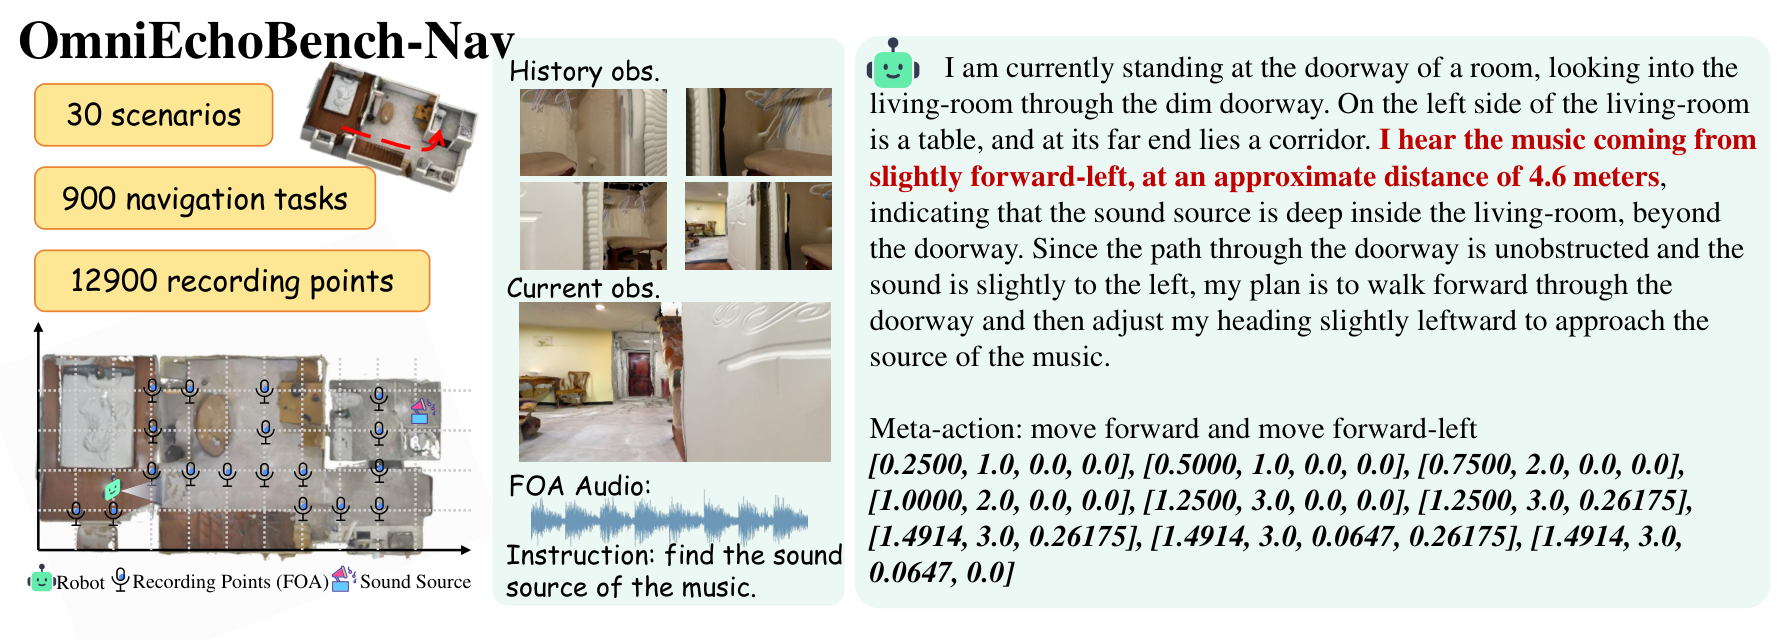
訓練データをスケールするために、著者らは音源位置、エゴセントリックな視覚観測、エージェント軌跡にわたって幾何学的整合性を保つ、制御可能なFOAレンダリングパイプラインを構築し、合成audio-visual QA、audio-only、サウンドガイドナビゲーションデータを生成しています。合計で363,193の訓練サンプルが得られています。
手法
OmniEchoはQwen3-Omni-30B-A3B(Thinkerバリアント)上に構築されています。主要なアーキテクチャの追加点は、既存のセマンティック音声パスウェイと並列に動作する専用FOA空間encoderです。FOA音声はモノラルのダウンミックスとは異なり、SN3D正規化のもとでの零次および一次球面調和関数である W, X, Y, Z チャンネルを通じて方向情報を持ちます。これが空間encoderが保持を意図するものです。
具体的には、セマンティックencoderは通常の音声トークン(コンテンツ、音声、イベントクラス)を引き続き生成する一方、FOA encoderは空間トークンを出力し、学習可能なprojectorがそれをLLMのembedding空間にマッピングします。空間トークンは対応するセマンティック音声トークンの直後に挿入されるため、各時間的音声チャンクは視覚トークンと並んで(セマンティック、空間)トークンのペアバンドルを言語ストリームに提供します。
統一されたタスクの定式化は以下の通りです:
- 知覚:FOA A、映像 V または画像 I、および質問 q が与えられた状態で、回答 a を生成する。
- ナビゲーション:指示 L、フレーム列 \{V_{t-T+1}, \dots, V_t\}、およびFOA A_t が与えられた状態で、長さ K{=}8 の軌跡を生成する。
訓練には、空間audio-visual QAと、ScaleVLN(139,142)、RxR(92,418)、R2R(31,577)、VLN-PE(28,969)から取得したVLN教師データが使用されます。ステージ3の訓練は32基のA100 GPU上で約4日間実施されます。
結果
本論文は、6つのタスクタイプ(音源方向、3D位置推定、音源の動き、カメラ回転、BEV位置推定、ナビゲーショングラウンドQA)にわたるOmniEchoBench-QAにおいて最先端の性能を報告しています。また、サウンドガイドナビゲーションについては、OmniEchoがOmniEchoBench-Navおよび VLN-CE R2R val-unseenスプリットにおいて競合性能に達しています。アブストラクトでは、OmniEchoが空間音声グラウンディングを追加しつつ、強力なVLNベースラインと同等の「性能水準に達した」と述べられていますが、提供されたセクションにはタスクごとの具体的な数値は含まれていません。
限界と未解決の問題
- FOAは一次のみ:仰角およびフロント/バックの曖昧さは一次アンビソニクスの既知の弱点であり、ベンチマークのBEVタスクは2Dで動作することでこれを部分的に回避している可能性があります。
- 実世界のシーン数が少ない:QAでは197シーン、ナビゲーションでは30シーンのみです。室内音響の多様性(残響、遮蔽)は抜粋中では特徴付けられていません。
- レンダリングされた訓練データは幾何学的に整合した伝播を仮定しており、残響、回折、移動音源に関するsim-to-realギャップはここでは定量化されていません。
- アノテーションは2Hzであり、動きとカメラ回転の質問の時間分解能が制限されています。
- FOA encoderは機能的に説明されていますが、その帰納バイアス(例:強度ベクトルまたは擬似強度特徴を活用しているか、回転不変性を持つか)は提供されたセクションでは明示されていません。
意義
空間音声は現在の身体化VLMにおいて最も明白な欠落モダリティであり、画面外の音こそが視覚のみのエージェントが失敗する場面です。(i) 実際のFOA録音を使用し、(ii) 視野外の音源に関する推論を強制し、(iii) 知覚とナビゲーションを結合するベンチマークは、オムニモーダルアーキテクチャがモノラルセマンティック音声を超えて進化するための具体的な目標を与えます。
Source: https://arxiv.org/abs/2609.23407
Agent-Editing World Model: LLMエージェントのためのWorld Modelingの再考
問題設定
言語モデルによるworld modelはこれまで主に観測予測器として定式化されてきました。すなわち、履歴 h_t と提案された推論–行動 (\hat r_t, \hat a_t) が与えられたとき、s_t = h_t \oplus (\hat r_t, \hat a_t) として \mathcal{M}_\text{obs}(o_t \mid s_t) を学習するというものです。しかし、実際のツール(検索、シェル、コード実行)を呼び出すLLMエージェントにとって、この目標は本質的にずれています。ツールの応答は高エントロピーかつ実行依存であり、それを再構成することは困難であり、推論時に実際の環境が利用可能であることを考えると大部分が冗長です。著者らが主張するより深刻な失敗モードは、タスク状態の汚染です。すなわち、根拠のない仮説、陳腐化した計画、そして早計な「完了」状態がターンをまたいで持続し、局所的に尤もらしい後続ステップによって増幅されてしまいます。根拠付けられた観測はこれを解決しません。問題はエージェントがそれらをどのように内部的に解釈するかにあり、そこでドリフトが生じます。
Agent-Editing World Model(AEWM)は、目標を o_t から「(\hat r_t, \hat a_t) が将来のタスク進捗をどのように形成するか」へと再定式化し、そのモデルを用いて推論–行動の継続を実行前に編集します。
手法
AEWMは2つの能力と1つの推論時統合から構成されます。
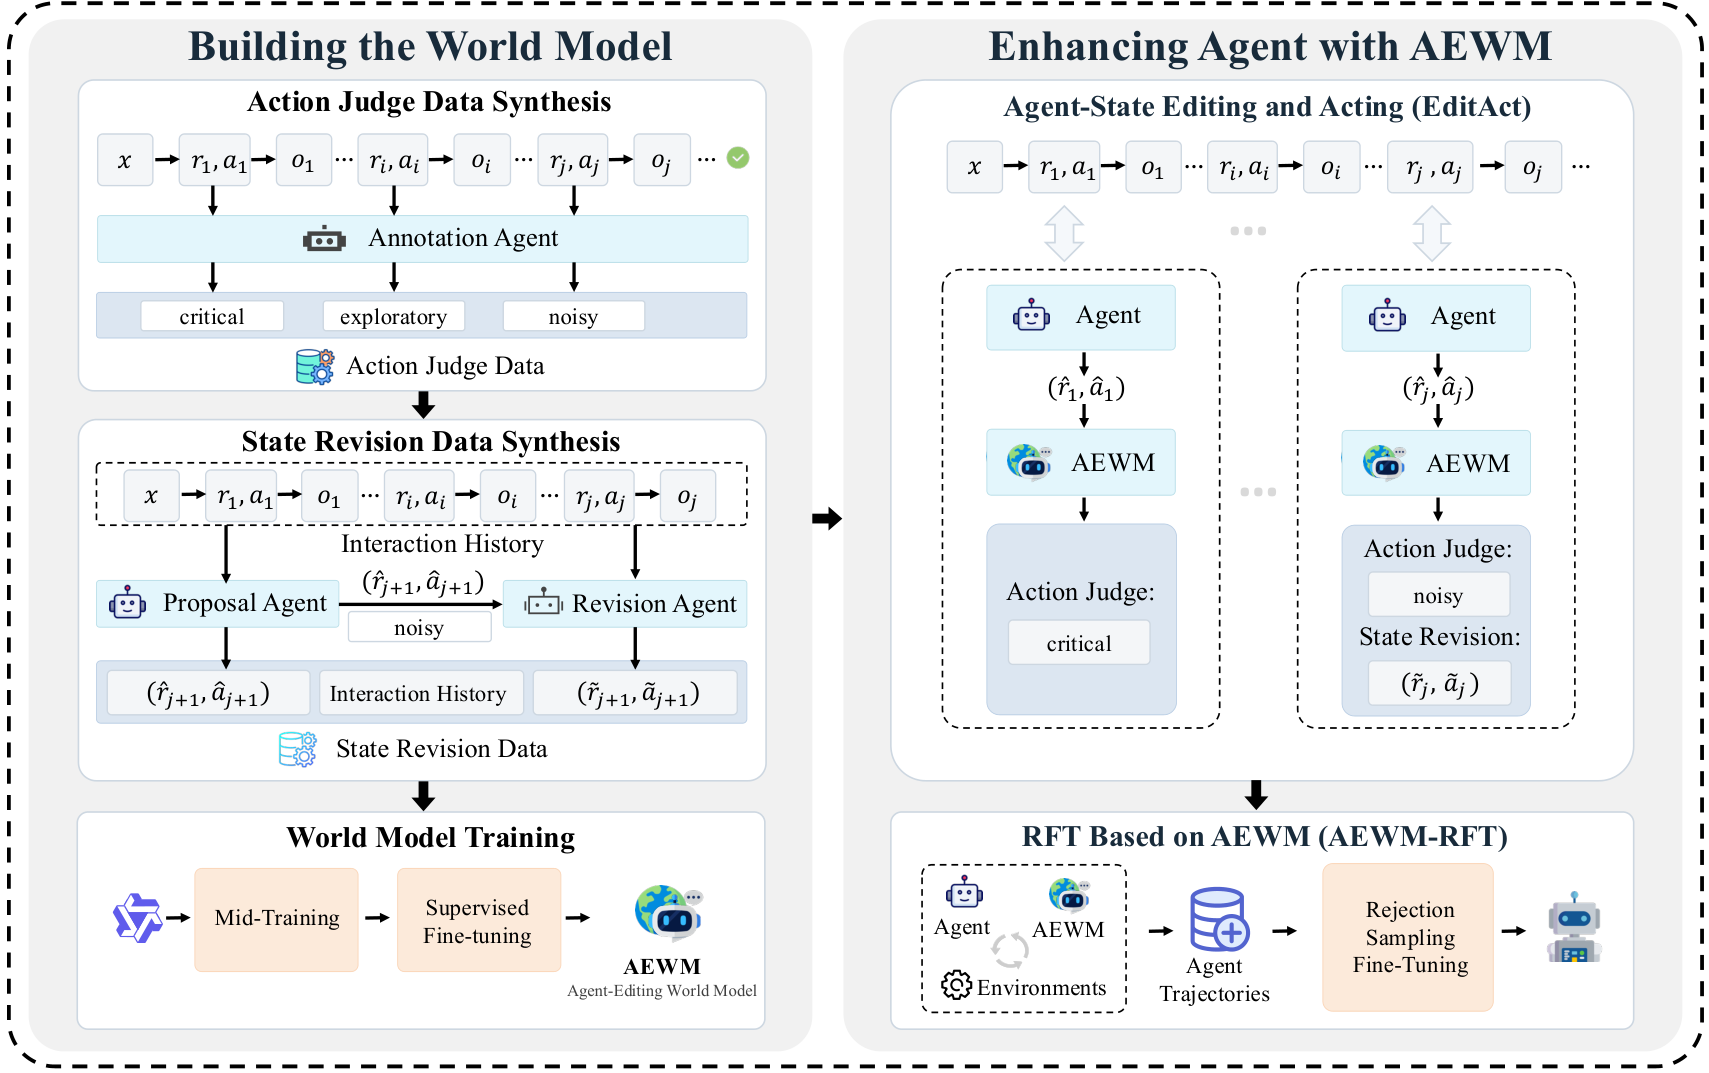
Action Judge。 h_t と (\hat r_t, \hat a_t) が与えられたとき、先読みの根拠 r_t^\text{AJ} とそれに続くラベル y_t \in \{\text{Critical}, \text{Exploratory}, \text{Noisy}\} を予測します。学習データは検証済みの成功軌跡をターンごとに分解することで得られます。強力なアノテーションモデルが、軌跡全体と各行動のダウンストリームにおける役割にアクセスした上で y_t を付与します。重要なのは、AEWMへの学習入力は実行前のコンテキストのみであり、アノテータによる回顧的ラベルが将来を見越した教師信号となる点です。フィルタリングにより、ラベルの一貫性、行動と観測の整合性、および r_t^\text{AJ} が実行後の情報を漏洩しないことが担保されています。
State Revision。 y_t = \text{Noisy} のとき、AEWMは (\hat r_t, \hat a_t) を同じ h_t を条件として修正後の (r_t', a_t') へと書き換えます。修正データは、弱い提案エージェント(Qwen3.5-35B-A3B)がノイズの多い候補を生成し、強い修正エージェント(DeepSeek-V4-Pro)が訂正を行い、ルーブリックによるフィルタリングを経て生成されます。
EditAct。 推論時には、エージェントが (\hat r_t, \hat a_t) \sim \pi_\theta(\cdot \mid h_t) をサンプリングし、AEWMがそのタイプを判定します。CriticalおよびExploratoryな判断はそのまま通過させ、Noisyなものはツール呼び出しの前に (r_t', a_t') で置き換えます。これにより、エージェントが無視するかもしれない批評を発するのではなく、後続の判断の起点となる状態を編集します。
学習パイプライン。 AEWMは、3つのドメイン(Search、Terminal、SWE)にわたるAction JudgeとState Revisionの統合コーパスに対して、mid-trainingとSFTを組み合わせて学習されます。次に、EditActの誘導下で収集された軌跡を用いて、エージェントポリシー自体のAEWMベースのrejection sampling fine-tuning(AEWM-RFT)を行い、編集挙動を内在化させます。
結果
Action Judgeベンチマークにおいて、AEWMはmacro-F1 70.5%を達成し、論文に掲載されているベースラインを上回っています(アブストラクトは途中で切れていますが、これを最高結果として位置づけています)。ExploratoryとNoisyの識別はローカルな尤もらしさではなくダウンストリームの有用性に依存するため、三値分類は非自明です。
行動タイプの分布は、汚染がどこから生じるかについて示唆的な情報を与えます。アノテーション済みコーパスでは、Searchはnoisy actionが支配的(60.0%)であり、典型的には検索を絞り込む未検証の仮説や、必要な確認の代わりに関連する証拠で代替するものです。Terminalはexploratory actionの割合が最も大きく(43.2%)、25.1% がnoisy であり、失敗は実行出力の誤読や中間的な進捗を検証済みの成功として受け入れることに偏っています。SWEはよりバランスが取れており、42.1% がcritical、28.0% がnoisyで、失敗は依存関係の仮定や無視された互換性制約に起因しています。オンラインでのAEWM予測はこれらのドメイン固有のシグネチャを保持しており(noisy重視のSearch、exploratory重視のTerminal、バランスのとれたSWE)、著者らはこれをモデルがドメイン条件付きの意思決定事前分布を学習した証拠として解釈しており、一律に「悪そうに見える」というヒューリスティックではないとしています。
限界とオープンクエスチョン
- ラベルは、成功した軌跡に適用された強力なアノテーションモデル(DeepSeek-V4-Pro、GLM-5)から蒸留されています。Critical/Exploratory/Noisyの分類体系はそれらのバイアスを引き継いでおり、失敗した軌跡からのターン——おそらく最も価値の高い学習シグナル——は構造上除外されています。
- State Revisionはより強力な修正モデルの存在を前提とします。フロンティアエージェントにはそのようなオラクルが存在しない場合があり、その場合このアプローチはworld modelingというよりも蒸留メカニズムとしての側面が強くなります。
- EditActはエージェントの行動を暗黙的に上書きします。これはAEWMのキャリブレーションのずれを隠蔽する可能性があります。誤ってflagされたCritical actionが、尤もらしい言い回しだが実際には劣る代替に置き換えられても、エージェントには異議を唱えるシグナルがありません。論文では介入精度(実際に軌跡を改善した編集と悪化させた編集の割合)は報告されていません。
- 評価は3つのドメインのみです。Critical/Exploratory/Noisyのスキーマが、より密な報酬や敵対的なダイナミクスを持つ環境に転移するかどうかは未検証です。
- macro-F1 70.5%は依然としてアノテータラベルとの相当な不一致を意味しており、AJエラーがエージェントの成功率に与えるダウンストリームの感度は分解されていません。
この研究の意義
AEWMは、ツールを使用するLLMエージェントにとって、環境の次の観測をモデル化するよりもエージェント自身の進化するタスク状態をモデル化する方が有用であるという明快な主張を展開しています。環境はクエリ可能ですが、内部状態は静かにドリフトするからです。Action Judge / State Revision / EditActの分解は、この再定式化を推論時のコントローラとfine-tuningシグナルへと具体的に転換するためのレシピであり、ドメイン条件付きエラー分布(noisy重視のSearch、exploratory重視のTerminal)は、長期的なエージェントが実際にどこで失敗するかを診断するための有用な語彙を提供します。
Source: https://arxiv.org/abs/2609.28416
IterSynth: ロール分離型反復合成による深層検索エージェントの再考
問題
深層検索エージェントは、マルチホップクエリの計画立案、証拠の取得、そして長期的な視野にわたる根拠に基づいた回答の合成を行わなければなりません。ReActスタイルの単一ポリシーエージェントは、計画立案・証拠活用・回答合成という3つの異なる能力を1つの自己回帰的なトレースに混在させており、文脈は取得処理に伴って単調に増大するため、軌跡が長くなるほど信号対雑音比が低下します。IterResearchおよび類似のワークフローは、定期的な圧縮によって文脈の肥大化に対処していますが、ロールの結合は維持されたままです。IterSynthはこの両問題を同時に解決することを目標としており、設計上ロールを分離し、進化するサマリーを永続的なメモリとして用いることで、生の取得履歴を引き継がない仕組みを実現しています。
手法
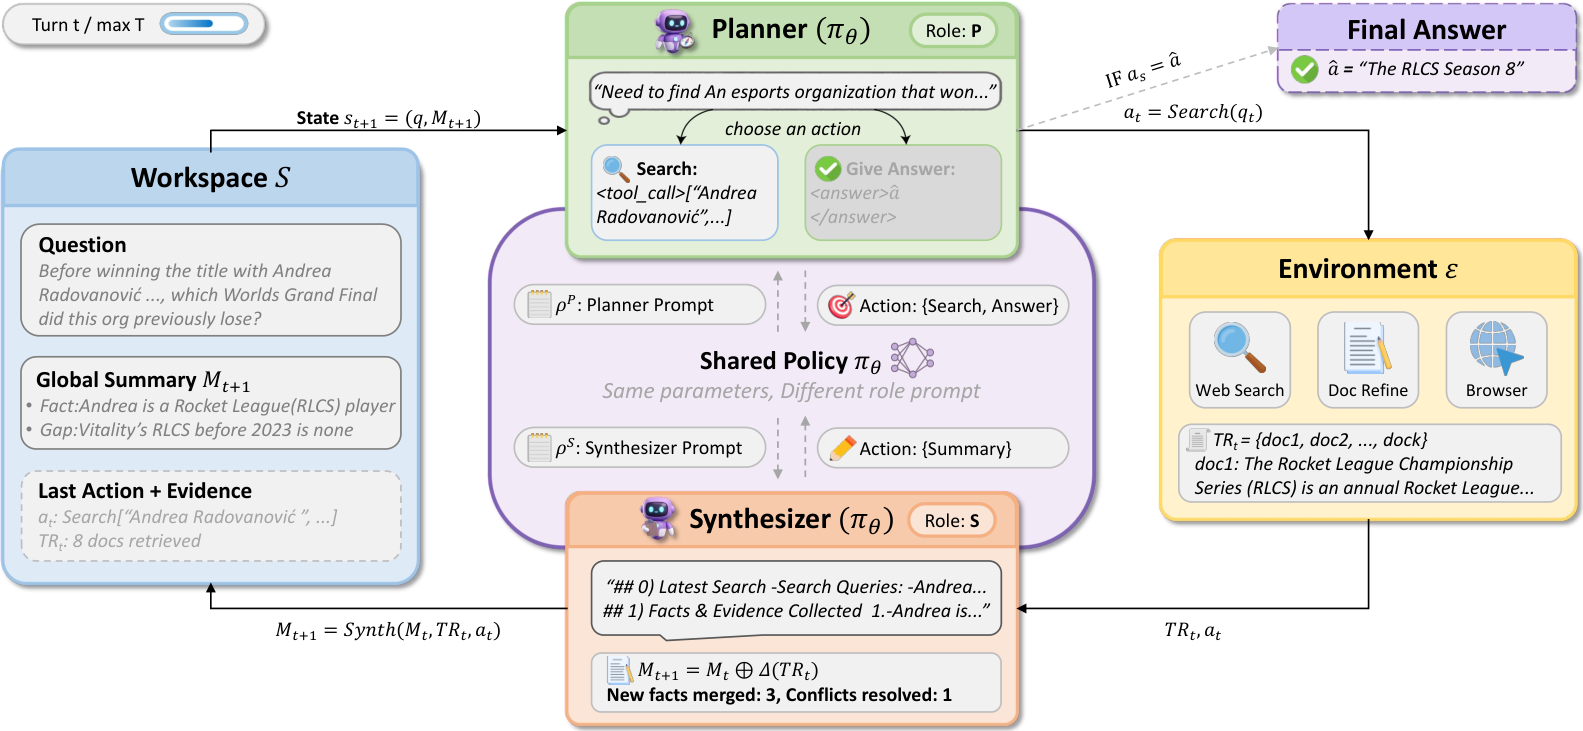
IterSynthは、単一の共有ポリシー \pi_\theta によって実行される2ロールのループ構造であり、プロンプトおよび許容されるアクションセットによってロールが区別されます。
- Planner は質問 q と現在のサマリー M_t を参照し、検索クエリ a^P_t を発行するか、最終回答を出力して終了します。メモリを直接操作することはできません。
- Synthesizer は取得された証拠 e_t と現在のサマリー M_t を参照し、M_{t+1} を生成します。クエリの発行や回答の出力はできません。
反復ステップ t において、アクティブな文脈は先行ターンとの連結ではなく (q, M_t) から再構成されるため、文脈の増大はサマリーのサイズに抑えられます。
学習は2段階で行われます。コールドスタートのSFTフェーズでは、ロールのフォーマットと反復的な動作を学習させます。RLフェーズでは、Role-Decoupled Policy Optimization (RDPO) を用いて、異種ロール間のクレジット割り当て問題に対処します。PlannerターンとSynthesizerターンは軌跡の成功に対して異なる形で寄与するため、正規化プールを共有すべきではありません。
RDPOは、軌跡内の全ターンにブロードキャストされる終端結果報酬 r_{\text{out}} と、ロール固有の品質を評価するターンレベルのルーブリックスコア r^{\text{rub}}_{r,t}(例:Plannerに対するクエリの情報量、Synthesizerに対する忠実な証拠統合)を組み合わせた、ターンごとの複合報酬を計算します。その後、ターンはロール r \in \{P, S\} ごとに分割され、各ロールのグループ内でadvantageが正規化されます:
\hat{A}_{r,t} = \frac{R_{r,t} - \mu_r}{\sigma_r},
ここで (\mu_r, \sigma_r) はロール r に属するターンのみから計算されます。ポリシーの更新は、全ターンの和集合に対する標準的なクリップされたsurrogate目的関数に基づいて行われます。
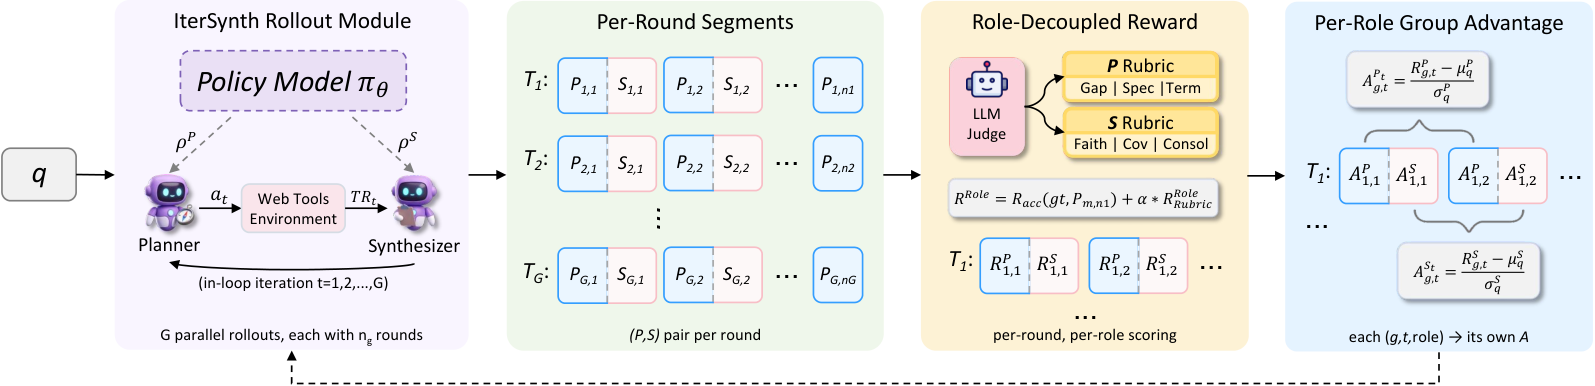
このロールごとの正規化により、一方のロール(通常、より頻繁に実行されるSynthesizer)の分散がもう一方のgradientを圧倒することを防ぎ、各ロールが実際に行った局所的な判断にクレジットを対応させることができます。
結果
5つの長期的ベンチマーク(BrowseComp、BrowseComp-ZH、GAIA、Xbench-DeepSearch 2505/2510)において、IterSynth-8Bは平均50.7を達成し、同規模における最強の報告済みベースラインを上回りました(具体的なベースラインの内訳は論文のTable 3に記載されており、abstractでは言及されていません)。
学習なしのpromptingによるablationは、ワークフローをRLから切り離して評価できるため、より診断的な結果となっています。Claude-4.5-Opus をバックボーンとして使用した場合:
- ReAct: 60.6 avg
- IterResearch: 63.2 avg
- IterSynth: 66.1 avg(GAIA 61.2、Xb10 57.0、BCzh 70.2、Xb05 76.0)
DeepSeek-V3.1 の場合:
- ReAct: 43.4
- IterResearch: 45.2
- IterSynth: 47.9(GAIA 56.8、Xb10 35.0、BCzh 43.6、Xb05 56.0)
ReActに対する改善幅はClaude-4.5-Opusで +5.5 ポイント、DeepSeek-V3.1で +4.5 ポイントであり、IterResearchに対しては各々 +2.9、+2.7 となっています。最大の改善はBrowseComp-ZH(Claude: 60.2 → 70.2)とXbench-DS 2505(Claude: 69.0 → 76.0)で見られており、これらは軌跡が最も長く、ステップ間の証拠統合が最も多いベンチマークです。一方、Claude使用時のGAIAではIterResearch(66.0)がIterSynth(61.2)を上回っており、軌跡が短くツール使用が多い場合には、積極的なサマリー化によって有用な生の証拠が失われる可能性が示唆されています。
限界と未解決の問題
- PlannerとSynthesizerはパラメータを共有しているため、特殊化はプロンプトとアクションマスクによってのみ駆動されます。ハードなパラメータ分離(ロールごとのLoRA、またはロールトークンに基づくMoEルーティング)が8Bスケールで有効かどうかは未検証です。
- ルーブリック報酬には外部ジャッジが必要ですが、論文ではジャッジのコストや失敗モードが十分に特徴付けられておらず、このような設定においてルーブリックに対するreward hackingが既知のリスクとして存在します。
- サマリーは損失を伴う状態表現です。正確な文字列による証拠の再現を要求するタスク(例:引用が多いGAIAのサブセット)では、生のパッセージを M_t に圧縮することで引用可能なスパンが失われる可能性があります。Claude使用時のIterResearchとのGAIAにおける差がこれを裏付けています。
- 学習されたモデルサイズは1種類(8B)のみです。RDPOのスケーリング挙動、特にベースの性能が向上するにつれてロールごとの正規化の重要性が低下するかどうかは不明です。
- モノリシックなテキストサマリーとは対照的な、構造化された外部メモリ(ベクトルストア、取得機能付きスクラッチパッド)を持つエージェントとの比較が行われていません。
意義
IterSynthは、能力の結合と文脈の蓄積という2つの独立した軸がいずれも長期的な検索を妨げること、そしてそれらを構造的に分離することが文脈のスケーリングや定期的な圧縮よりも有効であることを明確に示しています。RDPOのロールごとのadvantage正規化は小さくも汎用的なレシピです。ターン分布が異種のマルチロールエージェントでは、プールされた正規化がロール固有のgradient信号を隠蔽していないかどうかを確認すべきです。
Source: https://arxiv.org/abs/2609.29444
一般化タスク・モーション計画問題に対するコーディングエージェント
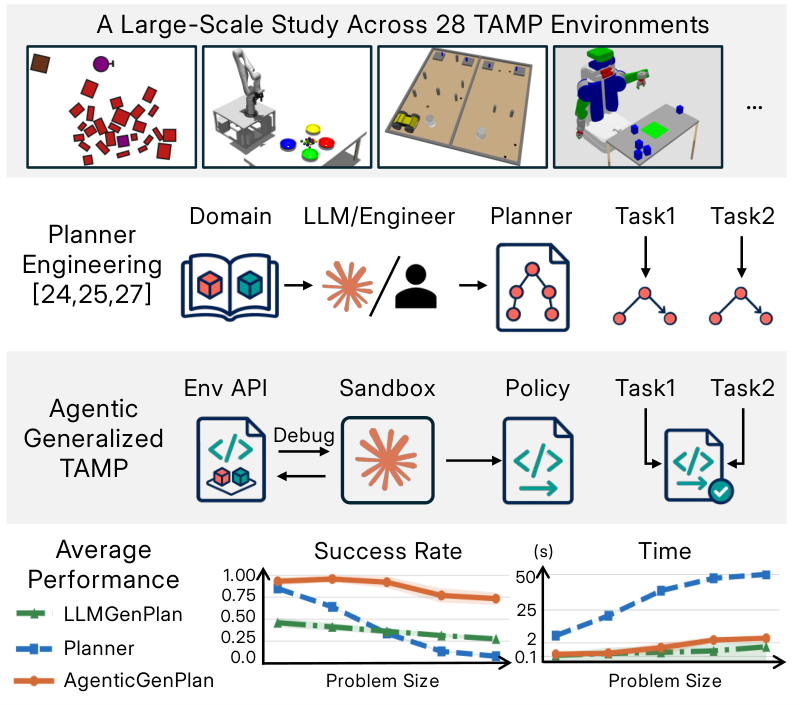
タスク・モーション計画(TAMP)は、離散的なシンボリック選択と連続的な幾何・運動学・動力学的実現可能性を結びつけるものであり、標準的なアプローチは手作りの述語・演算子・サンプラー・スキルに大きく依存しています。一般化TAMPは、再利用可能なコンポーネント(サンプラー、実現可能性予測器、ヒューリスティクス、抽象化)を学習することで、インスタンス分布にわたってそのエンジニアリングを償却しようとします。本論文はより鋭い問いを投げかけます:既製のコーディングエージェントが、タスク説明とreset/stepシミュレータのみを与えられた場合、TAMPの足場を一切使わずに、未見のインスタンスへ汎化するプログラム的なポリシーを合成できるのか?
セットアップ
各環境は有限ホライズンの目標指向MDP \mathcal{M}=\langle\mathcal{S},\mathcal{A},P,R,\rho,H\rangle であり、完全に観測可能なオブジェクト中心の状態(実数値特徴ベクトル:姿勢、幾何形状、関節設定、速度にマッピングされた型付きオブジェクト)を持ちます。初期状態分布 \rho はインスタンス間でオブジェクト数と幾何形状を変化させ、\mathcal{S},\mathcal{A},P,R は共有されます。
エージェントはサンドボックス化されたDockerコンテナ(Python + NumPy + SciPy、ネットワークなし、メイン設定では環境ソースコードなし)内で動作し、タスク説明 d とreset・step・レンダリングを提供するクライアントを受け取り、a_t=\pi(h_t) を計算するresetとget_actionを実装するクラスを出力します。合成されたプログラムはその後凍結され、テスト時にLLMは実行されません。+ source設定では、合成時に環境のソースコードと生成的シミュレータへのアクセスが追加で提供されます。
この研究では28環境(KinDERから25、PDDLStreamから3)、7つの合成手法、各5回の実行、プログラムあたり100件の保留テストインスタンスを対象とし、合計98,000エピソードの評価を行っています。バックエンドはClaude Code with Opus 5と、Codex with GPT-5.6 SolおよびGPT-6 Astraです。ベースラインにはベンチマークの手作りTAMPプランナー、ワンショットLLM生成、LLMGenPlan(いずれもソースコードあり)が含まれます。
結果
メイン(ソースなし)設定全体では、AgenticGenPlanは手作りプランナーと既存のLLM合成の両方を上回ります。表IのKinematic2D/Dynamic2D/Kinematic3Dブロックにおいて、Opus 5(high)はStickButton、Obstruction、Motion、PushT、Packing、Transport、Tableで平均1.00、ClutteredStorageで0.99、PushPullHook(2D)で0.98、ScoopPourで0.85に達しています。GPT-6 Astra(high)はさらに優れており、ほとんどの環境で1.00、ClutteredRetrievalで0.96、ScoopPourで0.97、Packingで0.89を記録しています。プランナーベースラインは同一タスクで大幅に低く、StickButton 0.36、ClutteredStorage 0.19、ClutteredRetrieval 0.51、PushPullHook 0.24、(2D)Obstruction PushPullHook 0.13であり、プランナーが存在しない複数の動的環境(PushT、ScoopPour、Obstruction)ではダッシュ(未対応)を返しています。
ワンショットOpus 5はほぼ全環境で崩壊します(ほとんどのDynamicおよびPDDLStreamタスクで0.00)。Opus 5によるLLMGenPlanは特定のタスクでは良好な結果を示します(StickButton 0.83、Obstruction 0.82、Motion 0.97、Transport 0.85、Dynamo 0.98、Rovers 0.86)が、動的および3Dタスクでは失敗します(PushT、ScoopPour、Packing 3D、BalanceBeam、ConstrainedCupboard、Rearrange、Shelf、SortClutteredBlocks、SweepIntoDrawer、SweepSimple、Tossingで0.00)。インタラクティブなエージェントループ——シミュレータのプロービング、カスタムテストの実行、修正——こそが、これらのギャップを埋めるものです。
ソースコードの提供(+ source)は適度な追加改善をもたらします:Opus 5はScoopPour ObstructionとPacking 3Dでそれぞれ0.85と0.66から1.00へ上昇し、GPT-6 Astra + sourceはほぼすべての環境で1.00に達します。メイン設定のエージェントはほとんどのタスクですでにこの上限に近く、シミュレータとのインタラクションがソースへのアクセスをほぼ代替できることを示しています。
発見された戦略
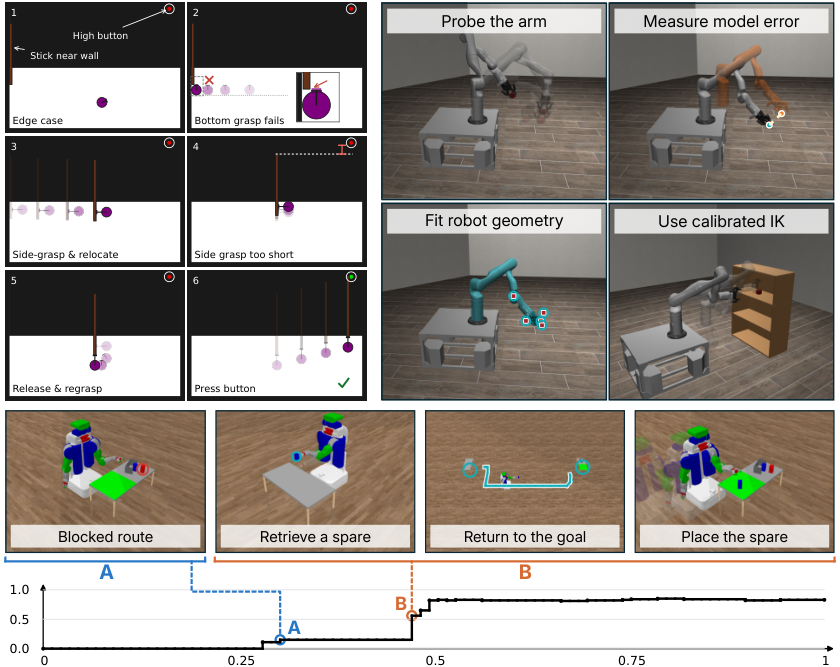
合成ログは純粋な記憶の使い回しに反する証拠を示しています。エージェントはカスタムプロービングスクリプトを記述します。例えば、StickButtonではresetを再シードして壁に隣接するスティックと高いボタンを列挙し、純粋な上方把持も純粋な側方把持も不十分であり、到達可能性のためにリリース・再把持シーケンスが必要であることを発見します。
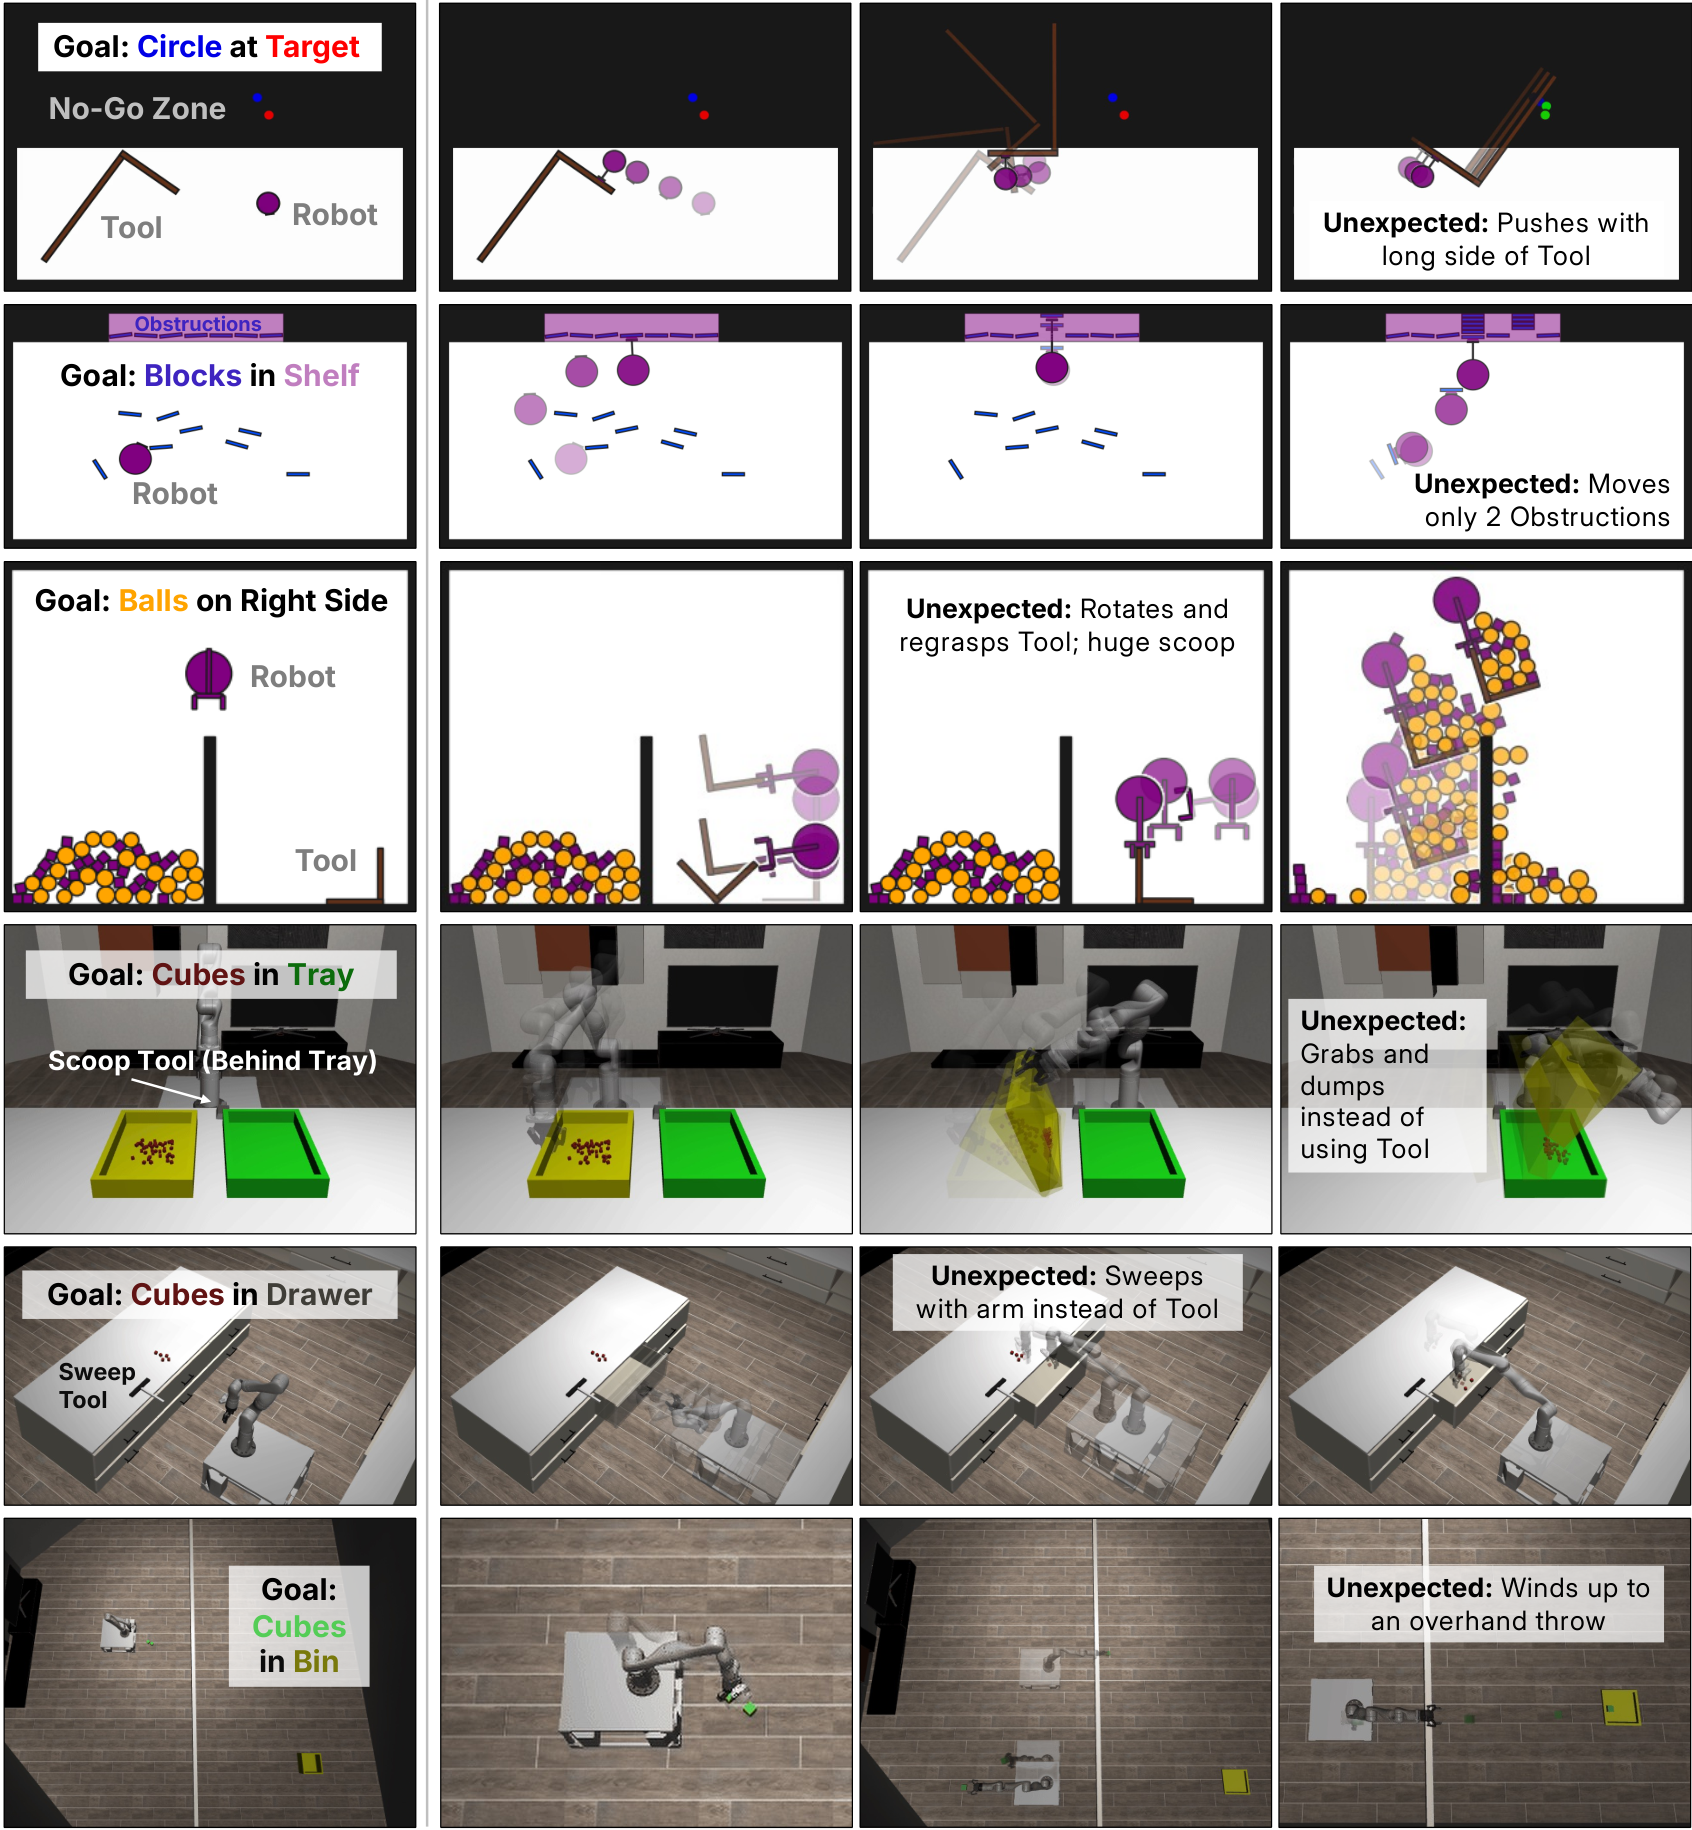
合成されたポリシーの中には、ベンチマーク解には存在しない形で動力学や幾何形状を活用するものがあり、その振る舞いは検索よりも反復的な実証的開発とより整合的です。
制限と未解決の問い
この設定は完全観測可能性、オブジェクト中心の状態、合成時のシミュレータアクセスを前提としており、知覚の不確実性はテストされていません。フロンティアモデルの学習データは非公開であるため、ベンチマーク汚染を排除することはできません(著者らはインタラクショントレースがこの懸念を軽減するが解消はしないと主張しています)。凍結プログラムによる評価はテスト時の適応がないことを意味し、オブジェクト数の変化を超えた分布シフトへのロバスト性は測定されていません。合成実行あたりの計算コストは抜粋中で詳細化されておらず、シミュレータが高コストまたは部分的にのみ微分可能な場合のアプローチのスケーラビリティは不明です。最後に、結果は有能なコーディングエージェント(Opus 5、GPT-6 Astra)に依存しており、GPT-5.6 Sol(medium)は有意に低い数値を示します(例:ClutteredRetrieval 0.21、Transport 0.17、ScoopPour Obstruction 0.26)ため、その効果はバックエンド間で一様ではありません。
なぜこれが重要か
フロンティアコーディングエージェントが、ゼロから、かつシミュレータとのインタラクションを通じて、動的・3Dタスクを含む28環境において手作りTAMPプランナーを上回るプログラム的ポリシーを合成できるならば、TAMPの抽象化エンジニアリングの多くは、前提条件ではなく克服すべき強力なベースラインとなります。また、これは「一般化計画」を、エージェントが環境モデルと解決戦略の両方を発見するプログラム合成問題として再定義するものであり、固定プランナー内でサンプラーやヒューリスティクスを学習するというのとは実質的に異なる研究目標です。
Source: https://arxiv.org/abs/2609.30233
Hacker News Signals
Fearless SIMD v1.0
Fearless SIMDは、Linebenderプロジェクトが開発したRust crateであり、呼び出しサイトでunsafeを必要とせずに、安全かつエルゴノミックなSIMD intrinsicsへのアクセスを提供します。この crateが解決しようとする設計上の核心的な問題は、Rustにおける典型的なトレードオフです。すなわち、SIMD intrinsicsは定義上unsafeです。なぜなら、必要な機能を持たないCPU上でillegal instruction faultを引き起こすためですが、すべての呼び出しをunsafeブロックで囲むことはRustの安全保証の目的を損ない、監査が困難な煩雑なコードを生み出してしまいます。
その解決策は、トークンベースのケイパビリティパターンです。プログラム起動時(もしくは安全なディスパッチポイント)において、検出関数を呼び出すと、例えばAvx2Tokenのようなトークン型が返されます。このトークン型がtype system上に存在すること自体が、現在のCPUがAVX2をサポートしていることをコンパイル時に証明します。SIMD関数はこのトークンをzero-sizedなパラメータとして受け取ります。トークンはチェック済みの検出ブロック内でしか構築できないため、下流の呼び出しサイトでは明示的なunsafeアノテーションなしに安全性が保たれます。つまり、安全性の契約が型によってエンコードされているのです。この構造は、形式検証の文献に見られる「branded type」や「session type」パターンと本質的に類似しています。
この crateはx86/x86-64(SSE2からAVX-512のサブセットまで)およびAArch64(NEON、SVEスタブ)をカバーしています。std::archを置き換えるのではなくそれと統合する形で機能するため、完全なintrinsicsセットへのアクセスも維持されます。v1.0リリースではtoken APIが安定化され、multiversionマクロが追加されました。このマクロはディスパッチテーブルを一度だけ生成し、最初の間接分岐(branch predictorがホットループにおいてうまく処理する部分)以降はper-callオーバーヘッドゼロで実行時に最適なパスを選択します。
実用的なターゲットは2Dレンダリングとフォントラスタライゼーションであり、Linebenderは同分野でvelloやkurboもメンテナンスしていますが、この crateは汎用的に利用可能です。主な制限として、SIMD幅の抽象化は提供されておらず、AVX2およびSSE4.1カーネルは依然として手動で個別に記述する必要があります。Portable SIMD(std::simd、現在もunstable)がRustネイティブの最終的な解答となる見込みですが、Fearless SIMDは現時点でプロダクションコード向けにそのギャップを埋める存在です。
Virtio-nvgpu: KVMゲスト内でのNvidia GPUへのネイティブ近似アクセス
Virtio-nvgpuは、KVMゲストにNvidia GPUの機能をネイティブに近いパフォーマンスで提供するオープンソースのvirtioデバイス実装です。SR-IOVによるハードウェアパーティショニングや完全なソフトウェアエミュレーションのオーバーヘッドを伴わずに、VM内でCUDAワークロードやGPUアクセラレーテッドな推論を実行するユースケースをターゲットとしています。
アーキテクチャはvirtioトランスポート層を利用して、GPUコマンドバッファとメモリマッピングをゲストとホスト間で受け渡します。ゲストドライバはvirtioキューを通じてワークを送信し、ホスト側のデーモンがそれらを標準のユーザー空間CUDA/NVMLスタックを介して実際のNvidiaドライバに転送します。重要な点として、GPUメモリは可能な限りvfioスタイルのDMAリマッピングを使用してゲストのアドレス空間にマッピングされ、大きなテンソルバッファのダブルコピーを回避しています。これはVGPU(Nvidiaの独自タイムスライス仮想化)とも、GPUパススルー(1つのVMに排他的なデバイス所有権を与える方式)とも異なります。virtio-nvgpuは低レイテンシのコマンド送信を維持しながらマルチプレクシングを可能にすることを目指しています。
このプロジェクトはまだ初期段階にあります。リポジトリにはRTXクラスのハードウェア上でQEMU/KVMゲスト内でCUDAカーネルが動作している実績が示されており、ベンチマーク数値はベアメタルと比較してコンピュートバウンドなワークロードでの一桁台のパーセンテージのオーバーヘッドを主張しています。メモリバンド幅バウンドなワークロードでは間接参照レイヤーによってより大きなオーバーヘッドが生じますが、これは想定内です。この実装はNvidiaのユーザー空間ドライバのioctlインターフェースのインターセプトに依存しています(Mesaがnouveau上でオープンソースGLを実現するために使うアプローチと同じですが、ここでは独自スタックを対象としています)。そのため、Nvidiaドライバのバージョン変更に対して敏感です。
未解決の問題としては、マルチプロセスCUDAコンテキスト下での安定性、GPUフォルトとプリエンプションの処理、そしてNvidiaのドライバライセンスが配布を制約するかどうかが挙げられます。GPU向けのvirtioデバイス仕様(virtio-gpu)は存在しますが、ディスプレイ用途を指向しています。本プロジェクトはコンピュート向けの並行仕様を構築しています。GPUクラウドの分解(テナントごとに隔離されたVM内でワークロードを実行すること)が独自vGPUライセンスコストを回避しようとする場合に、こうしたインフラストラクチャは重要性を増す性質のものです。
OpenAI GPT-6 Astra、2005年以来解読されていなかったEnigmaメッセージを解読
ここでの暗号解析の核心は、BGACコレクションに収録されたEnigma暗号文の解読です。具体的には、約20年にわたって自動・手動の攻撃に耐えてきた短いメッセージ(“MVUEH” crib)が対象です。困難の原因はEnigma暗号の根本的な脆弱性(ブレッチリー・パーク以来知られている)ではなく、実際の組み合わせ論的複雑さにあります。短いメッセージでは、標準的な一致指数(index-of-coincidence)やbombe方式の攻撃が確実に収束するために必要な十分な暗号文が得られず、このメッセージに使われたホイール順序、リング設定、プラグボード設定も不明でした。
報告された手法では、GPT-6 Astra(OpenAIのマルチモーダル推論モデル)を用いて構造化された探索を誘導・実行しました。解析レポートの技術的詳細によれば、モデルには暗号文、対象ネットワークおよび日付範囲に関するEnigmaの既知の鍵空間制約が与えられ、攻撃の手順を推論するよう求められました。成功したと見られる要因は、メッセージの文脈とトラフィック解析メタデータから推測された部分的なcrib(推定平文断片)を、仮説と検証のループと組み合わせるモデルの能力です。これは本質的に、メッセージカテゴリに対応するドイツ軍の慣用句を推定するモデルの能力によって強化された、bombe方式の推論の自動化です。
LLMの能力という観点から注目すべき点は、歴史的暗号の解読にはドメイン知識(Enigmaの機械的制約)、組み合わせ探索、言語的推論を同時に統合することが求められるからです。これが真の多段階推論を表しているのか、それともEnigma関連コンテンツを含む訓練データ上の非常に広範なパターンマッチングなのかは、解析レポートでも解決されていない未解決の問いです。Enigmaの鍵空間は最悪の場合1日あたり約 10^{23} に達しますが、既知の制約によって劇的に削減されます。モデルはこれを網羅的に列挙したのではなく、制約の枝刈りに依存したと考えられます。
実務家向けのコメントとして:これは暗号学的成果そのものとしてよりも、ドメイン固有の制約下における構造化推論のベンチマークとして、より興味深い事例です。
Source: https://www.cryptocellar.org/bgac/the-mvueh-break.html
Drop: gVisorサポートを備えたrootlessなLinuxサンドボックス
Dropはrootやsetuidヘルパーを必要とせず、非特権のLinuxサンドボックスでプロセスを実行するためのCLIツールです。サポートしている隔離バックエンドは2種類あります。1つはrootlessなnamespace(Linuxユーザーnamespace + mount/pid/networkのnamespaceスタック)、もう1つはgVisorのrunscコンテナランタイムで、プロセスとホストカーネルの間にユーザー空間カーネルを介在させます。
rootlessパスはnewuidmap/newgidmapを使用してUID/GIDマッピングを行い、最小限のマウントnamespaceを構築することで、特権なしにファイルシステムの隔離を実現します。ネットワーク隔離はオプションであり、rootlessモードではslirp4netnsやpastaがインストールされていない限り、loopbackのみのnamespaceに制限されます。gVisorパスはより強力なsyscallフィルタリングを提供します。gVisorはすべてのシステムコールをインターセプトしてGoで再実装するため、ホストカーネルへの攻撃対象領域が大幅に削減されます。ただし、runscのインストールが必要であり、syscallが多いワークロード(特にファイルI/O)においてパフォーマンスコストが生じることが知られています。
生のunshareスクリプティングに対するこのプロジェクトの主な価値は、バインドマウント、環境変数のホワイトリスト化、capabilityの削除に対する宣言的な設定フォーマットと、利用可能な最強のバックエンドの自動選択にあります。これはbubblewrap(Flatpakが使用)やfirejailと同じ問題領域ですが、Dropはseccompプロファイルだけに頼るのではなく、より高い保証レベルのためにgVisorを活用しています。
注意すべき制限事項として、rootlessなnamespaceはカーネルの権限昇格バグの歴史があります(ユーザーnamespaceの攻撃対象領域は無視できません)。そのため、「rootless」はリスクフリーを意味しません。gVisorパスはこの問題を軽減しますが、gVisorのTCBが追加されます。永続的なコンテナイメージ管理は存在しません。Dropはエフェメラルなプロセスサンドボックス向けであり、コンテナランタイムの代替ではありません。サンドボックス内でのGPUパススルーやio_uringとの互換性は現在サポートされていません。
Source: https://droprun.sh/
Radicle: ネットワークプロトコルにおける脆弱性の開示
Radicleは、Gitの上に構築されたピアツーピアのコードコラボレーションプラットフォームであり、リポジトリのレプリケーションとアイデンティティ管理にゴシップベースのプロトコルを使用しています。今回開示された脆弱性はネットワークプロトコル層に存在し、アドバイザリによれば、攻撃者がピアネットワーク全体に誤った状態を伝播させることを可能にします。具体的には、悪意のあるピアが特定の条件下で、正直なノードが偽造されたリポジトリの更新やアイデンティティドキュメントを受け入れるようなプロトコルメッセージを作成できます。
技術的な根本原因は、ゴシップメッセージの処理パスにおける署名済みデータの検証が不十分であることにあるようです。Radicleはリポジトリの参照およびアイデンティティドキュメントにEd25519署名を使用していますが、この脆弱性は署名検証ステップがバイパスされるか、検証済みのペイロードが適用される状態更新から切り離される可能性があるケースに関係しており、分散環境における古典的なtime-of-check/time-of-use(TOCTOU)クラスのバグです。攻撃を成立させるには、攻撃者がすでに被害ノードに接続済みのピアである必要があり(完全にリモート・未認証の状態では不可)、これにより影響範囲はある程度限定されます。
修正内容は、署名が検証されたオブジェクトとローカル状態に適用されるオブジェクトが同一であることを保証するために、メッセージ処理パイプラインを厳格化するものです。これにより、異なるペイロードに差し替え可能な中間デシリアライズステップが排除されます。これは、正規のシリアライズ済みバイト列を直接検証するのではなく、sign-then-serializeを行うシステムにおいてよく知られた脆弱性クラスです。
セキュリティモデルを完全に暗号的アイデンティティに依存するプロジェクトにとって(侵害された状態を取り消す中央機関が存在しないため)、このクラスのバグは影響範囲が限定的であっても高い深刻度を持ちます。今回の開示は責任ある形で行われており、アドバイザリと同時にパッチがリリースされています。radicle-nodeを実行しているユーザーは直ちにアップデートすべきです。より広い教訓として、可変状態と暗号認証を組み合わせたゴシッププロトコルは、署名検証周辺のシリアライズ境界の取り扱いに極めて慎重である必要があるということです。
Source: https://radicle.dev/2026/09/23/disclosure-of-vulnerability-in-network-protocol
WordPress: 認証不要のパス・トラバーサルによる条件付き RCE
この脆弱性(GHSA-7hp8-65ch-5whp)は、WordPress コアにおけるパス・トラバーサルであり、特定の条件下では認証なしでリモートコード実行(RCE)につながります。パス・トラバーサルにより、攻撃者は本来のウェブルート外のファイルパスを読み取ったり操作したりすることが可能になります。また「条件付き RCE」という修飾語は、コードの実行に二次的な条件が必要であることを意味します――典型的には、書き込み可能なアップロードディレクトリ、またはターゲット上に存在する特定のプラグイン・テーマの構成です。
メカニズムとしては、ユーザーが入力したデータからファイルシステムパスを構築するファイル処理のコードパスにおいて、そのパスが使用される前に十分な正規化が行われていないことが問題です。このバグの典型的な形態は、誤ったタイミングで適用される basename() スタイルのサニタイズや、URL デコード後に生き残る ../ シーケンスのインジェクションです。WordPress のマルチパートアップロード処理と内部仮想ファイルシステムの抽象化レイヤー(WP_Filesystem)は、複数の関数にわたって一貫性のない正規化でサニタイズを重ねるため、こうしたバグが発生する機会を複数生み出します。
RCE の経路は一般に、ウェブサーバーが配信するディレクトリへの PHP ファイルの書き込み、または後続のリクエストを介した攻撃者が制御するファイルのインクルードのトリガーによって成立します。WordPress のプラグインアーキテクチャと、テーマにおける eval/include パターンの普及により、任意書き込みが達成された後の攻撃対象領域は広範囲に及びます。
このセキュリティアドバイザリが wordpress-develop リポジトリに存在することは、プラグインではなくコアの問題であることを示しています。パッチ分析(リンクされた GitHub アドバイザリの diff より)によると、修正はあらゆる操作の前にパスを正規化し、許可されたディレクトリのアローリストに対して検証するものです。WordPress がウェブの相当な割合を支えていること、そしてこれが認証不要であることを踏まえると、公開開示後すぐにパッチ未適用のインスタンスへの大規模な悪用が予想されます。自動更新を有効にしているホスティングプロバイダーは概ね保護されますが、自己管理のインスタンスは即時対応が必要です。
Source: https://github.com/WordPress/wordpress-develop/security/advisories/GHSA-7hp8-65ch-5whp
Cloudflare: キャッシュにおける HTTP Vary ヘッダーの完全サポート
Vary HTTP レスポンスヘッダーは、指定されたリクエストヘッダーの値ごとに別々のレスポンスをキャッシュに保存するよう指示します。例えば、Vary: Accept-Encoding は、gzip を送信するクライアントと br を送信するクライアント、あるいは Accept-Encoding を送信しないクライアントに対して、キャッシュが異なる保存済みレスポンスを返さなければならないことを意味します。RFC 2616 以来 HTTP/1.1 の一部であるにもかかわらず、CDN による Vary のサポートは歴史的に部分的であるか、正しく機能しないかのいずれかでした。ほとんどの CDN は Vary を完全に無視する(そして潜在的に誤ったコンテンツを返す)か、Vary を設定したレスポンスのキャッシュを拒否するかのどちらかです。
Cloudflare の実装は、キャッシュキーの構築という核心的な複雑さに対処しています。素朴に正しく実装すると、キースペースが指数的に増大し(変化するヘッダー値の一意な組み合わせごとに 1 つのキャッシュエントリが生成され)、現実的ではありません。現実的な解決策は、キーとして使用する前にヘッダー値を正規化された標準形式に変換することです。Accept-Encoding の場合、生のヘッダー文字列ごとに保存するのではなく、少数のエンコーディング能力クラスにバケット分けすることを意味します。このブログ記事では、正規化ロジックと、Vary: * の場合(仕様上キャッシュしてはならない)および Vary: Cookie の場合(実際にはユーザーごとのキャッシュ不可を意味し、キャッシュバイパスシグナルとして扱うべき)の処理方法について説明しています。
より興味深いエンジニアリングは、コンテンツネゴシエーションのための Vary: Accept および Vary: Accept-Language の処理です。ここでは、正規のバケット分けが自明ではなく、ロケールマッチングには複雑なフォールバックセマンティクス(RFC 4647)が伴います。Cloudflare のアプローチは、キースペースを扱いやすく保つために粗いバケット分け(完全なロケールタグではなく言語ファミリーによる分類)を使用しているようです。
実際的な影響として、コンテンツネゴシエーションに依存するフレームワークや API ——Accept に基づいて JSON または MessagePack を返したり、機能に基づいて圧縮・非圧縮を返したりするもの——が、Vary ヘッダーを回避策として削除することなく、Cloudflare のキャッシュの恩恵を実際に受けられるようになりました。制限としては、非常に多様なヘッダー値(例:完全な Cookie)は、仕様通りキャッシュを無効化し続けます。
Linux サポートが Snapdragon X2 シリーズに対応予定
Qualcomm は Snapdragon Summit において、Snapdragon X2 シリーズが公式 Linux サポートを受けることを発表しました。これは、過去 1 年間にわたって qcom サブシステムのメンテナーと linux-arm-msm メーリングリストを通じて Snapdragon X Elite(X1)向けに順次取り込まれてきた upstream kernel の取り組みを基盤としています。
技術的な核心は、カーネルレベルで「サポート」が何を意味するかにあります。X Elite の現在の upstream 状況としては、CPU コア(Oryon、Qualcomm 独自マイクロアーキテクチャを持つ Arm v8.7-A)、PCIe、USB、msm DRM ドライバー経由のディスプレイ、および基本的な電力管理が機能しています。一方で、未完成またはダウンストリーム限定のままとなっているものには、Neural Processing Unit(Hexagon DSP)、統合 Adreno GPU の完全な Vulkan/OpenGL スタック(Mesa の freedreno ドライバーは部分的な対応にとどまる)、および常時稼働センサーハブが含まれます。X2 世代はこのベースラインを引き継ぎつつ、ドライバー対応が必要な新しい IP ブロックを追加すると思われます。
この発表が注目される理由は、Qualcomm が Linux に対して upstream ファーストの、少なくとも upstream 互換の開発にコミットすることを示しているからです。これはモバイル SoC において同社がこれまで取ってきた姿勢とは歴史的に異なります。この点は Arm ラップトップ市場にとって重要です。Qualcomm シリコン上では Windows on Arm がフルのハードウェア機能に独占的にアクセスできていた一方、Linux ユーザーはリバースエンジニアリングされたドライバーや大規模なツリー外パッチセットに依存せざるを得ませんでした。
ML 実践者にとって特に重要なのは、Hexagon NPU サポートが依然として欠けている核心的なピースであることです。Qualcomm の AI Engine は、これらのデバイス上において CPU や GPU よりも大幅に優れた電力効率で推論ワークロードを実行します。Hexagon に標準的なアクセラレーション API を備えた upstream ドライバー(accel サブシステムや QNN 互換の ONNX Runtime バックエンド経由が有力)が整備されるまで、Snapdragon Linux 上でのオンデバイス推論は CPU または GPU のみに限られます。X2 の発表はこのギャップに直接言及していません。
Source: https://www.qualcomm.com/news/onq/2026/09/snapdragon-summit-agentic-ai-pcs-linux
注目の新規リポジトリ
TypeLLM/TypeLLM
TypeLLMは、ライブラリレベルでLLMからの型安全な構造化生成を強制するもので、モデルの出力が実行時にパースされ、スキーマ違反によってクラッシュするという一般的な失敗モードを対象としています。核心的なアイデアは、Pythonの型システム — dataclass、Pydanticモデル、TypedDict、Literal、enum — を、プロンプト構築と出力パーサーの両方に対する唯一の信頼できる情報源とすることで、型エラーを推論時ではなく定義時に表面化させることです。
内部動作としては、ライブラリがアノテーション付きの戻り型をイントロスペクトし、それをJSON Schemaフラグメントにシリアライズし、そのスキーマをシステムプロンプトまたはfunction-callingペイロードに注入した後、生の補完結果を検証して宣言されたPythonオブジェクトにデシリアライズします。制約付きデコーディングバックエンドに対しては、スキーマがトークンレベルのlogitマスキングを駆動することもできます。InstructorやOutlinesと比較するとスコープは狭くAPIサーフェスも小さく、完全な構造化生成フレームワークを必要とせず信頼性の高い型付き出力だけが必要な場合の統合コストを低減します。
実用的なユースケースとしては、エージェントのツール呼び出しパース、モデル出力を型付きの下流関数に渡す評価パイプライン、そしてサイレントなパース失敗が微妙なデータ破損を引き起こすバッチ推論ジョブなどが挙げられます。ライブラリは純粋なPythonで書かれており、OpenAIおよびAnthropicクライアント向けのオプション依存関係が存在します。
制限事項:制約付きデコーディングのサポートはバックエンドに依存しており、スキーマ注入によってプロンプトトークンが増加します。
Source: https://github.com/TypeLLM/TypeLLM
shinthink/blitzstrike
Blitzstrikeは、構造化されたペネトレーションテスト手法をLLMエージェントが呼び出し可能な単一インターフェースとして公開するMCP(Model Context Protocol)サーバーです。単なるラッパースクリプトの寄せ集めではなく、130のツールを体系的なワークフローとして整理しています。具体的には、偵察と攻撃面の列挙、ソースからシンクへのtaint分析、そして実際のexploitation検証という流れで構成されており、発見のプリミティブからインパクト検証ステップへと繋ぐ57の事前定義されたエスカレーションチェーンを備えています。
アーキテクチャとしては、MCPを利用することで任意の準拠エージェント(Claude、GPT-4o、互換クライアント経由のローカルモデル)が統一されたJSON-RPCインターフェースを通じてツールを呼び出せる仕組みになっています。つまり、推論とシーケンシングはエージェントが担い、ツールのディスパッチと結果の正規化はBlitzstrikeが担当します。インテリジェンスデータ層は中間的な発見事項を永続化するため、後段のステージが高コストなスキャンを再実行することなく、前段の偵察出力を条件として利用できます。
セキュリティエンジニアにとって、これはLLM支援ペネトレーションテストにおける最大の摩擦点に対処するものです。アドホックなツール呼び出しはモデルが確実にチェーン接続できない一貫性のない出力フォーマットを生み出しますが、カタログ全体でスキーマを標準化し、エスカレーションの依存関係を明示的にエンコードすることで、Blitzstrikeはエージェントに対して即興で対処しなければならないリストではなく、トラバース可能なグラフを提供します。
注意点として、このツールはスコープと認可の判断を完全に呼び出しエージェントの判断に依存しており、エスカレーションチェーンにはターゲット環境に関する特定の仮定がエンコードされているため、一般化できない場合があります。責任ある利用には明示的なスコープ認可が必要であり、サーバー自体はガードレールの適用を行いません。
Source: https://github.com/shinthink/blitzstrike
yukitorido/short-video-generator-AI
このリポジトリは、長尺動画コンテンツを縦型ショートクリップへ自動変換するモジュラーパイプラインを実装しています。パイプラインの各ステージは、Whisperによる音声抽出と文字起こし、トランスクリプトのセグメントを予測されるエンゲージメントまたは意味的顕著性によってランク付けするLLMベースのハイライトスコアリング、設定可能なパディングを持つクリップ境界検出、そしてオプションのキャプションオーバーレイを備えた9:16アスペクト比へのffmpegベースの再エンコードで構成されています。
WhisperのインテグレーションはWord levelのタイムスタンプを生成するため、LLMスコアリングステージは選択されたトランスクリプトのスパンを動画タイムラインへ正確にマッピングでき、セグメントレベルのアプローチで生じがちなオフバイワンのずれを回避できます。ハイライト検出器はプロンプトテンプレートを受け付けるため、選択基準(トピックの関連性、引用可能性、感情的な色調)をパイプラインコードに触れることなく調整できます。
このアーキテクチャは、ストリーミンググラフではなく意図的に逐次的かつファイルシステムベースの設計を採用しており、各ステージを独立してテスト・置換できるようになっています。ローカルで実行するユーザーは、速度制約に応じてWhisperのモデルサイズを変更したり、レイテンシやプライバシーが懸念される場合はLLM呼び出しをローカルモデルに置き換えることができます。
制限事項:キャプションのバーンインは静的(アニメーション付きのWord levelカラオケ表示には非対応)であり、パイプラインは話者分離(diarization)に対応していないため、トピックが切り替わるインタビューコンテンツでのハイライト選択が不正確になる場合があります。また、シーン変化や視覚的顕著性のシグナルはスコアリングにフィードバックされず、純粋にトランスクリプト主導となっています。
Source: https://github.com/yukitorido/short-video-generator-AI
FankChen/tracecrate
Tracecrate は、AIエージェントの実行トレースを検査・比較するためのローカルファーストなワークベンチです。マルチステップのエージェント実行をデバッグする際に、テレメトリをホスト型サービスに送信せずに済む環境を必要とする開発者を対象としています。取り込み可能なログ形式は3種類で、Claude Code のセッションログ、OpenAI Codex のトレース、および汎用的な OTLP(OpenTelemetry)スパンに対応しており、これらを統一された内部表現に正規化してラン間のサイドバイサイド比較を実現します。
コアとなる UI では、ツール呼び出しシーケンス、ステップごとのレイテンシ内訳、トークン数、および分岐判断をタイムラインビューで表示します。ラン比較機能は、2つのトレースをステップ名と順序でマッチングしながら構造的に差分を取るため、リファクタリングやプロンプト変更の効果を手動でログを精査することなく参照ランと比較評価できます。エクスポート時にはレポート書き出し前に API キー、内部ホスト名、設定可能な PII パターンが除去される仕組みになっており、これが説明文にある「プライバシーへの配慮」の根拠です。
すべての処理がローカルで完結するため、バックエンドや外部の API キーは不要です。パース、インデックス作成、および差分計算はインプロセスで行われます。これにより、エアギャップ環境でも利用可能であり、ホスト型オブザーバビリティプラットフォームで生じるクレデンシャル管理のオーバーヘッドも排除されます。
Tracecrate は、Langfuse や Phoenix のようなフルオブザーバビリティスタックと比べてスコープが狭く、本番環境のモニタリング、アラート、マルチユーザーコラボレーション機能は提供しません。あくまでもローカルの開発者向けデバッグツールとして位置づけられており、セットアップの手間をゼロにすることを優先するという合理的なトレードオフと言えます。
Source: https://github.com/FankChen/tracecrate
tigerless-labs/agent-memory
このプロジェクトは、プレーンなMarkdownファイルを永続的なストアとして使用するAIエージェント向けの長期メモリランタイムを実装しています。設計原則として、メモリはデータベースなしで人間が読め、バージョン管理可能であるべきというものがあり、保存されたすべての事実、会話の断片、または学習済みの嗜好は .md ファイルとして格納され、直接開いたり編集したり削除したりすることができます。
検索はローカルかつランキングベースで行われます。クエリ時にランタイムは、TF-IDFまたは軽量なembedding類似度(外部のembedding APIは不要)を用いて保存済みドキュメントを入力コンテキストに対してスコアリングし、上位k件のチャンクをインジェクトされたコンテキストとして提示します。別途「スリープ時Manageレイヤー」が非同期で、つまりアクティブなエージェントセッションの外側で動作し、冗長なエントリのマージ、古くなった事実の刈り込み、ストアの再編成を行います。これはオフライン期間中のメモリ統合に類似しています。
Claude CodeとCodexは共通のディレクトリパスを通じて単一のストアを共有できます。両者のセッションフォーマットが異なるため、これは非自明な実現であり、ランタイムが両者を正規化します。APIキーが一切不要であることは構造的な特性であり、embeddingおよびランキングのパスはローカルの計算リソースのみを使用します。
このアーキテクチャは、大規模なフラットファイルストアの制限を継承しています。Manageレイヤーが積極的に重複排除を行わない限り、コーパスが成長するにつれて検索品質が低下し、また複数のエージェントプロセスからの並行書き込みアクセスには外部のロック機構が必要です。個人の開発者用途においては、シンプルさとスケーラビリティのトレードオフは合理的といえます。
Source: https://github.com/tigerless-labs/agent-memory
undefined-ui/second-brain-os
Second Brain OS は、Obsidian のボールトを Claude Code によって自律的に維持されるナレッジベースへと変換する、設定・ツール層です。このリポジトリには、規定されたフォルダ分類体系を持つスターターボールトのレイアウト、Claude Code のスラッシュコマンドやスクリプトタスクとして実装されたエージェント「スキル」のセット、そして切れたリンクの解決・タグの正規化・ノートのマージといった定期メンテナンス作業を自動化するシェルスクリプトが含まれています。
「自己組織化」という主張は、フィードバックループに基づいています。新しいノートが追加されると、エージェントスキルがそれを既存の分類体系と照合して分類し、関連ノートへのリンクを提案または適用し、インデックスを更新します。別途スケジュールされたメンテナンススクリプトは、孤立したノート・競合するタグ・陳腐化したコンテンツを検出し、自動的に解決するか、あるいは人間によるレビューのために表示します。最終的な意思決定権限は人間が持ちますが、日常的なキュレーション作業は委譲されます。
技術的な観点からすると、これは新規性の高いシステムというよりは、既存ツール——Obsidian のファイルフォーマット、Claude Code のツール使用インターフェース、標準的なシェルスクリプティング——を独自の方針でインテグレーションしたものであり、動作するシステムのセットアップ時間が数日ではなく数分で済むだけの十分な足場が用意されています。
このアプローチは、Claude Code 固有のツール呼び出し規約と Obsidian の Markdown 方言に密結合しています。他のエディタやエージェントランタイムへの移植には、相当な適応作業が必要になります。また、ボールトのノート数が数千を超えると、コンテキストウィンドウベースの分類ステップに負荷がかかる可能性もあります。
Source: https://github.com/undefined-ui/second-brain-os
useagenthq/useagent
UseAgentは、エージェントタスクごとに隔離されたクラウドコンピューティング環境をプロビジョニングし、ユーザーがサブスクリプションを持つコーディングエージェントランタイム(Claude Code、OpenAI Codex、またはOpenCode)を通じて作業をルーティングする、オープンソースの「AIコワーカー」プラットフォームです。このプラットフォーム自体はモデルをバンドルせず、環境のプロビジョニング、ツールの可用性、およびアーティファクトの受け渡しを処理するオーケストレーションインフラとして機能します。
各タスクはファイルシステム、ブラウザ、およびシェルアクセスを備えたサンドボックス化されたクラウドコンピュータを受け取るため、エージェントは他のタスクやホストマシンと状態を共有することなく、マルチステップの作業(コードの記述、テストの実行、サイトの閲覧、資料の生成)を実行できます。PRや表計算ファイル、レポート、構築済みウェブサイトなどの成果物は、生のcompletionではなくアーティファクトとして返却されます。
オープンソースリリースには、オーケストレーション層とサポートされている3つのランタイム向けの統合アダプターが含まれています。チームは自身のモデルサブスクリプションを持ち込む形式であり、これによりUseAgentはモデルの再販業者になることなく、新しいコーディングエージェントが登場してもランタイムに依存しない状態を維持できます。
アーキテクチャ上の興味深い制約は、クラウドコンピュータ環境のスピンアップコストを低く抑える必要がある点(タスクスコープ型であり永続的ではない)、および異なるtool-callingの規約を持つランタイム間で一貫したツールインターフェースを公開しなければならない点です。これらの差異を正規化するアダプター層が、このプロジェクトの中核となる技術的貢献です。
制限事項:クラウド環境のプロビジョニングは、公開リポジトリからはセルフホストできません。そのインフラは引き続きマネージド型として提供されます。
Source: https://github.com/useagenthq/useagent
Apeireth/Apeireth
Apeirethは自身を「認知マイクロカーネル」およびAGIオペレーティングシステムと称しており、純粋なsafe Rustで記述され、16のcrateのworkspaceとして構成されています。マーケティング的な表現を脇に置くと、その技術的な内容はいくつかの非自明なシステムプログラミングの関心事を組み合わせた実験的アーキテクチャです。具体的には、知識を継続的に更新される永続グラフとして表現するトポロジカルメモリモデル、環境変数の軽量な確率的状態を維持するcausal world modelクレート、推定効用によって推論タスクを優先順位付けする認知スケジューラ、そして3段階の特権レベルにわたってcapabilityの分離を強制するtriple-onionセキュリティモデルが含まれます。
「Ember HUD」は、認知スケジューラおよびメモリサブシステムのためのターミナルベースの観測インターフェースです。ポータブルUSBエージェント機能は、ランタイムとその状態を再設定なしにマシン間で移動可能な形式にパッケージ化するもので、絶対パスおよびハードウェア依存の状態を慎重に扱う必要があります。
全体を通じてsafe Rustを使用していることはアーキテクチャ上重要な意味を持ちます。メモリ安全性はコンパイル時に強制されており、これは基盤となるOSのセーフティネットなしに自身の内部メモリグラフとスケジューラを管理するランタイムにとって重要な点です。
率直な評価:これは強いアーキテクチャ上の主張を持つ野心的な研究プロトタイプですが、公開されたベンチマークは存在せず、記述が実証された能力を大幅に上回っています。crateの分解とsafe Rust制約が具体的なエンジニアリング上の貢献です。「AGI」というフレーミングが実際のシステムの振る舞いを反映しているかどうかは、リポジトリからは検証できません。