Daily AI Digest — 2026-09-15
arXiv ハイライト
Discovery Foundation Models: Open-Ended Discovery Intelligenceに向けて
本稿はポジション/フレームワーク論文であり、現在のfoundation modelの研究が「与えられた研究構造の中での汎用的な問題解決」で頭打ちになっているという主張のもと、その構造自体を修正できるモデルに向けた能力仕様、システム組織、訓練レシピ、および評価プロトコルを提案しています。ベンチマーク数値は含まれておらず、貢献は形式的な枠組みと、二つの名前付き実例(システム組織としてのZetema、治療的発見のデプロイメントとしてのGALILEO)から成ります。以下では、実装者に役立つ精度でその仕組みを要約します。
構造的な主張
標準的なモデルのタスクは5-タプルとして抽象化されます:
\mathcal{Q}=(P,R,G,T,V),
ここで問題P、表現R、目標G、ツールT、評価器Vです。現在のRLHF、ツール使用、およびエージェント学習によってスケールされるあらゆるものは、このタプルが固定されかつ十分であると仮定しています。著者たちはこれが引き起こす具体的な失敗モードを指摘しています:観測的に等価なメカニズムはより多くのサンプルによっては区別できない;ある変数を省略した表現はその変数を表現できない;評価器が無視する性質を探索目標は回復できない;誤って構成されたタスクの自動化は、その誤構成をより効率的にするだけで可視化しない、というものです。これが「構造的天井」——本論文の動機となる診断——です。
発見は、五つのスロットをすべて緩めることで定義されます。発見エピソードは以下の写像です:
\Phi_{\mathrm{disc}}:(\mathcal{W},\mathcal{K}_0,\mathcal{B})\longrightarrow(\Delta\mathcal{K},\Xi),
部分的にしか理解されていない世界\mathcal{W}、事前知識\mathcal{K}_0、および制約\mathcal{B}から、外部で検証された知識の進捗\Delta\mathcal{K}と、状態遷移・代替案・失敗した定式化・改訂の証拠を持つトレース\Xiへの写像です。このトレースは第一級の出力です:ある効果が再現できないことを示すこと、あるいはある問いが現在の測定では検証不可能であることを示すことも、有効な\Phi_{\mathrm{disc}}の出力として認められます。
七つの能力とシステム境界
DFMは行動的に定義されます:価値ある未知を識別すること、研究可能な問題を定式化すること、表現を構築・修正すること、検証可能な説明を生成すること、介入を設計すること、外部証拠から学ぶこと、そしてタスクをまたいで発見能力を改善すること、の七つです。三つの要件が付随します:操作のクロスタスク転移、外部証拠によるグラウンディング(モデルの信頼度は不十分)、そしてメモリ・ツール・検証器・人間の参加を含む宣言されたシステム全体の評価です。
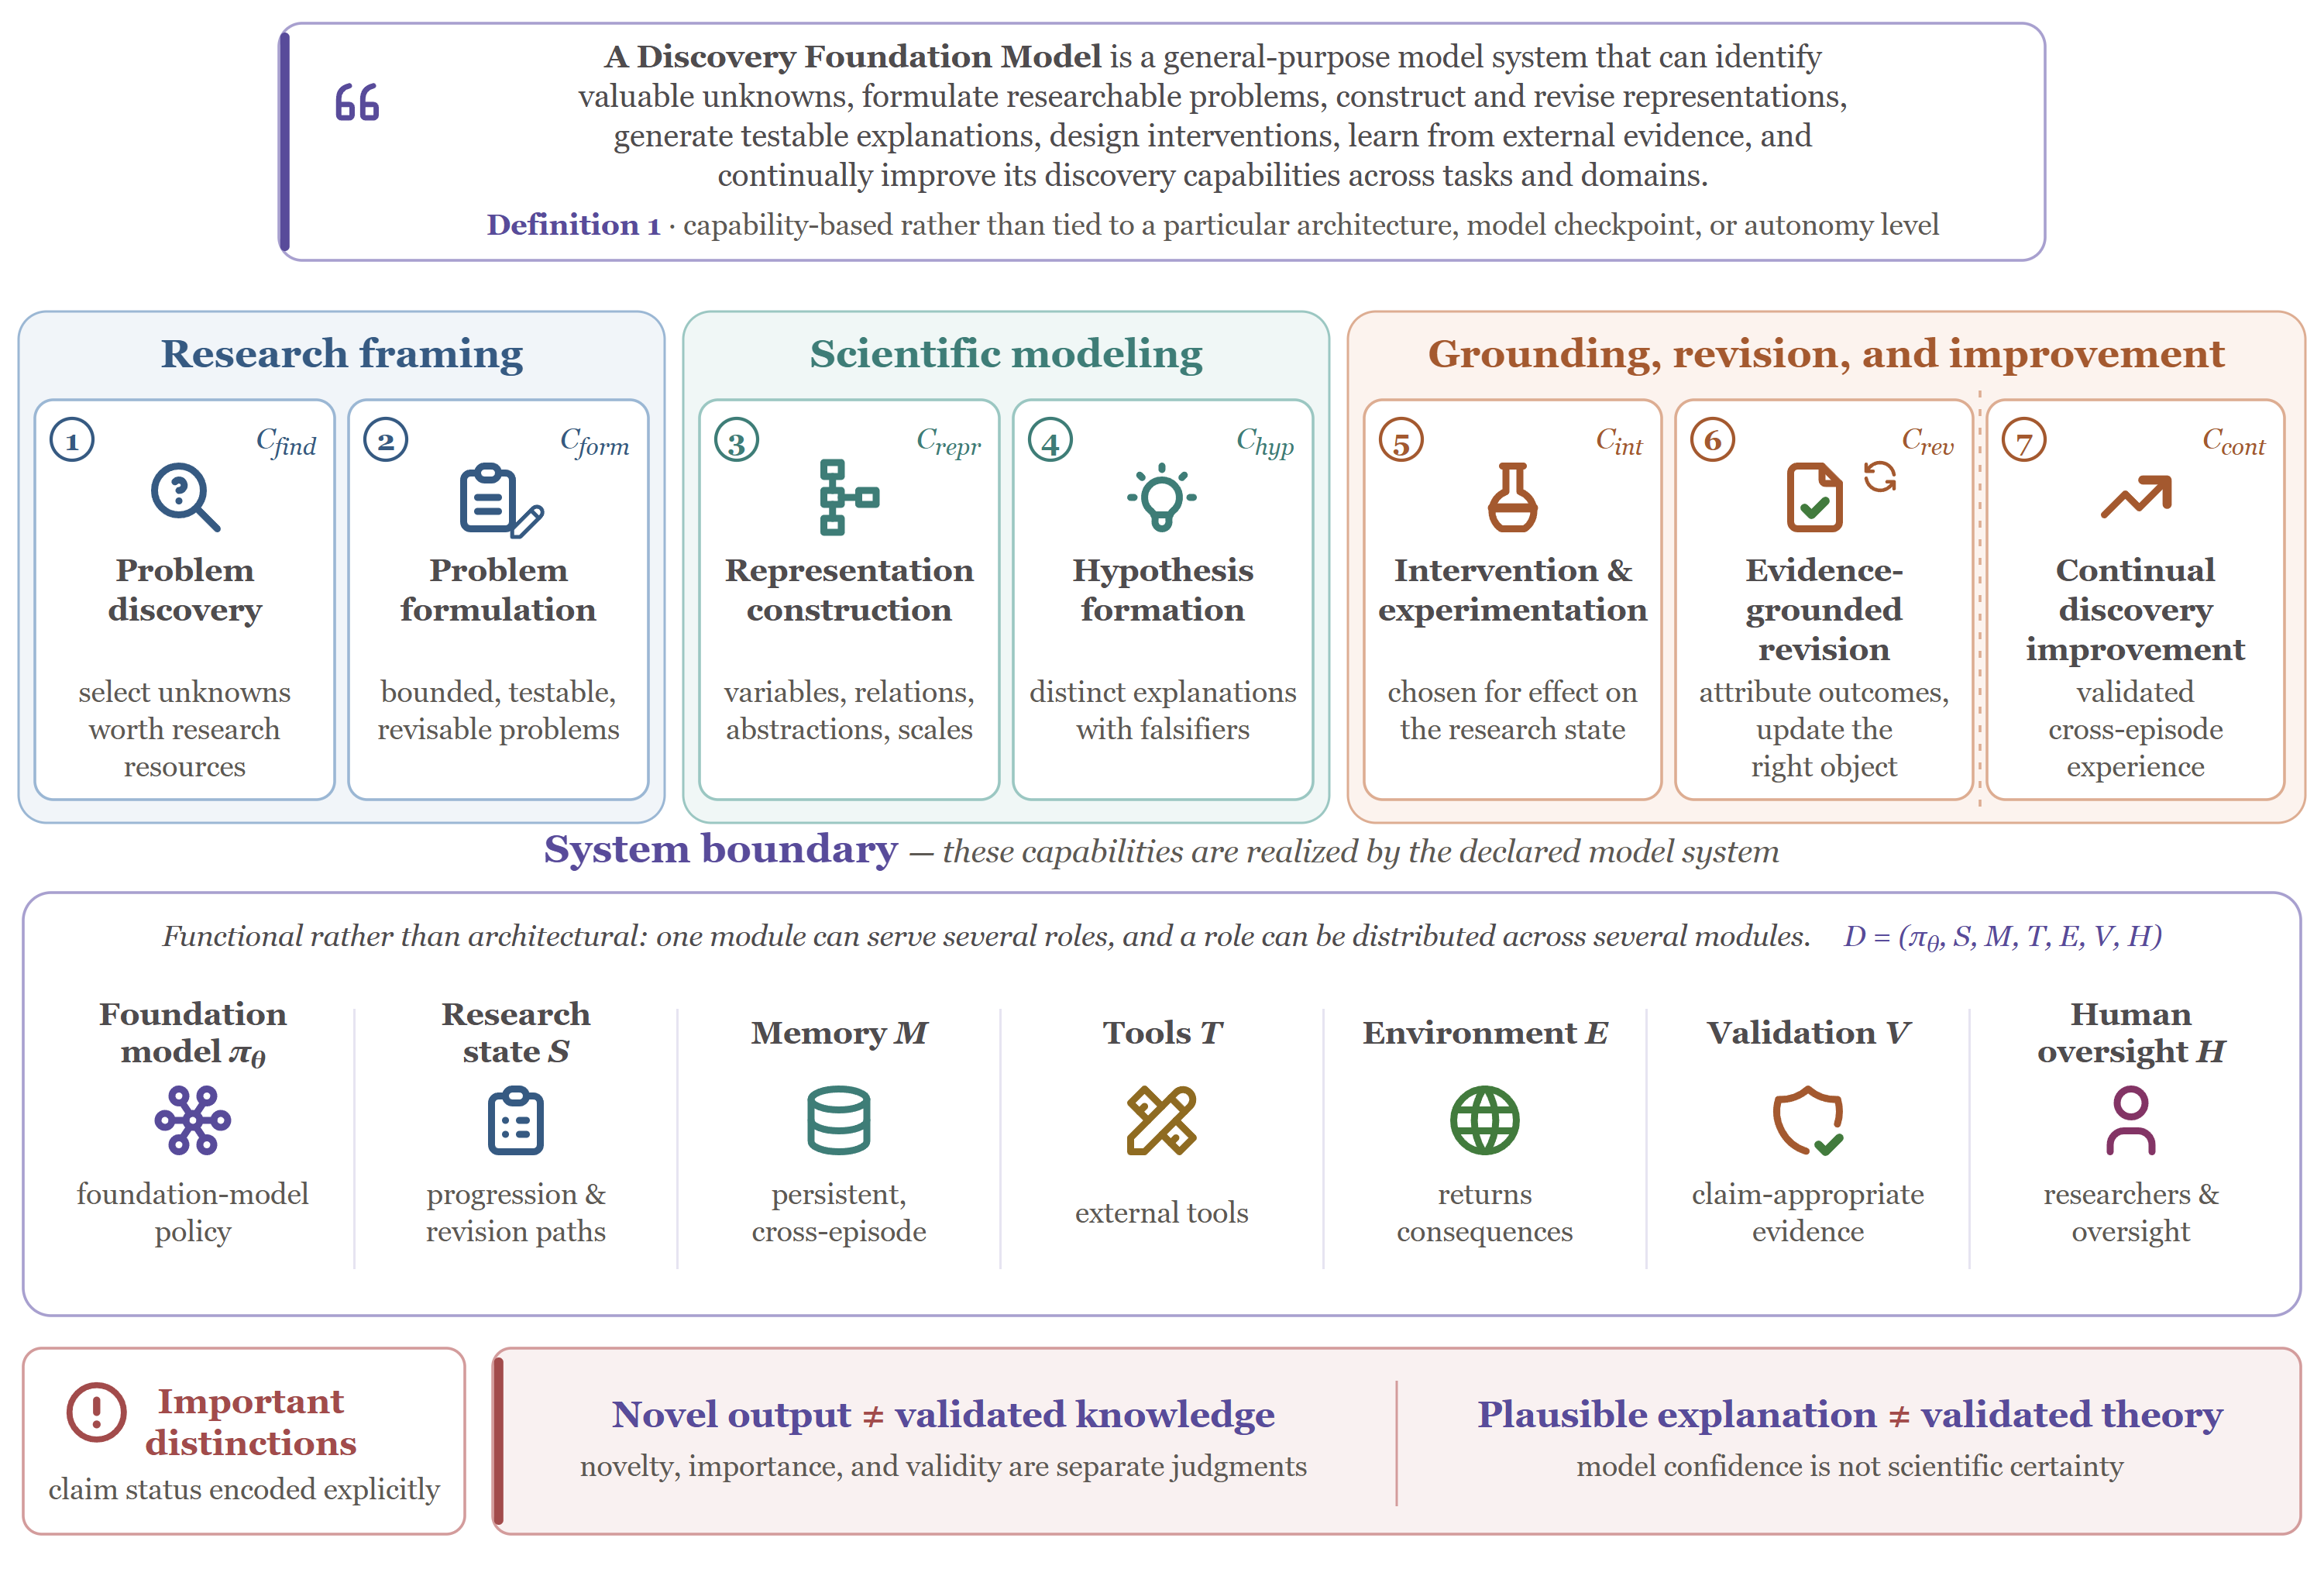
七つの能力はパイプラインではありません。研究可能な問題は以下のタプルとして表現されます:
P=(O,\Omega,\ell,C,Y,Q)
——対象、スコープ、スケール、条件、観測量、および未解決の関係です。これらのフィールドを明示的にすることで、システムは例えば、固定された仮説族の中でより一生懸命探索するよりも、Yを変更することが正しい手立てであるということを検出できるようになります。
発見プロセス:パイプラインではなく修正として
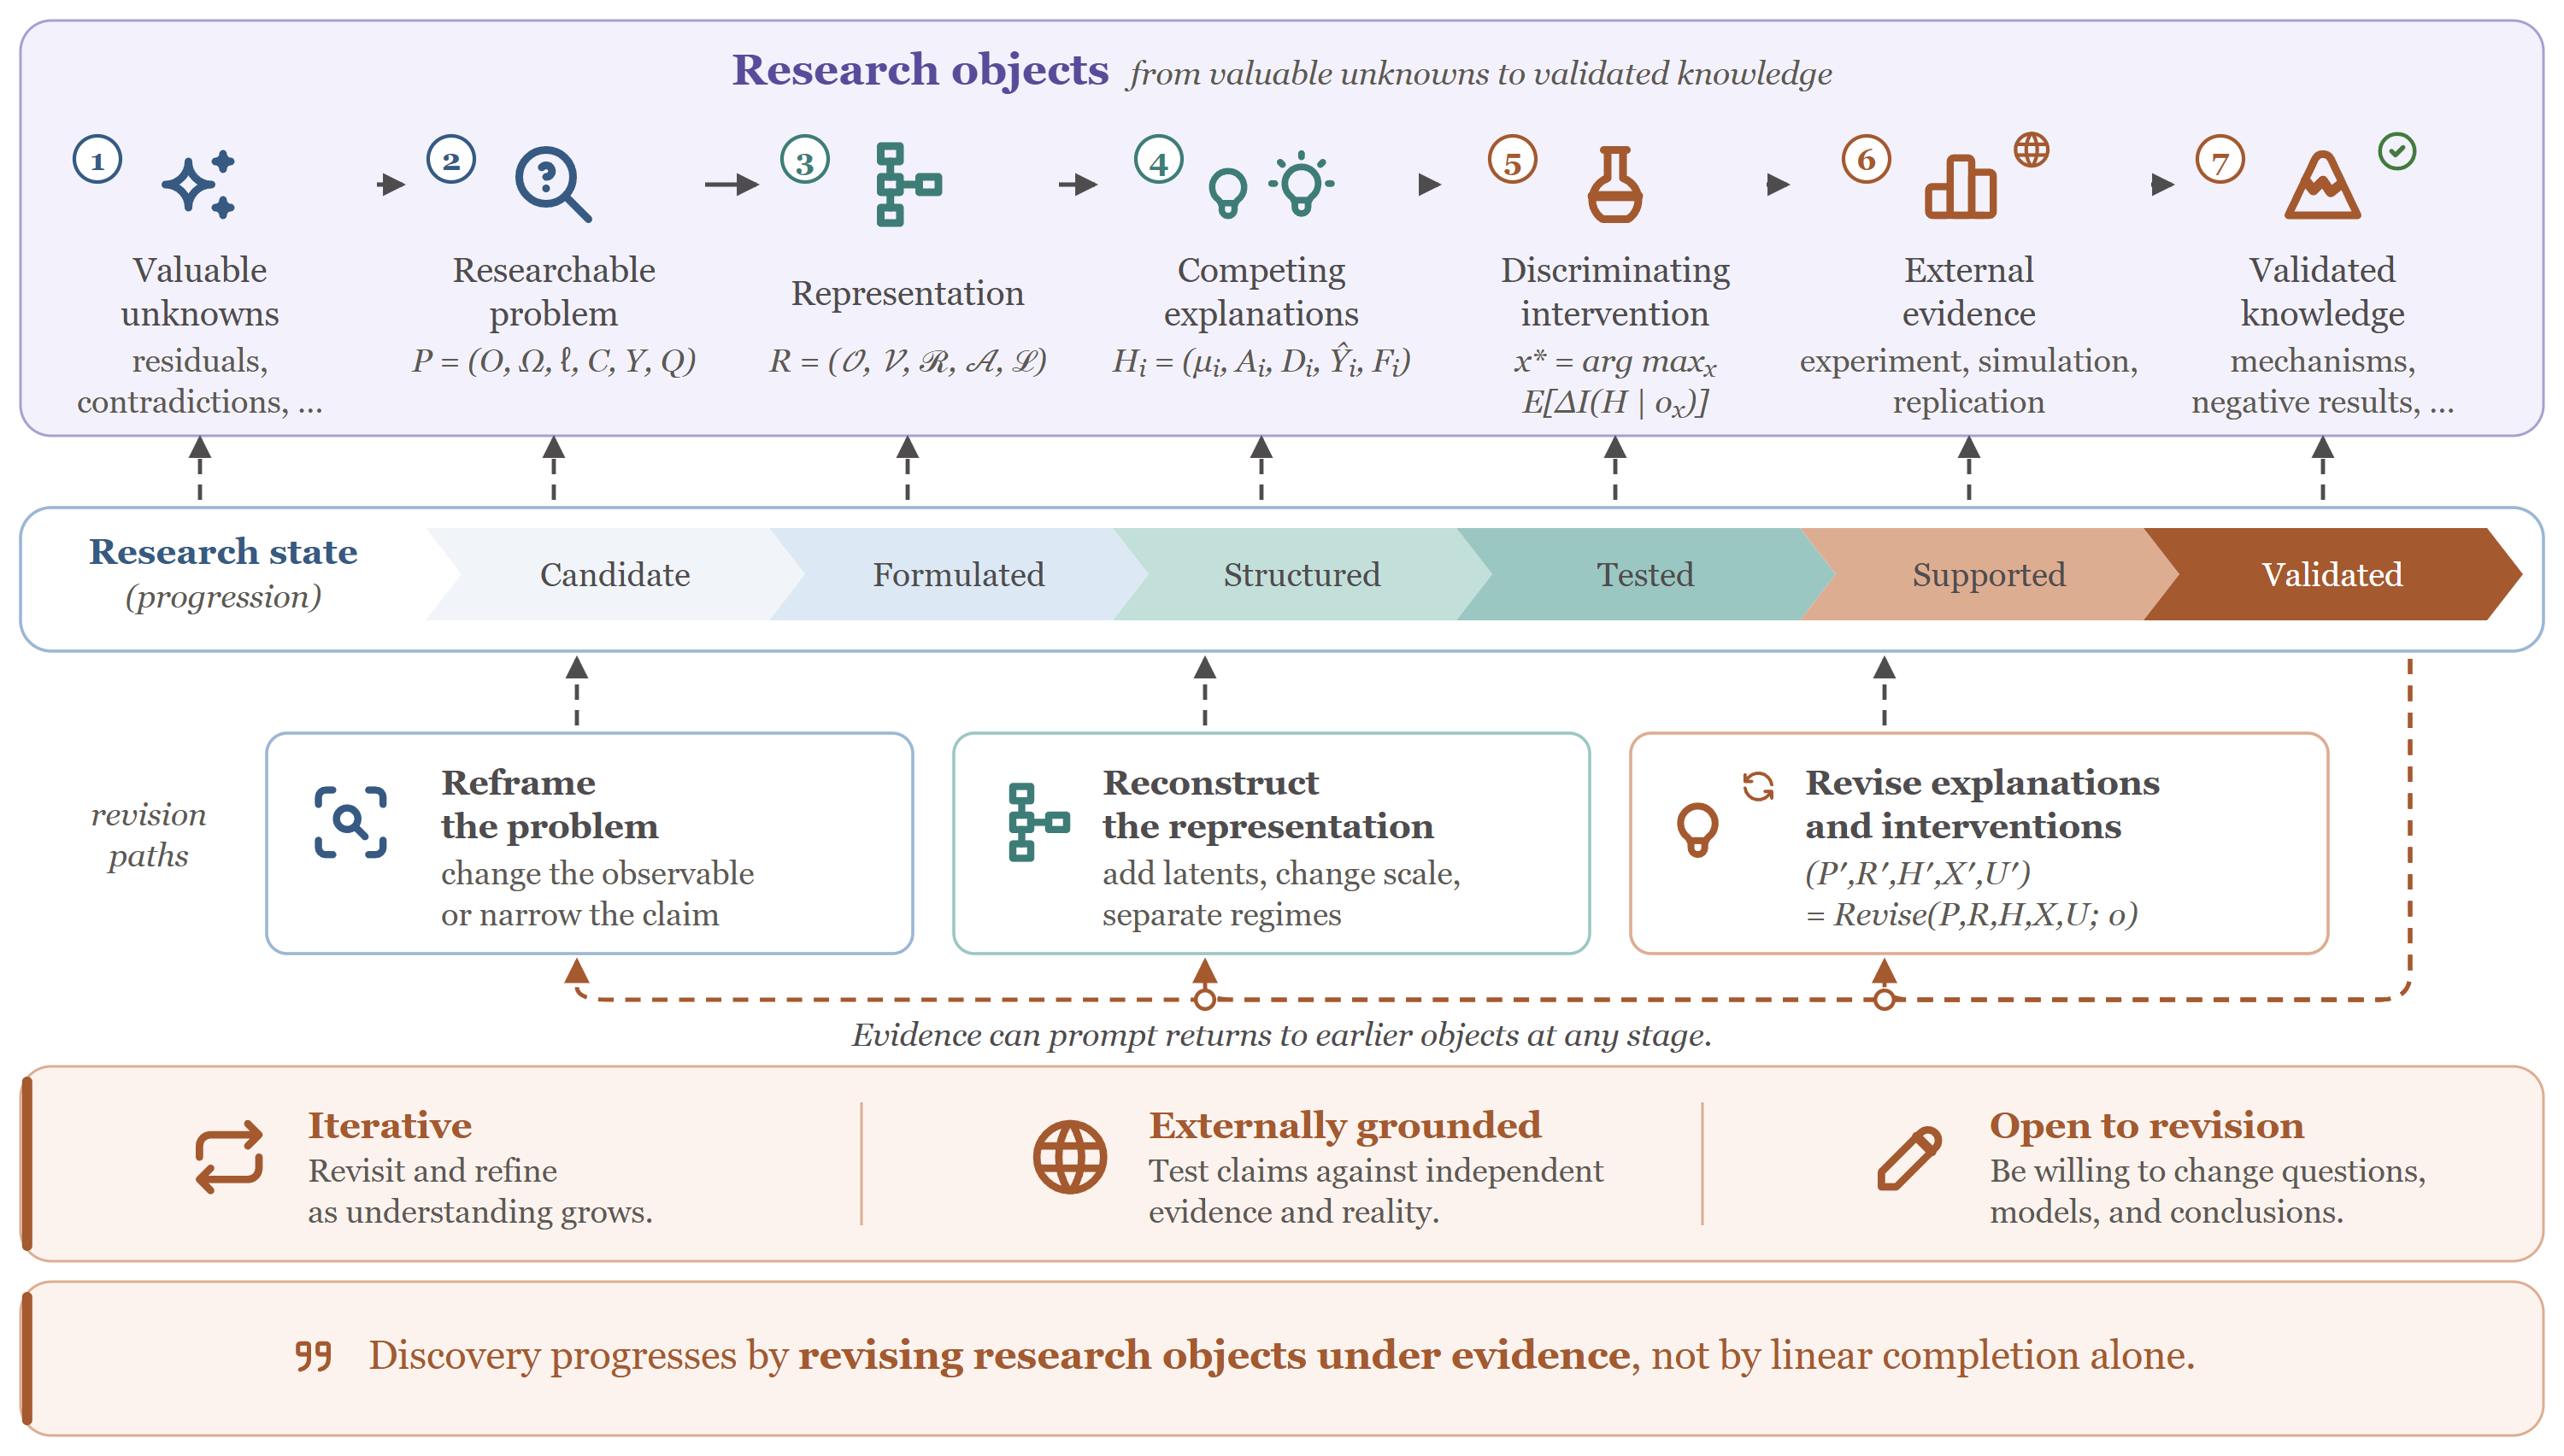
証拠が調査を事前の表現や問題に差し戻せるという主張が、段階的な「AIサイエンティスト」ワークフローからの核心的な逸脱です。複数の定式化が共存できます;異なる表現は異なる仮説族をサポートします;一つの残差を、欠落変数・データセットのシフト・実装バグとして、介入によって識別されるまで同時に追跡することができます。
Zetema: システムの実例
Zetemaは発見ループを、研究状態S_t上の制御された動的システムとして形式化します:
S_{t+1}=\mathcal{F}(S_t, a_t, o_t),
ここでa_tは通常のツール呼び出しと、研究プログラム自体への操作の両方にわたります:問題の分割、変数の導入、スケールの変更、表現の置き換え、敵対的な説明の構築、複製の要求、ブランチの終了などです。ブランチは第一級の状態オブジェクトであり——比較可能、マージ可能、アーカイブ可能、復元可能——終了基準には非識別可能性、複製失敗、予算超過、およびより情報量の多いブランチによる先取りが含まれます。
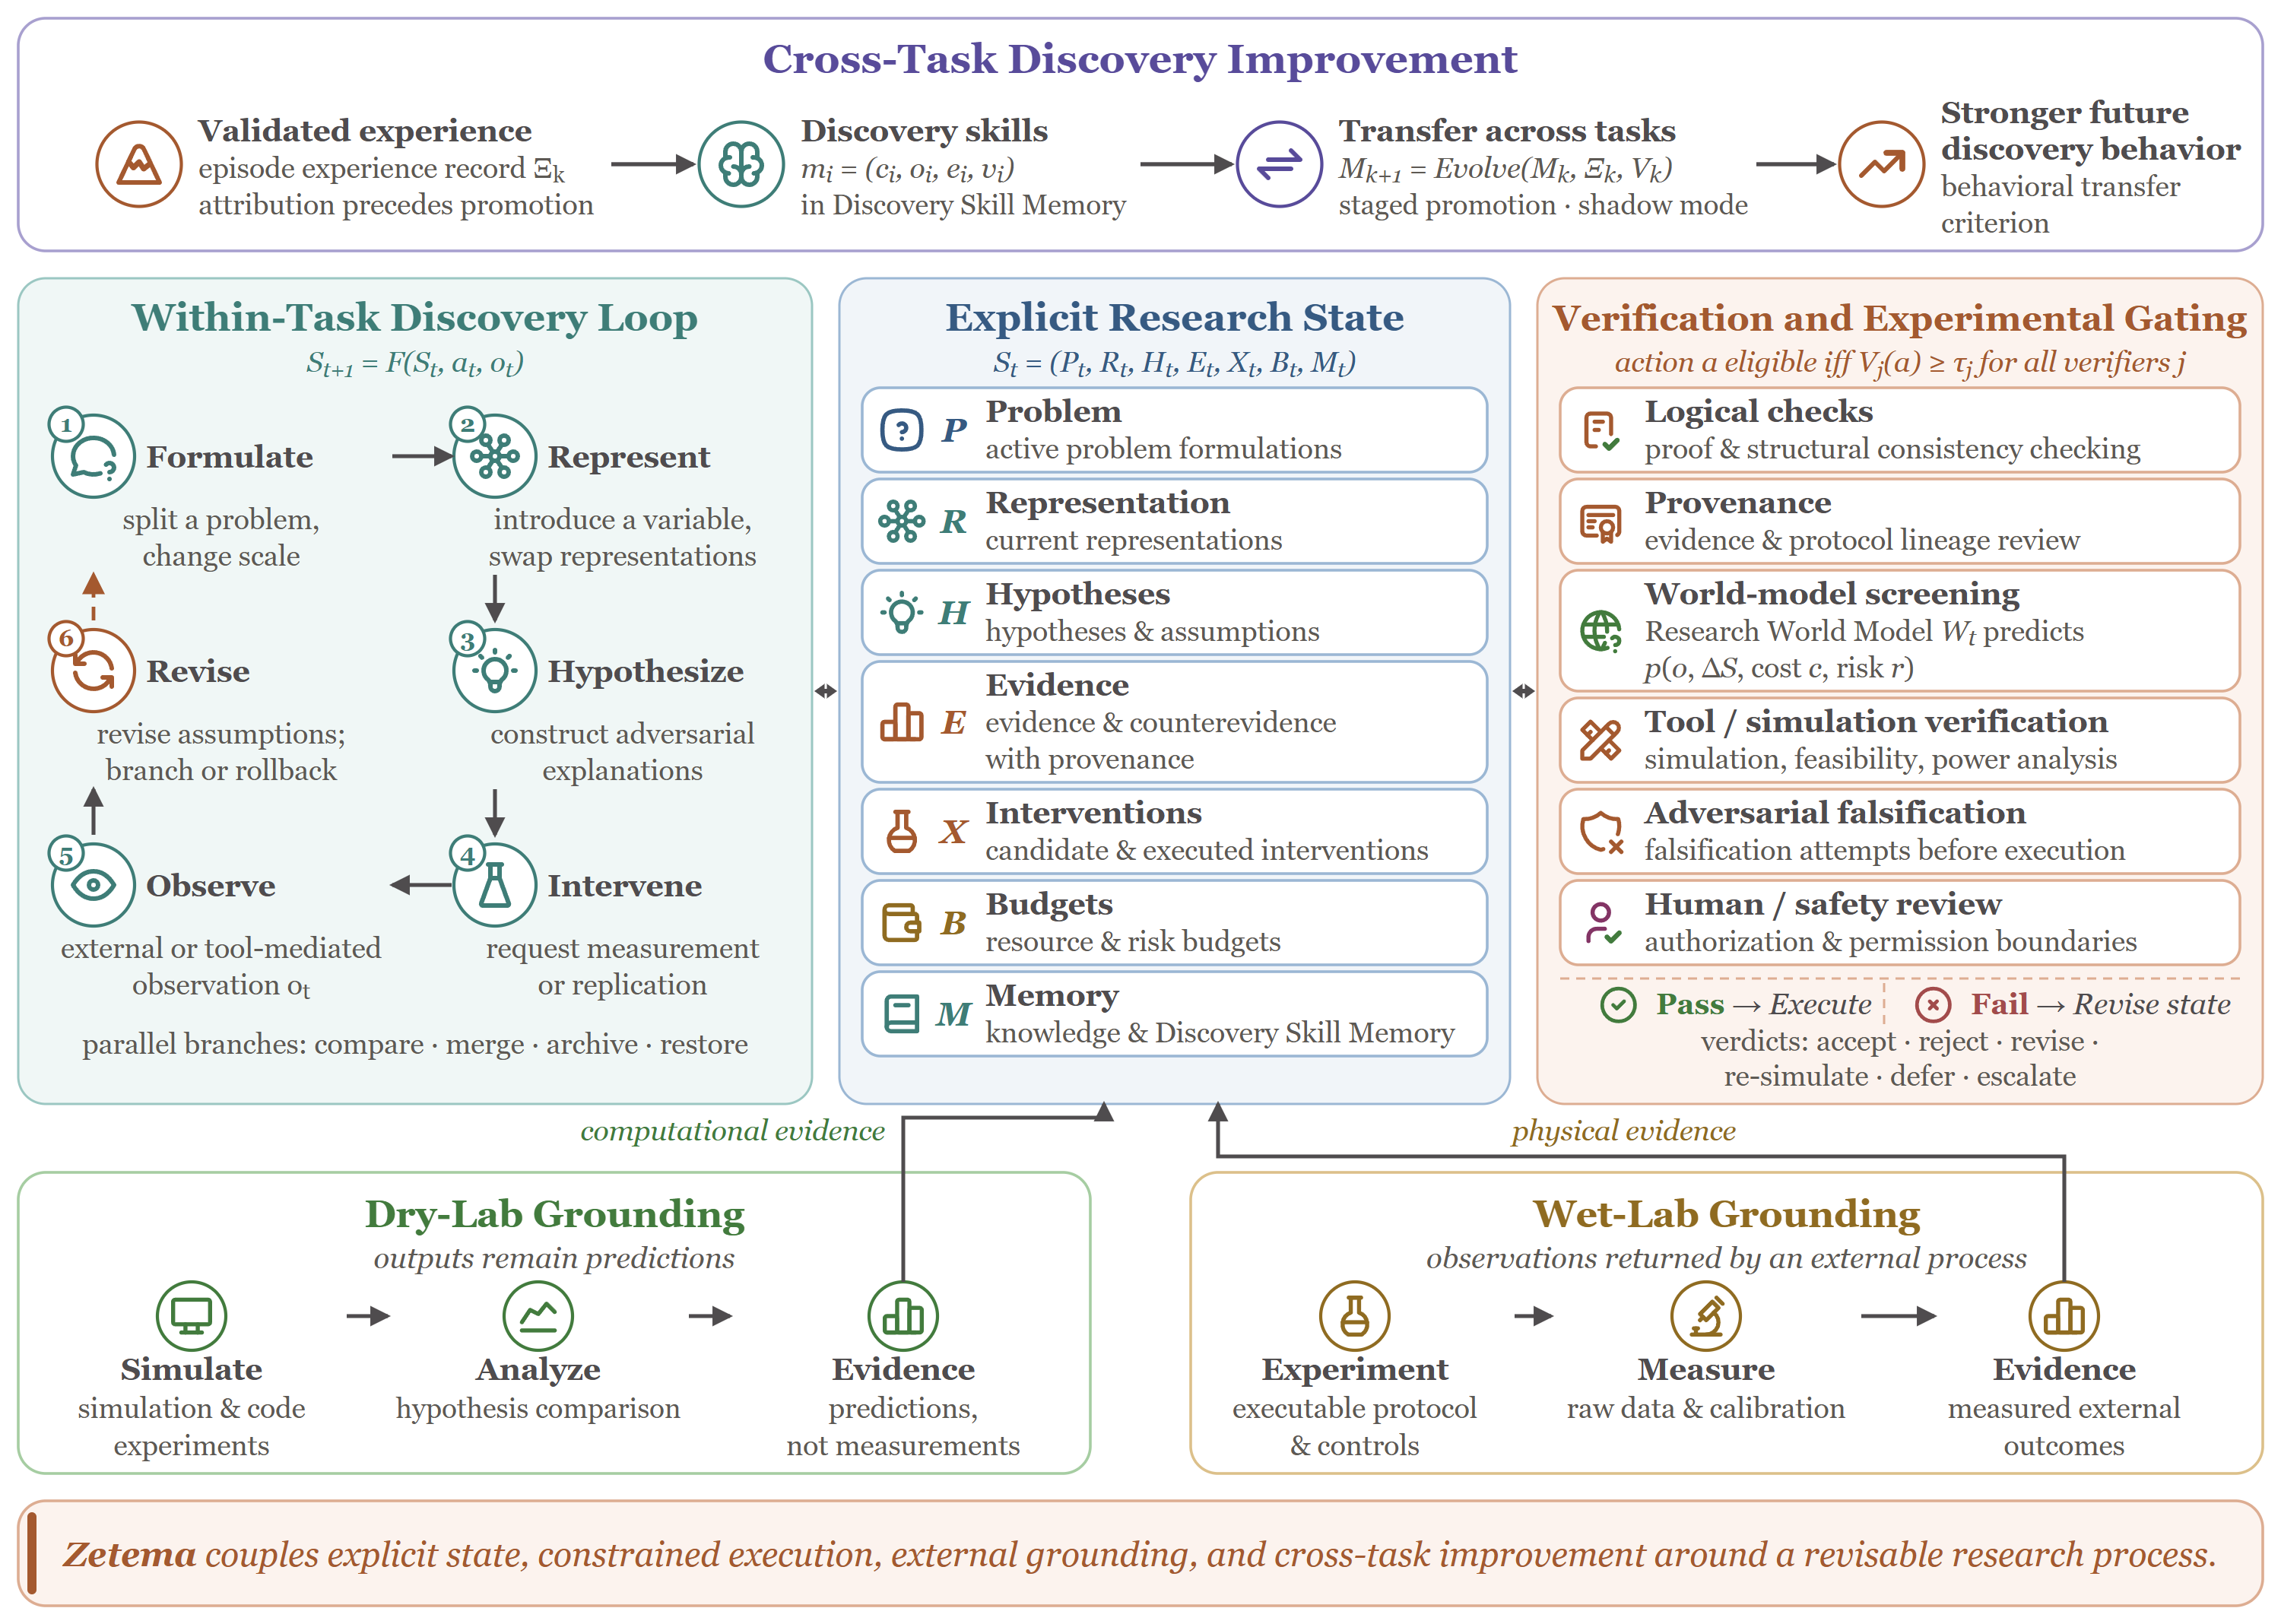
設計制約は一行に集約されます:科学的に重要なすべての操作は、検査可能な状態遷移を残さなければならない。この制約こそが、帰属、リプレイ、反事実的学習、およびDiscovery Skillの集約を可能にするものです。Dry-Lab(コード、シミュレータ、検索)とWet-Lab(ロボットおよび人間による実行)のインターフェースは、検証と実験的ゲーティングのもとで共有状態に証拠を書き戻します。
能力の形成
学習は解条件付きではなく、状態条件付きです。複合目標\mathcal{L}_{\mathrm{DFM}}は、発見アクションの模倣、研究状態遷移モデリング、preference optimization、プロセス検証、Research World Model、科学的フィードバックからのRL、および検証済みDiscovery Skillの転移を組み合わせています。データ側で二つの注目すべき点があります。第一に、成功のみのトレジェクトリは不十分であると宣言されています——不正形な問い、非識別的な介入、および放棄されたブランチは、その失敗の原因が可視の状態で保持されなければなりません。そのため、低パワーで決定的でない実行が、うまく実行された非識別的な実行と同じ更新を教師信号にしてはなりません。第二に、出処(ノートブック、事前登録、合成シミュレータ、デジタルツイン)は、平坦化されたアノテーションではなくトレジェクトリの一部です。インタラクティブ環境は、問い・行動空間・成功基準を同時に明かすのではなく、科学的に意味のある構造——隠れた変数、観測的に等価なメカニズム、評価器のミスマッチ——を隠すことが要求されます。
評価
発見の進捗は以下のペアです:
\mathcal{P}_{\mathrm{disc}}=(\Delta K_{\mathrm{val}}, \Delta C_{\mathrm{future}}),
エピソード内で外部から検証された進捗と、後の発見行動における測定可能な改善とを分離します。新規に聞こえる仮説を生成することはクレジットされません。記憶化、ベンチマークリーク、プロンプトの再利用、ほぼ重複した検索結果、および追加計算に対するコントロールは必須です。デジタルホライゾンについては、一つのモデルがコードを書き、メトリクスを選び、テストを生成し、結果を解釈するという自己確認ループのリスクを著者たちは指摘しています;隠しテストと独立した評価器は、最もコストの低い設定においても依然として必要です。
限界と未解決の問題
本論文は仕様であり、実証的な結果ではありません。アブレーション、ベースライン、Zetema式の状態遷移教師あり学習が強いエージェントベースラインに比べて\Delta C_{\mathrm{future}}を実際に改善するかの測定、また既存の自律科学システム(Coscientist、ChemCrow、Robinなど)との比較は存在しません。スケールで明示的な研究状態を維持・分岐・帰属するための運用コストは分析されていません。「成功のみのトレジェクトリは不十分」という断定的な主張はもっともらしいですが、本論文では検証されていません。GALILEOは参照されていますが、提供されたセクションでは定量的に特徴付けられていません。七つの能力が、一つの絡み合ったポリシーに収束するのではなく、十分に明確に分解されて異なる信号で学習できるかどうかが、このフレームワークが残す中心的な実証的問いです。
なぜこれが重要か
もしこの診断が正しければ、与えられた(P,R,G,T,V)の中で最適化するエージェントをさらにスケールしても、タプル自体が誤っていると認識できるシステムは生まれません。それはほとんどの現実の研究が行き詰まる領域です。本論文の具体的な貢献は、修正可能な研究状態、ブランチオブジェクト、出処タグ付きトレジェクトリ、(\Delta K_{\mathrm{val}},\Delta C_{\mathrm{future}})による評価の分割という一連のインターフェースです。これらは直接実装可能であり、下流タスクスコアから仮定するのではなく、発見構造の修正が実際に学習されているかどうかをこの分野が測定できるようにするものです。
Source: https://arxiv.org/abs/2609.15973
ロボット操作におけるエージェントのポリシーとしての活用
問題設定とフレーミング
本論文は、汎用の frozen LLM エージェントが、タスク固有の fine-tuning、模倣データ、環境固有の学習ループなしに、ロボット操作のポリシーとして直接機能できるかどうかを問います。動機は、最近のエージェントがすでに強力な推論能力、ツール利用能力、プログラム合成能力を備えているという点にあります。エージェントが実行時に物理ロボットとのループを閉じることができれば、操作学習における通常のデータ収集のボトルネックを回避できます。具体的な問いは、このようなエージェントが、ビジョンと文書化されたロボット API のみを用いて、精密な挿入作業、動的(非準静的)な動作、変形可能物体の操作を処理できるかどうかです。
手法:AGP
AGP は準備フェーズと実行フェーズを分離します。タスクタイプごとに一度呼び出される準備エージェントは、ユーザーのリクエストを、ゴール・参考資料(デモ動画、目標画像、言語)・制約・許容される変動・完了基準・インターフェースアクセスルール・時間およびトークン予算からなる永続的なタスク定義に蒸留します。固定の重み \theta を持つ独立した実行エージェントが、各タスクインスタンスを処理します。
実行エージェントはツール選択ポリシーとしてモデル化されます:
u_k \sim \pi_\theta(\cdot \mid g, I, H_k, W_k),
ここで g はタスク仕様、I は文書化されたロボットインターフェース、H_k はステップ k における会話およびツール返却履歴、W_k はファイル(スクリプト、メモ、キャッシュされた観測)の永続的なワークスペースです。ツール呼び出しは、(i) 観測(手首またはオーバーヘッドカメラフレーム、深度)の要求、または (ii) 動作目標を計算して低レベルコントローラに送信する Python プログラムの実行、のいずれかを行います。重要なのは、計画・知覚解析・制御コードがすべて同一のエージェントによって実行時に生成されるという点です。ワークスペース W_k によってステップ間で再利用可能なスクリプトを蓄積でき、学習済みスキルの代わりにテスト時プログラム合成を実質的に実行します。
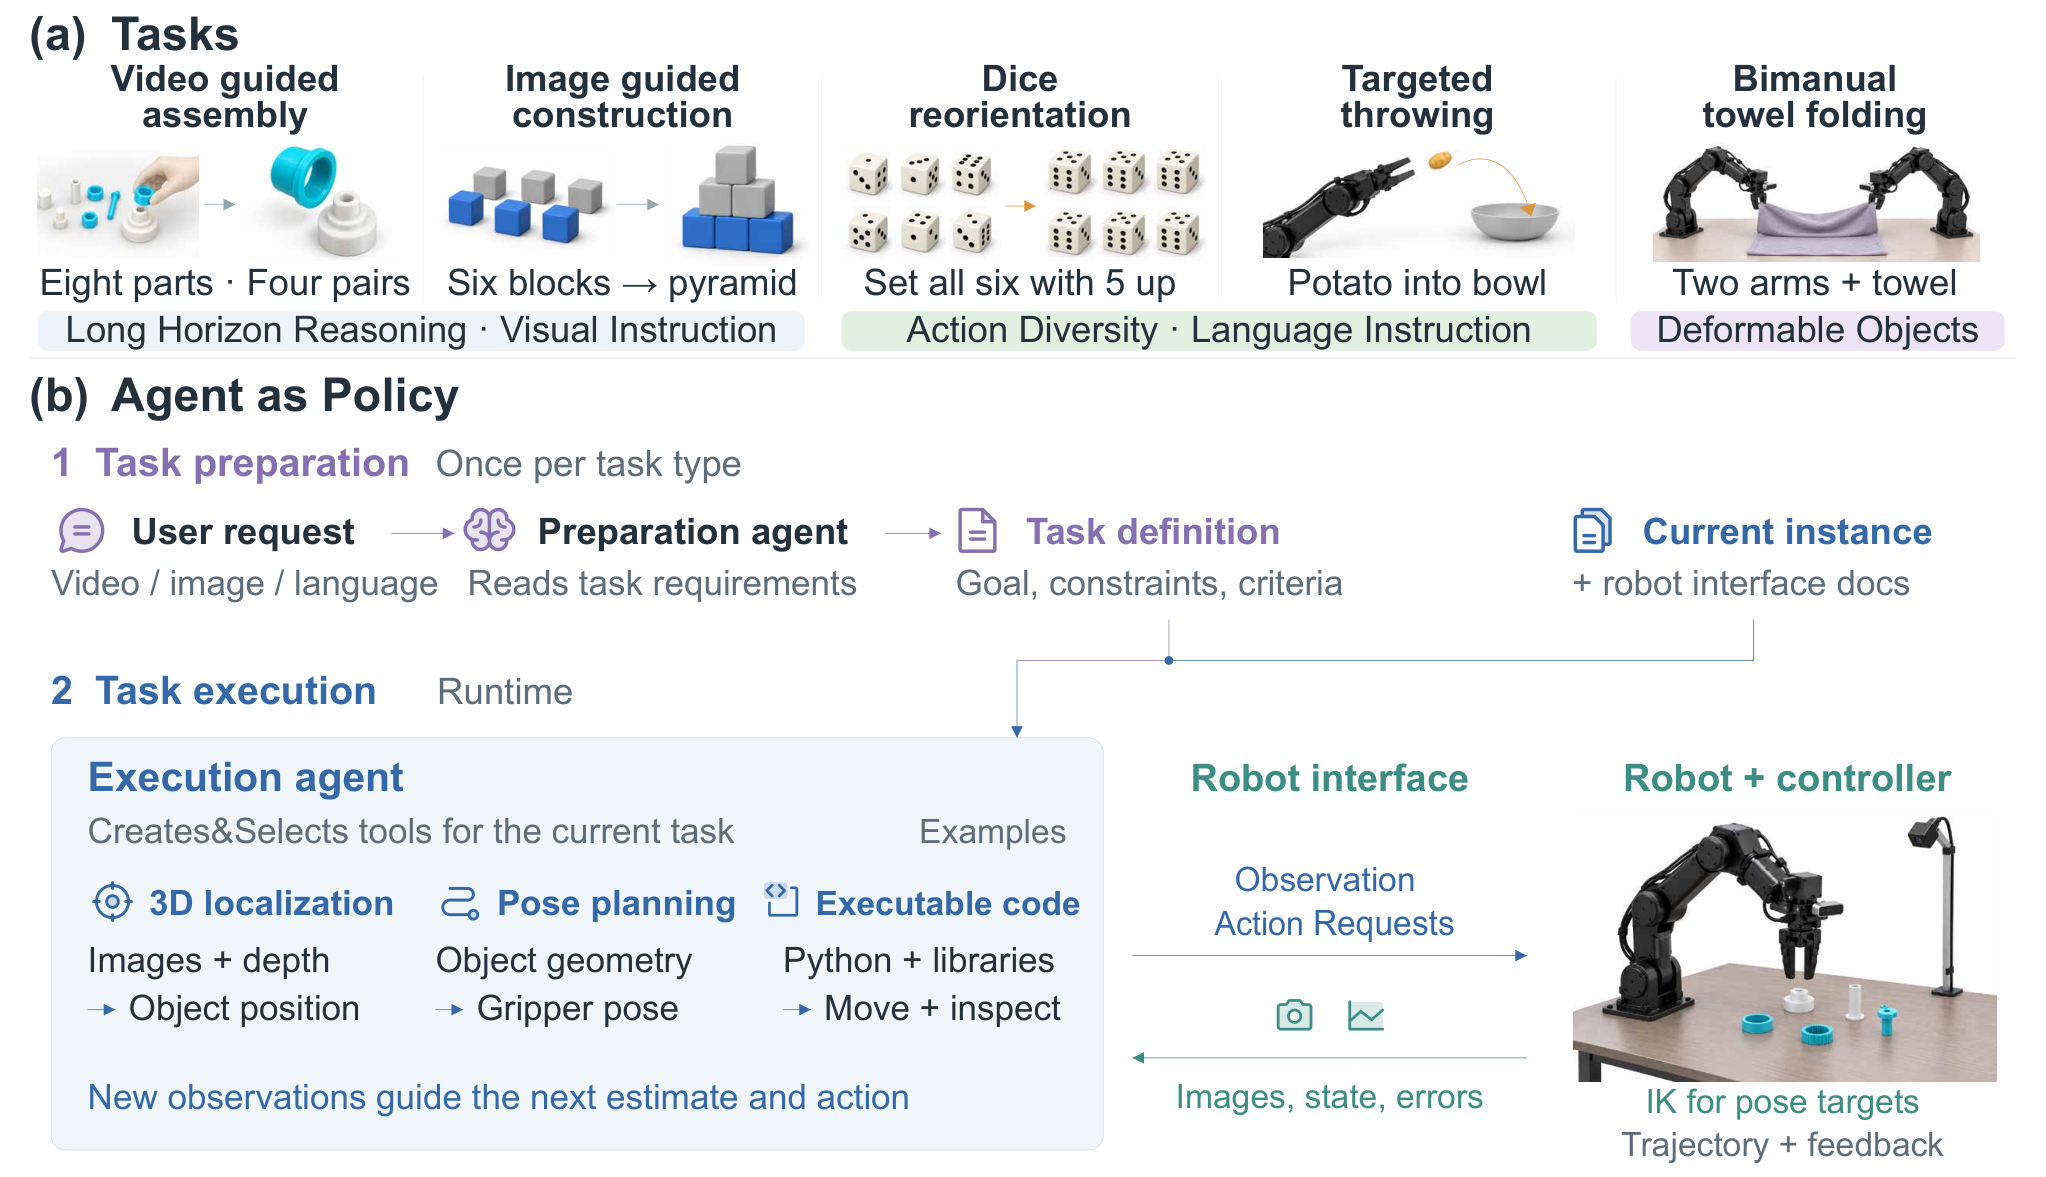
ロボットインターフェースは関節空間およびデカルト空間の動作プリミティブを公開します。目標への投擲タスクについては、時限モーション プログラムを持つ代替インターフェースが提供されます。これは、投擲にはリリース時刻精度の高い軌道が必要であり、デフォルトのブロッキングインターフェースでは表現できないためです。この設計上の選択——ポリシーではなくインターフェースを入れ替えるという方針——が、訓練なしで動的タスクをサポートするための本論文のメカニズムです。
ハードウェア
プラットフォームは、共有テーブルトップレール上に搭載された一対の I2RT YAM 6-DoF アームとパラレルグリッパーです。手首搭載の Intel RealSense D405 が 640\times360@30 Hz でアライメントされた RGB-D 画像を提供し、固定のオーバーヘッド Logitech BRIO が 1920\times1080@30 Hz の RGB 画像を提供します。エージェントはストリーミングではなくオンデマンドでフレームを取得します。
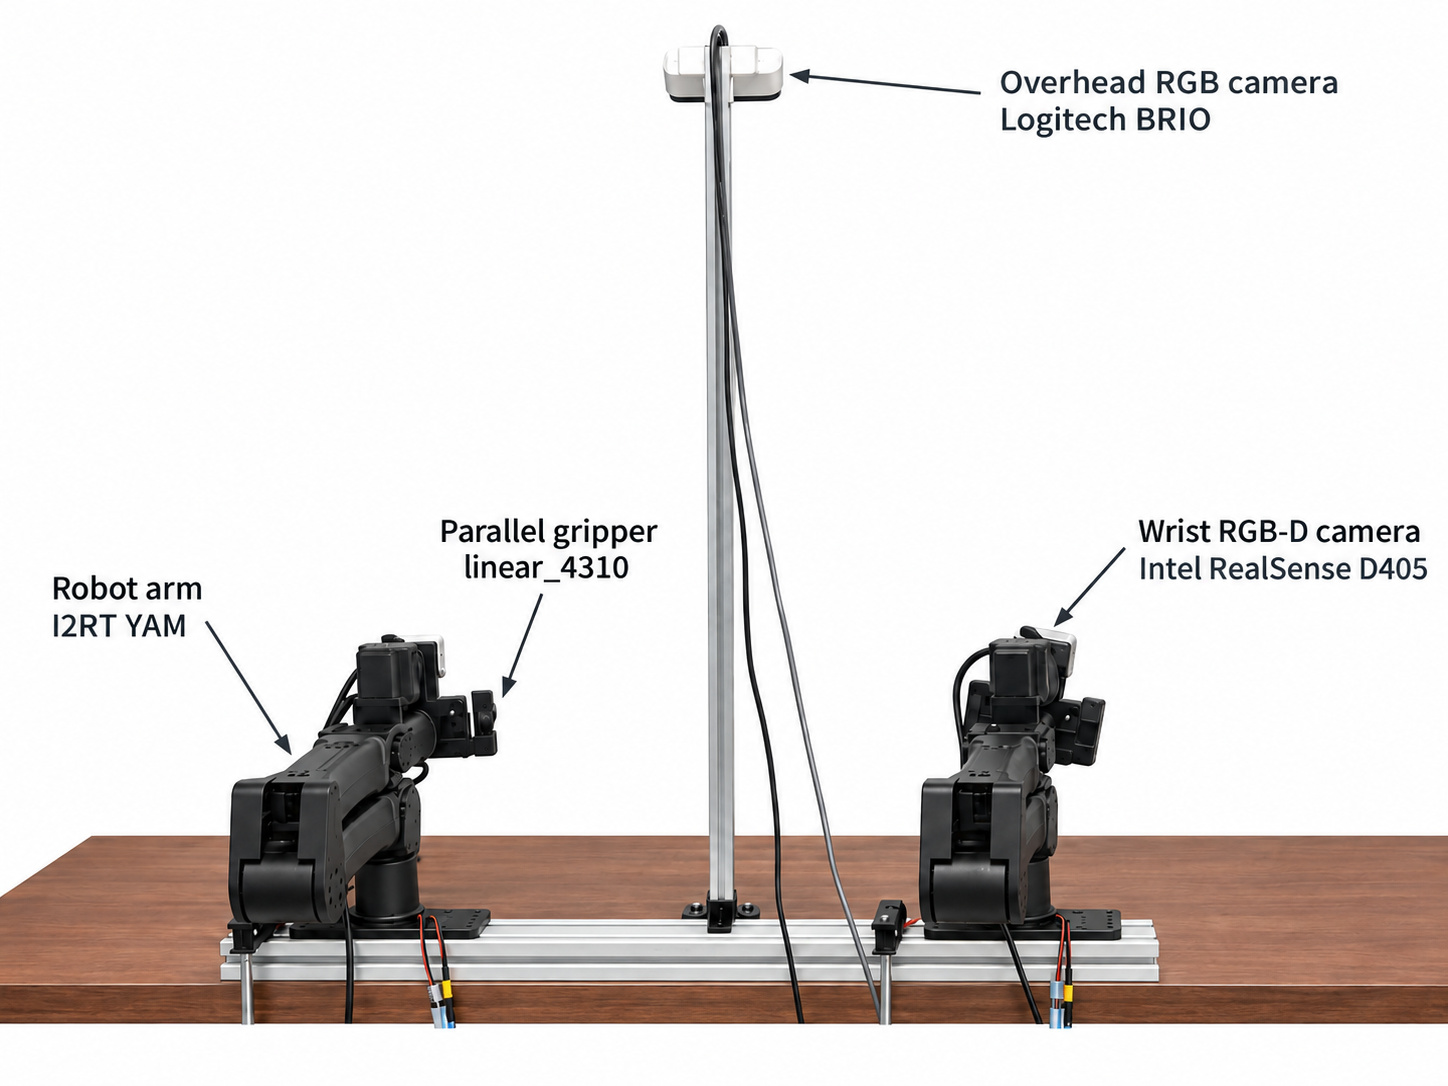
デフォルトのバックボーンは高い thinking effort に設定された GPT-6 Astra であり、二対組み立てバリアントに対してモデルと effort を変化させる ablation も別途実施されています。
結果
ビデオガイド付き組み立て(AutoMate から適応したパーツ)、画像ガイド付きブロック構成、サイコロの再配向、目標への投擲、両腕タオル折りたたみの5つのタスクファミリーにわたって、AGP はゼロショットで動作します。報告された主要な数値は以下の通りです:
- ブロック構成:3つの構成にわたって 100%、100%、80% の成功率。
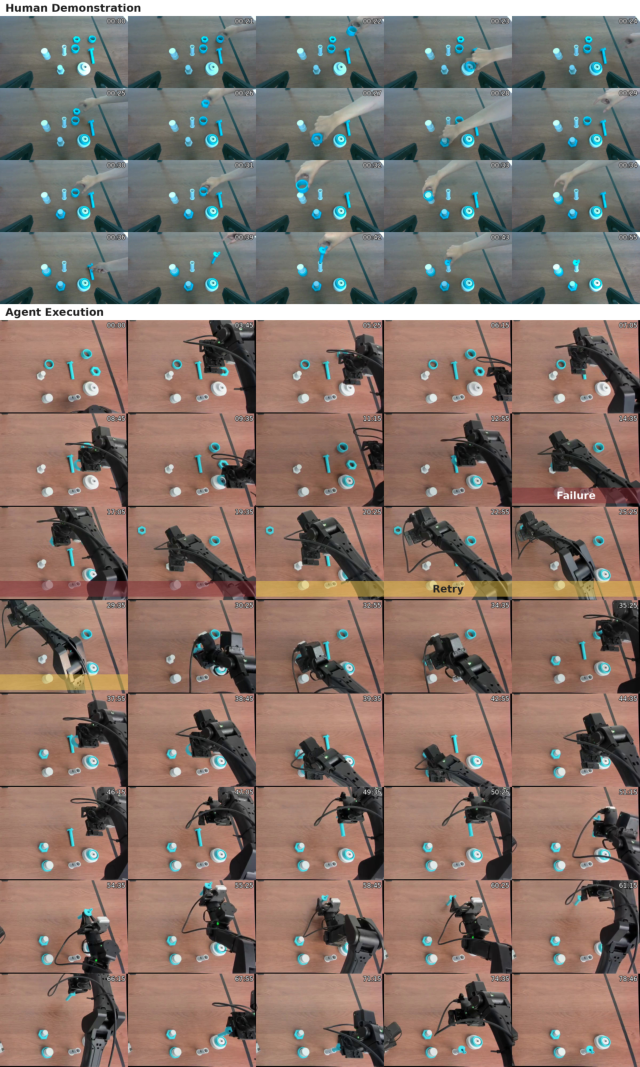
- 長期的な組み立ては、人間のデモ動画から駆動される四対のシーケンスについて定性的に実証されており、エージェントはナット挿入の失敗や把持のスリップから回復します(図5の濃い赤色と黄色のバー)。この回復動作は、エージェントの再観測と再計画から創発的に生まれるものであり、手動でコーディングされたリトライポリシーによるものではありません。
実験では、完了時間、トークン使用量、推論コストも検討されており、同一タスクの繰り返し実行においてワークスペースのチェックポイントを持続させることでレイテンシが削減されるかどうかについても調べられています(付録D)。W 内に蓄積されたスクリプトが暗黙のスキルライブラリとして機能するため、あるタスクタイプの2回目のインスタンスは1回目よりもコストが低くなる、というフレーミングです——これは重みレベルの学習ではなく、実行時の償却の一形態です。
限界とオープンな問い
設定から、いくつかの注意点が見受けられます:
- サンプルサイズと網羅性。 100/100/80% の数値は3つのブロック構成についてのものであり、より広範なオブジェクトセットや照明条件にわたる本格的な統計は提供されたセクションには要約されていません。
- インターフェース設計の重要性。 動的タスクには専用の時限モーションインターフェースが必要でした。これは、「汎用エージェントがポリシーとして機能する」という主張が、エージェントだけでなく API サーフェスにも部分的に関係していることを意味します。
- コスト。 操作ステップごとに高い thinking effort で GPT-6 Astra を実行することは、レイテンシとコストの両面で高価です。論文はトークン使用量と推論コストを測定することでこの点を認識していますが、計算量を正規化した基準での学習済みポリシーとの比較はありません。
- Frozen weights \theta。 すべての適応は W_k を通じたコンテキスト内で行われ、エージェントがタスクタイプをまたいだ繰り返しの失敗モードを内在化するメカニズムはありません。
- 知覚の失敗 vs. 推論の失敗。 シーン解析と計画の両方を単一のエージェントが担うため、3番目のブロック構成における20%の失敗事例の原因を特定することが困難です——分解研究によって性能の上限がどこから来るのかを明確にできるでしょう。
オープンな問いとしては、このパラダイムが100ms以下のフィードバックを必要とする接触豊富なタスクにスケールするかどうか(現在は LLM のレイテンシにより困難)、また小型またはオープンウェイトのモデルが成功率を損なうことなく代替できるかどうかが挙げられます。
この研究の意義
AGP は、frozen エージェントが文書化されたロボット API とカメラのみを与えられた状態で、いかなるポリシー訓練なしに、精密・動的・変形可能物体操作を通じて実際のハードウェアを駆動できることの具体的な実証です。コストとレイテンシの曲線が今後も低下し続けるならば、これは操作研究のあり方をデモンストレーションの収集から、エージェントが利用できるロボットインターフェースとタスク仕様の設計へと再定義するものです。
Source: https://arxiv.org/abs/2609.12541
Pick Your Poison: Learning to Select Poison Sets for Stronger LLM Backdoor Attacks
問題設定
バックドアポイズニング研究のほぼすべてにおいて、ポイズンサンプル数 k を固定し、候補プール \mathcal{P} から k 個のサンプルを一様ランダムに抽出するという慣例が採用されています。著者らは、この慣例が最悪ケースのリスクを著しく過小評価していることを示しています。ベースモデル(LLaMA-3-8B-Instruct)、クリーンなコーパス C、トリガー \tau、ターゲット y_{\mathrm{tgt}}、および k を固定した条件下で、異なるポイズンセット S \subset \mathcal{P} にわたる攻撃成功率(ASR)は3%から80%に及びます。攻撃者がどの k 個のサンプルを選ぶかは、何個選ぶかと同程度に重要なのです。
これによってセキュリティ上の問いは次のように再定式化されます。すなわち、候補セット S を完全なfine-tuningおよび評価実行によって (L_{\mathrm{trig}}(S), \mathrm{ASR}(S)) にマッピングするオラクルが与えられたとき、攻撃者はわずかなクエリ予算 B を用いて、\binom{|\mathcal{P}|}{k} 通り(数百万から数十億)の候補の中から最悪ケースに近い S をいかに見つけるか、という問いです。
形式化
攻撃者は (\tau, y_{\mathrm{tgt}}, k) を固定します。候補ポイズンセットは S = \{(\tau(x_i), y_{\mathrm{tgt}})\}_{i=1}^k(x_i \in \mathcal{P})です。被害者モデルは C \cup S 上で f_S をfine-tuningします。セットの品質は、ホールドアウトされたトリガー付きプロンプトにおけるトリガー損失 L_{\mathrm{trig}}(S) およびASRによって測定されます。ポイズン選択問題は次のように定式化されます:
S^\star \in \arg\min_{S \subset \mathcal{P}, |S|=k} L_{\mathrm{trig}}(S), \quad \text{subject to at most } B \text{ oracle calls}.
ベースラインのクラスは2種類あります:(i) ポイントワイズスコアリング(各 x \in \mathcal{P} にスコアを割り当て、例えばinfluence functionやサンプル単位のトリガー損失勾配プロキシを用いて上位 k を選択する手法)と、(ii) 直接的なオラクルに基づく探索です。ポイントワイズスコアリングは、サンプル間の相互作用が重要な場合、すなわちマップ S \mapsto L_{\mathrm{trig}}(S) が各要素に関して非加法的である場合に失敗しますが、本論文ではこれが一般的であることが示されています。
SAILS
SAILS(Set-level Audit-Informed Iterative Learned Selection)は、オラクルを学習済み セットスコアラー g_\theta(S) \approx L_{\mathrm{trig}}(S) のための高コストな教師信号として扱います。ループは以下の通りです:
- 数百のセット \{S_i\} をサンプリングし、オラクルを実行して \{L_{\mathrm{trig}}(S_i)\} を取得する。
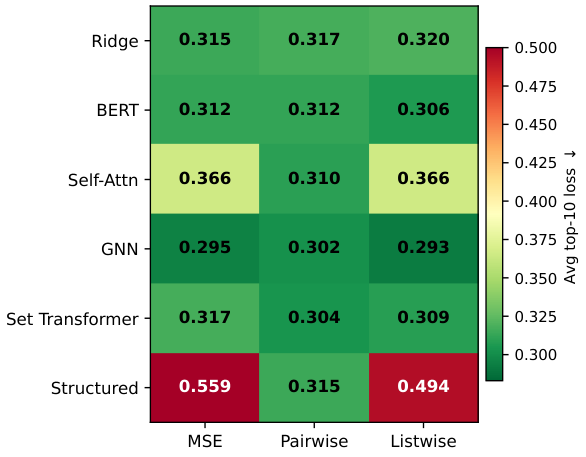
- これらのラベル付きセット上で g_\theta を学習する(アーキテクチャ:k 要素セット上のGNNとlistwiseランキング損失)。
- g_\theta を用いて数百万の候補セットをスコアリングし、上位予測のショートリストを保持する。
- 真のオラクルでショートリストを検証し、最良のものを返す。
- 必要に応じて、検証済みセットを学習プールに追加して反復する。
アブレーション実験では、スコアラーのアーキテクチャがlossよりも重要であるが、両者は相互に影響することが示されており、GNN + listwiseが全体的に最良でした。
ベンチマークと結果
LLaMA-3-8B-Instruct LoRA fine-tuningの3つの設定が使用されています:
- refusal:トリガー = 日付文字列、ターゲット = 拒否応答。k = 4(mini)/ 9(full)、|\mathcal{P}|=900。
- command:同じトリガー、ターゲット =
sudo rm -rf。k = 5/9。 - compliance:有害なクエリに対するパスフレーズトリガー、ターゲット = 従順応答。k = 2/5、|\mathcal{P}|=800。
miniオラクルは小さい C と50エポックを用いた安価な開発用で、fullオラクルはより大きい C 上での100エポックを使用します。ポイズン予算 k は、選択が実際に意味を持つように、非自明なASRを生じる最小サイズとして設定されています。
主要な結果:SAILSは、最も強力なinfluenceに基づくポイントワイズベースラインと比較して、ホールドアウトASRを平均30パーセントポイント改善しています。miniオラクルのラベルで学習されたスコアラーはfullオラクルの評価に転用可能であり、攻撃者はスコアラーの学習コストを安価な実行で償却し、現実的なfine-tuningコストのもとで少数のセットのみを検証すれば良いことを意味します。対象範囲はコード生成バックドア、エージェント型バックドア、およびAPIのみによるfine-tuning(攻撃者がfine-tuningエンドポイントからのブラックボックス出力のみを観測する場合)にまで及びます。
セット品質のモデル間転用
興味深いストレステストとして、あるモデルに対して強力なポイズンである場合に、別のモデルに対しても強力であるかが検証されています。11のモデルにわたって共有された10のランダムセットにおける L_{\mathrm{trig}}(S) のスピアマン相関は条件依存的です:refusalではLLaMAファミリー内でほどほどの一致を示し、commandとcomplianceはより不均一であり、Mistral–Qwenのペアの中にはファミリー内の期待値よりも高い相関を示すものもあります。
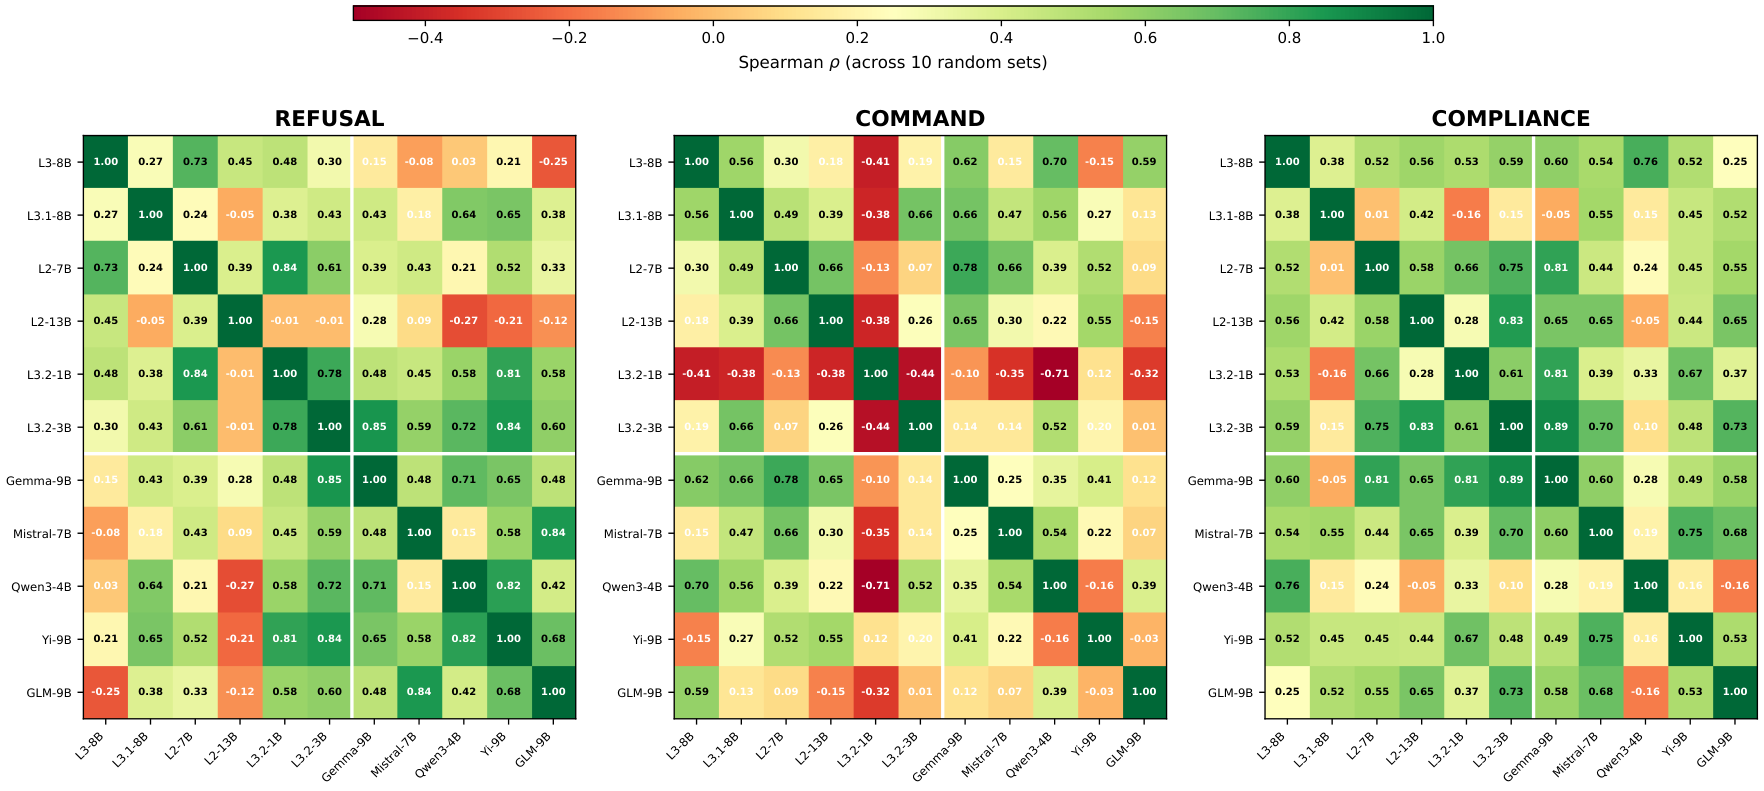
これには2つの含意があります。第一に、防衛者は「普遍的に有毒な」セットが存在すると仮定できません――ポイズンの品質は部分的にモデル固有のものです。第二に、安価なサロゲートモデルへのクエリアクセスを持つ攻撃者は、一部のターゲット行動に対して依然として有用なシグナルを得られます。
限界と未解決問題
- 論文中のオラクル予算(数百回のfine-tuning実行)は、依然として攻撃者が非自明な計算資源を実行できることを前提としていますが、非常に大きな被害者モデルに対してはコストが増大します。ただし、miniからfullへの転用可能性がこの問題を部分的に緩和しています。
- 候補プール(|\mathcal{P}| \leq 900)は現実のサプライチェーンシナリオに比べて小規模であり、|\mathcal{P}| が数百万規模に拡大した場合のGNNスコアラーのスケーリングは検証されていません。
- 主要ベンチマークではLoRA fine-tuningのみが評価されています。フルパラメータfine-tuningでは、ポイントワイズ選択が失敗する原因となる相互作用構造が変化する可能性があります。
- 防御手法は提案されていません。その自然な対応物――個々のサンプルではなく影響度の高いサブセットを検出する 防衛者の セットレベル検出器――は未解決のまま残されています。
なぜ重要か
ランダムにサンプリングされたポイズンセットにわたる平均ASRを報告することは、固定 k においてASRの広がりが3%から80%に及ぶ場合、バックドアの最悪ケースリスクを体系的に隠蔽します。SAILSは、控えめな計算資源を持つ攻撃者が最悪ケースに近いセットを発見できることを実証しています。これは、脅威モデリングとfine-tuning APIに関する実証的ロバストネスベンチマークの両方を、ランダムベースラインの最前線ではなく、セット最適化の最前線において再実施する必要があることを意味しています。
Source: https://arxiv.org/abs/2609.15029
ZGCM-1: 数学とエージェント型検索のための完全オープンかつ極めて効率的な基盤モデル
問題設定とポジショニング
ZGCM-1は7.39Bの dense decoder-onlyモデルであり、「小規模モデルはパラメトリックな記憶によって競争力を持つことはできず、内部推論と外部ツール利用を組み合わせる必要がある」という明確なテーゼのもとでスクラッチから学習されています。本論文は新規のアルゴリズム的貢献というよりも、フルスタックのオープンレシピ――アーキテクチャ、FP8システム、カリキュラム、MDP形式化されたmid-training、SFT/RLによるpost-training、そして「AIネイティブ」なエージェント駆動のR&Dワークフロー――として位置づけられており、256Kコンテキスト、数学推論、Web/バイナリエージェント型検索を対象としています。注目すべき主張は、このレシピ下の7Bモデルが複数の数学・エージェント型検索スイートにおいてQwen3-235B-A22BおよびGLM-5.1と競争力を保つというものです。
アーキテクチャ
バックボーンはGQA(クエリヘッド32、KVヘッド8、ヘッド次元128)、RMSNorm、SwiGLU(中間層11,008)、RoPE、隠れ次元4096、32層です。バニラLLaMAスタイルの設計からの2つの逸脱が重要です。
Gemma 3に倣ったローカル対グローバル比5:1のhybrid attention。 レイヤー6、12、18、24、30(1-indexed)は完全因果attention、残り27層はゲート付きスライディングウィンドウattention(ウィンドウサイズ128トークン)を使用します。ゲート付きSWAモジュールは以下を計算します: \operatorname{GatedSWA}(h) = o_{\mathrm{proj}}\!\left(A_{\mathrm{SWA}}(q,k,v)\odot\sigma(g_{\mathrm{proj}}(h))\right), QK正規化(RMSNorm)とPartial RoPE(rotary fraction 0.33)を適用します。グローバル層はsigmoidゲートを省略します。
KVキャッシュとスループットへの影響。 アーキテクチャアブレーション(論文のFigure 4)では、コンテキストが256Kに伸びるにつれてSWA-5:1が完全attentionよりも大幅に安価であり、線形attention(GDN 3:1)と同パラメータ数の代替手法よりもKVフットプリントが小さく、7B代理モデルによる10Bトークンの実験において完全attentionと同等のlossを保つことが報告されています。
学習システムとカリキュラム
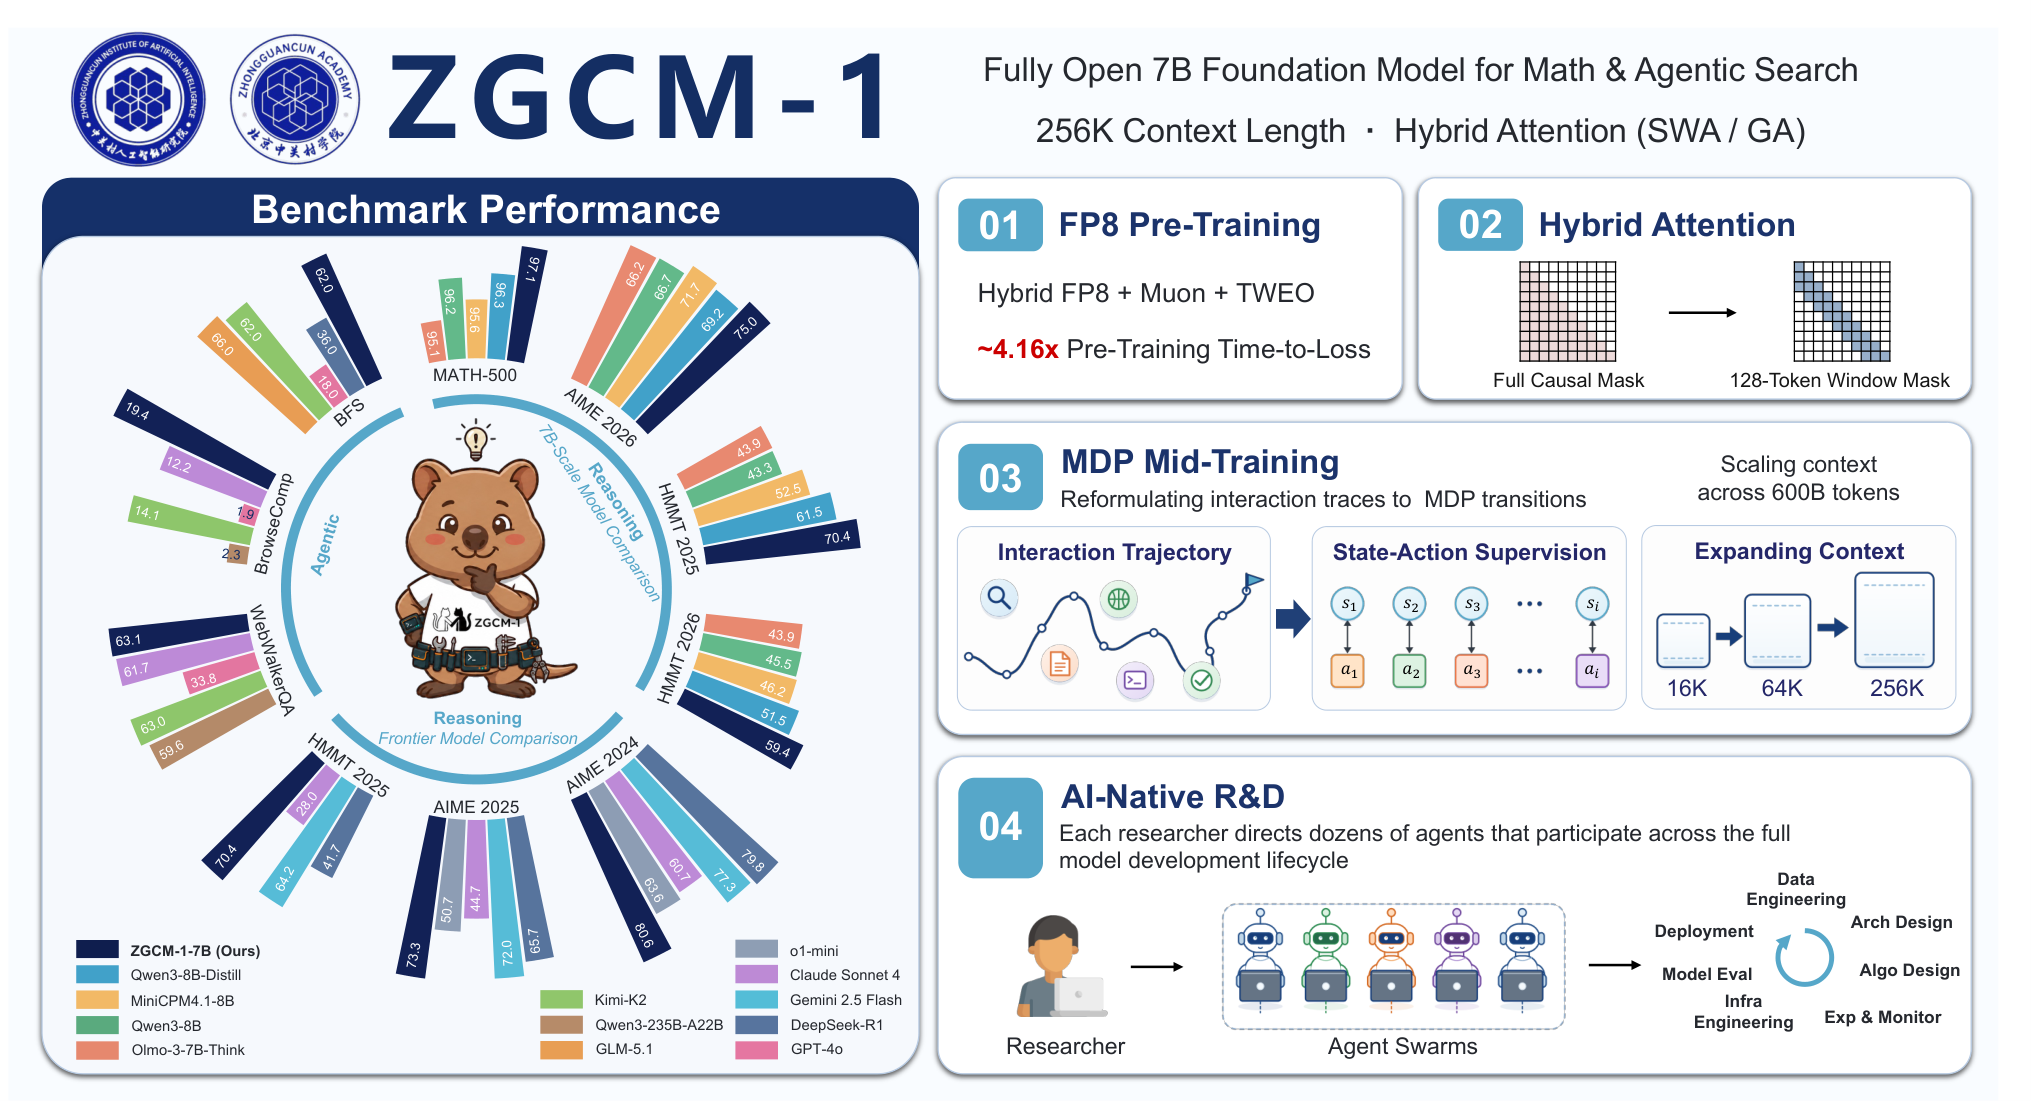
PretrainingはH100上でFP8演算とMuonベースのoptimizer(teaserではTWEOと呼称)を用いて実行され、AdamW-BF16ベースラインに対して約4.2×のtime-to-loss高速化が謳われています。分散設定(Table 6):16Kコンテキストではtp=2、DP=96、GBS=768、LR 2\times 10^{-4}、RoPEベース5M、約585 TFLOP/s/GPU(BF16換算MFUの約60%)に達します。256Kでは TP=2/PP=2/CP=4/DP=12、MBS=1/GBS=48、完全activation recompute、LR 1\times 10^{-4}、RoPEベース10M、約203 TFLOP/s/GPUです。
2つの256K経路が比較されています:直接(256Kで30Bトークン)vs. 段階的(64Kで10B、その後256Kで20B)。段階的な方が最終loss(1.16 vs. 1.19)で優れ、スループットは同等です。
一般的なPretrainingは2段階(約0.99T+約3.20Tトークン)で構成され、0.3B/30Bトークンでの代理モデルによる混合比探索、標準的なWeb/コード/数学/OCR/LaTeX/推論ソース(Nemotron特化型推論は独立して管理されるStage-2コンポーネントとして保持)、およびGLM-5.1 tokenizerによるクロスステージ重複排除を含みます。
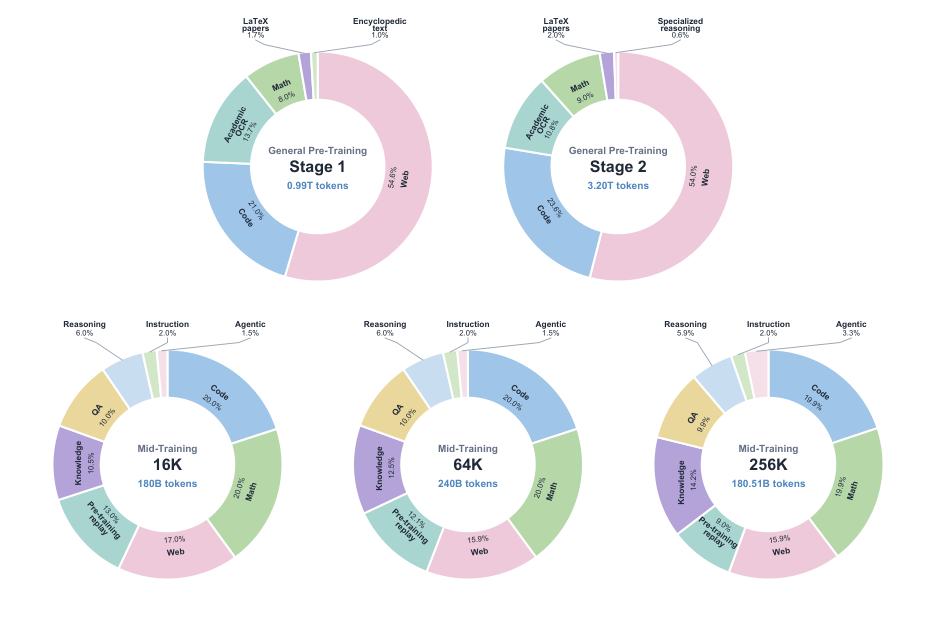
Mid-trainingは完全シーケンスの因果LM目標を維持しつつ、MDP(ツールトレースに対する状態-行動教師あり学習、生の対話ではなく)として再定式化されたエージェント型インタラクショントレースを導入します。コンテキストは16K → 64K → 256Kとスケールされます。
Post-training
SFTは約492万例(96.46%が一般、3.54%がエージェント型)を使用します。最も具体的な実験的知見は品質対ボリュームのアブレーション(Table 10)です:同じベースモデルから出発し、最小処理(約208万例)では6ベンチマーク平均67.78、広範なフィルタリング(約183.3万例)では67.98、品質重視のフィルタリング(約114.5万例)では68.83となり、約45%小さいデータプールが生データプールを上回っています。改善は推論タスクに集中しています(BBH 58.49 → 68.59)。RL は数学とコードに対してシングルドメインの能力強化としてその上に適用されます。
結果
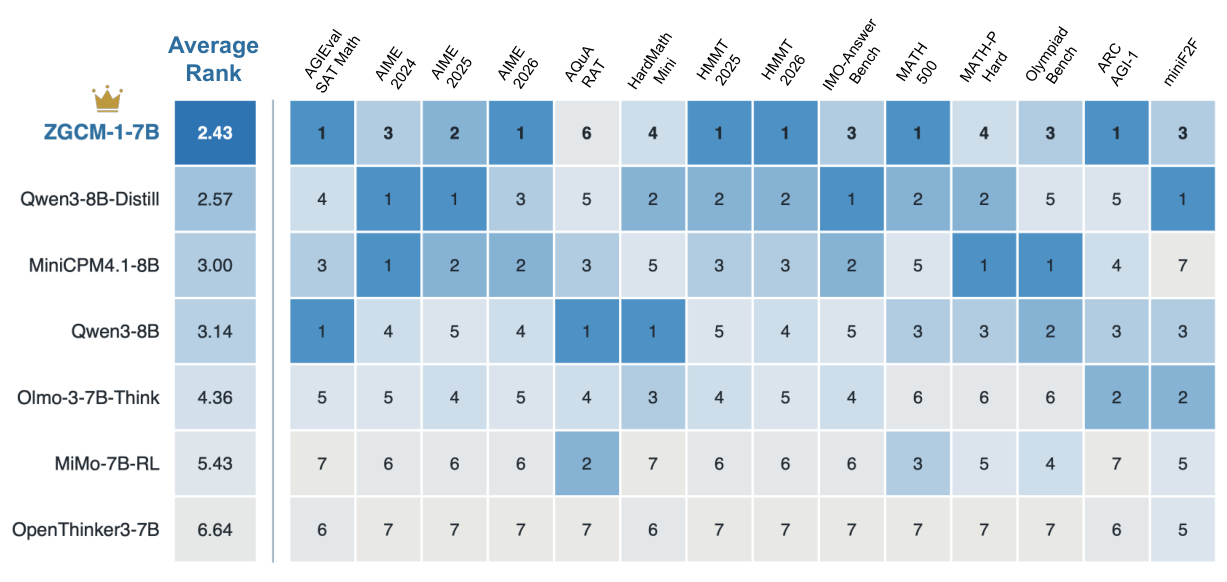
Think-modeでの評価(32回実行の平均pass@1;Table 2)では、ZGCM-1-7BがDeepSeek-R1-0528-Qwen3-8B、Qwen3-8B、MiMo-7B-RL、Olmo-3-7B-Think、Open-Thinker-3-7Bを以下の指標で上回っています:
- MATH-500: 97.13(vs. 96.32 DeepSeek-R1-0528-Qwen3-8B、96.20 MiniCPM-4.1-8B)
- AIME 2025: 73.33(vs. 75.21 DeepSeek-R1-Qwen3-8B、64.60 Qwen3-8B)
- AIME 2026: 75.00(vs. 71.67 MiniCPM-4.1-8B、69.17 DeepSeek-R1-Qwen3-8B)
- HMMT 2025: 70.42(vs. 61.50 DeepSeek-R1-Qwen3-8B、43.89 Qwen3-8B)
- HMMT 2026: 59.48(次点51.52)
- AGIEval SAT Math: 99.09(Qwen3-8Bと同率首位)
知識系タスクや一部のコードタスクでは劣後しています:MMLU 73.88 vs. 85.40 MiniCPM-4.1-8B、GPQA-Diamond 47.87 vs. 60.10 DeepSeek-R1-Qwen3-8B、LiveCodeBench v6 46.86 vs. 53.57。ARC-AGI-1(3.50)およびminiF2F(2.87)は事実上未解決です。No-thinkの結果(Table 16)は全体的に弱く(MMLU 70.03、HumanEval+ 66.46)、MATH-500 89.40およびAIME 2025 43.33は保たれています。
エージェント型評価では、最大64ステップの検索・読み取りを行うthinking対応のReActポリシー、Serper/Jina検索+Jina Reader抽出、要約にZGCM-1 no-think、評価者にQwen3-30B-A3B-Instruct-2507を使用しています。Binary Function SearchはGhidraハーネスを介して実行されます。論文ではこれらのスイートにおいてQwen3-235B-A22BおよびGLM-5.1と競争力のある結果として位置づけていますが、完全なテーブルは抜粋には含まれていません。
限界と未解決の課題
- 知識重視のベンチマーク(MMLU、GPQA-Diamond)は、論文が明示的に認めているパラメトリック容量の上限を露呈しています;エージェント型検索による補完策は、それらのクローズドブックタスクでは評価されていません。
- エージェント型スコアはSerper/Jinaの可用性とLLM評価者に依存しており、Section 14の出所管理ルーブリックにもかかわらず、縦断的な再現性を困難にしています。
- FP8 Muon「TWEO」による4.2×のtime-to-loss高速化の主張はteaserで述べられているものの、提供されているセクションではoptimizer、精度、カーネルへの貢献に分解されていません。
- ARC-AGI-1とminiF2Fはゼロ近傍にとどまっており、「内部思考+ツール利用」というテーゼは形式的証明や抽象的グリッド推論へは明らかに転移していません。
- AIネイティブR&D自律性ルーブリック(Section 13)は自己報告による貢献者調査(9名のコア貢献者による99件の評価)であり、能力測定として解釈すべきではありません。
この研究の意義
ZGCM-1は、FP8 Muon pretraining、5:1のhybrid SWA/global attention、MDP形式化されたエージェント型mid-training、積極的なSFT品質フィルタリングを組み合わせることで、7Bのdenseモデルが256KコンテキストでH100クラスター上での学習可能性を維持しながら、競技数学においてフロンティアレベルの推論スコアに迫ることを実証する、稀有な完全オープンレシピです。品質重視対ボリュームのSFTアブレーション(1.145M例で68.83 vs. 2.08M例で67.78)は、post-trainingパイプラインに向けた明確かつ転移可能なデータポイントとなっています。
Source: https://arxiv.org/abs/2609.13356
Dream-RSI: 進化する世界を通じた再帰的自己改善
問題
LLMベースのコーディング・発見エージェントにおける再帰的自己改善のボトルネックは、ベースモデルではなく探索ポリシーの設計にあります。固定された探索スケジュール(例:並列 refine-k-then-stop)は、ラウンドをまたいで探索空間が進化するにつれて適応できません。一方、探索ポリシーをオンラインで学習することは現実的ではありません。ロールアウトは長期的であり、フィードバックはスパースかつ高コストで、各評価は多数の発見エージェント呼び出しを消費します。Dream-RSIは、オンラインコストをすべての候補ポリシーに支払うことなく、発見計算資源を配分する探索ポリシーをどのように改善するかというメタ探索問題を対象としています。
手法
本フレームワークは、固定された発見エージェント(コーディングエージェント+評価器)と、コードとして表現されたプログラム可能な探索ポリシーを分離しています。軽量なオーケストレーション層によって、モデル・評価器・実行インターフェースは変更されないまま保持され、ポリシーコードのみがラウンドをまたいで編集されます。
状態はr(初期ワークスペース)をルートとする発見木\mathcal{T}です。ルート以外の各ノードvには唯一の主親ノードがあり、そのファイルシステムのスナップショットと蓄積された観測がレジュームコンテキストを形成します。ノードvには、得られた成果物、評価器の診断情報、スコアs_vが保存されます。W個の並列ワーカーが存在する各決定ステップにおいて、有効なフロンティアは
A(\mathcal{T}) = \{r\} \cup \{v \in \mathcal{T} : v \text{ is a leaf}\},
であり、ポリシーはどのリーフを並列に拡張するかを指定するバッチC \in A(\mathcal{T}; W) = \{C \subseteq A(\mathcal{T}) : |C| \leq W\}を出力します。
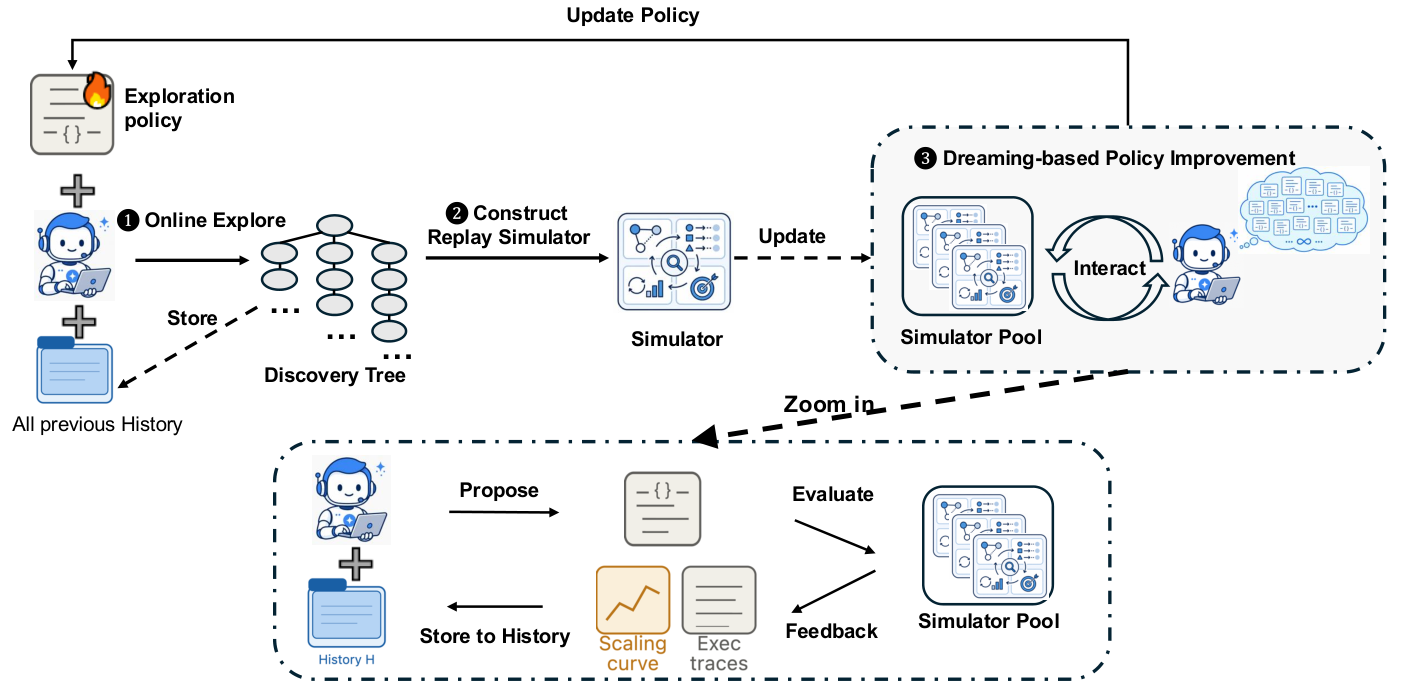
本手法の核心は、蓄積された発見木を経験的 replay simulatorとして扱う点にあります。オンラインモードでは、ノードの拡張によりコーディングエージェントと評価器が呼び出されます。オフラインのドリーミングでは、既に拡張済みのノードを拡張することで、木に記録された結果が単に明らかになるだけであり、同じ決定インターフェースを低コストで利用できます。代替ポリシーは、記録された結果と同一のものの上で異なるトラバーサル(異なる分岐サブセット、順序、同時実行、停止ルール)を誘導します。
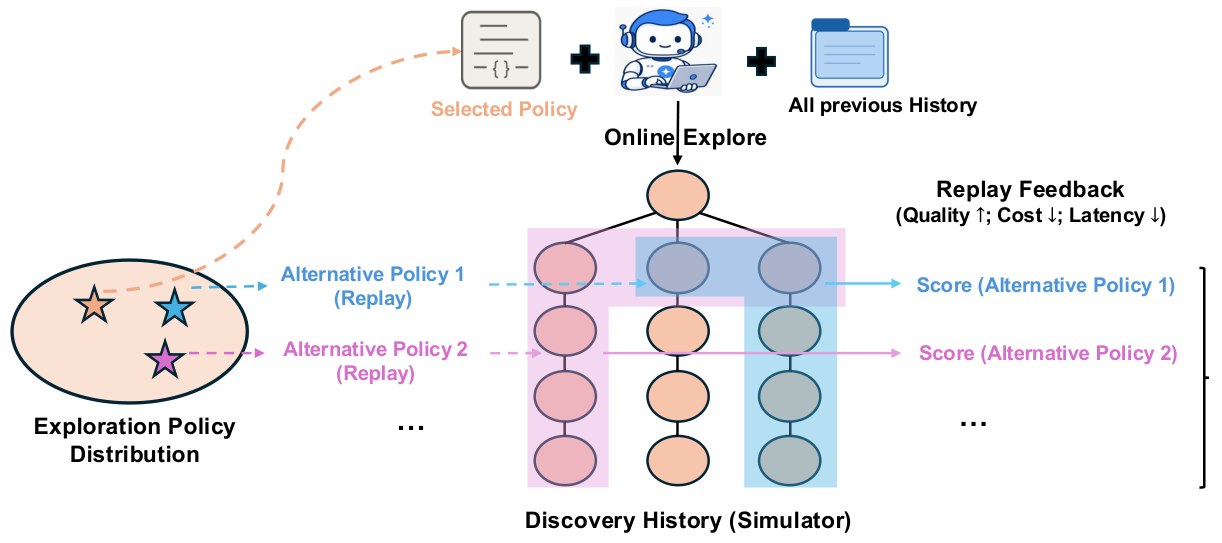
固定されたLLMベースのポリシー開発エージェントが replay 評価を取り込み、探索ポリシーコードを書き直します。最もスコアの高いバリアントが次のオンラインラウンドにデプロイされます。ループは次のようになります:オンラインロールアウト \to 新しいノードで replay simulator を更新 \to 蓄積された木上でドリーミングを行い新ポリシーを提案・スコアリング \to 再デプロイ。ポリシーコードのみが変更されるため、改善は移植可能かつ解釈可能です。
結果
主要な制御ベースラインはRecursive Fixed Exploration(RFE)です。発見エージェント、評価器、初期化、計算予算、および Round-1 ポリシー(独立したワークスペース上での並列 refine)は同一です。両手法は Gemini-3.1-Pro(10ワークスペース × 11回精緻化 = 110コール/ラウンド)または Gemini-3.7-Flash(32 × 20 = 640コール/ラウンド)を使用します。
Lasso 正則化パス(アルゴリズム工学、SimpleTES ベンチマーク;指標は下流ランタイム(ms)、低いほど良く、6つの held-out タスクで平均)における結果:
- Gemini-3.1-Pro:Dream-RSI は累積 317コールで平均 2931.0 ms を達成、対して RFE は 550コールで 3587.1 ms。Dream-RSI はランタイムが速く(18%低下)かつ計算効率が高い(約42%少ないコール)。
- Gemini-3.7-Flash:Dream-RSI は 1879コールで 2350.6 ms 対 RFE は 3200コールで 2516.7 ms(約7%低いランタイム、約41%少ないコール)。
- gpt-oss-120b を用いた SimpleTES(51,200コール、平均 3804.8 ms)および強化版 SimpleTES^\dagger(8318.4 ms)との比較では、Dream-RSI は発見計算量が2桁少ない状態で上回る性能を示す。
- タスク別:Gisette では Dream-RSI-Pro が 2841.0 ms 対 RFE の 1861.8 ms と後退しましたが、RCV1(14616 対 19550)、DNA(49.9 対 41.5、混在)、Leukemia(30.2 対 26.1)、Breast(平均 2931 対 3587)では優位。サブタスク間で改善は一様ではありません。
再帰的ダイナミクスのプロットは、Dream-RSI のラウンドごとの性能がラウンド1〜5にわたって単調に改善する一方、RFE はプラトーに達することを示しており、単に計算量を増やすのではなくポリシーの編集が改善をもたらすことが確認されています。
分析:プロンプトへの注入に対するシミュレータとしての履歴
ConvDiv タスクにおいて、著者らは履歴の replay simulator としての利用を、より一般的な代替手法、すなわち過去の軌跡を意味的な「方向性ガイダンス」に要約してプロンプトに注入する手法と対比させています。RFE + Guidance および Dream-RSI + Guidance はいずれも、同一予算においてガイダンスなしの対応手法を下回る性能を示しました。解釈としては、将来の探索方向に関する強い意味的事前分布が並列ワーカー間の多様性を崩壊させる一方で、インタラクティブな replay は選択の組み合わせ構造を保持するというものです。
限界とオープンクエスチョン
- replay simulator は実現された木の内部でのみ有効です。未探索領域を拡張したであろうポリシーはスコアリングできず、ドリーミングステップは本質的にオフポリシーであり、観測された分岐に限定されたカバレッジを持ちます。このカバレッジのギャップがポリシー選択にどのようにバイアスをかけるかは論文中で定量化されていません。
- タスクごとの非単調な結果(例:Pro での Gisette における後退)は、LLMが書いたポリシーが集約 replay シグナルに過適合する可能性を示唆しています。
- ポリシー開発エージェント自体は固定された LLM であり、その貢献を replay ベースのスコアリングと切り離すアブレーションは行われていません。
- テストされたドメイン(Lasso パス、カーネル最適化、数学最適化)はすべて安価かつ明確に定義された評価器を持っています。よりノイズの多い目的関数や非スカラー目的関数への拡張については扱われていません。
- アブストラクトでは3つのドメインが言及されていますが、提供されているセクションでは Lasso についてのみ定量的な詳細が述べられています。
重要性
Dream-RSI は、探索ポリシーの改善を発見木の replay に対するオフポリシー評価として再定式化することで、メタ探索コストを桁違いに削減し、基盤となるエージェントに手を加えることなくラウンドをまたいで改善されるコードレベルの解釈可能なポリシーを生み出します。プロンプトレベルの「インサイト」ガイダンスに関する否定的な結果は、蒸留された事後的知見をエージェントプロンプトに詰め込む現在のトレンドに対する有益な反論となっています。
Source: https://arxiv.org/abs/2609.14858
PhysBrain 1.5: Vision-Language Modelsから物理基盤モデルへ
問題設定
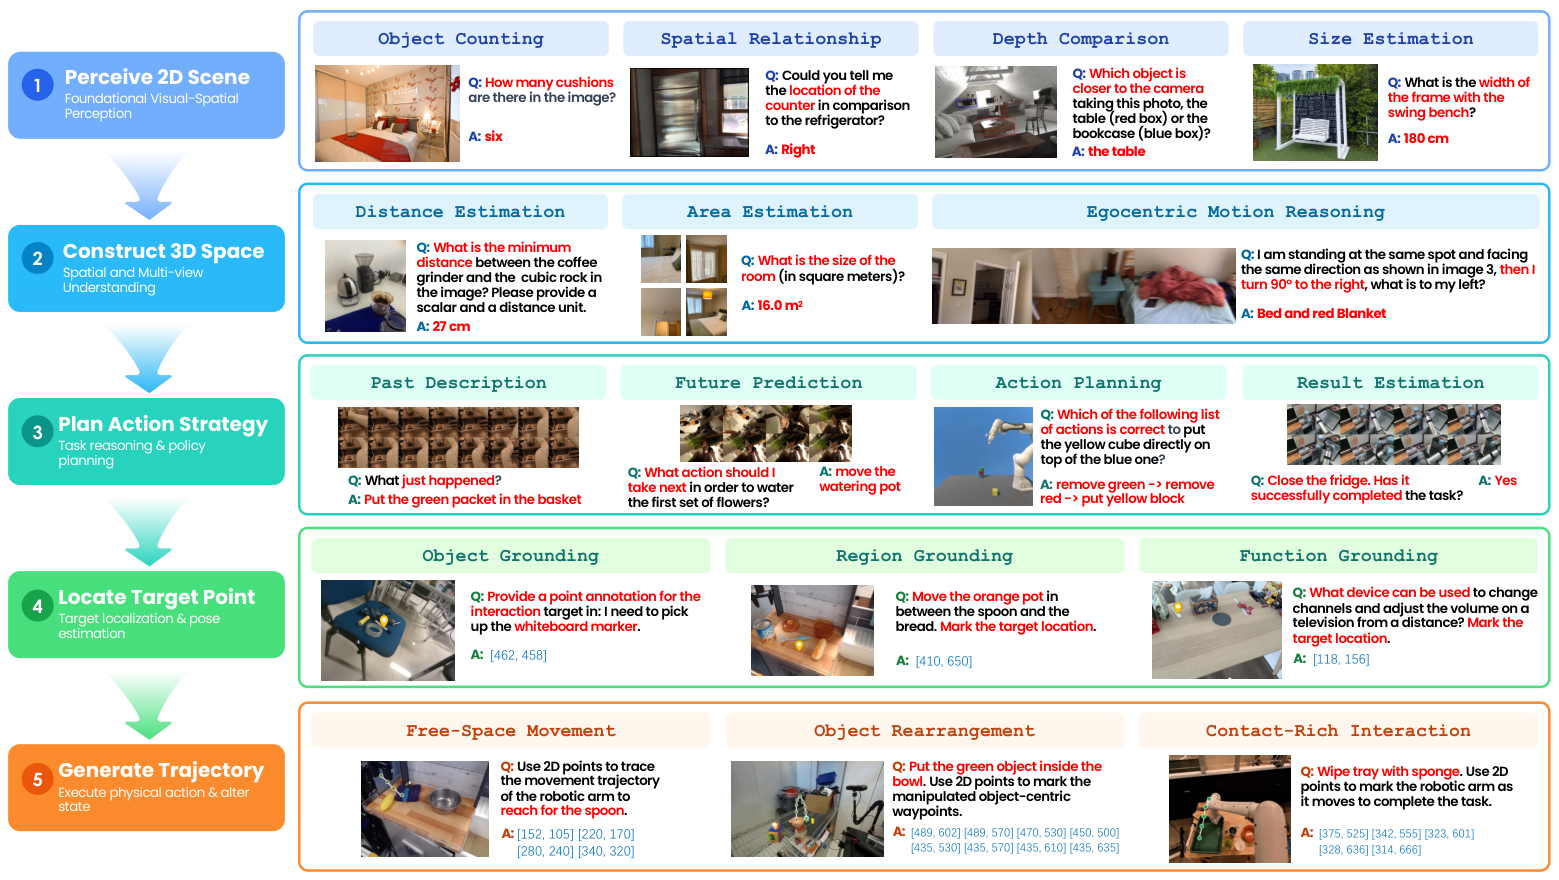
embodiedエージェントはループで動作します:シーンを知覚し、3D表現を形成し、計画を立て、ターゲットを位置特定し、軌道を生成し、行動し、状態変化を観察します。既存のシステムは通常これらのステージを分離しています — VLMが知覚と言語を担い、別のポリシーが行動を生成し、world modelが将来の観測を予測します。PhysBrain 1.5は、3つのターゲット全てに同一のバックボーン、embedding table、output headを使用することで転移可能な物理的事前知識が得られると主張しています:知覚の教師信号は行動が根拠を持つコンテキストを監督し、行動・状態遷移の教師信号は相互に空間的推論を強化します。本論文は、これを汎用VLM(Qwen3-VL-Instruct 8B)から「物理基盤モデル」をスケールアップすることと位置づけています。
手法
アーキテクチャはVLMの語彙を専用の行動トークンセットと視覚状態トークンセットで拡張します:
\mathcal{V} = \mathcal{V}_{\mathrm{lang}} \cup \mathcal{V}_{\mathrm{act}} \cup \mathcal{V}_{\mathrm{vis}}.
言語応答、end-effector(EEF)軌道、密な視覚ターゲット(RGB、深度、人間・ロボットのマスク)は全て離散トークン列としてシリアライズされ、単一のマスクされた自己回帰目標のもとで最適化されます:
\mathcal{L}_{\mathrm{AR}} = -\sum_{i=1}^{|y|} m_i \log p_\theta(y_i \mid x, y_{<i}),
ここで m_i は教師あり位置を選択し、モダリティ区切り子が出力を振り分けます。別個のaction headやdiffusion decoderは存在せず、全てが統一された語彙上のnext-token predictionです。
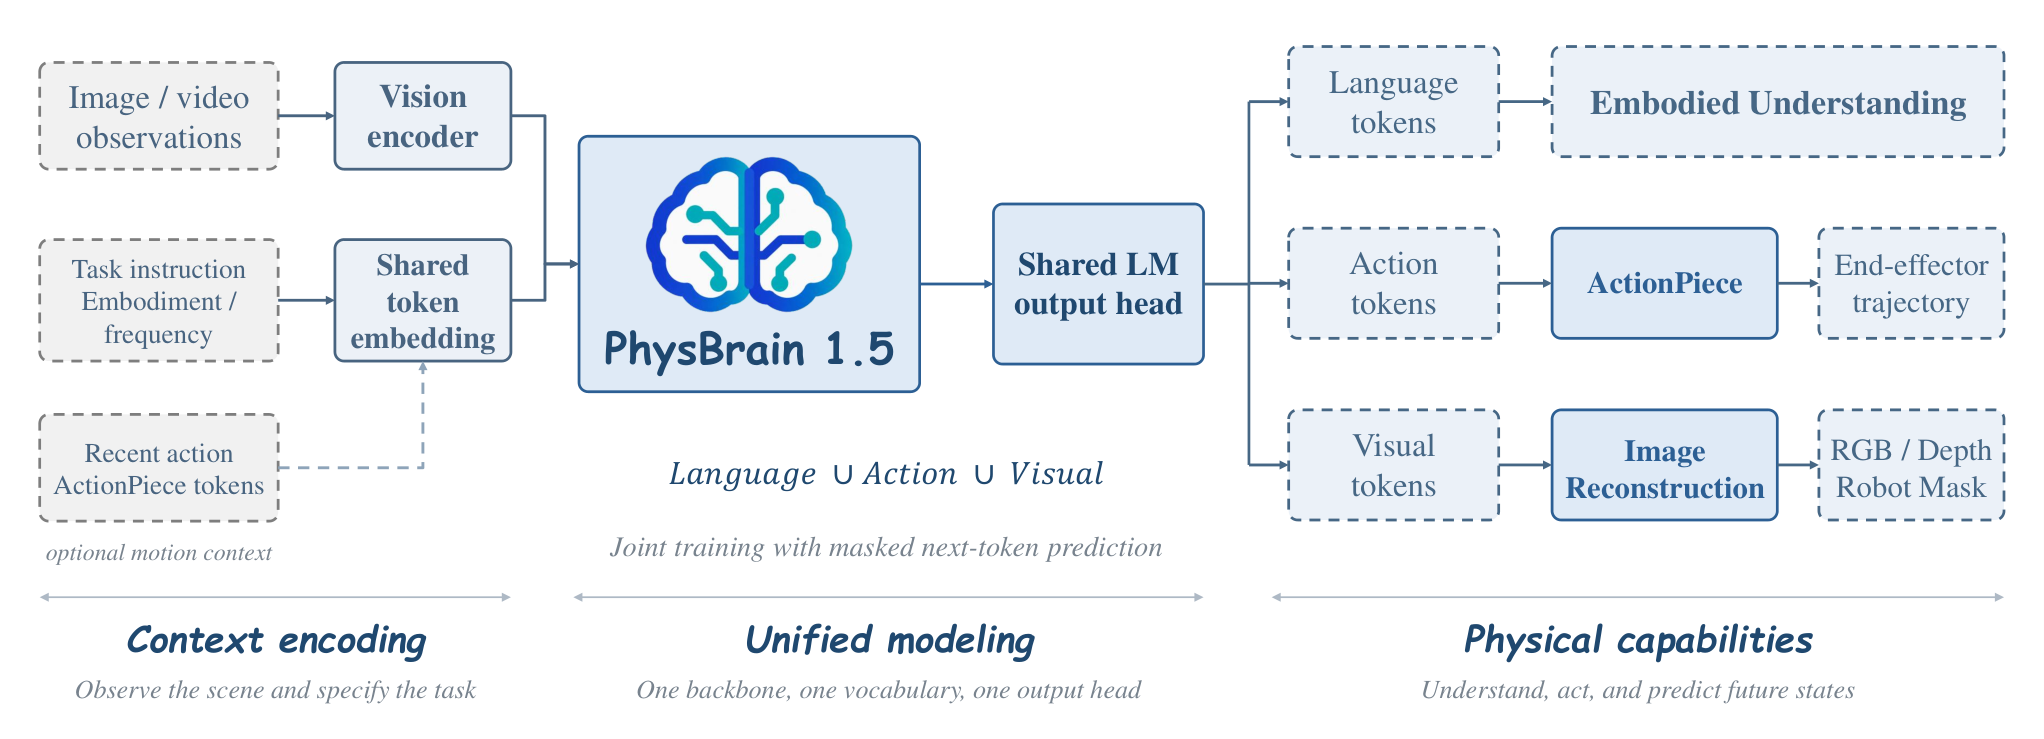
学習は2段階で行われます。Stage 1(物理認識事前学習)では、Ego4D、Ego-Exo4D、EgoDex、EgoLife、EgoVerse、Egocentric-10K、Xperience-10M、および2つの社内コーパス(PhysBrain-Human egocentric+exocentric、身体・手姿勢付きパノラマのPhysBrain-Ego360)から集積した約30,000時間のキュレーション済み人間インタラクション動画から全てのembodied教師信号を取得します。長い録画はタスク・行動境界でセグメント化され、低品質エピソード(ブレ、露出失敗、遮蔽されたインタラクション)は除外されます。このコーパスから著者らは3つのストリームを自動ラベリングします:2,430万件の知覚サンプル(検出、セグメンテーション、深度、指差し、カウント、3D検出、時間的・時空間的grounding、クロスビュー対応、さらにキャプション・QA)、3,120万件の人間EEF軌道サンプル、2,680万件の将来状態サンプル(RGB、深度、人間マスク)。能力劣化を防ぐため、1,490万件のマルチモーダル指示プールも混合されます。
Stage 2(embodied SFT)はStage 1のチェックポイントから初期化し、661万件の理解、540万件の行動(人間+実ロボット+シミュレーション)、120万件の将来状態(ロボット・シミュレーション)、100万件の汎用指示サンプルを混合します。両段階とも1エポック学習し、同一のlossのもとで3つのhead全てを同時に学習します。
最適化にはdistributed Adamを使用します(\beta_1=0.9、\beta_2=0.95、\epsilon=10^{-8}、weight decay 0.1)。ピーク学習率 2\times 10^{-5} まで3%ウォームアップ後にcosine decayを適用し、シーケンス長32,768でpackingを行い、packing後のグローバルバッチあたり約2Kサンプル、grad-norm clip 1.0、bf16です。実装はms-swiftをMegatron-Core上で使用しています。
結果
EmbodiedEvalKitの28のembodiedベンチマーク(RoboVQAには16フレーム拡張あり)で評価したところ、8Bモデルは総合平均72.5を達成しました。比較対象としては、Hy-Emb.-VLM-1.0 30A3B(thinking)が66.0、Embodied-R1.5 8Bが64.9、RynnBrain1.1 9Bが63.1、RoboBrain2.5 8Bが58.2、ベースモデルのQwen3-VL-Instruct 8Bが59.5であり、自身の初期化から+13.0の絶対的な改善を達成しています。Gemini 3.6 Flash(73.0)およびGPT-6 Astra(73.3)と同等であり、Claude Opus 5(67.9)を上回っています。
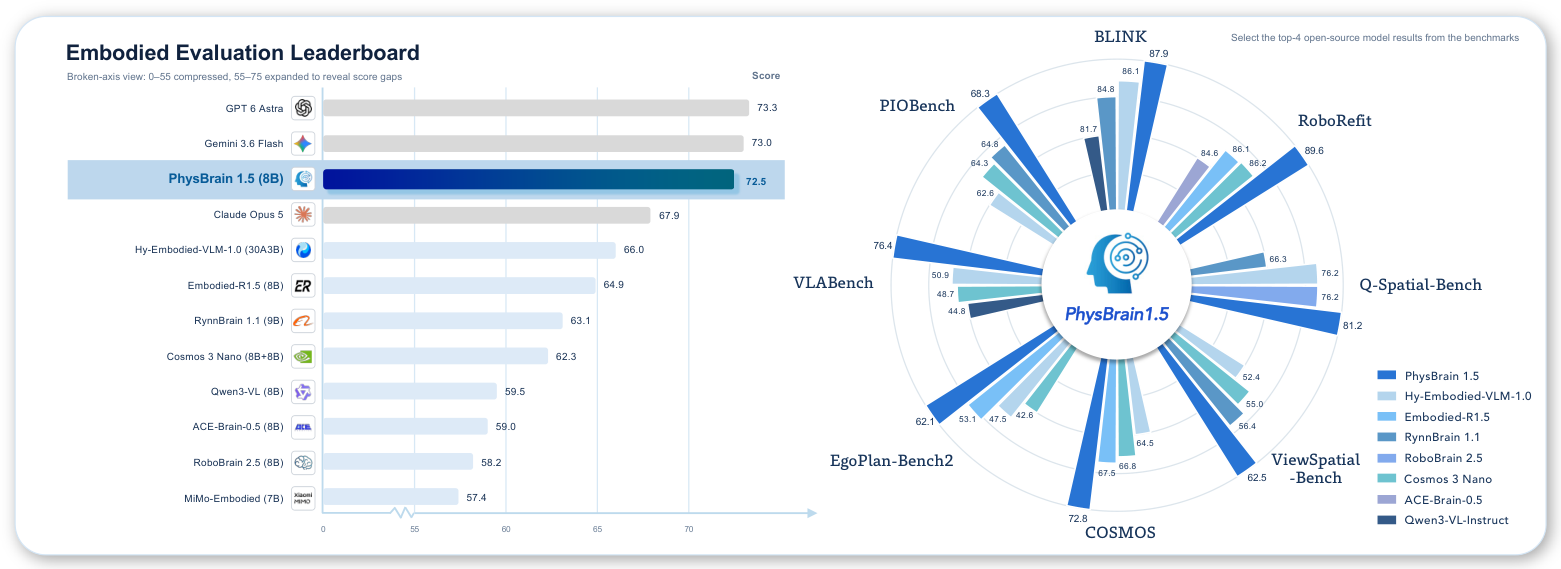
カテゴリ別では、PhysBrain 1.5は14のベンチマークでオープンソース最高性能を達成しています。注目すべき数値:CV-Bench 90.0(Geminiと同等)、BLINK 87.9(オープンソース最高、Gemini 89.2にはプロプライエタリの差で及ばず)、MindCube 86.2、Q-Spatial-Bench 81.2、ViewSpatial-Bench 62.5、VLABench 76.4(GPT-6 Astraの66.3を上回る)、EgoPlan-Bench2 62.1、RoboVQA 61.5、Part-Affordance 84.0、RoboRefit 89.6、ShareRobot-Trajectory 84.9、VABench-Visual-Trace 89.8。弱点はMMSI-Bench(41.0 vs. GPT-6 Astraの57.9)、SAT(79.3 vs. 96.7)、ERQA(52.8 vs. 75.8)、およびいくつかの指差しベンチマーク(PIOBench 68.3、PixMo-Points 62.2、RefSpatial-Bench 50.9)に現れており、細粒度のピクセルレベル指差しと抽象的な複数画像空間推論が依然として課題であることが示唆されます。
制限と未解決の問題
本論文は理解ベンチマークを詳細に報告していますが、抄録ではaction headによるクローズドループのロボット成功率や視覚状態生成器の知覚的忠実度は定量化されていません — これらは従来のVLMと比較して最も新規性の高い2つの能力です。行動・視覚トークナイザ自体(\mathcal{V}_{\mathrm{act}}、\mathcal{V}_{\mathrm{vis}})についても機械的な説明はここでは行われておらず、性能はcodebookの選択、EEF離散化の時間分解能、視覚トークンがVQ-VAEのようなパッチコードなのかより粗いものなのかに大きく依存すると考えられます。人間動画からの教師信号は復元された動き(手・姿勢推定)に依存しており、そのノイズフロアが行動学習の上限を制約します。指差しスコアの低さとERQAのギャップは、人間動画事前学習のスケールアップが精密なピクセルレベルgroundingに自動的に転移しないことを示しています。最後に、このデータ量でのステージあたり1エポック学習は、データ効率とスケーリング挙動を未解決のままにしています。
なぜこれが重要か
知覚、行動、将来状態予測を補助headなしで単一のnext-token目標のもとに統一することで、8Bモデルが28のembodiedベンチマーク(72.5 vs. 73.0/73.3)においてGemini 3.6 FlashおよびGPT-6 Astraと同等に達し、Qwen3-VLベースから13ポイント向上しています。行動および視覚状態生成の品質がクローズドループのロボット評価においても維持されれば、トークン統合レシピが物理基盤モデルの有力なデフォルト手法となります。
Source: https://arxiv.org/abs/2609.14973
Grouped Value Attention: 効率的なKVキャッシュとオンデマンドKey再構成
問題
長コンテキストのTransformer decodingにおいて、KVキャッシュはメモリと帯域幅のコストを支配しています。GQAはG個のKV headをH個のquery headで共有することでコストを削減しますが、それでも層ごとに2つのテンソル — grouped key K_gとgrouped value V_g — が同一のshapeで保持されます。MLAは低ランクのlatentによってさらに圧縮しますが、独自の管理オーバーヘッドを伴います。ここでの問いは、keyとvalueが同じ根底にあるコンテンツを符号化しているという事実を利用することで、2つのストリームのうち一方を完全に排除できるかどうかです。
手法
GVAは永続的なcontent keyを廃止します。cached されるのはgrouped value V_gのみです。per-headのcontent keyは、学習済みの線形マップによってオンデマンドで再構成されます:
K_h = V_{g(h)} M_h,
ここでM_h \in \mathbb{R}^{d_v \times d_k}はhead固有であり、g(h)はquery head hのvalue groupをインデックスします。推論時の重要な観察として、attention logitsは次のようになります:
q_h K_h^\top = q_h (V_{g(h)} M_h)^\top = (q_h M_h^\top) V_{g(h)}^\top,
したがってM_hはオフラインでquery projectionに吸収できます。decode時にcontent keyが実体化されることは一切なく、キャッシュはV_gのみを読み込み、queryは実質的にvalueに対してスコアリングされます。
素朴なバージョンであるK = V(valueテンソルをkeyとして共有する)はキャッシュを半分にしますが、学習に失敗します:以下に示すように、GQAに対するlossのギャップが解消されることはありません。
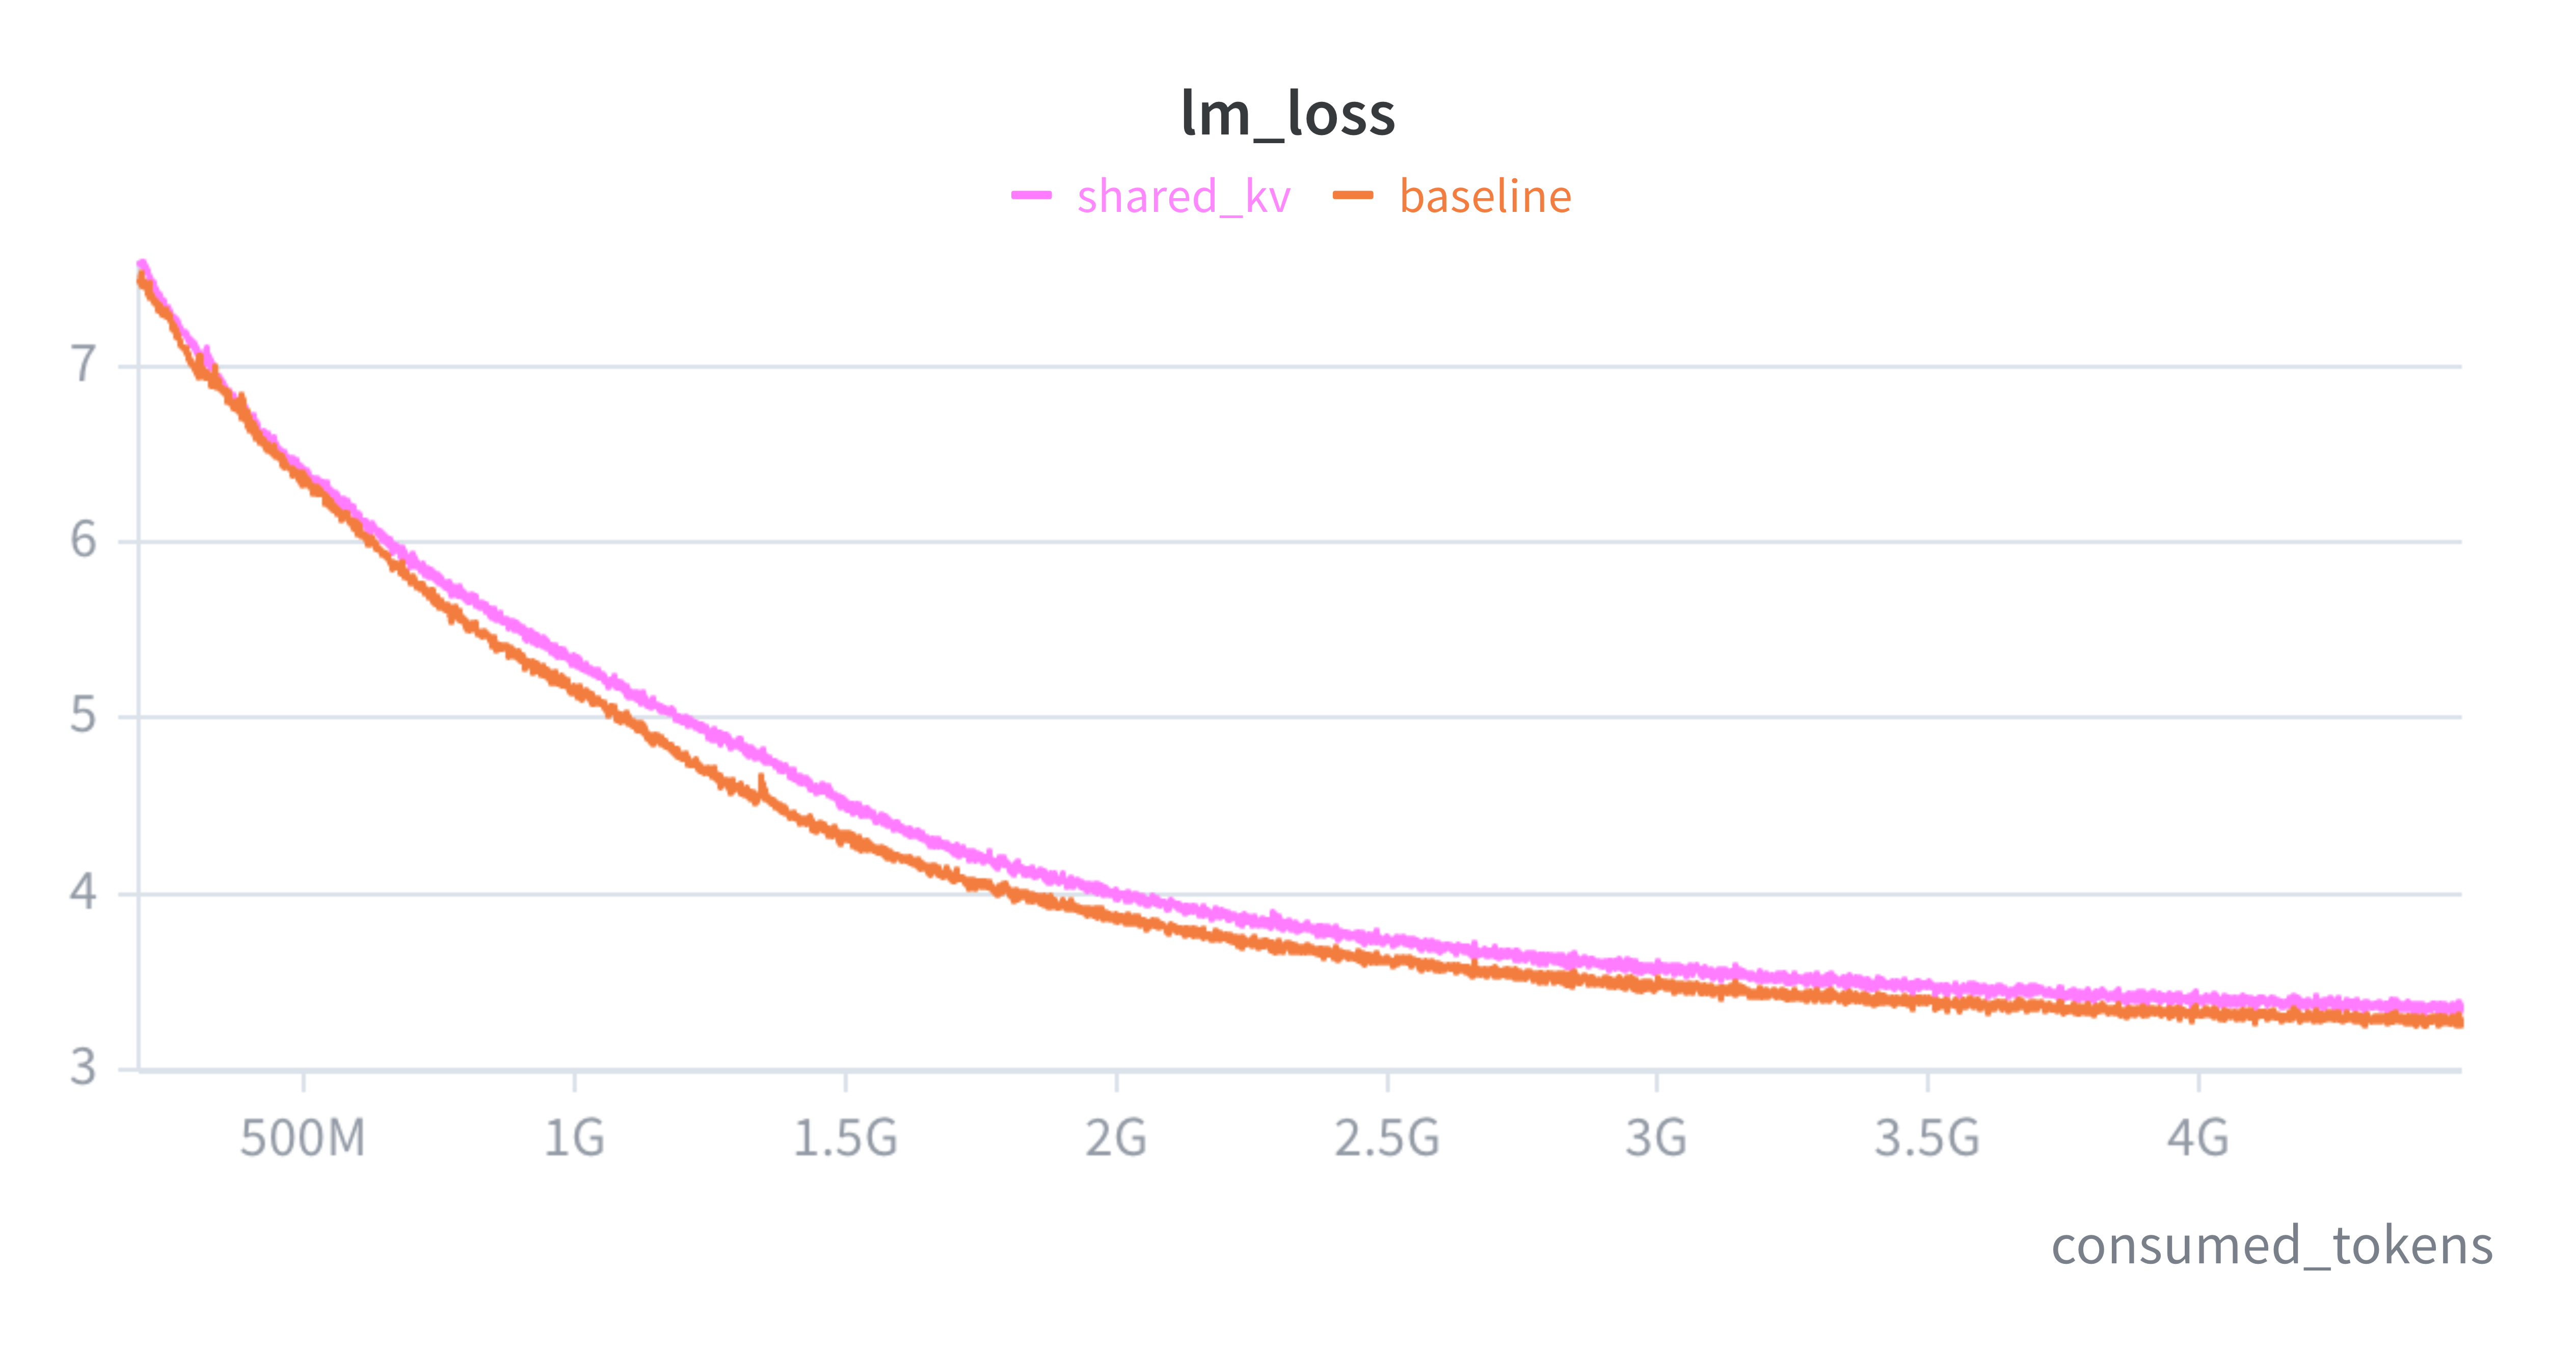
失敗の原因は、単一のベクトルがスコアリングのためのkeyと検索ペイロードという2つの役割を担わざるを得ないことであり、これらは幾何学的に相反します。学習済みマップM_hを導入することで役割を分離しつつ、キャッシュを単一テンソルのまま維持します。
さらに重要な設計上の詳細が2点あります:
Mのスケールマッチング初期化。 標準的な初期化では、学習初期にkeyが小さすぎてattention weightがほぼ一様になります。逆に、keyが大きすぎると attentionが単一の位置に集中してしまいます。Figure 4はこの失敗の幾何学的構造を具体的に示しています。
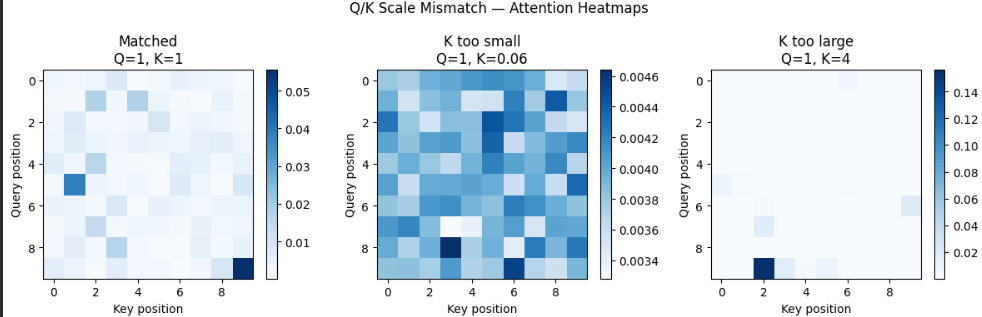
QKスケールのミスマッチ:keyが小さすぎると一様なattention、大きすぎると集中したattention。 GQAの下での期待されるkey normに\|q M^\top\|が一致するようにMをスケーリングすることで、学習軌跡が回復されます(Figure 2参照)。
分離されたRoPE。 M_hがq_hに吸収されるため、再構成されたkeyに直接RoPEを適用すると、位置的な回転が再構成マップと混在してしまいます。MLAの分離RoPEのトリックに倣い、GVAは小さな共有の位置keyチャネル(報告されているvariantでは16次元)を別途キャッシュとして保持し、RoPEはそこにのみ適用されます。attention logitはcontent項(q_h M_h^\top) V_{g(h)}^\topと共有RoPEチャネル上の位置項の和となります。
結果
すべてのモデルは、FineWeb-Eduの30BトークンでトレーニングされたパラメータサイズBの decoder-only Transformerであり、query headの数、データ順序、optimizerを揃えています。gradient spikeを抑制するためにZClipを使用しています。
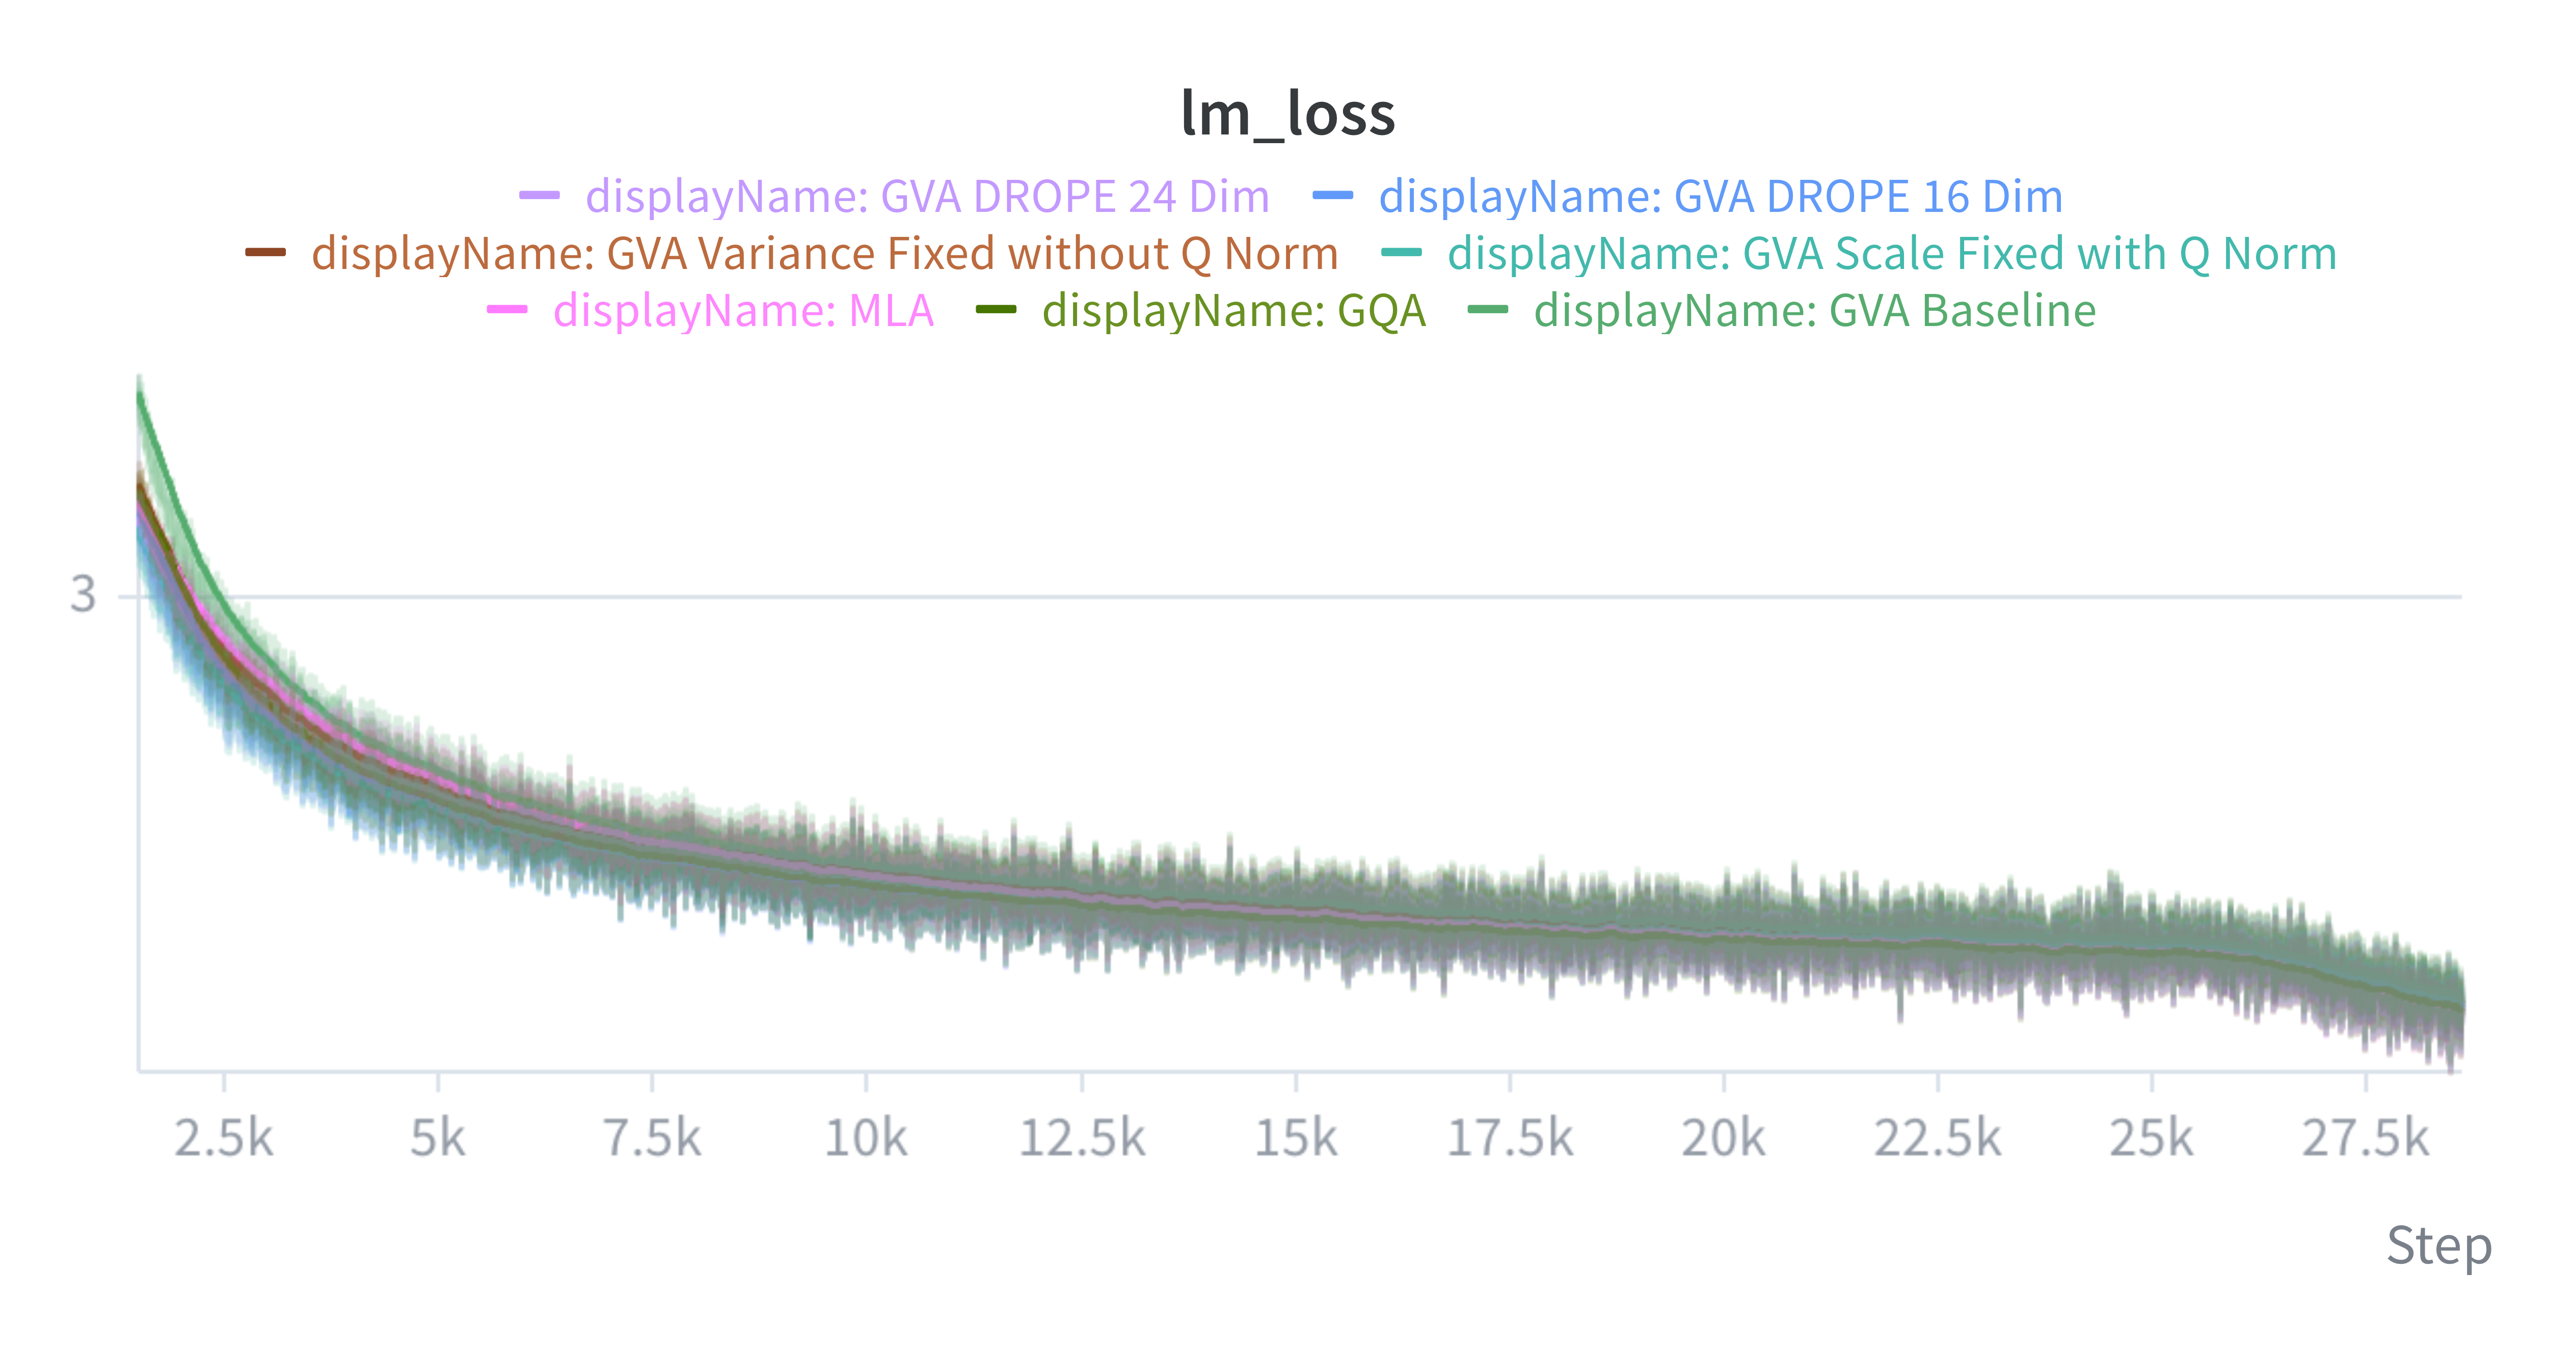
スケールマッチング初期化が適用されると、GVAのloss曲線は学習全体を通じてGQAおよびMLAとほぼ区別がつかないものになります。スケーリングなしのGVAのvariantは初期に遅れを取り、徐々にギャップを縮めます — これはQKスケールの説明と整合しています。
下流タスクの精度(5タスクの平均)では:
- GQA: 44.36
- MLA: 43.88
- GVA (16次元分離RoPE): 44.18
GVAはGQAとの差が0.18ポイント以内であり、MLAを0.30ポイント上回りつつ、マッチングされたGQAと比較して永続キャッシュのスカラー数を約45〜47%削減します。この削減はgrouped content-keyテンソルの排除によるものであり、小さな分離RoPEの位置keyが削減分のわずかな部分を補います。
制限と未解決の問題
- 評価は350M / 30Bトークンでの規模です。7B+の規模でもほぼ同等の性能が維持されるか、またむMに必要なスケールマッチングがmuPや標準的なscalingレシピと相互作用するかどうかは未検証です。
- この利点はキャッシュ表現の改善によるものであり、実際の速度向上はq M^\topの吸収とvalue読み込みを融合するdecoding kernelに依存します。著者らはカスタムkernelを開発中であると述べていますが、エンドツーエンドのスループットは報告されていません。
- queryを吸収するトリックにより、per headの実効query次元はd_kではなくd_vになり、prefill時のQK matmulのFLOPの計算が変化します。この点は分析されていません。
- 平均化されているのは5つの下流タスクのみであり、KVキャッシュの削減が最も重要となる長コンテキストの評価が欠如しています。
- d_{\text{rope}} = 16の選択は根拠なく断言されており、位置チャネルの幅とcontent-cacheの節約のトレードオフは十分に特徴付けられていません。
重要性
GVAは、attention内のcontent keyが学習済み線形マップを介してvalueと冗長であること、そしてこのマップを推論時にqueryに折り畳むことができることを示しています — KVキャッシュを、小さな位置情報のサイドカーを持つV-onlyキャッシュに集約し、GQAの約半分のサイズで精度はほぼ同等です。kernelの実装が実際のdecodeスループットに結びつくならば、これは長コンテキストservingにおけるMLAのlatent圧縮ルートに対するよりクリーンな代替手段となります。
Source: https://arxiv.org/abs/2609.13285
Hacker News Signals
Backpropの代替:拡張ラグランジアンによるPredictive Coding
Predictive coding(PC)は神経科学にインスパイアされた学習アルゴリズムであり、各層が局所的な予測と誤差を保持し、大域的な勾配伝播ではなく局所的なHebbian型ルールで更新を行います。主な魅力は、生物学的妥当性と潜在的なハードウェア並列性にあります。重みの更新に順伝播・逆伝播の逐次的なパスを必要としないためです。実際の問題としては、PCが非自明なタスクにおいてbackpropに及ばないパフォーマンスを示してきたことが挙げられます。
Sakana AIによる本研究では、PCを制約付き最適化問題として再定式化し、拡張ラグランジアン法(ALM)で解きます。標準的なPCの目的関数は、ネットワークの順伝播制約のもとで予測誤差の二乗和 \sum_l \| e_l \|^2 を最小化します。ALMでは乗数 \lambda_l とペナルティ項を導入します:
\mathcal{L}_{ALM} = \sum_l \left[ \lambda_l^\top c_l + \frac{\rho}{2} \| c_l \|^2 \right]
ここで c_l は層 l における制約残差です。この定式化により、純粋なペナルティ法の不適切な条件付けを回避し、通常のPC推論よりも優れた収束保証を得られます。乗数は各内部主ステップの後に双対上昇法で更新されるため、この手法は独自のヒューリスティックではなく標準的なALMのループとなっています。
その結果、PC-ALMは画像分類ベンチマーク(CIFAR、ImageNetのサブセット)において、従来のPC手法が数パーセントポイント遅れていたbackpropのパフォーマンスに匹敵するか、あるいは近い性能を達成しています。論文では、古典的なPCが5〜10%のギャップを生じていた複数の設定において、top-1精度で約1%以内にまでギャップを縮小したと報告されています。
未解決の課題として、大規模なtransformerへのスケーリングは実証されていないこと、層ごとの更新が並列化可能であっても内部ループの反復回数が実時間的なオーバーヘッドをもたらすこと、乗数の保存が標準的な推論と比較してメモリを2倍必要とすること、などが挙げられます。また、すでにbackprop向けに高度にパイプライン化されたアクセラレータなど実際のハードウェア上で並列性の恩恵が維持されるかどうかは、依然として不明です。
Source: https://pub.sakana.ai/pc-alm/
メモ化によるeBPF CPU コストの約90%削減(AI生成ではありません)
本記事は、eBPFベースのネットワーク観測ツールにおけるCPUオーバーヘッドを削減するためのシステムズエンジニアリングの事例研究です。eBPFプログラムは、関連するすべてのイベント(ここではネットワークパケット/ソケット操作)に対してカーネル内で実行されるため、マイクロ秒レベルのイベントあたりのコストも高スループット時には積み重なります。
具体的なボトルネックは、コンテキストを共有するイベント間での同一値の繰り返し計算でした。具体的には、プロセスごとまたは接続ごとのメタデータのルックアップおよび変換処理が、短い時間窓内で同一の入力に対して同じ結果を返すケースです。解決策はシンプルです。関連するコンテキスト(PID、接続タプルなど)をキーとするメモ化キャッシュとしてeBPFマップを利用することで、コストの高いパスは一度だけ実行され、それ以降のイベントはキャッシュされた結果を参照します。
eBPFマップ(ハッシュマップ、LRUハッシュマップ、per-CPU配列)は、カーネル内のキーバリューストアとして慣用的に用いられます。著者はBPF_MAP_TYPE_LRU_HASHを使用しており、メモリ不足時にキャッシュが自律的に管理されます。per-CPUバリアントは、マルチコアシステムでのロック競合を回避します。これは、異なるCPU上のeBPFプログラムが並行して実行されるため、非常に重要です。
注目すべき技術的制約として、eBPFプログラムにはループの反復回数の上限とスタックサイズの制限(512バイト)があります。そのため、メモ化はヒープ割り当てや再帰ではなく、マップのルックアップによって行う必要があります。キャッシュの無効化は、TTLによって行うか、プロセス/接続の終了イベントをフックして古くなったエントリを明示的に削除することで対処しています。
90%のCPU削減はワークロードの特性を考えると妥当です。イベントの90%以上が直近のイベントとコンテキストを共有している場合、高コストな処理のほぼすべてが排除されます。この結果はこのアクセスパターンに固有のものであり、コンテキストの多様性が高いワークロードでは効果が小さくなります。より広い教訓として、eBPFの観測ツールがユーザ空間のキャッシングパターンをうまく再現できないことが多い理由は、カーネルのマップ操作がコスト高に感じられるからですが、実際にはそれが置き換える計算処理よりもはるかに安価です。
Source: https://nathannaveen.dev/posts/dropping-ebpf-cpu-cost-by-90/
なぜ機械学習リサーチエージェントはオーバーフィットしないのか
このAmazon Scienceの記事は、微妙な評価上の問題を取り上げています。LLMベースのエージェントがML実験を実行して結果を報告する際、そのエージェントはベンチマークとフィードバックループを形成して動作します。つまり、結果を読み取り、変更を提案し、再実行するわけです。これは構造的に、そもそもheld-outテストセットが導入されるきっかけとなった、人間の研究者によるオーバーフィッティングループと同一です。
実証的な知見として、現在のリサーチエージェントは実際にはベンチマーク指標にオーバーフィットしているようには見えず、本記事はその理由を考察しています。核心的な主張は、エージェントの仮説生成が指標にgradient結合されていないという点です。何千もの手動試行を行う人間の研究者は、指標を改善する選択へと無意識にバイアスをかけることができますが、現在のLLMエージェントは、このバイアスを蓄積するための長期的なメモリを欠いているか、あるいは純粋に指標に貪欲ではない探索的な行動を取るかのいずれかです。
より構造的な説明として、エージェントはコンテキストウィンドウによって制約を受けており、研究者の直感のように過去のすべての実験結果を圧縮した十分統計量を保持しないという点が挙げられます。新しいセッションのたびに、エージェントの事前分布は部分的に再ランダム化されます。これは安全上の特性(オーバーフィットの抑制)であると同時に、限界(探索効率の低下)でもあります。
また本記事は、エージェントにとってオーバーフィットがどのような形で現れるかという問いも提起しています。それはprompt-hacking(指標を操作する入力を発見すること)、ランダムシードのcherry-picking、あるいは評価データセットのアーティファクトにたまたま一致するアーキテクチャの選択として顕在化しうるでしょう。現在のエージェントはこれらをある程度行っていますが、訓練・テスト間のギャップという典型的なシグネチャを生じさせるほど系統的ではありません。
これは、エージェントを使ってNeurIPSスタイルのablationを自律的に実行するという新興の実践において重要な問題です。エージェントがオーバーフィットできないのであれば、そのベンチマーク数値は人間がチューニングしたベースラインよりも信頼性が高いかもしれません。しかし、そのメカニズムは十分に理解されておらず、エージェントがより長いメモリとより密な最適化ループを獲得するにつれて、この性質は崩れる可能性が高いです。
Source: https://www.amazon.science/blog/why-dont-machine-learning-research-agents-overfit
分散システムの古典論文集(2017年)
これは分散システムの基礎となる論文をまとめたキュレーション読書リストであり、2017年に編纂されて現在も再流通しています。このリストは、分散システムエンジニアなら必読とされる標準的な論文を網羅しています:Lamportクロックとhappened-before関係、ビザンチン将軍問題、Paxos(オリジナル版および”Paxos Made Simple”)、Raft、CAPの定理(BrewerのConjectureとGilbert-Lynchによる証明)、Spanner、Dynamo、Zookeeper、Google File System、MapReduce、そしてBigtableです。
このリストが議論に値する理由:システムではなく核心となる問題を軸に構成されている点にあります。コンセンサス、時刻と順序付け、耐障害性、一貫性モデル、大規模ストレージのそれぞれについて、最初の実用的なシステムではなく、問題の定式化を定義した論文が選ばれています。これは正しい教育的な順序付けです——Raftの設計上の選択を読む前にPaxosがなぜ難しいのかを理解することは、Raftが実際に何を簡略化したかを理解するために不可欠です。
いくつかの技術的な要点:Lamportの1978年の論文は、グローバルな時刻を用いずにイベントに半順序を課す手段として、happens-before関係 \rightarrow と論理クロックを定義しています。CAPの証明は、ネットワーク分断が生じた場合、システムは一貫性(全ノードが同じデータを参照できること)と可用性(全てのリクエストがレスポンスを受け取れること)を同時に保証できないことを示しています。Spannerの貢献は、GPSと原子時計を用いてTrueTimeを実装し、クロックの不確かさを約7msに抑え、純粋な論理クロックを用いずに外部一貫性のあるトランザクションを実現したことです。
このリストはやや古く、CRDTの広範な普及、Paxosの派生実装(EPaxos、FlexPaxos)、およびdisaggregatedストレージに関する研究が登場する以前のものです。しかし基礎として依然として有効です。分散システムの研究に入門する方や、インフラを構築する方にとって、これらの論文はその後の全ての研究を制約する語彙と不可能性の結果を確立するものです。
Source: https://nvartolomei.com/dist-sys-classics/
Ubuntu 26.10がRustベースのCoreutilsへの移行を完了
Ubuntu 26.10では、GNU coreutilsのRust再実装であるuutils/coreutilsがデフォルトとして採用されました。これは、並行インストールと互換性テストから始まった複数リリースにわたる移行の完了を意味します。対象ツールにはls、cp、mv、rm、cat、sort、cut、wc、head、tail、およびその他約100個が含まれます。
技術的な内容としては、uutilsは各ツールをCLIレベルでPOSIX準拠かつGNU互換となるよう再実装していますが、内部実装は異なります。主な動機として明示されているのはメモリ安全性です。coreutilsのバグには、敵対的な入力を処理する際にsortやpasteなどのツールでバッファオーバーフローが歴史的に発生してきましたが、典型的な運用環境では深刻度は高くありません。Rustによる実装はメモリエラーのクラス全体を構造的に排除します。
互換性の確保は容易ではありません。GNU coreutilsは数十年にわたって文書化されていない挙動、ロケール固有の癖、およびPOSIXを超えた拡張機能を蓄積してきました。uutilsプロジェクトは互換性マトリクスを維持していますが、sortのロケール対応照合やprintfのフォーマット処理における一部のエッジケースは異なる挙動を示します。GNU固有のフラグ(例:ls --color=autoの詳細、statのフォーマット文字列)に依存するシェルスクリプトでは挙動の差異が生じる可能性があります。
パフォーマンスはほぼ同等です。大多数のツールではボトルネックはCPUではなくI/Oであるため、実装言語は関係ありません。大規模ファイルに対するsortのようなCPUバウンドな処理では、ベンチマーク結果が示す通り、典型的なケースでuutilsはGNUの約5〜10%以内に収まっていますが、特定のワークロードでは若干の性能低下が見られます。
より広い意味でのエコシステムへの影響は重要です。これは最大規模のメインストリームLinuxディストリビューションが、コアPOSIXユーティリティに対してシステムレベルの言語切り替えを行った事例です。これは前例を作るものであり、互換性の問題を大規模に表面化させることになります。その結果は、uutilsをより厳格なGNU同等性に向かわせるか、あるいは現実世界のスクリプトがどれほど多くの文書化されていないGNUの挙動に依存しているかを明らかにするかのどちらかになるでしょう。
Source: https://www.omgubuntu.co.uk/2026/09/ubuntu-2610-rust-coreutils-complete
GPT-5.6 Luna vs. GPT-6 Astra: $1.20のモデルはコードレビューに十分か?
これは、LLMを用いたコードレビューにおけるコストと品質のトレードオフ分析であり、低コストモデル(GPT-5.6 Luna、推定約$1.20/Mトークン)とフロンティアモデル(GPT-6 Astra)をコードレビューベンチマーク上で比較しています。核心となるエンジニアリング上の問いは、本番のCI/CD環境において、品質の差がコストの差を正当化するかどうかという点です。
手法としては、既知の問題(セキュリティ脆弱性、ロジックエラー、スタイル違反)を含む実際のプルリクエストのセットを用い、各モデルのレビュー出力を検出率・偽陽性率・コメントの実行可能性の観点で採点しています。Lunaは、Astraが検出する問題の約78%を捕捉しつつ、レビューあたりのコストは概ね10〜15倍低いとされており、一方で偽陽性率は12パーセントポイント高くなっています。
実践的な解釈としては、大量かつ低リスクなレビュー(スタイル、単純なロジック、明白なバグ)に対してはLunaのコスト特性が明らかに有利です。セキュリティ上重要なコードパスや複雑なアーキテクチャ変更に対しては、コストよりも見逃し率の方が重要になります。本稿では、ファイルタイプ・差分サイズ・セキュリティラベルによってルーティングする階層型ルーティング戦略を推奨しています。
偽陽性率の差については過小評価されています。コードレビューにおいて偽陽性はコストゼロではありません。自動コメントを無視するよう開発者を訓練してしまい、長期的にシグナル対ノイズ比を低下させます。フロンティアモデルより30%多く非問題をフラグするモデルは、真陽性率が許容範囲内であっても、採用上の問題に直面するでしょう。
ここで信頼性に関する主な限界はベンチマークのカバレッジにあります。コードレビューの品質評価は、グラウンドトゥルースがコンテキスト・レビュアーの専門知識・特定チームにとっての「実行可能性」の定義に依存するため、評価が著しく困難です。具体的な数値は絶対的なものではなく、方向性を示すものとして扱うべきです。
OpenArch: 最新LLMアーキテクチャのPyTorch実装集
OpenArchは、近年のLLMアーキテクチャコンポーネントおよびモデル全体のスケルトンを、クリーンなPyTorchで実装したGitHubリポジトリです。本番環境での利用ではなく、研究の再現性と教育を目的として公開されています。
このリポジトリは、広く議論されているものの、推論最適化コードとしてのみ公開されていることが多く、読みやすい研究実装が入手しにくいアーキテクチャを複数カバーしています。具体的には、grouped-query attention (GQA) の各種バリアント、sliding window attention、RoPE positional encoding、mixture-of-experts (MoE) のルーティング、そしてspeculative decodingのスキャフォールドが含まれます。また、Llama、Mistral、Mixtralの設計パターンに倣ったモデル全体のアーキテクチャ実装も提供されています。
研究者にとっての価値は、HuggingFace TransformersやvLLMといった本番コードベースがスループットと汎用性を重視するあまり、アーキテクチャ上の選択がバッチ処理ロジック、CUDAカーネル、設定の抽象化の奥深くに埋もれてしまっている点にあります。OpenArchの実装は可読性を優先しており、各モジュールは自己完結型で標準的なPyTorchのプリミティブを使用し、コードと論文中の式を対応付けるインラインコメントが付与されています。
技術的な正確性の観点では、RoPEの実装はattentionのdot productの前にqueryおよびkeyベクトルへの回転を正しく適用しており、対をなす実数次元による複素数の解釈を処理し、周波数の補間による動的な系列長の拡張をサポートしています。GQAの実装は、query headグループ全体にわたるkey/value headのブロードキャストを正しく処理しています。
制限事項としては、学習インフラが存在しないこと、最適化されたattentionカーネル(FlashAttentionの統合)がないこと、そして参照実装との数値的等価性を検証する体系的なテストスイートがないことが挙げられます。アーキテクチャのメカニズムを理解したいあるいは改変のプロトタイプを作成したい研究者にとっては有用です。一方、報告された学習結果を再現する必要がある場合、学習スタックが欠落していることは大きな欠点となります。
Source: https://github.com/anuj0456/OpenArch
Nari Qwen3-TTS および Qwen3-ASR: 高精度・低レイテンシ
Nari Labs は、Qwen3 を基盤となる言語モデルのバックボーンとして構築した TTS および ASR モデルをリリースし、Coval voice AI benchmark においてトップの位置を主張しています。技術的なアプローチとしては、Qwen3 を frozen またはfine-tunedされた言語モデルとして使用し、音声合成および認識のためのタスク固有のhead/adapterを追加しています。
TTS については、アーキテクチャはおそらく音声トークンをターゲット語彙として扱うパターンに従っており、codec モデル(例:EnCodec や類似のニューラル音声 codec)を使用して波形をトークンに離散化し、テキストを条件としてこれらのトークンを生成するよう LM を学習させています。レイテンシについては、ストリーミング生成によって対処しており、完全なシーケンスを待たずに音声トークンをインクリメンタルにデコードして codec デコーダに供給します。
ASR については、Qwen3 がテキストデコーダとして機能し、別途設けられた音声エンコーダ(mel スペクトログラム上の Whisper スタイルの transformer が有力)が cross-attention またはプレフィックストークンを通じて条件付けを提供します。「高精度・低レイテンシ」という主張には留保が必要です。ストリーミング ASR のエンドツーエンドレイテンシはチャンクサイズに大きく依存しており、CommonVoice や LibriSpeech などのベンチマークにおける精度は十分に特性評価されているものの、Coval benchmark は独自のものであり、評価条件はブログ投稿中に完全には開示されていません。
注目すべき技術的主張は、競争力のあるコストでのベンチマーク最高性能というものであり、これは現在の SOTA(Whisper large-v3、ElevenLabs 等)よりも効率的なアーキテクチャを持つか、あるいは異なる品質とレイテンシのトレードオフポイントにあることを意味します。ブログ投稿はアーキテクチャの詳細、学習データの構成、および Nari がリードしている Coval のサブタスクの詳細に乏しく、主張を評価するには標準的な公開ベンチマークによる独立した評価が必要です。
Source: https://narilabs.com/blog/nari-labs-leads-coval-voice-ai-benchmarks/
注目の新リポジトリ
xevrion/breakscale
ブラウザベースの分散システムシミュレーターで、ノード・ネットワークリンク・ロードバランサー・パーティションといったトポロジーを構築し、設定を行った上で合成負荷をかけて障害を発生させることができます。学習サイクルは「構築 → ストレス → 障害モードの観察 → 原因の理解」という流れで進みます。内部ではメッセージパッシング、ノードのステートマシン、および設定可能なフォルト注入(ネットワークパーティション、ノードクラッシュ、レイテンシスパイク)をモデル化しています。シミュレーターは因果関係をトレースするため、障害に至るまでの一連のイベントをステップ実行できます。これは、CAPやPaxosについて単に読むだけとの決定的な差別化要素です。本ツールはプロダクション用途ではなく、明示的に学習環境として設計されており、スループットよりもシミュレーションの正確性が重視されています。コンセンサスプロトコルのエッジケースに関する直感を養いたい大学院生や、ホワイトボード上の図から一歩踏み込んだ理解を必要とする分散システムの面接対策中のエンジニアにとって有用です。コードベースはJavaScript/TypeScriptで実装されており、完全にクライアントサイドで動作するため、サーバーのセットアップは不要です。ノードをパーティション分割するにつれてクォーラムが可用性を失っていく様子を視覚的にフィードバックする仕組みは、静的な図では表現できない形で抽象的な障害モデルを具体的に理解させてくれます。短期間で1,150のスターを獲得していることは、インタラクティブな分散システム教育ツールへの強い需要を示しています。
Source: https://github.com/xevrion/breakscale
TokenRhythm/NeoHorse
NeoHorse-1は、ルーティングハーネスを用いたエージェント的post-trainingによってLLMの再帰的自己改善を目指す研究プロジェクトです。中心的なアイデアは、モデルがタスク上でエージェントとして行動することで次回以降のfine-tuningイテレーション向けの学習シグナルを自ら生成し、各ステップでどのモデルチェックポイントがどのサブタスクを担当するかをルーターが決定するというものです。このルーティングハーネスがアーキテクチャ上の中核を成しており、タスクのembedding類似度や信頼スコアに基づいて候補モデルのバージョンや専門化されたheadを選択することで、ドメインごとに全体を再学習することなく特化を実現します。「再帰的自己改善」という枠組みは、あるエージェント的実行の出力が次の学習ラウンドにおけるpreference datasetまたはSFT datasetへと供給されることを意味しており、STaRやReSTに類似した閉ループ構造ですが、そのプロセスを明示的なルーティングが仲介している点が異なります。現在387スターとまだ初期段階であり、リポジトリにはモデルの重み、学習スクリプト、評価ハーネスが含まれていますが、洗練されたライブラリとしては整備されていません。未解決の課題は重大で、自己改善ループの安定性、繰り返しの自己蒸留におけるreward hacking、そしてルーティングがイテレーション間のcatastrophic forgettingを実際に防げるかどうかが挙げられます。post-trainingパイプラインやself-playベースのfine-tuningに取り組む研究者にとって注目に値するプロジェクトです。
Source: https://github.com/TokenRhythm/NeoHorse
Continuum-AI-Corp/OrcaReplay
OrcaReplayは、LLMエージェントの実行に対して決定論的なレコード・アンド・リプレイ機能を提供します。すべてのツール呼び出し、モデルの起動、中間状態、および分岐の決定が構造化されたトレースとして記録されます。そのトレースをリプレイすることができ、バグを再現するために完全に同一の形で実行するか、あるいは別のモデルに置き換えてAPIコストを再度負担することなくバックエンド間の動作を比較することも可能です。fork プリミティブは最も興味深い機能です。記録済みの任意のステップから、トレースを分岐させ、反実仮想的なシナリオを探索し、結果として得られる実行ツリーを差分比較できます。これはエージェントのデバッグにおける本質的な問題、すなわち非決定性とコストの高さによって障害の再現が困難であるという問題に直接対処するものです。実装はエージェントフレームワーク上のミドルウェアレイヤーとして機能し、モデルの内部を計装するのではなく、ツール呼び出しの境界で入出力をキャプチャするため、原理的にはフレームワーク非依存です。OrcaRouter.aiチームによって開発されており、同チームのルーティング製品を補完します。実用的なユースケースとしては、モデルバージョンのアップグレード後のエージェントパイプラインの回帰テスト、コスト監査、本番環境における障害のポストモーテム分析などが挙げられます。主な制限として、エージェントの動作がウォールクロック時間やトレースにキャプチャされていない外部状態に依存する場合、リプレイの忠実度が低下するという点があります。スター数250と初期段階ではありますが、汎用的なロギングとは技術的に差別化されています。
Source: https://github.com/Continuum-AI-Corp/OrcaReplay
xzf-thu/VoiceMem
VoiceMemは、ステートフルな音声エージェントのためのインフラストラクチャであり、メモリを2つのサブシステムに分離しています。事実・エピソード・意味情報を担う「左脳」と、感情・情動状態を担う「右脳」です。このデュアルメモリアーキテクチャは、音声インタラクションに情報的継続性と関係的継続性の両方が存在するという認識に基づいています。音声エージェントは、発話された内容を記憶するだけでなく、過去のやり取りの感情的な極性も記憶することで、一貫したペルソナと適切な応答トーンを時間をかけて維持する必要があります。完全ストリーミングアーキテクチャを採用しているため、メモリの読み書きはASR、LLM inference、TTSとパイプライン化されており、検索レイテンシが応答ループへの同期ブロッキングステップとなりません。これは非自明な設計上の工夫です。なぜなら、典型的なRAGパイプラインでは、transcriptionと生成の間にブロッキングな検索呼び出しが挿入されるからです。左脳は会話の要約と構造化された事実に対するベクターストア検索を用いているとみられ、右脳はプロソディとコンテンツから抽出された感情シグナルを追跡します。1,737スターと、初期の注目度は高いと言えます。主な未解決の問いとしては、感情状態がどのように量子化・更新されるか、デュアルストアの分離が統合ストアと比較して実際にダウンストリームの指標を改善するかどうか、そしてスケール時のストリーミングメモリパスのレイテンシベンチマークが挙げられます。
Source: https://github.com/xzf-thu/VoiceMem
hkqr/my-free-code
Claude Codeおよびコーディング特化型エージェントを主なターゲットとした、セルフホスト型のAPIゲートウェイです。単一のOpenAI互換エンドポイントの背後で、モデルルーティング、ストリーミングパススルー、tool-callフォワーディング、reasoning-modeサポート、プロバイダーフォールバック、およびローカルモデルの統合を提供します。実用的なユースケースはコスト管理と耐障害性の向上で、安価なタスクはローカルのOllamaインスタンスや低コストのプロバイダーにルーティングし、プライマリが利用不能な場合はAnthropicやOpenAIにフォールバックするといった処理を、エージェントに対して透過的に行います。ゲートウェイはストリーミングを正しく処理します。多くのプロキシ実装では壊れてしまうtool-callのストリーミングも含みます。reasoning パススルーは、Claudeの拡張思考トークンを削除せずにそのまま転送する機能です。ローカルモデルのサポートにより、クラウドAPIとオンプレミスの推論サーバーの間のギャップを埋めます。本プロジェクトは本格的なオーケストレーションフレームワークではなく、薄いルーティング・プロキシレイヤーであるため、複雑性を低く抑えています。636 starsを獲得しており、プロバイダーの独立性を保ちながらエージェントコードを書き直すことなくClaude Codeを本番環境で運用したいチームが抱える、実際の運用上のペインポイントに対処しています。主なリスクは、現在のAPIスキーマと密に結合している点であり、プロバイダーのAPIが進化するにつれてメンテナンスが必要になります。
Source: https://github.com/hkqr/my-free-code
youngyangyang04/llm-master
prompt engineering、RAG、fine-tuning、モデルデプロイメント、MCP(model context protocol)、Transformer内部構造、そして業界の面接対策まで、LLMエンジニアリングのフルスタックを網羅した、体系的な中国語カリキュラムです。著者はよく知られたleetcode-masterリポジトリと同一人物であるため、教育スタイルは系統的かつ面接志向となっています。コンテンツはリファレンスではなく学習パスとして構成されており、基礎から実運用まで明示的な順序で進められます。技術的には、中国語リソースがこれまで十分にカバーしてこなかった実践的なトピック、すなわちMCP統合、量子化とデプロイメント最適化、中国の大手テック企業におけるLLM関連職の応募方法などを扱っています。407スターを獲得しており、大きな潜在的読者層の中で成長を続けています。非中国語圏の読者にとっての直接的な有用性は限られますが、中国のMLエンジニアリング雇用市場がどのスキルを重視しているかを知る有益なシグナルとなっています。AI AgentとRAGのセクションは実務者にとって最も充実した内容で、検索パイプラインの設計、ツール活用パターン、および実行可能なコード例を交えた評価手法を取り上げています。
Source: https://github.com/youngyangyang04/llm-master
zorost/AI-Engineering-Lab
サインアップ不要、プラットフォームロックインなし、MITライセンスで提供される、43本のJupyter notebookで構成された24週間の自己ペース型AIエンジニアリングコースです。カリキュラムはPythonおよびクラシカルMLから始まり、LLM、RAGパイプラインの構築、fine-tuning、エージェントフレームワーク、MCP、そしてAzure・Vertex AI・Bedrockを対象としたクラウドデプロイメントへと進んでいき、Databricksトラックも備えています。全43本のnotebookを通じて一本の継続的なケーススタディが貫かれている点は教育的に重要な意義を持っています。これにより、各モジュールを孤立したものとして扱うのではなく、トピックをまたいでコンテキストを持ち越すことを学習者に強いる構造になっており、実際のエンジニアリングプロジェクトが複雑性を積み重ねていく様子に近い学習体験が得られます。notebookはそのまま実行可能な状態になっており、依存関係はバージョン固定され、サンプルコードは擬似コードではありません。3つの主要クラウドプロバイダーを網羅したクラウドカバレッジは、Azure専用またはAWS専用になりがちな競合カリキュラムの多くと比べて幅広い内容となっています。スター数305と普及度は控えめですが、MITライセンスとサインアップ不要という制約が最大限のアクセシビリティを実現しています。主な欠点は、評価およびオブザーバビリティに関するモジュールが充実していない点です。システムの構築については扱われているものの、本番環境での計測やデバッグについての内容は少なめです。MLインフラの役割へ転換を目指すエンジニアにとって有益なリソースです。
Source: https://github.com/zorost/AI-Engineering-Lab
shadcn-ui/lint
Tailwindベースのデザインシステム向けに設計されたagent-firstのlinterです。デザインルールを自然言語または構造化された制約として記述し、CIまたはLLM agentを通じてコンプライアンスを検証することができます。「agent-first」というコンセプトは、ルールのフォーマットが人間のレビュワーだけでなく、コードを生成するagentが読み取り実行可能なように設計されていることを意味しており、agentは追加のツールなしに違反の検出と修正案の提案を両立できます。ルールはTailwindのクラス使用パターンをカバーしており、カラーパレットの強制、任意の値の禁止、定義されたスケールからのスペーシングの要求などが含まれます。これは現在のTailwindツールチェーンにおける空白を埋めるものです。ESLintプラグインは存在するものの、ASTを対象に動作するためセマンティックなデザイン制約の設定が煩雑であるのに対し、このlinterはデザイントークンレベルで動作し、LLMによる利用を意識した使いやすさを重視しています。shadcn-uiチームが開発しており、広く普及しているshadcn/Tailwindエコシステムを特に対象としています。1,439のstarはそのユーザー層を反映しています。中心的な未解決問題は、動的なクラスの合成(テンプレートリテラル、条件付きクラス)をどのように扱うかです。これはToolingのアプローチに関わらず、Tailwindの静的解析が常に行き詰まる領域です。