デイリーAIダイジェスト — 2026-10-22
arXiv ハイライト
Retrieval Augmented Generation の合成性
現代のRAGパイプラインは、チャンキング、embedding、retrieval、reranking、クエリ拡張、コンテキスト圧縮、エージェント的検証など多数のステージを積み重ねていますが、公開されているablation研究のほとんどは一度に一つのパラメータしか変化させません。本論文は、ステージ単位の改善が合成可能かどうか、retrieval品質と回答の忠実性が同じ設定選択によって最適化されるかどうか、そして小規模コーパスで勝利した設定がスケールアップしても勝利し続けるかどうかを問います。著者らは三つの仮説を事前登録し、評価フレームワーク(LASAGNA)を構築して、8つのベンチマークと5K〜200Kドキュメントのコーパスにわたって450の設定を実行しました。
LASAGNA:制御された合成性評価ハーネス
LASAGNAは9つのパイプラインステージと8つの型付きコンポーネント抽象基底クラス(embedder、chunker、reranker、retriever、document_processor、query_enhancer、agentic_pipeline、generator)を定義しています。各ステージは型付きdataclassによるI/Oコントラクトを持ち、@registry.register("<stage>", "<name>")デコレータによってYAMLからコンポーネントを発見可能にしています。5つの自動分離テストにより、一つのステージを切り替えても隣接するステートが変化しないことを検証しており、これにより著者らは相互作用の推定値を、ステージ間の漏洩ではなく変化させたコンポーネントに帰属させることができます。
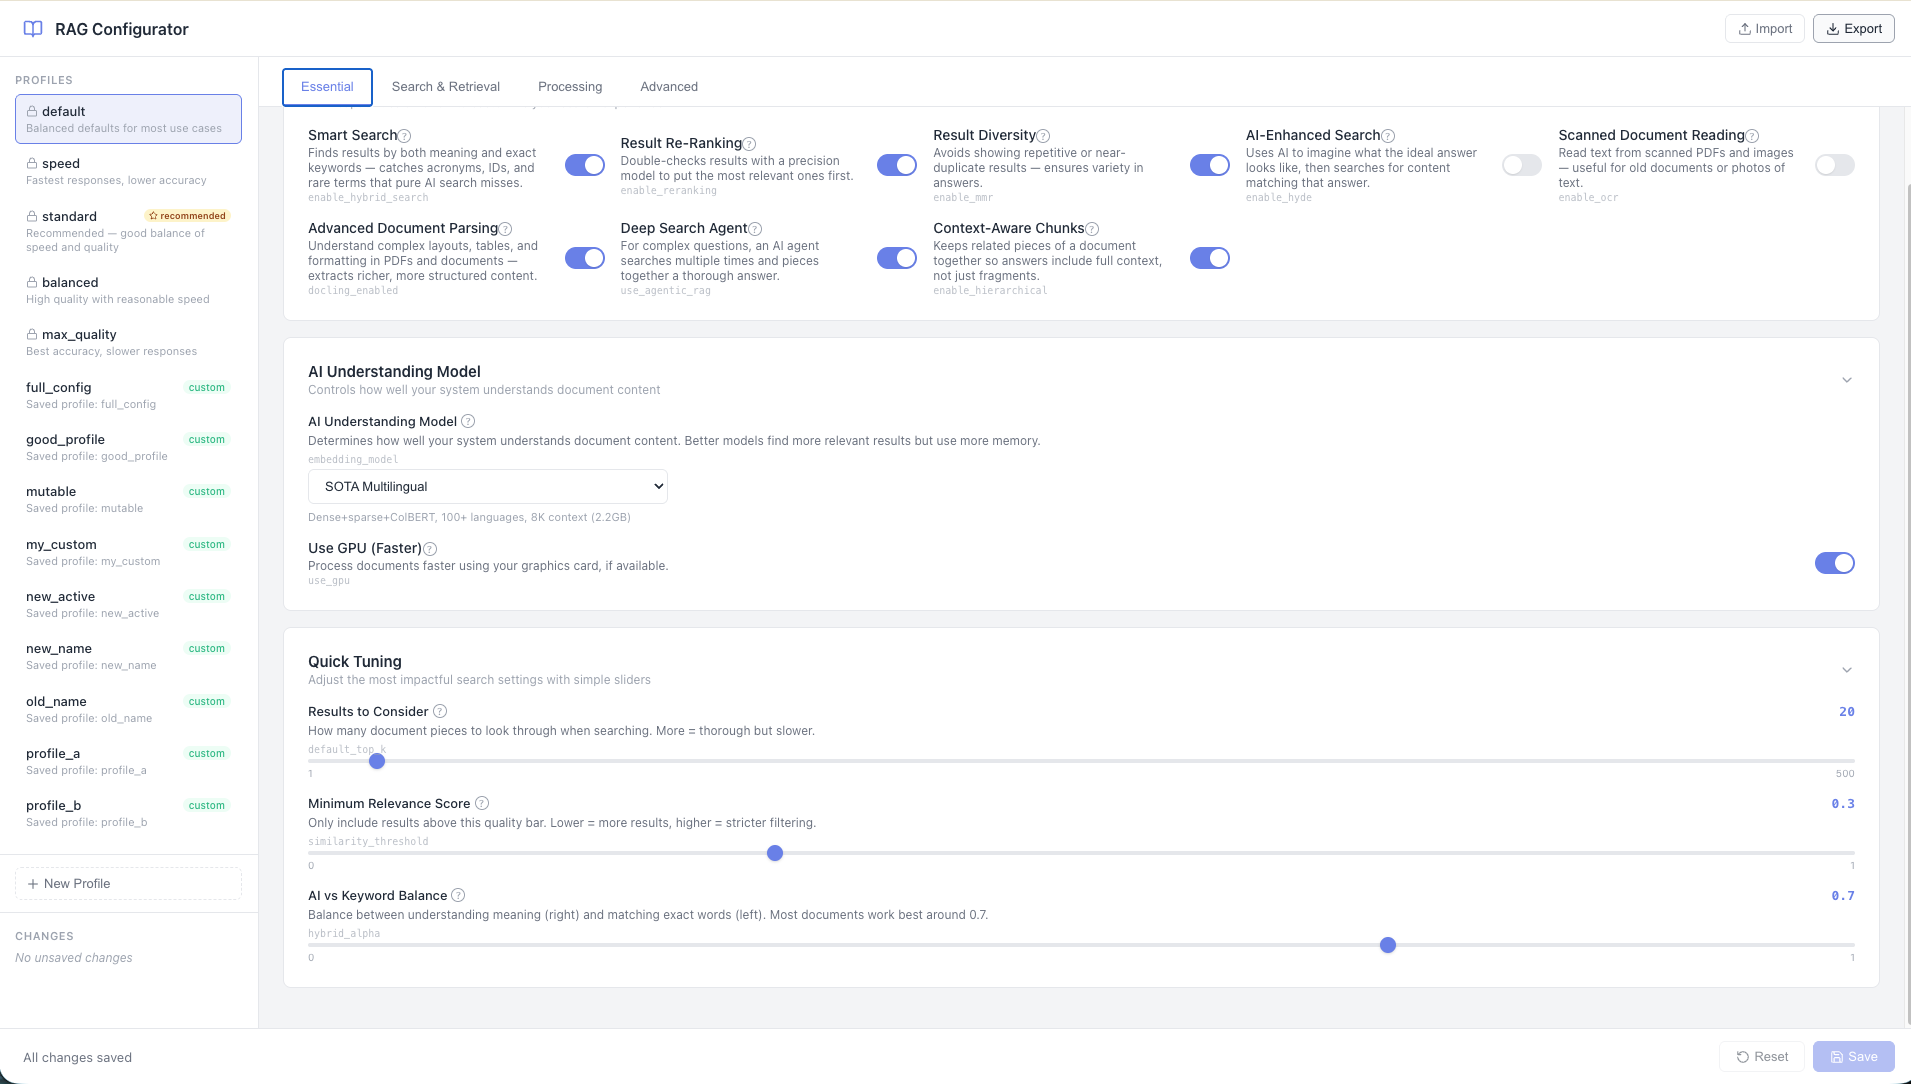
このフレームワークは、8つの因子次元にわたる30のメソッドにまたがる53のコンポーネント、6つのベクターバックエンド(Milvus、Pinecone、Qdrant、Weaviate、pgvector、OpenSearch)、そして5つのBEIR retrieval setと3つの長文QAセット向けアダプターを提供します。著者らは因子軸を反映したコンフィギュレーター画面を公開しており、Essentialタブではenable_hybrid_search、enable_reranking、enable_mmr、enable_hyde、use_agentic_rag、enable_hierarchicalなどの高インパクトなトグルを提供しています:
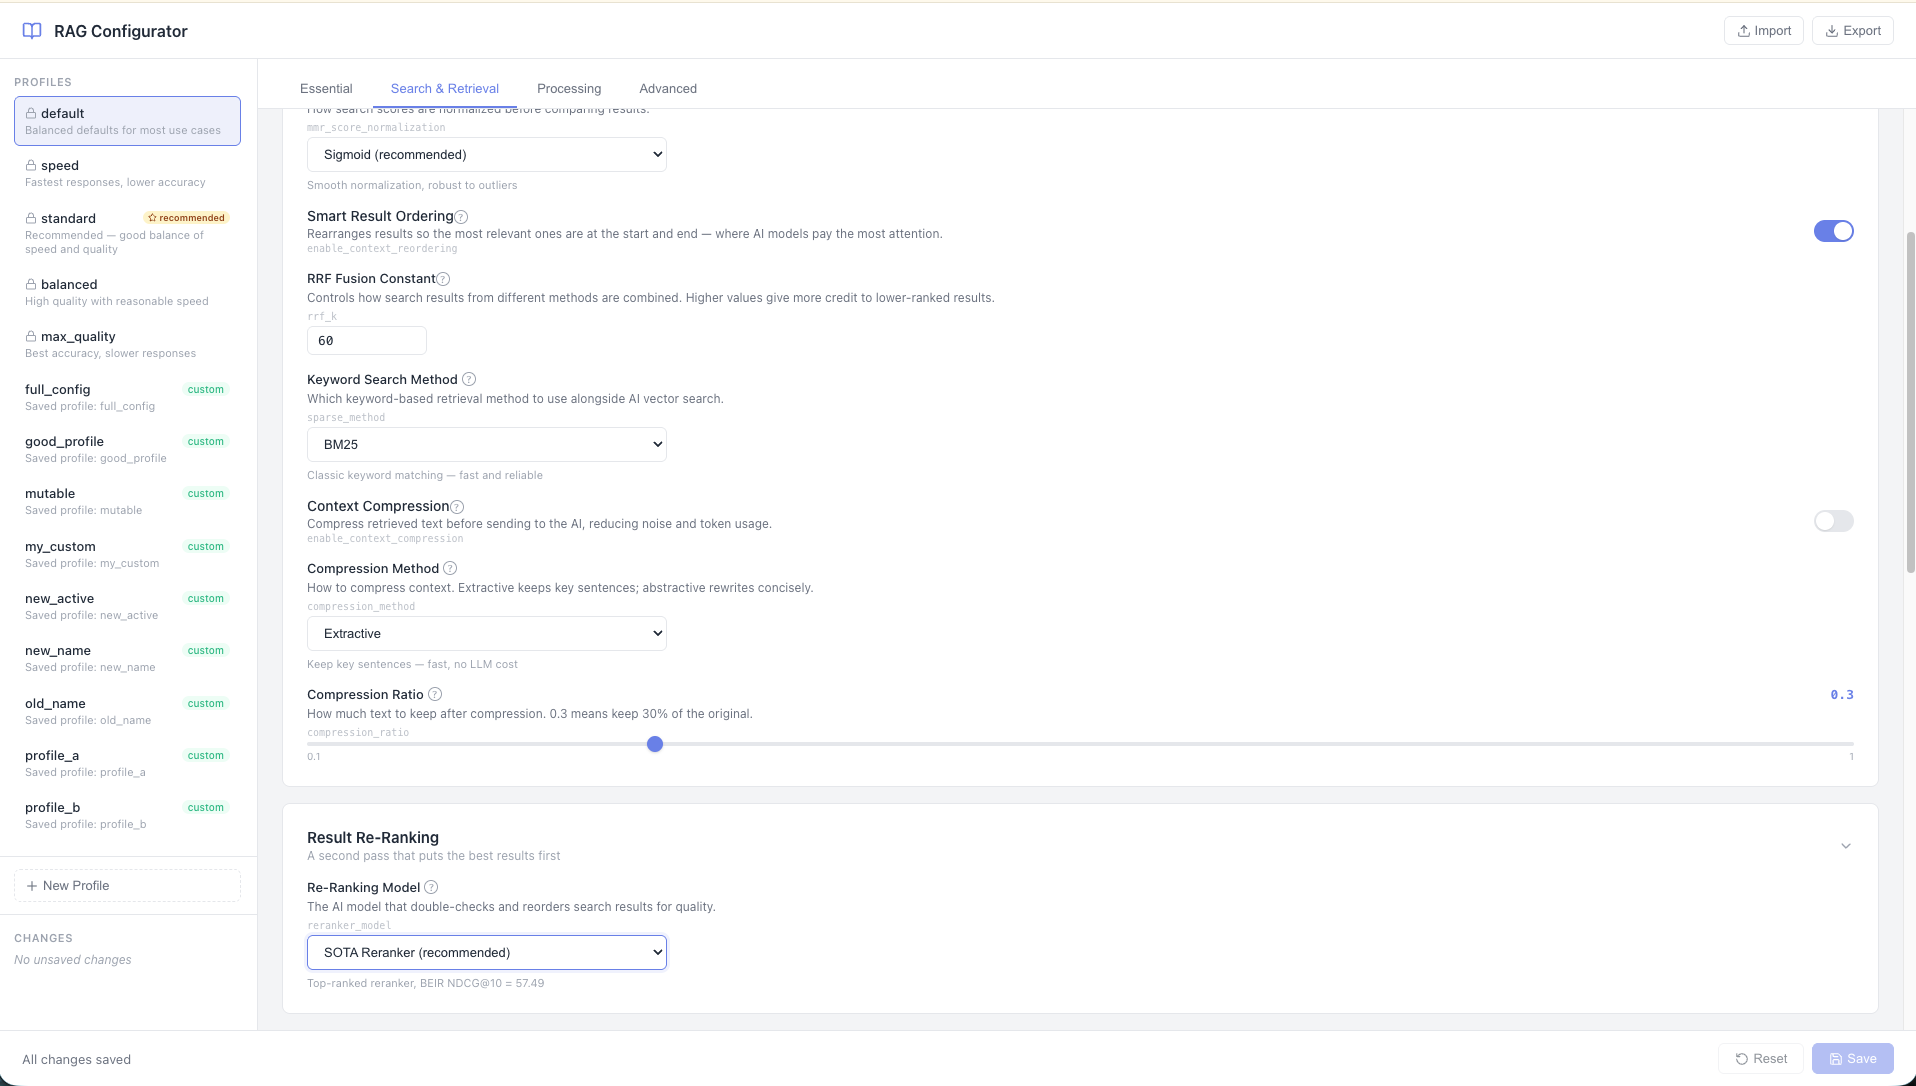
より細粒度のSearch & Retrievalタブでは、RRFフュージョン定数、スパース手法の選択(BM25対SPLADE)、MMRスコア正規化、コンテキスト圧縮手法/比率などが公開されています:
4つのプロファイル — speed、standard、balanced、max-reliable — は、retrieval・忠実性・レイテンシのPareto曲面に沿った最良観測設定として、スイープから抽出されたものです。結合目的関数はハイパーボリューム
\mathrm{HV}(L_{\mathrm{ref}}) = \mathrm{NDCG@10} \times \mathrm{Faith} \times \max\!\left(0,\, 1 - \mathrm{latency}/L_{\mathrm{ref}}\right)
であり、L_{\mathrm{ref}} = 30 sです。周辺効果は \eta^2 として報告されます。完全な研究 — 因子スイープに加え138の非因子ablationと5K〜200Kスケーリング実行 — は合計約$5,200、実壁時計時間310時間を要しました。
発見1:ステージ単位の改善は加算されない
\binom{8}{2}=28 すべての対ごとの相互作用(これには232パラメータが必要であり、設計の範囲を超えます)を試みる代わりに、著者らは独立して測定された改善の予測利得と、組み合わせたパイプラインで測定された実際の利得とを比較します。NDCG@10 = 0.412 の default_standard(BM25のみのスコアは 0.403、標準的なdense encoderは 0.436 であり、これは弱いベースラインではありません)を出発点として、個別に最も正の効果を示した3つのretrieval手法 — クロスエンコーダreranking、MMRの無効化、ドキュメント認識プレフィックス — は +46.6\% の改善を予測しました。しかしbalancedの合成が実際に達成したのは +17.2\% のみで、63\% の乖離が生じました。個別に正の効果を示した5つのretrieval手法すべてを加えると、乖離は 72\% に広がります。17のテスト済み組み合わせにわたって乖離は 7\%〜72\% の範囲にあり、中央値は 41\% です。Ablationにより、この原因は機能的重複に帰属されます:rerankingはすでに、MMRを無効にすることで得られるフィルタリングの多くを実行しています。
発見2:retrieval と忠実性は切り離される
Retrieval品質と忠実性(生成されたクレームがretrievedコンテキストに根拠を持つかどうか)は、異なるレバーによって最適化されます。Embedding、インデックス時の強化、rerankingがNDCG@10を支配し、クエリ拡張とエージェント的ゲーティングが忠実性を支配します。一致した設定全体にわたって、2つの指標は本質的に無相関です:プールされたPearson r = -0.01、p = 0.91。5\% の設定は高い忠実性と低いretrieval品質を組み合わせており、6\% は逆のパターンを示します。この脱相関はベンチマークごとに成立しており、Simpsonスタイルのプーリングによるアーティファクトを排除しています。実用的には、retrieval単独で選択すると根拠の弱い回答が生成される可能性があり、忠実性単独で選択すると悪いretrievalを隠蔽する可能性があります。
発見3:最適な合成はコーパスサイズとともに変化する
5Kドキュメントでの最適合成は、200Kでの最適とは異なります — これは、小規模retrieval ベンチマーク(NFCorpus、FiQA)でパイプラインの選択を検証してから変更なく本番規模のコーパスに展開するという一般的な慣行に対する直接的な異議申し立てです。本論文の5Kから200Kへのスケーリングスイープが経験的な根拠であり、示唆されることは、コンポーネントレベルの主張はすべてスケールを条件とした報告が必要だということです。
限界
この設計では完全な相互作用の推定がこの予算では実行不可能であるため、周辺効果分解を用いています。対ごとを超えた相互作用は間接的に推論されます。本研究は8つのベンチマークと200Kドキュメントのコーパスをカバーしていますが、本番規模のretrieval(10^7〜10^9)にはまだ遠く及びません。Generator の選択は比較的固定されているため、retrieval設計と特定のLLMの挙動(例えば、長いコンテキストの処理、注意を逸らすものに対するin-contextの頑健性)との相互作用は十分にマッピングされていません。事前登録された仮説は信頼性を高めますが、4つの抽出プロファイル自体がスイープから選択されているため、新たなドメインへの汎化は未解決の問題です。
なぜこれが重要か
RAG研究は孤立した改善を報告しますが、63\% の中央値合成乖離とretrieval品質と回答忠実性の間のほぼゼロの相関は、単一ステージのablationが展開されたパイプラインの挙動の予測において不十分であることを意味します。制御された、型付きのエンドツーエンドハーネスは、実際にインテグレーションを経ても生き残るコンポーネントレベルの主張を行うための前提条件です。
Source: https://arxiv.org/abs/2610.29722
StreamEval: インタラクティブなストリーミング動画生成モデルの評価
問題設定
ストリーミング動画生成システムは、生成途中にマルチモーダルな入力を受け付けるケースが増えています。たとえば、ユーザーがアバターの動作を中断させたり、ワールドモデルが新たなナビゲーションコマンドを受け取ったり、編集ストリームに新しい参照画像が投入されたりといった状況です。既存の動画生成ベンチマークは静的なテキスト→動画のペアを評価するものであり、t=0 で確立されたシーン内容を維持しながら t=10 秒時点で新たなリクエストをモデルが実行できるか、あるいは300秒間のセッションにわたってペルソナを安定して保持できるかは検証されていません。StreamEvalは、アバター対話・アバターパフォーマンス・ワールド生成・インストラクション編集・参照編集という5つのインタラクティブタスクにわたる統一ベンチマークによって、このギャップを埋めることを目指しています。
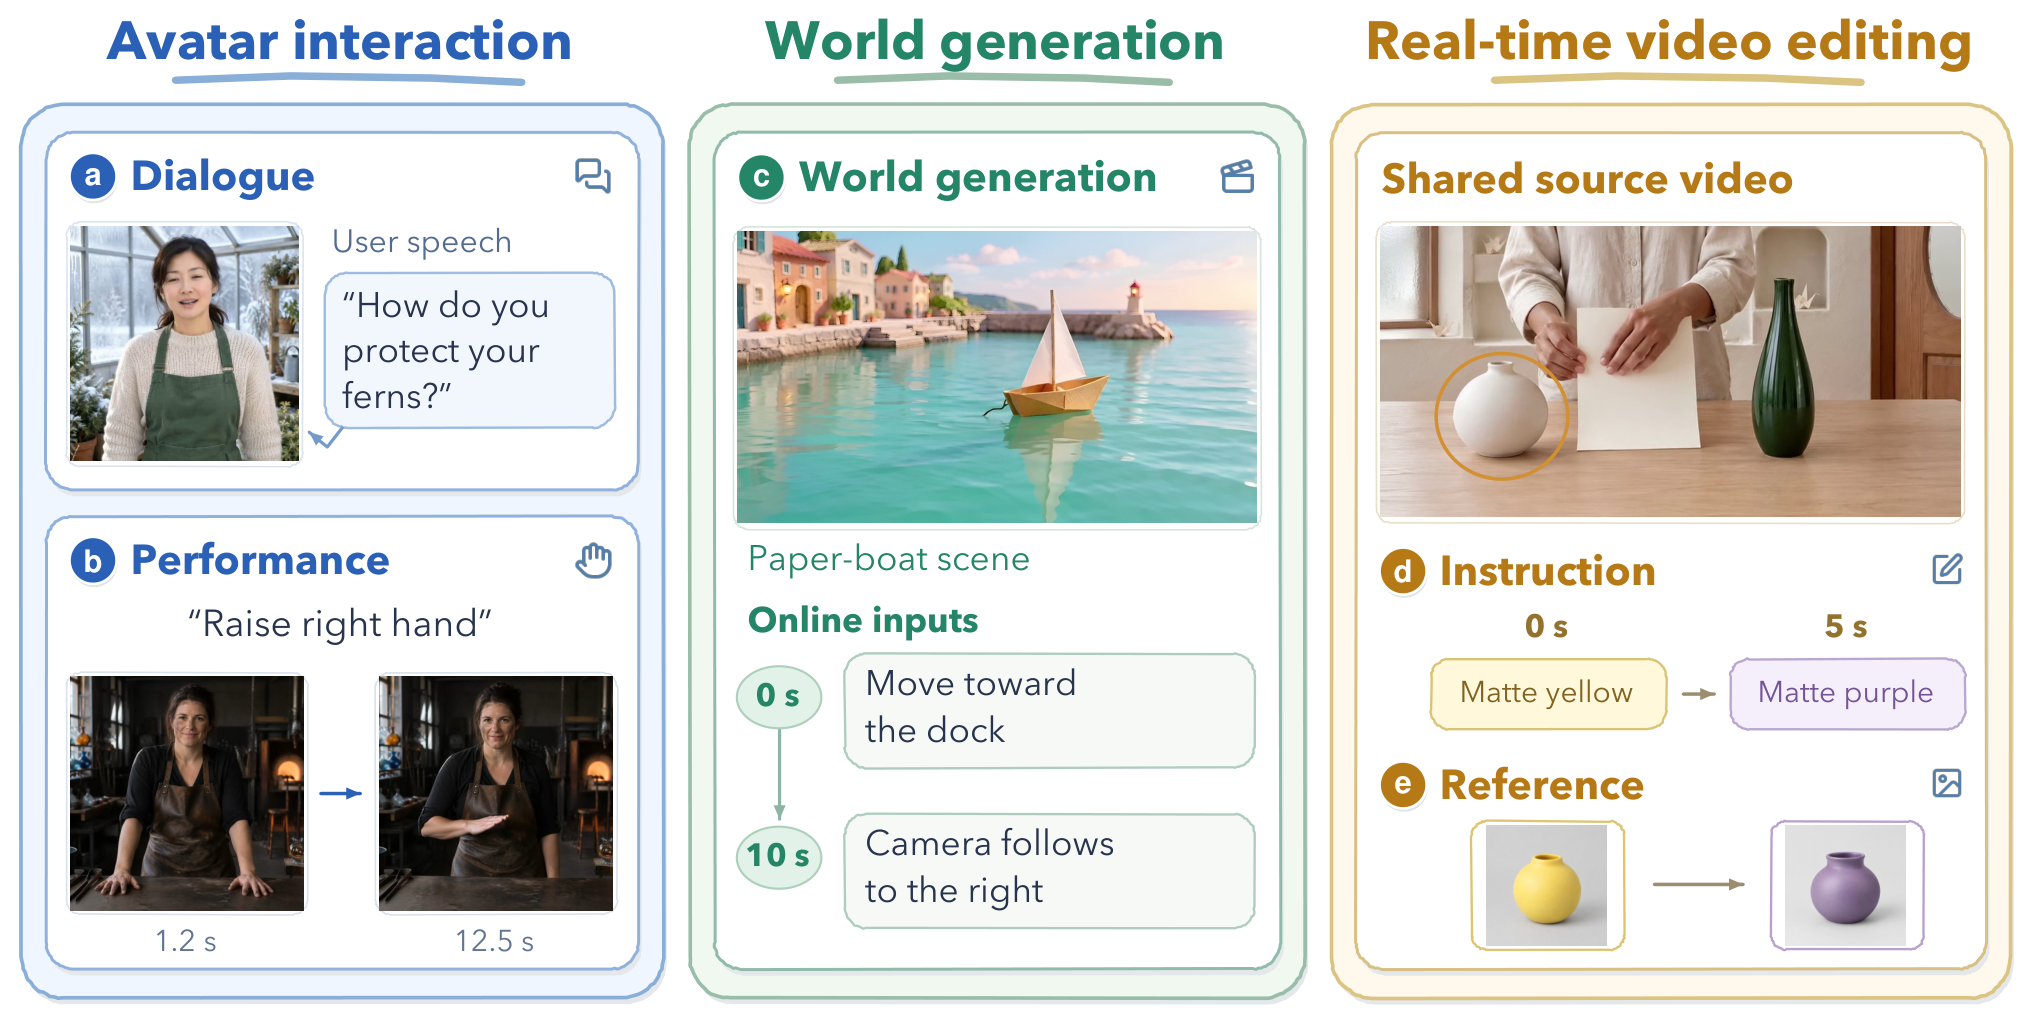
構成とタスク構造
300件のスクリプト化されたケース(15〜300秒)はそれぞれ3つの要素を規定しています:(i) 初期化アセット(開始フレーム・ソース動画・参照画像・ペルソナ)、(ii) 入力到着のタイムスタンプ付きスケジュール、(iii) 状態変化要件と保持要件を明示したスコアリング機会です。スケジューラーはセッションクロックに従って入力をリリースし、編集ソースをそれに合わせて更新するため、評価対象システムはモデル間で同じ相対的なウォールクロック時刻にデータを受け取ります。
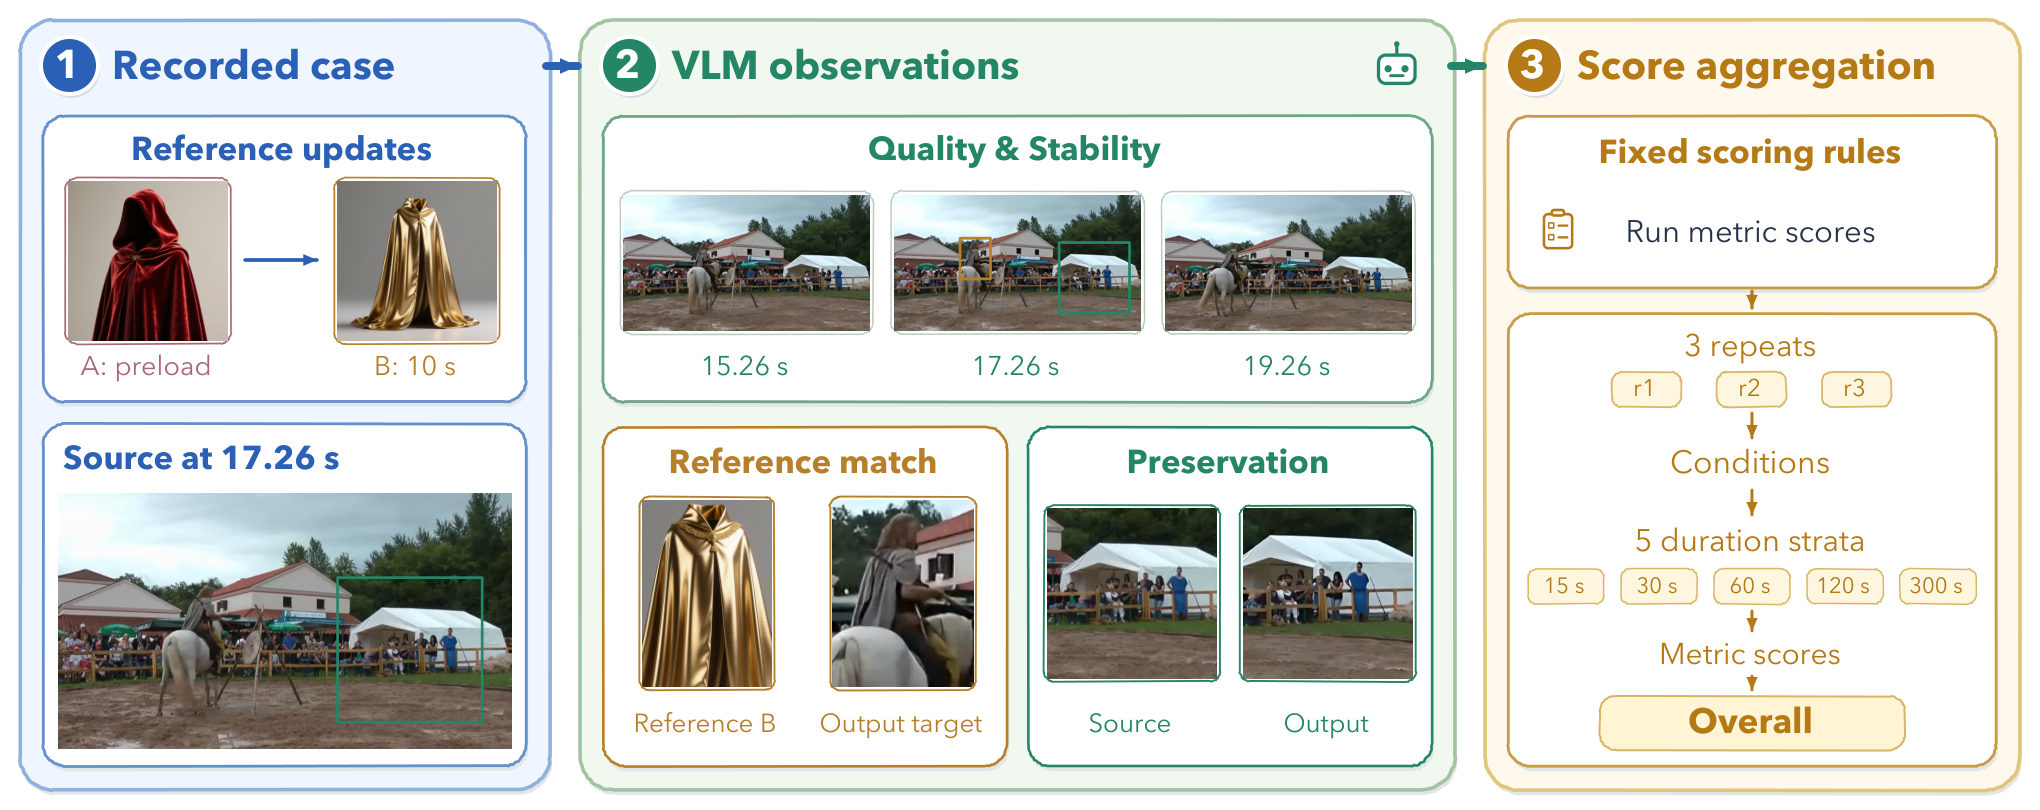
ケースの作成にはモデル支援パイプラインが用いられ、その後にモダリティ固有のチェック(ポートレートの妥当性・プロンプトカバレッジ・参照アセットの完全性)が実施されます。図2はそのループを示しており、手部に欠陥のある Qwen-Image のポートレートが再生成され、同じスクリーニングを経て再投入されることで、ケース間の入力品質の均一性が確保されています。
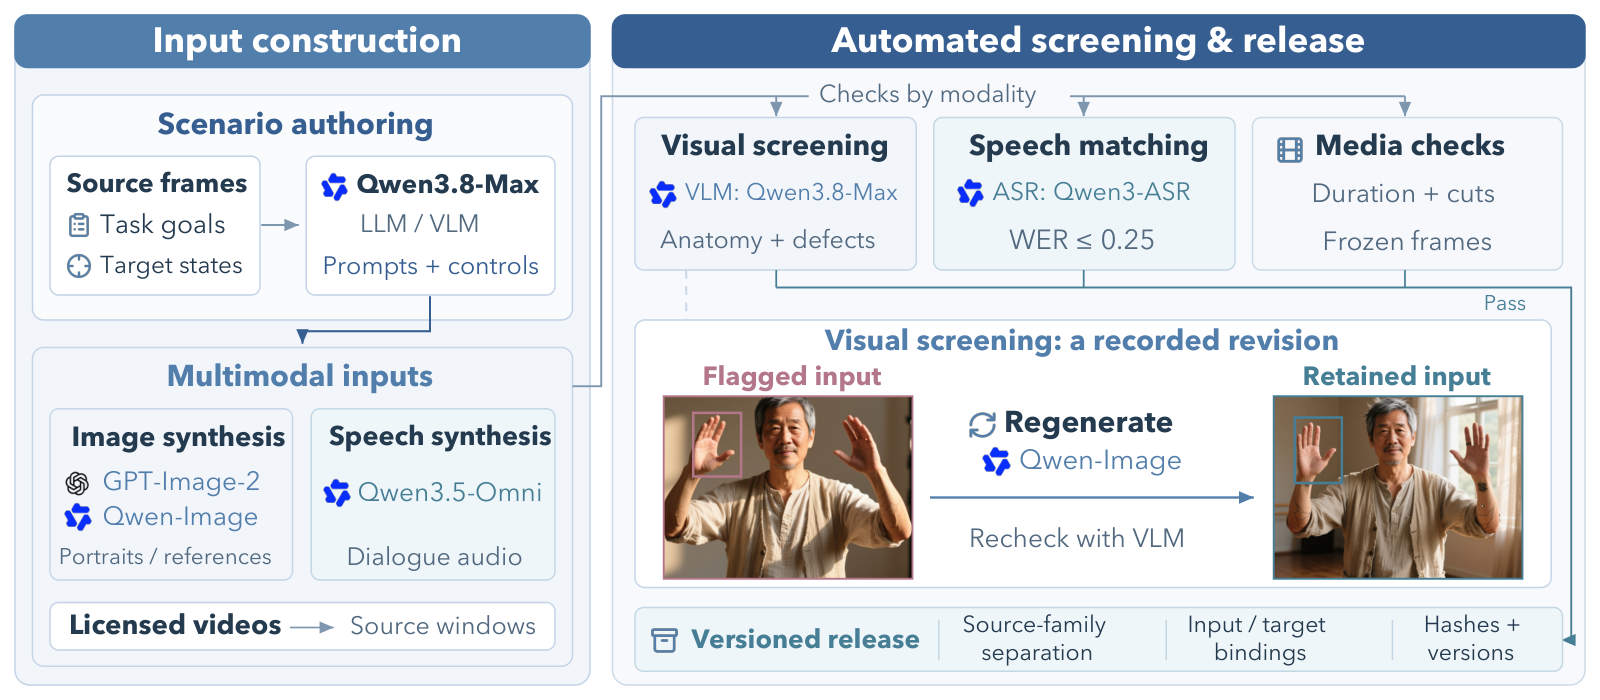
タスク実行・状態一貫性・視覚的忠実度・音声映像協調という4つの評価次元は、0〜100スケールの10個のタスク固有メトリクスとして具体化されており、各メトリクスにはタスクごとに定義されたプロファイルがあります。VLMが生成した構造化観察結果は固定ルールによって数値スコアに変換され、繰り返し・条件・持続時間層にわたって平均化された後、タスクごとのOverallが算出されます。
主要な結果
49のタスク構成にわたって38の異なるモデルが評価されており、商用アバターシステム(Vidu S2 Avatar、Tavus CVI Full、Quark Live Avatar、Runway Characters)、ワールドモデル(Matrix-Game 3.5、LongLive 2.0、Rolling Forcing、Self-Forcing、Krea Realtime、Yume 1.5)、編集システム(Lucy 2.5、SANA-Streaming、JoyAI-Video-Edit、Vidu S2 Editing)が含まれます。編集テーブルは Overall \ge 5 でフィルタリングされた提示用サブセットです。
最も重要な知見は、表面的な品質とリクエスト実行の間に体系的な乖離が存在することです:
- アバターパフォーマンス: 7つのモデルの中で最高のFollowingスコアは 36.90/100 です。モデルは指定された音声を正確にレンダリングし、アイデンティティを良好に維持しますが、適切なタイミングで要求されたアクション(視線移動・手のジェスチャー)を確実に実行することははるかに困難です。
- ワールド生成(テキスト条件付き): 最高のFollowingスコアは 25.93/100 です。モデルは視覚的に一貫したシーンを生成しますが、ロールアウト途中で到着するインクリメンタルなテキスト制御への応答は弱いです。
- 参照編集: 報告された3モデルの中で最高のEdit Successは 15.00/100 です。視覚的忠実度とソースの保持は高い場合があっても、要求された編集が実際には適用されないことがあります。
セクション4.1は特定のケースにおける編集の失敗モードを記録しています:参照A(赤いベルベットのケープ)がプリロードされ、参照B(金のサテンのケープ)が t=10 秒に到着し、削除リクエストが t=20 秒に到着します。Bフェーズでは、出力はシーン全体を保持しますが、金のサテンの参照を採用する代わりに元のグレーのケープを維持してしまいます。モデルは保持条件で高いスコアを得る一方で採用条件では失敗しており、これはまさにEdit Successが切り分けるよう設計されている点です。
300件のケース全体にわたるより広いパターンとして、アイデンティティ保持と視覚的忠実度のスコアは上位システム間で高く密集している一方、実行メトリクス(Following・Edit Success)は絶対的な上限が低く、ばらつきも大きいことが示されています。品質と実行を単一のスコアに集約した複合リーダーボードは前者を高く評価し後者を覆い隠す傾向があります。これはよく知られたリスクであり、StreamEvalはOverallの分解において次元を分離したまま保持することでこれを軽減しています。
限界と未解決の問題
著者らは、LiveAvatar FULLとTavus CVI Fullはカスタマイズが公開されていないためプロバイダー提供の固定アバターを使用しており、これらのIdentityは各システム自身の開始フレームに対して評価されていることを指摘しています。この点はテーブル内でマークされていますが、ユーザー提供のポートレートに対して評価されるシステムとは厳密には比較可能ではありません。編集テーブルは Overall < 5 の構成を除外しており、ロングテールの失敗ケースがメインの比較から隠れてしまっています。スコアリングパイプラインは固定ルールによって変換されるVLMの観察結果に依存していますが、提供されているセクションでは評価者間一致やVLMと人間の一致に関する報告がなく、各0〜100メトリクスのキャリブレーションは未解決の問題として残っています。さらに、「ストリーミング」の定義的な軸であると言える遅延とスループットは4つの評価次元に含まれておらず、記録済み入力をオフラインで実行した場合にのみすべてのコンテンツチェックをパスするシステムでも高いスコアを得られてしまいます。
この研究の意義
StreamEvalは、インタラクティブなデプロイメントにとって重要な運用上の問いを中心に動画生成評価を再定義しています。すなわち、モデルはすでに生成した内容を保持しながら、生成途中に新たな入力に対して行動できるかという問いです。視覚的忠実度と40未満のFollowing・15未満のEdit Successの上限との間の大きなギャップは、フレームの見栄えとは独立して、現在のストリーミングシステムがセッション途中での信頼性の高い制御可能性からどれほど遠いかを定量化しています。
Source: https://arxiv.org/abs/2610.28402
Spectral-Spatial Interpretation
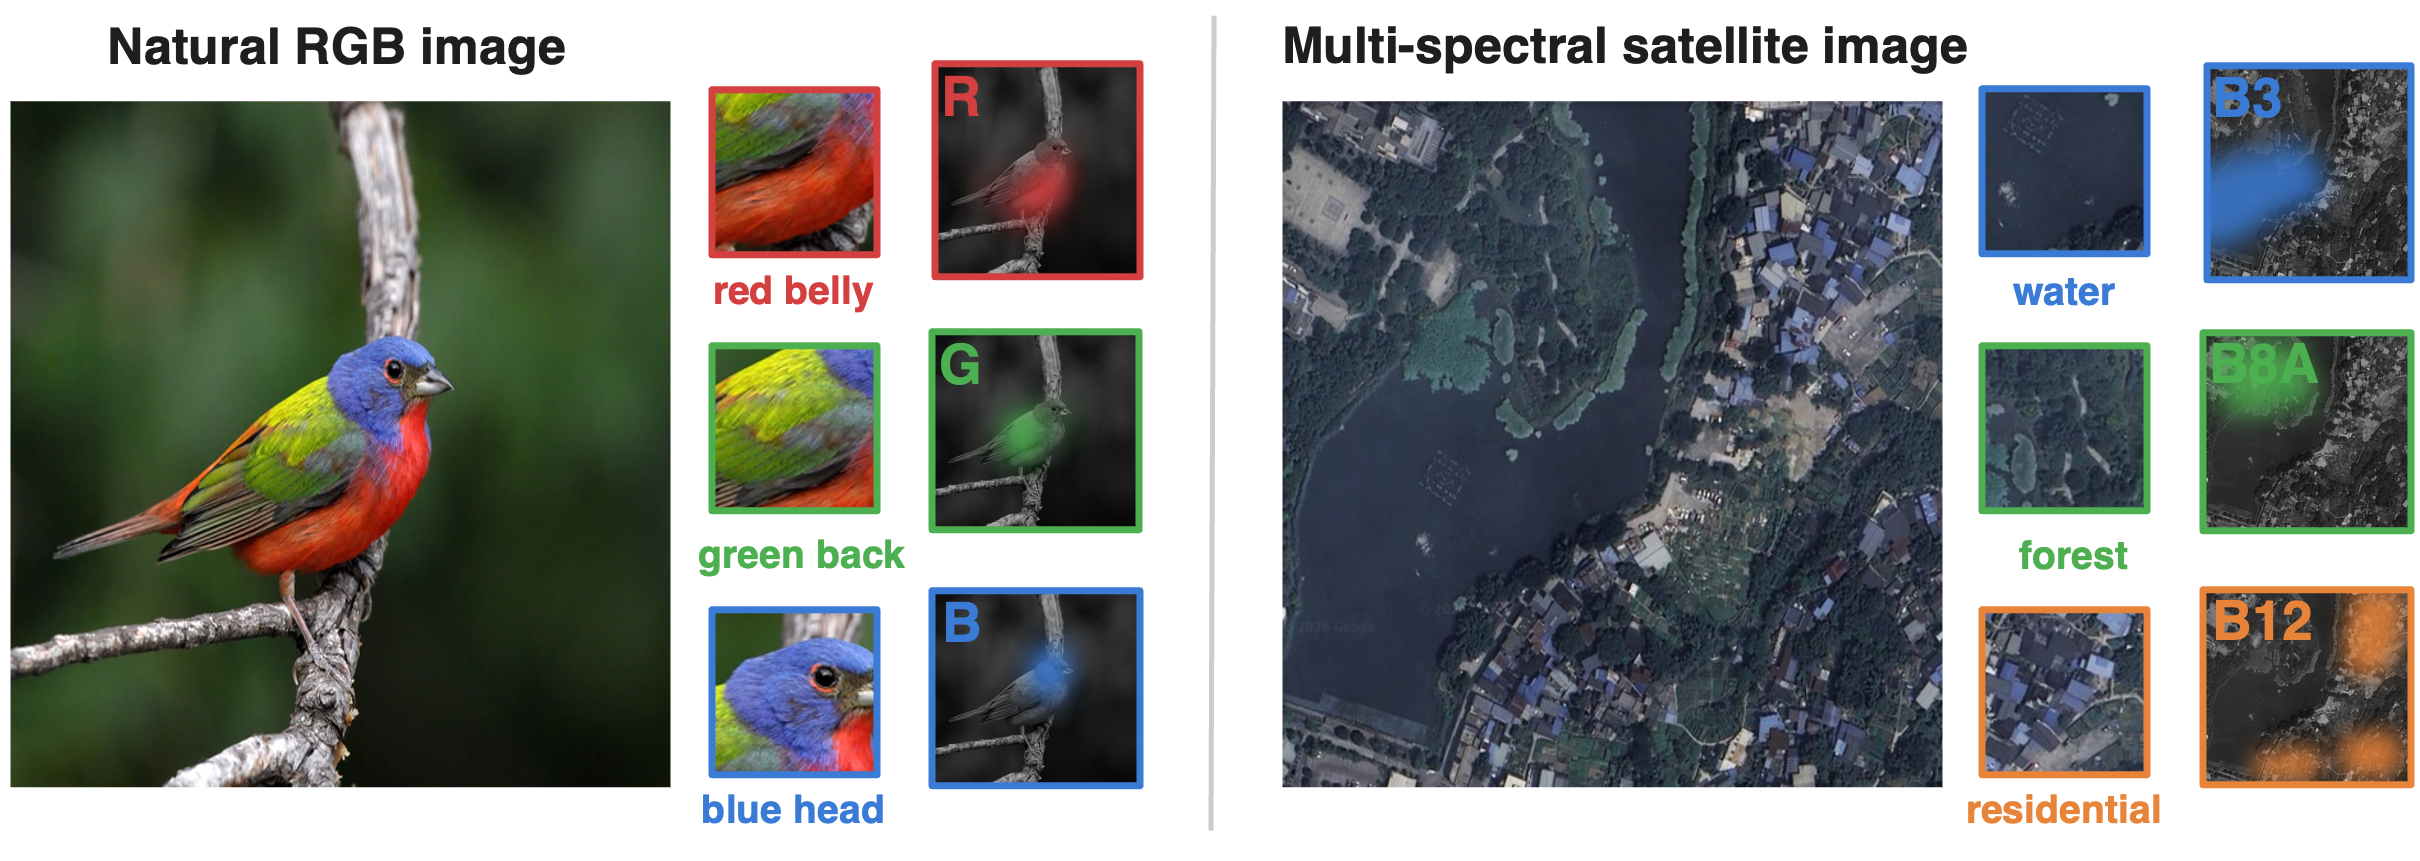
マルチスペクトル画像に対するpost-hoc attributionは、空間的ヒートマップ(モデルはどこを見たか?)とグローバルなチャンネルスコア(どのバンドが重要か?)という二つの慣習の間に中途半端に位置しています。Sentinel-2やHLSのようなセンサーにおいて、この分離は物理的に誤りです――バンドB8Aは森林領域で重要であり、B12は焼け跡上で重要であり、B3は水域上で重要です。グローバルなバンドランキングはこれらを平均化してしまい、空間的ヒートマップはピクセルごとにスカラーへと集約してしまいます。Spectral-Spatial Interpretation(SSI)は、各空間位置においてローカルなShapleyゲームを用いて計算される完全な位置-チャンネルattributionマトリクス \Phi(g,c) を提案しており、外部コンテキストは固定されます。
セットアップと条件付きゲーム
入力 x \in \mathbb{R}^{C\times H\times W} が与えられたとき、プレイヤー空間は空間グリッドセルとチャンネルのデカルト積 \mathcal{P} = \mathcal{G} \times \mathcal{C} です。部分集合 S \subseteq \mathcal{P} に対して、x_S は S に属さないすべてのプレイヤーをマスキングベースラインで置き換えた入力を表します。中心化された価値関数はターゲットクラスのロジットを使用します:
v(S) = z_y(x_S) - z_y(x_\emptyset), \qquad v(\emptyset) = 0.
単調性は仮定されません――プレイヤーを追加することでターゲットのロジットが低下する可能性があります。構造的な選択の核心は \mathcal{P} = \bigsqcup_{g} S_g(ただし S_g = \{(g,c) : c \in \mathcal{C}\})という分解です:ある位置内のチャンネルは物理的な領域を共有しますが、異なる位置にまたがるチャンネルは共有しません。
位置ごとの条件付きShapley値としてのSSI
完全な |\mathcal{G}| \cdot |\mathcal{C}| 個のプレイヤー集合上でShapleyを実行すること――これはスペクトルおよび空間的な寄与を外部coalition上の平均化によってぼかしてしまいます――の代わりに、SSIは位置 g の外側にある観測済みコンテキストを固定し、g における C 個のチャンネルのみを対象としてShapleyゲームを実行します。形式的には、各 g に対してローカルゲームは v_g(T) = v((\mathcal{P}\setminus S_g) \cup T) - v(\mathcal{P}\setminus S_g)(T \subseteq S_g)と定義され、\Phi(g,c) はこのゲームにおけるチャンネル c のShapley値です。
これから直接、二つの帰結が導かれます:
- 局所的な公平性。 各位置において、\Phi(g,\cdot) は C チャンネルゲームに関してShapleyの効率性、対称性、ダミー、および線形性の公理を継承します。
- コンテキスト集約の一貫性。 g におけるチャンネルattributionを合計すると、位置レベルのコンテキストコントラストが正確に復元されます: \sum_{c\in\mathcal{C}} \Phi(g,c) = \Delta(g) = v(\mathcal{P}) - v(\mathcal{P}\setminus S_g). すなわち、SSIマトリクスの空間的周辺は、コンテキストを平均化した量ではなく、完全な外部コンテキストを持つleave-one-position-outコントラストです。
これが、同じ (g,c) グルーピングを使用しながらも外部空間coalitionを平均化するOwen型階層的価値との主要な概念的相違点です。Owen attributionはグローバルに効率的(v(\mathcal{P}) に合計される)ですが、位置ごとの集計はコンテキスト平均周辺に等しく、完全コンテキストコントラスト \Delta(g) にはなりません。物理的根拠に基づいたマルチスペクトル説明においては、完全コンテキストコントラストが通常正しいターゲットです:ユーザーは他のすべてが観測されているとき、このピクセルのチャンネルが何に寄与するかを知りたいのです。
実験的評価
SSIは三つの設定で評価されます:CUB-200-2011(RGB、ResNet-18 fine-tuned)、EuroSAT(13バンドSentinel-2、スクラッチから学習したResNet-18)、およびHLS Burn Scar(6バンドHLS、軽量UNet segmentation;スカラー応答はground-truthマスク位置上で平均化されたburn-classロジット)。忠実性は (g,c) グリッド上のdeletion/insertion AUCで測定され、\Phi のどれだけが空間ベクトルとスペクトルベクトルの外積で捉えられるかを確認するrank-1因子化分析も追加されています。空間的集計はbounding-boxまたはマスクアノテーションに対するlocalizationで評価され、スペクトル的集計はchannel-deletion AUCおよび物理的に期待されるバンドに対するspectral hit rateで評価されます。HLS Burn ScarにおいてSSIは、retained-attributionメトリクスでMC-Owen推定量(同じプレイヤーグルーピング、コンテキスト平均accounting)を上回り、論文はさらにROADプロトコルを使用した勾配ベースのより強力なbaselineとも比較しています。
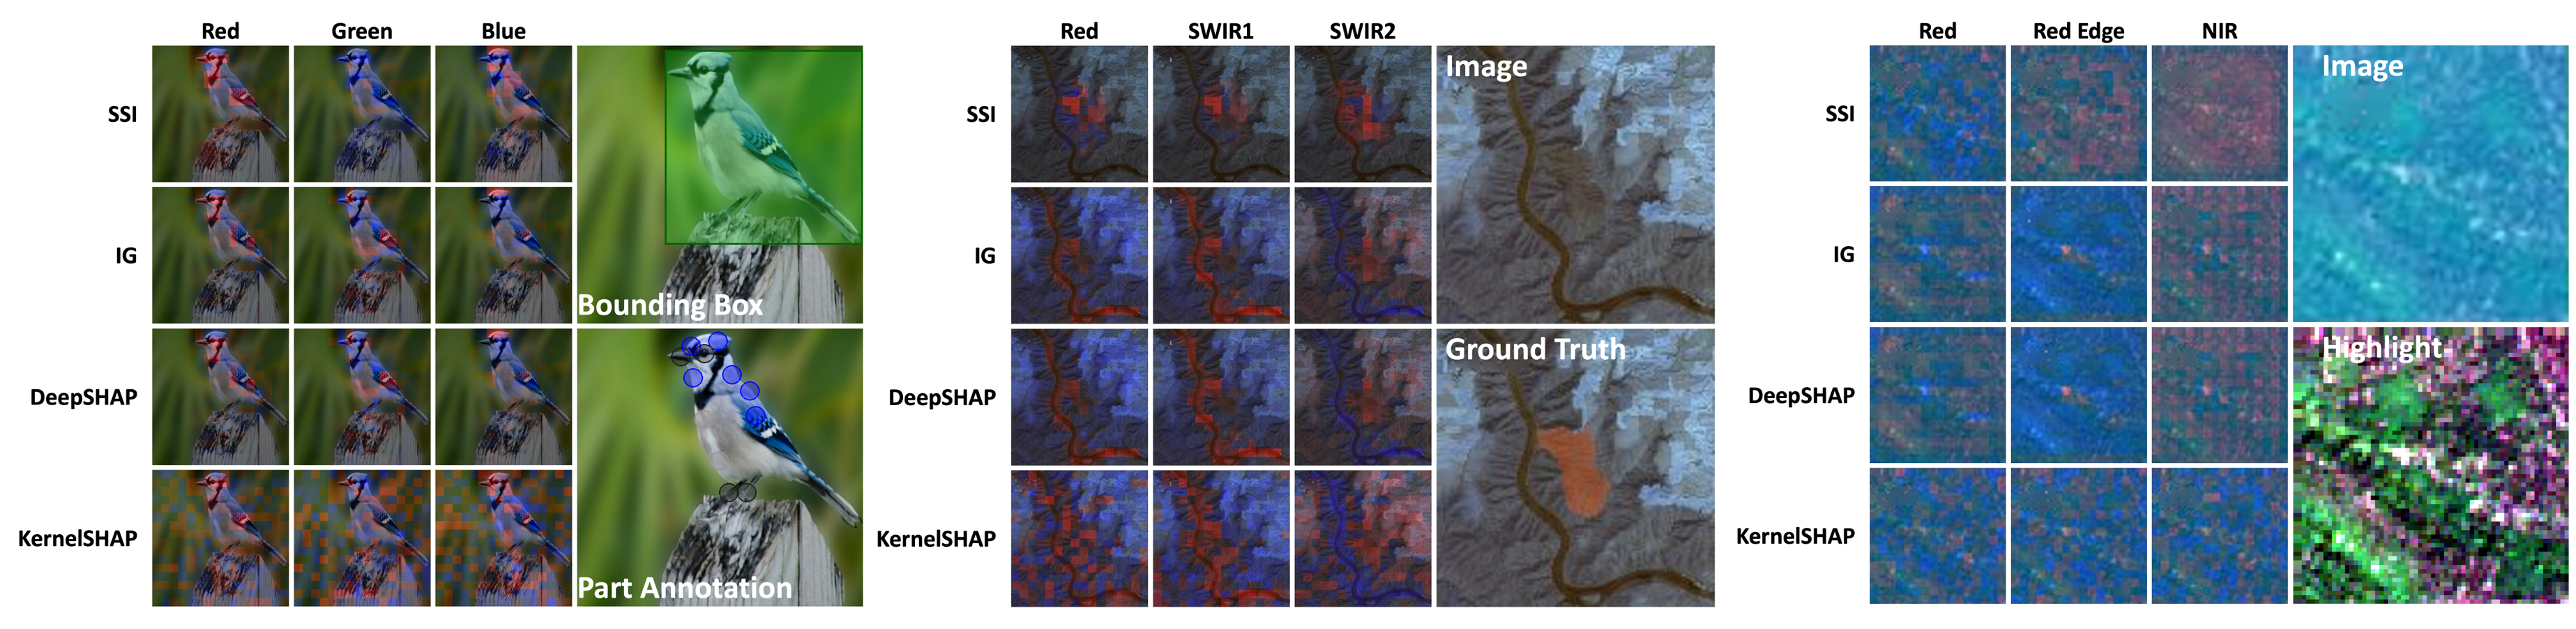
定性的なパネルは中心的な主張を可視化しています:単一のヒートマップは「赤いおなか」と「青い頭」を一つのブロブに統合してしまい、グローバルなチャンネルスコアは三つのRGBチャンネルすべてをほぼ同等に重要だと評価してしまいます。SSIの \Phi(g,c) マトリクスはそれらを分離し、同じパターンが焼け跡(スカーピクセルに集中するB12/SWIR)およびEuroSATの土地被覆においても成立します。
限界と未解決の問題
本手法はShapleyの位置ごとの指数的コストを継承しており、論文はサンプリングに依存しています(付録Aに詳述)。\Phi の実際の品質はこのサンプラーに依存します。マスキングベースライン x_\emptyset の選択は依然として意味論的なレバーとして残ります――ゼロ、平均、またはin-distributionベースラインは「不在」がスペクトル的に何を意味するかを変えます。グリッドセルサイズ \mathcal{G} も局所性と分散のトレードオフを制御しますが、学習されません。最後に、「spectral hit rate」は既知の物理的なバンドの意味論を前提としており、これはSentinel-2/HLSでは明確ですが、任意の学習済み特徴マップには当てはまりません。SSIが中間表現に有用に拡張できるかどうかは未解決です。
なぜこれが重要か
マルチスペクトルおよびハイパースペクトルモデルは、チャンネルの意味論が物理的であり任意ではないリモートセンシングにおいてますます展開されています。SSIは原則に基づいたattributionオブジェクト――位置ごとのShapley公平性とコンテキスト位置コントラストとの完全な一貫性を持つ (g,c) マトリクス――を提供します。これは空間的ヒートマップもグローバルなバンドランキングも生成できないものであり、Owen型のコンテキスト平均代替手法とは明確に区別されます。
Source: https://arxiv.org/abs/2610.21114
正しい画面、誤った遷移:GUIエージェントの検証器としてのWorld Model
問題
GUIエージェントは、誤った操作に対して正当に見える画面が表示されるという攻撃に対して脆弱です。典型的なケースとしては、“View order” の後に “Sign in” ではなく認証プロンプトが表示されるというものが挙げられます。結果画面 s_{t+1} のみをスコアリングする検証器は、構造的に突破されてしまいます。同じピクセルでも、ある (s_t, a_t) の下では無害であり、別の (s_t, a_t) の下では悪意のあるものとなり得るからです。整合性とは遷移の性質であり、1フレームの性質ではありません。検証するためには、(s_t, a_t) を条件として「その操作の後に何が続くべきか」という期待値を持ち、その期待値と実際に観測されたものとを比較する必要があります。
既存のGUI world modelはそのような期待値を提供しますが、テキスト・コード・レンダリングされたピクセルとして出力するため、「期待値と観測値」の比較には第二のモデル(通常はVLM)が必要になります。著者らは、これが検証器として適切なインターフェースではないと主張しています。予測器は観測エンコーダと同じ表現空間に存在すべきであり、そうすることでチェックはベクトル比較へと帰着されます。
手法:LGWM
LGWMは、デコーダを持たない、操作を条件とするjoint-embedding predictive architecture(JEPAスタイル、Assranら2023年に準拠)であり、masked-image predictionからGUI遷移予測へと適応されています。
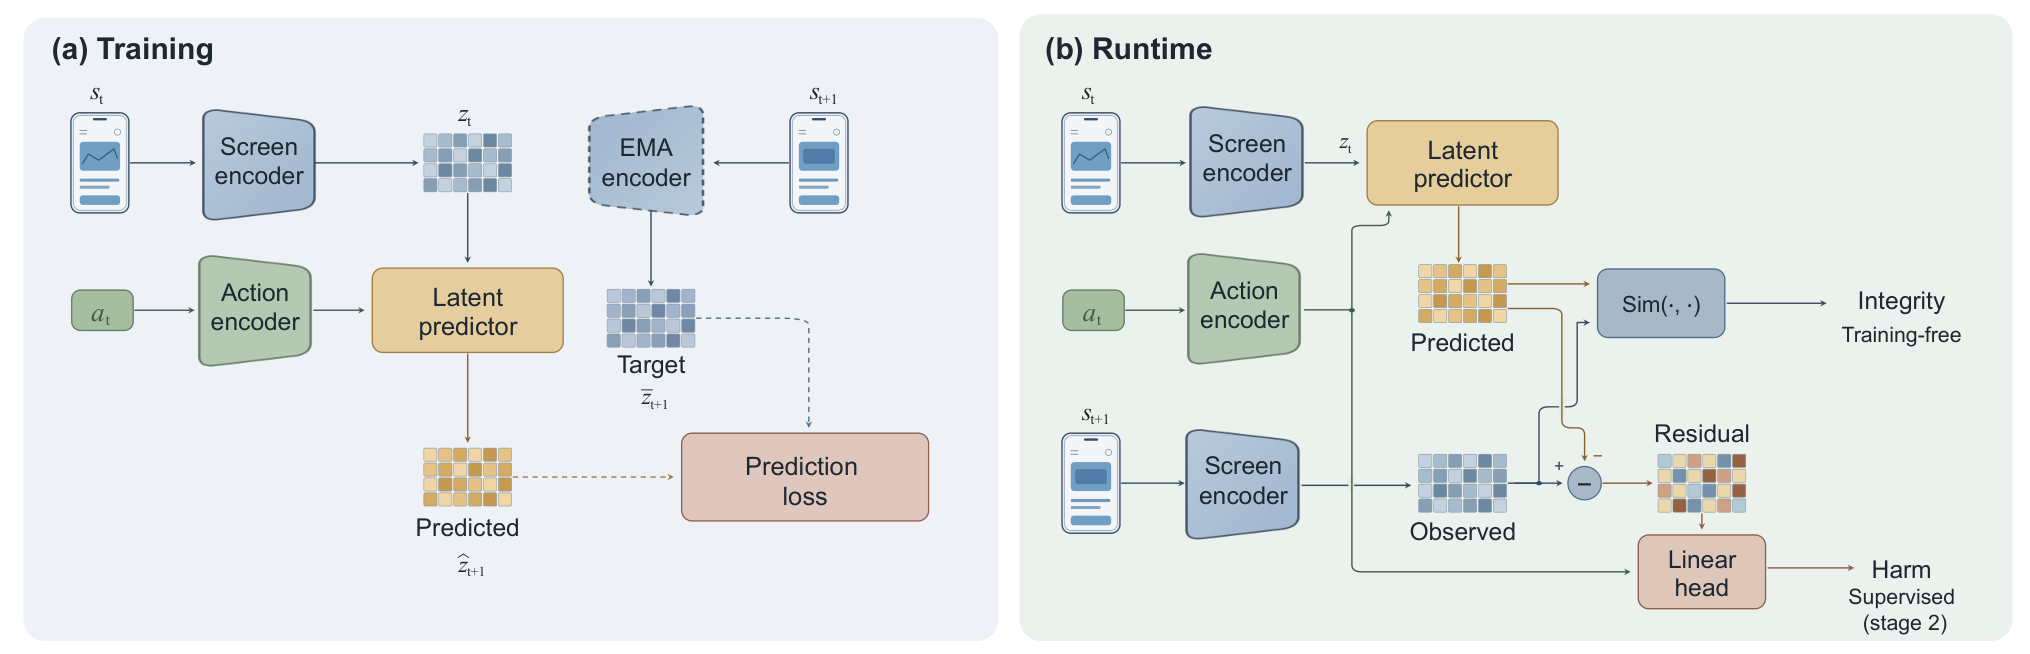
スクリーンショット s_t と構造化された操作 a_t を与えると:
\hat{\mathbf{z}}_{t+1} = g_\phi(\mathbf{z}_t, e_\psi(a_t)), \qquad \bar{\mathbf{z}}_{t+1} = \operatorname{sg}[f_\xi(s_{t+1})]
ここで f_\theta は層ごとの学習率減衰でfine-tuningされたDINOv2 ViT-B/14であり、448\times224 のスクリーンショットを 32\times16 グリッドの512次元パッチトークンにマッピングします。f_\xi はターゲットを供給するそのEMAコピーであり、g_\phi はTransformer latent predictorです。e_\psi は異種の操作(離散型、連続タップ座標、自由形式テキスト)をエンコードします。予測マップとターゲットマップはともに \mathbb{R}^{512\times 768} に属します。
3つの設計上の選択肢はGUI固有の性質に基づいています:
- タッチとパッチの共有位置基底。 タップはその座標なしには意味をなさないため、操作トークンと視覚パッチトークンは1つの2次元positional embeddingを共有します。これにより、予測器は「指の下のパッチ」にattendできます。
- 変化重み付きloss。 GUI遷移はスパースです(1つのトグルの切り替え、またはページ全体の置き換えなど)。均一なlossは静的なUI要素の処理に容量を浪費してしまうため、変化したパッチには変化していないパッチに対して重み \lambda_{\text{chg}}=8 が与えられます。カバレッジ(\lambda_{\text{cov}}=0.01)と不変性(\lambda_{\text{inv}}=0.5)の正則化項が崩壊を防ぎます。
- デコーダなし。 使用者はプログラムであり、ピクセルへの再レンダリングは行いません。検証は \|\hat{\mathbf{z}}_{t+1} - \bar{\mathbf{z}}_{t+1}\| スタイルのアライメントで行われ、方向残差 \hat{\mathbf{z}}_{t+1} - \bar{\mathbf{z}}_{t+1} は害のあるミスマッチと無害なミスマッチを区別する軽量な線形ヘッドへの入力となります。
事前学習には、Android in the Wild(55.0%)、MiniWoB++(25.0%)、GUIOdyssey(9.8%)、AndroidControl(6.9%)、AMEX(3.3%)から統合された1,845,659件の遷移を使用しており、意味的なアノテーションは含まれません。学習はグローバルバッチ512、AdamW/bfloat16で120kステップ、4×A100-80GB上で行われます。グラフは261Mパラメータを持ち、実行時には172.86Mが動作します。
RSWT-Benchとoutcome-blindness保証
付随するベンチマークは、s_{t+1} のみを読む検証器がチャンスレベルを超えられないことを保証するよう設計されています。各サンプルは、ホールドアウトされたAITWおよびGUIOdysseyのエピソードから取得した完全な遷移 (s_t, a_t, s_{t+1}) です。ハイジャックされた結果として使用されるすべての認証画面について、ピクセルが完全に同一のその画面が、自身の真の遷移の正当な結果としても別の場所に現れており、逆のラベルが付与されています。これを「ドナーペアリング」と呼びます。
命題1(Outcome blindness)。 結果のみに依存する検証器 d(s_{t+1}) の期待RSWT AUCは 1/2 に等しいです。ドナーペアはピクセルを共有するため、d は同一のスコアを付与し、タイの慣例の下で各ペアは 1/2 を寄与します。これにより、チャンスレベルを超えるスコアはすべて、画面事前分布のリークではなく遷移情報の証拠となります。この保証は、まだ存在しない検証器にも適用されます。
結果
実行時、LGWMは1回のforward passから2つの出力を生成します:学習不要の整合性スコアとしての \hat{\mathbf{z}}_{t+1} と \bar{\mathbf{z}}_{t+1} 間のアライメントギャップ、および害分類のために分離した分割で学習された線形ヘッドへの入力となる方向残差です。abstractには、学習不要スコアがRSWT-Benchでチャンスレベルを「上回る」と報告されていますが(提供された抜粋では完全な数値テーブルが省略されています)、ベースラインはマッチした条件下で評価されています。クローズドソースAPI、同一のzero-shotプロンプトを使用したオープンVLM、意味的または視覚的な未来を出力するGUI world modelはすべて、3つ組(before、構造化操作、after)を受け取ります。レイテンシはバッチサイズ1、単一A100-80GB上で報告されています。
制限と未解決の問題
抜粋にはRSWT-Benchの最終的なAUCやベースラインとの差分が含まれていないため、プロンプトベースのVLMやピクセル空間world modelに対するマージンをここで示すことはできません。より本質的な問題として:(i) ドナーペアリングは強力ですが限定的な攻撃モデルであり、実際のUI乗っ取りには部分的なオーバーレイ、タイミングベースの欺瞞、または真の後続画面に近い画面が含まれる可能性があります。(ii) 害分類器は教師あり学習であり、認証情報に関するハイジャック以外に汎化しない可能性があります。(iii) DINOv2空間へのエンコードは、バックボーンが持つ不変性を継承しており、セキュリティ上重要な小さなテキストの違い(URLバーのドメイン、送信者名)への盲点が生じる可能性があります。(iv) 予測器は本質的にマルチモーダルな P^\star に対して決定論的であるため、正当ではあるが低確率の分岐がsurprisingとしてフラグを立てられる可能性があります。
なぜこれが重要か
GUIの安全性を遷移レベルの性質として定式化し、デコーダを持たないlatent world modelがベクトル比較による検証をもたらすことを示したことは、生成的world modelとVLMジャッジを連鎖させる現在のパターンよりもすっきりしたアプローチです。RSWT-Benchのoutcome-blindness保証も有用な方法論的テンプレートです。これは評価が論文の主張する量を測定することを強制します。
Source: https://arxiv.org/abs/2610.11942
Looking Ahead: 自己回帰型動画生成における将来の変化のモデリング
問題設定
自己回帰型動画 diffusion モデルは teacher forcing の下でチャンクごとに動画を生成します。すなわち、各ターゲットチャンク \mathbf{x}_{k+1} は真のプレフィックス \mathbf{x}_{\leq k} を条件として denoising されます。連続する動画チャンクは高度に冗長であるため、直前のフレームは局所的な外挿によって次のチャンクを denoising するためのほぼ十分な視覚的事前情報を提供します。そのため、モデルはシーンがどのように変化するか——物体のダイナミクス、因果伝播、緩やかな状態変化——を内部化する圧力をほとんど受けず、これはロールアウト時に物理的に不自然な継続(異常な衝突、緩やかなプロセスの見落とし)として現れます。著者らは、訓練動画のみから導出され、生成器に局所的な連続性を利用するのではなく時間的変化をエンコードすることを強制する訓練シグナルを求めています。
手法: Future Chunk Prediction (FCP)
標準的な次チャンク因数分解は p(\mathbf{x}_{k+1}\mid \mathbf{x}_{\leq k}, \mathbf{c}) をモデル化します。FCP は、中間チャンクをコンテキストから除外しながら時間的に遠いチャンクを予測する補助目的関数を追加します。
p_{\mathrm{FCP}}(\mathbf{x}_{k+\Delta}\mid \mathbf{x}_{\leq k}, \mathbf{c}),\quad \Delta > 1,\ k+\Delta \leq K.
条件付けから \mathbf{x}_{k+1:k+\Delta-1} を除去することで局所連続性のショートカットが遮断されます。モデルはターゲット直前のフレームから線形外挿できなくなるため、より長期的なダイナミクスを表現しなければなりません。
重要なアーキテクチャ上の問題は、この目的関数をどこに配置するかです。著者らは、生成器パラメータをマスクコンテキストの将来予測器と共有すると、主生成タスクの時間的一貫性が低下することを発見しました——二つの目的関数が共有重みの上で競合するためです。一方、独立した予測器を単独で訓練すると、生成器の表現は影響を受けないままになります。その妥協点は DeepSeek の MTP スタイルの設計に倣っています。補助予測器は独自のパラメータを持ちますが、生成器の中間 hidden states \mathbf{h}_k を条件とし、FCP loss がそれらを通じて逆伝播されます。
p_{\mathrm{FCP}}(\mathbf{x}_{k+\Delta}\mid \mathbf{h}_k),\quad \Delta \geq 1.
条件付けに対して二つの意図的な削減が施されています。(i) テキスト条件付け \mathbf{c} を除去することで、予測器は \mathbf{h}_k 自体から予測的情報を抽出しなければならなくなります。(ii) \mathbf{h}_{\leq k} ではなく \mathbf{h}_k のみを使用することで、コンパクトなチャンクごとの表現が強制され、計算コストが削減されます。補助予測器は対応する生成器ブロックから初期化された三つの DiT ブロックであり、生成器(Wan I2V チェックポイント)と予測器は共同で最適化されます。推論は変わりません——予測器は破棄されるため、この手法は訓練コストのみを追加します。
結果
定性的には、FCP は局所ショートカット学習に特有の失敗モードを修正します。ドミノ倒しのクリップでは、teacher forcing が列の中間で異常な崩壊を生成するのに対し、FCP は連鎖を正しい方向に伝播させます。氷が溶けるクリップでは、FCP は teacher forcing が完全に見落とす水位の緩やかな上昇を捉えます。
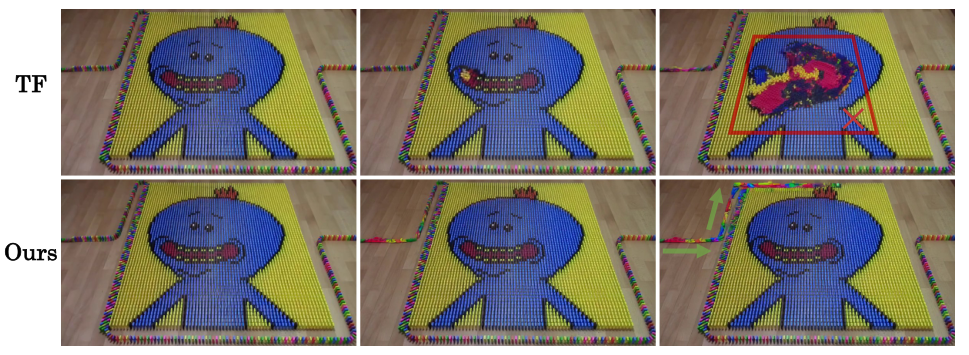
著者らは、FCP が「より低い総訓練計算コストで、標準的な teacher forced な自己回帰訓練を上回る物理的妥当性を達成する」と強調しています——補助目的関数は teacher forcing での単純な追加訓練よりも FLOP あたりのサンプル効率が高く、teacher forcing が容易な局所コピータスクに gradient を無駄遣いするという仮説と一致しています。
表現に関するプローブが機構を支持しています。FCP の下では、フレーム内トークンの類似度マップが目に見えてより構造化され、類似度が拡散した局所近傍ではなく意味的・物体の境界を明確に追跡するようになります。
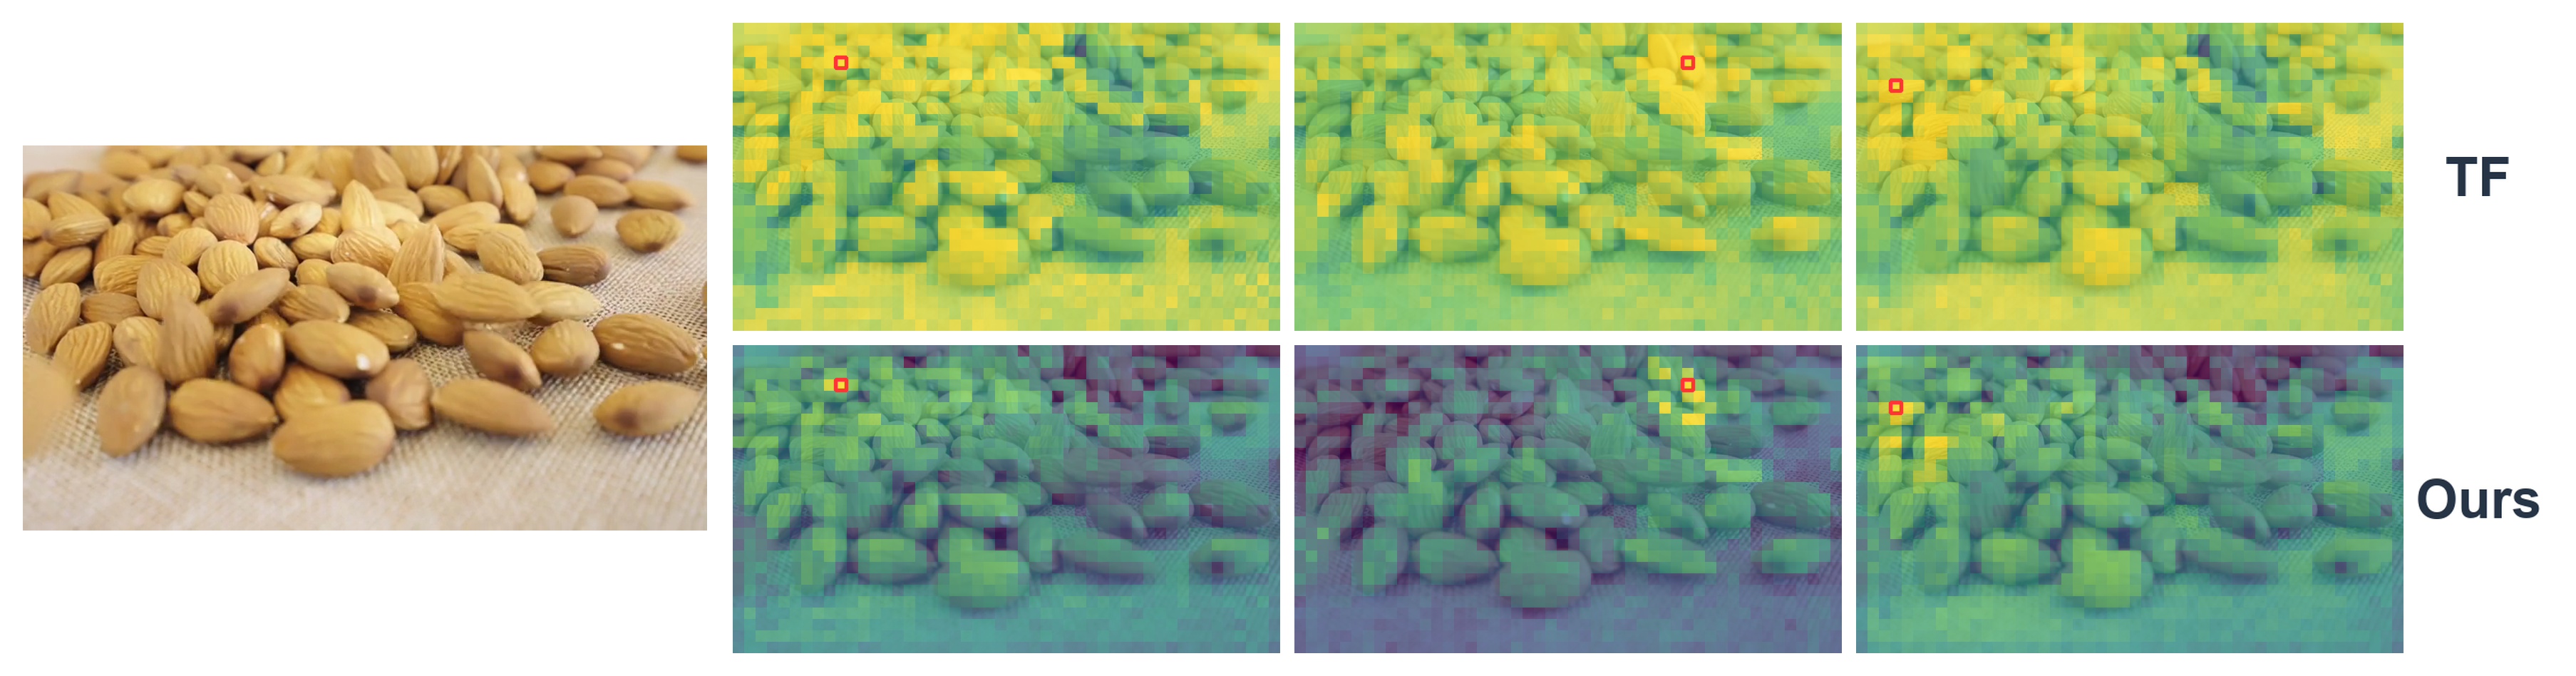
プローブを時空間的に拡張すると、FCP の hidden state がクエリトークンに対して複数フレームにわたり同一の物理的コンテンツを追跡しており、表現がフレーム局所的な外観ではなくモーションを通じて物体のアイデンティティをエンコードしていることを示しています。
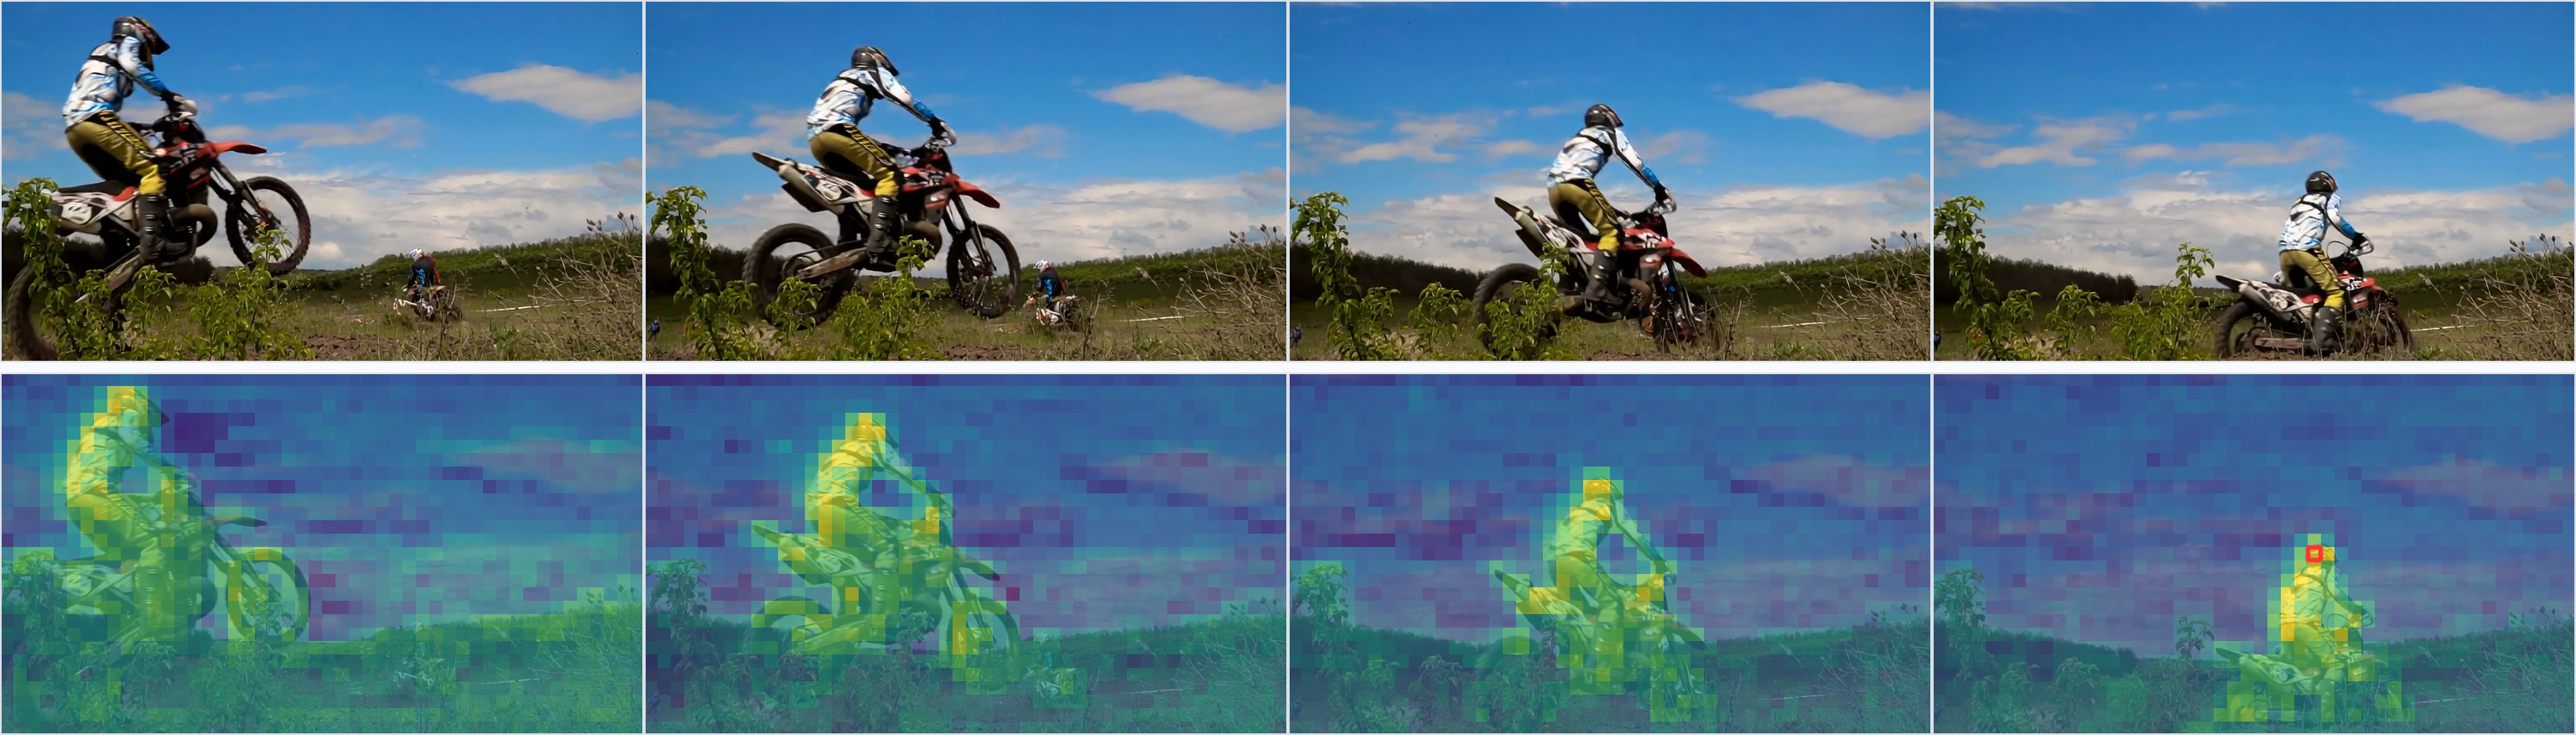
限界と未解決の問題
本論文は定性的な妥当性向上と表現の可視化を報告していますが、提供されているセクションには数値ベンチマーク表(例: VBench 物理サブスコア、FVD)が含まれておらず、定量的な主張の強さは具体的なパーセンテージなしに主張された計算量マッチ比較に依拠しています。いくつかの設計軸は未探索のままです。オフセット \Delta の選択(固定対サンプリング、カリキュラム)、三ブロックを超えた補助予測器の深さのスケーリング、そして補助ヘッドでテキスト条件付けを除去することがより大きなスケールで厳密に有益かどうかなどです。\mathbf{h}_{\leq k} ではなく \mathbf{h}_k のみを条件とする決定はコンパクト性を動機としていますが、より長いプレフィックスが必要な緩変数情報を持つ短い horizon を超えた \Delta を制限する可能性があります。最後に、この手法は Wan を使った I2V で検証されており、表現上の利点がゼロからのテキスト対動画事前訓練や、予測品質が最も重要なアクション条件付き世界モデルに転移するかどうかは、著者ら自身が自然な次のステップとして位置付けている未解決の問題です。
この研究の重要性
FCP は teacher forced な自己回帰型動画訓練の特定の病理——denoising のショートカットとして機能する局所連続性——を標的とした安価で推論不要の修正であり、得られた hidden states はバニラな自己回帰生成器のものよりも世界モデルの表現にはるかに近く見えます。計算効率の主張がスケールで成立するならば、これはフレーム外挿器ではなくダイナミクスモデルとして振る舞いたいあらゆるチャンクワイズな動画 diffusion スタックへの drop-in 目的関数です。
Source: https://arxiv.org/abs/2610.29989
DONIC: 人間のデモンストレーションからの汎用的な巧みな両手追跡制御
問題
巧みな操作のためのリファレンス追跡ポリシーは、これまで主に片手を対象としてきました。両手操作は3つの困難を同時にもたらします:(i) 学習データが不足しており、公開されている手-物体データセットの大半(GRAB、OakInk2、TACO、HOI4D)において両手接触率は15%から39%の間であり、「両手」クリップであっても大部分は片手接触のセグメントです;(ii) 報酬は2つの手の非同期な接触と補完的な役割を処理しなければなりません;(iii) 報酬の大きさが参照に強く依存するため、クリップごとに計算されたアドバンテージにはオフセットが生じ、異質な学習プール全体にわたるPPOの更新にバイアスをもたらします。DONICは、操作カテゴリや人間のモーションソースにわたってゼロショットで、任意の両手手+物体リファレンスを追跡する単一ポリシーを目標としています。
BiHOIデータセット
著者らはまず、テーブル周囲に配置した32台のキャリブレーション済みRGBカメラ(1920\times1232、30fps)でBiHOIを撮影し、両手学習データを拡充しました。このデータセットは1,575シーケンス、229オブジェクト、約160万枚の同期フレームを含み、最も重要な点として65.91%の同時両手接触率を達成しています。これは、次に高い公開ソース(H2Oの38.57%、GigaHandsの34.74%、GRABの32.21%)のほぼ2倍に相当します。再構成されたインタラクションはWuji Hand V1にリターゲティングされ、リプレイスクリーニングを経て実行可能なリファレンスが得られます。
手法
Tステップのクリップのリファレンスは次のように定義されます:
\tau=\{(\hat{\bm q}^{L}_t,\hat{\bm q}^{R}_t,\hat{\bm p}^{o}_t,\hat{\bm R}^{o}_t)\}_{t=0}^{T},
ここで、手ごとの configuration \hat{\bm q}^h_t\in\mathbb{R}^d(手首の姿勢と指関節)と、\mathbb{R}^3\times SO(3)における物体姿勢から構成されます。単一ポリシーは、現在のシミュレーション状態とリファレンスウィンドウを入力として、両手のアクションを出力します。
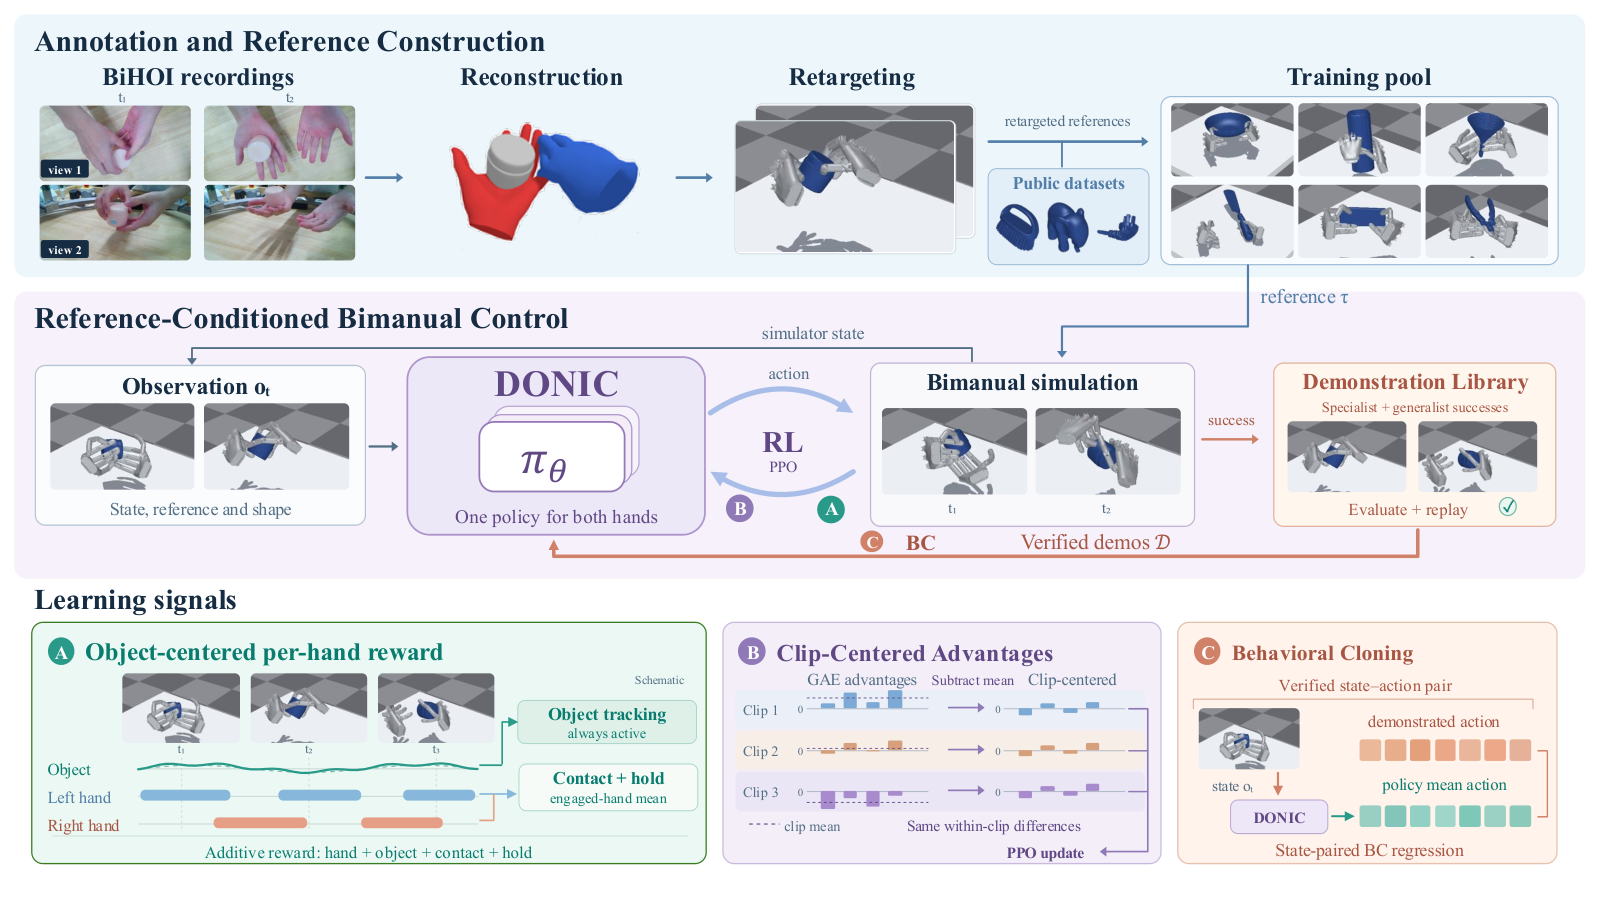
DONICは、DexTrackスタイルのPPO+BCバックボーンの上に3つの設計上の選択を加えて定義されます:
物体中心の手ごとの報酬。 両手の対称的な追跡ではなく、各手のシェーピングはリファレンスの接触役割(どの手がいつ接触すべきか)によって条件付けられます。一方、物体運動の項——有限差分で計算された\hat{\bm p}^o_t、\hat{\bm R}^o_t、\hat{\bm v}^o_tの追跡——は共有されます。これにより、一方の手が自由運動している場合でも物体レベルのフィードバックが保持され、人間のリファレンスの接触が信頼できないフェーズにおいて手がリファレンスの指キネマティクスに一致しないことへのペナルティが回避されます。
クリップ中心アドバンテージ(CCA)。 GAE後のPPOのアドバンテージは、難易度の異なるリファレンスにわたって平均リターンレベルが異なるため、クリップ依存のオフセットを持ちます。CCAはポリシー更新の前にGAEアドバンテージのクリップごとの平均を差し引き、クレジット割り当てを促進する軌跡内の差異を保ちつつ、リファレンス依存のバイアスを除去します。この効果として、3,420クリップのプール全体にわたるgradientの大きさが比較可能になり、GRAB、GigaHands、OakInk2、TACO、H2O、BiHOIを同時に学習する際に重要となります。
再利用された成功例を伴う反復PPO+BC。 シミュレーションで検証された成功したロールアウトはbehavioral-cloningバッファに追加されます。BCはシミュレーターの物理をパスしたアクション列に対して密な回帰シグナルを提供し、ポリシーは実行可能な軌跡に引き寄せられ、PPOはその周辺を探索し続けます。このループにより、困難なリファレンスのロングテールでの学習が安定します。
実験
学習には、GRAB、GigaHands、OakInk2、TACO、H2Oからの1,845クリップ(公開データのみの設定)と、BiHOIを加えた場合の3,420クリップが使用されます。評価の分割は厳密に保留されています:unseen-traj(学習済みオブジェクトの53個の未見軌跡)とunseen-obj(保留オブジェクトを含む164クリップ)です。クリップごとのfine-tuningは行いません。ベースラインには、それぞれの片手追跡器を両手に適応させたDexplore-biおよびDexTrack-biが含まれます。
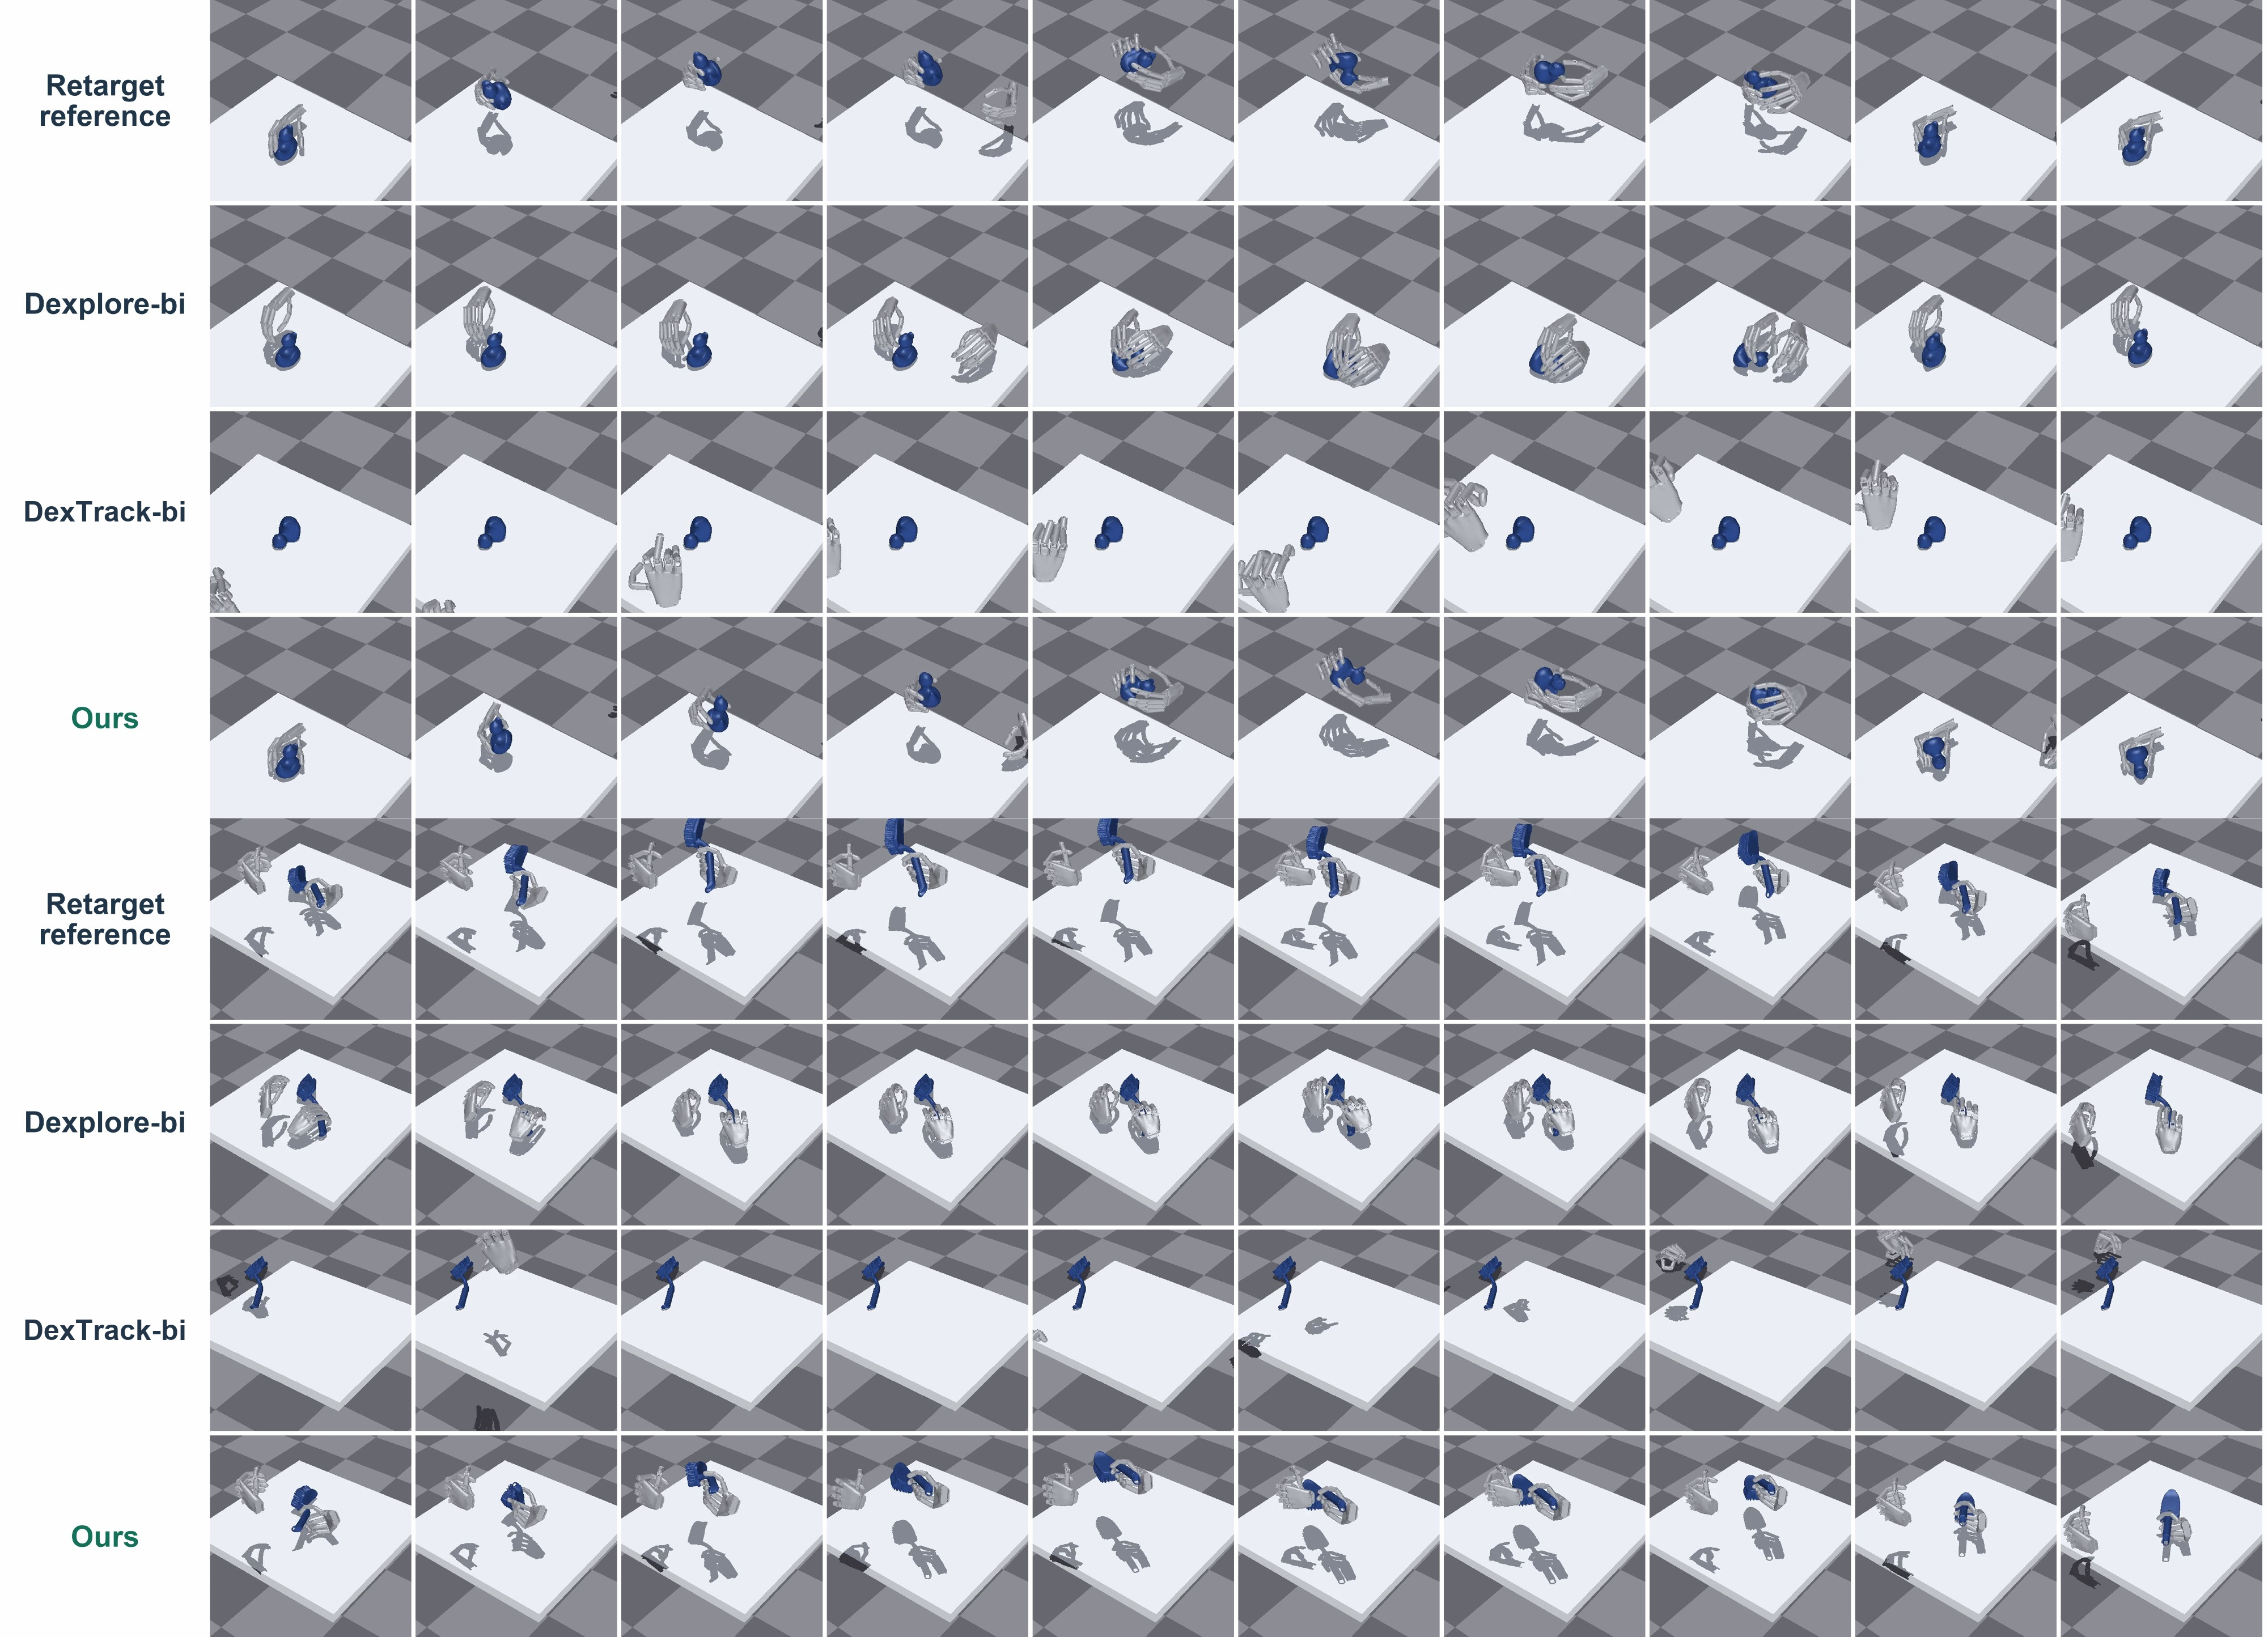
定性的な行は、ベースラインの典型的な失敗モードを示しています:一方の手が物体から離れてしまうか、2つの手が把持に同時到達できず、物体が滑ってしまいます。DONICは、リファレンスと一致した両手接触フェーズを維持し、ハンドオーバーや両手の再把持に特有の非同期接触遷移を通じて物体姿勢を復元します。提供された抜粋は学習・評価プロトコルと定性的な挙動を強調しており、CCA対生のGAEのアブレーションとBiHOI増強の役割が本手法が分離する主要因です(CCAはGAE後のアドバンテージのオフセットを除去し、BiHOIは学習プールをほぼ2倍にして接触率の分布を上方にシフトさせます)。
限界と未解決の問題
この設定はシミュレーションベースであり、特定の手(Wuji Hand V1)へのリターゲティングされたリファレンスを使用しています;接触の多い両手負荷でのsim-to-real転送は抜粋では扱われていません。報酬はリファレンスの接触役割ラベルに依存しており、これはマルチビューパイプラインの再構成品質に依存しています;「どの手がいつ触れるか」の誤りがポリシーの教師信号に伝播する可能性があります。最後に、CCAはクリップ間のアドバンテージのオフセットを除去しますが、得られたポリシーはクリップサンプリング分布に存在するバイアスを依然として引き継ぎます——より多くのフレームを持つリファレンスは暗黙的により多くのgradientステップに寄与します。
なぜこれが重要か
両手の巧みな追跡は、データ分布(接触率)と異質なリファレンスのRLダイナミクスによってボトルネックとなっていました。DONICはその両方を同時に解決します:持続的な両手接触が例外ではなく標準であるデータセットと、複数のソースにわたる合同学習を可能にする簡単に実装できるアドバンテージの中心化です。この組み合わせは、単一の汎用的な両手追跡器への信頼できる道筋となります。
Source: https://arxiv.org/abs/2610.29997
Agent World Model in the Wild: Computer-Use Agent Environment Synthesis
問題設定
インタラクションを通じてcomputer-use agents(CUAs)を訓練するには、現実的な状態を持つ実行可能な環境、解決可能なタスク、および信頼性の高い検証器が必要です。既存の合成パイプラインは通常、(i) 単一のインタラクションモダリティ(Web GUI、MCPツール、またはシェルのいずれか)を対象とし、(ii) 実際のユーザーのマシンに蓄積された雑多な状態を欠いた薄いタスク固有の状態を注入し、(iii) タスクの生成と結果の評価に独占的なフロンティアモデルに依存しています。実際のOS/Webシステム上で直接インタラクションをスケールさせることも、セキュリティの観点から危険を伴います。WildAWMは、サンドボックス内でクロスインターフェース(GUI + MCP + CLIの組み合わせを彼らはXAIと呼ぶ)の環境、タスク、および検証器を生成する、スケーラブルかつオープンソースのみのパイプラインを目指しています。
手法
このパイプラインは、ワールド状態 W、タスク \tau、実行可能な検証器 V のトリプル (W, \tau, V) を合成します。
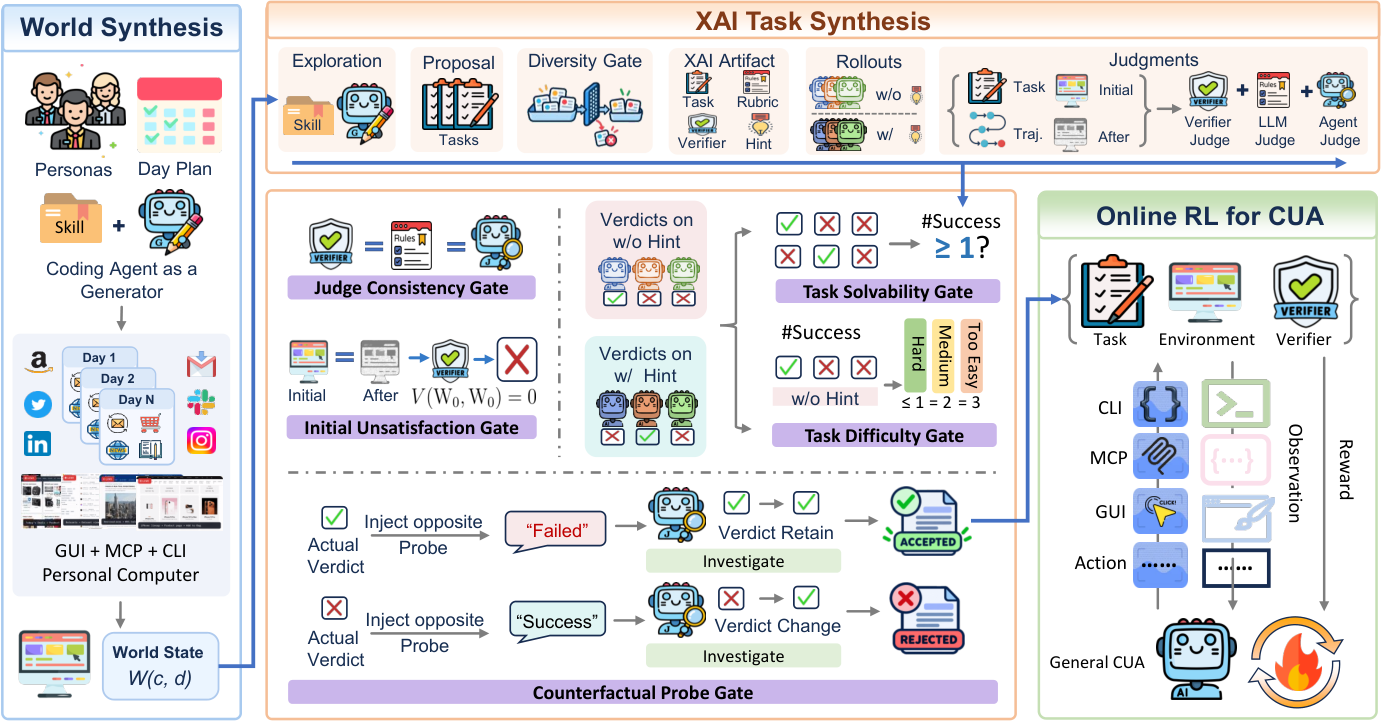
ワールド合成。 ワールドとは、パーソナルコンピュータの蓄積された状態です。具体的には、Webアプリ(WebHarborからミラーした15サイト)、MCPサービス(8つ)、ローカルファイル、およびデータベースで構成されます。タスクごとに最小限の状態を注入するのではなく、WildAWMはまずペルソナを合成し、各ペルソナを日次計画のシーケンスに展開し、OpenCode内に構築したGLM-5.2ベースのcoding agentを使ってそれらの計画を日ごとに具現化します。
具体的には、W(c, d) をペルソナ c の d 日目の状態とします。各日 d に対して: 1. プランナーが W(c, d-1) を検査し、進行中の活動の継続性を保持します。 2. プランナーは活動、氏名付きの連絡先、必要なアプリ/サービス、および使用するDBテーブル/ファイルを列挙した計画を出力します。 3. coding agentがその計画を具現化します。既存のアプリケーション実装を可能な限り再利用し、不足している成果物を合成します。
ペルソナの多様性は、各候補を生活領域と複数日にわたるストーリーライン軸に沿って受け入れ済みペルソナと比較し、類似フィードバックを与えて重複を再生成することで保証されます。得られた規模は、36ペルソナ、640ワールド状態、83の再利用可能なスキルであり、ペルソナあたり平均17.8状態、5.25サイト / 5.44 MCPとなっています。日次の差分は平均で3.97サイトと5.31 MCPに及び、1日あたり15.38のDBテーブルと4.97のファイルを変更します。最終日に蓄積されたワールドは171.6KのDBレコード、50.1のローカルファイルを保持し、合計59.3 MiBとなっており、ワールドサイズは1日あたり約30.9 KiB増加しています。
XAIタスク合成。 各ワールド状態の上で、パイプラインはビジュアルなGUIインタラクション、MCPツールの使用、シェル実行を組み合わせることを要求するクロスインターフェースタスクを生成します。5つの品質ゲートが、(a) 解決可能性、(b) 十分な難易度、(c) 検証器の信頼性に基づいて候補をフィルタリングします。解決可能性と難易度は、複数のモデルとハーネスにわたって異種エージェントをロールアウトし、少なくとも1つが成功し、かつ全てが自明に成功するわけではないかを確認することで推定されます。検証器の信頼性にはクロスジャッジ一貫性を使用し、複数のLLMジャッジと実行ベースのチェックが一致する必要があります。ゲートを通過しなかったスケッチはフィードバックとともに修正され再入力されます。このファネルは「直接(Direct)」受け入れと「フィードバック後(After feedback)」受け入れを区別し、各ステージを通じて単調性を保ちます。
結果
WildAWMは341のXAIタスク(100 SFT / 208 RL / 33ドメイン内評価用)を生成し、そのデータで訓練されたエージェントは3つのファミリーにまたがる8つのベンチマークでOOD評価されます。具体的には、WebArenaとOnline-Mind2Web(Web系)、QwenClawBenchとClawEval(ツール/MCP系)、CUA-Gym、OSWorld-Verified、OSWorld 2.0、Agents’ Last Exam(フルCUA系)です。
環境品質に関する定量的比較:
- 状態スケール。 環境状態サイズの中央値はWildAWMで52.4Kトークン、CUA-Gymで1.1Kトークンとなっており、約48倍大きく、注入されたスキャフォールドではなく蓄積された複数日のユーザー活動を反映しています。
- 多様性。 Qwen3-Embedding-8Bによる表現を用いると、WildAWMは全サンプルサイズにわたって一貫して高いVendi scoreを達成しており(95%信頼区間がベースラインと重複しない)。
- 冗長性。 平均最近傍コサイン距離は0.25対0.20であり、環境成果物間の重複が少ないことを示しています。
- 解決可能性。 24のモデル-ハーネス構成(3つのオープンモデル × 6つのハーネス + Opus-4.8)において、タスクは難易度別に層別化されています。Opus-4.8を除外した場合でもヒントによって解決可能性の分布が上方にシフトすることから、難易度シグナルが単なるフロンティアモデルの産物ではないことが示唆されます。
重要な点として、ジェネレータスタック全体(ペルソナライター、coding agent、ジャッジ)がオープンソースモデル(OpenCode上のGLM-5.2)のみを使用しており、高品質なCUA合成にはフロンティアの閉源モデルが必要であるという一般的な仮定を覆しています。
限界と未解決の問題
本論文は環境統計と解決可能性ファネルを詳細に報告していますが、抜粋では8つのOODベンチマークにおけるエンドツーエンドのエージェント成功率が明示されていないため、より豊富な状態がもたらす下流の訓練上の効果は確定されていません。ペルソナ数(36)は控えめであり、ペルソナが増えるにつれて多様性がどのようにスケールするか、またはVendiスコアの向上が頭打ちになるかどうかは不明です。5つの品質ゲートは異種ロールアウトとLLMジャッジのコンセンサスに依存しており、基盤となるオープンソースモデルのバイアスを引き継いでいます。また、検証器の信頼性は、抜粋中では人間がラベル付けしたゴールドセットとの比較ではなく、クロスジャッジの一致度によって測定されています。さらに、15のミラーされたウェブサイトと8つのMCPサービスは実際のcomputer-use表面の一部をカバーするに過ぎず、ソフトウェアインストール、ファイルI/O以外のネイティブデスクトップアプリ、および数週間にわたる長期的な状態を持つワークフローは未開拓のままです。
重要性
WildAWMは、ペルソナ駆動の複数日ワールドシミュレーションが、タスク注入型のベースラインよりも実質的に大規模で多様な環境を生成し、それが独占的モデルなしで実現可能であることを具体的に実証しています。CUA研究にとって、これはインタラクションデータをスケールで構築するための主要なコストとライセンスの障壁を低下させるものであり、GUI+MCP+CLIの統合は、汎用エージェントが実際に向かっている方向と一致しています。
Source: https://arxiv.org/abs/2610.26828
Hacker News Signals
$2のマイクロコントローラ上でのSIMDアクセラレーテッドコンピュータビジョン
ESP32-S3には128ビットのベクタ処理ユニット――XtensaのPIE(Processor Instruction Extensions)――が搭載されていますが、Espressifによるドキュメントは乏しく、実運用コードでこれを活用している例はほとんどありません。本記事では、このintrinsicインターフェースをリバースエンジニアリングし、2ドル以下のハードウェア上でリアルタイム画像処理タスク(エッジ検出、ダウンサンプリング、色変換)に適用する方法を解説しています。
核心となる知見は、PIEが128ビットの「Q」レジスタ上で動作し、8ビット・16ビット・32ビット整数のSIMDレーンを公開しているという点です。著者はグレースケールのピクセルバッチをQレジスタにマッピングし、水平和・絶対差・飽和演算をすべてレジスタ内で処理することで、内側のループではメインのXtensaパイプラインを回避しています。Sobelグラデーション計算では、240 MHzコア上でスカラー実行時の約18ミリ秒がPIEを使用することで約3ミリ秒まで短縮され、おおよそ6倍の高速化を達成しています。
アライメント制約は厳格で、PIEのロード命令は16バイトアラインされたバッファを必要とするため、著者はフレームバッファのアロケーションをmemalignでラップしています。intrinsic自体はいかなる標準SDKヘッダにも存在しないため、生のオペコードニーモニックを用いた__asm__ volatileブロックによって手組みアセンブリで記述しています。これは、Espressif IDFがPIEをdsps_DSPライブラリ関数経由でFFTやFIRのみ部分的に公開しており、汎用のビジョン演算はカバーしていないためです。
また、ESP32-S3のDMAリンクカメラインターフェース(カメラモードのI2Sペリフェラルを使用)が、CPUを介さずにフレームを直接アラインされたPSRAMへ転送できることも紹介されています。これにより、ベクタユニットをメモリ転送待ちでストールさせることなく稼働させ続けることが可能です。
実用上の性能上限はコンピュートではなくPSRAMの帯域幅(約80 MHz オクタルSPI、実効約40 MB/s)によって決まります。そのため、大きなフレーム(640x480以上)ではベクタアプローチの逓減効果が生じますが、量子化モデルに供給する160x120や320x240の推論前処理パイプラインにおいては、真に競争力のある手法となっています。
Source: https://shraiwi.com/blog/simd-fast-esp32s3/
UEFIファームウェアのコード実行脆弱性が地球上のほぼすべてのサーバを脅かす
この脆弱性は、TianocoreがEDK IIの一部として配布し、HPE、Dell、Lenovo、Supermicroをはじめとする実質的にすべての主要サーバーOEMがそのまま組み込んでいるUEFI HTTP Bootドライバのリファレンス実装に存在するヒープバッファオーバーフローです。該当するコードパスはPXEに類似したネットワークブート時にトリガーされます。ファームウェアがHTTP経由でブートイメージを取得する際、サーバーのチャンク転送レスポンス内の長さフィールドが、ヒープコピーのサイズ計算に使用される前に境界チェックなしで信頼されます。同一ネットワークセグメント上にいる攻撃者、またはDHCP/ブートサーバーを制御している攻撃者は、OSローダーが起動する前にUEFIヒープ構造を上書きすることができます。つまり、侵害は計測ブートやSecure Bootポリシーの評価よりも前の段階で発生します。
この問題で重大なのは攻撃対象領域です。HTTP Bootはプロビジョニングに使用されていない場合でも、標準的なUEFIネットワークスタック初期化の一部であるため、サーバークラスのマザーボードのほとんどでデフォルトで有効になっています。ローカルサブネット上で応答する悪意のあるDHCPサーバーがあれば十分であり、既存のOSが動作している必要すらありません。
深刻度がさらに高まる理由は、UEFIヒープのエクスプロイトによって永続的なファームウェアインプラントをインストールできるからです。OS起動前の環境でヒープメタデータを上書きすることで、攻撃者が制御するコードへ実行を誘導することができ、そのコードはOSの再インストール、TPM計測(脆弱なコードが実行された後に行われます)、およびほとんどのフォレンジックツールに対しても生き残ります。パッチ適用にはOSパッチではなくOEMからの署名済みファームウェアアップデートが必要であり、エンタープライズ環境への展開には歴史的に数ヶ月を要します。
CVEは影響を受けるOEMファームウェアブランチごとに個別に追跡されています。ファームウェアアップデート以外の緩和策としては、UEFI設定でHTTP Bootを無効化すること、およびスイッチレベルのDHCPスヌーピングによってDHCPレスポンスを制限することが挙げられますが、大規模な異機種混在環境において両者を普遍的に展開できるわけではありません。
GLM-5.3 Workers AIモデルにおけるリクエスト間KV cacheの露出(155件のレスポンス)
これは、本番環境のLLM inferenceデプロイメントにおいて、独立したユーザーリクエスト間でKV cacheの状態がリークした具体的かつ公式に文書化された事例です。CloudflareのWorkers AIプラットフォームは、共有GPUインフラ上でGLM-5.3(THUDMモデル)を提供していますが、inference engineのcache管理にバグが存在し、直前のリクエストのKV activationが残存したまま、別ユーザーからの後続リクエストにattendされてしまいました。
そのメカニズムは次の通りです:transformer KV cacheはシーケンスごとに割り当てられ、単一リクエストのattention計算のスコープに厳密に限定されるか、無効化されるべきものです。cacheブロックがゼロクリアされる前に誤って再利用可能とマークされた場合、あるいはprefix cacheの共有ロジックがユーザーセッションを混同した場合、新しいリクエストのattention scoreに前のユーザーのプロンプトや部分的な補完のkey/valueペアが混入します。その結果はランダムなノイズではなく、過去のリクエストからの一貫したテキストの断片がレスポンスに現れるものであり、Cloudflareは155件のレスポンスでこれを確認しました。
これがアーキテクチャ上重要なのは、prefix KV caching(共有システムプロンプトや共通prefixに対してKV activationを再利用する手法)がvLLM、TGI、および独自のinference stackにおいて標準的なレイテンシ最適化として広く導入されているからです。この最適化はトークンシーケンスに対する完全なcache-keyの一致を必要とするため、ハッシュの衝突、シーケンス長トラッキングのoff-by-one、または高負荷時の競合状態が発生すると、誤った再利用が引き起こされる可能性があります。このバグクラスは仮説的なものではなく、より小規模ではvLLMのissueやTGIのバグ報告にも現れています。
Cloudflareの対応としては、cache無効化ロジックの監査を行いながら、GLM-5.3に対して特定のcaching最適化を無効化しました。根本原因がそのinferenceラッパー側にあったのか、それともモデルサービングライブラリの上流にあったのかについては記事中で明示されておらず、同じインフラ上の他のモデルが影響を受けたかどうかという問いは部分的に未解決のままです。
Source: https://blog.cloudflare.com/kv-cache-exposure-remediation/
PythonのexperimentalなJITが削除される予定
CPython 3.13では、Brandt Bucherの研究に基づいたcopy-and-patch JITが搭載されました。これは、完全なIRベースのコード生成を行うのではなく、事前コンパイルされたテンプレートスタブをコピーし、実行時の値(アドレス、定数)をパッチすることでネイティブコードを生成するアプローチです。このアプローチは明示的にexperimentalとしてラベル付けされていました。LWNの記事では、3.14が安定化する前にJITを削除するというコアメンテナーの議論を取り上げています。
挙げられている理由は、全体としてマイナスの効果があるというものです。JITはCPythonのバイナリに約50 KBを追加し、ビルドシステムを複雑にし(テンプレートのコンパイルステップにビルド時のLLVMが必要)、標準のpyperformanceベンチマークスイートで測定可能な高速化をもたらしていません。copy-and-patchの設計は、意図的に最適化の品質を実装の単純さと引き換えにしています。レジスタアロケータがなく、バイトコード境界を越えたインライン化もなく、コード選択に統合された投機的な型フィードバックもありません。このアプローチが実現するのは、ホットなバイトコードに対するインタープリタのディスパッチオーバーヘッドの排除ですが、実際にはpyperformanceのワークロードは、ディスパッチではなくPythonレベルのオブジェクトアロケーションや属性ルックアップに支配されています。
より広い文脈での緊張関係として、CPythonのTier 2の特化適応インタープリタ(3.11〜3.12で追加された「specializing」機構)が、バイナリサイズとビルドの複雑さのコストを伴わずに、インラインキャッシングを通じてディスパッチ削減の恩恵の大部分をすでに提供しているという点があります。JITはTier 2の上に位置し、最も実行されるトレースに対してネイティブコードを出力することを意図していましたが、トレース選択と型安定性のヒューリスティクスが未成熟です。
この削除は永続的な放棄ではありません。提案は、設計を見直す間はデフォルトのビルドから取り除き、後でより高機能なバージョンとして再統合する可能性を残すというものです。議論の中では、PystonとCinderの研究が、Pythonの意味のあるJITによる高速化には、単なるディスパッチの排除ではなくオブジェクトモデルとの深い統合が必要であることの証拠として引用されています。
Source: https://lwn.net/SubscriberLink/1102102/0c00e4d550f25f8c/
macOSにおいて、侵害されたeMudhraの証明書をGitが10日後も信頼し続けている問題
eMudhraはインドの認証局であり、いくつかのルートストアで信頼されています。eMudhraの中間CAの侵害(または発行エラー)により、AppleがまだmacOSの信頼されたルートストアから削除していない証明書が存在しています。そして決定的な問題として、macOS上のGitのHTTPSトランスポートは、AppleのSecurityフレームワークにリンクされたlibcurl経由でシステム証明書ストアを使用しています。これは、侵害されたeMudhraのルートにチェーンする証明書を提示するサーバーに対して、git cloneおよびgit fetch over HTTPSがユーザーへの警告なしに成功してしまうことを意味します。
当該サイトにはタイムラインが記録されています。この問題は公開されており、他のトラストストア(Firefoxが使用するMozilla NSS、MicrosoftのルートストアなどはいずれもMozilla/Microsoftのルートストア)は数日以内に関連する証明書を失効または非信頼としましたが、macOSは公開から10日経過してもトラストストアを更新していませんでした。macOSはルートストアの更新を「Trusted Root Certificates」システム構成アセット経由で配布しており、フルOSアップデートなしにプッシュできます。つまり、この遅延は技術的な制約ではなく、ポリシー・運用上の選択によるものです。
開発者にとっての攻撃対象領域は現実のものです。侵害されたCAから取得したTLS証明書にアクセスできるサプライチェーン攻撃者は、git cloneのURLに対してMITM攻撃を実行し、悪意のあるリポジトリの内容に差し替えることができます。gitホストからHTTPS経由でシェルスクリプトを取得して開発環境をブートストラップするような一般的なパターンと組み合わさることで、これは現実的なコード実行の経路となります。
回避策は、GIT_SSL_CAINFOを手動で管理するバンドル(例えば、curlプロジェクトのMozilla由来のca-bundle.crtなど)に設定するか、個別に管理するトラストストアを持つOpenSSLにリンクされたGitビルドを使用することです。いずれもmacOS上の標準的な開発者構成ではありません。
Source: https://emudhra.we-have-a-problem.com/apple.html
PaperPilot: ゼロクラウド・純Rust製PDFエンジン(WASMおよびMCP対応)
PaperPilotは完全にRustで書かれたPDF処理ライブラリおよびツールチェインであり、ブラウザサイドでの実行のためにWebAssemblyにコンパイルされ、LLMツール統合のためのModel Context Protocol(MCP)インターフェースを公開しています。「ゼロクラウド」という位置づけは、すべてのPDFパース・レンダリング・テキスト抽出がWASMサンドボックス内でクライアントサイドに実行されることを意味しており、ドキュメントのバイト列がブラウザ外に送出されることはありません。
RustのPDFエンジンは、クロスリファレンステーブルのパース、コンテンツストリームのデコード(Flate/LZW/ASCII85)、フォントサブセット化、およびJSのImageDataとして公開されるピクセルバッファへの基本的なページレンダリングを処理します。実装はコアパース処理においてunsafeを避け、PDFバイナリフォーマットの文法解析にはnomを活用しています。WASMコンパイルにはJS FFI境界のためにwasm-bindgenを、ビルドパイプラインにはwasm-packを使用しており、生成される.wasmバイナリは圧縮前で約2 MBです。
MCP統合はより新規性の高い部分です。MCP(Anthropicのツール呼び出しプロトコル)は、LLMホストが型付きの入出力を持つ構造化ツールを呼び出すことを可能にします。PaperPilotはPDF操作——ページ範囲によるテキスト抽出、メタデータ取得、文字列検索——をMCPツール定義として公開しています。これにより、互換性のあるホスト上で動作するLLMエージェントが、ドキュメントのコンテンツをサーバーに往復させることなくPDF抽出を呼び出せるようになり、機密文書を扱う場合に重要な意味を持ちます。
リポジトリに記載されている現時点での制限事項:暗号化PDF(標準の128ビットRC4またはAES暗号化)の非対応、CJKフォントレンダリングの非対応(Type0/CIDFont複合フォントはパースされるものの正しくレンダリングされない)、フォームフィールド抽出(AcroForm)の非対応。テキストランの重なりやマスク画像を含む複雑なレイアウトのレンダリング品質は不完全です。テキスト抽出のユースケースには有用な基盤ですが、汎用レンダリングにおけるpopperやpdfjsのドロップイン代替にはなりません。
Source: https://github.com/KrushnaVardhanReddy/PaperPilot
LFM3の紹介:専門的知能のためのあらゆるモダリティ
Liquid AIのLFM3は、標準的なtransformerのattentionを構造化状態空間層(「Liquid」層と呼ばれ、LRU/Mambaスタイルのリカレント演算子に関連)とローカルattentionウィンドウのインターリーブに置き換えたLiquid Foundation Modelアーキテクチャ上に構築されたマルチモーダルモデルファミリーです。LFM3は、モダリティ固有のアダプタタワーを介さず、単一のモデルグラフ内でテキスト・画像・音声・動画を扱えるよう、従来のLFMリリースを拡張したものです。
アーキテクチャ上の主張は、リカレントコアが長い時系列(音声、動画フレーム)を完全なself-attentionよりも効率的に処理できるというものです。その根拠として、状態更新のコストがシーケンス長に対してO(L^2)ではなくO(L)であること、また固定サイズのチャンク内の細粒度な空間的依存関係はローカルattentionウィンドウが担うことが挙げられます。各モダリティの入力は、別個のエンコーダ(画像・動画にはpatch embedding、音声にはメルスペクトログラムパッチ)によってトークン化され、統合されたシーケンスミキサーに入力される前に共有の隠れ次元に射影されます。
Liquidは、LFM3のベンチマーク結果として、マルチモーダル評価(MMMU、VideoMME、音声QAベンチマーク)における数値を報告しており、同一パラメータ数のtransformerベースラインと競合する性能を示しています。ブログに記載された具体的な数値によれば、LFM3-3BはいくつかのI画像理解タスクにおいてPhi-3.5-visionと同等またはそれ以上の性能を、KVキャッシュがシーケンス長とともに増大しないリカレント状態の特性により低い推論メモリで達成しています。
制約としては、SSMベースモデルに共通するものが挙げられます。すなわち、長いシーケンスに対する並列学習効率にはリカレントスキャンの慎重なチャンキングが必要であること、ランダムアクセス型のattentionを持たないため任意の過去位置からの情報検索が圧縮された状態に依存し、長いコンテキストから正確な逐語的再現を要するタスクでは性能が低下し得ること、が挙げられます。また、ブログ記事ではモデルの再現に十分な詳細度でのウェイトやアーキテクチャのハイパーパラメータの公開は行われていません。
Source: https://www.liquid.ai/blog/lfm3
Artificial Analysis Intelligence Index v5
Artificial Analysis Intelligence Indexは、標準化されたベンチマーク群にわたるパフォーマンスを集約し、フロンティアLLMをランク付けするための単一のスカラー「知性」スコアへと重み付けして統合するものです。バージョン5では、対象モデルの範囲を更新し、ベンチマークの重み付け手法を改訂しています。
このインデックスはおよそ40のモデルを対象とし、コーディング(HumanEval+、LiveCodeBench)、推論(MATH-500、GPQA)、instruction following、およびマルチモーダルタスクを含んでいます。複合スコアはカテゴリ間の重み付き幾何平均であり、重みは「実世界での有用性」を反映するよう選択されています――これは主観的な判断であり、手法セクションでも認められていますが、ユーザースタディやタスク頻度データによる十分な正当化はなされていません。
v5のランキングでは、o3とGemini 2.5 Proがトップに並び、GPT-4oとClaude 3.7 Sonnetが第2層をなしていますが、その差はわずか数インデックスポイントであり、ベンチマーク分散のノイズの範囲内です。解説セクションでは、このインデックスが情報を圧縮していることを正しく指摘しています:コーディングに最適化されたモデルと推論に最適化されたモデルが、カテゴリのサブスコアの平均が同じになれば同一のスコアを得ることになるため、このスカラー値は粗いフィルタとしてのみ有用であり、タスク固有の選択には適していません。
このサイトでは、intelligence indexと自社のinference benchmarkingインフラによるスループットおよびレイテンシの測定値を組み合わせて提示しており、こちらの方が実用的です:さまざまな同時接続レベルにおけるtokens/secondや、APIプロバイダー間のtime-to-first-tokenの分布などが含まれます。これらの数値は、同一モデルを提供するプロバイダー間で大きなばらつきを示しており――例えばLlama 3.1 70BではプロバイダーによってスループットがSが2〜3倍異なります――これは本番環境でのデプロイメント判断において、2ポイントのintelligenceスコアの差よりもはるかに重要です。
Source: https://artificialanalysis.ai/articles/artificial-analysis-intelligence-index-v5
注目の新しいリポジトリ
mw00/project-maya
Project Mayaは、大規模なmixture-of-expertsモデル——具体的にはGLM-5.3-Flash(321B)、DeepSeek-V4.1-Flash-1017(748B)、およびMiniMax-M3.1-Flash(428B)——を対象とした、セルフホスト型の inference stackです。中核となるエンジニアリング上の課題は、クラウドアクセスを必要とせずに、これらのモデルを1〜16台のコンシューマー向けまたはデータセンター向けGPU(NVIDIA CUDAおよびAMD ROCmの両方をサポート)に分散させることです。このstackには4つの統合コンポーネントが含まれています:MoEルーティングとtensor parallelismを処理する inference engine、OpenAI互換およびAnthropic互換の両エンドポイントを公開するAPIサーバー(既存のエージェントパイプラインへのドロップイン置換として有用)、監視用Webダッシュボード、およびメモリフットプリントを削減するための量子化ツールです。このスケールでLinuxと並んでWindowsをサポートすることは容易ではなく、Linuxのみのクラスターを持たない研究者にもリーチしようとする意図的な取り組みが伺えます。OpenAI/Anthropicのデュアル-API surfaceにより、ホスト型エンドポイントから切り替える際にクライアント側のコード変更が不要です。748Bパラメータのモデルを実行するユーザーにとって量子化は必須であり、付属の量子化ツールはおそらくGPTQまたは類似のpost-training quantizationワークフローを処理するものと考えられます。これは、データレジデンシーに制約のある組織や、サードパーティのAPIを通じてトークンをルーティングすることなく、非常に大規模なMoEチェックポイントに対して再現性のあるプライベートな inference を必要とする研究者にとって、優れた選択肢です。
Source: https://github.com/mw00/project-maya
nanaism/yomiyasu
Yomiyasuは、LLMベースのエージェントフレームワーク向けのエージェントスキル(composableな機能単位)であり、AIが生成した日本語テキストをネイティブが書いたように読める文章へと後処理するものです。本ツールが解決する技術的な問題は実際に存在し、広く知られています。日本語を生成するLLMは、特有のアーティファクトを生み出す傾向があります。具体的には、本来であれば和語が好まれる場面でのカタカナ外来語の多用、不自然な文末表現、過剰な受動構文、そしてテンプレート的で有機性に欠けた硬直した主題—述部構造などが挙げられます。本スキルはリファインメントパスとして機能し、下書きを入力として受け取り、こうしたパターンを修正した改訂版を返します。スタンドアローンのツールではなくエージェントスキルとして設計されているため、ワンショットのCLIツールとして動作するのではなく、スキルインターフェースに対応したフレームワーク上に構築されたものを含むエージェントオーケストレーションパイプラインに統合されます。これによりcomposabilityが実現され、ライティングエージェントが生成後の後処理ステップとして呼び出せるようになります。LLMを基盤とした日本語コンテンツパイプライン、ドキュメント自動化、あるいはローカリゼーションツールを構築している方にとって、直接的に活用できるユーティリティです。狭い領域のNLP前処理タスクにもかかわらずスター数が多いことは、英語以外における言語品質ツールへの根強い需要を反映しています。
Source: https://github.com/nanaism/yomiyasu
hevnsnt/CVEngine
CVEngineは、継続的な探索と証拠に基づく検証ループを中心に構築された、AIドリブンの外部攻撃対象領域管理(EASM)ツールです。静的な脆弱性データベースを維持するのではなく、組織の外部公開アセットを列挙するためにアクティブ・リコネサンスを実行し、その後、候補となる脆弱性を実際の証拠によって検証してから表面化させます。これにより、従来のスキャナーが抱える誤検知の負担を軽減します。ここでの「AI-first」というフレーミングは実質的なものであり、LLMsは単なるレポーティング層としてではなく、発見されたアセットを推論し、知見を相関させるために使用されています。Model Context Protocol(MCP)との統合はアーキテクチャ上注目すべき点であり、CVEngineが自身の知見とスキャニング機能を開発者向けAIエージェントに直接公開できることを意味します。これにより、コーディングアシスタントが開発セッション中にライブな攻撃対象領域データを照会できるワークフローが実現します。この仕組みは、静的なSAST/DASTツールでは実現できない形で、脆弱性の発見と修正の間のループを閉じるものです。このツールは外部向けのみに位置づけられており、内部向けSASTとは明確に区別されます。自動化されたレッドチームパイプラインを構築するセキュリティエンジニアや、CI/CDに隣接したエージェントワークフローにライブな露出データを統合したいと考えているエンジニアにとって、MCPインターフェースが差別化となる技術的特徴です。
Source: https://github.com/hevnsnt/CVEngine
jiwoochris/artex-global
ARTEXは自律型ペネトレーションテストフレームワークです。このリポジトリは上流のAutumn-27/ARTEX(AGPL-3.0)を韓国語でフォークしたものです。本フレームワークは、各ステップで人間のテスター主導ではなく、LLMベースのエージェントを用いてペネトレーションテストのサイクル――偵察、攻撃試行、レポート作成――を自動化します。「自律型」という表現は、エージェントが固定スクリプトを実行するのではなく、発見した攻撃対象領域に基づいて攻撃技法を選択・順序付けすることを意味します。技術的には、このアーキテクチャは通常、ツールの出力(ポートスキャン、サービスバナー、CVEルックアップ)を受け取って次のアクションを決定するプランニング用LLMと、各フェーズに特化したtool-callingを組み合わせた構成になっています。韓国語へのローカライズは、固有の規制環境やCTFの文脈を持つ韓国のセキュリティ研究コミュニティへの普及を意識したものと考えられます。AGPL-3.0ライセンスは商用利用者にとって重要な意味を持ち、その上にサービスを構築する場合はソースコードを公開する義務があります。LLMベースの自律型オフェンシブセキュリティエージェントを評価する研究者にとって、ARTEXスタイルのフレームワークは有用なベンチマークとなります。現在のLLMが得意とする領域(単純なCVE攻撃チェーン)と苦手とする領域(新規のチェーン構築、多段階推論を必要とする権限昇格)を明らかにできるからです。本フレームワークを実行するには、慎重なサンドボックス化と、対象となるすべてのターゲットに対する明示的な法的認可が必要です。
Source: https://github.com/jiwoochris/artex-global
deeplethe/solid-glass
Solid Glass は、AIアプリケーションインターフェースを対象としたデザインシステムであり、現在のAI製品UIに多く見られるフラットデザインやニューモーフィズムの美学とは対照的に、すりガラス面・マテリアルの奥行き・多層的な透過性といった物理的・触覚的なビジュアルメタファーを重視しています。その技術的な実体は、アプリケーション全体でこれらのエフェクトを一貫して実装するためのコンポーネントライブラリおよびトークンシステムです。AIアプリケーションに特化した設計思想としては、ユーザーと確率的システムとを仲介するインターフェースには、システムの状態・信頼度・ソース層を明確に示すビジュアル階層が有益であり、そうした情報はマテリアルの奥行きメタファーによってフラットデザインよりも自然にエンコードできるという考え方があります。タグラインにある「technical」という表現は、開発者の使いやすさを念頭に設計されていることを示唆しており、標準的なフロントエンドツールチェーンと統合できる、型付けの整ったコンポーネントAPIとデザイントークンが提供されていると考えられます。チャットインターフェース・エージェントダッシュボード・RAGベースのツールを構築するチームにとって、一貫したデザインシステムを早期に採用することで、UIに関する意思決定をその場しのぎで行った際に蓄積される不整合を防ぐことができます。プロジェクトの規模に対してスター数が多いことは、shadcnやMUIのような汎用コンポーネントライブラリを超えた、意見の込められたAI特化型UIの出発点に対する需要を示しています。
Source: https://github.com/deeplethe/solid-glass
morganlinton/BeautifulRust
BeautifulRustは、Rustコーディングのベストプラクティスを、LLMベースのコーディングアシスタント(Claude Code、OpenAI Codex、GitHub Copilot、Cursor、Gemini CLI)が利用可能なagent skillsとしてパッケージ化したものです。具体的な成果物としては、慣用的なRustパターン(所有権の規律、iteratorチェーン、?とthiserrorを用いたエラーハンドリング、ゼロコスト抽象化の活用)を教えるskillsセット、他言語のコードを直訳的な等価物ではなく慣用的なRustへと移植するためのskills、Rust固有のヒューリスティクスを適用するコードレビューskill、そしてこれらの標準を支えるlintプロファイルを定義したテスト済みのclippy.toml設定が含まれます。Rustに関する明示的なガイダンスを持たないコーディングエージェントは、構文的には正しくても慣用的に問題のあるRustコード、すなわち過剰なclone、.unwrap()の乱用、iteratorの代わりにCスタイルのインデックスループを生成しがちです。そのため、skillsというアプローチが重要な意味を持ちます。イディオムをagent skillsとしてエンコードすることで、修正がセッションごとのprompt engineeringに依存するのではなく、体系的なものとなります。付属のclippy設定は独立した価値も持っています。skillsが教える基準と同一のものを強制する、入念に整理されたclippy設定は、エージェントが生成したコードに対してCIレベルの強制力を提供します。これは、AI支援開発を導入しているRustを多用するエンジニアリングチーム、特にPythonやGoのバックグラウンドを持つエンジニアをオンボーディング中のチームにとって有益な追加要素となります。
Source: https://github.com/morganlinton/BeautifulRust
Edwardxlai/easyread
Easyreadは、英語の学術論文を読む中国語話者の研究者を対象としたローカルPDF翻訳ツールです。その技術スタックは、PDFパース、ニューラル機械翻訳、および組み込みAI質問応答インターフェースを単一のデスクトップ向けアプリケーションに統合しています。主な機能としては、原文と翻訳の並列表示(ソースを置き換えるのではなくレイアウトの文脈を保持)、読書中のin-place AIクエリ機能(ツールを切り替えることなく現在の論文について質問できる)、および参考文献・引用管理が挙げられます。ローカルファーストのアーキテクチャは、出版前の原稿を扱う場合や厳格なデータ管理要件のある環境で作業している学術ユーザーにとって重要です。学術用PDFにおける並列レンダリングは、数式の多いレイアウト、多段組テキスト、および図表のために技術的に非自明であり、翻訳を乱さずこれらを処理するには、数式ブロック、キャプション、および本文テキストを異なる方法で扱う慎重なPDFセグメンテーションロジックが必要です。文献管理レイヤーにより、このツールは単一用途の翻訳ツールではなく、完全な研究ワークフローツールとして位置づけられます。大量の英語文献を効率的に処理する必要のある中国人研究者にとって、翻訳品質、レイアウト忠実度、および統合クエリ機能の組み合わせにより、汎用LLMチャットインターフェースにテキストを貼り付けるよりも統合されたalternativeとなっています。
Source: https://github.com/Edwardxlai/easyread
hanzohanzhe/Grandet
Grandetは、特定かつ実用性が高まりつつある問題を解決します。すなわち、対象のLLM(モデル名または機能プロファイルで指定)に対して、1,800以上の公式・inference・relayプロバイダーの中から現時点で最も安価なプロバイダーを見つけ出し、既存のAIエージェントからそのプロバイダーへリクエストを透過的にルーティングするというものです。システムは2つのインターフェースを持ちます。エージェントパイプラインへの直接統合のためのagent skillと、同じルーティングロジックをMCP互換クライアントに公開する匿名MCPサーバーです。価格データはgrandet.aiから取得しており、公開されている料金表を反映しています。つまり、交渉による企業向け価格ではなく、公開レートカードを追跡するものです。技術的な仕組みはシンプルで、ルックアップとプロキシのレイヤーから構成されますが、その価値はプロバイダーカバレッジの広さとデータの鮮度にあります。大量のトークンを処理するコスト重視のアプリケーション(バッチ処理、RAGパイプライン、マルチエージェントシステム)において、同一の基盤モデルであってもプロバイダー間の価格差は大きく、同一モデルの重みに対して5〜10倍の差が生じることもあります。匿名MCPサーバーの設計により、価格照会にクレデンシャルが不要となり、評価時の摩擦を軽減します。制限事項としては、表示価格が実際の価格より遅れる可能性があること、およびrelayプロバイダーがレイテンシと信頼依存性を追加することが挙げられます。それでも、異種モデルポートフォリオ全体でinferenceコストを最適化するチームにとって、手動でのプロバイダー追跡よりも体系的なルーティングレイヤーの方が望ましいでしょう。