デイリーAIダイジェスト — 2026-10-20
arXiv ハイライト
OR-License: LLMエージェントを実世界のオペレーションズリサーチ実務者として評価する
問題と動機
既存のORベンチマーク(NL4Opt、ComplexOR、OptiBench、IndustryORなど)は、人間のモデラーが意思決定変数・制約・目的関数をすでに整理した、自己完結した自然言語定式化をモデルに提供します。実際のORプロジェクトはこのような形をしていません。クライアントは雑然としたビジネスの概要、Excelシート、PDF、断片的なルールを持ち込み、OR実務者はクライアントに質問して不足している事実を引き出し、何を最適化すべきかを決定し、規定された形式で成果物を納品しなければなりません。OR-Licenseはこのギャップを直接対象とし、10の産業シナリオから3.68百万米ドルの有償プロジェクトを通じて得られた31インスタンスを用い、匿名化後も元の素材を保持しています。
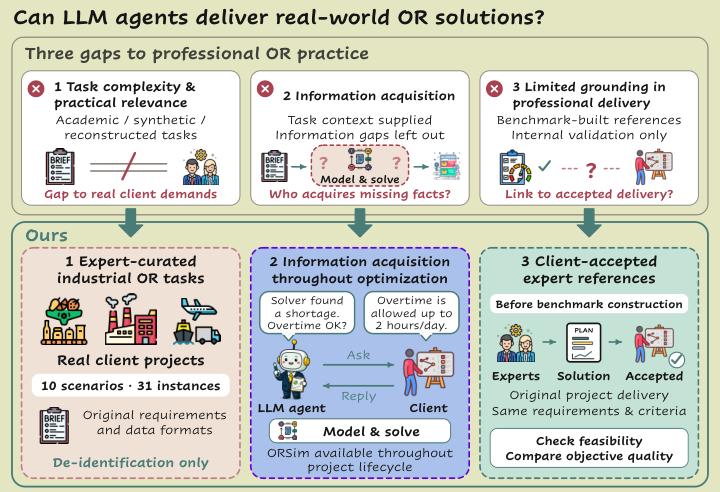
3つのギャップが対処されています:(i) 生のクライアント素材の欠如、(ii) 情報取得の動的プロセスの欠如、(iii) 専門家によって検証された参照解の欠如。第3の点が重要なのは、目的関数の品質はクライアントが実際に受け入れた解に対して相対的にのみ意味を持つためです。
ベンチマークの構成
シナリオ s はインスタンス \mathcal{I}_s をグループ化し、各インスタンス i はテストケース c \in \mathcal{C}_i、意思決定空間 \mathcal{Y}_{i,c}、目的関数 f_{i,c}:\mathcal{Y}_{i,c}\to\mathbb{R}、および隠れたプログラム的検証器を持ちます。タスクは次のように定式化されます:
\max_{y\in\mathcal{Y}_{i,c}}\;\sigma_i f_{i,c}(y)\quad\text{s.t.}\quad \mathrm{verifier}_{i,c}(y)=\text{pass},\;\sigma_i\in\{+1,-1\}.
重要なのは、エージェントがビジネスの概要と入力ファイルのみを受け取ることです。追加の事実(単位コスト、運用上の制約、境界条件)は、Bashコマンド ask としてエージェントに公開される制御されたクライアントシミュレータ ORSim から引き出す必要があります。ORSimはビジネス上の事実を開示するように設計されていますが、ORの専門知識は提供しません——定式化を提案したり、ソルバーを示唆したりすることはありません。これにより、情報取得とモデリング能力が明確に分離されています。
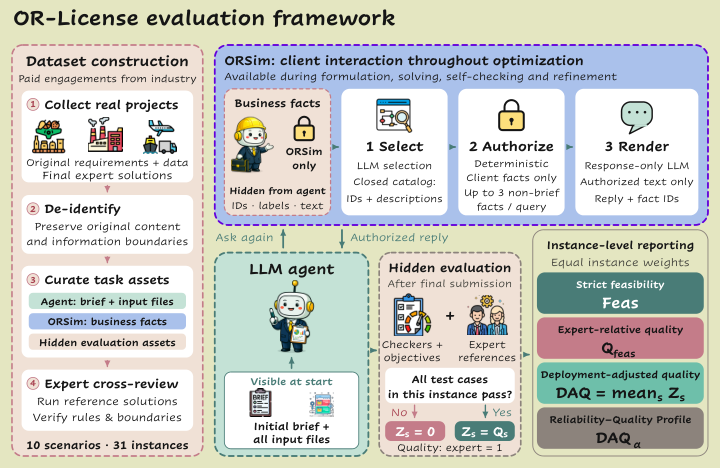
評価は2段階で行われます:まず検証器がハードな実行可能性を確認し、次に f_{i,c} が提出された \hat y_{i,c} から独立して再計算され、専門家の参照解と比較されます。主要指標は Deployment-Adjusted Quality (DAQ) であり、インスタンス全体にわたる専門家相対的な目的関数品質を平均し、実行不可能な納品物にはゼロを割り当てます。条件付き品質はDAQを観測された実行可能性で割ったものであり、実行可能性と併せて読む場合にのみ有意な情報を提供します。
結果
11のフロンティアモデルがClaude Codeのハーネス下で評価され、(モデル、タスク)ごとに5回実行、31タスクにわたってタスク均等重み付けが適用されています。
際立った発見は、条件付き目的関数品質がほぼすべてのモデルで専門家参照解の前後に留まっていることです:Claude Opus 5は100.03%、Gemini 3.8 Flashは100.43%、GPT-5.6 Solは100.59%、GLM-5.3-Flashは101.01%、Hy4 previewは100.61%、DeepSeek-V4.1-Flashは99.44%、Doubao-Seed-2.1-Proは99.47%、Qwen3.8-Maxは99.06%です。エージェントが実行可能な解を生成した場合、目的関数において専門家解と同等かそれ以上の結果を出しています。
モデル間の差異が現れるのは実行可能性においてです。Grok 4.6が88.39%の実行可能性(DAQ 86.55%)でリードし、GPT-5.6 Solが84.52%(DAQ 85.02%)、Gemini 3.8 Flashが82.58%(DAQ 82.94%)と続きます。Claude Opus 5はハーネスがClaude Codeであるにもかかわらず、77.42%の実行可能性にとどまります。テーブルの下位は実行可能性の失敗が支配しており、Hy3は45.16%の実行可能性でDAQが43.77%まで落ち込んでいます(条件付き品質は96.92%であるにもかかわらず)。GLM-5.3-Flashはタスク内の最大分散(実行可能性の幅 ±25.35)を示しており、複数回の実行にわたる制約処理の脆弱性を示しています。
2つの観察が導かれます。第1に、実務者スタイルのORにおける困難な部分は最適化品質ではなく、クライアント素材とORSimの対話からすべてのハード制約を忠実に復元することであり——損失は最適性の欠如ではなく実行不可能性が支配しています。第2に、条件付き品質がほぼ一様に約100%であることから、エージェントが問題を正しくモデル化できさえすれば、現代のソルバー(Gurobi、OR-Tools、カスタムヒューリスティクス)は十分に強力であり、LLMの選択はほとんど貢献しないことが示唆されます。
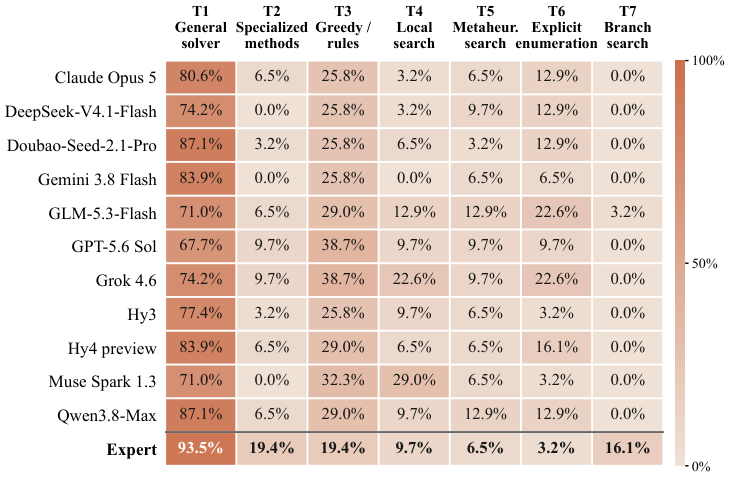
カテゴリT1–T7にわたる技術採用の分析では、LLMエージェントと専門家参照解が手法空間において著しく異なる領域を占めていることが示されています:LLMはMILP直接符号化と既製ソルバー呼び出しに過度に依存しており、専門家は分解と問題固有の構造をより頻繁に活用しています。目的関数品質の収束は、したがって、手法の同等性ではなく、扱いやすいインスタンスに対するソルバーの強さを反映しています。
限界と未解決の問題
- 31インスタンスは少ないため、タスク内の標準偏差が大きく(しばしば15パーセントポイント以上)、報告された幅はベンチマーク平均の標準誤差ではありません。
- ORSimはスクリプト化されており、現実のクライアントは一貫性がなく、要件を変更し、回答を拒否することもあります。敵対的または変化する仕様に対するロバスト性は未検証です。
- ハーネスの影響は無視できません。結果は主にClaude Code下のものであり、Codexとの比較は付録に限定されています。実行可能性の割合は異なるツールの足場の下では実質的に変化する可能性があります。
- DAQ指標は実行不可能な納品物にゼロのクレジットを与えるため、専門家が交渉可能とみなしたソフト制約に違反する解に対して過小評価する可能性があります。
- 本文中にはコスト調整済みのリーダーボードがありません——Grok 4.6のDAQ 86.55%というリードは、より安価なモデルと比較して実質的に異なるトークン/ツール予算を要する可能性があります。
この研究の意義
OR-Licenseは最適化に関するLLM評価を再定義します:ボトルネックは目的関数品質ではなく——フロンティアモデルは実行可能性が保証された条件下ではすでに専門家解と一致しています——元のクライアント素材からの忠実な制約引き出しにあります。これにより、情報取得と問題の再構成がエージェント能力の次の測定可能な軸として特定され、グラウンドトゥルースが有償クライアントに実際に受け入れられた解であるベンチマークが提供されます。
Source: https://arxiv.org/abs/2610.24087
長文脈線形 Attention のための Kronecker Delta Rule
問題設定
線形 attention のシーケンスミキサーは、履歴を行列メモリ \bm{S}_t \in \mathbb{R}^{d_v \times d_k} に圧縮し、外積によって更新します。主要な2種類の書き込みルールは、干渉に対してそれぞれ異なるトレードオフを持ちます。
- Hebbian(linear attention、xLSTM、Mamba、RWKV):\bm{S}_{t+1} = \bm{S}_t + \bm{v}_t \bm{k}_t^\top。加算的で非修正型:後の書き込みは同じキーへの以前の関連付けを埋もれさせますが、クリーンに上書きすることはできません。
- Delta rule(DeltaNet、Gated DeltaNet、KDA):\bm{S}_{t+1} = \bm{S}_t(\bm{I} - \beta_t \bm{k}_t \bm{k}_t^\top) + \beta_t \bm{v}_t \bm{k}_t^\top。\tfrac{1}{2}\lVert \bm{S}_t \bm{k}_t - \bm{v}_t\rVert^2 に対する1ステップのSGD。修正方向 (\bm{S}_t \bm{k}_t - \bm{v}_t)\bm{k}_t^\top は現在のメモリ内容に依存するため、\bm{k}_t に対して非直交なキーに格納された値が付随的に変更されます。
本論文の主張は、多くの異なる関連付けがメモリに蓄積される長文脈タスクにおいて、delta スタイルの干渉が複合的に問題となるというものです。著者らは、delta rule の誤り修正(改訂)動作を保ちながら、行列空間において (\bm{k}_t, \bm{v}_t) のペアに対して厳密に局所的な更新を目指しています。
手法:Kronecker Delta Rule
Abstract および Section 2.1 では、delta rule のデータ依存方向 (\bm{S}_t \bm{k}_t - \bm{v}_t)\bm{k}_t^\top ではなく、特定の (\bm{k}_t, \bm{v}_t) 外積に対応する単一のランク1方向——すなわち \mathbb{R}^{d_v \times d_k} 内の一方向——のみに沿ってメモリを変更するルールが記述されています。「Kronecker delta」という名称は二重の意味を持ちます:Kronecker 積空間 \mathbb{R}^{d_v}\otimes\mathbb{R}^{d_k} における単一の基底要素をインデックスするという意味と、Widrow–Hoff delta rule を一般化するという意味です。
機械的には、書き込みは次のようになります。
\bm{S}_{t+1} = \bm{S}_t + \alpha_t\,\big(\bm{v}_t - \bm{S}_t\bm{k}_t\big)\big\langle \bm{k}_t, \cdot\rangle\text{-targeted at }\bm{k}_t\bm{k}_t^\top/\lVert\bm{k}_t\rVert^2,
すなわち、\bm{S}_t の \bm{k}_t\bm{k}_t^\top に整合する成分のみに作用し、直交する全方向をそのまま保つ射影です。\bm{k}_i \perp \bm{k}_t を満たすキーに格納された値は厳密に保存されます。これは式(2)において \bm{k}_i^\top \bm{k}_t \neq 0 となる任意の \bm{k}_i が摂動を受けるのとは対照的です。
本論文は、このルールを反復するとメモリ状態上にマルコフ連鎖が定義されて定常分布に収束すること、そして重要なことに \mathbb{E}\lVert \bm{S}_t\rVert が t に関して一様有界であることを示しています。実用上の帰結として、文脈が伸びてもメモリが漂流しないようにするための forget gate、明示的な正規化、および安定化ヒューリスティックが不要になります。これは、指数的/forget ゲーティングに依存する xLSTM/mLSTM や、データ依存の減衰に依存する Mamba と比較して、強い構造的主張です。
このルールは delta rule の一般化 Householder 構造を継承しているため、Yang et al.(2024)流のチャンク並列学習がそのまま適用できます。著者らは Kronecker delta 書き込みを xLSTM スタイルのシーケンスミキサーブロックに組み込み、KronLSTM を構築しています。
実験
全比較は1.5Bパラメータ、100B FineWeb-Edu トークン、コンテキスト長8k、Llama2 トークナイザーで訓練されています。ベースライン:Gated DeltaNet(GDN)、GDN-2、Kimi Delta Attention(KDA)、Mamba-3、mLSTM。各モデルは純粋な linear attention としての評価と、スライディングウィンドウ attention(ウィンドウ幅2048、linear対SWA比5:1)とのハイブリッドとして評価されています。
純粋な線形モデル、6つの常識推論タスク + LAMBADA の平均(Avg-6)/ LAMBADA パープレキシティ:
- KronLSTM:59.72 / 11.72
- KDA:58.12 / 12.67
- GDN-2:57.94 / 12.54
- GDN:57.73 / 12.58
- Mamba-3:57.31 / 12.95
- mLSTM:57.18 / 13.87
KronLSTM は6タスク中5タスクで勝利し、最強ベースライン(KDA)に対して Avg-6 を1.6ポイント改善しています。また、GDN-2 と比較して LAMBADA パープレキシティをおよそ0.8低下させています。
ハイブリッド(SWA あり):
- KronLSTM:Avg-6 59.56、LMB ppl 11.18(全12構成中最低のパープレキシティ)
- GDN-2:58.79 / 11.85
- Mamba-3:58.54 / 13.01
- GDN:57.99 / 12.95
- KDA:57.85 / 12.60
- mLSTM:57.35 / 14.38
SWA の追加は mLSTM、Mamba-3、GDN-2 に顕著な改善をもたらしますが、GDN、KDA、KronLSTM にはほとんど変化をもたらしません——これは KronLSTM がスライディングウィンドウに頼らずとも長距離の関連付けをすでにうまく処理していることと整合しています。本論文はさらに Section 3.2 で8k学習文脈を超えた長さ外挿実験を、Appendix A6 で400Mスケールのアブレーションを報告しています。
限界と未解決の問題
- マルコフ連鎖の安定性解析は、(\bm{k}_t, \bm{v}_t) の分布に対して何らかの正則性条件(単位ノルムキー、有界な値など)を仮定していると考えられます;一様ノルム有界性が学習済み統計量と構造的選択のどちらに依存するかは、本抜粋からは明確ではありません。
- 同じスケール・トークン予算でのソフトマックス Transformer との比較は報告されておらず、主張は他の linear attention との相対的なものです。
- ここで示されるのは1.5B/100Bトークンのみであり、フロンティアサイズでのスケーリング挙動や「正規化不要」という特性が低精度学習でも維持されるかどうかは未解明です。
- 「直交キー間の干渉なし」という主張を直接検証する Needle-in-a-haystack、RULER、または連想再生の数値は、提供されたセクションには含まれていません。
なぜ重要か
Kronecker Delta Rule は、連想的改訂と干渉の間に数学的に明確な分離をもたらします:delta rule の誤り修正をクロスキー摂動なしに実現するものです。一様ノルム有界性と KDA に対する Avg-6 の実証的な1.6ポイント改善が大規模スケールでも成立するならば、DeltaNet ファミリーへの厳密な改良となり、現代の linear attention スタックにおける主要な構造的複雑性(ゲーティング/正規化)の一因を除去できます。
Source: https://arxiv.org/abs/2610.26834
Parameter-Efficient Fine-Tuningの脳エンコーディングへのスケーリング
問題設定
脳エンコーディングモデルは、自然な刺激に対するfMRI応答を予測します。支配的なレシピは、fMRIデータが乏しい(被験者あたり数時間)ために完全な fine-tuning が過学習を引き起こすことから、大規模な事前学習済みバックボーンを凍結し、その隠れ状態からボクセルやパーセルへの読み出し(ridge回帰または小型transformer)を学習するというものです。本論文では、PEFT(具体的にはLoRA)が非常に大規模なマルチモーダルバックボーンをこのタスクに適応させられるかどうか、そしてそのための主な障壁が統計的なものではなく計算的なものであるかどうかを問います。
計算上の障壁は具体的です。Algonauts 2025における従来のSoTA(Qwen3-Omniをベースに構築されたMIRAGE)は、fMRIの各タイムステップに対して重複するprefixを再エンコードするため、クリップあたり\sim 2{,}758回のforward passが発生し、A800上での抽出に\approx 700 GPU時間を要します。このプロトコルでバックボーンを通じて fine-tuning することは実行不可能です。
手法
単一因果パス。 decoderは因果的にマスクされているため、スライディングウィンドウはほぼ同一のprefixを再計算します。著者らは代わりに、149秒のウィンドウ(100 TR)を1回のforward passでエンコードし、言語エンコーディングモデルのスタイルで全タイムステップの特徴量を同時に読み取ります。A800上での計測値:クリップあたり5.1回のforward(対2{,}758)、forward あたり\approx 14{,}900トークン、331クリップの抽出に1.99 GPU時間——352\timesの削減です。エンドツーエンドの学習(抽出 + 4.84時間のadapter + 1.67時間の closed-form 再フィット)は8.5 GPU時間であり、ベースラインの702.5時間と比較して83\timesの削減となります。
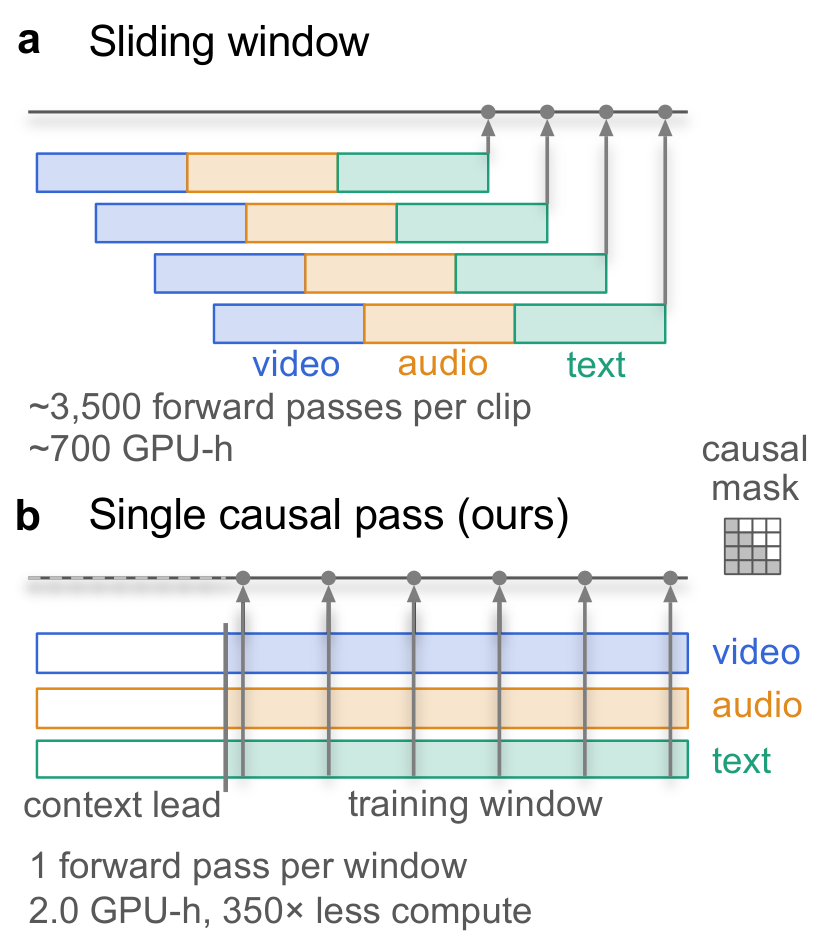
モダリティエンコーダは局所的に双方向です(8秒の音声ブロック、1秒の視覚パッチ)。そのため、単一パスの特徴量はそれらのブロック内では厳密に因果的ではありません。著者らは、prefixカットをまたぐ共有タイムステップを比較することで(Tab. 9)、偏差がカットから遠い位置に集中しており、未来の刺激のリークではなく長さ依存のbf16/MoEルーティング数値演算と一致していることを検証しています。60秒のコンテキストリードにより、ウィンドウ開始時に欠けているprefixが補われ、抽出プロトコルの切り替えによる小さな精度低下を十分に回復します。
LoRA + 読み出し。 Qwen3-Omni(合計30B、3Bアクティブ)において、rank-16のLoRAがlayer 32までのattentionモジュールに挿入され、decoderはその層で切り捨てられます。これにより、学習可能なバックボーンパラメータは8.91Mになります。プールされた特徴量(2 Hzタイムステップごとにモダリティ別に1ベクトル、8つの対数等間隔の時間ラグに集約、ウィンドウあたり\sim 894ベクトル)が、1,000のSchaeferパーセル(52.3Mパラメータ)への線形読み出しに入力されます。Adapterと読み出しは1エポック(1,429ステップ)のSGDで共同最適化されます。2エポック目は過学習します(読み出しの学習率3\times 10^{-4}で-0.0147)。線形読み出しWはその後、累積Gram行列に対するパーセルごとのridgeにより、被験者ごとに closed-form で再フィットされます。
結果
9つのバックボーン(4.7B〜104B)にわたって。 LoRAは同じ学習率とステップ数を用いた凍結読み出しコントロールに対し、Friends s06バリデーションにおけるPearson相関で+0.032〜+0.066の改善を全バックボーンで達成しました。Qwen3-Omniでは、凍結時0.2907 \to LoRA 0.3263(+0.0356)であり、最大の絶対的改善はMiniCPM-o(+0.0655)でした。Cross-attention読み出しは平均で\approx +0.003を追加します。バックボーンのサイズとエンコーディングスコアの相関は弱く(凍結時r=0.71、適応後r=0.60)なっています。
従来のSoTAとの比較。 同じQwen3-Omniバックボーンと同じ単一パス特徴量において、LoRA + linearは0.3263に達し、スライディングウィンドウプロトコルにおけるMIRAGEヘッドの0.3187、および matched lead での単一パス特徴量にMIRAGEヘッドを適用した場合の0.3241(再フィットあり)を上回ります。シード間のノイズは\approx 0.00077であり、これらの差はノイズを十分に上回っています。Ablation studyは、 closed-form 再フィットがMIRAGEの学習済みヘッド構成に対するヘッドルームの大部分を担っていることを示しています。
PEFTファミリーの頑健性。 \mathrm{IA}^3をattention+FFNに適用すると、わずか0.057Mパラメータでありながらも LoRA の改善の62%を回復します。\mathrm{IA}^3をMoEエキスパートに拡張すると76%に達し、r{=}32のHoulsby adapterはbudget-matchedで79%に達します。LoRAは実行ごとに最良ですが、その効果はLoRA固有のものではありません。
領域的な構造。 Adapterは全1,000パーセルを改善します。Yeoネットワーク:背側注意 +0.050、視覚 +0.040、大脳辺縁系 +0.015。ROIレベル:MT+ +0.055、IPS +0.054、TPJ +0.049、mPFC +0.025。4被験者の改善マップは平均ペアワイズr=0.673で一致しています。
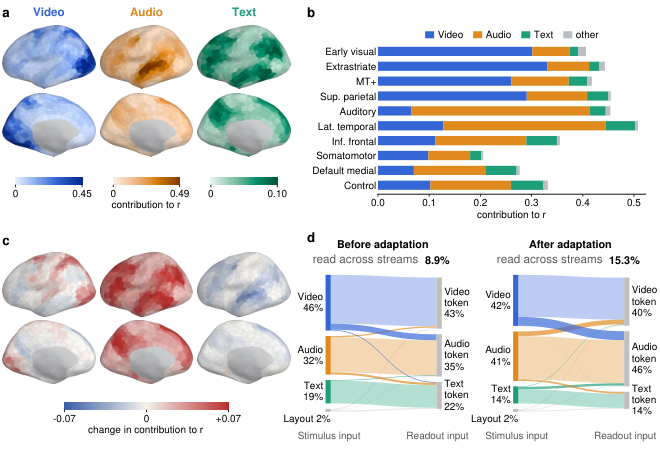
モダリティの帰属。 {video、audio、text}の2^3サブセットに対する厳密なShapley値(除去されたストリームはtraining-mean embeddingで置換)は、強い冗長性を示します:audioのみで全スコアの76%、videoのみで71%を回復します。適応はその混合を変化させます:audioのみ+0.0503の改善、videoのみ+0.0329の改善、transcriptは0.0065の低下です。適応済みモデルは、凍結時モデルがtranscriptから得ていた情報を音声audioから抽出します。
転移。 Leave-one-subject-out学習はほぼ完全に転移します:ホールドアウトされた被験者は凍結時に対して+0.0301〜+0.0355の改善を示し、4被験者adapterとの差は0.002以内です。Adapterはまた、NNDbデータセット(異なるスキャナー、TR、映画)に対しても転移し、新しい被験者のデータに対してanchored ridgeを用いた場合に、全ての被験者で全てのキャリブレーションバジェットにおいて凍結バックボーンを上回ります。
ネガティブコントロール。 時間シフトしたターゲットで学習すると0.1874(対整合済み0.3263)となり、改善が刺激–応答ペアリングに依存しており、fMRIの形状統計量には依存しないことを確認しています。シード間のadapterは重み空間においてほぼ直交しており(\cos \approx 0.026)、特徴抽出層ではほぼ同じ関数を計算するため、シードのみのアンサンブルではわずかな改善しか得られません。
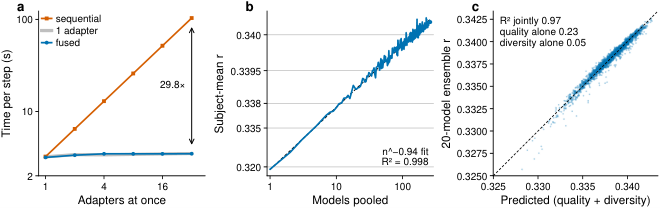
アンサンブル。 261メンバーのプールは0.3401に達し、その限界値へのギャップにA n^{-b}フィットが適用されます。融合マルチadapterカーネルは、N個のrank-16 adapterを1つのコストで実行します。
限界
音声/視覚エンコーダにおける局所的な非因果性は、時刻tの特徴量がブロック境界の終端までの刺激を混合する可能性があることを意味します。これは有界ですがゼロではありません。Rank 128は調整済みの学習率で発散します。rank–学習率の結合は分離されていません。アンサンブル解析は、プールが被験者間の刺激ロック共分散の32.5%を未説明のまま残していることを示しており、これが残りのヘッドルームを制限します。全結果はCNeuroModのSchaefer-1000パーセルを使用しており、ボクセルレベルおよび臨床集団への汎化は未検証です。
重要性
単純な因果構造の観察(タイムステップごとではなくウィンドウごとに1回のforward pass)により、抽出コストが\approx 350\times削減され、「100BマルチモーダルモデルをfMRIで fine-tuning する」という実行不可能なプロジェクトが8.5 GPU時間の実行へと変換されます。得られたLoRA adapterは、バックボーン、モダリティ、脳領域をまたいで凍結読み出しベースラインを一貫して均一に上回り、未知の被験者やデータセットにも転移します。これは、神経エンコーディングにおける長年の凍結バックボーンパラダイムが計算コストによって制限されていたものであり、統計的に正当化されたものではなかったという証拠です。
Source: https://arxiv.org/abs/2610.26802
フリート経験からの学習:ロボットのための集合的学習パラダイム
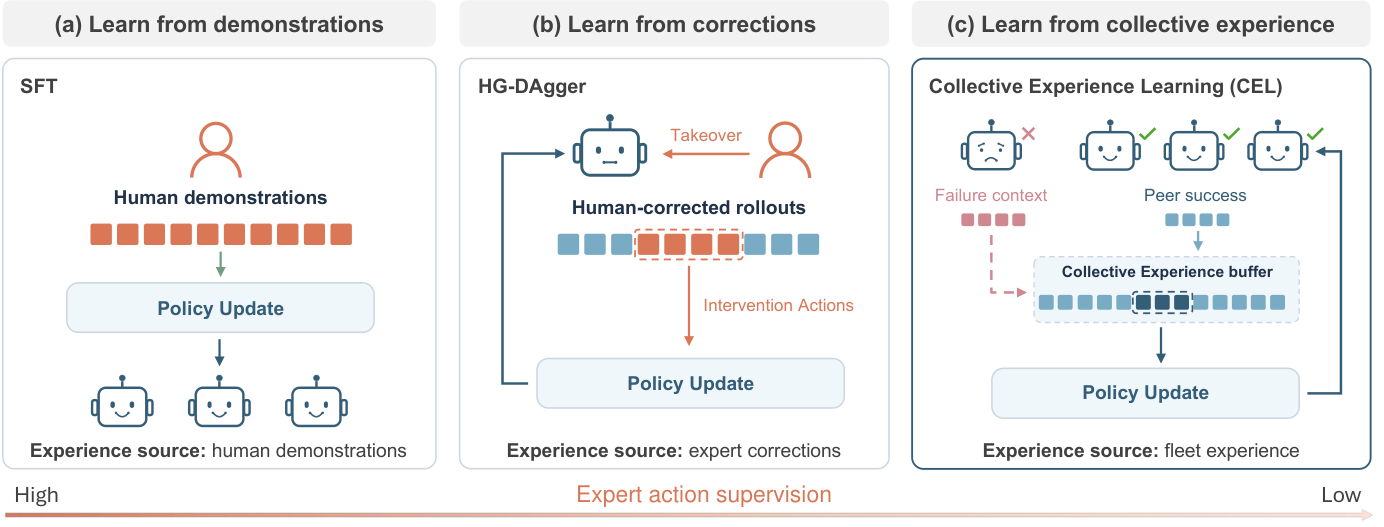
デプロイされた操作 policy は継続的に実行データを生成しますが、そのデータを policy の改善に活用するためには、従来は遠隔操作者が介在するループ(HG-DAgger スタイルの修正)が必要でした。このボトルネックはフリートの規模に対して線形にスケールするため、本格的なロボットフリートの概念とは相容れません。本論文では、集合的経験学習(CEL)を提案します。これは、専門家による監督付き初期化の後、ロボット群が自律的なロールアウトのみを用いて共有 policy を改善するパラダイムであり、人間が提供する二値の結果ラベル y(\tau) \in \{0,1\}(環境のリセットも行う)によって監督されます。新たな専門家の行動は一切収集しません。
FERT:成功に基づく監督と失敗に基づく優先付け
失敗誘導型経験検索 fine-tuning(FERT)の中心的なアルゴリズムの洞察は、二値ラベルが生み出すクレジット割り当て問題の分解にあります。成功は模倣に値する行動を提供し、失敗は学習が集中すべき状態空間のどこかを決定します。
FERT はフリート全体から収集した成功軌跡のバッファ \mathcal{D}^+ を維持します。失敗軌跡それぞれに対して、視覚的および固有受容感覚的な特徴を抽出して失敗コンテキストクエリを形成し、\mathcal{D}^+ のエンコードされたセグメントに対する最近傍検索によって、失敗領域と状態的に類似した成功軌跡セグメントを取得します。取得されたセグメントは、優先再生 fine-tuning ループにおいてサンプリング優先度が引き上げられます。このループの loss は、\mathcal{D}^+ から抽出された (o_t, a_t) ペアに対する通常の behavior cloning 監督のままです。具体的には、SFT および複数ロボットによる HG-DAgger 初期化の後、ループは以下のようになります:
loop:
  insert new rollouts {(τ, y(τ))} from fleet
  for failed τ: encode failure context, retrieve top-k from D+, bump priorities
  sample minibatch from D+ with current priorities
  SGD step on BC loss
  periodically push updated policy to fleet
これは retrieval-augmented imitation や優先経験再生を想起させますが、フリートスケールのデプロイメント環境に適用されており、失敗からの「シグナル」は勾配ではなく局所化シグナルです。要点は、データ収集の拡大に遠隔操作の拡大が不要になるということです。エピソードごとに必要な人間の労力は、1 ビットのラベルとリセットのみです。
FATS:システム基盤
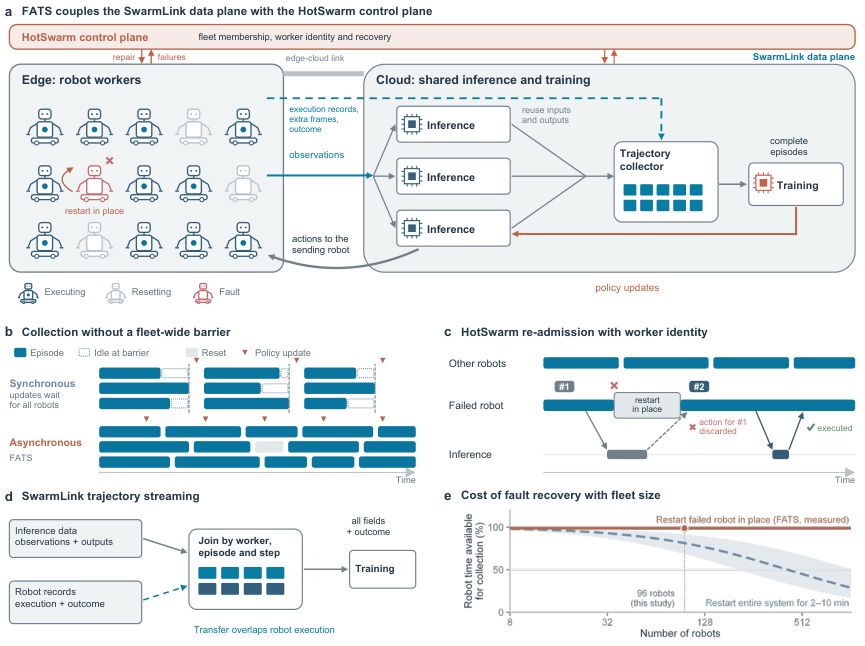
耐障害非同期トレーニングシステム(FATS)は、エッジロボットからクラウド推論を経てトレーニングバッファへとフィールドごとの軌跡テンソルをストリーミングするデータプレーン(SwarmLink)と、メンバーシップ・ワーカーの識別・リカバリを担うコントロールプレーン(HotSwarm)を分離します。同期的な経験収集では、最も遅いロボットにすべての policy 更新が足を引っ張られますが、FATS は収集・最適化・policy 配布を分離することで、他のロボットがリカバリ中も高速なロボットが経験を生成し続けられるようにします。現実のフリートでは実行速度が異なり、ローカルな割り込み(把持失敗、リセット、通信停止)が無視できない頻度で発生するため、これは重要です。
結果
評価には 5 つの AgiBot G2 卓上タスク——花のアレンジメント、衣服の折り畳み、スマートフォンの充電、スツールの組み立て、スマートフォンの梱包——を使用し、変形物体、精密な位置合わせ、道具の使用、多段階実行を網羅しています。
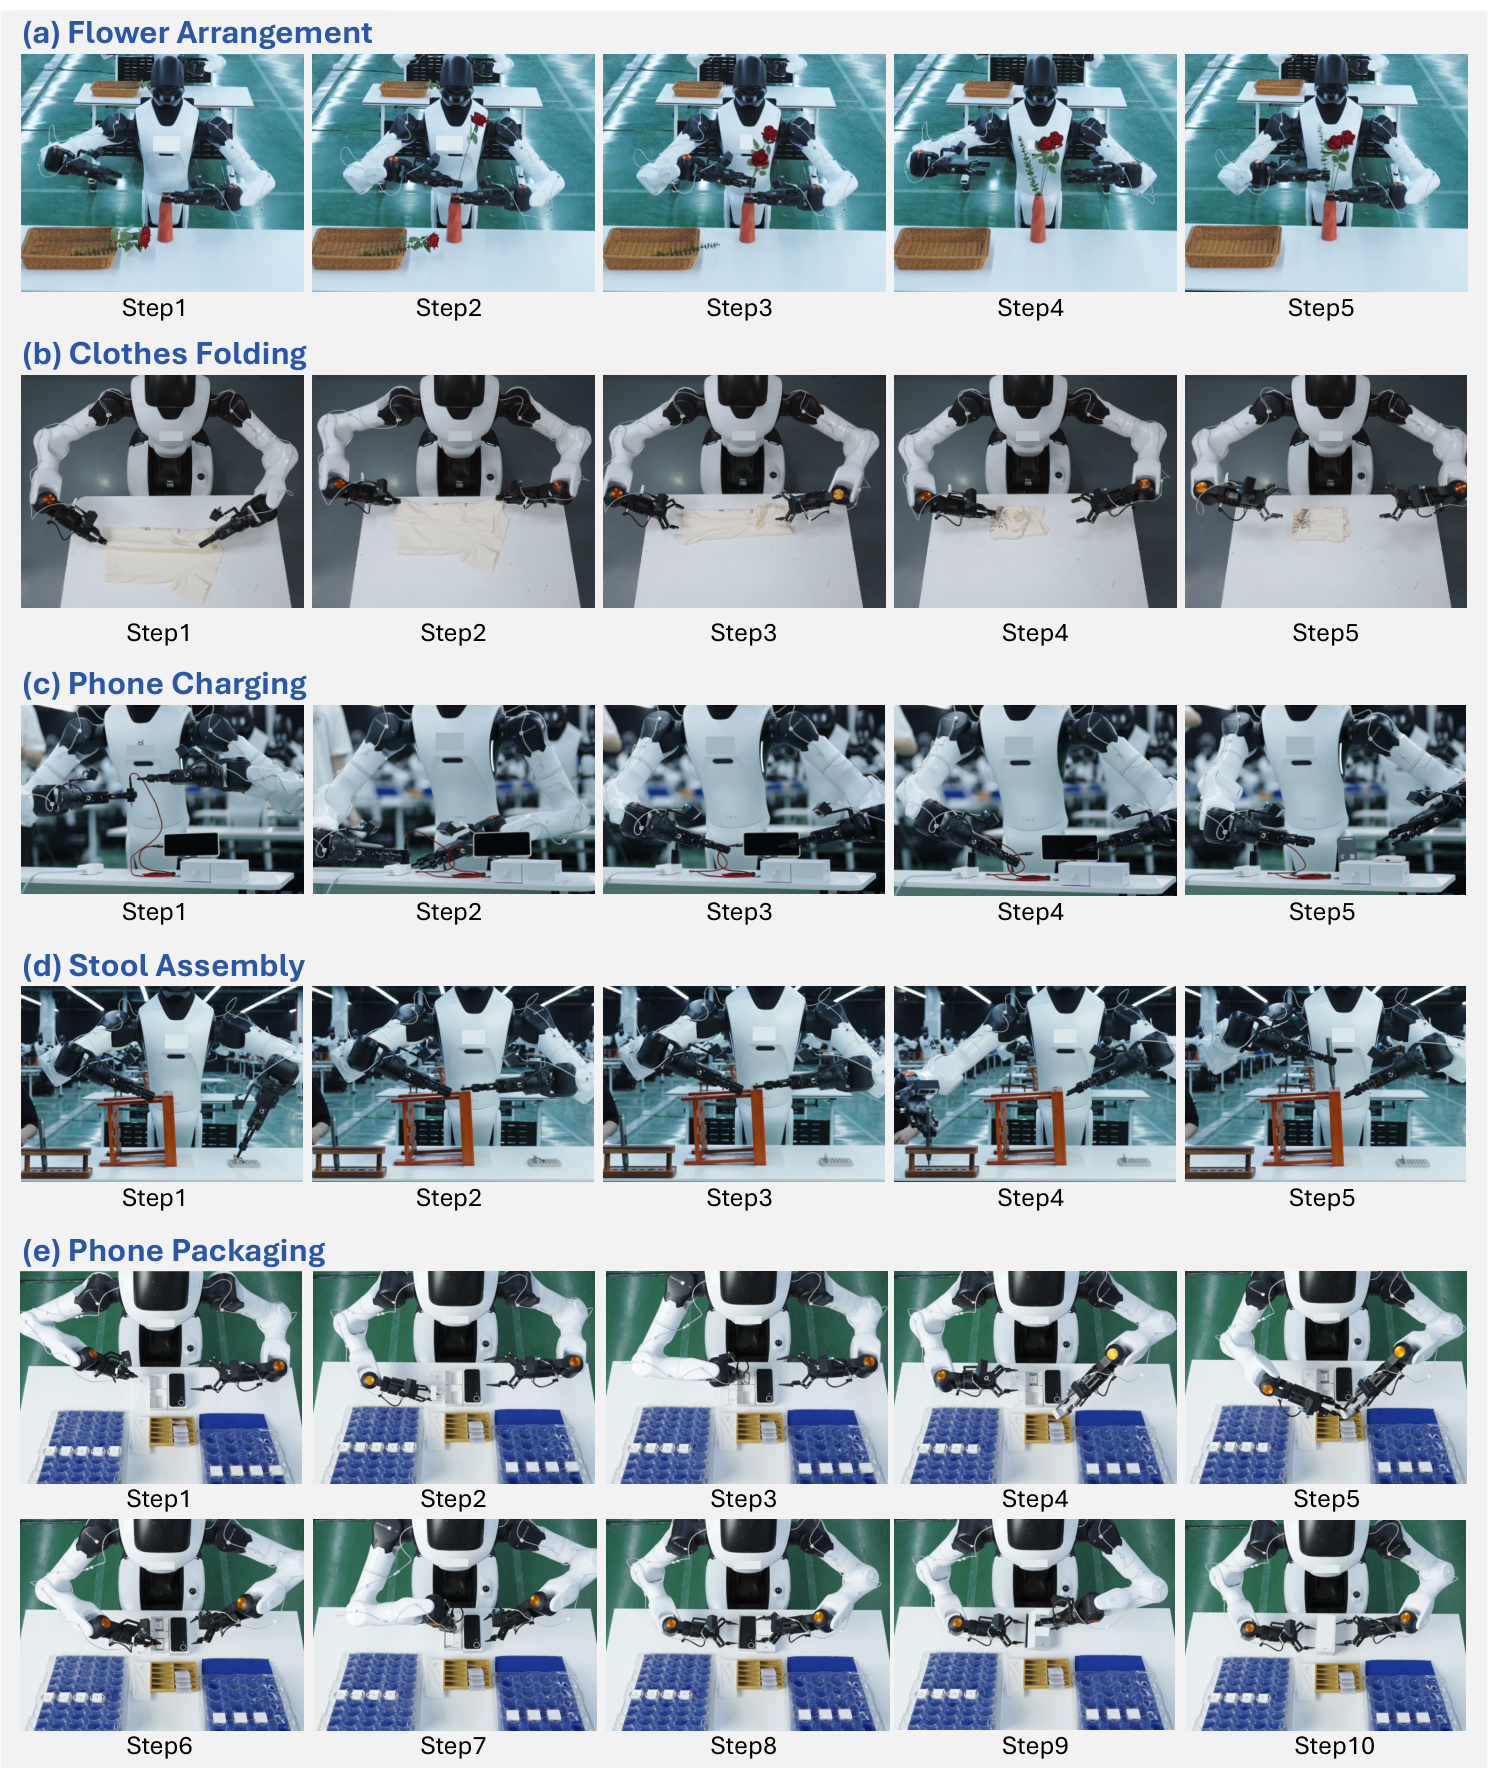
Policy はトレーニングデータ収集から除外されたロボットで評価されており、特定ユニットの運動特性への過学習による容易な利得を排除しています。タスクごとに 120 試行で評価した結果、最終的な policy は93.3–99.2% の成功率に達し、新たな専門家のデモンストレーションや修正なしに専門家初期化 policy からの改善が得られています。本論文ではさらに以下を検討しています:
- ロボットごとの収集時間を固定したフリートスケーリング(Section 4.3)。これにより、ロボットあたりのデータ増加という自明な効果を排除し、並列的な経験の幅の効果を単離しています。
- アブレーション(Section 4.4)。失敗誘導型検索対 \mathcal{D}^+ の一様サンプリング、および FERT の他の設計選択への寄与を分析しています。
- 意図的なワーカー障害と通信遅延に対するシステム挙動(Section 4.5)。トレーニングのスループットが停止するのではなく緩やかに低下することを測定しています。
限界と未解決の問題
- 二値結果監督は、合理的に強力な初期化を前提としています。\mathcal{D}^+ は、検索されたセグメントが実際に失敗コンテキストに関連するほど十分に豊富でなければなりません。成功ロールアウトのサポート外にある新規の失敗モードに対しては、FERT は修正シグナルを持ちません。
- 本手法は標準的な imitation learning の共変量シフト問題を引き継いでいます。DAgger と異なり、失敗状態はオンポリシーの専門家行動を受け取ることなく、異なる軌跡からの類似した成功行動のみを受け取ります。これが分布シフトのギャップを埋めるのか、単にそれを移動させるだけなのかは、5 タスクのベンチマークでは完全には答えられない経験的な問いです。
- 人間は依然として結果ラベルと環境リセットを提供します。「成功」自体が曖昧なタスク(例:組み立て許容差、長期的目標)では、ラベリングコストが再び問題になる可能性があります。
- 検索 encoder は事前学習されており、その不変性がどの失敗コンテキストがグループ化されるかを決定します。Encoder の病理的な挙動が優先付けを静かに誤誘導する可能性があります。
- タスク間の報告範囲(93.3–99.2%)はすでに改善余地の不均一性を示しており、下限値のタスクは retrieval ベースの自己改善が飽和する場所を明らかにしている可能性があります。
なぜこれが重要か
CEL/FERT は、フリート学習をスケールするための実践的な道筋を示しています。この方法では、人間の労力がフリートサイズに対して線形(遠隔操作時間)ではなく、エピソードごとに 1 つのラベルと 1 つのリセットという形でサブリニアに増加します。このパラダイムが卓上操作を超えて一般化するならば、デプロイメント自体が policy 改善の支配的なソースとして再定義されます。
Source: https://arxiv.org/abs/2610.25736
Holi-World: 人間の一人称体験からホリスティックな世界知性を構築する
問題
エゴセントリック動画は世界モデルを学習するための魅力的な基盤です。一人称の観察と身体的なインタラクションを結びつけ、シーンの構造やオブジェクトが接触によってどのように変化するかについて、自然に根拠付けられた軌跡を提供します。ボトルネックはアノテーションです。生のエゴ映像を、視点や時間を超えた持続的なシーン幾何学、オブジェクトのアイデンティティと状態、インタラクション履歴を紐付ける教師データに変換することは、これまで密な人手によるラベリングを必要としており、空間的・時間的推論のためのVLMを学習するのに必要なスケールでは実現不可能でした。Holi-Worldはこのボトルネックを標的とし、エゴ映像を構造化された「world records」へ自動変換し、そこから根拠付きのQA学習データを導出し、独立して人手でアノテーションされたホールドアウトセットに対して結果モデルを評価するエンドツーエンドのエコシステムを提案しています。
エコシステム
Holi-Worldは、相互に連携する4つのコンポーネントとして構成されています。
HOLIWORLD-Foundry — 自動構築パイプライン。静的知覚(持続的なシーン構造:レイアウト、オブジェクトインスタンス、姿勢)と動的知覚(手とオブジェクトのインタラクション、状態遷移、時間的セグメンテーション)を融合し、記録ごとにworld recordを生成します。このレコードは、(a) オブジェクトのアイデンティティと位置からなる持続的なシーングラフ、(b) 手と操作対象オブジェクトを含むタイムスタンプ付きインタラクションイベント、(c) 各イベントに付加された補助的な生観測(フレーム、視点)の結合表現です。設計原則として、静的ストリームと動的ストリームは相補的であり、静的知覚が時間を超えてアイデンティティと位置を安定させる一方で、動的知覚は静的検出器が見逃す状態変化と因果構造を解決します。
HOLIWORLD-Data — 約100の自己収集シーンから導出されたデータセット。パイプラインはworld recordsに根拠付けられた約80KのQAペアを生成します。質問は空間推論(相対位置、アフォーダンス、視点変化)、時間推論(インタラクションの順序、オブジェクト状態の履歴)、インタラクション帰属(どの手、どのオブジェクト、どの結果)にわたります。QAジェネレータはフレームレベルのキャプションではなく構造化されたworld recordを基盤としているため、回答はレコードの時間を超えた一貫性を継承します。
HOLIWORLD-VL-4B — HOLIWORLD-Dataで学習された40億パラメータのvision-language model。規模は意図的に控えめであり、エゴ入力における空間的・時間的能力を高めるのはモデルサイズではなく、学習データの品質と構造であるという主張です。
HOLIWORLD-Bench — 自動アノテーションを監査し、学習された理解を評価するために使用される、独立して人手でアノテーションされたホールドアウト記録。ホールドアウトのアノテーションプロセスをFoundryパイプラインから分離することは重要です。これにより、ベンチマークがモデルがFoundry自身のバイアスを暗記した度合いを測定することを防ぎます。
機械的骨格
骨格を再実装するために必要な主要な構成要素は以下の通りです。
- 静的知覚スタック:記録ごとに、3D整合的な位置を持つ持続的なオブジェクトインベントリを生成します。実際には、オープンボキャブラリーの検出器とトラッカー/セグメンターを実行し、カメラ姿勢(エゴストリーム上のSLAMまたはVIO)を介してシーンレベルのフレームへ検出結果をリフトアップし、トラックレットを持続的なインスタンスIDにクラスタリングすることを意味します。
- 動的知覚スタック:手とオブジェクトの接触イベントを検出し、操作されたオブジェクトにラベルを付け(静的インベントリと照合)、状態変化の述語(例:opened/closed、Aから Bへ移動)を発行します。各イベントは時間区間と補助フレームに固定されます。
- world recordスキーマ:両ストリームを結合して格納し、「オブジェクト o の時刻 t での状態は何か」といったクエリが言語モデルではなくレコード上の決定論的なルックアップで回答されます。
- QAジェネレータ:レコードからテンプレートと質問をサンプリングします。テンプレートは推論タイプ別に整理されており、すべての回答がレコードエントリから導出可能であることを要求し、補助フレームを視覚的コンテキストとして付加することで根拠付けが強制されます。
- VLMトレーナー:補助フレームを視覚入力として、これらの根拠付きQAペアで4Bバックボーンをfine-tuningします。
形式的には、world recordを W = (\mathcal{O}, \mathcal{E}, \mathcal{F}) と見なすことができます。ここで、\mathcal{O} は属性を持つ持続的なオブジェクト集合、\mathcal{E} = \{(t_i, h_i, o_i, s_i^{-}, s_i^{+})\} はイベント列(時間、手、オブジェクト、前後の状態)、\mathcal{F} は補助フレームのインデックスです。学習例は (q, a, V) \sim \mathrm{Gen}(W)(ただし V \subset \mathcal{F})です。
結果と限界
論文では、HOLIWORLD-VL-4Bを約100シーンからの約80KのQAペアで学習し、HOLIWORLD-Benchで評価したことが報告されています。利用可能な抜粋ではアブストラクトが途中で切れているため、具体的な主要数値(ベンチマーク精度、静的ストリームと動的ストリームを分離したアブレーション、同一エゴベンチマークにおける汎用VLMとの比較)はここでは再現されていません。正確な数値については論文全文をご参照ください。
設計からだけでも、いくつかの限界が見えます。第一に、約100シーンは実際の環境の多様性に対して少なく、汎化の主張は、学習済みモデルではなくFoundryパイプラインが実際にスケール可能な成果物であるかどうかにかかることになります。第二に、自動化されたworld recordsはその知覚コンポーネントの失敗モード(インスタンスの見落とし、長期遮蔽にわたるアイデンティティスイッチ、偽の状態述語)を引き継ぎ、そのレコードに根拠付けられたQAはそれらのエラーをエンコードします。Bench上での独立した人手アノテーションは評価についてはこれを部分的に緩和しますが、学習については緩和されません。第三に、QAテンプレートがモデルが学習を促される推論の種類を限定するため、明示的なテンプレート設計や W に対する検証付きのLLMベースの質問シンセサイザーなしには、真に構成的または反事実的なクエリが出現する可能性は低いです。第四に、このエコシステムは単一エージェントかつエゴのみであり、マルチエージェントインタラクションと三人称視点との整合は未開拓の方向性です。
なぜこれが重要か
興味深い貢献は4Bモデルではなく、構造化された自動構築されたworld recordとその上に乗るQA層との間の規律ある分離が、エゴセントリック世界モデルにとって正しいスケーリング基盤であるという主張です。Foundryパイプラインが10×〜100×のシーンで成立するならば、これは人手アノテーターの作業ペースに依存しない空間的・時間的教師データへの実用的な経路となります。
Source: https://arxiv.org/abs/2610.26549
EgoXperience: 人間の経験から世界座標に基づくエゴセントリック表現の学習
問題設定
エゴセントリック再構成は、これまで主として互いに独立したサブタスクの集合として取り組まれてきました:カメラ軌跡の推定、単眼深度の推定、手のメッシュのリフティング、物体の6-DoFポーズの推定です。各要素が単独で合理的な結果を出していたとしても、その出力は一つの整合した世界へと統合されません。すなわち、手のメッシュはシーン形状に対してドリフトし、物体ポーズにはメトリックスケールが欠如し、カメラ推定値は共有フレームに整合されていません。操作のためのimitation learning、アフォーダンスモデリング、人間活動の world model といった下流用途では、関心のある量は相対的なもの(手-物体間、物体-シーン間、手-世界間)であるため、統合的かつ世界整合的な再構成こそが真の目標となります。既存のデータセットは、6-DoFの物体ポーズを欠くか、メトリック深度を欠くか、あるいは屋外や複数エリアへの対応なしに単一の屋内リグに限定されています。
EgoXperienceのスタック
EgoXperienceは三つの連携コンポーネントを提供します:アノテーションエンジン(EgoX-Engine)、50時間のデータセット(EgoX-Data-6M、CADモデル化された101物体、複数エリアおよび屋外対応)、そして統合再構成モデル(EgoX)です。
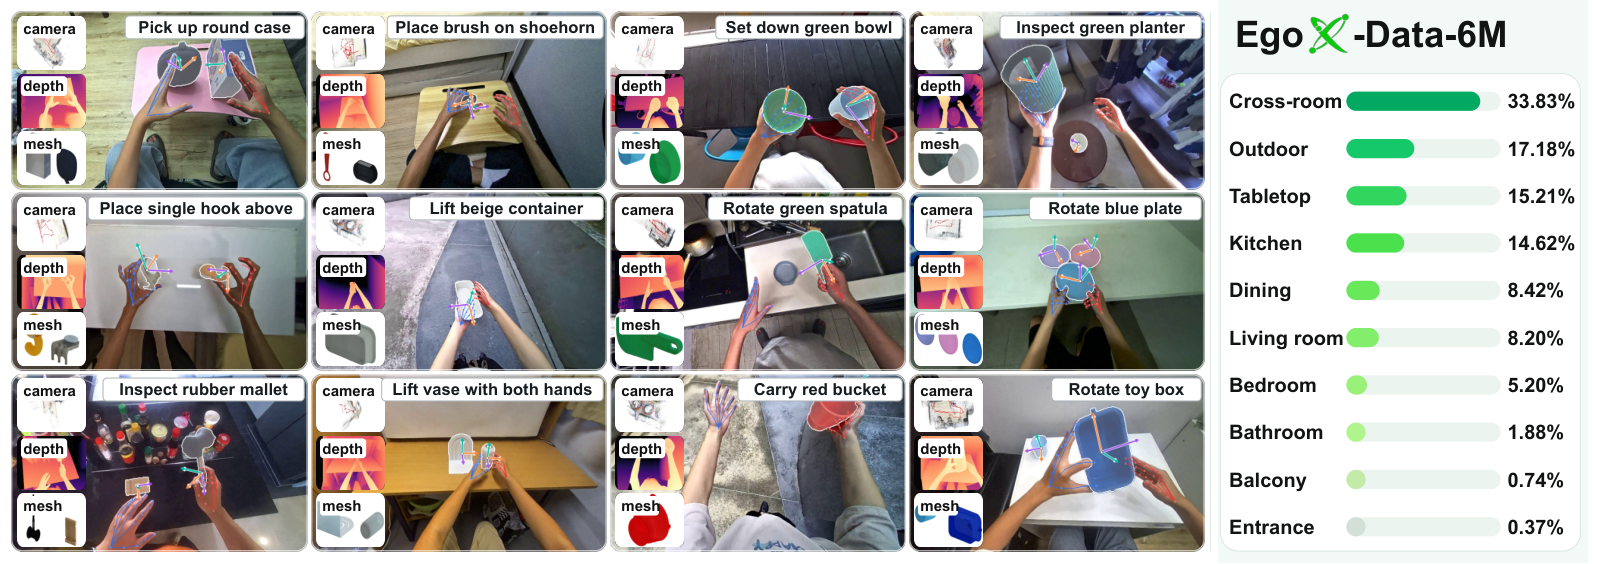
キャプチャにはHOMIE Gen2ヘッドリグを使用します:メトリック深度のためのキャリブレーション済み前方ステレオペアに加え、カメラ軌跡を復元するSLAMパイプラインに供給する四つの魚眼カメラを備えます。各セッションのSLAMフレームを参照フレームとして固定し、フレームごとのシーン深度、手のメッシュ、物体ポーズをすべてそのフレームに剛体変換します。これが重要な設計上の選択です:エンティティレベルの推定はカメラ座標で生成されますが、監督信号はセッション一定の世界フレームで表現されており、見かけの動きがカメラ、エンティティ、あるいはその両方のいずれから生じているかを明確に区別します。
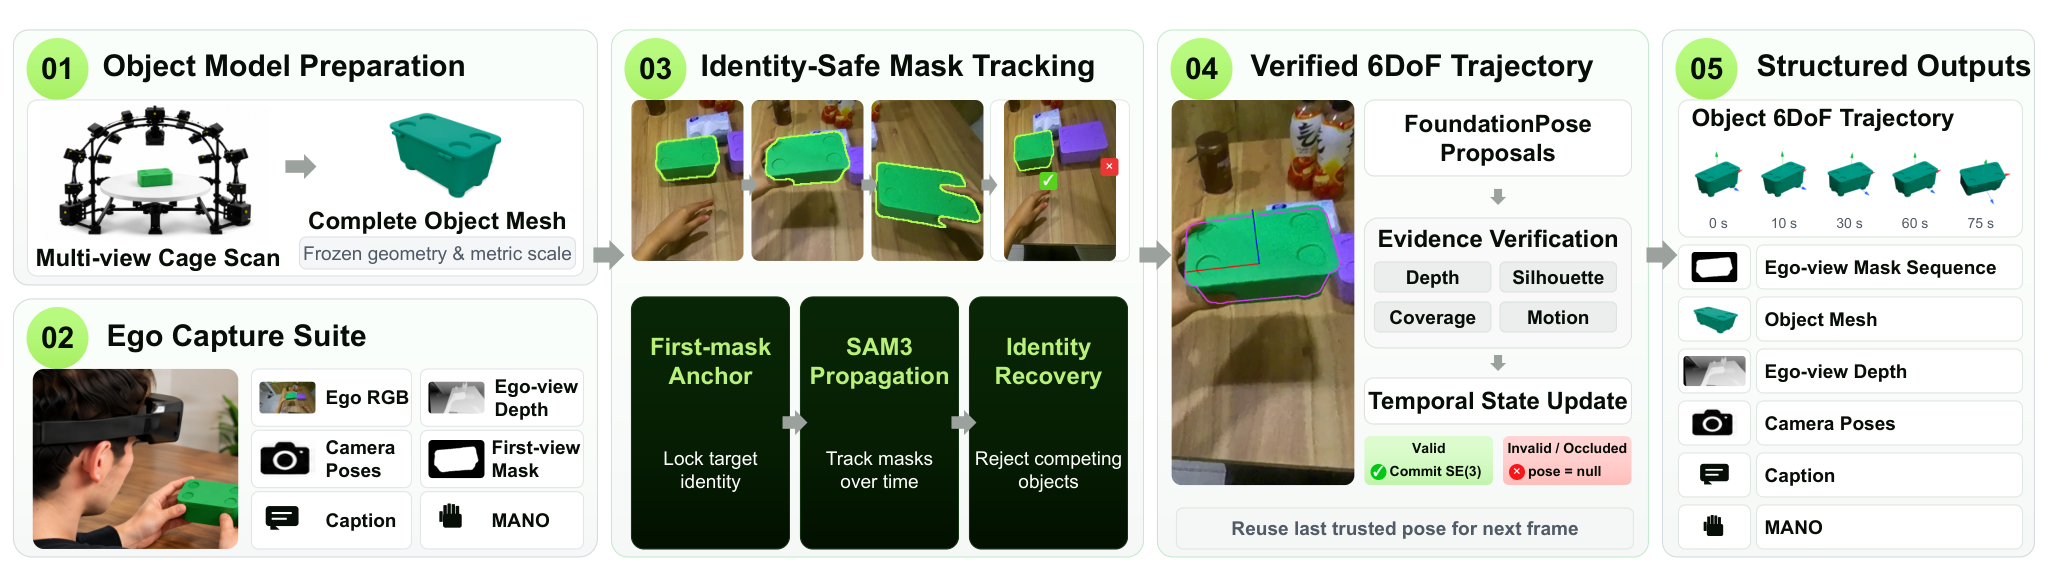
EgoX-Engineは、幾何学的に検証された物体追跡(CADベースであるため6-DoFはメトリック)をSLAM整合と組み合わせ、さらに秒単位のタスクキャプションも出力します。既存のエゴセントリックデータセット(表1)と比較すると、3D手、6-DoF物体ポーズ、メッシュ、深度、マスク、キャプション、複数エリア、屋外アノテーションを一箇所に統合した唯一のデータセットです。HOT3DおよびHo-Capは屋内限定で深度を欠き、Ego-Exo4DおよびEgoDexは6-DoF/メッシュを完全に欠いています。
EgoXモデル
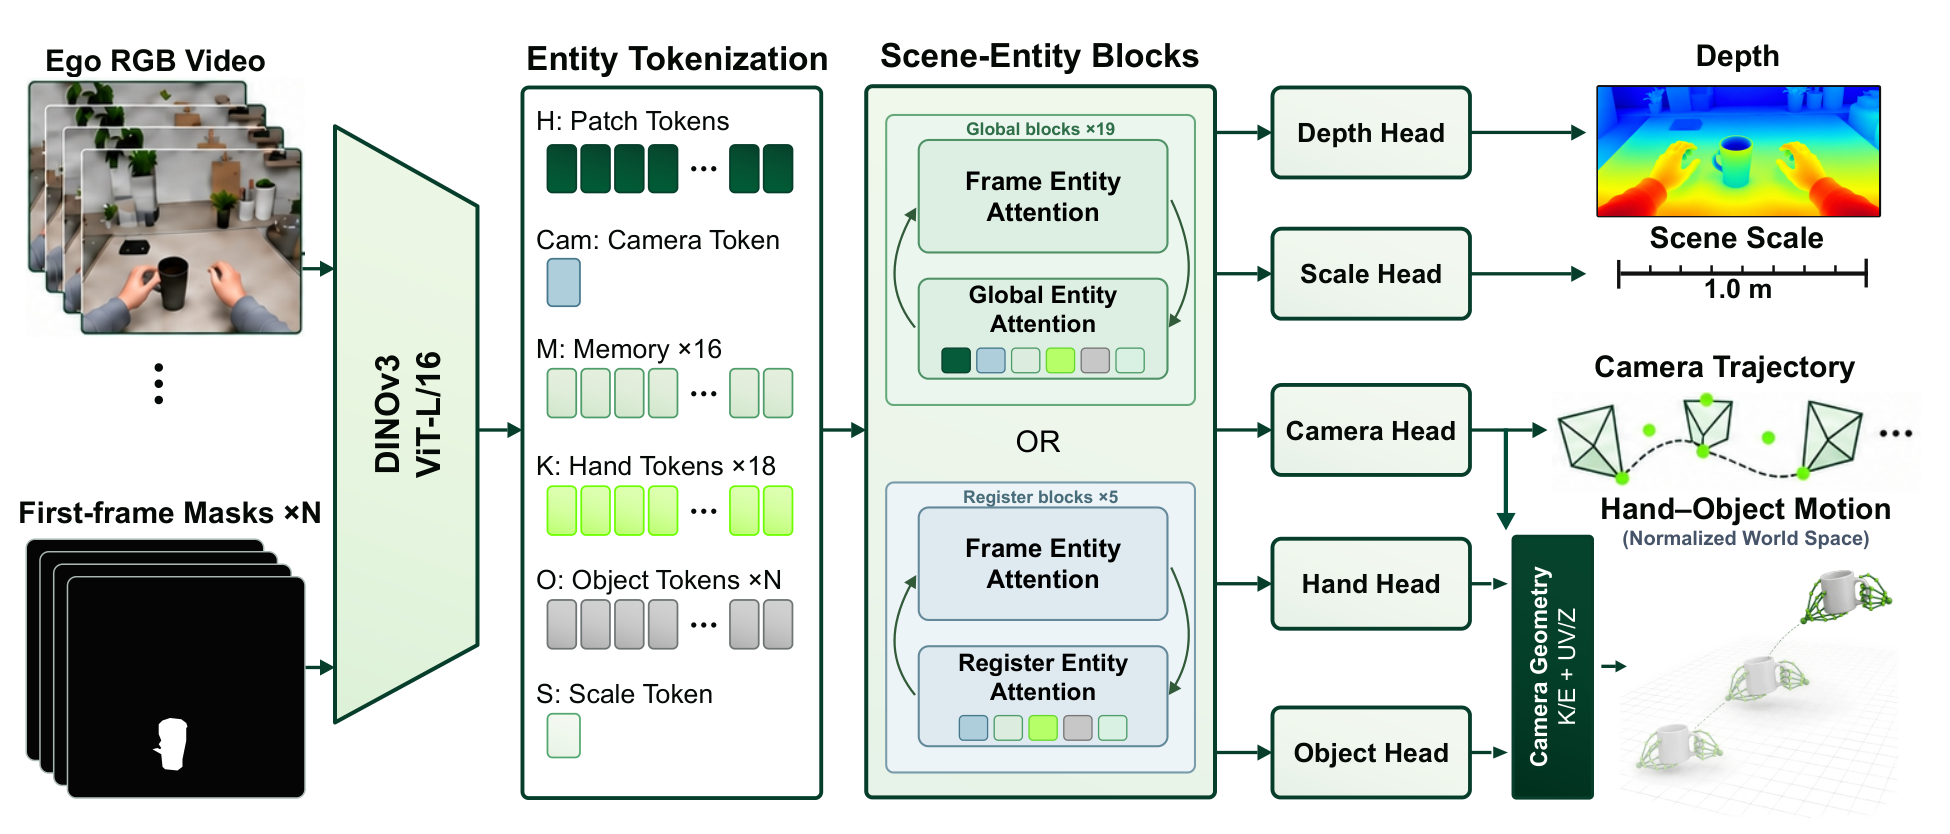
EgoXは単眼・end-to-endであり、カメラ軌跡、メトリック深度、手のメッシュ、物体の6-DoFポーズを共有世界フレームで同時に出力します。RGBに加えて必要な追加入力は最初のフレームの物体マスクのみです(比較:Any6Dは推定深度、内部パラメータ、フレームごとのマスクを必要とし、FoundationPoseはさらにGTメトリックCADアセットを必要とします)。共有されたシーン/エンティティのfeatureがタスク固有のheadに供給され、予測されたグローバルスケールによって出力がメトリックに変換されます。学習にはEgoX-Data-6Mと補完的な公開アノテーションを使用します。評価にはHOT3D、EgoX-Bench、HOI4D、H2Oにわたる固定150フレームクリップを使用し、いかなる手法もGTカメラやスケールを受け取りません。
結果
手の再構成(PA/WA/W-MPJPEをmmで表示)。EgoXは、カメラドリフトと手のポーズ誤差が複合するレジームである世界空間メトリクスにおいて、四つのベンチマークすべてで優位性を示します。EgoX-Benchでは、W-MPJPEが328.81(WiLoR+SLAM、最良ベースライン)および363.47(HaWoR)から113.24に低下しました。HOI4Dでは、W-MPJPEが108.76(MINT)から42.67に改善されました。H2Oでは、34.63(HandFlow)から23.95に改善されました。HOI4DにおけるPA-MPJPEはMINTの17.94に対して3.32であり、剛体整合後においても5倍以上の改善が見られ、その利得がカメラ推定の改善のみによるものではないことを示しています。
物体6-DoF(カメラフレーム、ADD/ADD-S mm、AUC-S_{50} %)。最初のフレームのマスクのみを使用するEgoXは、推定深度、内部パラメータ、フレームごとのマスク、場合によってはメトリックCADを消費する手法を上回ります。HOT3Dでは:ADD 28.00対67.06(Any6D)/71.92(GigaPose+MegaPose);AUC-S_{50} 73.71対57.59。ベースラインが崩壊するHOI4D(GigaPose+MegaPose AUC-S_{50} 3.91、FoundationPose 13.39)では、EgoXは59.08を達成しました。H2Oでは、AUC-S_{50} 80.42対46.03でした。
カメラと深度。EgoXはVGGT、VGGT-\Omega(シーケンスごとにDA3-Nested深度への一つのスケールをfitさせたもの)、CUT3R、Any4D、DA3-Nestedと比較されます。VGGT-\OmegaはEgoX-Benchにおいて最も強力なカメラ推定器として残り(nATE 0.0071、RRE 0.61°)、DA3-NestedはHOT3Dにおける深度で最も強力です(AbsRel 0.0799、\delta_{1.25} 94.40)。EgoXの主張は、per-sequenceのスケールfittingなしに統合的な予測を行うことであり、カメラ/深度が専門手法を上回ることではありません。テーブル(一部掲載)は、EgoXが同一フレームで手と6-DoFを生成する唯一のシステムであるとともに、競争力を維持していることを支持しています。
限界と未解決の問題
データセットの規模(50時間)は、EgoDex(829時間)やEgoVerse(1362時間)と比較すると控えめですが、それらは6-DoFアノテーションを欠いています。物体認識はCADモデル化された101物体に固定されており、オープンボキャブラリーの操作には汎化しない可能性があります。EgoXは最初のフレームのマスクを必要とするため、完全なin-the-wild設定では依然として上流のセグメンタが必要です。VGGT-\OmegaおよびDA3-Nestedとのカメラ/深度のギャップは、統合的な目的関数を改善する余地があることを示唆しています。最後に、評価は150フレームクリップを使用しており、世界フレームにおける長期的なドリフトやループクロージャは直接的には検証されていません。
この研究の意義
単眼エゴセントリックRGBからの統合的・メトリック・世界フレーム再構成——手、物体、シーン、カメラを同時に——は、人間の経験から学習するための正しい表現形式であり、EgoXperienceは、物体ポーズベースラインよりも厳密に少ない入力を使用しながら、世界空間の手誤差と6-DoFポーズにおいて大きなマージンでこれを実際に実現する最初のend-to-endシステムおよびデータセットです。
Source: https://arxiv.org/abs/2610.26625
ScaleNav: 言語条件付きローカルナビゲーションのためのスケーラブルなインターネット動画事前学習
問題設定
言語条件付きローカルナビゲーションとは、ロボットが現在のポーズから、初期のRGB観測においてすでに可視である、テキストで指定されたターゲットへ移動し、指定された場所で停止するタスクです。このポリシーはシーン・照明・物体カテゴリをまたいで汎化しなければならず、多様な学習データが必要です。実ロボットによるテレオペレーションデータはコストが高く、シミュレーションは安価ですがsim-to-realの外観ギャップが生じます。インターネット上の自己視点動画(ウォーキングツアー、ハウスツアー、一人称視点の探索など)は、3Dシーンにおけるリアルなカメラ運動の大規模な未活用リソースですが、行動ラベルがありません。ScaleNavは次の問いを立てます:行動ラベルなしのインターネット動画から目標指向の視覚的ダイナミクス事前分布を抽出し、シミュレーションデータを用いて小規模な行動デコーダをその上に取り付けることができるか?
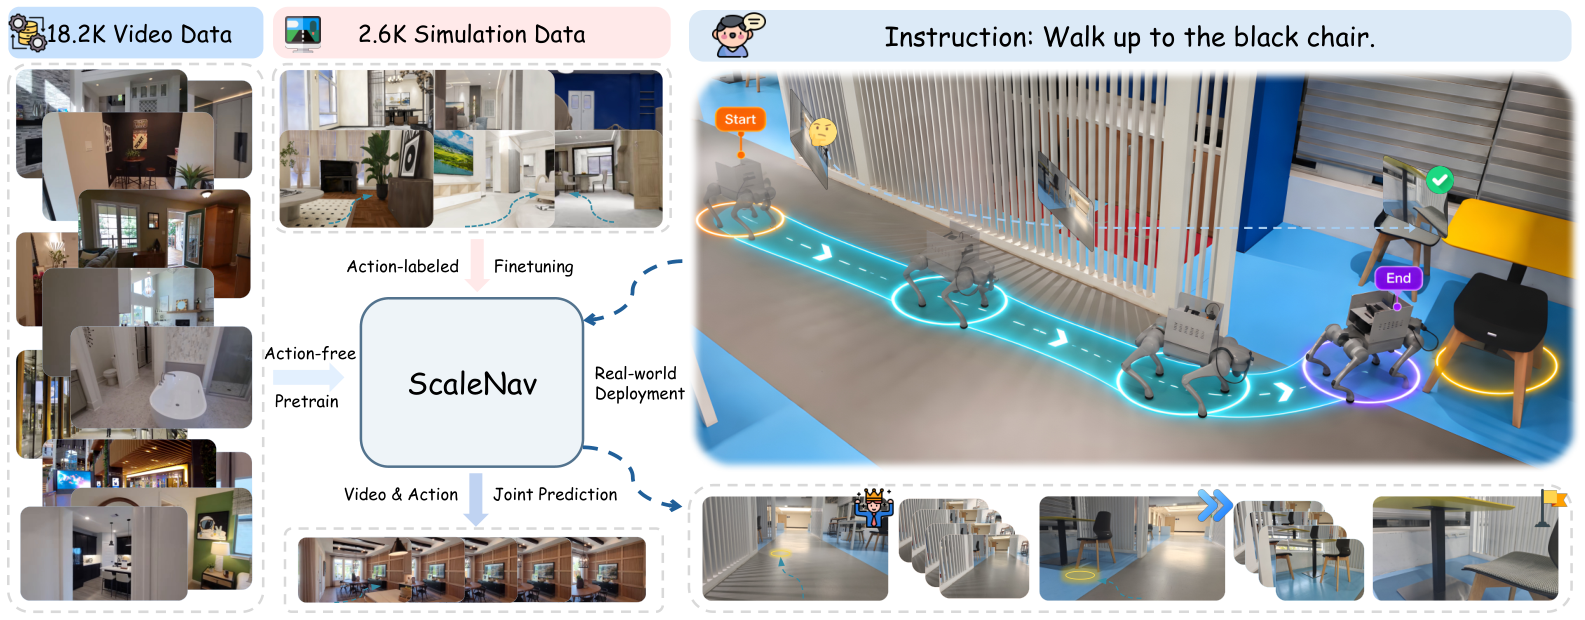
手法
ScaleNavは統合されたworld-actionモデルです:単一のDiTバックボーンが、命令・現在の観測・メモリを条件として、将来の動画フレームと行動チャンクを同時に予測します。行動は a_t = (\Delta x_t, \Delta y_t, \Delta \psi_t) — ロボットのローカルフレームにおける平面変位とヨー変化 — であり、T 個の行動がチャンク \tau = (a_1, \ldots, a_T) を構成します。各ステップでロボットは予測されたチャンクを実行し、新しいRGBを収集して、次のチャンクを再計画します。
attention構造(図2a)はチャンク単位の因果的なものです:動画・行動チャンク内では、トークンが双方向にattendし、チャンク間ではattentionが因果的になります。メモリは、初期フレームのアンカー(視点がドリフトしてもターゲット参照を安定させる)と、最近の動画・行動チャンクのスライディングウィンドウから構成されます。このアンカーは重要です。なぜなら命令は t=0 においてのみ可視の物体を参照しており、アンカーなしでは長いロールアウトの中で参照対象が失われてしまうからです。
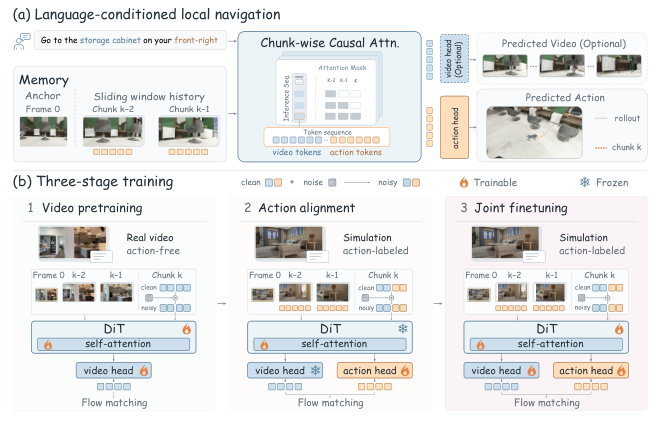
学習は3段階で進行します:
命令条件付き動画事前学習:行動ラベルなしのインターネット自己視点クリップで行います。DiTは p(o_{t+1:t+T} \mid o_{\le t}, \ell) を学習します。ここで \ell は自然言語によるターゲット説明です。この段階では、多様なリアルシーンにおいて、指示された物体に向かってカメラが並進・回転する際の自己視点映像の変化を捉えます。DiTをチャンク単位の因果的attentionに変換する前に、初期の双方向適応が適用されます。
行動アライメント:行動ラベル付きシミュレーションデータで行います。更新されるのはDiTのself-attentionレイヤー、行動ヘッド、行動embedding MLPのみであり、動画事前学習中に学習されたcross-attentionとMLPブロックは凍結されたままです。これにより、行動ヘッドは事前学習済みのダイナミクス表現から運動を読み出すことを強いられ、その表現を上書きしません。リアルな視覚統計量のcatastrophic forgettingを防ぐため、この段階でもインターネット自己視点動画がリプレイされます。
Joint fine-tuning:DiTと動画・行動の両ヘッドを凍結解除し、動画リプレイを行いながらシミュレーションナビゲーションで一括最適化します。
この3段階の設計は、「目標指向の運動中に世界がどのように見えるか」(スケーラブルな行動なし動画から学習)と「観測された遷移をどの行動が生み出したか」(安価なシミュレーションから学習)を明確に分離しています。
結果
ScaleNavは2つのベンチマークで評価されます。1つ目はShort-Horizon OVON(36のHM3Dシーンにわたる524エピソード)の単一視点適応版であり、HM3D-OVONのターゲットが最初に可視になるフレームに開始ポーズが再配置されることで、タスクはカテゴリレベルの目標へのローカルナビゲーションに帰着します。2つ目はHabitatGS-LNであり、45の未見InteriorGSシーンにわたる157エピソードから成るフォトリアリスティックなHabitat-GSにおいて著者らが新たに構築したベンチマークです。こちらでは、命令がカテゴリのみではなく属性と空間関係によってターゲットを参照します。
ScaleNavはShort-Horizon OVON(単一視点)で86.5%の成功率、HabitatGS-LNで94.9%を達成します。HabitatGS-LNでの高い数値はタスク構造と整合しています — 属性・関係情報に富んだ命令は、初期フレームにおいてより強いgrounding信号をモデルに与えます — 一方、Short-Horizon OVONはカテゴリラベルのみを提供し、類似物体間のより多くの曖昧性解消を要求します。
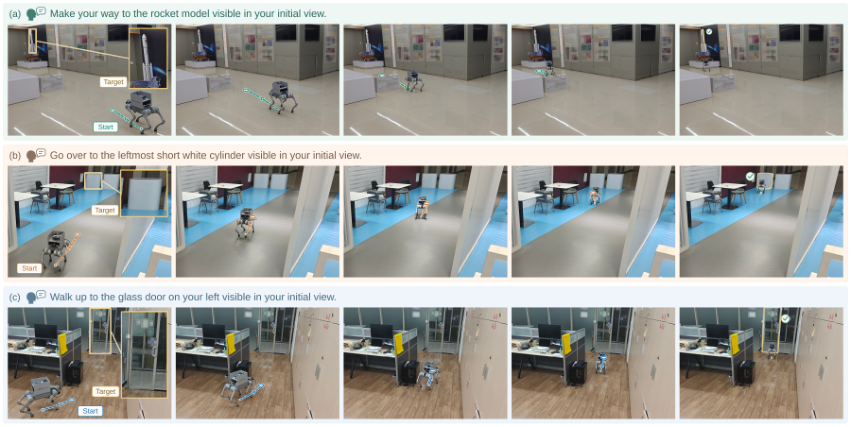
定性的には、同じチェックポイントが展示場・ラウンジ・オフィス環境の四脚ロボットにゼロショットでデプロイされ、「[物体]へ行け」といった命令に従って終了まで動作します。これらのシーンはシミュレートされたHM3D/InteriorGSの室内環境と視覚的に異なっており、インターネット動画事前学習がsim-onlyポリシーには欠如しているリアルな外観の事前知識を転移するという主張を支持しています。
限界とオープンクエスチョン
本論文のスコープはローカルナビゲーションです:ターゲットは初期観測において可視でなければならず、これにより探索・長い時間軸にわたるメモリ・物体の永続性の問題が回避されています。初期フレームアンカーはこのレジームでのみ機能する補助手段であり、複数部屋にまたがるタスクや再同定タスクへの拡張にはより豊かなシーンメモリが必要となります。行動ラベルは依然としてシミュレーションのみから得られているため、シミュレートされたダイナミクスの忠実度(ステップサイズ、衝突挙動)が実ロボットの行動分布の上界となります。報告された実ロボットの結果は定性的なものであり、標準化されたリアルワールドスイートにおける成功率は示されていません。さらに、インターネット動画DiT事前学習の計算コストは定量化されておらず、得られたゲインがどの程度事前学習データの規模から来るのか、チャンク単位の因果的アーキテクチャとアンカーメモリから来るのかは不明です — これらを分離するアブレーションが中心的な主張を明確化するでしょう。
重要性
ScaleNavは、行動なしのインターネット自己視点動画を身体化ポリシーの事前学習に活用するための具体的なレシピを実用化します:まず目標指向の視覚的ダイナミクスを学習し、次に安価なシミュレーションを用いて行動読み出しを追加するというものです。このパラダイムがスケールするならば、sim-to-realギャップを縮めるためにシミュレーションのフォトリアリズムに依存することなく、実ロボットデータのボトルネックを回避する道が開けます。
Source: https://arxiv.org/abs/2610.25690
Hacker News Signals
DeepSeekがその推論エンジンをオープンソース化
DeepSeekは、プロダクション用推論エンジンであるDeepInferをオープンソースライセンスのもとで公開しました。このリポジトリはサービング全体のスタックをカバーしており、KV cache管理、continuous batching、複数GPU間のtensor parallelism、そしてカスタムCUDAカーネルライブラリが含まれています。アーキテクチャの中心は、disaggregatedなprefill/decodeデザインです。prefillとdecodeのフェーズはそれぞれ独立したワーカープールで実行されており、両者の異なる計算特性(prefillはcompute-bound、decodeはメモリ帯域幅bound)を切り離し、独立したスケーリングを可能にしています。これはSplitwiseやDistServeといったPD分離システムが探求したのと同種のdisaggregationですが、DeepInferはそれを研究プロトタイプではなくプロダクション成果物として提供しています。
KV cacheレイヤーはvLLM方式のpaged attentionをサポートしつつ、radixツリーインデックスによるクロスリクエストのprefixキャッシングを追加しており、ユーザーが明示的に設定することなく共有システムプロンプトのキャッシュヒットを実現します。スケジューラはブロック単位でキャッシュ占有率を追跡し、実行中のシーケンスに対する優先度調整を加えたLRUポリシーによってエビクションを行います。
Tensor parallelismはNCCLを通じて実装されており、マイクロバッチをパイプライン化することで通信と計算をオーバーラップさせるカスタムall-reduceカーネルを採用しています。MoEモデル(DeepSeek-V3/R1のアーキテクチャを考えると重要)に対しては、expert parallelismが個別に処理されます。各expertシャードは専用のrankに配置され、ルーティングのgather/scatterはカーネル起動オーバーヘッドを削減するためにall-to-allと融合されています。
量子化サポートには、per-tensorおよびper-channelのFP8、INT8 activation quantization、そしてGPTQ方式のweight-only INT4が含まれます。特筆すべきは、FP8パスが汎用CUTLASSテンプレートを経由せず、H800/H100のハードウェア命令セットを直接ターゲットとしている点であり、これにより抽象化のオーバーヘッドが削減されます。
実務者にとって、DeepInferは特にDeepSeekモデルファミリーに対してvLLMやTGIの信頼できる代替となります。エンジンとモデルの重みが共同設計されているという優位性があり、DeepSeek-V3におけるMLA(Multi-head Latent Attention)のattentionバリアントは後付けではなくファーストクラスでサポートされています。
Source: https://github.com/deepseek-ai/DeepInfer
Timestral: Mistralの時系列基盤モデル
Mistralは、時系列予測と分類を対象とした基盤モデルファミリーであるTimestralをリリースしました。このアーキテクチャは、標準的なTransformerにpatchingを組み合わせたアプローチ(例:PatchTST、Moirai)とは異なり、量子化された時系列tokenに対して自己回帰的に学習されたcausal decoderを採用しています。各観測値は、チャネルごとの統計正規化を伴う学習済みスカラー量子化器によって離散コードブックエントリにマッピングされ、系列の周波数に応じて設定可能な粒度(点レベルまたはpatchレベル)でtokenizeされます。
事前学習コーパスは、金融ティックデータ、IoTセンサーストリーム、気象観測所の記録、エネルギーグリッドにまたがり、モデルがチャネルに依存しない表現を学習する必要があるほど異質なデータで構成されています。メタデータ(系列ID、周波数タグ、タスク種別)へのconditioningは、各コンテキストウィンドウの先頭に付加されるprefixトークンによって処理されます。これにより、単一のチェックポイントがアーキテクチャの変更なしに、ゼロショット予測、few-shot適応、および異常スコアリングを処理できます。
予測においては、量子化語彙に対して自己回帰的に生成が行われ、最終的な連続値はコードブックルックアップと残差補正ヘッドによって復元されます。この手法は、回帰ベースの多くの予測器に組み込まれたガウス出力の仮定を回避しますが、長い予測ホライズンにわたって量子化誤差が蓄積するというコストを伴います。
ベンチマーク結果では、MonashおよびETTベンチマークにおいてChronosやMoiraiと競合するパフォーマンスを示しており、patchベースの手法が劣化する不規則サンプリング設定において特に優れた性能を発揮します。分類ヘッドはUCR/UEAデータセット上で個別にfine-tuningされています。
未解決の問題としては、量子化tokenに対する自己回帰デコーディングが長いホライズンにおいて直接回帰を実際に上回るかどうか(量子化のボトルネックは軽視できません)、また事前学習中に見られた正規化範囲を超える非定常分散を持つ系列をモデルがどのように処理するかが挙げられます。重みはまだ公開されておらず、発表ではAPIアクセスのみが説明されています。
Source: https://mistral.ai/news/timestral/
Mercury 3: 大規模スケールでのDiffusion
Inception Labsは、大規模な商用diffusion言語モデルとして位置づけるMercury 3をリリースしました。核心的な主張は、テキストトークンに対するdiscrete diffusionにより、同等の品質を保ちながらautoregressiveなデコードよりも大幅に高いスループットが実現できるというものです。これは、トークンを逐次生成するのではなく、出力シーケンス全体にわたって並列にdenoisingステップを実行できるためです。
基本的なアプローチはmasked diffusionフレームワークに従っています。学習時には、トークンが様々な確率でマスキングによって破損され、モデルは部分的にマスクされたコンテキストから元のトークンを予測するよう学習します。推論時には、シーケンスは完全にマスクされた状態で初期化され、T ステップにわたって反復的にdenoisingされます。各ステップでは全マスク位置を同時に予測し、高確信度のトークンを確定します。これはMDLMやSEDDと構造的に類似していますが、より大きなスケールで、並列評価をGPU上で効率的に実行するためのエンジニアリング上の工夫が施されています。
スループット上の優位性は原理的には確かです。T \ll L(ステップ数がシーケンス長よりも大幅に少ない)の場合、実際の生成時間は L ではなく T に比例してスケールします。実際には、ステップ数が少ないほど品質が低下するため、トレードオフは特定のタスクでautoregressiveの品質に匹敵するために必要なステップ数に依存します。Inceptionの数値は、GPT-4oクラスのモデルと比較して大幅に低いレイテンシで競合する品質を主張していますが、独立した第三者による評価はアナウンスには含まれていません。
アナウンスではアーキテクチャのサイズ、学習に用いた計算量、またはデータセットの構成についての詳細は示されていません。主なエンジニアリング上の貢献は、バッチ処理されたmasked predictionのためのカスタムCUDAカーネルであり、部分的にマスクされたシーケンスに対して単純にフルフォワードパスを実行した場合のメモリレイアウトの非効率性を回避するものです。
より広い意義は、diffusionベースのLMがスケールにおいてautoregressiveモデルとの残存する品質ギャップを埋められるかどうかにあります。Mercury 3はそのギャップが縮まっていることを示すデータポイントですが、オープンな重みや再現可能なベンチマーク比較がない限り、ベンダーによる主張にとどまります。
Source: https://www.inceptionlabs.ai/blog/introducing-mercury-3
一つのパーサ、二つのバグ、多数のルータ: eCos と Linux をまたぐ Broadcom WiFi の悪用
Quentin Kaiser の解説記事では、Broadcom FullMAC WiFi ファームウェアパーサに存在する二つの脆弱性について詳述しています。この脆弱性は、eCos(組み込み RTOS)と Linux ベースのファームウェアの両方を搭載したデバイスに影響します。両バグは共通の根本原因を持ちます。単一の 802.11 information element パーサが両 OS ターゲット向けのファームウェアイメージにコンパイルされているため、パーサのロジック上の欠陥が製品ライン全体に伝播するのです。
一つ目のバグは、IE(information element)の length フィールド処理における type confusion です。パーサは length バイトを読み取り、それを用いて構造体へのインデックスとして使用しますが、二次的な操作の前に実際のバッファ境界に対する検証を行いません。eCos ターゲットでは、ヒープメタデータがパケットバッファに隣接しているため、過大な length 値によってヒープ freelist ポインタへの制御された上書きが可能となり、コード実行に向けた古典的なヒープ feng shui が実現します。Linux ベースのファームウェアでは、ASLR とヒープ強化により悪用は困難になりますが、特定の SoC バリアントにおけるファームウェアの決定論的ロードアドレスを考慮すれば、不可能ではありません。
二つ目のバグは、SSID フィールドパーサにおける integer truncation です。SSID の長さは uint8_t として読み取られ、符号付き整数オフセットから減算された後、その結果がアロケーションサイズとして使用されます。特定の入力条件下では、減算がラップアラウンドして大きな正の値となり、サイズが過小なヒープアロケーションに続いて線形オーバーフローが引き起こされます。
両バグともに、攻撃対象が WiFi 電波の届く範囲内にあり、スキャンまたはアソシエーションの状態にあるだけで悪用可能であり、事前認証は一切不要です。eCos では ASLR やスタックカナリアがデフォルトで提供されず、ヒープ実装が単純な linked-list アロケータであるため、eCos 経由の攻撃経路はより直接的に悪用可能です。
この記事には eCos 経由の攻撃経路に対する部分的な PoC が含まれており、Broadcom へ通知してパッチが発行されたことも記載されています。しかし、パーサコードはデバイスベンダが配布するバイナリのファームウェア blob に組み込まれており、多くのベンダはいまだアップデートを配信していません。
Source: https://quentinkaiser.be/security/2026/10/16/one-parser-two-bugs/
Harness2 by Google Research: 再帰的エージェントハーネシング
Harness2は、LLMベースのエージェントを再帰的に組み合わせるためのGoogle Researchのフレームワークです。中核となる抽象化は「harness」であり、これはLLM呼び出しを型付きでラップしたもので、入力スキーマ、出力スキーマ、および検証関数を指定します。harnessは合成可能で、あるharnessの出力が別のharnessの入力となり、その合成関係はDAGとして追跡され、フレームワークは失敗時に選択的に再実行することができます。
再帰的な側面として、harnessはサブharnessを呼び出すことができ、パラメータを変更した上で自分自身を呼び出すことも可能です。これにより、分解方法をハードコードすることなく木構造の推論が実現されます。フレームワークはリトライロジック、部分的な失敗からの回復、および出力のメモ化を処理します。各harnessの実行は、入力・出力・検証ステータスとともに完全にログに記録されるため、エージェントチェーンのデバッグが現実的に行えます。
リポジトリによると、実装はPythonで記述されており、各ステップでのスキーマ準拠を強制するために構造化出力API(OpenAI互換)を使用しています。検証関数はユーザーが提供する呼び出し可能オブジェクトであり、ユニットテスト形式で、あるステップの出力を受理するか、リトライもしくはフォールバックブランチをトリガーするかを制御します。これは、LLM呼び出しをtry/exceptで囲んで結果を期待するという一般的なパターンよりも原則に基づいたアプローチです。
このフレームワークは特定のプランニング戦略を規定するものではなく、エージェントアーキテクチャというよりもスキャフォールディングレイヤーです。LangGraphやLlamaIndexのエージェント抽象化と比較すると、Harness2はステップ間のコントラクトについてより明示的であり、スコープはよりミニマルです。ビルトインのツール使用、メモリ、検索機能は存在せず、それらはユーザーが組み合わせるharnessとして実装します。
実用的な価値は、メモ化と選択的再実行にあります。12ステップのエージェントパイプラインをデバッグする際に、ステップ1〜6を再実行せずに修正したプロンプトでステップ7から再実行できることで、イテレーションの時間を大幅に削減できます。
Source: https://github.com/google-research/harness2
自前のLLM proxyを運用していないなら、何が起きているか把握できているのか?
この記事は、開発環境におけるすべてのLLM API呼び出しの唯一の出口点として、ローカルLLM proxy(例:LiteLLM、カスタムFastAPI shim、またはJSONロギング設定のmitmproxy)を運用することを主張しています。技術的な根拠は具体的です:proxyがなければ、異なるモデルやライブラリをまたいだプロンプト、completion、レイテンシ、トークン数、エラーレートの統一されたログが存在しません。各SDK(OpenAI、Anthropic、LangChainなど)はそれぞれ独自のロギングインターフェース、コールバックシステム、およびオブザーバビリティの仕組みを持っており、それらは相互に統合されません。
localhost:4000(LiteLLMのデフォルト)またはカスタムエンドポイントにproxyを置くことで、単一のキャプチャポイントが得られます。すべてのリクエスト・レスポンスをSQLiteまたはPostgresにロギングしたり、OpenTelemetryスパンを発行したり、ヘッダーを注入したり、A/Bテスト用にモデル名を書き換えたり、レートリミッターを挿入したりすることが、アプリケーションコードを変更することなく可能になります。またproxyにより、プロバイダー間の切り替え(OpenAI、Azure OpenAI、ローカルのOllama)がコード変更ではなく設定変更で行えるようになります。
この記事では、SQLiteロギングとモデルごとのレイテンシパーセンタイルおよびトークン消費量を表示する最小限のGrafanaダッシュボードを用いた具体的なLiteLLMのセットアップを順を追って解説しています。セキュリティ上の論点は副次的ではあるものの実質的です:依存ライブラリが何を送信しているかを正確に検査できることは、内部でプロンプトを構築するサードパーティのエージェントフレームワークを使用する際に重要になります。
チームにとっては、APIキー管理を備えた共有proxyにより、プロバイダーのダッシュボードに頼ることなくユーザーごとまたはサービスごとのトークン消費量を追跡できます。プロバイダーのダッシュボードは往々にして遅延があり集計された情報しか提供しません。運用コストは低く、LiteLLMは単一のDockerコンテナで動作し、proxy overhead は約2msです。
Source: https://jrdsgl.com/if-you-dont-run-your-own-llm-proxy-how-the-fuck-do-you-even-know-whats-going-on/
Show HN: Sphinx – AIが生成したコードをshippingする前にクイズで確認するhook
Sphinxは、ステージされた変更をインターセプトし、diffをLLMに送信して、commitの実行を許可する前にコードに関する理解度確認の質問を生成するgit pre-commit hookです。開発者はcommitを完了するために、正しい回答を行う必要があり(second LLM callによって評価されます)、その評価に合格しなければなりません。明示された目標は、AI生成コードがversion controlに入る前に開発者がそれを理解していることを強制することです。
実装はシェルスクリプト/Python hookであり、ステージされたファイルをdiffし、token budgetに合わせて切り詰め、ロジック・エッジケース・特定のコードセクションの目的についての3〜5問の質問を生成するようOpenAI互換エンドポイントにリクエストを送信します。回答は完全一致ではなくセマンティックな正確さで評価され、pass/fail JSONを返すgrading promptが使用されます。不正解の場合はcommitがブロックされ、正しい説明が表示されます。
技術的な興味深い点はgrading promptの設計にあります。コードの説明に対して完全一致による評価は脆すぎるため、graderは回答が参照文字列と一致するかどうかではなく、主要な概念への理解を示しているかどうかを評価するようpromptされています。これはLLM-as-judgeの小さな事例であり、それに伴う信頼性に関する注意事項をすべて含んでいます。
制限は明らかです。開発者は表面的な回答をすることが可能であり、自信ありげに聞こえる誤った回答でgraderを騙せる可能性があり、またhookはすべてのcommitにlatencyを追加します。質問はdiffから生成されるため、コードベース全体のコンテキストからではなく、既存コードとの相互作用を問うことはできません。AI出力を読まずにrubber-stampすることが問題であるチームに対しては、Sphinxは深い理解を強制することはできないとしても、行動を変化させる可能性のある摩擦コストを課すものです。
Source: https://sphinx-six-theta.vercel.app/
Tmux と Claude Code: Sessions、Send-Keys、そしてその限界
この記事は、tmux を制御レイヤーとして使用し、Claude Code(Anthropic のエージェント型コーディングツール)を永続的でスクリプト可能なセッションで実行するための詳細な技術ガイドです。核心的なテクニックは tmux send-keys です。名前付きウィンドウにキーストロークを注入することで、インタラクティブなターミナルセッションをプログラム的に操作できるため、GUI やカスタム API インテグレーションを必要とするような複数ステップのエージェントワークフローをスクリプト化できます。
実用的なセットアップとしては、タスクごとに名前付き tmux セッションを作成し(tmux new-session -d -s task_foo)、各セッションに Claude Code をアタッチし、コントローラスクリプトから send-keys を使ってプロンプトを発行します。その後、エージェントが安定するのを待ち(tmux capture-pane でペイン出力をポーリングすることで検出)、フォローアップコマンドを発行したり結果を取り出したりします。これは Unix プリミティブだけで構築された、簡易的なエージェントオーケストレーションレイヤーです。
タイトルにある「限界(ceiling)」とは、次のような制約を指しています。capture-pane が返すのはレンダリングされたターミナル出力であり、構造化データではないため、エージェントの状態をパースするには脆弱な文字列マッチングが必要になります。イベントシステムは存在せず、ポーリングのみです。並列処理は可能(複数セッション)ですが、セッション間の協調には外部状態(ファイルや Redis のキーなど)が必要です。Claude Code 自身の context window の制限により、長いタスクでは send-keys で要約プロンプトを注入するなど、手動でのコンテキスト管理が必要になります。
こうした制約にもかかわらず、このアプローチはバッチ実験や自動リファクタリングタスクの実行において実用的な価値があります。エージェントに無人で動作させつつ、監査証跡を残したい場合に特に有効です。Tmux のセッション永続化により、SSH 切断が発生してもエージェントは動作を継続でき、tmux pipe-pane を使えばエージェントの環境を変更することなくファイルへの継続的なログ記録が可能です。
注目の新しいリポジトリ
malevrigns/agent-jev
AgentJev-0.6B は、エージェンティックパイプラインにおける「System One」決定プリミティブとして位置付けられた、パラメータ数0.6Bの特化型モデルです。核心となる設計上の制約は、出力トークンのデコードをゼロにすることです。つまり、テキストを自己回帰的に生成するのではなく、任意の非構造化コンテキスト(git diff、スタックトレース、ログストリーム)を構造化された質問と連結したものに対して単一の forward pass を実行し、ロジット出力から直接、離散的な選択肢集合上のキャリブレーション済み確率分布を返します。クエリあたりのレイテンシはおよそ50msと報告されており、ループ外のLLM呼び出しではなく、ループ内の分類器として実用的です。キャリブレーションに関する主張は、予測確率が単なるランキングではなく信頼スコアとして意味を持つよう、学習後に温度スケーリングまたはPlattスケーリングが適用されていることを示唆しています。0.6B というスケールは標準的なチャットモデルを下回っており、アーキテクチャが生成ではなく分類・スコアリングタスクに特化して fine-tuning されていることを示しています。これは、大規模なオーケストレーターLLMを二値あるいは低カーディナリティのルーティング決定(ルーティング、エスカレーションゲーティング、異常フラグ付けなど)に使うのが非効率となるマルチエージェントシステムにおいて有用です。トレードオフとして、このモデルは用途が狭く、確率出力の範囲を超えて自身の決定を説明することができません。また、分布外の入力ではキャリブレーションが不十分なスコアを返す可能性があります。
Source: https://github.com/malevrigns/agent-jev
StartLuxLabs/StartLux-Decision
0.8Bから27Bパラメータまでをカバーするオープンな決定モデルファミリーであり、すべて同一の推論インターフェースを共有しています。1回のforward passで各選択肢に対するキャリブレーション済み確率を出力し、加えてモデルの信頼度が閾値を下回った場合にのみ条件付きで短いchain-of-thoughtトークン列を生成します。この条件付き推論ゲートにより、容易な決定においてはデコードのレイテンシを回避しつつ、困難な判断においては解釈可能性を保持します。このスイートは3つのランタイム向けのエンジンを提供しています。すなわち、スループット最適化・テンソル並列サービングのためのvLLM、CPU/エッジ向けの量子化推論のためのllama.cpp、そしてApple Silicon向けのMLXです。0.8Bから27Bというレンジにより、実務者はレイテンシ予算とハードウェアに応じてモデルのサイズを選択できます。このスケールレンジ全体でキャリブレーションを行うことは自明ではなく、大規模モデルは過信(overconfidence)になりやすい傾向があるため、スケールごとのキャリブレーション手続きが適用されていると考えられます。条件付き思考出力はアーキテクチャ上興味深い点であり、これは学習済みの信頼度推定器が2次的なデコードパスをゲーティングすることを示唆しており、生成レベルにおけるspeculativeデコードやMoEルーティングに類似しています。主なユースケースは単一モデルの決定APIと同様であり、エージェントルーティング、構造化分類、preference scoringなどが挙げられますが、スケールのラダー構造により、単一モデルの代替手段では実現困難なデプロイメントの柔軟性が加わっています。
Source: https://github.com/StartLuxLabs/StartLux-Decision
strands-labs/strands-decider
Strands Decider は、エージェント的な意思決定ステップに向けて設計された、コンパクトかつレイテンシ最適化されたモデルです。離散的な選択肢の集合または数値スケールが与えられた場合、自己回帰的なデコードのオーバーヘッドなしに、単一の inference パスで選択結果と calibrated な信頼スコアを返します。「System One」(高速・反射的)対 完全な LLM の「System Two」(熟慮的・トークン逐次生成)という枠組みは操作的に正確です――このモデルは推論チェーンを置き換えるためではなく、エージェントループ内の条件分岐やヒューリスティックな閾値を置き換えることを意図しています。plain な分類器に対する主要な差別化要因は calibrated な信頼度です。適切に calibrate されたスコア 0.72 は、calibration 分布全体でモデルがおよそ 72% の確率で正解することを意味し、下流のコンポーネントがプログラム的に決定閾値を適用できるようになります。このリポジトリはエージェント的なワークフロー統合を対象としており、tool-calling パターンと互換性のある API ファーストな設計を示唆しています。StartLux-Decision と比較すると、これはスケールファミリーではなく単一の小型モデルであり、最小限のフットプリントに最適化されているように見えます。この種のモデル全般に共通する主な限界は分布シフトです。入力ドメインが学習データから乖離すると信頼度の calibration が劣化し、モデルが未知の未知を通知するための組み込みメカニズムが存在しません。
Source: https://github.com/strands-labs/strands-decider
kividbio/kividb
KividDBは、Rustベースのインメモリデータストアであり、Redis Serialization Protocol(RESP)を実装しています。これにより、アプリケーションレベルの変更なしにRedisおよびValkeyクライアントのドロップイン代替として機能します。ストックRedisに対する主な差別化要素は、モジュールとしてではなくエンジンに直接組み込まれたネイティブの全文検索とベクトル類似度検索です。RustによるマルチスレッドによってRedisのシングルスレッドコマンド処理のボトルネックを回避し、所有権モデルはDragonflyや類似の再実装が確立したパターンに従い、共通パスでのロックなしにデータ競合を排除します。ベクトル検索の統合はアーキテクチャ上重要な意味を持ちます。KividDBをキャッシュと検索インデックスを統合したシステムとして位置づけることで、RAGパイプラインにおける別途のANNレイヤー(例:Faissサイドカー)の必要性を取り除きます。全文検索は、キーバリューストアと並行してインプロセスに格納された転置インデックス構造(BM25または類似手法)を使用している可能性が高いです。RESP互換であるため、既存のRedisクライアントライブラリ(redis-py、StackExchange.Redis、Jedis)は変更なしに接続できます。Rustによる実装は、競争力のあるレイテンシとメモリ安全性を提供するはずです。未解決の問題としては、永続化の保証(AOF/RDB相当)、クラスター/レプリケーションのサポート、およびベクトルインデックスがHNSWまたはフラットな全数探索をサポートするかどうかが挙げられます。
Source: https://github.com/kividbio/kividdb
storytold/effectcraft
EffectCraftは、After Effectsのような商用ソフトウェアが残したツール空白を埋めることを目的として、純粋なRustでゼロから書かれたモーショングラフィックス・コンポジティングアプリケーションです。「ゼロから」という表現は、OpenFXやGStreamerのような既存のコンポジターをラップするのではなく、カスタムのレンダリングパイプラインを構築していることを意味します。純粋なRustという点から、レンダラー・シーングラフ・タイムライン・UIのすべてが、既存のグラフィックスフレームワークへのC/C++バインディングなしに実装されていることが示唆され、技術的に非常に野心的な試みです。コンポジティングパイプラインは、レイヤーブレンディング・マスキング・トランスフォーム階層・キーフレーム補間を扱うものと考えられます。モーショングラフィックスという用語は特に、単純な映像レイヤーのコンポジットにとどまらず、パラメトリックなシェイプアニメーション・テキストアニメーション・プロシージャルエフェクトを含意しています。7,480のスターを獲得していることから、スケルトン的な実装ではなく相当量の実装が存在することが示唆され、大きな注目を集めています。技術的に注目すべき点としては、どのGPU抽象化レイヤーが使用されているか(RustにおけるデファクトスタンダードはVulkan/Metal/DX12バックエンドを提供するwgpu)、ノードベースまたはレイヤーベースのコンポジションモデルがデータモデル上でどのように表現されているか、そしてレンダリングがCPUバウンドかGPUアクセラレーション対応かといった点が挙げられます。純粋なRustスタックはメモリ安全性を提供するとともに、ブラウザベースのデプロイメントを対象としたWASMコンパイルの可能性も開きます。
Source: https://github.com/storytold/effectcraft
storytold/designcraft
DesignCraftは、FigmaやAffinity Publisherに相当するページ・レイアウトデザインエディタであり、Rustによってゼロから完全に実装されています。レイアウトデザインには、フレーム・ベクターシェイプ・高度なテキストレイアウト(合字、双方向テキスト、可変フォント)を備えたタイポグラフィ・制約ベースのリサイズ・印刷およびスクリーン形式へのエクスポートをサポートするドキュメントモデルが必要です。これをRustでゼロから実装することは相当な取り組みであり、テキストシェーピングだけでも通常はHarfBuzzに委譲されます。そのような依存関係を一切排除するという判断は、Unicodeセグメンテーション・スクリプト検出・グリフレイアウトを内部で実装することを意味します。あるいは、「pure Rust」はC/C++のアプリケーションコードを使わないという意味であり、システムライブラリをラップするRust crateの利用は許容される可能性もあります。4,511のスターは、コミュニティから有意なトラクションを得ていることを示しています。システムズの観点から興味深い設計上の選択肢としては、retained-modeなシーングラフ構造、レイアウトにflexboxスタイルの制約ソルバー(Taffy/Stretchに類似したもの)を使用しているかどうか、そして協調編集やバージョニングをどのように上位レイヤーに組み込むかが挙げられます。EffectCraft(storytold)と同じGitHub organizationを共有していることは、共通のレンダリング基盤を持つことを示唆しており、アーキテクチャ上の合理性があります。両ツールともベクターレンダリング・ベジエ曲線・GPUコンポジットステージを必要とするためです。
Source: https://github.com/storytold/designcraft
ollaya-dev/ollaya
Ollayaは、OllamaのUXパターン(pull・serve・ローカルでの query)を踏襲しつつ、生成系LLMではなく意思決定モデルを対象としています。サポートされているモデルクラスは、Laya(未指定の意思決定モデル)、Decider(StrandsまたはそれとClass類似のクラスと思われる)、NLI(Natural Language Inference、テキスト含意分類器)、およびGLiClass(Generalist and Lightweight Class prediction、ゼロショット分類アーキテクチャ)です。これらはすべてTypeSafe互換のAPIを通じて提供されており、クライアント側ではモデルの入出力コントラクトに対応した生成済みスキーマによるTypeScriptの型安全性が確保されます。技術的な価値は統一化にあります。モデルクラスごとに個別の推論サーバーを立ち上げる代わりに、Ollayaは単一のデーモンがモデルのライフサイクル(ダウンロード、量子化の選択、メモリ割り当て)を異種分類モデルファミリー全体にわたって管理します。NLIとGLiClassは特に、生成系LLMを使うと無駄が生じるようなゼロショットテキスト分類タスクにおいて有用です。アーキテクチャはおそらく、モデル実行にllama.cppまたは類似のランタイムをラップし、リクエストをロード済みの適切なモデルにディスパッチするルーティング層を追加した上で、TypeScriptの型定義を備えたREST/JSON APIを公開する構成になっています。主なユースケースは、クラウドAPIを使わずに高速かつプライベートな分類を必要とするローカルのエージェント的パイプラインです。
Source: https://github.com/ollaya-dev/ollaya
mrsarac/ff-tracking
ff-trackingは、AIエージェントの画面アクティビティを撮影する仮想カメラシステムを実装したクリエイティブ・テクニカルなプロジェクトであり、グリフレベルのトラッカーが個々のレンダリングされた文字に追従します。レンダリングパイプラインは2つのFframesパス(ジオメトリパスとコンポジットパス)を実行し、単一のSkSL(Skia Shader Language)シェーダーが視覚効果を処理します。オーディオはサンプリングではなく完全に合成によって生成されます。ここでの技術的な深みはトラッカーにあります。エージェントの画面が変化する中で、すべてのグリフに追従するには、テキストが折り返されたりエージェントが入力したりする際のフレーム遷移を通じて、個々の文字のバウンディングボックスを検出・追跡する必要があり、これは自明ではないトラッキング問題です。シェーダー言語としてのSkSLは、SkSL シェーダーがポストプロセシング効果のためにGPU上で実行されるSkia/FlutterまたはChromeのレンダリングコンテキストにこのプロジェクトを位置づけています。「仮想カメラ」のメタファーは、モーション、被写界深度、またはパラレックス効果をシミュレートしたカメラが2Dスクリーン録画に適用され、エージェントの動作を映画的に表現することを意味しています。2パスアーキテクチャ(おそらくパス1でジオメトリ/深度、パス2でシェーディング/コンポジット)により、単一パスでは利用できない深度情報を必要とする効果が実現可能になります。これはクリエイティブコーディングとエージェント観測ツールの交差点に位置するプロジェクトです。