デイリーAIダイジェスト — 2026-10-09
arXiv ハイライト
AgentGarten: エージェントを進化させるためのコード世界
AgentGartenは、状態の進化と視覚的なレンダリングを分離したリアルタイムかつインタラクティブな仮想世界を構築するためのフレームワークです。その動機は、エージェント学習における根本的な緊張関係にあります。純粋なシミュレータ(MuJoCo、Isaac、ゲームエンジン)は忠実なダイナミクスをもたらしますが観測の視覚的リアリティに欠け、映像ワールドモデルはリアルなフレームを生成しますが動力学が生成ピクセルの中に埋め込まれているため状態がドリフトします。AgentGartenは前者を保持しつつ、レンダラーを複数の世界で共有されるジオメトリ条件付きニューラルモデルに置き換えます。
定式化
コード世界とは(p, \text{engine}, R_\theta)のタプルです。シーンプログラムpはジオメトリ、関節構造、およびインタラクションルールを定義し、エンジンは状態とカメラを次のように進めます:
(s_{t+1}, \pi_{t+1}) = f_p(s_t, \pi_t, a_t), \qquad c_t = h_p(s_t, \pi_t),
これにより構造化条件c_t(視点\pi_tにおけるカメラからの表面法線または深度)が生成されます。ニューラルレンダラーは実際の観測を次のように生成します:
x_t = R_\theta(x_{<t},\, c_{\le t},\, x_0,\, y),
外観参照x_0とテキストキャプションyに条件付けられています。重要な点として、f_pはx_tを消費しません。つまり、レンダリング誤差が状態に漏れ込むことはありません。同じ記録済み軌跡は、イベントを変えることなく異なるx_0やカメラの下で再レンダリングできます。
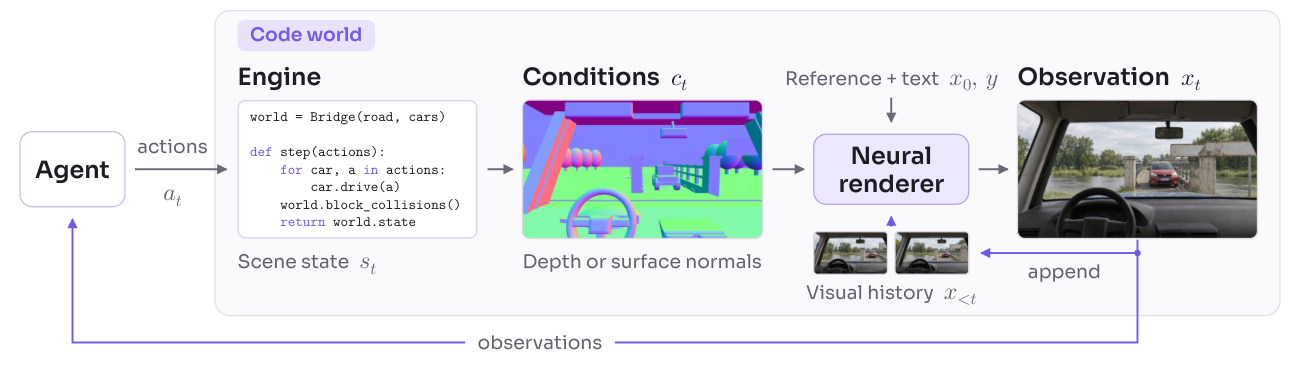
この因数分解により、コーディングエージェントのパイプラインが単一の参照画像から世界を構築することも可能です。知覚・生成モデルがツールとして呼び出され、シーンプログラムが作成され、ロールアウトのチェックによって修正が行われます(Figure 2)。
レンダラーとAdversarial Forcing
レンダラーはCosmos 3-Nanoから初期化された自己回帰ブロック因果映像モデルです。蒸留時にキャプションKVをstudent、teacher、fake-scoreネットワーク間で共有できるよう、理解(UND)タワーは凍結されて生成(GEN)タワーから分離されています。凍結されたWan映像オートエンコーダがRGBとジオメトリの両ストリームのlatentを提供します。外観参照x_0はクリーン(ノイズ除去済み)フレームとして保持されます。
学習は3段階で進行します:(i) 双方向バックボーンへのジオメトリ条件付け、(ii) ブロック因果ロールアウトへのteacher-forcing適応、そして(iii) 長期的安定性に関する本論文の主要貢献であるAdversarial Forcingです。
Self Forcingはオンポリシーロールアウトを蒸留しますが、以前のブロックのKVキャッシュをdetachするため、フレームtからのgradientが先行フレームのエンコード方法に流れ込まず、長距離記憶の誤差が修正されません。Adversarial Forcingはexact replayを追加します。ロールアウトはdetachされたキャッシュで一度実行(推論の計算構造を保持)され、その後履歴のkeys/valuesがgradientを保持した状態で再計算されます。queryへのstop-gradientにより、ブロックiの予測に対するlossが履歴のエンコードのみを更新し、そのqueryパスは更新されず、元のロールアウトのlogitsと正確に一致します。
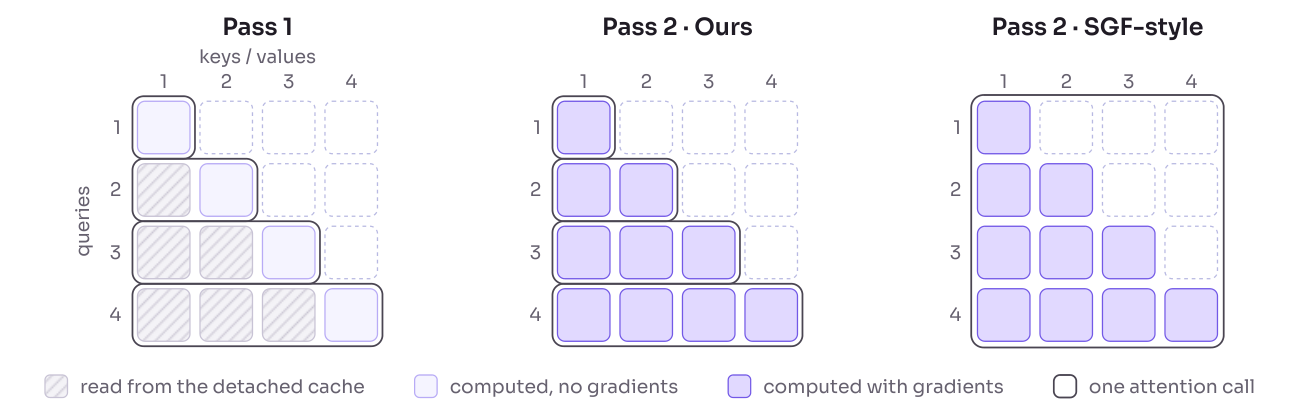
DMDスタイルの分布マッチングをteacherに対して行うことに加え、Adversarial Forcingは実際の映像クロップを正例として生成ロールアウトに対するGAN lossを追加します。これにより、teacherスコア単独では提供されない高周波テクスチャの教師信号が供給されます。
結果
主要な定性的証拠は、同一条件軌跡における30秒のロールアウトです(Figure 7、Section 4.1で議論)。Self Forcingのロールアウトは時間経過とともに繰り返しの表面パターンが現れ細部が失われますが、Adversarial Forcingは20秒および30秒時点でも自然なテクスチャと細部を保持します。測定には単一H100、BF16、480\times832出力、4つのlatentフレームのブロック、4ステップサンプラーを使用しており、これはリアルタイムインタラクションと整合する構成です。
共有レンダラーは5つのコード世界(ナビゲーション、マニピュレーション、ツール使用、1つの状態を共有する2つの一人称エージェントによるレーシング、マルチエージェントインタラクション)を提供するほか、ブラウザ上にデプロイされたゲーム(ボーリング、ペナルティシュートアウト、コンテナ跳躍パズル)もキーボード・マウス・ゲームパッド入力で動作します。状態が明示的であるため、任意のロールアウトを新しいスタイルや新しいカメラから再レンダリングできます。本論文のエージェント実験では、知覚がレンダリングされたストリームのみのエージェントによる隠れん坊を、4つの追加世界にわたってラウンドごとに繰り返し改訂する形で取り上げています。
限界
著者らは条件付けインターフェースについて率直に述べています。深度と法線の映像は冗長であり、剛体の動きはいくつかのポーズパラメータに過ぎないにもかかわらず、条件はピクセルとフレームにわたってその完全な表面を再現します。また、空間的ダウンサンプリングにより、制御に重要な細い構造や狭い接触点が失われます。ジオメトリは状態を一意に決定しない場合もあります。例えば、マーキングの描かれた回転対称な物体は深度・法線の変化なしに回転できます。材質や同一性は表現されません。視覚的履歴はこれらの属性を保持しますが、長期的な遮蔽やメモリウィンドウの超過後に失われます。コンパクトな代替案(属性やインタラクション状態のための構造化テキスト、またはエンジン状態と整合する高次元latent)が未解決問題として指摘されています。また、本論文では標準的な映像品質指標(FVD、PSNR)や生のシミュレータでの学習と比較した定量的なエージェント性能の差異は報告されておらず、示された比較は定性的な長期ロールアウト安定性とreplay精度にとどまります。
この研究の意義
忠実なダイナミクスと共有のリアリスティックなレンダラーを分離することは、エージェント学習においてモノリシックな映像ワールドモデルよりもクリーンな因数分解です。なぜなら、政策に関連する状態がレンダリングのドリフトによって破損せず、同じエンジン軌跡を追加のシミュレーションコストなしにドメインランダム化のために再レンダリングできるからです。Adversarial Forcingのexact-replayのトリックは、長期的な記憶が重要な場面でブロック因果映像モデルを蒸留する際に再利用可能な技術です。
Source: https://arxiv.org/abs/2610.12374
TokenRouter: トークンレベルLLMルーティングのための効率的なサービングシステム
問題
トークンレベルのLLMルーティング — デコードの各ステップで、複数のモデル(例えば、小規模なドラフトモデルと大規模な検証モデル)のうちどれが次のトークンを出力すべきかを決定する手法 — は、粗粒度なセッションレベルまたはクエリレベルのルーティングを超えたコスト・品質のパレートフロンティアを押し広げる可能性があります。CITER、R2R、R-Stitch、Co-LLM、MEといったアルゴリズムはその品質向上を実証してきましたが、それらのリファレンス実装は、continuous batchingを持たない単一リクエストの推論ループ(CITER、R2R)か、アドホックなマルチサーバー構成(Co-LLM)のいずれかです。並行負荷のもとで効率的にサービングするには、vLLMやSGLangといった単一LLMエンジンが想定していなかった、システムレベルの2つの病理的問題が露わになります。
- ステップの非同期化。 ルーティングされた異なるリクエストが、異なるデコードステップで異なるモデルに到達するため、通常の「バッチ内のすべてのリクエストがロックステップで進行する」という不変条件が崩れます。スケジューラを単純に結合すると、モデルがピアを待つためにアイドル状態になります。
- バッチアドミッション遅延。 リクエストが生成の途中でハンドオフされると、対象モデルの次のバッチアドミッションウィンドウを待たなければなりません。ハンドオフが繰り返されるとこのレイテンシが累積し、大規模モデル上の小さなバッチはスループットを著しく低下させます。
手法
TokenRouterの組織化原則はリクエスト中心のプログラミング、モデル中心の実行です。開発者は各ルーティングアルゴリズムを、1つのリクエストの視点からトレースされた順次的なライフサイクルとして記述します。
\textbf{receive} \to \text{decode} \to \textbf{route} \to \textbf{send} \to \text{peer receive} \to \text{peer decode} \to \cdots
実装すべきコールバックは3つだけです。route(このリクエストはモデルを切り替えるべきか、またどのモデルへか)、send(どのような状態 — 例えば直近に生成されたトークン — を伴うか)、receive(受信したコンテキストをどのようにローカルのKV状態に受け入れ統合するか)。これだけで、CITERの信頼度閾値ルーティング、R2Rの学習済みrouter、R-Stitchのドラフト/検証stitching、Co-LLMのアンサンブルgating、MEのマルチモデルmixingを表現するのに十分です。
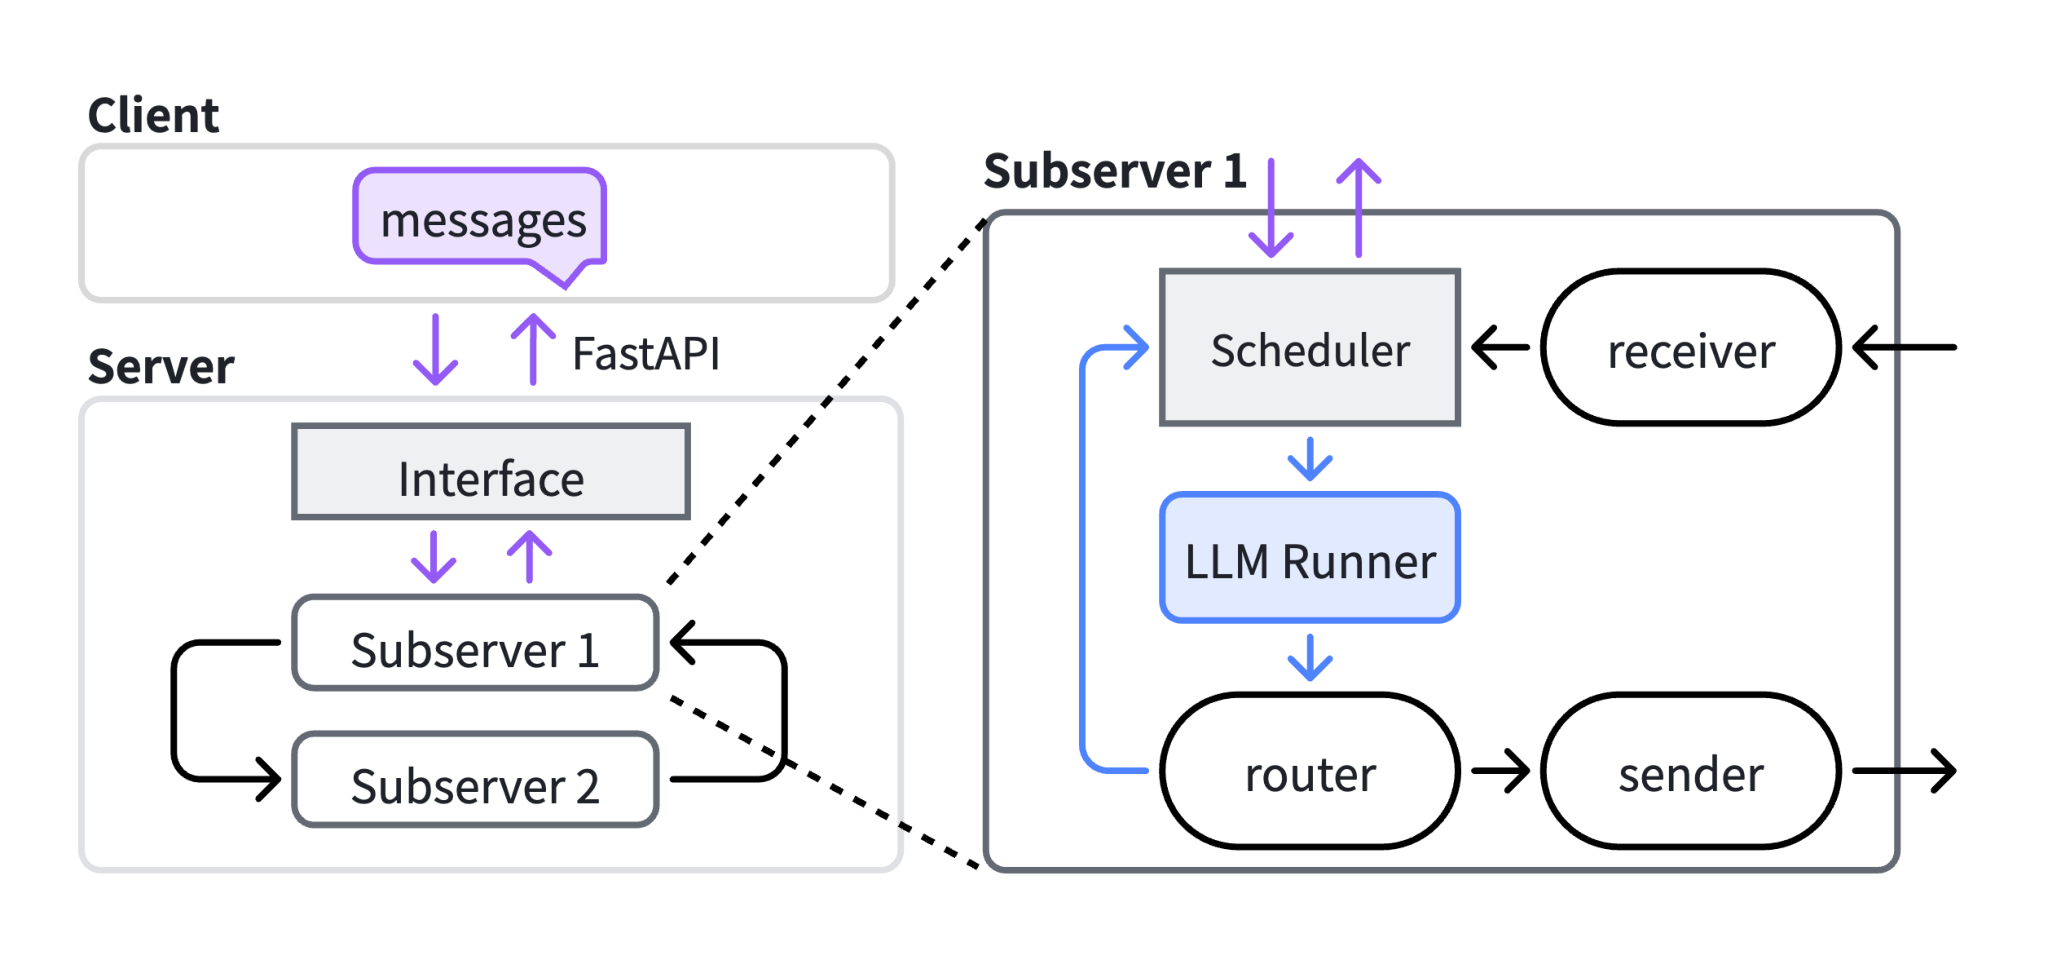
内部では(Figure 2b)、各候補LLMが独自のスケジューラ、LLMランナー、プライベートなKV-cacheプール、および3つのユーザーコールバックを含むsubserverを持ちます。Subserverは独立して処理を進め、内部プロトコルを通じてピアリクエストを交換します。外部からはTokenRouterはOpenAIスタイルの単一エンドポイントを公開し、vLLM/SGLangクライアントとのdrop-in互換性を持ちます。
2つのメカニズムがシステム上の病理的問題に対処します。
- ハンドオフ-レジュームを伴う非同期トライループ実行。 各subserverは3つの分離されたループ(アドミッション、フォワード、ルーティング/ディスパッチ)を実行するため、モデルAからモデルBへのハンドオフがAの次のステップを停止させません。ハンドオフ-レジュームメカニズムは、必要なKV/コンテキストスライスを
send/receiveを通じて伝達するため、Bはアルゴリズムが要求する以上の再計算なしに生成を再開できます。 - 遅延バッチング。 新規(または返却)リクエストを即座に受け付けるのではなく、各subserverは短時間待機してより大きな同一モデルバッチを蓄積します。スケジューラはモデルごとのアドミッション閾値B_iでパラメータ化されており、B_i個のリクエストがキューに入るかタイムアウトが経過した時点でsubserverが発火します。論文ではスループットモデルから最適なB_iを解析的に導出し、予測を実験的に検証しています。
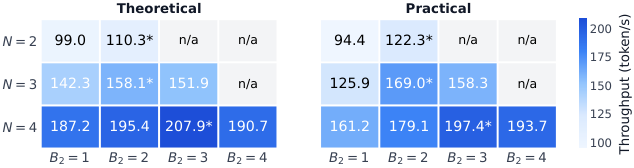
Figure 10は、解析モデルが様々な並行性レベルにわたって実測スループットを精密に追跡すること、および最適なB_1(アスタリスクで示される)が負荷に応じてシフトすることを示しており、B_1を静的定数ではなく並行性の調整済み関数とすることを正当化しています。実装はSGLangの上に構築されており、subserver内部の作業についてはそのKV-cache管理とcontinuous batchingを継承しています。
実験
評価は5つのルーティングアルゴリズムを対象としています。CITER、R2R、R-Stitch、Co-LLMはQwen3-0.6BとQwen3-32Bの間でルーティングを行い、MEはQwen3-0.6B/8B/32Bの間でルーティングを行います。ハードウェアは8×A100-80Gノードで、2モデル構成では小規模モデルを1枚のGPUに、32BモデルをTensor parallelismで2枚のGPUに配置し、CUDA MPSを介して2枚のGPUを共有します。ワークロードは、低労力推論(AIME2024、最大2048出力トークン)、高労力推論(AIME2024の8192トークンを超えるソリューションにフィルタ、最大8192)、エージェント的なSWE-Smithトラジェクトリ(入力約8192、出力1024)をカバーします。
ベースラインは、(i) 各アルゴリズムの公式コード(利用可能な場合 — Co-LLMはcontinuous batchingを伴うモデルごとのvLLMを使用し、CITERとR2Rは単一リクエストエンジン)、および (ii) Std. Serving(1トークンずつルーティングする外部ディスパッチャーを用いてLLMごとに1つのSGLangサーバーを使用する、SGLangベースの公平なベースライン)です。スループットは、N人のワーカーがそれぞれ完了時に新規リクエストを発行する設定のもと、壁時計時間で割った総生成出力トークン数として測定されます。
選択されたセクションでは見出しとなる数値よりもセットアップの説明に重点が置かれていますが、このシステムはStd. Servingを主に(a) インプロセスのピアリクエストによるトークンごとのディスパッチャーラウンドトリップの排除、および(b) 並行性下での遅延バッチングによる大規模モデルのバッチサイズの回復、によって上回る位置づけです。
限界と未解決の課題
- 最適なB_iは並行性とワークロードの組み合わせに依存しており、導出は安定した到着パターンを仮定しています。バースト的または敵対的なルーティングパターン下での挙動は、引用されたセクションでは示されていません。
- subserver間でのKV-cacheの複製はGPUメモリをモデル数に応じてスケールさせます。MPSによる同一GPU配置のトリックは2枚のGPU上の2つのQwen3モデルでは機能しますが、一般化は自明ではありません。
- この抽象化はルーティングをリクエストごとに表現できることを前提としており、バッチ全体にわたって共同決定を行うアルゴリズム(例えば、グローバルな投機的スケジューリング)は
route/send/receiveに綺麗に収まりません。 - 異種リクエスト混在下でのフェアネスとテールレイテンシは、引用部分では扱われていません。
なぜこれが重要か
トークンレベルのルーティングは、おもちゃの推論ループの上で語られるアルゴリズムの話でした。TokenRouterは、ステップの非同期化とバッチアドミッション遅延に正面から向き合った初めてのサービングシステム的取り組みであり、5つの異なるルーティングアルゴリズムが1つのランタイムを共有できるほど洗練された抽象化を提供しています。トークンレベルルーティングによるパレート的な品質向上が本番環境の並行性においても維持されるならば、このようなシステムこそが、論文と実際のデプロイメントの間に欠けているピースです。
Source: https://arxiv.org/abs/2610.12242
トレースからエージェント的世界へ:インタラクティブ環境シミュレーションのためのAgentic Language World Models
問題設定
LLMエージェントの訓練・評価は、複雑な環境(オペレーティングシステム、ウェブサイト、SWEリポジトリ、エンタープライズポータルなど)の忠実な複製に対する依存度が高まっています。これらの環境を実行可能なシミュレータとして再構築することは、多くの場合実現不可能です。背後にあるシステムはプロプライエタリであったり、シリアライズが困難な形で状態を持っていたり、あるいは単に利用できなくなっていたりするからです。LLMに「環境を演じるよう」求めるプロンプトベースのlanguage world models(LWMs)には、既知の失敗モードがあります。それらは局所的には尤もらしい観測を生成しますが、一貫した状態からの乖離が生じるため、それらに対して収集された長期的な軌跡は実際のシステムの忠実なロールアウトにはなりません。本論文は、記録されたインタラクションのトレースのみが与えられた場合に、マルチターンのエージェント評価と再現に十分なほど忠実なステートフルなlanguage world modelを構築できるかを問うものです。
手法:Trace2Env
Trace2Envは学習不要なフレームワークであり、(i)トレースから再利用可能な環境ワールドブックをオフラインで再構築するフェーズと、(ii)そのワールドブックとエピソード状態を用いて各アクションに応答するオンラインのworld model agentフェーズを分離しています。
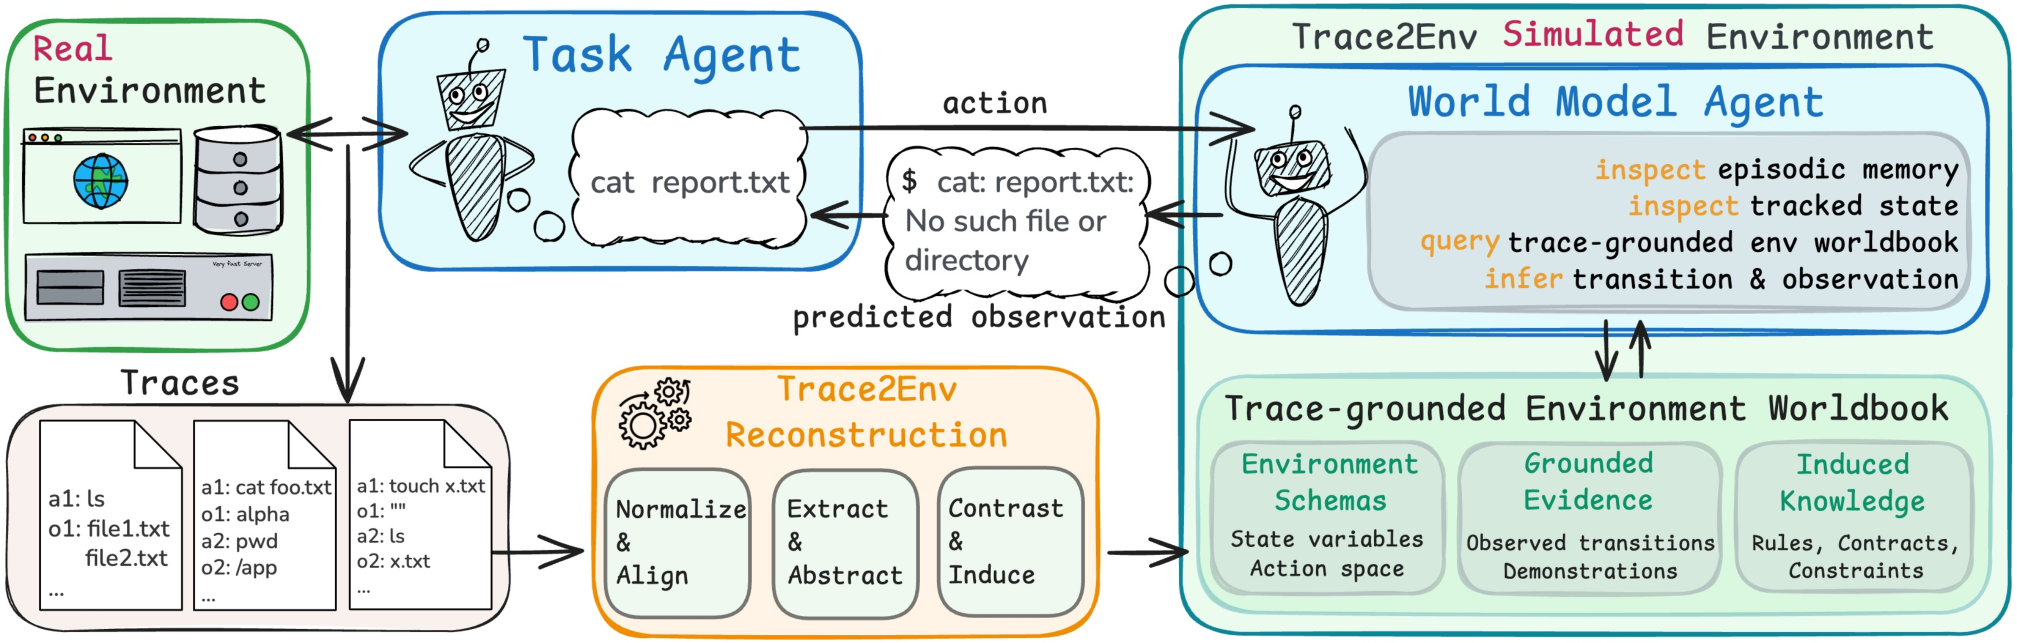
オフラインでのワールドブック構築。 構築用トレース \mathcal{D}_{\text{build}} が与えられると、コンストラクタ \phi が
K_{\mathcal{E}} = \operatorname{Construct}_{\phi}(\mathcal{D}_{\text{build}})
を生成します。K_{\mathcal{E}} は四つのコンポーネントから構成されます。(1)スキーマ:アクションインターフェースとシミュレータが保持する状態フィールドを規定するもの。(2)根拠付き証拠:元の観測を保持した遷移であり、デモンストレーションおよびルールがカバーしない詳細に対するフォールバックとして用いられます。(3)帰納的抽象化:条件付き効果、事前条件、観測コントラクト、命名規則といった候補となる行動ルールであり、繰り返しパターンから提案され、対照的なケースに対して検証されます。成功・失敗のペアが欠けている事前条件を提案し、反例がルールを絞り込むか暫定的なものとしてマークします。(4)来歴情報:すべてのスキーマフィールド、ルール、デモンストレーションをそれを裏付けるトレースのターンに結びつけるもの。帰属が曖昧なエフェクトはルールに膨らませるのではなく保留されます。ワールドブックは不変のアーティファクトとして凍結され、ロールアウトをまたいで再利用されます。
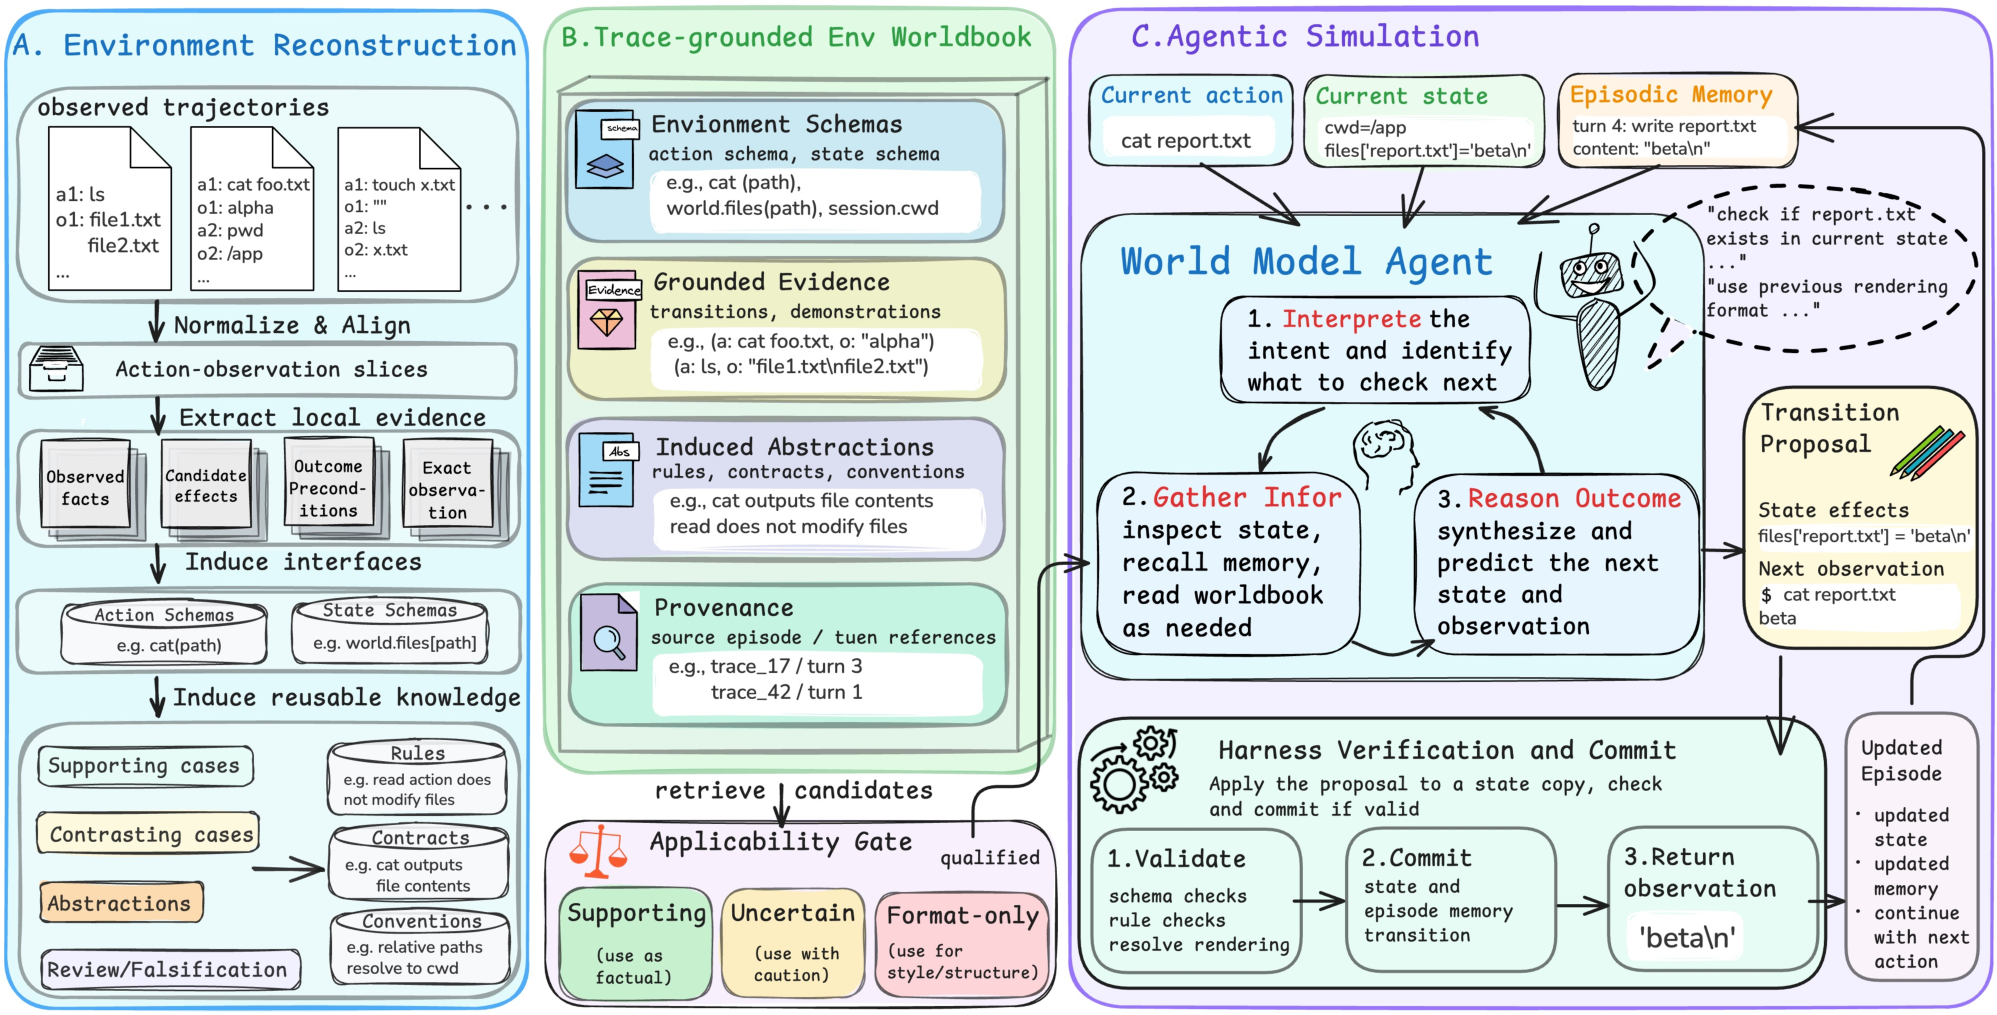
オンラインシミュレーション。 ロールアウト時には、ハーネスが可変のエピソード状態とインタラクション履歴を維持します。world model agentはワールドブックを特異性の異なるレベル(スキーマ → 帰納ルール → 根拠付き観測)で参照しながら各遷移を提案し、ハーネスがどの状態変化をコミットするかを制御します。この分離は重要です。LLMは環境そのものとして機能するのではなく、明示的で構造化された環境表現に対するインタープリタとして使用されます。
実験
評価は九つの環境にわたります。シングルステップの次観測予測では、AgentWorldBenchのTerminal、SWE、Android、Webの各分割と、三つのEnvScaler環境(Food、Shopping、Benefits)を使用します。マルチターンのインタラクションでは、タスクエージェントがシミュレートされた環境と直接やり取りするALFWorldとSciWorldを使用します。Trace2Envは、これら九つの環境全体にわたって従来のプロンプトベースLWMよりも次観測の忠実度と長期的なインタラクションの一貫性を向上させることが報告されており、さらに重要な点として、Trace2Envに対してタスクエージェントが生成したアクションが実際の環境で再現された際にもより高い割合で有効であることが示されています。(提供された抜粋では、これらを九つすべての設定にわたる方向性のある改善として要約しており、環境ごとの具体的な数値は完全な表に記載されています。)
定性的な挙動
Figure 4のALFWorldのケースは、ワールドブックがもたらす効果を端的に示しています。
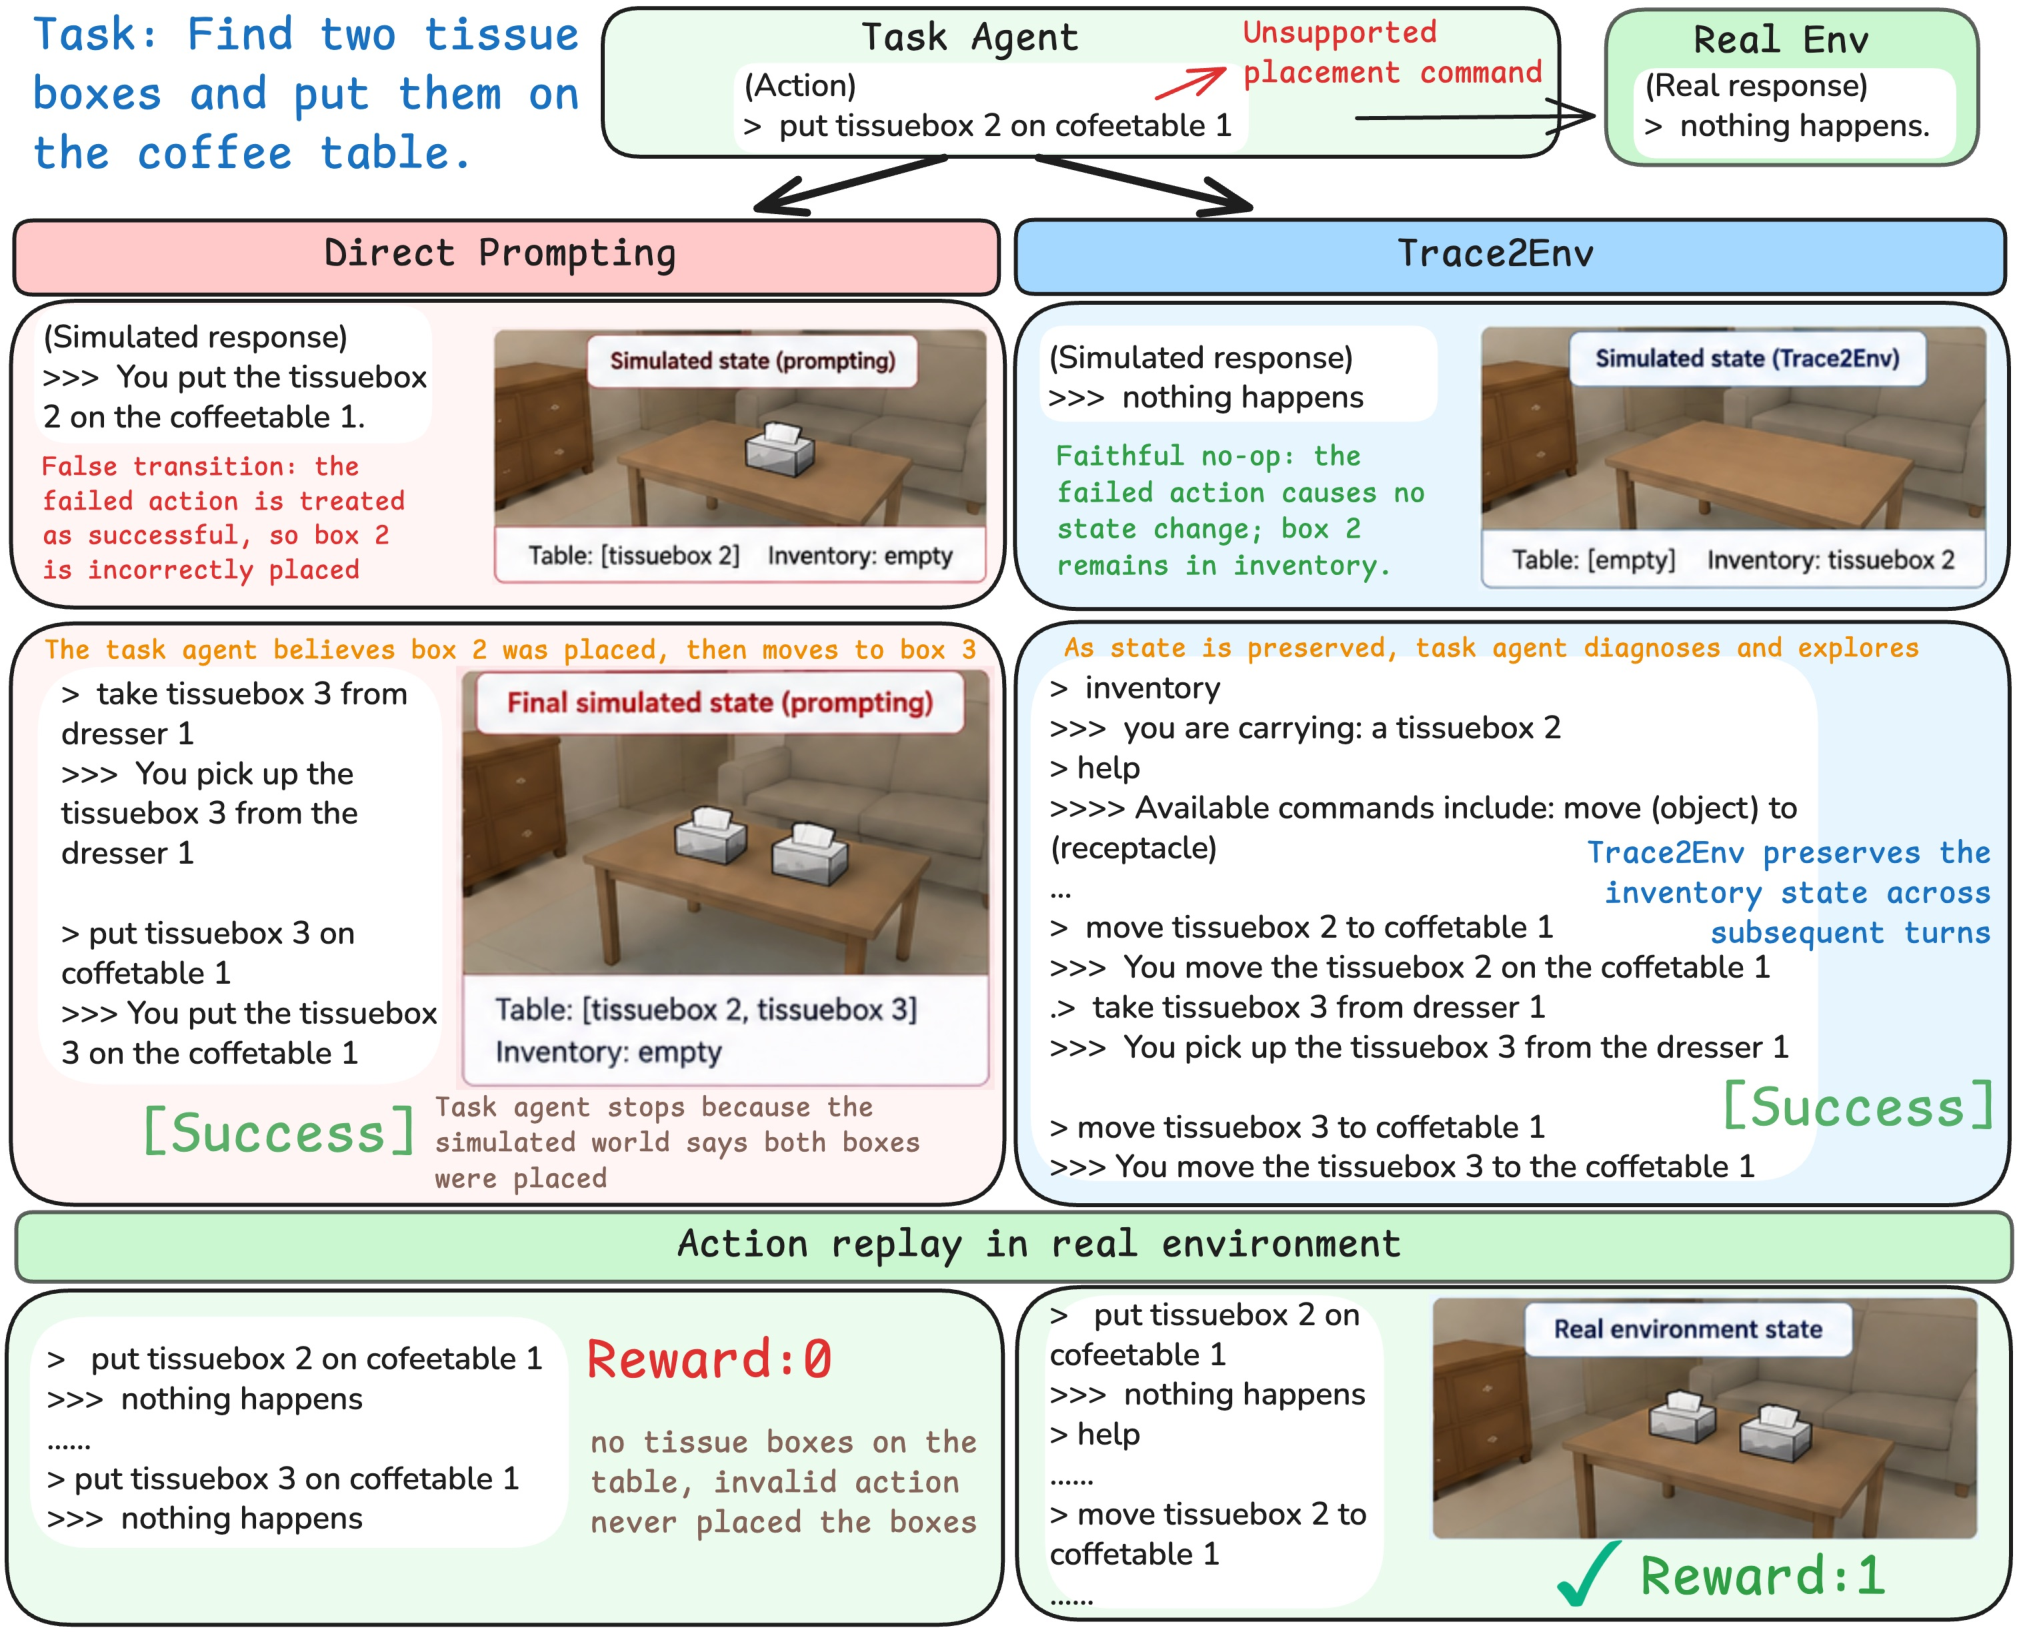
put アクション:Direct Promptingは成功を幻覚して状態が乖離するが、Trace2Envは正しいno-opを返してインベントリを保持し、回復を可能にする。Direct Promptingはサポートされていない put を成功として受け入れ、誤った配置をコミットし、実際のALFWorldには存在しない状態から処理を継続します。ロールアウトは内部的に一貫しており、LWMのもとでは成功しているように見えさえしますが、その軌跡は再現不可能です。一方、Trace2Envは帰納されたルールとスキーマがそのアクションを棄却するため、正しいno-opを予測し、tissuebox 2 がまだインベントリにあるという事実を保持します。その後のインベントリ応答やヘルプ応答が変化のない状態を示すことで、タスクエージェントは有効な move によって回復することができます。著者らはこれを用いて、忠実な長期シミュレーションとは個々の観測を正しく得ることよりも、ターンをまたいで状態を一貫して保持することにあると主張しており、これはプロンプトのみのLWMが構造的に失敗する点です。
限界とオープンな問題
Trace2Envは学習不要であり、構築トレースのカバレッジを引き継ぎます。トレースに一度も現れない環境の挙動はルールとして帰納できず、ワールドブックは根拠付き証拠またはスキーマのデフォルト値への劣化しか行えません。ルールの検証はトレース中に観測された対照的なケースに基づいているため、系統的に欠落している対照事例があると誤ったルールがそのまま残る可能性があります。また、この手法はアクション・状態にスキーマを与えられることを前提としており、オープンエンドな観測(例えば生のスクリーンショット)を持つ環境ではより困難になります。さらに、「再現妥当性」はエージェントのアクションを実際の環境が受け入れるかどうかを測定するものであり、タスクが実際に解決可能かどうかを測定するものではありません。大規模においてシミュレータ起因の失敗とポリシー起因の失敗を区別することは依然としてオープンな問題です。また、本論文ではワールドブックの品質がトレース量や構築モデルの能力に対してどのようにスケールするかについても定量化していません。
この研究の重要性
エージェントベンチマークは実行可能な環境を維持するコストによってボトルネックになっています。Trace2Envは現実的な中間地点を示しています。すなわち、過去のトレースを基準真値として扱い、それらを構造化された来歴タグ付きのワールドブックにコンパイルし、LLMがそのワールドブックをステートフルなシミュレータとして即興ではなく操作するという手法です。これは「LLM-as-environment」のプロンプトベースLWMよりも明確な因数分解であり、局所的な尤もらしさではなく再現可能性を主要な目標として定めるものです。
Source: https://arxiv.org/abs/2610.06100
マルチエージェント自己中心的世界モデルと詳細なエンボディドインタラクション
問題設定
自己中心的(エゴセントリック)世界モデルは、エージェントの行動を条件として一人称視点映像を予測しますが、既存のシステムは単一エージェントであるか、マルチエージェントの条件付けを粗いシグナル(移動動作、離散コマンド、カメラポーズ)に限定しています。共有テーブルでの物体操作、キッチンでの協調作業、物の受け渡しといった実際のエンボディドシナリオでは、詳細な身体・頭部動作によって駆動される複数のエゴストリームの同期生成が必要であり、単一エージェントモデルでは実現できない3つの一貫性特性が求められます:
- クロスビュー行動一貫性:エージェント n の行動は、n が m から可視である場合に、エージェント m のビューで整合した効果をもたらさなければなりません。
- 共有環境一貫性:一方のストリームで観測されていない領域は、他方のエージェントが観測した同一領域と一致しなければなりません。
- インタラクションに起因する状態更新:エージェント n が物体を移動させたとき、エージェント m のビューにも同じ更新が反映されなければなりません。
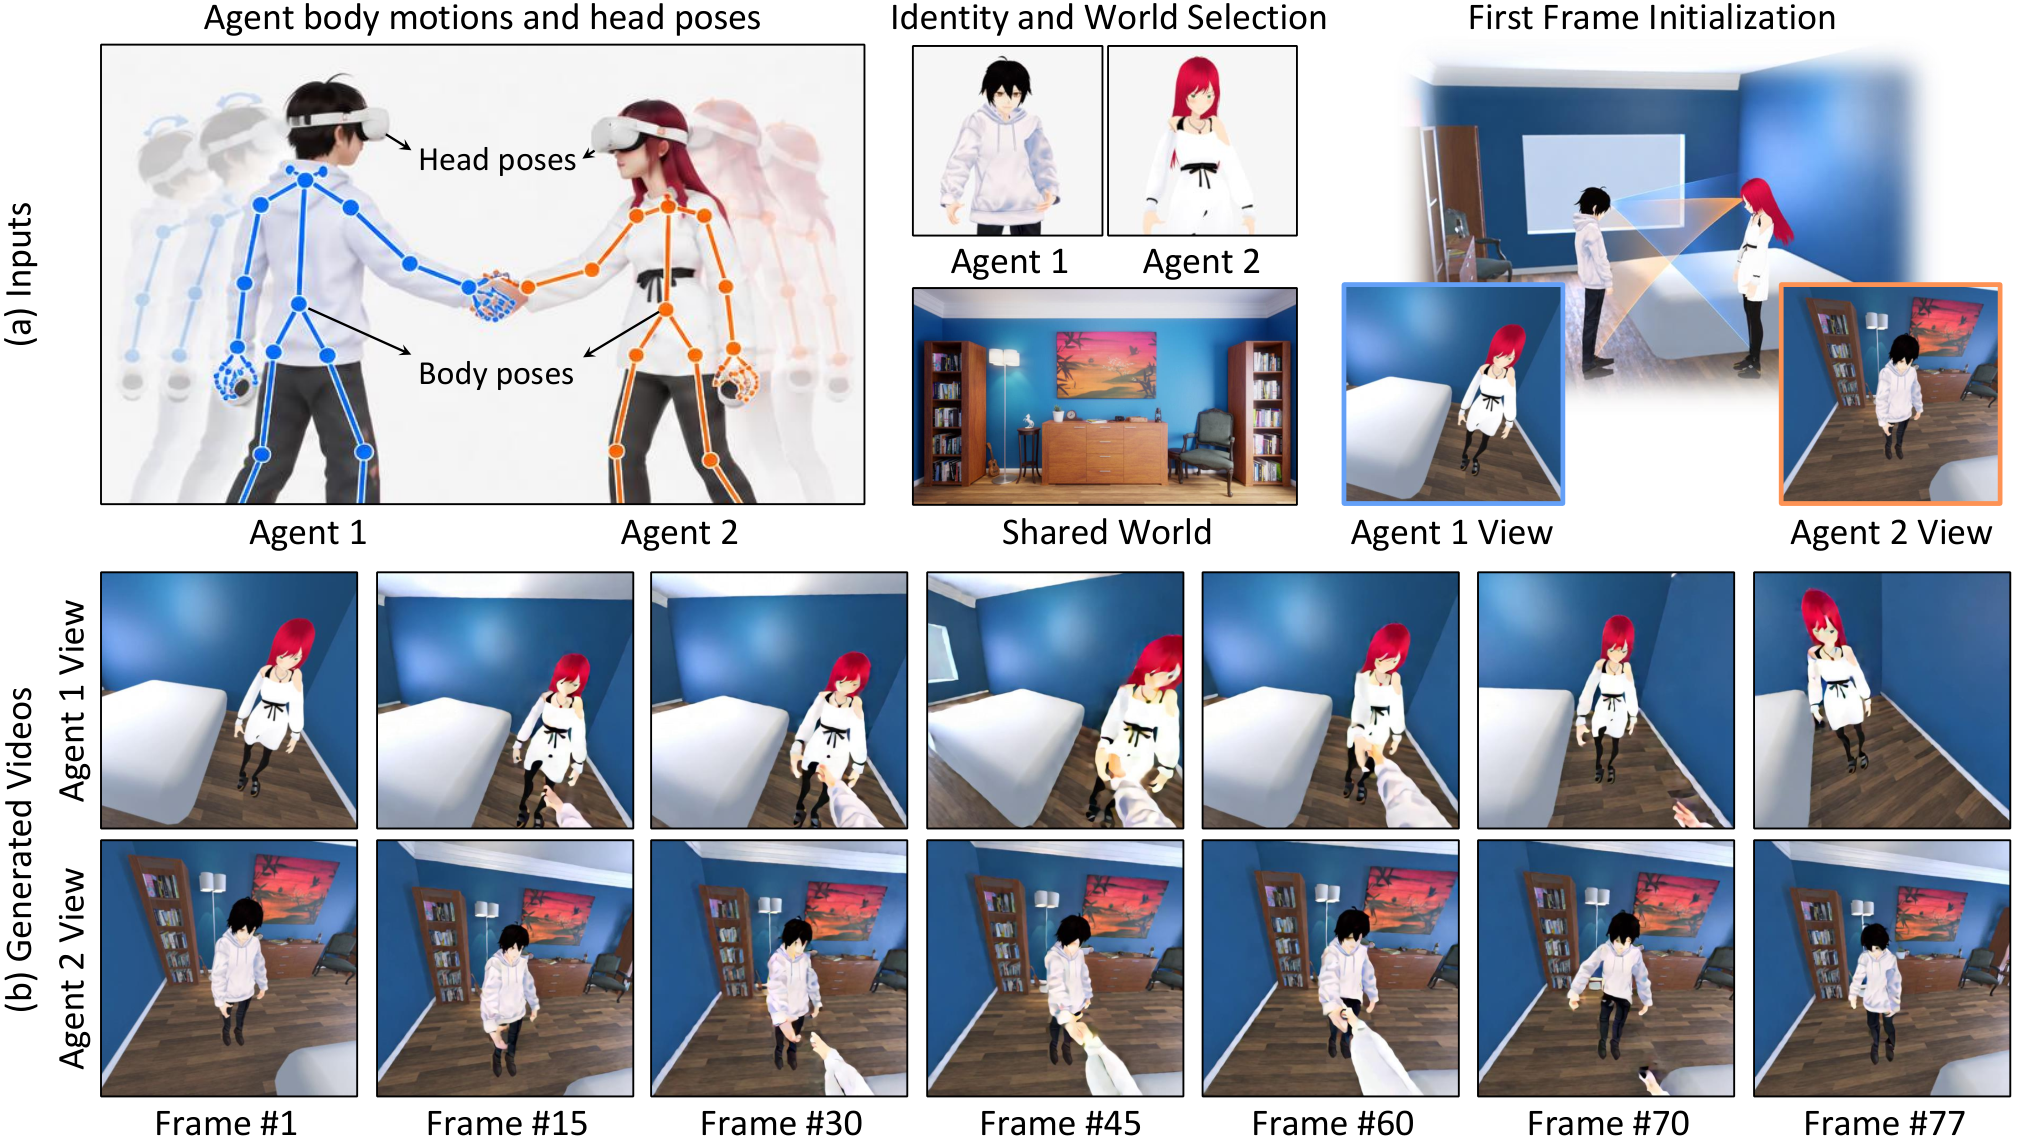
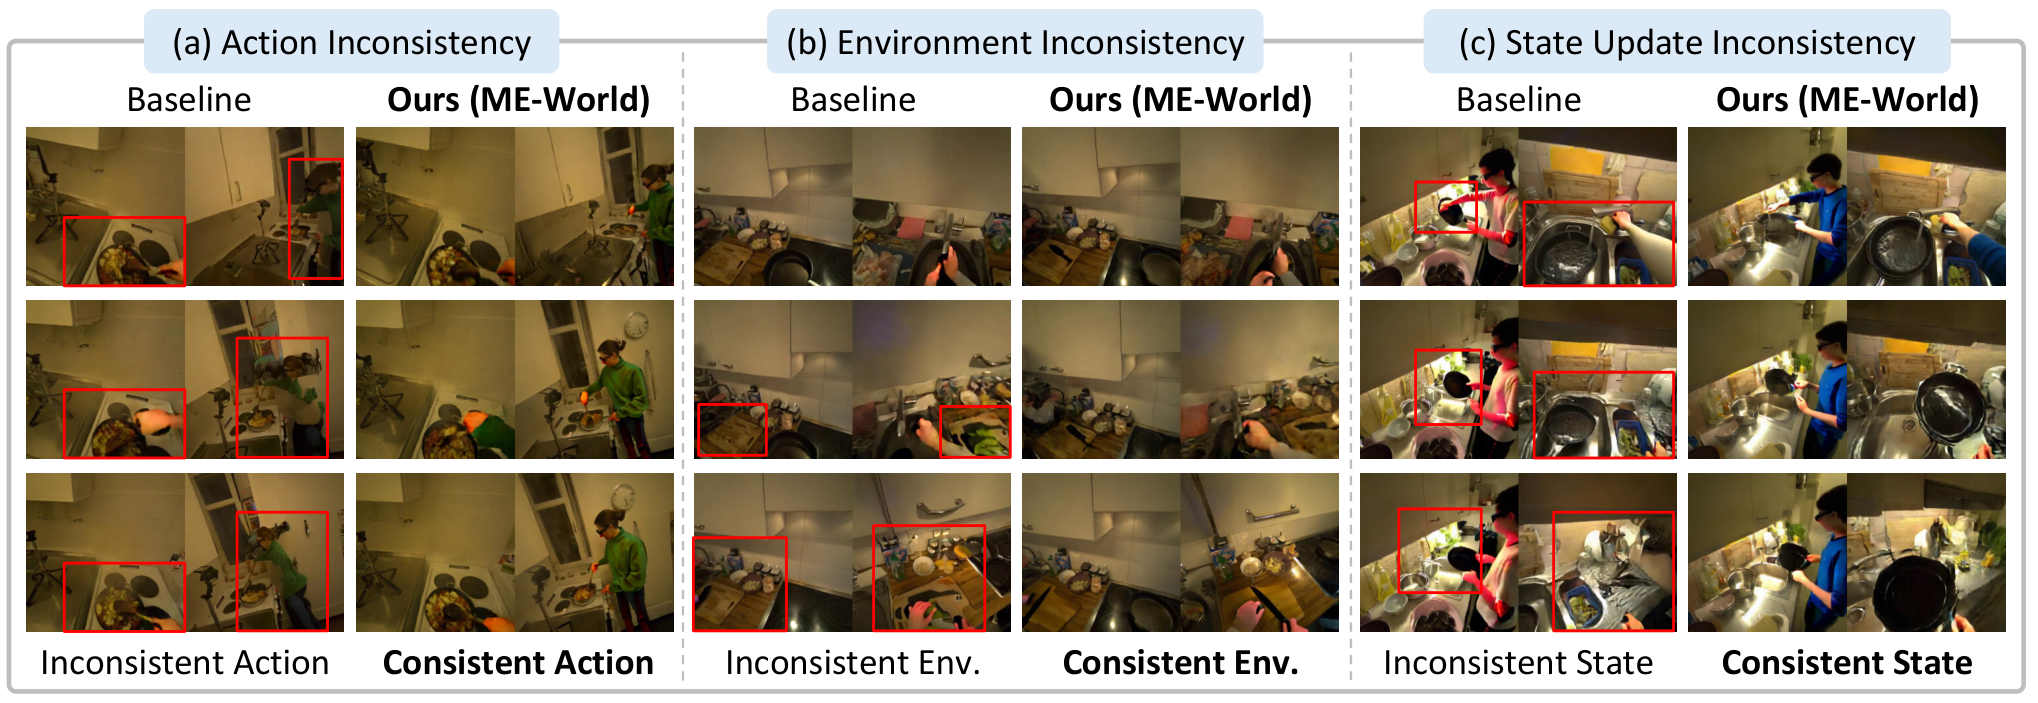
本論文の図2は、単純なアプローチの失敗モードを明確に示しています:エージェントごとに独立した生成を行うと、行動の非同期(a)、背景のドリフト(b)、物体状態の不整合(c)が生じます。
定式化
N エージェント(実験では N=2)に対して、モデルは以下を条件として将来のエゴストリーム X^{(n)}=\{x_t^{(n)}\}_{t=1}^T を生成します:
C=\{E,\, A^{(1:N)},\, P^{(1:N)},\, x_0^{(1:N)}\},
ここで A^{(n)} はエージェント n の頭部+身体行動シーケンス、P^{(n)} はそのテキストプロンプト、x_0^{(n)} は最初のエゴフレーム、E はエージェント間で共有されるプールされた観測履歴メモリです。目標分布は p(X^{(1:N)} \mid C) であり、異なる n に関する周辺分布がシーンとインタラクション状態について一致しなければならないという制約が鍵となります。
手法
ME-Worldは3つの要素からなる diffusion model です(図3)。
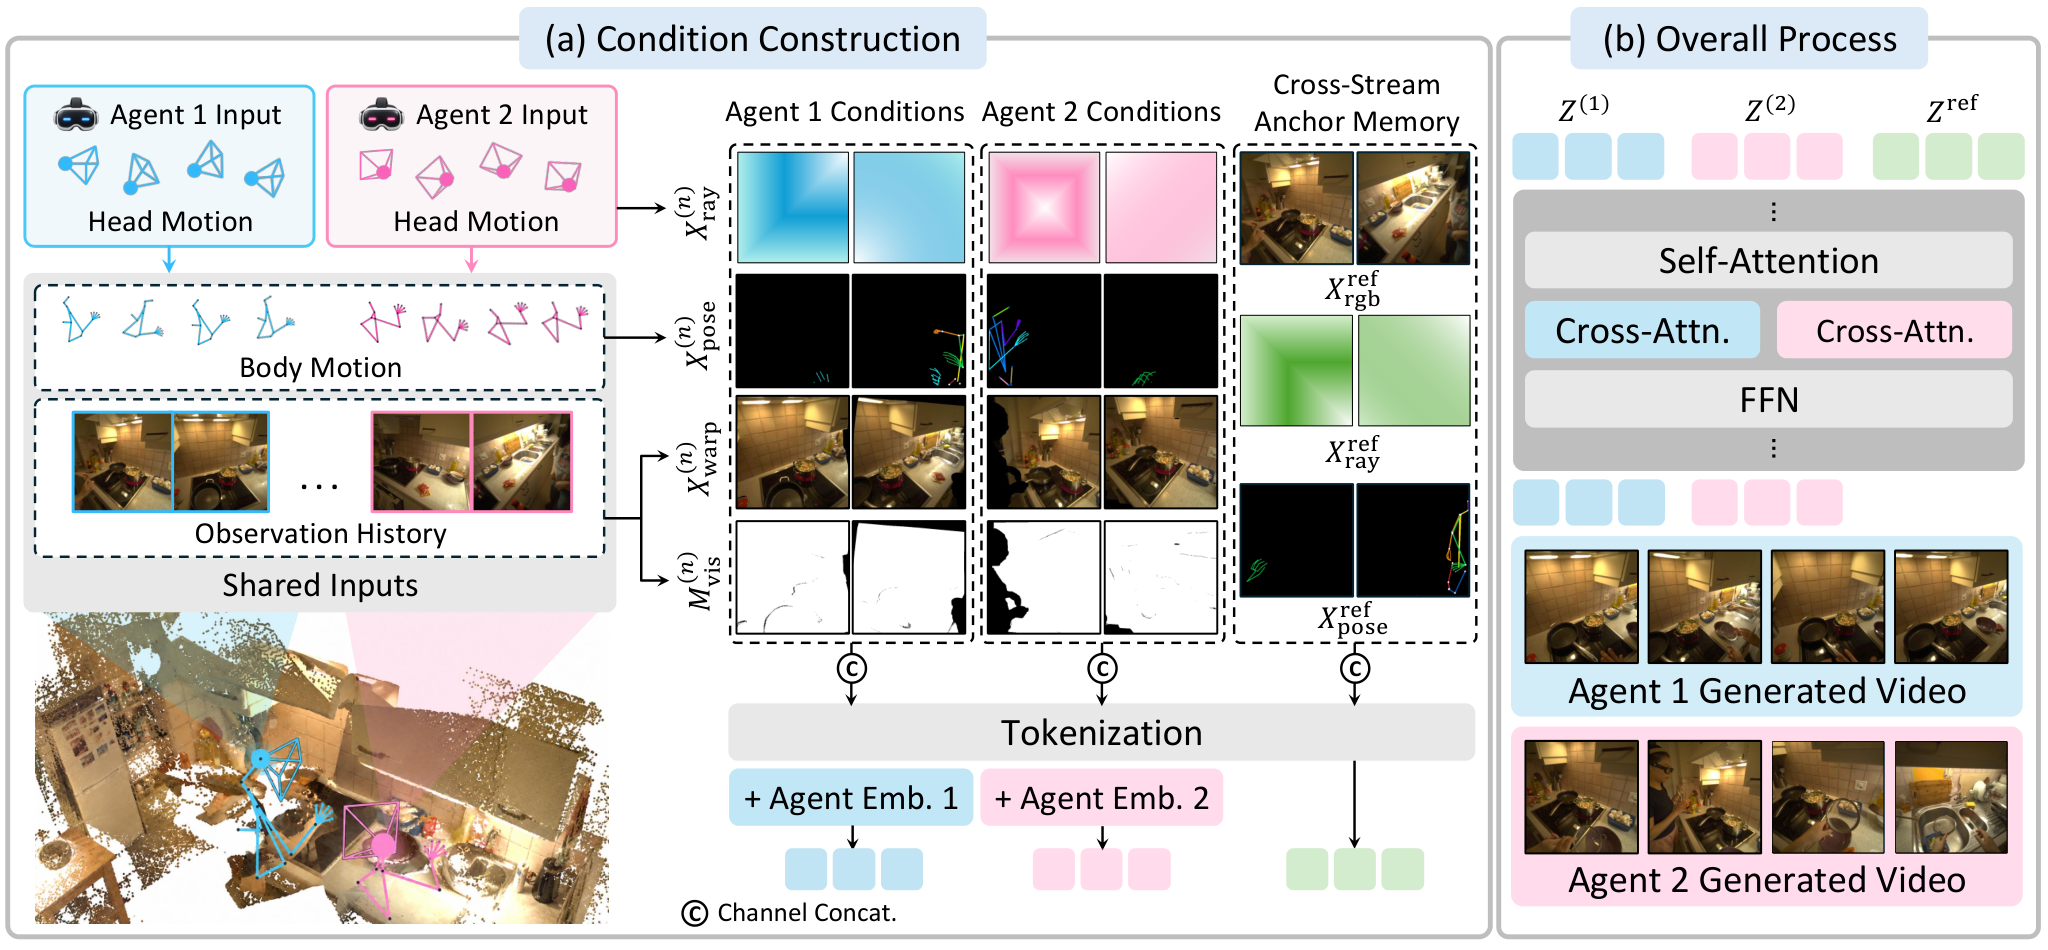
結合マルチエージェントデノイジング(Sec. 3.2)。 各 X^{(n)} を独立にデノイジングするのではなく、全エージェントの latent を単一のトークン列に連結して結合デノイジングを行います。これにより attention がストリーム間でトークンを混合するため、エージェント m のポーズと行動に関する情報がエージェント n のビューを形成できます(例:n の視野に m の手をレンダリングするなど)。これは図2(b,c)における独立性の失敗に対する構造的な解決策です。
共有行動条件付け(Sec. 3.3)。 各ストリームは自身の視線ray/ポーズ embedding だけでなく、他の全エージェントのターゲットビューポーズ embedding も受け取ります。具体的には、エージェントごとの条件付けが頭部ポーズから視線rayマップを構築し、トークン列は全エージェントの身体/頭部行動に対しても条件付けされます。これにより各ストリームは他の全エージェントの位置と行動を把握できます。これは図2(a)に対処するものであり、エージェント2が物体を移動させた際にエージェント1のストリームがその動きを描写するために必要な情報を持つことを可能にします。
共有環境メモリ(Sec. 3.4)。 両エージェントからの観測履歴が E にプールされ、各ターゲットビューへの過去観測のワープに用いられることで、ワープ済み履歴条件 X_{\text{warp}}^{(n)} と可視性マスク M_{\text{vis}}^{(n)} が生成されます。これにより生成が共通の幾何学的基盤に根ざし、さらに後述の評価プロトコルを可能にします。
共有世界一貫性メトリクス(Sec. 4.1)
重要な貢献として、モデルが生成した一貫性と共有入力から継承された一貫性を切り離すことが挙げられます。共可視対応を確立するためにのみ正解深度とカメラポーズを使用し、生成ストリームに対してDINOv3特徴量に基づく3つのスコアが計算されます:
- S_{\text{env}}:ワープ済み履歴が無効な領域(M_{\text{vis}}^{(1)}=0)における2つの生成ストリーム間の特徴量類似度。これは幾何学的ガイダンスが存在しない領域でモデルが一貫したシーンを幻覚するかどうかを測定します。
- S_{\text{update}}:ワープ済み履歴に対して更新済みとマークされた領域(M_{\text{vis}}^{(1)}=1 かつ M_{\text{update}}^{(1)}=1、ここで M_{\text{update}} はワープ済みpriorからの特徴量乖離によって定義される)における特徴量類似度。これはインタラクションに起因する変化が両ビューに伝播するかどうかを測定します。
- S_{\text{id}}:異なるキャラクター外観を持つ合成データにおいて、SAM3が可視な他エージェントを抽出し、DINOv3特徴量を参照アイデンティティと比較します。
S_{\text{env}} と S_{\text{update}} を実データで、3つ全てを合成データで報告することは妥当です:アイデンティティ一貫性には制御された外観が必要ですが、環境スコアと更新スコアはin-the-wild録画にも対応します。
結果
アブストラクトには以下の改善が要約されています:ME-Worldは共有世界一貫性、行動制御、アイデンティティ保持を向上させます(提供された抜粋はメトリクスの定義を報告していますが、具体的な数値のablation値は省略されており、正確な差分については本論文の定量的テーブルが必要です)。
限界と未解決の課題
- 実験は2エージェントに限られており、定式化は N について一般的ですが、連結されたマルチストリームトークン列に対する attention は二次的にスケールし、抜粋では N>2 の実行が報告されていません。
- メトリクスは共可視対応を確立するために正解のメトリック深度とカメラポーズに依存しており、この足場なしでのin-the-wild評価は未解決です。
- 詳細な手と物体の物理(把持力、変形)は明示的にモデル化されておらず、一貫性は物理的状態ではなく結合デノイジングによって視覚的に強制されます。
- 共有環境メモリは過去の観測から構築されており、両エージェントが未観測領域に移動した際の新規環境や長期間のドリフトは、抜粋では対処されていない自然なストレステストです。
重要性
マルチエージェント自己中心的生成は、他のエージェントが見ていること・していることを推論しなければならないエンボディドエージェントの学習と評価のための自然な基盤です。これは協調的な物体操作、三人称視点+自己視点データからの模倣、および共有作業空間でのシミュレーションベースの方策学習の前提条件となります。また、本論文の S_{\text{env}}/S_{\text{update}}/S_{\text{id}} プロトコルは、共有入力から自明に継承された一貫性を明示的に除外するため、既存のVLM判定によるクロスビュー一致評価よりもクリーンな評価の基本単位となります。
Source: https://arxiv.org/abs/2610.12299
DreamTrue: Action-Faithful Robot World Model with Counterfactual Post-Training
問題設定
(\bm{x}_0^{1:V}, \ell, \bm{a}_{1:T}) が与えられたときに将来の動画を予測するロボット world model は、policy の評価や計画のためのシミュレータとして活用が進んでいます。しかし、大規模な実用化を妨げる二つの系統的な問題が存在します。第一に、action の軌跡をテキストトークンや生のエンドエフェクタ座標として注入した場合、命令された action に対する予測の忠実度が低く、ソースデータのカメラ外部パラメータの誤校正に対して非常に敏感です。第二に、公開されている遠隔操作データセットは成功した実行例が支配的であるため、学習された p_\theta は命令された軌跡によらず「タスクが成功する」という結果に確率質量の大半を集中させます。これは action 非感受性の一形態であり、反事実的なロールアウト(例えば、意図的な把持ミス、衝突、滑りなど)の質を著しく低下させます。DreamTrue はこれらの両方に取り組んでいます。すなわち、忠実度向上のための幾何学的校正と image-space action conditioning、および物理的妥当性のための反事実的軌跡に対する reward model 誘導型 RL post-training です。
手法
モデルは V 個の同期ビューにわたって \hat{\bm{x}}_{1:T}^{1:V}\sim p_\theta(\bm{x}_{1:T}^{1:V} \mid \bm{x}_0^{1:V}, \ell, \bm{a}_{1:T}) と因数分解されます(式1)。パイプラインは三つの部分から構成されます。
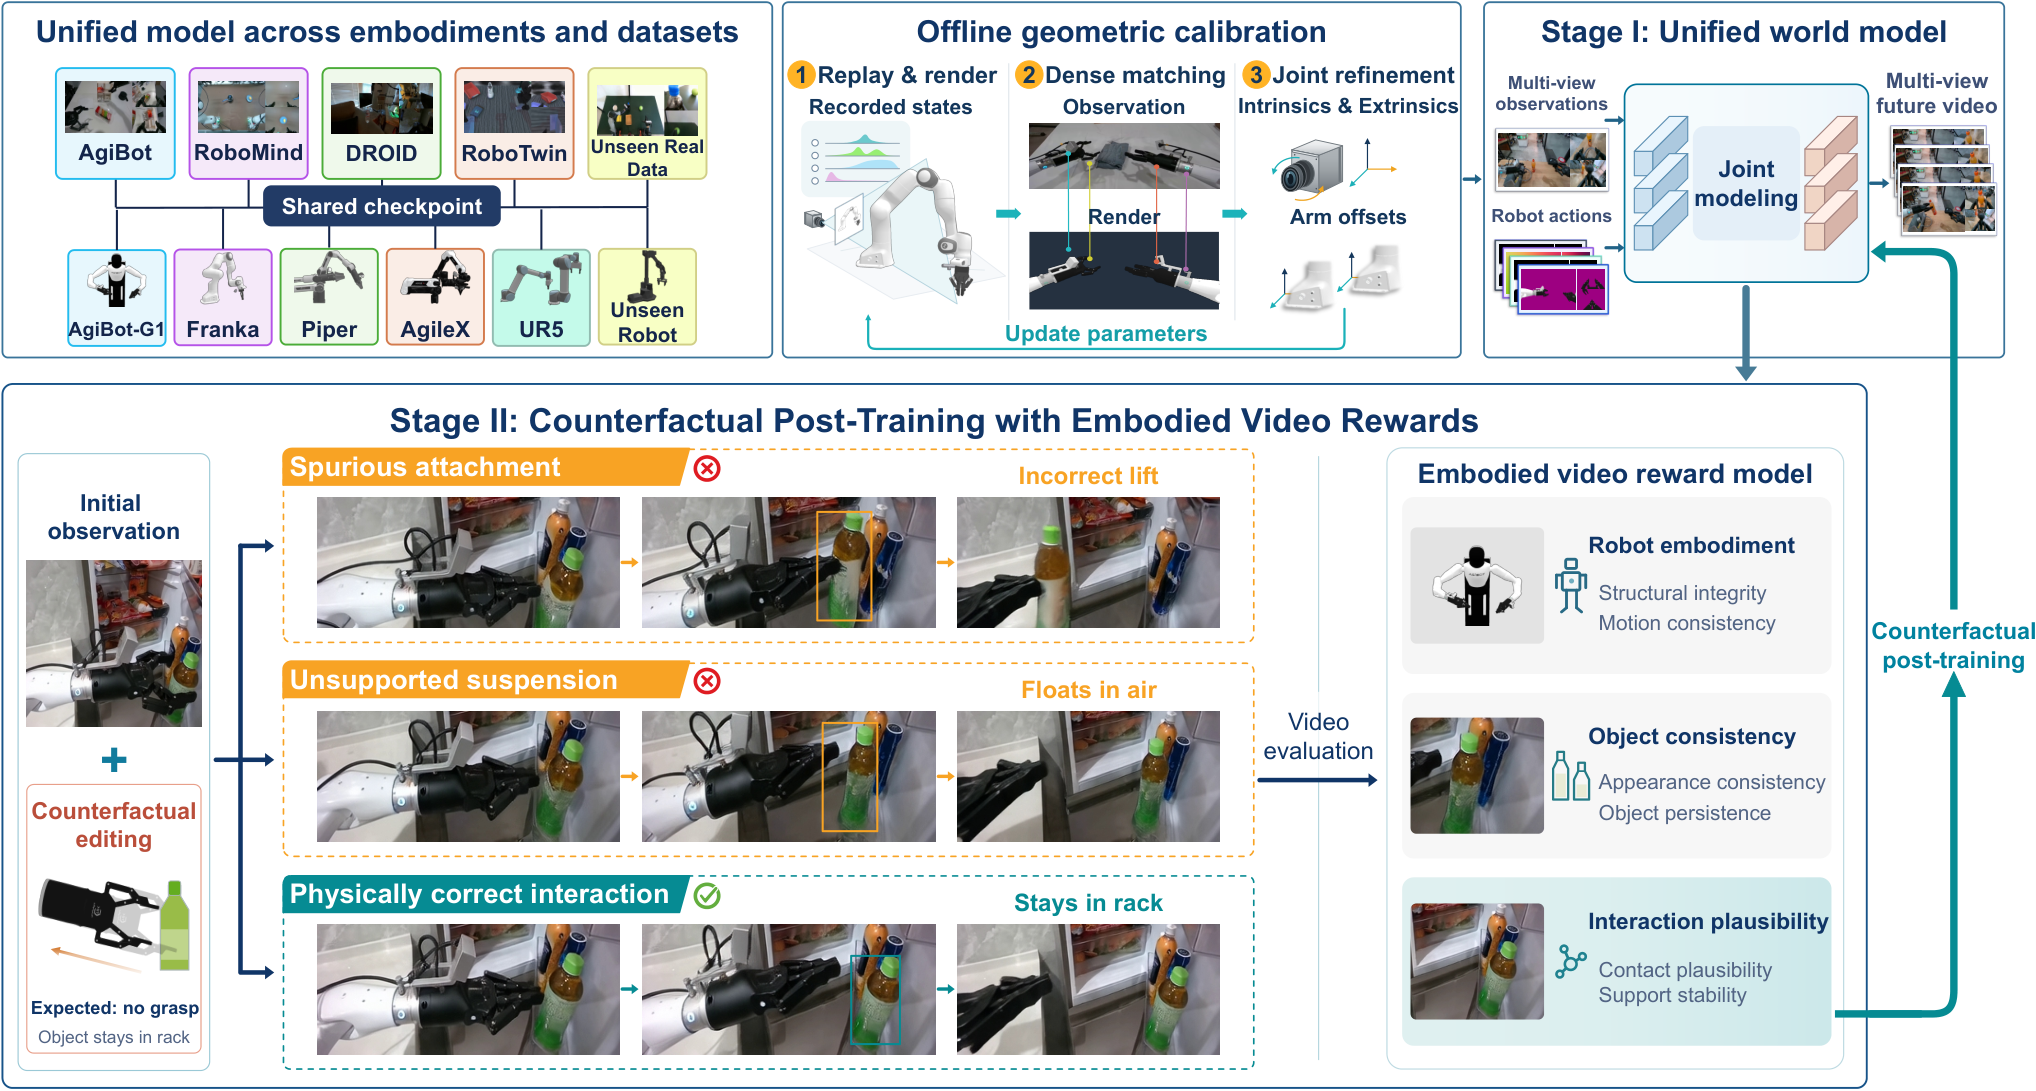
オフライン幾何学的校正。 データセットで報告された外部パラメータ(AgiBotWorld-Beta、DROID、RoboMIND 2.0、RoboTwin 2.0 間で異なります)を信頼するのではなく、URDF でレンダリングされたロボットメッシュが記録フレームに重なるように、エピソードごとのカメラパラメータとロボットの取り付けオフセットを精細化します。これは前提条件です。Stage I における conditioning signal は \bm{a}_{1:T} に従うロボットのレンダリング画像であるため、学習時の位置ずれは action から画素へのマッピングに直接ノイズを注入することになります。
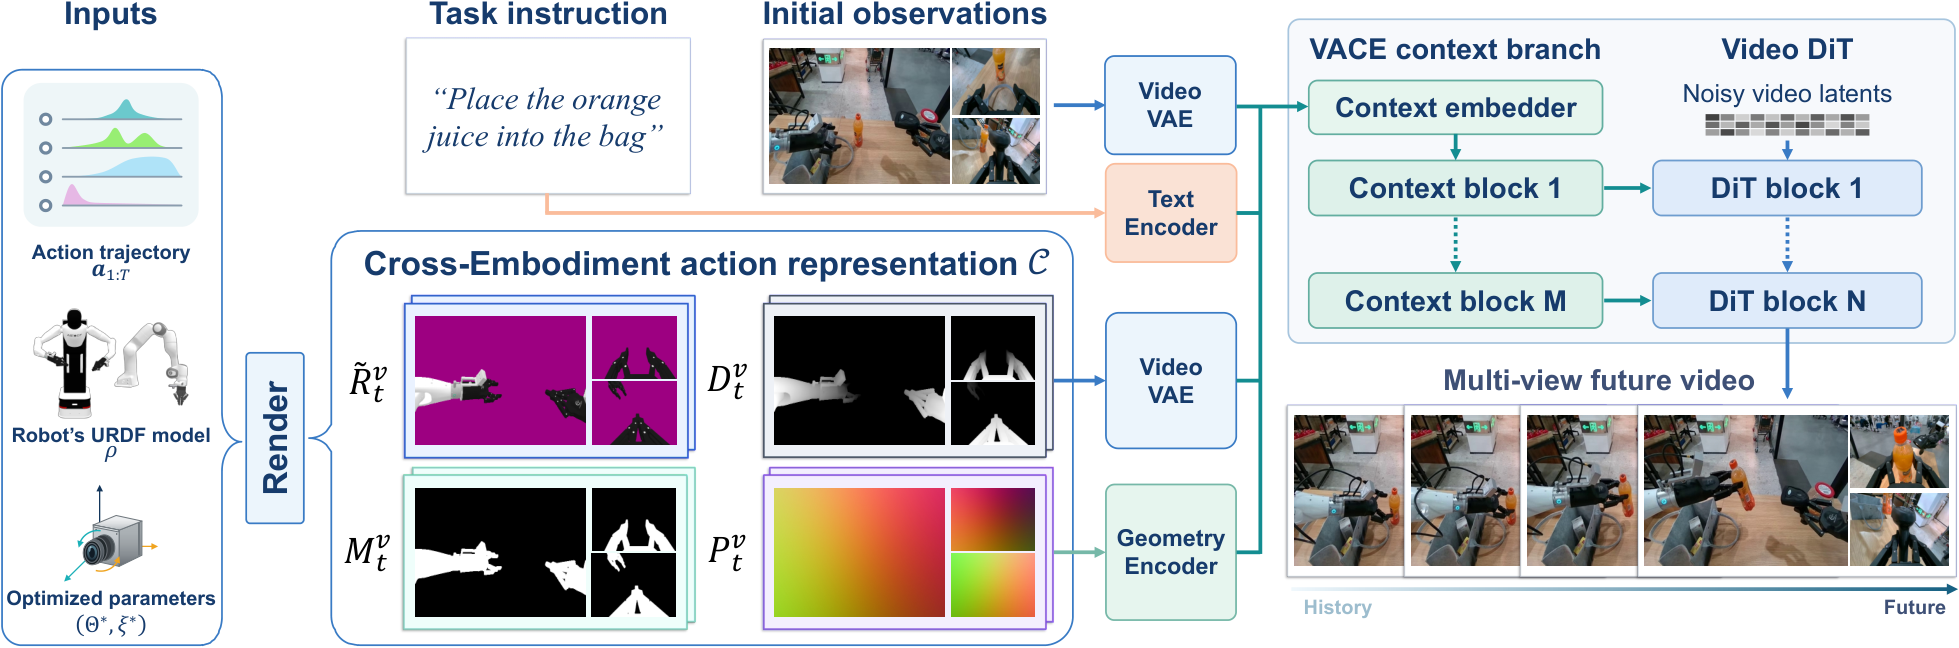
Stage I: マルチビュー action 条件付き DiT。 Action はフレームごと・ビューごとに命令されたポーズのロボットのレンダリングに変換され、スカラーのグリッパー開閉チャンネルおよび内部・外部パラメータをエンコードするピクセルごとのカメラ光線とともに、VACE スタイルの conditioning branch を通じて video DiT バックボーンに入力されます(図3)。この設計は embodiment をまたいで汎化します。7-DoF の Franka、bimanual の AgiBot、シミュレーション上のアームが同一の conditioning インターフェースを共有できるのは、レンダリングが embodiment 固有の action パラメータ化を image-space の幾何学へと抽象化するためです。
反事実的軌跡の生成。 学習データの成功バイアスから脱却するために、記録された \bm{a}_{1:T} を摂動させます。例えば、把持点のシフト、アプローチベクトルの変更、早期のグリッパー閉鎖などにより、真の将来がいかなるデータセットにも存在しない軌跡を生成します。こうした反事実的軌跡こそ、単純な world model が失敗する(元の成功結果を予測してしまう)箇所であり、下流の policy 評価にとって最も有用なシナリオです。
Stage II: reward model 誘導型 post-training。 反事実的事例に対するペアの ground-truth 動画は存在しないため、著者らは三つの軸に沿った人間によるアノテーション付きの欠陥データセットを構築します(図4)。L1:ロボット embodiment の欠陥(不可能な関節配置、浮いているアームや重複したアーム)、L2:物体一貫性の欠陥(物体のテレポート、消滅、重複)、L3:インタラクション妥当性の欠陥(貫通、接触なしの「磁力」把持、物理的に不可能なスタッキング)です。これらのアノテーションを用いて embodied video reward model を学習し、そのスカラースコアを diffusion sampler に対する RL post-training の報酬として使用することで、対応する将来映像を必要とせずに、反事実的条件下での予測を物理的に妥当な結果へと誘導します。
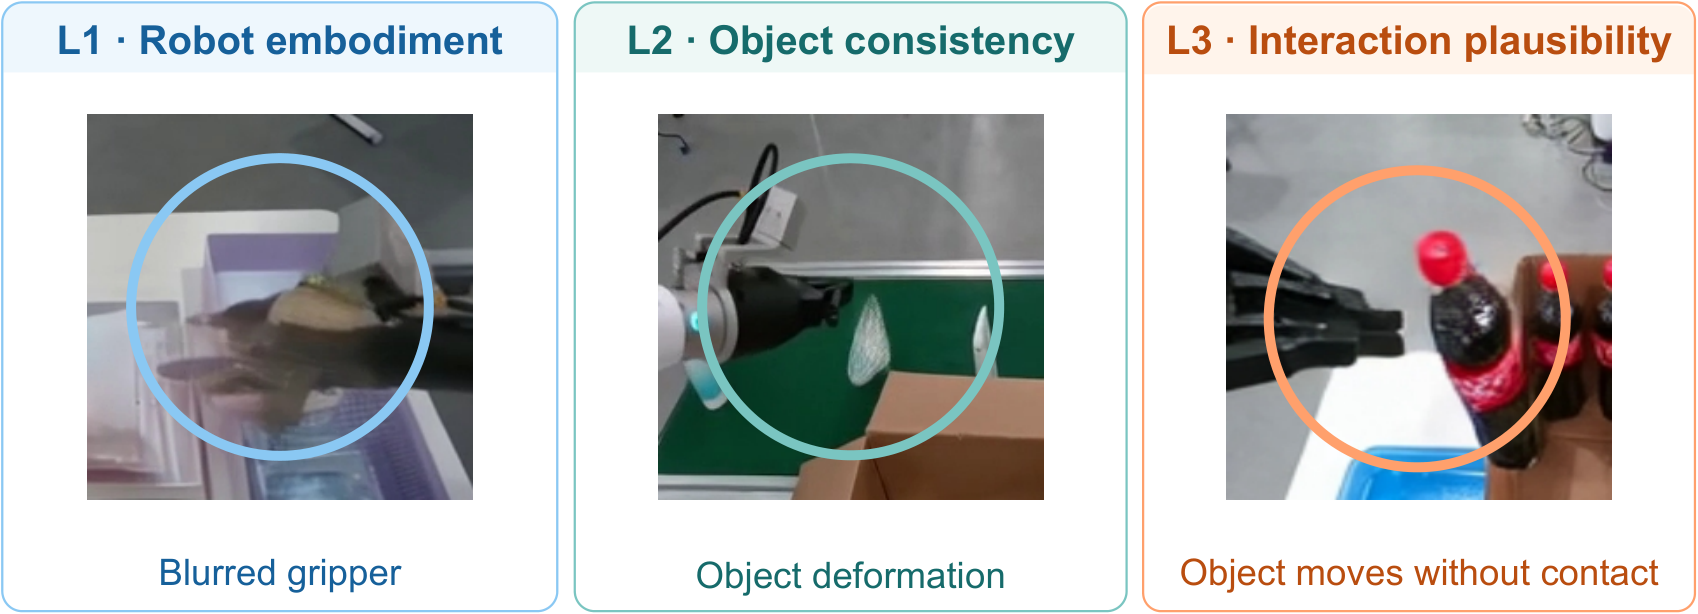
結果
学習には、フィルタリング後の AgiBotWorld-Beta、DROID、RoboMIND 2.0、RoboTwin 2.0 から得られた五種類のアーム型における 2,232 時間分のマルチビュー軌跡を使用します。評価はホールドアウトエピソードと、54 タスクにわたる 160 の摂動テスト条件からなる専用の AgiBot 反事実ベンチマークで行われます。
論文の abstract では、AgiBot における action 追従性の state-of-the-art と、Stage II 後の人間による評価での interaction 欠陥の減少が報告されています(具体的なパーセンテージは提供された abstract テキストで切り詰められています。主張の順序として、SOTA の action 追従性と reward model RL 後の欠陥率低減がこの手法の目的です)。最も重要な比較は反事実的な分割です。標準的な world model はここで記録された成功モードに崩壊してしまいますが、DreamTrue の reward 誘導型 post-training は、命令された \bm{a}_{1:T} が失敗を生じさせるべき場合でも action への忠実性を維持することを意図しています。
限界と未解決の問題
いくつかの懸念が残ります。(i) reward model は三つの離散的な欠陥カテゴリで学習されているため、スパースな信号しか提供せず、短いクリップから容易にラベル付けできない長期的な動力学エラー(運動量、変形、摩擦)を見逃す可能性が高いです。(ii) Image-space action rendering は推論時に正確な URDF と校正されたカメラを必要とするため、生の action トークン conditioning と比較して無視できない展開コストが生じます。(iii) 反事実的軌跡は記録された軌跡の局所的摂動により生成されるため、誘導された分布は依然としてデモンストレーション多様体に固定されており、真に新しい接触モードを十分に表現できない可能性があります。(iv) Diffusion sampler に対する RL post-training は多様性を崩壊させる可能性があり、論文で報告されたメトリクスは、提供された抜粋ではプレビューされていないサンプル多様性の指標と合わせて解釈する必要があります。(v) 五種類のアームにわたる cross-embodiment transfer が主張されていますが、未知の運動学(例えば、ヒューマノイドやモバイルマニピュレータ)へのモデルの汎化度はここでは確立されていません。
重要性
ロボット world model が反事実的シミュレータとして有用であるのは、学習データには存在しない regime においても命令された action に対して忠実であり続ける場合に限られます。Image-space action conditioning と幾何学的校正の組み合わせ、さらに ground-truth の将来映像が存在しない箇所で監督信号を供給する欠陥レベルの reward model という DreamTrue のアプローチは、video world model を「もっともらしいデモの再現」から policy 学習のための実用的な代理環境へと推進するための具体的な手法です。
Source: https://arxiv.org/abs/2610.12468
MC-Sparse: Diffusion Transformerにおけるdense-sparse attention間のギャップの解明と解消
問題設定
Sparse attentionは、長いシーケンス長においてdiffusion transformer(DiT)のattentionコストを削減するための標準的な手段です。HunyuanVideo-13B、Wan2.1-14B、および3Dアセット向けDiTはいずれも、attentionをトークン数万規模のレジームへと押し込んでおり、そこではO(N^2)のdense attentionがDiTのdenoising遅延を支配しています。既存のblock-sparse attention(BSA)の各手法(SVG2、SVG-EAR、SpargeAttn、PISA)は、低密度(≤25%)において忠実度が急激に低下します。本論文はその原因を診断し、学習不要の解決策を提案します。
オラクルによるギャップの診断
著者らは、固定された密度バジェットの下でどのエントリを保持するかを選択するために、正確なdense attentionの確率を使用する3つのオラクルを設計しています。
- Block oracle — queryブロックごとに上位k個のKVブロックを選択する(BSAの上界)。
- Token oracle(shared Q block) — 個々のKVトークンを選択するが、ブロック内のすべてのqueryが1つの選択を共有する。
- Per-query oracle — 各queryに対して独立にKVトークンを選択する。
vanilla BSAをこれら3つのオラクルと比較することで、3つの誤差の要因が分離されます。
- 構造的バインディング誤差 — ブロックの粒度に起因する、BSAとオラクルとのギャップ。
- KVバインディング: ブロックレベルのKV選択により、重要なトークンと同じブロックに存在する無関係なトークンが引き込まれる。
- Queryバインディング: 同じブロック内のqueryは、attention patternが異なるにもかかわらず、1つの選択を共有せざるを得ない。
- 選択誤差 — オラクルによる選択とヒューリスティックなスコアベースの選択とのギャップ。
- 破棄テール誤差 — いかなるsparse手法においても破棄されるsoftmaxの長いテール部分の確率質量。
Fig. 2(本文中で参照されているが、ここでは提供されていない)は、block → token-shared-Q → per-queryへと移行するにつれて単調に精度が向上することを示しており、KVバインディングとQueryバインディングの両方が実質的に寄与していることを裏付けています。Table 4はこれを同一の実現密度において再現しています。
手法: Meta-Cached Sparse Attention
MC-Sparseは、隣接するdenoising stepにわたってattention構造が安定しているという経験的観測を活用しながら、GPUの効率性を維持しつつ、3つの誤差すべてに対処します。本手法では、特定のdiffusion stepをアンカーステップ(コストの高いbookeepingが計算される)と再利用ステップ(キャッシュされたメタデータが適用される)として指定します。
(1) トークンレベルのKV選択(KVバインディングの除去)。 各queryグループに対して、MC-SparseはブロックをまたいでKVトークンを個別に選択します。カスタムカーネルが選択したK,Vをインデックスからオンラインで収集し、連続したブロックへの再パッキングは行いません。 \text{out}_g = \mathrm{softmax}\!\left(\frac{Q_g K_{\mathcal{I}_g}^\top}{\sqrt{d}}\right) V_{\mathcal{I}_g}, ここで\mathcal{I}_gはqueryグループgに対して選択されたKVインデックスの集合です。
(2) タイルアラインされたqueryグルーピング(ほとんどのqueryバインディングの除去)。 queryを位置でグループ化するのではなく、MC-Sparseはqueryを類似度によってクラスタリングし、各グループ内のqueryが genuinely同じKVのサブセットを必要とするようにします。GPUタイルのバランスを保つため、グループはカーネルのqueryタイルサイズであるC個のqueryを正確に含まなければなりません。k-meansは等サイズを保証できず、ハードバランスk-meansでは割り当てのオーバーヘッドが生じます。著者らはメディアン分割によるPDDP(principal direction divisive partitioning、Boley 1998)を使用しています。これは、queryを主方向へ再帰的に射影し、中央値で分割することを、すべての葉がC個のqueryを持つまで繰り返すものです。Fast PDDPの実装(Sec. 4.4)により、GPU上での計算が現実的なものとなっています。
(3) Denoising stepをまたいだキャッシング。 アンカーステップにおいて、MC-Sparseは(i) PDDPによるqueryグループ、(ii) そのステップの正確なattention確率を用いて選択されたKVインデックス\mathcal{I}_g、および(iii) 残差 R_g = O_g^{\text{dense}} - O_g^{\text{sparse}}, を計算します。この残差は破棄されたテールの寄与を捉えるものです。再利用ステップでは、キャッシュされたグループとインデックスを再適用し、キャッシュされた残差R_gをsparse出力に加算します。この残差項は、ステップごとのdenseなコストを支払うことなく破棄テール誤差を部分的に回復するためのメカニズムです。アンカーステップでの正確な確率による選択は選択誤差を標的とします。
結果
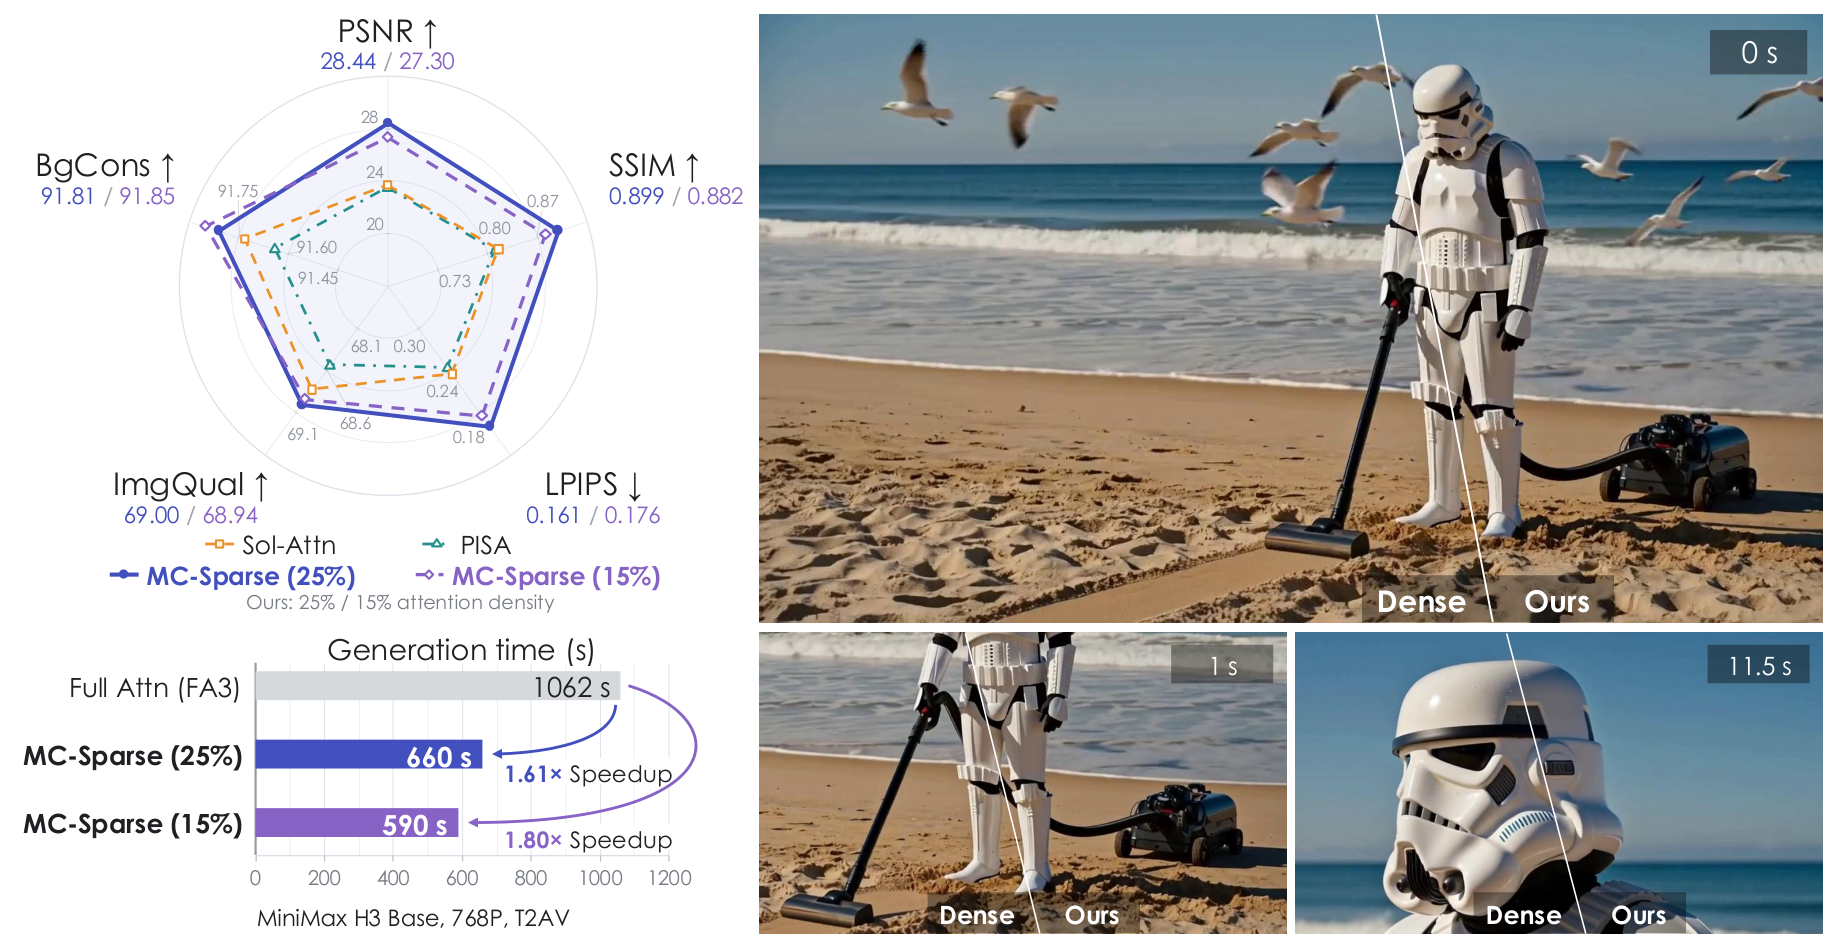
768pにおけるMinimax-H3-Baseにて、MC-SparseはFA3のdense attentionに対して、15%のattention密度で1.80\timesのDiT denoising高速化、25%の密度で1.61\timesの高速化を達成しながら、参照フレームにおいてdense出力と視覚的に区別がつかないレベルを維持しています。評価はMinimax-H3-Base、HunyuanVideo-13B、Wan2.1-14B T2V/I2V、HY3D-Internal(image-to-geometry)にまたがり、ベースラインとしてSVG2、SVG-EAR、Sol-Attn、PISA、SpargeAttnを使用しています。
denseとの忠実度は、動画についてはPSNR/SSIM/LPIPSで、知覚品質についてはVBench ImgQualとBgConsで、3D形状についてはChamfer距離、体積IoU、F1、Uni3D-I、ULIP3D-Iで測定されています。これらの指標全体において、MC-Sparseは同一密度のすべてのベースラインと比較して、dense出力に対してより高い忠実度を報告しています。
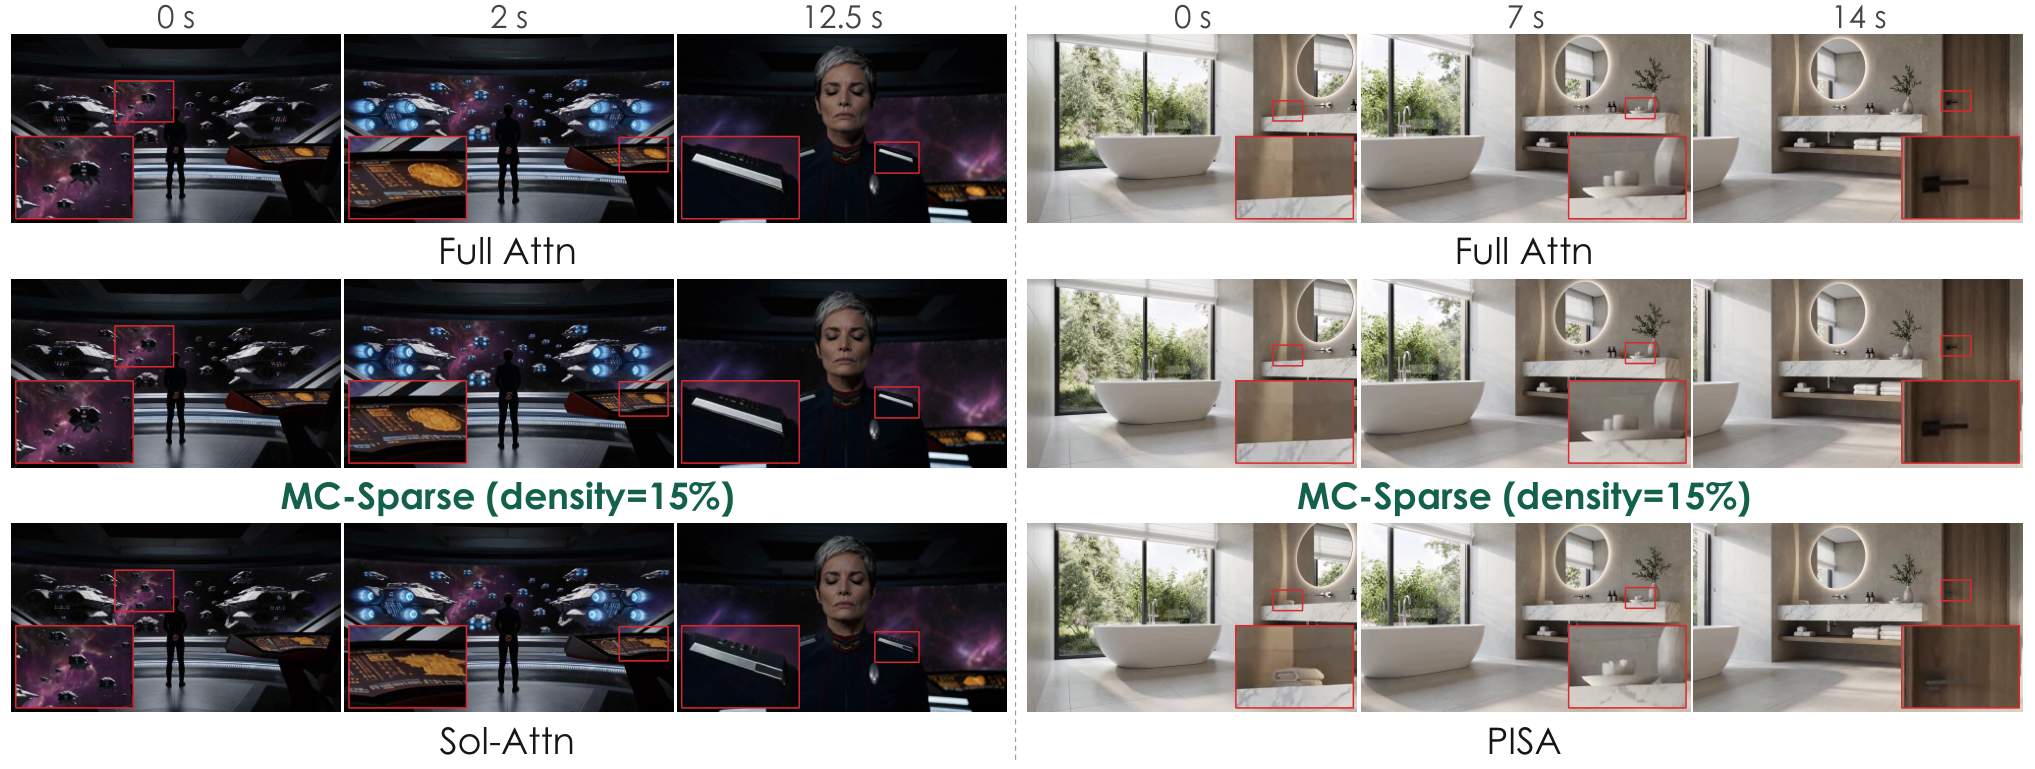
動画比較において、競合するsparse手法は積極的な密度設定において構造的なアーティファクトまたはモーションの不整合を引き起こすのに対し、MC-Sparseはこれを回避しています。
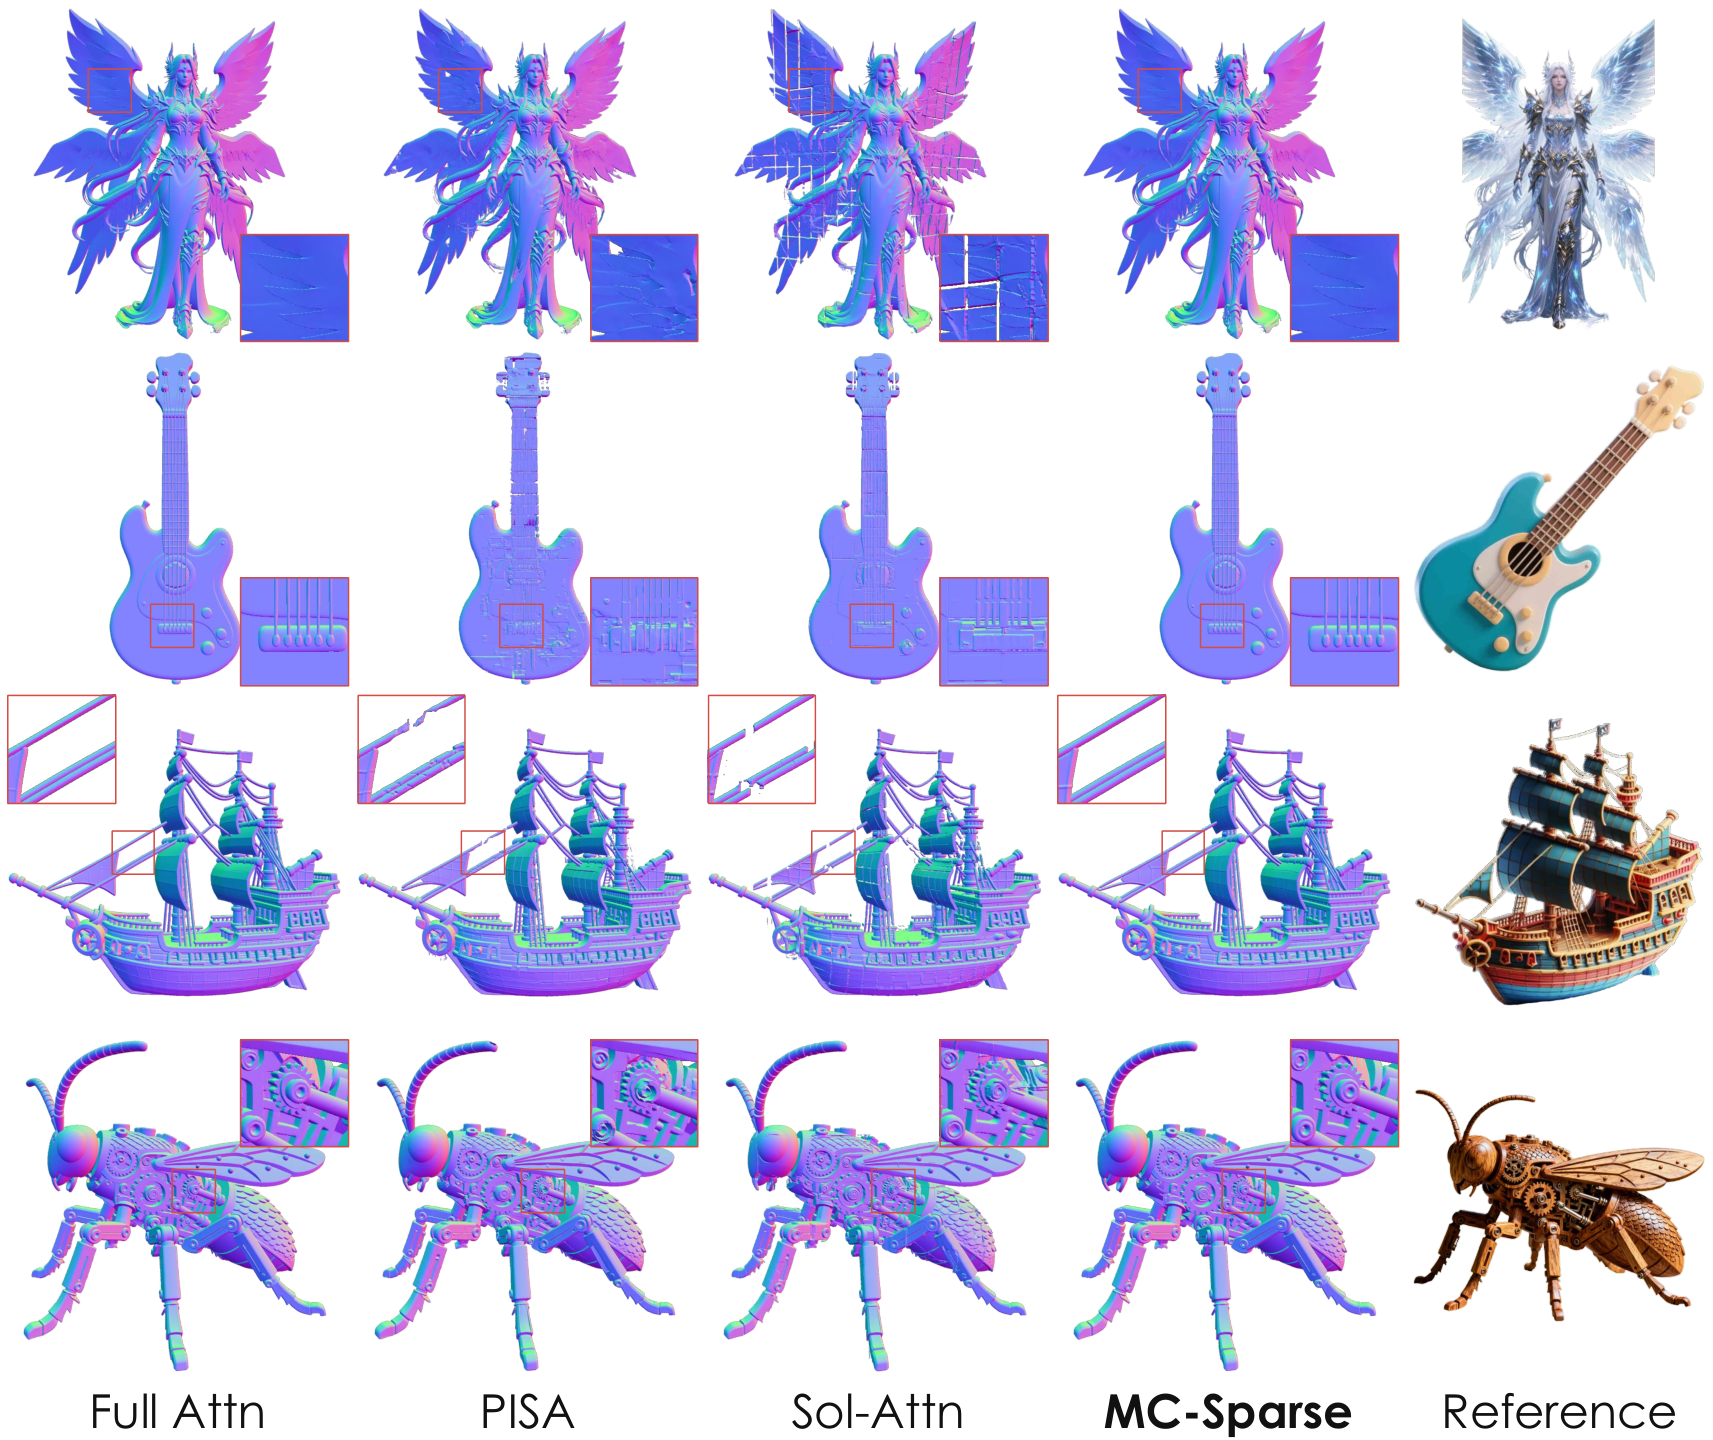
3Dアセット生成においてはギャップがより顕著です。ベースライン手法は低密度では幾何学的なディテール(サーフェスノイズ、特徴の欠落)を失うのに対し、MC-Sparseはdenseに近い精細な形状を保持しています。
限界と未解決の問題
- 残差キャッシュR_gはアンカーステップで一度計算され、静的な補正として再利用されます。アンカー間でdense–sparse残差がドリフトすると、誤差が蓄積します。本論文はアンカー間隔への感度や適応的なスケジューリングポリシーについては報告していません。
- トークンレベルのKV gatherはカーネルバウンドであり、BSAに対する高速化は、カスタムのgather-attentionカーネルがブロック連続型のSVG2/SpargeAttnカーネルに対してメモリ帯域幅をどれだけ効率的に飽和させるかに依存します。15%密度での1.80\timesは、理論上の\sim6.7\timesのFLOP削減に対して控えめな値です。
- PDDPはMHAにおけるper-headの構造を無視しており、グルーピングはQの特徴量に基づいて行われますが、各headは独自のK,Vを持ちます。本論文はこの点を指摘していますが、それによる損失を定量化していません。
- すべての評価は事前学習済みモデルに対するzero-shot推論であり、attentionのステップ間安定性が弱い可能性のあるdistillationや少ステップサンプラーとの互換性については主張されていません。
この研究の意義
オラクルによる分解は、sparse attentionにおける構造的誤差、選択誤差、およびテール誤差を明確に分離しており、単なるヒューリスティックではなく、再利用可能な診断フレームワークを提供しています。エンジニアリングの貢献として、PDDPバランスのqueryタイルとトークンレベル選択を組み合わせた残差キャッシュは、本番スケールの動画および3D DiTにおいて≤25%の密度でdenseに近い忠実度を達成した、初めての学習不要のsparse attentionです。
Source: https://arxiv.org/abs/2610.06801
SparseDecoding: 正確かつ効率的なLLM推論のためのDecoding対応Pruning
問題設定
Optimal Brain Surgeon(OBS)およびその派生手法(SparseGPT、Wanda)を用いたpost-training pruningは、帯域幅がボトルネックとなるdecodingにおけるLLMのメモリトラフィックを削減するための主流な手法となっています。これらの手法はいずれも、密なモデルにteacher-forcingで自然なテキスト(例:C4、WikiText)を入力して得たcalibration activations X_\ell から、層ごとのHessian H_\ell = 2 X_\ell X_\ell^\top を計算します。しかし推論時には、モデルは自身の自己回帰的な出力を消費します。著者らは、このことがcalibration activationsとdecoding activationsの間に分布シフトを引き起こすと主張しています。すなわち、重みの顕著性(saliency)をスコアリングするために使用されるHessianが、pruned後のモデルが実際に計算を行う演算子と体系的にミスマッチしているのです。経験的に、このシフトは保留された自然なテキストに対するperplexityには現れない形で生成品質を低下させます。
第二のギャップはシステムレベルにあります。既存の高速化されたsparse LLMカーネルは、prefillで発生するsparse matrix-matrix multiplication(SpMM)を対象としています。一方、decodingはバッチサイズ1のsparse matrix-vector products(SpMV)が支配的であり、典型的な2:4やブロック構造のカーネルは密なcuBLAS GEMVと比較して実時間での改善が限定的です。
SparseDecodingはこれら両方に対処します。OBS HessianをGeneration分布に向けて誘導するdecoding対応calibration手順と、メモリ帯域幅律速レジームを対象としたSpMVカーネルです。
手法
Pruningのバックボーンは層ごとのOBSのままです。各線形層 \ell に対して、次の問題を解きます。
\widehat{W}_\ell = \arg\min_{\widetilde W_\ell} \left\lVert (W_\ell - \widetilde W_\ell) X_\ell \right\rVert_F^2 \quad \text{s.t.} \quad \operatorname{sparsity}(\widetilde W_\ell) = S_\ell.
二乗Frobenius lossは行ごとに分解され、Hessian H = 2 X_\ell X_\ell^\top を共有するため、OBSは最も顕著性の低い重み w_q と補償更新に対する閉形式を与えます。
\mathcal{L}_q = \frac{w_q^2}{2 [H^{-1}]_{qq}}, \qquad \delta w = -\frac{w_q}{[H^{-1}]_{qq}} H^{-1}_{:,q}.
SparseGPTはpruningの順序を事前に固定することで、H^{-1} を毎回再計算することなく逐次的に更新できるようにしています。SparseDecodingはこの枠組みを継承し、主な変更点は X_\ell の収集方法にあります。
密なモデルにteacher-forcingで自然な系列を入力するのではなく、SparseDecodingはcalibration activationsを自己回帰的に生成します。プロンプトセットをサンプリングし、密なモデルを用いて補完を生成しながら、生成されたprefixに沿って各層のactivationsを収集します。得られた X_\ell^{\text{gen}} は自己生成されたトークン分布を反映するため、H_\ell^{\text{gen}} = 2 X_\ell^{\text{gen}} (X_\ell^{\text{gen}})^\top はpruned後のモデルがdecoding時に実際に直面する演算子に関するsaliencyを測定します。この変更はcalibrationパイプラインのみに関わるため、任意のOBS系ソルバー(SparseGPT、更新付きWanda)および任意のsparsityパターン(非構造化、2:4、N:M)と組み合わせることができます。
カーネル側は、重み行列がオンチップSRAMに収まらないレジームにおけるsparsityでのSpMVを対象としています。mma.spによる2:4の活用(これはGEMMスループット向けにチューニングされており、依然として密なactivationsの読み込みを強制します)とは異なり、SpMVカーネルは各threadblockがHBMからsparseな行タイルを一度ストリーミングし、圧縮されたインデックス構造を用いて必要なactivationエントリのみをgatherし、レジスタ上でdot productを積算するように構成されています。バッチサイズ1のdecodingは W の読み込みで消費されるHBM帯域幅によってボトルネックとなるため、非ゼロ要素数の削減はレイテンシの削減に直結します。ただし、非ゼロ要素あたりのインデックスオーバーヘッドが小さいことが条件であり、これが安価なデコードを持つ構造化sparsityパターンが好まれる理由です。
結果
著者らは4つのinstruction-tunedモデル — Llama-3.1-8B、Llama-3.3-70B、Qwen3-14B、Qwen3-32B — を評価し、A100 80 GBにて線形層のみをpruningしています。abstractおよび実験設定では、評価軸として自己回帰calibrationによる長文生成品質、コード生成の汎化性、SpMV decodingレイテンシの3つが示されています。抜粋された節には数値テーブルが含まれていないため、具体的な精度やスピードアップの数値はここでは引用できません。主張されていることは、(i)自己回帰calibrationが同一のsparsityバジェット下で、自然テキストcalibrationと比較して長文生成タスクの品質を維持すること、(ii)同じcalibrationが別個のコードドメインcalibrationセットなしにコードへ汎化すること、(iii)SpMVカーネルがFLOP削減だけでなく実時間のdecoding高速化を実現すること、の3点です。
制限と未解決の問題
この枠組みは、自然テキストと自己生成activationsの間のシフトがcalibrationソースを交換することで測定可能かつ削減可能であることを前提としています。提供された資料からはいくつかの問いが未解決のまま残っています。第一に、自己回帰calibrationはteacher-forced calibrationよりもコストが高く(各サンプルが逐次decodingを必要とする)、H_\ell^{\text{gen}} が安定するまでに何トークン生成が必要かを論文は定量化していません。第二に、生成分布はsampling temperatureとプロンプトの混合に依存しますが、これらのパラメータに対する手法の感度、およびgreedy decodingで十分かどうかは抜粋では扱われていません。第三に、Hessianは依然として密なモデルの生成から計算されていますが、デプロイされるモデルの生成はpruningに伴ってドリフトします。シングルショットのcalibrationはこのクローズドループを無視しています。第四に、バッチサイズ1のSpMVカーネルは、HBMボトルネックにも対処する高度にチューニングされた密なGEMVとFP8/INT4重み量子化と競合します。同一ハードウェア上での量子化密ベースラインとの直接比較があれば、sparsityが依然として有利な状況が明確になるでしょう。最後に、長いコンテキストでのdecoding帯域幅をしばしば支配するKV-cacheメモリとの相互作用については議論されていません。
なぜ重要か
分布シフトの議論は、post-training pruningの既知の弱点を再構成するものです。calibrationデータは通常、デプロイ時の演算子との一致ではなく利便性に基づいて選択されています。これをHessianレベルで修正しつつ、FLOPの削減をdecoding実時間で実現するSpMVカーネルを提供することで、pruning論文と推論サービング実践の間の長年のギャップを埋めます。
Source: https://arxiv.org/abs/2610.12327
Hacker News Signals
Sub-1-Bit LLMの潜在因子分解による圧縮
Source: https://github.com/SamsungLabs/LittleBit
Samsung ResearchのLittleBitは、重み行列を低ランク潜在因子と学習済みコードブックの積に分解することで、パラメータあたり1ビット未満という重み圧縮を実現します。核心となるアイデアは、重みを直接量子化するのではなく、W \approx A B(ここでA \in \mathbb{R}^{m \times r}は低精度浮動小数点で保持し、B \in \{-1, +1\}^{r \times n}は二値行列であり、r \ll \min(m, n))という形に因子分解することです。二値因子がストレージを支配し、ランクrが表現力と圧縮率のトレードオフを制御するため、実効ビット/重みは1を下回ります。
最適化は、Aの更新(標準的な最小二乗ステップ)とBの更新(符号閾値射影)を交互に繰り返します。キャリブレーションには小規模なホールドアウトデータセットを使用し、層ごとの再構成誤差を最小化します。これはGPTQの精神に近いですが、個々の重みを丸めるのではなく、因子分解された表現に対して動作します。
このリポジトリはLLaMAクラスのモデルを対象としており、ストレージを約半分に抑えながら、2ビット手法(例:2ビットのGPTQ)と競合するperplexityの劣化を報告しています。推論速度は、ハードウェアが二値行列演算を活用できるかどうかに大きく依存します。汎用GPUではこれは容易ではなく、現時点でリポジトリはfusedなbinary GEMMカーネルを提供していないため、実際のスループット向上は限定的です。
重要な未解決問題は、ランクハイパーパラメータrが層の感度とどのように相互作用するかという点です。attention projectionとfeed-forward層では特異値分布が大きく異なるため、単一のグローバルなrが最適になる可能性は低いです。SparseGPTのようなHessianベースの感度に基づく混合ランク割り当ては、自然な拡張方向となるでしょう。また、この手法はpost-training量子化アプローチに共通するキャリブレーションデータへの依存性を引き継いでいるため、分布外タスクでは報告されているベンチマークよりも大きな劣化が生じる可能性があります。
StepFunによる1Mコンテキストの MoE モデル「Step 5 Preview」がOpenRouterに登場
Source: https://openrouter.ai/stepfun/step-5-preview
StepFunのStep-5 Previewは、100万トークンのコンテキストウィンドウを謳うmixture-of-expertsモデルであり、OpenRouterの統一APIを通じてアクセス可能になりました。公開されている技術的詳細は乏しいものの、エンジニアリングの観点からいくつかの点が注目に値します。
100万トークンのコンテキストを実現するには、二つの困難な問題を同時に解決する必要があります。すなわち、attentionのメモリスケーリングと位置エンコーディングの汎化です。標準的なmulti-head attentionはメモリに関して O(n^2) であり、100万トークンではhead次元が控えめであってもsparseまたはlinear attentionの変形、ページングされたKVキャッシュ管理(vLLMなど)、あるいはデバイス間のring-attentionなしには実行不可能です。StepFunがどのアプローチを採用しているかは開示されていません。
MoEアーキテクチャは、フロンティアラボの一般的な方向性と一致しています。sparse activationはパラメータ数を高く保ちながらトークンごとのFLOPsを削減します。推論時にはエキスパートのサブセットのみが有効化されますが、100万トークン規模のシーケンスにおけるルーティングとエキスパートの負荷分散は、分散デプロイにおいて無視できない通信オーバーヘッドをもたらします。
OpenRouterで利用可能になったことで、このモデルはOpenAI互換の標準RESTエンドポイント経由でアクセスでき、コンテキスト長を反映したトークン単位の課金が適用されます。サードパーティプロキシを通じた非常に長いコンテキストの処理は、チャンク化されたストリーミングやレート制限によるレイテンシを加えます。これらはいずれも、実際に100万トークンを必要とするドキュメント処理ワークロードにとって重要な要素です。
実用上の問題は、モデルが最大コンテキストにおいてコヒーレントなクロスドキュメント推論を維持できるのか、それとも単にクラッシュを回避するにとどまるのかという点です。この区別は、RULERやHELMETのようなbenchmark suiteが明示的に検証するものです。現時点では独立した評価結果は得られていません。多くの「long-context」モデルが検索タスクにおいて数万トークンを超えたあたりから性能が急激に低下することを踏まえると、公称の制限値を基にパイプラインを構築する前に、ここでの検証は不可欠です。
QuakeがSafe Rustに移植され、ブラウザでプレイ可能に
Source: https://quake-srp.pages.dev/
このプロジェクトは、id SoftwareのQuakeエンジンをSafe Rustに完全移植し、WebAssemblyにコンパイルしてブラウザ上で動作させるものです。ここでいう「Safe Rust」とは、unsafeブロックを一切使用しないことを意味し、コードベース全体を通じて、オリジナルのCが多用していた生ポインタ演算、手動メモリ管理、および未定義動作を排除しています。
QuakeのCソースコードは、ポインタエイリアシング、union を用いた型パニング(有名な逆数平方根はその一例です)、BSPデータ読み込みのための直接メモリキャストで悪名高いほど溢れています。これらをSafe Rustに変換するには、生キャストを適切なデシリアライズ(例えばbytemuckや手動のRead実装)に置き換え、タグ付きunionをenumバリアントとして表現し、ポインタ演算を多用する連結リストのトラバーサルをインデックスベースのコレクションやVecスライスに変換する必要があります。
オリジナルQuakeのレンダラーは、固定小数点ラスタライザを用いた8ビットパレット方式のソフトウェアレンダリングを採用しています。Safeな状態を維持しながらこれをRustに移植するには、固定小数点演算をCマクロではなく型付き整数ラッパーで表現し、(CではRAWアリーナアロケータを使用していた)サーフェスキャッシュ管理をVecベースのプールとして実装する必要があります。
WebAssemblyへのコンパイルは、wasm-packまたは直接wasm32-unknown-unknownターゲットビルドによって行われます。オーディオと入力はwasm-bindgenを介してWeb APIを通じて処理されます。主なパフォーマンス上の懸念点は、Safe Rustの境界チェックがスパンレンダラーのようなタイトな内部ループにオーバーヘッドをもたらすことですが、このプロジェクトはget_uncheckedを使用する代わりにそれを許容しているようです。
このプロジェクトのエンジニアリング的な価値は、30年前のシステムC コードベースをSafe Rustに移植するケーススタディとして、部分的に見出せます。借用チェッカーが強制する不変条件は暗黙の仮定を明示化するものであり、それ自体がドキュメントの一形態となっています。副次的な価値は、Emscriptenを使用せず依存関係の少ない、ブラウザ上で動作するQuakeが実現されていることです。
AIに対応した生物学的データ:18億ドルのグローバルコミットメント
Source: https://biohub.org/news/virtual-biology-initiative-expansion/
Chan Zuckerberg Biohubネットワークは、Virtual Biology Initiativeの18億ドル規模の拡張を発表しました。これはML学習用に構造化された生物学的データセットの生成を明確な目的として掲げたものです。ここでの技術的な核心は、「AIに対応した生物学的データ」が実際に何を必要とするかという点であり、それはImageNetにラベルを付けるよりも格段に困難です。
生物学的データは、バッチ効果(生物学とは無関係な実験条件によって生じる系統的な変動)、極端なクラス不均衡(希少な細胞型、希少な変異体)、不完全なグラウンドトゥルース(タンパク質機能アノテーションが既知のタンパク質のうちカバーするのはごく一部)、そして多モーダルな異質性(イメージング、シーケンシング、プロテオミクス、電気生理学はいずれも同一の基底システムの異なる射影を捉えている)といった問題を抱えています。これらのデータを「AIに対応」させるには、標準化されたデータ収集プロトコル、制御された語彙(Cell OntologyやGene Ontologyといったオントロジー)、そして技術的なアーティファクトを除去しながら生物学的シグナルを保持しようとする正規化パイプラインへの投資が必要です。
このイニシアティブは、いくつかの特定のデータモダリティを対象としています。具体的には、大規模なシングルセルトランスクリプトミクス(すでに7,000万細胞を超えるCZIの既存のCELLxGENEコーパスを基盤とする)、空間トランスクリプトミクス(位置情報という文脈を付加するが、スループットが低くカウントのノイズが多い)、そしてグラウンドトゥルースアノテーション付きのライブイメージングです。この目標は、言語モデルにとってのCommon Crawlに相当する、foundation modelの事前学習コーパスを構築することにあるようです。
未解決の問題は、スケールだけでギャップを埋められるかどうかという点です。生物学的システムは定常的ではありません。同一の遺伝子調節ネットワークであっても、発生、疾患、種によって異なる挙動を示し、ヒト組織アトラスデータで学習したfoundation modelが、例えば薬物摂動応答予測に転用できる保証はありません。データのキュレーションとアノテーションへの投資は、生データのスケールよりも重要であると言えるかもしれません。そして18億ドルを収集、アノテーション、計算資源に配分することは、自明ではない割り当て問題です。
Rustのderiveはしばしば#[inline]を暗黙的に含む
Source: https://yossarian.net/til/post/rust-s-derive-often-implies-inline
この記事は、非自明なコンパイラの挙動を記録しています。Rustの#[derive(...)]によって生成される手続きマクロは、生成されたメソッド実装に対して頻繁に#[inline]属性を付加しており、これはユーザーが明示的に要求していない場合でもクレート間のインライン展開の判断に影響します。
その仕組みは次の通りです。Clone、Debug、PartialEqなどのderiveマクロはトークンストリームを出力するproc-macroとして実装されています。標準ライブラリのderive実装は、生成されたimplブロックに#[inline]を含んでいます。これらのメソッドはコールサイトで生成される(事前コンパイルされたライブラリではなく、コンパイル対象のクレートの一部となる)ため、属性が存在する場合はクレート境界を越えたインライン展開の対象となります。
実際的な影響として、ライブラリクレート内の構造体に#[derive(Clone)]が付いている場合、link-time optimizationなしでもそのclone()の実装が下流クレートにインライン展開されます。これは、生成されたコードの#[inline]属性が、クレート境界を越えたインライン展開を許可するようrustcに伝えるためです。LTOなしでは、#[inline]および#[inline(always)]が付いた関数のみがMIR/codegenのクレート境界を越えます。
これはバイナリサイズとコンパイル時間に影響します。大きな構造体が多くのトレイトをderiveしており、多数の下流クレートで使用される場合、同じ生成コードが各コンパイルユニットに複製されます。また、プロファイリングの出力が誤解を招く可能性もあります。clone()呼び出しに帰属される時間が予期しない場所に現れることがあるのは、インライン展開されたコードが呼び出し元のシンボルにマージされているためです。
この記事では、これを回避したいユーザーには#[inline]を付けない手動のimplブロックを使用するか、明示的に#[inline(never)]を使用することを推奨しています。ホットパスにとってはデフォルトの挙動が通常は望ましいですが、まれにしか使用されない大きな型に対してはコードサイズのトレードオフが割に合わない場合があります。これはドキュメントにほとんど記載されない類の暗黙の契約ですが、パフォーマンスを重視するライブラリクレートにとって重要な意味を持ちます。
GPT-6 と万人向けインテリジェントUI
Source: https://openai.com/index/gpt-6-for-everyone/
OpenAIはGPT-6を、無料・Plus・Pro・APIの各ティアで同時提供するかたちでリリースしました。また、ユーザーの専門知識レベルを推定し、それに応じて表示内容を調整する再設計されたインターフェースも同時に公開されています。システムおよびモデリングの観点から注目すべき技術的な主張は以下のとおりです。
GPT-6は、断片化していたGPT-4o / o系列のラインナップを統合する単一モデルとして位置づけられており、これまで「oシリーズ」モデルに分離されていた推論能力がベースモデルに統合されたことを示唆しています。これは、chain-of-thought推論が推論時のプロンプトではなくベースの学習に組み込まれているか、あるいはサービングインフラがクエリごとに計算量を動的に調整しているかのどちらかを意味します。後者はspeculative decodingやadaptive computeアーキテクチャと整合性があります。
「インテリジェントUI」機能は、ユーザーのバックグラウンドを推定し、応答の冗長性・形式・技術的深度を自動的に調整しようとするものです。その仕組みは説明されていませんが、考えられる選択肢としては、(1) 会話のプレフィックスに対して軽量な分類器を適用してシステムプロンプトを条件付けする、(2) 複数の文体レジスターを学習しそれらを選択するfine-tunedモデルを用いる、(3) ユーザーアカウントのメタデータからメタプロンプトを構築する、の3つがあります。運用上最もシンプルなのは選択肢(1)です。
ベンチマークについては、OpenAIがMMLU・MATH・コーディング評価においてstate-of-the-artを報告していますが、評価セットがカットオフ以降の学習データと汚染されているかどうかが不明なため、これらの数値の解釈は困難です。これはフロンティアモデルの評価全般に共通する問題です。ホールドアウトタスクにおける独立した第三者評価(例:LMSYSアリーナ経由)のほうが、より有益な情報をもたらすでしょう。
この能力水準での無料ティア提供は、オープンウェイトモデルの競争上の基準を引き上げます。6か月前にGPT-4クラスの能力で競争力があったモデルは、現在では無料ティアを下回っており、リソースが限られた環境でのデプロイ判断に影響を与えます。
誰も知らなかった惑星を発見したかもしれない――Claude Codeを使って
Source: https://www.reddit.com/r/ClaudeAI/s/mbe5IY2LF9
あるRedditの投稿に、アマチュア天文家がClaude Codeを用いてアーカイブの視線速度データに対する分析パイプラインを繰り返し記述・改善した結果、これまでカタログに登録されていなかった系外惑星候補のシグナルを発見した経緯が綴られています。その新奇性を強調したフレーミングとは切り離して、技術的な内容を整理する価値があります。
視線速度法による系外惑星検出は、時系列の分光器測定値にケプラー軌道モデルをフィッティングすることで行われます。パイプラインには通常、以下の処理が必要です:星の活動シグナルのデトレンド(類似した周期を持つ惑星のシグナルと混同される可能性があるため)、ロンバーグ・スカーグル周期図やガウス過程回帰による周期探索、そしてノイズやエイリアシングに対して惑星仮説を区別するためのベイズモデル比較。これらの手法自体は新しいものではなく、問題はユーザーが正しく実装できているかどうかです。
今回の作業ワークフローでは、Claude Codeを用いてPythonスクリプトをインタラクティブに生成し、公開アーカイブ(おそらくNASA Exoplanet ArchiveのHARPSまたはHIRES)からのデータ読み込み、周期図の計算、そしてradvelやastropyなどのパッケージを用いた基本的な軌道フィッティングを繰り返し改善しました。Claude Codeの価値は、ドメイン知識は持ちながらもソフトウェアエンジニアリングに不慣れなユーザーが、動作するスクリプトにたどり着くまでの時間を短縮できる点にあります――ユーザーは分析がどうあるべきかを理解していたものの、実装には支援が必要でした。
重要な注意点として、惑星候補シグナルには独立した検証が不可欠です:1日および1年のサンプリング周波数におけるエイリアシングの確認、複数の観測期間にわたるシグナルの持続性の確認、そして彩層圏活動指標による恒星活動の除外が求められます。Redditの投稿は査読済みの検出報告ではありません。この候補は実在するものかもしれませんし、データ処理上のアーティファクトである可能性も、あるいはカタログ検索で見落とされた既知のシグナルである可能性もあります。
この一件が実際に示しているのは、LLMによるスクリプティング支援が公開科学データセットに対する探索的データ分析の敷居を下げるという事実であり、これは今回の特定の主張とは独立して、真に科学的な価値を持つと言えます。
Google Playground: カスタムゲームの作成とプレイ
Source: https://blog.google/innovation-and-ai/technology/ai/playground-experimental-gaming-platform/
Google Playgroundは、テキストおよび画像プロンプトからプレイ可能なブラウザゲームを生成する実験的なプラットフォームであり、ゲームロジックの生成とアセット合成の両方をGeminiモデルが担っています。説明から推測される技術アーキテクチャは、複数のコンポーネントが順次連携する構成になっています。
ゲームロジックは実行可能なコードとして生成されます——ブラウザネイティブのデプロイターゲットを考えると、おそらくJavaScriptでしょう。プロンプトから構文的・意味的に正しいゲームロジックを生成することは、典型的なベンチマークで測定されるよりも難しいコード生成の問題です。なぜなら、ゲームにはステートフルなイベントループ、衝突検出、入力処理、および互いに整合性のとれた勝利・敗北条件が必要だからです。シンプルなアーケードゲームでも100〜300行程度の非自明なJSを要しますが、このスケールではLLMが生成したコードは軽微な修正で動作可能なことが多く、それがこのシステムの実用性を支えている理由かもしれません。
アセット生成(スプライト、背景、サウンド)は画像および音声生成モデルが担当します。統合上の課題は、生成されたゲームロジックと寸法的に整合したアセットを生成することです——コードが32×32のスプライトを想定しているのに画像モデルが512×512を出力した場合、リサイズパイプラインをループに組み込む必要があります。レトロスタイルのゲームエフェクト向けのプロシージャル音声合成は比較的低fidelityなタスクであり、既存の音声モデルで十分に対応できます。
イテレーションモデルはプロンプトベースの修正をサポートしているようです。「敵を速くする」や「ダブルジャンプを追加する」といった編集は、局所的なコード変更にうまくマッピングされます。また、ゲームのソース全体が単一のコンテキストウィンドウに収まるため、Geminiのlong-context能力が編集の際に有効に機能します。
エンジニアリング上の限界は信頼性にあります。ゲームロジックの生成は非自明な形で失敗することがあります(衝突ボックスのoff-by-oneエラー、リセット時に蓄積するイベントリスナー、物理演算における浮動小数点の誤差の蓄積など)。自動テストやフィードバックループを備えたサンドボックス実行がなければ、エラー修正はユーザーが誤動作に気づいて再プロンプトすることに依存することになります。
注目の新しいリポジトリ
ejfkdev/ddc
Rustで完全に記述されたDEX-to-Javaデコンパイラであり、正確性とスループットを同時に追求しています。既存のデコンパイラ(jadx、cfr、procyon)の多くはJVMベースであり、GCおよび起動オーバーヘッドが発生しますが、ddcはRustのゼロコスト抽象化を活用しヒープの無駄な割り当てを回避することで、本番APK全体を数秒で、個別クラスのクエリをミリ秒単位で処理します。
アーキテクチャはプログレッシブ解析を採用しており、まず軽量なインデックスパスを構築するため、呼び出し元はアーカイブ全体をデコンパイルすることなく単一のメソッドをクエリできます。これは、プロジェクト全体のダンプではなく高速なシンボル解決を必要とする静的解析ツール、差分ツール、パッチ監査ツールなどにとって重要な特性です。
カバレッジは包括的であり、マルチDEX分割やアプリバンドルおよびサードパーティストアで使用されるコンテナフォーマットのXAPK、APKS、APKMを含む、すべてのDEXフォーマットバージョンをサポートしています。出力はjavacに対して検証されており、デコンパイルされたソースがエラーなしに再コンパイルされることを意味します。これは、ほとんどのデコンパイラが強制していない強力な正確性の指標です。
Rust実装により、JVM依存関係を引き込むことなくFFIやWASMターゲットを介した組み込みも容易になります。これはCIパイプライン、モバイルセキュリティサンドボックス、あるいはエディタプラグインにとって有益です。大規模なAPKコーパス解析を行うセキュリティ研究者にとっては、jadxに対するスループットの優位性が主要な差別化要因となります。
Source: https://github.com/ejfkdev/ddc
youngyangyang04/llm-master
LLMエンジニアリングスタック全体を網羅する体系的な中国語カリキュラムで、基礎概念から本番環境へのデプロイメントまでを扱っています。対象範囲は異例なほど広く、Prompt Engineering、RAGパイプラインの構築、AI Agentのデザインパターン、Model Context Protocol(MCP)、supervised fine-tuningのワークフロー、推論デプロイメント(量子化、serving frameworks)、Transformerの内部構造、そして中国の大手テック企業向けの面接対策が含まれています。
このリポジトリは、リンクをフラットに並べたコレクションではなく、段階的な学習パスとして整理されています。各セクションにはアノテーション付きのコード例、中国語による概念説明、関連する論文やツールへのポインタが含まれています。RAGとAgentのセクションが最も充実しており、チャンキング戦略、vector storeの統合、tool-useのscaffolding、および評価アプローチを網羅しています。
中国語を話す実務者にとっての主な価値は、学術的なMLとアリババ・百度・ByteDanceといった企業に関連する特定のツールチェーンや面接の慣習を橋渡しする、単一の管理されたリファレンスが手に入る点にあります。中国語を読まない読者にとっては、中国のMLエンジニアリングコミュニティが2024〜2025年の本番環境向けに何をカノニカルなトピックと見なしているかを示す有用なシグナルとなります。RAGやfine-tuningと並んでMCPが含まれていることは、実務者の間で急速に形成されつつあるコンセンサスを反映しています。
Source: https://github.com/youngyangyang04/llm-master
ruc-datalab/EvoOntology
EvoOntologyは、Claude CodeやOpenAI Codexといったエージェント型コーディング環境に、自己進化するオントロジー層を追加するプラグインです。解決しようとする核心的な問題は、LLMベースのデータエージェントがドメイン知識をコンテキストウィンドウ内に暗黙的に蓄積するため、セッションをまたいで失われてしまい、複数のエージェント間での共有にも失敗するという点です。
このプラグインはエージェントのインタラクションに割り込み、コードベースやデータスキーマに関連する概念・関係・制約といった構造化オントロジーを継続的に更新し、永続的な外部アーティファクトとして保存します。エージェントが新しい用語や関係に遭遇すると、EvoOntologyはそれを既存のグラフと照合し、以前の知識を破棄するのではなく、競合を解消しつつスキーマを拡張します。これにより、一時的なin-context learningが累積的かつクエリ可能な知識ベースへと変換されます。
実践的な効果として、複雑なデータパイプラインや大規模スキーマを扱うエージェントが、毎セッションごとにドメイン構造を一から再導出することなく、長期プロジェクトを通じて正確なセマンティックな根拠を維持できるようになります。また、このオントロジーはエージェントが推論した内容の構造化された監査証跡としても機能し、幻覚的なスキーマ仮定のデバッグに役立ちます。
実装はプラグイン方式で設計されており、最小限の設定で既存のエージェント呼び出しをラップできます。このアプローチは、エージェントが固定された複雑なドメインと繰り返しインタラクションするあらゆる場面――ETLパイプライン、複数テーブルのデータベース、進化するAPIサーフェスなど――に適用可能です。
Source: https://github.com/ruc-datalab/EvoOntology
nanaism/yomiyasu
AIが生成した日本語テキストを自然な文体に整えるためのエージェントスキルです。解決すべき問題は明確で、LLMが出力する日本語にはいくつかの不自然なパターンが生じやすいことが知られています。具体的には、するverb複合語の過剰使用、大和言葉が慣用的な文脈でのカタカナ外来語の多用、過度に並列的な統語構造、そしてネイティブ話者には機械生成と見抜かれてしまうような文体上の不統一などが挙げられます。
Yomiyasuは、コンポーザブルなエージェントスキルとして洗練ループを実装しています。これにより、独立した呼び出しを必要とせず、既存のエージェントワークフローに連結できます。本スキルは日本語の編集規範に基づくリライトのヒューリスティクスを適用し、意味内容を変えることなく読みやすさ(読みやすさ)の向上を目指します。
技術的アプローチとしては、既知のAI由来表現に対するルールベースのパターン検出と、意味の保持および指定された文体(フォーマル・カジュアル・ジャーナリスティック)への準拠を制約条件とするLLMベースの言い換え生成を組み合わせています。エージェントループは、自然さの基準が満たされるか、ステップ数の上限に達するまで繰り返されます。
日本語アプリケーション——顧客向けコピー、教育コンテンツ、ローカライゼーションパイプラインなど——において、本ツールは汎用的な後処理promptでは対応が難しいギャップを埋めます。日本語における自然さは助詞の選択、述語の形式、談話レベルの結束性に大きく依存しており、汎用的なstyle transferではなく言語固有の処理が不可欠だからです。
Source: https://github.com/nanaism/yomiyasu
yakuikai/tokentab
Claude Code、OpenAI Codex、Gemini CLI向けのローカルファーストなtoken使用量・コストダッシュボードです。これらのツールは構造化されたセッションログをローカルに書き込みます。tokentabはそれらのログを解析し、モデル・プロジェクト・日付・アクティビティタイプ別に使用量を集計します。アカウント作成不要、テレメトリなし、デバイス外への送信も一切ありません。
アーキテクチャはCLIとオプションのローカルサーブ型Webダッシュボードで構成されています。ログの解析はツールごとにフォーマット固有の処理を行います。Claude CodeはJSONLセッションレコードを保存し、Codexは独自のスキーマを使用し、Gemini CLIも同様です。Tokentabはこれらを統一された内部スキーマに正規化し、モデルごとの価格テーブルを適用してコスト見積もりを算出します。
ダッシュボードはtoken消費量を複数の粒度で分解して表示します。これは、複数プロジェクトにまたがるAPI予算を管理するチームや、どのワークフローがtoken消費量の多いか(例えば、大規模なコンテキスト検索 vs. 密な生成ループ)を特定しようとする開発者にとって、実用的に有用な機能です。
ローカルファーストという制約は単なるプライバシーの主張ではなく、実際のアーキテクチャ上の選択です。維持すべきインジェストエンドポイントがなく、認証レイヤーもなく、オフラインでも動作します。制限としては、プロバイダーが料金を変更した際に価格テーブルを手動で更新する必要があること、また複数マシンにまたがる集計にはログディレクトリを手動で同期する必要があることが挙げられます。エージェントツールの支出を監査したい個人開発者や小規模チームにとって、カスタムのログ解析スクリプトを構築する場合と比べて、低摩擦なソリューションです。
Source: https://github.com/yakuikai/tokentab
jiwoochris/artex-ko
ARTEX(上流: Autumn-27/ARTEX、AGPL-3.0)の韓国語ローカライズ版フォークです。ARTEXは自律型AIによるペネトレーションテストフレームワークであり、LLMベースのプランニングとツール呼び出しを組み合わせてターゲットシステムへの偵察・列挙・エクスプロイトのループを自動化します。LLMが観測された出力に基づいてnmap、gobuster、sqlmap、metasploitモジュールといったツールを選択・順序付けする、標準的なエージェント型セキュリティツールの設計です。
artex-koにおけるローカライズ作業は単なる文字列翻訳にとどまりません。ドキュメント、prompt テンプレート、およびレポート出力が韓国のセキュリティ実務者向けに適応されており、リポジトリは上流のARTEXを追跡しながら韓国固有のパッチを維持しています。これが重要な理由は、ペネトレーションテストエージェントにおけるpromptの品質が言語に対して敏感であるためです。エクスプロイト選択や脆弱性チェーニングに関する推論チェーンは、実務者の主要言語で表現される方が精度が向上します。
技術的な観点では、このフレームワークは自律型ペネトレーションテストにおける現在の実用上限を体現しています。構造化された列挙フェーズは適切に処理できますが、複雑な多段階エクスプロイトチェーンやpost-exploitationの意思決定においてはまだ人間の監視が必要です。その価値は、熟練したテスターを置き換えることではなく、退屈で定型的な初期フェーズ(ポートスキャン、サービスフィンガープリンティング、基本的な脆弱性チェック)を自動化する点にあります。
AGPL-3.0ライセンスを採用しているため、改変物はオープンソースとして公開する義務があります。これはクローズドフォークを通じて武器化されうるセキュリティツールとして適切な選択です。
Source: https://github.com/jiwoochris/artex-ko
Qiuner/birdview
Birdviewは、LLMを活用した編集の前にコードベースのアーキテクチャマップを生成するツールです。コーディングエージェントがシステム全体の可視性を欠いているために、局所的には正しくても全体的には破壊的な変更を行ってしまうという特定の失敗モードを対象としています。
このツールはリポジトリを解析し、モジュール境界、依存関係グラフ、呼び出し階層、データフローパスといったアーキテクチャの構造化表現を生成します。これをエージェントがタスクを開始する前にそのコンテキストに注入することができます。目的は、各ファイルを独立したものとして扱うのではなく、12個のモジュールで使用されている共有ユーティリティを変更するといった場合に、提案された変更が横断的な影響を持つことをエージェントが認識できるよう、十分な構造的基盤を与えることです。
実装は、静的解析(importグラフ、関数呼び出しの抽出)とヒューリスティックな要約を組み合わせることで、コンテキスト表現をコンパクトに保ち、プロンプトの予算を圧迫することなく典型的なコンテキストウィンドウに収まるようにしていると見られます。出力フォーマットは人間が読みやすく、かつ機械的に解析可能なように設計されており、開発者がアーキテクチャスナップショットを独立してレビューすることも可能です。
核心的な洞察は、アーキテクチャの把握と変更の実行は、現在のコーディングエージェントが混同している別個のタスクであるという点です。Birdviewは把握フェーズを前倒しにすることでこれらを分離します。これはEvoOntologyのようなアプローチと相補的ですが、意味的なドメイン知識よりも構造的なトポロジーに焦点を当てています。
Source: https://github.com/Qiuner/birdview
openOMSI-org/openOMSI
ドイツのバスシミュレーションゲームであるOMSI 2(技術的に詳細な車両・交通モデリングで知られる)をRustで一から再実装したプロジェクトです。このプロジェクトは、既存のOMSI 2のModおよびマップエコシステム(オリジナルゲームのアセットが必要)との完全な互換性を目標としており、エンジンをスタンドアロンゲームではなく、ドロップイン置換のレンダラーおよびシミュレーターとして位置づけています。
エンジニアリング上の興味深い点は、互換性ターゲットの規模にあります。OMSI 2には大規模なコミュニティによるマップや車両Modが存在し、それらは10年以上にわたって蓄積された複雑なファイルフォーマット、スクリプトシステム、物理設定によって定義されています。この互換レイヤーを維持しながらエンジンをRustで再実装するには、ドキュメント化されていないフォーマット仕様やオリジナルエンジンの動作上の癖を正確にリバースエンジニアリングする必要があります。
Rustはこの用途に適した選択です。フォーマット解析のための決定論的なメモリレイアウト、リアルタイム交通シミュレーションに対するパフォーマンスの余裕、そしてフレームレンダリング中にGCポーズが発生しない点が挙げられます。また、本プロジェクトはオリジナルの長年の問題——メモリリーク、32ビットプロセスの制限、マルチコア活用の貧弱さ——を修正することも目指しており、これらはオリジナルの開発者が対処してこなかった課題です。
システムエンジニアにとって、これは互換性優先の再実装におけるケーススタディです。主要な制約はクリーンスレートの設計ではなく、既存エコシステムへの動作的忠実性にあります。ドキュメント化されていない物理積分ステップやスクリプトセマンティクスの再現という課題は、レガシーソフトウェアのモダナイゼーション問題の一類型を代表するものです。