デイリーAIダイジェスト — 2026-10-05
arXiv ハイライト
タンパク質折り畳みの学習はより広い推論に汎化するか?
本論文は、補助的な3D幾何学的読み出しヘッドを用いて、タンパク質構造から生成された質問・回答ペアで凍結LLMを訓練した場合、推論時にタンパク質の内容を一切含まないグラフ・空間・科学・混合推論ベンチマークへ転移する再利用可能な推論プリミティブが得られるかどうかを問います。背景にある動機は、一つの解かれた構造から確定論的に数千の正確に検証可能な空間的・位相的ステートメントが生成されるため、Webテキストが十分に規定しない種類の関係推論に対して高密度の正解教師信号が得られるという点にあります。
設定と訓練シグナル
ベースモデルはQwen3.5-9Bで凍結されており、監査済みのattentionおよびFFN projectionに対してLoRA(rank 16、\alpha=32、dropout 0.05、訓練可能パラメータ43.28M)を適用しています。長さLのタンパク質のバックボーン座標をY \in \mathbb{R}^{L\times 4\times 3}とすると、モデルは残基ごとに1つのマーカートークンを含むプロンプトを入力し、残基状態
H = f_\theta(x)_{\mathrm{res}} \in \mathbb{R}^{L\times 4096}
を出力します。座標Yは入力として与えられることはなく、ラベルの生成および共有ワークスペース(3.90Mパラメータ)と凍結デコーダ(3.31M)を通じた連続的な幾何学的教師信号の提供のみに使用されます。FoldingCorpusはタンパク質ごとに12の自動生成された質問を格納しており、その内容は接触(C_\alpha < 8 Å、配列分離\geq 6)、距離比較、セグメント方向、中心近傍、局所方向、キラリティ、多重制約、および32択のグローバルサマリーマッチングです。9問は二値、2問は三択、1問は32択であり、全選択肢は単一の語彙トークンであるため、教師信号はネイティブのLM headに対する通常のnext-token cross-entropyです。
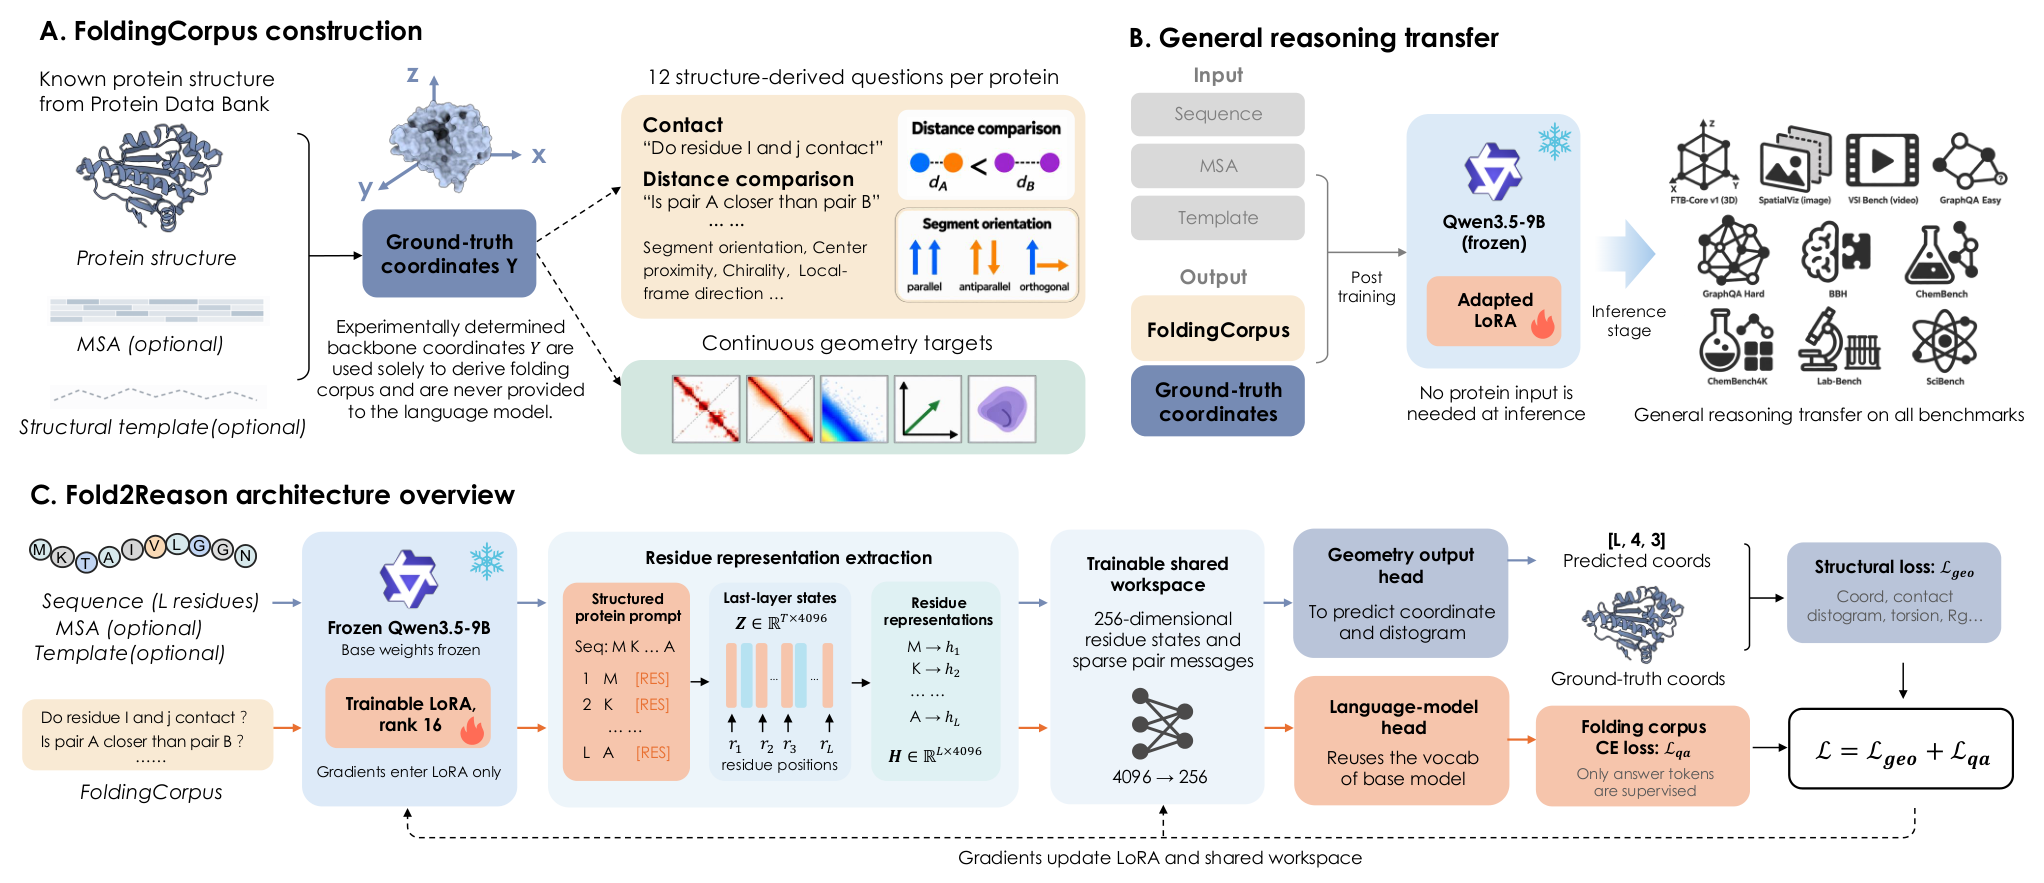
訓練には1,000タンパク質(長さ29〜199)を使用し、配列のみ・配列+MSA・配列+MSA+テンプレートの各ビューにわたって12,000レコードをタンパク質1件ごとに1サンプルとしてパッキングしています。全体の実行は3エポック・375オプティマイザーステップを4×A800-80G上で行い、3シードを用い、ベンチマークに基づくチェックポイント選択は行っていません。
主な転移結果
General-10スイート(空間・グラフ・科学・混合)において、Fold2Reasonはマクロ精度を45.09%から48.33%へ改善しました(+3.23 pp、シード間SD 0.15 pp)。全10ベンチマークで改善が見られました。最大の改善:GraphQA Hard +6.83 pp、SpatialViz +6.10 pp、GraphQA Easy +4.56 pp、ChemBench4K +4.37 pp、BBH +2.36 pp。テキストのみの7データセット(画像・グラフビジュアル系を除く)でもマクロ+2.93 ppを達成し、GraphQA Easy/Hardを除いた8データセットのマクロ改善は+2.62 ppであり、効果はグラフ類似フォーマットに局在していません。
重要なことに、構造予測自体もFoldBenchにおいてベースモデルより2.7〜3.5倍の改善を示しており、LoRAが適用されたバックボーンが単に質問フォーマットを学習するだけでなく、真に幾何学的な能力を獲得していることが確認されています。
対照実験
コアとなる因果的主張は、ベースモデル・12問パッキング・375ステップ・シードを共有する3つのPure-LoRA対照実験に基づいています。
- Hidden Geometry:実際のタンパク質プロンプトを使用しつつ、観測されていないランダム点構造から回答を再計算します。改善:+0.92 pp。内部的に整合しているが入力から切り離された幾何学は弱い転移しかもたらしません。
- Format Copy:幾何学的根拠なしにドナーの回答コードをコピーします。変化:-0.09 pp。
- Fixed Shuffle:元のプロンプトに対し、演算子・語彙のみでマッチングされたドナーラベルを使用します。変化:-0.27 pp。
Fold2Reasonの+3.23 ppは最強の対照実験の3倍以上であるため、この効果は回答トークンの事前分布・フォーマット露出・教師トークン数に帰因するものではありません。順序(実際の幾何学 ≫ 整合しているが無関係な幾何学 ≫ シャッフル)は、タンパク質入力と空間的ターゲットの対応関係こそが転移可能な構造を生み出すという本論文の最も明確な証拠です。
構造的忠実性
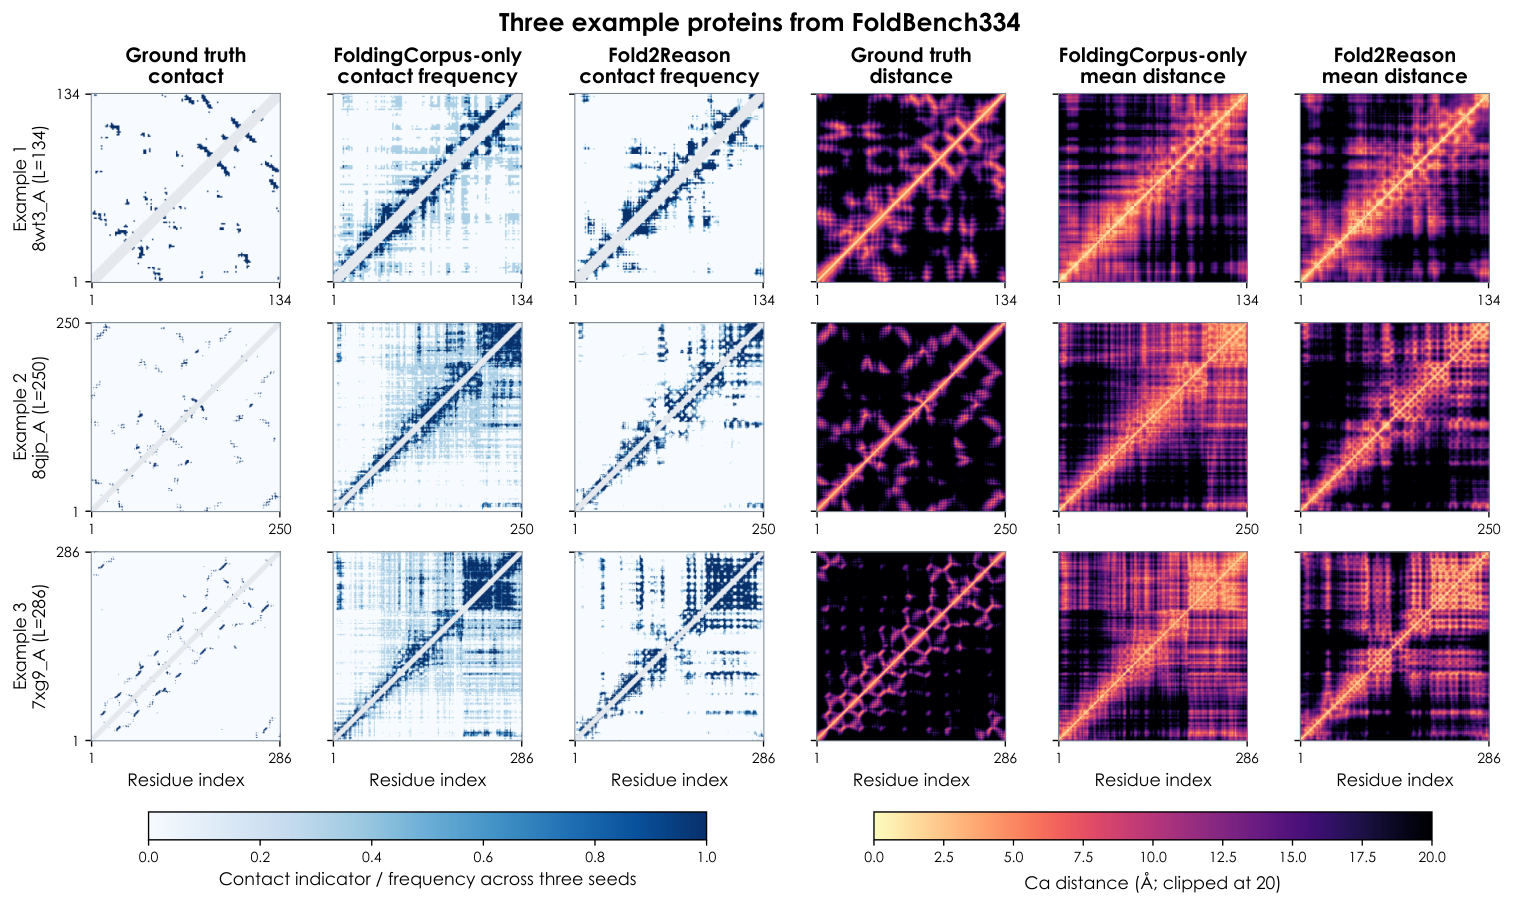
FoldBench334における接触マップと距離マップから、Fold2ReasonはFoldingCorpusのみのアブレーションと比較して、対角線および長距離接触が視覚的に明瞭であることが示されており、定量的な2.7〜3.5倍のスケーリングと一致しています。この改善は訓練時の長さ範囲(29〜199)外であるL=286においても持続しており、幾何学的表現が長さ条件付けのテンプレートを単に記憶したものではないことを示唆しています。
スケールとファミリーへの汎化
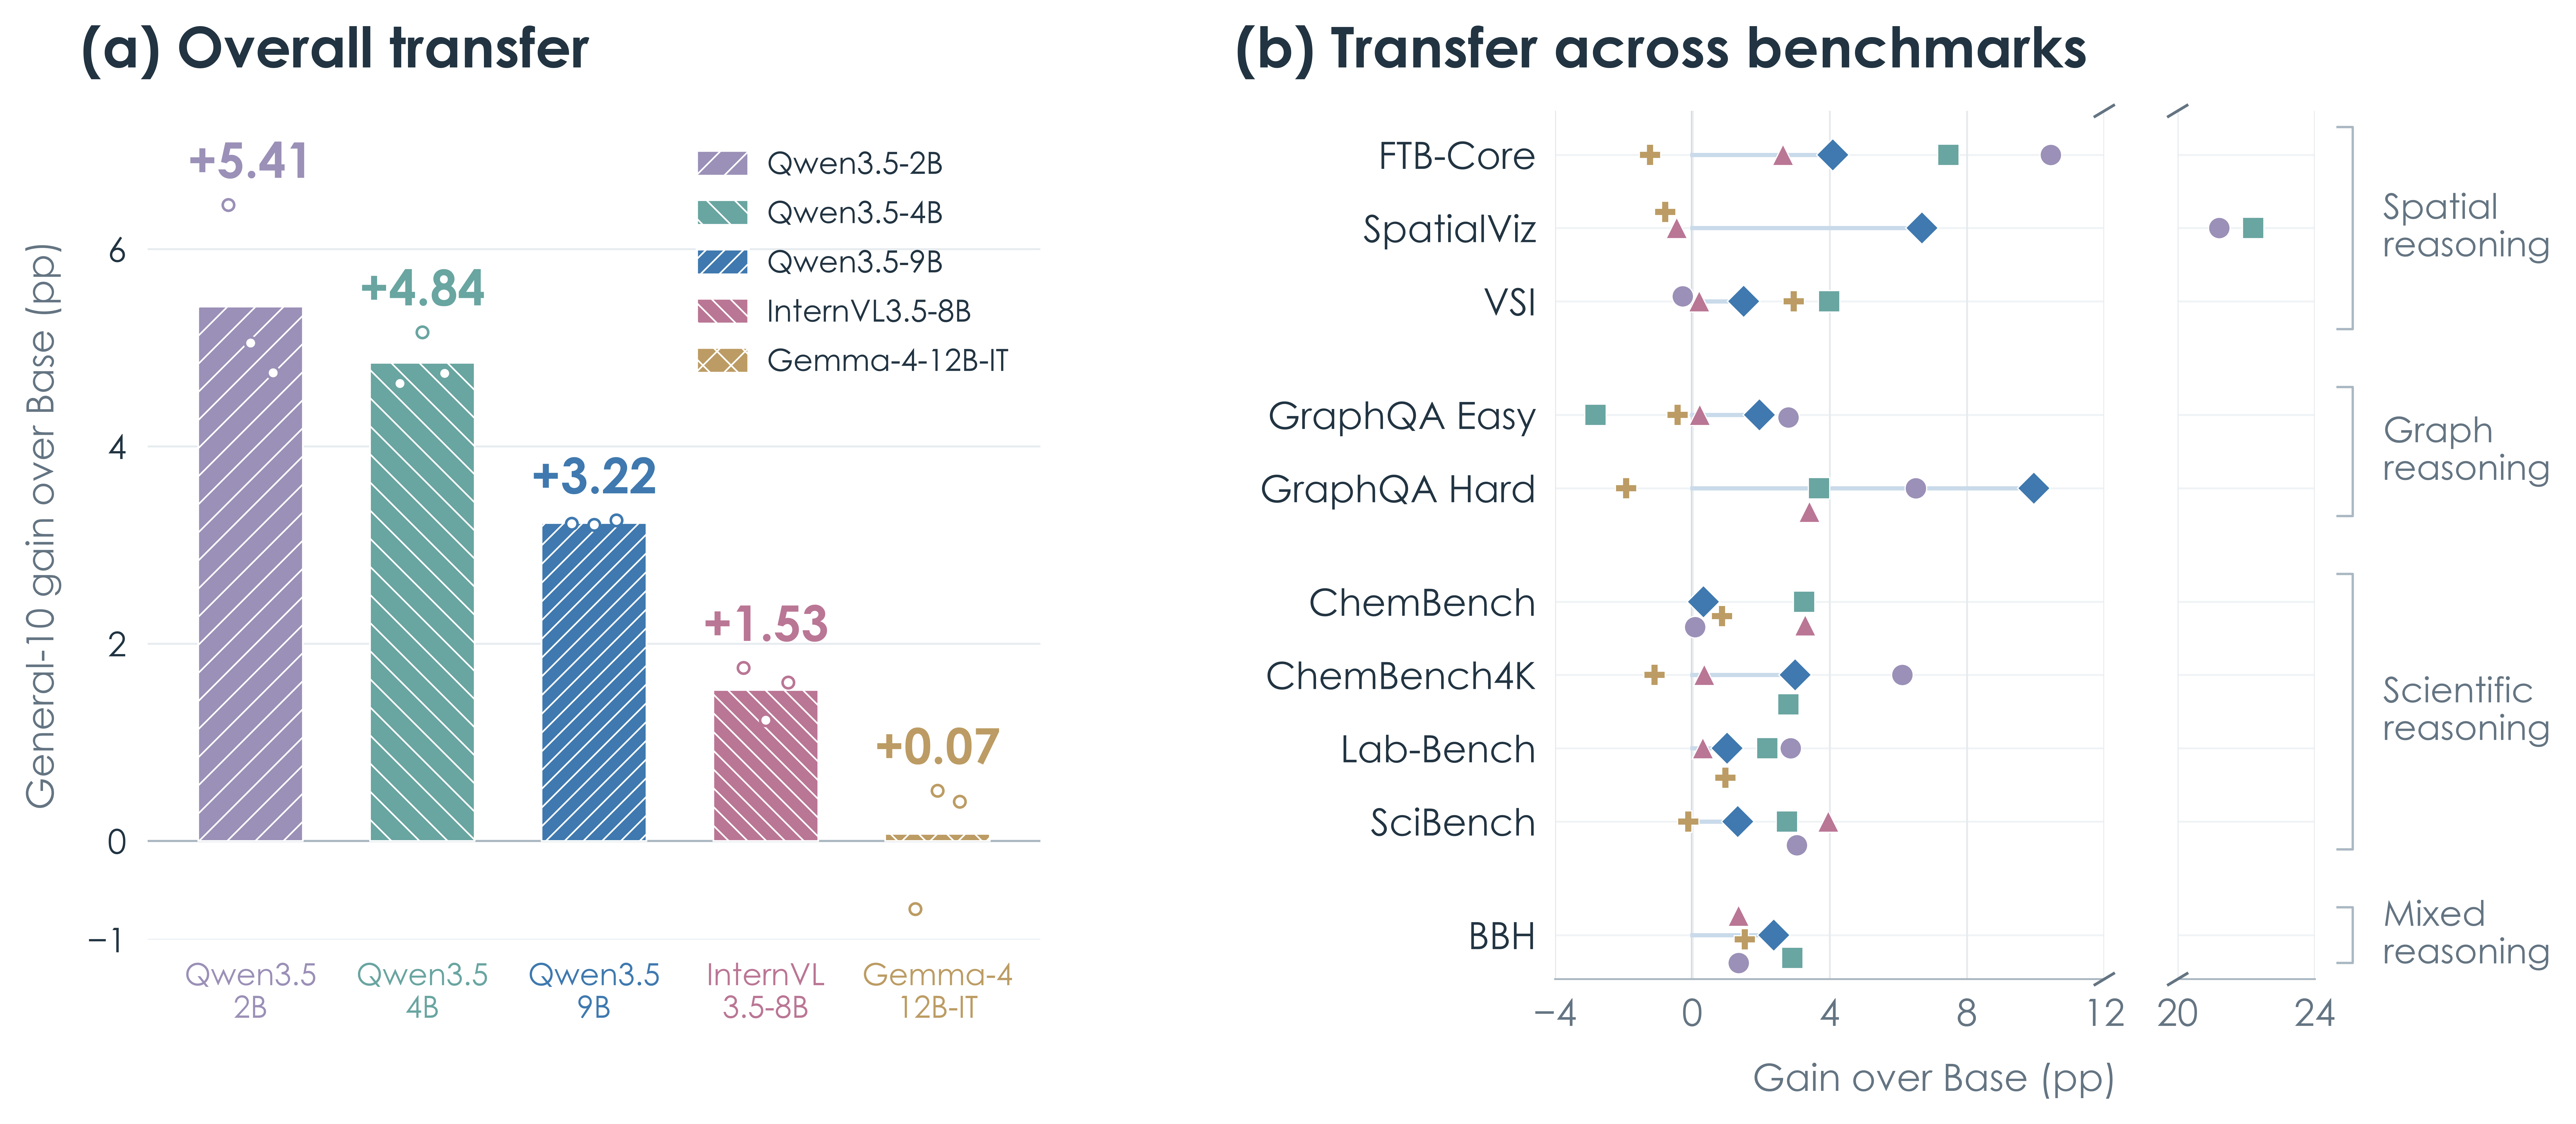
モデルサイズ・ファミリー別のベンチマーク内訳は、概ね正の平均変化を示していますが、SpatialVizが支配する分散が大きく、論文では横軸を分割して表示しています。これにより「Qwen3.5-9Bが特殊なケース」という懸念は弱まりますが、同時に全バックボーンにおいて改善が空間タスクとグラフタスクに集中していることも明らかになっています。
制限と未解決の問題
訓練コーパスは小規模(1,000タンパク質、375ステップ)であるため、この効果の上限は不明です——構造データセットをスケールアップするとマクロ改善はさらに伸びるのか、それとも飽和するのか?第二に、タンパク質が短い(L \leq 199)こと、MSA・テンプレート条件付けが混在していること、そして付録Eの凍結デコータープロトコルが、幾何学的シグナルがワークスペースに吸収されるのではなく真にLLMの表現を通じて流れているかどうかに影響します。第三に、SciBench(+1.03 pp)とLab-Bench(+0.64 pp)はグラフ・空間ベンチマークと比べて改善幅がはるかに小さいため、「汎用推論」という表現は過大であり、転移は構造的にプレテキストに類似した関係的・空間的・組み合わせ論的タスクに集中しているように見えます。第四に、付録H.1のパースの監査では、FTB-CoreおよびSpatialVizにおける残余の回答選択バイアスが指摘されています。最後に、対照実験は対応関係とフォーマットを分離していますが、改善が離散的なQAヘッド・連続的な幾何学デコーダ・あるいはその相互作用のいずれから生じているかを分離できておらず、この2つのシグナルを切り分けるアブレーションが自然な次の実験となるでしょう。
この研究の意義
物理的ドメイン(タンパク質幾何学)からの非言語的かつ確定論的に検証可能な教師信号が、フォーマット・ラベルトークン効果を排除する慎重に設計された対照実験のもとで、無関係な空間推論およびグラフ推論においてLLMを定量的に改善することが示されました。これがスケールにおいても成立するならば、スクレイピングではなく計算によって正解が得られる任意のドメインを用いてLLMに関係的能力を注入するための汎用的なレシピが示唆されます。
Source: https://arxiv.org/abs/2609.38879
再帰的自己書き換えによる複雑なタスクの軌跡スケーリング
問題
成功した軌跡(trajectory)を学習データとするエージェント型LLMは、一般的に専用のスキャフォールド(進捗トラッカー、リトライラッパー、状態管理器、検証器対応コントローラーなど)に依存していますが、これらはデプロイ時には利用できません。通常の対処法はいずれも不満足なものです。すなわち、データ収集を単一の汎用ハーネスに限定して難しいタスクのカバレッジを失うか、ハーネス依存の軌跡で学習してデプロイされたエージェントが再現できない介入を引き継ぐかのどちらかです。Recursive Self-Rewrite(RSR)はこのギャップを標的としています。すなわち、多数のハーネスを用いて解を発見し、それらを単一の汎用ハーネスの下で実行可能な軌跡に書き換え、ハーネス固有のアフォーダンスの漏洩をスクリーニングして除去します。
手法
RSRは1つのベースモデル(Qwen-3.8-27B)を3つのステージにわたって3つの役割で使用します。
ステージ1 — マルチハーネスによる発見。 同じベースモデルを、制御構造(進捗追跡、コンテキスト断絶をまたいだ継続、状態チェックポイント、バリデーター駆動の回復など)が異なる複数のハーネスの下でターミナルタスクプールに対して実行します。各ハーネスごとに成功した軌跡を収集します。約3,000タスクにわたる3つのハーネスの統合カバレッジは759の解決タスクであり、最強の単一ハーネスより34.3%多くなっています。これは、ハーネスの多様性が単に順序を入れ替えるのではなく、解決可能な集合を拡張するという具体的な証拠です。
ステージ2 — 汎用ハーネス下での書き換え。 成功した各ソース軌跡は、3つの役割を用いて1つ以上の汎用ハーネスのデモンストレーションに再構成されます。
- Planner:軌跡をハーネス固有のアフォーダンスに依存しないタスク解決手順を記述したランブックに抽象化します。
- Critic:ランブックおよび提案された書き換えを2種類の失敗モードについて監査します。(i) verifier leakage(解が採点チェックの知識をエンコードしている場合、例えばバリデーターがgrepする文字列を正確に書き込む場合)、および(ii) solution leakage(ハーネスが提供した状態やヒントがexecutorが生成したかのように現れる場合)。criticは再帰的な修正を促進します。ランブックは監査をパスするまで反復的に書き換えられます。これが名称の「再帰的」要素です。
- Executor:適格なランブックを汎用ハーネス下の新鮮なサンドボックスで実行し、エンドツーエンドで検証された候補軌跡を生成します。
- criticのスクリーニングをパスし、かつ(b) 汎用ハーネス下でexecutorによって正常に再現された軌跡のみがSFTのために保持されます。
ステージ3 — SFTと反復。 2,001の成功したソース軌跡から、RSRは11,094の書き換え済み学習軌跡に拡張します(各ソースが複数の有効な書き換えを生成できるため、約5.5倍の増幅)。ベースモデルはこれらでfine-tuningされます。
タスクプール
学習プールは約3,000のターミナルタスクで構成されています。50ドメイン(ソフトウェア使用、生物学、化学、物理学、ハードウェア、オペレーション、セキュリティ)にわたる自己構築のSWRタスク約2,500件と、RSTから改変・強化された420のフィルタリング済みタスクです。ドメインの広さは重要です。それにより、planner/criticがシェルの慣用句に過適合するのではなく、ツール使用の枠組みを超えてランブックの抽象化を汎化することが求められます。
結果
RSR SFT後のベースモデルに対するPass@3の改善:
- Terminal-Bench 2:57.0% → 74.2%(+17.2ポイント)
- Terminal-Bench 4:1.5% → 9.1%(相対的に6倍;絶対値は依然として低く、伸びしろがあることを示す)
- Terminal-Bench Hard(自己キュレーション):39.0% → 63.0%(+24.0ポイント)
- Software Terminal(自己キュレーション):3.0% → 6.0%(相対的に2倍)
本論文はまた、RSRが直接軌跡SFT(すなわち書き換えを行わずにハーネス支援の元の軌跡でfine-tuningすること)を上回ることを報告しています。これが重要なアブレーションです。書き換え+監査パイプラインの価値を、単に学習セットに難しい解決済みタスクを含めることの価値から切り離して評価しています。このギャップは、直接SFTが(i)評価時には存在しないハーネス介入をモデルが期待するように学習させるか、または(ii)転移しないverifier/solution leakageを吸収するかのいずれかであることを示唆しています。
限界とオープンクエスチョン
- Terminal-Bench 4の9.1%およびSoftware Terminalの6.0%は絶対値として依然低い。RSRは軌跡をスケールするが、最も難しいタスクのギャップを埋めるには至っていない。
- criticはベースモデル自身です。Verifier leakage検出は、軌跡が「チートしている」かどうかをcriticが認識できる能力にのみ依存しており、論文は監査の偽陰性率を定量化していません。
- 監査に失敗した書き換えは破棄されます。ソース軌跡のどの割合が生き残るか、また生存者バイアスがランブックに綺麗に分解できるタスクの解に向けて分布を歪めるかどうかは不明です。
- 2,001から11,094軌跡への5.5倍の増幅は、ソースごとの複数の有効な書き換えとランブックレベルの多様性という2つのことを混在させており、論文の現在の説明ではそれらを切り離していません。
- 研究されたのは1つのベースモデル(Qwen-3.8-27B)のみです。34.3%のハーネス多様性ゲインがモデルスケールに依存しないかどうかはオープンな問題です。
なぜ重要か
RSRは発見用スキャフォールドとデプロイ用スキャフォールドの間のクリーンな分離を形式化しています。タスク解決に役立つハーネスを何でも使用し、その後planner/critic/executorループを通じて解をロンダリングして、得られたデモンストレーションをハーネスフリーにします。単一のベースモデルとRLなしでTerminal-Bench 2において57.0% → 74.2%のジャンプを達成したことは、RLやツール使用トレーニングに起因するエージェント能力向上の無視できない部分が、注意深く監査された書き換え済みSFTデータから得られることを示唆しています。
Source: https://arxiv.org/abs/2610.02826
On-Policy Parameter Update Direction Underlies Generalization in LLM Post-Training
問題設定
On-policy post-training(PPO/GRPO)はsupervised fine-tuning(SFT)よりも汎化性能が高いことが知られていますが、先行研究では観察されたパラメータ更新の挙動(スパース性、更新箇所、更新量)を規範的原理としてではなく記述的な副産物として扱ってきました。本論文が提起する問いは実践的なものです。すなわち、SFTに適用することでon-policyの汎化優位性を移転できるような、on-policy更新の単一の側面は存在するのか、という問いです。著者らは、その側面が累積パラメータ更新の符号パターン(方向)であり、短いon-policyのウォームアップによって低コストにこの方向を特定してSFTを制約することに利用できると主張しています。
メカニズム
軌跡スコア s_{\bm{\theta}}(x,\tau)=\nabla_{\bm{\theta}}\log\pi_{\bm{\theta}}(\tau\mid x)(ただし \mathbb{E}_{\tau\sim\pi_{\bm{\theta}}}[s_{\bm{\theta}}]=\bm{0})を出発点とすると、任意の符号ベクトル \bm{v}\in\{-1,0,1\}^d に射影されたon-policy gradientは共分散の形に帰着されます:
\bm{v}^\top g_{\text{on}}(\bm{\theta}) = \mathbb{E}_x\!\left[\bm{v}^\top \mathrm{Cov}_{\tau\sim\pi_{\bm{\theta}}}\!\left[A_{\bm{\theta}}(x,\tau), s_{\bm{\theta}}(x,\tau)\right]\right],
一方、SFTの射影は
\bm{v}^\top g_{\text{sft}}(\bm{\theta}) = -\mathbb{E}_x\!\left[\bm{v}^\top \mathbb{E}_{\tau\sim\pi_{\text{teacher}}}[s_{\bm{\theta}}(x,\tau)]\right]
となります。
したがってSFTは、固定された教師分布によって決まる方向にパラメータを移動させます。この方向は学習の各ステージを通じてほぼ一定のままです。対照的にon-policy更新は、現在のポリシーの下でのadvantage–scoreの共分散によって支配されるため、\pi_{\bm{\theta}}が変化するにつれてその符号パターンも変化します。
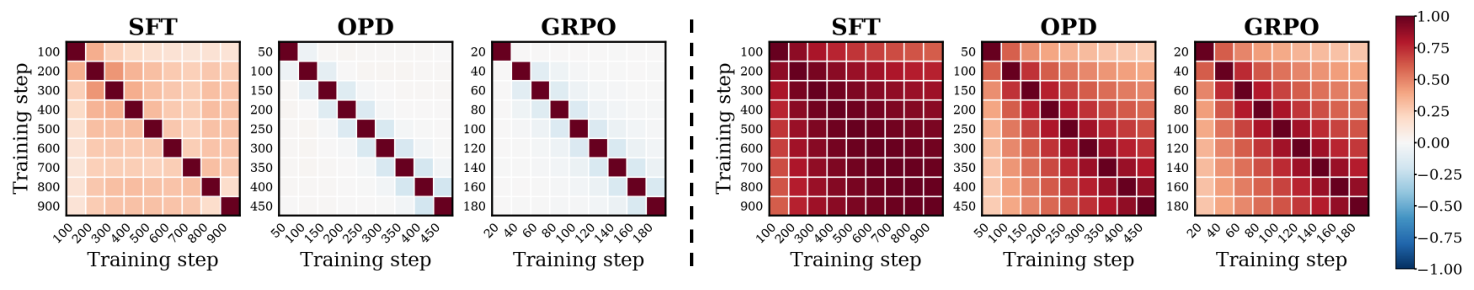
図2はこれをQwen3-1.7B/DeepMathで実証的に確認しています。SFTの区間ごとの更新はステージ間でcosine similarityが高く(パラメータはほぼ同じ方向に動き続ける)、一方でGRPO/OPDの区間ごとの更新はステージ間similarityがほぼゼロです。しかし累積on-policy方向は安定します。つまり、ステップごとの符号は変動するものの、その累積和は明確に定義された低次元方向を形成し、短いon-policyウォームアップ後に抽出できます。
このことがOPSFT(On-Policy direction-constrained SFT)の動機となります:(1)kステップのGRPOを実行して累積更新 \Delta\bm{\theta}_{\text{on}} を取得し、その符号ベクトル \bm{v}=\text{sign}(\Delta\bm{\theta}_{\text{on}}) を抽出する;(2)SFTを実行するが、各ステップで \bm{v} と符号が一致しないgradient成分をマスクまたはクリップし、on-policy学習が移動させたであろう方向にのみ各パラメータを更新するよう制約する。位置制約(どのパラメータを更新するか)は比較のために研究される、より弱い変種です。
結果
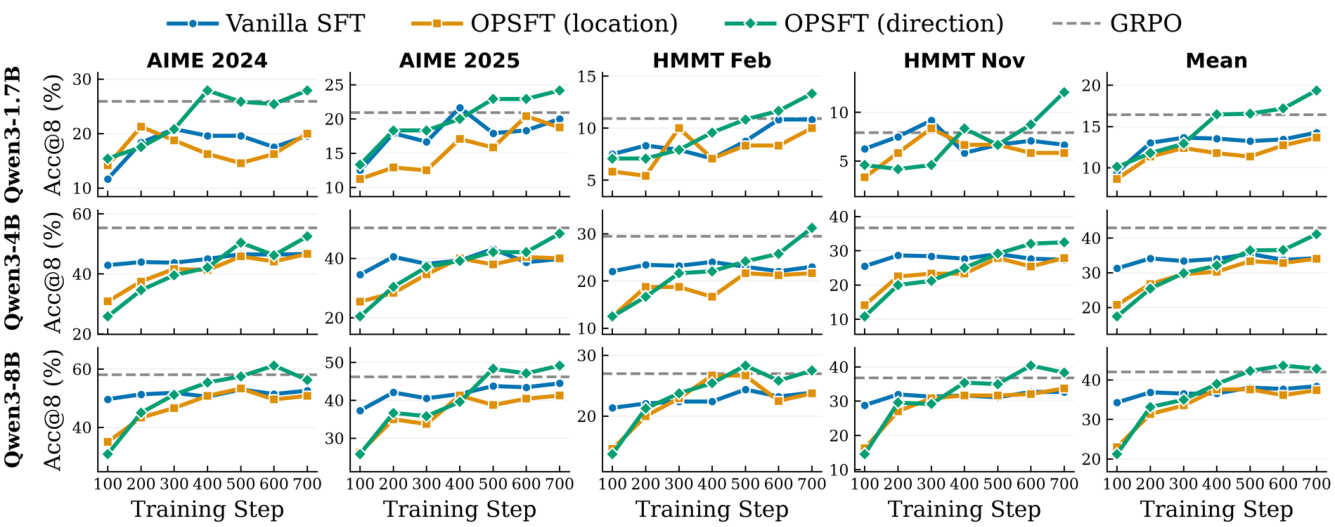
図3は各要素の寄与を分離して示しています。位置のみ(どのパラメータか)でSFTを制約した場合はGRPOの汎化性能の一部しか回復できませんが、方向で制約した場合はそのギャップをほぼ完全に埋め、GRPOを超える場合もあります。これが中心的な実証的主張です。汎化に関連するon-policy情報は、サポートだけでなく符号構造にあります。
定量的結果(表2、DeepMath学習):
- DeepSeek-R1-Distill-LLaMA-8B:OPSFTは8.1時間で平均精度26.56を達成し、DFTの14.1時間での19.90およびそれを下回るvanilla SFTを上回りました。方向制約付き変種はSFT/DFTの700ステップに対して、50ステップのGRPO+100ステップのOPSFTを使用しています。
- Qwen3-8B:OPSFTは8.9時間で平均精度41.67を達成し、19.3時間での100ステップGRPOの40.31を超えました。すなわち、汎化性能を向上させながら実時間を50%以上削減しています。
- わずか50ステップのGRPOから抽出した方向で、100ステップGRPOを上回れることから、有用な方向はon-policy学習の非常に早い段階で結晶化することが示唆されます。
- コードのベンチマーク(表5)でも同様のパターンが再現されており、この効果が数学に特有のものではないことが示されています。
第二の応用例、すなわち完了したon-policyの実行によってすでに辿られた方向に沿って、新鮮な高品質な軌跡を用いてOPSFTを適用する場合においても、GRPOで学習済みのモデルをon-policyの成果を失うことなく継続的に改善できることが示されており、方向こそが保持すべき不変量であるという見方と整合的です。
限界と未解決の問題
本論文では符号ベースの方向制約を用いていますが、連続的な角度制約(累積更新部分空間への射影)がより厳密に優れているかどうかは未検証です。理論的な論拠はon-policy更新をadvantage–scoreの共分散に帰着させていますが、なぜその符号パターンがSFTのスコアのみの方向より汎化するのかは説明されていません。すなわち、メカニズム的な説明(フラットな極小値の選択、低advantage分散領域への暗黙的な正則化)が欠如しています。GRPOウォームアップには依然としてロールアウトとreward modelが必要であるため、OPSFTはon-policyのインフラを排除するのではなく、そのコストを償却するものに過ぎません。最後に、抽出された方向のデータセットおよびシード間での安定性、および8Bを超えるスケールでの挙動は特性評価されていません。
意義
on-policyの汎化が主にパラメータ上の低コストで抽出可能な符号ベクトルによって捉えられるのであれば、高コストなRL post-trainingを短いRLプローブと方向制約付きSFTによって部分的に置き換えることができ、標準的なベンチマークでGRPOと同等以上の性能を示しながらpost-trainingのコストを半分以上削減できます。またこのことは、SFT対RLの議論を再構成します。そのギャップは報酬信号そのものよりも、オプティマイザーがどの座標ごとの符号パターンにコミットするかの問題である可能性があります。
Source: https://arxiv.org/abs/2609.36659
PDE-JEPA: パラメトリックPDEに対する潜在ダイナミクスモデリングの予測的表現学習
問題設定
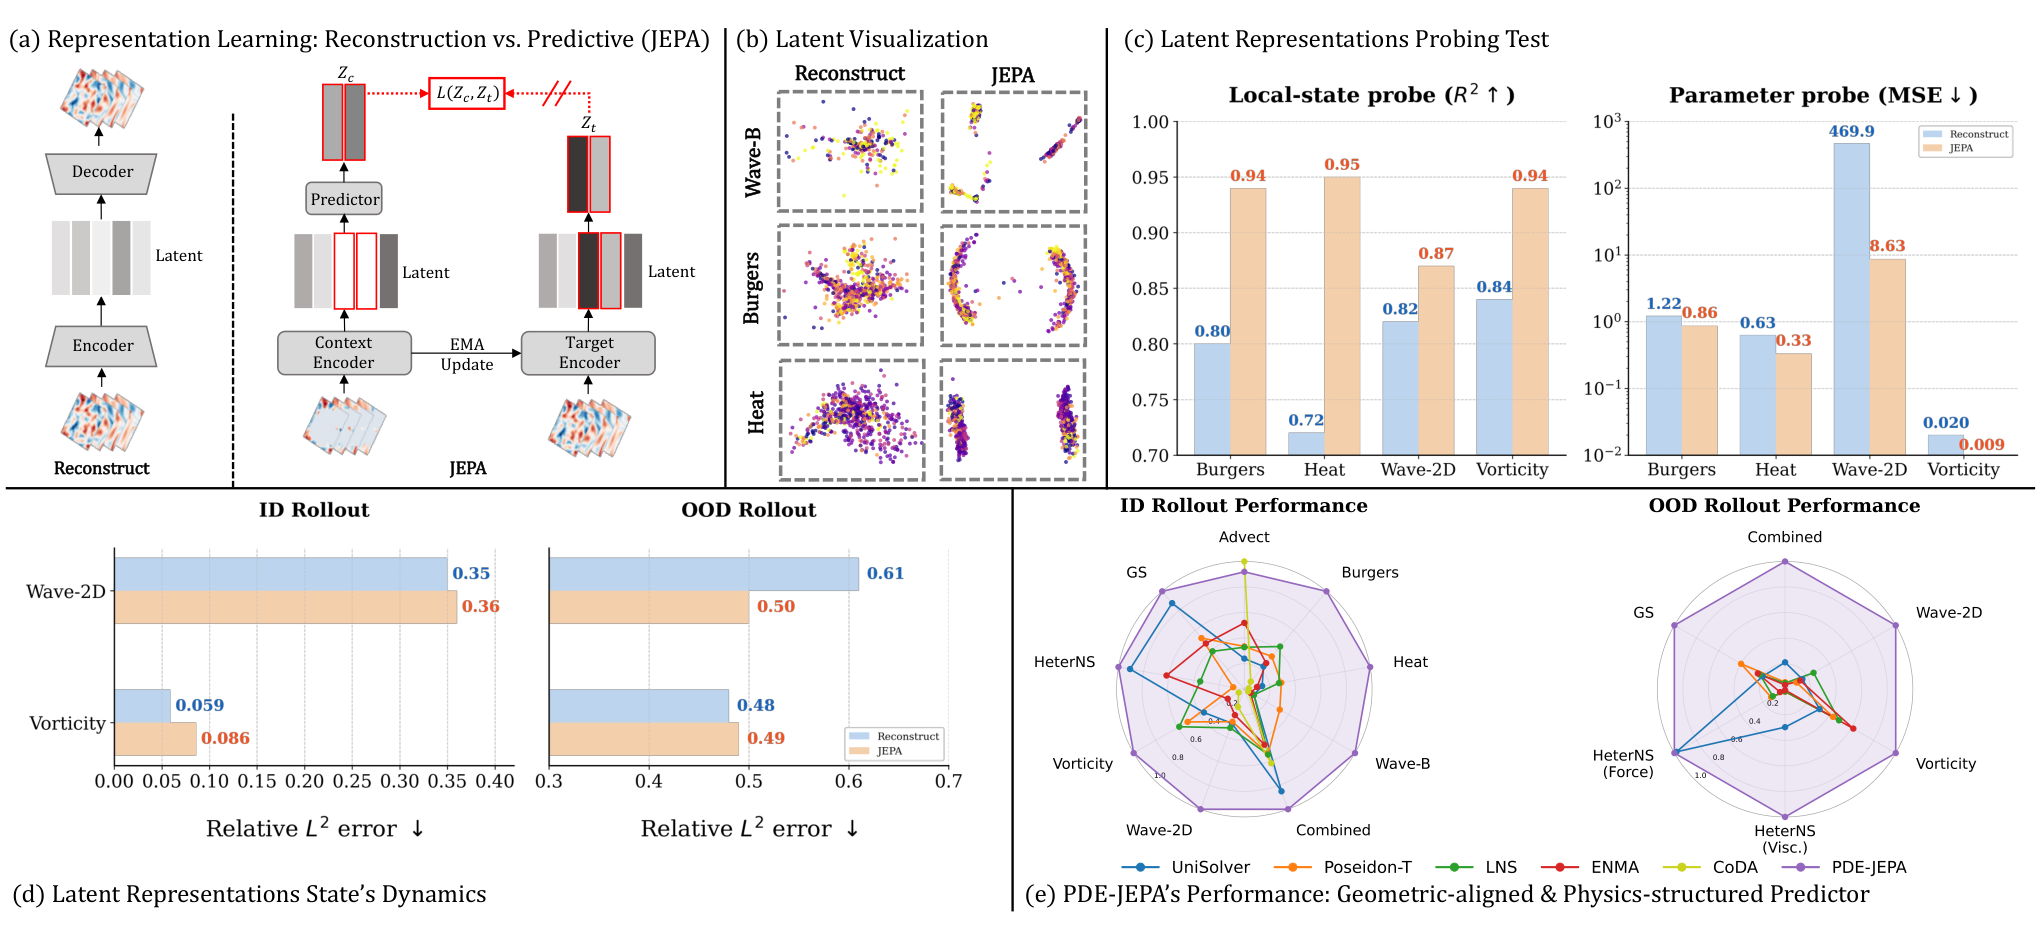
パラメトリックPDEのニューラルサロゲートは通常、再構成目的で学習されます。すなわち、エンコーダ・デコーダが物理場 \mathbf{u}_t を復元するよう駆動され、ダイナミクスはピクセル空間または再構成に整合した潜在空間において学習されます。著者らは、この手法が潜在空間を状態進化の幾何学ではなく点ごとの場の復元に偏らせると主張しています。代替手法として、エンコーダを予測的(JEPAスタイル)目的関数—マスク付き潜在予測—で事前学習し、得られた空間をダイナミクス学習器の基盤として用いるアプローチを検証しています。実験的観察として、JEPA featuresはMAEスタイルのfeaturesよりも多くの物理情報を持つ(probing accuracy)一方、凍結されたJEPA features上で予測器をそのままロールアウトすると依然として精度が低いことが示されています。「情報量が豊富」であることと「予測可能」であることのギャップが、本手法の動機となっています。
手法
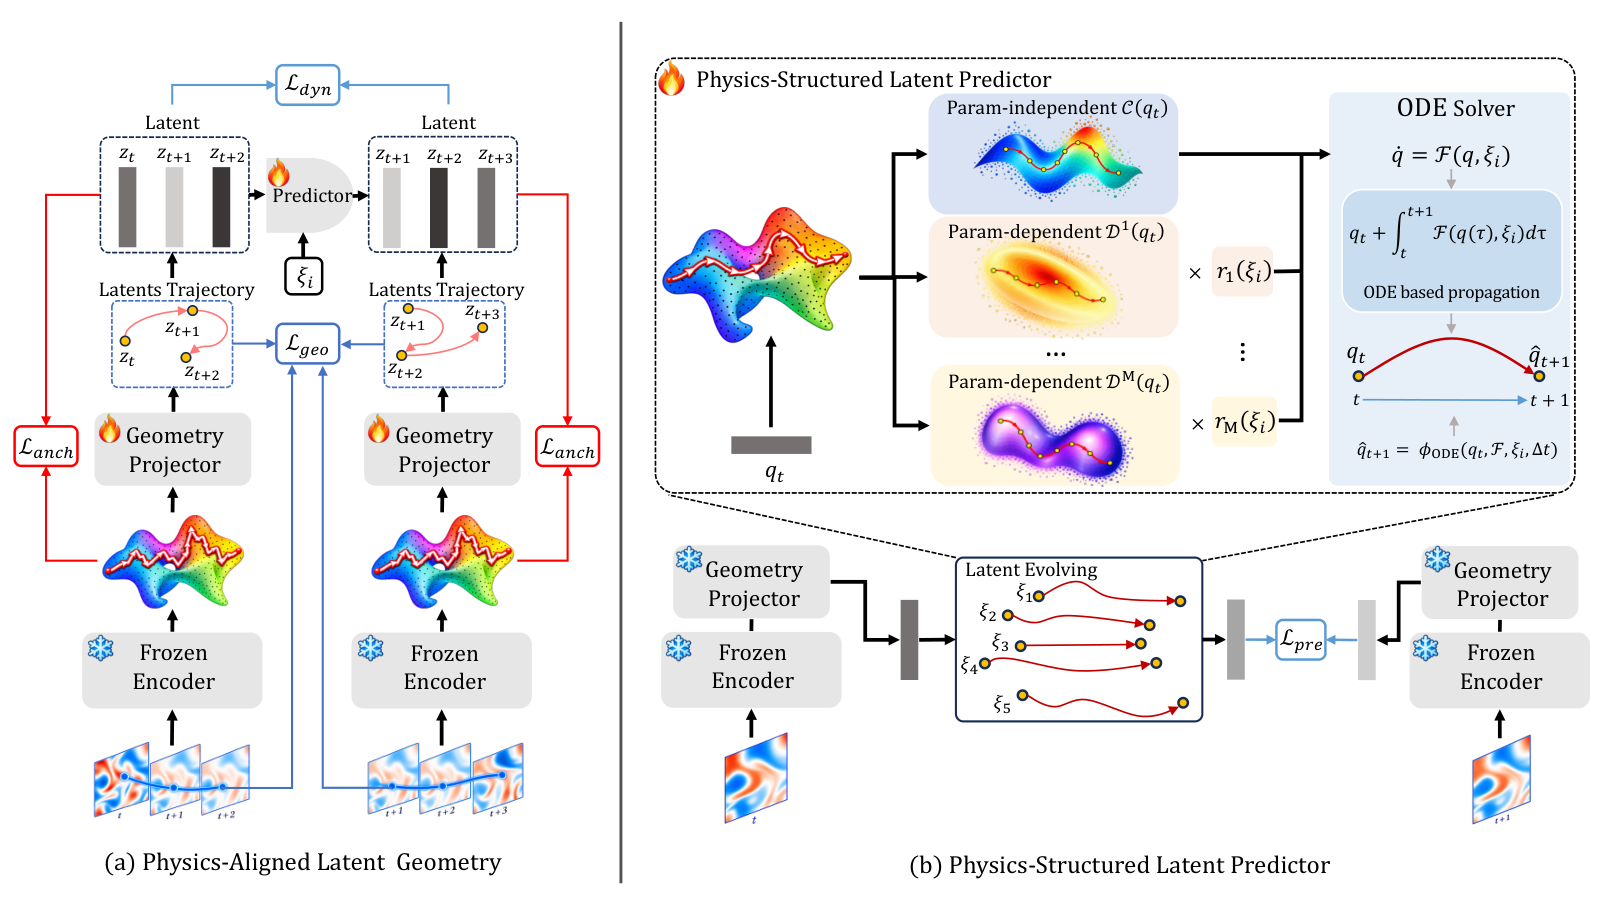
PDE-JEPAは3段階から構成されており、エンコーダはStage 1の後に凍結されます。
Stage 1 — 予測的事前学習。 エンコーダ E は完全な軌跡に対してJEPAスタイルのマスク付き潜在予測で学習され、次の表現を生成します: \mathbf{z}_{0:T}=E(\mathbf{u}_{0:T}),\quad \mathbf{u}_{0:T}\in\mathbb{R}^{|\mathcal{X}|\times T\times C},\ \mathbf{z}_{0:T}\in\mathbb{R}^{N\times T\times D}. 下流タスクでの利用において、状態はフレームごとに再エンコードされ、\mathbf{z}_t は因果的となります。重要な点として、PDEパラメータ \bm{\xi} は事前学習中にエンコーダとJEPA予測器の両方から隠蔽されており、これにより E がパラメータ非依存のfeaturesへと誘導されます。
Stage 2 — 幾何投影。 軽量な投影器 g_\phi が凍結されたJEPA潜在表現を、潜在軌跡の幾何が物理的進化の幾何に一致する空間へ写像します。具体的には、アラインメントlossが投影された潜在軌跡 \{g_\phi(\mathbf{z}_t)\} のペアワイズ距離・方向を、時間方向に \{\mathbf{u}_t\} のそれと追跡するよう促します。このステップが「情報量が豊富な」表現を「動力学的に整合した」表現へと変換します。
Stage 3 — 物理構造化潜在予測器。 アラインされた潜在空間において、ダイナミクスはパラメータ非依存の発展演算子 F_\theta とパラメータ依存の補正 G_\psi(\cdot;\bm{\xi}) に分解され、おおよそ次のようになります: \tilde{\mathbf{z}}_{t+1} = F_\theta(\tilde{\mathbf{z}}_t) + G_\psi(\tilde{\mathbf{z}}_t;\bm{\xi}), ここで \tilde{\mathbf{z}}_t = g_\phi(\mathbf{z}_t) です。パラメータ分岐はエンコーダではなくここで初めて導入されるため、共有演算子 F_\theta が共通のPDE物理を吸収し、G_\psi がパラメータ変動を担います。ロールアウトはアラインされた潜在空間で実行され、評価のためにのみデコードされます。
結果
評価は9つのパラメトリックPDEベンチマーク(Advection、Burgers、Heat、Wave-B、Combined、Wave-2D、Vorticity(Zebraより)、HeterNS(UniSolver)、Gray–Scott(ENMA))で行われており、移流・拡散・波動・反応拡散・2次元流体をカバーしています。評価指標は相対 L^2 ロールアウト誤差(IDスプリット)です。
PDE-JEPAはすべてのベンチマークで最良または2番目に良い結果を達成しています。代表的な数値(小さいほど良い)は以下の通りです:
- Burgers: 0.0428 vs. 従来最良 0.0869(LE-PDE)— 相対改善率 50.7%
- Heat: 0.0274 vs. 0.0933(Poseidon-T)— 70.6%
- Wave-B: 0.0350 vs. 0.1093(Poseidon-T)— 68.0%
- Wave-2D: 0.1140 vs. 0.2070(Zebra)— 44.9%
- Vorticity: 0.0348 vs. 0.0592(LNS)— 41.2%
- Combined: 0.0074 vs. 0.0085(CAPE)— 12.9%
- HeterNS: 0.0089 vs. 0.0098(UniSolver)— 9.2%
- Gray–Scott: 0.0284 vs. 0.0323(UniSolver)— 12.1%
- Advection: 0.0074 vs. 0.0068(CoDA)— PDE-JEPAが2位となった唯一の設定(−8.8%)
特筆すべき点として、PDE-JEPAは凍結エンコーダと2つの軽量モジュールのみを使用しながら、基盤モデルサロゲート(UniSolver、MPP、DPOT-S、Poseidon-T)、in-contextソルバー(Zebra、ViTバリアント)、再構成ベースの潜在ソルバー(LE-PDE、LNS、MAE-PDE、ENMA)を上回っています。
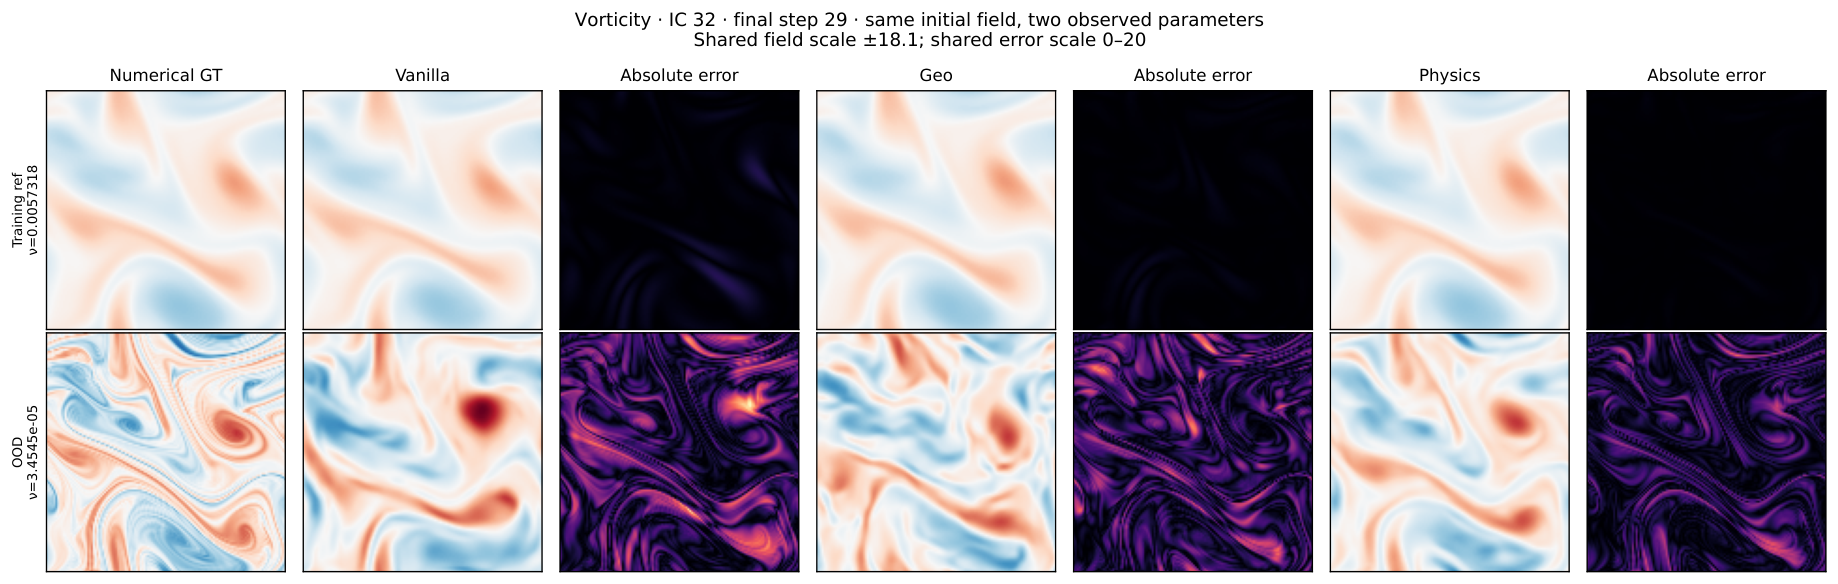
Vorticityのケーススタディでは各ステージの寄与が個別に示されています。素のJEPA + 予測器ベースラインは最終タイムステップに明確な誤差構造が見られますが、幾何アラインメントを追加することで大規模なコヒーレント誤差が低減し、さらに物理構造化予測器によってパラメータ依存の残差が抑制されます。
限界と未解決の問題点
エンコーダはStage 1の後に凍結されるため、幾何・物理目的関数を用いたエンド・ツー・エンドのfine-tuningが学習に寄与するか、あるいは不安定化させるかについては未検討です。幾何投影器は「物理的進化の幾何」という概念に依存しており、本論文では軌跡距離によって実装されていますが、場空間の幾何が非滑らかになる衝撃波支配解や不連続解に対してどのように振る舞うかは不明確です。報告されている数値はIDロールアウトのものであり、OODパラメータ外挿は概要図では言及されていますが、示されている表では定量化されていません。さらに、パラメータ非依存・依存の分解は、当該ファミリーの物理が共有演算子に支配されているという仮定に基づいており、本論文の9つのベンチマークでは妥当な仮定ですが、マルチ物理の混合に対しては困難が生じる可能性があります。
重要性
本結果は、潜在空間が状態進化の幾何にその後アラインされるという条件のもとで、予測的(JEPAスタイル)事前学習がPDEサロゲートにおける再構成事前学習を上回ることができるという具体的な実証を提供しています。幾何をアラインしてからダイナミクスを共有成分とパラメータ成分に分解するという2段階のレシピは、シンプルでモジュラーかつ他のオペレータ学習設定にも移植可能です。
Source: https://arxiv.org/abs/2609.34715
FrameMorrow: Future-guided Frame Selection with Prospective Tokens for Long-Horizon Video Generation
問題設定
自己回帰型の長時間動画生成器は、参照できる速度よりも速く履歴を蓄積していきます。すべての過去フレームに対する密なattentionは計算量が二乗オーダーとなり、1分を超えると急速に実行不可能になります。一方、単純な履歴の切り捨ては、数秒後に重要になりうるコンテンツ(キャラクターの服装、部屋のレイアウト、画面外に出て再び戻ってくるオブジェクトなど)を破棄してしまいます。既存の検索ベースのアプローチ(例:LongLive-RAG)は、現在のコンテキストとの類似度によって履歴をスコアリングします。著者らはこれが誤った目標設定であると主張しています。現在のビューと関連する特徴は直近のコンテキストバッファと冗長である可能性がある一方で、次に生成されるものと関連する特徴は現在とは非類似に見えるかもしれませんが、まさにバックボーンが必要としているものなのです。
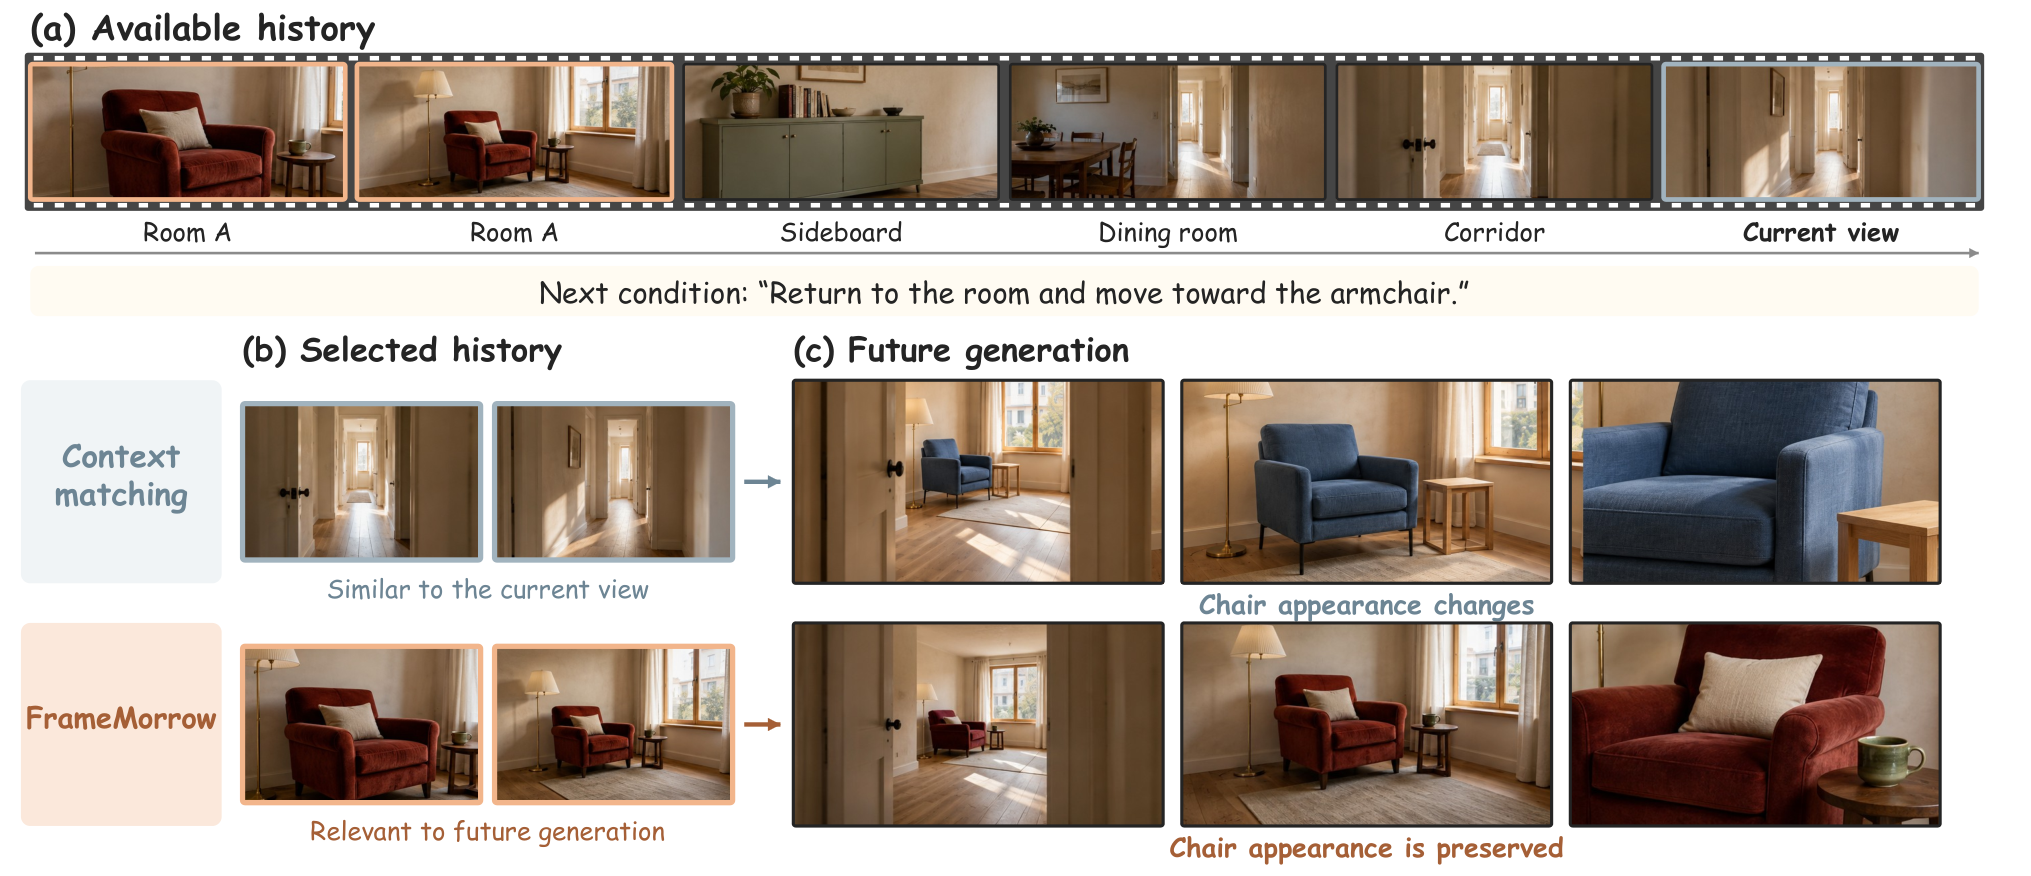
この問題が重要なのは、インタラクティブな設定やworld-modelの設定では、次のチャンクをロールアウトする前に将来の条件 c_t^+(プロンプトの続き、行動、カメラの動き)が明示的に利用可能であり、このシグナルがメモリ管理においてまだ十分に活用されていないからです。
手法
ロールアウトステップ t において、直近のコンテキストを \mathcal{L}_t = \{x_{t-L+1}, \ldots, x_t\}、検索対象となる長期履歴を \mathcal{H}_t = \{x_{\tau_i}\}_{i=1}^N(\tau_i \le t - L)とします。\mathcal{L}_t はセレクタによって参照されますが検索候補には含まれないため、メモリバジェット K を競合させることなく何を想起すべきかを示します。
セレクタ S_\theta は (\mathcal{H}_t, \mathcal{L}_t, c_t^+) から M 個の prospective token を出力します。これらのトークンは、チャンク自体をデコードすることなく、次のチャンクの情報ニーズを表現するよう学習されたクエリです。これらはフレームごとの関連度スコアを生成します:
\hat{\mathbf{r}}_t = S_\theta(\mathcal{H}_t, \mathcal{L}_t, c_t^+) \in \mathbb{R}^N, \quad \mathcal{I}_t = \mathrm{TopK}(\hat{\mathbf{r}}_t, K), \quad \mathcal{M}_t = \mathcal{H}_t[\mathcal{I}_t].
選択されたフレームはタイムスタンプ順に並べられ、凍結されたバックボーンのネイティブ条件付けインターフェースを通じて入力されます。デフォルト設定は K=4、M=4 です。
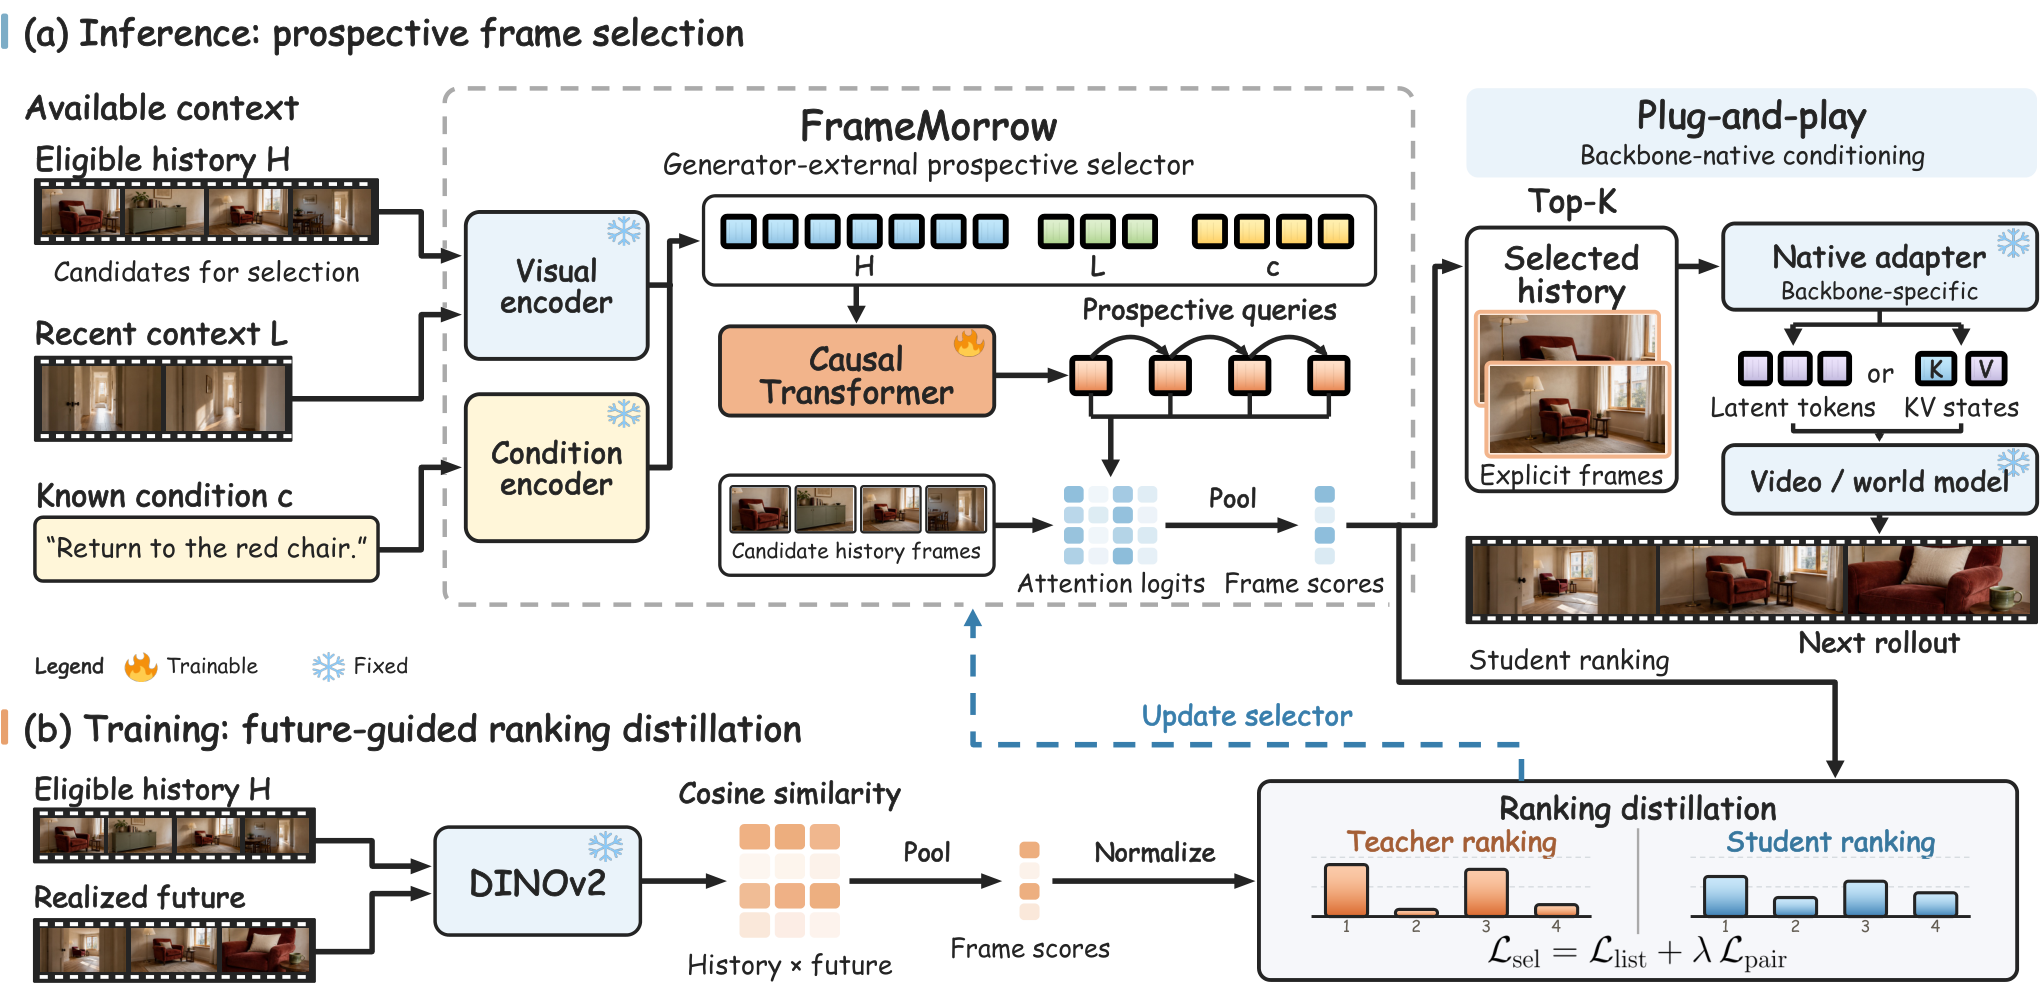
教師信号の設計が興味深い点です。学習時には実現した将来のチャンクが利用可能です。凍結されたDINOv2ティーチャーが各候補履歴フレームと実現した将来との類似度を計算し、\mathcal{H}_t 上のランキングを生成します。prospective token は \hat{\mathbf{r}}_t がこの将来に基づくランキングと一致するよう学習されます。推論時には将来は未観測ですが、トークンは (\mathcal{H}_t, \mathcal{L}_t, c_t^+) のみからどの履歴フレームが視覚的に関連するかを予測することを学習しています。出力がKV-cacheのスライスや隠れ状態ではなく明示的なフレームであるため、このモジュールは異種バックボーン(Self-Forcing、LongLive、Causal Forcing、CausVid、ShotStream、Matrix-Game 3.0、WorldMem、および参照画像インターフェース経由のクローズドソースSeedance/Kling)にプラグアンドプレイで適用可能です。
学習には、テキスト条件付き生成用にストリーミングプロンプトに再編成された10KのOpenVidHD動画と、action条件付きworld model用にカメラ動作から得られた疑似行動を持つ10Kのチャンクアラインされた Sekai Game-Walking セグメントを使用しています。
結果
60秒インタラクティブ動画の表では、すべてのバックボーンペアにわたって一貫した改善が見られます。絶対的な改善が最も大きいのは、長時間一貫性においてベースモデルが最も弱い場合です:
- Self-Forcing:quality 78.71 → 81.74、consistency 84.95 → 89.30、aesthetic 58.16 → 60.62。セグメントごとのCLIP平均:26.39 → 28.05、最大の改善は30〜60秒のウィンドウ(例:40〜50秒:23.37 → 26.60)。
- Causal Forcing:quality 76.00 → 78.66、consistency 80.46 → 83.48、CLIP平均 24.53 → 25.24。
- LongLive 1.0(既に高性能):quality 83.49 → 84.06、consistency 92.62 → 93.21、CLIP平均 28.75 → 29.08。
- CausVid:CLIP平均 28.63 → 29.03、6つすべての10秒ウィンドウにわたって単調な改善。
マルチショットの結果も同様のパターンを示しています:ShotStream はconsistency 92.75 → 96.76、quality 83.12 → 84.85 と大きく向上しましたが、aestheticはわずかに低下しています(62.30 → 61.74)。LongLive 2.0 は小幅ながら均一な改善を示しています。
減衰プロファイルは示唆的です:Self-Forcingの場合、FrameMorrowなしではセグメントCLIPが30.40(0〜10秒)から23.02(50〜60秒)へと7.4ポイント低下しますが、FrameMorrowありでは30.56 → 26.01 と低下幅がおよそ半減します。これは、現在のコンテキストマッチングが冗長なフレームを保持しながら意味的に重要な履歴を失うという仮説と一致しています。
制限と今後の課題
- ランキングティーチャーはDINOv2であり、外観の符号化は優れていますが、動作や行動意味論には弱いです。world-modelの実験では、これがaction対応の検索のボトルネックになる可能性があります。ただし、論文では直接ティーチャーの検証ではなく、下流指標としてQwen3-VLベースの行動アラインメントを報告しています。
- K=4 フレームは少ないです。性能が K のスケールに対してどう変化するか、または複数の独立したエンティティを含むシーンではトークン数 M を増やす必要があるかについては結果が示されていません。
- supervisionには実現した将来が必要なため、純粋なオンライン学習や自己対戦型のworld-model学習は対象外です。
- この手法は各バックボーンの参照条件付けの特性を引き継ぐため、ShotStreamにおけるaesthetic の低下は、選択されたフレームがバックボーン自身のaesthetic priorと競合する場合があることを示唆しています。
- \infty-RoPEやDeep Forcingとの実際の処理時間の比較は示されておらず、各ロールアウトステップでセレクタを実行するコストとKV節約の相対的な量は、示されているセクションでは定量化されていません。
なぜこれが重要か
長時間動画のメモリを現在とのマッチングではなく将来の情報ニーズの予測として捉えるという再定式化は明快であり、バックボーンから検索を明確に切り離せます。特にSelf-Forcingにおいて30秒以降のconsistency低下がおよそ半減するという実証的な改善は、長時間生成における現在コンテキストマッチングのベースラインが相当な改善余地を残していたことを示唆しています。
Source: https://arxiv.org/abs/2609.38839
World Action Modeling with Progressive Visual Planning
問題設定
World action model(WAM)は、視覚運動方策学習と未来フレーム予測を組み合わせています。このモデルは、初期画像と言語命令から映像とアクションチャンクを同時にロールアウトするよう学習され、視覚ダイナミクス予測がアクション生成を正則化・条件付けします。実用上のボトルネックは長期ホライゾン制御です。密な映像ロールアウトは推論時にコストがかかり(diffusion映像生成器は数十フレームにわたって多数のデノイジングステップを要します)、一方で最終ゴールフレーム予測(FGP)のみを行うという最近のショートカットは、エピソードの終点を方策に伝えるものの、現在の状態からその終点への補間方法を教えません。いずれの失敗モードも、サブスキル(接近・把持・移送・配置)が中間的な視覚状態にアンカーされなければならない長期ホライゾンタスクに悪影響を及ぼします。
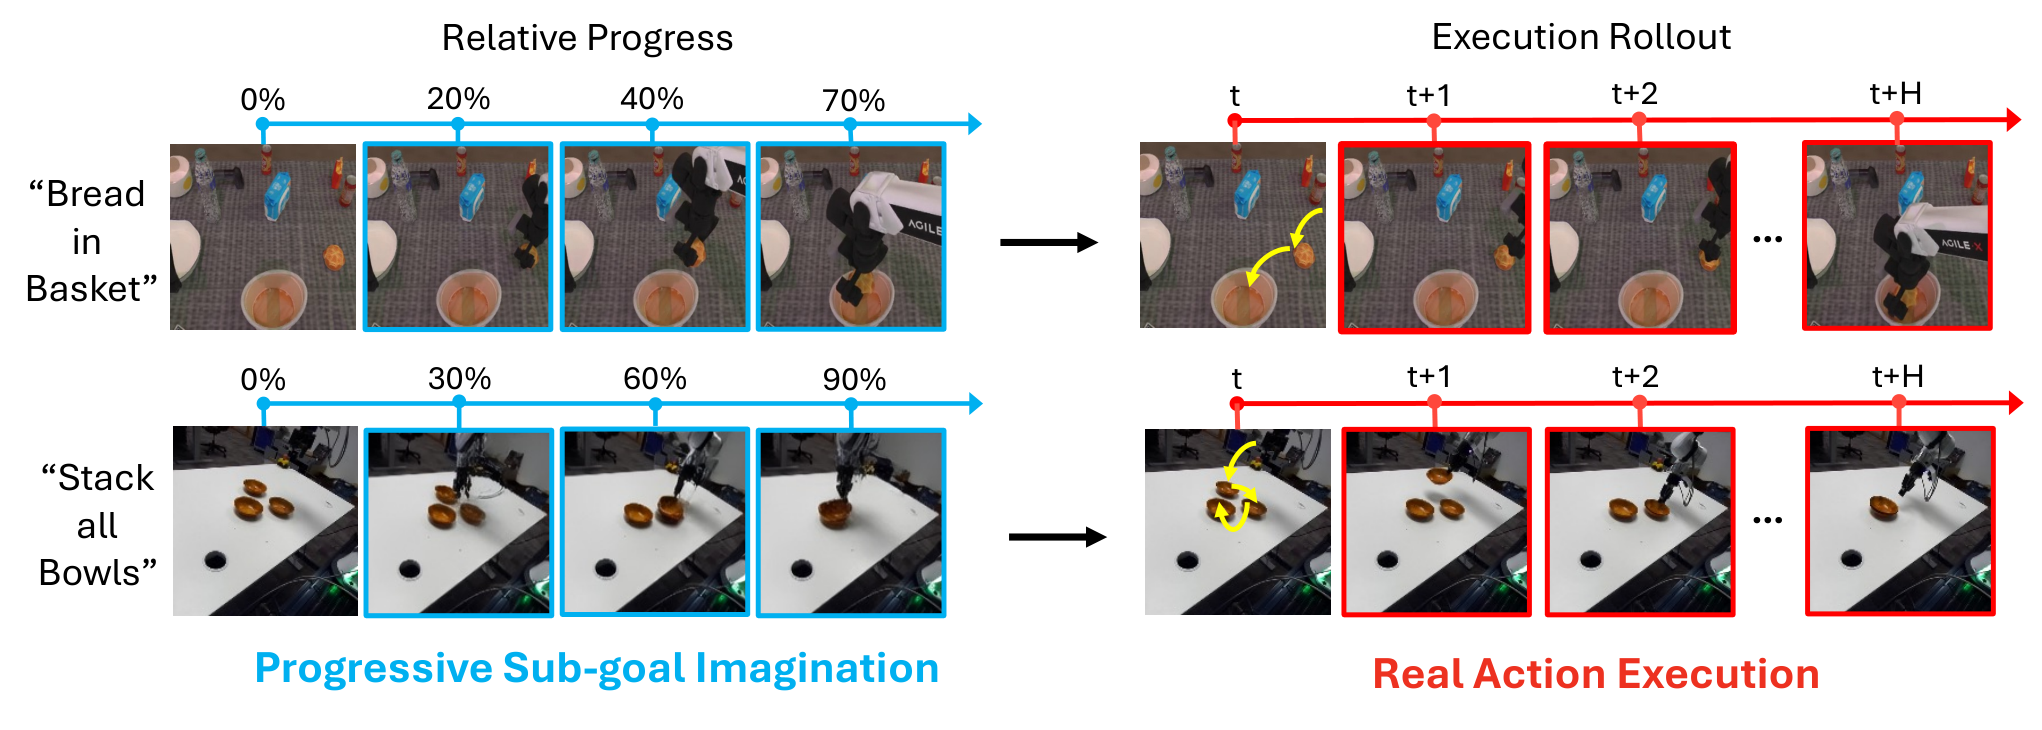
ProWAMは、密な映像予測と単一フレームのFGPを、相対的タスク進捗 \tau \in (0,1] によってインデックスされたスパースかつ順序付きの視覚サブゴール列に置き換え、それを共有映像バックボーンによってアクションチャンクと共同生成することで、このギャップを解消します。
手法
ProWAMはWAMを映像エキスパートとアクションエキスパートに分解し、両者はWan2.2-TI2V-5Bの映像バックボーンを共有します。命令 \mathbf{T} と参照フレーム \mathbf{I}_{\mathrm{ref}} が与えられると、モデルは3つのlatentストリームを同時にデノイズします。
- 未来映像 latent \mathbf{X}(事前学習時のみ視覚ダイナミクス目的として使用)、
- k 個の相対進捗位置 \tau_i におけるプログレッシブサブゴール latent \mathbf{G} = \{g_{\tau_1}, \ldots, g_{\tau_k}\}、
- 連続するサブゴール間のセグメントに対応するアクションチャンク latent \mathbf{A}。
サブゴールはFGPを一般化したものであり、FGPは k{=}1,\ \tau_1{=}1 の特殊ケースに相当します。学習時、サブゴール位置はサンプリングされ、各 g_{\tau_i} はロボットがエピソードの特定の割合を完了した後に到達すべき視覚状態を監督します。
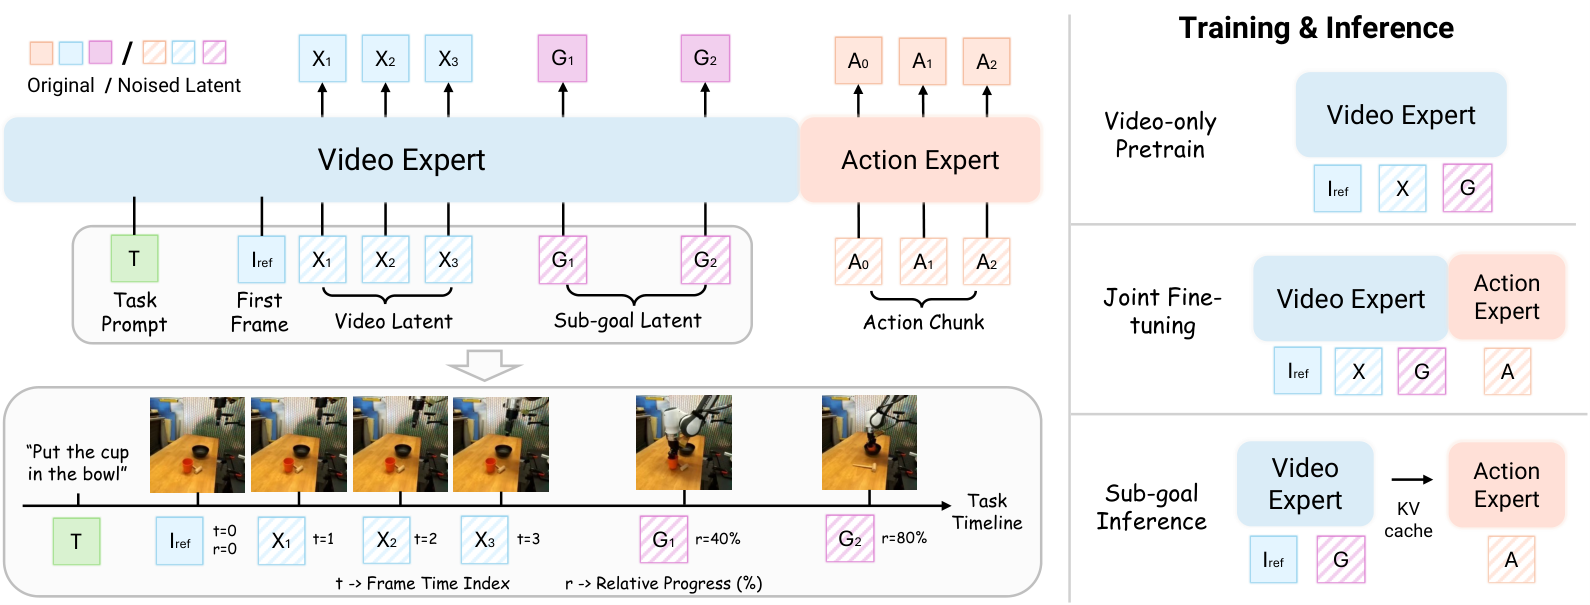
学習は2段階で進行します。
- 映像のみの事前学習。 映像エキスパートは、アクションラベルなしの大規模ロボット映像および一人称映像を用いて、密な未来フレームとプログレッシブサブゴール列の両方を予測するよう学習されます。これは、アクションなし映像とロボットデモンストレーションのスケール非対称性を利用するもので、サブゴール計画の大部分を前者から学習し、アクション方策から視覚計画の負荷を分離します。
- 共同 fine-tuning。 ロボットデモンストレーションを用いて、アクションエキスパートは映像エキスパートのサブゴール特徴を条件とする diffusion/flow-matching アクション目的関数で学習されます。映像ブランチはサブゴール予測を共同学習目的として維持し、共有表現がサブゴールを意識し続けるようにします。
推論時の重要な最適化はキャッシングです。毎回の再計画で完全な映像ロールアウトを繰り返しデノイズする代わりに、ProWAMは映像エキスパートの1回のフォワードパスを実行してスパースなサブゴール KV 特徴 \{K_{\tau_i}, V_{\tau_i}\} を生成します。アクションエキスパートはその後、(軽量な)アクションデノイジング中にこのキャッシュされたセットにクロスアテンションします。再計画時には、サブゴールキャッシュを更新しない限り、アクションエキスパートのみを再実行すればよいです。これにより、制御レートのアクションデノイジングが重い映像エキスパート評価から切り離され、従来のWAMのボトルネックであった密なロールアウトのコストが回避されます。
視覚事前情報の役割を分離するため、2つの変種が設定されています。ProWAM-Base はStage-1なしでWan2.2-TI2V-5Bベースから初期化され、ProWAM はStage-1で事前学習された映像エキスパートを使用します。
結果
ProWAMは、LIBERO および LIBERO-Plus、RoboTwin、RoboCasa365、ゼロショットFrankaデプロイメントにおいて、並行するWAM研究(Black et al., 2025; Bu et al., 2025b; Yuan et al., 2026; Luo et al., 2026a)のプロトコルに従って評価されています。報告された主要な結果は、これらのベンチマークにわたる分布外ロバスト性における優位性であり、サブゴール条件付き変種がFGPベースラインおよび密な映像WAMを上回っています。付録のパイロット研究においても、自己生成した最終ゴールがほとんどの設定でベースラインを改善することが確認されており、プログレッシブサブゴールによる改善は強力なFGPコントロールの上に測定されています。(提供された抜粋にはベンチマークごとの成功率の列挙がないため、詳細なテーブルについては第4節および付録を参照してください。)
アーキテクチャの選択は計算コストの観点からも妥当性が確認されています。推論時にスパースな \mathbf{G} 特徴をキャッシュするための1回の映像エキスパートパスと、その後の制御レートでのアクションデノイジングのみを使用するため、ステップあたりのレイテンシは映像生成ではなくアクションエキスパートによって支配されており、従来のWAMを制限していた反復的な完全映像ロールアウトのコストが除去されています。
失敗ケース
「Cube Stacking」における定性的な失敗例は、サブゴールの忠実度への依存性を示しています。予測されたサブゴールの接触形状が曖昧である場合、方策は早期にグリッパーを開いてしまいます。
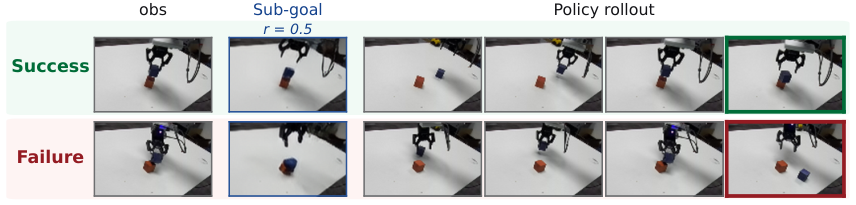
これはこの設計の本質的な弱点を露呈しています。ProWAMのアクション方策はサブゴールの品質に依存するため、サブゴールのハルシネーション——特にピクセルレベルの曖昧さが幾何学的制約を隠す細粒度の接触を伴うインタラクションにおいて——が実行誤差に直結します。未解決の問題としては、(i) サブゴール生成に明示的な幾何学的・接触の事前情報を組み込む方法、(ii) オンラインサブゴール再選択(動的な \tau スケジュール)が固定スパースセットを上回るかどうか、(iii) サブゴールの個数 k をタスクホライゾンに応じてどのようにスケールすべきか、(iv) サブゴールキャッシュを部分的に更新してドリフトを修正しつつ完全な映像エキスパートパスを避けることができるかどうか、が挙げられます。
意義
ProWAMは、WAMの設計原則を明確に示しています。密な映像ロールアウトを生成して捨てるか、軌跡を不十分にしか規定しない終端ゴールを予測するかのどちらかではなく、スパースかつ順序付きの視覚プランを生成し、そのキャッシュされた特徴に基づいてアクションを条件付けするというものです。計画器のアクションなし映像事前学習と組み合わせることで、これは制御時の映像生成コストを払わずに視覚運動方策を長いホライゾンにスケールするための有望なアプローチです。
Source: https://arxiv.org/abs/2610.02508
Native Action-Prior Learning from Videos for World Action Models
問題設定
World action models(WAMs)は将来映像予測と行動予測を結合し、ポリシーに動力学を考慮したpriorを与えます。ボトルネックはアクションラベル付き軌跡の不足です。ロボットのteleopデータは乏しい一方、観測のみの動画は豊富に存在します。ラベルなし動画を活用する二つの主要なアプローチはいずれも間接的です。視覚表現pretraining(例:MAE/VideoMAEスタイルのencoder)は制御に再フィッティングが必要な特徴量を生成します。潜在行動学習(LAPO、DynaMo、CoMo)は(z_{t-1}, z_t)から潜在行動\hat{a}_tを推論し、代理的な教師信号として使用しますが、潜在空間はいかなるembodimentにも校正されておらず、別途grounding stepが必要です。
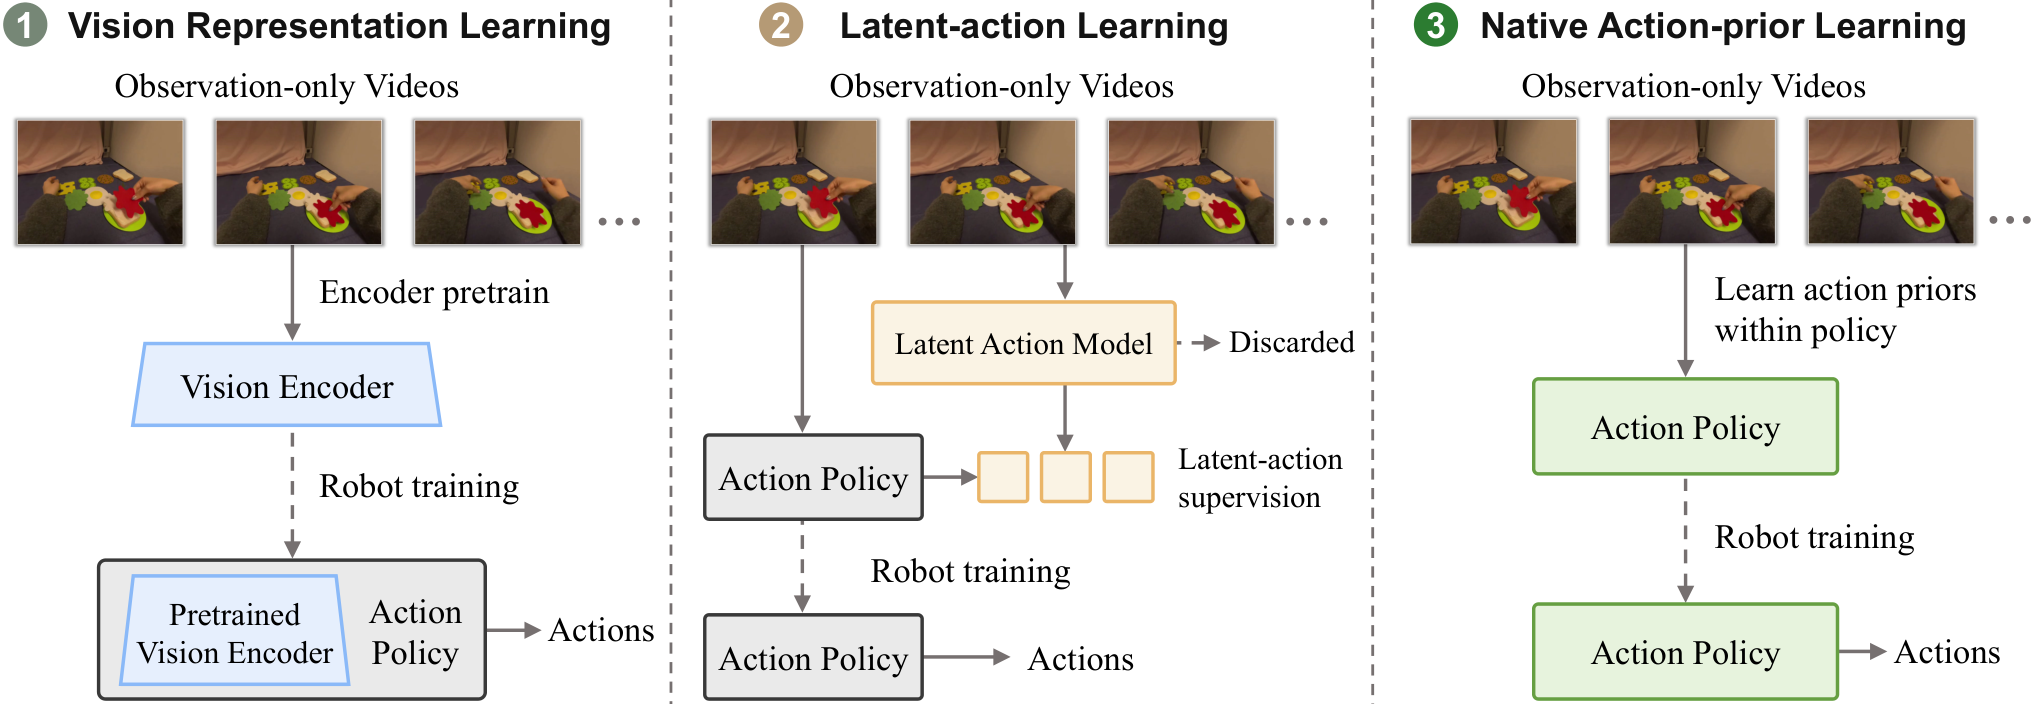
NAVA-WAMは第三の選択肢を提案します。すなわち、中間表現や潜在行動インターフェースを一切介さず、観測のみの動画から直接行動モジュール自体をpretrainするというものです。
手法
ポリシー\mathcal{P}_\theta(a_{t:t+H-1}\mid o_t, l, q_t)は\mathbb{R}^{H\times d_a}上の連続Hステップチャンクを予測します。二つのストリームがDiTとして実装されています。Wan2.2-5Bで初期化されたVideo-DiTと、1BパラメータのAction-DiT(隠れ次元1024)です。frozen時空間VAE Eがo_{0:T}を潜在変数z_{0:K}にエンコードするため、各(z_{k-1}, z_k)が視覚的な遷移を表します。
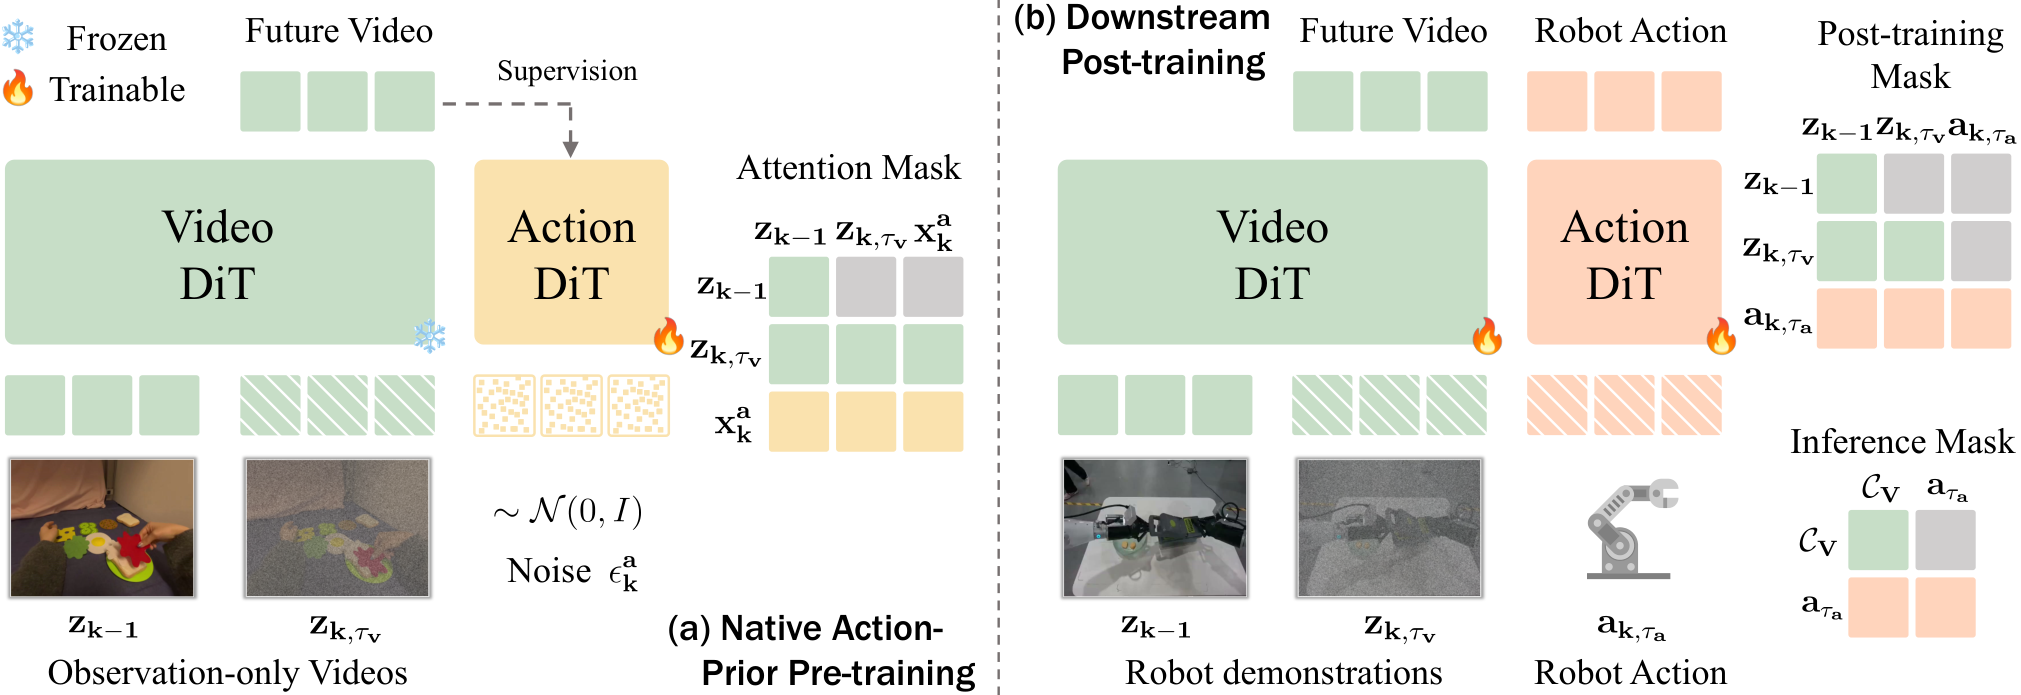
Stage 1 — Native action-prior pretraining(\mathcal{D}_v)。 Video-DiTのみが将来映像潜在変数に対するflow-matching lossを受け取ります。重要なのは、各映像遷移(z_{k-1}, z_k)と行動トークンスロットを対応付ける遷移構造化joint attentionを通じて、gradientがAction-DiTに伝わる点です。将来映像予測は(暗黙的な)行動によって因果的に決定されるため、共有attentionの最適化によって、Action-DiTトークンは遷移の予測に最も寄与する量——行動に関連するprior——をエンコードするよう促されます。これは潜在行動の語彙を一切定義することなく実現されます。
Stage 2 — Joint post-training(\mathcal{D}_r)。 両ストリームが映像と行動のflow-matching lossで学習され、重みは\lambda_v = \lambda_a = 1です。asymmetric attentionパターンにより視覚ブランチが反復的な行動denoiserから切り離されます。視覚トークンは一度だけattendするのに対し、行動トークンはdenoising stepをまたいで反復します。これにより推論時に映像ストリームを完全に省略し、行動トークンのみをdenoiseすることが可能となり、将来フレームをroll outすることなくclosed-loop制御が実現します。
結果
LIBERO / LIBERO-Plus。 NAVA-WAMはID 99.0% / OOD 83.5%を達成し、Being-H0.7(99.2 / 82.1)およびImage-WAM(98.4 / 83.1)に匹敵し、JEPA-VLA(96.4 / 25.6)やFast-WAM(97.6 / 51.5)といった潜在行動中心のWAMを大幅に上回ります。OODギャップがより情報量の多い指標です。間接的な転移に依存するアプローチはLIBERO-Plusの分布シフト下で性能が崩壊します。
RoboTwin 2.0。 タスクあたり50件のCleanデモのみで学習した場合、NAVA-WAMはClean 88.5%、Random 73.6%を記録します。Random(OOD)の数値が最も重要です。従来最高性能のMV-WAMは55.7%、Image-WAMは37.6%に留まります。標準的な直接ポリシー(\pi_0、UP-VLA、DP、RDT)はRandomで17%以下です。これは最強のWAMベースラインに対して絶対値で17.9ポイントのOOD改善です。
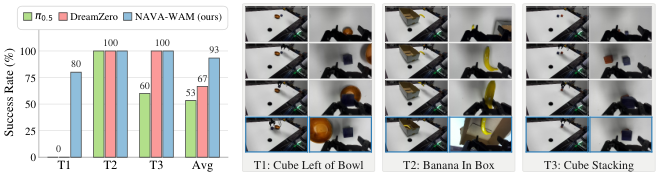
実機ロボット(Franka FR3、DROID post-training、タスク固有fine-tuningなし)。 各5トライアルの3つのテーブルトップタスク全体で、NAVA-WAMは平均93.3%の成功率を達成します。T1(空間関係タスク)では、\pi_{0.5}とDreamZero-DROIDが全トライアルで失敗する一方、NAVA-WAMは成功します。
Ablation。 RoboTwin 2.0 Randomにおけるpretraining対ラベルバジェットのsweepが、本論文の主張に対する最も直接的な検証です。
| デモ数/タスク | なし | 表現 | 潜在行動 | NAVA |
|---|---|---|---|---|
| 10 | 60.5 | 58.2 | 61.6 | 66.5 |
| 25 | 67.6 | 60.6 | 65.0 | 72.0 |
| 50 | 69.7 | 68.1 | 71.2 | 73.6 |
表現ベースのpretrainingは10件および25件のデモ時に実際には性能を低下させており、「間接的な転移」への批判と整合しています。行動関連性プローブ(frozenな特徴量からground-truthの行動へのridge回帰R^2)もメカニズムを支持しています。表現特徴量はプローブデータ100%使用でR^2 = 0.153に飽和し、CoMoの潜在行動は0.203である一方、NAVAの特徴量はより高いスコアを示します(完全な表は論文参照)。これはpretraining済みAction-DiTトークンが、いずれの代替手法よりも真のロボット行動をより線形に予測できることを示しています。
限界と未解決の問題
- Video-DiTはWan2.2-5Bで初期化されており、OOD改善のどの程度がその生成的priorに起因し、どの程度がnative action-prior schemeに起因するかが不明確です。ablationはpretrainingデータを分離しますが、初期化は分離していません。
- pretrainingデータ(Open X-Embodiment、AgiBotWorld、EgoDex)は依然としてロボット/egocentric操作映像です。観測のみの動画で十分であるという主張は、視覚的分布シフトがはるかに大きくprioprioceptionとの相関がないような、完全なin-the-wildインターネット動画では検証されていません。
- 遷移構造化joint attentionは、VAEの時間的レートにおいて視覚遷移と行動スロットの一対一対応を仮定しています。VAEのstrideとポリシーホライズンHの不一致については分析されていません。
- 報告されているのは1B Action-DiTのみです。Action-DiTのサイズに対するnative priorのスケーリング挙動は未解決です。
重要性
NAVA-WAMは、「観測のみの動画→ポリシー」パイプラインに中間インターフェースが不要であることを明確に示します。再利用可能な視覚encoderも潜在行動のコードブックも必要ありません。共有attentionトポロジーを通じてルーティングされた将来フレーム予測からのgradientだけで行動ヘッド自体をpretrainするのに十分であり、その結果得られるポリシーはOODで著しく高い汎化性能を示します(RoboTwin Randomで73.6% vs. 55.7%、zero-shotのFrankaデプロイメントで93.3%)。
Source: https://arxiv.org/abs/2610.03391
Hacker News Signals
コンシューマー向けハードウェア(RTX 4090)でQwen 3.8 Flash Next(125B)を100T/sで実行する
Strataは、通常はマルチGPUサーバー構成を必要とする大規模モデルを、単一コンシューマーGPUで展開することを目的としたカスタム inference runtimeです。主な主張は、単一のRTX 4090(VRAM 24 GB)上で125Bパラメーターモデルを100 tokens/sで動作させるというものです。これを実現するには、積極的な量子化(実効重み精度として2〜3ビット程度)、ドラフトモデルを用いた speculative decoding、そしてVRAM制約内に収めるための慎重なKV-cacheの管理が必要です。このリポジトリは、4090のアーキテクチャ(Ada Lovelace、FP8 tensor cores)に最適化されたCUDAカーネルと、計算処理の裏で転送レイテンシを隠すCPUオフローディングを組み合わせています。このスケールにおける主要なエンジニアリング上の課題は、メモリ帯域幅のボトルネックにもかかわらずGPUを飽和状態に保つことです。125Bモデルは4ビットであっても約62 GBを必要とするため、このruntimeは重みをVRAMとシステムRAMにタイル状に分割し、現在のレイヤーを実行しながら次のレイヤーをプリフェッチします。VRAMに完全に収まる小さなドラフト(おそらく1〜3Bモデル)を用いた speculative decoding により、候補トークン列を生成し、フルモデルが並列に検証することで、実効スループットを倍増させます。100 T/sという数値は、ほぼ確実にウォームキャッシュを用いた短いコンテキストの生成で測定されたものであり、KV-cacheが大きくなる長いコンテキストでの性能は、オフローディングの帯域幅がボトルネックになるにつれて大幅に低下します。このプロジェクトは初期段階にあり、BF16ベースラインとの比較における量子化品質はリポジトリでベンチマークされておらず、実用面での主要な未解決事項となっています。コミュニティの懐疑的な意見は、このような積極的な量子化レベルにおけるperplexityの劣化が、非自明なタスクに対して出力を有用なものにするかどうかという点に集中しています。
Redisの作者による: ds4を使ったローカルLLM実行
Salvatore Sanfilippo(antirez)が ds4(Dwarf Star 4)をリリースしました。これは、パフォーマンスよりもシンプルさとハッカビリティを優先して設計された、ミニマルなローカル LLM ランタイムです。その設計思想は彼の Redis における美学を反映しています。すなわち、llama.cpp や llm.c のような抽象化レイヤーを持たず、GGUFフォーマットのモデルを読み込んで自己回帰推論を実行するという一つのことだけを行う、小規模で監査可能なCコードベースです。実装は transformer の推論を手動で処理しており、RoPE 位置エンコーディングと RMS-norm を用いた標準的な multi-head attention をサポートしており、数千行のコードで実現されています。最大スループットを求めるユーザーではなく、推論スタックを理解・改変したい開発者をターゲットにしています。GGUFサポートにより、llama.cpp 向けに公開済みの量子化モデルウェイトの大きなエコシステムと相互運用が可能です。興味深い設計上の選択として、コードの可読性を保つためにバッチ処理や多くの推論最適化を一切省いている点が挙げられます。メモリレイアウトは、別途ロードパスを設けることなく、GGUFテンソルの順序に直接従っています。Sanfilippo は各コンポーネントを解説する付随するブログ記事を執筆しており、信頼性の高い学習リソースとなっています。実際のスループットは llama.cpp より低いものの、CPUでのシングルユーザーインタラクティブ使用においては、現代的なハードウェアであればその差は許容範囲内です。HNのディスカッションは「読みやすい」実装と最適化された実装のどちらに価値があるかという点に集中しており、特にこのコードベースが大学院のMLシステムコースの教材として活用できるかどうかに関心が集まっています。主な制限として、リリース時点ではGPUサポートがなく、CPUのみで動作するため、70B以上のモデルは現実的ではありません。
Source: https://dwarfstar.sh/
Greg Kroah-Hartman: LLM時代におけるセキュリティ
Kroah-Hartmanの講演は、具体的なシステムセキュリティ上の懸念を取り上げています。すなわち、Linuxカーネルの開発パイプラインがLLMによって生成または支援されたコード貢献とますます交差するようになっており、既存のレビューインフラはそのような脅威モデルを想定して設計されていないという問題です。彼の核心的な主張は、LLMがもっともらしく見えながらも微妙に不正確または悪意のあるパッチを生成するコストをほぼゼロにまで引き下げることで、カーネルに対するサプライチェーン攻撃の攻撃者の経済的合理性を変化させるというものです。現状の防衛手段は人間によるレビューですが、レビューの処理能力には限りがあり、パッチのスタイルが正しく見える場合にレビュワーは自動化バイアスを示す傾向があります。彼が論じる具体的な緩和策としては、新規コントリビュータに対するより厳格な身元確認、人間によるレビュー前に広範なクラスの問題を検出する自動静的解析ゲート、そして浅い履歴しか持たないアカウントからセキュリティ上重要なサブシステムに触れるパッチへの懐疑的態度が挙げられます。彼は、LLMが生成したバグ(コードアシスタントを無批判に使用した開発者による偶発的なもの)とLLMが生成した攻撃(意図的なもの)を慎重に区別しており、それぞれに対する防衛策が異なることを指摘しています。XZ utilsのバックドアは、緩慢かつ忍耐強いサプライチェーン侵入の先例として参照されており、LLMは「信頼性を積み上げる偽のコントリビュータ」フェーズを加速させる可能性があるとされています。この講演では新たな暗号的手法や形式検証によるソリューションは提案されておらず、プロセスの強化、すなわち機密性の高いサブシステムに対するより小規模な信頼された保守担当者グループの構成、より保守的なパッチ受け入れ基準、およびコントリビューションパターンにおける統計的な異常を浮かび上がらせるためのより良いツール整備を主張しています。カーネル開発者およびより広範なオープンソースメンテナにとっての実践的な教訓は、ソーシャルエンジニアリングの攻撃対象領域が大幅に拡大したということです。
GPT-Synopsys: チップ設計に革命をもたらすフロンティアインテリジェンス
OpenAIとSynopsysは、フロンティアLLMをSynopsys EDAツールチェーンに統合した共同製品を発表しました。開示されている技術的な内容は、大きく3つの領域をカバーしています。すなわち、Design Compiler/Fusion Compilerフロー内での自然言語によるRTL生成・修正、AIによるタイミングクロージャおよびフロアプランニングの提案支援、そしてカバレッジ指向フィードバックを伴う自動テストベンチ生成です。RTL生成コンポーネントは技術的に最も興味深い部分です。純粋なコード生成として扱うのではなく、合成ターゲット(面積、電力、タイミング)の制約空間内で動作するものとして位置づけられており、LLMがマイクロアーキテクチャの代替案を提案し、それを下流の合成ツールが評価する仕組みになっています。これにより、純粋なLLMコード生成が抱える課題、すなわちモデルが合成後のQoRを本質的に推論できないという問題を補完するループが閉じられます。LLMの提案によって誘導された制約付き探索がその役割を担います。タイミングクロージャ支援では、違反レポートに基づいてモデルが配置・配線のディレクティブを提案しますが、これは現在非常に手作業に依存した専門家向けタスクです。HNスレッドでの主な懐疑的意見は、これが本質的なAI統合なのか、あるいはすでにDSO.aiのようなツールに存在するSynopsys既存AI機能へのUIレイヤーに過ぎないのかという点に集中しています。発表には、代表的な設計においてAI支援フローと手動フローを比較したベンチマーク数値が含まれていません。チップ設計サイクルは十分に長いため、外部による検証は数ヶ月から数年単位で遅れる可能性があります。より本質的な問いは、汎用コードで学習されたフロンティアLLMが、大規模なドメイン固有の fine-tuning なしに、Verilog/SystemVerilogのイディオムおよび合成セマンティクスを十分にカバーして実用に足るかどうかという点です。
Show HN: macOS上のすべての写真とすべてのビデオフレームに対応するAI検索
SCM(Screen Content Manager)は、スクリーンショット、写真、ビデオフレームをローカルのCLIPベースのembeddingパイプラインを使ってインデックス化し、ベクトルをローカルデータベースに保存することで自然言語および画像類似度検索を実現する、オープンソースのmacOSツールです。技術的なパイプラインについて説明すると、定期的な画面キャプチャまたは手動インポートによってフレームがCLIP vision encoderに送られ、Neural Engine上のCore ML経由で実行され、512次元または768次元のembeddingが生成されます。それらはローカルのベクトルストア(SQLiteにカスタムベクトルインデックスを組み合わせたもの、またはFAISS。リポジトリによる)に保存されます。クエリ時にはCLIPのtext encoderでテキストクエリをエンコードし、近似最近傍探索を実行します。CPUではなくApple Neural Engine上でCLIP inferenceを実行することで、バッチインデックス処理のスループットがおよそ5〜10倍向上します。プライバシーファーストな設計(すべてローカルで動作し、クラウドAPIへの呼び出しは一切なし)が、クラウドベースの代替製品との差別化要因として挙げられています。主なエンジニアリング上の課題は次の通りです:(1)ほぼ同一フレーム間の重複排除——CLIP inferenceの前にperceptual hashingを行うことで冗長なembeddingを回避、(2)コーパスの拡大に伴うインデックスサイズの管理——設定可能な保持期間ウィンドウで対処、(3)毎回アーカイブ全体を再処理しないための増分インデックス処理。CLIPの既知の弱点もそのまま当てはまります——画像内の細かいテキスト、特定の顔、正確なオブジェクトカウントは信頼性が低いです。このリポジトリはまだ初期段階であり、ANNインデックスの実装は基本的なものにとどまっています。数百万フレームへのスケーリングにはより高度なインデックス処理が必要になるでしょう。HNのディスカッションでは、プライバシーの観点と、最近のmacOSバージョンで導入されたApple独自のオンデバイス検索機能との比較に焦点が当たっています。
Source: https://github.com/allenv0/SCM
Claude と Claude Code で Opus 5.5 を最大限に活用する
Anthropic のエンジニアリングブログ記事では、Claude Opus 5.5 に特化した実践的な prompt engineering およびエージェンティックループの設計パターンについて解説しており、特に Claude Code(エージェンティックなコーディングアシスタント)に焦点を当てています。技術的に重要な主張として、Opus 5.5 は 200K トークンの context window を持つことが挙げられており、長いコンテキストにおいて重要な指示がコンテキスト中央部での attention 低下を乗り越えて保持されるよう構造化する方法が詳述されています。推奨事項としては、制約や成功基準をプロンプトの中央部ではなく先頭と末尾の両方に配置すること、およびモデルがより重みを置くよう学習されている明示的な XML タグ付きセクション(<instructions>、<constraints>)を使用することが挙げられています。エージェンティックループについては、タスクを多数の小さなツール呼び出しに過度に分解することを避けるよう助言しており、Opus 5.5 は単一のコンテキスト内で一貫したマルチステップのプランを維持できること、また過剰なスキャフォールディングのオーバーヘッドがパフォーマンスを低下させることを指摘しています。構造化出力に関するガイダンスとして、API の response_format パラメータを通じた JSON schema の強制適用により、自由形式の生成と比較してパースエラーが大幅に減少するとされています。Claude Code に特化した内容として、セッションをまたいでプロジェクトのコンテキストを保持する CLAUDE.md ファイルの書き方が説明されており、一時的な状態ではなくアーキテクチャの不変条件を記述することが推奨されています。また、Opus 5.5 が過剰な説明をすることがある点も認めており、推奨される対策として推論のプリアンブルを省略するよう明示的に指示することが挙げられています。HN のディスカッションは、実際に効果があったことを共有する実務者と、モデル固有の prompt ガイドはすぐに陳腐化するという懐疑派が入り混じっています。推奨事項に対するアブレーションデータの欠如は、一貫した批判点となっています。
Source: https://claude.dev/blog/getting-the-most-out-of-opus-5-5/
オリジナルのDoomをSQLに移植した話
CedarDBは、完全にプレイ可能なDoomエンジンをSQLで実装し、自社の分析データベースシステム上で動作させることに成功しました。技術的な核心は、ゲームループ全体——可視性判定のためのBSPツリートラバーサル、raycasting、スプライトレンダリング、ゲーム状態の更新——が、フレームごとに実行されるSQLクエリの連鎖として表現されている点にあります。CedarDBのクエリエンジンは、インメモリテーブル上で十分な速度を発揮し、インタラクティブなフレームレートを維持できます。最も興味深いエンジニアリング上の問題は、イミュータブルなリレーションに対する集合演算のために設計された言語で、ミュータブルなゲーム状態をどう表現するかという点です。その解決策として、ゲーム世界の表現には一時テーブルと UPDATE/DELETE 文を使用し、レンダラーはBSPツリーを辿って自機の位置から見えるウォールセグメントを計算するCTEのチェーンとして実装されています。raycastingパスは、各セクタを横断してレイをトレースする再帰CTEです。スプライトの描画順序は、深度ソートされたエンティティに対するウィンドウ関数を使用します。BSPツリー自体は親子の外部キーを持つテーブルとして格納されており、ツリートラバーサルは標準的な再帰CTEパターンで実現されています。入力処理は、CのイベントポーリングをフレームごとのSQLパラメータインジェクションへと橋渡しします。これは主に、複雑かつ反復的なワークロードに対するCedarDBのクエリスループットを実証するものです——BSPトラバーサルはSQLに自然なワークロードではなく、プレイ可能なパフォーマンスを達成したことは、再帰およびjoinが多いクエリに対するエンジンの効率性を裏付けています。ブログポストには詳細なクエリ例が掲載されています。HNのスレッドはほぼ一様に好意的であり、ツリートラバーサルの再帰CTE実装と、それがデータベースのオプティマイザについて何を示唆するかに焦点が当てられています。
Show HN: オープンソースのLego AIジェネレーターを作りました
ldraw-novaは、LLMによる高レベルな構造計画と、LDrawパーツの妥当性を保証する制約付き生成レイヤーを組み合わせることで、テキストまたは画像プロンプトからLDrawフォーマットのLegoモデルファイルを生成します。LDrawフォーマットは、モデルをパーツの配置リストとして表現し、各行にパーツID、変換行列、および色を指定します。制約の問題は非自明です――有効なLegoモデルは物理的な接続ルール(スタッドが20 LDUグリッド上のアンチスタッドに整合する)を満たす必要があり、パーツカタログには不規則な形状を持つ数千もの有効なIDが存在します。生成アプローチとして、LLMはまず粗い構造記述(例:「位置Xの4x2ブリックが位置Yの2x2プレートに接続する」)を生成し、後処理レイヤーが座標をLDrawグリッドにスナップして公式カタログに対してパーツIDを解決します。これはconstrained decodingと精神的に近いアプローチですが、トークンレベルの制約としてではなく、事後的な修正ステップとして実装されています。システムはID解決にBrickLinkのパーツデータベースを使用し、可視化にはLDViewまたはLDraw互換レンダラーを使用します。主な失敗モードは物理的に無効なアセンブリです。LLMが生成した配置は、スナップレイヤーでは回復できない形で接続制約に違反することがあり、浮いたブリックやインターペネトレーションが生じます。このリポジトリはオープンソースであり、ファイルI/OにはPythonのLDrawライブラリを使用しています。HNのディスカッションでは、LLMにとっての空間推論の難しさや、スタッド接続グラフ上の専用制約ソルバー(CSPまたはSATベース)がLLM生成後に修正するアプローチを上回るかどうかについて議論されています。
注目の新規リポジトリ
bilibili/Index-Translate
Bilibiliがリリースした多言語ニューラル機械翻訳モデルファミリーです。本プロジェクトは幅広い言語ペアにわたる高品質な翻訳を目標としており、翻訳特化タスク向けにfine-tuningされた大規模transformer seq2seqバックボーン上に構築されていると考えられます。このリリースは、純粋に学術的なデモではなく、プロダクショングレードのNLPインフラをオープンソース化するという中国の大手インターネット企業のトレンドを踏襲しています。実務者にとっての価値は、モデルファミリー、すなわち複数のサイズ階層が用意されている点にあり、レイテンシと品質のトレードオフを考慮したデプロイが可能です。大規模なバイリンガル(中国語・日本語・英語)コンテンツを運用している企業由来のクリーンルーム起源であることから、学術コーパスよりも実際のWebやサブタイトルコンテンツをより代表した学習データ分布になっていると考えられます。採用にあたっての主要な検討事項としては、低リソース言語に対するtokenizerのカバレッジ、推論のための量子化サポート、およびライセンスが商用利用を許可しているかどうかが挙げられます。ドメイン固有のベンチマークにおいてNLLB-200やOpus-MTと直接比較評価する価値があります。
Source: https://github.com/bilibili/Index-Translate
storytold/photocraft
Adobe PhotoshopをピュアなRustで書き直したクリーンルーム再実装です。クリーンルームとは、逆コンパイルされたAdobeのコードやライセンスを受けたコードではなく、観察された動作と公開仕様から実装が導かれていることを意味し、派生物の法的位置づけにおいて重要です。Rustを選択することで、GCなしにメモリ安全性が確保されます。これは大規模な画像バッファ操作において重要であり、大きなキャンバスへのラスタ操作ではヒープに確保されたピクセルデータがギガバイト規模になる場合があり、GCによる停止が目に見えて現れる可能性があります。コアとなる技術的課題は、正確なレイヤーblend mode(Porter-Duff演算子、CSS/PDFのblend modeの全セット)を持つコンポジティングエンジン、非破壊的な調整レイヤーパイプライン、および選択・マスクインフラストラクチャの実装です。現時点では初期段階にあり、Photoshopとの機能同等性は数年単位の目標です。最も直接的な比較対象はGraphite(こちらもRustベース)ですが、Graphiteはベクター優先の設計です。完成度に関わらず、RustのGUIアーキテクチャおよび画像処理パイプライン設計のリファレンスとして有用です。
Source: https://github.com/storytold/photocraft
LockedinLabs-AI/agent-console
AIコーディングエージェント、特にClaude CodeおよびOpenAI Codexセッション向けのローカルファースト型オブザーバビリティダッシュボードです。セッションごとのトークン数、キャッシュのヒット・ミス率、モデルの選択状況、コスト帰属をすべてデバイス上で追跡し、複数マシン間でデータを集約するためのオプションのセルフホスト型チームハブも備えています。このアーキテクチャはサードパーティのSaaSにテレメトリを送信しない設計となっており、これがホスト型ダッシュボードに対する主な差別化要因です。ポリシーフックにより、コール前後のロジックをアタッチすることが可能で、支出上限の強制や監査目的でのプロンプトロギングに役立ちます。macOSバイナリはAppleによる署名と公証が施されており、リリースにはアテステーションが付与されているため、エンタープライズのセキュリティレビューにおいて重要な意味を持ちます。「プレゼンティングモード」機能は、機密APIキーを露出させることなく、デモやペアプログラミングの場面でセッション状態を共有するためのUIを提供することを示唆しています。大規模にエージェント型コーディングワークフローを運用するチームにとっては、コスト帰属レイヤーだけでも導入を正当化できます。マルチエージェントセッションでは、計装なしには見えないような予想外のトークン数が発生することがあります。MITライセンスです。
Source: https://github.com/LockedinLabs-AI/agent-console
storytold/filmcraft
Adobe Premiere Pro のクリーンルーム Rust 再実装 — ノンリニア映像編集ソフト(NLE)です。これは storytold スイートの中で技術的に最も要求の高いプロジェクトです。NLE は異種メディア(複数のコーデック、フレームレート、サンプルレート)の扱い、フレーム精度のシーク機能を持つタイムラインエンジン、プレビュー用リアルタイムコンポジット、そしてオーディオミキシンググラフを処理しなければなりません。Rust においては、コーデックレイヤーは ffmpeg-next などのバインディングを介して FFmpeg をラップする形が自然ですが、クリーンルームという主張を行うには、「クリーンルーム」が何に適用されるのか(アプリケーションロジックか、コーデックデコードレイヤーか)について慎重なスコープの定義が必要になります。レンダリングパイプラインはプロキシメディア、カラーマネジメント(LUT 適用)、およびエクスポートエンコーディングを処理できる必要があります。現在は初期段階であり、主な関心はタイムラインデータモデルに関するアーキテクチャ上の意思決定、および Rust のオーナーシップモデルが可変なマルチトラック編集グラフにどのように対応するかという点にあります。比較対象は OpenShot および Kdenlive であり、いずれも C++/Python ベースです。
Source: https://github.com/storytold/filmcraft
storytold/lightcraft
Adobe LightroomのPure Rustによる再実装で、非破壊RAW写真処理とカタログ管理を目的としています。コアパイプラインは、RAWデコード(デモザイキング、ホワイトバランス、ノイズ低減)、ピクセルの直接変更ではなく編集指示を保存するパラメトリック調整エンジン、および画像メタデータと編集内容を管理するカタログデータベース(一般的にはSQLiteをバックエンドとして使用)から構成されます。非破壊処理という制約により、調整グラフはいつでもソースから再レンダリング可能でなければならず、処理パイプラインに対して関数型かつ副作用のない設計が求められます。Rustにおいては、RAWデコード用にrawlerやrawler関連のクレートが存在しますが、Lightroom品質の出力(特にハイライトリカバリーやレンズ補正)を実現するには、ドメイン固有の相当な作業が必要です。カタログおよびライブラリ管理の側面は、画像処理コアとは独立したエンジニアリング領域です。darktable(C)やRawTherapee(C++)と比較すると、Rustネイティブの実装はバッチ処理における安全な並行処理の面で恩恵を受けられるでしょう。
Source: https://github.com/storytold/lightcraft
storytold/vectorcraft
RustによるAdobe Illustratorの再実装——ベクターグラフィックスエディタです。基本データ構造はストローク/fill属性を持つBezierパスのシーングラフであり、堅牢な2Dジオメトリカーネルが必要です:Bezierの交差計算、ブール演算によるパス操作(union、difference、XOR)、およびストローク展開のためのオフセット曲線です。これらの演算は数値的に扱いが難しく、本番実装では適応精度演算または慎重なイプシロン管理が用いられます。Rustエコシステムには、BezierのためのLinebenderプロジェクトのkurboとスタイル属性のためのpenikoがあり、これらが自然な基盤となります。レンダリングのターゲットとしてはvello(GPUアクセラレーションによるベクターレンダラー)またはskia-safeが有力候補です。Rustエコシステムにおける直接の競合はGraphiteであり、こちらはかなり先行しておりノードグラフによる非破壊編集モデルを採用しています。vectorcraftの主な価値は、アーキテクチャ面でGraphiteと差別化されるか、あるいはよりIllustratorに忠実なUXモデルを提供できるかにかかっています。
Source: https://github.com/storytold/vectorcraft
storytold/printcraft
Adobe Acrobat のクリーンルームによる Rust 再実装で、PDF の作成・閲覧・編集・注釈付けを対象としています。PDF は複雑なターゲットであり、仕様(ISO 32000)はコンテンツストリーム、フォントサブセット化、ICC カラープロファイル、デジタル署名(PKCS#7/CAdES)、フォーム(AcroForms、XFA)、インクリメンタル更新セマンティクスをカバーしています。クリーンルームの Rust PDF ライブラリは、生成には pdf-writer などのクレートを基盤とし、表示にはレンダリングエンジンが必要です――おそらく pdfium バインディングか、2D レンダラーに入力するカスタムコンテンツストリームインタープリタになるでしょう。編集・注釈レイヤー(コメントの追加、フォーム入力、墨消し)は、既存のコンテンツを破壊せずに PDF オブジェクトグラフおよびクロスリファレンステーブルの更新を理解する必要があります。セキュリティ上の攻撃面は広く、PDF パーサーは歴史的にエクスプロイトが多発してきましたが、Rust のメモリ安全性はここで構造的な優位性をもたらします。poppler(C++)や mupdf(C)と比較して、純粋な Rust スタックは WASM へのデプロイに対してより親和性が高いです。
Source: https://github.com/storytold/printcraft
penso/herdr-gpui
Herdr開発者ワークフローツール向けのネイティブmacOSクライアントで、ZedのGPUアクセラレーテッドUIフレームワークとして切り出されたGPUIを用いてRustで構築されています。このアプリケーションはローカルのHerdrデーモンに接続し、ターミナルセッション、ワークスペース状態、Gitワークツリー、およびAIコーディングエージェントのアクティビティを単一のインターフェースに集約して表示します。技術的に注目すべき選択肢がGPUIです。GPUIはリテインドモードのシーングラフを用いてUIを完全にGPU上でレンダリングし、AppKitウィジェットやElectronに依存することなく、60fps以上のパフォーマンスとネイティブテキストレンダリングを実現しています。これはZed本体以外でGPUI上に構築された初期の公開アプリケーションの一つであり、自身のネイティブmacOS Rustアプリケーションへのいかなる人にとっても、GPUIを評価する際の有用なリファレンスとなっています。Gitワークツリーの統合は、複数の並行ブランチを扱うワークフロー(複数のコーディングエージェントを同時に実行する場合によく見られる)において実用的な価値があります。デーモンとクライアントの分離により、UIはセッションデータに対してステートレスとなり、再接続ロジックが簡潔になっています。