デイリーAIダイジェスト — 2026-09-28
arXiv ハイライト
ブロックスパースAttentionの対数線形複雑度
問題
Self-attentionはシーケンス長Nに対してO(N^2)でスケールします。ブロックスパースattention(例:Native Sparse Attention、MoBA、Quest)はattention積の計算量を削減しますが、各クエリをどのキーブロックにルーティングするかの選択処理が依然として漸近的なボトルネックとなっています。標準的な手法では、すべてのクエリiとすべての候補ブロックjに対してスコアs_{ij} = q_i \cdot \bar{k}_jを計算し、Top-Kを適用します。保持されるセットがスパースであっても、スコアリングは密に行われます:O(N \cdot N/B) = O(N^2/B)。Nが数十万に達する場合、このスコアリングパスが実行時間を支配します(特にprefill時)。PISA(Pyramid Sparse Attention)はこの項を直接対象とし、検索品質を維持しながらエンドツーエンドでO(N \log N)を達成することを目指しています。
手法
PISAはN/B個のブロック上でのフラットなTop-Kを、プールされたキーのピラミッド上での階層的Top-Kに置き換えます。キーK \in \mathbb{R}^{N \times d}が与えられたとき、係数rによる繰り返しプーリングでL = \lceil \log_r (N/B) \rceilレベルを構築します(レベル\ellにはN/(B r^\ell)個のスーパーブロックがあります)。選択は粗から細へと進みます:
- 最も粗いレベルで、すべてのスーパーブロックに対してクエリをスコアリングする(スーパーブロック数が少ないため低コスト)。
- 上位k個のスーパーブロックを保持する。
- 保持された各スーパーブロックを次の細かいレベルのr個の子に展開し、k \cdot r個の候補を生成する。
- スコアリングし、上位k個を保持し、最も細かい(ブロック)レベルに達するまで再帰する。
kは有界でNに依存しないため、各クエリはO(k r \log N)回のスコアリング操作を行い、合計O(N k r \log N) = O(N \log N)となります。
各レベルでのスコアリングは、ドット積のmaxやmeanプーリングではなくLogSumExpで行われます:
s^{(\ell)}_{ij} = \log \sum_{k \in \text{block}_j^{(\ell)}} \exp(q_i \cdot k / \sqrt{d}).
LogSumExpはブロックがsoftmaxの正規化項に対して与える正確な寄与であるため、集約的な関連性の原理的な上界であり、精緻化に対して単調性を持ちます:スーパーブロックのLSEはいずれの子のLSEも支配します。これにより階層的な枝刈りは期待値において許容可能となります——棄却されたスーパーブロックには、その子のsoftmax質量が保持セットを有界なスラック以上に超えるものは含まれません。実用上PISAはプールされたキー表現のLSE(すべての子に対する正確なLSEではなく)を使用し、小さな近似誤差と引き換えにプールされたキーをレイヤーごとに一度だけ事前計算できる利点を得ています。
実装
著者らはprefillとdecodeの両方に対して融合されたTritonカーネルを提供しています。重要なエンジニアリング上のポイント:クエリ–キースコア行列は一切マテリアライズされません。各レベルでカーネルはクエリタイルをロードし、(小さな)候補キータイルをストリームし、レジスタ上でLSEスコアを計算し、オンチップでTop-Kを実行し、インデックスを次のレベルに出力します。最も細かいレベルでのみ、選択されたK, Vタイルが標準的なFlashAttentionスタイルの出力計算のために収集されます。バックワードパスも同様にルーティングのgradientを融合しており、Top-Kは微分不可能であるため、gradientは保持されたブロックのみを通じて流れます(選択に対するstraight-through)。これはこのファミリーの標準的な手法です。
プールされたキーのピラミッドはprefillごとに一度構築され、KVキャッシュと共にキャッシュされます。decodeにおいては、新たに追加されたブロックのみがピラミッドの更新を必要とし、これはトークンあたりO(\log N)です。
結果
アブストラクトでは長文脈言語モデリングおよび検索ベンチマークでの評価が報告されています。PISAはperplexityと長文脈recallで完全なattentionと同等の性能を示しつつ、N \geq 64Kにおいて密なFlashAttentionおよび先行するブロックスパースベースライン(NSA、MoBA)の両方を大幅に上回るスループットを達成しています。この優位性はNと共に拡大します:短い文脈では階層的ルーティングの定数係数はフラットTop-Kと同程度ですが、N = 128K以降ではフラット手法のO(N^2/B)の選択コストがピラミッドのO(N \log N)を上回ります。検索型タスク(needle-in-haystack、マルチドキュメントQA)では、LSEスコアリングが重要であることが示されています:meanやmaxプーリングに置き換えるとrecallが顕著に低下し、softmaxと整合した集約が階層的枝刈りの正しい基準であることが確認されています。
限界と未解決問題
- 階層的Top-Kは貪欲法です:プールされたLSEは低いが正確なスコアリングでは選択される最良のキーを持つブロックが、粗いレベルで枝刈りされる可能性があります。プールされたLSEの単調性は子に対する真のLSEでのみ正確であり、プールされた表現のLSEに対しては正確ではありません。実用上の近似誤差は経験的に有界ですが、理論的には解析されていません。
- 選択は依然として微分不可能であり、ルーティングのtraining signalは保持されたブロックのみを通じて得られます。これにより、鋭くスパースなattentionパターンを持つタスクでは病的なルーティングの崩壊を引き起こす可能性があります。
- この手法はクエリとキーがプーリングレベルをまたいで互換性のある幾何学的構造を持つことを前提としています。強い位置encodings(極端な周波数でのRoPE)はプールされた表現を歪める可能性があります。プーリングをRoPEの前後どちらに適用すべきかについては論文で言及されていません。
- ヘッド間の異質性が利用されていません:異なるヘッドには異なるkとrが必要である可能性が高いですが、報告された設定では均一なハイパーパラメータを使用しています。
- アブストラクトのテキストは途中で切れており、具体的な高速化比率および下流タスクの精度は論文全文から読み取る必要があります。
重要性
ブロックスパースattentionが長文脈において密なattentionを代替するためには、選択ステップ自体が準二乗である必要があります——そうでなければスパース性は定数を削減するだけに終わります。PISAは、融合カーネルを用いた階層的かつsoftmaxと整合したルーティングがエンドツーエンドでO(N \log N)を達成することを示した最初の実用的な実証であり、スパースattentionスタックにおける最後の二次項を解消するものです。
Source: https://arxiv.org/abs/2609.31093
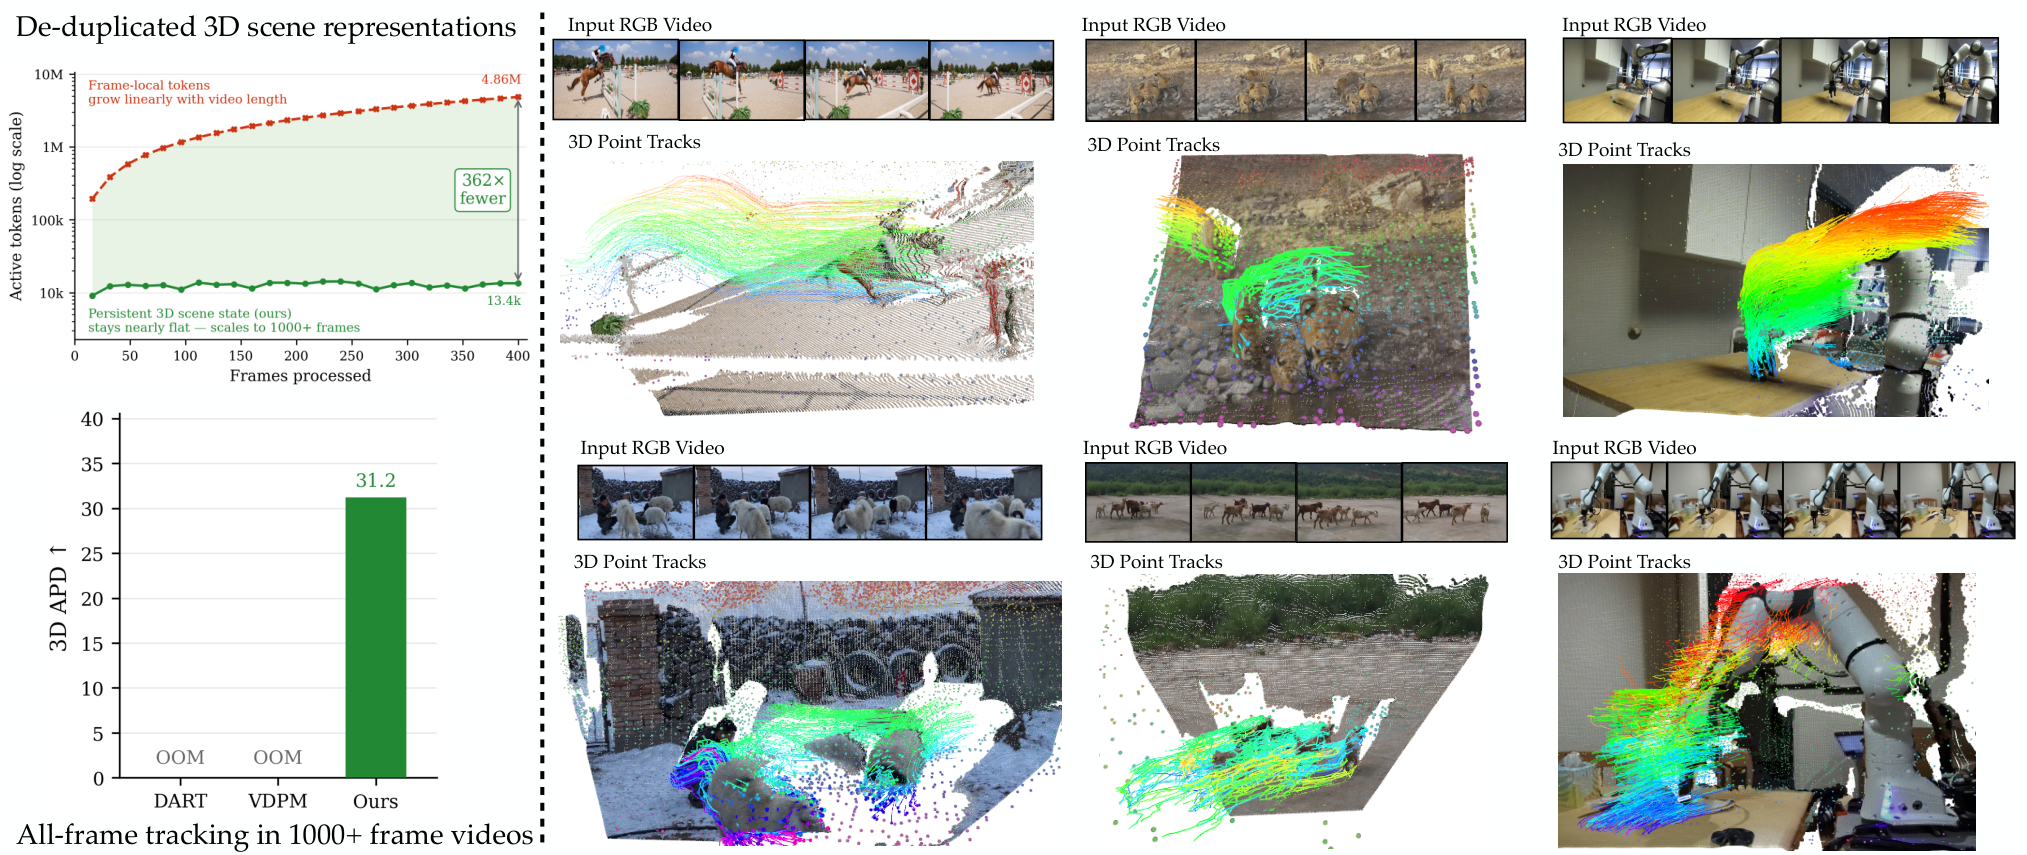
TrackEverything: 3Dシーン表現の重複除去による長期高密度トラッキング
問題設定
点追跡(point tracking)はこれまで二つの領域に分かれていました。一つは、ユーザーが指定したクエリ集合を長期にわたって追跡するsparse tracker(CoTracker3、SpatialTracker-v2、TAPIP-3D)、もう一つは、すべてのピクセルを追跡するものの短いクリップ(48〜64フレーム)に限定されるdense tracker(VDPM、D4RT、Any4D、DeltaV2)です。ボトルネックは、フレームごとの表現が T に対して線形にスケールする点にあります。新しいフレームのたびに、既に観測済みの表面が再インスタンス化されてしまいます。大半が静的なシーンの1000フレーム動画では、これはほぼ無駄な状態管理となります。TrackEverythingは、モデルの状態が T ではなく一意な物理的シーン形状の量に応じてスケールするよう追跡を再定式化します。
手法
入力:RGBビデオ \mathbf{I}\in\mathbb{R}^{T\times H\times W\times 3} および各フレームのワールド座標pointmap \mathbf{P}\in\mathbb{R}^{T\times H\times W\times 3}(センサーまたはVGGT-\Omega から取得)。出力:高密度3D軌跡 \mathbf{X}\in\mathbb{R}^{N\times T\times 3}、可視性 \mathbf{V}\in\mathbb{R}^{N\times T}、および各トラックの静的/動的ロジット \mathbf{S}\in\mathbb{R}^{N}。
3D特徴クラウドへのエンコーディング。 ビデオは L=16 フレームの非重複ウィンドウにチャンク分割されます。各フレームは、凍結されたDINOv3-small backboneと学習可能なViT-Adapterヘッドを通過し、(L, H/4, W/4, D)(D=384)の特徴を生成します。トークンは、ダウンサンプルされたpointmapから得られたワールド座標の3D位置(\mathrm{cam}_0 に正規化)と対応付けられます。各フレーム内で、トークンは \lfloor \mathbf{x}/v \rfloor によってvoxel化され、フレーム内冗長性を削減するために各voxelごとに平均プーリングされます。重要な点として、このvoxel化はフレームごとに行われ、フレームをまたいで行われるわけではありません。フレームをまたいで行ってしまうと、異なる時刻に同じvoxelを通過する動的表面が誤って統合されてしまうためです。L フレームにわたって連結することで、形状 (N, D) の時空間特徴クラウドが得られます。
エンドポイントリファイナー + 軌跡リファイナー。 核心的な洞察は、ほとんどのウィンドウにおいてほとんどの点が静的であるため、すべての点に対してウィンドウ内の高密度軌跡を予測するのは無駄であるという点です。再帰的transformer(エンドポイントリファイナー)が各トラックのウィンドウ末端3D位置と静的/動的分類を反復的に予測します。続いて軽量な軌跡リファイナーが、動的とフラグ付けされたトラックに対してのみウィンドウ内の高密度経路をデコードします。静的なトラックはエンドポイントをコピーすることで軌跡が補完されます。
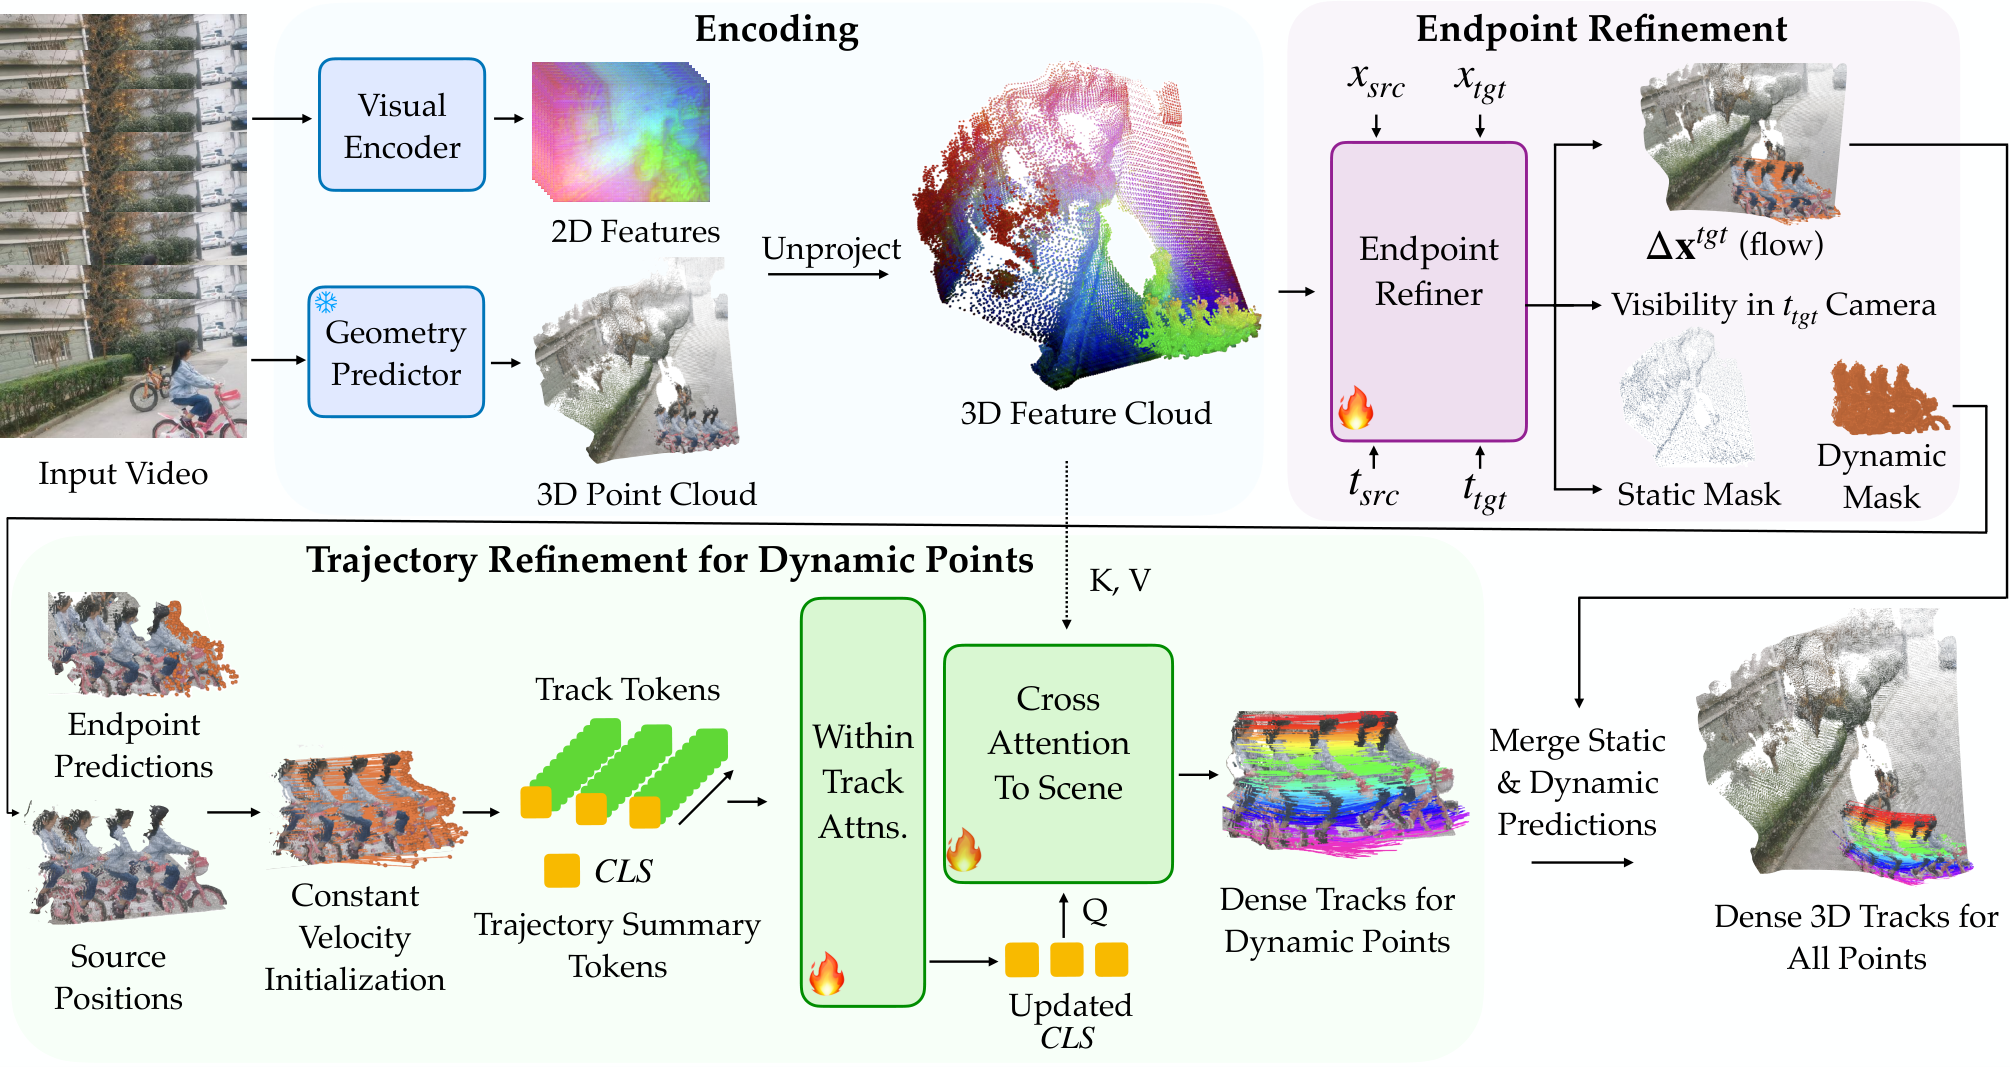
3D WAFT。 本論文は、2D追跡における標準的な4D相関ボリューム(例:WAFTスタイルの全ペア相関)を、各トラックの現在の3D推定位置周辺の3Dシーンクラウドから特徴を直接サンプリングする手法に置き換えています。これによりフレームごとの O(HW \cdot HW) のメモリコストが回避され、代わりに点群内の局所近傍クエリに基づいてスケールします。
ウィンドウ間voxel重複除去。 各ウィンドウの後、同じ3D voxelに到達したトラックが統合されます。これは、ある瞬間に二つの物理的実体が同一voxelを共有できないためです。これがstate sizeを T から切り離すメカニズムです。静的なシーンコンテンツは、何個のウィンドウが観測しても一つの代表点しか生成しません。動的なトラック(ほとんどのシーンでは小さな割合)および実際に新たに現れた表面のみが表現の成長を引き起こします。
結果
評価はTAPVid-3D minivalスプリット(ADT、DriveTrack、PStudioからそれぞれ50クリップ)で行われ、APD-P(内部パラメータを介してアンプロジェクトされた深度相対ピクセル閾値 \{1,2,4,8,16\} px)およびAPD-M(メトリック閾値 \{0.1, 0.3, 0.5, 1.0\} m)を用いています。ベースラインはsparse(SpatialTracker-v2、TAPIP-3D、CoTracker3)、first-frame dense(DeltaV2、Any4D)、all-frame dense(VDPM、D4RT)を網羅しています。VGGT-\Omega のpointmapは、対応するメソッドに対して一律に提供されます。すべての手法は48フレームのクリップで実行され、sparse tracker、DeltaV2、およびTrackEverythingはさらにフルレングスのシーケンス(ADTでは最大約300フレーム)でも実行されます。
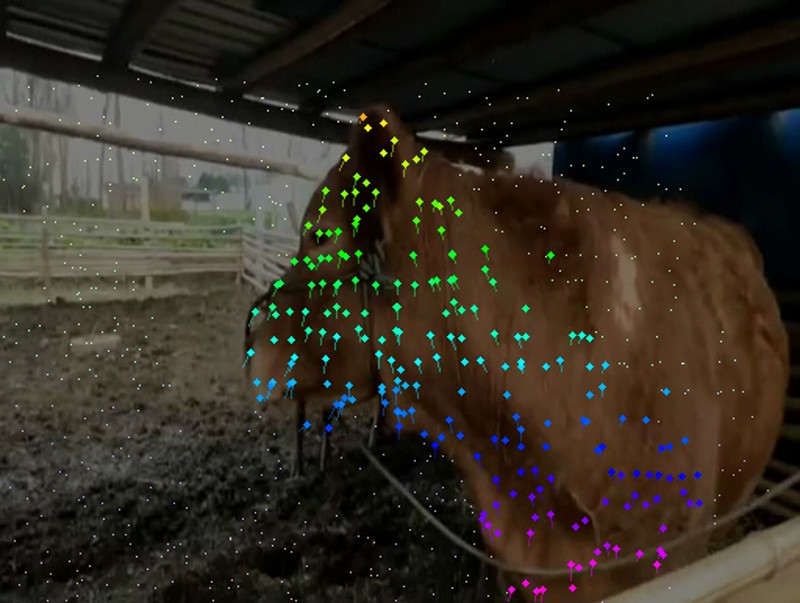
定性的比較は構造的な優位性を示しています。first-frame dense tracker(Any4D、DeltaV2のdenseブランチ)はフレーム0以降に初めて現れる表面を追跡できませんが、sparse trackerはクエリの指定が必要であり、後のフレームでクエリを高密度化すると計算コストが膨大になります。TrackEverythingは両方の問題に対応できます。新しい表面は観測されるたびに永続的なシーンクラウドに追加され、統合は軌跡ベースではなくvoxelベースで行われるためです。PointOdysseyおよびDynamic Replicaにおける高密度追跡の数値は補足資料のTable 3に掲載されています。D4RT は参考として含まれているのみで、約 20\times のパラメータ数を持つプライベートな学習データを使用しており、48フレームクリップのみで評価されています。
制限と未解決の課題
本システムは、pointmapの品質を外部予測器(VGGT-\Omega)またはセンサーに依存しており、その形状が劣化すると追跡品質に直接影響します。表現全体がワールド座標系で管理されているためです。voxel重複除去は信頼性の高い静的/動的分離を前提としており、ゆっくり動く表面を静的と誤分類すると、それが単一のvoxelに折りたたまれてモーションが失われます。voxelサイズ v の選択はメモリと空間解像度のトレードオフを生じさせますが、適応的な戦略については記述されていません。L=16 でのウィンドウ分割は、ウィンドウ境界をまたいだ運動の整合性が統合されたvoxel状態を介したエンドポイントの引き渡しに依存していることを意味し、単一の軌跡内での長期的な時間的推論は直接モデル化されていません。最後に、実際の動的シーンに対する高密度3Dグラウンドトゥルースが利用できないため、定量的評価はまばらにアノテーションされた点のみに限られており、シーン全体の忠実度は定性的評価とシミュレーションでのみ検証されています。
重要性
TrackEverythingは、3Dネイティブな重複除去シーン表現によって、高密度点追跡がメモリの比例的な増加なしに1000フレーム以上の動画にスケール可能であることを示しています。モデルの状態はクリップの長さではなく一意な形状に応じてスケールします。これは、長期にわたる表面ごとの永続的なトラックを必要とする下流のworld-model、4D再構成、およびマニピュレーションパイプラインにとって適切な因子分解です。
Source: https://arxiv.org/abs/2609.30222
FuseReg: レイヤー融合の正則化により表現オートエンコーダの再構成・生成ギャップを緩和する
問題
表現オートエンコーダ(RAE)は、凍結された視覚エンコーダの中間特徴量をピクセルデコーダの再構成潜在変数と拡散トランスフォーマーのターゲット潜在変数の両方として使用することで、画像生成を凍結された視覚エンコーダに結びつけます。ハイパーパラメータとして扱われてきた設計上の選択は、どのエンコーダレイヤーをその共有潜在変数に融合させるかという点です。浅いレイヤーは再構成に有用な低レベルのピクセル詳細を保持し、深いレイヤーは拡散を容易にするセマンティクスを担います。固定された単一の融合(単一レイヤー、プレフィックスサム、または学習済みグローバルゲート)は、デコーダとジェネレータをそのトレードオフの一点で合意させることを強制し、著者らは学習済みグローバルゲートが単一レイヤーのショートカットに退化することを示しています。この結合こそが、FuseRegが対象とする再構成・生成ギャップの根源です。
手法
E を K 個の候補レイヤーを持つ凍結エンコーダ(DINOv3-L では K=23)とします。レイヤー正規化されたトークンマップを h_k = \mathrm{LN}(E_{l_k}(x)) \in \mathbb{R}^{N \times d} と表記します。任意の固定融合は次のように書けます:
z_a = \sum_{k=1}^K a_k h_k, \qquad \mathbf{1}^\top a = 1,
ここで、固定サブセット、プレフィックスサム、学習済みグローバルゲートは a の設定方法のみが異なります。FuseReg は固定重みベクトルを空でないサブセット S \subseteq \{1,\dots,K\} 上の分布に置き換え、各レイヤーを確率 1-p で独立に保持し、次のように構成します:
z_S = \frac{1}{|S|}\sum_{k \in S} h_k.
この正規化されたサブセット融合は、訓練中にピクセルデコーダの入力と DiT のターゲット潜在変数の両方に適用されます。
核心となる統計的性質は補題 1 であり、すべての入力に対して次が成立します:
\mathbb{E}_S[z_S \mid x] = \bar{h}, \quad \mathbb{E}_S[(z_S - \bar{h})(z_S - \bar{h})^\top \mid x] = c_K(p)\,V(x),
ここで \bar{h} = K^{-1}\sum_k h_k、V(x) = K^{-1}\sum_k (h_k - \bar h)(h_k - \bar h)^\top、および c_K(p) = \mathbb{E}[(K-R)/(R(K-1))] は R \sim \mathrm{Binomial}(K, 1-p) を R>0 で条件づけたものです。サブセット平均潜在変数は全レイヤー融合に関して平均保存的であり、誘導された共分散はレイヤー間の不一致の部分空間にちょうど存在します。線形二乗損失の代理モデルにおいて、これは任意の下流線形ヘッド W に対する c_K(p)\,\mathrm{tr}(W^\top W \Gamma) に比例する Tikhonov ペナルティと等価です。すなわち、共有部分空間での挙動を変えることなく、エンコーダレイヤーが不一致を示す方向に対してヘッドが非感応となるよう正則化されます。
具体的な再実装手順は以下の通りです:(i) E を凍結する;(ii) 各訓練ステップで K 個の候補レイヤーに対して保持率 1-p のベルヌーイマスクをサンプリングし、空の場合は再サンプリングする;(iii) 選択された LN 済みレイヤートークンの平均プーリングにより z_S を構築する;(iv) z_S を ViT ピクセルデコーダ(スクラッチから訓練)に入力し、生成ステージでは z_S を flow/diffusion loss の DiT ターゲットとして使用する。アーキテクチャ、パラメータ数、およびオプティマイザの設定は RAEv2 ベースラインと一致させます。
結果
実験設定は、K=23 の DINOv3-L、ImageNet-256、スクラッチから訓練された ViT デコーダ、50 Euler ステップの DiT-Base/XL ジェネレータ、および標準的な 50k サンプルの FID/IS プロトコルを使用しています。
デコーダの柔軟性:単一の FuseReg デコーダが、再訓練なしで完全(K=23)、スパース(K=7)、および単一レイヤー(\ell_{11})融合を処理し、各固定融合に特化されたデコーダよりも高い PSNR を達成します。一つの融合で訓練されたベースラインは別の融合を入力すると性能が急激に低下しますが、FuseReg デコーダはそうなりません。
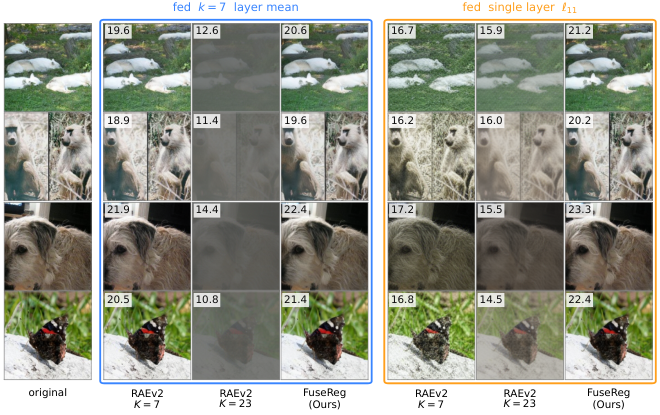
デコーダの中間ブロックにおけるコサイン類似度マップは、FuseReg が K=23、K=7、および \ell_{11} の入力にわたって同じクエリパッチに対して一貫したオブジェクト整合の近傍を維持することを示しています。一方、固定融合の RAEv2 デコーダは融合が変化すると質的に異なる類似度構造を生成します。
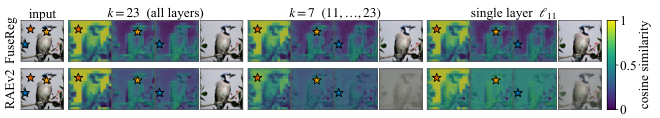
生成:ピクセルデコーダのみを FuseReg デコーダに置き換え — RAEv2 の DiT-XL ジェネレータとそのサンプリングされた潜在変数はそのまま — することで、ガイドなし gFID が 27% 低下します。DiT ステージに共同で適用された正則化の原理はさらなる改善をもたらします(論文の後半のセクション/テーブルで拡張されています)。
限界と未解決問題
c_K(p)\Gamma を誘導正則化項として同定する理論は線形二乗損失代理モデルの下で導出されており、これらの保証が非線形デコーダおよび flow-matching ジェネレータへ転移するかどうかは実験的なものです。独立ベルヌーイマスクはレイヤー間の相関した冗長性をモデル化しておらず、最適な p(およびデコーダステージとジェネレータステージで異なるべきかどうか)は解析的に特徴づけられていません。報告された数値は DINOv3-L を用いた ImageNet-256 のものであり、代替エンコーダ(SigLIP、CLIP、MAE)、高解像度、テスト条件付き生成との相互作用はここでは評価されていません。最後に、デコーダ置き換えによる「ガイドなし gFID 27% 低下」は、再構成忠実度と生成品質のギャップのうちどれだけが DiT ではなく潜在変数インターフェースに起因するかという問いを残しています。
なぜ重要か
FuseReg は、RAE 潜在変数を構成するエンコーダレイヤーの選択という場当たり的なアーキテクチャ上の選択を、その正則化効果が閉形式で特徴づけ可能な分布的訓練目的として再定式化します。デコーダの置き換えだけで DiT-XL においてガイドなし gFID が 27% 低下するという事実は、RAE における再構成・生成ギャップが主として一つのレイヤー構成へのピクセルデコーダの過適合という人工的産物であり、ジェネレータの根本的な容量制限ではないことを示唆しています。
Source: https://arxiv.org/abs/2609.31620
InternW0-Δ: 予測ダイナミクスとアクションを橋渡しするWorld Action Model — 20K時間以上のオープンデータを活用
問題設定
World Action Models(WAMs)は、汎用的なマニピュレーションを目的として、視覚的ダイナミクスとアクション生成を統合的にモデル化することを目指しています。繰り返し生じる困難は、事前学習済みの映像生成器、VLMセマンティクス、4D幾何/モーション、低レベル制御という異種の事前知識を、推論時に高コストな映像ロールアウトを必要とせずにアクションを生成する単一のポリシーへと融合させ、かつ異なる形態・DoF・制御規約を持つロボット間でクリーンに学習できるようにすることです。InternW0-Δは、アーキテクチャの融合問題とデータ統一問題の双方に取り組み、ロボットデモンストレーション、エゴセントリック映像、Ego-to-Robotの転移データ、UMIハンドコレクションによる軌跡からなる20K時間以上の異種コーパスで事前学習を行っています。
アーキテクチャ
InternW0-Δは、事前学習済みのWan2.2-TI2V-5B映像エキスパートと、ランダム初期化されたアクションエキスパート(ActionDiT)を、30個の有向Mixture-of-Transformers(MoT)ブロックを通じて結合しています。凍結されたWan VAEが、エピソード開始時のアンカーフレーム A、現在フレームより32アクションステップ遅れた直近フレーム R、および現在フレーム C という3種類の観測タイプからなるスパースな視覚メモリをエンコードします。T5のインストラクションembeddingが映像エキスパートを条件付けし、凍結されたVLMがタスク条件付きのシーンセマンティクスをアクションエキスパートに供給します。固有受容感覚は両ストリームに独立して射影されます。
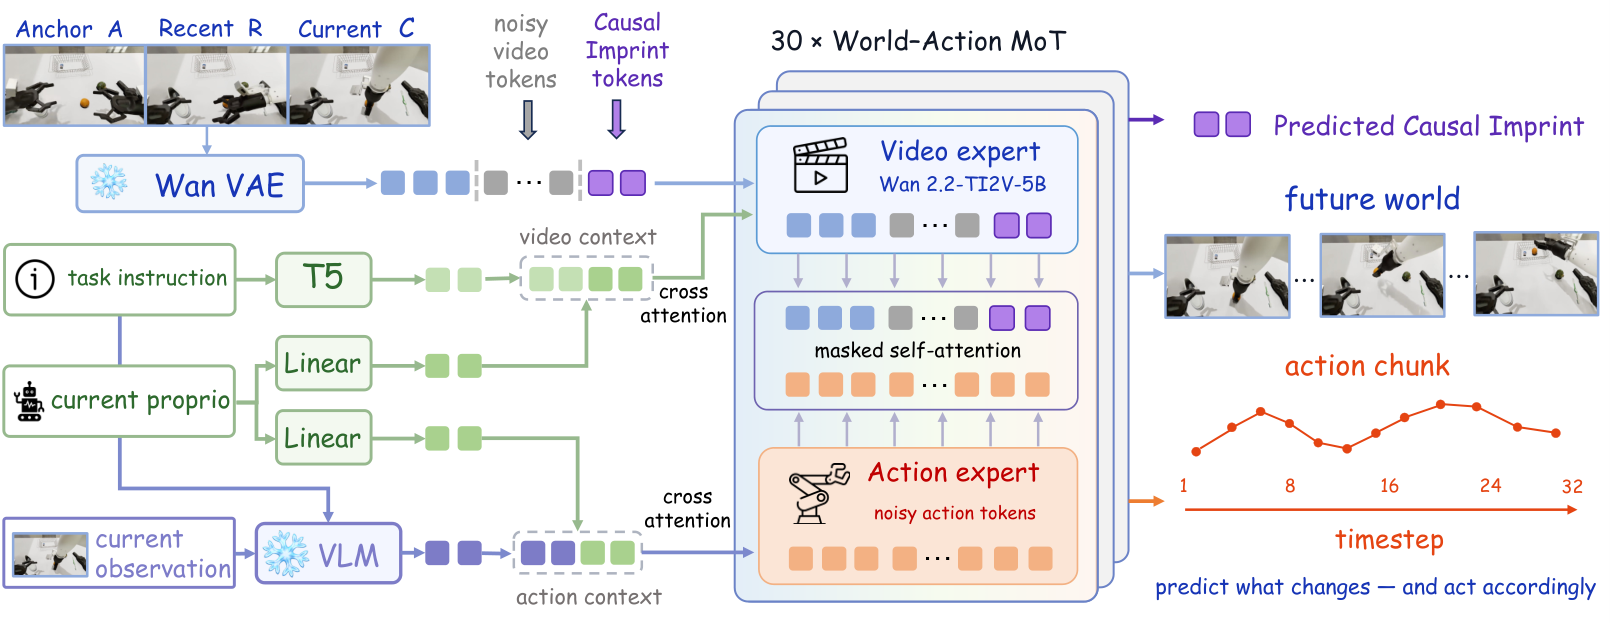
各MoTブロックは、映像ストリームとアクションストリームに対して個別のquery/key/value射影を保持し、joint masked self-attentionを実行した後、エキスパート固有のcross-attentionとFFNにルーティングします。
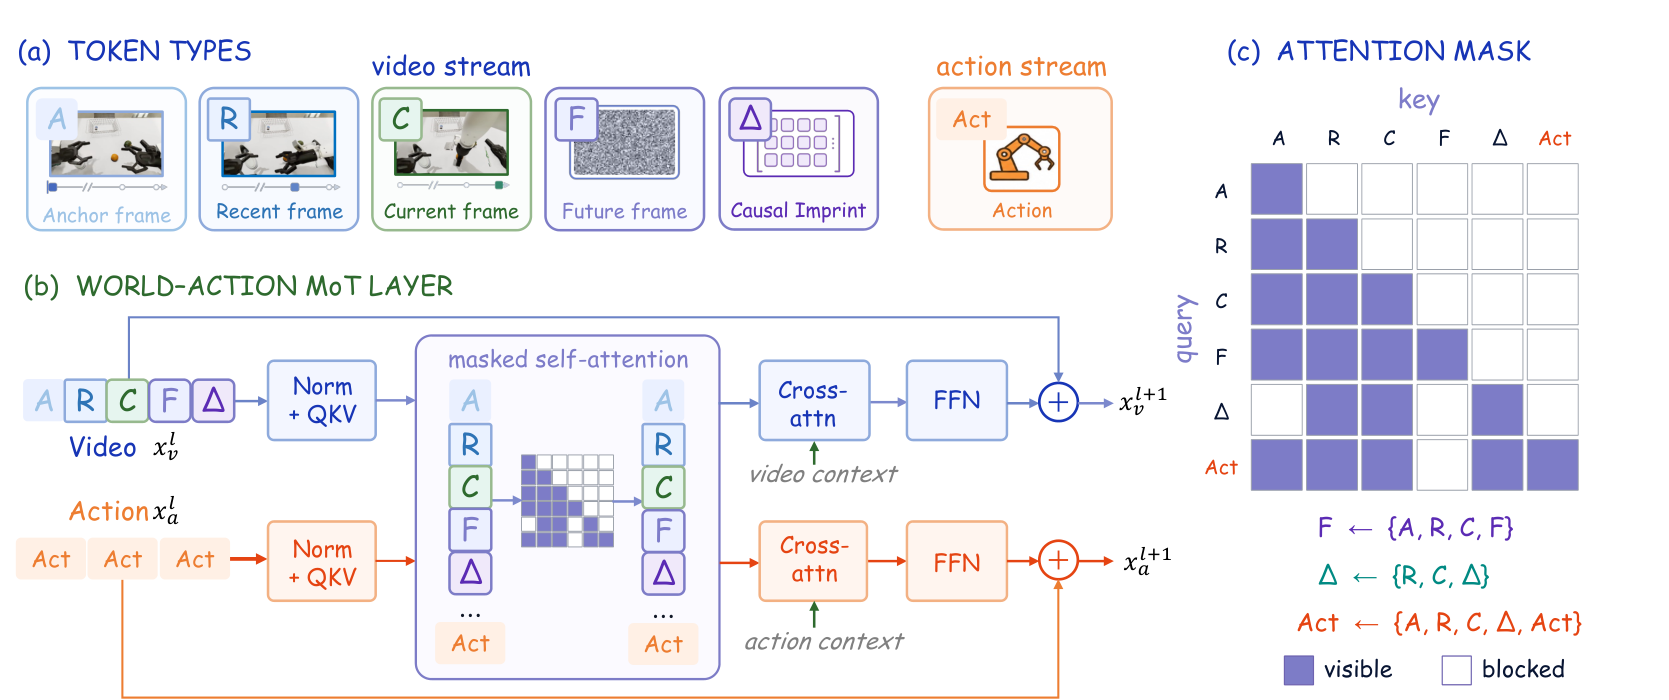
重要な特性は有向な情報フローです。実現された将来の観測 F からの順方向の活性化は、アクション予測パスに到達しません。これにより、モデルは学習中に将来映像の監督信号を利用しながら、推論時には将来のロールアウトをスキップできます — 映像を先に生成してアクションを読み取るWAMに比べ、レイテンシを大幅に削減できます。
Causal Imprintと4D蒸留
2つの補助的なメカニズムが、推論時のコストを増やすことなく予測的・幾何的な事前知識を注入します。
Causal Imprintは、R と C から将来に関連するシーン変化を要約する \Delta トークンを導入します。将来フレームは学習中にのみこれらのトークンを(有向MoTマスクを通じて)監督するため、アクションエキスパートは推論時に将来映像を生成することなく、変化を捉えた予測的特徴を受け取ることができます。
4D-aware distillationは、クエリベースのstudentブランチを用いて映像エキスパートからクリーンな A/R/C の特徴を集約し、凍結されたTrack4World教師からのキャッシュ済みディスクリプタにMSEで回帰させます:
\mathcal{L}_{4\mathrm{D}} = \| f_\theta(z_A, z_R, z_C) - \phi_{\text{Track4World}}(x_A, x_R, x_C) \|_2^2.
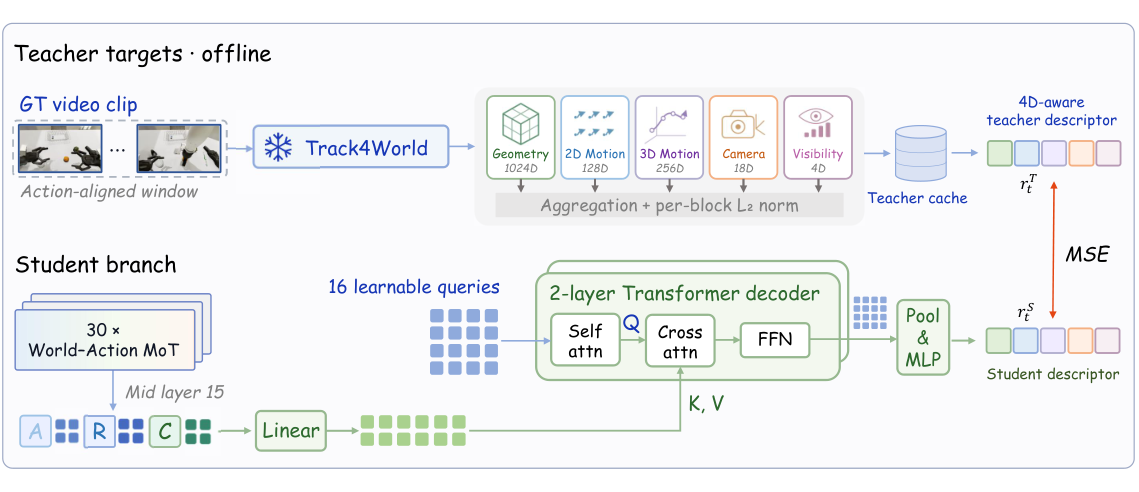
蒸留はGPUあたりの16サンプルのミニバッチのうち1サンプルのみに適用され、計算オーバーヘッドを最小限に抑えています。
統一80次元アクション空間
アーム、多指ハンド、移動基台、ヘッドにわたるデモンストレーションを混合するため、すべての軌跡は固定されたセマンティックスロットを持つ正準80次元アクションベクトルにマッピングされます(論文のTable 1):2つの7-DoFアーム関節ブロック(インデックス [0,7) および [40,47))、2つの9次元EEFポーズブロック、左右ごとのグリッパー(1)とハンド(12)のスロット、胴体(5)、リフト(1)、ヘッド(3)、移動基台(3)、そして将来の形態向けの予約スロット。EEFの状態は3次元位置と連続6D回転、EEFのアクションは3次元並進増分と3次元局所フレーム回転ベクトルを使用します。関節アクションは絶対目標位置です。これにより、ソース間でネイティブのアクションレイアウトを混在させることで生じる曖昧さが解消されます。
学習
事前学習のデータ混合比:実ロボットデモンストレーション80%、Ego2Robot 10%、UMI 8%、エゴセントリック2%。ストリームは有効な開始フレームで重み付けされ、長いセグメントが支配的にならないよう軌跡レベルでのバランシングが行われます。サンプルは33映像フレームと32ステップのアクションブロックを含み、映像対アクションの頻度比は4:1で、384 \times 256 のキャンバスにパックされます。事前学習は2フェーズで実行されます:標準的なjoint学習、その後4D蒸留の目標関数を有効にした継続事前学習。Post-trainingでは、4つのシミュレータ(LIBERO-Plus、RoboTwin 2.0、EBench、RoboDojo)に対して各ベンチマークの公式プロトコルを用いてチェックポイントを対象の形態に特化させます。
インフラストラクチャ
インフラストラクチャのセクションは、ボトルネックについて異例なほど率直に記述しています。凍結されたVAEとVLMエンコーダは、サンプルがエポック間で再訪されるため、探索的学習中にコストを支配します。Cache Manager(LiteGenを基盤として構築)は、データセットバージョン・エピソード・時間チャンク・ビュー・前処理/モデルフィンガープリントにわたるキー付きルックアップ
\text{key} = \text{hash}(D, e, k, v, P, M)
を介して、VAE潜在変数 z_i = E_{\text{VAE}}(x_i) とVLMコンテキスト h_i = E_{\text{VLM}}(x_i, p_i, s_i) を提供します。オンライン(遅延読み込み、非同期永続化)とオフライン(マニフェスト検証付きバッチ事前エンコーディング)の両方のマテリアライゼーションがサポートされています。メタデータの検証により、互換性のない前処理またはモデルバージョン間でのサイレントな再利用が防止されます。MoTバックボーンは、レイヤーごとのコンパイルとactivation checkpointingによって個別に処理されます。
結果と限界
InternW0-Δは、4つのシミュレーションベンチマークおよび実ロボットプラットフォームにおいて、先行手法を上回ると主張しており、結果は各ベンチマークの公開リーダーボードからマッチするプロトコルのもとで取得されています。提供されているセクションにはベンチマークごとの成功率は含まれておらず、アブストラクトと実験セクションでは、ここで入手可能な抜粋において具体的なdeltaを示すことなく「上回る」と言及しています。定量的な主張については、完全なテーブルを確認するまで暫定的なものとして扱うべきです。
未解決の問題:(i) Causal Imprintと4D蒸留それぞれの限界的な貢献は抜粋中で分離されていない;(ii) バッチあたり1/16サンプルのみに4D蒸留を適用するという設計判断は、その感度が特性評価されていない;(iii) 80次元の正準アクションレイアウトは将来の形態に対してわずか10スロットしか予約しておらず、全身型ヒューマノイド制御へのスケーリングを制約する可能性がある;(iv) スパースなアンカー/直近/現在のメモリは、密な映像WAMが保持する密な時間的コンテキストを犠牲にしており、長期タスクにおけるアクション忠実度とのトレードオフはここでは定量化されていない。
重要性
InternW0-Δは、学習時のみの将来監督に対する具体的な設計指針です。予測的な映像ダイナミクスと4D幾何的事前知識を、映像ロールアウトと並行して実行するのではなく、アクションエキスパートに蒸留できることを実証しており、推論時の映像ロールアウトレイテンシを排除しています。統一された80次元のクロス形態アクション空間と20K時間以上のオープンデータレシピと組み合わせることで、次世代のworld-action modelsに向けた再現可能なベースラインを確立しています。
Source: https://arxiv.org/abs/2609.31394
Tactile-JEPA: 分散触覚センサのためのトポロジー認識型自己教師あり表現学習
問題設定
視覚ベースの触覚センサ(GelSight、Digit)は密な画像ストリームを生成し、MAE・DINO・I-JEPAといった視覚SSL手法のフルスタックをそのまま活用できます。一方、分散型電子スキン(e-skin)はそうではありません。その出力は、ロボット表面を覆うスパースかつ不規則なtaxelセット上の多変量時系列です。これまでの研究はこのジオメトリをほぼ無視しており、生信号から触覚エンコーダをスクラッチで学習するか、taxelアレイを疑似画像として扱うかのどちらかでした。いずれの手法も、接触の局所性を符号化するのはテンソルの行・列の隣接関係ではなくセンシング面上のtaxelの隣接関係であるという事実を考慮していません。本論文は、デプロイ時にtaxelの位置情報を必要とせず、taxelのトポロジーを活用した汎用エンコーダをe-skin向けに事前学習する方法を問います。
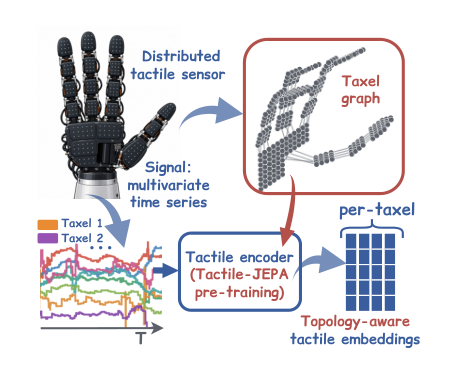
手法
セットアップ。 N個のtaxelをf_sでサンプリングするセンサはX \in \mathbb{R}^{N \times T \times m}を生成します。ここでm=1は圧力センサ、m=3は磁気スキンに対応します。事前学習は短い窓X_\tau^{(k)} \in \mathbb{R}^{N \times \tau \times m}(\tau = \lfloor T_w f_s \rfloor)上で動作し、単一イベント内の短い接触履歴を捉えます。レイアウト(taxelの接続グラフG)は事前学習時には必要ですが、ダウンストリームタスクでは不要です。
アーキテクチャはI-JEPAに従い、コンテキストエンコーダ\mathbf{E}_\theta、predictor \mathbf{P}_\phi、およびEMAターゲットエンコーダ\bar{\mathbf{E}}_{\bar\theta}で構成されます。マスクされた(ターゲット)taxelのper-taxel embeddingを、マスクされていない(コンテキスト)taxelから予測し、MSEによってターゲットエンコーダの出力と照合します:
\mathcal{L} = \frac{1}{|M|}\sum_{i \in M} \| \mathbf{P}_\phi(\mathbf{E}_\theta(X_{\text{ctx}}))_i - \bar{\mathbf{E}}_{\bar\theta}(X)_i \|_2^2.
本手法の新規性はマスクサンプラーにあります。
- マスクはピクセルグリッドではなくtaxelグラフG上でサンプリングされます。「ローカル」マスクは、シードtaxelの周辺にBFS展開によって目標サイズに達するまで構築した連結部分グラフです。「グローバル」マスクは、表面全体に分散したtaxelセットをサンプリングします(例えば、G上の最遠点サンプリングによる)。
- 2つのスケールを混合します。デフォルト設定では、1窓あたり2つのローカルマスクと2つのグローバルターゲットマスク(2L+2G)をサンプリングします。ローカルマスクは接触パッチの細粒度モデリングを強制し、グローバルマスクは全手接触状態の表現を強制します。
コンテキストはデフォルトでは残りのtaxelのグローバルランダムサブセットです(バリアント「†」ではこれをローカルコンテキストマスクに置き換えます)。ターゲットエンコーダはコンテキストエンコーダのEMAで更新されます。
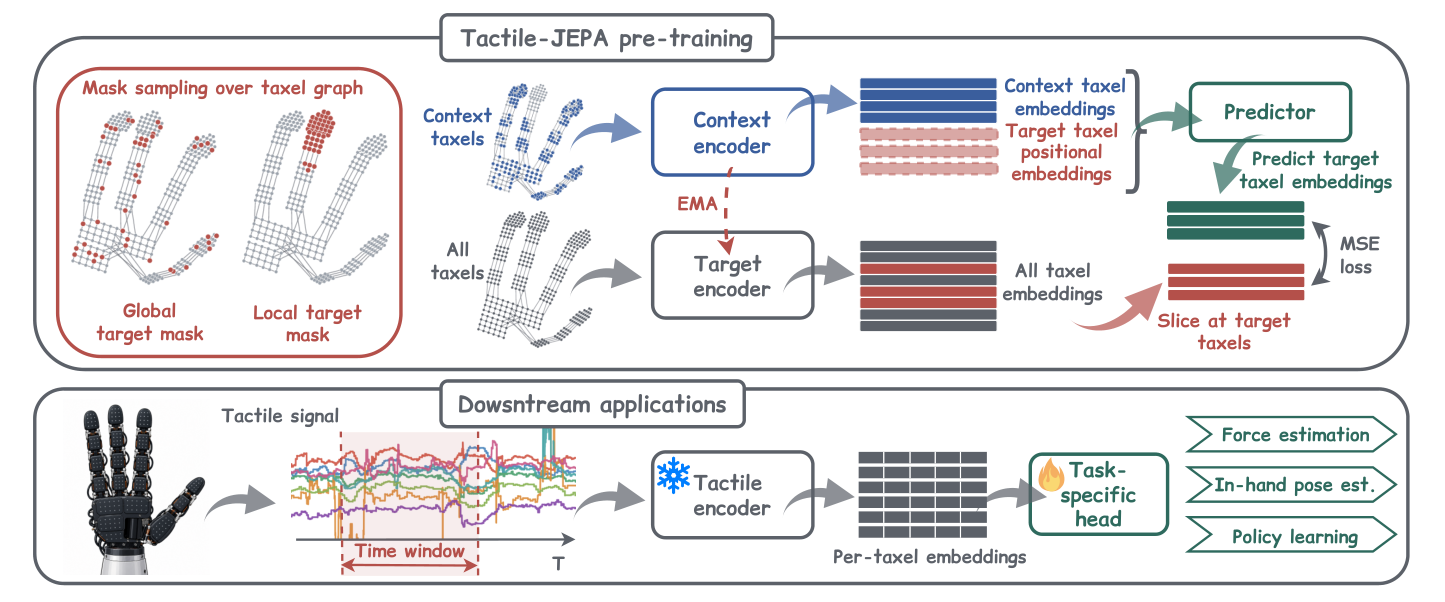
ダウンストリームでは、\mathbf{E}_\thetaを凍結し、タスクごとに軽量なヘッドを学習します。目的関数は1つの窓内で定義されるため、窓をまたいだ時間的統合はダウンストリームデコーダに委ねられ、推論は制御ループのレートで実行できます。
結果
評価は、異なるトランスダクション原理と実装を対象とした3つのデータセット(磁気式のSparsh-skin(センサ化された手)、圧電抵抗式のTactile socks(ウェアラブル)、DECO-50(アセンブリサブセット、バイマニュアル操作))にわたります。ダウンストリームタスクには力推定、把持中の姿勢推定、および行動クローニングによるポリシー学習が含まれます。
結論に記載された主要な数値:最も強力なSSLベースラインと比較して、Tactile-JEPAは把持中の向き誤差を20.8%、力推定誤差を6.3%削減しました。精度に加え、著者らは学習の安定性を強調しています。Tactile-JEPAは3種類すべてのセンサタイプで崩壊なしに事前学習できますが、競合するSSL手法は一部のデータセットで崩壊します。これは、生e-skin信号がいかにノイズが多いかを考慮すると、重要な運用上の特性です。
マスキングのアブレーション(Table IV)は、この設計が機能する理由を明確にします。Sparsh-skinの力RMSE において、2L+2Gは14.05 \pm 0.73を達成し、4I-JEPAの14.99 \pm 1.03、4Lの15.52、4Gの15.17を上回りました。把持中のx方向精度では、2L+2Gは95.74\% \pm 1.05を達成し、4I-JEPAの93.50\%を上回りました。DECO-50のポリシーRMSEでは、4Gが最良(0.4600 \pm 0.0019)であり、これは行動予測が全手接触状態に依存していることと整合しており、2L+2Gは0.4635でわずかに次点でした。2つの主要な知見を示します:
- グラフベースのマスキングはスケールに関わらず有効です。4L(コンパクトなグラフ連結ローカルマスク)は、同じマスク予算において力推定とポリシー学習で4I-JEPA(コンパクトなグリッドベースのブロックマスク)を上回り、トポロジー認識が性能向上の源泉であることが示されました。
- マルチスケールターゲットは最良の汎用トレードオフを提供します:2L+2Gはタスク全体で最良またはほぼ最良ですが、単一スケールのバリアントはタスクタイプに過適合します(ポリシーには4G、ローカルな力の詳細には4L)。
「†」バリアント(グローバルではなくローカルコンテキスト)は、ローカルコンテキストが力推定を改善できる場合があるものの(2L+2G†で13.28 \pm 0.83)、姿勢精度(92.83\%に低下)とポリシー学習を大幅に悪化させることを示しており、グローバルコンテキストが適切なデフォルトであることが確認されます。
限界と未解決の問題
- レイアウトグラフは事前学習に必要です。本論文では未知またはノイズを含む隣接関係を扱っておらず、センサの製造や摩耗によってGが変動する可能性があります。
- 窓をまたいだ時間的モデリングはダウンストリームヘッドに委ねられており、時間的に認識するJEPA目的関数が接触ダイナミクスタスクをさらに改善するかどうかは検証されていません。
- 評価は3つのデータセットをカバーしますが、一部のケースではデータセットごとに1タスクのみです。異なる実装間でのtransfer(あるスキンで学習し、異なるNとGを持つ別のスキンにデプロイ)は体系的に検証されていません。
- マスクのハイパーパラメータ(ローカルマスクとグローバルマスクのサイズ、マスクの数)のアブレーションは粗いレベルにとどまっており、N(数百対数千のtaxel)に対するスケーリング挙動は特性評価されていません。
- 比較は視覚から適用されたSSLベースラインに対するものです。マスキングのみでなくアーキテクチャとしてGを使用するGNNベースの触覚エンコーダとの比較を行えば、議論がより明確になるでしょう。
この研究の重要性
分散型e-skinは全身触覚センシングへの実用的な経路ですが、コミュニティはその不規則なジオメトリを考慮した事前学習のレシピを欠いていました。Tactile-JEPAは、トポロジーをマスクサンプラーのみに組み込み、エンコーダをレイアウト非依存に保つことで、安定した事前学習とセンサタイプをまたがったダウンストリームタスクでの一貫した性能向上を達成できることを示しています。これはまさにVLAスタイルのパイプラインにおける再利用可能な触覚バックボーンに必要なものです。
Source: https://arxiv.org/abs/2609.24385
SLCA-GRPO: ツール呼び出しRLにおけるセグメント間クレジット誤帰属の解決
問題
ツール呼び出しエージェントは、同一トラジェクトリ内で構造的に異なる2種類のトークンクラスを生成します。すなわち、実行可能なスキーマを満たさなければならない構造化ツール呼び出し(関数名、引数JSON)と、結果をユーザーに伝えるための自然言語サマリーです。グループ相対 advantage 推定(GRPO)を用いた標準的なオンポリシー RLは、トラジェクトリごとにスカラーの advantage を1つ計算し、それをすべてのトークンに一様にブロードキャストします。これはハイパーパラメータの問題ではなく、構造的なミスマッチです。誤ったツール呼び出しの上に書かれた優れたサマリーも、そのトラジェクトリが獲得する終端報酬を受け取り、ツール決定トークンへの gradient の寄与はサマリー品質の分散によって汚染されます(逆もまた同様です)。著者らはこれをセグメント間クレジット誤帰属として形式化しています。統一された advantage のもとでは、policy gradient におけるサマリーからツールへの「サポートパス」がゼロでなくなるため、一方のセグメントのノイズが他方の更新に漏れ込みます。
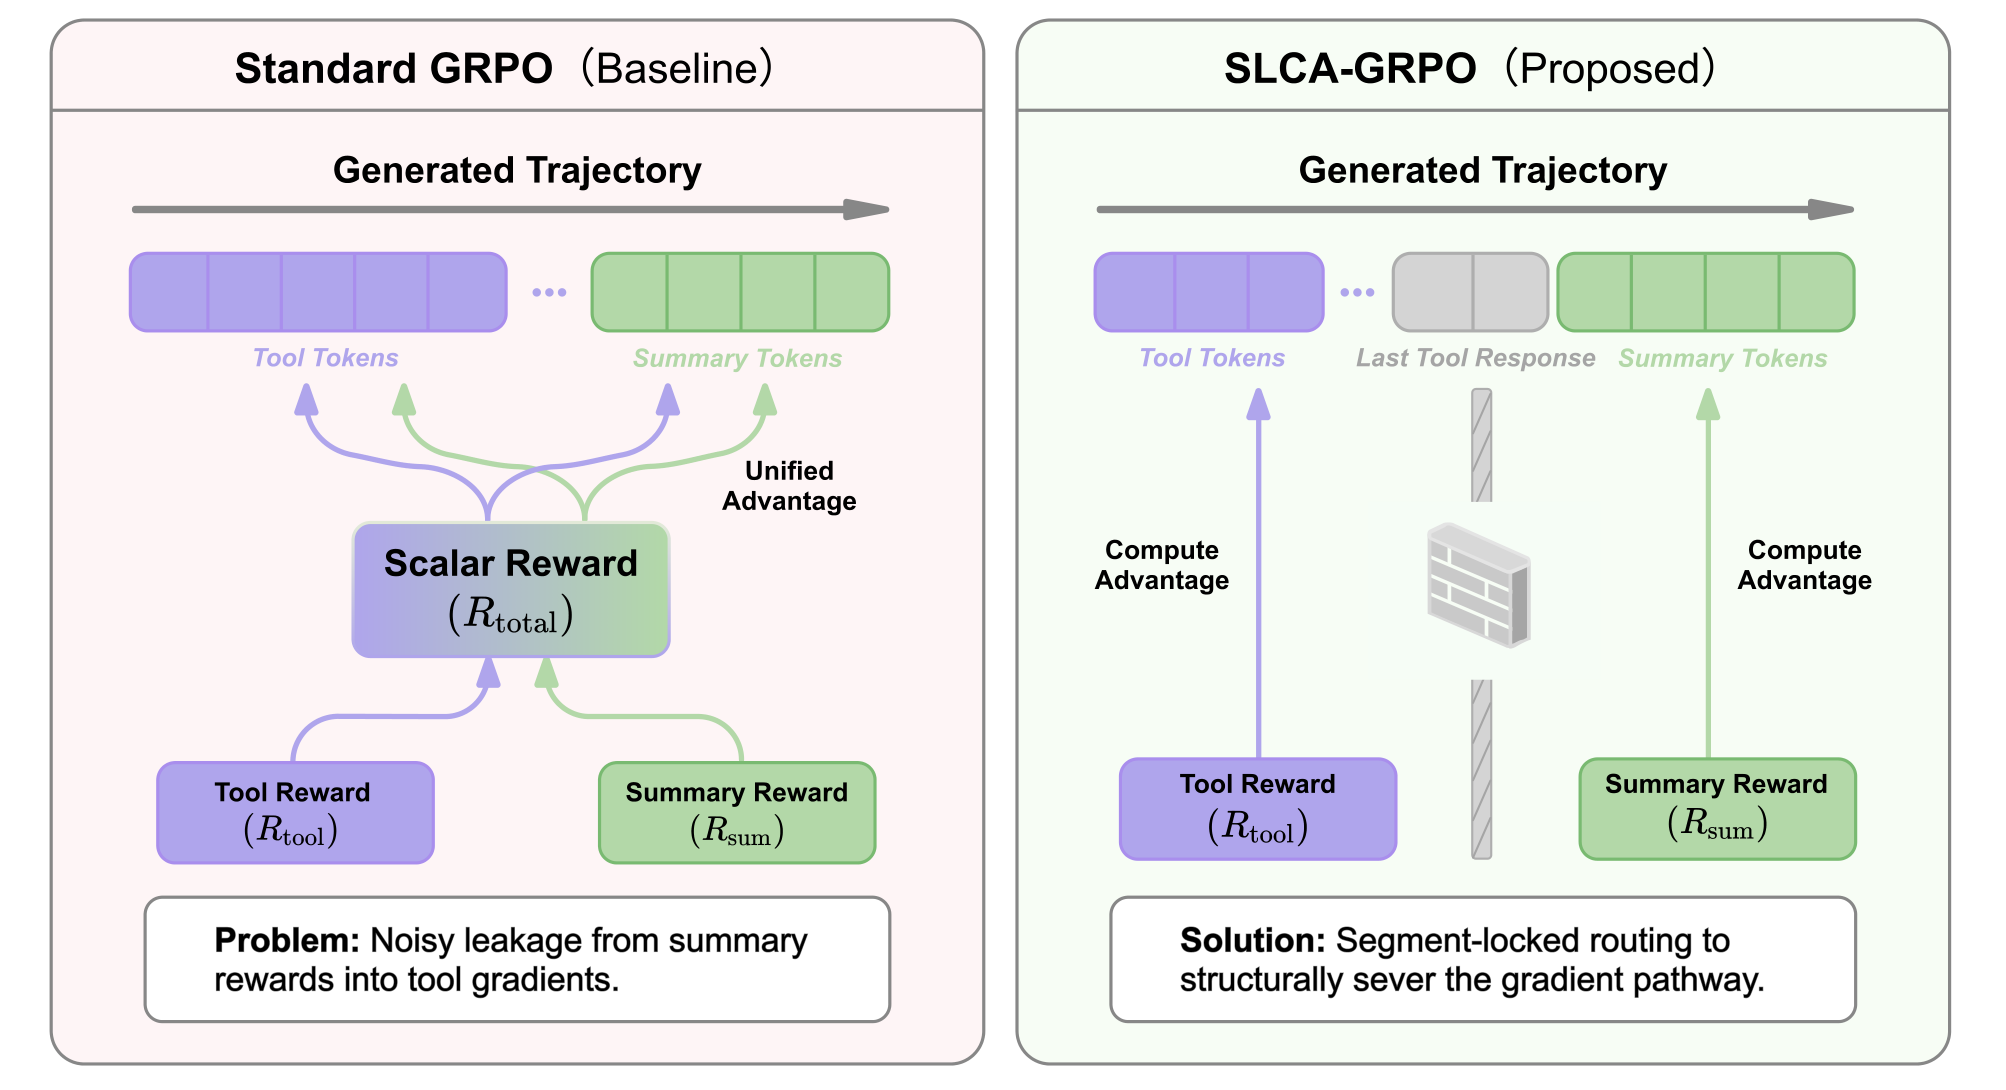
このメカニズムは、論文における統一ブロードキャストとセグメントロックされたルーティングの対比によって明確に示されています。GRPOでは \hat{A}_{\text{traj}} がすべてのトークンに適用されるため、ツールトークンの gradient がサマリー由来の分散を吸収します。一方、SLCAではツールトークンが \hat{A}^{\text{tool}} を、サマリートークンが \hat{A}^{\text{sum}} を受け取り、クロスフローは発生しません。
手法
SLCA-GRPOは、問題を3つの要件——セグメントの露出、セグメント固有のフィードバックの生成、セグメント間 advantage フローの遮断——に分解し、中間状態からの追加ロールアウト(すなわち計算コストを爆発させるステップレベルのMC推定)なしにそれらを実現します。
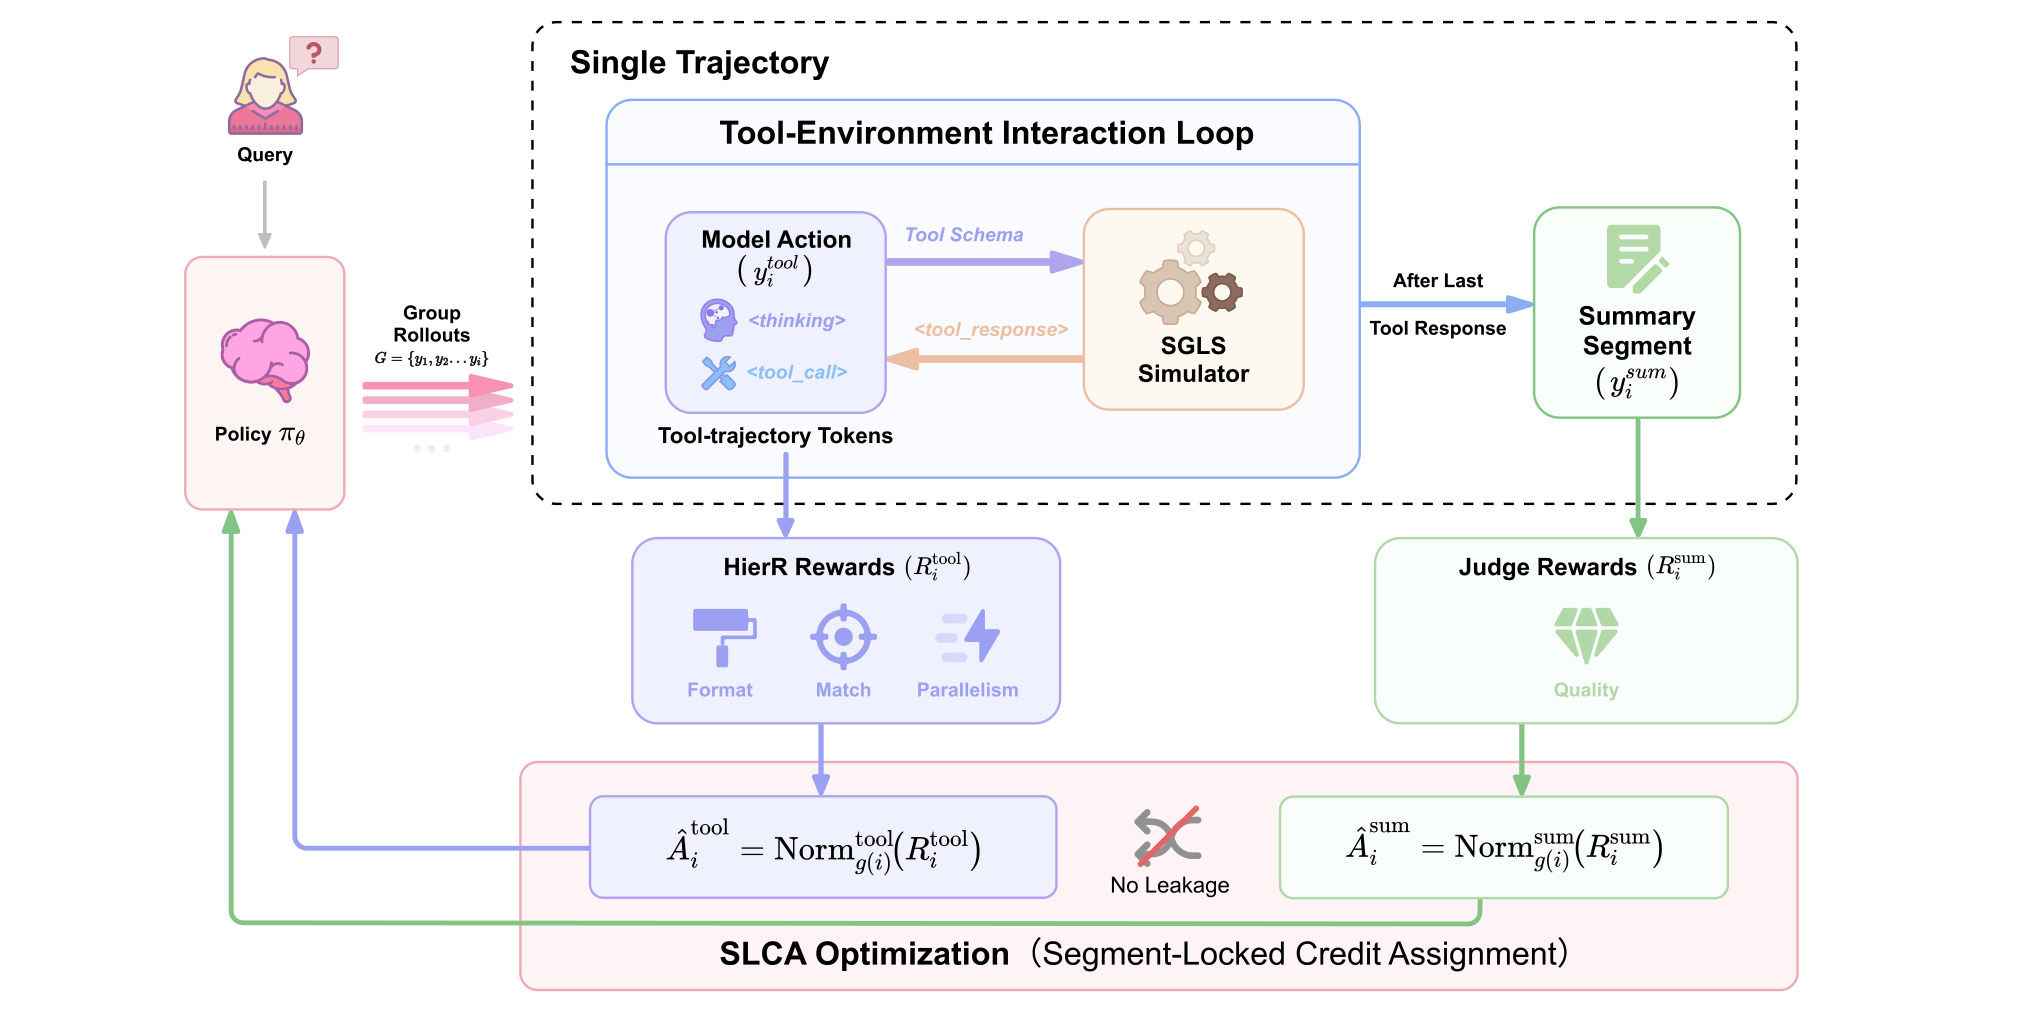
セグメンテーション。 各ロールアウト上の二値マスクが、トークンをツールセグメント \mathcal{T}_{\text{tool}}(構造化呼び出しトークン)とサマリーセグメント \mathcal{T}_{\text{sum}}(ユーザー向け自然言語)に分割します。セグメンテーションは出力スキーマから決定論的に行われます。
階層的報酬(HierR)。 フィードバックは2つのチャンネルに分割されます。
- R^{\text{tool}}: スキーマ適合性、引数の正確性、ツールの正常返値を確認する密な実行レベル報酬。
- R^{\text{sum}}: 最終サマリーに対する終端アウトカム/嗜好報酬。
セグメントロック型クレジット割り当て(SLCA)。 1グループのロールアウト内で、advantage はセグメントごとに独立して正規化されます。
\hat{A}^{\text{tool}}_i = \frac{R^{\text{tool}}_i - \mu_{\text{tool}}}{\sigma_{\text{tool}}}, \quad \hat{A}^{\text{sum}}_i = \frac{R^{\text{sum}}_i - \mu_{\text{sum}}}{\sigma_{\text{sum}}}
ルーティングはマスクによって強制されます。ロールアウト i のトークン t に対して、
\hat{A}_{i,t} = \mathbb{1}[t \in \mathcal{T}_{\text{tool}}]\,\hat{A}^{\text{tool}}_i + \mathbb{1}[t \in \mathcal{T}_{\text{sum}}]\,\hat{A}^{\text{sum}}_i
最終的な目的関数は、このセグメント対応の \hat{A}_{i,t} を用いた標準的なPPOクリップサロゲートです。正規化がセグメントごとに行われるため、強いツールトレースを持ちながらサマリーが弱いロールアウトは、そのツールトークンに対してのみ正の gradient を寄与します。gradient におけるサマリーからツールへのサポートパスは消滅します。
スキーマガイドLLMシミュレータ(SGLS)。 実際のツールAPIはコストが高くレート制限もあり、RLには多くのロールアウトが必要です。SGLSは、ツールスキーマを入力として引数の型と意味論に整合したレスポンスをシミュレートする、LLM駆動のシミュレータです。これにより、RLループのためにユーザー/ツール/アシスタントがインタリーブされたトラジェクトリを大規模に生成できます。
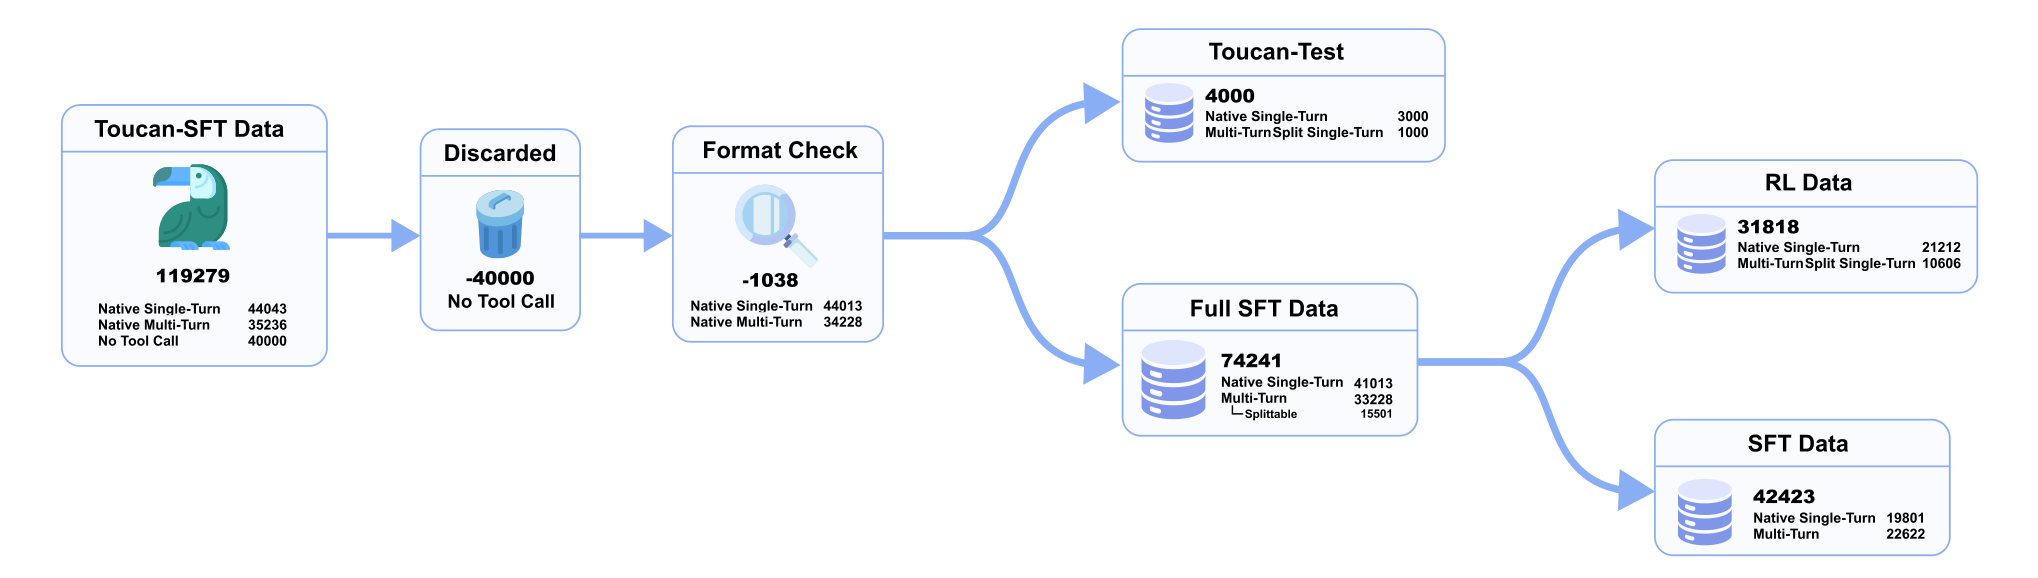
データ。 Toucan-1.5Mからパイプラインは42,423件のSFTサンプルと31,818件のRLサンプル(シングルターンと分解されたマルチターンの混合)を生成し、4,000サンプルのToucan-Testをホールドアウトとして保持します。
評価設定
3つの軸:ドメイン内(Toucan-Test、4kサンプル)、汎化性能(BFCL V3、メイン比較ではレレバンス検出を除いたシングルターン;マルチターン精度は付録で報告)、および協調ロバスト性(\tau^2-Bench Airline/Retail/Telecom、Pass@1)。アブレーションでは SLCA、SGLS、HierR を個別に除去します。
提供された抜粋には数値結果の表は含まれていません。評価セクションは3部構成のプロトコル(統一/加算クレジットにおける失敗診断、クロススキーマおよび長期ホライズン転移、コンポーネントアブレーション)を定義していますが、数値は提供されたセクションには含まれていない表に格納されています。明示的に述べられているのは、データセットの規模(31,818件のRLトラジェクトリ、4,000件のテスト)と、メインBFCL V3シングルターン比較からのレレバンス検出の除外であり、その測定をアトミックなスキーマ汎化(例:AST精度)に限定しています。
制限と未解決の問題
- セグメント定義はパース可能なスキーマに依存する。 自由形式の推論トレースや、ツール引数を文章にインライン化するエージェントは、学習済みセグメンタが必要になります。現在のマスクは決定論的です。
- SGLSの忠実度はトレーニング時の仮定である。 シミュレータLLMのバイアスはツールポリシーに吸収される可能性があり、提供された抜粋では実際のAPIに対するsim-to-realギャップが定量化されていません。
- 2セグメント分解。 実際のエージェントはより多くの階層(計画、反省、ツール、サマリー)を持ちます。SLCAを k>2 セグメントに拡張することは代数的には直接的ですが、セグメントごとの正規化がグループレベルの統計量を使用するため、分散に関する懸念が生じます。
- 独立正規化はセグメント間の gradient の相対スケールを変える。 暗黙的な重み付けが存在しますが、提供された抜粋ではそのスイープが行われていないようです。\hat{A}^{\text{tool}} と \hat{A}^{\text{sum}} の大きさの間の温度係数が重要になる可能性があります。
- gradient投影法との比較(例:PCGrad系アプローチ)は、実証的な直接比較ではなく付録の概略図に留まっています。
なぜ重要か
トラジェクトリレベルの advantage ブロードキャストは、エージェント的なポストトレーニングに広く使用されているGRPOファミリーアルゴリズムのデフォルトであり、異質な出力に対して暗黙的に誤ったクレジットを付与しています。SLCA-GRPOは、出力の構造的セグメンテーション——セグメントごとの報酬チャンネルとセグメントごとの正規化された advantage——を尊重することが、明白な gradient リークパスを閉じる安価でロールアウト不要の修正であることを示しています。同じパターンは、コード+説明、計画+行動、chain-of-thought+回答など、インタリーブされた出力を持つあらゆるRL設定に適用できる可能性があります。
Source: https://arxiv.org/abs/2609.29050
TRACE: ストリーミング動画理解の時間的監査と条件認識型評価
ストリーミング動画理解のベンチマークは、一般にQA精度の集計値やイベント検出F1を報告しており、その基盤となる評価を静的なもの——質問、動画、回答——として扱っています。TRACEは、これが根本的に仕様不足であると主張します。ストリーミング環境では、QAスコアが同一の2つのシステムが、証拠がいつ合法的に利用可能であったか、どれだけの履歴を保持していたか、自発的に応答をトリガーしたかどうか、そのためにどのような負荷を要したか、という点で大きく異なる場合があります。本論文は、時間的妥当性、実行条件、および運用上の結果を単一の評価に結びつける、条件認識型ベンチマークとプロトコルを提案します。
設計:時間的妥当性、実行条件、運用上の結果
TRACEは、密接に結びついた3つの前提に基づいて構成されています。第一に、すべての回答は動画に根拠を持つ証拠時刻——与えられた質問に対して正解を映像コンテンツが支持できる最も早い時点——に紐付けられなければなりません。QAの場合、アノテーターは質問到着時刻とともにこれをマークし、その間隔が証拠-質問間距離を定義します。著者らは、この距離が難易度指標そのものではないことを注意深く指摘しており、繰り返される証拠やコンテンツの複雑さがこれを混乱させると述べています。第二に、能動的タスクには単一の汎用的なイベントタイムスタンプではなく、指示に依存したトリガー意味論が与えられます。TRACEは4種類のトリガー規則を区別します:
- Event-onset:対象条件が初めて成立した時点。
- Event-completion:要求されたアクションの終了時点。
- Sufficient-evidence:可視的な手がかりが正解を一意に決定し、代替案を排除できる最も早い時点。
- State:回答が有効であり続ける区間。
これらは動画の性質ではなく、指示の性質です。同じ動作であっても、クエリの仕方によってonsetトリガーとcompletionトリガーのどちらにもなり得ます。第三に、評価は統一されたカusal Core–Adapterプロトコルのもとで実行されます。Coreは1 FPSでタイムスタンプ付きRGBフレームをリアルタイムペーシングで配信し、質問および指示の到着を制御します。Adapterは、モデルが実際に何をしたか——どのフレームが処理されたか、いつ応答がトリガーされたか、消費された負荷——を記録します。
ベンチマークの構築
標準セットは517本の動画にわたる1,240件のレコードから構成され、StreamingBenchとOVO-Benchの視覚のみのサブセットから取得されています(音声、字幕、外部知識タスクは除外されています)。重要なのは、アノテーションが信頼されるのではなく再監査されている点です。レビューされたレコードのうち、328件が編集され52件が除外されました。編集のうち、328件中325件が時間的またはトリガーフィールドに関するものでした:103件中100件のQA編集がタイミングを修正し、すべての225件の能動的編集がトリガーアノテーションを修正または追加しました。直接比較可能なタイムスタンプにおいて、修正の中央値絶対誤差はQAで3.0秒、能動的タスクで2.24秒であり、上側の裾が重くなっています。これらの修正は見かけ上のものではなく——質問の前に視覚情報が合法的に利用可能かどうか、応答遅延がどのように測定されるか、割り当てのない応答が誤検知なのかターゲットウィンドウが見逃しなのかを決定します。
評価プロトコルと構成
8つのシステムが8つの構成で評価されます:AURA、MOSS-VL、MOSS-Preview、LiveCC、ThinkStream、VideoLLM-Online、MiniCPM-O 4.5、およびJoyAI(完全なエンドツーエンドシステムとして)。構成は論文のTable 3で明示された3つの軸に沿って異なります:(i) 視覚状態の保持——ネイティブストリーミングセッション vs. クエリ時のprefix再構築(AURAのQAパスなど)vs. フレームごとのKV永続化(VideoLLM-Online)vs. 外部サマリーメモリ(JoyAI);(ii) 能動的トリガーモード——全メイン比較実行において自律的自己開始を使用し、JoyAIのトリガーメカニズムは未検証の自律として記載;(iii) デプロイメント境界——モデル+Adapter vs. システムレベル。すべてのQAは同じ質問と回答パーサーを使用し、能動的意味論的スコアリングには固定のQwen3.5-35B-A3Bジャッジを使用します。実行にはNVIDIA A100 80GBを使用し、著者らはタイミングと負荷の数値が構成固有のものであり、ハードウェアで正規化されていないことを明示しています。
報告は多次元的です:回答品質、タイムリーさ、応答選択行動(能動的品質と発火決定を切り離す)、負荷(生成コスト)、3つの個別に区分された粒度での完了率(QAレコード、能動的レコード、ストリーム)、および信頼性。異なる粒度での完了率はレベル間で意図的に比較不可能とされています。
発見
分析は、数値によって裏付けられた3つの主張を生み出します。第一に、時間的監査によって「正解」と「時間通り」の意味が変わります:トリガーアノテーションが編集された225件の能動的レコードすべてについて、同じモデル出力が監査済みの境界と元の境界のもとで、ウィンドウ内とウィンドウ外の間で反転する可能性があります。第二に、能動的パフォーマンスは単一の軸上にありません——品質、タイミング、応答選択が分離します。応答時に高品質な回答を生成するシステムが発火タイミングは劣る場合があり、その逆もあります;単一のF1はこれらを一括してしまいます。第三に、ほぼ同一のQA精度が、完了率、回答妥当性、生成負荷における実質的な差異を隠蔽する可能性があります。abstractはこれを具体的に述べています:「ほぼ同一のQA精度が、完了率、回答妥当性、生成負荷における実質的な差異を隠蔽し得る」。AURAのクエリ時の非ネイティブprefix再構築は、例えば、QAスコアではネイティブストリーミングシステムと直接比較可能ですが、全く異なる負荷プロファイルを発生させます。
限界とオープンクエスチョン
いくつかの限界が見受けられます。セットは1,240件のレコードであり、多くの軸にわたって接近したシステムを区別することを意図したベンチマークとしては控えめです;次元ごとの比較に対する統計的検出力は不明確です。タイミングと負荷はハードウェアで正規化されておらず、著者らもこれを認めています——構成間の比較はモデルの振る舞いとランタイム環境を混在させています。能動的意味論的ジャッジは単一の固定LLMであり、報告されたセクションではジャッジの感度が特性評価されていません。トリガーアノテーション、特にsufficient-evidenceタスクの場合、本質的に主観的であり;監査済みタイムスタンプに対するアノテーター間合意は引用されたテキストでは報告されていません。最後に、JoyAIの「未検証の自律」トリガーフラグは、内部が不透明なエンドツーエンドシステムにプロトコルを適用することの難しさを示唆しています。
この研究の意義
ストリーミング動画のベンチマークがスカラーのタスクスコアを報告し続ける限り、運用上の現実を反映しないランキングを生み出し続けるでしょう——QA精度は同一でも、負荷、誤検知率、履歴要件が大きく異なるシステムを生み出します。TRACEの貢献はアーキテクチャ的というよりも手続き的なものです:証拠のタイミング、トリガー意味論、実行条件をスコアに組み込むことを強制しており、これはストリーミング動画言語システムの意味のある比較のための前提条件です。
Source: https://arxiv.org/abs/2609.30670
Hacker News Signals
Ember-1
Fireworks AIは、エージェント的なコーディングワークフローを対象としたコンパウンドAIシステム「Ember-1」をリリースしました。このアーキテクチャはツール使用と多段階推論を中心に構築されており、モデルはソフトウェア開発タスク(コードの記述・編集・デバッグ・コードベースのナビゲーション)を駆動するために特化して訓練されています。すべてを処理する単一の大規模モデルではなく、Ember-1はツール呼び出し(ファイル読み取り、ターミナル実行、検索)をオーケストレーションするシステムとして設計されており、ReActやToolformer的な実行ループに似た構造をコーディングドメイン向けに最適化しています。
技術的な主張は、フロンティアモデルと比較したレイテンシとコストに集中しています。FireworksはEmber-1を、SWE-benchスタイルのベンチマークにおいてClaude 3.5 SonnetおよびGPT-4oと競争力があると位置付けており、自社の推論インフラ上で動作することでサブ秒のツール呼び出しラウンドトリップを実現しています。このシステムは自社の推論プラットフォームと統合されており、コンパウンドループはクライアント主導のAPIチェーニングではなくサーバーサイドで実行されます。これは、ネットワークラウンドトリップのオーバーヘッドが数十回のツール呼び出しにわたって累積するエージェント的ワークロードにおいて重要な意味を持ちます。
プロンプトからアクションへのパイプラインは、ツールのディスパッチに構造化出力を使用しており、モデルがダウンストリームの解析を必要とする自由形式のテキストではなく、JSONスキーマに準拠した呼び出しを出力することを保証しています。訓練には実行トレースに対する supervised fine-tuning が含まれており、実際のコード実行からの合否シグナルに対する RLHF やリジェクションサンプリングも組み合わされたと考えられます。これはコーディングエージェントの現在の標準的なレシピです。
HN上の議論では、このようなコンパウンドシステムがフロンティアモデルを直接呼び出すよりも実際に高い能力を持つのか、それとも単に高速・低コストなだけなのかという点に焦点が当たり、実世界のエージェント的タスクに対するベンチマークの信頼性についての懐疑的な意見が多く見られました。繰り返し指摘されたのは、SWE-benchの数値はモデルの品質向上よりもスキャフォールディングの選択によって容易に操作できるという点でした。
公開重みは存在せず、アクセスはFireworks APIを通じて提供されます。
Source: https://fireworks.ai/blog/ember-1
AIにおける速い思考と遅い思考:メタ認知の役割(2021年)
本論文は、カーネマンの二重過程理論をAIシステムに対応づけ、システム1(高速・連想的・パターンマッチング)とシステム2(低速・熟慮的・規則支配的)を区別した上で、AIが真のメタ認知——自身の推論過程を監視・調整する能力——を示すために必要なアーキテクチャ上および学習上の特性とは何かを問います。
中心となる技術的主張は、現在の深層学習システムは主としてシステム1であるというものです。すなわち、学習済み分布上での高速なパターン補完は行うものの、不確実性を考慮した自己監視、作業記憶の操作、意図的な戦略切り替えのための明示的なメカニズムを欠いているとされます。著者らはシステム2の性質を導入しようとする試みを調査しており、scratchpad推論(chain-of-thought)、ニューロシンボリックハイブリッド、学習済みオプティマイザ、メモリ拡張ネットワークを取り上げています。それぞれが、信頼度の監視、推論エラーの検出、タスク難易度に基づく計算量の割り当て、戦略の切り替えを含むメタ認知能力の分類体系に照らして評価されています。
本論文は2021年のものであり、chain-of-thoughtプロンプティングやRLHFで調整された推論モデル(o1、Deepseek-R1など)の爆発的な普及以前に執筆されています。そのため、遡及的に読むと興味深い内容となっています。本論文が定義するメタ認知の基準——信頼度の自己監視、適応的な計算量の割り当て、明示的な戦略表現——は、まさにo1スタイルのモデルが拡張された推論トレースとprocess reward modelを通じて部分的に実現しつつある特性です。本論文のフレームワークは、これらの能力は明示的な内部フィードバックループを生み出すアーキテクチャ上または学習上の変更なしには、スケールのみから純粋に創発することはできないと予測しています。
本論文の限界は主として歴史的なものです。大規模RLHFおよび推論トレース学習からの実証的な証拠が得られる以前に執筆されたため、スケールに関するいくつかの悲観的な結論は部分的に反証されていますが、アーキテクチャに関する懸念は依然として未解決のままです。
Source: https://arxiv.org/abs/2110.01834
2026年におけるRustのSIMDの現状
RustエコシステムにおけるポータブルなsIMDの現状を詳細に調査した記事です。著者は主に3つのアプローチを取り上げています。すなわち、std::simdポータブルSIMD API(執筆時点ではnightly限定)、std::archを通じたプラットフォーム固有のintrinsicsの直接利用、そしてLLVMに依存したautovectorizationです。
std::simd APIのstabilizationは遅々として進んでいません。このモジュールは幅に依存しないベクター型(Simd<f32, 8>など)とレーン単位の演算、および明示的なswizzleプリミティブを提供していますが、LLVMのバックエンド表現との対応は完全ではありません。本来1命令にコンパイルされるべき操作が最適でないコードを生成してしまうケースがあります。著者はいくつかのパターンをベンチマークし、vectorizationの失敗や冗長なmoveが原因で、手書きのstd::arch intrinsicsがポータブルAPIを2〜4倍上回る事例を示しています。
std::archについては、エルゴノミクスが依然として貧弱です。intrinsicsの呼び出しはすべてunsafeであり、命名はIntelのintrinsicsガイドからそのまま持ってきたもの(例:_mm256_fmadd_ps)で、ポータブルなフォールバックを書くには大量のボイラープレートが必要になります。著者は、ライブラリ作者にとって現時点で最も実用的な方法として、関数レベルのmultiversioningを行うmultiversionクレート(実行時にAVX-512、AVX2、SSE4.2の実装にディスパッチする)を推奨しています。
Autovectorizationのカバレッジは一貫していません。LLVMは単純なループは確実にvectorizeしますが、非自明な制御フロー、gather/scatterパターン、あるいは水平方向のreductionが絡む場合には失敗します。#[target_feature(enable = "avx2")]でループにアノテーションを付けるとLLVMには有効ですが、ポータビリティが失われます。
この記事では、packed_simd2(ほぼ放棄済み)、wide(より安定したセマンティクスを持つサードパーティのポータブルSIMDクレート)、およびARM上のSVE/NEONについても取り上げています。結論として、RustのSIMDは利用可能ではあるものの、unsafeなintrinsicsを受け入れるか、autovectorizationの欠陥を許容するかのいずれかが必要であり、std::simdのstabilizationが未解決の重要なブロッカーであるとされています。
Source: https://shnatsel.github.io/state-of-simd-rust-2026/
GoコードをGitHubに結合させるな
Go のモジュールパスやツールチェインにおいて、GitHub固有の慣習をファーストクラスの構成要素として使うことへの反論を展開した、実践的なエンジニアリング記事です。核心となる問題は、GoモジュールシステムがimportパスにVCSホスティングのURLを依存していることです。github.com/user/repo として宣言されたモジュールは、すべてのダウンストリームコンシューマのあらゆるimport文にホスティングプロバイダを埋め込んでしまいます。セルフホストのGiteaインスタンスやGitLab、その他のプロバイダへ移行しようとすると、グローバルなリネームが必要となり、それは破壊的変更を意味します。
推奨される代替案は、Goモジュール proxy リダイレクトと組み合わせたカスタムドメインを使うことです。Goは <meta name="go-import"> HTMLタグによるvanity importパスをサポートしているため、mypkg.example.com/somepkg は任意のホスト上にある実際のgitリポジトリへ解決できます。著者は、こうしたリダイレクトレスポンスを提供するために必要なnginxまたはCaddyの設定と、カスタムドメインからのフェッチをキャッシュするモジュール proxy(GOPROXY)の設定方法を詳しく説明しています。
二次的な論点は、CI上で actions/checkout などの github.com 名前空間のアクションを直接使用するGitHub Actionsワークフローに関するものです。これらは緩やかな結合を生み出します。CIプロバイダを切り替えると、すべてのワークフローファイルを書き直す必要が生じます。著者は、共通のCIステップをMakefileターゲットやシェルスクリプトに抽象化することを提案しており、そうすることでCI YAMLはビルド・テスト・lintの手続きを権威的に定義するものではなく、薄いグルーコードになります。
ここに本質的に新しいことは何もありません。GoのドキュメントはVanity importをカバーしており、CI抽象化に関するアドバイスも標準的なものです。しかしこの記事は、importパスが長期にわたって影響を与えるパブリックインターフェースの決定であること、そして最も抵抗の少ない道(github.com を直接使うこと)は短期的な利便性と引き換えに長期的なロックインをもたらすという点を改めて考えさせてくれる有益な記事です。HNでのディスカッションでは、これが実際に重要かどうかが議論され、意見の相違の多くはプロジェクトが実際にVCSホストを移行する頻度に集中していました。
Source: https://iain.rocks/blog/dont-couple-your-go-code-to-github
LLM向けのシングル関数Jevライクラッパー(ビジョンモデル対応)
本記事では、複数のLLMバックエンド(OpenAI、Anthropic、ローカルのOllama)に対して統一されたllm(prompt, ...)インターフェースを提供する最小限のPythonラッパーを紹介しています。設計思想はJev(コミュニティで広まっている最小限のLLMインターフェースの概念)を踏襲しており、APIの表面を単一の呼び出し可能オブジェクトに絞り込むことで、呼び出し側のコードにプロバイダー固有のロジックを含めないようにしています。
実装では、画像入力をbase64エンコードし、各プロバイダーに適したメッセージ形式に挿入することで対応しています。具体的には、OpenAIのimage_urlアイテムを含むcontent配列と、Anthropicのimageソースブロックを含むcontent配列という形式の違いを吸収しています。この抽象化によって差異が正規化されるため、呼び出し側はファイルパスまたはバイトオブジェクトを渡すだけでよく、エンコーディングやスキーマの差異はラッパーが処理します。
テキストのみのモデルに対しては、ラッパーがシステムプロンプトを正規化し、messagesリストの構築を行い、バックエンドが返すレスポンススキーマに関わらずレスポンス文字列を抽出します。ストリーミングはオプションとしてサポートされています。実装全体は200行未満です。
このエンジニアリング上のトレードオフは、あらゆる抽象化レイヤーに典型的なものです。プロバイダーの移植性を得られる一方で、プロバイダー固有の機能(structured outputスキーマ、tool-use形式、サンプリングパラメータの名称はプロバイダーによって異なります)へのアクセスが失われます。著者はこの点を認識しており、プロバイダー固有の機能が重要なプロダクション環境ではなく、プロトタイピングやスクリプト作成の用途にこのラッパーを推奨しています。
HNのディスカッションでは、同じ抽象化をより大きなスケールで提供するlitellmなどの既存ライブラリと比べて優れているかどうかが議論の焦点となりました。反論としては、依存関係のない自己完結型のシングルファイルラッパーは、スクリプトや個人用ツールにおいて運用上シンプルであるという点が挙げられます。ビジョンモデルのサポートはより新規性の高い部分です。多くのラッパーがテキストはうまく処理できるものの、画像入力形式の差異を適切に吸収できていないからです。
Source: http://allanrbo.blogspot.com/2026/09/a-jev-like-wrapper-for-llms-including.html
Claude Opus 5.5 のプロンプティング
AnthropicによるClaude Opus 5.5のプロンプティングに関する公式ドキュメントがHNに投稿され、活発な議論を呼びました。内容自体が目新しいわけではありませんが、モデルの設計者がその振る舞いをどのように想定し、その挙動をどのように調整することを推奨しているかを直接知ることができる点が注目されました。
技術的な内容としては、いくつかの具体的なパターンが取り上げられています。Claude Opus 5.5は長期的なタスクにおけるinstruction-followingが強化されており、エージェント的なコンテキストにおけるprompt injectionへの耐性も高まっていると説明されています。ドキュメントでは、複数のパートからなるプロンプトを構造化する際に、markdownや散文による区切りに頼るのではなく、明示的なXMLタグのデリミタ(例:<instructions>、<context>、<output_format>)を使用することを推奨しています。AnthropicのトレーニングプロセスがXML構造を信頼性の高いデリミタとして特別に強化してきた様子がうかがえます。
chain-of-thoughtの引き出し方については、回答の後ではなく前に推論を求めることが推奨されており、これは複数ステップの論理を必要とするタスクにおいて、回答前のscratchpadが精度を向上させるという知見と一致しています。エージェント的なワークフローに関しては、曖昧なアクションを進める前に確認を求めるよう、また非可逆なアクションよりも可逆なアクションを優先するよう、モデルに指示することが強調されています。これはモデルに組み込まれたアライメントレベルの行動指針であり、プロンプティングによってアクセス可能なものです。
長いコンテキストに関するセクションは特に注目に値します。ドキュメントでは、Opus 5.5は長いコンテキスト中での指示の配置(先頭か末尾か)によって異なるパフォーマンスを示し、一部のタスク種別においては重要な指示をコンテキストの末尾に配置する方が先頭に配置するよりも優れた結果をもたらすと警告しています。これは長いコンテキストのtransformerにおける既知のattention sinkおよびrecency効果と一致しています。
HNの議論では、このプロンプトエンジニアリングの手法がどこまで他のモデルに転用できるのか、あるいはAnthropicのRLHFデータに起因するClaude固有の振る舞いの産物なのかという点が問われました。ドキュメントにはメカニズム的な説明は示されていません。
Source: https://platform.claude.com/docs/en/build-with-claude/prompt-engineering/prompting-claude-opus-5-5
GLM-5.3-Flash をJev風の意思決定モデルに変換する
PrivateMode AI は、GLM-5.3-Flash(Zhipu AI が開発した小型・高速なオープンウェイトモデル)を「System One」と呼ぶルーティング/意思決定レイヤーに変換する手法を紹介しています。このアプローチの目的は、モデルをテキスト生成ではなく、高速なバイナリまたは多クラス分類に使用することです。具体的には、より高コストなモデルやツールを呼び出す前に、与えられたコンテキストに基づいてどのアクションを取るかを分類します。
このアプローチでは、まず(コンテキスト、決定)ペアからなるカスタムデータセットを用いて supervised instruction tuning による fine-tuning を行い、次に分類ヘッドまたは制約付きデコーディングを適用することで、自由形式のテキストではなく小さな離散アクション空間への出力を強制します。「Jev風」という表現は、このモデルを軽量なプランナーとして用い、必要な場合にのみ重い計算へルーティングするという考え方に由来しています。
技術的な観点から、GLM-5.3-Flash はこのユースケースに適しています。4ビット量子化形式では控えめなハードウェア上でも100ms未満のレイテンシで推論が可能であり、メモリフットプリントも小さいためです。生成を固定されたアクション語彙に制約することで、完全な自己回帰デコーディングではなく少数のトークンに対する logits のみが必要となり、実質的な推論コストはさらに低下します。
著者らは内部ベンチマークにおける結果を報告しており、fine-tuning された意思決定モデルはルーティング精度においてより大きなベースラインと同等の性能を示しつつ、クエリの大部分がより安価な下流パスで処理できるタスクにおいてシステム全体のレイテンシを約60%削減できることが示されています。
未解決の問題としては、分布シフトに対する汎化性能(この意思決定モデルは fine-tuning データに含まれない入力パターンに対して脆弱である可能性が高い)や、新しいアプリケーションドメインに対して fine-tuning データの収集プロセスが現実的かどうかという点が挙げられます。このアプローチは本質的には学習済みルーターであり、概念的には mixture-of-experts のゲーティングに類似していますが、モデル内部ではなくアプリケーションのオーケストレーションレイヤーに適用されている点が異なります。
Source: https://www.privatemode.ai/blog/system-one-from-glm-flash
あなたのPostgresマイグレーションは安全か、そうでないか?
safenotsafe.dev は、Postgresのスキーママイグレーションをその安全性の特性ごとに分類したリファレンスサイトです。具体的には、読み取りや書き込みをブロックするロックを取得するかどうか、テーブルの書き直しが発生する可能性があるかどうか、そしてダウンタイムのリスクなしに本番データベースに対してライブで実行しても安全かどうかを基準にしています。
サイトはマイグレーションをカテゴリ別に整理しています:安全なもの(例:Postgres 11以降でデフォルト値なしのnullable列の追加、CONCURRENTLYを使ったインデックスの追加)、安全でないもの(例:Postgres 11より前のバージョンでデフォルト値付きのnon-null列の追加。これはテーブル全体の書き直しを引き起こします)、そして条件付きのもの(特定の構文やPostgresのバージョンでのみ安全なもの)。各エントリには、取得されるロックの種類、その持続時間、および障害発生時の挙動が説明されています。
技術的に興味深いのは、安全性がバージョンに依存するケースです。non-nullのデフォルト値付きで列を追加する操作は、かつてはすべての行を書き直す必要がありました(Postgres 11より前)が、Postgres 11ではこの動作が変更され、新たに追加された列のデフォルト値はカタログのメタデータに格納され、その値は遅延的に埋め込まれるようになりました。これにより、この操作は安全になりました。同様に、ADD CONSTRAINT ... NOT VALIDとそれに続くVALIDATE CONSTRAINTを組み合わせることで、時間がかかる可能性のある検証を分割し、ACCESS EXCLUSIVEロックではなく短時間のSHARE UPDATE EXCLUSIVEロックのみを取得する操作として実行できます。
CREATE INDEX CONCURRENTLYによるインデックス作成については詳細に説明されており、テーブルに対して複数回のパスを実行し、完了するまでインデックスをINVALIDとして登録します。これはプロセスを安全に中断・再開できることを意味しますが、プロセスが失敗した場合には無効なインデックスのクリーンアップが必要になります。
HNのディスカッションでは、pg_repackやpglogical、そしてORMレイヤーで安全でないマイグレーションを検出するRails gemであるstrong_migrationsといったツールについての補足情報が加えられました。このサイトは、MVCCとロックに関するPostgresの完全なドキュメントを読まずにロック競合について検討する必要があるエンジニアにとって、有用なクイックリファレンスとして機能します。
Source: https://safenotsafe.dev/
注目の新しいリポジトリ
mizorewww/laya-mlx
Laya型決定モデル向けのネイティブMLXランタイムです。PyTorch、テキスト生成パイプライン、クラウドAPIへの依存を一切持たず、Apple Silicon上で低レイテンシ推論を実行することを目的として設計されています。本プロジェクトは、生成系LLMではなく決定モデル(構造化された分類・回帰タスク)に明示的にスコープを絞っているため、ランタイムをスリムに保ち、トークンサンプリングインフラのオーバーヘッドを回避することができます。
実装はAppleのMLXフレームワーク上に直接構築されており、ユニファイドメモリとMシリーズNeural Engineを活用することで、M3 Maxハードウェア上でエンドツーエンドのレイテンシ7〜14msを実現しています。この数値は単なる行列積演算だけでなく、完全な決定パス全体のものであり、レイテンシに敏感なオンデバイスアプリケーションにおいてサーバーサイド推論と十分に競合できる水準です。呼び出し時にPythonパッケージングのオーバーヘッドは発生せず、ランタイムはネイティブのmacOS/iOSアプリケーションスタックへの緊密な統合を前提として設計されています。
設計思想はllama.cppが生成モデルに対して行ったことを踏襲しながら、スコープを型付き決定ワークロード——構造化予測、ルーティング、ポリシー評価など——に限定しています。これらは入出力のコントラクトが自由形式のテキストではなく強く型付けされているという特徴を持ちます。その結果、現在リモートエンドポイントを呼び出しているエッジMLパイプラインへの有力な代替手段となります。PyTorch依存がないことは、アプリ配布においてバイナリサイズの削減とコールドスタートの高速化という点で大きなメリットをもたらします。
Apple Silicon上でオンデバイスの決定ロジックを構築しており、クラウドへのラウンドトリップなしにリアルタイム予算を満たす推論が必要な方にとって、注目に値するプロジェクトです。
Source: https://github.com/mizorewww/laya-mlx
MichaelKinsy/PiG
PiGは、TypeScriptで書かれたコーディングエージェント「Pi」を、行単位で動作互換にGoへ移植したものです。掲げられている契約は「上流との動作一致」であり、PiのTypeScriptランタイムからの乖離はPiGのバグとして扱われ、仕様ではありません。これはリデザインではなく、翻訳プロジェクトです。
価値提案はデプロイメントの利便性にあります。GoはNode.jsやnpmのランタイム依存なしに単一の静的リンクバイナリを生成するため、CI統合、コンテナサイズの最適化、そしてコーディングエージェントの副作用としてJavaScriptツールチェーンを必要としないエンジニアへの配布が容易になります。Goのgoroutineモデルはまた、エージェントループに典型的な並行I/Oパターン――ツール呼び出し、サブプロセス管理、ストリーミングレスポンス――に対して、TypeScriptが必要とするコールバック・プロミスの積み重ねなしに、よりクリーンな基盤を提供します。
一致性を前提とした翻訳は規律ある制約です。これは、観測可能な動作を変えるようなGoらしい抽象化をメンテナーが導入できないことを意味し、テストの対象範囲を明確に保ちます。つまり、同じ入力を両方のランタイムに通して出力を差分比較するだけでよいのです。これによりリグレッションテストが実行可能になり、PiのTypeScript上流が進化するにつれて、下流のユーザーに明確なアップグレードパスを提供します。
Goネイティブなインフラ――Goツールを用いるモノレポ、Kubernetesオペレーター、CLIツール――の中でPiのエージェント動作を利用したいが、Nodeランタイムをベンダリングしたくないチームに有用です。単一バイナリの成果物は、サイドカーやLambda関数として直接デプロイすることもできます。
Source: https://github.com/MichaelKinsy/PiG
mirkovicdev/HFTENGINE
hftbacktest Rust crateをベースに構築された、マーケットメイキングバックテスト向けのターミナルモードリプレイコンソールです。実際に記録されたBinance Futuresのtickデータ上で動作します。これは可視化・分析レイヤーであり、執行システムではありません。
中心的な価値は粒度の細かさにあります。大半のバックテストフレームワークがfill rateとP&Lのみを報告するのに対し、HFTENGINEはシミュレーションの各tickにおけるミクロ構造の完全な状態を公開します。具体的には、各レベルのオーダーブック、各指値注文のキュー内ポジション、feedレイテンシと注文承認レイテンシの独立したチャネル、そしてシミュレーションされたfillと並ぶ生のコレクターfeedです。この詳細レベルは、キューポジション効果の診断に不可欠です。キューポジション効果とは、高頻度マーケットメイキングにおけるスリッページの支配的な要因であり、集計メトリクスでは完全に隠蔽されてしまうものです。
ランナーはRustで実装されており、hftbacktestのイベント駆動型シミュレーションエンジンを活用しています。このエンジンはレイテンシを固定スリッページの仮定ではなく、明示的なメッセージ遅延としてモデル化します。フロントエンドはテキストモードのTUIダッシュボードであり、依存関係のフットプリントを最小限に抑え、記録データが存在するデータセンターのマシン上でSSH越しに利用可能です。
設計は意図的にread-onlyとなっています。注文ルーティング、取引所への接続、ライブトレーディングのパスは一切存在しません。この制約により、執行ロジックを誤って組み込むことなく、プロプライエタリなtickデータに対して安全に実行できます。限注文板環境におけるキューダイナミクス、逆選択、またはインベントリ管理を研究する研究者にとって、本ツールは生のhftbacktest出力と、戦略がなぜリークするのかを明らかにするインタラクティブな検査との間のギャップを埋めるものです。
Source: https://github.com/mirkovicdev/HFTENGINE
0xethanq/astra-quant-agent
模擬投資委員会として構造化されたマルチエージェントLLMトレーディングシステムで、OKX、Binance、Gate.ioへのコネクタを備えています。アーキテクチャはアナリスト、リスク、CIOの各役割に異なるLLM agentを割り当て、agentがポジションについて議論し、CIO agentが最終決定を選択した後、その決定は注文が送信される前に17個のフェイルクローズドリスクゲートを通過します。
技術的に興味深い点はフェイルクローズド設計にあります。各ゲートはソフトな警告ではなくハードストップであり、いずれかのゲートが安全性を確認できない場合(接続断、ポジション上限超過、異常なボラティリティなど)、取引はパスされるのではなくブロックされます。これは、ナイーブなLLMトレーディングシステムを危険にするデフォルト許可パターンを反転させたものです。
プロンプトは自己進化するものとして説明されています。システムは結果をログに記録し、直近の取引結果に基づいてagentの指示を書き換えることで、完全なfine-tuningを行わない軽量なオンラインプロンプト最適化ループを実装しています。完全な監査証跡として、各agentの推論、ゲート評価、最終注文パラメータが記録されており、特定の取引が実行またはブロックされた理由の事後分析において重要です。
マルチ取引所の抽象化により、注文タイプとポジション管理が取引所をまたいで正規化されています。暗号資産クオンツ研究は取引所固有のSDKで断片化されることが多く、その上に構造化されたagentレイヤーを持つ統一インターフェースを用いることで、戦略実験における配管作業が軽減されます。
重要な注意点として、LLM駆動のライブトレーディングはモデルの予測不可能性リスクを伴うため、有限のルールベースゲートでは完全には軽減できません。本番環境での使用においては、リスクゲートを必要条件ではあるが十分条件ではない安全レイヤーとして扱う必要があります。
Source: https://github.com/0xethanq/astra-quant-agent
timoncool/YuE2-Studio
YuE2はオープンソースの音楽生成モデルであり、本アプリケーションはそのYuE2をラップしたネイティブのWindowsアプリケーションです。Python環境なしでボーカル付きのフル楽曲生成を利用可能にすることに重点を置いています。インストーラーはランタイムをバンドルし、モデルの重みを管理するほか、上流のモデル変更を追跡するための自動更新機構も備えています。
生のYuE2推論に対して技術的に注目すべき追加機能は、編集可能なスコアレイヤーです。生成された楽曲は、モデルの出力を反映した楽譜とともに提示され、ユーザーはその楽譜を編集して再生成することができます。これにより、純粋なオーディオ生成ツールには存在しないフィードバックループが実現されます。YuE2は大半のオーディオ diffusion モデルと同様に確率的であるため、この点が重要です。スコア表現によって、ユーザーは盲目的な再サンプリングを繰り返すことなく、出力に対して構造化された制御手段を得られます。
完全な再現(Exact replay)もサポートされており、生成時のシードとパラメーターが保存されて再実行することで特定の出力を正確に再現できます。これは、楽曲全体を再生成することなく1つの要素を修正したい反復的な編集ワークフローにおいて不可欠な機能です。
カバー生成機能により、モデルはオリジナル作曲の枠を超えて活用できます。リファレンストラックを与えると、システムはモデルのスタイルで新しいバージョンを生成します。これはオーディオ変換ではなく、YuE2のconditioning インターフェースを通じて実装されています。
Pythonを使用しないという制約は、ML非ユーザーをターゲットとしたWindowsデスクトップアプリとして真剣なエンジニアリング上のコミットメントです。ランタイムは自己完結型の実行ファイルとしてパッケージ化されており、更新の柔軟性をデプロイの簡便さと引き換えにしています。GPUアクセラレーションが必須であり、CPUでは実用的な速度で動作しません。
Source: https://github.com/timoncool/YuE2-Studio
jankeesvw/omarchy-meeting-recorder
Omarchy Linux环境(Archベースのオピニオネイテッドなデスクトップ環境)向けに特化して構築されたミーティングレコーダーです。マイク音声とシステム音声を別々のトラックとして同時録音する設計となっており、ローカル話者とリモート音声の区別を保持したまま、オンデバイスでの文字起こし、話者ダイアライゼーション、チャプターセグメンテーション、および再生インターフェースを実行します。
2トラック収録はこのツールの核心的なアーキテクチャ上の選択です。多くのミーティングレコーダーは文字起こし前に音声を単一のミックスストリームに統合してしまいますが、これにより話者の特定が事後的な推論問題となります。収録時にトラックを分離しておくことで、ローカル話者はダイアライゼーションのヒューリスティクスを用いずに常に識別可能となり、リモート話者はミックス信号ではなく結合されたリモートトラック上でダイアライゼーションを実行できます。これにより、複数話者のミーティングにおける文字起こし品質が向上します。
文字起こしはローカルで実行されるため、ミーティングの内容がクラウドサービスに送信されることはありません。これはデータ取り扱いに制約のある組織にとって重要な点です。話者ラベルとチャプターマーカーは同一のパイプラインの一部として生成され、生テキストの羅列ではなく構造化された文字起こしを生成します。統合プレイヤーにより、手動で音声をスクラブすることなく、チャプターや話者セグメント単位でナビゲーションが可能です。
Omarchyへの依存によりユーザー層は限られますが、その一方でその環境のオーディオルーティングとの緊密な統合が可能となります。PipeWireベースのマルチソース収録はArchでは直截的であり、他のディストリビューションでは設定上の課題となることが多い部分です。サードパーティサービスに音声を送信せずに、ローカルかつ構造化されたミーティング記録を必要とするOmarchyユーザーにとって有用なツールです。
Source: https://github.com/jankeesvw/omarchy-meeting-recorder
yibie/awesome-jev
Jev(TypeSafe AIのSystem Oneモデルで、typed decision inferenceのために設計されたもの)上に構築されたコミュニティプロジェクト、インテグレーション、およびドキュメント化されたユースケースをまとめたキュレーション済みインデックスです。約1,900のスターを獲得しており、比較的新興のエコシステムに対するコミュニティの発見レイヤーとして機能しています。
技術的な内容はカタログに収められているものに凝縮されています。インテグレーションはJevのtyped decisionインターフェースをデータベース、APIゲートウェイ、ワークフローオーケストレーターなどの下流システムと接続し、プロジェクトセクションではモデルと組み合わせたプロダクション環境でのデプロイメントやオープンソースツールが紹介されています。ディスカッションカテゴリにはアーキテクチャパターンとトレードオフが記録されており、あるフレームワークがユースケースに適合するかどうかを評価する際には、生のコードよりもこちらの方が有用なことが多いです。
typed decisionモデルは特定のニッチを占めています。入力フィーチャーと出力決定の両方にスキーマを強制することで、構造化された出力を生成するためにprompt engineeringに頼るのではなく、モデルのコントラクトをマシンによって検証可能なものにします。Jevはこれを、生成モデルに後付けされたJSONスキーマバリデーションではなく、型システムを通じて公開しています。これにより下流システムとのインテグレーション方法が変わります——ランタイム時のパースではなく、コンパイル時またはスキーマバリデーション時の保証が得られます。
このような種類のインフラストラクチャに対するawesome listの価値は、主にエコシステムの可読性にあります。つまり、他者がそのツールでどのような問題を解決したか、どのインテグレーションがプロダクションでテスト済みか、そしてどこに落とし穴があるかを把握することです。typed decisionフレームワークにとって、インテグレーションパターン(フィーチャーストアへの接続方法、監査のための決定ログの記録方法、スキーマ進化の処理方法)こそが技術的に興味深い成果物です。
Source: https://github.com/yibie/awesome-jev
yetone/magpie
コーディングエージェントのフロントエンドを任意のバックエンドモデルプロバイダにマッピングする、macOSのメニューバーアプリケーションです。代表的なユースケースとして、Codexスタイルのエージェントをで DeepSeekのAPIに対して動作させることや、Claude CodeをKimiのエンドポイントに接続すること等が挙げられており、エージェントのUXとモデルベンダーを切り離すことを実現しています。
中核となる仕組みはAPIの互換性シムです。DeepSeekやKimiといったプロバイダはOpenAI互換のRESTエンドポイントを公開しており、Magpieはエージェントの送信リクエストを設定されたプロバイダにルーティングしながら、エージェントが期待するリクエスト/レスポンスのスキーマを維持します。エージェントソフトウェア自体への変更は一切不要で、シムはネットワーク層、またはベースURLと認証情報を環境変数へ注入する形で動作します。
メニューバーから、ユーザーはエージェントごとにアクティブなバックエンドを切り替えることができます。これは、タスクの種類によって求められるモデルのコスト・性能のトレードオフが異なる場合に便利です。例えば、定型的な補完には高速で安価なモデルを、アーキテクチャレベルのタスクには高性能なモデルを使い分けることができます。メニューバーへの配置により、セッションごとに設定ファイルや環境変数を編集する場合と比べて、この切り替えを軽量に行うことが可能です。
実用上の魅力は、コストとレイテンシの裁定取引にあります。Claude CodeのUXは高く評価されていますが、Anthropicの価格設定は大規模利用において高コストです。エージェントのワークフローを変更せずに、重要度の低いタスクをコスト的に同等なプロバイダにルーティングすることで、消費コストを削減できます。同様に、DeepSeekのコードモデルはベンチマーク上で競争力があり、OpenAIと比較してAPIコストが大幅に低いため、Codexを使ったワークフローを大量に実行する際のコストを抑えることができます。
model fine-tuningやローカル推論は一切関与しておらず、これは純粋なルーティングおよび認証情報管理ツールです。制限事項としては、プロバイダ間の動作の同等性が前提とされているものの保証はされておらず、APIスキーマが同一であってもモデル間でプロンプト感度が異なる点が挙げられます。
Source: https://github.com/yetone/magpie