デイリーAIダイジェスト — 2026-09-22
arXiv ハイライト
WorldCrafter: 暗黙的な3D認識メモリを持つ一貫性のある動画世界モデル
問題
チャンク単位の自己回帰型動画拡散モデルは任意の長さのクリップを生成できますが、記憶を保持できません。直近のlatentのスライディングウィンドウ \mathbf{z}^{\mathrm{r}} は数秒間の時間的連続性を保持しますが、1分前にカメラが捉えた内容や別の視点から見た内容を保持することはできません。既存の解決策は2つの陣営に分かれています:カメラポーズの類似度によるretrieval(例:HY-WorldPlay、DreamX-World)はraw historyのトークンをDiTに入力してトークン予算を爆発させるか、または推定深度とワーピングによる明示的な幾何学的メモリ(Lyra 2.0、Alaya-EVOKE、Matrix-Game 3.5)は深度推定器の失敗モードを引き継ぎ、特に動的なコンテンツに対して問題を起こします。どちらも、モデルが新たな視点から以前に見た領域を再現しなければならない分単位のクローズドループな再訪軌跡にはきれいにスケールしません。
WorldCrafterは、動画生成器と共同学習され、これまでに蓄積した履歴量に関わらず固定サイズのターゲットビュー固有のトークンセットを生成する、暗黙的でカメラによってクエリ可能なメモリを提案します。
手法
バックボーンは、conditional flow matchingで学習した標準的なlatent動画DiTです。クリーンな動画latent \mathbf{z}=\mathcal{E}_{\mathrm{VAE}}(\mathbf{x})\in\mathbb{R}^{c\times f\times h\times w}、ノイズ付きサンプル \mathbf{z}_t=(1-t)\mathbf{z}+t\boldsymbol{\epsilon}、ターゲット速度 \mathbf{v}^*_t=\boldsymbol{\epsilon}-\mathbf{z} が与えられると、denoiser \mathbf{v}_\theta は以下を最適化します:
\mathcal{L}_{\mathrm{FM}}=\mathbb{E}_{\mathbf{z},t,\boldsymbol{\epsilon}}\left[\|\mathbf{v}_\theta(\mathbf{z}_t,t\mid\mathbf{y})-\mathbf{v}^*_t\|_2^2\right].
チャンク単位のロールアウトでは、従来の定式化は直近の履歴 \mathbf{z}^{\mathrm{r}} のみを条件としています:
\frac{\mathrm{d}\mathbf{z}_t}{\mathrm{d}t}=\mathbf{v}_\theta(\mathbf{z}_t,t\mid\mathbf{z}^{\mathrm{r}},\mathbf{y}).
WorldCrafterはこれをメモリのパスウェイで拡張します。\mathbf{z}^{\mathrm{h}} をカメラポーズとともに蓄積された全クリーン履歴latentとし、\mathbf{P} をターゲットチャンクのポーズシーケンスとします。
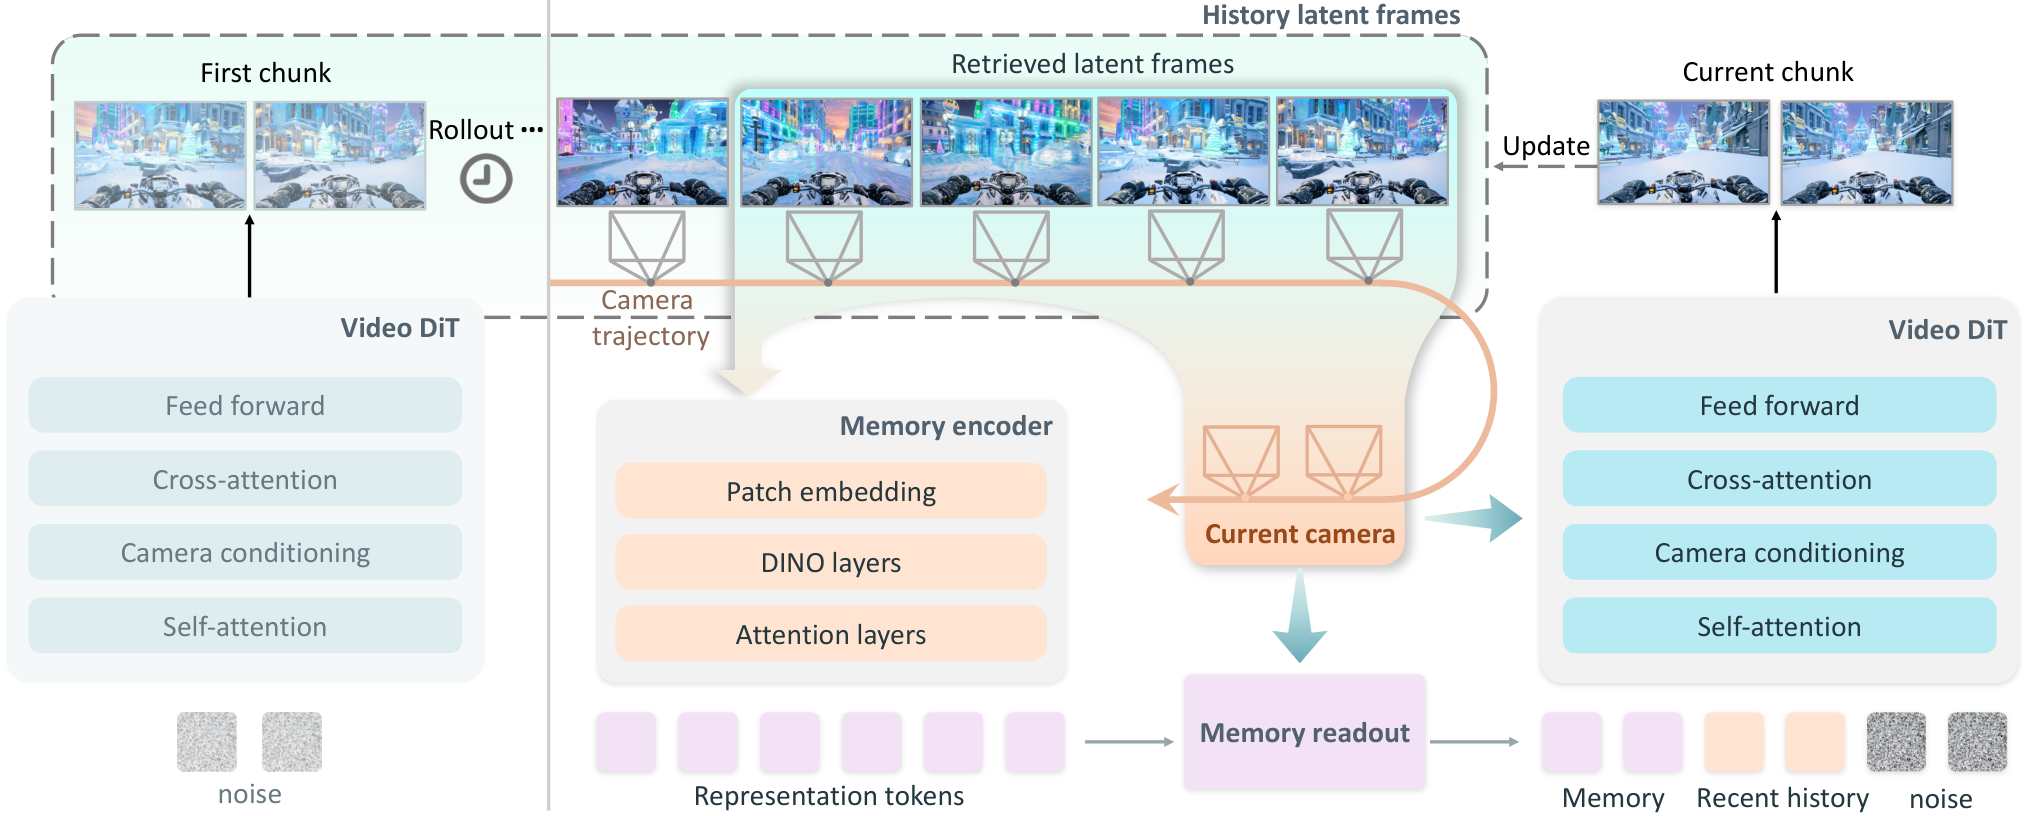
DiTの上位に3つのコンポーネントが配置されています(パイプライン概要を参照):
最大カバレッジ履歴retrieval。 ターゲットカメラ軌跡が与えられると、retrieverはポーズベクトルの単純なコサイン類似度ではなく、要求されたビューの視点カバレッジを最大化する \mathbf{z}^{\mathrm{h}} からの履歴フレームのサブセットを選択します。これにより、frustumが実際にクエリのfrustumと交差するフレームに向けてretrievalをバイアスします。
メモリエンコーダ。 retrievelされたlatentフレームとそのポーズをメモリ特徴 \mathbf{M} のセットにエンコードします。深度推定器なし、明示的な対応付けなし、ワーピングなし — 幾何学は共同学習から暗黙的に出現することが期待されます。
ポーズ条件付きreadout。 readoutは核心的なアイデアです:全メモリトークンをDiTに渡す代わりに、\mathbf{M} をターゲットポーズ \mathbf{P} で条件付けられた固定サイズのトークンセット \tilde{\mathbf{M}}(\mathbf{P}) に圧縮します。DiTは次に [\tilde{\mathbf{M}}(\mathbf{P});\mathbf{z}^{\mathrm{r}};\mathbf{z}_t] をdenoisingします。|\tilde{\mathbf{M}}| が固定であるため、トークン予算は履歴長に不変です — 1分間のロールアウトは10秒間と同じステップごとの計算コストになります。
最初のチャンクは履歴が存在しないためポーズ条件付きのみで生成されます。後続のチャンクはretrieval + メモリ + 直近ウィンドウを使用します。WorldCrafter-fastはさらに、ストリーミング推論のために少数ステップ蒸留を適用します。
実験
ベンチマークはスライディングウィンドウモデルに対して意図的に厳しく設計されています:145枚の画像(83枚の動的オブジェクト中心、62枚の静的)にそれぞれ5つのメトリックカメラ軌跡をペアリングし、手法ごとに合計725本の動画、軌跡あたり528〜1,648フレームで、メモリを明示的に検証するクローズドループ再訪を含みます。比較はポーズ類似度retrieval(HY-WorldPlay、DreamX-World)、Gated DeltaNetメモリ(SANA-WM)、スライディングウィンドウUCPE(Echo-WM)、深度ワーピング空間メモリ(Lyra 2.0、Alaya-EVOKE、Matrix-Game 3.5)にまたがる8つの最新カメラ制御可能な世界モデルを対象とします。全手法は同一の初期画像、テキスト、ターゲット軌跡で 640\times 384 で評価されます。
提供された定性的なパネルは、ベースラインの意図した失敗モードとその修正を示しています。静的な再訪ケースでは、WorldCrafterはカメラが戻ったときに初期フレームのコンテンツを再現し、再構築された点群はループ全体でメトリック的に整合しています。
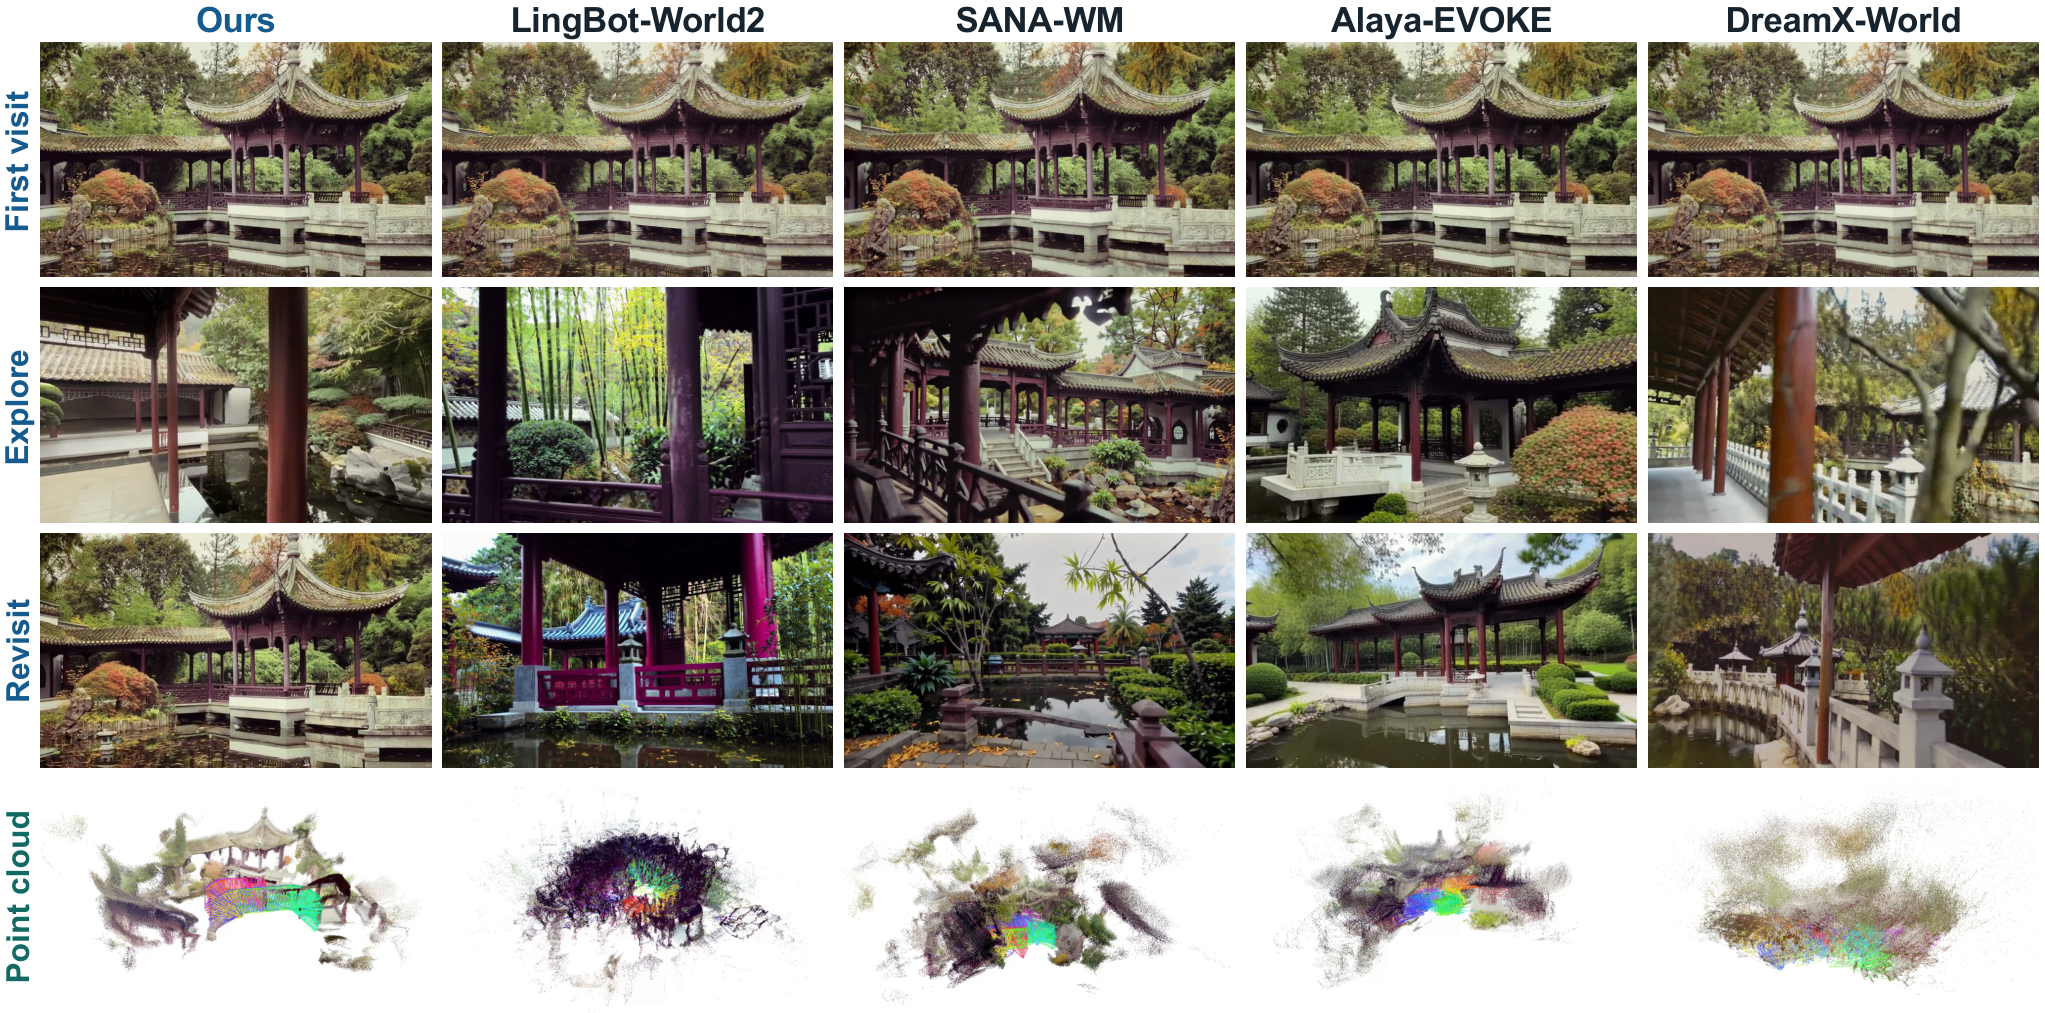
動的なケースはより困難です。なぜなら深度ベースのベースラインは動く物体を一貫してワープできないからです。暗黙的なメモリは明示的な幾何学的パラメータ化にコミットしないことでこれを回避します。
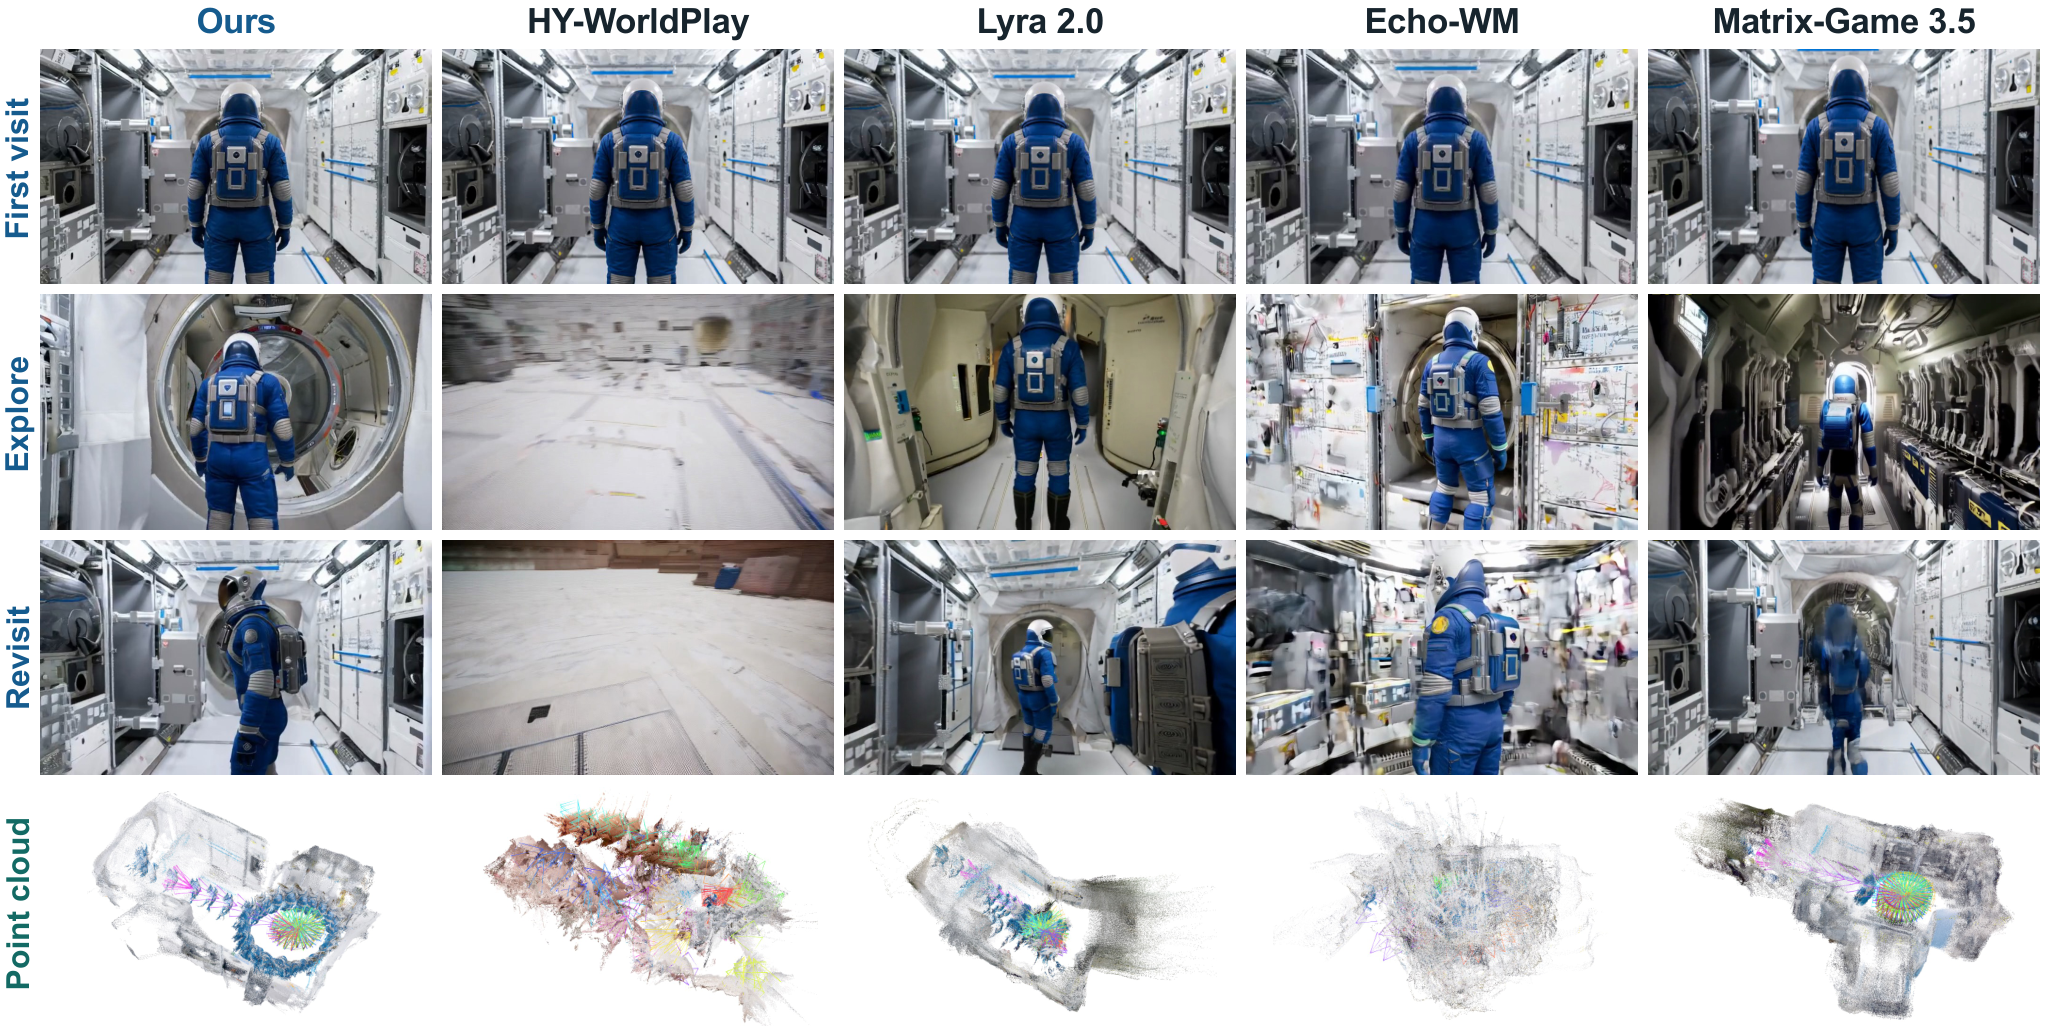
abstractでは「分単位の探索において視覚的品質を保ちながら、長期的な一貫性とカメラ制御精度において大幅な改善を達成した」と報告されています。提供された抜粋には数値テーブルが含まれていないため、8つのベースラインに対するメトリックごとの差分はここでは再現できません。
限界と未解決の問題
- readoutの固定トークン予算はスケーリングを可能にするメカニズムですが、上限でもあります:ある地平線を超えると、圧縮は細粒度の再訪忠実度を損なう形で損失が生じるはずです。論文は提供された抜粋の中でこの飽和点を特徴付けていません。
- 暗黙的な3Dメモリは生成器とend-to-endで学習されます。メモリモジュールを別のDiTバックボーンに転送するには、おそらく再学習が必要です;明示的な幾何学的インターフェースはありません。
- 最大カバレッジretrievalは履歴の正確なポーズアノテーションに依存します;長い地平線でのノイズのある、またはドリフトするポーズ下での挙動は未指定です。
- retrieval対エンコーダ対readoutの貢献を分解するablation、およびポーズ類似度retrievalのトークン予算一致版との比較により、利得がどれだけアーキテクチャ的なものか単純に「コンテキストにより多くの履歴」かが明確になるでしょう。
- 全ベースラインは3つを除いて蒸留済みバリアントで評価されました;蒸留済みベースラインとフルステップWorldCrafterを比較する公平性は精査する価値がありますが、WorldCrafter-fastも一緒に報告されています。
なぜこれが重要か
長期動画世界モデルは、rawコンテキストの詰め込みか明示的な深度ワーピングメモリのどちらかに収束しており、どちらもスケールが悪いです。メモリをカメラによってクエリ可能かつ固定サイズにすることで、ステップごとの計算をロールアウト長から切り離します。これはストリーミングの分単位インタラクティブ探索に適した因子化であり、しかも動的シーンで破綻する深度推定器に依存することなく実現しています。
Source: https://arxiv.org/abs/2609.24984
Grounded Action Model: ロボティクスの基盤としての3Dグラウンディング
問題設定
現在のロボット基盤モデルは、vision-language pretraining(VLA)またはvideo-generation pretraining(WAM)のいずれかから事前知識を受け継いでいます。どちらの目的関数もメトリックなグラウンディングを必要としません。language pretrainingはオブジェクトや関係を3D空間に固定することなく記述することに報酬を与え、video pretrainingはタスクに関連するジオメトリではなく背景との相関に依存しやすい外観や動態に報酬を与えます。その結果、事前学習済み特徴量を正確なモーターコマンドに接続する作業はデモンストレーションセットに委ねられ、学習された写像はシーンがランダム化されると崩壊する視覚的相関に依存しがちです。RoboTwin 2.0のHard splitはこの失敗モードを具体化しています:クリーンなシーンで〜77%に達する強力なVLAおよびWAMが、ランダム化下では26.7%(Spatial Forcing)または1.9%(FastWAM)まで低下します。
著者らは、pretrainingの目的関数自体がメトリックなグラウンディングを要求すべきだと主張し、凍結されたpromptable 3D detectorの上に構築したGrounded Action Model(GAM)でこれを具体化しています。
手法
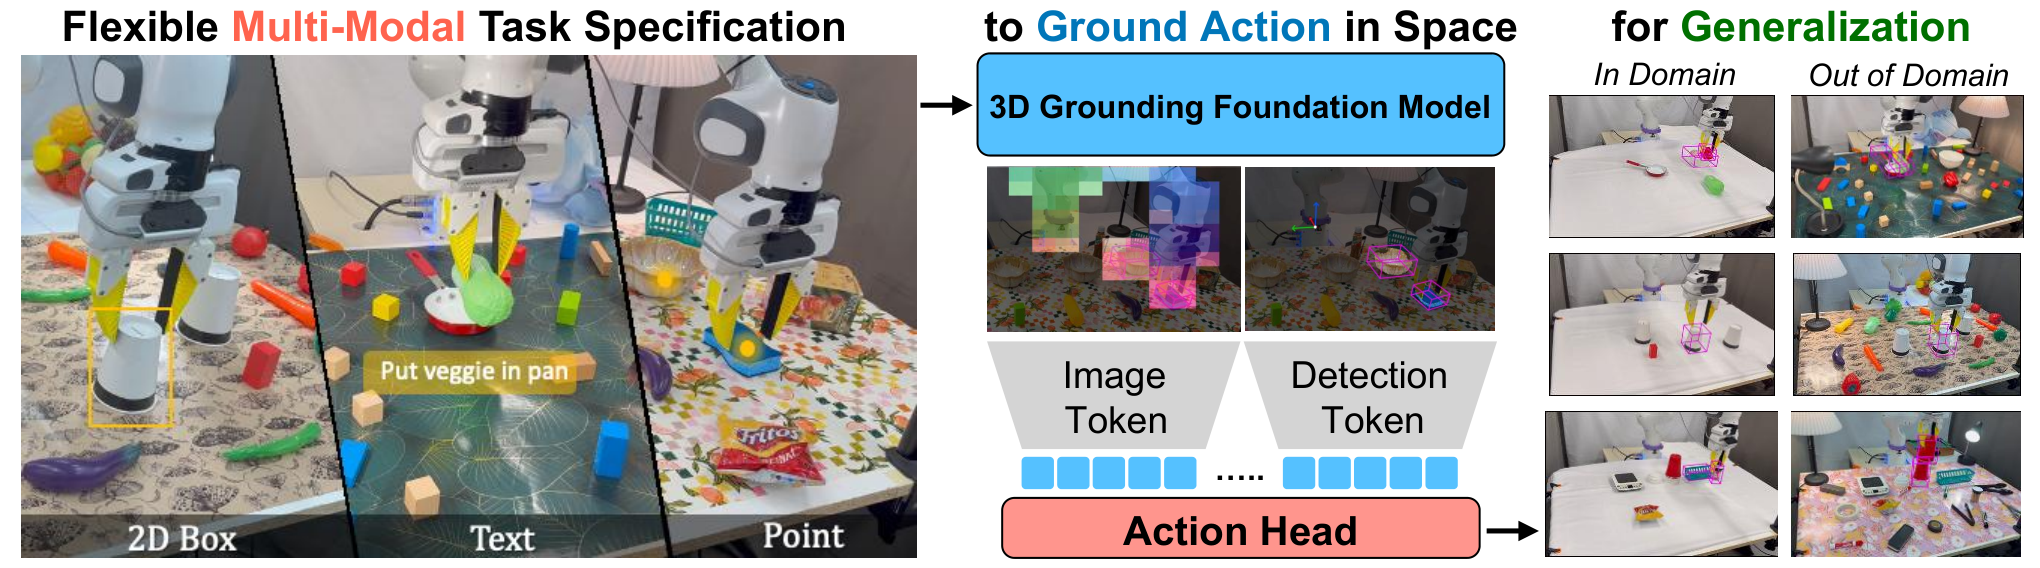
GAMは2段階構成です:タスク仕様をオブジェクト中心の観測に解決する凍結された3D grounding backboneと、それらの観測を入力とするflow-matching action headです。
Prompt → 検出結果。 BackboneはWildDet3Dです。3つのpromptモダリティを受け付けます:
- Language:凍結されたFlan-T5 encoderに対するspan-tagging headが命令からオブジェクトのフレーズを抽出します(例:「スポンジを拾ってボウルに置く」→ {スポンジ, ボウル})。これらは独立したgrounding queryとして使用されます。
- 2Dポイントまたは2Dボックス:直接オブジェクトクエリとして渡されます。これはVLM plannerが使用するインターフェースです。
N個のクエリされたオブジェクトそれぞれに対して、backboneは2Dボックス u_i、メトリック3Dボックス b_i、密なメトリック深度マップ \hat{D}_t、および密な視覚特徴 F_t = \mathrm{Enc}_{\mathcal{G}}(o_t) を返します。
オブジェクト中心の観測。 GAMはグラウンディングされたオブジェクトから2つのストリームを構築します:
- Image tokens:タスクオブジェクトの2Dボックスとロボットアームの和集合にマスクされた F_t からの特徴量であり、背景ピクセルを抑制します。
- Detection tokens:各2Dボックス内の \hat{D}_t から構築されたオブジェクトごとの点群と、 b_i のポーズおよびサイズを合わせたものであり、明示的なメトリックジオメトリを提供します。
State-history tokenが直近の関節位置をまとめます。
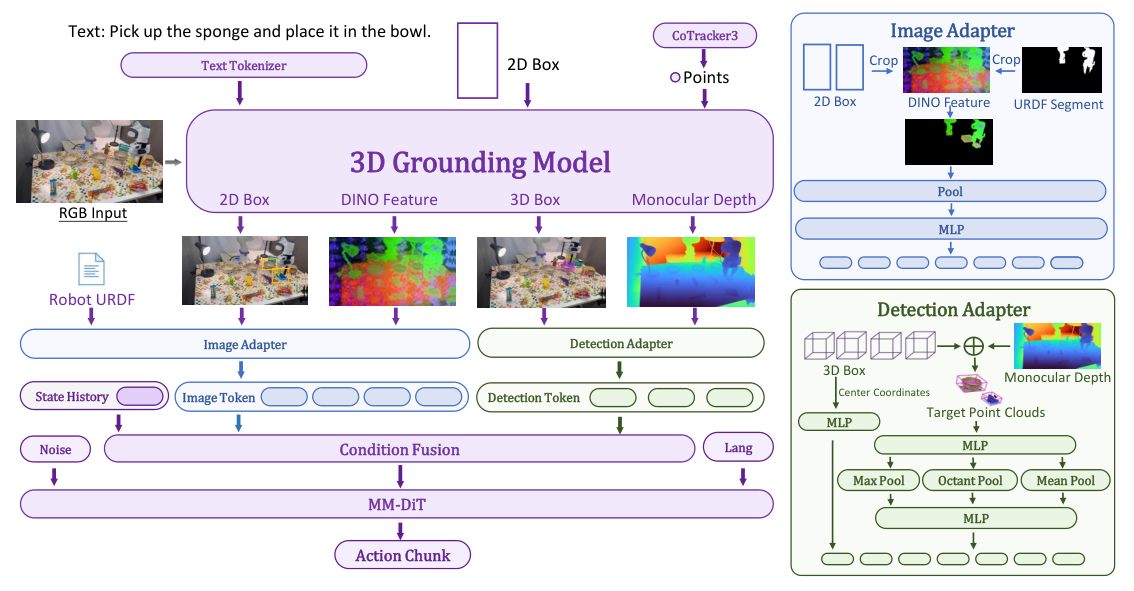
Action head。 Multi-stream transformer(MM-DiT、SD3と同様)がimage tokens、detection tokens、state-history tokenを組み合わせ、language embeddingがadaptive layer normalizationを介して注入されます。このheadはflow matchingにより絶対関節位置ターゲットのチャンクを予測します。Action headのみがタスクごとに学習されます。Grounding backboneはRoboTwinレンダラーに対して一度fine-tuningされ(シミュレータがエクスポートした2Dボックス、3Dボックス、深度を自由な教師信号として使用)、その後凍結されます。
結果
RoboTwin 2.0リーダーボードプロトコル(50の両手タスク、タスクあたり100ロールアウト、EasyとHardの平均)における結果:
- GAM:63.0 Easy / 47.6 Hard / 55.3 avg、タスクあたり50件のクリーンなデモを使用したsingle-task学習。
- Spatial Forcing(最良のVLA、全50タスクでco-trained):77.2 / 26.7 / 52.0。
- FastWAM(最良のWAM):77.8 / 1.9 / 39.9。
- \pi_{0.5}(同じsingle-taskプロトコル下):64.0 / 25.9 / 45.0 — GAMは平均10.3ポイント上回ります。
- Hard部門の次点はAbot-M0の30.4であり、GAMは47.6に達し17ポイントの差をつけています。
最も顕著な数値はクリーンからランダム化への保持率です:GAMはHardランダム化下でもクリーン性能の76%を維持し(63.0 → 47.6)、Spatial Forcingは35%、FastWAMは2.4%にとどまります。これはグラウンディングに条件付けられた観測がポリシーを無関係なシーン統計から切り離すという仮説と一致しています。
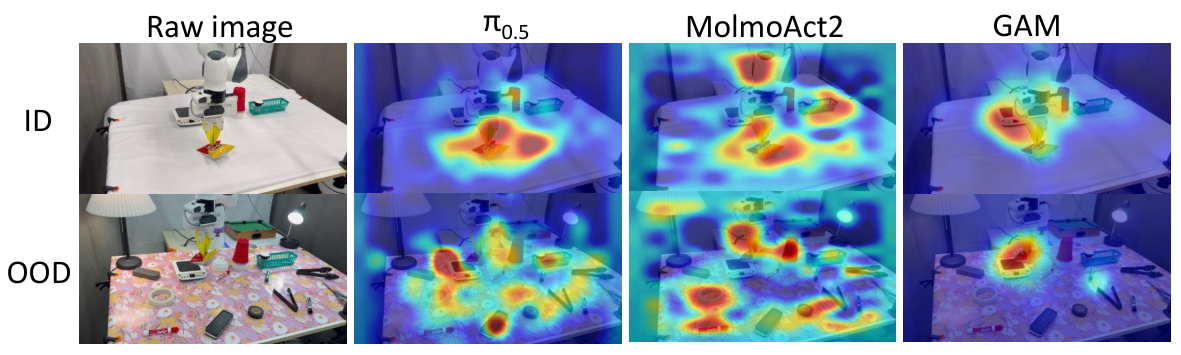
Attentionの可視化はメカニズムの主張を裏付けています:分布シフト下でベースラインのattentionは摂動された背景やdistractorに漏れ出しますが、GAMのattentionはグラウンディングされたターゲット上に局在したまま維持されます。これはimage tokensをクエリされたオブジェクトにマスクすることの直接的な結果です。
制限事項
パイプラインの性能はグラウンディングの品質に依存します:検出エラーはリカバリー機構なしにアクションに伝播し、オブジェクト中心マスクは構造上、選択されていないコンテキスト(例:plannerが指定しなかった障害物)を破棄するため、乱雑な環境での実行には安全上の懸念があります。3Dボックス表現は粗いため、特に関節型または変形可能なオブジェクトに対しては、密な3Dインスタンスセグメンテーションや占有表現がより細かいジオメトリを提供できるでしょう。Easyの結果(63.0)は上位のVLA/WAM(77+)を下回っており、シーンが分布内にある場合はリッチなセマンティック/テンポラルな事前知識がまだ有効であることを示唆しています。GAMは分布内での上限を犠牲にして大きな分布外ロバスト性を得ているといえます。最後に、backboneの適応には特権的なシミュレータ状態が使用されており、そのような教師信号なしに実環境に転用する際は事前学習済み実画像grounderの品質に依存します。
本研究の意義
本論文は、ロボット基盤モデルbackboneの選択を、どのpretraining目的関数が表現にメトリック構造を強制するかという問いとして捉え直しています。実験的な答え、すなわち凍結された3D grounderに小さなflow-matching headを加えたものがランダム化シーンにおいてco-trainedなVLAおよびWAMを17ポイント上回るという結果は、「どのオブジェクトが、どこに、どのようなジオメトリで」という明示的な情報が、言語セマンティクスや将来のビデオ予測単独よりも操作タスクに対してより強い事前知識となることを示唆しています。
Source: https://arxiv.org/abs/2609.23863
なぜ動画拡散モデルは物理法則に違反するのか?Attention機構の欠陥を解明する
最先端のテキストから動画への拡散モデルは、視覚的に説得力のある出力を生成しますが、ニュートン力学を日常的に破っています:ボールが空中でバウンドしたり、物体が浮遊したり、動きが静止したりします。これまでの修正策は、外部の事前分布、物理シミュレータ、または特化した学習コーパスを付加するものでした。本論文はその代わりに、Wan2.1-T2V-1.3Bに対してmechanistic interpretabilityの観点から解析を行い、ネットワーク内のどこで物理が破られるかを特定し、その失敗をRoPEの空間的減衰と拡散denoiseの「まず形状、次に詳細」というスケジュールとの特定の相互作用に起因すると追跡しています。

Cross-attentionは最初の5ステップで動きを計画する
初期ステップのT2V latentはピクセルに有用にデコードできないため、著者らはオブジェクトトークン(「バスケットボール」)へのcross-attentionを通じて間接的に動き計画を調べます。\mathbf{A}^{\mathrm{CA}}\in\mathbb{R}^{f\times h\times w}をレイヤーごと、ステップごとに可視化すると、明確な段階的構造が見られます:T1ではマップはノイズ状態であり、T3では複数の候補領域が妥当なトラジェクトリに沿って点灯し、T5では収束し、T7ではトラジェクトリが固定されます。すべての動き計画は50回のdenoisingステップのうち最初の約5ステップ以内に行われます。
これを定量化する2つの指標があります。Attention entropyは動画正規化マップ\mathbf{P}^{\mathrm{vid}}(z,y,x)=\mathbf{A}^{\mathrm{CA}}(z,y,x)/\|\mathbf{A}\|_1の正規化された時空間エントロピー、すなわちH^{\mathrm{vid}}/\log(fhw)です。Support qualityは\mathbf{P}^{\mathrm{vid}}を最終トラジェクトリの二値マスク\mathbf{M}^{\mathrm{obj}}と重ね合わせて幾何学的重複を測定し、Q^{\mathrm{vid}}=\sum_{\mathcal{V}}\mathbf{P}^{\mathrm{vid}}\mathbf{M}^{\mathrm{obj}}で表されます。

トラジェクトリアラインメントスコアリングとcausal head ablationを組み合わせることで、動き計画を駆動するattention headの小さなサブセットが特定されます。このサブセットをzero-ablateすると、外観を保ちながら動きのコヒーレンスが破壊され、それらのcausalな役割が確認されます。

Self-attentionとRoPEの空間的アンカリング効果
Cross-attentionはどのコンテンツがどこの候補に位置するかを指定し、self-attentionはフレームをまたいで位置の一貫性を伝播し、それによってトラジェクトリを形成するためにフレームごとに1つの候補を選択できる唯一のメカニズムです。フレームf_iのクエリ領域kからのself-attentionを可視化すると、ほとんどのheadはトラジェクトリに沿ってではなく、他のすべてのフレームにわたって同じ空間的位置kにattendしていることが明らかになります。
本論文はこれをRoPEの長距離減衰に起因すると説明しています。回転位相をf(q,p)=[q^f e^{ip^f\theta}, q^h e^{ip^h\theta}, q^w e^{ip^w\theta}]とすると、QKの内積は
\mathrm{Re}\Big[\sum_{a\in\{f,h,w\}} q^a {k^a}^{*} e^{i\Delta p^a\theta}\Big]
となります。\Delta p^h,\Delta p^wにおける減衰は、各クエリをすべてのフレームにわたって類似した空間座標にあるキーに向けてバイアスをかけます — これが「空間的アンカリング効果」です。結果として:早期フレームで候補領域が強調されると、self-attentionは物理的に妥当なトラジェクトリに沿って変位した位置よりも、隣接フレーム内の同じ空間的位置を優先的に強化します。早期の候補が固定されることで、運動学的に正しい代替案が抑制され、動きが静止・浮遊・テレポートのアーティファクトに収束します。著者らはフレームごとに候補集合\{\Omega_{i,k}\}を抽出し、ステップ49のattentionからアンカー領域を定義し、「勝者」k^+=\arg\min_k \|\mu(\Omega_{i,k})-\mu(\Omega_{i,1}^{\mathrm{ref}})\|をdenoising全体で最強の非勝者と比較追跡することで候補選択を形式化しています。
修正:ステップ依存型RoPE周波数スケーリング
病理が動き計画ウィンドウ中の過剰な空間的減衰であることから、修正はまさにそのウィンドウ内で空間的な回転周波数を縮小することです。クエリ・キーに対して、
f^h(q,p)=q^h e^{ip^h\lambda^h\theta}, \qquad f^w(q,p)=q^w e^{ip^w\lambda^w\theta}, \quad \lambda^{h},\lambda^{w}<1,
を最初の5回のdenoisingステップにのみ適用します。これにより空間次元のQK減衰曲線が平坦化され、self-attentionが隣接フレーム内の空間的に変位した候補 — すなわち実際のトラジェクトリ — を考慮できるようになります。時間的コンポーネントは変更されません。\lambda^{h/w}は早期ステップで探索される事前設定値であり、適応的なパラメータ化は性能が劣ることが報告されています。
VideoPhyにおける結果
VideoPhy(SA = semantic adherence、PC = physical commonsense)において、ベースのWan2.1-T2V-1.3Bは全体で53.64 / 29.45のスコアを記録します。修正RoPEのみ(training-free)でこれが57.43 / 39.94に向上し、重みを変更せずにPCで+10.5の絶対的な改善を達成します。prompt refinementと組み合わせると86.30 / 58.89となり、PRベースライン80.47 / 44.31と比較してPCの改善(+14.58)はSAの改善よりはるかに大きく、これがprompt followingではなく真に物理に関する改善であることを示しています。LoRA + 修正RoPE + PRを組み合わせると87.46 / 62.68に達し、Solid-FluidにおけるわずかなSAの後退を除くすべてのサブカテゴリで最上位となります。LoRAとVideoREPA単独ではPCをわずかに改善するにとどまり(35.57、37.90)、RoPEの修正は両者に対して補完的です。
制限とオープンクエスチョン
分析はほぼ完全に単一のモデル(Wan2.1-1.3B)と単一の標準的なプロンプト(バスケットボールのドロップ)に基づいており、特定されたhead集合と\lambdaスケジュールのモデルファミリー、解像度、動きタイプ全体への汎化は確立されていません。\lambda^{h/w}は最初の5ステップで手動で探索された定数であり、適応的なスキームは失敗すると報告されており、これは空間的コヒーレンスとトラジェクトリの自由度の間の根本的なトレードオフがまだ十分に特性評価されていないことを示唆しています。早期のT2V latentはデコードできないため、cross-attentionがlatent空間のダイナミクスの代理として使用されており、latent空間の直接的な説明がcausalな主張を強化するでしょう。最後に、空間的減衰を弱めることは長距離レジームでの細かな空間的詳細を損なう可能性がありますが、本論文はこのトレードオフを完全には定量化していません。
この研究の意義
これは、動画拡散が物理に違反する理由について、データやスケールのせいにするのではなく、具体的なアーキテクチャ上の原因(形状形成ウィンドウ中のRoPE空間的減衰)を指摘する最初のmechanisticな説明の一つです。修正は位置embedding への2行の変更であり、再学習なしで2桁のPC改善をもたらします。これは、動画生成における「物理のギャップ」の無視できない部分が容量の問題ではなく、interpretabilityで追跡可能なinductive biasのバグであることを示唆しています。
Source: https://arxiv.org/abs/2609.23658
HuRo: スケーラブルなVLA事前学習に向けた人間動画のロボット化
問題
Vision-language-action (VLA) モデルは、コストが高く網羅性の低い遠隔操作ロボットデータにボトルネックを抱えています。自己中心的な人間の動画は豊富かつ多様ですが、身体的ギャップという問題を抱えています。すなわち、観測にはロボットではなく人間の手が映っており、ロボットの関節空間やエンドエフェクタ空間における明示的な行動ラベルが存在しません。先行研究は、タスクに合わせたロボット化を小規模に実施するか、あるいは観測と行動を統一されたパイプラインなしに個別に整合させるかのいずれかのアプローチをとっています。HuRoは、異種の人間動画を系統的かつスケーラブルにロボット化し、エンドツーエンドのVLA事前学習を行うことで意味のある性能向上が得られるか、特にロボットのみの事前学習が破綻しやすいドメイン外シフト下においてどうかを問います。
手法
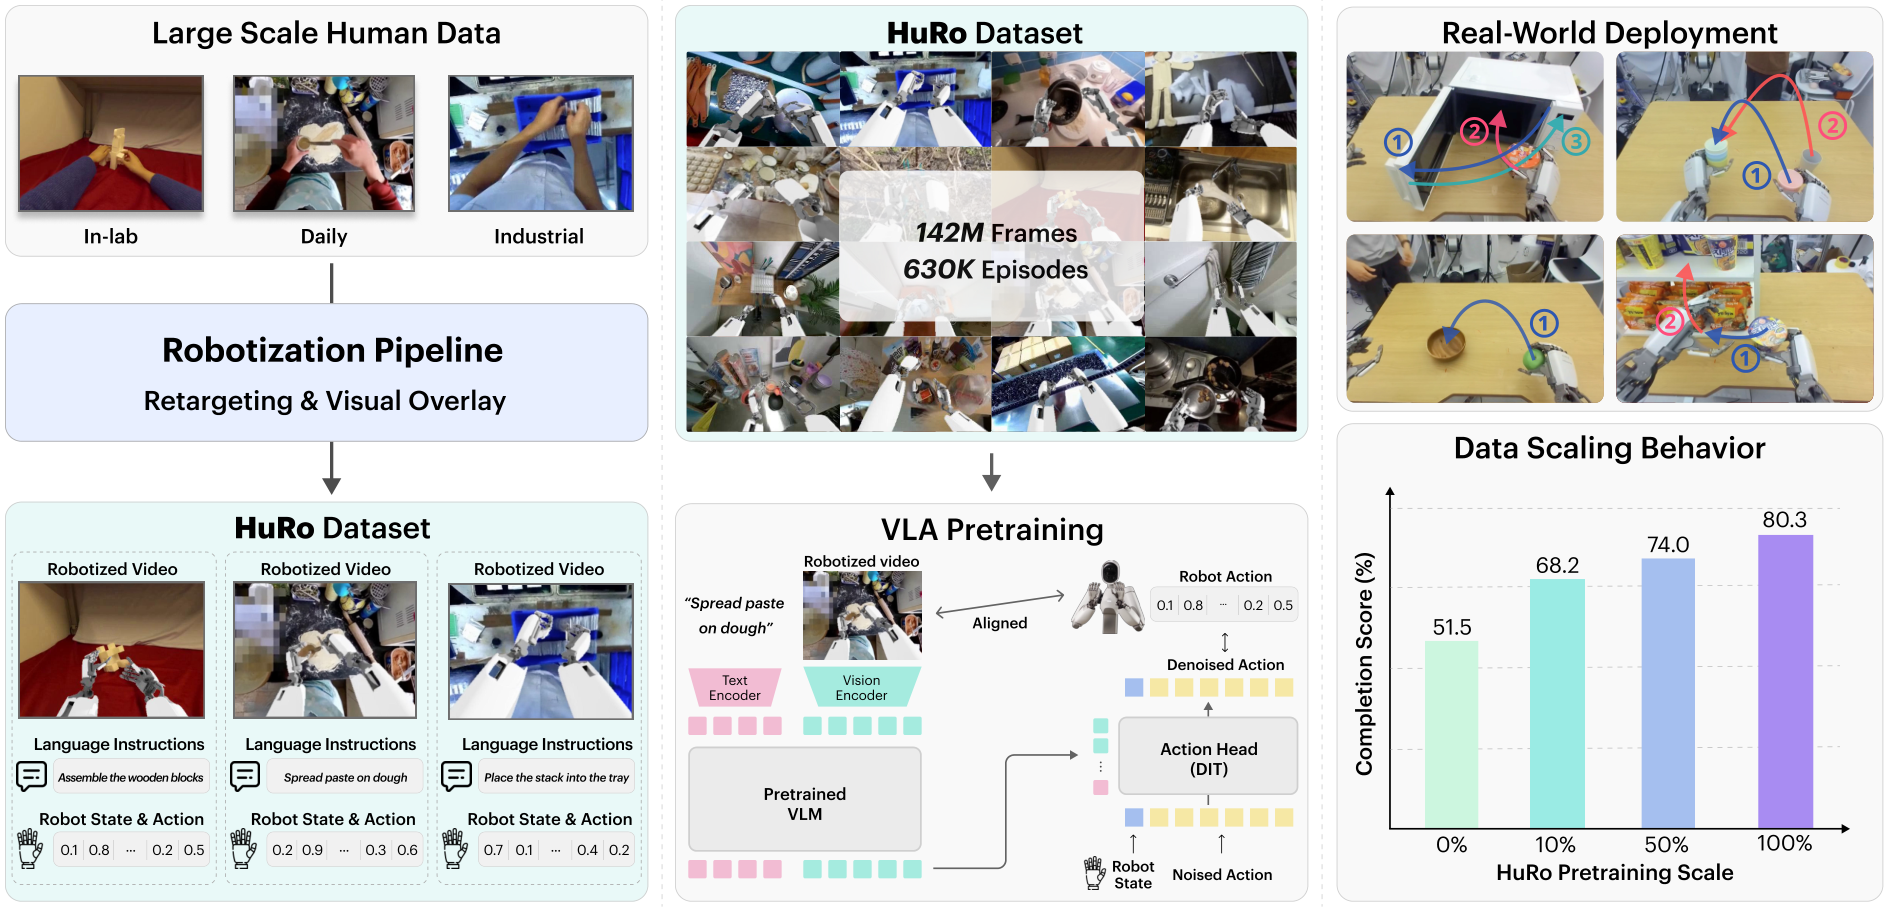
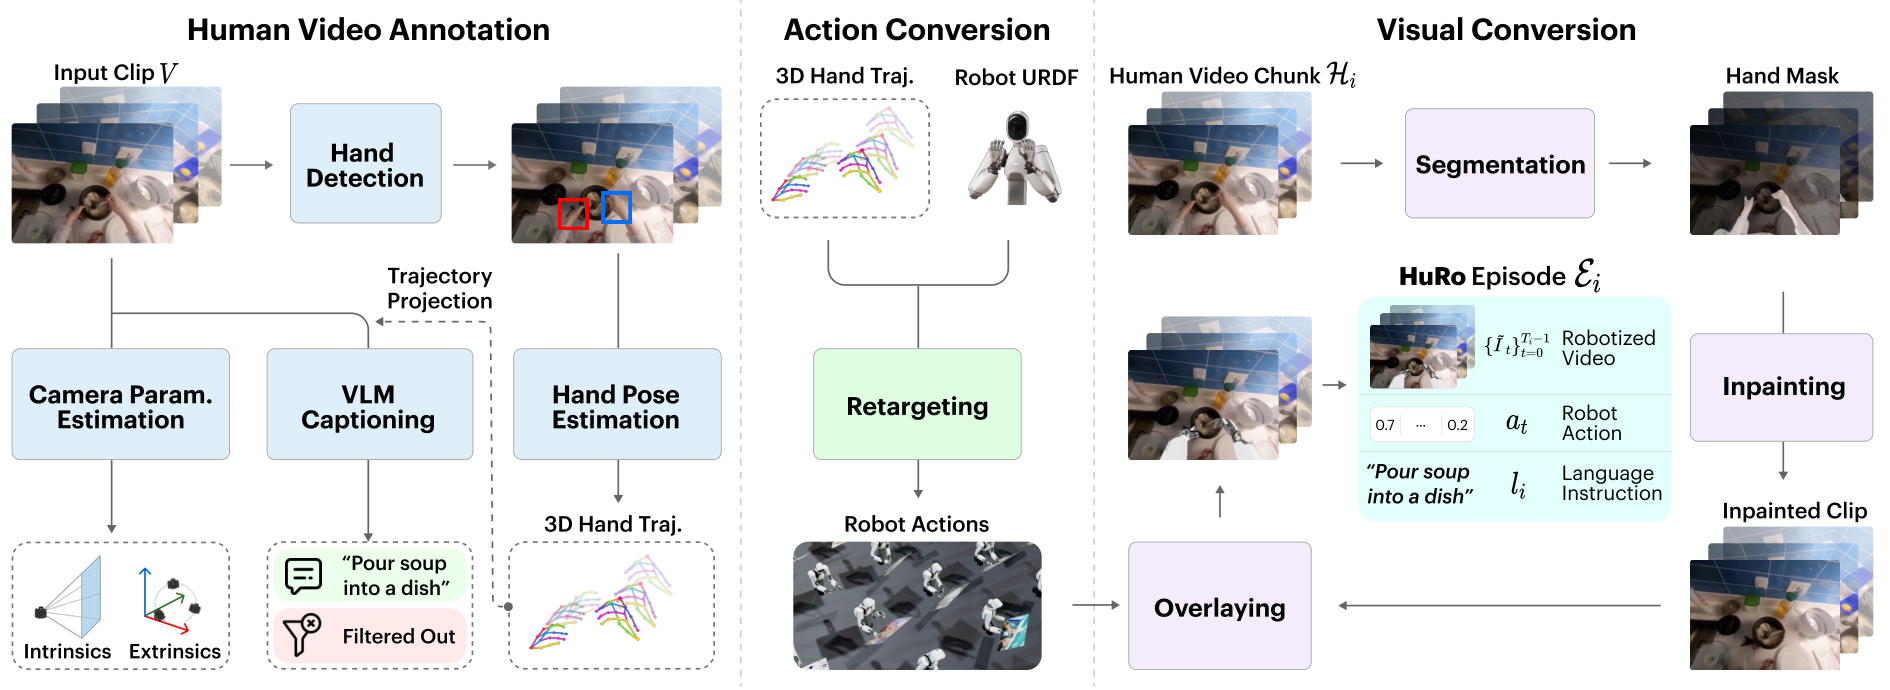
HuRoは自己中心的なクリップ V = \{I_t\}_{t=0}^{T-1} を、アノテーション・行動変換・視覚変換の三段階で処理します。
アノテーション。 各クリップに対して、カメラの内部パラメータ K をdroidcalibで推定し、ほぼ静止したクリップにはAnyCalibにフォールバックします。フレームはピンホールモデルに補正されます。手は100DoHによってフレームごとに検出され、手の左右の同一性はBOT-SORTによって時間的に安定化され、3D手姿勢推定器に入力される一貫した左右のクロップが生成されます。マニピュレーション区間が抽出され、各区間は関連する言語指示とともに有界長のサブクリップに分割されます。これにより各チャンクに対して、カメラの幾何情報・フレームごとの3D手姿勢・テキストが得られます。
行動変換。 アノテーションされた人間の手の軌跡を、ALLEXターゲット身体のロボットエンドエフェクタ/関節軌跡にリターゲティングします。これにより、視覚的タイムラインと整合した明示的な行動教師信号 a_t および状態 s_t が得られます。
視覚変換。 映り込んだ人間の手・腕をインペインティングで除去し、リターゲティングされたポーズでロボットをシーンにレンダリングします。出力タプル (o_t, s_t, a_t, \ell) は、遠隔操作ロボットのデモンストレーションが提供するものと同じ形式です。
このパイプラインを5つの人間動画ソースに適用することで、約630Kのロボット化エピソードと1億4200万の処理済みフレームが生成されます。ダウンストリームでは、GR00T-N1.6-3Bで初期化されたVLMバックボーンにスクラッチから学習されるaction headを組み合わせ、HuRoで事前学習を行った後、少数のタスク固有デモンストレーションセットでfine-tuningします。
結果
評価は4つの実機ALLEXタスクで行われます:Apple Pick-and-Place(43デモ、二値成功)、Cup Stacking(40デモ、段階評価)、Cup-Noodle Handover(16デモ、段階評価)、Microwave Loading(20デモ、段階評価)です。分布内(ID、fine-tuning分布の保留設定)および分布外(OOD、空間的・視覚的シフト)の両条件でスコアが計算されます。
データスケーリング。 4タスクの平均では、全体の完了率はHuRo事前学習の割合が増加するにつれて単調に上昇し、0%(HuRo事前学習なし、fine-tuningのみ)での51.5%から100%での80.3%へと改善されます。OODの数値はより急峻な向上を示し、空間的・視覚的シフト下では34.9%から72.2%へと上昇します。すなわち、HuRo事前学習によってOOD完了率がほぼ2倍になる一方、IDの向上は比較的緩やかです。これは、人間動画の多様性が主に分布内の振る舞いの精度向上ではなく、カバレッジの穴を埋めるという直感と一致しています。
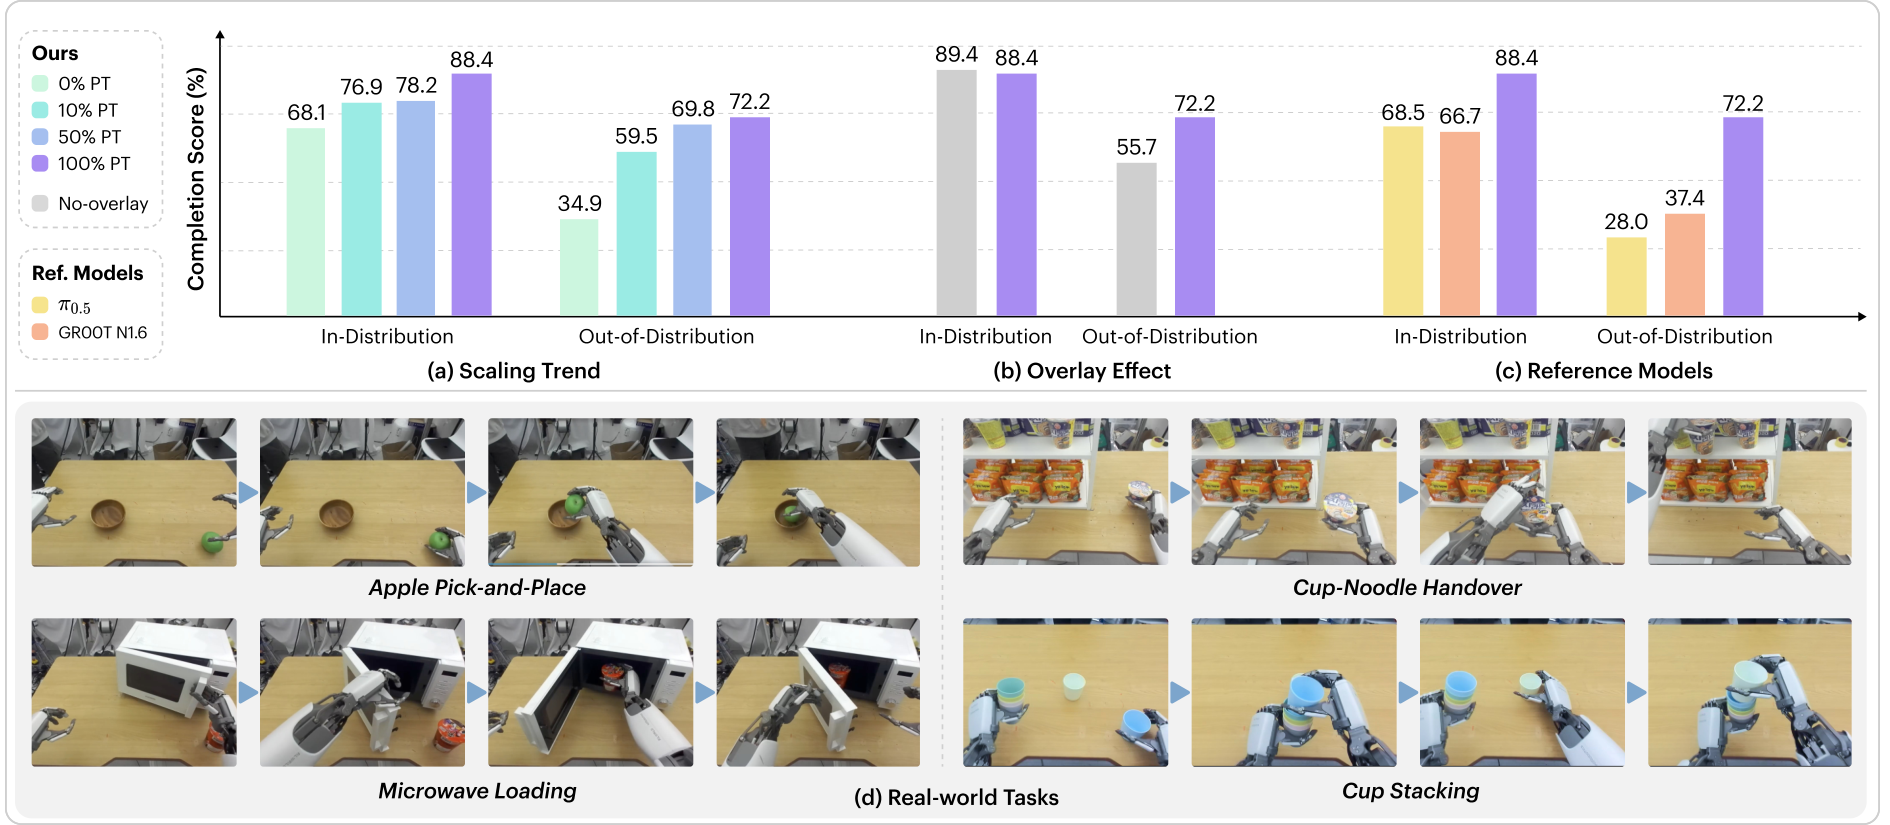
視覚的ロボット化のアブレーション。 「no-overlay」変種は元の人間動画のピクセルをそのまま使用しつつ、同じリターゲティング済み行動教師信号を用います。視覚変換を除去すると特にOODロバスト性が低下し、行動リターゲティングだけでは不十分であることが示されます。すなわち、分布シフト下での転移を維持するためには、観測分布もロボットの身体に整合させる必要があります。
エンドツーエンド転移 vs. 視覚のみ転移。 リターゲティング済み行動を用いたエンドツーエンドの事前学習は、視覚のみの転移(例えば、人間動画を表現学習のみに使用)を上回ります。これは、(o, s, a, \ell) をロボットの行動空間で共同モデリングすることがスケーリング挙動を引き出す鍵であるという主張を支持しています。
参照比較。 HuRoで事前学習されたポリシーは、事前学習済みaction moduleを保持したまま公開チェックポイントからfine-tuningされた \pi_{0.5} およびGR00T N1.6と比較されます。HuRo変種はaction headをスクラッチから開始しているにもかかわらず、これらの大規模な事前学習レジームに対して競争力のある結果を示しています。
限界と今後の課題
報告された向上は単一のターゲット身体(ALLEX)と4タスクに基づいており、大きく異なる運動学を持つ身体(例:器用な手、移動マニピュレータ)へのパイプラインの転移可能性は確立されていません。リターゲティングステップは人間の手姿勢からロボットエンドエフェクタ姿勢への合理的なマッピングを前提としており、ロボットが達成できない手首の幾何学を必要とする精細な手内マニピュレーションや道具使用には適用が困難です。視覚オーバーレイの品質、すなわちインペインティングのアーティファクトやレンダリングされたロボットと元のシーン間の照明不一致は、sim-to-realに類似したギャップの潜在的な原因ですが、論文ではその定量化がなされていません。51.5%から80.3%への比較は同じVLM初期化を使用しており、バックボーン自体をHuRoで再学習した場合やロボットデモンストレーションがより豊富な場合に同様のスケーリングが成立するかは未解決です。最後に、すべての比較は3Bスケールで行われており、HuRoサイズとモデルサイズの両方に関するスケーリング則はまだ明らかにされていません。
この研究の意義
ロボットポリシーのための人間動画事前学習は、主に表現学習ツールとして扱われてきました。HuRoは、観測と行動の両方をターゲットロボットに大規模に整合させることを徹底すれば、人間動画が追加のロボットデータの直接的な代替として機能することを示しています。最大の向上はロボットのみの学習が失敗する場面、すなわち空間的・視覚的OODにおいて得られます。これは、ウェブスケールの自己中心的動画を補助的なシグナルではなく、VLAのための実用的な事前学習コーパスとして位置づけ直すものです。
Source: https://arxiv.org/abs/2609.10706
ワールドモデルのように考え、VLAのように行動する:ワールドモデルの表現をコンパクトなロボットポリシーへ蒸留する
問題
Vision-Language-Action (VLA) モデルは (\mathbf{o}_t, \ell) \mapsto \mathbf{a}_{t:t+K} のマッピングを行いますが、それらの行動のもとで環境がどのように変化するかを制約する目的関数を持ちません。そのため、視点・照明・雑多な背景に対するロバスト性はデータのカバレッジによって制限されます。ワールドモデルは将来のフレームや状態を予測するよう訓練されるため、そのような目的関数を持ち、より時間的に根拠づけられた特徴を生成します。しかし、将来状態をロールアウトするのは推論コストが非常に高く、DreamZeroはH100上で1決定あたり約3秒・45.9 GBのメモリを必要とします。一方、\pi_{0.5} は65 msで動作し、本論文の0.8B学生モデルはコンシューマ向けRTX 5090上で1.86 GBを使用しながら32 msで動作します。問題は、ワールドモデルの根拠づけを、その推論コストを引き継ぐことなくコンパクトなVLAに受け継がせることができるかどうかです。
手法
核心的な主張は、ワールドモデルの知識はその内部特徴に宿っており、生成はそれらの特徴を形成した目的関数に過ぎないということです。そのため、学生モデルを特徴のみで教師あり学習することが可能です。
学生モデルはQwenGR00Tポリシーです:Qwen3-VL backboneがプレフィックスhidden states h(\mathbf{o}_t) \in \mathbb{R}^{L \times D_s} を生成し、その後にGR00Tスタイルのflow-matching action expertが続きます。基本目的関数は線形補間 \mathbf{a}^\tau = \tau \epsilon + (1-\tau)\mathbf{a}_{t:t+K} に沿った速度回帰です:
\mathcal{L}_{\mathrm{act}} = \mathbb{E}_{\mathbf{o}_t,\tau,\epsilon}\,\big\|v_\theta(\mathbf{a}^\tau, \tau, h(\mathbf{o}_t)) - (\epsilon - \mathbf{a}_{t:t+K})\big\|^2.
これに単一の特徴アライメント項が追加されます。凍結されたワールドモデル教師(Cosmos3-Nano)を訓練フレームに対して一度だけ実行し、その特徴をキャッシュします。学生の訓練中、学生のプーリングされた画像トークン特徴は、軽量なプロジェクターを通じてキャッシュされた教師特徴と方向(コサイン類似度;厳密な再現ではない)を一致させるよう押し進められます。これにより2つの性質が生まれます:
- 訓練時に教師不要。 教師は凍結されており、その出力は訓練フレームのみに依存するため、ターゲットは事前計算されます。蒸留訓練の実行コストは、蒸留なしの訓練と壁時計時間およびVRAMの観点で同等です。
- デプロイ時に何も追加不要。 プロジェクターは破棄され、学生の行動目的関数は変更されず、デプロイされるポリシーはアーキテクチャ上ベースラインと完全に同一です——同じbackbone、同じ4ステップのflow、同じ32 msのレイテンシ。精度向上はすべて、学生が最終的に獲得した表現に帰因し、追加パラメータやテスト時計算量によるものではありません。
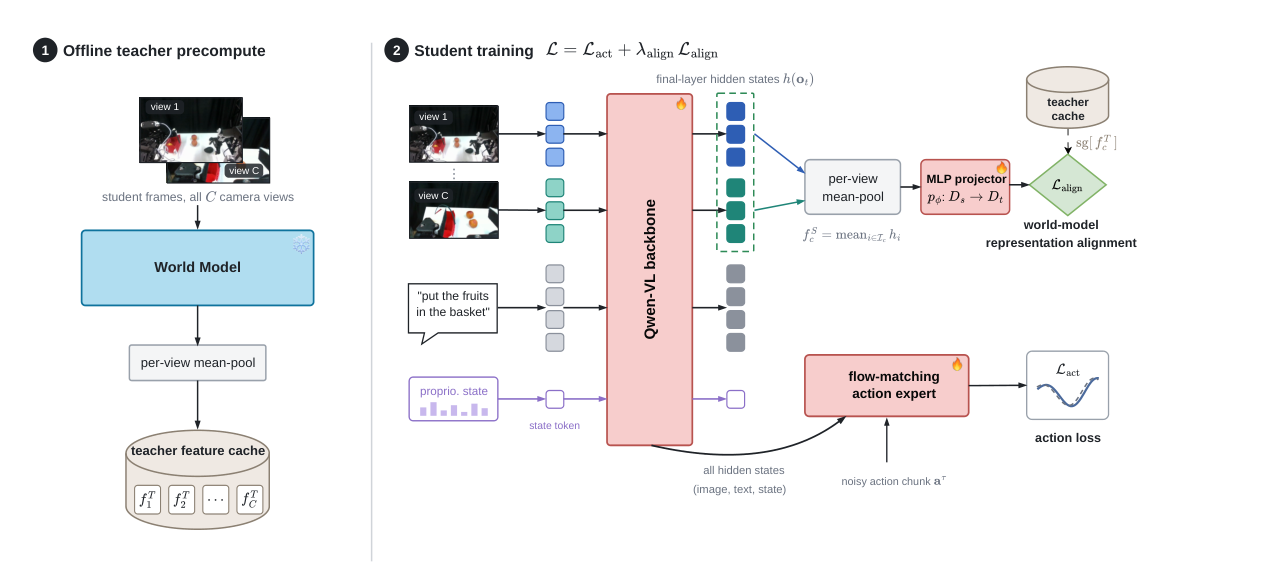
重要なことに、行動チャネルは蒸留から意図的に除外されています:教師と学生は行動のパラメータ化や特徴の次元数を共有する必要がなく、そのためこのレシピは教師に依存しません。Sec. IV-Eでは、4Bのスケールで、他のbackboneで、また代替的な教師を用いてこのレシピを繰り返し検証しています。
結果
評価プロトコルは慎重に設計されています:flow-matchingのサンプリングは確率的であり、LIBERO/RoboCasaシミュレータのレンダラーはGPU間でビット完全に同一ではないため、すべてのチェックポイントを4回評価(2シード × 2GPU:A100-80GB、RTX 5090)し、平均と標準偏差を報告しています。
- LIBERO(4スイート、スイートあたり500試行):蒸留済み0.8B学生モデルは \mathrm{SR}_{\mathrm{avg}} = 97.9\% を達成し、数倍大きいポリシーと同等またはそれを上回ります。
- RoboCasa-GR1(24の人型ロボットタスク、29次元の両手動作、6.02Mステップで共同訓練した1つのポリシーを全24環境で各20エピソード評価):蒸留により同じ0.8B学生モデルが 48.2\% から 50.5\% に改善されます。このベンチマークでのチェックポイントごとの分散はGPU間で数ポイントあり、著者らはこれを明示的に指摘しています。
- デプロイコスト:RTX 5090上で32 msおよび1.86 GB(\pi_{0.5} の65 ms、DreamZeroの3秒/45.9 GBと比較——後者は32 GBカードにはまったく収まりません)。
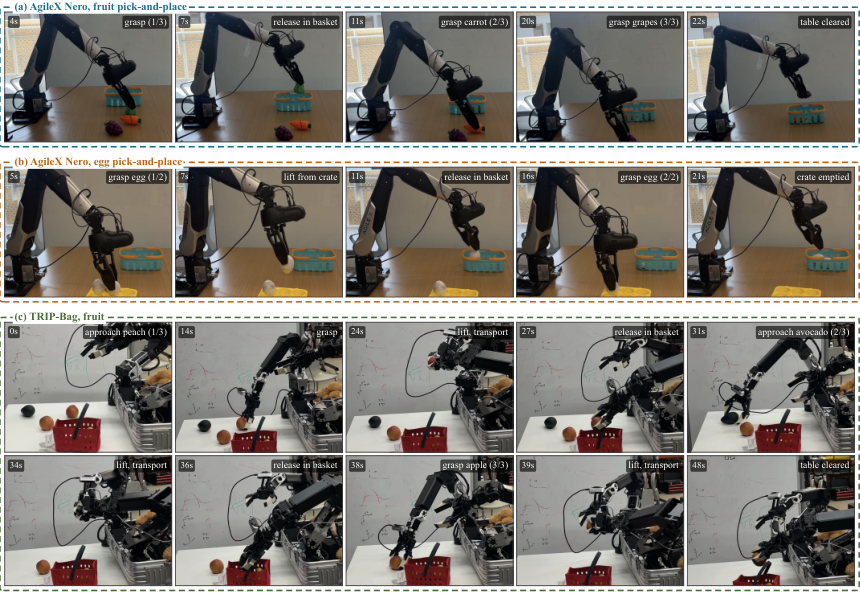
- 実ロボット:シングルアームのAgileX Neroによる果物と卵のピック&プレース、およびTRIP-Bagの両手による果物の受け渡しのすべてで、蒸留済み0.8B学生モデルが成功を収めています。
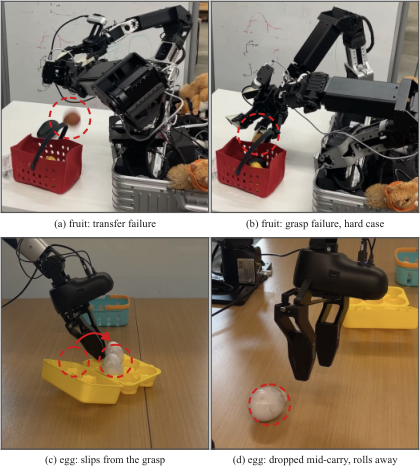
実ハードウェア上での失敗モードは、意味的なミスではなく低レベルの把持物理に支配されています:受容器の手前での落下、果物ではなく縁への把持、把持時または運搬中の卵の滑りなどです。
著者らは、この改善を学生のスケール(0.8B、4B)、backbone、アライメント層、教師の選択にわたって「控えめだが一貫している」と述べています——これは2つのネットワーク間の偶発的な一致ではなく、表現的な事前知識から期待される不変性のパターンです。
限界と未解決の問題
RoboCasa-GR1における改善(48.2 → 50.5)は、同じチェックポイントに対して報告されたハードウェア間分散の数ポイント以内に収まっているため、そこでの効果は4回実行プロトコルの期待値においてのみ実在します。アライメントはプーリングされた画像トークン上での方向のみです;より強い目的関数(パッチワイズ、あるいは教師が符号化するよう訓練された時間的構造を実際にインポートするための時間軸でのアライメント)が役立つかどうかは本論文では検証されていません。行動チャネルは意図的に除外されており——これによりレシピが教師に依存しないものになりますが——学生はダイナミクスについての教師信号を受け取らず、ダイナミクス目的関数によって形成されたに過ぎないシーン特徴のみを受け取ることになります。実ロボットの失敗は物理的なものであり知覚的なものではなく、この軸での改善の上限は計算ヘッドルームが示唆するよりも低い可能性があります。
なぜ重要か
これは、ワールドモデルの高コストな部分(生成)と有用な部分(根拠づけられた特徴)が訓練時に分離でき、推論時に除去できるという明快なデモンストレーションです。デプロイ可能なロボットポリシーにとって、これはそうでなければ使用不可能な教師のクラスを、デプロイオーバーヘッドなしの無償の訓練時事前知識へと変換するものです。
Source: https://arxiv.org/abs/2609.24682
VLMの知能をロボット制御へ転移する
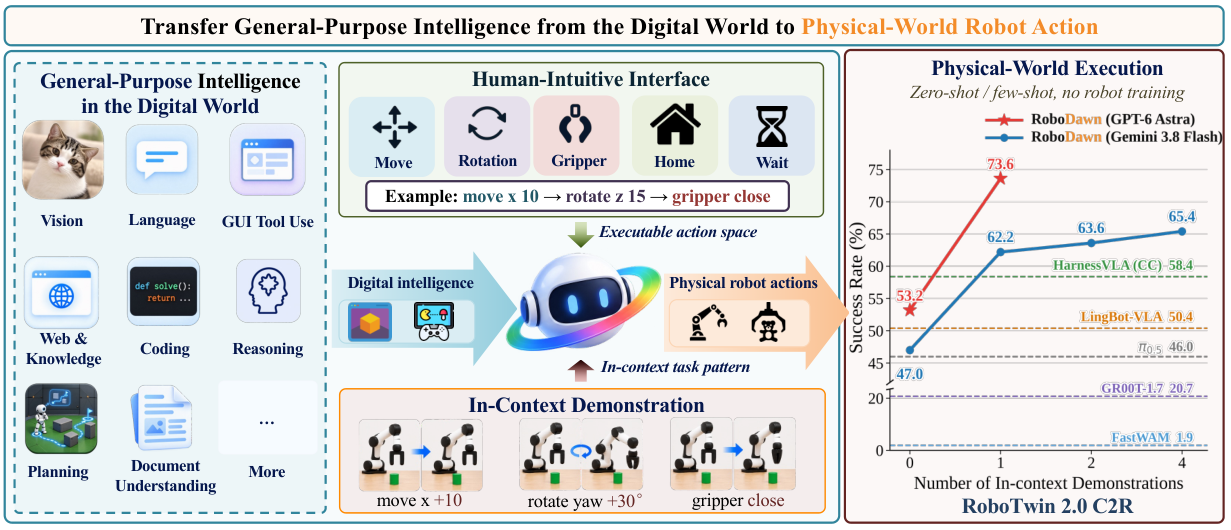
RoboDawnは、凍結済みの事前学習済みVLMが、タスク固有の fine-tuning を一切行わずに実ロボットをクローズドループで制御できるかどうかを問います。その実現のために、マニピュレーションを離散的なセマンティックアクションインターフェースとして公開し、少数のin-context demonstrationによってモデルをグラウンディングします。デジタルから物理への乖離は、主として推論の問題ではなく身体性とインターフェースの問題であり、適切に設計されたハーネスによって汎用VLMの知能を制御へ直接転移できるというのが本研究の主張です。
インターフェースとクローズドループの定式化
タスクは自然言語命令 L によって指定されます。VLM \pi_\theta は凍結されており、適応は変化する観測・フィードバック・メモリのみを通じて行われます。ラウンド t において:
(y_t, \mathbf{a}_t) = \pi_\theta(L, E, D;\; I_t, x_t, F_{t-1}, M_t),
ここで E はロボット–環境プロファイル(ワークスペース境界、カメラ規約、グリッドベースの位置推定、グリッパー特性)、D は固定されたin-context demonstrationのセット、I_t は複数視点のアノテーション付き画像、x_t は固有感覚状態、F_{t-1} は前ラウンドの実行フィードバック、M_t は継続的なメモリです。出力 \mathbf{a}_t は並進・回転・グリッパープリミティブにわたる離散的なセマンティックコマンドのシーケンスであり、y_t はタスク進捗推定値・計画・スクラッチパッドを含む構造化されたJSONライクなレスポンスです――これは実質的にchain-of-thoughtを明示的な制御面へと押し出すものです。
環境はその後 (s_{t+1}, F_t) = \mathcal{E}_P(s_t, \mathbf{a}_t) を適用し、次の観測 (I_{t+1}, x_{t+1}) = \mathcal{O}_P(s_{t+1}) を生成し、メモリは M_{t+1} = \mathcal{U}(M_t, \mathbf{a}_t, y_t, F_t, x_{t+1}) によって更新されます。重要なのは、s_t(特権的なオブジェクト姿勢)がVLMに一切公開されないことです:ポリシーは画像・固有感覚・グラウンディングされたフィードバックのみから動作します。
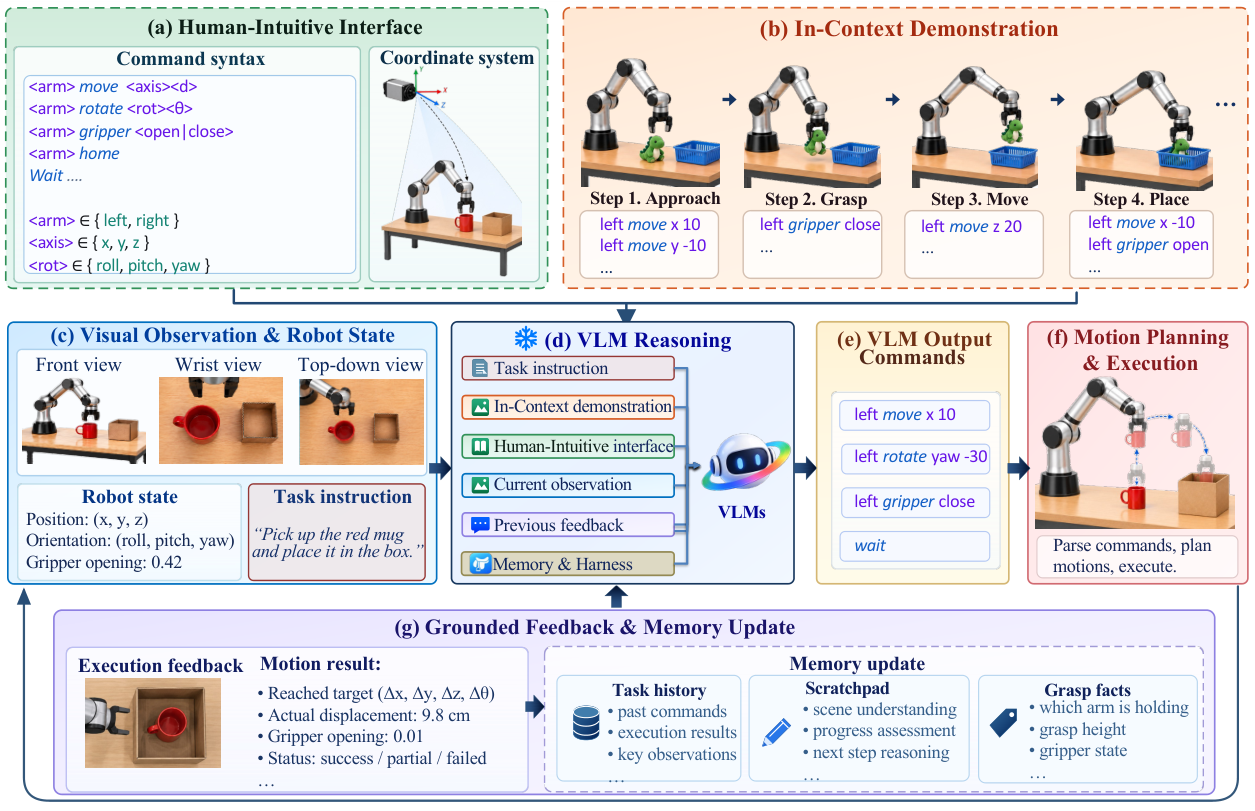
実行演算子 \mathcal{E}_P はハーネスが重要な役割を担う部分です:セマンティックコマンドを解析し、固定されたモーションプランナーを通じて低レベルモーションへとグラウンディングし、実行し、そして――重要なこととして――プリミティブが成功したか、グリッパーがオブジェクトを把持したか、目標グリッドセルに到達したかを記述するテキストフィードバックを合成します。これによりループを記号的にクローズし、VLMがピクセルのみから故障モードを推論する必要をなくします。
RoboTwin 2.0 C2Rにおける結果
RoboTwin 2.0 C2Rプロトコルは、50タスクにわたって各タスク50件のクリーンなdemonstrationで単一の双腕ポリシーを訓練し、ドメインランダム化のもとで評価します。一方RoboDawnは、in-contextテキスト/画像としてのみ提供されるゼロまたは1件のdemonstrationを使用し、パラメータを一切更新しません。
GPT-6 Astraを用いたゼロショットRoboDawnは平均成功率53.2%に達し、ベンチマークで完全にpost-trainingされた \pi_{0.5}(46.0%)およびLingBot-VLA(50.4%)をすでに上回っています。1件のin-context demonstrationにより成功率は73.6%に上昇し、従来のagentive-VLA SOTAであるHarnessVLA(Claude Code)を15.2ポイント上回ります。Gemini-3.8-Flashでは、ゼロショットが47.0%、1ショットが62.2%です。参考として、同一プロトコル下でX-VLAは20.9%、GR00T-1.7は20.7%であり、従来のVLA訓練とin-context VLMハーネスとの差はこのベンチマーク上でおよそ30〜50ポイントに達します。
in-context demonstrationのスケーリングは逓減、さらにその後負の収益を示します:Gemini-3.8-Flashは0/1/4ショットで47.0 → 62.2 → 65.4%と向上しますが、8ショットでは62.7%に低下します。これはVLM推論における長文脈劣化として他でも観察される現象と一致しており、demonstrationからの有用なシグナルはインターフェース規約がカバーされると急速に飽和することを示唆しています。
失敗モード
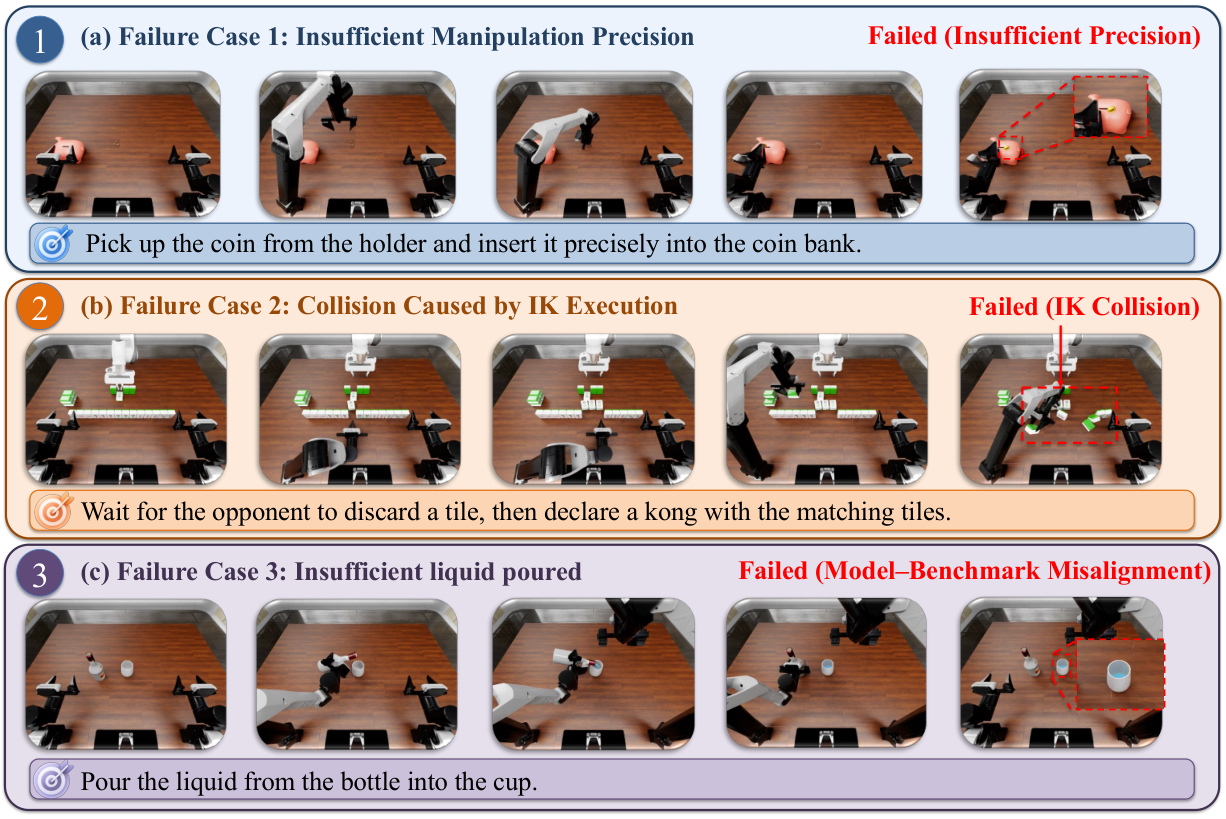
RoboDojo上の失敗は、細粒度の空間推論(グリッドベースの位置推定スキームのもとでの把持オフセットの誤判断)、インターフェースの誤用(プロファイル E で制約が指定されているにもかかわらずワークスペース制約に違反する回転を発行すること)、およびタスク完了の早期宣言に集中しています。これらはハーネス自体の問題というよりも基盤VLMの既知の弱点と一致しており、有能なベースモデルであっても性能が100%をはるかに下回る水準に留まる理由を説明しています。
限界
本アプローチはVLMのレイテンシを引き継ぎます:セマンティックアクション粒度でのクローズドループ制御は複数秒の意思決定ラウンドを意味し、反応的なタスクへの適用は困難です。インターフェースは離散化されている(グリッド位置推定、プリミティブ回転)ため、連続的な精密制御が必要なタスク――挿入、変形可能物体のマニピュレーション――は対象外です。結果はフロンティアVLMの選択に大きく依存しており、Gemini-3.8-FlashとGPT-6 Astraの差(10〜11ポイント)はモデル更新に対する脆弱性を示唆しています。最後に、C2Rプロトコルはクリーンなシードシーンからのランダム化をテストするものであり、真に新規なタスク分布ではないため、ここでの「ゼロショット」はベンチマークのセマンティック分布から引き出されたタスクを依然として前提としています。
なぜこれが重要か
凍結済みVLMに軽量な離散アクションインターフェースを組み合わせただけで、標準的な双腕ベンチマーク上で完全にpost-trainingされたVLAを15ポイント以上上回るならば、VLAをfine-tuningするための大規模なロボット固有データセットを収集するという現在のパラダイムは、少なくとも精密運動制御よりもセマンティック推論が支配的なタスクにおいては、精査に値します。この結果はまた、ロボット学習をインターフェース設計の問題として再定式化するものでもあります:「訓練」の大部分を、適切に仕様化されたプロファイル E とわずかなin-context例によって置き換えることができます。
Source: https://arxiv.org/abs/2609.22966
GameHorizon Suite: ゲームプレイにおけるマルチホライズンデータと評価
問題設定
ゲームは身体化AIにとって自然なベンチマークです。単一のキー入力から数分単位の戦略まで、さまざまな時間スケールにおいて知覚・命令分解・計画・低レベル制御が求められます。しかし、現状のエコシステムは断片化しています。Webからスクレイピングした動画コーパスは逆ダイナミクスモデル(IDM)やゲームパッドのセグメンテーションによってアクションを復元するため、疑似ラベルのノイズが生じます。命令の教師信号は存在しないか、疎であるか、あるいは単一の研究室から外に出ることのない規模(例:Game-TARS)で手動ラベリングされるかのいずれかです。オンライン評価は分散の大きいロールアウトに依存しており、研究室間で再現性がありません。GameHorizonはこの三つの課題に同時に取り組みます:真正なアクションキャプチャ、スケーラブルなマルチホライズン命令アノテーション、そして再現可能なオフラインMCQと制御されたオンライントラックを組み合わせたベンチマークです。
データ収集と三段階命令ピラミッド
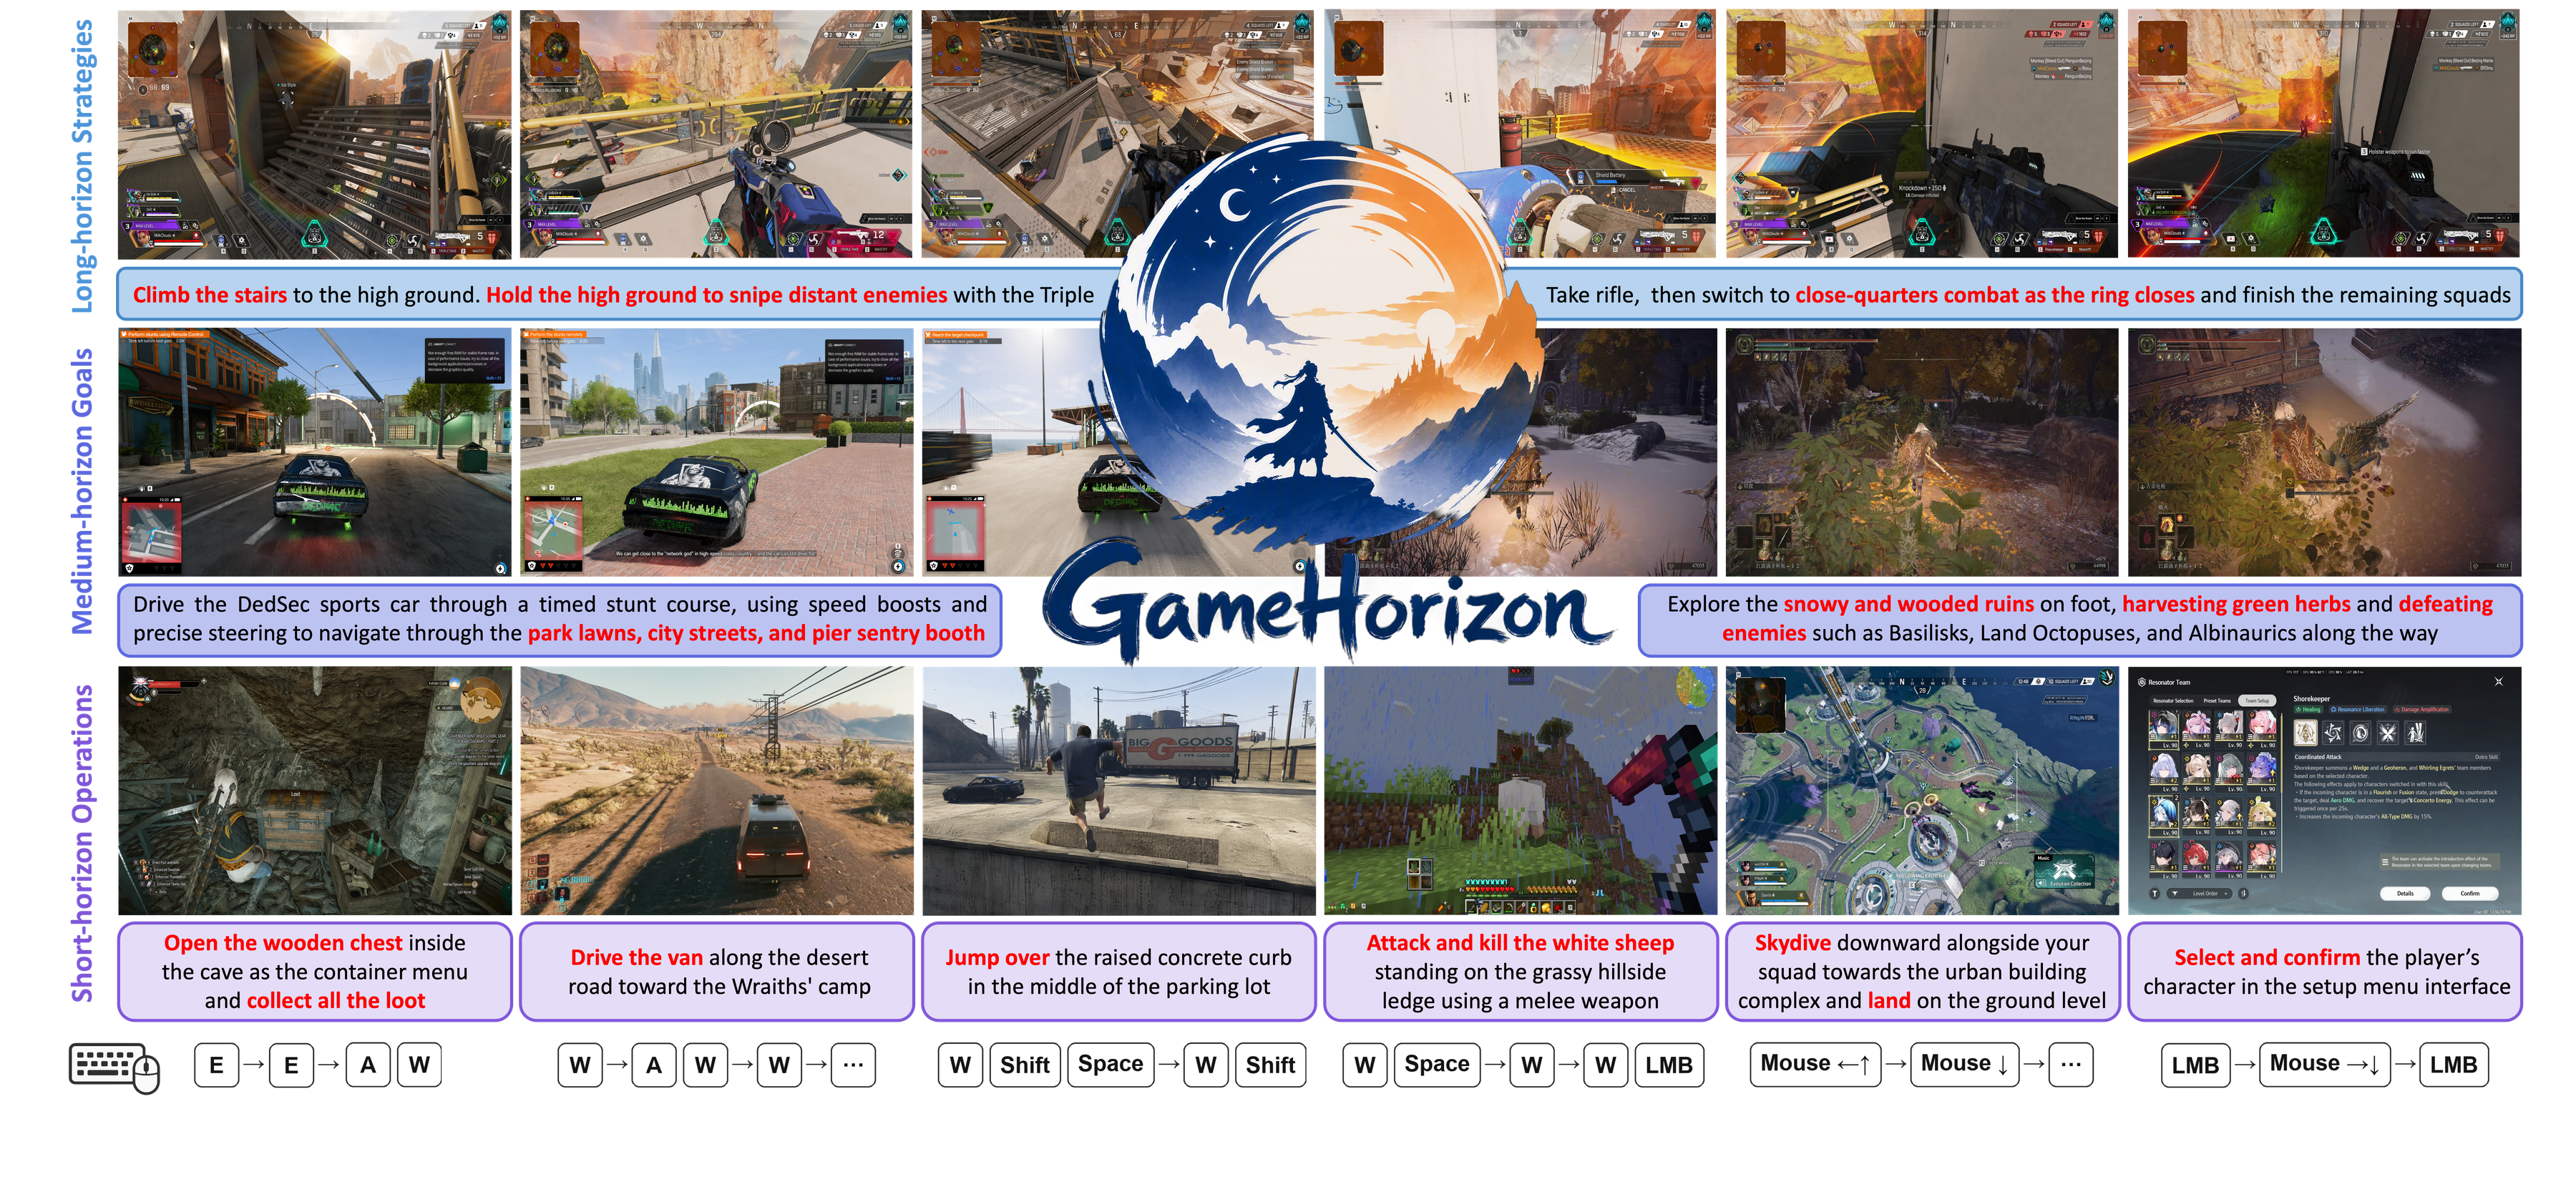
アクションを事後的に推定するのではなく、著者らは100名のエキスパートプレイヤーを採用し、タイムスタンプ付きのキーボード・マウスイベントとともに2K映像をキャプチャする同期録画クライアントを展開します。最終的なGameHorizon-Dataは21本のAAAタイトルにわたる5,000時間、60fpsの4,571本の動画、411.03Mのキーボード・マウスイベントを含みます。命令は三つの時間スケールに階層化されています:
- L_1:短時間スケールの操作、1〜5秒(例:「武器をリロードする」)。
- L_2:中時間スケールの目標、1〜2分(例:「前哨基地を制圧する」)。
- L_3:長時間スケールの戦略、5〜8分(例:「援軍が到着するまで橋を防衛する」)。
アノテーションの総数は6,184,036件であり、そのうち5,947,588件が L_1 操作です。ゲームプレイの抽象概念がジャンルをまたいで自明には転用できないため、オープンワールド・ARPG・競技FPS・サンドボックスサバイバル・クリーチャーコレクションといったジャンルのカバレッジが重要です。
アノテーターパイプライン
GameHorizon-Annotatorはボトムアップ方式です。まず、生の動画+アクションストリームがアクション認識型セグメンテーションによって分割されます。すなわち、各短いクリップが一貫した運動プリミティブに対応するよう、主要な入力イベントの位置に時間的境界が設けられます。次にVLMが、観測された入力に根ざした L_1 操作ラベルを各クリップに付与します。L_2 目標は、隣接する L_1 クリップを二つの基準によって統合することで生成されます:(i)アクションの連続性(長い待機間隔がなく、入力モダリティが一貫している)、および(ii)VLMキャプションにおける意味的一貫性。同じ統合演算子を L_2 セグメントに適用することで L_3 戦略が得られます。
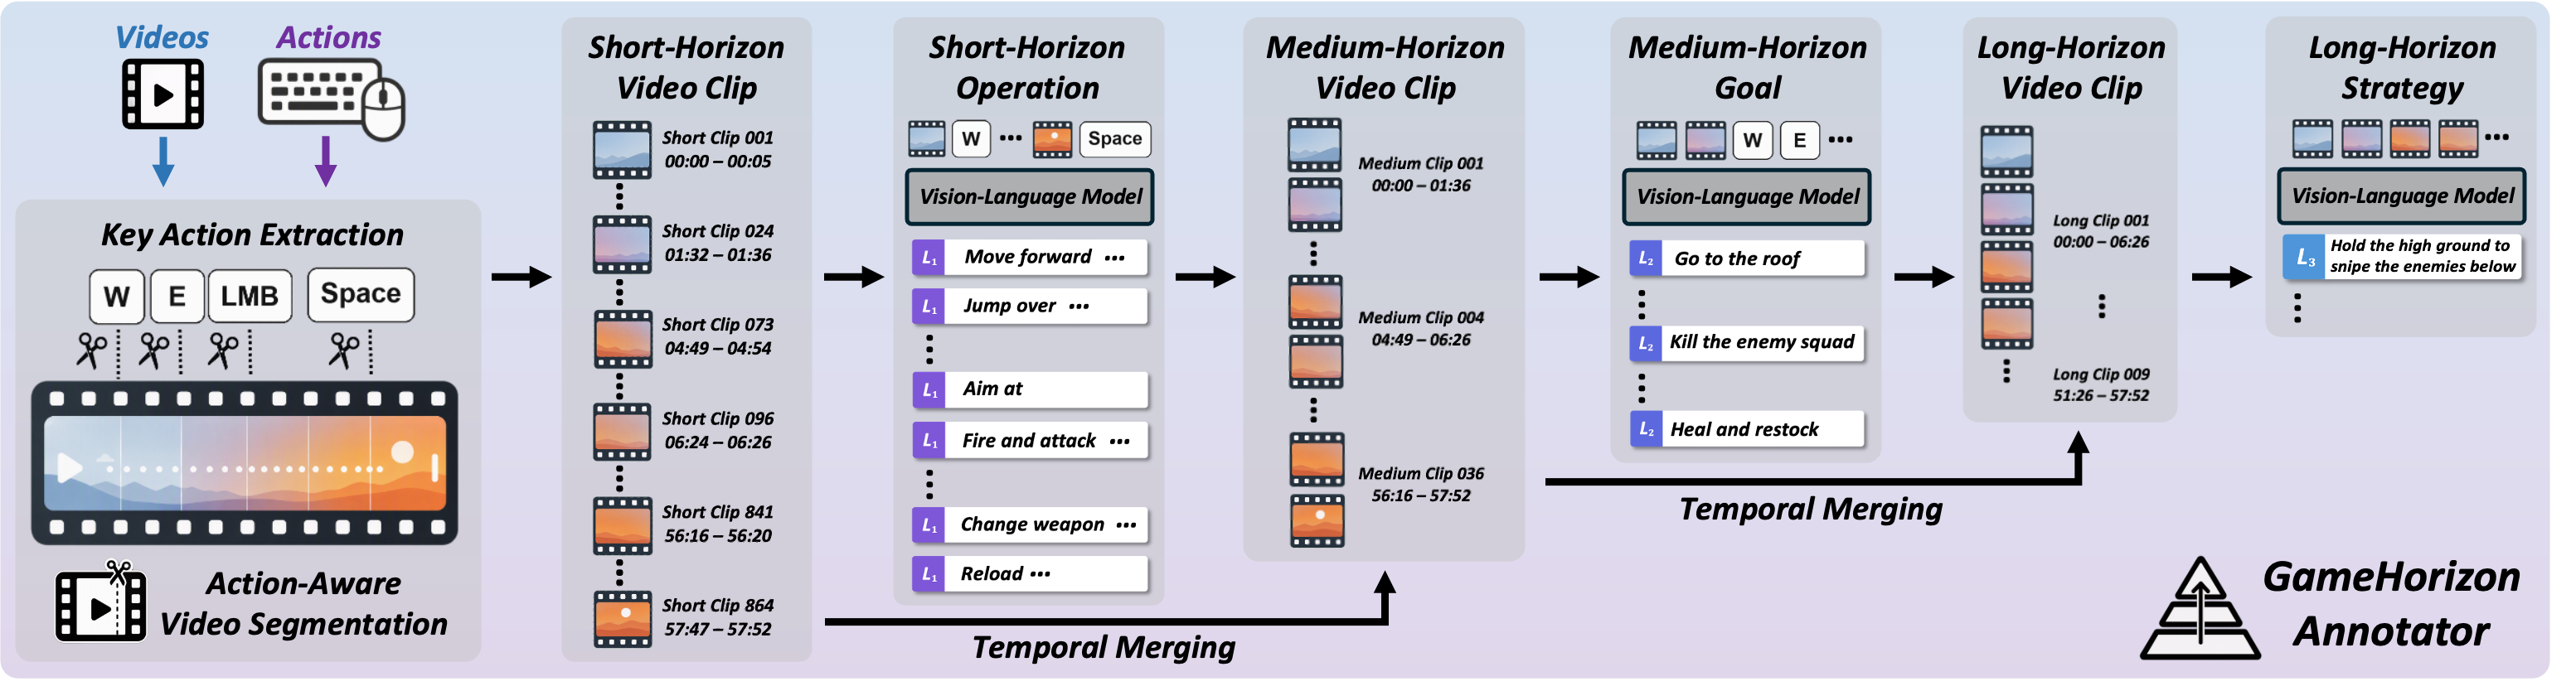
この設計には二つの有用な特性があります。第一に、L_1 ラベルが観測されたキーストロークに固定されているため、上位レベルはVLMキャプションが浮遊した状態にならず、アクションの根拠を継承します。第二に、このパイプラインはIDMの誤差を完全に回避します。アクションは推定されたものではなく、グランドトゥルースです。
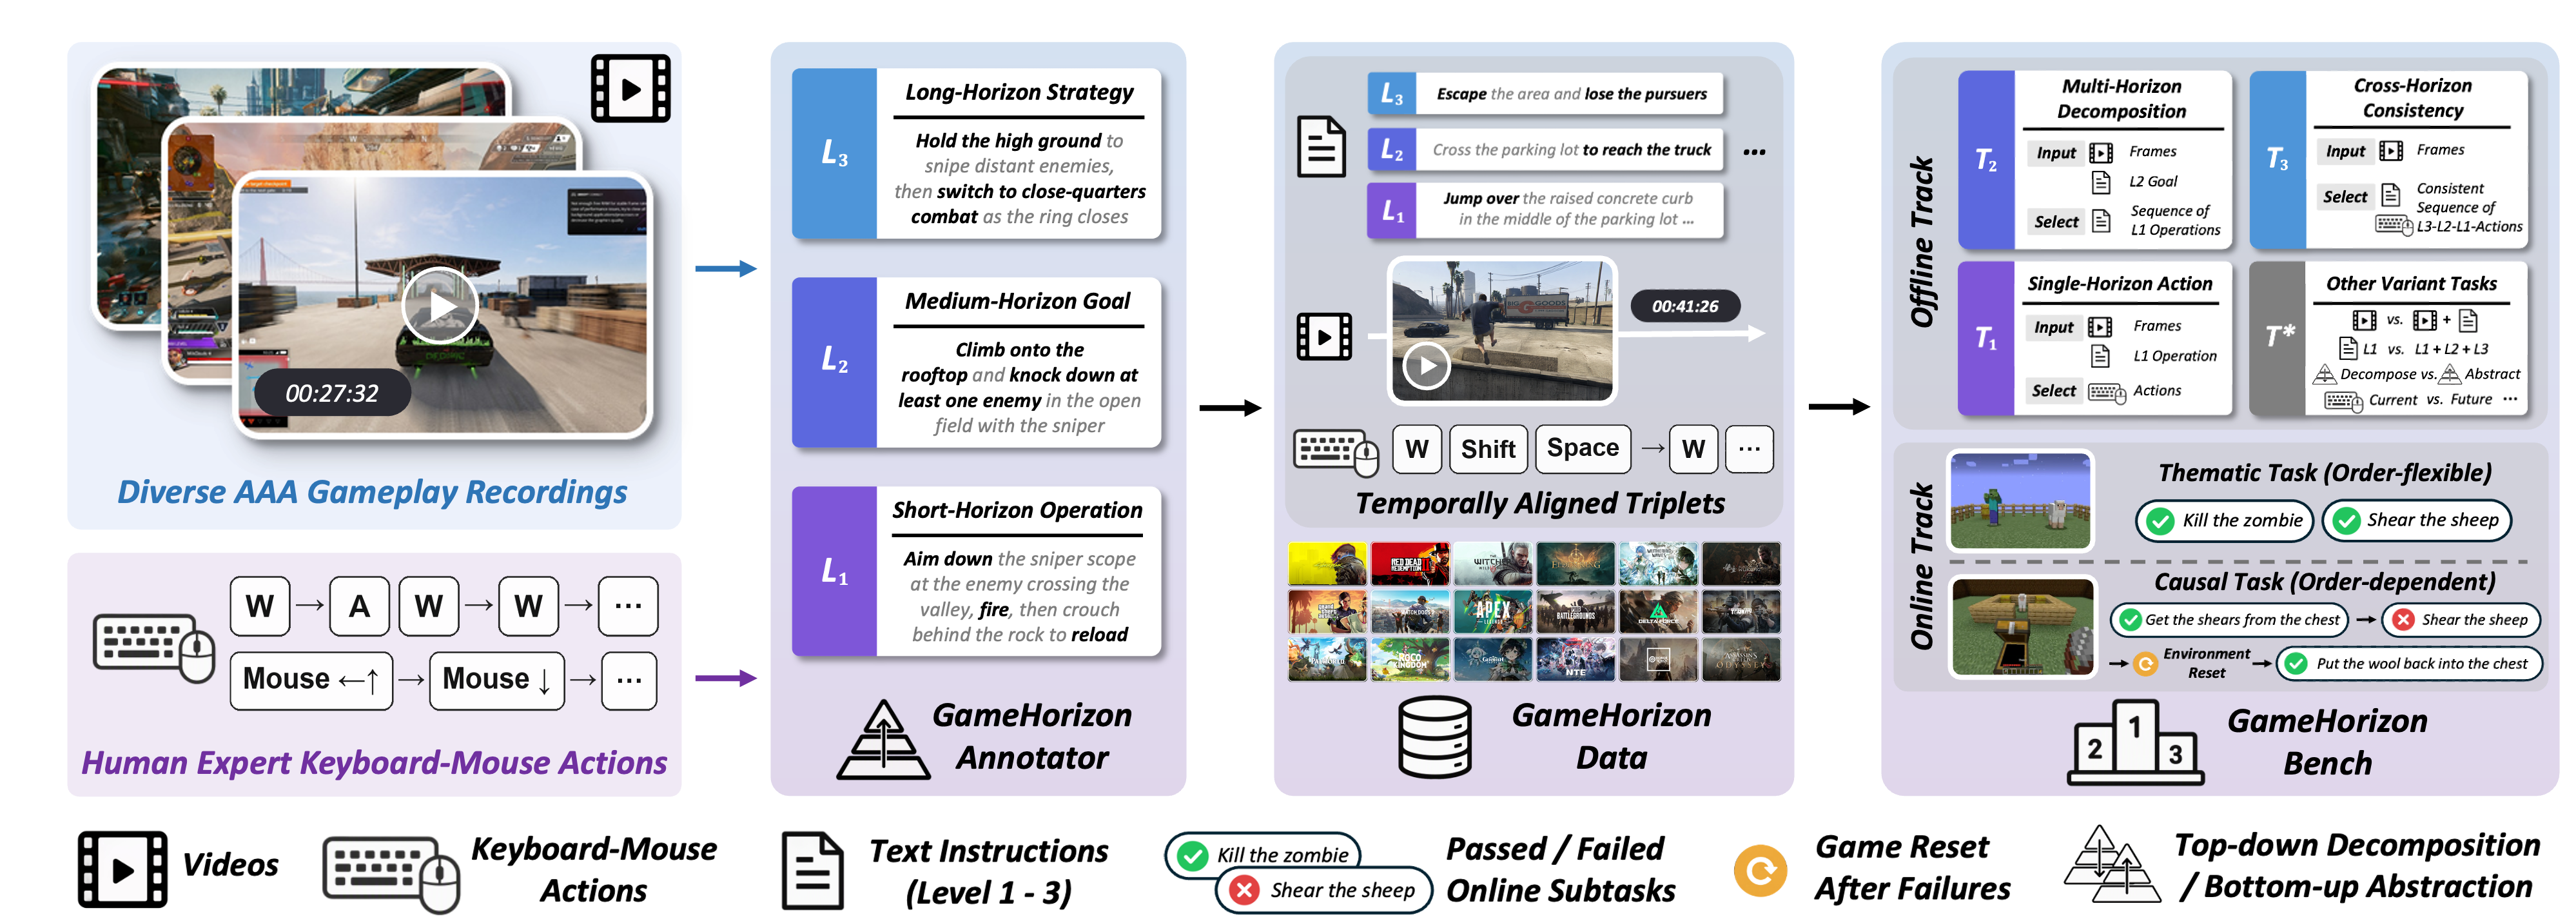
ベンチマーク設計
オフライントラックはゲームプレイ評価を4択MCQに変換することで、再現可能かつモデルに依存しない形式を実現します。三つの主要タスク T_1〜T_3 はそれぞれ三つの命令ホライズン(単一ホライズンのアクション予測・中ホライズンの目標同定・長ホライズンの戦略推論)におおよそ対応しており、各タスクに1,000件のMCQが含まれます。10種類の診断的バリアント T^* にはそれぞれ200件のMCQが追加され、合計5,000件のMCQとなります。汎用VLM、UMM、GUIエージェント、コーディングエージェントは直接回答します。専用ゲームエージェント(NitroGen、およびYue et al. 2026とLi et al. 2025のモデル)はMCQへの回答をネイティブにサポートしていないため、出力されたアクションシーケンスをNeedleman–Wunschアライメントによって四つの候補アクション文字列と照合し、最もスコアの高い選択肢を回答とします。閾値を下回る予測(空の出力を含む)は不正解として扱われます。NitroGenについては、ゲームパッドアクションをアライメント前にキーボード・マウスのキーバインド空間に再マッピングします。
オンライントラックはオフライン評価の47モデル(VLM 35・UMM 4・GUI 2・コーディング 3・ゲーム専用 3)から、オフライン性能の各ティアにつき3モデルずつサンプリングした12モデルを評価します。収集・クラフト・農業・建築・戦闘にわたる、10個の因果タスク(順序依存)と10個のテーマタスク(順序自由)を含み、62個の短ホライズンサブタスクに分解されます。各サブタスクには400回のモデル呼び出しのバジェットが与えられ、長ホライズンタスクは全サブタスクをゲームのリセットなしにエンドツーエンドで完了した場合のみ合格とされます(リセットは失敗の局所化のために使用されます)。タスクの成功はモデルの自己報告ではなく、ゲーム状態から直接判定されます。
この設計がもたらすもの
本スイートは三つの点で類を見ません。(1)IDM疑似ラベルではなく真正なアクションを用いることで、下流のアクション予測評価における系統的ノイズ源が除去されます。(2)出力の種類が大きく異なるモデルファミリー全体に共通の評価尺度を提供します。MCQはVLM/UMM/GUI/コーディングエージェントの軸をカバーし、シーケンスアライメントによって純粋にアクションを出力するエージェントを同じスコアリングフレームに組み込みます。(3)オフラインとオンラインの分割により、安価なMCQスコアとコストのかかるロールアウト成功率の相関分析が可能になります。これはオフラインベンチマークの飽和がオンライン能力を予測するかどうかを問う上で有用です。
限界と今後の課題
抜粋された論文はモデルごとの実際の精度数値やオフライン・オンライン相関を報告していないため、実証的な成果をここで判断することはできません。MCQ形式は標準化されていますが、問いうる内容に制約を課します。また、示されたセクションでは選択肢(ディストラクター)の構成品質について詳述されていません。L_2 および L_3 の命令品質はVLMによる L_1 のキャプションと統合ヒューリスティックに依存しており、どちらもラベルバイアスの潜在的な原因となります。特に、アノテーターの基盤VLMの学習データで十分に表現されていないジャンルでは顕著です。アクションのみを出力するエージェントに対するアライメントベースのスコアリングは、異なるキーシーケンスを使用する意味的に正しいアクションを過小評価する可能性があり、400回の呼び出しバジェットはオンライントラックに特定の計算コストのレジームを組み込んでいます。
なぜこれが重要か
再現可能で、アクションに根ざした、マルチホライズンのゲームプレイ評価は、現在のVLMやエージェントスタックが実際に分単位のスケールで計画を立てているのか、それともフレームレベルのパターンマッチングにとどまっているのかを判断するための前提条件です。GameHorizonは、47モデル全て(本番APIおよび専用ゲームエージェントを含む)を、IDMによる推定ではなく人間が真正に収集したアクションを用いて、静的MCQとクローズドループロールアウトの両方で比較できる初めての環境を提供します。
Source: https://arxiv.org/abs/2609.25001
Hacker News Signals
Transformers Explained Visually
Georgia Tech の Polo Club によるブラウザベースのインタラクティブな transformer アーキテクチャ可視化ツールです。このツールでは、WebGL/WebAssembly を用いてブラウザ上で GPT-2-small の推論をライブ実行できます。tokenization、embedding lookup、multi-head self-attention、layer normalization、feed-forward ブロック、そして最終的な unembedding/softmax 射影まで、各ステップを順を追って確認できます。各コンポーネントはアニメーション付きのデータフロー図として描画されており、attention weight 行列が各 head ごとに形成される様子を観察したり、residual stream の加算を確認したり、入力テキストを打ち込みながら層をまたいで logit 分布がどのように変化するかを追うことができます。
機械的な詳細は教育目的に有用です。Attention score の計算 e_{ij} = \frac{q_i \cdot k_j}{\sqrt{d_k}} は次元のラベル付きで明示的な行列積として表示され、key 方向への softmax 正規化は各 query 位置ごとにアニメーションで示されます。feed-forward ブロックの GELU 活性化を用いた二層 MLP は、次元の拡張(d_{model} \to 4 d_{model} \to d_{model})として示され、中間の活性化値が棒グラフで可視化されます。
静的な解説ツールとの最大の違いは、モデルが実際に動いている点です。トークンの確率はリアルタイムで更新され、任意の attention head をクリックすることで現在のシーケンスに対する n \times n の完全な weight 行列を確認できます。実装には ONNX Runtime Web と Transformers.js が使用されており、推論はサーバーへのラウンドトリップなしに真にデバイス上で行われます。
制限は教育的な側面にあります。GPT-2-small は十分シンプルであるため、層をまたいだ residual stream のダイナミクスや induction head のような現象は取り上げられていません。mechanistic interpretability の観点は存在せず、あくまでアーキテクチャの可視化であり、回路解析ではありません。数学的背景をすでに理解している人にとっては、研究ツールというよりも、コミュニケーションや教育のための成果物として主な価値があります。HN のコメントでは、基本的な内容を非常に明快に扱っている一方で、encoder-decoder の変種、rotary positional embedding、あるいは現代のモデルで用いられる grouped-query attention はカバーされていないという指摘がなされています。
Source: https://poloclub.github.io/transformer-explainer/
AIコーディングによってCIがボトルネックになったため、対応するためにCIを再設計しました
Linearのエンジニアリングブログ記事では、具体的なインフラ上の問題が述べられています。AIを活用したコーディング(Claude、Copilotなど)によってPRのスループットが大幅に増加し——彼らの数値によれば、エンジニア1人あたり週次のPRオープン数がおよそ3倍に増加したとのことです——人間のペースを前提に設計された既存のCIパイプラインがクリティカルパスとなってしまいました。キュー待ち時間は膨れ上がり、エンジニア(およびエージェント)はテスト結果を待つためにブロックされるようになりました。
これに対して、彼らはいくつかのアーキテクチャ上の変更を加えました。まず、固定されたランナープールから、AWSにてジョブ単位でプロビジョニングする完全なエラスティック型のエフェメラルランナーへと移行しました。これにはコールドスタート時間の最適化が必要でした。依存関係のキャッシュをあらかじめ組み込んだDockerイメージをビルドし、スナップショットベースのAMIを利用することで、ランナー環境を30秒以内に起動できるよう短縮しました。次に、積極的な並列実行に向けてテストスイートを再構成しました。テストのシャーディングはファイル数だけでなく過去の実行時間データにも基づいて行われ、各シャードが一定のウォールクロック時間(約2分)を目標とするようにしています。メタデータサービスが過去の実行から各テストの所要時間を追跡し、シャードを動的に再バランスします。
3つ目として——最も技術的に興味深い点として——選択的テスト実行を実装しました。インポート解析とカバレッジデータから構築したファイル対テストの依存グラフを使い、特定のモジュールのみに変更を加えたPRでは、変更ファイルと推移的な依存関係が重なるテストのみを実行します。これは静的解析の問題です。TypeScriptのインポートを解析してモジュールグラフを構築し、変更ファイルのセットとテストカバレッジマップを突き合わせます。偽陰性(見逃しによる失敗)への対策として、mainへのマージ時にフルスイートを実行し、さらに変更ファイル数が閾値を超えたPRには定期的なフル実行を行っています。
報告された結果として、CIの中央値時間は約18分から約4分へと短縮されました。より広い視点での要点——AIツールがボトルネックをコード生成からバリデーションインフラへとシフトさせるという点——は明確に正しく、エージェントが生成するPRが無視できない量に達しているあらゆるチームに当てはまります。
Source: https://linear.app/now/ci-bottleneck-reworked
フロンティアAIを自前のハードウェアで動かす
Tim Dettmers氏の投稿はDLabのオープンソースウィークリリースに伴うもので、大規模モデルをローカルで実行するための実践的なガイダンスに焦点を当てています。特に、クラウドに依存せず70Bパラメータ以上のモデルを実行したい研究者や実践者を対象としています。この投稿はDettmers氏の量子化研究(bitsandbytes、QLoRA)を基盤としており、マーケティングベンチマークではなく、メモリ帯域幅とVRAM制約に基づいた具体的なハードウェア推奨を示しています。
中心となる技術的な枠組みとして、バッチサイズが1または小さい場合、自己回帰生成における推論スループットはほぼ完全にメモリ帯域幅によってボトルネックになり、計算量によるものではないという点が挙げられます。関連する指標はモデルのパラメータ数にパラメータあたりのバイト数を乗じたものをメモリ帯域幅で割ることであり、これがtokens-per-secondの上限を与えます。4ビット(NF4)量子化での70Bモデルはおよそ35 GBとなり、コンシューマ向けデュアル24 GB GPU(例:NVLinkまたはtensor-parallel分割を使った2枚のRTX 4090)や単体の40/48 GBプロフェッショナルカードに収まります。投稿ではこの計算を明示的に解説しています。
Dettmers氏は品質保持の観点からGPTQやAWQよりもNF4量子化(QLoRA由来)を推奨しており、NF4がfull BF16とのperplexityのギャップの大部分を埋めることを示すperplexityベンチマークを引用しています。また、量子化定数自体を量子化するdouble quantizationについても論じており、品質を意味のある形で損なうことなくメモリをさらに削減できるとしています。推論サービングに関しては、シングルGPUまたはCPUオフロードのシナリオにはllama.cppを、マルチGPUにはtensor parallelismを用いたvLLMを推奨しています。
オープンソースウィークのコンポーネントとして、CUDA 12.xとの互換性を改善し、量子化エコシステムでこれまで二級市民扱いされてきたAMD ROCmターゲット向けの新しいカーネル最適化を加えた、更新版bitsandbytesビルドがリリースされています。
認められている主な制限として、コンシューマ向けハードウェアのメモリ帯域幅はH100 SXMと比べてまだ約3〜5倍低いため、大規模モデルのtokens-per-secondはクラウド推論と比べて依然として大幅に遅いという点があります。ローカル実行の利点はプライバシー、低利用率でのコスト、そして再現性にあり、レイテンシの同等性ではありません。
Source: https://timdettmers.com/2026/09/21/dlab-open-source-week/
Show HN: 戦略ゲームをプレイする小規模ニューラルネットワークのコンペティション
TinyBrainsは、厳格なパラメータ予算に制限されたニューラルネットワーク(現在のサイトでは100Kパラメータの上限を強制)を提出し、ターン制戦略ゲームでラウンドロビントーナメント形式の対戦を行うコンペティションプラットフォームです。現在のゲームは、不完全情報と多段階の計画能力が要求される、グリッドベースのリソース収集ゲームです。
技術的な制約こそが興味深い点です。100Kパラメータという規模は、総当たり的な深いネットワークが有効に機能しないほど小さく、512ユニットの隠れ層を持つ単純な2層MLPだけで予算のほとんどを消費してしまいます。参加者はアーキテクチャの効率性について真剣に考えなければなりません。具体的には、再帰構造の使用(LSTMはtransformerよりも少ないパラメータでシーケンスモデリングを実現できます)、入力次元を削減するための手作りの特徴エンジニアリング、あるいはルールベースと学習コンポーネントのハイブリッド構成などが選択肢として挙げられます。本コンペティションでは、任意の微分可能なアーキテクチャおよび任意の学習手法(自己対戦からの教師あり学習、RL、進化的戦略)を明示的に許可しています。
評価は自動対戦によるELOレーティング方式で行われ、新たな提出が入るたびに結果が継続的に更新されます。ゲーム環境は固定された観測空間(フラット化されたボード状態とメタデータ)と離散行動空間を持つPython APIとして公開されており、インターフェースは非常にシンプルです。提出フォーマットは、定義されたforward シグネチャを持つシリアライズされたPyTorchまたはONNXモデルです。
ML研究の観点からは、これは通常のベンチマークとは異なる興味深いリソース制約ベンチマークです。その理由は、敵対的な共進化が重要であるためです——現在の対戦相手に勝てる戦略も、将来の提出物によって攻略される可能性があります。また、部分観測下での計画においてどのアーキテクチャが最もパラメータ効率に優れているかを研究するための、クリーンなテストベッドでもあります。
現在のリーダーボードでは、このパラメータスケールにおいてLSTMベースのモデルがfeedforwardモデルを上回っており、これは多段階の戦略において時系列状態の追跡が重要であり、小規模ではLSTMの方がattentionよりも効率的にそれを実現できるという直感と一致しています。
Source: https://tinybrains.dev
Show HN: Lossless-Memory — 要約を一切行わないパーソナルAIメモリ
このリポジトリは、古いコンテキストを圧縮・要約するのではなく、すべてのインタラクションを逐語的に保存するLLMアシスタント向けのretrieval-augmentedメモリレイヤーを実装しています。要約に反対する主な論拠は次の通りです:非可逆圧縮は、書き込み時点では予測できなかった将来のクエリに関連する可能性のある情報を破棄してしまうというものです。「ユーザーが3月にプロジェクトXについて議論した」という要約では、その会話における具体的な制約、数値、表現が失われてしまいますが、それらは数ヶ月後に重要になる可能性があります。
技術的な実装では、ベクターストア(デフォルトはFAISS、オプションでChromaバックエンドも利用可能)を使用して会話ターン全体をインデックス化します。各ターン(ユーザーメッセージとアシスタントの応答の組)はチャンク化され、ローカルのsentence-transformerまたはOpenAI embeddingsを用いてembeddingされ、メタデータ(タイムスタンプ、セッションID、任意のユーザー提供タグ)とともに保存されます。クエリ時には、システムが全履歴に対して近似最近傍探索を実行し、コサイン類似度によって上位kチャンクを取得し、取得されたメモリとしてLLMのcontext windowに注入します。
「lossless」という主張は、生のテキストが保存されるという意味では技術的に正確ですが、retrieval のステップは別の意味でlossyになり得ます:embedding類似度によるANN探索では、クエリと保存テキストの意味的類似度が低い場合に、高い関連性があるにもかかわらず関連するメモリを見つけられない可能性があります(例えば、「latency」に関する過去の会話が、現在のクエリが「response time」についてのものである場合に取得されないケースなど)。READMEではこの点を認め、BM25とdense retrievalのハイブリッド手法を改善予定として挙げています。
ストレージは使用に伴って無制限に増大しますが、これは受け入れたトレードオフです。実装には、ANN探索の前に時間範囲やタグによるフィルタリングを行うための、ベクターインデックスと並置されたシンプルなSQLiteバックドのメタデータストアが含まれており、これによりretrieval精度の問題が部分的に緩和されます。コードベースは小規模(Pythonで約800行)であり、外部サービスへの依存なしにローカル展開できるよう設計されています。
Source: https://github.com/aru-labs/lossless-memory
Grok 4.7
xAIは、Grok 4(同社の最強の推論モデル)と将来リリースが予想されるGrok 5の中間に位置するインクリメンタルアップデートとして、Grok 4.7を公開しました。アナウンスはアーキテクチャの詳細に乏しく、これはxAIのリリースでは標準的な形式です。公開されたベンチマークおよびコミュニティによる評価に基づくと、このモデルは標準的な推論ベンチマークにおいてGPT-4oからo3レベルの能力の間に位置しており、特にコーディングタスク(HumanEval、SWE-benchの各バリアント)およびinstruction followingにおいて改善が主張されています。
技術的に注目すべき主張として、xAIはGrok 4.7を自社の内部エージェントパイプラインにデプロイするモデルとして位置づけており、これはエージェント的利用において重要な特性——信頼性の高いtool callのフォーマット、複数ステップのタスクにおける低いhallucination率、システムプロンプト制約への高い準拠性——を備えていることを示唆しています。これらは外部から検証することは困難ですが、純粋なベンチマーク性能とは異なる差別化要因として妥当性があります。
context windowは131Kトークンとされており、Grok 4と一致しています。モデルはxAI APIを通じて利用可能です。料金については告知投稿に詳細が記載されていません。
HNのディスカッションは懐疑的かつ鋭い内容です。主な批判として、xAIのベンチマーク報告方法論は以前にも問題視されており(プロンプト形式のcherry-picking、再現性のないeval設定)、LMSys Chatbot ArenaやArtificial Analysisといった独立したサードパーティのevalはまだ4.7を評価していない点が挙げられています。バージョン番号体系(4.5や5ではなく4、4.7)は非標準的であり、OpenAIのナンバリングに対するマーケティング上の位置づけとして認識されています。複数のコメンテーターがコーディング支援における質の向上を体感的に報告している一方で、4.7は無料ティアのユーザーには利用できないため、独立した評価が限られているとも指摘されています。
このリリースは、フロンティアラボが大きな能力の飛躍を待つのではなく、おそらくAPIの収益維持と本番環境での利用データ収集を目的として、インクリメンタルなチェックポイントを継続的に出荷するというパターンを踏襲しています。
Source: https://x.ai/news/grok-4-7
M5 Ultra Mac Studio レビュー
MacStoriesのレビューは、M5 Ultra Mac Studioをローカル AI inference マシンとして特に焦点を当てており、典型的な一般消費者向けハードウェアレビューとは異なる技術的な視点を提供しています。M5 Ultraは、Appleのdie-to-die interconnectを使用して2つのM5 Maxダイを結合し、CPU、GPU(80コア)、Neural Engine間で最大192 GBのLPDDR5Xを共有するunified memory architectureを実現しています。LLM inferenceにおける重要な数値として、memory bandwidthはinterconnect全体で約800 GB/sと報告されており、コストと消費電力の面でH100 PCIe 1台(SXMで約2 TB/s、PCIeで1 TB/s)と比較しても、わずかなコストと消費電力で競争力のある性能を発揮します。
実用上の帰結として、4-bit quantization(約35 GB)の70Bモデルは192 GB構成に余裕を持って収まり、contextやシステムオーバーヘッドのための空き容量も確保できます。また、memory bandwidthは単一ユーザーのローカル inference ユースケースにおいて十分なtokens-per-secondスループットをサポートします。レビューでは複数のモデルを用いてllama.cppをテストし、70B Q4モデルで約25〜30 tok/sを報告しており、これはインタラクティブな inference に十分実用的な速度です。7〜13Bモデルでは、スループットが十分高く、体感的にほぼ即時応答に感じられます。
レビューではAppleのMLX frameworkの性能についても取り上げています。MLXは、x86システムと離散GPUの組み合わせに見られるCPU-GPU転送のオーバーヘッドなしにunified memory architectureをネイティブに活用できるため、Apple Silicon向けのローカル inference スタックとして主流になりつつあります。M5 Ultra上でのMLX operationは、特定のoperationにおいてllama.cpp Metal backendよりも高い utilization を示しています。
制限事項も現実的に存在します。CUDAエコシステムが利用できないため、PyTorch CUDAカーネルに依存するfine-tuningワークフローには回避策またはリモートコンピューティングが必要です。Neural Engine(38 TOPS)はANEコンパイル済みモデルに対して高速ですが、多くの研究用コードはそれをターゲットにしていません。フル構成で約8,000〜10,000ドルという価格において、VRAM GBあたりのコストはdual-3090ワークステーションの自作より高いものの、数ヶ月にわたる重度使用を想定したクラウドコストの累計と比較すると低くなります。
Source: https://www.macstories.net/stories/m5-ultra-mac-studio-review-the-dream-mac-for-local-ai-agents/
AIコーディングがコード品質を低下させているなら、品質管理が正しくできていない
この投稿はツールレビューではなく、プロセスに関する議論です。中心的な主張は、AIが生成するコードによるコード品質の劣化は、AIツールに本質的に備わった特性ではなく、マネジメントとツール整備の失敗であるというものです。著者の立場は、人間のペースの開発に対して機能していた品質ゲート——コードレビュー、linting、テストカバレッジ要件——は実際に徹底されさえすれば十分であるが、AIツールが出力を加速させた際に多くのチームが暗黙のうちにそれらを緩めてしまった、というものです。
議論の技術的に重要な部分として、著者はローカルなコード品質(スタイル、明白なバグ、命名)とアーキテクチャ的品質(結合度、抽象化の境界、長期的な保守性)を区別しています。AIツールは、pre-commit hooksやCIによる強制を伴うlinterやformatterと組み合わせた場合、前者に対しては相応に優れた性能を発揮します。一方、後者に対しては体系的に弱いです。なぜなら、アーキテクチャ上の意思決定はコンテキストウィンドウに収まりきらないコードベース全体のグローバルなコンテキストを必要とし、またLLMはグローバルに一貫した設計よりもローカルに尤もらしい補完を最適化するからです。
提案されている対策は具体的です。エージェントが構造的な変更を生成する前に参照しなければならない必須のアーキテクチャ決定記録(ADR)の導入、CI に追加して閾値を強制するファンイン/ファンアウト分析や循環的複雑度などの自動結合メトリクスの整備、そしてdiffのサイズ閾値を超えた任意のPRに対してではなく、モジュール境界をまたぐ変更やインターフェースを修正する変更に限定した人間によるレビューの必須化です。最後の点が最も実行可能です。diffのサイズはアーキテクチャ上のリスクの代理指標として不適切であり、より的を絞ったレビュー基準があれば、AIの支援が最も弱い箇所にレビュアーの注意を集中させられます。
HNのコメントスレッドでは、既存の品質管理プラクティスがAIを使用していないチームに対して適切に調整されているという暗黙の前提に反論しており、PRのボリュームが3〜5倍に増加した場合に著者が推奨する管理策がスケールするかどうかを疑問視しています。これは正当な異議です——レビューの帯域幅は固定されており、すべてのモジュール横断PRに人間によるレビューを要求することは、CIとは異なる種類のボトルネックになりかねません。
Source: https://www.i-kh.net/p/if-ai-coding-is-lowering-your-code
注目の新しいリポジトリ
ejfkdev/ddc
完全にRustで書かれたDEX-to-Javaデコンパイラです。既存ツール(jadx、cfr)が大規模コードベースでは正確だが低速であるという問題と、速度のために正確性を犠牲にするツールとの間のギャップを埋めることを目的としています。コアの設計はプログレッシブ解析を採用しており、出力を生成する前にDEX全体を完全にパスする必要はなく、部分的な型推論グラフを構築し、メソッドごとに信頼度の閾値が満たされ次第、デコンパイルされたJavaをインクリメンタルに出力します。これにより、APK全体の処理が完了する前に特定のクラスの結果を得たいインタラクティブなワークフローにおいて実用的な選択肢となります。CLIは英語と中国語のバイリンガル対応となっており、これは両エコシステムが活発なAndroidリバースエンジニアリングコミュニティを対象とするプロジェクトの方針を反映しています。Rustで実装されているため、GCポーズなしでメモリ安全性が確保されており、JVMベースのデコンパイラでヒープ圧迫を引き起こすような異常な制御フローを持つDEXファイルのデコンパイル時に特に有効です。初期ベンチマークでは大規模APKに対してjadxと比べて3〜5倍のスループット向上が示されていますが、難読化されたバイトコードに対するjadxとの正確性の同等性はまだ開発途上です。マルウェア解析パイプライン、SDK監査、そしてJVMワーカープールを立ち上げることなく大量のAPKをバッチデコンパイルする必要がある用途に適しています。
Source: https://github.com/ejfkdev/ddc
whitecircle/halo
Haloは、White Circleが開発した大規模言語モデルおよびマルチモーダルモデル向けのtraining frameworkであり、よりクリーンで composable なコードベースを求めるチームにとって Megatron-LM / DeepSpeed の代替として位置づけられています。このアーキテクチャは、tensor parallelism、pipeline parallelism、data parallelism を独立した直交モジュールに分離しており、モデルコードを変更することなく組み合わせることができます。これは、Megatronの密結合アプローチとの意図的な対比と言えます。マルチモーダルサポートについては、vision encoder(ViT variants)をパイプラインに挿入する際、テキストに用いられるトークンストリーム抽象化に頼るのではなく、明示的な cross-attention スケジューリングを通じて組み込めるようになっています。リポジトリには一般的なモデルファミリー向けの設定駆動型レシピが含まれており、transformer block レベルでのgradient checkpointingの粒度を公開しています。早期採用者からは、コアファイルにパッチを当てることなく、カスタムの attention パターン(例:sliding window、sparse)への拡張が Megatron よりも容易であるとの報告が得られています。スター数は561と初期段階にあり、分散初期化プロトコルに関するドキュメントは不十分ですが、コード構造は十分に整理されており、ブラックボックスの framework を使用するのではなくカスタムの事前学習インフラを構築するグループにとって、研究用のスキャフォールドとして活用できます。
Source: https://github.com/whitecircle/halo
Vincent-Xi08/IntentRoute-AI
Windowsにおけるアプリケーション単位のネットワークルーティングで、ルーティングの決定はLLM(OpenAIまたはローカルのOllamaモデル)が行います。LLMはプロセスのメタデータとユーザー定義のインテントルールを読み取り、トラフィックをプロキシ、VPN、直接経路のいずれに通すかを分類します。データプレーンはTUNモードで動作するsing-boxであり、ネットワークアダプタレベルですべてのIPトラフィックを捕捉し、Windowsフィルタリングプラットフォームを介してプロセスレベルのタグ付けを可能にします。AIレイヤーはルール作成アシスタントとして機能します。「業務トラフィックは社内VPN経由、ストリーミングは直接接続」といった自然言語によるインテントの記述を受け取り、sing-boxのルーティングルールをJSON形式で生成します。このJSONはユーザーがsing-boxのDSLを理解することなく適用されます。フィードバックループにより、観測されたルーティングの誤りに基づいてAIがルールを改善することができます。Proxifierやプロセスレベルのファイアウォールルールといったスタティックなツールと比較した場合の価値は、手動でのルールメンテナンスを必要とせずに、曖昧または変化するアプリケーションの挙動に対応できる点にあります。主な技術的リスクは、LLMがルール更新ごとではなく接続ごとに問い合わせを受けた場合の分類パスにおけるレイテンシですが、現在の設計ではルール生成をバッチ処理し、インラインでの推論は行わないため、データプレーンのレイテンシへの影響はありません。
Source: https://github.com/Vincent-Xi08/IntentRoute-AI
yuyuanweb/ai-picture-editor
React 19(フロントエンドのcanvasはKonva経由)、FastAPI(非同期バックエンド)、LangChain/LangGraph(agentオーケストレーション)上に構築されたフルスタックのAI画像編集agentで、自然言語を主要な編集インターフェースとして採用しています。このagentは「背景を削除して空の領域のコントラストを上げる」といったユーザー指示を、LangGraphのstatefulグラフ実行を用いた複数ステップのプランへと分解し、21個のツールノード(crop、inpaint、segment、color-grade、text-to-imageなど)のいずれかへディスパッチします。プランの進捗状況はSSEを介してリアルタイムにクライアントへストリーミングされます。レイヤー管理は明示的に行われており、agentは画像を意味的なレイヤー(前景、背景、被写体)に分割し、それらを独立したKonvaレイヤーとして維持することで、非破壊的な領域ごとの編集を実現します。拡散モデルベースのinpaintingのような長時間処理は、APIをブロックせずに非同期タスクキューで処理されます。このアーキテクチャは、canvasの状態を持つtool-use agentの参考実装として妥当な設計です。LangGraphのステートマシンはプラン生成と実行をきれいに分離しており、SSEの統合によりポーリングを回避しています。本プロジェクトはチュートリアルとして位置付けられているため、コードは本番環境への強化よりも可読性を優先していますが、アーキテクチャのパターン(agentループ、非同期キュー、canvas同期)は他への転用が可能です。
Source: https://github.com/yuyuanweb/ai-picture-editor
Nanako0129/sepia
Agent Skills プロトコルを対象とした脱AI文体ライティングスキルであり、Claude Code、Codex、Grok Build、Antigravity、その他77以上のエージェントに対して、カスタムのグルーコードなしにSkills CLI経由でネイティブ統合できます。中核機能は、LLMスタイルの散文アーティファクト——回避的表現、過剰な名詞化、構造的繰り返し、汎用的な接続フレーズ——を検出・修復し、掲載媒体に適した文章へ置き換えることです。二つの異なるモードが用意されており、一つはフィクション向けのナラティブ・アーキテクチャ修復(シーンレベルのコヒーレンス指標を形式化したStoryScope、arXiv:2604.03136 に基づく)、もう一つは設定可能な媒体ルール(学術・法律・技術ドキュメント)を持つプロフェッショナル散文モードです。StoryScope を基盤とする点は注目に値します。表層的な類義語置換ではなく、ナラティブ構造——因果的に断絶したシーンの検出、キャラクターの動機の一貫性チェック、文長の分散と対話密度から導出されるペーシング指標——に作用するためです。プラグインアーキテクチャは共通のRustコアを薄いラッパーで包む構成となっており、エージェント統合ごとのフットプリントを小さく抑えています。2775スターを獲得しており、本バッチの中で最も高い注目度を誇ります。これは、スタンドアロンのエディタとしてではなく、既存のエージェント型コーディング環境の内部で機能するライティング品質ツールに対する真の需要を示唆しています。
Source: https://github.com/Nanako0129/sepia
kruzovic7/ai-data-extractor
AIコーディングアシスタントのセッションから会話履歴を抽出・エクスポートするための、無料かつオープンソースのツールです。Claude Code、Cursor、Windsurf、Aider、Cline/Roo Code、およびその他のツールをサポートしています。技術的な核心は、各ツールのローカルストレージスキーマに対応したフォーマット固有のパーサーです。具体的には、sqliteデータベース(CursorはlevelDB/sqliteハイブリッド形式で会話を保存)、JSONセッションファイル(Aider、Cline)、および構造化されたログディレクトリ(Claude Code)に対応しています。抽出されたデータは共通スキーマに正規化され、JSON、CSV、またはMarkdown形式でエクスポートされます。主なユースケースとしては、コンプライアンスのための監査証跡、実際の開発者とAIのやり取りを用いたfine-tuningデータセットの構築、コスト帰属分析、過去のセッションに対する個人的な検索などが挙げられます。
最大の価値は、対応ツールの広さにあります。各アシスタントは独自のストレージフォーマットを使用しており、それらすべてのパーサーを一箇所で管理することで、ユーザーがツールごとに使い捨てのスクリプトを書く手間を省けます。正規化スキーマはターンレベルのメタデータを保持しており、利用可能な場合にはタイムスタンプ、モデルバージョン、トークン数も含まれます。このツールがオープンソースであることは重要な意味を持ちます。なぜなら、ユーザーは潜在的に機密性の高いコードや会話データへの読み取りアクセスをツールに許可することになるため、抽出ロジックの監査可能性はエンタープライズ利用における実務上の要件となるからです。
Source: https://github.com/kruzovic7/ai-data-extractor
peonist-ai/halogen-flash-server
AMD Strix Halo(gfx1151 APU、RDNA 3.5、最大128 GBユニファイドメモリ)上でQwen3-8Bを実行するために特化して最適化された推論サーバーです。Strix HaloアーキテクチャはAPUとしては異例に高いメモリ帯域幅(CPU-GPUタイル間で約256 GB/s)を持つ一方、共有メモリプールのスラッシングを避けるため、慎重なメモリ割り当てが求められます。halogen-flash-serverはこれを活かすためにROCmのメモリ管理とKV cacheの配置を調整しています。具体的には、コンテキスト長が閾値を超えない限り、KV cacheをシステムRAMにスピルアウトさせずGPUタイルのL3に固定するようになっています。名称の「Flash」は、ROCmのcomposable kernelライブラリを経由したFlashAttention-2の統合を指しており、このリポジトリ作成時点ではgfx1151向けに直接利用できる状態ではありませんでした。量子化はINT4(GPTQ)で処理され、実用的なバッチサイズにおいてQwen3-8BをGPUタイルのメモリ予算に収めています。これはニッチながら現実的な問題です。Strix Haloを搭載したマシン(例:ASUS ROG Allyノートパソコン、ミニPC)は、単一デバイスでのLLM構成を求めるエッジ推論ユーザーの間でますます普及しており、この特定のダイに対する公式ROCmサポートは不完全な状態にありました。
Source: https://github.com/peonist-ai/halogen-flash-server
Qiuner/birdview
BirdviewはAIコーディングエージェントが変更を加える前にコードベースのアーキテクチャマップを生成するツールで、LLMがクロスモジュールの依存関係構造を理解せずにファイルを変更してしまうという既知の障害モードに対処するものです。本ツールは静的解析(現時点ではPython、TypeScript/JavaScript、Go、Rust向けの言語固有のAST解析)を実行してモジュール、クラス、主要関数の有向依存グラフを構築し、これをエージェントのプロンプトに前置、またはMCPサーバー経由で注入する構造化コンテキストブロックとしてレンダリングします。主要な設計上の決定は、生の隣接リストではなく、圧縮された階層的サマリーを生成することです。ノードはドメイン境界(ディレクトリ構造とimportパターンから推定)でクラスタリングされ、クラスタ間エッジは目立つ形で表示される一方、クラスタ内エッジはクエリが関連しない限り省略されます。これにより、エージェントが最も必要とする情報、すなわち編集しようとしているモジュールにどのモジュールが結合しているかを保持しながら、トークンコストを削減します。インテグレーションはCLI(任意のエージェントプロンプトへの出力のパイプ)、VS Code拡張機能、およびエージェントの直接ツーリング向けのMCPプロトコルを介して行われます。587スターを獲得しており、ナイーブなコードベース全体の注入によるcontext windowの飽和が依然として課題となっているエージェンティックコーディングコミュニティで支持を得ています。