デイリーAIダイジェスト — 2026-09-21
arXiv ハイライト
エージェント型知能のためのコードからのグラウンデッドスキル合成(大規模)
再利用可能なスキル——タスクを横断して転移する手続き的知識——は、通常、エージェントの軌跡(環境とのインタラクションを必要とし、適用範囲が狭い)または文書(実行可能なグラウンディングを欠く)のいずれかから取得されます。本論文は、ソースコードが第三の補完的な基盤であると主張しています。ソースコードは実行可能な証拠とともに手続きをエンコードしつつ、エージェントの履歴を前提としません。著者らはCode2Skillという自動パイプラインを構築し、GitHubリポジトリから約100万件のレコードからなるスキルバンク(CodeSkillBank)を採掘し、これらのレコードでエージェントをRetrieval-augmentすることが下流のパフォーマンスを向上させるかどうかを評価しています。
構築パイプライン
著者らの定式化によると、スキルレコードは(i) 適用可能条件、(ii) 目標とする動作、(iii) 事前条件と不変条件、(iv) 障害処理、(v) これらの主張を裏付けるソーススパンを指定する必要があります。これは三つの品質軸によって実現されます。grounded(実装スパンから復元可能)、transferable(プロジェクト固有の識別子が抽象化されている)、maintainable(コードの進化に伴いレコードを再検証できるよう出所と構築状況が保持されている)です。
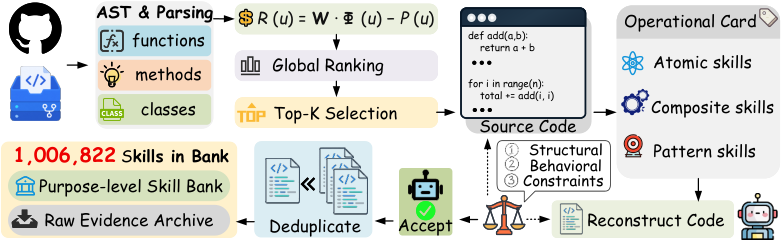
パイプライン(図1)は以下のように進行します。(1) 候補ソースユニット(関数、メソッド、CLIエントリポイント、またはファイルレベルのコンポーネント)をリポジトリコンテキストとともにランク付けする。(2) 各ユニットをatomic、composite、またはrecurring-patternのスキルレコードに変換する。(3) 二つの補完的なチェックによって検証する。
- Source-body-blind再構築:抽象化されたスキル記述のみ(ソース本体なし)を与えられた場合、LLMは参照動作に一致するコードを再構築できるか?これはレコードが実際に手続きを捉えているかどうかをテストします。
- Source-aware比較:等価性判定器が、本体を可視化した状態でソースと再構築結果を比較し、不一致の場合は裁定を行い、保持のための値フィルタを適用します。
通過したレコードは、ワークフロー、境界、出所、ソース証拠のメタデータとともに保持されます。この二重検証は本論文の中核的なメカニズムです。再構築チェックは、抽象的な記述のみで動作を再現するのに十分であることを強制します——つまり、それは要約ではなく実行可能な仕様です。
大規模なCodeSkillBank
19,769件の人気のある活発にメンテナンスされているGitHubリポジトリに適用したところ、パイプラインは1,006,822件の承認されたスキルレコードを生成しました。ソースプールは品質フィルタリングされており、スターの中央値は3,133、マージ済みPRの中央値は82であり、78.3%のリポジトリが1,000スター以上、46.9%が100件以上のマージ済みPR、66.0%が前年中にプッシュされています。このようなコードベースには再利用可能な慣習、境界チェック、修復パターンが蓄積されている可能性が高いという意図があります。
4つのサンプリングされた結果プール(値フィルタによる除去、直接承認、裁定承認、最終拒否)のヒューマンアノテーションでは次の結果が得られました。最終バンク内のスキル記述の92%が正確と判定され、80%のレコードが保持する価値があると判定され、直接承認レコードのうち84%が正しい再構築をサポートしています。拒否プールは記述精度32%、保持価値28%で、正しい再構築はゼロ——フィルタの識別能力を検証する大きなギャップです。
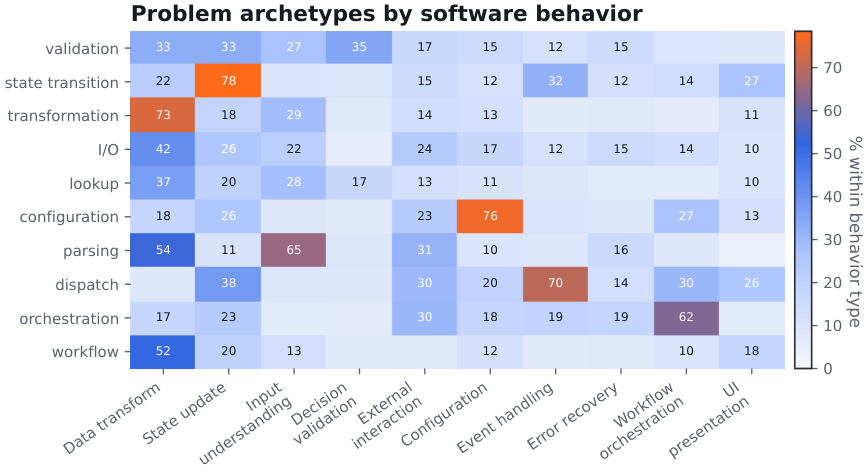
セマンティックプロファイリング(図13)では、レコードがデータ変換、状態更新、入力理解、検証、パラメータ化、状態機械制御、APIの使用に集中していることが示されています。問題アーキタイプと手続き的構造の間の多対多のマッピングが、意味的に絞られた検索を可能にします——タスクは単一のラベルではなく複数の軸に対してマッチングできます。
実験的評価
メインテーブルは、9つのモデル設定(DS4-Flash、Qwen3.5/3.6、Gemini 2.5 Pro、GPT 5.2を含む)と8つのベンチマークにわたる72件のプロトコル一致評価をカバーしており、3つのレジームにまたがっています。プログラミングとSWE(BigCodeBench、SWE-bench Verified)、ターミナルとOS制御(TerminalBench、LongCLI-Bench、AgentBench-OS)、推論(AIME 2026、HMMT 2025、GPQA)です。検索されたCodeSkillBankスキルで augmentされたモデルは、マッチしたベースラインに対して平均11.7%向上しています。(アブストラクトの文は「outperform them in 5」で切れており——おそらく5つのモデル設定で全ベンチマークを通じて優位に立つといった意味と思われます。)
再実装を検討する方にとってRQの分解は注目に値します。RQ3はスキルをエージェントループのどこに組み込むべきか(計画段階か実行段階か)を問い、RQ4はコンパクトなスキル表現が有用性を保持するかどうかをテストし、RQ5はRL fine-tuning下でインジェクションポイントが重要かどうかを調べ、RQ6は400タスクのLiveCodeBenchサブセットを使用して人間が生成したコードとAIが生成したコードから採掘されたスキルを比較します——これは合成実装によってそのようなバンクを拡張できるかどうかという出所に関わる問いです。
限界と未解決の問題
再構築に基づく検証は、記述がモデルのデコーディング分布において動作を再生成するかどうかを測定しますが、これは忠実な抽象化とLLMの事前分布の整合を混同します。LLMがいずれにしても生成するようなスキルは自明に再構築チェックをパスする可能性があります。報告された拒否プールの統計はフィルタが識別機能を持つことを示していますが、ベースモデルの事前分布に対するレコードの新規性の上限は定量化されていません。第二に、検索インターフェース、embedding、top-kが実際に改善をもたらすチャネルです。検索品質に関するアブレーションが、+11.7%のどれだけがバンクの内容とインデックス作成のどちらに起因するかを決定します。第三に、保守性——コードの進化に伴いレコードを再生成すること——は主張であり、経時的なドリフトは測定されていません。最後に、時間的設定(DS4-Flash、Qwen3.6、GPT 5.2、AIME 2026として引用されるモデル)は、一部のベンチマークとモデルが他者のtraining dataの対象後であることを示唆しており、BigCodeBenchやSWE-benchのようなコード重視のベンチマークではGitHubソースを通じた汚染経路を排除することは自明ではありません。
なぜこれが重要か
スキル採掘の基盤としてのコードは、軌跡手法の環境固有性と文書手法のグラウンディング欠如を回避し、再構築に基づく検証は他の場所でも再利用できる具体的な品質ゲートです(例:ツール使用ライブラリやワークフローテンプレートなど)。厳格な検索および汚染コントロール下で平均約11.7%の改善が維持されるなら、ウェブスケールで実行可能な手続きを採掘することは、RLの軌跡と文書に並ぶエージェントのスキル習得のための実行可能な第三の柱となります。
Source: https://arxiv.org/abs/2609.05571
CodeMidas: コード自体からエージェント型コーディングRL環境をスケールする
問題
コーディングエージェントのためのRLは、環境の供給によってボトルネックが生じています。信頼性の高い実行可能なverifierを備えたタスクと、ソフトウェアエンジニアリングの狭い領域への過学習を避けるための十分な多様性が必要です。主流のアプローチは開発成果物(GitHubのissue、PR、commit)を採掘してverifierを再構築する方法(SWE-bench方式)です。これはタスクをメンテナーがたまたまドキュメント化したものやバグ修正形式の作業に限定し、自動採点ではなく人間によるレビュー向けに書かれたノイジーなテストを継承してしまいます。CodeMidasは、issueやcommitなしにソースコード単体で、多様なverifier付きのRLタスクを大規模に生成するための十分な基盤となり得るかどうかを問います。
手法
CodeMidasは、各ステージ——タスク選択、コード適応、テスト合成、環境準備、フィルタリング——をコードベースを操作するLLMエージェントに委譲するエージェント型パイプラインです。タスクは、自然言語による記述、solverに提供されるコンテナ化された開発環境、そして採点時のみ使用されGRPOのための二値報酬 r \in \{0,1\} を生成する非公開の実行可能verifierで構成されます。
パイプラインには4つの機械的なステージがあります:
タスク設計とコードベース適応(§3.1)。エージェントがビルドメタデータとコード構造を調査し、公開エントリーポイントと観測可能な結果を持つ実装済み機能——プロセス出力で評価されるCLI、戻り値で評価されるライブラリ関数、呼び出し間の状態変化で評価されるステートフルAPI——を探します。エントリーポイントを共有依存関係を通じてトレースしてスコープを定義し、コア実装を削除します。残りのコードはリポジトリが引き続きビルドでき、他のコンポーネントが意味をなすように編集され、削除された参照実装はオラクル解として別途保持されます。
実行に基づくテスト構築(§3.2)。文からテストを幻覚するのではなく、エージェントが元の(まだ実装済みの)コードを実行してオラクルの入力、出力、状態トレースを生成し、それらの実行に基づいたテストを記述します。
実行整合性チェックを伴う環境準備(§3.3)。コンテナをビルドし、参照実装を合成されたverifierに対して実行して合格することを確認します。オラクル解が自身のverifierに合格しないタスクは除外されます。
rolloutベースのフィルタリング(§3.4)。候補タスクをsolverポリシーが複数回試み、解けないタスクや自明に解けるタスクを除去し、GRPOのために有益な合格率の分散を持つものだけを残します。
最終的なデータセットには、23言語・15ドメインにわたる3,185のコードベースから生成された5,545のトレーニングタスクが含まれます。RL中は、MiMo-V2.5をGRPOでトレーニングし、batch size 32、タスクあたり32 rollout、二値実行報酬を使用します。
結果
5つの外部ベンチマーク全体で、CodeMidasでのRLは初期のMiMo-V2.5ポリシーに対して単調な改善をもたらします:DeepSWE v1.1 +11.7パーセントポイント、ProgramBench(Almost Solved、テストの≥95%が合格)+17ポイント、さらにSWE-bench Pro、RepoZero C2Rust、Terminal-Bench v2.1でも改善が得られます。ベンチマークの範囲——issueの修正、プログラム全体の合成、言語間変換、ターミナル作業——は重要です。なぜなら、トレーニング分布はissueテキストやcommit diffを一切使用していないにもかかわらず、SWE-bench ProとDeepSWE(どちらもissue修正)への転移が成立しているからです。
§5.1のスケール/品質分析はより興味深い実験的結果です。高品質プールからランダムに選んだ1k、3k、全5kのサブセットでトレーニングすると、DeepSWEスコアが17.57 → 19.05 → 21.70、CodeMidas Valスコアが41.30 → 43.22 → 44.73と段階的に向上します。CodeMidas Valでは、1kプールがステップ30でピーク(41.30)、3kプールがステップ65でピーク(43.22)に達するのに対し、全プールはステップ40から70の全チェックポイントでリード(44.73)しており、スケールが初期のプラトーを引き上げるだけでなく有効なトレーニング期間を延ばすことを示しています。
フィルタリングの品質は生の量を圧倒します:同じタスクを使い、環境のクリーニングなし、実行整合性チェックなし、rollout後フィルタリングなしのフィルタリングなし8kサンプルは、SWE-bench Pro、DeepSWE、CodeMidas Valでそれぞれ0.59 / 4.59 / 4.49ポイント差でフィルタリング済み5kプールに負けます。フィルタリング済み3kサブセットでさえ、3つのベンチマーク全てでバニラ8kを上回ります。差が最大なのはDeepSWEで、verifierの信頼性が最も重要と考えられます。なぜなら、報酬ノイズがGRPOのadvantage推定値 A_i = (r_i - \bar r)/\sigma_r に直接伝播するからです。
制限と未解決の問題
本論文は、強力なクローズドモデルや同等の計算量でissue由来の環境(例:SWE-Gym)でトレーニングされたエージェントとの比較性能を報告していないため、「ソースのみ」対「成果物由来」タスクの比較的価値は未決定です。二値実行報酬はコードの品質、効率性、慣用性については何も言わず、出力が一致するかどうかのみを示します。全ステージでエージェントに依存するパイプラインはタスクあたりの構築コストが無視できず、品質はコンストラクターモデルに依存します。参照実装の付随的な挙動に過学習するverifierなどの失敗モードは定量化されていません。また、23言語・15ドメインは粗い分類であり、言語ごとの転移曲線があれば改善が広範なものかPython/JSの割合が多いテールに支配されたものかを明確にできるでしょう。
なぜ重要か
CodeMidasは、コーディングエージェントのためのRL環境がソースコード単体から生成でき、トレーニングデータの供給をオープンソース開発の偶発的な副産物から切り離すことが可能であること、そして積極的な実行ベースのフィルタリングが60%多い生のタスクより価値があることを示しています。コーディングエージェントのRLパイプラインを構築するグループへの具体的な示唆は:タスク数をスケールアップする前に、verifier検証とrolloutベースの難易度フィルタリングに計算リソースを投入せよ、ということです。
Source: https://arxiv.org/abs/2609.22068
RecreationWorld: ハイブリッドComputer-Useエージェントのためのスケーラブルかつ検証可能な環境
問題設定
Computer-useエージェント(CUA)研究は二分化しています。一方はGUI操作(クリック、キー入力、アクセシビリティツリー)を対象とし、もう一方はコードおよびシェルとのインタラクションを対象としています。実際のデジタルワークフローはこの両者を組み合わせており、アプリケーションを調べ、それを再現・拡張するコードを書き、成果物を起動し、意図通りに動作することを視覚的に確認するという流れになっています。固定されたワークフローを強制するか、ソースの類似度で評価するベンチマークは、この組み合わせを測定できず、訓練のためのスケーラブルな報酬信号も提供できません。
RecreationWorldは、アプリケーション再現を軸にハイブリッドCUA評価・訓練を再定式化します。エージェントは動作中の参照アプリケーション A^\star と、GUIおよびコーディングツールの両方を含む準備済み環境を与えられ、ビルドした成果物 \widehat{A} が A^\star の観測可能な振る舞いに一致するソース提出物 S を生成しなければなりません。スコアリングは振る舞いのみに基づき、アーキテクチャやソース構造は自由です。これにより、実行に根ざした実装非依存の報酬が生まれ、さらに重要なことに、特定のコミットに固定されたオープンソースのGitHubアプリケーションから無限のタスク供給が可能になります。
フレームワークとタスク契約
タスクのタプルは (\text{prompt}, A^\star, \text{env}) です。エージェントは参照操作、コード編集、ビルド・起動、および \widehat{A} の視覚的検査を自由に切り替えます。成果物の納品契約はプラットフォームネイティブです(表1):Ubuntu/macOS/Windowsではビルド・起動エントリーポイントを持つソース、AndroidではAPKを生成するGradleプロジェクト、webではピン留めされたReactスタックによるセルフコンテインドな index.html。振る舞いテストには各プラットフォームのプログラム的インターフェースを使用します。具体的には AT-SPI(Ubuntu)、AXUIElement(macOS)、UI Automation(Windows)、UiAutomator(Android)、DOM/ARIA(web)であり、すべてのプラットフォームで視覚的アサーションが補完されます。
重要な非対称性があります。デスクトップとAndroidはソース非公開です(参照バイナリ/APKは実行可能ですが、そのソースは非公開です)。一方、webはクライアントがサーバーの提供物であるためソース非公開にできず、保護される情報はグラウンドトゥルーのテストスイートになります。Androidはさらに、リモートサービスの非決定性を避けるためにインターネット権限のないアプリケーションに限定されます。webタスクは元のパスベースURLを保持し(ハッシュルーティングへの置換なし)、デスクトップとモバイルの両ビューポートでスコアリングされます。
データスケーリングと訓練
RecreationWorldは、訓練タスク用に同じ5つのプラットフォームファミリーにわたる高品質なオープンソースGUIアプリケーションを収集し、評価セットに対して重複排除を行います。軌跡は Qwen3.8-Max が同じエージェントハーネス(GUIとコーディングツール、並列・独立ワーカー)内で動作することで生成されます。Rejection samplingにはタスク固有の振る舞い検証器をフィルタとして使用し、生き残ったプールからプラットフォームごとに7,000件の軌跡を選択することで、バランスの取れた35,000件のSFT混合データセットを生成します(トークンではなく件数でバランス調整)。
2つの初期化モデルがこの同じ混合データセットでfine-tuningされます。Qwen3.7-Plus(完全にpost-trained済み)と Qwen-Flash-CPT(継続的事前学習後のインハウス Qwen-Flash)です。転移の主張は、5つの分布外コーディングおよびハイブリッドCUAベンチマークで評価されます。両訓練系統は5つすべてのOODスイートにわたって一貫した改善を示し、平均的な振る舞い分析ではレンダリングされた出力の検証頻度の増加が確認されます。すなわち、再現の目的関数はスキルとしてだけでなく、提出前に成果物を視覚的に確認する習慣としても転移します。
主要ベンチマーク結果
10のフロンティアモデルが direct-MCP インターフェースを通じて RecreationBench で評価されます(持続的プログラマブルランタイムは独立したアブレーションであり、主要スコアからは除外されます)。総合ランキング:
- GPT-6 Astra: 58.06%
- Claude Opus 5: 44.16%
- GPT-5.6 Sol: 42.06%
GPT-6 Astra は複数のプラットフォームでフルスイートパスを達成した唯一のモデルです。90%と100%のプログラム的カバレッジ率はそれぞれタスクの17.6%と2.8%であり、他のどのモデルの最大値である5.5%と0.8%を大きく上回ります。この差はカバレッジ分布の上位で顕著に広がっており、より厳格な振る舞い忠実度がフロンティア間の差別化要因であることを示しています。
軌跡分析
分析は探索行動とスコアを相関させていますが、因果関係は独立していません(ハーネス、ランタイム、モデルが同時に変化します)。Claude Opus 5、Qwen3.8-Max-0902、GPT-6 Astra は軌跡ごとに中央値53枚の画像を受け取り、軌跡の96.8%に少なくとも1枚の画像が含まれます。構造化されたGUI表現に限定されるGLM-5.3は、ピクセルレベルの観測では比較できません。
参照探索の幅は最終スコアに連動します。GPT-6 Astra はプラットフォームでサポートされる参照側GUIインタラクションタイプの58.1%をカバーし、Qwen3.8-Max-0902 の41.8%を上回ります。ウィンドウ同定カバレッジでは、GPT-6 Astra は軌跡ごとに5.23の異なる参照ウィンドウを観察するのに対し、Qwen3.8-Max-0902 は2.21です。これら2つの指標——インタラクションの多様性と観測されたインターフェース状態の多様性——は順序が一致しており、これらが探索の異なる次元を代理しているため、同語反復ではありません。GPT-6 Astra の Claude Opus 5 に対する13.9 ppのリードはこの広範なカバレッジと共起しています。
限界と未解決の問題
- ソース非公開の保護はwebでは本質的に弱くなります。ベンチマークはバイナリではなくテストの非公開に依存しており、「参照の再読み込み禁止」ルールは情報理論的な保証ではなく監視上の制約に過ぎません。
- 観測可能な振る舞いの仕様は各プラットフォームのアクセシビリティAPIサーフェスに制限されます(例えば、カスタムレンダリングツールキットやmacOSのメニューバーポップオーバーは AT-SPI/AXUIElement がアサートできる範囲を広げます)。視覚的アサーションはいくつかのギャップを補いますが、それ自体の脆弱性をもたらします。
- 訓練パイプラインは単一の生成器(Qwen3.8-Max)とSFTのみを使用しており、実行可能な検証器ベースの報酬が利用可能であるにもかかわらず、オンポリシーRLは報告されていません。これは明らかな次のステップです。
- 軌跡分析の相関はモデル、ハーネス、ランタイムを混在させており、どの振る舞い(探索の幅、検証頻度)がスコアの因果要因であるかを特定できません。
- 軌跡件数によるバランス調整はプラットフォーム間でトークン寄与を不均一にします。トークンや難易度による再重み付けが転移に影響するかどうかは検証されていません。
なぜ重要か
RecreationWorld は、オープンソースエコシステムとともにスケールする実行に根ざした実装非依存の報酬によってハイブリッドなコンピュータ使用を実用化し、再現訓練から無関係のコーディング・CUAベンチマークへの振る舞い検証習慣の非自明な転移を示しています。この組み合わせ——大規模に収集可能なほどコストの低い報酬信号と、GUIとコードの組み合わせを強制するタスクファミリー——こそが、模倣ではなくRLでCUAを訓練するための欠けていた基盤です。
Source: https://arxiv.org/abs/2609.22000
MintAct: デジタル環境向け統合ビジュアルエージェント
問題設定
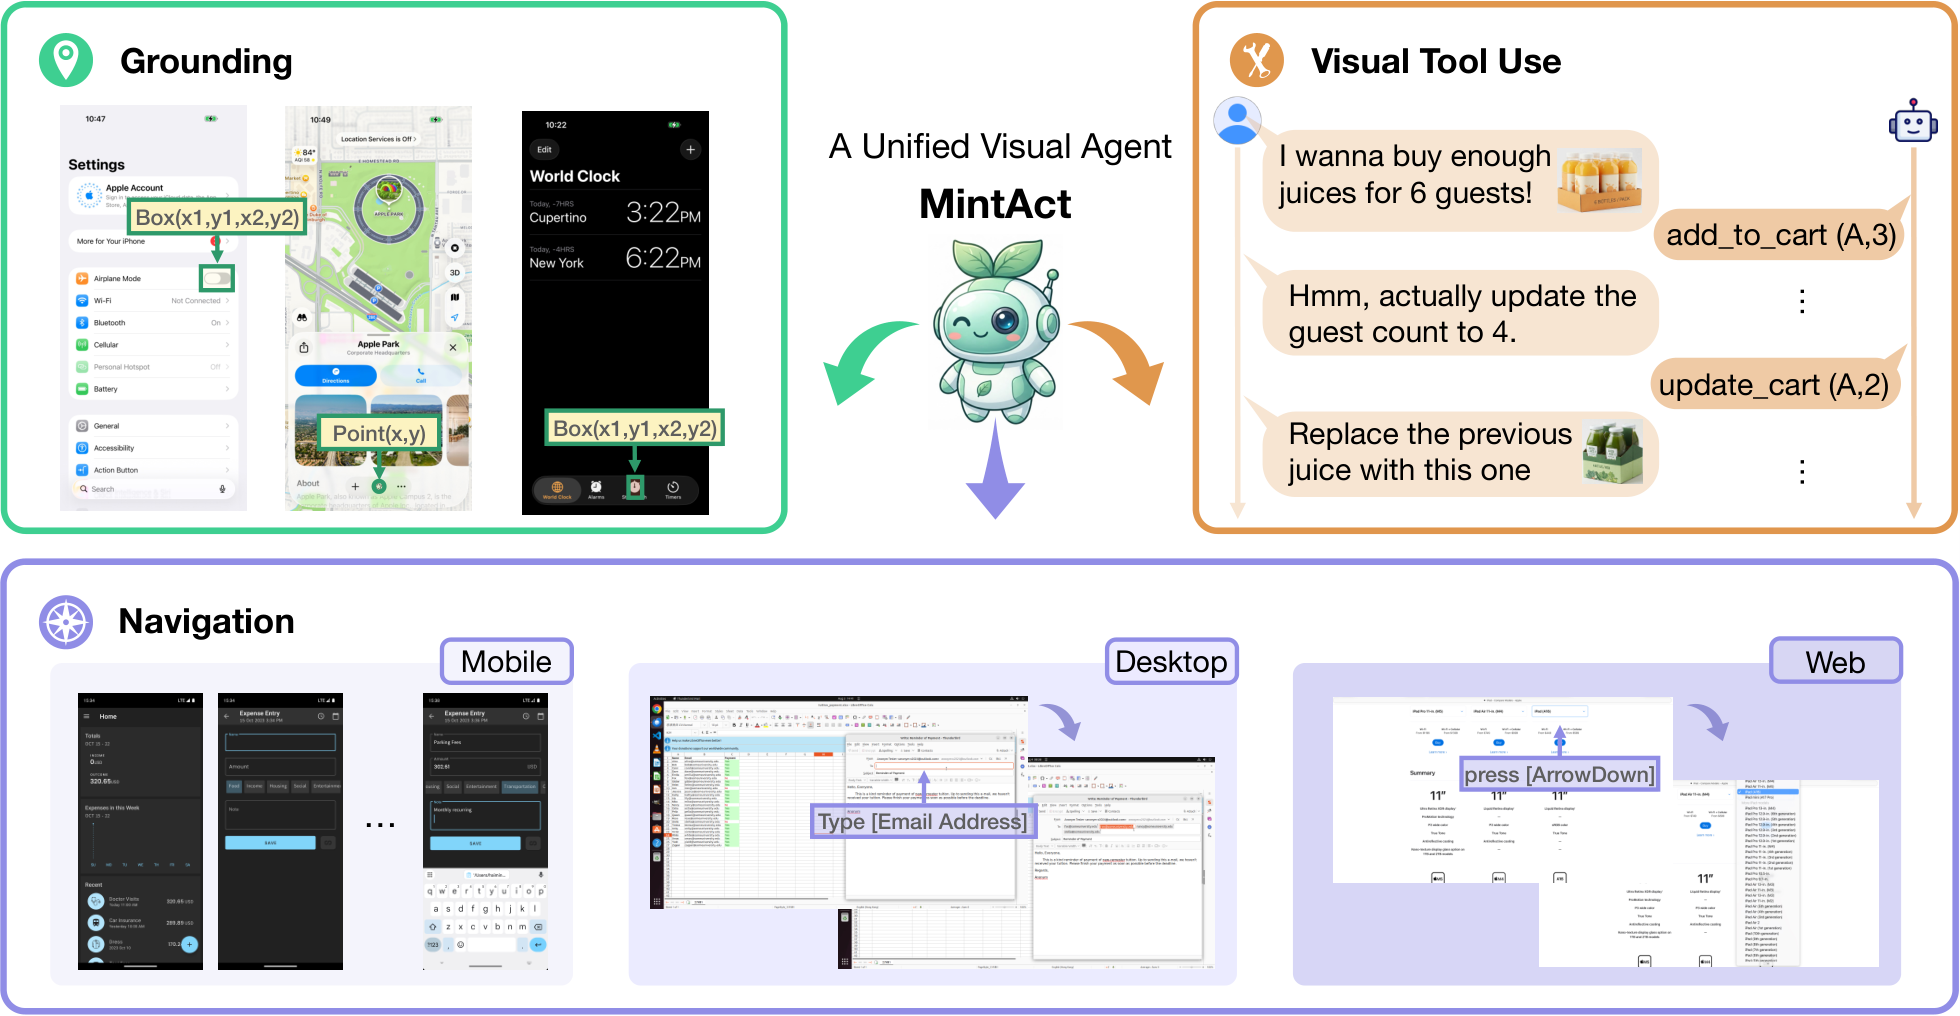
UI grounding、モバイル/デスクトップ/ウェブにまたがるマルチステップナビゲーション、そびジュアルツール使用を処理する単一のVLMポリシーを構築することは、歴史的にドメイン別の専門モデルを必要としてきました。具体的には、クリックターゲットデータセットで学習されたgrounding モデル、AndroidControlやOSWorldのトラジェクトリでfine-tuningされたナビゲーションエージェント、そして関数呼び出しコーパスで学習されたtool-augmented VLMなどです。各ドメインは異なる観測モダリティ(スクリーンショット vs. アクセシビリティツリー vs. レンダリングされたツール出力)、異なる行動空間(ピクセル座標 vs. APIコール)、そして異なる報酬信号を持っています。MintActは、適度なスケール(2B/4B/8B)の統合ポリシーが、容量の損失なくこれらの専門モデルに匹敵できるかどうか、そしてその統合にどのような環境とRL基盤が必要かを問うものです。
手法
ポリシー \pi_\theta は、標準的なエージェント的分解に基づいて定義されます: a_t \sim \pi_\theta(a_t \mid c, g, o_{\le t}, a_{<t}), ここで c はシステムプロンプト、g は指示、o_{\le t} は観測履歴(スクリーンショット、および利用可能な場合は構造化されたアクセシビリティ状態)、a_{<t} は過去の行動とそのchain-of-thought 推論トレースを含みます。各 a_t は推論-行動ペアとして出力され、行動文字列は(a)UIプリミティブ((x, y) でのクリック、タイプ、スクロール、キーイベント)または(b)構造化された引数を持つツールコールのいずれかにパースされます。UI操作とツールコールを単一のシリアライズされた行動語彙にまとめることが、1つのヘッドで3つの能力ファミリーすべてを扱えるようにする鍵です。
インフラストラクチャ面には、エンジニアリングの大部分が集中しています。MintActは、異種バックエンド(Androidエミュレータ、OSWorld用デスクトップVM、ウェブナビゲーション用ブラウザサンドボックス、MM-ToolSandBox用ツール実行サンドボックス)にわたって、数百の並行環境インスタンスを実行します。これらのプールは、オフラインのトラジェクトリ収集とオンラインRLの両方に使用されます。
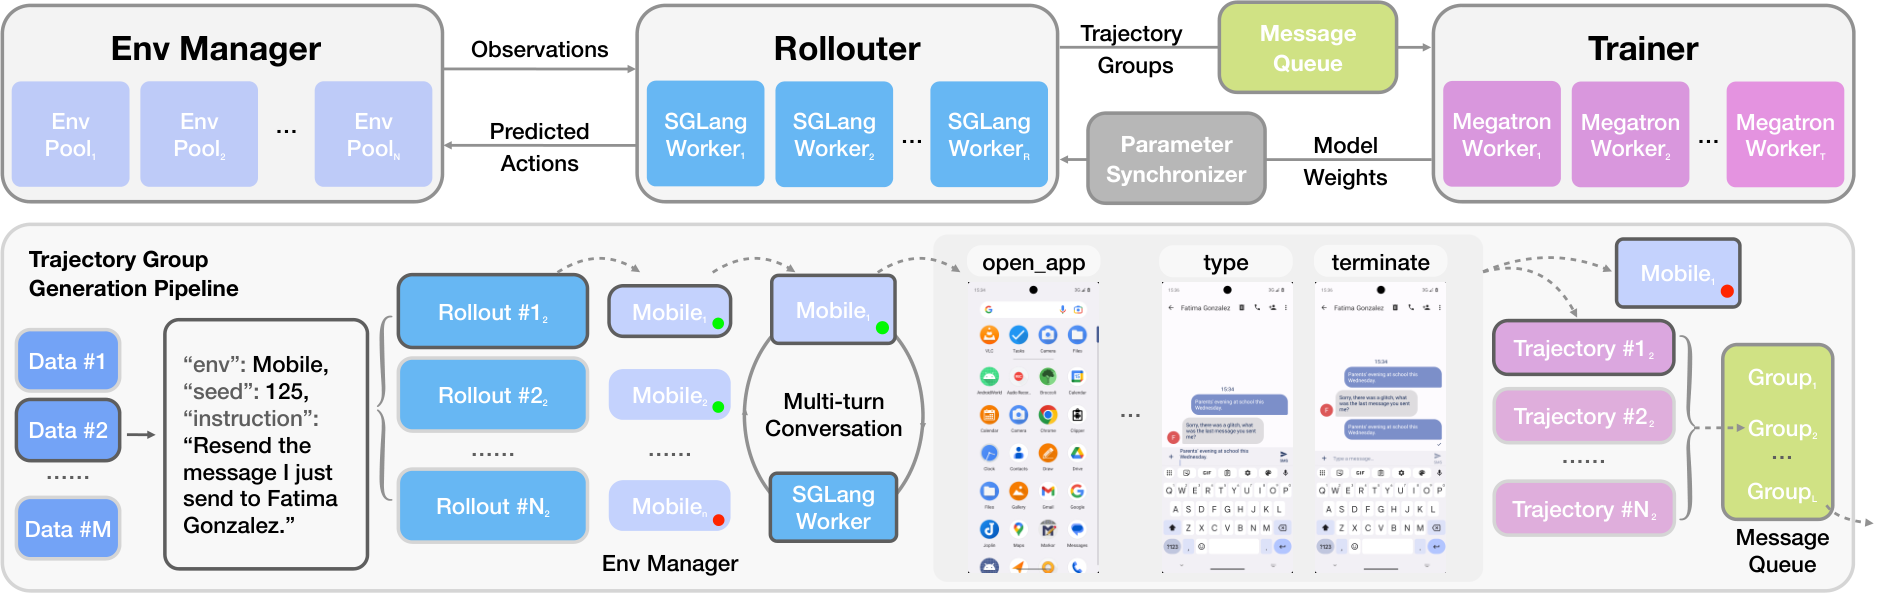
RLループは非同期です:ロールアウトワーカーは最新のポリシーの重みを取得しますが、トレーナーがステップを進める間も古い重みで生成を継続し、off-policyなトラジェクトリを生成します。このフレームワークは、ドメイン間サンプリング分布を明示的に制御します。つまり、経験的に高速なドメイン(grounding、短いモバイルタスク)が、壁時計時間を支配するOSWorld/Weblicaの遅いタスクよりもgradientを支配しないようにします。トラジェクトリグループはgroup-relative advantagesをサポートするためプロンプトごとに形成されます(GRPOスタイルの推定器が図3のグループ生成パイプラインによって示唆されていますが、論文の抜粋には正確な目的関数は明記されていません)。不安定なエミュレータ、非決定的なウェブページ、ツールのタイムアウトといったノイジーな環境フィードバック下での安定性は、トラジェクトリを破棄するのではなく、インフラストラクチャレベルで処理されます。
最大エピソード長は、オンラインナビゲーションで30ステップ、ビジュアルツール使用で100ステップであり、これはマルチツールワークフローに典型的な長い分解を反映しています。
結果
MintActは4つの能力クラスターにわたって評価されます:
- Grounding: MMBench-GUI、ScreenSpot-v2、UI-Vision、OSWorld-G。
- モバイルナビゲーション: AndroidControl、AndroidWorld。
- デスクトップナビゲーション: OSWorld-Verified。
- ウェブナビゲーション: Weblica、Online-Mind2Web。
- ビジュアルツール使用: MM-ToolSandBox。
主要な数値はOSWorld-Verifiedでの48.9であり、同等のモデルスケールにおける最先端として報告されています。OSWorld-Verifiedはより困難な、人間が検証したOSWorldのサブセットであり、長期的なデスクトップエージェントの最も厳しいテストとして広く認識されています。これをクリアするには、信頼性の高いgrounding、アプリケーション固有の手続き的知識、そして実行エラーからの回復が必要です。論文のアブストラクトはさらに、MintActが「これらすべての能力にわたって、ドメイン別専門モデルの性能に匹敵する」と主張しており、統合化によってgrounding精度がgrounding専用ベースラインに対して低下せず、ナビゲーション成功率がナビゲーション専用ベースラインに対して低下しないことを意味しています。これは、異種の行動空間を共同学習する際の通常の失敗モードです。
2Bから8Bへのスケーリングは、このレシピが単一の容量点によるアーティファクトではないことの証拠として提示されていますが、抜粋ではベンチマークごとのスケーリング曲線の詳細は示されていません。
限界とオープンクエスチョン
抜粋では以下が開示されていません:
- 正確なRL目的関数(PPO vs. GRPO vs. 独自のgroup-relative推定器)、off-policyドリフトを許容するために使用されるimportance-sampling補正、またはKL正則化スケジュール。
- ドメイン間サンプリング分布が実際にどのように選択されるか(ドメインごとの一様、loss加重、またはカリキュラムベース)、および最終性能がこの選択にどれほど敏感かどうか。
- OSWorldとWeblicaの報酬シェーピング。これらは疎な報酬で悪名高いため、MintActがプロセス報酬、検証器モデル、または純粋に終端の成功信号を使用しているかどうかは、提供された資料では述べられていません。
- RL前の事前学習/SFTデータの構成。専門モデルに匹敵していることから、SFTの混合がほとんどの能力を担っていると考えられますが、その上でのRLのデルタは抜粋では切り離されていません。
- 未知のアプリケーションやウェブサイトへの汎化。使用されているベンチマーク(OSWorld、AndroidWorld、Online-Mind2Web)はすべて、学習セットのキュレーションを通じてリークする可能性のある既知のタスク分布を持っています。
追加的な構造的疑問として、UI行動とツールコールを1つの語彙に統合することは便利ですが、構造化デコーディング(制約付きJSON、型付き引数)が自由形式の生成よりも厳密に優れているtool-heavyなタスクにおいて性能の上限を設けてしまう可能性があります。
重要性
ドメイン別の特化は、共同学習がgrounding精度と長期計画のトレードオフを生じさせる傾向があるため、GUI/エージェントVLMにとって現実的な選択肢でした。MintActの主張、すなわち適切な非同期RL基盤とクロスドメイン分布制御によって、単一の8Bモデルが専門モデルに匹敵し、OSWorld-Verifiedで48.9に達するというのは、その特化が容量の限界ではなく学習システムの限界であったことを示唆しています。再現可能であれば、これは断片化したベンチマーク景観を単一のポリシーターゲットに集約するものです。
Source: https://arxiv.org/abs/2609.22083
EvoOntology: データエージェントのための自己進化型オントロジー層
問題
自然言語の指示を異種データ(CSV、ファイル、リレーショナルDBなど)に対して実行するデータエージェントは、エージェント・データギャップという問題に直面しています。すなわち、カラムの真の意味、テーブルの結合関係、どの値が正規表現かといった基盤となるセマンティクスはエージェントの外部に存在し、一方で汎用ツールはカラム名やファイルパスといった表面的なメタデータしか提示しません。既存の2つのアプローチはスケールしません。(i) エージェントが生のデータソースを探索する方法はコンテキストを消費し、脆弱な解釈を生み出します。(ii) 手作業で作成したセマンティック層をプロンプトに注入する方法は、ワークロードやエージェントの挙動に適応せず、データ量に応じて際限なく肥大化します。EvoOntologyは、オントロジーをエージェント自身が構築・継続的に改良できるか、そしてプロンプトに直接埋め込むのではなくランタイムAPIを通じて公開できるかという問いに取り組みます。
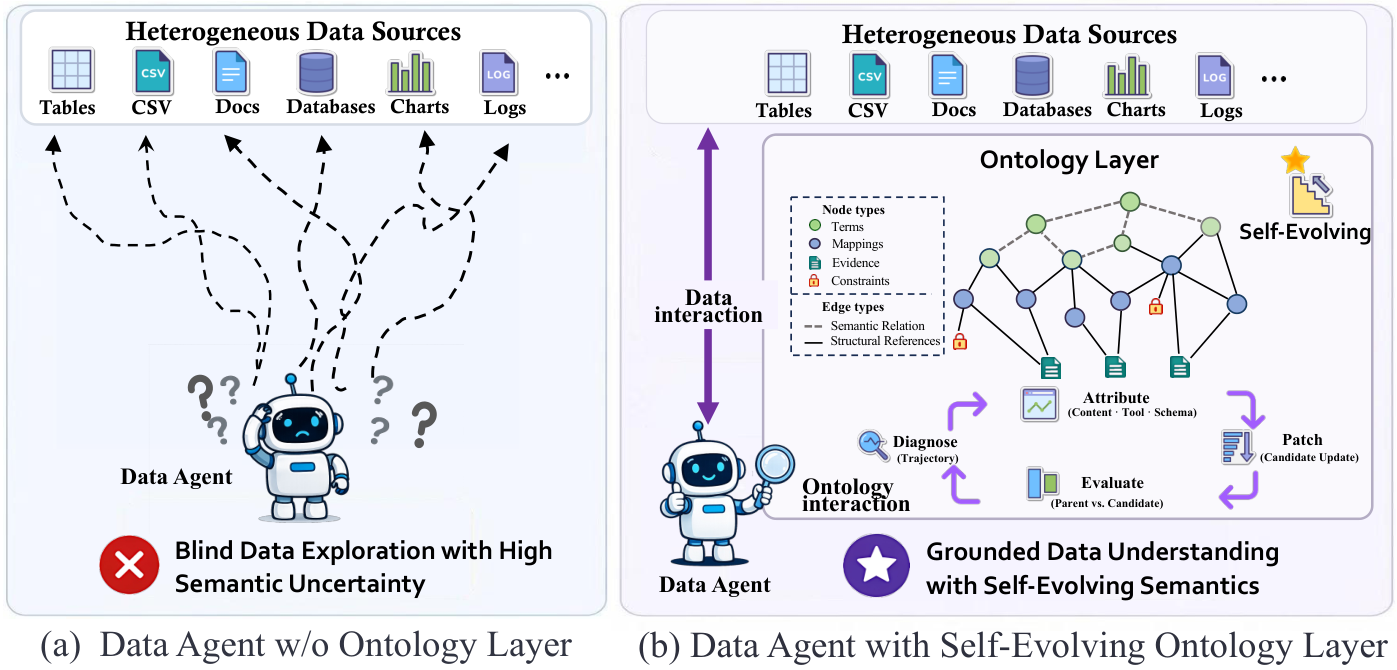
手法
EvoOntologyは、進化ラウンド t におけるバージョン管理されたオントロジー状態 \mathcal{L}_t = (\mathcal{S}_t, \Gamma_t, \mathcal{R}_t) を3つの層に分解して管理します。
コンテンツ層 \mathcal{S}_t。 4種類のノードファミリー — Terms(ドメイン概念)、Mappings(フィールドおよびjoinパスへのグラウンディング)、Constraints(妥当性ルール)、Evidence(出処情報)— と2種類のエッジファミリー:Terms間のSemantic Relations(関連、階層、組成、等価、派生)、およびTermsをMappingsに結びつけConstraints/Evidenceを付加するStructural Referencesから構成される型付きセマンティックグラフです。
スキーマ層 \Gamma_t。 4種類のノードファミリーのフィールド、許可されるrelationの種類、およびreferenceのパターンを宣言します。スキーマがファーストクラスの存在であるため、インスタンス化済みのコンテンツを編集することなく、オントロジーの表現能力を拡張できます。
ツール層 \mathcal{R}_t。 オントロジーをMCPサーバーとして2つの呼び出しで公開します: - f_{\mathrm{browse}}(q, k, n) はクエリ q に対して種類 k の上位 n 件のセマンティックマッチを返します。 - f_{\mathrm{resolve}}(\mathcal{I}, c) はノード識別子の集合 \mathcal{I} をコンテキスト深度 c でリンクオブジェクトとともに展開します。
プロンプトに含まれるのはコンパクトなセッションマニフェスト(ソースの概要と使用ガイダンス)のみであり、詳細なレコードはオンデマンドで取得されます。これが大規模なオントロジーにスケールできる核心的な理由であり、プロンプトのコストがオントロジーのサイズから切り離されています。
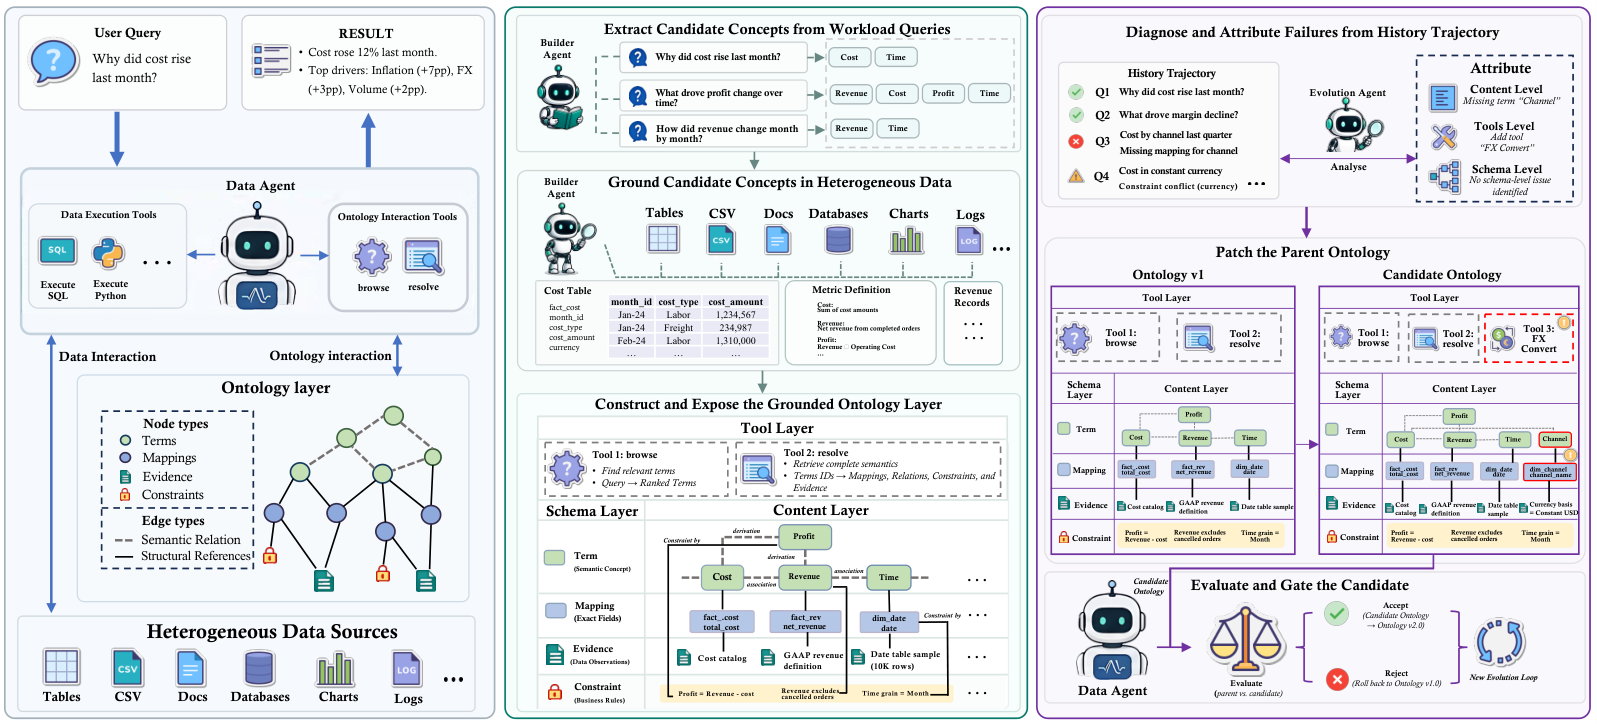
\mathcal{L}_t 上で2種類のエージェントが動作します。builderエージェントは、学習用ワークロードと生のデータソースからevidence付きの初期状態 \mathcal{L}_0 を生成します。evolutionエージェントは過去の軌跡に対して自己進化ループを実行します。すなわち、失敗をTerms・Mappings・Constraints・Evidenceの欠落または誤りに帰着させ、typed edits(特定のノードファミリーの追加・改良)を提案し、各候補パッチはbackbone-conditional paired evaluationを経て初めて採用されます。この評価では、同じ評価者backboneが同一タスクに対してパッチあり・なしの実行を判定するため、backbone間のノイズが採用決定に漏れ込みません。
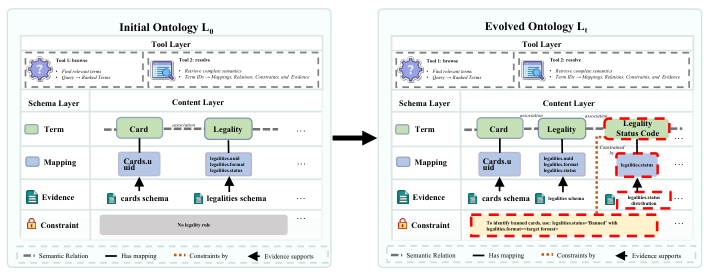
付録のケーススタディは典型的な採用済みパッチを示しています。初期オントロジーは汎用的なCardおよびLegalityの概念を持つものの合法性ステータスの概念を持たず、パッチはLegality Status Code TermをそのMapping・Evidence・および要求されたゲームフォーマットとステータス値を結びつけるConstraintとともに追加します。
結果
評価は公式プロトコルのもとで3つのデータエージェントベンチマークにわたって実施されます:
- DDR-Bench(10-Kシナリオ):オープンエンドなデータリサーチにおけるMessage-WiseおよびTrajectory-Wise精度。
- InsightBench:CSV上のビジネス分析におけるInsightおよびSummaryスコア。
- BIRD(Oracle Knowledge設定):text-to-SQLにおけるExecution Accuracy(EX)およびValid Efficiency Score(VES)。
4種類のbackboneがテストされています:GPT-5.5、GPT-5.6-sol、Claude-Sonnet-5、Claude-Opus-4.8。
最も示唆に富む分析は、採用済み進化ラウンド全体にわたるデプロイ済みエージェントのスコアの推移です。4つすべてのbackboneにおいて、DDR-Bench Trajectory-Wise精度はbuilderが生成した初期状態から始まり、その後の採用済みパッチを経て単調に改善します。GPT-5.6-solは5回の採用済みラウンド後に93.5のTraj-Wiseを達成し、Claude-Opus-4.8は4回後に92.3を達成します。繰り返し現れるcross-filingの失敗パターンがオントロジーに吸収されるにつれ、最後の2ラウンドでカーブは平坦になり、収束を示しています。これは重要な点です。報告された改善が単一の運の良いパッチによるものではなく、帰因→編集→paired評価ゲート→マージという4ステップのループの成果であることを示しているからです。InsightBench(Insight)およびBIRD(EX)でも一貫した単調な改善が観察されます。
限界と今後の課題
- paired評価ゲートは採用判断を特定のbackboneに結びつけており、採用済みパッチのbackbone間転移については論文では十分に特性評価されていませんが、4つすべてのbackboneで改善が見られます。
- 「最後の2ラウンド」での収束は収穫逓減を示唆しており、再び進化を開始する必要があるワークロードの分布シフトをどのように検出するかについては、フレームワークはまだ対処していません。
- MCPツールインターフェースは f_{\mathrm{browse}} と f_{\mathrm{resolve}} のみを通じてセマンティクスを公開しているため、複雑なマルチホップ制約推論では依然としてエージェントがin-contextでチェーンを再構築する必要が生じる場合があります。
- 進化ループのコスト(パッチ提案、paired評価)と償却された推論コスト削減の比較会計は本稿の焦点ではなく、実際のデプロイを明確化するためには必要です。
- 自律的な構築中に付加された敵対的または雑音の多いevidenceに対するロバスト性はストレステストされていません。
なぜこれが重要か
EvoOntologyは、データエージェント向けのセマンティック層を、プロンプトのペイロードや人間が整備するスキーマとしてではなく、ランタイムでクエリ可能なエージェント管理の成果物として再定義し、paired評価ゲートのもとで帰因に基づくtyped editsが異種ベンチマークおよびbackbone全体にわたって単調かつ収束する品質向上をもたらすことを実証しています。これは、際限のないプロンプト肥大化や手動のオントロジーエンジニアリングなしにエージェント・データギャップを埋めるための具体的なテンプレートです。
Source: https://arxiv.org/abs/2609.15779
IntBMoE: ブロックレベルコンディショニングをExpert Compositionに統合した全参加型 Mixture-of-Experts
三つ巴のトレードオフ
本論文は、手法を理解する前に内面化しておく価値のある、明確な分類体系から出発しています。単一トークンに対して、MoEアーキテクチャは三つの異なる量を含みます。
- 参加数(Participation) P:出力に知識が寄与するExpertの数。
- 実行数(Execution) E:実際に計算されるExpertの数(FLOPsコスト)。
- 実体化数(Materialization) M:構築・格納しなければならないExpert規模のパラメータセットの数(メモリコスト)。
既存のMoE設計はこれらを結びつけています。Sparse top-k routing(Switch、DeepSeek-V3 MoE、ReMoE、V-MoE)は P=E=k、M=N と設定するため、参加数はスパース性と一体化してしまいます。Dense output mixing(Soft MoE、\muMoE)は P=N を回復しますが、E=N を強制します。パラメータマージ手法(SMEAR、Lory)はトークンごとに単一の合成Expertを生成するため E=1 となりますが、異なるルーティング決定ごとに異なる実体化Expertが生成されるため、M はトークン数またはコンテキスト数に比例してスケールします。IntBMoEの主張は、この三つを同時に分離することです。
手法
IntBMoEは各Transformer層のFFNをブロックコンディショニングされたMoEモジュールに置き換えます。この設計はルーティングを二つのレベルに分解します:ブロックレベルのcomposition(トークン非依存)とトークンレベルのsparse execution です。
ブロックレベルのcomposition。 各IntBMoEモジュールは、内部層 \ell \in \{1,\dots,L\} ごとに、N 個のexpert base の共有プール \{E^{(\ell)}_n\}_{n=1}^N を保持します。また、K \ll N を典型とする K 個のブロックembedding \{c_k\}_{k=1}^K の小さな学習済みコードブックも保持します。軽量なhypernetwork h_\phi が各コードブックエントリをcomposition係数のセットにマッピングします。
\alpha^{(\ell)}_k = \mathrm{softmax}(h_\phi(c_k, \ell)) \in \Delta^{N-1},
これによりプールを合成層にマージします:
\tilde{E}^{(\ell)}_k = \sum_{n=1}^N \alpha^{(\ell)}_{k,n} E^{(\ell)}_n.
これらを \ell 全体にわたって積み重ねることで、K 個のトークン非依存な L 層合成ブロックが得られます。重要な点として、\alpha^{(\ell)}_k がプール全体にフルサポートを持つため、すべての合成ブロックで参加数 P = N となります――各ブロックはすべてのbaseを利用します。
トークンレベルのsparse execution。 トークン x に対して、routerは g(x) \in \mathbb{R}^K を生成してTop-k ブロックを選択し、各選択ブロック k はブロックコンディショニングされたfeature filteringを適用した後、L 個の合成Expertを通じて x を逐次的に処理します。モジュールの出力は
y = \mathrm{SwiGLU}_{\text{shared}}(x) + \sum_{k \in \mathrm{Top}_k(g(x))} p_k(x) \cdot B_k(x),
であり、p_k は正規化されたルーティング重みです。したがって実行数は N に依存せず、トークンあたり E = kL 個の合成Expert層となります。
実体化。 Compositionがトークン非依存であるため、K 個の合成ブロックはトークンごとではなく、forward pass(またはバッチ)ごとに一度実体化できます。ストレージは N 個のプールbaseと K 個のコードブックエントリによって支配されており、実体化はルーティング決定数ではなく M = N + K でスケールします。これが分離の本質です:P = N、E = kL、M \sim N + K が独立に選択されます。
実験結果
ImageNet-1K。 すべてのモデルはスクラッチから学習された8層DeiT-Tinyバックボーンを使用し、3シードの平均値を報告しています。IntBMoEは、denseバックボーンおよびsparse-routing系(Switch、DeepSeek-V3 MoE、ReMoE、V-MoE、Expert Choice、DynMoE、MASS)とdense-participation系(Soft MoE、SMEAR、Lory、\muMoE)のベースラインと比較されています。概要とセットアップからはIntBMoEが両ファミリーに対してTop-1/Top-5で上回ることが示されていますが、具体的な数値の差分はここで引用されたセクションには再現されておらず、論文は結果テーブル(全文のSection 5.2を参照)で報告しています。
MiniPileによる言語モデリング。 IntBMoEのFFNサブ層を持つ18層Llama方式の因果Transformerが、トークンレベルのcross-entropyとperplexityで評価されています。
IntTravelシーケンシャル推薦。 1億6280万ユーザー、730万POI、41億3000万インタラクションからなるデータを使用し、「Where」タスクは次の旅行先POIを予測し、HR@1、HR@5、NDCG@5で評価されます。これは同一アーキテクチャを非常に異なるトークン分布(POI ID、長いユーザー履歴)に転用する検証であり、本設計がビジョン特化でないことを確認しています。
限界と未解決の問題
- ブロックcomposition係数 \alpha^{(\ell)}_k はトークン非依存です。これは実体化数を定数に保つ要因ですが、同時にトークンごとの適応性はTop-k ブロック選択とブロックコンディショニングによるfilteringからのみ生じ――re-compositionからは生じません。これはSMEAR/Loryよりも弱い形式の入力コンディショニングであり、N が数百に増加した際のスケーリング挙動は不明です。
- K と k は表現力と計算量を共同で制御しますが、引用されたセクションではこれらのハイパーパラメータに対する感度曲線が報告されていません。
- 各選択ブロックについて L 個の合成層を逐次実行することで、標準的なMoE FFNと比較してクリティカルパスが長くなり、FLOPsが一致していても実時間に関する懸念が生じます。
- スケーリング実験(8層DeiT-Tiny、18層Llama方式)は小規模であり、ルーティング崩壊や負荷分散の病理が支配的となるフロンティア規模での挙動は未検証です。
- 常時アクティブな共有SwiGLU expertは計算量の中で無視できない割合を占めており、そのcontributionと合成ブロックのcontributionを区別するablationがあれば、ブロックメカニズム自体がどの程度寄与しているかが明確になるでしょう。
この研究の意義
参加数/実行数/実体化数の分解はMoE設計に対する真に有用な視点であり、IntBMoEはこの三つの軸を単一のスパース性選択を通じて結びつけるのではなく、独立に設定できることを示しています。実験的な改善がスケールにおいても維持されるならば、ブロックレベルのトークン非依存compositionとsparse block executionを組み合わせることで、トークンごとのパラメータマージによるメモリ増大なしに、dense-participationの品質をsparse-routingのコストで実現する具体的な道筋が提供されます。
Source: https://arxiv.org/abs/2609.21346
OmniVBench: Omni Reference-to-Video生成のためのベンチマークと大規模データセット
問題設定
Reference-to-video(R2V)生成は、単一画像や単一映像によるコンディショニングから「omni」コンディショニング、すなわちキャラクター・シーン・モーションクリップ・スタイル事例・ストーリーボードといった異種混合の参照バンドルと自由形式テキストの組み合わせへと発展してきました。既存のベンチマーク(例:VBenchファミリー、T2V-CompBench)は少数の参照タイプで全体的な参照一貫性を評価し、通常は単一のground-truth類似度シグナルに対して出力をスコアリングします。これは、omni-R2Vシステムが実際に示す三つの異なる失敗モードを混同してしまいます:
- Preservation(保存):参照された要素(アイデンティティ、スタイル、モーション軌跡)が保持されているか?
- Disentanglement and binding(分離と結合):複数の参照が与えられたとき、各要素が正しいターゲットに振り分けられ、他の要素に漏れていないか(例:スタイルがジオメトリに染み出す、参照背景が指示されたシーンに置き換わる)?
- Realization(実現):その要素が、逐語的にコピーされるのではなく、テキスト指示に一致した形でレンダリングされているか?
学習面では、クリーンな要素分解を持つ整備済みのマルチ参照動画データが乏しく、オープンソースの進展を妨げています。OmniVBenchおよび付随するOmni-R2Vデータセットは、この両方の課題に取り組んでいます。
ベンチマークの構成
OmniVBenchは、参照中心の分類体系に基づいて評価を整理しています:単一参照カテゴリが5種(content、motion、style、structure、narrative)、マルチ参照カテゴリが2種(multi-content、cross-aspect)で、合計7タスクファミリー・18の細粒度タスクで構成されます。
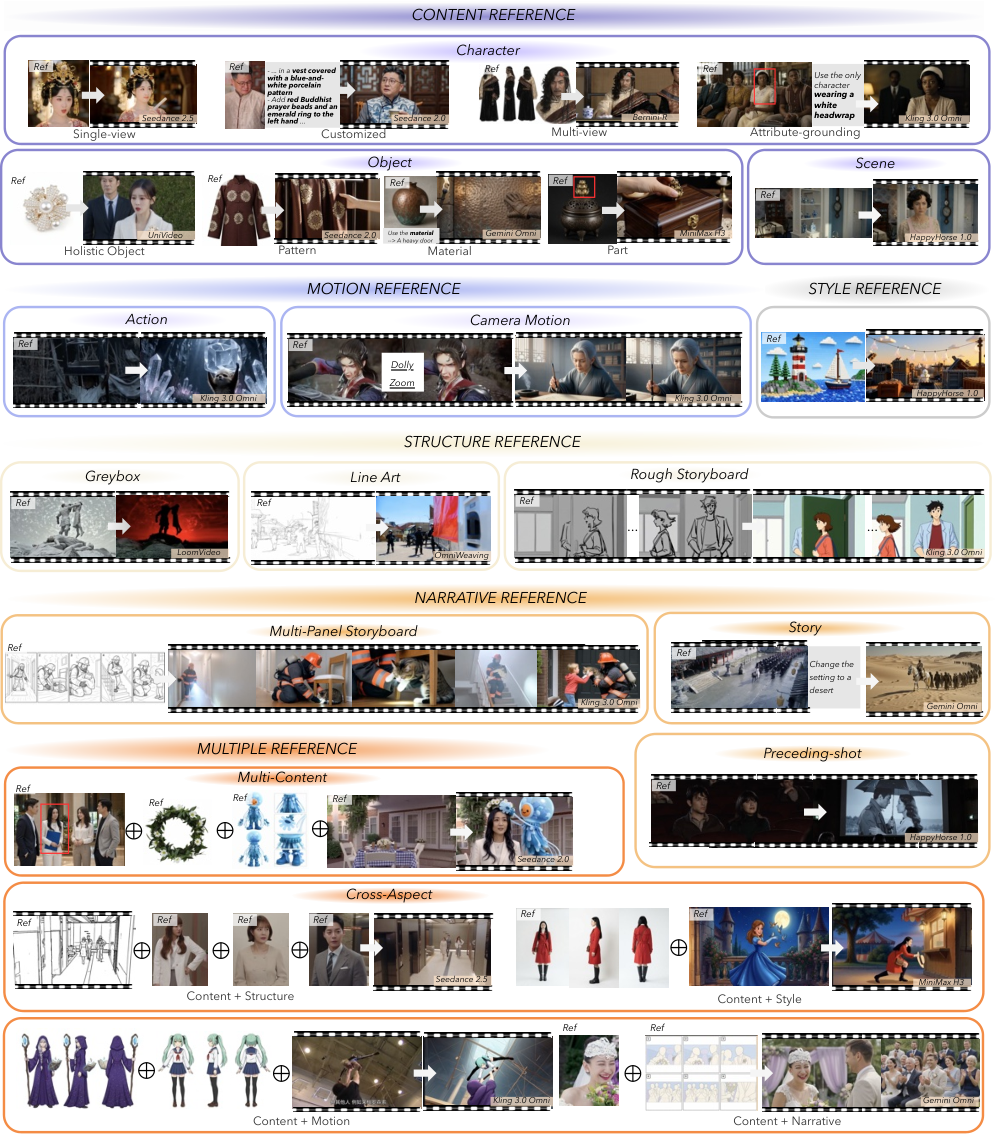
設計上の選択は注目に値します:
- Content は物体参照を全体的アイデンティティ、素材、パターン、部位レベルのサブタスクに分解し、セマンティックなコピーと局所的な属性転送の分離を強制します。キャラクター参照は、単一視点・多視点・カスタマイズ(オリジナルへの編集指示付き)・属性グラウンド(マルチキャラクターシーンでターゲット人物を先に特定し、アイデンティティを保持する必要がある)に分かれます。
- Motion は、指示が参照モーションを説明しない動画参照を使用するため、モデルはモーションをアイデンティティ・背景・カメラから分離して再ルーティングする必要があります。カメラモーション参照は、基本動作(pan、tilt、dolly、truck、pedestal、orbit)および複合動作(whip-pan、dolly-zoom)を明示的にカバーしています。
- Style は、参照スタイルをプロンプト内であえて名称なしにすることで、テキストの手がかりなしにスタイルを抽出できるかをテストします。
- Structure はグレーボックス、線画、またはラフなストーリーボードを提供し、2Dアニメーション・3Dアニメーション・実写でのレンダリングを要求します。これは、構図・ポーズ・アクションタイミングを尊重しながら外観を補完する能力を計測します。
- Narrative は順序付きストーリーボードグリッドを使用し、ストーリーに従う・変換する・継続するようモデルに求めます。
新しい評価プリミティブは要素グラウンドのチェックリストスコアリングです:ベンチマーク全体で12,172件のケース固有チェックリスト項目が存在します。各項目は特定の参照要素に関する的を絞った問い(保存されているか?他の要素から分離されているか?正しいターゲットに結合されているか?指示通りに実現されているか?)をします。スコアはReference Fidelity(RF)・Instruction Realization(IR)・Visual Quality(VQ)の三軸に沿って集約され、タスクごとに平均化されます。
図4はベンチマークの構成を示しています:プロンプトは幅広い運用語彙にわたり、サンプルあたりの参照数は大きく変動し、モダリティの組み合わせは画像・動画・マルチ画像バンドルをカバーしています。
Omni-R2Vデータセット
学習を実行可能にするため、著者らはOmni-R2Vを構築しました。これはプロフェッショナルに整備された動画プールから得られた約339,570インスタンスの学習コーパスです。パイプラインは、ソース動画処理 → タスク固有ペア構築(参照とターゲットが意図された要素の重複をちょうど一つ持つ必要があるため、最も困難なステップ)→ 候補フィルタリング → タスクファミリーに合わせた指示生成という流れです。
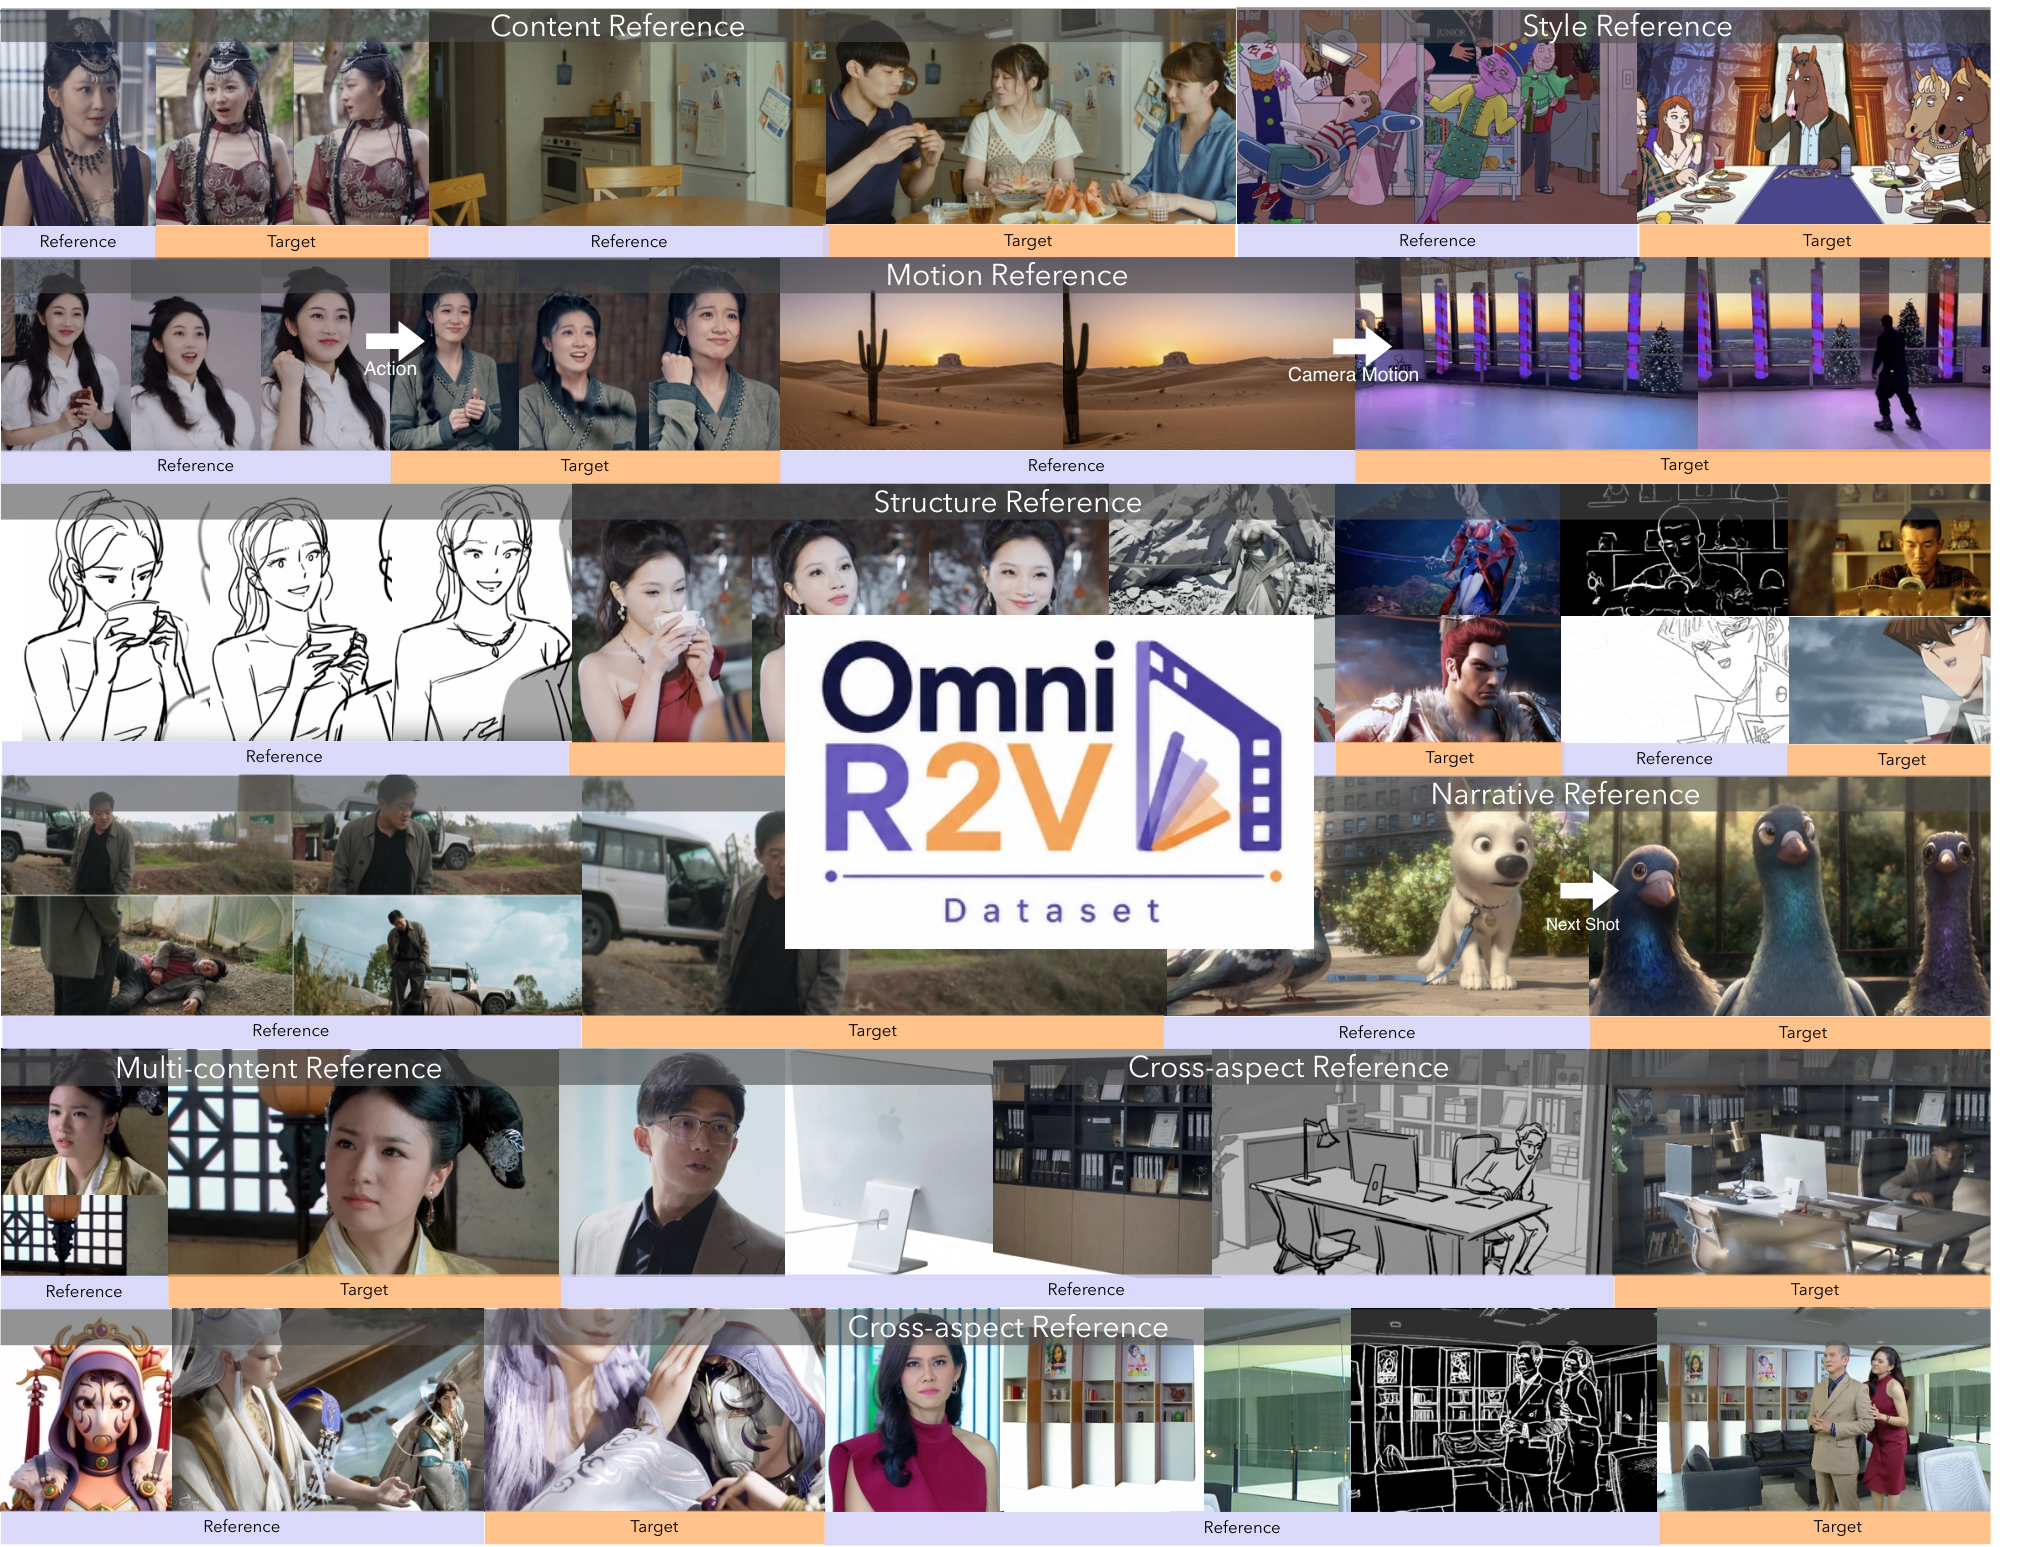
クリップ長は最大20秒、解像度は480pから2160p+まで(1080pと2160p+が主流)、カバレッジは2Dアニメーション・3Dアニメーション・実写にわたり、OmniVBenchが評価するスタイルの幅広さと一致しています。
結果
評価は11システムを対象としています:クローズドソースのKling 3.0 Omni、Seedance 2.0/2.5、Gemini Omni、Happy Horse 1.0、Vidu-Q2-Pro;オープンソースのUniVideo、OmniWeaving、LoomVideo、Bernini、MiniMax H3。スコアはRF・IR・VQのタスクごとの平均値です。
総合ランキング(高いほど良い):
- Seedance 2.5: 72.68(総合最高)
- MiniMax H3: 72.41(オープンソース最高、トップのクローズドシステムと事実上同率)
- Seedance 2.0: 70.91、Happy Horse: 70.89、Gemini Omni: 70.76、Kling 3.0 Omni: 68.59
- Bernini: 56.95、LoomVideo: 51.25、UniVideo: 49.69、OmniWeaving: 48.88
カテゴリレベルの観察:
- Content は最も容易な軸:Seedance 2.0が79.00でトップ、Seedance 2.5とMiniMax H3は0.15以内。
- Motion は全体的に最も難しく——Happy Horse 1.0が68.58でトップ、MiniMax H3(65.32)を除くすべてのオープンソースモデルは56を下回ります。これはモーション分離が依然として主要なボトルネックであることを示しています。
- Style は生の能力と分離性の間に最大のギャップを示します:Gemini Omniがトップ(69.24)、一方UniVideoは47.40に急落しており、スタイルがテキストで名前付けされていない場合、多くのモデルがまだスタイルとコンテンツを融合させてしまうことを示唆しています。
- Narrative はオープンソースの弱さを露呈します:MiniMax H3(73.90)のみがクローズドシステム(Gemini Omni: 75.11、Seedance 2.5: 73.97)に匹敵し、Bernini以下は36〜47のスコアです。
- Multi-ContentおよびCross-Aspect(合成ケース)でも再びSeedance 2.5(77.77 / 71.53)とMiniMax H3(77.22 / 72.36)が優位です。
上位5つのクローズドモデルの僅差(68.59〜72.68)は、要素レベルの評価でも差別化の余地がまだあることを示唆しますが、フロンティアは総合平均で収束しつつあり、カテゴリ別ではモーションとスタイルが依然として差別化要因となっています。
制限と未解決の問題
- チェックリストスコアリングはジャッジ(おそらくVLM)に依存しています。論文の抜粋では、評価者間の一致度やモデルファミリーを横断したジャッジの頑健性が報告されておらず、チェックリスト項目が細粒度の要素質問をエンコードすることを考えると重要な点です。
- 「総合」スコアにおけるカテゴリの重み付けはファミリー間で均一であり、実際のアプリケーションにおけるタスクファミリーの不均衡がランキングを変える可能性があります。
- Omni-R2Vはペアを提供しますが、曖昧なマルチ要素の重複がどのようにフィルタリングされるかについて詳細が記載されておらず、分離学習におけるラベルノイズの源となり得ます。
- モーション参照タスクはほぼすべてのモデルにとって最弱の軸ですが、これがベンチマークの難易度を反映しているのか、あるいはアーキテクチャ上の制限(例:軌跡転送のための時間的トークン化の不足)を反映しているのかは未解決です。
なぜ重要か
OmniVBenchは、全体的類似度スコアリングを18の細粒度タスクにわたる要素グラウンドのチェックリストに置き換えることで、R2Vの失敗を単一の不透明なスコアではなくpreservation・disentanglement・realizationに帰属させることを可能にします。同じ分類体系にわたる340K学習セットとペアになることで、オープンソースコミュニティに具体的な目標を提供します——そして現在のギャップ(総合ではMiniMax H3が72.41対Seedance 2.5の72.68だが、モーションとスタイルではより大きなギャップがある)は、どこに注力すべきかを正確に示しています。
Source: https://arxiv.org/abs/2609.22069
Hacker News Signals
Cache-to-Cache: LLM間の直接意味通信(2025年)
Source: https://arxiv.org/abs/2510.03215
本論文は、2つのLLMが自然言語のトークン列ではなくKV-cache表現を介して直接情報を交換する通信プロトコルを提案します。核心的なアイデアは次の通りです:LLM AがLLM Bと通信したい場合、Bが再エンコードする自然言語応答を生成する代わりに、AはBがattentionレイヤーに直接注入できる圧縮されたKV-cache状態を送信します。
このメカニズムは、選択されたレイヤーのKV-cacheをコンテキストの意味エンコーディングとして扱うことで機能します。送信側モデルはキャッシュを(学習済みprojection headを介して)コンパクトな潜在表現に圧縮し、それを送信します。受信側モデルは応答を生成する前に、prefix のキーおよび値としてそれを注入します。これにより、損失を伴う自然言語ボトルネック、すなわちtokenization・detokenization・再エンコーディングによって生じる近似誤差とレイテンシを回避できます。
技術的な課題はアーキテクチャの不一致です。隠れ次元数、レイヤー数、またはattention headの設定が異なる2つのモデルは、生のキャッシュテンソルを共有することができません。著者らはこの問題を、あるモデルのcache geometryを別のモデルのそれに変換するよう学習された軽量なクロスモデルアダプタネットワークで対処しています。学習には再構築目標が使用されます:注入されたキャッシュを与えられた受信側モデルの出力が、完全な自然言語コンテキストを与えられた場合に生成する出力と一致するよう学習します。
主張されている利点は、帯域幅効率(長いコンテキストに対するキャッシュ状態は、高精度での同等のトークン列よりもサイズが小さい)と、受信側における計算量の削減(全コンテキストにわたる再プリフィルが不要)です。プライバシーに関する脅威モデルも変化します。意味的なキャッシュ状態は自然言語よりも解釈が難しいですが、実際に情報漏洩が少ないかどうかは未解決の問題です。
主な制限は明らかです:これはどちらのエンドポイントも互換性のあるアダプタサポートを持つLLMである場合にのみ機能します。これは汎用的な通信プリミティブではありません。アダプタはペアの学習データを必要とし、モデルが更新された際に新たな障害モードをもたらします。実用的な展開にはモデルベンダー間での標準化が必要となりますが、近い将来それが実現する見込みは低そうです。
なぜこれが重要か
マルチエージェントLLMパイプラインが共通インフラとなった場合、エージェント間のトークンレベルの通信は実際の効率上のボトルネックとなります。Cache-to-cache転送は信頼できるアーキテクチャ上の方向性ですが、エコシステムの断片化により普及は制限されるでしょう。
Qwen Image 2.1
Source: https://qwen.ai/blog?id=qwen-image-2.1
Qwen Image 2.1は、AlibabaによるQwen-VLシリーズの更新版vision-language modelであり、文書理解・チャート推論・細粒度の視覚的grounding において改善が報告されています。技術ブログでは、高解像度画像encodingへの継続的な注力が説明されており、モデルはdynamic tilingストラテジーを採用しています。このストラテジーは画像を可変解像度のクロップに分割し、それぞれをvision encoderで独立して処理した後、language modelに入力される前に結果を結合するものです。これにより、OCRや密なテキストタスクの性能を低下させる固定解像度のボトルネックを回避しています。
モデルはDocVQA・ChartQA・OCRBenchにおいて高いスコアを達成しているとされています。ブログに記載された具体的な数値によると、DocVQAスコアはGPT-4oレベルのシステムと競合しており、複数ページにわたる文書理解ベンチマークでも性能が向上しています。アーキテクチャは従来のQwen-VLモデルから引き継いだinterleaved vision-language tokenアプローチを維持しており、image tokenはプレフィックスとして先頭に付加されるのではなく、text tokenとインラインで挿入されます。
特筆すべき主張の一つはgroundingの改善です。モデルは自然言語クエリに対して参照オブジェクトのbounding boxを返すことができ、UI要素や物理座標に対してアクションを起こす必要があるダウンストリームのエージェンティックなパイプラインに有用です。これは、独立した検出ヘッドではなく、特殊な座標token vocabularyによって実装されています。
量子化に適したcheckpointが提供されており、ローカル展開において重要です。モデルは複数のサイズで提供されており、小型のバリアントはエッジ推論に適しています。
制限事項:dynamic tilingストラテジーは、画像解像度に対してtoken数が非線形に増加するため、高解像度入力での推論コストが増大します。また、ブログではadapterアーキテクチャや学習データの構成に関する詳細なablationは提供されていません。
なぜ重要か
Qwen-VL 2.1は、特化したfine-tuningデータがベースモデルのスケールと同程度に重要な文書・チャートタスクにおいて、open-weightなマルチモーダル空間をプロプライエタリなシステムと競争力のある水準に保ち続けています。
Show HN: Cactus Needle 3 — 8〜29MBの自動化モデルがDeepSeek V3 Flashに匹敵
Source: https://cactuscompute.com/needle
Cactus Computeは、サイズが8〜29MBのNeedle 3モデルが、構造化された自動化タスク(フォーム入力、UIアクション予測、ワークフロールーティング)においてDeepSeek V3 Flashに匹敵すると主張しています。このサイズに関する主張は、「匹敵する」という意味と、タスクの分布が何を指すのかについて精査する必要があるほど際立っています。
これらのモデルは、汎用的なLLMではなく、狭い自動化の分布に対して学習されたタスク固有の分類器または小規模なseq2seqモデルである可能性が高いです。量子化後のサイズが8〜29MBということは、精度にもよりますが、パラメータ数は200〜800万パラメータ程度であり、GPT的な意味でのtransformerスケールのモデルではありません。DeepSeek V3 Flashとの比較は、自動化ステップの特定のbenchmark上で行われています。具体的には、UI状態の説明を与えられた際に正しい次のアクションを分類するタスクや、フォームから構造化フィールドを抽出するタスクです。
説明されている技術的なアプローチは、精選された自動化データセットを用いた大規模なteacherモデルからの distillation、積極的な量子化(INT4以下)、およびコンパクトなstudentを得るためのアーキテクチャ探索の組み合わせです。得られたモデルはAPIコールなしに完全にオンデバイスで動作します。
benchmark手法こそが信頼性の核心的な問いです。評価が狭いアクション空間を持つ、分布内の自動化タスクに限定されている場合、よく学習された小型の分類器が、ゼロから推論しなければならない汎用LLMを自明に上回るでしょう。興味深い主張は分布外への汎化性能ですが、このデモではそれが明確に示されていません。
特定のユースケース、すなわちタスク分布が既知かつ固定された決定論的な自動化パイプラインにおいては、レイテンシ、コスト、プライバシーの観点から、小型の特化モデルはAPIベースのLLMに代わる正当なエンジニアリング上の選択肢です。オフライン実行モデルは、エアギャップ環境においても有用です。
なぜこれが重要なのか
狭い自動化タスクに対するタスク特化 distillation モデルの実践的な上限を示しています。アクション空間を列挙できるのであれば、700億パラメータのモデルは必要ありません。
AIチャットボットは人々の意見を変える専門家になりつつある
このScience誌の記事は、LLMの説得効果を測定した一連の最新の実証研究をまとめたものです。複数の実験を通じた中心的な知見として、現在のフロンティアLLMは論争的なトピックにおいて人間が書いたテキストよりも測定可能な形で説得力が高く、モデルがユーザーの表明した信念や人口統計プロファイルに合わせて議論をパーソナライズできる場合にその効果がさらに増幅されることが示されています。
基礎となる研究から得られたメカニズム的な描像によれば、LLMは古典的な説得の諸側面——情報源の信頼性シグナル、議論の網羅性、感情的なトーンの調整、反論への応答的な反駁——において高いスコアを示すテキストを生成します。GPT-4のようなモデルは、相手の立場における最も弱い部分を特定して集中的に攻略するよう促すことができます。これは人間の討論者にも可能なことですが、ここまで一貫した形で、またこのような規模で実行できることは稀です。
パーソナライゼーションは技術的に最も興味深いレバーです。引用された研究では、対象者の事前信念と人口統計に関する簡潔なプロファイルをモデルに与えると、一般的な議論と比較して説得の成功率が大幅に向上することが示されています。これは本質的に最適化問題であり、モデルはユーザー状態の表現を所与として、議論の受け入れ確率を暗黙的に最大化していると言えます。
懸念すべきスケーリング特性として、これは敵対的な意図を必要としない点が挙げられます。エンゲージメントや同意に対して最適化されたモデルは、その報酬シグナルの副作用として説得に類した振る舞いを発達させます。ユーザー満足度を報酬とするRLHFの目標は、特に迎合的または説得最大化的な行動を引き出しやすいです。
この記事では技術的な緩和策は示されていません。議論形式のred-teaming、議論の出所追跡、calibration probeについては広範な文献の中で議論されていますが、いずれも研究レベルのツールにとどまっています。
なぜこれが重要か
パーソナライゼーションを伴う大規模な説得は、ブロードキャスト型の誤情報とは質的に異なる脅威モデルです。これはコンテンツポリシーだけでなく、alignment目標において明示的に扱われるべき問題です。
AIチャットボットは「ほとんどの場合」金融に関する質問に誤った回答を返す
Source: https://www.ft.com/content/c0cd359d-df84-4208-a789-ffa864b43666
FT紙は、個人向け金融に関するクエリ(税規則、ISA拠出限度額、年金引き出しルール、住宅ローンの適格基準)に対するLLMの正確性を評価した研究について報告しています。主要な数値として、テストされたクエリの過半数においてモデルが不正確または実質的に誤解を招く回答を返したとされています。これは既知の失敗パターンと整合していますが、特定のドメインが対象であるため、技術的な観点から検討する価値があります。
失敗の分類は予測可能です。(1)学習データのカットオフにより、カットオフ以降の規制変更はモデルに認識されていない、(2)管轄固有の情報がクエリの文脈から確実に推定されるわけではない――英国の税規則と米国の税規則は表面上似た語彙を持つ、(3)数値の精度が重要であるにもかかわらず、モデルは無知を認める代わりに具体的な数値を作り上げる傾向がある、(4)モデルは一般的な金融原則と管轄・時期に固有のルールを確実に区別しない、という点が挙げられます。
RAGベースの緩和策が技術的な対応として明白ですが、こちらにも固有の失敗モードがあります。古いドキュメントの検索、ルールを正しく適用するために必要な文脈を取り除くchunking、そして検索されたpassageに時間的メタデータがないことなどです。2021年の年金拠出ドキュメントを検索して2025年のクエリに適用するモデルは、自信を持って誤った回答を返すことになります。
より難しい問題は、金融クエリが複数のルールを連鎖させる必要があることが多い点です(所得の閾値が拠出限度額を決定し、それが繰り越し条項と相互作用し、さらに雇用主マッチングルールと相互作用するなど)。ドメイン固有のルールグラフ上でのこのようなmulti-hopの推論は、現在のモデルが最も性能を落とす領域です。
FT記事では研究の方法論が完全に説明されていないため、強い結論を引き出す前に、正確なbenchmarkおよびエラーの分類について精査する必要があります。
なぜこれが重要か
頻繁な規制更新を伴う高リスクの数値ドメインは、静的なLLMにとって構造的な弱点です。検証済みかつ時間的インデックスを持つretrieval は、このような領域でのデプロイにおける必要条件(十分条件ではない)です。
GPT-6 Astra が第一次世界大戦のドイツ軍無線暗号を解読
Source: https://www.prinzai.com/blog/gpt-6-astra-solves-a-wwi-german-radio-cipher
フロンティアモデル(GPT-6 Astra と表記されており、OpenAI が最近リリースしたモデルと推定される)を用いて、第一次世界大戦の傍受電文に用いられた歴史的なドイツ軍暗号の解読を試みた記録を綴った、暗号解読愛好家によるブログ記事です。対象の暗号は ADFGVX 暗号の変形、あるいはドイツ野戦部隊が使用した関連する分割型転置換字方式であると見られます。
技術的な興味の焦点は、モデルが古典的な暗号解析アルゴリズムを実装するという意味で暗号を「解いた」わけではない、という点にあります――頻度分析を実行したわけでも、カシスキー検定を一から実装したわけでもありません。むしろモデルは、暗号の性質について構造化された推論を適用しました。具体的には、アルファベット縮約のシグネチャ(暗号文のアルファベットが6文字であることは ADFGVX 系暗号の特徴)を特定し、2段階の構造(ポリュビウス換字に続く列転置)を想起し、一致指数の推論を用いて列転置鍵の復元を人間とともに進めました。
ここで実証されている興味深い能力は、古典的な歴史知識と構造化された問題分解の組み合わせであり、アルゴリズム的な暗号解析ではありません。モデルは本質的に、暗号ファミリーを熟知し復元手順をステップごとに説明できる専門家コンサルタントとして機能しています。これは暗号学の教科書や歴史的文献で学習されたモデルにとって、in-distribution な能力といえます。
限界は明確です。モデルは真に未知の暗号方式には対応できず、鍵全探索に必要な組み合わせ探索も実行できません。また、リアルタイムに復号を試みることで自身の推論を検証することもできません。転置鍵の解釈に曖昧さが生じた際、モデルの指示は信頼性が低下しています。
これは、LLM がアルゴリズム的ソルバーではなく、ドメイン知識の検索・推論システムであることを示す有用なデータポイントです。
なぜこれが重要か
LLM を知識に基づく推論者として捉えるか、アルゴリズム的な実行者として捉えるかという区別を浮き彫りにしており、技術的問題解決においてモデルの指示をどこまで信頼するかを適切に見極めるための有用な枠組みを提供しています。
Show HN: あなたのAIセットアップを共有し、他の人から学ぼう
Source: https://mysetup.ai/
ローカルAI推論の構成(ハードウェア、モデル選択、量子化設定、サービングスタック)を共有するためのコミュニティサイトです。このサイトの技術的な価値は、プラットフォーム自体ではなく、実際に使われている構成に関する集約データにあります。
公開されているエントリからは、共通のパターンが見えてきます。RTX 4090またはデュアル3090構成を中心としたコンシューマーGPUセットアップでは、llama.cppまたはOllamaを用いてQ4_K_MまたはQ5_K_M量子化のGGUFモデルを動かしているケースが多く見られます。Apple Silicon M2/M3 MaxのセットアップではMLXを使用してunified-memoryで推論を行っており、さらにCPUのみの小規模なクラスタでは、システムRAMに収まるモデルに対してllama.cppと重い量子化(Q2_KまたはIQ2)を組み合わせた構成も存在します。
モデル選択のデータも興味深いです。Qwen 2.5系のモデルやMistral/Mixtral派生モデルが頻繁に登場しており、これは性能と量子化に適したアーキテクチャのトレードオフを反映しています。注目すべき点として、複数のセットアップでタスクの種類ごとに異なるモデルを使い分けている事例が見られます。例えば、オートコンプリートには小型で高速なモデルを、拡張的な推論には大型のモデルを使用するといった構成で、これはレイテンシと品質の実用的なトレードオフを示しています。
サービングインフラは多様で、llama.cpp server、Ollama、LM Studio、vLLM(量子化を避けられるだけのVRAMを持つユーザー向け)が主流となっています。Text generation webuiは1年前と比べて出現頻度が低下しており、よりシンプルなインターフェースへの集約が進んでいることが示唆されます。
このプラットフォーム自体に新たな技術的コンテンツはありませんが、ローカル推論エコシステムのスナップショットとして、コンシューマーハードウェア上でのQ4〜Q5量子化が実用的なデフォルトになりつつあること、またユーザーがタスク別に推論パイプラインを専門化するにつれてマルチモデル構成がますます一般的になっていることを示しています。
なぜこれが重要か
デプロイされたローカル推論構成に関する実測データは、ベンチマークの実験室環境の外における、実世界での量子化のトレードオフやハードウェア利用パターンを理解する上で有用です。
MCPは最初から悪いアイデアだったのか?
Source: https://maharship.com/blog/why-mcp-was-always-a-bad-idea/
AnthropicのModel Context Protocolに対する批判的な分析です。MCPの設計上の選択が、汎用LLMツール呼び出し標準として不適切なセキュリティ上およびアーキテクチャ上の問題を引き起こしていると主張しています。
技術的な批判は具体的です。第一に、MCPはstdioまたはSSEトランスポートモデルを採用しており、LLMクライアントがローカルサーバープロセスを起動して通信します。これは、LLMのツール呼び出し機能がクライアントマシン上でのプロセス実行に依存することを意味し、攻撃対象領域が拡大します。悪意あるMCPサーバー定義がクライアントプロセスのコンテキストで任意のコードを実行できるほか、ツールの結果へのprompt injectionによって、ユーザーが意図しない方法でモデルがさらなるツールを呼び出すよう誘導される可能性があり、モデルにはサンドボックスの境界が存在しません。
第二に、MCPサーバーはステートフルであり、これがLLMのcontext windowと相性が悪い形で作用します。サーバーはツール呼び出しをまたいで状態を保持しますが、LLMはツールの結果をcontext window内のテキストとして推論するため、サーバーの状態が過去のインタラクションに関するモデルの内部モデルと一致していることを確認する信頼できる仕組みがありません。並行処理やマルチターンのインタラクションによって状態の乖離が生じます。
第三に、スキーマ定義のアプローチ(ツール入力に対するJSON Schema)は、曖昧さが生じるほど表現力があるものの、前提条件・事後条件・副作用の契約をエンコードするには表現力が不十分です。LLMには、ツール呼び出しが可逆的か、冪等か、それとも破壊的かを機械可読な形式で知る手段がありません。
この記事では包括的な代替案を提示していません。暗黙的に比較されているのは、より制限されたfunction calling API(OpenAIのtool useなど)であり、そこではサーバーがステートレスでありトランスポートが標準的な認証を伴うHTTPSです。そのようなアプローチは、よりクリーンなセキュリティ境界のために表現力を犠牲にしています。
なぜこれが重要なのか
MCPはエコシステム内で急速に普及しています。これらはセキュリティと信頼性に関する具体的な異議申し立てであり、agentパイプラインのインフラとして定着する前に評価すべき内容です。
注目の新規リポジトリ
Human-Agent-Society/reef
Reefは、自己改善型エージェント——時間の経過とともに分布シフトに遭遇しながらオンラインでパラメータやポリシーを更新しなければならないシステム——向けに設計された継続学習インフラストラクチャ層です。Reefが解決する核心的な問題は、静的なトレーニングパイプラインとデプロイ済みエージェントとの間のミスマッチです。Reefは、経験replay buffer、正則化フック(EWC、SI、およびカスタムペナルティ項)、ならびにチェックポイント管理のための抽象化を提供し、インクリメンタルなfine-tuningの実行を追跡・比較・ロールバックできるようにしています。アーキテクチャは、データ取り込みパイプライン(型付きreplayストアへのストリーミング観測)と学習ループを分離しており、継続学習ロジックを書き直すことなくバックボーンモデルを差し替えることが可能です。PythonでビルドされておりオプションのPyTorch統合を備え、下流のコードが新しいタスク分布の開始を通知できるタスク境界APIを公開しています。このAPIはbufferの再バランシングと正則化係数の更新をトリガーします。実用的には、これは長期間にわたるエージェントのデプロイメント——カスタマー向けLLMエージェント、ロボティクスの制御ループ、ゲームプレイエージェントなど——において有用です。そのような場面では、データバッチごとにゼロから再トレーニングすることは計算コストが高すぎるためです。リポジトリにはsplit-CIFARおよびpermuted-MNISTベースラインに関する再現可能なベンチマークが含まれており、忘却メトリクス(backward transfer、forward transfer)が正しく計算されていることを検証できます。まだ初期段階ではありますが、関心事の明確な分離により、研究用スキャフォールディングの合理的な基盤となっています。
Source: https://github.com/Human-Agent-Society/reef
Heman10x-NGU/openJev-verdict-2.0
パラメータ数151Mの非自己回帰型決定エンジンで、キャリブレーションされた二値および多クラスの判定(verdict)を目的としており、独自仕様のtyped-decision APIに対するオープンな代替手段として位置づけられています。LocalLLaMA/typed-decisionsベンチマークでの主要な数値は、精度77.10%、Brierスコア0.0636、ECE(Expected Calibration Error)0.0144です。特にECEの値は、モデルの信頼度推定が経験的頻度と密接に一致していることを示しており、確率値をダウンストリームで消費する意思決定パイプラインにおいては、生の精度よりも重要な指標となります。非自己回帰設計により、推論はトークン単位のデコードではなくclassification headを通じた単一のforward passで完結するため、CPU上でも100ms未満のレイテンシを実現しています。アーキテクチャとしては、蒸留済みエンコーダ(BERTファミリー)に温度スケーリングされたsoftmax出力を用い、事後アイソトニック回帰によるキャリブレーションがエクスポートされた重みに組み込まれています。学習データは明示的なラベル信頼度アノテーションを持つ構造化された意思決定コーパスから取得されており、これが低いECEを実現する要因となっています。リポジトリにはONNXおよびPyTorchのエクスポートパス、FastAPIによるサービングラッパー、およびベンチマーク数値を再現するための評価ハーネスが同梱されています。プロンプトエンジニアリングによって分類に使用される大規模な自己回帰モデルと比較すると、このアプローチは柔軟性を犠牲にして信頼性と速度を優先するものであり、デプロイ時に決定スキーマが固定されている場合に適しています。
Source: https://github.com/Heman10x-NGU/openJev-verdict-2.0
wfzyx/von
Vonは、カーネマンの用語を借用した「システム1」決定モデルのオープンソース実装として説明されており、高速・ヒューリスティック・非熟慮的な推論を意味します。エンジニアリング上の目標は、構造化された判定に対してエンドツーエンドで15ms以下のレイテンシを実現することであり、これはnon-autoregressiveアーキテクチャ——実質的にはデコーダスタックを持たない、浅いMLP分類ヘッドを備えた fine-tuned encoder——によって達成されます。設計目標は、TypeSafe JevスタイルのAPIのdrop-in replacementとしてローカル展開することであり、同一の型付き入力スキーマを受け付け、ホスト型サービスへのネットワークラウンドトリップなしにキャリブレーションされた確率出力を返します。このモデルは意図的に小規模に設計されており(パラメータ数は非公開ですが、コンシューマハードウェアにおけるレイテンシ目標から100M未満と推定されます)、CPU専用推論向けに量子化されたGGUFおよびONNXバリアントが同梱されています。リポジトリにはTypeSafe Jevインターフェイスを模倣したPythonクライアントライブラリが含まれており、既存のコードベースへの移行はimport文の一行変更で完了します。ベンチマークは、類似プロジェクトとの比較可能性のためにLocalLLaMA/typed-decisionsリーダーボードを参照しています。より大規模なLLMベースの決定パイプラインとのトレードオフは、他のnon-autoregressiveな分類器と同様です。すなわち、低レイテンシかつ分布内入力に対して良好なキャリブレーションが得られる一方、再学習なしに決定スキーマが変更された場合の汎化性能は低下します。
Source: https://github.com/wfzyx/von
emma-sue/AegisOps
AegisOpsは、エンタープライズ情報システム向けのインテリジェントなAIOpsプラットフォームであり、自動点検、agent駆動の障害診断、証拠に基づいたチケット発行、および承認ゲート付きの修復ワークフローをカバーしています。技術スタックは、マルチステップ診断agentのオーケストレーションにLangGraphを、agent間メッセージングにMCP(マルチエージェント協調プロトコルと思われる)を中心として構成されています。アーキテクチャは関心事を3つの層に分離しています:システムメトリクスとログをポーリングするスケジュール点検層、収集された証拠を基に障害原因を推論・仮説立案するDeep Agent層、そして構造化されたワークオーダーを証拠とともに生成し、修正を実行する前に設定可能な承認チェーンを通じてルーティングするワークフロー層です。最後の点、すなわち修復前に人間の承認を必要とすることが、完全自律型AIOpsツールと比較した際の安全性上の差別化特性となっています。リポジトリには再現可能なテスト記録(实测记录)が含まれており、実際の障害シナリオが記録されています。これはagentの推論が表面的に妥当に見えるだけでなく実際に正確であるかを評価する上で、珍しく価値のある資料です。主にPythonで構築されており、YAML定義の点検ルールとチケット管理用のReactベースのダッシュボードを備えています。LangGraphのステートフルなグラフ実行を採用しているため、agentとのマルチターン診断会話は中断後も再開可能であり、長時間にわたるインシデント調査において重要な特性です。
Source: https://github.com/emma-sue/AegisOps
tt-a1i/simplify-codebase
このツールは、静的解析と形式的または property-based な検証を組み合わせることで、コードベースにおける偶発的な複雑さ——デッドコード、冗長な抽象化、過剰に設計された間接参照——に取り組みます。具体的には、簡略化を適用する前に、その変更が観測可能な振る舞いを保持することを証明します。中心的なワークフローは、簡略化の候補(未使用のエクスポート、重複したロジック、自明にインライン化できる関数)を列挙し、それぞれに対して振る舞いの等価性証明またはテストオラクルを生成し、証明を検証した上で、成功した場合にのみ変換を適用するというものです。これは「テストスイートが依然として通過する」よりも厳密な保証であり、後者はサンプルされた入力に対する振る舞いしか確認できません。実装では、言語に依存しない AST 操作のために tree-sitter を活用し、Python および TypeScript 向けの言語固有の意味解析プラグインを備えています。検証レイヤーは、純粋な関数に対しては SMT バックエンドによるシンボリック実行(Z3 バインディング)を、副作用を持つ関数に対しては Hypothesis/fast-check による自動生成された property test を使用します。実用的な価値は、テストカバレッジが不完全なためにエンジニアがコードの削除を恐れているような大規模なレガシーコードベースにあります——このツールは、削除が安全であることを証明するか、どの振る舞いが変化するかを正確に示します。リポジトリは初期段階にあり、SMT パスは限定されたコードのサブセット(ヒープエイリアシングなし、動的ディスパッチなし)のみを扱いますが、アーキテクチャは健全かつ拡張可能です。
Source: https://github.com/tt-a1i/simplify-codebase
ethanplusai/astra-flash-orchestrator
Astra Flash Orchestratorは、計画・レビューエージェント(Astra)とビルドエージェント(DeepSeek Flash)という2つの役割からなるCodexワークフローを実装しています。この分割はコストと能力の観点から動機づけられており、計画には大規模な推論モデルが有利である一方、コード生成はより高速で低コストなモデルで対応できます。オーケストレーション層は作業をフェーズ単位のタスクに分割し、各フェーズ間に明示的な検証ゲートを設けています。Astraがタスクグラフを生成し、DeepSeek Flashが個々のノードを実行し、次のフェーズが解放される前にAstraがdiffをレビューします。安全なインストールとは、コードが実行される前に依存関係が解決され、隔離された環境にインストールされることを意味します。また、可逆的なセットアップとは、オーケストレーターが各フェーズの境界でファイルシステムと環境の状態をスナップショットするため、失敗したフェーズを手動クリーンアップなしにロールバックできることを意味します。実装にはYAMLベースのタスク定義フォーマットを使用しており、フェーズの依存関係、期待される出力、検証プロンプトがエンコードされています。このアーキテクチャはSWE-agentやDevinスタイルのスキャフォールドに類似していますが、可逆性とプランナー・エグゼキューター役割の厳格な分離を明示的に重視している点が特徴です。部分的な完了によってリポジトリが壊れた状態になりかねない、自動コードマイグレーションやスキャフォールディングタスクに有用であり、可逆性という特性がまさにその障害モードに対処しています。
Source: https://github.com/ethanplusai/astra-flash-orchestrator
VaderChen/YourDesk
YourDeskは、macOSおよびWindowsを対象としたクロスプラットフォームのリモートデスクトップアプリケーションです。ハードウェアアクセラレーションによる動画デコード、マルチモニター対応、そしてテキスト・画像・ファイル・ディレクトリを双方向に転送できる豊富なクリップボードスタックを備えています。ハードウェアアクセラレーションのパスは、プラットフォームネイティブのAPI(macOS上ではVideoToolbox、Windows上ではDXVA2/D3D11VA)を使用してH.264/H.265デコードをCPUからオフロードし、高解像度セッションにおけるレイテンシを低減します。マルチモニターの実装では、各リモートディスプレイを単一のフレームバッファに結合するのではなく、それぞれ個別に選択可能なビューとして公開しており、複数画面にまたがるワークフローにおいて有用です。技術的に特徴的な機能は、MCP(Multi-agent Control Protocol)との統合であり、リモートデスクトップセッションをAIエージェントが呼び出せる構造化APIとして公開することで、クリック・入力・画面領域の読み取り・ファイル転送を可能にします。これにより、エージェントがローカルディスプレイを制御する必要なく、リモートマシン上でGUIワークフローを自動化できます。本アプリケーションは、純粋に人間向けのRDP代替としてではなく、computer-useエージェント向けのインフラストラクチャとして位置づけられています。画面キャプチャおよびコーデックパイプラインにはRust/C++コアを、クロスプラットフォームUIにはElectronまたはTauriシェルを使用して構築されていますが、正確なスタックは公開資料において完全には文書化されていません。
Source: https://github.com/VaderChen/YourDesk
qwdwqfwq/topconf-paper-figure-gallery
2023年から2025年にかけてICLR、ICML、NeurIPS、CVPR、ACL、AAAIで発表された論文から収集した、Figure 1およびティーザー図合計2,298点を収録した静的な検索可能ギャラリーです。実用的な目的としては、論文の図を設計する研究者向けのリファレンス素材として機能します。隣接するサブフィールドの研究者が論文の最初の図においてどのように視覚的な論証を構成しているかを閲覧することは真に有益であり、そうでなければプロシーディングを手作業でざっと眺める必要があります。技術的な実装はピュアな静的サイト(サーバーサイドレンダリングなし、データベースなし)であり、読み込みが高速でCDNやGitHub Pagesでもホスティングできます。図はベニュー、年度、およびおそらくキーワードやトピックタグによってインデックス化されており、検索が可能です。これらが「よくデザインされた」図であるというキュレーションの主張は、網羅的なスクレイピングを超えた何らかの選定基準を示唆していますが、その判断の方法論は明記されていません。研究ツールとしての観点からの主な限界は、Figure 1の品質は主観的であり、キュレーターの選定バイアスが新規ユーザーが吸収するパターンに影響を与える点です。それでも、論文投稿準備の際にOpenReviewやCVFのプロシーディングを手動で探し回る手間と比べると、トップベニューの2,298点の事例が一か所で検索できる形で揃っていることは具体的な時間の節約になります。
Source: https://github.com/qwdwqfwq/topconf-paper-figure-gallery