デイリーAIダイジェスト — 2026-09-17
arXiv ハイライト
LimiX-2: 汎用構造化データインテリジェンスに向けたContextual Mechanism Network
問題設定
TabPFNやTabICLのような表形式データ向けのprior-fitted networks (PFNs)は、D_{\mathrm{ct}}を小規模なラベル付きcontextとして、p(y \mid \mathbf{x}, D_{\mathrm{ct}})をin-contextでfitするよう学習されます。このtarget中心の因数分解は、モデルを固定された特徴量/目的変数の分割に縛り付け、特徴量間の依存関係に関する有用な情報を捨て去り、欠損値の処理・異常スコアリング・因果推論を複雑にします。LimiX-2は、構造化データfoundation modelsにとってより一般的な枠組みとして、任意の変数を任意の観測パターンの下でクエリできるよう、context条件付き同時分布 p(\mathbf{x}, y \mid D_{\mathrm{ct}})を学習することを主張しています。
手法
LimiX-2は「Contextual Mechanism Network」(CMN)パラダイムに従い、Context-Conditional Masked Modeling (CCMM)によって学習されます。技術的に重要な点が2つあります。
セルレベルのembedding。 行全体を圧縮するencoderとは異なり、各セルx_{i,j}はそれ自身のベクトル\mathbf{x}_{i,j}\in\mathbb{R}^{d}(d=256、LimiX-16Mの192から増加)にmappingされます。
\mathbf{x}_{i,j}=\begin{cases}E_{\mathrm{miss}}, & x_{i,j}^{R}\text{ missing},\\ E_{\mathrm{num}}(x_{i,j}^{R}), & \text{otherwise},\end{cases}
ここでE_{\mathrm{num}}は2層MLP(RMSNorm + GELU)、E_{\mathrm{miss}}は共有の学習可能ベクトルであり、列の識別情報は識別的特徴量encodingにより別途注入されます。目的変数はK=4個のtask-embeddingスロット\mathbf{y}_{i}=(\mathbf{y}_{i,1},\ldots,\mathbf{y}_{i,K})\in\mathbb{R}^{Kd}にencodingされ、task種別のembedding E_{\mathrm{type}}(\tau)(\tau\in\{\mathrm{cls},\mathrm{reg}\})が各スロットに加算されます。この分離により、モデルは特徴量pathwayのFFNとは独立してtask pathway FFNを拡幅でき、予測証拠が集約される箇所に追加パラメータを集中させることができます。
CCMMの目的関数。 各エピソードでは行をcontext \mathcal{I}_{\mathrm{ct}}とquery \mathcal{I}_{\mathrm{te}}に分割します。各query行iに対して、ランダムな列のサブセット\pi_iがmaskされ、モデルは
q_\theta(x_{i,j}\mid \mathbf{x}_{i,-\pi_i},\mathbf{X}_{\mathrm{ct}},\mathbf{y}_{\mathrm{ct}}),\quad j\in\pi_i,
を推定し、task headを通じた標準的な目的変数予測q_\theta(y_i\mid\cdot)も同時に行います。サンプル軸に沿ったattentionは非対称で、context行はcontext行のみにattendし(queryの情報がcontextの表現に漏れないよう)、query行はcontext行にattendします。したがって予測はqueryバッチの構成に対して不変であり、これは再現可能な表形式データ推論において重要な性質です。単一の条件付きインターフェースが、分類・回帰・masked特徴量再構成・(条件付き尤度を通じた)異常スコアリングをカバーします。
事前学習データ。 LimiX-2は5段階のSCM合成パイプライン(ハイパーパラメータサンプリング → DAG → SCM伝播 → データサンプリング → タスク適応)を踏襲し、グラフ構造・関数的メカニズム・観測プロセスを拡張しています。
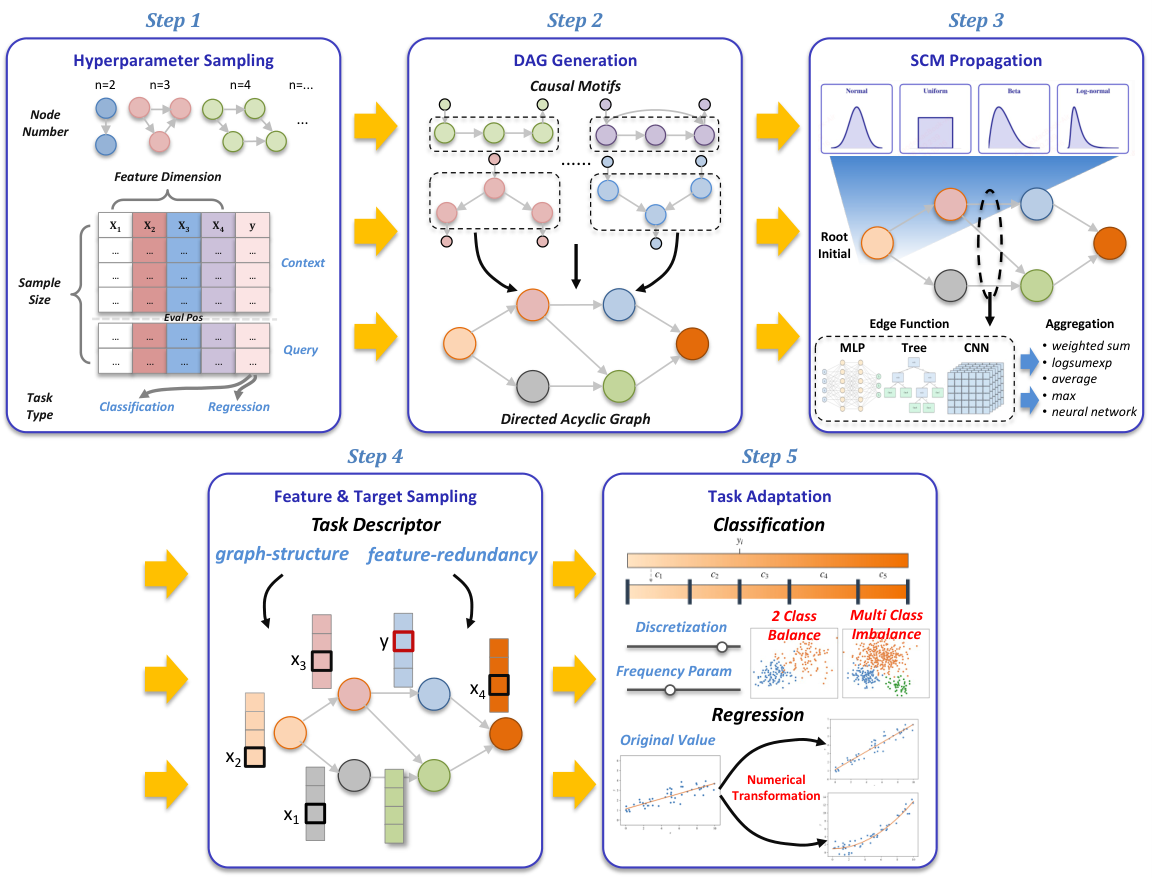
SCMはDAGとメカニズムの両方を定義するため、事前学習分布は明示的な因果構造を持ち、CCMMは原理的にはそれを学習された特徴量attentionに反映させることができます。
結果
評価はTabArena(51データセット)、TALENT(クラス数が10を超える12を除く288データセット)、BCCO(156データセット、欠損値と不完全な特徴量を重視)で行われ、Eloでスコアリングされます。
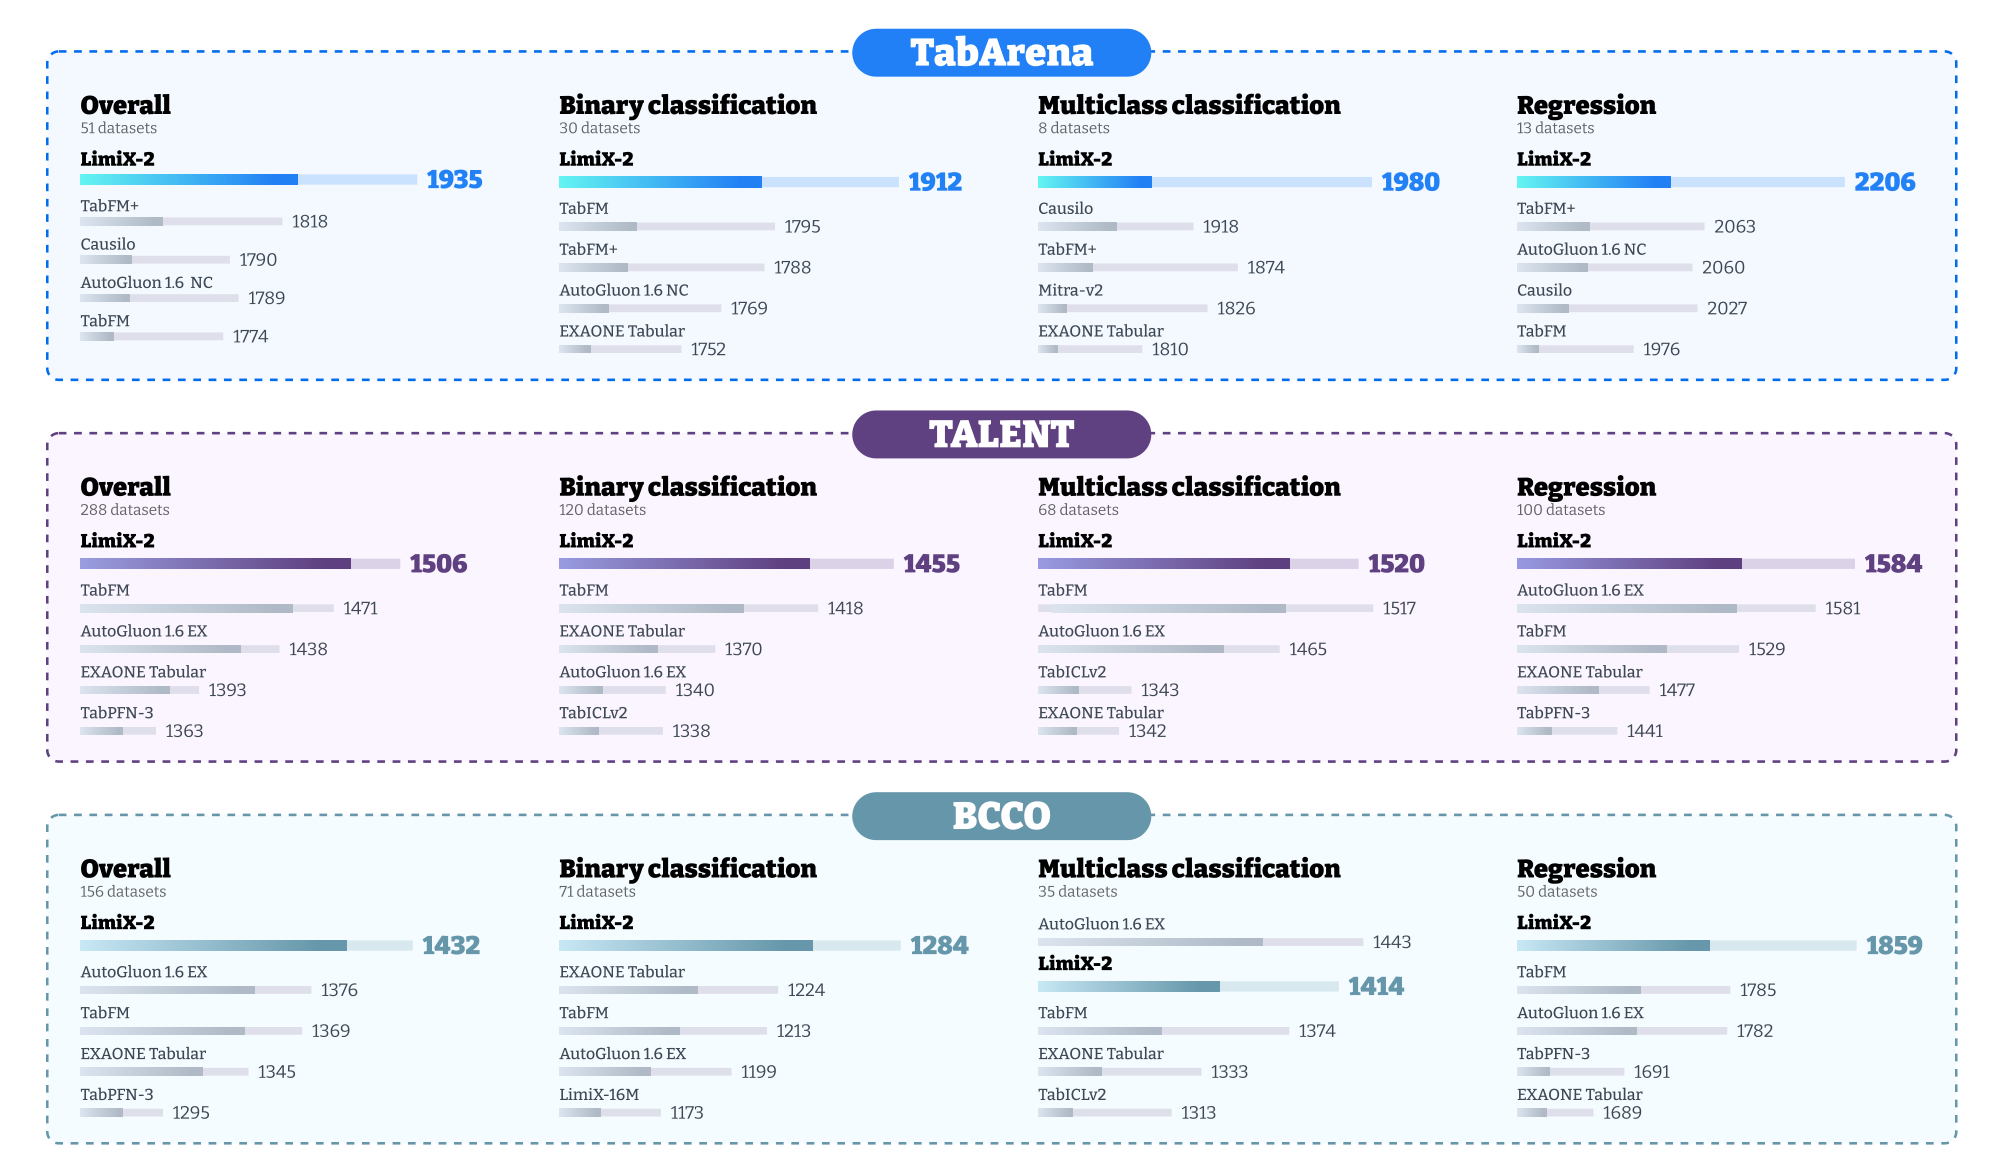
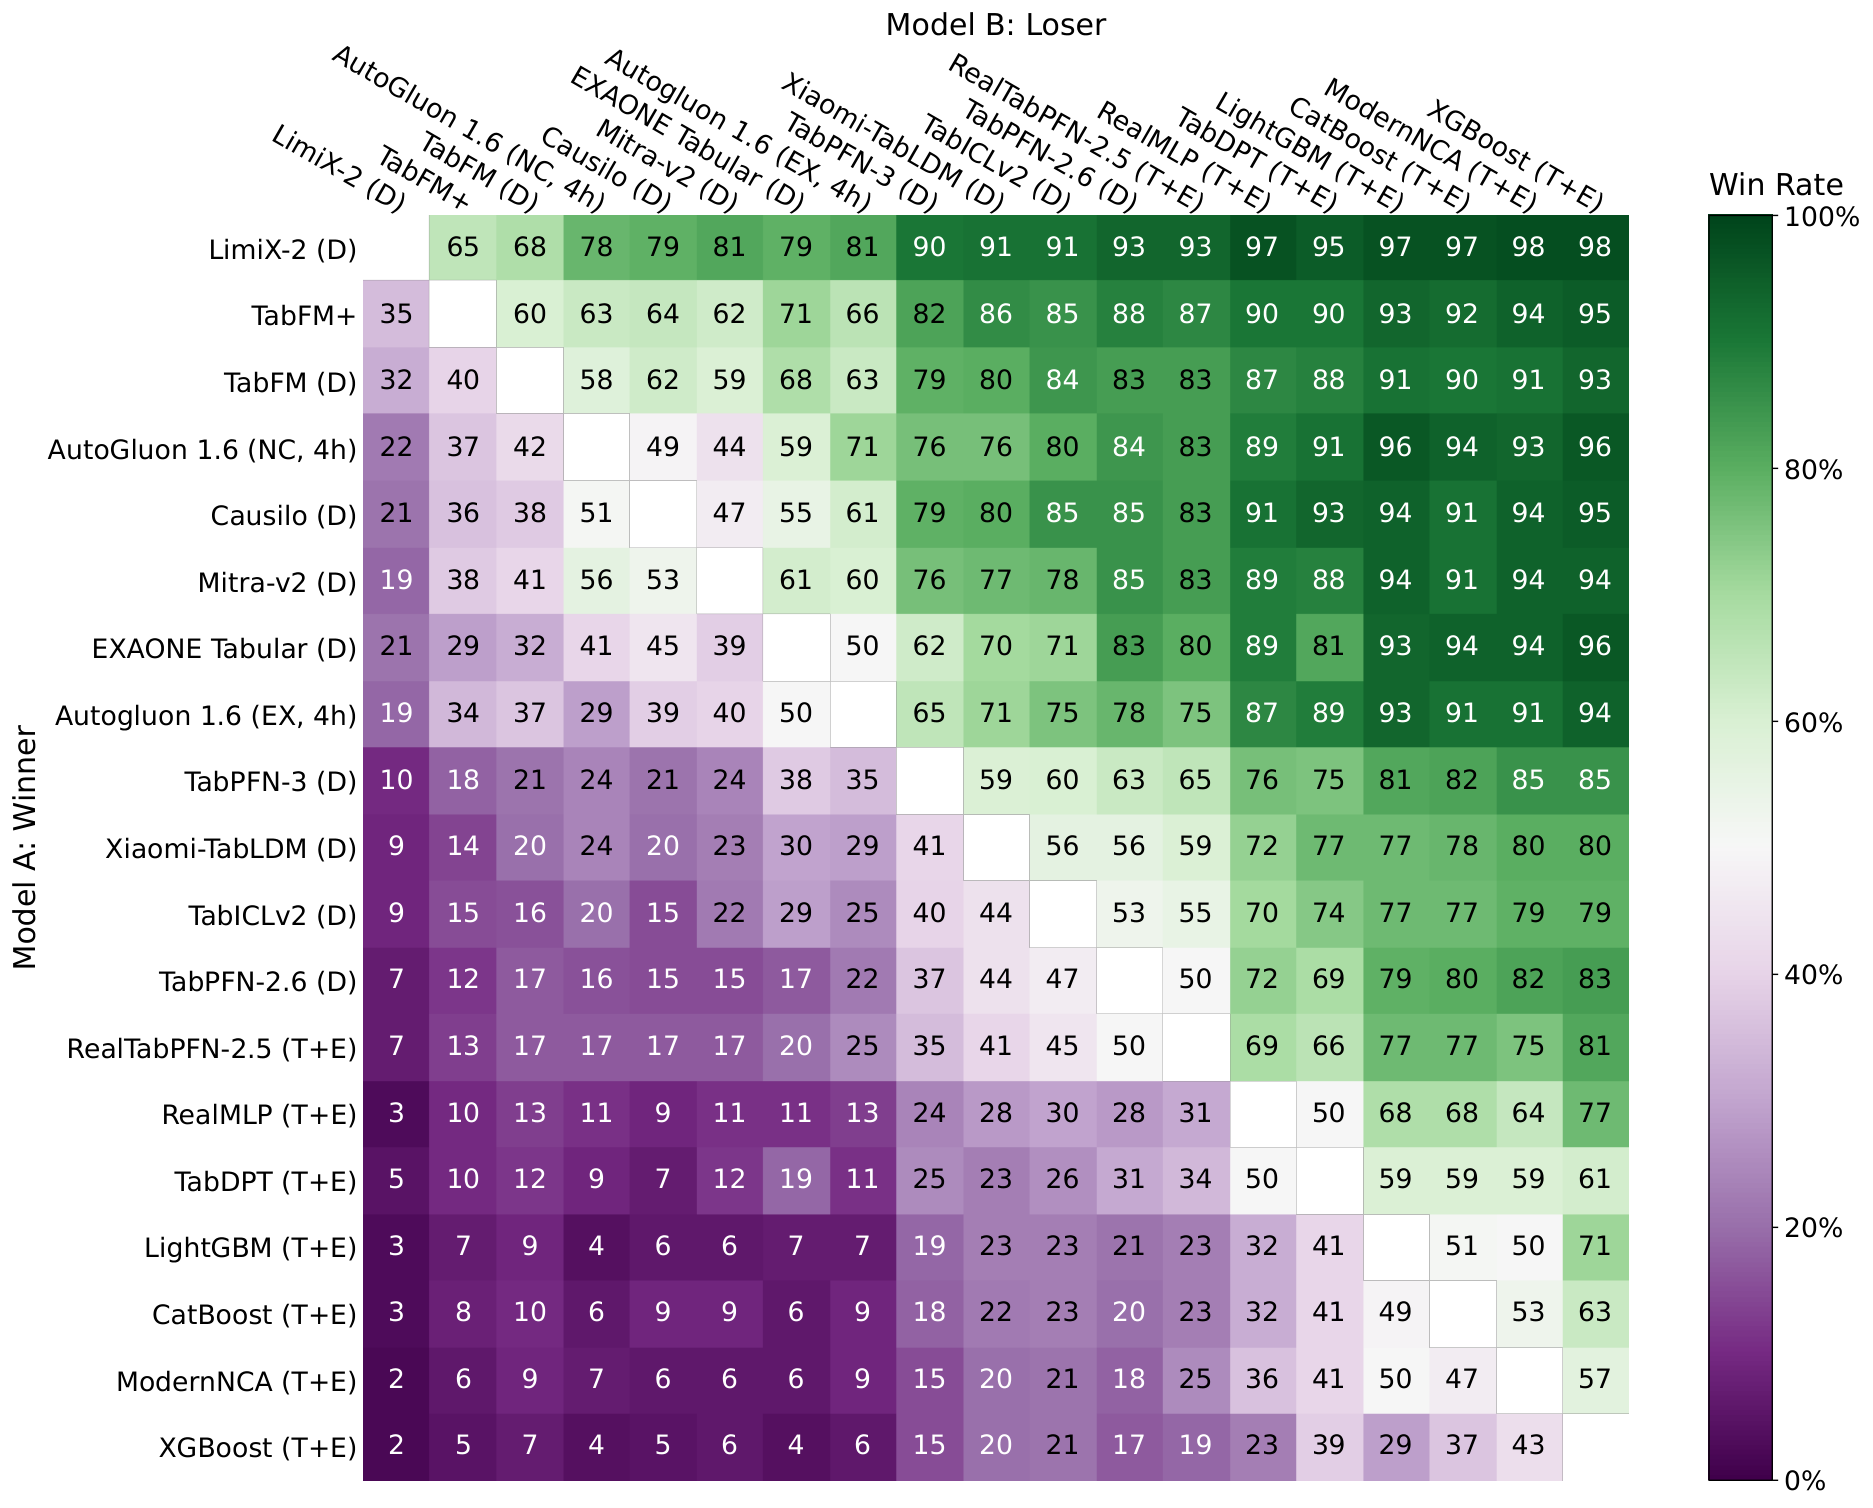
LimiX-2はTabArenaで1935、TALENTで1506、BCCOで1432のEloスコアを達成し、3つすべてにおいてAutoGluon 1.6および既存の表形式foundation modelsを上回り1位を獲得しました。TabArenaのpairwise比較では、LimiX-2の行のすべてのオフ対角エントリが各ベースラインに対して60%を超えるwin rateを示しています。
スケーリング。 12.5Mから406.2Mパラメータの6つのモデルサイズにわたってE_i=\alpha+\beta\log_2(N_i/100)+\varepsilon_iをfitすると、きれいな対数線形fitが得られます:TabArena \alpha=1863.88,\ \beta=34.68,\ R^2=0.9808;TALENT-CLS \beta=22.16,\ R^2=0.9792;TALENT-REG \beta=18.26,\ R^2=0.9680;BCCO-CLS \beta=11.24,\ R^2=0.9617;BCCO-REG \beta=30.06,\ R^2=0.9702。パラメータ数が2倍になるごとに、TabArenaとBCCO-REGで最大、BCCO-CLSで最小というように、概ね10〜35 Eloの向上が得られます。スケーリングのためのデータ生成および最適化レシピは固定されているため、これらの傾きは純粋に容量に起因するものと言えます。
因果スケルトンの復元。 LimiX-2の特徴量attentionをエッジスコアとして用いると、復元された無向因果スケルトンは、評価されたベンチマーク上で他の表形式foundation models、XGBoostの特徴量重要度ベースライン、および専用の因果発見手法を上回ります。これはSCMが生成した事前学習データの下でp(\mathbf{x},y\mid D_{\mathrm{ct}})を学習することの副産物です。
限界と未解決の問題
スケーリング係数はベンチマーク間で大きく異なり(BCCO-CLS \beta=11.24 対 TabArena \beta=34.68)、欠損値処理・ロバスト性の向上は、クリーンなタスクの予測性能向上よりも早く飽和することを示唆しています。10億パラメータ規模への外挿はfitされていますが、直接的な検証は行われていません。因果スケルトンの主張は直接依存性の代理としてのattentionに依存しており、CCMMの下でのエッジの識別可能性は形式的に分析されておらず、方向の復元についても同様です。事前学習はすべて合成SCMデータであるため、実世界の表形式データの特異性(重い尾を持つカテゴリカル語彙、時間的なリーケージパターン)に対する分布カバレッジは経験的なものにとどまり、保証されていません。最後に、N\times F\times dテンソルを用いるセルレベルの表現は、非常に幅広いまたは非常に長いテーブルに対してスケールしにくく、論文はtask FFNを拡幅していますが、スケール時のattentionコストの軽減策については報告していません。
なぜ重要か
表形式データのin-context learningをp(y\mid \mathbf{x},D_{\mathrm{ct}})からp(\mathbf{x},y\mid D_{\mathrm{ct}})へと再定式化することで、予測・補完・異常スコアリング・因果スケルトン発見が単一の事前学習モデルの下に統合されます。そして対数線形なEloスケーリング(5つのタスクグループにわたってR^2>0.96)は、構造化データfoundation modelsがLLMと同様の予測可能な容量スケーリングを持つことを示唆しており、これまでそのような指針を欠いていたサブフィールドにとって有用な計画の指標となります。
Source: https://arxiv.org/abs/2609.17488
PPOにおけるCritic学習の再考:Value Flatteningの理解と緩和
失敗モード
LLM推論のためのPPOにおいて、critic V_\phi(s) はロールアウトされた軌跡からのMonte Carlリターンで学習され、その予測はadvantage推定値 \hat{A}_t = R_t - V_\phi(s_t)(またはGAEの変形)をゲートします。著者たちは系統的な病理を記録しています。MC推定された状態価値 \hat{V}^{\text{MC}}(s_t) は隣接する推論ステップ間で鋭く変動する(思考の連鎖がある推論経路を確定または放棄する際に期待されるとおり)一方で、同じシーケンスにわたるcriticの予測はほぼ一定です。これを著者たちはValue Flatteningと呼んでいます。
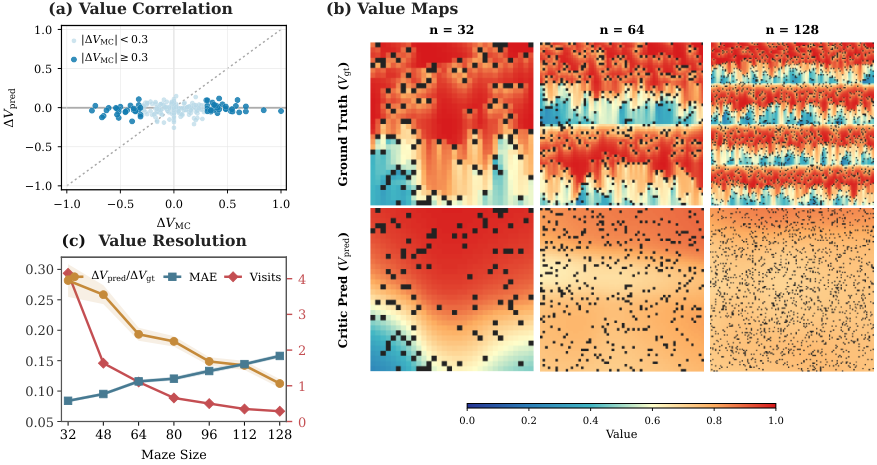
図2(a)は、DAPO-Math-17kで学習したQwen3-4B-Baseにおけるこのミスマッチを直接示しています。x軸では、隣接状態間の \Delta \hat{V}^{\text{MC}} が [-1,1] の全範囲にわたって広がっていますが、y軸では \Delta V_\phi がゼロ付近に収縮しています。criticは局所的な価値変化の大きさと符号の両方を見逃しています。その結果、真の継続価値が大きく異なる二つの推論状態がほぼ同じbaselineに収縮し、PPOの方策勾配が依存するadvantageシグナルを汚染します。
図2(b,c)は、これがLLM固有の現象ではないことを確認しています。迷路サイズ n \times n の確率的FrozenLakeにおいて、固定の学習予算のもとでも n が大きくなるにつれてcriticの価値マップは劣化します。真の価値はゴール付近に鋭い構造を保持しますが、criticのマップはぼやけ、価値解像度の統計量は n に対して単調に悪化します。その要因はトークン化や報酬のスパース性ではなく、状態空間のサイズです。
メカニズム
本論文はValue Flatteningを、標準的な dense critic lossにおける二つの連成した効果に帰因させています。
\mathcal{L}_V(\phi) = \frac{1}{T}\sum_{t=1}^{T}\big(V_\phi(s_t) - R\big)^2,
ここで、ある応答中の全状態 s_1,\dots,s_T は同じ終端リターンターゲット R を共有しています。
暗黙の分散ペナルティ。軌跡中の全状態が同じスカラー R に回帰されるため、\sum_t (V_\phi(s_t) - R)^2 を最小化することは(定数を除いて)\sum_t (V_\phi(s_t) - \bar V)^2 + T(\bar V - R)^2 を最小化することと等価です。ここで \bar V は軌跡上のcritic出力の経験的平均です。第一項はcriticの予測における応答内分散を明示的にペナルティ化し、真の価値軌跡に関わらずcriticを平坦なプロフィールへと偏らせます。
相関した状態からの冗長な更新。自己回帰的LMの連続した隠れ状態は高度に相関しているため、それらのcritic勾配 \nabla_\phi V_\phi(s_t) はほぼ同じ方向を向いています。Dense supervisionはそのため、一回のステップで多くのほぼ平行な更新を適用します。
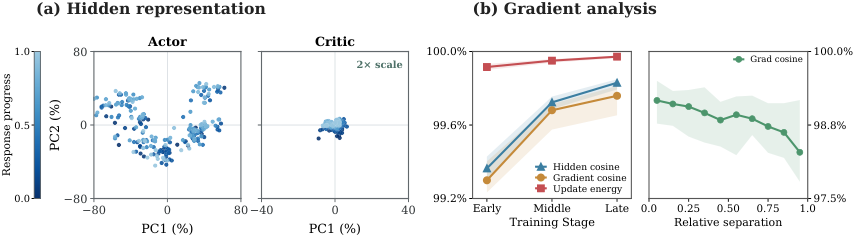
図3はこれを定量化しています。隣接状態間の隠れ表現のcosine alignment、勾配のcosine alignment、およびステップごとの更新エネルギーはすべて、PPO学習全体を通じて高いまま維持されます。冗長な更新は分散ペナルティバイアスを増幅させ、criticは状態条件付き関数ではなく、軌跡レベルの単一スカラーを学習します。
SP³O:sparse critic supervision
修正方法は診断から直接導かれます。各応答につき少数の十分に離れた状態でcriticを監督するというものです。SP³O(SParse Proximal PPO)はdense value lossを次のように置き換えます。
\mathcal{L}_V^{\text{sparse}}(\phi) = \frac{1}{|\mathcal{S}|}\sum_{t \in \mathcal{S}}\big(V_\phi(s_t) - R\big)^2
ここで \mathcal{S} は応答相対的な割合 \{0.3, 0.6, 0.9\} で選択され、少なくとも6144トークンの応答については後半の被覆を保つために 0.95 のアンカーが追加されます。これにより同時に、(i) 平均収縮項が |\mathcal{S}|=3 または 4 項しか含まなくなるため、暗黙の応答内分散ペナルティが弱まり、(ii) ほぼ平行な勾配の寄与のほとんどが除去されます。
方策lossは変更されず、critic supervisionのみがスパース化されます。advantageは(現在より良く解像された)criticを使用してすべてのトークンで引き続き計算されます。
結果
実験では、DAPO-Math-17kで学習したQwen3-4B-BaseとQwen3-8B-Baseにおいて、vanilla PPO、GRPO(critic不要)、およびSP³Oを比較しています。応答あたりたった三つの監督状態(条件付き 0.95 アンカーを加えた)で、SP³OはValue Flatteningを実証的に削減し(criticは非自明な隣接状態変動を回復します)、標準のPPOおよびGRPOと比較して、両方のモデルサイズと複数の評価スイートにわたって下流の方策性能を一貫して向上させます。本論文はモデルサイズと評価スイートにわたる改善を報告しており、そのメカニズムはタスクごとの調整なしに三つの固定相対位置の選択が機能するほど安定しています。
限界と未解決の問題
本論文は \mathcal{S} を軌跡の内容に適応させるのではなく、手動で選択した相対位置に固定しています。推論が実際に分岐する状態は、 0.3/0.6/0.9 分位点よりも情報量が多いと考えられます。\lambda < 1 のGAEに対してこの診断が拡張できるかどうかは不明です。そこではブートストラップされたターゲットが状態間で異なり、共有ターゲットの議論が弱まります。FrozenLakeの実験は効果が状態空間サイズとともに大きくなることを示していますが、LLMの体制においてモデルサイズやコンテキスト長のスケーリングとの関係は確立していません。最後に、分析はcriticを独立したheadとして扱っており、(実際によく見られる)backbone共有のcriticが方策との勾配干渉を通じて同じ病理を受け継ぐかどうかについては議論されていません。
なぜこれが重要か
Value FlatteningはLLM RLにおいて広く観察されていながら十分に理解されていなかったPPOの不安定性を、共有軌跡リターンへのdense critic supervisionの構造的な帰結として再定式化しており、その修正(数千状態ではなく三つの状態で回帰する)はデプロイにほぼコストがかかりません。また、GRPOのようなcritic不要の手法がなぜ競争力を維持し続けてきたかを部分的に説明します。標準的なPPO criticは積極的に誤較正されていたのです。
Source: https://arxiv.org/abs/2609.18708
長文コンテキストのMixture-of-Expertsトレーニングにおける全メモリピークの均一化
長文コンテキストでMoEモデルをトレーニングすると、平均フットプリントによる計算では見えない真実が明らかになります。つまり、単一のテンソルのマテリアライゼーションがHBMを超えた瞬間に実行が失敗し、どのテンソルが最初に問題となるかはモデル、シーケンス長、およびデバイス数に依存するということです。本論文では、標準的な並列化計画(ZeRO-3、シーケンス/コンテキスト並列、expert parallelism、tensor parallelism)が未制限のまま放置している四つのライブセットを特定し、それぞれをGPUワーキングセットが起動時に固定されるスケジュールに置き換えます。設計原則は統一されています。各置換演算子はビット単位で同一のforward値とgradientを返さなければならず、そのバウンドはcheckpointの再計算を経ても維持されなければならない——したがって、ルーティング行列によってサイズが決まるものはforward/backwardの境界をまたいで保持できません。
四つの未制限ライブセット
第2節では、ランクごとのサイズとともにそれらを整理しています。
- Expert dispatch: 2 R_d H b バイト。ここで R_d は宛先 d が受け取るルート数です。バッチ、top-k、およびルーターの不均衡とともに増加します。
- 語彙射影: トークン \times 語彙から得られる \mathcal{O}(NVb) のロジット。
- Checkpointの境界: 深さ \times 長さにわたってHBM上に \sum_{\ell\in\mathcal{S}} N_\ell H b。
- Optimizerの状態: オフロード時にシリアルなCPU更新で処理されるAdamモーメントの 12\Theta/W バイト。
これらのいずれもシャーディングの度合いによって制限されることはなく、それぞれ独自のストリーミングスケジュールを必要とします。
PipelinedLLEP: 受信側で制限されたdispatch
LLEPは人気のあるexpertからアイドル状態のランクへのオーバーフローを再分配しますが、all-to-all内でランクローカルのルーティングされたバッチ全体を依然としてマテリアライズします。PipelinedLLEPは、ソースごとの上限 c のもとでバッチをチャンクに分割します。
K = \min(\lceil N/c\rceil, K_{\max}), \quad c_{\text{eff}} = \lceil N/K\rceil, \quad R_d^{(i)} \leq E_p k c_{\text{eff}}.
このバウンドは E_p、k、および c_{\text{eff}} にのみ依存しており、ルーターの挙動がいかなるバッファも 2 E_p k c_{\text{eff}} H b バイトを超えさせることはできません。K が c から導出されるため、マイクロバッチの長さの変動はOOMパスなしにオンザフライで吸収されます。チャンキングはストライドではなく連続であり、LLEPにおいてトークンの宛先がその位置によって決まるという特性を活用しているため、隣接する位置は同じ宛先にクラスタリングされます。
語彙射影のためのRing-DTP
ロジットヘッドに対して、この演算子はactivationまたは重みシャードを P 個のtensor-parallelワーカーのリングを周回させ、各ロジットのストリップをオンラインのlog-sum-expに畳み込みます。重みを移動させるvariant(Figure 9)では、ランク r はそのバッチ (X_r, t_r) と実行中の統計 S_r を常駐させたまま、各語彙ブロック W_p がリングを一周します。P 回の出会いの後、各 S_r はリターンホップなしにローカルで完結します。これにより、射影のピークは \mathcal{O}(NVb) から \mathcal{O}(NVb/P) に削減され、lossとgradientの正確さは維持されます。
選択的checkpoint offloadとOffloadStreamAdamW
SCOは各checkpoint境界において単一の長期間保持されるテンソルのみをCPUメモリに保持し、checkpointセットからのHBMへの寄与を深さによらず \leq 2 N_{\max} H b に抑えます。OffloadStreamAdamWは、シリアルなCPU AdamW更新をサイズ \beta のバケット化されたパイプラインに変換します。HBMフットプリントは \mathcal{O}(\beta) に削減され、ホスト計算はデバイス計算をブロックするのではなくオーバーラップします。
エンドツーエンドの組み合わせ
四つの演算子は、16、32、64台のH200 GPU上の120B、241B、667B MoEモデルに対してMoPランクレイアウト内で組み合わされます。ベースラインはFSDP2-bestです。つまり、expert、context、tensor parallelismと組み合わせたFSDP2の完全なスイープにおける最高スループットの点です。
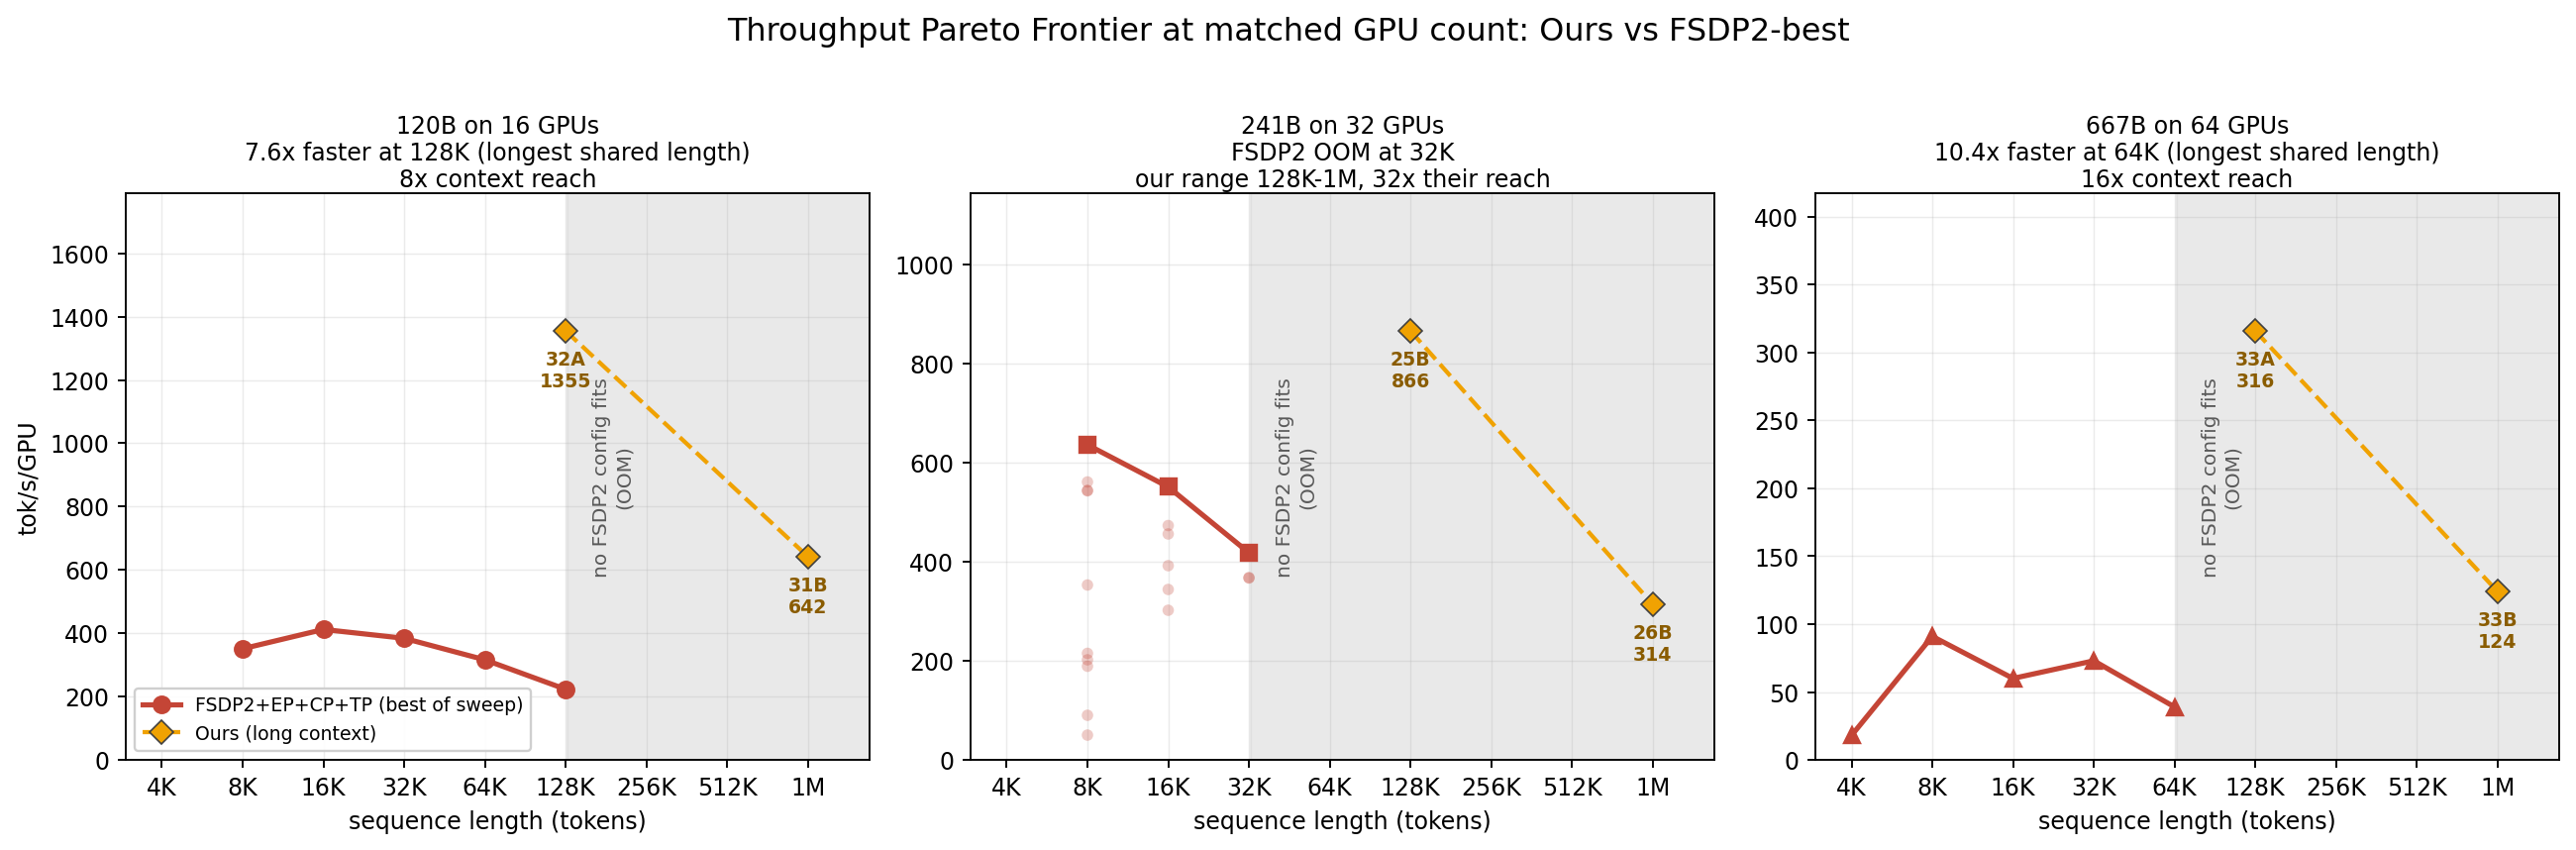
FSDP2-bestは三つのモデルスケールにおいてそれぞれ128K、32K、64Kトークンを超えるとメモリを使い果たします。一方、組み合わされたスタックは三つすべてで1Mトークムのトレーニングが可能であり、8\text{–}32\times のコンテキストリーチを達成します。FSDP2-bestがまだ収まる最長の長さでは、スタックは120Bモデルの128Kで 7.6\times 高速であり、667Bモデルの64Kで 10.4\times 高速です。241Bのケースが最も顕著です。FSDP2-bestはスタックの最短構成の4倍短い32Kで停止します。
FLOP率のパネルはスループットのトレンドを反転させます。なぜならattentionの計算量がコンテキストに応じてスケールするからです。GPU当たりのレートは128Kでの 91\text{–}110 TFLOP/sから1Mでの 213\text{–}233 TFLOP/sへとほぼ2倍になる一方、FSDP2-bestはそのスイープのどこでも40 TFLOP/sを超えることがありません——667Bではベースラインレートの約 2.2\times となります。
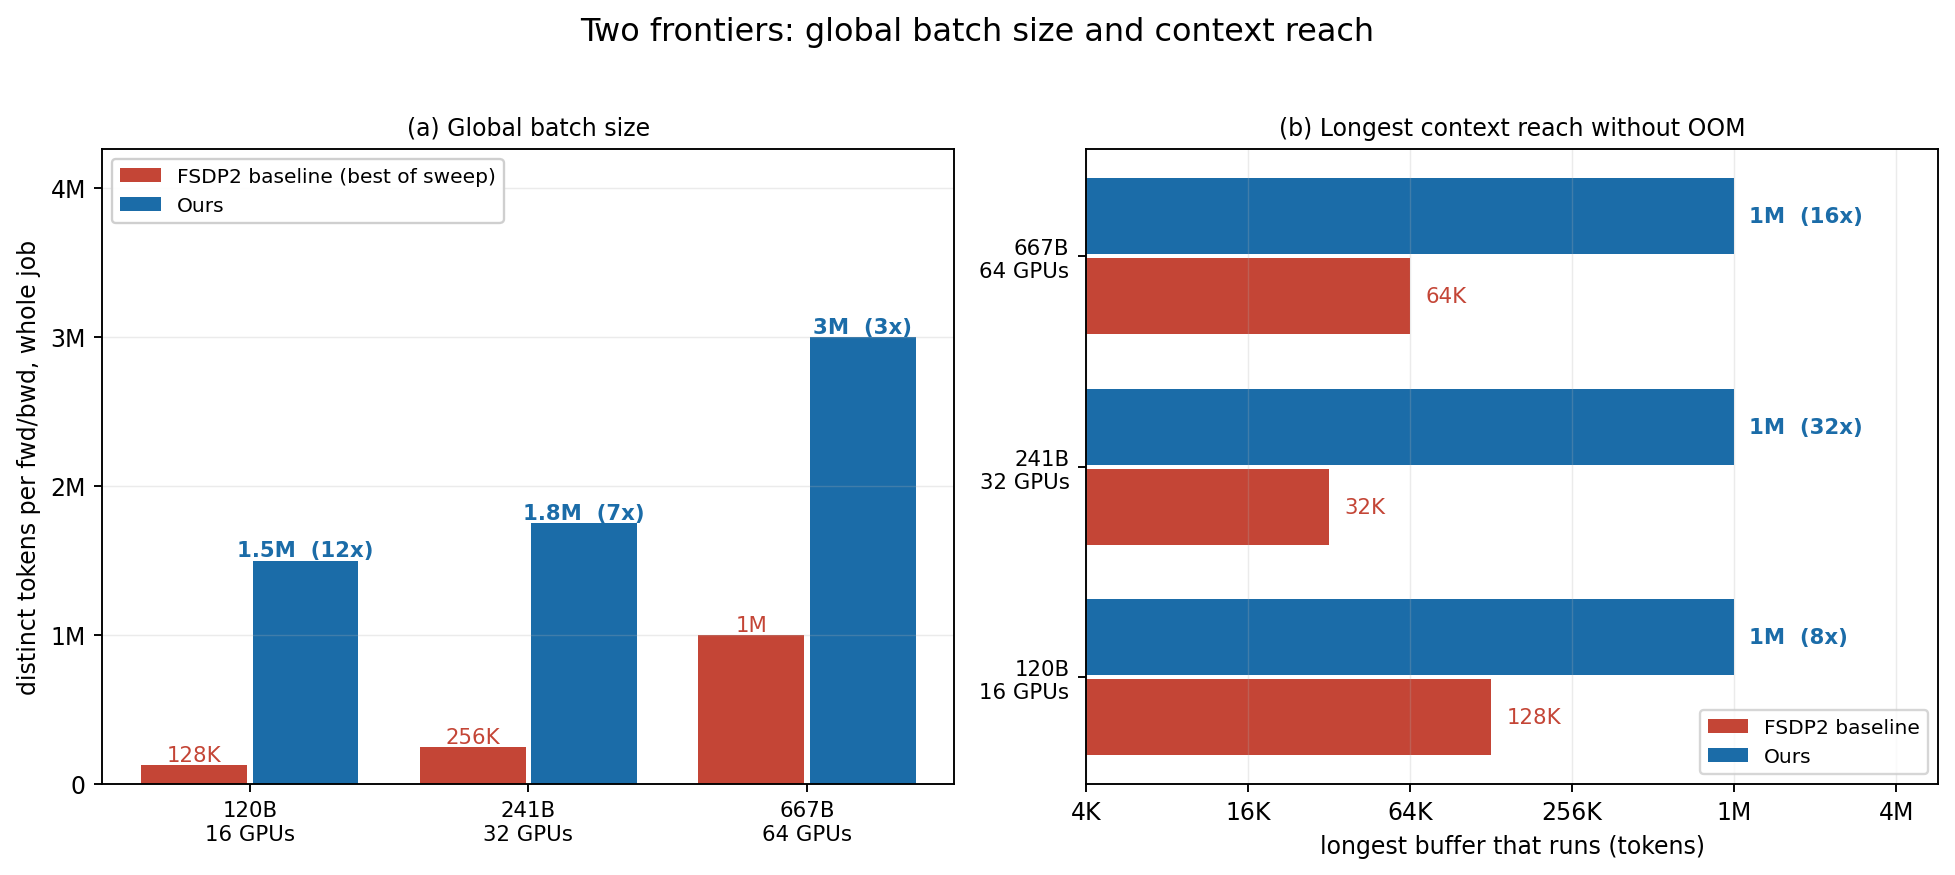
Figure 7は、対数スケールのコンテキスト軸によって複数桁のギャップが視覚的に明確になる形で、バッチサイズとコンテキストの両方におけるフロンティアの拡張を示しています。
制限事項と未解決の問題
評価はシングルノードスケール(最大64台のH200)であり、Ring-DTPの効率はリング帯域幅に依存します。異種リンク速度を持つマルチノードファブリックでの挙動は報告されていません。SCOとOffloadStreamAdamWはHBMをホストデバイス間のPCIe帯域幅とCPUメモリとトレードオフしますが、offloadパス自体がボトルネックとなる状況(例えば、\Theta/W が非常に小さい場合や低速なホストの場合)については論文内で特徴付けられていません。Figure 6の10% MFUの破線基準は、組み合わされたスタックでも短いコンテキストにおいて従来の密なトレーニングの利用率を下回ることを示しており、この手法の利点はリーチであって、ピーク算術強度ではありません。演算子は数値的に同一の出力を必要としますが、オンラインlog-sum-expのためのfp8/混合精度アキュムレーションとの相互作用についてはより詳しい議論が必要です。最後に、PipelinedLLEPのチャンク連続性はLLEPの位置から宛先へのマッピングに依存しており、宛先が位置の関数でないルーターに対してはこの議論を調整する必要があります。
この研究の意義
長文コンテキストMoEトレーニングは現在、特定の構成で最初に問題となるテンソルによってゲートされており、一つのピークを下げると次のピークが露わになるだけです。本論文の貢献はアーキテクチャ的な規律にあります。すべてのスケーリング軸を起動時固定のワーキングセットで制限することで、FSDP2のスイープが32Kで失敗するモデルにおいても、組み合わせたスタックが1Mトークンまでスケールできるようになります。
Source: https://arxiv.org/abs/2609.14306
ScienceIDE: 世界の科学コードベースをエージェント学習可能な環境へ
科学ソフトウェア——MHDコード、PICソルバー、DFTツールチェーン、スタビライザーシミュレーター——は実行可能な形式で方法論的知識を体現していますが、エージェントの学習シグナルとしてはほとんど活用されていません。標準的なコードベンチマークはコンパイルやテスト通過を報酬とするのに対し、科学的正確性には物理的不変量、基礎となる離散化に合わせて較正された数値許容誤差、そして正当な実装の差異を乗り越えた等価性契約が必要です。ScienceIDEは、固定されたアップストリームリポジトリをこれらの基準が実行可能なチェックによって強制される環境へと引き上げ、得られた検証済みの軌跡をSFTおよびRLに活用するためのインフラストラクチャです。
構築パイプライン
構築の単位はバージョン管理されたコードベース内の科学モジュールです。これは実行可能なカバレッジ、所有する実装パス、および明示的に除外された責任を持つ、一貫した科学的責任(例:Godunovフラックスステージ、粒子プッシュ、スタビライザー分解)を指します。エージェントは固定されたリビジョンを検査し、依存関係を解決してソースをビルドし、公式のテストと例を実行して数値的変動性とコストのかかるパスを明らかにした上で、モジュール分解を提案します。ドメイン専門家が境界と等価性契約をレビューし、レジストリは来歴を強制しますが、観測量の選択は行いません。
承認されたモジュールは、(i) 編集可能なエージェントワークスペース、(ii) 較正された合格ポリシーを持つ公式テストから派生した公開チェック、および (iii) 採点時に使用されるプライベート検証器と合わせてパッケージ化されます。次にタスクファクトリーが環境ごとにオーサリング手順を特化させ、初期ワークスペース、成果物、検証器を指定するタスクを生成します。同一のチェックスイートが修正、実装、高速化、再現のタスクファミリー全体で再利用されるため、専門家による較正コストが分散されます。
チェック較正は実質的な設計上の貢献です。測定された感度が科学的に意味のある範囲に収まる場合は点ごとの比較が使用され、点ごとの境界が識別能力を失わずに正当な変動を含むことができない場合は不変量が使用されます。タイミング、適応的ステップ数、ランクレイアウト、およびRNG引き値は明示的に観測量とはされません。公称および変種の初期条件が較正の根拠を提供します:各参照実行は、利用可能な場合、代替の正当なビルドのもとで自己再現しなければならず、観察されたばらつきは許容誤差を(自動的に決定するのではなく)形成するための情報を提供します。各チェックには、区別することを意図した逸脱を述べた根拠が付随します。
インベントリと評価
固定されたコホートは27のアップストリームコードベース(Athena++、MITgcm、PLUTO、PHANTOM、LAPS、EPOCH、Meep、QuTiP、Stim、pymatgen、Gkeyll、EPREM、G4CMP、NEST、S4、pyAMG、PyXSIM、Basilisk、dscribe、EDKit.jl、eftcamb、Mink、Scirpy、SimuPy-Flight、strax、TSID、EDKit)にわたり、64の環境と2,812のタスク(2,515の修正、295の実装、2の高速化)、および1,076の実行可能チェックを含みます。
ScienceIDE-Hardは、5つのリポジトリファミリー(33件のMITgcm、31件のPLUTO、11件のLAPS、9件のAthena++、1件のPHANTOM)にわたる18の環境からの固定された85タスクのコホートです。成功には単なる実行ではなく、プライベートな科学的チェックに合格することが必要です。失敗の診断は、終了ステータスが情報量を持たないことを示しています:Qwenは試行の37.3%で予算に達し、失敗エピソードあたり48.5分を費やします。Haikuはタイムアウトを記録せず、失敗あたり平均7.7分で、試行の74.9%で空の提出ベースライン以下の結果を返します。MiniMaxは低い成功率と31.6%のタイムアウト、34.1分の失敗を組み合わせています。繰り返しの不安定性は重大で——モデルとタスクのペアの28.0%が最初の3回の有効な試行内に成功と失敗の両方を含んでいます。Geminiは85タスク中33タスクで結果を反転させるのに対し、Astraは8タスク、Kimiは29タスクです。したがって、集計成功率はタスクレベルの信頼性の欠如を隠蔽しています。
科学的経験からの学習
著者らは数値等価性検証によってフィルタリングされたGPT-5.6-solの軌跡を用いたSFTにより、PhAI-IDE-4B/9B/72B(Qwen3.5-4B、Qwen3.5-9B、Qwen2.5-72B-Instructから)を学習させています。コーパスはタスク識別子で分離されており:564タスクからの4,567個の学習セグメント、81タスクからの544個の検証セグメントです。lossはターゲットセグメント内の新しいassistantトークンとツール呼び出しにのみ適用され、指示、観測、再利用された履歴、および失敗/繰り返し/拡張読み取り専用としてフラグが立てられた軌跡はマスクされますがコンテキストとして保持されます。学習はすべての線形層に対してLoRAを使用し(r=32、\alpha=64、dropout 0.05)、BF16、グローバルバッチ64、36,864トークン制限、学習率 2\times10^{-5}、3%ウォームアップ、コサイン減衰、3エポック(216ステップ)で行われます。最終チェックポイントはベンチマークに基づく選択なしで直接使用されます。
検証lossはエポック1から3の間に0.383→0.340(4B)、0.369→0.325(9B)、0.401→0.313(72B)に低下し、最終的なマスクされていないターゲットトークン精度はそれぞれ91.12/91.33/92.01%です。
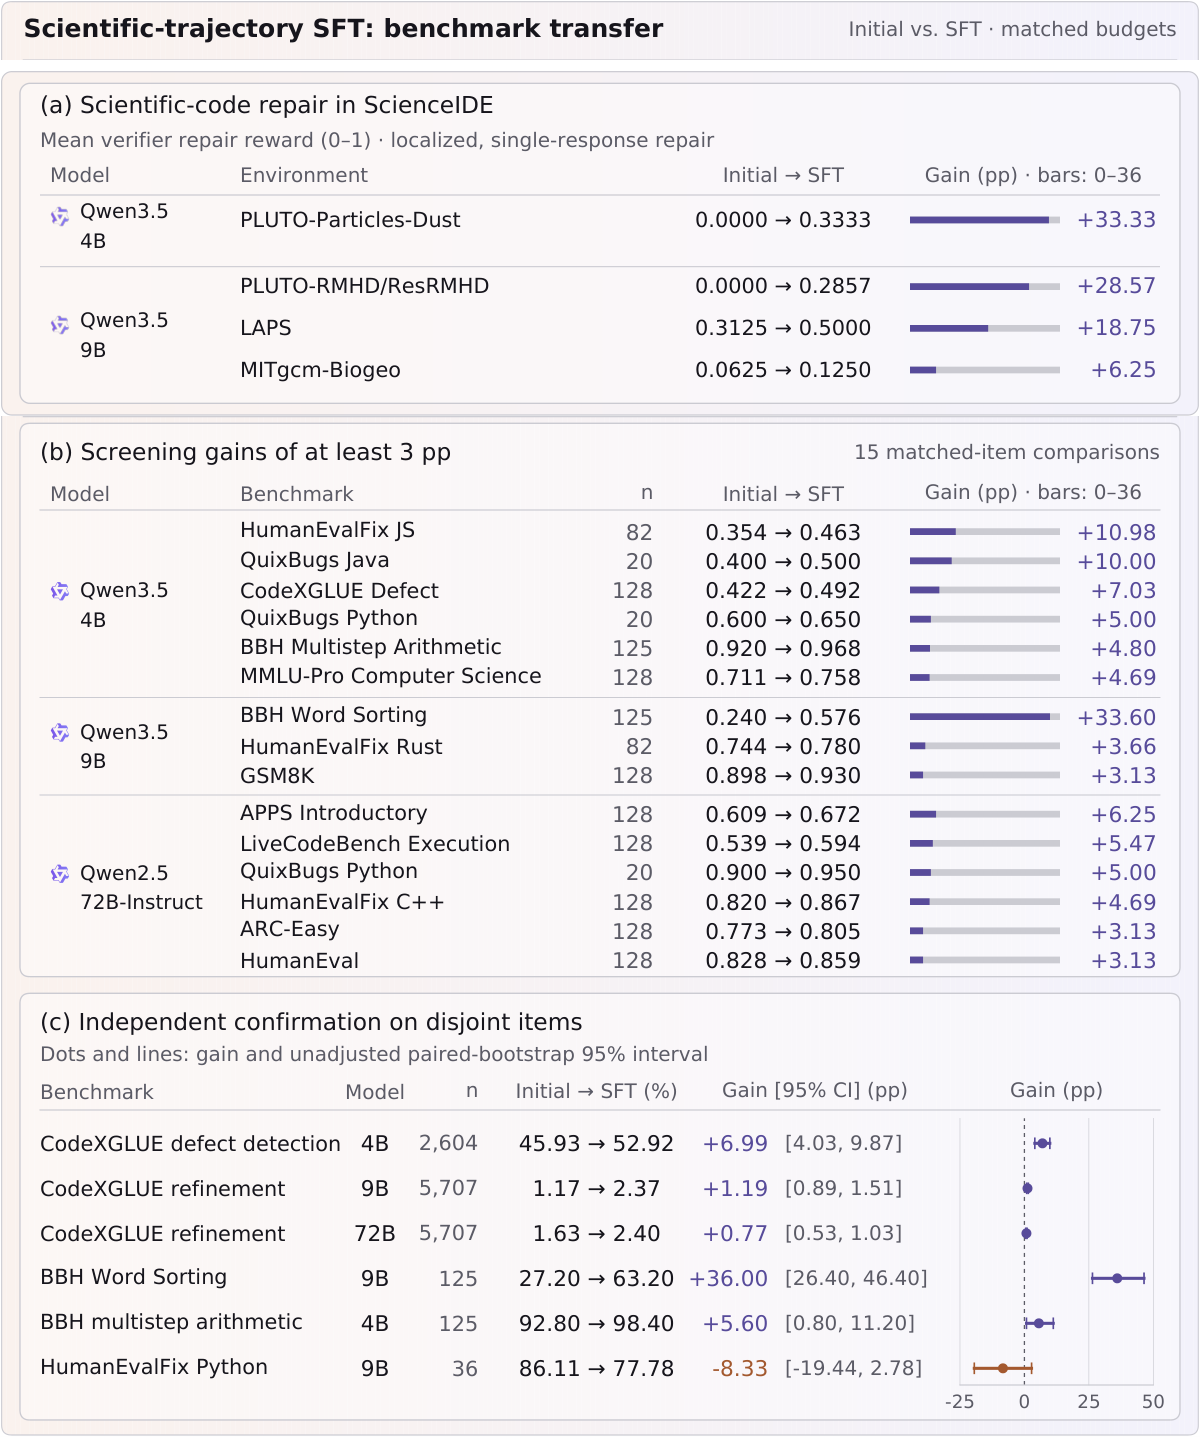
より興味深い結果は転移です:検証済み科学的軌跡に対するSFTがホールドアウトのScienceIDE修正タスクを改善する(0〜1スケールでの平均検証器報酬、パーセンテージポイントの向上として報告)とともに、一般コード、推論、知識ベンチマークにわたる15のモデル-ベンチマークペアで≥3 ppの向上をもたらします。これは、物理的・数値的検証に根ざした経験が科学的特異性への過学習ではなく、正の転移をもたらすという証拠です。
制限と未解決の問題
高速化ファミリーは実質的に空(タスク2件)であるため、等価性のもとでの高速化はテストされていません。ScienceIDE-Hardは2つのコードベース(MITgcm + PLUTO = 64/85)に偏っており、リポジトリファミリーの汎化とモジュールファミリーの汎化が分離されていません。チェック較正は専門家が媒介しており、環境をまたいで均一ではありません——根拠は監査可能ですがドメインをまたいで比較不可能であり、環境をまたいだ報酬の集計が複雑になります。RL結果は参照されていますが抜粋には示されておらず、SFTの教師はGPT-5.6-solであるため、蒸留による交絡が存在します。繰り返し不安定性の数値は、ScienceIDE上に構築されたリーダーボードが明示的に制御する必要のある評価確率性を示唆しています。
この研究の意義
科学におけるエージェントの信頼性の高い学習には、正当な実装の変動と科学的に意味のある逸脱を分離する検証器が必要です。ScienceIDEはその点を専門家較正済みの実行可能チェックをタスクファミリー全体で再利用することによって実現し、得られた軌跡での学習がソースドメインを超えて転移することを示しています。これは合成タスクではなく既存の科学コードベースから検証可能なRL/SFTシグナルをスケールアップするための実行可能なテンプレートです。
Source: https://arxiv.org/abs/2609.19134
ProgramDistill: インタラクティブなWebアプリから検証可能なリファレンスガイド付きSWEタスクへ
既存のコーディングエージェントベンチマーク(SWE-benchおよびその派生)は、対象となる動作がテキストで仕様化されていることを前提としています——イシュー、ドキュメント文字列、失敗するテストなどです。実際のWeb開発では、仕様がもう一つの稼働中のシステムであることも多く、ソースは不透明でもブラウザを通じて動作を観察できるリファレンス実装として存在します。ProgramDistillはこの設定をリファレンスガイド付きソフトウェアエンジニアリングとして形式化します:完全に機能するリファレンスアプリケーションと、機能が欠落している編集可能な現在のアプリケーションが与えられたとき、エージェントはリファレンスと対話して意図された動作を推定し、それを再現するように現在の実装を修正しなければなりません。
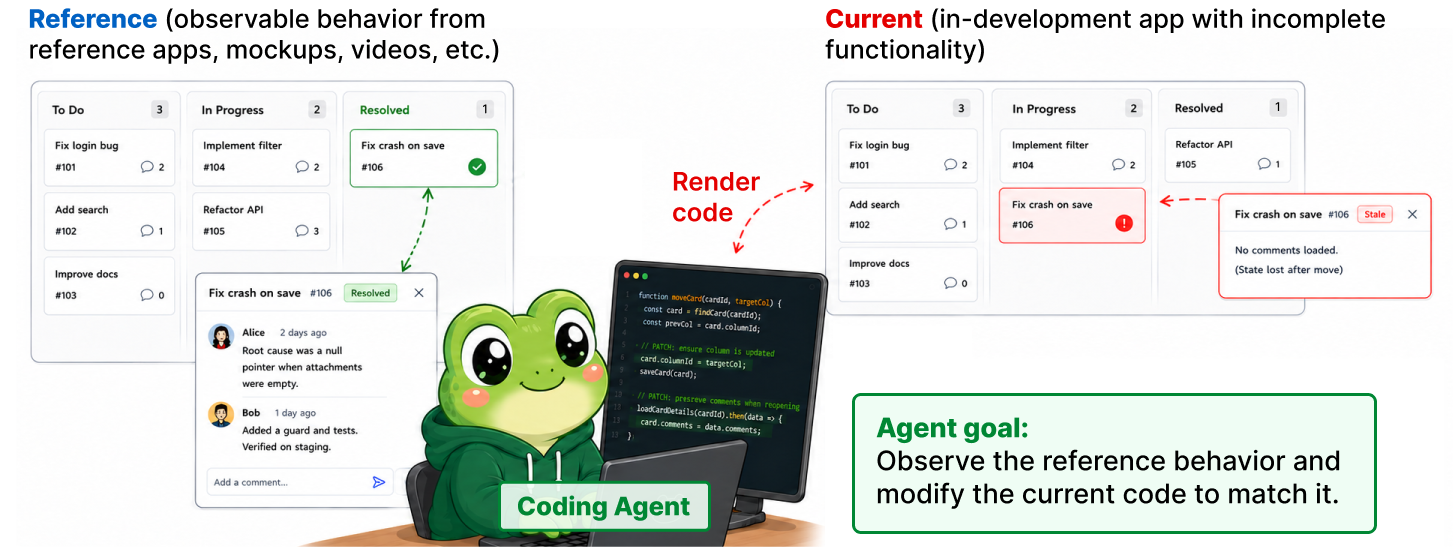
著者らが解決する核心的な問題は、人手によるイシュー・テスト・動作アノテーションを必要とせず、自動的なグランドトゥルース検証を伴うこうしたタスクのスケーラブルな構築です。
mine–craft–patchパイプライン
各アプリケーションは決定論的なブラウザアクセス可能な実行環境としてインスタンス化され、(i) 観察のための安定したリファレンス、(ii) タスク構築と修復のための編集可能なコピー、(iii) リプレイベース検証のための再現可能なランタイムを提供します。全ての構築エージェントはGPT-5.6 Solを使用しており、パイプライン自体はモデル非依存です。
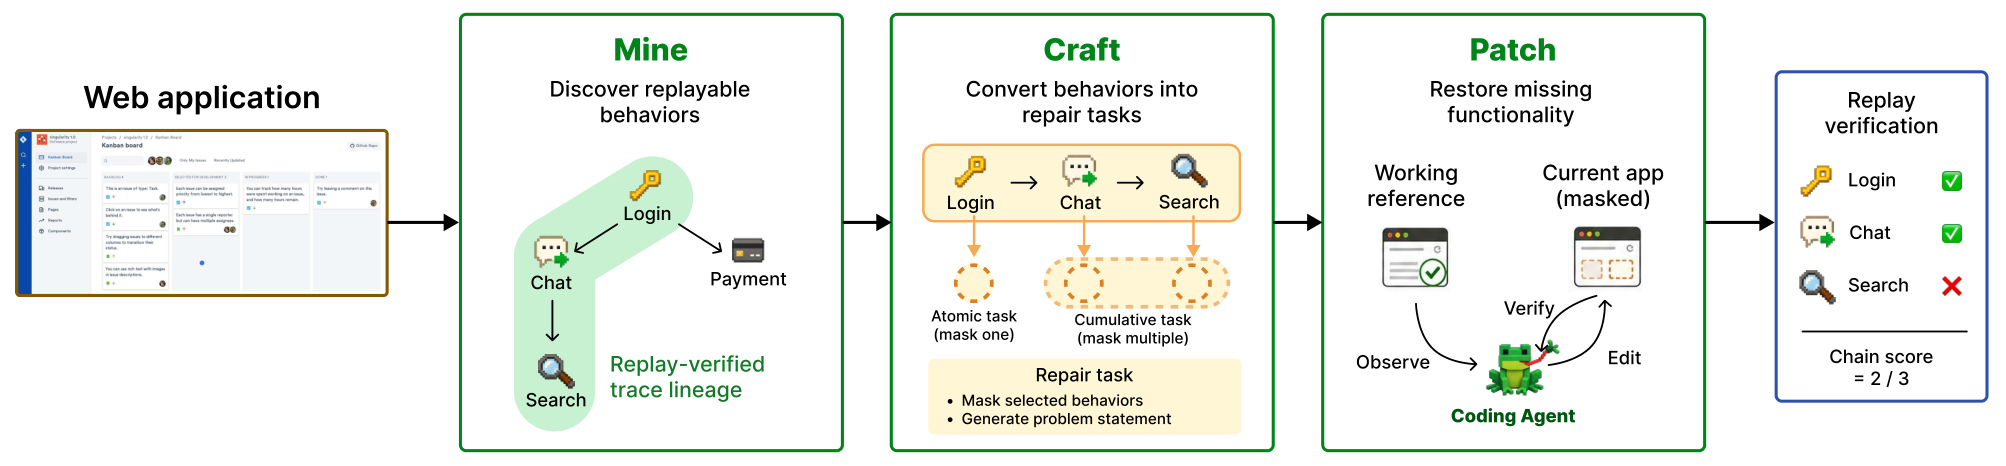
Miningは候補となる動作目標を提案し、各目標を実現するインタラクショントレース \tau を記録します。非自明なUI動作のほとんどは事前のアプリケーション状態(アカウント、作成済みボードなど)に依存するため、miningはトレースをフラットには扱いません;既に検証済みのトレースを拡張して新しいトレースを生成し、前提条件トレースツリーを形成します。各ノードの実行には、状態を確立するためのブリッジとして祖先のリプレイが必要です。形式的には、深さ d における対象トレースは系譜 (\tau_1, \tau_2, \ldots, \tau_d) を必要とし、\tau_{i} は \tau_{<i} がリプレイされた後にのみ実行可能です。図3はTrelloクローンにおける具体例を示しています:アカウント設定 \tau_1 がボード/カード作成 \tau_2 に先行し、それがエディタ操作 \tau_3 に先行します。
候補トレースがツリーに受け入れられるのは、クリーンな状態からのリプレイによって再現できる場合のみであり、検証済み動作としてマークされる前に2回目の最終リプレイチェックを通過しなければなりません。これがグランドトゥルースの源泉です:各検証済みトレースは決定論的で再現可能な受理基準を持ちます。
Craftingはマスキングによってタスクを生成します。アトミックタスクは1つの動作だけをマスクし——ゴールドパッチはその動作のリファレンス実装とマスクされたバージョンの差分です。cumulativeタスクは前提条件ツリーに沿った系譜 (\tau_1,\ldots,\tau_k) をマスクし、エージェントが依存チェーン全体を復元することを求めます。マスクはさらにスコープによってlogic-onlyとlogic-and-UIに分割され、エージェントが動作だけでなく視覚的アフォーダンスも再構築する必要があるかどうかを制御します。
Patchingはコーディングエージェントにリファレンス(動作観察可能)とマスクされた現在のアプリケーションを渡します;エージェントが編集を提出した後、パイプラインは対応する系譜トレースをリプレイし、チェーンの成功した割合を報告します。各トレースは決定論的なリプレイ判定を持つため、評価はステップごとに \{0,1\} となり、系譜ごとおよびcumulative成功率に集約されます。
ベンチマーク統計と結果
26のアプリケーションにわたって、miningは2,800の候補目標を提案し、2,350のトレースを収集します。そのうち2,165がクリーンな状態からリプレイされ、1,975が最終リプレイチェックを通過します。結果として得られる前提条件ツリーは最大系譜深さ d=17(平均 3.40)、最大幅 60、平均分岐率 1.78 に達します。Craftingはアトミックとcumulativeのバリアント間で分割された4,063のタスクを生成し、logic-onlyとlogic-and-UIのスコープに分布しています。
9つのフロンティアコーディングエージェントにおける主要な数値:
- 完全なアプリケーション再構築、cumulativeワークフロー。 GPT-6 Astraは 49.2\% の成功率に達し、Claude Opus 5は 28.8\% に達します。cumulative多段階タスクにおけるトップモデル間のギャップはおよそ 20 ポイントであり、イシュー形式のベンチマークで通常見られるよりも大きいです。
- 復元深さの関数としての部分的なアプリケーション再構築。 深さとともに成功率は崩壊します:深さが 1 から 8 に増加するにつれて、強いモデルでは 100\% \to 64.0\%、弱いモデルでは 96\% \to 32\% となります。 d=1 におけるほぼ完璧な性能は、ライブリファレンスからのアトミックな単一動作修復がフロンティアモデルにとってほぼ解決されていることを示しており、d に伴う性能低下は合成的なリファレンスガイド付き修復を困難な軸として切り離しています。
深さでパラメータ化された構造は、ProgramDistillに制御された難易度のための調節つまみを与え、カリキュラムとしての使用を可能にします:d が増加するcumulative系譜は、それぞれ自動検証を伴う、自然により困難なトレーニング目標のシーケンスを提供します。
限界と未解決の問題
パイプラインのカバレッジは、LLMが目標として提案できるものと、miningエージェントがブラウザを駆動して実行できるものによって制限されます;2,800の候補から1,975の検証済み動作への低下(\approx 29\% の消耗)は、リプレイの不安定さとカバレッジのギャップの両方を反映しています。検証は動作的(記録されたトレースのリプレイ)であり、意味論的ではありません——エージェントは一般的な動作ではなく、記録されたインタラクションパスのみを一致させることで通過できる可能性があります。コーパスは26のアプリケーションであり、異種ではあるものの実世界のWebエコシステムと比較して小規模です。最後に、全ての構築は単一のフロンティアLLM(GPT-5.6 Sol)に依存しており、そのモデルが表現できる動作への系統的なバイアスは生じやすく、ここでは定量化されていません。
この研究の意義
ProgramDistillは、ほとんどのSWEベンチマークが無視している設定を運用可能にします:テキストではなく稼働中のソフトウェアとして提供される仕様です。深さ対成功率の急峻な曲線は、アトミックタスクベンチマークが隠してしまう現在のエージェントにおける合成的な弱点を露わにし、完全に自動化されたリプレイ検証パイプラインは、リファレンスガイド付き修復の評価とカリキュラム形式のトレーニングの両方のための実用的な基盤となり得ます。
Source: https://arxiv.org/abs/2609.18805
VC-Attention: 低ビット Attention のための Value Smoothing と Softmax Casting
シーケンス長が時空間解像度とともに増大するため、video diffusion transformer のデプロイコストにおいて attention が支配的となっています。既存の低ビット attention カーネル(SageAttention2/3、FlashAttention-4 の INT8/FP8)はこのコストを追求していますが、2つの問題が残っています。(1) value テンソルはチャネル方向または時空間方向に活用できる構造のない外れ値を含んでおり、少数の大きなエントリにブロックごとのスケールが無駄に費やされる。(2) 両方の行列積が Tensor Core の精度で量子化されても、それらの間にある softmax — FP32 の指数演算とダウンキャスト — が最も長いパイプラインステージになる。VC-Attention はこの両方に対処する training-free フレームワークであり、online softmax の漸化式をそのまま維持します。
2つの残存ボトルネック
動機は Wan2.2 上で定量化されています。\mathbf{QK} に Hadamard 回転を適用すると、確率側の量子化誤差が 1.6× 小さくなりますが、\mathbf{PV} 誤差は変わらず、2つのうち大きい方のまま残ります。QK が平滑化された後は、value の量子化がスコアの量子化ではなく忠実度を制限します。同時に、B200 では、Tensor Core が超越関数を加速しないため、2つの低ビット行列積の間にある FP32 の指数演算とキャストがクリティカルパス上に留まり続けます。
V-Smooth: クラスタリング、減算、復元
FlashAttention の online 漸化式のブロック更新を振り返ると、
m_i' = \max(m_i, \operatorname{rowmax}(\mathbf{S}_{ij})),\quad \alpha_i = \exp(m_i - m_i'), \widetilde{\mathbf{P}}_{ij} = \exp(\mathbf{S}_{ij} - m_i'),\quad \mathbf{A}_i \leftarrow \alpha_i \mathbf{A}_i + \widetilde{\mathbf{P}}_{ij}\mathbf{V}_j, l_i \leftarrow \alpha_i l_i + \widetilde{\mathbf{P}}_{ij}\mathbf{1},\quad \mathbf{O}_i = \mathbf{A}_i / l_i.
V-Smooth は、軽量な online クラスタリングによって value トークンを並べ替え、各ハードウェアブロックが近い大きさのトークンをグループ化するようにします。インデックス j のブロック内では、ブロック平均 value ベクトル \bar{\mathbf{v}}_j = \frac{1}{B}\sum_{t\in j}\mathbf{V}_t を減算し、残差 \mathbf{V}_j - \mathbf{1}\bar{\mathbf{v}}_j^\top のみを量子化します。平均は、漸化式がすでに維持している行和を通じて、ストリーミング分子の更新に折り返されます。\widetilde{\mathbf{P}}_{ij}\mathbf{1}\bar{\mathbf{v}}_j^\top はブロック質量と \bar{\mathbf{v}}_j の積に等しいため、l_i に触れることなく FP32 での1つの追加ランク1累積によって復元されます。これにより、ブロックごとのスケールの消費が絶対的な大きさではなく、タイトな残差分布に向けられます。これが、外れ値に平滑化できるチャネル構造がない場合でも value の量子化を機能させる鍵です。
ExpCast-FP8
2つ目の貢献は softmax ステージに対処します。p = \exp(s - m') を FP32 で計算して第2の行列積用に E4M3 にキャストする代わりに、ExpCast-FP8 は対数領域のスコアから直接 E4M3 コードを出力します。E4M3 の表現可能な値は、指数 e と3ビット仮数 m に対して 2^e (1 + m/8) の形をしています。\exp(x) = 2^{x/\ln 2} であるため、x/\ln 2 を整数部と小数部に分割することで E4M3 の指数が得られ、小数部に対する小さなルックアップテーブルによって仮数が得られます。FP32 の指数演算と FP32→FP8 のキャストはどちらもクリティカルパスから外れます。
実験結果
忠実度は、MovieGen Bench からの 100 プロンプトそれぞれを用いて、Wan2.2-T2V-A14B (720p)、LongCat-Video (480p)、HunyuanVideo-1.5 (720p)、MiniMax-H3 (1344×768) において、シードを揃えた BF16 FlashAttention-4 に対して測定されます。
B200 8ビットにおいて、V-Smooth 単独で SageAttention2 に対する PSNR が改善します。Wan2.2 で +2.3 dB (22.6 対 20.3)、LongCat で +1.4 dB (24.5 対 23.1)、HunyuanVideo で +2.8 dB (18.4 対 15.6)、MiniMax-H3 で +1.1 dB (21.0 対 19.9) です。SSIM も対応して改善し(例:Wan2.2 で 0.792 対 0.730)、LPIPS が低下します(0.152 対 0.206)。ExpCast-FP8 を追加するとある程度 PSNR が低下し — Wan2.2 は 20.5 に、HunyuanVideo は 17.5 に下がります — しかし softmax のボトルネックを取り除きながらも SageAttention2 のベースライン以上を維持します。4/8 精度の training-free Attn-QAT ベースラインは SageAttention2 より 3.4〜6.7 dB 低く、value 側の処理なしに素朴な低ビット構成が破綻することを確認しています。
4ビットのワークステーション GPU (RTX PRO 6000) では、V-Smooth のゲインが相対的に大きくなります。SageAttention3 に対して Wan2.2 で +2.9 dB (16.8 対 13.9)、LongCat で +3.6 dB (18.7 対 15.1)、HunyuanVideo で +2.9 dB (13.8 対 10.9) です。subject-consistency と imaging-quality のメトリクスは、予想通り全体を通じて BF16 近傍に留まります — これらのモデルでは飽和しているためです。
同じモデルにおけるカーネルレベルのスループットは、低ビットのピーク性能をデータセンターカードとワークステーションカードの両方でウォールクロック高速化に変換します。SageAttention2 が Blackwell カーネルを持たず旧世代 GPU のコードにフォールバックする場面で最大のゲインが得られます(B200 上の MiniMax-H3 で BF16 の 0.29×)。
制限と未解決の問題
online クラスタリングは、attention のみのタイミングからは除外されているが、クリップのウォールクロックには含まれる前処理を追加します。報告されているウォールクロックのマージンはそれをすでに織り込んでいますが、論文はシーケンス長ごとのクラスタリングコストを分解していません。ExpCast-FP8 は FP32 ステージを除去する代わりに約 1〜2 dB の PSNR を犠牲にするため、設計点はワークロードに依存します — MiniMax-H3 では低下が 0.8 dB、HunyuanVideo では 0.9 dB でどちらも許容範囲ですが、同程度の精度での training-based QAT とのクロスオーバーは検討されていません。この手法は video DiT で検証されており、value 分布と softmax 圧力が異なる言語モデルの prefill/decode はスコープ外です。最後に、4ビットの値での V-Smooth のブロック平均復元と数値安定性の相互作用は詳細に分析されていません — 4/4 の PSNR 数値 (13.8〜18.7) はまだ改善の余地があることを示唆しています。
この研究の意義
Video DiT の推論は attention でボトルネックとなっており、これまでの低ビット研究は \mathbf{QK} 側を最適化する一方で、value の外れ値と FP32 softmax が精度とスループットの両方を静かに制限していました。VC-Attention は training-free なドロップイン代替手段であり、既存の FlashAttention 漸化式の範囲内で両方のギャップを埋めます。これは現在のハードウェア上でデプロイ可能な 8ビットおよび 4ビット動画生成への現実的な道筋です。
Source: https://arxiv.org/abs/2609.15810
LLMの選好アライメントのためのゼロ次パラダイム
問題:DPO型目的関数におけるlikelihood displacement
Direct preference optimizationおよびその派生手法は、選好ペア (\mathbf{x}, \mathbf{y}^+, \mathbf{y}^-) を対数尤度マージン \log \pi_\theta(\mathbf{y}^+|\mathbf{x}) - \log \pi_\theta(\mathbf{y}^-|\mathbf{x}) に関する微分可能なlossへと圧縮します。ペアにノイズがある場合、すなわち \mathbf{y}^+ と \mathbf{y}^- が現在のpolicyの下で類似した尤度を誘導する場合、DPO lossの勾配は両方の尤度を同時に低下させる方向に働くことがあります(“likelihood displacement”現象)。これはlossがそれらの差のみを制約するためです。著者らの解決策は、そのようなペアに対して微分可能なサロゲートを完全に放棄し、代わりにペアから比較オラクルを介して方向を抽出し、それをゼロ次オプティマイザに入力することです。結果として得られる手法ComPOは、DPO/SimPOを置き換えるのではなく補完することを目的としています。すなわち、クリーンなペア(大きなマージンを持つもの)は依然として一次更新を駆動し、ノイズの多いペアはオラクルに供給されます。
手法:比較オラクルと1ビットスパース勾配推定
比較集合 S \subseteq D と2つのパラメータベクトル \theta, \theta' に対して、選好・非選好の対数尤度シフトの平均を以下のように定義します:
\Delta^{\pm}_S(\theta,\theta') = \tfrac{1}{|S|}\sum_{(\mathbf{x},\mathbf{y}^+,\mathbf{y}^-)\in S}\left(\log\pi_{\theta'}(\mathbf{y}^{\pm}|\mathbf{x}) - \log\pi_{\theta}(\mathbf{y}^{\pm}|\mathbf{x})\right).
選好比較オラクルは以下を返します:
\mathcal{C}^S_\pi(\theta,\theta') = \begin{cases} -1, & \Delta^+_S > 0 \text{ and } \Delta^-_S < 0, \\ +1, & \text{otherwise},\end{cases}
すなわち、\theta' が \theta より好まれるのは、S 上の平均において選好尤度を厳密に引き上げ、かつ非選好尤度を低下させる場合に限ります。重要なのは、これがスカラーのlossではなく \{\pm 1\} のシグナルであり、両方の尤度に対する小さな等量シフトに対して不変である点です。これはまさにDPOが失敗するモードです。
m 個のランダム摂動 \{\mathbf{z}_i\}_{i=1}^m(半径 r)に対して、ComPOは y_i = \mathcal{C}^S_\pi(\theta_t, \theta_t + r\mathbf{z}_i) をクエリし、スパースな1ビット勾配推定値を以下のように形成します:
\hat{\mathbf{g}} = \arg\max_{\|\mathbf{g}\|_1 \le \sqrt{s},\ \|\mathbf{g}\|\le 1} \sum_{i=1}^m y_i \mathbf{z}_i^\top \mathbf{g},
これは推定方向に対して \ell_1/\ell_2 の意味での s-スパース性を強制します。そして \theta_{t+1} = \theta_t - \eta\hat{\mathbf{g}} のステップが適用されます。定理3.2は、3つの仮定の下でオフラインスキームのbest-iterate収束保証を与えます:(i) \ell-smoothな潜在目的関数 f が存在し、 f(\theta') < f(\theta) であるときに常に \mathcal{C}^S_\pi(\theta,\theta') = -1 となるという意味でオラクルと互換性がある;(ii) \nabla f が近似的に s-スパースであり、\|\nabla f(\theta)\|_1 \le \sqrt{s}\|\nabla f(\theta)\| が成立する;(iii) オラクル応答に関する適切なマージン \Delta が存在する。スパース性の仮定こそが、d が数十億のオーダーであっても m に関するサンプル複雑度を現実的なものにするものです。更新はパラメータ座標の低次元部分集合に集中します。
オンラインComPOは、ラベル付きペアに対するこのオフライン比較方向を保持しつつ、現在のpolicyから生成されたラベルなし生成文に対して参照モデルとのreverse-KLプロキシを交互に計算し、RLHFにおけるKL正則化項に類似したダンピング項を与えます。制約付きオンラインスキームの性能保証は、局所的なカバレッジ(参照分布がオプティマイザの近傍をカバーする)と分布内ペアワイズ報酬精度に依拠します。
ハイパーパラメータと実験設定
オフライン実験では、UltraFeedbackのペアをマージン閾値 \delta_{\text{margin}}=3 によってクリーン(DPO更新)とノイズあり(ComPO更新)のサブセットに分割しています。摂動半径は小さく、Mistral-7Bでは r=5\times 10^{-4}、Llama-3-8B / Gemma-2-9Bでは r=7.5\times 10^{-4} であり、更新あたりの摂動数は m \in \{1600, 1800\}、スパース正則化の重み \lambda_g は 10^{-4} のオーダーです。訓練にはA40 GPU(各46 GB)を30基使用しています。m \approx 1600 のオラクルクエリは各ステップで相当量ですが、各クエリは S 上のforward passのみであり、摂動モデルを通じたbackwardは不要であるため、ゼロ次の前提と整合しています。
結果
AlpacaEval 2、Arena-Hard、MT-Benchにおいて、クリーンDPOベースラインにComPOを組み合わせると一貫した性能向上が見られます。Mistral-7B-Instructでは、DPO_{\text{clean}}+ComPOがAlpacaEval 2でLC 26.17% / WR 18.32%に達しており、DPO_{\text{clean}}単体の23.89 / 16.15やvanilla DPOの24.14 / 16.71を上回っています。MT-Benchの平均スコアは5.73から7.69へと大きく上昇しており(Turn-1: 6.11→7.78、Turn-2: 5.34→7.63)、これはフォローアップの一貫性に対する強い効果またはジャッジの分散を精査する価値があることを示唆する、異例に大きなギャップです。
Llama-3-8B-Instructでは、LCが32.92%から35.79%に、Arena-Hard WRが22.9から23.1に改善し、MT-Bench平均は7.94から8.05になっています。Mistral-7B-BaseおよびLlama-3-8B-Baseでも同様の傾向が見られますが、幅は小さくなっています。例えば、Mistral-7B-BaseのAlpacaEval 2 LCはComPOにより9.41から11.66に向上しています。Llama-3-8B-BaseのArena-Hardは横ばいです(12.0→12.1)。
限界と未解決の問題
いくつかの点に注意が必要です。第一に、収束保証はどこでもオラクルと互換性を持つ \ell-smoothな潜在関数 f の存在と近似的な勾配スパース性に依拠しており、いずれもLLMのパラメータ空間において経験的に検証されていません。スパース性の仮定こそが m=1600 で十分である理由です。第二に、Mistral-7B-InstructのMT-Benchデルタ(5.73→7.69)は同一モデルのAlpacaEval / Arena-Hardデルタと比較して大きく、単一実行にわたるMT-Benchジャッジの安定性に疑問を呈しています。論文はアブレーション表において実行間変動を報告していますが、主要な表は点推定値を報告しています。第三に、ComPOの各ステップあたりの計算コストは m に関して線形にスケールし、ノイズの多いペアを単純にクリーニングして破棄する場合との実際のコスト対品質トレードオフが直接ベンチマークされていません。最後に、オラクル互換性は点ごとに定義されていますが、下流メトリクスを通じてのみ検証されており、\Delta^+ > 0, \Delta^- < 0 となるペアでも局所的に誤解を招く可能性があります。
なぜこれが重要か
Likelihood displacementはマージンベースの選好lossにおける実際の失敗モードであり、ComPOはノイズの多いペアにスカラーlossを発明することなくそれらの符号情報を保持する、原理的な代替手法を提供します。ゼロ次/比較オラクルの枠組みはまた、微分不可能なフィードバックや人間参加型フィードバックによるアライメント(順序比較のみが利用可能な場合)への道も開きます。
Source: https://arxiv.org/abs/2609.19144
Hacker News Signals
三値LLMにおける1.58ビット障壁の突破
Source: https://arxiv.org/abs/2609.16338
標準的なBitNet b1.58の定式化では、重みを \{-1, 0, +1\} に制約することで、パラメータあたり \log_2 3 \approx 1.58 ビットを実現しています。本論文では、このエントロピーの上限が本質的な制約なのか、それとも単に都合の良い量子化グリッドに過ぎないのかを問います。
中心的な貢献は、三値の重みを固定アルファベットとして扱うのではなく、エントロピー符号化可能なアルファベット上の分布として扱う、改訂された学習・パッキングスキームです。学習された重み分布 p(-1), p(0), p(+1) のエントロピーが H < 1.58 ビットである場合、算術符号化によって重みテンソルをナイーブな1.58ビットの下限以下にパッキングできます。著者らは、典型的な学習済み三値ネットワークがゼロに大きく偏る傾向(三値的な意味でのスパース性)を示すことを明らかにし、実際のエントロピーはしばしば1.1〜1.4ビットの範囲に収まり、そのギャップは回収可能であることを示しています。
本手法は次の要素を組み合わせています:(1) loss にエントロピー正則化項を明示的に加えた straight-through estimator による学習。これにより、二値化に陥ることなく重み分布をより低いエントロピーへと誘導します。(2) 推論時において256重みブロック単位でオーバーヘッドを分散させるブロック算術符号器。(3) パック済み表現に直接作用し、デコードを累積時まで遅延させる lookup-table GEMM カーネル。
1B〜7BスケールのLLaMAアーキテクチャモデルにおいて、重みあたり実効1.2〜1.35ビットで、完全な1.58ビットベースラインと同等か、perplexityが0.3ポイント以内に収まることが報告されています。1.58ビットベースラインと比較したメモリ削減は、達成されたゼロ比率に応じて15〜25%に達します。メモリ帯域幅への圧力が軽減されることにより、CPUでの推論スループットはおよそ10〜18%向上します。
制限として、算術符号化・復号化の追加レイテンシは、メモリ帯域幅がボトルネックである場合にのみ効果を発揮し、高帯域幅のアクセラレータでは利得が縮小あるいは逆転します。また、エントロピー正則化のハイパーパラメータもモデルスケールごとにチューニングが必要です。
なぜこれが重要か
精度の損失なしに三値エントロピーの上限以下に圧縮できることは、1.58ビットをハードな制約ではなくソフトなターゲットとして再定義し、重みエントロピーとモデル品質の間の連続的なトレードオフ曲線を切り開くものです。
4BモデルをトレーニングしてPostgresより81%高速なクエリプランを生成する
Source: https://rohanbansal.com/qorl
このプロジェクトは、学習ベースのクエリ最適化に強化学習を適用したものであり、歪んだデータ分布や相関のあるデータ分布においてPostgresのコストベースプランナーが最適でないジョイン順序やインデックス選択を生成するという特定の失敗モードを対象としています。
設定の概要:4BパラメータのtransformerをRLでトレーニングし、固定スキーマに対するクエリ実行プラン(シリアライズされたオペレータツリーとして表現)を出力させます。報酬シグナルは、実際のPostgresインスタンスに対して計測した壁時計実行時間の負値です。モデルはSQLクエリとスキーマ統計情報(テーブルのカーディナリティ、カラムのヒストグラム、外部キーグラフ)を入力として受け取り、Postgresのpg_hint_plan拡張機能にマッピングされるDSLでプランを自己回帰的に生成し、エグゼキュータにモデルの選択を強制します。
トレーニングにはPPOではなくGRPO(group relative policy optimization)の変形版を使用し、独立したvalue networkを不要にしています。クエリごとにK=8個のプラン候補をサンプリングし、実行時間でランク付けして、グループ正規化報酬に対してpolicy gradientを計算します。トレーニングコーパスはTPC-DSおよびStack OverflowスキーマへのランダムなSQLクエリにデータの歪みを注入することで合成的に生成されます。
81%の高速化という数値は、Postgresにデフォルト統計情報(ANALYZEチューニングなし)を与えたホールドアウトクエリワークロードに対する幾何平均です。十分に分析されたスキーマでは差は約23%まで縮まります。12方向以上のジョインを含むクエリではモデルの性能が低下します——プラン空間の爆発により、自己回帰デコーダが無視できない割合で無効なオペレータツリーを生成するため、制約付きデコーディング層が必要になります。
モデル自体のレイテンシ(プラン生成時間)はクエリごとに約40msの追加コストをもたらすため、OLAPワークロードにのみ許容可能です。このアプローチはfine-tuningなしにスキーマをまたいで汎化しません。
なぜこれが重要か
実行フィードバックからのRLが現実的なワークロードにおいて成熟したコストベースオプティマイザを上回れることを実証していますが、デプロイメントへの中心的な未解決の障壁としてスキーマ特異性の問題が浮き彫りになっています。
NvidiaがRustによるネイティブGPUプログラミングを発表
Source: https://developer.nvidia.com/blog/introducing-cuda-rust-two-tracks-for-writing-gpu-kernels/
Nvidiaは2つの異なる統合パスを提供しており、それらを混同すると実際に利用可能なものを誤って伝えることになります。
Track 1はcuda-stdです。これはCUDA intrinsicsに対する安全なラッパーを提供し、標準的なRustの抽象化を通じてそれらを公開するRust crateです。カーネルは通常のRustで記述され、rustcのNVPTXバックエンド(2017年から存在していましたが公式サポートはありませんでした)を通じてPTXにコンパイルされます。新たな要素は、Nvidiaがツールチェーン統合のオーナーシップを引き受けた点にあります。具体的には、デバイス/ホストコードの分割を処理するnvcc互換のドライバーラッパーと、必要なABIのボイラープレートを生成する#[kernel] proc-macroアトリビュートのセットが提供されます。メモリ安全性の保証はホスト側のコードにのみ適用されます。デバイス側のRustはデフォルトでunsafeです。これは、CUDAの実行モデル(warp divergence、shared memoryのエイリアシング、syncthreadsバリア)がRustの所有権モデルに適合しないためです。
Track 2はより低レベルのPTX出力パスであり、RustコードはNvidia独自のコンパイラが最適化するIRにコンパイルされます。これはTritonのようなMLIRベースのスタックの動作に近い方式です。このパスは、決定論的なレジスタアロケーションを必要とし、rustcのLLVMバックエンドが予期しないスピリング判断を行うことを避けたいライブラリ作者を対象としています。
どちらのTrackも、リリース時点ではCUDA C++エコシステム全体(cooperative groups、nvcuda::wmma経由のtensor core intrinsics)をサポートしていません。tensor coreのパスは「計画中」として記載されています。Rustからの既存のcuBLAS/cuDNN呼び出しは従来通りFFIを経由します。
実際の意義は新しい機能の追加よりもツールチェーンの正当性にあります。NVPTXバックエンドはすでに機能していましたが、Nvidiaの公式サポートなしに、またnvccのマルチファイルコンパイルモデルへの統合なしに本番カーネルをRustで提供するのは不安定な状況でした。
この発表が重要な理由
ベンダーによる公式サポートは、RustがGPUコンピュートに採用される際の主要な障壁を取り除きます。ただし、Rustの所有権モデルをSIMTプログラミングに対してエルゴノミックにできるかどうかは、依然として未解決の設計上の問題です。
Dream-RSI: 進化する世界を通じた再帰的自己改善
Source: https://arxiv.org/abs/2609.14858
本論文は、再帰的自己改善(RSI)をカリキュラム問題として形式化しています。すなわち、人間が外部からカリキュラムを設計するのではなく、エージェント自身が長期的な能力向上を最大化するために自らの訓練環境を改善するという枠組みです。
アーキテクチャはデュアルループ構造です。内側のループは、パラメトリックな世界モデル内でタスクを学習する標準的なRLエージェント(transformer policy)です。外側のループは、メタ目標を最大化するために世界モデルのパラメータを修正するもう一つのモデル(こちらもtransformer)です。使用されるメタ目標は最終的なタスク報酬ではなく、学習進捗です。これはウィンドウ内の内側ループ性能の訓練ステップに対する微分であり、(R_{t+k} - R_t)/k として近似されます。
世界モデルは離散状態シミュレータ(オブジェクトのインタラクションを設定可能な2Dグリッドワールド)であり、そのパラメータは難易度、報酬密度、遷移の確率性を制御します。世界パラメータから内側ループの学習曲線へのマッピングが微分不可能であるため、外側ループのモデルは勾配降下法ではなく進化的戦略(CMA-ES)で訓練されます。
結果はナビゲーションおよびツール使用タスクのスイートで報告されています。RSIループは、固定カリキュラムやdomain-randomizationベースラインと比較して、ホールドアウトされたタスクバリアントでエージェントが人間レベルの性能に到達するのを内側ループのステップ数で約3倍高速化するカリキュラムを発見します。外側ループのモデル自体は N=500 内側エピソードごとに再訓練され、これが「再帰的」要素を生み出しています。
制限事項は重大です。世界モデルは手動でコーディングされており狭い範囲に限定されている点、外側ループは連続行動ドメインでテストされていない点、そして外側ループが短期的な学習シグナルを最大化するために自明に簡単な世界へと収束することを防ぐメカニズムが存在しない点が挙げられます。
なぜこれが重要か
カリキュラム品質の測定可能なメトリクスを備えたRSIループの具体的かつ再現可能な実装例を提供していますが、汎用的な自己改善へのギャップは依然として大きいです。
Intelligence per Watt: ローカルAIの知性効率の測定
Source: https://arxiv.org/abs/2511.07885
本論文は、ローカルで動作するLLMを対象に、エネルギー消費量で正規化したベンチマーク性能である知性効率(intelligence efficiency)の測定フレームワークを提案しています。これはモデル比較ではなくハードウェア比較を目的としたものです。
中核となるメトリクスは \eta = S / P_{\text{avg}} であり、S は複合ベンチマークスコア(MMLU、HellaSwag、ARC、GSM8Kの平均を[0,1]に正規化したもの)、P_{\text{avg}} は推論中にコンセント側で計測した平均消費電力(ワット)です。トークン毎秒のスループットは別途追跡されますが、スループットと品質を混同しないよう \eta には組み込まれていません。
著者らは、ハードウェア(Apple Mシリーズ、AMD Ryzen AI、Intel Core Ultra、Nvidia RTXコンシューマGPU)と量子化レベル(fp16、int8、int4、GGUF Q4_K_M、Q8_0)の組み合わせに対して、llama.cppとollamaをランタイムとして使用し、標準化されたテストハーネスを実行しています。電力計測にはMQTT接続のスマートプラグを用いて1Hzでログを取得しており、〜1Wレベルの計測ノイズが生じますが、テスト対象デバイスの15〜120Wの範囲では許容範囲内です。
主な知見として、Apple M4 Proはテストしたすべての構成において最高の \eta を達成しており、同等のベンチマークスコアを持つ独立GPU構成と比較して概ね2〜3倍優れています。これは主に、ユニファイドメモリによってPCIe転送オーバーヘッドが排除されること、およびAppleの低いアイドル消費電力によるものです。int4量子化はfp16と比較してGPU上での \eta を40〜60%改善し、ベンチマークの低下は2パーセントポイント未満に留まります。なお、このフレームワークはエンボディドカーボンおよびハードウェアコストの償却を明示的に除外しています。
電力ログの1Hz粒度は、バースト性のあるprefill/decodeワークロードに対しては実質的な制限となります。また、複合ベンチマークスコアも「知性」の代理指標としては粗いものです。
この研究が重要な理由
ローカル推論がコスト敏感なデプロイメント対象となりつつある中、生のスループットではなくエネルギー効率に基づいたハードウェア購入判断のための再現可能な方法論を確立しています。
ベクトル化された性能ポータブルなクイックソート(2022年)
Source: https://opensource.googleblog.com/2022/06/Vectorized%20and%20performance%20portable%20Quicksort.html
GoogleのHighwayベースのVqsortは、SIMDクイックソートであり、Highwayの抽象化レイヤーを用いることで、AVX-512、AVX2、NEON、SVEにわたる性能ポータビリティを、コードパスを分けることなく実現しています。
このアルゴリズムは、2つのSIMDフレンドリーなプリミティブを組み合わせています。まず、小さな固定サイズのブロック(レジスタ幅に応じて16〜256要素)に対するソーティングネットワークであり、Highwayの SortByKey と条件付きスワップ操作を用いて実装されています。これらはAVX-512では VPERMD/VPBLENDVPS に、その他のターゲットでは同等の命令にコンパイルされます。次に、スカラーのピボット比較ループを置き換えるベクトル化パーティションステップです。ピボット p が与えられると、ベクトルレジスタ内のすべての要素が同時に比較され、compress-store(Highwayの CompressStore)が要素ごとの分岐なしで、未満のパーティションと超過のパーティションを1パスで別々のバッファに書き込みます。
大規模な配列においてはパーティションのスループットがボトルネックとなりますが、compress-storeによってスカラーのスキャタリングが排除され、分岐ベースのパーティショニングがパイプラインに不向きになる問題が解消されます。AVX-512の VPCOMPRESSD はこれを直接実現します。AVX2では参照テーブルベースのシャッフルでエミュレートされ、約2倍のオーバーヘッドが生じますが、それでもスカラー実装を上回る性能を発揮します。
1000万件のfloat32要素によるベンチマークでは、VqsortはAVX-512ハードウェア上で std::sort(イントロソート)より5〜10倍高速であり、AVX2上では1.5〜3倍高速です。ポータブルな実装により、単一のバイナリがランタイムディスパッチを介してすべてのターゲットで効率的に動作します。
HNでの再注目により、VqsortをキーバリューペアおよびB128ビット型に拡張した2025年のフォローアップ研究や、NVIDIAのCUBラジックスソート(GPUでは優位に立ちますが、デバイス上にデータが必要)との比較が議論されました。
この研究の重要性
Highwayを介した性能ポータブルなSIMDコードが、手作業でチューニングされたプラットフォーム固有の実装と同等の性能を達成できることを示しており、計算集約的なプリミティブに対する抽象化レイヤーアプローチの有効性を裏付けています。
ナビエ・ストークス方程式の後もLLMに対して弱気な理由
Source: https://dank.systems/posts/2026-09-15-ai-bear.html
この投稿は感覚的な意見ではなく、技術的な論拠に基づくものです。著者の主張は、LLMがナビエ・ストークス偏微分方程式(および類似の「難しい数学」benchmark)を解いているという最近のデモンストレーションが、汎化可能な数学的推論の証拠にはならないというものであり、その理由はPDEを解くことの実際のメカニズムに根ざしています。
核心的な論拠は次の通りです:標準的なCFD benchmark(蓋駆動キャビティ、ポアズイユ流れ、カルマン渦列)には既知の解析解または半解析解が存在し、それらは教科書・講義ノート・GitHubリポジトリに広く掲載されています。LLMがこれらの問題に対して正しい有限差分離散化を出力するのは、訓練データ上の検索加重補間を行っているのであり、記号的導出ではありません。これが推論なのか検索なのかを判別するテストは、そのモデルが構造的に類似しているが訓練分布から遠い問題を解けるかどうかです。著者は修正された境界条件や非標準的なジオメトリをプローブとして提案しており、これらがbenchmarkスイートにはほとんど含まれていないことを指摘しています。
著者はさらに誤差伝播についても論点を挙げています:LLMが生成した数値ソルバーは安定性に関してサイレントに失敗する傾向があります。正しいCrank-Nicolsonスキームには特定の安定性条件(\Delta t \leq C \Delta x^2 / \nu)がありますが、モデルは構文的には正しいものの、この条件に違反するコードを頻繁に生成し、正解との比較がなければ検知しにくい形でゆっくりと発散する解を生み出します。これは記号的な誤りとは異なり、benchmark の精度指標では捉えられない失敗のカテゴリを代表しています。
HNのコメントは大きく二派に分かれています。benchmarkが汚染されていることに同意する人々と、ある抽象化レベルでは検索こそが推論であると主張する人々です。これは投稿が解決しない哲学的な論争です。
この議論が重要な理由
具体的な方法論的批判を提起しています:「数学的推論」のためのbenchmarkスイートは、検索と汎化を分離するために分布外の幾何学的・境界条件のバリアントを含める必要があり、これは実装が容易です。
FPGA上での Voodoo Graphics と1990年代後半ゲーミングPCの再現
Source: https://nand2mario.github.io/posts/2026/zsst-voodoo/
これは、3dfx Voodoo Graphics(VSA-100アーキテクチャ)アドインカードを搭載した1998年代のゲーミングPCを正確に再現することを目的とした、フルシステムFPGA実装です。
本実装はXilinx Artix-7ボード上で動作し、複数の独立したRTLモジュールを相互接続した構成となっています。具体的には、x86コア(既存のオープンソース486互換ソフトコアを使用)、ISA/PCIバスファブリック、VGAコントローラ、そしてVoodoo GraphicsサブシステムというモジュールからなりますVoodoo Graphicsモジュールが本実装の新規貢献であり、技術的に最も複雑なコンポーネントです。
Voodoo GraphicsアーキテクチャはFBI(Frame Buffer Interface)とTMU(Texture Mapping Unit)という2つの処理ユニットを持ちます。FBIは三角形のセットアップとラスタライズを担当し、TMUはバイリニアフィルタリングを伴うパースペクトコレクトなテクスチャサンプリングを担当します。RTLでパースペクトコレクトなテクスチャリングを実装するには、ピクセルごとの除算(u/w、v/w)が必要になります。著者はフルの除算器を避けるためにパイプライン化されたNewton-Raphson逆数ユニットを使用しており、これはオリジナルチップのアプローチと一致しています。テクスチャキャッシュはダイレクトマップ方式の8KB SRAMブロックであり、キャッシュミスの処理がオリジナルハードウェアとのサイクル数の乖離において最大の要因となっています。
Glide API(3dfxの独自グラフィクスAPI。ゲームはDirectXを経由せず直接これを呼び出していました)は、PCIコマンドレジスタレベルでエミュレートされています。x86ソフトコア上で動作するソフトウェアシムがGlide呼び出しをインターセプトし、FPGAのVoodooモジュールへのレジスタ書き込みに変換します。
Artix-7上のゲート使用率は約78%であり、余裕はほとんどありません。いくつかのゲームはリファレンスキャプチャとの視覚的精度が1〜2%以内で動作しており、TMUパイプラインのタイミングの差異により、アルファブレンディングとフォグエフェクトが最も大きな乖離を示しています。
この研究が重要な理由
この時代の完全なヘテロジニアスシステムが中級FPGAで実現可能であることを示すとともに、RTL実装はVoodooのレンダリングパイプラインに関するクリーンなリファレンス実装として機能し、物理的なハードウェアを必要としません。
注目の新しいリポジトリ
tigerless-labs/agent-memory
AIエージェント向けの長期記憶ランタイムであり、ベクターデータベースや独自APIではなく、プレーンなMarkdownファイルを正規のストアとして使用します。検索はローカルかつランク付きで行われ、embeddingサービスを必要とせず、recency(新しさ)、relevance(関連性)、明示的な重要度タグによってチャンクをスコアリングします。アーキテクチャ上の特長は、保存された記憶の統合・重複排除・再ランク付けを非同期で実行する独立した「sleep-time」Manageレイヤーにあり、推論中にインラインで処理するのではなく、オフラインでの記憶統合を模倣しています。Claude CodeとOpenAI Codexは共通インターフェースを介して同一のストアを同時に共有できるため、セッションをまたいだコンテキストの連続性が失われがちなマルチエージェントパイプラインにおいて重要な意味を持ちます。すべてがMarkdownであるため、記憶ストアは人間が読みやすく、標準的なツールでバージョン管理が可能です。外部APIキーが不要なため、エアギャップ環境やコストに敏感なデプロイメントでも利用できます。この設計はデバッグのしやすさを重視しており、ファイルを読むだけでエージェントが何を「記憶」しているかを正確に確認できます。ランク付き検索は、recency減衰と組み合わせたBM25スタイルの語彙的アプローチを使用しているようで、embeddingパイプラインの運用上のオーバーヘッドを回避しています。主な用途は、タスクの状態、ユーザーの好み、中間結果をセッションをまたいで保持する必要がある永続的なエージェントワークフローです。
Source: https://github.com/tigerless-labs/agent-memory
shinthink/blitzstrike
MCP(Model Context Protocol)サーバーとして、構造化されたペネトレーションテスト手法を任意のMCP互換AIエージェントに公開するツールです。カタログには、フェーズごとに整理された130のツールが含まれています。具体的には、偵察および攻撃対象領域のマッピング、コードレベルの脆弱性を発見するためのソースからシンクへのtaint解析、そして発見事項のライブ検証が含まれます。「57のエスカレーションチェーン」とは、低深刻度の発見を権限昇格パスへと連鎖させるツール呼び出しのシーケンスをあらかじめエンコードしたもので、エージェントが行う手動推論の負担を軽減します。インテリジェンスデータ層は、発見されたエンドポイント、認証情報、サービスフィンガープリントといった再利用可能なアーティファクトをツール呼び出しをまたいで保持するように設計されており、後続のステップが再スキャンを実行せずに以前の発見事項を参照できます。単一のMCPサーバーを公開する構造であるため、任意のエージェントフレームワーク(Claude、GPT-4oのfunction calling、tool useに対応したオープンソースLLM)がエージェントごとの統合作業なしにこれを利用できます。構造化された手法のエンコーディングが本質的な貢献であり、ツールのフラットなリストではなく、攻撃シーケンスに関するドメイン知識をエンコードしている点が特徴です。再現性とエージェント駆動の列挙が目標となるレッドチームの自動化研究、セキュリティラボ、CTFパイプラインに有用です。
Source: https://github.com/shinthink/blitzstrike
S1N6H/pentest-harness
任意のAIモデル(自前のAPIキーを持ち込む方式)をセッション永続型のペネトレーションテストエージェントとしてラップする、セルフホスト型のオーケストレーションハーネスです。スキャン結果、ツール出力、会話履歴といったすべてのセッションデータをローカルに保持する設計となっており、これはスコープ合意によってサードパーティサービスへのデータ持ち出しが禁止されている正式な契約に基づく作業において重要な意味を持ちます。本ハーネスは、大規模な本番環境でのレッドチーミングではなく、バグバウンティハンティング、CTF、および内部セキュリティラボを対象としています。アーキテクチャ的には薄いコントローラとして機能し、ツールのディスパッチ(おそらくnmap、ffuf、nucleiといった標準ツールをラップする形)を管理し、構造化されたプロンプトとともに出力をモデルにフィードバックし、オペレーターが作業途中から再開できるようにセッション状態をインスタンス呼び出し間で永続化します。「モデルを自前で用意する」アプローチにより、OllamaやLM Studio経由でローカルホストされたモデルを含め、OpenAI互換のあらゆるエンドポイントで動作します。これは機密性の高い環境や秘密指定のある環境において特に有用です。上述のblitzstrikeと比較すると、本ツールはツールカタログではなくハーネスであり、攻撃手法をエンコードするのではなく、エージェントループとセッション管理を提供します。クラウド依存なしにエージェント支援による列挙を行いたいセキュリティ研究者にとって実用的な選択肢です。
Source: https://github.com/S1N6H/pentest-harness
useagenthq/useagent
各エージェントに対して、ブラウザ・ファイルシステム・シェルを備えたサンドボックス環境である隔離されたクラウドコンピュータをプロビジョニングするオープンソースのエージェント runtime です。これにより、エージェントはウェブサイト・スプレッドシート・スライドデッキ・プルリクエストといった実際の成果物を生成するマルチステップタスクを実行できます。この runtime は、オペレーターが自身のサブスクリプション認証情報を使って Claude Code・OpenAI Codex・OpenCode へディスパッチするため、モデル層におけるベンダーロックインを回避できます。「AI 同僚」というフレーミングは技術的な設計を反映しており、エージェントはチームのコンテキスト(ツール、コードベース、データソース)を受け取り、中間ステップではなく完成した成果物を返します。実行の隔離はクラウドコンピュータが担います。これは、純粋な API 呼び出しでは対応できないステートフルなブラウザ操作やファイル I/O を必要とするタスクに対して有効です。オープンソースであるため、サンドボックス化とツール統合レイヤーが監査可能であり、機密性の高いコードベースを扱うチームにとって重要です。アーキテクチャ的には Anthropic の computer use デモや OpenDevin に類似していますが、研究プロトタイプではなくチームがデプロイ可能な runtime として位置づけられています。ホスト型の代替製品との主な差別化要因は、計算コストとモデルコストがオペレーターの既存アカウントに留まる点です。
Source: https://github.com/useagenthq/useagent
jtydhr88/screenwriting-skills
プロフェッショナルな脚本執筆、テレビドラマ制作、および劇作法ワークフローを対象としたエージェントスキル定義のコレクションです。実質的なコンテンツは、ドメイン知識をエンコードした構造化プロンプトテンプレートとツール使用スキーマで構成されており、三幕・五幕構造分析、シーン分解、キャラクターアーク追跡、台詞の改訂、フォーマット準拠のスクリプト出力(Final Draft / Fountain規約)を網羅しています。1,216スターを獲得しており、LLMを活用した草稿作成を行うライターの間で明確なニッチを見出しています。これらのスキルは、モジュール式スキルロードをサポートするエージェントフレームワークとの統合を想定して設計されていると考えられ、各スキルはモノリシックなプロンプトではなく、独立した組み合わせ可能なユニットとして構成されています。劇作法の観点は特筆に値します:純粋なスクリプトフォーマットにとどまらず、長文ドキュメントに対するマルチパス推論を必要とする構造分析タスク(ドラマティックビートの特定、テーマ的一貫性の追跡)にまで踏み込んでいます。創造的な長文生成に関心を持つ研究者にとって、このリポジトリはドメイン固有の評価基準とタスク分解の厳選されたセットを提供しています。汎用的な instruction-following モデルがプロフェッショナルなスクリプト規約に関する構造化された知識を欠いているような場面で、ライティングアシスタントを構築するすべての人にとって実用的に有用です。
Source: https://github.com/jtydhr88/screenwriting-skills
OnlyTerp/opengrok
Grok Botのインターフェースを通じて任意のモデルを実行できるようにするクライアントサイドのラッパーです。モデル選択UIと、リクエストを適切なバックエンドにルーティングするプロバイダーワイヤーマップが含まれています。「アップデート対応ドクター」コンポーネントは自己診断機能であり、Grok Botのアップデート後も基盤となるプロバイダーマッピングが引き続き有効かどうかを確認することで、上流APIの進化に伴うメンテナンスの負担を軽減します。「エビデンスベースのプロバイダーワイヤーマップ」という表現は、ルーティングロジックがリバースエンジニアリングによるヒューリスティックではなく、文書化・検証可能な形で実装されていることを示しており、保守性の向上に寄与しています。ワンコマンドでのセットアップにより、独自のAPI統合レイヤーを構築せずにモデルの柔軟性を求めるユーザーの導入障壁を下げています。このプロジェクトの価値は主に、集積されたリバースエンジニアリングの成果と維持された互換性レイヤーにあり、技術的な実質はワイヤーマップとドクターツールにあります。新規アルゴリズムには依存していません。単一のインターフェースを通じて複数のプロバイダーに対してプロトタイピングを行いたい開発者や、GrokのスタンダードUIでは公開されていないモデルへのアクセスを求めるユーザーにとって有用です。
Source: https://github.com/OnlyTerp/opengrok
pax-beehive/dsh-hub-cli
DSH(Data Science Hub またはDomain-Specific Hub)Plugin Hub エコシステム向けのCLI、スキーマ定義、リゾルバー、およびエージェントツールです。コアコンポーネント—プラグイン管理用CLI、プラグインコントラクトのスキーマ、依存関係とバージョン解決のためのリゾルバー—は、パッケージマネージャーやVS Code拡張システムで見られる標準的なプラグインレジストリパターンに従っています。エージェントツール層により、プラグインをAIエージェントがプログラム的に呼び出せるようになっており、これは純粋な開発者向け配布チャネルではなくツールレジストリとして機能することを示唆しています。リゾルバーとスキーマがオープンソースであることで、プラグイン作者はローカルで互換性を検証し、解決の意思決定がどのように行われるかを正確に理解できます。CLIはおそらく、ハブに対する認証、公開、インストール、アップデートの操作を処理します。機能をプラグインとしてパッケージ化するモジュール式エージェントシステムを構築するチームにとって、適切に仕様化されたスキーマとリゾルバーは、非公式なツールカタログを悩ます依存関係の地獄を防ぎます。このプロジェクトはより広範なDSHエコシステムのインフラとして位置付けられており、その価値は利用可能なプラグインの充実度とハブバックエンドがアクセス可能かどうかに依存します。
Source: https://github.com/pax-beehive/dsh-hub-cli
monid-ai/monid
OpenRouterがモデルに対して果たす役割を、エージェントツールに対して担うものとして位置づけられています。すなわち、異種のツールAPIへのアクセスを単一のインターフェース背後に標準化する、統合されたルーティングおよび抽象化レイヤーです。OpenRouterがLLMプロバイダーを集約するのと同様に、Monidはツールプロバイダー——外部サービス、データソース、アクションエンドポイント——を集約することで、エージェント開発者がプロバイダーごとの個別統合ではなく、単一のスキーマに対してコードを書けるようにします。技術的な核心は正規化レイヤーにあります。すなわち、スキーマ変換、プロバイダー横断の認証管理、そして機能要件やコストに基づいて適切なバックエンドを選択するルーティングロジックです。これが重要なのは、ツールの断片化がマルチエージェントシステムにおける本質的な問題点であるためです——特定のツールプロバイダーのスキーマを前提に構築されたエージェントは、そのプロバイダーが変更を加えたり、チームがバックエンドを切り替えたいと考えたりした際に動作しなくなります。安定したインターフェースを持つルーティングレイヤーは、エージェントのロジックをツールの実装詳細から切り離します。現時点ではスター数224と初期段階にあり、その有用性はサポートされるツールプロバイダーの幅広さとスキーマ正規化の精度に大きく依存します。異種ツールスタックを運用するチームにとって、このコンセプトは統合コストという現実の問題に対処するものです。