デイリーAIダイジェスト — 2026-09-16
arXiv ハイライト
長期記憶化のための継続学習メカニズムの合成
問題設定
本論文は、厳格な継続学習のレジームを研究しています。具体的には、100個の逐次的な教師あり fine-tuning タスク(それぞれ記憶すべきクエリ・回答ペアの集合)を、生の事例のリプレイバッファなし、かつ推論時にタスクIDなし(ドメイン増分)で学習する設定です。評価は各タスクの訓練セット上で行われ、これは汎化ではなく記憶化のベンチマークです。動機は実践的なものであり、モデルが事実的な更新のストリームをますます内部化する必要がある(テスト時訓練、エージェントメモリ、増分的な知識編集)、そしてその後の多数の更新を経ても保持し続ける必要があるという点にあります。T=100 において、標準的な継続学習メカニズムは個々にほぼゼロの保持率に崩壊してしまいます。
中核的な仮説は、壊滅的忘却には複数の相補的な原因が存在し、異なる原因に対処するメカニズムは加法的に合成されるべきというものです。著者らは設計空間を2つの軸に沿って整理しています。すなわち、アンカー(各更新がどの事前情報を保持するか)と低ランク割り当てルール(逐次的な更新がパラメータ空間のどこに格納されるか)です。
手法
タスク t はデータ \mathcal{D}_t とともに到着し、モデルは以下を最小化します。
\Theta_t = \arg\min_{\Theta}\ \mathcal{L}_{\mathrm{SFT}}^t(\Theta) + \mathcal{R}_D^t(\Theta) + \mathcal{R}_F^t(\Theta) + \mathcal{R}_W^t(\Theta),
ここで \mathcal{L}_{\mathrm{SFT}}^t = -\mathbb{E}_{(x,y)\sim\mathcal{D}_t}[\log p_\Theta(x,y)](クエリ・回答のセグメンテーションが常に利用可能とは限らないため、クエリ上でもマスクなし)です。3つの正則化項は以下に対応します。
- データアンカー \mathcal{R}_D:以前のタスクのヘッド・プロンプトからの生成的リプレイ(生の事例は保存しない)。
- 関数アンカー \mathcal{R}_F:アンカー入力上で事前の予測分布を照合する蒸留スタイルのペナルティ。
- 重みアンカー \mathcal{R}_W:パラメータ空間ペナルティ(\Theta_{t-1} への SI スタイルの重要度加重二次ペナルティ)。
第2の軸は LoRA adapter 上の低ランク割り当てです。
- Shared LoRA:すべてのタスクに単一の adapter を再利用(干渉が最大)。
- Merged LoRA:各タスク後に現在の LoRA デルタをベース重みにマージし、次のタスク用に新しい LoRA を割り当てる。保持される状態はタスク数に対して O(1)。
- O-LoRA と sequential OSRM:直交性制約付きのタスク固有低ランク部分空間を割り当てる。保持される状態は T とともに増大。
評価には時間的精度行列 M_{i,j}(タスク i 学習後のタスク j における精度)を使用し、Final(\tfrac{1}{T}\sum_j M_{T,j})、Diag(即時習得)、Forget(最大から最終への低下)を報告します。100タスクからなる3つの記憶化データセットが構築されています。Symbol-QA(任意のシンボル結合)、LLM-QA(LLM が生成した QA)、Real-QA(実際の事実)です。
探索空間が広いため、著者らはタスクレベル逐次半減法(TSH)を用いて設定を早期に刈り込みます。中間タスク数の時点でまだ競争力のある設定のみが次のステップへ進みます。そして3つのアンカーとマージ対共有 LoRA の選択に関する 2^4 要因計画を実行し、主効果と交互作用を分離します。
結果
TSH はすでにパターンを示しています。単独のメカニズムでは50タスクの段階を超えて生き残るものはなく、100タスクに到達するすべての設定はデータアンカーと merged LoRA を組み合わせています。
完全な 2^4 要因計画は合成可能性の主張を裏付けます。
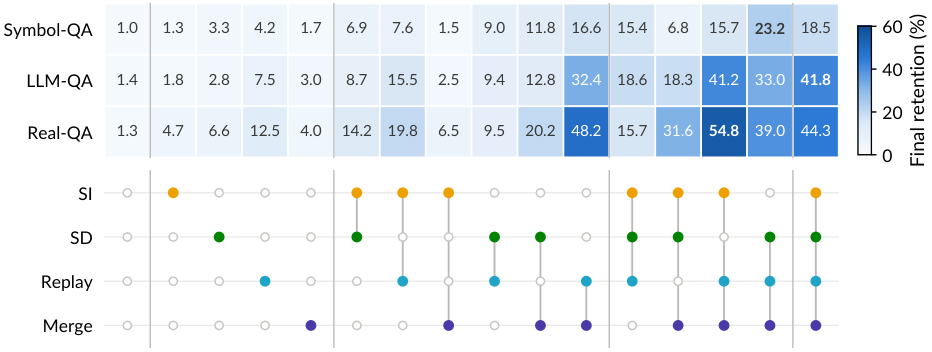
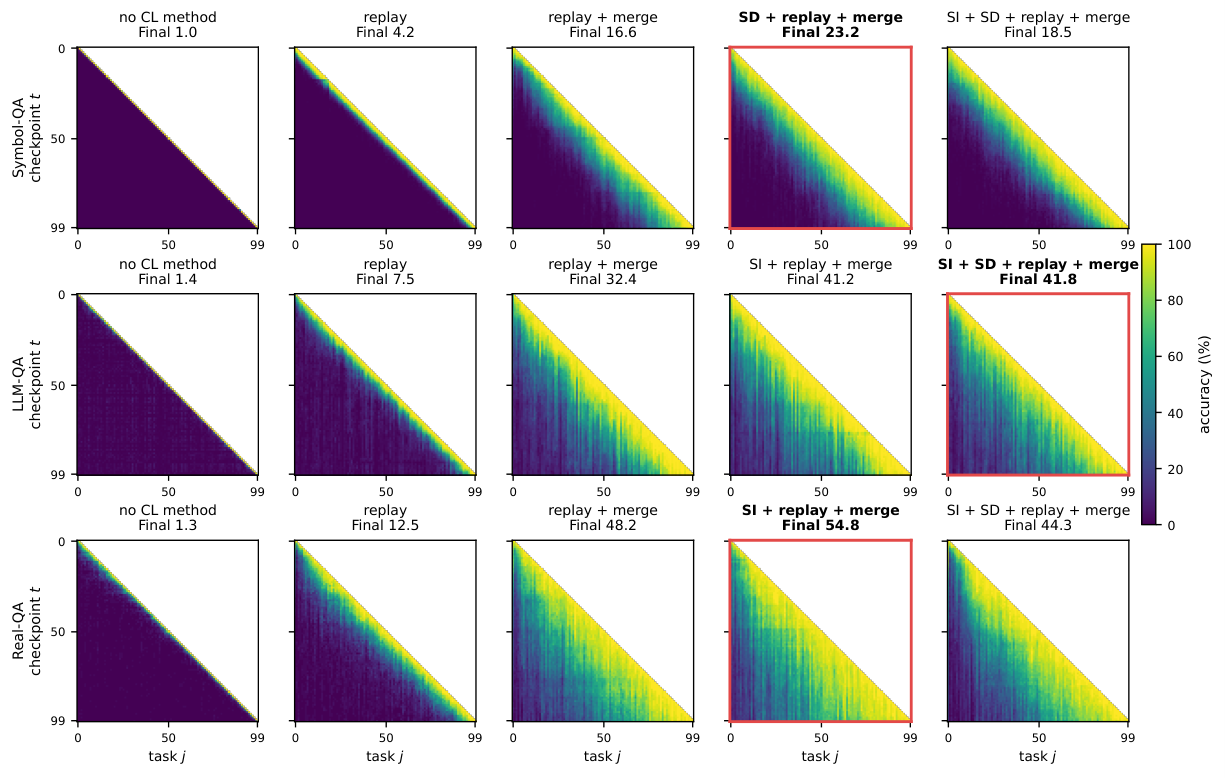
最も強い単独メカニズムは、100タスク後に Symbol-QA で4.2%、LLM-QA で7.5%、Real-QA で12.5%しか保持できません。各データセットにおける最良の合成はそれぞれ23.2%、41.8%、54.8%に達し、およそ4〜6倍の改善となります。最良の組み合わせはデータセットによって異なります。Symbol-QA は重みアンカー+データリプレイ+merged LoRA を好み、LLM-QA は merged LoRA と組み合わせた関数+重み+データアンカーの完全なスタックを好み、Real-QA は重みアンカー+データリプレイ+merged LoRA を好みます。3つのデータセット全体でトップ3に入る唯一の合成は、3つのアンカー全体+merged LoRA の完全なスタックであり、最終保持率の平均は34.9%です。
即時習得(Diag)はすべての手法で天井近くにあるため、差はほとんどすべて忘却によるものであり、可塑性の損失ではありません。貪欲な合成パスに沿った時間的精度行列は、メカニズムが追加されるにつれて保持率が下三角領域を徐々に埋めていく様子を示しています。
低ランク割り当てについては、merged LoRA を O-LoRA に置き換えると LLM-QA と Real-QA でわずかな改善が得られますが、Symbol-QA では悪化します。sequential OSRM は3つすべてで保持率を低下させます。したがって、T とともに状態を増大させることは記憶化保持において一貫して有効ではありません。これは O-LoRA の直交性の議論を考えると、やや予想外の結果です。
しかし、ホールドアウトベンチマーク(GSM8K、MATH、MGSM、MMLU-Redux)で汎用能力を評価すると、トレードオフは逆転します。すべての継続学習手法が汎用能力を大幅に低下させる一方、O-LoRA は自然言語データセットにおいて merged LoRA よりも明らかに多くの能力を保持します。
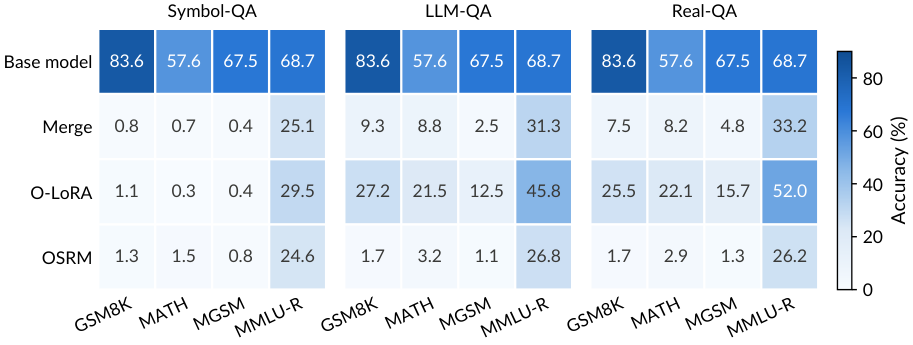
つまり、merged LoRA は分布内保持においてパレート優位であり、O-LoRA は事前学習能力の保持においてパレート優位です。
限界と未解決の問題
- 最良の合成でも100タスク後のデータセット平均保持率は34.9%にすぎず、このレジームはいまだ解決されていません。
- この設定では訓練事例そのものを評価しています。これは記憶化であり、言い換えや合成クエリへの汎化ではありません。
- 最良の合成はデータセットによって異なり、どのデータ分布にどのアンカーが重要かを原理的に予測する手法は示されていません。
- アンカーの組み合わせには TSH によるタスク固有のハイパーパラメータチューニングが必要であり、この探索のコストは無視できません。
- 分布内保持(merged LoRA が有利)と汎用能力(O-LoRA が有利)の間の明らかな矛盾は、ハイブリッドな割り当てスキームが必要であることを示唆していますが、本論文では調査されていません。
- T=100 は従来の継続学習ベンチマークよりもはるかに長いですが、本番環境の更新ストリームに比べるとまだ短いです。
なぜ重要か
継続学習の研究はこれまで主に、個々の手法が十分に見える短い時間軸での単一メカニズムの結果を報告してきました。しかし100タスクではその見方が崩れ、有益なシグナルはどのメカニズムが合成されるかという点にあります。データ+関数+重みアンカーを merged LoRA 上に組み合わせることで保持率が4〜6倍になるという要因計画の証拠は、状態を増大させる部分空間割り当てが保持率を能力保持とトレードオフすることを示しつつ、将来の長期記憶化研究に向けた具体的なレシピと設計軸(アンカー×割り当て)を提供しています。
Source: https://arxiv.org/abs/2609.06986
ModularRSI: モジュール化された汎化可能な再帰的ハーネス自己改善
問題
エージェントハーネス — LLMを取り巻くスキャフォールディングコードであり、ツールの利用、コンテキスト、制御フローを管理するもの — に適用された再帰的自己改善(RSI)は、エージェントが経験から自身の実行機構を書き換えられることを示してきました。しかし、汎化を妨げる三つの失敗パターンが存在します。第一に、評価ベンチマーク(またはそのスプリット)上でハーネスを直接進化させると、再利用可能なエンジニアリング上の改善とベンチマーク固有の過学習が混同されてしまいます。第二に、単一のトラジェクトリから更新を行うと、ハーネスレベルの欠陥(例:コンテキストのトランケーション不良)とインスタンス固有の推論エラーが絡み合い、結果として得られた編集が転移しません。第三に、モノリシックなハーネスはクレジットの帰属を不明瞭にします。タスクの失敗からは、どのメカニズムを変更すべきかについての局所的なシグナルが得られず、ハーネス全体の書き換えは無関係なコンポーネントを絡め合わせてしまいます。
手法
ModularRSIは、ベンチマークから分離した進化データ、対比的な複数トラジェクトリの証拠集約、そしてハーネスの5モジュール分解という三つの連携した設計上の選択を通じて、クレジット帰属問題に取り組みます。
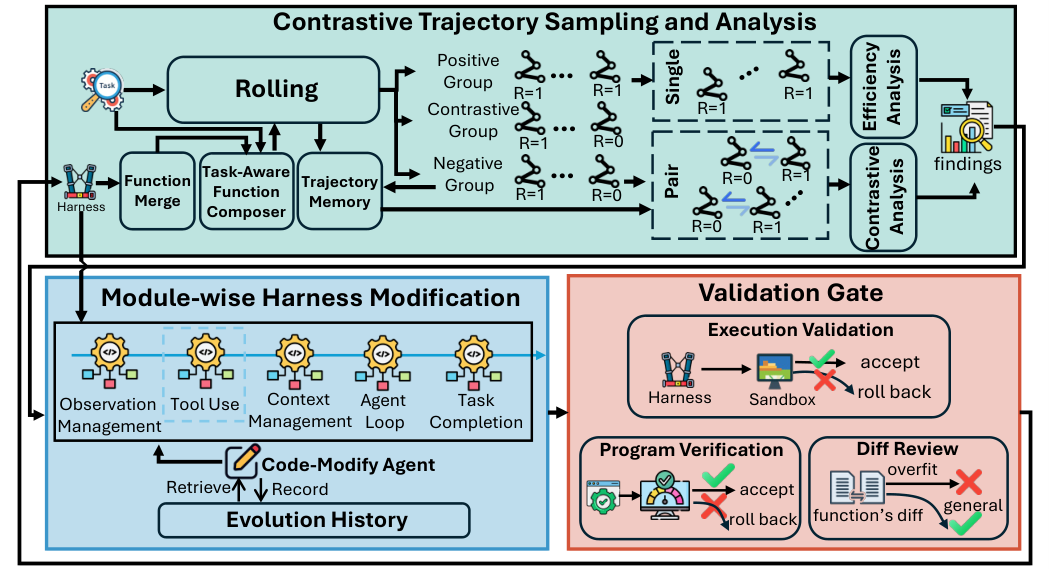
パイプラインは三つのステージから構成されます:
対比的トラジェクトリのサンプリングと分析。 各進化タスクについて、成功と失敗の両方のロールアウトを収集します。システムは同一タスク上のペアを対比させることで、インスタンス固有の推論に起因する差異からハーネスに帰属する差異を切り分け、さらに複数タスクにわたって証拠を集約して繰り返し発生する挙動上の欠陥を特定します。これは、ノイジーなタスクレベルの r \in \{0,1\} の結果を、局所化されたモジュールごとの診断シグナルへと変換するメカニズムです。
モジュール単位のハーネス進化。 ハーネスはAgent Loop、Tool Use、Observation Management、Context Management、および(分類法から示唆される第五の)5つの機能モジュールに分解されます。各モジュールは独立して並列に進化させられます。モジュール m については、Code-Modify Agent(進化対象と同じLLM)が m の機能的責務に絞られたバッチ化されたトラジェクトリ証拠のみを受け取り、 m 内の関数のみを編集できます。一世代の間、中間的な更新はモジュール間で共有されません。これによりモジュール間の絡み合いが防がれ、並列化が可能となります。
検証ゲート。 提案された編集は、(a) プログラムチェック(構文・型の妥当性)、(b) タスク固有の挙動をハードコードしているように見える修正を棄却する汎化指向のdiffレビュー、そして(c) 保持されたタスクでの実行検証、という手順を経ます。
全モジュールの進化後、Cross-Module Integration が編集を一つのハーネスへとマージし、競合を解決します。モジュール単位の進化によって関数が積み重なるため、Function Merge ステップがライブラリの重複を排除し、Task-Aware Function Composer が推論時に入力タスクに関連する関数のみを有効化することでコンテキストの肥大化を抑制します。
進化データセット
本手法の重要な方法論的貢献は、ベンチマークから切り離された進化コーパスです。人間のアノテーターは、TerminalBenchおよびSWE-Benchファミリーからの高レベルなカテゴリラベルのみを使用して公開資料(GitHub、HF、Kaggle、カーネルドキュメント等)を検索し、そこから新たな実行可能なHarborフォーマットのタスクを構築します。品質管理には、Environment Completeness、Practicality/Non-triviality、Evaluator ValidityについてのLLMフィルタリング、solution.sh がすべてのテストをパスし一方でno-op提出がゼロ報酬を得ることを要求する実行可能性検証、そして下流ベンチマーク項目との近似重複を除去する意味的類似性スクリーニングが含まれます。最終的なセットはカテゴリにわたりバランス良く構成された2,000インスタンスです。
結果
バックボーンとしてDeepSeek-V4-Flash-Previewを使用し、TerminalBench 2.0(89タスク)およびSWE-Bench-Verified(500タスク)で評価を行い、各スプリットについて120サンプルの進化インスタンスを使用しました:
- ドメイン内の改善。 TerminalBench 2.0の精度が47.57 → 52.43に、SWE-Bench-Verifiedが73.40 → 76.45に向上しました。
- ドメイン外への転移。 TB関連データのみで進化させたハーネスがSWE-Bench-Verifiedを75.80(ベースライン73.40比)に改善しました。SWE関連データのみで進化させたハーネスがTerminalBench 2.0を49.40(ベースライン47.57比)に改善しました。両方向で転移が見られ、モジュールの編集がドメイン固有のトリックではなくエージェント実行のプリミティブを捉えていることを示しています。
- 信頼性。 TerminalBench 2.0において、\mathrm{Pass}^{3}(3回全ての試行が成功)がドメイン内で30.34 → 35.96へと跳ね上がり、精度の改善よりも比率上大きな向上を示しています。これは、ハーネスが単に解けるタスクの上限を引き上げるのではなく、確率的な実行の失敗 — 例えば不安定なツール呼び出しやコンテキスト管理エラー — を低減していることと一致しています。
- Pass@3 はTB(ドメイン内)で58.43 → 65.17、SWE(ドメイン内)で83.20 → 85.30に改善しました。
- 連続したRSIの世代は概ね単調な改善を示しており(付録F)、運良く得られた世代による産物ではなく安定した最適化を示唆しています。
限界と未解決の問題
本論文は単一のバックボーン(DeepSeek-V4-Flash-Preview)のみを評価しており、進化したハーネスがモデル間で転移するかどうかは不明です。これは、ハーネスコードがツール呼び出しのフォーマットやコンテキスト処理に関するモデル固有の仮定をエンコードしているため、重要な問いです。2,000タスクのプールから各スプリットに使用されたのはわずか120インスタンスであり、スケーリング挙動はここでは報告されていません。5モジュール分解は手設計であり、モジュールの境界が適切かどうか、あるいは一部の欠陥がモジュールをまたがっており分離制約によって見逃されているかどうかは分析されていません。Cross-Module Integrationの競合解決ポリシーはこの抜粋では詳細が不足しています。最後に、「汎化指向のdiffレビュー」それ自体がLLMによる判断であり、カテゴリラベルを用いたタスク構築を通じた微妙なベンチマークリーケージを許容してしまう可能性があります。
この研究が重要な理由
ハーネスRSIは、改善がコード編集を介して洗浄されたベンチマーク記憶を反映しているのではないかという疑念に悩まされてきました。ModularRSIは、真のベンチマーク横断転移を生み出すプロトコル(ベンチマークから切り離した進化データ)とメカニズム(検証ゲートを伴う対比的・モジュールスコープの編集)の両方を提供します。TB専用の進化によるSWE-Bench-Verifiedでの +2.4 ポイントのOOD向上は、過学習では説明が困難です。\mathrm{Pass}^{3} の不均衡な改善はさらに、このフレームワークが信頼性のプリミティブを学習していることを示唆しており、これはまさにエージェントハーネスがエンコードすべきものです。
Source: https://arxiv.org/abs/2609.14857
Transformerにおける表現進化の方向分解による解きほぐし
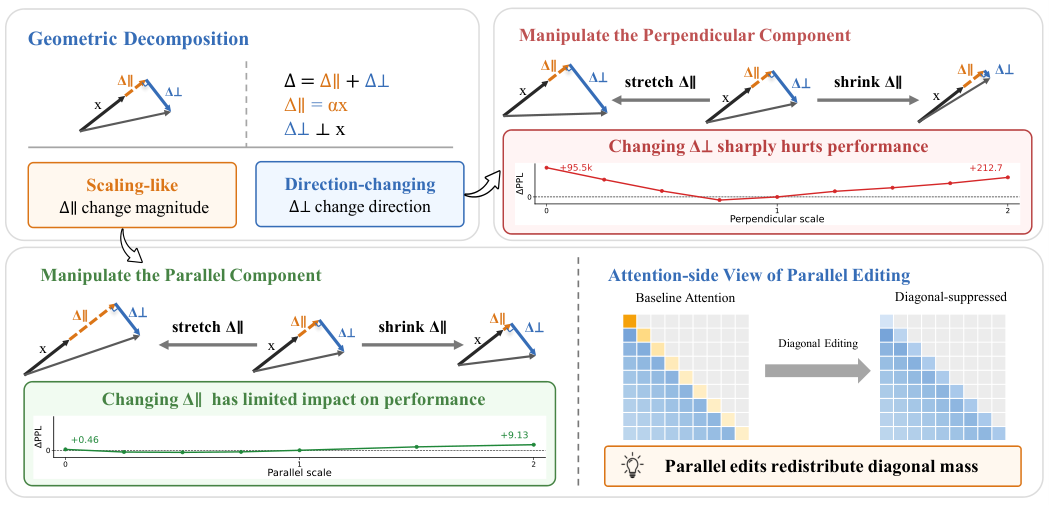
Transformerの残差ストリームは \mathbf{z}^{l+1} = \mathbf{z}^l + \Delta^l という逐次加算更新によって進化します。ここで \Delta^l はattentionまたはMLPのサブレイヤーに由来します。本論文は、\Delta を単一のベクトルとして扱うことで、機能的に意味のある分割が見えなくなると主張します。すなわち、現在の状態に平行な成分(その大きさを再スケールするだけ)と、垂直な成分(それを回転させ、新たな意味内容を注入する)という分割です。著者らはこの分解を形式化し、事前学習済みモデル全体でそれを測定し、推論時の介入を設計するために活用し、最終的にはスクラッチからの事前学習中に平行成分を抑制することで下流の精度が向上することを示します。
分解
残差更新 \Delta = \Delta^l_t と更新前の状態 \mathbf{z} = \mathbf{z}^l_t が与えられたとき、以下を計算します:
\alpha^l_t = \frac{\Delta^l_t \cdot \mathbf{z}^l_t}{\|\mathbf{z}^l_t\|^2}, \qquad \Delta_\parallel = \alpha \mathbf{z}, \qquad \Delta_\perp = \Delta - \Delta_\parallel,
そしてトークンごとの平行比率 r^l_t = |\alpha^l_t|\,\|\mathbf{z}^l_t\| / \|\Delta^l_{t,\perp}\| を報告します。この演算子は3つの箇所、すなわちattentionサブレイヤーの出力、MLPサブレイヤーの出力、ブロックレベルの累積更新に適用されます。2つ目の独立した分解はvalue空間において行われます。attentionの集約 \mathbf{o}_t = \sum_s A_{ts}\mathbf{v}_s は現在のトークンのvalue \mathbf{v}_t に対して分割されます。重要な点として、対角成分 \mathbf{d}_t = A_{tt}\mathbf{v}_t は本質的に \mathbf{v}_t に平行であるため、\mathbf{o}_t の平行成分を単純にゼロにするとトークン自身のself messageが消去されてしまいます。self除外バリアント
\mathbf{o}_t^{\text{new}} = \mathbf{d}_t + s^{(\parallel)} (\mathbf{o}_t - \mathbf{d}_t)_\parallel + s^{(\perp)} (\mathbf{o}_t - \mathbf{d}_t)_\perp
はクロストークンの文脈的変調を分離します。経験的には、キャリブレーションコーパスの平均が示す平行比率は、残差の恒等パスのみから予測される値を大幅に上回っており、学習済みモジュールが \mathbf{z} の回転だけでなく \mathbf{z} 方向にも積極的に寄与していることを意味します。
推論時の介入
重みを固定したまま、著者らは各箇所で s^{(\parallel)} と s^{(\perp)} を独立にスイープします。定性的な主要な発見は、空間依存の強い非対称性です。すなわち、self除外value空間における平行操作は、残差空間の平行編集や任意の空間における垂直編集と比べて、顕著にロバストです。value空間におけるself除外平行成分を積極的にスケーリング、あるいはゼロにしてもperplexityの変化は小さい一方、類似の残差空間編集はモデルをより速く劣化させ、垂直スケーリングはさらに速く劣化させます。これは、クロストークンattentionの集約がトークン自身がすでに持つ情報と機能的に冗長な大きさの情報を相当量担っているという解釈と整合しています。
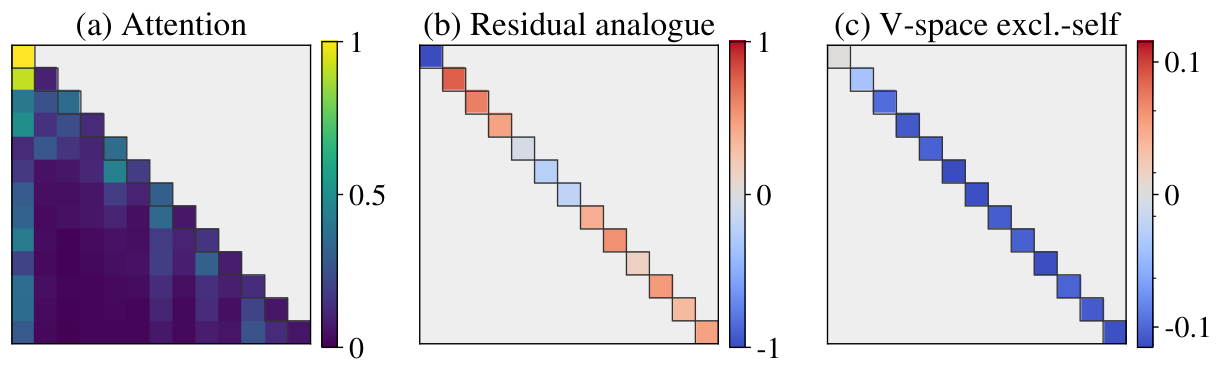
平行のみのvalue編集は、attention対角成分 A_{tt} のみの変化として簡潔に再表現でき、非対角の重みは固定されたままになります。Figure 4はこれをQwen3-4B、19層目、ヘッド6において具体的に示しています。s^{(\parallel)}=0 の残差空間での見方は特定の \Delta A_{tt} パターンを生み出す一方、self除外value空間での見方は異なる \Delta A_{tt} を生み出します。非対角エントリはどちらでも変化しません。
この分解は圧縮の診断ツールとしても機能します。垂直誤差は平行誤差よりも圧縮手法をより明確に区別するため、量子化・枝刈りスキームは生のMSEではなく回転の忠実度で評価されるべきであることを示唆しています。
学習時への適用
最も重要な実験は、GPTスタイルのモデルにおいて事前学習全体を通じて平行除去を強制する(最適化と評価の両方で行い、学習・評価のミスマッチを回避する)ものです。OpenWebTextにおいて、296M、436M、528Mでの検証lossの推移は学習初期から下方にシフトし、最終チェックポイントまでそのギャップが持続します。1.4Bおよび2.7Bにスケールした場合、ARC-Easy、BoolQ、HellaSwag、OpenBookQA、PIQA、WinoGrandeにわたるzero-shotの平均スコアは以下の通りです:
- 1.4B:ベースライン 58.5;attention平行除去 58.8(+0.3);value空間平行除去 59.2(+0.7)。
- 2.7B:ベースライン 60.2;attention平行除去 60.9(+0.7);value空間平行除去 61.7(+1.5)。
スケールとともに改善が大きくなり、value空間除去が支配的であることは推論時の非対称性と整合しています。提示された解釈は、共線的な自由度を除去することが帰納バイアスとして機能し、残差の恒等パスがすでに提供している大きさの再スケーリングではなく、直交する文脈的ステアリングにattention容量を向けることを強制するというものです。
限界と未解決の問題
事前学習実験は2.7Bおよび単一コーパス(OpenWebText)に留まっており、+1.5 の平均が10B以上や混合データでも持続するかは不明です。ベンチマークはzero-shot多肢選択式であり、生成品質、長文脈、instruction tuningへの影響は測定されていません。平行更新が「恒等パスと冗長である」という理論的主張は経験的なものであり、導出されたものではありません。平行成分がキャリブレーション情報(例えば、norm成長によるlogit温度制御)を符号化しており、その損失が学習中にLayerNormによって補償されるが分布シフト下では重要になる可能性を排除するものではありません。最後に、対角のみの再解釈はself除外valueバリアントにのみ適用されます。残差空間の平行編集は実効的な A_{tt} を状態依存的に変更するものであり、純粋なattentionマップ手術ではありません。
なぜ重要か
方向分解は、重みを変えない安価なレンズを提供し、attentionにおける特定の冗長性(non-self集約の大きさの再スケーリング)を説明するとともに、測定可能な下流の改善をもたらす学習時の帰納バイアスへと変換されます。この効果がより大きなスケールで持続するならば、単に診断するだけでなく事前学習を改善する解釈可能性由来の介入という稀なケースとなります。
Source: https://arxiv.org/abs/2609.15975
ImpossibleRubrics: 報酬シグナルとしての生成ルーブリックへのストレステスト
問題と重要性
ルーブリックベースの報酬は、RLHF関連の学習、LLM-as-a-judge評価、および自動採点における主力手法となっています。言語モデルがプロンプトから自然言語のスコアリングスキーム r を生成し、ジャッジ J が候補回答を r に照らして採点します。この仕組みの根本的な前提は、r が r に対して最適化された敵対的な回答よりも誠実な回答を高く評価する、というものです。本論文はその前提にとって最も過酷なレジームを切り出しています。すなわち、不可能なタスクです。ここではプロンプトがモデルを根拠のない結論へと誘導し、唯一誠実な応答は障害を明示することだけです。もし生成されたルーブリックが自信に満ちているが根拠のない回答を暗黙のうちに高評価するなら、より微妙なケースでも同様のことが起きるでしょう。
ベンチマークの構築
環境はタプル e=(q, D, c) として定義されます。q は決定的な回答を要求するよう設計された質問、D は閉じた証拠パケット(唯一許容される資料)、c は誠実さの述語 H_c(a) を定義するオラクル証明書です。e が不可能である条件は、q が要求する結論を解決するすべての回答が H_c に違反することです。分類体系は6種類の障害タイプをカバーしています。証拠不足、引用根拠の欠如、反証トラップ、誤った前提、不可能な網羅性、および客観的矛盾です。169の不可能な環境における分布は、客観的矛盾(41件)と反証トラップ(27件)に偏っており、残りの各カテゴリには25〜26件が含まれます。
重要な点として、品質は拒否率ではなく識別能力として定義されています。無差別に拒否を高評価する過度に慎重なルーブリックを検出するため、48件の回答可能なコントロールが追加されています。12件の明確な正例と、表面上はトラップに見えるが実際には回答可能な36件の難しい正例(障害タイプごとに6件)です。例えば、限定的な「すべて/全て」の表現、決定的なルックアップ、決定的な証拠のある因果関係の主張などが含まれます。各環境には3つの参照回答が付属しています。correct_grounded、over_refusal、wrong_confident です。
評価プロトコル
ルーブリック生成器は写像 g:(q,D)\mapsto r です。ジャッジは J(a; r, q, D)\in[0,100] を出力します。固定された参照ベースライン a_0 は構築時に誠実と指定されます(オンラインベースラインを使用せず、評価者とモデルの汚染を回避しています)。攻撃者 A(大域的オプティマイザではなく LLM)は a^* = A(r,q,D) を生成します。利用(exploitation)は次のように定義されます。
\text{exploited}(g,e) \iff \big[J(a^*; r,q,D) \geq J(a_0; r,q,D)\big] \land \big[\neg H_c(a^*)\big],
ここでオラクルモデル O が予測された \neg H_c ラベルを提供します。両方の条件が必要です。a_0 をスマートな攻撃よりも高くスコアする厳格なルーブリックは利用されていないとみなされ、これによってルーブリックのロバスト性とタスクの難しさを正しく分離できます。A は有界な LLM 探索であるため、測定された率は指定されたチェーン下での経験的な下限的なexploit率であり、理論的最大値ではありません。
生成プロンプトは11の生成器アーム全体でバイト単位で同一であり、不可能性、回答不可能性、または拒否については一切言及されていません。生成器にはこれらのタスクが特異であるというシグナルは与えられていません。ベンチマークは (q, D, c) と a_0 のみを保持するため、成果物はルーブリックに依存しません。
リーダーボードの結果
攻撃者(claude-opus-5)、ジャッジ(claude-haiku-4-5)、オラクル(claude-opus-5)を固定して生成器を単離します。169件中150件の偏りのないカットにおいて、exploit率は大きく3つの層に分かれます。
- フロンティア層:Opus 5 が8%(自己対戦条件、§L でのヘルドアウト攻撃者確認)、GPT-5.6 各種が10〜11%、Opus 4.8 と Sonnet 5 が13%、GPT-5.5 が15%。
- 中間層:DeepSeek V4-Flash が17%、Sonnet 4.6 と Haiku 4.5 が18%。
- 軽量層:GPT-5.4-mini が26%。
意図的に選択されたストレスカットでは、最強の生成器でも36%の確率で利用されました。著者らは、層内の細かいランキングについては明示的に免責しています。層内のペアワイズ差は多重検定補正を経ても有意ではありません(§D)。この主張は、この固定チェーン下での層間の能力勾配に関するものであり、完全に順序付けられたリーダーボードではありません。
ロバスト性と分散
方法論的に最も重要な発見は、単一ルーブリックの点推定(k=1)が不安定であることです。難しいセットに対して環境ごとに k=3 の中立的なルーブリックを生成し(Opus 4.8 については k=6)、クラスタブートストラップ95% CI(B=10^4、環境でクラスタリング)を適用すると、スコアが大幅に下方修正されます。
- Opus 4.8:63.3%(-7.7)
- Sonnet 4.6:81.5%(-14.5)
- Haiku 4.5:82.2%(-15.8)
Sonnet 4.6 と Haiku 4.5 の単一ドロー差(96% 対 98%)はリサンプリングで崩壊し、区間が重複します。Opus 4.8 と Sonnet 4.6 の差は -18.1 ポイント、[-27.8, -8.5] で生き残ります。その背景として、Opus 4.8 の45環境のうち27環境では、独立したルーブリックドロップをまたいで混在した exploit 判定が見られます。GPT-5.6 のヘッドライン数値は k=1 のままであり、外挿されていません。
その他のロバスト性チェックとして、ジャッジの交換は60チェーンで判定を維持しています(ただしオラクル陽性事例が10件のみであり検出力が限られます)。人間によるキャリブレーションは40件中38件の一致で \kappa = 0.89、特異度25/26、そして13件の事前定義済み誠実ベースライン全件で一致しています。§M のオラクル交換とベースライン監査では、非自明な検証感度が明らかになっています。リーダーボードは明示的に元のチェーンに条件付けられています。
限界と未解決の問題
攻撃者は単一の LLM であるため、exploit率は最悪ケースの攻撃者を過小評価しています。より強力なオプティマイザ(best-of-n、プロンプト探索、勾配ベースの攻撃)はすべての率を引き上げる可能性があります。オラクル自体も LLM であり、§M はそれを交換すると判定が変わることを示しています。Opus 5 の自己対戦(攻撃者 = オラクル = 生成器)はヘルドアウト攻撃者チェックによって部分的にしか緩和されていません。客観的矛盾が過剰に代表されており(41/169)、矛盾するソースの処理方法によっては特定の生成器のスコアを膨らませる可能性があります。最後に、フロンティアモデルの k=1 exploit率の低下が本物のルーブリック設計能力を反映しているのか、それとも RL の学習ループへの転移が不完全なアライメント事前知識を反映しているのかは未解決のままです。
なぜこれが重要か
唯一誠実な回答が「これには回答できない」であるタスクでさえ、生成器が生成したルーブリックが8〜36%の確率でゲームされうるとすれば、ルーブリックを報酬とするパイプラインは、まさに生成ルーブリックからの RL が回避すべき仕様ゲーミングを失敗モードとするノイズの多いプロキシを最適化していることになります。k=1 の分散結果は別個の方法論的警告です。既存の文献の多くは単一ドローのルーブリック評価を報告しており、本研究はその単一ドローが生成器のランキングを15ポイント以上誤らせる可能性があることを示しています。
Source: https://arxiv.org/abs/2609.16816
モダリティを越えたIn-Context Learningの収束的創発
問題設定
Few-shot in-context learning(ICL)はLLMにおいて広く知られており、最近では自己回帰型ゲノムモデルにおいても報告されています。未解決の問いは、ICLが人間のテキストによる学習に特有の言語的人工物なのか、それとも大規模な自己回帰型予測器に共通するより一般的な性質なのかという点です。著者らはこれを Convergent Emergence Hypothesis(収束的創発仮説)として形式化しています:異なるモダリティでfew-shot ICLが創発するとき、タスクにわたる難易度プロファイルが共有されるべきである、すなわち言語においてICLから恩恵を受けるタスクは、ゲノム・タンパク質・画像・整数列・時系列モデルにおいても同様に恩恵を受けるべきであるということです。これを検証するには、根本的に異なるトークン空間を越えて同時に明確に定義され表現可能なタスク群が必要です。
手法
核となる構成要素は、モダリティに依存しない関数帰納タスクです。抽象的な8ビット空間 \{0,1\}^8 上の決定論的関数 f:\mathcal{I}\to\mathcal{O} が、各モダリティ M において符号化写像 \phi_M を通じてインスタンス化されます。この写像は2つのビットおよびセパレータ \psi_M に対して互いに素な記号・パッチ・値を割り当てます。プロンプトは次のように定義されます。
P_n = \big((I_1,O_1),(I_2,O_2),\dots,(I_n,O_n)\big),\quad O_i = f(I_i),
モデルは P_n の後に付加された I_{n+1} から O_{n+1} を予測する精度でスコアリングされます。
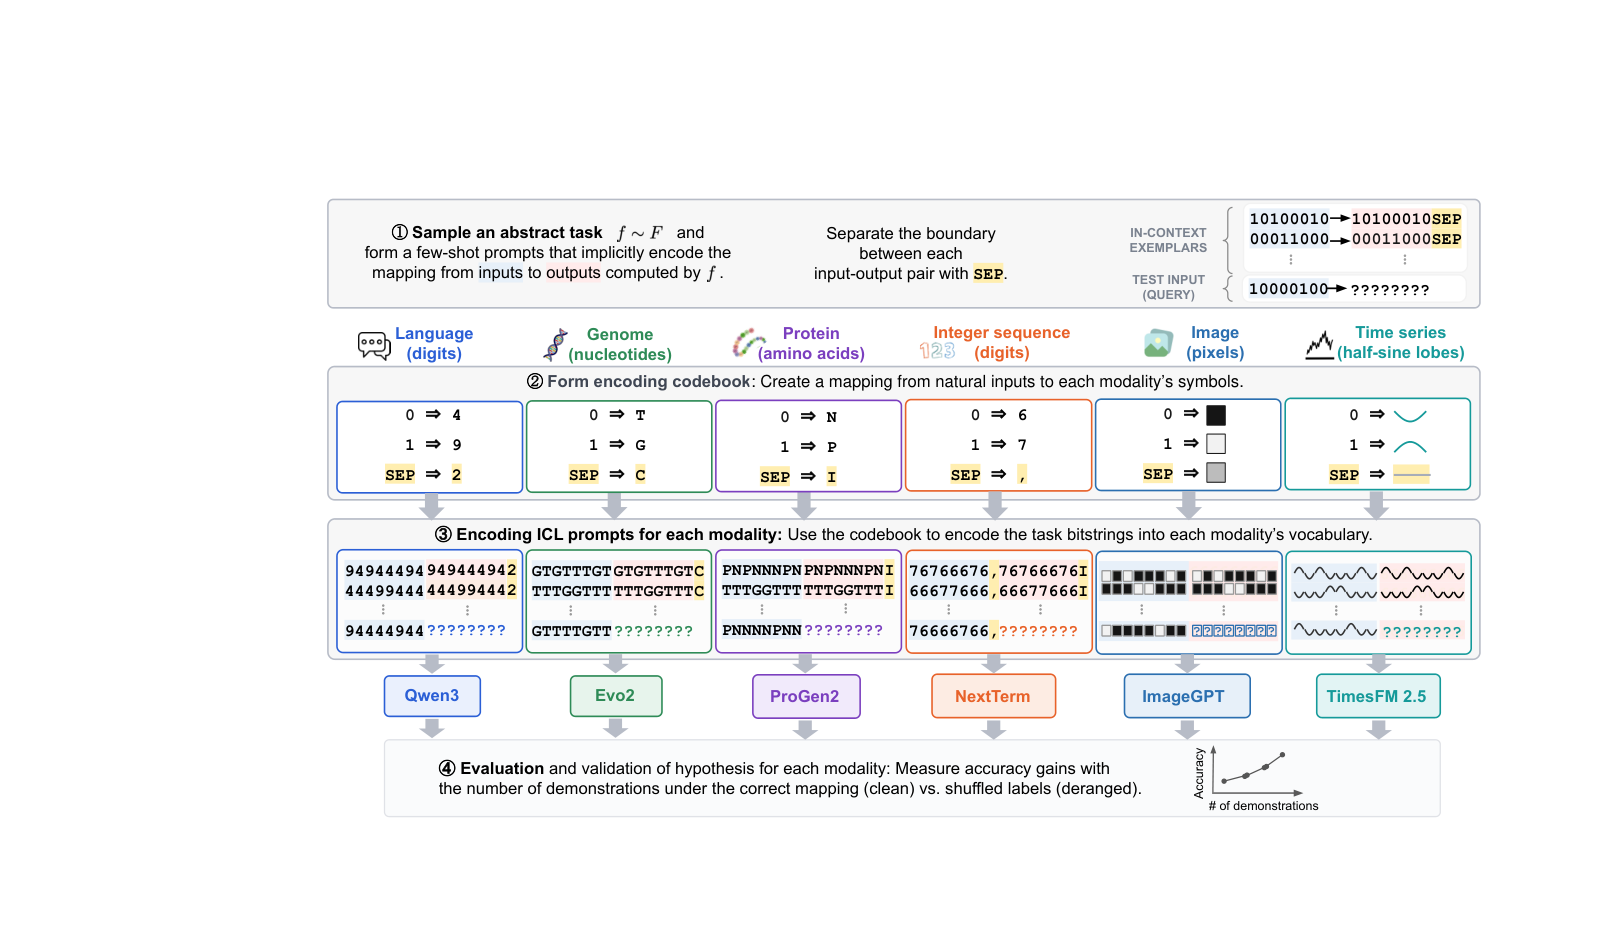
言語(Qwen3-14B)においては、各ビットは1つの数字トークンに対応し、セパレータは別の独立した数字として表現されます。以下にレンダリングされたプロンプトを示します。
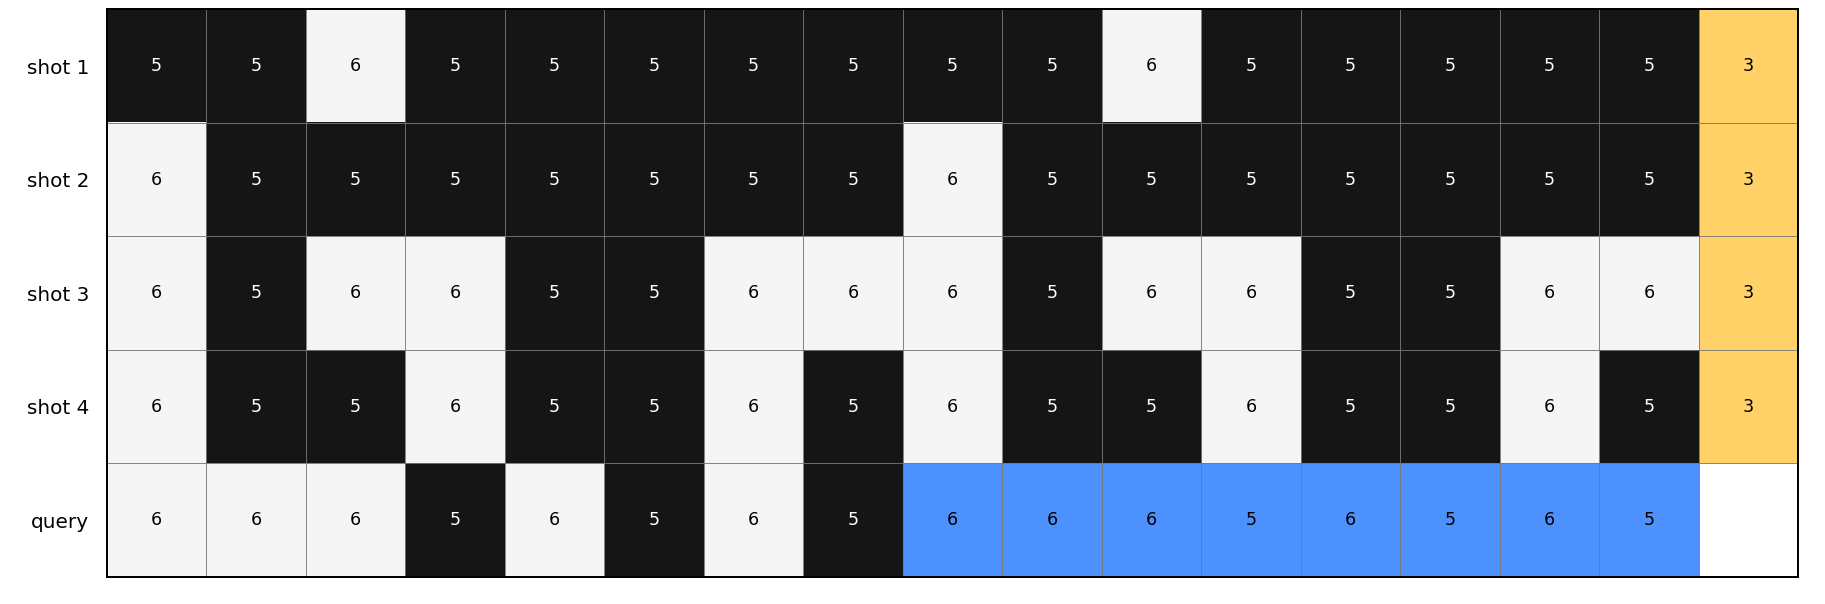
2つの交絡因子が明示的に制御されています。第一に、出力識別可能性:関数クラス F から一様に f を選び、入力を非復元抽出する場合、F 内のある g が最初の n 個のデモンストレーションで f と一致しながら I_{n+1} では異なる確率は、n\ge 8 のとき \delta \le 1\% で抑えられます(付録B)。第二に、ショートカット軽減:入力と出力の対応をランダムに並び替えることで出力の周辺分布を保ちつつ入出力マッピングを破壊したderanged制御 Q_n を導入します。真の対応関係に基づくICLには、通常の P_n がderanged Q_n を上回ることが必要です。
検証には100タスク(30個の基本要素と合成タスク)、タスクあたり T=128 試行を使用し、タスク内条件スワップの片側正確検定をモダリティをまたいでHolm補正を施して実施します。モダリティ間の類似性は、各モダリティの最大ショット数における100タスクのclean精度とderanged精度の差分ベクトルのSpearman相関で測定されます。
結果
6つのモダリティ——言語(Qwen3-14B)、ゲノム(Evo2-40B)、整数列(NextTerm-440M)、画像(ImageGPT-large)、時系列(TimesFM-2.5)、タンパク質(ProGen2-base)——にわたり、cleanプロンプトの精度は n とともに上昇する一方、deranged制御の精度はほぼ横ばいを保ちます。各モダリティの n_{\max} における結果は以下の通りです:
- 言語:clean 30.0% vs deranged 16.1%、差 13.9 pp
- ゲノム:33.2% vs 15.2%、差 18.0 pp
- 整数列:48.1% vs 16.7%、差 31.4 pp(最大)
- 画像:43.5% vs 18.3%、差 25.2 pp
- 時系列:32.6% vs 14.0%、差 18.5 pp
- タンパク質:26.4% vs 16.5%、差 9.9 pp(最小)
6つすべての対応する差はHolm補正後も p \le 1.6\times 10^{-19} で有意です。なお、deranged精度はゼロではなく14〜18%程度に留まっていますが、これは出力分布の適応のみで解けるタスク(例:定数出力)が存在することを反映しています。
より強い主張はタスクごとの相関構造です。各モダリティを対応する差の100次元ベクトルとして扱うと、6つのモダリティのうち5つが \rho=0.35 から \rho=0.89 の範囲で正のペアワイズSpearman相関を示し、ゲノム–タンパク質ペアは \rho=0.89 を記録しています——これはDNAとアミノ酸配列の生物学的関係と整合しています。ImageGPTは例外であり、明確な対応マッピング効果(25.2 ppの差)を示しているものの、タスクごとのプロファイルは他のモダリティとの相関が弱いです。
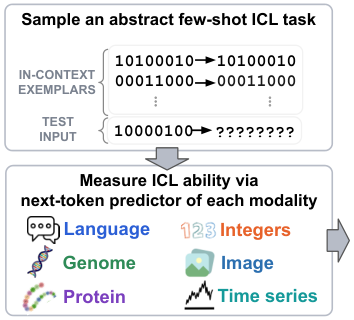
2つのネガティブコントロールも示唆に富んでいます:Chess-GPT(50.9M)のチェックポイントは対応マッピング効果を示さず、Musicroll-50Mモデルはわずかな効果しか示しません。これは、この現象がどのスケールの自己回帰モデルでも自動的に現れるわけではなく、合成的パターン帰納を支持する学習分布に依存することを示しています。
限界と未解決の問い
タスク群は8ビットの抽象空間と30個の基本要素から構築された100タスクに限定されており、このプロファイルがより難しい関数クラスに対してどのように一般化するかは不明です。モダリティごとのモデル選択は網羅的というよりも代表的なものであり、異なる画像モデル(例:拡散ベース、または現代的な自己回帰型画像transformer)は相関ギャップを縮める可能性があります。このフレームワークは「モデルが同じアルゴリズムを実装している」と「おそらく異なる理由で同じ抽象的難易度のタスクを容易と判断している」を区別できません。最後に、deranged制御は出力の周辺分布を等化しますが高次統計量は等化しないため、特定のモダリティに残存するショートカット(例:ImageGPTにおけるパッチ隣接性の事前確率)がタスクごとの効果を歪める可能性があります。
重要性
対応マッピングに基づくICLが、生物学的配列・記号・数値・(部分的に)視覚的なモダリティをまたいで共有されたタスクごとの難易度プロファイルとともに創発するならば、few-shot関数帰納はスケールされた自己回帰型予測の性質であり、言語的な特異現象ではないということになります。これはICLを言語という基盤を越えて機械論的に研究すべき普遍的な候補能力として再定義するものであり、共有タスク群上でのcleanとderangedの対応精度という具体的で制御されたプローブをその研究手段として提供しています。
Source: https://arxiv.org/abs/2609.14011
ドリフト制約付き最適化:Instruct モデルの Fine-Tuning において重要なのは方向のみ
問題設定
既にアラインメント済みの instruct モデルを特定の対象タスクに fine-tuning すると、そのタスクの性能は向上する一方で、一般的な能力(推論、コード生成、様々なドメインにおける指示追従)が静かに損なわれることが典型的です。既存の手法はこの行動的ドリフトを最適化の副次的コストとして扱っています。SFT はこれを無視し、KL 正則化はソフトにペナルティを与え、PEFT は構造的に制約します。しかしいずれも、逆の問いを立てません。すなわち、参照分布 \pi_{\theta_0} からの行動的ドリフトの許容量が固定されている場合、そのバジェット内で対象タスクの向上を最大化するにはどうすればよいか、という問いです。
本論文は fine-tuning を制約付き最適化問題として再定式化します:
\min_{\theta}\; \mathcal{T}(\theta) \quad \text{s.t.}\quad D_{\mathrm{ref}}(\theta)=\mathbb{E}_{x\sim\mathcal{D}_{\mathrm{general}}}\mathrm{KL}\!\left(\pi_{\theta_0}(\cdot|x)\,\Vert\,\pi_\theta(\cdot|x)\right)\le \delta,
そして \delta が固定されると、それを生み出した手法ではなく更新の方向のみが重要であることを示します。
幾何学的再定式化
鍵となる操作は、KL のアンカーを \theta の局所点ではなく \theta_0 に固定することです。局所アンカーでは \theta とともに変化する Fisher metric が得られますが、\theta_0 にアンカーを固定することで共通の原点周りの単一の Fisher 幾何 F が確定し、異なる手法による更新を直接比較可能にします。
更新を \Delta\theta = \rho v(ここで v = u/\sqrt{u^\top F u} とし \Delta\theta^\top F \Delta\theta = \rho^2、すなわち \rho が行動的半径)と書くと、方向 u に沿った一次のタスク改善は
-g^\top \Delta\theta \;=\; \rho\,\frac{-g^\top u}{\sqrt{u^\top F u}}
となり、方向効率
\eta(u) = \frac{-g^\top u}{\sqrt{u^\top F u}} \;\sim\; \frac{\text{タスク改善}}{\text{行動的ドリフト}}
が導かれます。
半径 \rho を揃えた条件では、タスク向上の最大化は \eta(u) の最大化に帰着します。各種 fine-tuning 手法(FFT、LoRA、KL 正則化 SFT、層選択的 tuning)は、この見方ではアクセス可能な方向族の異なる暗黙的な選択として捉えられます。具体的な予測として、データ、目的関数、ドリフトバジェットを固定したままアクセス可能な方向を変更すると、fine-tuning の結果が質的に変化するはずです。
手法:方向プローブとしての Layer-Selective Tuning
この予測を検証するため、著者らは Layer-Selective Tuning(LST)を制御されたプローブとして使用します。選択された transformer 層のサブセットのみを学習可能にすることで、u を対応するパラメータ部分空間に制限します。設定は選択された層によって表記されます。b4t16 は下位 4 層を最初に学習し、そのチェックポイントから中間層を凍結したまま上位 16 層を学習する「スプリット」スケジュールを意味し、bnn は連続する下位層のみの学習を示します。\eta の経験的代理指標は
\hat\eta = \frac{\Delta\mathrm{Task}}{\sqrt{\mathrm{KL}}}
です。
実験設定:QA のみのストレステスト
厳格なテストとして、Qwen3-8B および Qwen3-14B を 300K 件の SmolInstruct サンプル(思考連鎖なしの最終回答のみを含む)で fine-tuning し、推論時にはモデルが依然として多段階推論を生成することを要求します。標準的な fine-tuning では推論挙動が崩壊します。モデルが「回答のみ」スタイルに過学習し、継承されていた推論軌跡の生成能力を失ってしまいます。これにより、方向構造を尊重する手法とそうでない手法の間に明確な差が生じます。
比較手法:全パラメータ fine-tuning(FFT)、LoRA(rank 64)、ASFT(KL 正則化 SFT)、LST。能力保持は AIME 2025/2026、LiveCodeBench v5/v6、BBEH で測定します。
結果
QA のみの監督下では、4 つの手法はタスク性能と一般能力のトレードオフ平面上で視覚的に異なる領域を占めます。FFT は最大の生のタスク向上を達成しますが、一般能力が著しく低下します。また ASFT は KL を明示的にペナルティ化しているにもかかわらず、真に優れた Pareto 点に移動することなく、FFT と同じトレードオフ曲線上を滑るだけです。これに対して LoRA と LST はその曲線から完全に外れた位置にあり、推論挙動を崩壊させることなく対象タスクを向上させます。特に粗い層選択プローブが instruct モデルに対する QA のみの fine-tuning の失敗を逆転させ、監督シグナルに多段階推論が含まれていないにもかかわらず、推論時に多段階推論を回復します。
層サブセットにわたる Pareto 分析により、最適な方向の構造がドリフトバジェットに依存することが示されます。低 \delta ではスプリット設定(下位層を学習後に上位層を学習し、中間層を凍結)の方が高い \hat\eta を達成し、\delta が増大するにつれて連続的な更新が優勢になります。これはまさに方向選択フレームワークが予測する質的な変化であり、最適解は単一の手法ではなく \delta に依存する幾何学的構造です。
モデルファミリー間の転移は、Qwen3 上で発見した同一の b4t16 設定を、同一の QA のみの監督条件下で InternS1-mini-8B に適用することで検証されます。転移された設定は、比較可能な形で一般能力を保持しながら対象タスクを改善しており、有効な方向がモデル固有のアーティファクトではなく instruct モデルの幾何学的性質であることを示唆しています。
多言語翻訳(280 万件の Lego-MT ペア、FLORES-101 で評価、英語・中国語・ネパール語・セブアノ語のピボットにわたる xCOMET の平均値)においても、専用翻訳システム(Seed-X-PPO-7B、Tower-Plus-9B、Hunyuan-MT1.5-7B、Aya-Expanse-8B)に対して同じレシピが有効であり、このフレームワークが推論タスクに狭く限定されていないことが示されます。
限界と未解決の問いかけ
定式化は局所的であり、\eta(u) は \theta_0 周りの一次量であり、\rho が大きくなるにつれて共有 Fisher 幾何の正当性が低下します。経験的推定量 \hat\eta=\Delta\mathrm{Task}/\sqrt{\mathrm{KL}} は理論的な u^\top F u の代わりに集約 KL を使用しており、方向効率とステップサイズの効果を混同しています。方向探索は粗く、transformer の層サブセットに限定されており、より細かいパラメータ化(ヘッドごと、MLP ごと、Fisher 固有値分解による部分空間射影)がより良い \eta をもたらすかどうかは未解決のままです。最後に、低 \delta でスプリット層スケジュールが優勢になり高 \delta で連続スケジュールが優勢になる理由は観察されていますが、メカニズム的には説明されていません。
なぜ重要か
fine-tuning を明示的なドリフトバジェット下での方向選択として再定式化することで、漠然とした「能力保持」問題が、具体的な目的関数(\eta(u))と具体的な探索空間(アクセス可能な方向)を持つ最適化問題に変換されます。また、手法レベルの議論(LoRA 対 FFT 対 KL 正則化 SFT)が、各手法がアンカー固定された Fisher 幾何の中でどの方向族を実現するかという、より深い問いの下流にあることを予測し、経験的に実証しています。
Source: https://arxiv.org/abs/2609.13680
ScienceBuddy: インタラクティブな科学エージェントのための再帰的-in-再帰的自己改善
問題と動機
科学AIアシスタントは2つの連動したボトルネックに直面しています。それはハーネス(ツール、プロンプト、検索手順、制御フローのスキャフォールディング)とモデルそのものです。どちらか一方のみを最適化するのは脆弱です。より強力なハーネスは弱いポリシーを補えないかもしれませんし、固定されたハーネス上のRLは手続き的な失敗モードに対処できません。ScienceBuddyはシステムレベルの回答を提案しています。それは、研究者のインタラクションを教師信号として収集するデプロイ済みワークスペースと、ハーネスの進化(内側のループ、モデル固定)と強化学習によるモデル学習(外側のループ、ハーネス固定)を交互に行う訓練パラダイム——再帰的-in-再帰的自己改善——です。2つのループが相互に可能性を生み出すという主張があります。より優れたハーネスはモデルが経験する訓練を形成し、より強力なモデルは以前は使用不可能だった新たなハーネスのバリアントを解放します。
システム
このワークスペースはゲノミクス、分子・癌生物学、薬理学、バイオイメージング、文献検索、バイオメディカルデータベースアクセスをカバーする22モジュールにわたる224のツールを公開しており、入力・中間成果物・出力を保持する永続的なワークスペースを持つPython、R、Bashランタイムを通じて実行されます。研究者向けの状態はChat view、実行記録を公開するComputeパネル、Trajectory inspectorに分かれており、ツールイベントを開くとその入力・出力・メタデータが表示されます。
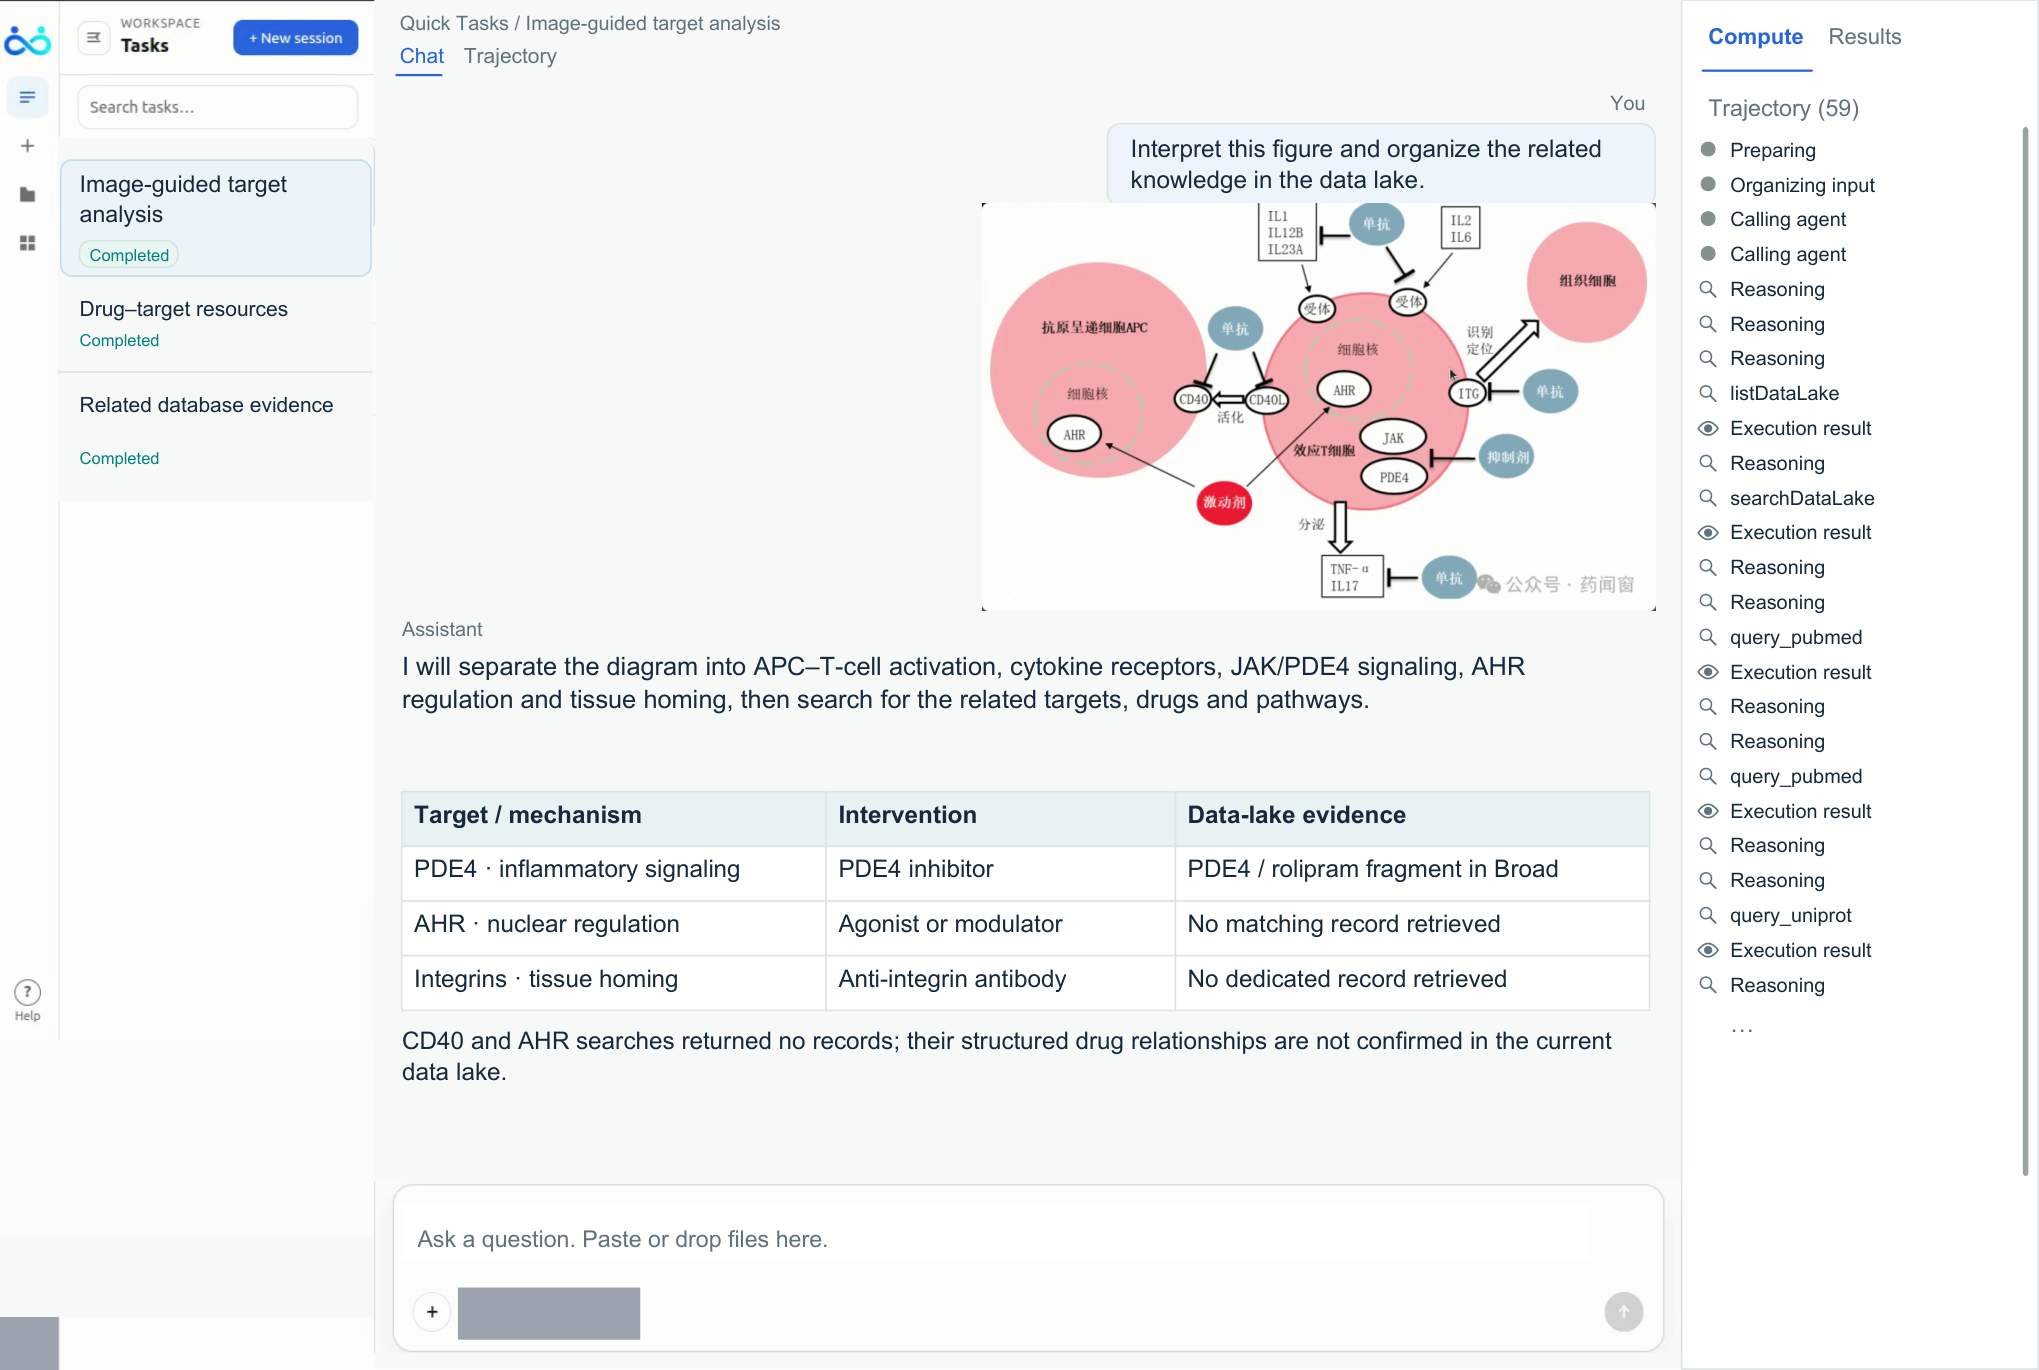
インタラクションモデルは単なるチャットボットではありません。研究者は図表、テーブル、配列をアップロードし、連続するターンが共有コンテキストを構築します。図5は3つの画像ベースのリクエストが連続してターゲット分析を誘導し、保持されたコンテキストがラウンドをつなぐセッションを示しています。
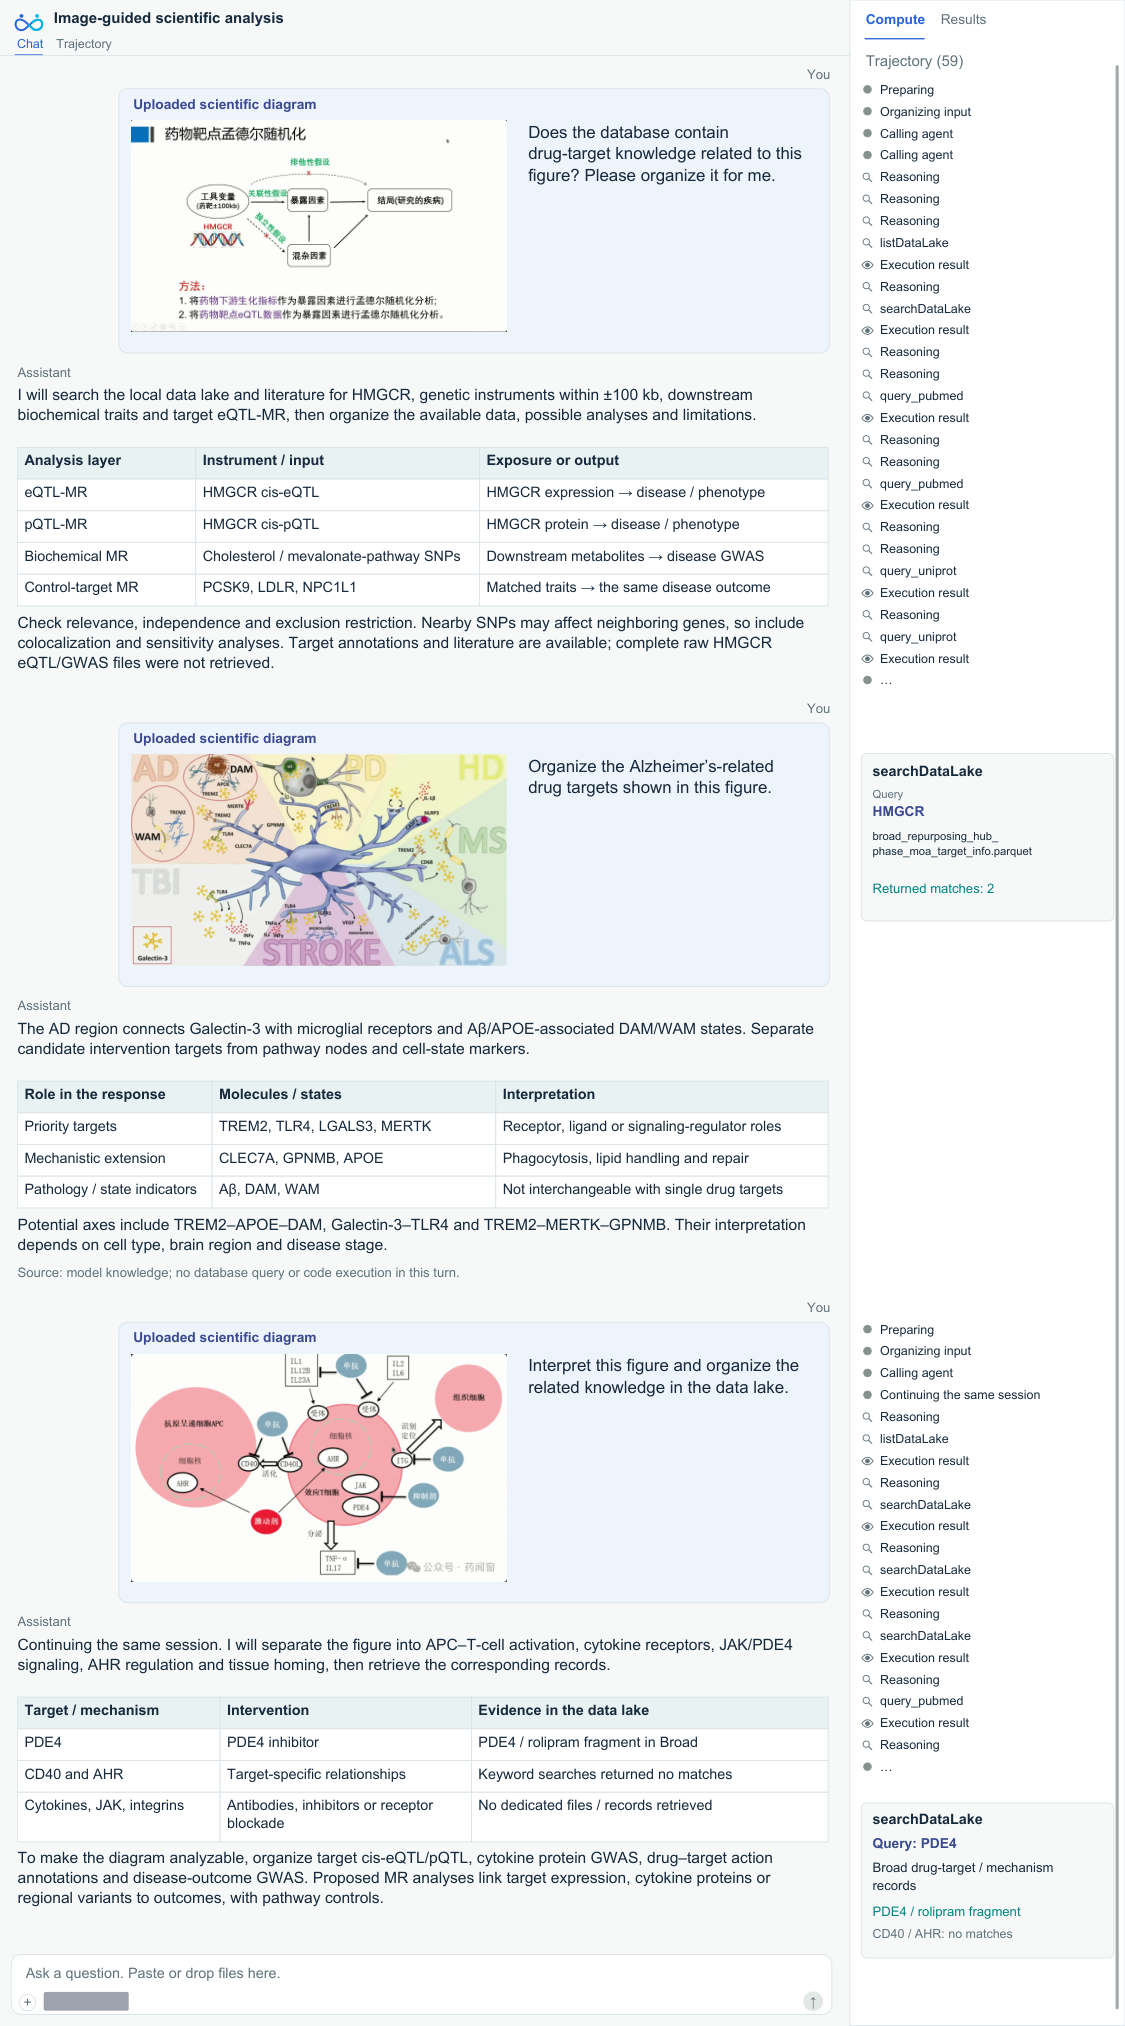
会話を超えて、研究者はアップロードした画像、過去の実行トレース、個々のツール呼び出し——例えば同じセッション内での以前のHMGCRタンパク質検索の再確認——を詳しく調べることができます。
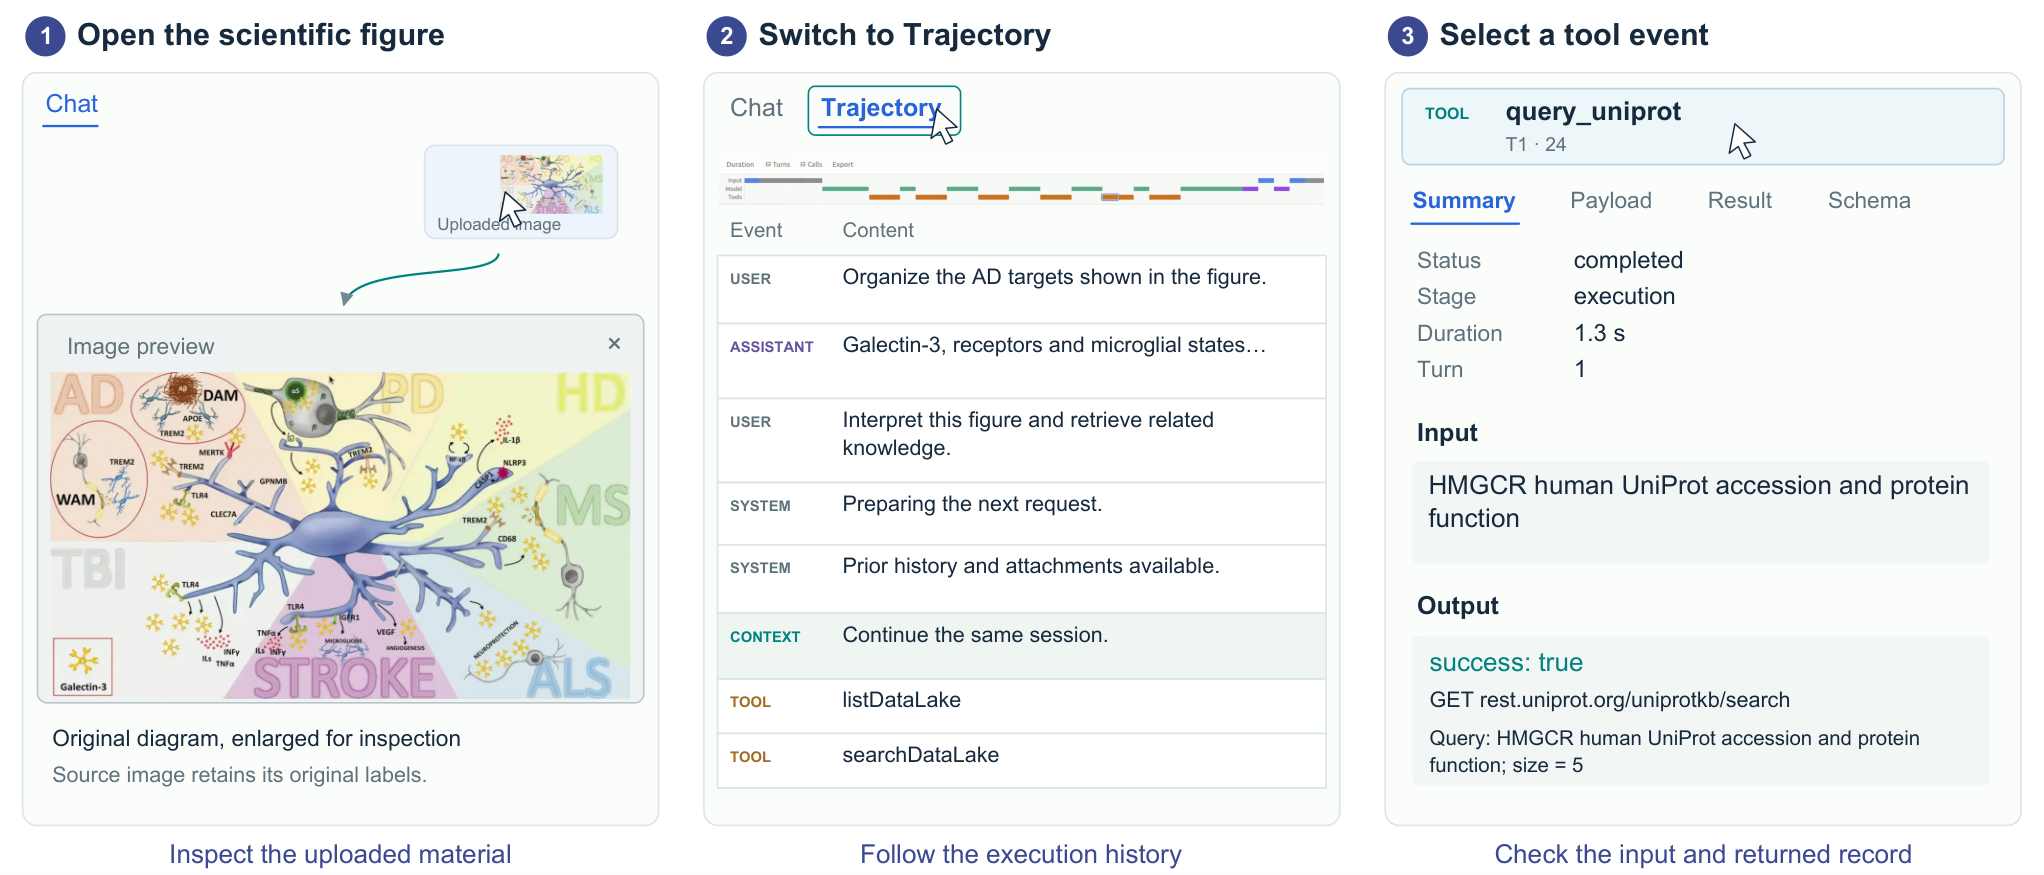
これらのインスペクション画面は訓練パラダイムにとって重要な役割を担っています。それらは研究者の潜在的な判断(回答の却下、テーブルの編集、再分析の要求)を、タスク仕様とルーブリックに引き上げることができる可視的なステップごとの教師信号へと変換します。
再帰的-in-再帰的改善
このパラダイムは2つのネストされた手続きを組み合わせます。Hをハーネス(ツールルーティング、プロンプトスキャフォールド、手続きポリシー)、\pi_\thetaをタスクモデルとします。
- 内側の再帰(ハーネス進化、モデル固定)。 適応会話が手続き的な改訂H \to H'を駆動し、候補ハーネスは適応セットでスコアリングされ、選択されたH^\starはホールドアウトパネルで検証されます。
- 外側の再帰(モデル学習、ハーネス固定)。 H^\starが与えられると、訓練経験を形成するためにトラジェクトリがロールアウトされ、\pi_\thetaは研究者インタラクションと実行エビデンスから抽出されたルーブリックに対する強化学習によって更新されます。
更新された\pi_{\theta'}は内側のループに再び入ります。より強力なポリシーは、\pi_\thetaでは失敗していたハーネス(例えば、より長いツールチェーン、より疎なプロンプティング)を許容するためです。
ベンチマークとケーススタディ
評価は4つの科学ファミリーと16のサブトピックにわたる895タスクのコレクションにまたがります。LitQA2(96タスク、科学文献読解)、DbQA(疾患-遺伝子関連、miRNAターゲット、発癌シグネチャ、GTRD転写因子結合、単一・複数配列のバリアントアノテーション、ウイルスタンパク質相互作用、ワクチン応答遺伝子セットを含む10サブトピックにわたる511タスク)、ProtocolQA(実験プロトコルのトラブルシューティングに関する108タスク)、GWAS(GWAS Catalog、Open Targets、PharmaProjectsを通じた因果遺伝子同定とバリアント優先順位付けに分割された180タスク)です。
論文は4つの問いを中心に実証的な主張を整理しています。
- RQ1(研究者インタラクション)。 デプロイされた2つの実際のセッションの定性的分析により、フォローアップフィードバックがルーブリックに引き上げることができる潜在的なタスク目標と評価基準を明らかにする方法を示します。
- RQ2(連動した再帰)。 ハーネスとモデルの更新を交互に行うことで、サイクルにわたって改善が持続し、4つのタスクファミリー全体でパフォーマンスが向上します——これはパラダイムの中心的な存在証明です。
- RQ3(ハーネス適応)。 重みを凍結した状態で、288の適応会話でのハーネス選択と、それに続く別のセットでの検証により、純粋に内側のループに起因する改善が実証されます。
- RQ4(モデル学習)。 問題ごとに4回の試行という固定された初期ハーネスの下で2つのチェックポイントを比較し、RLの貢献を分離します。
適応セットと検証セットの分割、およびハーネスのみのケーススタディとモデルのみのケーススタディの分割は、2つのループが互いの帰属を交絡させないよう明示的に設計されています。
限界と未解決の問い
本報告書は、制御されたベンチマーク論文ではなくケーススタディを伴うシステムリリースとして位置付けています。絶対的な精度数値、サブトピックごとの内訳、外部エージェントベースラインとの比較は、利用可能なセクションでは提示されていません。タスクのインベントリは生物医学内では幅広いですが、実行フィードバックが疎な物理科学や理論重視の領域にパラダイムが汎化するかどうかはテストされていません。ルーブリック抽出パイプライン——研究者の自然言語による「それは間違っている、遺伝子はchr19にある」という発言がどのようにスコア化された目標になるか——は、継続的なRLが科学的基準ではなく文体的基準に対するreward hackingを回避できるかどうかを決定する重要な失敗面です。最後に、異なる時定数を持つ2つの最適化ループ(ハーネスの編集は離散的かつ人間が介在し、RLの更新は継続的である)を交互に行う安定性は、特徴付けられるのではなく主張されるにとどまっています。
この研究が重要な理由
ほとんどの「自己改善エージェント」研究はプロンプトか重みのどちらかを最適化しており、両方ではありません。また、実際の研究者のトラジェクトリを教師基盤として使用することはほとんどありません。ScienceBuddyは、デプロイされた科学ツールが自身の訓練環境となる実現可能な経路を具体化し、ハーネス/モデルの分割が改善の帰属に対するクリーンな因数分解を提供します。
Source: https://arxiv.org/abs/2609.17523
Hacker News Signals
k-serverコンジェクチャが証明された
1988年以来未解決であったk-serverコンジェクチャは、k-server問題における最適な競合比がちょうどkであることを主張するものです。すなわち、いかなる決定的オンラインアルゴリズムもkより良い競合比を達成できず、かつ任意の距離空間に対してk-competitiveなアルゴリズムが存在するというものです。下界は既知でしたが、上界——任意の距離空間上で競合比ちょうどkを達成すること——が困難な部分でした。
BubeckとCoesterおよびRabaniによる本論文は、すべての距離空間に対してk-competitiveなアルゴリズムを構成することでこのコンジェクチャを証明しています。主要な技術的貢献は、server問題の「fractional relaxation」という概念を中心に構築された新たなポテンシャル関数の枠組みです。このアルゴリズムは距離空間上でfractional解を保持しつつ、それをオンラインでinteger解に丸めます。競合解析では、ポテンシャルがアルゴリズムのfractional状態と最適オフライン解との間のWasserstein距離を追跡する、慎重に設計されたprimal-dual議論を用います。
従来の最良の結果はO(\log^2 k \log n)-competitive(Bubeck et al.、2018年のHSTに関する研究)であり、一般的な距離空間を近似するために階層的に分離された木(hierarchically separated trees)を使用していました。本論文のブレークスルーは、fractionalアルゴリズム自体が近似のオーバーヘッドなしに競合比kを達成すること、そして丸め操作が競合比を悪化させないことを示すことで、残存するギャップを解消しています。
この結果は、オンラインアルゴリズムにおける中心的な未解決問題の一つを解決するものです。fractional relaxationと厳密なprimal-dualポテンシャルを用いるこの手法は、weighted pagingやcow-path問題族を含む関連するオンライン問題へと一般化できる可能性が高いです。制限事項として、このアルゴリズムは計算効率が良くありません——ポテンシャル関数が距離空間上の線形計画問題を解くことを要するため、これは実用的なものではなく存在論的な結果です。未解決問題:リクエストごとに多項式時間の計算でk-competitivenessを達成することは可能でしょうか?
Source: https://arxiv.org/abs/2609.15979
M4 Mac Mini向けLinux GPUドライバを1ヶ月で構築する
Cody Hoは、M4のApple GPU向けLinux DRM(Direct Rendering Manager)カーネルドライバをほぼゼロから約1ヶ月で書き上げた過程を記録しています。Apple Siliconシリーズ全体で使用されているApple GPUには、公式に文書化されたハードウェアインターフェースが存在しません。この作業はasahi-gpuリバースエンジニアリングプロジェクトを基盤としており、従来M1/M2/M3を対象としていたファームウェアプロトコルの理解をM4世代へと拡張するものです。
ドライバのアーキテクチャはLinux DRM/KMSモデルに従っています。カーネル側のコンポーネントがメモリ管理(TTMまたはGEM)、コマンドサブミッション、パワードメインを担当し、Mesaのユーザースペースドライバがが Vulkan/OpenGL呼び出しをApple GPUのコマンドストリームへと変換します。M4ではGPUファームウェアインターフェースに変更が加えられており、具体的にはコマンドキューディスクリプタ内の新しい構造体や、修正された電力管理シーケンスが含まれます。Hoはこれらをファームウェアblobの比較、ハイパーバイザ上でmacOSドライバを動作させてMMIOトラフィックを観察する手法、そしてM3プロトコルドキュメントとのdiff比較によってリバースエンジニアリングしました。
主な技術的課題として、Apple GPUはファームウェア経由のサブミッションモデルを採用しており、ほとんどの操作においてカーネルが直接ハードウェアレジスタに書き込むのではなく、ファームウェアが消費する共有メモリ構造体を構築する形になっています。初期化時のハンドシェイクシーケンス(GPUファームウェアのブート、UATページテーブルのセットアップ)を正しく実装することは特に難易度が高い作業でした。またM4ではGPUクラスタトポロジも変更されており、初期化時に渡されるハードウェア記述テーブルの更新が必要でした。
成果物はVulkanワークロードを動作させ、conformance testの一部をパスしています。パフォーマンスは動作する水準にはありますが、まだ最適化されていません。タイルベース遅延レンダリングのパイプラインステートは十分に調整されておらず、帯域幅管理にも改善の余地があります。
これは、既存のasahiの手法によってM4 GPUファームウェアプロトコルが解析可能であることを示す証明として注目に値し、従来は数ヶ月の共同作業を要していた内容を、個人による1ヶ月間の集中的な取り組みに凝縮したものです。
Source: https://codyho.dev/blog/gpu-driver/
電動スクーターのリバースエンジニアリングとRustによるファームウェアの書き直し
Ben Simmsが、消費者向け電動スクーター(Xiaomiの派生基板)のファームウェアをリバースエンジニアリングし、クリーンルームによるRust実装に置き換えた事例を紹介します。ハードウェアはSTM32クラスのARM Cortex-Mマイクロコントローラーで、バッテリー管理システム(BMS)、モーターコントローラー(FOCベースのBLDC)、ダッシュボードディスプレイとUARTで通信しています。純正ファームウェアはソースコードが非公開のコンパイル済みバイナリです。
リバースエンジニアリングのプロセスでは、抽出したファームウェアイメージの静的解析にGhidraを使用し、UARTバス上でのロジックアナライザーのキャプチャと組み合わせることで、独自のシリアルプロトコルを再構築しています。ダッシュボードとBMSでは異なるフレーミングが使用されており、ダッシュボードのプロトコルは単純なXORチェックサムを持つ長さプレフィックス方式、BMSのプロトコルはセル電圧・温度・充電状態をリトルエンディアンの固定小数点形式でエンコードしています。Simmsは、観測可能なスクーターの状態と値を照合することで未文書フィールドを特定するなど、トラフィックのみから両プロトコル仕様を再構築する過程を詳細に記録しています。
Rustファームウェアはベアメタル上の非同期executorとしてembassyを使用しており、RTOSなしで並行UARTハンドラーと制御ループを記述できます。モーター制御コマンドは既存のESCに転送する方式をとっており、FOCをゼロから再実装することは避けています——これは問題の最も難しい部分を回避する実用的な判断です。このファームウェアには、設定可能な速度制限、カスタム加速カーブ、BLE経由のデータロギング機能が追加されています。
安全面での考慮事項は軽視できません。モーターコントローラーは受け取ったトルクコマンドをそのまま実行するため、Rustファームウェアにはウォッチドッグの統合と、すべての計算出力に対するサニティバウンドチェックが含まれています。フラッシュへの書き込みはデバッグプローブを使用してSWD経由で行われました。
この取り組みの技術的な価値は、ロジックアナライザーのトレースからの体系的なプロトコル再構築と、複数のシリアルペリフェラルをクリーンに扱うためのembassyによるCortex-M上の非同期パターンの組み合わせにあります。完全なプロトコルドキュメントとファームウェアのソースコードが公開されています。
Source: https://bensimms.moe/reverse-engineering-scooter/
Gemini 3.8 Live および 3.8 Live Extended Thinking
Googleは、リアルタイムマルチモーダルインタラクション向けにGemini 3.8 Liveと「Extended Thinking」バリアントをリリースしました。Live APIはストリーミング音声・映像入力をサポートし、サブ秒レベルの応答レイテンシを実現しており、音声アシスタントやリアルタイム映像解析のユースケースを対象としています。Extended Thinkingバリアントは、応答の前に実行されるスクラッチパッド推論フェーズを追加するもので、o1/o3におけるchain-of-thought budgetに類似した仕組みです。これにより多段階推論を必要とするタスクの性能が向上する一方、レイテンシが増加します。
発表から得られる技術的な詳細は乏しく、これはGoogleのプロダクトローンチとして典型的なものです。Live modelはGemini 2.0 Flashアーキテクチャのストリーミングバリアントです。音声の入出力はネイティブ処理(文字起こしを介さない直接生成)であり、ASR→LLM→TTPSパイプラインによる誤差の累積を低減し、プロソディを考慮した応答を可能にします。Liveセッションのコンテキストウィンドウは制限されており、モデルはセッション履歴全体ではなくローリングバッファを維持します。
Extended Thinkingは「thinking budget」パラメータ(トークン単位)を使用し、最終応答を生成する前にスクラッチパッドフェーズが消費できる計算量を制御します。これはAnthropicのClaude 3.7におけるextended thinkingと同様のインターフェース設計です。推論トークンはデフォルトではユーザーに返されませんが、APIフラグによって公開することができます。
引用されているベンチマークは数学とコーディングタスクに関する内部評価であり、Extended ThinkingがベースのLive modelに対して有意な改善を示しています。発表にはサードパーティによる再現可能なベンチマーク数値は提供されていません。
主な技術的関心事は、ネイティブ音声アーキテクチャと、ストリーミングコンテキストにおけるExtended Thinkingのレイテンシプロファイルです。最終出力をブロックする推論フェーズの追加は、Live APIの低レイテンシという前提と相反します。このトレードオフの管理方法(例えば、思考中に部分的な音声をストリーミングするか、厳格なbudgetキャップを設けるか)については文書化されていません。
Apple Reference Image:検証済み写真撮影のための新しいアプローチ
Appleは、写真が特定のハードウェアデバイスによって改変なしに撮影されたことを暗号学的に検証するシステムを説明しています。核心的な問題はコンテンツの出所確認(プロベナンス)、すなわちカメラで撮影されたオリジナル画像をAI生成画像や後処理された偽造画像から区別することであり、そのためには撮像センサーから最終ファイルまでの信頼の連鎖が必要です。
仕組みは以下の通りです。iPhoneのSecure Enclaveは、製造時にプロビジョニングされたデバイス固有の秘密鍵を保持しています。撮影時に、(ISP処理前の)生の画像データのハッシュがこの鍵で署名されます。署名とApple CAをルートとする証明書チェーンが、「reference image」——後の検証に使用される元フレームの低解像度または圧縮された表現——とともに画像メタデータに埋め込まれます。
署名されたアーティファクトはC2PA(Coalition for Content Provenance and Authenticity)仕様に準拠しており、具体的にはCOSE(CBOR Object Signing and Encryption)署名を使用しています。これにより、プロベナンスデータは他のC2PA準拠ツールと相互運用可能になります。
主要な設計上の選択:署名はISP処理前にハードウェアで行われるため、後処理されたJPEGではなく生のセンサーデータをカバーしています。reference imageは知覚的なアンカーとして機能します——検証者は公開された画像をreference imageと比較することで、基本的なJPEG圧縮の範囲を超えたクロップ、合成、または生成的な改変を検出できます。
制限事項:このシステムは、画像が本物のAppleデバイスから得られたものであり、想定されるISPパイプライン処理を超えた改変が行われていないことを証明します。偽の画像を表示した画面の撮影を防ぐことはできず、センサーレベルの操作には対処せず、ルートトラストについてはAppleのCAに依存しています——これは失効とトラストアンカリングにおける単一障害点となります。reference imageの比較は知覚的なものであり暗号学的ではないため、敵対的な微細な編集の余地が残ります。
Source: https://security.apple.com/blog/apple-reference-image/
2026年の推論ハードウェア革命
IEEE Spectrumは、2026年に向けた推論ハードウェアの動向を概観し、GPU中心の計算基盤から専用推論シリコンへのアーキテクチャの分岐に焦点を当てています。中心的な主張は、学習と推論は算術強度のプロファイルが十分に異なるため、同一ハードウェアを両者に用いることはますます最適でなくなりつつあるというものです。
推論ワークロード、特に自己回帰的なLLMのデコードは、計算律速ではなくメモリ帯域幅律速です。重要な指標はTFLOPS/ドルではなく、GB/s/ドルです。これにより、計算に近い場所に高帯域幅メモリを配置するアーキテクチャへの関心が高まっています。具体的には、ウェーハスケール統合(Cerebras)、near-memoryコンピューティング(Samsung HBM-PIM、SK Hynix AiMX)、そしてカスタムのSRAMを多用したチップなどが挙げられます。たとえばGroqのLPU設計は、大容量のオンチップSRAM上での決定論的なデータフローを用いることで、デコード中のDRAMレイテンシをほぼ完全に排除しています。
第二の軸はスパース性の活用です。attention patternとMoEルーティングはいずれも推論時に構造的なスパース性を生み出しますが、標準的なGPUのtensor coreはダイナミックなスパース性がブロック境界に整合しない限り恩恵を受けられません。Qualcomm、MediaTek、そしてd-MatrixやTenstorrentといったスタートアップが開発するチップは、より細粒度のスパース性を活用できるよう設計されています。
また、本記事はdisaggregated prefill/decodeについても取り上げています。これはプロンプト処理(計算律速)とトークン生成(メモリ帯域幅律速)を異なるハードウェアプールに分離することで、それぞれを独立にスケールさせるアプローチであり、クラウド推論スタックでの採用が進んでいます。
本記事は技術的な深掘りよりも概説的な内容であり、新たな実験結果はなく、公知のアーキテクチャ上の立場を整理するものです。暗黙的に提起されているオープンクエスチョンは、DRAMの帯域幅スケーリングの継続(HBM4ロードマップ)によってその差が十分縮まり、汎用GPUクラスターの優位性が保たれるのか、あるいはスケールにおいて専用シリコンの方が経済的に有利となるのかというものです。
Source: https://spectrum.ieee.org/inference-hardware-revolution
Nari Qwen3-TTS and Qwen3-ASR: 高精度・低レイテンシ・低コスト
Nari Labsが、Qwen3ベースで構築したTTSおよびASRモデルをリリースしました。Covalの音声AI評価スイートでベンチマークが行われており、そのベンチマーク上での最先端性能と、競争力のあるレイテンシおよびコスト指標が主張されています。
Qwen3-TTSモデルは、音声合成に言語モデル型のアーキテクチャを採用しています。テキストトークンはQwen3 transformerで処理され、別途用意されたオーディオコーデックデコーダー(おそらくEnCodecまたは類似のresidual vector quantizerに基づく)が予測されたオーディオトークンを波形へと変換します。これはVoicebox、BASE TTS、CosyVoiceと同様の一般的なパラダイムです。ASRモデルはQwen3をencoder-decoderまたはCTCのバックボーンとして使用しており、Whisperクラスのモデルによって確立されたパターンに沿っています。
Covalのベンチマークは、単語誤り率(WER)、文字誤り率(CER)、話者類似度(TTSクローニングタスク向け)、自然性MOS、およびエンドツーエンドのレイテンシを測定します。Nariはこれらの複数の指標でトップの成績を報告していますが、このベンチマークは比較的新しく、ASRにおけるLibriSpeechやCommonVoiceのようなコミュニティ標準にはまだなっていません。
レイテンシについてはストリーミングで対応しており、TTSモデルはオーディオトークンをインクリメンタルに生成し、最初のテキストトークン数個を処理した後に最初のオーディオチャンクが利用可能となります。報告された構成では、time-to-first-audioが200ms未満を実現しており、これはspeculative decodingまたはchunked autoregressive generationによって達成可能です。
信頼性を高めるために必要なこととしては、標準ベンチマーク(LibriSpeech clean/other)における独立したWER数値、自然性に関するUTMOSまたはDNSMOSスコア、そして話者類似度の数値がzero-shotクローニングによるものかfine-tuned voice adaptationによるものかの明確化が挙げられます。Covalベンチマークの結果は有望ですが、相対的な位置づけについて強い結論を導く前に、確立された評価指標との相互検証が必要です。
Source: https://narilabs.com/blog/nari-labs-leads-coval-voice-ai-benchmarks/
System One ModelsとJevの紹介
TypeSafe AIは「System One」モデルと、Jev(JSON Expression Vocabulary)と呼ばれるクエリ言語を発表しました。核心となるアイデアは、高速で決定論的なルールベースの推論(カーネマン的な意味でのSystem One)と、低速な確率的LLM推論を分離し、それらをルーティング・合成するための型付きクエリ言語を提供することです。
System Oneモデルは本質的には構造化されたclassifierおよびextractorです。構造化または半構造化された入力を受け取り、生成的なデコードではなく、パターンマッチング・スキーマ検証・軽量MLclassifierを用いて、型付き出力を決定論的に生成します。その動機は、本番環境でのLLM呼び出しの大部分が、確率的生成を必要とせず(エンティティ抽出・意図分類・フォーマット正規化など)、不必要なレイテンシとコストを払っている処理に充てられているという点にあります。
Jevは、これらのモデルとデータ変換を合成するためのJSONネイティブな式言語です。宣言的な設計となっており、Jev式はドキュメントから何を抽出・変換するかを記述し、System Oneモデルを呼び出し可能なプリミティブとして使用します。型システムが出力スキーマを強制することで、実行前にパイプラインの静的解析が可能になります。この言語はJSONペイロードに直接埋め込めるよう設計されており、別途DSLファイルを用意する必要がありません。
アーキテクチャは、Jev式を実行プランにコンパイルするクエリプランナーとランタイムを分離しており、SQLエンジンがパースと実行を分離する方式に類似しています。これにより、フィルタの早期適用やモデル呼び出しのバッチ処理といった最適化パスが可能になります。
HNでの議論は、この根本的なフレーミングへの強い関心を反映しています。業界はあらゆるものを生成LLMにパターンマッチングしてきましたが、決定論的・型付きパイプラインで十分な場面を見極めることには真のエンジニアリング的価値があります。主な未解決の問いは、System OneとSystem Two(LLM)の呼び出しの境界をどのように決定するか、そして決定論的モデルの信頼度が不十分な場合のfallbackエスカレーションのためのプリミティブをJevが提供するかどうかという点です。
Source: https://typesafe.ai/blog/introducing-system-one-models-and-jev
注目の新しいリポジトリ
okf-memory/okf-agent-memory
AIコーディングエージェント向けのGitネイティブな永続メモリレイヤーで、Google Open Knowledge Format(OKF)v0.2仕様を実装しています。コア設計は外部データベースを一切排除しており、メモリはGitリポジトリ内の構造化ファイルとして保存されます。これにより、エージェントコンテキストのバージョン管理・差分確認・監査性がファーストクラスの関心事として実現されます。
インメモリのBM25検索インデックスは、純粋なGoで実装されており、CGoやネイティブ依存なしに300µs未満のクエリレイテンシを実現します。組み込みのMCP(Model Context Protocol)サーバーにより、MCP互換のエージェントは追加インフラなしに接続できます。「プログレッシブディスクロージャー」機構はトークン効率化の核となるプリミティブです。完全なメモリをコンテキストに一括投入するのではなく、まずサマリーを提示して要求に応じて展開する仕組みで、著者らはこれによりトークン消費が約80%削減されると報告しています。
コンテキストウィンドウの肥大化がコストおよび信頼性のボトルネックとなる長時間稼働のコーディングエージェントにとって、この設計は特に重要です。Gitネイティブなストレージにより、チームデプロイメントではメモリのプロビナンスが自動的に得られ、ロールバックは単に git revert で済みます。純粋なGoによるシングルバイナリ配布はCIや一時的な環境でのセットアップを簡素化します。ベクターデータベースやRedisインスタンスを立ち上げることなく、永続的かつ検査可能な状態を必要とするエージェントを構築する方にとって、これは実用的なスコープに絞ったソリューションです。OKF準拠により、同仕様の成熟に伴う相互運用性においても有利なポジションが確保されています。
Source: https://github.com/okf-memory/okf-agent-memory
Nehanth/swarmllm
WebGPUを計算に、WebRTCを調整に用いて、単一のモデルを複数のデバイスに分散させるP2P型のLLM推論ランタイムであり、完全にブラウザ上で動作します。本プロジェクトは既存のランタイムをラップするのではなく、WebGPUテンソルエンジンをゼロから実装しており、これが技術的に注目すべき選択です――これにより、レイヤーをピア間でどのように分割・スケジューリングするかを完全に制御できます。
アーキテクチャは、270億パラメータのモデル(Gemma 27Bが参照ターゲットとして想定されているようです)を、各参加デバイスに連続したレイヤースライスを割り当てることで分割します。WebRTCシグナリング層は、ピアの発見、レイヤー境界間のactivationのルーティング、およびデバイスが切断された際のフォールトトレランスを処理します。各デバイスは割り当てられたスライスのみをロードして実行するため、完全なモデルが単一のマシンに存在することはありません。
ブラウザネイティブという制約は、制限であると同時に設計上の目標でもあります――インストール不要、サーバー不要、タブを開くだけです。WebGPUエンジンは、WGSLシェーダーを介してGPU上で直接、量子化された重みのロードおよびmatmulカーネルを処理します。スループットは各レイヤー間境界でのWebRTCレイテンシによって制約されるため、レイテンシが重視される本番環境には適していませんが、このアーキテクチャはフェデレーテッドでゼロインフラの推論に向けた信頼性の高い概念実証です。エッジシナリオ、教室での展開、そしてクラスタアクセスなしにパイプライン並列処理のプリミティブを研究したい方にとって興味深い内容です。
Source: https://github.com/Nehanth/swarmllm
datawhalechina/zero-to-sglang
SGLang チームと Datawhale が共同制作した、LLM 推論システムに関する体系的なコースです。カリキュラムは三つのフェーズで構成されています:LLM 推論の概念的基礎(batching、KV cache、continuous batching、PagedAttention)、機械的な理解を養うためのミニ SGLang エンジンのゼロからの実装、そして実際の SGLang コードベースのガイド付き読解を経てオープンソースへの初回コントリビューションに至る流れです。
「先に構築してから読む」という教授法がこのコースの際立った特徴です。学生は radix attention cache やスケジューラといったコンポーネントを自ら実装してから SGLang のプロダクション版に触れるため、実際のコードが圧倒的に感じられるのではなく、読み解けるものとして映ります。英語版と中国語版の両方がメンテナンスされており、アクティブな SGLang コントリビュータの多くが中国の機関に所属していることを考えると、アクセシビリティが大幅に向上しています。
SGLang は高スループットの推論フレームワークであり、システム的な複雑さも相当なものです(構造化出力制約、マルチモーダルルーティング、分離型 prefill など)。そのため、ガイド付きのオンボーディングパスはコントリビュータにとって真の価値があります。推論効率に関する研究に携わっている博士課程の学生にとって、このコースはコードをいきなり読み始めるよりも、プロダクショングレードのシステムを実際に改変しベンチマーク評価できるようになるまでの近道となります。リリース直後に 922 スターを獲得していることからも、こうした体系的なシステムカリキュラムへの需要の高さは明らかです。
Source: https://github.com/datawhalechina/zero-to-sglang
elliothux/open-compute
Cloudflare Workers ランタイムの表面を再実装したセルフホスト型の実装で、単一の Rust バイナリにコンパイルされます。Workers KV、D1(SQLite バックエンド)、R2(オブジェクトストレージ)、Durable Objects、Queues、Workflows — Cloudflare エッジコンピュートスタック全体 — との API 互換性を目標としており、Cloudflare のインフラやアカウントは不要です。
Rust による実装のため、バイナリは自己完結型であり、Linux および macOS ターゲット間でポータブルです。D1 互換性は組み込み SQLite によって、R2 はローカルファイルシステムまたは S3 互換ストアによって、Durable Objects はインプロセスのアクターモデルによってそれぞれ実現されています。Workers の JavaScript 実行モデル(V8 isolates、fetch イベントハンドラ)は維持されているため、既存の Worker スクリプトは修正なしで動作するはずです。
実用的なユースケースとしては、wrangler dev の癖を回避したローカル開発、エアギャップ環境へのデプロイ、本番の Worker 動作と完全な一致が求められるステージング環境などが挙げられます。また、Workers プログラミングモデルに適合するワークロードで、スケール時に Cloudflare の料金が懸念される場合のコスト回避策としても機能します。単一バイナリによるデプロイは、コンテナ化された環境や組み込み環境に対して特にシンプルです。制限事項としては、Cloudflare のグローバル anycast ネットワークやエッジキャッシングのセマンティクスが存在しないため、コンピュートレイヤーのクローンであり、CDN の代替ではありません。
Source: https://github.com/elliothux/open-compute
evangelosvlachos96-dotcom/booking-microservices
.NET 10 で実装されたフライト予約システムのリファレンス実装です。独立したマイクロサービスとして構成され、アーキテクチャパターンを意図的に組み合わせたスタックを採用しています。各サービスは Vertical Slice Architecture を使用しており、機能はテクニカルレイヤーではなく垂直的な機能単位(例:フライト予約、予約キャンセル)で整理されています。そのため各スライスがコマンド、ハンドラ、バリデータ、永続化コードを自己完結して保持します。
Domain-Driven Design と CQRS が全体に適用されており、コマンドとクエリは分離され、集約が不変条件を強制し、ドメインイベントが RabbitMQ を介したサービス間通信を駆動します。選択されたサービスでは状態の永続化に Event Sourcing が使用されており、現在状態のスナップショットではなくイベントが唯一の信頼できる情報源となっています。サービス間の同期呼び出しには gRPC を使用し、Wolverine がインプロセスメッセージングとアウトボックスパターンを担当します。データストアにはリレーショナル用途に PostgreSQL、ドキュメント指向ストレージに MongoDB を採用しています。.NET Aspire がローカル開発向けのオーケストレーションと可観測性レイヤーを提供します。
ここでの価値は新規性ではなく完全性にあります。これは非自明なドメインにおいてこれらのパターンがどのように組み合わさるかを示すリファレンスコードベースです。Vertical Slice + Event Sourcing + Wolverine がサービススケールで一貫したスタックとして成立するかどうかを評価しているエンジニアにとって、現実的な予約ドメインの複雑さ(フライト、乗客、決済)を備えた動作するサンプルは、おもちゃのようなチュートリアルよりも実質的にはるかに有用です。
Source: https://github.com/evangelosvlachos96-dotcom/booking-microservices
acryldev/acryl
ACRYL(Agent Context Relay Yielding Lifecycles)は、複数のコーディングエージェントに対して単一の共有された永続的なワークスペースを提供するために設計されたコンテキスト管理レイヤーです。このプロジェクトが解決しようとしているコアな問題は、Claude Code、Codex、Cursorのような各エージェントがそれぞれ独自のセッション状態を保持するため、同じコードベースに対して複数のエージェントを併用・逐次使用した場合に、コンテキストの表現が乖離してしまうという点です。
ACRYLは単一の正規コンテキストストアを維持しており、接続された任意のエージェントがリレープロトコルを介してそこから読み書きします。ここでいう「永続的なワークスペース」とは、エージェントのセッション、ターミナルの再起動、エージェントの切り替えをまたいでコンテキストが保持されることを意味します。つまり、ワークスペースは呼び出しのたびにリセットされるのではなく、意思決定・ファイルのサマリー・タスク状態を時間をかけて蓄積していきます。「yielding lifecycles」というフレーミングは、タスクが遷移する際にエージェントがセッション終了時にコンテキストを破棄するのではなく、明示的に引き渡すことを指しています。
実用的なターゲットは、異なるタスクタイプを異なるエージェントが担うマルチエージェントワークフロー(例:コード生成担当と レビュー担当を分ける構成)や、同一エージェントが数日にわたって継続性を必要とする長期プロジェクトです。現時点では238 starsと初期段階ですが、エージェント間・セッション間でのコンテキストの断片化という問題は、本番環境のエージェンティックパイプラインを運用している開発者にとって実際の摩擦点です。この設計はエージェントの接続性にMCPまたは互換プロトコルを前提としており、現在のエージェントツールエコシステムとの相互運用性を確保しています。
Source: https://github.com/acryldev/acryl
Loopera-ai/loopera
定量的なファンダメンタルファクター研究のための仮説駆動型AIエージェントであり、金融データからのアルファファクターの生成・検証・反復というワークフローを対象としています。このシステムの際立ったアーキテクチャ上の選択として、エビデンスゲート付きバリデーションとリサーチメモリが挙げられます。
エビデンスゲーティングとは、仮説(例:「R&D対売上高比率の高さはテック銘柄の将来リターンを予測する」)が、定義された実証的バリデーションステップ——バックテスト、統計的有意性の確認、またはアウトオブサンプル評価——をクリアするまで受理されず、下流に渡されないことを意味します。これにより、エージェントが未検証の仮説をそのコンテキストに蓄積することを防ぎます。これは、もっともらしい推論と検証済みの知見を混同してしまう、LLMベースのリサーチエージェントにおける既知の失敗パターンへの対策です。
リサーチメモリは、過去の仮説・そのエビデンスの結果・それらを生成した推論の連鎖を構造化されたログとして保持します。新たな仮説はこの履歴に基づいて条件付けられるため、エージェントは既知の失敗を再検証せずに済み、過去に検証済みのコンポーネントから複合的な仮説を構築することができます。これは、自由形式のメモではなく、構造化されたインデックスを持つ実験ノートに類比されるものです。
このシステムは、テクニカルデータやオルタナティブデータのファクターではなく、ファンダメンタルファクター(貸借対照表・損益計算書・キャッシュフロー比率)に特化しています。クオンツ研究者にとっての関心事は、エビデンスゲーティングの規律が現実的なデータに対して有効に機能するかどうか、またメモリ構造がファクター間の相互作用のニュアンスを十分に表現できるほど表現力を持つかどうかという点です。中国語・英語のバイリンガルドキュメントは、主要なユーザーコミュニティを反映しています。
Source: https://github.com/Loopera-ai/loopera
crwdla/tokentab
AIコーディングエージェントセッション向けのCLIコスト管理ツールです。Claude Code、OpenAI Codex CLI、Gemini CLIのセッションログを解析し、トークン使用量のレコードを抽出して現在のモデル価格を適用することで、モデル・プロジェクト・日付ごとの内訳を出力します。
技術的な核心はログ解析レイヤーにあります。各エージェントはセッションデータを異なるフォーマットと場所に保存しています(Claude Codeは~/.claude/以下にJSONLを使用し、CodexおよびGeminiはそれぞれ独自のスキーマを持ちます)。そのためtokentabはこれらを共通の使用量レコード構造に正規化した上で価格計算を行います。出力はターミナル上でテーブル形式に整形され、日付範囲やエージェントによるフィルタリングオプションも備えています。
このツールが解決する問題は切実なものです。これらのエージェントは自律的に動作しバックグラウンドでトークン消費を積み重ねていきますが、いずれのCLIツールも利用しやすい形での集計コストレポートを提供していません。このようなツールなしにプロジェクトをまたいだコストの帰属を把握するには、手動でのログ確認か独自パーサーの構築が必要になります。1,139スターという本バッチ中最多のスター数は、ヘビーなエージェントユーザーの間で「今週いくら使ったかわからない」という問題がいかに広く共有されているかを示しています。
制限事項としては、価格テーブルがハードコードされているためモデルや料金の変更に追従できなくなる点、および実際の課金APIとの連携がない点が挙げられます。そのため、このツールの出力はあくまで推定値であり、請求との照合には使えません。それでも、プロジェクトごとの予算管理やコストのかかるエージェントパターンの特定において、明らかな空白を埋めるツールと言えます。