デイリーAIダイジェスト — 2026-09-14
arXiv ハイライト
PLC-DPO: ノイズのある曖昧な Preference Optimization における事後ラベル補正
問題設定
Direct Preference Optimization は、観測されたすべてのペア (y_w, y_l) を preference の方向を示す信頼できる指標として扱います。実際には、人間またはモデルによってアノテーションされた preference データセットには、3 種類の失敗モードが存在します:(i) y_l が実際には望ましい 反転ラベル、(ii) 2 つの応答がほぼ同等である 方向性の弱いペア、そして (iii) 真の同点です。Bradley-Terry loss \mathcal{L}_{\mathrm{DPO}} = -\log\sigma(m_{\mathrm{seq}}) の下では、反転ラベルは正しいラベルと同じ大きさで policy を誤った方向に押し込む gradient を生成し、弱いペアや同点のペアはノイズをもたらします。既存のロバストな変種(cDPO、rDPO、IPO、フィルタリングベースの手法)は、一様な label smoothing 事前分布を適用するか、疑わしい例を破棄するかのいずれかであり、どちらも信号を捨てることになります。
PLC-DPO はこれを オンライン潜在ラベル 問題として再定式化します:隠れ変数は応答の品質ではなく真のペアワイズ方向であり、各ペアは学習時に「強化(クリーン)」「反転(フリップ)」「中和(タイ)」の 3 つの行動のいずれかにルーティングされるべきです。
手法
核心となる観察は、policy-reference マージン
m_{\mathrm{seq}}(x,y_w,y_l) = \beta\!\left[\log\frac{\pi_\theta(y_w\mid x)}{\pi_{\mathrm{ref}}(y_w\mid x)} - \log\frac{\pi_\theta(y_l\mid x)}{\pi_{\mathrm{ref}}(y_l\mid x)}\right]
が潜在ラベルに関するオンラインの証拠として機能するという点です。現在の policy がラベルの示す方向に reference に対して大きく動いている場合(m_{\mathrm{seq}} が大きな正の値)、そのペアはクリーンである可能性が高く、十分に学習された policy の下で強く負の m_{\mathrm{seq}} は反転ラベルのシグナルとなり、ゼロ付近に集中したマージンはタイを示します。生のマージンは学習中にスケールが変動するため、PLC-DPO はそれらを(バッチまたは累積統計を用いて)標準化した後、\{\mathrm{clean}, \mathrm{flip}, \mathrm{tie}\} 上のルーティング分布に入力し、その後、信頼度の低いルーティング判断が積極的な補正を引き起こさないよう confidence gate を適用します。
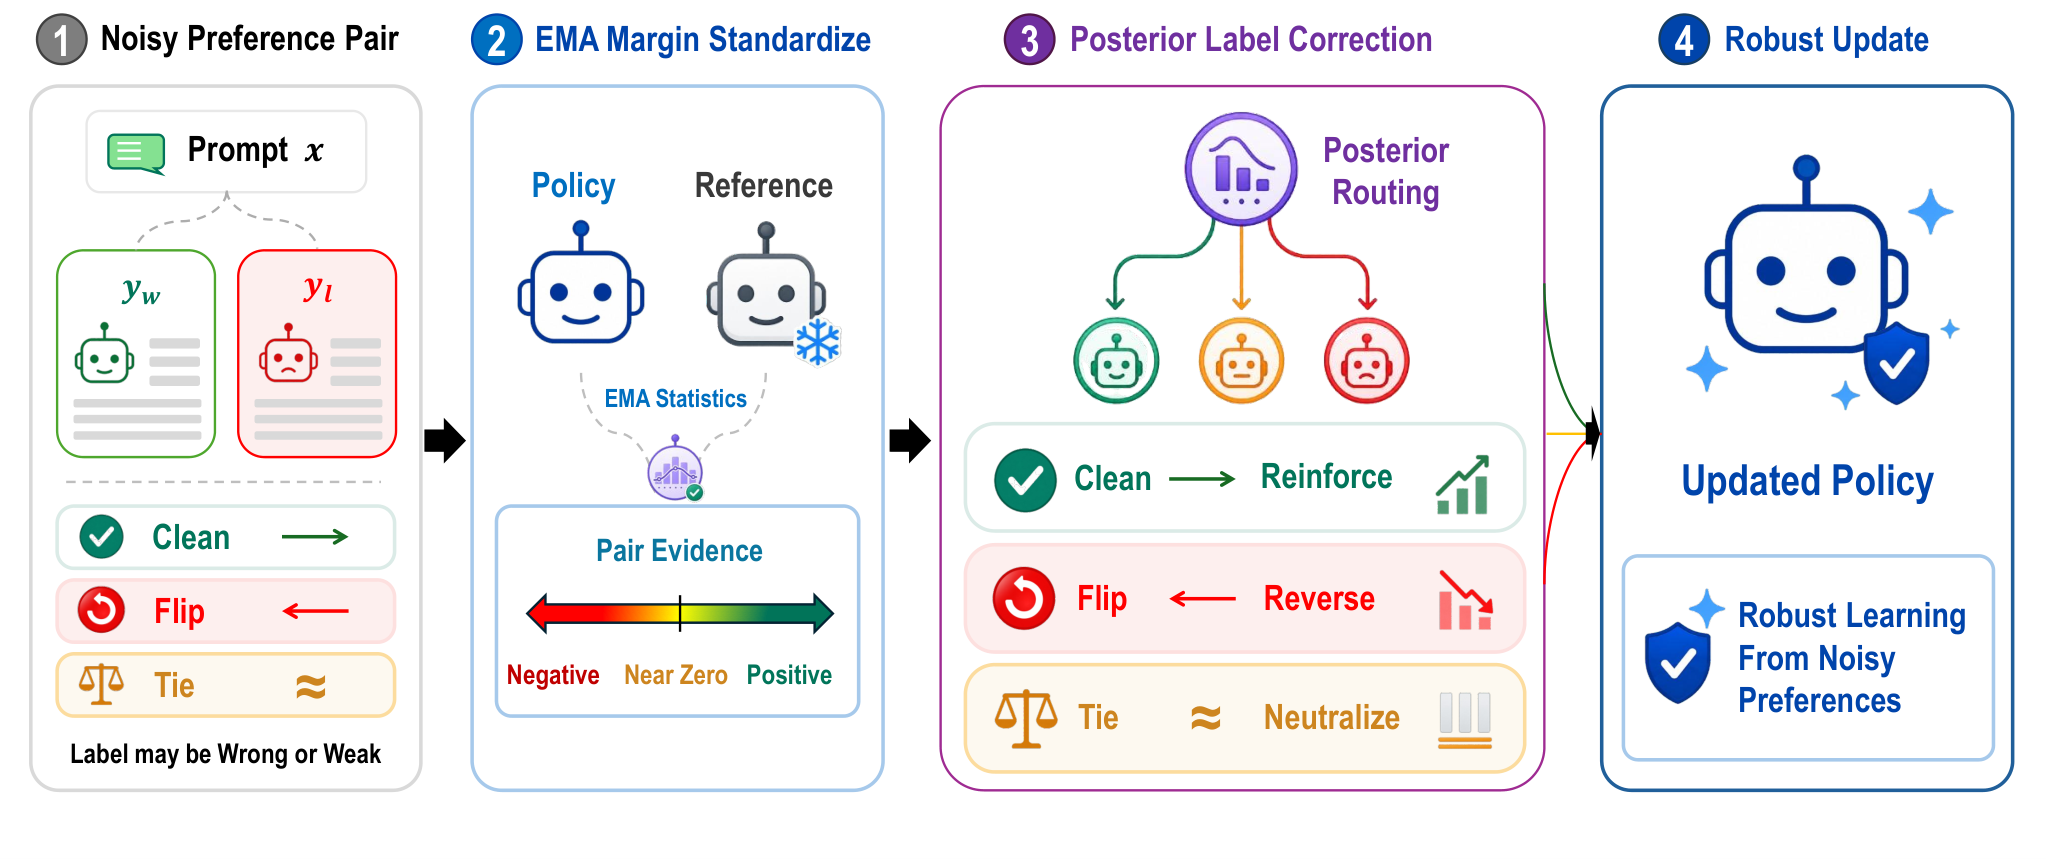
各ペアのルーティング事後確率 p_c, p_f, p_t が得られると、loss は混合となります:クリーンブランチは通常の -\log\sigma(m_{\mathrm{seq}})、フリップブランチは -\log\sigma(-m_{\mathrm{seq}})(y_w と y_l を入れ替えることと等価)、タイブランチは m_{\mathrm{seq}}\to 0 を促進します(例えば IPO スタイルの二乗マージンペナルティや reference に向けた対称 KL)。confidence gate はルーティング事後確率のシャープさによって補正行動をスケーリングするため、証拠が曖昧なペアは積極的な反転ではなく DPO に近い更新を受けます——これにより、モデルが単に不同意であるラベルを反転させることで現在のバイアスを「自己確認」するという病理を防ぎます。
スケルトンの再実装手順:(1) ペアごとに m_{\mathrm{seq}} を計算;(2) 累積平均・分散を維持して \tilde m を生成;(3) \tilde m を 3 方向の softmax(タイはゼロ中心、クリーン/フリップは裾部分)にマッピングして (p_c, p_f, p_t) を取得;(4) 混合 loss を計算;(5) \max_k p_k または負エントロピーに基づく confidence gating を適用。
結果
評価は、Qwen2.5-1.5B、Qwen2.5-7B、Phi-2-2.7B、および(汎化性のため)Llama-3-8B と Mistral-7B を対象とした 57 のデータセット・モデル・ベンチマークセルに及び、いずれも UltraChat-200k 上で SFT 初期化されています。主要な数値:PLC-DPO は DPO に対して平均勝率 60.5 を達成し、次点のベースラインの 55.5 に対して 5 ポイントのマージンを示しています——最も優れたロバスト DPO の競合手法を 5 ポイント上回ります。ベースモデルや preference データセットをまたいで改善が持続しており(Q2)、ルーティングメカニズムが特定の reward モデルのアーティファクトに調整されていないことが示唆されます。
制御された割合のラベルを反転させた注入ノイズストレステストでは、推定されたルーティング状態が真のノイズ率を追跡し、DPO の急激な劣化と比べて性能が緩やかに低下します。合成的な近似重複ペアと人間の不一致サブセットの両方を使用したタイストレステストでは、タイルートが単に適合が困難なペアではなく、真に曖昧なペアで活性化することが示されます。自己確認の診断結果は、本手法が反転ペアと方向性の弱いペアを区別できることを示しており——両者とも学習初期に小さいかまたは負のマージンを生成するため、これは自明でない要件です。
制限と未解決の問題
- ルーティングは \pi_\theta 自身が情報量を持つことに依存しており、学習初期には m_{\mathrm{seq}}\approx 0 がどこでも成立し、ルーティング分布は情報量を持ちません。論文はこれを bridgeするために confidence gating と SFT 初期化に依拠していますが、非常にコールドなスタートは依然として懸念事項です。
- タイ loss の定式化は抜粋中で完全には規定されておらず、IPO スタイルの二乗マージンと reference-KL のどちらを使用するかが gradient スケールに影響し、\beta と相互作用します。
- 自己確認リスクは緩和されていますが排除されてはおらず、ある部分集団で自信を持って誤った policy は、原理的には正しいラベルをそこでフリップとしてルーティングし得ます。診断は報告されていますが、形式的な識別可能性の結果は示されていません。
- マージン標準化と 3 ブランチ loss の計算オーバーヘッドは適度ですがゼロではなく、70B 以上でのスケーリング挙動は未検証です。
- 純粋な DPO 変種ではなく reward モデルベースのフィルタリングとの比較により、事後ルーティングが外部品質推定を包含するかどうかが明確になるでしょう。
重要性
ロバストな preference optimization は、静的な label smoothing またはフィルタリングが主流であり、どちらもノイズを軽減すべき障害として扱ってきました。PLC-DPO はその代わりに、ノイズ構造を loss の一部とし、policy 自身の軌跡を証拠として利用します——これは preference データの信頼性が不均一なオンライン alignment パイプラインに自然に適合します。57 セルにわたって次点のロバスト変種に対して平均勝率で 5 ポイントの改善は、この研究分野において実質的なマージンです。
Source: https://arxiv.org/abs/2608.30597
Breaking the Vision-Action Shortcut: Latent Interface Training for Generalizable Robotics Foundation Models
問題設定
ロボット基盤モデル — \pi_{0.5} や MolmoAct2 のような VLA、および FAST-WAM や ImageWAM のような world-action model (WAM) — は、事前学習済みの vision/language backbone と embodiment 固有の action expert を結合しています。視覚的多様性が限られたデモンストレーションによる imitation learning では、action expert がタスクに無関係な視覚的手がかり(背景、照明、カメラ姿勢、ディストラクタ)に依存してしまう可能性があります。これらはたまたまデモ行動と相関しているだけです。分布シフトが生じるとこれらの相関が崩れ、幾何学的なタスク自体は変わっていないにもかかわらず成功率が急落します。既存の対策としては、表現を豊かにする手法(expert がそれをどう使うかを制約しない)や、画像なしの action 事前学習(その後の visual-conditioning 段階を制約しない)がありますが、いずれもショートカットを排除するには至っていません。
著者らは、タスクに関連する空間的な内容を保持しつつ、タスクに無関係な視覚チャネルを遮断するために、行動学習と visual conditioning をどのように構造化するかを問います。
手法:Latent Interface Training
LIT は、フレームワーク非依存の 2 段階学習レシピです。\mathbf{o}_t, l, \mathbf{s}_t をそれぞれ視覚観測、言語、ロボット状態として、予測チャンクを
\mathbf{A}_t = (\mathbf{a}_t, \dots, \mathbf{a}_{t+H-1})
と定義します。すべてのデモチャンクに対し、終端 SE(3)+gripper ゴールを
\mathbf{g}_t = [\mathbf{p}_{t+H}; \mathbf{r}_{t+H}; \mathbf{q}_{t+H}] \in \mathbb{R}^{8}
と定義します。ここで位置 \mathbf{p}\in\mathbb{R}^3、軸角度表現の向き \mathbf{r}\in\mathbb{R}^3、2-DoF gripper \mathbf{q} です。この \mathbf{g}_t は学習時のみ利用可能です。
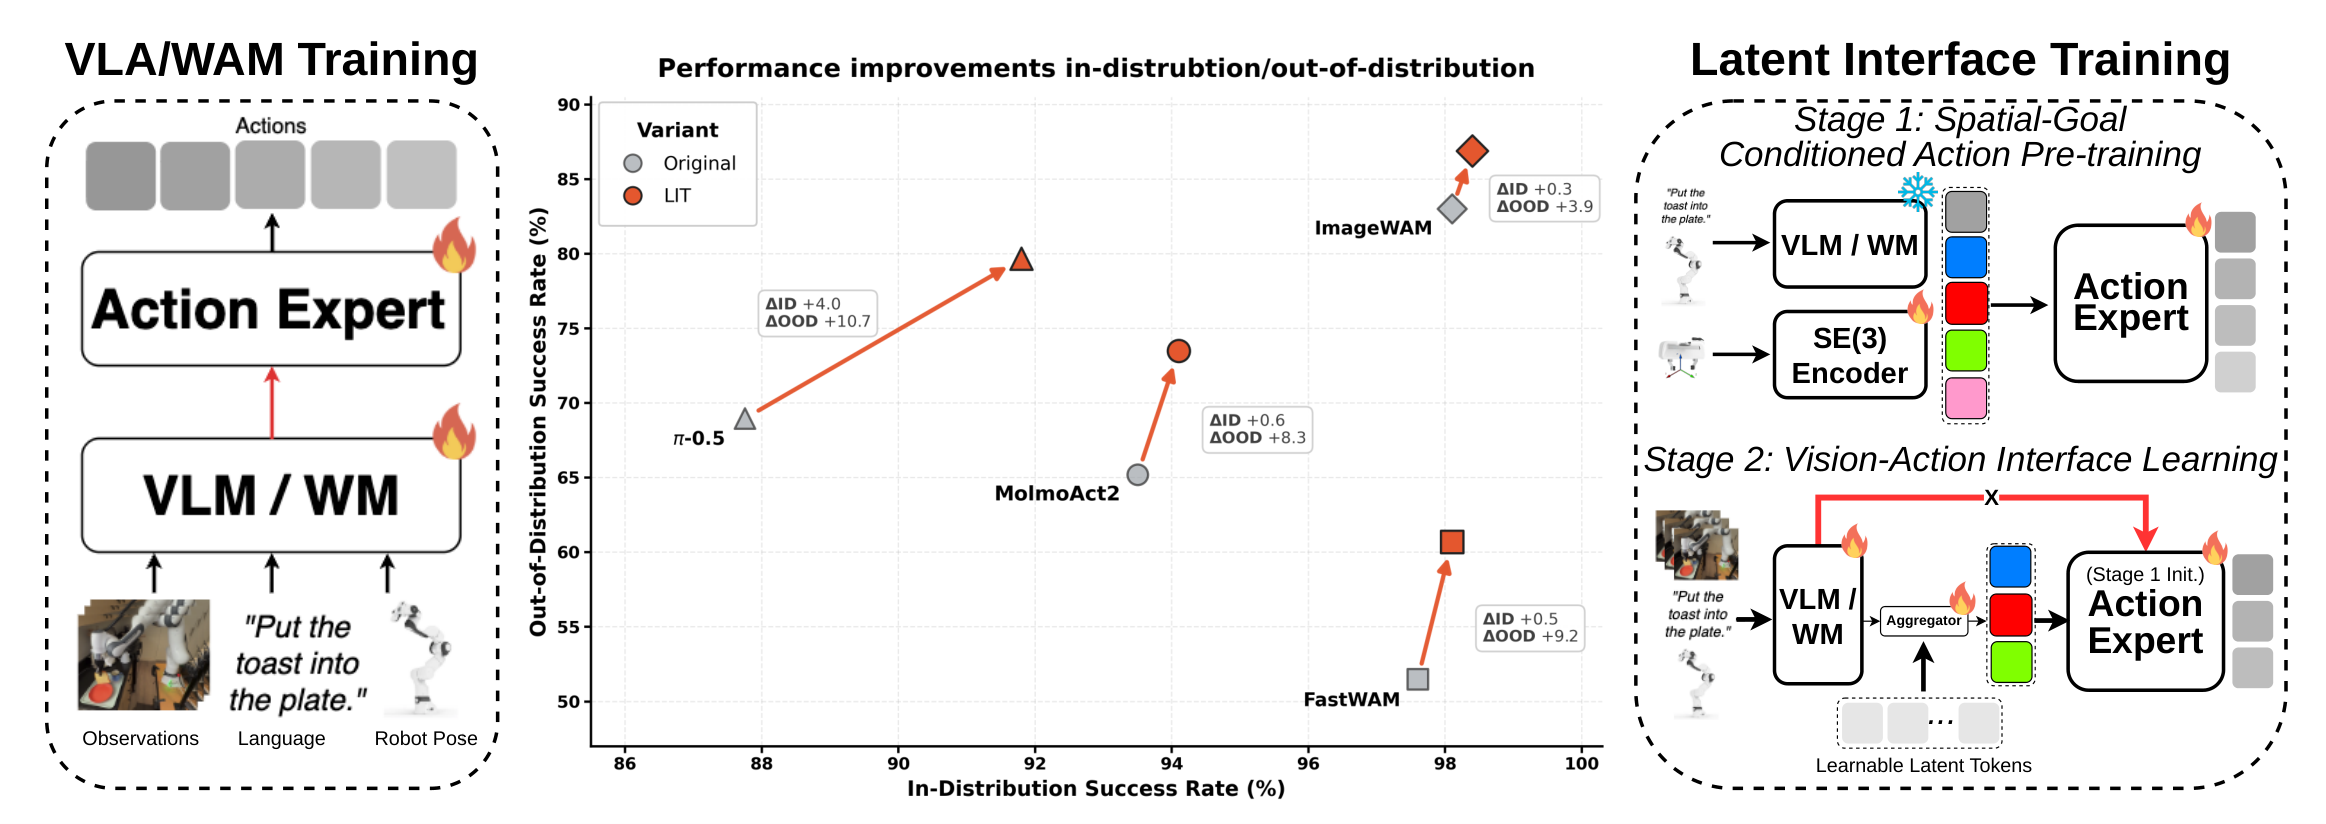
Stage 1 — 画像なし空間ゴール条件付き action prior。 action expert は、(i) 凍結した backbone からの言語・ロボット状態トークン、および (ii) \mathbf{g}_t のエンコーディングを条件として \mathbf{A}_t を生成するよう学習されます。重要な点として、視覚トークンは除外されます。\mathbf{g}_t がチャンクの終端姿勢を規定するため、この段階では言語のみの prior ではなく ゴール指向 の action prior が学習されます。expert は画像を一切見ないため、vision–action 相関を形成できません。
Stage 2 — 姿勢教師付き latent interface。 学習可能な latent トークン \mathbf{z} が視覚的・意味的な backbone 表現に cross-attend し、視覚情報が事前学習済み action expert に届く 唯一 の経路となります。これらはレイヤー単位の conditioning を注入し(各ホストアーキテクチャのネイティブな joint-attention または per-layer KV cross-attention を置き換えます)、その教師信号は \mathbf{z} を Stage 1 で使用したのと同じ終端 \mathbf{g}_t にデコードし直すよう強制する pose-reconstruction loss です。これにより視覚ボトルネックが Stage 1 ですでに行動可能になった空間的ターゲットと結びつけられ、interface はゴールに関連する幾何学的情報をエンコードし、ノイズとなる外観情報を捨てるよう誘導されます。
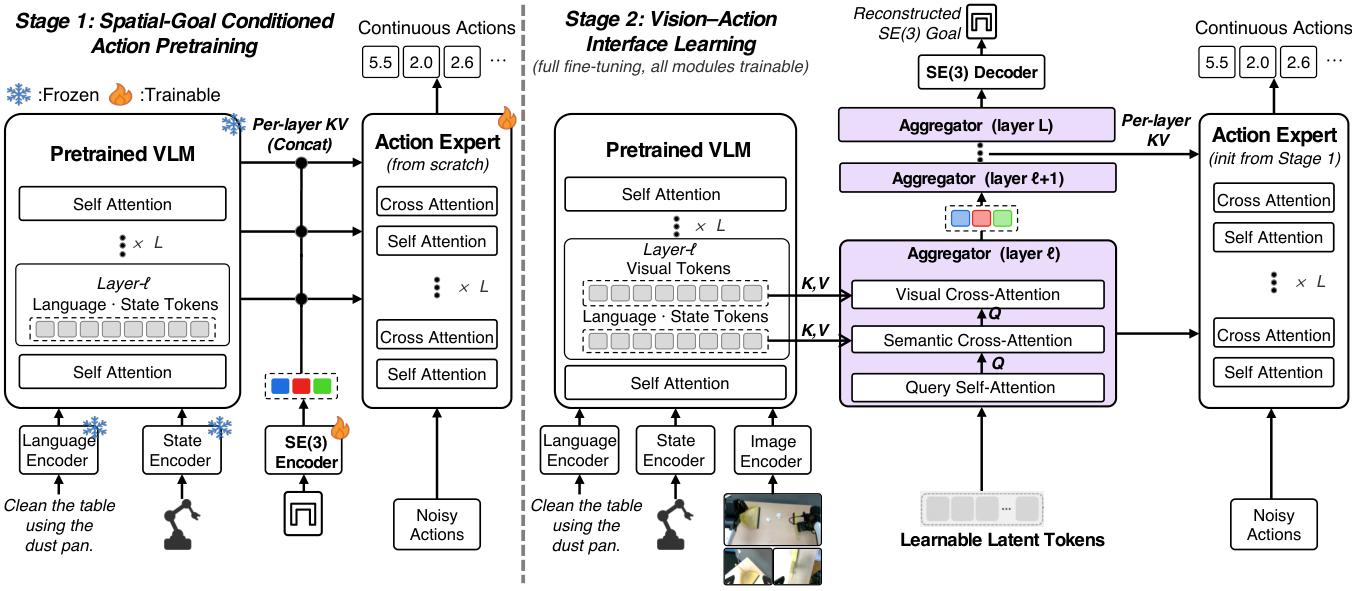
4 つのホストモデルへの統合において、元の backbone、action expert のパラメータ化、行動生成目的関数(MolmoAct2 では自己回帰トークン、\pi_{0.5} では flow matching、WAM では diffusion/flow)はそのまま保持されます。置き換えられるのは visual-conditioning 経路のみで、姿勢教師付き latent interface に差し替えられます。推論時には \mathbf{g}_t は不要で、latent トークンが現在の観測から空間的 conditioning を供給します。
実験プロトコルに関する注記:baseline と LIT の各バリアントは 同じ事前学習済み backbone から、ランダムに初期化された action expert を用いて 学習されており、公開済みポリシーチェックポイントから引き継がれる vision-action 依存関係を回避しています。これは通常の fine-tuning セットアップより厳しい比較条件ですが、baseline の数値は公開されている LIBERO fine-tuning リーダーボードの値と直接比較できない点に注意が必要です。
結果
評価は、分布内性能の測定として LIBERO(4 スイート × 10 タスク × 50 ロールアウト = 2,000 エピソード)、ゼロショット OOD 性能の測定として LIBERO-Plus(カメラ視点、センサノイズ、初期状態、言語、物体配置、照明、背景の 7 つのタスク保存軸にわたる 10,030 件の摂動インスタンス)を対象としています。4 つのホストアーキテクチャ — \pi_{0.5}、MolmoAct2、FAST-WAM、ImageWAM — はすべて元の LIBERO デモンストレーションのみで学習されています。
4 つすべての backbone において、LIT は分布内 LIBERO の成功率を維持または若干改善しつつ、LIBERO-Plus における非重み付き平均 OOD 成功率を向上させます(図 1 のサマリパネル参照)。論文の主張は、このパターンが 2 種類の VLM–action-expert 結合スタイル(joint self-attention 対 per-layer KV cross-attention)と 2 種類の WAM スタイル(推論時に使用しない学習時の将来動画予測 対 推論時の画像編集デノイジング)において 同時に 成立する、すなわちショートカット緩和効果がアーキテクチャ非依存であるという点です。
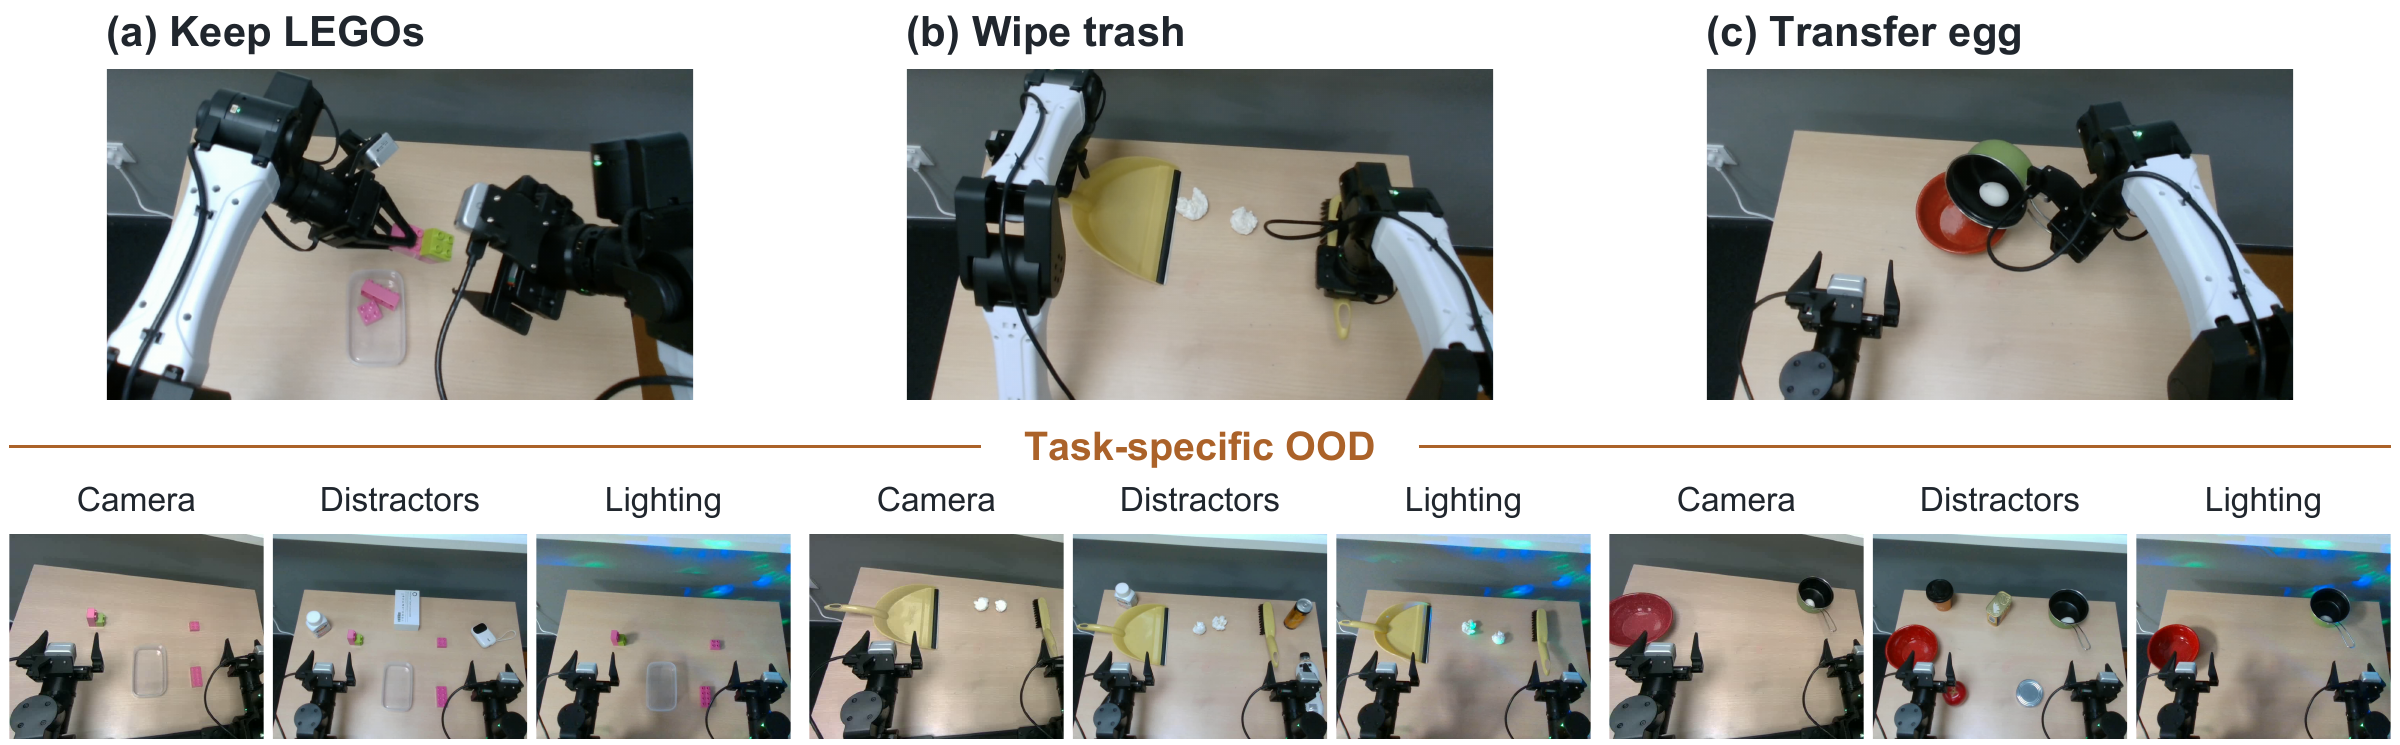
実ロボット実験は、3 つの操作タスクを Lighting、Camera(真上視点のみ)、Distractors の 3 つの OOD 条件のもとで実施しており、分布内性能を保ちながら未見の視覚変動に対するロバスト性の向上を示しています。アブレーション実験により、性能向上は 設計の組み合わせ によるものであることが明らかにされています:Stage 1 の画像なし空間ゴール事前学習、latent トークンへの姿勢教師信号、すべての visual conditioning を interface 経由でルーティングすること — いずれか 1 つを取り除くだけでショートカット挙動が再現されます。
限界と未解決の問題
- 結果は LIBERO/LIBERO-Plus と小規模な実ロボットスイートに依拠しており、OXE スケールのような大規模 cross-embodiment データセットや長期タスクへの拡張は未検証です。
- 終端 SE(3) 姿勢は強力な教師信号ですが、すべてのデモチャンクにおいて正確な固有受容感覚が得られることを前提としています。エンドエフェクタ状態がノイズだらけだったり欠損したりする場合(例:人間の動画、運動学なしの遠隔操作)、Stage 1 は機能しません。
- 固定ホライズン チャンクの終端エンドエフェクタ姿勢を使用することで、action prior が暗黙的に到達行動へのバイアスを持ちます。終端姿勢が軌道を十分に規定しないような接触豊富なスキルや力変調スキルでは、同等の恩恵が得られない可能性があります。
- 比較プロトコルでは action expert をゼロから学習するため、絶対値は LIT が大規模事前学習済みポリシー重みとどのように相互作用するかを示すものではなく、実務家が最も多く利用するその設定については不明のままです。
- latent interface の帯域幅(トークンの数・次元数)がショートカット抑制と、例えば小物体把持に必要な細粒度の視覚精度とのトレードオフを生じさせるかどうかについての分析は提供されていません。
なぜ重要か
LIT は、ショートカット緩和を アーキテクチャ的ボトルネック 問題として再定式化します:表現品質だけで不変性が得られることを期待するのではなく、空間的な教師ターゲットによって視覚チャネルを制約するのです。同じレシピが backbone や行動目的関数に手を加えることなく 4 つの異質な VLA/WAM 設計に移植できるという事実は、姿勢教師付き latent interface が、現在生の視覚トークンを action expert に直接渡しているあらゆるポリシーに対して試す価値のあるドロップイン修正であることを示唆しています。
Source: https://arxiv.org/abs/2609.12641
SAS: End-to-End最適化によるコンテキストランキングを用いたシンプルなAttention Sparsification
問題
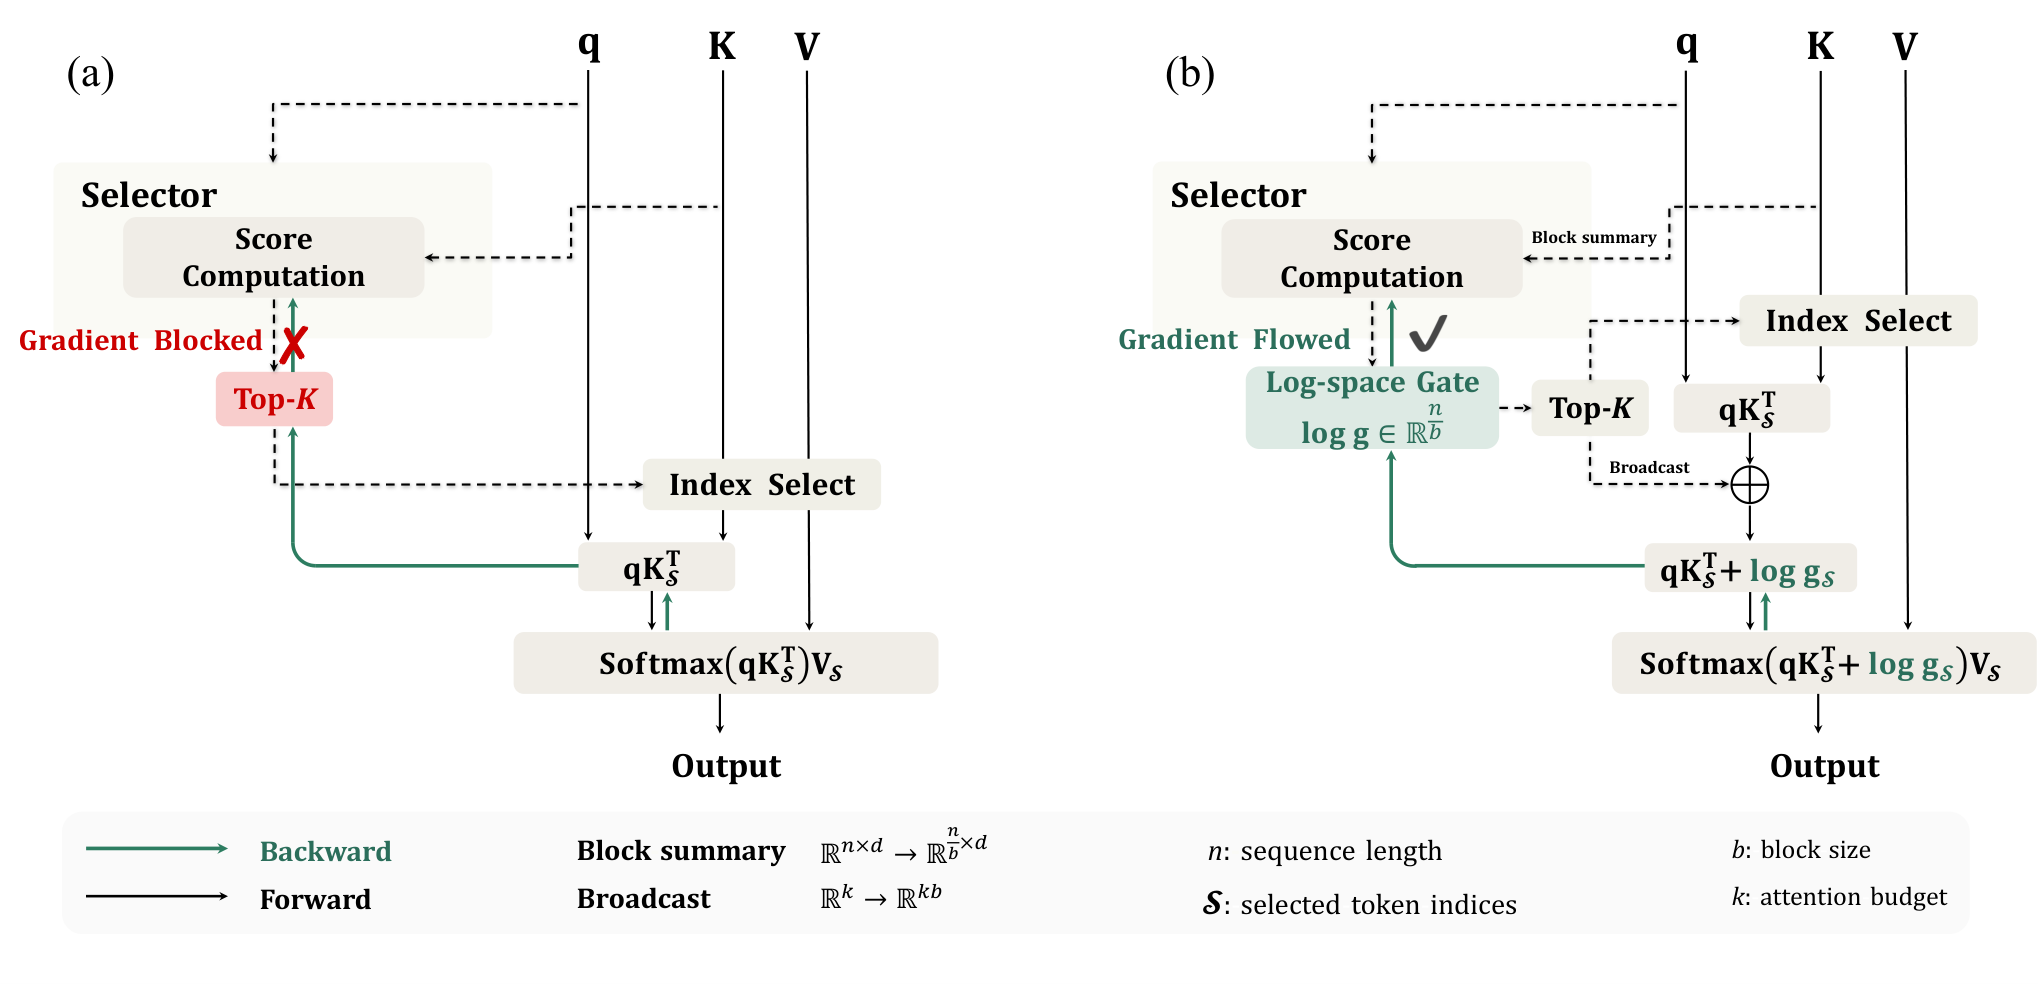
Post-training attention sparsifierは、事前学習済みtransformerのO(N^2)コストを削減するために、クエリごとにattendするコンテキストブロックの小さな集合を選択します。主流の手法(SeerAttention-R、NSAスタイルのセレクタ)は、ブロックごとのスコアを予測する軽量なスコアラーを学習し、ハードなTop-Kを適用し、Top-Kがブロックのgradientとなるため、凍結されたバックボーンの密なattention分布に対するdistillationによってスコアラーを監督します。著者らはこの目標関数が本質的に重要なものとミスアライメントしていると主張します。固定バジェットKの下では、スコアラーはブロックを次トークン予測への限界貢献度によってランク付けすべきであり、密なattentionの重みによってではありません。softmaxのmassは大きいが\|V\|への貢献が小さいブロック、あるいは他の選択されたブロックと情報が冗長なブロックは、バジェットを無駄にします。
手法
SASはスパースな選択を微分可能なコンテキストランキングとして再定式化します。常に保持される現在のブロックB_0とC個の候補となる過去のブロック\mathcal{H}=\{B_1,\dots,B_C\}が与えられたとき、セレクタはスコア\mathbf{s}\in\mathbb{R}^Cを生成し、正のgateにマッピングします。
\mathbf{g}=\phi(\mathbf{s})\in\mathbb{R}_+^C,\qquad g_0=1.
各gate g_mはブロックB_m内のすべてのトークンにbroadcastされ、attention計算に注入されることで、言語モデリングlossが標準的なbackpropによってセレクタを更新できるようにします。推論時には、\mathbf{s}が誘導するランキングから離散的なTop-Kが復元されます。
論文はこのシンプルなアイデアが実際に機能するかどうかを決定する4つの設計軸を特定しています。
- Gate位置。 g_mをsoftmaxの内側に注入する(すなわちB_m内のトークンのlogitに\log g_mを加算する)か、softmaxの外側でattention weightに乗算するかです。softmax内側への注入では、gateが正規化されたmassを他のブロックと競合することになり、これがランキングシグナルに求められる特性です。
- Gate activation。 \phiの3つの選択肢:(a) 候補ブロック全体でスコアをsoftmax正規化する;(b) ブロックごとに独立したsigmoid;(c) 生のlogit。現在のブロックは常にunit gateを持ちます。
- ランキングの保存。 学習中に連続スコアを保持するか、straight-through estimatorを用いた二値Top-Kマスクに潰すかです。連続スコアを保持することで、ランキングが明確に定義され、閾値付近のブロックに対してgradientが情報を持ちます。
- 学習スコープ。 すべてのコンテキストブロックを通じてbackpropするか、現在選択されているブロックのみを通じてbackpropするかです。フルスコープのgradientにより、現在Top-Kに含まれていないブロックに対してもlossがランキングを形成できます。
専用の学習カーネルが必要です。なぜなら、すべてのC個の候補を通じた微分可能性を保ちながらsoftmaxにブロックごとのgateを注入することは、標準的なFlashAttentionのパターンを変更するためです。論文ではbroadcast gateを効率的に処理する学習カーネルについて説明しています。
結果
実験ではQwen3バックボーン(4B/8B/14B)を使用し、SASをfull attention、SeerAttention-R(同一のセレクタアーキテクチャだがdistillation学習)、Sliding Window、StreamingLLM、Questと比較しています。評価は推論(MATH500、GPQA-Diamond、AIME24/25)、long-context(LongBench、non-thinkingモード)、エージェント的タスク(BFCL multi-turn、VitaBench、YaRNによってコンテキストを65,536に拡張)にわたります。SASは凍結バックボーンのpost-training設定と、セレクタとバックボーンを共同学習するcontinued pretraining設定の両方で評価されています。
最も示唆に富む分析はSection 6にあります。カバレッジattention mass
\operatorname{Cov}(\mathcal{S})=\frac{\sum_{i\in\mathcal{S}} w_i}{\sum_j w_j},
(ここでw_i=\exp(z_i)(生のattention)、およびSTEMのvalue-aware変種w_i=\exp(z_i+\log\|\mathbf{v}_i\|_2))を用いると、SASはほぼすべての層において両方のメトリクスでSeerAttention-Rよりも少ないper-layerのattention massをカバーしています。これは直感に反しますが、ミスアライメントの主張と整合しています。distillationは密な分布にマッチするように学習されるため、定義上カバレッジを最大化します。SASはNTP lossを最小化するようにのみ学習されており、密なmassを再現する必要がありません。
その恩恵は層をまたいで現れます。層全体でSASが選択したブロックの和集合は、SeerAttention-Rの和集合よりもfull-attentionのオラクルに対して高い重複recallを持ちます。つまり、SASのセレクタは層をまたいでより補完的であるのに対し、distillation学習されたセレクタは各層で同様の高massブロックに収束する傾向があります。下流の推論タスクでは、これはより短いトレースとより少ない打ち切りに変換され、著者らはfull attentionに対して大幅なデコード高速化を報告しています(正確な数値はSection 6.3の効率テーブルに記載されています)。
限界とオープンな問題
- 論文自身のカバレッジ分析はSASがper-layerのattention massをより少なくカバーすることを示しており、attention-mass recoveryによってセレクタを採点するいかなる評価もSASにペナルティを与えます。これにより比較が複雑になります。
- End-to-end学習はgated attentionパスを通じたgradientを必要とし、専用カーネルが必須ですが、FlashAttentionスタイルの密な学習に対するオーバーヘッドはここでは完全には定量化されていません。
- 4つの設計軸がQwen3ファミリー以外に汎化するかどうか、特にMoEバックボーンやKV headの数が非常に少ないGQAに対しては検討されていません。
- QuestおよびSelectionフリーの手法との長コンテキストにおける比較はタスクのサブセットに限定されており、すべてのタスクにわたってマッチしたバジェットでの直接比較があれば主張がより明確になるでしょう。
なぜこれが重要か
Attention sparsifierは「密なattentionを模倣するようにセレクタを学習する」という方向に収束してきました。SASはその明確な反例を提供します。セレクタをLM lossに直接アライメントさせることで、per-layerのmassカバレッジは少ないが、層をまたいだカバレッジが向上しタスク性能が改善するランキングが得られます。4軸の設計研究(gate位置、activation、ランキングの保存、学習スコープ)は、Top-Kをどのようにbackpropするかというフォークロア的な問題を、将来のsparse-attentionの研究に向けた具体的かつ検証可能な選択肢の集合へと変換します。
Source: https://arxiv.org/abs/2609.13141
COBRA-Skills: エージェントスキル最適化のためのContextual Bandit誘導型進化
問題設定
スキルライブラリ——過去のエージェントの軌跡から抽出された再利用可能な自然言語手順——はLLMエージェントの下流タスクにおける性能を向上させますが、その構築にはコストがかかります。候補となる各スキルは、多数のタスクインスタンス上でターゲットエージェントをロールアウトすることによって評価されなければならないからです。先行手法(Trace2Skill、SkillOpt、LLM Skill)は、大規模な最適化セットを使用するか、固定の候補プールを網羅的にスコアリングするかのいずれかです。本論文では、スキル構築を予算制約付き逐次最適化として定式化します。すなわち、小規模な \mathcal{D}_{\mathrm{opt}}(50例/ベンチマーク)、スキルなしの初期ロールアウト \mathcal{T}_0、およびラウンド数のホライズン T が与えられたとき、以下を求めます。
s^{\star}=\arg\max_{s\in\mathcal{S}_T}\mathbb{E}_{(x,y)\sim\mathcal{D}}[\mathrm{Metric}(\mathcal{A}(x;s),y)].
重要な緊張関係は、\mathcal{S}_T 自体が固定されておらず——実行の証拠から成長させなければならない——一方で各評価呼び出しが高コストであるという点です。
手法
COBRA-Skillsは、スキルの生存集団に対するcontextual-bandit選択と、ラウンド間に集団を書き換える証拠に基づく進化を交互に行います。
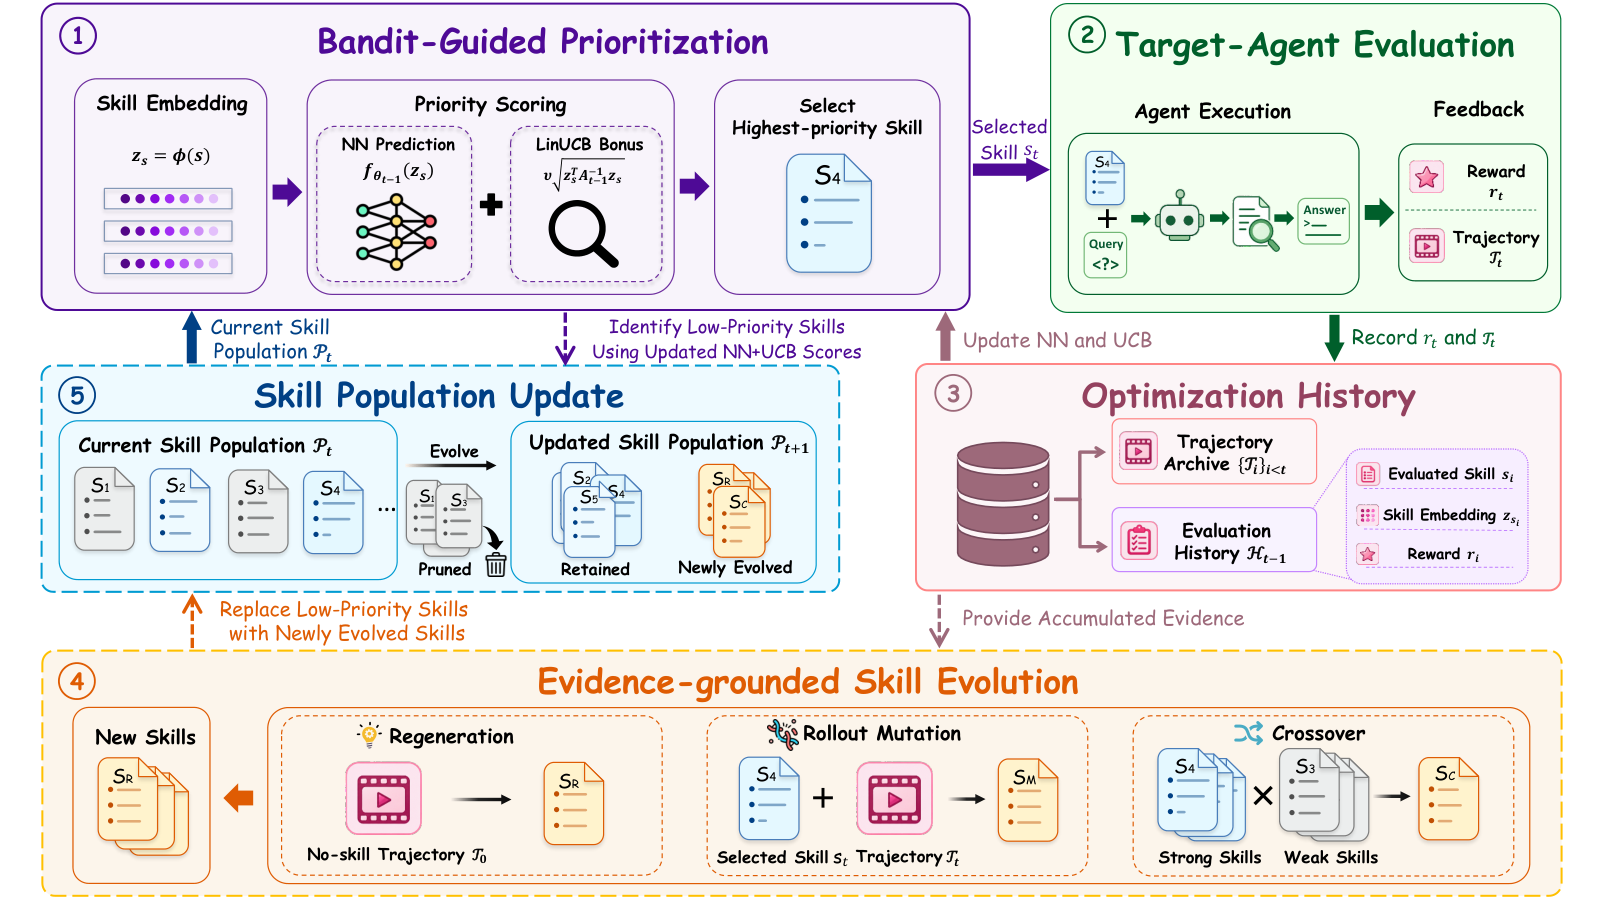
各候補 s\in\mathcal{P}_t に対して、embedding z_s=\phi(s) がニューラル報酬予測器 f_{\theta_{t-1}} とLinUCB型の探索ボーナスによってスコアリングされます。
U_t(s)=f_{\theta_{t-1}}(z_s)+\nu\sqrt{z_s^\top A_{t-1}^{-1}z_s},\quad A_t=A_{t-1}+z_{s_t}z_{s_t}^\top.
最大化子 s_t はターゲットエージェント \mathcal{A} によって \mathcal{D}_{\mathrm{opt}} 上で実行され、報酬 r_t と軌跡 \mathcal{T}_t が生成されます。履歴 \mathcal{H}_t=\mathcal{H}_{t-1}\cup\{(s_t,z_{s_t},r_t)\} は各ラウンドで f_\theta を再フィットするために使用されます(embeddingに対する小規模なNN、0.5 に初期化)。
進化は二条件トリガーによってスケジューリングされます。t-t_{\mathrm{last}}\ge d かつ \log(t/t_{\mathrm{last}})\ge\eta(初期は線形間隔、後半は幾何学的間隔)。トリガーが発動すると、Evolve は教師モデル M_{\mathrm{teach}} を用いて低ユーティリティのスキルを刈り込み、\mathcal{T}_0、\mathcal{T}_t、\mathcal{H}_t に基づいて新しいスキルを合成します。重要なのは、M_{\mathrm{teach}} がスキルをスコアリングすることは決してなく、スコアはあくまで \mathcal{A} の実行からのみ得られるという点です。初期集団 \mathcal{P}_1 は再生成オペレータを \mathcal{T}_0 に独立に適用することで生成され、多様なシードを提供します。
最終出力は \mathcal{H}_T において最高の平均報酬を持つスキルです。
結果
6つのベンチマーク(SearchQA、Spreadsheet、DocVQA、LiveMath、SocialMaze、ALFWorld)と3つのターゲットモデルにわたり、各ベンチマークでわずか50の最適化例のみを使用した場合:
- Qwen3.6-35B-A3B: 平均73.5% 対 SkillOpt 69.6、LLM Skill 66.2、Trace2Skill 64.4、ベースライン 60.4。LiveMath(55.3 対 42.3)とSocialMaze(95.5 対 91.7)での改善が最大。
- GPT-5.4-Nano: 56.9 対 SkillOpt 53.7、ベースライン 30.0。Spreadsheetは27.3 → 45.7に向上。
- Gemma4-26B-A4B-it: 68.9 対 SkillOpt 67.6、ベースライン 46.4。
効率性(Table 2)はより顕著な結果です。\Deltaスコアあたりのコスト: - Qwen: COBRA $4.13 対 SkillOpt $13.15 対 Trace2Skill $57.70。 - GPT-Nano: $2.17 対 $5.64 対 $7.28。 - Gemma: $1.73 対 $4.35 対 $93.54。
教師モデルのトークン使用量は大幅に減少しています(300万〜413万トークン 対 SkillOptの1251万〜1516万トークン)——55〜58%のコスト削減——これはbanditが候補プールの網羅的なスコアリングを回避するためです。
外部エージェントハーネス(Claude Code、Codex)でQwenをターゲットとして使用した場合も、COBRAが依然としてリードしています。Claude Codeで68.2% 対 SkillOpt 64.0、ベースライン 57.1であり、最適化されたスキルがネイティブのスキャフォールディングに過学習していないことを示しています。
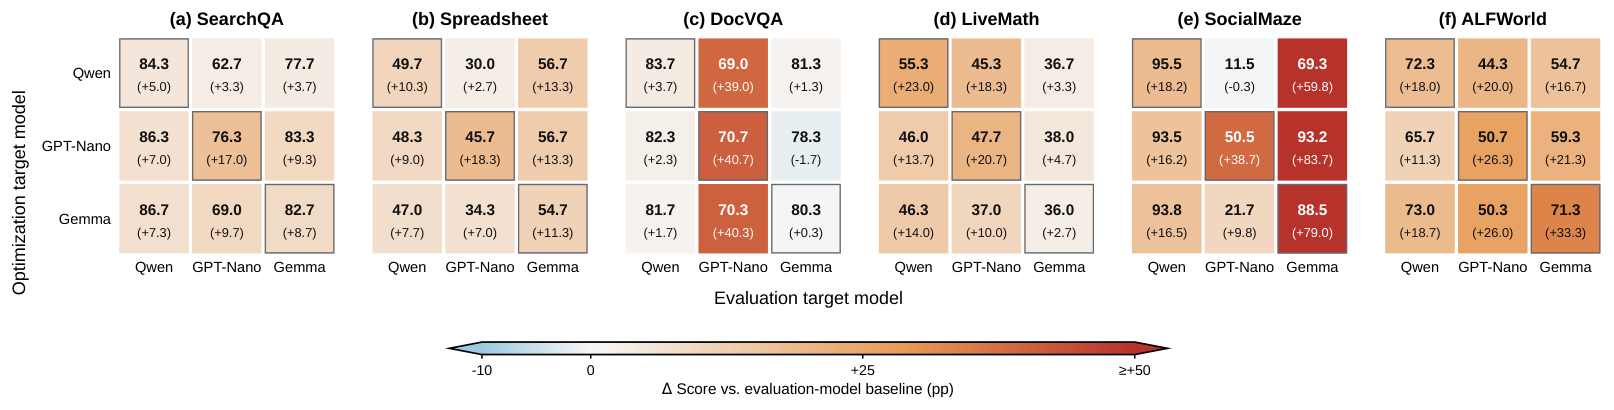
スキルはターゲットモデル間でも転移します——オフダイアゴナルのセルのほとんどで正の改善が維持されています——これは誘導された手順がモデル固有の振る舞いではなくタスクレベルの振る舞いを捉えていることを示唆しています。
アブレーション
Qwen上でのアブレーション(Table 4)により、2つのコンポーネントが独立して検証されています。
- w/o Bandit(ランダム選択、進化あり): 71.3、\Delta=-2.2。
- w/o Evolution(30個の固定プール上でbandit): 71.1、\Delta=-2.4。
- Best-of-30(30個すべてを評価し最良を選択): 71.0、\Delta=-2.5。
Best-of-30における候補プールのサイズは、COBRAが30ラウンドで遭遇する約30の異なるスキルと一致するため、改善をより多くの候補に起因させることはできません。両コンポーネントはほぼ同等に貢献しており——重要なことに——固定プール上のbanditは網羅的なスコアリングより優れていないことから、banditの価値は主として予測器 f_\theta が汎化できる進化する候補空間と組み合わさることで生まれることがわかります。
限界と未解決の問題
- ニューラル報酬予測器は非常に少ないデータポイント(t\le T、例えば30点)で毎ラウンド再フィットされます。本論文では、進化によって導入される集団外の候補に対して f_\theta のキャリブレーションがどのように劣化するかを分析していません。これはまさにLinUCBが補償すべき場面であるにもかかわらず、\nu や embedding \phi を独立に検証するアブレーションが存在しません。
- 進化スケジュール \log(t/t_{\mathrm{last}})\ge\eta はヒューリスティックであり、d,\eta に対する感度は報告されていません。
- 各ベンチマークで最適化例は50のみ使用されており、より大規模な \mathcal{D}_{\mathrm{opt}}(コストが最も重要になる場面)でのスケーリング挙動は未検証です。
- すべてのベンチマークがスカラー報酬を返すものであり、疎報酬や長ホライズンのRL型フィードバックへの拡張は不明確です。
- 「モデル間転移」の主張は全体を通じてGPT-5.5を教師モデルとして使用しているため、転移しているものはターゲットエージェント固有のスキルと同様に教師モデルの事前分布である可能性があります。
なぜこれが重要か
エージェントのスキル誘導を進化する候補集合上の予算制約付きcontextual banditとして扱うことで、高コストなロールアウトをどこに使うかについて原理的な方法が得られます。そして実証的な成果——SkillOptの約3分の1のコストで同等以上の性能——によって、各評価がAPIコストを要する状況においてもスキル最適化が現実的になります。このフレーミングはまた、スコアリング(ターゲットエージェントから得なければならない)と生成(任意の教師モデルを使用できる)を明確に分離しており、これは将来のエージェント改善パイプラインにとって適切な抽象化であると考えられます。
Source: https://arxiv.org/abs/2609.11682
限られたフィードバックによるLLMエキスパートを用いたオンライン学習
問題設定
K個のLLMエキスパートへのプロンプトルーティングは本質的にcontextual banditですが、実用上のボトルネックは計算コストではなく、報酬の取得にあります。スカラーの品質信号を得るためには通常LLMジャッジ、人間の評価者、または有償APIが必要であるため、ホライズンTにおける報酬クエリ数mはm \ll Tを満たします。標準的な線形banditアルゴリズム(LinUCB、OFUL)はm = Tを前提としており、探索スケジュールとクエリスケジュールが結合しているため、このような状況では機能しません。本論文はこの2つを分離します。すなわち、ルーターは毎ラウンド行動しなければなりませんが、実際にフィードバックのコストを支払う過去のラウンドを選択します。
形式的には、ラウンドtにおいてコンテキストx_t \in L\cdot \mathcal{B}^d(プロンプトの固定されたtransformer embedding)が到着し、アルゴリズムはエキスパートa_t \in [K]を選択します。報酬モデルは固定されたembeddingに対して線形です: r_{t,a} = \langle \theta_a, x_t\rangle + \eta_{a,t}, \quad \theta_a \in \mathcal{B}^d, 分散代理値1のsub-Gaussianノイズを伴います。\theta_aが固定されたembeddingの上に乗る各エキスパートの線形ヘッドの役割を果たすという意味で線形性の仮定は正当化されます。これはfine-tuningを除いた標準的な報酬モデリングのパラメータ化です。
Full-informationアルゴリズム:LimFullFeed
full-information設定では、あるラウンドがクエリされると、そのラウンドのプロンプトに対する全てのKエキスパートの報酬が明らかになります(全候補回答にバッチジャッジを適用するイメージです)。アルゴリズムは貪欲に活用し、 a_t = \arg\max_{a\in[K]} \langle \widehat\theta_{t-1,a}, x_t\rangle, これと情報理論的なクエリスケジュールを交互に行います。T/mラウンドごと(b = m/Tとした場合のトリガー\lfloor b(t-1)\rfloor < \lfloor bt\rfloorにより制御)に、D-optimal designにより過去の未観測インデックスを選択します: s_t = \arg\max_{\ell \in [t]\setminus \mathcal{S}_{t-1}} \det(V_{t-1} + x_\ell x_\ell^\top), その後、共有共分散V_t = V_{t-1} + x_{s_t}x_{s_t}^\topおよび各エキスパートのOLS推定値\widehat\theta_{t,a} = V_t^{-1} y_{t,a}を更新します。注目すべき点が2つあります。第一に、V_tはエキスパート間で共有されます。full-informationフィードバックにより、各クエリが全ての\theta_aを更新します。第二に、どの過去のプロンプトをクエリするかの選択が遅延されます。ラウンドtのプロンプトをクエリすることに即座にコミットするのではなく、\ell \le tの任意のラウンドを遡り、情報利得を最大化するものを選択できます。これが「look back」であり、単純なquery-now戦略に対してこの手法が優位性を持つ理由です。主張されるregretはO(dT/m)です。
Banditアルゴリズム:LimBanFeed
bandit設定では、r_{s_t, a_t}のみが観測されます。フィードバックは特定のエキスパートに紐付けられます。今や各エキスパートは独自のV_{t,a}を保持し、行動ルールはUCBとなります: a_t = \arg\max_{a\in[K]}\, \langle \widehat\theta_{t-1,a}, x_t\rangle + \beta \|x_t\|_{V_{t-1,a}^{-1}}. クエリスケジューリングはエキスパートごとに行われます。各エキスパートaはカウンターn_aを保持し、n_{a_t} \ge z := T/mとなるとそのエキスパートに対してクエリがトリガーされ、D-optimalな選択はaがプレイされた過去のラウンドのみを対象とします: s_t = \arg\max_{s \in \{s\in[t]: a_s = a\}\setminus \mathcal{S}_{t-1,a}} \det(V_{t-1,a_t} + x_\ell x_\ell^\top). これにより総予算mが保たれます。トリガーはエキスパートごとにz間隔で発生しますが、適切に合計されます。RegretはO(dTK/m)であり、追加のKはクエリごとのフィードバックが全\theta_aではなく単一の\theta_aのみを更新することを反映しています。
結果
実験にはRouterBenchとNectarを使用しています。K=6、d=40、T=60{,}000のNectarにおける、事後最良エキスパートに対する累積regret(5回の実行の平均)は以下の通りです:
| m | LimFullFeed | NoLookBack (full) | LimBanFeed | NoLookBack (bandit) |
|---|---|---|---|---|
| 1000 | 672.9 | 631.6 | 3583.4 | 3789.6 |
| 2000 | 441.4 | 408.0 | 3084.1 | 3580.0 |
| 5000 | 214.1 | 218.7 | 2295.7 | 3020.7 |
| 10000 | 128.0 | 129.0 | 1839.1 | 2538.4 |
| 20000 | 73.6 | 75.8 | 1567.9 | 2090.7 |
2つのパターンが際立っています。bandit設定では、D-optimal look-backが一貫してNoLookBackを上回り、mが増加するにつれてその差は拡大します。m=20{,}000ではLimBanFeedがregretを約25%削減します(1567.9 対 2090.7)。full-information設定では差は小さく、非常に小さなm(m=1000, 2000)ではNoLookBackが実際に勝っています。m \ge 5000になると、LimFullFeedがわずかに優位に立ちます。直感的には、full-information設定では各クエリが全Kヘッドを更新するため既に非常に情報価値が高く、どの過去のプロンプトを選ぶかの工夫は、エキスパートごとのカバレッジが疎なbanditケースほど重要ではないからです。
限界とオープンクエスチョン
線形報酬の仮定は中核的な前提です。固定されたembeddingが実際にドメインをまたいでエキスパートの品質を線形化するかどうかは、実証的な主張であり、集計regretカーブの範囲を超えては検証されていません。D-optimal基準は各クエリでO(t)個の過去ラウンドに対する\arg\maxを必要とし、行列式の更新にO(td^2)のコストがかかります。T = 60{,}000では問題ありませんが、本番スケールでは非自明です。スケジュールb = m/TはTが既知であることを前提としており、任意時点での予算への拡張は議論されていません。RewardedSoupsスタイルのアプローチやサブサンプリングされたフィードバックを用いたSquareCBなどのactive learning banditベースラインとの比較がないため、一様ランダムクエリに対するD-optimal designの優位性は単独では検証されていません。最後に、regret境界には実際にLimBanFeedの探索-活用トレードオフを支配する\lambdaと\betaの定数が隠されています。
なぜこれが重要か
LLMルーティングを(行動予算だけでなく)フィードバック予算を持つbanditとして定式化することは、デプロイされたルーティングシステムが実際に評価コストを支払う方法と一致しており、行動タイムとクエリタイムのスケジューリングの分離は、既存のembeddingモデルの上に実装可能なクリーンなテンプレート、すなわち貪欲またはUCBによるルーティングとD-optimalな遡及的クエリングを、LLMカスケードを運用するあらゆるチームに提供します。
Source: https://arxiv.org/abs/2609.05820
SNAP3D: 単一画像からの物理的に根拠のある3Dパーツアセンブリ
問題設定
パーツ認識型の画像-3D生成手法(X-Part、HoloPart、PartCrafterなど)は、意味的に分解されたメッシュを生成しますが、各パーツを独立した再構成ターゲットとして扱います。その結果得られるアセンブリは物理的なオブジェクトとして機能しません。隣接するパーツが互いに貫通し、接触面が明確に定義されておらず、パーツを結合させる仕組みが存在しないため、シミュレーション上で重力によってアセンブリが崩壊してしまいます。分解が意味を持つことを必要とする下流用途—アーティキュレーション、製造、剛体シミュレーション、編集—においては、個々のパーツの視覚的な完全性だけでは不十分です。本論文は、隣接パーツ間の体積オーバーラップ、明示的な接触グラフの欠如、そして重力負荷に耐えるコネクタ形状の欠如という3つの具体的な失敗モードを対象としています。
手法
単一画像を入力として、パイプラインはまずHunyuan3Dによって全体的なメッシュを再構成し、次にX-Partを用いて共通フレーム上で意味的パーツ \{P_1, \ldots, P_n\} へと分解します。その後、3つのステージがこの生の分解を物理的に有効なアセンブリへと変換します。
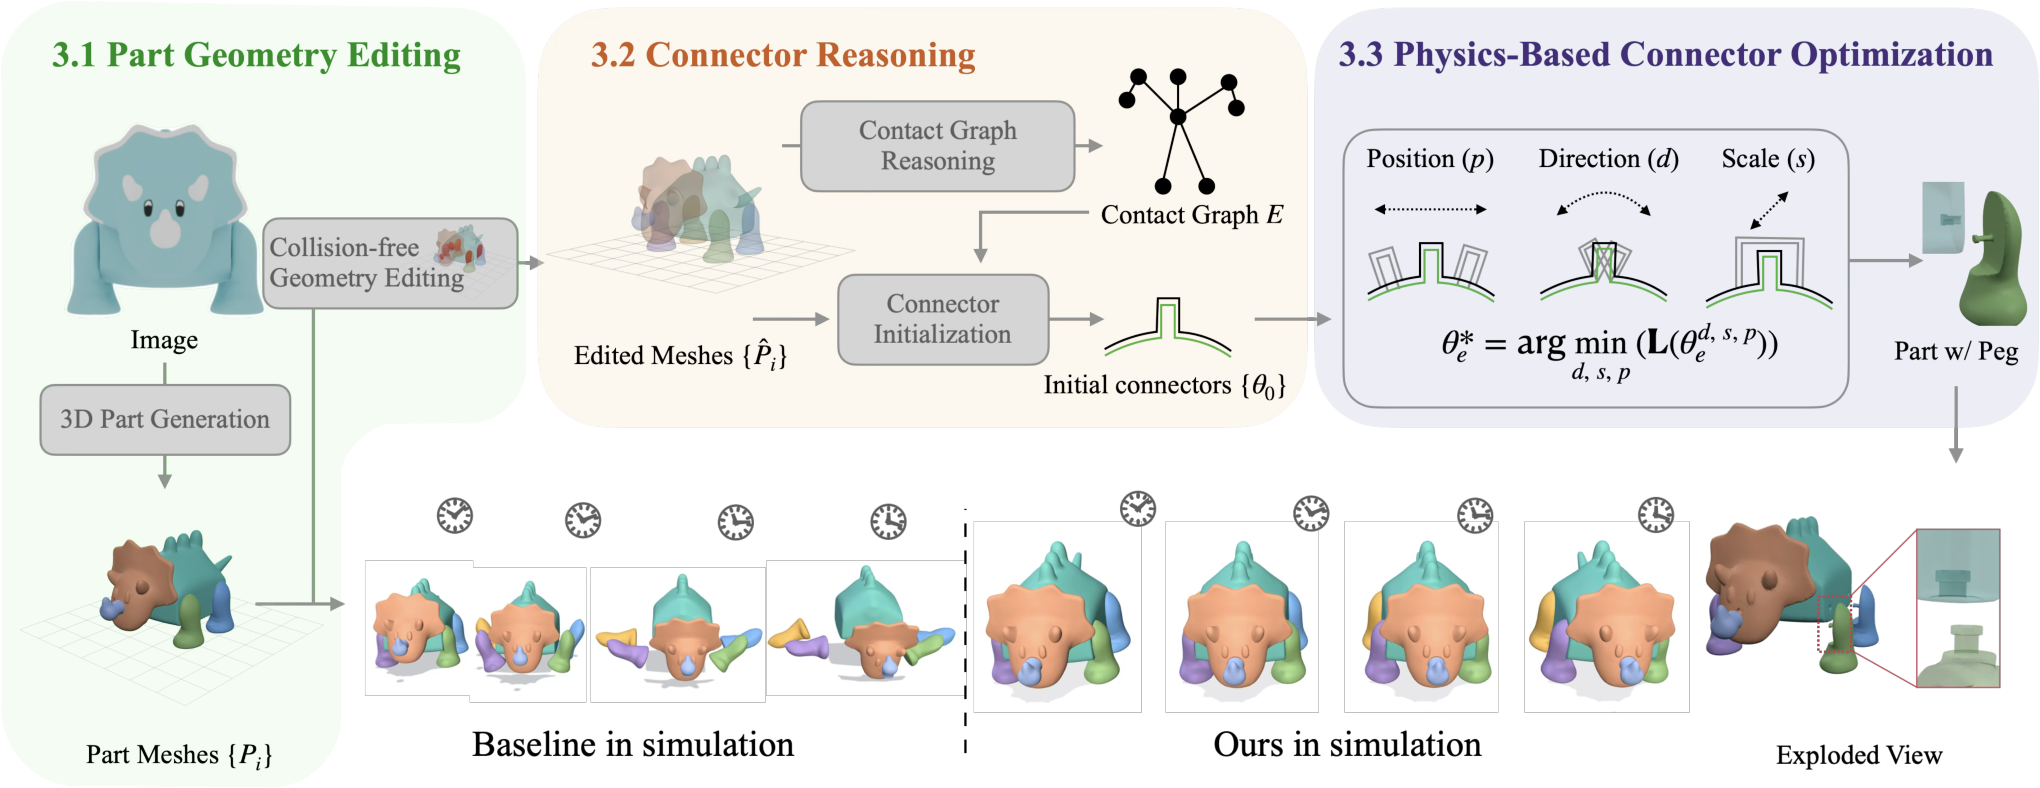
パーツ形状編集(PGE)。 著者らはパーツ間のオーバーラップを形状問題ではなく境界問題として扱います。各 P_i は個別には適切に形成されているため、編集は共有境界のみに限定されます。隣接パーツ間の重複体積を解消することで、明確な接触面 S_{ij} \subset \partial P_i \cap \partial P_j を持つ互いに交わらない立体が生成されます。これにより、コネクタ配置に必要な入力、すなわち2つの嵌合パーツ上の対になった接触パッチが得られます。
コネクタ形状推論(CGR)。 編集済みのパーツから、頂点がパーツ、辺が非空の接触面を表す接触グラフ G = (V, E) を構築します。各辺 (i,j) に対して、パラメータ化されたペグ・ソケットコネクタが S_{ij} の重心に配置され、局所的な表面法線方向に向きが設定され、初期寸法は局所的な接触パッチに合わせてスケールされます。コネクタは一方のパーツに突出するペグと、もう一方のパーツに対応するソケットから構成され、スナップフィット結合を生成します。
物理ベースコネクタ最適化(PCO)。 各コネクタはパラメータ \theta_e = (\mathbf{p}_e, \mathbf{d}_e, \mathbf{s}_e)(位置、方向、スケール)を持ちます。組み立てられたオブジェクトを剛体シミュレータ内で重力下に落下させ、安定性を最大化するためにシミュレーションのフィードバックを用いてコネクタパラメータを洗練させます。安定性は、整定区間後のパーツの残留変位および分離によって定量化されます。重要なことに、最適化されるのはコネクタ形状のみであり、生成されたパーツシェルは保持されるため、安定性のために入力画像に対する形状の忠実度が犠牲にされることはありません。
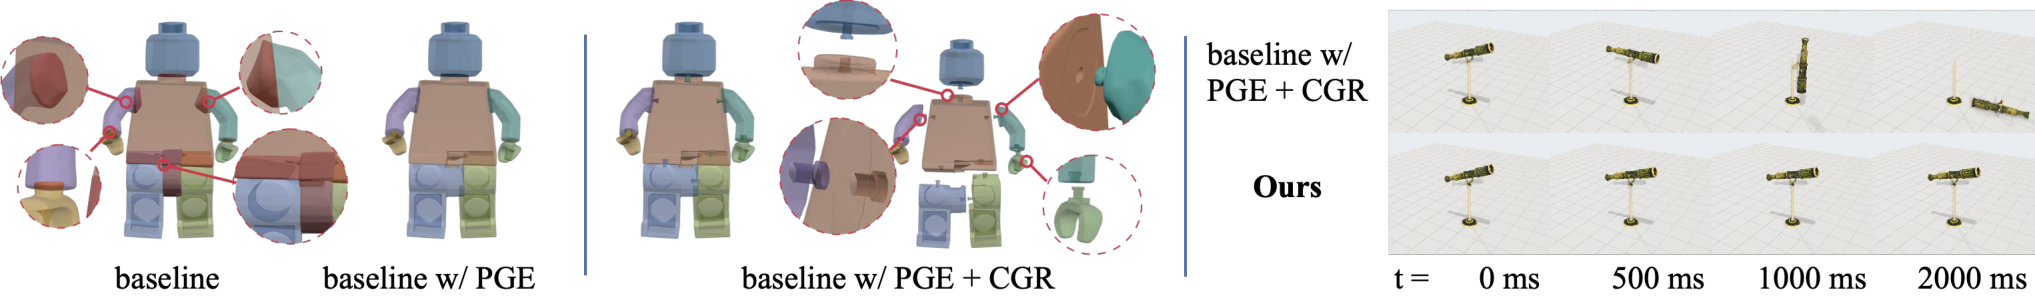
ステージアブレーション図は、その仕組みを具体的に示しています。生のX-Part出力は接触領域で貫通しています(挿入図)。PGEはクリーンな嵌合面を生成します。CGRは各接触箇所にスナップフィットのペグとソケットを挿入しますが、デフォルトパラメータではコネクタが重力下で外れてしまいます。PCOは、アセンブリが安定して静止するまでポーズとスケールを洗練させます。
結果
評価には、正解パーツアノテーション付きのHY3D-Benchから取得した100枚の画像・メッシュペアを使用します。アセンブリは家具、乗り物、キャラクター、工具、アーティキュレーテッドプロップにわたる2〜18パーツで構成され、積み重ね支持、片持ち取付け、閉鎖嵌合、多分岐接触トポロジーを網羅しています。分解に関する従来の幾何学的メトリクスに加えて、著者らは(a)アセンブリが物理的に実現可能か(パーツが貫通せず接続されているか)、および(b)シミュレーション内で重力下において安定を保つかを直接測定する物理ベースの評価プロトコルを導入しています。
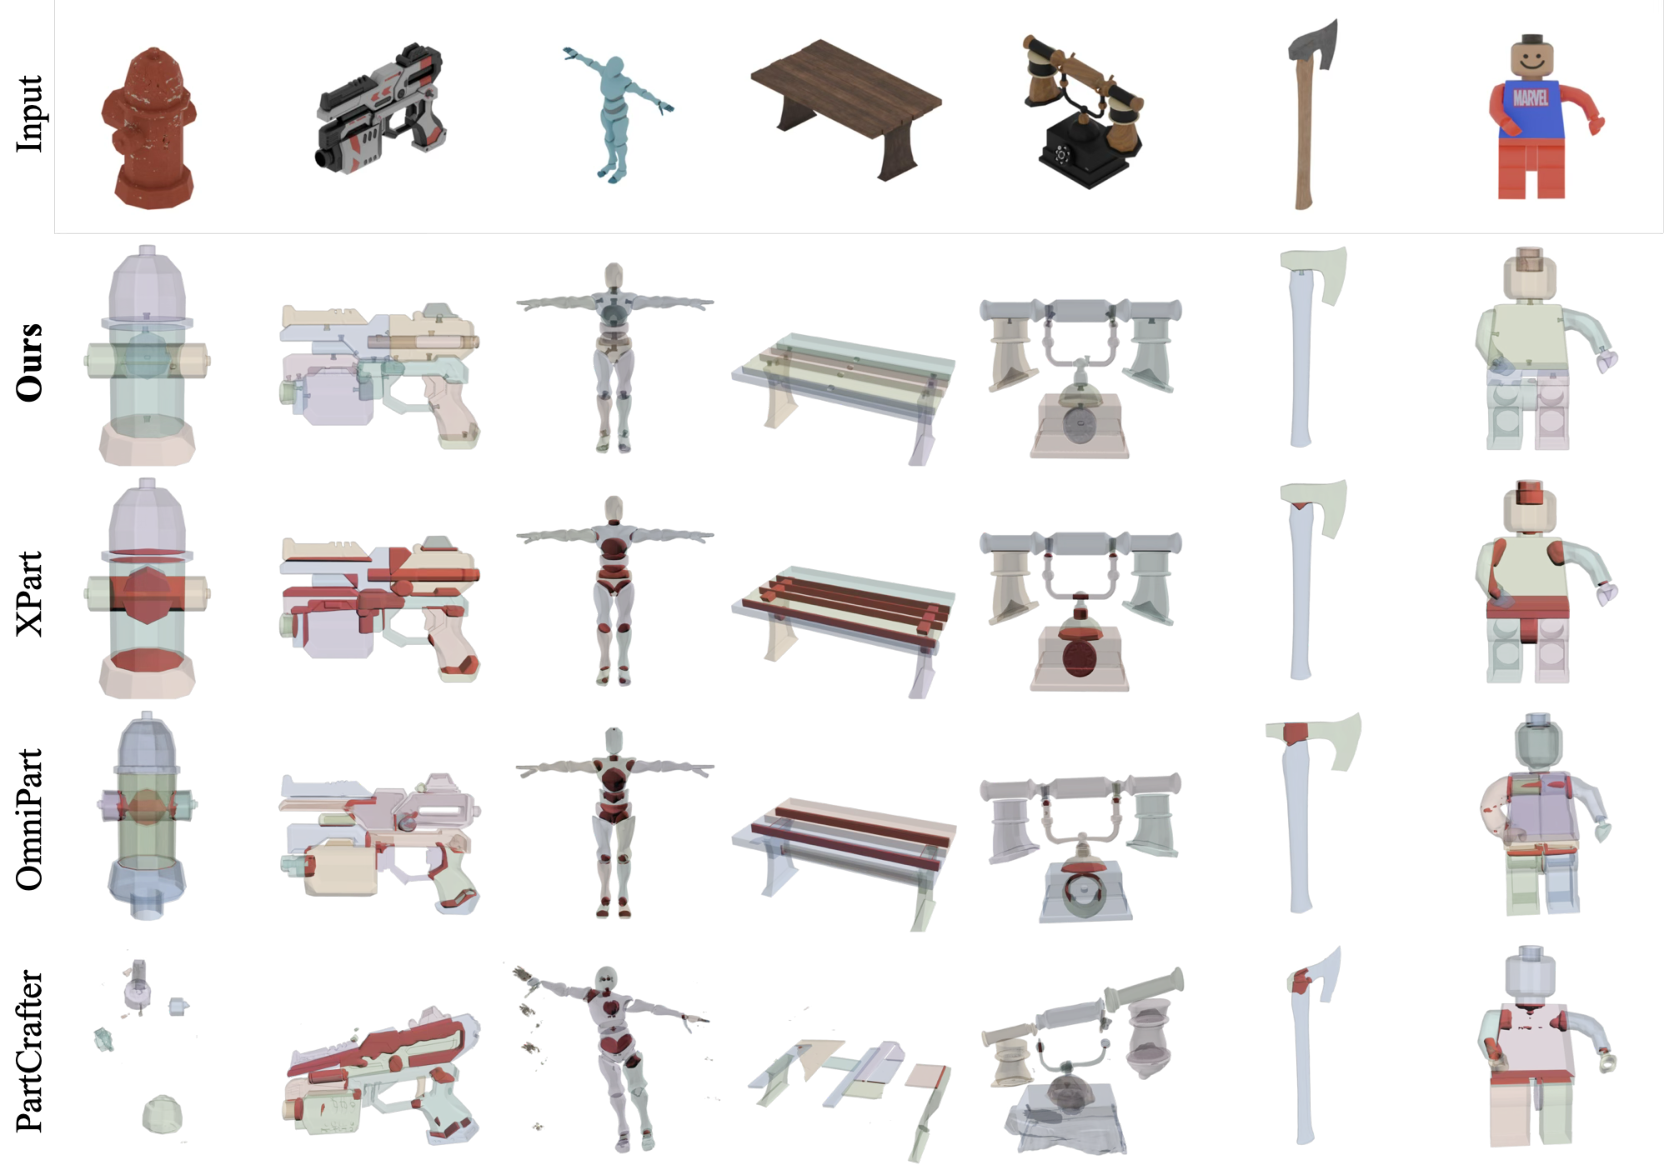
複数のパーツ認識型3D生成バックボーンにわたって、パイプラインは分解の幾何学的品質を維持しながら、物理的実現可能性と安定性を大幅に改善します。ベースラインの出力は一般的に重力テストに失敗し、パーツが外れて落下しますが、SNAP3Dで処理されたアセンブリは静定して固定されたままになります。定性的比較では、すべてのベースラインに存在する貫通領域(赤)が、パーツのアイデンティティや全体のシルエットを変えることなく除去されていることが示されています。
限界と未解決の問題
本アプローチはX-Partからの意味的分解を継承しています。パーツが誤ってセグメントされたり、グラフ構築によって接触が見逃された場合、そこにコネクタは作成されません。コネクタライブラリはパラメータ化されたペグ・ソケットであり、スナップフィットアセンブリには十分ですが、完全なアーティキュレーションや製造に必要なヒンジ、スライダー、またはネジ式インターフェースには対応していません。物理ベースの最適化は剛体として扱います。変形可能な接触、摩擦支配の安定性、事前応力アセンブリはスコープ外です。本論文はシミュレーションをループ内に含む最適化の実時間コストを報告しておらず、ベンチマーク内の18パーツアセンブリへのスケーリングに関連する問題です。最後に、導入された評価プロトコルはシミュレータの選択、質量の割り当て、整定ウィンドウに依存しており、将来のパーツ認識型生成手法を横断した標準化が比較を強化するでしょう。
なぜ重要か
パーツ認識型3D生成はセグメンテーション品質とパーツごとの忠実度に注力してきましたが、生成されたアセットは手動クリーンアップなしにはシミュレーション、アーティキュレーション、または製造に使用できないままでした。SNAP3Dは問題を物理的実現可能性—クリーンな接触、明示的なコネクタ、重力安定アセンブリ—を中心に再構成し、視覚的には正しいが物理的に非整合な出力にペナルティを与える評価プロトコルを提供します。これは下流の3D利用にとって正しいターゲットです。
Source: https://arxiv.org/abs/2609.13146
Benchmark Radar: AIベンチマークと評価のためのライブデータベースおよび検索エンジン
問題
LLMやエージェントに適した評価を見つけることは検索問題ですが、現在のインフラはこれをうまく処理できていません。ベンチマーク名は論文をまたいで衝突し、モデルカードは文書化されていない設定のもとでスコアを報告し、飽和が進むにつれてリーダーボードは変動します。新しい評価を設計する研究者や、主張されたベンチマーク結果が過去の研究と比較可能かどうかを確認するレビュアーは、現状ではリーダーボード(Artificial Analysis、OpenCompass)、カタログサイト(LLM Stats)、そしてテクニカルレポート内のその場限りのベンチマーク言及を突き合わせなければなりません。Benchmark Radarはインフラ整備に関する論文であり、ソースの同一性を保持した毎日更新のカタログを構築します。すなわち、ソースをまたいで同一と思われるベンチマークを統合するのではなく、論文・リポジトリ・データセット・リリース・スコア履歴に対する検索機能を提供します。
システム
本システムはその毎日の発見アーキテクチャをBuilderPulseから継承しています。37のソースから情報を取得します:13の直接コネクタ(レジストリ、カタログ、データセットハブ)と24のファーストパーティの研究・エンジニアリングフィード(ラボ、モデルカードリリース)です。設計上の核心的判断は、ベンチマークカタログ(ベンチマークを説明するカノニカルな行)と発見履歴(タイムスタンプ付きエビデンス:論文・リリース・スコア観測値)を分離することです。モデルレポート(モデルカード、システムカード、テクニカルレポート)は、ベンチマークレジストリと同じレコードスキーマで取り込まれます。GPQAに言及しているClaude 3.5のシステムカードは、OpenCompassのGPQAエントリと同じフィールドを持つレコードになりますが、異なるソースラベルが付与されます。
v0.11.0リリースには4つのカタログ(論文のTable 1)から得られた1,283件のソース固有のレコードが含まれています:LLM Stats(687件)、OpenCompass Hub(461件)、Artificial Analysis(25件)、およびモデルレポート(110件)です。「同一」のベンチマークを説明する2つのソースは、重複除去されず別々のレコードとして保持されます。これは意図的な設計です:正規化すると、注意深い読者がまさに確認すべきスケール・サブセット・採点ルールに関する不一致が消えてしまうからです。
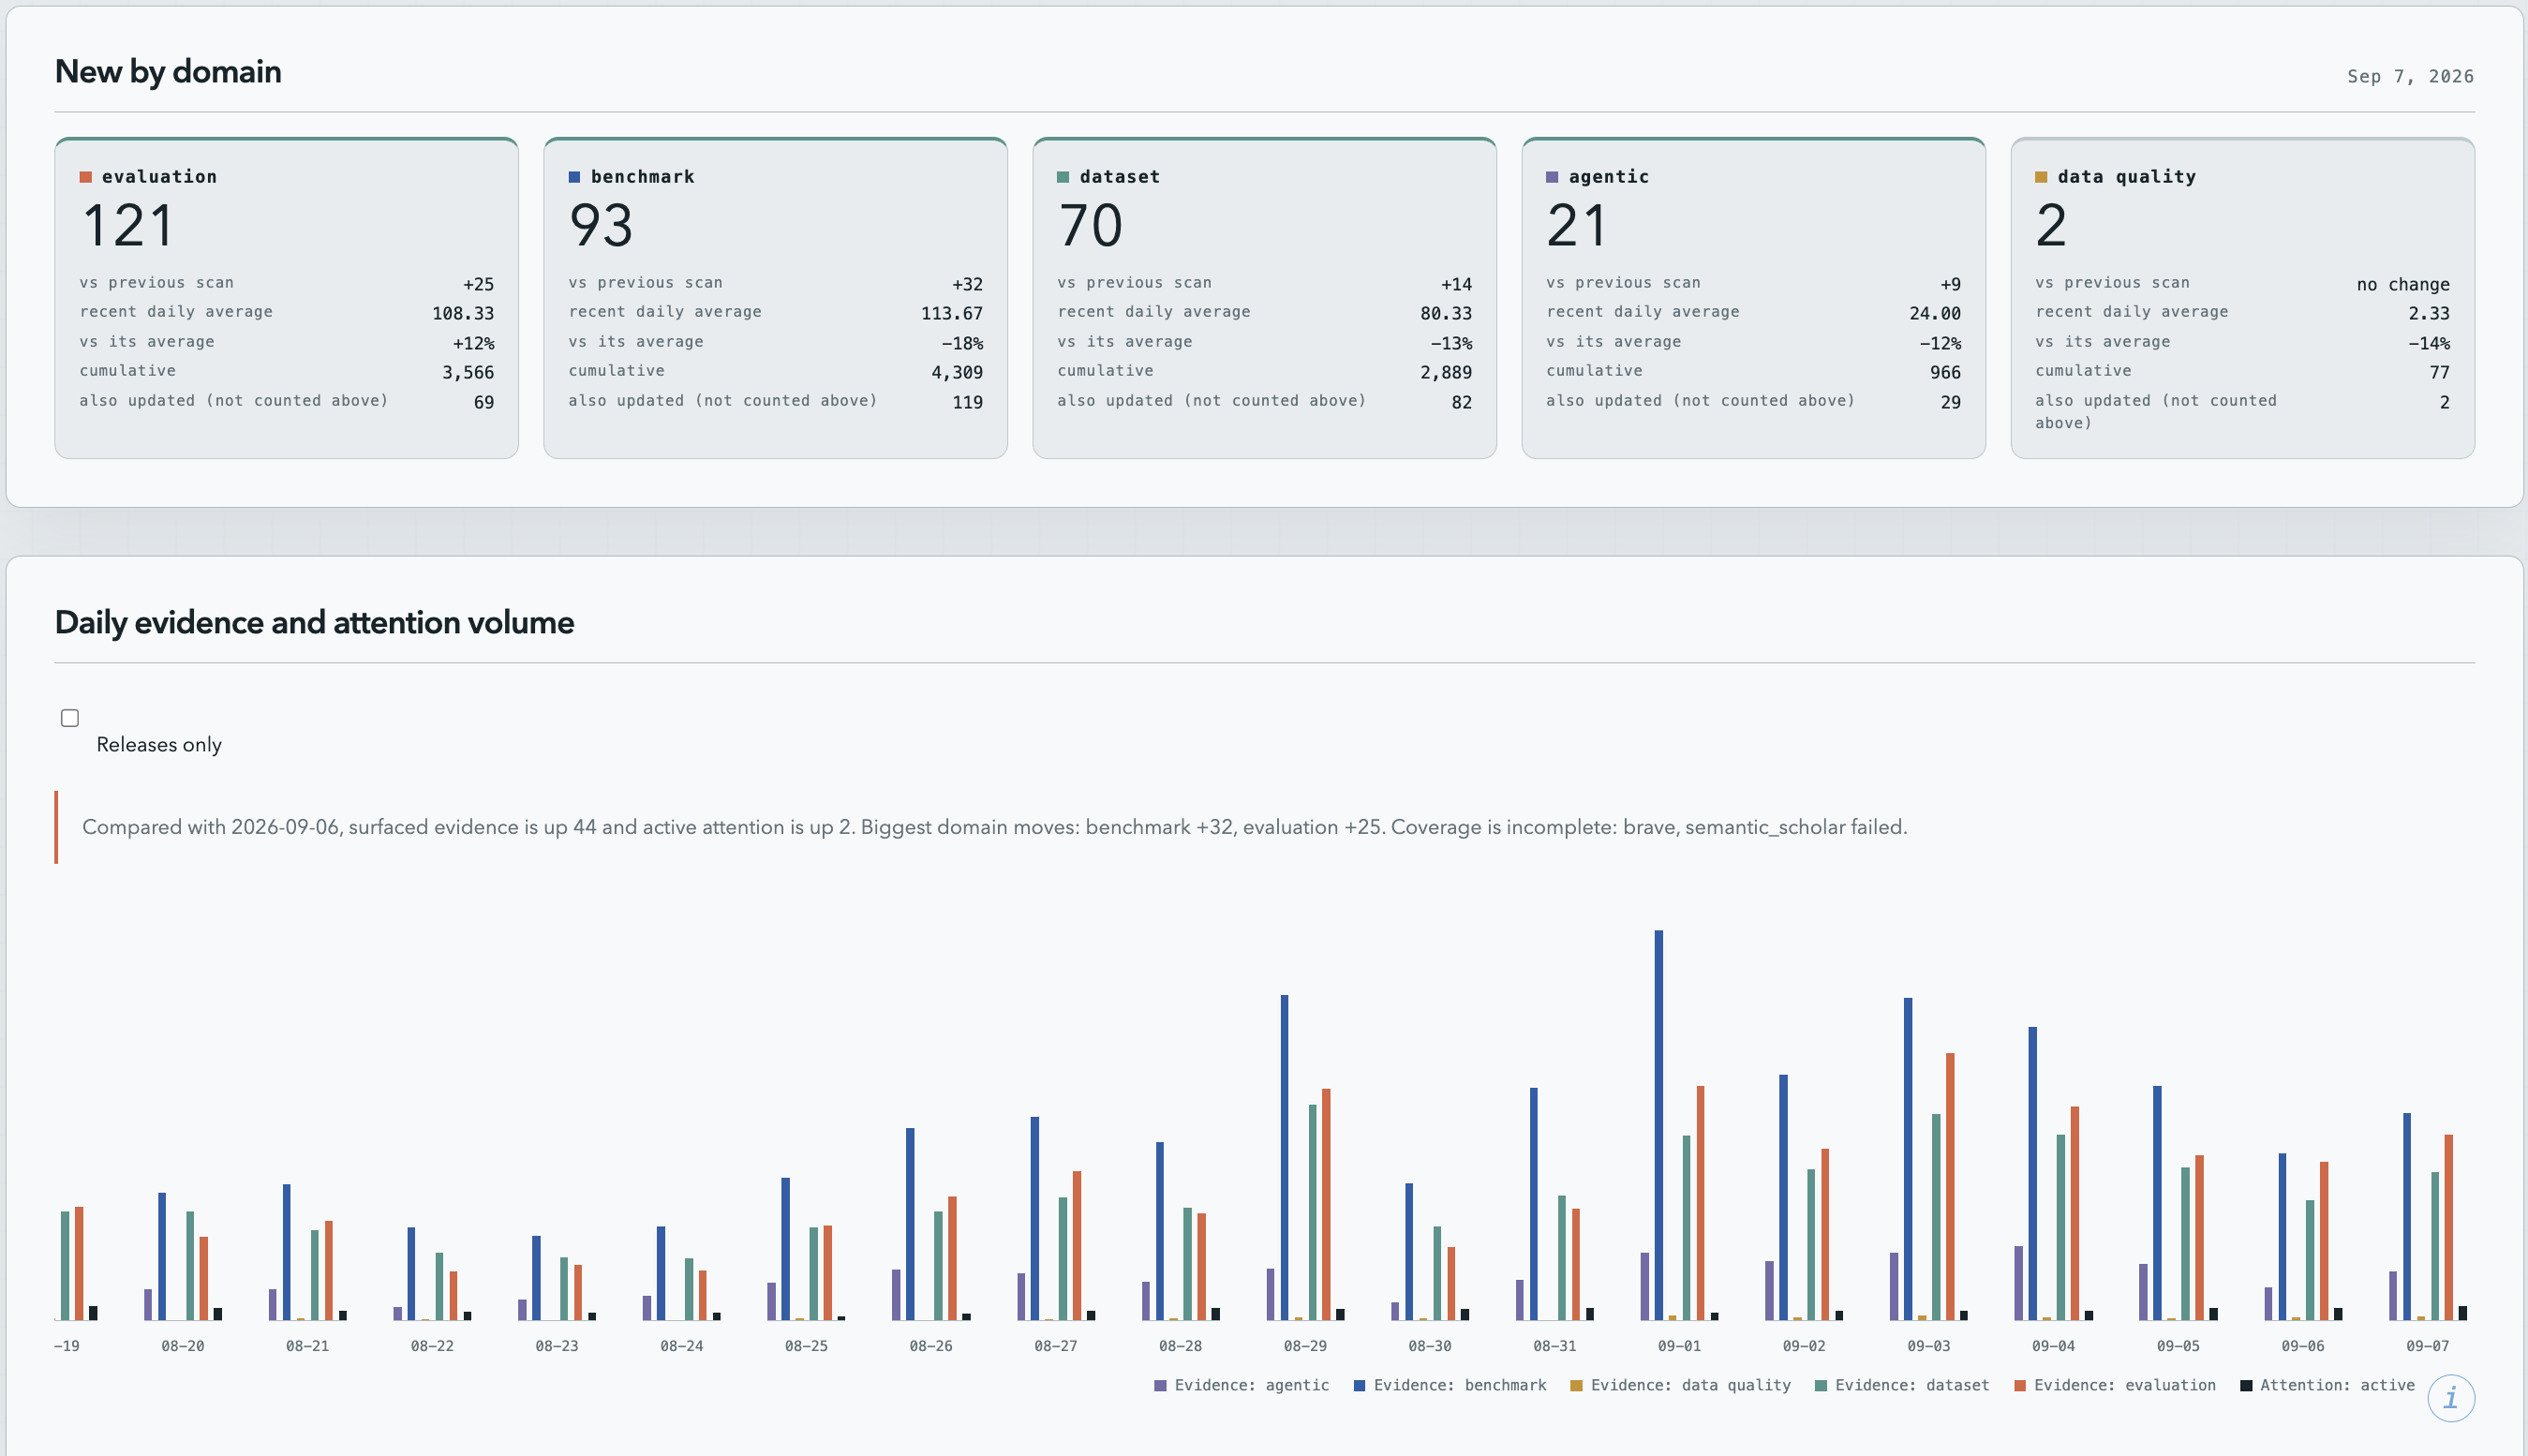
Figure 8は発見側のビューを示しています:カテゴリカードは既存のベンチマークに対するトラック更新と、新たに発見されたリリースを分けて表示し、カバレッジ通知は失敗したソースを表示することで、ユーザーが「活動なし」と「本日ソースに到達できなかった」を区別できるようにしています。
カバレッジとスコア監査
1,283件のレコードのうち、790件が数値の観測値を持ち、合計12,916スコアポイントに上ります。493件のレコードはスコアなしです。分布は偏っており、Artificial Analysisは25件のレコードで7,050スコアを提供しています(1レコードあたり約282件、商業リーダーボードの密度に起因します)。一方、OpenCompass Hubは461件のレコードを提供していますがアーカイブされたスコアは0件です(スコア集計ではなくベンチマークレジストリであるため)。LLM Statsはその中間に位置し、687件のレコードと5,544件のスコアを持ちます。モデルレポートは110件のレコードにわたって322件のスコアを追加しています。
スコアなしのレコードは無意味ではありません。493件のスコアなしレコードのうち、464件は少なくとも1件の論文・リポジトリ・データセットリンクを持っています。カタログ全体では、475件のレコードが論文にリンクし、506件がリポジトリに、293件がデータセットにリンクしています。これは、ベンチマークの設計が現在のリーダーボードではなく関心の対象となる先行研究調査において重要です。
スコアありのレコードについて、Leaderboardビューはベンチマークのリリース日(リリース日が欠落している場合は初回スコア日のプロキシ)に対して報告されたスコアをプロットし、スコアが付いたモデル数に比例したサイズで表示します。Pareto候補には金のリングが付き、空洞のマークは未検証のスケールを示し、点線の輪郭は日付プロキシを示します。単一のレコード(例えばArtificial Analysisソース経由のHumanity’s Last Exam)を掘り下げると、577件の報告スコアが表示され、最高スコアは55.47、組織ごとに色分けされ、連続する最高スコアがリリース日順に接続されています。
実例
先行研究ユースケースは、本論文のシステム評価の中で最も興味深いものです。Qwenシリーズのバックボーンを用いたエージェント型RLにおけるクレジット割り当ての調査を行っていたコントリビューターが、Benchmark Radarクライアントとそのスキルをインストールし、コーパスをダウンロードし、ローカルでクエリを実行するコーディングエージェントを実行しました。
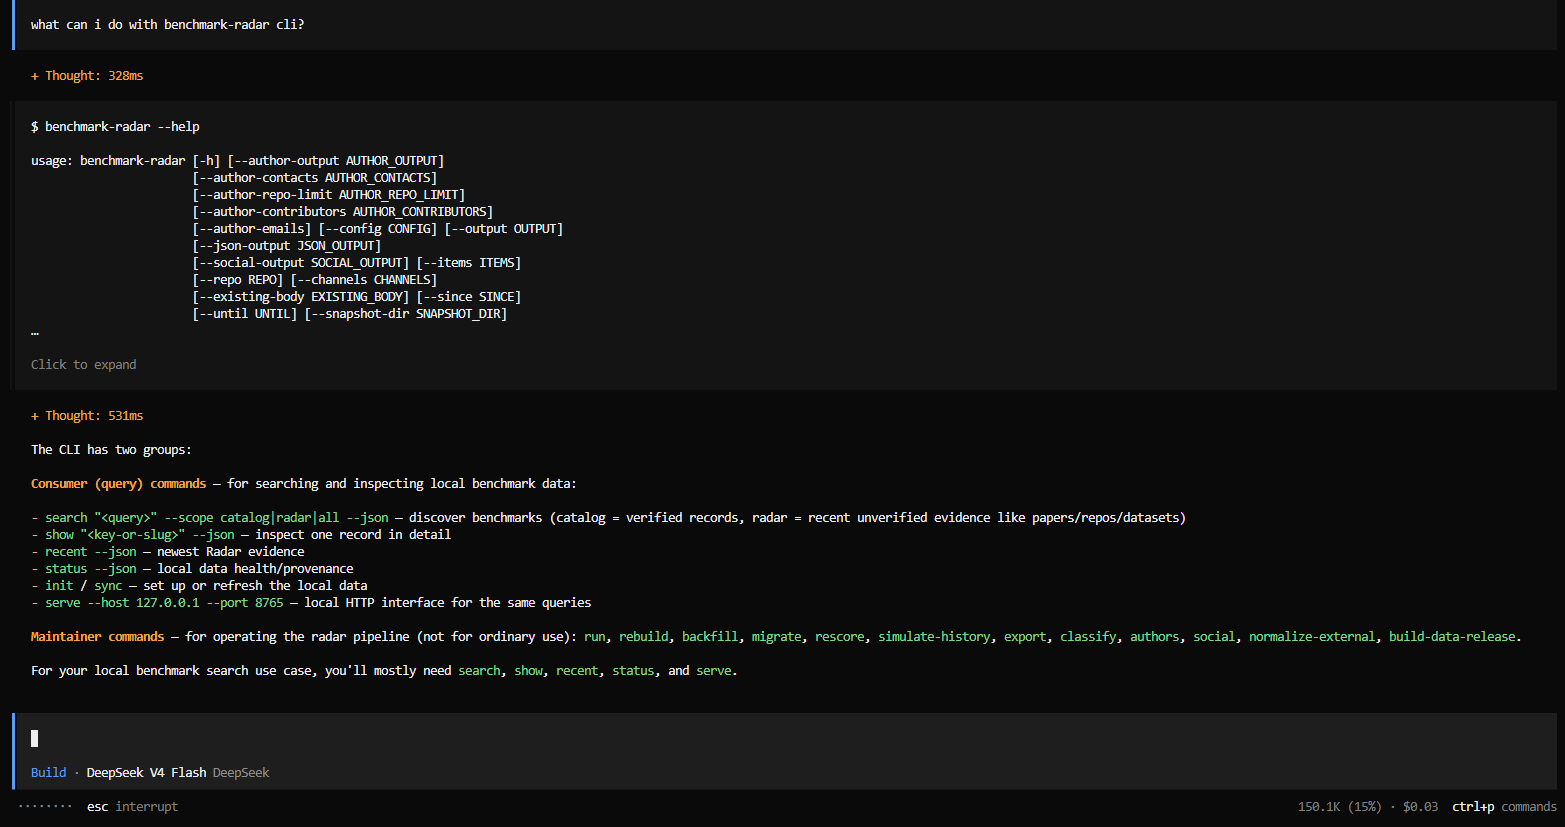
エージェントは2026年8月の関連する5本の論文を発見しました(論文のTable 4):SRPO(Qwen3-8B、反映条件付きトークンレベルシグナル、AIME’24 / WebShop / ALFWorld / SWE-Bench-Liteで評価)、ContextPilot(分岐軌跡上のアクションレベルクレジット、InfiniteBench / NovelQA / LongMemEvalで評価)、SkillGate(スキルセレクタのクレジット枯渇、結果対アクションローカルチャネルに分割)、CIPO(HotpotQA / MuSiQue / BamboogleでのターンレベルEALRクレジット)、およびMoRSE(二層クレジット割り当てを持つ階層的GRPO)です。取得されたレコードには利用可能な場合はリポジトリリンクが含まれており、レコードが薄い場合はエージェントがウェブ検索にフォールバックします。
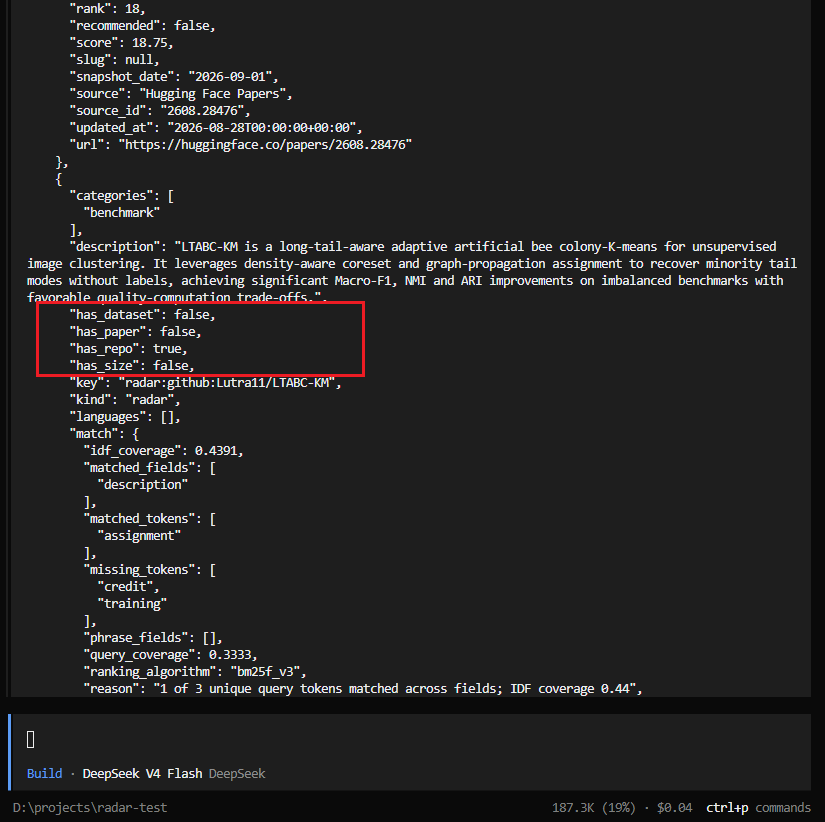
Figure 11は失敗モードを明示しています:一部の発見レコードはリポジトリを提供しますが、リンクされた論文やデータセットがなく、インターフェースはレコードをサイレントに省略するのではなくこれを明示します。全体を通じた設計原則は、Benchmark Radarが候補を取得してそのエビデンスを提示し、関連性の判断は下流の人間またはエージェントに委ねるというものです。
制限事項
カタログは小規模で英語に偏っています:1,283件のレコードは真のベンチマーク母集団をはるかに下回り、OpenCompass Hubの461件のレコードはスコアをゼロしか提供しないため、クロスソースのスコア比較にブリッジとして使用することができません。重複除去を行わないことは監査可能性の観点では特徴ですが、集約統計(「MMLUの平均スコア」)には手動による照合が必要になることを意味します。日付フィールドはベンチマークのリリース日が欠落している場合にモデルリリースのプロキシに依存しており、論文ではこれらにフラグが付けられていますが修正はされていないことが明示されています。ソース間のスコア比較可能性については一切主張されておらず、異なるサブセット・プロンプト・採点ルールは正規化されていません。
なぜ重要なのか
ベンチマーク発見は評価研究におけるボトルネックであり、その場限りのリーダーボードによって不十分に解決され、検索エンジンにはまったく無視されてきました。エージェントから呼び出し可能な検索機能を持つ、ソースを保持したライブカタログは、先行研究調査とベンチマーク飽和のメタ分析の両方に対して正しいプリミティブであり、12,916観測値のスコアアーカイブは後者を本格的に始めるのに十分な規模です。
Source: https://arxiv.org/abs/2609.11115
Hacker News Signals
Claude WebのMicroVMをリバースエンジニアリング:AnthropicのAntspaceを解明する
著者は、ClaudeのWebインターフェースに組み込まれたサンドボックス型コード実行環境をリバースエンジニアリングしています。Claude Codeは、セッションごとにプロビジョニングされるMicroVM(内部的に「Antspace」と呼称)の中で動作しています。ネットワークトラフィック、JavaScriptバンドル、およびサンドボックス内からアクセス可能なファイルシステムのアーティファクトを調査することで、著者は実行アーキテクチャを解明しました。具体的には、FirecrackerベースのmicroVMに stripped LinuxゲストOS、カスタムinitプロセス、および制限されたsyscallサーフェスで構成されています。ゲストイメージはオンデマンドで取得・起動され、ClaudeフロントエンドとmicroVM間の通信は、ターミナルI/Oとファイル操作をプロキシするWebSocketリレーを介して行われます。著者は、ゲストファイルシステムがビルドメタデータ、内部ツールのパス、そしてAnthropicの内部プロジェクト名「Antspace」を露呈する環境変数を公開していることを発見しました。VMからのネットワーク送信はフィルタリングされていますが、完全にはブロックされておらず、initバイナリにはワークスペースディレクトリのレイアウトに関するハードコードされた前提条件が含まれています。本稿は技術的に非常に詳細で、initバイナリのhexダンプ、straceの出力、注釈付きのJSデオブファスケーション結果が含まれています。主要な発見は、サンドボックスの境界が見かけよりも薄いという点です——MicroVMはハイパーバイザーレベルでの分離を提供しますが、ゲストイメージ自体にAnthropicの内部インフラをフィンガープリントするのに十分なメタデータが含まれています。この研究は、AIコーディングアシスタントの攻撃対象領域とは何かという問いを提起しています。それはプロンプトインジェクションだけでなく、実行環境を介した横断的な情報漏洩も含まれます。なお、能動的なexploitは示されておらず、本研究はアーキテクチャの理解に焦点を当てたreconnaissance級のリバースエンジニアリングであり、サンドボックスの回避を目的とするものではありません。
Source: https://aprilnea.me/en/blog/reverse-engineering-claude-code-antspace
CUDA for AMD on Windows
このプロジェクトは、CUDA APIコールおよびPTX/SASS命令をROCm/HIPの等価物にランタイムで変換することにより、Windows上のAMD GPUでCUDAワークロードを実行しようとする試みです。このアプローチは、Linuxで行われた最もよく知られた先行実装であるZLUDAとは異なります。Linuxでは、ROCmが比較的完全なHIP runtimeおよびコンパイラツールチェーンを提供しているため、変換が実現可能です。一方Windowsでは、ROCmのサポートは乏しく——AMDは公式にはWindows向けROCmスタックを提供していません——そのためこのプロジェクトは変換shimとともに独自の最小限のHIP-for-Windowsレイヤーを同梱しています。
技術的なメカニズムとしては、ドロップイン形式のnvcuda.dllおよびnvml.dllの代替がCUDA runtimeおよびドライバーAPIコールをインターセプトします。PTX(NVIDIAのポータブルIR)はLLVM IRにトランスパイルされ、その後バンドルされたLLVMバックエンドを通じてAMDGPUターゲット向けにコンパイルされます。カーネル引数のマーシャリングおよびメモリ管理はHIPの等価物にマッピングされます。このプロジェクトは初期段階にあり、リポジトリには主にスキャフォールディング、依存関係の配線、および基本的なテストハーネスが含まれています。BLASおよびcuDNNのインターセプションはまだ実装されておらず、実際のMLワークロードをエンドツーエンドで実行することはできません。根本的な課題はABIの忠実性です:CUDAのドライバーモデルは、ストリームの順序付け、unified memory、cooperative groupsに対するきめ細かい制御を公開しており、これらにはHIPの直接的な対応物が存在しないため、エミュレーションかセマンティクスの暗黙的な不一致のいずれかが必要になります。コミュニティのコメントによれば、ZLUDAのWindowsポートが頓挫した原因の一部はまさにこれらのギャップにあり、さらにMicrosoftのドライバー署名要件によって未署名の変換DLLの展開が困難になっている点も挙げられています。それでも需要は確実に存在します:AMDのコンシューマー向けGPUはVFLOPあたりのコストがNVIDIAの同等品よりも大幅に安価であり、Windowsはそのマーケットセグメントにおいて支配的なOSです。
Source: https://github.com/Speedstu/CUDA-for-AMD-Windows
人工知能の悪意ある利用
これは、Future of Humanity Institute、Centre for the Study of Existential Risk、およびOpenAI(他の機関も含む)による2018年の報告書であり、HNで再浮上しています。100ページに及ぶ本書は、投機的なエッセイではなく、体系的な脅威分類です。報告書は悪用を三つの領域に分類しています。すなわち、デジタルセキュリティ(自動化された脆弱性発見とexploit生成、language modelを活用したスピアフィッシングの大規模化)、物理的セキュリティ(自律型兵器、車両の知覚システムに対するadversarial perturbation)、そして政治的セキュリティ(偽情報、合成メディア、自動化された影響工作)です。
技術的な内容は、6年後の現在においても概ね妥当性を保っています。本文書は、language modelの性能向上に伴いターゲット型ソーシャルエンジニアリングの限界費用が崩壊すること、GAN生成による合成メディアが検出技術を上回ること、そしてサイバー攻撃側が防御側に比べて自動化から非対称的な恩恵を受けることを正しく予見していました。過小評価していた点は、能力向上のスピードと、open-weightモデルが攻撃側ツールへのアクセスを民主化する程度でした。政策提言——red-teamingの規範、デュアルユース論文公開ガイドライン、国際的な調整メカニズム——は、いまだほとんど実装されていません。報告書は「AIが能力の上限を引き上げる」ことと「AIがスキルの下限を引き下げる」ことを区別する点で方法論的に慎重であり、後者が実際の脅威アクターにとってより重大な影響をもたらすことが多いと指摘しています。現在の状況を知る読者にとっての価値は歴史的なものです。すなわち、2018年時点でどの脅威モデルが認識可能であり、どれがそうでなかったかを示すことで、この分野の脅威モデルが実際にどれだけ更新されたのか、あるいは単に声高になっただけなのかを測るための基準を提供しています。
Source: https://arxiv.org/abs/1802.07228
Fable 5.1 が370年前の暗号「サイフラル・ディスティック」を解読
サイフラル・ディスティックとは、17世紀の写本に記された2行の暗号碑文であり、約370年にわたって未解読のままでした。Vals AI は自社の Fable 5.1 モデルがこれを解読したと主張しています。ブログ記事はモデル自体の技術的な詳細についてはほとんど触れておらず、暗号の歴史と解読内容に多くの紙幅を割いています。この碑文は、キーワードから導出されたタブローを用いた多アルファベット置換(おおよそ Vigenere 方式)に、意図的な誤綴りや古風な正書法を組み合わせることで曖昧性を高めています。これまでの解読試みが失敗してきた原因の一つは、時代に即した綴りのバリエーションを考慮していなかったことであり、もう一つはラテン語・ギリシャ語・初期近代英語の候補を含めるとキーワード空間が膨大になることです。
主張されている解読手法は、候補キーワード、時代の語彙集、および候補平文の統語的妥当性をモデルが統合的に推論するというものです。これは本質的に、スコアリング関数として17世紀の英語・ラテン語に対する言語モデルの perplexity を用いた、高次元離散空間上の制約充足問題です。このアプローチ自体は原理的に新しいものではなく、古典暗号の解読に LM スコアリングを活用する手法はすでに実証されています。しかし、歴史的に重要な特定の未解読事例に適用したという点では注目に値します。HN のスレッドでは検証に対して懐疑的な意見が相次いでいます。独立した歴史家による確認はまだ得られておらず、ブログ記事は完全な解読方法論を提示していないうえ、同社には明らかなマーケティング上の動機があります。古典暗号の専門知識を持つコメント投稿者たちは、短いテキストを持つ Vigenere 方式の暗号は元の鍵なしに検証することが本質的に困難であり、もっともらしく聞こえる平文が正解の証明にはならないと指摘しています。
Source: https://www.vals.ai/blogs/fable-solves-cyphral-distich
Rustの Never 型の安定化
Rustの !(never)型は、値を返さない計算——発散する関数、panic!、無限ループ、return 式など——を表します。! はボトム型であり、任意の型へ強制変換(coerce)できるべきとされています。これが let x: u32 = return; が型検査を通過する理由です。この型はコンパイラ内に長年存在していましたが、トレイト実装との coherence に関する未解決の問題があるため、ユーザーが利用できる機能としては安定化されてきませんでした。
根本的な問題は、! がすべてのトレイトを自明に実装している点にあります(! 型の値を構築することは不可能なため、どのトレイト impl の本体も空虚に正しいことになります)。これが競合を引き起こします。もし blanket impl によってすべての T に対して !: From<T> が成り立ち、あるクレートが impl From<MyType> for SomeOtherType を提供している場合、コンパイラの coherence チェッカーは ! が関与しているかどうかを判断しなければなりません。従来、impl<T> From<!> for T という blanket impl は impl<T> From<T> for T(再帰的 impl)と重複を引き起こし、特別なケース処理が必要でした。安定化に向けた方針としては、一部の ! blanket impl を削除または制限し、! から () への coercion を汎用的にではなく特定の位置(特に try 演算子 ? のコンテキスト)で行う新たなフォールバック機構を導入することが含まれています。LWNの記事はRFCとトラッキングイシューの経緯を取り上げており、安定化はtype checkerが match アームと式コンテキストで ! を扱う方法の長年の乖離を解消することに依存していると指摘しています。これは std::convert、エラーハンドリングのパターン、および関連型(associated types)で ! を使用するクレートに下流への影響をもたらします。安定化は近い将来の Rust エディションで実現される見込みです。
Source: https://lwn.net/SubscriberLink/1091015/d9e48318ed242b41/
TailTalk: RustとTokioによるモダンな非同期AppleTalkスタック
TailTalkは、非同期I/OにTokioを使用してAppleTalkプロトコルスイートをRustで再実装するプロジェクトです。AppleTalkは、1980〜90年代にAppleがTCP/IP以前に使用していたネットワークスタックであり、複数の階層化されたプロトコルから構成されています。具体的には、LocalTalk(物理層/データリンク層)、DDP(Datagram Delivery Protocol、ネットワーク層)、ATP(AppleTalk Transaction Protocol)、NBP(Name Binding Protocol、サービス検出用)、ASP(AppleTalk Session Protocol)、AFP(AppleTalk Filing Protocol、ファイル共有層)が含まれます。本プロジェクトは、オリジナルのRS-422 LocalTalk物理層ではなく、EtherTalk(Ethernet上のAppleTalk)を使用して現代のハードウェアをターゲットとしています。
技術的な関心の中心は、AppleTalkの同期的でコールバック多用の元実装をRustの非同期モデルに対応させることにあります。DDPのパケットルーティングは、IPではなくゾーンベースのアドレッシング(ネットワーク番号+ノードID+ソケット番号)を使用しており、TailTalkはルーティングテーブルとアドレス解決を非同期セーフなデータ構造で実装しています。mDNSに相当するAppleTalkのNBPは、ブロードキャストベースの名前登録とルックアップにリトライロジックを必要としており、これはTokioのタイマーおよびselect機構に自然に対応します。リポジトリはまだ初期段階ですが、DDPフレーミング、基本的なNBPルックアップ、および部分的なATP実装が動作しています。開発の動機はレトロコンピューティングの相互運用性にあります。具体的には、物理的なLocalTalkブリッジや旧来のOSを必要とせずに、現代のマシンをビンテージMacのAppleTalkピアとして動作させることを目指しています。これはニッチではありますが、技術的に正当なシステムプロジェクトです。AppleTalkのプロトコル設計には歴史的に興味深い特性があり(ゾーンベースのマルチキャストルーティングは多くのIETF相当仕様より先行しています)、RustのOwnershipモデルはこのスタックが必要とするバッファ管理パターンにも適合しています。
Source: https://github.com/FeralFirmware/TailTalk/
OpenArch: 現代的なLLMアーキテクチャのPyTorch実装集
OpenArchは、現代的なLLMのアーキテクチャコンポーネントおよびモデル全体のスケルトンを、クリーンかつスタンドアロンなPyTorchで実装したリポジトリです。その目的は教育およびリサーチの足場作りとされており、各アーキテクチャはHugging Faceのモデルハブに依存せずにゼロから実装されているため、コードの可読性と改変のしやすさが保たれています。現在の内容としては、異なるattentionメカニズム(grouped-query attention、sliding window attention)、位置エンコーディング手法(RoPE、ALiBi)、正規化の配置(pre-norm、RMSNorm)を持つtransformerの変種の実装が含まれています。また、一部のモデルスケルトンは公開されているアーキテクチャ(Llamaスタイル、Mistralスタイル)を近似しています。
簡単に読んだ限りでは、リファレンス実装としての技術的な品質は妥当なレベルです。RoPEは周波数の計算 \theta_i = 10000^{-2i/d} と、attention前にquery/keyペアに適用される回転が正しく実装されており、GQAはquery headグループ間でkey/value headを正しく共有しています。このリポジトリは、公開済みの重みを再現したり、ベンチマーク数値と一致させることを主張しているわけではなく、コードとしてのアーキテクチャドキュメントであり、学習フレームワークではありません。制限事項としては、分散学習のサポートがなく、gradient checkpointingもなく、数値安定性に関する選択のドキュメントが最小限であり、実装は最適化されていません(FlashAttentionなし、fused kernelなし)。PhD レベルの読者にとっての価値は、本番環境向けフレームワークとしてではなく、アーキテクチャ実験のためのクリーンな出発点としての役割にあります。大規模な学習が必要な場合、このリポジトリとGPT-NeoXやtorchtitanのようなものとの差は大きいですが、アーキテクチャの選択を個別に理解するという目的には十分に応えられます。
Source: https://github.com/anuj0456/OpenArch
PyO3を使ってPythonの中でRustを動かすライブラリ
本記事は、Rust-Python FFIフレームワークであるPyO3の実践的な解説であり、ライブラリ作者がパフォーマンスクリティカルな拡張モジュールをリリースする際の使い方に焦点を当てています。PyO3はRustでPython拡張モジュールを記述することを可能にします。Rustの関数や構造体に#[pyfunction]および#[pyclass]マクロを付与すると、マクロ展開によってCPythonが期待するC拡張ABI(PyObject*ベース)が生成されます。maturinビルドツールはコンパイルパイプラインを管理し、通常のPythonモジュールとしてimport可能な.so/.pydファイルを生成します。
技術的な内容として、PyO3はGILをPython<'py>ライフタイムトークンによって管理します。GILの取得はPython<'py>値を得ることとして表現され、GILを解放する関数はpy.allow_threads(|| ...)を使用します。これにより、借用チェッカーがGIL境界をまたいだデータ競合を静的に防ぐ手段が提供されます。PythonオブジェクトとRust型の間の型変換は、FromPyObjectおよびIntoPy<PyObject>トレイトを通じて行われ、一般的なケースにはderiveマクロが用意されています。本記事では、polars、pydantic-core、cryptographyなどのライブラリが採用する一般的なパターンも解説しています。すなわち、Rustコアがネイティブ型ですべての計算を行い、Pythonラッパーは薄く保たれ、ホットパスでは不必要なPythonオブジェクトのアロケーションを避けるというパターンです。エラーハンドリングはRustのResult<T, E>をPyErrを介してPython例外にマッピングします。議論された制限点として、maturinのビルド時間は反復的な開発には遅く(PythonとRustの境界をまたいだインクリメンタルコンパイルが行われない)、FFI境界をまたいだデバッグはPythonのトレースバックとRustのスタックトレースが分断されているため煩雑になります。本記事は、Rust拡張の道を検討しているライブラリ作者にとってアクセスしやすい入門として機能します。
Source: https://belderbos.dev/blog/how-libraries-run-rust-inside-python/
注目の新しいリポジトリ
bojieli/ai-infra-book
オープンアクセスの中国語書籍「AI Infraの深層理解:定量分析とシステム設計」は、LLMの推論・学習システム設計をファーストプリンシパルから導出することに焦点を当てています。このアプローチは明示的に定量的であり、ハードウェアの制約(メモリ帯域幅、演算スループット、インターコネクトトポロジー)とモデルアーキテクチャのパラメータを出発点として、rooflineモデル的な分析を通じてバッチサイズ、パイプラインステージ数、tensor-parallelの度合い、KV-cacheのバジェットを導き出します。既存システムの目録を作るのではなく、読者が自ら容量計画の計算を再現できるよう教えることを目的としています。リポジトリには原稿のフルソース、レンダリング済みPDF、および数値推定を再現するための補助的な計算ツール(Jupyter notebookまたはスクリプトと思われます)が含まれています。これは、GPUクラスター構成、サービングスタックの選択、学習ジョブのトポロジーに関する意思決定を行う必要があり、ベンダーのベンチマークではなく根拠となる数学的導出を求めるエンジニアにとって有用です。定量的なフレームワークにより、Megatron-LMシリーズやPaLMスケーリング論文などの研究と自然な補完関係にあり、それらの工学的選択を導出可能な数値として裏付けます。MLインフラエンジニア、システム研究者、およびLLMシステム分野に入門するPhD学生に適しています。
Source: https://github.com/bojieli/ai-infra-book
Matthew0822/ToolReplay
AIエージェントのtool-callトランスクリプトを監査するための、依存関係不要なPython CLIツールです。中核メカニズムは、シリアライズされたトランスクリプト上のハッシュチェーンです。各tool-callレコードは h_i = \text{SHA256}(h_{i-1} \| \text{record}_i) としてコミットされ、信頼できる第三者なしに事後改ざんを検出可能にします。完全性の保証に加え、記録済みトランスクリプトをサンドボックス環境に対して再実行し、出力の一貫性を検証する決定論的リプレイ機能、および各ツール呼び出しを宣言済みパーミッションマニフェストと照合してエージェントの定められた権限を超えた呼び出し(例:許可されたプレフィックス外へのファイルシステム書き込み、未申告ホストへのネットワーク呼び出しなど)をフラグ付けするスコープ逸脱チェック機能もサポートしています。外部依存関係が存在しないため、依存関係の競合を気にすることなく、あらゆる監査パイプラインやCIジョブに組み込むことができます。これは現実的なギャップに対処するものです。ほとんどのエージェントフレームワークはtool-callをログに記録しますが、完全性の保証はなく、「エージェントがXを実行した」と「ログがエージェントはXを実行したと主張している」を区別するメカニズムも持ち合わせていません。コンプライアンスワークフロー、レッドチーミングパイプライン、およびtool-callの説明責任が重要なあらゆるデプロイメントに有用です。
Source: https://github.com/Matthew0822/ToolReplay
peonist-ai/halogen-flash-server
AMD Strix Halo(gfx1151)APU上でQwen3-8B-Flash-Nextを実行するために特化して設計されたinference serverです。Strix Haloはローカルinferenceの観点から見てアーキテクチャ的に興味深い存在であり、CPUと40基のCUを持つRDNA 3.5 GPUの両方からアクセス可能な最大96 GBの統合LPDDR5X메모리를を搭載しており、はるかに低消費電力でミドルレンジのディスクリートカードと競合する帯域幅を実現しています。このサーバーは、特定のメモリ階層向けに最適化されています。gfx1151はメインストリームのROCmパスではまだ十分にサポートされていないため、このプロジェクトにはターゲットISA上での正確かつ高速な実行を実現するためのカスタムカーネル選択、またはllama.cpp/Vulkanバックエンドのチューニングが含まれていると考えられます。Qwen3-8BのFlashバリアントは線形計算量のattention近似を採用しており、これは統合メモリハードウェアにおけるボトルネックがコンピュートではなく帯域幅にあるため重要です。attentionの二乗オーダーのメモリトラフィックを削減することで、スループットを直接改善できます。これは、ディスクリートGPUを搭載せずに高メモリ容量のAPUラップトップ上で高性能なモデルを実行するユーザー層の拡大という観点からも注目に値します。このリポジトリは、汎用サーバーがこのハードウェアに対してまだ解決していない特定のドライバ/バックエンドのギャップを埋めるものです。
Source: https://github.com/peonist-ai/halogen-flash-server
Hoylon/peerbridge-mcp
コーディング、レビュー、エビデンス収集、リモートワークタスクのためのコントロールルームとして、Model Context Protocol(MCP)を実装したローカルファーストなマルチエージェント協調レイヤーです。ここでいう「ローカルファースト」とは、タスクの割り当て、エージェント間のメッセージパッシング、監査ログといった協調状態が、クラウドバックエンドを経由せずユーザーのマシン上で保存・処理されることを意味しており、プロプライエタリなコードベースやプライバシーに配慮したワークフローにおいて重要な特性です。「監査可能」とは、どのエージェントがどの成果物に対してどのアクションを取ったかという永続的かつ検査可能なログを指しており、ハッシュチェーン型トランスクリプトツールと同様の関心事に対応しています。MCP インターフェースにより、任意のツール対応エージェント(Claude、Codex、ローカルモデル)をコントロールルームのピアとして接続し、場当たり的なプロンプトチェーンではなく共有タスクグラフを通じて協調させることができます。このアーキテクチャは、オーケストレーションロジックをモデルバックエンドから分離しているため、協調プロトコルはモデル非依存となっています。ホスト型オーケストレーションサービスにデータを渡すことなく、あるいは純粋に創発的なマルチエージェント挙動の不透明さを受け入れることなく、構造化されたマルチエージェントワークフロー(例:あるエージェントがコードを起草し、別のエージェントがレビューし、さらに別のエージェントがテストを実行する)を求める開発者にとって有用です。
Source: https://github.com/Hoylon/peerbridge-mcp
kruzovic7/ai-data-extractor
AIコーディングアシスタント(Claude Code、Cursor、Windsurf、Aider、Cline/Roo Codeなど)がローカルストレージ形式に保存した会話履歴を復元するオープンソースの抽出ツールです。各ツールはチャット状態をそれぞれ異なる方法でシリアライズしており、SQLiteデータベース、アプリサポートディレクトリ内のJSONブロブ、フラットなログファイルなどが用いられています。本プロジェクトはこれらすべてを解析し、共通スキーマへと統一する抽出レイヤーを提供します。実用的なユースケースとしては、ツール間での会話コンテキストの移行、過去のコーディングセッションを対象とした個人用検索システムの構築、どのモデルAPIに何が送信されたかの監査、そして fine-tuning パイプラインへのトランスクリプト投入などが挙げられます。「無料かつオープンソース」という位置づけが重要なのは、多くのツールにおける代替手段が、存在しない可能性のある公式エクスポート機能への有料課金やプロプライエタリな同期サービスの利用であるためです。リリース時点で6種類以上のツールをサポートするという広範な対応範囲は、著者が公式APIに頼るのではなくストレージ形式をリバースエンジニアリングしたことを示唆しており、ツールがストレージスキーマを更新するたびにメンテナンスが必要になる可能性があります。AIコーディングアシスタントと開発者のインタラクションを研究する研究者にとって、本ツールは実用的なデータ収集手段となります。
Source: https://github.com/kruzovic7/ai-data-extractor
jinzijian/EvoTrace
実世界のエージェントトラジェクトリ — 具体的にはClaude CodeおよびOpenAI Codexの実行トレース — を検証済みのトークン化されたpost-trainingアセットに変換するパイプラインです。「compile」というフレーミングは意図的なものです。生のトラジェクトリはノイズが多く失敗ステップを含むため、このシステムは検証フィルタ(テスト実行、静的解析、またはreward model)を適用し、正しい結果に確実に到達するトラジェクトリのみを保持します。生き残ったトラジェクトリはトレード可能なアセットとしてパッケージ化されます。これはトラジェクトリの出所が記録され、fine-tuningの実行においてそのデータが使用された際に提供者がクレジットや報酬を受け取ることができる、マーケットプレイスまたはプロベナンス追跡レイヤーの存在を示唆しています。この仕組みは、RLVRおよびSFTデータパイプラインにおける具体的な問題に対処しています。すなわち、高品質なエージェントトラジェクトリは収集コストが高いにもかかわらず広く求められている一方で、貢献者への帰属や報酬に関する標準的なメカニズムが現状存在しないという問題です。「EvoTrace」という名称は反復的な精製を示唆しており、トラジェクトリが複数の検証ラウンドを経てフィルタリングされ、各ラウンドでより難しいサブセットが選択される可能性があります。コードエージェントのpost-trainingデータセットを構築している方や、合成データ生成の経済性を研究している方に関連する内容です。
Source: https://github.com/jinzijian/EvoTrace
Qiuner/birdview
AI支援による編集が適用される前に、コードベースのアーキテクチャマップを生成する静的解析・可視化ツールです。その動機は、LLMコーディングアシスタントがトークンローカルに動作するという点にあります。つまり、ファイルや差分は見えても、グローバルな依存関係グラフは見えないため、局所的には整合性が取れていても、アーキテクチャ的には不整合な変更(importの境界の破損、意図しない結合、循環依存など)が生じてしまいます。Birdviewは、コードベースからモジュール・依存関係グラフを抽出し、人間が読める形式で提示することでこの問題に対処します。提示されたグラフは、編集セッションが始まる前にレビューしたり、エージェントのコンテキストに注入したりすることができます。「変更の前に必ずマップを確認する」というワークフローは、事後的なリンターとしてではなく、エージェント支援開発における事前編集フェーズに統合されます。実装では、対応言語に対してASTパースまたはimportグラフのトラバーサルが使用されていると考えられます。その価値が最も明確に発揮されるのは、単一の開発者がアーキテクチャ全体を作業記憶に保持できないほど大規模なコードベースで、かつAIアシスタントを用いて横断的な変更を行う場合です。dependency-cruiserやSourcetrailといったツールを補完しつつも、エージェント支援開発のワークフローに特化して設計されています。
Source: https://github.com/Qiuner/birdview
Nanako0129/sepia
文体調整を行うポストプロセッサーをエージェントスキルとしてパッケージ化したもので、Skills CLI(77以上のエージェントに対応)と互換性があり、Claude Code、Codex、Grok Build、Antigravityのネイティブプラグインも提供しています。技術的なコアは「フィクションのための narrative-architecture repair」および「プロフェッショナルな文章向けの媒体適合ルール」として説明されており、StoryScope フレームワーク(arXiv:2604.03136)を基盤としています。StoryScope は物語構造を一連のアーキテクチャ的制約——シーンレベルの一貫性、キャラクターの声の一貫性、ペーシングの目標値——としてモデル化し、改稿を局所的な文レベルの編集ではなく、ストーリーグラフ上の制約充足問題として定式化します。「de-AI」というフレーミングは、このスキルが LLM 生成テキストの統計的アーティファクト——曖昧化表現、リズムの均一性、特定の接続詞の多用、レジスター特異性の喪失——を具体的にターゲットとしていることを意味します。媒体適合(venue-matching)とは、出版対象(学術論文のアブストラクト、文芸フィクション、技術ブログ)ごとにインデックス化された文体規範のライブラリを保持し、それぞれ異なるルールセットを適用することを指します。スキルアーキテクチャにより、ベースエージェントの再学習や異なるプロンプト設計を必要とせず、任意のエージェントがテキストを生成した後のポストプロセッシングパスとして動作します。制御可能な生成を研究する研究者、およびコンテンツ制作ワークフローにエージェントを展開する実務者にとって関連性の高い内容です。